
1. 概要
このチュートリアルは、Tensorflow 2.2 向けに更新されています。

この Codelab では、手書き数字を認識するニューラル ネットワークを構築してトレーニングする方法を学びます。また、ニューラル ネットワークを強化して 99% の精度を達成する過程で、ディープ ラーニングの専門家がモデルを効率的にトレーニングするために使用するツールについても学びます。
この Codelab では、MNIST データセットを使用します。これは、ラベル付きの数字 60,000 個のコレクションで、20 年近くにわたって多くの博士課程の学生が研究に使用してきました。100 行未満の Python / TensorFlow コードで問題を解決します。
学習内容
- ニューラル ネットワークとは何か、またそのトレーニング方法
- tf.keras を使用して基本的な 1 層ニューラル ネットワークを構築する方法
- レイヤを追加する方法
- 学習率スケジュールを設定する方法
- 畳み込みニューラル ネットワークの構築方法
- 正則化手法(ドロップアウト、バッチ正規化)の使用方法
- 過学習とは
必要なもの
ブラウザさえあれば十分です。このワークショップは、Google Colaboratory で完全に実行できます。
フィードバック
このラボに不適切な点や改善すべき点がある場合は、お知らせください。フィードバックは GitHub の問題 [フィードバック リンク] を通じて処理されます。
2. Google Colaboratory のクイック スタート
このラボでは Google Colaboratory を使用するため、設定は必要ありません。Chromebook から実行できます。以下のファイルを開き、セルを実行して Colab ノートブックに慣れてください。

追加の手順は以下のとおりです。
GPU バックエンドを選択する

Colab メニューで、[ランタイム] > [ランタイムのタイプを変更] を選択し、GPU を選択します。ランタイムへの接続は、最初の実行時に自動的に行われます。または、右上の [接続] ボタンを使用することもできます。
ノートブックの実行
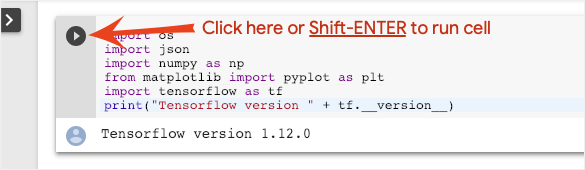
セルをクリックして Shift+Enter キーを押すと、セルを 1 つずつ実行できます。[ランタイム] > [すべてのセルを実行] を選択して、ノートブック全体を実行することもできます。
目次

すべてのノートブックには目次があります。左側の黒い矢印を使用して開くことができます。
非表示のセル
一部のセルにはタイトルのみが表示されます。これは Colab 固有のノートブック機能です。ダブルクリックすると内部のコードが表示されますが、通常はあまり興味深いものではありません。通常はサポート機能または可視化機能です。内部の関数を定義するには、これらのセルを実行する必要があります。
3. ニューラル ネットワークのトレーニング
まず、ニューラル ネットワークのトレーニングを観察します。以下のノートブックを開き、すべてのセルを実行してください。コードについては後で説明しますので、まだ気にしないでください。
ノートブックを実行するときは、可視化に注目してください。詳しくは以下をご覧ください。
トレーニング データ
手書きの数字のデータセットがあり、各画像が何を表しているか(0 ~ 9 の数字)がわかるようにラベル付けされています。ノートブックに、次のような抜粋が表示されます。

構築するニューラル ネットワークは、手書きの数字を 10 個のクラス(0 ~ 9)に分類します。分類が適切に機能するには、内部パラメータに正しい値が設定されている必要があります。この「正しい値」は、画像とそれに関連付けられた正解を含む「ラベル付きデータセット」を必要とするトレーニング プロセスを通じて学習されます。
トレーニング済みのニューラル ネットワークのパフォーマンスが良好かどうかを判断するにはどうすればよいでしょうか。トレーニング データセットを使用してネットワークをテストするのは、不正行為にあたります。モデルはトレーニング中にそのデータセットをすでに複数回参照しており、そのデータセットに対しては非常に高いパフォーマンスを発揮するはずです。ネットワークの「本番環境」でのパフォーマンスを評価するには、トレーニング中に使用されていない別のラベル付きデータセットが必要です。これは「検証データセット」と呼ばれます。
トレーニング
トレーニングが進むにつれて、トレーニング データのバッチが 1 つずつ処理され、内部モデルのパラメータが更新されて、モデルの手書き数字の認識精度が向上していきます。これはトレーニング グラフで確認できます。

右側の「accuracy」は、正しく認識された数字の割合です。トレーニングが進むにつれて上昇しています。これは良いことです。
左側には「損失」が表示されています。トレーニングを推進するために、システムが数字を認識する際の精度の低さを表す「損失」関数を定義し、それを最小限に抑えるようにします。トレーニングが進むにつれて、トレーニング データと検証データの両方で損失が減少していることがわかります。これは良いことです。これは、ニューラル ネットワークが学習していることを意味します。
X 軸は、データセット全体に対する「エポック」数(反復回数)を表します。
予測
トレーニングが完了したモデルは、手書きの数字を認識するために使用できます。次の可視化は、ローカル フォントからレンダリングされたいくつかの数字(最初の行)と、検証データセットの 10,000 個の数字に対するパフォーマンスを示しています。予測されたクラスは各数字の下に表示されます。間違っている場合は赤で表示されます。

ご覧のとおり、この初期モデルはあまり良くありませんが、一部の数字を正しく認識しています。最終的な検証精度は約 90% です。これは、最初に作成した単純なモデルとしてはそれほど悪くありませんが、10, 000 個の検証用数字のうち 1,000 個を見逃していることになります。これは表示できる数よりもはるかに多いため、すべての回答が間違っている(赤色)ように見えます。
テンソル
データは行列に格納されます。28x28 ピクセルのグレースケール画像は、28x28 の 2 次元行列に収まります。しかし、カラー画像の場合は、さらに多くのディメンションが必要です。ピクセルごとに 3 つの色値(赤、緑、青)があるため、[28, 28, 3] のディメンションを持つ 3 次元テーブルが必要になります。128 個のカラー画像のバッチを保存するには、[128, 28, 28, 3] のディメンションを持つ 4 次元テーブルが必要です。
このような多次元テーブルは「テンソル」と呼ばれ、そのディメンションのリストは「形状」と呼ばれます。
4. [情報]: ニューラル ネットワークの基礎
概要
次の段落の太字の用語をすべてすでに知っている場合は、次の演習に進んでください。ディープ ラーニングを始めたばかりの方は、ぜひこのまま読み進めてください。

Keras には、一連のレイヤとして構築されたモデル用の Sequential API が用意されています。たとえば、3 つの密なレイヤを使用する画像分類器は、Keras で次のように記述できます。
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

単一の Dense レイヤ
MNIST データセットの手書き数字は、28x28 ピクセルのグレースケール画像です。これらを分類する最も簡単な方法は、28x28=784 ピクセルを 1 層のニューラル ネットワークの入力として使用することです。

ニューラル ネットワークの各「ニューロン」は、すべての入力の加重合計を行い、「バイアス」と呼ばれる定数を加算してから、結果を非線形の「活性化関数」に渡します。「重み」と「バイアス」は、トレーニングを通じて決定されるパラメータです。最初はランダムな値で初期化されます。
上の図は、10 個の出力ニューロンを持つ 1 層のニューラル ネットワークを表しています。これは、数字を 10 個のクラス(0 ~ 9)に分類するためです。
行列乗算を使用する
画像のコレクションを処理するニューラル ネットワーク層を、行列乗算で表す方法を以下に示します。

重み行列 W の重みの最初の列を使用して、最初の画像のすべてのピクセルの加重和を計算します。この合計は最初のニューロンに対応します。2 番目のニューロンには 2 番目の重みの列を使用し、10 番目のニューロンまで同じ処理を行います。残りの 99 枚の画像についても、この操作を繰り返します。100 枚の画像を含む行列を X とすると、100 枚の画像で計算された 10 個のニューロンのすべての加重和は、単純に行列乗算 X.W になります。
各ニューロンは、バイアス(定数)を追加する必要があります。10 個のニューロンがあるため、10 個のバイアス定数があります。この 10 個の値のベクトルを b とします。このベクトルは、以前に計算された行列の各行に追加する必要があります。「ブロードキャスト」と呼ばれるちょっとした魔法を使って、単純なプラス記号でこれを記述します。
最後に、活性化関数(たとえば、以下で説明する「softmax」)を適用し、100 枚の画像に適用される 1 層ニューラル ネットワークを記述する式を取得します。

Keras の場合
Keras のような高レベルのニューラル ネットワーク ライブラリを使用すると、この式を実装する必要はありません。ただし、ニューラル ネットワーク層は、単に多数の乗算と加算を行うものであることを理解することが重要です。Keras では、高密度レイヤは次のように記述されます。
tf.keras.layers.Dense(10, activation='softmax')
詳細な分析
ニューラル ネットワーク層を連結するのは簡単です。最初のレイヤでは、ピクセルの加重合計を計算します。後続の層は、前の層の出力の加重和を計算します。

ニューロンの数以外で唯一異なるのは、活性化関数の選択です。
活性化関数: relu、softmax、sigmoid
通常は、最後のレイヤを除くすべてのレイヤで "relu" 活性化関数を使用します。分類器の最後のレイヤでは、"softmax" 活性化関数を使用します。

ここでも、「ニューロン」はすべての入力の加重合計を計算し、「バイアス」と呼ばれる値を加算して、その結果を活性化関数に渡します。
最も一般的な活性化関数は、正規化線形ユニット(RELU)です。上のグラフに示すように、これは非常に単純な関数です。
ニューラル ネットワークの従来の活性化関数は「シグモイド」でしたが、「relu」はほぼすべての場所で収束特性が優れていることが示され、現在では好まれています。

分類用のソフトマックス活性化関数
このニューラル ネットワークの最後のレイヤには 10 個のニューロンがあります。これは、手書きの数字を 10 個のクラス(0 ~ 9)に分類するためです。このモデルは、0 ~ 1 の 10 個の数値を出力します。これらの数値は、この数字が 0、1、2 などである確率を表します。このため、最後のレイヤでは "softmax" という活性化関数を使用します。
ベクトルにソフトマックスを適用するには、各要素の指数を求めてから、ベクトルを正規化します。通常は、正規化された値の合計が 1 になり、確率として解釈できるように、L1 ノルム(絶対値の合計)で割ります。
活性化前の最後のレイヤの出力は、ロジットと呼ばれることがあります。このベクトルが L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9] の場合、次のようになります。


交差エントロピー損失
ニューラル ネットワークが入力画像から予測を生成するようになったので、その予測の精度を測定する必要があります。つまり、ネットワークが示す内容と正解(「ラベル」と呼ばれることが多い)との距離を測定する必要があります。データセット内のすべての画像に正しいラベルが付いていることを思い出してください。
どの距離でも機能しますが、分類問題では、いわゆる「交差エントロピー距離」が最も効果的です。これを誤差関数または「損失」関数と呼びます。

勾配降下法
ニューラル ネットワークの「トレーニング」とは、実際には、トレーニング画像とラベルを使用して、交差エントロピー損失関数を最小限に抑えるように重みとバイアスを調整することを意味します。仕組みは次のとおりです。
クロスエントロピーは、重み、バイアス、トレーニング画像のピクセル、既知のクラスの関数です。
すべての重みとすべてのバイアスに対してクロスエントロピーの偏導関数を計算すると、特定の画像、ラベル、重みとバイアスの現在値に対して計算された「勾配」が得られます。重みとバイアスは数百万個に及ぶ可能性があるため、勾配の計算は大変な作業のように思えます。幸い、TensorFlow がこの処理を行ってくれます。勾配の数学的特性は、「上」を指すことです。交差エントロピーが低い方向に向かうため、反対方向に進みます。重みとバイアスは、勾配の割合によって更新されます。次に、トレーニング ループで、次のトレーニング画像とラベルのバッチを使用して同じことを何度も繰り返します。この最小値が一意であるとは限りませんが、この方法により、クロスエントロピーが最小になる場所に収束することが期待されます。

ミニバッチとモメンタム
1 つのサンプル画像だけで勾配を計算し、重みとバイアスをすぐに更新することもできますが、たとえば 128 個の画像のバッチで計算すると、さまざまなサンプル画像によって課される制約をより適切に表す勾配が得られるため、より迅速に解に収束する可能性があります。ミニバッチのサイズは調整可能なパラメータです。
この手法は「確率的勾配降下法」と呼ばれることもありますが、もう 1 つの実用的なメリットがあります。バッチを処理するということは、より大きな行列を処理するということでもあり、通常、GPU や TPU での最適化が容易になります。
ただし、収束が少し混沌とすることもあります。勾配ベクトルがすべてゼロの場合、収束が停止することもあります。これは、最小値が見つかったということでしょうか?必ずしも違反警告を受けるとは限りません。勾配コンポーネントは、最小値または最大値でゼロになることがあります。数百万の要素を持つ勾配ベクトルがあり、それらがすべてゼロである場合、すべてのゼロが最小値に対応し、最大値に対応するゼロが 1 つもない確率は非常に小さくなります。多次元の空間では、鞍点は非常に一般的であり、鞍点で停止することは望ましくありません。

図: 鞍点。勾配は 0 ですが、すべての方向で最小値ではありません。(画像の帰属 Wikimedia: By Nicoguaro - Own work, CC BY 3.0)
解決策は、最適化アルゴリズムにモメンタムを追加して、サドルポイントを停止せずに通過できるようにすることです。
用語集
バッチまたはミニバッチ: トレーニングは常にトレーニング データとラベルのバッチに対して行われます。これにより、アルゴリズムが収束しやすくなります。「バッチ」ディメンションは通常、データテンソルの最初のディメンションです。たとえば、形状 [100, 192, 192, 3] のテンソルには、192x192 ピクセルの画像が 100 枚含まれ、ピクセルごとに 3 つの値(RGB)があります。
交差エントロピー損失: 分類器でよく使用される特別な損失関数。
高密度レイヤ: 各ニューロンが前のレイヤのすべてのニューロンに接続されているニューロンのレイヤ。
特徴量: ニューラル ネットワークの入力は「特徴量」と呼ばれることがあります。データセットのどの部分(または部分の組み合わせ)をニューラル ネットワークにフィードすれば適切な予測が得られるかを判断する技術は、「特徴量エンジニアリング」と呼ばれます。
ラベル: 教師あり分類問題における「クラス」または正解の別名
学習率: トレーニング ループの各イテレーションで重みとバイアスが更新される勾配の割合。
ロジット: 活性化関数が適用される前のニューロンの層の出力は「ロジット」と呼ばれます。この用語は、かつて最も一般的だった活性化関数である「ロジスティック関数」(別名「シグモイド関数」)に由来しています。「ロジスティック関数前のニューロン出力」を短縮して「ロジット」と呼ぶようになりました。
loss: ニューラル ネットワークの出力と正解を比較する誤差関数
ニューロン: 入力の加重合計を計算し、バイアスを加えて、結果を活性化関数に渡します。
ワンホット エンコード: 5 つのクラスのうちの 3 番目のクラスは、5 つの要素のベクトルとしてエンコードされます。3 番目の要素は 1 で、それ以外はすべて 0 です。
relu: 正規化線形ユニット。ニューロンでよく使用される活性化関数。
sigmoid: 以前はよく使われていた別の活性化関数で、特殊なケースでは今でも有用です。
softmax: ベクトルに作用する特別な活性化関数。最大コンポーネントと他のすべてのコンポーネントの差を大きくし、ベクトルを正規化して合計が 1 になるようにします。これにより、確率のベクトルとして解釈できるようになります。分類器の最後のステップとして使用されます。
テンソル: 「テンソル」は行列に似ていますが、任意の数のディメンションを持ちます。1 次元テンソルはベクトルです。2 次元のテンソルは行列です。また、3、4、5 以上の次元を持つテンソルもあります。
5. コードを確認する
学習ノートブックに戻り、今度はコードを読みましょう。
このノートブックのすべてのセルを確認しましょう。
セル「パラメータ」
バッチサイズ、トレーニング エポック数、データファイルの場所はここで定義します。データファイルは Google Cloud Storage(GCS)バケットでホストされているため、アドレスは gs:// で始まります。
セル「Imports」
ここでは、TensorFlow や可視化用の matplotlib など、必要な Python ライブラリがすべてインポートされます。
セル「visualization utilities [RUN ME]****」
このセルには、重要でない可視化コードが含まれています。デフォルトでは折りたたまれていますが、ダブルクリックすると開いてコードを確認できます。
セル「tf.data.Dataset: parse files and prepare training and validation datasets」
このセルでは、tf.data.Dataset API を使用して、データファイルから MNIST データセットを読み込みました。このセルにあまり時間をかける必要はありません。tf.data.Dataset API に興味がある場合は、TPU スピードのデータ パイプラインで説明されているチュートリアルをご覧ください。現時点での基本は次のとおりです。
MNIST データセットの画像とラベル(正解)は、4 つのファイルの固定長レコードに保存されます。ファイルは、専用の固定レコード関数を使用して読み込むことができます。
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
これで、画像バイトのデータセットが作成されました。これらを画像にデコードする必要があります。そのための関数を定義します。画像は圧縮されていないため、関数は何もデコードする必要はありません(decode_raw は基本的に何もしません)。次に、画像は 0 ~ 1 の浮動小数点値に変換されます。ここで 2D 画像として再形成することもできますが、実際には 28x28 のサイズのピクセルのフラット配列として保持します。これは、最初の Dense レイヤが想定している形式です。
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
この関数を .map を使用してデータセットに適用し、画像のデータセットを取得します。
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
ラベルについても同様の読み取りとデコードを行い、画像とラベルを一緒に .zip します。
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
これで、ペア(画像、ラベル)のデータセットが作成されました。これはモデルが想定しているものです。トレーニング関数で使用する準備はまだ整っていません。
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
tf.data.Dataset API には、データセットの準備に必要なユーティリティ関数がすべて用意されています。
.cache は、データセットを RAM にキャッシュします。これは小さなデータセットなので、この方法で問題ありません。.shuffle は、5,000 個の要素のバッファでシャッフルします。トレーニング データを十分にシャッフルすることが重要です。.repeat はデータセットをループします。このデータセットで複数回(複数のエポック)トレーニングを行います。.batch は、複数の画像とラベルをまとめてミニバッチに pull します。最後に、.prefetch は、現在のバッチが GPU でトレーニングされている間に、CPU を使用して次のバッチを準備できます。
検証データセットも同様の方法で準備されます。これで、モデルを定義し、このデータセットを使用してトレーニングする準備が整いました。
セル「Keras Model」
すべてのモデルはレイヤの直線的なシーケンスになるため、tf.keras.Sequential スタイルを使用して作成できます。最初は、単一の Dense レイヤです。手書きの数字を 10 個のクラスに分類するため、10 個のニューロンがあります。分類器の最後のレイヤであるため、「softmax」活性化関数を使用します。
Keras モデルは、入力の形状も認識する必要があります。tf.keras.layers.Input を使用して定義できます。ここで、入力ベクトルは長さ 28*28 のピクセル値のフラットなベクトルです。
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
モデルの構成は、Keras で model.compile 関数を使用して行います。ここでは、基本的なオプティマイザー 'sgd'(確率的勾配降下法)を使用します。分類モデルには、Keras で 'categorical_crossentropy' と呼ばれる交差エントロピー損失関数が必要です。最後に、モデルに 'accuracy' 指標を計算するように指示します。これは、正しく分類された画像の割合です。
Keras には、作成したモデルの詳細を出力する非常に便利な model.summary() ユーティリティが用意されています。親切な講師が PlotTraining ユーティリティ(「可視化ユーティリティ」セルで定義)を追加してくれました。これを使用すると、トレーニング中にさまざまなトレーニング曲線を表示できます。
セル「Train and validate the model」
ここで、model.fit を呼び出し、トレーニング データセットと検証データセットの両方を渡すことで、トレーニングが行われます。デフォルトでは、Keras は各エポックの最後に検証ラウンドを実行します。
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
Keras では、コールバックを使用してトレーニング中にカスタム動作を追加できます。このワークショップでは、動的に更新されるトレーニング プロットがこのように実装されています。
セル「予測を可視化する」
モデルのトレーニングが完了したら、model.predict() を呼び出して予測を取得できます。
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
ここでは、テストとして、ローカル フォントからレンダリングされた印刷された数字のセットを用意しました。ニューラル ネットワークは、最後の「softmax」から 10 個の確率のベクトルを返します。ラベルを取得するには、どの確率が最も高いかを特定する必要があります。numpy ライブラリの np.argmax がそれを行います。
axis=1 パラメータが必要な理由を理解するには、128 枚の画像のバッチを処理したため、モデルが 128 個の確率ベクトルを返すことを思い出してください。出力テンソルの形状は [128, 10] です。各画像に対して返される 10 個の確率全体で argmax を計算しているため、axis=1(最初の軸は 0)となります。
このシンプルなモデルでも、すでに 90% の数字を認識できます。悪くはありませんが、これを大幅に改善します。

6. レイヤの追加

認識精度を向上させるために、ニューラル ネットワークにレイヤを追加します。

最後のレイヤの活性化関数として softmax を維持します。これは、分類に最適な関数であるためです。ただし、中間層では、最も古典的な活性化関数であるシグモイドを使用します。
たとえば、モデルは次のようになります(カンマを忘れないでください。tf.keras.Sequential はカンマ区切りのレイヤリストを受け取ります)。
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
モデルの「概要」を確認します。現在、パラメータ数は 10 倍以上になっています。10 倍の改善を目指しましょう。しかし、何らかの理由で、

損失も急増しているようです。不正解です。
7. ディープ ネットワークに関する特別な配慮
今体験したニューラル ネットワークは、1980 年代から 1990 年代にかけて設計されていたものです。彼らがこのアイデアを諦め、いわゆる「AI の冬」が到来したのも無理はありません。実際、レイヤを追加するにつれて、ニューラル ネットワークの収束はますます困難になります。
多くのレイヤ(20、50、さらには 100)を持つディープ ニューラル ネットワークは、収束させるための数学的なトリックをいくつか使用することで、非常にうまく機能することがわかっています。このようなシンプルな手法の発見は、2010 年代にディープ ラーニングが復活した理由の一つです。
RELU 活性化関数

シグモイド活性化関数は、ディープ ネットワークでは実際にはかなり問題があります。すべての値を 0 ~ 1 の範囲に圧縮するため、この処理を繰り返すと、ニューロンの出力とその勾配が完全に消失する可能性があります。歴史的な理由から言及しましたが、最新のネットワークでは、次のような RELU(正規化線形ユニット)を使用します。

一方、ReLU の導関数は、少なくとも右側では 1 です。ReLU 活性化関数を使用すると、一部のニューロンからの勾配がゼロになることがあっても、他のニューロンからは常にゼロ以外の明確な勾配が得られるため、トレーニングを適切なペースで継続できます。
より優れたオプティマイザー
この例のように、非常に高次元の空間(1 万程度の重みとバイアスがある)では、「鞍点」が頻繁に発生します。鞍点とは、局所最小値ではないものの、勾配がゼロであり、勾配降下法オプティマイザーがそこで停滞する点です。TensorFlow には、慣性量で動作し、鞍点を安全に通過するものなど、利用可能なオプティマイザーがすべて揃っています。
ランダムな初期化
トレーニング前に重みとバイアスを初期化する技術は、それ自体が研究分野であり、このトピックに関する多数の論文が発表されています。Keras で使用できるすべての初期化子については、こちらをご覧ください。幸いなことに、Keras はデフォルトで適切な処理を行い、ほとんどすべてのケースで最適な 'glorot_uniform' 初期化子を使用します。
Keras がすでに適切な処理を行っているため、何もする必要はありません。
NaN ???
クロスエントロピーの数式には対数が含まれており、log(0) は数値ではありません(NaN、つまり数値クラッシュ)。交差エントロピーへの入力は 0 にできますか?入力はソフトマックスから取得されます。ソフトマックスは本質的に指数であり、指数がゼロになることはありません。だから安全です。
本当にそうでしょうか数学の美しい世界では安全ですが、コンピュータの世界では、float32 形式で表される exp(-150) は 0 になり、クロスエントロピーがクラッシュします。
幸いなことに、ここでも何もする必要はありません。Keras がこの処理を行い、特に慎重な方法でソフトマックスを計算してからクロスエントロピーを計算して、数値の安定性を確保し、恐ろしい NaN を回避します。
成功したか?

これで、精度が 97% になるはずです。このワークショップの目標は 99% を大幅に上回ることなので、さらに進めましょう。
行き詰まった場合は、この時点での解決策をこちらで確認してください。
8. 学習率の減衰
トレーニングを高速化する方法はないでしょうか。Adam オプティマイザーのデフォルトの学習率は 0.001 です。増やしてみましょう。
速度を上げてもあまり効果がないようです。このノイズは何でしょうか?

トレーニング曲線は非常にノイズが多く、両方の検証曲線を見ると、上下に変動しています。これは、速度が速すぎることを意味します。以前の速度に戻すこともできますが、もっと良い方法があります。

適切な解決策は、最初は速く、学習率を指数関数的に減衰させることです。Keras では、tf.keras.callbacks.LearningRateScheduler コールバックを使用してこれを行うことができます。
コピーして貼り付けるのに便利なコード:
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
作成した lr_decay_callback を忘れずに使用してください。model.fit のコールバックのリストに追加します。
model.fit(..., callbacks=[plot_training, lr_decay_callback])
この小さな変更の影響は、目を見張るものがあります。ノイズのほとんどが除去され、テストの精度が 98% を超えて維持されていることがわかります。

9. ドロップアウト、過学習
モデルは適切に収束しているようです。さらに詳しく見ていきましょう。
役に立ちますか?

そうでもありません。精度は 98% のままで、検証損失は上昇しています。学習アルゴリズムはトレーニング データのみを対象に動作し、それに応じてトレーニング損失を最適化します。検証データは参照されないため、しばらくすると、検証損失に対する効果がなくなり、検証損失の減少が止まり、場合によっては再び増加することもあります。
これは、モデルの実際の認識機能にすぐに影響するわけではありませんが、多くの反復処理を実行できなくなり、一般的にはトレーニングがプラスの効果をもたらさなくなったことを示します。

この乖離は通常「過学習」と呼ばれ、これが発生した場合は「ドロップアウト」と呼ばれる正則化手法を適用してみることができます。ドロップアウト手法では、トレーニングの反復処理ごとにランダムなニューロンを削除します。
成果

ノイズが再び現れます(ドロップアウトの仕組みを考えると、これは当然のことです)。検証損失はこれ以上増加していないようですが、全体的にドロップアウトなしの場合よりも高くなっています。検証精度は少し低下しました。これはかなり残念な結果です。
ドロップアウトは正しい解決策ではなかったようです。あるいは、「過学習」はより複雑な概念であり、その原因の一部は「ドロップアウト」による修正に適していないのでしょうか?
「過学習」とは何ですか?過学習は、ニューラル ネットワークが「不適切に」学習し、トレーニング サンプルでは機能するものの、実際のデータではあまり機能しない場合に発生します。ドロップアウトなどの正則化手法を使用すると、より適切な方法で学習させることができますが、過学習にはより深い原因もあります。

基本的な過学習は、ニューラル ネットワークの自由度が、手元の問題に対して高すぎる場合に発生します。ネットワークがすべてのトレーニング画像を保存し、パターン マッチングによって認識できるほど多くのニューロンがあるとします。現実世界のデータでは完全に失敗します。ニューラル ネットワークは、トレーニング中に学習した内容を一般化するように、ある程度制約される必要があります。
トレーニング データが非常に少ない場合、小さなネットワークでもそれを暗記してしまい、「過学習」が発生します。一般的に、ニューラル ネットワークのトレーニングには常に大量のデータが必要です。
最後に、すべてをマニュアルどおりに行い、さまざまなサイズのネットワークを試して自由度が制限されていることを確認し、ドロップアウトを適用して、大量のデータでトレーニングしても、パフォーマンス レベルが向上しないことがあります。これは、現在の形状のニューラル ネットワークでは、今回のケースのように、データからこれ以上の情報を抽出できないことを意味します。
画像をフラット化して 1 つのベクトルに変換して使用していることを思い出してください。これは本当に悪いアイデアでした。手書きの数字は形状で構成されていますが、ピクセルをフラット化したときに形状情報が破棄されました。しかし、形状情報を利用できるニューラル ネットワークの種類があります。それが畳み込みネットワークです。試してみましょう。
行き詰まった場合は、この時点での解決策をこちらで確認してください。
10. [INFO] 畳み込みネットワーク
概要
次の段落の太字の用語をすべてすでに知っている場合は、次の演習に進んでください。畳み込みニューラル ネットワークを初めて使用する場合は、このまま読み進めてください。

図: 4x4x3=48 の学習可能な重みで構成される 2 つの連続したフィルタで画像をフィルタリングする。
Keras での単純な畳み込みニューラル ネットワークは次のようになります。
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
畳み込みネットワークのレイヤでは、1 つの「ニューロン」が、画像の小さな領域のみにわたって、そのすぐ上のピクセルの加重和を計算します。通常の高密度レイヤのニューロンと同様に、バイアスを追加し、活性化関数を介して合計をフィードします。このオペレーションは、同じ重みを使用して画像全体で繰り返されます。高密度レイヤでは、各ニューロンに独自の重みがありました。ここでは、重みの単一の「パッチ」が画像全体を両方向にスライドします(「畳み込み」)。出力には、画像内のピクセル数と同じ数の値が含まれます(ただし、エッジにはパディングが必要です)。これはフィルタリング オペレーションです。上の図では、4x4x3=48 の重みのフィルタを使用しています。
ただし、48 個の重みでは不十分です。自由度をさらに高めるために、新しい重みのセットを使用して同じオペレーションを繰り返します。これにより、新しいフィルタ出力セットが生成されます。入力画像の R、G、B チャンネルとの類似性から、これを出力の「チャンネル」と呼びましょう。

2 つ(またはそれ以上)の重みセットは、新しいディメンションを追加することで 1 つのテンソルとして合計できます。これにより、畳み込みレイヤの重みテンソルの一般的な形状が得られます。入力チャネルと出力チャネルの数はパラメータであるため、畳み込みレイヤのスタックとチェーンを開始できます。

図: 畳み込みニューラル ネットワークがデータの「キューブ」を別のデータの「キューブ」に変換する。
ストライド畳み込み、最大プーリング
ストライド 2 または 3 で畳み込みを行うことで、結果のデータキューブを水平方向に縮小することもできます。これには、次の 2 つの一般的な方法があります。
- ストライド畳み込み: 上記のようなスライディング フィルタですが、ストライドが 1 より大きい
- 最大プーリング: MAX 演算を適用するスライディング ウィンドウ(通常は 2x2 パッチで、2 ピクセルごとに繰り返される)

図: 計算ウィンドウを 3 ピクセル スライドすると、出力値が少なくなります。ストライド畳み込みまたは最大プーリング(ストライド 2 でスライドする 2x2 ウィンドウの最大値)は、水平方向のデータキューブを縮小する方法です。
最後のレイヤ
最後の畳み込みレイヤの後、データは「キューブ」の形式になります。最終的な Dense レイヤに渡す方法は 2 つあります。
1 つ目は、データのキューブをベクトルにフラット化してから、ソフトマックス レイヤにフィードする方法です。場合によっては、ソフトマックス レイヤの前に密レイヤを追加することもできます。これは、重みの数の点で高価になる傾向があります。畳み込みネットワークの最後にある高密度レイヤには、ニューラル ネットワーク全体の重みの半分以上が含まれることがあります。
高価な高密度レイヤを使用する代わりに、入力データの「キューブ」をクラスの数だけ分割し、それらの値を平均して、ソフトマックス活性化関数に渡すこともできます。この方法で分類ヘッドを構築すると、重みは 0 になります。Keras には、このためのレイヤ tf.keras.layers.GlobalAveragePooling2D() があります。

次のセクションに進み、手元の問題に対応する畳み込みネットワークを構築します。
11. 畳み込みネットワーク
手書き数字を認識する畳み込みネットワークを構築しましょう。上部に 3 つの畳み込みレイヤ、下部に従来の softmax 読み出しレイヤを使用し、それらを 1 つの全結合レイヤで接続します。

2 番目と 3 番目の畳み込み層のストライドは 2 であるため、出力値の数が 28x28 から 14x14、そして 7x7 に減少しています。
Keras コードを記述してみましょう。
最初の畳み込みレイヤの前に、特別な注意が必要です。実際、このレイヤは 3D の「キューブ」データを想定していますが、これまでのデータセットは高密度レイヤ用に設定されており、画像のすべてのピクセルがベクトルにフラット化されています。28x28x1 の画像(グレースケール画像の場合は 1 チャンネル)に再形成する必要があります。
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
これまでの tf.keras.layers.Input レイヤの代わりに、この行を使用できます。
Keras で「relu」活性化関数を使用する畳み込みレイヤの構文は次のとおりです。

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
ストライド畳み込みの場合は、次のように記述します。
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
データのキューブをベクトルにフラット化して、高密度レイヤで使用できるようにするには、次のようにします。
tf.keras.layers.Flatten()
Dense レイヤの構文は変更されていません。
tf.keras.layers.Dense(200, activation='relu')
モデルの精度は 99% の壁を破りましたか?かなり近いですね。しかし、検証損失曲線を見てください。ご興味はおありでしょうか。

予測も確認します。10,000 個のテスト用数字のほとんどが正しく認識されるようになります。誤検出は 4.5 行ほど(10,000 桁中 110 桁ほど)しか残っていません。

行き詰まった場合は、この時点での解決策をこちらで確認してください。
12. 再度ドロップアウト
前回のトレーニングでは、過学習の明確な兆候が見られます(精度も 99% に達していません)。ドロップアウトをもう一度試すべきでしょうか?
今回はどうでしたか?

今回はドロップアウトが機能したようです。検証損失はこれ以上増加せず、最終的な精度は 99% をはるかに上回るはずです。お疲れさまでした
最初にドロップアウトを適用しようとしたとき、過学習の問題があると考えていましたが、実際にはニューラル ネットワークのアーキテクチャに問題がありました。畳み込みレイヤがなければこれ以上進むことはできず、ドロップアウトでできることは何もありません。
今回は、過学習が問題の原因であり、ドロップアウトが実際に役立ったようです。トレーニングと検証の損失曲線が乖離し、検証損失が徐々に増加する原因は、数多くあります。過学習(自由度が多すぎて、ネットワークで不適切に使用される)はその 1 つにすぎません。データセットが小さすぎる場合や、ニューラル ネットワークのアーキテクチャが適切でない場合、損失曲線に同様の動作が見られることがありますが、ドロップアウトは役に立ちません。
13. バッチ正規化

最後に、バッチ正規化を追加してみましょう。
これは理論上の話ですが、実際には、次のいくつかのルールを覚えておいてください。
ここでは、基本に忠実に、最後の層を除く各ニューラル ネットワーク層にバッチ正規化層を追加しましょう。最後の「softmax」レイヤには追加しないでください。そこでは役に立ちません。
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
現在の精度はどうですか?

少し調整を加え(BATCH_SIZE=64、学習率減衰パラメータ 0.666、高密度レイヤのドロップアウト率 0.3)、運が良ければ、99.5% に到達できます。学習率とドロップアウトの調整は、バッチ正規化を使用する際の「ベスト プラクティス」に沿って行われました。
- バッチ正規化は、ニューラル ネットワークの収束を助け、通常はトレーニングを高速化できます。
- バッチ正規化は正則化です。通常は、使用するドロップアウトの量を減らすか、ドロップアウトをまったく使用しないようにします。
ソリューション ノートブックには、99.5% のトレーニング実行が含まれています。
14. 強力なハードウェアを使用してクラウドでトレーニングする: AI Platform

クラウド対応バージョンのコードは、GitHub の mlengine フォルダにあります。Google Cloud AI Platform で実行する手順も記載されています。この部分を実行する前に、Google Cloud アカウントを作成し、課金を有効にする必要があります。ラボを完了するために必要なリソースは、数ドル未満です(1 つの GPU で 1 時間のトレーニング時間を想定)。アカウントを準備するには:
- Google Cloud Platform プロジェクトを作成します(http://cloud.google.com/console)。
- 課金の有効化
- GCP コマンドライン ツールをインストールします(GCP SDK はこちら)。
- Google Cloud Storage バケットを作成します(リージョン
us-central1に配置します)。これは、トレーニング コードをステージングし、トレーニング済みモデルを保存するために使用されます。 - 必要な API を有効にして、必要な割り当てをリクエストします(トレーニング コマンドを 1 回実行すると、有効にする必要がある API を示すエラー メッセージが表示されます)。
15. 完了
最初のニューラル ネットワークを構築し、99% の精度に達するまでトレーニングしました。このラボで学習する手法は、MNIST データセットに固有のものではなく、ニューラル ネットワークを扱う際に広く使用されているものです。最後に、このラボの要約カードを漫画版でご紹介します。学習した内容を思い出すために使用できます。

次のステップ
- 全結合ネットワークと畳み込みネットワークの次は、回帰型ニューラル ネットワークについて確認してください。
- 分散インフラストラクチャのクラウドでトレーニングまたは推論を実行するために、Google Cloud には AI Platform が用意されています。
- 最後に、皆様のフィードバックをお待ちしています。このラボに不適切な点や改善すべき点がある場合は、お知らせください。フィードバックは GitHub の問題 [フィードバック リンク] を通じて処理されます。

|
|
 著者: Martin GörnerTwitter:

このラボで使用されているすべての漫画画像の著作権: alexpokusay / 123RF ストックフォト