

1. Przegląd
Ten samouczek został zaktualizowany pod kątem TensorFlow 2.2.

W ramach tego ćwiczenia dowiesz się, jak utworzyć i wytrenować sieć neuronową, która rozpoznaje odręcznie napisane cyfry. W trakcie ulepszania sieci neuronowej, aby osiągnąć dokładność na poziomie 99%, poznasz też narzędzia, których specjaliści od deep learningu używają do efektywnego trenowania modeli.
W tym ćwiczeniu wykorzystamy zbiór danych MNIST, czyli kolekcję 60 tys. oznaczonych cyfr,która od prawie 20 lat zajmuje kolejne pokolenia doktorantów. Rozwiążesz ten problem za pomocą mniej niż 100 wierszy kodu w Pythonie lub TensorFlow.
Czego się nauczysz
- Co to jest sieć neuronowa i jak ją trenować
- Jak utworzyć podstawową 1-warstwową sieć neuronową za pomocą tf.keras
- Dodawanie kolejnych warstw
- Jak skonfigurować harmonogram tempa uczenia się
- Jak tworzyć konwolucyjne sieci neuronowe
- Jak używać technik regularyzacji: dropout, normalizacja wsadowa
- Co to jest nadmierne dopasowanie?
Czego potrzebujesz
Wystarczy przeglądarka. Te warsztaty można przeprowadzić w całości w Google Colaboratory.
Prześlij opinię
Jeśli zauważysz w tym module coś nieprawidłowego lub uważasz, że można go ulepszyć, daj nam znać. Opinie przyjmujemy w formie zgłoszeń na GitHubie [link do opinii].
2. Krótkie wprowadzenie do Google Colaboratory
W tym module używamy Google Colaboratory, więc nie musisz niczego konfigurować. Możesz uruchomić go na Chromebooku. Otwórz plik poniżej i wykonaj komórki, aby zapoznać się z notatnikami Colab.

Dodatkowe instrukcje znajdziesz poniżej:
Wybierz backend GPU

W menu Colab kliknij Środowisko wykonawcze > Zmień typ środowiska wykonawczego, a potem wybierz GPU. Połączenie z czasem działania nastąpi automatycznie przy pierwszym wykonaniu kodu. Możesz też użyć przycisku „Połącz” w prawym górnym rogu.
Wykonywanie notatnika
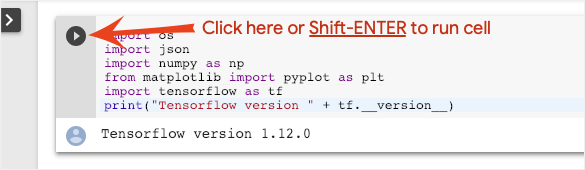
Uruchamiaj komórki pojedynczo, klikając je i naciskając Shift + Enter. Możesz też uruchomić cały notatnik, klikając Środowisko wykonawcze > Uruchom wszystko.
Spis treści

Wszystkie notatniki mają spis treści. Możesz go otworzyć, klikając czarną strzałkę po lewej stronie.
Ukryte komórki
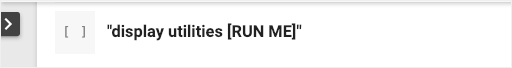
Niektóre komórki będą wyświetlać tylko swój tytuł. Jest to funkcja notatnika Colab. Możesz kliknąć je dwukrotnie, aby zobaczyć kod w środku, ale zwykle nie jest on zbyt interesujący. Zwykle są to funkcje pomocnicze lub wizualizacyjne. Aby zdefiniować funkcje w komórkach, musisz je uruchomić.
3. Trenowanie sieci neuronowej
Najpierw zobaczymy, jak trenuje sieć neuronowa. Otwórz poniższy notatnik i uruchom wszystkie komórki. Nie zwracaj jeszcze uwagi na kod. Wyjaśnimy go później.
Podczas wykonywania notatnika skup się na wizualizacjach. Wyjaśnienia znajdziesz poniżej.
Dane treningowe
Mamy zbiór danych z odręcznie napisanymi cyframi, które zostały oznaczone etykietami, dzięki czemu wiemy, co przedstawia każdy obraz, czyli cyfrę od 0 do 9. W notatniku zobaczysz fragment:

Zbudowana przez nas sieć neuronowa będzie klasyfikować cyfry pisane odręcznie w 10 klasach (0, ..., 9). Odbywa się to na podstawie parametrów wewnętrznych, które muszą mieć prawidłową wartość, aby klasyfikacja działała prawidłowo. Ta „prawidłowa wartość” jest uzyskiwana w procesie trenowania, który wymaga „oznakowanego zbioru danych” zawierającego obrazy i powiązane z nimi prawidłowe odpowiedzi.
Skąd mamy wiedzieć, czy wytrenowana sieć neuronowa działa dobrze? Używanie zbioru danych do trenowania do testowania sieci byłoby oszustwem. Podczas trenowania widział już ten zbiór danych wiele razy i z pewnością osiąga w nim bardzo dobre wyniki. Aby ocenić „rzeczywistą” skuteczność sieci, potrzebujemy innego zbioru danych z etykietami, który nie był używany podczas trenowania. Jest to tzw. zbiór danych do weryfikacji.
Szkolenie
W miarę postępów trenowania, po jednej partii danych treningowych, wewnętrzne parametry modelu są aktualizowane, a model coraz lepiej rozpoznaje odręczne cyfry. Możesz to zobaczyć na wykresie trenowania:

Po prawej stronie „dokładność” to po prostu odsetek prawidłowo rozpoznanych cyfr. Wzrasta on w miarę postępów trenowania, co jest dobrą oznaką.
Po lewej stronie widzimy „stratę”. Aby przeprowadzić trenowanie, zdefiniujemy funkcję „straty”, która określa, jak źle system rozpoznaje cyfry, i spróbujemy ją zminimalizować. Widać, że w miarę postępów trenowania funkcja straty maleje zarówno w przypadku danych treningowych, jak i walidacyjnych. To dobrze. Oznacza to, że sieć neuronowa się uczy.
Oś X reprezentuje liczbę „epok” lub iteracji w całym zbiorze danych.
Prognozy
Po wytrenowaniu modelu możemy go używać do rozpoznawania odręcznych cyfr. Kolejna wizualizacja pokazuje, jak dobrze radzi sobie z kilkoma cyframi wyrenderowanymi z lokalnych czcionek (pierwszy wiersz), a następnie z 10 tys. cyfr ze zbioru danych weryfikacyjnych. Pod każdą cyfrą znajduje się przewidywana klasa. Jeśli jest nieprawidłowa, jest oznaczona na czerwono.

Jak widać, ten początkowy model nie jest zbyt dobry, ale nadal rozpoznaje niektóre cyfry. Ostateczna dokładność weryfikacji wynosi około 90%, co nie jest złym wynikiem w przypadku prostego modelu, od którego zaczynamy, ale nadal oznacza, że z 10 000 cyfr weryfikacyjnych model nie rozpoznaje 1000. To znacznie więcej niż można wyświetlić, dlatego wygląda na to, że wszystkie odpowiedzi są nieprawidłowe (czerwone).
Tensory
Dane są przechowywane w macierzach. Obraz w odcieniach szarości o wymiarach 28 x 28 pikseli mieści się w dwuwymiarowej macierzy o wymiarach 28 x 28. W przypadku obrazu kolorowego potrzebujemy więcej wymiarów. Każdy piksel ma 3 wartości kolorów (czerwony, zielony, niebieski), więc potrzebna będzie tabela trójwymiarowa o wymiarach [28, 28, 3]. Aby przechowywać partię 128 kolorowych obrazów, potrzebna jest czterowymiarowa tabela o wymiarach [128, 28, 28, 3].
Te wielowymiarowe tabele nazywane są „tensorami”, a lista ich wymiarów to „kształt”.
4. [INFO]: neural networks 101
W skrócie
Jeśli wszystkie pogrubione terminy w następnym akapicie są Ci już znane, możesz przejść do kolejnego ćwiczenia. Jeśli dopiero zaczynasz przygodę z uczeniem głębokim, witamy. Zapraszamy do dalszej lektury.

W przypadku modeli zbudowanych jako sekwencja warstw Keras oferuje interfejs Sequential API. Na przykład klasyfikator obrazów z 3 warstwami gęstymi można zapisać w Kerasie w ten sposób:
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

pojedyncza warstwa gęsta,
Ręcznie napisane cyfry w zbiorze danych MNIST to obrazy w odcieniach szarości o rozmiarze 28 x 28 pikseli. Najprostszym sposobem ich klasyfikacji jest użycie 28 x 28=784 pikseli jako danych wejściowych dla 1-warstwowej sieci neuronowej.

Każdy „neuron” w sieci neuronowej oblicza ważoną sumę wszystkich danych wejściowych, dodaje stałą wartość zwaną „odchyleniem”, a następnie przekazuje wynik przez nieliniową „funkcję aktywacji”. „Wagi” i „odchylenia” to parametry, które zostaną określone podczas trenowania. Początkowo są one inicjowane losowymi wartościami.
Obraz powyżej przedstawia 1-warstwową sieć neuronową z 10 neuronami wyjściowymi, ponieważ chcemy klasyfikować cyfry w 10 klasach (od 0 do 9).
Za pomocą mnożenia macierzy
Oto jak warstwa sieci neuronowej przetwarzająca zbiór obrazów może być reprezentowana przez mnożenie macierzy:

Korzystając z pierwszej kolumny wag w macierzy wag W, obliczamy ważoną sumę wszystkich pikseli pierwszego obrazu. Ta suma odpowiada pierwszemu neuronowi. Korzystając z drugiej kolumny wag, robimy to samo w przypadku drugiego neuronu i tak dalej aż do dziesiątego neuronu. Następnie możemy powtórzyć tę operację w przypadku pozostałych 99 obrazów. Jeśli macierz zawierającą 100 obrazów nazwiemy X, wszystkie ważone sumy dla 10 neuronów obliczone na podstawie 100 obrazów to po prostu X.W, czyli mnożenie macierzy.
Każdy neuron musi teraz dodać swój bias (stałą). Ponieważ mamy 10 neuronów, mamy 10 stałych wartości odchylenia. Ten wektor 10 wartości nazwiemy b. Należy go dodać do każdego wiersza wcześniej obliczonej macierzy. Użyjemy do tego odrobiny magii zwanej „rozgłaszaniem” i zapiszemy to za pomocą prostego znaku plusa.
Na koniec stosujemy funkcję aktywacji, np. „softmax” (wyjaśnioną poniżej), i otrzymujemy wzór opisujący 1-warstwową sieć neuronową zastosowaną do 100 obrazów:

W Keras
W przypadku bibliotek sieci neuronowych wysokiego poziomu, takich jak Keras, nie musimy implementować tego wzoru. Warto jednak pamiętać, że warstwa sieci neuronowej to tylko zbiór mnożeń i dodawań. W Keras warstwa gęsta wyglądałaby tak:
tf.keras.layers.Dense(10, activation='softmax')
Postaw na głębsze relacje
Łączenie warstw sieci neuronowych jest bardzo proste. Pierwsza warstwa oblicza ważone sumy pikseli. Kolejne warstwy obliczają ważone sumy wyników poprzednich warstw.

Jedyną różnicą, oprócz liczby neuronów, będzie wybór funkcji aktywacji.
Funkcje aktywacji: relu, softmax i sigmoid
Zwykle w przypadku wszystkich warstw z wyjątkiem ostatniej używa się funkcji aktywacji „relu”. Ostatnia warstwa klasyfikatora używa funkcji aktywacji „softmax”.

„Neuron” oblicza ważoną sumę wszystkich danych wejściowych, dodaje wartość zwaną „obciążeniem” i przekazuje wynik przez funkcję aktywacji.
Najpopularniejsza funkcja aktywacji to RELU, czyli Rectified Linear Unit. Jest to bardzo prosta funkcja, co widać na wykresie powyżej.
Tradycyjną funkcją aktywacji w sieciach neuronowych była „funkcja sigmoidalna”, ale funkcja „relu” ma lepsze właściwości zbieżności niemal w każdym przypadku i jest obecnie preferowana.

Funkcja aktywacji softmax do klasyfikacji
Ostatnia warstwa naszej sieci neuronowej ma 10 neuronów, ponieważ chcemy klasyfikować odręcznie napisane cyfry do 10 klas (0–9). Powinno ono zwracać 10 liczb z zakresu od 0 do 1, które reprezentują prawdopodobieństwo, że cyfra jest równa 0, 1, 2 itd. W tym celu w ostatniej warstwie użyjemy funkcji aktywacji o nazwie „softmax”.
Zastosowanie funkcji softmax do wektora polega na obliczeniu wartości wykładniczej każdego elementu, a następnie znormalizowaniu wektora, zwykle przez podzielenie go przez normę „L1” (czyli sumę wartości bezwzględnych), tak aby znormalizowane wartości sumowały się do 1 i mogły być interpretowane jako prawdopodobieństwa.
Dane wyjściowe ostatniej warstwy przed aktywacją są czasami nazywane „logitami”. Jeśli wektor to L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9], to:


Funkcja straty entropii krzyżowej
Gdy nasza sieć neuronowa generuje prognozy na podstawie obrazów wejściowych, musimy zmierzyć, jak dobre są te prognozy, czyli odległość między tym, co mówi nam sieć, a prawidłowymi odpowiedziami, często nazywanymi „etykietami”. Pamiętaj, że mamy prawidłowe etykiety dla wszystkich obrazów w zbiorze danych.
Sprawdzi się dowolna odległość, ale w przypadku problemów z klasyfikacją najskuteczniejsza jest tzw. odległość entropii krzyżowej. Nazwiemy ją funkcją błędu lub „straty”:

Metoda gradientu prostego
„Trenowanie” sieci neuronowej polega na używaniu obrazów i etykiet treningowych do dostosowywania wag i odchyleń w celu zminimalizowania funkcji straty entropii krzyżowej. Działa to w następujący sposób:
Entropia krzyżowa jest funkcją wag, odchyleń, pikseli obrazu treningowego i jego znanej klasy.
Jeśli obliczymy pochodne cząstkowe entropii krzyżowej względem wszystkich wag i wszystkich odchyleń, otrzymamy „gradient” obliczony dla danego obrazu, etykiety oraz bieżącej wartości wag i odchyleń. Pamiętaj, że możemy mieć miliony wag i odchyleń, więc obliczanie gradientu wydaje się bardzo pracochłonne. Na szczęście TensorFlow robi to za nas. Własnością matematyczną gradientu jest to, że wskazuje on „w górę”. Chcemy, aby entropia krzyżowa była jak najmniejsza, więc idziemy w przeciwnym kierunku. Aktualizujemy wagi i odchylenia o ułamek gradientu. Następnie powtarzamy ten proces w przypadku kolejnych partii obrazów i etykiet treningowych w pętli trenowania. Mamy nadzieję, że zbiegnie się to w miejscu, w którym entropia krzyżowa jest minimalna, chociaż nic nie gwarantuje, że to minimum jest unikalne.

Mini-batching i momentum
Możesz obliczyć gradient na podstawie tylko jednego przykładowego obrazu i od razu zaktualizować wagi i odchylenia, ale zrobienie tego na podstawie np. 128 obrazów daje gradient, który lepiej odzwierciedla ograniczenia narzucone przez różne przykładowe obrazy, a tym samym prawdopodobnie szybciej zbiega się do rozwiązania. Rozmiar mini-partii jest parametrem, który można dostosować.
Ta technika, zwana czasem „stochastycznym spadkiem gradientu”, ma jeszcze jedną, bardziej praktyczną zaletę: praca z partiami oznacza też pracę z większymi macierzami, które zwykle łatwiej jest optymalizować na GPU i TPU.
Proces zbieżności może być jednak nieco chaotyczny, a nawet zatrzymać się, jeśli wektor gradientu będzie składać się z samych zer. Czy to oznacza, że znaleźliśmy minimum? Nie zawsze. Składnik gradientu może wynosić zero w przypadku wartości minimalnej lub maksymalnej. W przypadku wektora gradientu z milionami elementów, jeśli wszystkie są zerami, prawdopodobieństwo, że każde zero odpowiada minimum, a żadne z nich nie odpowiada maksimum, jest dość małe. W przestrzeni wielowymiarowej punkty siodłowe są dość powszechne i nie chcemy się na nich zatrzymywać.

Ilustracja: punkt siodłowy. Gradient wynosi 0, ale nie jest to minimum we wszystkich kierunkach. (Atrybucja obrazu: Wikimedia: By Nicoguaro - Own work, CC BY 3.0)
Rozwiązaniem jest dodanie do algorytmu optymalizacji pewnego rozpędu, aby mógł on przechodzić przez punkty siodłowe bez zatrzymywania się.
Słownik
wsadowe lub miniwsadowe: trenowanie jest zawsze przeprowadzane na partiach danych treningowych i etykiet. Ułatwia to algorytmowi zbieżność. Wymiar „batch” jest zwykle pierwszym wymiarem tensorów danych. Na przykład tensor o kształcie [100, 192, 192, 3] zawiera 100 obrazów o wymiarach 192 x 192 piksele z 3 wartościami na piksel (RGB).
Entropia krzyżowa: specjalna funkcja straty często używana w klasyfikatorach.
warstwa gęsta: warstwa neuronów, w której każdy neuron jest połączony ze wszystkimi neuronami w poprzedniej warstwie.
cechy: dane wejściowe sieci neuronowej są czasami nazywane „cechami”. Sztuka określania, które części zbioru danych (lub ich kombinacje) należy przekazać do sieci neuronowej, aby uzyskać dobre prognozy, jest nazywana „inżynierią cech”.
etykiety: inna nazwa „klas” lub prawidłowych odpowiedzi w problemie klasyfikacji nadzorowanej.
Tempo uczenia się: ułamek gradientu, o który wagi i odchylenia są aktualizowane w każdej iteracji pętli trenowania.
Logity: wyniki warstwy neuronów przed zastosowaniem funkcji aktywacji. Nazwa pochodzi od „funkcji logistycznej”, czyli „funkcji sigmoidalnej”, która była najpopularniejszą funkcją aktywacji. „Neuron outputs before logistic function” (Wyniki neuronu przed funkcją logistyczną) zostało skrócone do „logits” (logity).
loss: funkcja błędu porównująca dane wyjściowe sieci neuronowej z prawidłowymi odpowiedziami.
Neuron: oblicza ważoną sumę danych wejściowych, dodaje odchylenie i przekazuje wynik do funkcji aktywacji.
Kodowanie 1 z n: klasa 3 z 5 jest kodowana jako wektor składający się z 5 elementów, z których wszystkie są zerami z wyjątkiem 3 elementu, który ma wartość 1.
relu: jednostka liniowa z prostownikiem. Popularna funkcja aktywacji neuronów.
sigmoid: kolejna funkcja aktywacji, która była kiedyś popularna i nadal jest przydatna w szczególnych przypadkach.
softmax: specjalna funkcja aktywacji, która działa na wektor, zwiększa różnicę między największym komponentem a wszystkimi innymi, a także normalizuje wektor, aby jego suma wynosiła 1, dzięki czemu można go interpretować jako wektor prawdopodobieństw. Używany jako ostatni krok w klasyfikatorach.
tensor: „tensor” to macierz o dowolnej liczbie wymiarów. Tensor 1-wymiarowy to wektor. Tensor 2-wymiarowy to macierz. Możesz też mieć tensory o 3, 4, 5 lub większej liczbie wymiarów.
5. Przejdźmy do kodu
Wróć do notatnika z badaniem i tym razem przeczytaj kod.
Przejdźmy przez wszystkie komórki w tym notatniku.
Komórka „Parametry”
Określa wielkość wsadu, liczbę epok trenowania i lokalizację plików danych. Pliki danych są hostowane w zasobniku Google Cloud Storage (GCS), dlatego ich adres zaczyna się od gs://.
Komórka „Importy”
Wszystkie niezbędne biblioteki Pythona są tutaj importowane, w tym TensorFlow i matplotlib do wizualizacji.
Komórka „narzędzia do wizualizacji [URUCHOM MNIE]****”
Ta komórka zawiera nieciekawy kod wizualizacji. Jest domyślnie zwinięty, ale możesz go otworzyć i sprawdzić kod, gdy masz czas, klikając go dwukrotnie.
Komórka „tf.data.Dataset: parse files and prepare training and validation datasets”
Ta komórka używa interfejsu tf.data.Dataset API do wczytywania zbioru danych MNIST z plików danych. Nie musisz poświęcać zbyt dużo czasu na tę komórkę. Jeśli interesuje Cię interfejs tf.data.Dataset API, zapoznaj się z tym samouczkiem: Potoki danych o szybkości TPU. Na razie podstawowe informacje to:
Obrazy i etykiety (prawidłowe odpowiedzi) ze zbioru danych MNIST są przechowywane w rekordach o stałej długości w 4 plikach. Pliki można wczytywać za pomocą specjalnej funkcji rekordu stałego:
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
Mamy teraz zbiór danych bajtów obrazu. Muszą zostać zdekodowane do postaci obrazów. Definiujemy funkcję, która to robi. Obraz nie jest skompresowany, więc funkcja nie musi niczego dekodować (decode_raw w zasadzie nic nie robi). Obraz jest następnie przekształcany na wartości zmiennoprzecinkowe z zakresu od 0 do 1. Możemy przekształcić go w obraz 2D, ale w rzeczywistości zachowujemy go jako płaską tablicę pikseli o rozmiarze 28 x 28, ponieważ tego oczekuje nasza początkowa warstwa gęsta.
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
Stosujemy tę funkcję do zbioru danych za pomocą .map i uzyskujemy zbiór obrazów:
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
W przypadku etykiet wykonujemy podobne odczytywanie i dekodowanie, a następnie .zip obrazy i etykiety:
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
Mamy teraz zbiór danych składający się z par (obraz, etykieta). Tego oczekuje nasz model. Nie jesteśmy jeszcze gotowi, aby używać go w funkcji szkoleniowej:
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
Interfejs tf.data.Dataset API zawiera wszystkie niezbędne funkcje użytkowe do przygotowywania zbiorów danych:
.cache buforuje zbiór danych w pamięci RAM. To niewielki zbiór danych, więc będzie działać. .shuffle tasuje go z buforem 5000 elementów. Ważne jest, aby dane treningowe były dobrze przetasowane. .repeat zapętla zbiór danych. Będziemy trenować go wielokrotnie (wielokrotnie). .batch pobiera wiele obrazów i etykiet do mini-batcha. Wreszcie .prefetch może używać procesora do przygotowywania następnej partii, podczas gdy bieżąca partia jest trenowana na procesorze graficznym.
Zbiór danych do weryfikacji jest przygotowywany w podobny sposób. Możemy teraz zdefiniować model i użyć tego zbioru danych do jego wytrenowania.
Komórka „Model Keras”
Wszystkie nasze modele będą prostymi sekwencjami warstw, więc do ich tworzenia możemy użyć stylu tf.keras.Sequential. Początkowo jest to jedna gęsta warstwa. Ma 10 neuronów, ponieważ klasyfikujemy odręcznie napisane cyfry w 10 klasach. Używa funkcji aktywacji „softmax”, ponieważ jest ostatnią warstwą klasyfikatora.
Model Keras musi też znać kształt danych wejściowych. Możesz go określić za pomocą tf.keras.layers.Input. W tym przypadku wektory wejściowe to płaskie wektory wartości pikseli o długości 28*28.
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
Konfigurowanie modelu odbywa się w Keras przy użyciu funkcji model.compile. Używamy tu podstawowego optymalizatora 'sgd' (stochastycznego spadku gradientu). Model klasyfikacji wymaga funkcji straty entropii krzyżowej, która w Kerasie jest oznaczana jako 'categorical_crossentropy'. Na koniec prosimy model o obliczenie wartości 'accuracy', czyli odsetka prawidłowo sklasyfikowanych obrazów.
Keras oferuje przydatne narzędzie model.summary(), które wyświetla szczegóły utworzonego modelu. Twój życzliwy instruktor dodał narzędzie PlotTraining (zdefiniowane w komórce „Narzędzia do wizualizacji”), które będzie wyświetlać różne krzywe treningowe podczas szkolenia.
Komórka „Trenowanie i weryfikowanie modelu”
W tym miejscu odbywa się trenowanie przez wywołanie funkcji model.fit i przekazanie zarówno zbioru danych treningowych, jak i zbioru danych do weryfikacji. Domyślnie Keras przeprowadza rundę weryfikacji na końcu każdej epoki.
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
W Keras można dodawać niestandardowe zachowania podczas trenowania za pomocą wywołań zwrotnych. W ten sposób w przypadku tych warsztatów zaimplementowano dynamicznie aktualizowany wykres szkoleniowy.
Komórka „Wyświetl prognozy”
Po wytrenowaniu modelu możemy uzyskiwać z niego prognozy, wywołując funkcję model.predict():
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
Przygotowaliśmy zestaw wydrukowanych cyfr wyrenderowanych z lokalnych czcionek. Pamiętaj, że sieć neuronowa zwraca wektor 10 prawdopodobieństw z ostatniej funkcji „softmax”. Aby uzyskać etykietę, musimy znaleźć najwyższe prawdopodobieństwo. np.argmax z biblioteki numpy.
Aby zrozumieć, dlaczego parametr axis=1 jest potrzebny, pamiętaj, że przetworzyliśmy partię 128 obrazów, więc model zwraca 128 wektorów prawdopodobieństwa. Kształt tensora wyjściowego to [128, 10]. Obliczamy argmax dla 10 prawdopodobieństw zwracanych dla każdego obrazu, czyli axis=1 (pierwsza oś to 0).
Ten prosty model rozpoznaje już 90% cyfr. Nieźle, ale teraz znacznie to poprawisz.

6. Dodawanie warstw

Aby zwiększyć dokładność rozpoznawania, dodamy do sieci neuronowej więcej warstw.

Na ostatniej warstwie zachowujemy funkcję aktywacji softmax, ponieważ najlepiej sprawdza się ona w klasyfikacji. W przypadku warstw pośrednich użyjemy jednak najbardziej klasycznej funkcji aktywacji, czyli funkcji sigmoidalnej:
Model może na przykład wyglądać tak (nie zapomnij o przecinkach, funkcja tf.keras.Sequential przyjmuje listę warstw rozdzielonych przecinkami):
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
Sprawdź „podsumowanie” modelu. Ma teraz co najmniej 10 razy więcej parametrów. Powinien być 10 razy lepszy! Ale z jakiegoś powodu tak nie jest…

Strata też chyba poszybowała w górę. Coś jest nie tak.
7. Specjalna opieka nad głębokimi sieciami
Właśnie poznałeś sieci neuronowe w takiej postaci, w jakiej były projektowane w latach 80. i 90. Nic dziwnego, że zrezygnowali z tego pomysłu, co zapoczątkowało tzw. „zimę AI”. W miarę dodawania warstw sieci neuronowe mają coraz większe trudności z konwergencją.
Okazuje się, że głębokie sieci neuronowe z wieloma warstwami (dziś nawet 20, 50 czy 100) mogą działać bardzo dobrze, pod warunkiem zastosowania kilku matematycznych sztuczek, które sprawią, że będą zbieżne. Odkrycie tych prostych sztuczek jest jednym z powodów renesansu uczenia głębokiego w latach 2010.
Aktywacja RELU

Funkcja aktywacji sigmoid jest w sieciach głębokich dość problematyczna. Spłaszcza wszystkie wartości między 0 a 1, a gdy robisz to wielokrotnie, dane wyjściowe neuronu i ich gradienty mogą całkowicie zniknąć. Zostało ono wspomniane ze względów historycznych, ale nowoczesne sieci korzystają z funkcji RELU (Rectified Linear Unit), która wygląda tak:

Z drugiej strony funkcja ReLU ma pochodną równą 1, przynajmniej po prawej stronie. Dzięki funkcji aktywacji RELU nawet jeśli gradienty pochodzące z niektórych neuronów mogą wynosić zero, zawsze będą inne, które dają wyraźny gradient niezerowy, a trenowanie może być kontynuowane w dobrym tempie.
Lepszy optymalizator
W przestrzeniach o bardzo dużej liczbie wymiarów, takich jak ta – mamy tu około 10 tys. wag i odchyleń – „punkty siodłowe” występują często. Są to punkty, które nie są lokalnymi minimami, ale w których gradient wynosi zero, a optymalizator metody gradientu prostego utyka w nich. TensorFlow ma pełną gamę dostępnych optymalizatorów, w tym niektóre, które działają z pewną bezwładnością i bezpiecznie pokonują punkty siodłowe.
Losowe inicjowanie
Sztuka inicjowania wag i odchyleń przed trenowaniem to osobny obszar badań, w którym opublikowano wiele artykułów. Wszystkie inicjatory dostępne w Keras znajdziesz tutaj. Na szczęście Keras domyślnie stosuje odpowiednie rozwiązanie i używa inicjatora 'glorot_uniform', który w większości przypadków jest najlepszy.
Nie musisz nic robić, ponieważ Keras już wykonuje odpowiednie działania.
NaN ???
Wzór na entropię krzyżową zawiera logarytm, a log(0) to NaN (Not a Number, czyli „nie liczba”, co w przypadku obliczeń numerycznych powoduje błąd). Czy dane wejściowe entropii krzyżowej mogą wynosić 0? Dane wejściowe pochodzą z funkcji softmax, która jest w zasadzie funkcją wykładniczą, a ta nigdy nie przyjmuje wartości 0. Jesteśmy bezpieczni.
Naprawdę? W pięknym świecie matematyki bylibyśmy bezpieczni, ale w świecie komputerów exp(-150) w formacie float32 jest tak bliskie zera, jak to tylko możliwe, a entropia krzyżowa się załamuje.
Na szczęście nie musisz nic robić, ponieważ Keras zajmuje się tym i oblicza funkcję softmax, a następnie entropię krzyżową w szczególnie staranny sposób, aby zapewnić stabilność numeryczną i uniknąć niepożądanych wartości NaN.
Sukces?

Powinna teraz osiągać dokładność na poziomie 97%. Celem tego szkolenia jest osiągnięcie wyniku znacznie powyżej 99%, więc kontynuujmy.
Jeśli utkniesz, wykonaj te czynności:
8. Osłabianie tempa uczenia się
Może spróbujemy trenować szybciej? Domyślne tempo uczenia się w optymalizatorze Adam wynosi 0,001. Spróbujmy go zwiększyć.
Szybsze poruszanie się nie wydaje się zbyt pomocne, a skąd ten hałas?

Krzywe uczenia są bardzo zaszumione, a krzywe weryfikacji skaczą w górę i w dół. Oznacza to, że działamy zbyt szybko. Możemy wrócić do poprzedniej prędkości, ale jest lepszy sposób.

Dobre rozwiązanie to szybki start i wykładnicze zmniejszanie tempa uczenia się. W Kerasie możesz to zrobić za pomocą wywołania zwrotnego tf.keras.callbacks.LearningRateScheduler.
Przydatny kod do skopiowania i wklejenia:
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
Nie zapomnij użyć utworzonego przez siebie lr_decay_callback. Dodaj go do listy wywołań zwrotnych w model.fit:
model.fit(..., callbacks=[plot_training, lr_decay_callback])
Wpływ tej niewielkiej zmiany jest spektakularny. Widzisz, że większość szumów zniknęła, a dokładność testu utrzymuje się na poziomie powyżej 98%.

9. Porzucanie, nadmierne dopasowanie
Model wydaje się teraz dobrze zbieżny. Spróbujmy jeszcze bardziej zagłębić się w temat.
Czy to pomaga?

Nie, dokładność nadal wynosi 98%, a strata weryfikacyjna jest wysoka. Rośnie! Algorytm uczenia się działa tylko na danych treningowych i odpowiednio optymalizuje stratę treningową. Nigdy nie widzi danych weryfikacyjnych, więc nie jest zaskakujące, że po pewnym czasie jego praca przestaje mieć wpływ na utratę weryfikacji, która przestaje spadać, a czasami nawet odbija w górę.
Nie ma to natychmiastowego wpływu na możliwości rozpoznawania w rzeczywistym świecie, ale uniemożliwia przeprowadzenie wielu iteracji i jest ogólnie oznaką, że trenowanie nie przynosi już pozytywnych efektów.

To rozłączenie jest zwykle nazywane „nadmiernym dopasowaniem”. Gdy je zauważysz, możesz spróbować zastosować technikę regularyzacji zwaną „wypadaniem”. Technika dropout polega na losowym wyłączaniu neuronów w każdej iteracji trenowania.
Jaki był efekt

Szum powraca (co nie jest zaskakujące, biorąc pod uwagę, jak działa wyciszanie). Utrata walidacji nie wydaje się już rosnąć, ale ogólnie jest wyższa niż bez dropoutu. Dokładność weryfikacji nieco spadła. To dość rozczarowujący wynik.
Wygląda na to, że dropout nie był właściwym rozwiązaniem lub że „nadmierne dopasowanie” jest bardziej złożonym pojęciem, a niektóre z jego przyczyn nie podlegają poprawce „dropout”?
Co to jest „nadmierne dopasowanie”? Nadmierne dopasowanie występuje, gdy sieć neuronowa uczy się „źle”, czyli w sposób, który sprawdza się w przypadku przykładów treningowych, ale nie w przypadku rzeczywistych danych. Istnieją techniki regularyzacji, takie jak dropout, które mogą wymusić lepsze uczenie się, ale nadmierne dopasowanie ma też głębsze przyczyny.

Podstawowe przeuczenie występuje, gdy sieć neuronowa ma zbyt wiele stopni swobody w stosunku do danego problemu. Wyobraź sobie, że mamy tak wiele neuronów, że sieć może przechowywać w nich wszystkie obrazy treningowe, a potem rozpoznawać je na podstawie dopasowywania wzorców. W przypadku rzeczywistych danych nie sprawdzi się w ogóle. Sieć neuronowa musi być w pewnym stopniu ograniczona, aby była zmuszona do uogólniania tego, czego nauczyła się podczas trenowania.
Jeśli masz bardzo mało danych treningowych, nawet mała sieć może nauczyć się ich na pamięć i zobaczysz „przetrenowanie”. Ogólnie rzecz biorąc, do trenowania sieci neuronowych zawsze potrzebujesz dużej ilości danych.
Jeśli wszystko zostało zrobione zgodnie z zasadami, przeprowadzono eksperymenty z różnymi rozmiarami sieci, aby upewnić się, że jej stopnie swobody są ograniczone, zastosowano dropout i przeprowadzono trenowanie na dużej ilości danych, nadal możesz utknąć na poziomie wydajności, którego nic nie jest w stanie poprawić. Oznacza to, że sieć neuronowa w obecnej postaci nie jest w stanie wyodrębnić z danych większej ilości informacji, jak w naszym przypadku.
Pamiętasz, jak używamy naszych obrazów spłaszczonych do postaci jednego wektora? To był bardzo zły pomysł. Ręcznie napisane cyfry składają się z kształtów, a informacje o kształtach zostały odrzucone podczas spłaszczania pikseli. Istnieje jednak rodzaj sieci neuronowej, która może wykorzystywać informacje o kształcie: sieci konwolucyjne. Wypróbujmy je.
Jeśli utkniesz, wykonaj te czynności:
10. [INFO] sieci konwolucyjne
W skrócie
Jeśli wszystkie pogrubione terminy w następnym akapicie są Ci już znane, możesz przejść do kolejnego ćwiczenia. Jeśli dopiero zaczynasz przygodę z konwolucyjnymi sieciami neuronowymi, czytaj dalej.

Ilustracja: filtrowanie obrazu za pomocą 2 kolejnych filtrów, z których każdy ma 48 wag do nauczenia (4 x 4 x 3=48).
Tak wygląda prosta konwolucyjna sieć neuronowa w Keras:
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
W warstwie sieci konwolucyjnej jeden „neuron” oblicza ważoną sumę pikseli znajdujących się bezpośrednio nad nim, ale tylko w niewielkim obszarze obrazu. Dodaje ona odchylenie i przekazuje sumę przez funkcję aktywacji, tak jak neuron w zwykłej warstwie gęstej. Następnie operacja jest powtarzana na całym obrazie z użyciem tych samych wag. Pamiętaj, że w warstwach gęstych każdy neuron miał własne wagi. W tym przypadku pojedynczy „fragment” wag przesuwa się po obrazie w obu kierunkach (jest to „splot”). Dane wyjściowe mają tyle wartości, ile pikseli na obrazie (na krawędziach wymagane jest pewne dopełnienie). Jest to operacja filtrowania. Na ilustracji powyżej używa filtra o wymiarach 4 x 4 x 3=48 wag.
Jednak 48 wag nie wystarczy. Aby dodać więcej stopni swobody, powtarzamy tę samą operację z nowym zestawem wag. Spowoduje to wygenerowanie nowego zestawu wyników filtrowania. Nazwijmy go „kanałem” wyników, analogicznie do kanałów R, G, B na obrazie wejściowym.

Dwa (lub więcej) zestawy wag można zsumować w jeden tensor, dodając nowy wymiar. Daje nam to ogólny kształt tensora wag dla warstwy splotowej. Liczba kanałów wejściowych i wyjściowych jest parametrem, więc możemy zacząć układać i łączyć warstwy konwolucyjne.

Ilustracja: splotowa sieć neuronowa przekształca „kostki” danych w inne „kostki” danych.
Konwolucje z krokiem, maksymalne próbkowanie
Wykonując operacje splotu z krokiem 2 lub 3, możemy też zmniejszyć wynikową kostkę danych w wymiarach poziomych. Można to zrobić na 2 sposoby:
- Konwolucja z krokiem: filtr przesuwny jak powyżej, ale z krokiem > 1.
- Maksymalne uśrednianie: okno przesuwne stosujące operację MAX (zwykle na fragmentach 2x2, powtarzane co 2 piksele).

Ilustracja: przesunięcie okna obliczeniowego o 3 piksele powoduje zmniejszenie liczby wartości wyjściowych. Sploty z krokiem lub maksymalne próbkowanie (maksymalna wartość w oknie 2x2 przesuwającym się o krok 2) to sposób na zmniejszenie kostki danych w wymiarach poziomych.
Ostatnia warstwa
Po ostatniej warstwie konwolucyjnej dane mają postać „kostki”. Można to zrobić na 2 sposoby.
Pierwsza polega na spłaszczeniu kostki danych do postaci wektora, a następnie przekazaniu go do warstwy softmax. Czasami przed warstwą softmax można dodać warstwę gęstą. Zwykle wiąże się to z dużą liczbą wag. Gęsta warstwa na końcu sieci konwolucyjnej może zawierać ponad połowę wag całej sieci neuronowej.
Zamiast używać kosztownej warstwy gęstej, możemy też podzielić przychodzącą „kostkę” danych na tyle części, ile mamy klas, uśrednić ich wartości i przekazać je przez funkcję aktywacji softmax. Ten sposób tworzenia głowicy klasyfikacji nie wymaga żadnych wag. W Kerasie jest do tego warstwa: tf.keras.layers.GlobalAveragePooling2D().

Aby utworzyć sieć konwolucyjną do rozwiązania tego problemu, przejdź do następnej sekcji.
11. sieć konwolucyjna,
Utwórzmy sieć konwolucyjną do rozpoznawania odręcznie napisanych cyfr. Użyjemy 3 górnych warstw konwolucyjnych, tradycyjnej dolnej warstwy odczytu softmax i połączymy je z 1 w pełni połączoną warstwą:

Zauważ, że druga i trzecia warstwa konwolucyjna mają krok 2, co wyjaśnia, dlaczego zmniejszają liczbę wartości wyjściowych z 28 x 28 do 14 x 14, a następnie do 7 x 7.
Napiszmy kod w Keras.
Szczególnej uwagi wymaga warstwa przed pierwszą warstwą konwolucyjną. Oczekuje ona bowiem trójwymiarowej „kostki” danych, ale nasz zbiór danych został do tej pory skonfigurowany pod kątem gęstych warstw, a wszystkie piksele obrazów są spłaszczone do postaci wektora. Musimy przekształcić je z powrotem w obrazy o wymiarach 28 x 28 x 1 (1 kanał dla obrazów w odcieniach szarości):
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
Możesz użyć tej linii zamiast warstwy tf.keras.layers.Input, której używasz do tej pory.
W Keras składnia warstwy konwolucyjnej aktywowanej funkcją „relu” jest następująca:

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
W przypadku konwolucji z krokiem możesz napisać:
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
Aby spłaszczyć kostkę danych do postaci wektora, który może być używany przez warstwę gęstą:
tf.keras.layers.Flatten()
W przypadku warstwy gęstej składnia nie uległa zmianie:
tf.keras.layers.Dense(200, activation='relu')
Czy Twój model przekroczył próg dokładności 99%? Prawie… ale spójrz na krzywą utraty podczas sprawdzania poprawności. Czy to coś Ci mówi?

Sprawdź też prognozy. Po raz pierwszy zobaczysz, że większość z 10 tys. cyfr testowych jest teraz prawidłowo rozpoznawana. Pozostało tylko około 4½ wiersza błędnych wykryć (około 110 cyfr na 10 000).

Jeśli utkniesz, wykonaj te czynności:
12. Ponowne porzucenie
Poprzednie trenowanie wykazuje wyraźne oznaki przetrenowania (a mimo to nie osiąga dokładności na poziomie 99%). Czy mamy ponownie spróbować z dropoutem?
Jak tym razem poszło?

Wygląda na to, że tym razem dropout zadziałał. Wartość funkcji straty w przypadku zbioru walidacyjnego nie rośnie już, a ostateczna dokładność powinna być znacznie wyższa niż 99%. Gratulacje!
Gdy po raz pierwszy próbowaliśmy zastosować dropout, myśleliśmy, że mamy problem z nadmiernym dopasowaniem, ale w rzeczywistości problem tkwił w architekturze sieci neuronowej. Bez warstw konwolucyjnych nie moglibyśmy pójść dalej, a dropout nic by na to nie poradził.
Tym razem wygląda na to, że przyczyną problemu było nadmierne dopasowanie, a metoda dropout pomogła. Pamiętaj, że istnieje wiele czynników, które mogą powodować rozbieżność między krzywymi strat treningowych i walidacyjnych, przy czym straty walidacyjne mogą rosnąć. Nadmierne dopasowanie (zbyt wiele stopni swobody, źle wykorzystywanych przez sieć) to tylko jeden z nich. Jeśli zbiór danych jest zbyt mały lub architektura sieci neuronowej jest nieodpowiednia, na krzywych funkcji straty może wystąpić podobne zachowanie, ale dropout nie pomoże.
13. Normalizacja wsadowa

Na koniec spróbujmy dodać normalizację wsadową.
To teoria, ale w praktyce wystarczy pamiętać o kilku zasadach:
Na razie postępujmy zgodnie z instrukcjami i dodajmy warstwę normalizacji wsadowej do każdej warstwy sieci neuronowej z wyjątkiem ostatniej. Nie dodawaj go do ostatniej warstwy „softmax”. Nie byłoby tam przydatne.
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
Jak dokładne są teraz wyniki?

Po niewielkich zmianach (BATCH_SIZE=64, parametr zaniku tempa uczenia się 0,666, współczynnik wyłączania w warstwie gęstej 0,3) i przy odrobinie szczęścia możesz osiągnąć wynik 99,5%. Dostosowanie tempa uczenia się i współczynnika wyłączania zostało przeprowadzone zgodnie ze „sprawdzonymi metodami” korzystania z normalizacji wsadowej:
- Normalizacja wsadowa pomaga sieciom neuronowym zbiegać się i zwykle umożliwia szybsze trenowanie.
- Normalizacja wsadowa jest regularyzatorem. Zazwyczaj możesz zmniejszyć liczbę wyłączeń lub w ogóle ich nie używać.
Notatnik z rozwiązaniem ma 99,5% sesji trenowania:
14. Trenowanie w chmurze na wydajnym sprzęcie: AI Platform

Wersję kodu gotową do uruchomienia w chmurze znajdziesz w folderze mlengine w serwisie GitHub wraz z instrukcjami dotyczącymi uruchamiania go na platformie AI w Google Cloud. Zanim uruchomisz tę część, musisz utworzyć konto Google Cloud i włączyć rozliczenia. Zasoby potrzebne do ukończenia modułu powinny kosztować mniej niż kilka dolarów (przy założeniu 1 godziny szkolenia na 1 procesorze GPU). Aby przygotować konto:
- Utwórz projekt Google Cloud Platform ( http://cloud.google.com/console).
- Włącz płatności.
- Zainstaluj narzędzia wiersza poleceń GCP ( pakiet SDK GCP znajdziesz tutaj).
- Utwórz zasobnik Google Cloud Storage (umieść go w regionie
us-central1). Będzie on używany do przechowywania kodu trenowania i wytrenowanego modelu. - Włącz niezbędne interfejsy API i poproś o odpowiednie limity (uruchom polecenie szkolenia raz, a powinny pojawić się komunikaty o błędach informujące o tym, co należy włączyć).
15. Gratulacje!
Utworzyliśmy pierwszą sieć neuronową i wytrenowaliśmy ją do poziomu 99% dokładności. Techniki, których się nauczysz, nie są specyficzne dla zbioru danych MNIST. W rzeczywistości są one powszechnie stosowane podczas pracy z sieciami neuronowymi. Na pożegnanie przesyłam kartę z „notatkami” do modułu w wersji rysunkowej. Możesz go używać, aby zapamiętywać to, czego się uczysz:

Dalsze kroki
- Po sieciach w pełni połączonych i splotowych warto zapoznać się z rekurencyjnymi sieciami neuronowymi.
- Aby przeprowadzić trenowanie lub wnioskowanie w chmurze w infrastrukturze rozproszonej, Google Cloud udostępnia AI Platform.
- Twoja opinia jest dla nas ważna. Jeśli zauważysz w tym module coś nieprawidłowego lub uważasz, że można go ulepszyć, daj nam znać. Opinie przyjmujemy w formie zgłoszeń na GitHubie [link do opinii].

|
|
 Autor: Martin GörnerTwitter:

Wszystkie ilustracje w tym module są chronione prawami autorskimi: alexpokusay / 123RF stock photos