

1. 總覽
本教學課程已更新,適用於 TensorFlow 2.2!

在本程式碼實驗室中,您將瞭解如何建構及訓練可辨識手寫數字的類神經網路。在過程中,您會逐步強化類神經網路,達到 99% 的準確率,同時也會瞭解深度學習專家用來有效訓練模型的專業工具。
本程式碼實驗室使用 MNIST 資料集,其中包含 60,000 個已加上標籤的數字,近二十年來,許多博士生都致力於研究這個資料集。您將使用不到 100 行的 Python/TensorFlow 程式碼解決問題。
課程內容
- 什麼是類神經網路?如何訓練?
- 如何使用 tf.keras 建構基本的 1 層類神經網路
- 如何新增更多圖層
- 如何設定學習率排程
- 如何建構卷積類神經網路
- 如何使用正規化技術:dropout、批次正規化
- 什麼是過度配適
軟硬體需求
只要有瀏覽器就能使用。本工作坊可完全在 Google Colaboratory 中執行。
意見回饋
如果您發現本實驗室有任何問題,或認為有改進空間,請告訴我們。我們會透過 GitHub 問題處理意見回饋 [意見回饋連結]。
2. Google Colaboratory 快速入門導覽課程
本實驗室使用 Google Colaboratory,您不需進行任何設定。您可以在 Chromebook 上執行這項工具。請開啟下方檔案並執行儲存格,熟悉 Colab 筆記本。

其他操作說明如下:
選取 GPU 後端

在 Colab 選單中,依序選取「執行階段」>「變更執行階段類型」,然後選取「GPU」。首次執行時,系統會自動連線至執行階段,你也可以使用右上角的「連線」按鈕。
Notebook 執行
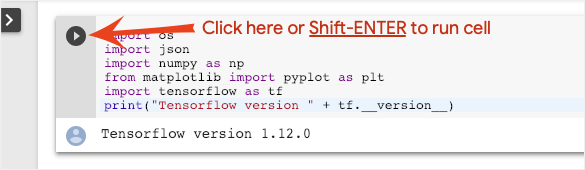
點選儲存格並按下 Shift + Enter 鍵,即可逐一執行儲存格。您也可以依序點選「執行階段」>「全部執行」,執行整個筆記本
Table of contents

所有筆記本都有目錄。點選左側的黑色箭頭即可開啟。
隱藏的儲存格
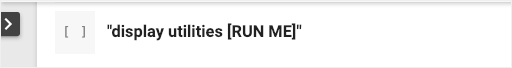
部分儲存格只會顯示標題。這是 Colab 專屬的筆記本功能。按兩下即可查看其中的程式碼,但通常沒什麼特別。通常是支援或視覺化函式。您仍須執行這些儲存格,才能定義其中的函式。
3. 訓練類神經網路
首先,我們會觀察類神經網路的訓練過程。請開啟下方筆記本,並執行所有儲存格。請先不要注意程式碼,我們稍後會開始說明。
執行筆記本時,請著重於圖表。請參閱下方的說明。
訓練資料
我們有一個手寫數字資料集,其中已加上標籤,因此我們知道每張圖片代表什麼,也就是 0 到 9 之間的數字。筆記本中會顯示以下摘錄:

我們將建構的類神經網路會將手寫數字分為 10 個類別 (0 到 9)。這項作業會根據內部參數執行,這些參數必須具有正確的值,分類才能順利運作。這個「正確值」是透過訓練程序習得,而訓練程序需要「已加上標籤的資料集」,其中包含圖片和相關聯的正確答案。
如何判斷訓練後的類神經網路成效是否良好?如果使用訓練資料集測試網路,就等於作弊。模型在訓練期間已多次看過該資料集,因此在該資料集上的成效肯定非常出色。我們需要另一個在訓練期間從未出現過的已加上標籤資料集,才能評估網路的「實際」效能。這稱為「驗證資料集」。
訓練
隨著訓練進展,每次處理一批訓練資料,內部模型參數就會更新,模型也會越來越擅長辨識手寫數字。訓練圖表會顯示這項資訊:

右側的「準確率」只是正確辨識數字的百分比。隨著訓練進行,準確率會提高,這是好現象。
左側是「損失」,為了推動訓練,我們會定義「損失」函式,代表系統辨識數字的成效有多差,並嘗試將其降至最低。如您所見,隨著訓練進行,訓練和驗證資料的損失都會降低,這是好現象。這表示類神經網路正在學習。
X 軸代表「訓練週期」數,也就是整個資料集的疊代次數。
預測
模型訓練完成後,就能用來辨識手寫數字。下一個圖表顯示模型在從本機字型 (第一行) 算繪的幾個數字上的表現,以及在驗證資料集的 10,000 個數字上的表現。每個數字下方會顯示預測類別,如果預測錯誤,則會以紅色顯示。

如您所見,這個初始模型並不是很好,但仍能正確辨識部分數字。最終驗證準確率約為 90%,對於我們一開始使用的簡化模型來說,這個結果還算不錯,但這仍表示在 10, 000 個驗證數字中,有 1,000 個數字未正確辨識。這遠超過可顯示的數量,因此所有答案看起來都是錯誤的 (紅色)。
張量
資料會儲存在矩陣中。28x28 像素的灰階圖片可放入 28x28 的二維矩陣。但如果是彩色圖片,就需要更多維度。每個像素有 3 個顏色值 (紅、綠、藍),因此需要維度為 [28, 28, 3] 的三維表格。如要儲存 128 張彩色圖片,則需要四維表格,維度為 [128, 28, 28, 3]。
這些多維度表格稱為「張量」,維度清單則稱為「形狀」。
4. [INFO]: neural networks 101
簡要說明
如果您已瞭解下一段中所有粗體字詞,可以繼續進行下一個練習。如果您剛開始接觸深度學習,歡迎您,請繼續閱讀。

如果模型是由一系列層組成,Keras 會提供 Sequential API。舉例來說,使用三個密集層的圖像分類器,在 Keras 中可以寫成:
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

單一稠密層
MNIST 資料集中的手寫數字是 28x28 像素的灰階圖片。最簡單的分類方法,是將 28x28=784 像素做為 1 層類神經網路的輸入內容。

類神經網路中的每個「神經元」都會對所有輸入內容進行加權總和,加上稱為「偏差」的常數,然後透過一些非線性「活化函數」提供結果。「權重」和「偏誤」是透過訓練決定的參數。一開始會以隨機值初始化。
上圖代表 1 層類神經網路,其中有 10 個輸出神經元,因為我們要將數字分為 10 個類別 (0 到 9)。
使用矩陣乘法
以下說明如何使用矩陣乘法,表示處理圖片集合的類神經網路層:

使用權重矩陣 W 的第一欄權重,計算第一張圖片所有像素的加權總和。這個總和對應第一個神經元。接著,我們使用第二欄權重,對第二個神經元執行相同操作,以此類推,直到第 10 個神經元。接著,我們可以對其餘 99 張圖片重複這項操作。如果我們將包含 100 張圖片的矩陣稱為 X,則 10 個神經元的所有加權總和 (以 100 張圖片計算) 就是 X.W,也就是矩陣乘法。
現在,每個神經元都必須加上偏誤 (常數)。由於有 10 個神經元,因此有 10 個偏誤常數。我們將這個包含 10 個值的向量稱為 b。必須加到先前計算矩陣的每一行。我們將使用名為「廣播」的魔法,以簡單的加號編寫。
最後,我們套用活化函數,例如「softmax」(說明如下),並取得描述 1 層類神經網路的公式,套用至 100 張圖片:

在 Keras 中
有了 Keras 等高階類神經網路程式庫,我們就不需要實作這個公式。不過,請務必瞭解,類神經網路層只是一堆乘法和加法。在 Keras 中,密集層的寫法如下:
tf.keras.layers.Dense(10, activation='softmax')
深入探索
串連類神經網路層非常簡單。第一層會計算像素的加權總和。後續層會計算前一層輸出的加權總和。

除了神經元數量外,唯一的差異在於活化函數的選擇。
活化函數:relu、softmax 和 sigmoid
除了最後一層,所有層通常都會使用「relu」活化函數。分類器的最後一層會使用「softmax」活化函式。

同樣地,「神經元」會計算所有輸入內容的加權總和,加上稱為「偏誤」的值,然後將結果傳送至活化函數。
最常見的活化函數是 RELU,也就是線性整流函數。如上圖所示,這是一個非常簡單的函式。
神經網路中的傳統活化函數是「S 函數」,但「relu」在幾乎所有情況下都具有更好的收斂屬性,因此現在更受青睞。

用於分類的 Softmax 活化函數
神經網路的最後一層有 10 個神經元,因為我們要將手寫數字分為 10 個類別 (0 到 9)。輸出內容應為 10 個介於 0 到 1 之間的數字,代表這個數字為 0、1、2 等的機率。因此,我們會在最後一層使用名為「softmax」的活化函數。
如要對向量套用 Softmax,請先計算每個元素的指數,然後將向量正規化,通常是除以「L1」範數 (即絕對值的總和),使正規化值的總和為 1,並可解讀為機率。
最後一層在啟用前的輸出內容有時稱為「logits」。如果這個向量是 L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9],則:


交叉熵損失
現在,類神經網路會根據輸入圖片產生預測結果,我們需要評估這些結果的品質,也就是網路提供的結果與正確答案 (通常稱為「標籤」) 之間的距離。請記住,資料集中的所有圖片都有正確的標籤。
任何距離都適用,但對於分類問題,所謂的「交叉熵距離」最有效。我們將這個函式稱為誤差或「損失」函式:

梯度下降法
「訓練」類神經網路實際上是指使用訓練圖片和標籤來調整權重和偏差,盡可能降低交叉熵損失函式。運作方式如下:
交叉熵是權重、偏誤、訓練圖片像素及其已知類別的函式。
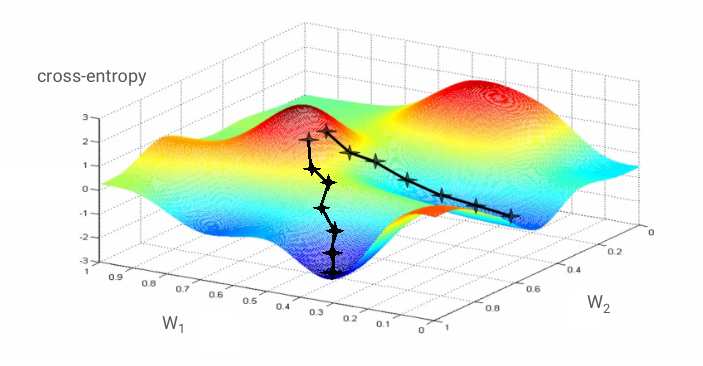
如果我們計算交叉熵相對於所有權重和所有偏誤的偏導數,就會得到「梯度」,這是針對指定圖片、標籤以及權重和偏誤的現值計算而得。請注意,我們可能有數百萬個權重和偏誤,因此計算梯度聽起來很費工夫。幸好 TensorFlow 會代勞。梯度的數學屬性是「向上」指向。由於我們希望交叉熵越低越好,因此會朝相反方向移動。我們會依據梯度的一小部分更新權重和偏差。接著,我們在訓練迴圈中,使用下一批訓練圖片和標籤,一次又一次地重複相同動作。希望這會收斂到交叉熵最小的地方,雖然不保證這個最小值是唯一的。
小批次和動量
您可以只計算一張範例圖片的梯度,並立即更新權重和偏誤,但如果對一批 (例如 128 張) 圖片執行這項操作,則可取得更能代表不同範例圖片所施加限制的梯度,因此可能更快收斂至解決方案。小批次的大小是可調整的參數。
這項技術有時稱為「隨機梯度下降」,還有另一個更實用的好處:使用批次也代表使用較大的矩陣,而這些矩陣通常更容易在 GPU 和 TPU 上最佳化。
不過,收斂過程仍可能有些混亂,甚至在梯度向量全為零時停止。這是否代表我們已找到最小值?不一定。梯度分量在最小值或最大值時可能為零。如果梯度向量有數百萬個元素,且全都是零,那麼每個零都對應到最小值,且沒有任何一個對應到最大值的機率非常小。在多維度空間中,鞍點相當常見,我們不希望在鞍點停止。

插圖:鞍點。梯度為 0,但並非所有方向的最小值。(圖片來源:Wikimedia:Nicoguaro - Own work, CC BY 3.0)
解決方法是在最佳化演算法中加入一些動量,讓演算法能順利通過鞍點,不會停下來。
詞彙
批次或小批:訓練一律會對訓練資料和標籤批次執行。這有助於演算法收斂。「批次」維度通常是資料張量的第一個維度。舉例來說,形狀為 [100, 192, 192, 3] 的張量包含 100 張 192x192 像素的圖片,每個像素有三個值 (RGB)。
交叉熵損失:分類器常用的特殊損失函式。
密集層:神經元層,其中每個神經元都與前一層的所有神經元相連。
特徵:神經網路的輸入有時稱為「特徵」。找出要將資料集的哪些部分 (或部分組合) 輸入類神經網路,以取得良好預測結果的技術,稱為「特徵工程」。
標籤:監督式分類問題中「類別」或正確答案的別稱
學習率:在訓練迴圈的每次疊代中,更新權重和偏差的梯度比例。
logits:套用活化函數前,神經元層的輸出內容稱為「logits」。這個詞源自「邏輯函數」,又稱「S 函數」,曾是最熱門的活化函數。「Neuron outputs before logistic function」(邏輯函式前的神經元輸出) 縮寫為「logits」。
loss:誤差函式,用於比較類神經網路輸出內容與正確答案
神經元:計算輸入內容的加權總和、加上偏誤,然後透過活化函數提供結果。
one-hot 編碼:5 個類別中的第 3 個類別會編碼為 5 個元素的向量,除了第 3 個元素為 1 之外,其餘元素皆為 0。
relu:線性整流函數。神經元常用的活化函數。
sigmoid:另一種過去很熱門的活化函數,在特殊情況下仍很實用。
softmax:一種特殊的活化函數,可作用於向量、增加最大元件與所有其他元件之間的差異,並將向量正規化,使其總和為 1,以便解讀為機率向量。用於分類器的最後一個步驟。
張量:「張量」類似矩陣,但維度數量不限。1 維張量是向量。2 維張量是矩陣。張量也可以有 3、4、5 或更多維度。
5. 讓我們來看看程式碼
回到學習筆記本,這次我們來解讀程式碼。
讓我們逐一查看這個筆記本中的所有儲存格。
儲存格「參數」
這裡會定義批次大小、訓練週期數和資料檔案的位置。資料檔案託管於 Google Cloud Storage (GCS) bucket,因此位址開頭為 gs://
儲存格「匯入」
這裡會匯入所有必要的 Python 程式庫,包括 TensorFlow 和用於視覺化的 matplotlib。
儲存格「visualization utilities [RUN ME]****」
這個儲存格包含不重要的圖表程式碼。這個區塊預設為收合狀態,但您有空時可以按兩下開啟,查看程式碼。
儲存格「tf.data.Dataset: parse files and prepare training and validation datasets」
這個儲存格使用 tf.data.Dataset API,從資料檔案載入 MNIST 資料集。不必在這個儲存格花太多時間。如果您對 tf.data.Dataset API 感興趣,請參閱這篇教學課程,瞭解 TPU 高速資料管道。目前的基本概念如下:
MNIST 資料集中的圖片和標籤 (正確答案) 會儲存在 4 個檔案的固定長度記錄中。您可以使用專用的固定記錄函式載入檔案:
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
現在我們有圖片位元組資料集。必須解碼為圖片。我們定義了執行這項操作的函式。圖片未經壓縮,因此函式不需要解碼任何內容 (decode_raw 基本上不會執行任何操作)。接著,圖片會轉換為介於 0 和 1 之間的浮點值。我們可以在這裡將其重塑為 2D 圖片,但實際上我們將其保留為大小為 28*28 的像素平面陣列,因為這是初始密集層所預期的。
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
我們使用 .map 將這個函式套用至資料集,並取得圖片資料集:
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
我們對標籤執行相同的讀取和解碼作業,並將圖片和標籤 .zip 在一起:
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
現在我們有圖片和標籤組合的資料集。這是模型預期的格式。我們還不打算在訓練函式中使用:
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
tf.data.Dataset API 具備準備資料集所需的所有公用函式:
.cache 會將資料集快取到 RAM。這個資料集很小,因此可以運作。.shuffle 會使用 5,000 個元素的緩衝區,隨機排列資料。請務必充分隨機排列訓練資料。.repeat 會循環資料集。我們會多次訓練 (多個訓練週期)。.batch 會將多張圖片和標籤彙整成一個小批。最後,.prefetch 可以在 GPU 訓練目前批次的同時,使用 CPU 準備下一個批次。
驗證資料集的準備方式也類似。現在可以定義模型,並使用這個資料集訓練模型。
「Keras Model」儲存格
我們所有的模型都是由層組成的直線序列,因此可以使用 tf.keras.Sequential 樣式建立。一開始,這裡只有一個稠密層。由於我們要將手寫數字分為 10 個類別,因此有 10 個神經元。由於這是分類器中的最後一層,因此會使用「softmax」活化。
Keras 模型也需要知道輸入內容的形狀。tf.keras.layers.Input 可用於定義。這裡的輸入向量是長度為 28*28 的像素值平面向量。
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
在 Keras 中,您可以使用 model.compile 函式設定模型。這裡我們使用基本最佳化工具 'sgd' (隨機梯度下降)。分類模型需要交叉熵損失函式,在 Keras 中稱為 'categorical_crossentropy'。最後,我們要求模型計算 'accuracy' 指標,也就是正確分類的圖片百分比。
Keras 提供非常實用的 model.summary() 公用程式,可列印您建立的模型詳細資料。好心的講師已新增 PlotTraining 公用程式 (定義於「視覺化公用程式」儲存格),可在訓練期間顯示各種訓練曲線。
「Train and validate the model」儲存格
呼叫 model.fit 並傳入訓練和驗證資料集,即可開始訓練。根據預設,Keras 會在每個訓練週期結束時執行一輪驗證。
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
在 Keras 中,您可以使用回呼,在訓練期間新增自訂行為。這就是本工作坊實作動態更新訓練圖的方式。
「Visualize predictions」儲存格
模型訓練完成後,我們可以呼叫 model.predict() 來取得預測結果:
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
我們準備了一組以本機字型算繪的印刷數字,用於測試。請注意,類神經網路會從最終的「softmax」傳回 10 個機率的向量。如要取得標籤,我們必須找出哪個機率最高。numpy 程式庫中的 np.argmax 即可執行這項操作。
如要瞭解為何需要 axis=1 參數,請記住,我們已處理一批 128 張圖片,因此模型會傳回 128 個機率向量。輸出張量的形狀為 [128, 10]。我們正在計算每張圖片傳回的 10 個機率的 argmax,因此 axis=1 (第一個軸為 0)。
這個簡單的模型已能辨識 90% 的數字。雖然表現不錯,但您現在可以大幅提升成效。

6. 新增圖層

為了提高辨識準確度,我們會在類神經網路中加入更多層。

我們將 Softmax 保留為最後一層的活化函數,因為這是最適合分類的函數。不過,在中間層,我們會使用最經典的活化函數:S 函數:
舉例來說,模型可能如下所示 (請務必加上逗號,tf.keras.Sequential 接受以逗號分隔的清單):
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
查看模型的「摘要」。參數數量至少增加 10 倍。應該要好上 10 倍!但不知道為什麼,

損失似乎也大幅增加。發生錯誤。
7. 深層網路的特殊注意事項
您剛才體驗的是 80 和 90 年代設計的類神經網路。難怪他們會放棄這個想法,迎來所謂的「AI 寒冬」。事實上,隨著層數增加,類神經網路會越來越難收斂。
事實證明,只要使用一些數學技巧讓網路收斂,具有多層 (目前為 20、50 甚至 100 層) 的深層類神經網路就能發揮良好效果。發現這些簡單技巧,是深度學習在 2010 年代復興的原因之一。
RELU 激活

在深度網路中,S 函數活化函數其實相當棘手。它會將所有值壓縮到 0 和 1 之間,如果重複執行這個動作,神經元輸出和梯度可能會完全消失。我們提及這個函數是基於歷史原因,但現代網路使用的是線性整流函數 (RELU),如下所示:

另一方面,relu 的導數為 1,至少在右側是如此。使用 RELU 活化函式時,即使部分神經元的梯度可能為零,其他神經元仍會提供明確的非零梯度,訓練作業也能以良好速度繼續進行。
更優異的最佳化工具
在維度非常高的空間中 (例如這裡,我們有大約 1 萬個權重和偏誤),「鞍點」很常見。這些點並非局部最小值,但梯度仍為零,且梯度下降法最佳化工具會卡在該處。TensorFlow 提供全方位的最佳化工具,其中有些工具會運用慣性,安全地越過鞍點。
隨機初始化
在訓練前初始化權重和偏誤是一門學問,本身就是一個研究領域,有許多相關論文發表。如要查看 Keras 中所有可用的初始化器,請按這裡。幸好,Keras 預設會執行正確的操作,並使用 'glorot_uniform' 初始化器,這在幾乎所有情況下都是最佳做法。
Keras 會自動執行正確操作,因此您不必採取任何行動。
NaN ???
交叉熵公式涉及對數,而 log(0) 不是數字 (NaN,如果可以的話,也可以是數值崩潰)。交叉熵的輸入值可以為 0 嗎?輸入內容來自 Softmax,基本上是指數,而指數絕不會是零。所以我們很安全!
真的嗎?在數學世界中,我們不會遇到問題,但在電腦世界中,以 float32 格式表示的 exp(-150) 會被視為零,導致交叉熵崩潰。
幸好,您在這裡也不必採取任何行動,因為 Keras 會處理這項作業,並以特別謹慎的方式計算 Softmax 和交叉熵,確保數值穩定性,並避免出現可怕的 NaN。
成功了嗎?

現在準確率應該會達到 97%。本研討會的目標是大幅超越 99%,因此請繼續努力。
如果卡關,請參考以下解決方案:
8. 學習率衰減
也許我們可以試著加快訓練速度?Adam 最佳化工具的預設學習率為 0.001。我們來試著提高這個值。
加快速度似乎沒有太大幫助,而且怎麼會有這麼多雜訊?

訓練曲線非常雜亂,而且兩條驗證曲線都上下跳動。這表示我們速度太快。我們可以回到先前的速度,但有更好的方法。

理想的解決方案是從快速開始,並以指數方式衰減學習率。在 Keras 中,您可以使用 tf.keras.callbacks.LearningRateScheduler 回呼執行這項操作。
可複製貼上的實用程式碼:
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
請務必使用您建立的 lr_decay_callback。將其新增至 model.fit 的回呼清單:
model.fit(..., callbacks=[plot_training, lr_decay_callback])
這項小小的變更帶來了驚人的影響。您會發現大部分雜訊都已消失,測試準確率現在持續高於 98%。

9. Dropout、過度配適
模型現在似乎收斂得很好。我們來試著進一步探討。
這樣有幫助嗎?

不盡然,準確率仍停留在 98%,而且驗證損失正在上升!學習演算法只會處理訓練資料,並據此最佳化訓練損失。它從未看過驗證資料,因此一段時間後,它的工作不再對驗證損失產生影響,驗證損失停止下降,有時甚至會反彈,這並不奇怪。
這不會立即影響模型的實際辨識能力,但會導致您無法執行多次疊代,而且通常表示訓練不再有正面效果。

這種落差通常稱為「過度配適」,如果發生這種情況,可以嘗試套用稱為「丟棄」的正則化技術。丟棄技術會在每次訓練疊代時隨機丟棄神經元。
最終成效

雜訊會再次出現 (考量到 Dropout 的運作方式,這並不令人意外)。驗證損失似乎不再上升,但整體而言,比不使用丟棄法時更高。驗證準確率則略微下降。這個結果相當令人失望。
看來丟棄法並非正確的解決方案,或者「過度配適」是更複雜的概念,有些原因無法透過「丟棄法」修正?
什麼是「過度配適」?如果類神經網路學習「不佳」,就會發生過度配適,導致模型雖然適用於訓練樣本,但無法妥善處理實際資料。雖然有 Dropout 等正規化技術,可以強制模型以更好的方式學習,但過度配適也有更深層的原因。

當類神經網路在處理手邊問題時有太多自由度,就會發生基本過度配適。假設我們有許多神經元,網路可以將所有訓練圖片儲存在其中,然後透過模式比對辨識圖片。在實際資料上則會完全失敗。類神經網路必須受到一定程度的限制,才能強制歸納訓練期間學到的內容。
如果訓練資料非常少,即使是小型網路也能記住資料,您會看到「過度配適」現象。一般來說,訓練類神經網路需要大量資料。
最後,如果您已按照指示完成所有步驟,嘗試過不同大小的網路,確保其自由度受到限制,套用丟棄,並在大量資料上進行訓練,您可能仍會停留在效能層級,似乎無法改善。這表示神經網路目前的狀態無法從資料中擷取更多資訊,就像我們這裡的情況一樣。
還記得我們如何將圖片扁平化為單一向量嗎?這真是個糟糕的主意。手寫數字是由形狀組成,而我們在扁平化像素時捨棄了形狀資訊。不過,有一種類神經網路可以利用形狀資訊,那就是卷積網路。讓我們試試看。
如果卡關,請參考以下解決方案:
10. [INFO] 卷積網路
簡要說明
如果您已瞭解下一段中所有粗體字詞,可以繼續進行下一個練習。如果您剛開始接觸卷積類神經網路,請繼續閱讀。

插圖:使用兩個連續篩選器篩選圖片,每個篩選器由 4x4x3=48 個可學習權重組成。
以下是 Keras 中簡單的卷積類神經網路:
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
在卷積網路的某個層中,一個「神經元」會對其正上方的像素進行加權總和,但僅限於圖片的一小部分區域。它會加上偏誤,並透過活化函數提供總和,就像一般密集層中的神經元一樣。接著,系統會使用相同的權重,在整張圖片上重複這項操作。請注意,在密集層中,每個神經元都有自己的權重。在這裡,單一權重「區塊」會沿著兩個方向在圖片上滑動 (「卷積」)。輸出內容的值與圖片中的像素數量相同 (不過邊緣需要一些邊框間距)。這是一項篩選作業。在上圖中,系統使用 4x4x3=48 個權重的篩選器。
不過,48 個權重並不夠。如要增加自由度,我們會使用一組新的權重重複相同作業。這會產生一組新的篩選器輸出內容。我們將其稱為輸出內容的「通道」,類似於輸入圖片中的 R、G、B 通道。

您可以新增維度,將兩組 (或更多組) 權重加總為一個張量。這樣就能取得卷積層權重張量的一般形狀。由於輸入和輸出通道數量是參數,我們可以開始堆疊和鏈結卷積層。

插圖:卷積類神經網路將資料「立方體」轉換為其他資料「立方體」。
跨步卷積、最大池化
如果以 2 或 3 的步幅執行卷積,也可以縮減結果資料立方體的水平維度。常見的做法有兩種:
- 跨步卷積:如上所述的滑動篩選器,但跨步 >1
- 最大池化:套用 MAX 運算的滑動視窗 (通常在 2x2 區塊上,每 2 個像素重複一次)

插圖:將運算視窗滑動 3 個像素,會產生較少的輸出值。跨步卷積或最大池化 (在 2x2 視窗上以 2 的步幅滑動) 是在水平維度縮減資料立方體的方法。
最後一層
在最後一個卷積層之後,資料會以「立方體」的形式呈現。將輸入內容傳入最後稠密層的方式有兩種。
第一種方法是將資料立方體扁平化為向量,然後饋送至 Softmax 層。有時,您甚至可以在 Softmax 層之前新增密集層。就權重數量而言,這種做法通常成本較高。卷積網路末端的密集層可能包含整個類神經網路一半以上的權重。
除了使用昂貴的密集層,我們也可以將傳入的資料「立方體」分割成與類別數量相同的多個部分,計算其平均值,然後透過 softmax 活化函數提供這些值。這種建立分類頭的方式不會耗用權重。Keras 有一個專門用於此目的的層:tf.keras.layers.GlobalAveragePooling2D()。

請跳至下一節,為手邊的問題建構卷積網路。
11. 卷積網路
我們來建構卷積網路,用於辨識手寫數字。我們會在頂端使用三個卷積層,在底部使用傳統的 Softmax 讀出層,並使用一個全連接層連接兩者:

請注意,第二和第三個卷積層的步幅為 2,因此輸出值數量會從 28x28 降至 14x14,然後降至 7x7。
現在來編寫 Keras 程式碼。
在第一個卷積層之前,需要特別注意。事實上,它預期會收到 3D「立方體」資料,但我們的資料集目前是針對密集層設定,且圖像的所有像素都已扁平化為向量。我們需要將其重塑為 28x28x1 圖片 (灰階圖片為 1 個通道):
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
您可以使用這行程式碼,取代目前為止使用的 tf.keras.layers.Input 層。
在 Keras 中,以「relu」啟用的卷積層語法如下:

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
如果是跨步卷積,請輸入:
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
如要將資料立方體扁平化為向量,以便密集層使用:
tf.keras.layers.Flatten()
密集層的語法不變:
tf.keras.layers.Dense(200, activation='relu')
您的模型是否突破 99% 準確率的門檻?很接近了... 但請查看驗證損失曲線。您是否有印象呢?

此外,也請查看預測結果。您應該會首次看到,10,000 個測試數字中,大部分都已正確辨識。只剩下約 4.5 列誤判 (10,000 個數字中約有 110 個)

如果卡關,請參考以下解決方案:
12. 再次丟棄
先前的訓練明顯出現過度配適的跡象,且準確率仍未達到 99%。要再試一次 Dropout 嗎?
這次體驗如何?

這次丟棄法似乎發揮了作用。驗證損失不再緩慢上升,最終準確率應遠高於 99%。恭喜!
我們第一次嘗試套用丟棄法時,以為發生過度配適問題,但實際上問題出在類神經網路的架構。如果沒有卷積層,我們就無法進一步提升準確率,而丟棄法對此也無能為力。
這次看來,過度配適確實是問題的原因,而 Dropout 確實有幫助。請注意,許多因素都可能導致訓練和驗證損失曲線脫節,使驗證損失逐漸上升。過度配適 (自由度過高,網路使用不當) 只是其中之一。如果資料集太小或類神經網路架構不夠完善,損失曲線可能會出現類似行為,但丟棄法並不會有所幫助。
13. 批次正規化

最後,我們來試著加入批次正規化。
以上是理論,在實務上,只要記住以下幾項規則即可:
現在,我們就按照標準做法,在每個神經網路層 (最後一層除外) 新增批次常態化層。請勿將其新增至最後一個「softmax」層。在該處無法發揮作用。
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
現在的準確度如何?

只要稍微調整 (BATCH_SIZE=64、學習率衰減參數 0.666、密集層的丟棄率 0.3),再加上一點運氣,就能達到 99.5%。學習率和 dropout 調整是按照使用批次標準化的「最佳做法」進行:
- 批次正規化有助於類神經網路收斂,通常可加快訓練速度。
- 批次正規化是一種正規化器。通常可以減少或完全不使用 dropout。
解決方案筆記本的訓練執行準確率為 99.5%:
14. 在雲端使用強大的硬體進行訓練:AI 平台

您可以在 GitHub 的 mlengine 資料夾中找到雲端就緒版本的程式碼,以及在 Google Cloud AI 平台上執行程式碼的操作說明。您必須先建立 Google Cloud 帳戶並啟用計費功能,才能執行這個部分。完成實驗室所需的資源費用應低於幾美元 (假設在一個 GPU 上訓練 1 小時)。如要準備帳戶,請按照下列步驟操作:
- 建立 Google Cloud Platform 專案 (http://cloud.google.com/console)。
- 啟用計費功能。
- 安裝 GCP 指令列工具 (GCP SDK)。
- 建立 Google Cloud Storage bucket (位於
us-central1區域),用於暫存訓練程式碼及儲存訓練後的模型。 - 啟用必要的 API 並要求必要的配額 (執行訓練指令一次,系統應會顯示錯誤訊息,告知您要啟用哪些項目)。
15. 恭喜!
您已建立第一個類神經網路,並訓練到準確率達 99%。您在過程中學到的技術並非僅適用於 MNIST 資料集,實際上,這些技術在處理類神經網路時廣泛使用。最後,我們送你一張卡通版的實驗室「重點摘要」卡片。你可以用來複習學過的內容:

後續步驟
- 瞭解全連結和卷積網路後,請接著認識循環類神經網路。
- 如要在雲端的分散式基礎架構上執行訓練或推論,Google Cloud 提供 AI 平台。
- 最後,我們非常歡迎你提供意見。如果您發現本實驗室有任何問題,或認為有改進空間,請告訴我們。我們會透過 GitHub 問題處理意見回饋 [意見回饋連結]。

|
|
 作者:Martin GörnerTwitter:

本實驗室中所有卡通圖片的版權:alexpokusay / 123RF 圖庫相片