

1. Einführung
Ein 90-minütiger Workshop zum diskriminativen Modell, dem System One-Entscheidungsmodell von TypeSafe AI, und zur Verwendung neben Gemini in einem Google ADK-Workflow. Dieser Workshop besteht aus sechs Schritten, die sich um ein Kampfspiel drehen. Zuerst kämpfen Sie mit dem Oger, dann übergeben Sie die Reflexe an das diskriminative Modell und sehen zu, wie ein ADK-Workflow den Kampf gewinnt. Das diskriminative Modell entscheidet über jeden Tick und Gemini liest Zauberkarten vom Bildschirm ab, um Zaubersprüche zu singen.
Übersicht
Das diskriminative Modell (jev-1.13, Alias jev-latest) ist ein gehostetes Modell von TypeSafe AI, das am 19. September 2026 veröffentlicht wurde. Es wird kein Text generiert. Sie senden state (Text, JSON oder eine Liste) und eingegebene questions (Choice, Score, Noul) und erhalten typisierte Antworten mit kalibrierten Wahrscheinlichkeiten in etwa 70 bis 500 ms für 0,042 $ pro Million Eingabetokens und nichts für die Ausgabe. Seine Aufgabe ist die Entscheidung vor, zwischen und hinter den Sprachmodellen: Routing, Klassifizierung, Gating und hier die Reflexe eines Kämpfers.
Ein Spiel als Beispiel
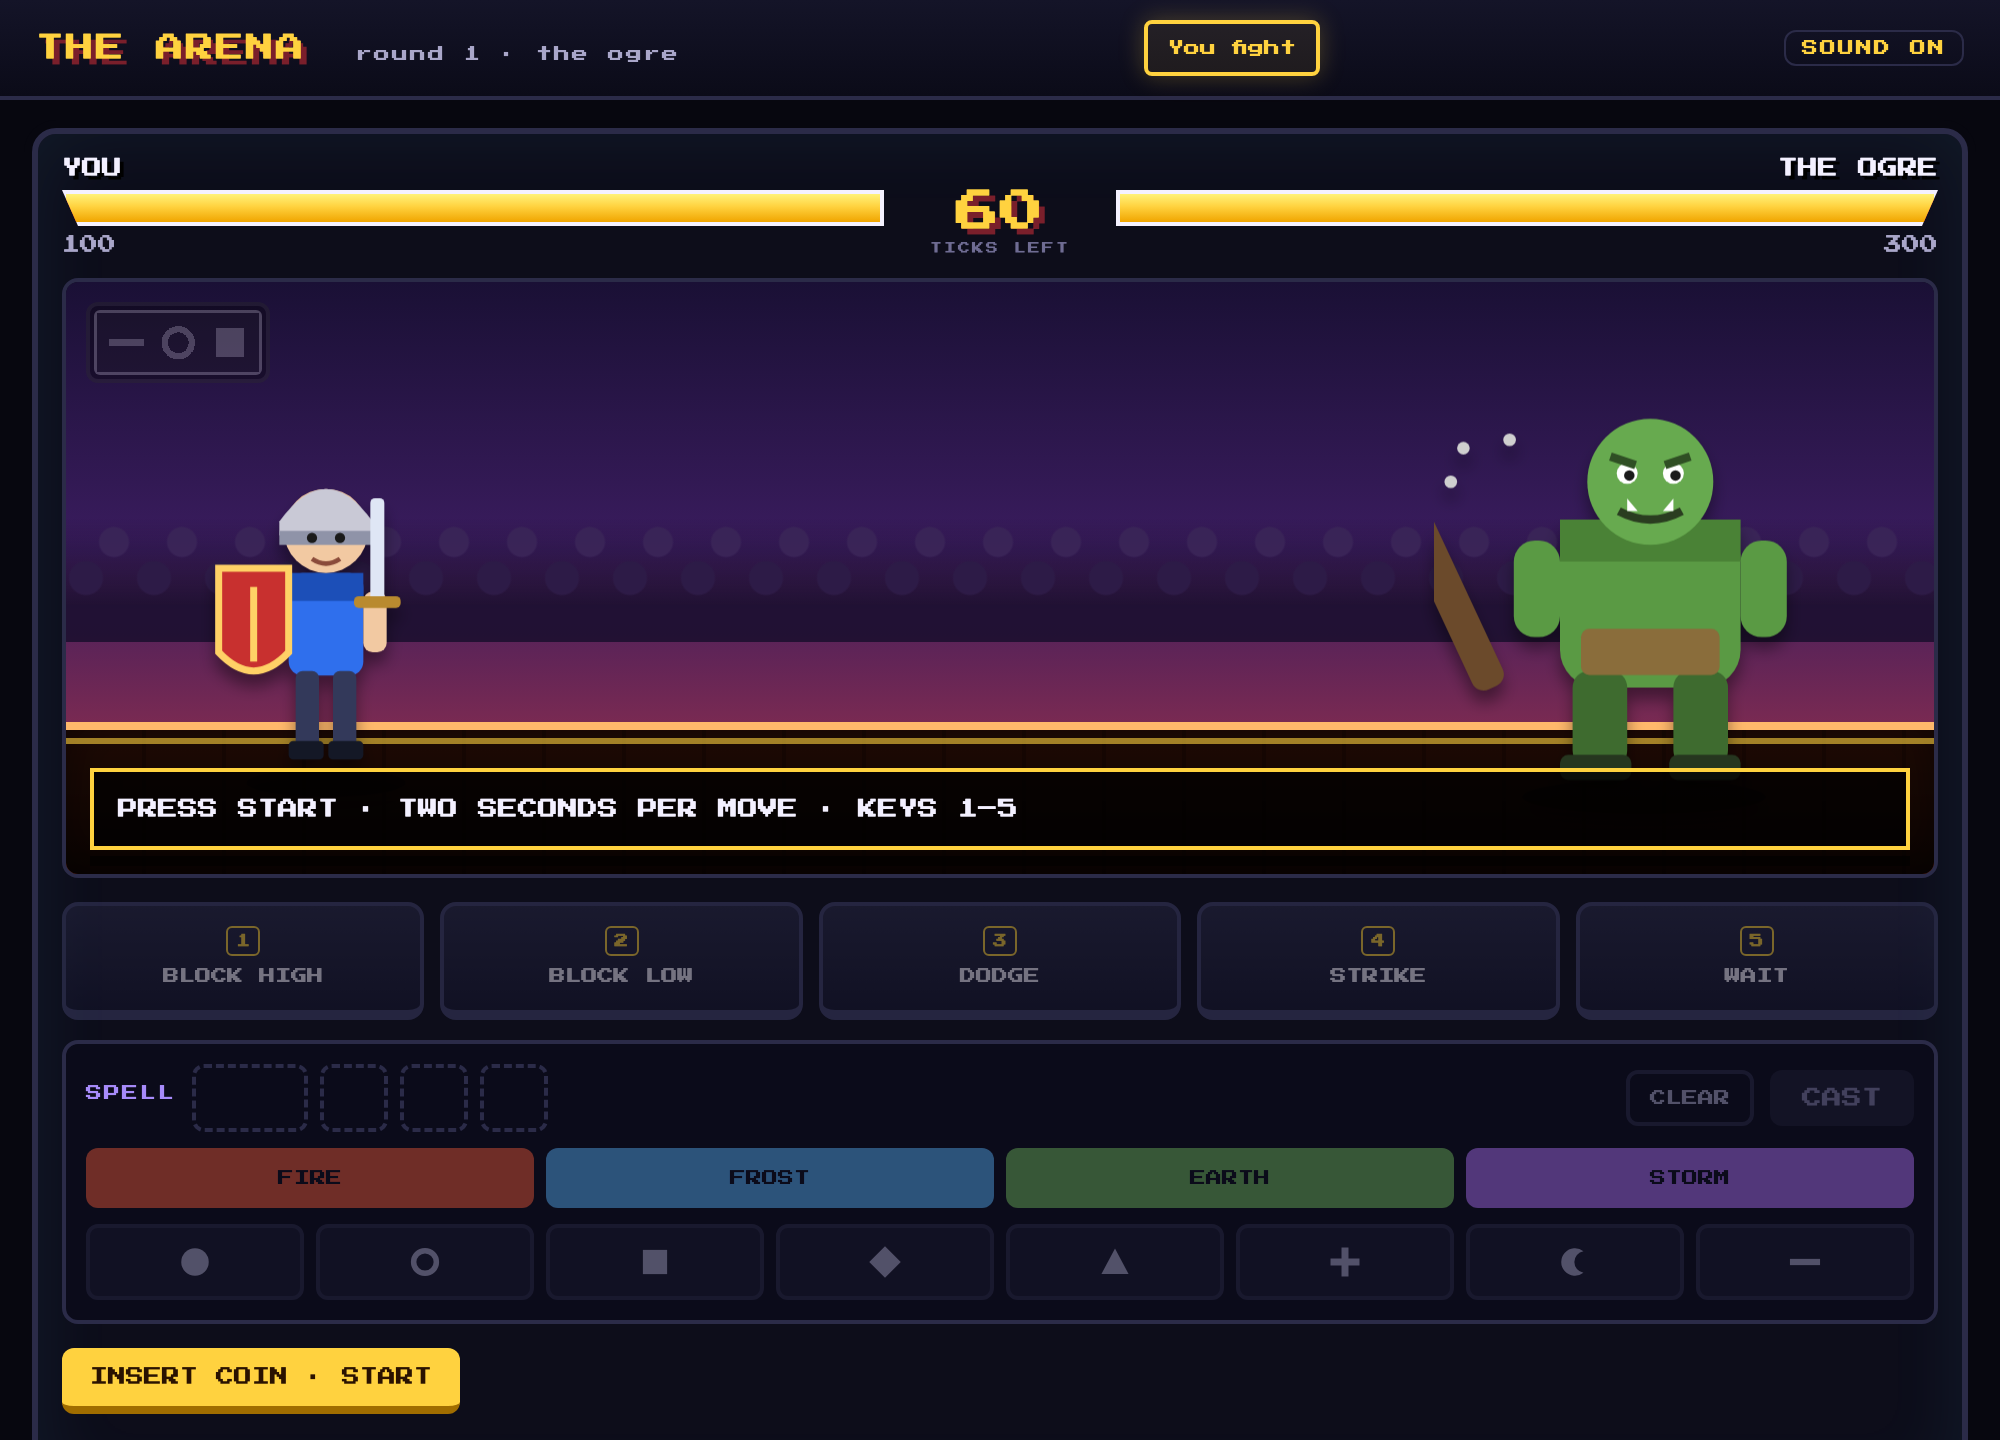
Hast du schon einmal ein Kampfspiel gespielt? Sie stehen einem Gegner gegenüber und müssen sofort auf seine Züge reagieren. Bei einer falschen Antwort wird deine Lebensenergie reduziert. Außerdem ist es in Spielen oft schwierig, Zauber zu wirken. In unserem Spiel müssen Sie die Farbe und die Formen der Zauberkarte in der richtigen Reihenfolge auswählen, bevor der Zauber gewirkt wird. In diesem Workshop erfahren Sie, wie Sie beide Arten von Modellen kombinieren, damit Ihre Figur gewinnt.
Jedes Element des Spiels entspricht einem realen System:
- Der Zug des Gegners ist ein eingehendes Ereignis, z. B. eine Anfrage oder eine Transaktion.
- Die Antwort ist eine begrenzte Entscheidung, die vom diskriminativen Modell getroffen und vom Code geprüft wird.
- Die Zauberkarte ist eine unstrukturierte Eingabe, die von einem Language Model gelesen werden muss.
- Die Übereinstimmung ist der Workflow, bei dem schnelle und langsame Aufgaben in ihrem eigenen Tempo ausgeführt werden.
Der Fokus liegt auf der Kombination der vier Komponenten, um ein schnelles und intelligentes System zu schaffen.
Lerninhalte
- Erklären Sie, wie sich diskriminative (System 1) und generative (System 2) Modelle unterscheiden und wann sie jeweils verwendet werden sollten.
- Beschreiben Sie, wie Jev und DiffusionGemma bereitgestellt werden, und richten Sie eine für den Workshop ein, einschließlich DiffusionGemma auf einer Compute Engine-GPU-VM.
- Fragen vom Typ „Choice“, „Score“ und „Noul“ erstellen und Wahrscheinlichkeiten und Konfidenz interpretieren
- Verwenden Sie Grenzwerte in deterministischem Code, um Wahrscheinlichkeiten in Aktionen umzuwandeln.
- Erstellen Sie eine Anfrage mit dem TypeSafe SDK und lassen Sie das Modell dann jeden Zug in einem Spiel auswählen.
- Erstellen Sie einen langsamen Zweig, in dem Gemini ein Bild liest, und einen schnellen Zweig, in dem das diskriminative Modell in einer Schleife Entscheidungen trifft, und führen Sie die beiden Zweige unabhängig voneinander aus.
- Verbinden Sie beide Zweige in einem ADK-Graphen-Workflow, der den Status in einer Ereignisschleife freigibt, damit langsame Vorgänge schnelle Entscheidungen nicht verzögern.
Architektur
Die Workbench befindet sich in Cloud Shell(oder auf Ihrem Computer). Sie schreibt in das lokale Dateisystem und interagiert mit der Arena sowie mit Gemini und dem Entscheidungsmodell. ② ruft das Entscheidungsmodell in „Discriminative model fights“ auf, ③ ruft beide in „Workflow fights“ auf.
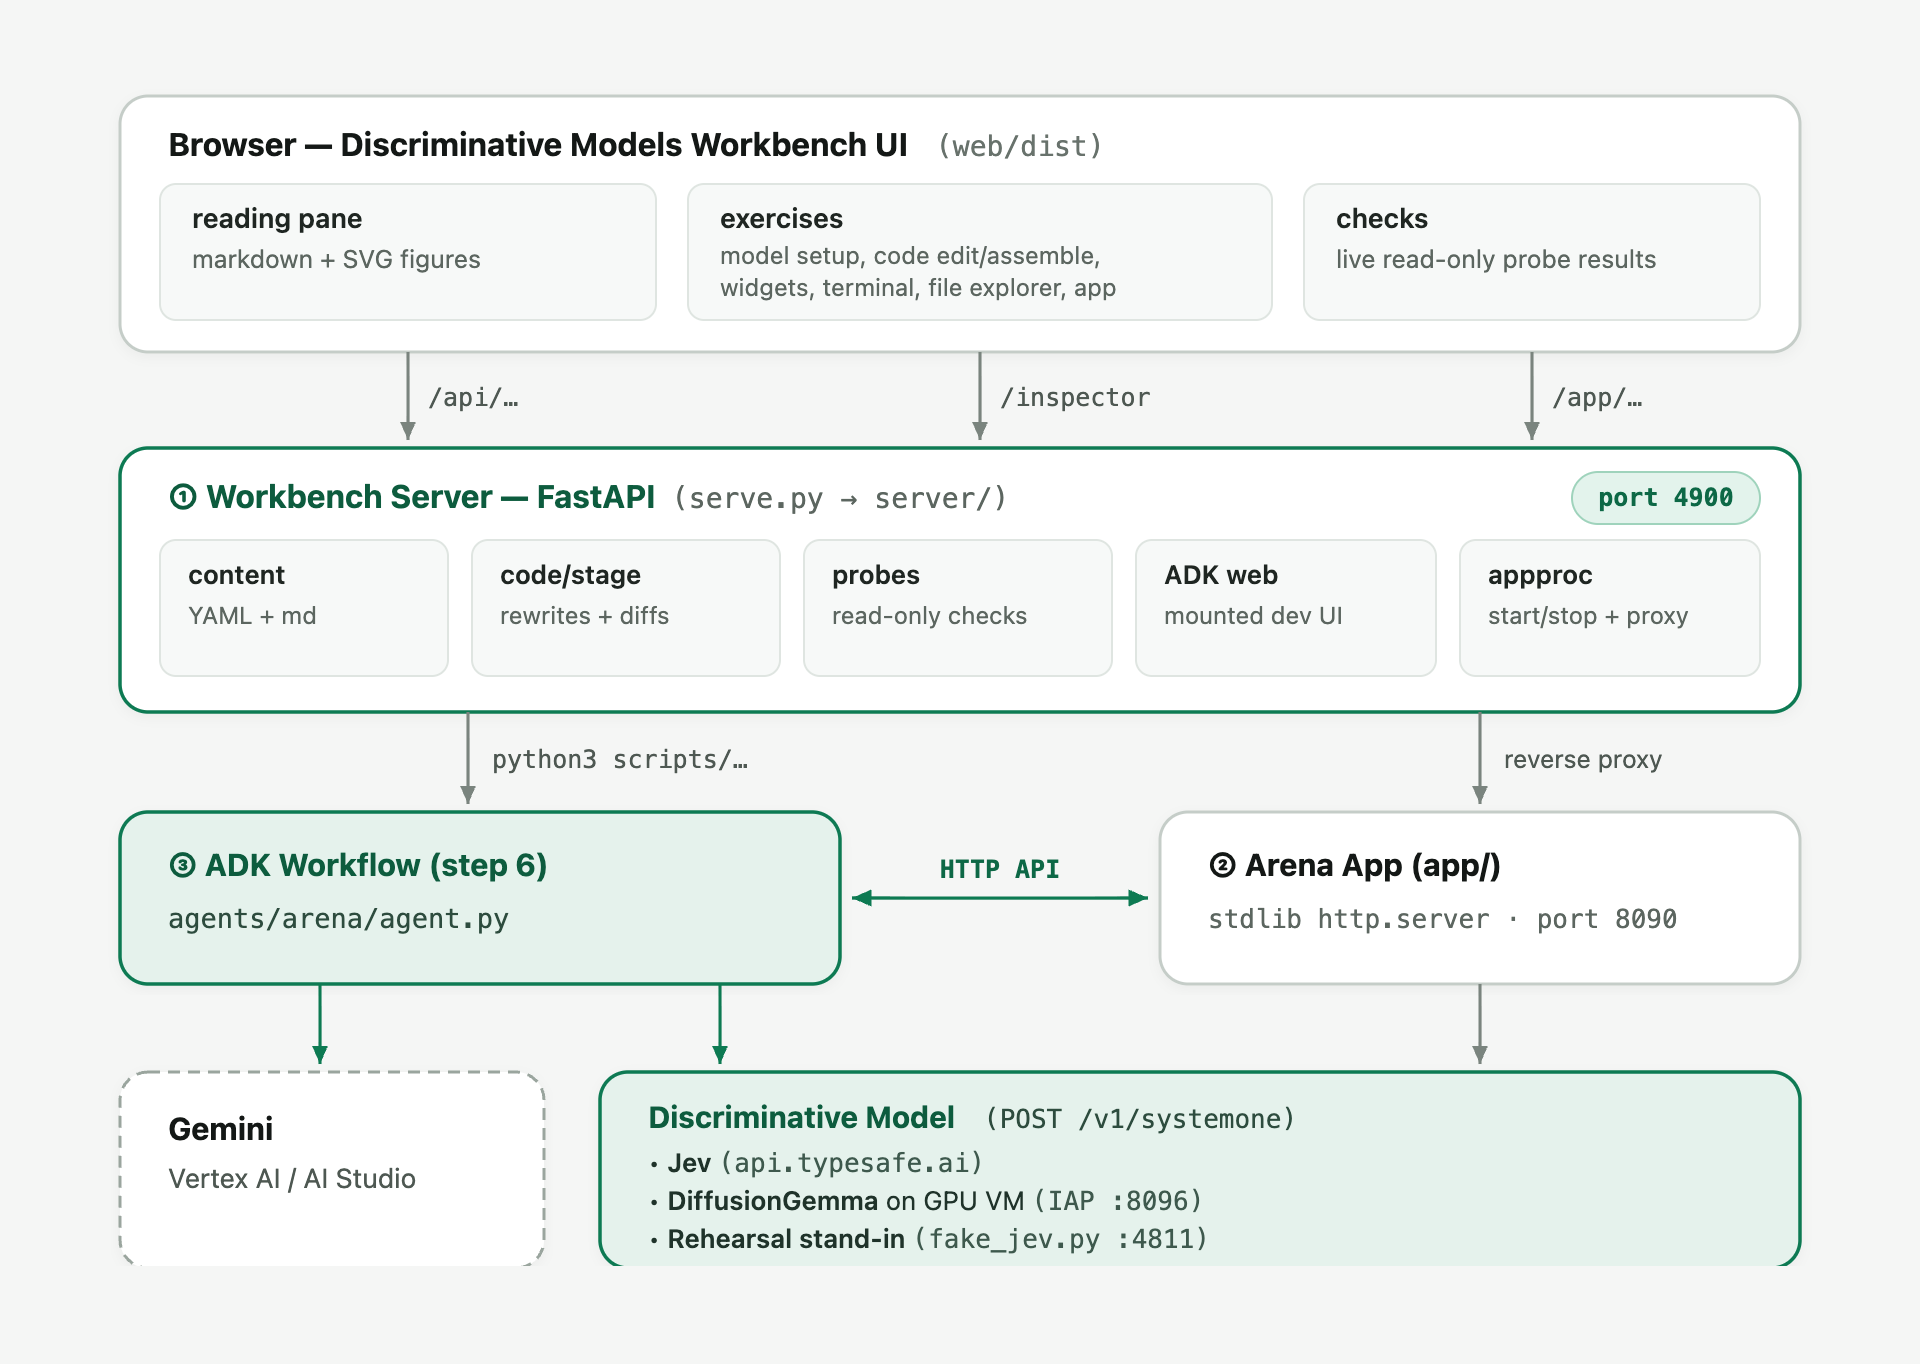
Wer ruft was an? Der Browser kommuniziert nur mit ①. Beide Modelle werden über Python auf dem Computer aufgerufen:
Anrufer | Diskriminatives Modell | Gemini |
② Arena, „Discriminative model fights“ (Kämpfe zwischen diskriminativen Modellen) | Bei jedem Tick, | Nein |
③ Workflow | Bei jedem Tick, | Nein |
③ Workflow | Nein | das Bild der Zauberkarte; die Geschichte nach dem Kampf |
| Ja | Nein |
Ein Häkchen pro Modus
- Du kämpfst. Auf der Seite wird ② ein Telegramm angezeigt, das mit einem 2‑Sekunden-Timer eingeblendet wird. Außerdem wird der Button, den Sie drücken, oder die Eingabe, die Sie eingeben, zurückgegeben. ② behebt das Problem.
- Kämpfe mit diskriminativen Modellen Auf der Seite wird ② nach einem Häkchen gefragt. ② zeichnet ein Telegramm, stellt dem Modell drei Fragen in einem Aufruf, führt
choose()aus und gibt die Antworten und das Ergebnis zurück. Auf der Seite werden die Balken gezeichnet. - Workflow-Konflikte: Start ruft ② auf, die wiederum ③ als untergeordneten Prozess startet (Anmeldung
runs/arena-workflow.log). ③ steuert den Kampf: Es fragt ② nach jedem Telegraph, ruft das Modell auf und postet die Entscheidung. Der Zauber von Gemini wird in einem eigenen Zweig ausgeführt, sobald er fertig ist. Auf der Seite werden nur ②-Umfragen und -Ziehungen angezeigt. „Pause“ ist ein Flag für ②, das ③ vor jedem Tick prüft.
Wo das Entscheidungsmodell gehostet wird: Jeder Aufruf durchläuft dieselbe typesafe-sdk. Nur die Basis-URL ändert sich. scripts/jevauth.py gibt das Backend an und legt den Schlüssel und das Zeitlimit fest:
Backend |
| Schlüssel | Einrichtung durch |
TypeSafe, gehostet | unset (api.typesafe.ai) |
|
|
DiffusionGemma auf Ihrer L4-VM |
| Keine |
|
DiffusionGemma in Cloud Run |
| Ein Google-Identitätstoken, das stündlich abgerufen wird |
|
Proben |
| Keine |
|
Antwort der Zauberkarte ②: Der Workflow erhält nur das PNG und ② bewertet den Zauber, den er zurücksendet. Das macht den Zauberspruch zu einem echten Test für die Lesefähigkeit von Gemini und den Zauberspruch, den Sie in „You fight“ erstellen, zu einem echten Test für Sie.
2. Einrichtung
Workshop-Guthaben einlösen
Wenn Sie für diese Sitzung ein Google Cloud-Guthaben erhalten haben, lösen Sie es zuerst ein. Das dauert etwa eine Minute und dabei wird das Abrechnungskonto für Sie erstellt.
Cloud Shell öffnen
Google Cloud Shell ist eine über den Browser zugängliche Linux-Umgebung, die mit gcloud, Python, Node.js, uv und git vorkonfiguriert ist und bereits mit Ihrem Google-Konto authentifiziert wurde.
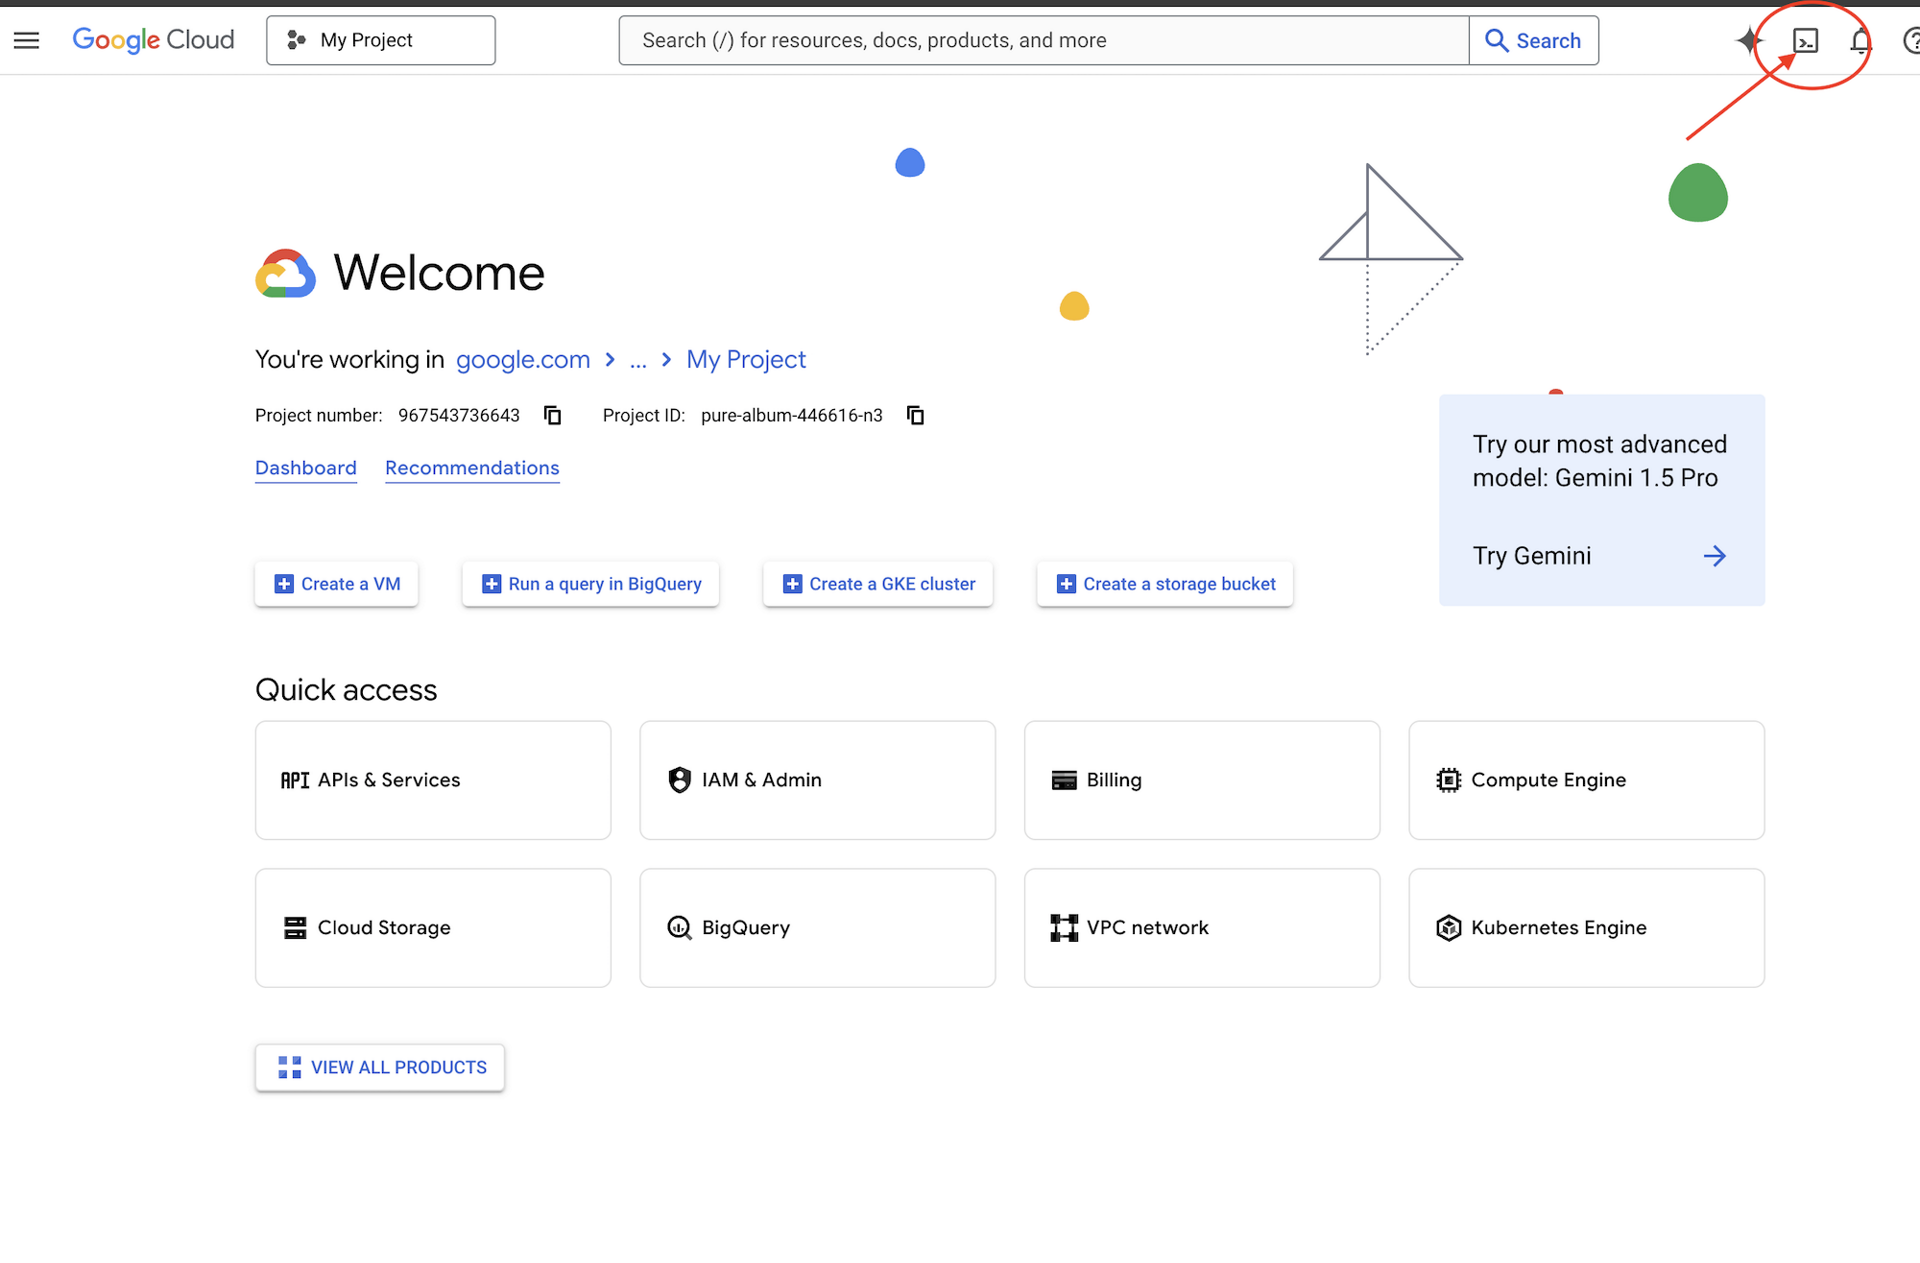
- Öffnen Sie die Google Cloud Console.
- Klicken Sie auf Cloud Shell aktivieren (das Terminalsymbol in der oberen Navigationsleiste), um unten in Ihrem Browser eine Terminalsitzung zu öffnen.
Workbench starten
In Cloud Shell oder an einem beliebigen Ort, an dem gcloud angemeldet ist:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh erstellt ein Projekt (discrim-models-XXXX), verknüpft die Abrechnung damit und bevorzugt ein Event-Guthabenkonto, falls vorhanden. Anschließend wird gewartet, bis das Projekt bereit ist. Wenn Sie den Vorgang noch einmal ausführen, wird das Projekt in ~/project_id.txt wiederverwendet. Wenn Sie ein vorhandenes Projekt verwenden möchten, geben Sie dessen ID in dieser Datei an und überspringen Sie dieses Skript.
setup_codelab.sh fragt nichts. Es werden uv und die Python-Pakete installiert, Vertex AI, Compute Engine und IAP aktiviert, Gemini auf Vertex AI im Projekt in .env verwiesen, ein echter Gemini-Aufruf mit einem Modell ausgeführt, das das Projekt aufrufen kann, die Seite erstellt, die Workbench im Hintergrund gestartet und scripts/check_setup.py ausgeführt. Wenn du sie noch einmal ausführst, bleiben deine Trainingsdateien erhalten. Bei scripts/starter.sh werden sie zurückgesetzt. Das Entscheidungsmodell wird in Schritt 2 der Workbench ausgewählt.
So öffnen Sie die Workbench-Benutzeroberfläche in Cloud Shell:
- Klicken Sie auf den Vorschau-Link, der am Ende von
./setup_codelab.shausgegeben wird, oder klicken Sie rechts oben in der Cloud Shell-Symbolleiste auf Webvorschau. - Wählen Sie Port ändern aus, geben Sie 4900 ein und klicken Sie auf Ändern und Vorschau.
Gemini wird in Ihrem Projekt in Vertex AI mit Ihren eigenen Google-Anmeldedaten ausgeführt: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT und GOOGLE_CLOUD_LOCATION=global in .env.
Das Entscheidungsmodell wird in Schritt 2 der Workbench oder über ein Terminal mit scripts/setup_model.sh ausgewählt:
Große Auswahl | Anforderungen | Einrichtung | Kosten |
Das diskriminative Modell (TypeSafe, gehostet) | ein TypeSafe-API-Schlüssel | Keine | pro Token, Bruchteile eines Cents |
DiffusionGemma (Google, offene Gewichte) | Abrechnung + Compute Engine-Kontingent für GPU | ~15 Minuten, automatisch | ~0,71 $ pro Stunde, während die VM ausgeführt wird |
Probe (kein Modell) | nothing | Keine | Keine |
DiffusionGemma auf einer Compute Engine-VM
scripts/setup_gemma.sh prüft zuerst das GPU-Kontingent und erstellt dann eine g2-standard-4-VM (1 × L4 24 GB, 4 vCPU, 16 GB) aus dem Deep-Learning-Image von Google mit dem NVIDIA-Treiber 580. Beim ersten Start installiert die VM Docker, lädt die Gewichte von Hugging Face herunter (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, öffentlich, kein Token) und führt djev-run aus: DiffusionGemma hinter der genauen API des diskriminativen Modells. Der Port des Modells ist nicht für das Internet geöffnet: Die Workbench erreicht ihn über einen IAP-Tunnel auf localhost:8096, der von scripts/start.sh geöffnet wird.
Pausieren / fortsetzen |
| |
Tunnel |
| |
Entfernen |
| |
Befehle üben |
| |
Repository-Layout
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Zusammenfassung
Umgebung bereinigen
Wenn Sie den Workshop abgeschlossen haben, führen Sie die folgenden Schritte aus, um alle DiffusionGemma-GPU-Ressourcen zu entfernen, die Hintergrundprozesse für Workbench und Übung zu beenden, die Workshop-Dateien aus Cloud Shell zu entfernen und (optional) Ihr Google Cloud-Projekt für den Workshop zu löschen.
- DiffusionGemma-GPU-VM und Firewallregel löschen (falls erstellt): Wenn Sie DiffusionGemma in Schritt 2 auf einer Compute Engine-GPU-VM bereitgestellt haben, entfernen Sie die VM, die Festplatte und die IAP-Firewallregel, damit keine laufenden Gebühren für Compute- oder Festplattenspeicher anfallen:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Workbench- und Übungsprozesse in Cloud Shell beenden: Beenden Sie in Ihrem Cloud Shell-Terminal den Workbench-Server im Hintergrund und alle Übungs-Ersatzprozesse:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Workshop-Ordner aus Cloud Shell löschen: Kehren Sie zu Ihrem Basisverzeichnis zurück und entfernen Sie den geklonten Repository-Ordner und die Projekt-ID-Datei:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Google Cloud-Projekt löschen: Wenn
./setup_project.shein spezielles Workshop-Projekt erstellt hat (z. B.discrim-models-XXXX), werden durch das Beenden des Projekts alle darin erstellten Ressourcen dauerhaft gelöscht. Ihr Cloud-Rechnungskonto bleibt jedoch erhalten:- Öffnen Sie in der Google Cloud Console die Seite Ressourcen verwalten.
- Wählen Sie Ihr Workshop-Projekt (z. B.
discrim-models-...) aus der Ressourcenliste aus. - Klicken Sie in der oberen Symbolleiste auf Löschen, geben Sie zur Bestätigung Ihre Projekt-ID ein und klicken Sie auf Herunterfahren.
Sie haben diesen Workshop abgeschlossen.
Lab-Zusammenfassung
- Sie haben ein diskriminatives Modell (Jev oder DiffusionGemma) auf einer Compute Engine-GPU-VM ausgewählt und geprüft, ob es antwortet.
- Ich habe die Arena manuell und gegen die Uhr gespielt, um die Regeln zu lernen.
- Sie haben gelernt, wie ein diskriminatives Modell Fragen mit Choice, Score und Noul beantwortet, wie es Wahrscheinlichkeiten und Konfidenzwerte verwendet und wie in Ihrem Code Schwellenwerte darauf angewendet werden.
- Sie haben Ihre erste Anfrage gesendet und das Modell hat dann jede Bewegung in der Arena ausgewählt, wobei
choose()die Antworten in Aktionen umgewandelt hat. - Jeder Zweig eines ADK-Workflows wurde einzeln erstellt. Gemini liest ein Bild einer Zauberkarte und das Modell trifft in einer Schleife Entscheidungen.
- Sie wurden in einem Workflow zusammengeführt, der den Status teilt, sodass der Kampf nie auf Gemini wartet und der Zauber bei einer Eröffnung gewirkt wird.
Von der Unterhaltung zur Entscheidung
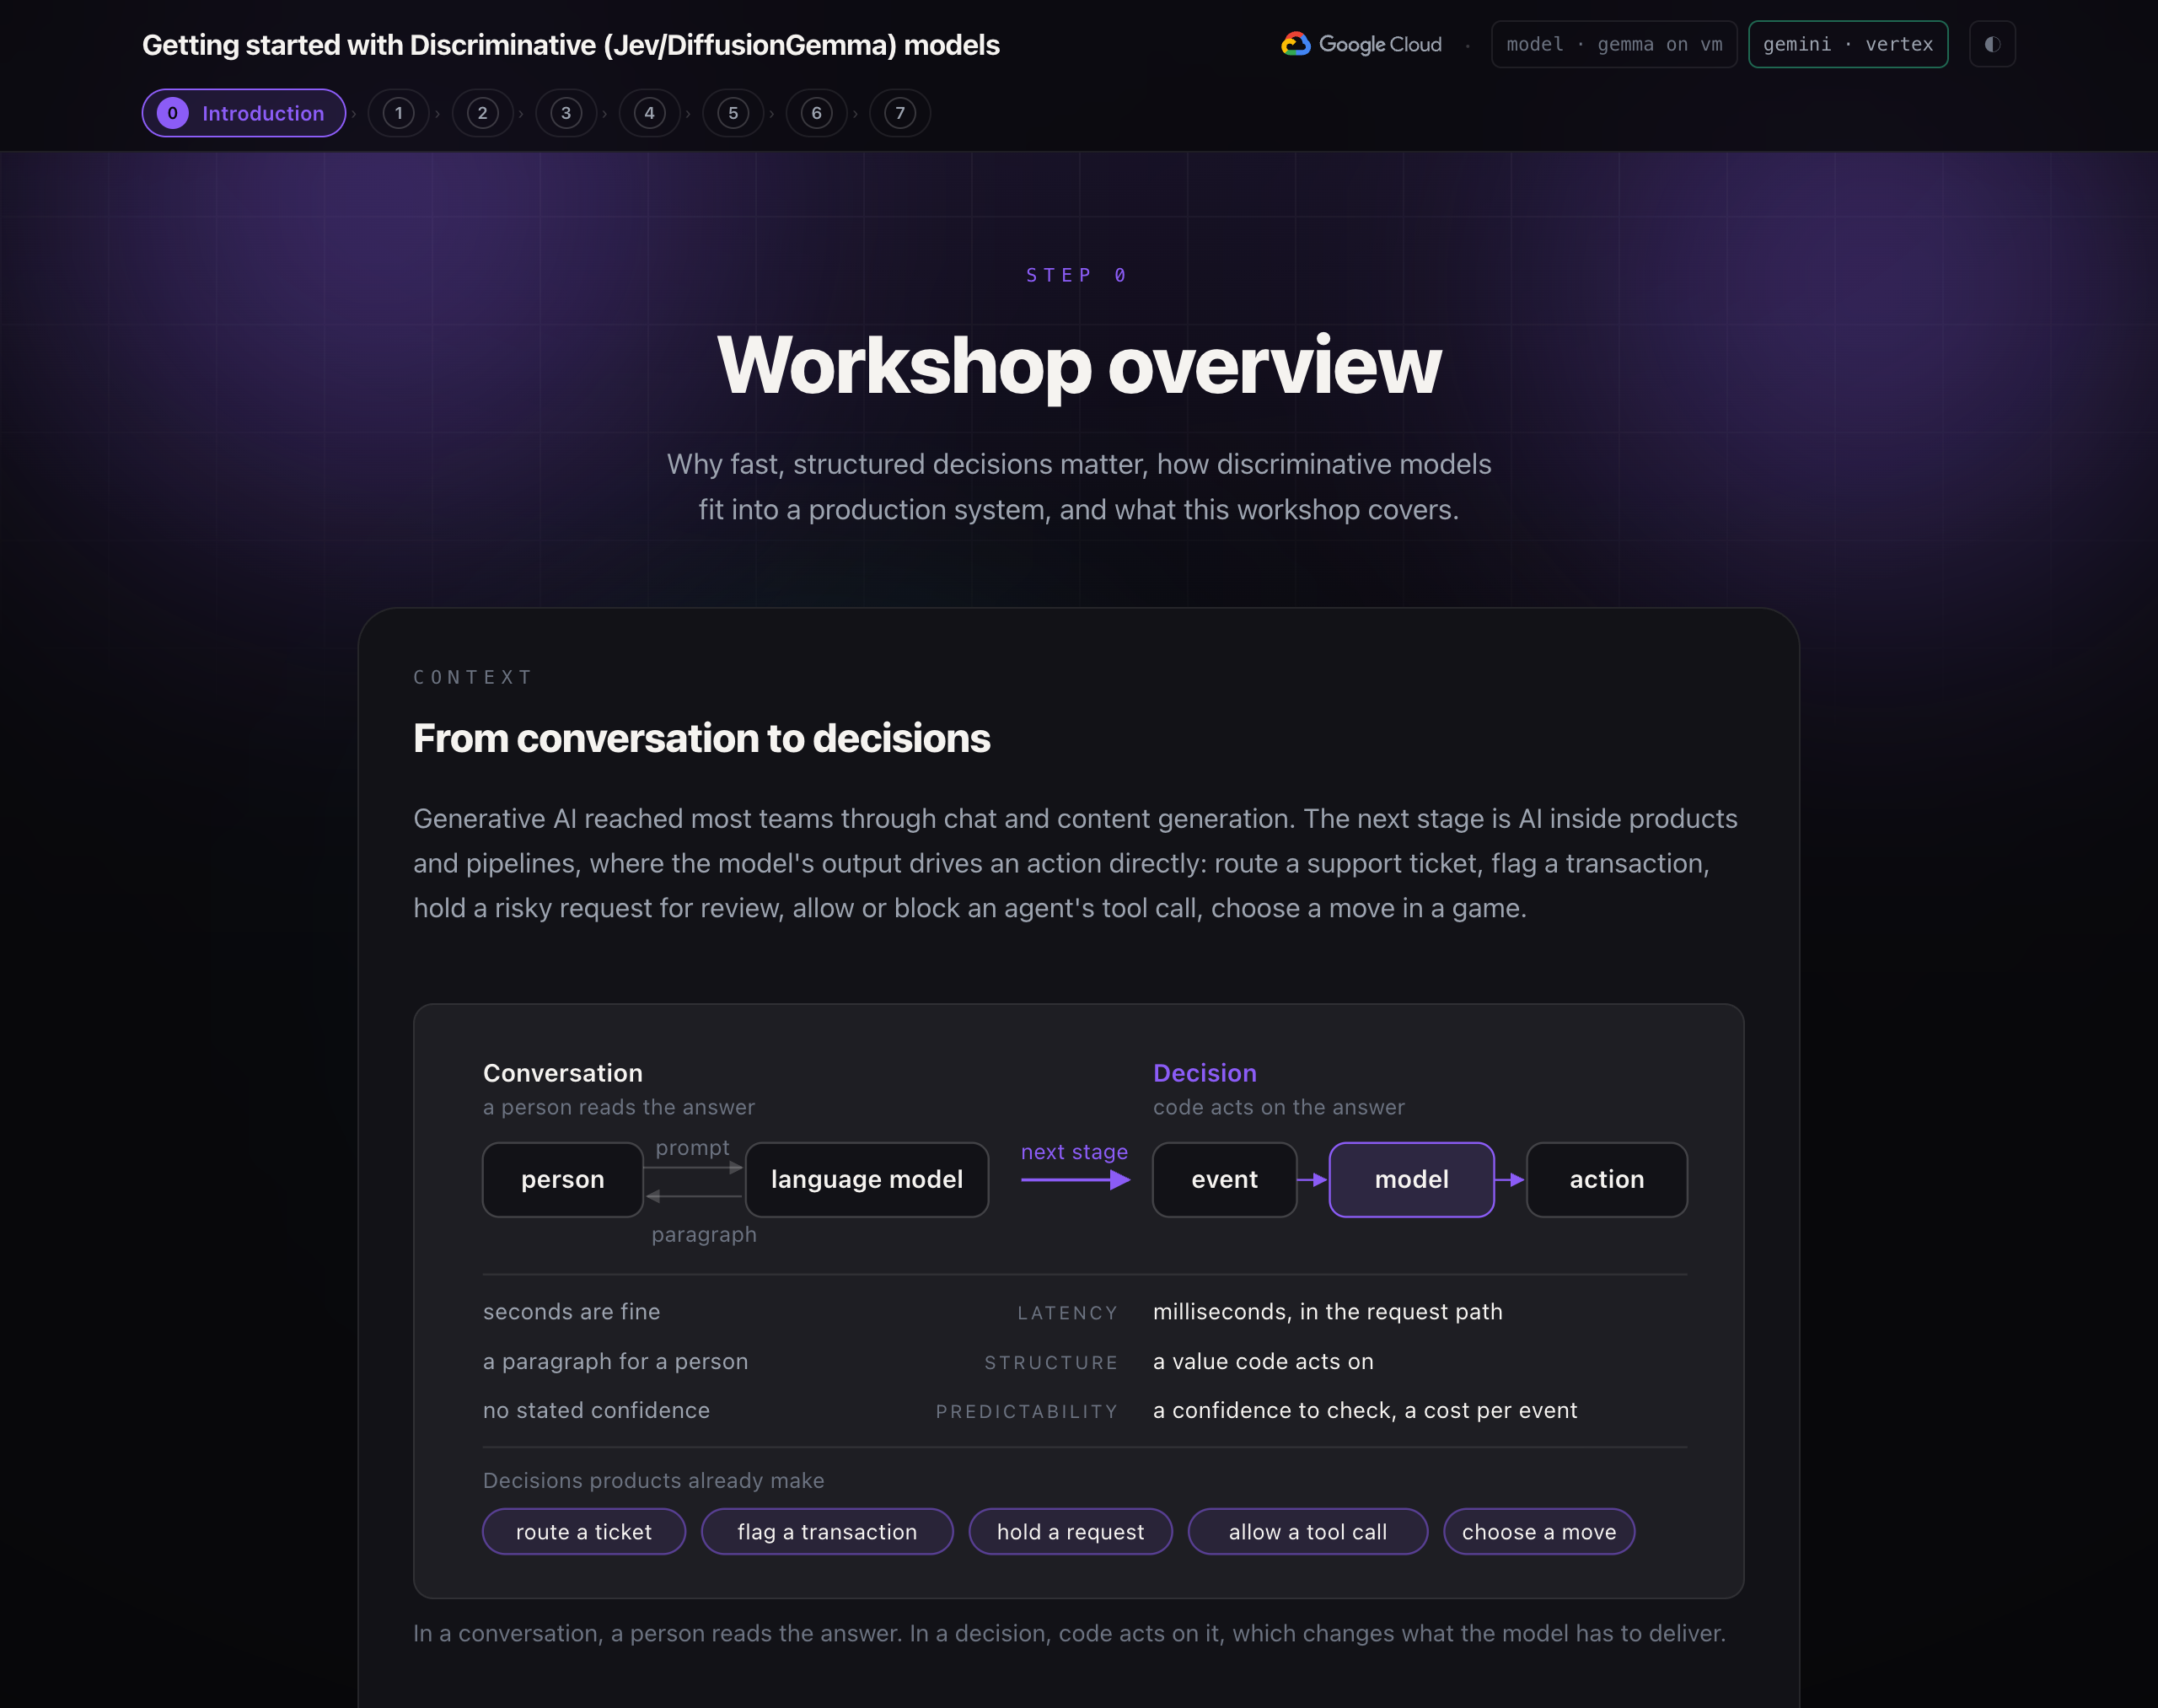
Die meisten Teams nutzten generative KI für Chat und die Erstellung von Inhalten. In der nächsten Phase wird KI in Produkte und Pipelines eingebunden. Die Ausgabe des Modells löst dann direkt eine Aktion aus: ein Support-Ticket wird weitergeleitet, eine Transaktion wird gekennzeichnet, eine riskante Anfrage wird zur Überprüfung zurückgehalten, der Tool-Aufruf eines Kundenservicemitarbeiters wird zugelassen oder blockiert oder ein Zug in einem Spiel wird ausgewählt.
Diese Entscheidungen haben drei Anforderungen gemeinsam, die für den Chat nicht gelten:
- Latenz: Die Antwort ist oft im Anfragepfad oder in einer Echtzeitschleife eines Nutzers enthalten und muss daher innerhalb von Millisekunden, nicht Sekunden, eintreffen.
- Struktur: Der Aufrufer ist Code. Die Antwort muss also ein Wert sein, auf den er reagieren kann, nicht ein Absatz, den er parsen muss.
- Planbarkeit. Für jede Entscheidung ist ein Vertrauensniveau erforderlich, das der Code prüfen kann, und die Kosten müssen niedrig genug sein, um bei jedem Ereignis eine Anfrage zu stellen.
Ein Language Model generiert Text Token für Token. Es kann in ein Ja oder Nein umgewandelt werden, ist aber für einen Echtzeit-Loop zu langsam, seine Ausgabe muss geparst werden und es wird nicht angegeben, wie sicher es ist.
Modelle für Entscheidungen
Ein diskriminatives Modell beantwortet eine Frage mit einer Wahrscheinlichkeit für jede zulässige Option in einem einzigen Durchgang. Es wird kein Text generiert. Dieser Workshop bietet zwei Optionen:
Modell | Anbieter | Wo das Modell in diesem Workshop ausgeführt wird |
Jev | TypeSafe AI | Der gehostete Dienst von TypeSafe wird mit einem API-Schlüssel aufgerufen. |
DiffusionGemma | Google, offene Gewichte | Selbst gehostet auf einer GPU-VM in Ihrem eigenen Google Cloud-Projekt |
Die Modelle können je nach Bedarf ausgetauscht werden. Der Code, der eine Verbindung zu ihnen herstellt, muss nicht geändert werden.
Komponenten kombinieren
Ein erfolgreiches System besteht aus mehreren Komponenten:
Komponente | Rolle | In diesem Workshop |
Workflow | Orchestriert Schritte, führt Branches parallel aus, verwaltet den gemeinsamen Status | Ein ADK-Graph-Workflow |
Deterministischer Code | Regeln, Grenzwerte, Validierung. Sofort, kostenlos und nachvollziehbar | Die Spielregeln, |
Diskriminatives Modell | Schnelle, fundierte Entscheidungen mit einem Konfidenzwert | Bei jedem Tick eine Antwort auswählen |
Sprachmodell | Wahrnehmung und Generierung: Bilder und offener Text | Gemini liest das Bild der Zauberkarte und schreibt den Zauber |
Architektur der Modellbereitstellung
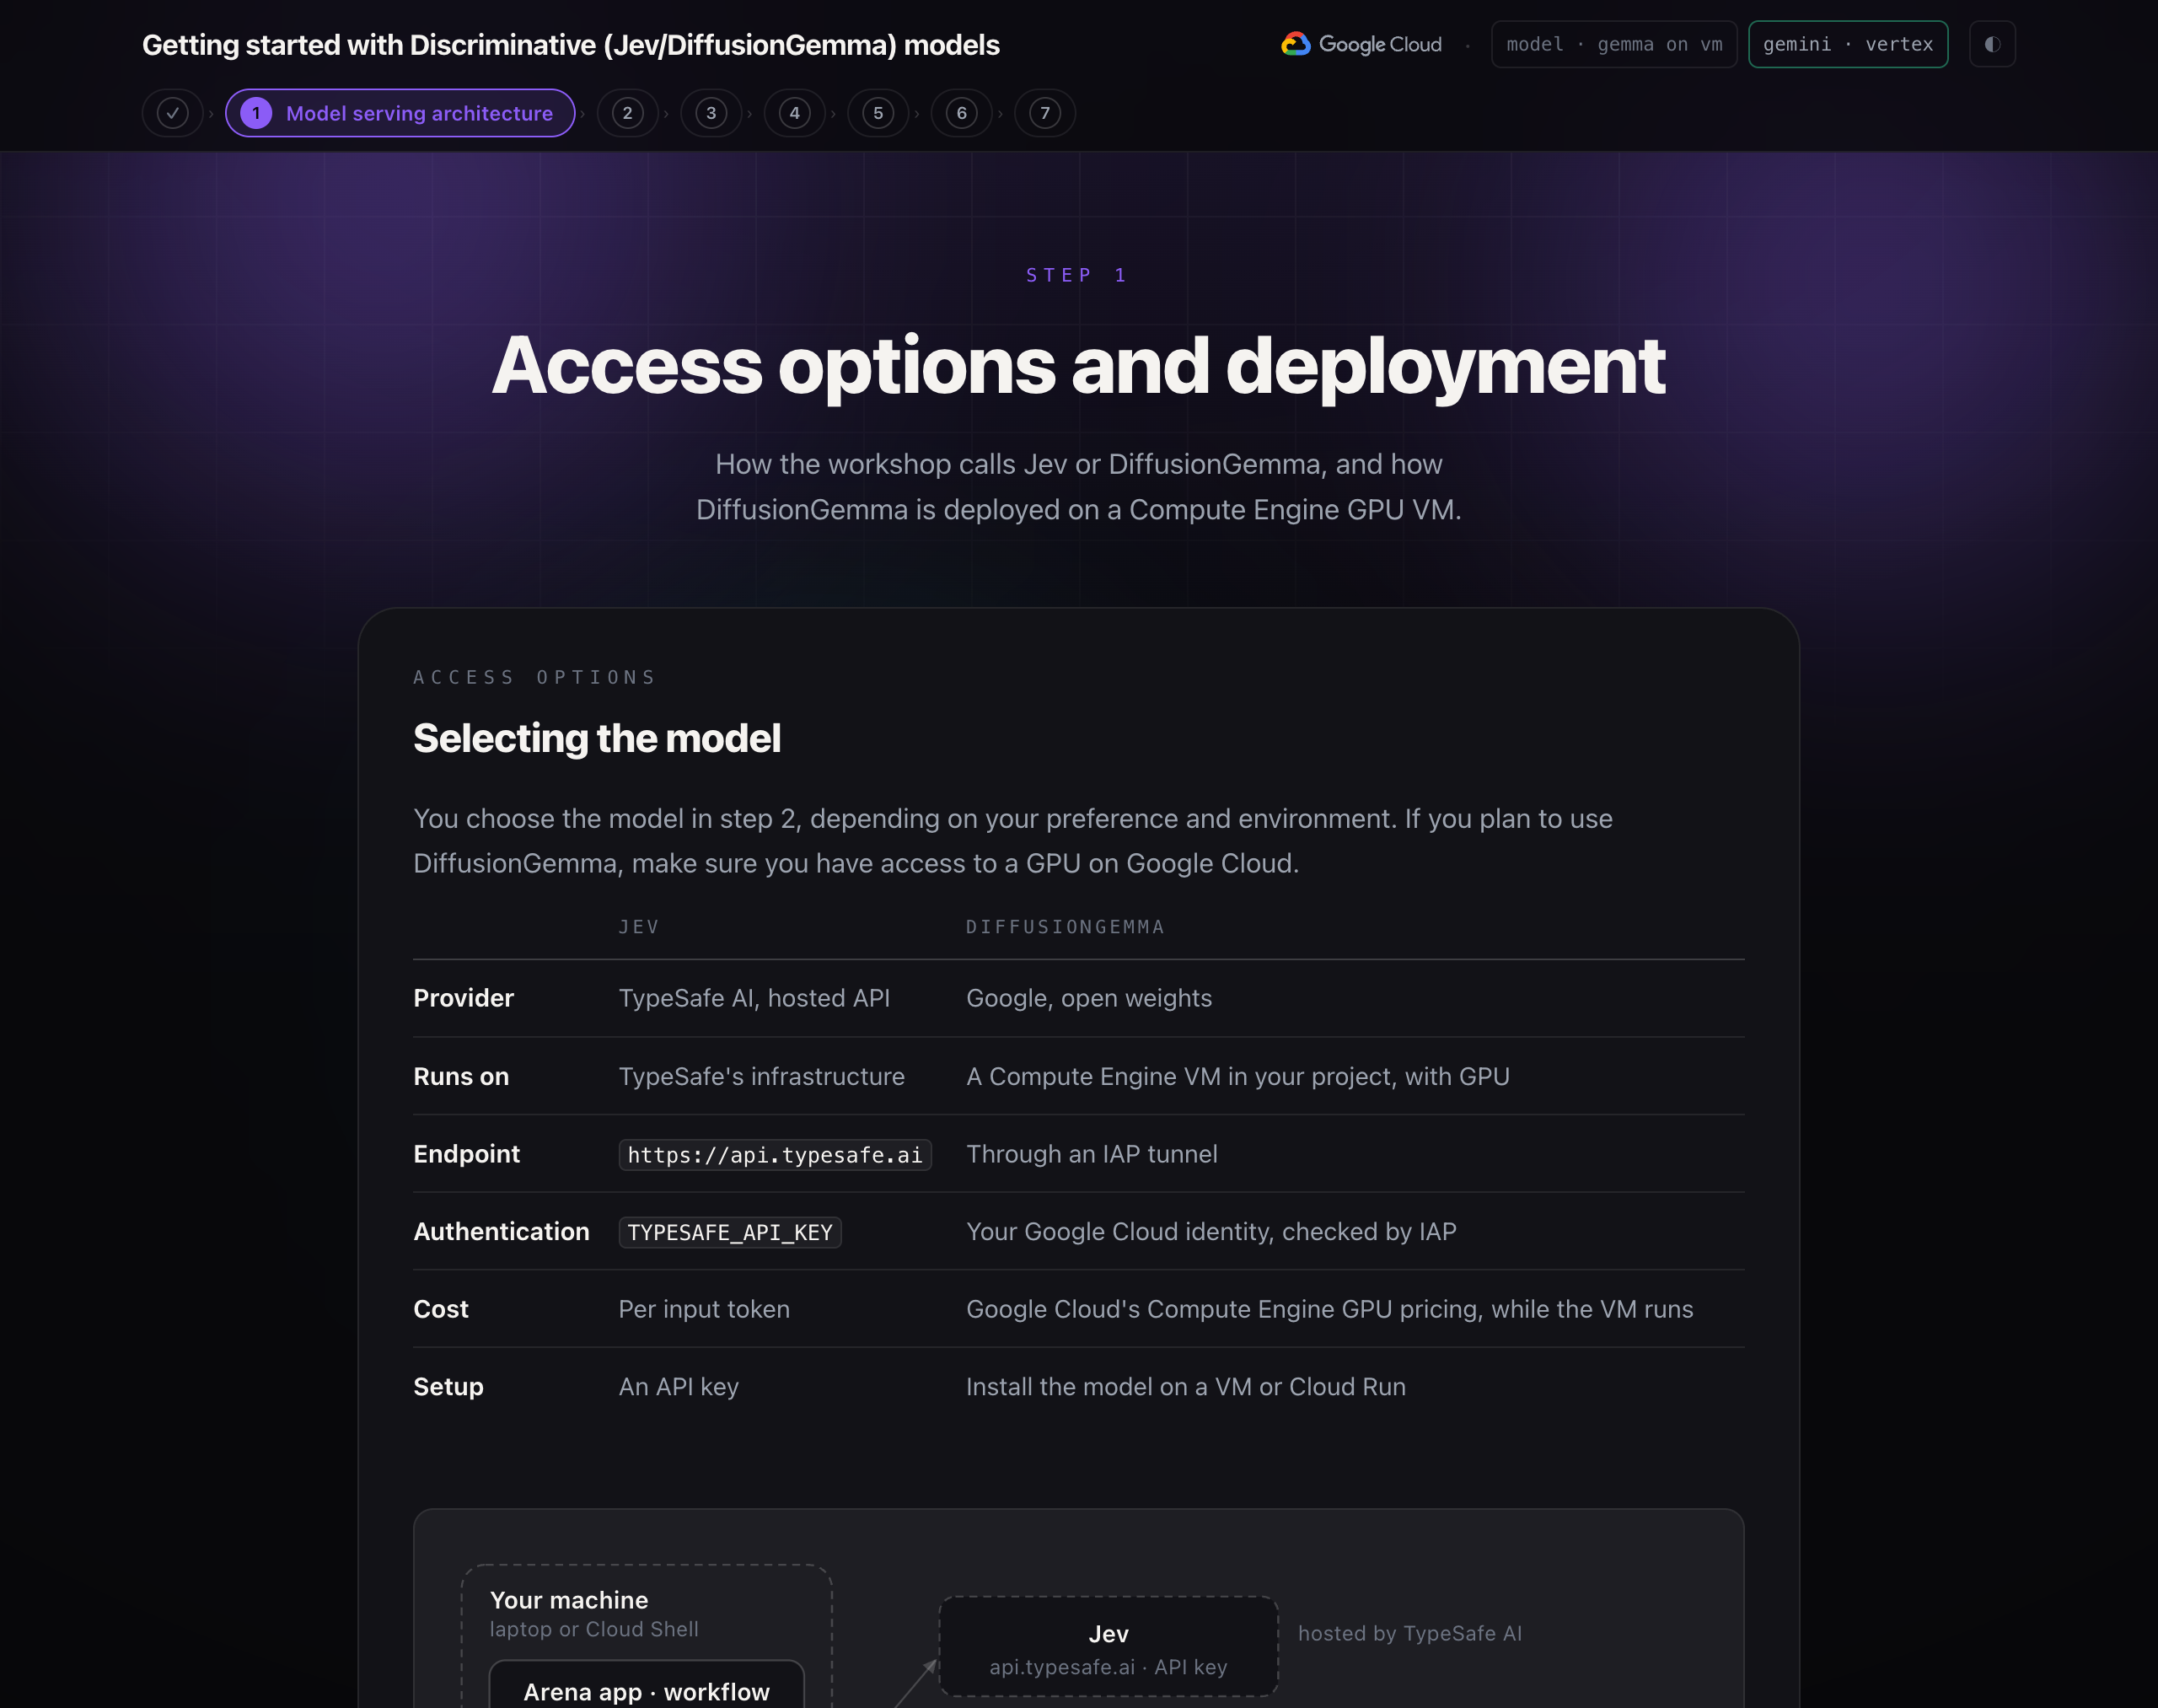
Sie wählen das Modell in Schritt 2 aus, je nach Ihren Vorlieben und Ihrer Umgebung. Wenn Sie DiffusionGemma verwenden möchten, benötigen Sie Zugriff auf eine GPU in Google Cloud.
Jev | DiffusionGemma | |
Anbieter | TypeSafe AI, gehostete API | Google, offene Gewichte |
Läuft auf | Infrastruktur von TypeSafe | Eine Compute Engine-VM in Ihrem Projekt mit GPU |
Endpunkt |
| Über einen IAP-Tunnel |
Authentifizierung |
| Ihre Google Cloud-Identität, die von IAP überprüft wird |
Kosten | Pro Eingabetoken | Compute Engine-GPU-Preise von Google Cloud während der Ausführung der VM |
Einrichtung | API-Schlüssel | Modell auf einer VM oder in Cloud Run installieren |
Datenfluss
- Die Arena-App oder der ADK-Workflow erstellt eine Anfrage: den Status (was der Gegner getan hat) und drei Fragen.
- Das TypeSafe SDK sendet sie als
POST /v1/systemonean die konfigurierte Basis-URL. - Bei Jev wird die Anfrage über HTTPS an
api.typesafe.aigesendet, wobei der API-Schlüssel als Bearer-Token verwendet wird. - Bei DiffusionGemma wird die Anfrage an
localhost:8096gesendet. Ein Hintergrundprozessgcloud compute start-iap-tunnelleitet sie über Identity-Aware Proxy weiter, das Ihre Google-Identität prüft, an Port 8080 auf der VM. - Auf der VM empfängt „djev-run“ die Anfrage, führt DiffusionGemma über vLLM auf der GPU aus und liest die Wahrscheinlichkeit jeder zulässigen Option.
- Beide Back-Ends geben dieselbe Antwort zurück: eine Antwort pro Frage mit Wahrscheinlichkeiten und einem Konfidenzwert. Der Workshop-Code wendet seine Grenzwerte und Aktionen an.
DiffusionGemma in Compute Engine
scripts/setup_gemma.sh erstellt Folgendes in Ihrem Projekt:
- Prüft, ob die Region ein Kontingent für eine GPU hat.
- Aktiviert die Compute Engine- und IAP-APIs und erstellt die Firewallregel
allow-iap-djev. Es werden nur die IAP-Adressbereiche auf den Ports 22 und 8080 zugelassen. - Erstellt die VM
djev-l4: Maschinentypg2-standard-4(4 vCPUs, 16 GB Arbeitsspeicher), eine GPU mit 24 GB, ein 100-GB-Laufwerk und das Deep Learning VM-Image mit dem NVIDIA-Treiber 580. Wenn in einer Zone keine GPU-Kapazität vorhanden ist, wird die nächste Zone ausprobiert. - Beim ersten Start installiert das Startskript der VM Docker und das NVIDIA Container Toolkit, ruft das djev-run-Container-Image ab, lädt die Gewichte von Hugging Face (17,5 GB) herunter und startet den Container mit GPU-Zugriff auf Port 8080. Das dauert etwa 15 Minuten. Spätere Starts dauern etwa 2 Minuten.
- Schreibt die Verbindungseinstellungen in
.envund öffnet den Tunnel.
Aufgabe | Befehl |
VM beenden (Laufwerk wird beibehalten) |
|
Nochmal starten |
|
Tunnel prüfen |
|
Alles löschen |
|
Modell einrichten
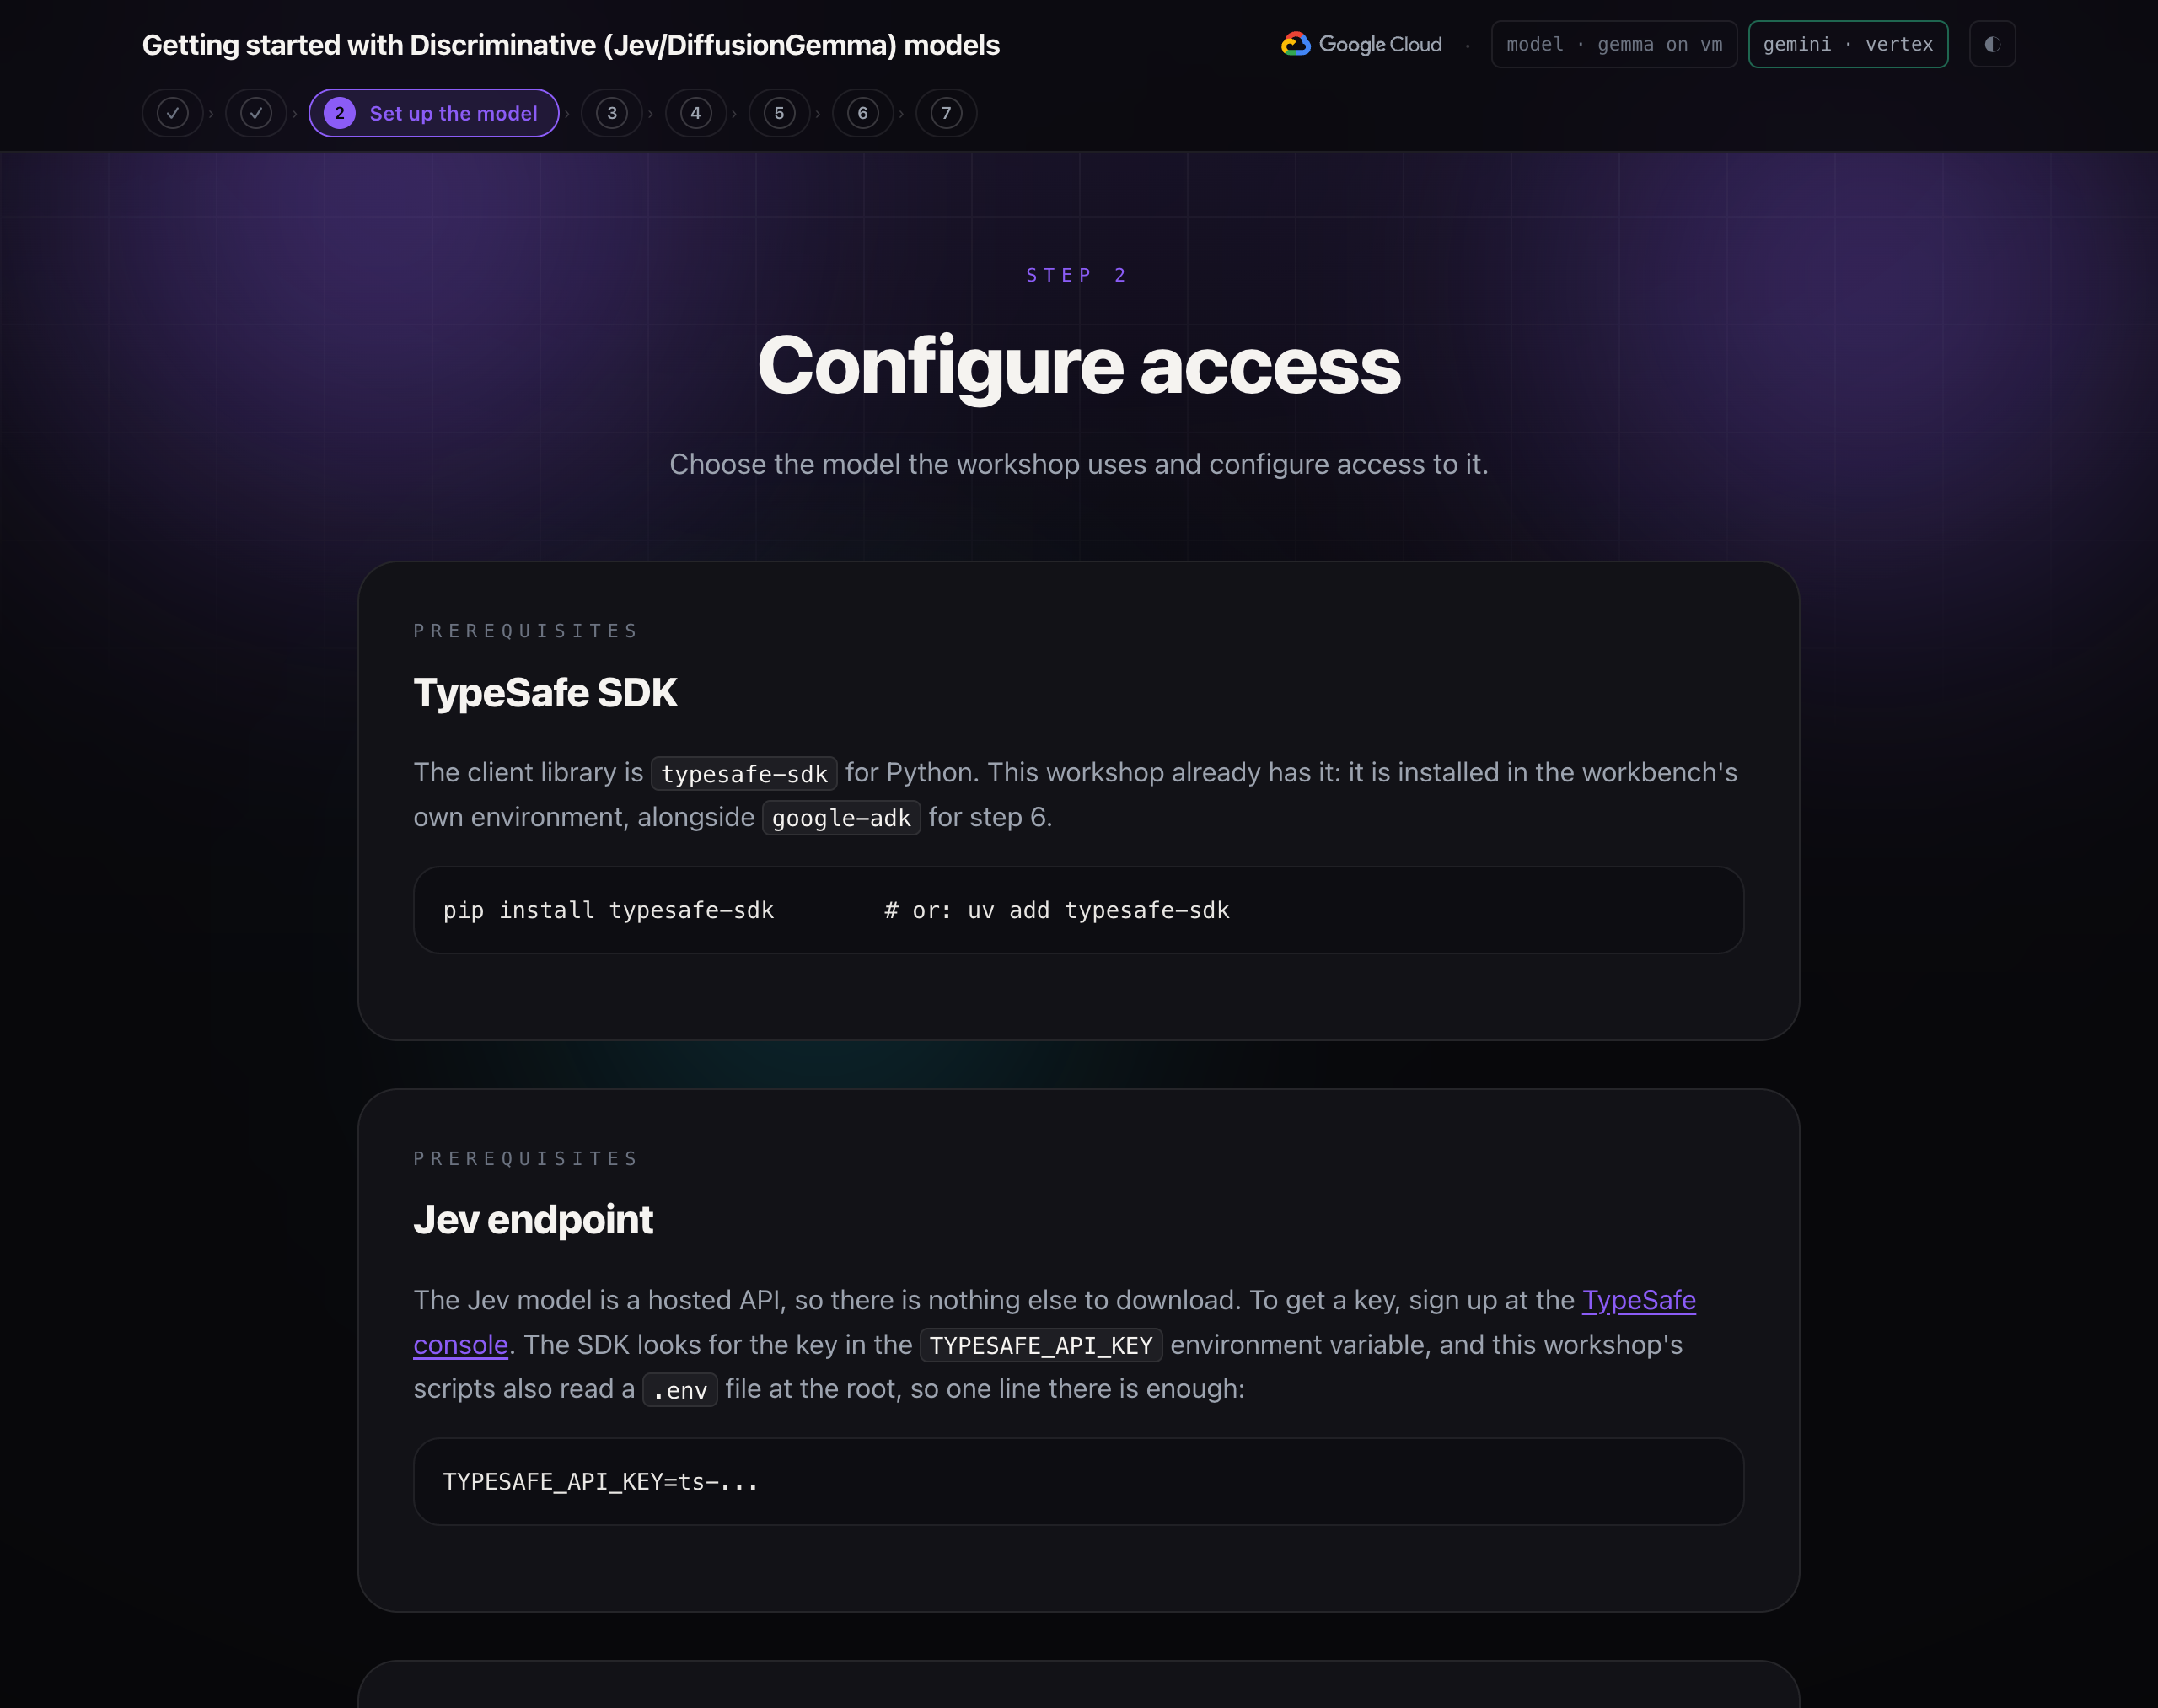
TypeSafe SDK
Die Clientbibliothek ist typesafe-sdk für Python. In diesem Workshop ist sie bereits vorhanden: Sie ist in der Umgebung der Workbench installiert, zusammen mit google-adk für Schritt 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev-Endpunkt
Das Jev-Modell ist eine gehostete API, daher ist kein weiterer Download erforderlich. Um einen Schlüssel zu erhalten, registrieren Sie sich in der TypeSafe Console. Das SDK sucht nach dem Schlüssel in der Umgebungsvariablen TYPESAFE_API_KEY. Die Skripts dieses Workshops lesen auch eine .env-Datei im Stammverzeichnis. Eine Zeile reicht also aus:
TYPESAFE_API_KEY=ts-...
DiffusionGemma verwenden
djev-run implementiert die API des diskriminativen Modells neu. Es wird derselbe POST /v1/systemone-Endpunkt mit denselben Fragen zu „noul“, „choice“ und „score“ von DiffusionGemma, dem offenen Diffusionsmodell von Google DeepMind (insgesamt 26 Milliarden Parameter, etwa 4 Milliarden aktiv, Apache 2.0), bereitgestellt. Da das Wire-Format dasselbe ist, kommuniziert das TypeSafe SDK unverändert damit.
Wenn Sie im Rahmen der Übung DiffusionGemma auswählen, wird es auf einer GPU in einer VM in Ihrem eigenen Google Cloud-Projekt ausgeführt. Die Pille oben rechts lautet dann gemma on vm. Die Workbench erreicht sie über einen privaten IAP-Tunnel und der Port des Modells ist nicht für das Internet geöffnet. Schritt 1 beschreibt die vollständige Architektur.
Warum ein Diffusionsmodell das kann:Es füllt einen ganzen Block von Positionen gleichzeitig aus. Dabei wird jede Position mit der vollständigen Eingabe versehen, sodass die Wahrscheinlichkeit jeder zulässigen Option in einem einzigen Schritt abgelesen werden kann. Ein normales Language Model erzeugt jeweils nur ein Token und müsste wiederholt gesampelt werden.
Spiel manuell spielen
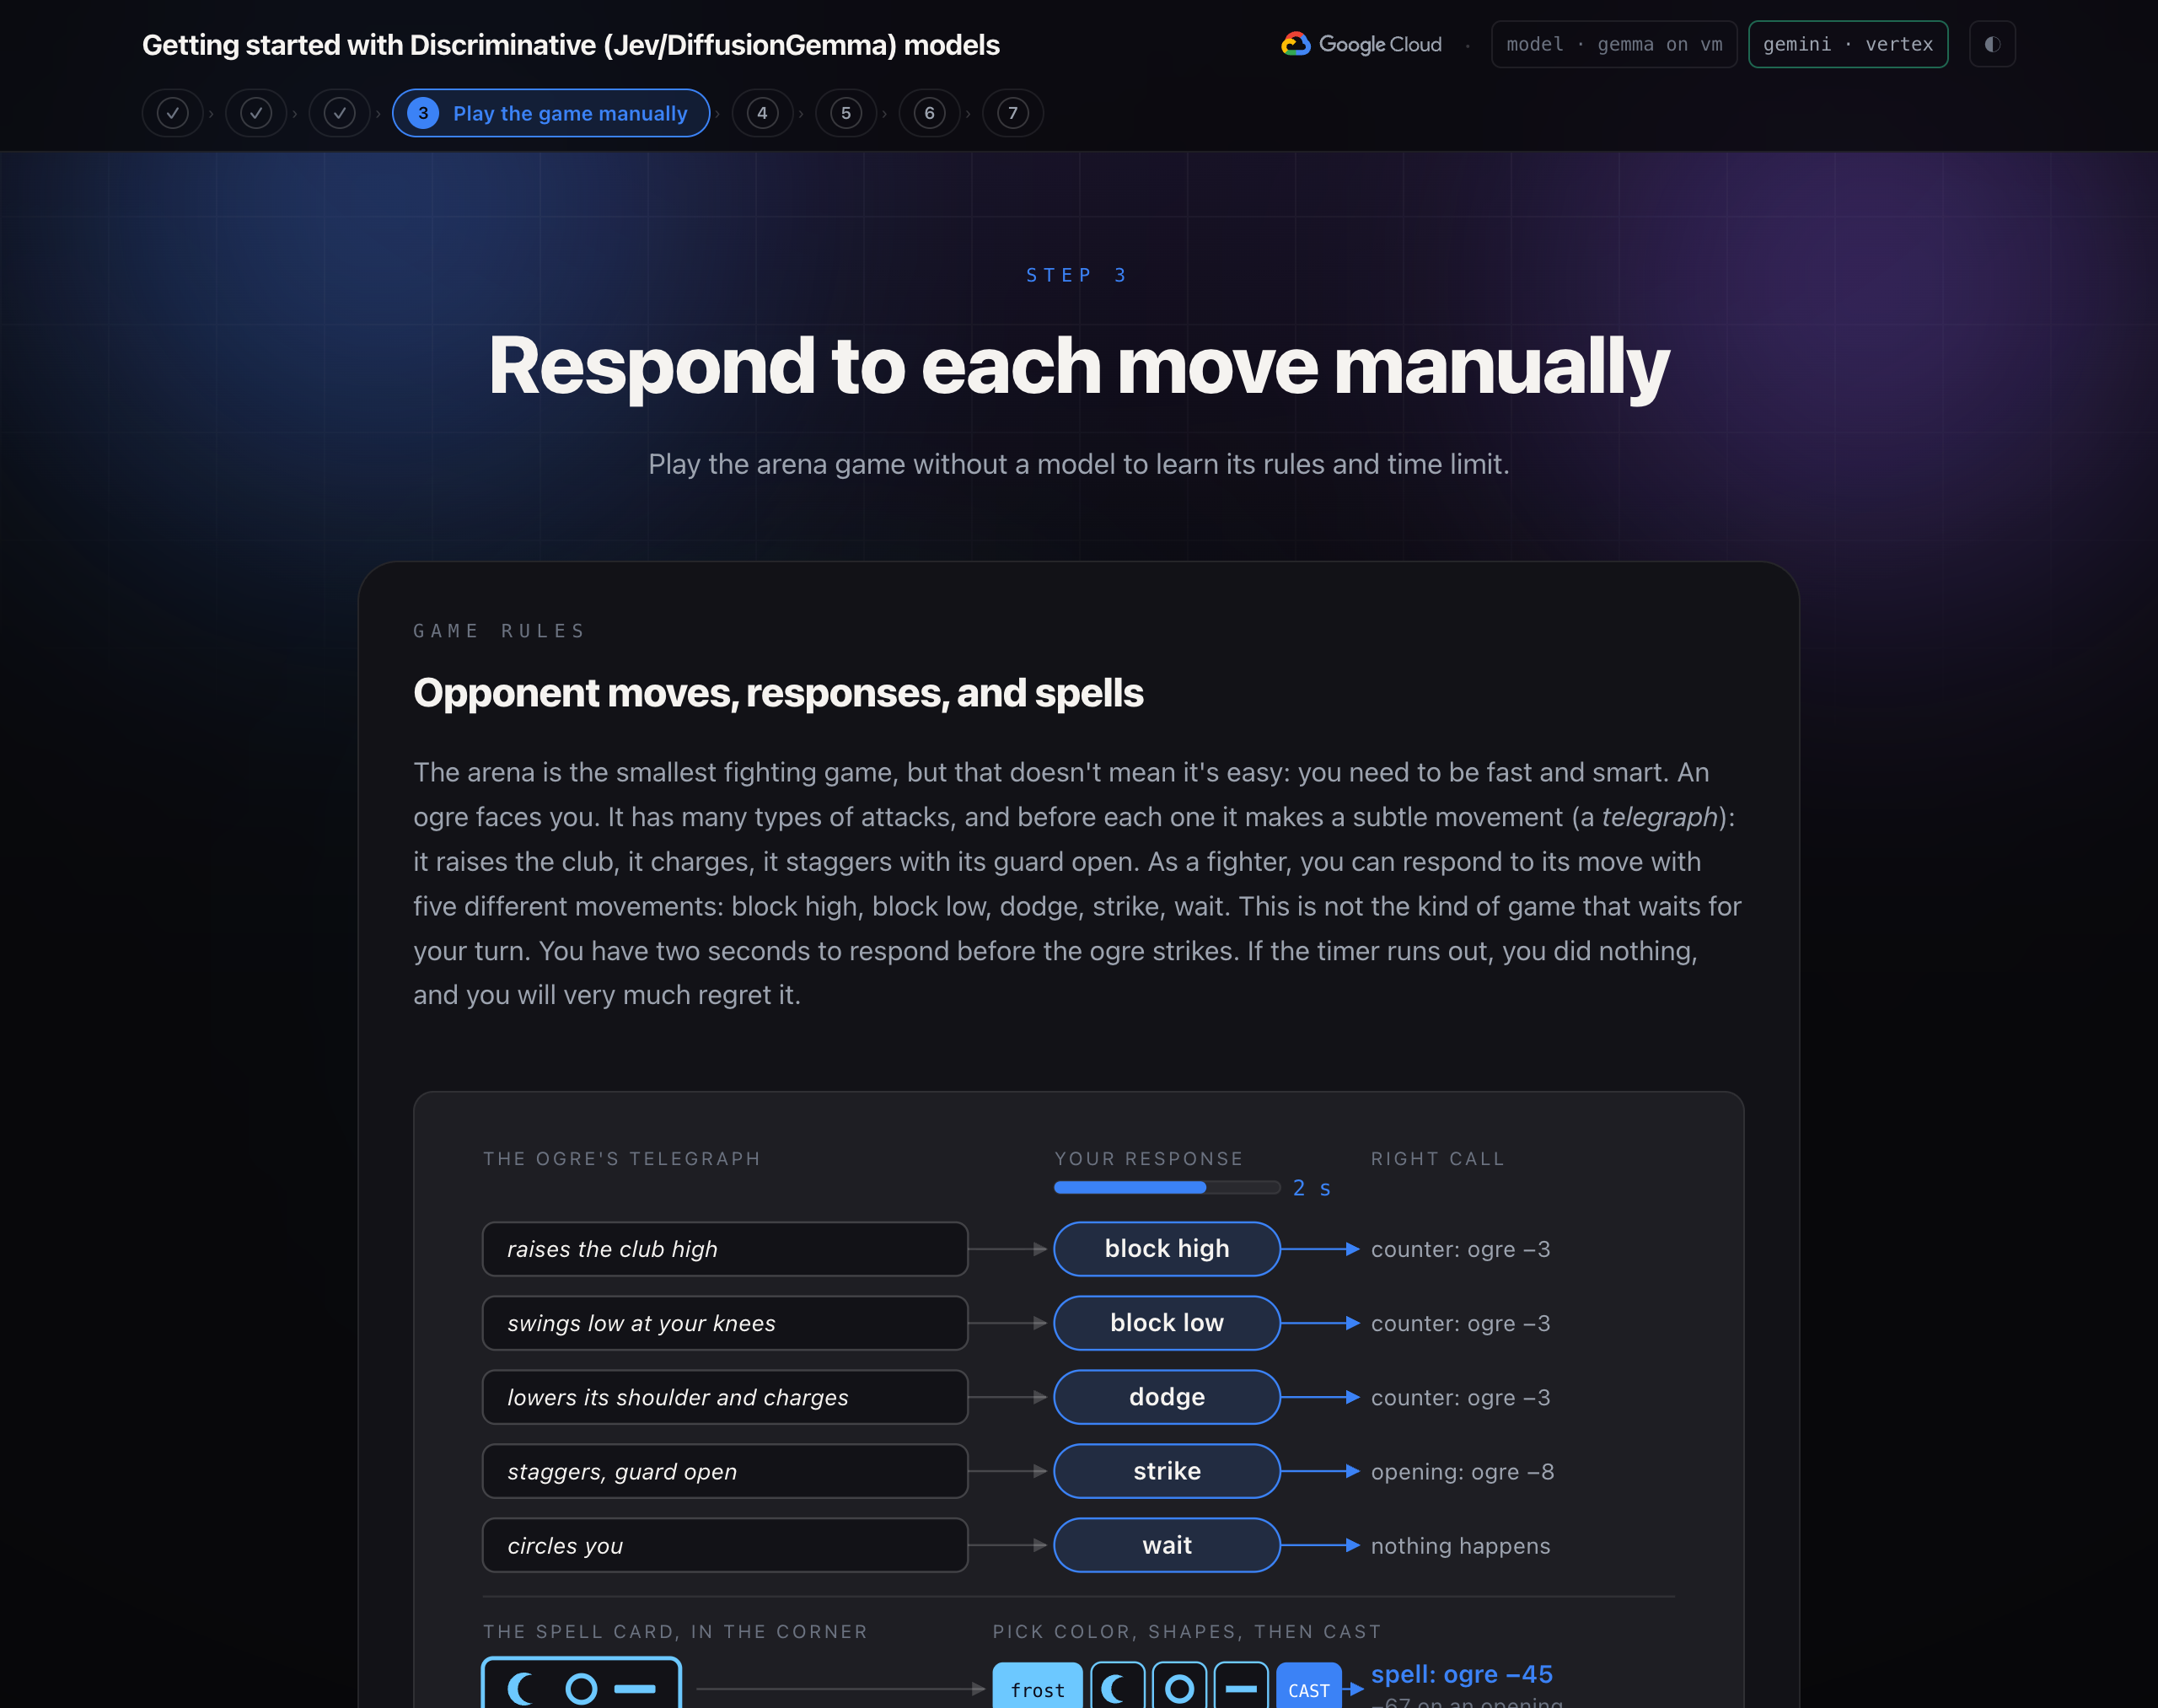
Die Arena ist das kleinste Kampfspiel, aber das bedeutet nicht, dass es einfach ist: Du musst schnell und clever sein. Ein Oger steht vor dir. Es gibt viele Arten von Angriffen und vor jedem macht es eine subtile Bewegung (ein Telegraf): Es hebt den Schläger, es stürmt los, es taumelt mit offener Deckung. Als Kämpfer kannst du auf den Zug mit fünf verschiedenen Bewegungen reagieren: hoch blocken, tief blocken, ausweichen, schlagen, warten. Das ist kein Spiel, bei dem man auf seinen Zug warten muss. Du hast zwei Sekunden Zeit, um zu reagieren, bevor der Oger zuschlägt. Wenn der Timer abläuft, haben Sie nichts unternommen und werden es sehr bereuen.
Oben links auf dem Ring befindet sich eine Zauberkarte: eine farbige Karte mit drei Formen. Nur ein Zauber, der dazu passt, kann wirklich Schaden anrichten. Im Spiel können Sie mit den Schaltflächen unter dem Kampf einen Zauber wirken: Wählen Sie die Farbe der Karte aus, dann die Formen von links nach rechts und drücken Sie dann CAST (ZAUBER WIRKEN). Die Uhr läuft weiter, während Sie die Zauber auswählen. Sie müssen also gleichzeitig den Zauber zusammenstellen und auf die Angriffe des Ogers reagieren. Die Tasten 1 bis 5 können weiterhin für die Antworten auf die einzelnen Züge verwendet werden. Ein falscher Zauberspruch verpufft. In Schritt 6 liest Gemini die Zauberkarte für Sie vor.
Wichtigster Punkt:Ein Kampf ist eine Reihe kleiner Entscheidungen, für die jeweils eine Frist gilt. So sieht die meisten Softwareautomatisierung in der Praxis aus – ohne den Club.
Konzepte für diskriminative Modelle
Entscheidungen in Software
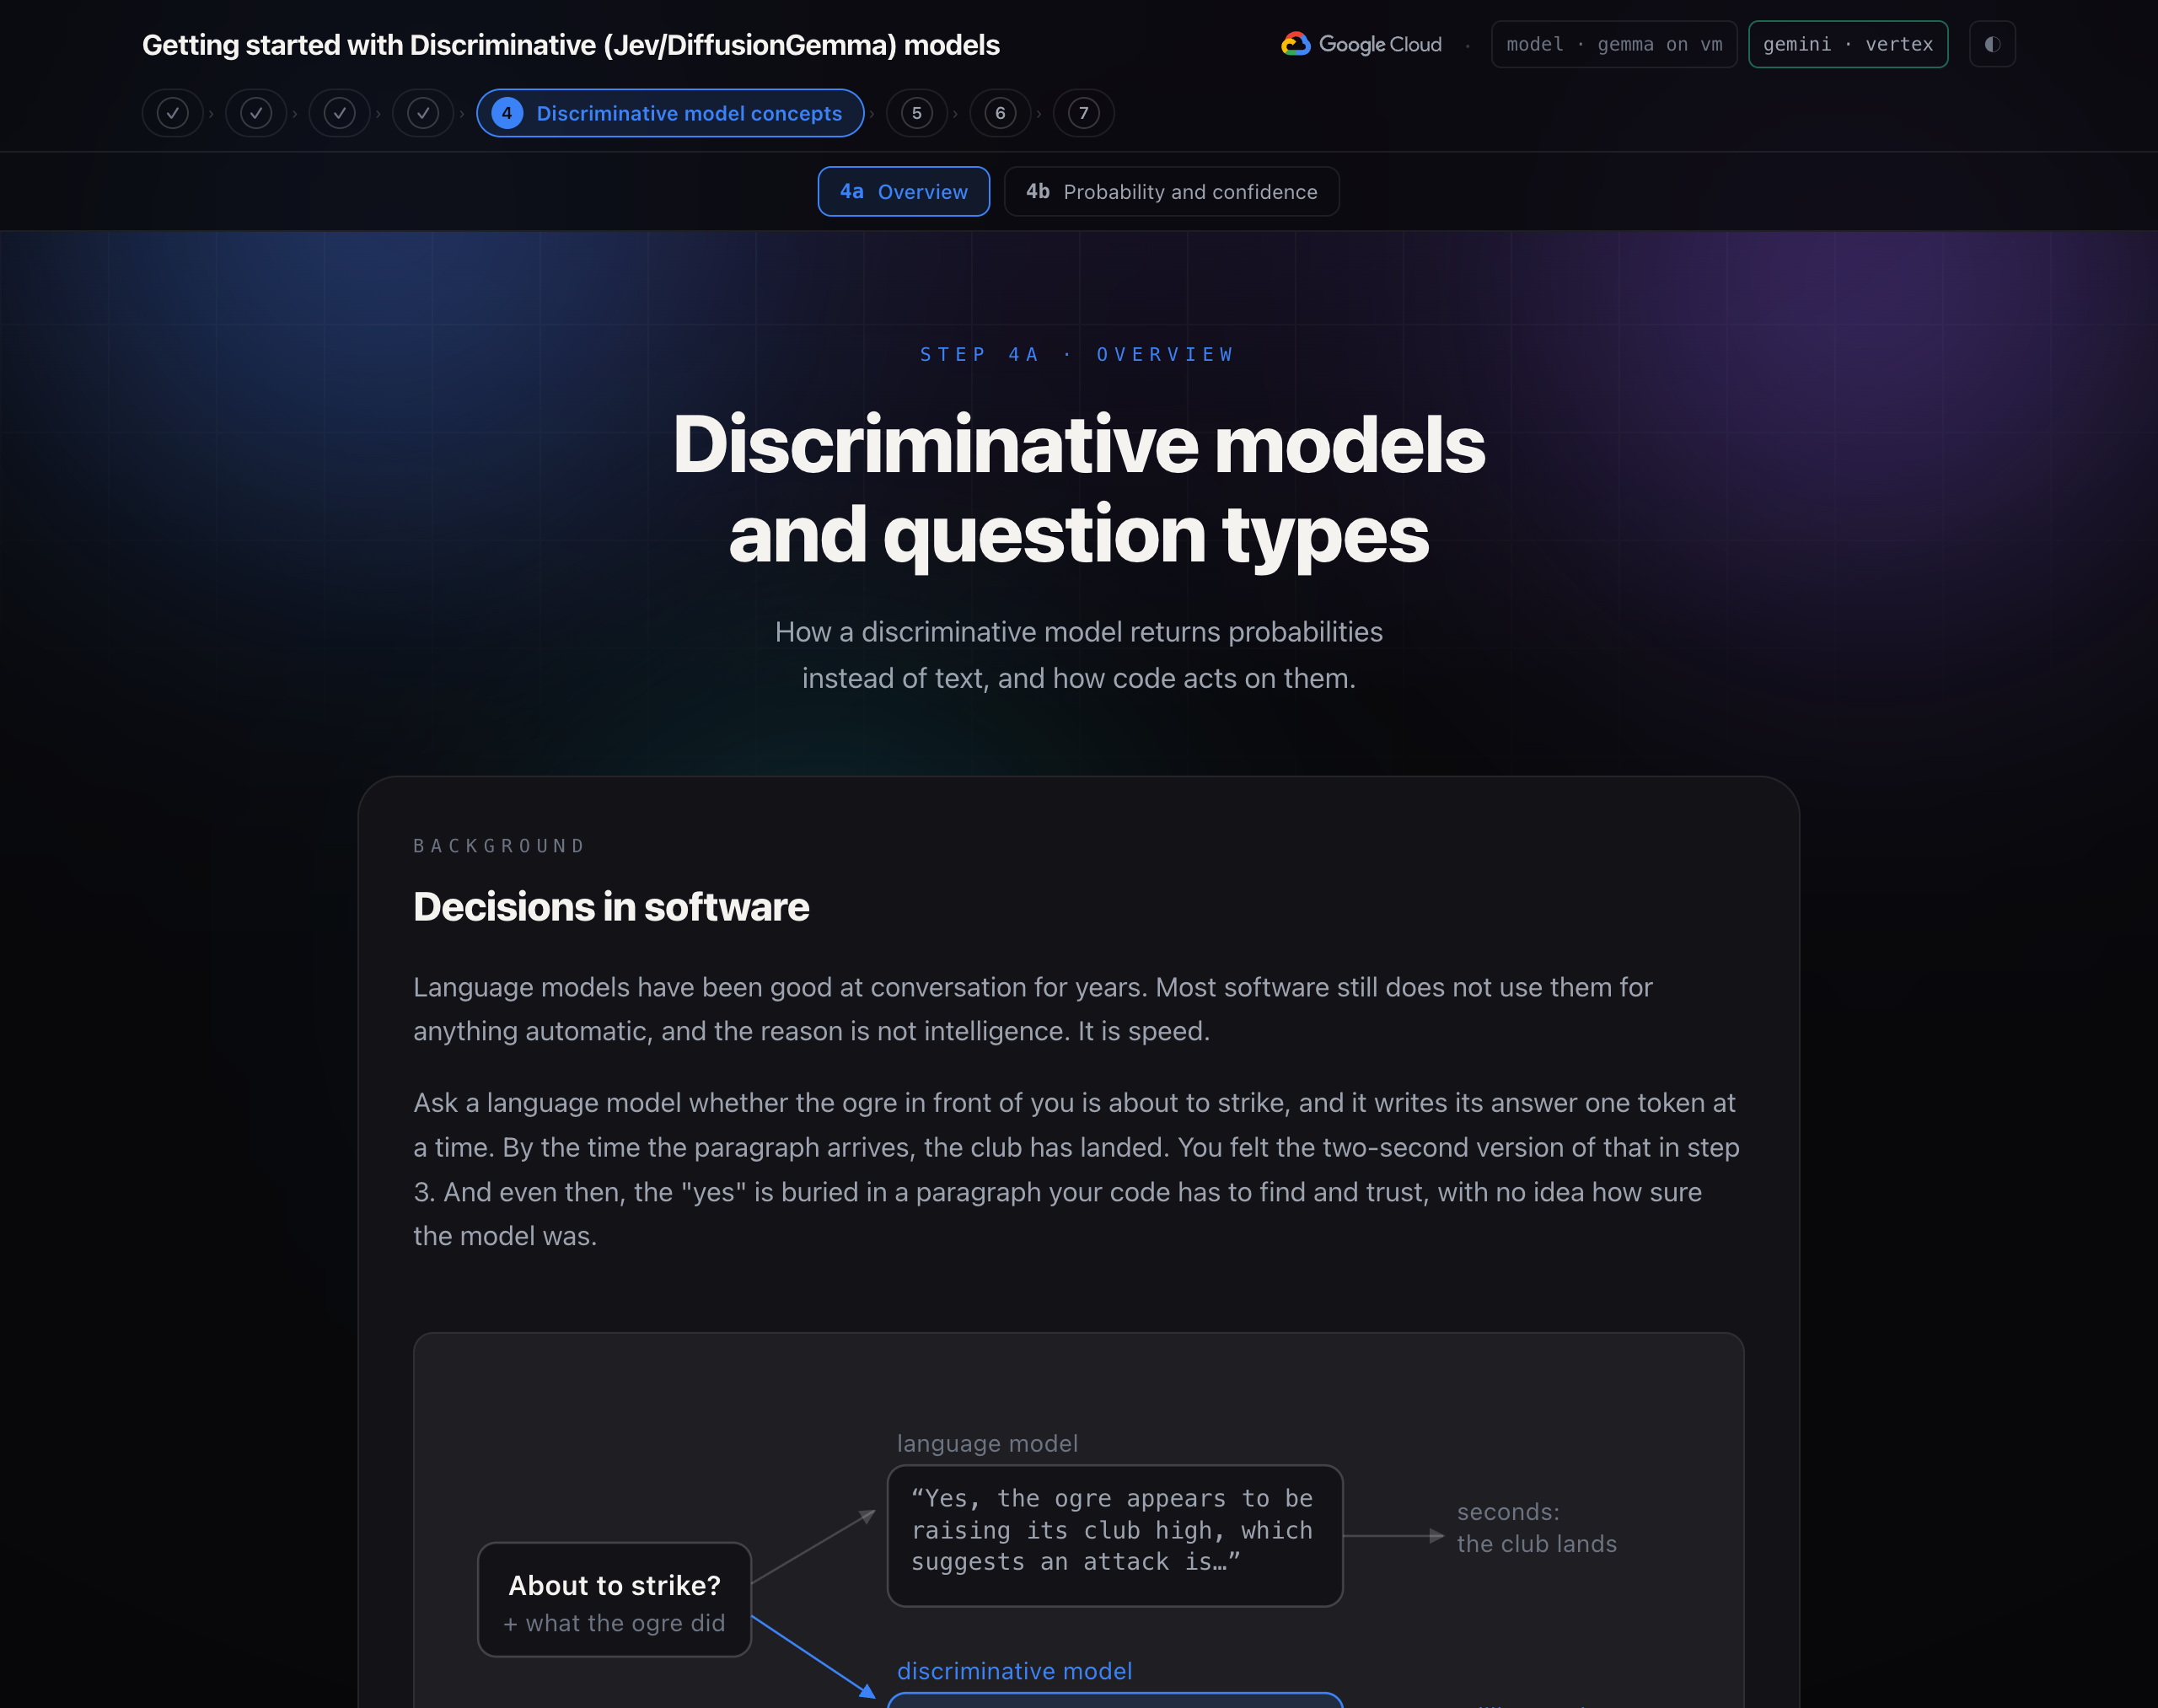
Sprachmodelle eignen sich schon seit Jahren gut für Unterhaltungen. Die meisten Softwareprogramme nutzen sie noch nicht für automatische Prozesse. Das liegt aber nicht daran, dass sie nicht intelligent genug sind. Es ist Geschwindigkeit.
Wenn Sie ein Sprachmodell fragen, ob der Oger vor Ihnen gleich zuschlagen wird, schreibt es seine Antwort Token für Token. Bis der Absatz ankommt, ist der Club gelandet. Die 2-Sekunden-Version haben Sie in Schritt 3 erlebt. Selbst dann ist die Antwort „Ja“ in einem Absatz versteckt, den Ihr Code finden und dem er vertrauen muss. Es ist nicht ersichtlich, wie sicher sich das Modell war.
Das diskriminative Modell berücksichtigt den Status und Ihre eingegebenen Fragen und Antworten in einem Durchgang in Millisekunden. Jede Antwort hat eine kalibrierte Wahrscheinlichkeit: 0,9 bedeutet, dass die Antwort in neun von zehn Fällen richtig ist. Es gibt keinen Text zum Parsen und keine JSON-Daten, die daraus extrahiert werden können.
Modelle für System 1 und System 2
Der Name stammt aus Daniel Kahnemans Schnelles Denken, langsames Denken. System 2 ist langsames, bewusstes Denken, ein Schritt nach dem anderen. System 1 ist schnell und basiert auf Mustererkennung.
Ein Language Model ist eine Maschine vom Typ 2. Die KI führt die Argumentation in einzelnen Tokens durch. Das diskriminative Modell ist ein System 1-Modell: Es gibt keine Begründungen, generiert nichts und beantwortet jede Frage in einem Durchgang. Deshalb ist es schnell (ca. 70 bis 500 Millisekunden) und kostengünstig (Bruchteile eines Cents pro tausend Entscheidungen).
Wichtigste Erkenntnis:Ein Sprachmodell schreibt. Ein Entscheidungsmodell entscheidet. Die meiste Software benötigt von KI eine Entscheidung.
Beschränkungen
Das diskriminative Modell kann keinen Text generieren, keinen Code schreiben, keine Unterhaltung führen, keine Rechenaufgaben lösen, keine Bilder lesen und keine Abfolge von Schritten ausführen.
Im Workshop wählen wir eines der diskriminativen Modelle aus:
- Eines der diskriminativen Modelle ist Jev. Es handelt sich um eine gehostete API von TypeSafe AI, die im September 2026 veröffentlicht wurde. Das erste Modell ist
jev-1.13, das über den Aliasjev-latesterreicht wird. Es sind keine veröffentlichten Gewichte vorhanden, daher wird der Aufruf ausgeführt, aber nichts heruntergeladen. - Jev ist nicht die einzige Möglichkeit, ein System One-Modell zu erhalten. DiffusionGemma von Google ist ein Modell mit offenen Gewichten, das einen ganzen Block von Tokens parallel statt einzeln schreibt. Bei demselben parallelen Durchlauf können Wahrscheinlichkeiten für eine feste Anzahl von Optionen ausgelesen werden. Open-Source-Server wie djev-run verwenden die genaue API von Jev, sodass alles in diesem Workshop unverändert ausgeführt wird.
Bundesstaat und Fragen: Choice, Score und Noul
Bei jedem Aufruf werden Status und Fragen gesendet. Der Status ist der Text, der bewertet werden soll. Es kann ein String, ein JSON-Objekt oder eine Liste sein. In den Fragen wird gefragt, was Sie über den Text wissen möchten. Jede Frage hat einen Typ: „Choice“ (Auswahl), „Score“ (Punktzahl) oder „Noul“ (Null). Die Fragen werden parallel verarbeitet, sodass Gemini schnell reagieren kann. Bei Bedarf können Sie mehrere Fragen hinzufügen.
- Mit Choice wird eine Option aus einer von Ihnen angegebenen Menge von bis zu 255 Optionen ausgewählt. Die Antwort besteht aus der Option, einer Wahrscheinlichkeit für jede Option und einem Konfidenzwert. Verwenden Sie sie, wenn die Optionen keine Reihenfolge haben: „Block high“, „Block low“, „Dodge“, „Strike“, „Wait“.
- Mit Score wird der Status anhand von zwei bis zehn geordneten Stufen bewertet, die Sie beschreiben. Die Antwort ist eine Position auf der Skala (eine Dezimalzahl, z. B. 1, 4 bedeutet „zwischen eins und zwei, näher an eins“), die Wahrscheinlichkeit für jede Stufe und ein Konfidenzwert. Verwenden Sie sie, wenn die Antwort eine Frage des Grades ist, z. B. wie hart der eingehende Schlag landen wird.
- „Choice“ und „Score“ geben beide eine Wahrscheinlichkeit für jede Option und einen Konfidenzwert zurück. Der Unterschied ist die Hauptantwort. „Choice“ gibt die wahrscheinlichste Option zurück. Bei einem Score werden die Optionen als geordnete Stufen behandelt und ihr wahrscheinlichkeitgewichteter Durchschnitt zurückgegeben, der zwischen zwei Stufen liegen kann. Bei „none“ 0,05, „light“ 0,55 und „heavy“ 0,40 wird bei „Choice“ die Antwort „light“ und bei „Score“ die Antwort 1,35 ausgegeben, was zwischen „light“ und „heavy“ liegt. Die Arena verwendet diesen Wert: Bei
choose()wird ein Gefahrenwert von 1,5 oder mehr als schwerer Treffer behandelt.
- „Choice“ und „Score“ geben beide eine Wahrscheinlichkeit für jede Option und einen Konfidenzwert zurück. Der Unterschied ist die Hauptantwort. „Choice“ gibt die wahrscheinlichste Option zurück. Bei einem Score werden die Optionen als geordnete Stufen behandelt und ihr wahrscheinlichkeitgewichteter Durchschnitt zurückgegeben, der zwischen zwei Stufen liegen kann. Bei „none“ 0,05, „light“ 0,55 und „heavy“ 0,40 wird bei „Choice“ die Antwort „light“ und bei „Score“ die Antwort 1,35 ausgegeben, was zwischen „light“ und „heavy“ liegt. Die Arena verwendet diesen Wert: Bei
- Noul stellt eine Ja/Nein-Frage und gibt die Wahrscheinlichkeit zurück, dass die Antwort „Ja“ lautet. Ein Wert nahe 1 bedeutet ein starkes „Ja“, ein Wert nahe 0 ein starkes „Nein“ und ein Wert nahe 0, 5 „könnte beides sein“. Es gibt kein separates Konfidenzniveau, da die Wahrscheinlichkeit das Konfidenzniveau ist.
Gezielte Fragen stellen
Das diskriminative Modell funktioniert am besten, wenn eine Frage sich auf eine bestimmte, gut abgegrenzte Sache bezieht. „What is the situation?“ (Wie ist die Situation?) gibt eine plausible Antwort mit geringem Konfidenzwert zurück. „Was ist die richtige Antwort?“ Die Fragen „Ist der Gegner ungeschützt?“ und „Wie hart wird dieser Schlag?“ liefern drei fokussierte Antworten, die Ihr Code kombiniert.
Beschreibungen von Optionen und Stufen sind kostengünstig und wichtig. Die Regeln, die Sie in Schritt 3 lesen, werden zu den Optionsbeschreibungen: block_high: "Raise the shield. Right against an overhead or a high swing." So lernt das diskriminative Modell die Regeln des Kampfes zur Anfragezeit in jeweils einer Zeile. Die Optionen können sich je nach Situation ändern: Die Arena bietet nur cast an, wenn ein Zauber bereit ist.
Wahrscheinlichkeiten und Konfidenz
Eine Choice-Antwort ist kein Label. Es handelt sich um eine Verteilung über die Labels. Das Label ist einfach der höchste Balken.
So ermittelt das Modell die Nummer. Dabei wird derselbe Schritt verwendet, den ein Sprachmodell nutzt, um das nächste Wort auszuwählen. Ein Transformer liest den Text und weist an einer bestimmten Position jedem Token im Vokabular einen Rohwert zu, der als Logit bezeichnet wird. Ein höherer Logit-Wert bedeutet, dass das Token besser zu dieser Position passt. Mit softmax werden die Logits in Wahrscheinlichkeiten umgewandelt, die sich zu 1 addieren. Ein Sprachmodell wählt dann ein Token aus, fügt es dem Text hinzu und wiederholt den Vorgang. Ein diskriminatives Modell stoppt nach den Wahrscheinlichkeiten.
Die Leerstelle ist eine Lücke in einem Antwortformular. Der Server schreibt das Formular selbst, z. B. response: ▢, und lässt für jede Frage eine Lücke. Die einzige Aufgabe des Modells besteht darin, zu bewerten, was in die einzelnen Lücken gehört.
- Der Prompt enthält den Status und jede Frage mit jeder zulässigen Antwort als kurzes Label:
afür „block_high“,bfür „block_low“ usw. - Der Server fügt das Antwortformular mit einem leeren Feld pro Frage hinzu.
- Das Modell liest den Prompt und das Formular in einem Durchgang und weist jedem Token in jeder Lücke einen Logit zu. Das Diffusionsmodell sieht das gesamte Formular auf einmal und bewertet alle Felder zusammen.
- Der Server behält nur die Logits der zulässigen Labels bei und wendet eine Softmax-Funktion auf sie an, sodass die zulässigen Antworten in der Summe 1 ergeben.
- Wenn die Lesung unsicher erscheint, liest der Server noch einmal von einem anderen zufälligen Startpunkt und mittelt die Lesungen.
Konfidenz ist eine Zahl, die angibt, wie sicher die Antwort ist. TypeSafe berechnet sie aus der Verteilung der Wahrscheinlichkeit auf die Optionen. Wenn alles auf eine Option entfällt, ist der Wert 1. Bei einer gleichmäßigen Verteilung ist er 0. Bei drei Optionen ist es (3 × größter – 1) / 2.
TypeSafe trainiert Jev für abgestimmte Wahrscheinlichkeiten. Die Wahrscheinlichkeit entspricht der Häufigkeit, mit der die Antwort richtig ist. In einem abgestimmten Modell sind Antworten, die mit einem Konfidenzwert von 0,7 ausgegeben werden, zu etwa 70% richtig.Ein Schwellenwert für den Konfidenzwert ist also ein Schwellenwert dafür, wie oft Sie eine falsche Antwort akzeptieren. Der DiffusionGemma-Server in diesem Workshop gibt die höchste Wahrscheinlichkeit selbst als Konfidenz an, gemittelt über die Lesevorgänge. Wenn die Lesevorgänge nicht übereinstimmen, wird der Durchschnittswert verteilt und die Konfidenz sinkt.
Wichtigster Punkt:Die Antwort gibt Aufschluss darüber, was passiert. Die Konfidenz gibt an, ob Sie Maßnahmen ergreifen sollten.
Grenzwerte
Der Grenzwert gibt an, wie Sie die Aktion im Code definieren. Das Modell gibt einen Konfidenzwert oder eine Wahrscheinlichkeit zurück. Ihr Code vergleicht sie mit einer von Ihnen ausgewählten Zahl. Das Ergebnis bestimmt, was passiert.
Ein Grenzwert pro Aktion: TypeSafe schlägt vor, die Konfidenz in Bereiche aufzuteilen. Bei hoher Konfidenz wird automatisch gehandelt. Bei mittlerer Konfidenz wird eine Überprüfung durchgeführt, z. B. durch eine Bestätigungsanfrage oder durch Markieren des Falls zur Überprüfung. Bei geringer Konfidenz wird nicht gehandelt und auf etwas Sicheres oder auf eine Person zurückgegriffen.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Die Regeln der Arena. Die Grenzwerte der Arena befinden sich in choose(), die Sie in Schritt 5 ausführen.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Achtung:Eine gültige Antwort ist nicht immer eine richtige Antwort. Das diskriminative Modell kann keine Option zurückgeben, die Sie nicht angeboten haben. Es kann also keine Züge halluzinieren, aber es kann den falschen Zug auswählen, manchmal mit hoher Konfidenz. Testen Sie Ihre Fragen anhand von Situationen, die Sie bereits bewertet haben, bevor Sie einem Schwellenwert vertrauen.
Entscheidungen mit dem Modell automatisieren
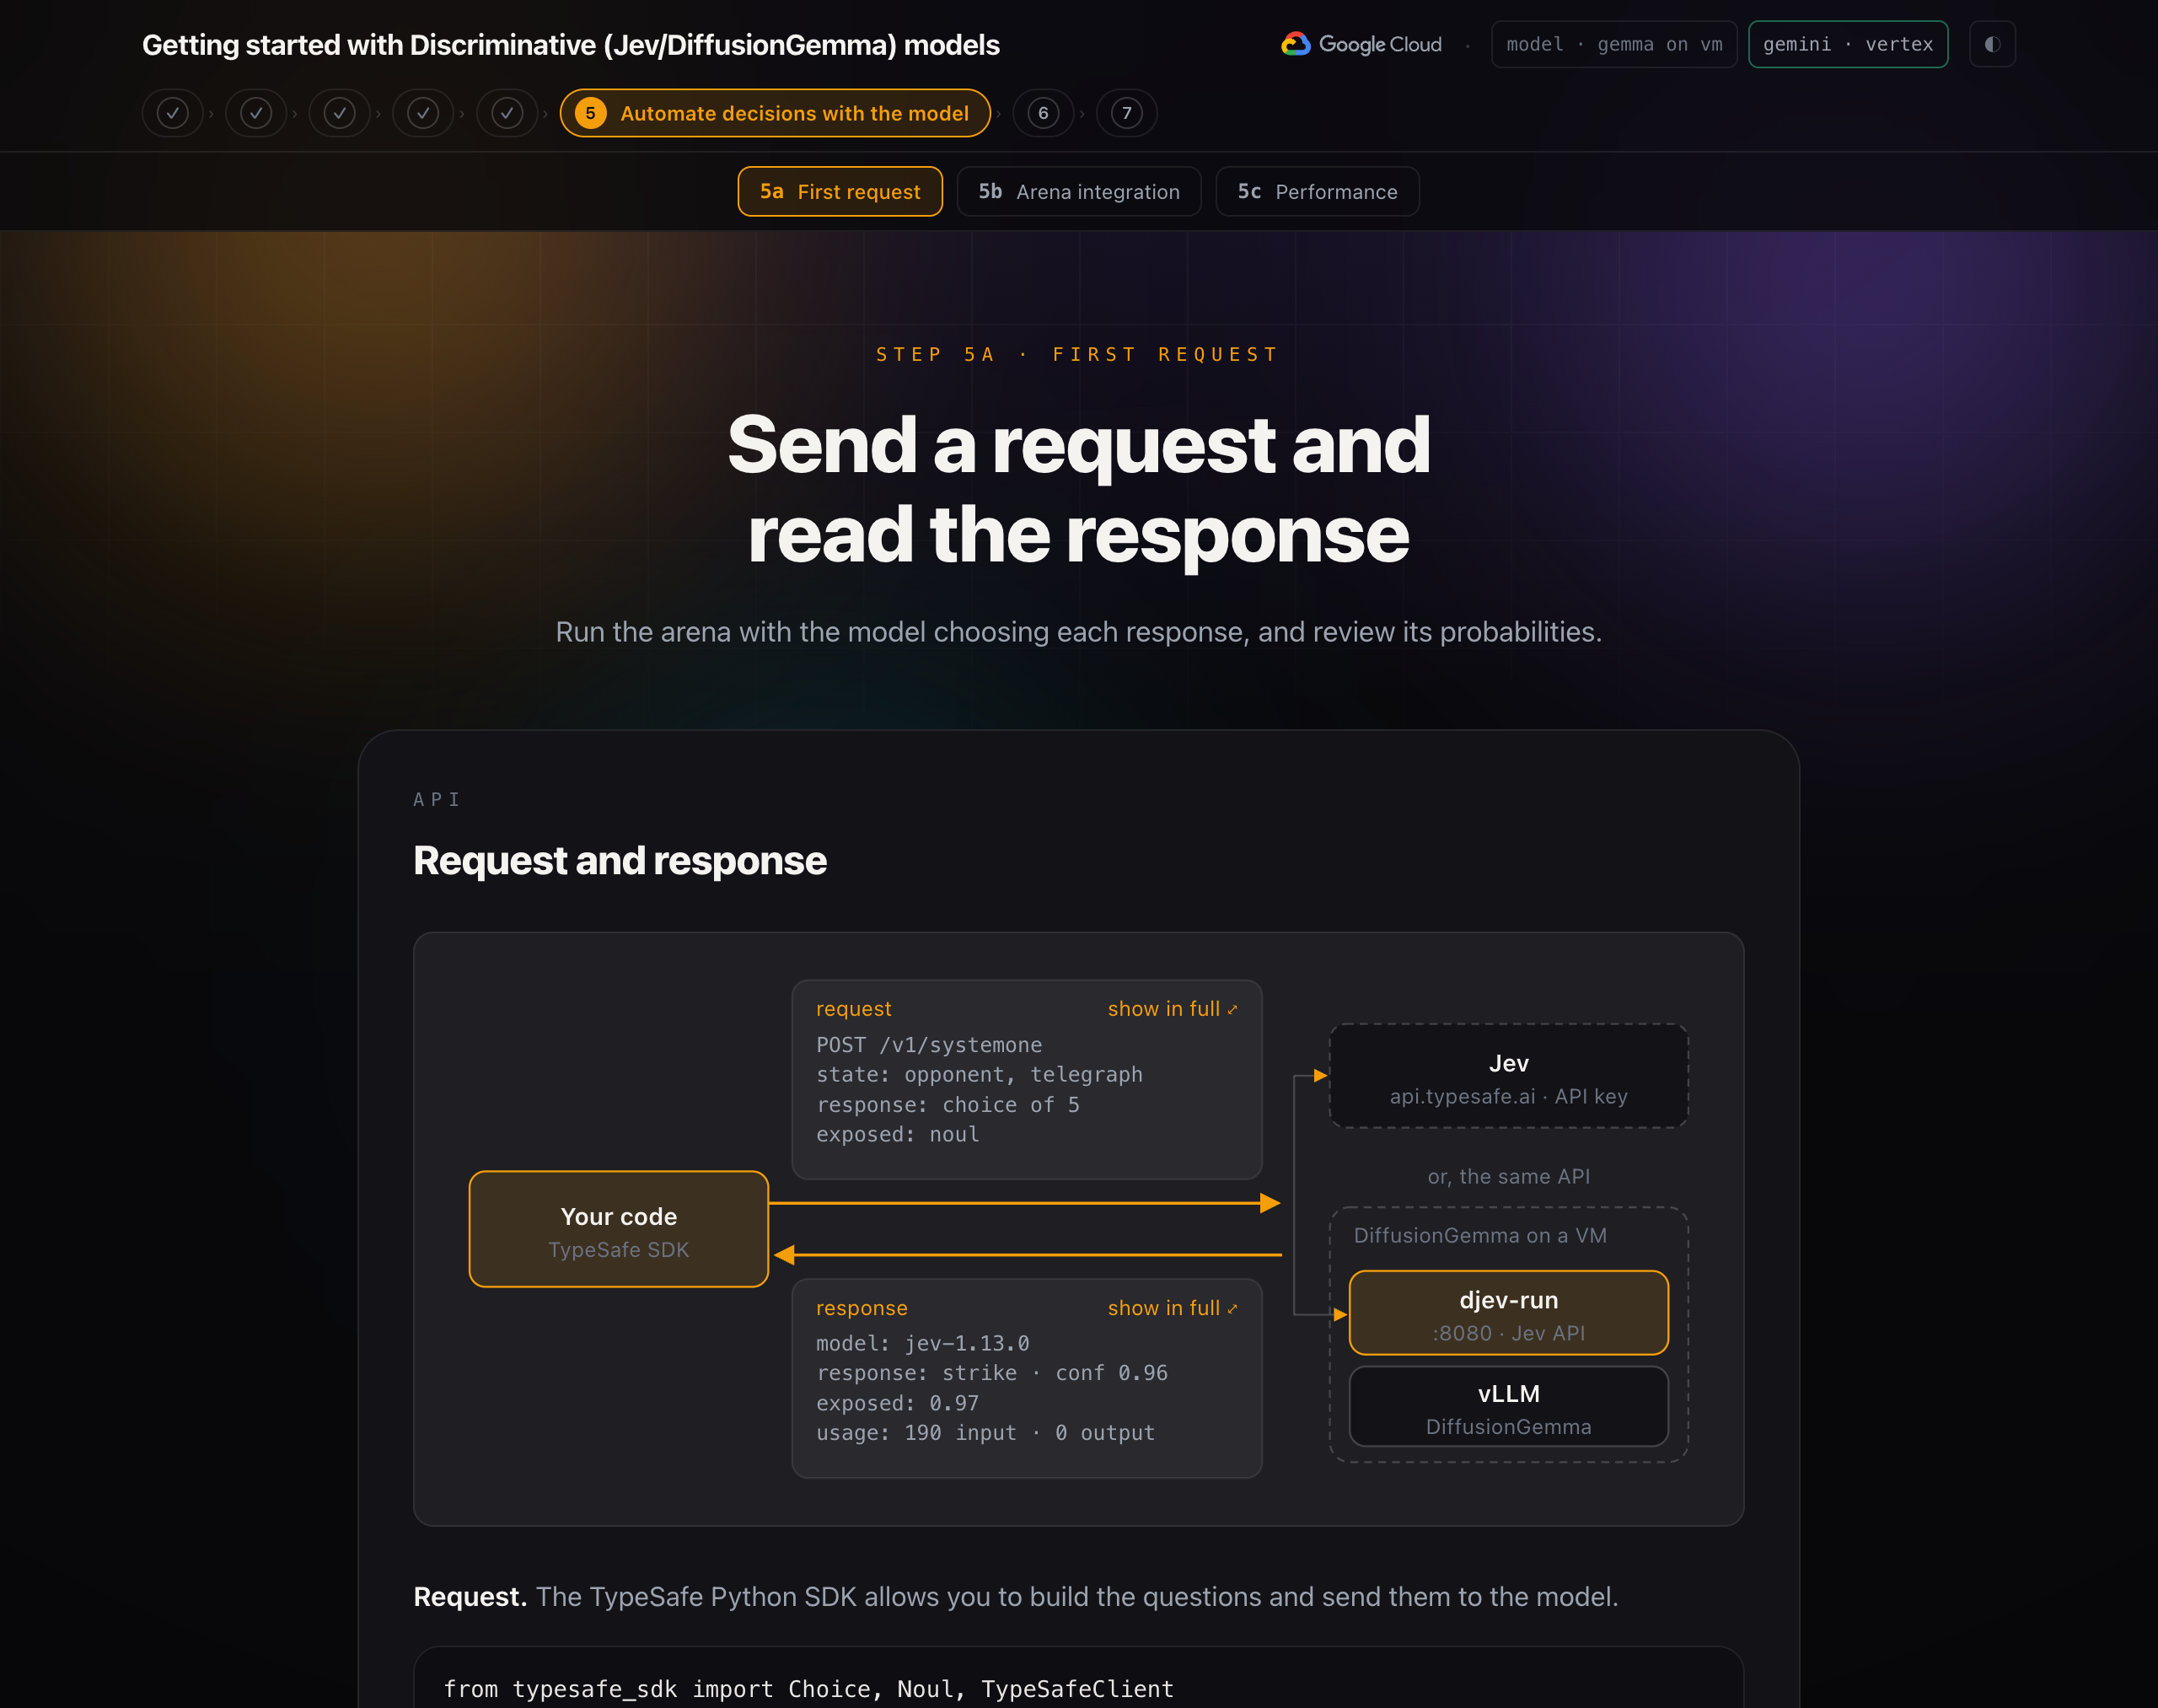
Anfrage und Antwort
Anfrage Mit dem TypeSafe Python SDK können Sie die Fragen erstellen und an das Modell senden.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Eine Anfrage pro Tick
Bei jedem Tick sendet die App den Telegrafen als Status und fragt drei Dinge in einem Aufruf ab:
- Welche Antwort ist richtig? Eine Auswahl.
- Ob der Ogre derzeit einem Zähler ausgesetzt ist. A Noul.
- Wie hart der eingehende Treffer ist, auf einer dreistufigen Skala. Ein Ergebnis.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Die choose()-Funktion
Erinnern Sie sich an die Grenzwerte aus Schritt 4? choose() vergleicht die Antworten des Modells mit festen Zahlen, die die Grenzwerte darstellen.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() ist das normale Lesen von typisierten Werten in Python mit zwei Regeln. Das diskriminative Modell liefert die Wahrscheinlichkeit und Analyse, und im Code werden die Grenzwerte für die Regeln verwendet. Die ausgewählte Aktion wird an die Engine gesendet, wo sie verwendet wird, um gegen den Oger zu kämpfen.
Wichtigster Punkt:Fragen und Grenzwerte an einem Ort aufbewahren. Sie sind der Teil einer System One-Integration, den Sie am häufigsten anpassen werden.
Reaktionszeit, eingabebasierte Preisgestaltung und Entscheidungslogik
- Reaktionszeit pro Entscheidung: Jeder Tick des Kampfes in Teil b dauerte etwa hundert Millisekunden, einige zwei oder drei. Das ist schnell genug für einen Game-Loop, einen Anfragepfad oder eine Überprüfung jeder Nachricht, bevor sie von einer Person oder einem Sprachmodell gesehen wird.
- Eingabebasierte Preise: Ein ganzer Kampf mit 60 Entscheidungen mit jeweils drei Fragen kostet weit unter einem Zehntel Cent. Die Ausgabetokens sind null, da nichts generiert wurde. Das bedeutet, dass Sie mehr fragen können, als Sie eigentlich benötigen. In der Arena wird gefragt, ob der Oger bei jedem Tick sichtbar ist, obwohl nur
strikeundcastrelevant sind. Das Fragen ist jedoch fast kostenlos und die Antwort ist im Dashboard nützlich. TypeSafe nennt das speculative fan-out. - Zuversicht und Gefahr kombinieren: Wenn die Konfidenz des diskriminativen Modells in seine Antwort unter 0,40 liegt und der Gefahrenwert einen starken Treffer vorhersagt, wird dies von
choose()mit einem Ausweichen überschrieben. Eine Ausweichantwort ist selten die beste, aber auch selten die schlechteste Antwort. Wählen Sie Grenzwerte anhand der Kosten jedes Fehlers aus, nicht anhand einer runden Zahl, und testen Sie sie anhand von Telegrammen, die Sie bereits manuell bewertet haben. TypeSafe empfiehlt, die Frage zu präzisieren, bevor Sie den Schwellenwert ändern, wenn eine Entscheidung immer wieder fehlschlägt.
Modelle in einem ADK-Workflow kombinieren
Grenzen von Entscheidungen pro Tick und warum korrekte Antworten nicht ausreichen
In der letzten Zeile des Kampfes in Schritt 5 heißt es: Der Oger trottet davon, kaum verletzt. Das diskriminative Modell hat keinen Schaden genommen und bei jedem Tick ein wenig Schaden verursacht. 300 Trefferpunkte sind mehr als ein wenig mal 60. Die Zauberkarte in der Ecke des Rings war die ganze Zeit da. Dazu ist ein Modell erforderlich, das Bilder sehen kann.
Der Oger hat 300 Trefferpunkte. Ein richtiger Anruf zählt für 3. Ein Schlag in eine Öffnung bringt 8 Punkte, weil das Versteck dick ist. Selbst nach einem perfekten Kampf über 60 Ticks steht der Oger noch und das Spiel wertet das Ergebnis als Unentschieden. Hier endete Schritt 5: Das Modell hat sich gut verteidigt, konnte aber trotzdem nicht gewinnen.
Nur ein Zauber verursacht echten Schaden: 45 bei einem perfekten Zauber, 67, wenn er auf einer Öffnung landet.
Weisen Sie jede Aufgabe dem richtigen Modell zu.
Die Zauberkarte in der Ecke des Rings ist der Weg zum Sieg. Das Lesen der Karte ist kein Textproblem, da es sich um ein Bild mit einer Farbe und drei Formen in einer Reihe handelt. Der Zauber muss passend gesungen werden. Dazu ist ein Modell erforderlich, das sich ein Bild ansehen und sich einige Sekunden Zeit nehmen kann. Im Kampf sind ein paar Sekunden zehn Ticks.
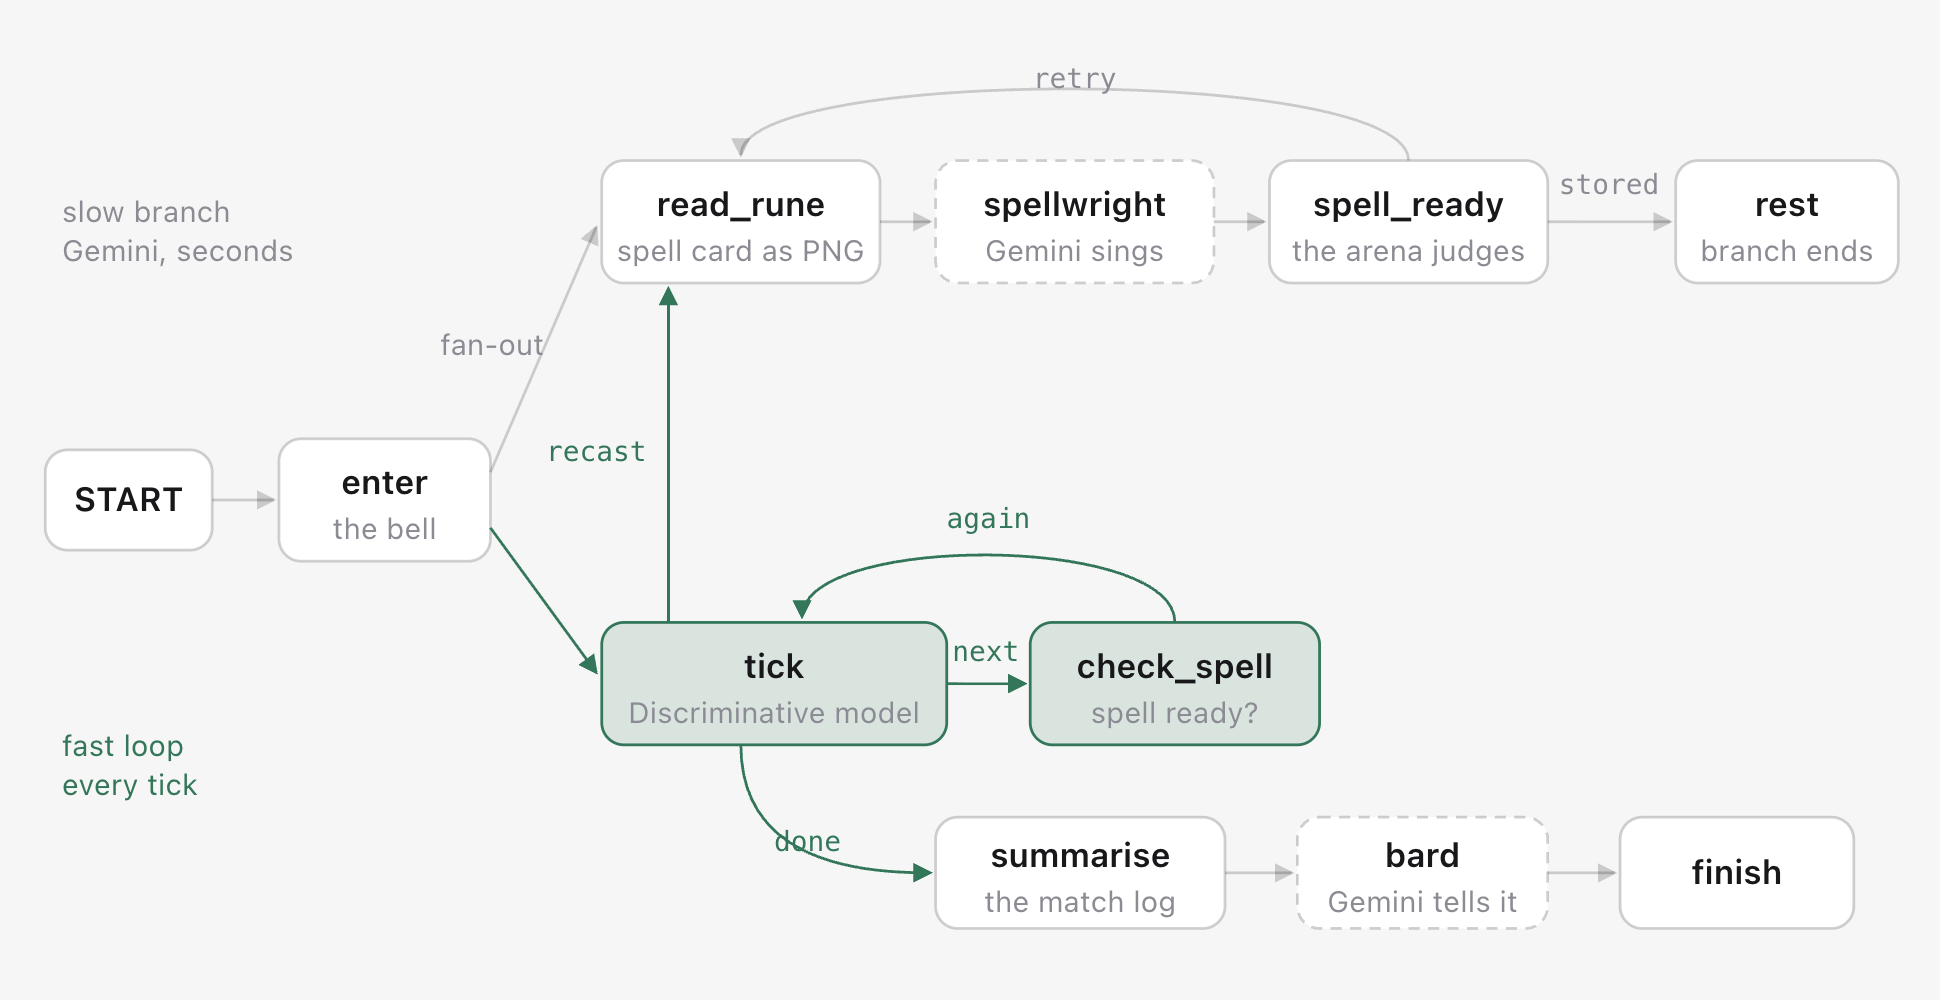
Im Workflow werden also beide verwendet, jeweils mit eigener Geschwindigkeit:
- Das diskriminative Modell kämpft. Bei jedem Tick eine Anfrage, eine Entscheidung, hundert Millisekunden. Die Schleife wartet nie auf etwas, das langsamer ist als sie selbst.
- Gemini liest und singt. Auf einem eigenen Ast, der an der Glocke beginnt, nimmt sie die Zauberkarte vom Bildschirm der Arena als Bild auf, benennt die Farbe und die Formen und singt eine Beschwörung. Die Arena vergleicht das Lied mit der Antwort der Zauberkarte, die den Server nie verlässt.
- Nach jedem Schlagabtausch prüft der Kämpfer den Slot. Ein
check_spell-Knoten betrachtet den Status. Nicht bereit: Das wird angezeigt, zusammen mit der Dauer, die Gemini gesungen hat, und es wird direkt zum nächsten Tick weitergeleitet. Es wartet nie. Bereit:castwird den Optionen hinzugefügt, die dem diskriminativen Modell angeboten werden, undchoose()gibt den Zauber aus, sobald das diskriminative Modell eine Öffnung meldet. Wenn der Zauber aufgebraucht ist, wird eine neue Zauberkarte auf dem Bildschirm angezeigt und der langsame Thread beginnt von Neuem. Wenn ein Song falsch gelesen wird, wird die Zauberkarte verbrannt und der langsame Thread liest die neue. - Gemini schreibt eine kurze Geschichte einmal am Ende.
Parallele Zweige mit unterschiedlichen Latenzen und einer Ereignisschleife
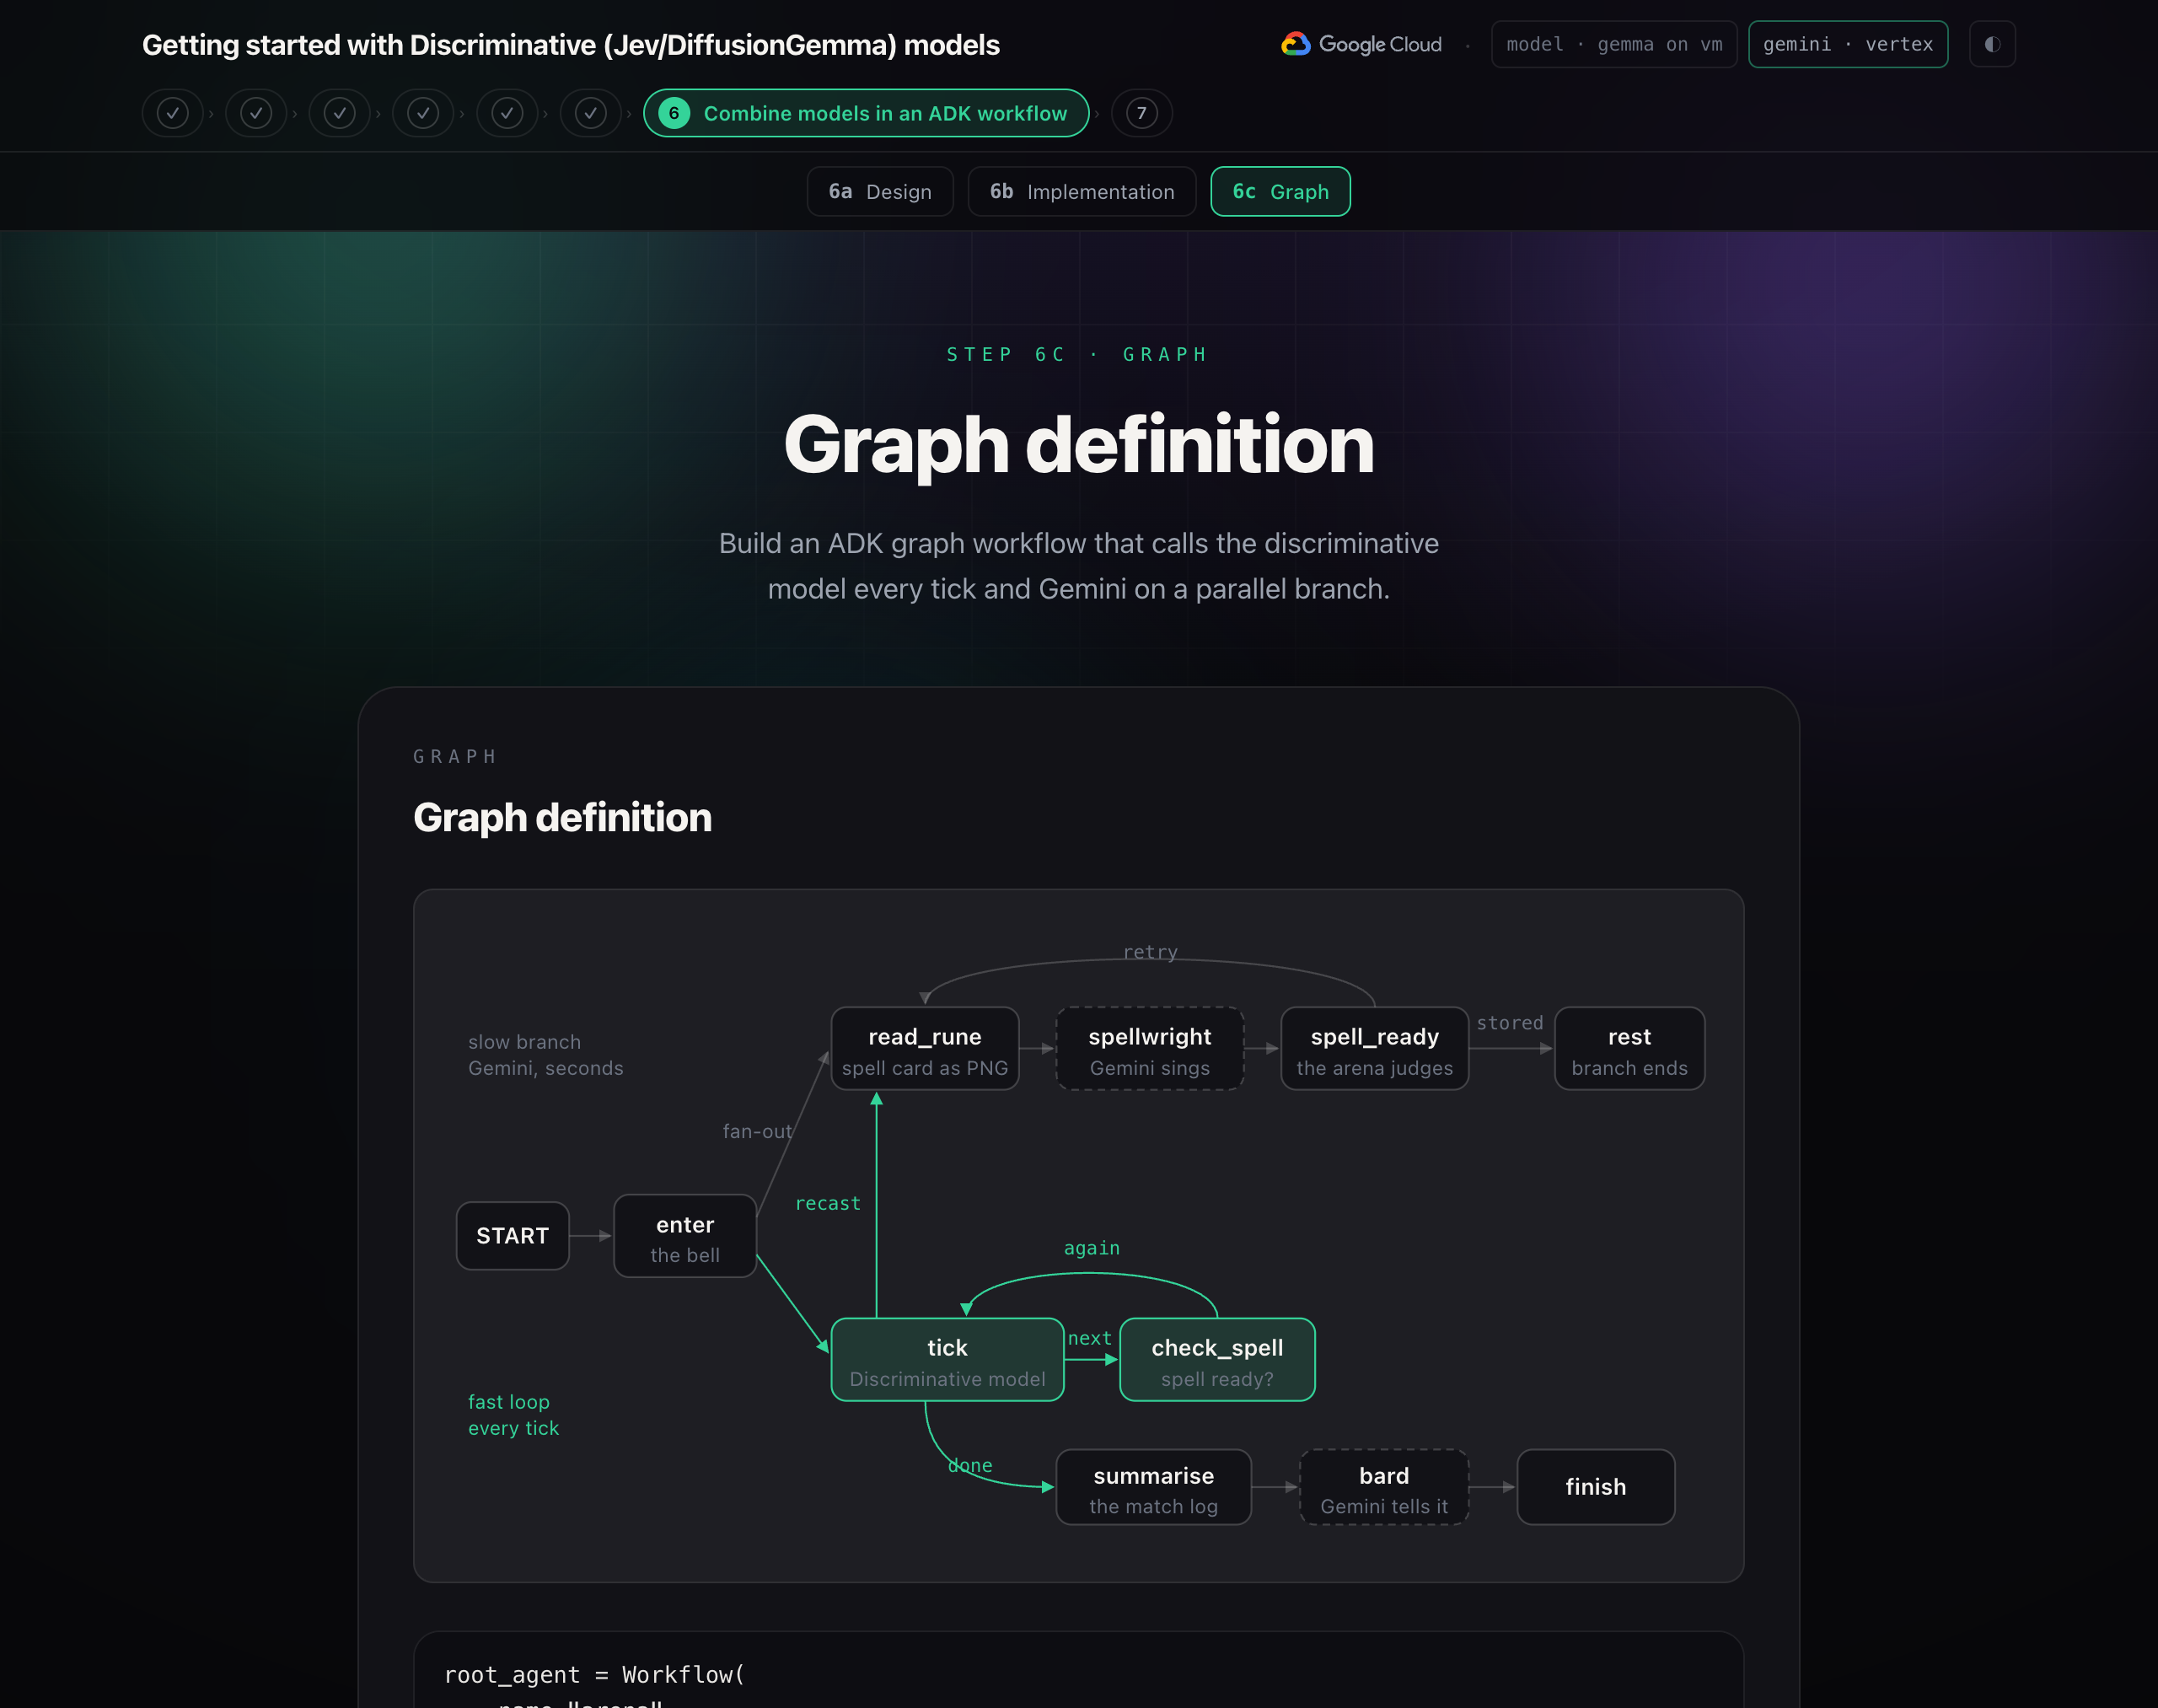
Dies ist ein ADK-Workflow: ein Diagramm mit Knoten, die durch Kanten verbunden sind. Ein Knoten ist eine einfache Python-Funktion oder ein LLM-Agent. Eine Kante von einem Knoten zu einem Tupel von Knoten ist ein Fan-Out: Beide werden gleichzeitig gestartet. Ein Knoten, der ein Event mit einem route zurückgibt, wählt die nächste Kante aus. Ein Knoten, der zu sich selbst weiterleitet, ist eine Schleife.
Stellen Sie sich das wie zwei Threads vor. Thread 1 ist langsam: Lies die Zauberkarte vor, singe und speichere den Zauber. Thread 2 ist schnell: Häkchen, Slot prüfen, Häkchen. Thread 1 endet in einer Funktion, die den bewerteten Zauberspruch in den Sitzungsstatus schreibt und keine Ausgabe zurückgibt. Im check_spell von Thread 2 wird dieser Status nach jedem Austausch gelesen. Kein Thread ruft den anderen auf oder wartet auf ihn. Sie teilen sich nur den Status.
Wichtigster Punkt:Treffen Sie die Entscheidungen im Code und weisen Sie jedem Modell eine enge Aufgabe zu, die es in seinem eigenen Tempo erledigen kann.
Im ADK werden beide Zweige als Aufgaben in einer Ereignisschleife in einem einzelnen Thread ausgeführt. Es kann jeweils nur eine Aufgabe ausgeführt werden. Wenn eine Aufgabe await erreicht, wartet sie auf ihre Antwort und die Schleife führt in der Zwischenzeit den anderen Zweig aus. Der schnelle Zweig wartet etwa eine Zehntelsekunde auf das Modell und der langsame Zweig mehrere Sekunden auf Gemini. So wird der eine Zweig nicht durch den anderen aufgehalten.
Langsamer Zweig
read_rune() nimmt die Zauberkarte als Bild vom Bildschirm.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright ist Gemini. Es liest das Bild und gibt die Antwort in einer festen Form aus.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
Bei spell_ready() wird der Zauber von der Arena bewertet und dann gespeichert oder es wird noch einmal versucht.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Ein Funktionsknoten kann ein Content mit einem Bildteil zurückgeben und der LLM-Knoten empfängt es als Nutzerzug. spell_ready gibt ein Event mit einem Zustandsdelta und ohne output zurück. Beim nächsten Tick wird der Zauber aus dem Status gelesen und ein Zweig ohne Ausgabe ist kein zweites Ende für das Diagramm: Das ADK erfordert eine Terminalausgabe und das ist die des Kampfes.
Hinweis:Die Bewertung erfolgt anhand des Codes in der Arena im Vergleich zur verborgenen Antwort der Zauberkarte. Bei einer perfekten Messung werden 45 % mehr in eine Öffnung geleitet. Zwei Formen rechts ergibt 25. Ein falsches Lesen führt dazu, dass die Zauberkarte verpufft. Gemini wird nicht gefragt, ob es richtig war.
Schneller Zweig
tick() führt einen Austausch durch und wählt dann die nächste Kante aus.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() prüft den Zauberslot nach jedem Austausch.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell prüft den Slot nach jedem Austausch. Es wird nie blockiert: Wenn der Befehl nicht bereit ist, wird das gemeldet und es geht weiter.
Das Design basiert auf drei Elementen. Der Aufruf des diskriminativen Modells wird mit dem asynchronen Client await, sodass die Schleife wartet und der Gemini-Zweig weiter ausgeführt wird. Die Fragen werden bei jedem Tick neu erstellt. cast wird also nur angezeigt, wenn etwas übertragen werden kann. route kann auch eine Liste sein: ["recast", "next"] berücksichtigt beide Ränder gleichzeitig.
Die Arena selbst befindet sich hinter einem kleinen Client: der laufenden App über HTTP, falls vorhanden. In diesem Fall wird der Kampf auf der Seite angezeigt. Andernfalls wird die Engine im Prozess angezeigt.
Graphen definieren
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Ein Tupel als Ziel ist ein Fan-out. Ein Tupel als Kante ist eine Kette. Ein Dictionary ordnet Routennamen Knoten zu. tick → check_spell → tick ist der schnelle Loop. "recast": read_rune startet den langsamen Thread nach einem Zauber wieder, "retry" tut dasselbe nach einem Fizzle und "stored": rest lässt den langsamen Thread ruhig enden, ohne Ausgabe, sobald der Zauber im Slot ist. Für das ADK ist mindestens eine geroutete Kante in einem Zyklus erforderlich. Eine bedingungslose Schleife wird daher abgelehnt, bevor sie unendlich lange ausgeführt werden kann.
Hinweis : Die ADK-Tools suchen nach root_agent. adk web agents öffnet die Entwickler-UI mit der Arena, wenn Sie das Diagramm und die Ereignisse in einem Browser anstelle eines Terminals sehen möchten.