

1. Introducción
Un taller de 90 minutos sobre el modelo discriminativo, el modelo de decisión del sistema uno de TypeSafe AI, y sobre cómo colocarlo junto a Gemini en un flujo de trabajo del ADK de Google. En este taller, hay seis pasos basados en un juego de lucha. Primero, lucharás contra el ogro con las manos, luego le darás los reflejos al modelo discriminativo y, después, verás cómo un flujo de trabajo del ADK gana la pelea con el modelo discriminativo decidiendo cada tic y Gemini leyendo las cartas de hechizos en la pantalla para cantar hechizos.
Descripción general
El modelo discriminativo (jev-1.13, alias jev-latest) es un modelo alojado de TypeSafe AI que se lanzó el 19 de septiembre de 2026. No genera texto. Le envías estado (texto, JSON o una lista) y preguntas escritas (Choice, Score, Noul), y devuelve respuestas escritas con probabilidades calibradas, en aproximadamente 70 a 500 ms, por USD 0.042 por millón de tokens de entrada y sin costo por la salida. Su trabajo es la decisión que se toma antes, durante y después de los modelos de lenguaje: enrutamiento, clasificación, control y, en este caso, los reflejos de un luchador.
Un juego como ejemplo
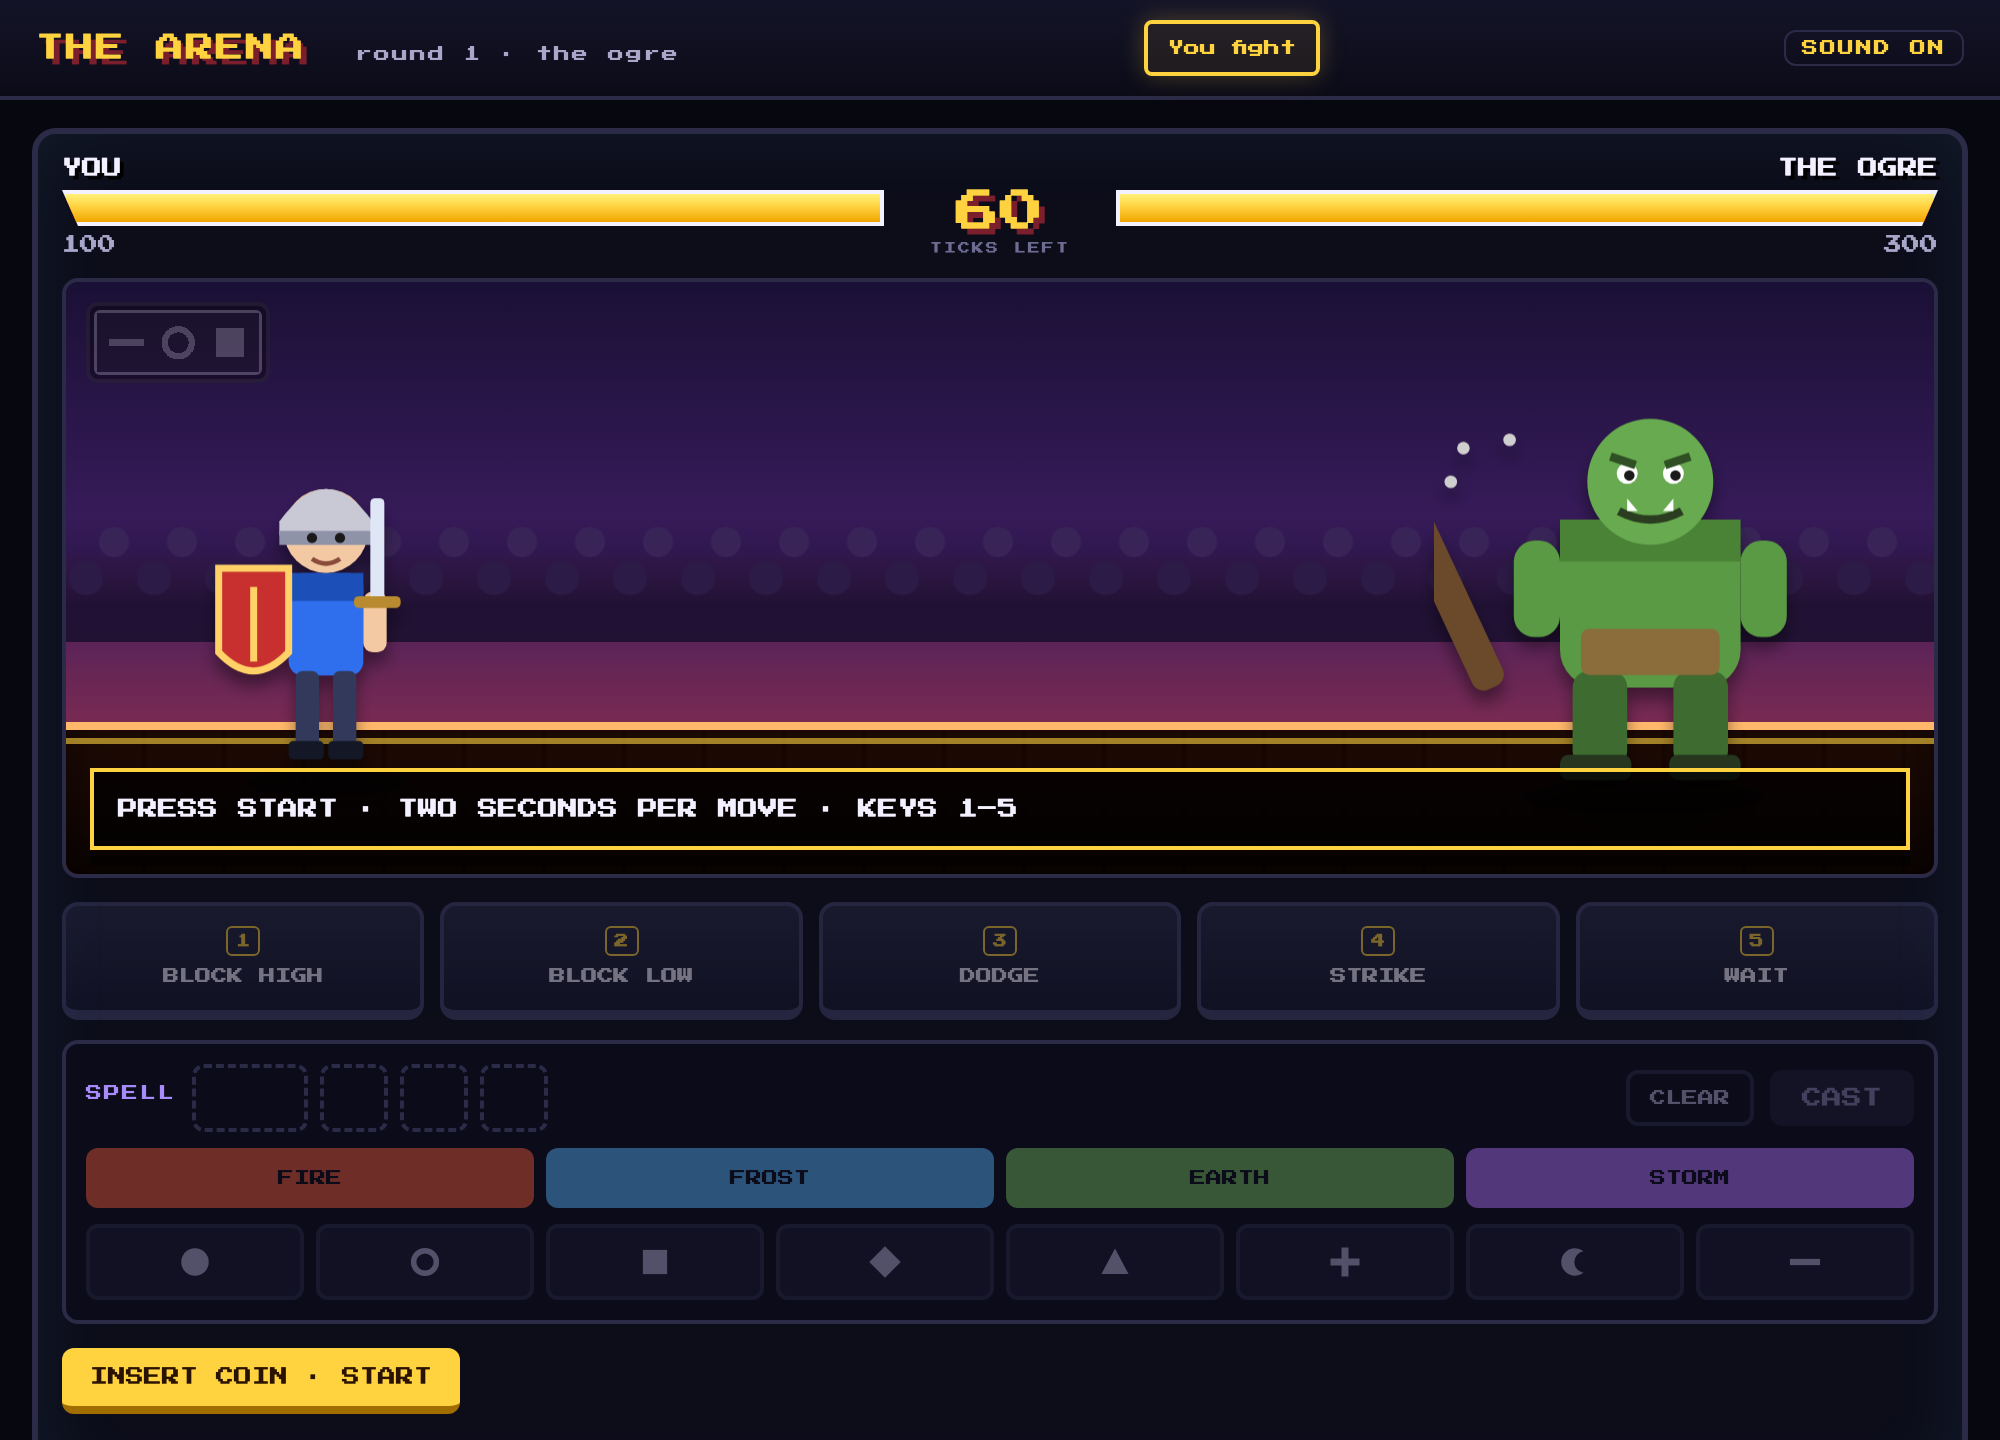
¿Alguna vez jugaste un juego de combate? Te enfrentas a un oponente y debes reaccionar de inmediato a sus movimientos. Si te equivocas, tu HP se verá afectado. Los juegos también suelen dificultar el lanzamiento de hechizos. En nuestro caso, debes elegir el color y las formas de la carta de hechizo, en orden, antes de que se libere el hechizo. En este taller, se muestra cómo combinar ambos tipos de modelos para que tu personaje gane.
Cada elemento del juego se asigna a un sistema real:
- El movimiento del oponente es un evento entrante, como una solicitud o una transacción.
- La respuesta es una decisión limitada que toma el modelo discriminativo y que se verifica con código.
- La tarjeta de hechizo es una entrada no estructurada que necesita que un modelo de lenguaje lea.
- La coincidencia es el flujo de trabajo, que ejecuta el trabajo rápido y el lento a sus propias velocidades.
El objetivo es combinar los cuatro componentes y unirlos para crear un sistema rápido e inteligente.
Qué aprenderás
- Explicar en qué se diferencian los modelos discriminativos (Sistema 1) y generativos (Sistema 2), y cuándo usar cada uno
- Describe cómo se entregan Jev y DiffusionGemma, y configura uno para el taller, incluido DiffusionGemma en una VM con GPU de Compute Engine.
- Escribir preguntas de opción múltiple, de puntuación y de Noul, e interpretar probabilidades y confianza
- Usa umbrales en el código determinístico para convertir las probabilidades en acciones.
- Compila una solicitud con el SDK de TypeSafe y, luego, deja que el modelo elija cada movimiento en un juego.
- Crea una rama lenta, en la que Gemini lee una imagen, y una rama rápida, en la que el modelo discriminativo decide en un bucle, y ejecuta cada una por separado.
- Une ambas ramas en un flujo de trabajo de gráfico del ADK que comparte el estado en un bucle de eventos, de modo que el trabajo lento nunca retrase las decisiones rápidas.
Arquitectura
El banco de trabajo se encuentra en Cloud Shell(o en tu máquina), escribirá en el sistema de archivos local e interactuará con la arena, así como con Gemini y el modelo de decisión. ② llama al modelo discriminativo en "Discriminative model fights"; ③ llama a ambos en "Workflow fights".
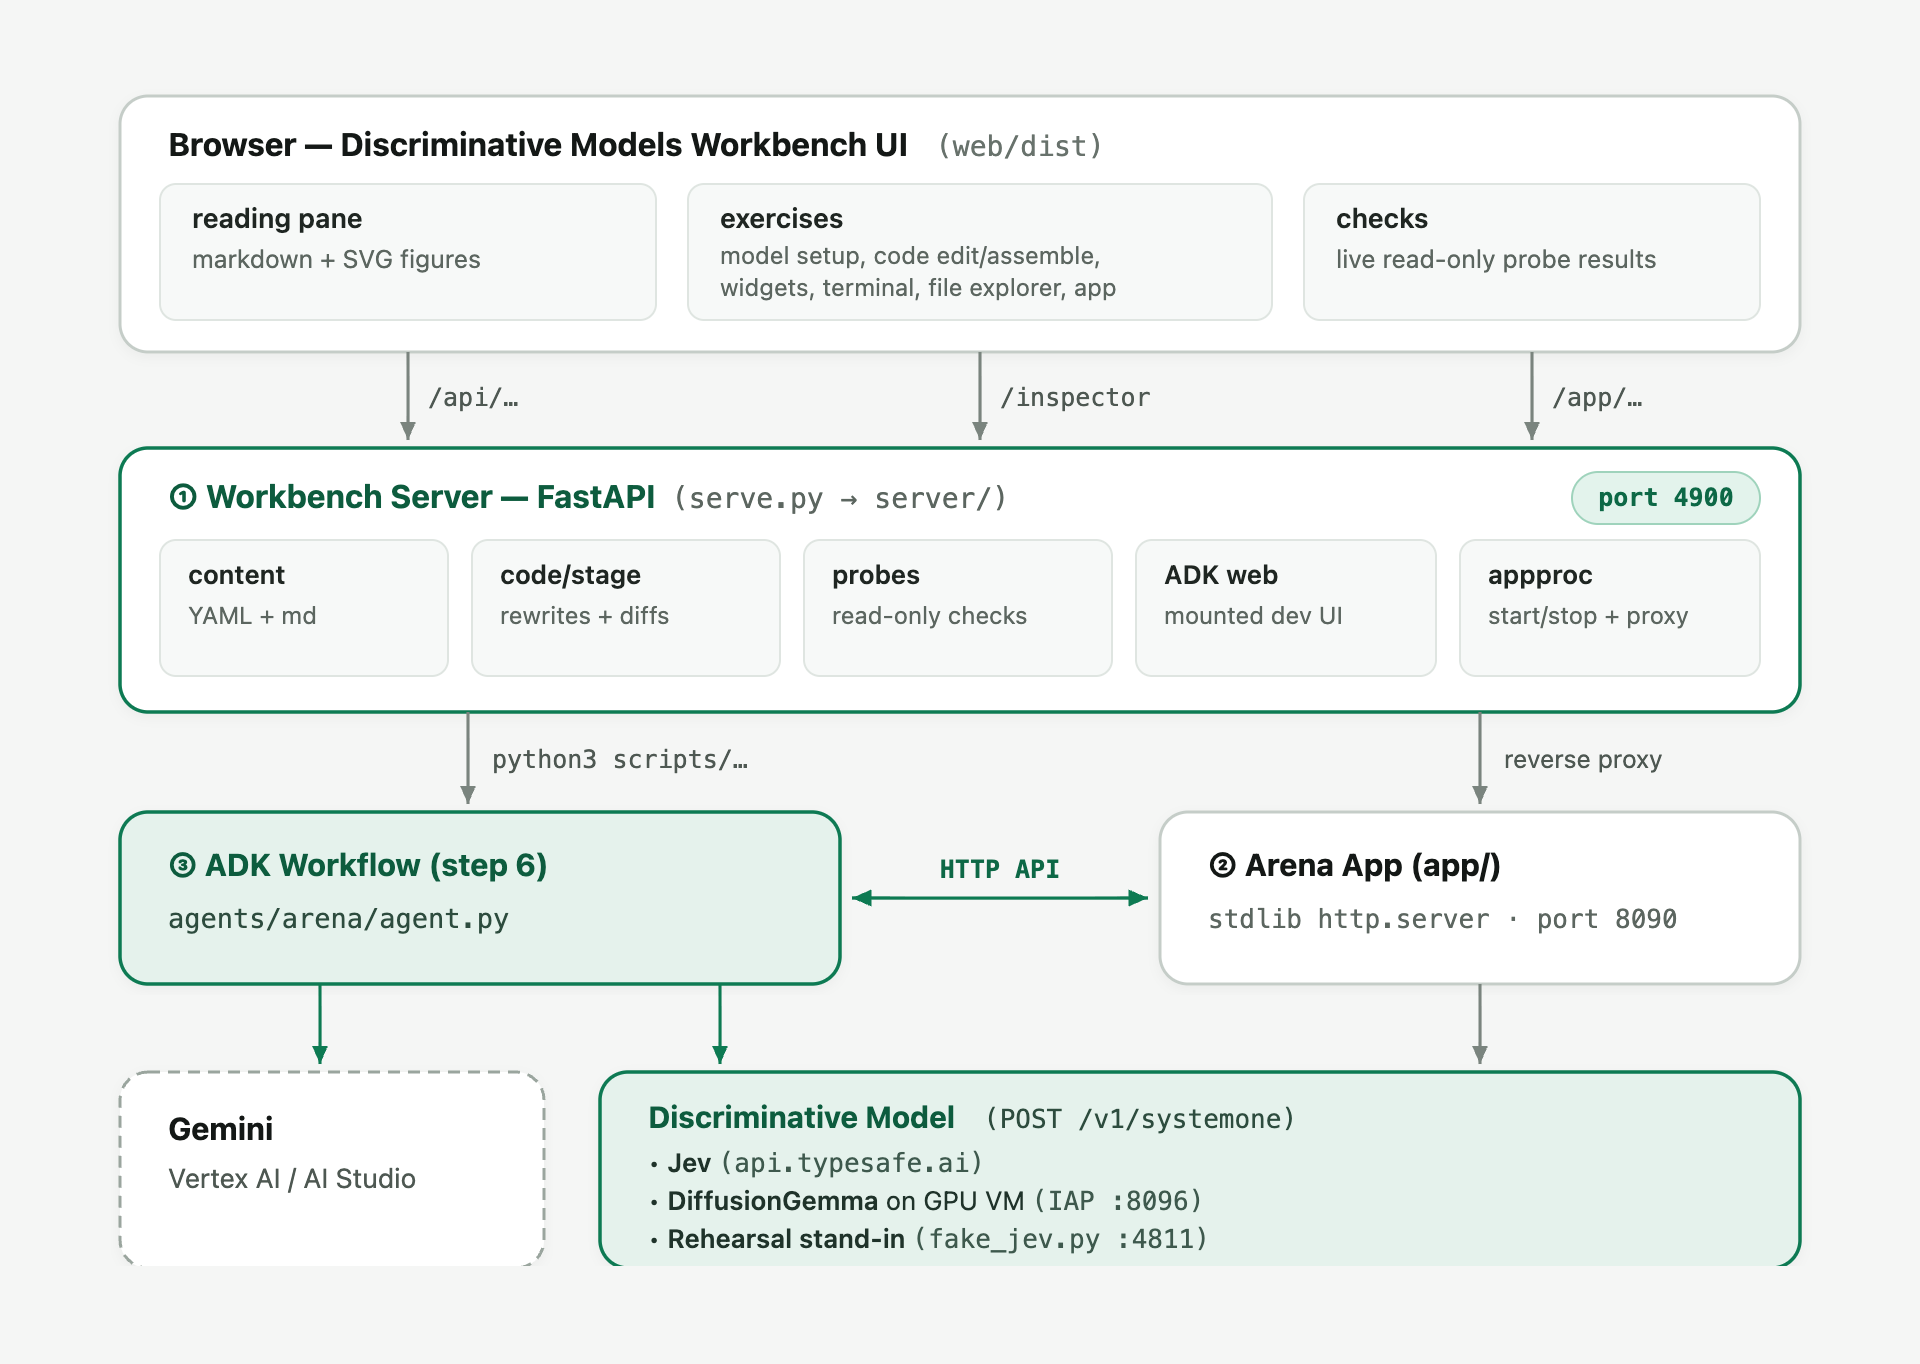
Quién llama a quién. El navegador solo se comunica con ①. Ambos modelos se llaman desde Python en la máquina:
Emisor | Modelo discriminativo | Gemini |
② Arena, "Luchas de modelos discriminativos" | cada marca, | no |
③ flujo de trabajo | cada marca, | no |
③ flujo de trabajo | no | la imagen de la carta de hechizo y el relato posterior a la pelea |
| sí | no |
Una marca por modo.
- Tú luchas. La página pide ② un telégrafo, lo muestra con un temporizador de 2 s y vuelve a publicar el botón que presionas (o la ortografía que escribes). ② lo resuelve.
- Peleas de modelos discriminativos. La página pide ② una marca de verificación; ② dibuja un telégrafo, le hace tres preguntas al modelo en una sola llamada, ejecuta
choose()y devuelve las respuestas y el resultado. La página dibuja las barras. - Peleas de flujo de trabajo. Start hace que ② inicie ③ como un subproceso (acceso a
runs/arena-workflow.log). ③ dirige la pelea: le pide a ② cada telégrafo, llama al modelo y publica la decisión; el hechizo de Gemini llega a su propia rama cuando está listo. En la página, solo se realizan encuestas ② y se dibujan. Pause es una marca en ② que ③ verifica antes de cada tic.
Ubicación en la que se aloja el modelo de decisión. Todas las llamadas pasan por el mismo typesafe-sdk; solo cambia la URL base. scripts/jevauth.py nombra el backend y establece la clave y el tiempo de espera:
Backend |
| Clave | Configuración realizada por |
TypeSafe, alojado | unset (api.typesafe.ai) |
|
|
DiffusionGemma en tu VM L4 |
| ninguno |
|
DiffusionGemma en Cloud Run |
| Un token de identidad de Google, que se recupera cada hora |
|
Ensayo |
| ninguno |
|
La respuesta de la carta de hechizo ②: El flujo de trabajo solo obtiene el PNG, y ② juzga el hechizo que envía. Eso es lo que hace que el hechizo sea una prueba real de la lectura de Gemini y que el hechizo que creas en "Tú luchas" sea una prueba real de la tuya.
2. Configuración
Reclama los créditos de tu taller
Si recibiste un crédito de Google Cloud para esta sesión, primero canjéalo. Esto tarda aproximadamente un minuto y crea la cuenta de facturación por ti.
Abre Cloud Shell
Google Cloud Shell es un entorno de Linux accesible desde el navegador que está preconfigurado con gcloud, Python, Node.js, uv y git, y ya está autenticado con tu Cuenta de Google.
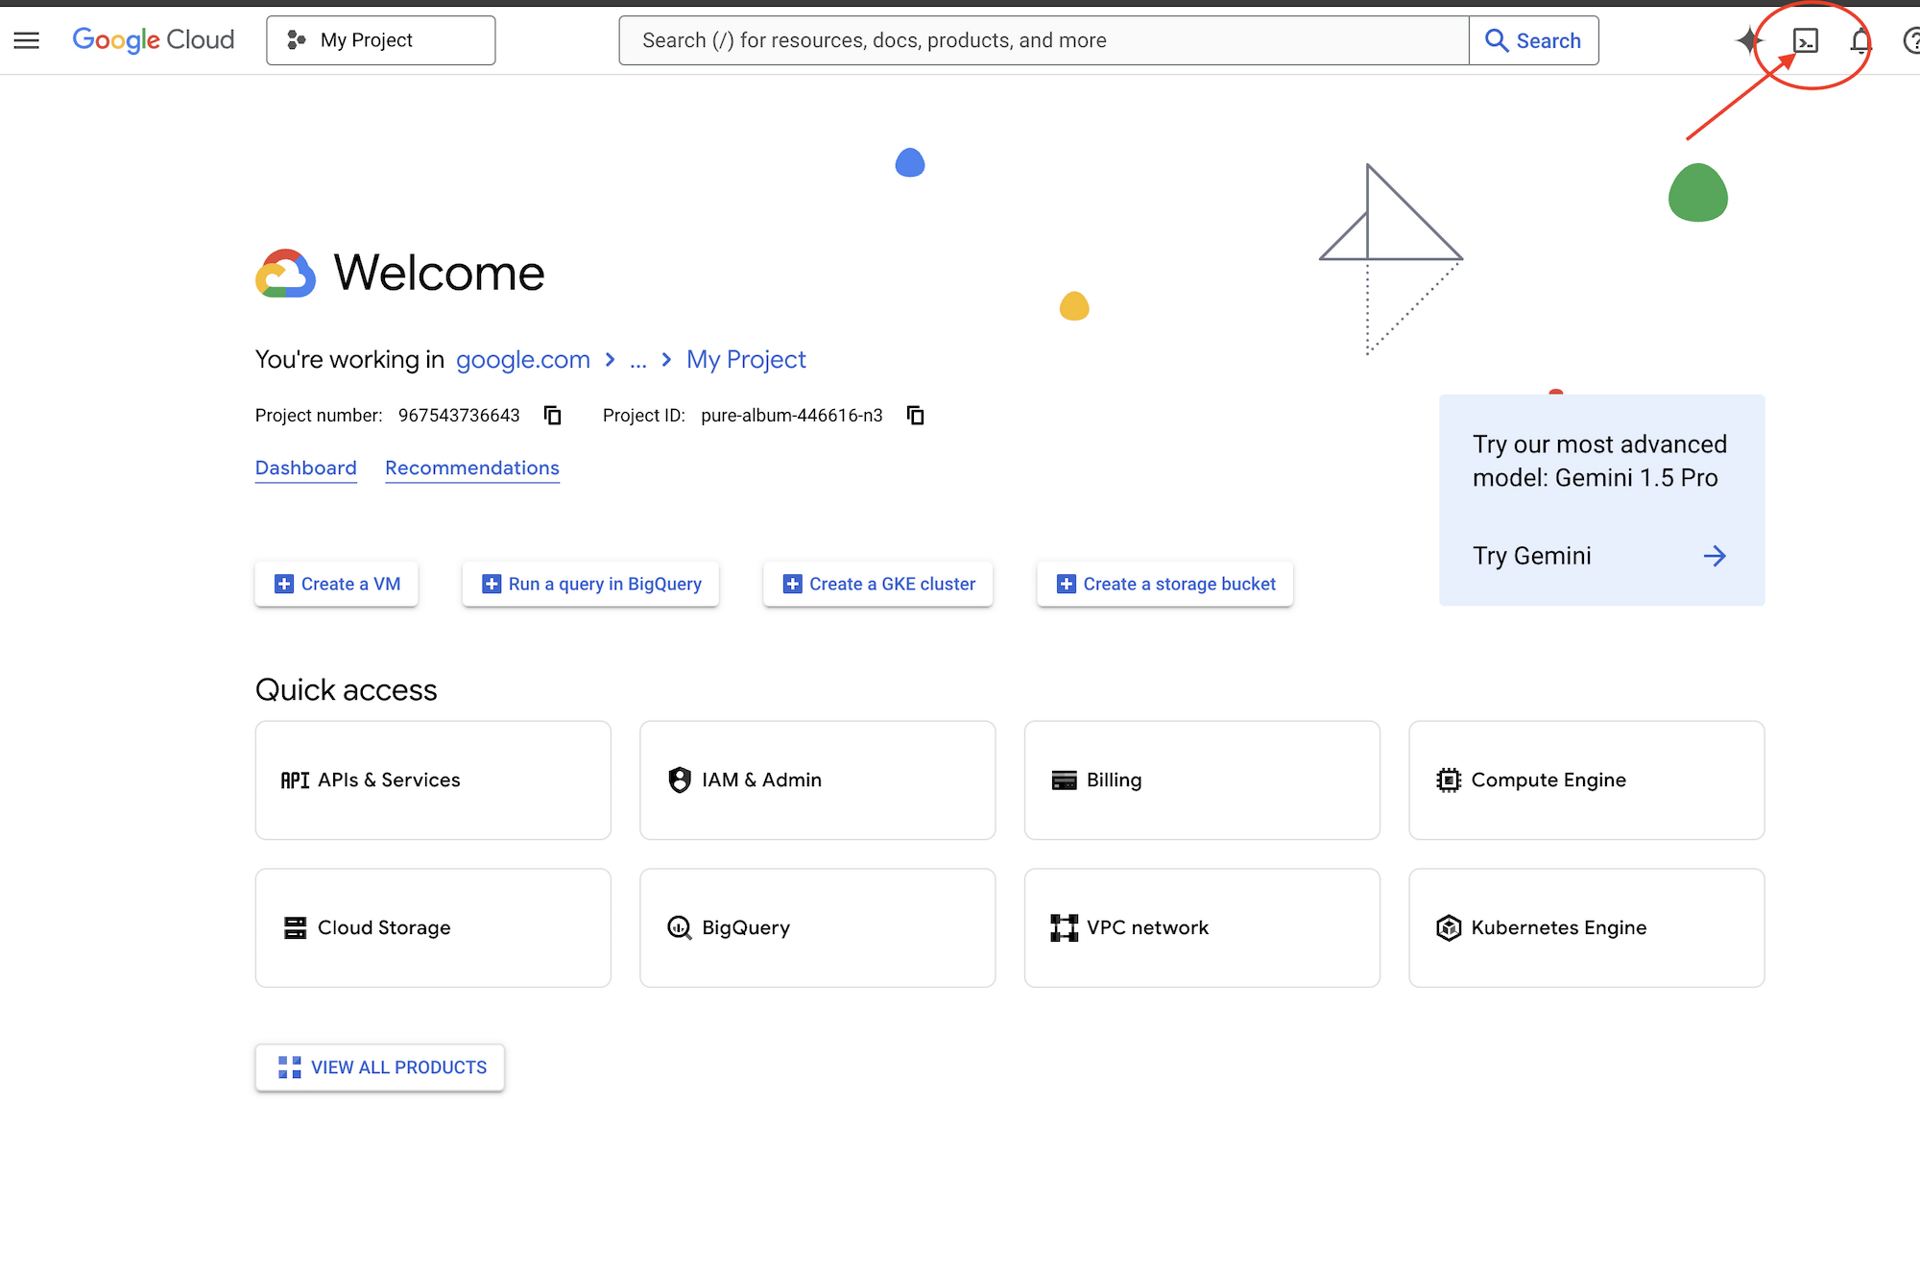
- Abre Google Cloud Console
- Haz clic en Activar Cloud Shell (el ícono de terminal en la barra de navegación superior) para abrir una sesión de terminal en la parte inferior del navegador.
Inicia Workbench
En Cloud Shell o en cualquier lugar en el que se haya accedido a gcloud:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh crea un proyecto (discrim-models-XXXX), vincula la facturación a él (preferentemente, una cuenta de crédito para eventos si tienes una) y espera hasta que el proyecto pueda publicarse. Si lo vuelves a ejecutar, se reutilizará el proyecto en ~/project_id.txt. Para usar un proyecto que ya tienes, coloca su ID en ese archivo y omite esta secuencia de comandos.
setup_codelab.sh no pregunta nada. Instala uv y los paquetes de Python, habilita Vertex AI, Compute Engine y IAP, dirige Gemini a Vertex AI en el proyecto en .env, realiza una llamada real a Gemini con un modelo al que puede llamar el proyecto, compila la página, inicia el banco de trabajo en segundo plano y ejecuta scripts/check_setup.py. Si lo vuelves a ejecutar, se conservarán tus archivos de ejercicios; scripts/starter.sh los restablecerá. El modelo de decisión se elige en el paso 2 del banco de trabajo.
Para abrir la IU del banco de trabajo en Cloud Shell, haz lo siguiente:
- Haz clic en el vínculo de vista previa que se imprimió al final de
./setup_codelab.sho en Vista previa en la Web, en la esquina superior derecha de la barra de herramientas de Cloud Shell. - Selecciona Cambiar puerto, ingresa 4900 y haz clic en Cambiar y obtener vista previa.
Gemini se ejecuta en Vertex AI en tu proyecto, con tus propias credenciales de Google: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT y GOOGLE_CLOUD_LOCATION=global en .env.
El modelo de decisión se elige por sí solo, en el paso 2 de Workbench o desde una terminal con scripts/setup_model.sh:
Opciones | Necesidades | Configuración | Costo |
El modelo discriminativo (TypeSafe, alojado) | Una clave de API de TypeSafe | ninguno | por token, fracciones de centavo |
DiffusionGemma (Google, pesos abiertos) | facturación + cuota de Compute Engine para GPU | Aprox. 15 min, automático | ~$0.71 por hora mientras se ejecuta la VM |
Ensayo (sin modelo) | nothing | ninguno | ninguno |
DiffusionGemma en una VM de Compute Engine
scripts/setup_gemma.sh primero verifica la cuota de GPU y, luego, crea una VM g2-standard-4 (1 × L4 de 24 GB, 4 CPU virtuales y 16 GB) a partir de la imagen de aprendizaje profundo de Google con el controlador NVIDIA 580. En el primer inicio, la VM instala Docker, descarga los pesos de Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17.5 GB, públicos, sin token) y ejecuta djev-run: DiffusionGemma detrás de la API exacta del modelo discriminativo. El puerto del modelo no está abierto a Internet: Workbench llega a él a través de un túnel de IAP en localhost:8096, que scripts/start.sh abre.
Pausar o reanudar |
| |
Túnel |
| |
Quitar |
| |
Ensaya los comandos |
| |
Diseño del repositorio
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Resumen
Limpia tu entorno
Cuando termines el taller, completa los siguientes pasos para desmantelar los recursos de GPU de DiffusionGemma, detener los procesos de banco de trabajo y ensayo en segundo plano, quitar los archivos del taller de Cloud Shell y, de manera opcional, borrar tu proyecto de Google Cloud del taller.
- Borra la VM con GPU de DiffusionGemma y la regla de firewall (si se creó): Si aprovisionaste DiffusionGemma en una VM con GPU de Compute Engine en el paso 2, quita la VM, el disco y la regla de firewall del IAP para que no se acumulen cargos continuos de procesamiento o almacenamiento en disco:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Detén los procesos de banco de trabajo y ensayo en Cloud Shell: En la terminal de Cloud Shell, detén el servidor de banco de trabajo en segundo plano y cualquier proceso de ensayo sustituto:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Borra la carpeta del taller de Cloud Shell: Vuelve a tu directorio principal y quita la carpeta del repositorio clonado y el archivo del ID del proyecto:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Borra tu proyecto de Google Cloud: Si
./setup_project.shcreó un proyecto de taller dedicado (por ejemplo,discrim-models-XXXX), cerrar el proyecto borrará de forma permanente todos los recursos creados en él y dejará intacta tu cuenta de Facturación de Cloud:- Abre la página Administrar recursos en la consola de Google Cloud.
- Selecciona tu proyecto del taller (por ejemplo,
discrim-models-...) en la lista de recursos. - Haz clic en Borrar en la barra de herramientas superior, escribe el ID del proyecto para confirmar y haz clic en Cerrar.
Completaste este taller.
Resumen del lab
- Elegimos un modelo discriminativo, Jev o DiffusionGemma, en una VM con GPU de Compute Engine y verificamos que responda.
- Jugó en el estadio de forma manual, contra el reloj, para aprender sus reglas.
- Aprendiste cómo un modelo discriminativo responde con preguntas de opción, puntuación y Noul, probabilidades y confianza, y cómo tu código aplica umbrales a ellas.
- Enviaste tu primera solicitud y, luego, dejaste que el modelo eligiera cada movimiento en el estadio, con
choose()convirtiendo sus respuestas en acciones. - Se creó cada rama de un flujo de trabajo del ADK por separado, con Gemini leyendo una imagen de tarjeta de hechizo y el modelo decidiendo en un bucle.
- Se unieron en un flujo de trabajo que comparte el estado, por lo que la lucha nunca espera a Gemini y el hechizo se lanza en una apertura.
De la conversación a las decisiones
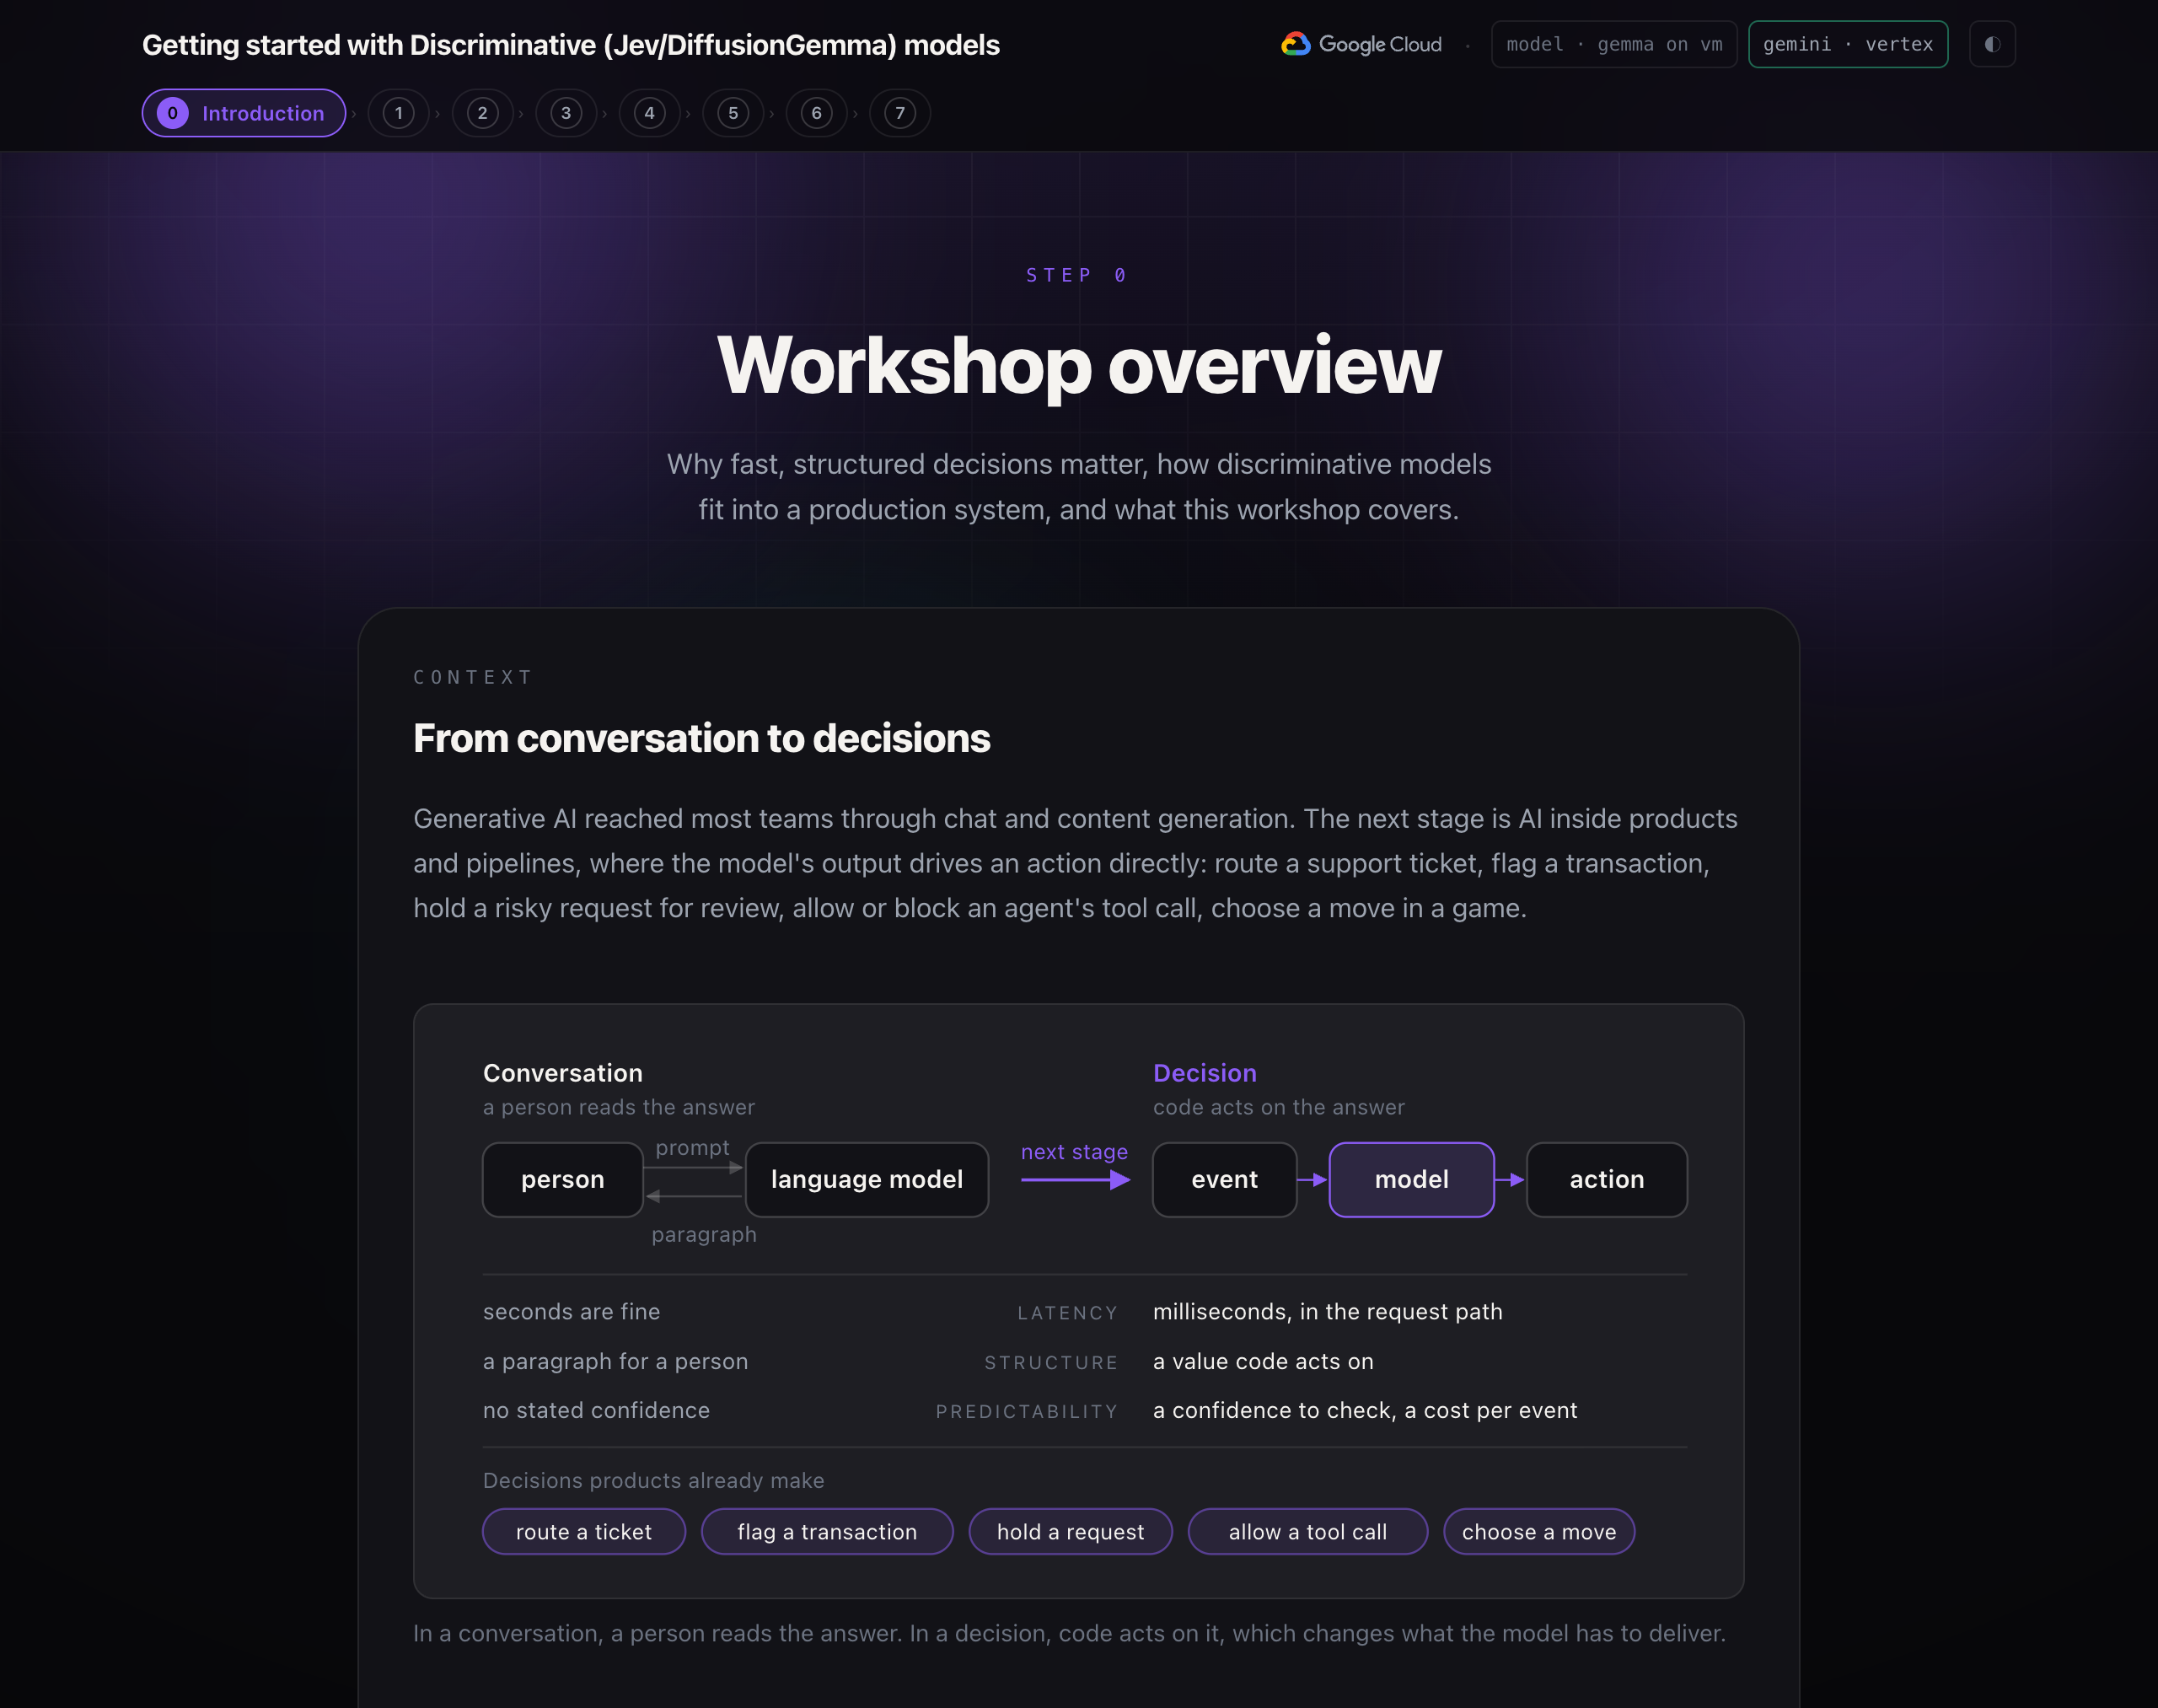
La IA generativa llegó a la mayoría de los equipos a través de la generación de contenido y el chat. La siguiente etapa es la IA dentro de los productos y las canalizaciones, en la que el resultado del modelo impulsa una acción directamente: enrutar un ticket de asistencia, marcar una transacción, retener una solicitud riesgosa para su revisión, permitir o bloquear la llamada a una herramienta de un agente, elegir un movimiento en un juego.
Estas decisiones comparten tres requisitos que el chat no tiene:
- Latencia. La respuesta suele estar en la ruta de solicitud de un usuario o en un bucle en tiempo real, por lo que debe llegar en milisegundos, no en segundos.
- Estructura: El llamador es código, por lo que la respuesta debe ser un valor sobre el que pueda actuar, no un párrafo que deba analizar.
- Previsibilidad. Cada decisión necesita una confianza que el código pueda verificar y un costo lo suficientemente bajo como para preguntar en cada evento.
Un modelo de lenguaje genera texto un token a la vez. Se le puede solicitar que responda sí o no, pero es lento para un bucle en tiempo real, su salida debe analizarse y no informa qué tan seguro está.
Modelos creados para tomar decisiones
Un modelo discriminativo responde una pregunta escrita con una probabilidad para cada opción permitida, en una sola pasada. No genera texto. En este taller, se ofrecen dos opciones para ejecutarlo:
Modelo | Proveedor | Dónde se ejecuta el modelo en este taller |
Jev | IA de TypeSafe | Servicio alojado de TypeSafe, llamado con una clave de API |
DiffusionGemma | Google, Open Weights | Autoalojado en una VM con GPU en tu propio proyecto de Google Cloud |
Los modelos se pueden intercambiar según tus necesidades, y no es necesario cambiar el código que se conecta a ellos.
Cómo combinar componentes
Un sistema exitoso consta de varios componentes:
Componente | Rol | En este taller |
Flujo de trabajo | Coordina los pasos, ejecuta las ramas en paralelo y mantiene el estado compartido | Un flujo de trabajo de gráfico del ADK |
Código determinístico | Reglas, umbrales y validación Instantánea, gratuita y auditable | Las reglas del juego, |
Modelo discriminativo | Decisiones rápidas y acotadas con una puntuación de confianza | Elegir una respuesta en cada marca |
Modelo de lenguaje | Percepción y generación: imágenes y texto abierto | Gemini lee la imagen de la carta de hechizo y escribe el hechizo |
Arquitectura de entrega de modelos
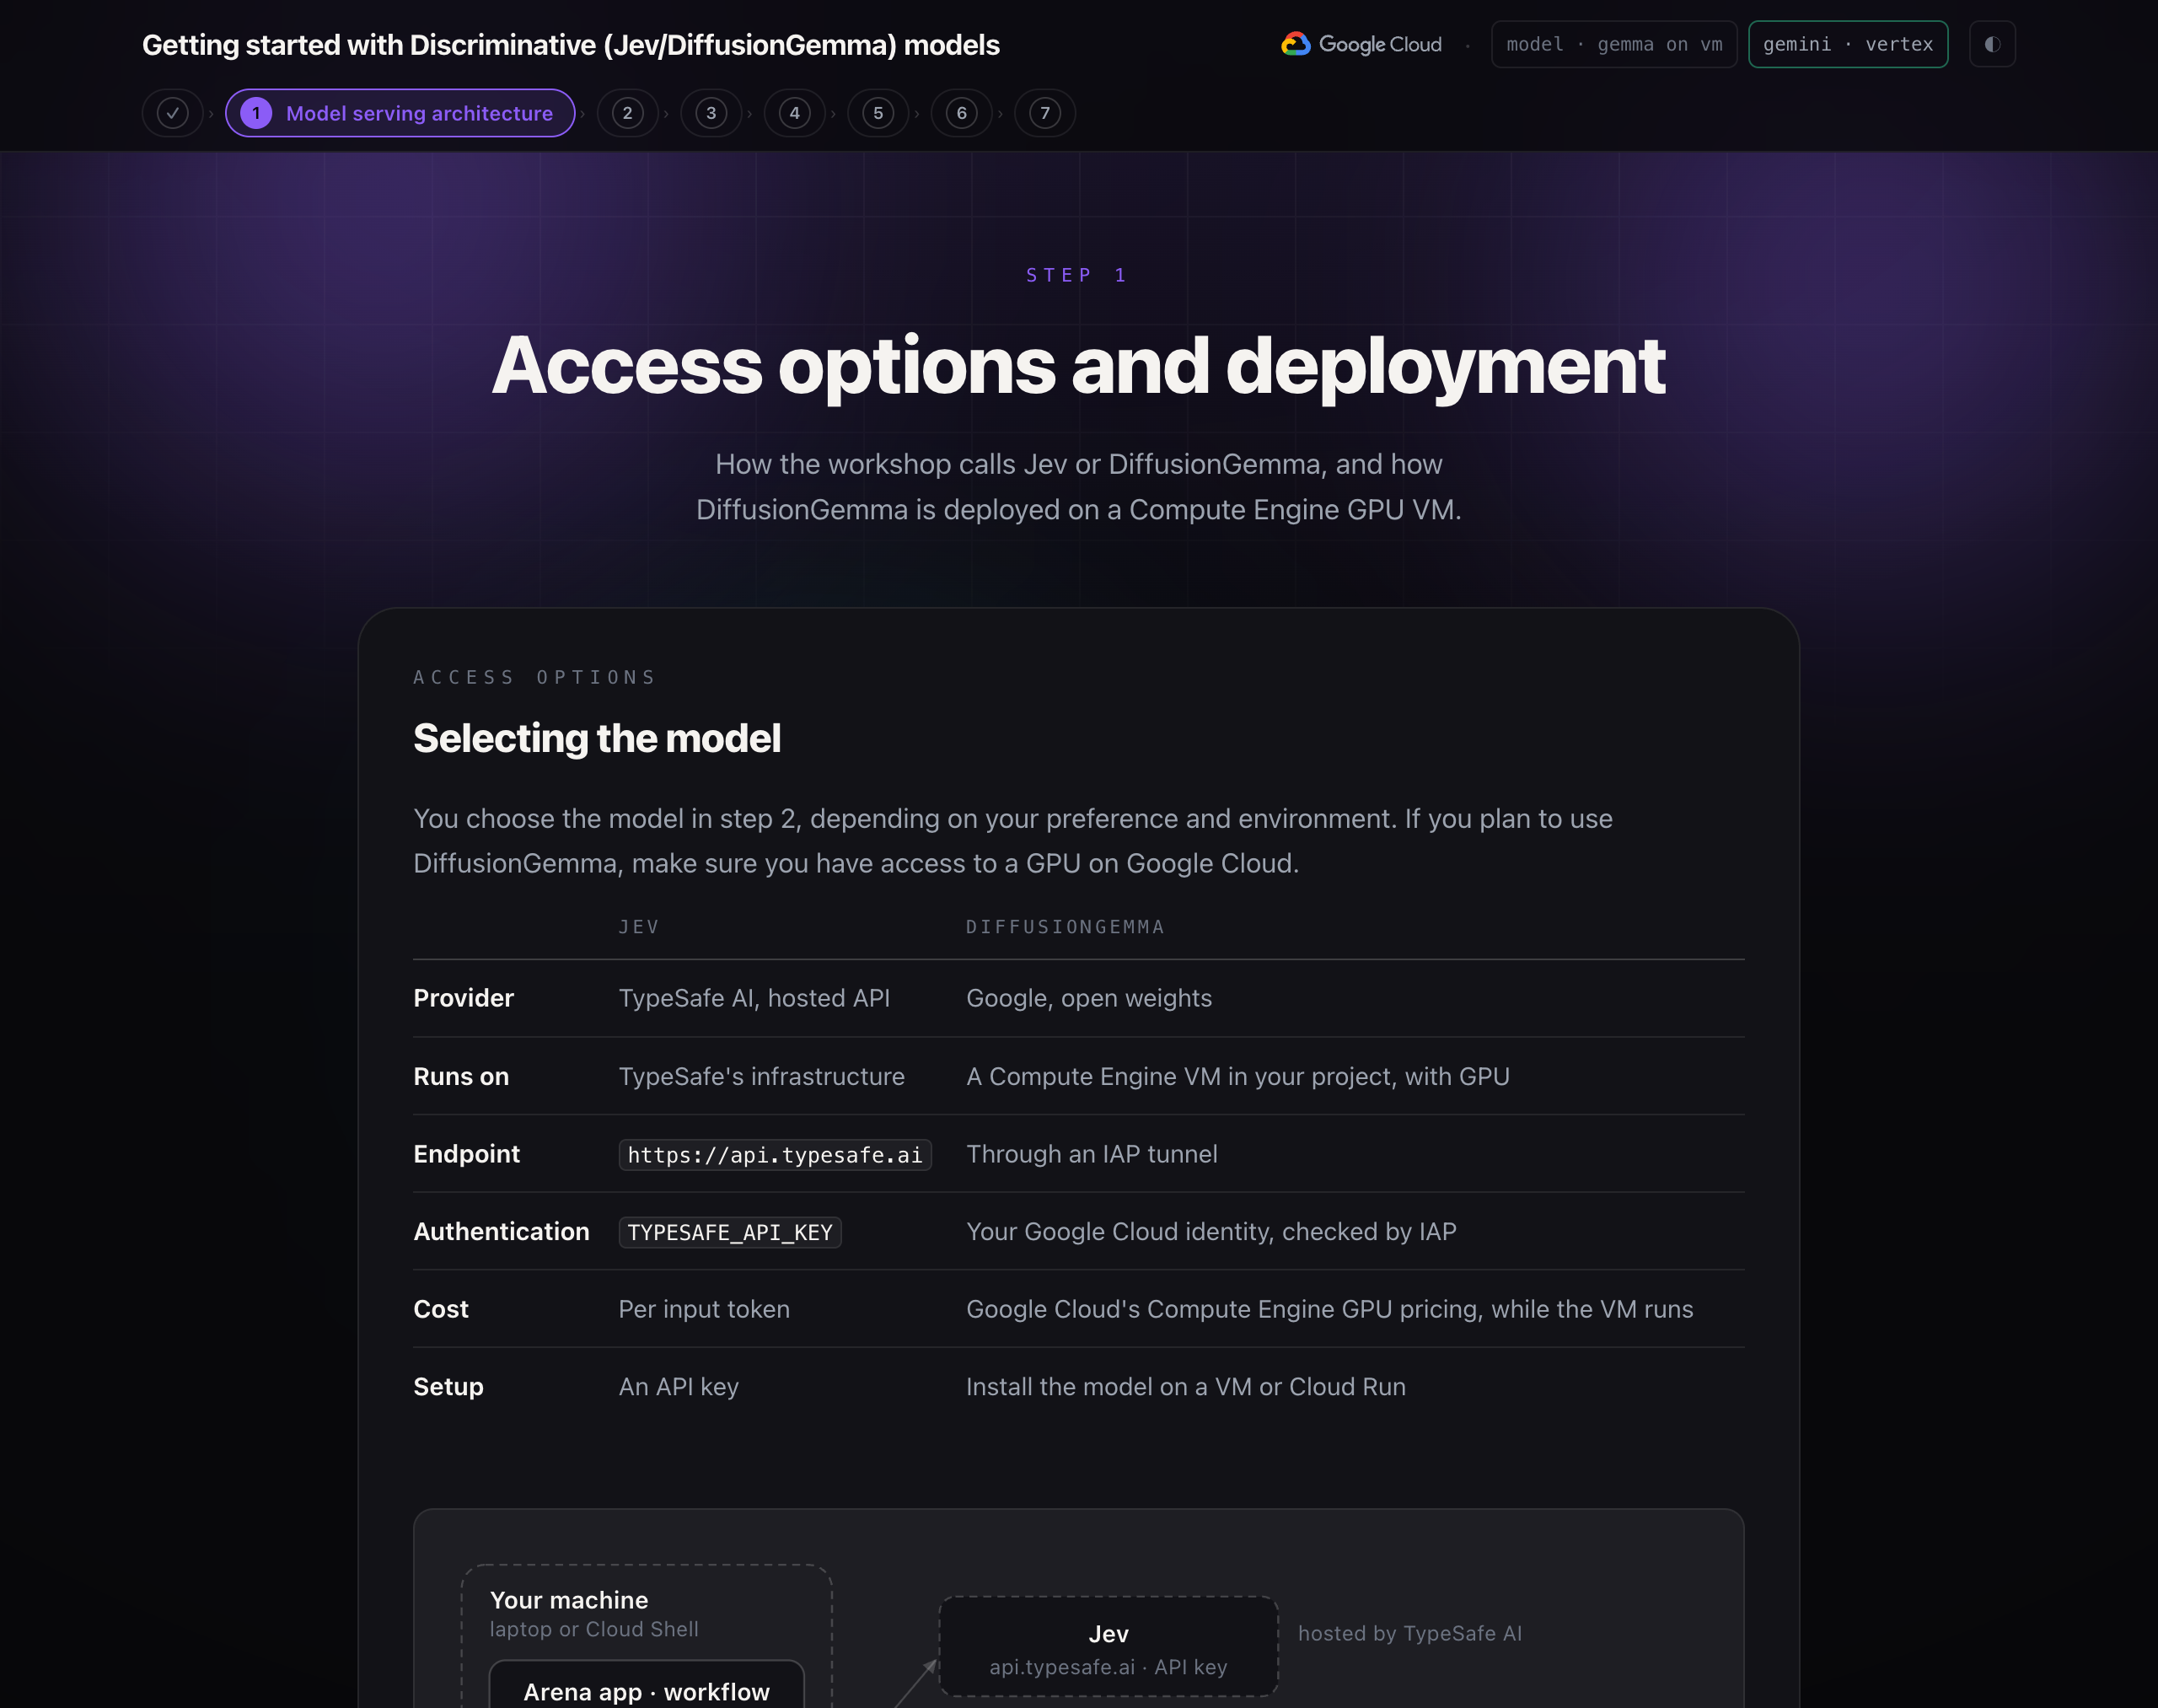
En el paso 2, eliges el modelo según tus preferencias y tu entorno. Si planeas usar DiffusionGemma, asegúrate de tener acceso a una GPU en Google Cloud.
Jev | DiffusionGemma | |
Proveedor | API alojada de TypeSafe AI | Google, Open Weights |
Se ejecuta en | Infraestructura de TypeSafe | Una VM de Compute Engine en tu proyecto, con GPU |
Extremo |
| A través de un túnel de IAP |
Autenticación |
| Tu identidad de Google Cloud, verificada por IAP |
Costo | Por token de entrada | Precios de las GPU de Compute Engine de Google Cloud mientras se ejecuta la VM |
Configuración | Una clave de API | Instala el modelo en una VM o en Cloud Run |
Flujo de datos
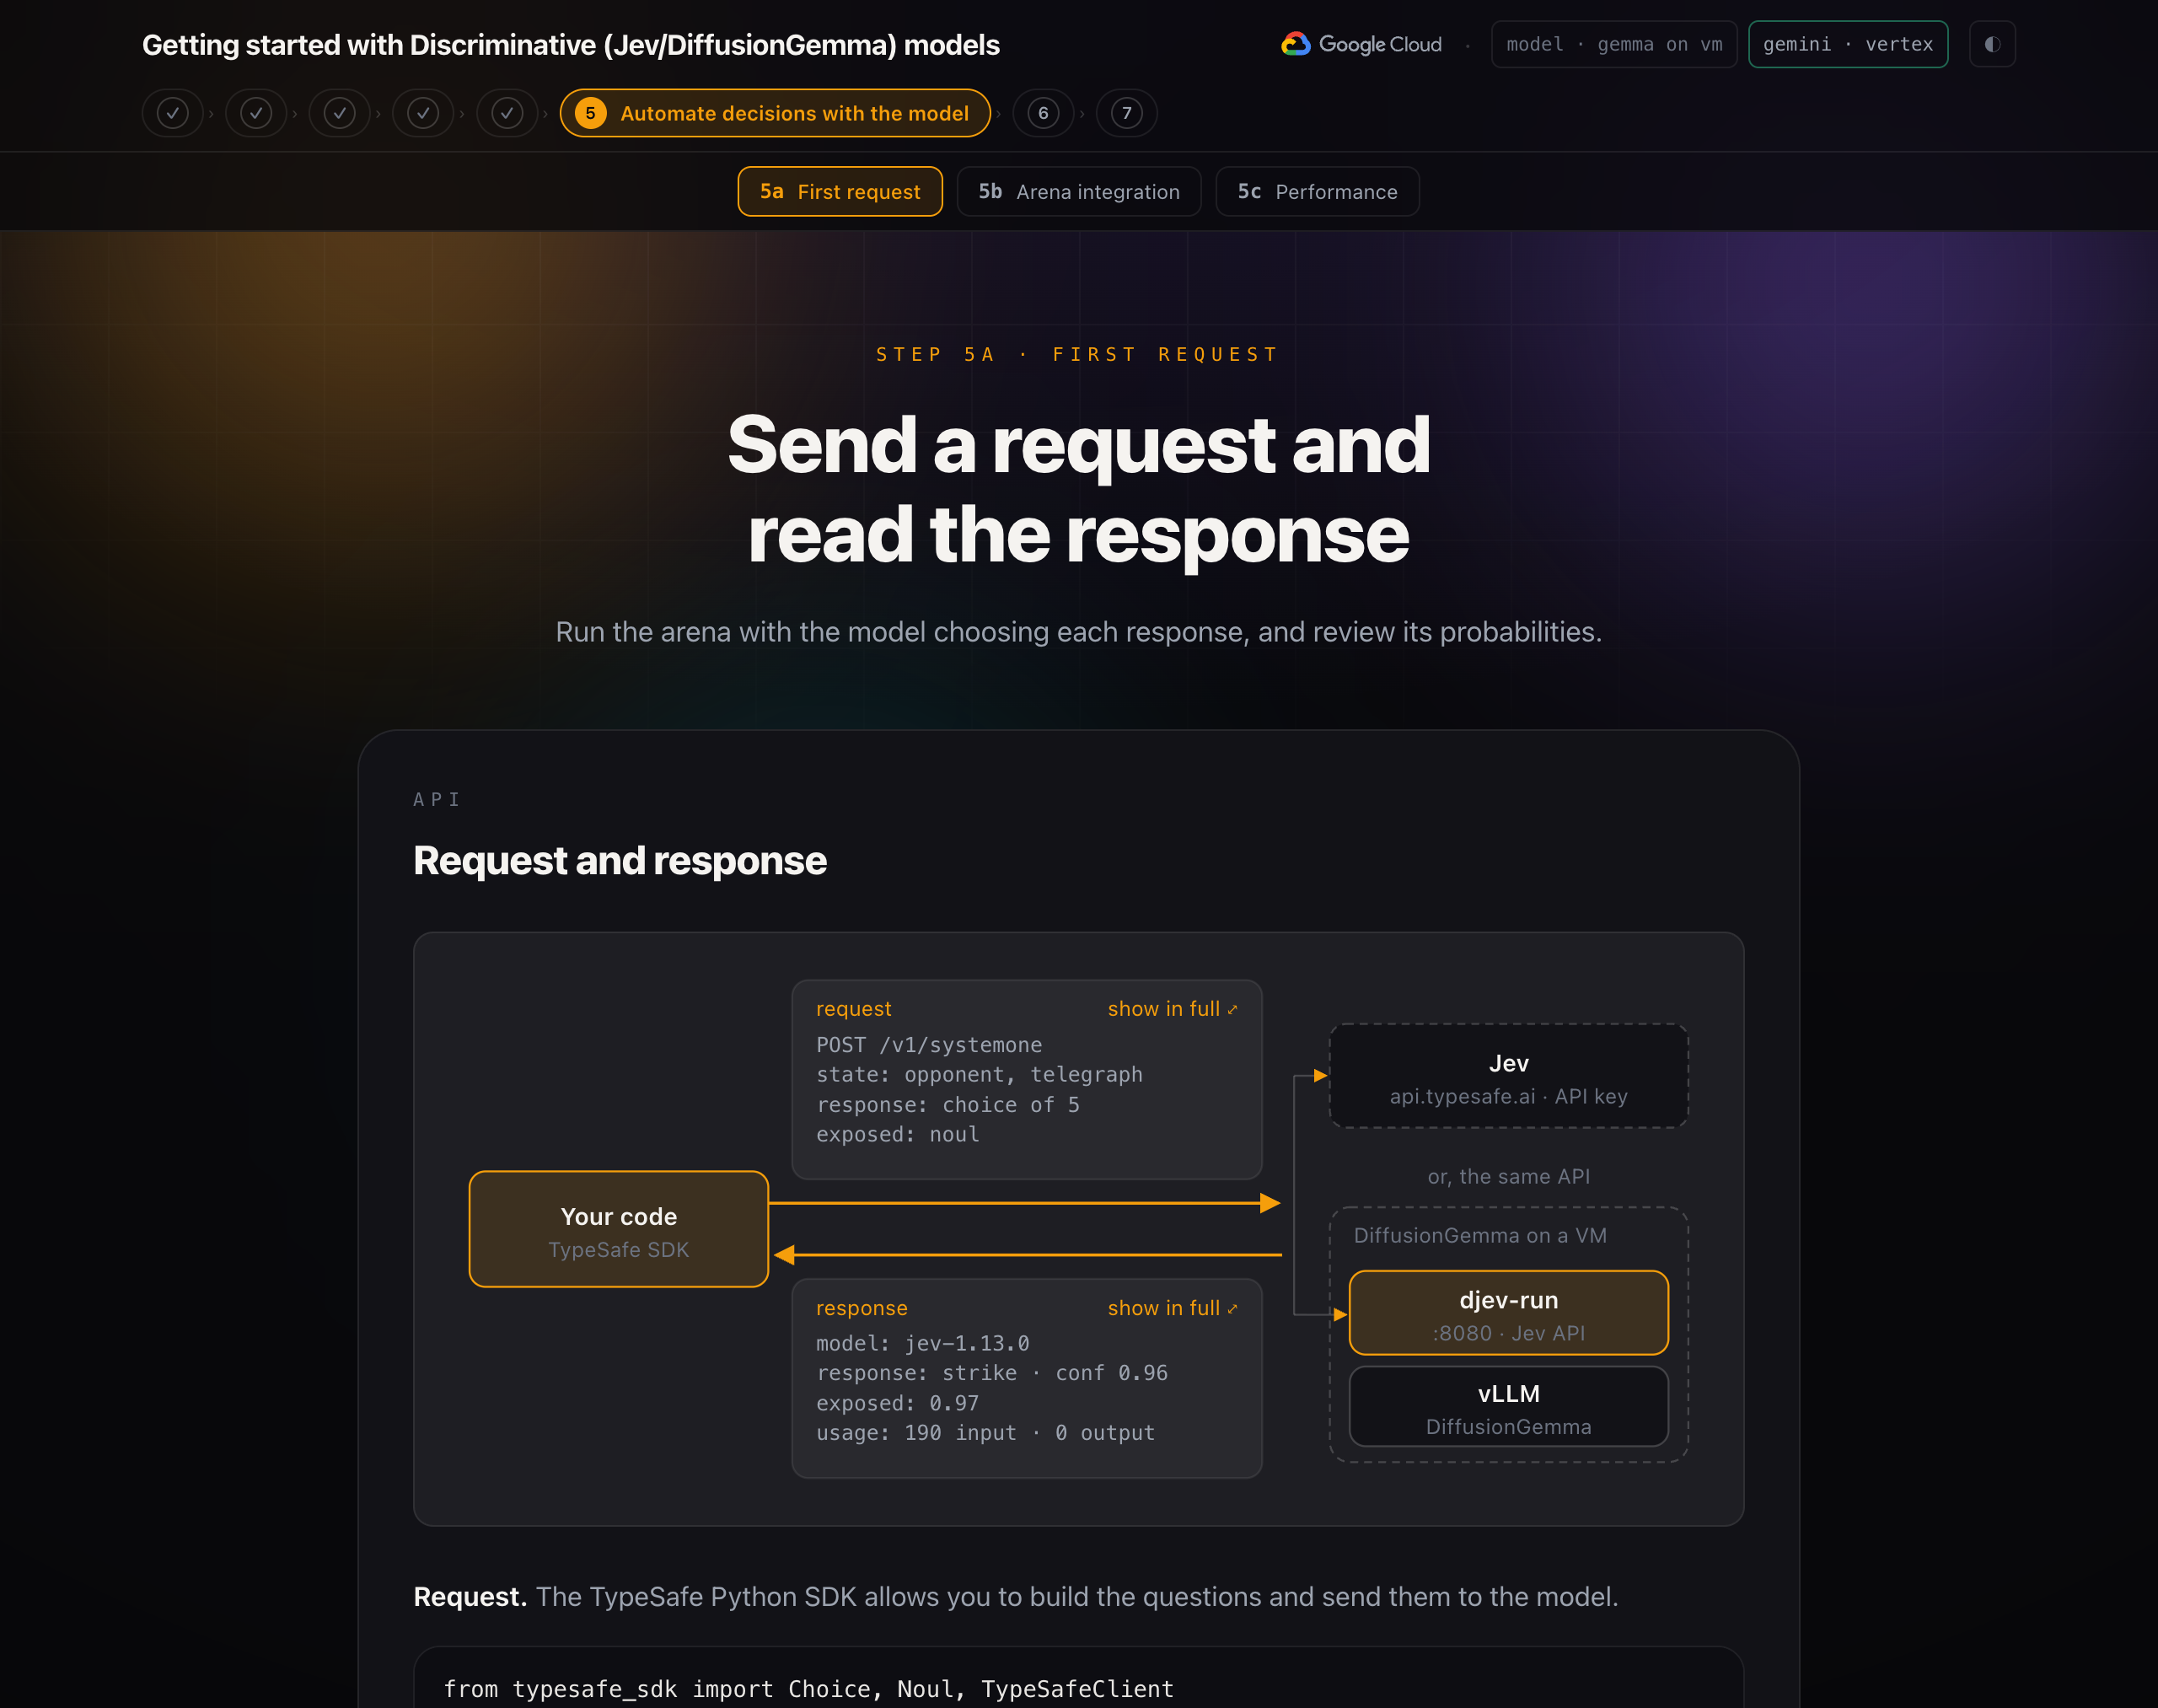
- La app de la arena o el flujo de trabajo del ADK compilan una solicitud: el estado (lo que hizo el oponente) y tres preguntas.
- El SDK de TypeSafe lo envía como
POST /v1/systemonea la URL base configurada. - En el caso de Jev, la solicitud se envía a través de HTTPS a
api.typesafe.ai, con la clave de API como token de portador. - En el caso de DiffusionGemma, la solicitud se envía a
localhost:8096. Un proceso en segundo plano degcloud compute start-iap-tunnello reenvía a través de Identity-Aware Proxy, que verifica tu identidad de Google, al puerto 8080 de la VM. - En la VM, djev-run recibe la solicitud, ejecuta DiffusionGemma a través de vLLM en la GPU y lee la probabilidad de cada opción permitida.
- Ambos backends devuelven la misma respuesta: una respuesta por pregunta, con probabilidades y una puntuación de confianza. El código del taller aplica sus umbrales y actúa.
DiffusionGemma en Compute Engine
scripts/setup_gemma.sh compila lo siguiente en tu proyecto:
- Verifica que la región tenga cuota para una GPU.
- Habilita las APIs de Compute Engine y de IAP, y crea la regla de firewall
allow-iap-djev. Solo admite el rango de direcciones del IAP en los puertos 22 y 8080. - Crea la VM
djev-l4: tipo de máquinag2-standard-4(4 CPU virtuales, 16 GB de memoria), una GPU con 24 GB, un disco de 100 GB y la imagen de VM de aprendizaje profundo con el controlador 580 de NVIDIA. Si una zona no tiene capacidad de GPU, se intenta con la siguiente. - En el primer inicio, la secuencia de comandos de inicio de la VM instala Docker y NVIDIA Container Toolkit, extrae la imagen del contenedor djev-run, descarga los pesos de Hugging Face (17.5 GB) y, luego, inicia el contenedor con acceso a la GPU en el puerto 8080. Este proceso tarda unos 15 minutos. Los inicios posteriores tardan alrededor de 2.
- Escribe la configuración de conexión en
.envy abre el túnel.
Tarea | Comando |
Detén la VM (conserva el disco) |
|
Vuelve a iniciarlo |
|
Revisa el túnel |
|
Borrar todo |
|
Configura el modelo
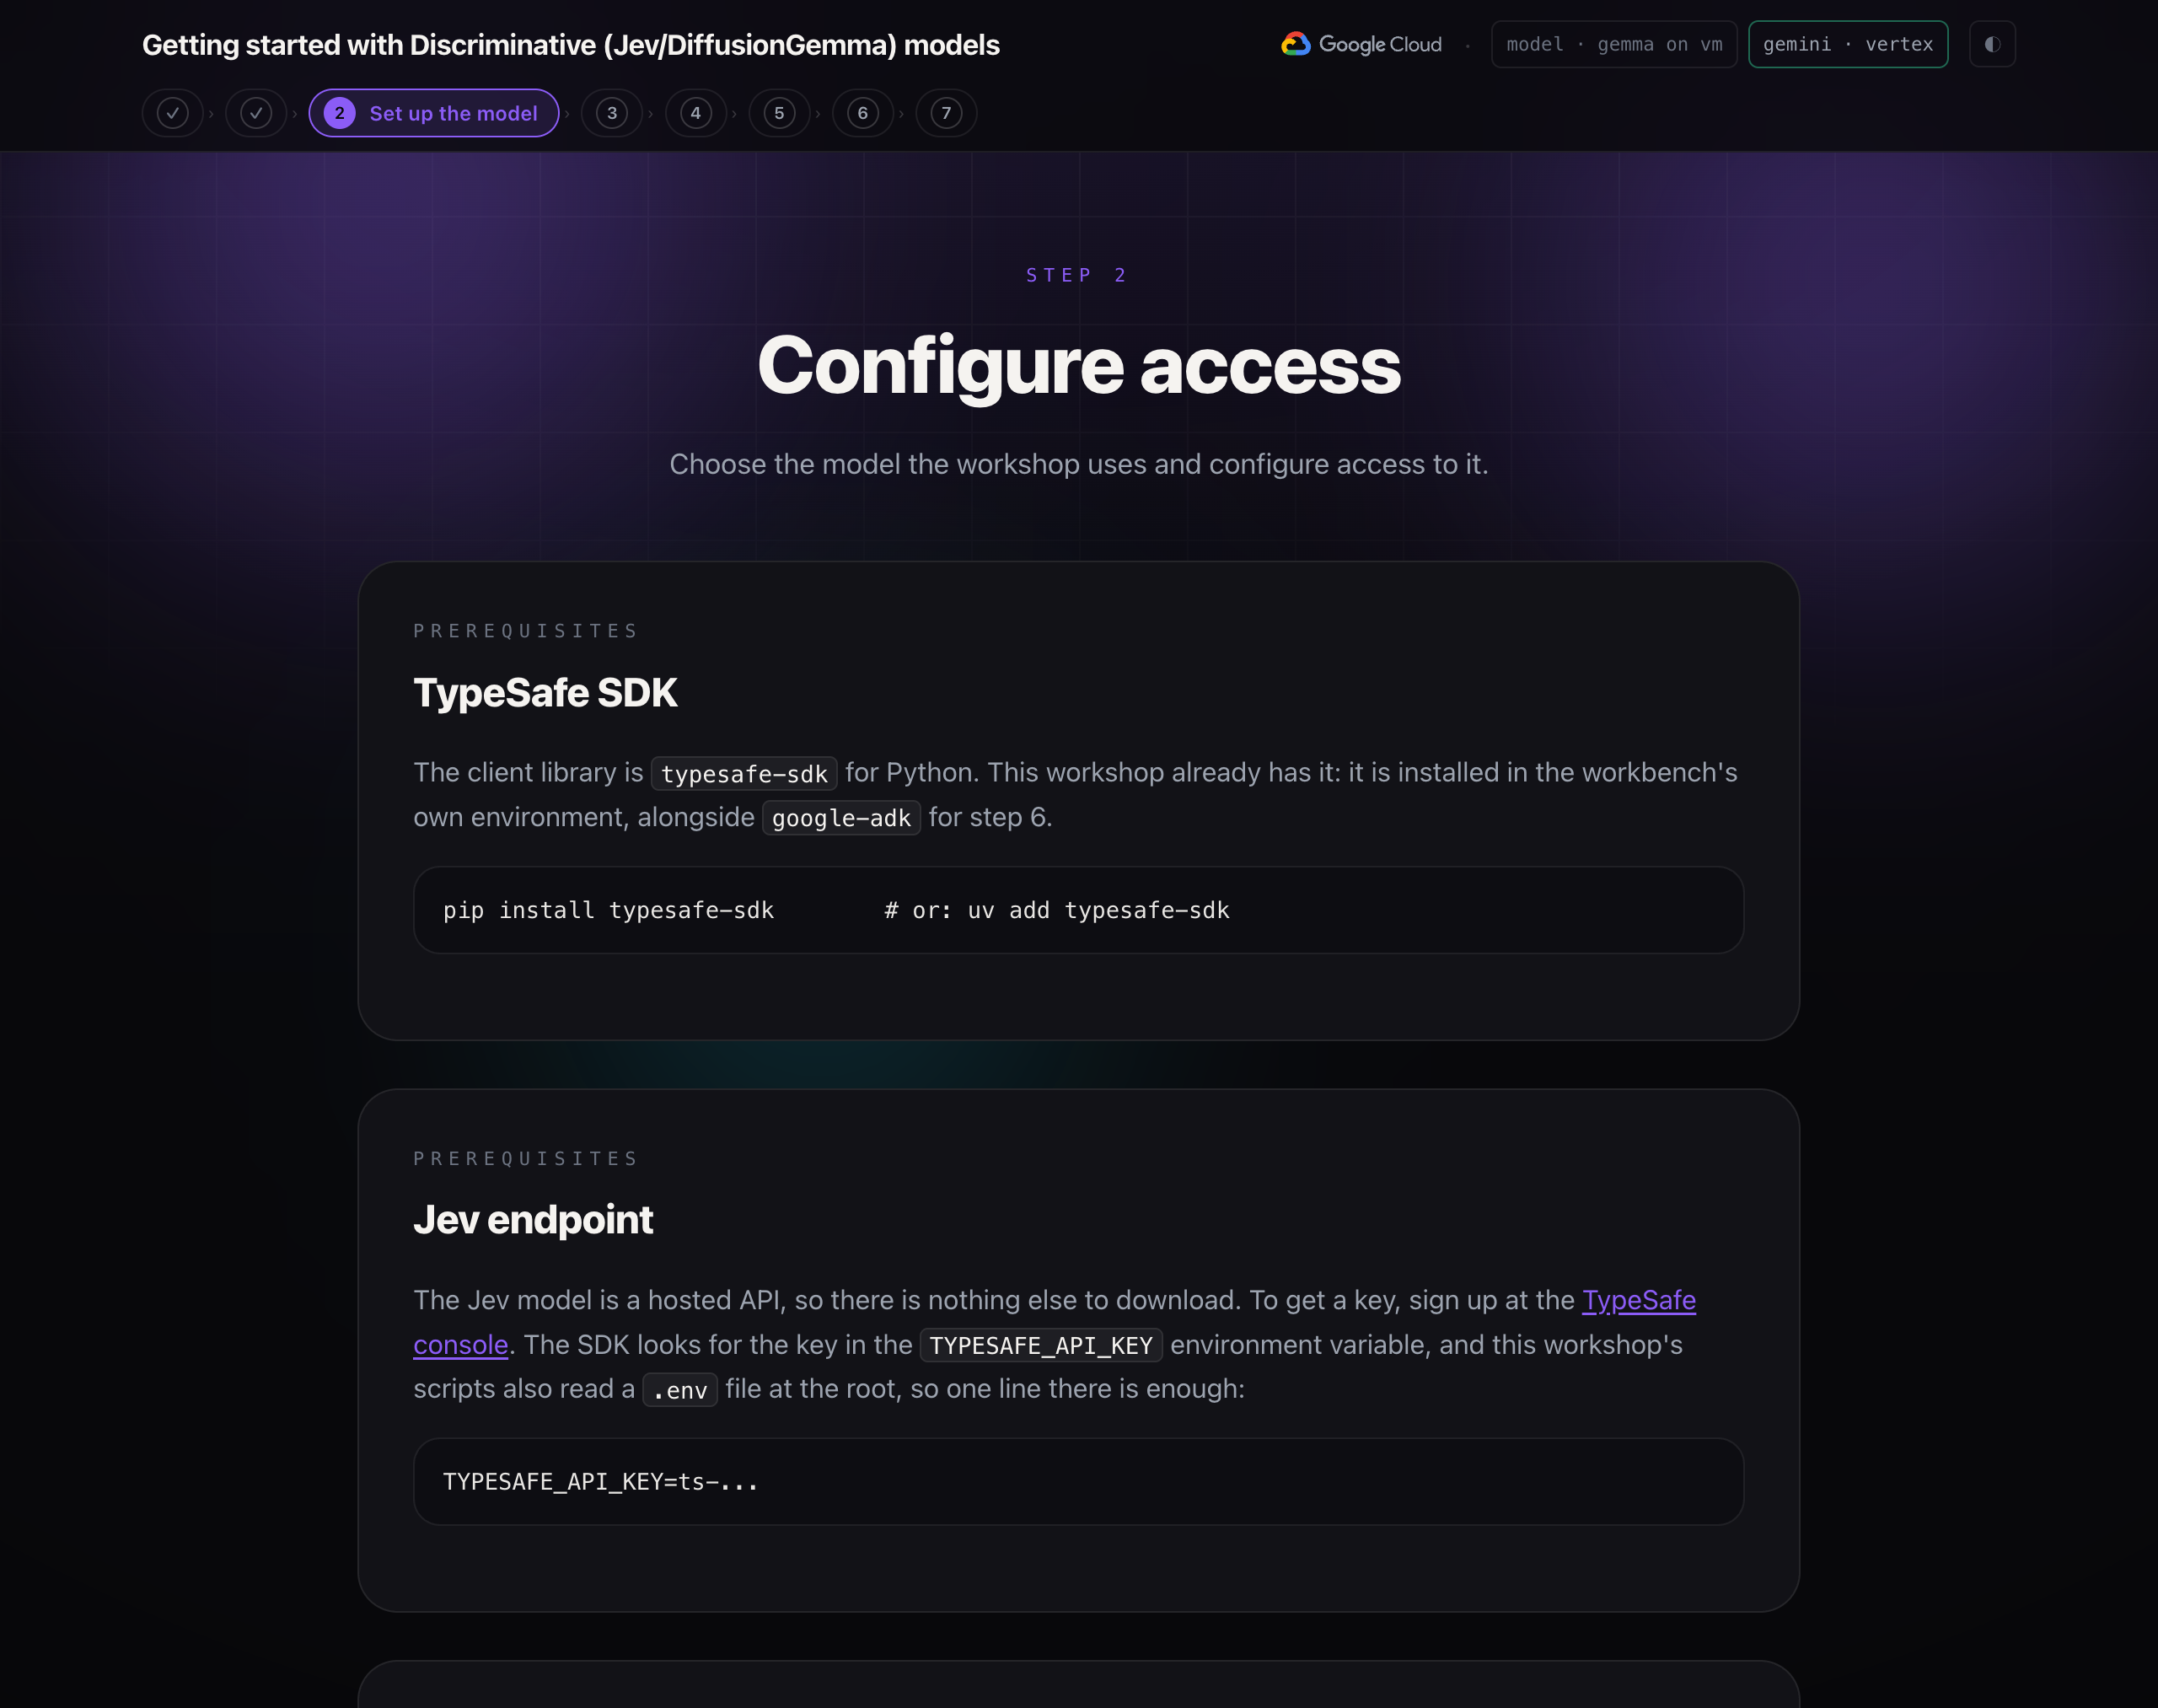
SDK con seguridad de tipos
La biblioteca cliente es typesafe-sdk para Python. Este taller ya lo tiene: está instalado en el entorno del banco de trabajo, junto con google-adk para el paso 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Extremo de Jev
El modelo de Jev es una API alojada, por lo que no hay nada más que descargar. Para obtener una clave, regístrate en la consola de TypeSafe. El SDK busca la clave en la variable de entorno TYPESAFE_API_KEY, y las secuencias de comandos de este taller también leen un archivo .env en la raíz, por lo que una línea allí es suficiente:
TYPESAFE_API_KEY=ts-...
Usa DiffusionGemma
djev-run reimplementa la API del modelo discriminativo. Publica el mismo endpoint POST /v1/systemone, con las mismas preguntas de noul, elección y puntuación, desde DiffusionGemma, el modelo de difusión abierto de Google DeepMind (26 mil millones de parámetros en total, alrededor de 4 mil millones activos, Apache 2.0). Dado que el formato de transferencia es el mismo, el SDK de TypeSafe se comunica con él sin cambios.
Si eliges DiffusionGemma en el ejercicio, se ejecutará en una GPU en una VM de tu propio proyecto de Google Cloud, y la píldora en la esquina superior derecha dirá gemma on vm. Workbench accede a él a través de un túnel de IAP privado, y el puerto del modelo no está abierto a Internet. En el paso 1, se describe la arquitectura completa.
Por qué un modelo de difusión puede hacer esto: Completa un bloque completo de posiciones a la vez, y cada posición ve la entrada completa, por lo que la probabilidad de cada opción permitida se puede leer en un solo paso. Un modelo de lenguaje normal produce un token a la vez y tendría que muestrearse de forma repetida.
Juega el juego de forma manual
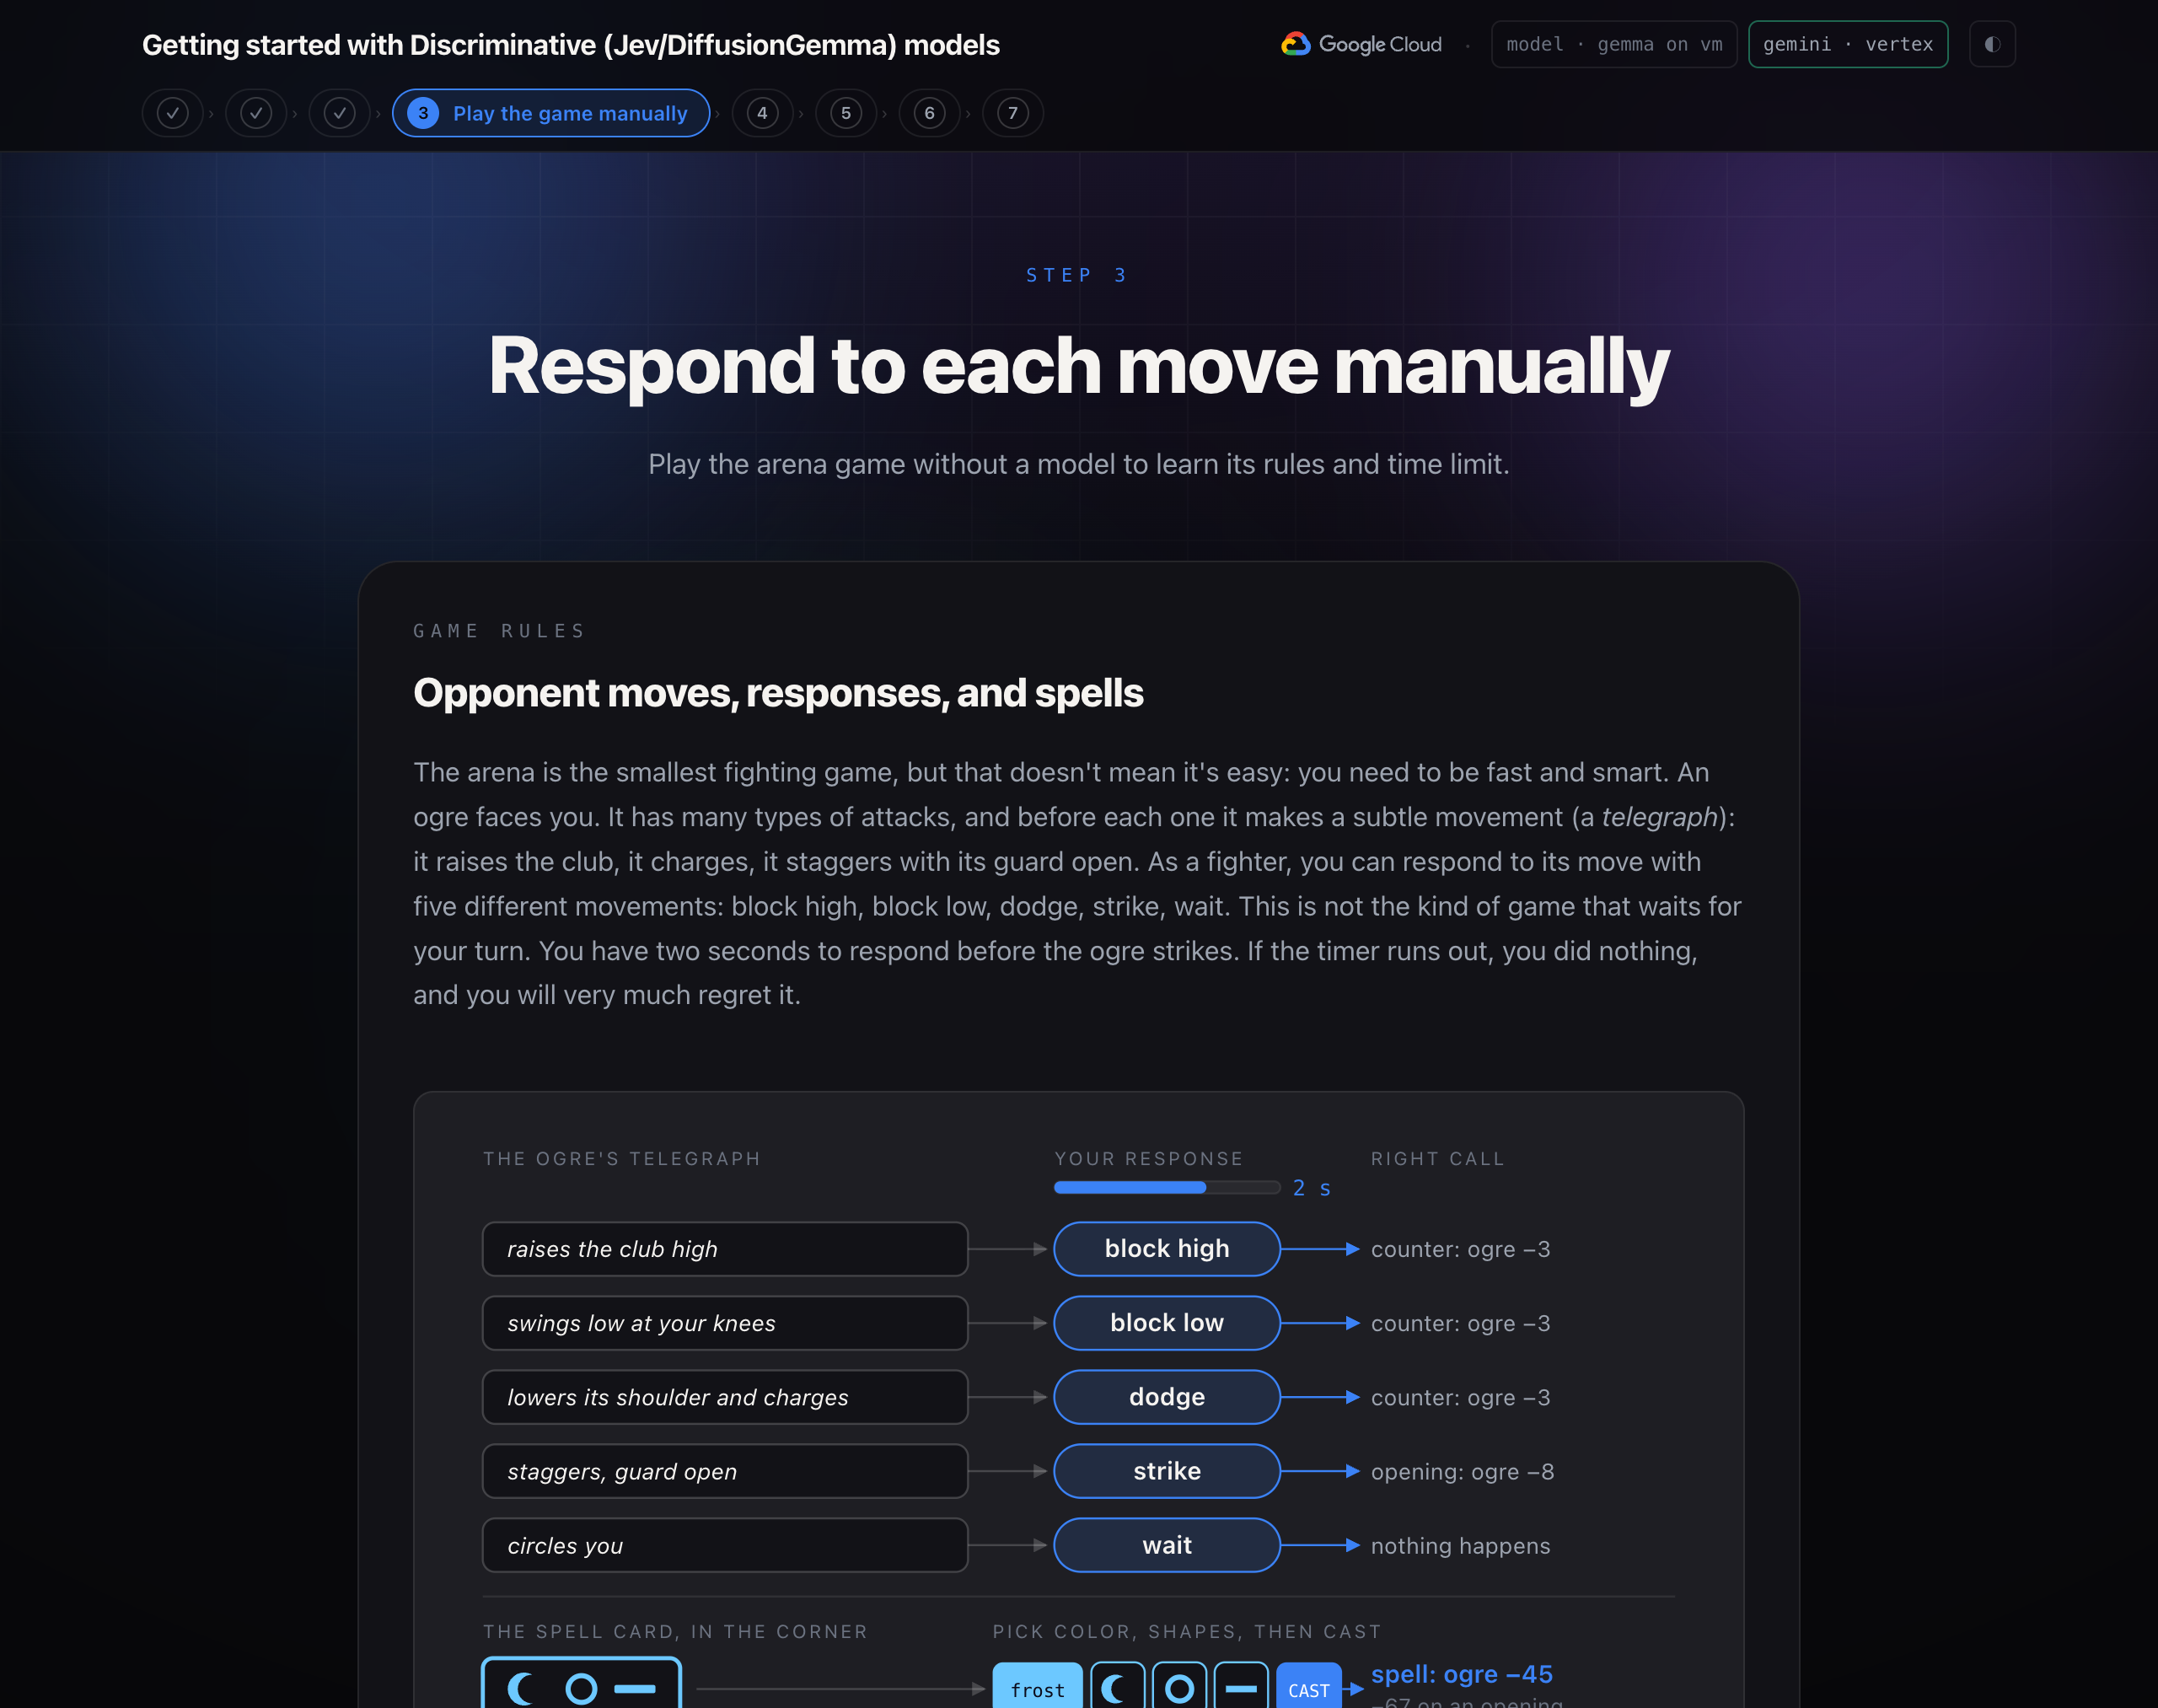
La arena es el juego de lucha más pequeño, pero eso no significa que sea fácil: debes ser rápido y hábil. Un ogro te enfrenta. Tiene muchos tipos de ataques y, antes de cada uno, hace un movimiento sutil (un aviso): levanta el palo, se carga, se tambalea con la guardia abierta. Como luchador, puedes responder a su movimiento con cinco movimientos diferentes: bloquear arriba, bloquear abajo, esquivar, golpear y esperar. Este no es el tipo de juego que espera tu turno. Tienes dos segundos para responder antes de que el ogro ataque. Si se agota el tiempo, no habrás hecho nada y te arrepentirás.
En la esquina superior izquierda del anillo, hay una tarjeta de hechizo: una tarjeta de color con tres formas. Solo un hechizo que coincida con él le hace daño real. En el juego, puedes lanzar un hechizo con los botones que se encuentran debajo de la pelea: elige el color de la carta, luego sus formas de izquierda a derecha y, por último, presiona LANZAR. El reloj sigue funcionando mientras eliges, por lo que debes crear el hechizo y reaccionar a los ataques del ogro al mismo tiempo. Las teclas del 1 al 5 siguen respondiendo a cada movimiento. Un hechizo incorrecto se desvanece. En el paso 6, Gemini lee la carta de hechizo por ti.
Conclusión clave: Una pelea es un flujo de pequeñas decisiones con una fecha límite para cada una. Así es como se ve la mayoría de la automatización de software, sin el club.
Conceptos de modelos discriminativos
Decisiones en el software
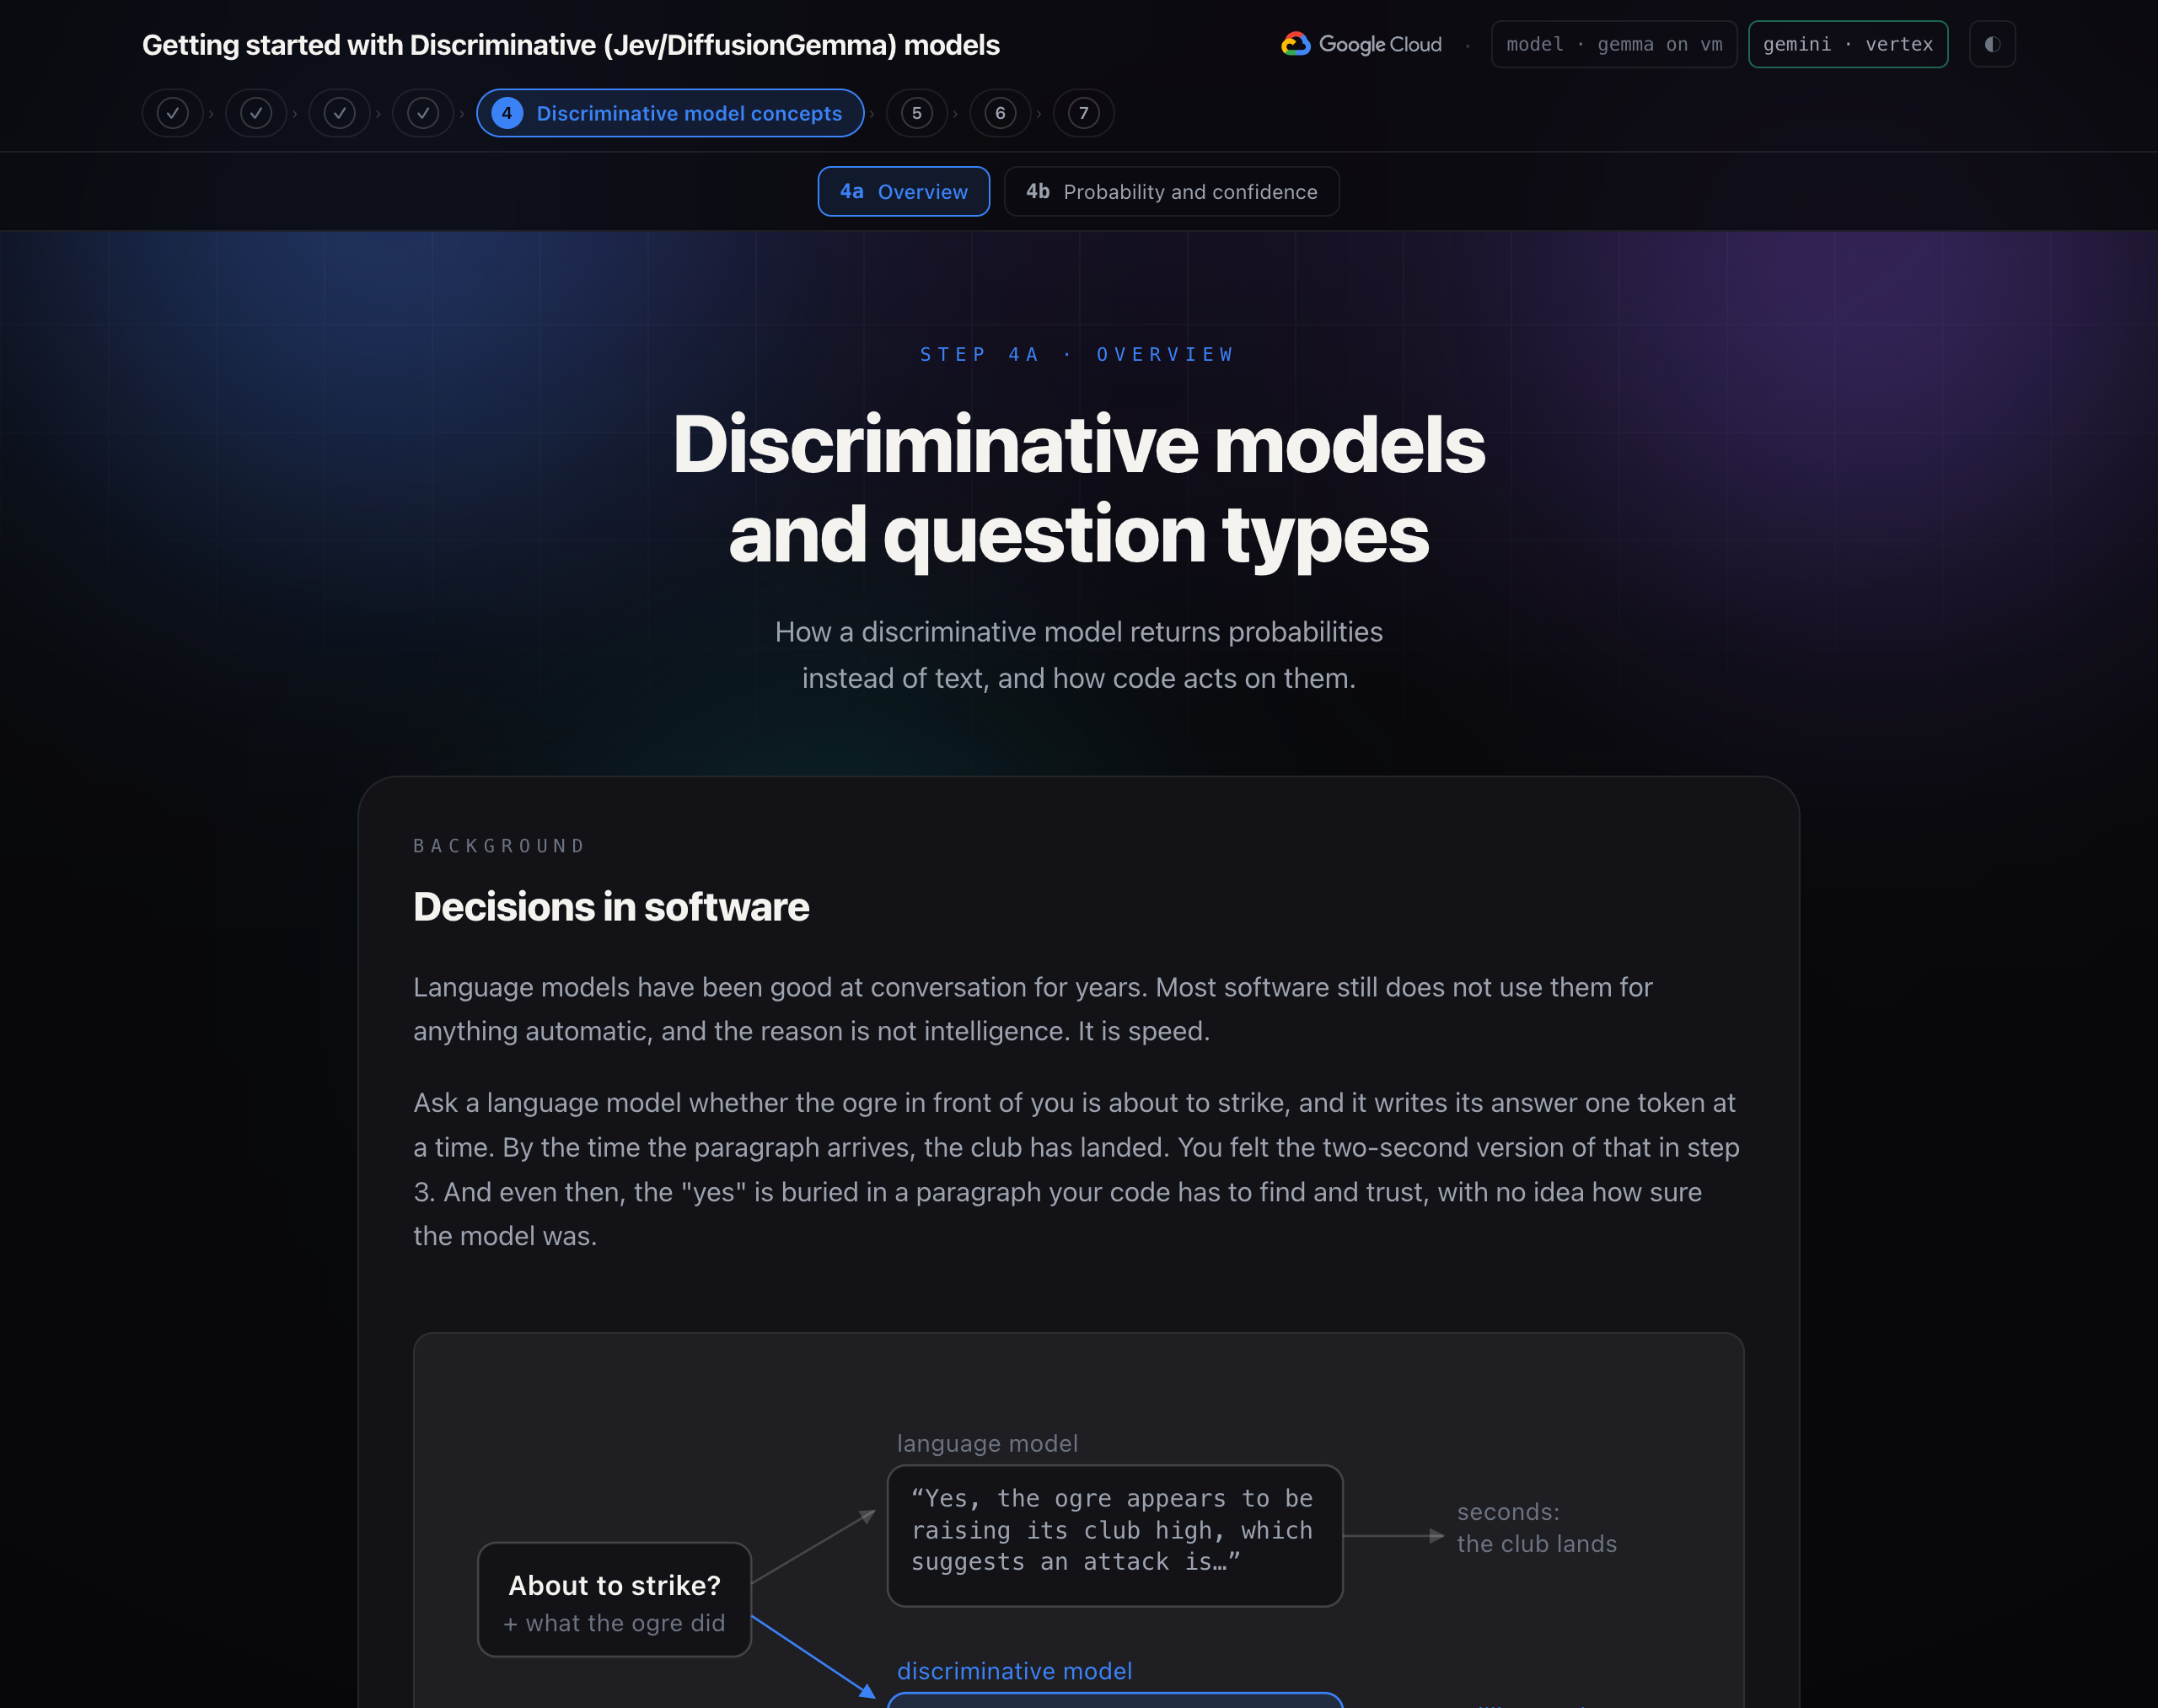
Los modelos de lenguaje han sido buenos para la conversación durante años. La mayoría del software aún no los usa para nada automático, y el motivo no es la inteligencia. Es la velocidad.
Pregúntale a un modelo de lenguaje si el ogro que tienes delante está a punto de atacar, y escribirá su respuesta un token a la vez. Cuando llega el párrafo, el club ya aterrizó. En el paso 3, sentiste la versión de dos segundos de eso. Incluso en ese caso, el "sí" está oculto en un párrafo que tu código debe encontrar y en el que debe confiar, sin saber qué tan seguro estaba el modelo.
El modelo discriminativo toma el estado y las preguntas y respuestas que escribiste en una sola pasada, en milisegundos. Cada respuesta incluye una probabilidad calibrada: 0.9 significa que es correcta nueve de cada diez veces. No hay texto para analizar ni JSON para extraer de él.
Modelos del sistema 1 y el sistema 2
El nombre proviene del libro Pensar rápido y pensar despacio de Daniel Kahneman. El Sistema 2 es un razonamiento lento y deliberado, un paso tras otro. El Sistema 1 es rápido y se basa en la coincidencia de patrones.
Un modelo de lenguaje es una máquina del Sistema 2. Razona en tokens, uno a la vez. El modelo discriminativo es un modelo del sistema 1: no razona en voz alta, no genera nada y responde cada pregunta en una sola pasada. Por eso es rápido (aproximadamente de 70 a 500 milisegundos) y económico (fracciones de centavos por cada mil decisiones).
Conclusión clave: Un modelo de lenguaje escribe. Un modelo de decisión decide. La mayoría de lo que el software necesita de la IA es una decisión.
Limitaciones
El modelo discriminativo no generará texto, escribirá código, mantendrá una conversación, hará cálculos aritméticos, leerá una imagen ni seguirá una cadena de pasos.
En el taller, elegiremos uno de los modelos discriminativos:
- Uno de los modelos discriminativos es Jev. Es una API alojada de TypeSafe AI que se lanzó en septiembre de 2026. El primer modelo es
jev-1.13, al que se accede a través del aliasjev-latest. No hay pesos publicados, por lo que se llama, no se descarga. - Jev no es la única forma de obtener un modelo de System One. DiffusionGemma de Google es un modelo de código abierto que escribe un bloque completo de tokens en paralelo en lugar de uno a la vez, y ese mismo paso paralelo puede leer probabilidades sobre un conjunto fijo de opciones. Los servidores de código abierto, como djev-run, colocan la API exacta de Jev frente a él, por lo que todo en este taller se ejecuta sin cambios.
Estado y preguntas: Choice, Score y Noul
Cada llamada envía el estado y las preguntas. El estado es el texto que quieres que se juzgue. Puede ser una cadena, un objeto JSON o una lista. Las preguntas te consultan qué quieres saber sobre ese texto. Cada pregunta tiene un tipo: opción, puntuación o Noul. Las preguntas se procesan en paralelo, lo que permite que responda rápidamente. Puedes agregar varias preguntas si es necesario.
- Opción elige una opción de un conjunto que nombres, hasta 255 de ellas. La respuesta es la opción, una probabilidad para cada opción y un nivel de confianza. Úsala cuando las opciones no tengan un orden entre ellas: bloquear probabilidad alta, bloquear probabilidad baja, esquivar, golpear, esperar.
- La puntuación califica el estado según los niveles ordenados que describes, de dos a diez. La respuesta es una posición a lo largo de la escala (un decimal, por lo que 1.4 significa "entre uno y dos, más cerca de uno"), la probabilidad de cada nivel y un nivel de confianza. Úsalo cuando la respuesta sea una cuestión de grado: qué tan fuerte será el impacto entrante.
- Choice y Score devuelven una probabilidad para cada opción y un nivel de confianza. La diferencia es la respuesta principal. Una elección devuelve la opción más probable. Una puntuación trata las opciones como niveles ordenados y devuelve su promedio ponderado por probabilidad, que puede ubicarse entre dos niveles. Con ninguno 0.05, ligero 0.55 y pesado 0.40, una respuesta de opción múltiple responde "ligero" y una respuesta de puntuación responde 1.35, entre ligero y pesado. La arena usa ese valor:
choose()trata una puntuación de peligro de 1.5 o más como un golpe fuerte.
- Choice y Score devuelven una probabilidad para cada opción y un nivel de confianza. La diferencia es la respuesta principal. Una elección devuelve la opción más probable. Una puntuación trata las opciones como niveles ordenados y devuelve su promedio ponderado por probabilidad, que puede ubicarse entre dos niveles. Con ninguno 0.05, ligero 0.55 y pesado 0.40, una respuesta de opción múltiple responde "ligero" y una respuesta de puntuación responde 1.35, entre ligero y pesado. La arena usa ese valor:
- Noul hace una pregunta de sí o no y devuelve la probabilidad de que la respuesta sea sí. Cerca de 1 significa un sí rotundo, cerca de 0 significa un no rotundo y cerca de 0.5 significa "podría ser cualquiera de las dos". No hay una confianza separada, ya que la probabilidad es su nivel de confianza.
Escribe preguntas enfocadas
El modelo discriminativo funciona mejor cuando una pregunta solicita una cosa específica y bien delimitada. "¿Cuál es la situación?" devuelve una respuesta plausible y de baja confianza. "¿Cuál es la respuesta correcta?". "¿El oponente está expuesto?" y "¿Qué tan fuerte será este golpe?" devuelven tres respuestas enfocadas que tu código combina.
Las descripciones de las opciones y los niveles son económicas y relevantes. Las reglas que leíste en el paso 3 se convierten en las descripciones de las opciones: block_high: "Raise the shield. Right against an overhead or a high swing." Así es como el modelo discriminativo aprende las reglas de la pelea, en el momento de la solicitud, en una línea cada una. Además, las opciones pueden cambiar según la situación: la arena solo ofrece cast cuando un hechizo está listo.
Probabilidades y confianza
Una respuesta de opción no es una etiqueta. Es una distribución sobre las etiquetas, y la etiqueta es solo la barra más alta.
Cómo obtiene el número el modelo. Utiliza el mismo paso que un modelo de lenguaje usa para elegir su siguiente palabra. Un Transformer lee el texto y, en una posición, le asigna a cada token de su vocabulario una puntuación sin procesar, denominada logit. Un logit más alto significa que el token se ajusta mejor a esa posición. Una softmax convierte los logits en probabilidades que suman 1. Luego, un modelo de lenguaje elige un token, lo agrega al texto y repite el proceso. Un modelo discriminativo se detiene después de las probabilidades.
El espacio en blanco es un espacio vacío en un formulario de respuesta. El servidor escribe el formulario en sí, como response: ▢, y deja un espacio por pregunta. La única tarea del modelo es calificar lo que corresponde a cada brecha.
- La instrucción contiene el estado y cada pregunta, con cada respuesta permitida como una etiqueta corta:
apara block_high,bpara block_low, y así sucesivamente. - El servidor agrega el formulario de respuestas, con un espacio en blanco por pregunta.
- El modelo lee la instrucción y el formulario en una sola pasada, y le asigna un logit a cada token en cada espacio en blanco. El modelo de difusión ve todo el formulario a la vez y califica todos los espacios en blanco juntos.
- El servidor solo conserva los logits de las etiquetas permitidas y les aplica una función softmax, de modo que las respuestas permitidas sumen 1.
- Si la lectura parece imprecisa, el servidor vuelve a leer desde otro punto de inicio aleatorio y calcula el promedio de las lecturas.
Confianza es un número que indica qué tan segura es la respuesta. TypeSafe la calcula en función de cómo se distribuye la probabilidad entre las opciones. Si se asigna todo a una opción, se obtiene 1, y si se distribuye de manera uniforme, se obtiene 0. Para tres opciones, es (3 × mayor – 1) / 2.
TypeSafe entrena a Jev para obtener probabilidades calibradas. La probabilidad coincide con la frecuencia con la que la respuesta es correcta. En un modelo calibrado, las respuestas que se dan con una confianza de 0.7 son correctas aproximadamente el 70% de las veces, por lo que un umbral de confianza es un umbral sobre la frecuencia con la que aceptas una respuesta incorrecta. El servidor de DiffusionGemma en este taller informa la probabilidad superior como confianza, promediada en sus lecturas. Cuando las lecturas no coinciden, el promedio se dispersa y la confianza disminuye.
Conclusión clave: La respuesta te indica qué. La confianza te indica si debes actuar.
Umbrales
El umbral es la forma en que defines la acción en el código. El modelo devuelve un nivel de confianza o una probabilidad. Tu código lo compara con un número que elegiste, y el resultado decide qué sucede.
Un umbral por acción. TypeSafe sugiere dividir la confianza en bandas. La alta confianza actúa por sí sola. La confianza media actúa con una verificación, como solicitar confirmación o marcar el caso para su revisión. La confianza baja no actúa y recurre a algo seguro o a una persona.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Las reglas de la arena Los umbrales de la arena se encuentran en choose(), que ejecutas en el paso 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Advertencia: Una respuesta válida no siempre es correcta. El modelo discriminativo no puede devolver una opción que no ofreciste, por lo que nunca alucina un movimiento, pero puede elegir el incorrecto, a veces con un alto nivel de confianza. Prueba tus preguntas en situaciones que ya hayas juzgado antes de confiar en un umbral.
Automatiza las decisiones con el modelo
Solicitud y respuesta
Solicitud. El SDK de Python de TypeSafe te permite crear las preguntas y enviarlas al modelo.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Una solicitud por marca
En cada tic, la app envía el telégrafo como estado y pregunta tres cosas en una sola llamada:
- Qué respuesta es correcta entre las cinco (o seis, cuando un hechizo está listo). Una opción
- Indica si el ogro está expuesto a un contador en este momento. Un Noul.
- Qué tan fuerte es el golpe entrante, según una rúbrica de tres niveles Es una puntuación.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
La función choose()
¿Recuerdas los umbrales del paso 4? choose() compara las respuestas del modelo con números fijos, y estos números fijos son los umbrales.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() es la lectura ordinaria de Python de valores escritos, con dos reglas. El modelo discriminativo proporciona su probabilidad y análisis, y el código usa los umbrales para las reglas. La acción elegida se envía al motor, donde se usará para luchar contra el ogro.
Conclusión clave: Mantén las preguntas y los umbrales en un solo lugar. Son la parte de una integración de System One que más ajustarás.
Tiempo de respuesta, precios basados en la entrada y lógica de decisión
- Tiempo de respuesta por decisión. Cada tic de la pelea en la parte b regresó en unos cien milisegundos, algunos en dos o tres. Esto es lo suficientemente rápido para un bucle de juego, una ruta de solicitud o una verificación de cada mensaje antes de que lo vea una persona o un modelo de lenguaje.
- Precios basados en la entrada. Una pelea completa, con sesenta decisiones y tres preguntas cada una, cuesta mucho menos de un centavo. Los tokens de salida son cero porque no se generó nada. La consecuencia es que puedes permitirte preguntar más de lo que necesitas. La arena pregunta si el ogro está expuesto en cada tic, aunque solo
strikeycastse preocupan, porque preguntar es casi gratis y la respuesta es útil en el panel. TypeSafe llama a esto fan-out especulativo. - Combina confianza y peligro. Cuando la confianza del modelo discriminativo en su respuesta es inferior a 0.40 y la puntuación de peligro indica que se producirá un impacto grave,
choose()lo anula con una evasión. Una evasiva rara vez es la mejor respuesta, pero tampoco es la peor. Elige umbrales a partir del costo de cada error, no de un número redondo, y pruébalos con los mensajes que ya juzgaste de forma manual. Sugerencia de TypeSafe: Si una decisión sigue activándose de forma incorrecta, ajusta la pregunta antes de cambiar el umbral.
Combina modelos en un flujo de trabajo del ADK
Límites de las decisiones por tic y por qué las respuestas correctas no son suficientes
La última línea de la pelea en el paso 5 lo dice: el ogro se aleja con dificultad, apenas arañado. El modelo discriminativo no recibió daño y causó un poco en cada marca, y 300 puntos de golpe son más que un poco por sesenta. La carta de hechizo en la esquina del anillo estuvo allí todo el tiempo. Para leerlo, se necesita un modelo que pueda ver una imagen.
El ogro tiene 300 puntos de golpe. Un contador de llamadas correctas para 3. Un golpe en una abertura hace 8 de daño, porque el escondite es grueso. Incluso una pelea perfecta de sesenta tics deja al ogro magullado y de pie, y el juego la declara empate. Ahí terminó el paso 5: El modelo defendió bien y aun así no pudo ganar.
Solo un hechizo inflige daño real: 45 por un lanzamiento perfecto y 67 cuando impacta en una apertura.
Asigna cada tarea al modelo correcto
La carta de hechizo que se encuentra en la esquina del anillo es la forma de ganar, y leerla no es un problema de texto: es una imagen, con un color y tres formas en fila, y el hechizo se debe cantar para que coincida. Esto requiere un modelo que pueda observar una imagen y dedicarle unos segundos. En una pelea, unos segundos son diez marcas.
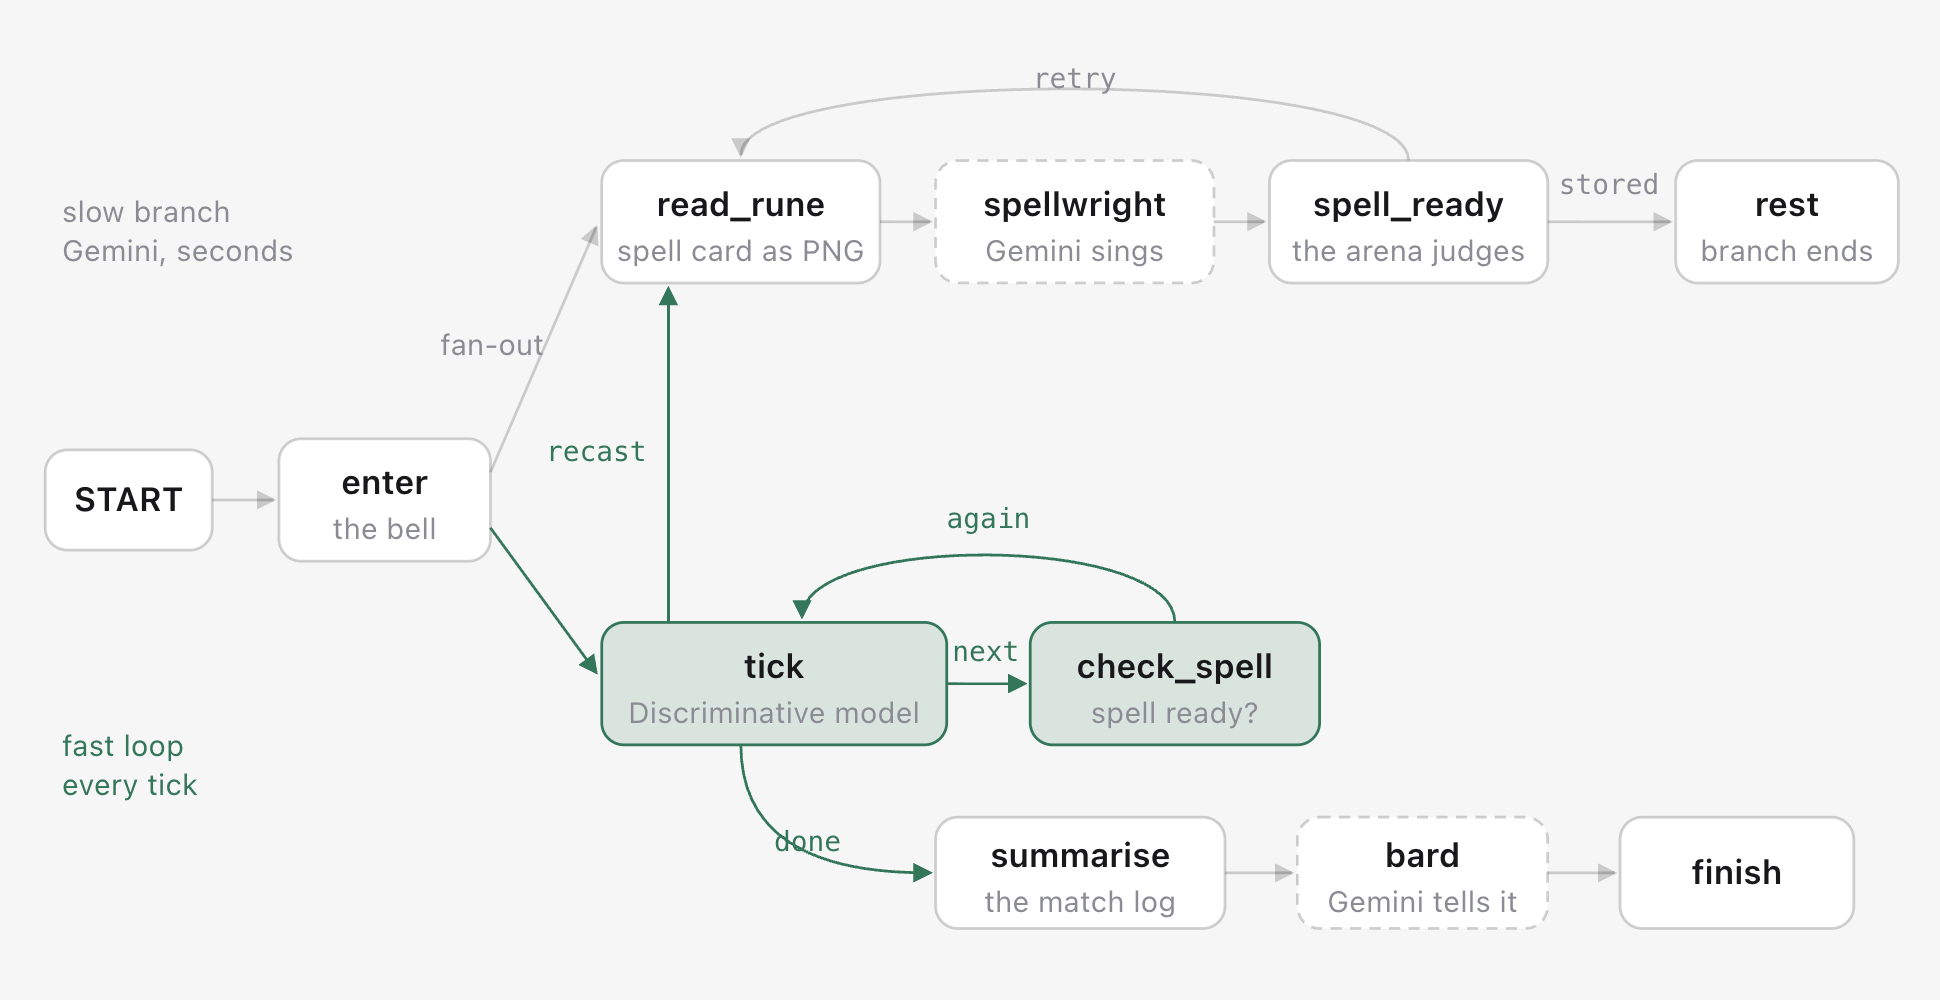
Por lo tanto, el flujo de trabajo usa ambos, cada uno a su propia velocidad:
- El modelo discriminativo lucha. Cada marca, una llamada, una decisión, cien milisegundos. El bucle nunca espera nada más lento que él mismo.
- Gemini lee y canta. En su propia rama, que comienza en la campana, toma la carta de hechizo de la pantalla de la arena como una imagen, nombra el color y las formas, y canta una incantación. La arena juzga la canción en función de la respuesta de la carta de hechizo, que nunca sale del servidor.
- Después de cada intercambio, el luchador revisa la ranura. Un nodo
check_spellobserva el estado. No está listo: Lo indica con el tiempo que Gemini lleva cantando y vuelve directamente al siguiente tic. Nunca espera. Listo:castse une a las opciones que se le ofrecen al modelo discriminativo, ychoose()gasta el hechizo en el momento en que el modelo discriminativo informa una apertura. Cuando se agota el hechizo, la pantalla dibuja una nueva carta de hechizo y el hilo lento vuelve a comenzar. Si se lee mal una canción, se quema la carta de hechizo y el hilo lento lee la nueva. - Gemini escribe un cuento corto una sola vez, al final.
Ramas paralelas con diferentes latencias y un bucle de eventos
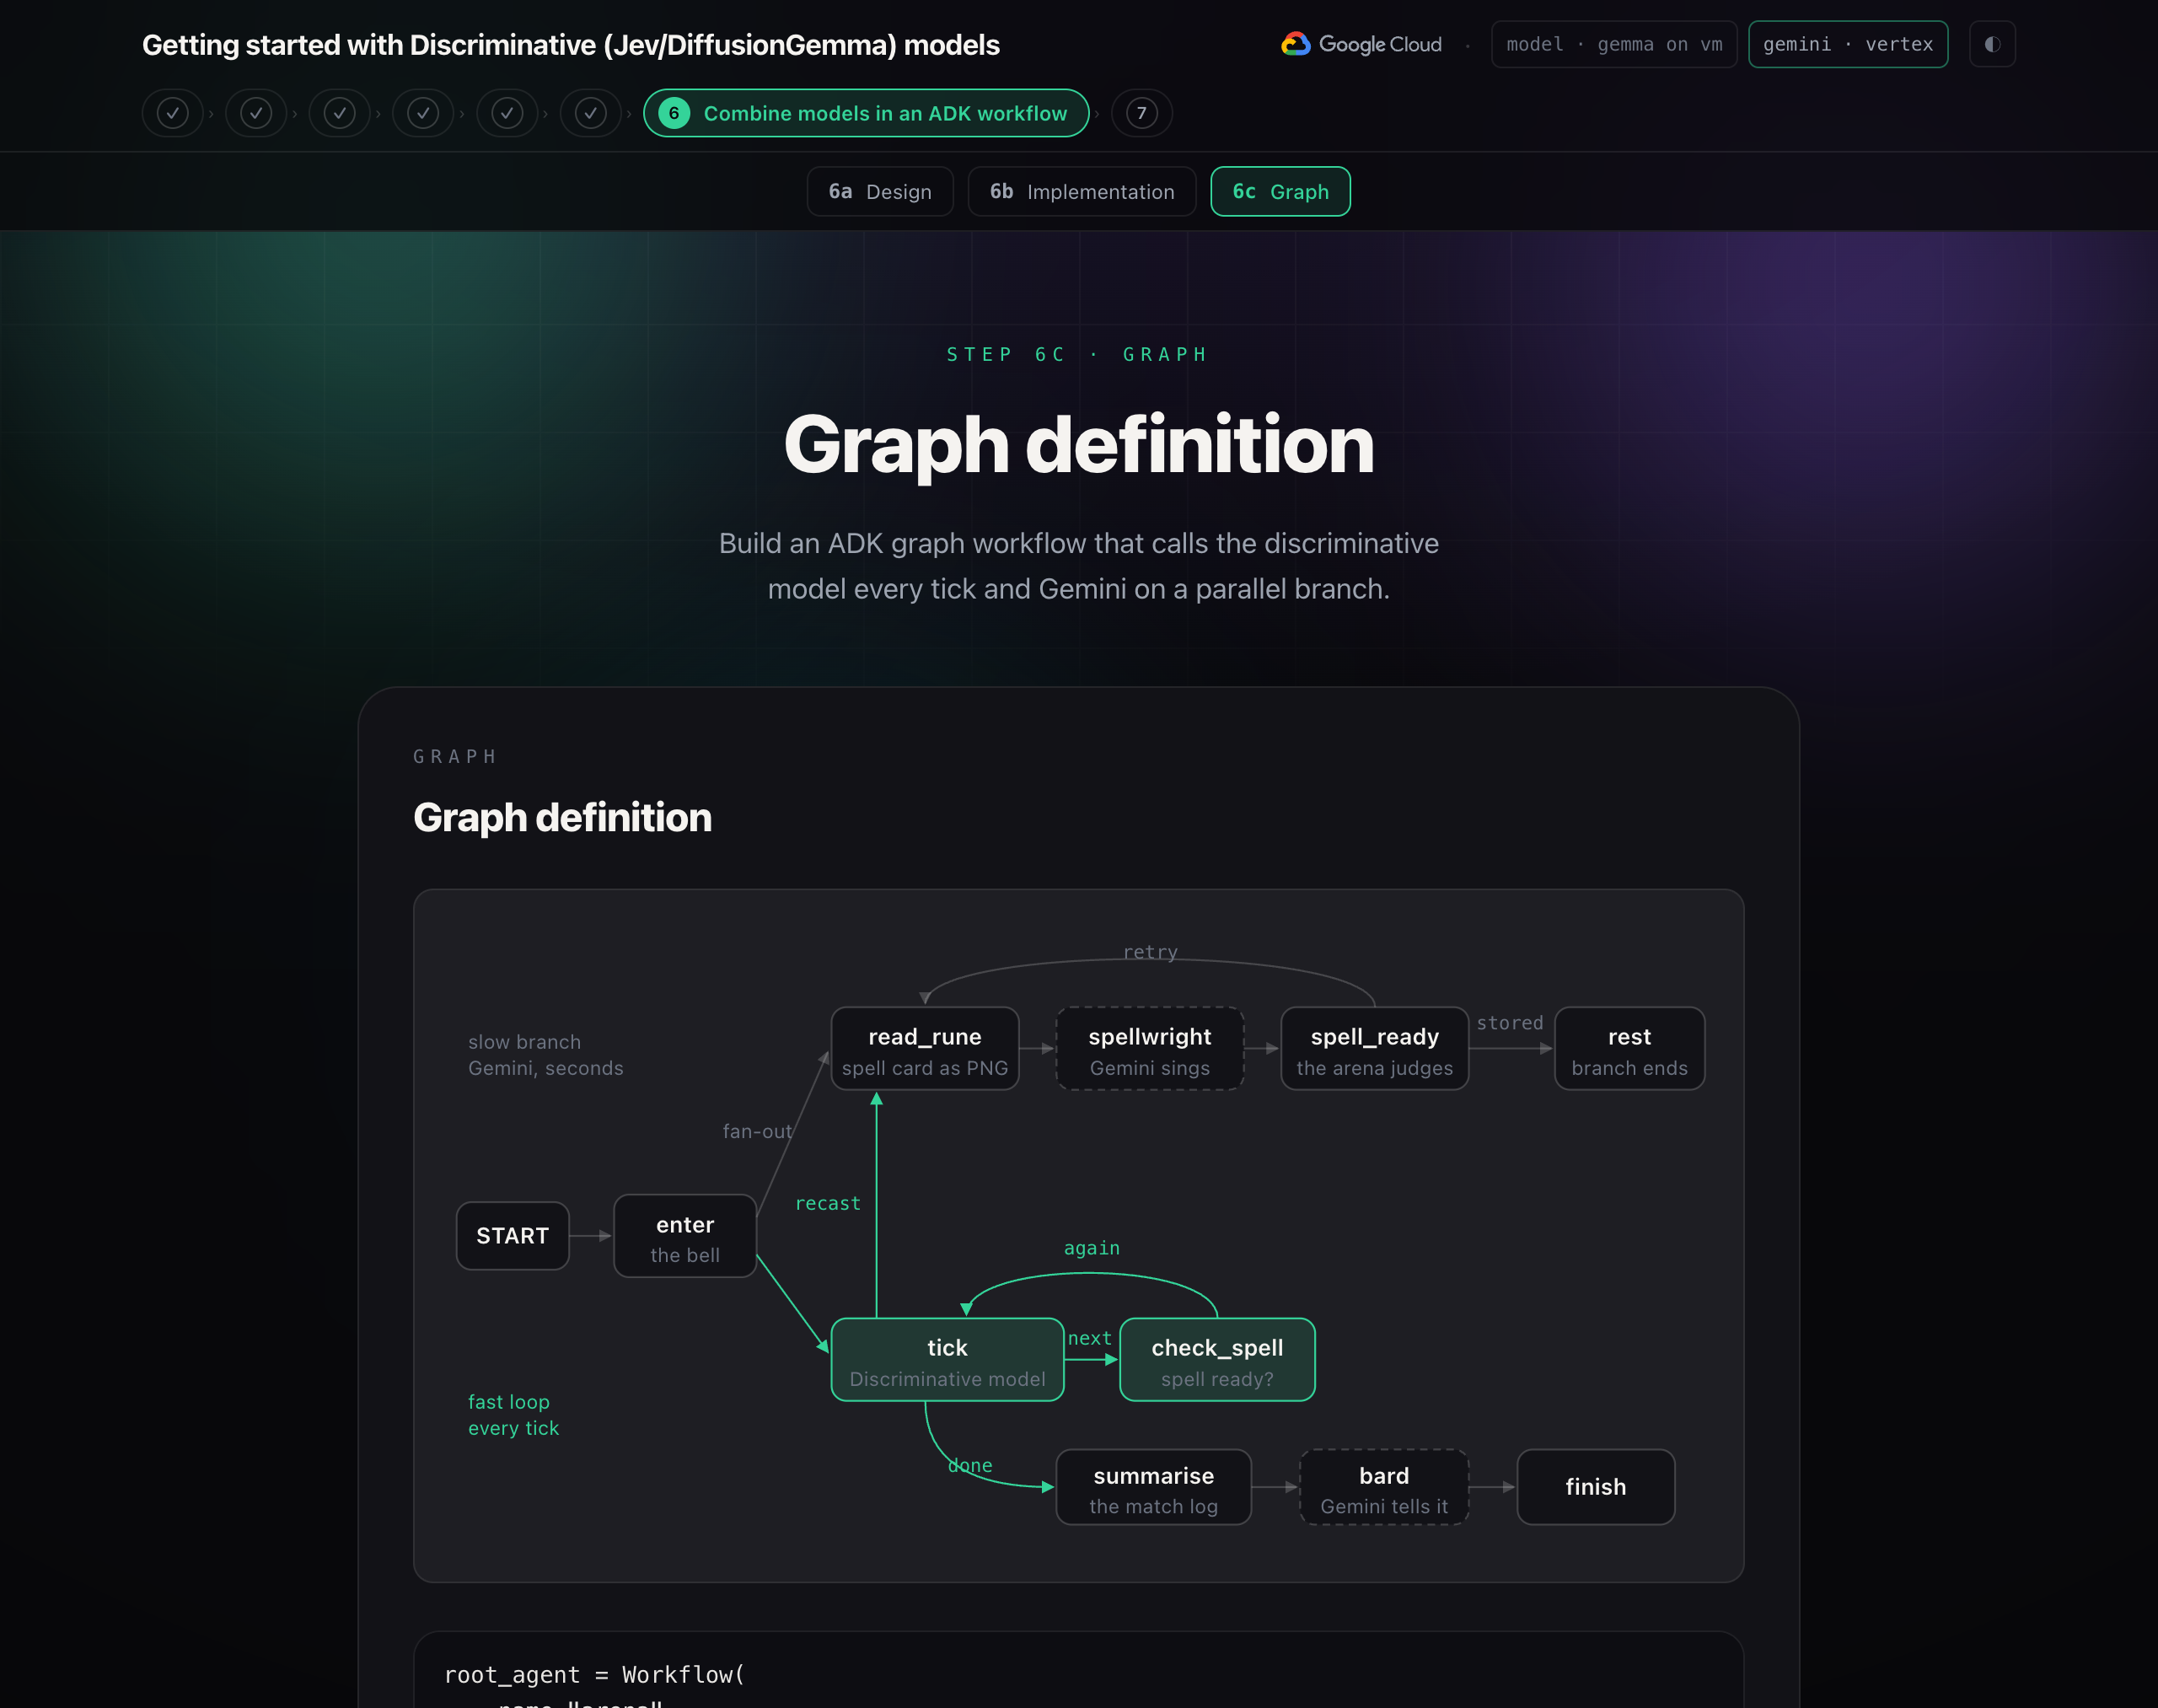
Este es un flujo de trabajo del ADK: un gráfico de nodos unidos por bordes. Un nodo es una función simple de Python o un agente de LLM. Una arista de un nodo a una tupla de nodos es un fan-out: ambos comienzan de forma simultánea. Un nodo que devuelve un Event con un route elige qué borde se tomará a continuación, y un nodo que se enruta a sí mismo es un bucle.
Piensa en ello como dos hilos. El subproceso 1 es lento: lee la carta de hechizo, canta y almacena el hechizo. El hilo 2 es rápido: marca, verifica la ranura y vuelve a marcar. El subproceso 1 finaliza en una función que escribe la ortografía juzgada en el estado de la sesión y no devuelve ningún resultado. El check_spell del subproceso 2 lee ese estado después de cada intercambio. Ninguno de los subprocesos llama al otro ni espera a que este termine; solo comparten el estado.
Conclusión clave: Coloca las decisiones en el código y asigna a cada modelo un trabajo específico a su propio ritmo.
El ADK ejecuta ambas ramas como tareas en un bucle de eventos, en un solo subproceso. Solo se ejecuta una tarea a la vez. Cuando una tarea llega a await, espera su respuesta, y el bucle ejecuta la otra rama mientras tanto. La rama rápida espera el modelo durante aproximadamente una décima de segundo, y la rama lenta espera a Gemini durante varios segundos, por lo que ninguna detiene a la otra.
Rama lenta
read_rune() quita la carta de hechizo de la pantalla como una imagen.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright es Gemini. Lee la imagen y responde en una forma fija.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() hace que el juez de la arena evalúe el hechizo y, luego, lo almacene o vuelva a intentarlo.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Un nodo de función puede devolver un Content con una parte de imagen, y el nodo del LLM lo recibe como turno del usuario. spell_ready devuelve un Event con un delta de estado y sin output. El siguiente tic lee el hechizo del estado, y una rama sin salida no es un segundo final para el gráfico: el ADK requiere una salida terminal, y esa es la de la pelea.
Nota: La evaluación se realiza con código, en la arena, en comparación con la respuesta oculta de la tarjeta de hechizo. Una lectura perfecta hace 45, más en una apertura. Dos formas a la derecha equivalen a 25. Una lectura incorrecta hace que la carta de hechizo se queme y se consuma. No se le pregunta a Gemini si la respuesta fue correcta.
Rama rápida
tick() reproduce un intercambio y, luego, elige la siguiente arista.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() observa el espacio de hechizo después de cada intercambio.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell analiza la posición después de cada intercambio. Nunca se bloquea: si el hechizo no está listo, lo informa y continúa.
El diseño se basa en tres elementos. La llamada al modelo discriminativo se realiza con await con el cliente asíncrono, por lo que el bucle cede mientras espera y la rama de Gemini sigue ejecutándose. Las preguntas se generan de nuevo en cada marca, por lo que cast solo aparece cuando hay algo para transmitir. Además, route puede ser una lista: ["recast", "next"] toma ambos bordes a la vez.
La arena en sí está detrás de un cliente pequeño: la app en ejecución a través de HTTP cuando hay una, por lo que la página muestra la pelea; el motor en proceso cuando no hay una.
Definición del gráfico
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Una tupla como destino es un fan-out. Una tupla como borde es una cadena. Un diccionario asigna nombres de rutas a nodos. tick → check_spell → tick es el bucle rápido. "recast": read_rune reinicia el subproceso lento después de que se gasta un hechizo, "retry" hace lo mismo después de un error y "stored": rest permite que el subproceso lento finalice de forma silenciosa, sin ninguna salida, una vez que el hechizo está en la ranura. El ADK requiere al menos un borde con ruta en un ciclo, por lo que se rechaza un bucle incondicional antes de que pueda ejecutarse de forma indefinida.
Nota: root_agent es lo que buscan las herramientas del ADK. adk web agents desde la raíz del taller abre la IU para desarrolladores con el estadio, si quieres ver el gráfico y los eventos en un navegador en lugar de una terminal.