

۱. مقدمه
یک کارگاه ۹۰ دقیقهای در مورد مدل تشخیص ، مدل تصمیمگیری سیستم یک TypeSafe AI و قرار دادن آن در کنار Gemini در گردش کار Google ADK. در این کارگاه شش مرحله وجود دارد که حول یک بازی مبارزهای ساخته شدهاند. ابتدا با غول به صورت دستی مبارزه خواهید کرد، سپس رفلکسها را به مدل تشخیص میدهید، و سپس شاهد پیروزی گردش کار ADK در مبارزه با مدل تشخیص هستید که هر تیک را تعیین میکند و Gemini کارتهای طلسم را از روی صفحه میخواند تا طلسمها را بخواند.
نمای کلی
مدل تشخیصی ( jev-1.13 ، با نام مستعار jev-latest ) یک مدل میزبانی شده از TypeSafe AI است که در 19 سپتامبر 2026 منتشر شد. این مدل متن تولید نمیکند. شما حالت (متن، JSON یا یک لیست) و سوالات تایپ شده ( Choice ، Score ، Noul ) را برای آن ارسال میکنید و پاسخهای تایپ شده را با احتمالات کالیبره شده، تقریباً در 70 تا 500 میلیثانیه، با قیمت 0.042 دلار به ازای هر میلیون توکن ورودی و بدون دریافت هیچ خروجی، برمیگرداند. وظیفه آن تصمیمگیری در جلو، بین و پشت مدلهای زبانی است: مسیریابی، طبقهبندی، دروازهبندی و در اینجا، رفلکسهای یک جنگنده.
یک بازی به عنوان مثال
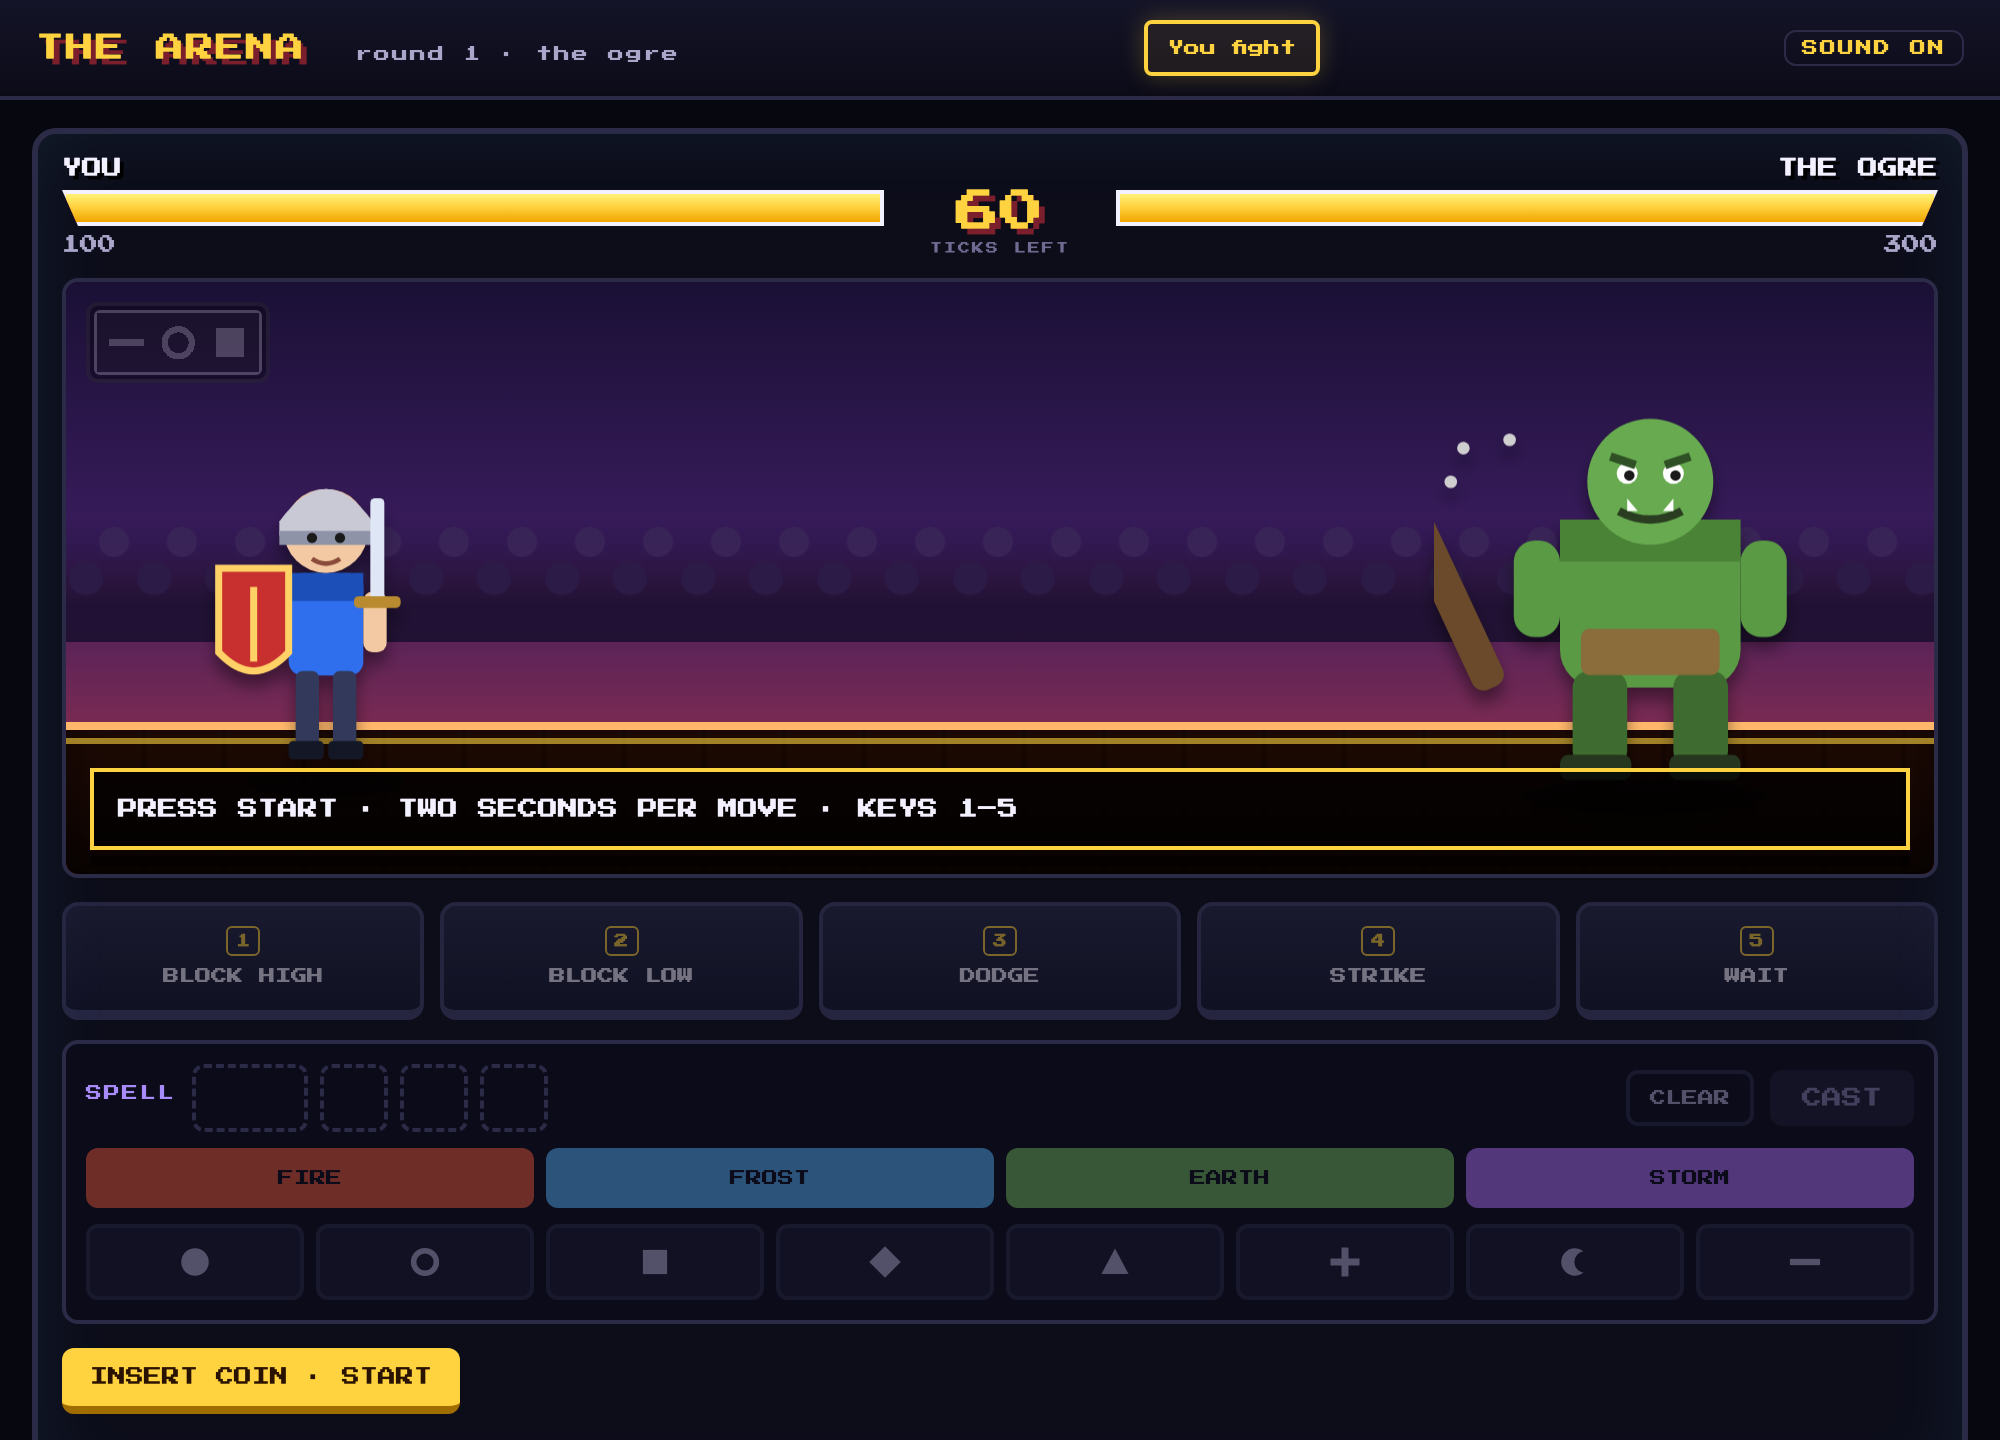
آیا تا به حال یک بازی جنگی انجام دادهاید؟ با حریفی روبرو میشوید و باید فوراً به حرکات او واکنش نشان دهید. یک حدس اشتباه باعث میشود HP شما از بین برود. بازیها همچنین تمایل دارند که استفاده از طلسمها را دشوار کنند. در بازی ما، باید قبل از آزاد شدن طلسم، رنگ و شکل کارت طلسم را به ترتیب انتخاب کنید. این کارگاه به شما نشان میدهد که چگونه هر دو نوع مدل را برای پیروزی شخصیت خود ترکیب کنید.
هر عنصر بازی به یک سیستم واقعی نگاشت میشود:
- حرکت حریف یک رویداد ورودی است، مانند یک درخواست یا یک تراکنش.
- پاسخ یک تصمیم محدود است که توسط مدل تشخیصی گرفته شده و توسط کد بررسی میشود.
- کارت طلسم، ورودی بدون ساختار است که برای خواندن به یک مدل زبانی نیاز دارد.
- تطابق ، گردش کار است، کارهای سریع و آهسته با سرعت خودشان انجام میشوند.
تمرکز بر ترکیب چهار جزء و کنار هم قرار دادن آنها برای ساخت یک سیستم سریع و هوشمند است.
آنچه یاد خواهید گرفت
- توضیح دهید که مدلهای تشخیصی (سیستم اول) و مولد (سیستم دوم) چه تفاوتی با هم دارند و چه زمانی باید از هر کدام استفاده کرد.
- نحوهی ارائهی Jev و DiffusionGemma را شرح دهید و یکی از آنها را برای کارگاه تنظیم کنید، که شامل DiffusionGemma روی یک ماشین مجازی GPU با موتور محاسباتی باشد.
- سوالات Choice، Score و Noul را بنویسید و احتمالات و اطمینان را تفسیر کنید.
- از آستانهها در کد قطعی برای تبدیل احتمالات به اقدامات استفاده کنید.
- با استفاده از TypeSafe SDK یک درخواست بسازید، سپس اجازه دهید مدل هر حرکت در بازی را انتخاب کند.
- یک شاخه کند بسازید، جایی که Gemini یک تصویر را میخواند، و یک شاخه سریع، جایی که مدل تشخیصی در یک حلقه تصمیم میگیرد، و هر کدام را به تنهایی اجرا کنید.
- هر دو شاخه را در یک گردش کار گراف ADK که حالت را در یک حلقه رویداد به اشتراک میگذارد، به هم متصل کنید، بنابراین کار کند هرگز مانع تصمیمات سریع نمیشود.
معماری
میز کار در cloudshell (یا دستگاه شما) قرار میگیرد و فایل سیستم محلی را مینویسد و با آرنا و همچنین با Gemini و مدل تصمیمگیری تعامل میکند. ② مدل تصمیمگیری را در "Discriminative model fights" فراخوانی میکند؛ ③ هر دو را در "Workflow fights" فراخوانی میکند.
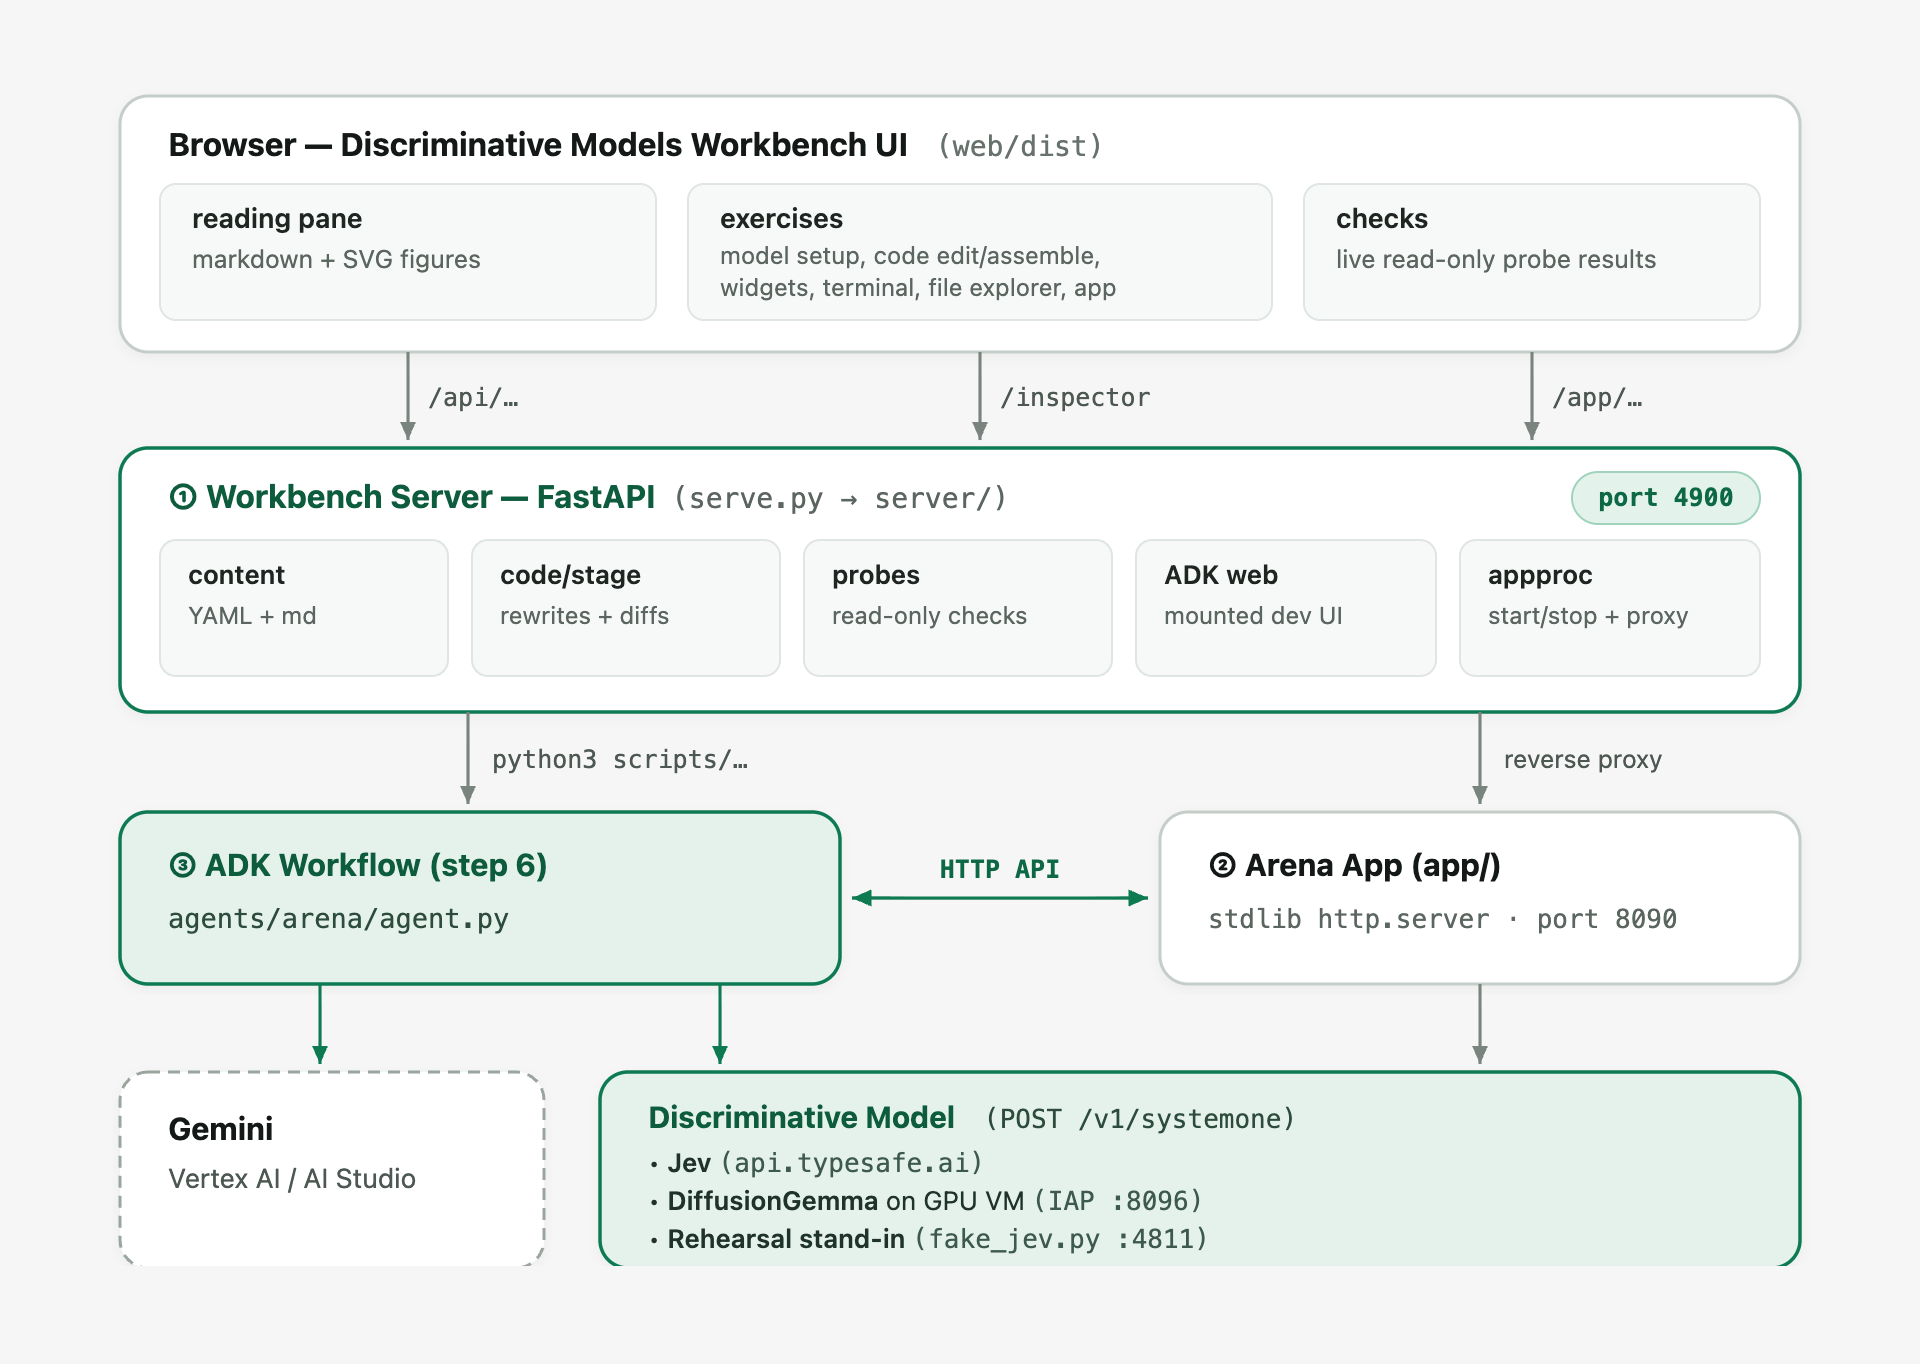
چه کسی، چه چیزی را فراخوانی میکند. مرورگر فقط با ① ارتباط برقرار میکند. هر دو مدل از پایتون روی دستگاه فراخوانی میشوند:
تماس گیرنده | مدل تبعیضآمیز | جوزا |
② عرصه، "مبارزه با مدل تبعیضآمیز" | هر تیک، | خیر |
③ | هر تیک، | خیر |
③ گردش کار | خیر | تصویر کارت طلسم؛ داستان پس از مبارزه |
| بله | خیر |
یک تیک، برای هر حالت.
- شما مبارزه میکنید. صفحه از شما ۲ تلگراف میخواهد، آن را با تایمر ۲ ثانیهای نشان میدهد و دکمهای که فشار میدهید (یا طلسمی که تایپ میکنید) را برمیگرداند. ۲ آن را حل میکند.
- مدل تشخیصی دچار مشکل میشود. صفحه از ② یک تیک میخواهد؛ ② یک تلگراف رسم میکند، سه سوال را در یک فراخوانی از مدل میپرسد،
choose()را اجرا میکند و پاسخها و نتیجه را برمیگرداند. صفحه میلهها را رسم میکند. - جریان کاری میجنگد. شروع باعث میشود ②، ③ را به عنوان یک زیرفرآیند راهاندازی کند (وارد شوید
runs/arena-workflow.log). ③ جریان را هدایت میکند: از ② برای هر تلگراف سوال میکند، مدل را فراخوانی میکند و تصمیم را ارسال میکند؛ طلسم Gemini هر زمان که آماده باشد، روی شاخه خودش میرسد. صفحه فقط ② را نظرسنجی میکند و قرعهکشی میکند. مکث یک پرچم روی ② است که ③ قبل از هر تیک بررسی میکند.
جایی که مدل تصمیمگیری میزبانی میشود. هر فراخوانی از طریق typesafe-sdk یکسانی انجام میشود؛ فقط URL پایه تغییر میکند. scripts/jevauth.py نام backend را تعیین کرده و کلید و زمان انقضا را تنظیم میکند:
بکاند | | کلید | تنظیم شده توسط |
TypeSafe، میزبانی شده | تنظیم نشده (api.typesafe.ai) | | |
DiffusionGemma روی ماشین مجازی سطح ۴ شما | | هیچ کدام | |
DiffusionGemma در Cloud Run | | یک توکن هویت گوگل، که در هر ساعت دریافت میشود | |
تمرین | | هیچ کدام | |
پاسخ کارت طلسم ۲: گردش کار فقط PNG را دریافت میکند، و ۲ طلسمی را که برمیگرداند قضاوت میکند. این همان چیزی است که طلسم را به آزمونی واقعی برای خواندن جوزا تبدیل میکند، و طلسمی که شما در «میجنگی» میسازید، آزمونی واقعی برای شماست.
۲. راهاندازی
امتیاز کارگاه خود را مطالبه کنید
اگر برای این جلسه اعتبار Google Cloud به شما داده شد، ابتدا آن را مطالبه کنید - حدود یک دقیقه طول میکشد و حساب صورتحساب را برای شما ایجاد میکند.
پوسته ابری را باز کنید
پوسته ابری گوگل (Google Cloud Shell ) یک محیط لینوکس قابل دسترسی از طریق مرورگر است که از پیش با gcloud ، پایتون، Node.js، uv و git پیکربندی شده و از قبل با حساب گوگل شما احراز هویت شده است.
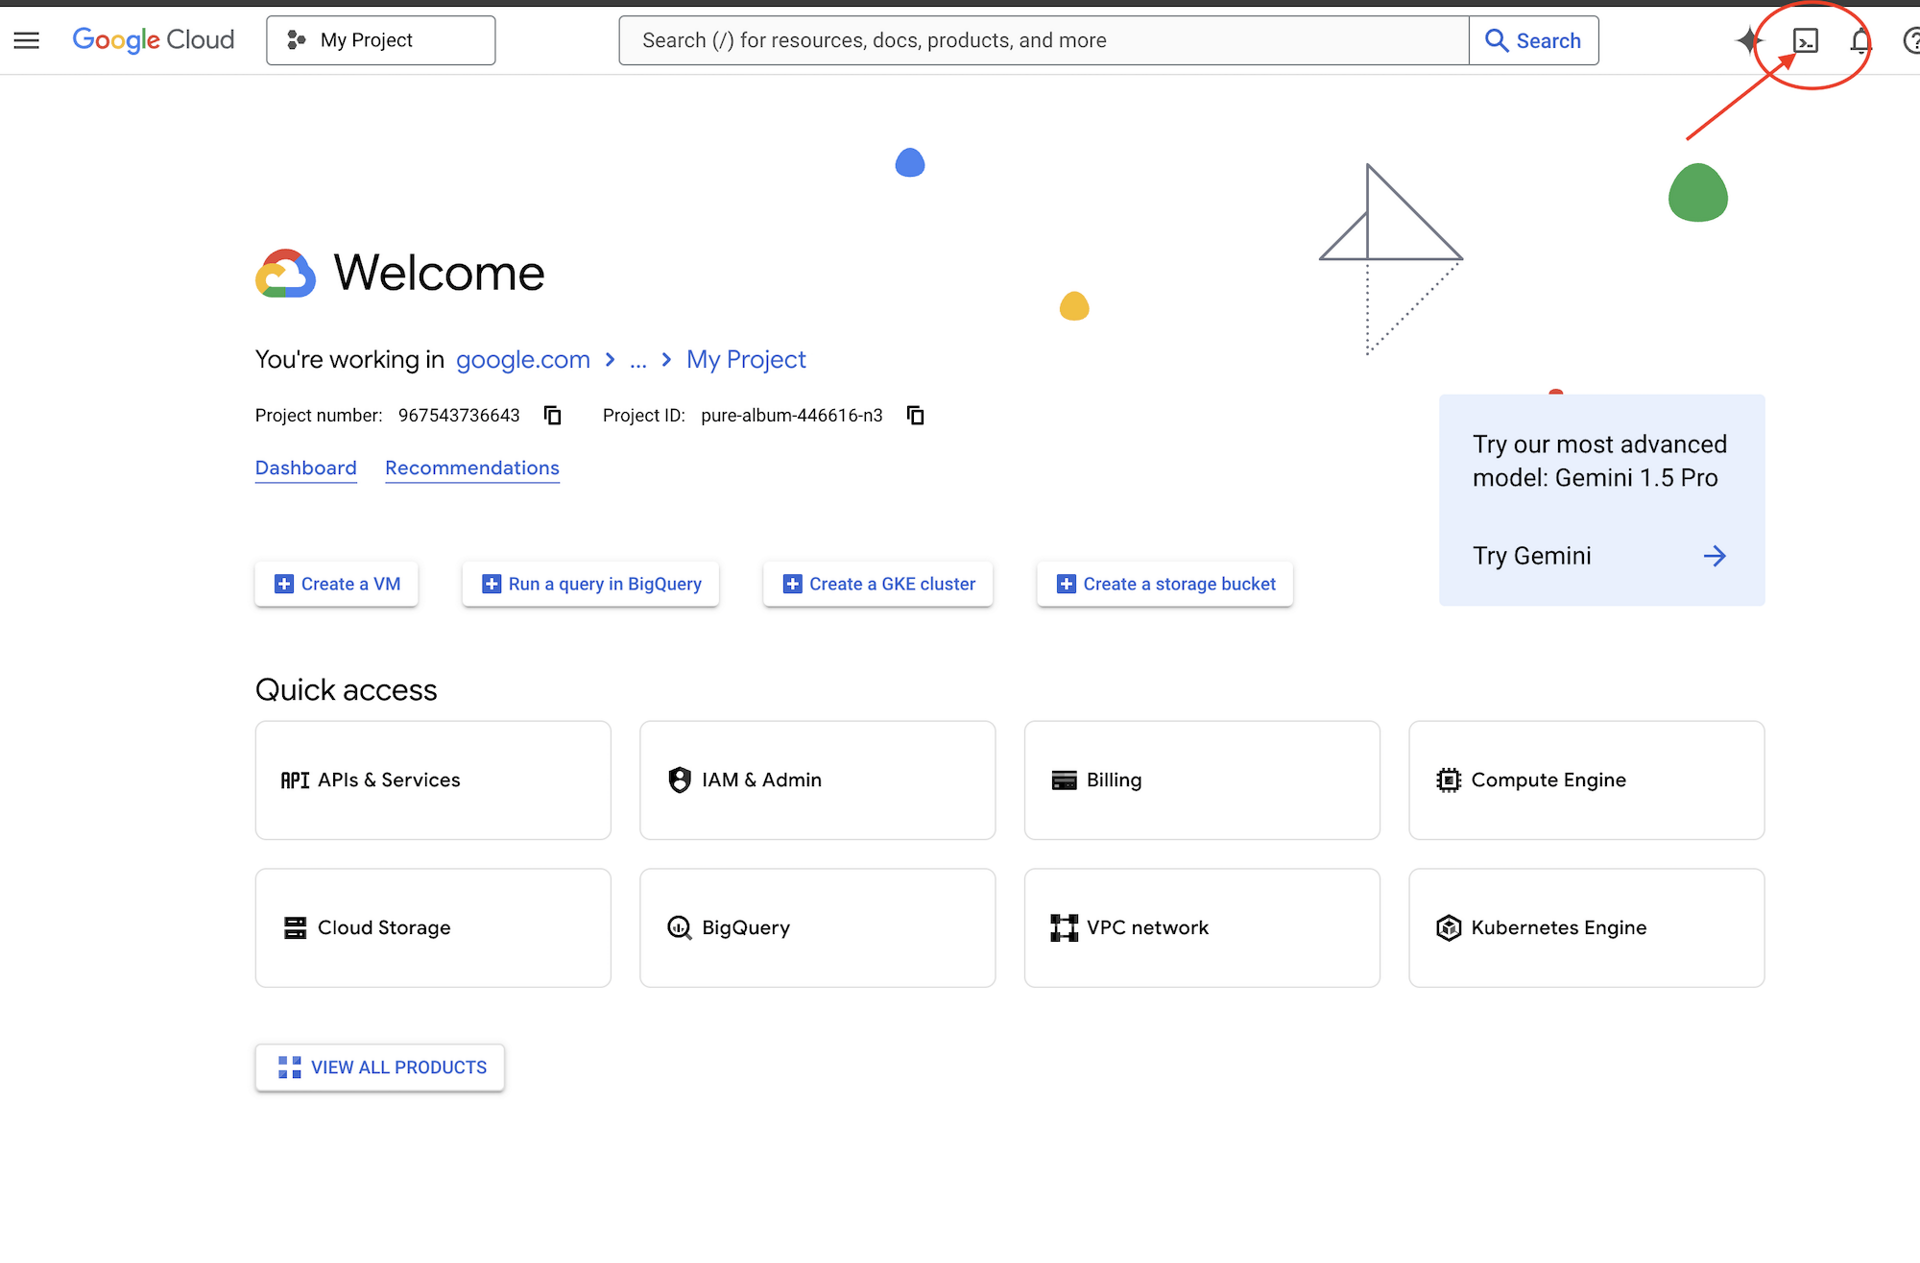
- کنسول گوگل کلود را باز کنید.
- برای باز کردن یک جلسه ترمینال در پایین مرورگر خود، روی فعال کردن Cloud Shell (آیکون ترمینال در نوار ناوبری بالا) کلیک کنید.
میز کار را راه اندازی کنید
در Cloud Shell یا هر جایی که gcloud وارد سیستم شده است:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh یک پروژه ( discrim-models-XXXX ) ایجاد میکند، صورتحساب را به آن پیوند میدهد، در صورت وجود حساب اعتباری رویداد، آن را ترجیح میدهد و منتظر میماند تا پروژه بتواند سرویسدهی کند. اجرای مجدد آن، پروژه موجود در ~/project_id.txt را دوباره استفاده میکند. برای استفاده از پروژهای که از قبل دارید، شناسه آن را در آن فایل قرار دهید و از این اسکریپت صرف نظر کنید.
setup_codelab.sh هیچ سوالی نمیپرسد. این فایل uv و بستههای پایتون را نصب میکند، Vertex AI، Compute Engine و IAP را فعال میکند، Gemini را در پروژه در فایل .env به Vertex AI ارجاع میدهد، یک فراخوانی واقعی Gemini با مدلی که پروژه میتواند فراخوانی کند انجام میدهد، صفحه را میسازد، میز کار را در پسزمینه شروع میکند و scripts/check_setup.py را اجرا میکند. اجرای مجدد آن فایلهای تمرین شما را نگه میدارد؛ scripts/starter.sh آنها را بازنشانی میکند. مدل تصمیمگیری در مرحله 2 میز کار انتخاب میشود.
برای باز کردن رابط کاربری میز کار در Cloud Shell:
- روی پیوند پیشنمایش چاپ شده در انتهای
./setup_codelab.shکلیک کنید، یا روی پیشنمایش وب در گوشه بالا سمت راست نوار ابزار Cloud Shell کلیک کنید. - تغییر پورت را انتخاب کنید، عدد ۴۹۰۰ را وارد کنید و روی تغییر و پیشنمایش کلیک کنید.
Gemini در پروژه شما روی Vertex AI و با اعتبارنامههای گوگل شما اجرا میشود: GOOGLE_GENAI_USE_VERTEXAI=1 ، GOOGLE_CLOUD_PROJECT و GOOGLE_CLOUD_LOCATION=global در .env .
مدل تصمیمگیری به خودی خود، در مرحله ۲ میز کار، یا از یک ترمینال با scripts/setup_model.sh انتخاب میشود:
انتخاب | نیازها | راهاندازی | هزینه |
مدل تبعیضآمیز (TypeSafe، میزبانیشده) | یک کلید API از نوع TypeSafe | هیچ کدام | به ازای هر توکن، کسری از یک سنت |
DiffusionGemma (گوگل، وزنهای آزاد) | صورتحساب + سهمیه موتور محاسباتی برای پردازنده گرافیکی | حدود ۱۵ دقیقه، خودکار | حدود ۰.۷۱ دلار در ساعت در حالی که ماشین مجازی در حال اجرا است |
تمرین (بدون الگو) | هیچ چیز | هیچ کدام | هیچ کدام |
DiffusionGemma روی یک ماشین مجازی موتور محاسباتی
scripts/setup_gemma.sh ابتدا سهمیه GPU را بررسی میکند، سپس یک ماشین مجازی g2-standard-4 (1 × L4 24 GB, 4 vCPU, 16 GB) از تصویر یادگیری عمیق گوگل با درایور NVIDIA 580 میسازد. در اولین بوت، ماشین مجازی Docker را نصب میکند، وزنها را از Hugging Face ( nvidia/diffusiongemma-26B-A4B-it-NVFP4 ، 17.5 GB، public، no token) دانلود میکند و djev-run : DiffusionGemma را پشت API دقیق مدل Discriminative اجرا میکند. پورت مدل به اینترنت باز نیست: میز کار از طریق یک تونل IAP در localhost:8096 به آن میرسد، که scripts/start.sh آن را باز میکند.
مکث / ادامه | | |
تونل | | |
حذف | | |
دستورات را تمرین کنید | | |
طرح مخزن
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
۳. خلاصه
محیط خود را پاکسازی کنید
وقتی کارگاه را تمام کردید، مراحل زیر را برای از بین بردن هرگونه منابع GPU مربوط به DiffusionGemma، متوقف کردن فرآیندهای میز کار و تمرین پسزمینه، حذف فایلهای کارگاه از Cloud Shell و (اختیاری) حذف پروژه Google Cloud کارگاه خود انجام دهید.
- حذف قانون DiffusionGemma GPU VM و فایروال (در صورت ایجاد) : اگر DiffusionGemma را در مرحله 2 روی یک Compute Engine GPU VM تنظیم کردهاید، قانون فایروال VM، دیسک و IAP را حذف کنید تا هیچ هزینه محاسباتی یا ذخیرهسازی دیسکی در حال انجام ایجاد نشود:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - متوقف کردن فرآیندهای میز کار و تمرین در Cloud Shell : در ترمینال Cloud Shell خود، سرور میز کار پسزمینه و هر فرآیند جایگزین تمرین را متوقف کنید:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - پوشه workshop را از Cloud Shell حذف کنید : به پوشه home خود برگردید و پوشه مخزن کلون شده و فایل شناسه پروژه را حذف کنید:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - پروژه Google Cloud خود را حذف کنید : اگر
./setup_project.shیک پروژه کارگاه اختصاصی ایجاد کرده باشد (برای مثال،discrim-models-XXXX)، خاموش کردن پروژه تمام منابع ایجاد شده در داخل آن را به طور دائم حذف میکند در حالی که حساب Cloud Billing شما دست نخورده باقی میماند:- صفحه مدیریت منابع را در کنسول Google Cloud باز کنید.
- پروژه کارگاه خود (مثلاً
discrim-models-...) را از فهرست منابع انتخاب کنید. - روی حذف در نوار ابزار بالا کلیک کنید، شناسه پروژه خود را برای تأیید تایپ کنید و روی خاموش کردن کلیک کنید.
شما این کارگاه را به پایان رساندید.
خلاصه آزمایشگاه
- یک مدل تشخیصی، Jev یا DiffusionGemma را روی یک ماشین مجازی GPU با موتور محاسباتی انتخاب کردم و بررسی کردم که آیا جواب میدهد یا خیر.
- با دست و طبق برنامه در میدان بازی کردم تا قوانینش را یاد بگیرم.
- یاد گرفتم که چگونه یک مدل تشخیصی به سوالات Choice، Score و Noul، احتمالات و اطمینان پاسخ میدهد و چگونه کد شما آستانهها را برای آنها اعمال میکند.
- اولین درخواست خود را ارسال کنید، سپس به مدل اجازه دهید هر حرکت در میدان را انتخاب کند، و
choose()پاسخهای آن را به اقدامات تبدیل میکند. - هر شاخه از گردش کار ADK را به تنهایی ساخت، به طوری که Gemini تصویر یک کارت طلسم را میخواند و مدل در یک حلقه تصمیم میگیرد.
- به آنها در یک گردش کار که وضعیت را به اشتراک میگذارد، ملحق شدم، بنابراین مبارزه هرگز منتظر جوزا نمیماند و طلسم در یک نقطه شروع اجرا میشود.
از گفتگو تا تصمیم گیری
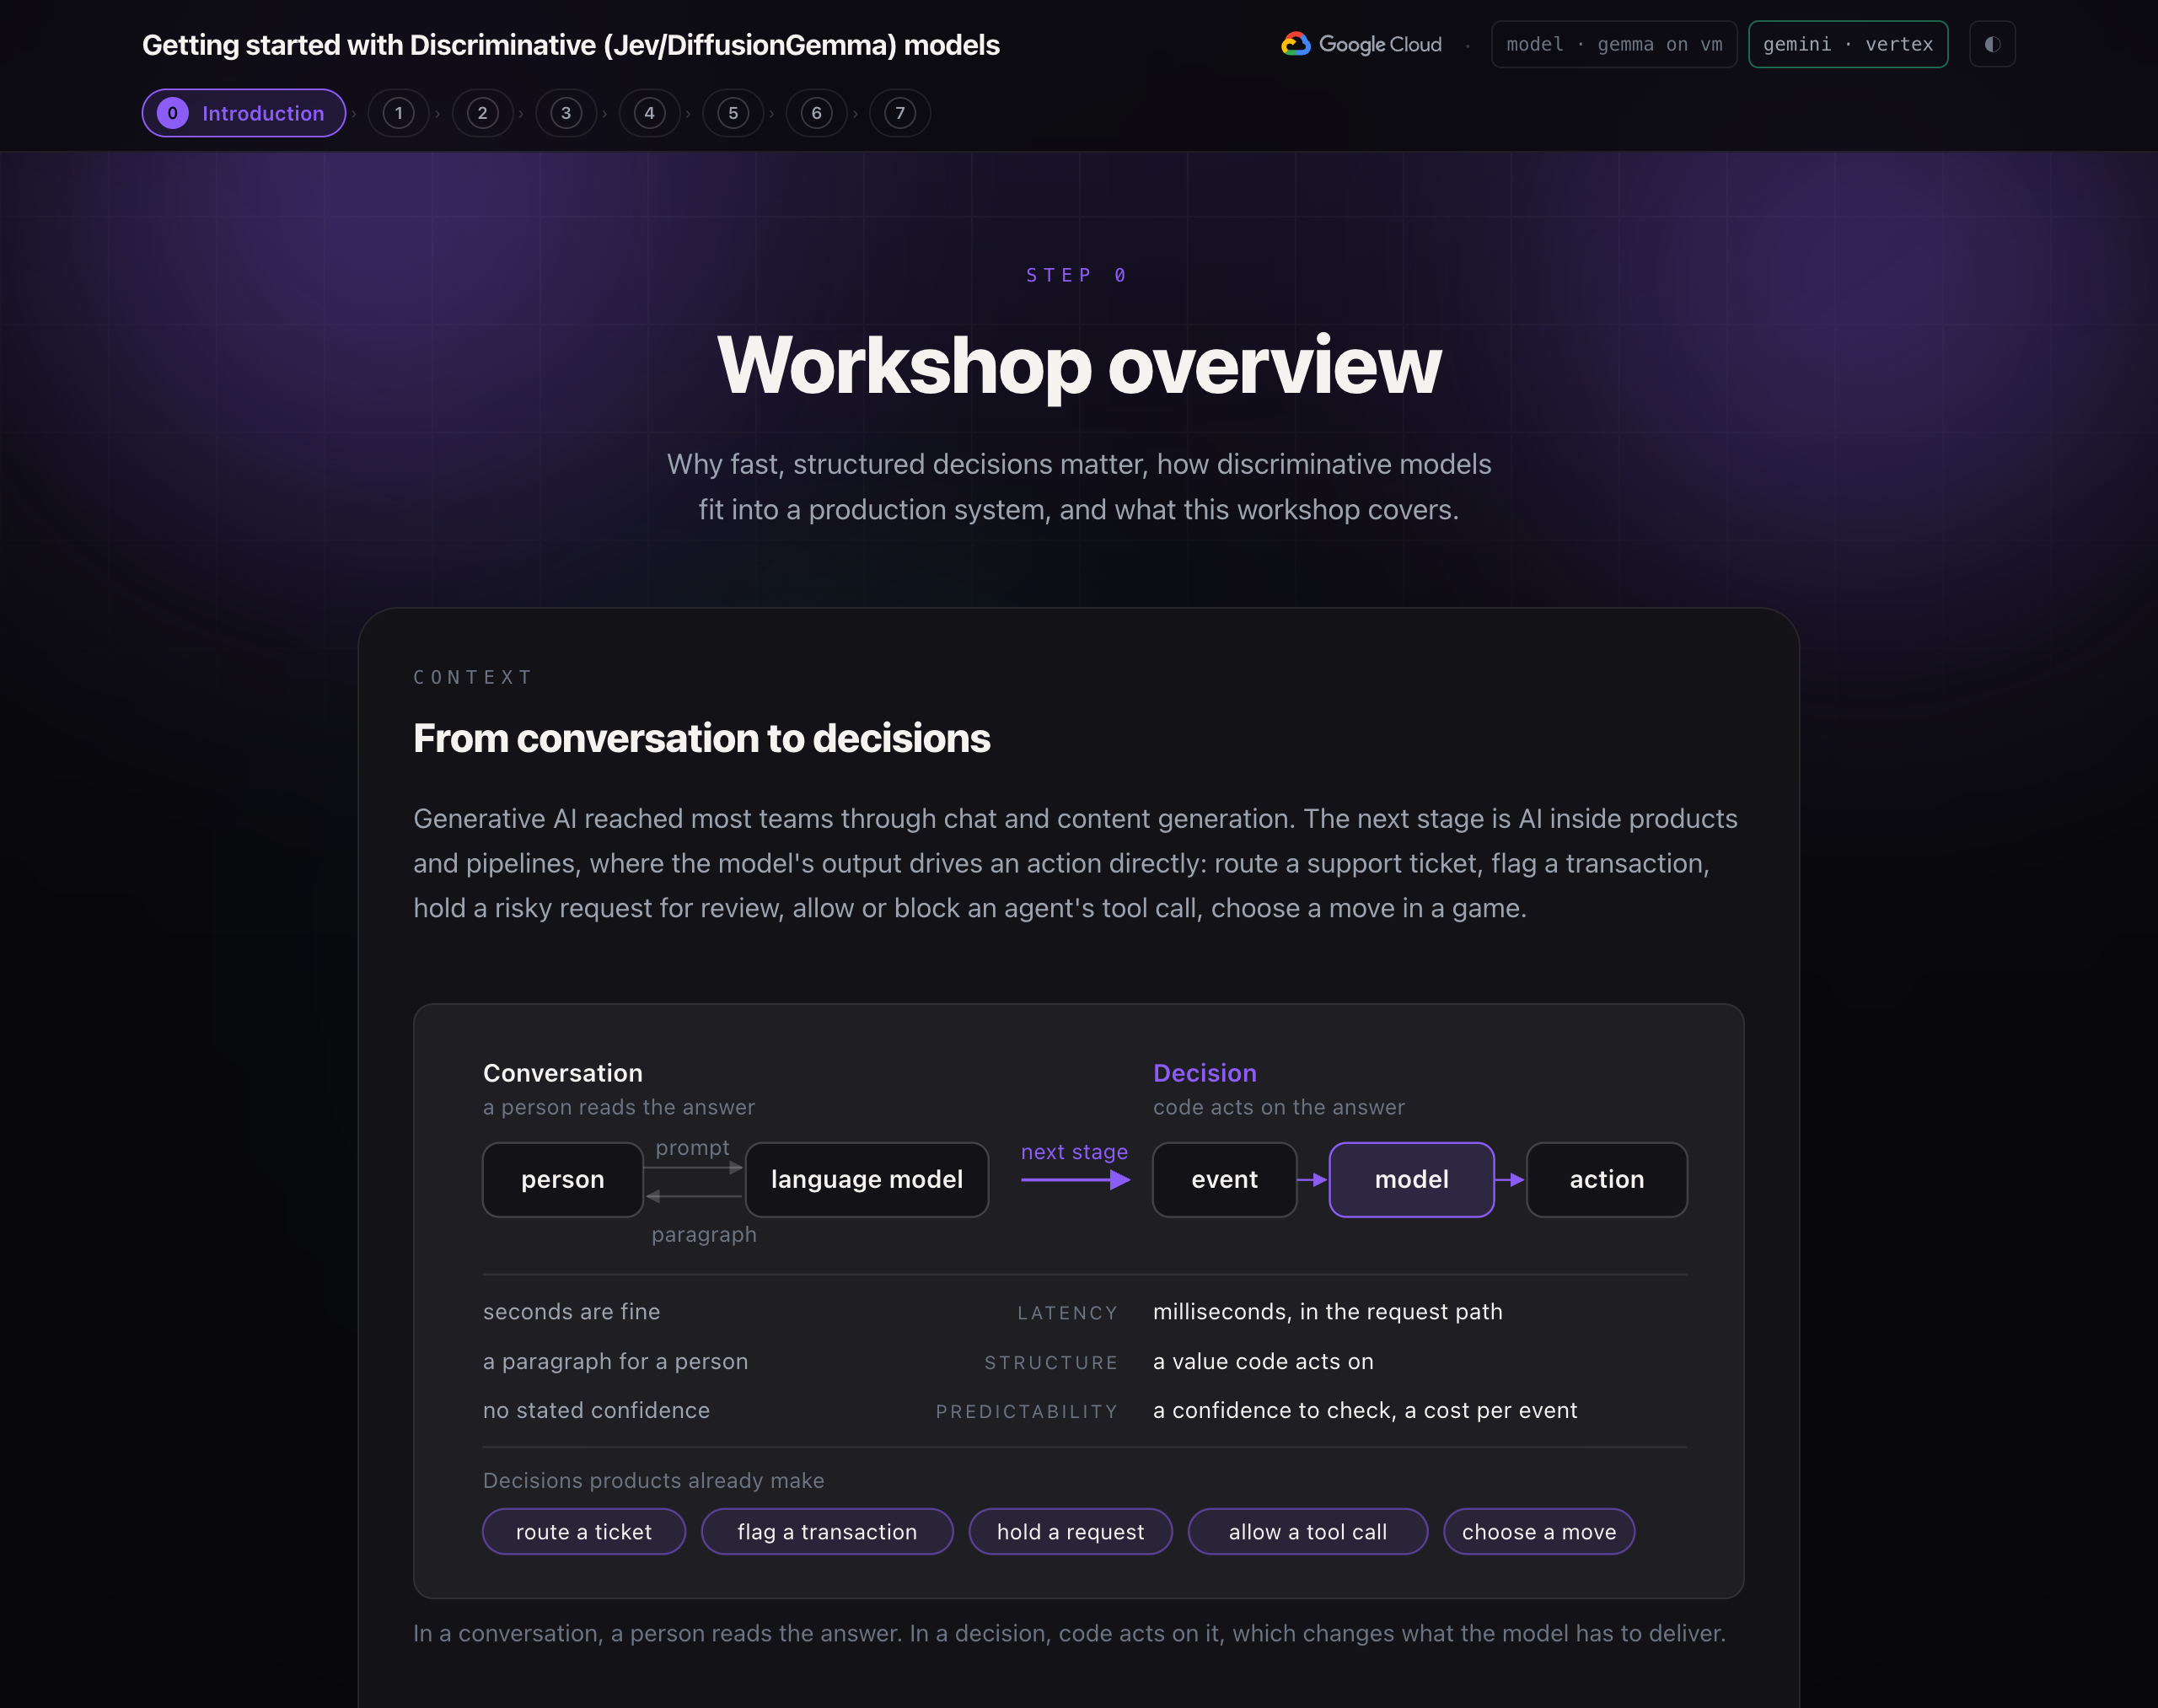
هوش مصنوعی مولد از طریق چت و تولید محتوا به اکثر تیمها رسید. مرحله بعدی، هوش مصنوعی درون محصولات و خطوط تولید است، جایی که خروجی مدل مستقیماً یک اقدام را هدایت میکند: مسیریابی یک تیکت پشتیبانی، علامتگذاری یک تراکنش، نگهداشتن یک درخواست پرخطر برای بررسی، اجازه یا مسدود کردن فراخوانی ابزار یک عامل، انتخاب یک حرکت در یک بازی.
این تصمیمات سه الزام مشترک دارند که چت ندارد:
- تأخیر. پاسخ اغلب در مسیر درخواست کاربر یا یک حلقه بلادرنگ است، بنابراین باید در میلیثانیه برسد، نه ثانیه.
- ساختار. فراخوانیکننده کد است، بنابراین پاسخ باید مقداری باشد که بتواند روی آن عمل کند، نه پاراگرافی که باید تجزیه شود.
- پیشبینیپذیری. هر تصمیمی نیاز به اطمینانی دارد که کد بتواند آن را بررسی کند، و هزینهای به اندازه کافی پایین که بتوان در هر رویدادی از آن سوال کرد.
یک مدل زبانی، متن را به صورت تک تک توکنها تولید میکند. میتوان آن را به صورت بله یا خیر فراخوانی کرد، اما برای یک حلقه بلادرنگ کند است، خروجی آن باید تجزیه شود و میزان اطمینان آن را گزارش نمیدهد.
مدلهای ساخته شده برای تصمیمگیریها
یک مدل تشخیصی به یک سوال تایپ شده با احتمال هر گزینه مجاز، در یک مرحله پاسخ میدهد. این مدل متنی تولید نمیکند. این کارگاه دو گزینه برای اجرا ارائه میدهد:
مدل | ارائه دهنده | جایی که مدل در این کارگاه اجرا میشود |
جِو | هوش مصنوعی TypeSafe | سرویس میزبانیشدهی TypeSafe، که با یک کلید API فراخوانی میشود |
دیفیوژنجما | گوگل، وزنههای باز | خود میزبانی شده روی یک ماشین مجازی GPU در پروژه Google Cloud خودتان |
مدلها را میتوان بر اساس نیاز شما تعویض کرد؛ کدی که به آنها متصل میشود نیازی به تغییر ندارد.
ترکیب اجزا
یک سیستم موفق از اجزای متعددی تشکیل شده است:
کامپوننت | نقش | در این کارگاه |
گردش کار | مراحل را هماهنگ میکند، شاخهها را به صورت موازی اجرا میکند، حالت مشترک را نگه میدارد | گردش کار گراف ADK |
کد قطعی | قوانین، آستانهها، اعتبارسنجی. فوری، رایگان و قابل حسابرسی | قوانین بازی، |
مدل تبعیضآمیز | تصمیمات سریع و محدود با امتیاز اطمینان | انتخاب یک پاسخ در هر تیک |
مدل زبان | ادراک و تولید: تصاویر و متن بیانتها | جوزا تصویر کارت طلسم را میخواند و طلسم را مینویسد |
معماری مدل محور
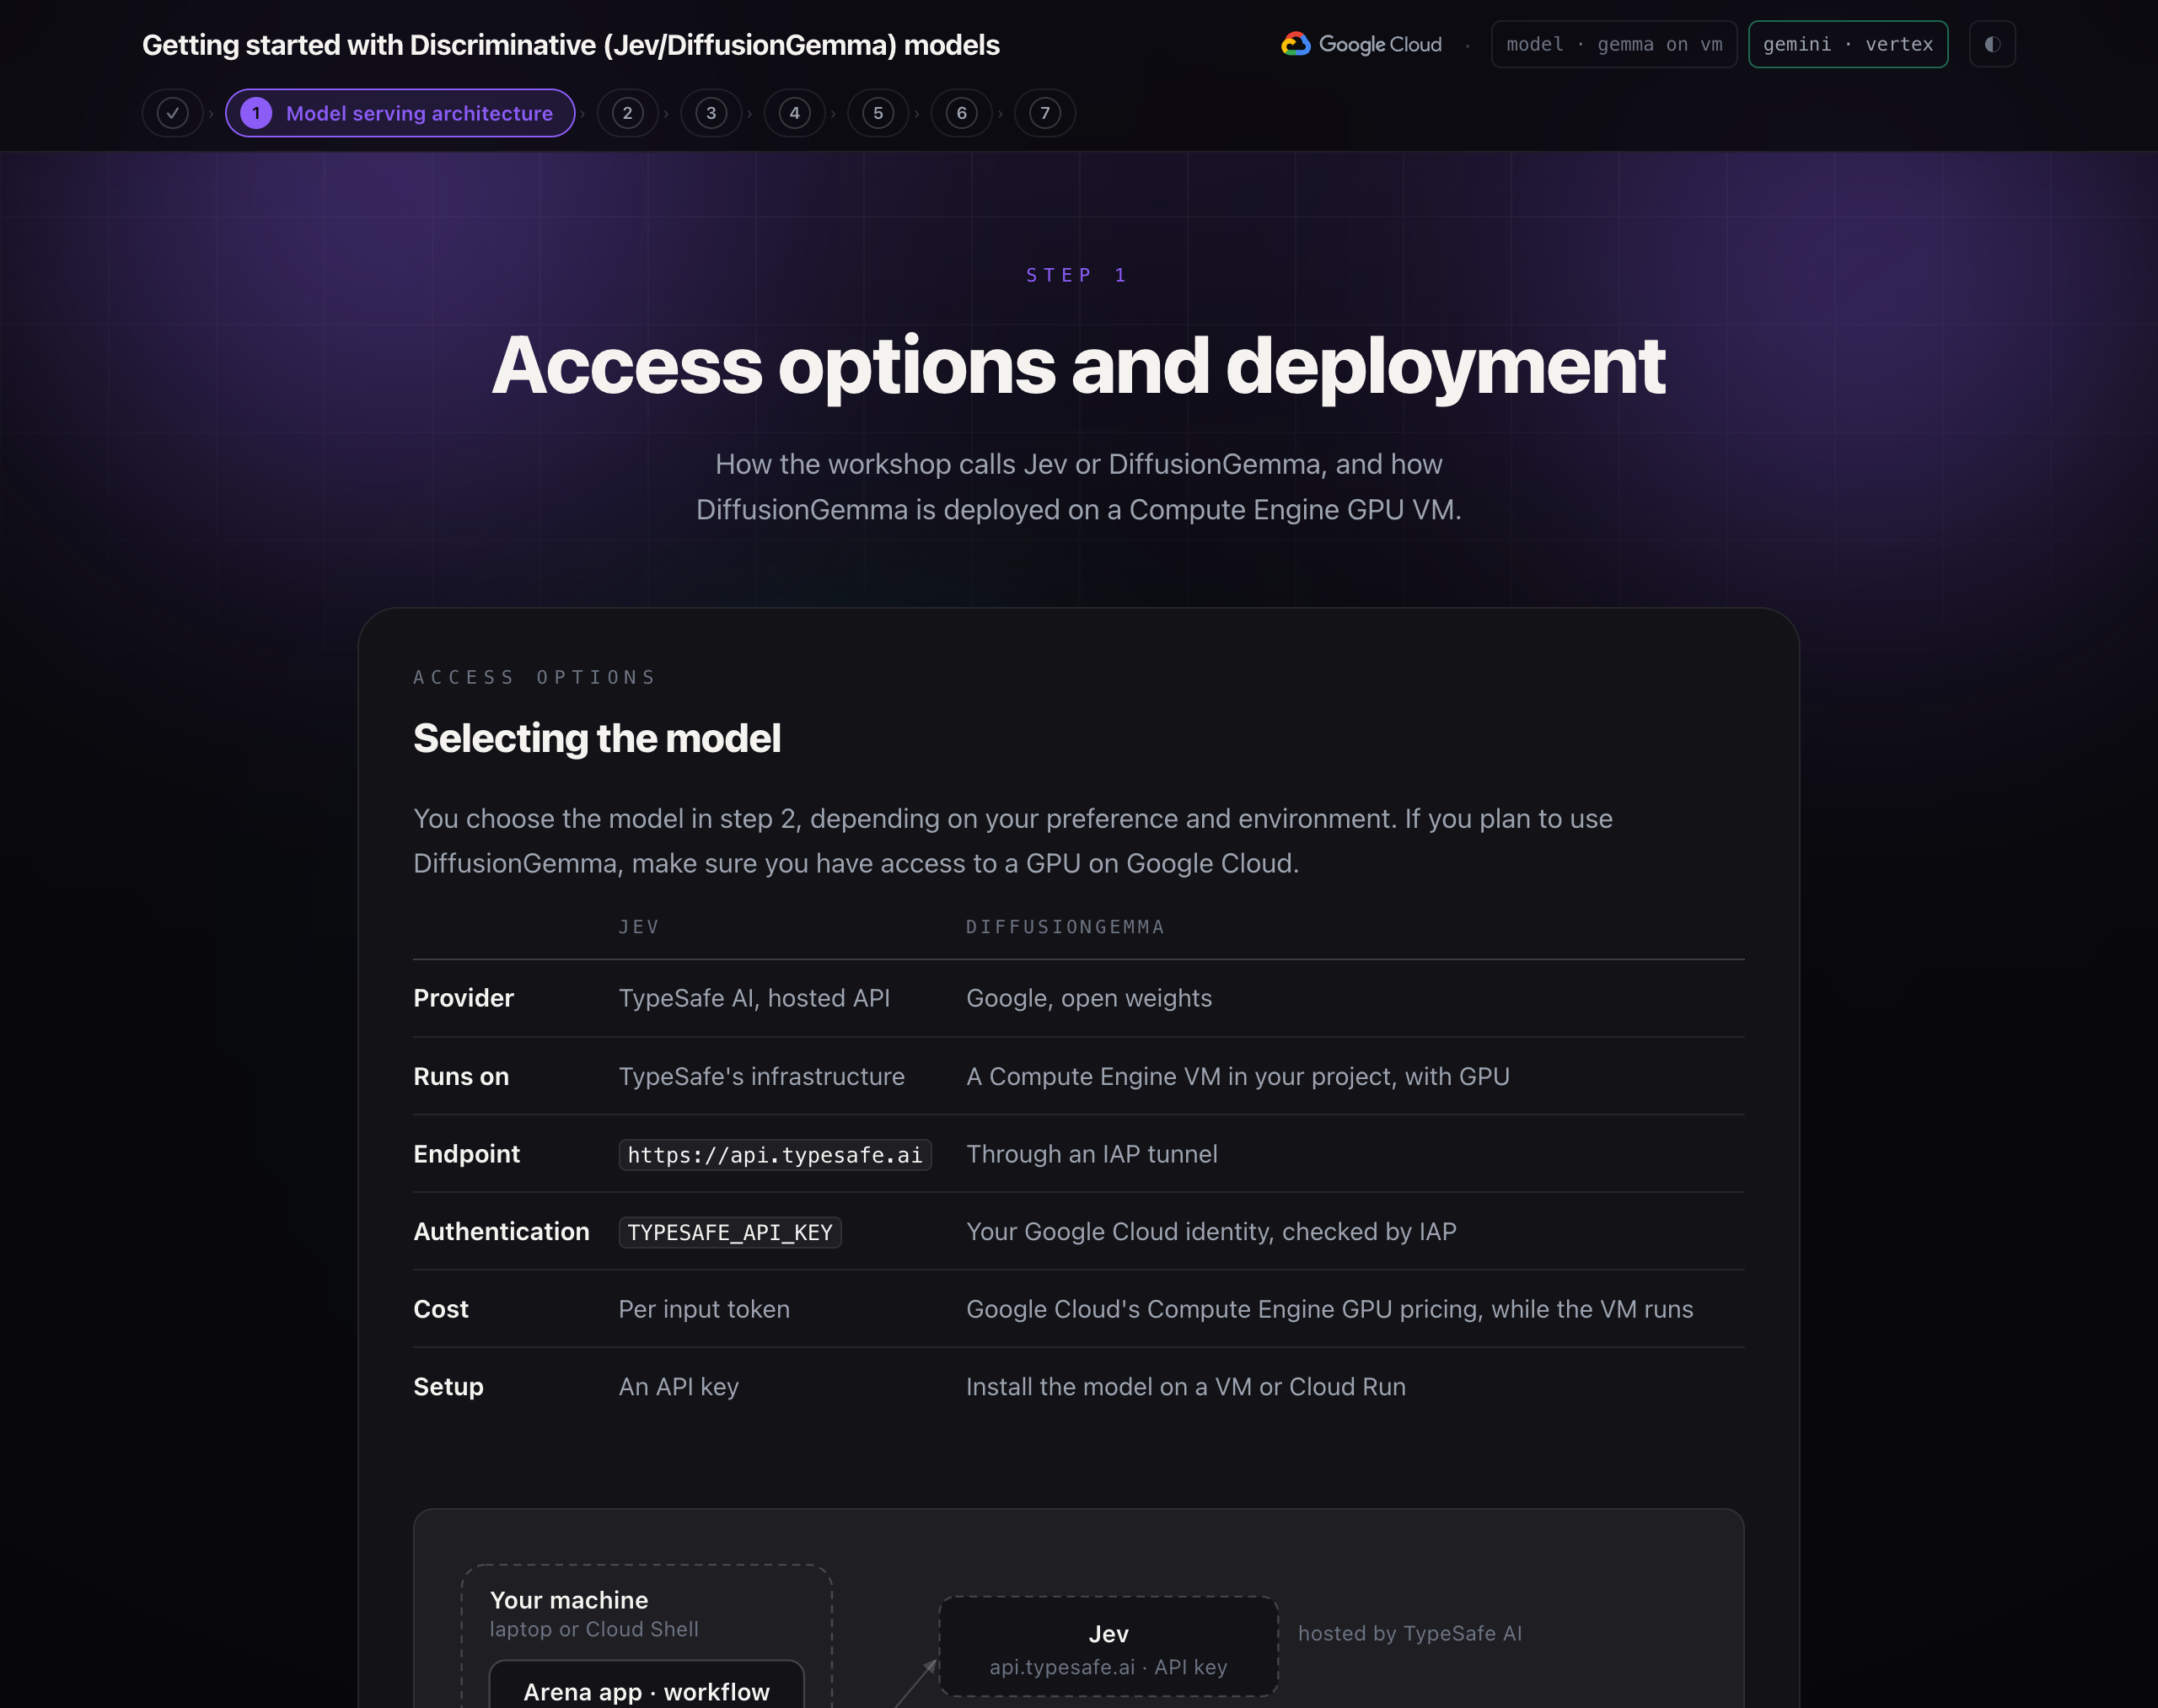
شما در مرحله ۲، بسته به ترجیح و محیط خود، مدل را انتخاب میکنید. اگر قصد استفاده از DiffusionGemma را دارید، مطمئن شوید که به یک پردازنده گرافیکی (GPU) در Google Cloud دسترسی دارید.
جِو | دیفیوژنجما | |
ارائه دهنده | هوش مصنوعی TypeSafe، رابط برنامهنویسی کاربردی میزبانیشده | گوگل، وزنههای باز |
اجرا میشود | زیرساخت TypeSafe | یک ماشین مجازی Compute Engine در پروژه شما، به همراه GPU |
نقطه پایانی | | از طریق تونل IAP |
احراز هویت | | هویت Google Cloud شما، توسط IAP بررسی شده است |
هزینه | به ازای هر توکن ورودی | قیمتگذاری پردازنده گرافیکی موتور محاسباتی گوگل کلود، در حالی که ماشین مجازی اجرا میشود |
راهاندازی | یک کلید API | مدل را روی یک ماشین مجازی یا فضای ابری نصب کنید |
جریان داده
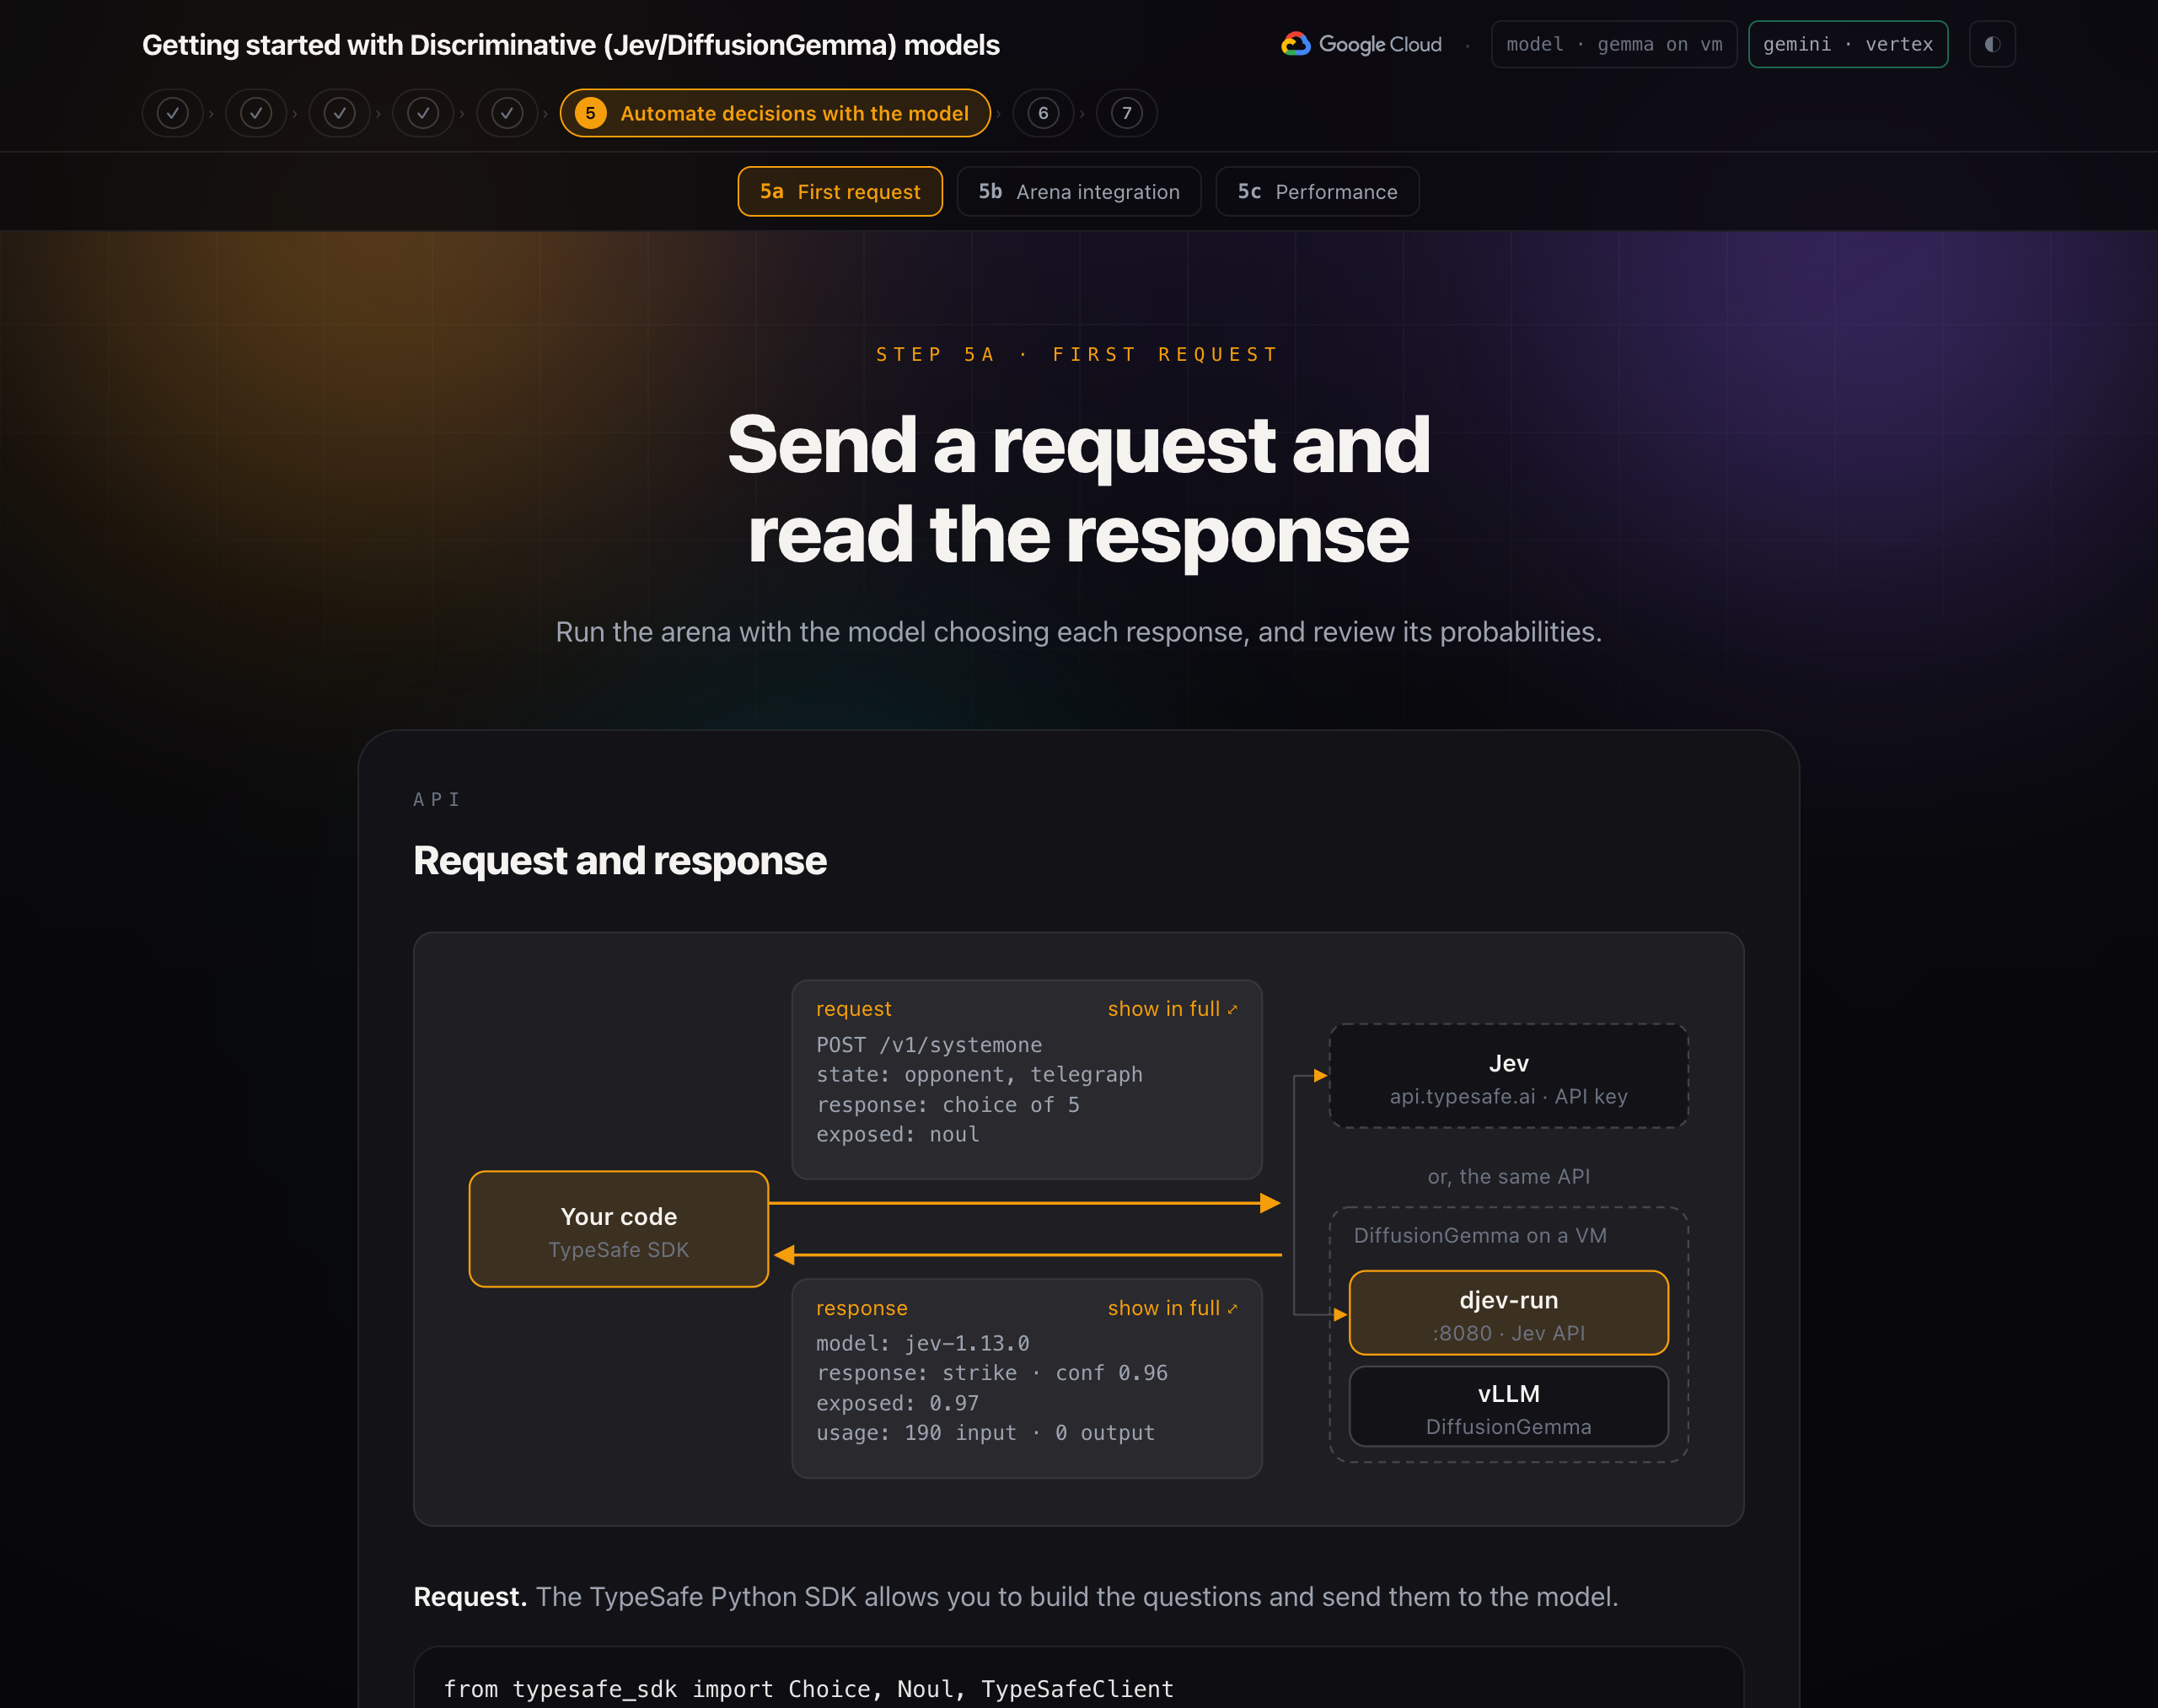
- برنامهی آرنا یا گردش کار ADK یک درخواست ایجاد میکند: وضعیت (کاری که حریف انجام داده است) و سه سوال.
- کیت توسعه نرمافزار TypeSafe آن را با فرمت
POST /v1/systemoneبه آدرس اینترنتی پایه پیکربندیشده ارسال میکند. - برای Jev ، درخواست از طریق HTTPS به
api.typesafe.aiارسال میشود و کلید API به عنوان توکن حامل در آن قرار دارد. - برای DiffusionGemma ، درخواست به
localhost:8096میرود. یک فرآیند پسزمینهgcloud compute start-iap-tunnelآن را از طریق Identity-Aware Proxy که هویت گوگل شما را بررسی میکند، به پورت ۸۰۸۰ روی ماشین مجازی ارسال میکند. - در ماشین مجازی، djev-run درخواست را دریافت میکند، DiffusionGemma را از طریق vLLM روی GPU اجرا میکند و احتمال هر گزینه مجاز را میخواند.
- هر دو backend پاسخ یکسانی را برمیگردانند: یک پاسخ برای هر سوال، به همراه احتمالات و امتیاز اطمینان. کد کارگاه آستانههای خود را اعمال کرده و عمل میکند.
DiffusionGemma روی موتور محاسباتی
scripts/setup_gemma.sh این را در پروژه شما ایجاد میکند:
- بررسی میکند که آیا منطقه سهمیهای برای GPU دارد یا خیر.
- موتور محاسباتی و رابطهای برنامهنویسی IAP را فعال میکند و قانون فایروال
allow-iap-djevرا ایجاد میکند. این قانون فقط محدوده آدرس IAP را روی پورتهای ۲۲ و ۸۰۸۰ میپذیرد. - ماشین مجازی
djev-l4را ایجاد میکند: نوع ماشینg2-standard-4(4 پردازنده مجازی، 16 گیگابایت حافظه)، یک پردازنده گرافیکی (GPU) با 24 گیگابایت، یک دیسک 100 گیگابایتی و تصویر ماشین مجازی یادگیری عمیق با درایور NVIDIA 580. اگر یک منطقه ظرفیت پردازنده گرافیکی نداشته باشد، منطقه بعدی را امتحان میکند. - در اولین بوت، اسکریپت راهاندازی ماشین مجازی، داکر و جعبه ابزار کانتینر NVIDIA را نصب میکند، تصویر کانتینر djev-run را دریافت میکند، وزنها را از Hugging Face (17.5 گیگابایت) دانلود میکند و کانتینر را با دسترسی به پردازنده گرافیکی (GPU) روی پورت 8080 راهاندازی میکند. این کار حدود 15 دقیقه طول میکشد. بوتهای بعدی حدود 2 دقیقه طول میکشد.
- تنظیمات اتصال را در
.envمینویسد و تونل را باز میکند.
وظیفه | فرماندهی |
ماشین مجازی را متوقف میکند (دیسک را نگه میدارد) | |
دوباره شروع کن | |
تونل را بررسی کنید | |
همه چیز را حذف کنید | |
مدل را تنظیم کنید
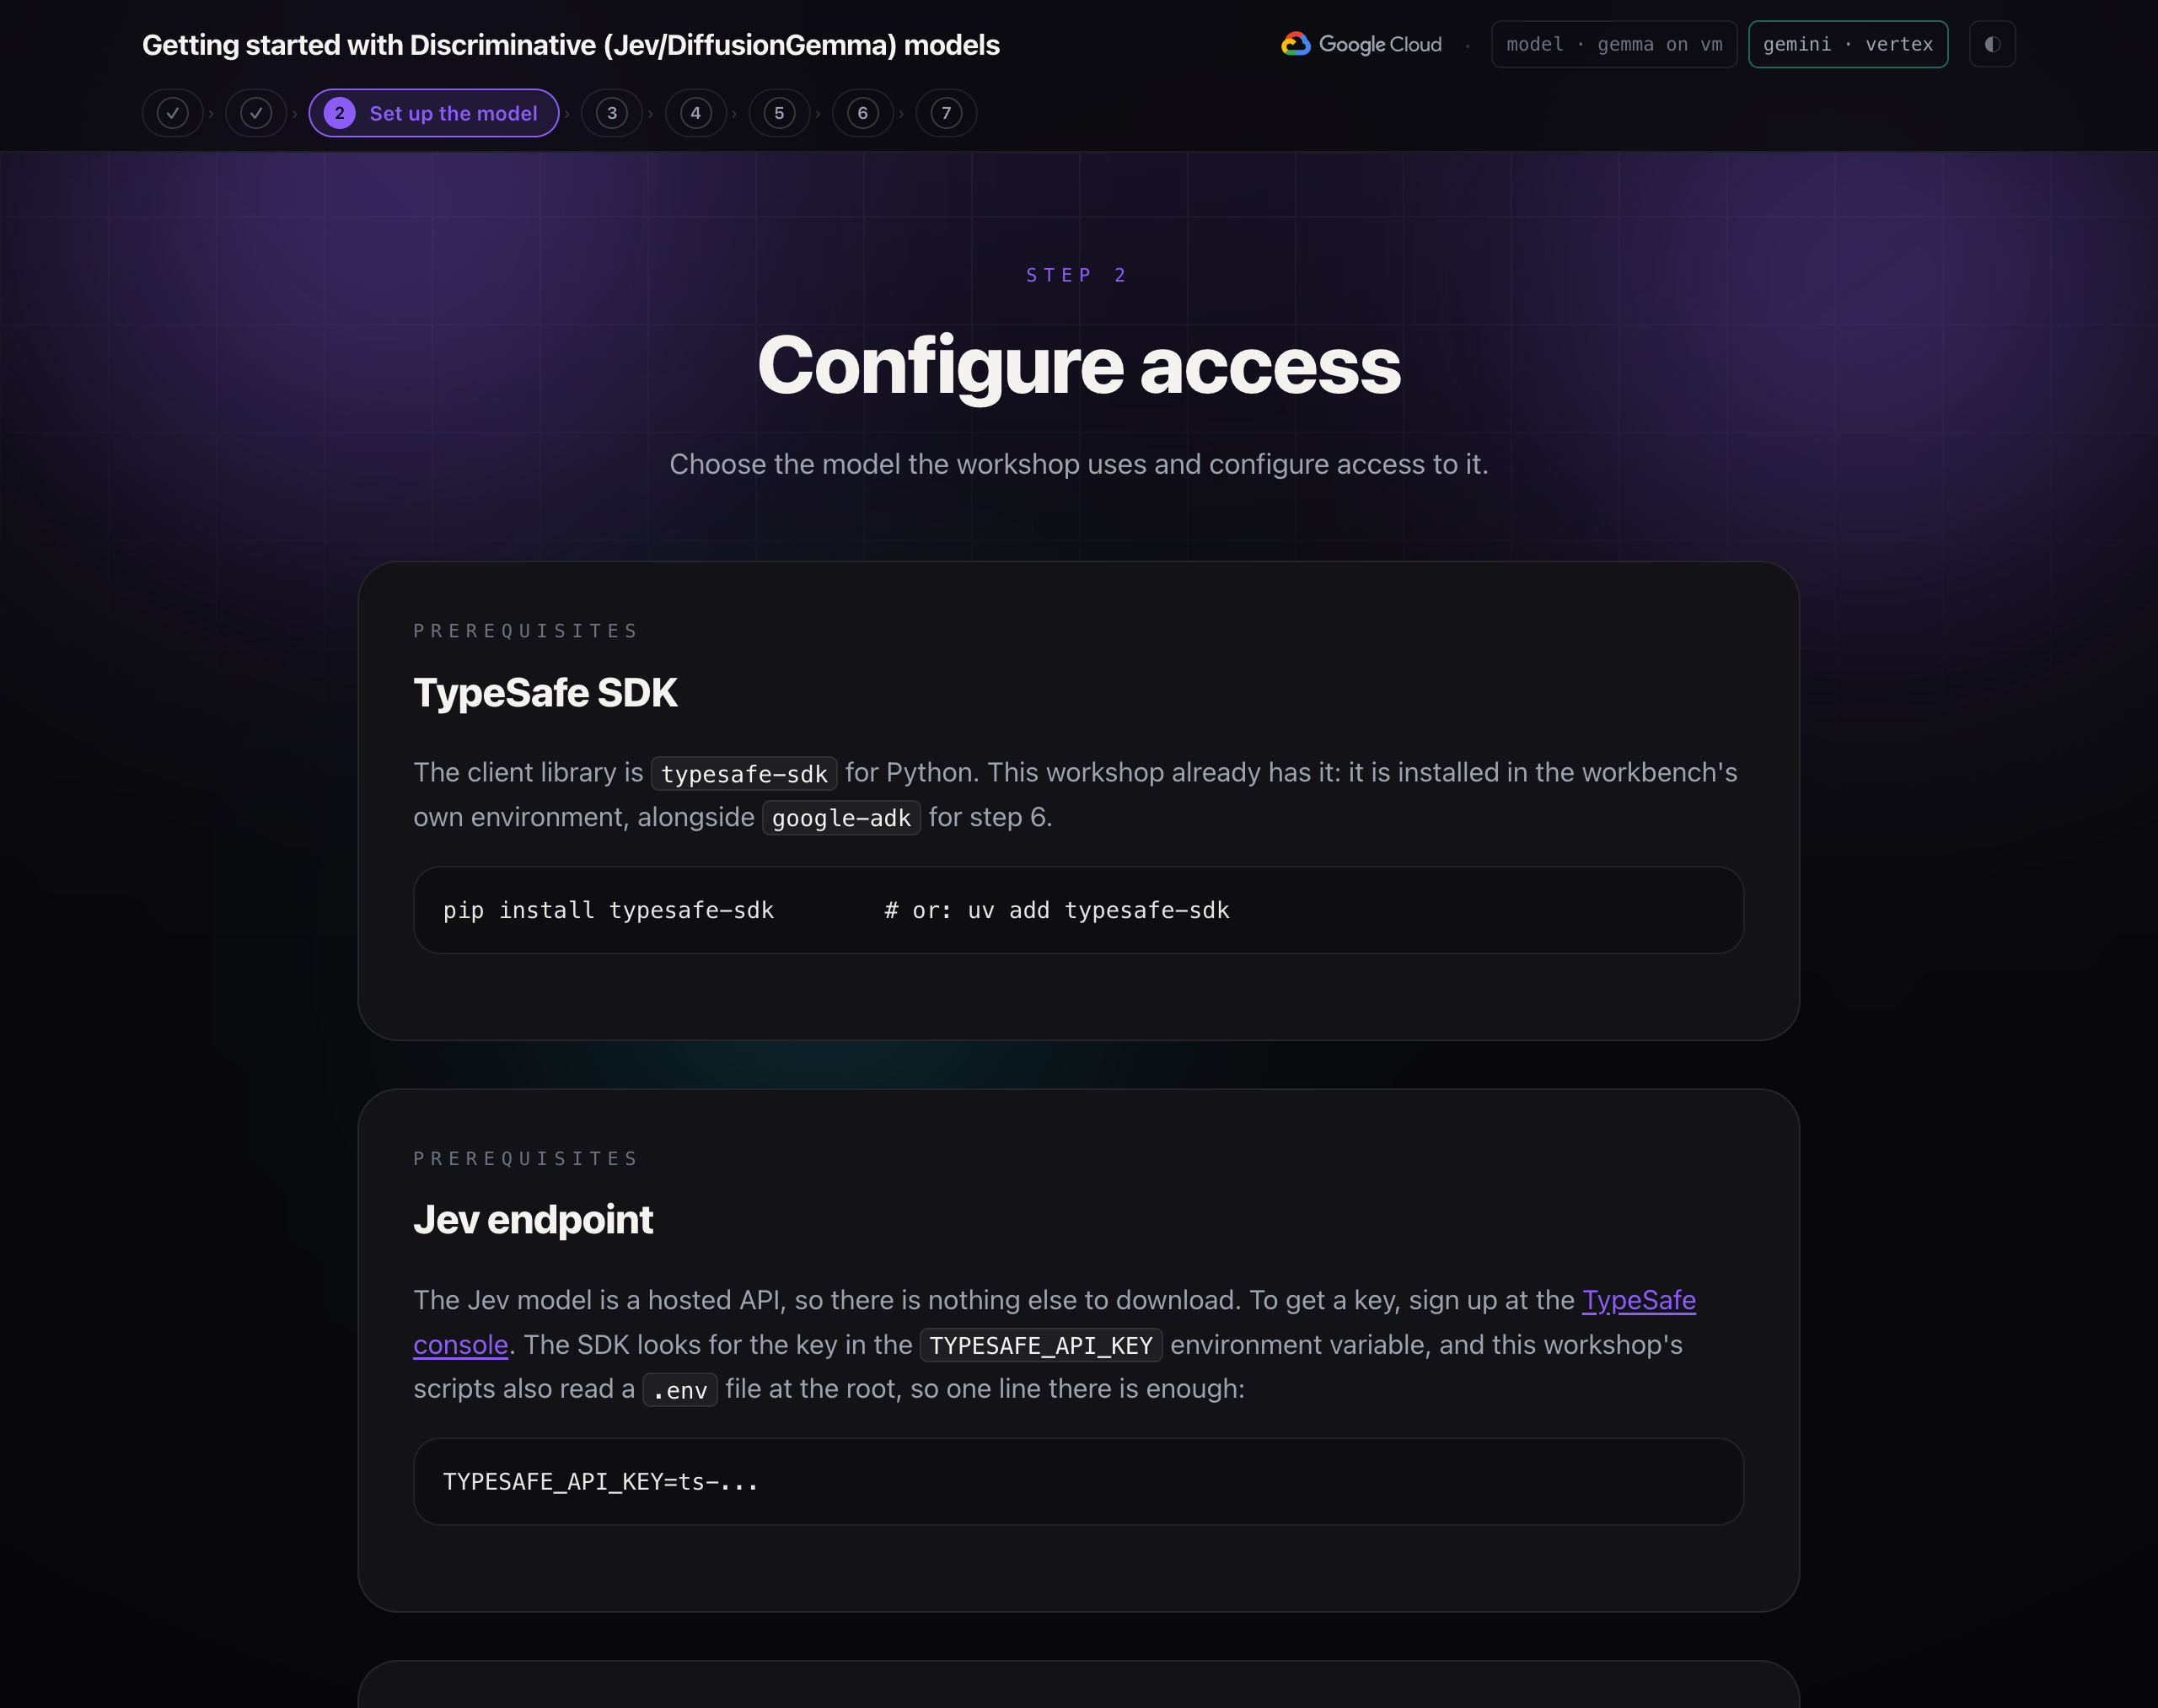
کیت توسعه نرمافزار TypeSafe
کتابخانه کلاینت برای پایتون typesafe-sdk است. این کارگاه از قبل آن را دارد: در محیط خود میز کار، در کنار google-adk برای مرحله ۶ نصب شده است.
pip install typesafe-sdk # or: uv add typesafe-sdk
نقطه پایانی Jev
مدل Jev یک API میزبانیشده است، بنابراین چیز دیگری برای دانلود وجود ندارد. برای دریافت کلید، در کنسول TypeSafe ثبتنام کنید. SDK به دنبال کلید در متغیر محیطی TYPESAFE_API_KEY میگردد و اسکریپتهای این کارگاه نیز یک فایل .env را در ریشه میخوانند، بنابراین یک خط کافی است:
TYPESAFE_API_KEY=ts-...
از DiffusionGemma استفاده کنید
djev-run رابط برنامهنویسی کاربردی (API) مدل تشخیص (Discriminative) را مجدداً پیادهسازی میکند. این رابط، همان نقطه پایانی POST /v1/systemone را با همان سوالات noul، choice و score از DiffusionGemma ، مدل انتشار باز Google DeepMind (۲۶B پارامتر کل، حدود ۴B فعال، Apache 2.0) ارائه میدهد. از آنجا که قالب سیم (wire) یکسان است، TypeSafe SDK بدون تغییر با آن ارتباط برقرار میکند.
اگر در تمرین DiffusionGemma را انتخاب کنید، روی یک پردازنده گرافیکی (GPU) در یک ماشین مجازی در پروژه گوگل کلود خودتان اجرا میشود و قرص بالا سمت راست ، gemma را روی ماشین مجازی میخواند. میز کار از طریق یک تونل IAP خصوصی به آن میرسد و پورت مدل به اینترنت باز نیست. مرحله 1 معماری کامل را شرح میدهد.
چرا یک مدل انتشار میتواند این کار را انجام دهد: این مدل یک بلوک کامل از موقعیتها را به طور همزمان پر میکند، به طوری که هر موقعیت ورودی کامل را میبیند، بنابراین احتمال هر گزینه مجاز را میتوان در یک مرحله خواند. یک مدل زبان عادی هر بار یک توکن تولید میکند و باید بارها و بارها نمونهبرداری شود.
بازی را به صورت دستی اجرا کنید
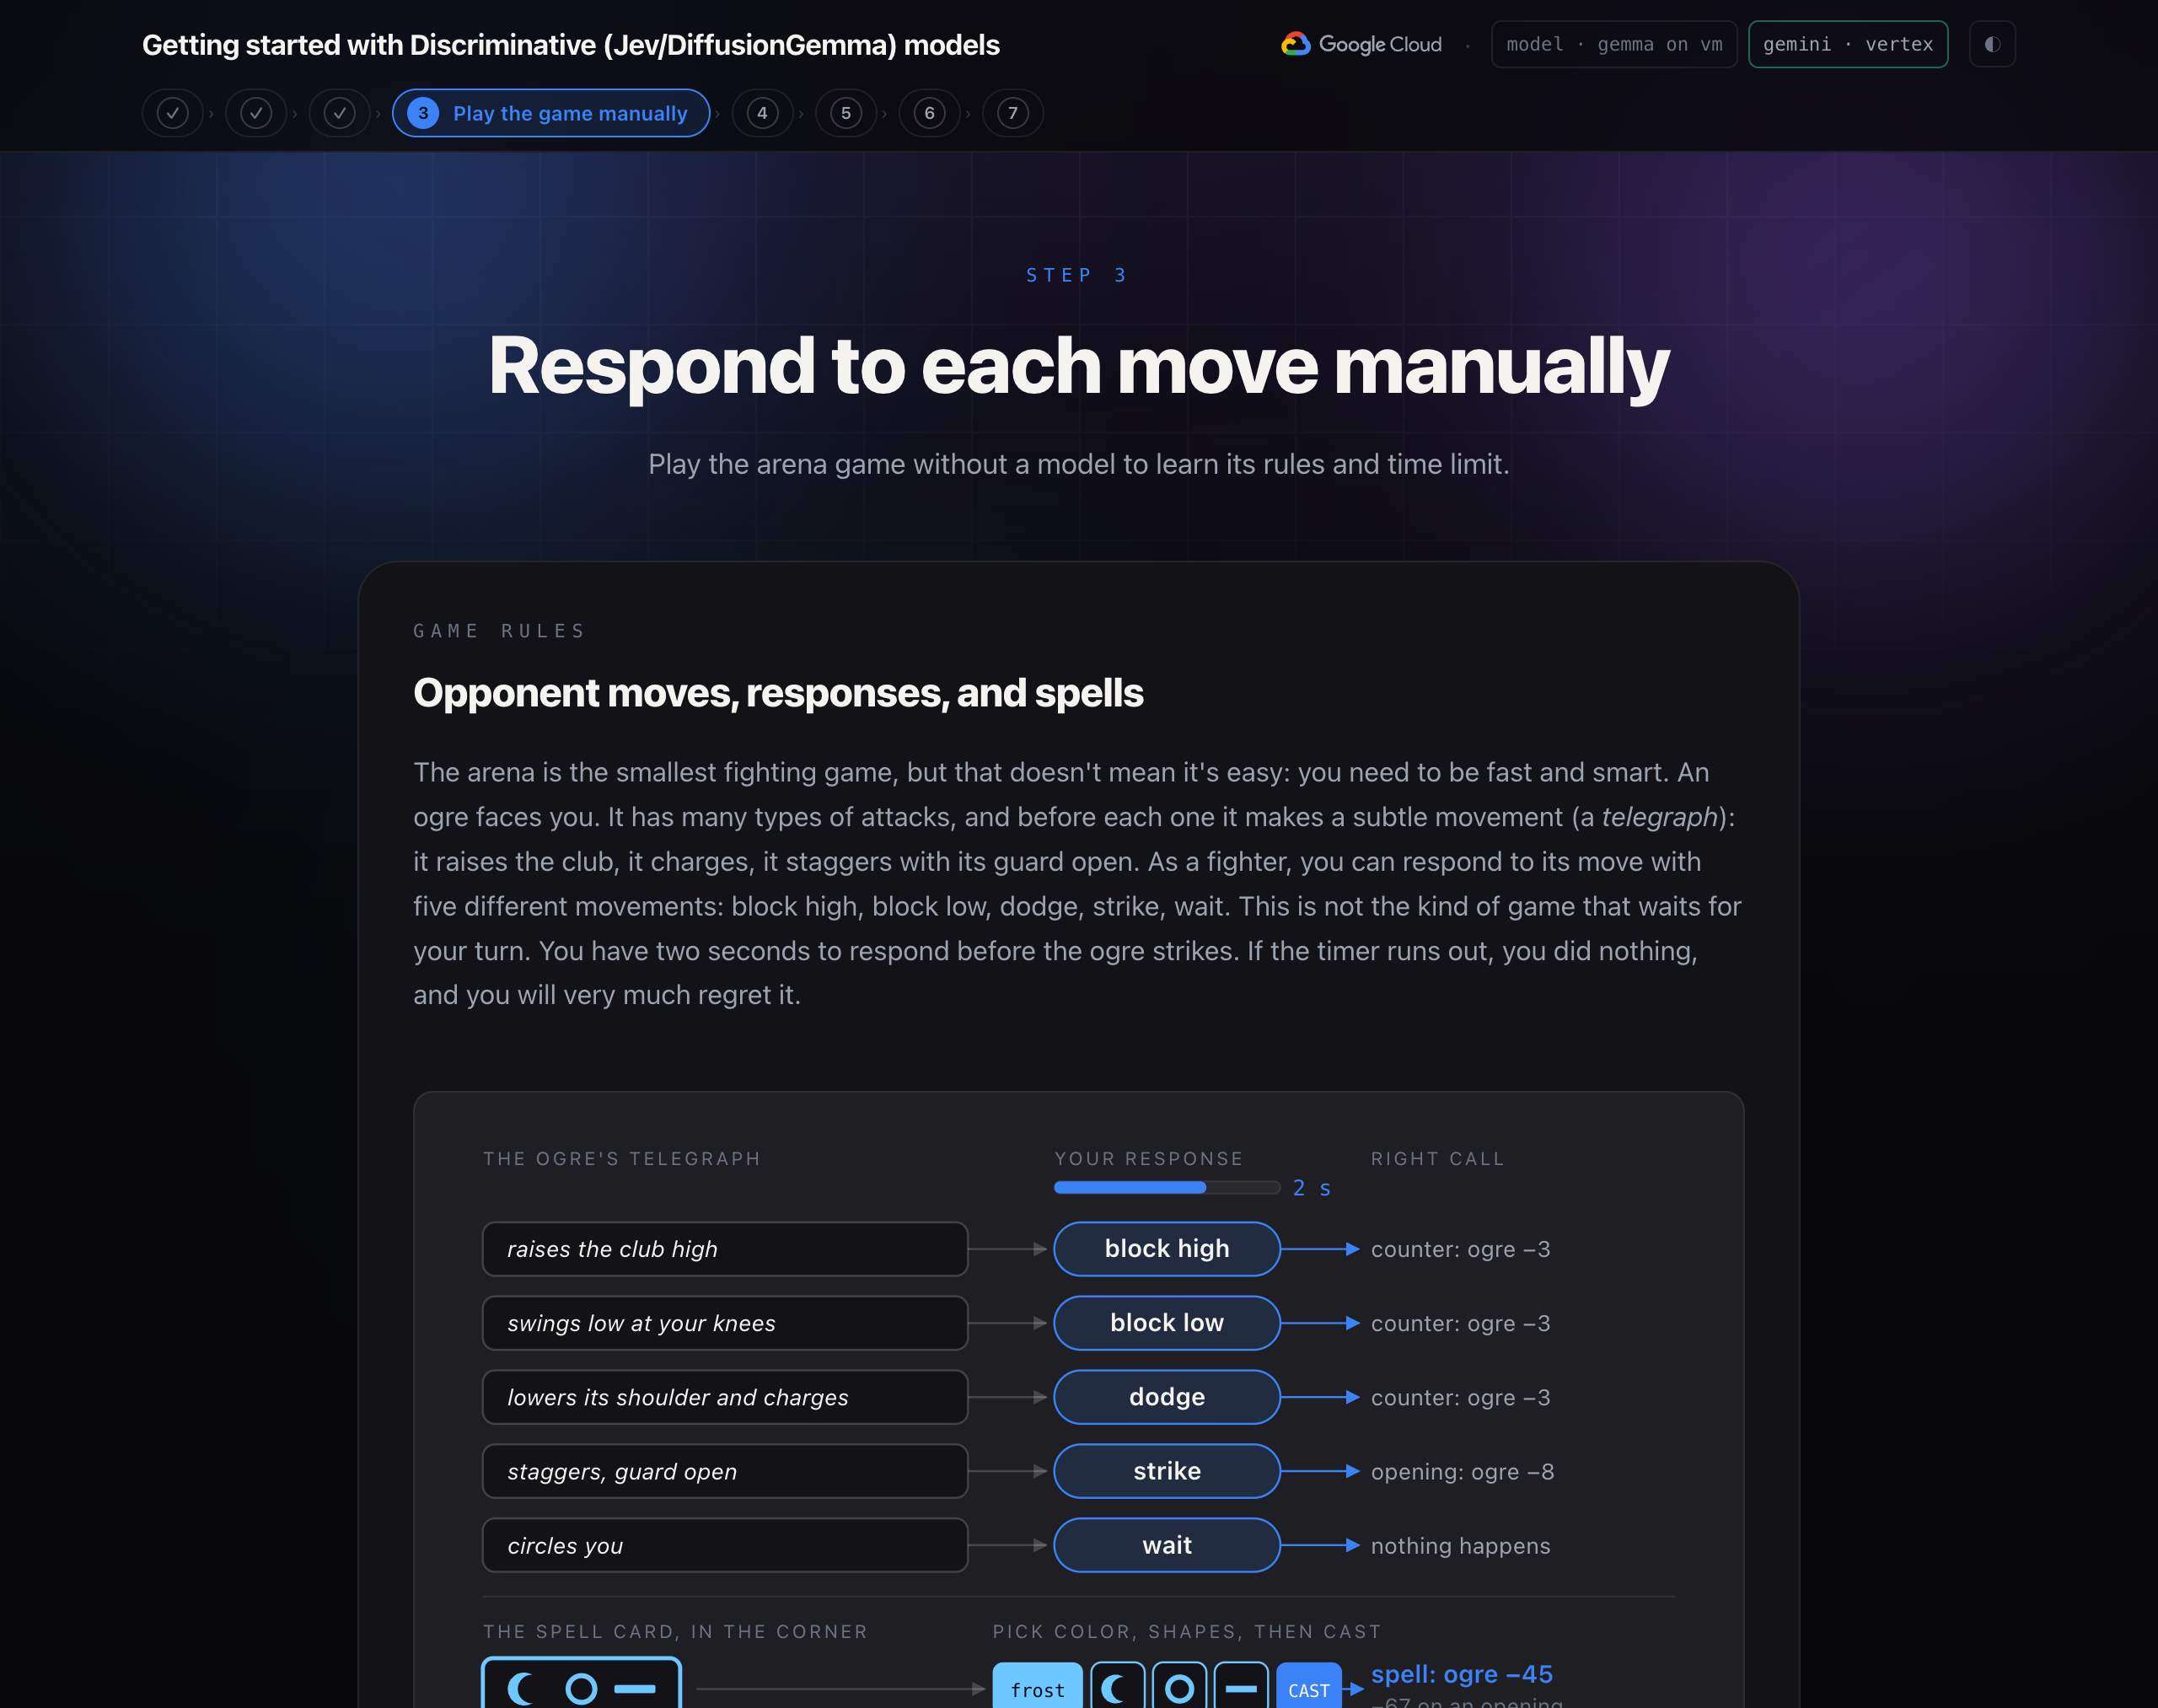
میدان مبارزه کوچکترین بازی مبارزهای است، اما این به آن معنا نیست که آسان است: باید سریع و باهوش باشید. یک غول با شما روبرو میشود. انواع مختلفی از حملات دارد و قبل از هر حمله، یک حرکت ظریف ( تلگراف ) انجام میدهد: چماق را بالا میبرد، حمله میکند، با گارد باز تلوتلو میخورد. به عنوان یک جنگجو، میتوانید با پنج حرکت مختلف به حرکت او پاسخ دهید: دفاع بالا، دفاع پایین، جاخالی، حمله، صبر. این نوع بازی منتظر نوبت شما نیست. شما دو ثانیه فرصت دارید تا قبل از حمله غول پاسخ دهید. اگر تایمر تمام شود، شما هیچ کاری نکردهاید و بسیار پشیمان خواهید شد.
در گوشه بالا سمت چپ حلقه، یک کارت طلسم وجود دارد: یک کارت رنگی با سه شکل. فقط طلسمی که با آن مطابقت داشته باشد، آسیب واقعی وارد میکند. در بازی میتوانید با دکمههای زیر مبارزه، طلسمی را اجرا کنید: رنگ کارت، سپس شکلهای آن را از چپ به راست انتخاب کنید، سپس CAST را فشار دهید. در حین انتخاب، ساعت همچنان کار میکند، بنابراین باید طلسم را بسازید و همزمان به حملات غول واکنش نشان دهید. کلیدهای ۱ تا ۵ همچنان به هر حرکت پاسخ میدهند. یک طلسم اشتباه بیاثر میشود. در مرحله ۶، جمینی کارت طلسم را برای شما میخواند.
نکتهی کلیدی: یک مبارزه، جریانی از تصمیمات کوچک است که برای هر کدام مهلت مشخصی دارد. این همان چیزی است که اکثر اتوماسیونهای نرمافزاری در واقع به آن شبیه هستند، البته منهای باشگاه.
مفاهیم مدل تمایزی
تصمیمگیری در نرمافزار
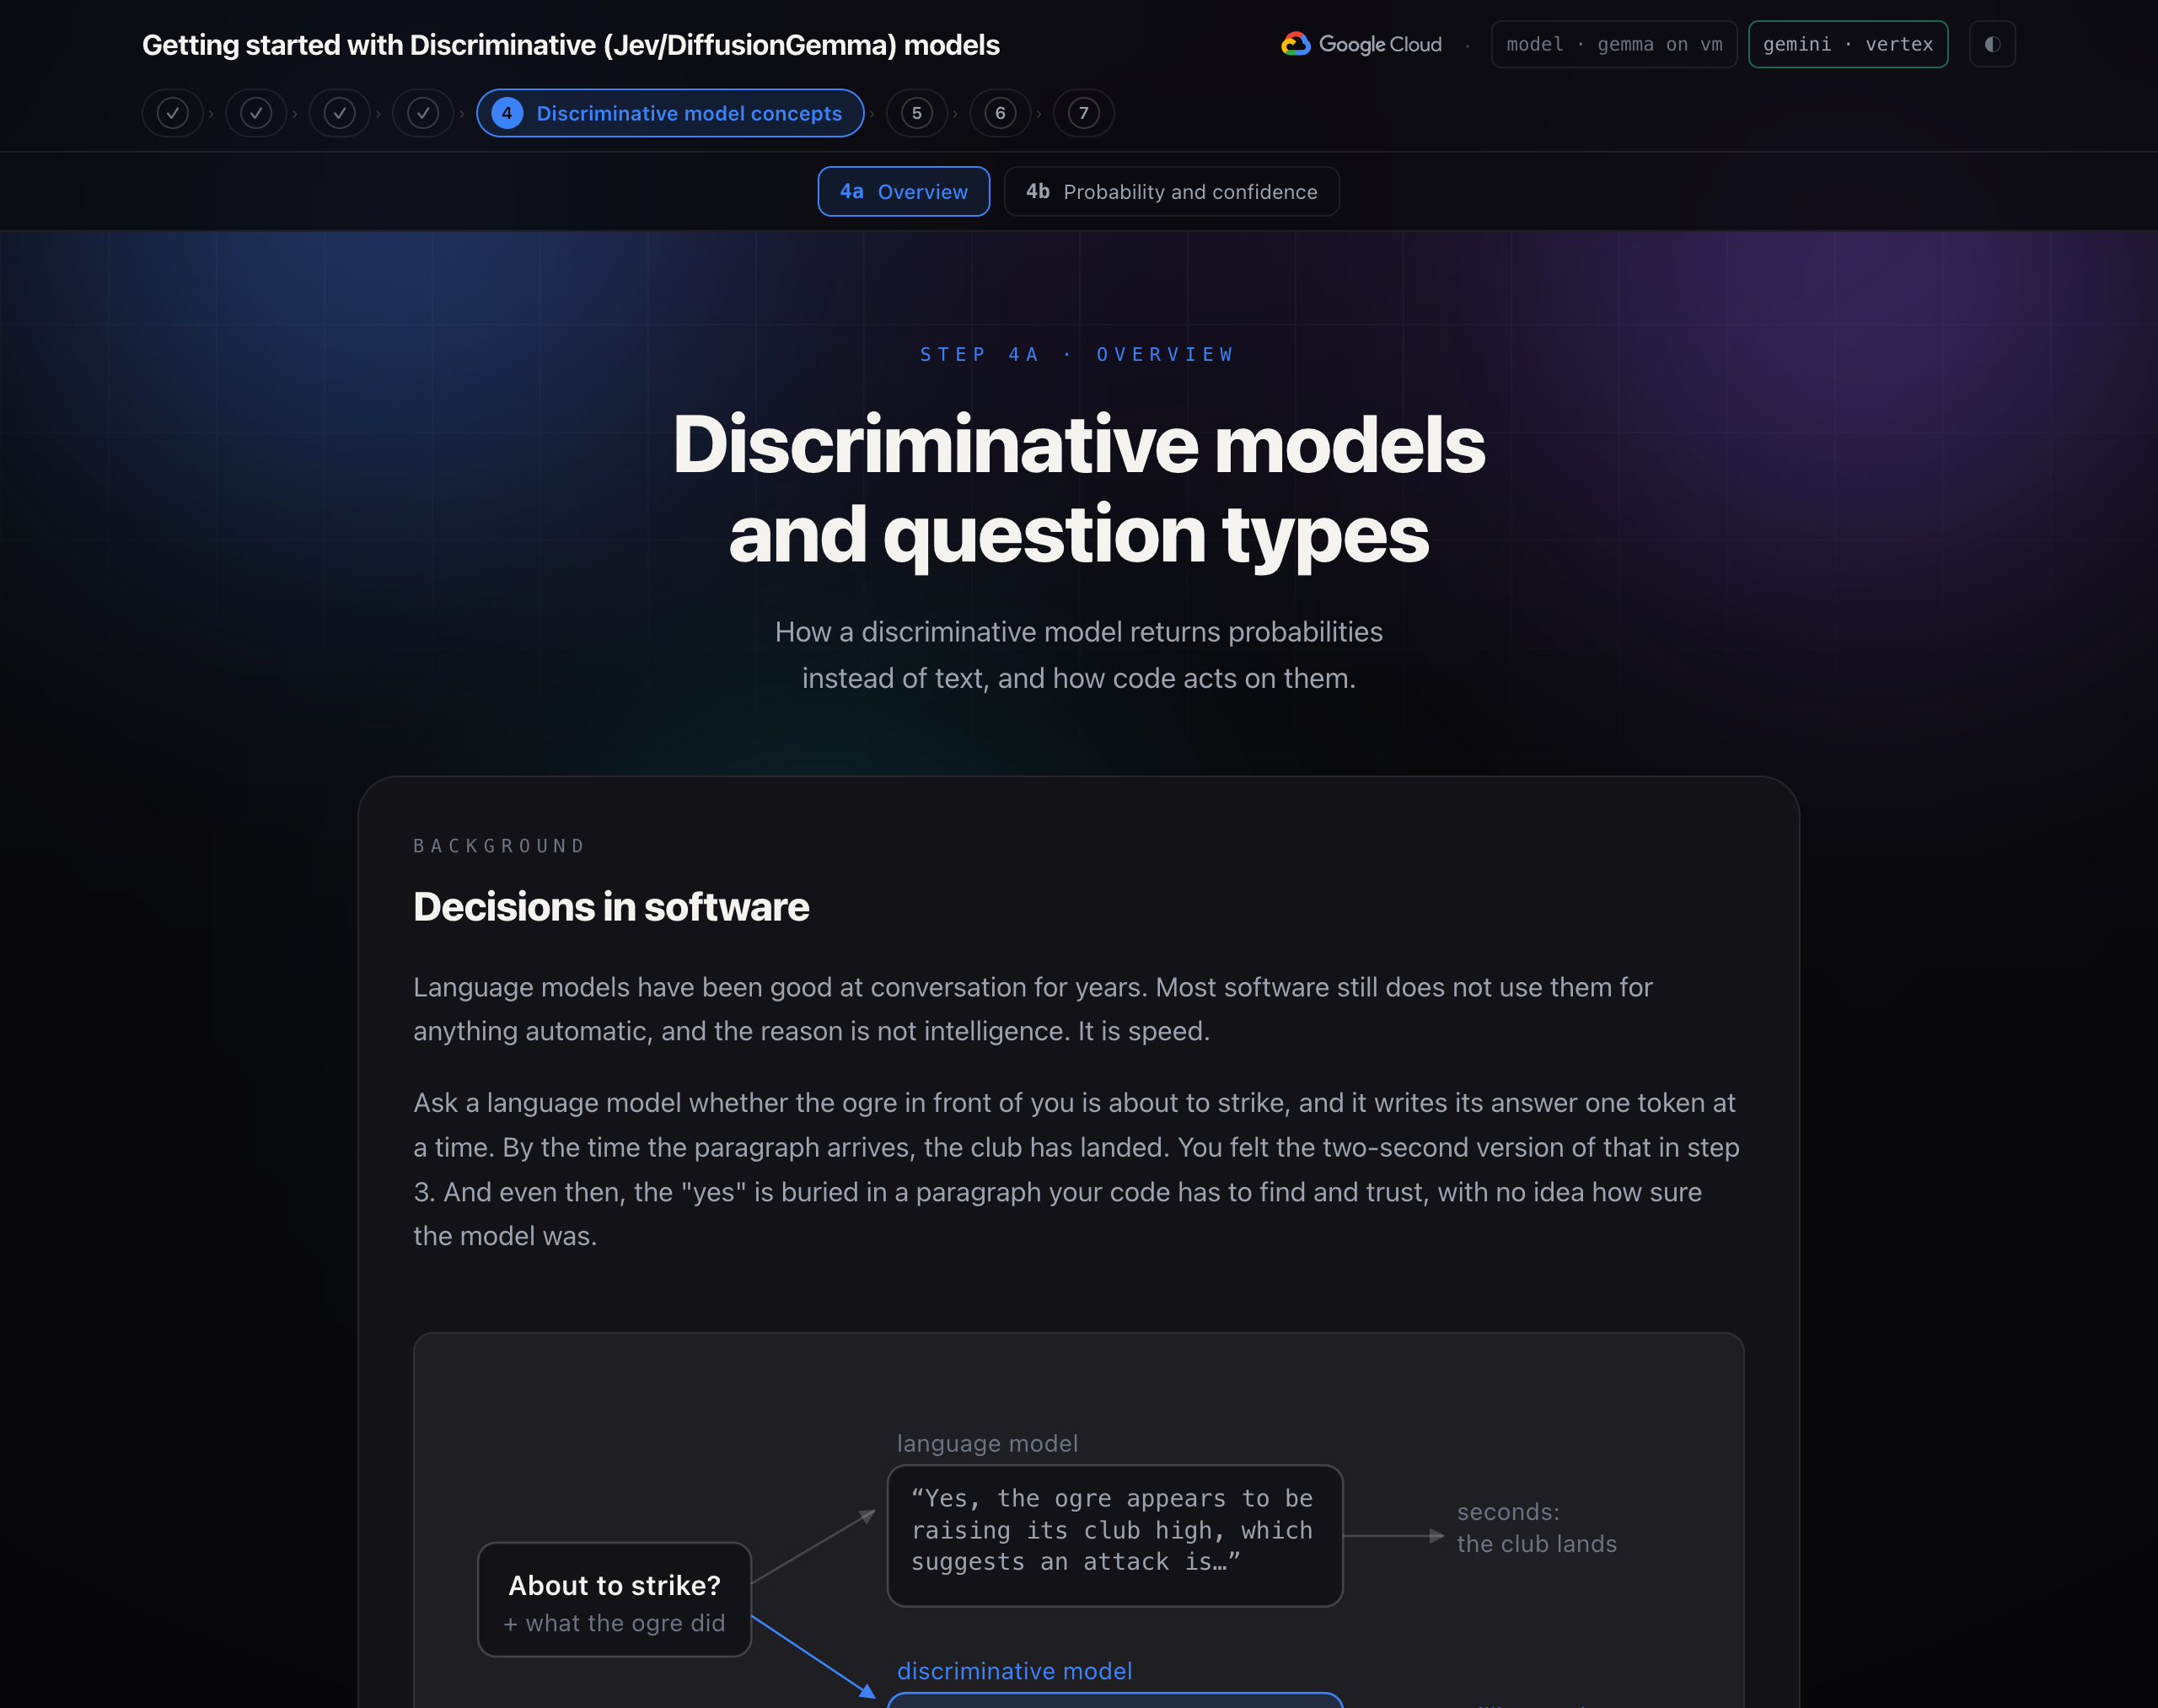
مدلهای زبانی سالهاست که در مکالمه خوب عمل میکنند. اکثر نرمافزارها هنوز از آنها برای هیچ کار خودکاری استفاده نمیکنند و دلیل آن هوش نیست. سرعت است.
از یک مدل زبانی بپرسید که آیا غول جلوی شما در شرف حمله است یا خیر، و مدل پاسخ خود را یکی یکی مینویسد. تا زمانی که پاراگراف برسد، چماق فرود آمده است. شما نسخهی دو ثانیهای آن را در مرحلهی ۳ حس کردید. و حتی در آن صورت، «بله» در پاراگرافی دفن شده است که کد شما باید آن را پیدا کند و به آن اعتماد کند، بدون اینکه بداند مدل چقدر مطمئن بوده است.
مدل تشخیصی، وضعیت و سوالات و پاسخهای تایپشده شما را در یک مرحله، بر حسب میلیثانیه، دریافت میکند. هر پاسخ با یک احتمال کالیبرهشده ارائه میشود: ۰.۹ به معنای درست بودن نه بار از ده بار است. هیچ متنی برای تجزیه و تحلیل وجود ندارد و هیچ JSON برای استخراج آن وجود ندارد.
مدلهای سیستم یک و سیستم دو
این نام از کتاب «تفکر، سریع و آهسته» نوشته دنیل کانمن گرفته شده است. سیستم دو، استدلال آهسته و سنجیده، گام به گام است. سیستم یک، سریع و منطبق با الگو است.
یک مدل زبانی، یک ماشین سیستم دو است. این ماشین با استفاده از توکنها، یکی یکی، استدلال میکند. مدل تشخیصی، یک مدل سیستم یک است: با صدای بلند استدلال نمیکند، چیزی تولید نمیکند و به هر سوال در یک مرحله پاسخ میدهد. به همین دلیل است که سریع (تقریباً ۷۰ تا ۵۰۰ میلیثانیه) و ارزان (کسری از یک سنت در هر هزار تصمیم) است.
نکته کلیدی: یک مدل زبانی مینویسد. یک مدل تصمیمگیری تصمیم میگیرد. بیشتر چیزی که نرمافزار از هوش مصنوعی نیاز دارد، یک تصمیم است.
محدودیتها
مدل تشخیصی متن تولید نمیکند، کد نمینویسد، مکالمهای برگزار نمیکند، محاسبات انجام نمیدهد، تصویر را نمیخواند یا زنجیرهای از مراحل را دنبال نمیکند.
در کارگاه، یکی از مدلهای تشخیصی را انتخاب خواهیم کرد:
- یکی از مدلهای متمایزکننده Jev است. این یک API میزبانیشده از TypeSafe AI است که در سپتامبر ۲۰۲۶ منتشر شد. اولین مدل
jev-1.13است که از طریق نام مستعارjev-latestقابل دسترسی است. هیچ وزن منتشر شدهای وجود ندارد، بنابراین به آن گفته میشود، دانلود نشده است. - Jev تنها راه برای دستیابی به مدل System One نیست. DiffusionGemma گوگل یک مدل با وزنهای باز است که به جای نوشتن تک تک توکنها، یک بلوک کامل از توکنها را به صورت موازی مینویسد و همین گذرگاه موازی میتواند احتمالات را روی مجموعهای ثابت از گزینهها بخواند. سرورهای متنباز مانند djev-run API دقیق Jev را در مقابل آن قرار میدهند، بنابراین همه چیز در این کارگاه بدون تغییر در برابر آن اجرا میشود.
حالت و سوالات: Choice ، Score و Noul
هر فراخوانی، وضعیت و سوالاتی را ارسال میکند. وضعیت، متنی است که میخواهید مورد قضاوت قرار گیرد. میتواند یک رشته، یک شیء JSON یا یک لیست باشد. سوالات، آنچه را که میخواهید در مورد آن متن بدانید، میپرسند. هر سوال دارای یک نوع است: Choice، Score یا Noul. سوالات به صورت موازی پردازش میشوند که به آن امکان پاسخ سریع میدهد. در صورت نیاز میتوانید چندین سوال اضافه کنید.
- انتخاب، یک گزینه را از مجموعهای که شما نامگذاری میکنید، تا سقف ۲۵۵ گزینه، انتخاب میکند. پاسخ، خود گزینه، یک احتمال برای هر گزینه و یک ضریب اطمینان است. زمانی از آن استفاده کنید که گزینهها ترتیبی بین خود نداشته باشند: بلاک بالا، بلاک پایین، جاخالی، حمله، صبر.
- امتیاز ، وضعیت را در امتداد سطوح مرتبشدهای که توصیف میکنید، از دو تا ده، رتبهبندی میکند. پاسخ، موقعیتی در امتداد مقیاس (یک عدد اعشاری است، بنابراین ۱.۴ به معنای «بین یک و دو، نزدیکتر به یک» است)، احتمال هر سطح و یک ضریب اطمینان است. وقتی پاسخ مسئله درجه است، از آن استفاده کنید: ضربه ورودی چقدر محکم فرود خواهد آمد.
- انتخاب و امتیاز هر دو برای هر گزینه یک احتمال و یک اطمینان برمیگردانند. تفاوت، پاسخ اصلی است. انتخاب، محتملترین گزینه را برمیگرداند. امتیاز، گزینهها را به عنوان سطوح مرتب در نظر میگیرد و میانگین وزنی احتمال آنها را برمیگرداند که میتواند بین دو سطح قرار گیرد. با هیچکدام ۰.۰۵، سبک ۰.۵۵ و سنگین ۰.۴۰، انتخاب «سبک» و امتیاز ۱.۳۵ را، بین سبک و سنگین، پاسخ میدهد. میدان بازی از این مقدار استفاده میکند:
choose()امتیاز خطر ۱.۵ یا بیشتر را به عنوان یک ضربه سنگین در نظر میگیرد.
- انتخاب و امتیاز هر دو برای هر گزینه یک احتمال و یک اطمینان برمیگردانند. تفاوت، پاسخ اصلی است. انتخاب، محتملترین گزینه را برمیگرداند. امتیاز، گزینهها را به عنوان سطوح مرتب در نظر میگیرد و میانگین وزنی احتمال آنها را برمیگرداند که میتواند بین دو سطح قرار گیرد. با هیچکدام ۰.۰۵، سبک ۰.۵۵ و سنگین ۰.۴۰، انتخاب «سبک» و امتیاز ۱.۳۵ را، بین سبک و سنگین، پاسخ میدهد. میدان بازی از این مقدار استفاده میکند:
- نول یک سوال بله/خیر میپرسد و احتمال اینکه جواب بله باشد را برمیگرداند. نزدیک به ۱ به معنای بله قوی، نزدیک به ۰ به معنای خیر قوی و نزدیک به ۰.۵ به معنای «هر دو میتواند باشد» است. هیچ اطمینان جداگانهای وجود ندارد، زیرا احتمال، سطح اطمینان آن است.
سوالات متمرکز بنویسید
مدل تشخیصی زمانی بهترین عملکرد را دارد که یک سوال، یک چیز خاص و با دامنه مشخص را بپرسد. «وضعیت چیست؟» یک پاسخ محتمل و با اطمینان پایین را برمیگرداند. «پاسخ درست چیست؟»، «آیا حریف در معرض خطر است؟» و «این ضربه چقدر شدید خواهد بود؟» سه پاسخ متمرکز را برمیگرداند که کد شما آنها را ترکیب میکند.
توضیحات مربوط به گزینهها و سطوح ارزان و مهم هستند. قوانینی که در مرحله ۳ میخوانید، توضیحات گزینهها میشوند: block_high: "Raise the shield. Right against an overhead or a high swing." اینگونه است که مدل تشخیص، قوانین مبارزه را در زمان درخواست، در هر خط یاد میگیرد. و گزینهها میتوانند با توجه به شرایط تغییر کنند: میدان بازی فقط زمانی که یک طلسم آماده باشد، cast ارائه میدهد.
احتمالات و اطمینان
پاسخ انتخابی یک برچسب نیست. بلکه توزیعی روی برچسبها است و برچسب فقط بلندترین میله است.
چگونه مدل عدد را دریافت میکند. این مدل از همان مرحلهای استفاده میکند که یک مدل زبانی برای انتخاب کلمه بعدی خود استفاده میکند. یک مبدل متن را میخواند و در یک موقعیت، به هر نشانه در واژگان خود یک امتیاز خام میدهد که لوجیت نامیده میشود. لوجیت بالاتر به این معنی است که نشانه در آن موقعیت بهتر قرار میگیرد. یک سافتمکس، لوجیتها را به احتمالاتی تبدیل میکند که مجموع آنها ۱ میشود. سپس یک مدل زبانی یک نشانه را انتخاب میکند، آن را به متن اضافه میکند و تکرار میکند. یک مدل تشخیصی پس از احتمالات متوقف میشود.
جای خالی ، یک جای خالی در فرم پاسخ است. سرور خود فرم را مینویسد، مانند response: ▢ ، و برای هر سوال یک جای خالی میگذارد. تنها وظیفه مدل، امتیازدهی به هر جای خالی است.
- این اعلان، وضعیت و هر سوال را در خود نگه میدارد و هر پاسخ مجاز را به صورت یک برچسب کوتاه نمایش میدهد:
aبرای block_high،bبرای block_low و غیره. - پیشخدمت فرم پاسخ را اضافه میکند، و برای هر سوال یک جای خالی در نظر میگیرد.
- این مدل، دستور و فرم را در یک مرحله میخواند و در هر جای خالی به هر نشانه یک لوجیت میدهد. مدل انتشار، کل فرم را به طور همزمان میبیند و تمام جاهای خالی را با هم امتیازدهی میکند.
- سرور فقط لوجیتهای برچسبهای مجاز را نگه میدارد و یک softmax روی آنها اعمال میکند، بنابراین مجموع پاسخهای مجاز برابر با ۱ میشود.
- اگر خوانش نامطمئن به نظر برسد، سرور دوباره از یک شروع تصادفی دیگر میخواند و میانگین خوانشها را محاسبه میکند.
اطمینان عددی است که میزان اطمینان به جواب را نشان میدهد. TypeSafe آن را از نحوه پراکندگی احتمال بین گزینهها محاسبه میکند. اگر همه این احتمالات روی یک گزینه باشد، عدد ۱ و اگر پراکندگی زوج باشد، عدد ۰ میشود. برای سه گزینه، این مقدار (۳ × بزرگترین - ۱) / ۲ است.
TypeSafe، Jev را برای احتمالات کالیبره شده آموزش میدهد. این احتمال با تعداد دفعاتی که پاسخ درست است، مطابقت دارد. در یک مدل کالیبره شده، پاسخهای داده شده با ۰.۷ حدود ۷۰٪ مواقع درست هستند، بنابراین آستانه اطمینان، آستانهای است که نشان میدهد شما چند بار یک پاسخ اشتباه را میپذیرید. سرور DiffusionGemma در این کارگاه، خودِ احتمال بالا را به عنوان اطمینان، که میانگین آن بر اساس خواندههایش محاسبه شده است، گزارش میدهد. وقتی خواندهها با هم اختلاف دارند، میانگین پخش میشود و اطمینان کاهش مییابد.
نکته کلیدی: پاسخ به شما میگوید چه چیزی را . اعتماد به نفس به شما میگوید که آیا باید اقدام کنید یا خیر .
آستانهها
آستانه، نحوه تعریف عمل در کد است. مدل یک مقدار اطمینان یا یک احتمال را برمیگرداند. کد شما آن را با عددی که انتخاب کردهاید مقایسه میکند و نتیجه، تصمیم میگیرد که چه اتفاقی بیفتد.
یک آستانه برای هر اقدام. TypeSafe پیشنهاد میکند که اطمینان به باندهایی تقسیم شود. اطمینان بالا به خودی خود عمل میکند. اطمینان متوسط با یک بررسی، مانند درخواست تأیید یا علامتگذاری پرونده برای بررسی، عمل میکند. اطمینان پایین عملی ندارد و به چیزی امن یا به یک شخص برمیگردد.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
قوانین میدان نبرد. آستانههای میدان نبرد در choose() قرار دارند که در مرحله ۵ اجرا میکنید.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
هشدار: یک پاسخ معتبر همیشه درست نیست. مدل تشخیصی نمیتواند گزینهای را که شما ارائه ندادهاید، برگرداند، بنابراین هرگز حرکتی را توهم نمیکند، اما میتواند حرکت اشتباه را انتخاب کند، گاهی اوقات با اطمینان بالا. قبل از اینکه به یک آستانه اعتماد کنید، سوالات خود را در برابر موقعیتهایی که قبلاً قضاوت کردهاید، بیازمایید.
خودکارسازی تصمیمگیریها با مدل
درخواست و پاسخ
درخواست. کیت توسعه نرمافزار TypeSafe Python به شما امکان میدهد سوالات را بسازید و آنها را به مدل ارسال کنید.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
یک درخواست در هر تیک
هر تیک، برنامه تلگراف را به عنوان وضعیت ارسال میکند و در یک تماس سه چیز را میپرسد:
- کدام پاسخ از بین پنج (یا شش، وقتی طلسم آماده است) درست است؟ یک انتخاب.
- اینکه آیا غول الان در معرض یک ضدحمله قرار دارد یا خیر. یک نول.
- میزان شدت ضربه وارده ، بر اساس یک معیار سه سطحی. امتیاز.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() choose
آستانههای مرحله ۴ را به خاطر دارید؟ choose() پاسخهای مدل را با اعداد ثابت مقایسه میکند و این اعداد ثابت، آستانهها هستند.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() یک تابع معمولی پایتون است که مقادیر تایپشده را با دو قانون میخواند. مدل تشخیص، احتمال و تحلیل خود را ارائه میدهد و کد از آستانهها برای قوانین استفاده میکند. عمل انتخابشده به موتور ارسال میشود، جایی که برای نبرد با غول استفاده خواهد شد.
نکته کلیدی: سوالات و آستانهها را در یک جا نگه دارید. آنها بخشی از یکپارچهسازی سیستم یک هستند که بیشتر از همه با آنها هماهنگ خواهید شد.
زمان پاسخ، قیمتگذاری مبتنی بر ورودی و منطق تصمیمگیری
- زمان پاسخگویی به ازای هر تصمیم. هر تیک از مبارزه در بخش ب در حدود صد میلیثانیه، و چند تا در دو یا سه میلیثانیه، پاسخ داده میشد. این سرعت برای یک حلقه بازی، یک مسیر درخواست یا بررسی هر پیام قبل از اینکه توسط شخص یا مدل زبانی دیده شود، کافی است.
- قیمتگذاری مبتنی بر ورودی. یک مبارزه کامل، شصت تصمیم با سه سوال برای هر کدام، هزینهای کمتر از یک دهم سنت دارد. توکنهای خروجی صفر هستند زیرا هیچ چیزی تولید نشده است. نتیجه این است که شما میتوانید بیشتر از نیاز خود سوال بپرسید. در این عرصه، حتی با وجود مراقبتهای
strikeوcast، این سوال مطرح میشود که آیا غول در هر تیک در معرض دید قرار میگیرد یا خیر، زیرا پرسیدن تقریباً رایگان است و پاسخ در داشبورد مفید است. TypeSafe این را fan-out حدسی مینامد. - اطمینان و خطر را با هم ترکیب کنید. وقتی اطمینان مدل تشخیصی به پاسخش کمتر از ۰.۴۰ است و امتیاز خطر میگوید که ضربه سنگینی در راه است،
choose()آن را با یک جاخالی لغو میکند. جاخالی به ندرت بهترین پاسخ است، اما به ندرت بدترین پاسخ نیز هست. آستانهها را از هزینه هر اشتباه انتخاب کنید، نه از یک عدد رند، و آنها را در برابر تلگرافهایی که قبلاً به صورت دستی قضاوت کردهاید، آزمایش کنید. توصیه خود TypeSafe: اگر تصمیمی مدام اشتباه از آب در میآید، قبل از اینکه آستانه را تغییر دهید، سوال را محدودتر کنید.
مدلها را در گردش کار ADK ترکیب کنید
محدودیتهای تصمیمگیری در هر تیک و اینکه چرا پاسخهای صحیح کافی نیستند
آخرین خط مبارزه در مرحله ۵ این را میگوید: غول به سختی و با سرعت حرکت میکند . مدل تشخیصدهنده هیچ آسیبی ندید و در هر تیک تیک کمی ضربه وارد کرد، و ۳۰۰ امتیاز ضربه بیشتر از کمی ضربدر شصت است. کارت طلسم در گوشه رینگ تمام مدت آنجا بوده است. خواندن آن به مدلی نیاز دارد که بتواند یک تصویر را ببیند.
غول ۳۰۰ امتیاز ضربه دارد. یک ضربهی درست ۳ امتیاز ضربه را خنثی میکند. ضربه به یک نقطهی شروع ۸ امتیاز میدهد، زیرا پوست ضخیم است. حتی یک مبارزهی بینقص با شصت تیک، غول را زخمی و سرپا نگه میدارد و بازی آن را مساوی اعلام میکند. مرحلهی ۵ به همین جا ختم شد: مدل به خوبی دفاع کرد و هنوز هم نتوانست برنده شود.
فقط یک طلسم آسیب واقعی وارد میکند: ۴۵ برای یک اجرای بینقص، و ۶۷ وقتی که روی یک نقطه خالی فرود بیاید.
هر وظیفه را به مدل مناسب اختصاص دهید
کارت طلسم در گوشه رینگ، راه برنده شدن است و خواندن آن مشکل متنی نیست: یک تصویر است، با یک رنگ و سه شکل در یک ردیف، و طلسم باید خوانده شود تا با آن مطابقت داشته باشد. این به مدلی نیاز دارد که بتواند به یک تصویر نگاه کند و چند ثانیه روی آن وقت بگذارد. در یک مبارزه، چند ثانیه معادل ده تیک است.
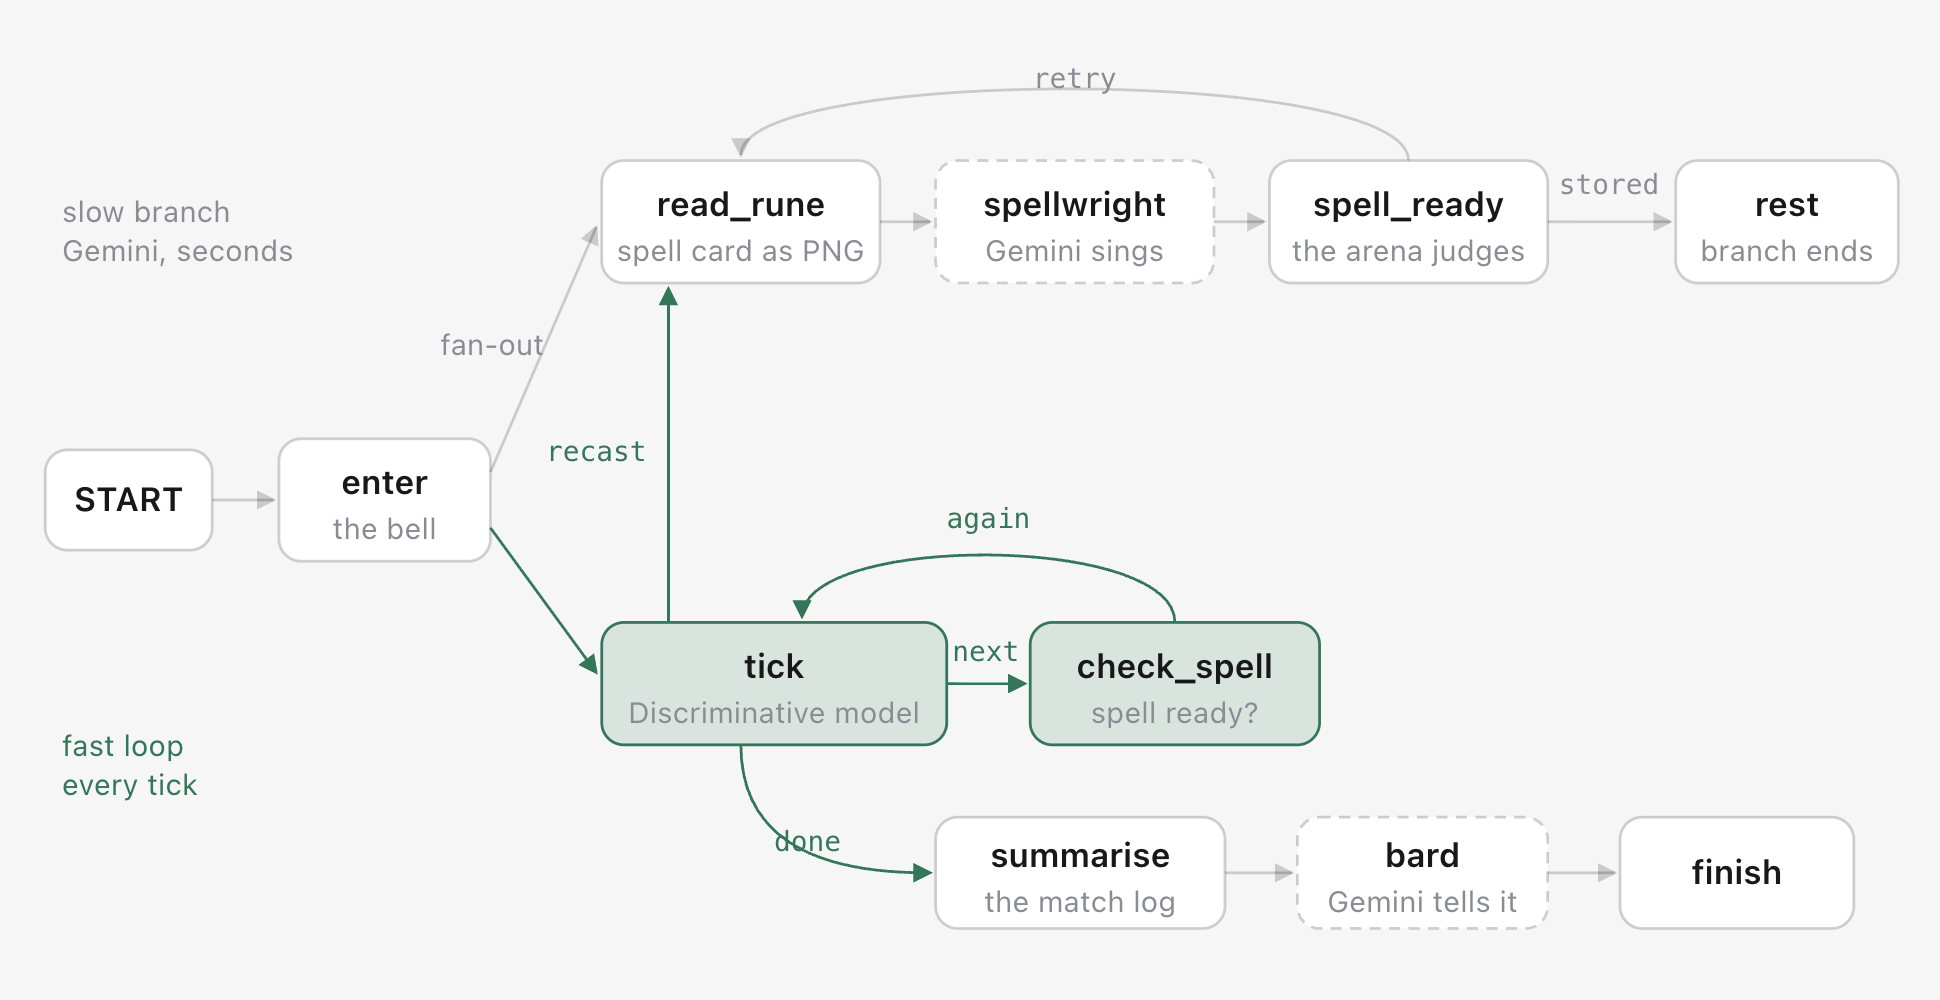
بنابراین گردش کار از هر دو استفاده میکند، هر کدام با سرعت خاص خود:
- مدل تشخیص (Discriminative) میجنگد. هر تیک، یک فراخوانی، یک تصمیم، صد میلیثانیه. حلقه هرگز منتظر چیزی کندتر از خودش نمیماند.
- جوزا میخواند و میخواند. در شاخهی خودش، که از زنگوله شروع شده، کارت طلسم را از روی صفحهی میدان به عنوان تصویر برمیدارد، رنگ و شکلها را نام میبرد و یک ورد میخواند. میدان، آهنگ را در برابر پاسخ کارت طلسم که هرگز از سرور خارج نمیشود، قضاوت میکند.
- بعد از هر تبادل، مبارز اسلات را بررسی میکند. یک گره
check_spellبه وضعیت نگاه میکند. Not ready: این را میگوید، با مدت زمانی که Gemini آواز خوانده است، و مستقیماً به تیک بعدی برمیگردد. هرگز منتظر نمیماند. Ready:castگزینههایی را که مدل تشخیصی ارائه میدهد به هم متصل میکند وchoose()طلسم را در لحظهای که مدل تشخیصی یک شروع را گزارش میدهد، خرج میکند. وقتی طلسم خرج میشود، صفحه یک کارت طلسم جدید میکشد و رشته کند دوباره شروع میشود. یک آهنگ اشتباه خوانده شده کارت طلسم را میسوزاند و رشته کند کارت جدید را میخواند. - جمینی یک بار، در پایان، یک داستان کوتاه مینویسد .
شاخههای موازی با تأخیرهای مختلف و یک حلقه رویداد
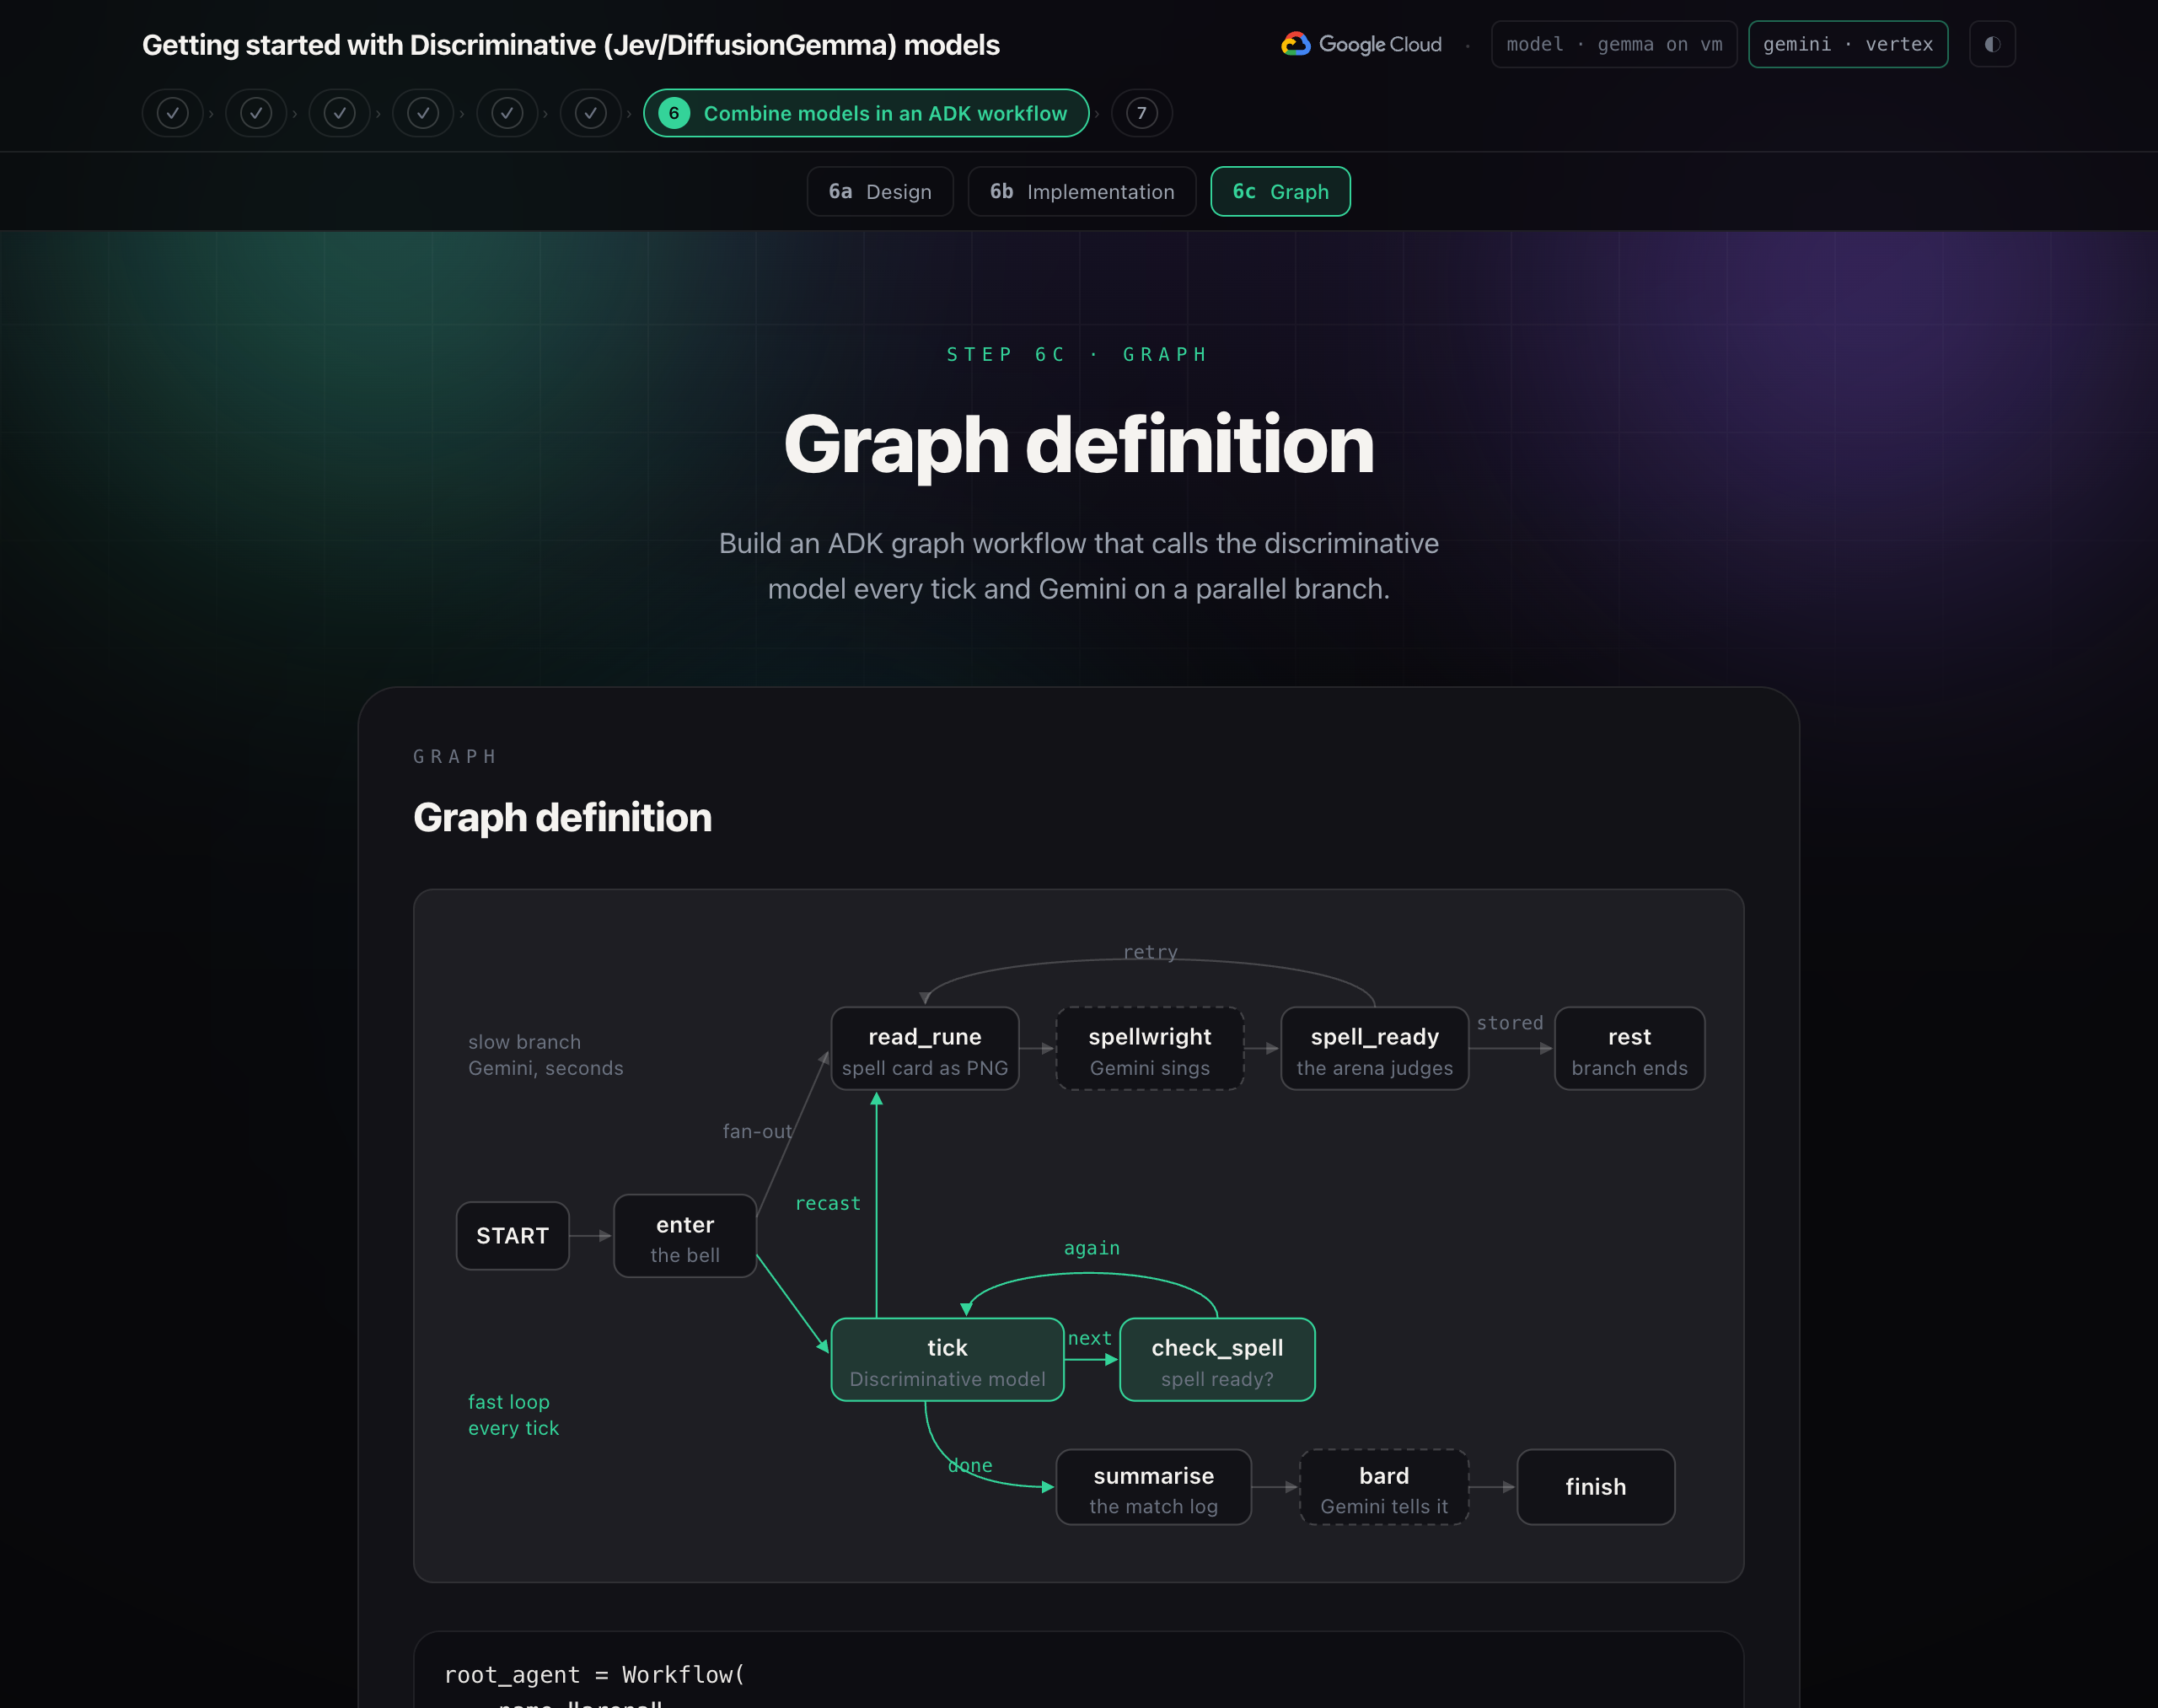
این یک گردش کار ADK است: گرافی از گرهها که توسط یالها به هم متصل شدهاند. یک گره، یک تابع پایتون ساده یا یک عامل LLM است. یک یال از یک گره به یک تاپل از گرهها، یک fan-out است: هر دو به طور همزمان شروع میشوند. گرهای که یک Event با یک route برمیگرداند، یال بعدی را انتخاب میکند و گرهای که به خودش مسیر میدهد، یک حلقه است.
Think of it as two threads. Thread 1 is slow: read the spell card, sing, store the spell. Thread 2 is fast: tick, check the slot, tick again. Thread 1 ends in a function that writes the judged spell into session state and returns no output. Thread 2's check_spell reads that state after every exchange. Neither thread calls or waits for the other; they only share state.
Key takeaway: Put the decisions in code and give each model a narrow job at its own pace.
ADK runs both branches as tasks on one event loop, in a single thread. Only one task runs at a time. When a task reaches await , it waits for its answer, and the loop runs the other branch in the meantime. The fast branch waits for the model for about a tenth of a second, and the slow branch waits for Gemini for several seconds, so neither holds up the other.
Slow branch
read_rune() takes the spell card off the screen as an image.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright is Gemini. It reads the image and answers in a fixed shape.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() has the arena judge the spell, then stores it or tries again.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
A function node can return a Content with an image part, and the LLM node receives it as its user turn. spell_ready returns an Event with a state delta and no output . The next tick reads the spell from state, and a branch with no output is not a second ending for the graph: ADK requires one terminal output, and that is the fight's.
Note: The judging is code, in the arena, against the spell card's hidden answer. A perfect reading does 45, more into an opening. Two shapes right does 25. A misread fizzles and burns the spell card. Gemini is not asked whether it was right.
Fast branch
tick() plays one exchange, then picks the next edge.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() looks at the spell slot after every exchange.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell looks at the slot after every exchange. It never blocks: if the spell is not ready, it reports that and moves on.
Three things carry the design. The Discriminative model call is await ed with the async client, so the loop yields while it waits and the Gemini branch keeps running. The questions are built fresh each tick, so cast appears only when there is something to cast. And route can be a list: ["recast", "next"] takes both edges at once.
The arena itself is behind a small client: the running app over HTTP when there is one, so the page shows the fight; the engine in-process when there is not.
Graph definition
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
A tuple as a target is a fan-out. A tuple as an edge is a chain. A dict maps route names to nodes. tick → check_spell → tick is the fast loop. "recast": read_rune starts the slow thread again after a spell is spent, "retry" does the same after a fizzle, and "stored": rest lets the slow thread end quietly, with no output, once the spell is in the slot. ADK requires at least one routed edge in a cycle, so an unconditional loop is rejected before it can run forever.
Note: root_agent is what ADK's tools look for. adk web agents from the root of the workshop opens the dev UI with the arena in it, if you want to see the graph and the events in a browser rather than a terminal.