

1. Introduction
Atelier de 90 minutes sur le modèle discriminatif, le modèle de décision System One de TypeSafe AI et sur la façon de le comparer à Gemini dans un workflow Google ADK. Cet atelier comporte six étapes, qui s'articulent autour d'un jeu de combat. Vous allez d'abord combattre l'ogre à la main, puis transmettre les réflexes au modèle discriminatif. Vous allez ensuite regarder un workflow ADK gagner le combat avec le modèle discriminatif qui décide à chaque tick et Gemini qui lit les cartes de sorts hors écran pour chanter les sorts.
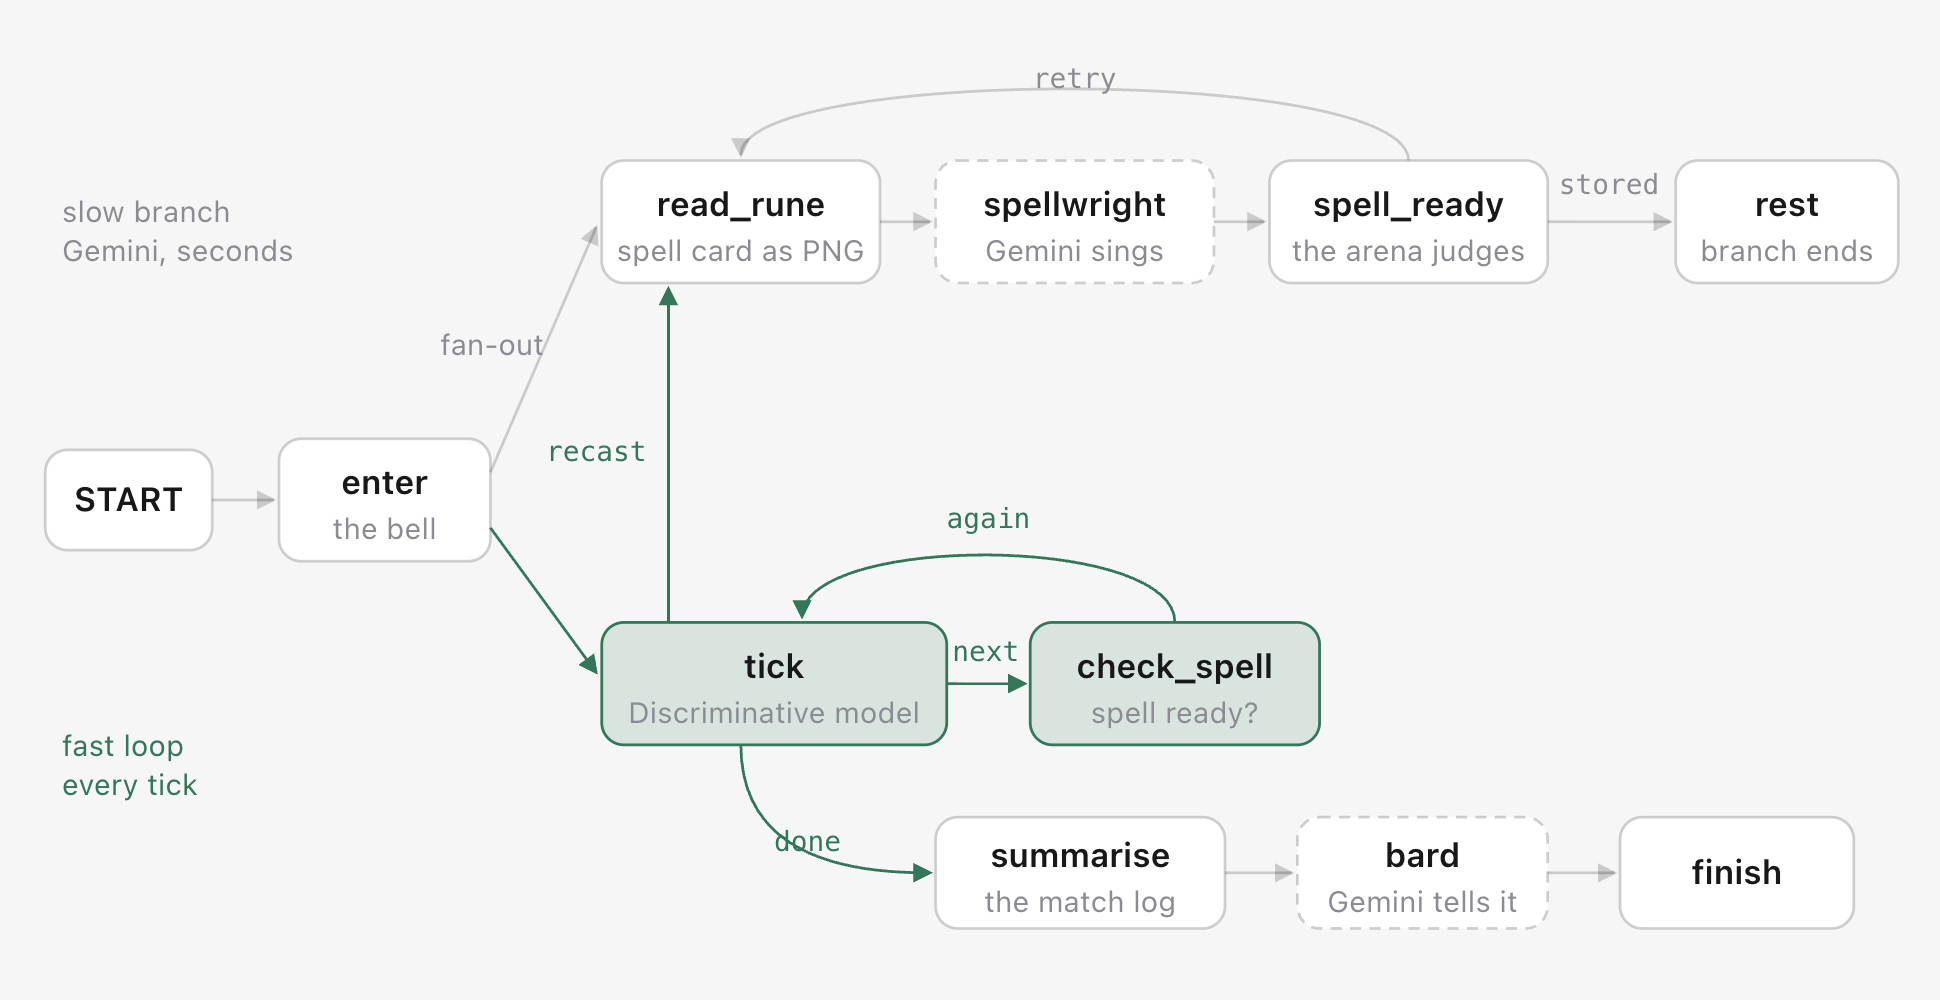
Présentation
Le modèle discriminatif (jev-1.13, alias jev-latest) est un modèle hébergé de TypeSafe AI, publié le 19 septembre 2026. Elle ne génère pas de texte. Vous lui envoyez un état (texte, JSON ou liste) et des questions typées (Choice, Score, Noul). Il renvoie des réponses typées avec des probabilités calibrées, en 70 à 500 ms environ, pour 0,042 $ par million de jetons d'entrée et sans frais pour la sortie. Son rôle est de prendre des décisions devant, entre et derrière les modèles de langage : routage, classification, gating et, ici, réflexes d'un combattant.
Un jeu comme exemple
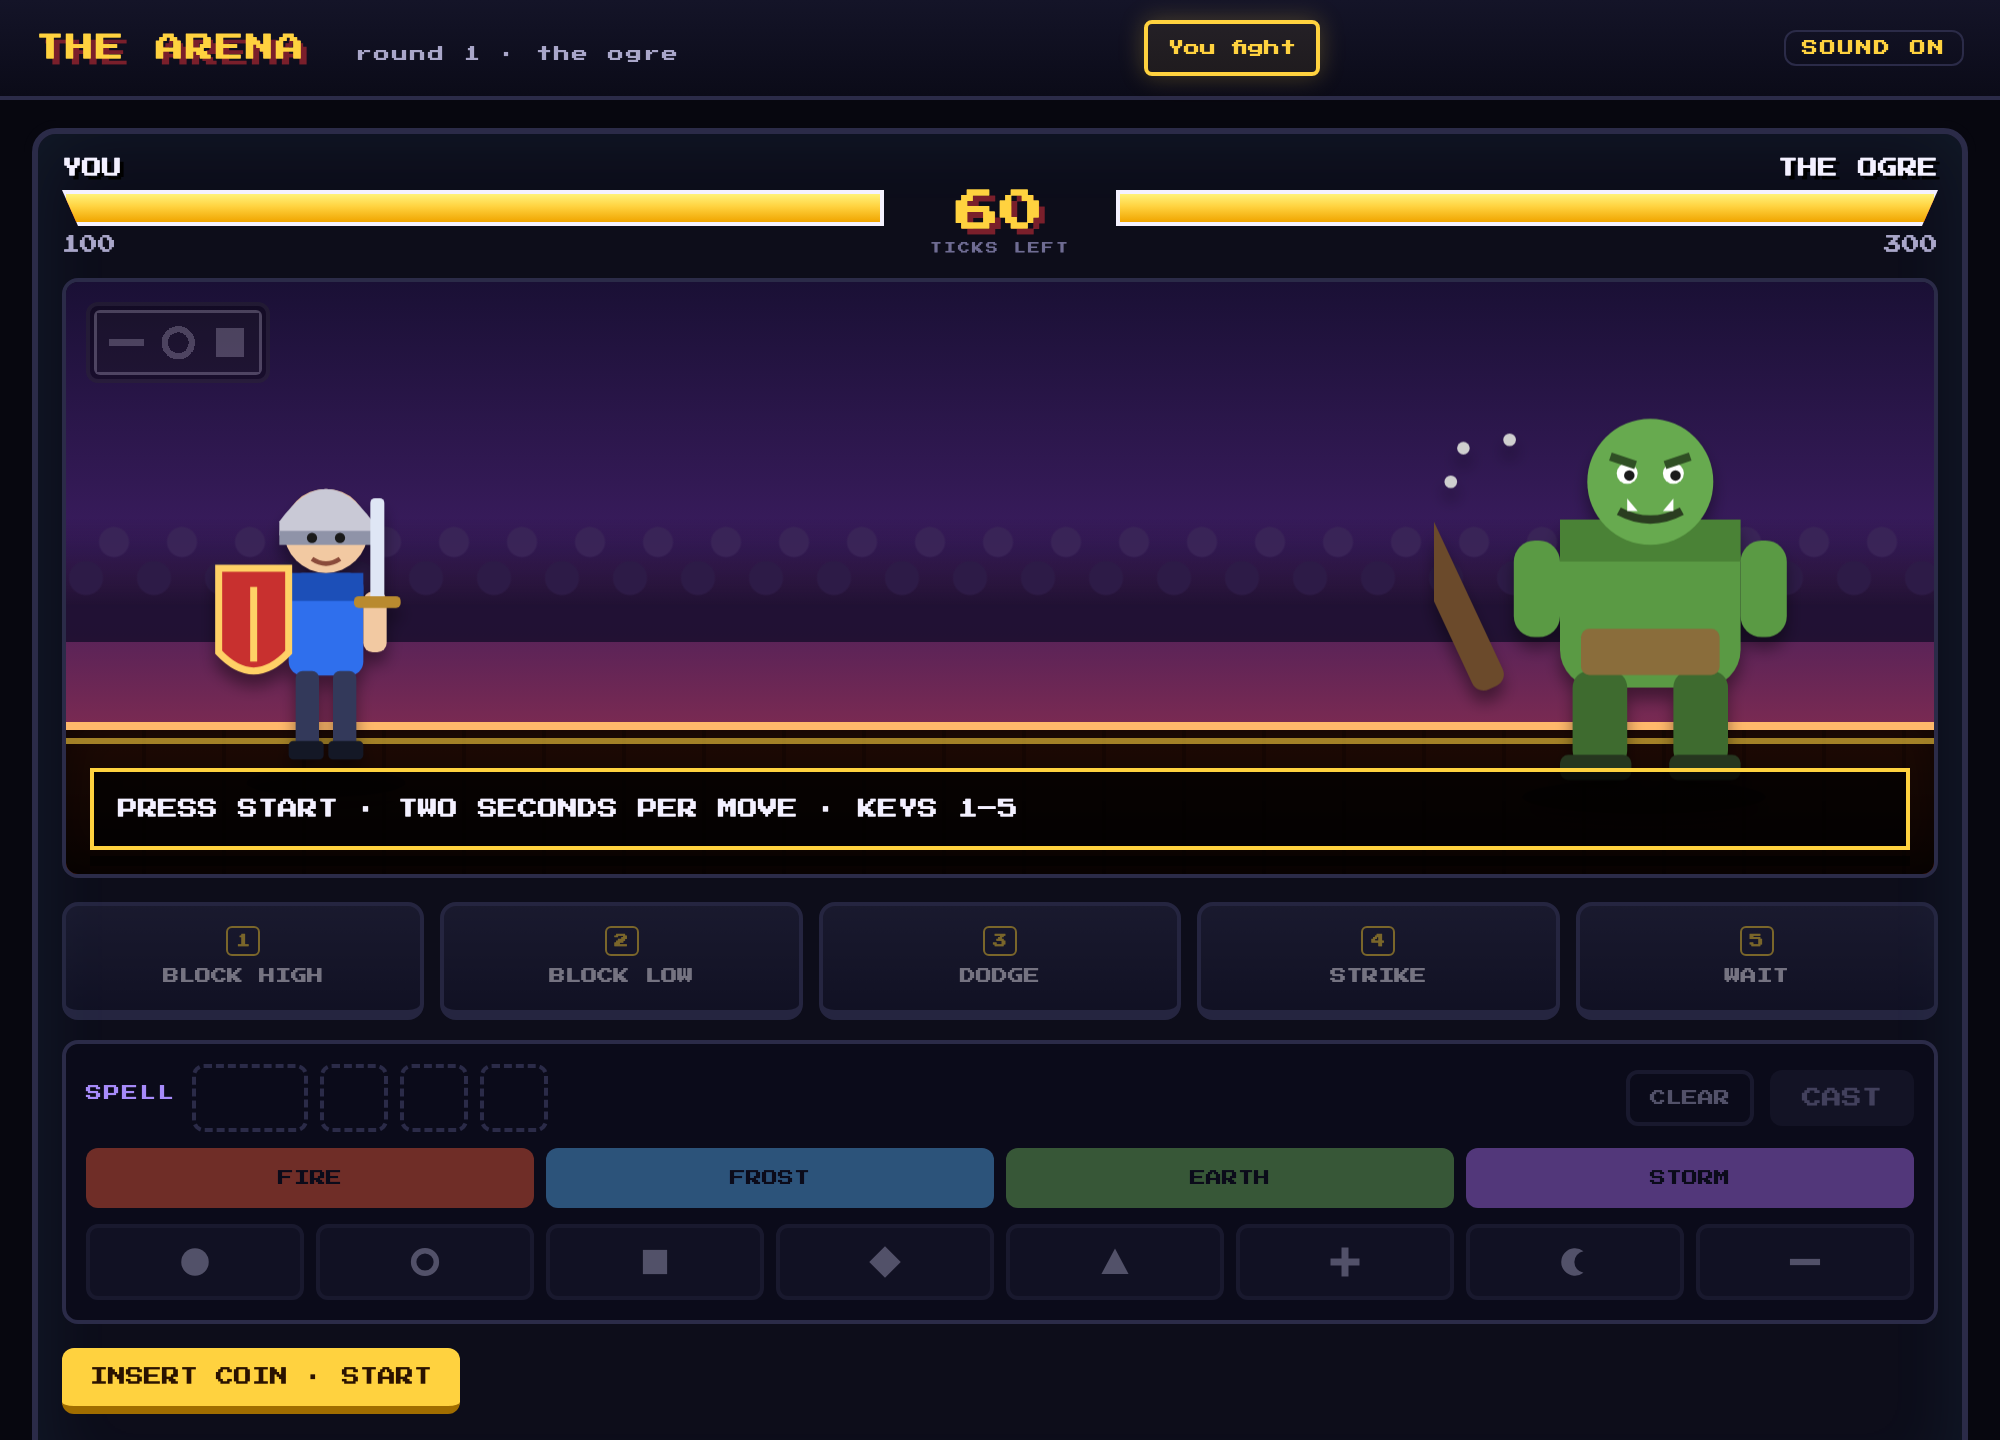
Avez-vous déjà joué à un jeu de combat ? Vous affrontez un adversaire et devez réagir instantanément à ses mouvements. Une seule mauvaise réponse et vos PV en prennent un coup. Les jeux ont également tendance à rendre les sorts difficiles à lancer. Dans le nôtre, vous devez choisir la couleur et les formes de la carte de sort, dans l'ordre, avant que le sort ne soit lancé. Cet atelier vous montre comment combiner les deux types de modèles pour faire gagner votre personnage.
Chaque élément du jeu correspond à un système réel :
- Le coup de l'adversaire est un événement entrant, comme une requête ou une transaction.
- La réponse est une décision limitée, prise par le modèle discriminatif et vérifiée par le code.
- La carte de sort est une entrée non structurée qui nécessite un modèle de langage pour être lue.
- L'association est le workflow, qui exécute les tâches rapides et lentes à leur propre vitesse.
L'objectif est de combiner les quatre composants et de les assembler pour créer un système rapide et intelligent.
Objectifs de l'atelier
- Expliquer la différence entre les modèles discriminatifs (système 1) et génératifs (système 2), et savoir quand utiliser chacun d'eux
- Décrivez comment Jev et DiffusionGemma sont diffusés, et configurez-en un pour l'atelier, y compris DiffusionGemma sur une VM GPU Compute Engine.
- Rédiger des questions à choix multiples, des questions sur le score et des questions Noul, et interpréter les probabilités et la confiance
- Utilisez des seuils dans le code déterministe pour transformer les probabilités en actions.
- Créez une requête avec le SDK TypeSafe, puis laissez le modèle choisir chaque mouvement dans un jeu.
- Créez une branche lente, où Gemini lit une image, et une branche rapide, où le modèle discriminatif décide en boucle, et exécutez chacune d'elles séparément.
- Joignez les deux branches dans un workflow de graphique ADK qui partage l'état sur une boucle d'événement. Ainsi, les tâches lentes n'empêchent jamais les décisions rapides.
Architecture
Le workbench se trouve dans Cloud Shell(ou sur votre machine). Il écrit dans le système de fichiers local et interagit avec l'arène, ainsi qu'avec Gemini et le modèle de décision. ② appelle le modèle de décision dans "Discriminative model fights" (Combats de modèles discriminatifs) ; ③ appelle les deux dans "Workflow fights" (Combats de workflows).
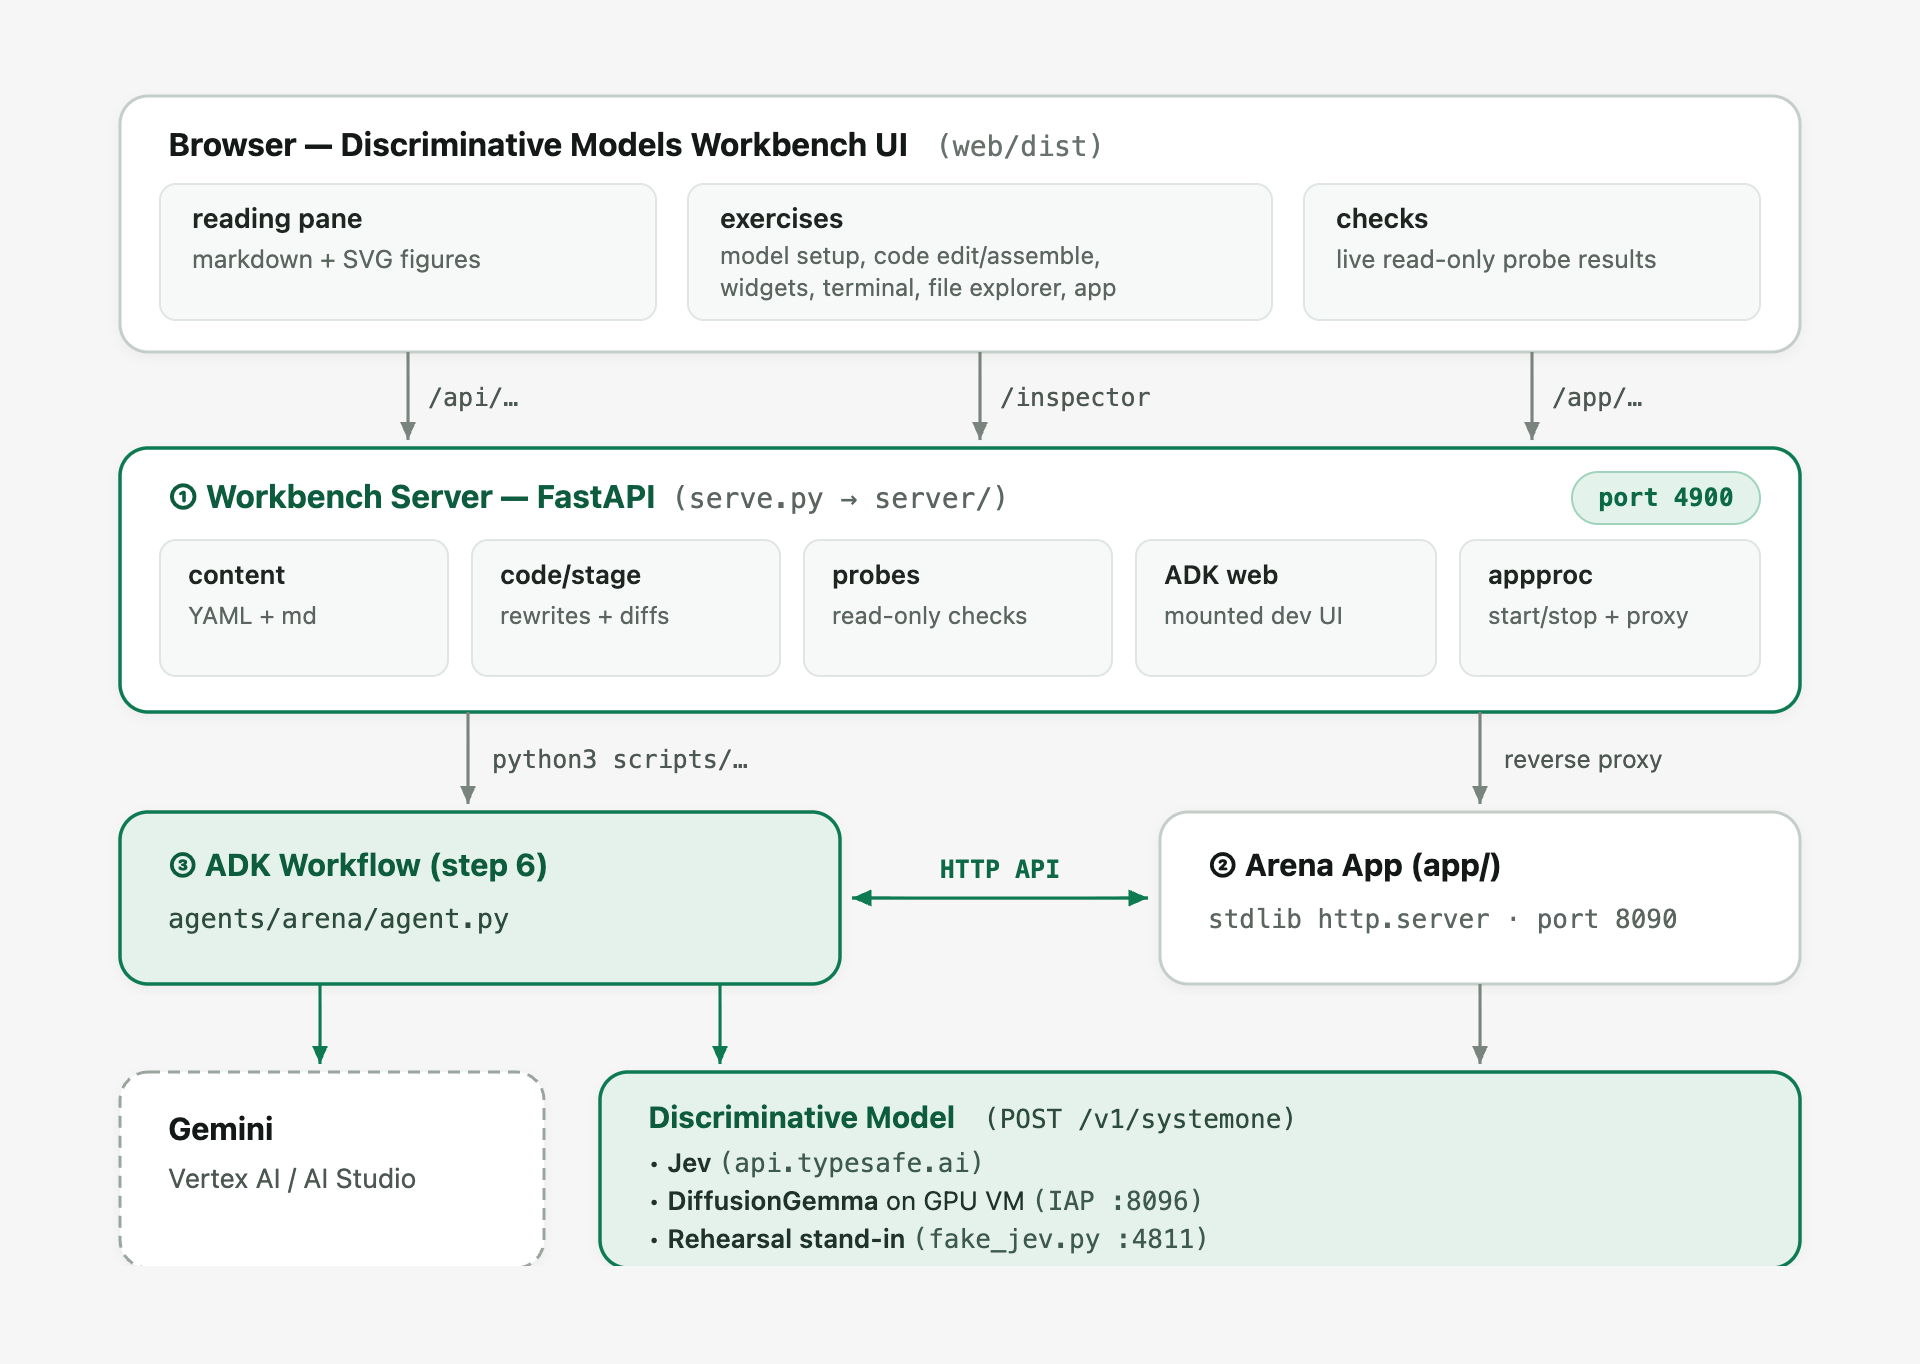
Qui appelle quoi ? Le navigateur ne communique qu'avec ①. Les deux modèles sont appelés depuis Python sur la machine :
Appelant | Modèle discriminatif | Gemini |
② arena, "Combats de modèles discriminatifs" | à chaque tic, | non |
③ workflow | à chaque tic, | non |
③ workflow | non | l'image de la carte de sort ; le conte après le combat |
| oui | non |
Un seul tick par mode.
- Vous vous battez. La page demande ② un télégramme, l'affiche avec un minuteur de 2 secondes et renvoie le bouton sur lequel vous appuyez (ou le sort que vous saisissez). ② résout le problème.
- Combats de modèles discriminatifs La page ② demande une coche, ② dessine un télégraphe, pose trois questions au modèle en un seul appel, exécute
choose()et renvoie les réponses et le résultat. La page dessine les barres. - Les conflits de workflow Start lance ② en tant que sous-processus (connexion
runs/arena-workflow.log). ③ gère le combat : il demande à ② chaque télégraphe, appelle le modèle et publie la décision. Le sort de Gemini arrive sur sa propre branche quand il est prêt. La page interroge uniquement ② et dessine. "Pause" est un indicateur sur ② que ③ vérifie avant chaque tick.
Emplacement d'hébergement du modèle de décision. Chaque appel passe par le même typesafe-sdk. Seule l'URL de base change. scripts/jevauth.py nomme le backend et définit la clé et le délai avant expiration :
Backend |
| Clé | Configuré par |
TypeSafe, hébergé | unset (api.typesafe.ai) |
|
|
DiffusionGemma sur votre VM L4 |
| aucun |
|
DiffusionGemma sur Cloud Run |
| un jeton d'identité Google récupéré toutes les heures. |
|
Répétition |
| aucun |
|
Réponse de la carte de sort ② : le workflow n'obtient que le PNG et ② évalue le sort qu'il renvoie. C'est ce qui fait du sortilège un véritable test de lecture pour Gemini et du sortilège que vous créez dans "Vous combattez" un véritable test pour vous.
2. Configuration
Réclamer vos crédits d'atelier
Si vous avez reçu un crédit Google Cloud pour cette session, demandez-le d'abord. Cela prend environ une minute et crée le compte de facturation pour vous.
Ouvrir Cloud Shell
Google Cloud Shell est un environnement Linux accessible par navigateur, préconfiguré avec gcloud, Python, Node.js, uv et git, et déjà authentifié avec votre compte Google.
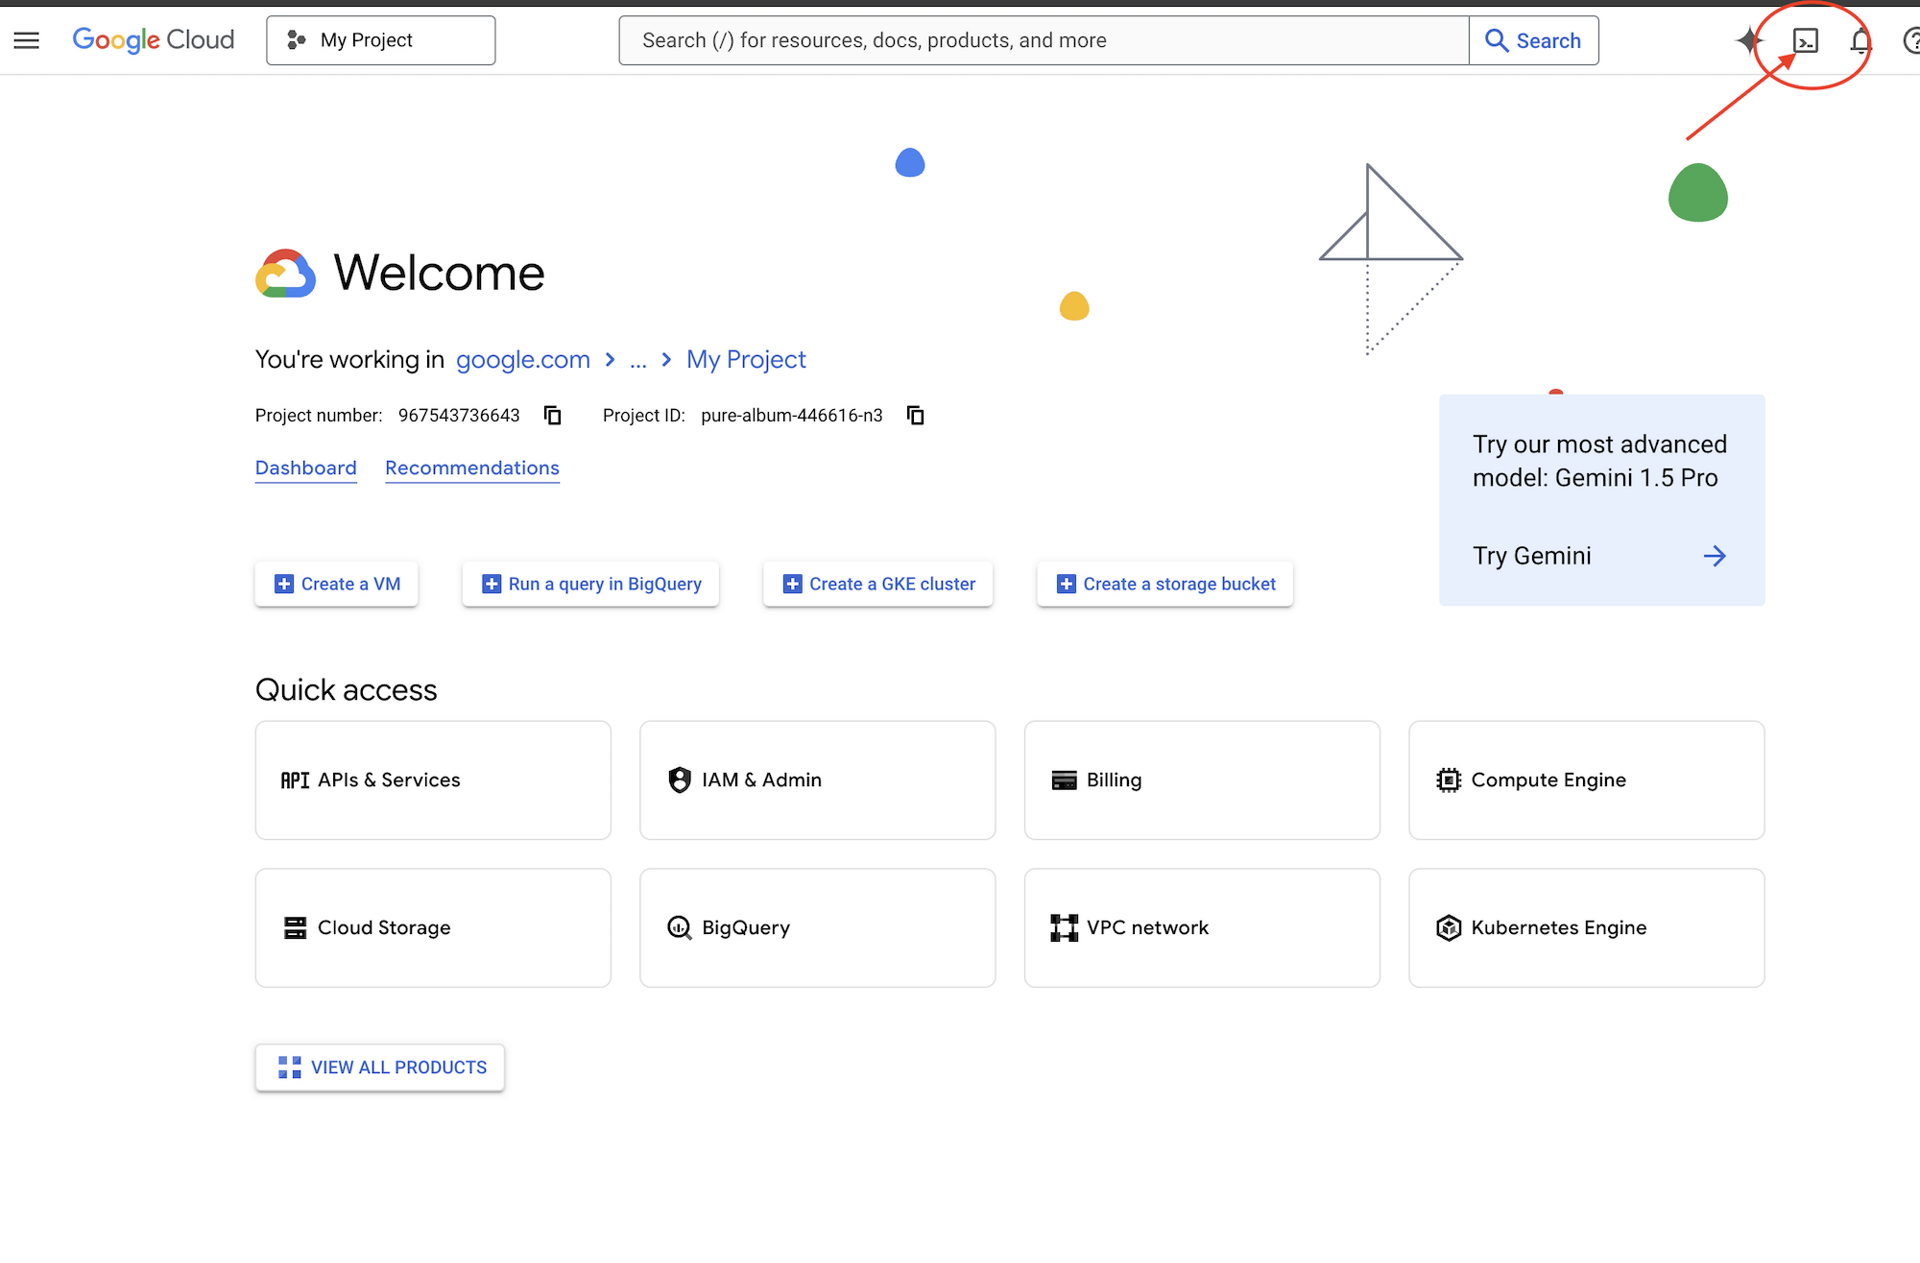
- Ouvrez Google Cloud Console.
- Cliquez sur Activer Cloud Shell (l'icône de terminal dans la barre de navigation supérieure) pour ouvrir une session de terminal en bas de votre navigateur.
Lancer le workbench
Dans Cloud Shell ou n'importe où gcloud est connecté :
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh crée un projet (discrim-models-XXXX), y associe la facturation, en privilégiant un compte de crédit événementiel si vous en avez un, et attend que le projet puisse diffuser des annonces. Si vous l'exécutez à nouveau, le projet est réutilisé dans ~/project_id.txt. Pour utiliser un projet existant, saisissez son ID dans ce fichier et ignorez ce script.
setup_codelab.sh ne demande rien. Il installe uv et les packages Python, active Vertex AI, Compute Engine et IAP, pointe Gemini vers Vertex AI dans le projet dans .env, effectue un véritable appel Gemini avec un modèle que le projet peut appeler, crée la page, démarre le workbench en arrière-plan et exécute scripts/check_setup.py. Si vous l'exécutez à nouveau, vos fichiers d'exercice sont conservés. scripts/starter.sh les réinitialise. Le modèle de décision est choisi à l'étape 2 de l'atelier.
Pour ouvrir l'interface utilisateur de l'atelier dans Cloud Shell :
- Cliquez sur le lien d'aperçu affiché à la fin de
./setup_codelab.shou sur Aperçu sur le Web en haut à droite de la barre d'outils Cloud Shell. - Sélectionnez Modifier le port, saisissez 4900, puis cliquez sur Modifier et prévisualiser.
Gemini s'exécute sur Vertex AI dans votre projet, avec vos propres identifiants Google : GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT et GOOGLE_CLOUD_LOCATION=global dans .env.
Le modèle de décision est choisi seul, à l'étape 2 de l'atelier ou à partir d'un terminal avec scripts/setup_model.sh :
Choix | Besoins | Configuration | Coût |
Modèle discriminatif (TypeSafe, hébergé) | une clé API TypeSafe ; | aucun | par jeton, fractions de centime |
DiffusionGemma (Google, poids ouverts) | Facturation + quota Compute Engine pour les GPU | ~15 min, automatique | ~0,71 $/h pendant l'exécution de la VM |
Répétition (sans modèle) | nothing | aucun | aucun |
DiffusionGemma sur une VM Compute Engine
scripts/setup_gemma.sh vérifie d'abord le quota de GPU, puis crée une VM g2-standard-4 (1 × L4 24 Go, 4 vCPU, 16 Go) à partir de l'image Deep Learning de Google avec le pilote NVIDIA 580. Au premier démarrage, la VM installe Docker, télécharge les poids depuis Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 Go, public, sans jeton) et exécute djev-run : DiffusionGemma derrière l'API exacte du modèle discriminatif. Le port du modèle n'est pas ouvert sur Internet : le workbench y accède via un tunnel IAP sur localhost:8096, qui s'ouvre sur scripts/start.sh.
Mettre en pause / Reprendre |
| |
Tunnel |
| |
Supprimer |
| |
Répéter les commandes |
| |
Mise en page du dépôt
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Résumé
Nettoyer votre environnement
Une fois l'atelier terminé, suivez les étapes ci-dessous pour supprimer les ressources GPU DiffusionGemma, arrêter les processus d'atelier et de répétition en arrière-plan, supprimer les fichiers de l'atelier de Cloud Shell et (facultatif) supprimer votre projet Google Cloud de l'atelier.
- Supprimez la VM GPU DiffusionGemma et la règle de pare-feu (si vous en avez créé une) : si vous avez provisionné DiffusionGemma sur une VM GPU Compute Engine à l'étape 2, supprimez la VM, le disque et la règle de pare-feu IAP pour éviter d'accumuler des frais de calcul ou de stockage sur disque :
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Arrêtez les processus de l'atelier et de répétition dans Cloud Shell : dans votre terminal Cloud Shell, arrêtez le serveur d'atelier en arrière-plan et tout processus de répétition de remplacement :
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Supprimez le dossier de l'atelier de Cloud Shell : revenez à votre répertoire d'accueil, puis supprimez le dossier du dépôt cloné et le fichier d'ID du projet :
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Supprimez votre projet Google Cloud : si
./setup_project.shvous avez créé un projet d'atelier dédié (par exemple,discrim-models-XXXX), l'arrêt du projet supprime définitivement toutes les ressources créées à l'intérieur, tout en laissant intact votre compte de facturation Cloud :- Ouvrez la page Gérer les ressources dans la console Google Cloud.
- Sélectionnez votre projet d'atelier (par exemple,
discrim-models-...) dans la liste des ressources. - Cliquez sur Supprimer dans la barre d'outils supérieure, saisissez l'ID de votre projet pour confirmer, puis cliquez sur Arrêter.
Vous avez terminé cet atelier.
Résumé de l'atelier
- J'ai choisi un modèle discriminatif, Jev ou DiffusionGemma, sur une VM GPU Compute Engine et vérifié qu'il répondait.
- J'ai joué dans l'arène à la main, contre la montre, pour apprendre ses règles.
- Vous avez appris comment un modèle discriminatif répond aux questions Choice, Score et Noul, aux probabilités et à la confiance, et comment votre code leur applique des seuils.
- Envoyez votre première requête, puis laissez le modèle choisir chaque mouvement dans l'arène, en transformant ses réponses en actions avec
choose(). - Chaque branche d'un workflow ADK a été créée individuellement, Gemini lisant une image de carte de sort et le modèle prenant des décisions en boucle.
- Nous les avons regroupés dans un workflow qui partage l'état, de sorte que le combat n'attend jamais Gemini et que le sort est jeté dès le début.
De la conversation aux décisions
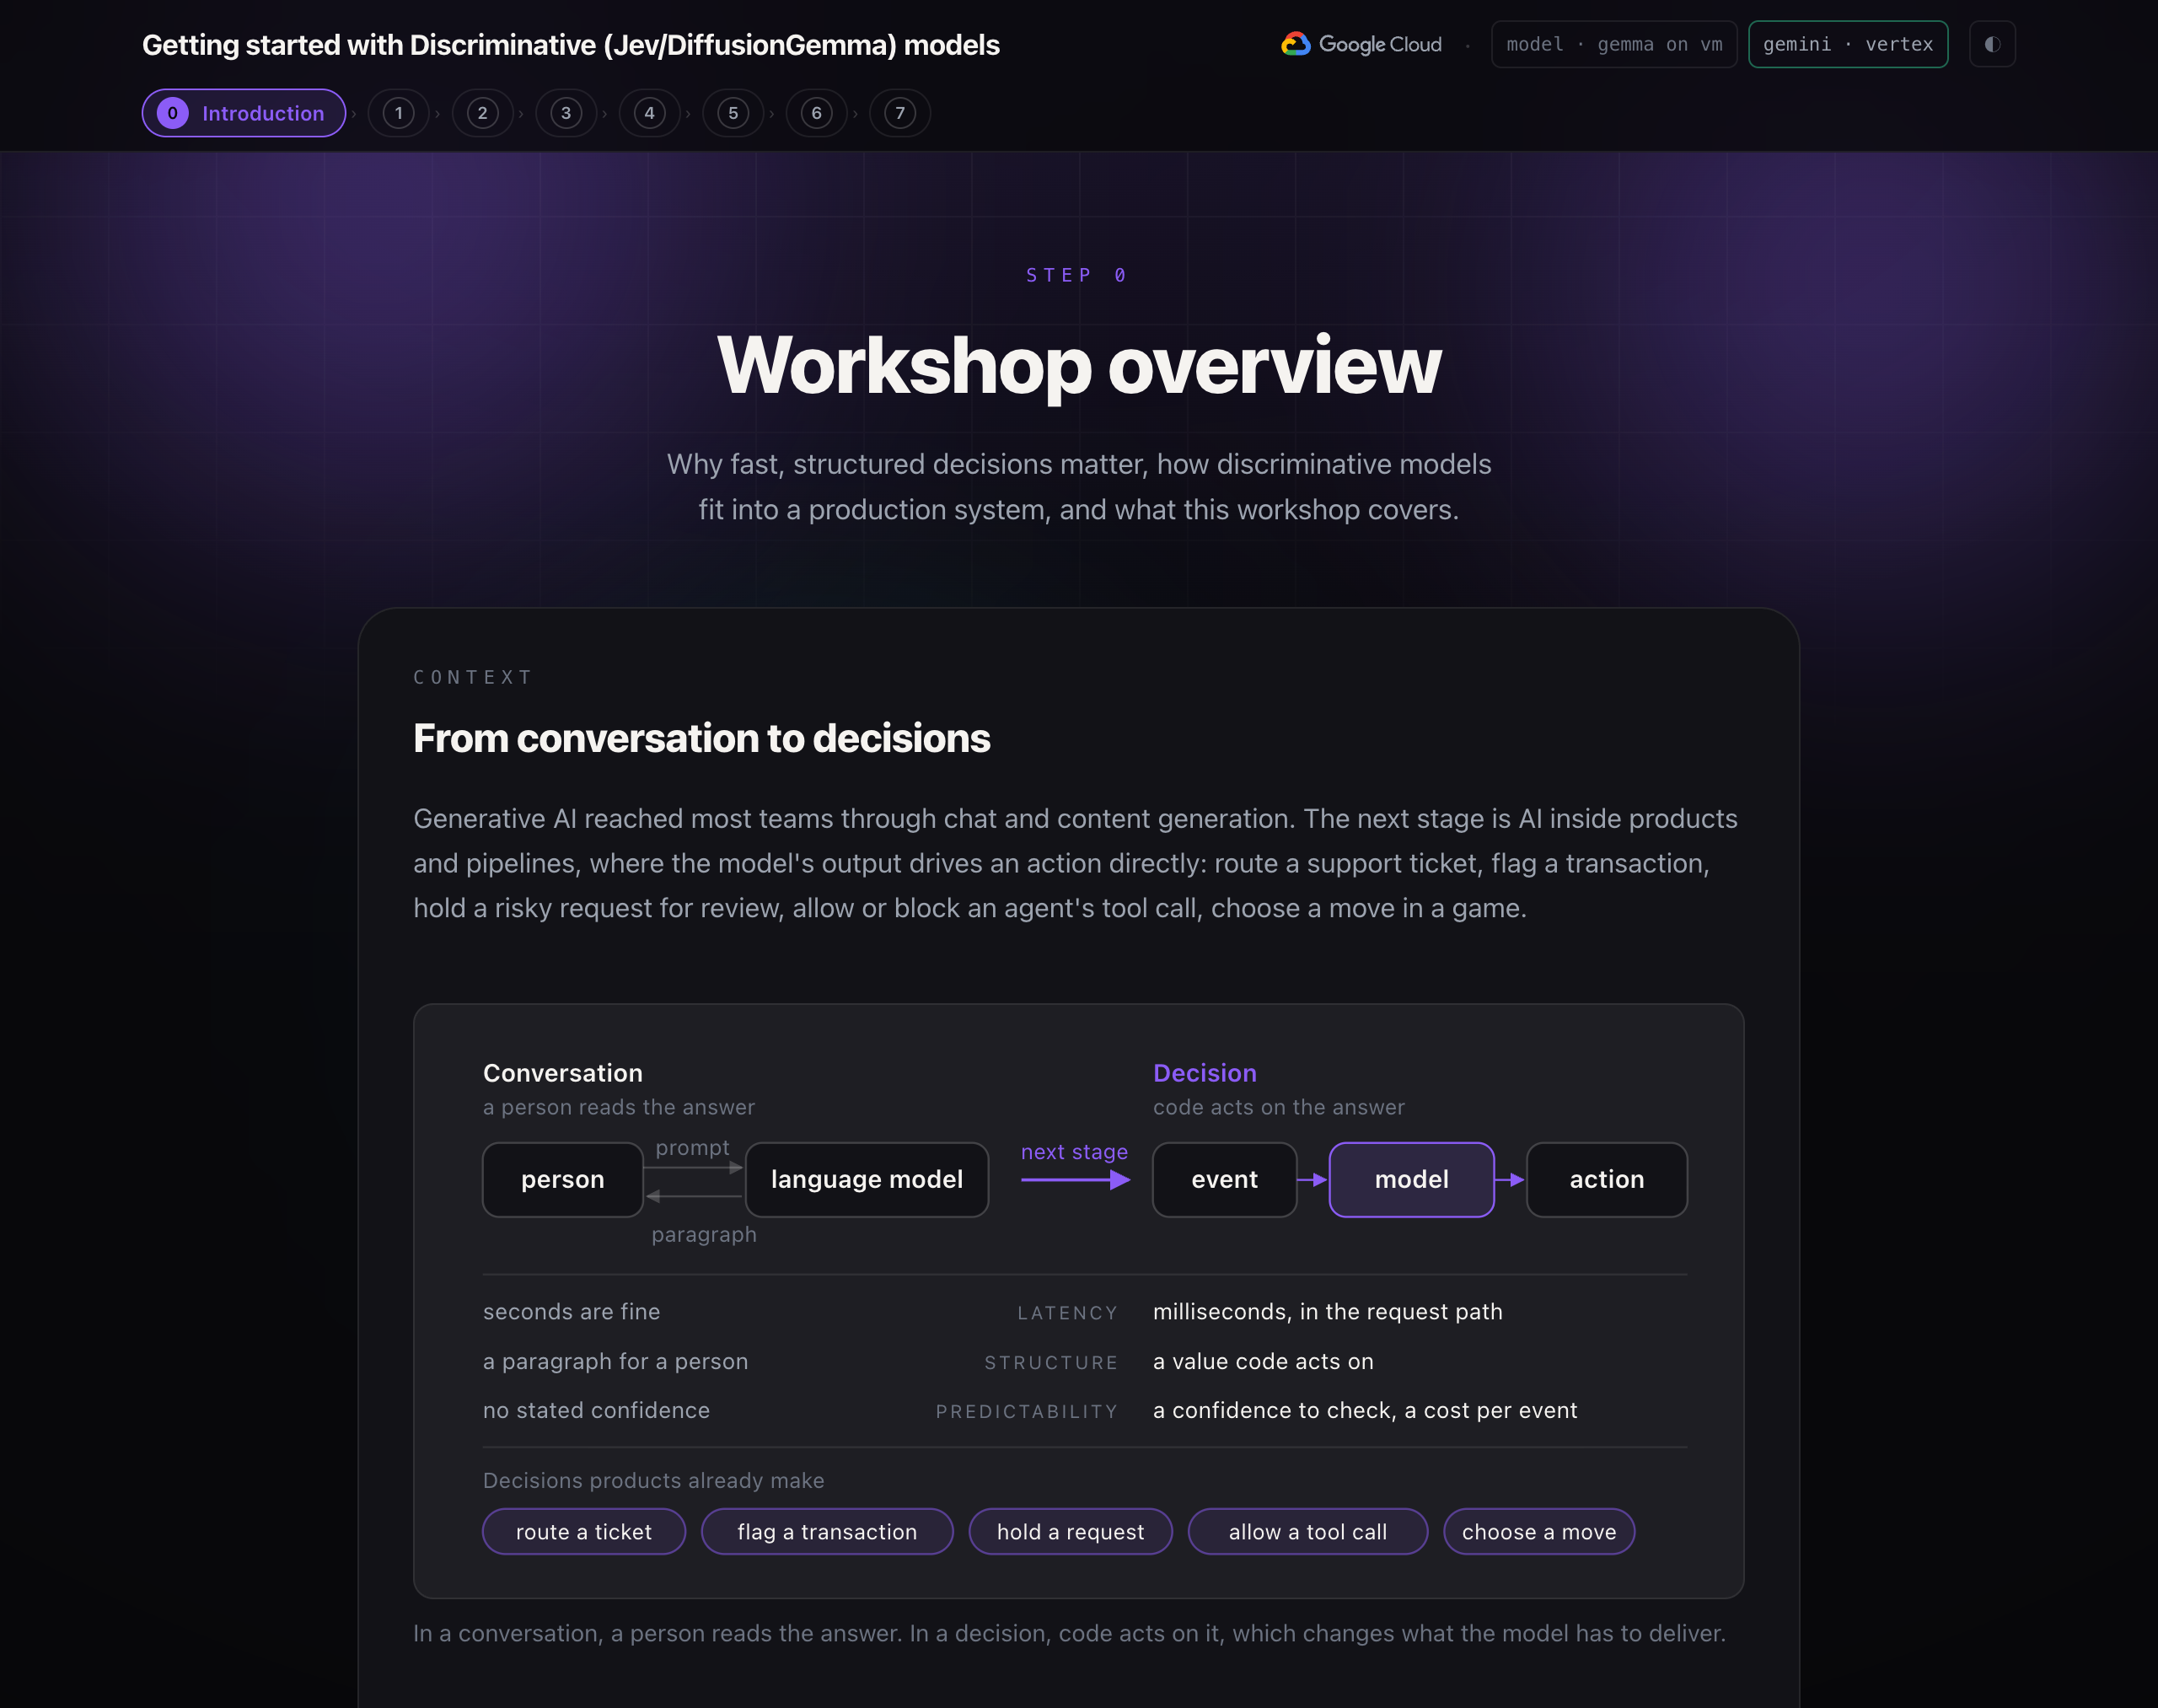
L'IA générative a été déployée dans la plupart des équipes via la génération de chat et de contenu. L'étape suivante est l'IA intégrée aux produits et aux pipelines, où la sortie du modèle déclenche directement une action : routage d'une demande d'assistance, signalement d'une transaction, mise en attente d'une demande risquée pour examen, autorisation ou blocage de l'appel d'outil d'un agent, choix d'un mouvement dans un jeu.
Ces décisions partagent trois exigences que le chat n'a pas :
- Latence. La réponse se trouve souvent dans le chemin de requête d'un utilisateur ou dans une boucle en temps réel. Elle doit donc arriver en quelques millisecondes, et non en quelques secondes.
- Structure. L'appelant est un code. La réponse doit donc être une valeur sur laquelle il peut agir, et non un paragraphe qu'il doit analyser.
- Prévisibilité. Chaque décision doit être associée à un niveau de confiance que le code peut vérifier et à un coût suffisamment bas pour être demandé à chaque événement.
Un modèle de langage génère du texte un jeton à la fois. Il peut être invité à répondre par oui ou par non, mais il est lent pour une boucle en temps réel, sa sortie doit être analysée et il ne signale pas son degré de certitude.
Modèles conçus pour les décisions
Un modèle discriminatif répond à une question typée avec une probabilité pour chaque option autorisée, en une seule passe. Elle ne génère pas de texte. Cet atelier propose deux options d'exécution :
Modèle | Fournisseur | Où le modèle s'exécute-t-il dans cet atelier ? |
Jev | TypeSafe AI | Service hébergé de TypeSafe, appelé avec une clé API |
DiffusionGemma | Google, pondérations ouvertes | Auto-hébergé sur une VM GPU dans votre propre projet Google Cloud |
Vous pouvez échanger les modèles en fonction de vos besoins. Le code qui s'y connecte n'a pas besoin d'être modifié.
Combiner des composants
Un système efficace se compose de plusieurs éléments :
Composant | Rôle | Dans cet atelier |
Workflow | Orchestre les étapes, exécute les branches en parallèle, conserve l'état partagé | Workflow de graphique ADK |
Code déterministe | Règles, seuils et validation. Instantané, sans frais et auditable | Règles du jeu, |
Modèle discriminatif | Des décisions rapides et limitées avec un score de confiance | Choisir une réponse à chaque tic |
Modèle de langage | Perception et génération : images et texte ouvert | Gemini lit l'image de la carte de sort et écrit le sort |
Architecture de mise en service des modèles
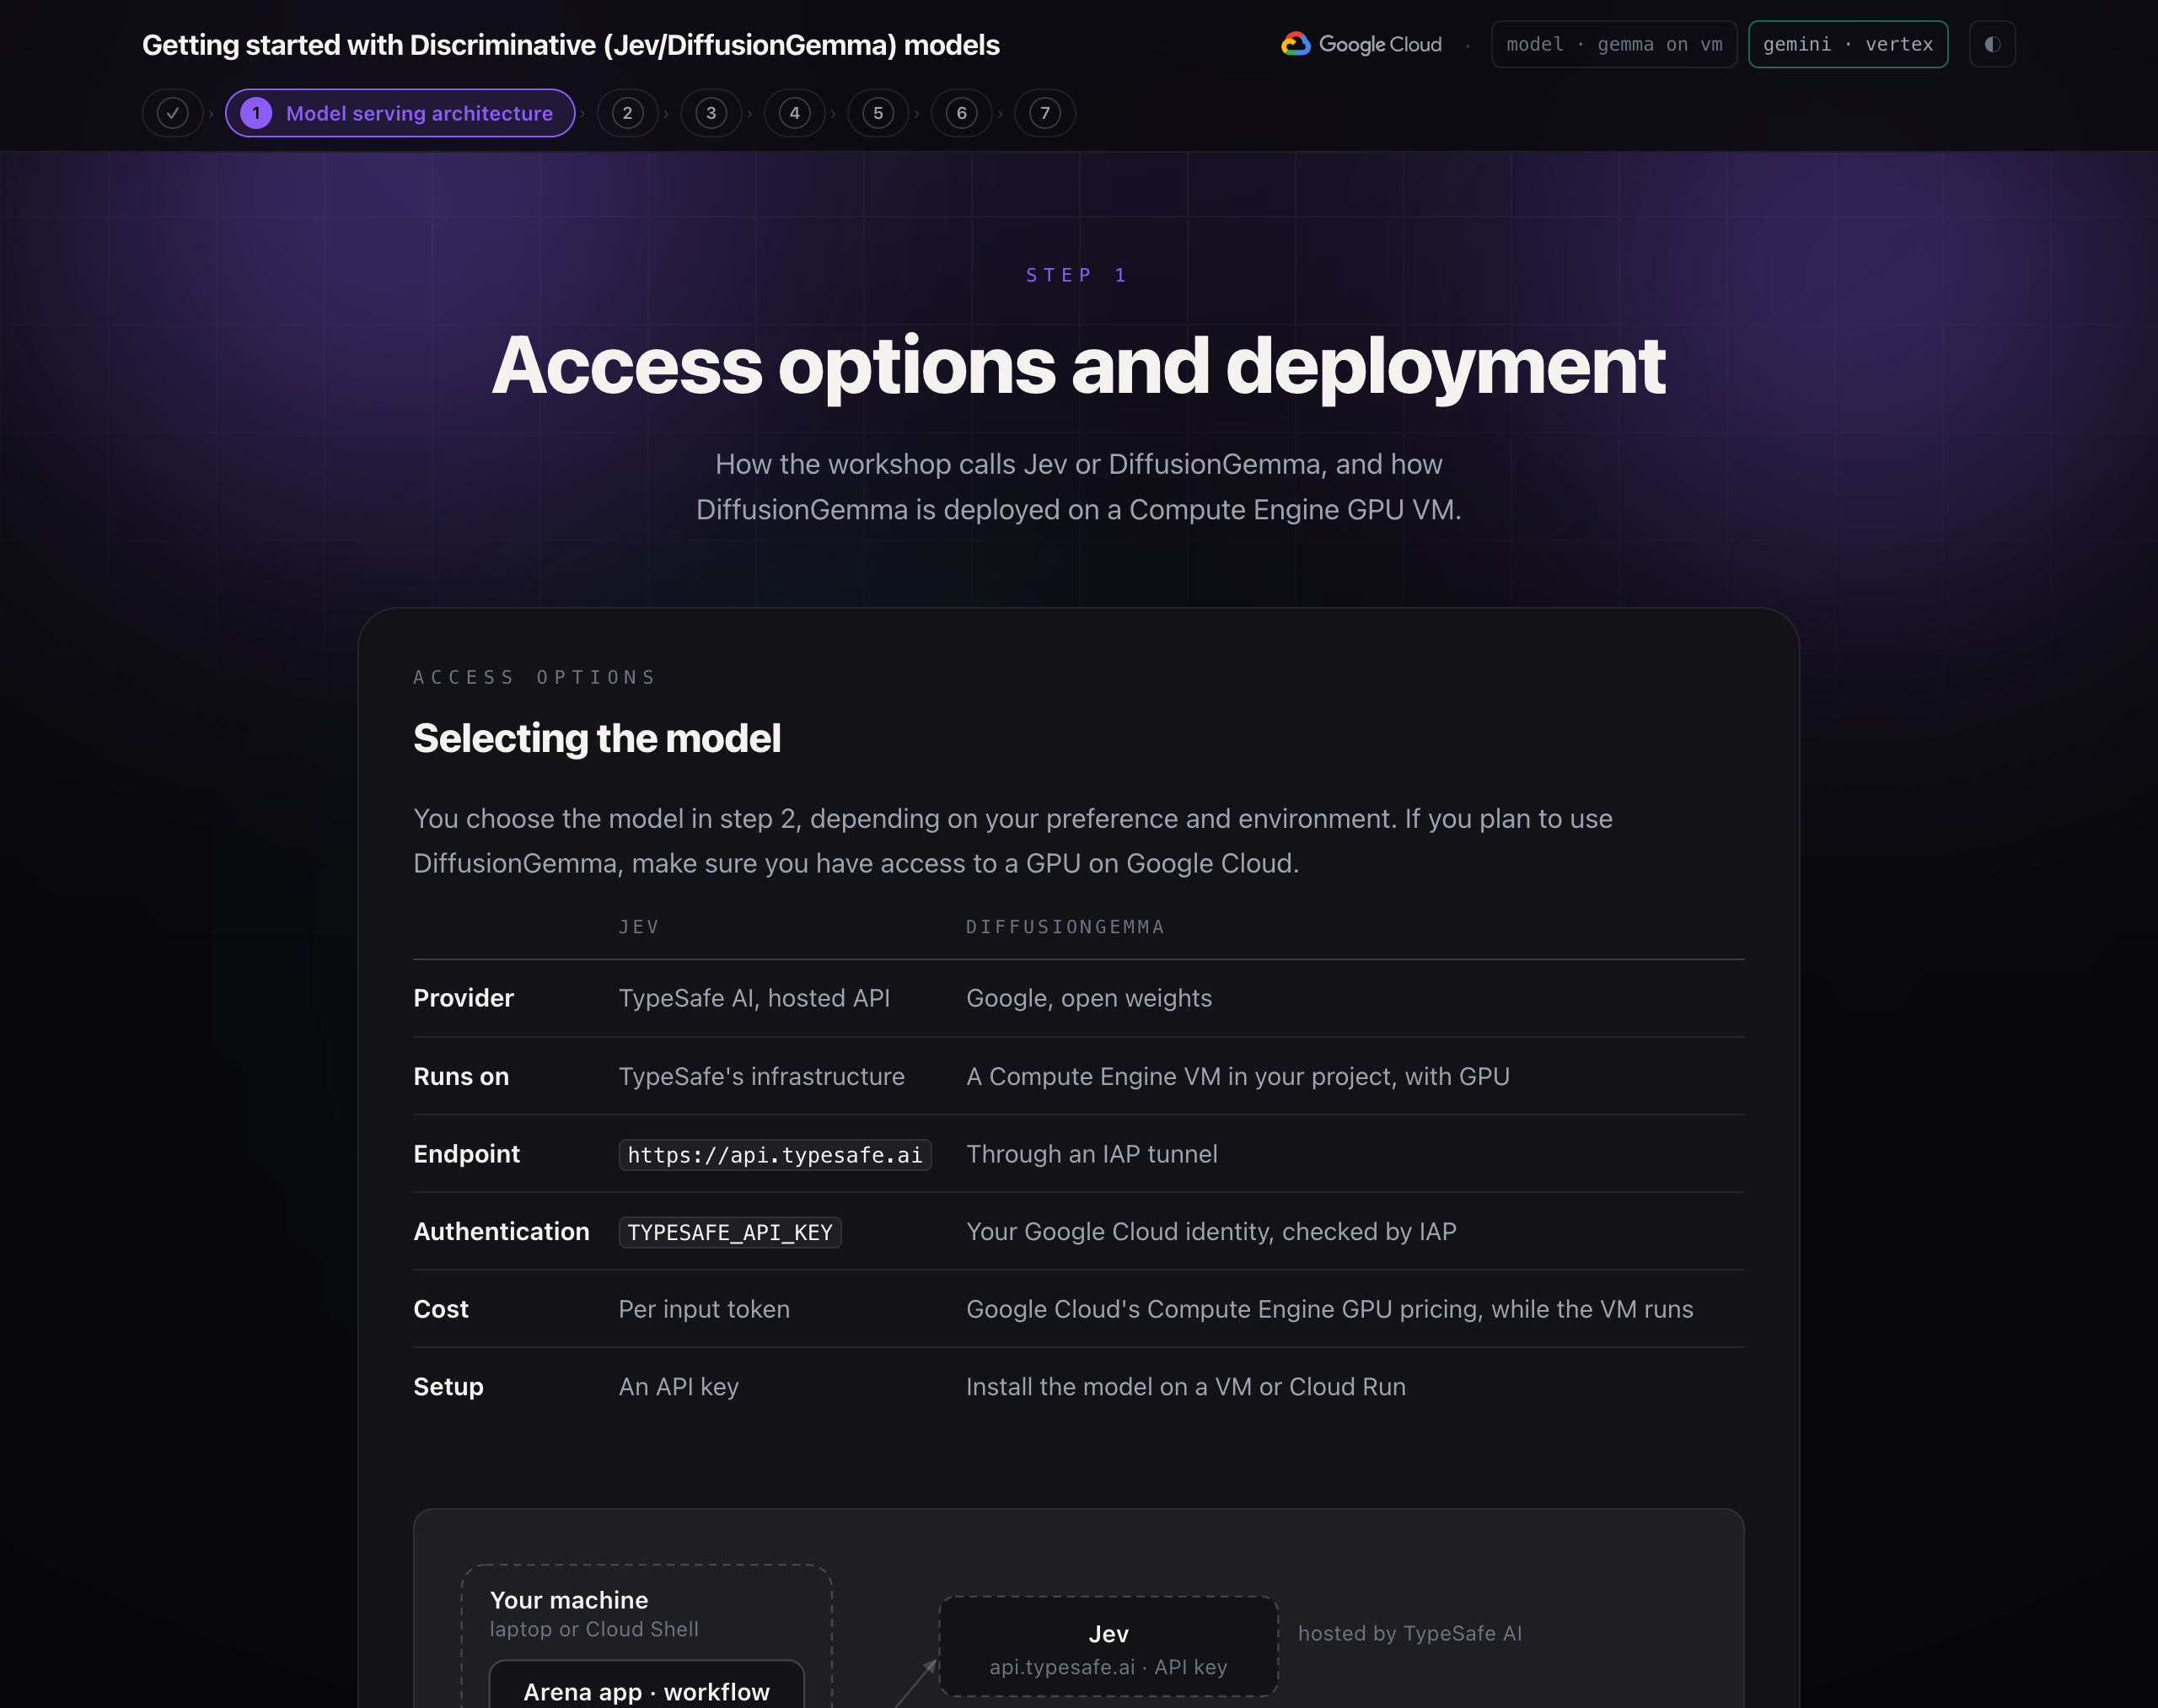
Vous choisissez le modèle à l'étape 2, en fonction de vos préférences et de votre environnement. Si vous prévoyez d'utiliser DiffusionGemma, assurez-vous d'avoir accès à un GPU sur Google Cloud.
Jev | DiffusionGemma | |
Fournisseur | TypeSafe AI, API hébergée | Google, pondérations ouvertes |
Fonctionne sur | Infrastructure TypeSafe | Une VM Compute Engine dans votre projet, avec GPU |
Point de terminaison |
| Via un tunnel IAP |
Authentification |
| Votre identité Google Cloud, vérifiée par IAP |
Coût | Par jeton d'entrée | Tarifs des GPU Compute Engine de Google Cloud pendant l'exécution de la VM |
Configuration | Une clé API | Installer le modèle sur une VM ou Cloud Run |
Flux de données
- L'application Arena ou le workflow ADK créent une requête : l'état (ce que l'adversaire a fait) et trois questions.
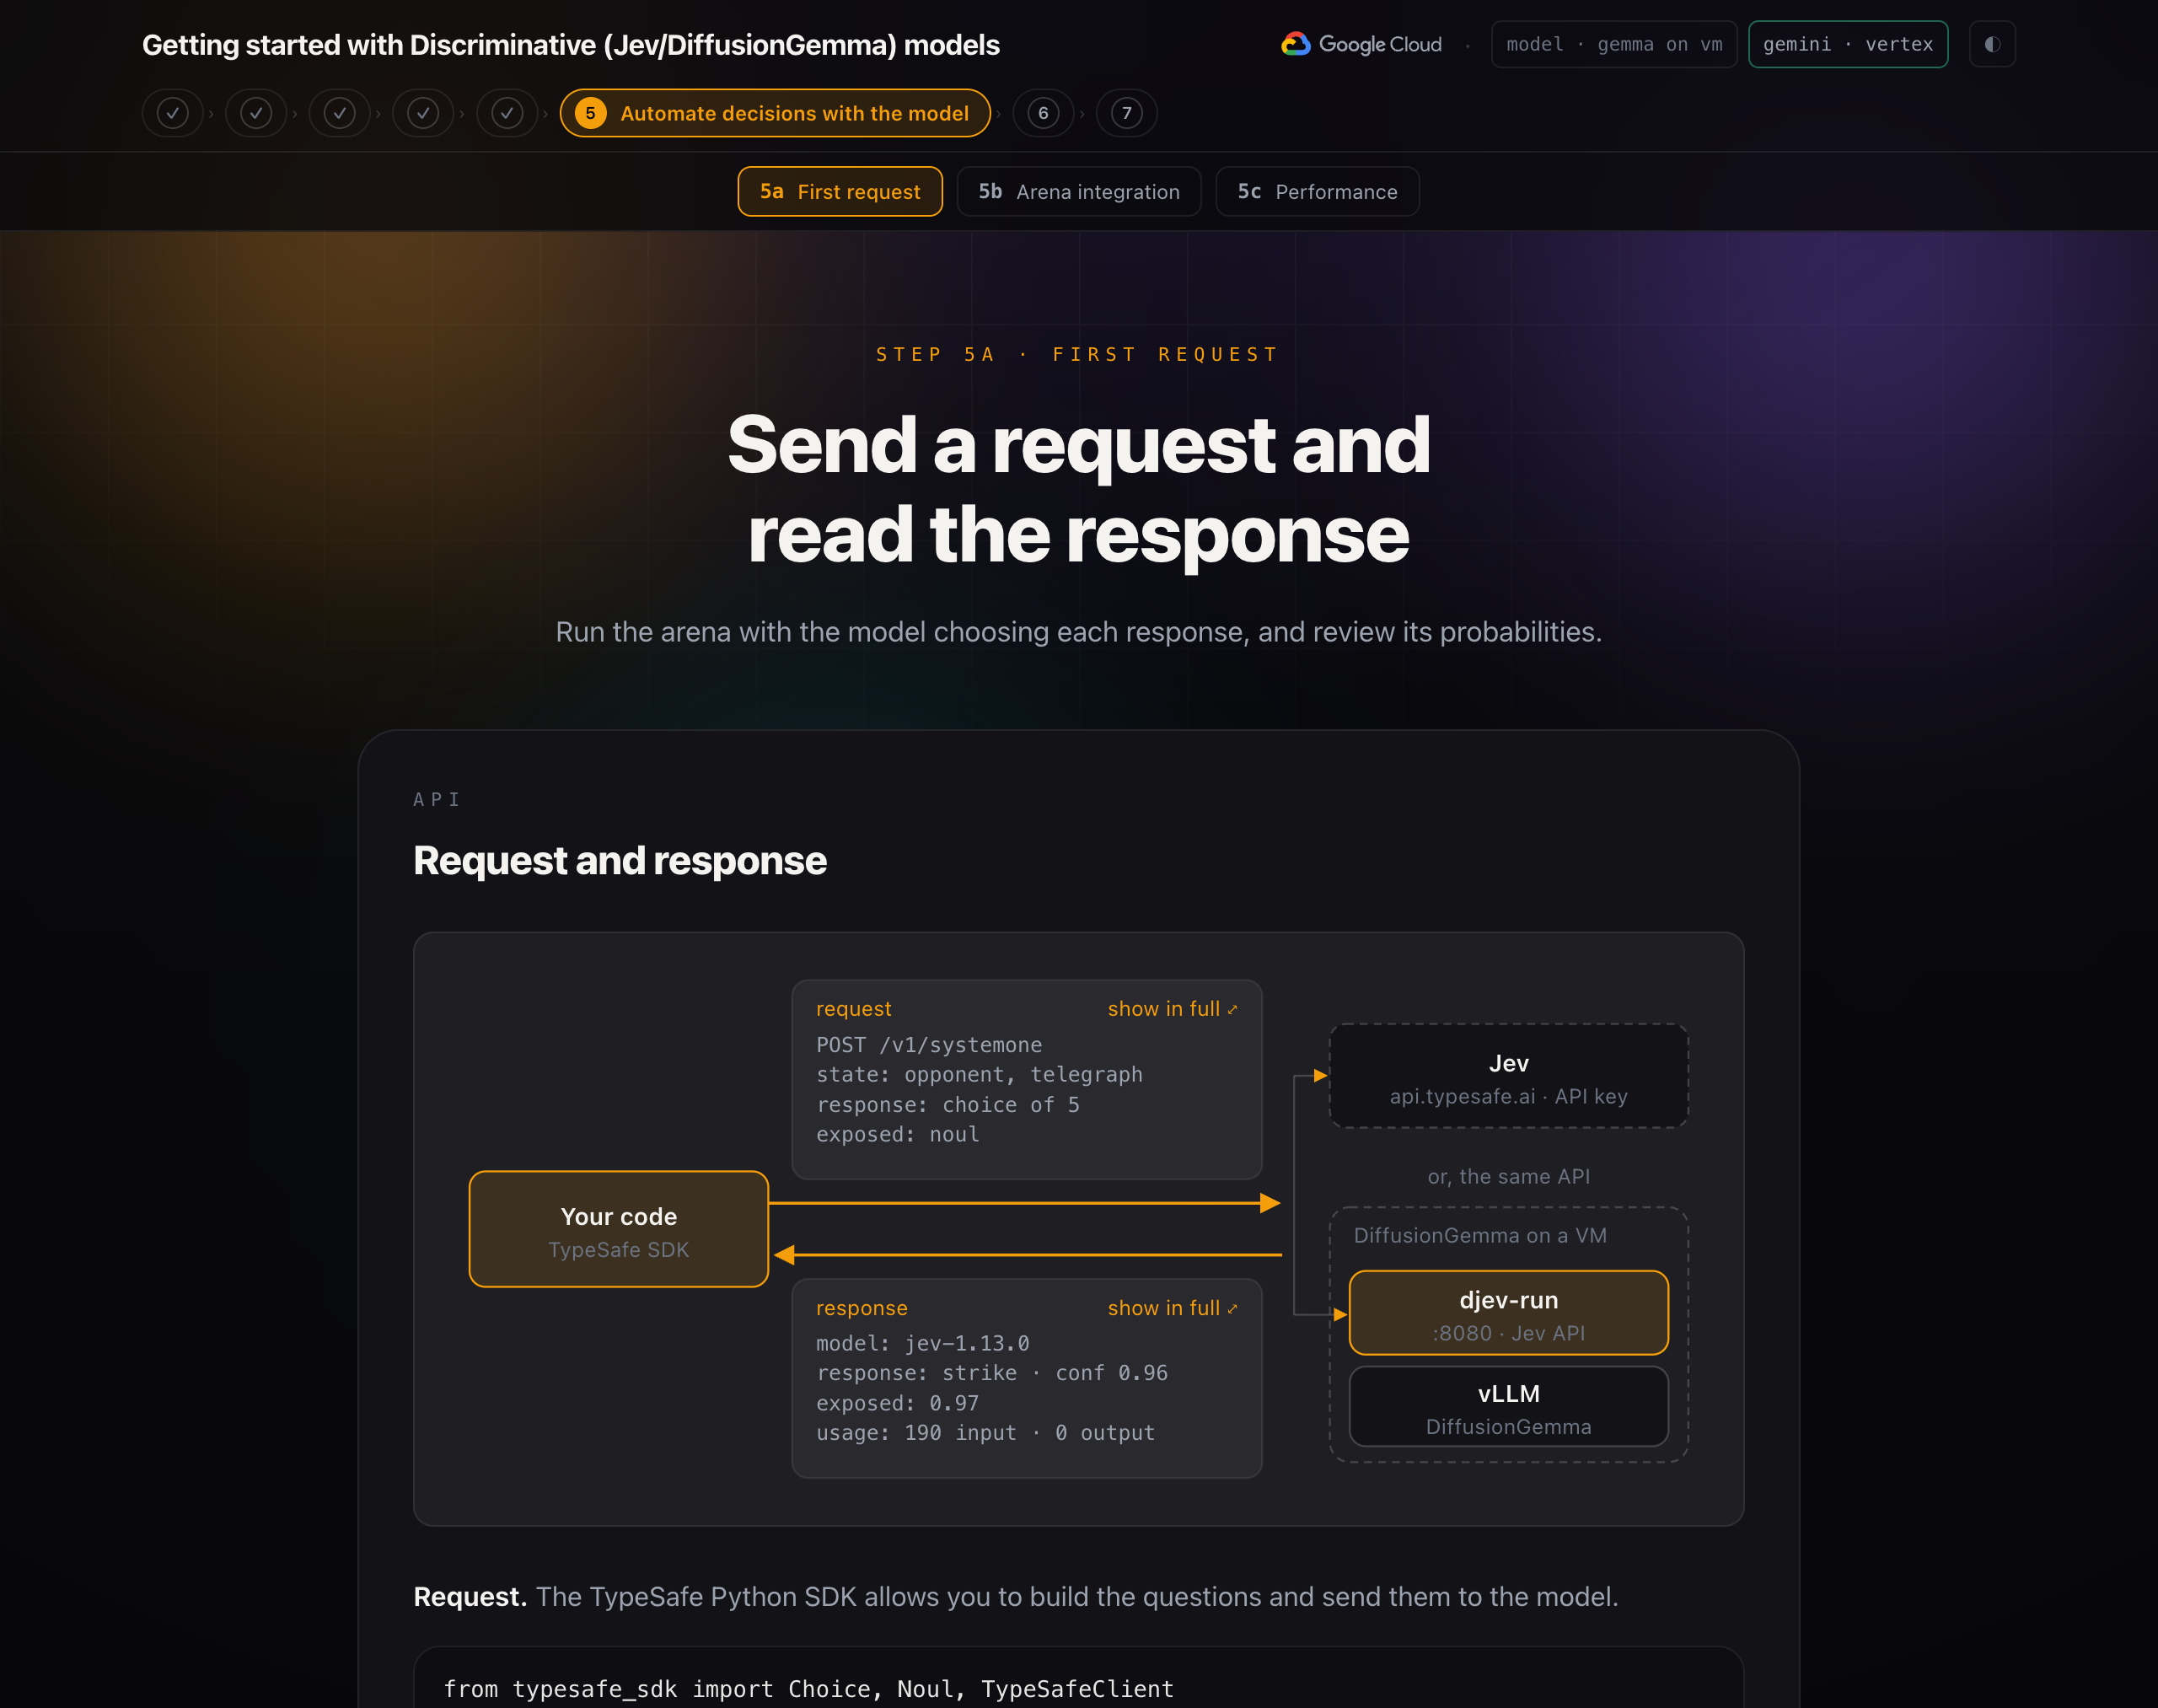
- Le SDK TypeSafe l'envoie sous la forme
POST /v1/systemoneà l'URL de base configurée. - Pour Jev, la requête est envoyée via HTTPS à
api.typesafe.ai, avec la clé API en tant que jeton du porteur. - Pour DiffusionGemma, la demande est envoyée à
localhost:8096. Un processusgcloud compute start-iap-tunnelen arrière-plan le transfère via Identity-Aware Proxy, qui vérifie votre identité Google, vers le port 8080 de la VM. - Sur la VM, djev-run reçoit la requête, exécute DiffusionGemma via vLLM sur le GPU et lit la probabilité de chaque option autorisée.
- Les deux backends renvoient la même réponse : une réponse par question, avec des probabilités et un score de confiance. Le code de l'atelier applique ses seuils et agit.
DiffusionGemma sur Compute Engine
scripts/setup_gemma.sh crée ce qui suit dans votre projet :
- Vérifie que la région dispose d'un quota pour un GPU.
- Active les API Compute Engine et IAP, et crée la règle de pare-feu
allow-iap-djev. Il n'autorise que la plage d'adresses IAP, sur les ports 22 et 8080. - Crée la VM
djev-l4: type de machineg2-standard-4(4 vCPU, 16 Go de mémoire), un GPU avec 24 Go, un disque de 100 Go et l'image Deep Learning VM avec le pilote NVIDIA 580. Si une zone n'a pas de capacité de GPU, elle essaie la suivante. - Au premier démarrage, le script de démarrage de la VM installe Docker et le NVIDIA Container Toolkit, extrait l'image de conteneur djev-run, télécharge les poids depuis Hugging Face (17,5 Go) et démarre le conteneur avec un accès au GPU sur le port 8080. Cette opération prend environ 15 minutes. Les démarrages suivants prennent environ deux minutes.
- Écrit les paramètres de connexion dans
.envet ouvre le tunnel.
Tâche | Commande |
Arrêter la VM (en conservant le disque) |
|
Recommencer |
|
Vérifier le tunnel |
|
Tout supprimer |
|
Configurer le modèle
SDK TypeSafe
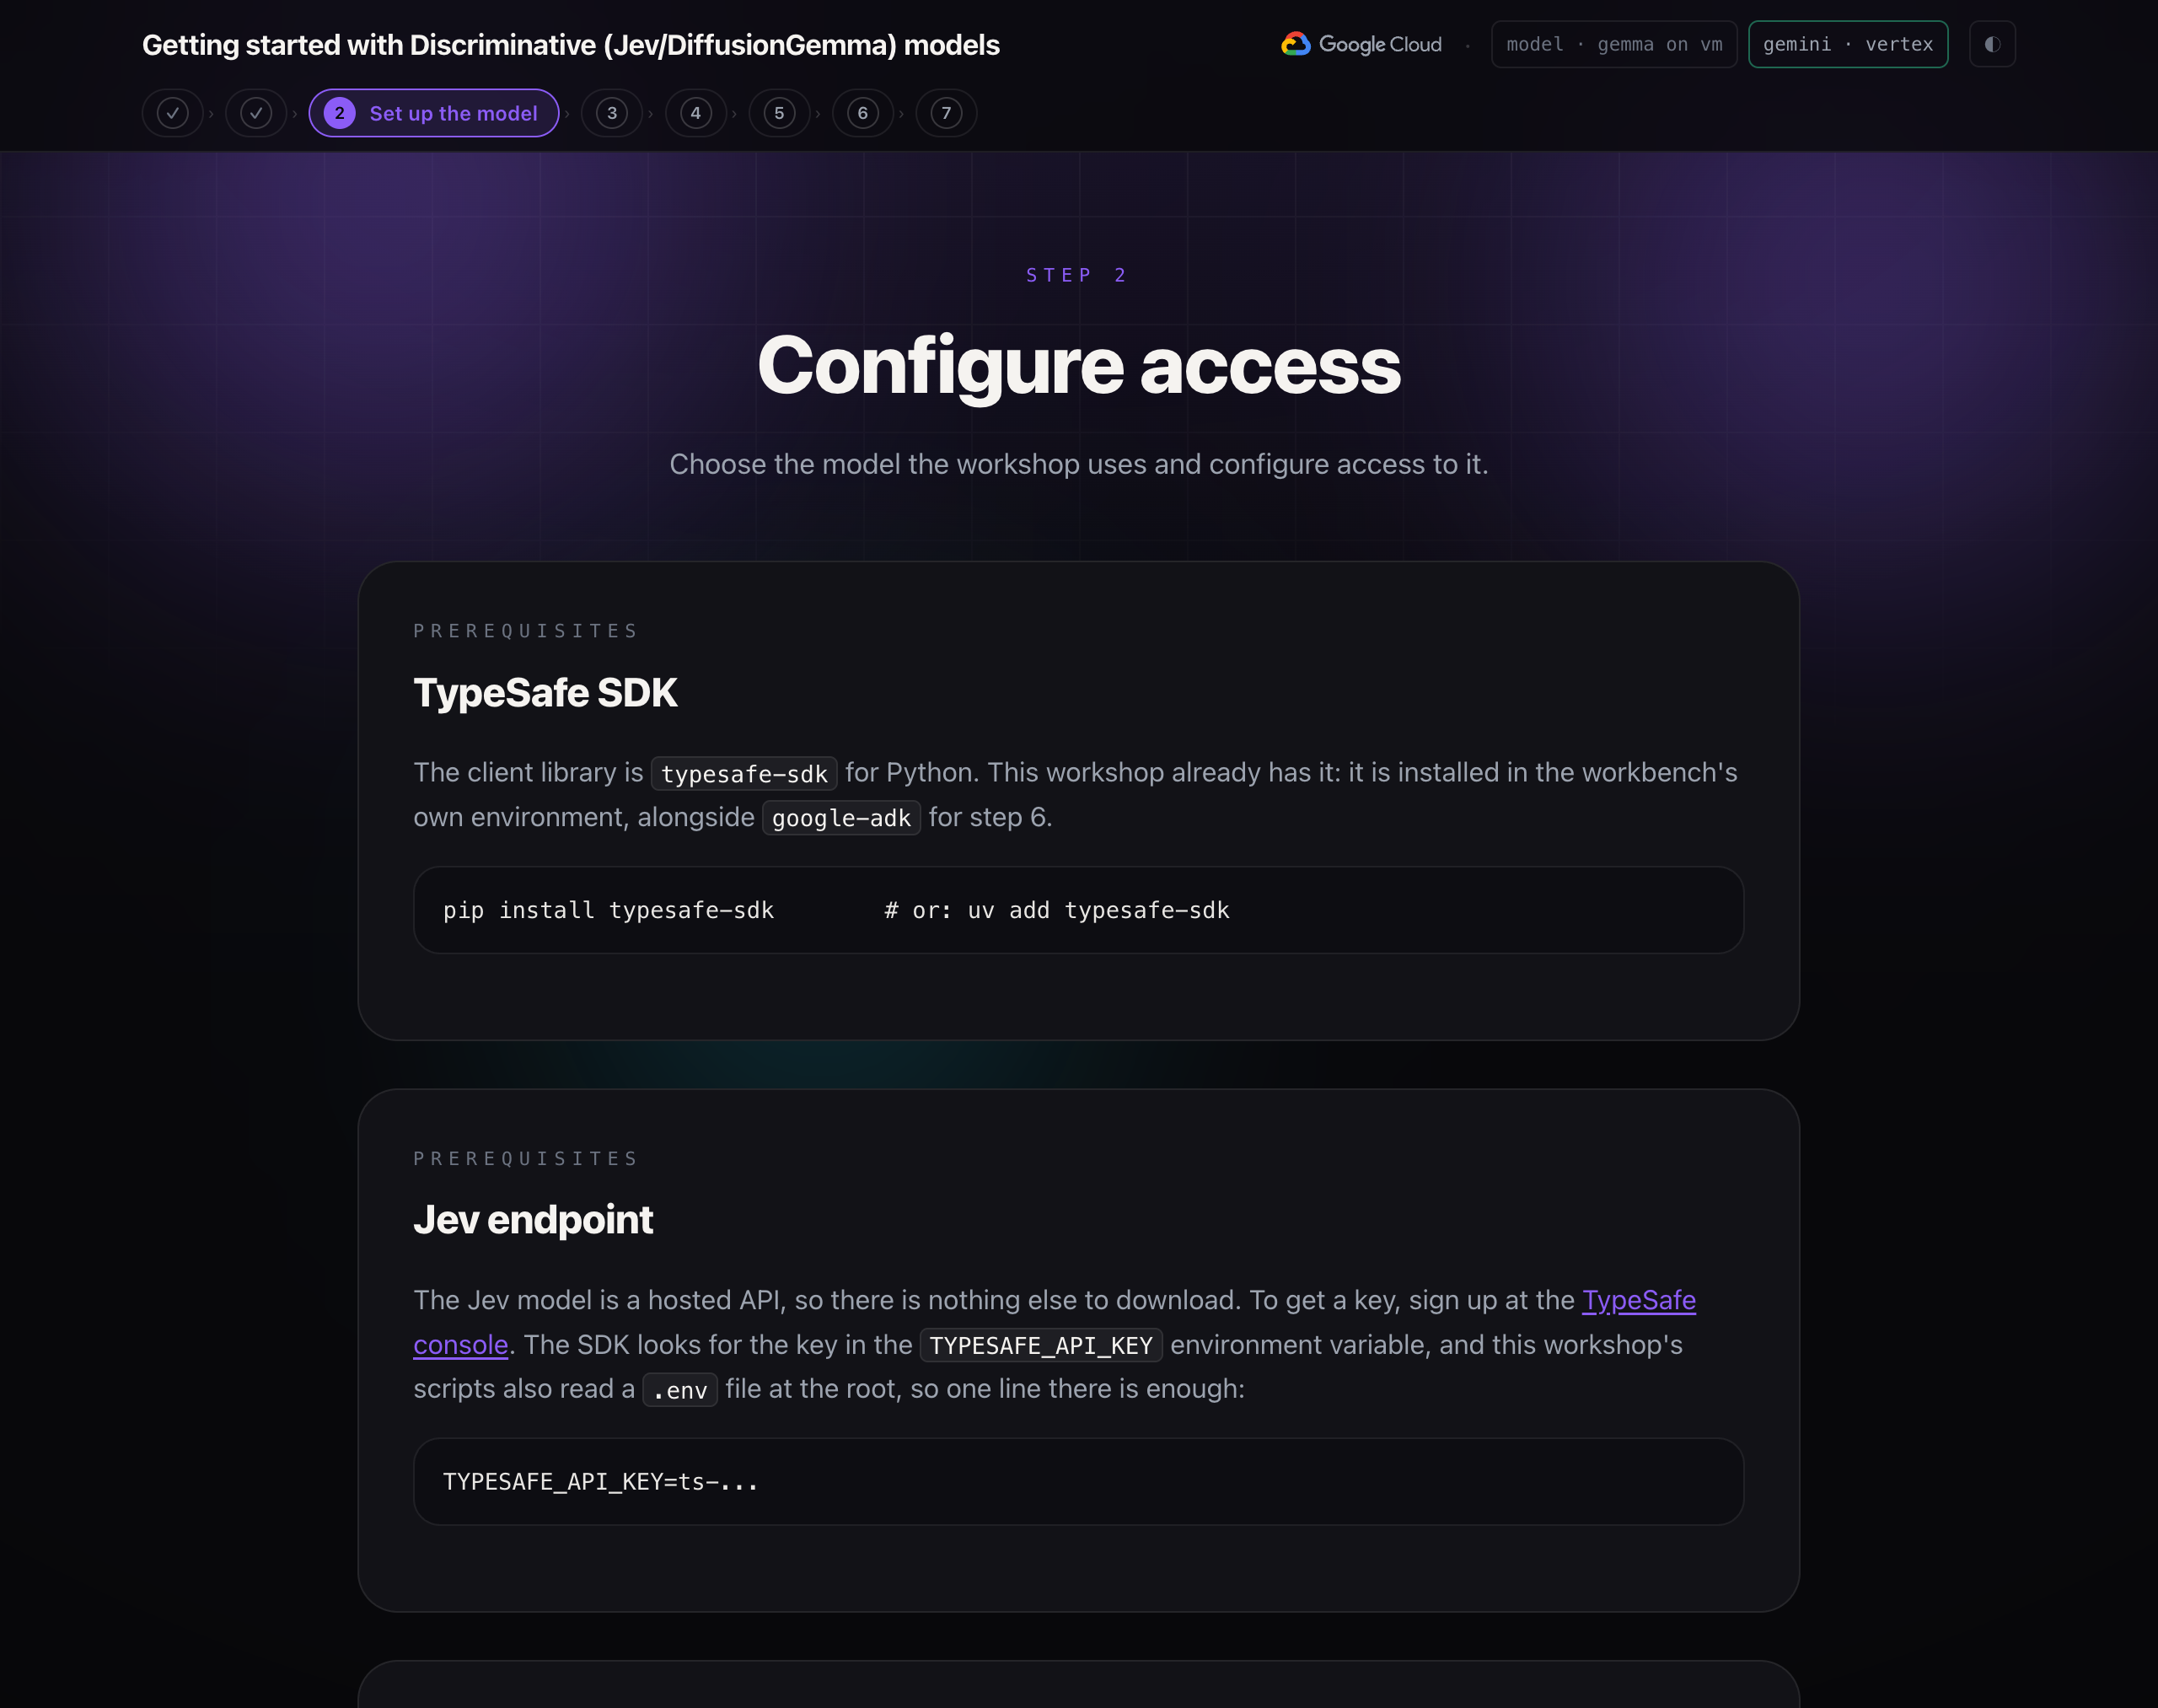
La bibliothèque cliente est typesafe-sdk pour Python. Cet atelier l'a déjà : il est installé dans l'environnement de l'atelier, à côté de google-adk pour l'étape 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Point de terminaison JEV
Le modèle Jev est une API hébergée. Vous n'avez donc rien d'autre à télécharger. Pour obtenir une clé, inscrivez-vous sur la console TypeSafe. Le SDK recherche la clé dans la variable d'environnement TYPESAFE_API_KEY. Les scripts de cet atelier lisent également un fichier .env à la racine. Une ligne suffit donc :
TYPESAFE_API_KEY=ts-...
Utiliser DiffusionGemma
djev-run réimplémente l'API du modèle discriminatif. Il utilise le même point de terminaison POST /v1/systemone, avec les mêmes questions sur le noul, le choix et le score, que DiffusionGemma, le modèle de diffusion ouvert de Google DeepMind (26 milliards de paramètres au total, environ 4 milliards actifs, Apache 2.0). Comme le format filaire est le même, le SDK TypeSafe communique avec lui sans le modifier.
Si vous choisissez DiffusionGemma dans l'exercice, il s'exécute sur un GPU dans une VM de votre propre projet Google Cloud, et la capsule en haut à droite indique gemma on vm. Le workbench y accède via un tunnel IAP privé, et le port du modèle n'est pas ouvert sur Internet. L'étape 1 décrit l'architecture complète.
Pourquoi un modèle de diffusion peut-il le faire ? Il remplit un bloc entier de positions à la fois, chaque position voyant l'intégralité de l'entrée. La probabilité de chaque option autorisée peut donc être lue en une seule étape. Un modèle de langage normal produit un jeton à la fois et devrait être échantillonné à plusieurs reprises.
Jouer manuellement
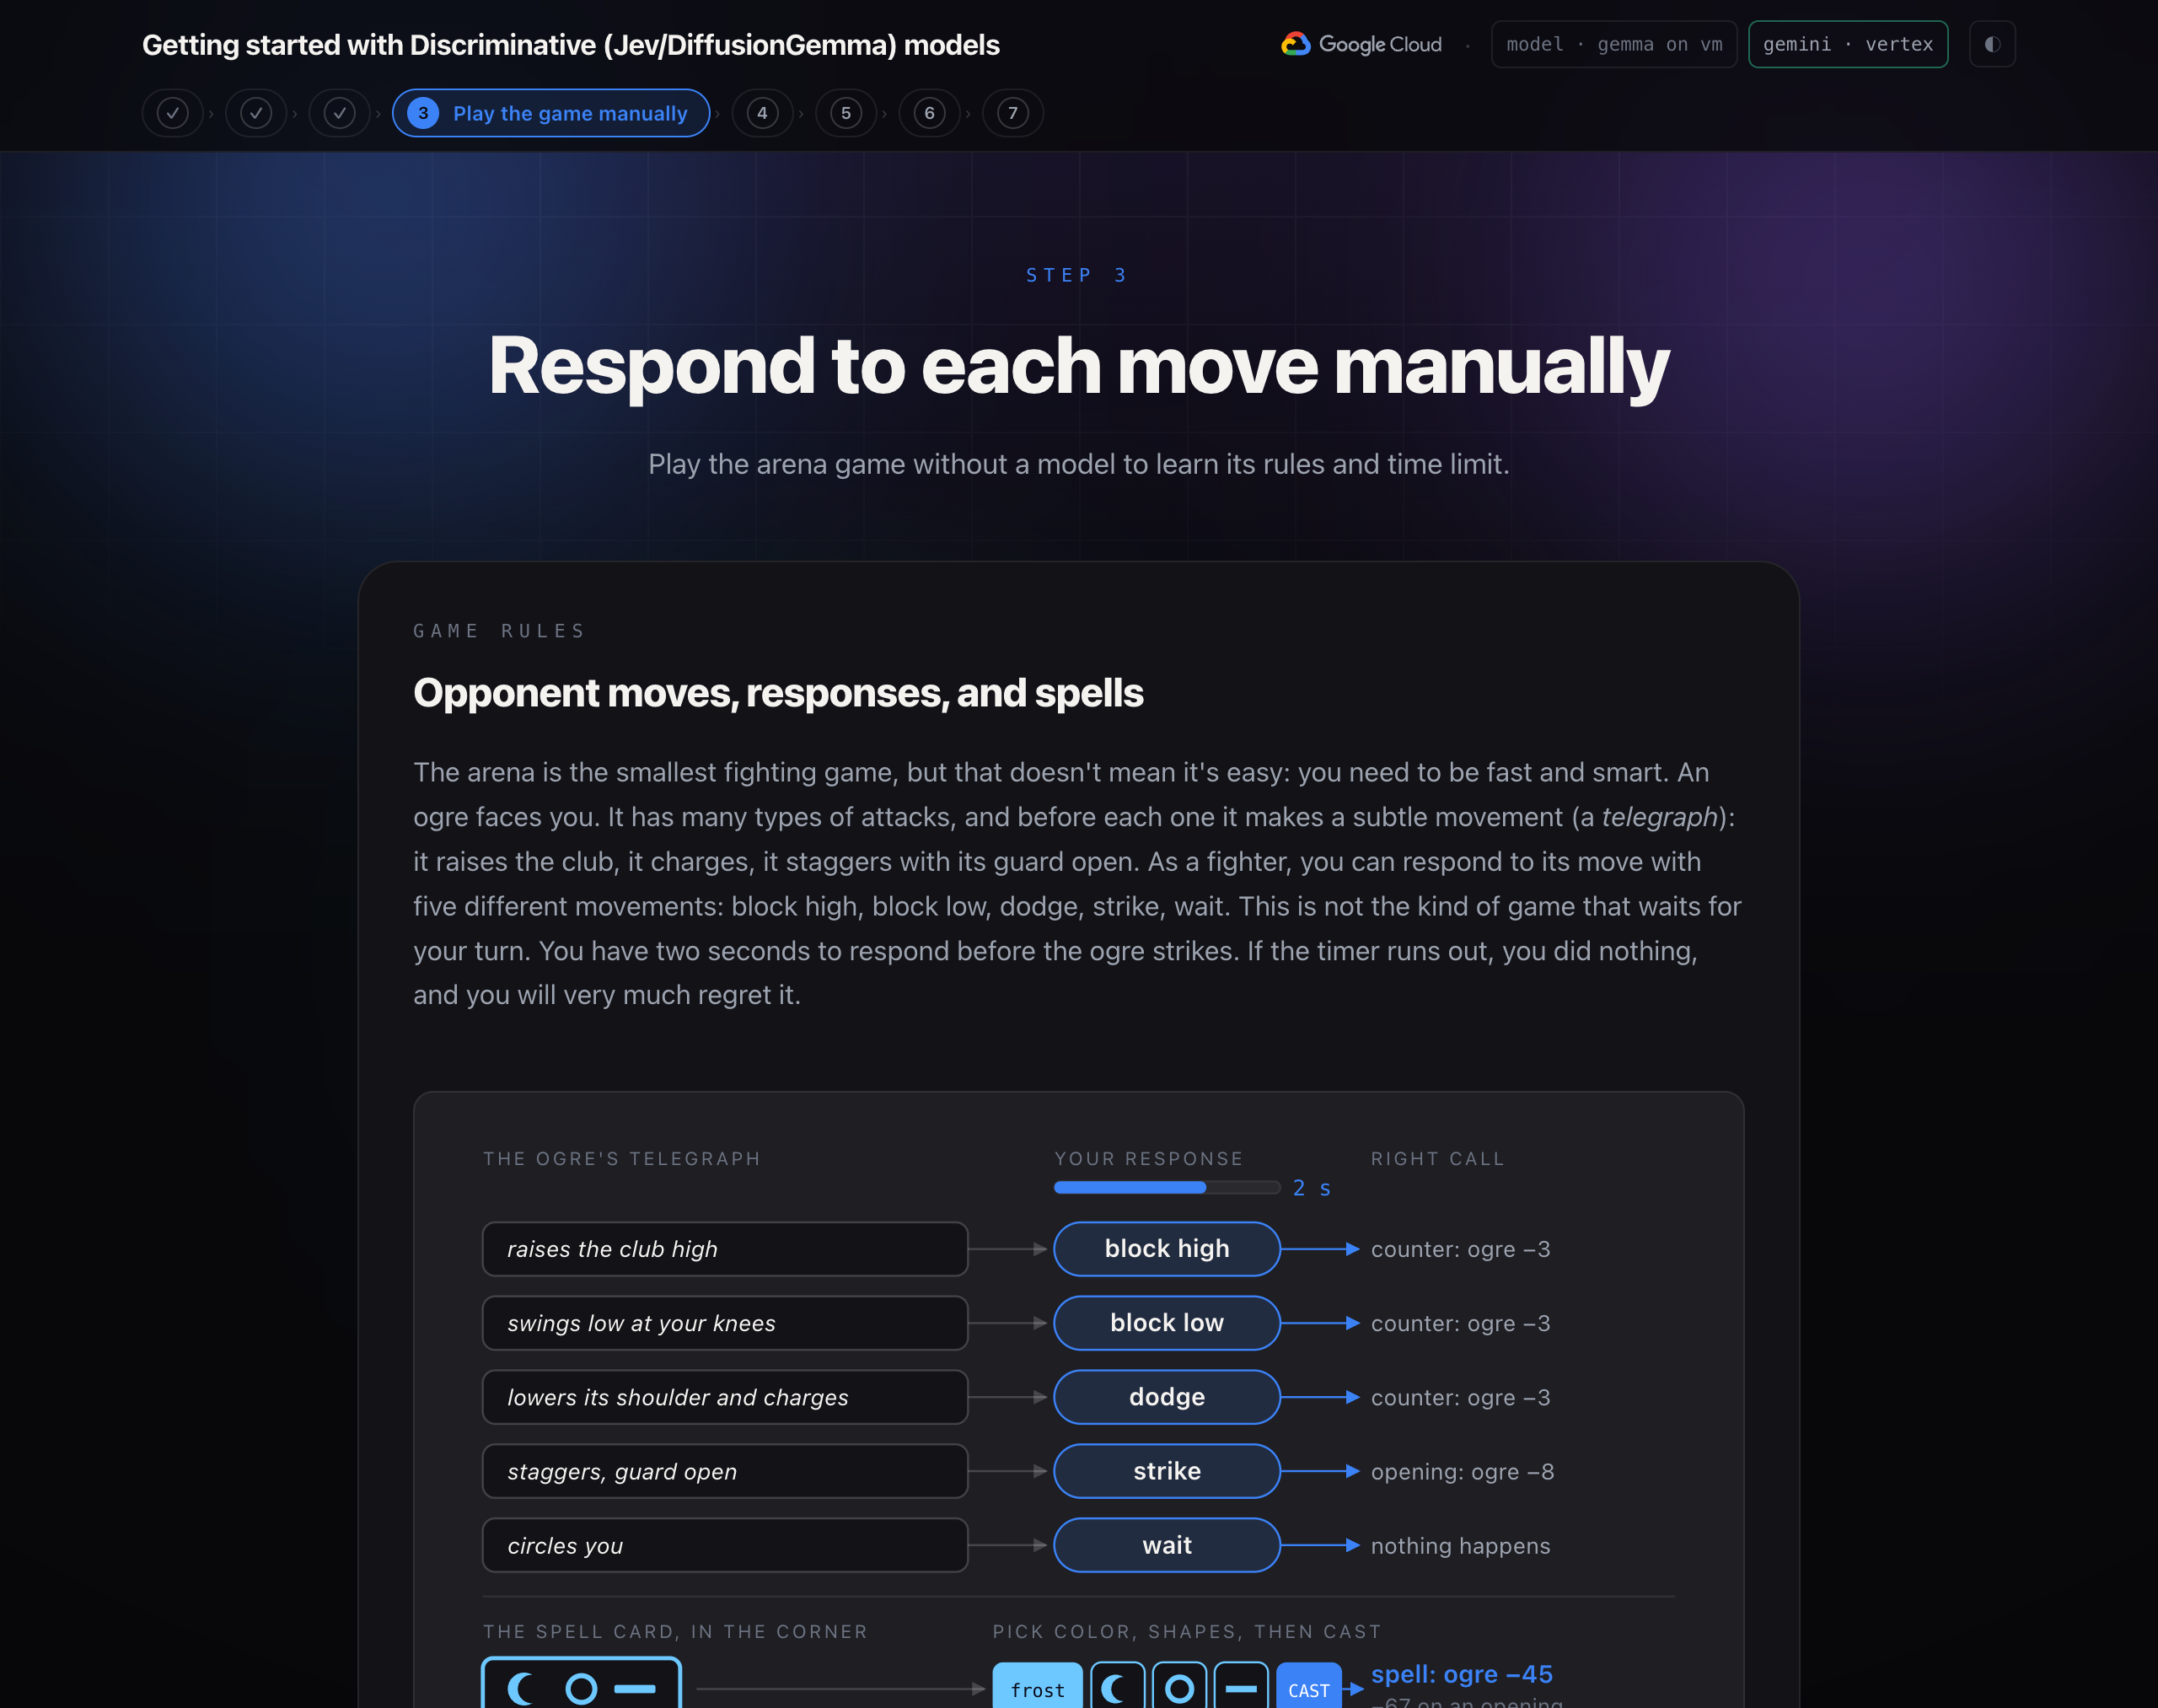
L'arène est le plus petit jeu de combat, mais cela ne signifie pas qu'il est facile : vous devez être rapide et intelligent. Un ogre vous fait face. Il existe de nombreux types d'attaques, et avant chacune d'elles, il effectue un mouvement subtil (un télégraphe) : il lève le club, il charge, il chancelle avec sa garde ouverte. En tant que combattant, vous pouvez répondre à son mouvement par cinq mouvements différents : bloquer en haut, bloquer en bas, esquiver, frapper, attendre. Ce n'est pas le genre de jeu qui attend votre tour. Vous avez deux secondes pour répondre avant que l'ogre ne frappe. Si le minuteur expire et que vous n'avez rien fait, vous le regretterez amèrement.
En haut à gauche du cercle se trouve une carte de sort : une carte colorée avec trois formes. Seul un sort correspondant peut infliger de réels dégâts. Dans le jeu, vous pouvez lancer un sort à l'aide des boutons situés sous le combat : choisissez la couleur de la carte, puis ses formes de gauche à droite, puis appuyez sur LANCER. Le temps continue de s'écouler pendant que vous choisissez, vous devez donc créer le sort et réagir aux attaques de l'ogre en même temps. Les touches 1 à 5 permettent toujours de répondre à chaque mouvement. Un sort mal prononcé s'évanouit. À l'étape 6, Gemini lit la carte de sort pour vous.
Point clé à retenir : un combat est une série de petites décisions, chacune avec une date limite. C'est à cela que ressemble la plupart des automatisations logicielles, sans le club.
Concepts de modèle discriminatif
Décisions dans les logiciels
Les modèles de langage sont performants pour les conversations depuis des années. La plupart des logiciels ne les utilisent toujours pas pour des tâches automatiques, et ce n'est pas une question d'intelligence. Il s'agit de la vitesse.
Demandez à un modèle de langage si l'ogre devant vous est sur le point de frapper, et il écrira sa réponse un jeton à la fois. Au moment où le paragraphe arrive, le club a atterri. Vous avez ressenti la version de deux secondes à l'étape 3. Et même dans ce cas, la réponse "oui" est enfouie dans un paragraphe que votre code doit trouver et auquel il doit faire confiance, sans savoir à quel point le modèle était sûr.
Le modèle discriminatif prend l'état, ainsi que les questions et réponses que vous avez saisies, en une seule passe, en quelques millisecondes. Chaque réponse est associée à une probabilité calibrée : 0,9 signifie que la réponse est correcte neuf fois sur dix. Il n'y a pas de texte à analyser ni de JSON à extraire.
Modèles System One et System Two
Le nom provient de l'ouvrage Thinking, Fast and Slow de Daniel Kahneman. Le système 2 est un raisonnement lent et délibéré, étape par étape. Le système 1 est rapide et basé sur la reconnaissance de formes.
Un modèle de langage est une machine du système 2. Il raisonne en jetons, un à la fois. Le modèle discriminatif est un modèle de type 1 : il ne raisonne pas à voix haute, ne génère rien et répond à chaque question en une seule passe. C'est pourquoi il est rapide (environ 70 à 500 millisecondes) et peu coûteux (fractions de centime pour mille décisions).
Point clé : Un modèle de langage écrit. Un modèle de décision décide. La plupart du temps, ce dont les logiciels ont besoin de l'IA, c'est d'une décision.
Limites
Le modèle discriminatif ne générera pas de texte, n'écrira pas de code, ne tiendra pas de conversation, ne fera pas d'arithmétique, ne lira pas d'image et ne suivra pas une série d'étapes.
Dans l'atelier, nous choisirons l'un des modèles discriminatifs :
- Jev est l'un des modèles discriminatifs. Il s'agit d'une API hébergée de TypeSafe AI, publiée en septembre 2026. Le premier modèle est
jev-1.13, accessible via l'aliasjev-latest. Aucun poids n'étant publié, il est appelé, et non téléchargé. - Jev n'est pas le seul moyen d'obtenir un modèle System One. DiffusionGemma de Google est un modèle à poids ouverts qui écrit un bloc entier de jetons en parallèle au lieu d'un à la fois. Cette même passe parallèle peut lire les probabilités sur un ensemble fixe d'options. Les serveurs Open Source tels que djev-run placent l'API exacte de Jev devant lui, de sorte que tout ce qui se trouve dans cet atelier s'exécute sans modification.
État et questions : Choice, Score et Noul
Chaque appel envoie l'état et les questions. L'état correspond au texte que vous souhaitez faire évaluer. Il peut s'agir d'une chaîne, d'un objet JSON ou d'une liste. Les questions portent sur ce que vous souhaitez savoir sur ce texte. Chaque question est associée à un type : "Choix", "Score" ou "Noul". Les questions sont traitées en parallèle, ce qui lui permet de répondre rapidement. Vous pouvez ajouter plusieurs questions si nécessaire.
- Choix sélectionne une option parmi un ensemble que vous nommez (jusqu'à 255). La réponse est l'option, une probabilité pour chaque option et un niveau de confiance. Utilisez-le lorsque les options n'ont pas d'ordre entre elles : bloquer en cas de probabilité élevée, bloquer en cas de probabilité basse, esquiver, frapper, attendre.
- Score évalue l'état selon des niveaux ordonnés que vous décrivez (entre deux et dix). La réponse est une position sur l'échelle (un nombre décimal, par exemple 1, 4 signifie "entre un et deux, plus proche de un"), la probabilité de chaque niveau et un niveau de confiance. Utilisez-le lorsque la réponse est une question de degré : avec quelle force le coup reçu sera encaissé.
- "Choice" et "Score" renvoient tous deux une probabilité pour chaque option et une confiance. La différence correspond à la réponse principale. Un choix renvoie l'option la plus probable. Un score traite les options comme des niveaux ordonnés et renvoie leur moyenne pondérée par la probabilité, qui peut se situer entre deux niveaux. Si la réponse "Aucune" est associée à un poids de 0,05, la réponse "Légère" à un poids de 0,55 et la réponse "Forte" à un poids de 0,40, une réponse "Légère" dans la colonne "Choix" et une réponse "1,35" dans la colonne "Score" (entre "Légère" et "Forte") sont possibles. L'arène utilise cette valeur :
choose()considère un score de danger de 1,5 ou plus comme un coup violent.
- "Choice" et "Score" renvoient tous deux une probabilité pour chaque option et une confiance. La différence correspond à la réponse principale. Un choix renvoie l'option la plus probable. Un score traite les options comme des niveaux ordonnés et renvoie leur moyenne pondérée par la probabilité, qui peut se situer entre deux niveaux. Si la réponse "Aucune" est associée à un poids de 0,05, la réponse "Légère" à un poids de 0,55 et la réponse "Forte" à un poids de 0,40, une réponse "Légère" dans la colonne "Choix" et une réponse "1,35" dans la colonne "Score" (entre "Légère" et "Forte") sont possibles. L'arène utilise cette valeur :
- Noul pose une question à laquelle il faut répondre par "oui" ou "non" et renvoie la probabilité que la réponse soit "oui". Une valeur proche de 1 signifie "oui", une valeur proche de 0 signifie "non", et une valeur proche de 0,5 signifie "peut-être". Il n'y a pas de niveau de confiance distinct, car la probabilité est son niveau de confiance.
Rédiger des questions ciblées
Le modèle discriminatif fonctionne mieux lorsqu'une question porte sur un point spécifique et bien défini. La réponse à la question "Quelle est la situation ?" est plausible, mais peu fiable. "Quelle est la bonne réponse ?" Les questions "L'adversaire est-il exposé ?" et "Quelle sera la force de ce coup ?" renvoient trois réponses ciblées que votre code combine.
Les descriptions des options et des niveaux sont peu coûteuses, mais elles sont importantes. Les règles que vous avez lues à l'étape 3 deviennent les descriptions des options : block_high: "Raise the shield. Right against an overhead or a high swing." C'est ainsi que le modèle discriminatif apprend les règles du combat, au moment de la requête, sur une ligne chacune. Les options peuvent changer en fonction de la situation : l'arène ne propose cast que lorsqu'un sort est prêt.
Probabilités et confiance
Une réponse de type "Choix" n'est pas une étiquette. Il s'agit d'une distribution sur les libellés, et le libellé n'est que la barre la plus haute.
Comment le modèle obtient-il le nombre ? Il utilise la même étape qu'un modèle linguistique pour choisir son mot suivant. Un Transformer lit le texte et, à une position donnée, attribue à chaque jeton de son vocabulaire un score brut, appelé logit. Plus le logit est élevé, plus le jeton correspond à cette position. Une softmax transforme les logits en probabilités dont la somme est égale à 1. Un modèle de langage choisit ensuite un jeton, l'ajoute au texte et répète l'opération. Un modèle discriminatif s'arrête après les probabilités.
Un blanc est un espace vide dans un formulaire de réponse. Le serveur écrit le formulaire lui-même, par exemple response: ▢, et laisse un espace vide par question. Le seul rôle du modèle est d'évaluer ce qui doit être inséré dans chaque espace vide.
- Le prompt contient l'état et chaque question, avec chaque réponse autorisée sous forme de libellé court :
apour block_high,bpour block_low, etc. - Le serveur ajoute le formulaire de réponse, avec un champ vide par question.
- Le modèle lit la requête et le formulaire en une seule passe, et attribue un logit à chaque jeton dans chaque espace vide. Le modèle de diffusion voit l'ensemble du formulaire en même temps et évalue tous les espaces vides ensemble.
- Le serveur ne conserve que les logits des libellés autorisés et leur applique une fonction softmax. Les réponses autorisées totalisent donc 1.
- Si la lecture semble incertaine, le serveur relit à partir d'un autre point de départ aléatoire et fait la moyenne des lectures.
La confiance est un nombre qui indique le degré de certitude de la réponse. TypeSafe la calcule en fonction de la répartition de la probabilité entre les options. Si vous choisissez une seule option, vous obtenez 1. Si vous répartissez les réponses de manière égale, vous obtenez 0. Pour trois options, la formule est (3 × plus grande – 1) / 2.
TypeSafe entraîne Jev pour obtenir des probabilités calibrées. La probabilité correspond à la fréquence à laquelle la réponse est correcte. Dans un modèle calibré, les réponses données à 0, 7 sont correctes environ 70% du temps.Un seuil de confiance est donc un seuil de fréquence d'acceptation d'une mauvaise réponse. Dans cet atelier, le serveur DiffusionGemma indique lui-même la probabilité la plus élevée comme niveau de confiance, moyennée sur ses lectures. Lorsque les lectures ne sont pas d'accord, la moyenne s'étale et la confiance diminue.
Point clé à retenir : la réponse vous indique quoi. Le niveau de confiance vous indique si vous devez agir.
Seuils
Le seuil correspond à la façon dont vous définissez l'action dans le code. Le modèle renvoie une confiance ou une probabilité. Votre code le compare à un nombre que vous avez choisi, et le résultat détermine ce qui se passe.
Un seuil par action. TypeSafe suggère de diviser la confiance en bandes. Les actions à niveau de confiance élevé sont effectuées automatiquement. Les actions de confiance moyenne sont signalées par une coche, comme demander une confirmation ou signaler la demande pour examen. Lorsque le niveau de confiance est faible, l'IA ne fait rien et se rabat sur une action sûre ou sur une personne.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Les règles de l'arène. Les seuils de l'arène se trouvent dans choose(), que vous exécutez à l'étape 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Avertissement : Une réponse valide n'est pas toujours correcte. Le modèle discriminatif ne peut pas renvoyer une option que vous n'avez pas proposée. Il n'hallucine donc jamais un mouvement, mais il peut choisir la mauvaise option, parfois avec une grande confiance. Testez vos questions sur des situations que vous avez déjà jugées avant de faire confiance à un seuil.
Automatiser les décisions avec le modèle
Requête et réponse
Demande Le SDK Python TypeSafe vous permet de créer les questions et de les envoyer au modèle.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Une demande par tick
À chaque tic, l'application envoie le télégraphe en tant qu'état et demande trois choses en un seul appel :
- Quelle réponse est correcte parmi les cinq (ou six, lorsqu'un sort est prêt) ? Un choix.
- Indique si l'ogre est actuellement exposé à un compteur. A Noul.
- L'intensité du choc entrant, selon une grille à trois niveaux. Un score.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Fonction choose()
Vous vous souvenez des seuils de l'étape 4 ? choose() compare les réponses du modèle à des nombres fixes, qui sont les seuils.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() est une lecture Python ordinaire des valeurs saisies, avec deux règles. Le modèle discriminatif fournit sa probabilité et son analyse, et le code utilise les seuils pour les règles. L'action choisie est envoyée au moteur, où elle sera utilisée pour combattre l'ogre.
Point clé à retenir : regroupez les questions et les seuils au même endroit. C'est la partie d'une intégration System One que vous ajusterez le plus.
Temps de réponse, tarification basée sur les entrées et logique de décision
- Temps de réponse par décision. Chaque tick du combat dans la partie b revenait en une centaine de millisecondes, quelques-uns en deux ou trois. C'est suffisamment rapide pour une boucle de jeu, un chemin de requête ou une vérification de chaque message avant qu'une personne ou un modèle linguistique ne le voie.
- Tarification basée sur les entrées : Un combat entier, soit 60 décisions avec trois questions chacune, coûte bien moins d'un dixième de centime. Les jetons de sortie sont nuls, car rien n'a été généré. Vous pouvez donc vous permettre de demander plus que ce dont vous avez besoin. L'arène demande si l'ogre est exposé à chaque tick, même si seuls
strikeetcasts'en soucient, car la demande est presque sans frais et la réponse est utile sur le tableau de bord. TypeSafe appelle cela la distribution ramifiée spéculative. - Combiner confiance et danger Lorsque le modèle discriminatif a un niveau de confiance inférieur à 0,40 dans sa réponse et que le score de danger indique qu'un coup violent est imminent,
choose()le remplace par une esquive. L'esquive est rarement la meilleure réponse, mais rarement la pire non plus. Choisissez des seuils en fonction du coût de chaque erreur, et non d'un nombre rond, et testez-les par rapport aux signaux que vous avez déjà jugés manuellement. Conseil de TypeSafe : si une décision continue de mal fonctionner, précisez la question avant de modifier le seuil.
Combiner des modèles dans un workflow ADK
Limites des décisions par tick et pourquoi les réponses correctes ne suffisent pas
La dernière ligne du combat à l'étape 5 le dit : l'ogre s'éloigne en boitant, à peine égratigné. Le modèle discriminatif n'a subi aucun dégât et en a infligé un peu à chaque tic. Or, 300 points de vie, c'est plus qu'un peu multiplié par 60. La carte de sort située dans le coin de l'anneau est là depuis le début. Pour lire, il faut un modèle capable de voir une image.
L'ogre a 300 points de vie. Un appel correct est comptabilisé pour 3. Un coup dans une ouverture fait 8, car la peau est épaisse. Même un combat parfait de soixante ticks laisse l'ogre meurtri et debout, et le jeu le considère comme un match nul. C'est là que s'est terminée l'étape 5 : le modèle a bien défendu, mais n'a toujours pas réussi à gagner.
Seul un sort inflige de réels dégâts : 45 points pour un sort lancé parfaitement, 67 points s'il atterrit sur une ouverture.
Attribuer chaque tâche au bon modèle
La carte de sortilège dans le coin du ring est le moyen de gagner. La lire n'est pas un problème de texte : il s'agit d'une image, avec une couleur et trois formes d'affilée, et le sortilège doit être chanté pour correspondre. Cela nécessite un modèle capable d'examiner une image pendant quelques secondes. Lors d'un combat, quelques secondes correspondent à dix ticks.
Le workflow utilise donc les deux, chacun à sa propre vitesse :
- Le modèle discriminatif se bat. Chaque tic, un appel, une décision, cent millisecondes. La boucle n'attend jamais quelque chose de plus lent qu'elle-même.
- Gemini lit et chante. Sur sa propre branche, commencée à la cloche, il récupère la carte de sort sur l'écran de l'arène sous forme d'image, nomme la couleur et les formes, et chante une incantation. L'arène juge la chanson par rapport à la réponse de la carte de sort, qui ne quitte jamais le serveur.
- Après chaque échange, le combattant vérifie l'emplacement. Un nœud
check_spellexamine l'état. Pas prêt : l'application indique que Gemini n'a pas fini de chanter et revient directement au prochain tic. Il n'attend jamais. Prêt :castrejoint les options proposées au modèle discriminatif, etchoose()lance le sort dès que le modèle discriminatif signale une ouverture. Lorsque le sort est épuisé, l'écran affiche une nouvelle carte de sort et le fil lent recommence. Une lecture incorrecte d'une chanson brûle la carte de sort, et le fil lent lit la nouvelle. - Gemini écrit une courte histoire une seule fois, à la fin.
Branches parallèles avec des latences différentes et une boucle d'événements
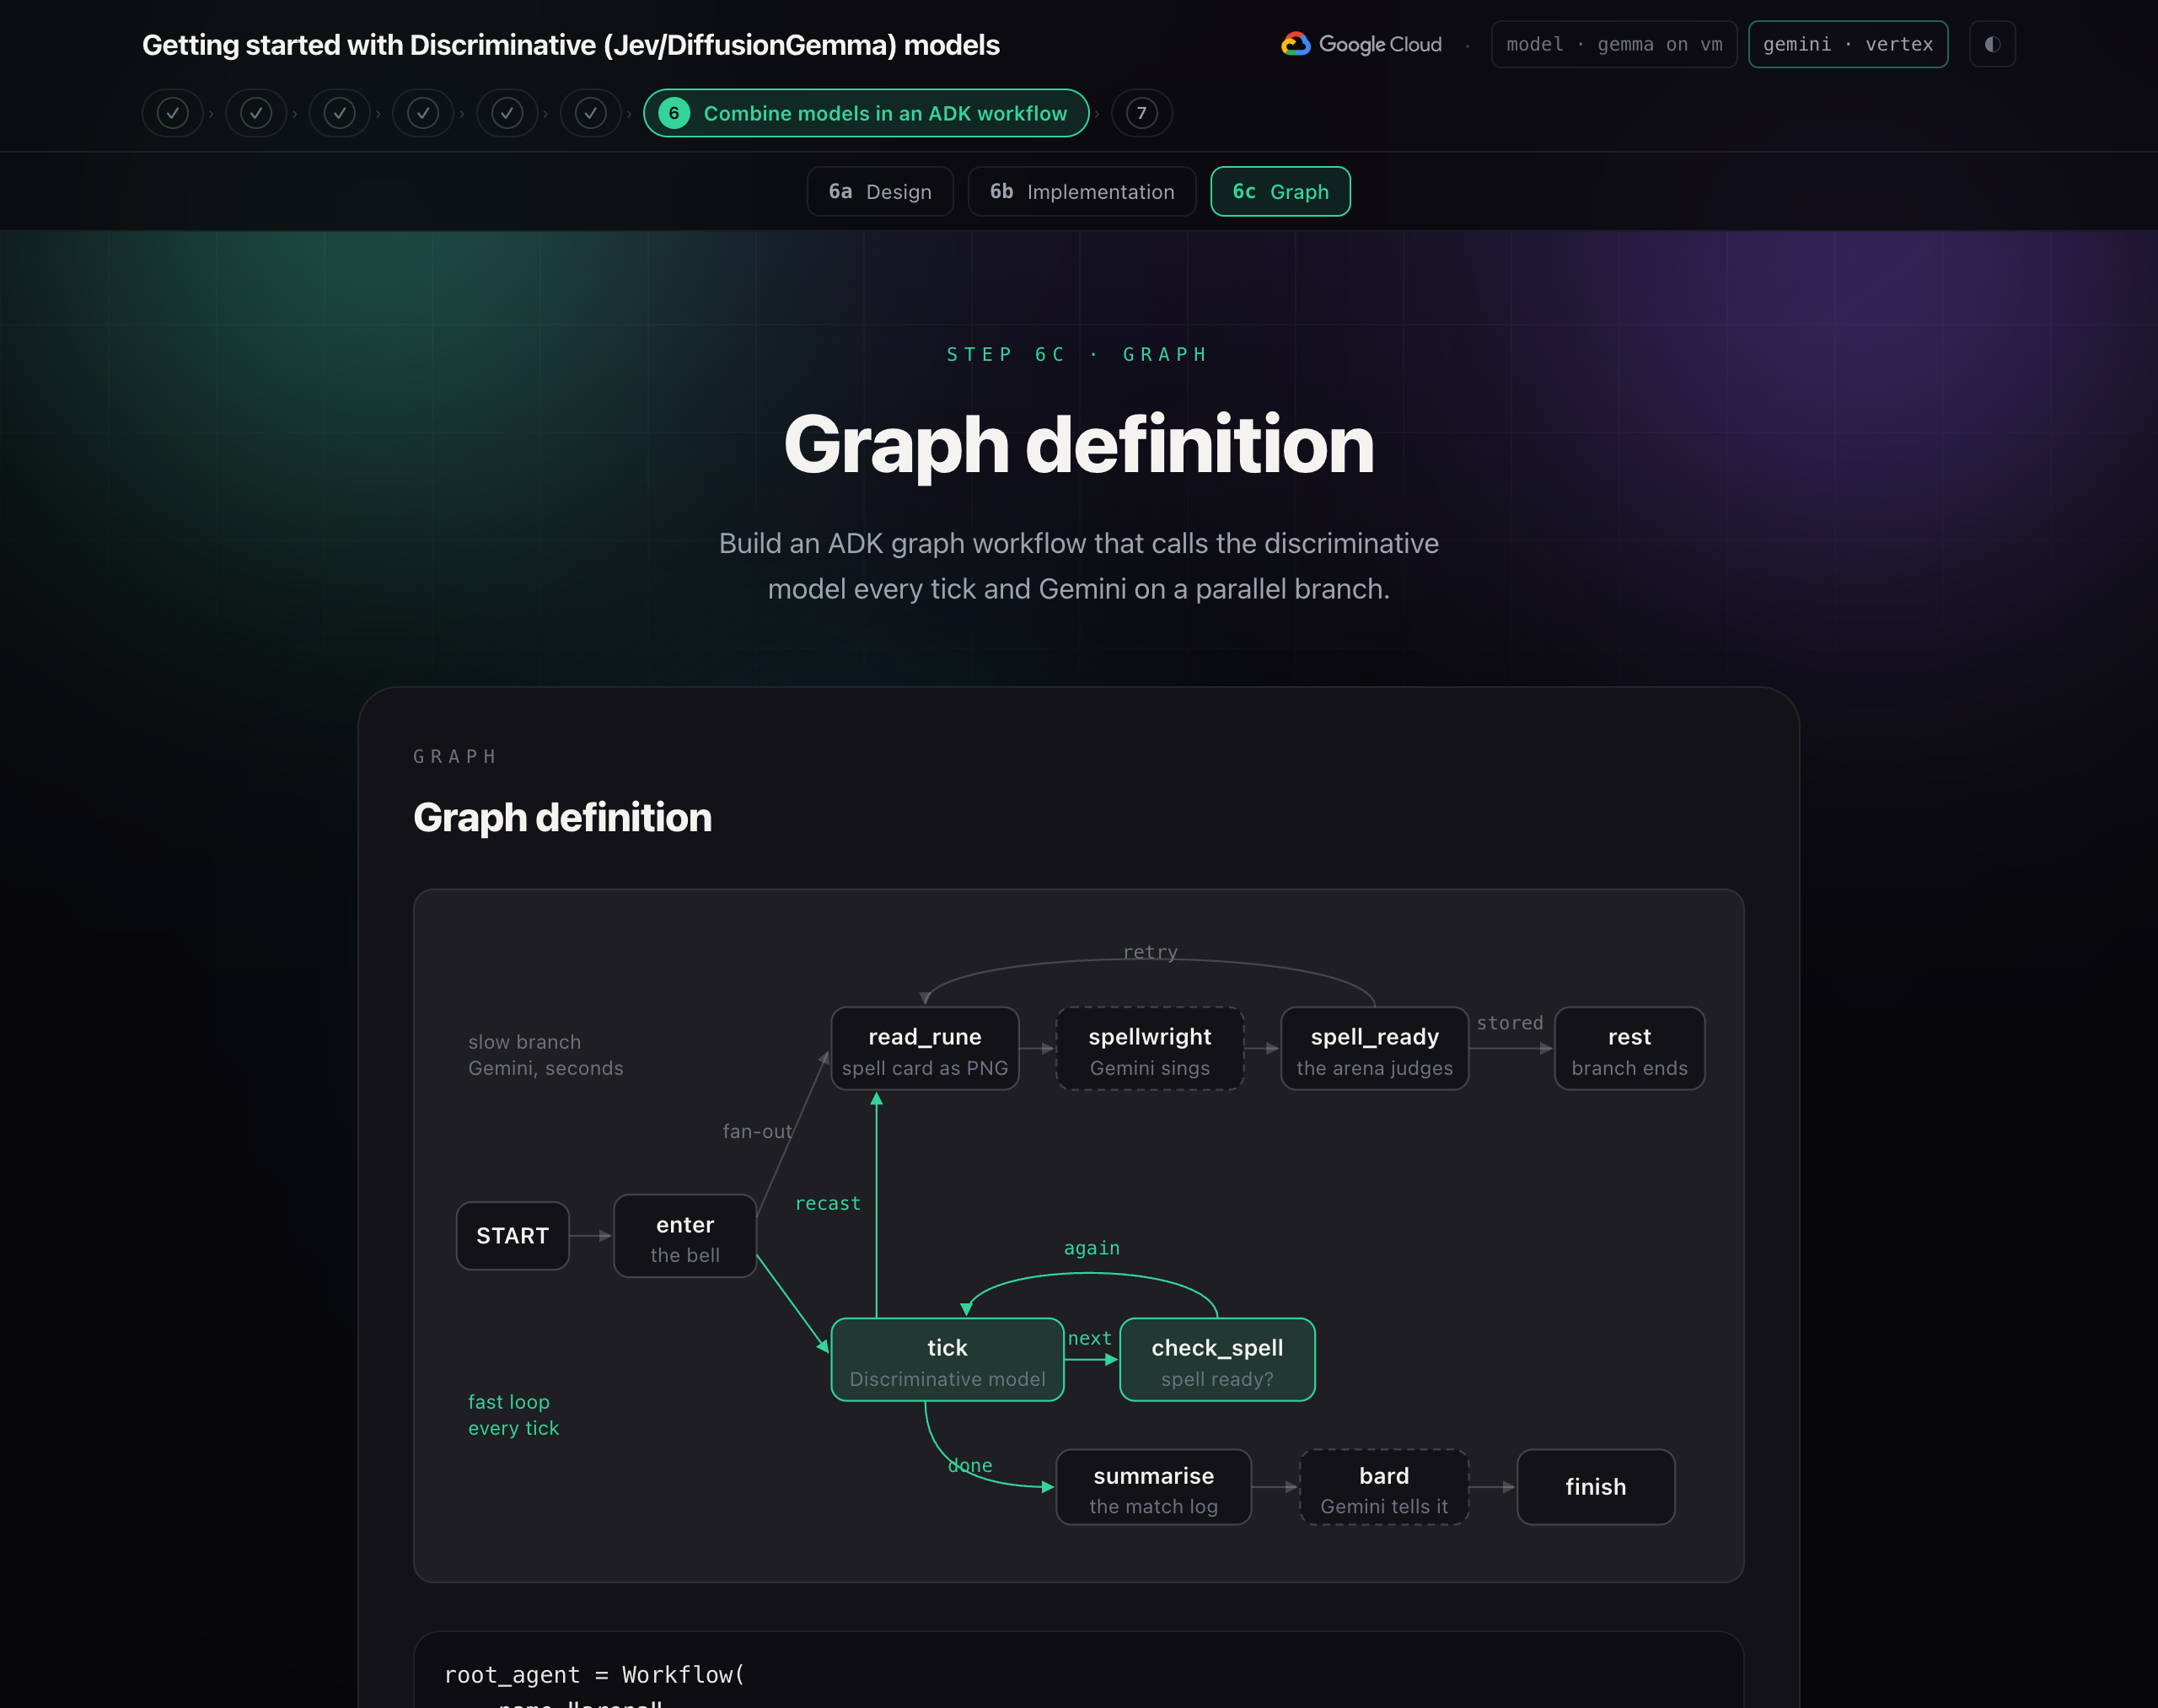
Il s'agit d'un workflow ADK : un graphique de nœuds reliés par des arêtes. Un nœud est une fonction Python simple ou un agent LLM. Une arête d'un nœud vers un tuple de nœuds est une distribution ramifiée : les deux démarrent simultanément. Un nœud qui renvoie un Event avec un route choisit le bord suivant, et un nœud qui se route vers lui-même est une boucle.
Imaginez deux fils. Le fil 1 est lent : lire la carte de sort, chanter, stocker le sort. Le thread 2 est rapide : cochez, vérifiez l'emplacement, cochez à nouveau. Le thread 1 se termine dans une fonction qui écrit le mot jugé dans l'état de la session et ne renvoie aucune sortie. Le check_spell du thread 2 lit cet état après chaque échange. Aucun thread n'appelle ni n'attend l'autre. Ils partagent uniquement l'état.
Point clé à retenir : codez les décisions et donnez à chaque modèle une tâche précise à effectuer à son propre rythme.
L'ADK exécute les deux branches en tant que tâches sur une boucle d'événement unique, dans un seul thread. Une seule tâche s'exécute à la fois. Lorsqu'une tâche atteint await, elle attend sa réponse, et la boucle exécute l'autre branche en attendant. La branche rapide attend le modèle pendant environ un dixième de seconde, et la branche lente attend Gemini pendant plusieurs secondes. Aucune des deux branches ne retarde l'autre.
Branche lente
read_rune() retire la carte de sort de l'écran sous forme d'image.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright est Gemini. Il lit l'image et répond dans une forme fixe.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() fait juger le sort par l'arène, puis le stocke ou réessaie.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Un nœud de fonction peut renvoyer un Content avec une partie image, et le nœud LLM le reçoit comme tour utilisateur. spell_ready renvoie un Event avec un delta d'état et sans output. Le prochain tick lit le sort à partir de l'état, et une branche sans sortie n'est pas une deuxième fin pour le graphique : ADK nécessite une sortie terminale, qui est celle du combat.
Remarque : L'évaluation est basée sur le code, dans l'arène, par rapport à la réponse cachée de la carte de sort. Une lecture parfaite fait 45, plus dans une ouverture. Deux formes à droite font 25. Une lecture incorrecte fait échouer le sort et brûle la carte de sort. Gemini n'est pas invité à dire s'il a eu raison.
Branche rapide
tick() lit un échange, puis sélectionne le prochain bord.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() examine l'emplacement de sort après chaque échange.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell examine le slot après chaque échange. Il ne bloque jamais : si le sort n'est pas prêt, il le signale et passe à autre chose.
Trois éléments sont essentiels à la conception. L'appel du modèle discriminatif est await avec le client asynchrone. La boucle cède donc pendant l'attente et la branche Gemini continue de s'exécuter. Les questions sont générées à chaque tic, donc cast n'apparaît que lorsqu'il y a quelque chose à caster. route peut être une liste : ["recast", "next"] prend les deux bords à la fois.
L'arène elle-même se trouve derrière un petit client : l'application en cours d'exécution sur HTTP, le cas échéant, de sorte que la page affiche le combat ; le moteur en cours de traitement, le cas échéant.
Définition du graphique
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Un tuple en tant que cible est une distribution ramifiée. Un tuple en tant qu'arête est une chaîne. Un dict mappe les noms de routes aux nœuds. tick → check_spell → tick correspond à la boucle rapide. "recast": read_rune relance le thread lent après l'utilisation d'un sort, "retry" fait de même après un échec, et "stored": rest permet au thread lent de se terminer discrètement, sans sortie, une fois le sort dans l'emplacement. L'ADK exige au moins une arête routée dans un cycle. Une boucle inconditionnelle est donc rejetée avant de pouvoir s'exécuter indéfiniment.
Remarque : root_agent est ce que les outils ADK recherchent. adk web agents à la racine de l'atelier ouvre l'UI de développement avec l'arène, si vous souhaitez voir le graphique et les événements dans un navigateur plutôt que dans un terminal.