

1. परिचय
यह 90 मिनट की वर्कशॉप है. इसमें डिस्क्रिमिनेटिव मॉडल, TypeSafe AI के System One डिसिज़न मॉडल, और Google ADK वर्कफ़्लो में Gemini को इसके साथ इस्तेमाल करने के बारे में बताया गया है. इस वर्कशॉप में छह चरण हैं. ये सभी चरण, लड़ाई वाले गेम के हिसाब से बनाए गए हैं. इसमें दिखाया गया है कि पहले, हाथ से ओगर से लड़ाई की जाती है. इसके बाद, हाथ के रिफ़्लेक्स को डिसक्रिमिनेटिव मॉडल को दिया जाता है. फिर, एडीके वर्कफ़्लो को डिसक्रिमिनेटिव मॉडल से लड़ाई जीतते हुए दिखाया जाता है. इसमें डिसक्रिमिनेटिव मॉडल, हर टिक का फ़ैसला लेता है और Gemini, स्क्रीन से स्पेल कार्ड पढ़कर मंत्र गाता है.
खास जानकारी
भेदभाव करने वाला मॉडल (jev-1.13, जिसे jev-latest भी कहा जाता है) TypeSafe AI का होस्ट किया गया मॉडल है. इसे 19 सितंबर, 2026 को रिलीज़ किया गया था. यह टेक्स्ट जनरेट नहीं करता. इसे स्टेट (टेक्स्ट, JSON या सूची) और टाइप किए गए सवाल (Choice, Score, Noul) भेजे जाते हैं. इसके बाद, यह टाइप किए गए जवाबों को कैलिब्रेट की गई संभावनाओं के साथ दिखाता है. इसमें करीब 70 से 500 मि॰से॰ लगते हैं. इसके लिए, हर 10 लाख इनपुट टोकन पर 0.042 डॉलर का शुल्क लगता है. आउटपुट के लिए कोई शुल्क नहीं लगता. इसका काम, भाषा मॉडल के सामने, बीच में, और पीछे फ़ैसले लेना है: राउटिंग, क्लासिफ़िकेशन, गेटिंग, और यहां, एक फ़ाइटर के रिफ़्लेक्स.
उदाहरण के तौर पर एक गेम
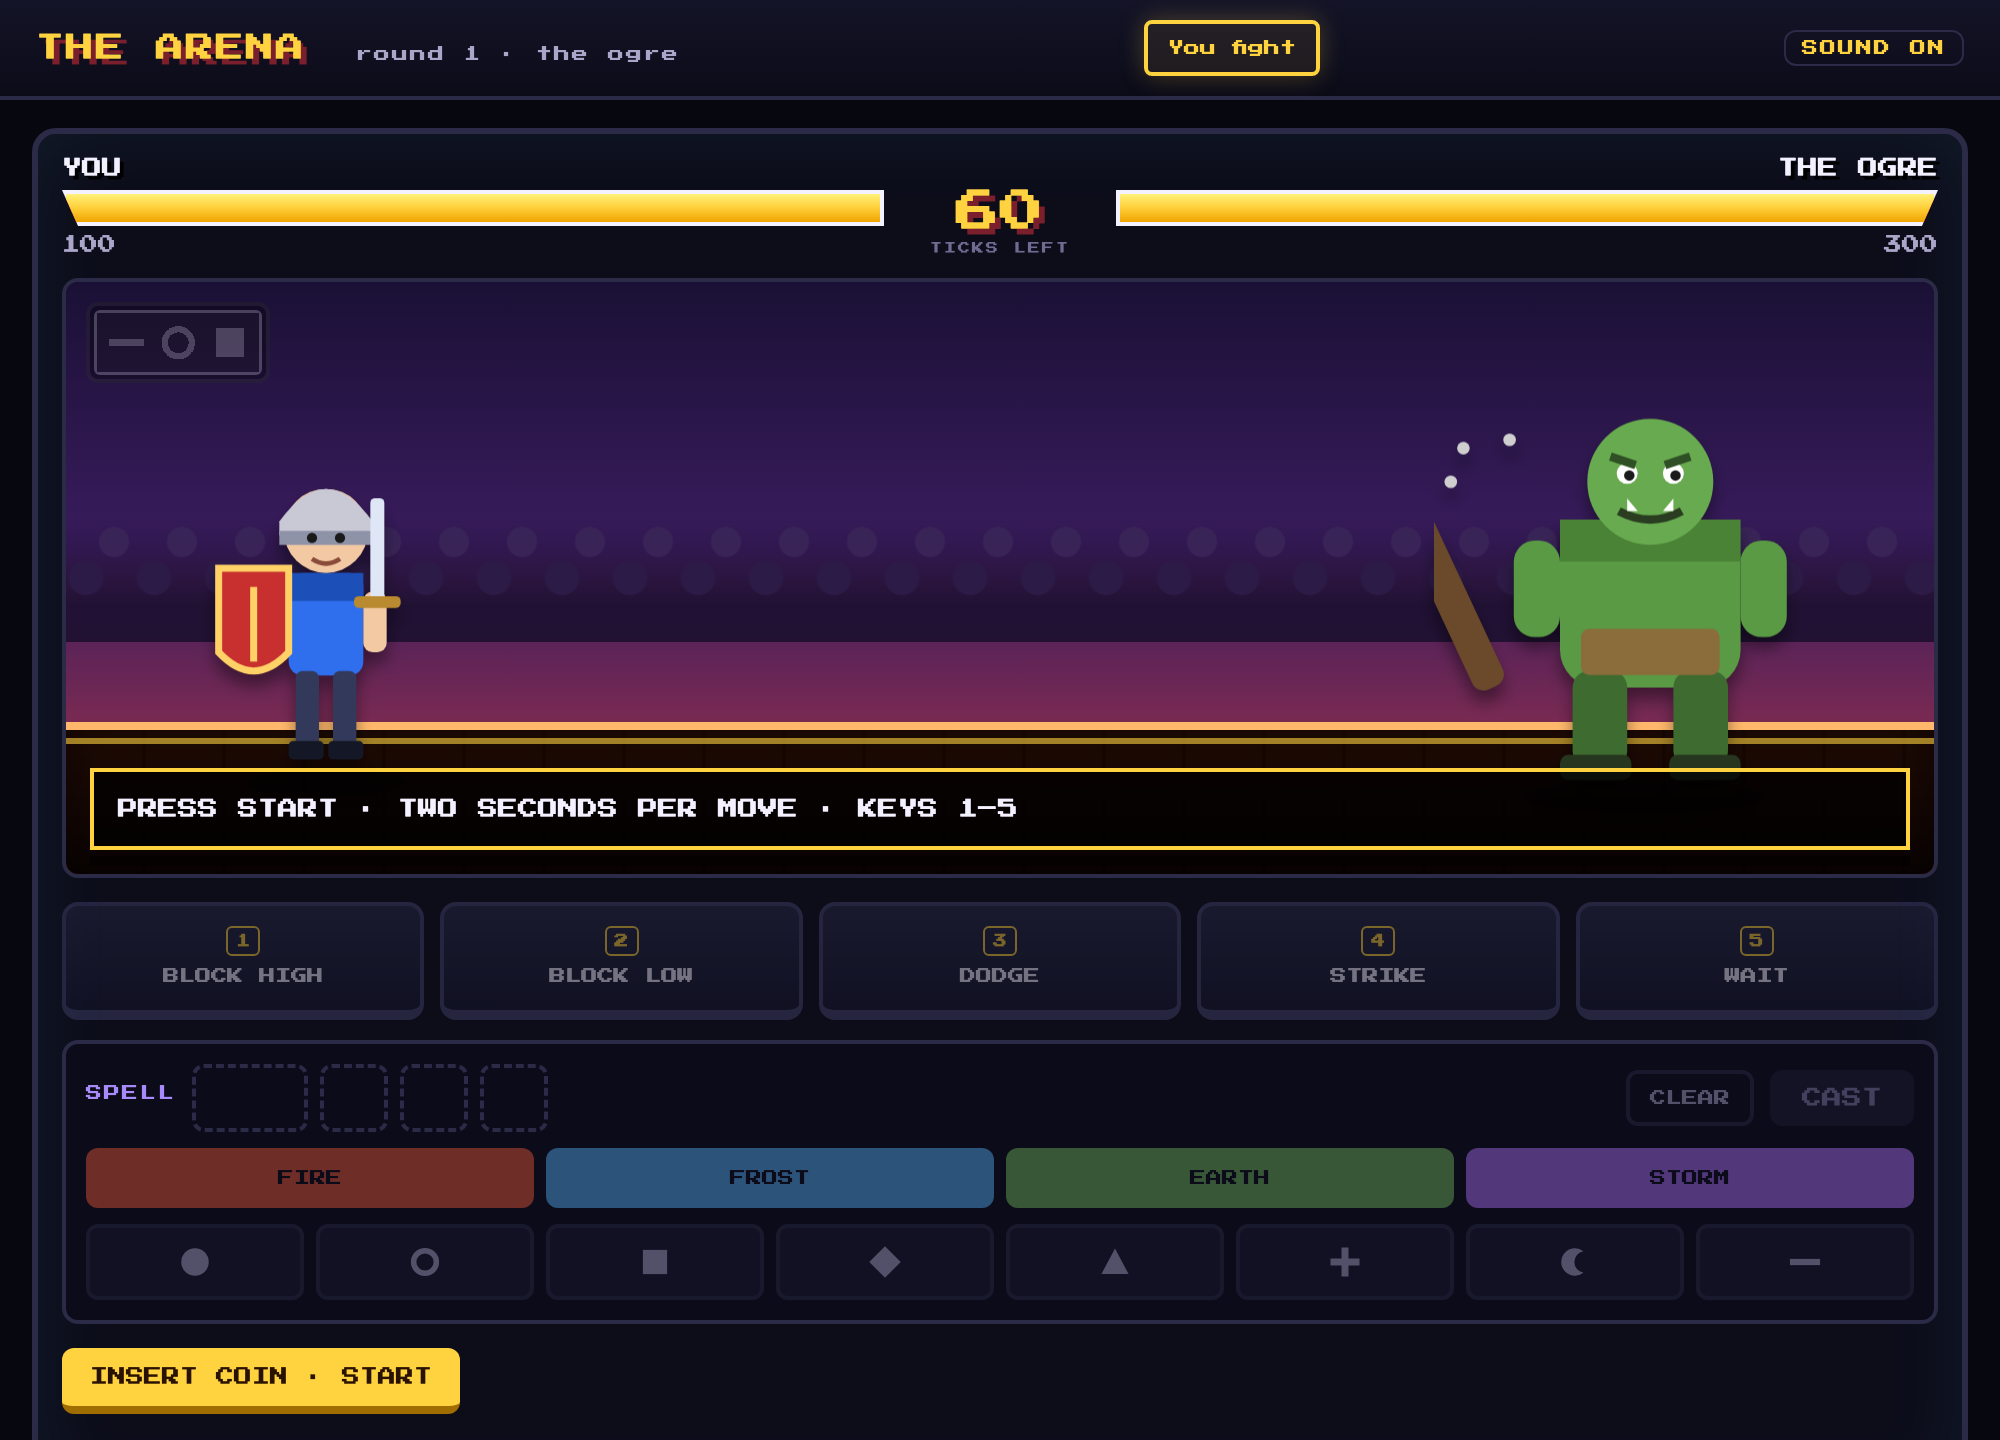
क्या आपने कभी कोई कॉम्बैट गेम खेला है? आपके सामने एक विरोधी होता है और आपको उसके मूव पर तुरंत प्रतिक्रिया देनी होती है. एक गलत जवाब देने पर, आपके एचपी में कमी आ जाती है. गेम में, स्पेल को कास्ट करना भी मुश्किल होता है. हमारे गेम में, जादू के असर को रिलीज़ करने से पहले, आपको क्रम से स्पेल कार्ड का रंग और आकार चुनना होता है. इस वर्कशॉप में, दोनों तरह के मॉडल को मिलाकर इस्तेमाल करने का तरीका बताया गया है, ताकि आपका किरदार जीत सके.
गेम का हर एलिमेंट, किसी असली सिस्टम से जुड़ा होता है:
- विरोधी की चाल एक इनकमिंग इवेंट है. जैसे, कोई अनुरोध या लेन-देन.
- जवाब, एक सीमित फ़ैसला है. यह फ़ैसला, भेदभाव करने वाले मॉडल के आधार पर लिया जाता है और इसकी जांच कोड के ज़रिए की जाती है.
- स्पेल कार्ड, बिना किसी स्ट्रक्चर वाला इनपुट होता है. इसे पढ़ने के लिए, भाषा मॉडल की ज़रूरत होती है.
- मैच एक वर्कफ़्लो है, जिसमें तेज़ और धीमे काम अपनी-अपनी स्पीड से होते हैं.
इसमें चार कॉम्पोनेंट को मिलाकर, एक तेज़ और स्मार्ट सिस्टम बनाने पर फ़ोकस किया जाता है.
आपको क्या-क्या सीखने को मिलेगा
- बताएं कि भेदभाव करने वाले (सिस्टम वन) और जनरेटिव (सिस्टम टू) मॉडल में क्या अंतर है. साथ ही, यह भी बताएं कि इनमें से किसका इस्तेमाल कब करना चाहिए.
- बताएं कि Jev और DiffusionGemma को कैसे इस्तेमाल किया जाता है. साथ ही, वर्कशॉप के लिए एक सेट अप करें. इसमें Compute Engine GPU VM पर DiffusionGemma शामिल है.
- यह Choice, Score, और Noul के सवाल लिख सकता है. साथ ही, संभावनाओं और भरोसे की व्याख्या कर सकता है.
- डिटरमिनिस्टिक कोड में थ्रेशोल्ड का इस्तेमाल करके, संभावनाओं को कार्रवाइयों में बदलें.
- TypeSafe SDK की मदद से अनुरोध बनाएं. इसके बाद, मॉडल को गेम में हर चाल चुनने दें.
- एक स्लो ब्रांच बनाएं, जिसमें Gemini किसी इमेज को पढ़े. साथ ही, एक फ़ास्ट ब्रांच बनाएं, जिसमें भेदभाव करने वाला मॉडल लूप में फ़ैसला करे. इसके बाद, दोनों को अलग-अलग चलाएं.
- ADK ग्राफ़ वर्कफ़्लो में दोनों ब्रांच को शामिल करें. इससे एक इवेंट लूप पर स्थिति शेयर की जा सकती है. इसलिए, धीमे काम की वजह से कभी भी फ़ैसले लेने में देरी नहीं होती.
आर्किटेक्चर
वर्कबेंच, Cloud Shell(या आपकी मशीन) में मौजूद होता है. यह लोकल फ़ाइल सिस्टम में लिखता है और अरीना के साथ-साथ Gemini और फ़ैसले लेने वाले मॉडल के साथ इंटरैक्ट करता है. ② "भेदभाव करने वाले मॉडल की तुलना" में डिसिज़न मॉडल को कॉल करता है; ③ "वर्कफ़्लो की तुलना" में दोनों को कॉल करता है.
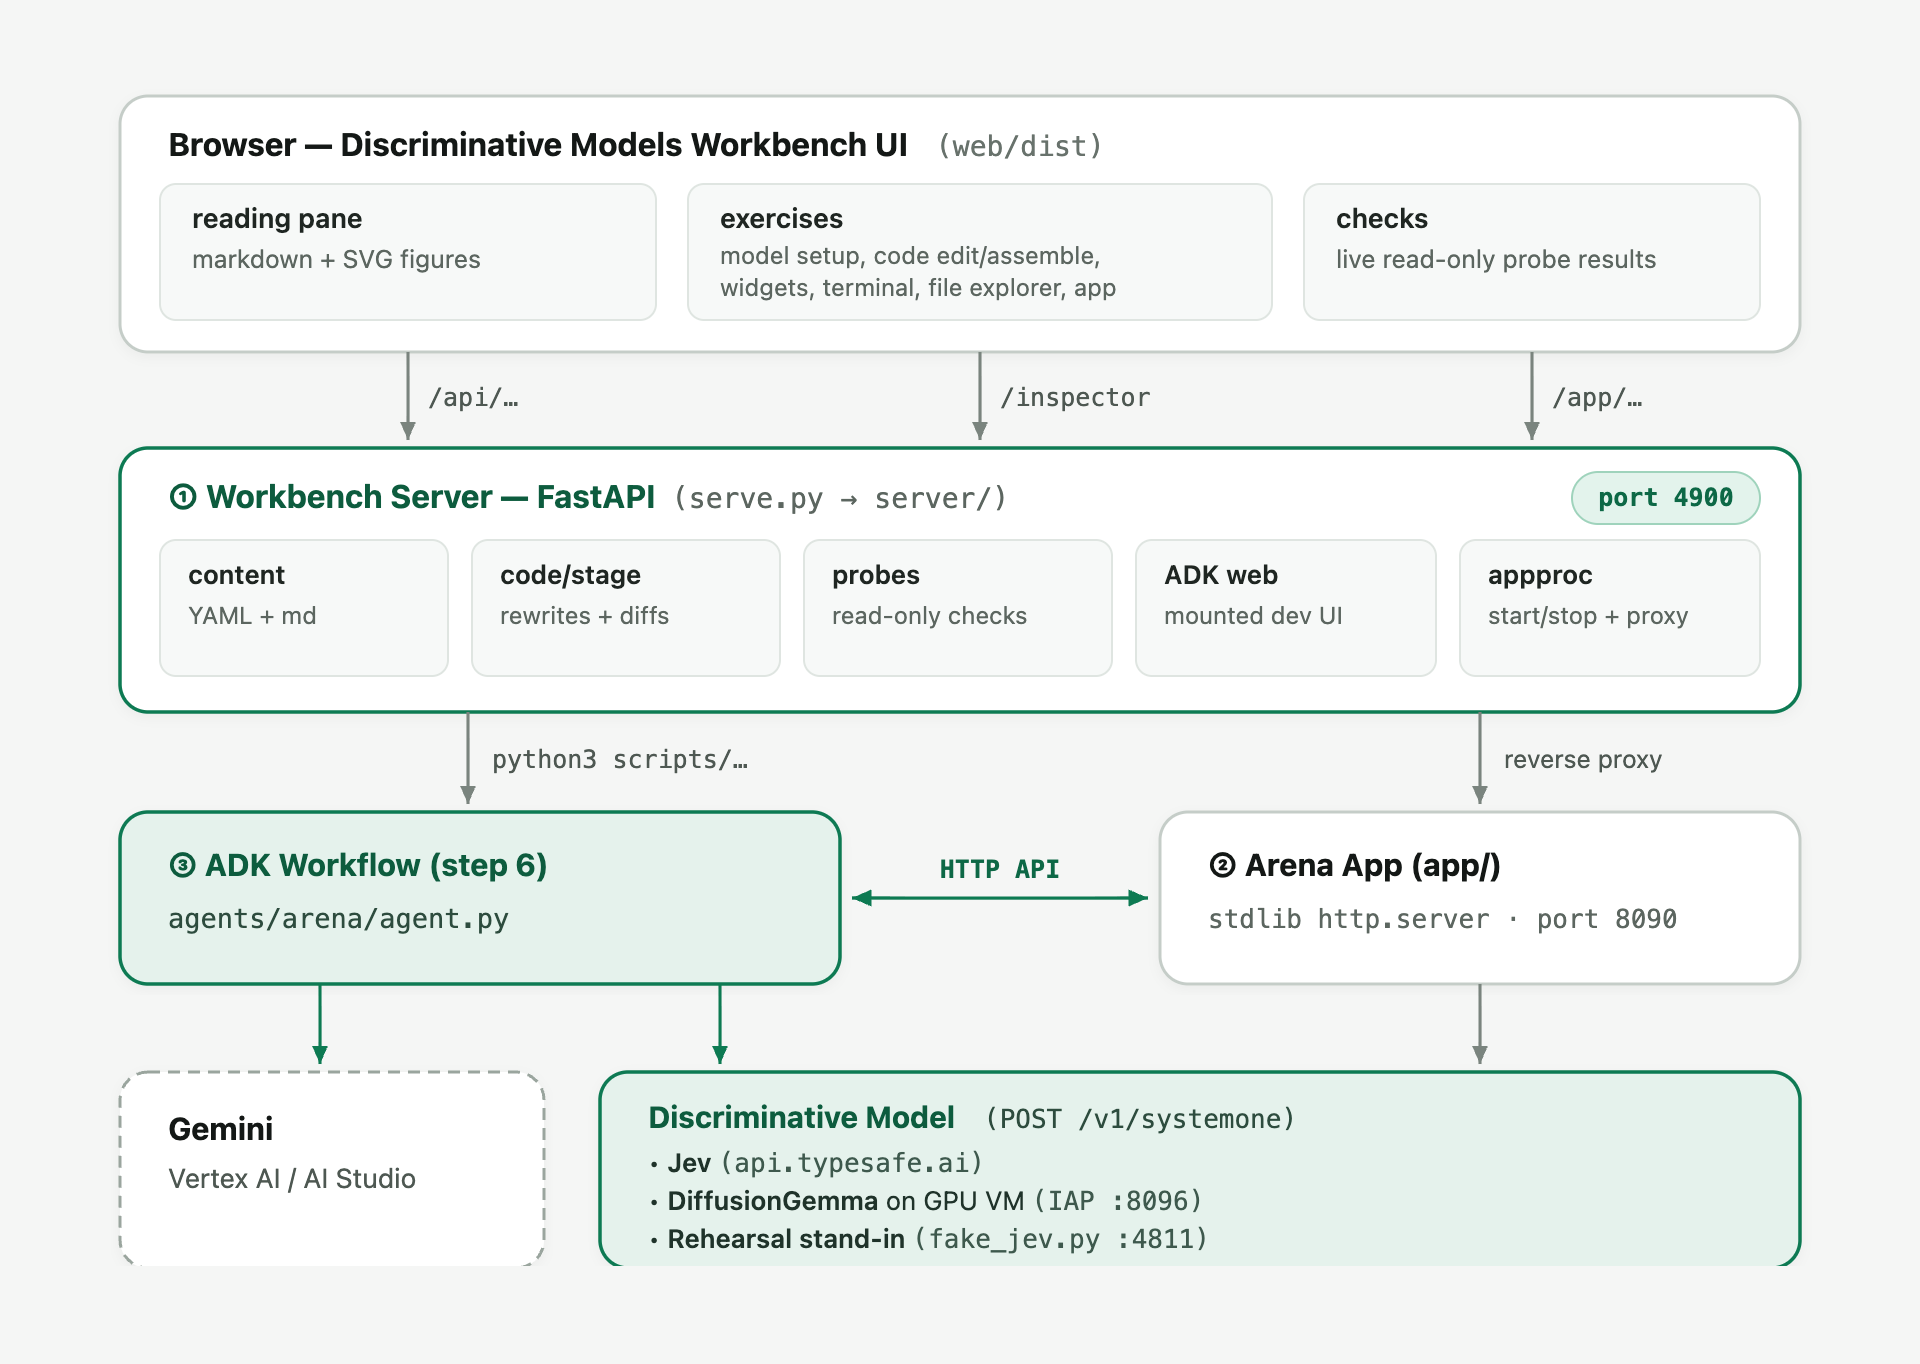
कौन क्या कहता है. ब्राउज़र सिर्फ़ ① से कम्यूनिकेट करता है. दोनों मॉडल को मशीन पर Python से कॉल किया जाता है:
कॉल करने वाले | भेदभाव करने वाला मॉडल | Gemini |
② अरीना, "भेदभाव करने वाले मॉडल की लड़ाई" | हर टिक, | नहीं |
③ वर्कफ़्लो | हर टिक, | नहीं |
③ वर्कफ़्लो | नहीं | स्पेल कार्ड की इमेज; लड़ाई के बाद की कहानी |
| हां | नहीं |
हर मोड के लिए एक टिक.
- तुम लड़ो. पेज ② पर, टेलीग्राफ़ के लिए कहा जाता है. इसके बाद, उसे दो सेकंड के टाइमर के साथ दिखाया जाता है. साथ ही, दबाए गए बटन (या टाइप किए गए शब्द) को वापस पोस्ट किया जाता है. ② इसे हल करता है.
- भेदभाव करने वाले मॉडल की फ़ाइट. पेज, ② पर टिक करने के लिए कहता है. ② एक टेलीग्राफ़ बनाता है, मॉडल से एक कॉल में तीन सवाल पूछता है,
choose()को चलाता है, और जवाब और नतीजे दिखाता है. इस पेज पर बार बनाए जाते हैं. - वर्कफ़्लो में टकराव. Start, ② को सबप्रोसेस के तौर पर लॉन्च करता है (लॉग इन करें
runs/arena-workflow.log). ③ लड़ाई को आगे बढ़ाता है: यह ② से हर टेलीग्राफ़ के बारे में पूछता है, मॉडल को कॉल करता है, और फ़ैसले को पोस्ट करता है; Gemini का स्पेल, तैयार होने पर अपनी ब्रांच पर पहुंच जाता है. इस पेज पर सिर्फ़ ② को पोल किया जाता है और ड्रा किया जाता है. Pause, ② पर मौजूद एक फ़्लैग है. ③ हर टिक से पहले इसकी जांच करता है.
वह जगह जहां फ़ैसले लेने वाले मॉडल को होस्ट किया जाता है. हर कॉल एक ही typesafe-sdk से होकर गुज़रता है. सिर्फ़ बेस यूआरएल बदलता है. scripts/jevauth.py बैकएंड का नाम देता है और कुंजी और टाइमआउट सेट करता है:
बैकएंड |
| कुंजी | इन्होंने सेट अप किया |
TypeSafe, होस्ट किया गया | unset (api.typesafe.ai) |
|
|
L4 वीएम पर DiffusionGemma |
| कोई नहीं |
|
Cloud Run पर DiffusionGemma |
| Google आइडेंटिटी टोकन, जिसे हर घंटे फ़ेच किया जाता है |
|
रिहर्सल |
| कोई नहीं |
|
स्पेल कार्ड का जवाब ②: वर्कफ़्लो को सिर्फ़ PNG मिलता है और ②, स्पेल की जांच करके उसे वापस भेजता है. इसलिए, इस स्पेल को Gemini की पढ़ने की क्षमता की असली परीक्षा माना जाता है. साथ ही, "You fight" में बनाए गए स्पेल को आपकी असली परीक्षा माना जाता है.
2. सेटअप
वर्कशॉप के क्रेडिट पर दावा करना
अगर आपको इस सेशन के लिए Google Cloud क्रेडिट दिया गया है, तो पहले उस पर दावा करें. इसमें करीब एक मिनट लगता है और इससे आपके लिए बिलिंग खाता बन जाता है.
Cloud Shell खोलें
Google Cloud Shell, ब्राउज़र से ऐक्सेस किया जा सकने वाला Linux एनवायरमेंट है. इसमें gcloud, Python, Node.js, uv, और git पहले से कॉन्फ़िगर किए गए होते हैं. साथ ही, यह आपके Google खाते से पहले से ही पुष्टि कर चुका होता है.
- Google Cloud Console खोलें.
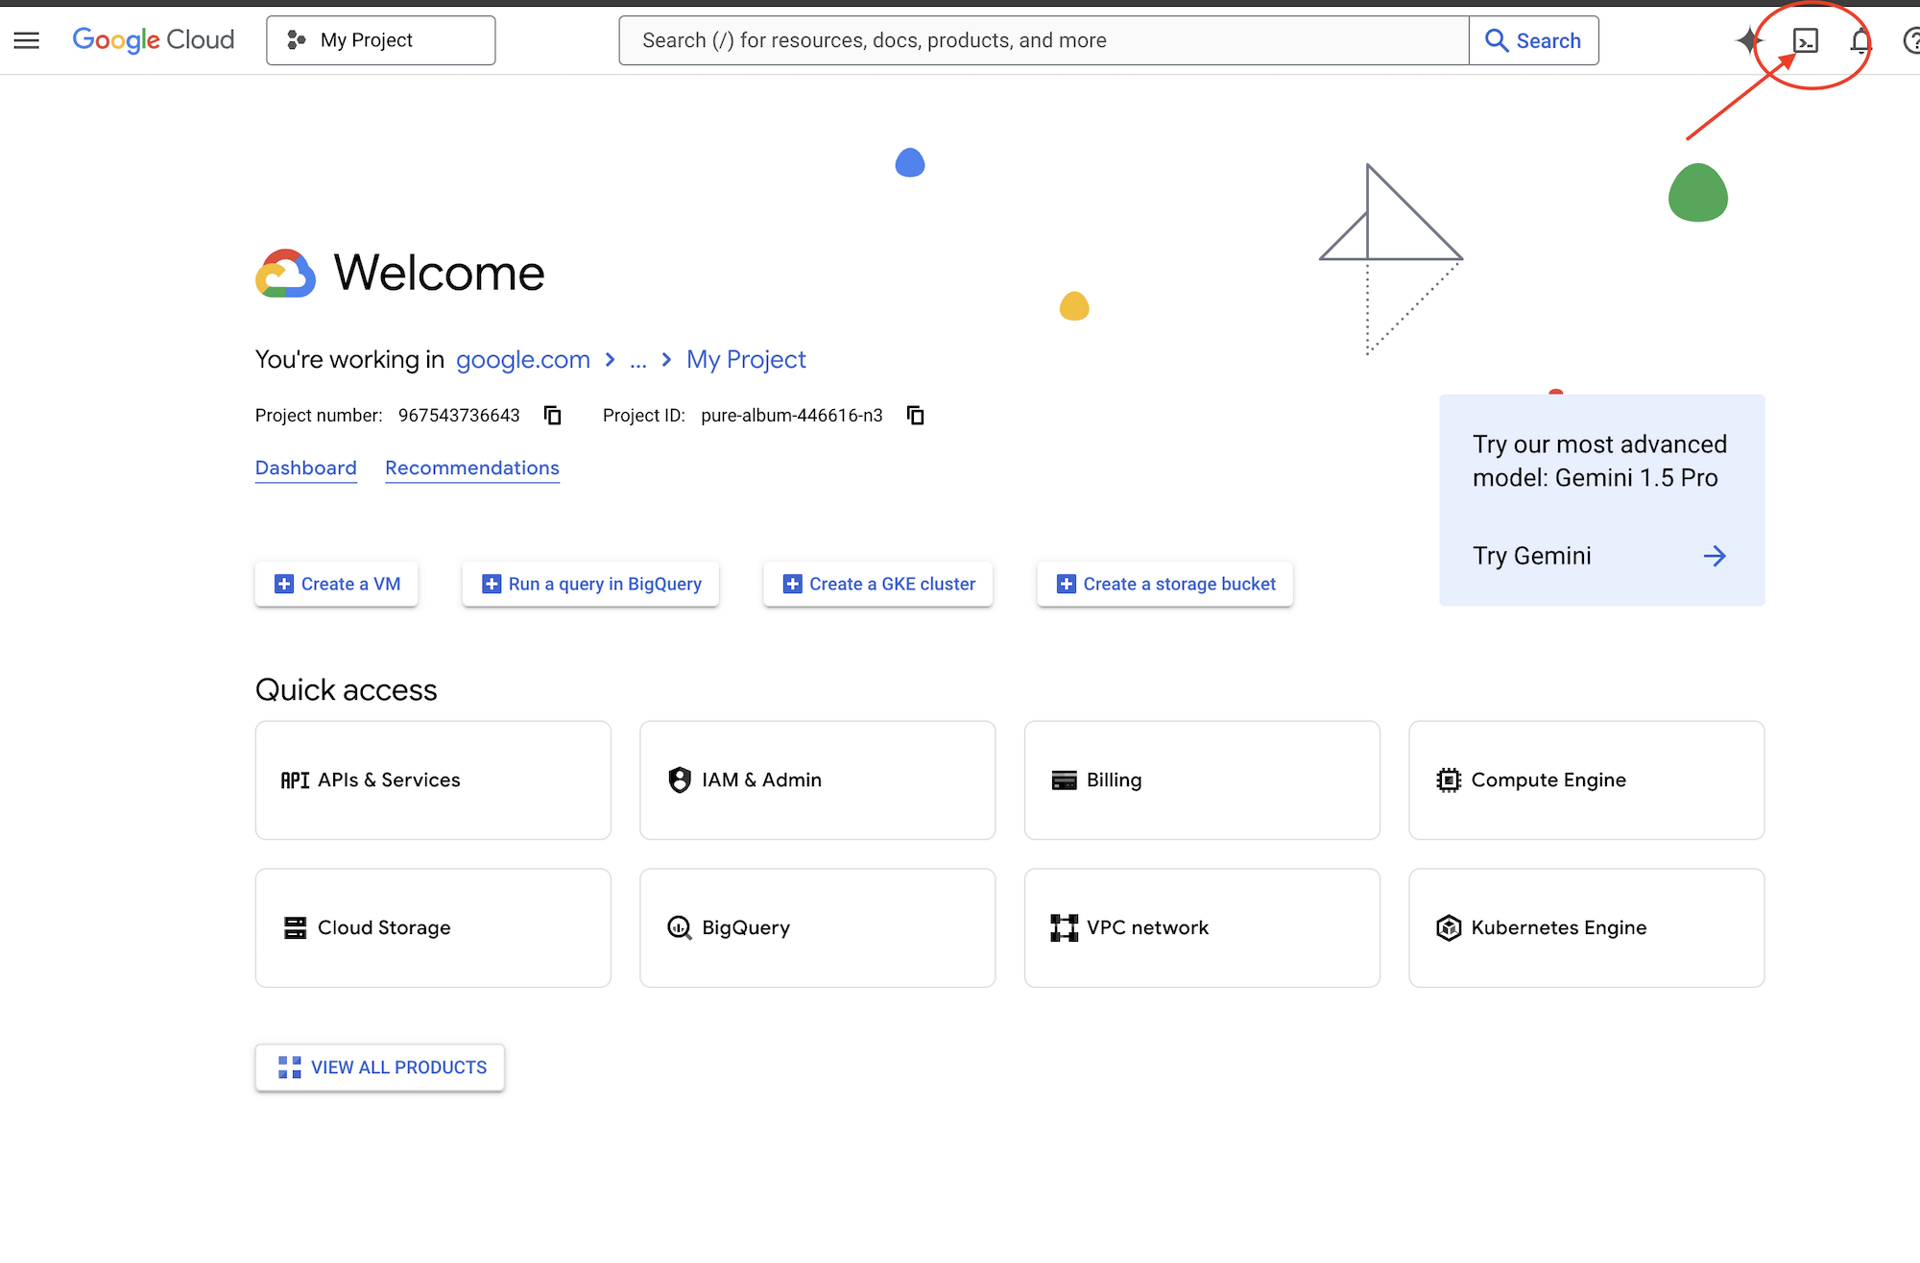
- अपने ब्राउज़र में सबसे नीचे टर्मिनल सेशन खोलने के लिए, सबसे ऊपर मौजूद नेविगेशन बार में मौजूद टर्मिनल आइकॉन Cloud Shell चालू करें पर क्लिक करें.
वर्कबेंच लॉन्च करना
Cloud Shell में या gcloud में साइन इन किए गए किसी भी डिवाइस पर:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh एक प्रोजेक्ट (discrim-models-XXXX) बनाता है और उसे बिलिंग से लिंक करता है. अगर आपके पास इवेंट क्रेडिट खाता है, तो उसे प्राथमिकता दी जाती है. इसके बाद, प्रोजेक्ट के चालू होने का इंतज़ार किया जाता है. इसे फिर से चलाने पर, ~/project_id.txt में मौजूद प्रोजेक्ट का फिर से इस्तेमाल किया जाता है. अगर आपको पहले से मौजूद किसी प्रोजेक्ट का इस्तेमाल करना है, तो उस फ़ाइल में उसका आईडी डालें और इस स्क्रिप्ट को छोड़ दें.
setup_codelab.sh कुछ नहीं पूछता. यह uv और Python पैकेज इंस्टॉल करता है. साथ ही, Vertex AI, Compute Engine, और IAP को चालू करता है. यह .env में Gemini को Vertex AI पर ले जाता है. यह प्रोजेक्ट के लिए उपलब्ध मॉडल के साथ Gemini को एक कॉल करता है. यह पेज बनाता है, बैकग्राउंड में वर्कबेंच शुरू करता है, और scripts/check_setup.py को चलाता है. इसे फिर से चलाने पर, आपकी कसरत की फ़ाइलें सेव रहती हैं. हालांकि, scripts/starter.sh से ये फ़ाइलें रीसेट हो जाती हैं. वर्कबेंच के दूसरे चरण में, फ़ैसले लेने वाला मॉडल चुना जाता है.
Cloud Shell में वर्कबेंच यूज़र इंटरफ़ेस (यूआई) खोलने के लिए:
./setup_codelab.shके आखिर में प्रिंट किए गए झलक लिंक पर क्लिक करें या Cloud Shell टूलबार के सबसे ऊपर दाएं कोने में मौजूद, वेब झलक पर क्लिक करें.- पोर्ट बदलें को चुनें. इसके बाद, 4900 डालें और बदलें और झलक देखें पर क्लिक करें.
Gemini, आपके प्रोजेक्ट में Vertex AI पर चलता है. इसके लिए, आपके Google क्रेडेंशियल इस्तेमाल किए जाते हैं: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT, और GOOGLE_CLOUD_LOCATION=global, .env में.
फ़ैसले लेने वाले मॉडल को वर्कबेंच के दूसरे चरण में या scripts/setup_model.sh वाले टर्मिनल से अपने-आप चुना जाता है:
विकल्प | प्रॉडक्ट | सेटअप | लागत |
भेदभाव करने वाला मॉडल (TypeSafe, होस्ट किया गया) | TypeSafe API पासकोड | कोई नहीं | हर टोकन के लिए, एक सेंट से भी कम |
DiffusionGemma (Google, ओपन वेट) | बिलिंग + जीपीयू के लिए Compute Engine का कोटा | ~15 मिनट, अपने-आप | वीएम के चालू रहने के दौरान ~0.71 डॉलर/घंटा |
रिहर्सल (कोई मॉडल नहीं) | nothing | कोई नहीं | कोई नहीं |
Compute Engine वीएम पर DiffusionGemma
scripts/setup_gemma.sh सबसे पहले जीपीयू कोटे की जांच करता है. इसके बाद, NVIDIA ड्राइवर 580 के साथ Google की डीप लर्निंग इमेज से एक g2-standard-4 वीएम (1 × L4 24 जीबी, 4 वीसीपीयू, 16 जीबी) बनाता है. पहली बार बूट करने पर, वीएम Docker इंस्टॉल करता है. साथ ही, Hugging Face से वज़न डाउनलोड करता है (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17.5 जीबी, सार्वजनिक, कोई टोकन नहीं). इसके बाद, djev-run को चलाता है: Discriminative मॉडल के सटीक एपीआई के पीछे DiffusionGemma. मॉडल का पोर्ट इंटरनेट के लिए खुला नहीं है: वर्कबेंच, localhost:8096 पर मौजूद IAP टनल के ज़रिए इस तक पहुंचता है. scripts/start.sh इसे खोलता है.
रोकें / फिर से शुरू करें |
| |
सुरंग |
| |
हटाएं |
| |
निर्देशों का अभ्यास करना |
| |
डेटाबेस का लेआउट
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. खास जानकारी
अपने एनवायरमेंट को साफ़ करना
वर्कशॉप पूरी होने के बाद, DiffusionGemma के किसी भी जीपीयू संसाधन को बंद करने के लिए, यह तरीका अपनाएं. साथ ही, बैकग्राउंड वर्कबेंच और रिहर्सल प्रोसेस को बंद करें, Cloud Shell से वर्कशॉप की फ़ाइलें हटाएं, और (ज़रूरी नहीं) वर्कशॉप के Google Cloud प्रोजेक्ट को मिटाएं.
- DiffusionGemma GPU VM और फ़ायरवॉल नियम (अगर बनाया गया है) मिटाएं: अगर आपने दूसरे चरण में Compute Engine GPU VM पर DiffusionGemma को प्रोविज़न किया है, तो VM, डिस्क, और IAP फ़ायरवॉल नियम को हटाएं. इससे कंप्यूट या डिस्क स्टोरेज के लिए कोई शुल्क नहीं लगेगा:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Cloud Shell में वर्कबेंच और रिहर्सल की प्रोसेस बंद करें: Cloud Shell टर्मिनल में, बैकग्राउंड में चल रहे वर्कबेंच सर्वर और रिहर्सल की किसी भी स्टैंड-इन प्रोसेस को बंद करें:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Cloud Shell से वर्कशॉप फ़ोल्डर मिटाएं: अपनी होम डायरेक्ट्री पर वापस जाएं. इसके बाद, क्लोन की गई रिपॉज़िटरी फ़ोल्डर और प्रोजेक्ट आईडी फ़ाइल को हटाएं:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - अपना Google Cloud प्रोजेक्ट मिटाएं: अगर
./setup_project.shआपने वर्कशॉप के लिए कोई प्रोजेक्ट बनाया है (उदाहरण के लिए,discrim-models-XXXX), तो उसे बंद करने पर, उसमें बनाए गए सभी संसाधन हमेशा के लिए मिट जाते हैं. हालांकि, इससे आपके Cloud Billing खाते पर कोई असर नहीं पड़ता:- Google Cloud Console में, संसाधन मैनेज करें पेज खोलें.
- संसाधन सूची से, अपने वर्कशॉप प्रोजेक्ट (उदाहरण के लिए,
discrim-models-...) को चुनें. - सबसे ऊपर मौजूद टूलबार में, मिटाएं पर क्लिक करें. इसके बाद, पुष्टि करने के लिए अपना प्रोजेक्ट आईडी डालें और बंद करें पर क्लिक करें.
आपने यह वर्कशॉप पूरी कर ली है.
लैब की खास जानकारी
- Compute Engine GPU VM पर, भेदभाव करने वाला मॉडल, Jev या DiffusionGemma चुना गया है. साथ ही, यह भी देखा गया है कि यह जवाब देता है या नहीं.
- अरीना को हाथ से खेला गया, ताकि इसके नियमों के बारे में जाना जा सके.
- आपने यह जाना कि भेदभाव करने वाला मॉडल, Choice, Score, और Noul सवालों के जवाब कैसे देता है. साथ ही, यह भी जाना कि वह जवाबों के सही होने की संभावना और भरोसेमंद होने के बारे में कैसे बताता है. इसके अलावा, आपने यह भी जाना कि आपका कोड, इन जवाबों पर थ्रेशोल्ड कैसे लागू करता है.
- आपने पहला अनुरोध भेजा. इसके बाद, मॉडल को अरीना में हर चाल चुनने दें. साथ ही,
choose()को अपने जवाबों को कार्रवाइयों में बदलने दें. - ADK वर्कफ़्लो की हर ब्रांच को अलग-अलग बनाया गया है. इसमें Gemini, स्पेल कार्ड की इमेज को पढ़ता है और मॉडल, लूप में फ़ैसले लेता है.
- इन दोनों को एक ही वर्कफ़्लो में शामिल किया गया है, ताकि दोनों के बीच की स्थिति शेयर की जा सके. इससे Gemini को लड़ाई शुरू होने का इंतज़ार नहीं करना पड़ता और वह तुरंत जादू कर देता है.
बातचीत से लेकर फ़ैसले लेने तक
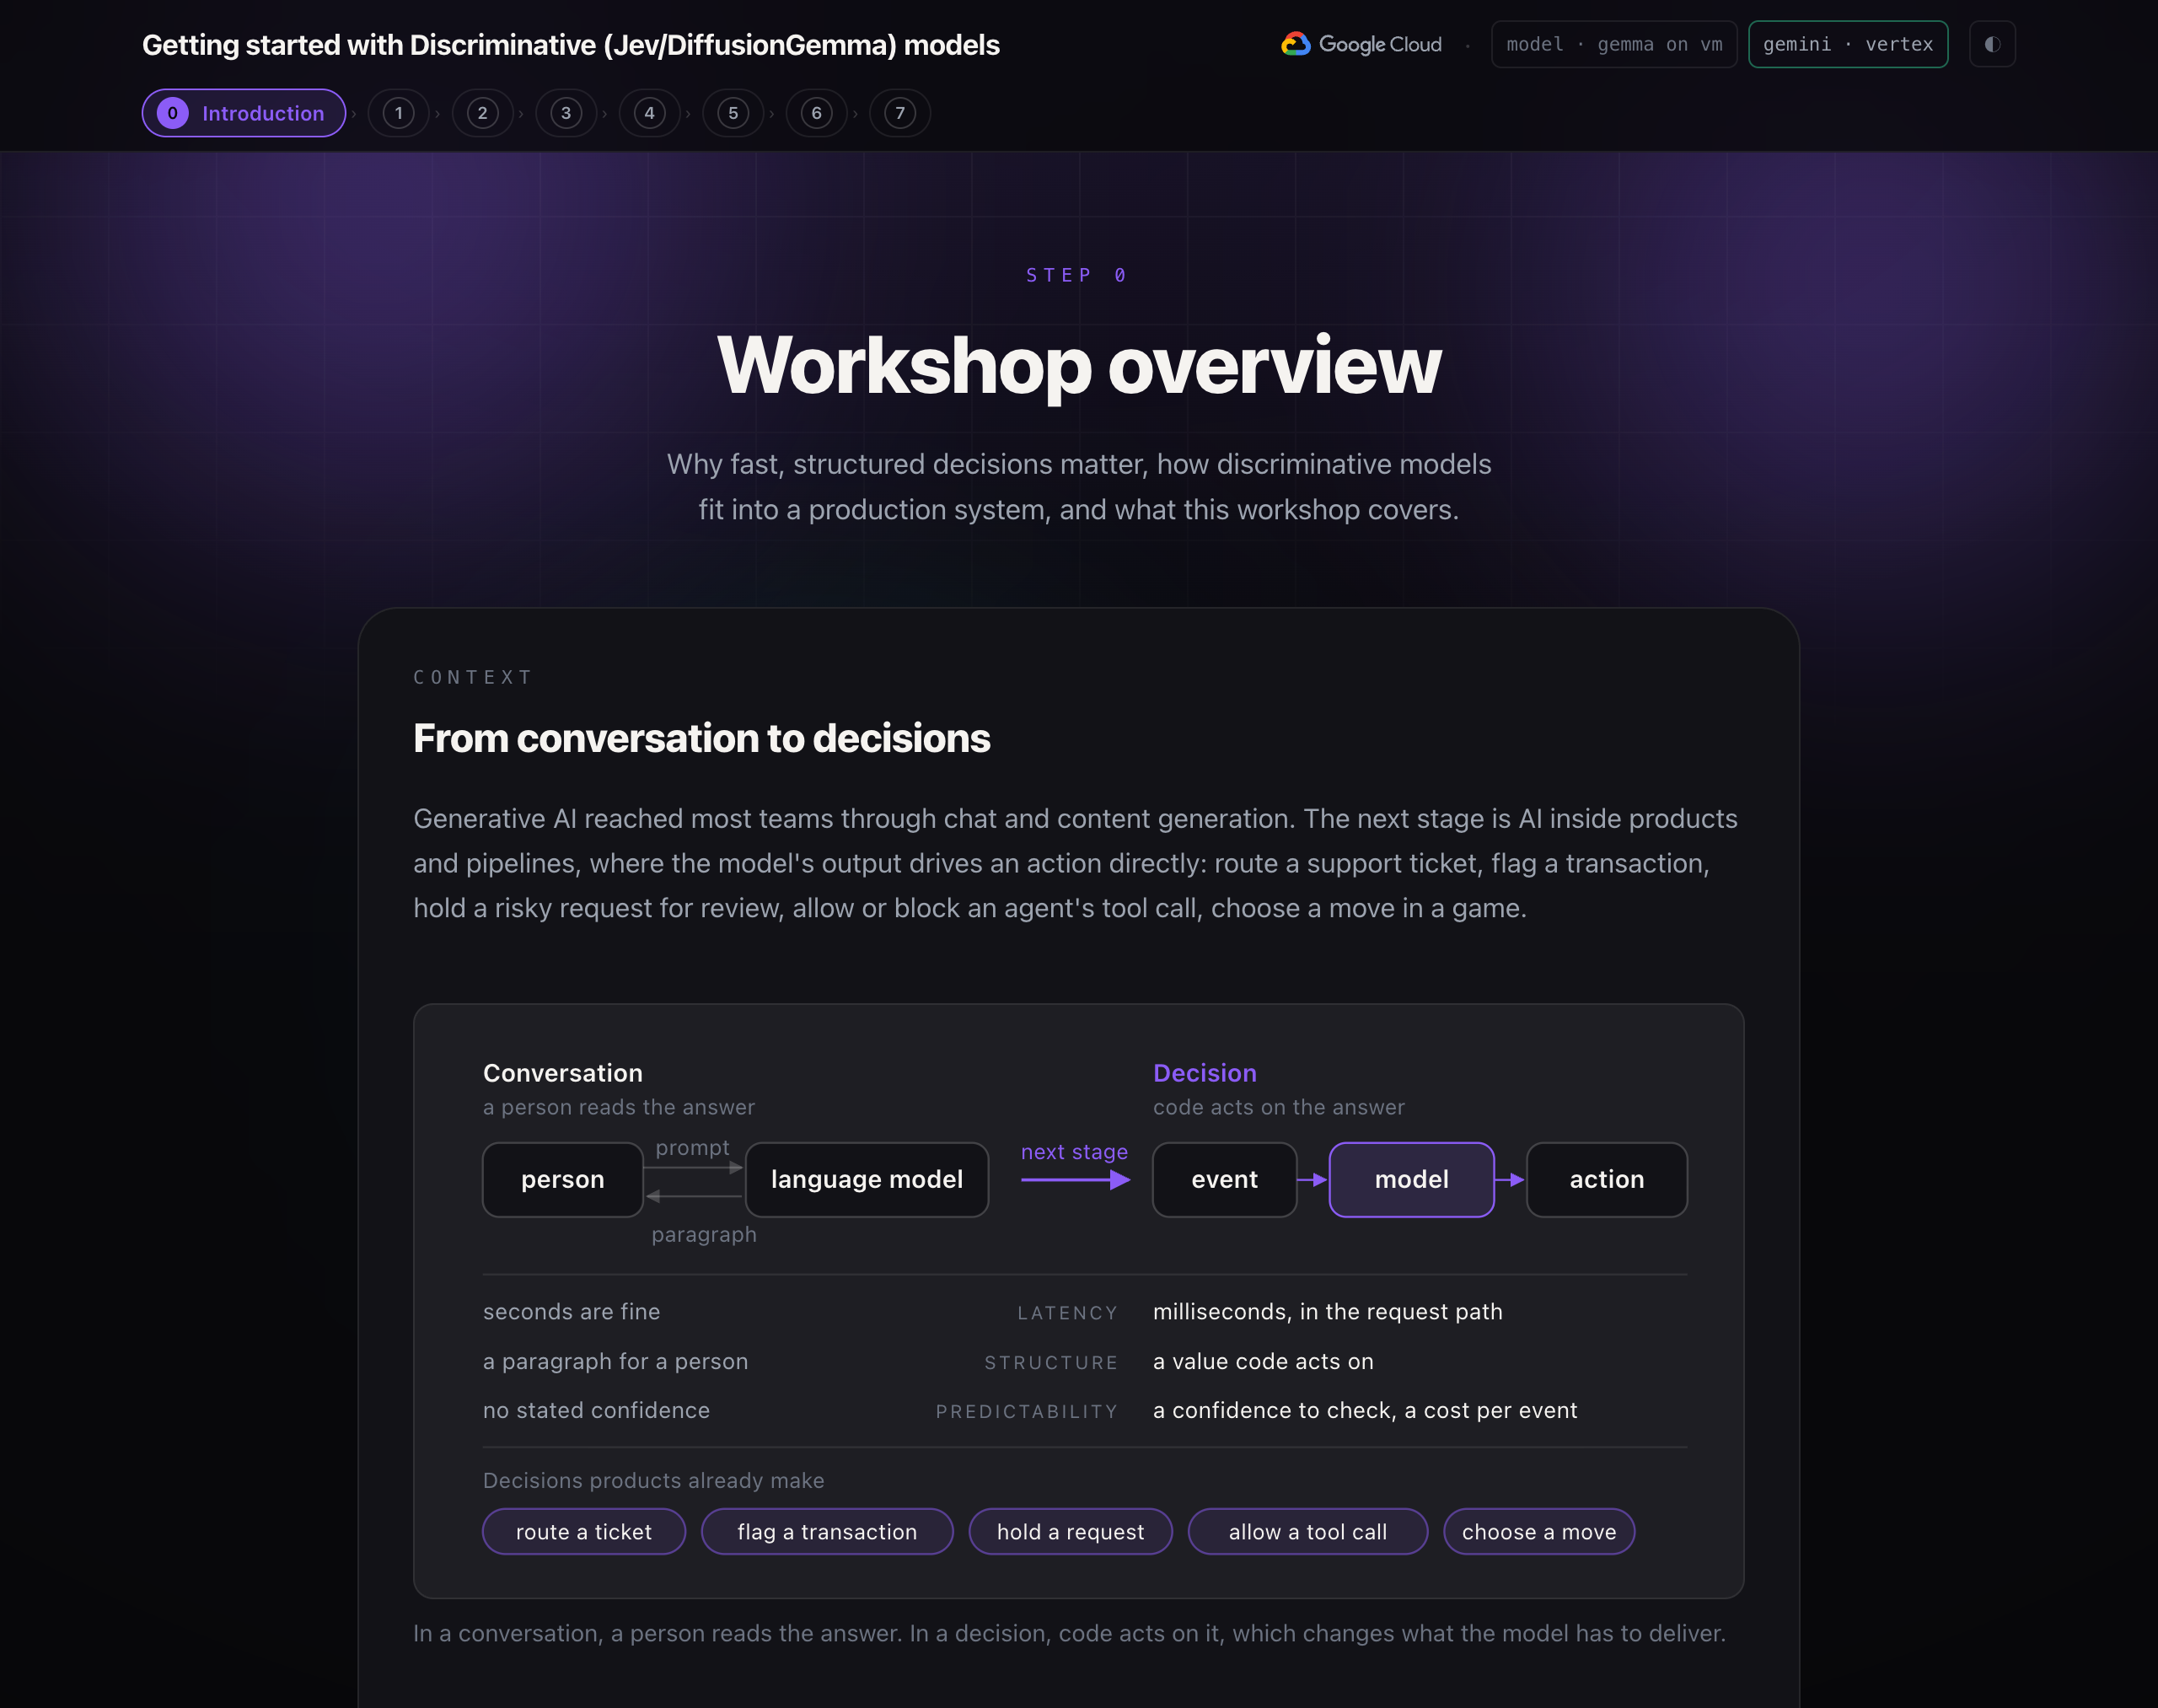
जनरेटिव एआई, चैट और कॉन्टेंट जनरेट करने की सुविधा के ज़रिए ज़्यादातर टीमों तक पहुंचा. अगला चरण, प्रॉडक्ट और पाइपलाइन में एआई का इस्तेमाल करना है. इसमें मॉडल का आउटपुट सीधे तौर पर किसी कार्रवाई को ट्रिगर करता है. जैसे: सहायता टिकट को रूट करना, लेन-देन को फ़्लैग करना, जोखिम भरी किसी अनुरोध को समीक्षा के लिए रोकना, एजेंट के टूल कॉल को अनुमति देना या ब्लॉक करना, और गेम में कोई चाल चुनना.
इन फ़ैसलों के लिए तीन ज़रूरी शर्तें पूरी करनी होती हैं. हालांकि, चैट के लिए ये शर्तें पूरी करना ज़रूरी नहीं है:
- लेटेंसी. जवाब अक्सर उपयोगकर्ता के अनुरोध पाथ या रीयल-टाइम लूप में होता है. इसलिए, इसे सेकंड में नहीं, बल्कि मिलीसेकंड में पहुंचना चाहिए.
- स्ट्रक्चर. कॉलर एक कोड है. इसलिए, जवाब ऐसी वैल्यू होनी चाहिए जिस पर वह कार्रवाई कर सके. यह ऐसा पैराग्राफ़ नहीं होना चाहिए जिसे उसे पार्स करना पड़े.
- अनुमान लगाने की क्षमता. हर फ़ैसले के लिए, कोड को कॉन्फ़िडेंस की ज़रूरत होती है. साथ ही, हर इवेंट पर पूछने के लिए, लागत इतनी कम होनी चाहिए.
लैंग्वेज मॉडल, एक-एक करके टोकन जनरेट करता है. इसे हां या नहीं में जवाब देने के लिए कहा जा सकता है. हालांकि, रीयल-टाइम लूप के लिए यह धीमा है. इसके आउटपुट को पार्स करना होता है. साथ ही, यह नहीं बताता कि यह कितना सटीक है.
फ़ैसले लेने के लिए बनाए गए मॉडल
भेदभाव करने वाला मॉडल, टाइप किए गए सवाल का जवाब देता है. इसमें हर विकल्प के लिए संभावना होती है. यह काम एक ही बार में होता है. यह टेक्स्ट जनरेट नहीं करता. इस वर्कशॉप को चलाने के लिए, दो विकल्प उपलब्ध हैं:
मॉडल | सेवा देने वाली कंपनी | इस वर्कशॉप में मॉडल कहां चलता है |
Jev | टाइपसेफ़ एआई | TypeSafe की होस्ट की गई सेवा, जिसे एपीआई पासकोड के साथ कॉल किया जाता है |
DiffusionGemma | Google, ओपन वेट | आपके Google Cloud प्रोजेक्ट में मौजूद जीपीयू वीएम पर खुद होस्ट किया गया हो |
अपनी ज़रूरतों के हिसाब से मॉडल बदले जा सकते हैं. हालांकि, उनसे कनेक्ट करने वाले कोड में बदलाव करने की ज़रूरत नहीं होती.
कॉम्पोनेंट जोड़ना
एक सफल सिस्टम में कई कॉम्पोनेंट होते हैं:
कॉम्पोनेंट | भूमिका | इस वर्कशॉप में |
Workflow | यह चरणों को व्यवस्थित करता है, ब्रांच को एक साथ चलाता है, और शेयर की गई स्थिति को बनाए रखता है | ADK का ग्राफ़ वर्कफ़्लो |
डिटरमिनिस्टिक कोड | नियम, थ्रेशोल्ड, पुष्टि. तुरंत, बिना किसी शुल्क के, और ऑडिट किया जा सकता है | गेम के नियम, |
भेदभाव करने वाला मॉडल | कॉन्फ़िडेंस स्कोर के साथ, तेज़ी से और सटीक फ़ैसले लेना | हर टिक पर जवाब चुनना |
लैंग्वेज मॉडल | इमेज और ओपन-एंडेड टेक्स्ट को समझना और जनरेट करना | Gemini, स्पेल कार्ड की इमेज को पढ़कर स्पेल लिखता है |
मॉडल सर्व करने का आर्किटेक्चर
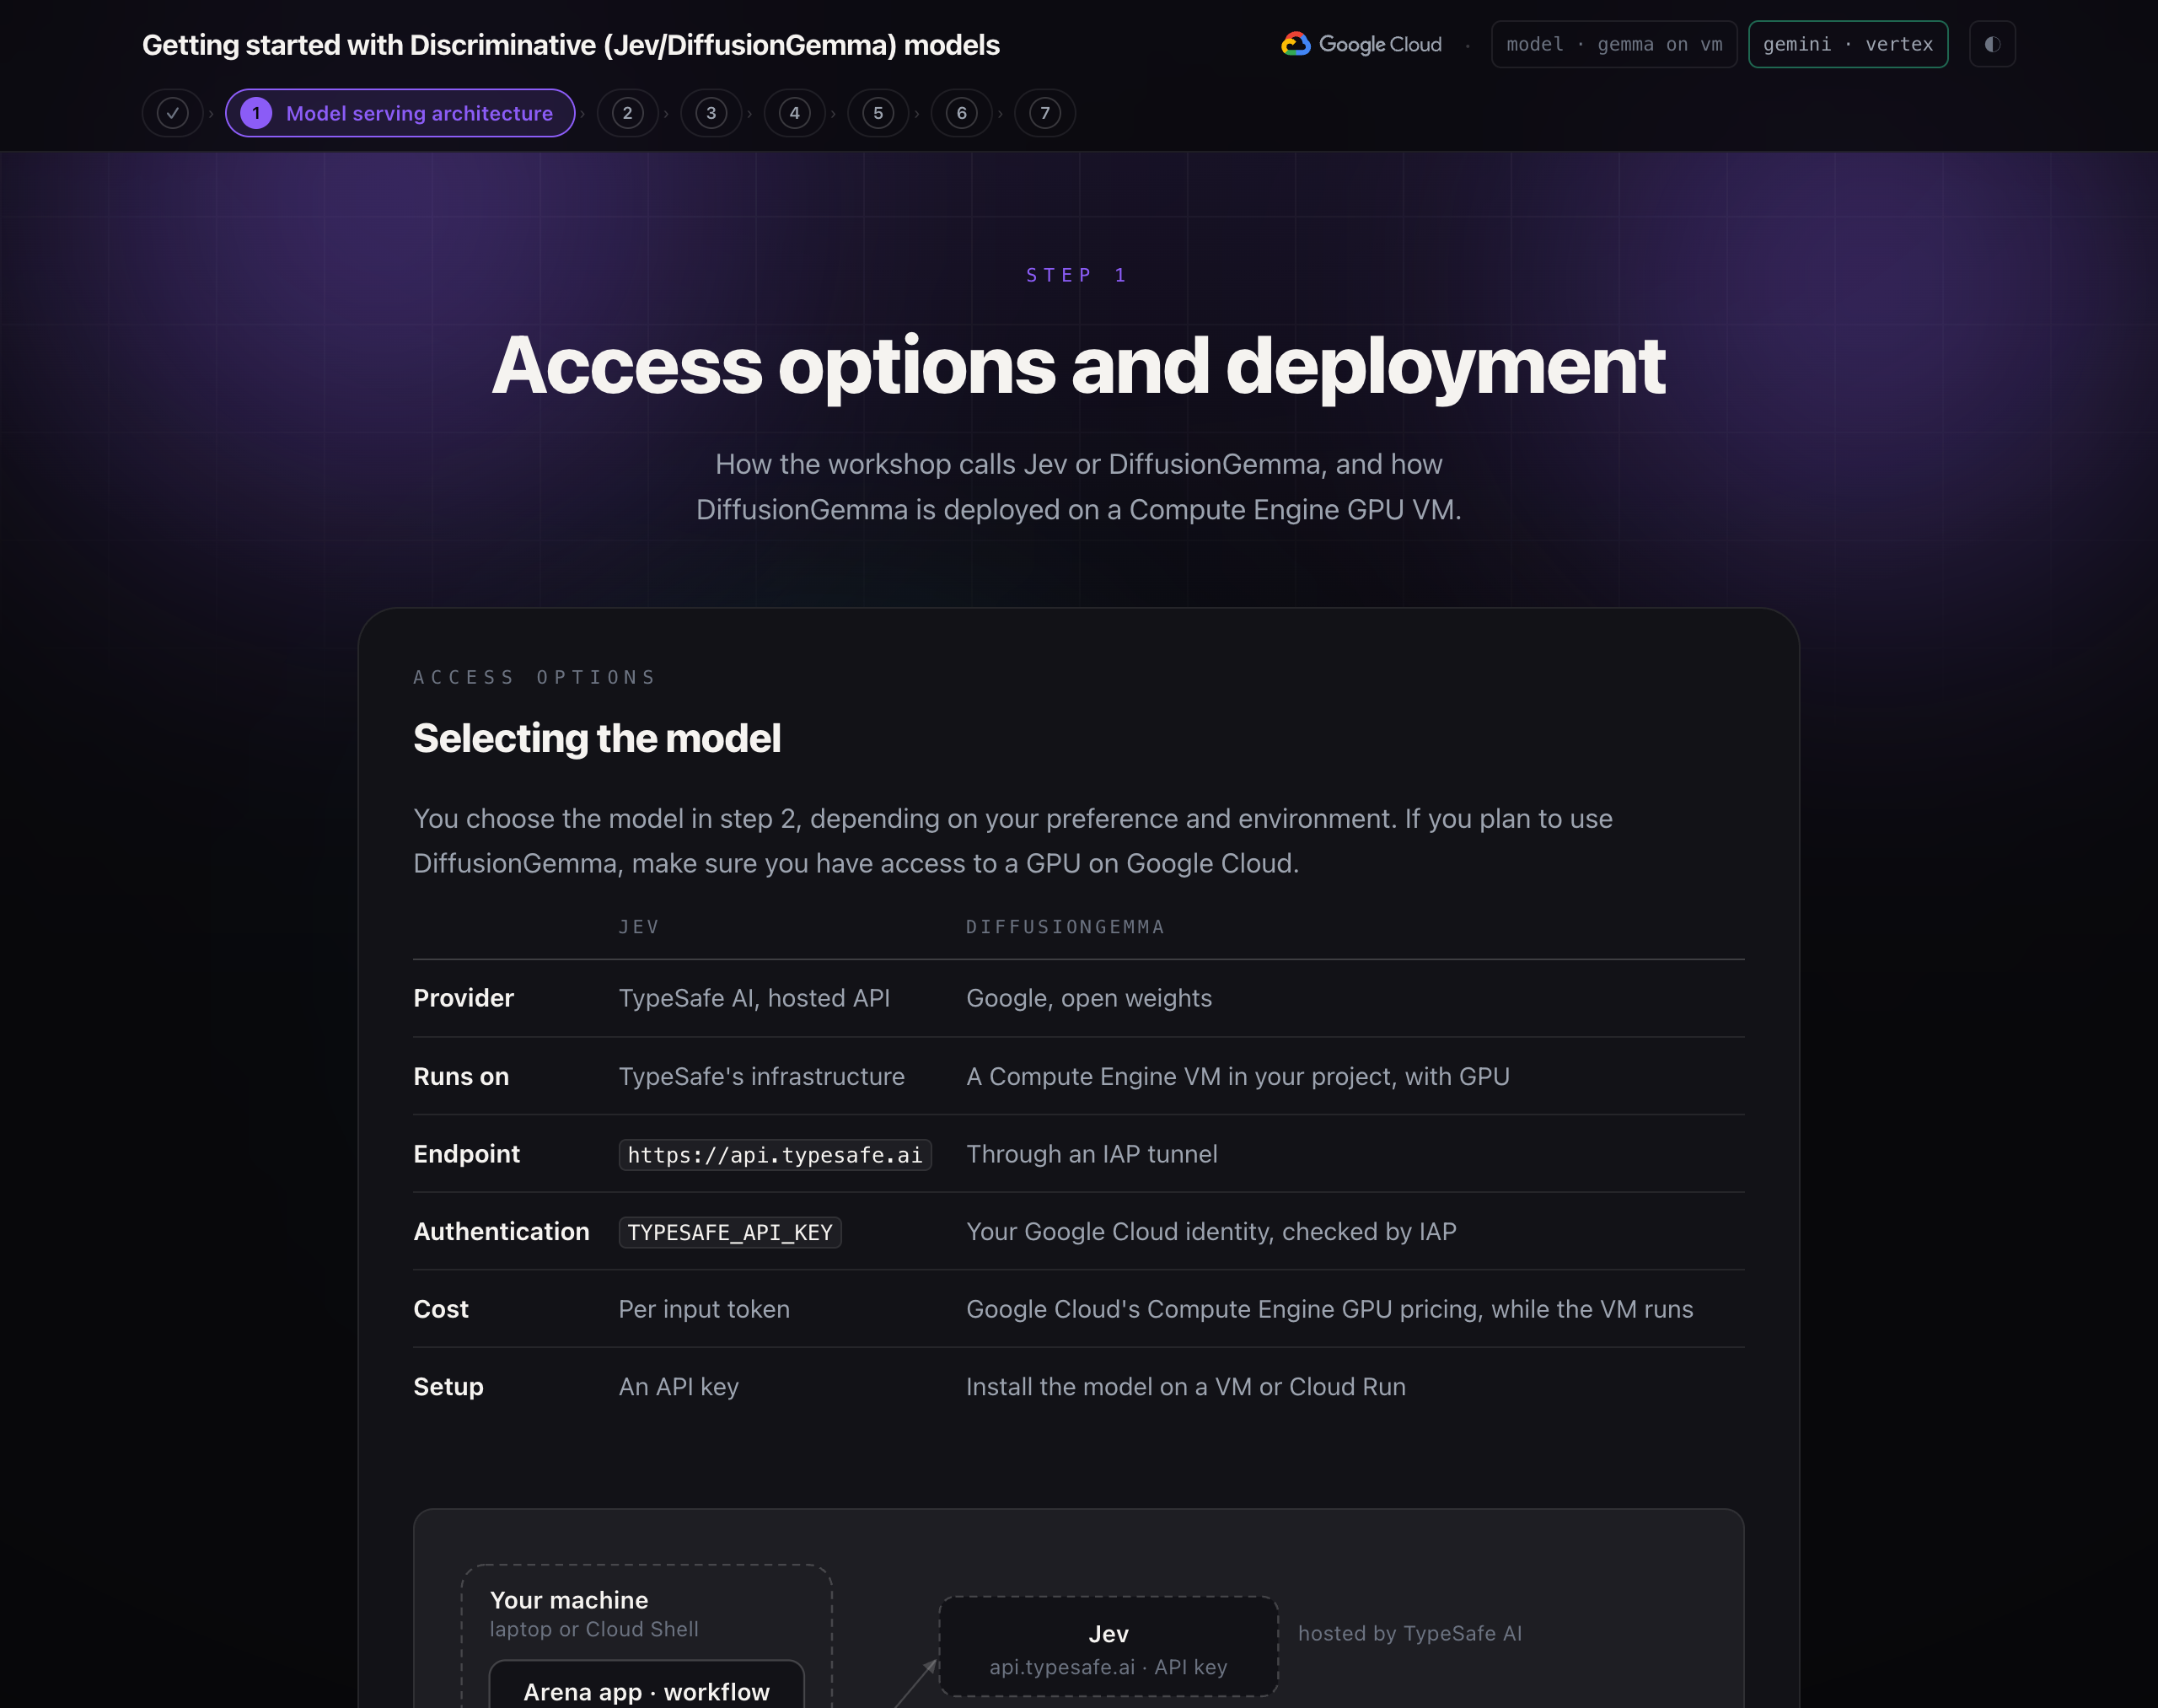
दूसरे चरण में, अपनी पसंद और एनवायरमेंट के हिसाब से मॉडल चुना जाता है. अगर आपको DiffusionGemma का इस्तेमाल करना है, तो पक्का करें कि आपके पास Google Cloud पर जीपीयू का ऐक्सेस हो.
जेव | DiffusionGemma | |
Provider | TypeSafe AI, होस्ट किया गया एपीआई | Google, ओपन वेट |
इस पर काम करता है | TypeSafe का इन्फ़्रास्ट्रक्चर | आपके प्रोजेक्ट में, जीपीयू के साथ Compute Engine वीएम |
एंडपॉइंट |
| IAP टनल के ज़रिए |
पुष्टि करना |
| आपकी Google Cloud पहचान की पुष्टि, IAP करता है |
लागत | हर इनपुट टोकन के लिए | Google Cloud के Compute Engine में जीपीयू की कीमत, जब वीएम चल रहा हो |
सेट अप | एपीआई पासकोड | वर्चुअल मशीन (वीएम) या Cloud Run पर मॉडल इंस्टॉल करना |
डेटा फ़्लो
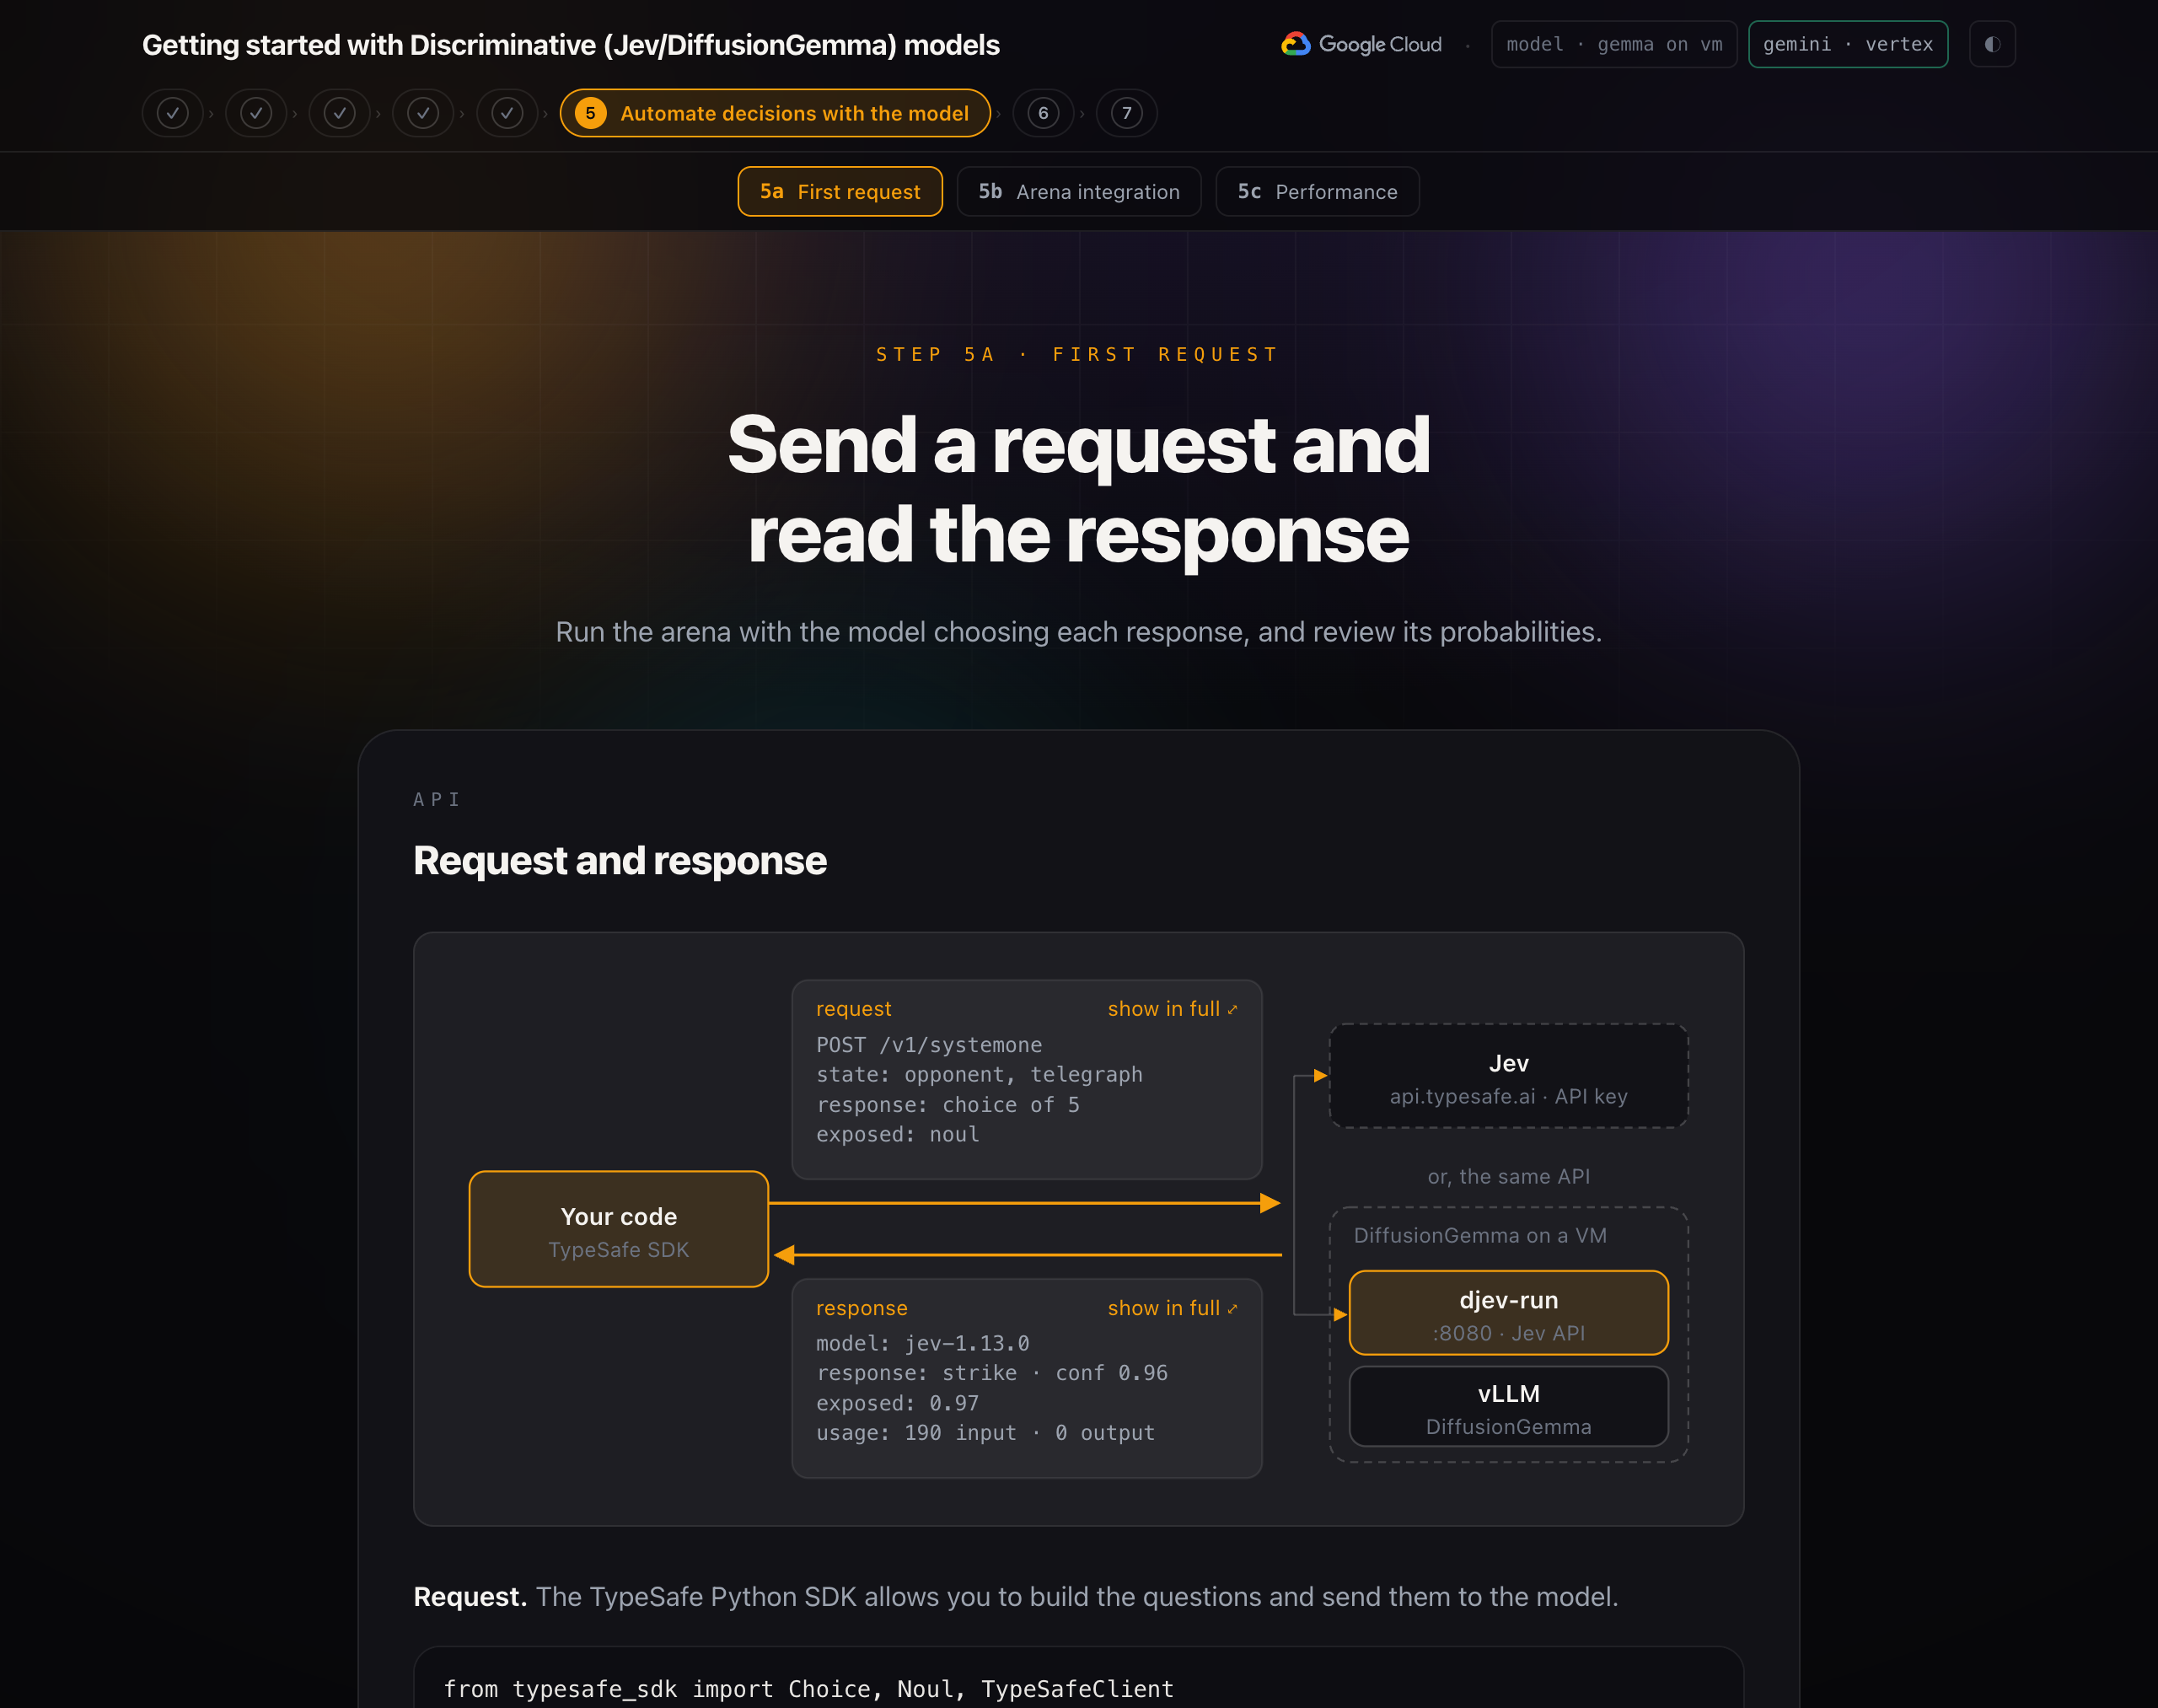
- अरीना ऐप्लिकेशन या एडीके वर्कफ़्लो, अनुरोध बनाता है: स्थिति (विरोधी ने क्या किया) और तीन सवाल.
- TypeSafe SDK टूल, इसे कॉन्फ़िगर किए गए बेस यूआरएल पर
POST /v1/systemoneके तौर पर भेजता है. - Jev के लिए, अनुरोध एचटीटीपीएस के ज़रिए
api.typesafe.aiपर जाता है. इसमें एपीआई पासकोड को बेयरर टोकन के तौर पर इस्तेमाल किया जाता है. - DiffusionGemma के लिए, अनुरोध
localhost:8096को भेजा जाता है. बैकग्राउंडgcloud compute start-iap-tunnelप्रोसेस, इसे Identity-Aware Proxy के ज़रिए VM पर पोर्ट 8080 पर फ़ॉरवर्ड करती है. यह प्रोसेस, आपकी Google पहचान की पुष्टि करती है. - वीएम पर, djev-run को अनुरोध मिलता है. इसके बाद, यह जीपीयू पर vLLM के ज़रिए DiffusionGemma को चलाता है. साथ ही, अनुमति वाले हर विकल्प की संभावना को पढ़ता है.
- दोनों बैकएंड एक जैसा जवाब देते हैं: हर सवाल का एक जवाब, जिसमें संभावनाओं और भरोसेमंद होने की रेटिंग शामिल होती है. वर्कशॉप का कोड, थ्रेशोल्ड लागू करता है और कार्रवाई करता है.
Compute Engine पर DiffusionGemma
scripts/setup_gemma.sh आपके प्रोजेक्ट में यह बनाता है:
- इस कुकी से यह पता चलता है कि किसी क्षेत्र में जीपीयू के लिए कोटा है या नहीं.
- यह Compute Engine और IAP API चालू करता है. साथ ही, फ़ायरवॉल का नियम
allow-iap-djevबनाता है. यह सिर्फ़ आईएपी पते की रेंज को पोर्ट 22 और 8080 पर अनुमति देता है. - यह वीएम बनाता है
djev-l4: मशीन टाइपg2-standard-4(4 vCPU, 16 जीबी मेमोरी), 24 जीबी वाला जीपीयू, 100 जीबी डिस्क, और NVIDIA ड्राइवर 580 के साथ Deep Learning VM इमेज. अगर किसी ज़ोन में जीपीयू की क्षमता नहीं है, तो यह अगले ज़ोन को आज़माता है. - पहली बार बूट करने पर, वीएम की स्टार्टअप स्क्रिप्ट, Docker और NVIDIA Container Toolkit इंस्टॉल करती है. साथ ही, djev-run कंटेनर इमेज को पुल करती है, Hugging Face से वेट डाउनलोड करती है (17.5 जीबी), और पोर्ट 8080 पर जीपीयू ऐक्सेस के साथ कंटेनर शुरू करती है. इसमें करीब 15 मिनट लगते हैं. बाद के बूट में करीब दो मिनट लगते हैं.
- यह कुकी,
.envमें कनेक्शन की सेटिंग लिखती है और टनल खोलती है.
टास्क | निर्देश |
वीएम को बंद करना (डिस्क को सेव रखना) |
|
इसे फिर से शुरू करो |
|
सुरंग की जांच करना |
|
सभी आइटम मिटाएं |
|
मॉडल सेट अप करना
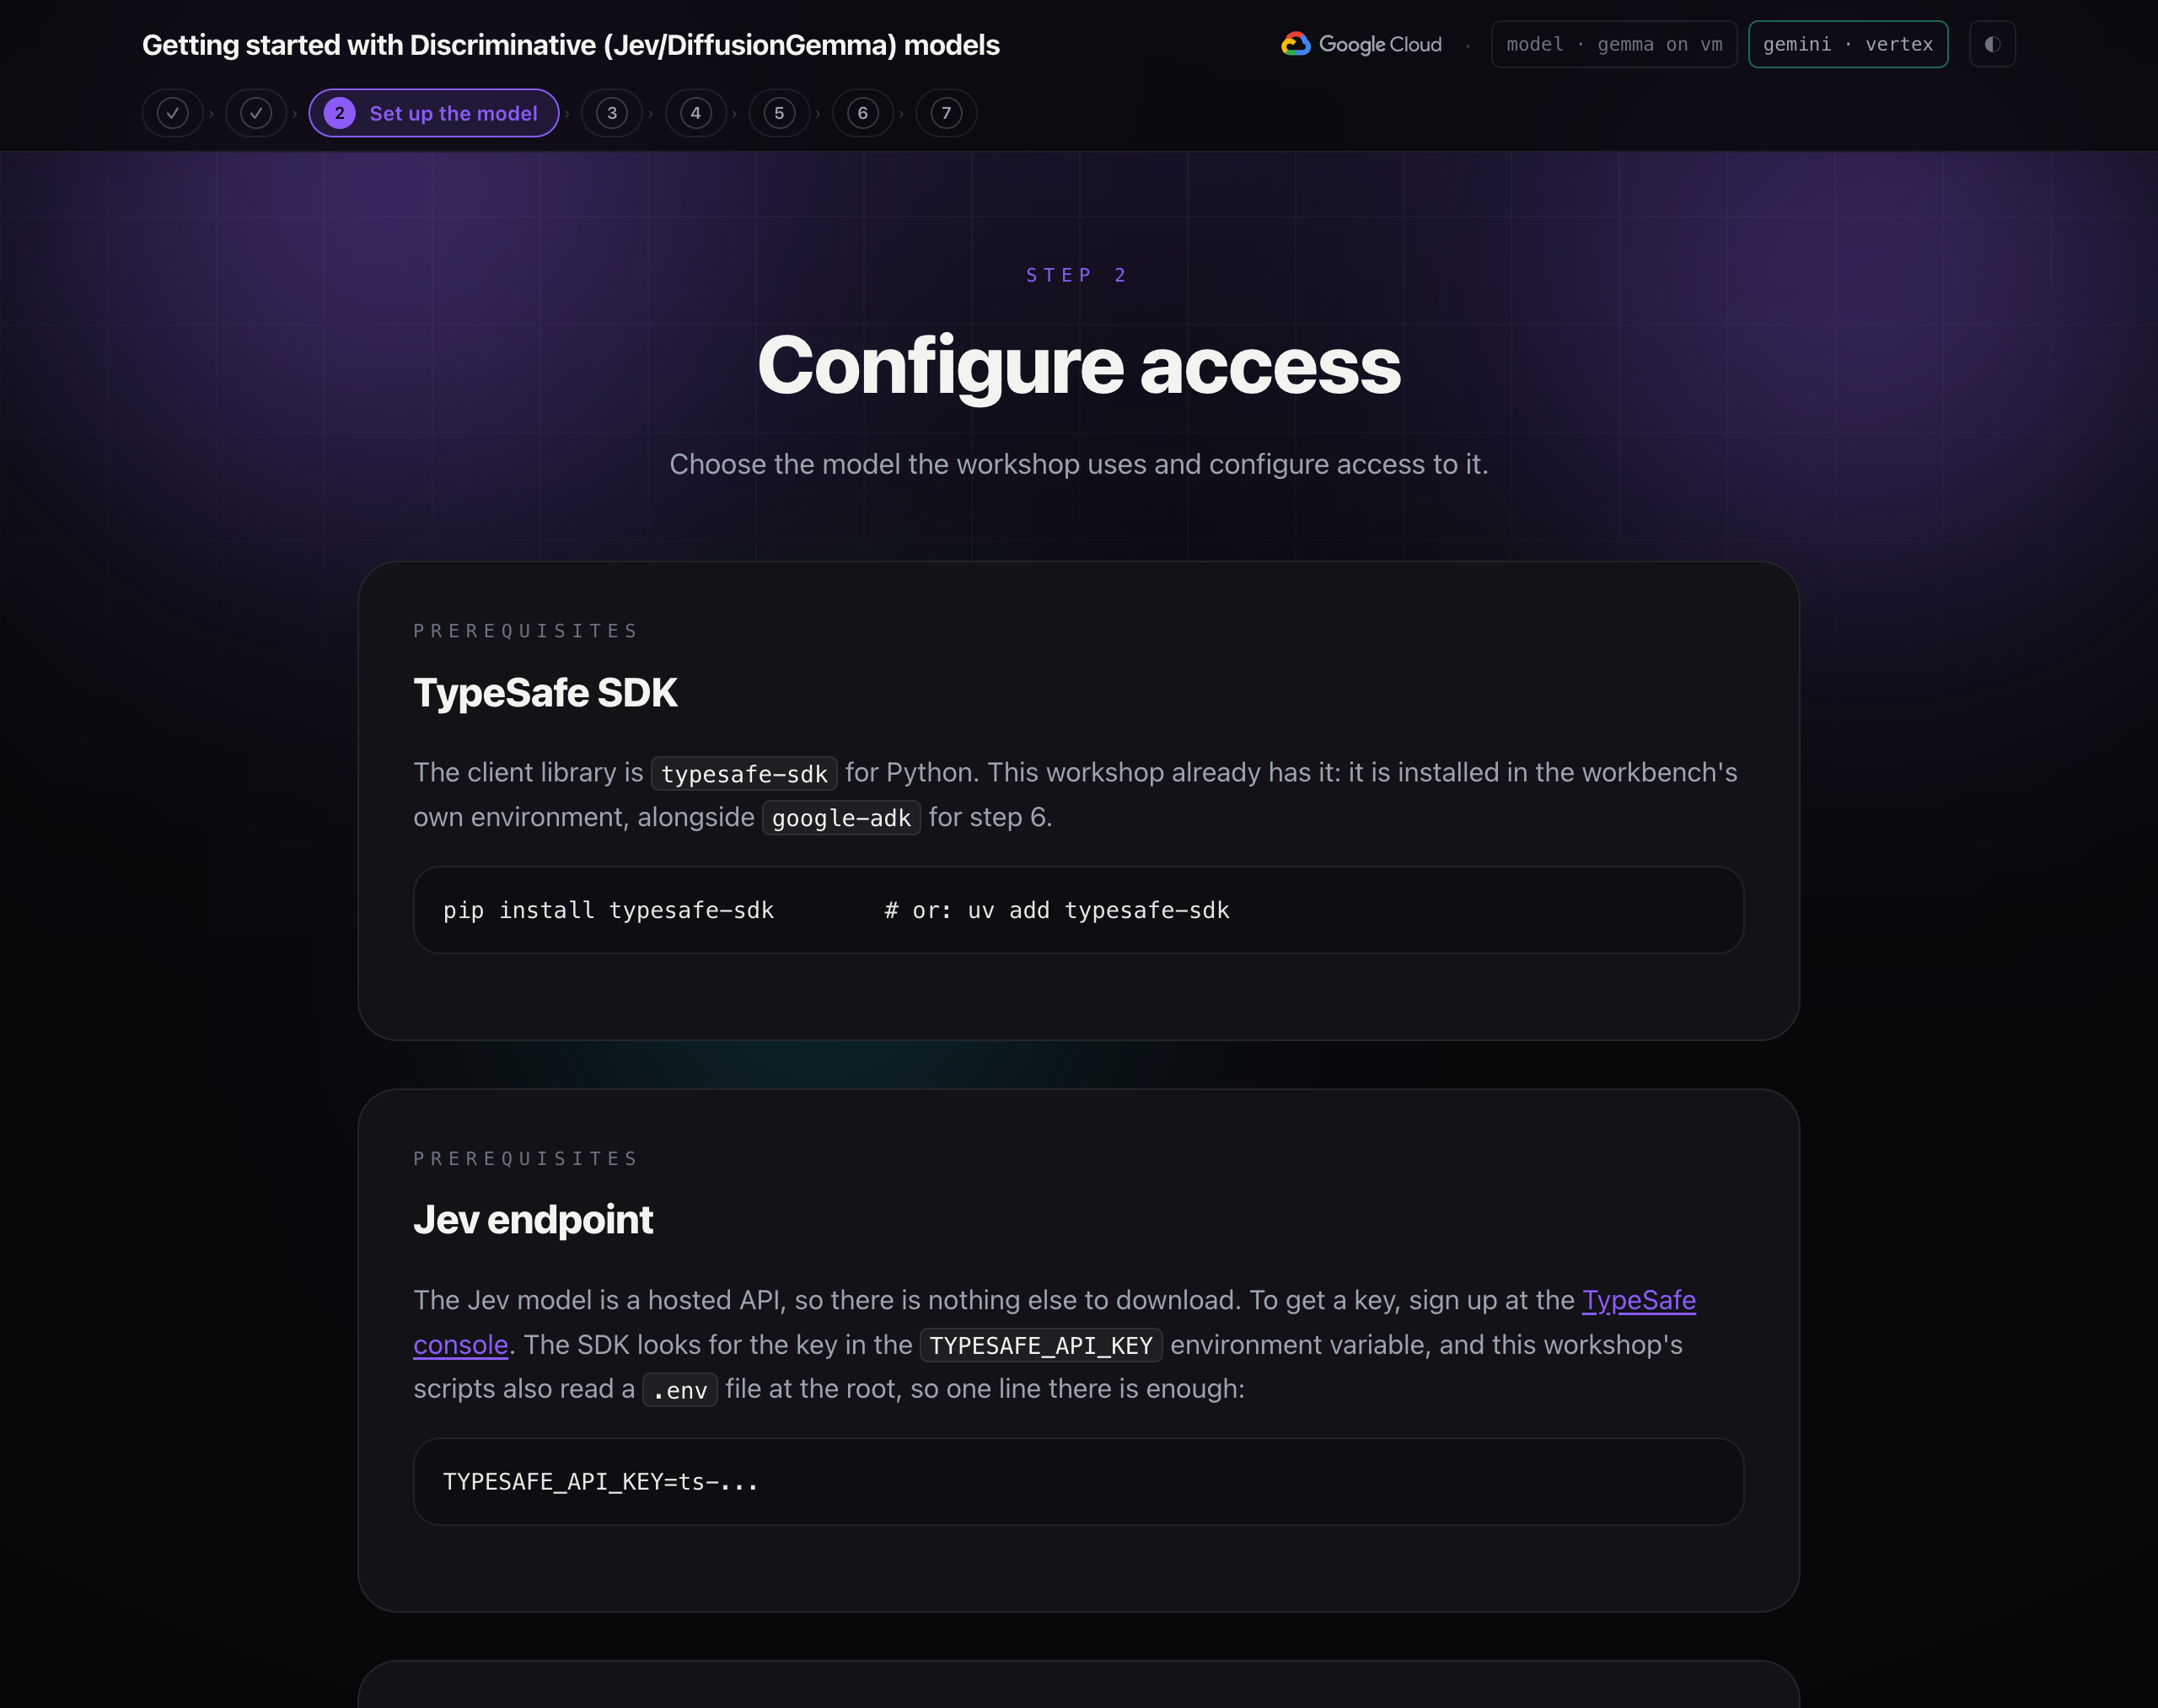
TypeSafe SDK
क्लाइंट लाइब्रेरी, Python के लिए typesafe-sdk है. इस वर्कशॉप में यह पहले से मौजूद है: यह वर्कबेंच के एनवायरमेंट में इंस्टॉल है. साथ ही, यह छठे चरण के लिए google-adk के साथ इंस्टॉल है.
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev एंडपॉइंट
Jev मॉडल एक होस्ट किया गया एपीआई है. इसलिए, इसे डाउनलोड करने की ज़रूरत नहीं है. कुंजी पाने के लिए, TypeSafe console पर साइन अप करें. एसडीके, TYPESAFE_API_KEY एनवायरमेंट वैरिएबल में मौजूद कुंजी को ढूंढता है. साथ ही, इस वर्कशॉप की स्क्रिप्ट भी रूट में मौजूद .env फ़ाइल को पढ़ती हैं. इसलिए, यहां एक लाइन काफ़ी है:
TYPESAFE_API_KEY=ts-...
DiffusionGemma का इस्तेमाल करना
djev-run, Discriminative मॉडल के एपीआई को फिर से लागू करता है. यह DiffusionGemma से, एक ही POST /v1/systemone एंडपॉइंट पर, एक ही noul, पसंद और स्कोर के सवाल दिखाता है. यह Google DeepMind का ओपन डिफ़्यूज़न मॉडल है. इसमें कुल 26 अरब पैरामीटर हैं, जिनमें से करीब 4 अरब पैरामीटर ऐक्टिव हैं. यह Apache 2.0 के तहत उपलब्ध है. वायर फ़ॉर्मैट एक जैसा होने की वजह से, TypeSafe SDK में कोई बदलाव नहीं होता.
अगर आपने इस गतिविधि में DiffusionGemma को चुना है, तो यह आपके Google Cloud प्रोजेक्ट में मौजूद वीएम के जीपीयू पर काम करेगा. साथ ही, सबसे ऊपर दाईं ओर मौजूद पिल में gemma on vm लिखा होगा. वर्कबेंच, इसे प्राइवेट IAP टनल के ज़रिए ऐक्सेस करता है. साथ ही, मॉडल का पोर्ट इंटरनेट के लिए खुला नहीं होता. पहले चरण में, पूरे आर्किटेक्चर के बारे में बताया गया है.
डिफ़्यूज़न मॉडल ऐसा क्यों कर सकता है: यह एक बार में पूरे ब्लॉक की पोज़िशन भर देता है. हर पोज़िशन में पूरा इनपुट दिखता है, इसलिए अनुमति वाले हर विकल्प की संभावना को एक ही चरण में पढ़ा जा सकता है. सामान्य लैंग्वेज मॉडल, एक बार में एक टोकन बनाता है. इसलिए, इसे बार-बार सैंपल करना पड़ता है.
गेम को मैन्युअल तरीके से खेलना
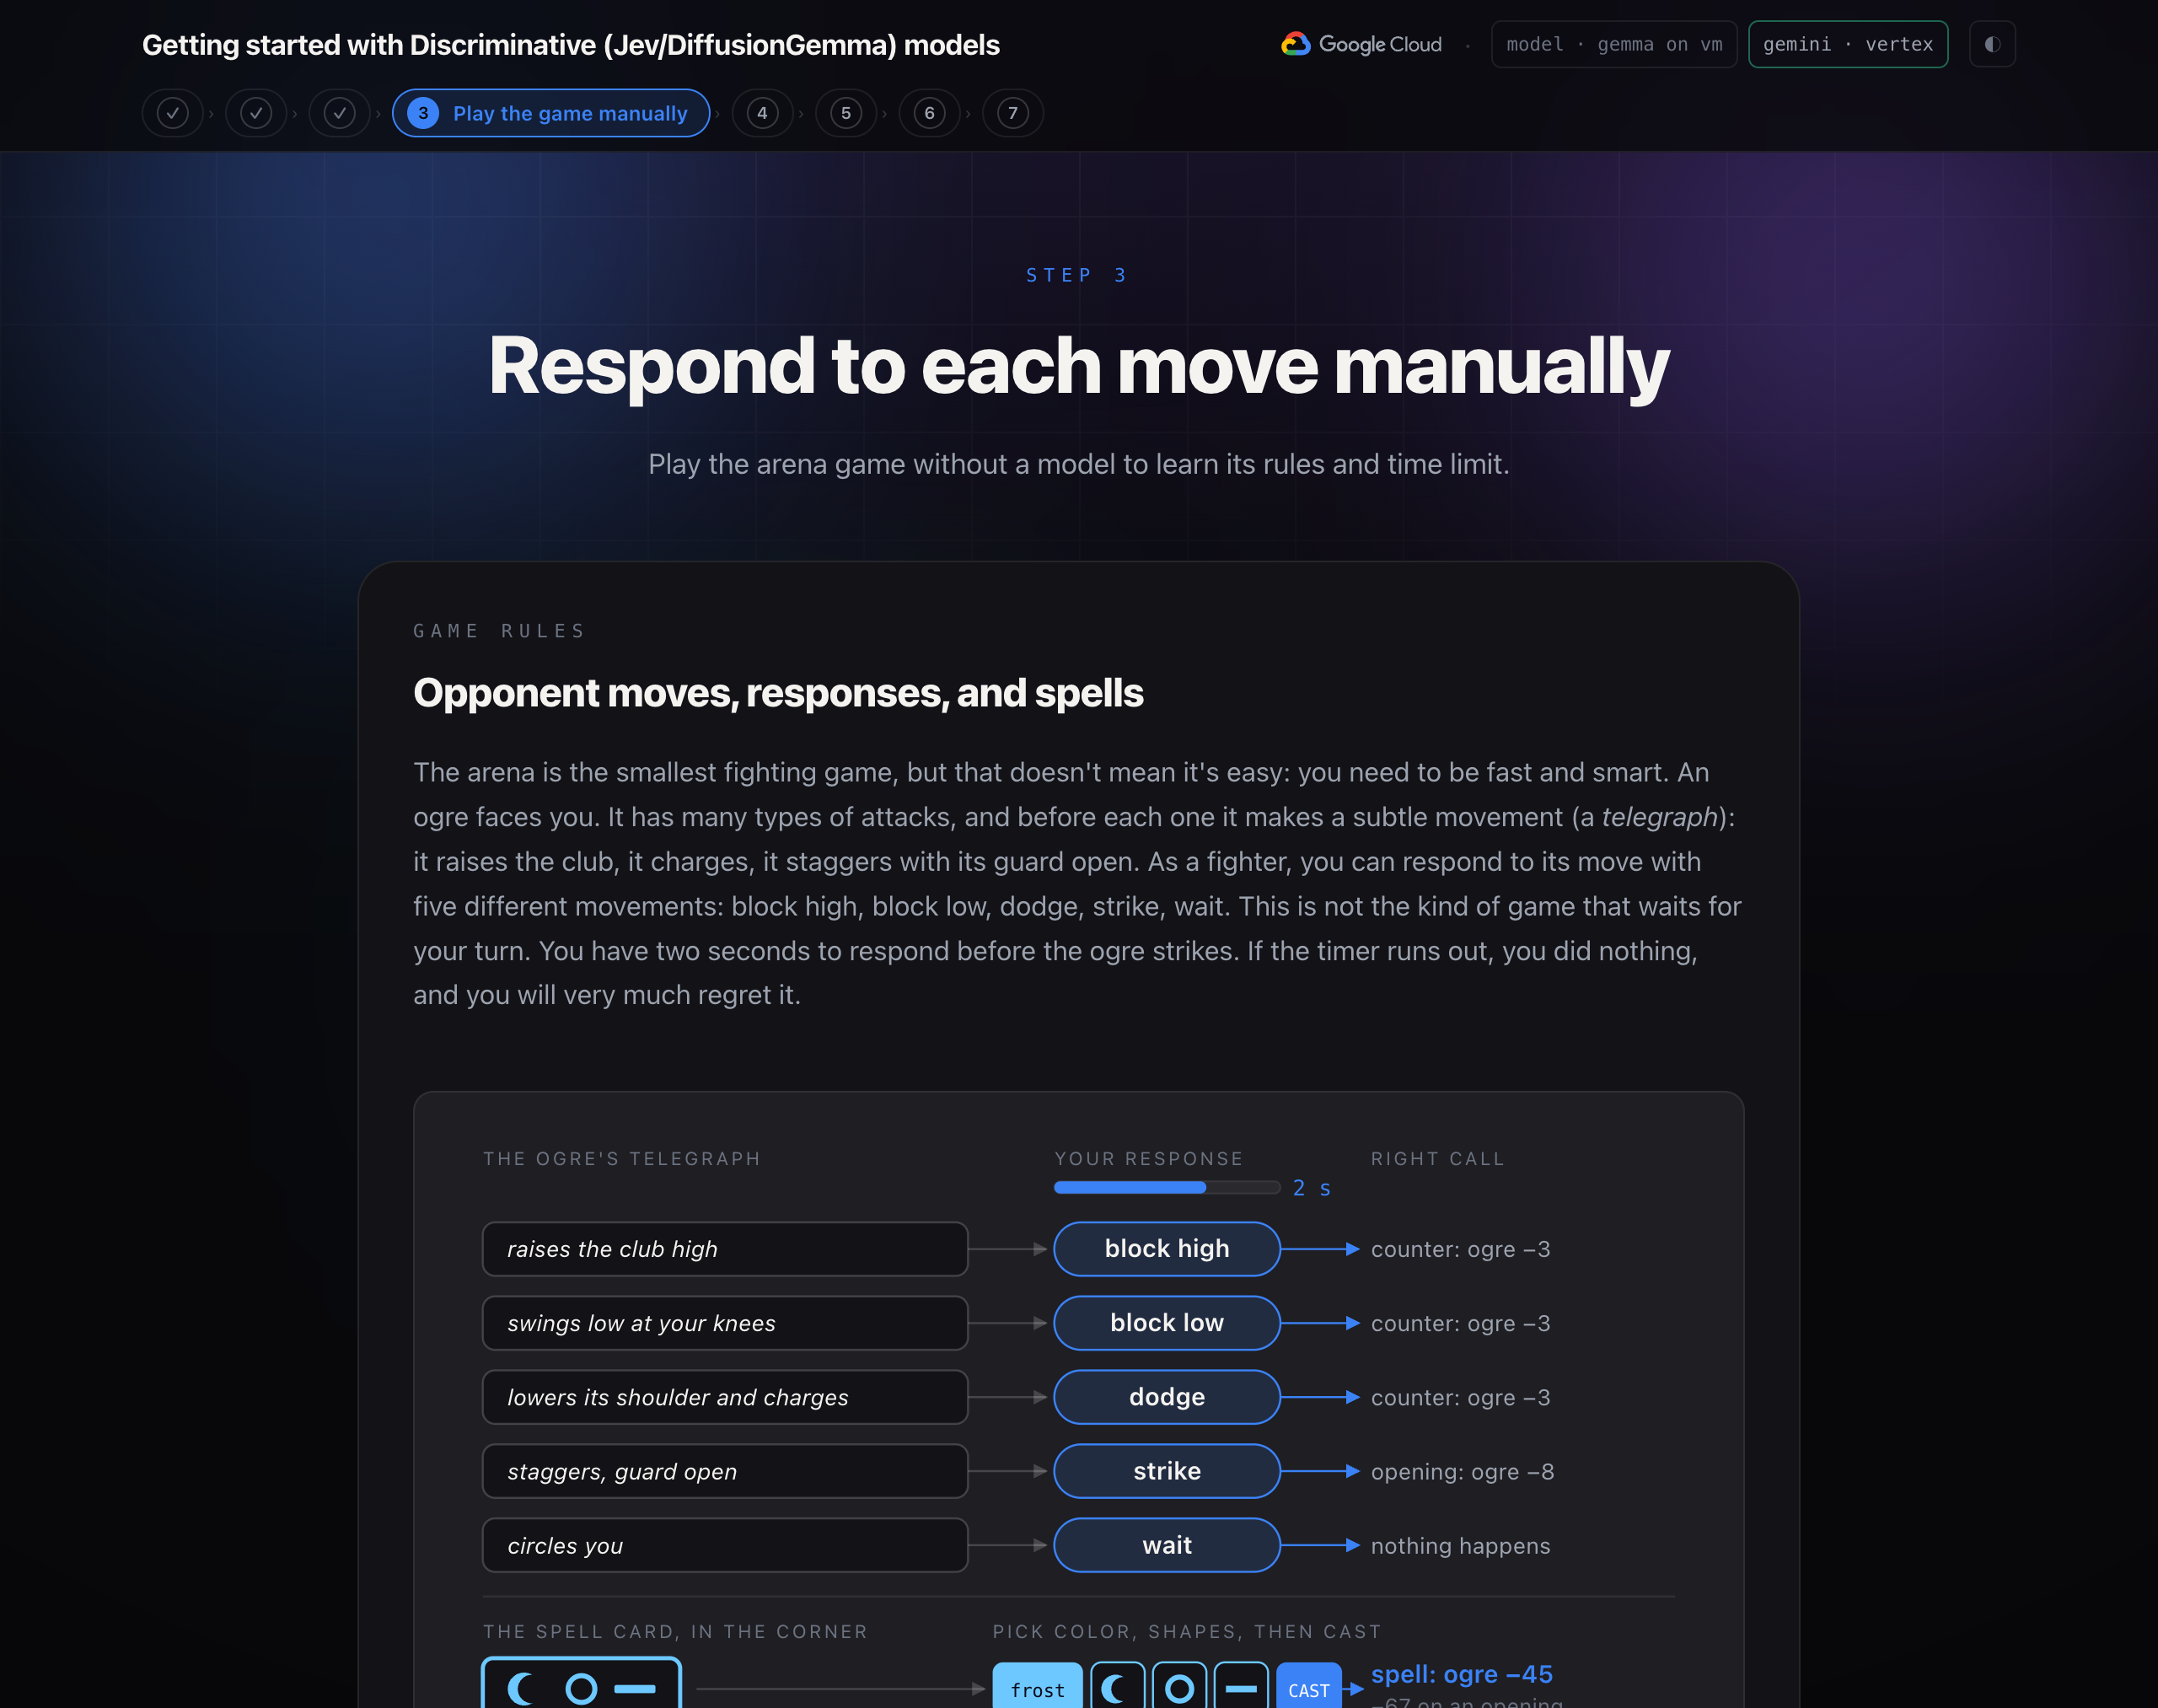
अरीना, सबसे छोटा लड़ाई वाला गेम है. हालांकि, इसका मतलब यह नहीं है कि इसे खेलना आसान है: आपको तेज़ और स्मार्ट होना होगा. एक राक्षस आपकी ओर देख रहा है. यह कई तरह के हमले करता है. हर हमले से पहले, यह थोड़ा हिलता है (टेलीग्राफ़): यह क्लब को ऊपर उठाता है, चार्ज करता है, और गार्ड को खुला रखता है. फ़ाइटर के तौर पर, उसके मूव का जवाब पांच अलग-अलग तरीकों से दिया जा सकता है: ऊपर से ब्लॉक करना, नीचे से ब्लॉक करना, चकमा देना, हमला करना, इंतज़ार करना. यह ऐसा गेम नहीं है जिसमें आपको अपनी बारी का इंतज़ार करना पड़े. राक्षस के हमला करने से पहले, आपके पास जवाब देने के लिए दो सेकंड का समय होता है. अगर टाइमर खत्म हो जाता है और आपने कोई कार्रवाई नहीं की, तो आपको इसका अफ़सोस होगा.
रिंग के सबसे ऊपर बाएं कोने में, स्पेल कार्ड है: यह तीन शेप वाला रंगीन कार्ड है. सिर्फ़ इससे मेल खाने वाला स्पेल ही इसे नुकसान पहुंचा सकता है. गेम में, लड़ाई के दौरान बटन की मदद से जादू किया जा सकता है: कार्ड का रंग चुनें. इसके बाद, बाईं से दाईं ओर उसके आकार चुनें. इसके बाद, CAST दबाएं. कार्ड चुनने के दौरान टाइमर चलता रहता है. इसलिए, आपको एक ही समय में स्पेल बनाना होता है और ओगर के हमलों का जवाब देना होता है. अब भी 1 से 5 तक की कुंजियों से हर चाल का जवाब दिया जा सकता है. गलत स्पेल फ़िज़ल हो जाता है. छठे चरण में, Gemini आपके लिए स्पेल कार्ड पढ़ता है.
अहम जानकारी: लड़ाई में, छोटे-छोटे फ़ैसले लेने होते हैं. हर फ़ैसले के लिए समयसीमा तय होती है. ज़्यादातर सॉफ़्टवेयर ऑटोमेशन ऐसे ही काम करते हैं. हालांकि, इनमें क्लब की सुविधा नहीं होती.
भेदभाव करने वाले मॉडल के कॉन्सेप्ट
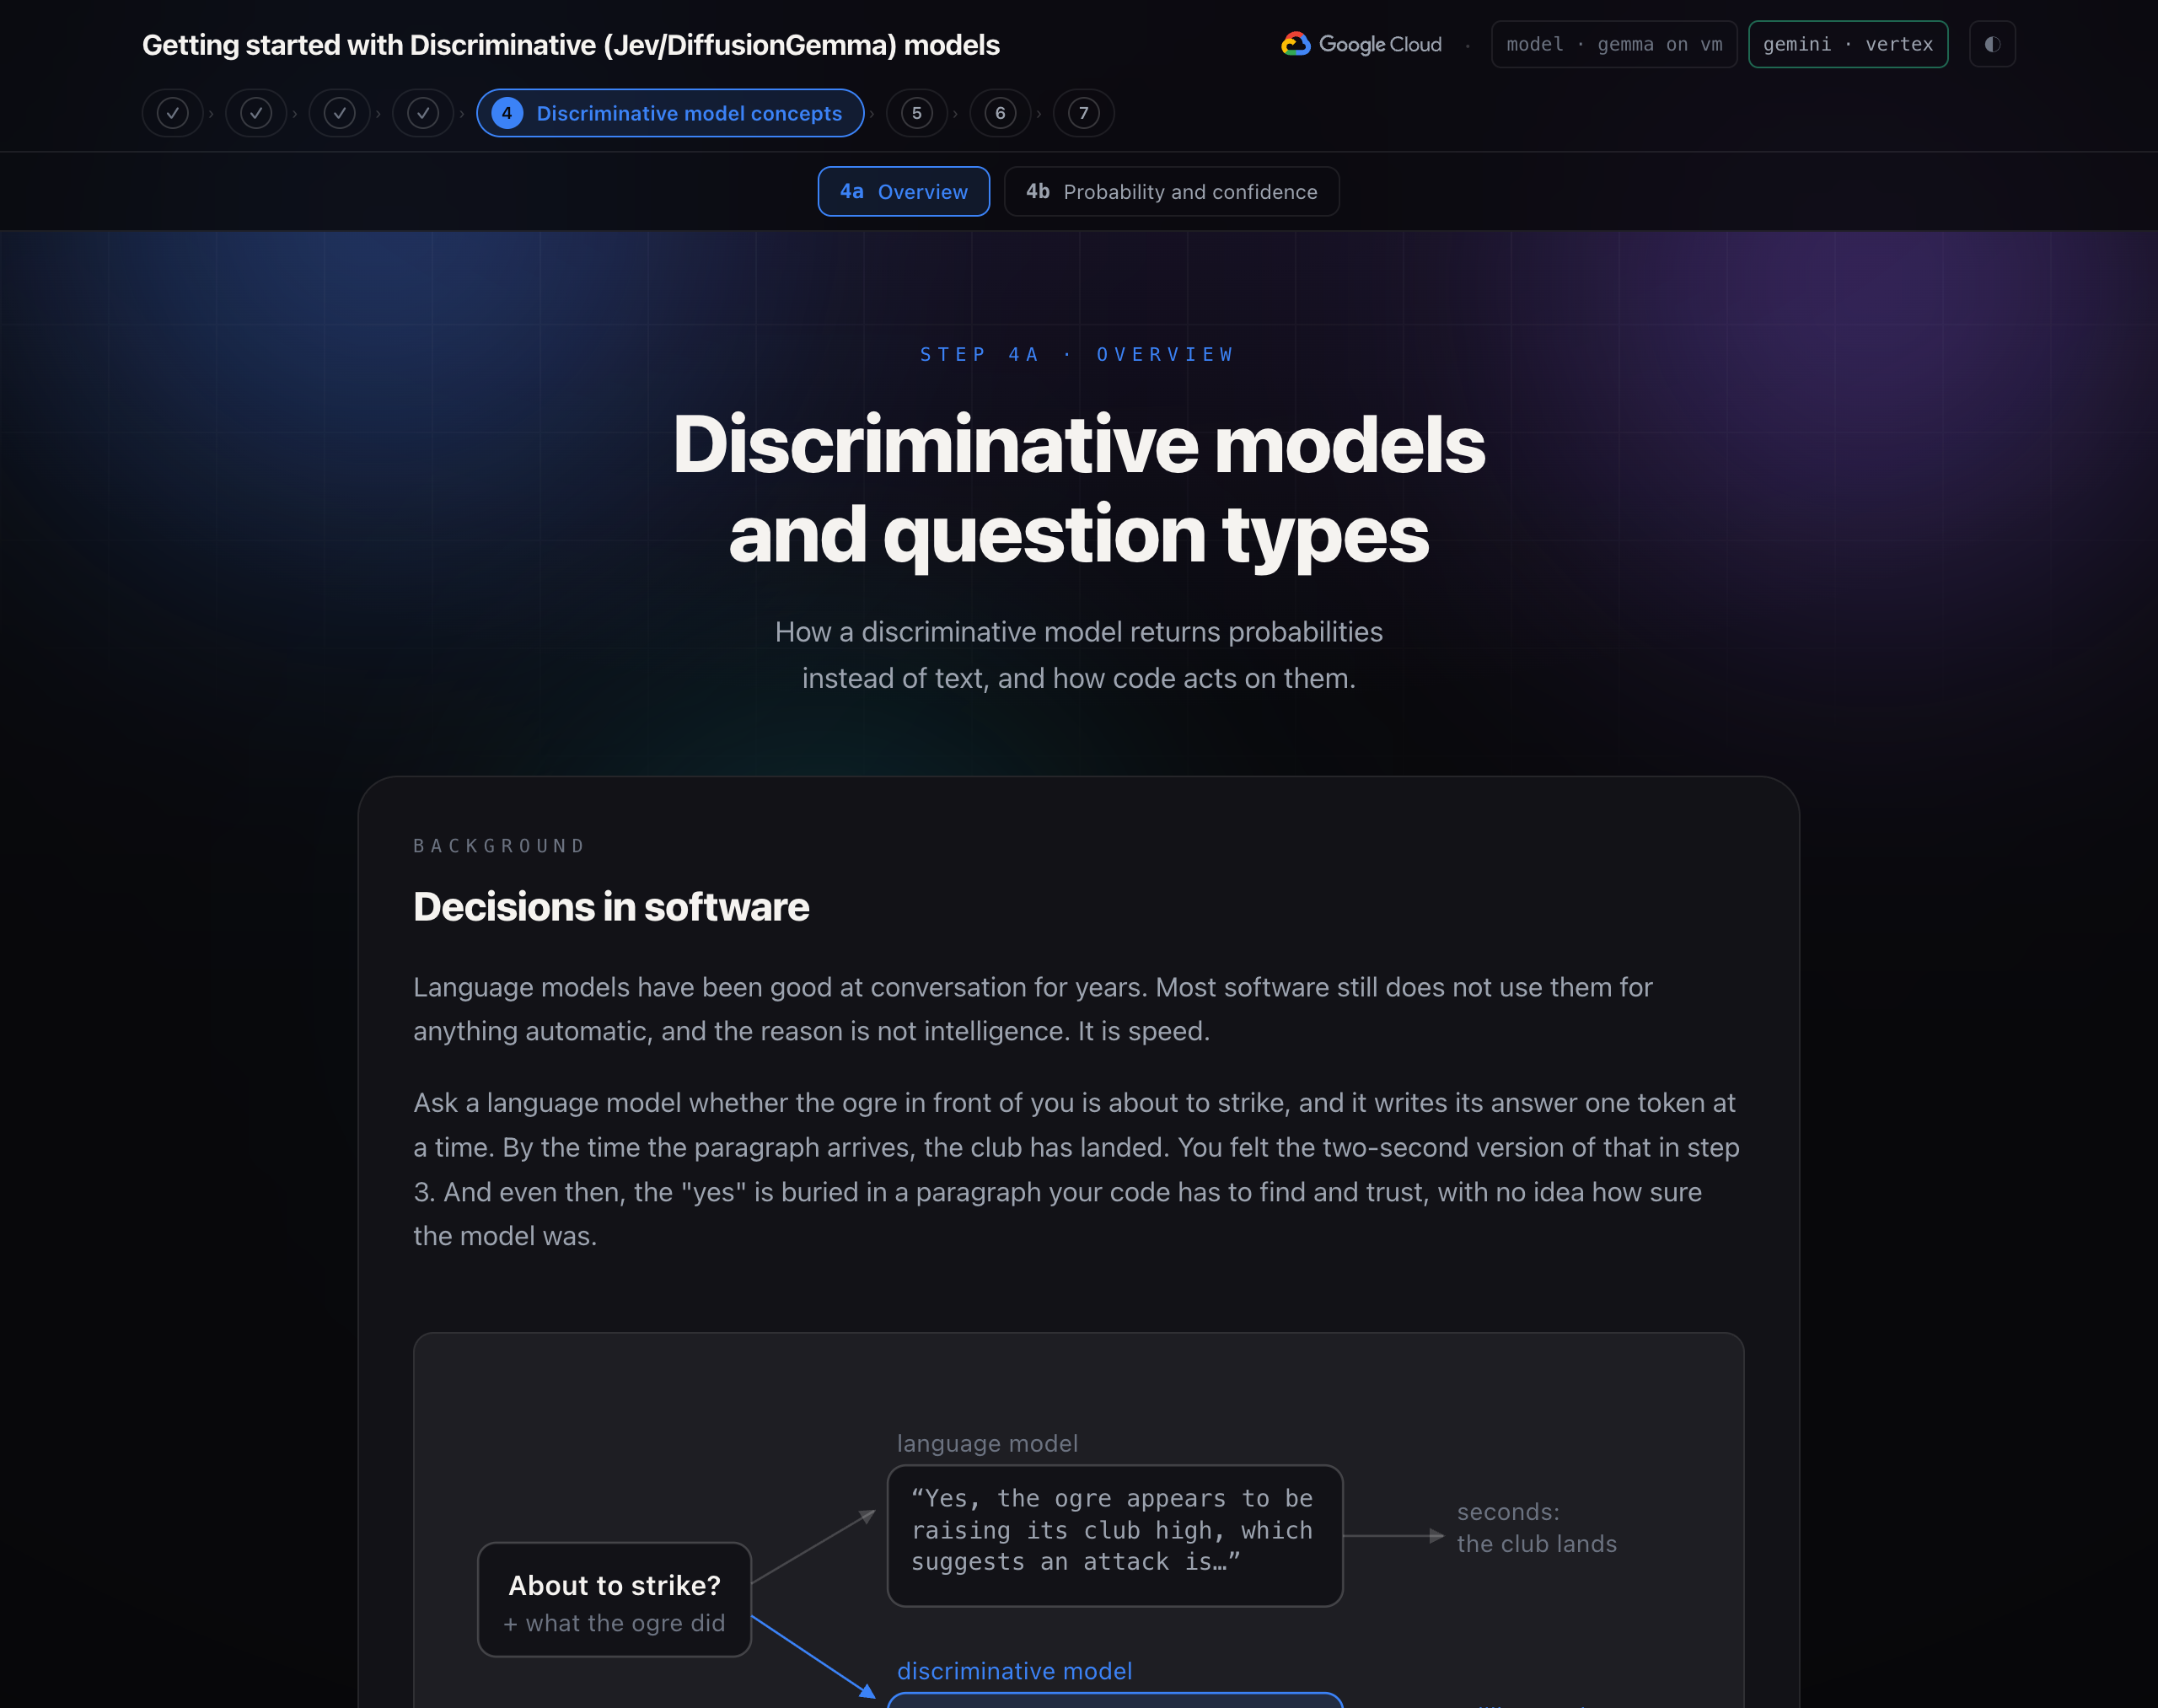
सॉफ़्टवेयर में फ़ैसले
लैंग्वेज मॉडल, सालों से बातचीत करने में बेहतर रहे हैं. ज़्यादातर सॉफ़्टवेयर अब भी इनका इस्तेमाल किसी भी काम को अपने-आप करने के लिए नहीं करते हैं. इसकी वजह, एआई नहीं है. यह स्पीड है.
किसी लैंग्वेज मॉडल से पूछें कि क्या आपके सामने खड़ा राक्षस हमला करने वाला है. इसके बाद, वह एक-एक टोकन करके जवाब लिखता है. पैराग्राफ़ के आने तक, क्लब की इमेज दिख जाती है. आपको तीसरे चरण में, दो सेकंड के लिए ऐसा ही महसूस हुआ. इसके बाद भी, "हां" जवाब एक पैराग्राफ़ में छिपा होता है. आपके कोड को इसे ढूंढना होता है और इस पर भरोसा करना होता है. हालांकि, यह पता नहीं होता कि मॉडल को इस जवाब के सही होने का कितना भरोसा है.
डिस्क्रिमिनेटिव मॉडल, स्टेट और टाइप किए गए आपके सवालों और जवाबों को एक बार में ही प्रोसेस कर लेता है. इसमें कुछ मिलीसेकंड लगते हैं. हर जवाब के साथ, कैलिब्रेट की गई संभावना दी जाती है. 0.9 का मतलब है कि जवाब दस में से नौ बार सही है. पार्स करने के लिए कोई टेक्स्ट नहीं है और न ही इसमें से कोई JSON निकाला जा सकता है.
System One और System Two मॉडल
यह नाम, डैनियल काह्नमैन की किताब थिंकिंग, फ़ास्ट ऐंड स्लो से लिया गया है. सिस्टम टू, धीरे-धीरे और सोच-समझकर काम करता है. यह एक के बाद एक चरण में काम करता है. सिस्टम वन तेज़ी से काम करता है और पैटर्न मैच करता है.
लैंग्वेज मॉडल, सिस्टम टू मशीन है. यह एक बार में एक टोकन के हिसाब से तर्क देता है. भेदभाव करने वाला मॉडल, सिस्टम वन मॉडल है: यह ज़ोर से तर्क नहीं देता, कुछ भी जनरेट नहीं करता, और हर सवाल का जवाब एक ही बार में देता है. इसलिए, यह तेज़ी से काम करता है (लगभग 70 से 500 मिलीसेकंड) और सस्ता है (हर हज़ार फ़ैसलों के लिए एक सेंट से भी कम).
मुख्य जानकारी: भाषा मॉडल लिखता है. फ़ैसला, डिसिजन मॉडल के आधार पर लिया जाता है. सॉफ़्टवेयर को एआई से ज़्यादातर मामलों में, सिर्फ़ फ़ैसले लेने में मदद चाहिए होती है.
सीमाएं
भेदभाव करने वाला मॉडल, न तो टेक्स्ट जनरेट करेगा, न कोड लिखेगा, न बातचीत करेगा, न अंकगणित करेगा, न इमेज पढ़ेगा, और न ही चरणों की एक सीरीज़ का पालन करेगा.
वर्कशॉप में, हम भेदभाव करने वाले मॉडल में से किसी एक को चुनेंगे:
- डिस्क्रिमिनेटिव मॉडल में से एक Jev है. यह TypeSafe AI का होस्ट किया गया एपीआई है. इसे सितंबर 2026 में रिलीज़ किया गया था. पहला मॉडल
jev-1.13है, जिसेjev-latestके ज़रिए ऐक्सेस किया जाता है. पब्लिश किए गए कोई भी वेट मौजूद नहीं हैं. इसलिए, इसे डाउनलोड नहीं किया जाता, बल्कि कॉल किया जाता है. - System One मॉडल पाने का सिर्फ़ एक तरीका Jev नहीं है. Google का DiffusionGemma एक ओपन-वेट मॉडल है. यह एक बार में एक टोकन लिखने के बजाय, एक साथ पूरे ब्लॉक के टोकन लिखता है. साथ ही, एक साथ कई विकल्पों की संभावनाओं को पढ़ सकता है. djev-run जैसे ओपन-सोर्स सर्वर, Jev के सटीक एपीआई को सबसे ऊपर रखते हैं. इसलिए, इस वर्कशॉप में मौजूद सभी चीज़ें, बिना किसी बदलाव के इसके साथ काम करती हैं.
स्टेट और सवाल: Choice, Score, और Noul
हर कॉल में स्थिति और सवाल भेजे जाते हैं. स्टेट वह टेक्स्ट होता है जिसके बारे में आपको फ़ैसला चाहिए. यह स्ट्रिंग, JSON ऑब्जेक्ट या सूची हो सकती है. इन सवालों में पूछा जाता है कि आपको उस टेक्स्ट के बारे में क्या जानना है. हर सवाल का एक टाइप होता है: विकल्प, स्कोर या नोल. इन सवालों को एक साथ प्रोसेस किया जाता है. इससे, यह तेज़ी से जवाब दे पाता है. अगर ज़रूरी हो, तो एक से ज़्यादा सवाल जोड़े जा सकते हैं.
- Choice फ़ंक्शन, आपके दिए गए सेट में से कोई एक विकल्प चुनता है. इस सेट में ज़्यादा से ज़्यादा 255 विकल्प हो सकते हैं. जवाब में विकल्प, हर विकल्प के लिए संभावना, और कॉन्फ़िडेंस शामिल होता है. इसका इस्तेमाल तब करें, जब विकल्पों के बीच कोई क्रम न हो: ब्लॉक हाई, ब्लॉक लो, चकमा देना, हमला करना, इंतज़ार करना.
- स्कोर, आपके बताए गए क्रम के हिसाब से स्थिति को रेटिंग देता है. यह रेटिंग दो से लेकर दस तक हो सकती है. जवाब में स्केल के साथ-साथ एक डेसिमल वैल्यू (जैसे, 1.4 का मतलब है "एक और दो के बीच, एक के ज़्यादा करीब"), हर लेवल की संभावना, और कॉन्फ़िडेंस स्कोर शामिल होता है. इसका इस्तेमाल तब करें, जब जवाब में डिग्री का अंतर हो. जैसे, आने वाली गेंद कितनी तेज़ी से आएगी.
- Choice और Score, दोनों ही हर विकल्प के लिए संभावना और कॉन्फ़िडेंस दिखाते हैं. मुख्य जवाब में अंतर है. Choice, सबसे सही विकल्प दिखाता है. स्कोर, विकल्पों को क्रम से लगाए गए लेवल के तौर पर देखता है. साथ ही, उनकी संभावना के हिसाब से औसत स्कोर दिखाता है. यह स्कोर दो लेवल के बीच में हो सकता है. किसी भी विकल्प को 0.05, हल्के को 0.55, और ज़्यादा को 0.40 का स्कोर देने पर, 'विकल्प' के तौर पर "हल्का" जवाब मिलता है. वहीं, 'स्कोर' के तौर पर 1.35 जवाब मिलता है, जो हल्के और ज़्यादा के बीच का स्कोर है. अखाड़ा उस वैल्यू का इस्तेमाल करता है:
choose(), 1.5 या इससे ज़्यादा के डेंजर स्कोर को गंभीर हिट मानता है.
- Choice और Score, दोनों ही हर विकल्प के लिए संभावना और कॉन्फ़िडेंस दिखाते हैं. मुख्य जवाब में अंतर है. Choice, सबसे सही विकल्प दिखाता है. स्कोर, विकल्पों को क्रम से लगाए गए लेवल के तौर पर देखता है. साथ ही, उनकी संभावना के हिसाब से औसत स्कोर दिखाता है. यह स्कोर दो लेवल के बीच में हो सकता है. किसी भी विकल्प को 0.05, हल्के को 0.55, और ज़्यादा को 0.40 का स्कोर देने पर, 'विकल्प' के तौर पर "हल्का" जवाब मिलता है. वहीं, 'स्कोर' के तौर पर 1.35 जवाब मिलता है, जो हल्के और ज़्यादा के बीच का स्कोर है. अखाड़ा उस वैल्यू का इस्तेमाल करता है:
- Noul, हाँ/नहीं में जवाब देने वाला सवाल पूछता है और जवाब के 'हाँ' होने की संभावना दिखाता है. 1 के आस-पास का स्कोर, "हाँ" के लिए मज़बूत स्कोर होता है. 0 के आस-पास का स्कोर, "नहीं" के लिए मज़बूत स्कोर होता है. 0.5 के आस-पास का स्कोर, "हाँ या नहीं, कुछ भी हो सकता है" के लिए मज़बूत स्कोर होता है. इसमें कोई अलग कॉन्फ़िडेंस नहीं होता, क्योंकि संभावना ही इसका कॉन्फ़िडेंस लेवल होती है.
फ़ोकस किए गए सवाल लिखना
भेदभाव करने वाला मॉडल, सबसे सही तरीके से तब काम करता है, जब किसी सवाल में एक खास और सीमित जानकारी मांगी गई हो. "क्या स्थिति है?" सवाल का जवाब, भरोसेमंद नहीं है. "सही जवाब क्या है?", "क्या विरोधी टीम के खिलाड़ी खुले में हैं?" और "यह हिट कितनी मुश्किल होगी?" सवालों के जवाब में, तीन ऐसे जवाब मिलते हैं जिन्हें आपका कोड एक साथ जोड़ता है.
विकल्पों और लेवल के बारे में दी गई जानकारी कम शब्दों में होनी चाहिए और काम की होनी चाहिए. तीसरे चरण में पढ़े गए नियम, विकल्प के ब्यौरे बन जाते हैं: block_high: "Raise the shield. Right against an overhead or a high swing." इस तरह, डिसक्रिमिनेटिव मॉडल, अनुरोध के समय लड़ाई के नियमों को सीखता है. हर नियम को एक लाइन में लिखा जाता है. हालात के हिसाब से विकल्प बदल सकते हैं: जब कोई स्पेल तैयार होता है, तब अरीना सिर्फ़ cast का विकल्प देता है.
संभाव्यताएं और कॉन्फ़िडेंस
विकल्प वाला जवाब, लेबल नहीं होता. यह लेबल के हिसाब से डिस्ट्रिब्यूशन है. इसमें सबसे लंबा बार, लेबल होता है.
मॉडल को नंबर कैसे मिलता है. यह उसी तरीके का इस्तेमाल करता है जिसका इस्तेमाल कोई लैंग्वेज मॉडल, अगले शब्द को चुनने के लिए करता है. ट्रांसफ़ॉर्मर, टेक्स्ट को पढ़ता है. इसके बाद, एक पोज़िशन पर, अपनी शब्दावली के हर टोकन को रॉ स्कोर देता है. इसे लॉगिट कहा जाता है. लॉगिट जितना ज़्यादा होगा, टोकन उस पोज़िशन के लिए उतना ही बेहतर होगा. softmax, लॉजिट को ऐसी संभावनाओं में बदलता है जिनका योग 1 होता है. इसके बाद, लैंग्वेज मॉडल एक टोकन चुनता है और उसे टेक्स्ट में जोड़ता है. यह प्रोसेस बार-बार दोहराई जाती है. डिसक्रिमिनेटिव मॉडल, प्रॉबबिलिटी के बाद रुक जाता है.
खाली जगह, जवाब वाले फ़ॉर्म में मौजूद एक गैप होता है. सर्वर, फ़ॉर्म को खुद लिखता है. जैसे, response: ▢. साथ ही, हर सवाल के लिए एक जगह छोड़ देता है. मॉडल का काम सिर्फ़ यह स्कोर करना है कि हर गैप में क्या होना चाहिए.
- प्रॉम्प्ट में स्थिति और हर सवाल के साथ-साथ, जवाब के तौर पर इस्तेमाल किए जा सकने वाले हर शब्द को छोटे लेबल के तौर पर शामिल किया जाता है:
a, block_high के लिए,b, block_low के लिए, वगैरह. - सर्वर, जवाब वाला फ़ॉर्म जोड़ता है. इसमें हर सवाल के लिए एक खाली जगह होती है.
- मॉडल, प्रॉम्प्ट और फ़ॉर्म को एक बार में पढ़ता है. साथ ही, हर खाली जगह पर हर टोकन को लॉजिट देता है. डिफ़्यूज़न मॉडल, पूरे फ़ॉर्म को एक साथ देखता है और सभी खाली जगहों को एक साथ स्कोर करता है.
- सर्वर, अनुमति वाले लेबल के सिर्फ़ लॉजिट रखता है और उन पर सॉफ़्टमैक्स लागू करता है. इसलिए, अनुमति वाले जवाबों का योग 1 होता है.
- अगर सर्वर को पढ़ने में मुश्किल होती है, तो वह किसी दूसरी रैंडम जगह से फिर से पढ़ना शुरू करता है और पढ़े गए डेटा का औसत निकालता है.
आत्मविश्वास एक ऐसी संख्या है जिससे पता चलता है कि जवाब कितना सटीक है. TypeSafe, इस संख्या का हिसाब इस आधार पर लगाता है कि विकल्पों में संभावना कितनी फैली हुई है. सभी का एक ही विकल्प पर होना 1 और सभी का बराबर होना 0 देता है. तीन विकल्पों के लिए, यह (3 × सबसे बड़ी संख्या − 1) / 2 है.
TypeSafe, कैलिब्रेट की गई संभावनाओं के लिए Jev को ट्रेन करता है. संभावना से पता चलता है कि जवाब कितनी बार सही होता है. कैलिब्रेट किए गए मॉडल में, 0.7 पर दिए गए जवाब करीब 70% बार सही होते हैं. इसलिए, कॉन्फ़िडेंस के लिए थ्रेशोल्ड, इस बात का थ्रेशोल्ड होता है कि कितनी बार गलत जवाब स्वीकार किया जाता है. इस वर्कशॉप में, DiffusionGemma सर्वर सबसे ज़्यादा संभावना को कॉन्फ़िडेंस के तौर पर रिपोर्ट करता है. यह इसकी रीडिंग का औसत होता है. जब रीडिंग अलग-अलग होती हैं, तो औसत वैल्यू में अंतर आ जाता है और कॉन्फ़िडेंस लेवल कम हो जाता है.
अहम जानकारी: जवाब से आपको क्या के बारे में पता चलता है. कॉन्फ़िडेंस स्कोर से पता चलता है कि कार्रवाई करनी है या नहीं.
थ्रेशोल्ड
थ्रेशोल्ड से यह तय होता है कि कोड में कार्रवाई को कैसे तय किया जाता है. मॉडल, कॉन्फ़िडेंस या संभावना दिखाता है. आपका कोड इसकी तुलना आपकी चुनी हुई संख्या से करता है. इसके बाद, नतीजे के आधार पर यह तय होता है कि आगे क्या होगा.
हर कार्रवाई के लिए थ्रेशोल्ड. TypeSafe, कॉन्फ़िडेंस को बैंड में बांटने का सुझाव देता है. ज़्यादा भरोसेमंद होने पर, यह अपने-आप काम करता है. मध्यम संभावना वाले मामलों में, पुष्टि करने के लिए कहा जाता है या समीक्षा के लिए फ़्लैग किया जाता है. कम कॉन्फ़िडेंस होने पर, कोई कार्रवाई नहीं की जाती है. इसके बजाय, किसी सुरक्षित विकल्प का इस्तेमाल किया जाता है या किसी व्यक्ति से मदद मांगी जाती है.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
अखाड़े के नियम. अखाड़े की थ्रेशोल्ड वैल्यू, choose() में मौजूद होती हैं. इन्हें पांचवें चरण में चलाया जाता है.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
चेतावनी: ऐसा ज़रूरी नहीं है कि मान्य जवाब हमेशा सही हो. भेदभाव करने वाला मॉडल, ऐसा विकल्प नहीं दे सकता जो आपने नहीं दिया है. इसलिए, यह कभी भी कोई गलत चाल नहीं बताता. हालांकि, यह कभी-कभी गलत चाल चुन सकता है. किसी थ्रेशोल्ड पर भरोसा करने से पहले, अपने सवालों की जांच उन स्थितियों के हिसाब से करें जिनके बारे में आपने पहले ही फ़ैसला ले लिया है.
मॉडल की मदद से फ़ैसले अपने-आप लेने की सुविधा
अनुरोध और जवाब
अनुरोध. TypeSafe Python SDK की मदद से, सवाल बनाए जा सकते हैं और उन्हें मॉडल को भेजा जा सकता है.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
हर टिक के लिए एक अनुरोध
हर टिक पर, ऐप्लिकेशन टेलीग्राफ़ को स्थिति के तौर पर भेजता है और एक कॉल में तीन चीज़ों के बारे में पूछता है:
- पांच (या स्पेल तैयार होने पर छह) जवाबों में से कौनसा जवाब सही है. विकल्प.
- क्या ओग्रे को फ़िलहाल किसी काउंटर से जोड़ा गया है. ए नोल.
- आने वाली हिट कितनी तेज़ है, यह तीन लेवल के रूब्रिक पर तय किया जाता है. स्कोर.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() फ़ंक्शन
क्या आपको चौथे चरण में बताए गए थ्रेशोल्ड याद हैं? choose(), मॉडल के जवाबों की तुलना तय की गई संख्याओं से करता है. ये तय की गई संख्याएं, थ्रेशोल्ड होती हैं.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() में, टाइप की गई वैल्यू को पढ़ने के लिए सामान्य Python का इस्तेमाल किया जाता है. इसमें दो नियम होते हैं. डिसक्रिमिनेटिव मॉडल, संभावना और विश्लेषण देता है. साथ ही, कोड नियमों के लिए थ्रेशोल्ड का इस्तेमाल करता है. चुनी गई कार्रवाई को इंजन को भेजा जाता है. इसका इस्तेमाल, ओगर से लड़ने के लिए किया जाएगा.
अहम जानकारी: सवालों और थ्रेशोल्ड को एक ही जगह पर रखें. ये सिस्टम वन इंटिग्रेशन का हिस्सा हैं, जिन्हें आपको सबसे ज़्यादा ट्यून करना होगा.
जवाब देने में लगने वाला समय, इनपुट के आधार पर कीमत तय करना, और फ़ैसले का आधार
- हर फ़ैसले के लिए रिस्पॉन्स मिलने में लगने वाला समय. लड़ाई के दूसरे हिस्से में, हर टिक को वापस आने में करीब सौ मिलीसेकंड लगे. कुछ को दो या तीन मिलीसेकंड लगे. यह गेम लूप, अनुरोध पाथ या किसी व्यक्ति या लैंग्वेज मॉडल को मैसेज दिखाने से पहले उसकी जांच करने के लिए काफ़ी तेज़ है.
- इनपुट के आधार पर कीमत तय करना. पूरी लड़ाई में, हर सवाल के लिए तीन जवाबों के साथ साठ फ़ैसले लेने में, एक सेंट का दसवां हिस्सा भी खर्च नहीं होता. आउटपुट टोकन की संख्या शून्य है, क्योंकि कुछ भी जनरेट नहीं किया गया है. इसका मतलब है कि आपके पास ज़रूरत से ज़्यादा सवाल पूछने का विकल्प होता है. अरीना पूछता है कि क्या हर टिक पर ओगर दिखता है. हालांकि, सिर्फ़
strikeऔरcastको इसकी परवाह है, क्योंकि पूछने में कोई खर्च नहीं होता और जवाब डैशबोर्ड पर काम का होता है. TypeSafe इसे speculative फ़ैन-आउट कहता है. - आत्मविश्वास और खतरे को एक साथ दिखाओ. जब डिसक्रिमिनेटिव मॉडल को अपने जवाब पर 0.40 से कम भरोसा होता है और ख़तरे के स्कोर से पता चलता है कि जवाब में काफ़ी हद तक गलत जानकारी शामिल है, तो
choose()उस जवाब को बदलकर, जवाब में शामिल गलत जानकारी को हटा देता है. जवाब को घुमा-फिराकर देना, कभी-कभी सबसे अच्छा जवाब नहीं होता. हालांकि, यह कभी-कभी सबसे खराब जवाब भी नहीं होता. हर गड़बड़ी की लागत के हिसाब से थ्रेशोल्ड चुनें, न कि किसी राउंड नंबर के हिसाब से. साथ ही, उन्हें उन टेलीग्राफ़ के ख़िलाफ़ टेस्ट करें जिन्हें आपने पहले ही मैन्युअल तरीके से जज कर लिया है. TypeSafe की सलाह: अगर कोई फ़ैसला बार-बार गलत साबित हो रहा है, तो थ्रेशोल्ड को बदलने से पहले सवाल को और ज़्यादा सटीक बनाएं.
ADK वर्कफ़्लो में मॉडल को एक साथ इस्तेमाल करना
हर टिक के हिसाब से फ़ैसले लेने की सीमाएं और सही जवाब क्यों काफ़ी नहीं हैं
पांचवें चरण में लड़ाई की आखिरी लाइन में लिखा है: राक्षस लड़खड़ाता हुआ चला जाता है, उसे मामूली चोट लगी है. भेदभाव करने वाले मॉडल को कोई नुकसान नहीं हुआ. साथ ही, हर टिक पर उसे थोड़ा नुकसान हुआ. 300 हिट पॉइंट, साठ से ज़्यादा बार थोड़ा नुकसान होने से ज़्यादा है. रिंग के कोने में मौजूद स्पेल कार्ड, पूरे समय से वहीं है. इसे पढ़ने के लिए, इमेज को समझने वाले मॉडल की ज़रूरत होती है.
ओगर के पास 300 हिट पॉइंट हैं. सही कॉल के लिए तीन काउंटर. किसी छेद में स्ट्राइक करने पर आठ पॉइंट मिलते हैं, क्योंकि छिपाने वाली जगह मोटी होती है. साठ टिक वाली फ़ाइट में भी, ओगर को चोट लगती है और वह खड़ा रहता है. इसलिए, गेम को ड्रॉ घोषित कर दिया जाता है. पांचवां चरण यहीं खत्म हुआ: मॉडल ने अच्छी तरह से बचाव किया, लेकिन फिर भी जीत नहीं सका.
सिर्फ़ एक स्पेल से ही असली नुकसान होता है: सही तरीके से कास्ट करने पर 45 और ओपनिंग पर लैंड करने पर 67.
हर टास्क के लिए सही मॉडल असाइन करना
रिंग के कोने में मौजूद स्पेल कार्ड से गेम जीता जा सकता है. इसे पढ़ने में कोई समस्या नहीं होती, क्योंकि यह एक तस्वीर होती है. इसमें एक रंग और एक लाइन में तीन शेप होते हैं. स्पेल को मैच करने के लिए, उसे गाना होता है. इसके लिए, एक ऐसे मॉडल की ज़रूरत होती है जो किसी इमेज को देखकर, कुछ सेकंड में उसका विश्लेषण कर सके. लड़ाई में, कुछ सेकंड का मतलब दस टिक होता है.
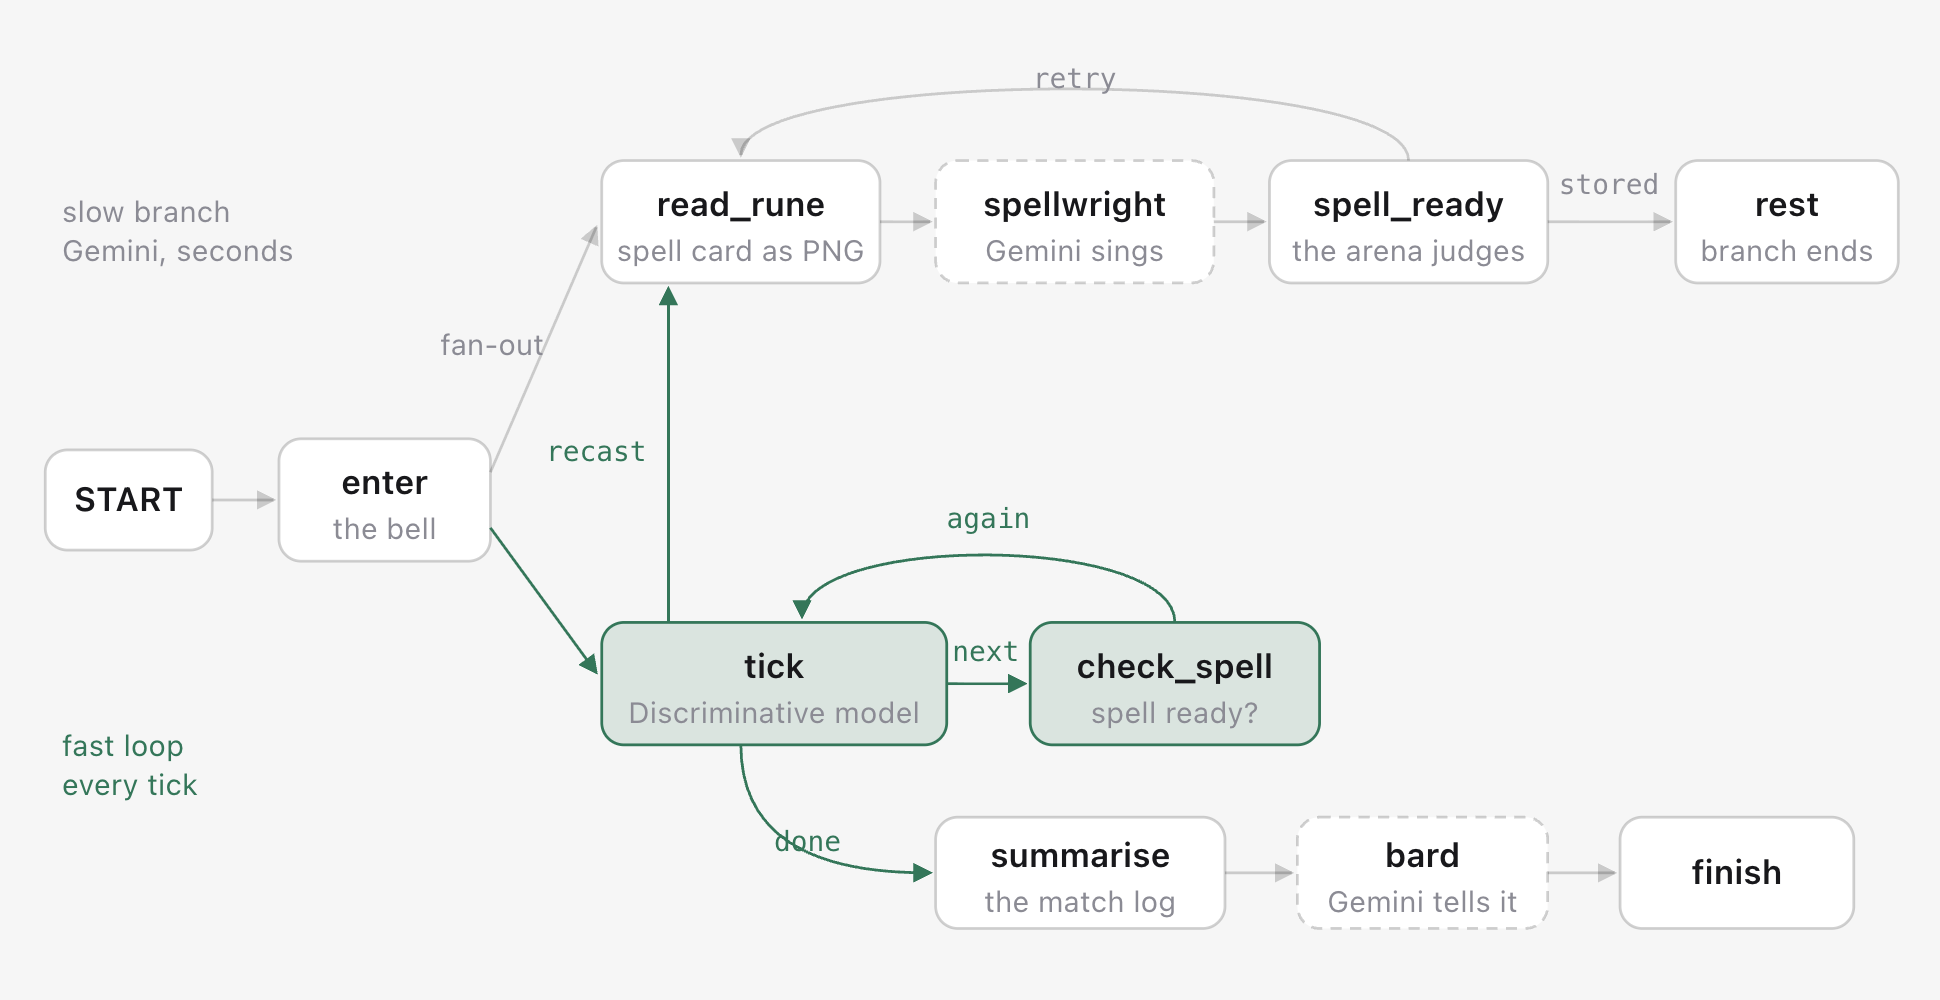
इसलिए, वर्कफ़्लो में दोनों का इस्तेमाल किया जाता है. हालांकि, दोनों की स्पीड अलग-अलग होती है:
- भेदभाव करने वाला मॉडल, लड़ाई करता है. हर टिक, एक कॉल, एक फ़ैसला, सौ मिलीसेकंड. लूप, खुद से ज़्यादा समय लेने वाले किसी भी काम के पूरा होने का इंतज़ार नहीं करता.
- Gemini, बोलकर सुनाता है और गाता है. यह अपनी शाखा पर, घंटी से शुरू होकर, अखाड़े की स्क्रीन से स्पेल कार्ड को इमेज के तौर पर पकड़ता है. साथ ही, रंग और आकृतियों के नाम बताता है और मंत्र गाता है. अरीना, गाने की तुलना स्पेल कार्ड के जवाब से करता है. यह जवाब कभी भी सर्वर से नहीं हटता.
- हर एक्सचेंज के बाद, फ़ाइटर स्लॉट की जांच करता है.
check_spellनोड, स्थिति को देखता है. तैयार नहीं है: इसमें यह जानकारी दी जाती है कि Gemini कब से गा रहा है. साथ ही, यह सीधे अगले टिक पर पहुंच जाता है. यह कभी इंतज़ार नहीं करता. तैयार:castउन विकल्पों में शामिल हो जाता है जो डिसक्रिमिनेटिव मॉडल को दिए जाते हैं. साथ ही, डिसक्रिमिनेटिव मॉडल के ओपनिंग की रिपोर्ट करने पर,choose()तुरंत स्पेल कर देता है. जब स्पेल खत्म हो जाता है, तो स्क्रीन पर एक नया स्पेल कार्ड दिखता है. इसके बाद, थ्रेड फिर से धीरे-धीरे आगे बढ़ने लगता है. गाने को गलत तरीके से पढ़ने पर, स्पेल कार्ड जल जाता है. इसके बाद, धीमी थ्रेड नए कार्ड को पढ़ती है. - Gemini, आखिर में एक बार छोटी कहानी लिखता है.
अलग-अलग लेटेंसी और एक इवेंट लूप वाली पैरलल ब्रांच
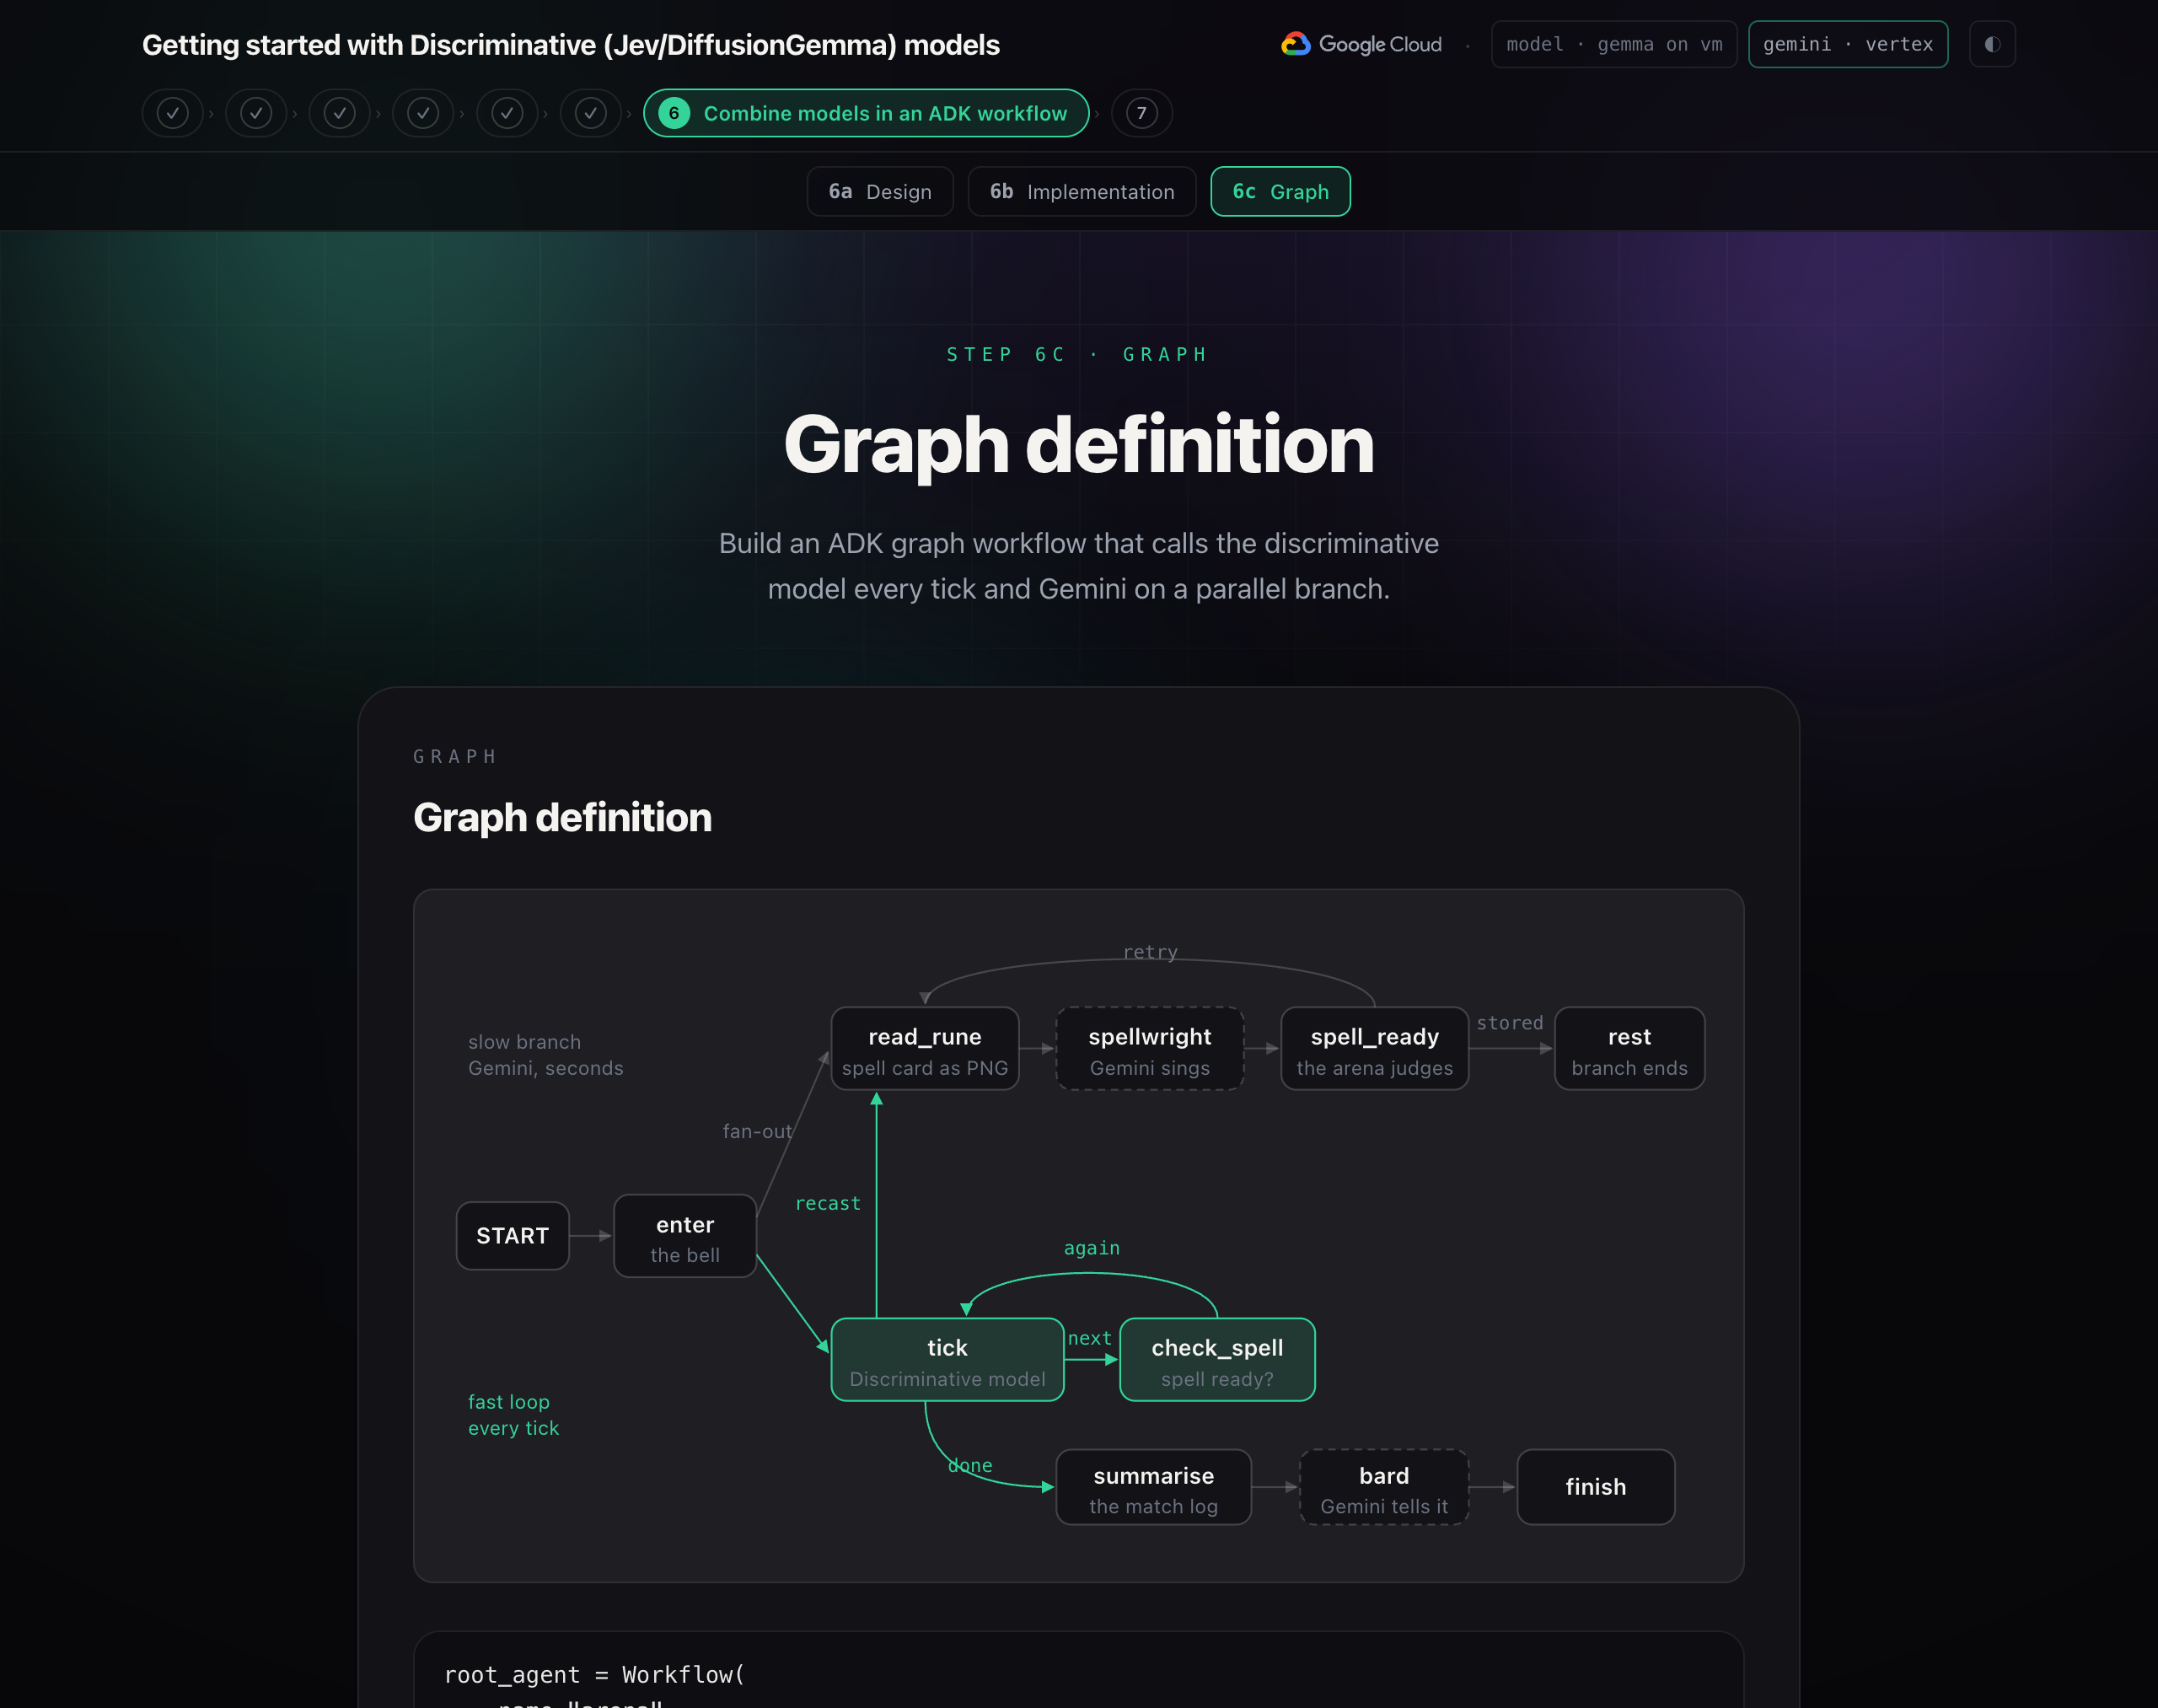
यह एडीके वर्कफ़्लो है: किनारों से जुड़े नोड का ग्राफ़. नोड, सामान्य Python फ़ंक्शन या एलएलएम एजेंट होता है. एक नोड से नोड के टपल तक जाने वाले एज को फ़ैन-आउट कहा जाता है. ये दोनों एक साथ शुरू होते हैं. Event दिखाता है. route यह तय करता है कि अगला किनारा कौन-सा होगा. साथ ही, जो नोड खुद को रूट करता है वह लूप होता है.
इसे दो थ्रेड के तौर पर समझें. थ्रेड 1 में ये काम धीरे-धीरे हो रहे हैं: स्पेल कार्ड पढ़ना, गाना गाना, और स्पेल को सेव करना. थ्रेड 2 तेज़ी से काम करता है: टिक, स्लॉट की जांच करें, फिर से टिक करें. थ्रेड 1, ऐसे फ़ंक्शन में खत्म होता है जो जज किए गए स्पेल को सेशन state में लिखता है और कोई आउटपुट नहीं दिखाता है. थ्रेड 2 का check_spell, हर एक्सचेंज के बाद उस स्थिति को पढ़ता है. न तो थ्रेड कॉल करता है और न ही दूसरे का इंतज़ार करता है. वे सिर्फ़ स्थिति शेयर करते हैं.
अहम जानकारी: फ़ैसलों को कोड में डालें और हर मॉडल को उसकी रफ़्तार से काम करने दें.
ADK, दोनों ब्रांच को एक ही इवेंट लूप पर टास्क के तौर पर चलाता है. ऐसा एक ही थ्रेड में होता है. एक बार में सिर्फ़ एक टास्क चलता है. जब कोई टास्क await पर पहुंचता है, तो वह अपने जवाब का इंतज़ार करता है. इस दौरान, लूप दूसरी ब्रांच को चलाता है. फ़ास्ट ब्रांच, मॉडल के लिए करीब 0.1 सेकंड तक इंतज़ार करती है. वहीं, स्लो ब्रांच, Gemini के लिए कई सेकंड तक इंतज़ार करती है. इसलिए, दोनों में से कोई भी ब्रांच, दूसरी ब्रांच के काम में रुकावट नहीं डालती.
स्लो ब्रांच
read_rune(), स्क्रीन से स्पेल कार्ड को इमेज के तौर पर हटाता है.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright, Gemini है. यह इमेज को पढ़कर, तय किए गए फ़ॉर्मैट में जवाब देता है.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() फ़ंक्शन, अरीना में मौजूद जज को स्पेल के बारे में बताता है. इसके बाद, वह स्पेल को सेव करता है या फिर से कोशिश करता है.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
फ़ंक्शन नोड, इमेज वाले हिस्से के साथ Content दिखा सकता है. साथ ही, एलएलएम नोड इसे उपयोगकर्ता के टर्न के तौर पर पाता है. spell_ready, Event दिखाता है. इसमें राज्य के डेल्टा की जानकारी होती है और कोई output नहीं होता. अगले टिक में, राज्य से मंत्र पढ़ा जाता है. साथ ही, बिना आउटपुट वाली ब्रांच, ग्राफ़ के लिए दूसरा एंडिंग पॉइंट नहीं होती है: ADK को एक टर्मिनल आउटपुट की ज़रूरत होती है, और वह लड़ाई का आउटपुट होता है.
ध्यान दें: अरीना में कोड की जांच की जाती है. यह जांच, स्पेल कार्ड के छिपे हुए जवाब के हिसाब से की जाती है. एक बेहतरीन रीडिंग में, 45 से ज़्यादा शब्द शुरुआती हिस्से में होते हैं. दाईं ओर मौजूद दो शेप से 25 मिलता है. गलत तरीके से पढ़ने की वजह से, जादू का असर नहीं होता और कार्ड जल जाता है. Gemini से यह नहीं पूछा जाता कि वह सही है या नहीं.
फ़ास्ट ब्रांच
tick() एक एक्सचेंज चलाता है. इसके बाद, अगले एज को चुनता है.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() फ़ंक्शन, हर एक्सचेंज के बाद स्पेल स्लॉट की जांच करता है.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell, हर एक्सचेंज के बाद स्लॉट देखता है. यह कभी ब्लॉक नहीं करता: अगर स्पेल तैयार नहीं है, तो यह इसकी सूचना देता है और आगे बढ़ता है.
डिज़ाइन में तीन चीज़ें शामिल होती हैं. असमानता का पता लगाने वाले मॉडल को एसिंक क्लाइंट के साथ await किया जाता है. इसलिए, यह इंतज़ार करते समय लूप को बंद कर देता है और Gemini ब्रांच चलती रहती है. हर टिक पर नए सवाल तैयार किए जाते हैं. इसलिए, cast आइकॉन सिर्फ़ तब दिखता है, जब कास्ट करने के लिए कोई कॉन्टेंट मौजूद हो. साथ ही, route एक सूची हो सकती है: ["recast", "next"] दोनों किनारों को एक साथ लेता है.
अरीना, एक छोटे क्लाइंट के पीछे होता है: जब कोई ऐप्लिकेशन एचटीटीपी पर चल रहा होता है, तो पेज पर लड़ाई दिखती है. जब कोई ऐप्लिकेशन नहीं चल रहा होता है, तो इंजन प्रोसेस में होता है.
ग्राफ़ की परिभाषा
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
टारगेट के तौर पर टपल का इस्तेमाल करने से, फ़ैन-आउट होता है. edge के तौर पर टपल एक चेन होती है. डिक्शनरी, रूट के नामों को नोड पर मैप करती है. tick → check_spell → tick फ़ास्ट लूप है. "recast": read_rune किसी स्पेल के खत्म होने के बाद, स्लो थ्रेड को फिर से शुरू करता है. "retry" किसी स्पेल के फ़िज़ल होने के बाद, स्लो थ्रेड को फिर से शुरू करता है. "stored": rest स्पेल के स्लॉट में होने के बाद, स्लो थ्रेड को बिना किसी आउटपुट के चुपचाप खत्म होने देता है. ADK को किसी साइकल में कम से कम एक राउट किया गया एज चाहिए. इसलिए, बिना शर्त वाले लूप को हमेशा के लिए चलने से पहले अस्वीकार कर दिया जाता है.
ध्यान दें: ADK के टूल, root_agent को ढूंढते हैं. अगर आपको टर्मिनल के बजाय ब्राउज़र में ग्राफ़ और इवेंट देखने हैं, तो वर्कशॉप के रूट से adk web agents कमांड चलाएं. इससे, अरीना के साथ डेवलपर यूज़र इंटरफ़ेस (यूआई) खुल जाएगा.