

1. Pengantar
Workshop berdurasi 90 menit tentang Model diskriminatif, model keputusan System One TypeSafe AI, dan cara menggunakannya bersama Gemini dalam alur kerja ADK Google. Dalam workshop ini, ada enam langkah yang dibangun di sekitar game pertarungan. Anda akan melawan raksasa dengan tangan terlebih dahulu, lalu menyerahkan refleks ke model Diskriminatif, kemudian menyaksikan alur kerja ADK memenangkan pertarungan dengan model Diskriminatif yang memutuskan setiap tanda centang dan Gemini membaca kartu mantra di luar layar untuk menyanyikan mantra.
Ringkasan
Model Diskriminatif (jev-1.13, alias jev-latest) adalah model yang dihosting dari TypeSafe AI, yang dirilis pada 19 September 2026. Model ini tidak menghasilkan teks. Anda mengirimkan status (teks, JSON, atau daftar) dan pertanyaan yang diketik (Choice, Score, Noul), dan model akan menampilkan jawaban yang diketik dengan probabilitas yang dikalibrasi, dalam waktu sekitar 70 hingga 500 md, dengan biaya $0,042 per satu juta token input dan tanpa biaya untuk output. Tugasnya adalah membuat keputusan di depan, di antara, dan di belakang model bahasa: perutean, klasifikasi, gating, dan di sini, refleks petarung.
Game sebagai contoh
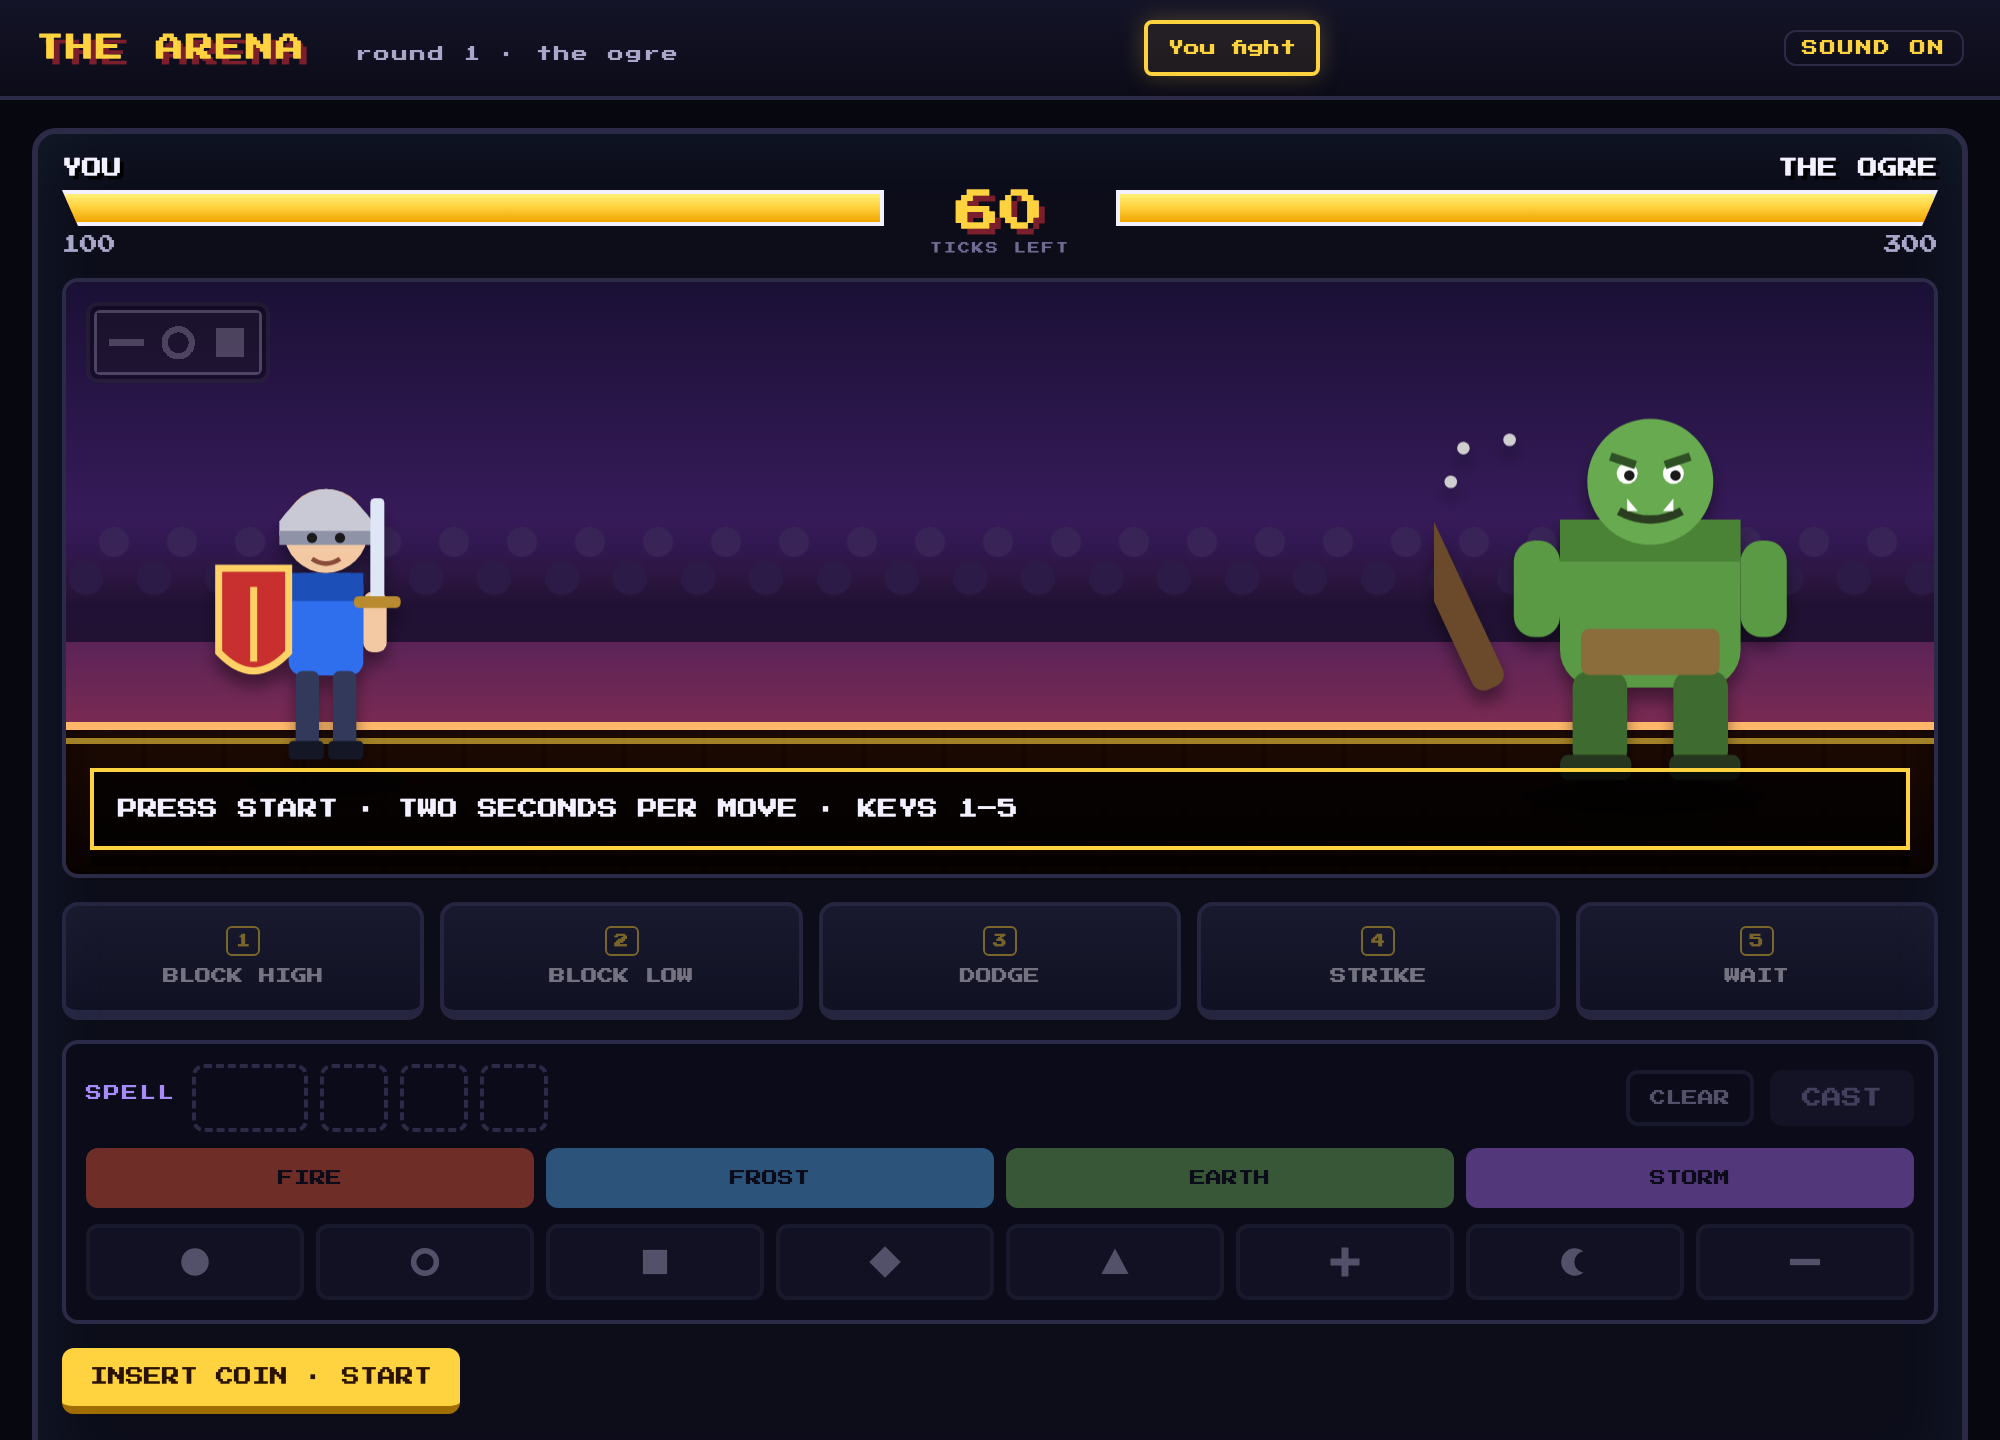
Pernahkah Anda memainkan game pertarungan? Anda menghadapi lawan dan harus bereaksi secara instan terhadap gerakan mereka. Satu tebakan salah dan HP Anda akan berkurang. Game juga cenderung membuat mantra sulit diucapkan. Dalam game kami, Anda harus memilih warna dan bentuk kartu mantra, secara berurutan, sebelum mantra dilepaskan. Workshop ini menunjukkan cara menggabungkan kedua jenis model untuk membuat karakter Anda menang.
Setiap elemen game dipetakan ke sistem nyata:
- Langkah lawan adalah peristiwa masuk, seperti permintaan atau transaksi.
- Respons adalah keputusan terbatas, yang dibuat oleh model diskriminatif dan diperiksa oleh kode.
- Kartu ejaan adalah input tidak terstruktur yang memerlukan model bahasa untuk dibaca.
- Pertandingan adalah alur kerja, yang menjalankan pekerjaan cepat dan lambat dengan kecepatan masing-masing.
Fokusnya adalah menggabungkan keempat komponen dan menyusunnya untuk membangun sistem yang cepat dan cerdas.
Yang akan Anda pelajari
- Jelaskan perbedaan antara model diskriminatif (Sistem Satu) dan generatif (Sistem Dua), serta kapan harus menggunakan masing-masing model tersebut.
- Jelaskan cara Jev dan DiffusionGemma ditayangkan, dan siapkan salah satunya untuk workshop, termasuk DiffusionGemma di VM GPU Compute Engine.
- Tulis pertanyaan Pilihan, Skor, dan Noul, serta interpretasikan probabilitas dan keyakinan.
- Gunakan nilai minimum dalam kode deterministik untuk mengubah probabilitas menjadi tindakan.
- Buat permintaan dengan TypeSafe SDK, lalu biarkan model memilih setiap langkah dalam game.
- Buat cabang lambat, tempat Gemini membaca gambar, dan cabang cepat, tempat model diskriminatif memutuskan dalam loop, lalu jalankan masing-masing.
- Gabungkan kedua cabang dalam alur kerja grafik ADK yang membagikan status pada satu loop peristiwa, sehingga pekerjaan yang lambat tidak pernah menunda keputusan yang cepat.
Arsitektur
Workbench berada di cloudshell(atau mesin Anda), yang akan menulis ke sistem file lokal dan berinteraksi dengan arena serta dengan Gemini dan model keputusan. ② memanggil model keputusan dalam "Pertarungan model diskriminatif"; ③ memanggil keduanya dalam "Pertarungan alur kerja".
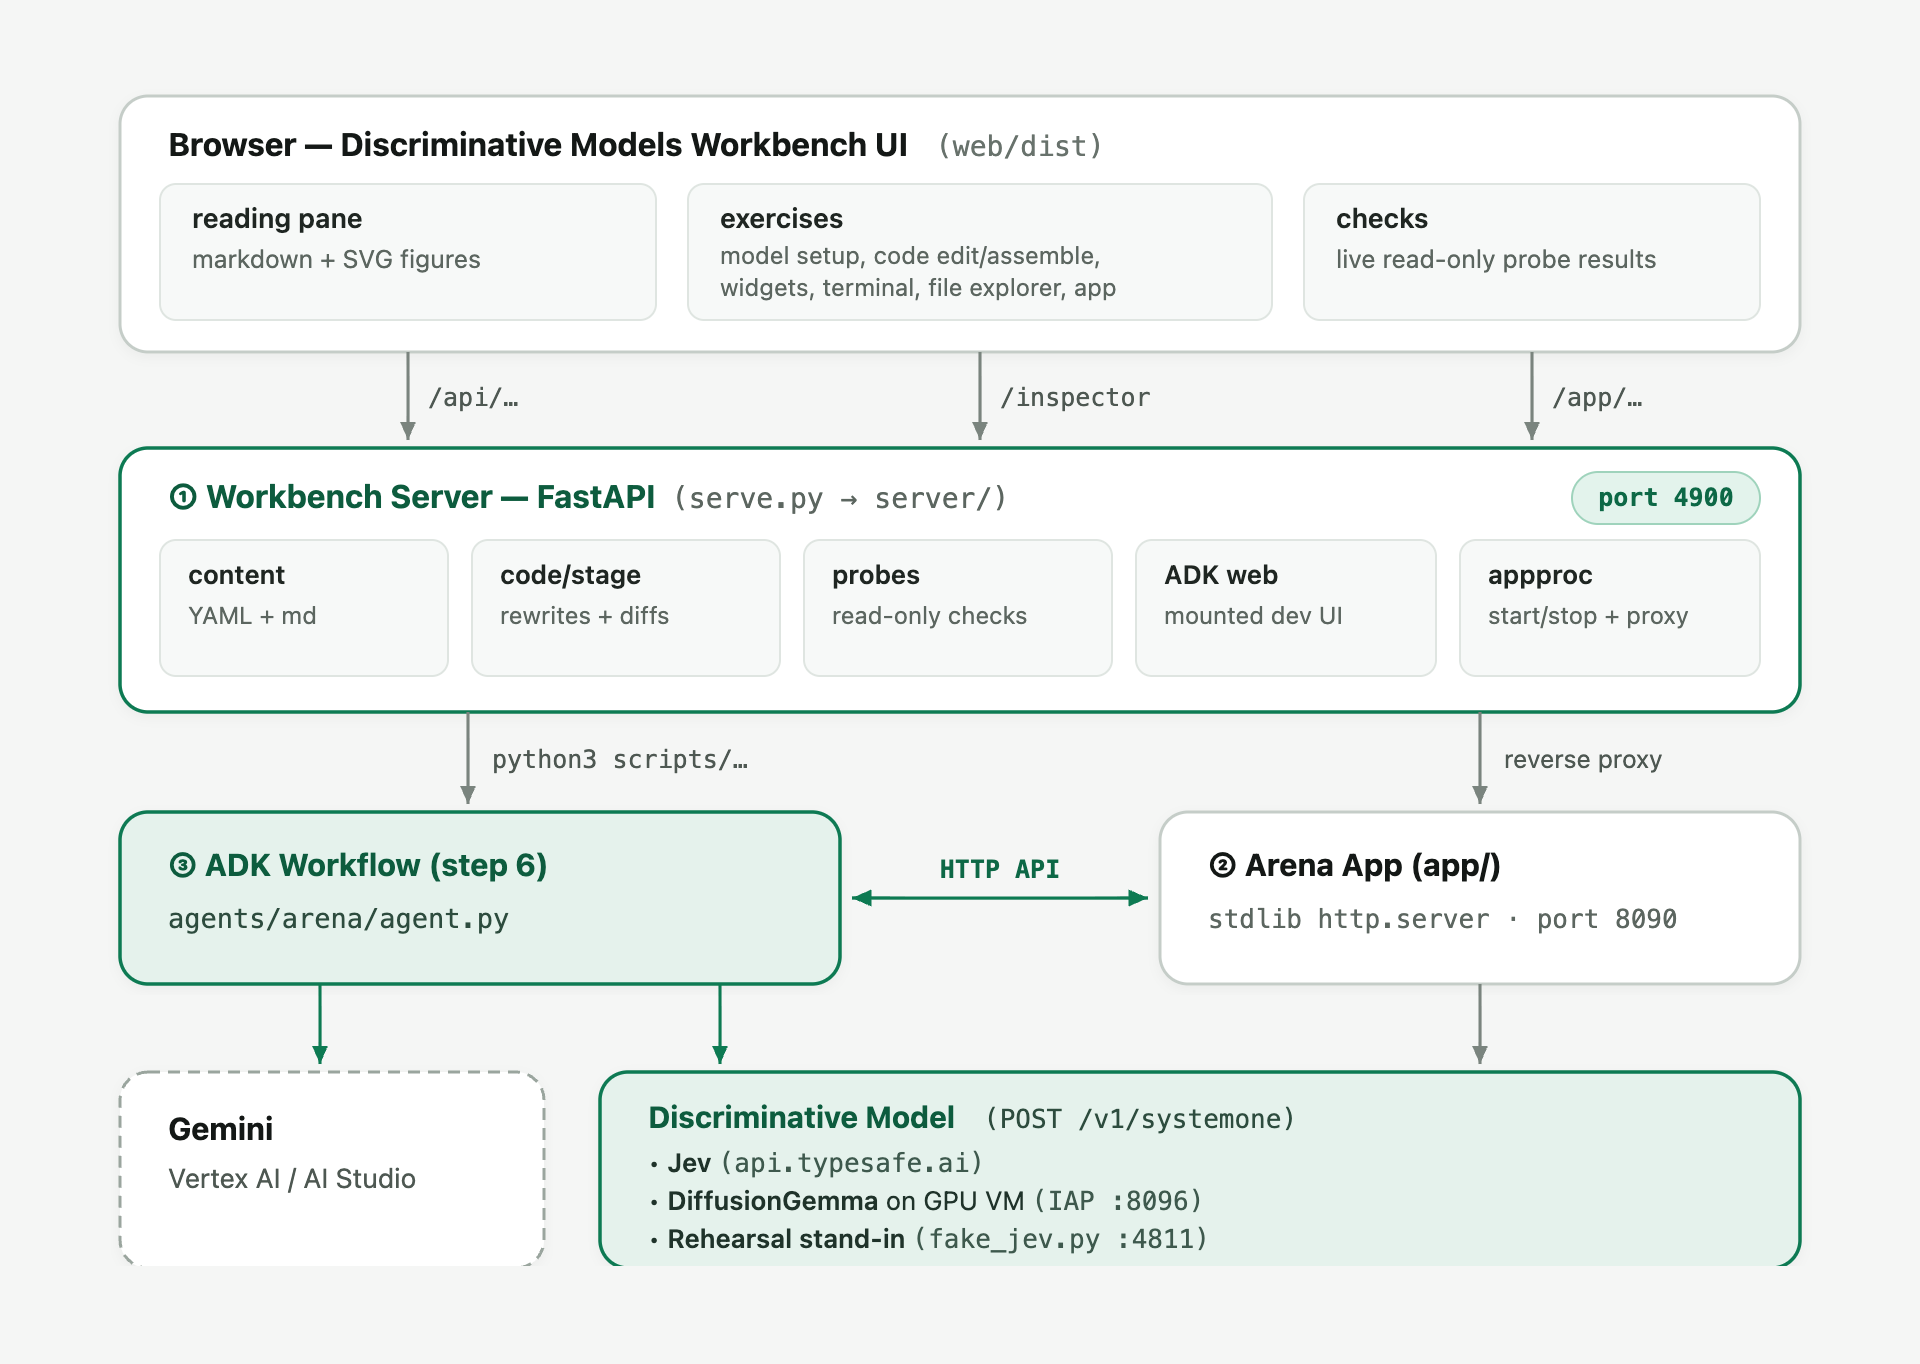
Siapa yang memanggil apa. Browser hanya berkomunikasi dengan ①. Kedua model dipanggil dari Python di mesin:
Penelepon | Model diskriminatif | Gemini |
② arena, "Discriminative model fights" (Pertarungan model diskriminatif) | setiap tanda centang, | tidak |
③ alur kerja | setiap tanda centang, | tidak |
③ alur kerja | tidak | gambar kartu mantra; kisah setelah pertarungan |
| ya | tidak |
Satu tanda centang, per mode.
- Anda berjuang. Halaman meminta ② telegraf, menampilkannya dengan timer 2 detik, dan memposting kembali tombol yang Anda tekan (atau ejaan yang Anda ketik). ② menyelesaikannya.
- Pertarungan model diskriminatif. Halaman meminta ② untuk tanda centang; ② menggambar telegraf, mengajukan tiga pertanyaan kepada model dalam satu panggilan, menjalankan
choose(), dan menampilkan jawaban serta hasilnya. Halaman menggambar batang. - Konflik alur kerja. Start membuat ② meluncurkan ③ sebagai subproses (login
runs/arena-workflow.log). ③ mendorong pertarungan: ia meminta setiap sinyal kepada ②, memanggil model, dan memposting keputusan; mantra Gemini tiba di cabangnya sendiri kapan pun sudah siap. Halaman hanya melakukan polling ② dan menggambar. Pause adalah tanda pada ② yang diperiksa oleh ③ sebelum setiap tanda centang.
Tempat model keputusan dihosting. Setiap panggilan melewati typesafe-sdk yang sama; hanya URL dasarnya yang berubah. scripts/jevauth.py memberi nama backend serta menetapkan kunci dan waktu tunggu:
Backend |
| Kunci | Disiapkan oleh |
TypeSafe, dihosting | unset (api.typesafe.ai) |
|
|
DiffusionGemma di VM L4 Anda |
| tidak ada |
|
DiffusionGemma di Cloud Run |
| token identitas Google, diambil per jam |
|
Gladi Bersih |
| tidak ada |
|
Jawaban kartu ejaan ②: alur kerja hanya mendapatkan PNG, dan ② menilai ejaan yang dikirimkannya kembali. Itulah yang membuat mantra menjadi ujian nyata kemampuan membaca Gemini, dan mantra yang Anda buat di "Anda bertarung" menjadi ujian nyata bagi Anda.
2. Penyiapan
Mengklaim kredit workshop
Jika Anda diberi kredit Google Cloud untuk sesi ini, klaim terlebih dahulu — proses ini memerlukan waktu sekitar satu menit dan membuat akun penagihan untuk Anda.
Buka Cloud Shell
Google Cloud Shell adalah lingkungan Linux yang dapat diakses melalui browser yang telah dikonfigurasi sebelumnya dengan gcloud, Python, Node.js, uv, dan git, yang sudah diautentikasi dengan akun Google Anda.
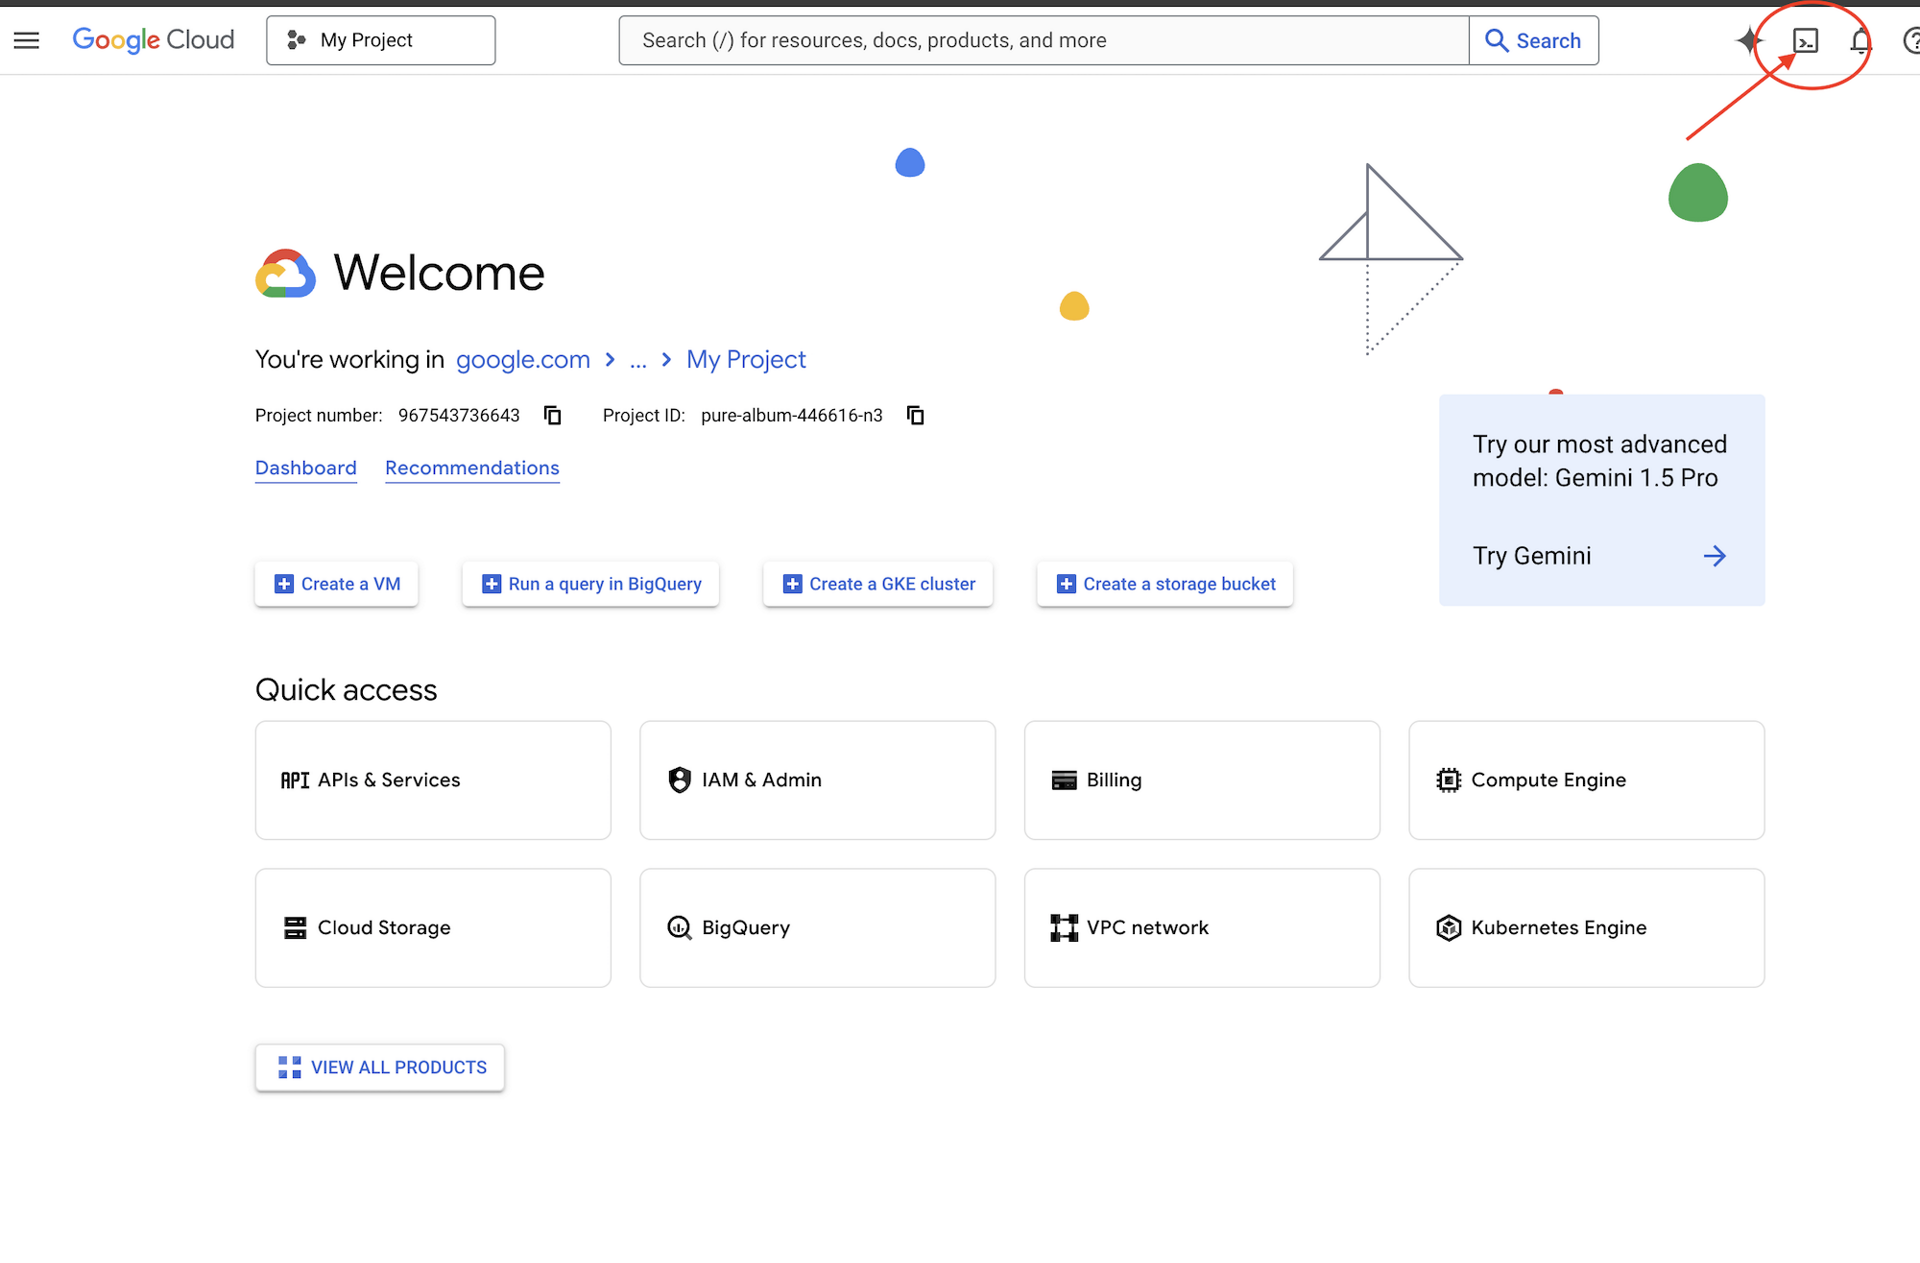
- Buka Konsol Google Cloud.
- Klik Activate Cloud Shell (ikon terminal di panel navigasi atas) untuk membuka sesi terminal di bagian bawah browser Anda.
Luncurkan workbench
Di Cloud Shell, atau di mana pun gcloud login:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh membuat project (discrim-models-XXXX), menautkan penagihan ke project tersebut, lebih memilih akun kredit acara jika Anda memilikinya, dan menunggu hingga project dapat melayani. Menjalankannya kembali akan menggunakan kembali project di ~/project_id.txt. Untuk menggunakan project yang sudah Anda miliki, masukkan ID-nya ke dalam file tersebut dan lewati skrip ini.
setup_codelab.sh tidak meminta apa pun. Skrip ini menginstal uv dan paket Python, mengaktifkan Vertex AI, Compute Engine, dan IAP, mengarahkan Gemini ke Vertex AI dalam project di .env, melakukan satu panggilan Gemini nyata dengan model yang dapat dipanggil project, membuat halaman, memulai workbench di latar belakang, dan menjalankan scripts/check_setup.py. Menjalankannya kembali akan menyimpan file latihan Anda; scripts/starter.sh akan meresetnya. Model keputusan dipilih pada langkah 2 workbench.
Untuk membuka UI workbench di Cloud Shell:
- Klik link pratinjau yang dicetak di akhir
./setup_codelab.sh, atau klik Web Preview di sudut kanan atas toolbar Cloud Shell. - Pilih Ubah port, masukkan 4900, lalu klik Ubah dan Pratinjau.
Gemini berjalan di Vertex AI dalam project Anda, dengan kredensial Google Anda sendiri: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT, dan GOOGLE_CLOUD_LOCATION=global di .env.
Model keputusan dipilih sendiri, di langkah 2 workbench, atau dari terminal dengan scripts/setup_model.sh:
Pilihan | Kebutuhan | Penyiapan | Biaya |
Model Diskriminatif (TypeSafe, dihosting) | kunci API TypeSafe | tidak ada | per token, pecahan sen |
DiffusionGemma (Google, bobot terbuka) | penagihan + kuota Compute Engine untuk GPU | ~15 menit, otomatis | ~$0,71/jam saat VM berjalan |
Latihan (tanpa model) | nothing | tidak ada | tidak ada |
DiffusionGemma di VM Compute Engine
scripts/setup_gemma.sh memeriksa kuota GPU terlebih dahulu, lalu membuat satu VM g2-standard-4 (1 × L4 24 GB, 4 vCPU, 16 GB) dari image Deep Learning Google dengan driver NVIDIA 580. Saat booting pertama, VM menginstal Docker, mendownload bobot dari Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, publik, tanpa token), dan menjalankan djev-run: DiffusionGemma di belakang API persis model Diskriminatif. Port model tidak terbuka ke internet: workbench mencapainya melalui tunnel IAP di localhost:8096, yang dibuka oleh scripts/start.sh.
Menjeda / melanjutkan |
| |
Terowongan |
| |
Hapus |
| |
Latih perintah |
| |
Tata letak repositori
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Ringkasan
Membersihkan lingkungan Anda
Setelah Anda menyelesaikan workshop, selesaikan langkah-langkah berikut untuk menghapus semua resource GPU DiffusionGemma, menghentikan proses workbench dan latihan di latar belakang, menghapus file workshop dari Cloud Shell, dan (opsional) menghapus project Google Cloud workshop Anda.
- Hapus VM GPU DiffusionGemma dan aturan firewall (jika dibuat): Jika Anda menyediakan DiffusionGemma di VM GPU Compute Engine pada Langkah 2, hapus VM, disk, dan aturan firewall IAP agar tidak ada biaya komputasi atau penyimpanan disk yang terus berlanjut:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Hentikan proses workbench dan latihan di Cloud Shell: Di terminal Cloud Shell, hentikan server workbench latar belakang dan proses pengganti latihan:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Hapus folder workshop dari Cloud Shell: Kembali ke direktori utama Anda, lalu hapus folder repositori yang di-clone dan file project ID:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Hapus project Google Cloud Anda: Jika
./setup_project.shmembuat project workshop khusus (misalnya,discrim-models-XXXX), menonaktifkan project akan menghapus semua resource yang dibuat di dalamnya secara permanen, sekaligus membiarkan akun Penagihan Cloud Anda tetap utuh:- Buka halaman Manage resources di konsol Google Cloud.
- Pilih project workshop Anda (misalnya,
discrim-models-...) dari daftar resource. - Klik Hapus di toolbar atas, ketik project ID Anda untuk mengonfirmasi, lalu klik Matikan.
Anda telah menyelesaikan workshop ini.
Ringkasan lab
- Memilih model diskriminatif, Jev atau DiffusionGemma di VM GPU Compute Engine, dan memeriksa apakah model tersebut memberikan jawaban.
- Memainkan arena secara manual, melawan waktu, untuk mempelajari aturannya.
- Mempelajari cara model diskriminatif menjawab pertanyaan Pilihan, Skor, dan Noul, probabilitas dan keyakinan, serta cara kode Anda menerapkan nilai minimum keyakinan padanya.
- Mengirim permintaan pertama Anda, lalu biarkan model memilih setiap gerakan di arena, dengan
choose()mengubah jawabannya menjadi tindakan. - Setiap cabang alur kerja ADK dibangun sendiri-sendiri, dengan Gemini membaca gambar kartu mantra dan model memutuskan dalam loop.
- Bergabung dalam satu alur kerja yang membagikan status, sehingga pertarungan tidak pernah menunggu Gemini dan mantra dilafalkan saat pembukaan.
Dari percakapan hingga keputusan
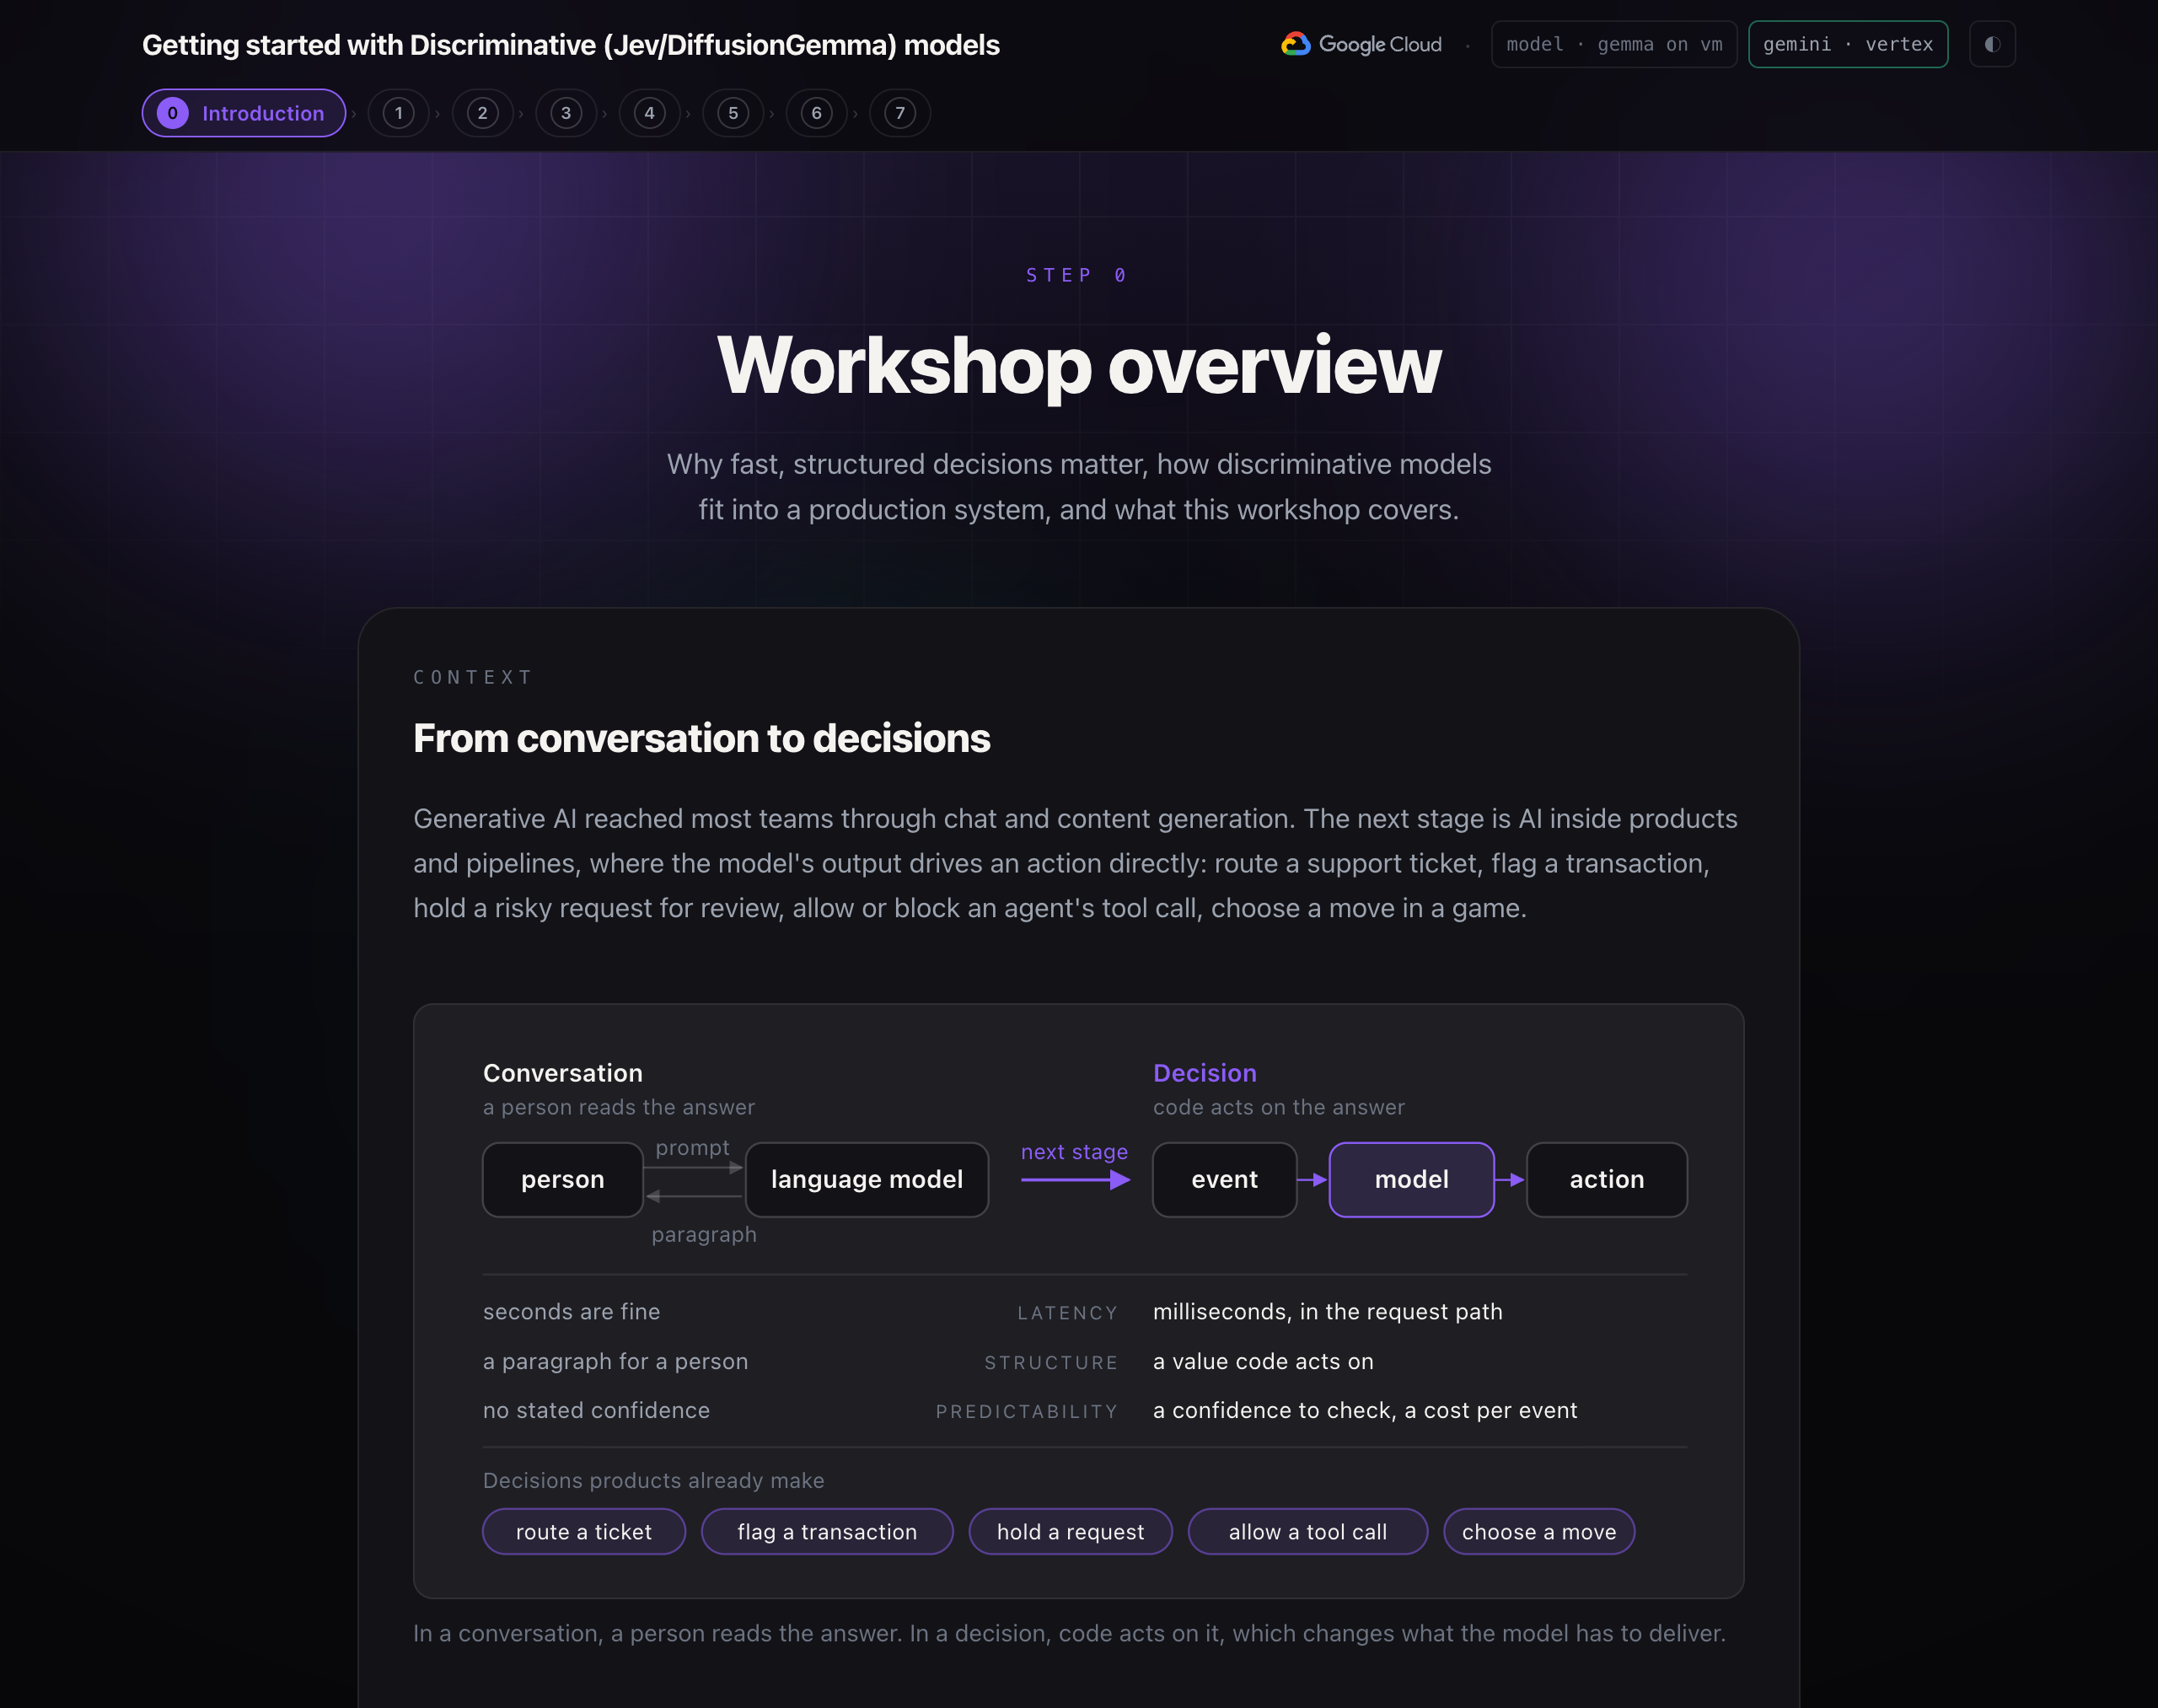
AI generatif menjangkau sebagian besar tim melalui pembuatan konten dan chat. Tahap berikutnya adalah AI di dalam produk dan pipeline, di mana output model mendorong tindakan secara langsung: mengarahkan tiket dukungan, menandai transaksi, menahan permintaan berisiko untuk ditinjau, mengizinkan atau memblokir panggilan alat agen, memilih langkah dalam game.
Keputusan ini memiliki tiga persyaratan yang tidak dimiliki chat:
- Latensi. Jawabannya sering kali ada di jalur permintaan pengguna atau loop real-time, sehingga harus tiba dalam milidetik, bukan detik.
- Struktur. Pemanggil adalah kode, jadi jawabannya harus berupa nilai yang dapat ditindaklanjuti, bukan paragraf yang harus diuraikan.
- Dapat diperkirakan. Setiap keputusan memerlukan keyakinan yang dapat diperiksa oleh kode, dan biaya yang cukup rendah untuk ditanyakan pada setiap peristiwa.
Model bahasa menghasilkan teks satu token dalam satu waktu. LLM dapat dipicu untuk memberikan jawaban ya atau tidak, tetapi lambat untuk loop real-time, outputnya harus diuraikan, dan tidak melaporkan seberapa yakinnya LLM.
Model yang dibuat untuk pengambilan keputusan
Model diskriminatif menjawab pertanyaan yang diketik dengan probabilitas untuk setiap opsi yang diizinkan, dalam satu proses. Model ini tidak menghasilkan teks. Workshop ini menyediakan dua opsi untuk dijalankan:
Model | Penyedia | Tempat model berjalan dalam workshop ini |
Jev | TypeSafe AI | Layanan yang dihosting TypeSafe, dipanggil dengan kunci API |
DiffusionGemma | Google, buka beban | Dihosting sendiri di VM GPU dalam project Google Cloud Anda sendiri |
Model dapat ditukar berdasarkan kebutuhan Anda; kode yang terhubung ke model tersebut tidak perlu diubah.
Menggabungkan komponen
Sistem yang berhasil terdiri dari beberapa komponen:
Komponen | Peran | Dalam workshop ini |
Alur kerja | Mengatur langkah-langkah, menjalankan cabang secara paralel, menyimpan status bersama | Alur kerja grafik ADK |
Kode deterministik | Aturan, batas, validasi. Instan, gratis, dan dapat diaudit | Aturan game, |
Model diskriminatif | Keputusan yang cepat dan terbatas dengan skor keyakinan | Memilih respons setiap detiknya |
Model bahasa | Persepsi dan pembuatan: gambar dan teks terbuka | Gemini membaca gambar kartu ejaan dan menulis ejaan |
Arsitektur penyajian model
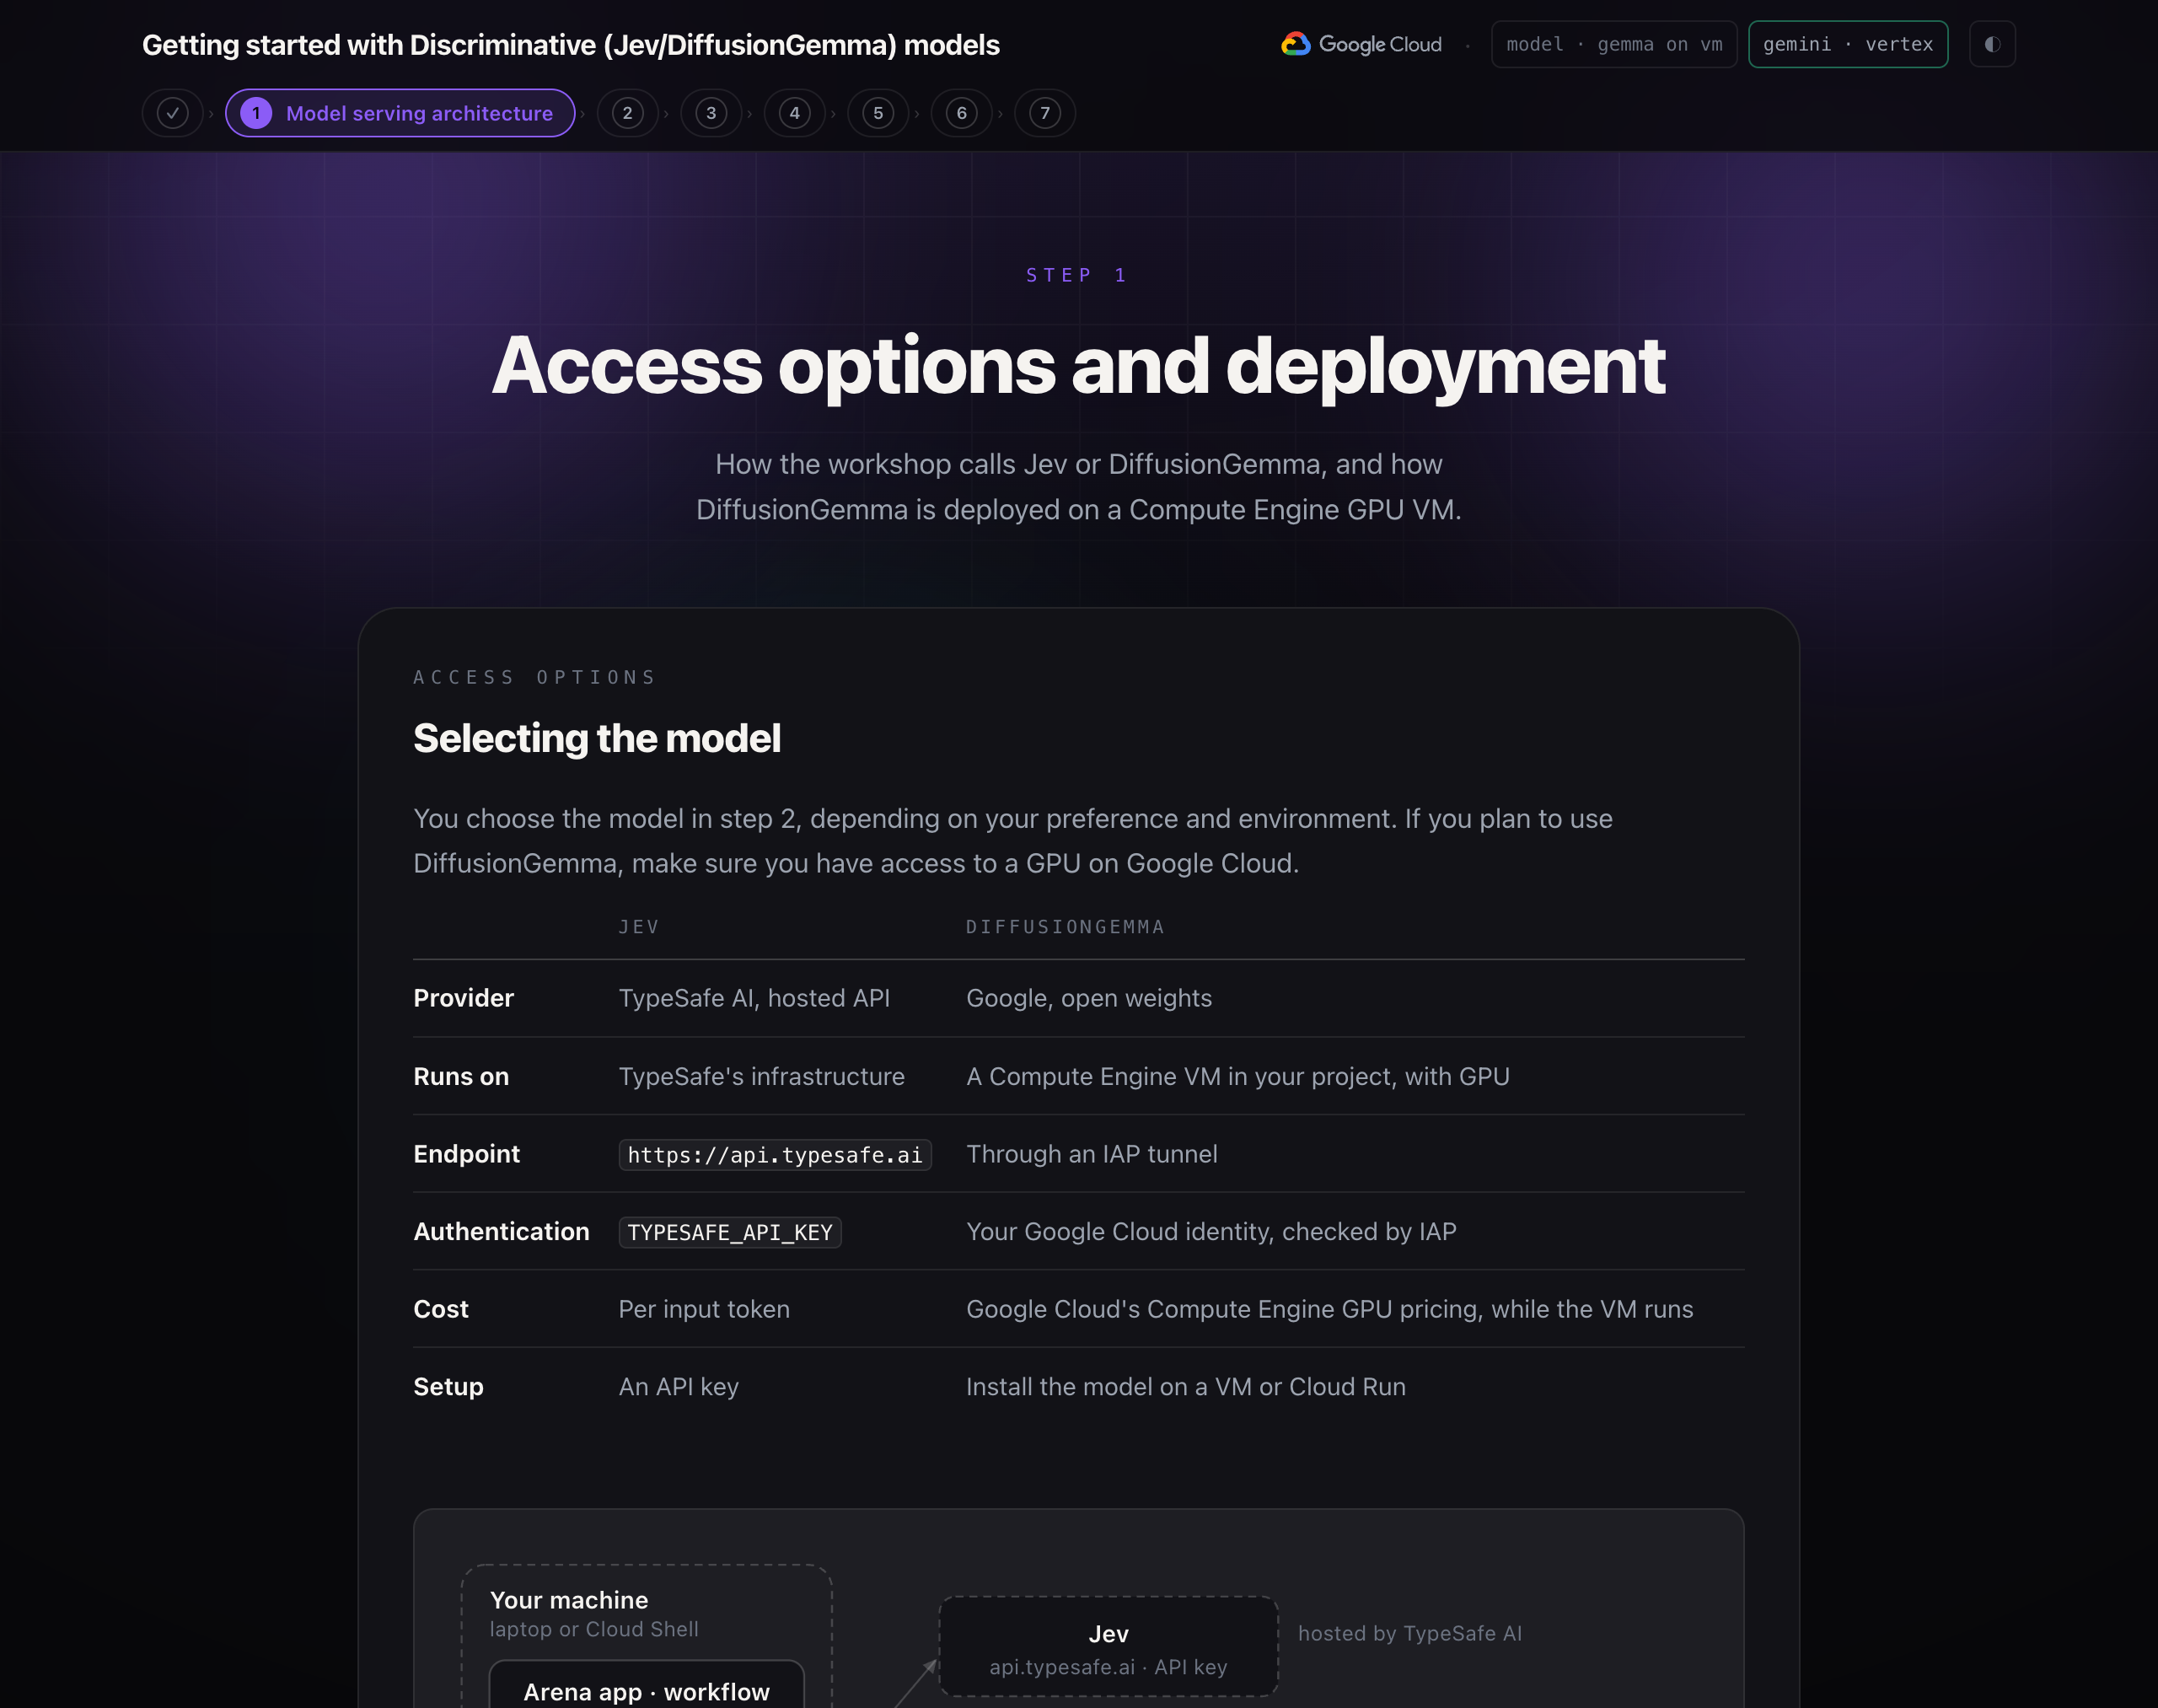
Anda memilih model pada langkah 2, bergantung pada preferensi dan lingkungan Anda. Jika Anda berencana menggunakan DiffusionGemma, pastikan Anda memiliki akses ke GPU di Google Cloud.
Jev | DiffusionGemma | |
Penyedia | TypeSafe AI, API yang dihosting | Google, buka beban |
Berjalan di | Infrastruktur TypeSafe | VM Compute Engine di project Anda, dengan GPU |
Endpoint |
| Melalui tunnel IAP |
Authentication |
| Identitas Google Cloud Anda, yang diperiksa oleh IAP |
Biaya | Per token input | Harga GPU Compute Engine Google Cloud, saat VM berjalan |
Penyiapan | Kunci API | Menginstal model di VM atau Cloud Run |
Aliran data
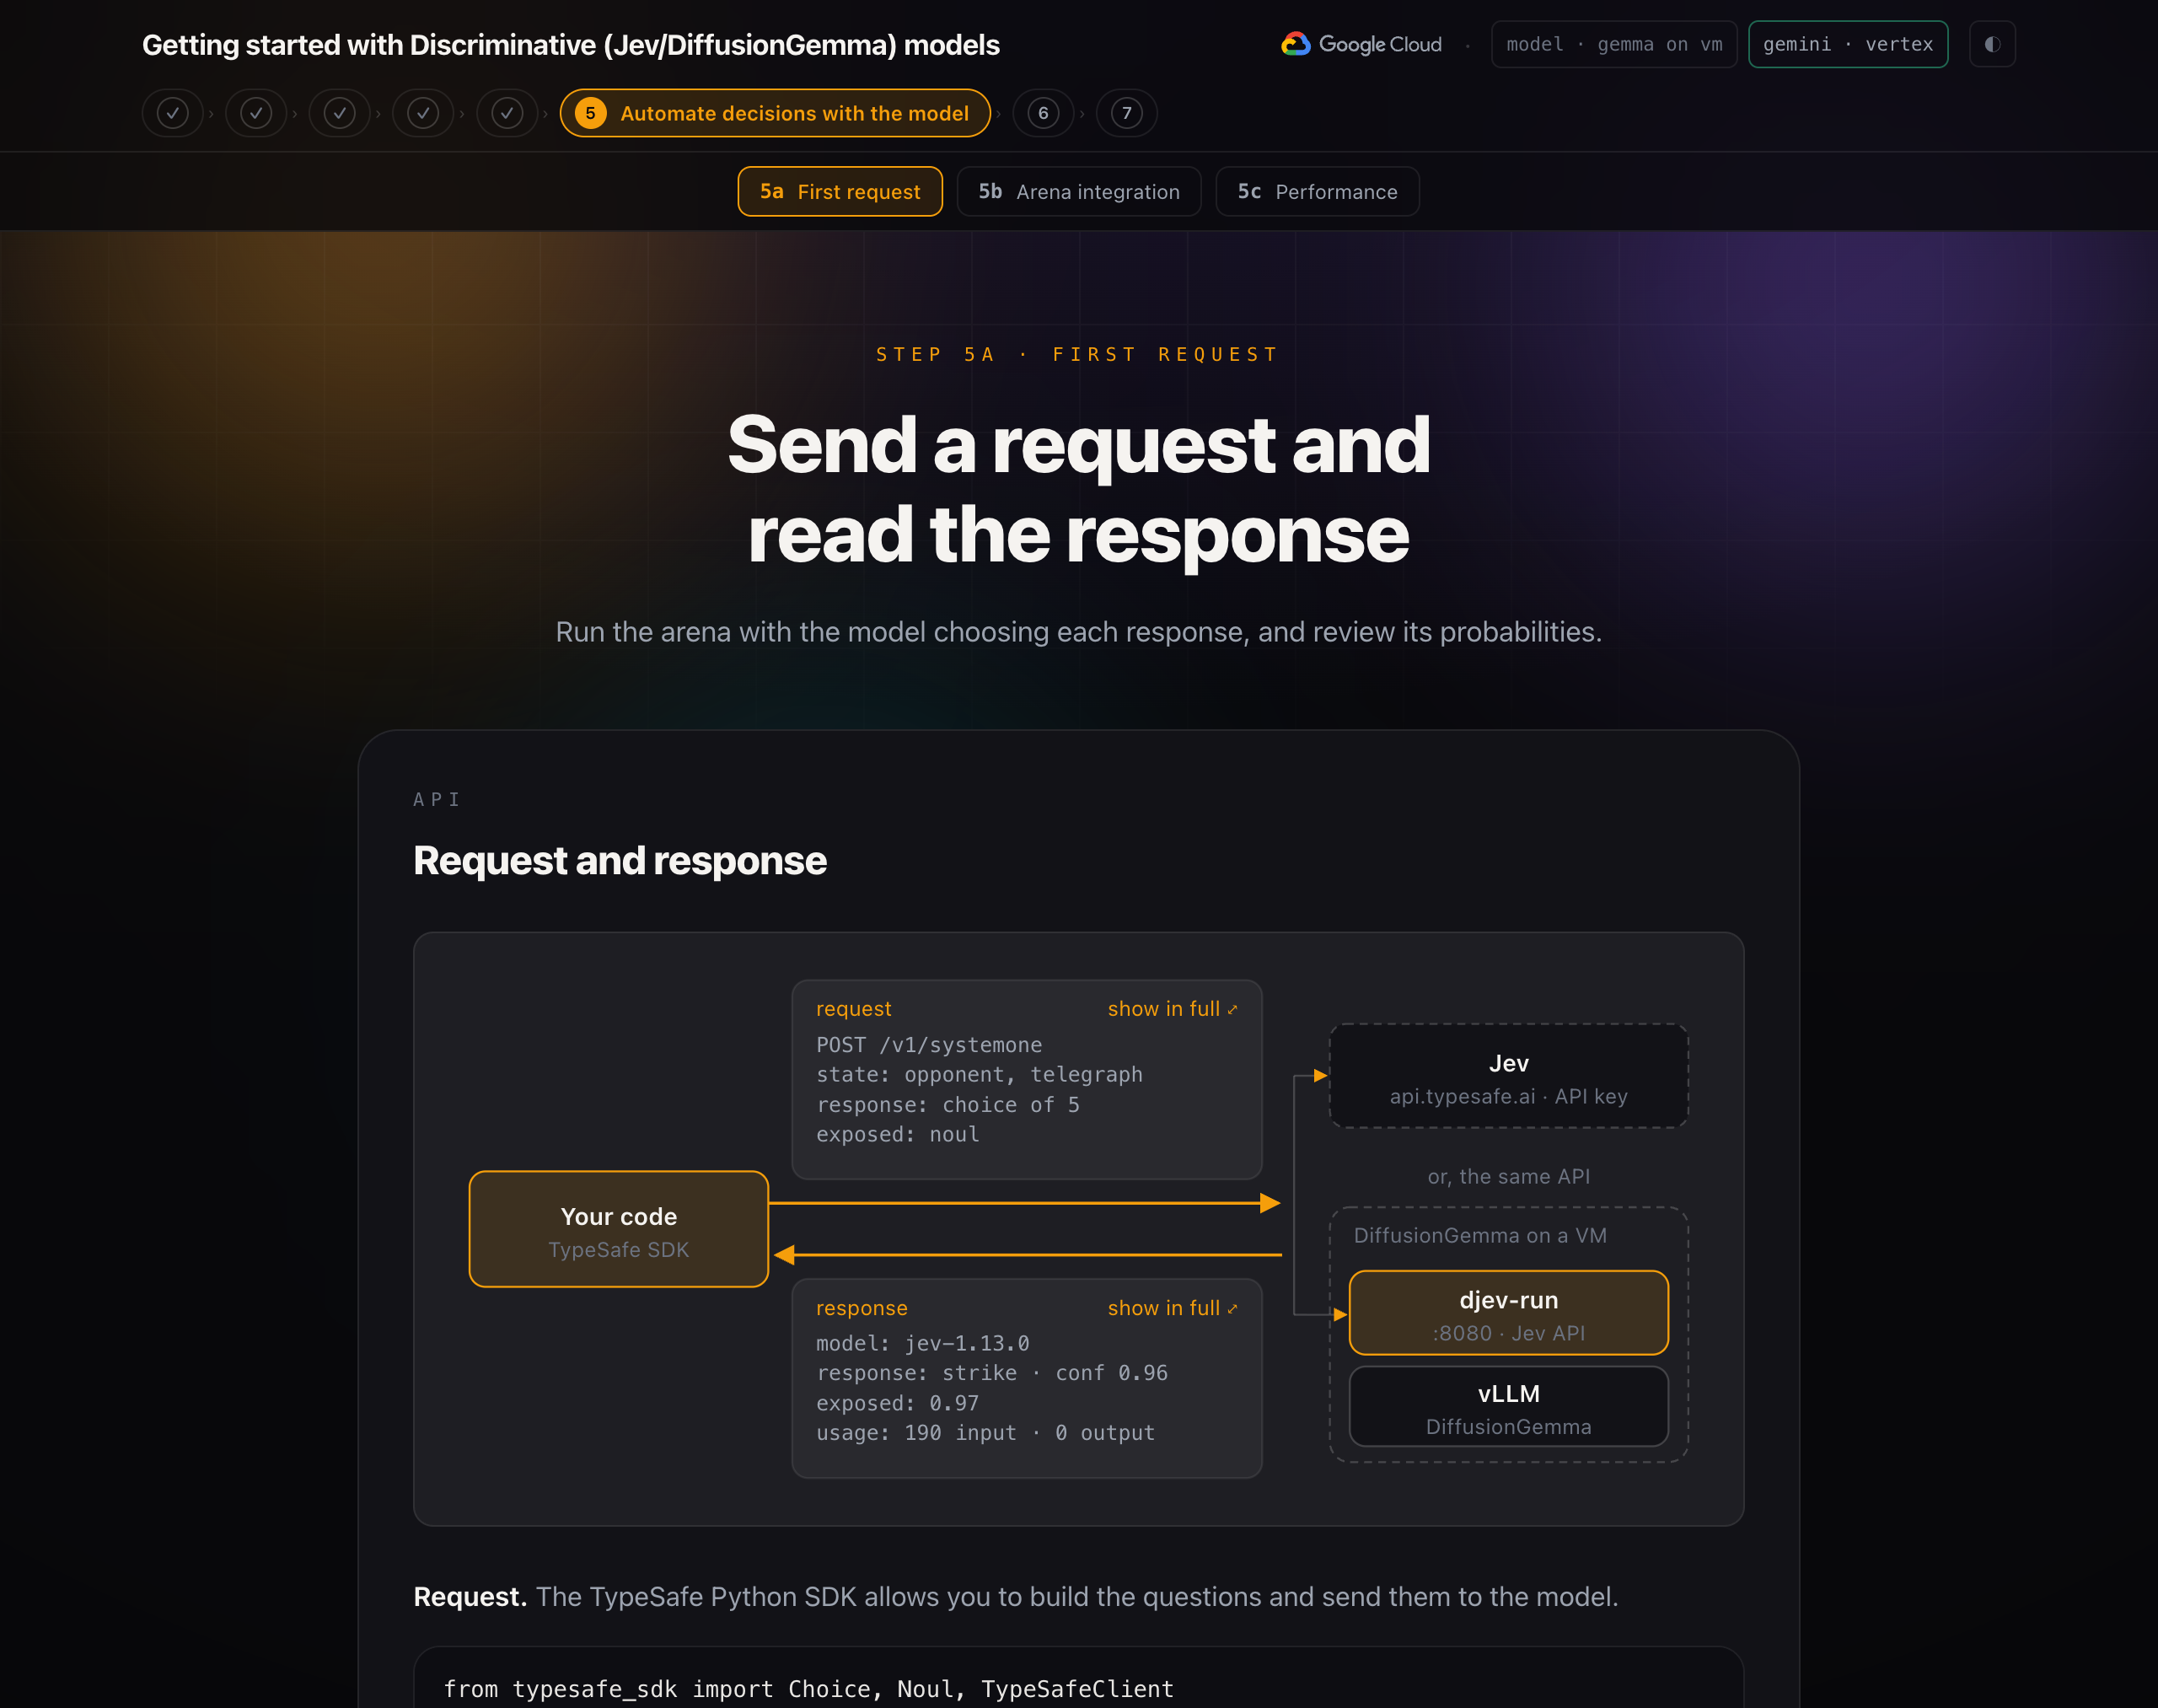
- Aplikasi arena atau alur kerja ADK membuat permintaan: status (apa yang dilakukan lawan) dan tiga pertanyaan.
- TypeSafe SDK mengirimkannya sebagai
POST /v1/systemoneke URL dasar yang dikonfigurasi. - Untuk Jev, permintaan dikirim melalui HTTPS ke
api.typesafe.ai, dengan kunci API sebagai token pembawa. - Untuk DiffusionGemma, permintaan akan dikirim ke
localhost:8096. Prosesgcloud compute start-iap-tunneldi latar belakang meneruskannya melalui Identity-Aware Proxy, yang memeriksa identitas Google Anda, ke port 8080 di VM. - Di VM, djev-run menerima permintaan, menjalankan DiffusionGemma melalui vLLM di GPU, dan membaca probabilitas setiap opsi yang diizinkan.
- Kedua backend menampilkan respons yang sama: jawaban per pertanyaan, dengan probabilitas dan skor keyakinan. Kode workshop menerapkan nilai minimum dan maksimumnya.
DiffusionGemma di Compute Engine
scripts/setup_gemma.sh membangun ini di project Anda:
- Memeriksa apakah region memiliki kuota untuk GPU.
- Mengaktifkan Compute Engine dan IAP API, serta membuat aturan firewall
allow-iap-djev. Hanya rentang alamat IAP yang diizinkan, di port 22 dan 8080. - Membuat VM
djev-l4: jenis mesing2-standard-4(4 vCPU, memori 16 GB), GPU dengan 24 GB, disk 100 GB, dan image Deep Learning VM dengan driver NVIDIA 580. Jika suatu zona tidak memiliki kapasitas GPU, zona tersebut akan mencoba zona berikutnya. - Saat booting pertama, skrip startup VM akan menginstal Docker dan NVIDIA Container Toolkit, menarik image container djev-run, mendownload bobot dari Hugging Face (17,5 GB), dan memulai container dengan akses GPU di port 8080. Proses ini memerlukan waktu sekitar 15 menit. Booting berikutnya memerlukan waktu sekitar 2 menit.
- Menulis setelan koneksi ke
.envdan membuka tunnel.
Tugas | Perintah |
Hentikan VM (mempertahankan disk) |
|
Mulai lagi |
|
Periksa tunnel |
|
Menghapus semuanya |
|
Menyiapkan model
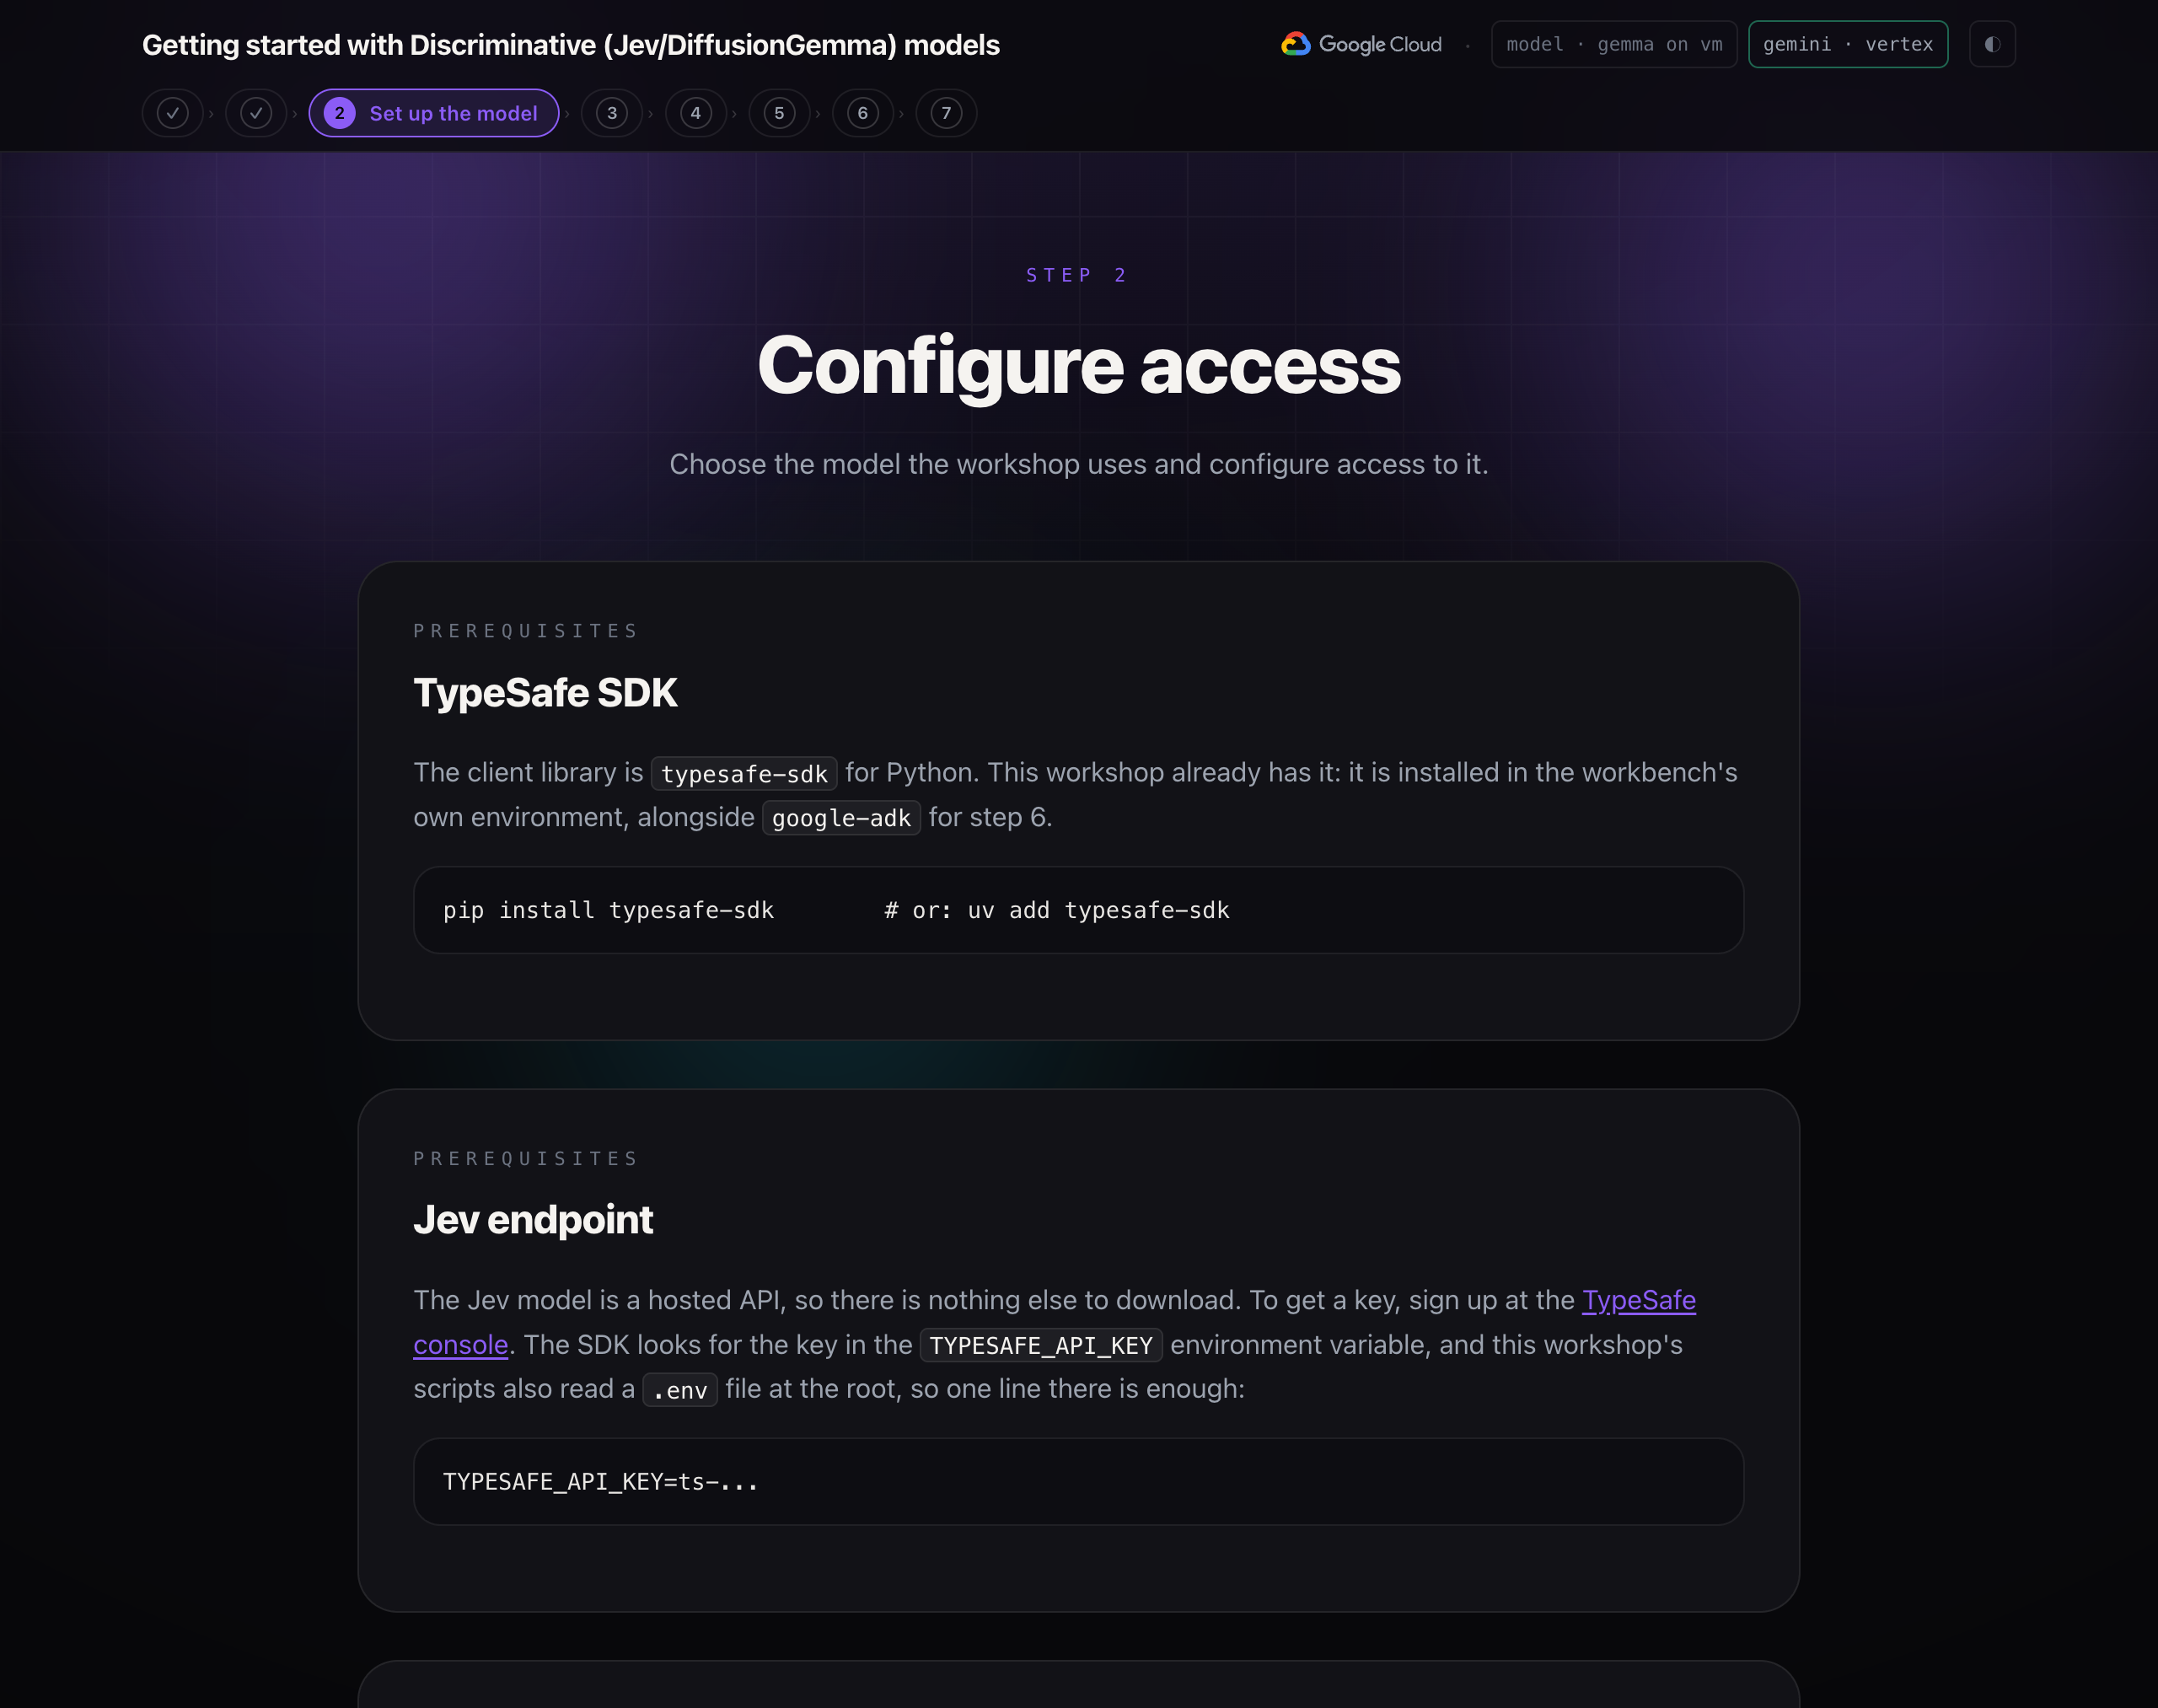
TypeSafe SDK
Library klien adalah typesafe-sdk untuk Python. Workshop ini sudah memilikinya: diinstal di lingkungan workbench itu sendiri, bersama google-adk untuk langkah 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Endpoint Jev
Model Jev adalah API yang dihosting, jadi tidak ada lagi yang perlu didownload. Untuk mendapatkan kunci, daftar di konsol TypeSafe. SDK mencari kunci di variabel lingkungan TYPESAFE_API_KEY, dan skrip workshop ini juga membaca file .env di root, jadi satu baris di sana sudah cukup:
TYPESAFE_API_KEY=ts-...
Menggunakan DiffusionGemma
djev-run menerapkan kembali API model Diskriminatif. Model ini melayani endpoint POST /v1/systemone yang sama, dengan pertanyaan noul, pilihan, dan skor yang sama, dari DiffusionGemma, model difusi terbuka Google DeepMind (total 26 miliar parameter, sekitar 4 miliar aktif, Apache 2.0). Karena format wire-nya sama, TypeSafe SDK akan berkomunikasi dengannya tanpa perubahan.
Jika Anda memilih DiffusionGemma dalam latihan, model ini akan berjalan di GPU dalam VM di project Google Cloud Anda sendiri, dan chip di kanan atas akan bertuliskan gemma on vm. Workbench mencapainya melalui tunnel IAP pribadi, dan port model tidak terbuka ke internet. Langkah 1 menjelaskan arsitektur lengkap.
Mengapa model difusi dapat melakukan hal ini: model ini mengisi seluruh blok posisi sekaligus, dengan setiap posisi melihat input penuh, sehingga probabilitas setiap opsi yang diizinkan dapat dibaca dalam satu langkah. Model bahasa normal menghasilkan satu token dalam satu waktu dan harus diambil sampelnya berulang kali.
Memainkan game secara manual
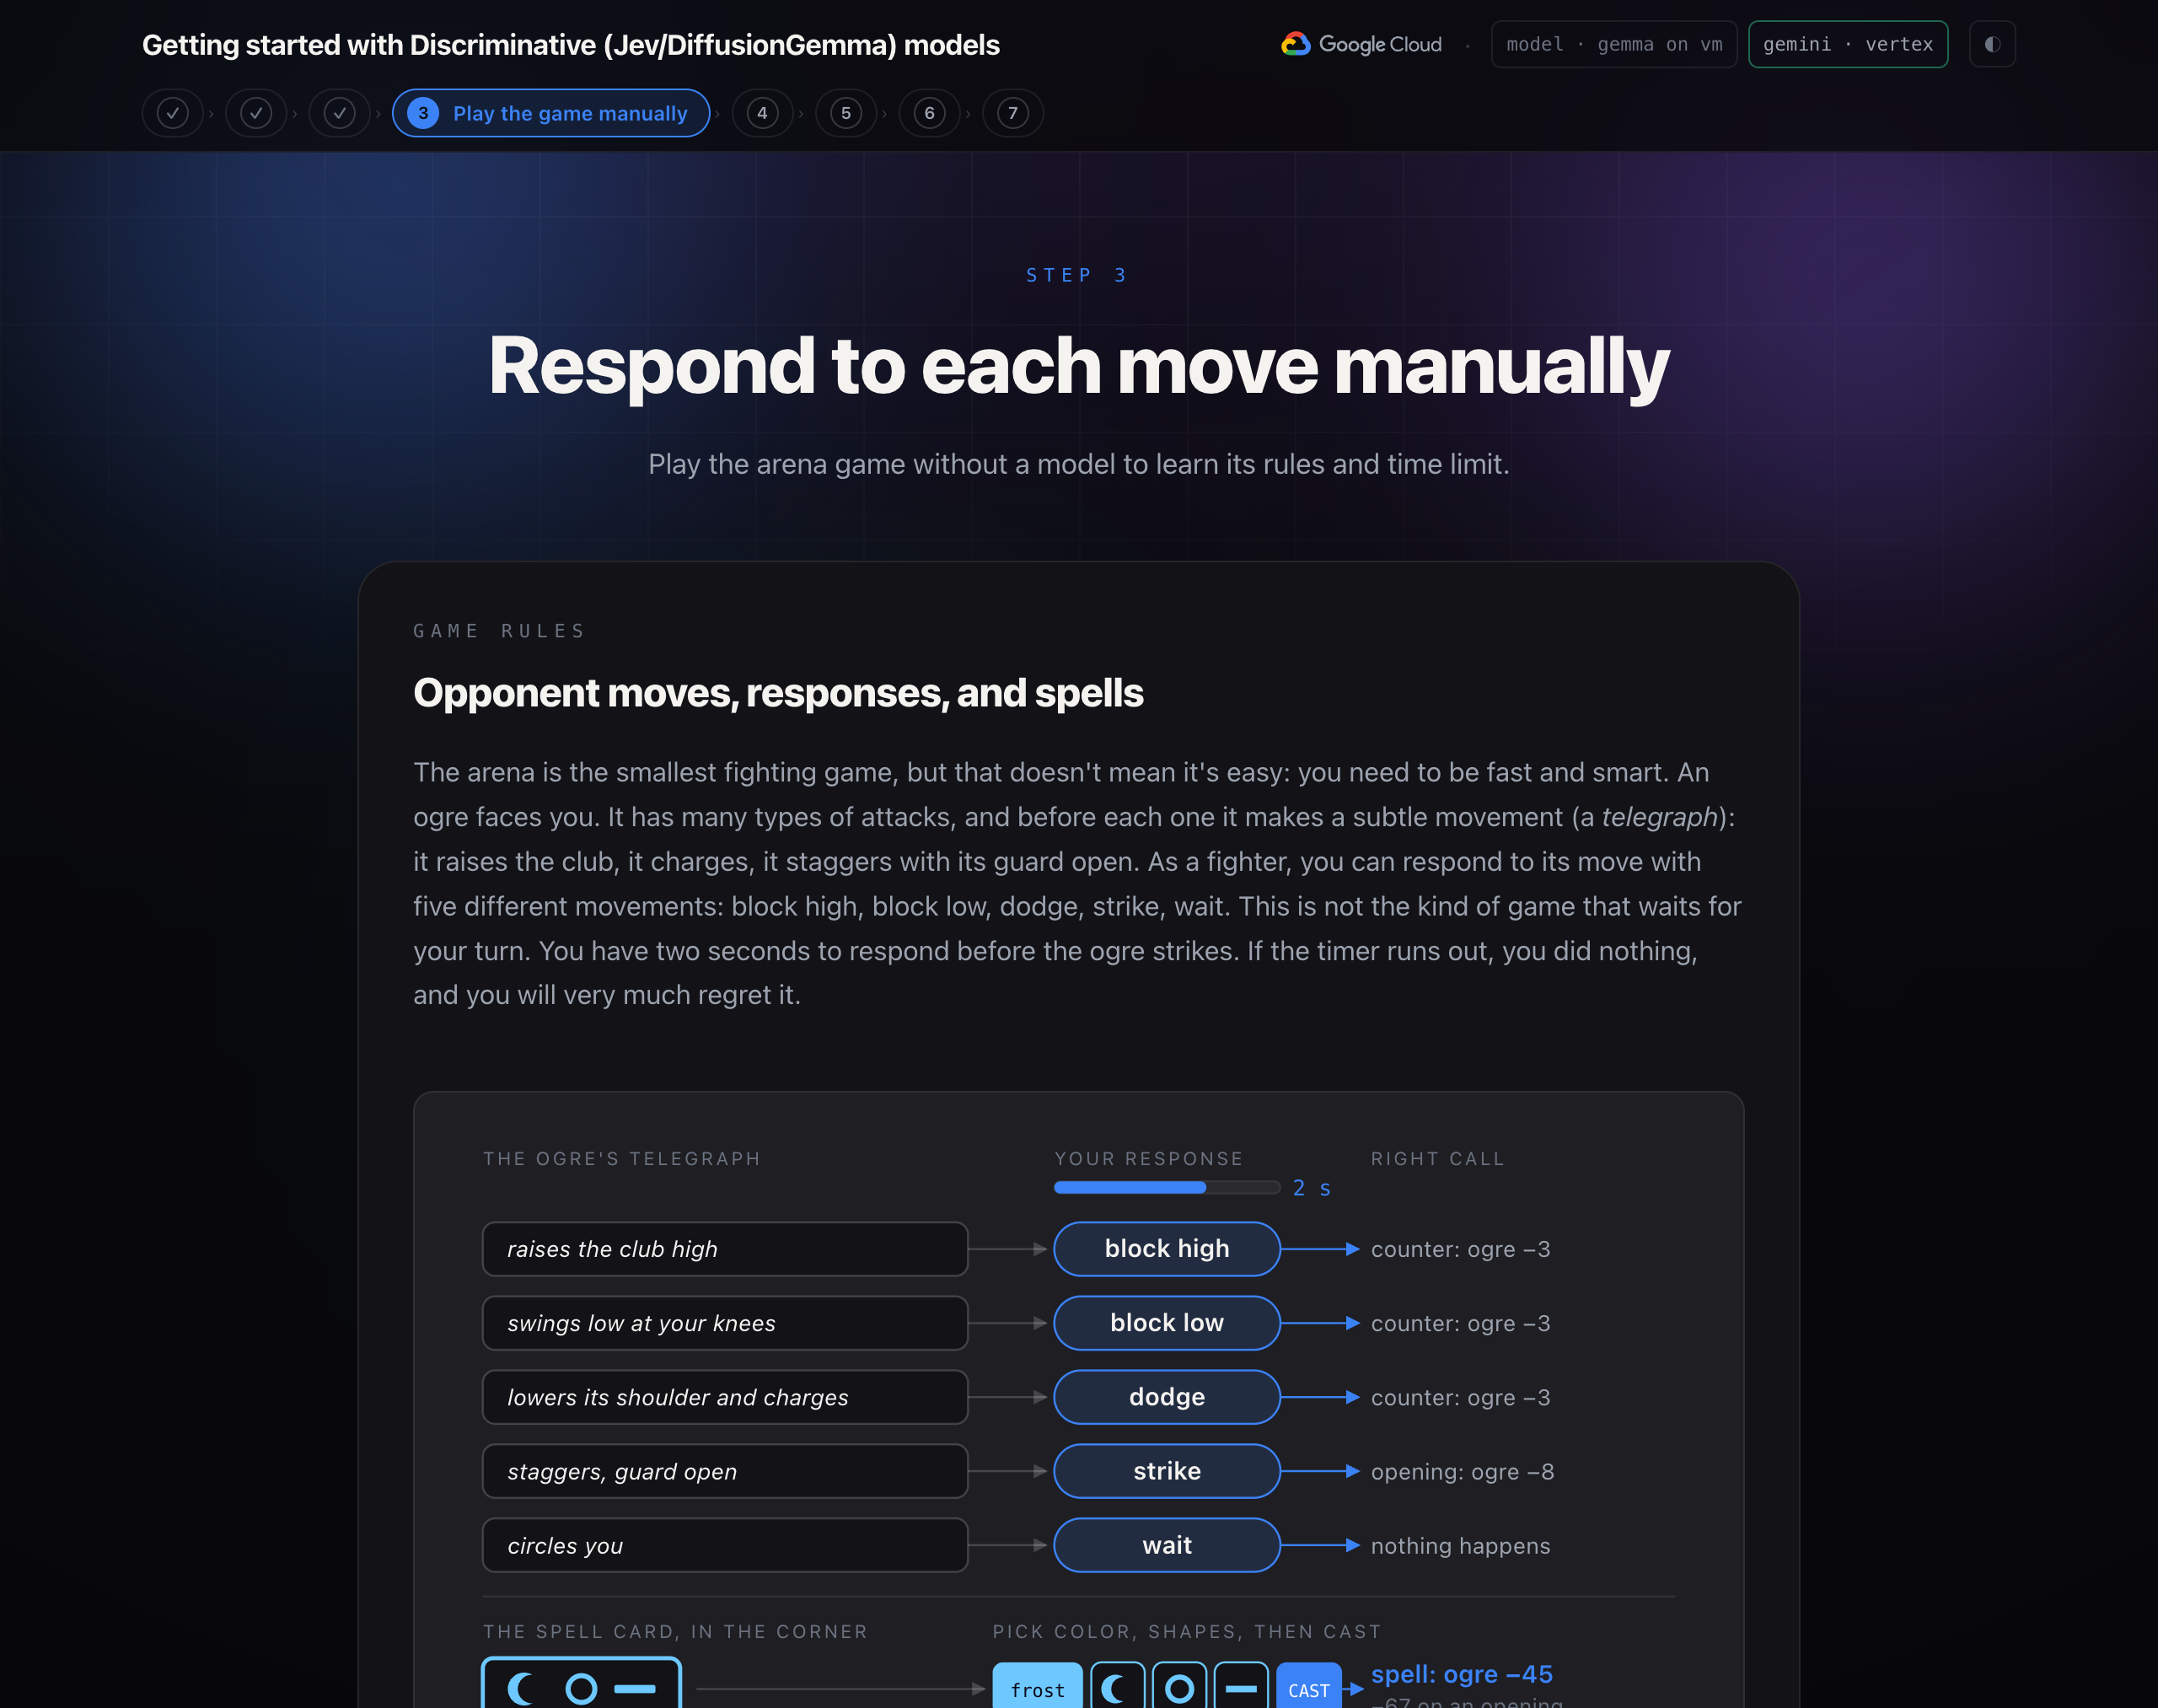
Arena adalah game pertarungan terkecil, tetapi bukan berarti mudah: kamu harus cepat dan pintar. Ogre menghadap Anda. Ia memiliki banyak jenis serangan, dan sebelum melakukan setiap serangan, ia melakukan gerakan halus (isyarat): ia mengangkat tongkat, menyerang, dan terhuyung-huyung dengan pertahanan terbuka. Sebagai petarung, Anda dapat merespons gerakannya dengan lima gerakan berbeda: menahan serangan atas, menahan serangan bawah, menghindari serangan, menyerang, menunggu. Ini bukan jenis game yang menunggu giliran Anda. Anda memiliki waktu dua detik untuk merespons sebelum raksasa menyerang. Jika timer habis, Anda tidak melakukan apa pun, dan Anda akan sangat menyesalinya.
Di sudut kiri atas lingkaran terdapat kartu ejaan: kartu berwarna dengan tiga bentuk. Hanya mantra yang cocok yang dapat memberikan kerusakan nyata. Dalam game, Anda dapat mengucapkan mantra dengan tombol di bawah pertarungan: pilih warna kartu, lalu bentuknya dari kiri ke kanan, lalu tekan CAST. Waktu terus berjalan saat Anda memilih, jadi Anda harus menyusun mantra dan bereaksi terhadap serangan ogre secara bersamaan. Tombol 1 hingga 5 masih menjawab setiap gerakan. Mantra yang salah akan gagal. Pada langkah 6, Gemini membacakan kartu mantra untuk Anda.
Poin penting: Pertarungan adalah serangkaian keputusan kecil dengan tenggat waktu di setiap keputusan. Seperti itulah tampilan sebagian besar otomatisasi software, tanpa klub.
Konsep model diskriminatif
Keputusan dalam software
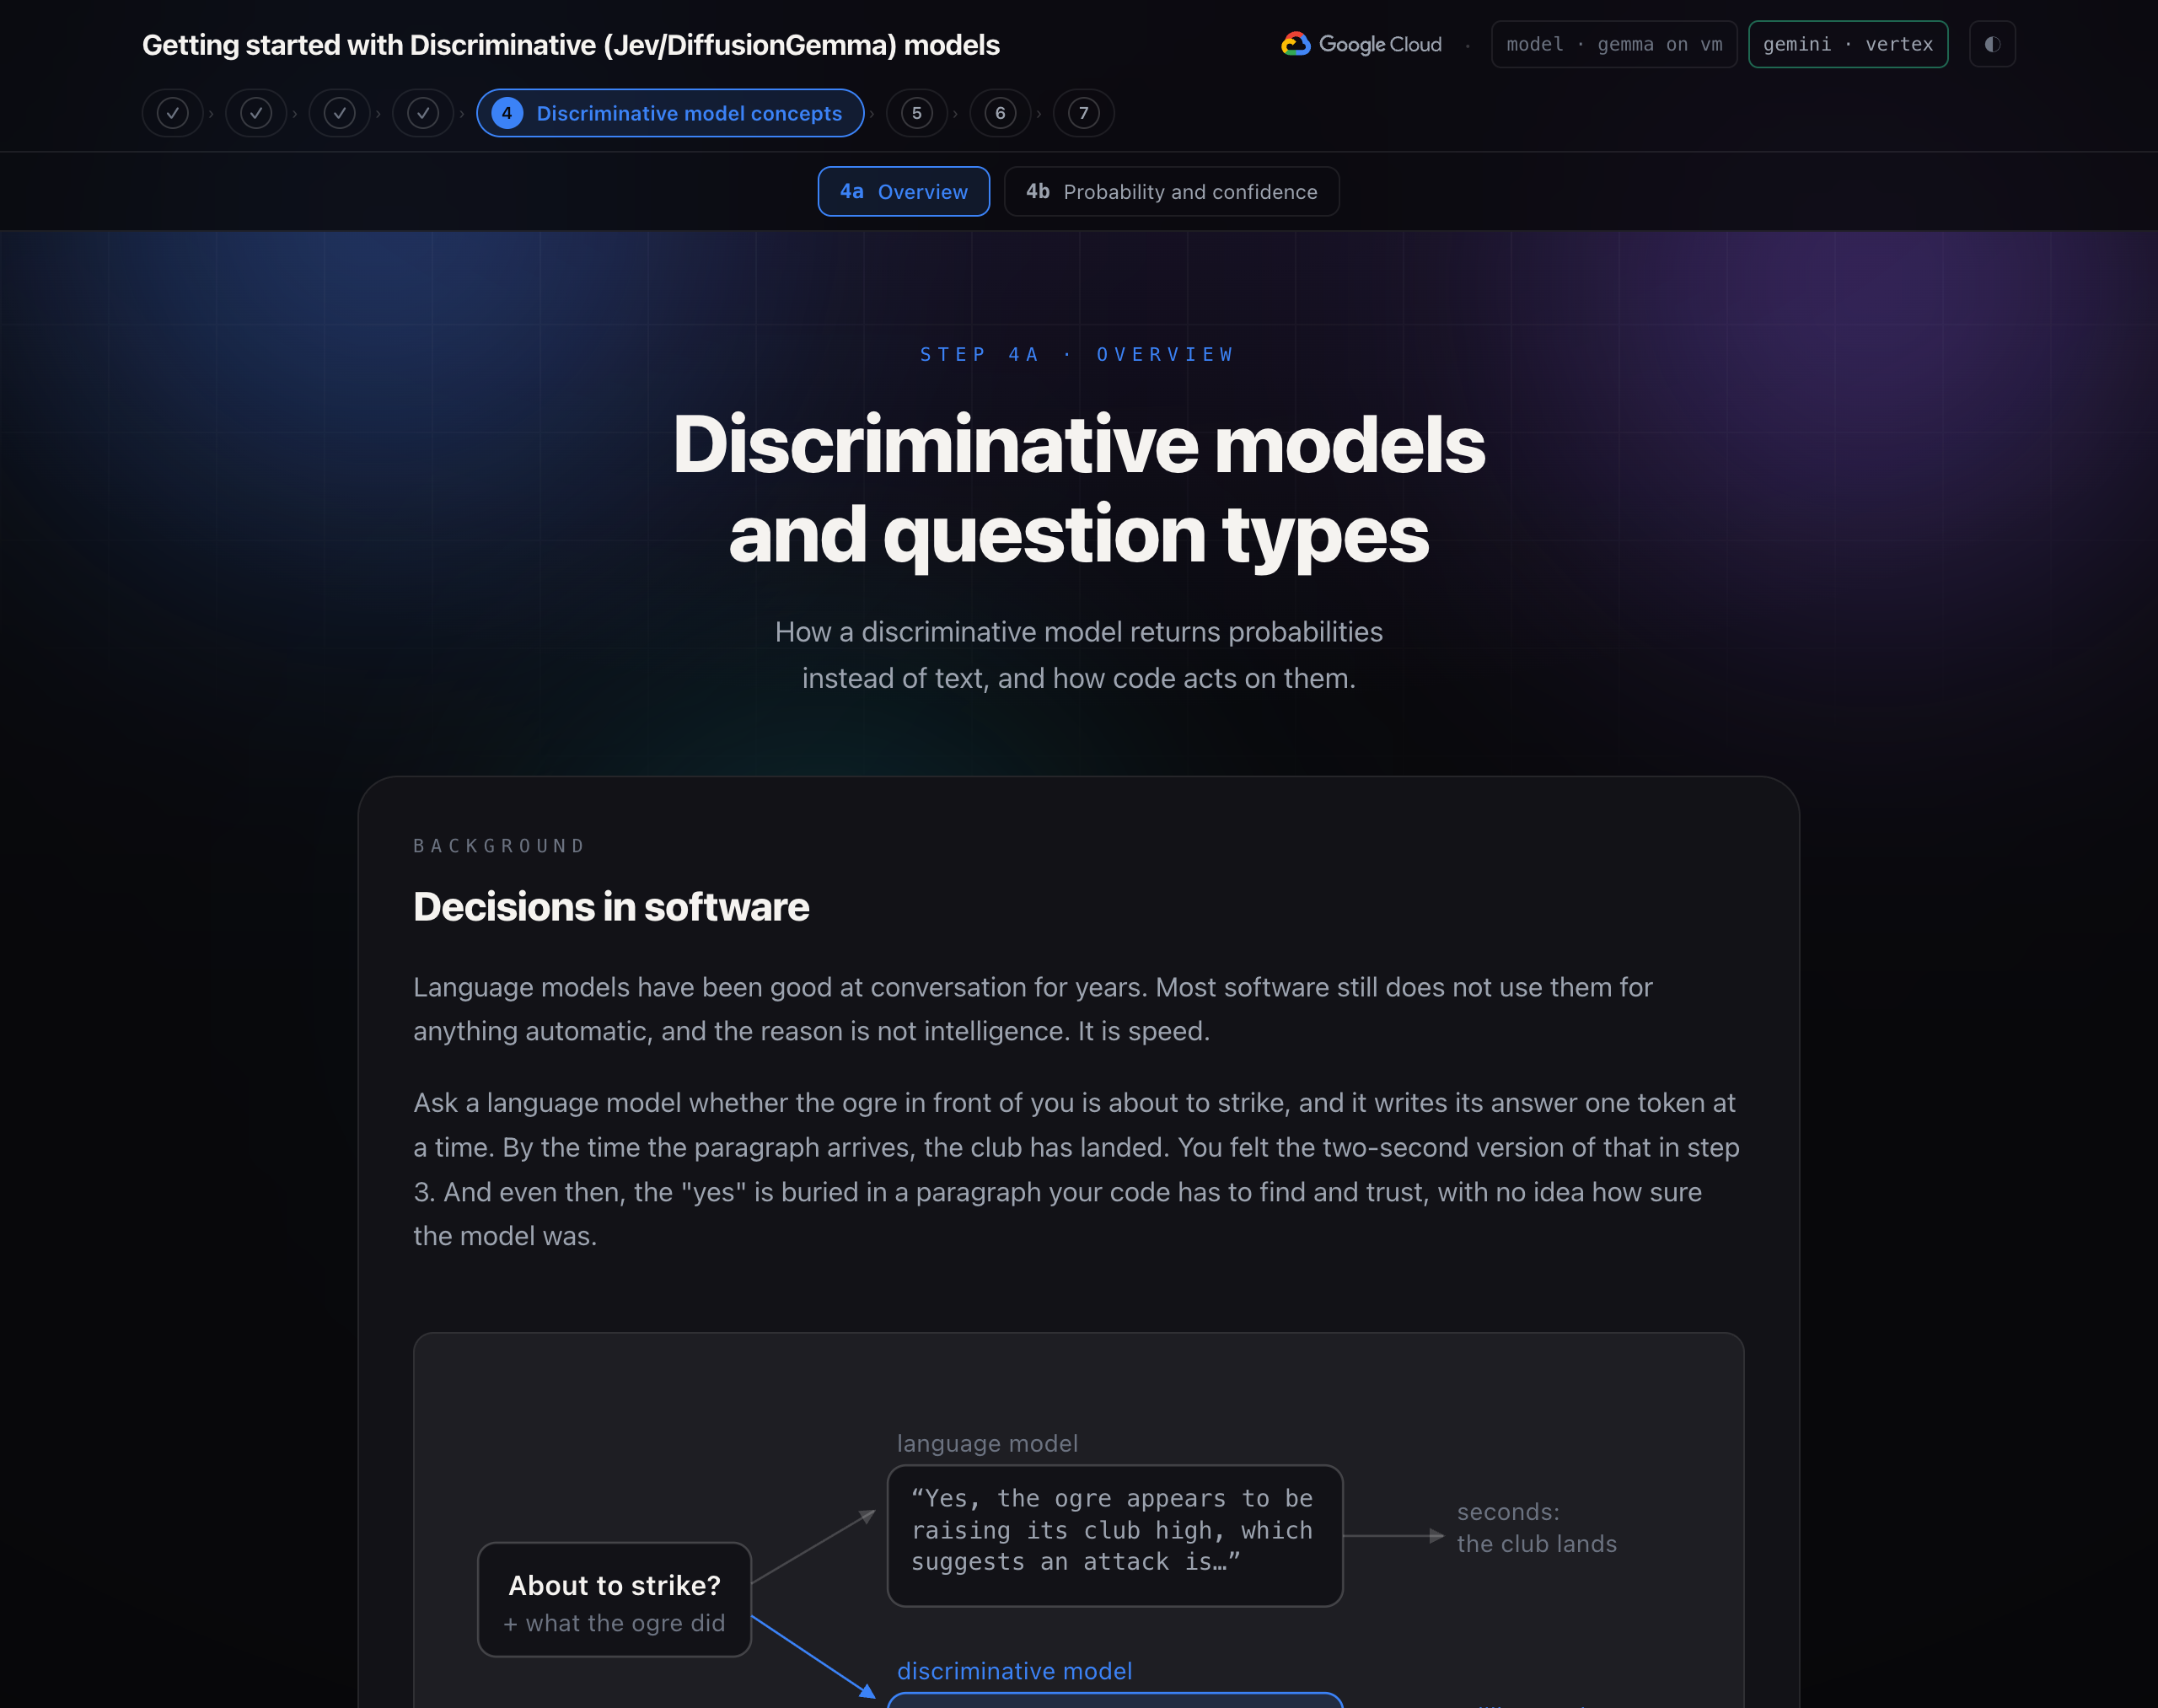
Model bahasa telah mampu melakukan percakapan dengan baik selama bertahun-tahun. Sebagian besar software masih tidak menggunakannya untuk hal-hal otomatis, dan alasannya bukan karena kecerdasan. Ini adalah kecepatan.
Tanyakan kepada model bahasa apakah raksasa di depan Anda akan menyerang, dan model akan menulis jawabannya satu token dalam satu waktu. Saat paragraf tiba, klub sudah mendarat. Anda telah merasakan versi dua detik dari langkah 3. Bahkan saat itu, "ya" tersembunyi dalam paragraf yang harus ditemukan dan dipercayai oleh kode Anda, tanpa tahu seberapa yakin model tersebut.
Model Diskriminatif mengambil status dan pertanyaan serta jawaban yang Anda ketik dalam satu proses, dalam milidetik. Setiap jawaban dilengkapi dengan probabilitas yang dikalibrasi: 0,9 berarti benar sembilan kali dari sepuluh kali. Tidak ada teks yang perlu diuraikan dan tidak ada JSON yang perlu diekstrak.
Model Sistem Satu dan Sistem Dua
Nama ini berasal dari buku Daniel Kahneman yang berjudul Thinking, Fast and Slow. Sistem Dua adalah penalaran yang lambat dan disengaja, satu langkah demi langkah. System One cepat dan mencocokkan pola.
Model bahasa adalah mesin Sistem Dua. Model ini melakukan penalaran dalam token, satu per satu. Model Diskriminatif adalah model Sistem Satu: model ini tidak memberikan alasan secara lisan, tidak membuat apa pun, dan menjawab setiap pertanyaan dalam satu kali proses. Itulah sebabnya, layanan ini cepat (sekitar 70 hingga 500 milidetik) dan murah (sepersekian sen per seribu keputusan).
Kesimpulan utama: Model bahasa menulis. Model keputusan akan memutuskan. Sebagian besar yang dibutuhkan software dari AI adalah keputusan.
Batasan
Model Diskriminatif tidak akan menghasilkan teks, menulis kode, melakukan percakapan, melakukan perhitungan aritmatika, membaca gambar, atau mengikuti serangkaian langkah.
Dalam workshop ini, kita akan memilih salah satu model Diskriminatif:
- Salah satu model Diskriminatif adalah Jev. API ini adalah API yang dihosting dari TypeSafe AI, yang dirilis pada September 2026. Model pertama adalah
jev-1.13, yang dapat diakses melalui aliasjev-latest. Tidak ada bobot yang dipublikasikan, sehingga bobot dipanggil, bukan didownload. - Jev bukan satu-satunya cara untuk mendapatkan model System One. DiffusionGemma dari Google adalah model dengan bobot terbuka yang menulis seluruh blok token secara paralel, bukan satu per satu, dan proses paralel yang sama dapat membaca probabilitas dari serangkaian opsi tetap. Server open source seperti djev-run menempatkan API persis Jev di depannya, sehingga semua yang ada di workshop ini berjalan tanpa perubahan.
Negara bagian dan pertanyaan: Choice, Score, dan Noul
Setiap panggilan mengirimkan status dan pertanyaan. Status adalah teks yang ingin Anda nilai. Nilai ini dapat berupa string, objek JSON, atau daftar. Pertanyaan tersebut menanyakan apa yang ingin Anda ketahui tentang teks tersebut. Setiap pertanyaan memiliki jenis: Pilihan, Skor, atau Noul. Pertanyaan diproses secara paralel, sehingga memungkinkan model merespons dengan cepat. Anda dapat menambahkan beberapa pertanyaan jika diperlukan.
- Pilihan memilih satu opsi dari sekumpulan opsi yang Anda beri nama, hingga 255 opsi. Jawabannya adalah opsi, probabilitas untuk setiap opsi, dan keyakinan. Gunakan saat opsi tidak memiliki urutan di antaranya: blokir tinggi, blokir rendah, hindari, serang, tunggu.
- Skor memberi peringkat status di sepanjang tingkat berurutan yang Anda jelaskan, dari dua hingga sepuluh tingkat. Jawabannya adalah posisi di sepanjang skala (desimal, jadi 1,4 berarti "antara satu dan dua, lebih dekat ke satu"), probabilitas setiap tingkat, dan tingkat keyakinan. Gunakan saat jawaban berupa tingkat: seberapa keras pukulan yang masuk akan mendarat.
- Pilihan dan Skor menampilkan probabilitas untuk setiap opsi dan keyakinan. Perbedaannya adalah jawaban utama. Pilihan (Choice) menampilkan opsi yang paling mungkin. Skor memperlakukan opsi sebagai tingkat yang diurutkan dan menampilkan rata-rata berbobot probabilitasnya, yang dapat berada di antara dua tingkat. Dengan tidak ada 0,05, ringan 0,55, dan berat 0,40, Choice menjawab "ringan" dan Score menjawab 1,35, antara ringan dan berat. Arena menggunakan nilai tersebut:
choose()memperlakukan skor bahaya 1,5 atau lebih sebagai pukulan berat.
- Pilihan dan Skor menampilkan probabilitas untuk setiap opsi dan keyakinan. Perbedaannya adalah jawaban utama. Pilihan (Choice) menampilkan opsi yang paling mungkin. Skor memperlakukan opsi sebagai tingkat yang diurutkan dan menampilkan rata-rata berbobot probabilitasnya, yang dapat berada di antara dua tingkat. Dengan tidak ada 0,05, ringan 0,55, dan berat 0,40, Choice menjawab "ringan" dan Score menjawab 1,35, antara ringan dan berat. Arena menggunakan nilai tersebut:
- Noul mengajukan pertanyaan ya/tidak dan menampilkan probabilitas bahwa jawabannya adalah ya. Mendekati 1 berarti sangat ya, mendekati 0 berarti sangat tidak, mendekati 0,5 berarti "bisa jadi". Tidak ada keyakinan terpisah, karena probabilitas adalah tingkat keyakinannya.
Menulis pertanyaan yang terfokus
Model Diskriminatif berfungsi paling baik saat pertanyaan menanyakan satu hal spesifik yang tercakup dengan baik. "Bagaimana situasinya?" menampilkan jawaban yang masuk akal dengan tingkat keyakinan rendah. "Apa respons yang tepat?", "Apakah lawan rentan?", dan "Seberapa parah dampaknya?" menampilkan tiga jawaban terfokus yang digabungkan oleh kode Anda.
Deskripsi tentang opsi dan level tidak mahal dan penting. Aturan yang Anda baca di langkah 3 menjadi deskripsi opsi: block_high: "Raise the shield. Right against an overhead or a high swing." Dengan begitu, model Diskriminatif mempelajari aturan pertarungan, pada waktu permintaan, dalam satu baris. Opsi juga dapat berubah sesuai situasi: arena hanya menawarkan cast saat mantra siap.
Probabilitas dan keyakinan
Jawaban Pilihan bukan label. Ini adalah distribusi label, dan labelnya hanyalah batang tertinggi.
Cara model mendapatkan angka. Cara ini menggunakan langkah yang sama dengan yang digunakan model bahasa untuk memilih kata berikutnya. Transformer membaca teks dan, pada satu posisi, memberikan skor mentah untuk setiap token dalam kosakata, yang disebut logit. Logit yang lebih tinggi berarti token lebih cocok dengan posisi tersebut. softmax mengubah logit menjadi probabilitas yang berjumlah 1. Kemudian, model bahasa memilih satu token, menambahkannya ke teks, dan mengulanginya. Model diskriminatif berhenti setelah probabilitas.
Kosong adalah celah dalam formulir jawaban. Server menulis formulir itu sendiri, seperti response: ▢, dan menyisakan satu celah per pertanyaan. Satu-satunya tugas model adalah memberi skor pada apa yang termasuk dalam setiap celah.
- Perintah menyimpan status dan setiap pertanyaan, dengan setiap jawaban yang diizinkan sebagai label singkat:
auntuk block_high,buntuk block_low, dan sebagainya. - Server menambahkan formulir jawaban, dengan satu kolom kosong per pertanyaan.
- Model membaca perintah dan formulir dalam satu kali proses dan memberikan logit setiap token di setiap bagian kosong. Model difusi melihat seluruh formulir sekaligus dan memberi skor pada semua kotak kosong secara bersamaan.
- Server hanya menyimpan logit label yang diizinkan dan menerapkan softmax padanya, sehingga jawaban yang diizinkan berjumlah 1.
- Jika pembacaan terlihat tidak pasti, server akan membaca lagi dari awal acak lain dan merata-ratakan pembacaan.
Keyakinan adalah satu angka yang menunjukkan seberapa yakin jawaban tersebut. TypeSafe menghitungnya dari seberapa besar probabilitas tersebar di seluruh opsi. Semua opsi pada satu pilihan memberikan nilai 1, dan penyebaran yang merata memberikan nilai 0. Untuk tiga opsi, rumusnya adalah (3 × terbesar − 1) / 2.
TypeSafe melatih Jev untuk probabilitas yang terkalibrasi. Probabilitas cocok dengan seberapa sering jawabannya benar. Dalam model yang dikalibrasi, jawaban yang diberikan pada 0,7 benar sekitar 70% dari waktu, sehingga batas keyakinan adalah batas seberapa sering Anda menerima jawaban yang salah. Server DiffusionGemma dalam workshop ini melaporkan probabilitas teratasnya sendiri sebagai keyakinan, yang dirata-ratakan di seluruh pembacaannya. Jika pembacaan tidak sesuai, rata-rata akan menyebar dan keyakinan akan menurun.
Poin penting: Jawaban memberi tahu Anda apa. Tingkat keyakinan memberi tahu Anda apakah harus bertindak.
Batas
Nilai minimum adalah cara Anda menentukan tindakan dalam kode. Model menampilkan keyakinan atau probabilitas. Kode Anda membandingkannya dengan angka yang Anda pilih, dan hasilnya menentukan apa yang terjadi.
Nilai minimum per tindakan. TypeSafe menyarankan untuk membagi keyakinan menjadi beberapa rentang. Tingkat keyakinan tinggi bertindak sendiri. Tindakan dengan tingkat keyakinan sedang, seperti meminta konfirmasi atau menandai kasus untuk ditinjau. Tingkat keyakinan rendah tidak bertindak, dan kembali ke sesuatu yang aman atau ke orang.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Aturan arena. Nilai minimum arena berada di choose(), yang Anda jalankan di langkah 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Peringatan: Jawaban yang valid tidak selalu benar. Model Diskriminatif tidak dapat menampilkan opsi yang tidak Anda tawarkan, sehingga tidak pernah berhalusinasi gerakan, tetapi dapat memilih yang salah, terkadang dengan keyakinan yang tinggi. Uji pertanyaan Anda terhadap situasi yang telah Anda nilai sebelumnya sebelum Anda memercayai nilai minimum.
Mengotomatiskan keputusan dengan model
Permintaan dan respons
Permintaan. TypeSafe Python SDK memungkinkan Anda membuat pertanyaan dan mengirimkannya ke model.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Satu permintaan per tanda centang
Setiap detak, aplikasi mengirimkan telegraf sebagai status dan meminta tiga hal dalam satu panggilan:
- Respons mana yang benar, dari lima (atau enam, saat mantra siap). Pilihan.
- Apakah ogre saat ini terpapar ke penghitung. A Noul.
- Seberapa sulit hit masuk, berdasarkan rubrik tiga tingkat. Skor.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Fungsi choose()
Ingat nilai minimum dari langkah 4? choose() membandingkan jawaban model dengan angka tetap, dan angka tetap ini adalah nilai minimum.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() adalah pembacaan nilai yang diketik Python biasa, dengan dua aturan. Model Diskriminatif memberikan probabilitas dan analisisnya, dan kode menggunakan nilai minimum untuk aturan. Tindakan yang dipilih dikirim ke mesin, tempat tindakan tersebut akan digunakan untuk melawan raksasa.
Kesimpulan penting: Simpan pertanyaan dan nilai minimum di satu tempat. Ini adalah bagian dari integrasi System One yang paling sering Anda sesuaikan.
Waktu respons, harga berbasis input, dan logika keputusan
- Waktu respons per keputusan. Setiap tanda pertarungan di bagian b kembali dalam sekitar seratus milidetik, beberapa dalam dua atau tiga. Hal ini cukup cepat untuk loop game, jalur permintaan, atau pemeriksaan pada setiap pesan sebelum dilihat oleh orang atau model bahasa.
- Harga berbasis input. Seluruh pertarungan, enam puluh keputusan dengan tiga pertanyaan masing-masing, harganya jauh di bawah sepersepuluh sen. Token output adalah nol karena tidak ada yang dihasilkan. Konsekuensinya adalah Anda dapat meminta lebih banyak dari yang Anda butuhkan. Arena menanyakan apakah ogre terekspos pada setiap tick meskipun hanya
strikedancastyang peduli, karena bertanya hampir gratis dan jawabannya berguna di dasbor. TypeSafe menyebutnya speculative fan-out. - Menggabungkan kepercayaan diri dan bahaya. Jika tingkat keyakinan model Diskriminatif terhadap responsnya di bawah 0,40 dan skor bahaya menunjukkan bahwa serangan berat akan datang,
choose()akan menggantikannya dengan menghindar. Menghindar jarang menjadi jawaban terbaik, tetapi juga jarang menjadi jawaban terburuk. Pilih nilai minimum dari biaya setiap kesalahan, bukan dari angka bulat, dan uji terhadap sinyal yang telah Anda nilai secara manual. Saran TypeSafe sendiri: jika keputusan terus salah, perketat pertanyaan sebelum Anda memindahkan nilai minimum.
Menggabungkan model dalam alur kerja ADK
Batasan keputusan per-tick dan alasan respons yang benar saja tidak cukup
Baris terakhir pertarungan di langkah 5 mengatakan: raksasa itu berjalan pergi, hampir tidak tergores. Model Diskriminatif tidak menerima damage dan memberikan sedikit damage pada setiap tick, dan 300 poin hit lebih dari sedikit dikalikan enam puluh. Kartu mantra di sudut ring sudah ada di sana selama ini. Untuk membacanya, diperlukan model yang dapat melihat gambar.
Ogre memiliki 300 poin hit. Panggilan yang benar dihitung 3. Pukulan ke dalam bukaan menghasilkan 8, karena kulitnya tebal. Bahkan pertarungan enam puluh tick yang sempurna membuat raksasa itu terluka dan tetap berdiri, dan game menyebutnya seri. Di sinilah langkah 5 berakhir: model bertahan dengan baik dan tetap tidak dapat menang.
Hanya mantra yang memberikan kerusakan nyata: 45 untuk casting yang sempurna, 67 saat mendarat di celah.
Menetapkan setiap tugas ke model yang tepat
Kartu mantra di sudut ring adalah cara untuk menang, dan membacanya bukanlah masalah teks: itu adalah gambar, dengan warna dan tiga bentuk berturut-turut, dan mantra harus dinyanyikan agar cocok. Hal itu memerlukan model yang dapat melihat gambar dan memprosesnya selama beberapa detik. Dalam pertarungan, beberapa detik adalah sepuluh detak.
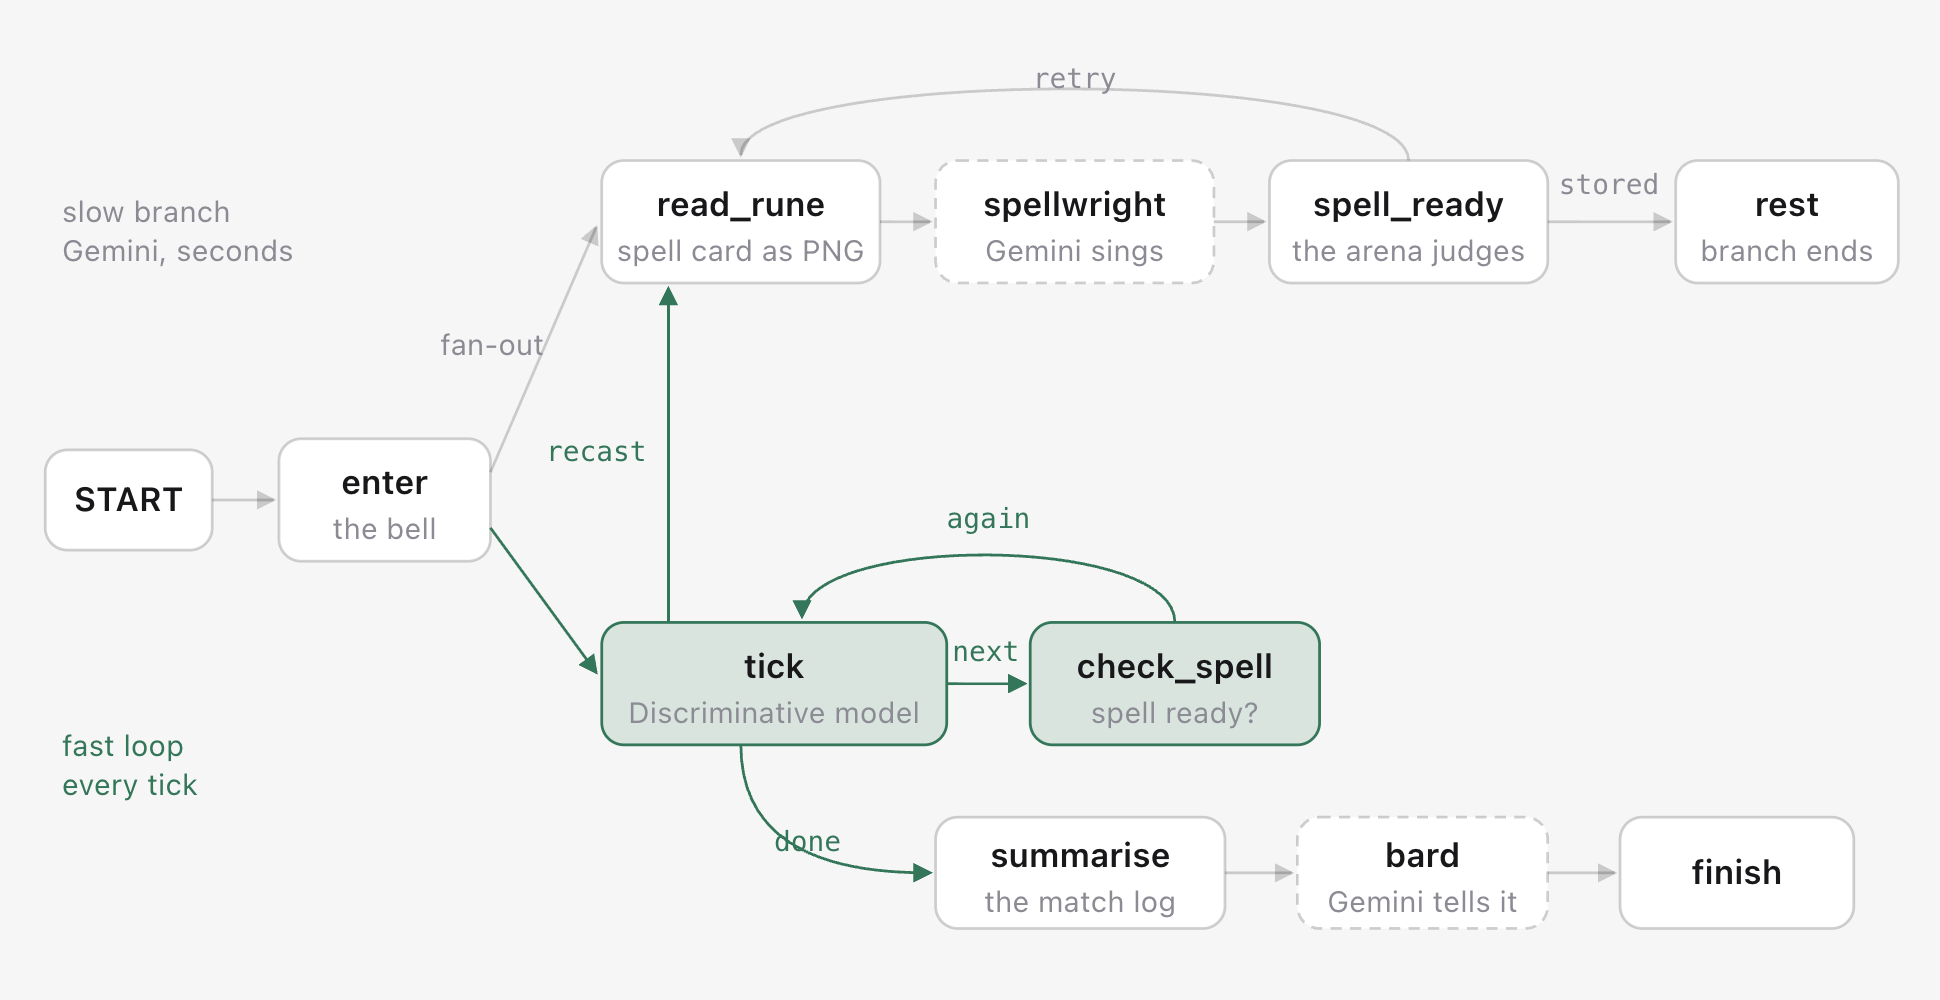
Jadi, alur kerja menggunakan keduanya, masing-masing dengan kecepatannya sendiri:
- Model Diskriminatif bertarung. Setiap centang, satu panggilan, satu keputusan, seratus milidetik. Loop tidak pernah menunggu apa pun yang lebih lambat dari dirinya sendiri.
- Gemini membaca dan bernyanyi. Di cabangnya sendiri, yang dimulai saat bel berbunyi, ia mengambil kartu mantra dari layar arena sebagai gambar, menyebutkan warna dan bentuknya, serta menyanyikan mantra. Arena menilai kecocokan lagu dengan jawaban kartu mantra, yang tidak pernah keluar dari server.
- Setelah setiap pertukaran, petarung memeriksa slot. Node
check_spellmelihat status. Belum siap: hal ini ditunjukkan dengan berapa lama Gemini telah bernyanyi, dan langsung kembali ke tanda berikutnya. Tidak pernah menunggu. Siap:castbergabung dengan opsi yang ditawarkan model Diskriminatif, danchoose()mengucapkan mantra saat model Diskriminatif melaporkan peluang. Saat mantra habis, layar akan menggambar kartu mantra baru dan thread lambat akan dimulai lagi. Lagu yang salah dibaca akan membakar kartu mantra, dan thread lambat akan membaca kartu yang baru. - Gemini menulis cerita pendek satu kali, di bagian akhir.
Cabang paralel dengan latensi yang berbeda dan satu loop peristiwa
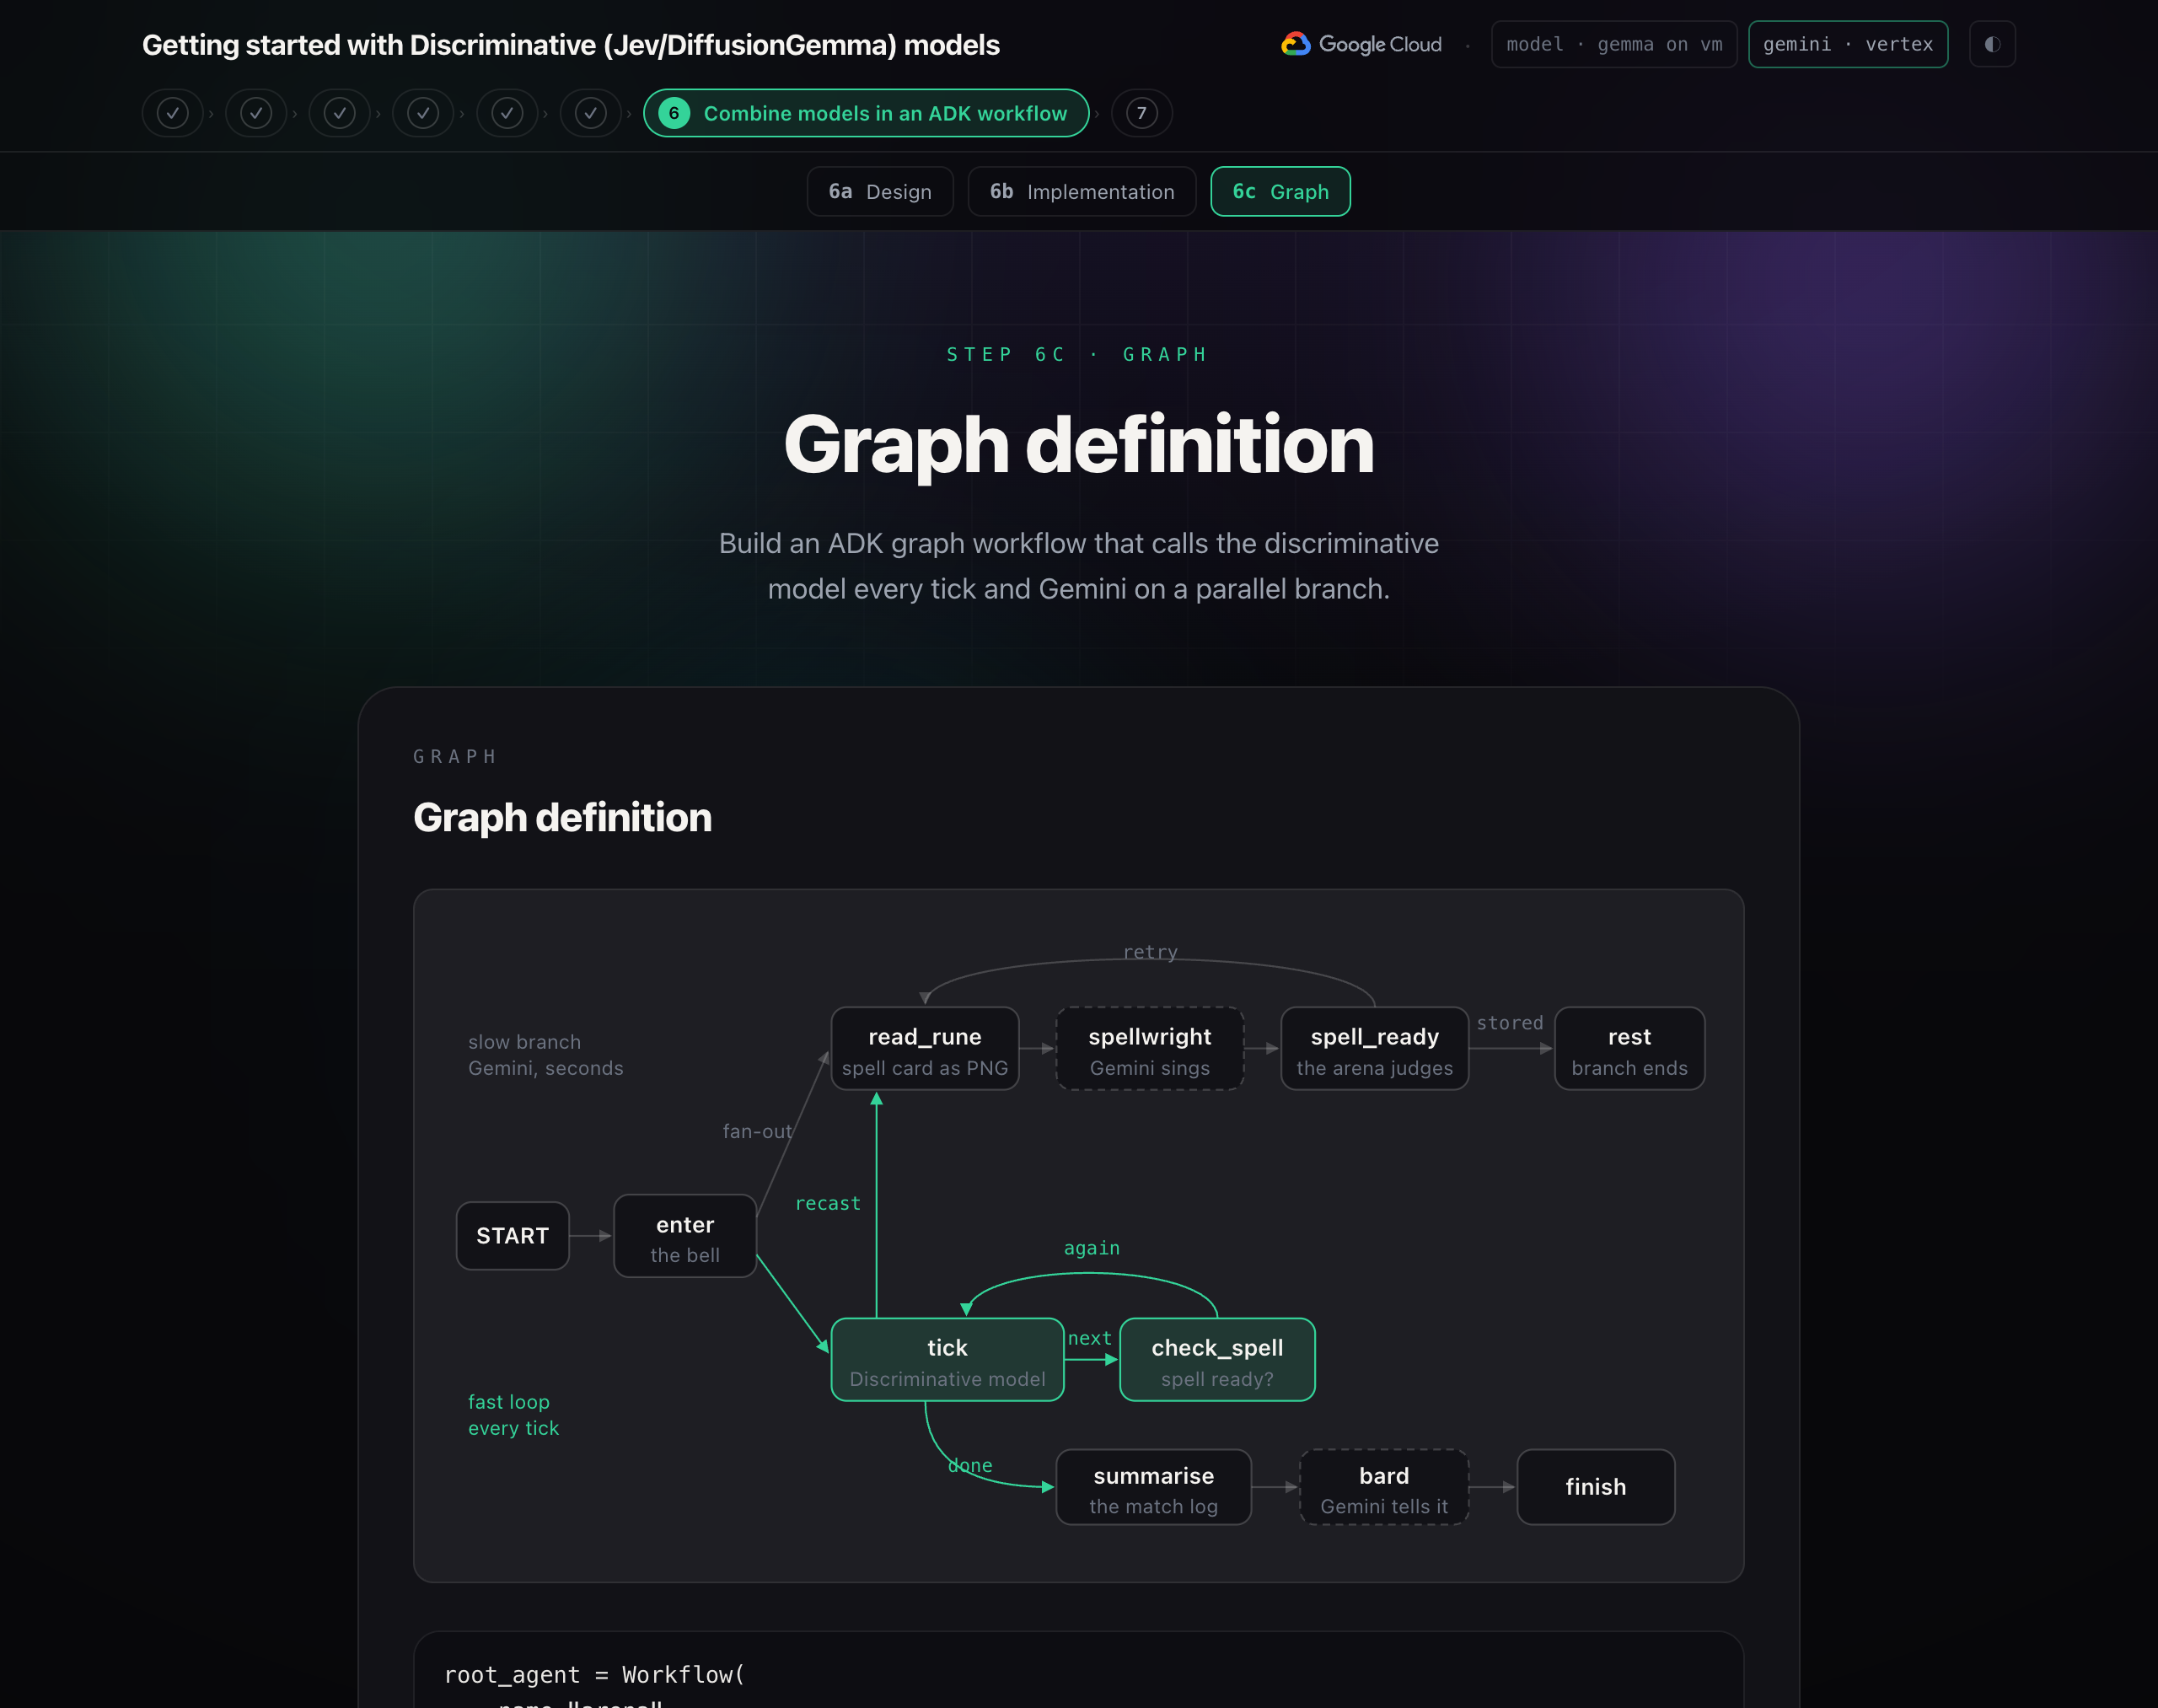
Ini adalah Alur Kerja ADK: grafik node yang digabungkan oleh tepi. Node adalah fungsi Python biasa atau agen LLM. Edge dari satu node ke tuple node adalah fan-out: keduanya dimulai secara bersamaan. Node yang menampilkan Event dengan route akan memilih tepi mana yang akan diambil berikutnya, dan node yang merutekan ke dirinya sendiri adalah loop.
Anggap saja seperti dua rangkaian. Thread 1 lambat: membaca kartu mantra, bernyanyi, menyimpan mantra. Thread 2 cepat: centang, periksa slot, centang lagi. Thread 1 berakhir dalam fungsi yang menulis ejaan yang dinilai ke state sesi dan tidak menampilkan output. check_spell Thread 2 membaca status tersebut setelah setiap pertukaran. Kedua thread tidak memanggil atau menunggu thread lain; keduanya hanya berbagi status.
Kesimpulan utama: Masukkan keputusan ke dalam kode dan berikan setiap model tugas yang sempit dengan kecepatannya sendiri.
ADK menjalankan kedua cabang sebagai tugas pada satu loop peristiwa, dalam satu thread. Hanya satu tugas yang berjalan dalam satu waktu. Saat tugas mencapai await, tugas akan menunggu jawabannya, dan loop menjalankan cabang lainnya sementara itu. Cabang cepat menunggu model selama sekitar sepersepuluh detik, dan cabang lambat menunggu Gemini selama beberapa detik, sehingga keduanya tidak saling menghambat.
Cabang lambat
read_rune() mengambil kartu mantra dari layar sebagai gambar.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright adalah Gemini. Model ini membaca gambar dan jawaban dalam bentuk tetap.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() membuat juri arena menilai mantra, lalu menyimpannya atau mencoba lagi.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Node fungsi dapat menampilkan Content dengan bagian gambar, dan node LLM menerimanya sebagai giliran pengguna. spell_ready menampilkan Event dengan delta status dan tanpa output. Tick berikutnya membaca ejaan dari status, dan cabang tanpa output bukanlah akhir kedua untuk grafik: ADK memerlukan satu output terminal, dan itulah pertarungan.
Catatan: Penilaiannya adalah kode, di arena, terhadap jawaban tersembunyi kartu mantra. Bacaan sempurna melakukan 45, lebih ke pembukaan. Dua bentuk kanan menghasilkan 25. Salah baca akan membuat kartu mantra gagal dan terbakar. Gemini tidak ditanya apakah jawabannya benar.
Cabang cepat
tick() memutar satu pertukaran, lalu memilih tepi berikutnya.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() melihat slot ejaan setelah setiap pertukaran.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell melihat slot setelah setiap pertukaran. Tidak pernah memblokir: jika ejaan belum siap, ejaan akan melaporkan hal tersebut dan melanjutkan.
Tiga hal yang menentukan desain. Panggilan model Diskriminatif di-await dengan klien asinkron, sehingga loop akan menghasilkan saat menunggu dan cabang Gemini akan terus berjalan. Pertanyaan dibuat baru setiap detiknya, sehingga cast hanya muncul saat ada sesuatu yang dapat ditransmisikan. Dan route dapat berupa daftar: ["recast", "next"] mengambil kedua tepi sekaligus.
Arena itu sendiri berada di belakang klien kecil: aplikasi yang berjalan melalui HTTP jika ada, sehingga halaman menampilkan pertarungan; mesin dalam proses jika tidak ada.
Definisi grafik
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Tuple sebagai target adalah fan-out. Tuple sebagai tepi adalah rantai. Dict memetakan nama rute ke node. tick → check_spell → tick adalah loop cepat. "recast": read_rune memulai thread lambat lagi setelah mantra digunakan, "retry" melakukan hal yang sama setelah gagal, dan "stored": rest memungkinkan thread lambat berakhir dengan tenang, tanpa output, setelah mantra berada di slot. ADK memerlukan setidaknya satu tepi yang dirutekan dalam siklus, sehingga loop tanpa syarat ditolak sebelum dapat berjalan selamanya.
Catatan: root_agent adalah yang dicari oleh alat ADK. adk web agents dari root workshop akan membuka UI dev dengan arena di dalamnya, jika Anda ingin melihat grafik dan peristiwa di browser, bukan di terminal.