

1. Introduzione
Un workshop di 90 minuti sul modello discriminativo, sul modello decisionale System One di TypeSafe AI e su come affiancarlo a Gemini in un flusso di lavoro Google ADK. Questo workshop è suddiviso in sei passaggi, incentrati su un picchiaduro. All'inizio combatterai l'orco a mani nude, poi passerai i riflessi al modello discriminativo, quindi osserverai un flusso di lavoro ADK vincere la battaglia con il modello discriminativo che decide ogni tick e Gemini che legge le carte degli incantesimi fuori dallo schermo per cantarli.
Panoramica
Il modello discriminativo (jev-1.13, alias jev-latest) è un modello ospitato di TypeSafe AI, rilasciato il 19 settembre 2026. Non genera testo. Invii lo stato (testo, JSON o un elenco) e le domande digitate (Choice, Score, Noul) e restituisce risposte digitate con probabilità calibrate, in circa 70-500 ms, a un costo di 0,042 $per milione di token di input e nessun costo per l'output. Il suo compito è la decisione prima, tra e dopo i modelli linguistici: routing, classificazione, gating e, in questo caso, i riflessi di un combattente.
Un gioco come esempio
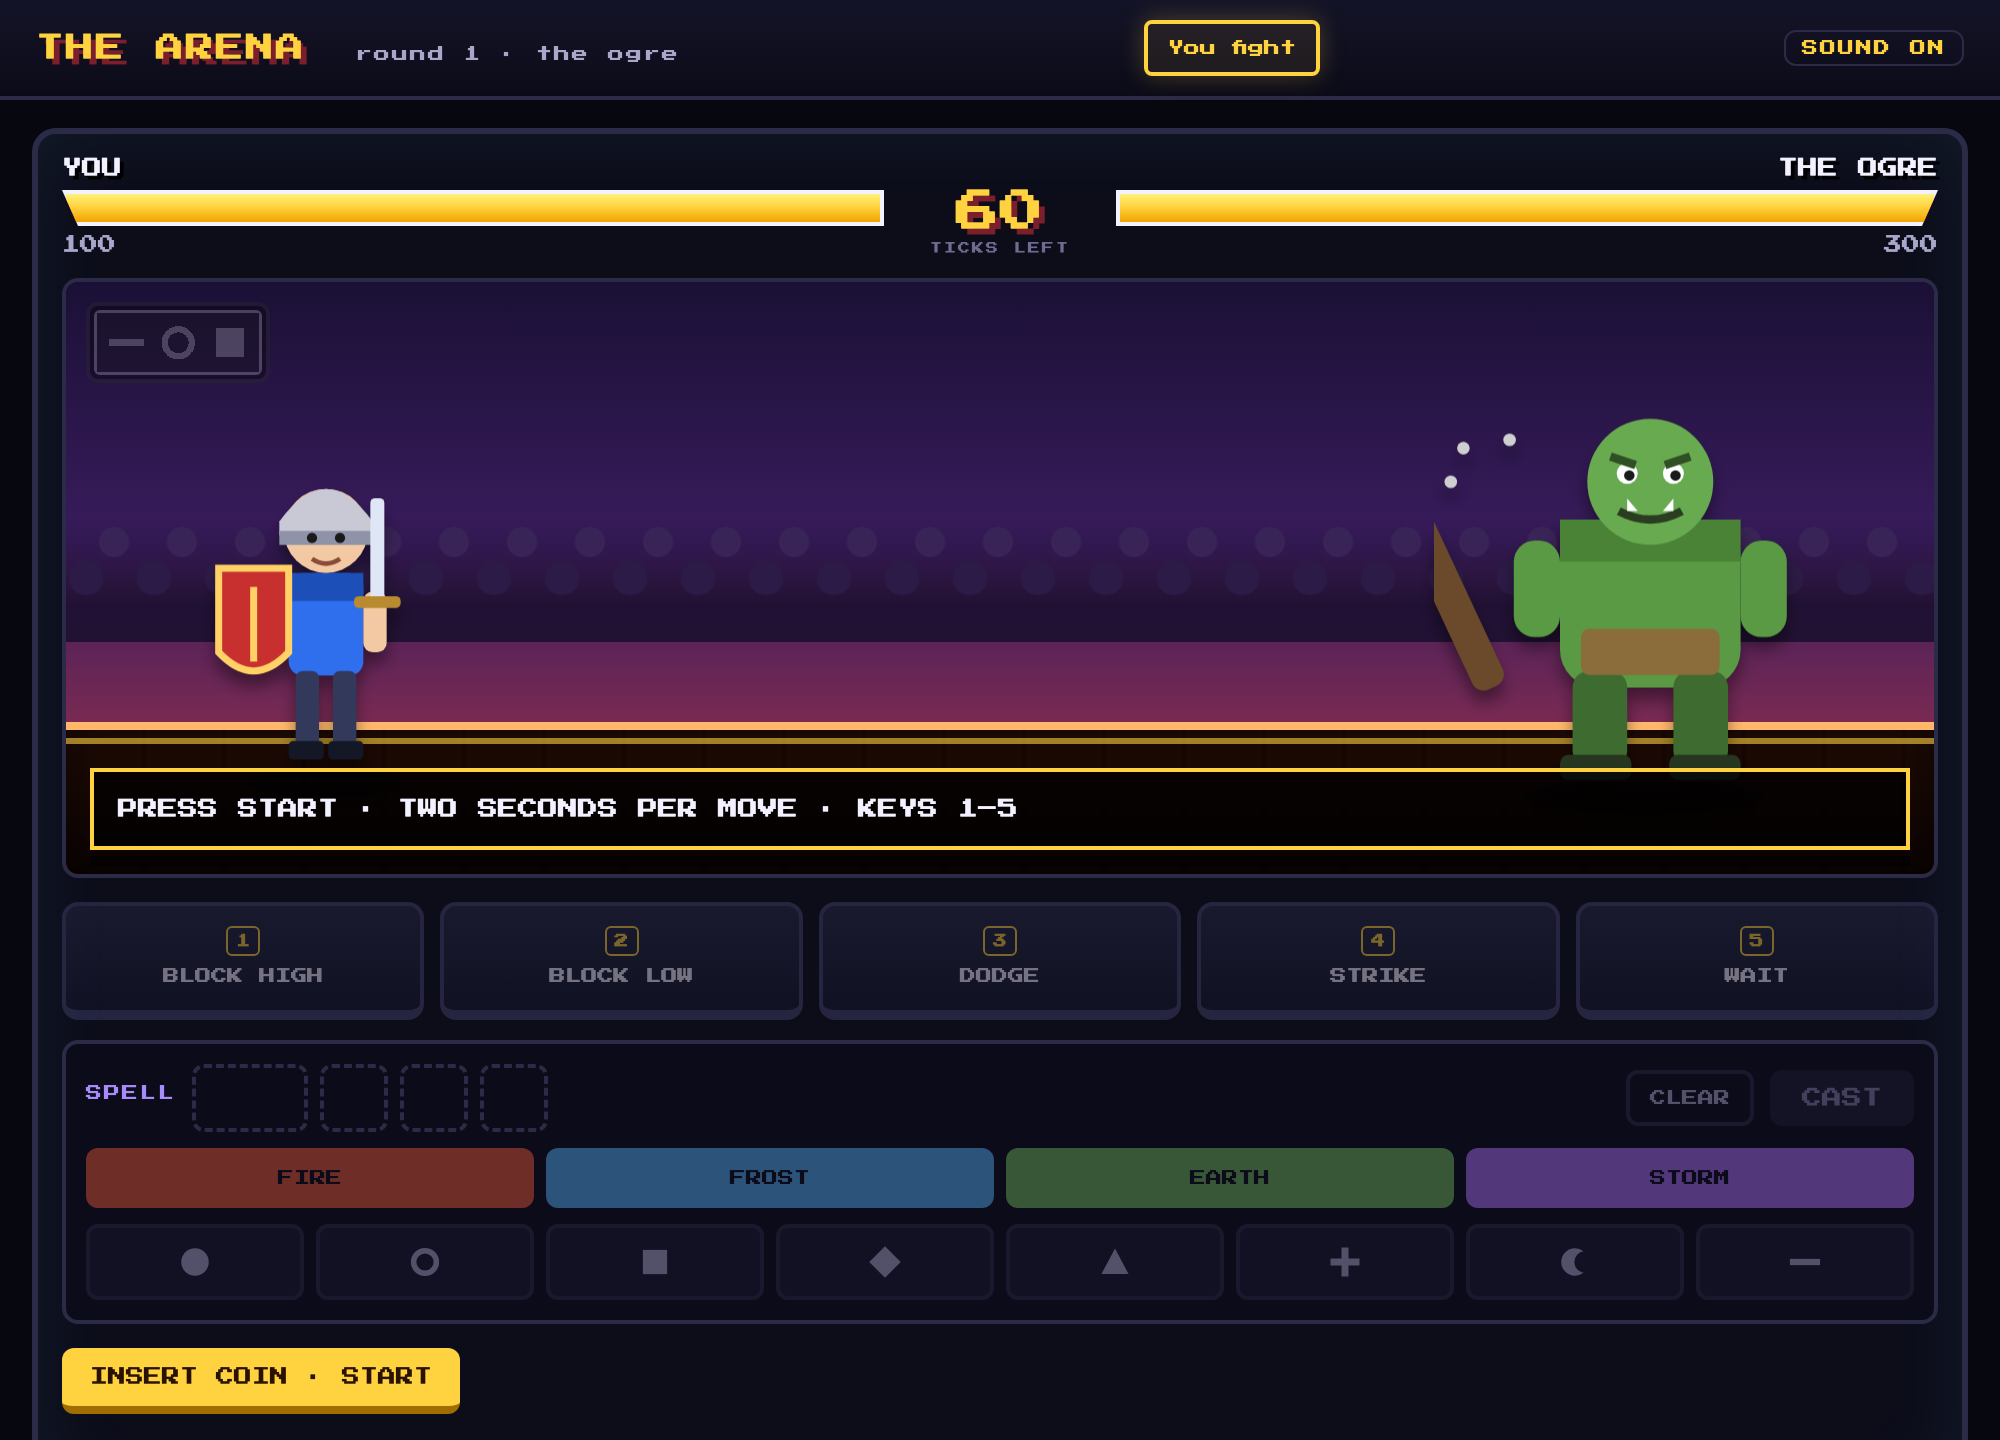
Hai mai giocato a un gioco di combattimento? Affronti un avversario e devi reagire immediatamente alle sue mosse. Un'ipotesi sbagliata e i tuoi HP ne risentiranno. Inoltre, i giochi tendono a rendere difficile il lancio degli incantesimi. Nel nostro, devi scegliere il colore e le forme della carta incantesimo, in ordine, prima che l'incantesimo venga lanciato. Questo workshop mostra come combinare entrambi i tipi di modello per far vincere il tuo personaggio.
Ogni elemento del gioco corrisponde a un sistema reale:
- La mossa dell'avversario è un evento in entrata, come una richiesta o una transazione.
- La risposta è una decisione limitata, presa dal modello discriminativo e controllata dal codice.
- La scheda di incantesimo è un input non strutturato che richiede un modello linguistico per essere letto.
- La partita è il flusso di lavoro, che esegue il lavoro veloce e lento alle rispettive velocità.
L'obiettivo è combinare i quattro componenti e metterli insieme per creare un sistema veloce e intelligente.
Cosa imparerai a fare
- Spiega in che modo differiscono i modelli discriminativi (Sistema 1) e generativi (Sistema 2) e quando utilizzare ciascuno.
- Descrivi come vengono pubblicati Jev e DiffusionGemma e configura uno dei due per il workshop, inclusa DiffusionGemma su una VM GPU di Compute Engine.
- Scrivi domande a scelta multipla, con punteggio e Noul e interpreta le probabilità e l'affidabilità.
- Utilizza le soglie nel codice deterministico per trasformare le probabilità in azioni.
- Crea una richiesta con l'SDK TypeSafe, poi lascia che il modello scelga ogni mossa in una partita.
- Crea un ramo lento, in cui Gemini legge un'immagine, e un ramo veloce, in cui il modello discriminativo decide in un ciclo, ed esegui ciascuno separatamente.
- Unisci entrambi i rami in un flusso di lavoro del grafico ADK che condivide lo stato in un unico ciclo di eventi, in modo che il lavoro lento non ritardi mai le decisioni rapide.
Architettura
Il banco di prova si trova in Cloud Shell(o nella tua macchina), scrive nel file system locale e interagisce con l'arena, nonché con Gemini e il modello decisionale. ② chiama il modello decisionale in "Discriminative model fights"; ③ chiama entrambi in "Workflow fights".
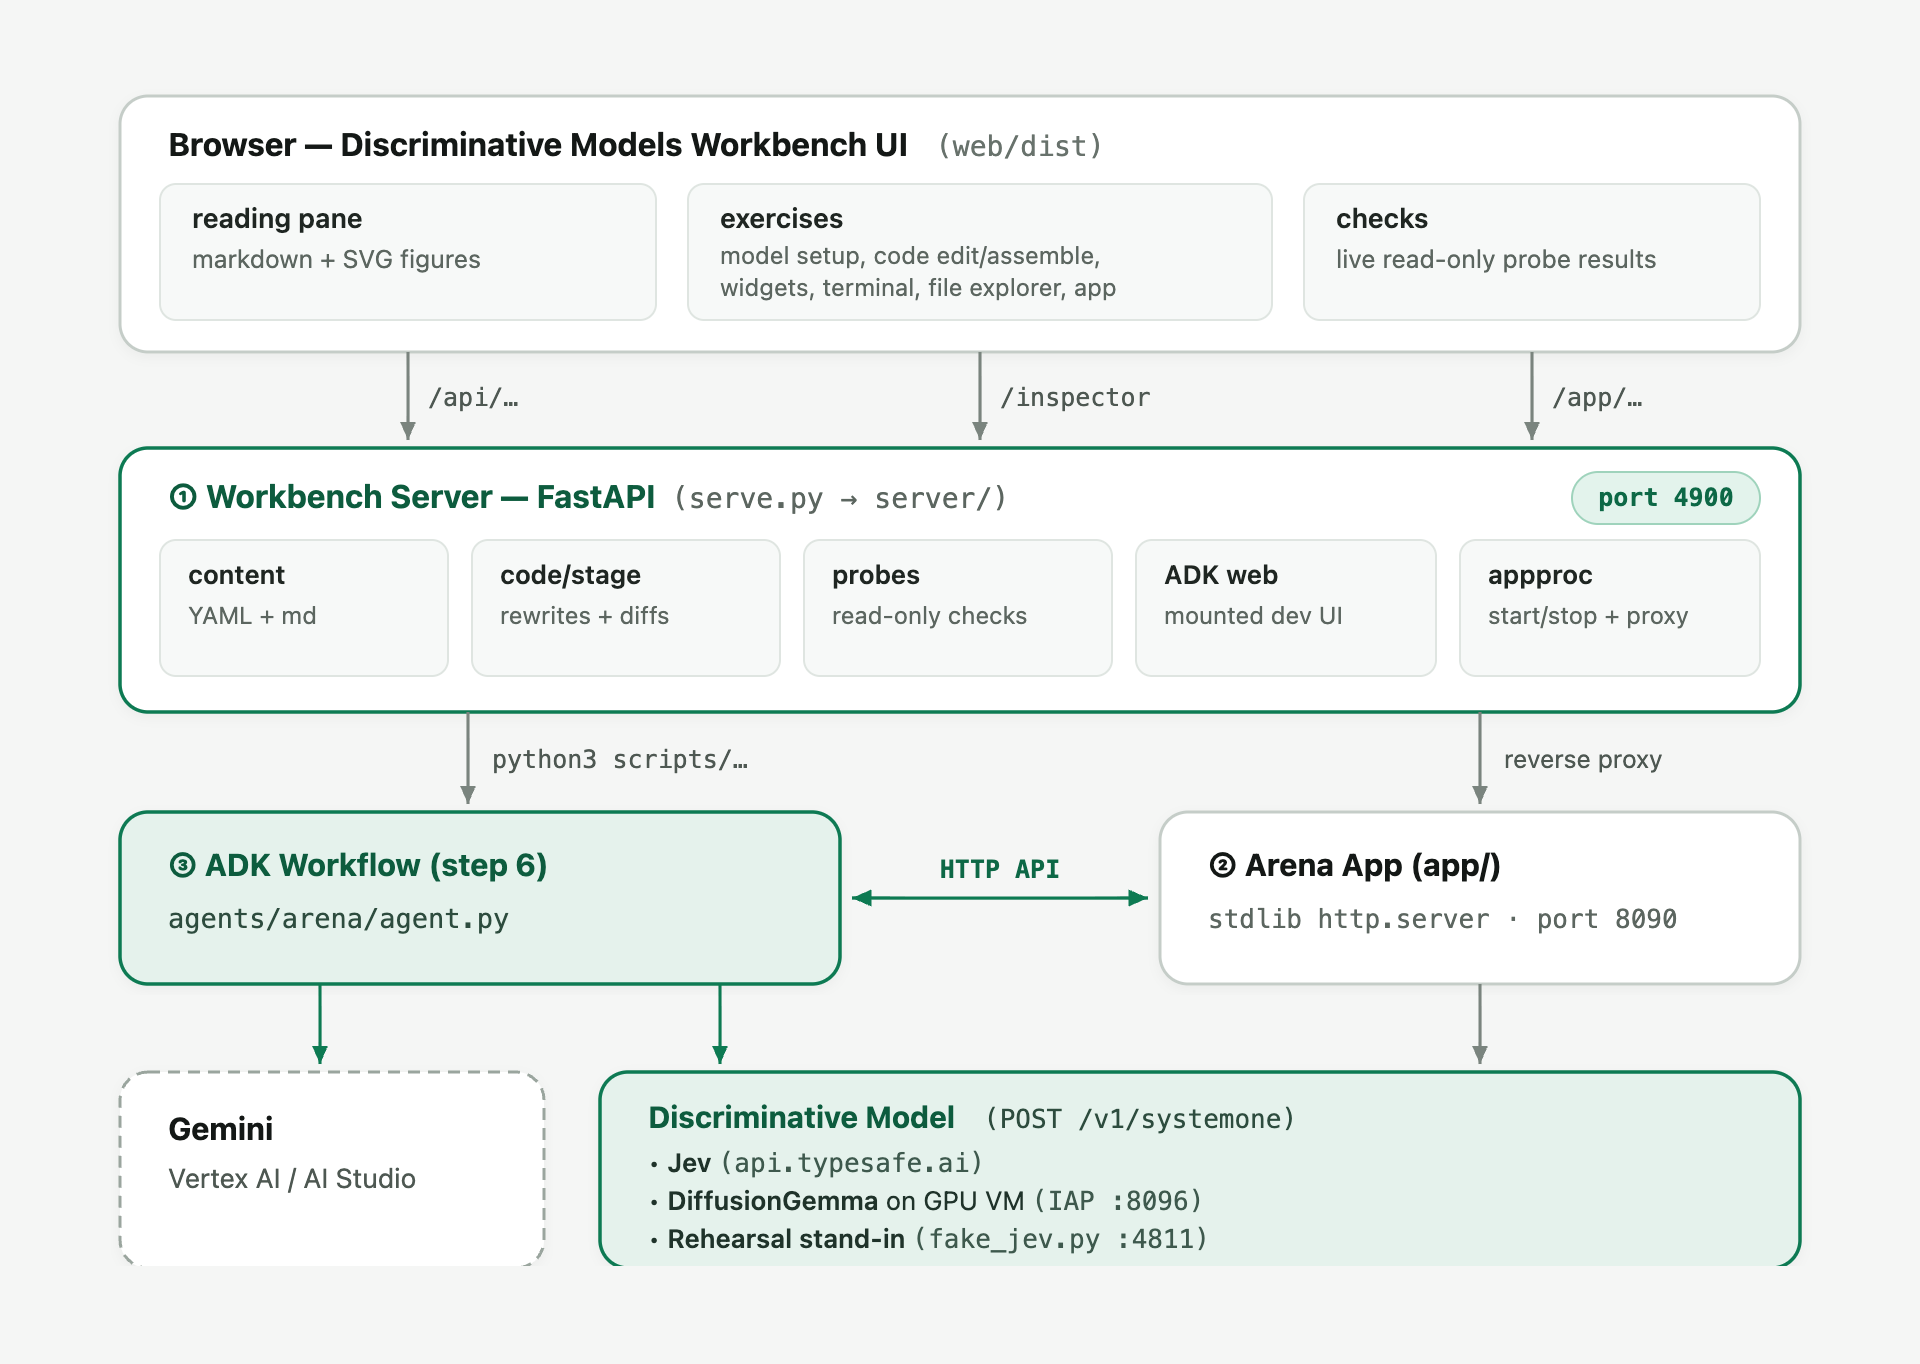
Chi chiama cosa. Il browser comunica solo con ①. Entrambi i modelli vengono chiamati da Python sulla macchina:
Chiamante | Modello discriminativo | Gemini |
② arena, "Discriminative model fights" | ogni segno di spunta, | no |
③ workflow | ogni segno di spunta, | no |
③ workflow | no | l'immagine della carta magia; la storia dopo il combattimento |
| sì | no |
Un segno di spunta per modalità.
- Combatti. La pagina chiede ② un telegramma, lo mostra con un timer di 2 secondi e pubblica il pulsante che premi (o la parola che digiti). ② lo risolve.
- Modelli discriminativi in competizione. La pagina chiede ② un segno di spunta; ② disegna un telegrafo, pone al modello tre domande in una sola chiamata, esegue
choose()e restituisce le risposte e il risultato. La pagina disegna le barre. - Workflow fights. Start fa sì che ② avvii ③ come sottoprocesso (accedi a
runs/arena-workflow.log). ③ guida il combattimento: chiede a ② ogni telegrafo, chiama il modello e pubblica la decisione; l'incantesimo di Gemini arriva sul suo ramo quando è pronto. La pagina mostra solo i sondaggi ② e i pareggi. Pause è un flag su ② che ③ controlla prima di ogni tick.
Dove è ospitato il modello decisionale. Ogni chiamata passa attraverso lo stesso typesafe-sdk; cambia solo l'URL di base. scripts/jevauth.py assegna un nome al backend e imposta la chiave e il timeout:
Backend |
| Chiave | Impostato da |
TypeSafe, ospitato | unset (api.typesafe.ai) |
|
|
DiffusionGemma sulla tua VM L4 |
| nessuno |
|
DiffusionGemma su Cloud Run |
| un token identità Google recuperato ogni ora |
|
Prove |
| nessuno |
|
La risposta della carta incantesimo ②: il workflow riceve solo il PNG e ② giudica l'incantesimo che invia. Questo rende l'incantesimo un vero test di lettura per Gemini e quello che crei in "Combatti" un vero test per te.
2. Configurazione
Richiedere i crediti del workshop
Se ti è stato assegnato un credito Google Cloud per questa sessione, richiedilo prima. L'operazione richiede circa un minuto e crea l'account di fatturazione.
Apri Cloud Shell
Google Cloud Shell è un ambiente Linux accessibile tramite browser preconfigurato con gcloud, Python, Node.js, uv e git, già autenticato con il tuo Account Google.
- Apri la console Google Cloud.
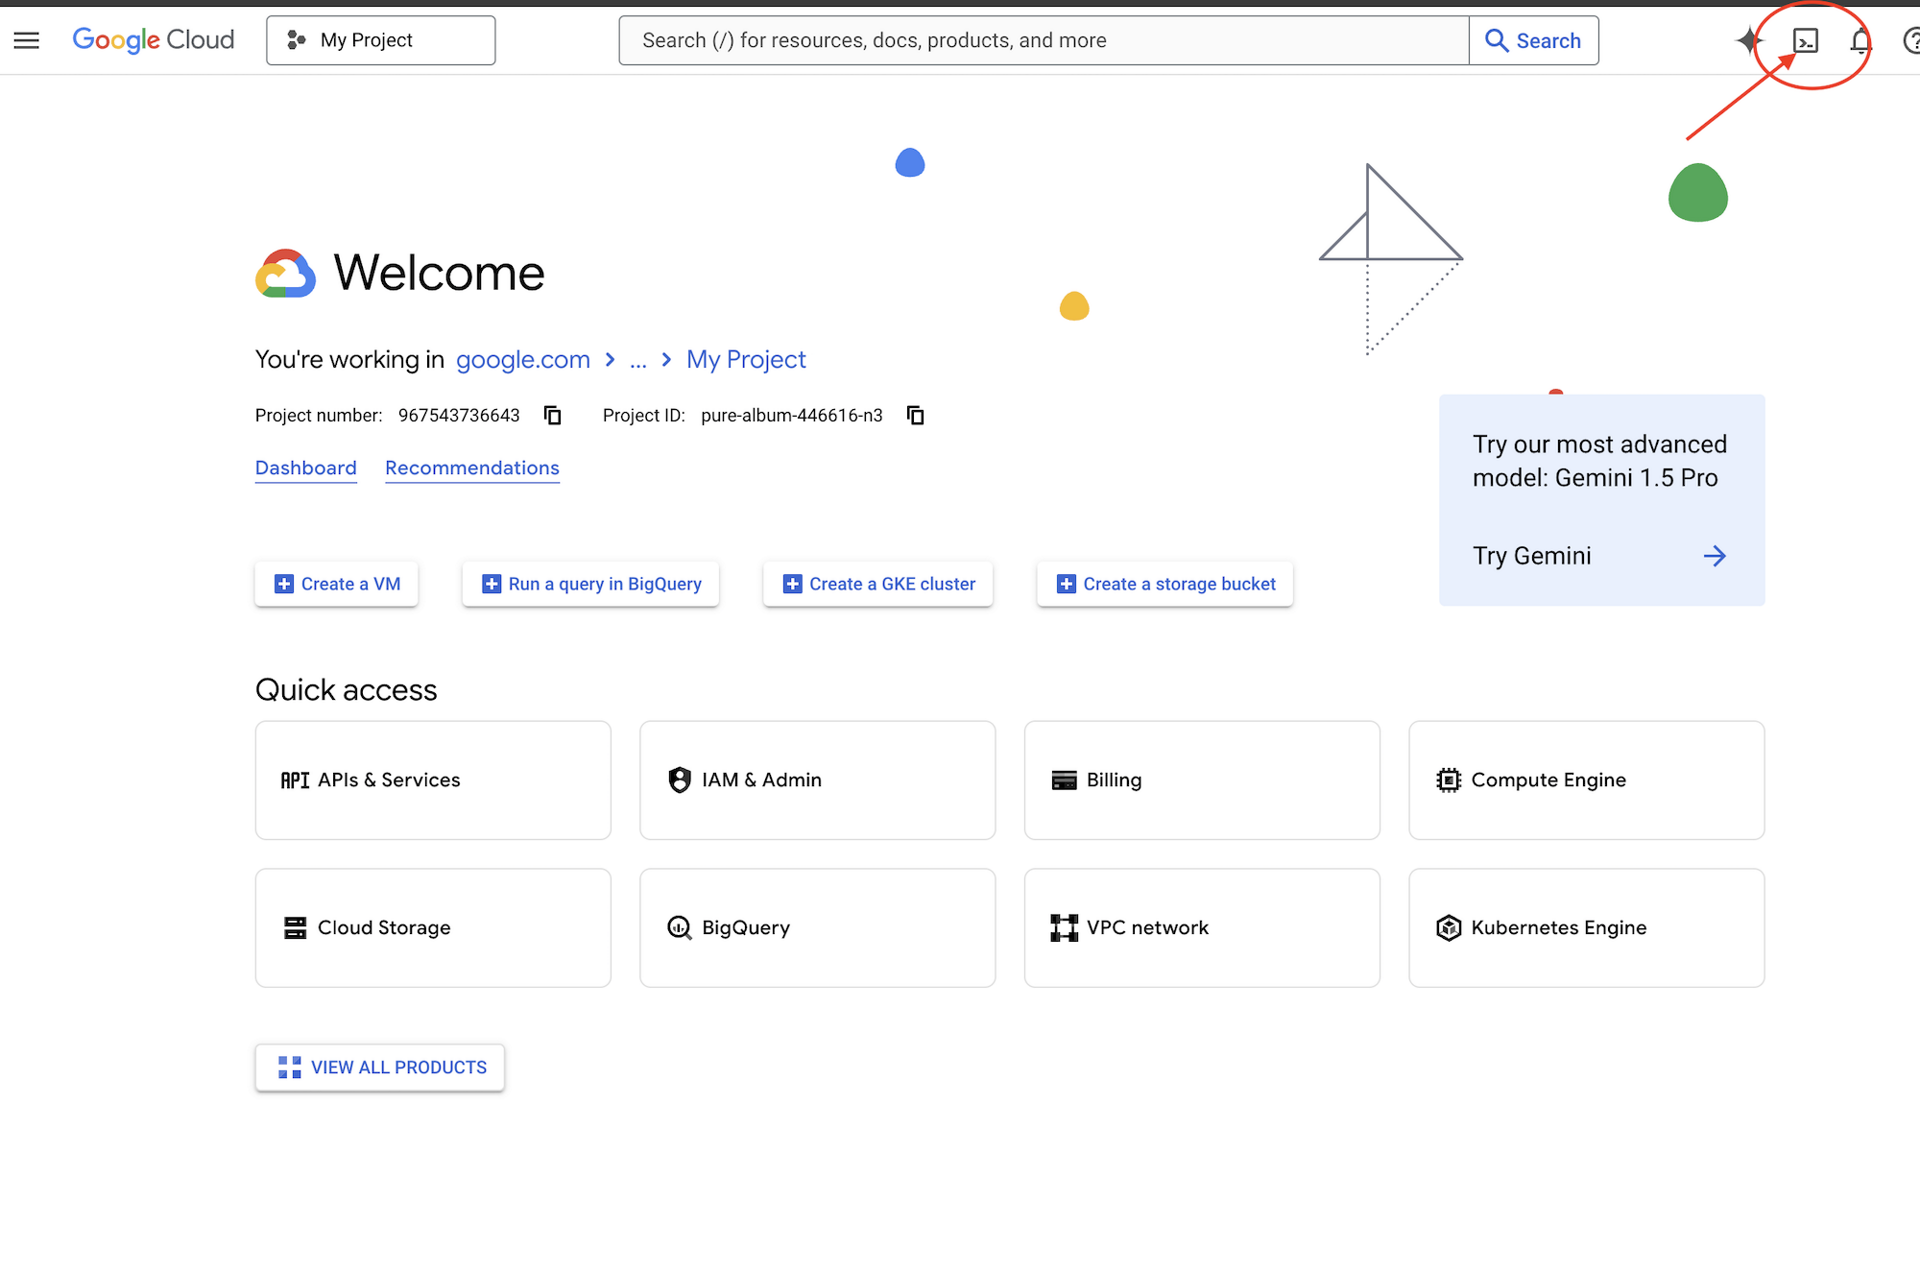
- Fai clic su Attiva Cloud Shell (l'icona del terminale nella barra di navigazione in alto) per aprire una sessione del terminale nella parte inferiore del browser.
Avvia il workbench
In Cloud Shell o ovunque sia stato eseguito l'accesso a gcloud:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh crea un progetto (discrim-models-XXXX), lo collega alla fatturazione, preferendo un account con crediti per eventi, se ne hai uno, e attende che il progetto possa essere pubblicato. Se lo esegui di nuovo, il progetto viene riutilizzato in ~/project_id.txt. Per utilizzare un progetto che hai già, inserisci il relativo ID nel file e salta questo script.
setup_codelab.sh non chiede nulla. Installa uv e i pacchetti Python, attiva Vertex AI, Compute Engine e IAP, indirizza Gemini a Vertex AI nel progetto in .env, effettua una chiamata Gemini reale con un modello che il progetto può chiamare, crea la pagina, avvia il workbench in background ed esegue scripts/check_setup.py. Se lo esegui di nuovo, i file di allenamento vengono mantenuti; scripts/starter.sh li reimposta. Il modello decisionale viene scelto nel passaggio 2 del workbench.
Per aprire la UI del workbench in Cloud Shell:
- Fai clic sul link di anteprima stampato alla fine di
./setup_codelab.sho su Anteprima web nell'angolo in alto a destra della barra degli strumenti di Cloud Shell. - Seleziona Cambia porta, inserisci 4900 e fai clic su Cambia e visualizza anteprima.
Gemini viene eseguito su Vertex AI nel tuo progetto, con le tue credenziali Google: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT e GOOGLE_CLOUD_LOCATION=global in .env.
Il modello decisionale viene scelto autonomamente, nel passaggio 2 del workbench o da un terminale con scripts/setup_model.sh:
Scelta | Esigenze | Configurazione | Costo |
Il modello discriminativo (TypeSafe, ospitato) | una chiave API TypeSafe | nessuno | per token, frazioni di centesimo |
DiffusionGemma (Google, pesi aperti) | fatturazione + quota di Compute Engine per la GPU | Circa 15 minuti, automatico | Circa 0,71 $/ora durante l'esecuzione della VM |
Prova (nessun modello) | nothing | nessuno | nessuno |
DiffusionGemma su una VM Compute Engine
scripts/setup_gemma.sh controlla prima la quota GPU, poi crea una VM g2-standard-4 (1 × L4 24 GB, 4 vCPU, 16 GB) dall'immagine Deep Learning di Google con il driver NVIDIA 580. Al primo avvio, la VM installa Docker, scarica i pesi da Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, pubblico, nessun token) ed esegue djev-run: DiffusionGemma dietro l'API esatta del modello discriminativo. La porta del modello non è aperta a internet: il workbench la raggiunge tramite un tunnel IAP su localhost:8096, che scripts/start.sh si apre.
Metti in pausa / Riprendi |
| |
Tunnel |
| |
Rimuovi |
| |
Provare i comandi |
| |
Layout del repository
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Riepilogo
Libera spazio
Al termine del workshop, completa i seguenti passaggi per eliminare le risorse GPU DiffusionGemma, arrestare i processi di banco di prova e prova in background, rimuovere i file del workshop da Cloud Shell e (facoltativamente) eliminare il progetto cloud del workshop Google Cloud.
- Elimina la VM GPU DiffusionGemma e la regola firewall (se creata): se hai eseguito il provisioning di DiffusionGemma su una VM GPU Compute Engine nel passaggio 2, rimuovi la VM, il disco e la regola firewall IAP in modo che non vengano accumulati costi di calcolo o di archiviazione su disco in corso:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Arresta i processi di workbench e prova in Cloud Shell: nel terminale Cloud Shell, arresta il server workbench in background e qualsiasi processo sostitutivo di prova:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Elimina la cartella del workshop da Cloud Shell: torna alla home directory e rimuovi la cartella del repository clonato e il file ID progetto:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Elimina il tuo progetto Google Cloud: se
./setup_project.shha creato un progetto workshop dedicato (ad esempiodiscrim-models-XXXX), la chiusura del progetto elimina definitivamente tutte le risorse create al suo interno, lasciando intatto il tuo account di fatturazione Cloud:- Apri la pagina Gestisci risorse nella console Google Cloud.
- Seleziona il progetto del workshop (ad esempio
discrim-models-...) dall'elenco delle risorse. - Fai clic su Elimina nella barra degli strumenti in alto, digita l'ID progetto per confermare e fai clic su Chiudi.
Hai completato questo workshop.
Riepilogo del lab
- Ha scelto un modello discriminativo, Jev o DiffusionGemma, su una VM GPU Compute Engine e ha verificato che risponda.
- Ho giocato nell'arena a mano, contro il tempo, per imparare le regole.
- Hai imparato come un modello discriminativo risponde con domande di scelta, punteggio e Noul, probabilità e confidenza e come il tuo codice applica le soglie.
- Hai inviato la tua prima richiesta, poi hai lasciato che il modello scegliesse ogni mossa nell'arena, con
choose()che trasforma le sue risposte in azioni. - Ha creato ogni ramo di un workflow ADK separatamente, con Gemini che legge un'immagine di una carta di magia e il modello che decide in un ciclo.
- Uniti in un unico flusso di lavoro che condivide lo stato, così il combattimento non aspetta mai Gemini e l'incantesimo viene lanciato all'apertura.
Dalla conversazione alle decisioni
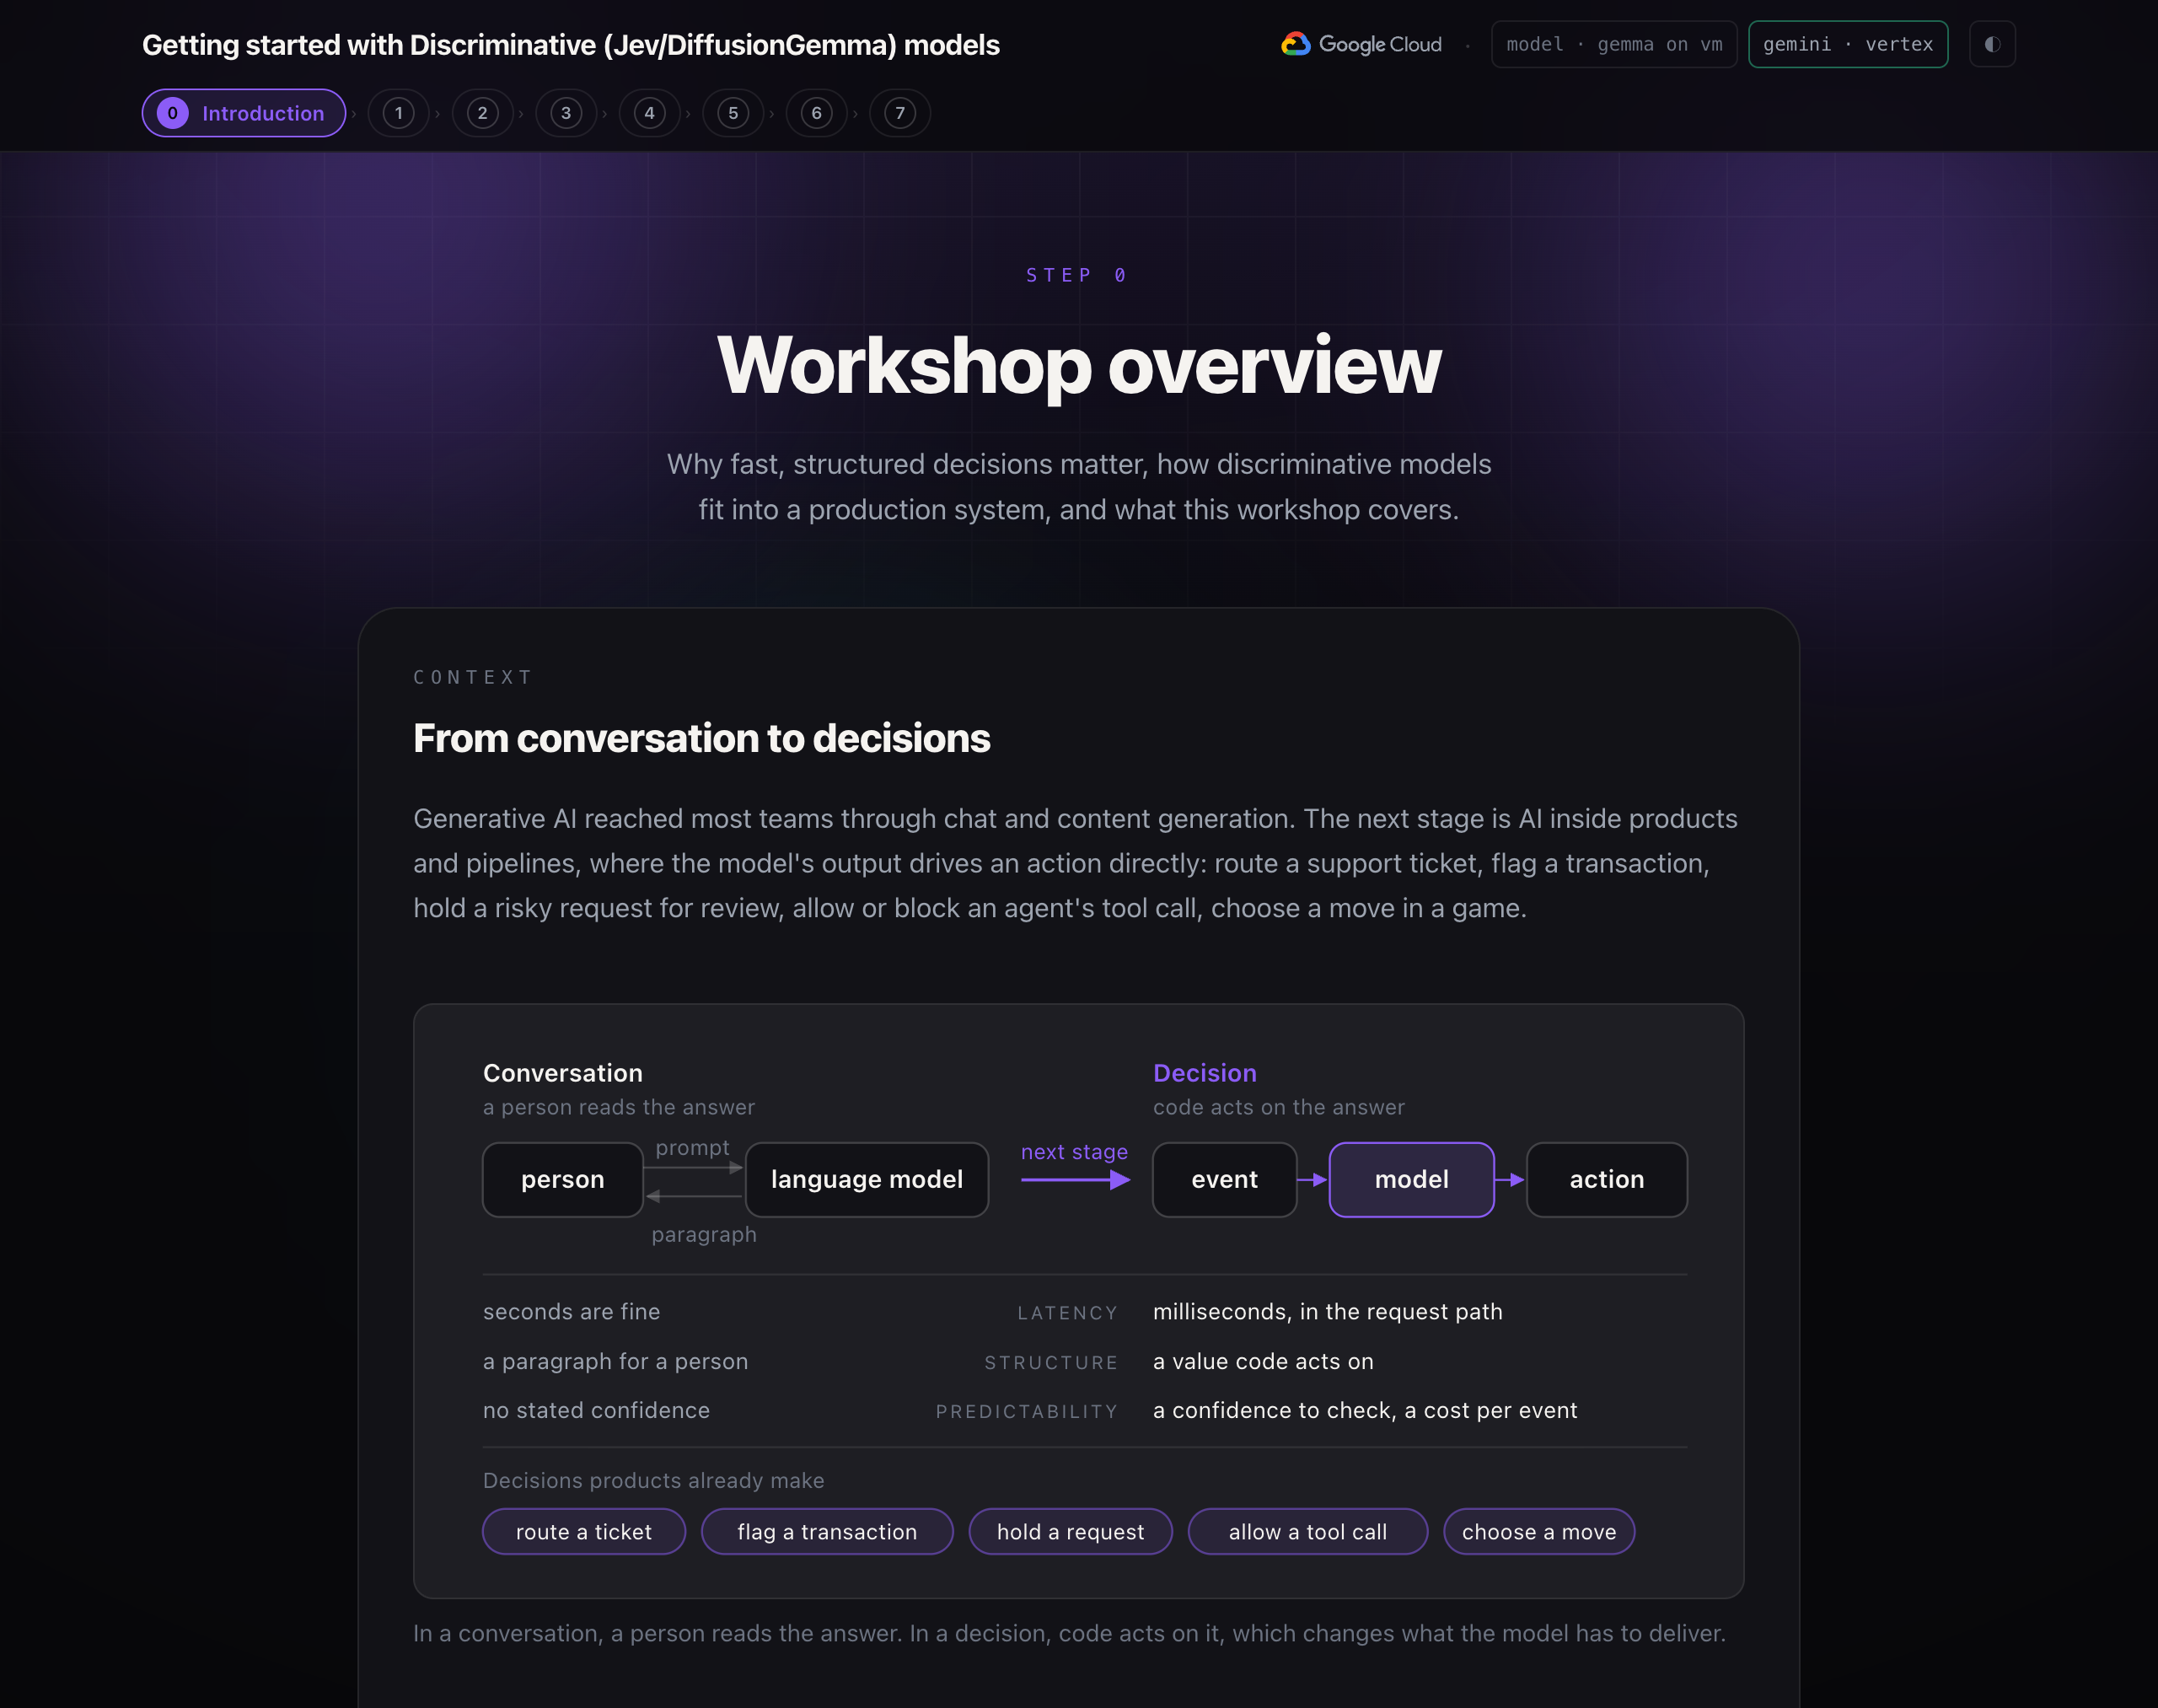
L'AI generativa ha raggiunto la maggior parte dei team tramite la chat e la generazione di contenuti. La fase successiva è l'AI all'interno di prodotti e pipeline, in cui l'output del modello determina direttamente un'azione: indirizzare un ticket di assistenza, segnalare una transazione, mettere in attesa una richiesta rischiosa per la revisione, consentire o bloccare la chiamata di uno strumento di un agente, scegliere una mossa in una partita.
Queste decisioni condividono tre requisiti che la chat non ha:
- Latenza. La risposta si trova spesso nel percorso della richiesta di un utente o in un ciclo in tempo reale, quindi deve arrivare in millisecondi, non in secondi.
- Struttura. Il chiamante è un codice, quindi la risposta deve essere un valore su cui può agire, non un paragrafo da analizzare.
- Prevedibilità. Ogni decisione deve avere un livello di confidenza che il codice possa controllare e un costo sufficientemente basso da poter essere richiesto per ogni evento.
Un modello linguistico genera il testo un token alla volta. Può essere richiesto di rispondere sì o no, ma è lento per un ciclo in tempo reale, il suo output deve essere analizzato e non indica il livello di certezza.
Modelli creati per le decisioni
Un modello discriminativo risponde a una domanda digitata con una probabilità per ogni opzione consentita, in un unico passaggio. Non genera testo. Questo workshop offre due opzioni di esecuzione:
Modello | Provider | Dove viene eseguito il modello in questo workshop |
Jev | TypeSafe AI | Servizio ospitato di TypeSafe, chiamato con una chiave API |
DiffusionGemma | Google, open weights | Self-hosted su una VM GPU nel tuo progetto Google Cloud |
I modelli possono essere scambiati in base alle tue esigenze; il codice che si connette a questi modelli non deve essere modificato.
Combinare i componenti
Un sistema efficace è composto da più componenti:
Componente | Ruolo | In questo workshop |
Workflow | Coordina i passaggi, esegue i rami in parallelo e mantiene lo stato condiviso | Un workflow del grafico ADK |
Codice deterministico | Regole, soglie, convalida. Istantaneo, senza costi e verificabile | Regole del gioco, |
Modello discriminativo | Decisioni rapide e delimitate con un punteggio di confidenza | Scegliere una risposta ogni tick |
Modello linguistico | Percezione e generazione: immagini e testo aperto | Gemini legge l'immagine della carta incantesimo e scrive l'incantesimo |
Architettura di erogazione del modello
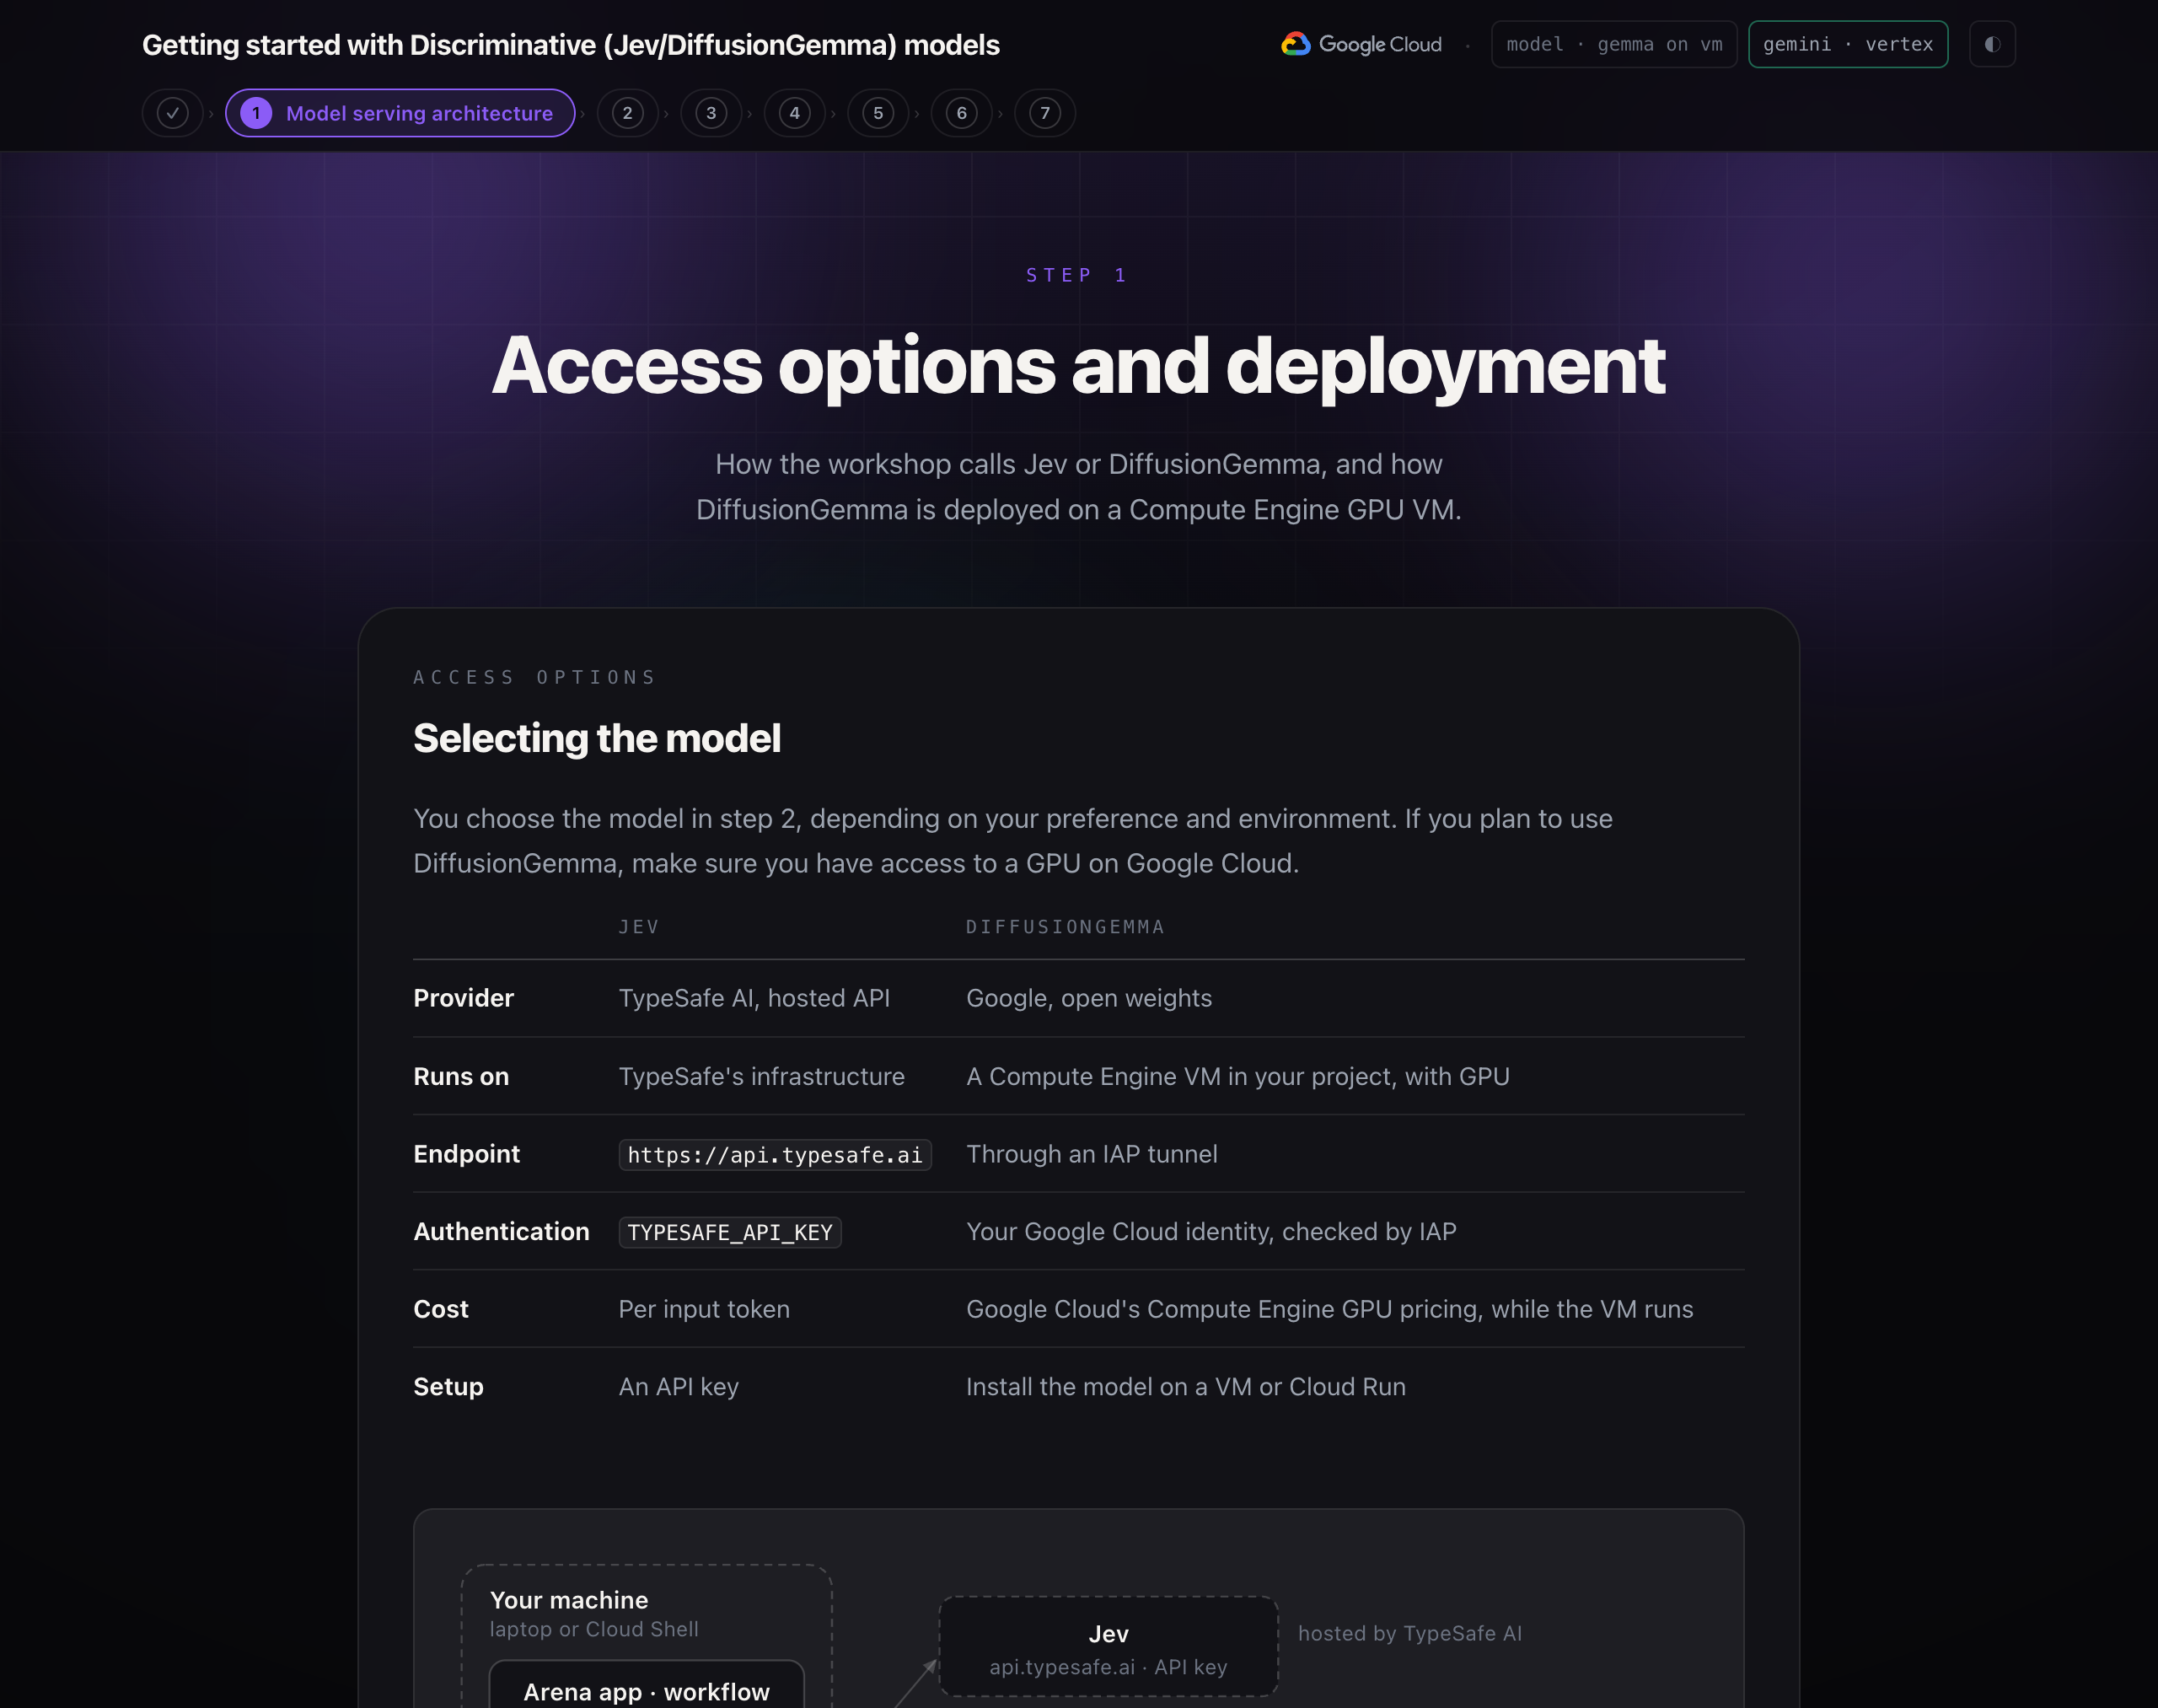
Scegli il modello nel passaggio 2, in base alle tue preferenze e all'ambiente. Se prevedi di utilizzare DiffusionGemma, assicurati di avere accesso a una GPU su Google Cloud.
Jev | DiffusionGemma | |
Fornitore | TypeSafe AI, API ospitata | Google, open weights |
Eseguito su | Infrastruttura di TypeSafe | Una VM Compute Engine nel tuo progetto, con GPU |
Endpoint |
| Tramite un tunnel IAP |
Autenticazione |
| La tua identità Google Cloud, controllata da IAP |
Costo | Per token di input | Prezzi delle GPU Compute Engine di Google Cloud durante l'esecuzione della VM |
Configurazione | Una chiave API | Installa il modello su una VM o Cloud Run |
Flusso di dati
- L'app arena o il flusso di lavoro ADK crea una richiesta: lo stato (cosa ha fatto l'avversario) e tre domande.
- L'SDK TypeSafe lo invia come
POST /v1/systemoneall'URL di base configurato. - Per Jev, la richiesta viene inviata tramite HTTPS a
api.typesafe.ai, con la chiave API come token di autenticazione. - Per DiffusionGemma, la richiesta viene inviata a
localhost:8096. Un processogcloud compute start-iap-tunnelin background lo inoltra tramite Identity-Aware Proxy, che controlla la tua identità Google, alla porta 8080 della VM. - Sulla VM, djev-run riceve la richiesta, esegue DiffusionGemma tramite vLLM sulla GPU e legge la probabilità di ogni opzione consentita.
- Entrambi i backend restituiscono la stessa risposta: una risposta per domanda, con probabilità e un punteggio di affidabilità. Il codice dell'officina applica le sue soglie e agisce.
DiffusionGemma su Compute Engine
scripts/setup_gemma.sh crea questo elemento nel tuo progetto:
- Verifica che la regione disponga di una quota per una GPU.
- Abilita le API Compute Engine e IAP e crea la regola firewall
allow-iap-djev. Ammette solo l'intervallo di indirizzi IAP, sulle porte 22 e 8080. - Crea la VM
djev-l4: tipo di macchinag2-standard-4(4 vCPU, 16 GB di memoria), una GPU con 24 GB, un disco da 100 GB e l'immagine Deep Learning VM con il driver NVIDIA 580. Se una zona non ha capacità GPU, prova la successiva. - Al primo avvio, lo script di avvio della VM installa Docker e NVIDIA Container Toolkit, estrae l'immagine container djev-run, scarica i pesi da Hugging Face (17,5 GB) e avvia il container con accesso alla GPU sulla porta 8080. L'operazione richiede circa 15 minuti. Gli avvii successivi richiedono circa 2 minuti.
- Scrive le impostazioni di connessione in
.enve apre il tunnel.
Attività | Comando |
Arresta la VM (mantiene il disco) |
|
Riavvia |
|
Controlla il tunnel |
|
Elimina tutto |
|
Configurare il modello
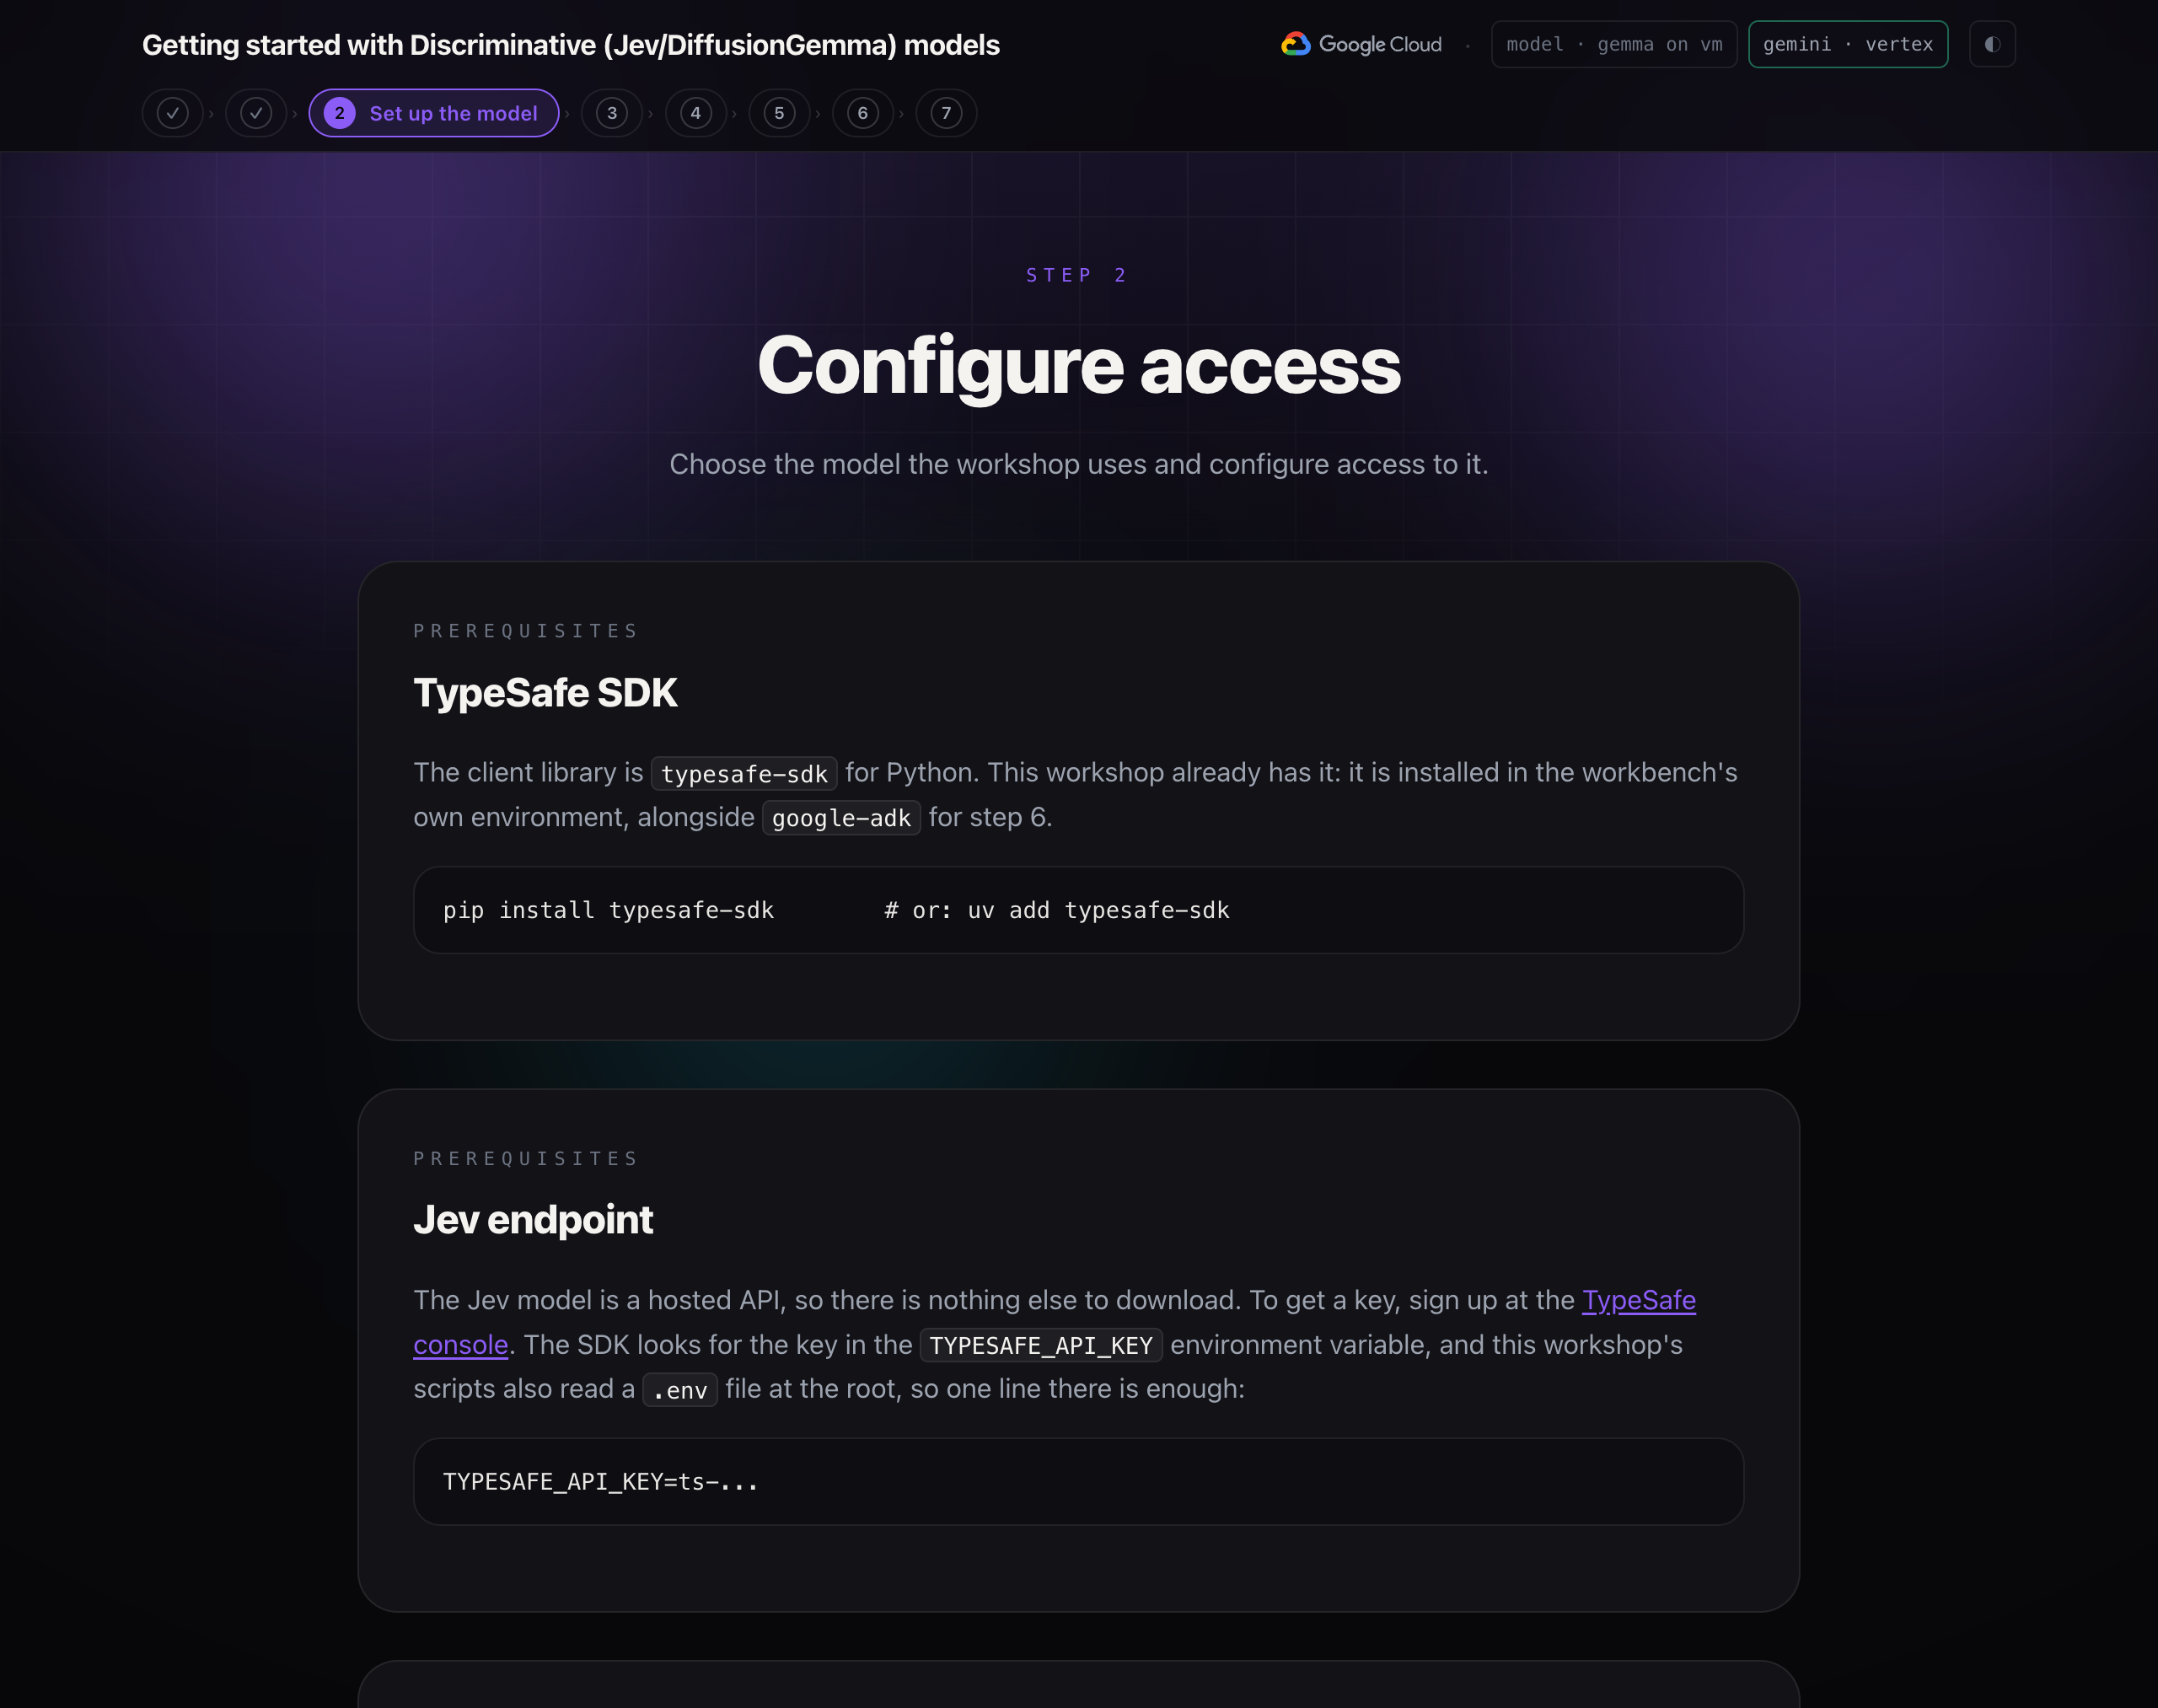
SDK TypeSafe
La libreria client è typesafe-sdk per Python. Questo workshop ce l'ha già: è installato nell'ambiente del workbench, insieme a google-adk per il passaggio 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Endpoint Jev
Il modello Jev è un'API ospitata, quindi non è necessario scaricare altro. Per ottenere una chiave, registrati nella console TypeSafe. L'SDK cerca la chiave nella variabile di ambiente TYPESAFE_API_KEY e gli script di questo workshop leggono anche un file .env nella radice, quindi è sufficiente una riga:
TYPESAFE_API_KEY=ts-...
Utilizzare DiffusionGemma
djev-run implementa nuovamente l'API del modello discriminativo. Serve lo stesso endpoint POST /v1/systemone, con le stesse domande su noul, scelta e punteggio, da DiffusionGemma, il modello di diffusione open source di Google DeepMind (26 miliardi di parametri totali, circa 4 miliardi attivi, Apache 2.0). Poiché il formato del cavo è lo stesso, l'SDK TypeSafe comunica con esso senza modifiche.
Se scegli DiffusionGemma nell'esercizio, viene eseguito su una GPU in una VM nel tuo progetto Google Cloud e il badge in alto a destra indica gemma on vm. Il workbench lo raggiunge tramite un tunnel IAP privato e la porta del modello non è aperta a internet. Il passaggio 1 descrive l'architettura completa.
Perché un modello di diffusione può farlo: riempie un intero blocco di posizioni contemporaneamente, con ogni posizione che vede l'input completo, quindi la probabilità di ogni opzione consentita può essere letta in un unico passaggio. Un normale modello linguistico produce un token alla volta e deve essere campionato ripetutamente.
Giocare manualmente
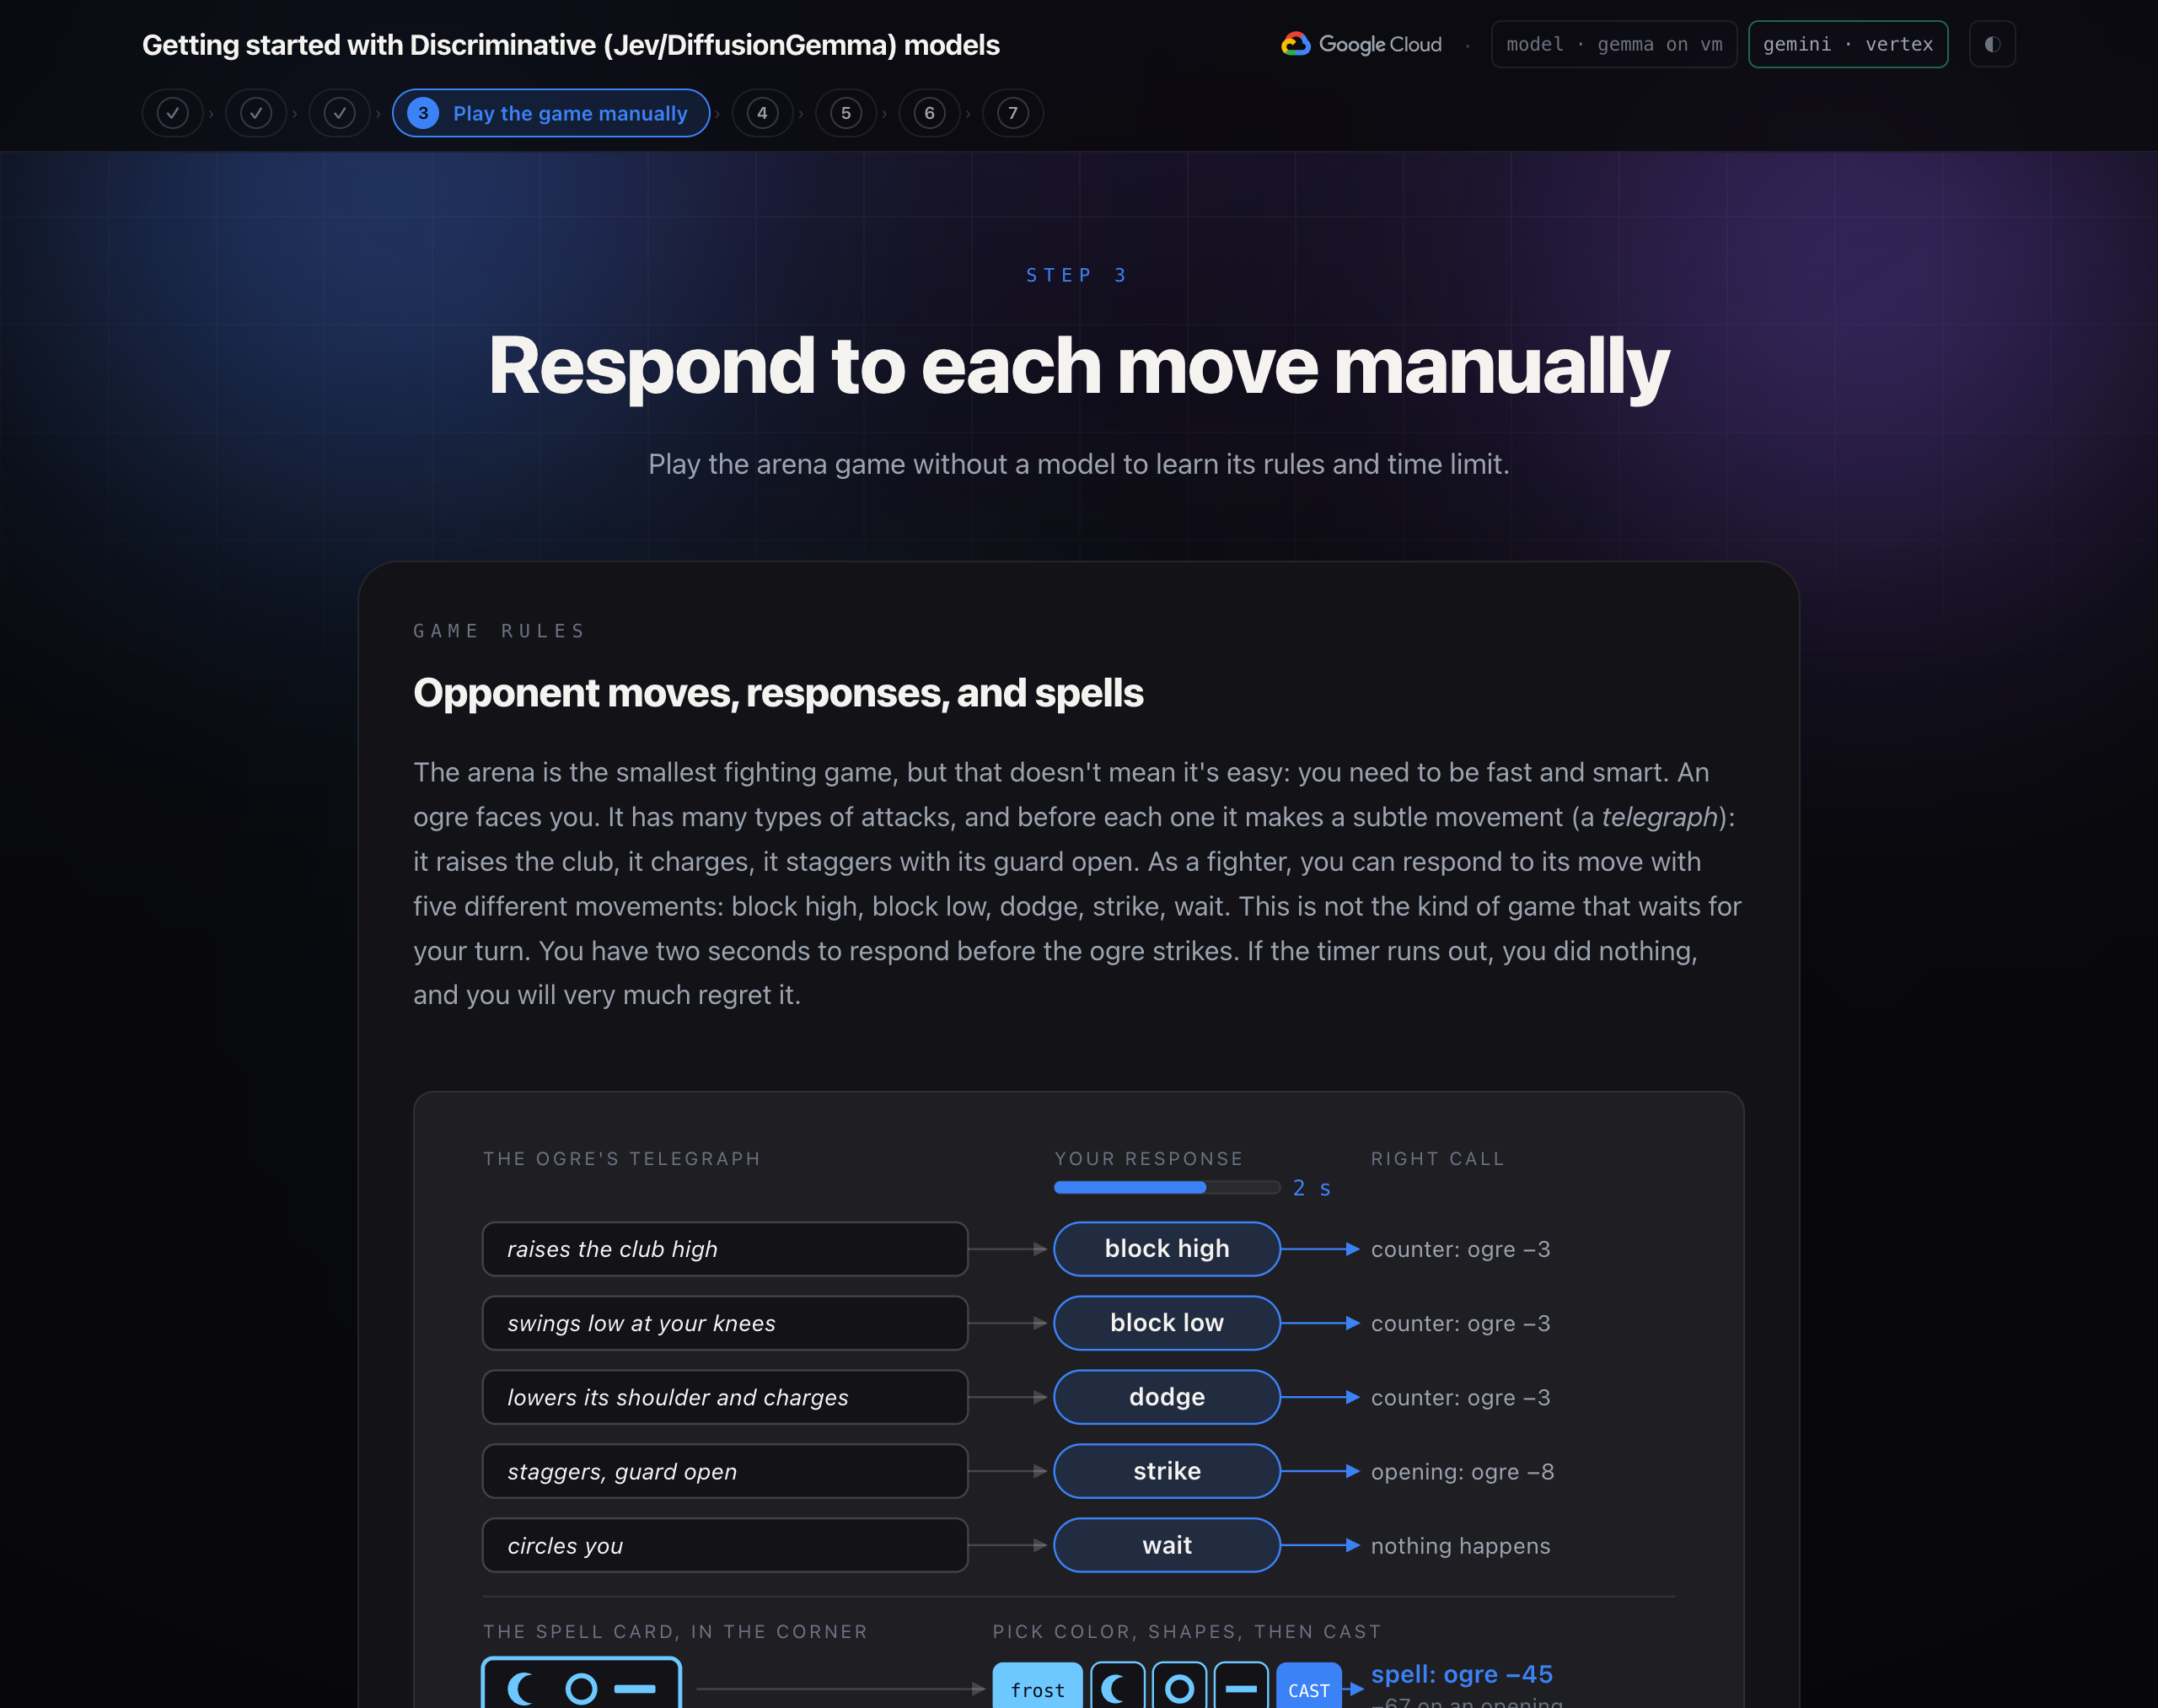
L'arena è il picchiaduro più piccolo, ma non significa che sia facile: devi essere veloce e intelligente. Un orco ti guarda. Ha molti tipi di attacchi e prima di ognuno fa un movimento sottile (un segnale): alza la mazza, carica, barcolla con la guardia aperta. In qualità di combattente, puoi rispondere alla sua mossa con cinque movimenti diversi: parata alta, parata bassa, schivata, colpo e attesa. Questo non è il tipo di gioco che aspetta il tuo turno. Hai due secondi per rispondere prima che l'orco colpisca. Se il timer scade, non hai fatto nulla e te ne pentirai molto.
Nell'angolo in alto a sinistra dell'anello c'è una scheda incantesimo: una scheda colorata con tre forme. Solo un incantesimo corrispondente può infliggere danni reali. Nel gioco puoi lanciare un incantesimo con i pulsanti sotto il combattimento: scegli il colore della carta, poi le sue forme da sinistra a destra, quindi premi LANCIATE. Il tempo continua a scorrere mentre scegli, quindi devi costruire l'incantesimo e reagire agli attacchi dell'orco contemporaneamente. I tasti da 1 a 5 rispondono ancora a ogni mossa. Un incantesimo sbagliato si esaurisce. Nel passaggio 6, Gemini legge la carta incantesimo per te.
Punto chiave:un combattimento è un flusso di piccole decisioni con una scadenza per ciascuna. È così che appare la maggior parte dell'automazione del software, senza il club.
Concetti del modello discriminativo
Decisioni nel software
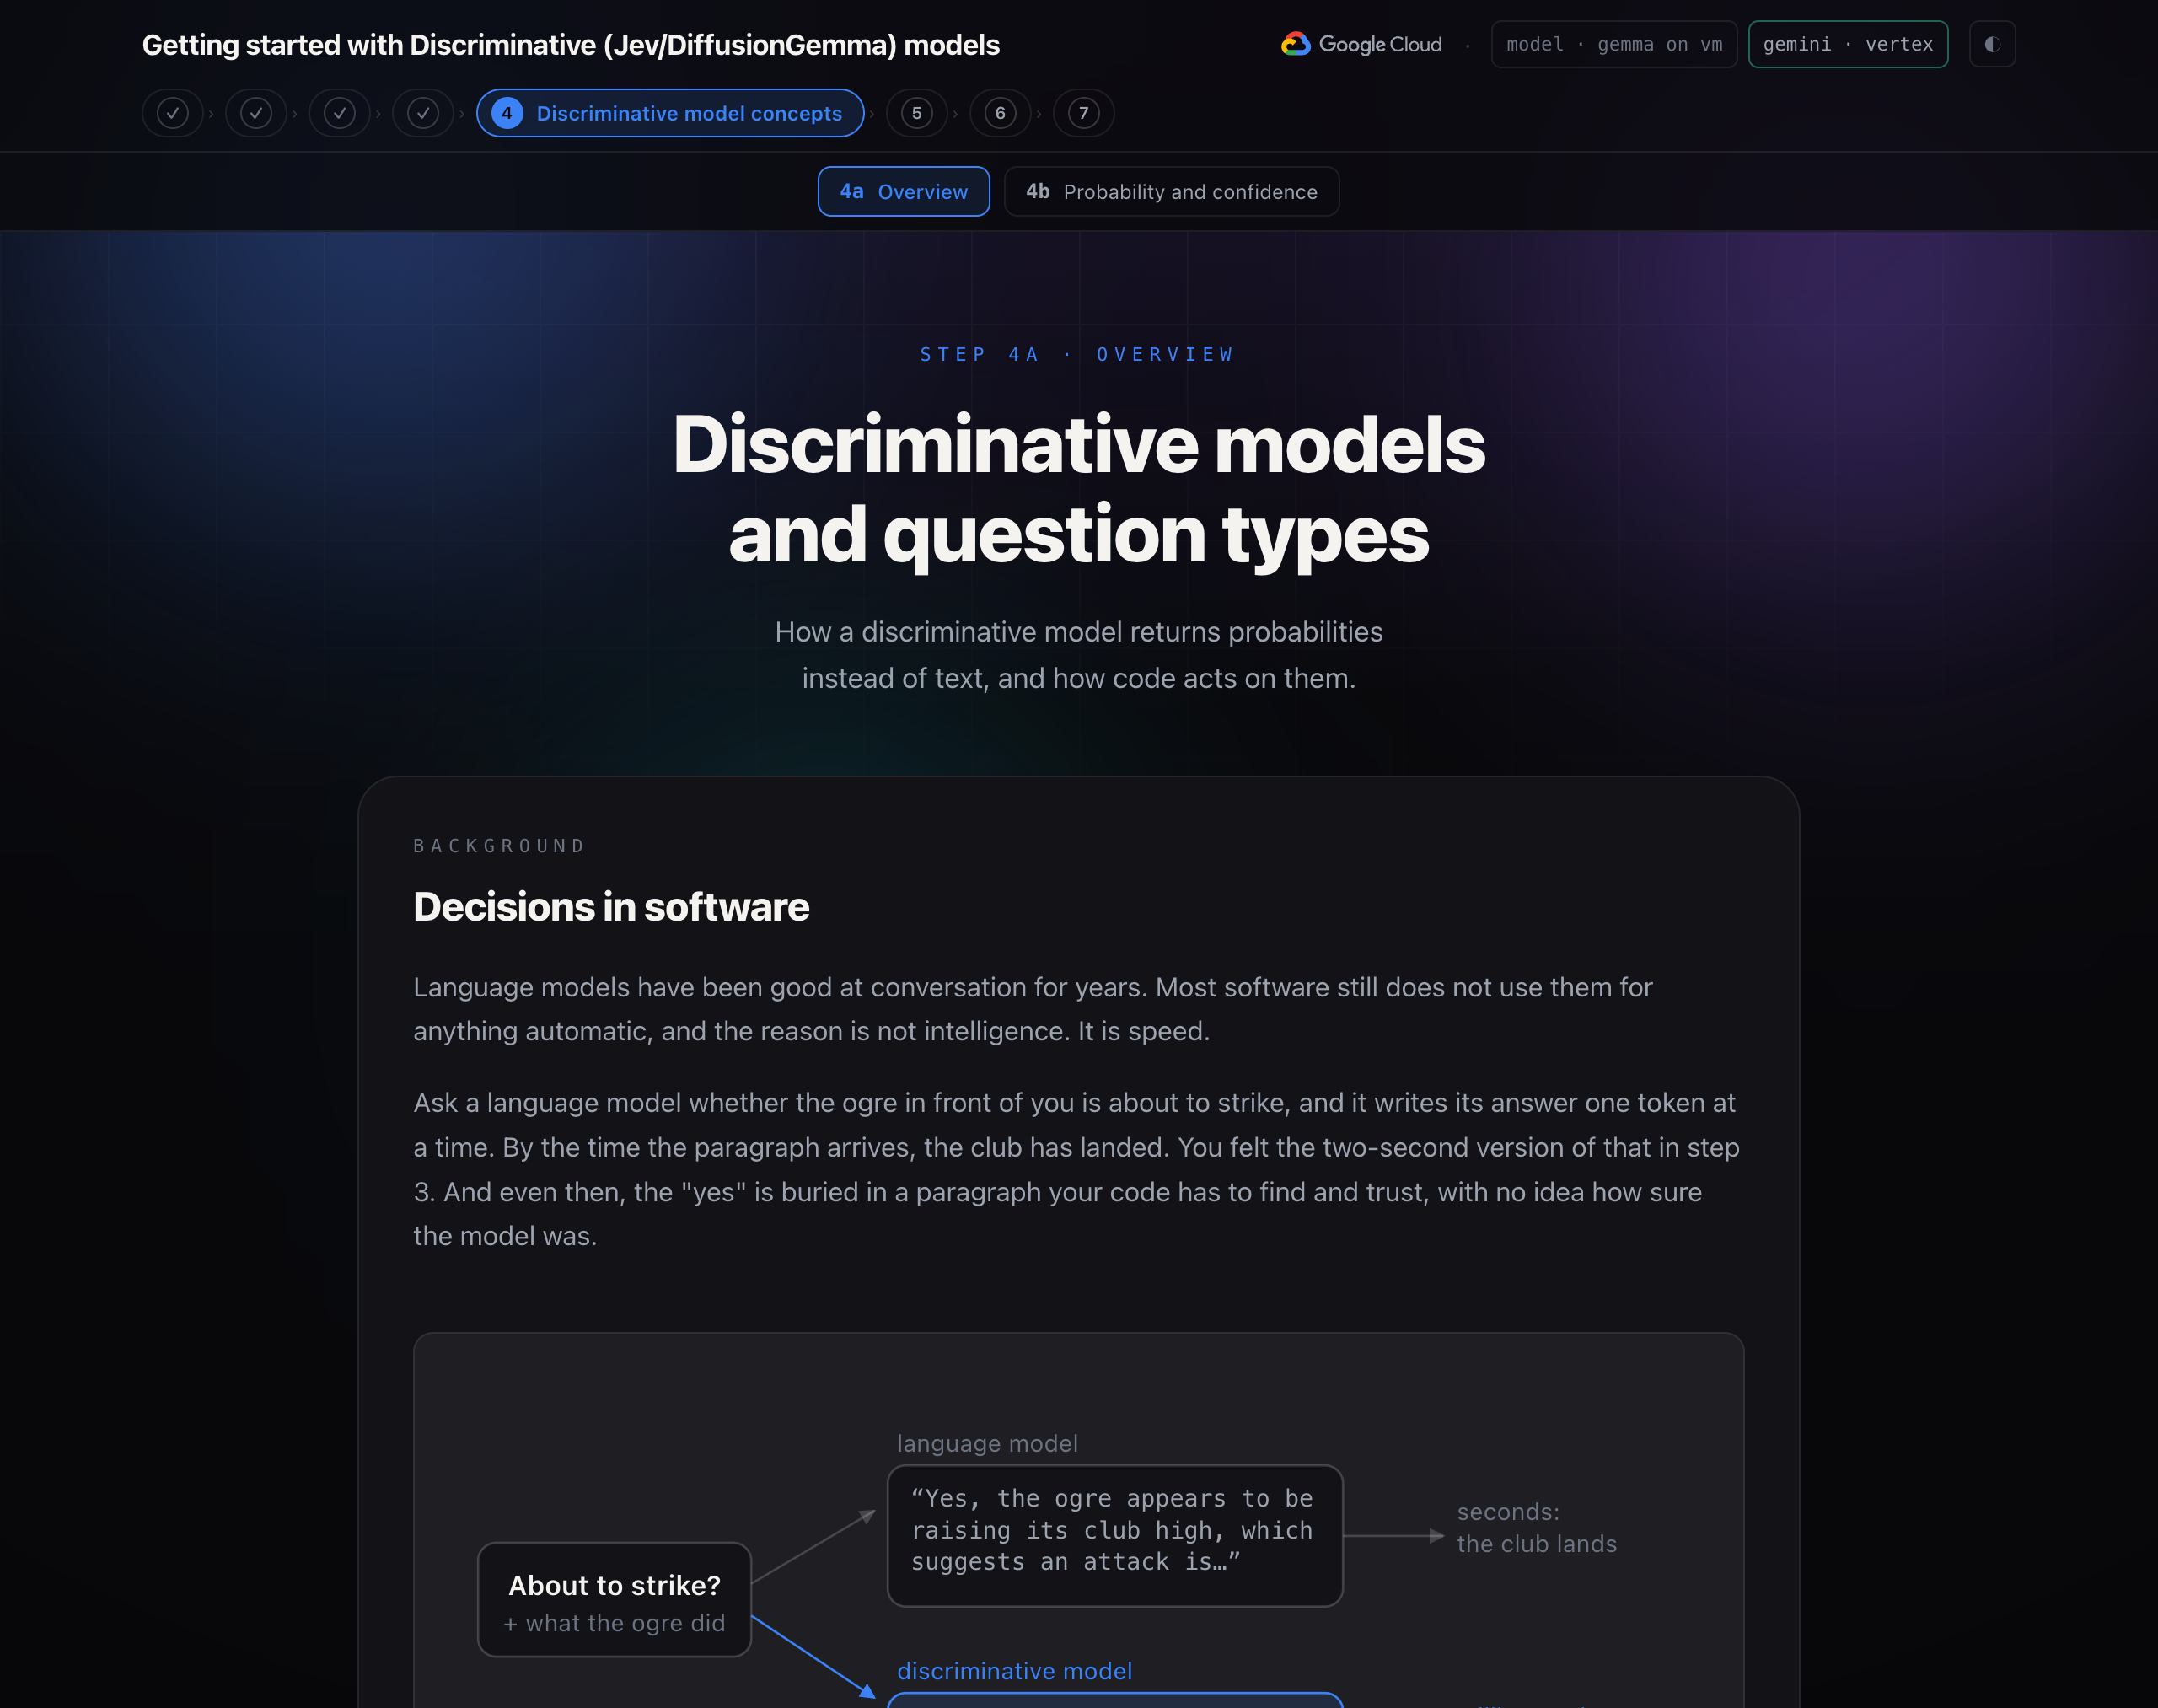
I modelli linguistici sono bravi a conversare da anni. La maggior parte dei software non li utilizza ancora per nulla di automatico e il motivo non è l'intelligenza. È velocità.
Chiedi a un modello linguistico se l'orco di fronte a te sta per attaccare e lui scrive la sua risposta un token alla volta. Quando arriva il paragrafo, il club è atterrato. Hai provato la versione di due secondi nel passaggio 3. E anche in questo caso, la risposta "sì" è nascosta in un paragrafo che il tuo codice deve trovare e di cui deve fidarsi, senza sapere quanto il modello fosse sicuro.
Il modello discriminativo prende lo stato e le domande e risposte che hai digitato in un'unica passata, in millisecondi. Ogni risposta viene fornita con una probabilità calibrata: 0,9 significa che è corretta nove volte su dieci. Non c'è testo da analizzare e nessun JSON da estrarre.
Modelli Sistema 1 e Sistema 2
Il nome deriva dal libro Pensieri lenti e veloci di Daniel Kahneman. Il Sistema 2 è un ragionamento lento e deliberato, un passo alla volta. System One è veloce e si basa sul riconoscimento di pattern.
Un modello linguistico è una macchina di tipo 2. Ragiona in token, uno alla volta. Il modello discriminativo è un modello di sistema 1: non ragiona ad alta voce, non genera nulla e risponde a ogni domanda in un'unica passata. Per questo motivo è veloce (circa 70-500 millisecondi) ed economico (frazioni di centesimo per mille decisioni).
Concetto fondamentale:un modello linguistico scrive. Decide un modello decisionale. La maggior parte di ciò che il software richiede all'AI è una decisione.
Limitazioni
Il modello discriminativo non genererà testo, non scriverà codice, non terrà una conversazione, non farà calcoli aritmetici, non leggerà un'immagine e non seguirà una sequenza di passaggi.
Nel workshop, sceglieremo uno dei modelli discriminativi:
- Uno dei modelli discriminativi è Jev. Si tratta di un'API ospitata di TypeSafe AI, rilasciata a settembre 2026. Il primo modello è
jev-1.13, raggiunto tramite l'aliasjev-latest. Non sono presenti pesi pubblicati, quindi viene chiamato, non scaricato. - Jev non è l'unico modo per ottenere un modello System One. DiffusionGemma di Google è un modello con pesi aperti che scrive un intero blocco di token in parallelo anziché uno alla volta e lo stesso passaggio parallelo può leggere le probabilità su un insieme fisso di opzioni. I server open source come djev-run mettono davanti l'API esatta di Jev, quindi tutto in questo workshop viene eseguito senza modifiche.
Stato e domande: Choice, Score e Noul
Ogni chiamata invia lo stato e le domande. Lo stato è il testo che vuoi che venga giudicato. Può essere una stringa, un oggetto JSON o un elenco. Le domande chiedono cosa vuoi sapere del testo. Ogni domanda ha un tipo: Scelta, Punteggio o Noul. Le domande vengono elaborate in parallelo, il che consente di rispondere rapidamente. Se necessario, puoi aggiungere più domande.
- Scelta seleziona un'opzione da un insieme che specifichi, fino a 255. La risposta è l'opzione, una probabilità per ogni opzione e un livello di confidenza. Usala quando le opzioni non hanno un ordine: blocca alto, blocca basso, schiva, colpisci, aspetta.
- Punteggio valuta lo stato in base ai livelli ordinati che descrivi, da 2 a 10. La risposta è una posizione lungo la scala (un numero decimale, quindi 1, 4 significa "tra 1 e 2, più vicino a 1"), la probabilità di ogni livello e un valore di confidenza. Usalo quando la risposta è una questione di intensità: quanto sarà forte il colpo in arrivo.
- Sia Scelta che Punteggio restituiscono una probabilità per ogni opzione e un'affidabilità. La differenza è la risposta principale. Una scelta restituisce l'opzione più probabile. Un punteggio considera le opzioni come livelli ordinati e restituisce la loro media ponderata per probabilità, che può trovarsi tra due livelli. Con nessuno 0,05, leggero 0,55 e pesante 0,40, una risposta a scelta "leggero" e una risposta con punteggio 1,35, tra leggero e pesante. L'arena utilizza questo valore:
choose()considera un punteggio di pericolo pari o superiore a 1,5 come un colpo pesante.
- Sia Scelta che Punteggio restituiscono una probabilità per ogni opzione e un'affidabilità. La differenza è la risposta principale. Una scelta restituisce l'opzione più probabile. Un punteggio considera le opzioni come livelli ordinati e restituisce la loro media ponderata per probabilità, che può trovarsi tra due livelli. Con nessuno 0,05, leggero 0,55 e pesante 0,40, una risposta a scelta "leggero" e una risposta con punteggio 1,35, tra leggero e pesante. L'arena utilizza questo valore:
- Noul pone una domanda di tipo sì/no e restituisce la probabilità che la risposta sia sì. Un valore vicino a 1 indica un forte sì, un valore vicino a 0 indica un forte no, un valore vicino a 0,5 indica che "potrebbe essere l'uno o l'altro". Non esiste una confidenza separata, poiché la probabilità è il suo livello di confidenza.
Scrivere domande mirate
Il modello discriminativo funziona meglio quando una domanda riguarda un aspetto specifico e ben definito. "Qual è la situazione?" restituisce una risposta plausibile e con un basso livello di confidenza. "Qual è la risposta corretta?" "L'avversario è esposto?" e "Quanto sarà forte questo colpo?" restituiscono tre risposte mirate che il codice combina.
Le descrizioni delle opzioni e dei livelli sono economiche e importanti. Le regole che hai letto nel passaggio 3 diventano le descrizioni delle opzioni: block_high: "Raise the shield. Right against an overhead or a high swing." in questo modo, il modello discriminativo apprende le regole del combattimento, al momento della richiesta, in una riga ciascuna. E le opzioni possono cambiare a seconda della situazione: l'arena offre cast solo quando un incantesimo è pronto.
Probabilità e confidenza
Una risposta a scelta non è un'etichetta. Si tratta di una distribuzione sulle etichette e l'etichetta è solo la barra più alta.
Come viene calcolato il numero dal modello. Utilizza lo stesso passaggio che un modello linguistico utilizza per scegliere la parola successiva. Un transformer legge il testo e, in una posizione, assegna a ogni token del suo vocabolario un punteggio grezzo, chiamato logit. Un logit più alto indica che il token si adatta meglio a quella posizione. Una funzione softmax trasforma i logit in probabilità che sommate danno 1. Un modello linguistico sceglie quindi un token, lo aggiunge al testo e ripete l'operazione. Un modello discriminativo si ferma dopo le probabilità.
Lo spazio vuoto è un'interruzione in un modulo di risposta. Il server scrive il modulo stesso, ad esempio response: ▢, e lascia uno spazio vuoto per ogni domanda. L'unico compito del modello è assegnare un punteggio a ciò che appartiene a ogni spazio vuoto.
- Il prompt contiene lo stato e ogni domanda, con ogni risposta consentita come etichetta breve:
aper block_high,bper block_low e così via. - Il server aggiunge il modulo di risposta, con uno spazio vuoto per domanda.
- Il modello legge il prompt e il modulo in un'unica passata e assegna un logit a ogni token in ogni spazio vuoto. Il modello di diffusione vede l'intero modulo contemporaneamente e assegna un punteggio a tutti gli spazi vuoti insieme.
- Il server conserva solo i logit delle etichette consentite e applica una funzione softmax, in modo che le risposte consentite sommino a 1.
- Se la lettura sembra incerta, il server legge di nuovo da un altro punto di partenza casuale e calcola la media delle letture.
Confidenza è un numero che indica il grado di certezza della risposta. TypeSafe lo calcola in base alla distribuzione della probabilità tra le opzioni. Se tutte le risposte sono concentrate su un'unica opzione, il risultato è 1, mentre se sono distribuite in modo uniforme, il risultato è 0. Per tre opzioni, la formula è (3 × valore più grande − 1) / 2.
TypeSafe addestra Jev per probabilità calibrate. La probabilità corrisponde alla frequenza con cui la risposta è corretta. In un modello calibrato, le risposte date a 0,7 sono corrette circa il 70% delle volte, quindi una soglia di confidenza è una soglia sulla frequenza con cui accetti una risposta errata. Il server DiffusionGemma in questo workshop riporta la probabilità più alta come confidenza, calcolata come media delle sue letture. Quando le letture non coincidono, la media si distribuisce e l'affidabilità diminuisce.
Concetto chiave: la risposta ti dice cosa. La confidenza indica se intervenire.
Soglie
La soglia è il modo in cui definisci l'azione nel codice. Il modello restituisce un'affidabilità o una probabilità. Il codice lo confronta con un numero che hai scelto e il risultato decide cosa succede.
Una soglia per azione. TypeSafe suggerisce di dividere la confidenza in bande. L'azione immediata viene eseguita automaticamente. Le azioni a media confidenza vengono eseguite con un controllo, ad esempio la richiesta di conferma o il contrassegno della richiesta per la revisione. La scarsa probabilità di corrispondenza non agisce e ripiega su qualcosa di sicuro o su una persona.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Le regole dell'arena. Le soglie dell'arena si trovano in choose(), che esegui nel passaggio 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Avviso:una risposta valida non è sempre corretta. Il modello discriminativo non può restituire un'opzione che non hai offerto, quindi non inventa mai una mossa, ma può scegliere quella sbagliata, a volte con un alto grado di certezza. Verifica le tue domande in base a situazioni che hai già giudicato prima di considerare attendibile una soglia.
Automatizzare le decisioni con il modello
Richiesta e risposta
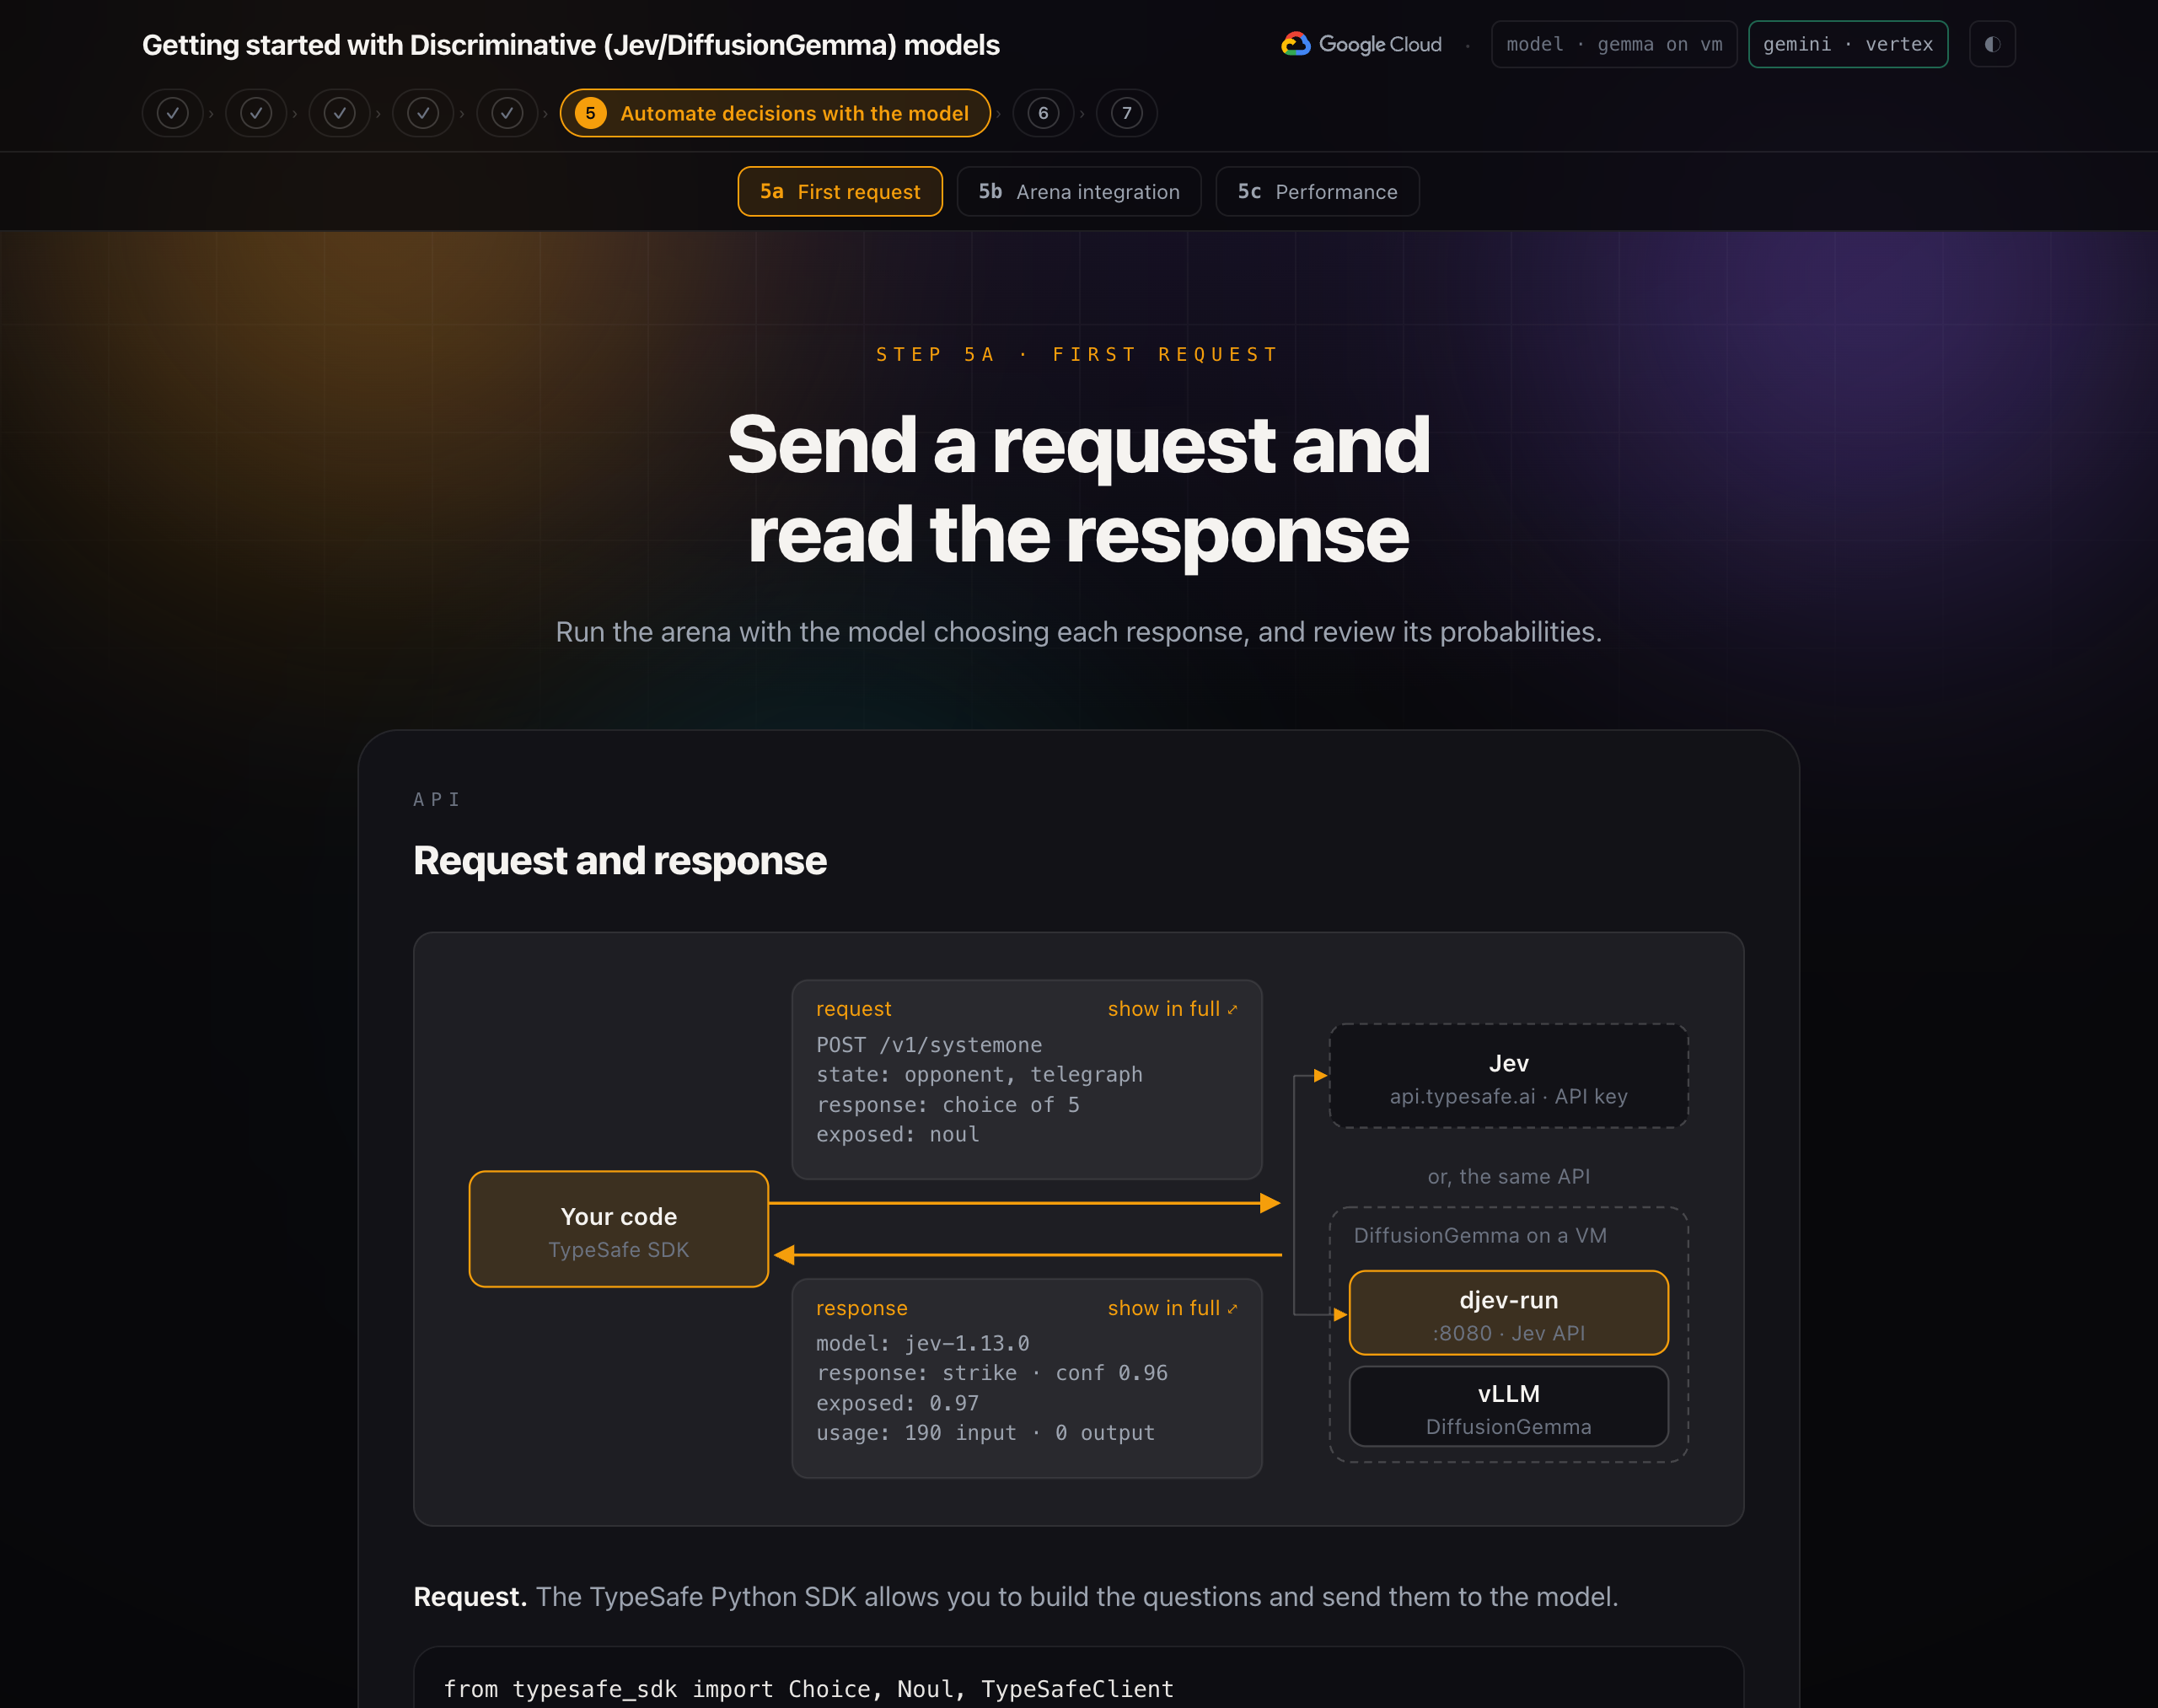
Richiesta. L'SDK Python TypeSafe ti consente di creare le domande e inviarle al modello.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Una richiesta per segno di spunta
A ogni segno di spunta, l'app invia il telegrafo come stato e chiede tre cose in una sola chiamata:
- Quale risposta è corretta tra le cinque (o sei, quando un incantesimo è pronto)? Una scelta.
- Indica se l'orco è esposto a un contatore in questo momento. A Noul.
- L'intensità del colpo in arrivo, in base a una griglia a tre livelli. Un punteggio.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
La funzione choose()
Ricordi le soglie del passaggio 4? choose() confronta le risposte del modello con numeri fissi e questi numeri fissi sono le soglie.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() è la normale lettura di Python dei valori digitati, con due regole. Il modello discriminativo fornisce la sua probabilità e la sua analisi e il codice utilizza le soglie per le regole. L'azione scelta viene inviata al motore, dove verrà utilizzata per combattere contro l'orco.
Aspetto chiave:conserva le domande e le soglie in un unico posto. Sono la parte di un'integrazione di System One che regolerai di più.
Tempo di risposta, prezzi basati sull'input e logica decisionale
- Tempo di risposta per decisione. Ogni segno di spunta della parte b è tornato in circa cento millisecondi, alcuni in due o tre. È una velocità sufficiente per un ciclo di gioco, un percorso di richiesta o un controllo di ogni messaggio prima che una persona o un modello linguistico lo veda.
- Prezzi basati sugli input. Un intero incontro, sessanta decisioni con tre domande ciascuna, costa ben meno di un decimo di centesimo. I token di output sono pari a zero perché non è stato generato nulla. La conseguenza è che puoi permetterti di chiedere più di quanto ti serve. L'arena chiede se l'orco è esposto a ogni tick anche se solo
strikeecastse ne preoccupano, perché la domanda è quasi senza costi e la risposta è utile nella dashboard. TypeSafe lo chiama speculative fan-out. - Combina sicurezza e pericolo. Quando l'affidabilità della risposta del modello discriminativo è inferiore a 0,40 e il punteggio di pericolosità indica un impatto elevato,
choose()lo sostituisce con una schivata. Una risposta evasiva raramente è la migliore, ma raramente è la peggiore. Scegli le soglie in base al costo di ogni errore, non in base a un numero intero, e testale rispetto ai segnali che hai già giudicato manualmente. Il consiglio di TypeSafe: se una decisione continua a non funzionare, stringi la domanda prima di spostare la soglia.
Combinare modelli in un workflow ADK
Limiti delle decisioni per tick e perché le risposte corrette non sono sufficienti
L'ultima riga del combattimento nel passaggio 5 dice: l'orco si allontana, appena graffiato. Il modello discriminativo non ha subito danni e ne ha inflitti un po' a ogni tick, e 300 punti salute sono più di un po' moltiplicato per 60. La carta incantesimo nell'angolo del ring è rimasta lì per tutto il tempo. Per leggerlo, è necessario un modello in grado di vedere un'immagine.
L'orco ha 300 punti ferita. Un contatore di chiamate corrette per 3. Un colpo in un'apertura fa 8, perché la pelle è spessa. Anche un combattimento perfetto da 60 tick lascia l'orco in piedi e ammaccato, e la partita viene dichiarata patta. È qui che si è conclusa la fase 5: il modello si è difeso bene, ma non è riuscito a vincere.
Solo un incantesimo infligge danni reali: 45 per un lancio perfetto, 67 se colpisce un'apertura.
Assegna ogni attività al modello giusto
La carta magica nell'angolo del ring è il modo per vincere e leggerla non è un problema di testo: è un'immagine, con un colore e tre forme di fila, e l'incantesimo deve essere cantato in modo che corrisponda. Per farlo, è necessario un modello che possa esaminare un'immagine e impieghi alcuni secondi. In una lotta, pochi secondi corrispondono a dieci tick.
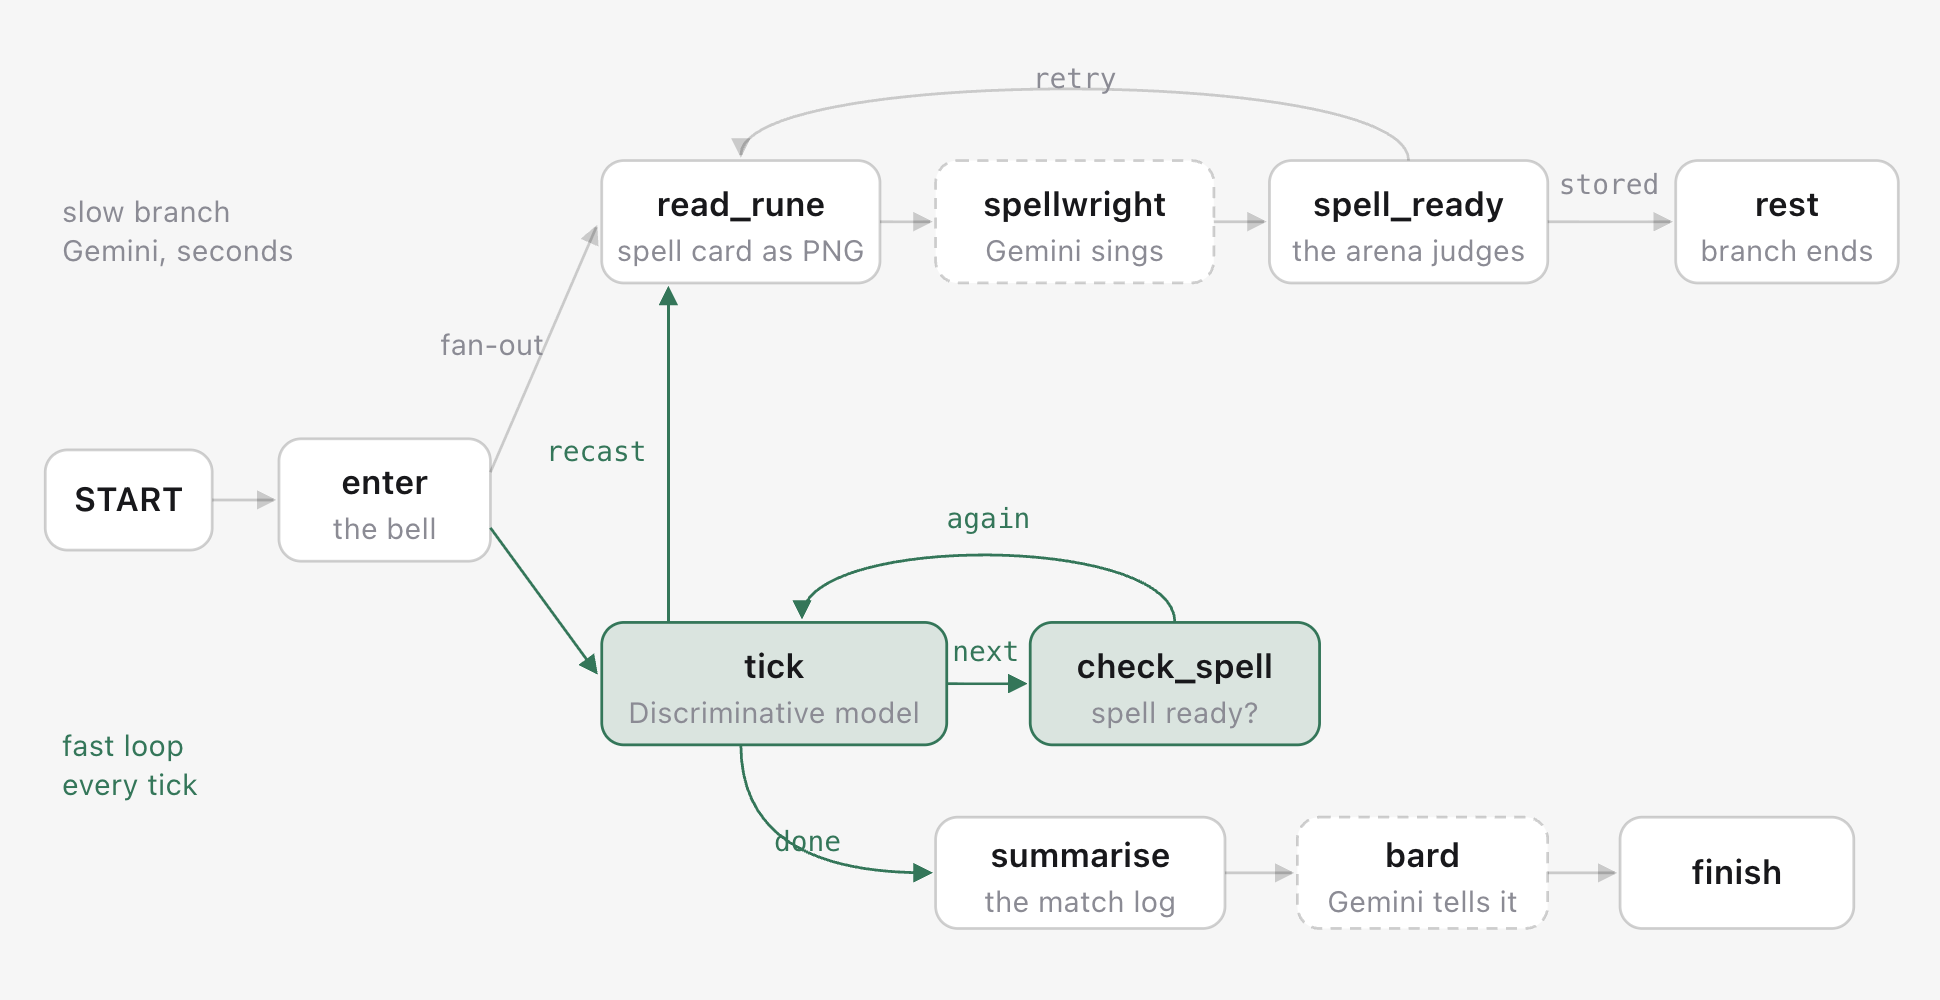
Pertanto, il workflow utilizza entrambi, ognuno alla propria velocità:
- Il modello discriminativo combatte. Ogni tick, una chiamata, una decisione, cento millisecondi. Il ciclo non attende mai nulla di più lento di sé.
- Gemini legge e canta. Nel suo ramo, iniziato al suono della campana, prende la carta magica dallo schermo dell'arena come immagine, nomina il colore e le forme e canta un incantesimo. L'arena giudica la canzone in base alla risposta della carta incantesimo, che non lascia mai il server.
- Dopo ogni scambio, il combattente controlla lo slot. Un nodo
check_spellesamina lo stato. Non pronto: lo indica, con la durata del canto di Gemini e i percorsi che riportano direttamente al segno di spunta successivo. Non aspetta mai. Pronto:castsi unisce alle opzioni offerte al modello discriminativo echoose()spende l'incantesimo nel momento in cui il modello discriminativo segnala un'apertura. Quando l'incantesimo è terminato, sullo schermo viene disegnata una nuova carta incantesimo e il filo lento ricomincia. Una canzone letta male brucia la carta incantesimo e il filo lento legge quella nuova. - Gemini scrive un breve racconto una sola volta, alla fine.
Rami paralleli con latenze diverse e un ciclo di eventi
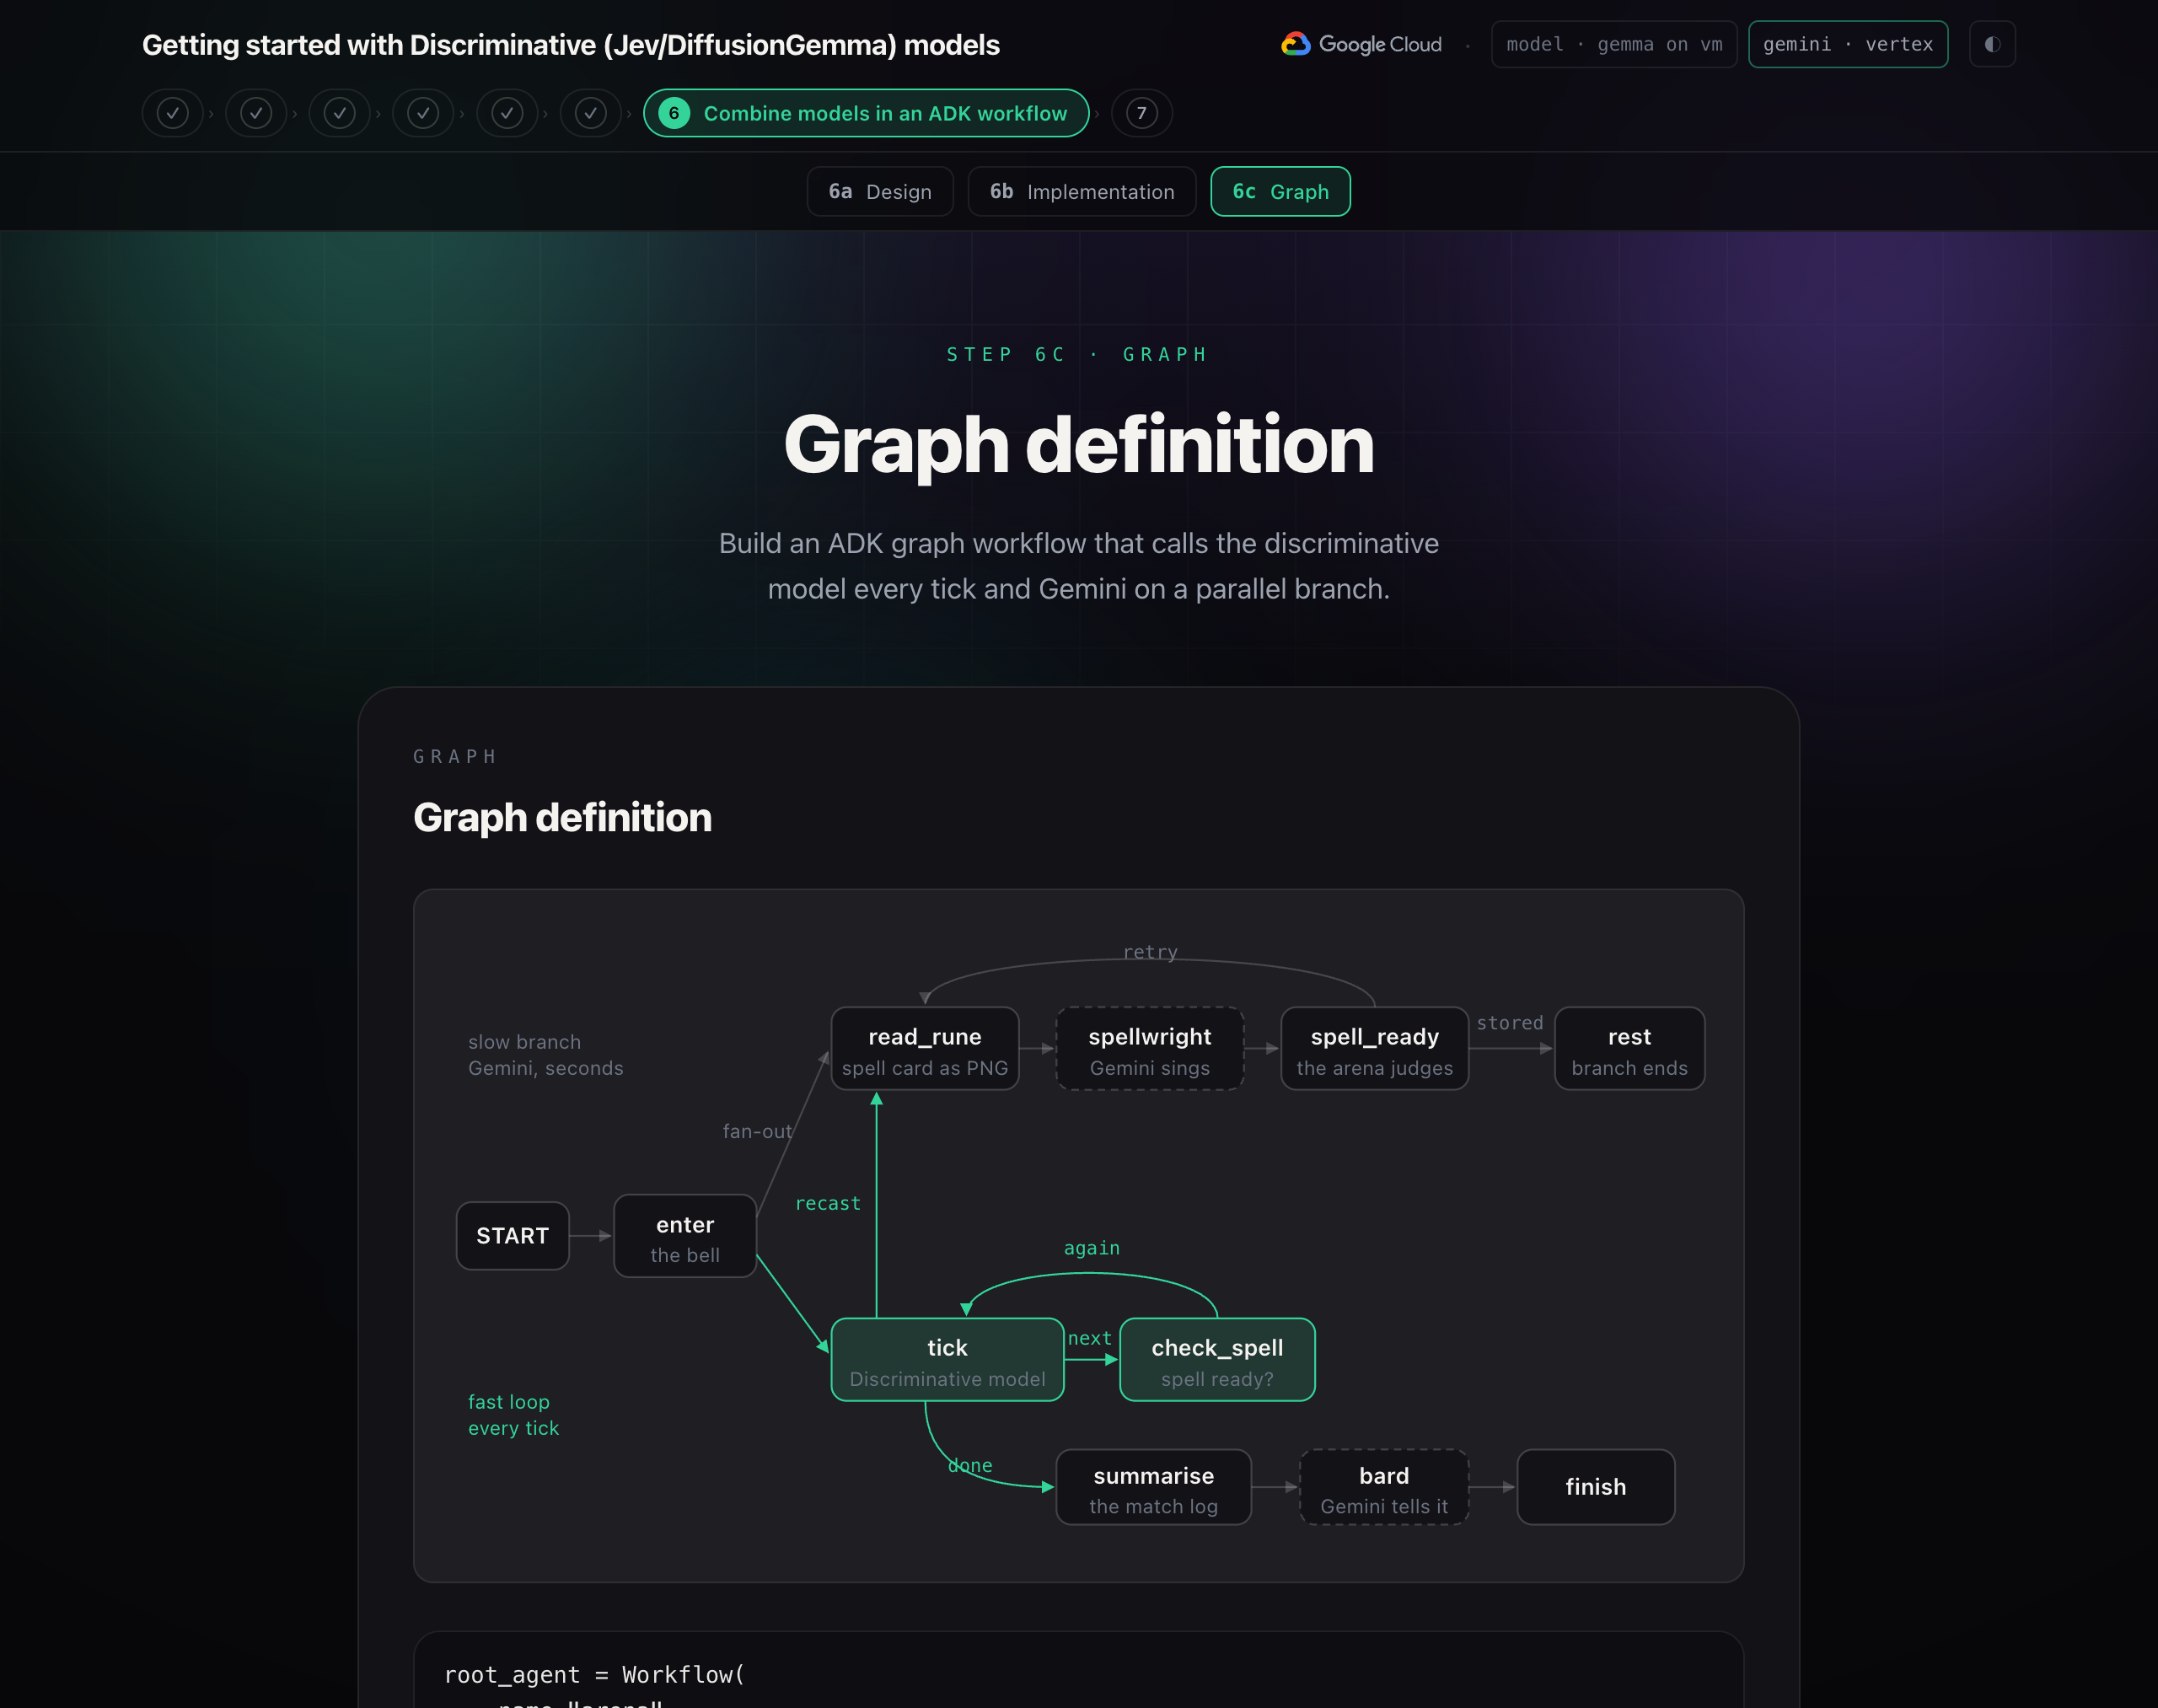
Si tratta di un workflow ADK: un grafico di nodi uniti da archi. Un nodo è una semplice funzione Python o un agente LLM. Un arco da un nodo a una tupla di nodi è un fan-out: entrambi iniziano contemporaneamente. Un nodo che restituisce un Event con un route sceglie quale arco verrà preso successivamente, mentre un nodo che si indirizza a se stesso è un ciclo.
Immagina che siano due thread. Thread 1 è lento: leggi la carta incantesimo, canta, memorizza l'incantesimo. Il thread 2 è veloce: spunta, controlla lo slot, spunta di nuovo. Il thread 1 termina con una funzione che scrive l'incantesimo giudicato nello stato della sessione e non restituisce alcun output. check_spell del thread 2 legge lo stato dopo ogni scambio. Nessun thread chiama o attende l'altro; condividono solo lo stato.
Aspetto chiave:inserisci le decisioni nel codice e assegna a ogni modello un compito specifico al proprio ritmo.
ADK esegue entrambi i rami come attività in un unico ciclo di eventi, in un singolo thread. Viene eseguita una sola attività alla volta. Quando un'attività raggiunge await, attende la risposta e nel frattempo il ciclo esegue l'altro ramo. Il ramo veloce attende il modello per circa un decimo di secondo, mentre il ramo lento attende Gemini per diversi secondi, quindi nessuno dei due blocca l'altro.
Slow branch
read_rune() rimuove la carta incantesimo dallo schermo come immagine.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright è Gemini. Legge l'immagine e risponde in una forma fissa.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() fa giudicare l'incantesimo all'arbitro dell'arena, quindi lo memorizza o riprova.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Un nodo funzione può restituire un Content con una parte di immagine e il nodo LLM lo riceve come turno dell'utente. spell_ready restituisce un Event con un delta di stato e nessun output. Il segno di spunta successivo legge l'incantesimo dallo stato e un ramo senza output non è un secondo finale per il grafico: ADK richiede un output terminale, ovvero il combattimento.
Nota:il giudizio è un codice nell'arena, rispetto alla risposta nascosta della carta incantesimo. Una lettura perfetta è di 45, più in apertura. Due forme a destra fanno 25. Una lettura errata fa fallire la scheda incantesimo. A Gemini non viene chiesto se la risposta è corretta.
Fast branch
tick() riproduce uno scambio, quindi sceglie il bordo successivo.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() esamina lo slot degli incantesimi dopo ogni scambio.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell esamina lo slot dopo ogni scambio. Non blocca mai: se l'incantesimo non è pronto, lo segnala e va avanti.
Tre cose portano avanti il design. La chiamata al modello discriminativo viene await con il client asincrono, quindi il ciclo viene interrotto durante l'attesa e il ramo Gemini continua a essere eseguito. Le domande vengono create di nuovo a ogni tick, quindi cast viene visualizzato solo quando c'è qualcosa da trasmettere. route può essere un elenco: ["recast", "next"] prende entrambi i bordi contemporaneamente.
L'arena stessa si trova dietro un piccolo client: l'app in esecuzione tramite HTTP, se presente, in modo che la pagina mostri l'incontro; il motore in-processo, se non presente.
Definizione del grafico
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Una tupla come destinazione è un fan-out. Una tupla come arco è una catena. Un dizionario mappa i nomi delle route ai nodi. tick → check_spell → tick è il loop veloce. "recast": read_rune riavvia il thread lento dopo che un incantesimo è stato utilizzato, "retry" fa lo stesso dopo un fallimento e "stored": rest consente al thread lento di terminare silenziosamente, senza output, una volta che l'incantesimo è nello slot. ADK richiede almeno un bordo instradato in un ciclo, quindi un ciclo incondizionato viene rifiutato prima che possa essere eseguito per sempre.
Nota: root_agent è ciò che cercano gli strumenti dell'ADK. adk web agents dalla radice del workshop apre la UI di sviluppo con l'arena, se vuoi vedere il grafico e gli eventi in un browser anziché in un terminale.