

1. はじめに
判別モデル、TypeSafe AI の System One 意思決定モデル、および Google ADK ワークフローで Gemini の横に配置する方法に関する 90 分間のワークショップ。このワークショップは、格闘ゲームを題材とした 6 つのステップで構成されています。まず手でオーガと戦い、次に反射神経を判別モデルに渡し、ADK ワークフローが判別モデルで戦いに勝つ様子を見ます。判別モデルはすべてのティックを決定し、Gemini は画面から呪文カードを読み取って呪文を唱えます。
概要
判別モデル(jev-1.13、エイリアス jev-latest)は、TypeSafe AI のホストモデルで、2026 年 9 月 19 日にリリースされました。テキストは生成されません。状態(テキスト、JSON、リスト)と型付きの質問(Choice、Score、Noul)を送信すると、約 70 ~ 500 ミリ秒で、調整された確率を含む型付きの回答が返されます。料金は、入力トークン 100 万個あたり $0.042 で、出力は無料です。その役割は、言語モデルの前、間、後ろでの意思決定です。ルーティング、分類、ゲーティング、そしてここでは、格闘家の反射神経です。
ゲームを例として使用する
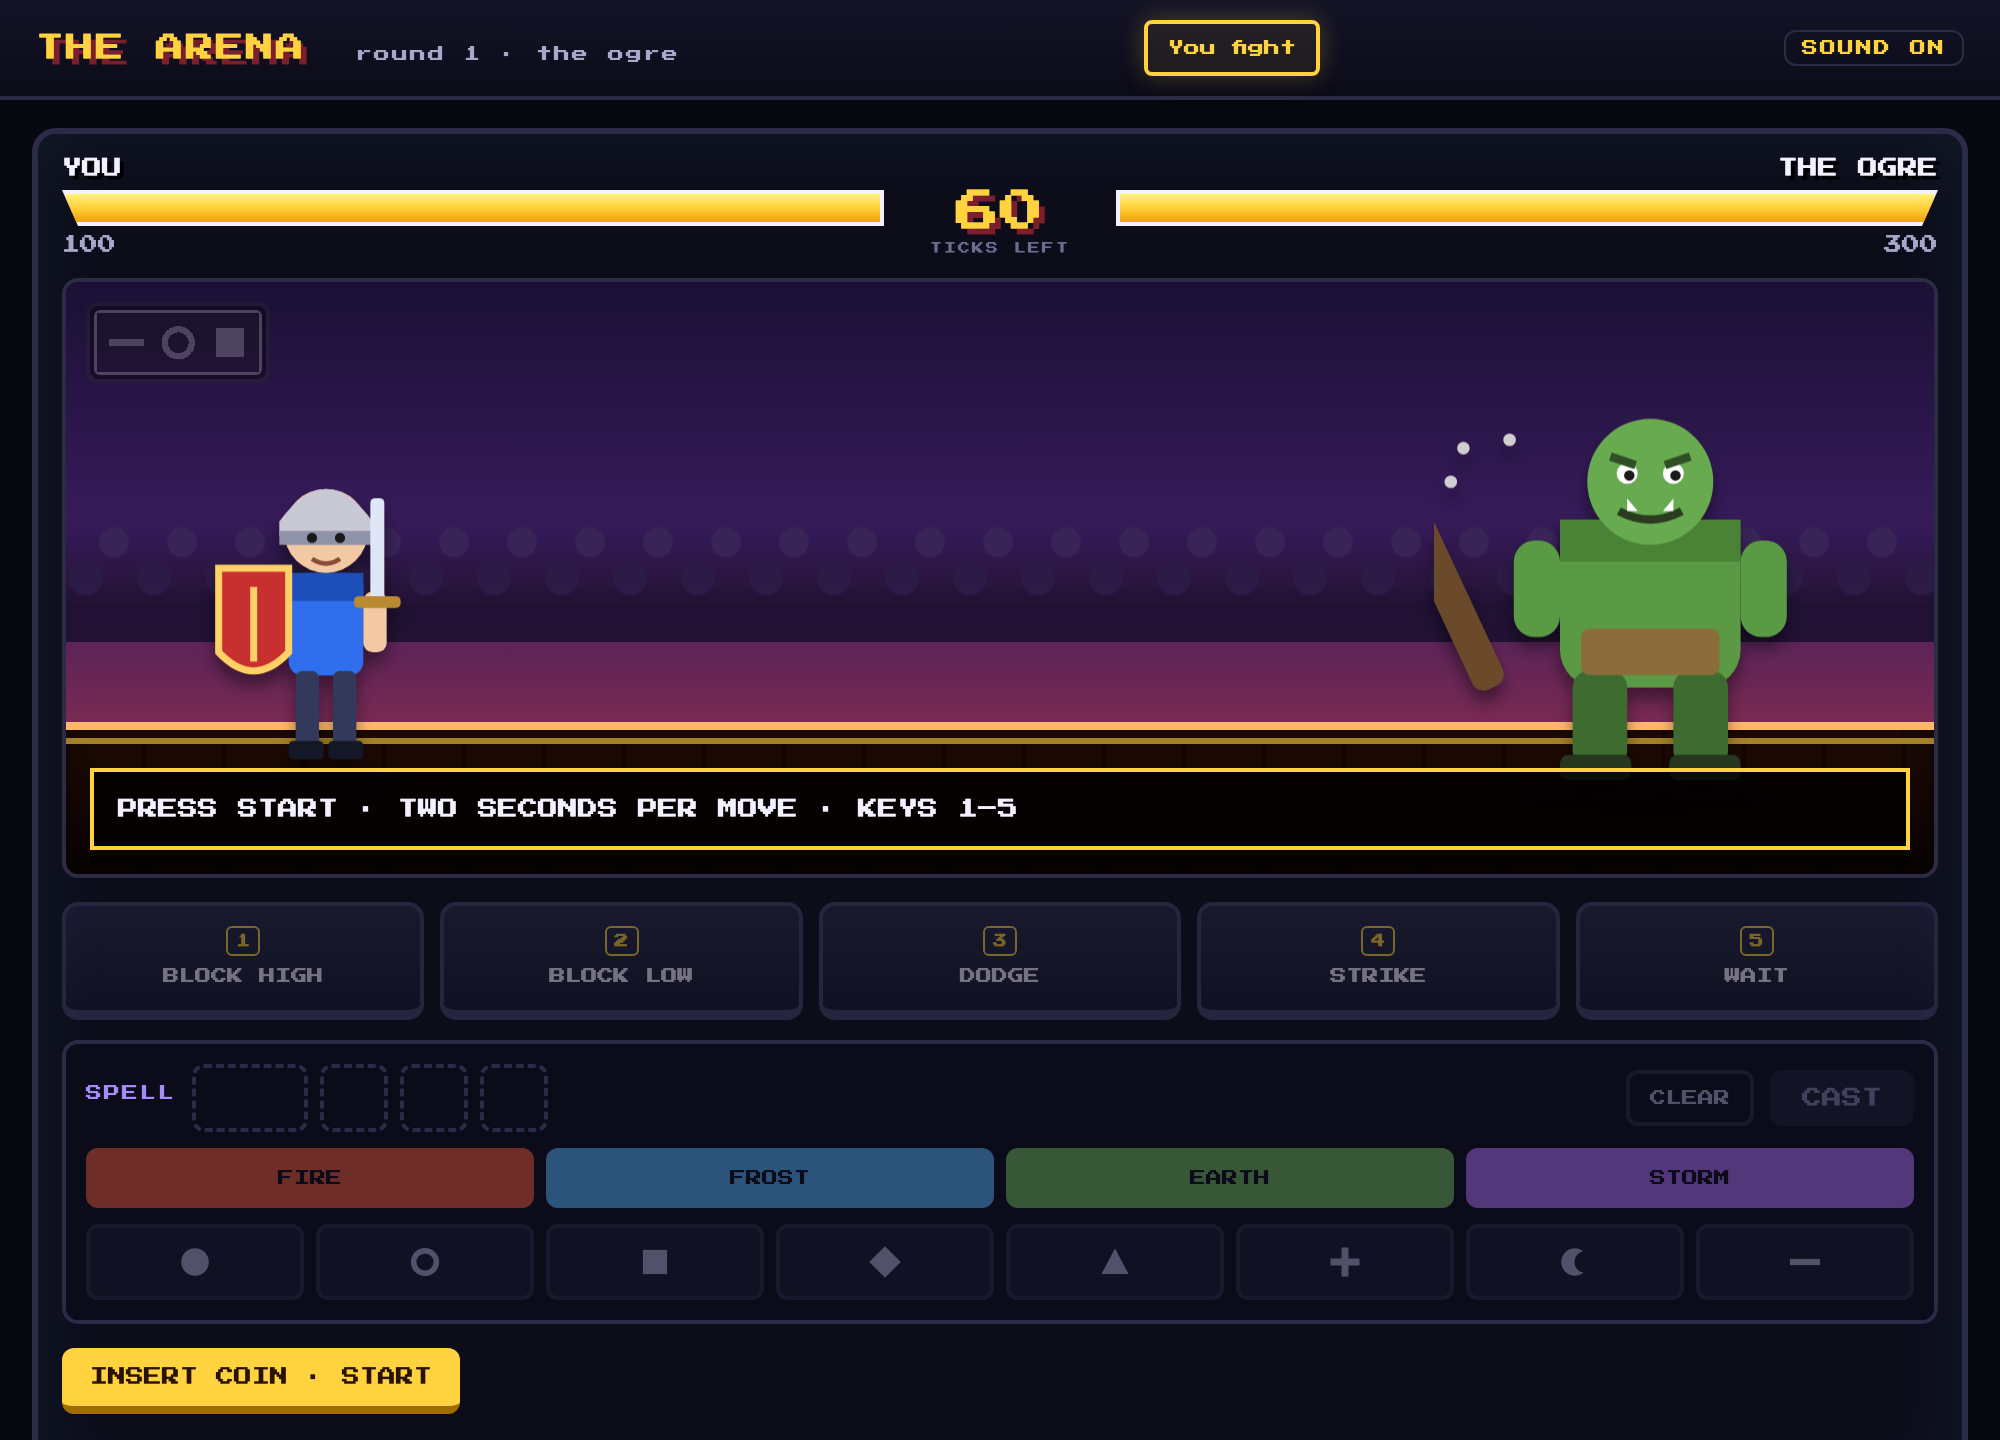
戦闘ゲームをプレイしたことはありますか?相手と対戦し、相手の動きに即座に反応する必要があります。間違った推測をすると、HP が減ります。ゲームでは、呪文を唱えにくくする傾向もあります。このゲームでは、呪文が発動する前に、呪文カードの色と形を順番に選択する必要があります。このワークショップでは、両方のタイプのモデルを組み合わせてキャラクターを勝利させる方法について説明します。
ゲームの各要素は実際のシステムにマッピングされます。
- 相手の動きは、リクエストやトランザクションなどの受信イベントです。
- レスポンスは、識別モデルによって行われ、コードによってチェックされる境界付きの決定です。
- 呪文カードは、言語モデルで読み取る必要がある非構造化入力です。
- 一致は、高速な作業と低速な作業をそれぞれの速度で実行するワークフローです。
このアプローチでは、4 つのコンポーネントを組み合わせて、高速でスマートなシステムを構築することに重点が置かれています。
学習内容
- 識別モデル(システム 1)と生成モデル(システム 2)の違いと、それぞれの使用場面を説明します。
- Jev と DiffusionGemma の提供方法について説明し、Compute Engine GPU VM 上の DiffusionGemma を含むワークショップ用に 1 つ設定します。
- 選択肢、スコア、Noul の質問を作成し、確率と信頼度を解釈します。
- 決定論的コードでしきい値を使用して、確率をアクションに変換します。
- TypeSafe SDK でリクエストをビルドし、モデルにゲームのすべての動きを選択させます。
- Gemini が画像を読み取る遅いブランチと、判別モデルがループ内で決定する速いブランチを構築し、それぞれを個別に実行します。
- 1 つのイベントループで状態を共有する ADK グラフ ワークフローで両方のブランチを結合します。これにより、遅い処理が速い判断を妨げることはありません。
アーキテクチャ
ワークベンチは cloudshell(またはマシン)にあり、ローカル ファイル システムに書き込み、アリーナ、Gemini、意思決定モデルとやり取りします。② は「Discriminative model fights」で決定モデルを呼び出し、③ は「Workflow fights」で両方を呼び出します。
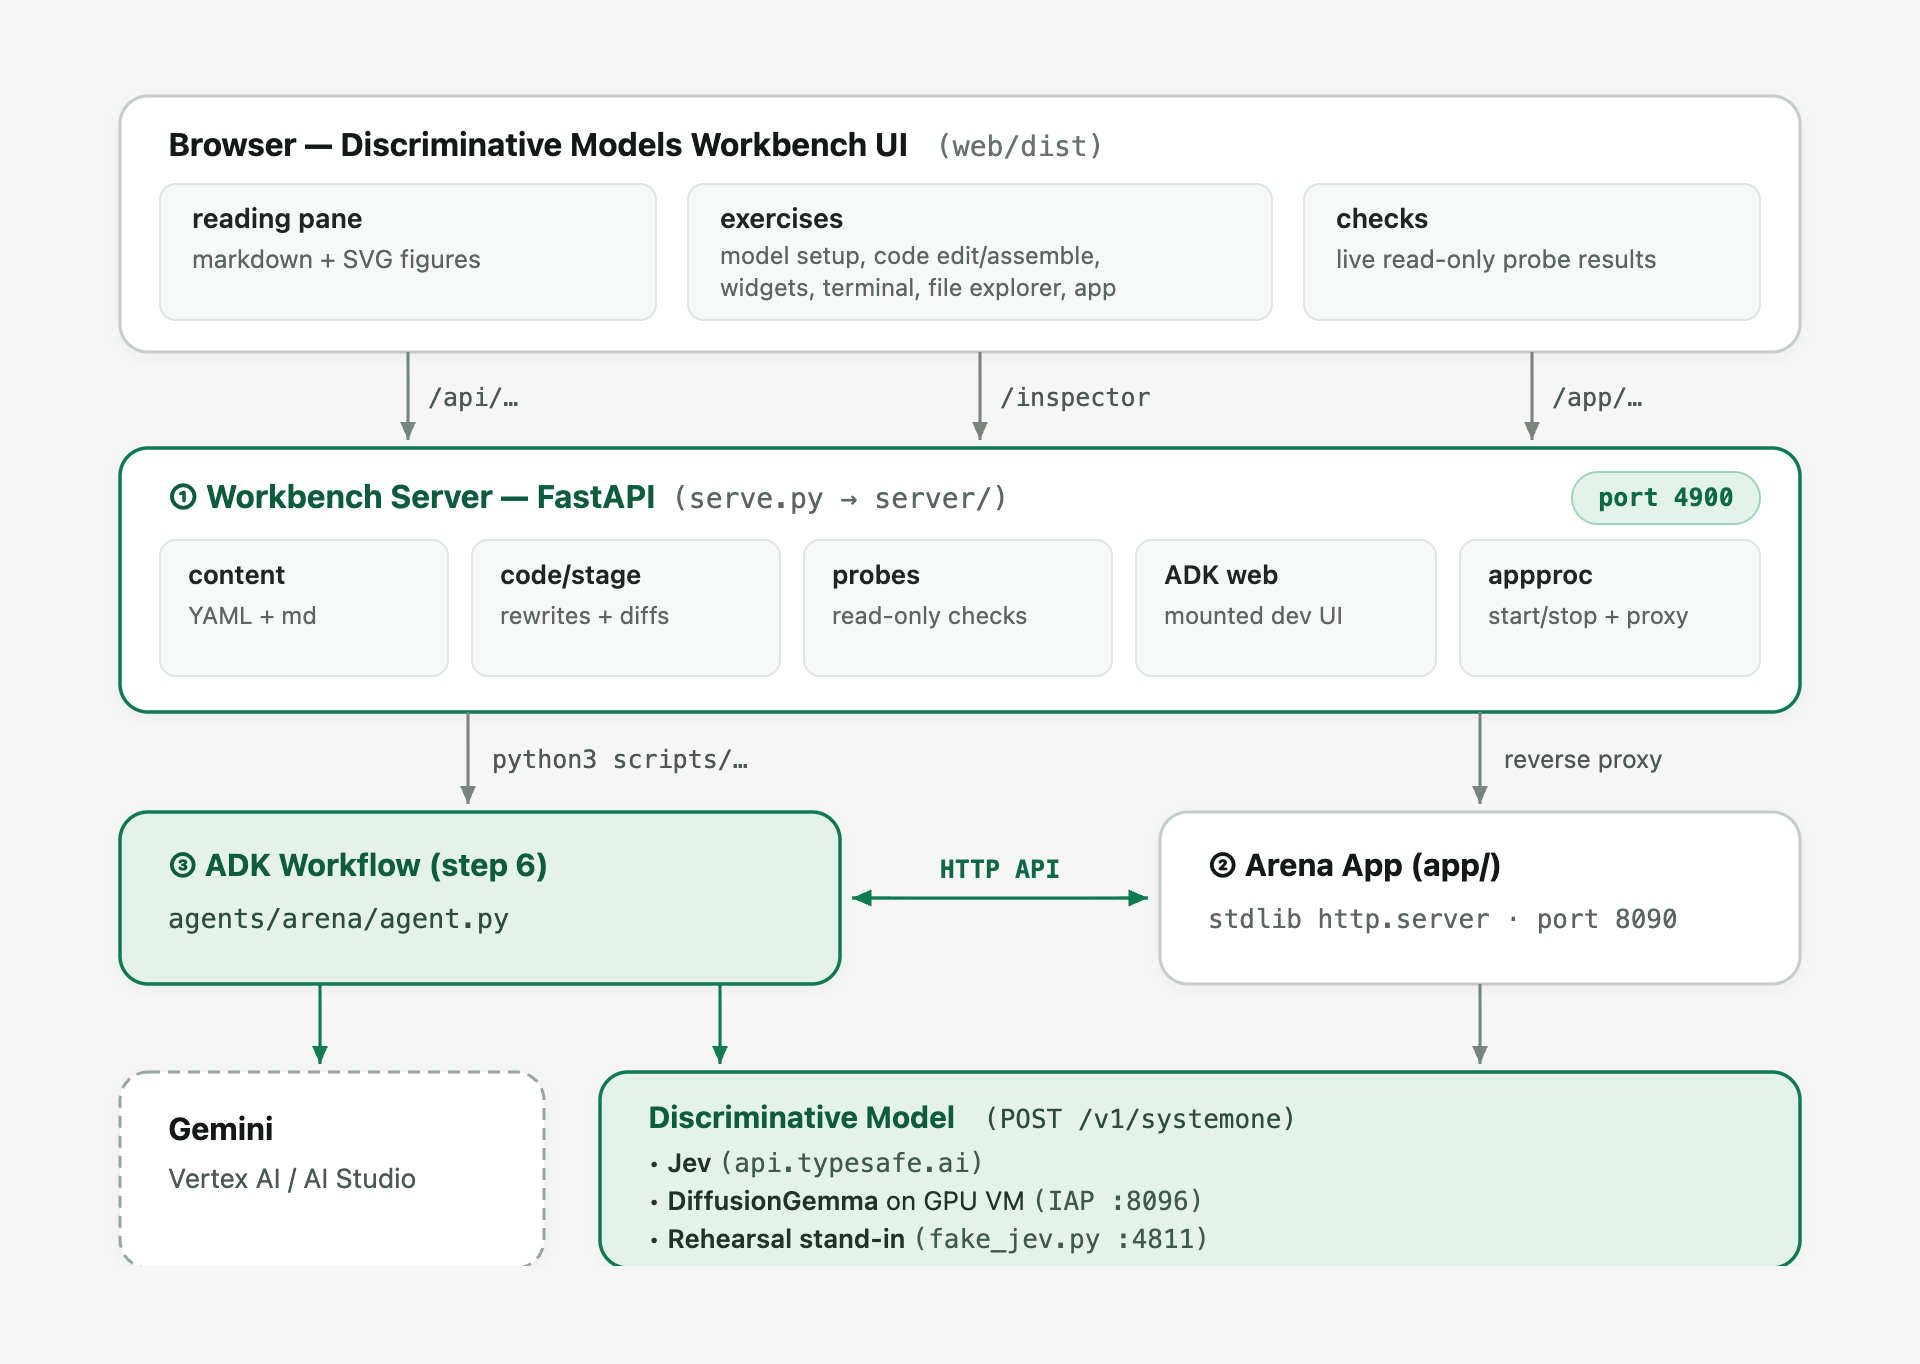
誰が何を呼び出すか。ブラウザは ① とのみ通信します。両方のモデルは、マシンの Python から呼び出されます。
発信者 | 識別モデル | Gemini |
② アリーナ、「判別モデルの戦い」 | すべてのティックで | × |
③ ワークフロー | すべてのティックで | × |
③ ワークフロー | × | スペルカードの画像、戦いの後の物語 |
| はい | × |
モードごとに 1 つの目盛り。
- 戦う。ページは ② で電報を要求し、2 秒のタイマーで表示して、押したボタン(または入力したスペル)を返します。② で解決します。
- 識別モデルの競合。ページは ② にチェックマークを要求します。② は電信を送信し、1 回の呼び出しでモデルに 3 つの質問をして、
choose()を実行し、回答と結果を返します。ページにバーが描画されます。 - ワークフローの競合。Start は ② をサブプロセスとして起動します(
runs/arena-workflow.logにログイン)。③ は戦闘を制御します。② に各電信を要求し、モデルを呼び出して、決定を投稿します。Gemini のスペルは、準備ができ次第、独自のブランチに到着します。このページは ② のポーリングと描画のみを行います。一時停止は ② のフラグで、③ が各ティックの前にチェックします。
意思決定モデルがホストされている場所。すべての呼び出しは同じ typesafe-sdk を通過します。ベース URL のみが変更されます。scripts/jevauth.py は、バックエンドに名前を付け、キーとタイムアウトを設定します。
バックエンド |
| キー | 設定したユーザー |
TypeSafe、ホスト型 | unset(api.typesafe.ai) |
|
|
L4 VM での DiffusionGemma |
| なし |
|
Cloud Run での DiffusionGemma |
| 1 時間ごとに取得される Google ID トークン |
|
リハーサル |
| なし |
|
スペルカードの回答 ②: ワークフローは PNG のみを取得し、② は送り返すスペルを判断します。これにより、呪文は Gemini の読解力を試す真のテストとなり、「You fight」で作成する呪文は自分の読解力を試す真のテストとなります。
2. セットアップ
ワークショップのクレジットを申請する
このセッションで Google Cloud クレジットが付与された場合は、まずクレジットを請求してください。1 分ほどで請求先アカウントが作成されます。
Cloud Shell を開く
Google Cloud Shell は、ブラウザからアクセスできる Linux 環境です。gcloud、Python、Node.js、uv、git が事前に構成されており、Google アカウントで認証済みです。
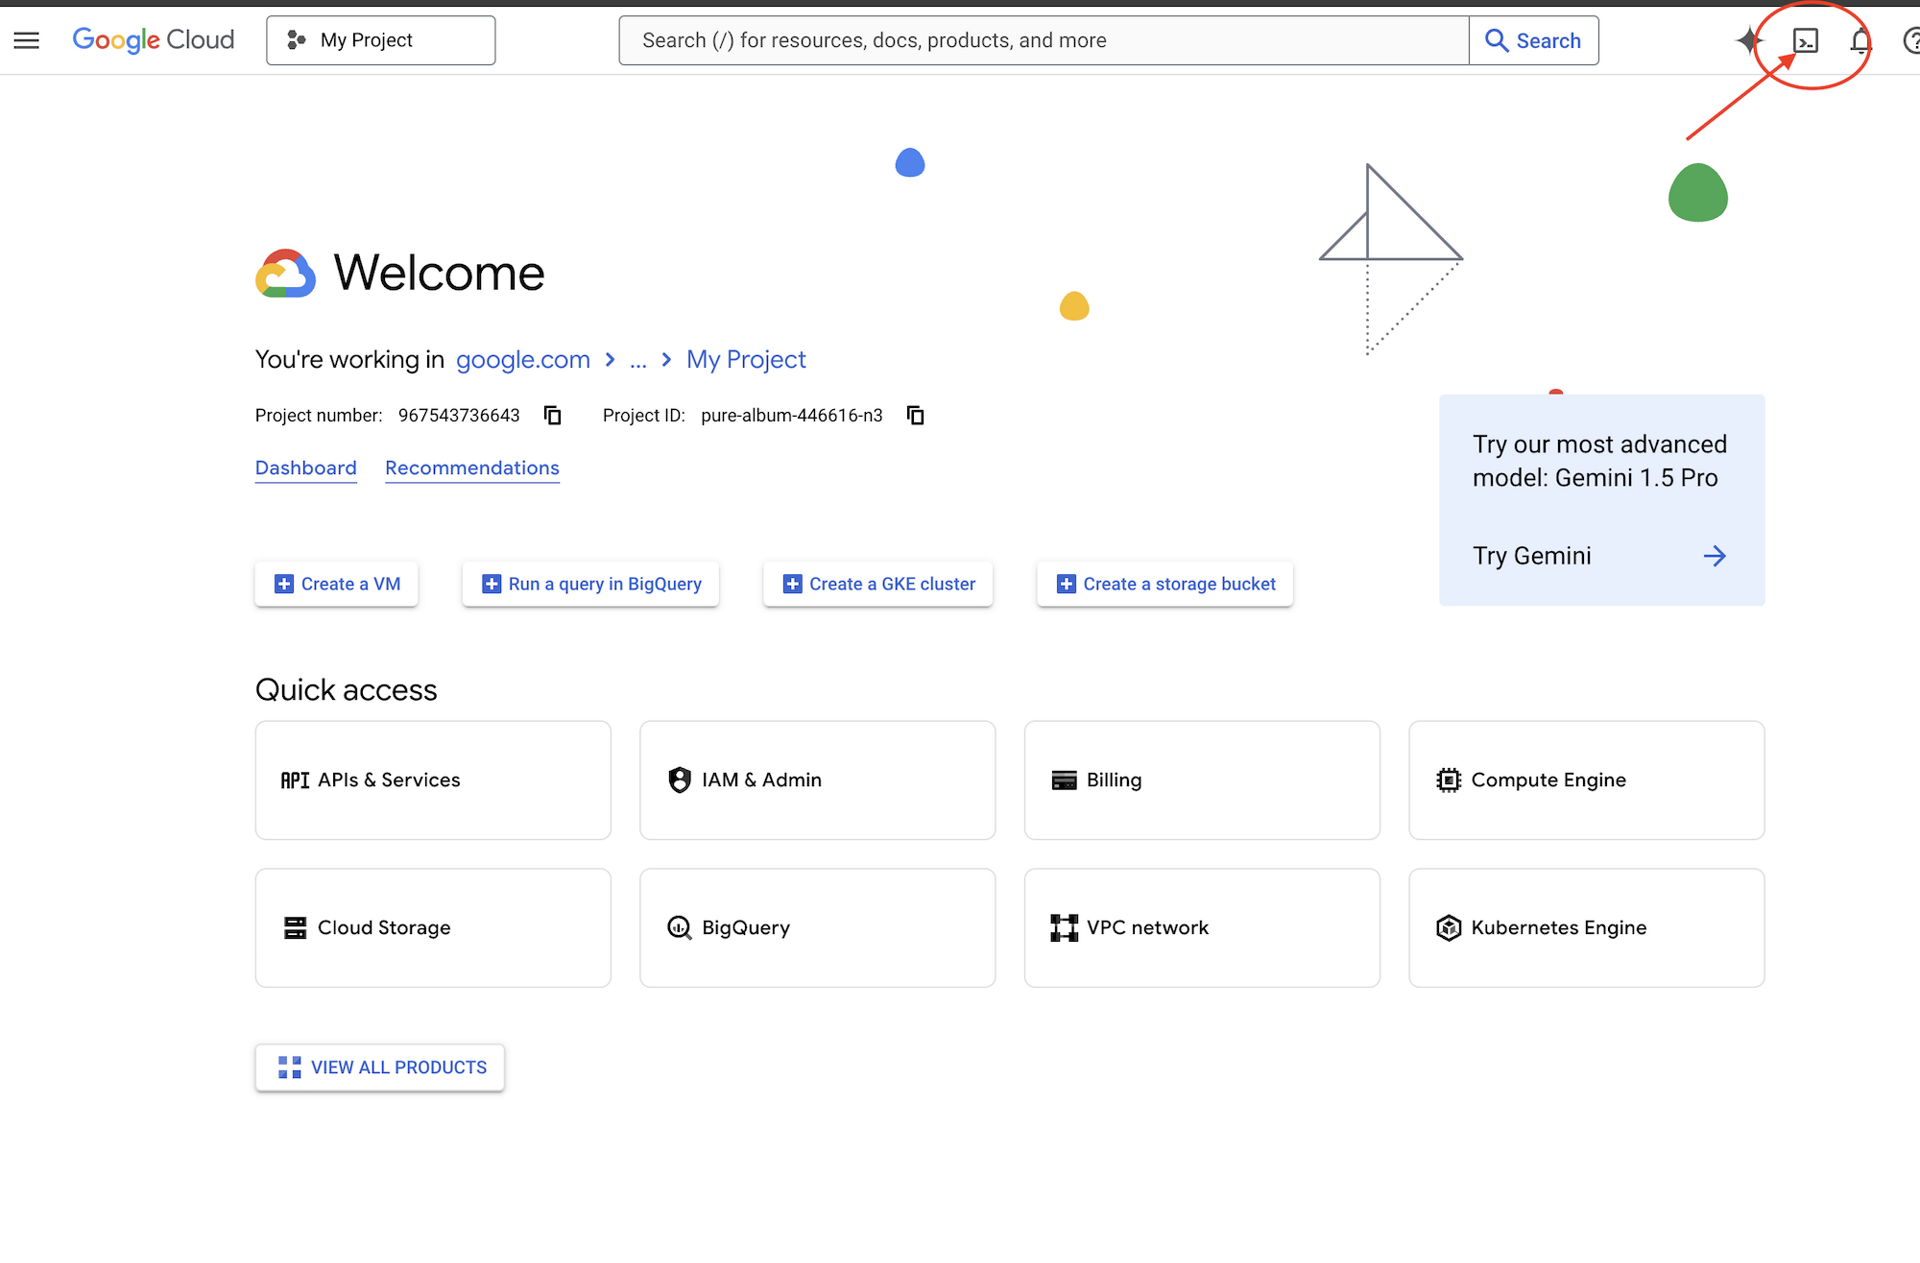
- Google Cloud コンソールを開きます。
- [Cloud Shell をアクティブにする](上部のナビゲーション バーにあるターミナル アイコン)をクリックして、ブラウザの下部にターミナル セッションを開きます。
ワークベンチを起動する
Cloud Shell または gcloud にログインしている場所:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh はプロジェクト(discrim-models-XXXX)を作成し、請求先アカウントをリンクします。イベント クレジット アカウントがある場合は、そちらを優先します。プロジェクトがサービス提供可能になるまで待機します。再実行すると、~/project_id.txt のプロジェクトが再利用されます。既存のプロジェクトを使用するには、その ID をファイルに配置して、このスクリプトをスキップします。
setup_codelab.sh は何も要求しません。uv と Python パッケージをインストールし、Vertex AI、Compute Engine、IAP を有効にします。.env で Gemini をプロジェクトの Vertex AI に関連付け、プロジェクトが呼び出すことができるモデルを使用して Gemini を 1 回呼び出し、ページをビルドし、ワークベンチをバックグラウンドで起動して scripts/check_setup.py を実行します。再実行すると、演習ファイルが保持されます。scripts/starter.sh を実行すると、演習ファイルがリセットされます。意思決定モデルは、ワークベンチのステップ 2 で選択します。
Cloud Shell でワークベンチ UI を開くには:
./setup_codelab.shの末尾に表示されたプレビュー リンクをクリックするか、Cloud Shell ツールバーの右上にある [ウェブでプレビュー] をクリックします。- [ポートを変更] を選択し、「4900」と入力して、[変更してプレビュー] をクリックします。
Gemini は、プロジェクトの Vertex AI で、独自の Google 認証情報(.env の GOOGLE_GENAI_USE_VERTEXAI=1、GOOGLE_CLOUD_PROJECT、GOOGLE_CLOUD_LOCATION=global)を使用して実行されます。
意思決定モデルは、ワークベンチのステップ 2 で、または scripts/setup_model.sh を使用してターミナルから独自に選択します。
豊富な選択肢 | ニーズ | セットアップ | 費用 |
識別モデル(TypeSafe、ホスト型) | TypeSafe API キー | なし | トークンあたり、1 セント未満の端数 |
DiffusionGemma(Google、オープン ウェイト) | GPU の課金と Compute Engine の割り当て | ~ 15 分、自動 | VM の実行中は 1 時間あたり約$0.71 |
リハーサル(モデルなし) | nothing | なし | なし |
Compute Engine VM 上の DiffusionGemma
scripts/setup_gemma.sh は、まず GPU 割り当てを確認し、次に NVIDIA ドライバ 580 を使用して Google の Deep Learning イメージから 1 つの g2-standard-4 VM(1 × L4 24 GB、4 vCPU、16 GB)を作成します。初回起動時に、VM は Docker をインストールし、Hugging Face から重みをダウンロード(nvidia/diffusiongemma-26B-A4B-it-NVFP4、17.5 GB、公開、トークンなし)して、djev-run(Discriminative モデルの正確な API の背後にある DiffusionGemma)を実行します。モデルのポートはインターネットに公開されていません。ワークベンチは localhost:8096 の IAP トンネルを介してモデルにアクセスします。このトンネルは scripts/start.sh によって開かれます。
一時停止 / 再開 |
| |
トンネル |
| |
削除 |
| |
コマンドをリハーサルする |
| |
リポジトリのレイアウト
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. まとめ
環境をクリーンアップする
ワークショップが終了したら、次の手順に沿って DiffusionGemma GPU リソースを削除し、バックグラウンドのワークベンチとリハーサル プロセスを停止し、Cloud Shell からワークショップ ファイルを削除します。必要に応じて、ワークショップの Google Cloud プロジェクトを削除します。
- DiffusionGemma GPU VM とファイアウォール ルール(作成した場合)を削除する: 手順 2 で Compute Engine GPU VM に DiffusionGemma をプロビジョニングした場合は、VM、ディスク、IAP ファイアウォール ルールを削除して、継続的なコンピューティング料金やディスク ストレージ料金が発生しないようにします。
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Cloud Shell でワークベンチとリハーサルのプロセスを停止する: Cloud Shell ターミナルで、バックグラウンドのワークベンチ サーバーとリハーサルのスタンドイン プロセスを停止します。
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Cloud Shell からワークショップ フォルダを削除する: ホーム ディレクトリに戻り、クローンされたリポジトリ フォルダとプロジェクト ID ファイルを削除します。
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Google Cloud プロジェクトを削除する:
./setup_project.shが専用のワークショップ プロジェクト(discrim-models-XXXXなど)を作成した場合、プロジェクトをシャットダウンすると、プロジェクト内に作成されたすべてのリソースが完全に削除されますが、Cloud 請求先アカウントはそのまま残ります。- Google Cloud コンソールで [リソースの管理] ページを開きます。
- リソース リストからワークショップ プロジェクト(
discrim-models-...など)を選択します。 - 上部のツールバーで [削除] をクリックし、プロジェクト ID を入力して確定し、[シャットダウン] をクリックします。
このワークショップはこれで完了です。
ラボの概要
- Compute Engine GPU VM で識別モデル(Jev または DiffusionGemma)を選択し、回答を確認しました。
- アリーナのルールを学ぶために、手動でアリーナをプレイしました。
- 判別モデルが Choice、Score、Noul の質問、確率、信頼度で回答する方法と、コードでしきい値を適用する方法について学習しました。
- 最初のリクエストを送信し、モデルがアリーナでのすべての動きを選択できるようにします。
choose()は回答をアクションに変換します。 - ADK ワークフローの各ブランチを個別に構築し、Gemini が呪文カードの画像を読み取り、モデルがループ内で決定します。
- 状態を共有する 1 つのワークフローに統合したため、戦闘が Gemini を待つことはなく、戦闘開始時に呪文が唱えられます。
会話から意思決定へ
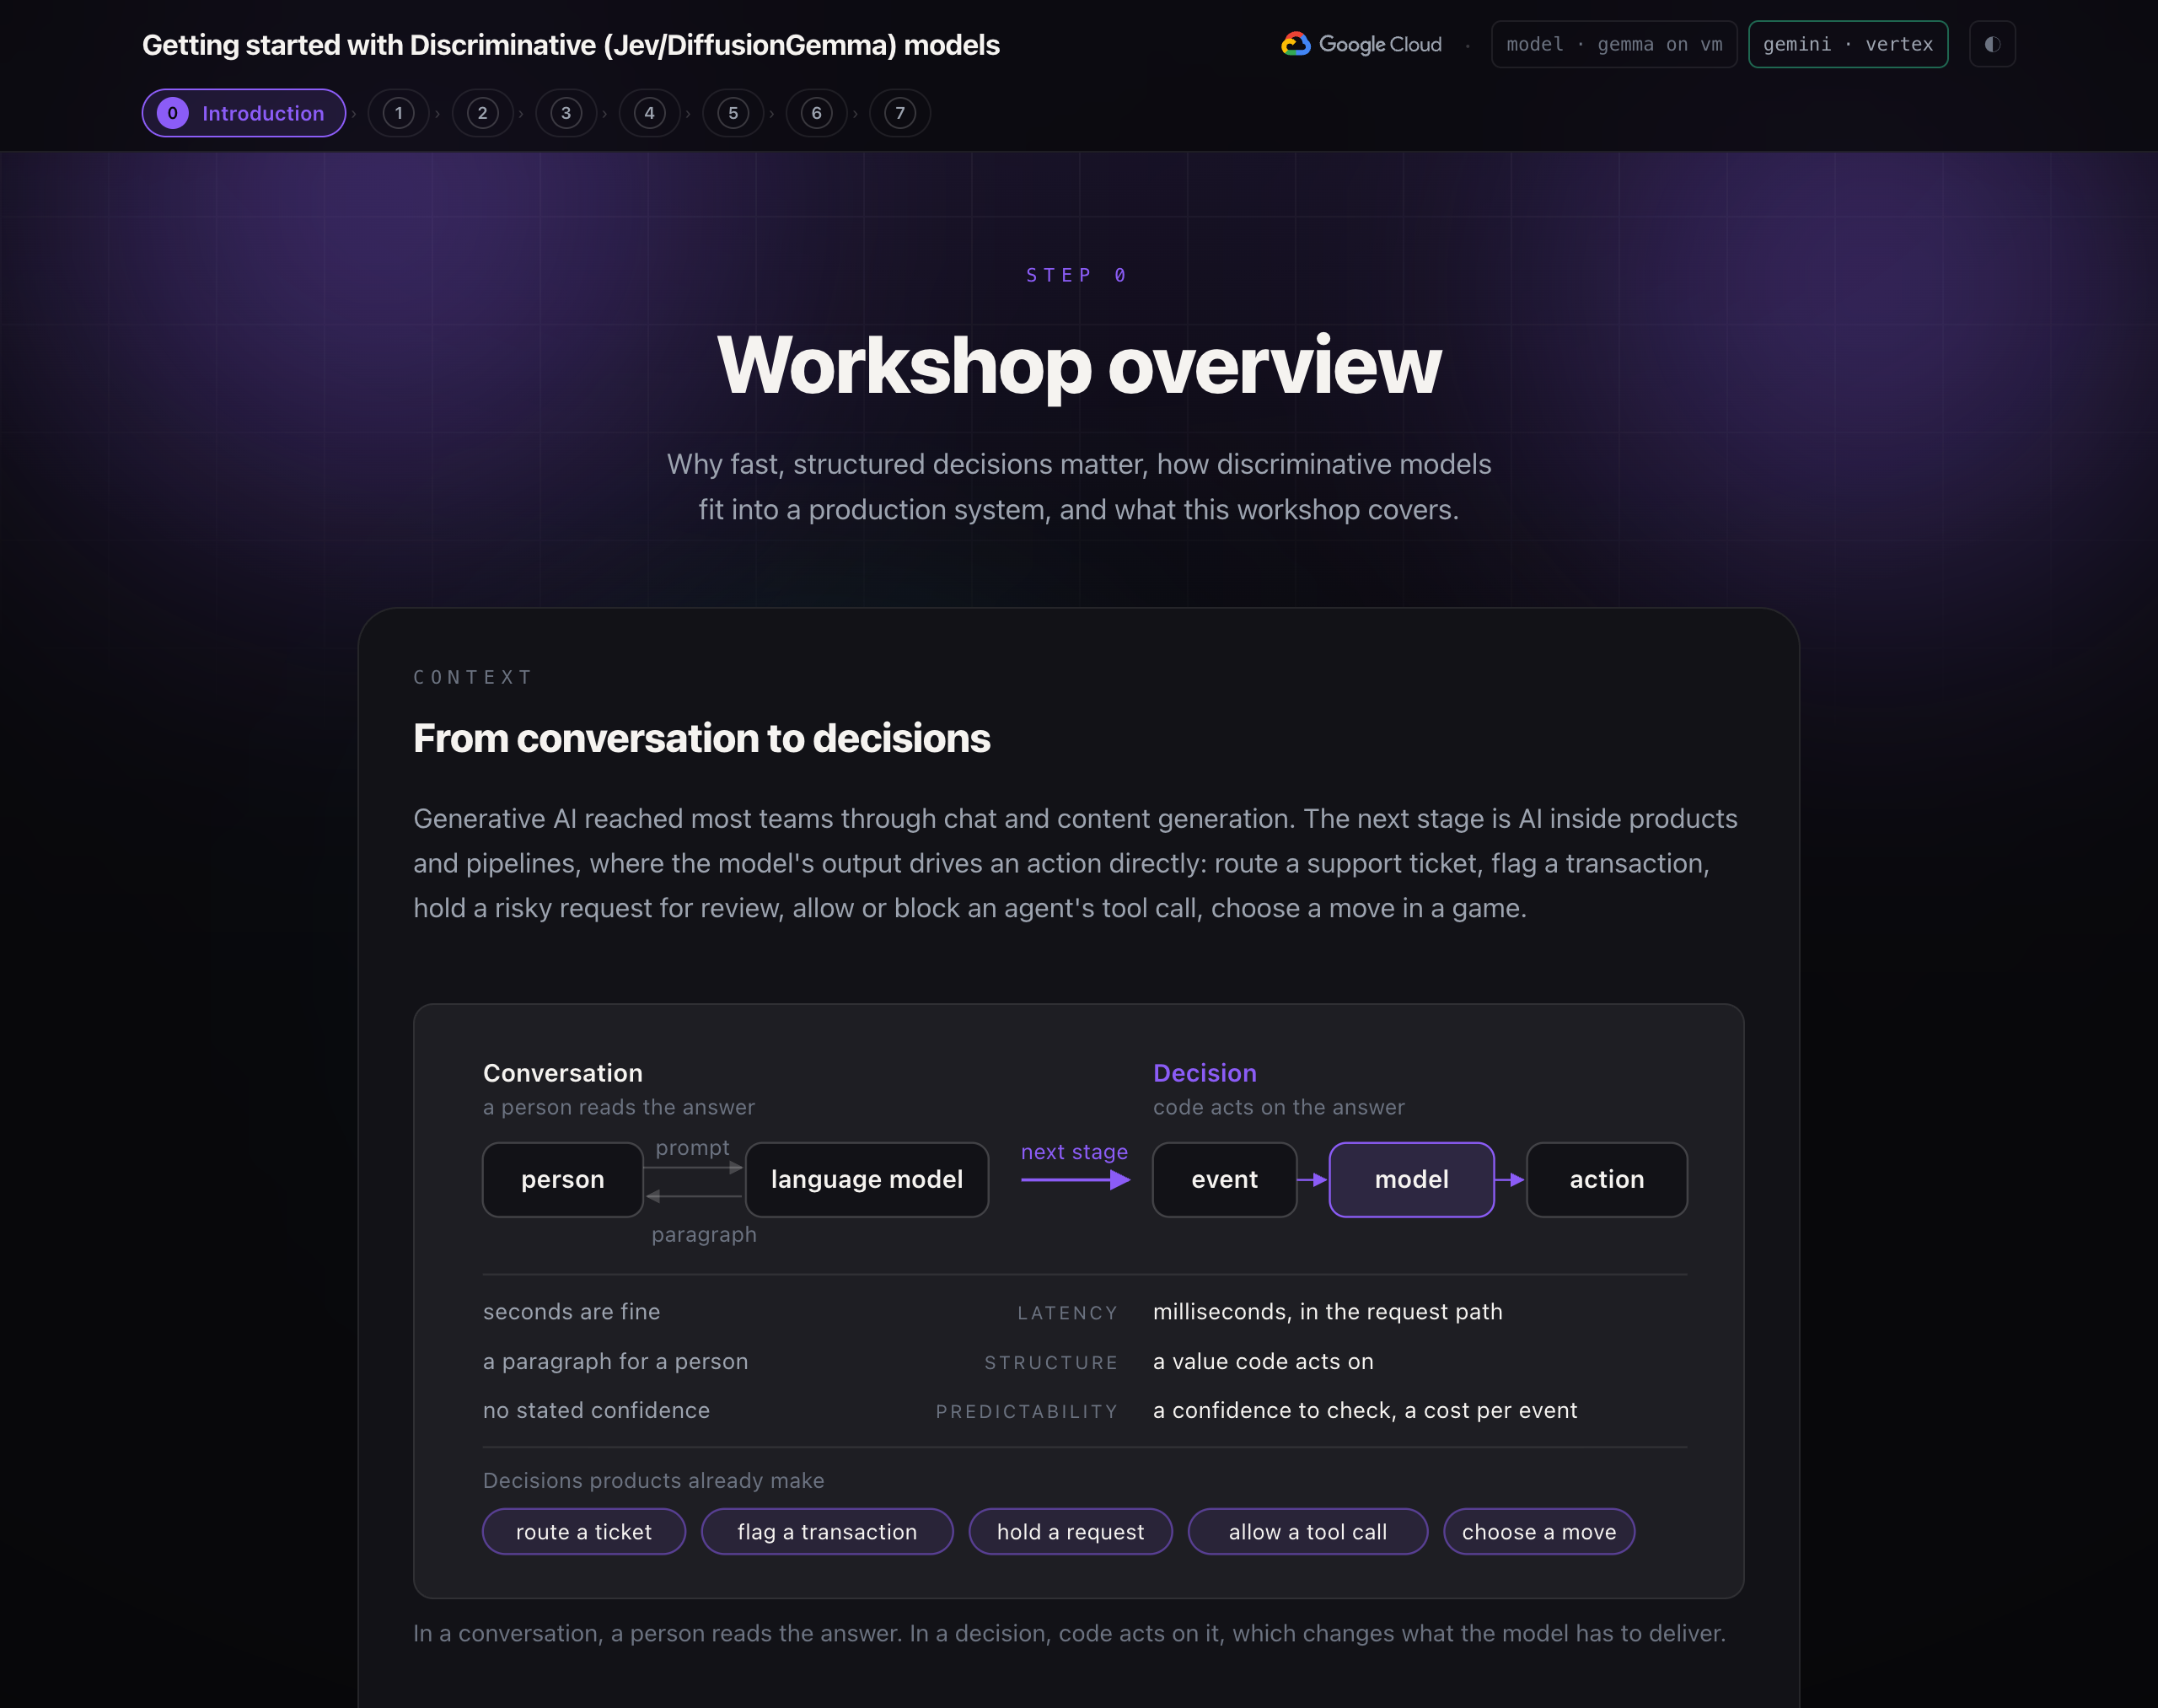
生成 AI は、チャットやコンテンツ生成を通じてほとんどのチームに導入されました。次の段階は、プロダクトとパイプライン内の AI です。ここでは、モデルの出力によってアクションが直接実行されます。サポート チケットの転送、トランザクションのフラグ設定、リスクの高いリクエストの審査保留、エージェントのツール呼び出しの許可またはブロック、ゲームでの動きの選択などです。
これらの決定には、チャットにはない 3 つの要件があります。
- レイテンシ。答えはユーザーのリクエスト パスまたはリアルタイム ループにあることが多いため、数秒ではなくミリ秒で届く必要があります。
- 構造。呼び出し元はコードであるため、回答は解析する必要がある段落ではなく、コードが処理できる値である必要があります。
- 予測可能性。すべての決定には、コードで確認できる信頼度と、すべてのイベントで確認できるほど低いコストが必要です。
言語モデルは一度に 1 つのトークンずつテキストを生成します。イエスかノーで応答できますが、リアルタイム ループには遅く、出力の解析が必要で、確信度を報告しません。
意思決定用に構築されたモデル
判別モデルは、1 回のパスで、許可された各オプションの確率を使用して型付きの質問に回答します。テキストは生成されません。このワークショップでは、次の 2 つの実行オプションが用意されています。
モデル | プロバイダ | このワークショップでモデルが実行される場所 |
Jev | TypeSafe AI | API キーを使用して呼び出される TypeSafe のホスト型サービス |
DiffusionGemma | Google、オープンウェイト | 独自の Google Cloud プロジェクトの GPU VM で自己ホストされている |
モデルは必要に応じて交換できます。モデルに接続するコードを変更する必要はありません。
コンポーネントを結合する
成功するシステムは、複数のコンポーネントで構成されています。
コンポーネント | ロール | このワークショップでは |
ワークフロー | ステップをオーケストレートし、ブランチを並列で実行し、共有状態を保持します | ADK グラフ ワークフロー |
決定論的コード | ルール、しきい値、検証。即時、無料、監査可能 | ゲームルール、 |
判別モデル | 信頼スコア付きの高速で有界な意思決定 | すべてのティックで応答を選択する |
言語モデル | 認識と生成: 画像と自由形式のテキスト | Gemini がスペルカードの画像を読み取り、スペルを書き込みます |
モデル提供アーキテクチャ
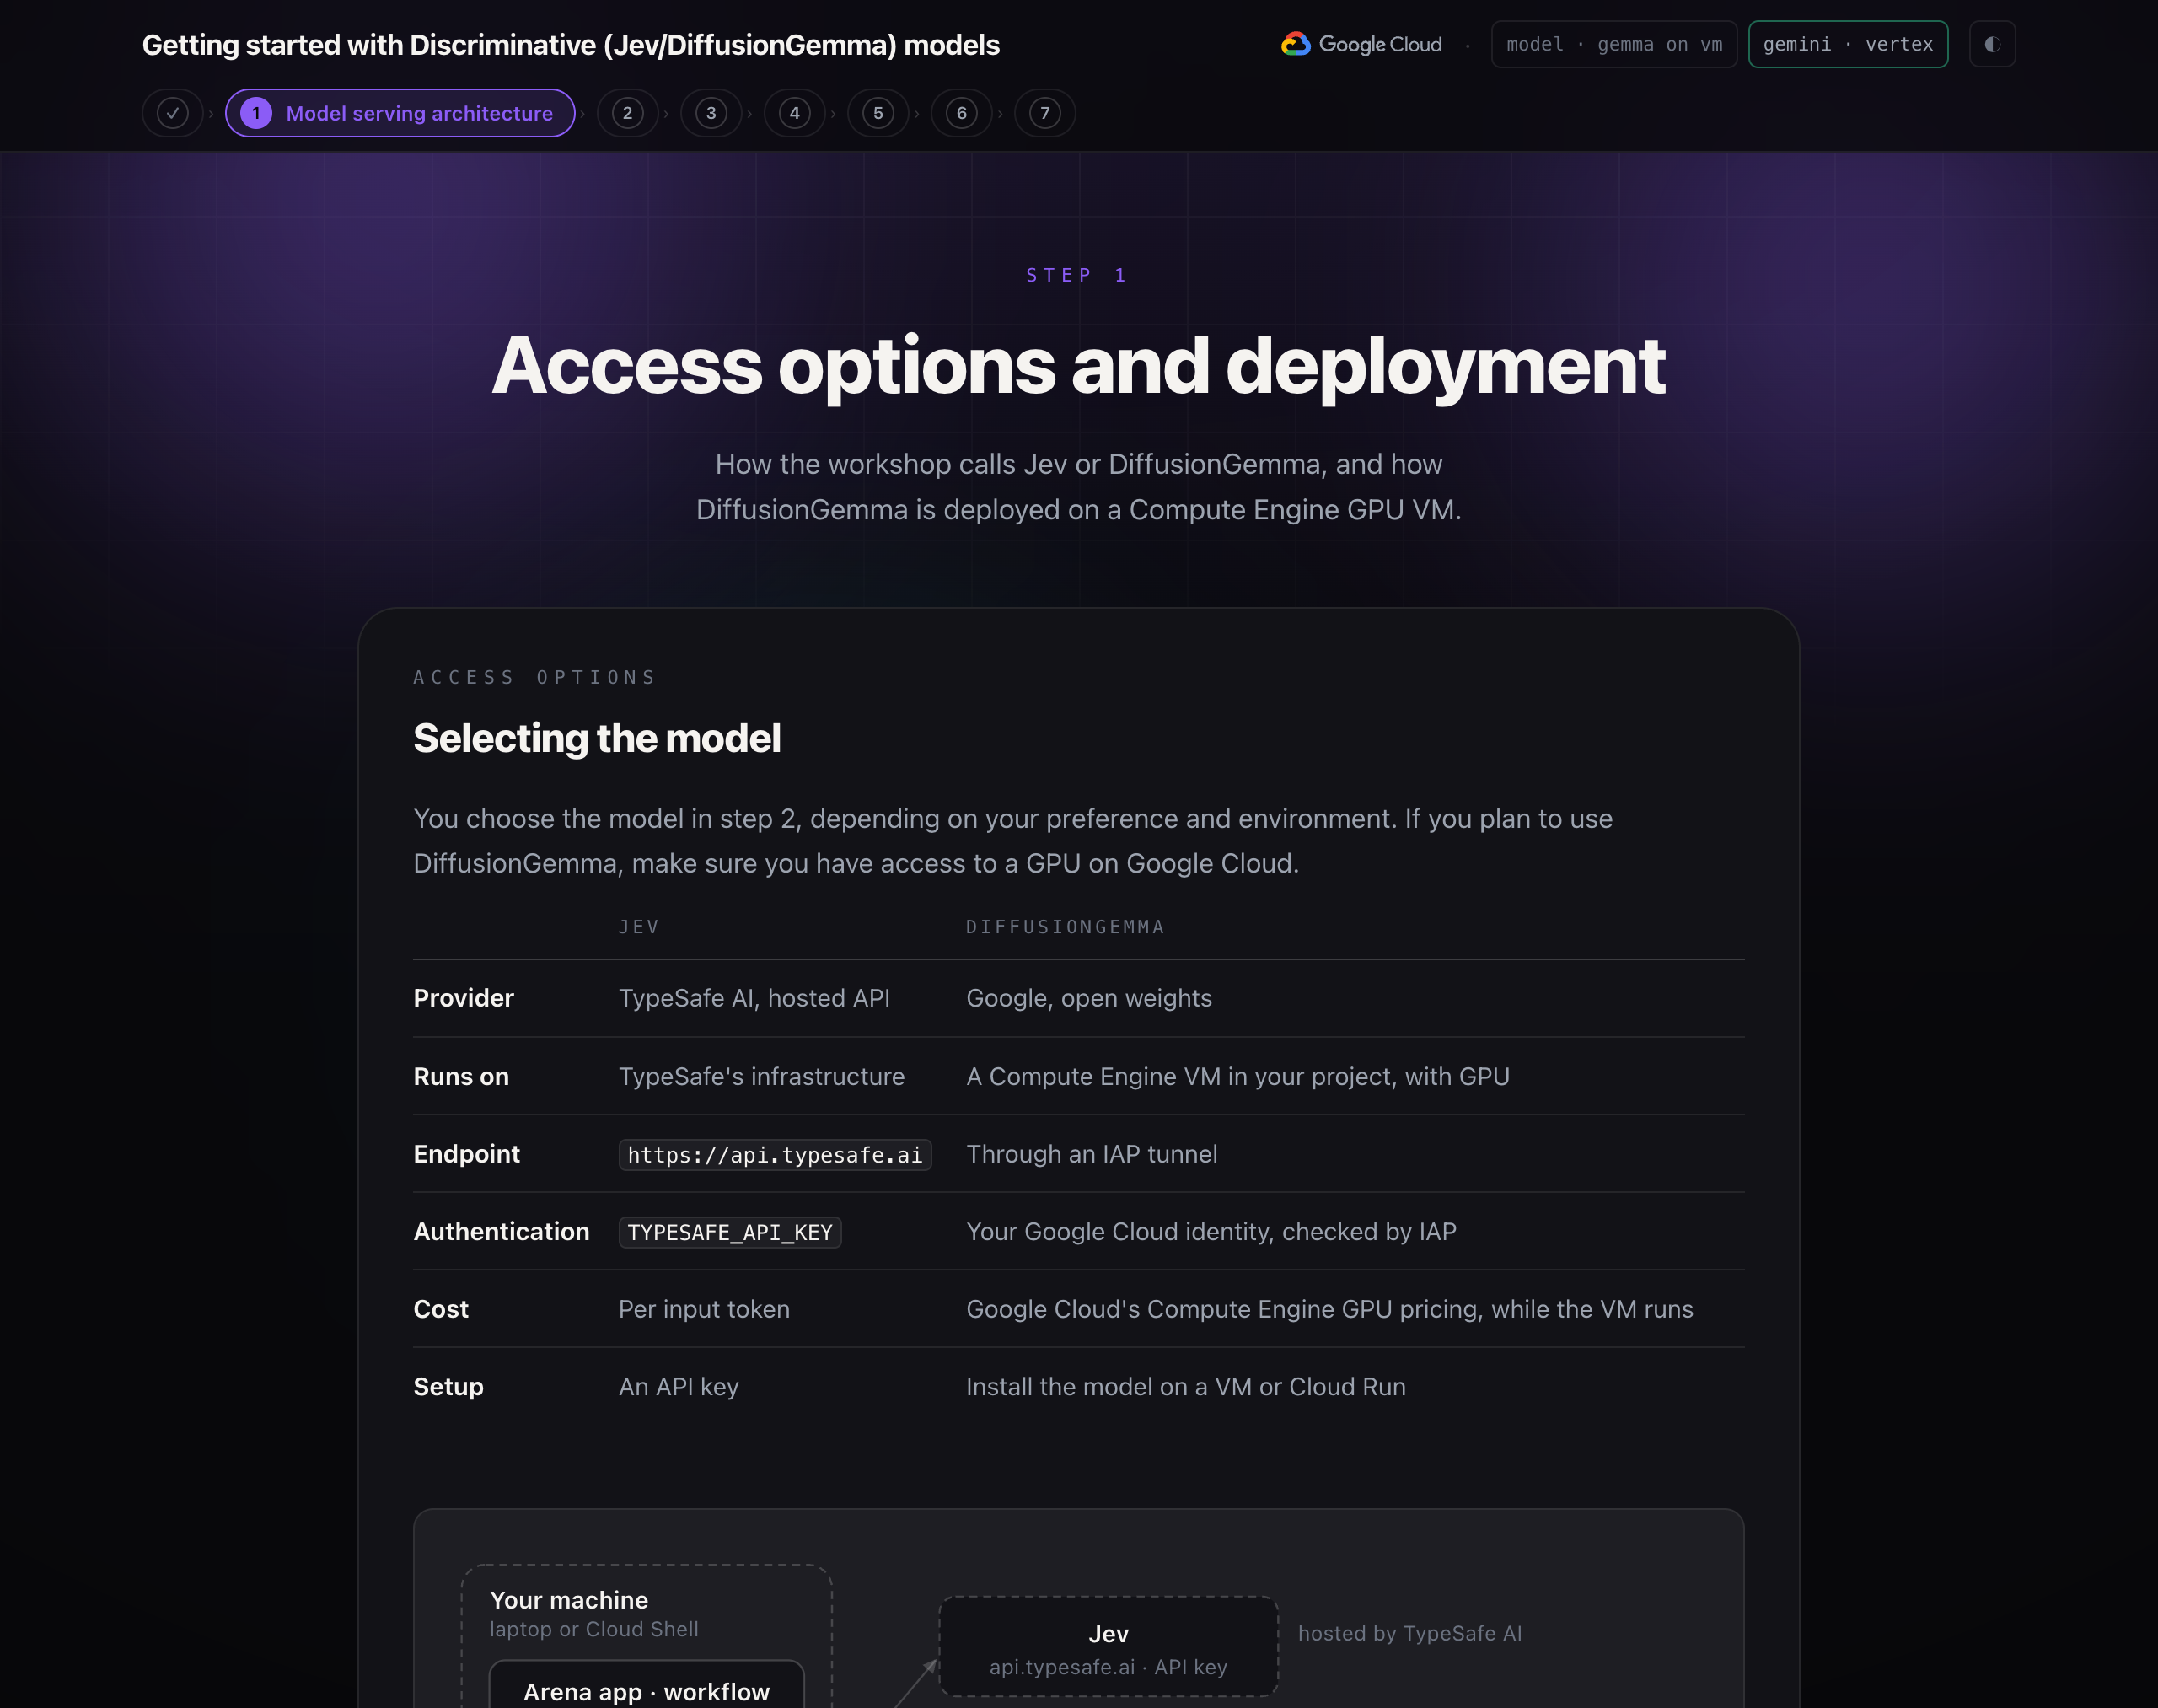
ステップ 2 で、設定と環境に応じてモデルを選択します。DiffusionGemma を使用する場合は、Google Cloud の GPU にアクセスできることを確認してください。
Jev | DiffusionGemma | |
プロバイダ | TypeSafe AI(ホスト型 API) | Google、オープンウェイト |
実行環境 | TypeSafe のインフラストラクチャ | プロジェクト内の GPU を搭載した Compute Engine VM |
エンドポイント |
| IAP トンネル経由 |
認証 |
| IAP によって確認された Google Cloud ID |
費用 | 入力トークンあたり | Google Cloud の Compute Engine GPU の料金(VM の実行中) |
設定 | API キー | VM または Cloud Run にモデルをインストールする |
データフロー
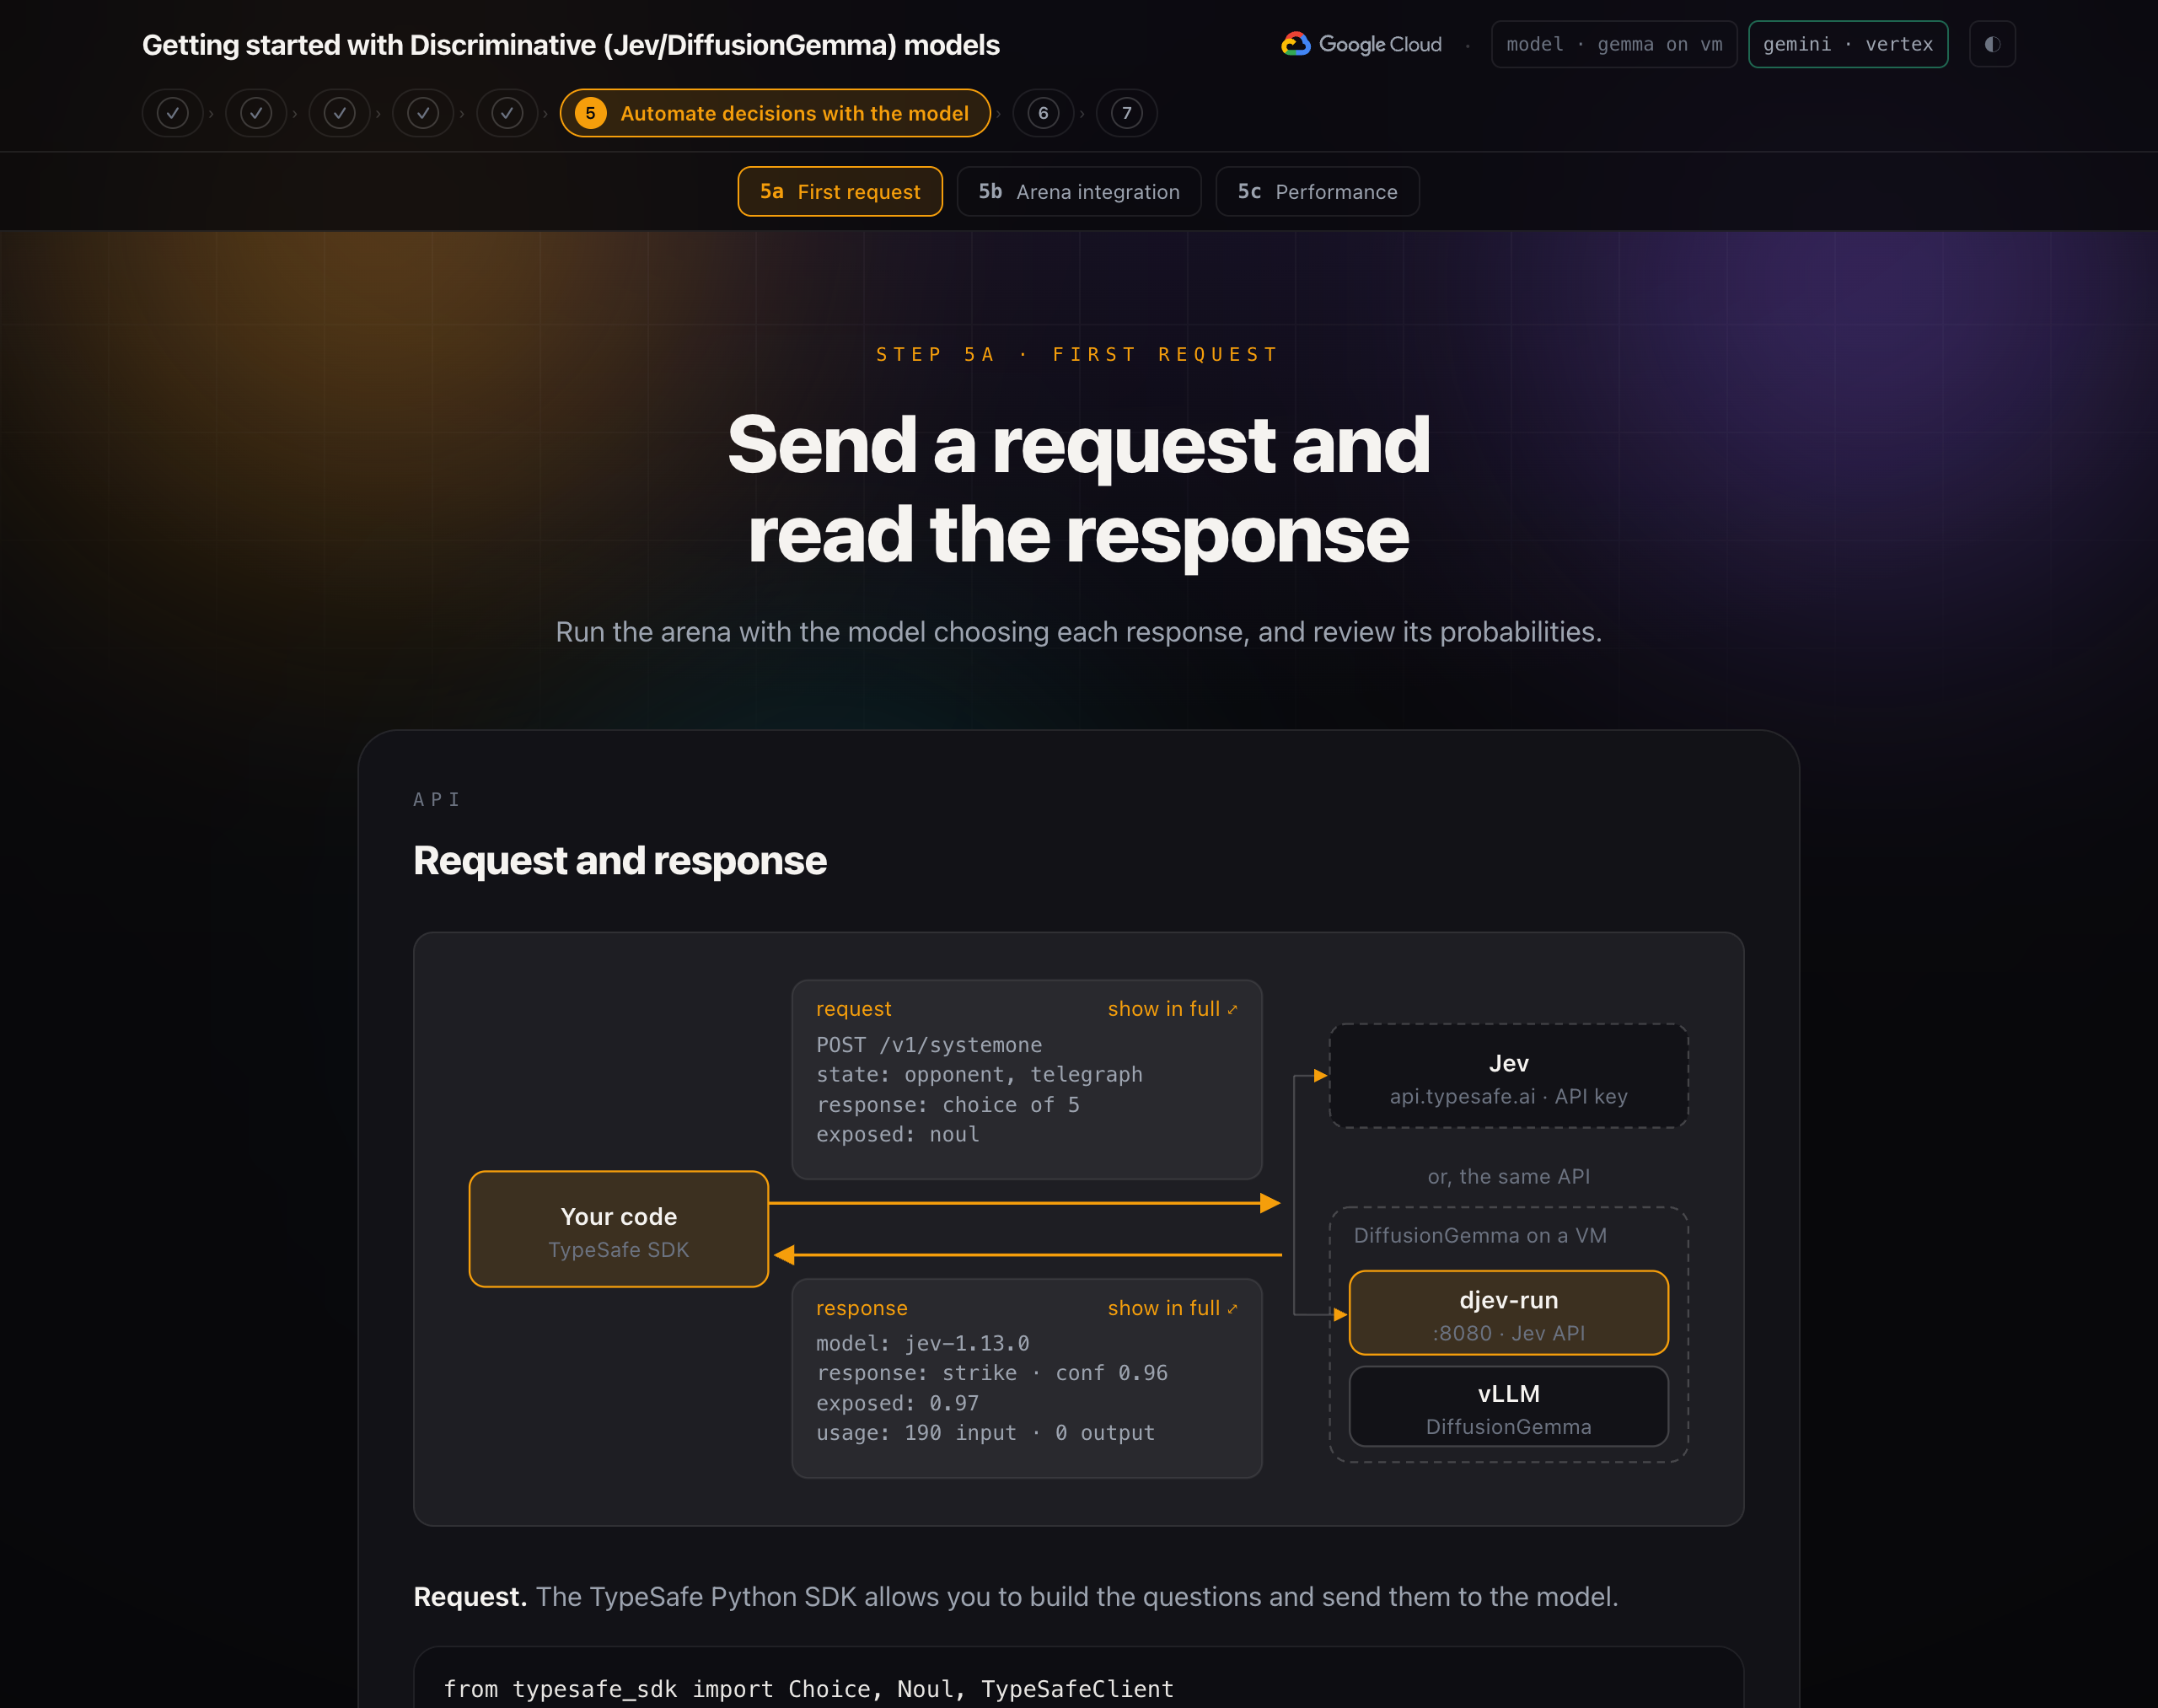
- アリーナアプリまたは ADK ワークフローが、状態(対戦相手の行動)と 3 つの質問を含むリクエストを構築します。
- TypeSafe SDK は、構成されたベース URL に
POST /v1/systemoneとして送信します。 - Jev の場合、リクエストは HTTPS 経由で
api.typesafe.aiに送信され、API キーはベアラートークンとして使用されます。 - DiffusionGemma の場合、リクエストは
localhost:8096に送信されます。バックグラウンドのgcloud compute start-iap-tunnelプロセスは、Identity-Aware Proxy を介して、Google ID をチェックし、VM のポート 8080 に転送します。 - VM で、djev-run はリクエストを受け取り、GPU で vLLM を介して DiffusionGemma を実行し、許可された各オプションの確率を読み取ります。
- どちらのバックエンドも同じレスポンス(質問ごとの回答、確率、信頼スコア)を返します。ワークショップ コードは、しきい値を適用して動作します。
Compute Engine 上の DiffusionGemma
scripts/setup_gemma.sh は、プロジェクトに次のものをビルドします。
- リージョンに GPU の割り当てがあることを確認します。
- Compute Engine API と IAP API を有効にし、ファイアウォール ルール
allow-iap-djevを作成します。ポート 22 と 8080 で IAP アドレス範囲のみを許可します。 - VM
djev-l4を作成します。マシンタイプg2-standard-4(4 個の vCPU、16 GB のメモリ)、24 GB の GPU、100 GB のディスク、NVIDIA ドライバ 580 を含む Deep Learning VM イメージ。ゾーンに GPU 容量がない場合、次のゾーンが試されます。 - 初回起動時に、VM の起動スクリプトは Docker と NVIDIA Container Toolkit をインストールし、djev-run コンテナ イメージを pull して、Hugging Face から重み(17.5 GB)をダウンロードし、ポート 8080 で GPU アクセスを使用してコンテナを起動します。この処理には 15 分ほどかかります。その後の起動には約 2 分かかります。
- 接続設定を
.envに書き込み、トンネルを開きます。
タスク | コマンド |
VM を停止する(ディスクは保持) |
|
もう一度開始する |
|
トンネルを確認する |
|
すべて削除する |
|
モデルをセットアップする
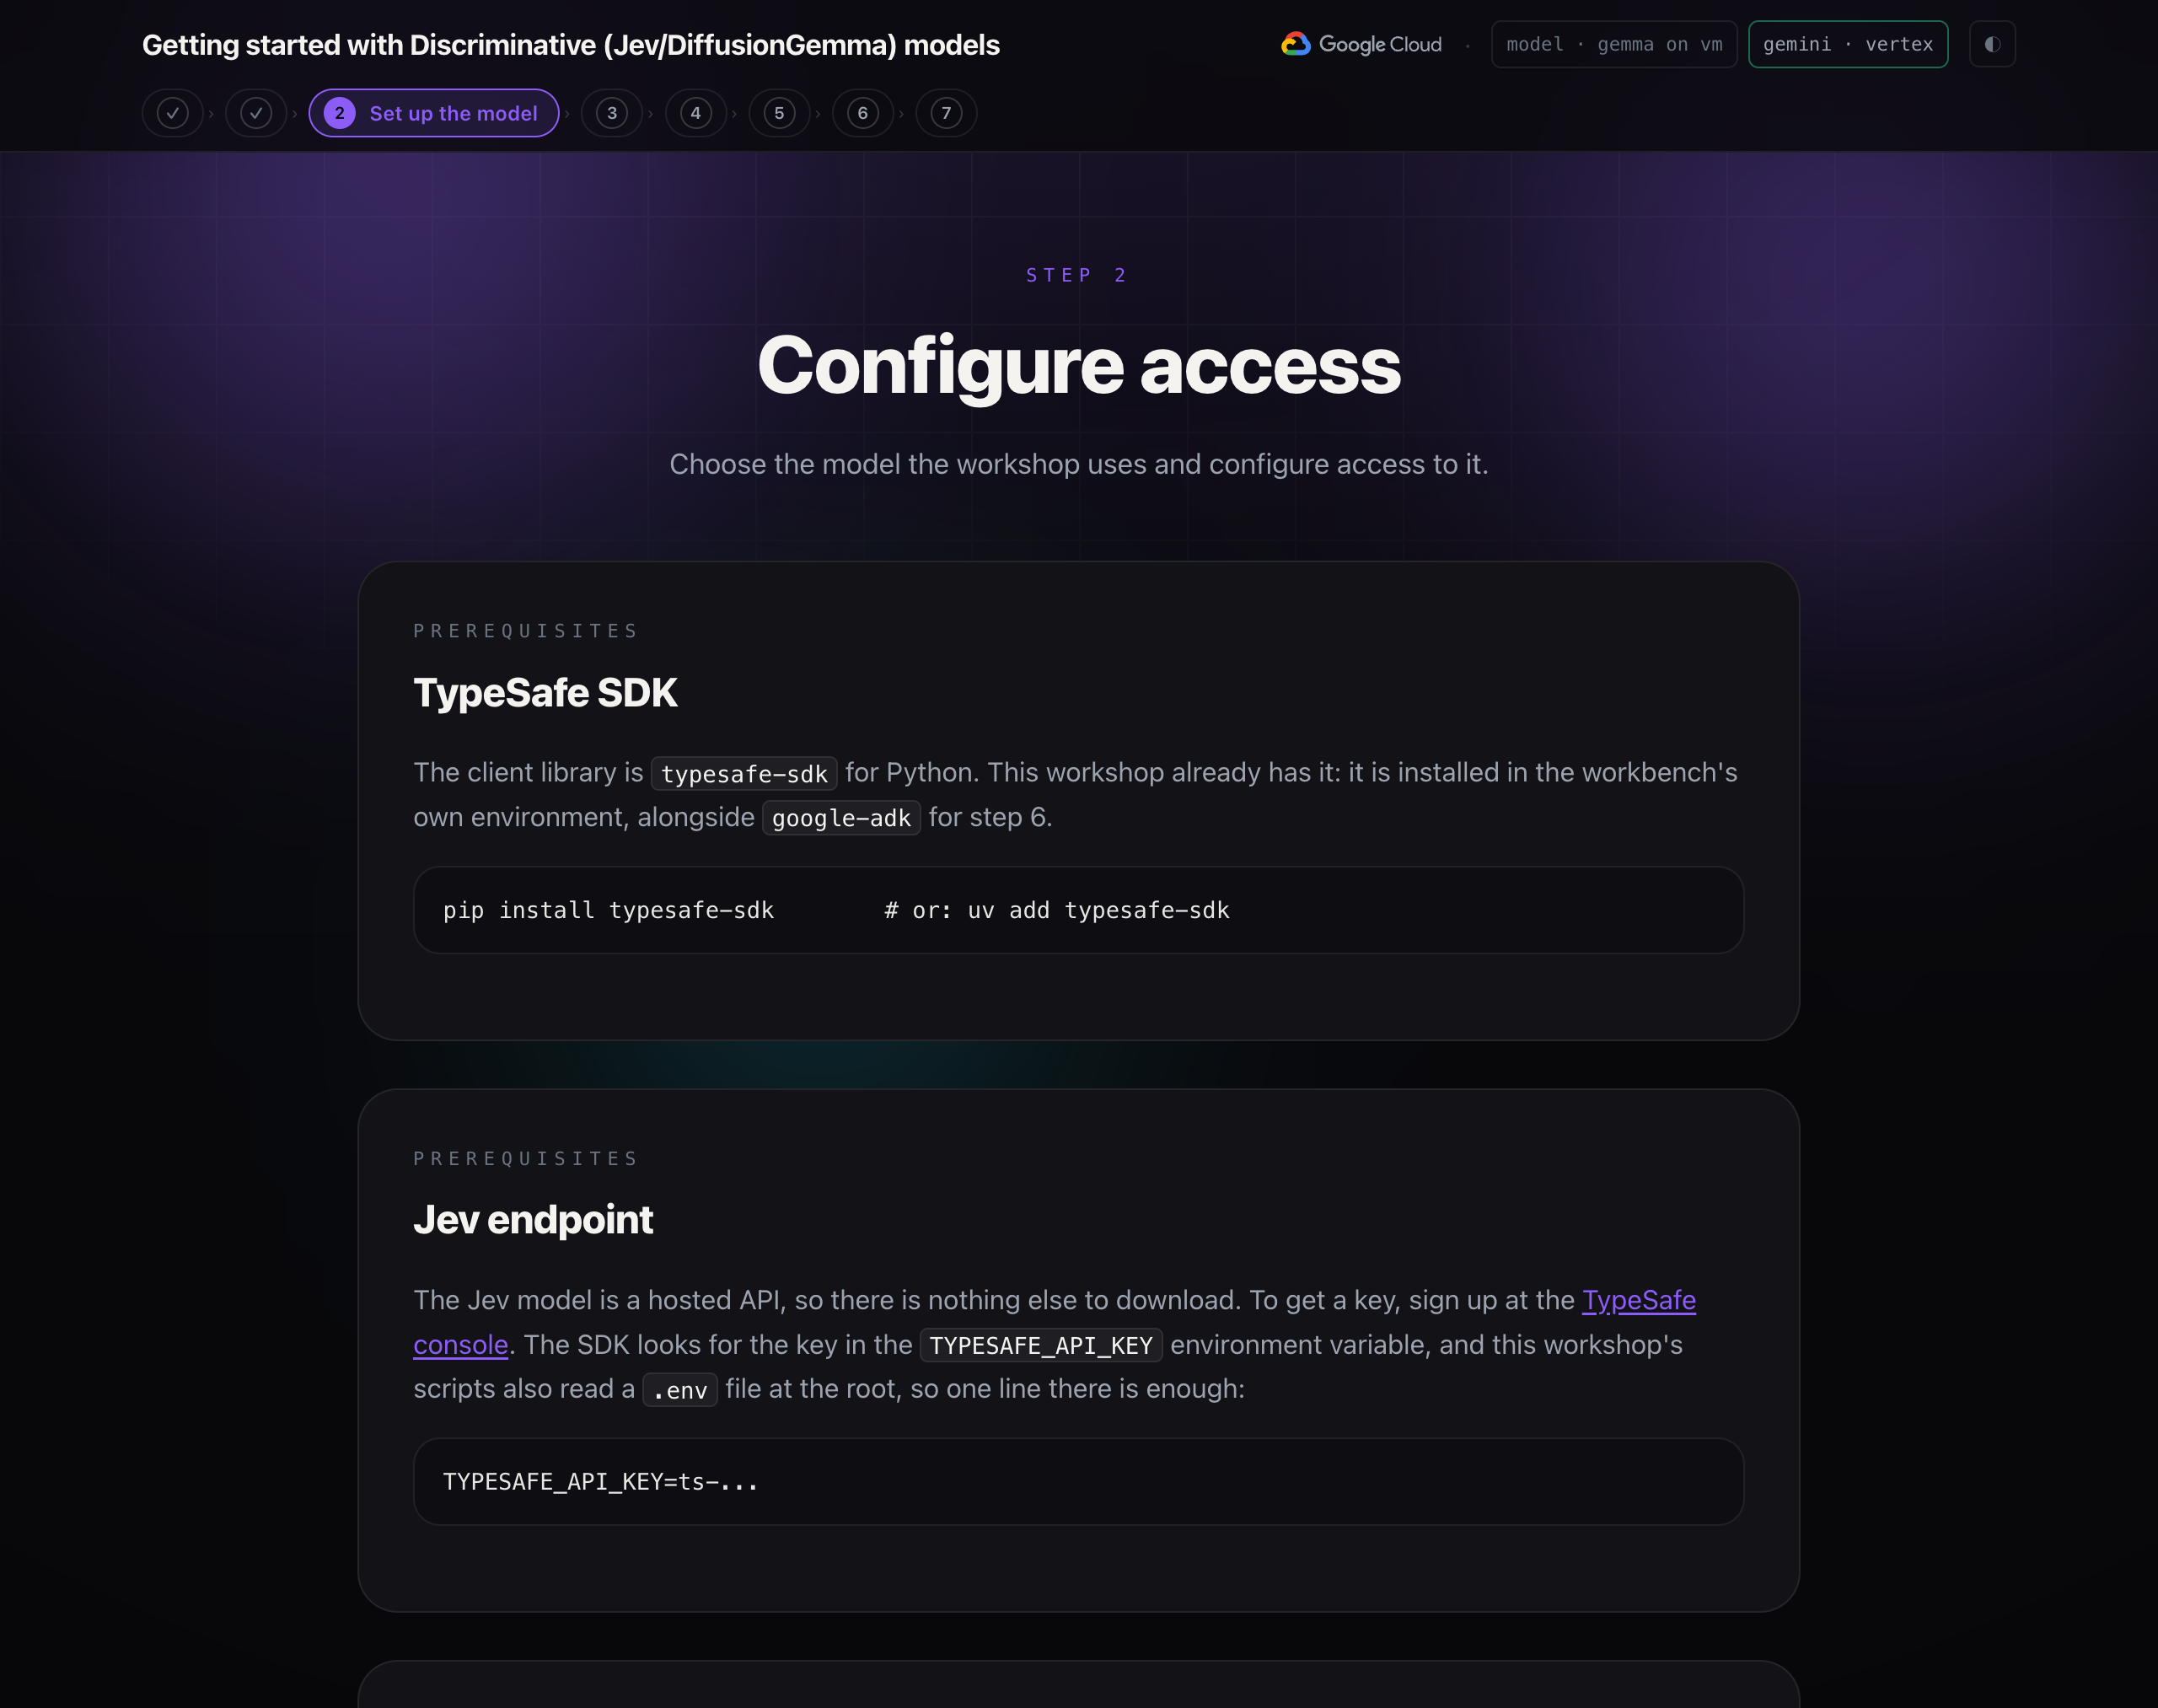
TypeSafe SDK
クライアント ライブラリは Python の typesafe-sdk です。このワークショップにはすでに用意されています。ステップ 6 の google-adk とともに、ワークベンチの独自の環境にインストールされています。
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev エンドポイント
Jev モデルはホスト型 API であるため、他にダウンロードするものはありません。キーを取得するには、TypeSafe コンソールに登録します。SDK は TYPESAFE_API_KEY 環境変数でキーを探します。このワークショップのスクリプトもルートの .env ファイルを読み取るため、1 行で十分です。
TYPESAFE_API_KEY=ts-...
DiffusionGemma を使用する
djev-run は、判別モデルの API を再実装します。DiffusionGemma(Google DeepMind のオープン拡散モデル、合計 260 億個のパラメータ、約 40 億個のアクティブ パラメータ、Apache 2.0)から、同じ POST /v1/systemone エンドポイントに同じ noul、選択、スコアの質問を送信します。ワイヤー形式は同じであるため、TypeSafe SDK は変更なしで通信します。
演習で DiffusionGemma を選択すると、独自の Google Cloud プロジェクトの VM の GPU で実行され、右上にあるピルに「gemma on vm」と表示されます。ワークベンチはプライベート IAP トンネルを介してモデルにアクセスし、モデルのポートはインターネットに公開されません。ステップ 1 では、完全なアーキテクチャについて説明します。
拡散モデルでこれが可能な理由: 拡散モデルでは、位置のブロック全体が一度に埋められ、すべての位置で完全な入力が認識されるため、許可された各オプションの確率を 1 ステップで読み取ることができます。通常の言語モデルは一度に 1 つのトークンを生成するため、繰り返しサンプリングする必要があります。
手動でゲームをプレイする
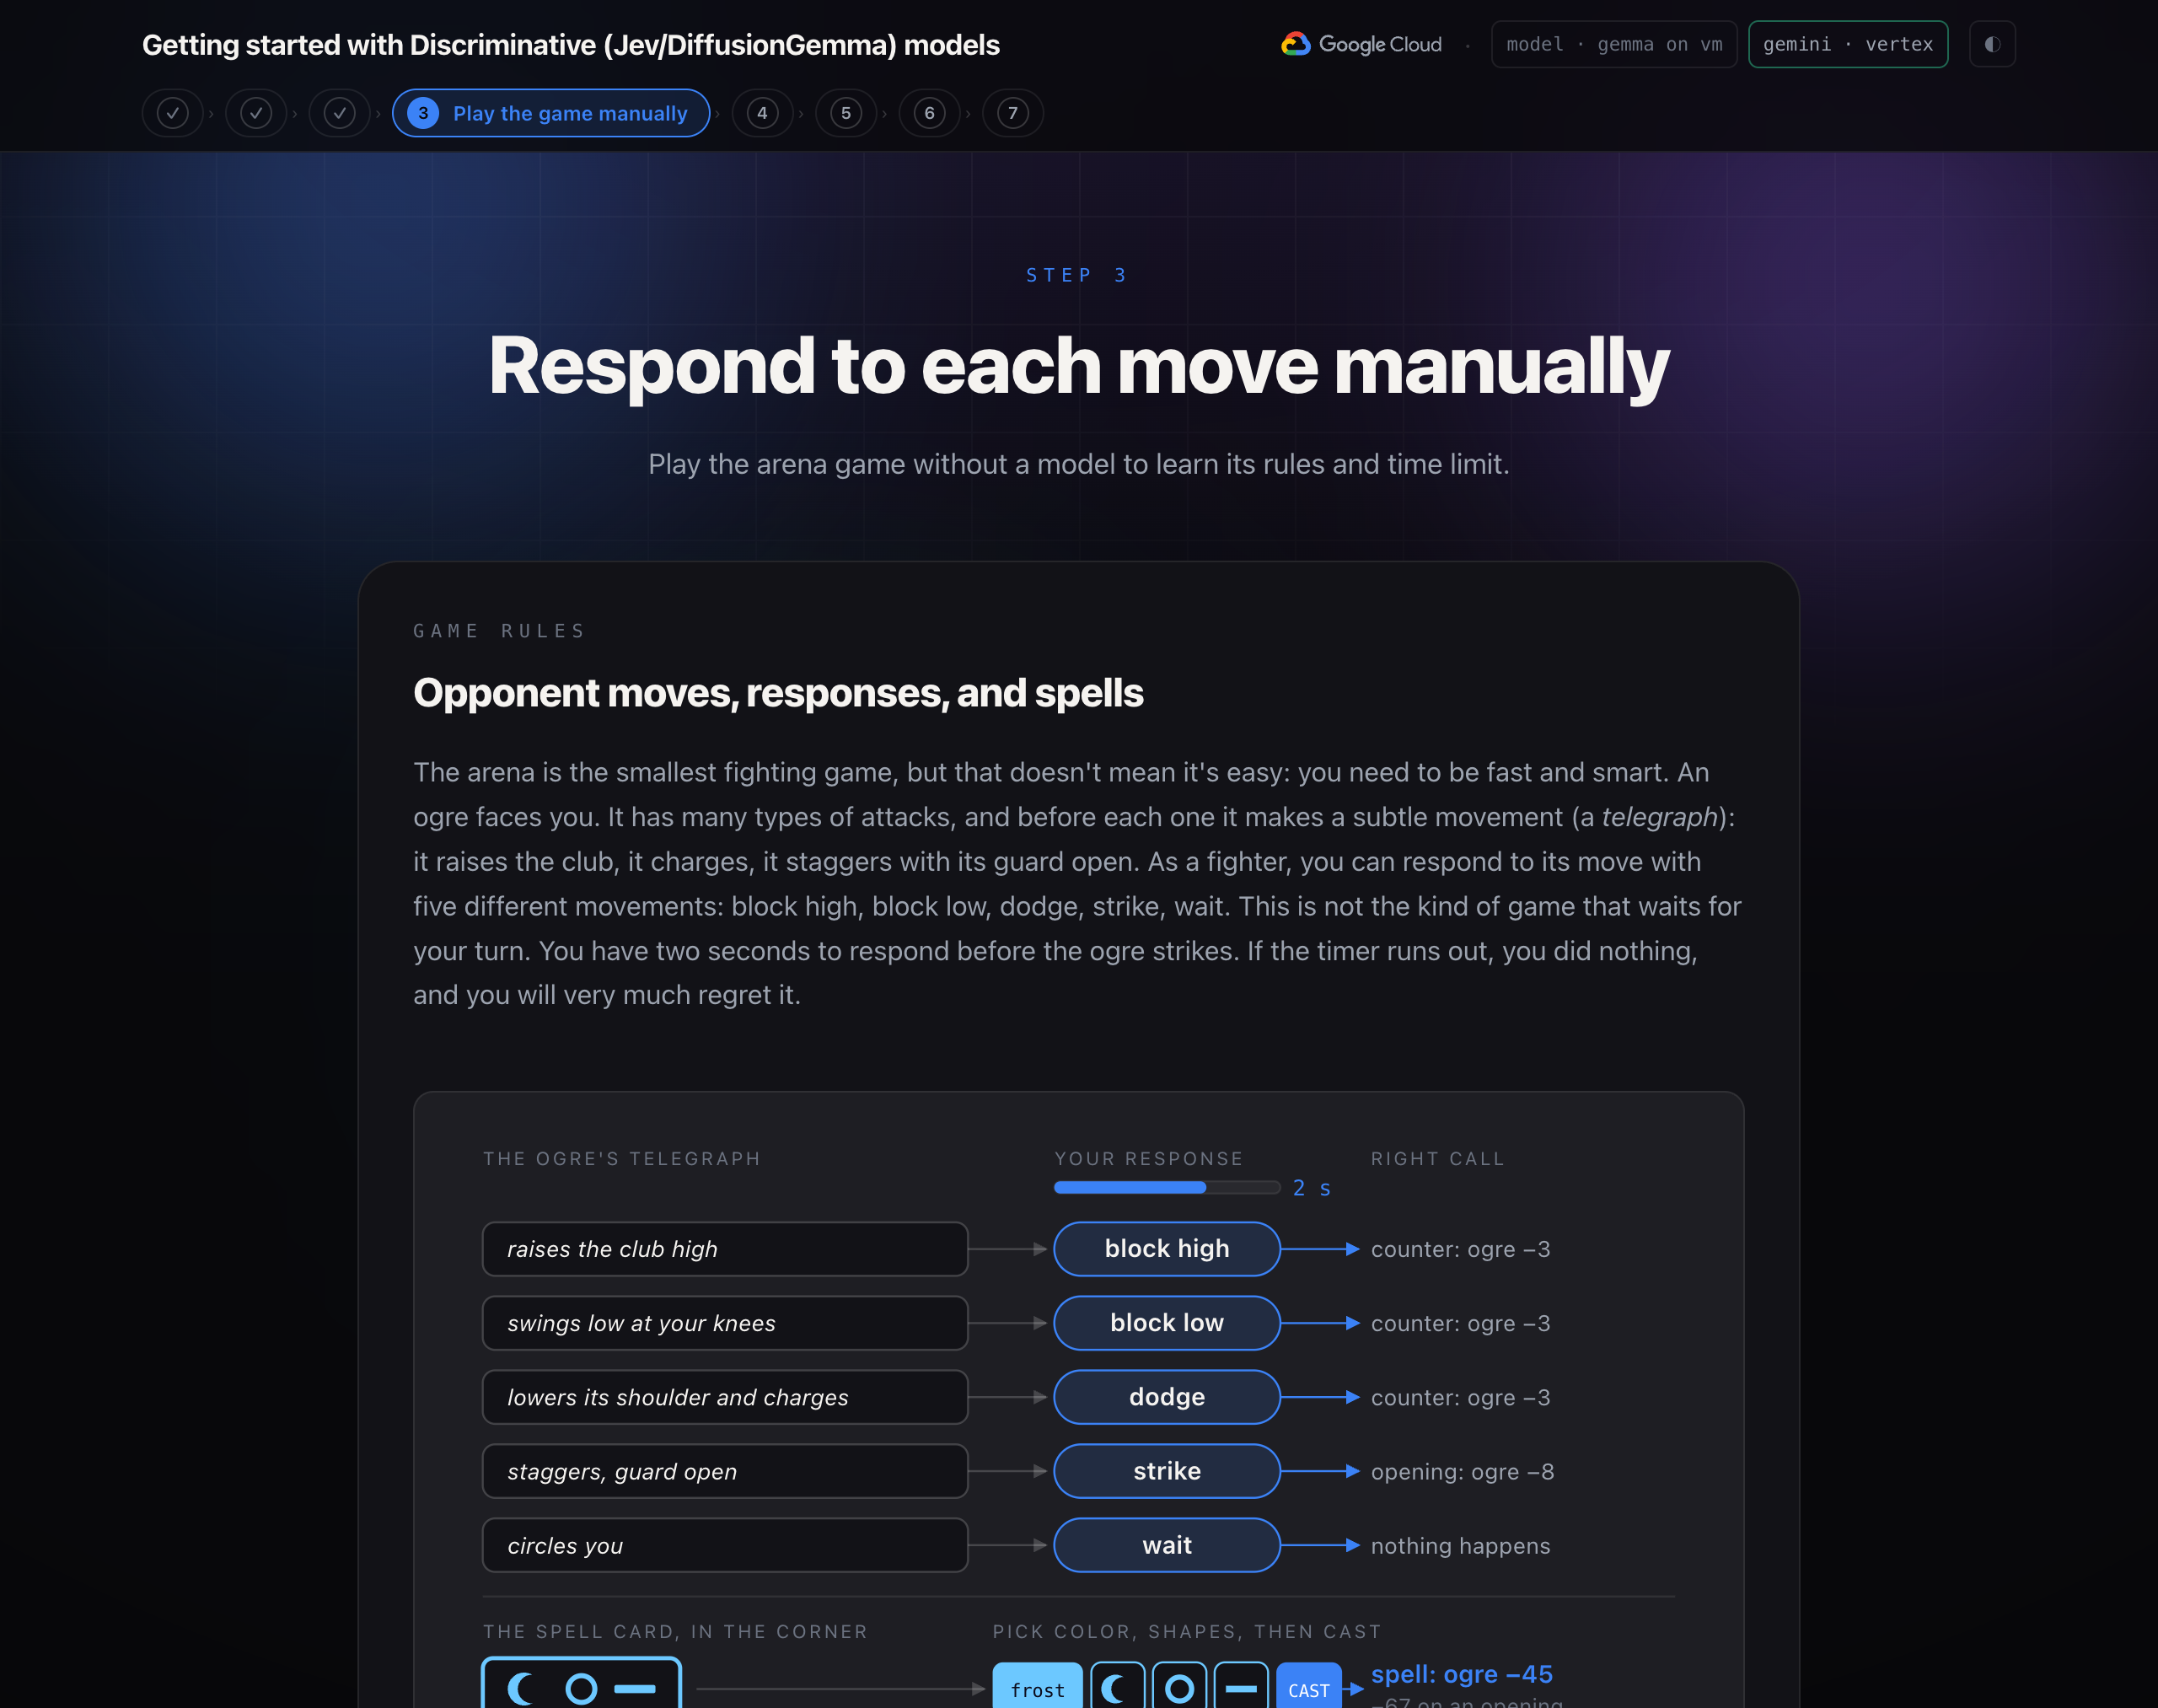
アリーナは最小の格闘ゲームですが、簡単ではありません。素早く賢く戦う必要があります。鬼がこちらを向いています。攻撃にはさまざまな種類があり、攻撃の前に微妙な動き(電信)をします。クラブを振り上げたり、突進したり、ガードを開いてよろめいたりします。ファイターは、相手の動きに対して、ハイブロック、ローブロック、回避、攻撃、待機の 5 つの異なる動きで対応できます。このゲームは、自分の番を待つようなゲームではありません。オーガが攻撃するまで 2 秒間あります。タイマーが切れると、何も行われず、後悔することになります。
リングの左上には、3 つの図形が描かれた色の付いたカードである呪文カードがあります。一致する呪文のみがダメージを与えます。ゲームでは、戦闘の下にあるボタンで呪文を唱えることができます。カードの色、左から右の順に形を選択し、[CAST] を押します。選択中も時計は進み続けるため、呪文を構築しながらオーガの攻撃に同時に対応する必要があります。キー 1 ~ 5 は、各動きの答えとして機能します。スペルが間違っていると、呪文は失敗します。ステップ 6 で、Gemini が呪文カードを読み上げます。
重要なポイント: 戦闘は、それぞれに期限が設定された小さな決断の連続です。ほとんどのソフトウェア自動化は、クラブを除いて、実際にはこのようなものです。
識別モデルのコンセプト
ソフトウェアの決定
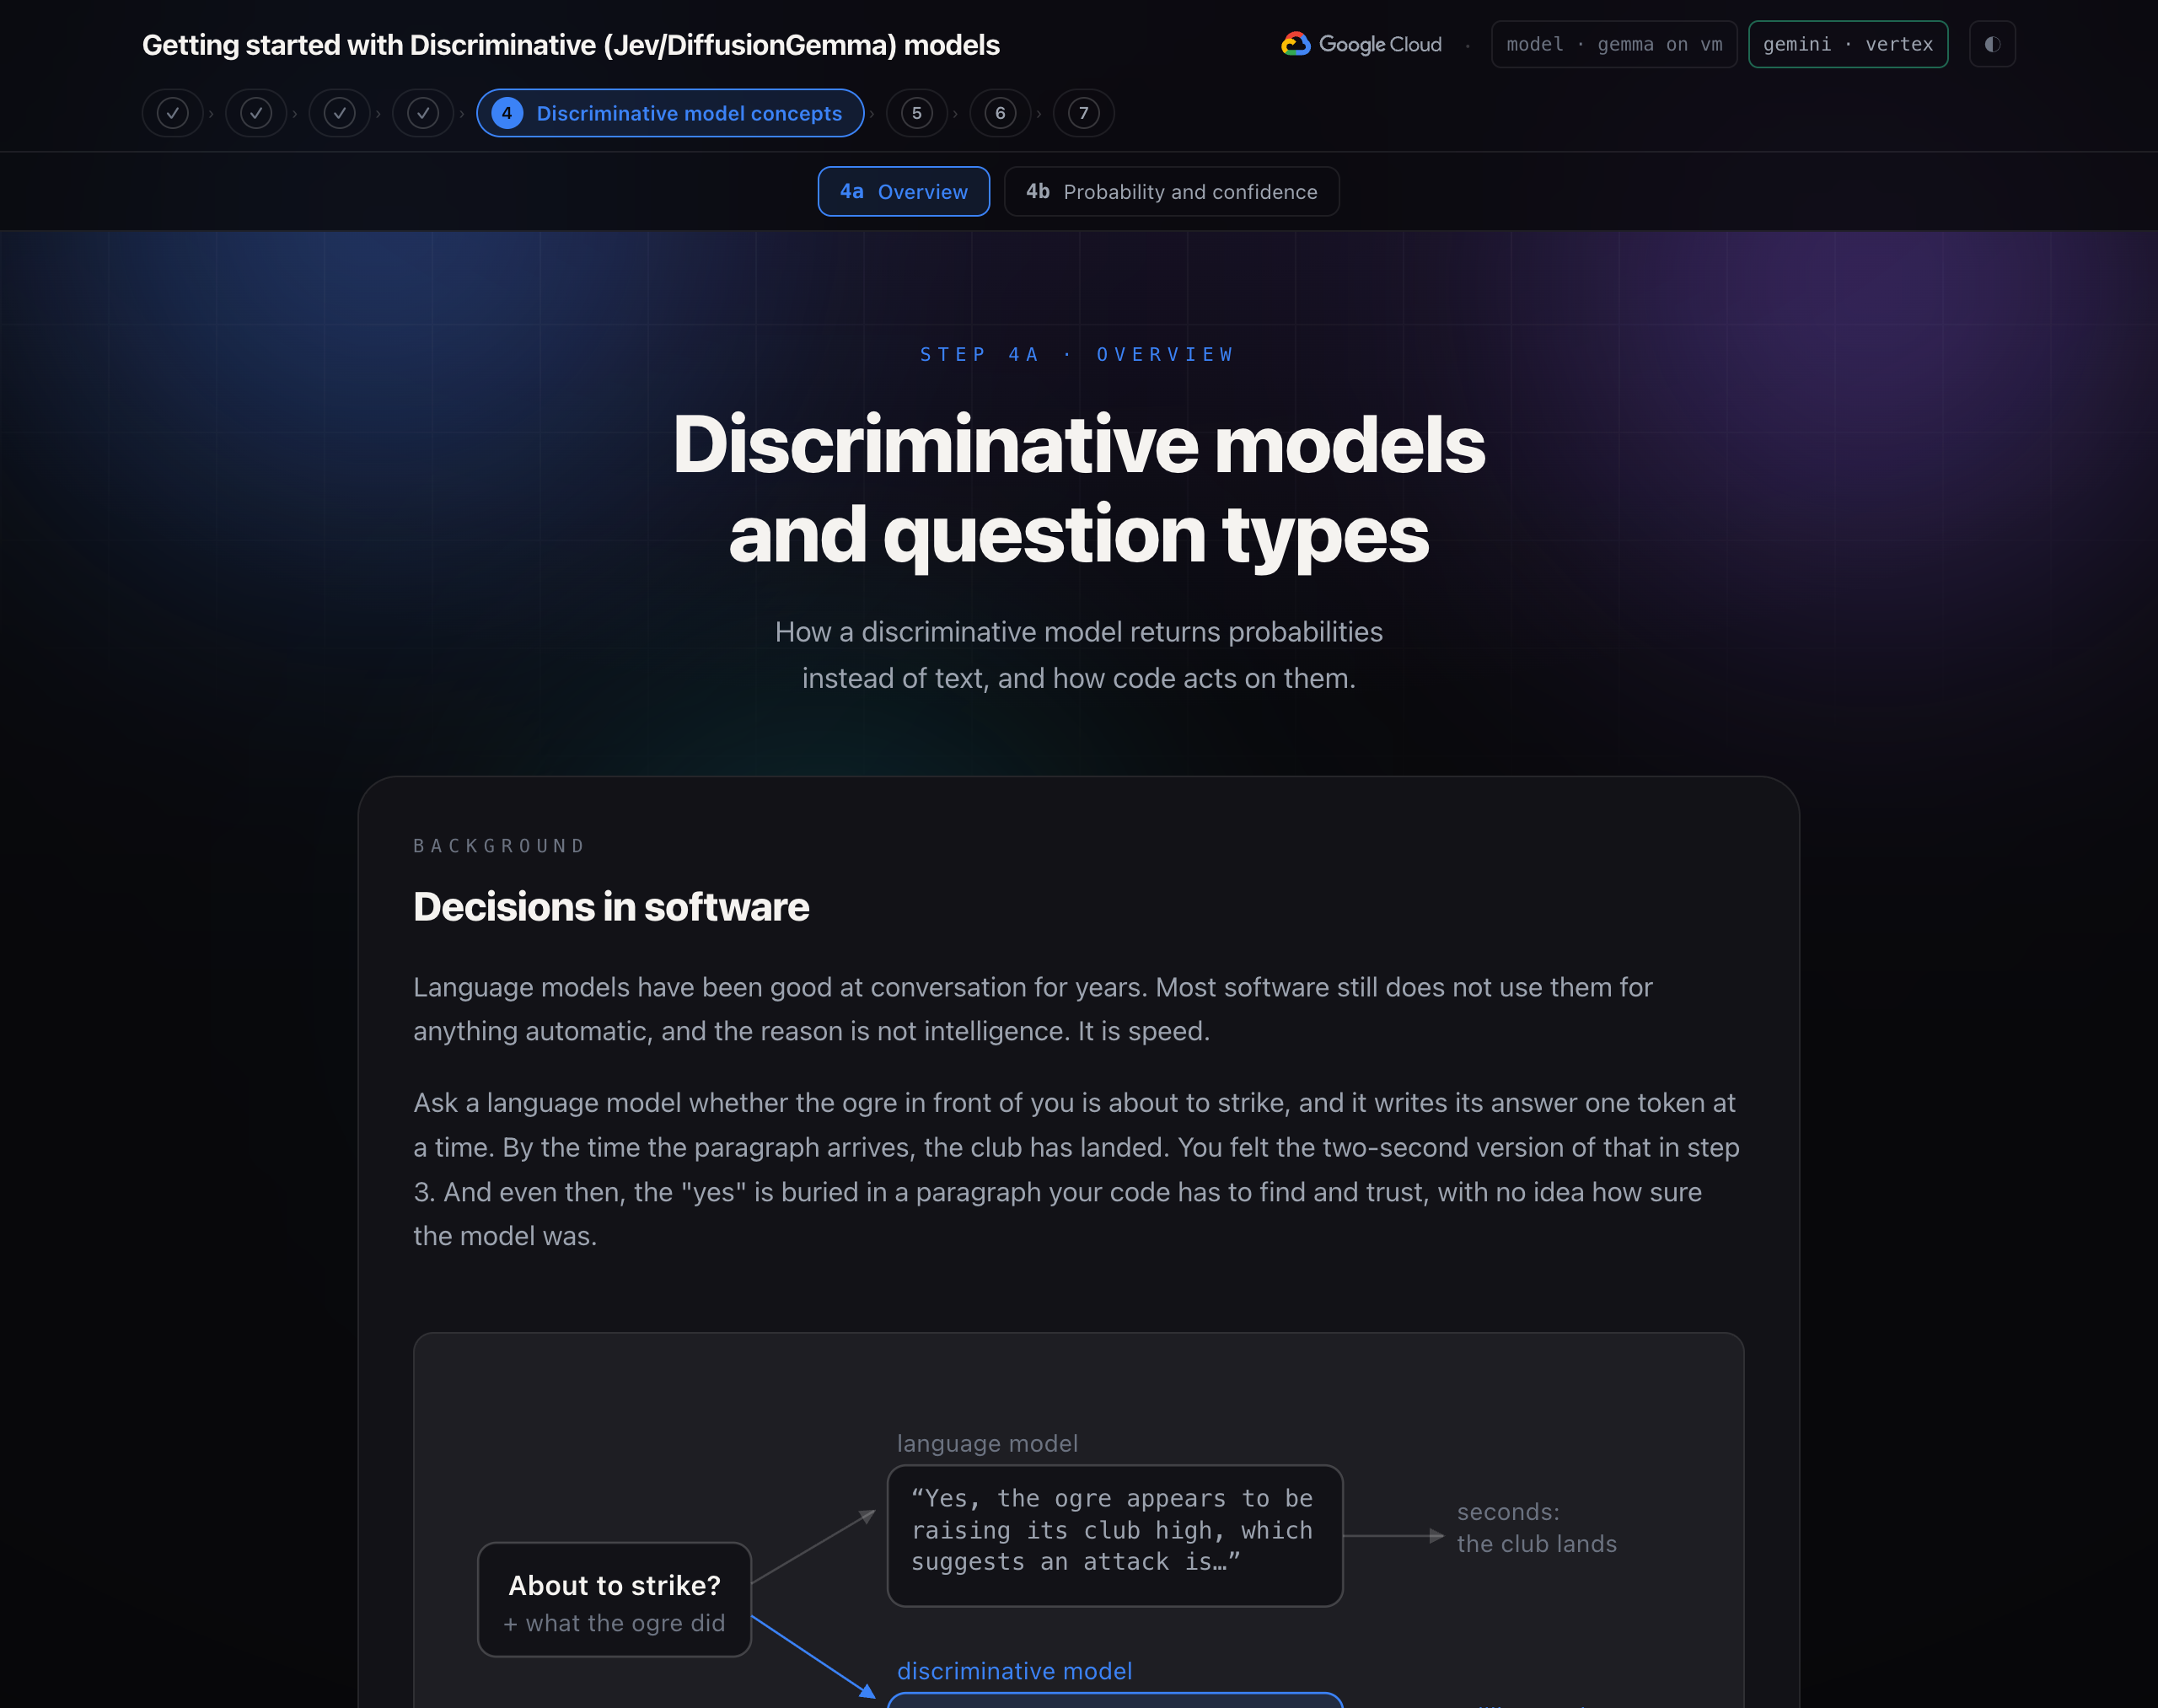
言語モデルは長年にわたり会話に優れてきました。ほとんどのソフトウェアでは、自動化にこれらの技術はまだ使用されていません。その理由は、インテリジェンスではありません。スピードです。
目の前にいるオーガが攻撃しようとしているかどうかを言語モデルに尋ねると、モデルは回答を 1 トークンずつ書き出します。段落が届く頃には、クラブは着陸しています。ステップ 3 で、2 秒間のバージョンを体験しました。その場合でも、「はい」という答えは、コードが探し出して信頼する必要がある段落に埋め込まれており、モデルがどの程度確信しているかはわかりません。
判別モデルは、状態と入力された質問と回答を 1 回のパスでミリ秒単位で取得します。各回答には調整された確率が示されます。0.9 は 10 回中 9 回正解することを意味します。解析するテキストがなく、JSON を抽出することもできません。
システム 1 とシステム 2 のモデル
この名前は、ダニエル・カーネマンの著書『ファスト&スロー』に由来しています。システム 2 は、ゆっくりとした、慎重な推論を段階的に行います。System One は高速なパターン マッチングです。
言語モデルはシステム 2 のマシンです。トークン単位で一度に 1 つずつ推論します。判別モデルはシステム 1 モデルです。大声で推論したり、何かを生成したりすることはありません。すべての質問に 1 回で回答します。そのため、高速(約 70 ~ 500 ミリ秒)かつ安価(1,000 件の決定あたり 1 セント未満)です。
重要なポイント: 言語モデルは文章を作成します。意思決定モデルが決定します。ソフトウェアが AI に求めるもののほとんどは、意思決定です。
制限事項
識別モデルは、テキストの生成、コードの作成、会話、算術演算、画像の読み取り、一連の手順の実行を行いません。
このワークショップでは、次の識別モデルのいずれかを選択します。
- 識別モデルの 1 つは Jev です。これは、2026 年 9 月にリリースされた TypeSafe AI のホスト型 API です。最初のモデルは
jev-1.13で、エイリアスjev-latestを介してアクセスされます。公開されている重みがないため、ダウンロードではなく呼び出されます。 - System One モデルを入手する方法は Jev だけではありません。Google の DiffusionGemma は、一度に 1 つずつではなく、トークンのブロック全体を並行して書き込むオープンウェイト モデルです。同じ並列パスで、固定されたオプションのセットに対する確率を読み取ることができます。djev-run などのオープンソース サーバーは、Jev の正確な API を前面に配置するため、このワークショップのすべての内容は変更なしで実行できます。
状態と質問: Choice、Score、Noul
各呼び出しは状態と質問を送信します。状態は、判断するテキストです。文字列、JSON オブジェクト、リストのいずれかになります。質問では、そのテキストについて知りたいことを尋ねます。各質問には、選択肢、スコア、Noul のいずれかのタイプがあります。質問は並行して処理されるため、迅速な回答が可能です。必要に応じて、複数の質問を追加できます。
- Choice は、指定したセットから 1 つのオプションを選択します(最大 255 個)。回答は、オプション、各オプションの確率、信頼度です。オプション間に順序がない場合(ブロック(高)、ブロック(低)、回避、攻撃、待機)に使用します。
- スコアは、ユーザーが記述した 2 ~ 10 個の順序付きレベルに沿って状態を評価します。回答は、スケール上の位置(1.4 は「1 と 2 の間、1 に近い」という意味の小数)、各レベルの確率、信頼度です。着信ヒットの強さなど、回答が程度に関するものである場合に使用します。
- Choice と Score はどちらも、各オプションの確率と信頼度を返します。この違いが主な回答となります。Choice は、最も可能性の高いオプションを返します。Score は、オプションを順序付きレベルとして扱い、確率で重み付けされた平均値を返します。この値は 2 つのレベルの中間になることがあります。なし 0.05、軽 0.55、重 0.40 の場合、選択肢は「軽」、スコアは 1.35(軽と重の間)になります。アリーナではこの値が使用されます。
choose()では、危険度スコアが 1.5 以上の場合は重いヒットと見なされます。
- Choice と Score はどちらも、各オプションの確率と信頼度を返します。この違いが主な回答となります。Choice は、最も可能性の高いオプションを返します。Score は、オプションを順序付きレベルとして扱い、確率で重み付けされた平均値を返します。この値は 2 つのレベルの中間になることがあります。なし 0.05、軽 0.55、重 0.40 の場合、選択肢は「軽」、スコアは 1.35(軽と重の間)になります。アリーナではこの値が使用されます。
- Noul は、Yes/No の質問をして、答えが Yes である確率を返します。1 に近いほど「はい」の可能性が高く、0 に近いほど「いいえ」の可能性が高く、0.5 に近いほど「どちらの可能性もある」となります。確率は信頼度であるため、個別の信頼度はありません。
具体的な質問をする
判別モデルは、質問が特定の範囲内のことを尋ねている場合に最適です。「状況はどうなっていますか?」という質問に対して、信頼度の低い妥当な回答が返されます。「適切な応答はどれですか?」「相手は露出しているか?」と「この攻撃はどのくらい効果があるか?」という質問に対して、コードが組み合わせる 3 つの回答が返されます。
オプションとレベルの説明は安価で重要です。ステップ 3 で読み取ったルールがオプションの説明になります。block_high: "Raise the shield. Right against an overhead or a high swing." これが、判別モデルがリクエスト時に 1 行ずつ対戦のルールを学習する方法です。状況に応じてオプションを変更することもできます。たとえば、呪文の準備ができたときにのみ cast を提供するアリーナなどです。
確率と信頼度
選択肢の回答はラベルではありません。これはラベルの分布であり、ラベルは最も高いバーです。
モデルが数値を取得する方法。言語モデルが次の単語を選択するのと同じステップを使用します。変換モデルはテキストを読み取り、ある位置で、語彙内のすべてのトークンに ロジットと呼ばれる生スコアを付与します。ロジットが高いほど、トークンがその位置に適合していることを意味します。softmax は、ロジットを合計が 1 になる確率に変換します。言語モデルはトークンを 1 つ選択してテキストに追加し、この処理を繰り返します。識別モデルは確率の後に停止します。
空白は、回答フォームの空欄です。サーバーが response: ▢ などのフォーム自体を書き込み、質問ごとに 1 つのギャップを残します。モデルの唯一の仕事は、各ギャップに何が入るかをスコアリングすることです。
- プロンプトには、状態と各質問が含まれ、許可されるすべての回答が短いラベル(block_high の場合は
a、block_low の場合はbなど)として含まれます。 - サーバーは、質問ごとに 1 つの空白を含む回答フォームを追加します。
- モデルはプロンプトとフォームを 1 回で読み取り、各空白のすべてのトークンにロジットを付与します。拡散モデルはフォーム全体を一度に認識し、すべての空欄をまとめてスコアリングします。
- サーバーは許可されたラベルのロジットのみを保持し、それらに softmax を適用するため、許可された回答の合計は 1 になります。
- 読み取りが不確実な場合、サーバーは別のランダムな開始位置から再度読み取りを行い、読み取りの平均値を計算します。
信頼度は、回答の確実性を示す 1 つの数値です。TypeSafe は、確率がオプション全体にどのように分布しているかに基づいて計算します。すべてが 1 つのオプションに集中している場合は 1、均等に分散している場合は 0 になります。3 つのオプションの場合は、(3 × 最大値 - 1)/ 2 です。
TypeSafe は、キャリブレーションされた確率で Jev をトレーニングします。確率は、回答が正しい頻度と一致します。調整されたモデルでは、0.7 で得られた回答は 70% の確率で正しいため、信頼度のしきい値は、間違った回答を受け入れる頻度のしきい値になります。このワークショップの DiffusionGemma サーバーは、読み取りの平均値として、確率の高いものを信頼度として報告します。読み取り結果が一致しない場合、平均値が広がり、信頼度が低下します。
重要なポイント: 回答は「何」を教えてくれます。信頼度は、行動すべきかどうかを示します。
しきい値
しきい値は、コードでアクションを定義する方法です。モデルは信頼度または確率を返します。コードは、選択した数値と比較し、その結果によって何が起こるかが決まります。
アクションごとのしきい値。TypeSafe は、信頼度を帯域に分割することを提案しています。信頼度が高い場合は、自動的に処理されます。中程度の信頼度の場合、確認を求める、審査のためにケースにフラグを設定するなどのチェックを行います。信頼度が低い場合は行動せず、安全なものや人にフォールバックします。
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
アリーナのルール。アリーナのしきい値は choose() にあり、ステップ 5 で実行します。
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
警告: 有効な回答が必ずしも正しいとは限りません。判別モデルは、提供していないオプションを返すことはできないため、動きを幻覚することはありませんが、間違ったオプションを選択することがあります。しきい値を信頼する前に、すでに判断した状況に対して質問をテストします。
モデルを使用して意思決定を自動化する
リクエストとレスポンス
Request. TypeSafe Python SDK を使用すると、質問を作成してモデルに送信できます。
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
1 回のティックにつき 1 つのリクエスト
アプリは、各ティックで電信を状態として送信し、1 回の呼び出しで次の 3 つをリクエストします。
- 5 つ(または呪文の準備が整っている場合は 6 つ)の応答のうち、どの応答が正しいですか?選択肢。
- オーガが現在カウンターに公開されているかどうか。A Noul.
- 着弾の強さを 3 段階のルーブリックで評価します。スコア。
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() 関数
ステップ 4 で設定したしきい値を思い出してください。choose() は、モデルの回答を固定数と比較します。この固定数がしきい値です。
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() は、2 つのルールに従って型付きの値を読み取る通常の Python です。識別モデルは確率と分析を提供し、コードはルールのしきい値を使用します。選択したアクションがエンジンに送信され、オーガとの戦いで使用されます。
重要なポイント: 質問としきい値を 1 か所にまとめておきます。これらは、System One 統合で最も調整する部分です。
応答時間、入力ベースの料金設定、判断ロジック
- 決定ごとの応答時間。パート b の戦闘の各ティックは、約 100 ミリ秒で戻ってきました。2、3 回は 2、3 ミリ秒で戻ってきました。これは、ゲームループ、リクエスト パス、または人間や言語モデルがメッセージを確認する前のチェックに十分な速さです。
- 入力ベースの料金。1 回の対戦(3 つの質問を含む 60 回の判定)の費用は 1 セントの 10 分の 1 を大きく下回ります。何も生成されなかったため、出力トークンはゼロです。その結果、必要な数よりも多くを要求できるようになります。アリーナは、
strikeとcastのみが気にする場合でも、オーガがすべてのティックで公開されているかどうかを尋ねます。これは、尋ねるコストがほとんどかからず、回答がダッシュボードで役立つためです。TypeSafe では、これを投機的ファンアウトと呼んでいます。 - 信頼度と危険性を組み合わせます。判別モデルのレスポンスの信頼度が 0.40 未満で、危険スコアが重い攻撃が来ると示している場合、
choose()は回避でオーバーライドします。回避は最善の答えになることはほとんどありませんが、最悪の答えになることもほとんどありません。しきい値は、きりの良い数字ではなく、各間違いのコストから選択し、手動で判断した電報に対してテストします。TypeSafe のアドバイス: 決定が誤って発動し続ける場合は、しきい値を移動する前に質問を厳しくします。
ADK ワークフローでモデルを組み合わせる
1 回の判断の限界と、正しい回答だけでは不十分な理由
ステップ 5 の戦いの最後の行に、「オーガはほとんど傷を負うことなくよろめきながら去っていった」とあります。識別モデルはダメージを受けず、毎ティック少しずつダメージを与えます。300 ヒットポイントは、少しの 60 倍以上です。指輪の隅にある呪文カードは、最初からそこにありました。読み取りには、画像を見ることができるモデルが必要です。
オーガのヒット ポイントは 300 です。正解のカウンタが 3 になります。開口部への攻撃は、皮が厚いため 8 ダメージを与えます。60 回の攻撃を完璧に決めても、オーガは傷を負った状態で立ち上がり、ゲームは引き分けと判定されます。ステップ 5 は、モデルがうまく防御したものの、まだ勝てないという結果で終わりました。
呪文のみが実際のダメージを与えます。完璧な詠唱で 45、隙を突いて 67 です。
各タスクを適切なモデルに割り当てる
リングの隅にある呪文カードが勝利の鍵です。呪文カードはテキストではなく、色と 3 つの図形が並んだ絵で、呪文を歌って一致させる必要があります。画像を見て数秒で処理できるモデルが必要です。戦闘では、数秒は 10 ティックです。
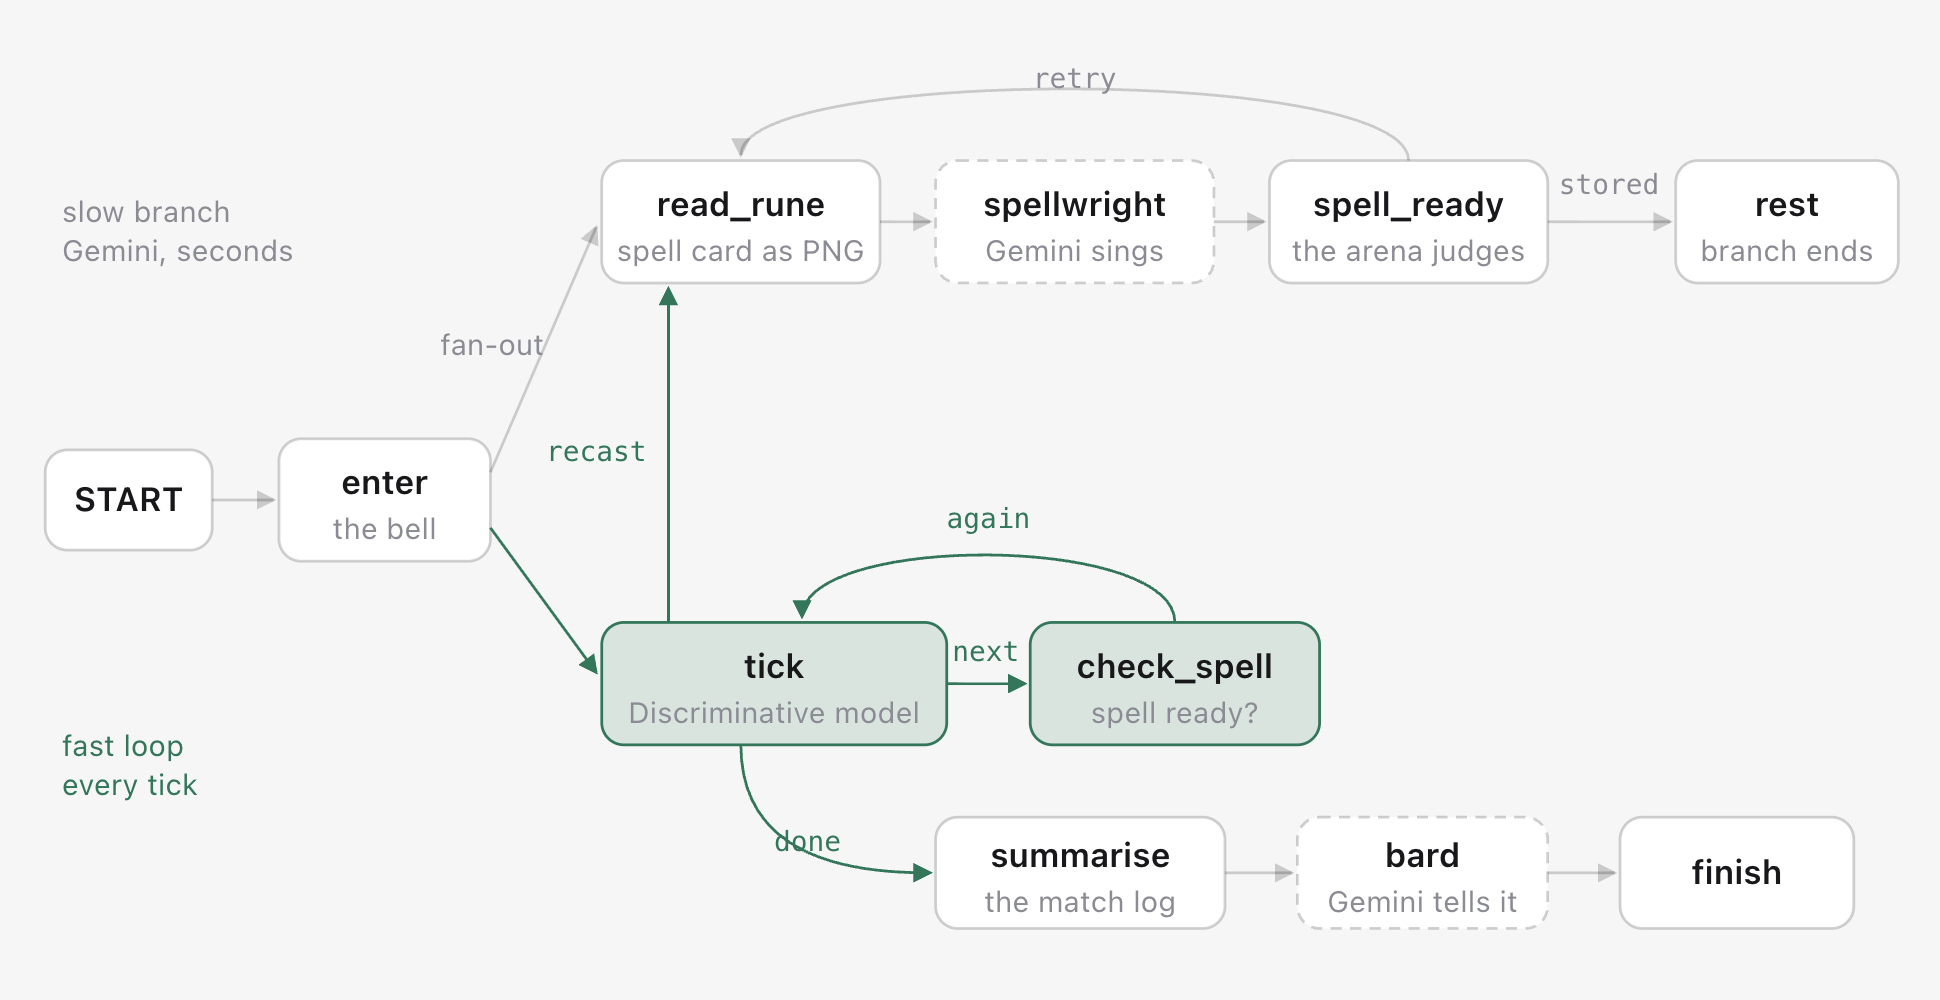
そのため、ワークフローでは両方がそれぞれの速度で使用されます。
- 識別モデルが戦います。1 回のティック、1 回の呼び出し、1 回の決定、100 ミリ秒。ループは、自身よりも遅いものを待つことはありません。
- Gemini が読み上げたり歌ったりします。独自のブランチで、ベルが鳴ると、アリーナの画面からスペルカードを画像として取得し、色と形を特定して、呪文を唱えます。アリーナは、サーバーから離れることのないスペルカードの答えと照らし合わせて曲を判定します。
- 交換のたびに、ファイターはスロットを確認します。
check_spellノードは状態を確認します。準備ができていない: その旨が表示され、Gemini が歌っている時間と、次のティックに戻るルートが示されます。待機することはありません。準備完了:castが識別モデルに提供されるオプションに加わり、識別モデルがオープニングを報告した瞬間にchoose()が呪文を唱えます。呪文が使い果たされると、画面に新しい呪文カードが描画され、スロー スレッドが再び開始されます。歌を間違えるとスペルカードが燃え、遅いスレッドが新しいスペルカードを読み取ります。 - Gemini は、最後に一度だけ短い物語を書きます。
レイテンシが異なる並列ブランチと 1 つのイベント ループ
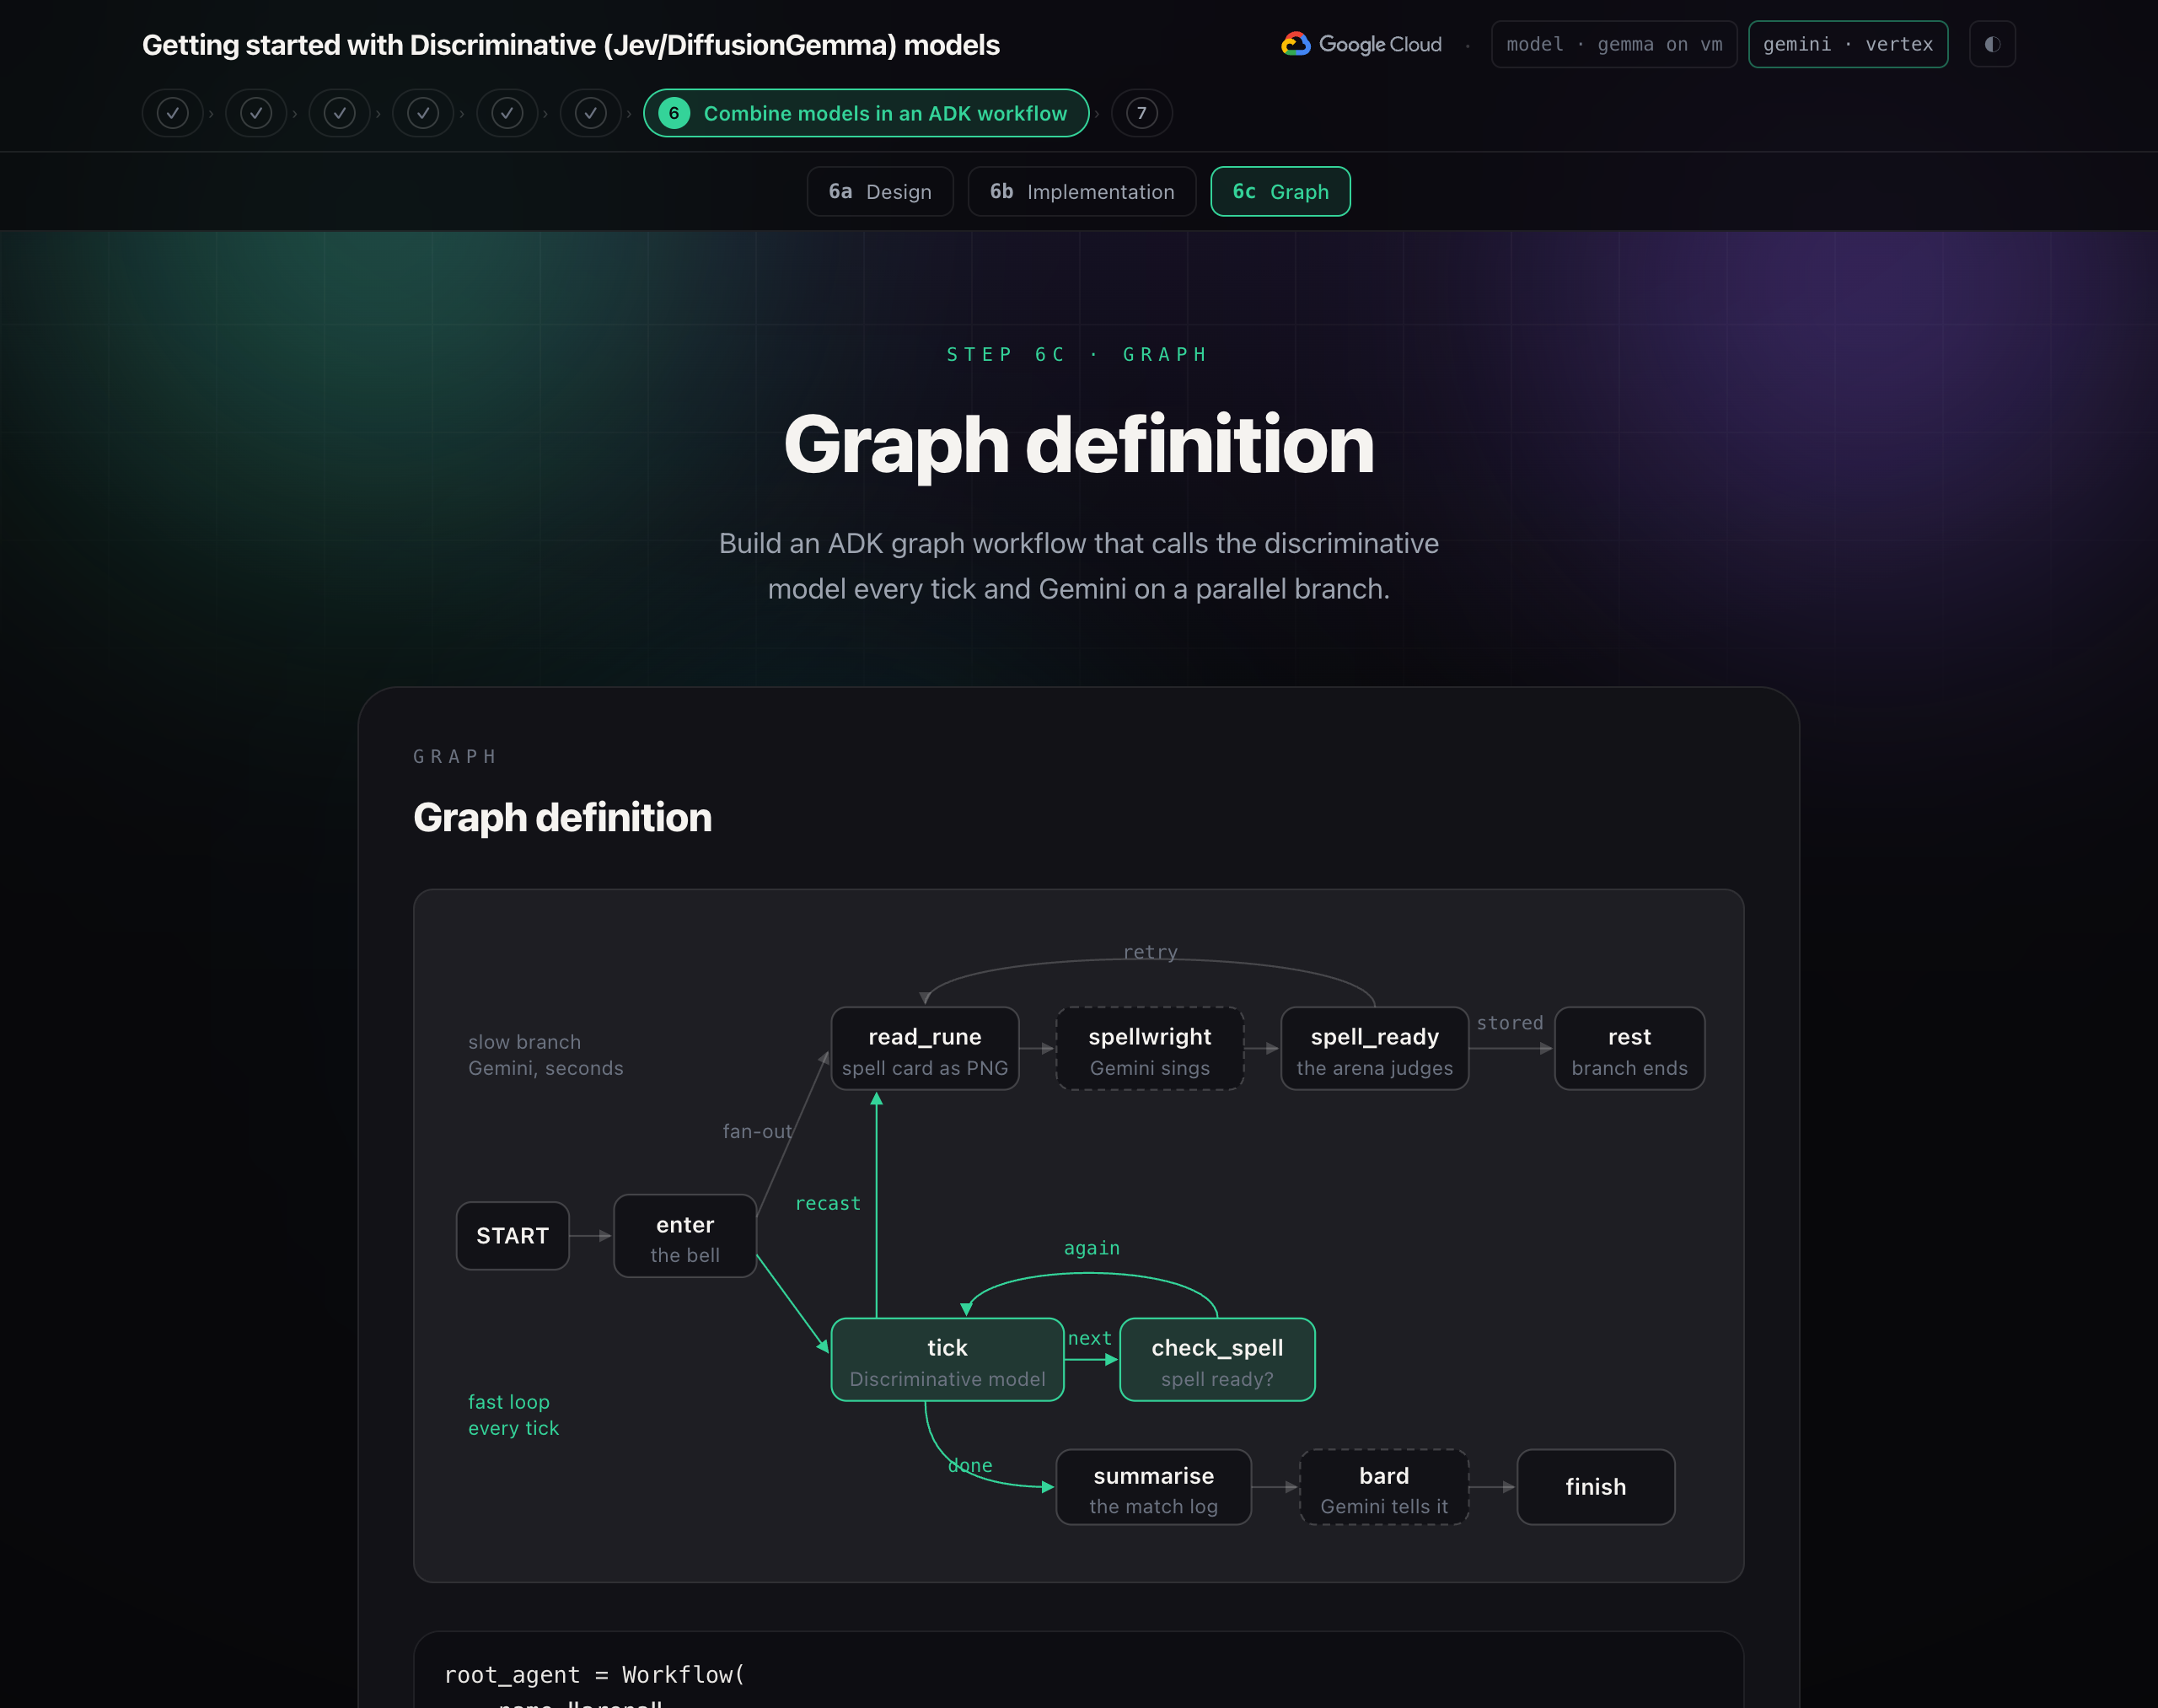
これは、エッジで結合されたノードのグラフである ADK ワークフローです。ノードは、プレーンな Python 関数または LLM エージェントです。1 つのノードからノードのタプルへのエッジはファンアウトです。両方が同時に開始します。route を含む Event を返すノードは、次にどのエッジが使用されるかを選択します。また、それ自体にルーティングするノードはループです。
2 つのスレッドとして考えてください。スレッド 1 は遅く、呪文カードを読み取り、歌い、呪文を保存します。スレッド 2 は高速です。ティック、スロットの確認、ティック。スレッド 1 は、判定されたスペルをセッションの状態に書き込み、出力を返さない関数で終了します。スレッド 2 の check_spell は、交換のたびにその状態を読み取ります。どちらのスレッドも他方を呼び出したり待機したりせず、状態のみを共有します。
重要なポイント: 意思決定をコードに記述し、各モデルに独自のペースで狭い範囲のジョブを割り当てます。
ADK は、両方のブランチを 1 つのイベントループのタスクとして、1 つのスレッドで実行します。一度に実行されるタスクは 1 つだけです。タスクが await に達すると、回答を待ち、その間にループは他のブランチを実行します。高速ブランチはモデルを約 10 分の 1 秒待機し、低速ブランチは Gemini を数秒待機するため、どちらも他方を妨げることはありません。
遅いブランチ
read_rune() は、スペルカードを画像として画面から取り出します。
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright は Gemini です。画像を読み取り、固定された形状で回答します。
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() は、アリーナの審判に呪文を判定させ、保存するか、もう一度試します。
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
関数ノードは画像部分を含む Content を返すことができ、LLM ノードはそれをユーザーのターンとして受け取ります。spell_ready は、状態の差分と output を含まない Event を返します。次のティックでは状態からスペルが読み取られ、出力のないブランチはグラフの 2 番目の終了ではありません。ADK には 1 つのターミナル出力が必要であり、それは戦闘の出力です。
注: 判定は、アリーナ内のコードとスペルカードの隠された答えを照合して行われます。完璧な読みは 45 で、さらにオープニングに移行します。2 つの図形が正解すると 25 になります。読み間違えると、呪文カードが燃え尽きてしまいます。Gemini に正しかったかどうかは尋ねられません。
高速ブランチ
tick() は 1 回の交換を行い、次のエッジを選択します。
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() は、やり取りのたびに spell スロットを確認します。
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell は、交換のたびにスロットを確認します。ブロックされることはありません。スペルが準備できていない場合は、そのことを報告して次に進みます。
デザインを支える 3 つの要素があります。判別モデルの呼び出しは非同期クライアントで await されるため、ループは待機中に yield し、Gemini ブランチは実行を継続します。質問は各ティックで新たに作成されるため、キャストするコンテンツがある場合にのみ cast が表示されます。また、route はリストにすることもできます。["recast", "next"] は両方のエッジを一度に取得します。
アリーナ自体は小さなクライアントの背後にあります。実行中のアプリがある場合は HTTP 経由で、ページに試合が表示されます。実行中のアプリがない場合は、エンジンがインプロセスで実行されます。
グラフ定義
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
ターゲットとしてのタプルはファンアウトです。エッジとしてのタプルはチェーンです。辞書は、ルート名をノードにマッピングします。tick → check_spell → tick は高速ループです。"recast": read_rune は、呪文が消費された後にスロー スレッドを再開します。"retry" は、呪文が失敗した後にスロー スレッドを再開します。"stored": rest は、呪文がスロットに入ると、出力なしでスロー スレッドを静かに終了させます。ADK ではサイクルに少なくとも 1 つのルーティングされたエッジが必要なため、無条件ループは実行される前に拒否されます。
注: root_agent は ADK のツールが探すものです。ターミナルではなくブラウザでグラフとイベントを確認する場合は、ワークショップのルートから adk web agents を実行すると、アリーナを含む開発 UI が開きます。