

1. 소개
분류 모델, TypeSafe AI의 시스템 1 결정 모델, Google ADK 워크플로에서 Gemini와 함께 사용하는 방법에 관한 90분 워크숍입니다. 이 워크숍은 격투 게임을 중심으로 6단계로 구성되어 있습니다. 먼저 손으로 오우거와 싸우고, 그다음에 차별 모델에 반사 신경을 넘겨준 다음, ADK 워크플로가 차별 모델로 싸움에서 승리하는 것을 지켜봅니다. 차별 모델은 매 틱을 결정하고 Gemini는 화면에서 주문 카드를 읽어 주문을 노래합니다.
개요
분류 모델 (jev-1.13, 별칭 jev-latest)은 TypeSafe AI의 호스팅 모델로, 2026년 9월 19일에 출시되었습니다. 텍스트를 생성하지 않습니다. 상태 (텍스트, JSON 또는 목록)와 입력된 질문 (Choice, Score, Noul)을 보내면 입력 토큰 백만 개당 0.042달러의 비용으로 약 70~500ms 내에 보정된 확률이 포함된 유형화된 답변을 반환하며 출력에는 비용이 청구되지 않습니다. 이 모델의 역할은 언어 모델 앞, 사이, 뒤에서 라우팅, 분류, 게이팅, 그리고 여기서는 격투기 선수의 반사 신경과 같은 결정을 내리는 것입니다.
게임 예
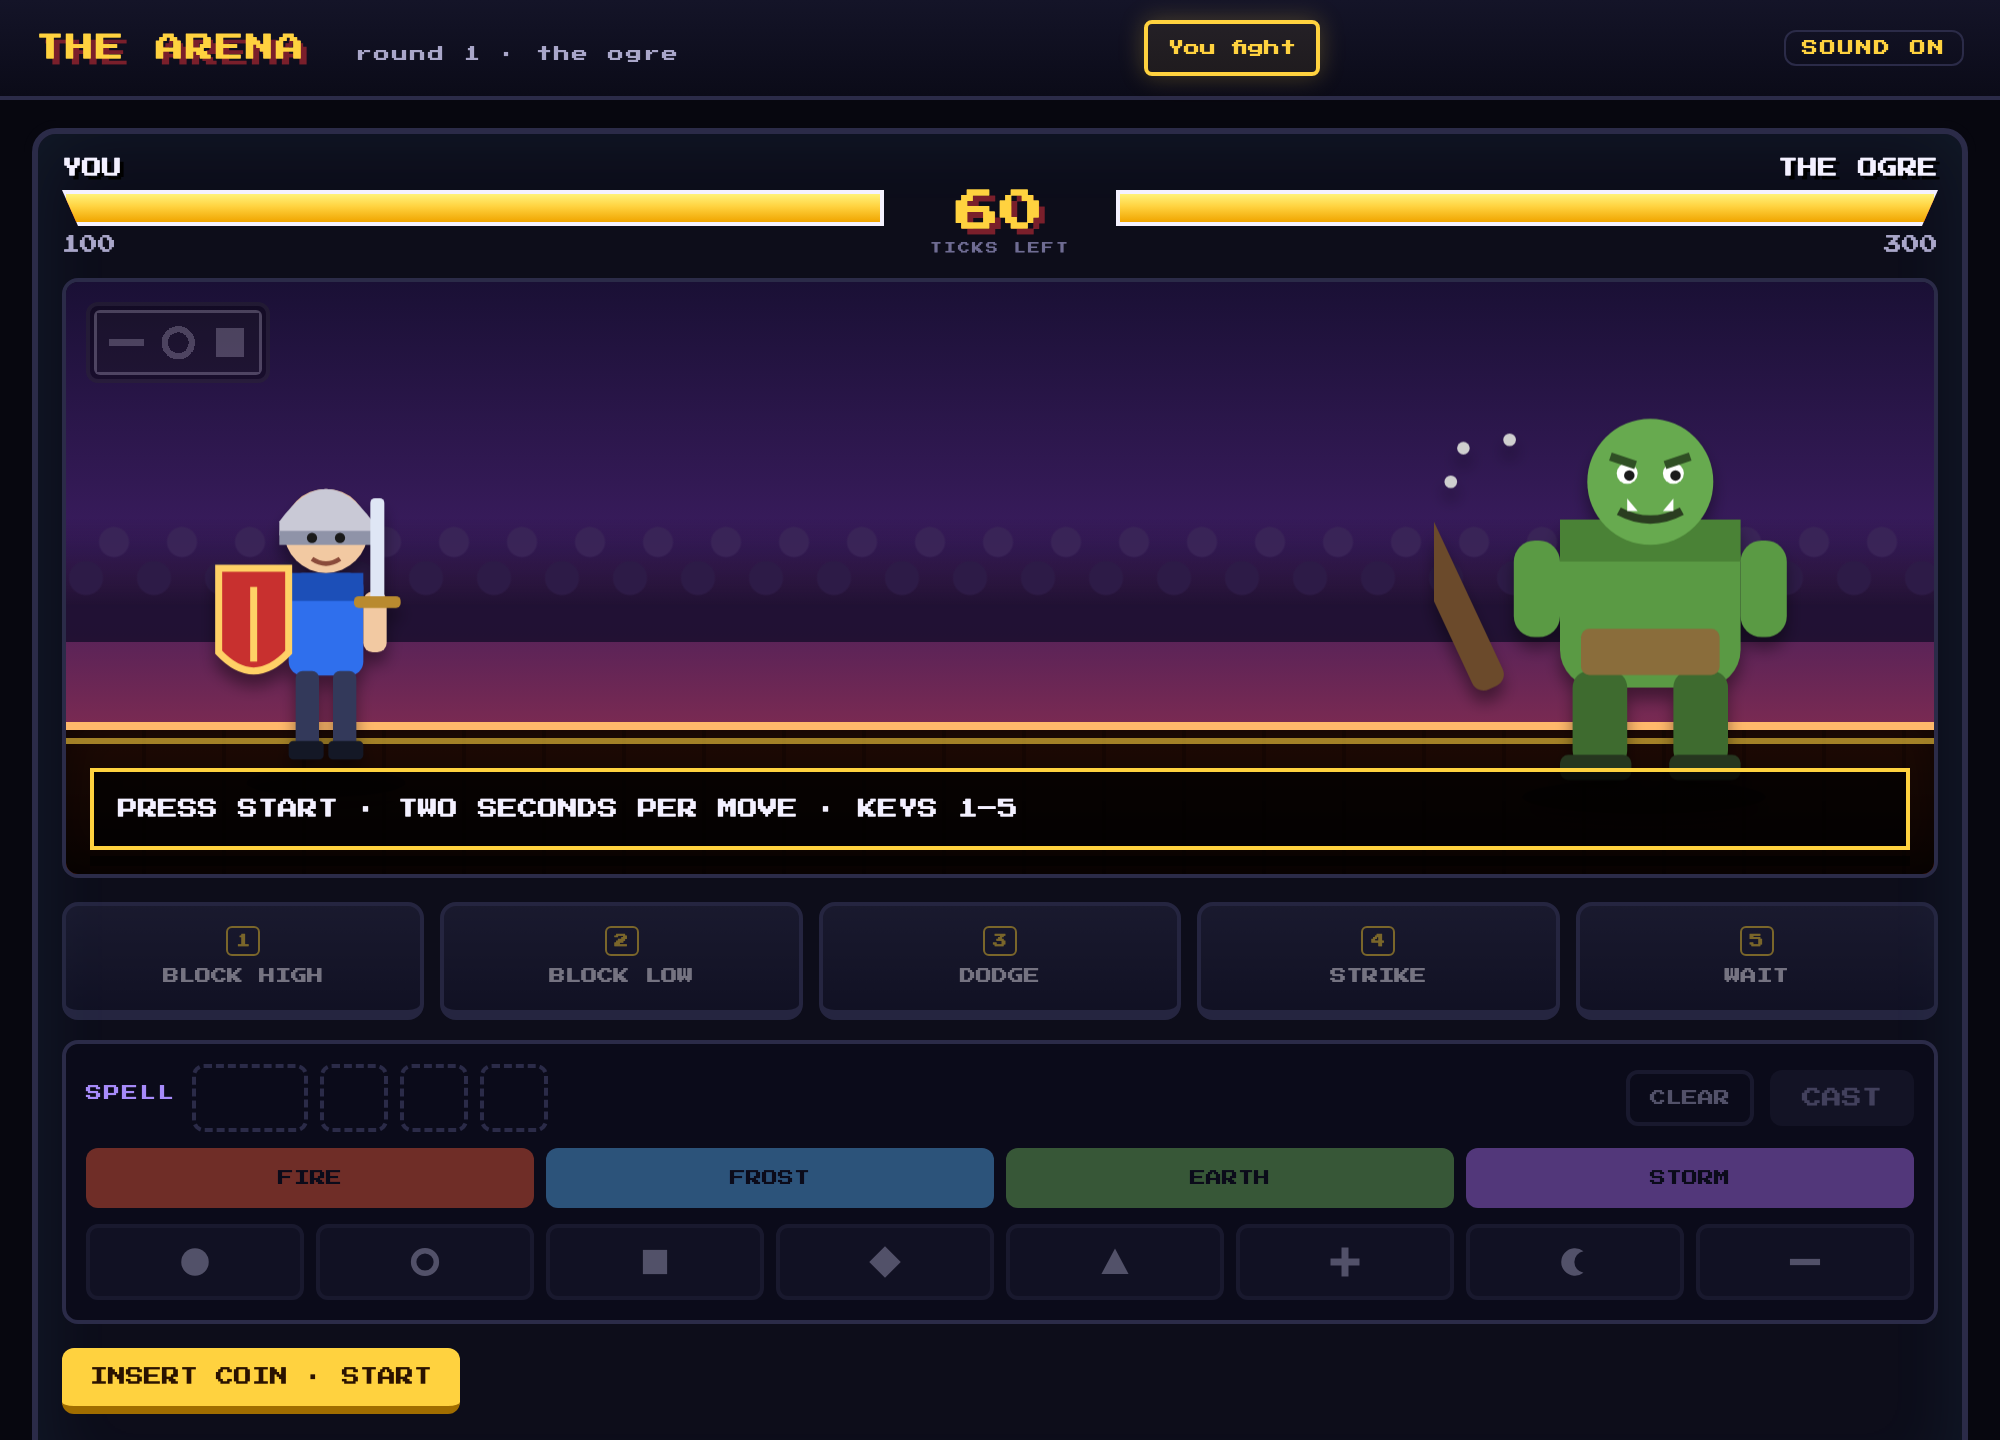
전투 게임을 플레이해 본 적이 있나요? 상대와 마주하고 상대의 움직임에 즉시 반응해야 합니다. 잘못된 추측을 하면 HP가 감소합니다. 게임은 주문을 시전하기 어렵게 만드는 경향도 있습니다. 이 게임에서는 주문이 시전되기 전에 주문 카드의 색상과 모양을 순서대로 선택해야 합니다. 이 워크숍에서는 두 가지 유형의 모델을 결합하여 캐릭터가 승리하도록 하는 방법을 보여줍니다.
게임의 각 요소는 실제 시스템에 매핑됩니다.
- 상대방의 움직임은 요청이나 거래와 같은 수신 이벤트입니다.
- 대답은 분류 모델에서 내린 제한된 결정이며 코드에 의해 확인됩니다.
- 주문 카드는 언어 모델이 읽어야 하는 비구조화된 입력입니다.
- 일치는 빠르고 느린 작업을 자체 속도로 실행하는 워크플로입니다.
네 가지 구성요소를 결합하고 이를 연결하여 빠르고 스마트한 시스템을 빌드하는 데 중점을 둡니다.
학습할 내용
- 판별 모델 (시스템 1)과 생성 모델 (시스템 2)의 차이점과 각각을 사용하는 경우를 설명합니다.
- Jev와 DiffusionGemma가 제공되는 방식을 설명하고 Compute Engine GPU VM의 DiffusionGemma를 포함하여 워크숍을 위해 하나를 설정합니다.
- 선택형, 점수, Noul 질문을 작성하고 확률과 신뢰도를 해석합니다.
- 결정적 코드에서 임계값을 사용하여 확률을 작업으로 전환합니다.
- TypeSafe SDK로 요청을 빌드한 다음 모델이 게임의 모든 움직임을 선택하도록 합니다.
- Gemini가 이미지를 읽는 느린 브랜치와 분류 모델이 루프에서 결정하는 빠른 브랜치를 빌드하고 각 브랜치를 별도로 실행합니다.
- 하나의 이벤트 루프에서 상태를 공유하는 ADK 그래프 워크플로에서 두 브랜치를 모두 조인하여 느린 작업이 빠른 결정을 방해하지 않도록 합니다.
아키텍처
워크벤치는 Cloud Shell(또는 머신)에 있으며 로컬 파일 시스템에 쓰고 아레나, Gemini, 결정 모델과도 상호작용합니다. ② '분류 모델 싸움'에서 결정 모델을 호출하고 ③ '워크플로 싸움'에서 둘 다 호출합니다.
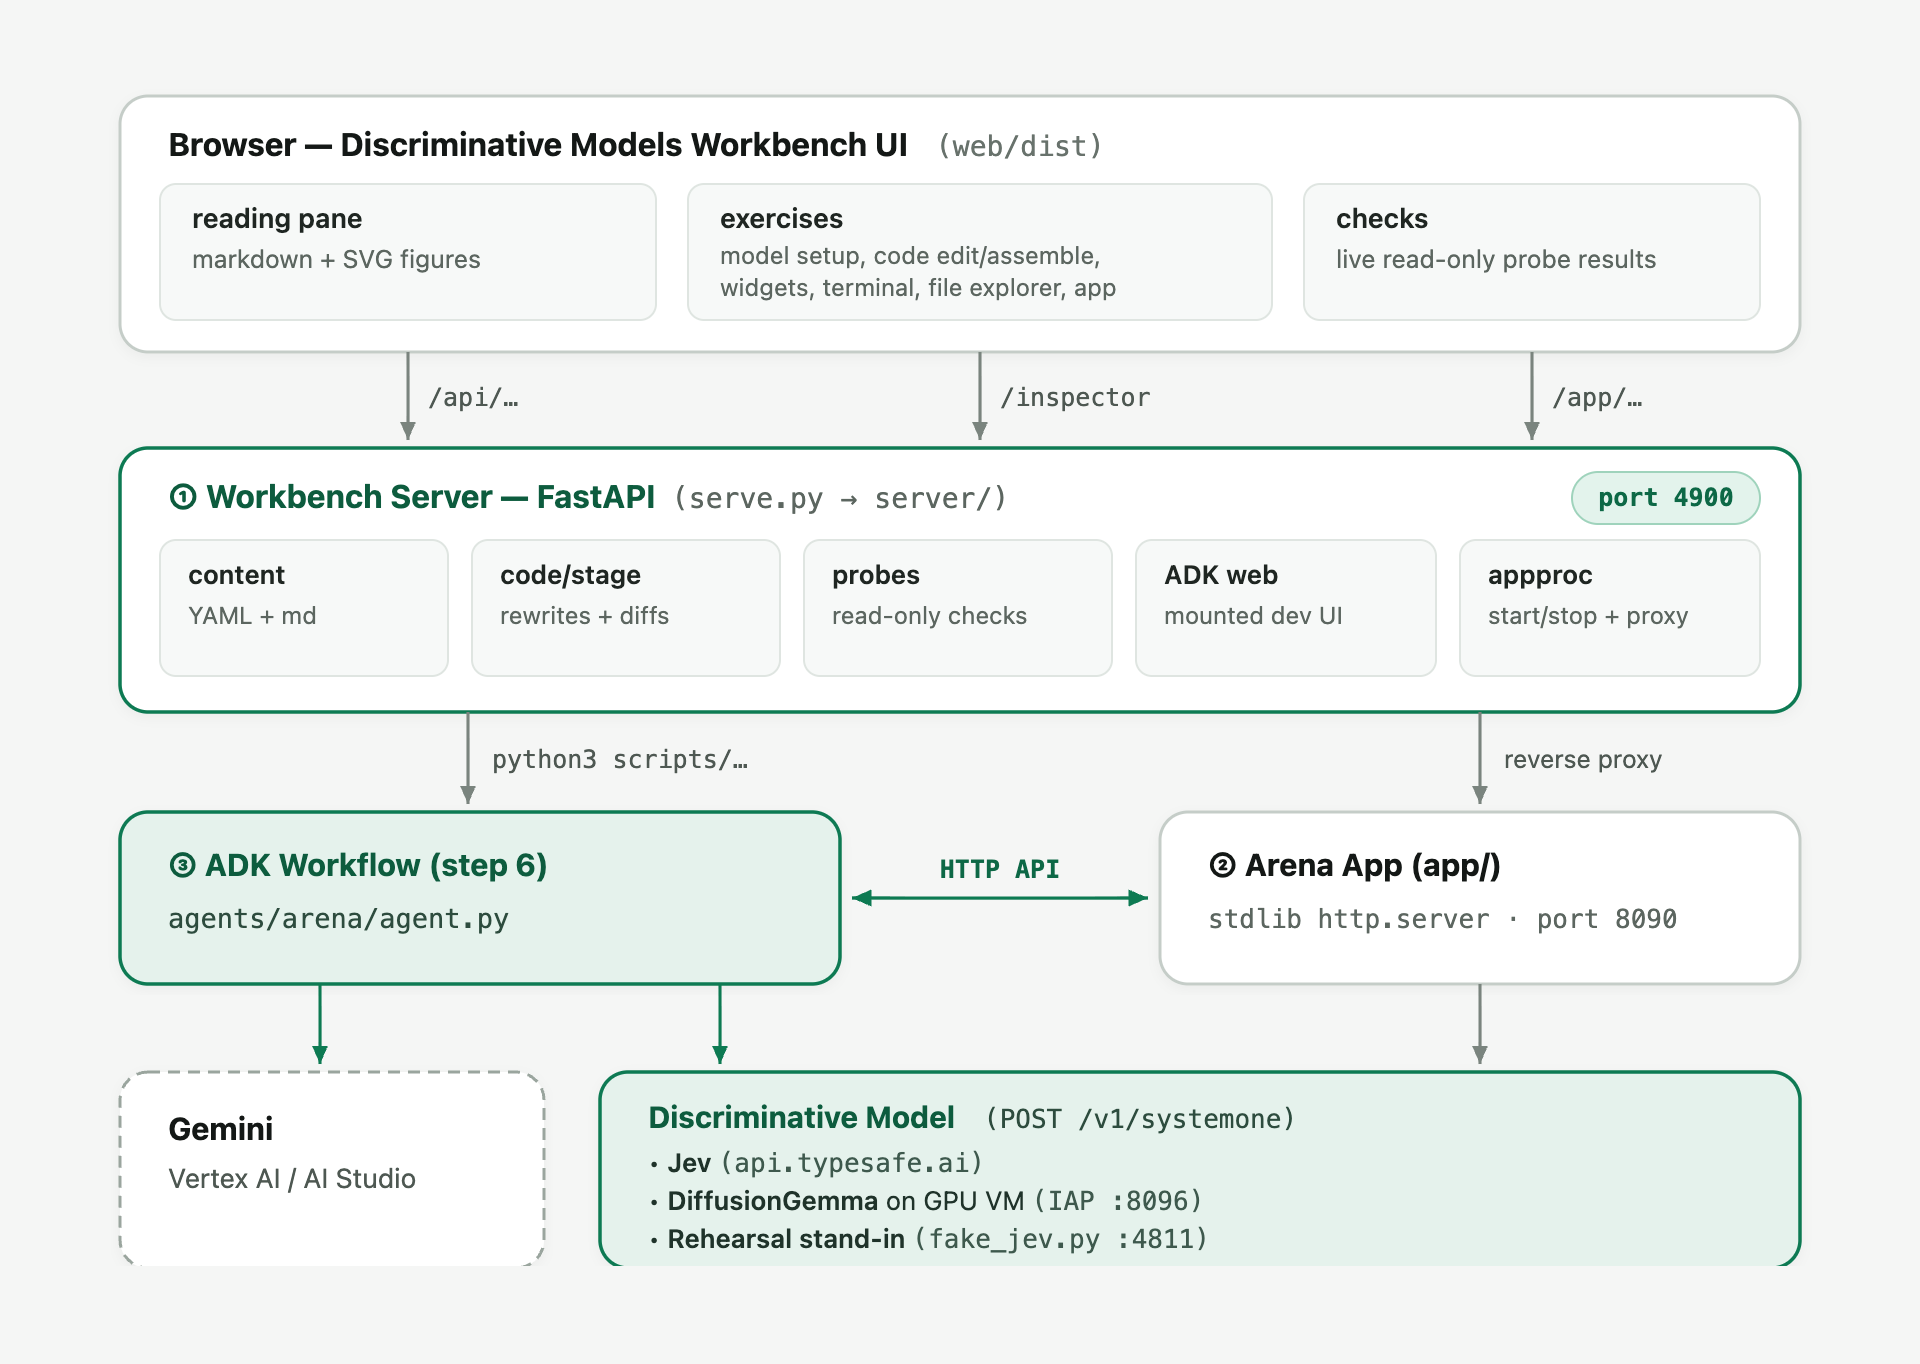
누가 무엇을 호출하는가. 브라우저는 ①과만 통신합니다. 두 모델 모두 머신의 Python에서 호출됩니다.
발신자 | 분류 모델 | Gemini |
② 아레나, '분류 모델 싸움' | 매 틱마다 | 아니요 |
③ 워크플로 | 매 틱마다 | 아니요 |
③ 워크플로 | 아니요 | 주문 카드 이미지, 전투 후 이야기 |
| 예 | 아니요 |
모드당 하나의 틱
- 싸우세요. 페이지에서 ② 전보를 요청하고 2초 타이머와 함께 표시하며 누른 버튼 (또는 입력한 주문)을 다시 게시합니다. ② 해결합니다.
- 분류 모델 싸움 페이지는 ②에 체크 표시를 요청하고, ② 전보를 그리고, 한 번의 호출에서 모델에 세 가지 질문을 하고,
choose()를 실행하고, 답변과 결과를 반환합니다. 페이지에서 막대를 그립니다. - 워크플로 충돌 Start는 ②를 하위 프로세스로 실행합니다 (
runs/arena-workflow.log에 로그인). ③은 전투를 주도합니다. ②에 각 전조를 요청하고, 모델을 호출하고, 결정을 게시합니다. Gemini의 주문은 준비가 되면 자체 브랜치에 도착합니다. 페이지는 ②만 폴링하고 그립니다. 일시중지는 ③이 각 틱 전에 확인하는 ②의 플래그입니다.
결정 모델이 호스팅되는 위치입니다. 모든 호출은 동일한 typesafe-sdk를 거치며 기본 URL만 변경됩니다. scripts/jevauth.py은 백엔드 이름을 지정하고 키와 제한 시간을 설정합니다.
백엔드 |
| 키 | 설정자 |
TypeSafe, 호스팅 | unset (api.typesafe.ai) |
|
|
L4 VM의 DiffusionGemma |
| 없음 |
|
Cloud Run의 DiffusionGemma |
| 시간당 가져온 Google ID 토큰 |
|
리허설 |
| 없음 |
|
주문 카드 대답 ②: 워크플로는 PNG만 가져오고 ②는 다시 전송하는 주문을 판단합니다. 이것이 주문을 Gemini의 읽기 능력을 테스트하는 실제 테스트로 만들고, 'You fight'에서 만드는 주문을 사용자를 테스트하는 실제 테스트로 만듭니다.
2. 설정
워크숍 크레딧 받기
이 세션에 사용할 수 있는 Google Cloud 크레딧이 제공된 경우 먼저 크레딧을 사용하세요. 크레딧을 사용하는 데는 약 1분이 걸리며 결제 계정이 생성됩니다.
Cloud Shell 열기
Google Cloud Shell은 브라우저에서 액세스할 수 있는 Linux 환경으로, gcloud, Python, Node.js, uv, git이 사전 구성되어 있으며 Google 계정으로 이미 인증되어 있습니다.
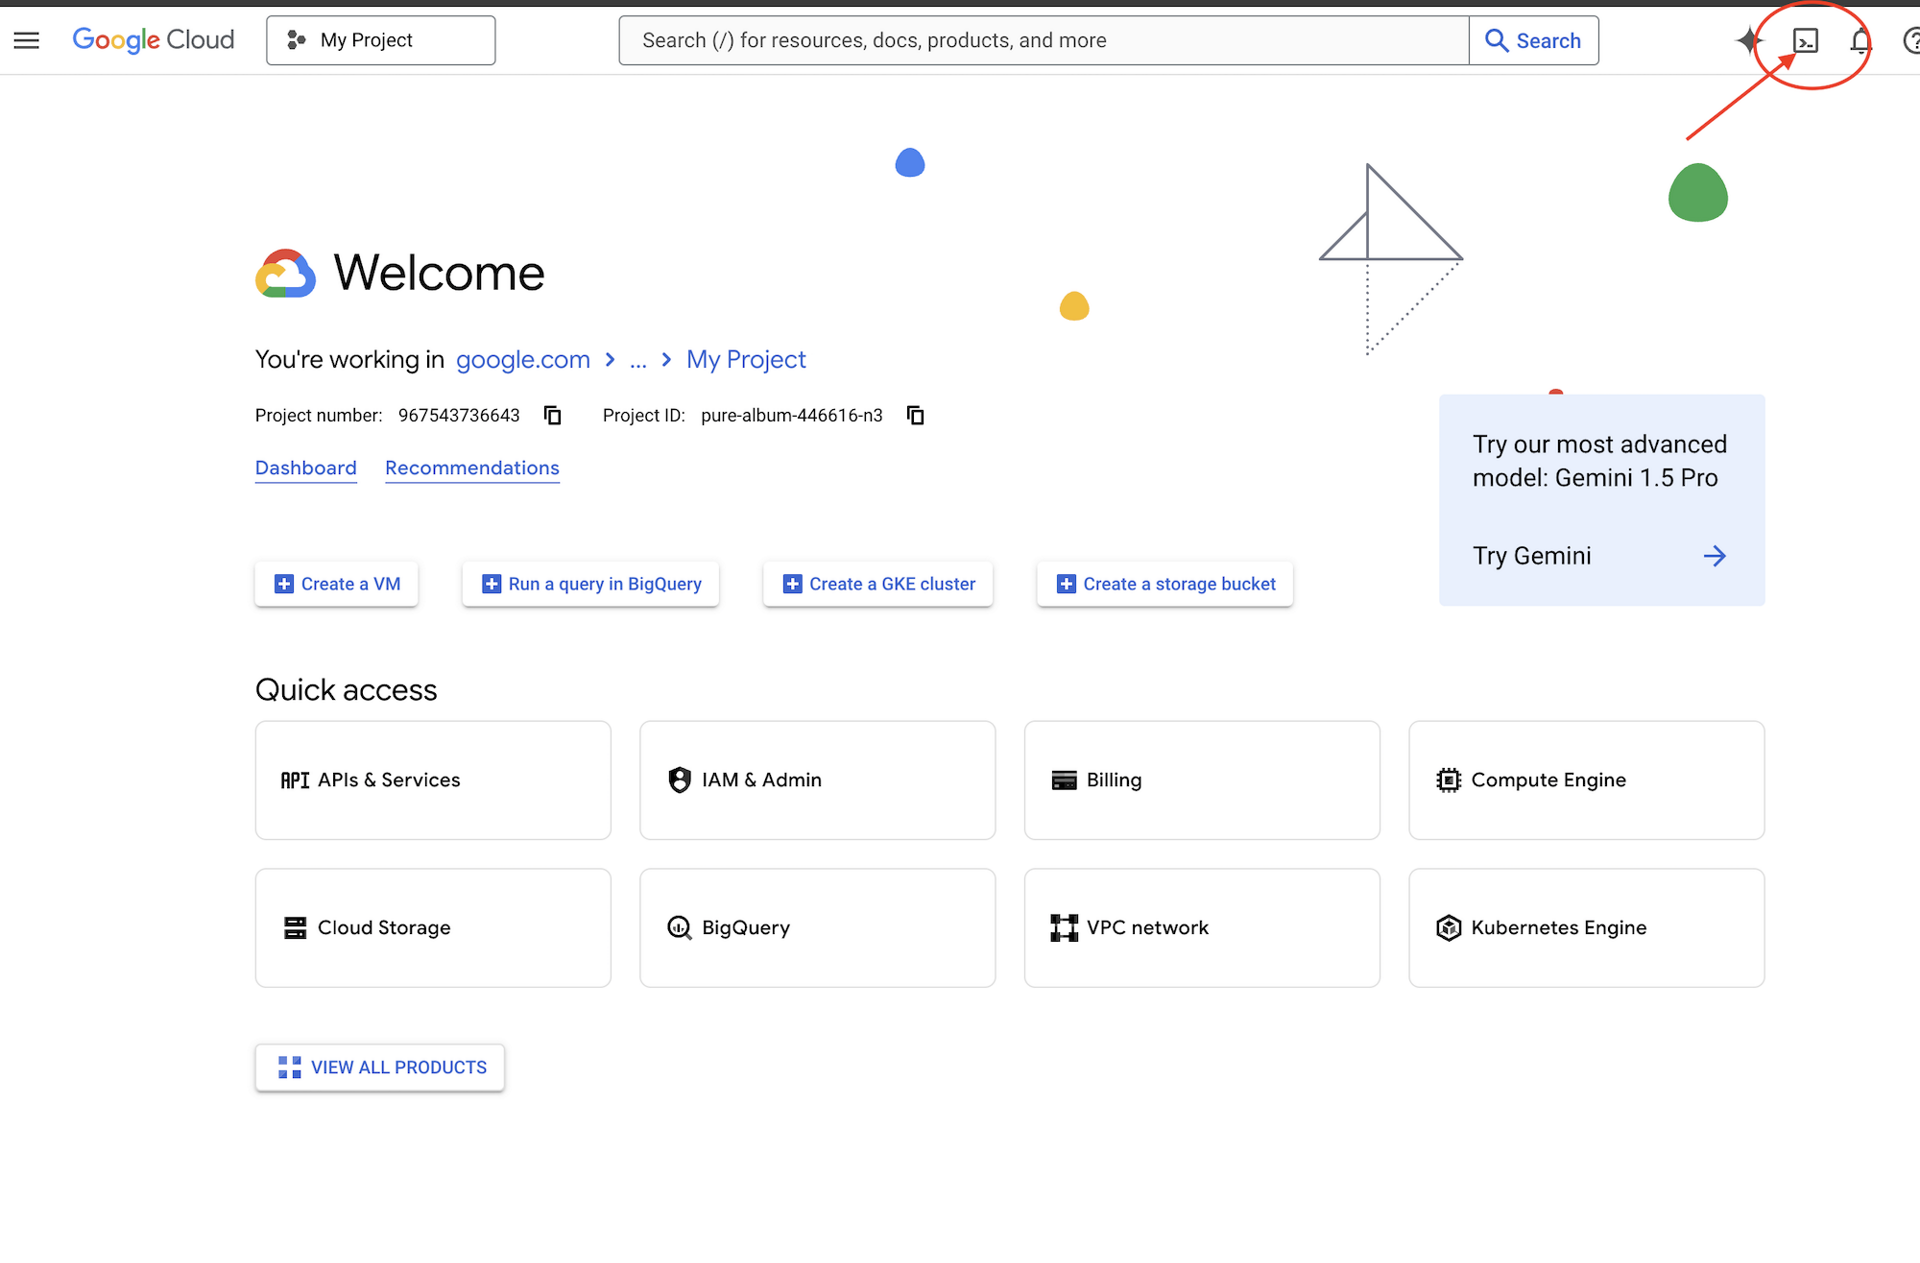
- Google Cloud 콘솔을 엽니다.
- Cloud Shell 활성화 (상단 탐색 메뉴의 터미널 아이콘)를 클릭하여 브라우저 하단에 터미널 세션을 엽니다.
워크벤치 실행
Cloud Shell 또는 gcloud에 로그인한 위치에서 다음을 실행합니다.
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh는 프로젝트 (discrim-models-XXXX)를 만들고, 결제를 연결하며, 이벤트 크레딧 계정이 있는 경우 이를 우선적으로 사용하고, 프로젝트가 제공될 수 있을 때까지 기다립니다. 다시 실행하면 ~/project_id.txt의 프로젝트가 재사용됩니다. 이미 있는 프로젝트를 사용하려면 해당 파일에 ID를 넣고 이 스크립트를 건너뛰세요.
setup_codelab.sh은 아무것도 묻지 않습니다. uv와 Python 패키지를 설치하고, Vertex AI와 Compute Engine, IAP를 사용 설정하고, .env에서 Gemini를 프로젝트의 Vertex AI로 지정하고, 프로젝트에서 호출할 수 있는 모델로 실제 Gemini 호출을 한 번 실행하고, 페이지를 빌드하고, 백그라운드에서 워크벤치를 시작하고, scripts/check_setup.py을 실행합니다. 다시 실행하면 연습 파일이 유지되고 scripts/starter.sh를 사용하면 파일이 재설정됩니다. 결정 모델은 워크벤치의 2단계에서 선택합니다.
Cloud Shell에서 워크벤치 UI를 열려면 다음 단계를 따르세요.
./setup_codelab.sh끝에 인쇄된 미리보기 링크를 클릭하거나 Cloud Shell 툴바의 오른쪽 상단에 있는 웹 미리보기를 클릭합니다.- 포트 변경을 선택하고 4900을 입력한 다음 변경 및 미리보기를 클릭합니다.
Gemini는 프로젝트의 Vertex AI에서 자체 Google 사용자 인증 정보(.env의 GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT, GOOGLE_CLOUD_LOCATION=global)를 사용하여 실행됩니다.
결정 모델은 워크벤치의 2단계에서 또는 scripts/setup_model.sh를 사용하여 터미널에서 자체적으로 선택됩니다.
선택 | 요구사항 | 설정 | 비용 |
분류 모델 (TypeSafe, 호스팅됨) | TypeSafe API 키 | 없음 | 토큰당 센트의 일부 |
DiffusionGemma (Google, 공개 가중치) | 결제 + GPU의 Compute Engine 할당량 | 약 15분, 자동 | VM 실행 시 시간당 약$0.71 |
리허설 (모델 없음) | nothing | 없음 | 없음 |
Compute Engine VM의 DiffusionGemma
scripts/setup_gemma.sh는 먼저 GPU 할당량을 확인한 다음 NVIDIA 드라이버 580이 포함된 Google의 딥 러닝 이미지에서 g2-standard-4 VM (1 × L4 24GB, 4vCPU, 16GB)을 하나 만듭니다. 처음 부팅 시 VM은 Docker를 설치하고, Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17.5GB, 공개, 토큰 없음)에서 가중치를 다운로드하고, djev-run을 실행합니다. 이는 판별 모델의 정확한 API 뒤에 있는 DiffusionGemma입니다. 모델의 포트가 인터넷에 열려 있지 않습니다. 워크벤치는 localhost:8096의 IAP 터널을 통해 모델에 연결되며, scripts/start.sh가 열립니다.
일시중지 / 재개 |
| |
터널 |
| |
삭제 |
| |
명령어 리허설 |
| |
저장소 레이아웃
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. 요약
환경 정리
워크숍을 마친 후 다음 단계를 완료하여 DiffusionGemma GPU 리소스를 해체하고, 백그라운드 워크벤치 및 리허설 프로세스를 중지하고, Cloud Shell에서 워크숍 파일을 삭제하고, 원하는 경우 워크숍 Google Cloud 프로젝트를 삭제합니다.
- DiffusionGemma GPU VM 및 방화벽 규칙 삭제 (생성된 경우): 2단계에서 Compute Engine GPU VM에 DiffusionGemma를 프로비저닝한 경우 VM, 디스크, IAP 방화벽 규칙을 삭제하여 지속적인 컴퓨팅 또는 디스크 스토리지 요금이 발생하지 않도록 합니다.
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Cloud Shell에서 워크벤치 및 리허설 프로세스 중지: Cloud Shell 터미널에서 백그라운드 워크벤치 서버와 리허설 스탠드인 프로세스를 중지합니다.
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Cloud Shell에서 워크숍 폴더 삭제: 홈 디렉터리로 돌아가서 클론된 저장소 폴더와 프로젝트 ID 파일을 삭제합니다.
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Google Cloud 프로젝트 삭제:
./setup_project.sh가 전용 워크숍 프로젝트 (예:discrim-models-XXXX)를 만든 경우 프로젝트를 종료하면 프로젝트 내에 생성된 모든 리소스가 영구적으로 삭제되지만 Cloud Billing 계정은 그대로 유지됩니다.- Google Cloud 콘솔에서 리소스 관리 페이지를 엽니다.
- 리소스 목록에서 워크숍 프로젝트 (예:
discrim-models-...)를 선택합니다. - 상단 툴바에서 삭제를 클릭하고, 프로젝트 ID를 입력하여 확인한 후 종료를 클릭합니다.
이 워크숍을 완료했습니다.
실습 요약
- Compute Engine GPU VM에서 분류 모델(Jev 또는 DiffusionGemma)을 선택하고 답변을 확인했습니다.
- 아레나의 규칙을 익히기 위해 시계를 보며 직접 플레이했습니다.
- 선택, 점수, Noul 질문, 확률, 신뢰도로 판별 모델이 답변하는 방법과 코드가 여기에 기준점을 적용하는 방법을 학습했습니다.
- 첫 번째 요청을 보낸 다음 모델이 경기장에서 모든 움직임을 선택하도록 하고
choose()가 답변을 행동으로 전환하도록 합니다. - Gemini가 주문 카드 이미지를 읽고 모델이 루프에서 결정하는 방식으로 ADK 워크플로의 각 브랜치를 자체적으로 빌드했습니다.
- 상태를 공유하는 하나의 워크플로에 결합하여 전투가 Gemini를 기다리지 않고 오프닝에서 주문이 시전됩니다.
대화에서 결정까지
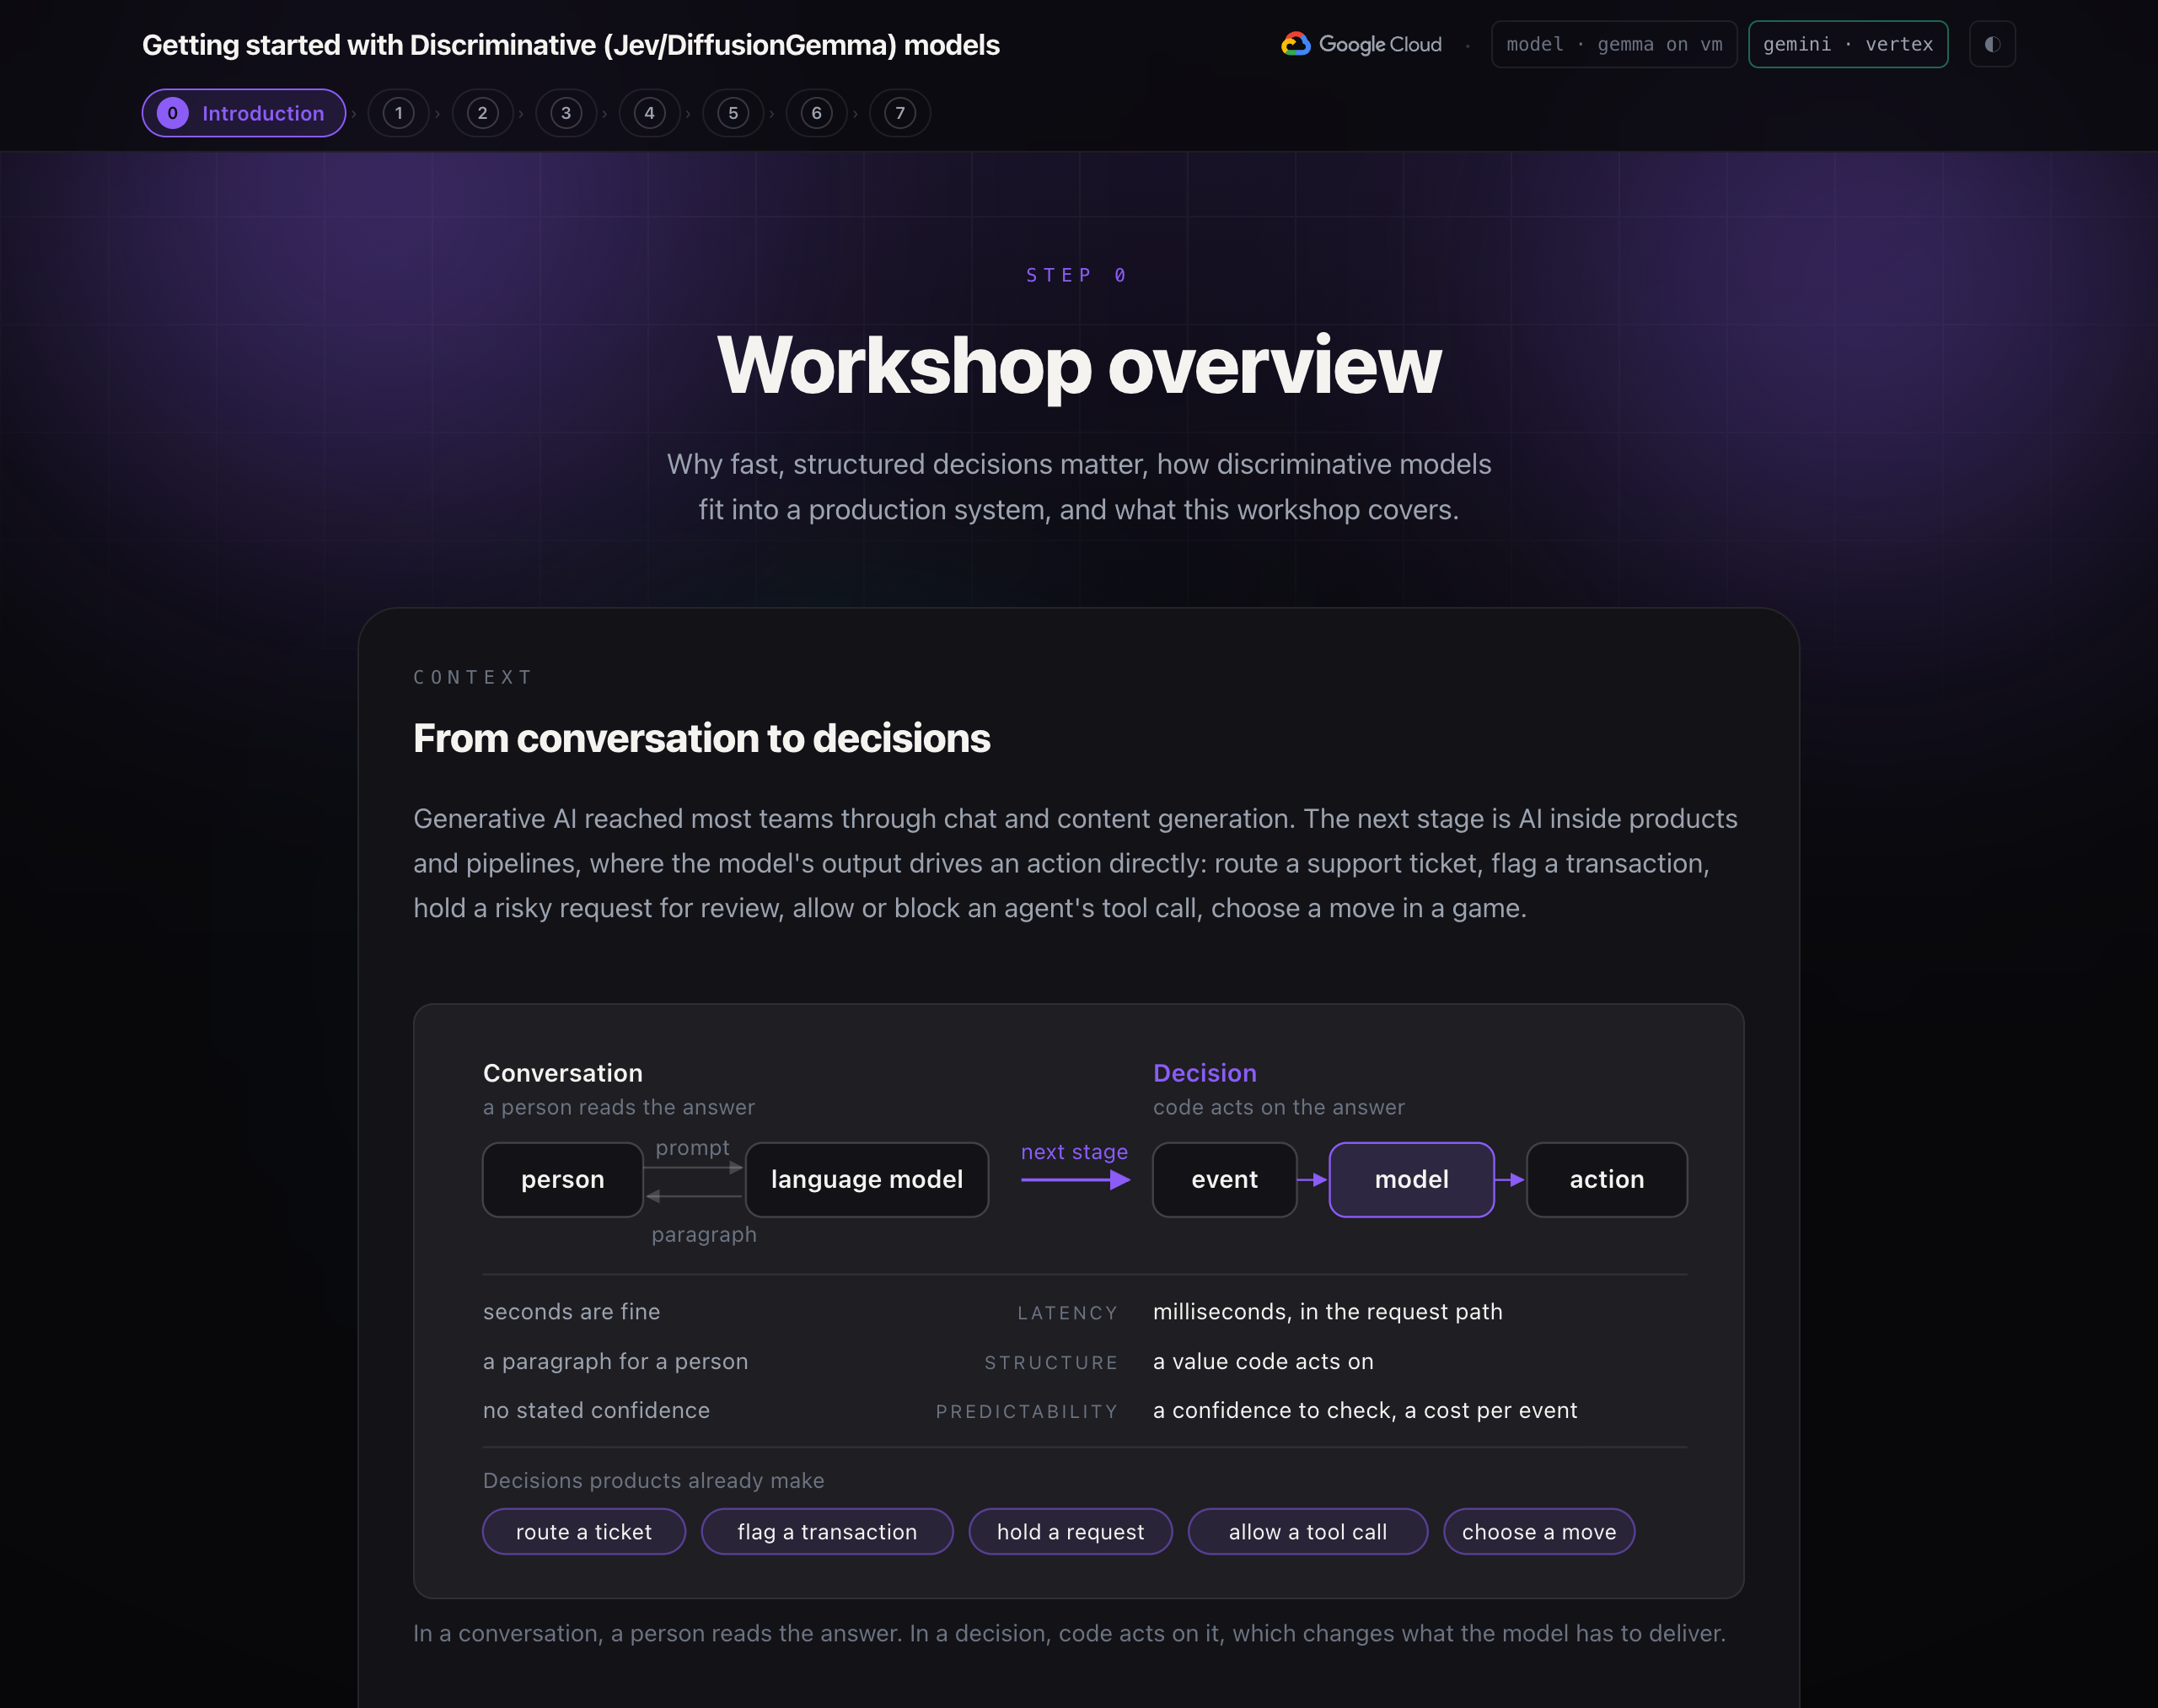
생성형 AI는 채팅과 콘텐츠 생성을 통해 대부분의 팀에 도달했습니다. 다음 단계는 제품 및 파이프라인 내 AI로, 모델의 출력이 지원 티켓 라우팅, 거래 신고, 위험한 요청 검토 보류, 상담사의 도구 호출 허용 또는 차단, 게임에서의 이동 선택과 같은 작업을 직접 실행합니다.
이러한 결정에는 채팅에 없는 세 가지 요구사항이 있습니다.
- 지연 시간. 답변은 사용자의 요청 경로 또는 실시간 루프에 있는 경우가 많으므로 초가 아닌 밀리초 단위로 도착해야 합니다.
- 구조 호출자는 코드이므로 대답은 파싱해야 하는 단락이 아닌 조치를 취할 수 있는 값이어야 합니다.
- 예측 가능성.. 모든 결정에는 코드가 확인할 수 있는 신뢰도와 모든 이벤트에서 요청할 수 있을 만큼 낮은 비용이 필요합니다.
언어 모델은 한 번에 하나의 토큰을 생성합니다. 예 또는 아니오로 프롬프트할 수 있지만 실시간 루프에는 느리고 출력을 파싱해야 하며 얼마나 확신하는지 보고하지 않습니다.
결정을 위해 구축된 모델
분류 모델은 허용된 각 옵션의 확률을 사용하여 단일 패스에서 입력된 질문에 답변합니다. 텍스트를 생성하지 않습니다. 이 워크숍에서는 두 가지 실행 옵션을 제공합니다.
모델 | 제공업체 | 이 워크숍에서 모델이 실행되는 위치 |
Jev | TypeSafe AI | API 키로 호출되는 TypeSafe의 호스팅 서비스 |
DiffusionGemma | Google, 오픈 웨이트 | 자체 Google Cloud 프로젝트의 GPU VM에서 자체 호스팅 |
필요에 따라 모델을 교체할 수 있으며, 모델에 연결되는 코드는 변경하지 않아도 됩니다.
구성요소 결합
성공적인 시스템은 여러 구성요소로 구성됩니다.
구성요소 | 역할 | 이 워크숍에서는 |
워크플로 | 단계를 조정하고, 브랜치를 병렬로 실행하고, 공유 상태를 유지합니다. | ADK 그래프 워크플로 |
결정론적 코드 | 규칙, 기준점, 검증 즉각적이고 무료이며 감사 가능 | 게임 규칙, |
분류 모델 | 신뢰도 점수를 사용한 빠르고 제한된 의사 결정 | 매 틱마다 응답 선택 |
언어 모델 | 인식 및 생성: 이미지 및 개방형 텍스트 | Gemini가 주문 카드 이미지를 읽고 주문을 작성합니다. |
모델 서빙 아키텍처
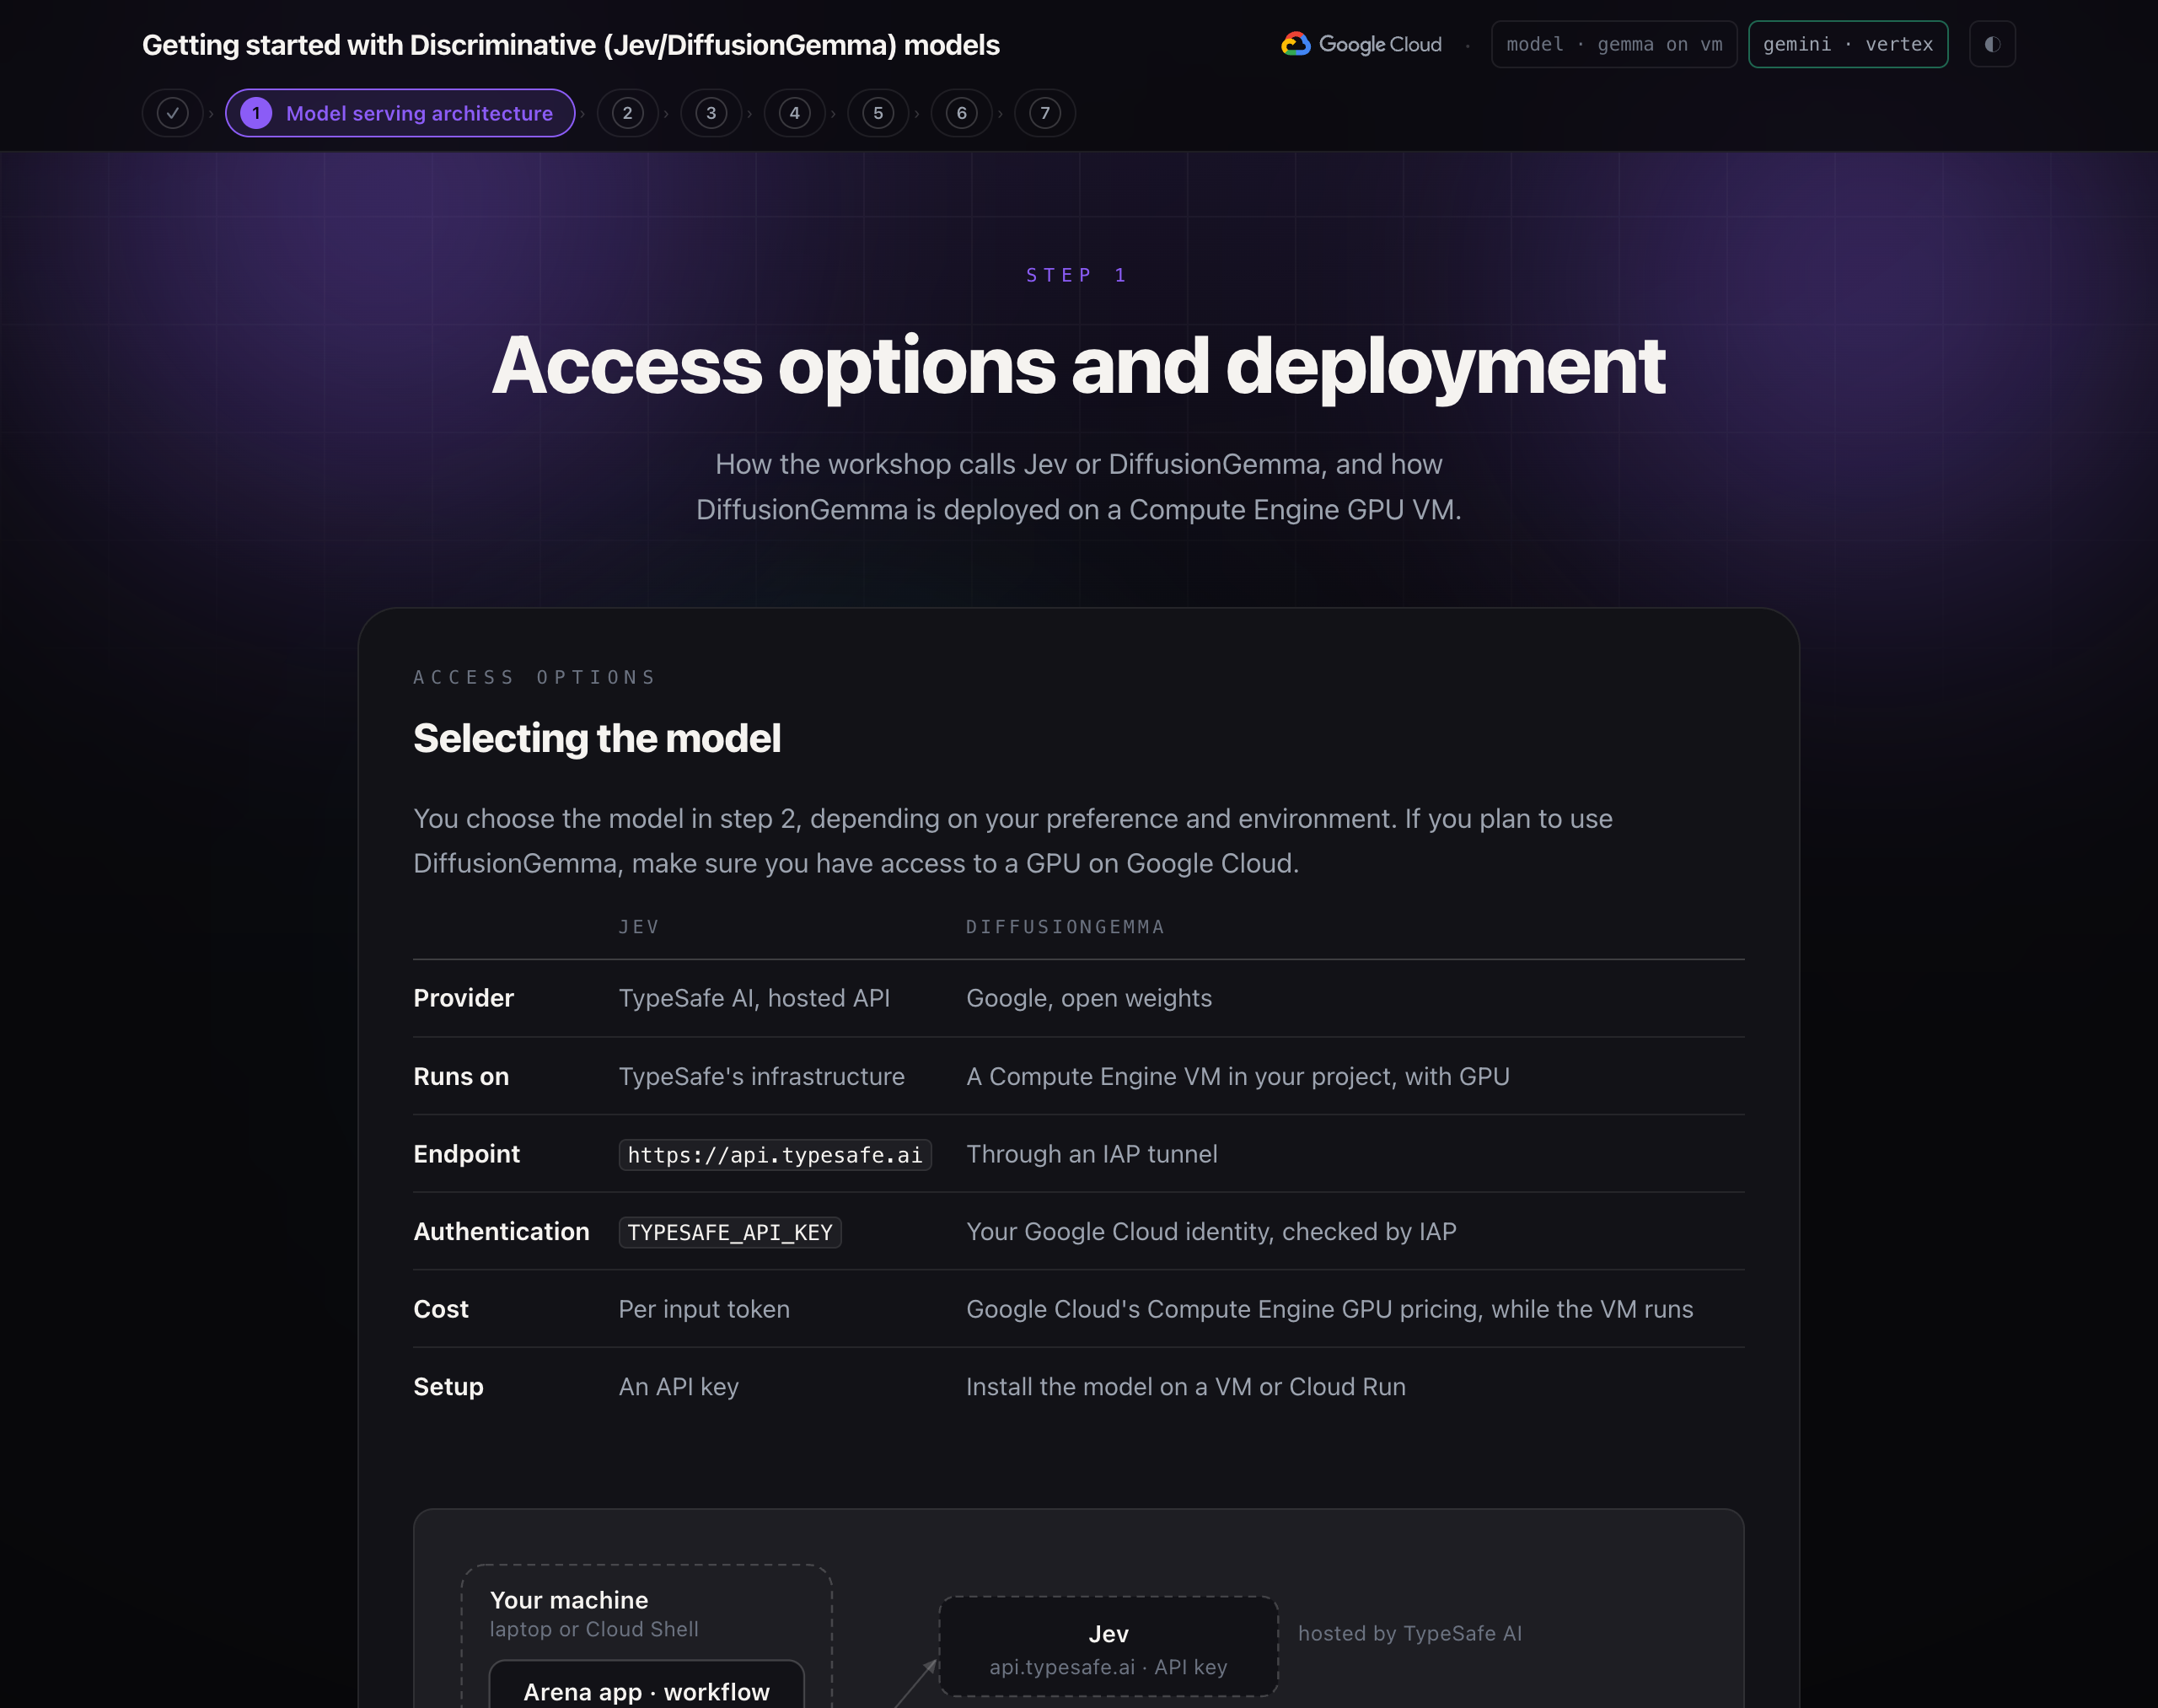
선호도와 환경에 따라 2단계에서 모델을 선택합니다. DiffusionGemma를 사용하려면 Google Cloud에서 GPU에 액세스할 수 있어야 합니다.
Jev | DiffusionGemma | |
프로바이더 | TypeSafe AI, 호스팅 API | Google, 오픈 웨이트 |
실행 | TypeSafe의 인프라 | GPU가 있는 프로젝트의 Compute Engine VM |
엔드포인트 |
| IAP 터널을 통해 |
인증 |
| IAP에서 확인한 Google Cloud ID |
비용 | 입력 토큰당 | VM이 실행되는 동안의 Google Cloud Compute Engine GPU 가격 책정 |
설정 | API 키 | VM 또는 Cloud Run에 모델 설치 |
데이터 흐름
- 아레나 앱 또는 ADK 워크플로가 상태 (상대가 한 일)와 세 가지 질문으로 구성된 요청을 빌드합니다.
- TypeSafe SDK는 이를 구성된 기본 URL로
POST /v1/systemone로 전송합니다. - Jev의 경우 요청은 HTTPS를 통해
api.typesafe.ai로 전송되며 API 키는 베어러 토큰으로 사용됩니다. - DiffusionGemma의 경우 요청이
localhost:8096로 전송됩니다. 백그라운드gcloud compute start-iap-tunnel프로세스는 Google ID를 확인하는 IAP(Identity-Aware Proxy)를 통해 VM의 포트 8080으로 전달합니다. - VM에서 djev-run은 요청을 수신하고, GPU에서 vLLM을 통해 DiffusionGemma를 실행하고, 허용된 각 옵션의 확률을 읽습니다.
- 두 백엔드 모두 질문당 답변, 확률, 신뢰도 점수가 포함된 동일한 응답을 반환합니다. 워크숍 코드가 기준을 적용하고 조치를 취합니다.
Compute Engine의 DiffusionGemma
scripts/setup_gemma.sh는 프로젝트에서 다음을 빌드합니다.
- 리전에 GPU 할당량이 있는지 확인합니다.
- Compute Engine 및 IAP API를 사용 설정하고 방화벽 규칙
allow-iap-djev를 만듭니다. 포트 22 및 8080에서 IAP 주소 범위만 허용합니다. - VM
djev-l4생성: 머신 유형g2-standard-4(vCPU 4개, 메모리 16GB), 24GB GPU, 100GB 디스크, NVIDIA 드라이버 580이 포함된 Deep Learning VM 이미지 영역에 GPU 용량이 없으면 다음 영역을 시도합니다. - 처음 부팅 시 VM의 시작 스크립트는 Docker 및 NVIDIA Container Toolkit을 설치하고, djev-run 컨테이너 이미지를 가져오고, Hugging Face에서 가중치를 다운로드 (17.5GB)하고, 포트 8080에서 GPU 액세스 권한으로 컨테이너를 시작합니다. 15분 정도 걸립니다. 나중에 부팅하는 데는 약 2분이 걸립니다.
- 연결 설정을
.env에 쓰고 터널을 엽니다.
작업 | 명령어 |
VM 중지 (디스크 유지) |
|
다시 시작해 줘. |
|
터널 확인 |
|
모두 삭제 |
|
모델 설정
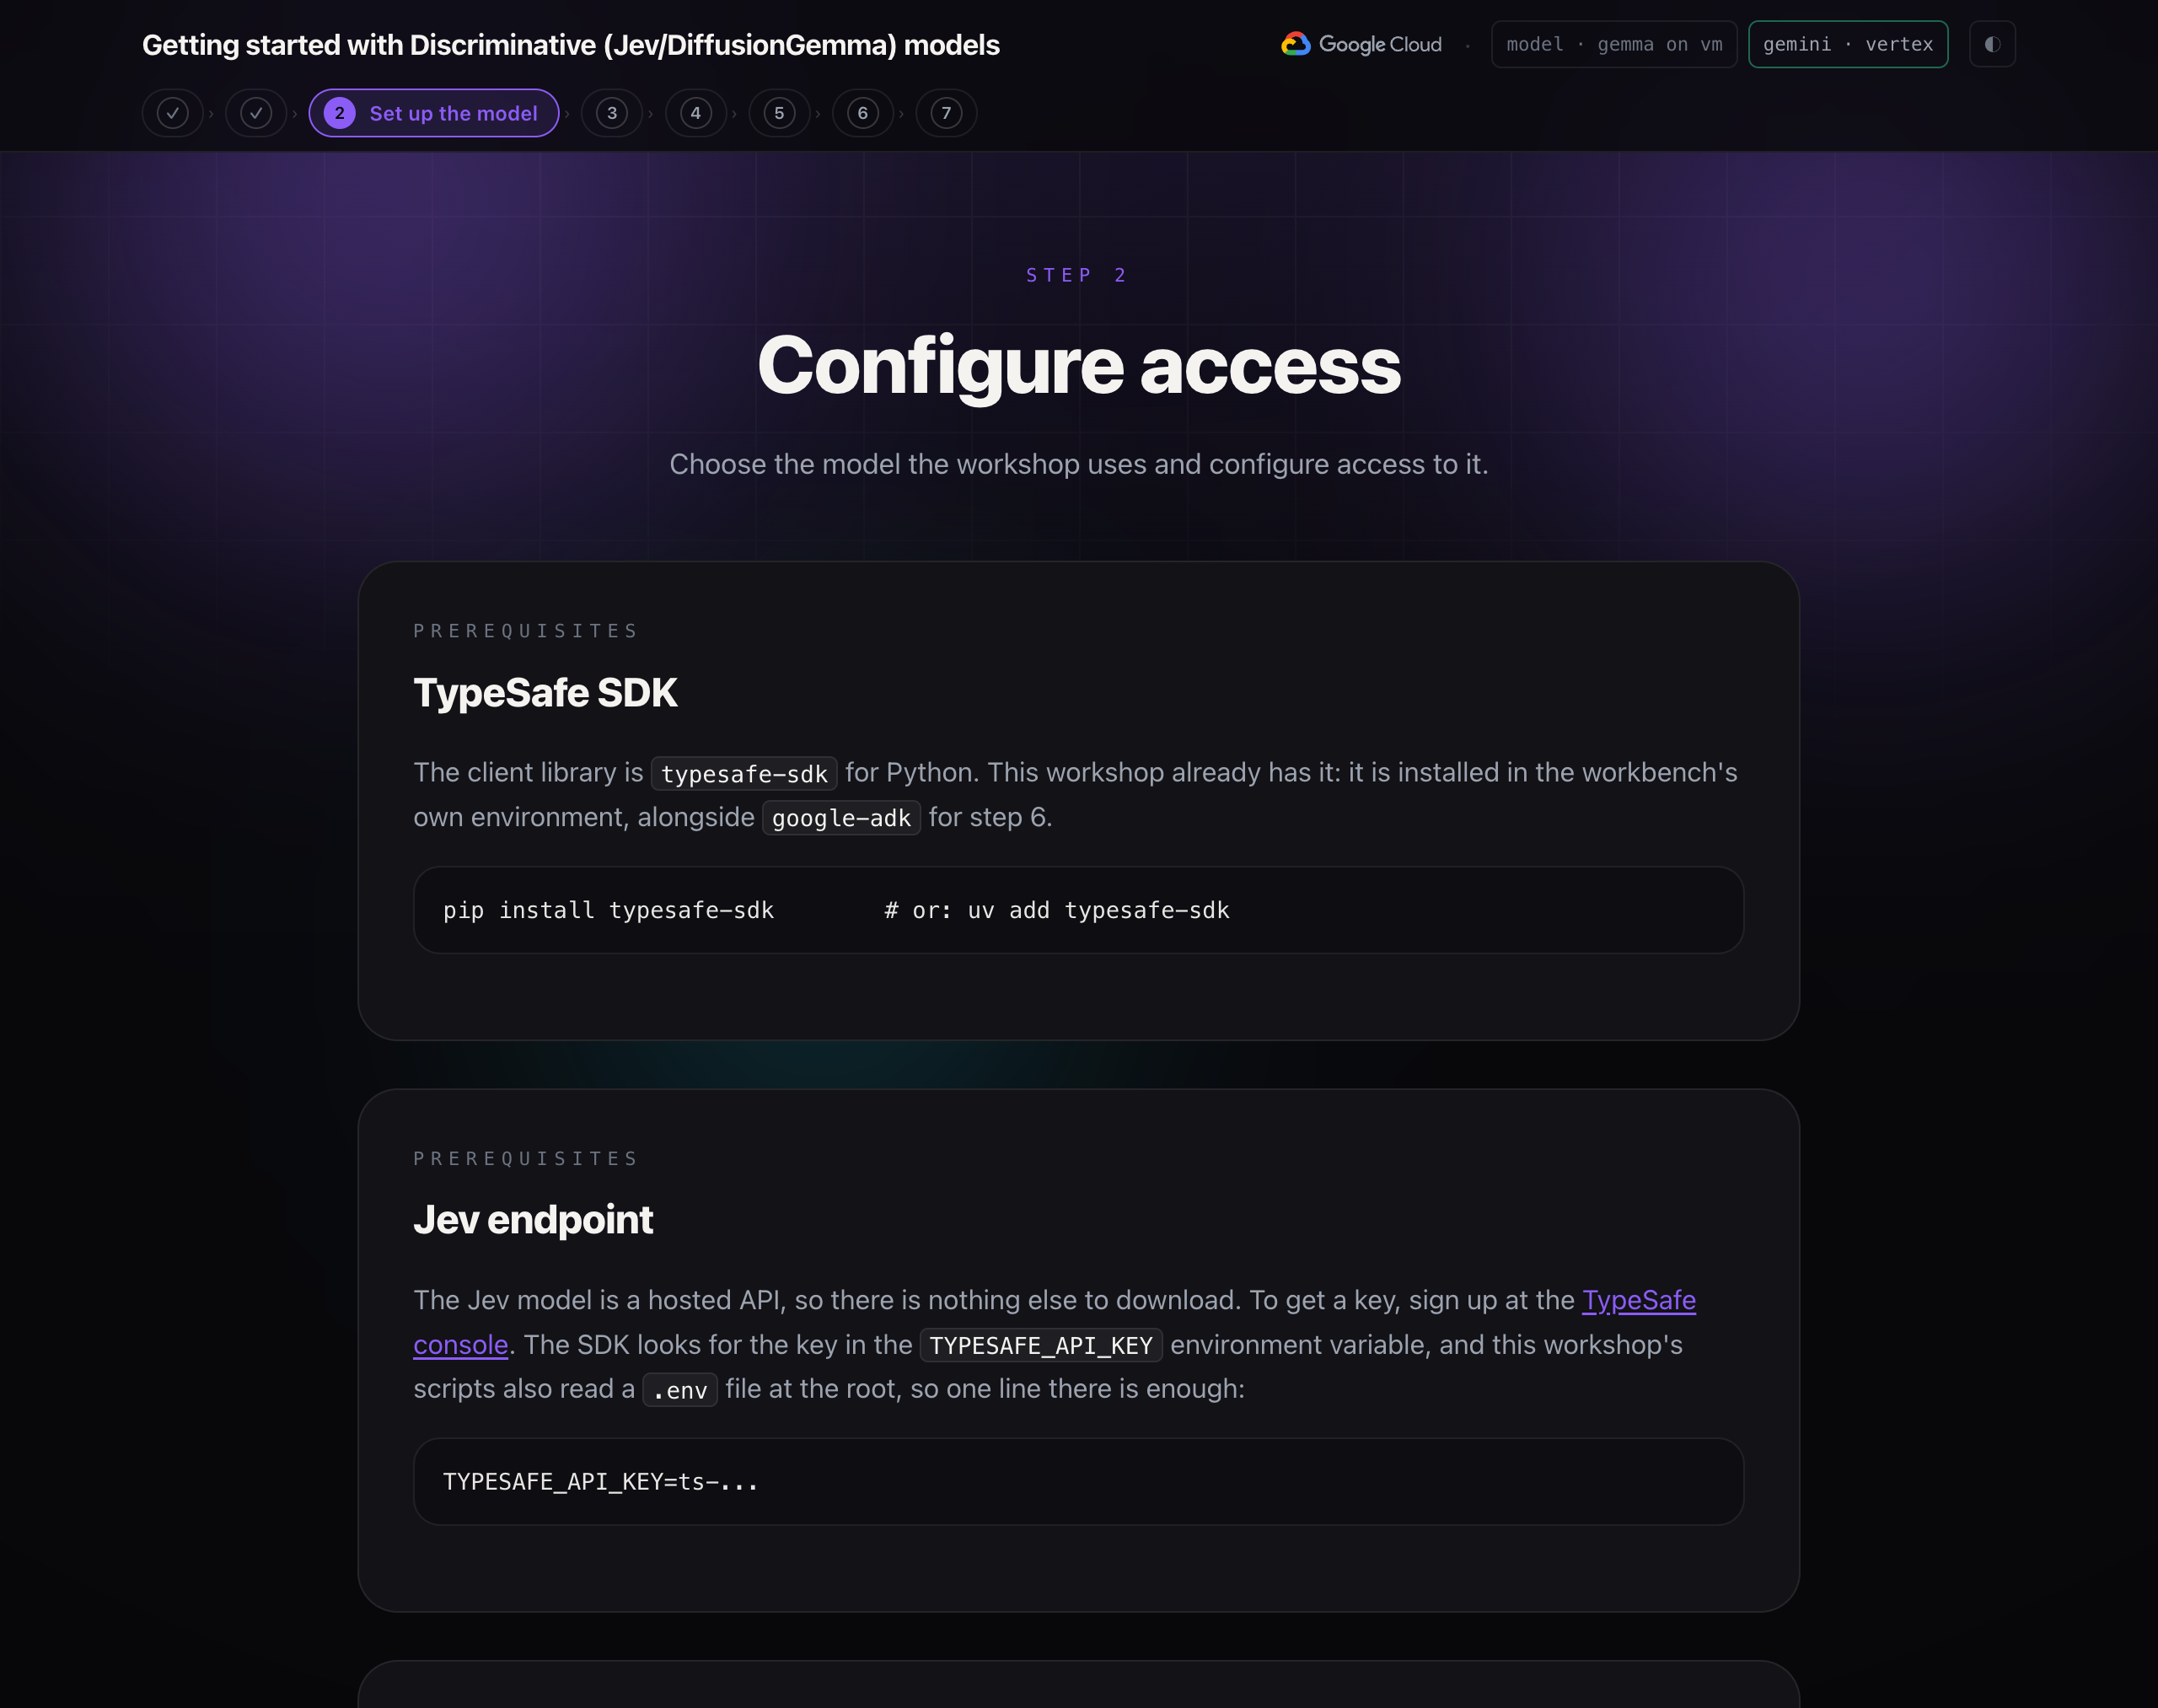
TypeSafe SDK
클라이언트 라이브러리는 Python용 typesafe-sdk입니다. 이 워크숍에는 이미 설치되어 있습니다. 6단계의 google-adk와 함께 워크벤치의 자체 환경에 설치되어 있습니다.
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev 엔드포인트
Jev 모델은 호스팅 API이므로 다른 것을 다운로드할 필요가 없습니다. 키를 받으려면 TypeSafe 콘솔에서 가입하세요. SDK는 TYPESAFE_API_KEY 환경 변수에서 키를 찾고 이 워크숍의 스크립트도 루트에서 .env 파일을 읽으므로 한 줄이면 충분합니다.
TYPESAFE_API_KEY=ts-...
DiffusionGemma 사용
djev-run은 판별 모델의 API를 재구현합니다. Google DeepMind의 개방형 확산 모델인 DiffusionGemma (총 매개변수 260억 개, 활성 매개변수 약 40억 개, Apache 2.0)에서 동일한 noul, 선택, 점수 질문과 함께 동일한 POST /v1/systemone 엔드포인트를 제공합니다. 와이어 형식이 동일하므로 TypeSafe SDK는 변경되지 않은 상태로 통신합니다.
실습에서 DiffusionGemma를 선택하면 자체 Google Cloud 프로젝트의 VM에 있는 GPU에서 실행되며 오른쪽 상단의 필에 gemma on vm이 표시됩니다. 워크벤치는 비공개 IAP 터널을 통해 모델에 연결하며 모델의 포트는 인터넷에 열려 있지 않습니다. 1단계에서는 전체 아키텍처를 설명합니다.
확산 모델이 이를 수행할 수 있는 이유: 모든 위치가 전체 입력을 확인하여 허용된 각 옵션의 확률을 한 단계로 읽을 수 있으므로 한 번에 전체 위치 블록을 채웁니다. 일반적인 언어 모델은 한 번에 하나의 토큰을 생성하므로 반복적으로 샘플링해야 합니다.
수동으로 게임 플레이
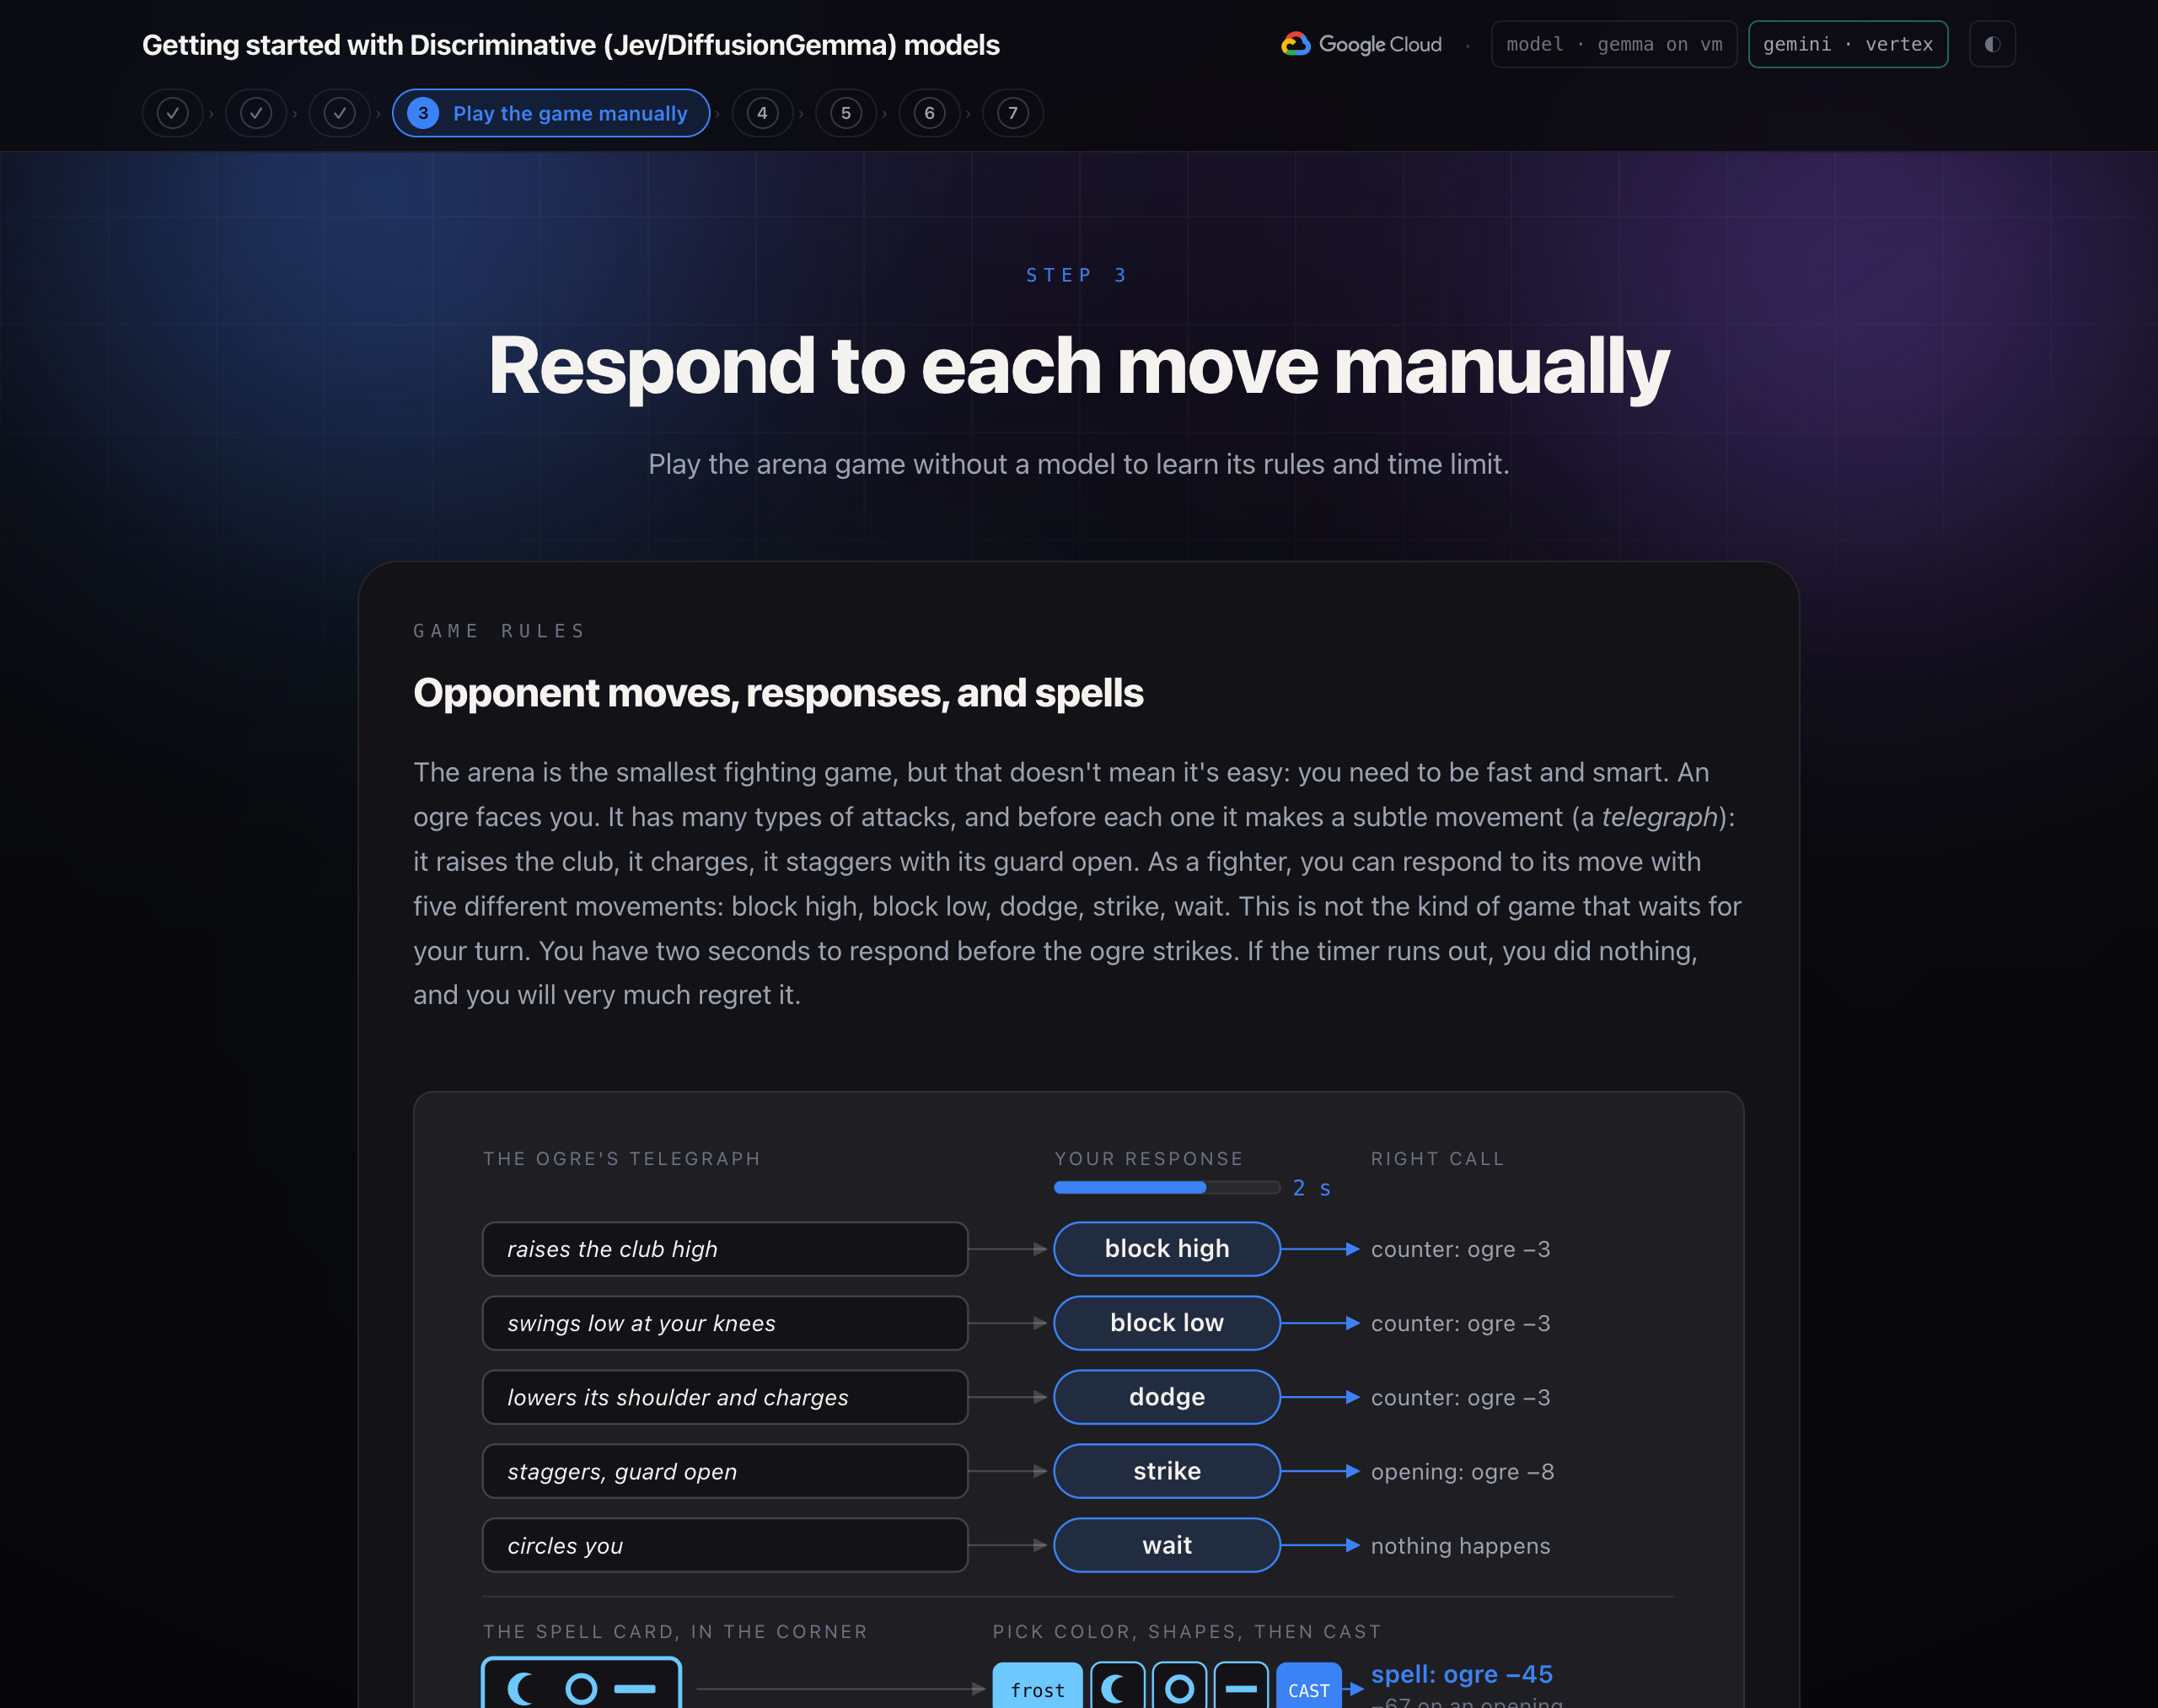
아레나는 가장 작은 격투 게임이지만 쉽다는 의미는 아닙니다. 빠르고 똑똑해야 합니다. 오우거가 당신을 마주하고 있습니다. 다양한 유형의 공격을 하며, 각 공격 전에 미묘한 움직임 (텔레그래프)을 보입니다. 클럽을 들어 올리거나, 돌진하거나, 가드를 열고 비틀거립니다. 격투가로서 상대의 움직임에 대해 상단 방어, 하단 방어, 회피, 공격, 대기 등 다섯 가지 움직임으로 대응할 수 있습니다. 이 게임은 내 차례를 기다리는 게임이 아닙니다. 오우거가 공격하기 전에 2초 안에 대답해야 합니다. 타이머가 만료되면 아무것도 하지 않은 것이므로 매우 후회하게 될 것입니다.
링의 왼쪽 상단에는 주문 카드가 있습니다. 세 가지 모양이 있는 컬러 카드입니다. 이 속성과 일치하는 주문만 실제 피해를 입힙니다. 게임에서 전투 아래에 있는 버튼으로 주문을 걸 수 있습니다. 카드의 색상을 선택한 다음 왼쪽에서 오른쪽으로 모양을 선택하고 주문을 누릅니다. 선택하는 동안 시계가 계속 작동하므로 주문을 만들고 오우거의 공격에 동시에 반응해야 합니다. 1~5번 키는 여전히 각 이동에 응답합니다. 잘못된 주문은 실패합니다. 6단계에서 Gemini가 주문 카드를 읽어 줍니다.
핵심 내용: 격투는 각각 기한이 있는 작은 결정의 흐름입니다. 이것이 대부분의 소프트웨어 자동화의 실제 모습입니다(클럽 제외).
분류 모델 개념
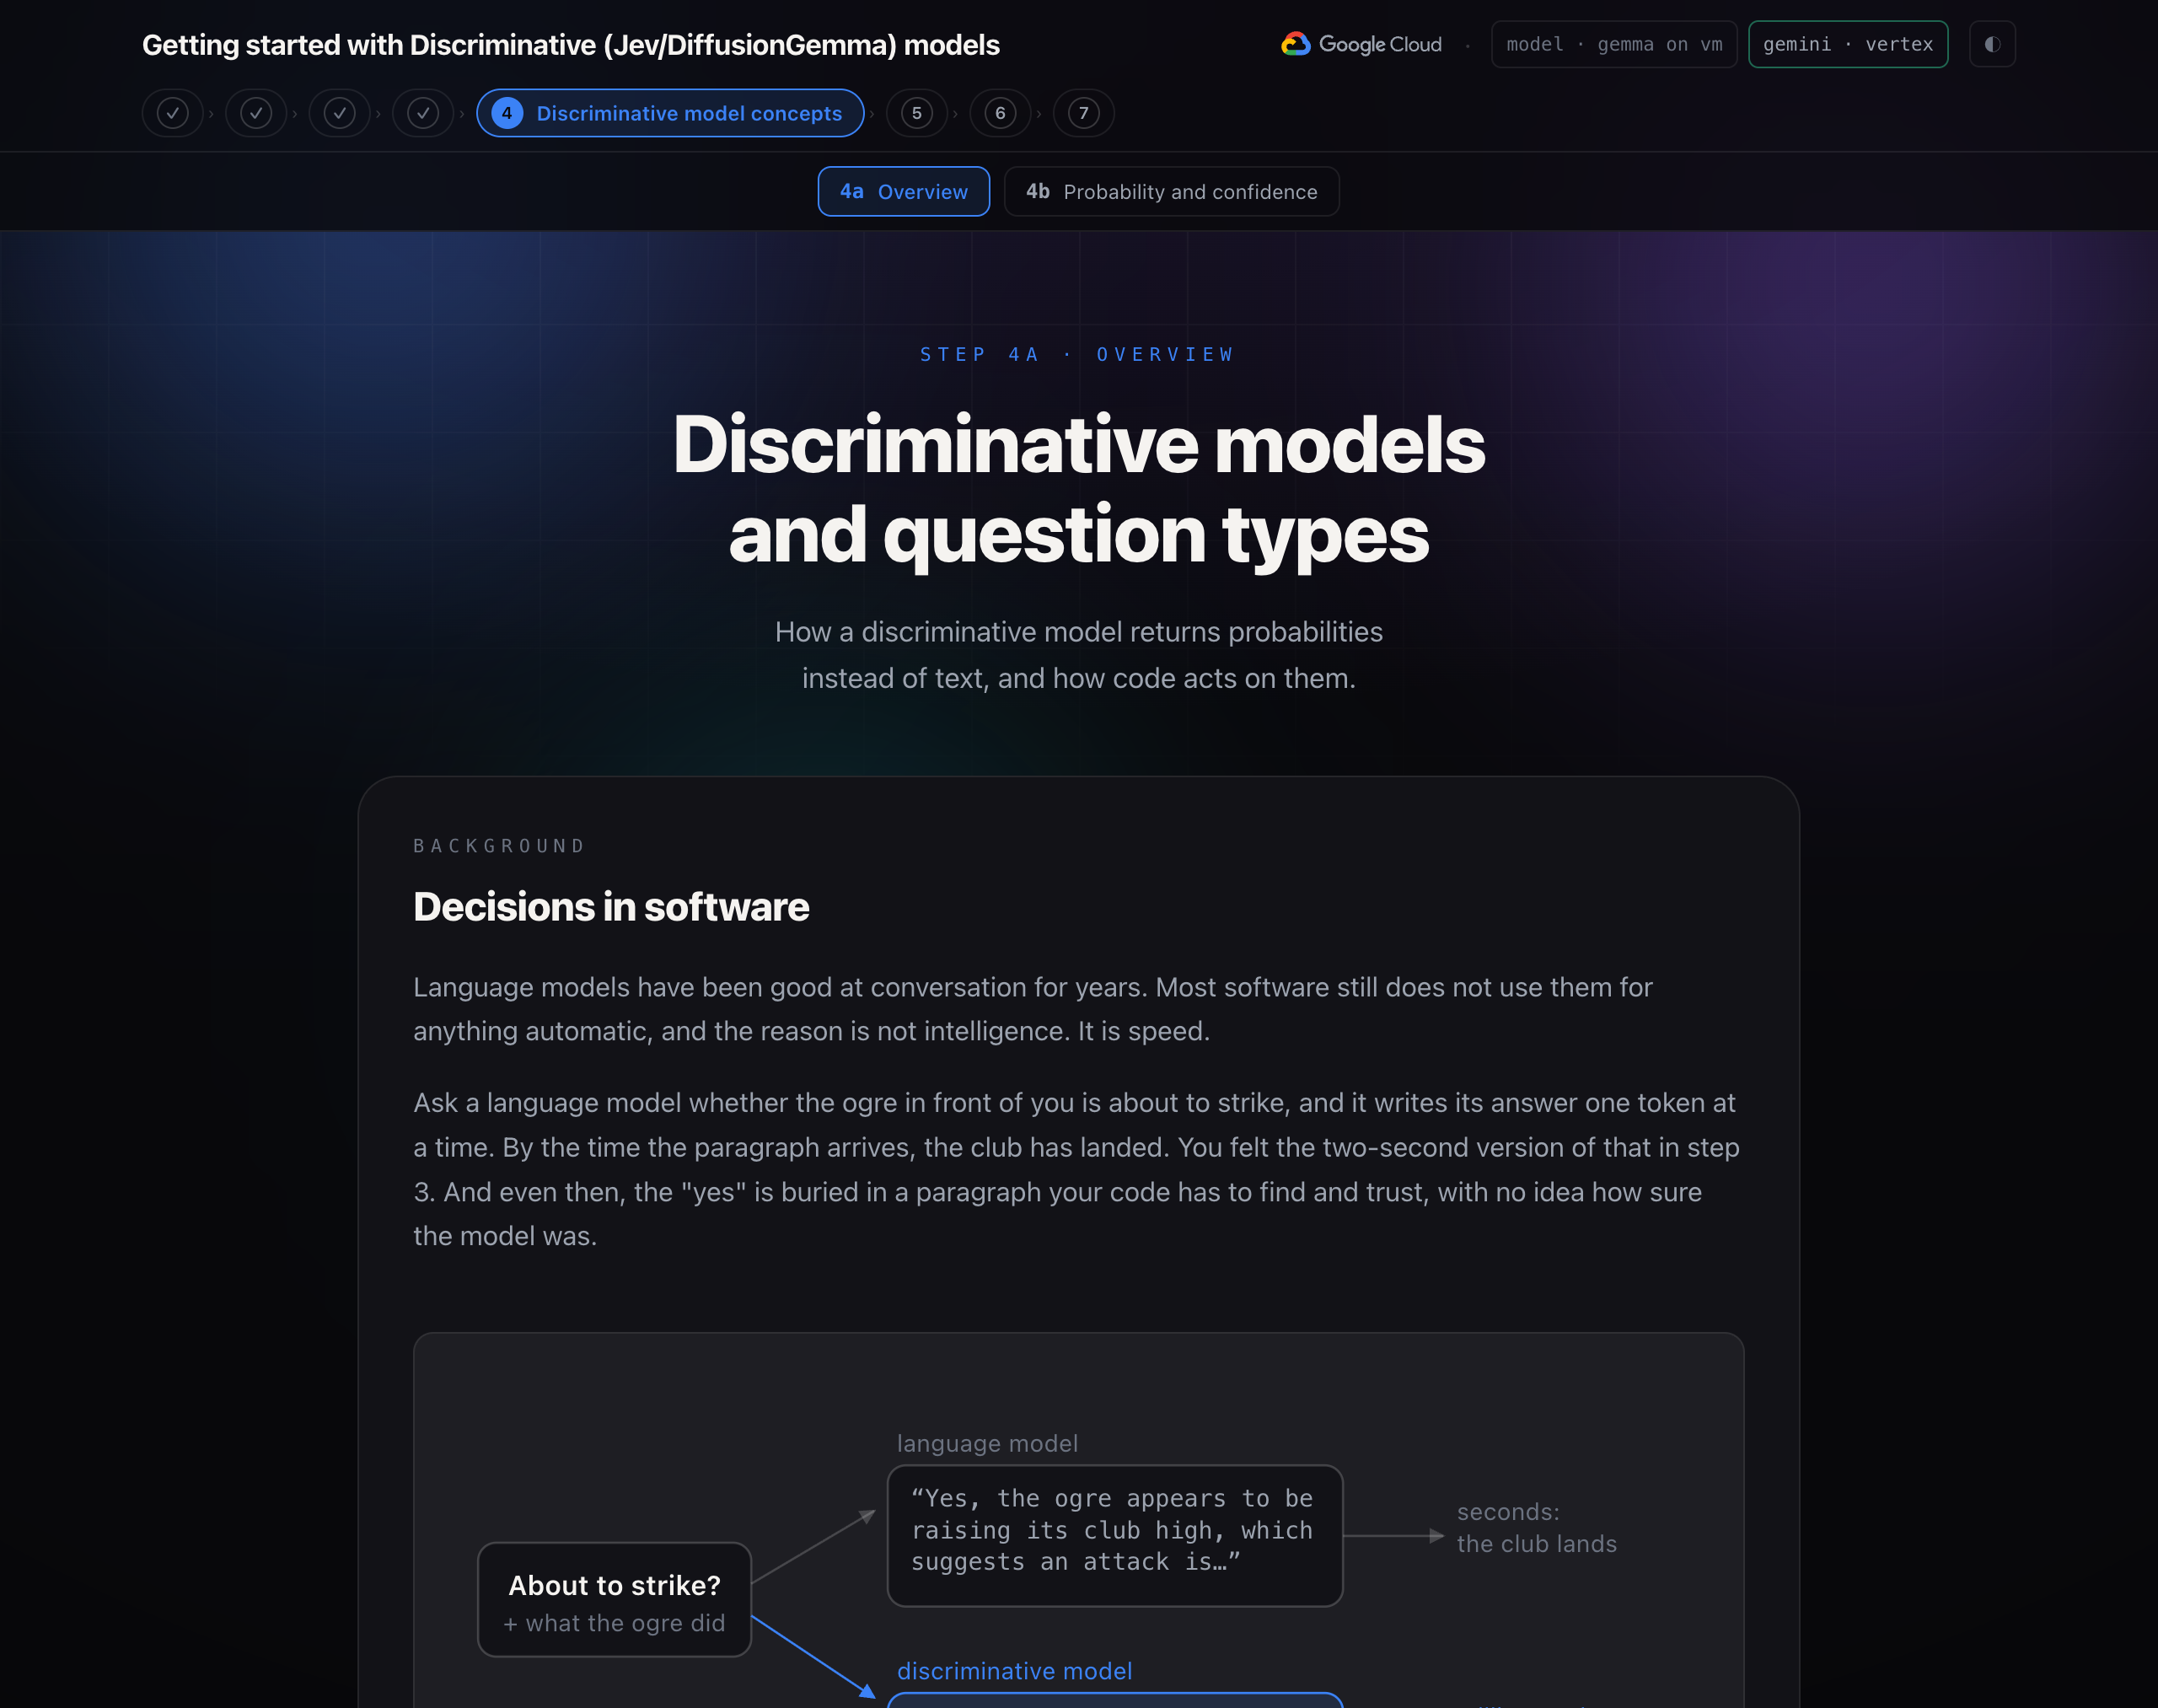
소프트웨어의 결정
언어 모델은 수년 동안 대화에 능숙했습니다. 대부분의 소프트웨어는 여전히 자동화된 작업에 이를 사용하지 않으며, 그 이유는 지능이 아닙니다. 속도입니다.
내 앞에 있는 오우거가 공격하려고 하는지 언어 모델에 물어보면 모델은 한 번에 하나의 토큰씩 답변을 작성합니다. 단락이 도착할 때쯤이면 클럽이 착륙합니다. 3단계에서 2초 버전의 음악을 들었습니다. 이 경우에도 '예'는 코드가 찾아 신뢰해야 하는 단락에 숨겨져 있으며 모델이 얼마나 확신했는지 알 수 없습니다.
분류 모델은 상태와 입력된 질문 및 답변을 한 번에 밀리초 단위로 가져옵니다. 각 대답에는 보정된 확률이 표시됩니다. 0.9는 10번 중 9번이 맞다는 의미입니다. 파싱할 텍스트가 없고 JSON을 추출할 수 없습니다.
시스템 1 및 시스템 2 모델
이 이름은 다니엘 카너먼의 생각에 관한 생각에서 따왔습니다. 시스템 2는 느리고 신중한 추론으로, 한 단계씩 진행됩니다. 시스템 1은 빠르고 패턴 매칭입니다.
언어 모델은 시스템 2 기계입니다. 한 번에 하나의 토큰으로 추론합니다. 분류 모델은 시스템 1 모델입니다. 소리 내어 추론하지 않고, 아무것도 생성하지 않으며, 한 번에 모든 질문에 답변합니다. 따라서 빠르고 (약 70~500밀리초) 저렴합니다 (결정 1,000개당 1센트 미만).
핵심 사항: 언어 모델은 글을 씁니다. 결정 모델이 결정합니다. 소프트웨어가 AI로부터 필요로 하는 대부분은 결정입니다.
제한사항
판별형 모델은 텍스트를 생성하거나, 코드를 작성하거나, 대화를 나누거나, 산수를 하거나, 이미지를 읽거나, 일련의 단계를 따르지 않습니다.
워크숍에서는 판별 모델 중 하나를 선택합니다.
- 분류 모델 중 하나는 Jev입니다. 2026년 9월에 출시된 TypeSafe AI의 호스팅 API입니다. 첫 번째 모델은
jev-latest별칭을 통해 도달하는jev-1.13입니다. 게시된 가중치가 없으므로 다운로드되지 않고 호출됩니다. - System One 모델을 얻는 방법은 Jev뿐만이 아닙니다. Google의 DiffusionGemma는 한 번에 하나씩이 아닌 병렬로 전체 토큰 블록을 작성하는 개방형 가중치 모델이며, 동일한 병렬 패스를 통해 고정된 옵션 집합에 대한 확률을 읽을 수 있습니다. djev-run과 같은 오픈소스 서버는 Jev의 정확한 API를 앞에 배치하므로 이 워크숍의 모든 항목이 변경되지 않은 상태로 실행됩니다.
상태 및 질문: Choice, Score, Noul
각 호출은 상태와 질문을 전송합니다. 상태는 판단하려는 텍스트입니다. 문자열, JSON 객체 또는 목록일 수 있습니다. 질문은 텍스트에 관해 알고 싶은 내용을 묻습니다. 각 질문에는 선택, 점수 또는 Noul 유형이 있습니다. 질문이 병렬로 처리되므로 빠르게 대답할 수 있습니다. 필요한 경우 질문을 여러 개 추가할 수 있습니다.
- Choice는 사용자가 지정한 옵션 세트에서 최대 255개의 옵션 중 하나를 선택합니다. 답변은 옵션, 모든 옵션의 확률, 신뢰도입니다. 옵션 간에 순서가 없는 경우(높은 공격 차단, 낮은 공격 차단, 회피, 공격, 대기) 사용합니다.
- 점수는 사용자가 설명한 순서대로 2~10개의 수준에 따라 상태를 평가합니다. 답변은 척도에 따른 위치 (소수점, 따라서 1.4는 '1과 2 사이, 1에 더 가까움'을 의미), 각 레벨의 확률, 신뢰 수준입니다. 대답이 정도의 문제인 경우(예: 들어오는 타격이 얼마나 강한지) 사용합니다.
- Choice와 Score는 모두 각 옵션의 확률과 신뢰도를 반환합니다. 차이점은 기본 답변입니다. 선택사항은 가장 가능성이 높은 옵션을 반환합니다. 점수는 옵션을 순서가 지정된 수준으로 취급하고 확률 가중 평균을 반환하며, 이 평균은 두 수준 사이에 있을 수 있습니다. '없음' 0.05, '가벼움' 0.55, '무거움' 0.40인 경우 선택사항은 '가벼움'이라고 대답하고 점수는 가벼움과 무거움 사이인 1.35라고 대답합니다. 아레나에서는 이 값을 사용합니다.
choose()에서는 위험 점수가 1.5 이상이면 심각한 타격으로 간주합니다.
- Choice와 Score는 모두 각 옵션의 확률과 신뢰도를 반환합니다. 차이점은 기본 답변입니다. 선택사항은 가장 가능성이 높은 옵션을 반환합니다. 점수는 옵션을 순서가 지정된 수준으로 취급하고 확률 가중 평균을 반환하며, 이 평균은 두 수준 사이에 있을 수 있습니다. '없음' 0.05, '가벼움' 0.55, '무거움' 0.40인 경우 선택사항은 '가벼움'이라고 대답하고 점수는 가벼움과 무거움 사이인 1.35라고 대답합니다. 아레나에서는 이 값을 사용합니다.
- Noul은 예/아니요 질문을 하고 답변이 예일 확률을 반환합니다. 1에 가까울수록 '예'에 가깝고, 0에 가까울수록 '아니요'에 가깝고, 0.5에 가까울수록 '둘 다 가능'에 가깝습니다. 확률이 신뢰도 수준이므로 별도의 신뢰도는 없습니다.
집중된 질문 작성
분류 모델은 질문에서 범위가 명확한 한 가지 사항을 묻는 경우에 가장 효과적입니다. '상황이 뭐야?'라고 물으면 신뢰도가 낮은 그럴듯한 답변이 반환됩니다. '올바른 대답은 무엇인가요?' '상대가 노출되었나요?' 및 '이 공격은 얼마나 강할까요?'는 코드에서 결합하는 세 가지 집중된 답변을 반환합니다.
옵션과 등급에 대한 설명은 저렴하며 중요합니다. 3단계에서 읽은 규칙이 옵션 설명이 됩니다. block_high: "Raise the shield. Right against an overhead or a high swing." 이렇게 하면 요청 시 차별 모델이 격투 규칙을 각 줄에 하나씩 학습합니다. 상황에 따라 옵션이 변경될 수 있습니다. 아레나에서는 주문이 준비된 경우에만 cast가 제공됩니다.
확률 및 신뢰 수준
선택 답변은 라벨이 아닙니다. 라벨에 대한 분포이며 라벨은 가장 높은 막대일 뿐입니다.
모델이 숫자를 가져오는 방법 언어 모델이 다음 단어를 선택하는 데 사용하는 것과 동일한 단계를 사용합니다. 트랜스포머는 텍스트를 읽고 한 위치에서 어휘의 모든 토큰에 로짓이라는 원시 점수를 부여합니다. 로짓이 높을수록 토큰이 해당 위치에 더 적합합니다. softmax는 로짓을 합계가 1인 확률로 변환합니다. 그러면 언어 모델이 토큰 하나를 선택하여 텍스트에 추가하고 이 과정을 반복합니다. 분류 모델은 확률 이후에 중지됩니다.
빈칸은 답변 양식의 빈칸입니다. 서버가 response: ▢와 같은 양식을 직접 작성하고 질문당 하나의 간격을 남깁니다. 모델의 유일한 작업은 각 빈칸에 속하는 항목에 점수를 매기는 것입니다.
- 프롬프트는 상태와 각 질문을 보유하며, 허용된 모든 답변은 짧은 라벨(block_high의 경우
a, block_low의 경우b등)로 표시됩니다. - 서버는 질문당 하나의 빈칸이 있는 답변 양식을 추가합니다.
- 모델은 프롬프트와 양식을 한 번에 읽고 각 빈칸에 모든 토큰의 로짓을 제공합니다. 확산 모델은 전체 양식을 한 번에 확인하고 모든 빈칸을 함께 점수화합니다.
- 서버는 허용된 라벨의 로지트만 유지하고 여기에 소프트맥스를 적용하므로 허용된 답변의 합계는 1이 됩니다.
- 읽기가 확실하지 않은 경우 서버는 다른 무작위 시작부터 다시 읽고 읽기를 평균화합니다.
신뢰도는 대답의 확실성을 나타내는 숫자입니다. TypeSafe는 옵션에 걸쳐 확률이 분산되는 방식을 기반으로 신뢰도를 계산합니다. 한 옵션에 모두 할당하면 1이 되고 균등하게 분산하면 0이 됩니다. 세 가지 옵션의 경우 (3 × 가장 큰 값 − 1) / 2입니다.
TypeSafe는 보정된 확률을 위해 Jev를 학습시킵니다. 확률은 대답이 올바른 빈도와 일치합니다. 보정된 모델에서 0.7로 제공된 대답은 약 70% 의 경우에 올바르므로 신뢰도에 대한 임계값은 잘못된 대답을 수락하는 빈도에 대한 임계값입니다. 이 워크숍의 DiffusionGemma 서버는 읽기에서 평균을 낸 가장 높은 확률을 신뢰도로 보고합니다. 읽기 값이 일치하지 않으면 평균이 분산되고 신뢰도가 떨어집니다.
핵심 내용: 대답은 무엇인지 알려줍니다. 신뢰도는 행동 여부를 알려줍니다.
기준
기준점은 코드에서 작업을 정의하는 방법입니다. 모델은 신뢰도 또는 확률을 반환합니다. 코드는 이를 선택한 숫자와 비교하고 결과에 따라 어떤 일이 일어날지 결정합니다.
작업별 기준점입니다. TypeSafe는 신뢰도를 구간으로 분할할 것을 제안합니다. 신뢰도가 높으면 자체적으로 작동합니다. 신뢰도가 중간인 경우 확인을 요청하거나 검토를 위해 케이스에 플래그를 지정하는 등 확인을 거칩니다. 신뢰도가 낮으면 행동하지 않고 안전한 것으로 대체하거나 사람에게 돌아갑니다.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
경기장의 규칙 아레나의 임계값은 5단계에서 실행하는 choose()에 있습니다.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
경고: 유효한 답변이 항상 정답은 아닙니다. 판별 모델은 사용자가 제공하지 않은 옵션을 반환할 수 없으므로 이동을 환각하지는 않지만, 때로는 높은 신뢰도로 잘못된 옵션을 선택할 수 있습니다. 기준을 신뢰하기 전에 이미 판단한 상황에 대해 질문을 테스트하세요.
모델로 결정 자동화
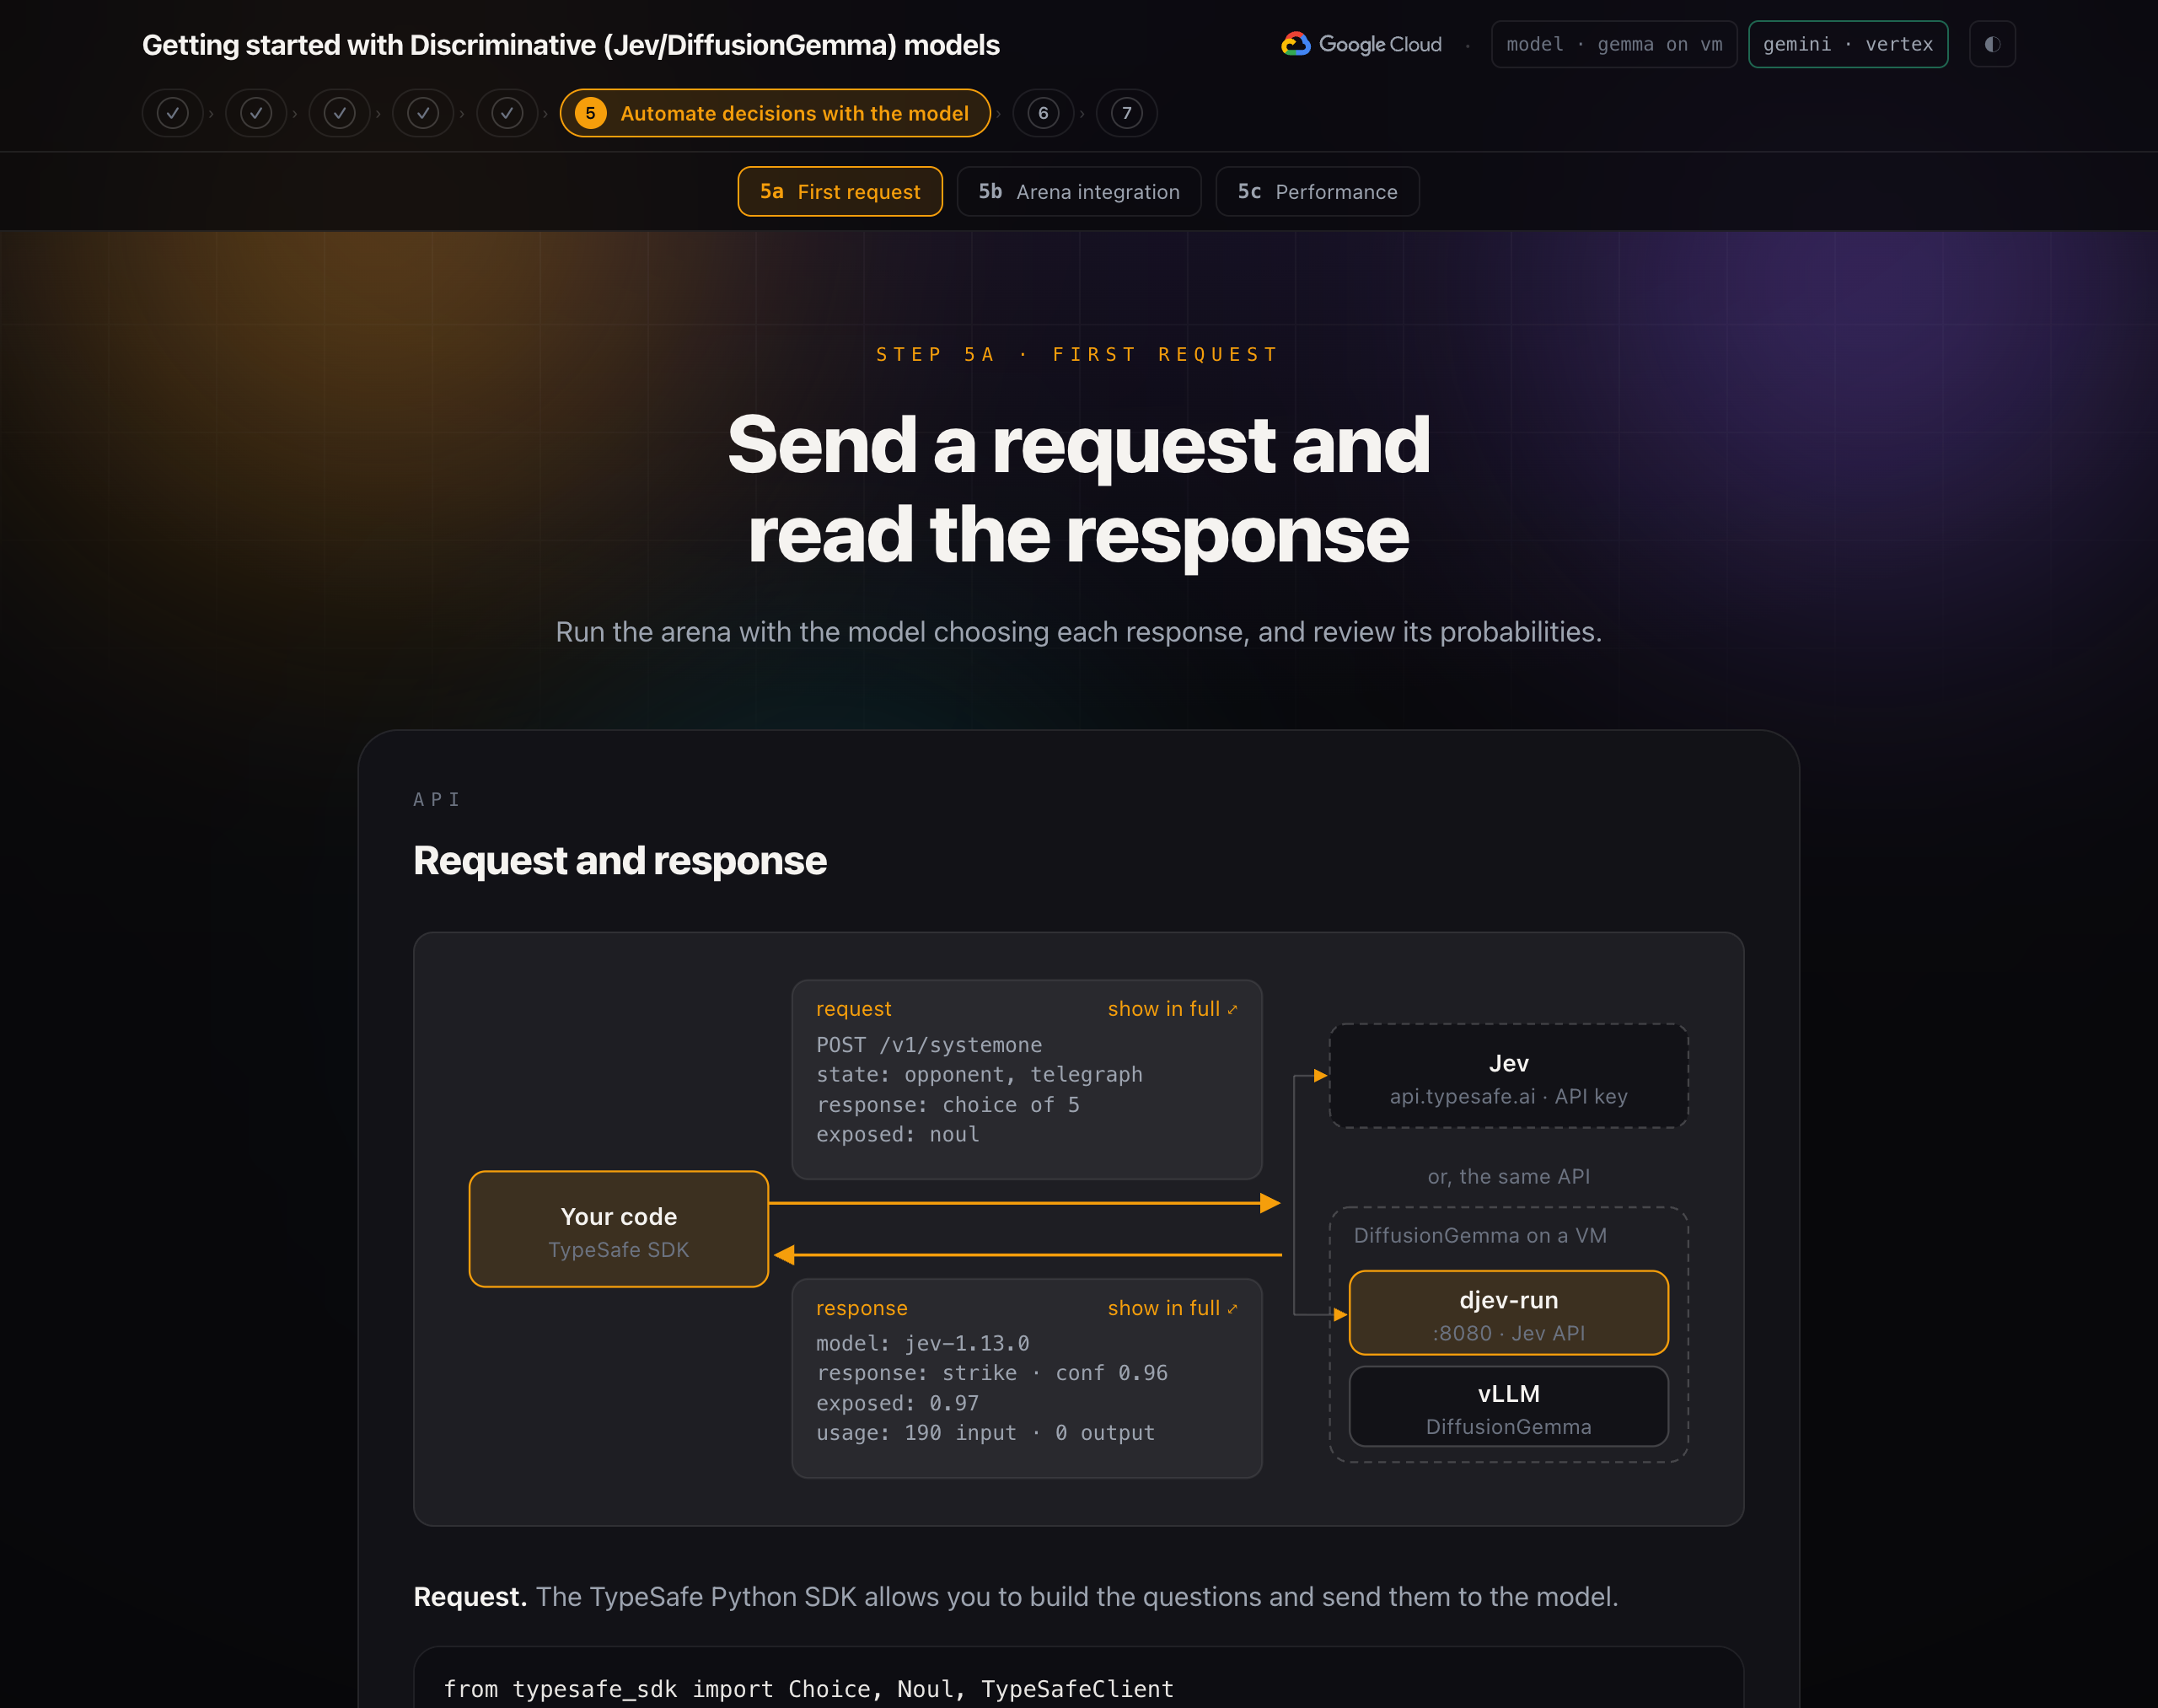
요청 및 응답
요청 TypeSafe Python SDK를 사용하면 질문을 빌드하고 모델에 전송할 수 있습니다.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
틱당 요청 하나
매번 앱은 전신을 상태로 전송하고 하나의 호출에서 다음 세 가지를 요청합니다.
- 다섯 개 (또는 주문이 준비된 경우 여섯 개)의 응답 중 어떤 것이 올바른가요? 선택
- 오그레가 현재 카운터에 노출되는지 여부 A Noul.
- 3단계 루브릭에서 들어오는 타격의 강도 점수입니다.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() 함수
4단계의 기준점을 기억하시나요? choose()는 모델의 답변을 고정된 숫자와 비교하며, 이 고정된 숫자가 기준점입니다.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose()는 두 가지 규칙이 있는 일반적인 Python 입력 값 읽기입니다. 분류 모델은 확률과 분석을 제공하고 코드는 규칙의 기준점을 사용합니다. 선택한 동작은 엔진으로 전송되며, 여기에서 오우거와 싸우는 데 사용됩니다.
핵심 사항: 질문과 기준을 한곳에 보관하세요. 이러한 파라미터는 System One 통합에서 가장 많이 조정하는 부분입니다.
응답 시간, 입력 기반 가격 책정, 결정 로직
- 결정당 응답 시간. b 부분의 각 싸움은 약 100밀리초 후에 다시 나타났고, 일부는 2~3개로 나타났습니다. 이는 게임 루프, 요청 경로 또는 사람이나 언어 모델이 메시지를 보기 전에 모든 메시지를 확인하는 데 충분히 빠른 속도입니다.
- 입력 기반 가격 책정 전체 경기, 각 질문이 3개인 60개의 결정은 1센트의 1/10 미만입니다. 생성된 항목이 없으므로 출력 토큰이 0입니다. 따라서 필요한 것보다 더 많은 권한을 요청할 수 있습니다. 아레나는
strike와cast만 신경 쓰는데도 모든 틱에서 오그라가 노출되는지 묻습니다. 묻는 것은 거의 무료이고 대답은 대시보드에서 유용하기 때문입니다. TypeSafe에서는 이를 추측성 팬아웃이라고 합니다. - 자신감과 위험을 결합하세요. 차별 모델의 응답 신뢰도가 0.40 미만이고 위험 점수가 심각한 타격이 임박했다고 표시되면
choose()가 회피로 재정의합니다. 회피는 최선의 대답은 아니지만 최악의 대답도 아닙니다. 각 실수 비용에서 임계값을 선택하고 반올림된 숫자가 아닌 이미 손으로 판단한 텔레그래프에 대해 테스트합니다. TypeSafe의 자체 조언: 결정이 계속 잘못 트리거되는 경우, 기준점을 이동하기 전에 질문을 강화하세요.
ADK 워크플로에서 모델 결합
틱당 결정의 한계와 올바른 대답이 충분하지 않은 이유
5단계의 전투 마지막 줄에 오우거가 거의 긁히지 않은 채로 비틀거리며 사라집니다라고 나와 있습니다. 분류 모델은 피해를 입지 않았고 매 틱마다 약간의 피해를 입혔으며 300의 체력은 약간의 60배보다 큽니다. 링 모서리에 있는 주문 카드는 처음부터 있었습니다. 이를 읽으려면 이미지를 볼 수 있는 모델이 필요합니다.
오우거의 히트 포인트는 300입니다. 3에 대한 올바른 호출 카운터 숨김이 두껍기 때문에 오프닝에 대한 스트라이크는 8을 줍니다. 60틱의 완벽한 전투를 펼쳐도 오우거는 타박상을 입은 채로 서 있고 게임에서는 무승부로 처리합니다. 5단계는 모델이 잘 방어했지만 여전히 이길 수 없는 상황에서 끝났습니다.
주문만 실제 피해를 입힙니다. 완벽하게 시전하면 45, 빈틈을 노려 시전하면 67의 피해를 입힙니다.
각 작업을 적절한 모델에 할당
링 모서리에 있는 주문 카드가 승리의 열쇠이며, 이를 읽는 것은 텍스트 문제가 아닙니다. 색상과 세 가지 모양이 연속으로 있는 그림이며, 주문은 이에 맞춰 불러야 합니다. 이미지를 보고 몇 초 동안 생각할 수 있는 모델이 필요합니다. 전투에서 몇 초는 10틱입니다.
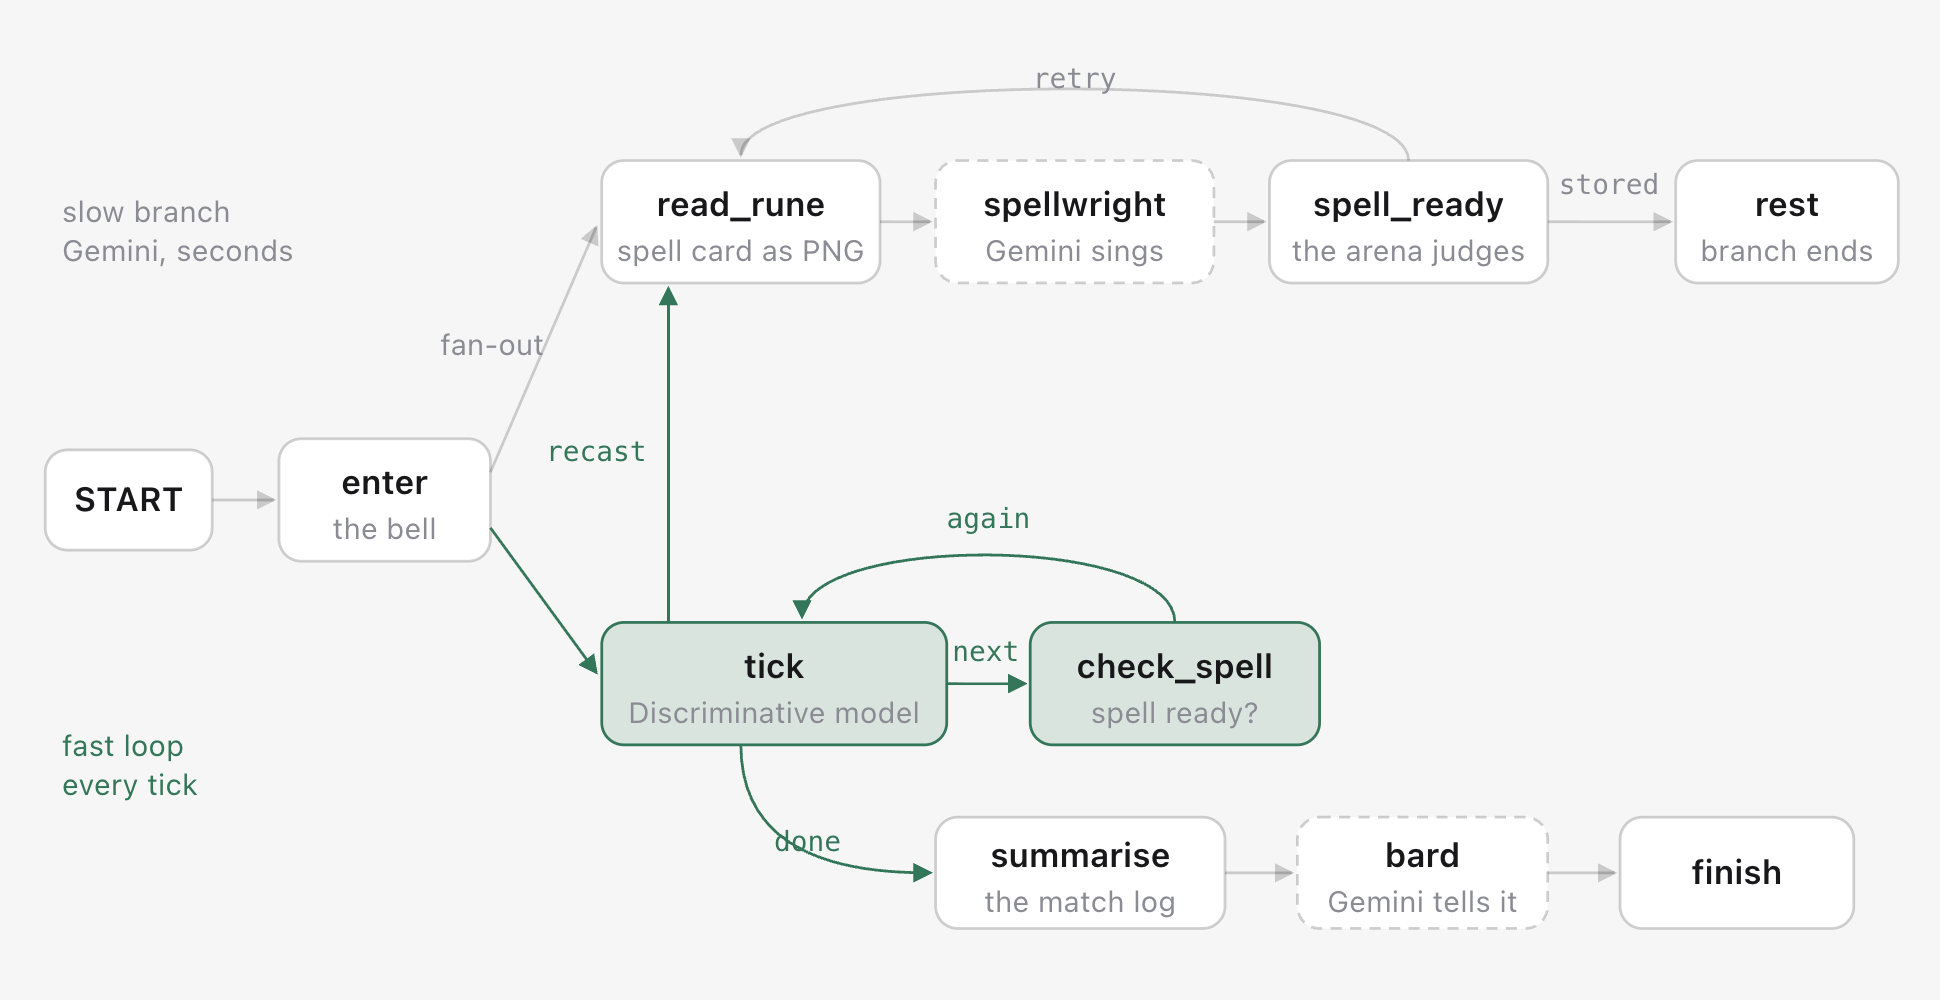
따라서 워크플로는 각각 자체 속도로 두 가지를 모두 사용합니다.
- 분류 모델이 싸웁니다. 매 틱마다 하나의 호출, 하나의 결정, 100밀리초가 걸립니다. 루프는 자체보다 느린 것을 기다리지 않습니다.
- Gemini가 읽어주고 노래를 불러줍니다. 벨이 울리면 자체 브랜치에서 경기장 화면의 주문 카드를 이미지로 가져와 색상과 모양을 지정하고 주문을 노래합니다. 아레나는 서버를 벗어나지 않는 주문 카드에 대한 대답을 기준으로 노래를 평가합니다.
- 공격이 끝날 때마다 격투사는 슬롯을 확인합니다.
check_spell노드는 상태를 확인합니다. 준비되지 않음: Gemini가 노래를 부른 시간과 함께 표시되며 다음 체크로 바로 이동합니다. 기다려 주지 않습니다. 준비:cast가 분류 모델에 제공되는 옵션에 추가되고, 분류 모델이 오프닝을 보고하는 순간choose()가 주문을 사용합니다. 주문을 사용하면 화면에 새 주문 카드가 그려지고 느린 스레드가 다시 시작됩니다. 잘못 읽은 노래는 주문 카드를 소진하고 느린 스레드는 새 노래를 읽습니다. - Gemini가 짧은 이야기를 작성합니다.
지연 시간이 서로 다른 병렬 브랜치와 하나의 이벤트 루프
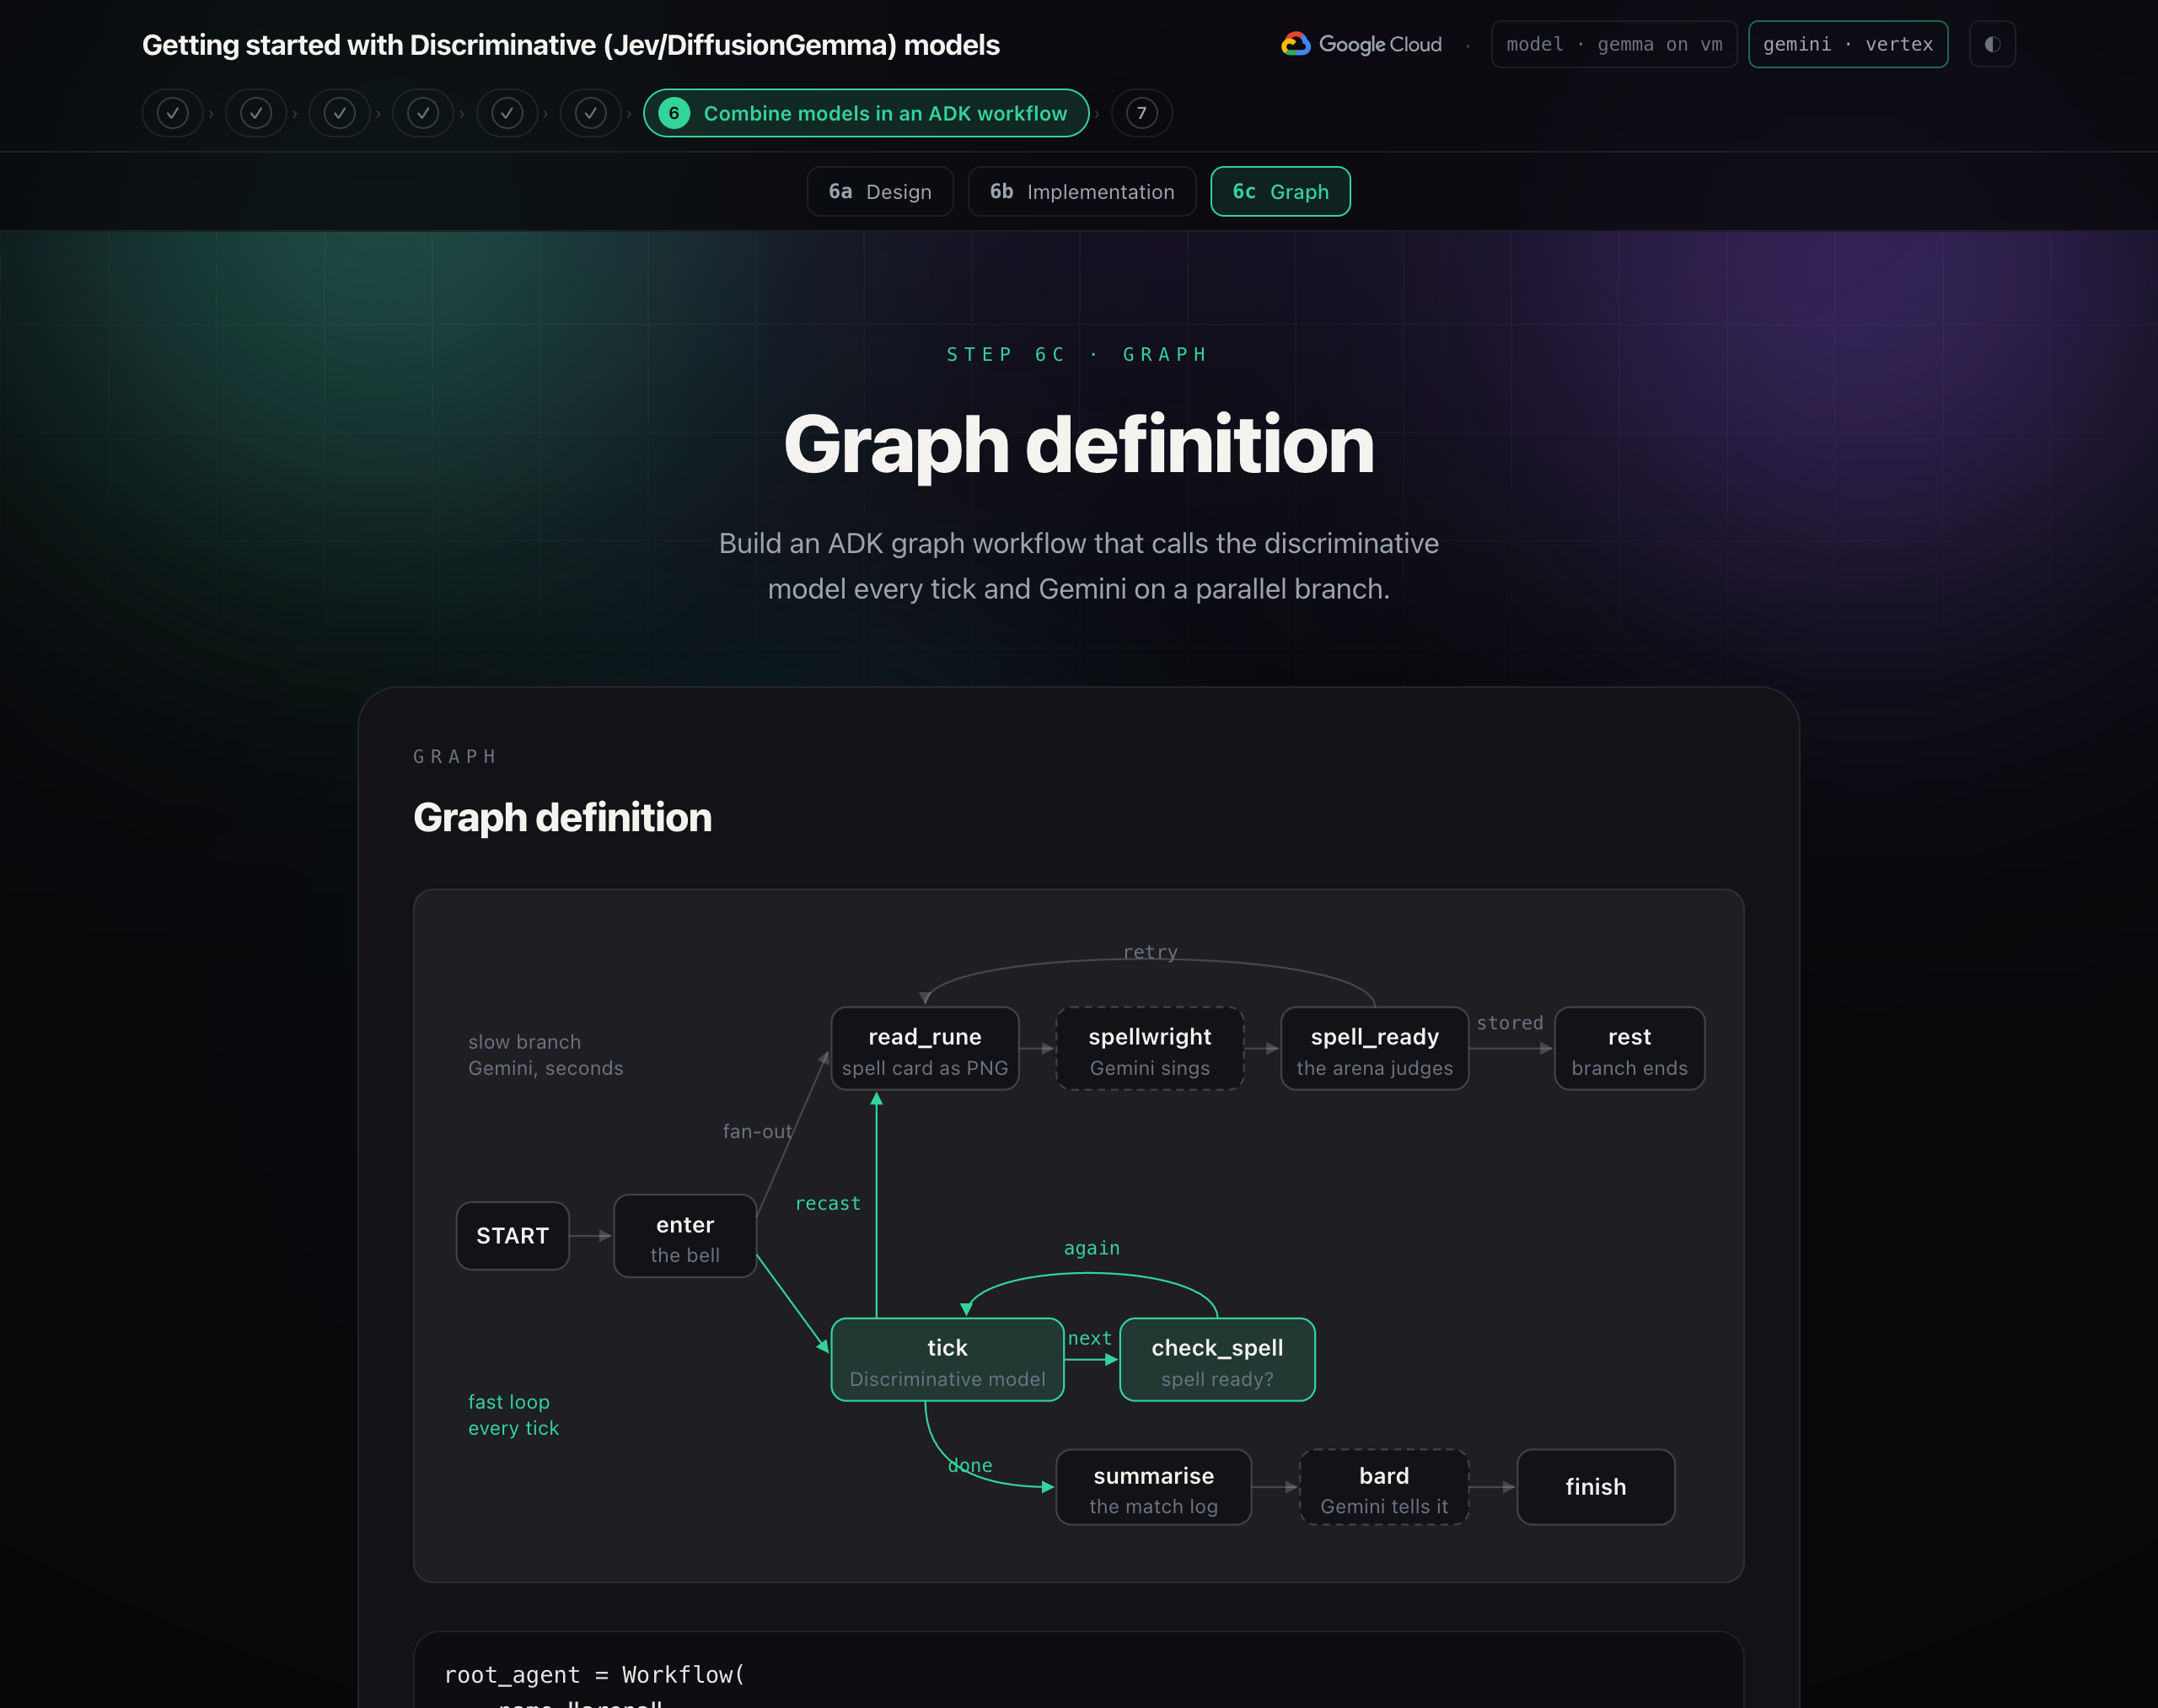
이는 ADK 워크플로입니다. 에지로 연결된 노드 그래프입니다. 노드는 일반 Python 함수 또는 LLM 에이전트입니다. 한 노드에서 노드의 튜플로 이어지는 에지는 팬아웃입니다. 둘 다 동시에 시작됩니다. route이 있는 Event를 반환하는 노드는 다음에 사용할 에지를 선택하고, 자체로 라우팅되는 노드는 루프입니다.
두 개의 스레드라고 생각하면 됩니다. 스레드 1이 느림: 주문 카드 읽기, 노래 부르기, 주문 저장 스레드 2는 빠릅니다. 틱, 슬롯 확인, 다시 틱. 스레드 1은 판단된 주문을 세션 상태에 쓰고 출력을 반환하지 않는 함수에서 종료됩니다. 스레드 2의 check_spell는 교환 후마다 해당 상태를 읽습니다. 두 스레드 모두 서로를 호출하거나 기다리지 않고 상태만 공유합니다.
핵심 내용: 결정을 코드에 넣고 각 모델에 자체 속도로 좁은 작업을 부여하세요.
ADK는 단일 스레드에서 하나의 이벤트 루프에 두 브랜치를 모두 태스크로 실행합니다. 한 번에 하나의 작업만 실행됩니다. 작업이 await에 도달하면 대답을 기다리고 루프는 그동안 다른 브랜치를 실행합니다. 빠른 브랜치는 모델을 약 0.1초 동안 기다리고 느린 브랜치는 Gemini를 몇 초 동안 기다리므로 서로 지연되지 않습니다.
느린 브랜치
read_rune()은 주문 카드 이미지를 화면에서 가져옵니다.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright는 Gemini입니다. 이미지를 읽고 고정된 모양으로 대답합니다.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready()는 경기장에서 주문을 심판한 다음 저장하거나 다시 시도합니다.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
함수 노드는 이미지 부분이 있는 Content를 반환할 수 있으며 LLM 노드는 이를 사용자 턴으로 수신합니다. spell_ready는 상태 델타가 있고 output가 없는 Event를 반환합니다. 다음 틱은 상태에서 주문을 읽고 출력이 없는 분기는 그래프의 두 번째 엔딩이 아닙니다. ADK에는 터미널 출력이 하나 필요하며 이는 전투의 출력입니다.
참고: 심사는 경기장에서 주문 카드에 숨겨진 답변에 대해 코드로 진행됩니다. 완벽한 리딩은 오프닝에 45개 이상을 넣습니다. 두 모양이 오른쪽으로 이동하면 25가 됩니다. 잘못 읽으면 주문 카드가 소멸됩니다. Gemini에게 올바른지 묻지 않습니다.
빠른 브랜치
tick()은 한 번의 교환을 플레이한 후 다음 가장자리를 선택합니다.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell()은 모든 교환 후 주문 슬롯을 확인합니다.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell는 교환 후 슬롯을 확인합니다. 절대 차단하지 않습니다. 주문이 준비되지 않으면 이를 보고하고 다음으로 넘어갑니다.
디자인을 전달하는 세 가지 요소가 있습니다. 분류 모델 호출은 비동기 클라이언트로 await되므로 대기하는 동안 루프가 생성되고 Gemini 브랜치가 계속 실행됩니다. 질문은 매번 새로 생성되므로 cast는 전송할 항목이 있는 경우에만 표시됩니다. route가 목록일 수도 있습니다. ["recast", "next"]는 두 가장자리를 한 번에 가져옵니다.
아레나 자체는 작은 클라이언트 뒤에 있습니다. 하나가 있는 경우 HTTP를 통해 실행되는 앱이므로 페이지에 경기가 표시됩니다. 없는 경우 엔진이 인프로세스됩니다.
그래프 정의
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
타겟으로 사용되는 튜플은 팬아웃입니다. 에지로서의 튜플은 체인입니다. 딕셔너리는 경로 이름을 노드에 매핑합니다. tick → check_spell → tick은 빠른 연속 재생입니다. "recast": read_rune는 주문이 소모된 후 느린 스레드를 다시 시작하고, "retry"는 주문이 실패한 후 동일한 작업을 실행하며, "stored": rest는 주문이 슬롯에 있으면 출력 없이 느린 스레드가 조용히 종료되도록 합니다. ADK에는 사이클에 라우팅된 에지가 하나 이상 필요하므로 무조건 루프는 영원히 실행되기 전에 거부됩니다.
참고: root_agent는 ADK의 도구가 찾는 것입니다. 터미널이 아닌 브라우저에서 그래프와 이벤트를 보려면 워크숍의 루트에서 adk web agents를 실행하여 경기장이 포함된 개발 UI를 엽니다.