

1. Wprowadzenie
90-minutowe warsztaty na temat modelu dyskryminacyjnego, modelu decyzyjnego System One od TypeSafe AI i jego wykorzystania w przepływie pracy Google ADK obok Gemini. Warsztaty składają się z sześciu etapów, a ich tematem jest bijatyka. Najpierw będziesz walczyć z ogrem ręcznie, a potem przekażesz refleks do modelu dyskryminacyjnego. Następnie zobaczysz, jak przepływ pracy ADK wygrywa walkę z modelem dyskryminacyjnym, który podejmuje decyzje w każdym momencie, a Gemini odczytuje karty zaklęć z ekranu, aby śpiewać zaklęcia.
Przegląd
Model dyskryminacyjny (jev-1.13, alias jev-latest) to hostowany model od TypeSafe AI, który został udostępniony 19 września 2026 r. Nie generuje tekstu. Wysyłasz do niego stan (tekst, JSON lub listę) i wpisane pytania (Choice, Score, Noul), a on zwraca odpowiedzi z skalibrowanymi prawdopodobieństwami w czasie od 70 do 500 ms.Koszt to 0,042 USD za milion tokenów wejściowych, a za dane wyjściowe nie pobieramy opłat. Jego zadaniem jest podejmowanie decyzji przed, między i za modelami językowymi: kierowanie, klasyfikacja, bramkowanie i w tym przypadku refleks wojownika.
Gra jako przykład
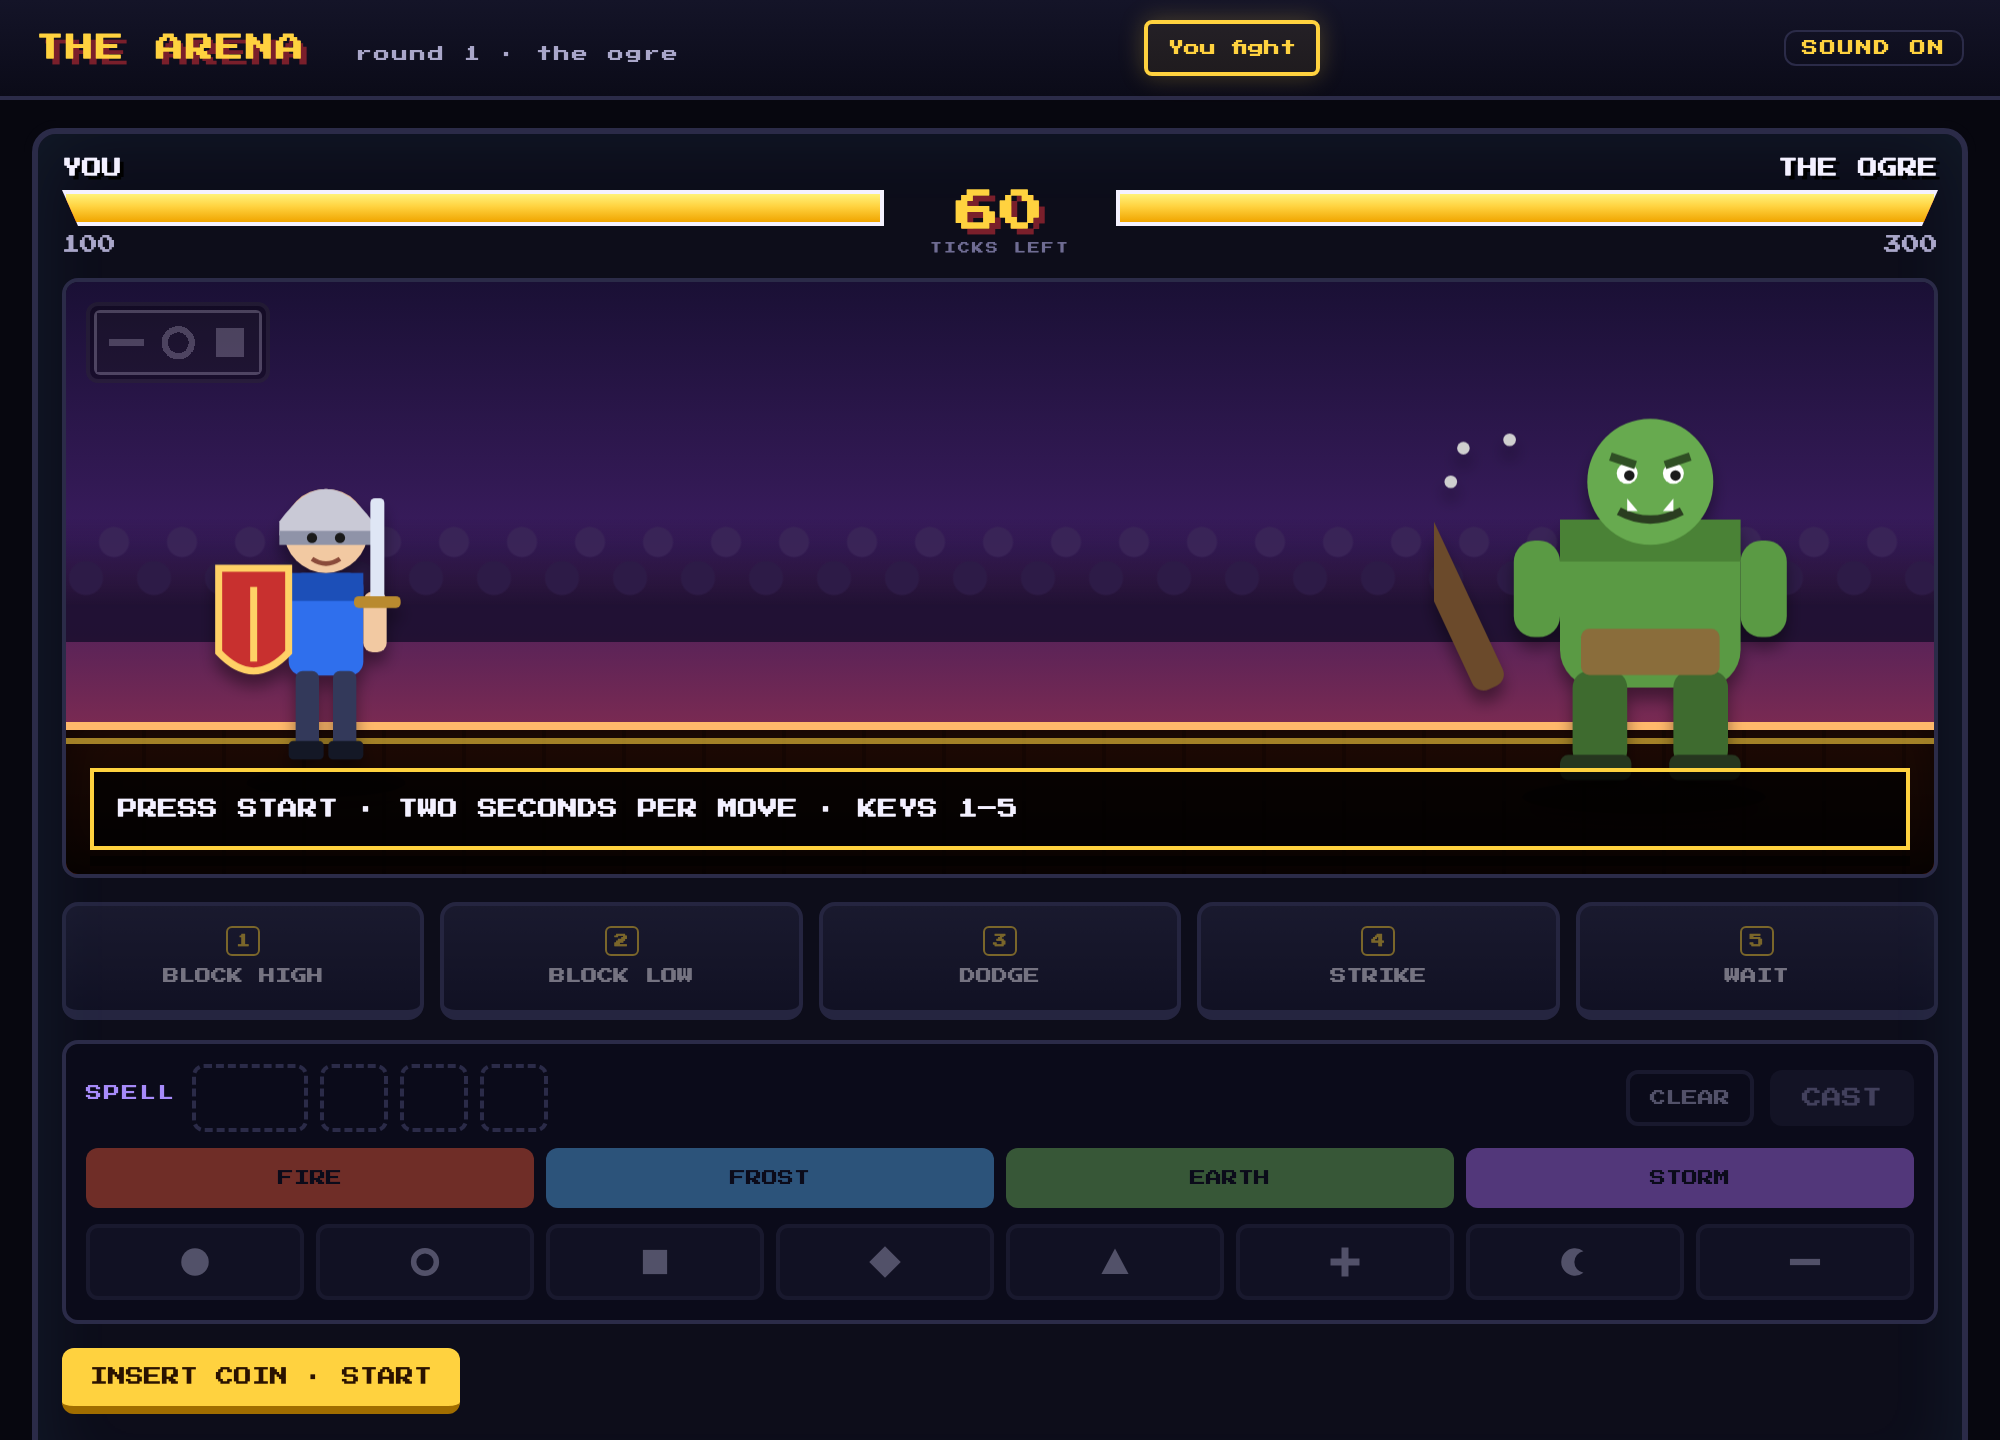
Czy kiedykolwiek grałeś(-aś) w grę walki? Stajesz naprzeciwko przeciwnika i musisz natychmiast reagować na jego ruchy. Jedna zła odpowiedź i tracisz punkty zdrowia. W grach rzucanie zaklęć jest zwykle utrudnione. W naszej musisz wybrać kolor i kształty karty zaklęcia w odpowiedniej kolejności, zanim zaklęcie zostanie rzucone. Z tego warsztatu dowiesz się, jak połączyć oba typy modeli, aby Twoja postać wygrała.
Każdy element gry jest powiązany z rzeczywistym systemem:
- Ruch przeciwnika to zdarzenie przychodzące, takie jak żądanie lub transakcja.
- Odpowiedź to ograniczona decyzja podjęta przez model dyskryminacyjny i sprawdzona przez kod.
- Karta zaklęcia to nieustrukturyzowane dane wejściowe, które wymagają odczytania przez model językowy.
- Dopasowanie to przepływ pracy, w którym szybkie i wolne zadania są wykonywane w odpowiednim dla nich tempie.
Chodzi o połączenie tych 4 komponentów i złożenie ich w szybki i inteligentny system.
Czego się nauczysz
- Wyjaśnij, czym różnią się modele dyskryminacyjne (System 1) i generatywne (System 2) oraz kiedy należy używać każdego z nich.
- Opisz, jak udostępniane są modele Jev i DiffusionGemma, i skonfiguruj jeden z nich na potrzeby warsztatów, w tym DiffusionGemma na maszynie wirtualnej Compute Engine z procesorem GPU.
- Twórz pytania typu „Wybierz odpowiedź”, „Wynik” i „Noul” oraz interpretuj prawdopodobieństwa i poziom ufności.
- Używaj progów w kodzie deterministycznym, aby przekształcać prawdopodobieństwa w działania.
- Utwórz żądanie za pomocą pakietu SDK TypeSafe, a potem pozwól modelowi wybrać każdy ruch w grze.
- Utwórz wolną gałąź, w której Gemini odczytuje obraz, i szybką gałąź, w której model dyskryminacyjny podejmuje decyzje w pętli, a następnie uruchom każdą z nich osobno.
- Połącz obie gałęzie w przepływie pracy wykresu ADK, który udostępnia stan w jednej pętli zdarzeń, dzięki czemu powolna praca nigdy nie opóźnia szybkich decyzji.
Architektura
Platforma robocza znajduje się w Cloud Shell(lub na Twoim urządzeniu). Zapisuje dane w lokalnym systemie plików i wchodzi w interakcje z platformą testową, a także z Gemini i modelem decyzyjnym. ② wywołuje model decyzyjny w przypadku „Discriminative model fights” (Walki modeli dyskryminacyjnych); ③ wywołuje oba modele w przypadku „Workflow fights” (Walki przepływów pracy).
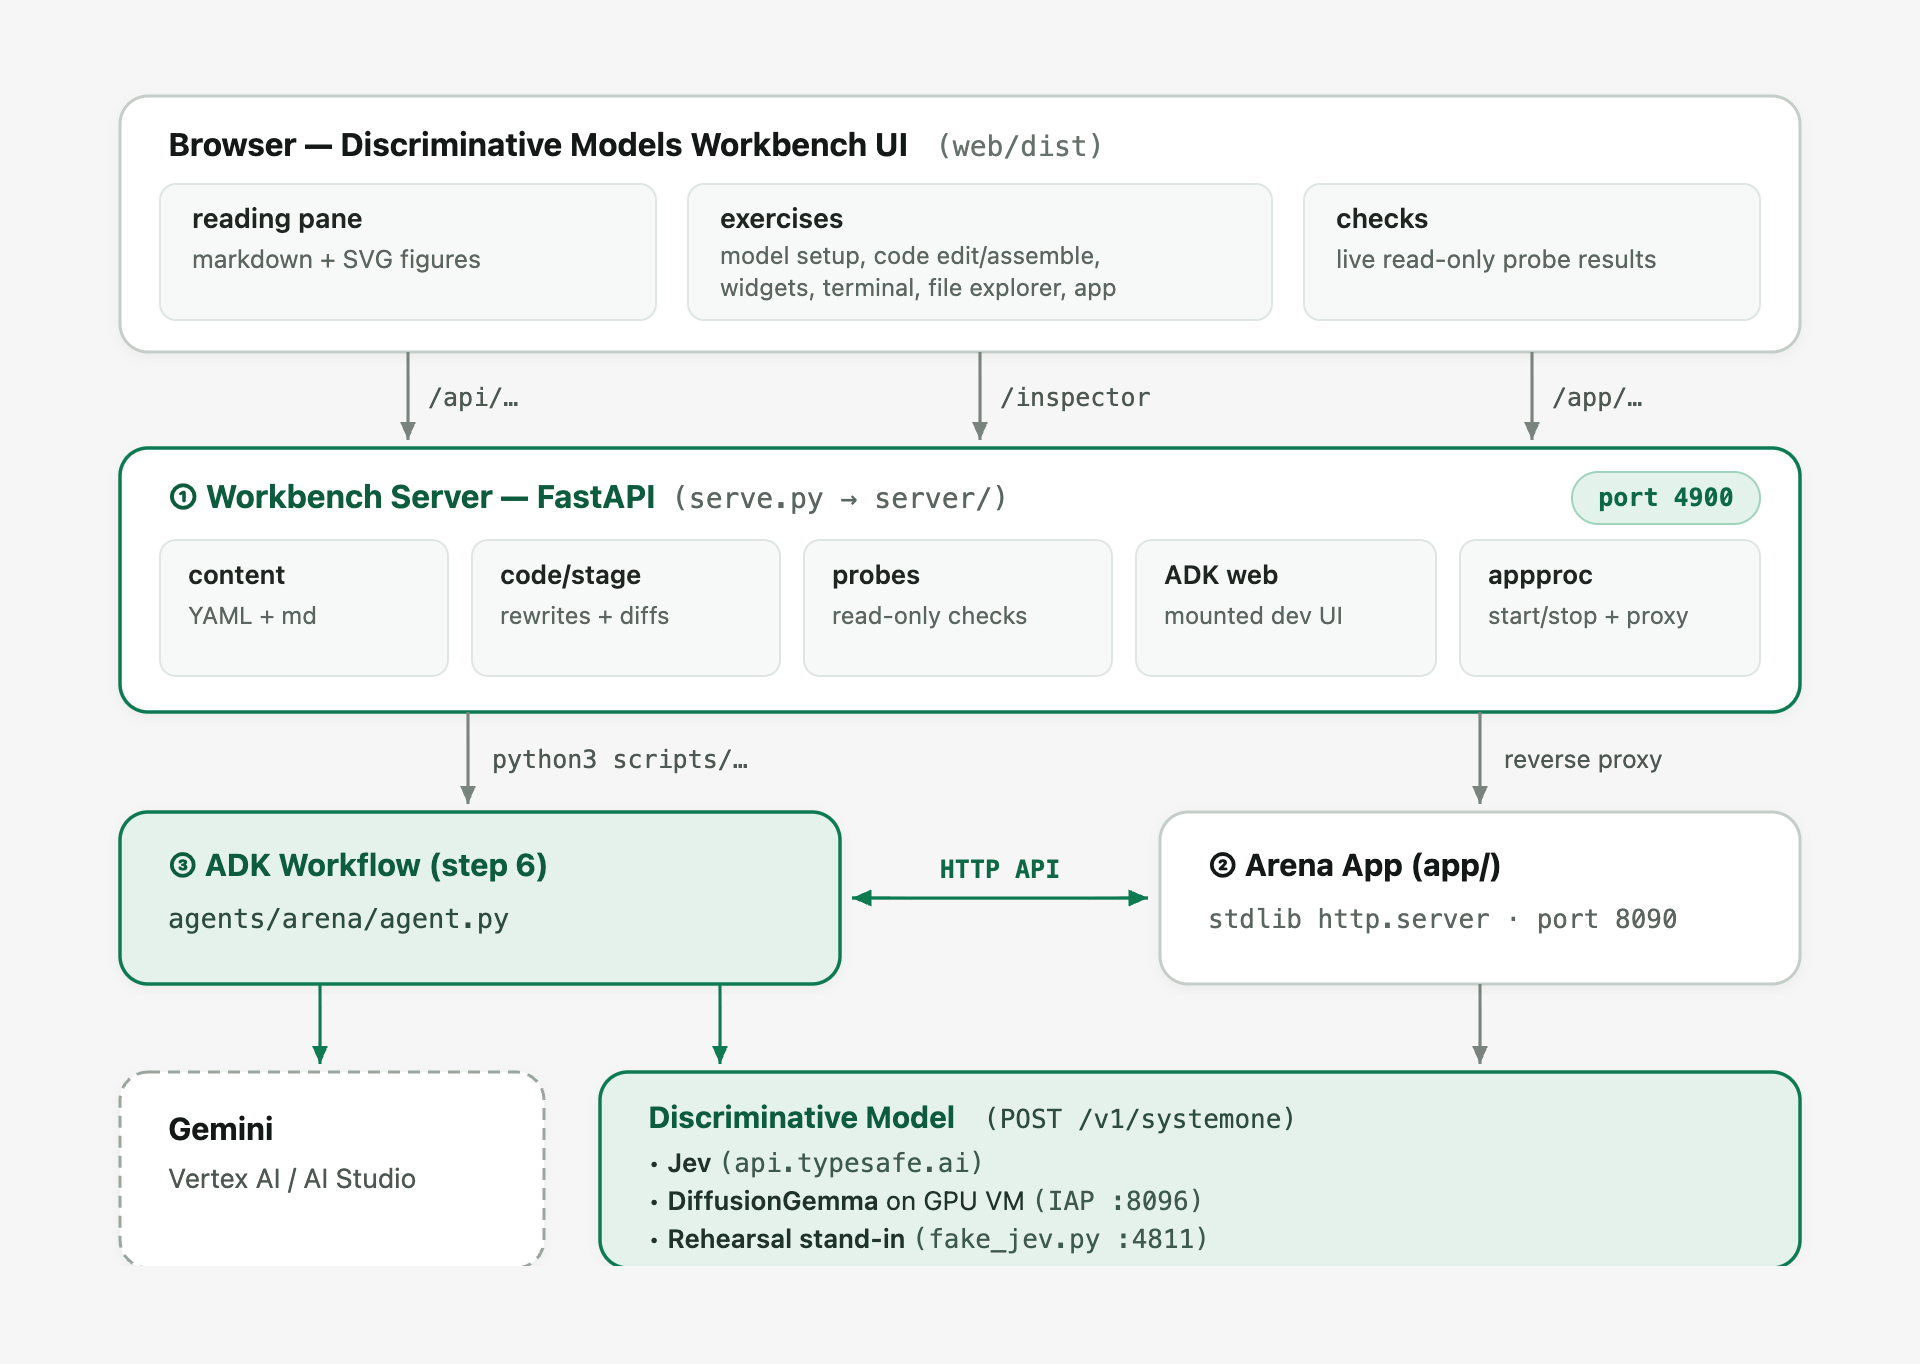
Kto co nazywa. Przeglądarka komunikuje się tylko z ①. Oba modele są wywoływane z poziomu Pythona na urządzeniu:
Rozmówca | Model dyskryminacyjny | Gemini |
② arena, „Discriminative model fights” | co | nie |
③ przepływ pracy | co | nie |
③ przepływ pracy | nie | obraz karty zaklęcia; opowieść po walce; |
| tak | nie |
Jeden znacznik na tryb.
- Walczysz. Strona ② prosi o podanie telegrafu, wyświetla go z 2-sekundowym odliczaniem i odsyła naciśnięty przycisk (lub wpisane słowo). ② rozwiązać problem.
- Walki modeli dyskryminacyjnych Strona ② prosi o zaznaczenie pola wyboru, ② rysuje telegraf, zadaje modelowi 3 pytania w jednym wywołaniu, uruchamia
choose()i zwraca odpowiedzi oraz wynik. Strona rysuje słupki. - Konflikty w przepływie pracy Start uruchamia ② jako podproces (zaloguj się
runs/arena-workflow.log). ③ steruje walką: prosi ② o każdy telegraf, wywołuje model i publikuje decyzję; zaklęcie Gemini pojawia się w osobnej gałęzi, gdy jest gotowe. Strona zawiera tylko ankiety ② i rysunki. Wstrzymanie to flaga w ②, którą ③ sprawdza przed każdym taktem.
Miejsce hostowania modelu decyzyjnego. Każde wywołanie przechodzi przez ten sam typesafe-sdk; zmienia się tylko podstawowy adres URL. scripts/jevauth.py nadaje nazwę backendowi oraz ustawia klucz i limit czasu:
Backend |
| Klucz | Skonfiguruj do |
TypeSafe, hostowana | unset (api.typesafe.ai) |
|
|
DiffusionGemma na maszynie wirtualnej L4 |
| brak |
|
DiffusionGemma w Cloud Run |
| token tożsamości Google pobierany co godzinę; |
|
Próby |
| brak |
|
Odpowiedź karty zaklęcia ②: przepływ pracy otrzymuje tylko plik PNG, a ② ocenia zaklęcie, które wysyła z powrotem. Dlatego właśnie zaklęcie jest prawdziwym testem umiejętności czytania Gemini, a zaklęcie, które tworzysz w „You fight”, jest prawdziwym testem Twoich umiejętności.
2. Konfiguracja
Odbieranie środków na warsztaty
Jeśli w ramach tej sesji przyznano Ci środki w Google Cloud, najpierw je odbierz – zajmie to około minuty i utworzy dla Ciebie konto rozliczeniowe.
Otwórz Cloud Shell
Google Cloud Shell to środowisko Linux dostępne w przeglądarce, wstępnie skonfigurowane z gcloud, Pythonem, Node.js, uv i git, już uwierzytelnione na Twoim koncie Google.
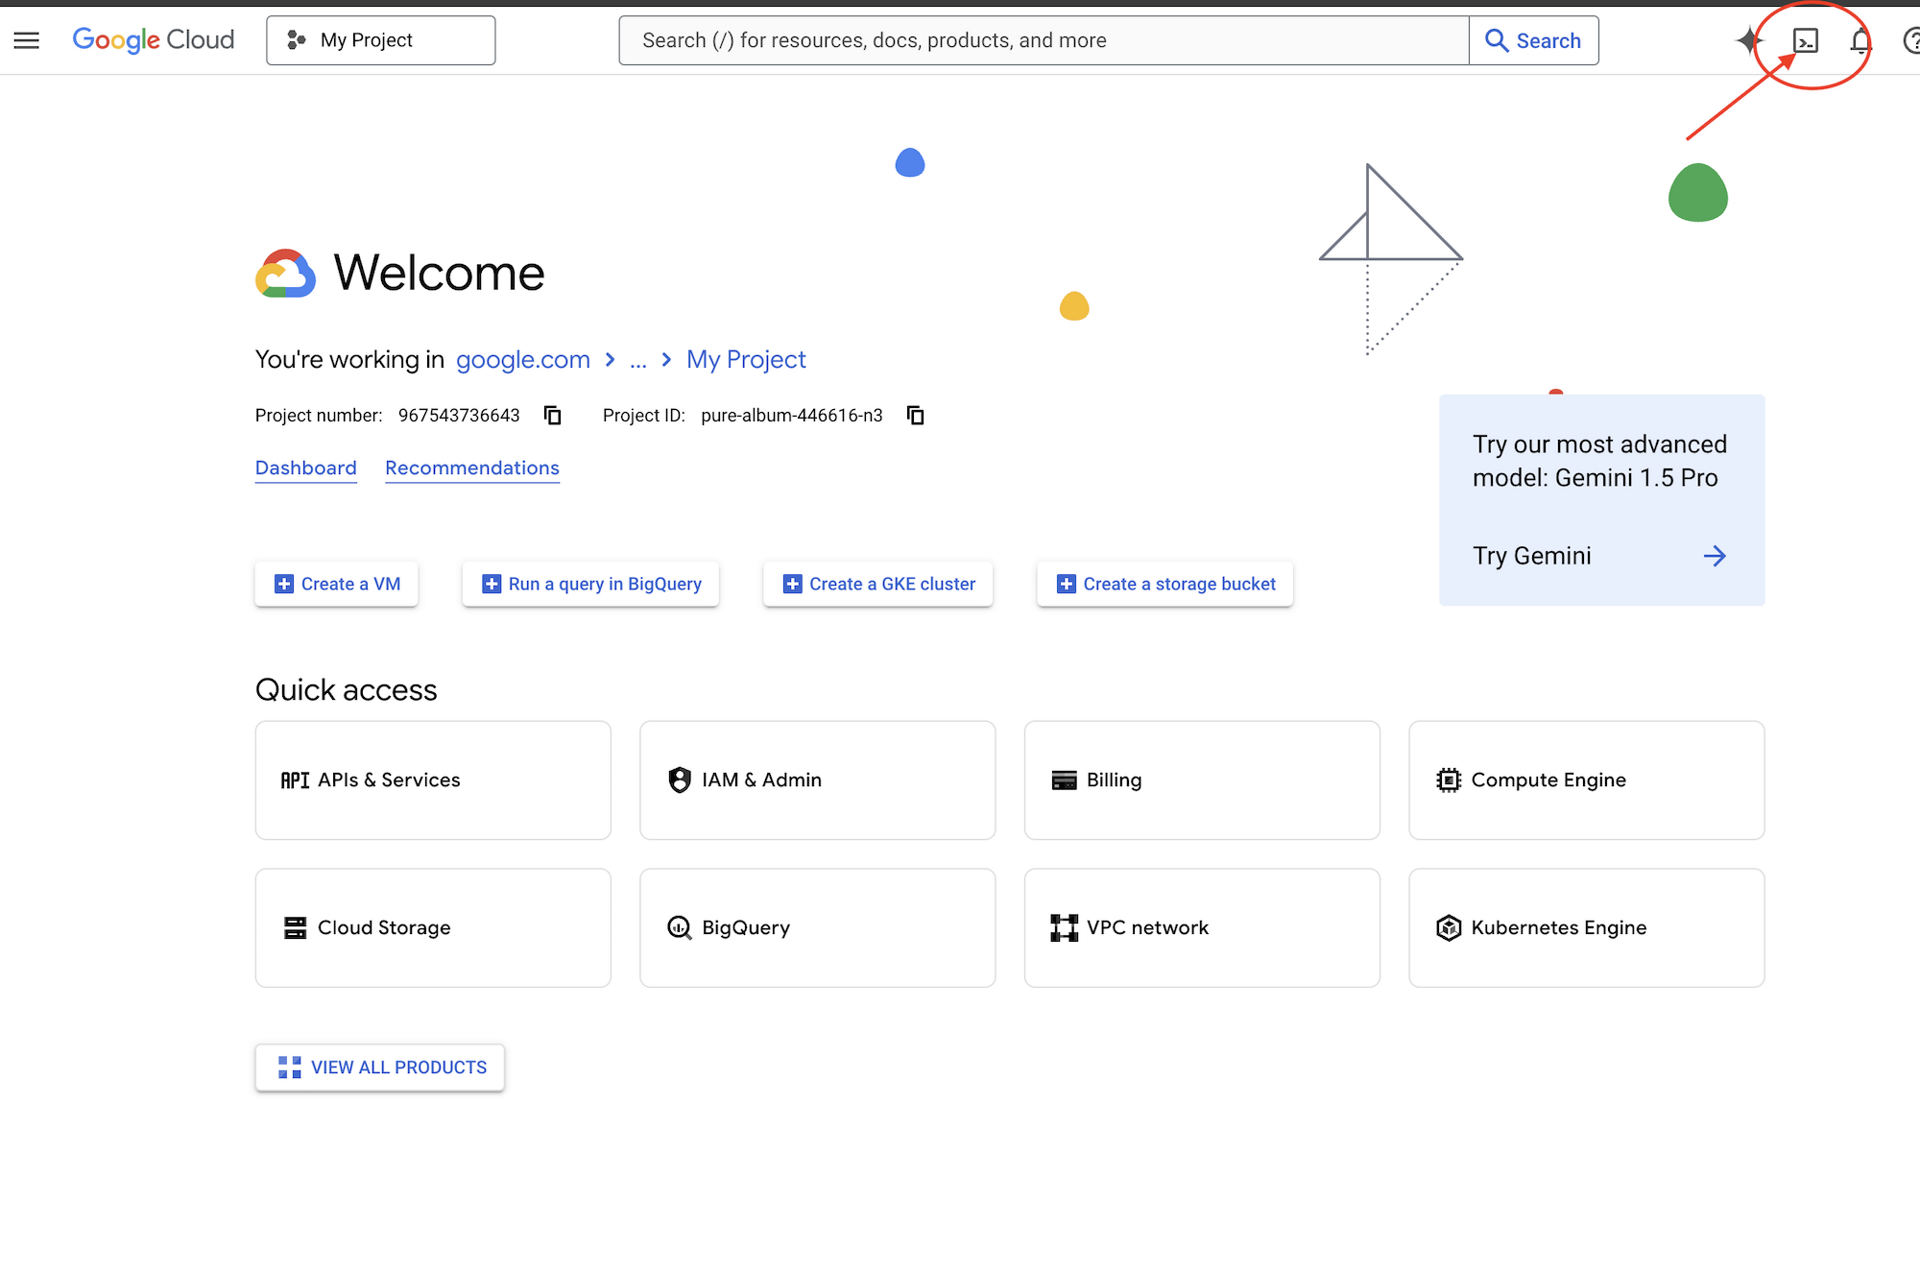
- Otwórz konsolę Google Cloud.
- Kliknij Aktywuj Cloud Shell (ikonę terminala na górnym pasku nawigacyjnym), aby otworzyć sesję terminala u dołu przeglądarki.
Uruchamianie platformy
W Cloud Shell lub w dowolnym miejscu, w którym zalogowano się na konto gcloud:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh tworzy projekt (discrim-models-XXXX), łączy z nim płatności, preferując konto z kredytem na wydarzenie, jeśli takie masz, i czeka, aż projekt będzie mógł wyświetlać reklamy. Ponowne uruchomienie spowoduje ponowne użycie projektu w ~/project_id.txt. Aby użyć projektu, który już masz, umieść jego identyfikator w tym pliku i pomijaj ten skrypt.
setup_codelab.sh nie zadaje żadnych pytań. Instaluje uv i pakiety Pythona, włącza Vertex AI, Compute Engine i IAP, kieruje Gemini na Vertex AI w projekcie w .env, wykonuje jedno rzeczywiste wywołanie Gemini z modelem, który może wywołać projekt, tworzy stronę, uruchamia w tle komponent Workbench i uruchamia scripts/check_setup.py. Ponowne uruchomienie zachowuje pliki ćwiczeń, a scripts/starter.sh je resetuje. Model decyzyjny wybiera się w kroku 2 platformy.
Aby otworzyć interfejs platformy w Cloud Shell:
- Kliknij link podglądu wydrukowany na końcu
./setup_codelab.shlub kliknij Podgląd w przeglądarce w prawym górnym rogu paska narzędzi Cloud Shell. - Kliknij Zmień port, wpisz 4900 i kliknij Zmień i wyświetl podgląd.
Gemini działa w Vertex AI w Twoim projekcie, z Twoimi danymi logowania Google: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT i GOOGLE_CLOUD_LOCATION=global w .env.
Model decyzyjny jest wybierany samodzielnie w kroku 2 platformy lub z terminala za pomocą polecenia scripts/setup_model.sh:
Wybór | Potrzeby | Konfiguracja | Koszt |
Model dyskryminacyjny (TypeSafe, hostowany) | klucz interfejsu API TypeSafe, | brak | za token, ułamki centa |
DiffusionGemma (Google, otwarte wagi) | rozliczenia + limit Compute Engine dla GPU. | ~15 min, automatycznie | ~0,71 USD/godz.podczas działania maszyny wirtualnej |
Próba (bez modelu) | nothing | brak | brak |
DiffusionGemma na maszynie wirtualnej Compute Engine
scripts/setup_gemma.sh najpierw sprawdza limit GPU, a potem tworzy 1 maszynę wirtualną g2-standard-4 (1 × L4 24 GB, 4 vCPU, 16 GB) z obrazu Google Deep Learning ze sterownikiem NVIDIA 580. Podczas pierwszego uruchomienia maszyna wirtualna instaluje platformę Docker, pobiera wagi z Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, publiczne, bez tokena) i uruchamia djev-run: DiffusionGemma za dokładnym interfejsem API modelu dyskryminacyjnego. Port modelu nie jest otwarty na internet: stacja robocza uzyskuje do niego dostęp przez tunel IAP na localhost:8096, który otwiera scripts/start.sh.
Wstrzymaj / wznów |
| |
Tunel |
| |
Usuń |
| |
Przećwicz polecenia |
| |
Układ repozytorium
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Podsumowanie
Zwalnianie miejsca w środowisku
Po ukończeniu warsztatów wykonaj te czynności, aby usunąć wszystkie zasoby GPU DiffusionGemma, zatrzymać procesy w tle na platformie roboczej i w środowisku testowym, usunąć pliki warsztatów z Cloud Shell i (opcjonalnie) usunąć projekt Google Cloud, w którym odbywały się warsztaty.
- Usuń maszynę wirtualną GPU DiffusionGemma i regułę zapory sieciowej (jeśli została utworzona): jeśli w kroku 2 udostępniono DiffusionGemma na maszynie wirtualnej GPU Compute Engine, usuń maszynę wirtualną, dysk i regułę zapory sieciowej IAP, aby nie naliczać bieżących opłat za obliczenia ani za miejsce na dysku:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Zatrzymaj procesy platformy i próby w Cloud Shell: w terminalu Cloud Shell zatrzymaj serwer platformy działający w tle i wszystkie procesy zastępcze prób:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Usuń folder warsztatów z Cloud Shell: wróć do katalogu głównego i usuń sklonowany folder repozytorium oraz plik identyfikatora projektu:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Usuń projekt Google Cloud: jeśli
./setup_project.shutworzono dedykowany projekt warsztatowy (np.discrim-models-XXXX), zamknięcie projektu spowoduje trwałe usunięcie wszystkich utworzonych w nim zasobów, ale konto rozliczeniowe Cloud pozostanie nienaruszone:- Otwórz stronę Zarządzanie zasobami w konsoli Google Cloud.
- Na liście zasobów wybierz projekt warsztatowy (np.
discrim-models-...). - Na górnym pasku narzędzi kliknij Usuń, wpisz identyfikator projektu, aby potwierdzić, i kliknij Wyłącz.
Warsztaty zostały ukończone.
Podsumowanie laboratorium
- Wybrałem model dyskryminacyjny, Jev lub DiffusionGemma, na maszynie wirtualnej GPU Compute Engine i sprawdziłem, czy odpowiada.
- Ręcznie rozegrałem arenę, ścigając się z czasem, aby poznać jej zasady.
- Dowiedz się, jak model dyskryminacyjny odpowiada na pytania typu Choice, Score i Noul, jakie są prawdopodobieństwa i poziomy ufności oraz jak Twój kod stosuje do nich progi.
- Wyślij pierwszą prośbę, a potem pozwól modelowi wybierać każdy ruch na arenie, przy czym
choose()przekształca odpowiedzi w działania. - Każda gałąź przepływu pracy ADK została utworzona osobno. Gemini odczytuje obraz karty zaklęcia, a model podejmuje decyzję w pętli.
- Połączone w jednym przepływie pracy, który współdzieli stan, dzięki czemu walka nigdy nie czeka na Gemini, a zaklęcie jest rzucane na początku.
Od rozmowy do decyzji
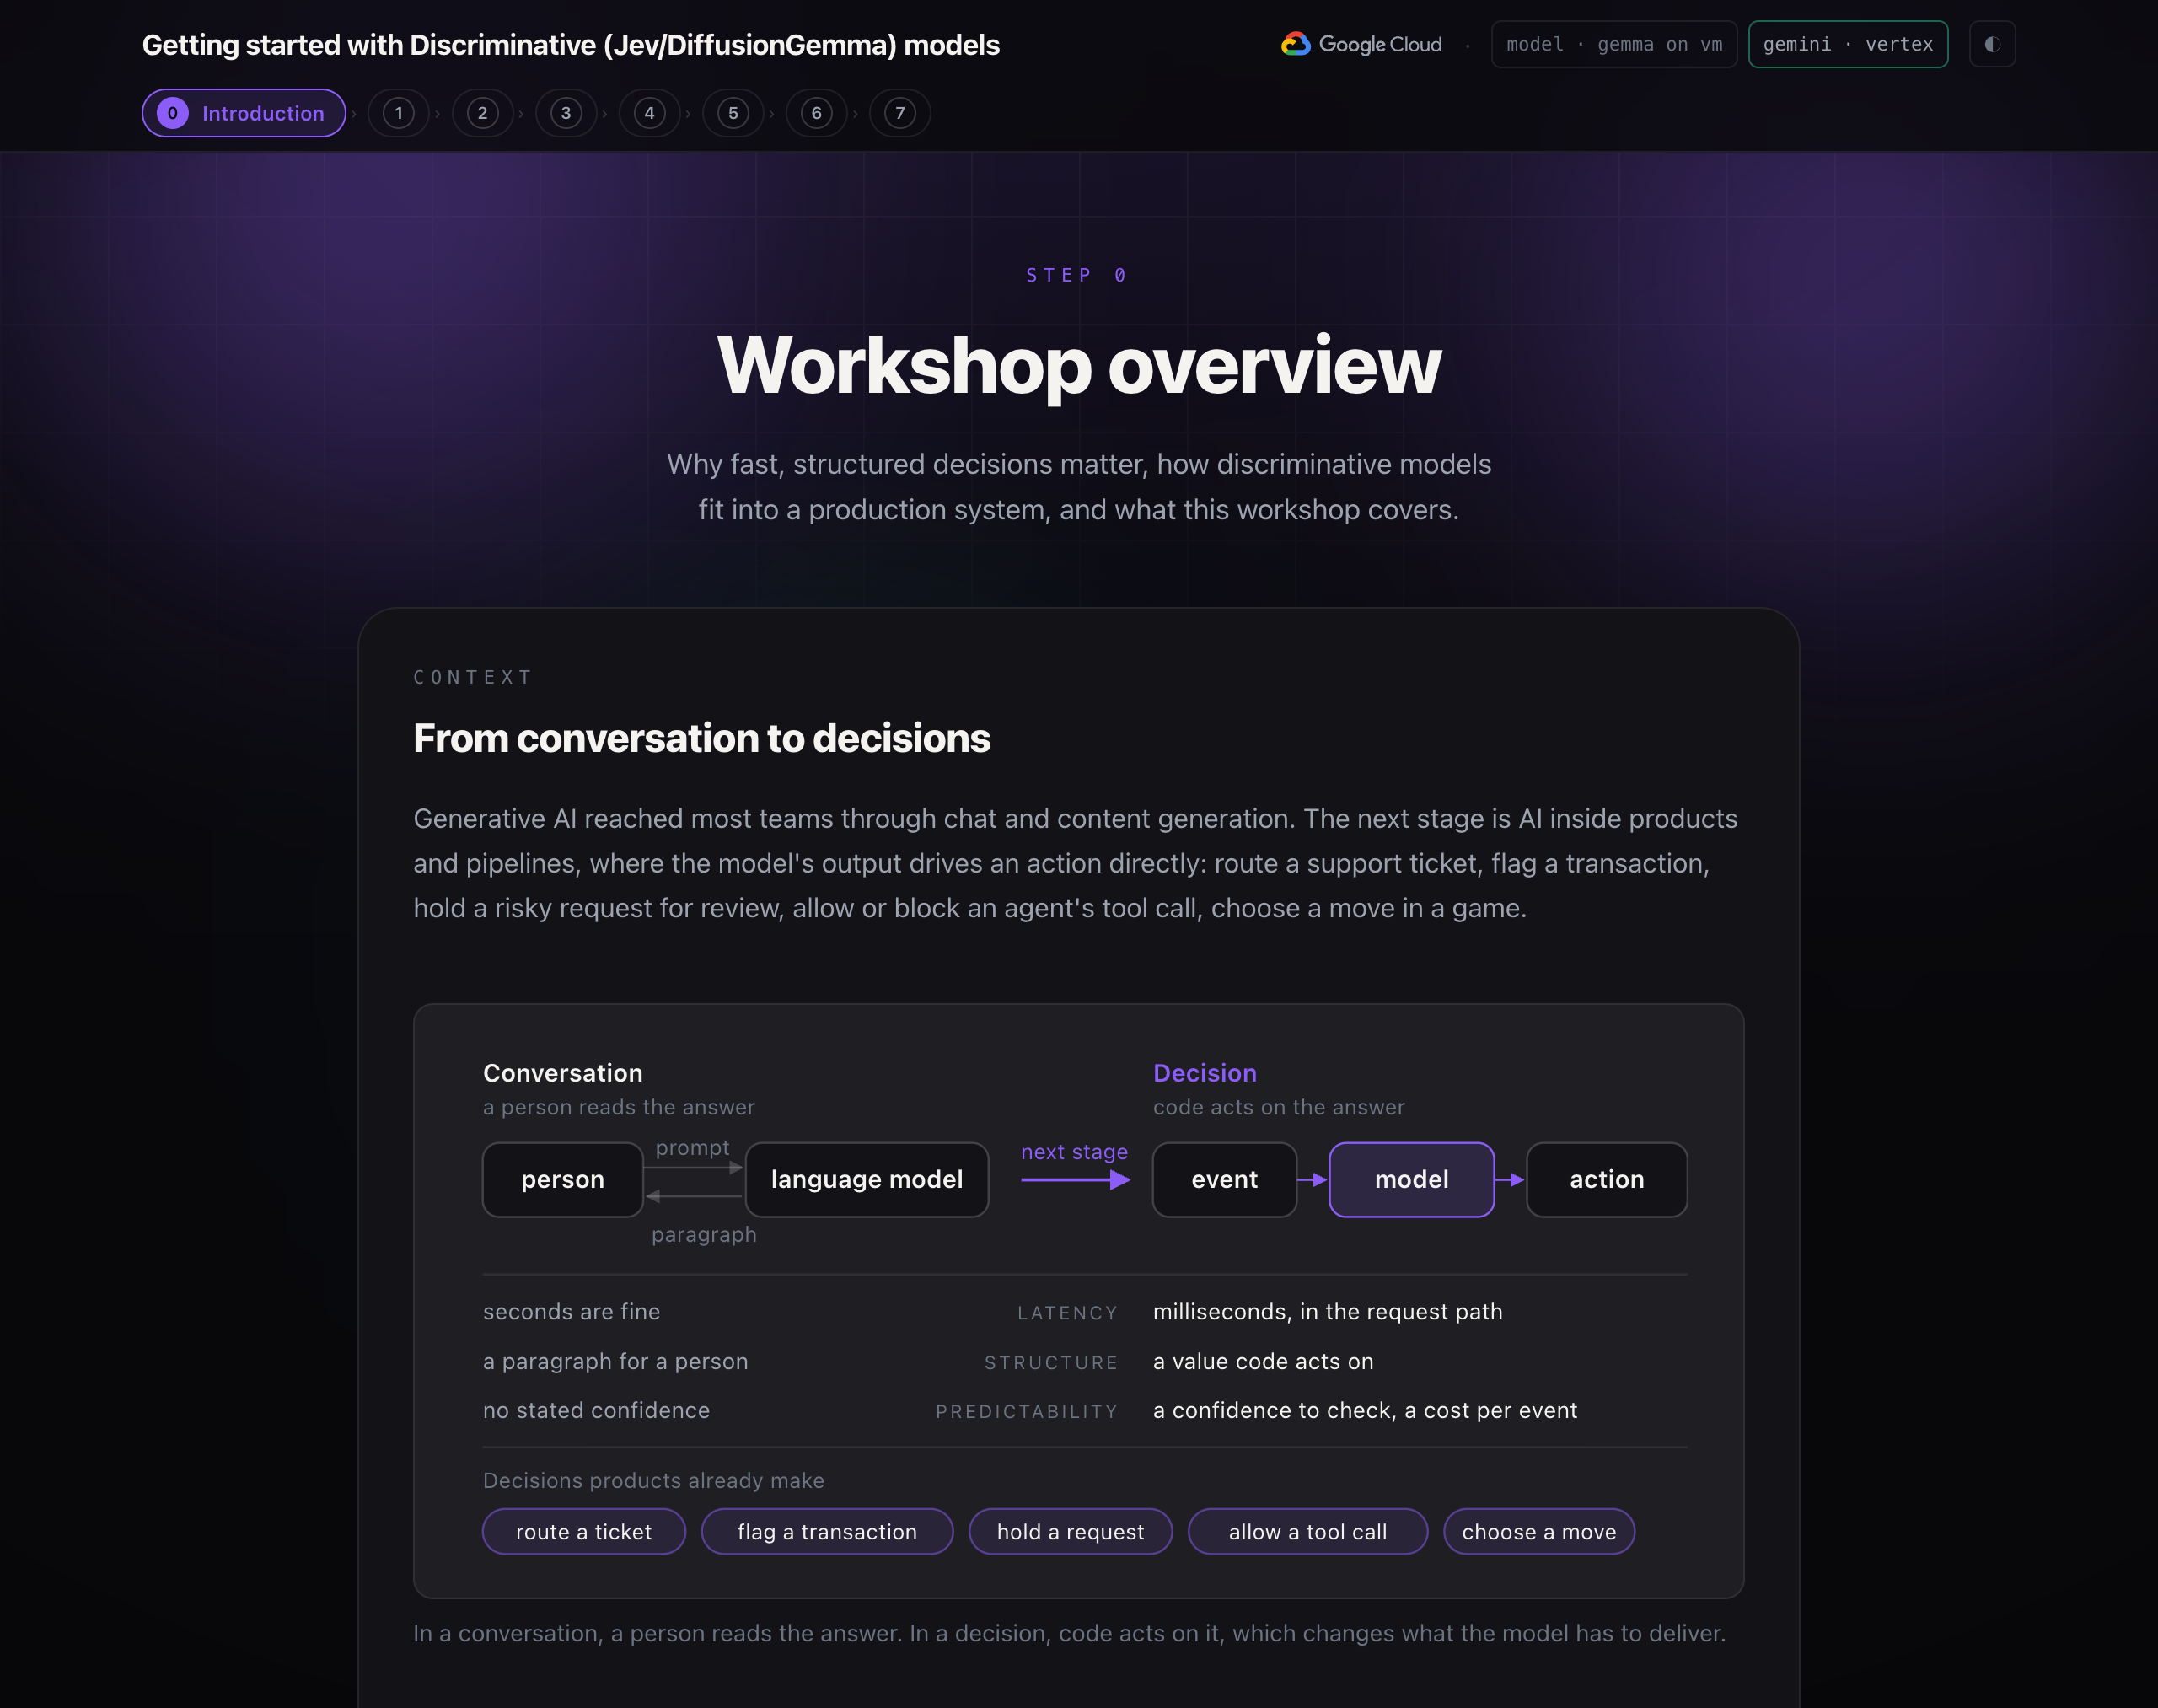
Generatywna AI trafiła do większości zespołów dzięki czatowi i generowaniu treści. Kolejny etap to AI w produktach i procesach, gdzie dane wyjściowe modelu bezpośrednio wywołują działanie: przekierowują zgłoszenie do pomocy, oznaczają transakcję, wstrzymują ryzykowną prośbę do sprawdzenia, zezwalają na wywołanie narzędzia przez agenta lub je blokują, wybierają ruch w grze.
Te decyzje spełniają 3 wymagania, których nie ma czat:
- Opóźnienie Odpowiedź często znajduje się na ścieżce żądania użytkownika lub w pętli w czasie rzeczywistym, więc musi dotrzeć w milisekundach, a nie w sekundach.
- Struktura Wywołujący to kod, więc odpowiedź musi być wartością, na podstawie której może on działać, a nie akapitem, który musi przeanalizować.
- Przewidywalność. Każda decyzja wymaga poziomu ufności, który kod może sprawdzić, oraz kosztu wystarczająco niskiego, aby można było o nią pytać przy każdym zdarzeniu.
Model językowy generuje tekst po jednym tokenie. Można ją poprosić o odpowiedź „tak” lub „nie”, ale w przypadku pętli w czasie rzeczywistym działa powoli, jej dane wyjściowe muszą zostać przeanalizowane, a ona sama nie podaje, jak bardzo jest pewna odpowiedzi.
Modele stworzone z myślą o podejmowaniu decyzji
Model dyskryminacyjny odpowiada na wpisane pytanie, podając prawdopodobieństwo każdej dopuszczalnej opcji w jednym przebiegu. Nie generuje tekstu. Warsztat można przeprowadzić na 2 sposoby:
Model | Dostawca | Miejsce, w którym model jest uruchamiany w ramach tego warsztatu |
Jev | TypeSafe AI | usługa hostowana TypeSafe, wywoływana za pomocą klucza interfejsu API; |
DiffusionGemma | Google, otwarte wagi | hostowane samodzielnie na maszynie wirtualnej z GPU w Twoim projekcie w chmurze Google |
Modele można wymieniać w zależności od potrzeb, a kod, który się z nimi łączy, nie musi się zmieniać.
Łączenie komponentów
Skuteczny system składa się z kilku komponentów:
Komponent | Rola | W tym warsztacie |
Workflow | Orkiestruje etapy, uruchamia gałęzie równolegle i przechowuje stan udostępniony. | Przepływ pracy z wykresem ADK |
Kod deterministyczny | Reguły, progi, weryfikacja. Natychmiastowe, bezpłatne i podlegające audytowi | zasady gry |
Model dyskryminacyjny | Szybkie, ograniczone decyzje z oceną pewności | Wybieranie odpowiedzi co sekundę |
Model językowy | Percepcja i generowanie: obrazy i tekst otwarty | Gemini odczytuje obraz karty zaklęcia i zapisuje zaklęcie. |
Architektura udostępniania modelu
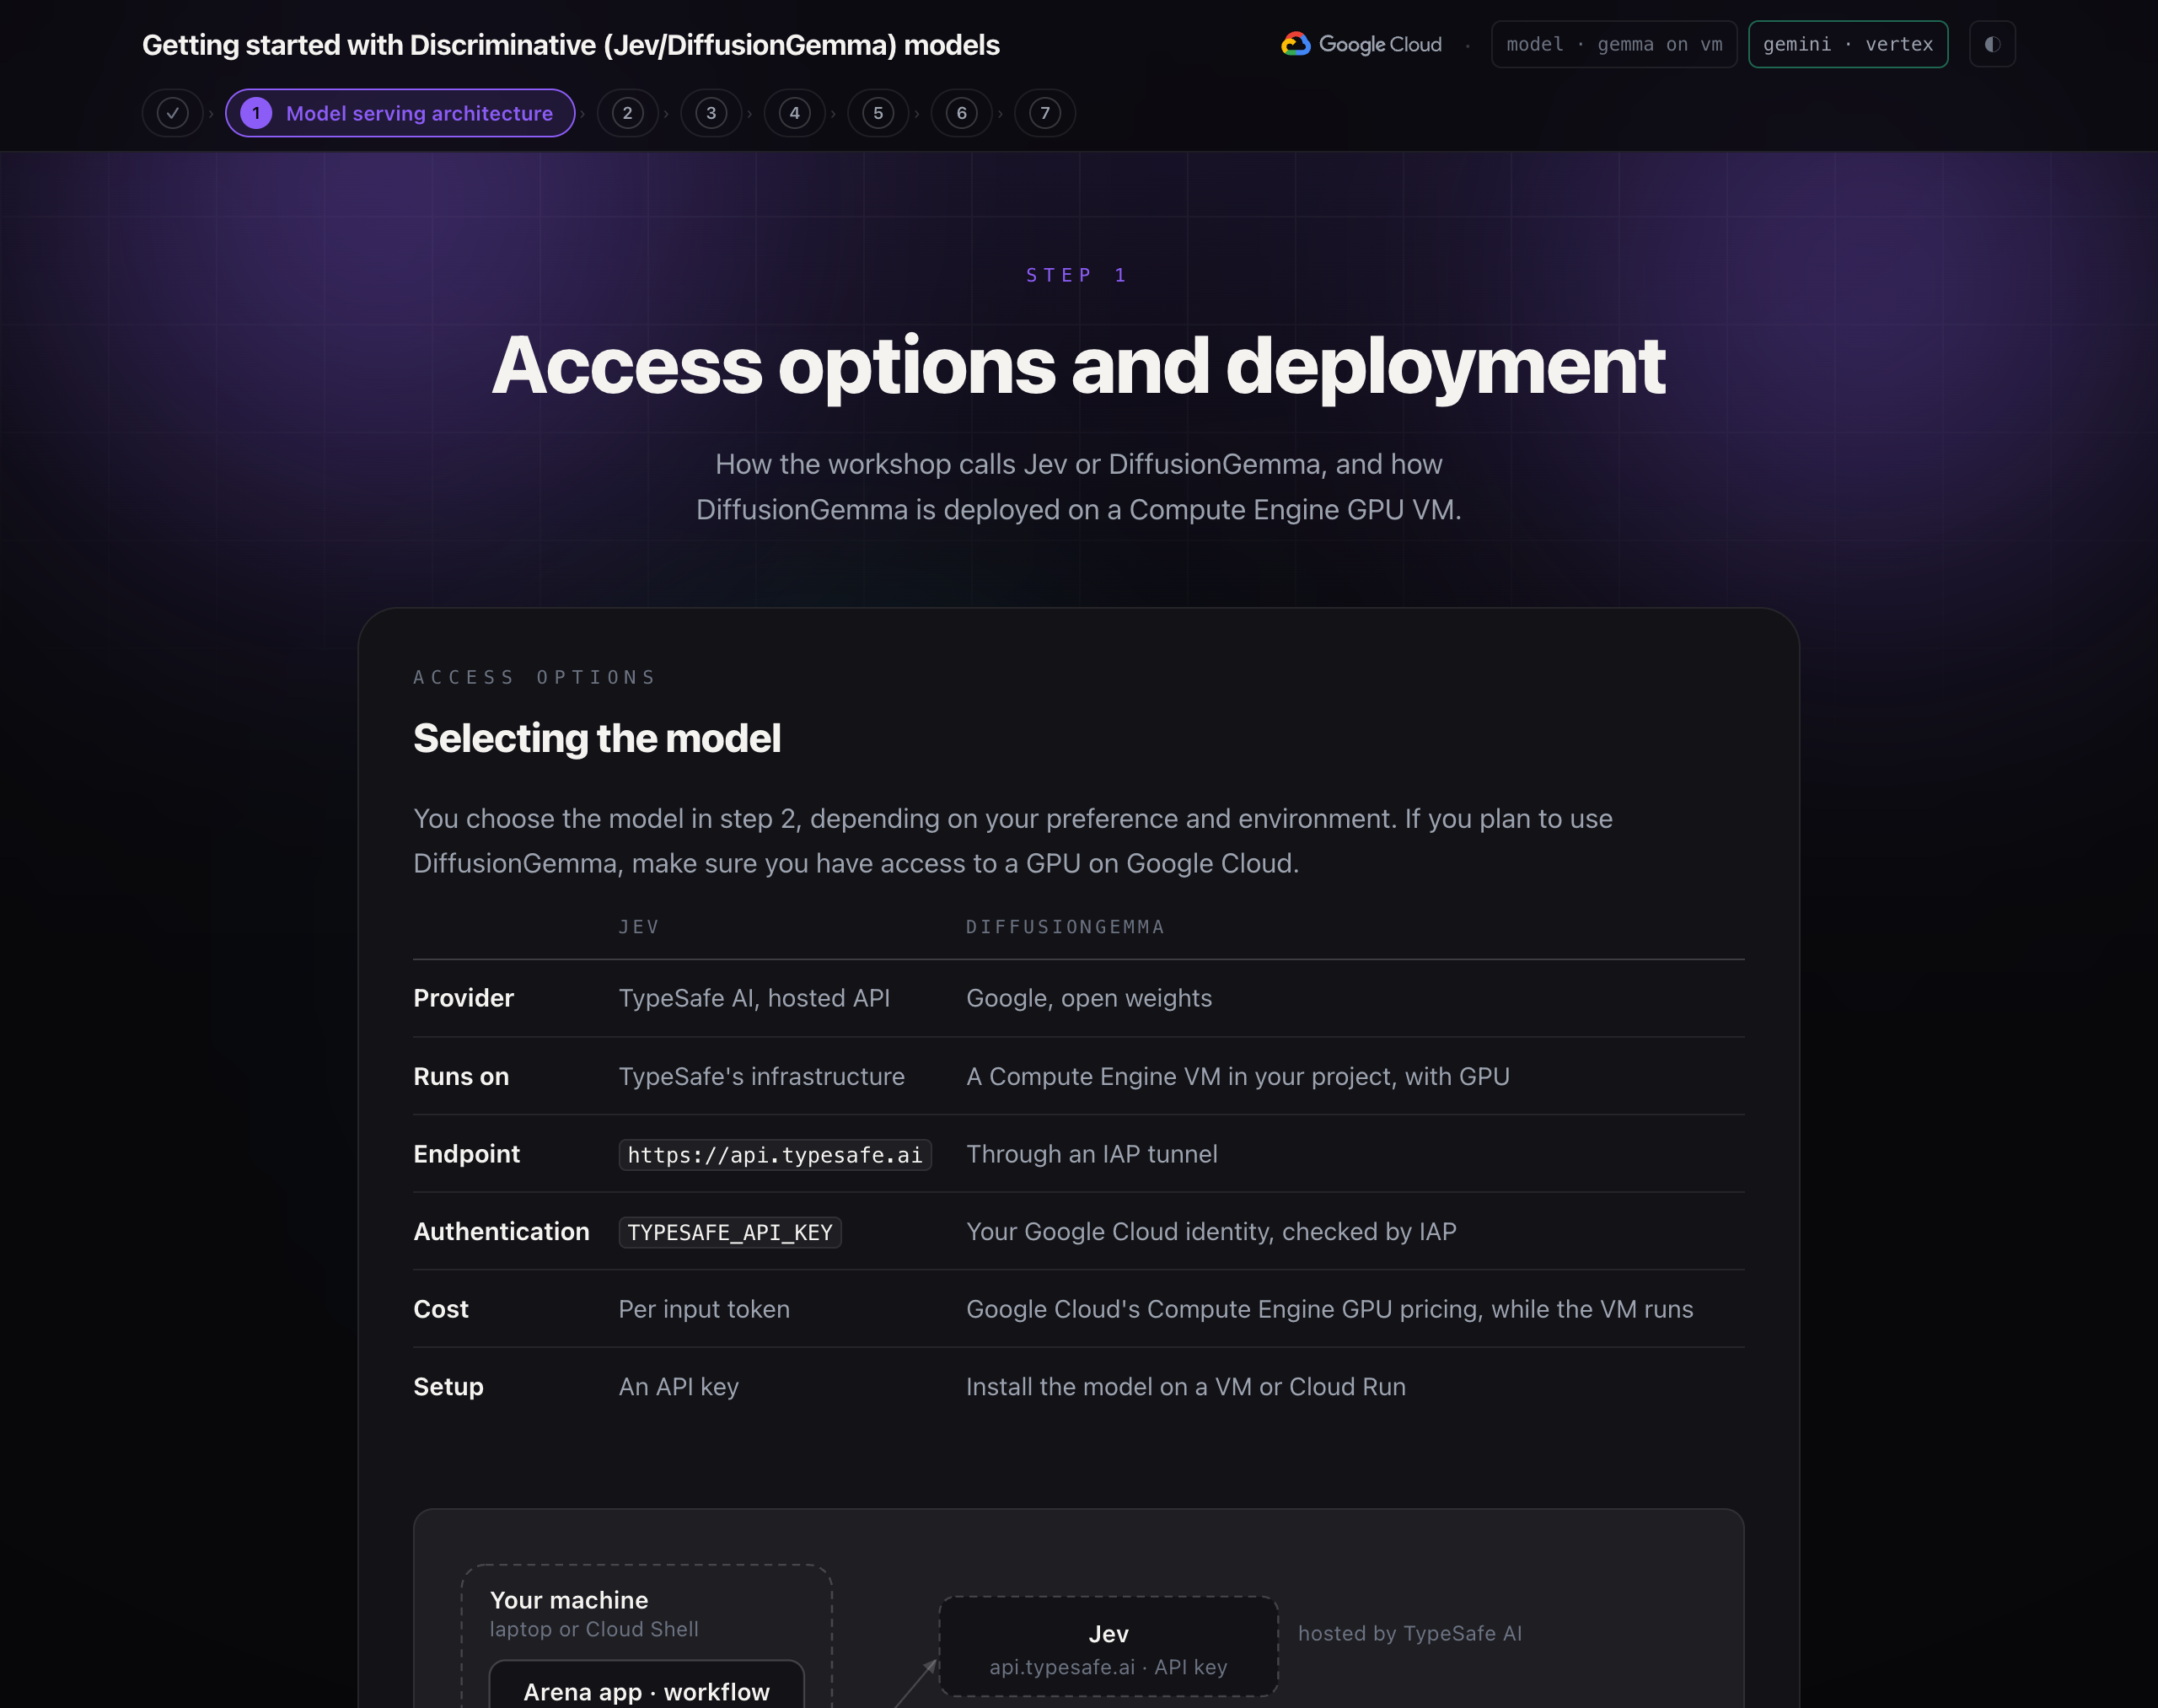
W kroku 2 wybierzesz model w zależności od preferencji i środowiska. Jeśli planujesz używać modelu DiffusionGemma, upewnij się, że masz dostęp do procesora GPU w Google Cloud.
Jev | DiffusionGemma | |
Dostawca | TypeSafe AI, hostowany interfejs API | Google, otwarte wagi |
Działa w | Infrastruktura TypeSafe | maszyna wirtualna Compute Engine w projekcie z GPU; |
Punkt końcowy |
| przez tunel IAP, |
Uwierzytelnianie |
| Twoja tożsamość Google Cloud sprawdzana przez IAP |
Koszt | Za token wejściowy | Ceny GPU w Compute Engine w Google Cloud podczas działania maszyny wirtualnej |
Konfiguracja | klucz interfejsu API, | Instalowanie modelu na maszynie wirtualnej lub w Cloud Run |
Przepływ danych
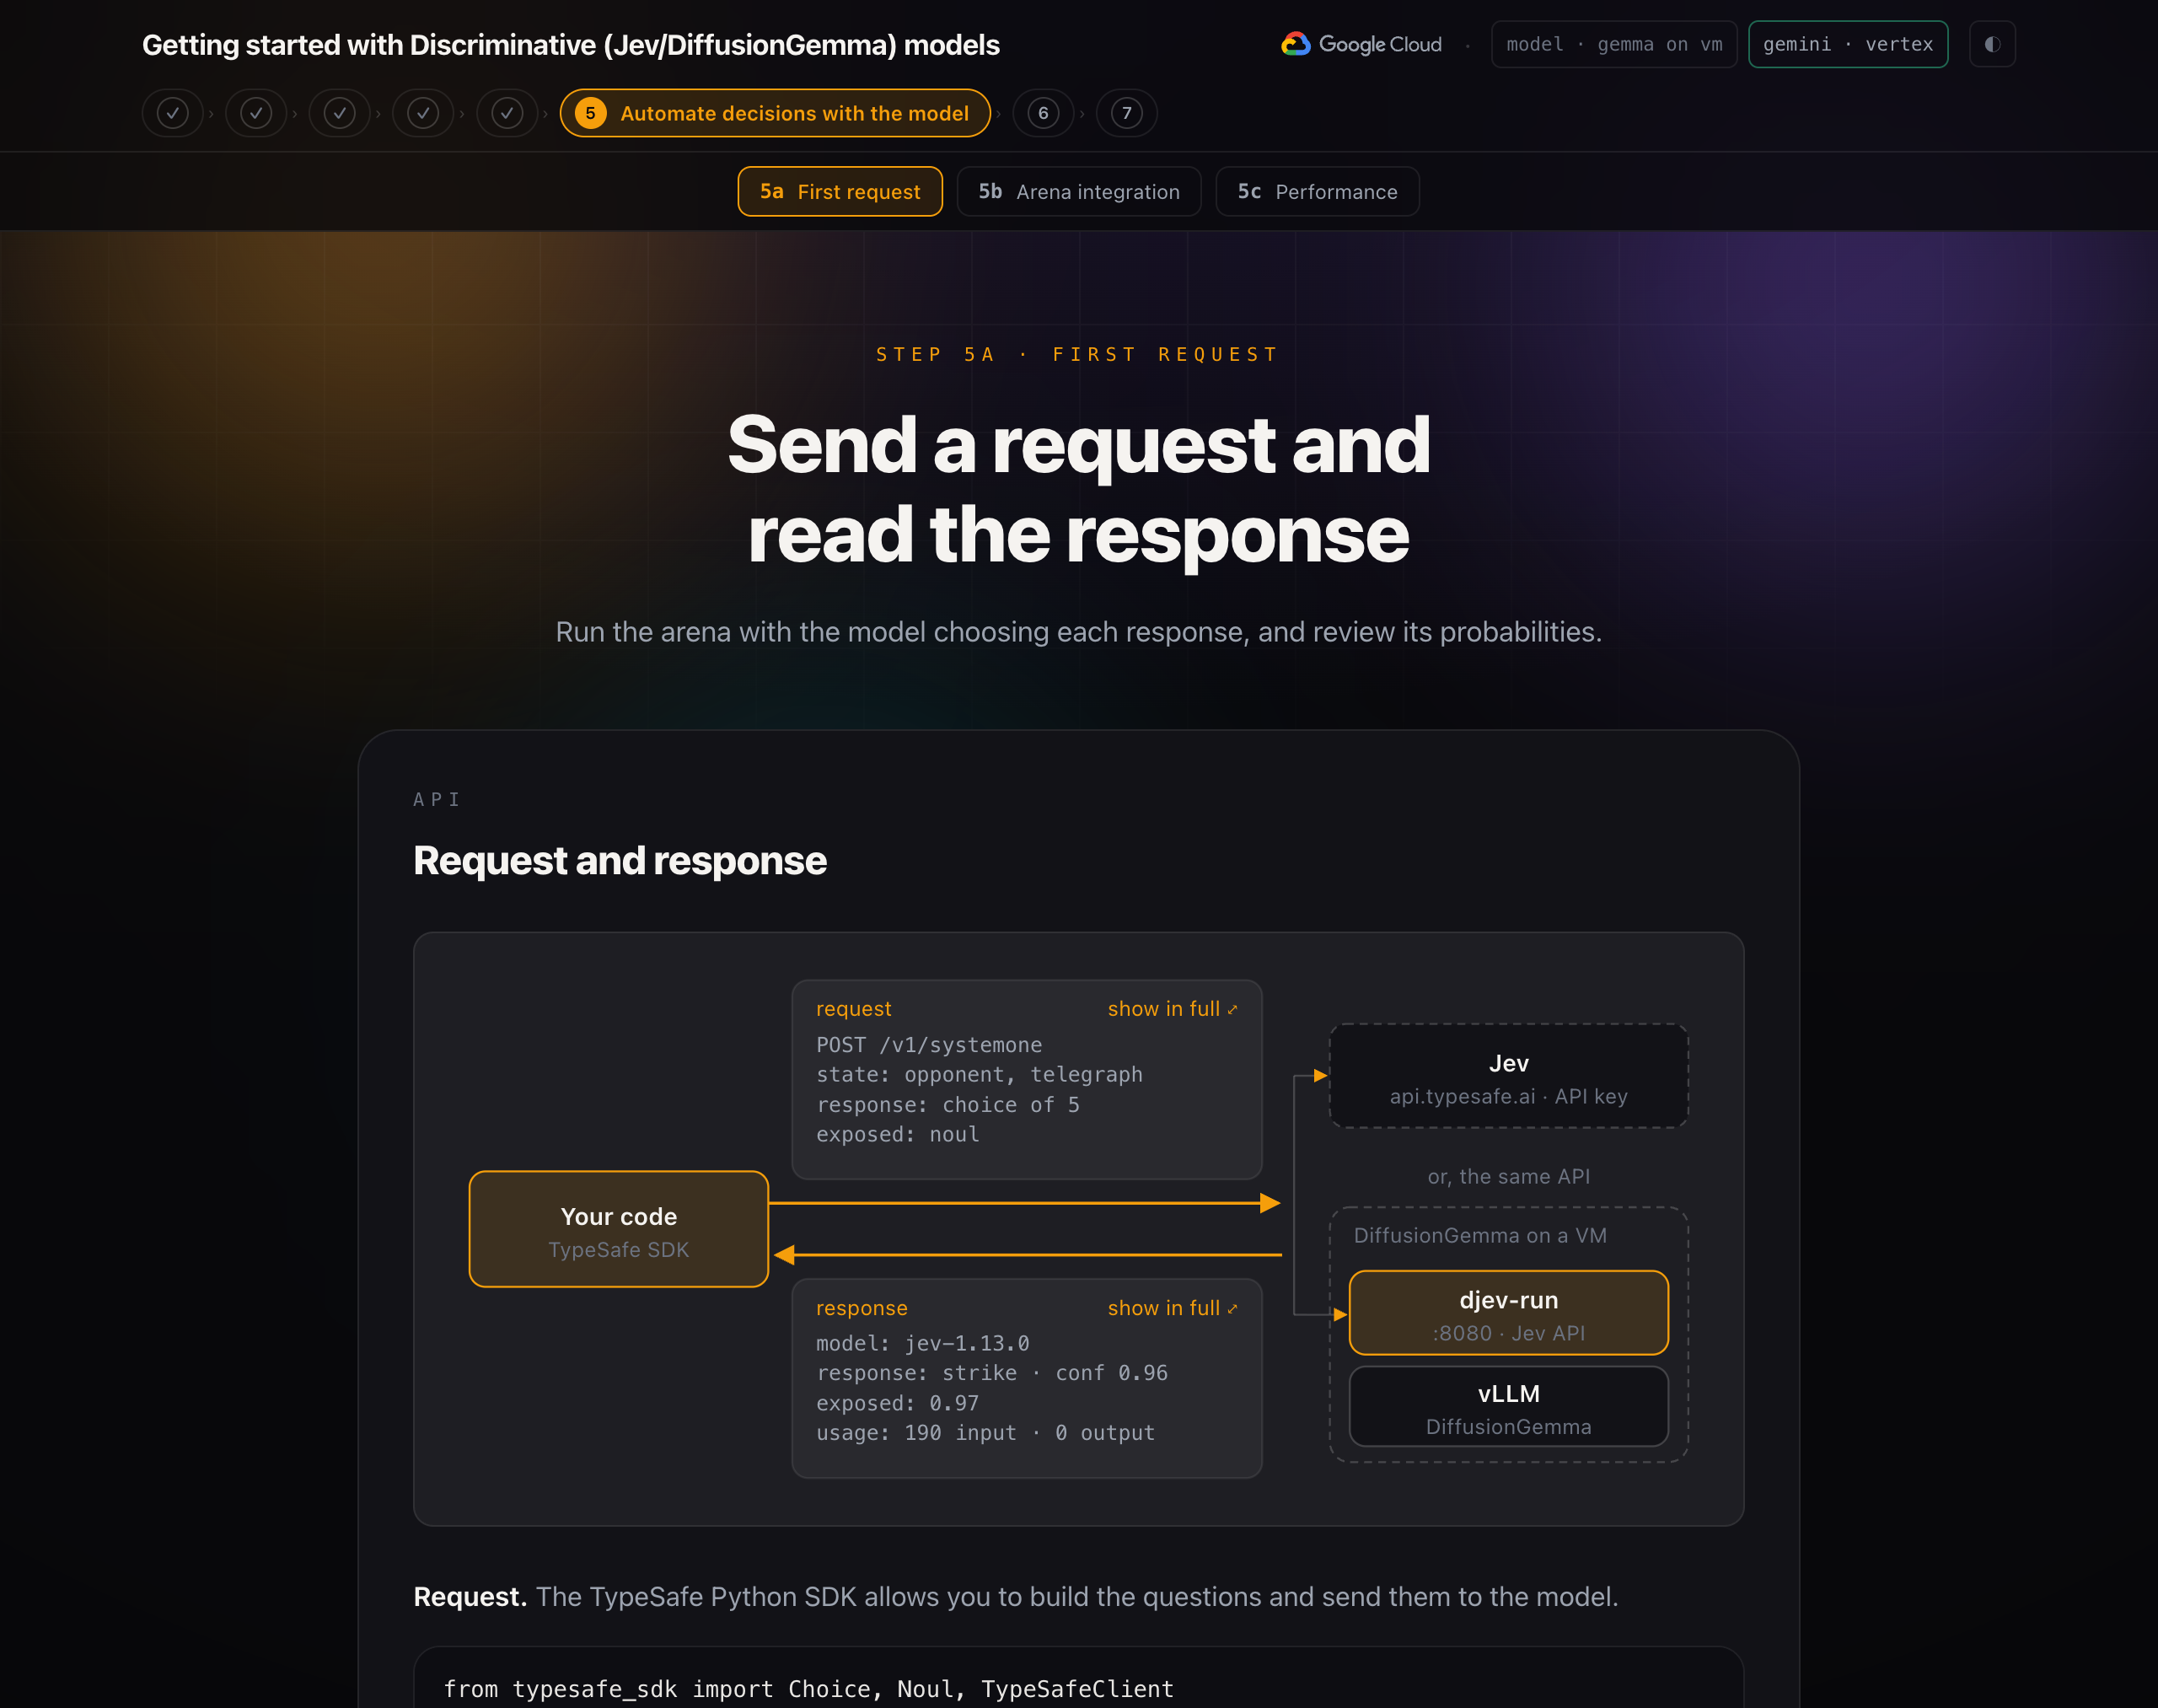
- Aplikacja na arenie lub przepływ pracy ADK tworzy żądanie: stan (co zrobił przeciwnik) i 3 pytania.
- Pakiet SDK TypeSafe wysyła go jako
POST /v1/systemonena skonfigurowany podstawowy adres URL. - W przypadku Jev żądanie jest wysyłane przez HTTPS na adres
api.typesafe.ai, a klucz API jest tokenem dostępu. - W przypadku modelu DiffusionGemma żądanie jest wysyłane na adres
localhost:8096. Proces w tlegcloud compute start-iap-tunnelprzekierowuje go przez Identity-Aware Proxy, który sprawdza Twoją tożsamość w Google, do portu 8080 na maszynie wirtualnej. - Na maszynie wirtualnej djev-run odbiera żądanie, uruchamia DiffusionGemma za pomocą vLLM na GPU i odczytuje prawdopodobieństwo każdej dozwolonej opcji.
- Oba backendy zwracają tę samą odpowiedź: odpowiedź na każde pytanie wraz z prawdopodobieństwami i wskaźnikiem ufności. Kod warsztatu stosuje swoje progi i działania.
DiffusionGemma w Compute Engine
scripts/setup_gemma.sh tworzy w Twoim projekcie:
- Sprawdza, czy region ma limit GPU.
- Włącza interfejsy Compute Engine i IAP API oraz tworzy regułę zapory sieciowej
allow-iap-djev. Zezwala ona tylko na zakres adresów IAP na portach 22 i 8080. - Tworzy maszynę wirtualną
djev-l4: typ maszynyg2-standard-4(4 procesory wirtualne, 16 GB pamięci), procesor graficzny z 24 GB pamięci, dysk o pojemności 100 GB i obraz maszyny wirtualnej do uczenia głębokiego ze sterownikiem NVIDIA 580. Jeśli w danej strefie nie ma mocy obliczeniowej GPU, usługa próbuje użyć następnej. - Przy pierwszym uruchomieniu skrypt startowy maszyny wirtualnej instaluje Dockera i NVIDIA Container Toolkit, pobiera obraz kontenera djev-run, pobiera wagi z Hugging Face (17,5 GB) i uruchamia kontener z dostępem do GPU na porcie 8080. Zajmie to około 15 minut. Późniejsze uruchomienia trwają około 2 minut.
- Zapisuje ustawienia połączenia w usłudze
.envi otwiera tunel.
Zadanie | Polecenie |
Zatrzymywanie maszyny wirtualnej (dysk pozostaje) |
|
Uruchom ponownie |
|
Sprawdź tunel |
|
Usuń wszystko |
|
Konfigurowanie modelu
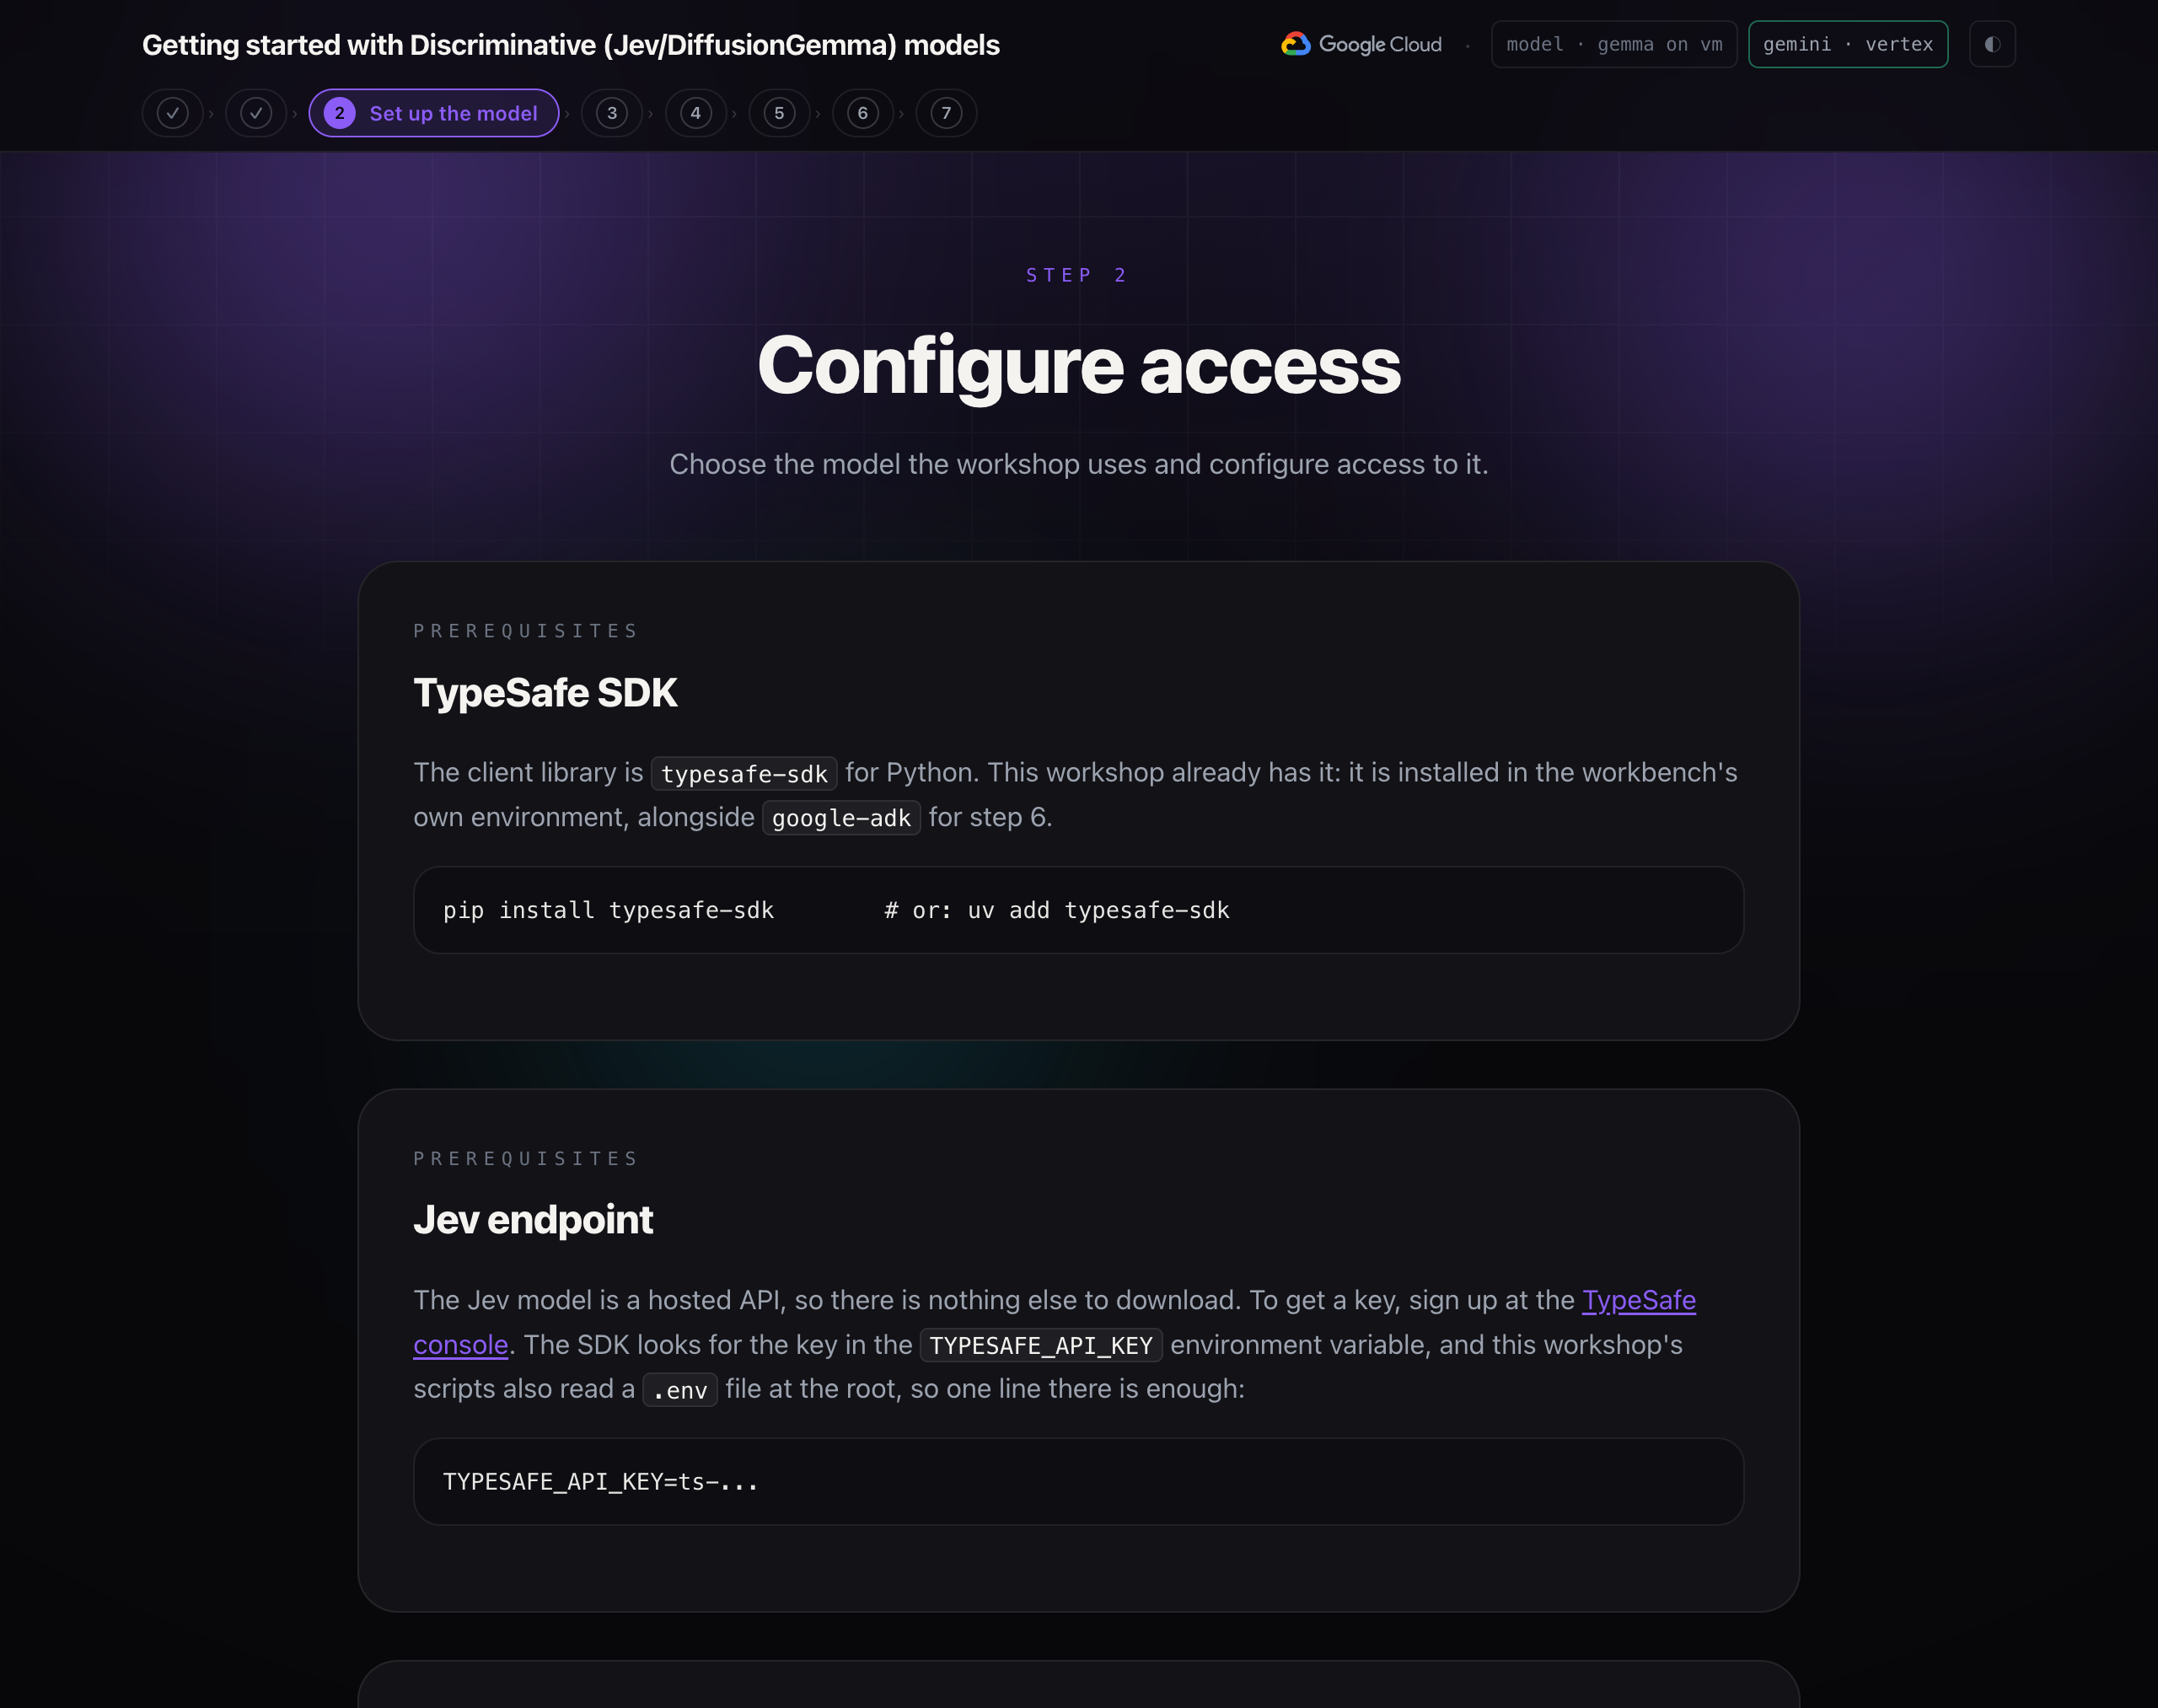
TypeSafe SDK
Biblioteka klienta jest dostępna typesafe-sdk w języku Python. W tym warsztacie jest już zainstalowany w środowisku platformy roboczej, obok google-adk w kroku 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Punkt końcowy Jev
Model Jev to hostowany interfejs API, więc nie musisz niczego pobierać. Aby uzyskać klucz, zarejestruj się w konsoli TypeSafe. Pakiet SDK szuka klucza w zmiennej środowiskowej TYPESAFE_API_KEY, a skrypty tego warsztatu odczytują też plik .env w katalogu głównym, więc wystarczy jeden wiersz:
TYPESAFE_API_KEY=ts-...
Korzystanie z DiffusionGemma
djev-run ponownie implementuje interfejs API modelu dyskryminacyjnego. Korzysta z tego samego punktu końcowego POST /v1/systemone i zawiera te same pytania dotyczące noul, wyboru i wyniku, ale pochodzi z DiffusionGemma, otwartego modelu dyfuzyjnego Google DeepMind (26 mld parametrów, ok. 4 mld aktywnych, licencja Apache 2.0). Format transmisji jest taki sam, więc pakiet SDK TypeSafe komunikuje się z nim bez zmian.
Jeśli w ćwiczeniu wybierzesz DiffusionGemma, będzie ona działać na GPU na maszynie wirtualnej w Twoim projekcie w chmurze Google, a w prawym górnym rogu pojawi się informacja gemma on vm (Gemma na maszynie wirtualnej). Workbench uzyskuje do niego dostęp przez prywatny tunel IAP, a port modelu nie jest otwarty na internet. Krok 1 zawiera opis pełnej architektury.
Dlaczego model dyfuzyjny może to zrobić: wypełnia cały blok pozycji naraz, a każda pozycja widzi pełne dane wejściowe, więc prawdopodobieństwo każdej dozwolonej opcji można odczytać w jednym kroku. Zwykły model językowy generuje po jednym tokenie i musi być wielokrotnie próbkowany.
Ręczne granie w grę
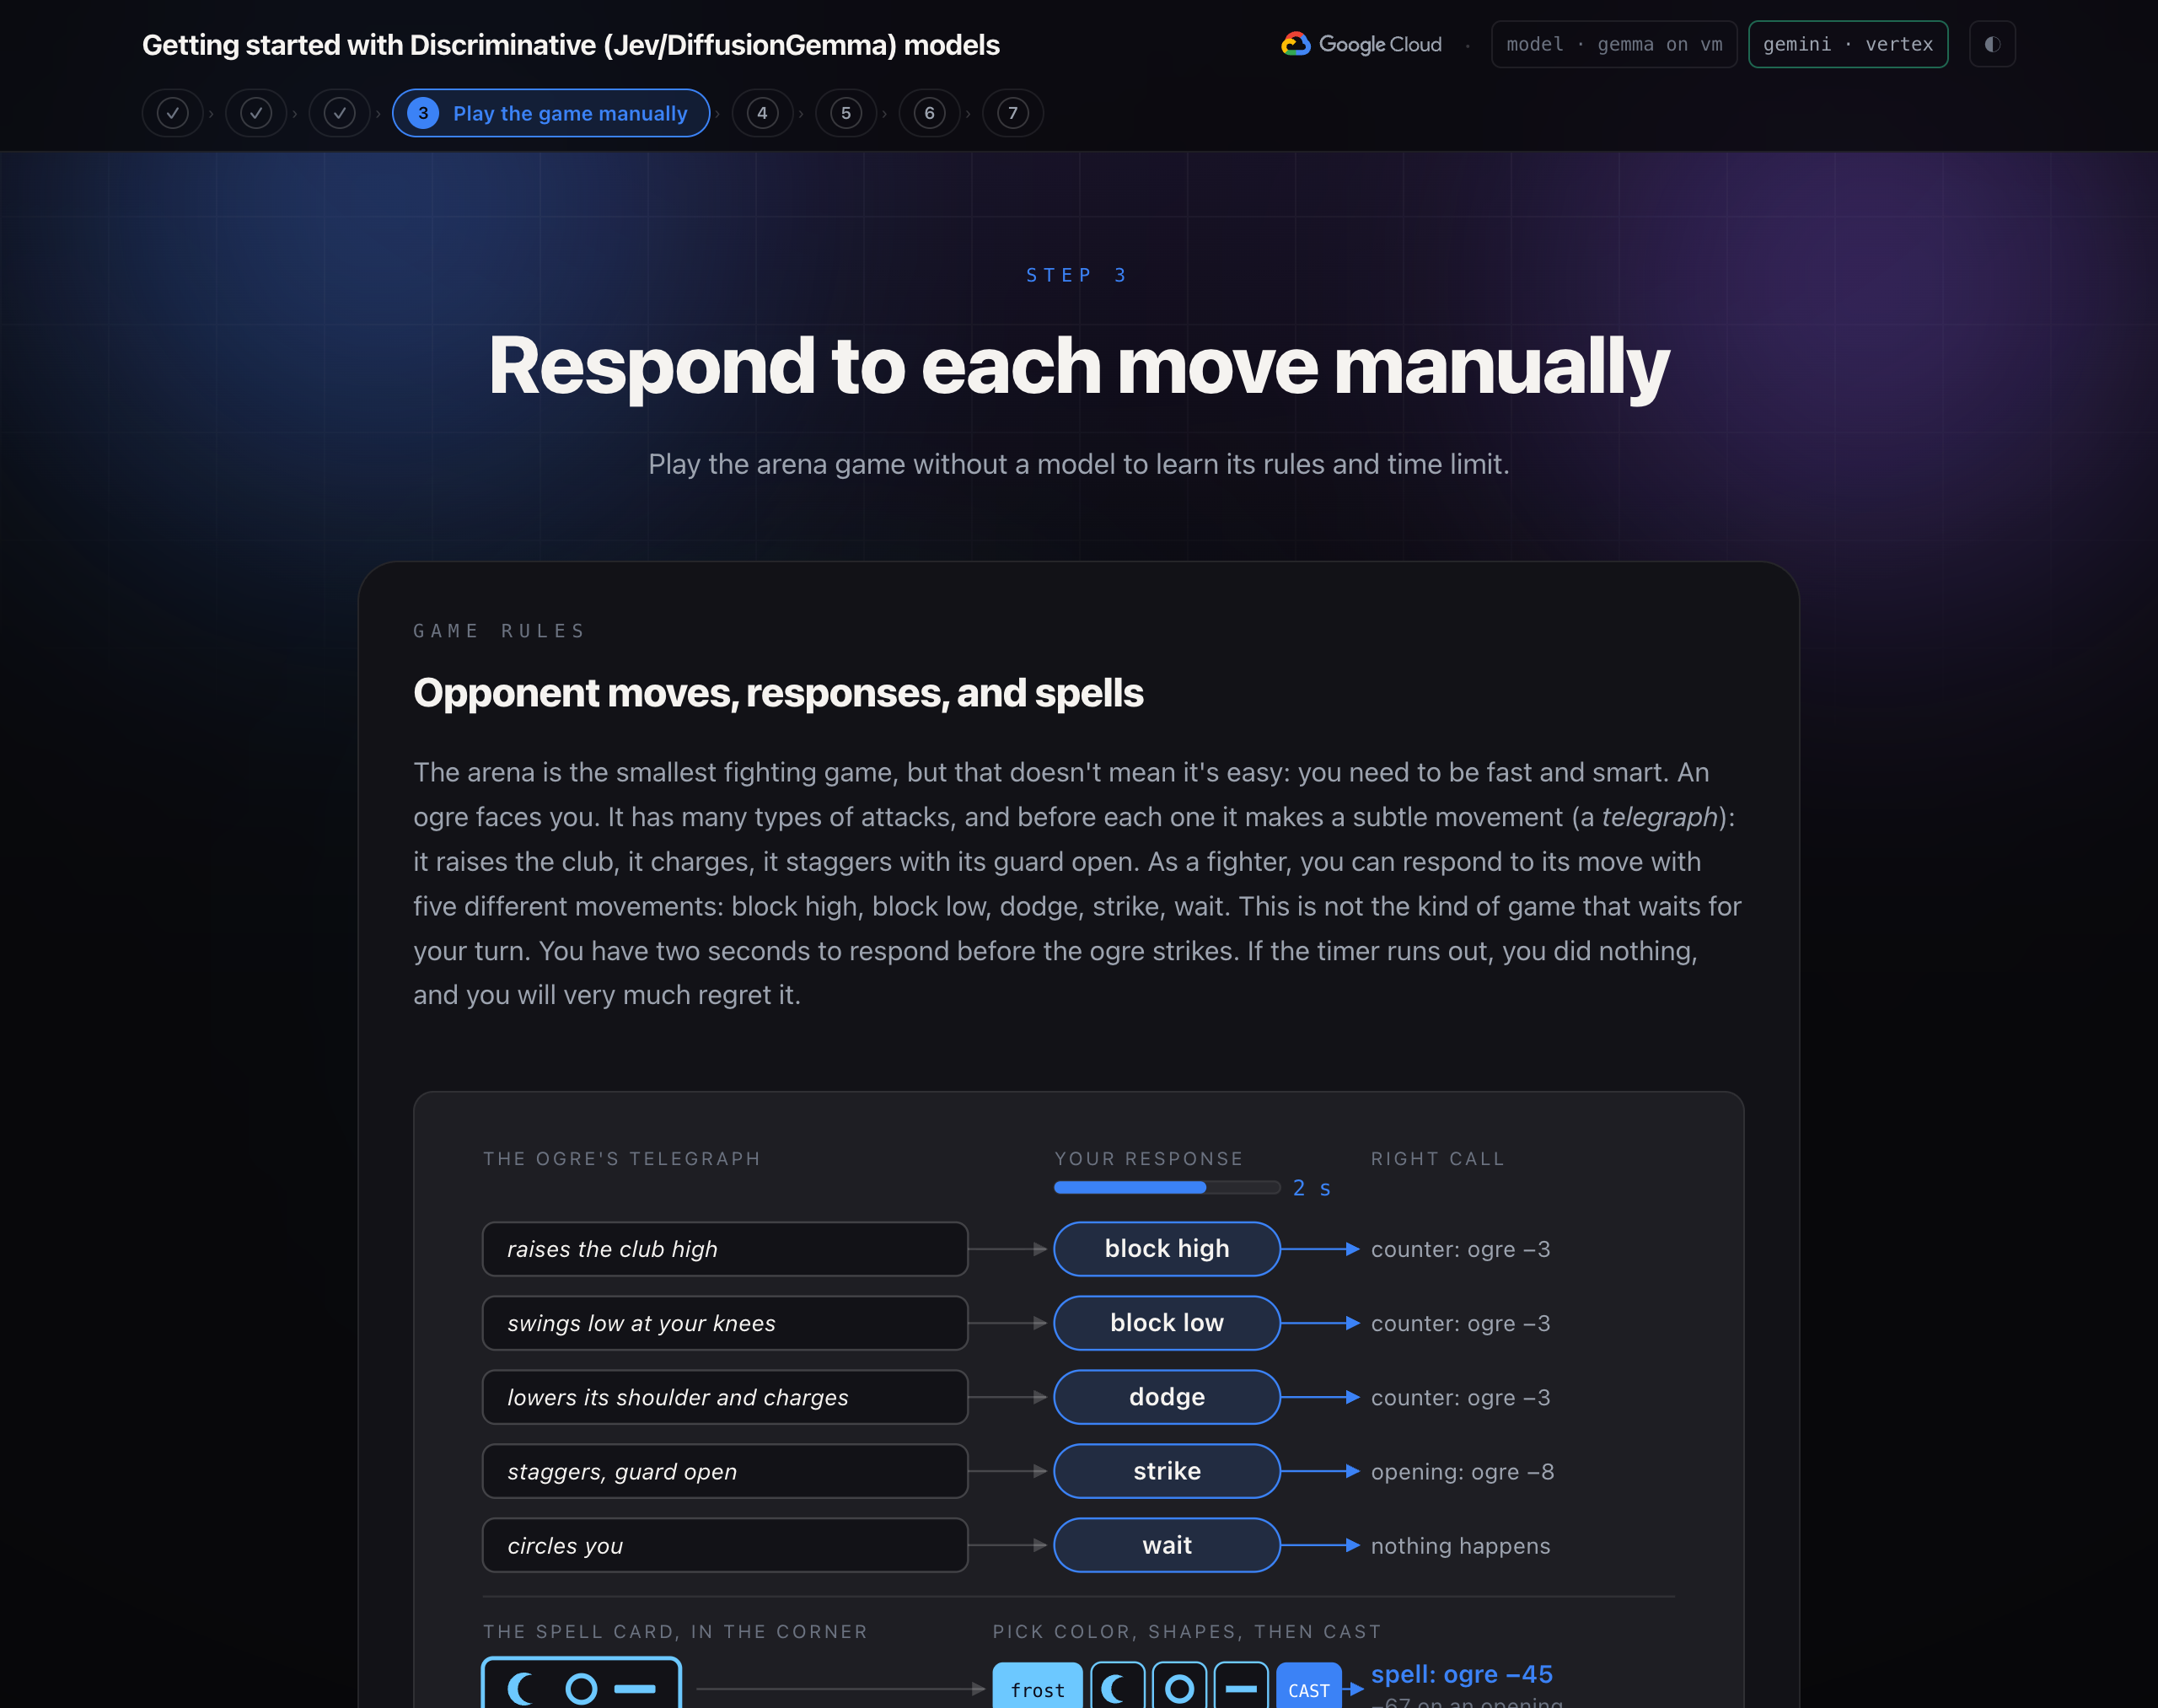
Arena to najmniejsza bijatyka, ale to nie znaczy, że jest łatwa: musisz być szybki i sprytny. Ogr patrzy na Ciebie. Ma wiele rodzajów ataków, a przed każdym z nich wykonuje subtelny ruch (sygnał): podnosi maczugę, szarżuje, chwieje się z otwartą gardą. Jako wojownik możesz odpowiedzieć na jego ruch 5 różnymi działaniami: blok górny, blok dolny, unik, atak i czekanie. To nie jest gra, w której czekasz na swoją kolej. Masz 2 sekundy na reakcję, zanim ogr zaatakuje. Jeśli czas się skończy, a Ty nic nie zrobisz, będziesz tego żałować.
W lewym górnym rogu pierścienia znajduje się karta zaklęcia: kolorowa karta z 3 kształtami. Prawdziwe obrażenia zadaje tylko zaklęcie, które do niego pasuje. W grze możesz rzucić zaklęcie za pomocą przycisków pod walką: wybierz kolor karty, a następnie kształty od lewej do prawej i kliknij RZUCIĆ. Zegar tyka, gdy wybierasz elementy, więc musisz jednocześnie budować zaklęcie i reagować na ataki ogra. Klawisze od 1 do 5 nadal odpowiadają poszczególnym ruchom. Nieudane zaklęcie nie działa. W kroku 6 Gemini odczytuje kartę zaklęcia.
Najważniejsza informacja: walka to strumień małych decyzji, z których każda ma swój termin. Tak w rzeczywistości wygląda większość automatyzacji oprogramowania, z wyjątkiem klubu.
Pojęcia związane z modelami dyskryminacyjnymi
Decyzje w oprogramowaniu
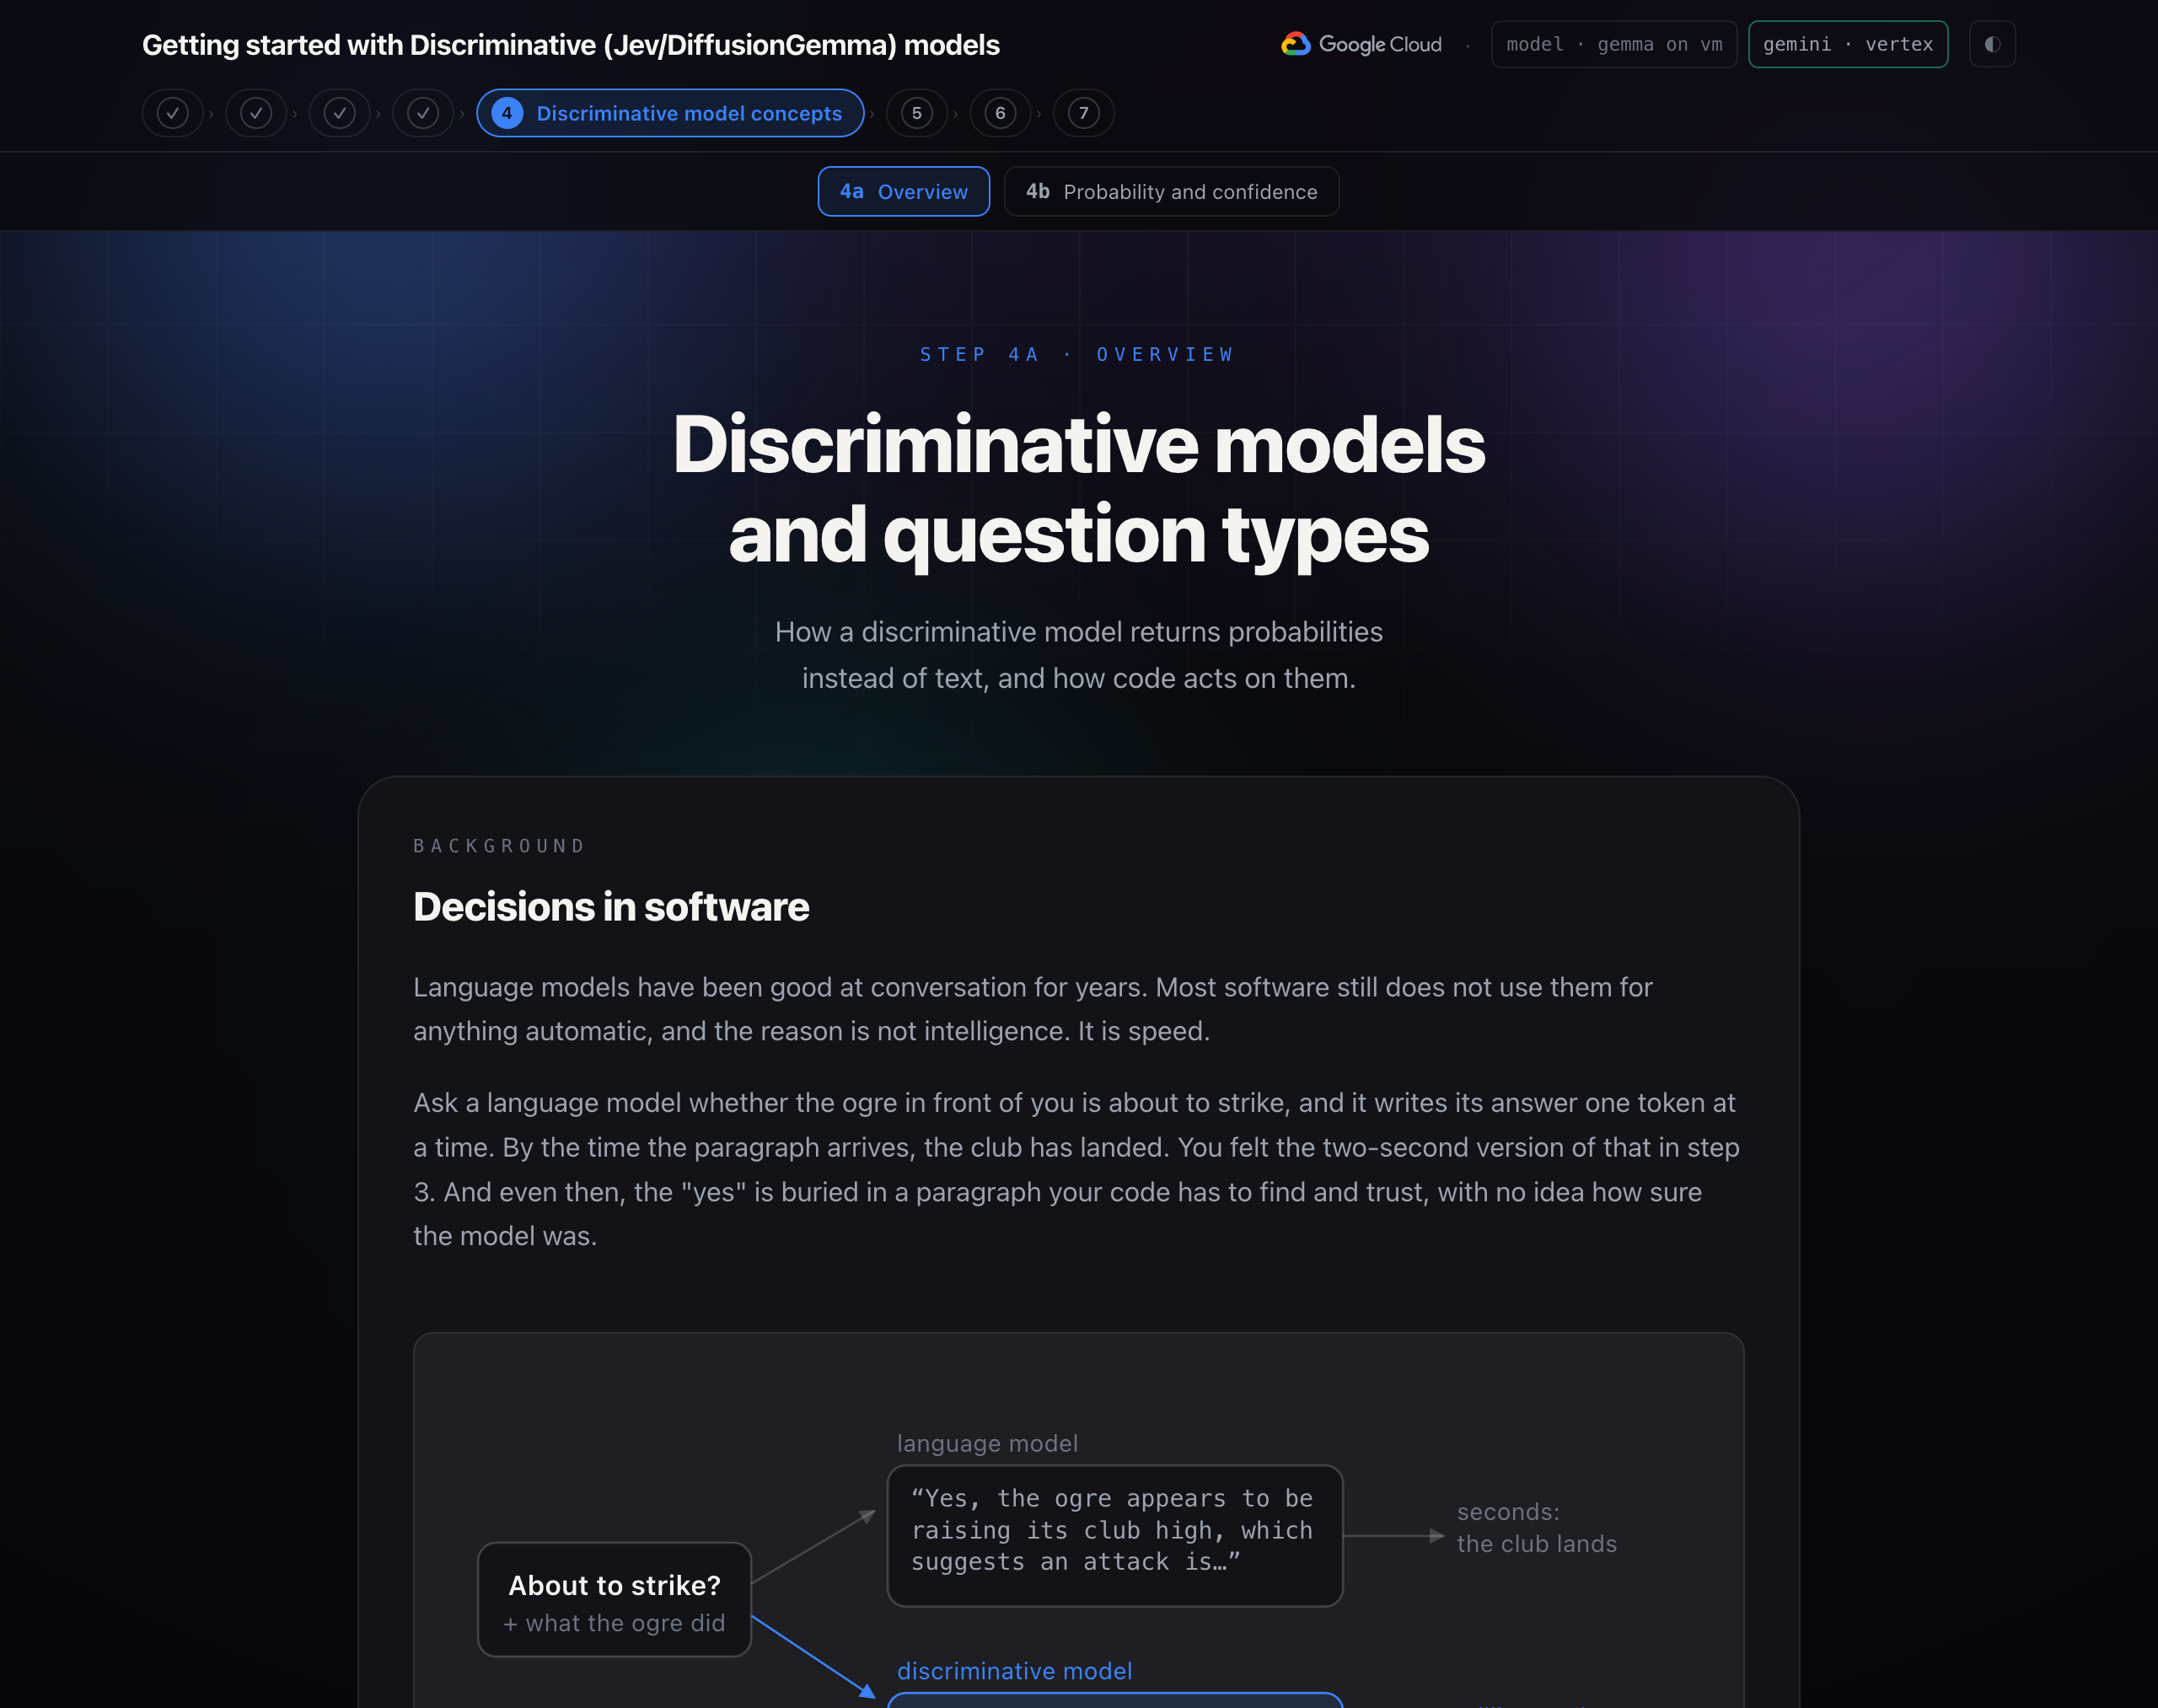
Modele językowe od lat dobrze radzą sobie w rozmowach. Większość oprogramowania nadal nie używa ich do niczego automatycznego, a powodem tego nie jest inteligencja. To szybkość.
Zapytaj model językowy, czy ogr przed Tobą zamierza zaatakować, a on będzie pisać odpowiedź po jednym tokenie. Zanim dotrze do Ciebie akapit, klub już wyląduje. W kroku 3 była to 2-sekundowa wersja. Nawet wtedy odpowiedź „tak” jest ukryta w akapitach, które Twój kod musi znaleźć i uznać za wiarygodne, nie mając przy tym pojęcia, jak pewny był model.
Model dyskryminacyjny przetwarza stan oraz wpisane pytania i odpowiedzi w jednym przebiegu w milisekundach. Każda odpowiedź ma skalibrowane prawdopodobieństwo: 0,9 oznacza, że odpowiedź jest prawidłowa 9 razy na 10. Nie ma tekstu do przeanalizowania ani kodu JSON do wyodrębnienia.
Modele System One i System Two
Nazwa pochodzi od książki Daniela Kahnemana Pułapki myślenia. O szybkim i wolnym myśleniu. System 2 to powolne, rozważne rozumowanie, krok po kroku. System One jest szybki i dopasowuje wzorce.
Model językowy to maszyna typu System 2. Działa na tokenach, po jednym naraz. Model dyskryminacyjny to model Systemu 1: nie uzasadnia odpowiedzi, niczego nie generuje i odpowiada na każde pytanie za jednym razem. Dlatego jest szybki (około 70–500 milisekund) i tani (ułamki centa za tysiąc decyzji).
Najważniejszy wniosek: pisze model językowy. Decyzję podejmuje model decyzyjny. Większość oprogramowania potrzebuje od AI decyzji.
Ograniczenia
Model dyskryminatywny nie będzie generować tekstu, pisać kodu, prowadzić rozmowy, wykonywać działań arytmetycznych, odczytywać obrazów ani wykonywać sekwencji działań.
Na warsztatach wybierzemy jeden z modeli dyskryminacyjnych:
- Jednym z modeli dyskryminacyjnych jest Jev. Jest to hostowany interfejs API od TypeSafe AI, który został udostępniony we wrześniu 2026 r. Pierwszy model to
jev-1.13, do którego można uzyskać dostęp za pomocą aliasujev-latest. Nie ma opublikowanych wag, więc model jest wywoływany, a nie pobierany. - Jev to nie jedyny sposób na zdobycie modelu System One. DiffusionGemma od Google to model o otwartych wagach, który zapisuje cały blok tokenów równolegle, a nie pojedynczo. Ten sam równoległy przebieg może odczytywać prawdopodobieństwa w ustalonym zbiorze opcji. Serwery open source, takie jak djev-run, udostępniają dokładny interfejs API Jev, więc wszystko w tych warsztatach działa bez zmian.
Stan i pytania: Choice, Score i Noul
Każde wywołanie wysyła stan i pytania. Stan to tekst, który ma zostać oceniony. Może to być ciąg znaków, obiekt JSON lub lista. Pytania dotyczą tego, czego chcesz się dowiedzieć o tekście. Każde pytanie ma typ: Choice, Score lub Noul. Pytania są przetwarzane równolegle, co pozwala na szybkie udzielanie odpowiedzi. W razie potrzeby możesz dodać więcej pytań.
- Funkcja Choice wybiera jedną z maksymalnie 255 opcji z określonego przez Ciebie zbioru. Odpowiedź to opcja, prawdopodobieństwo dla każdej opcji i poziom ufności. Używaj go, gdy opcje nie są uporządkowane: blokuj wysokie, blokuj niskie, unikaj, uderzaj, czekaj.
- Wynik ocenia stan na podstawie uporządkowanych poziomów, które opiszesz (od 2 do 10). Odpowiedź to pozycja na skali (liczba dziesiętna, np.1, 4 oznacza „między 1 a 2, bliżej 1”), prawdopodobieństwo każdego poziomu i poziom ufności. Używaj jej, gdy odpowiedź zależy od stopnia: jak mocne będzie nadchodzące uderzenie.
- Zarówno Choice, jak i Score zwracają prawdopodobieństwo dla każdej opcji oraz poziom ufności. Różnica polega na głównej odpowiedzi. Obiekt Choice zwraca najbardziej prawdopodobną opcję. W przypadku wyniku opcje są traktowane jako uporządkowane poziomy, a wynik to średnia ważona prawdopodobieństwa, która może się znajdować między 2 poziomami. Jeśli waga odpowiedzi „brak” wynosi 0,05, „lekka” – 0,55, a „ciężka” – 0,40, a odpowiedź na pytanie wielokrotnego wyboru to „lekka”, a odpowiedź na pytanie z oceną to 1,35, czyli między „lekka” a „ciężka”. Arena używa tej wartości:
choose()traktuje wynik zagrożenia wynoszący co najmniej 1,5 jako silne uderzenie.
- Zarówno Choice, jak i Score zwracają prawdopodobieństwo dla każdej opcji oraz poziom ufności. Różnica polega na głównej odpowiedzi. Obiekt Choice zwraca najbardziej prawdopodobną opcję. W przypadku wyniku opcje są traktowane jako uporządkowane poziomy, a wynik to średnia ważona prawdopodobieństwa, która może się znajdować między 2 poziomami. Jeśli waga odpowiedzi „brak” wynosi 0,05, „lekka” – 0,55, a „ciężka” – 0,40, a odpowiedź na pytanie wielokrotnego wyboru to „lekka”, a odpowiedź na pytanie z oceną to 1,35, czyli między „lekka” a „ciężka”. Arena używa tej wartości:
- Noul zadaje pytanie, na które można odpowiedzieć „tak” lub „nie”, i zwraca prawdopodobieństwo, że odpowiedź będzie twierdząca. Wartość bliska 1 oznacza zdecydowane „tak”, bliska 0 – zdecydowane „nie”, a bliska 0,5 – „może być tak lub tak”. Nie ma osobnego poziomu ufności, ponieważ prawdopodobieństwo jest jego poziomem ufności.
Zadawaj konkretne pytania
Model dyskryminacyjny działa najlepiej, gdy pytanie dotyczy jednej konkretnej, dobrze określonej kwestii. „What is the situation?” (Jaka jest sytuacja?) zwraca prawdopodobną odpowiedź o niskim poziomie ufności. „Jaka jest prawidłowa odpowiedź?”, „Is the opponent exposed?” (Czy przeciwnik jest odsłonięty?) i „How hard will this hit?” (Jak mocne będzie to uderzenie?) zwracają 3 skoncentrowane odpowiedzi, które Twój kod łączy.
Opisy opcji i poziomów są tanie, ale mają znaczenie. Reguły, które zostały odczytane w kroku 3, stają się opisami opcji: block_high: "Raise the shield. Right against an overhead or a high swing." w ten sposób model dyskryminacyjny uczy się reguł walki w momencie wysłania żądania, po jednej regule w wierszu. Opcje mogą się zmieniać w zależności od sytuacji: arena oferuje tylko cast, gdy zaklęcie jest gotowe.
Prawdopodobieństwa i pewność
Odpowiedź typu „Wybór” nie jest etykietą. Jest to rozkład etykiet, a etykieta to po prostu najwyższy słupek.
Sposób, w jaki model uzyskuje numer. Wykorzystuje ten sam krok, którego model językowy używa do wyboru następnego słowa. Model Transformer odczytuje tekst i w jednym miejscu przypisuje każdemu tokenowi w swoim słowniku surowy wynik, zwany logitem. Wyższy logit oznacza, że token lepiej pasuje do tej pozycji. Funkcja softmax przekształca logity w prawdopodobieństwa, których suma wynosi 1. Model językowy wybiera token, dodaje go do tekstu i powtarza ten proces. Model dyskryminacyjny zatrzymuje się po obliczeniu prawdopodobieństw.
Puste miejsce to luka w formularzu odpowiedzi. Serwer sam tworzy formularz, np. response: ▢, i pozostawia jedną lukę na pytanie. Jedynym zadaniem modelu jest ocena, co pasuje do każdej luki.
- Prompt zawiera stan i każde pytanie z każdą dopuszczalną odpowiedzią jako krótką etykietą:
adla block_high,bdla block_low itd. - Serwer dodaje formularz odpowiedzi z jednym pustym polem na pytanie.
- Model odczytuje prompt i formularz w jednym przebiegu i przypisuje każdemu tokenowi logit w każdym pustym polu. Model dyfuzyjny widzi cały formularz naraz i ocenia wszystkie puste pola jednocześnie.
- Serwer zachowuje tylko logity dozwolonych etykiet i stosuje do nich funkcję softmax, dzięki czemu dozwolone odpowiedzi sumują się do 1.
- Jeśli odczyt jest niepewny, serwer odczytuje ponownie z innego losowego miejsca i oblicza średnią odczytów.
Pewność to liczba określająca, jak bardzo prawdopodobna jest odpowiedź. TypeSafe oblicza ją na podstawie rozkładu prawdopodobieństwa między opcjami. Wszystko w jednej opcji daje 1, a równomierny rozkład daje 0. W przypadku 3 opcji jest to (3 × największa – 1) / 2.
Trenuje model TypeSafe Jev, aby uzyskać skalibrowane prawdopodobieństwa. Prawdopodobieństwo odpowiada częstotliwości, z jaką odpowiedź jest prawidłowa. W skalibrowanym modelu odpowiedzi udzielane z ufnością na poziomie 0,7 są prawidłowe w około 70% przypadków, więc próg ufności jest progiem określającym, jak często akceptujesz błędną odpowiedź. Serwer DiffusionGemma w tych warsztatach zgłasza najwyższe prawdopodobieństwo jako poziom ufności, uśredniony na podstawie odczytów. Gdy odczyty są różne, średnia się rozkłada, a ufność spada.
Kluczowa informacja: odpowiedź informuje Cię co. Poziom ufności informuje, czy należy podjąć działanie.
Progi
Próg określa sposób zdefiniowania działania w kodzie. Model zwraca wskaźnik ufności lub prawdopodobieństwo. Kod porównuje ją z wybraną przez Ciebie liczbą, a wynik decyduje o tym, co się stanie.
Próg dla każdego działania TypeSafe sugeruje podzielenie poziomu ufności na przedziały. Działanie o wysokim poziomie pewności jest wykonywane automatycznie. Działania o średnim poziomie pewności są wykonywane z sprawdzeniem, np. prośba o potwierdzenie lub oznaczenie sprawy do sprawdzenia. Gdy poziom ufności jest niski, model nie podejmuje działania i wraca do bezpiecznego stanu lub przekazuje zadanie osobie.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Zasady obowiązujące na arenie. Progi areny znajdują się w pliku choose(), który uruchomisz w kroku 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Ostrzeżenie: prawidłowa odpowiedź nie zawsze jest poprawna. Model dyskryminacyjny nie może zwrócić opcji, której nie zaproponowano, więc nigdy nie generuje ruchu, ale może wybrać niewłaściwy ruch, czasami z dużą pewnością. Zanim ustalisz próg ufności, przetestuj pytania w odniesieniu do sytuacji, które już zostały przez Ciebie ocenione.
Automatyzowanie decyzji za pomocą modelu
Żądanie i odpowiedź
Żądanie. Pakiet SDK TypeSafe Python umożliwia tworzenie pytań i wysyłanie ich do modelu.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Jedno żądanie na interwał
Przy każdym takcie aplikacja wysyła telegraf jako stan i w ramach jednego wywołania zadaje 3 pytania:
- Która odpowiedź jest prawidłowa spośród 5 (lub 6, gdy zaklęcie jest gotowe). Wybór.
- Czy ogr jest obecnie narażony na kontrę. A Noul.
- Jak silne jest uderzenie (w 3-stopniowej skali). Wynik.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Funkcja choose()
Pamiętasz progi z kroku 4? choose() porównuje odpowiedzi modelu ze stałymi liczbami, które są progami.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() to zwykłe odczytywanie wartości wpisanych w Pythonie z 2 regułami. Model dyskryminacyjny podaje prawdopodobieństwo i analizę, a kod używa progów dla reguł. Wybrane działanie jest wysyłane do silnika, gdzie zostanie użyte do walki z ogrem.
Najważniejsze informacje: pytania i wartości progowe powinny być przechowywane w jednym miejscu. To element integracji System One, który będziesz dostosowywać najczęściej.
Czas odpowiedzi, ceny oparte na danych wejściowych i logika podejmowania decyzji
- Czas odpowiedzi na decyzję. Każdy etap walki w części b trwał około 100 milisekund, a kilka z nich – 2–3 milisekundy. To wystarczy na pętlę gry, ścieżkę żądania lub sprawdzenie każdej wiadomości, zanim zobaczy ją człowiek lub model językowy.
- Ceny oparte na danych wejściowych Cała walka, 60 decyzji po 3 pytania każda, kosztuje znacznie mniej niż dziesiąta część centa. Tokeny wyjściowe mają wartość zero, ponieważ nic nie zostało wygenerowane. Dzięki temu możesz poprosić o więcej, niż potrzebujesz. Arena pyta, czy ogr jest widoczny w każdym takcie, mimo że tylko
strikeicastsię tym przejmują, ponieważ zadawanie pytań jest prawie bezpłatne, a odpowiedź jest przydatna na panelu. Firma TypeSafe nazywa to spekulacyjnym zwielokrotnieniem wyjściowym. - Połącz pewność siebie z niebezpieczeństwem. Gdy poziom ufności modelu dyskryminatywnego w odniesieniu do odpowiedzi jest niższy niż 0,40, a wynik zagrożenia wskazuje na silne uderzenie,
choose()zastępuje go uniknięciem. Unik jest rzadko najlepszą odpowiedzią, ale też rzadko najgorszą. Wybierz progi na podstawie kosztu każdego błędu, a nie na podstawie liczby całkowitej, i przetestuj je na telegrafach, które zostały już ocenione ręcznie. Rada od TypeSafe: jeśli decyzja jest często błędna, przed przesunięciem progu zaostrz pytanie.
Łączenie modeli w przepływie pracy ADK
Ograniczenia decyzji podejmowanych w każdym takcie i dlaczego prawidłowe odpowiedzi nie wystarczą
Ostatnia linia walki w kroku 5 mówi: ogr odchodzi, ledwo zadrapany. Model dyskryminacyjny nie odniósł żadnych obrażeń i zadawał niewielkie obrażenia co sekundę, a 300 punktów życia to więcej niż niewielkie obrażenia pomnożone przez 60. Karta zaklęcia w rogu ringu była tam cały czas. Do odczytania go potrzebny jest model, który potrafi zobaczyć obraz.
Ogr ma 300 punktów życia. Prawidłowe wywołanie zwiększa licznik o 3. Uderzenie w otwór zadaje 8 punktów obrażeń, ponieważ skóra jest gruba. Nawet idealna walka trwająca 60 tur pozostawia ogra z siniakami, ale wciąż stojącego na nogach, a gra uznaje ją za remis. Na tym zakończył się krok 5: model dobrze się bronił, ale nadal nie mógł wygrać.
Prawdziwe obrażenia zadaje tylko zaklęcie: 45 pkt przy idealnym rzucie i 67 pkt, gdy trafi w otwór.
Przypisywanie każdego zadania do odpowiedniego modelu
Karta zaklęcia w rogu ringu to sposób na wygraną, a jej odczytanie nie jest problemem tekstowym: to obrazek z kolorem i trzema kształtami w rzędzie, a zaklęcie musi być zaśpiewane tak, aby pasowało do obrazka. Wymaga to modelu, który może przyjrzeć się obrazowi i poświęcić mu kilka sekund. W walce kilka sekund to 10 tur.
Dlatego przepływ pracy korzysta z obu tych metod, każda z nich działa z inną prędkością:
- Model dyskryminacyjny walczy. Każdy cykl to jedno połączenie, jedna decyzja, sto milisekund. Pętla nigdy nie czeka na nic, co działa wolniej od niej.
- Gemini czyta i śpiewa. Na własnej gałęzi, zaczynając od dzwonka, pobiera kartę zaklęcia z ekranu areny jako obraz, podaje nazwę koloru i kształtów oraz śpiewa inkantację. Arena ocenia piosenkę na podstawie odpowiedzi karty zaklęcia, która nigdy nie opuszcza serwera.
- Po każdej wymianie ciosów zawodnik sprawdza miejsce. Węzeł
check_spellsprawdza stan. Nie gotowe: informacja o tym, jak długo Gemini śpiewa, i bezpośrednie przejście do następnego taktu. Nigdy nie czeka. Gotowy:castdołącza do opcji oferowanych modelowi dyskryminacyjnemu, achoose()rzuca zaklęcie w momencie, gdy model dyskryminacyjny zgłosi otwarcie. Gdy czar się skończy, na ekranie pojawi się nowa karta czaru i ponownie rozpocznie się powolne odliczanie. Źle odczytana piosenka spala kartę zaklęcia, a powolna nić odczytuje nową. - Gemini pisze krótkie opowiadanie tylko raz, na końcu.
Równoległe gałęzie o różnych opóźnieniach i jedna pętla zdarzeń
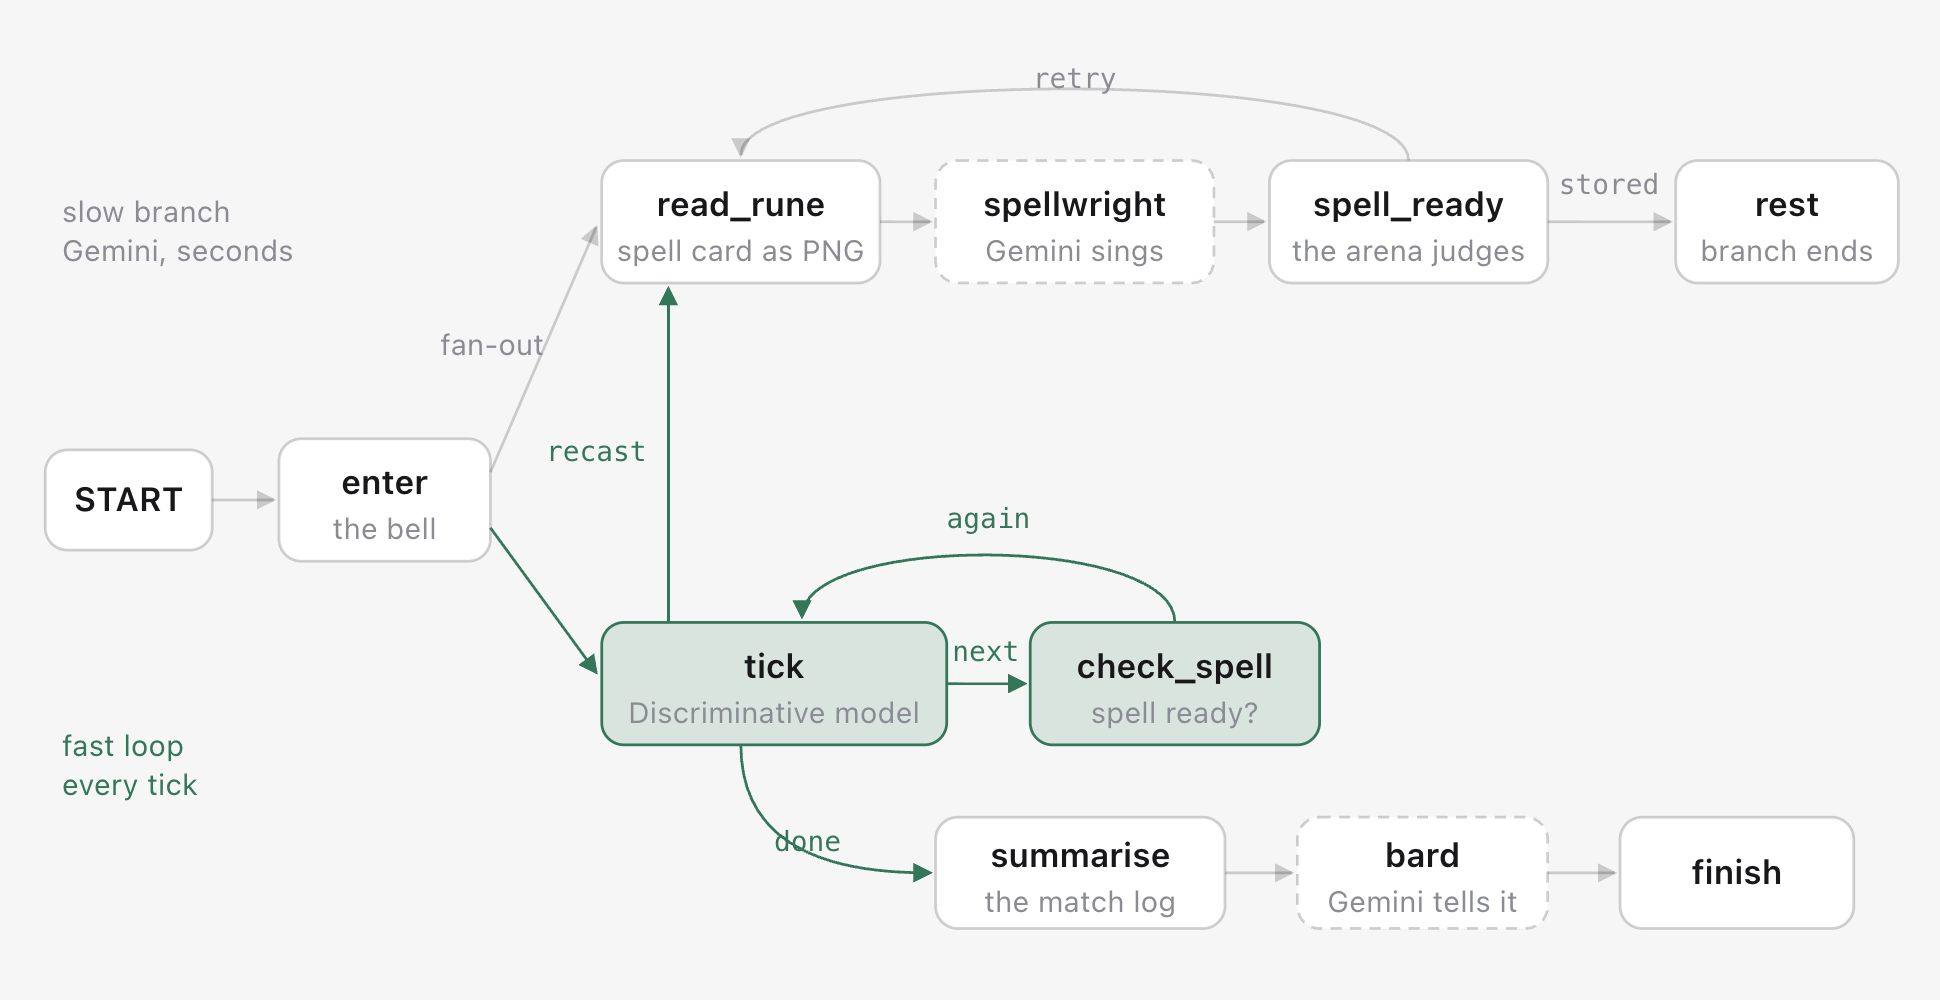
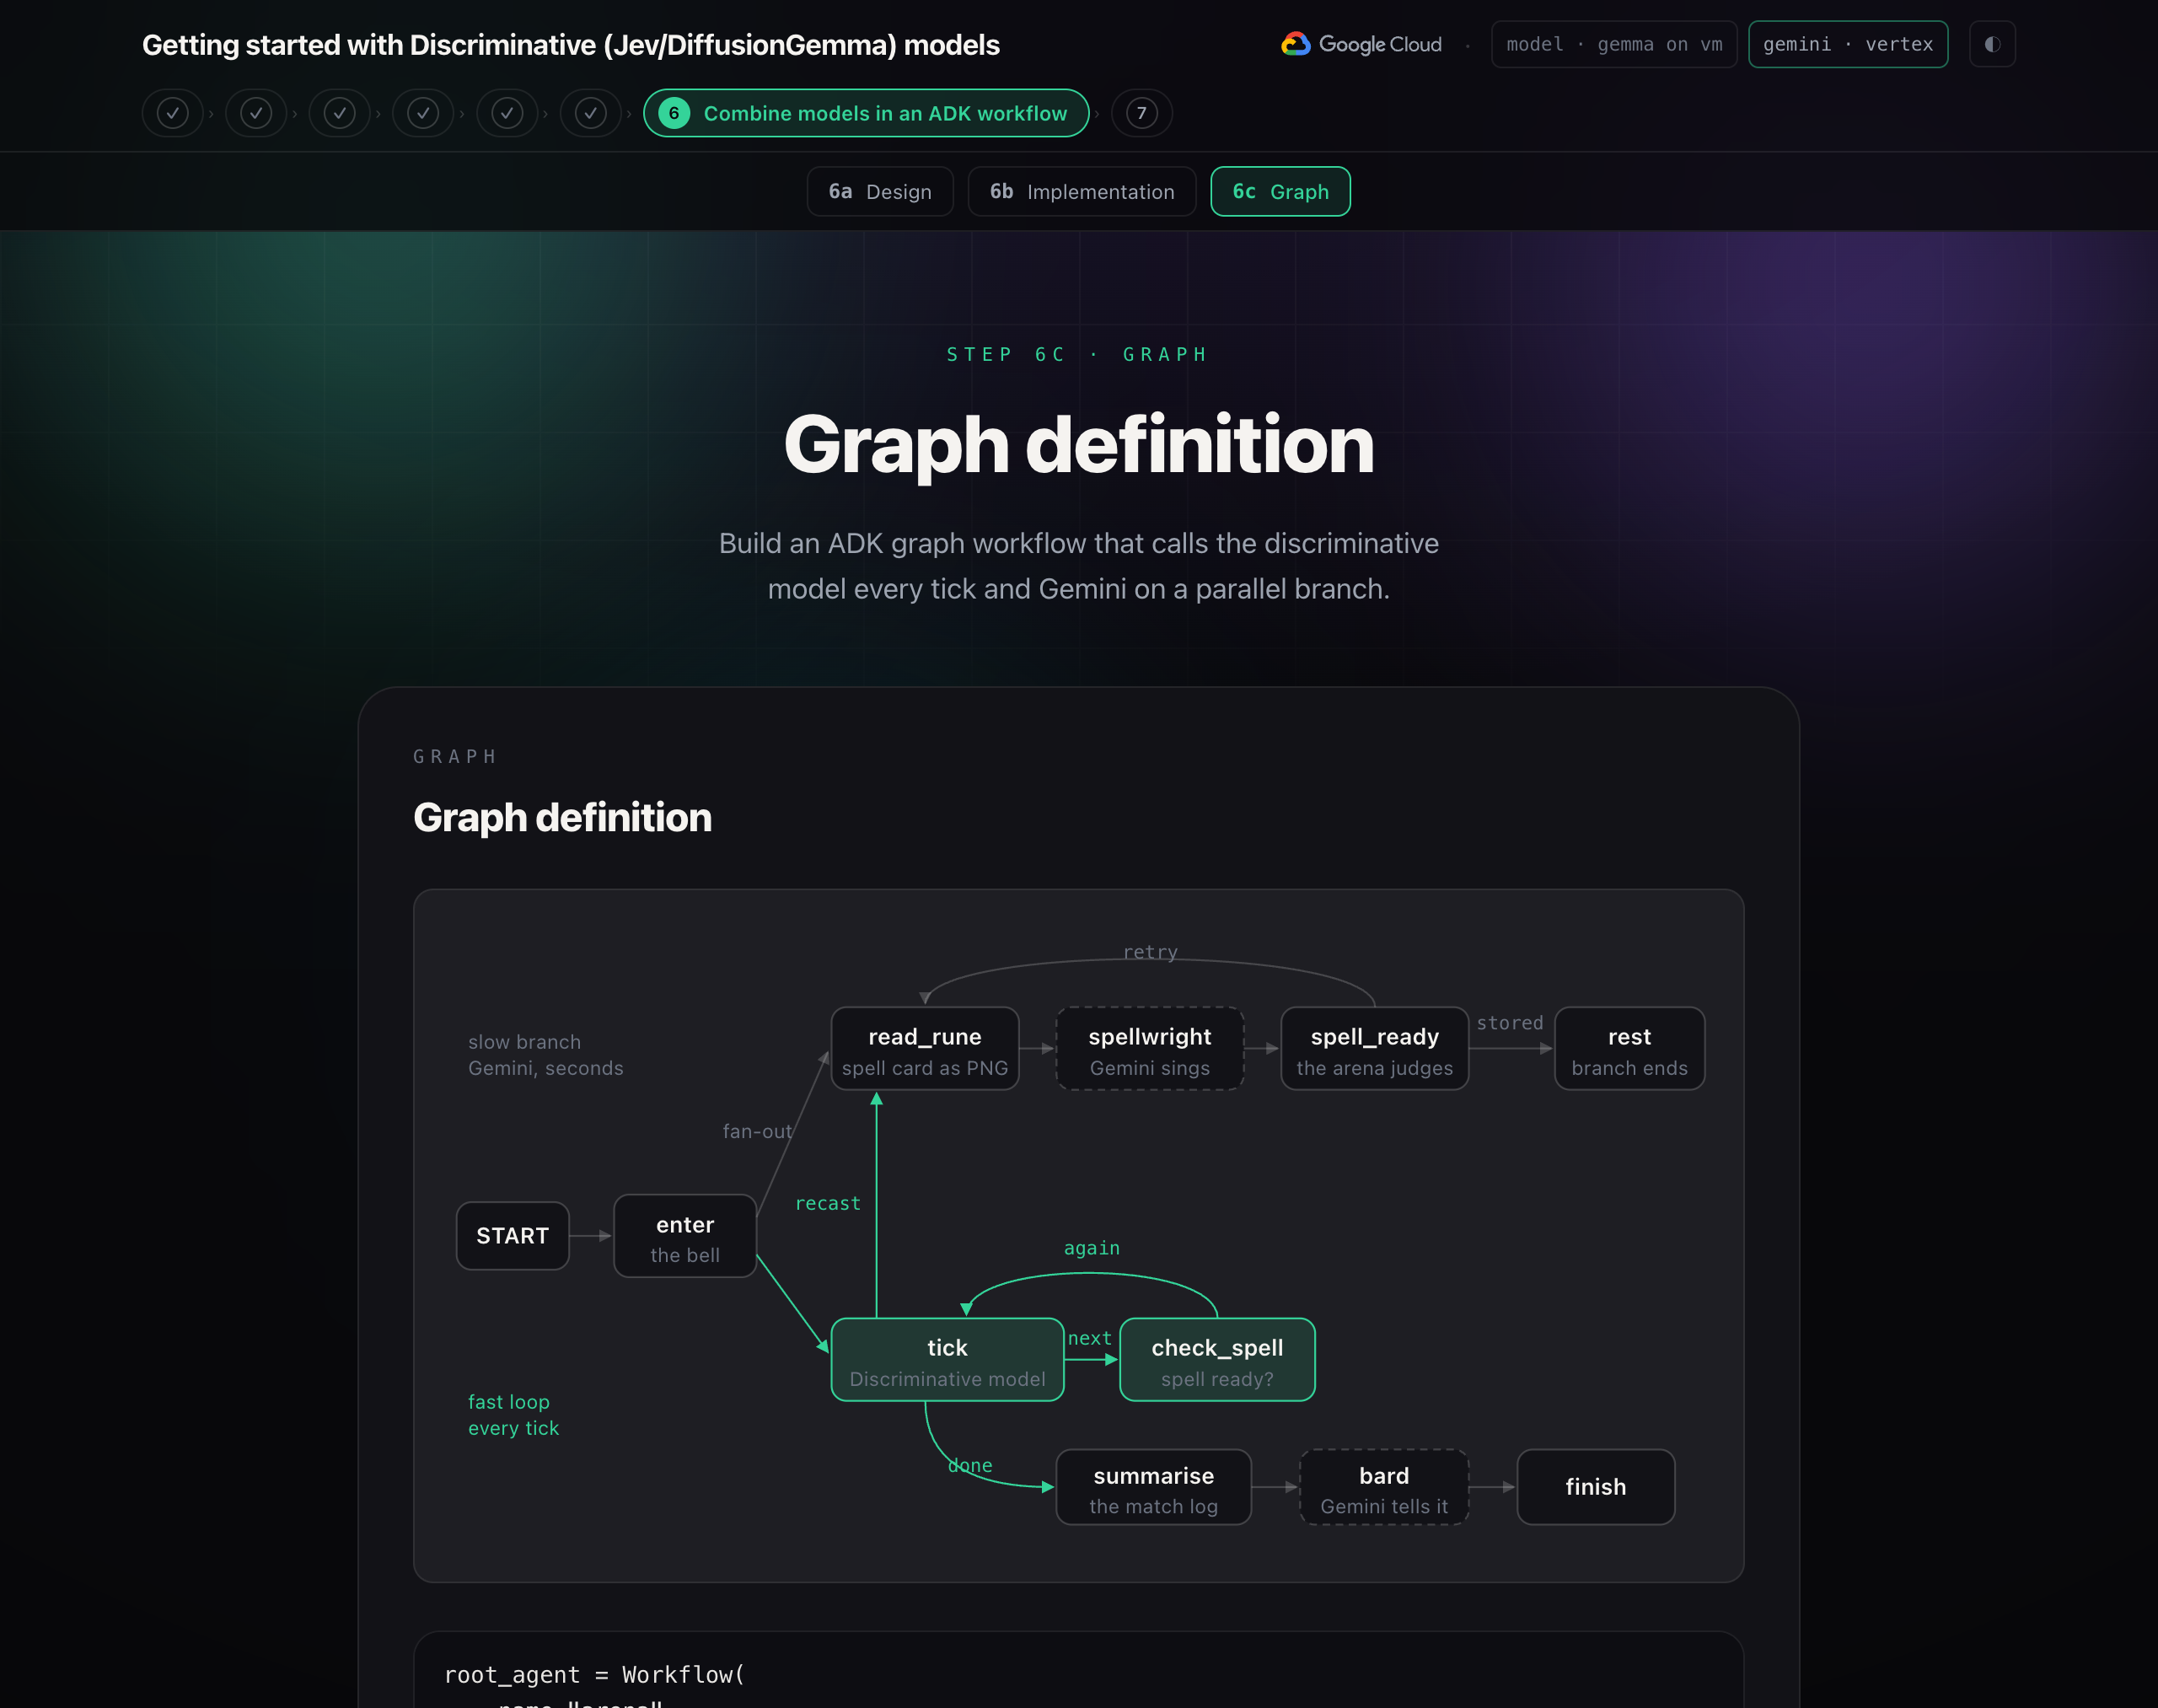
Jest to przepływ pracy pakietu ADK, czyli graf węzłów połączonych krawędziami. Węzeł to zwykła funkcja Pythona lub agent LLM. Krawędź od jednego węzła do krotki węzłów to zwielokrotnienie wyjściowe: oba węzły zaczynają działać jednocześnie. Węzeł, który zwraca wartość Event z wartością route, wybiera, która krawędź zostanie użyta jako następna, a węzeł, który kieruje do samego siebie, tworzy pętlę.
Wyobraź sobie, że to 2 wątki. Wątek 1 jest powolny: przeczytaj kartę zaklęcia, zaśpiewaj, zapisz zaklęcie. Wątek 2 jest szybki: tyk, sprawdź gniazdo, tyk ponownie. Wątek 1 kończy się funkcją, która zapisuje ocenioną pisownię w sesji state i nie zwraca żadnych danych wyjściowych. Wątek 2 check_spell odczytuje ten stan po każdej wymianie. Żaden wątek nie wywołuje ani nie czeka na drugi. Wątki tylko współdzielą stan.
Kluczowa informacja: umieść decyzje w kodzie i przypisz każdemu modelowi wąskie zadanie, które będzie wykonywać we własnym tempie.
ADK uruchamia oba rozgałęzienia jako zadania w jednej pętli zdarzeń, w jednym wątku. Jednocześnie może być aktywne tylko 1 zadanie. Gdy zadanie osiągnie await, czeka na odpowiedź, a pętla w tym czasie wykonuje inną gałąź. Szybka gałąź czeka na model około dziesiątej sekundy, a wolna gałąź czeka na Gemini kilka sekund, więc żadna z nich nie opóźnia drugiej.
Gałąź wolna
Funkcja read_rune() zdejmuje kartę zaklęcia z ekranu w formie obrazu.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright to Gemini. Odczytuje obraz i udziela odpowiedzi w ustalonym formacie.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
Funkcja spell_ready() powoduje, że sędzia na arenie ocenia zaklęcie, a następnie je zapisuje lub próbuje ponownie.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Węzeł funkcji może zwrócić Content z częścią obrazu, a węzeł LLM otrzyma go jako turę użytkownika. spell_ready zwraca Event z różnicą stanu i bez output. Następny znacznik odczytuje zaklęcie ze stanu, a gałąź bez danych wyjściowych nie jest drugim zakończeniem wykresu: ADK wymaga jednego wyjścia terminala, którym jest walka.
Uwaga: ocena jest dokonywana na podstawie kodu na arenie w porównaniu z ukrytą odpowiedzią na karcie zaklęcia. Idealny odczyt to 45, a nawet więcej w otwarciu. Dwa kształty w prawo to 25. Nieprawidłowe odczytanie powoduje, że karta zaklęcia się spala. Gemini nie jest pytany, czy miał rację.
Szybka gałąź
Funkcja tick() odtwarza jedną wymianę, a potem wybiera następną krawędź.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
Funkcja check_spell() sprawdza miejsce na zaklęcie po każdej wymianie.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell – sprawdza miejsce docelowe po każdej wymianie. Nigdy nie blokuje: jeśli zaklęcie nie jest gotowe, zgłasza to i przechodzi dalej.
Projekt opiera się na 3 elementach. Wywołanie modelu dyskryminacyjnego jest awaited za pomocą klienta asynchronicznego, więc pętla ustępuje, gdy czeka, a gałąź Gemini działa dalej. Pytania są generowane na bieżąco, więc ikona cast pojawia się tylko wtedy, gdy jest coś do przesłania. A route może być listą: ["recast", "next"] przyjmuje oba wierzchołki jednocześnie.
Sama arena znajduje się za małym klientem: działającą aplikacją przez HTTP, gdy jest dostępna, więc strona wyświetla walkę; silnikiem w procesie, gdy nie jest dostępna.
Definicja wykresu
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Krotka jako miejsce docelowe to zwielokrotnienie wyjściowe. Krotka jako krawędź to łańcuch. Słownik mapuje nazwy tras na węzły. tick → check_spell → tick to szybka pętla. "recast": read_rune ponownie uruchamia powolny wątek po wykorzystaniu zaklęcia, "retry" robi to samo po nieudanym zaklęciu, a "stored": rest pozwala powolnemu wątkowi cicho się zakończyć bez żadnych danych wyjściowych, gdy zaklęcie jest w slocie. ADK wymaga co najmniej 1 krawędzi w cyklu, więc bezwarunkowa pętla jest odrzucana, zanim zacznie działać w nieskończoność.
Uwaga: narzędzia ADK szukają root_agent. adk web agents z katalogu głównego warsztatu otwiera interfejs programisty z areną, jeśli chcesz zobaczyć wykres i wydarzenia w przeglądarce, a nie w terminalu.