

1. Introdução
Um workshop de 90 minutos sobre o modelo discriminativo, o modelo de decisão do Sistema Um da TypeSafe AI e como colocá-lo ao lado do Gemini em um fluxo de trabalho do ADK do Google. Este workshop tem seis etapas, todas baseadas em um jogo de luta. Primeiro, você vai lutar contra o ogro com as mãos, depois vai passar os reflexos para o modelo discriminativo e, em seguida, vai assistir um fluxo de trabalho do ADK vencer a luta com o modelo discriminativo decidindo cada movimento e o Gemini lendo cartas de feitiços na tela para cantar feitiços.
Visão geral
O modelo discriminativo (jev-1.13, alias jev-latest) é um modelo hospedado da TypeSafe AI, lançado em 19 de setembro de 2026. Ele não gera texto. Você envia estado (texto, JSON ou uma lista) e perguntas digitadas (Choice, Score, Noul), e ele retorna respostas digitadas com probabilidades calibradas, em aproximadamente 70 a 500 ms, por US $0, 042 por milhão de tokens de entrada e nada por saída. A função dele é a decisão antes, entre e depois dos modelos de linguagem: roteamento, classificação, controle e, aqui, os reflexos de um lutador.
Um jogo como exemplo
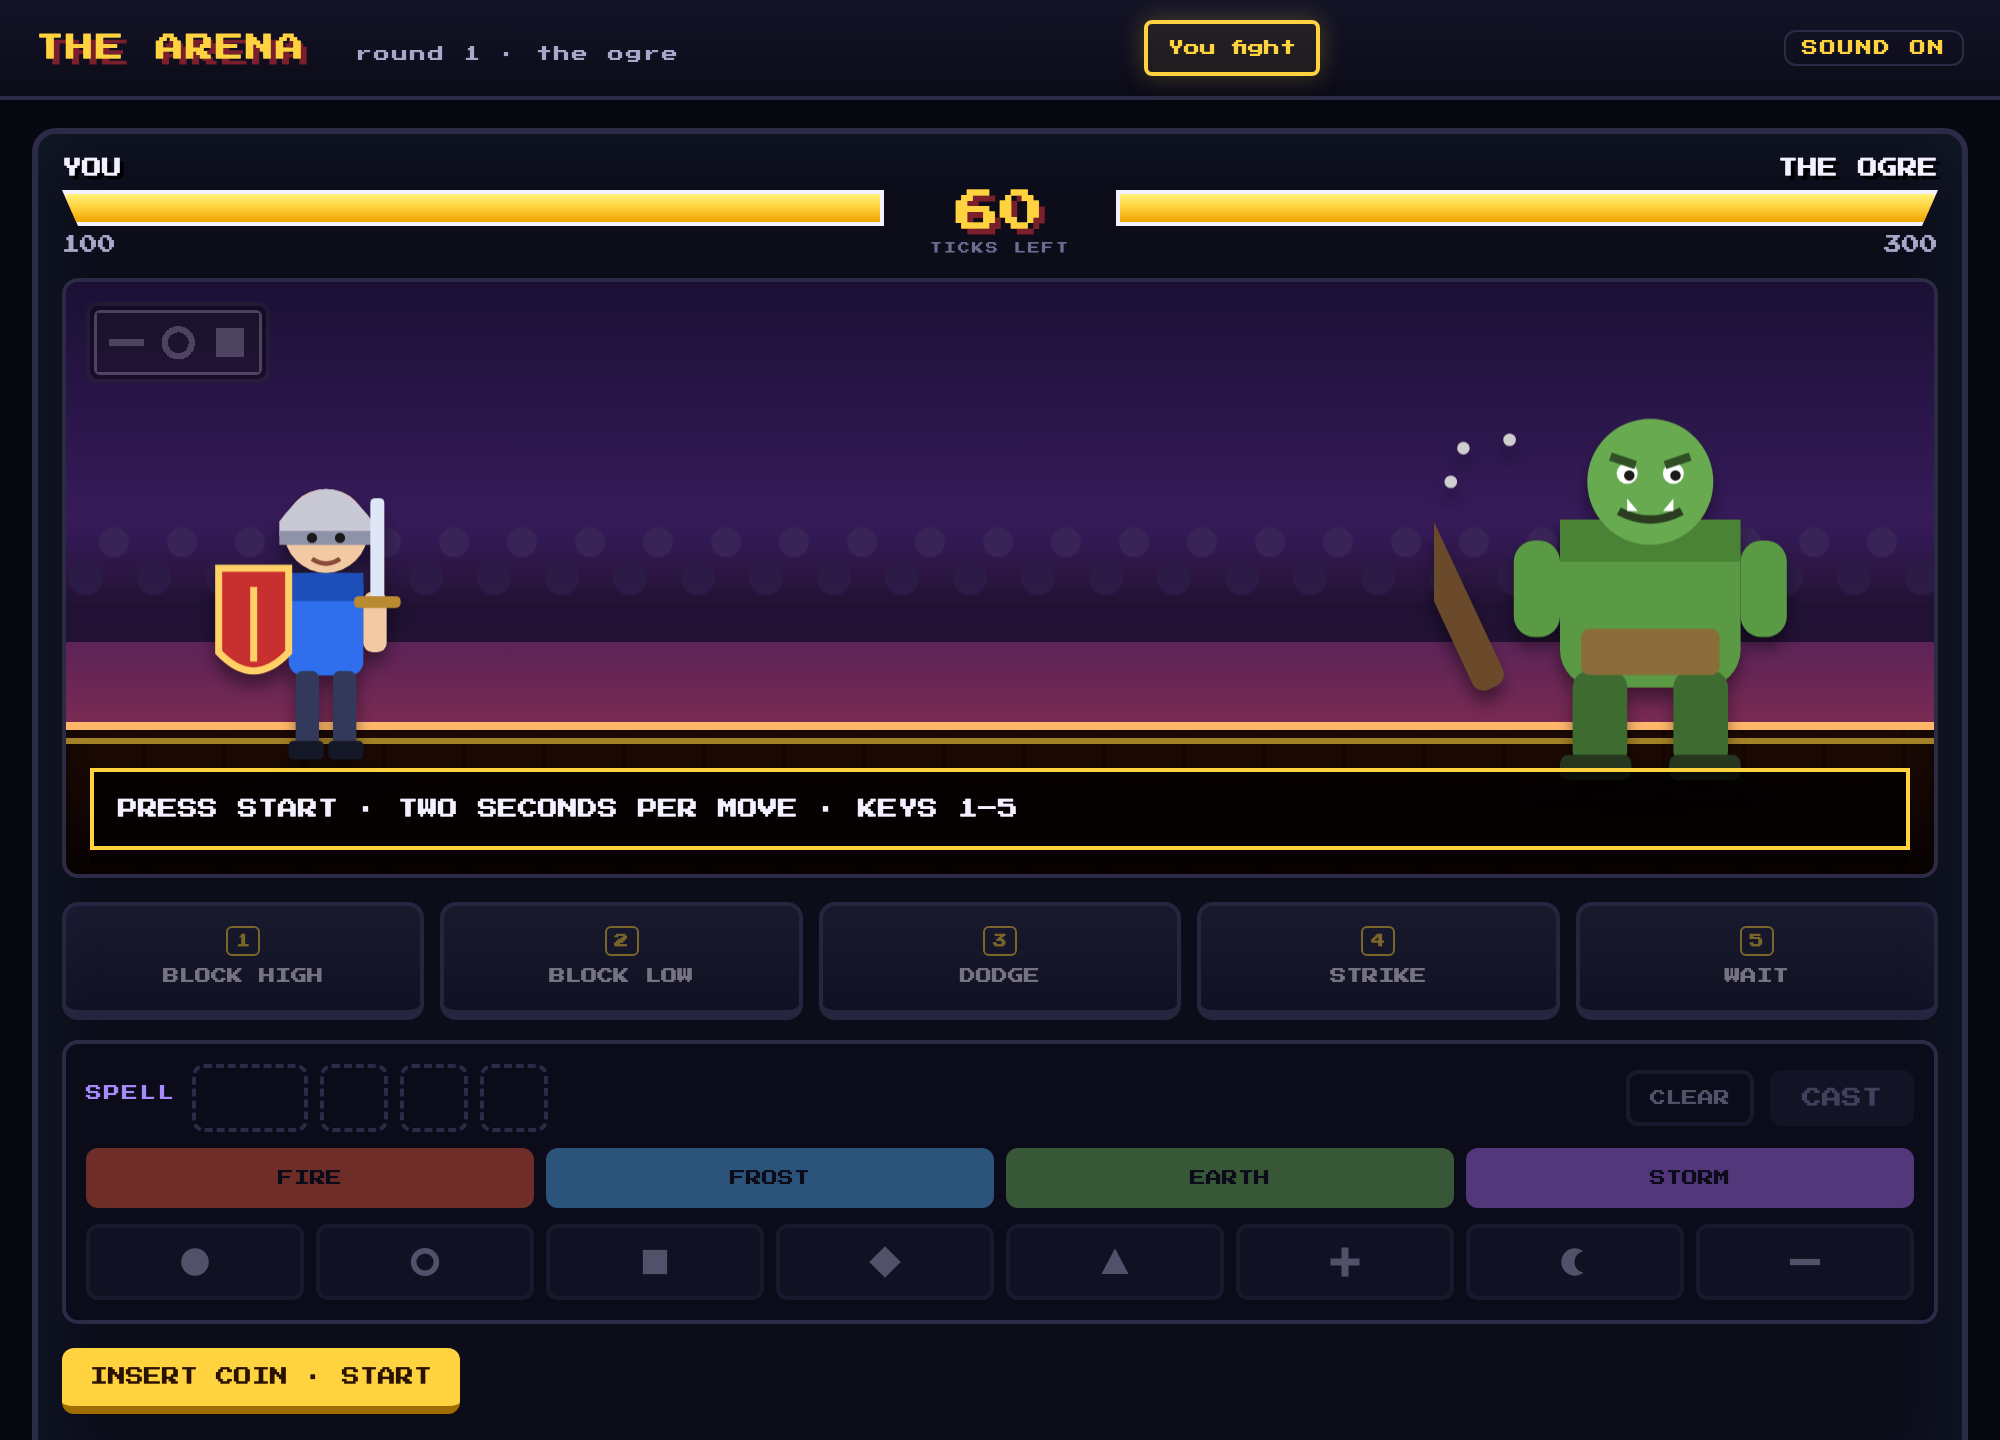
Você já jogou um jogo de combate? Você enfrenta um oponente e precisa reagir instantaneamente aos movimentos dele. Um palpite errado e seus HP são afetados. Os jogos também tendem a dificultar o lançamento de feitiços. No nosso, você precisa escolher a cor e as formas do card de feitiço, em ordem, antes que o feitiço seja lançado. Este workshop mostra como combinar os dois tipos de modelo para fazer seu personagem vencer.
Cada elemento do jogo corresponde a um sistema real:
- O movimento do oponente é um evento de entrada, como uma solicitação ou uma transação.
- A resposta é uma decisão limitada, tomada pelo modelo discriminativo e verificada por código.
- O cartão de feitiço é uma entrada não estruturada que precisa de um modelo de linguagem para ser lida.
- A correspondência é o fluxo de trabalho, executando tarefas rápidas e lentas nas próprias velocidades.
O foco é combinar os quatro componentes e juntá-los para criar um sistema rápido e inteligente.
O que você vai aprender
- Explicar como os modelos discriminativos (Sistema 1) e generativos (Sistema 2) são diferentes e quando usar cada um deles.
- Descrever como o Jev e o DiffusionGemma são veiculados e configurar um para o workshop, incluindo o DiffusionGemma em uma VM de GPU do Compute Engine.
- Escrever perguntas de escolha, pontuação e Noul, além de interpretar probabilidades e confiança.
- Use limites no código determinístico para transformar probabilidades em ações.
- Crie uma solicitação com o SDK TypeSafe e deixe o modelo escolher cada jogada em uma partida.
- Crie uma ramificação lenta, em que o Gemini lê uma imagem, e uma ramificação rápida, em que o modelo discriminativo decide em um loop, e execute cada uma por conta própria.
- Junte as duas ramificações em um fluxo de trabalho de gráfico do ADK que compartilha o estado em um loop de eventos. Assim, o trabalho lento nunca atrasa decisões rápidas.
Arquitetura
O ambiente de trabalho fica no Cloud Shell(ou na sua máquina), grava no sistema de arquivos local e interage com a arena, o Gemini e o modelo de decisão. ② chama o modelo de decisão em "Lutas de modelo discriminativo"; ③ chama os dois em "Lutas de fluxo de trabalho".
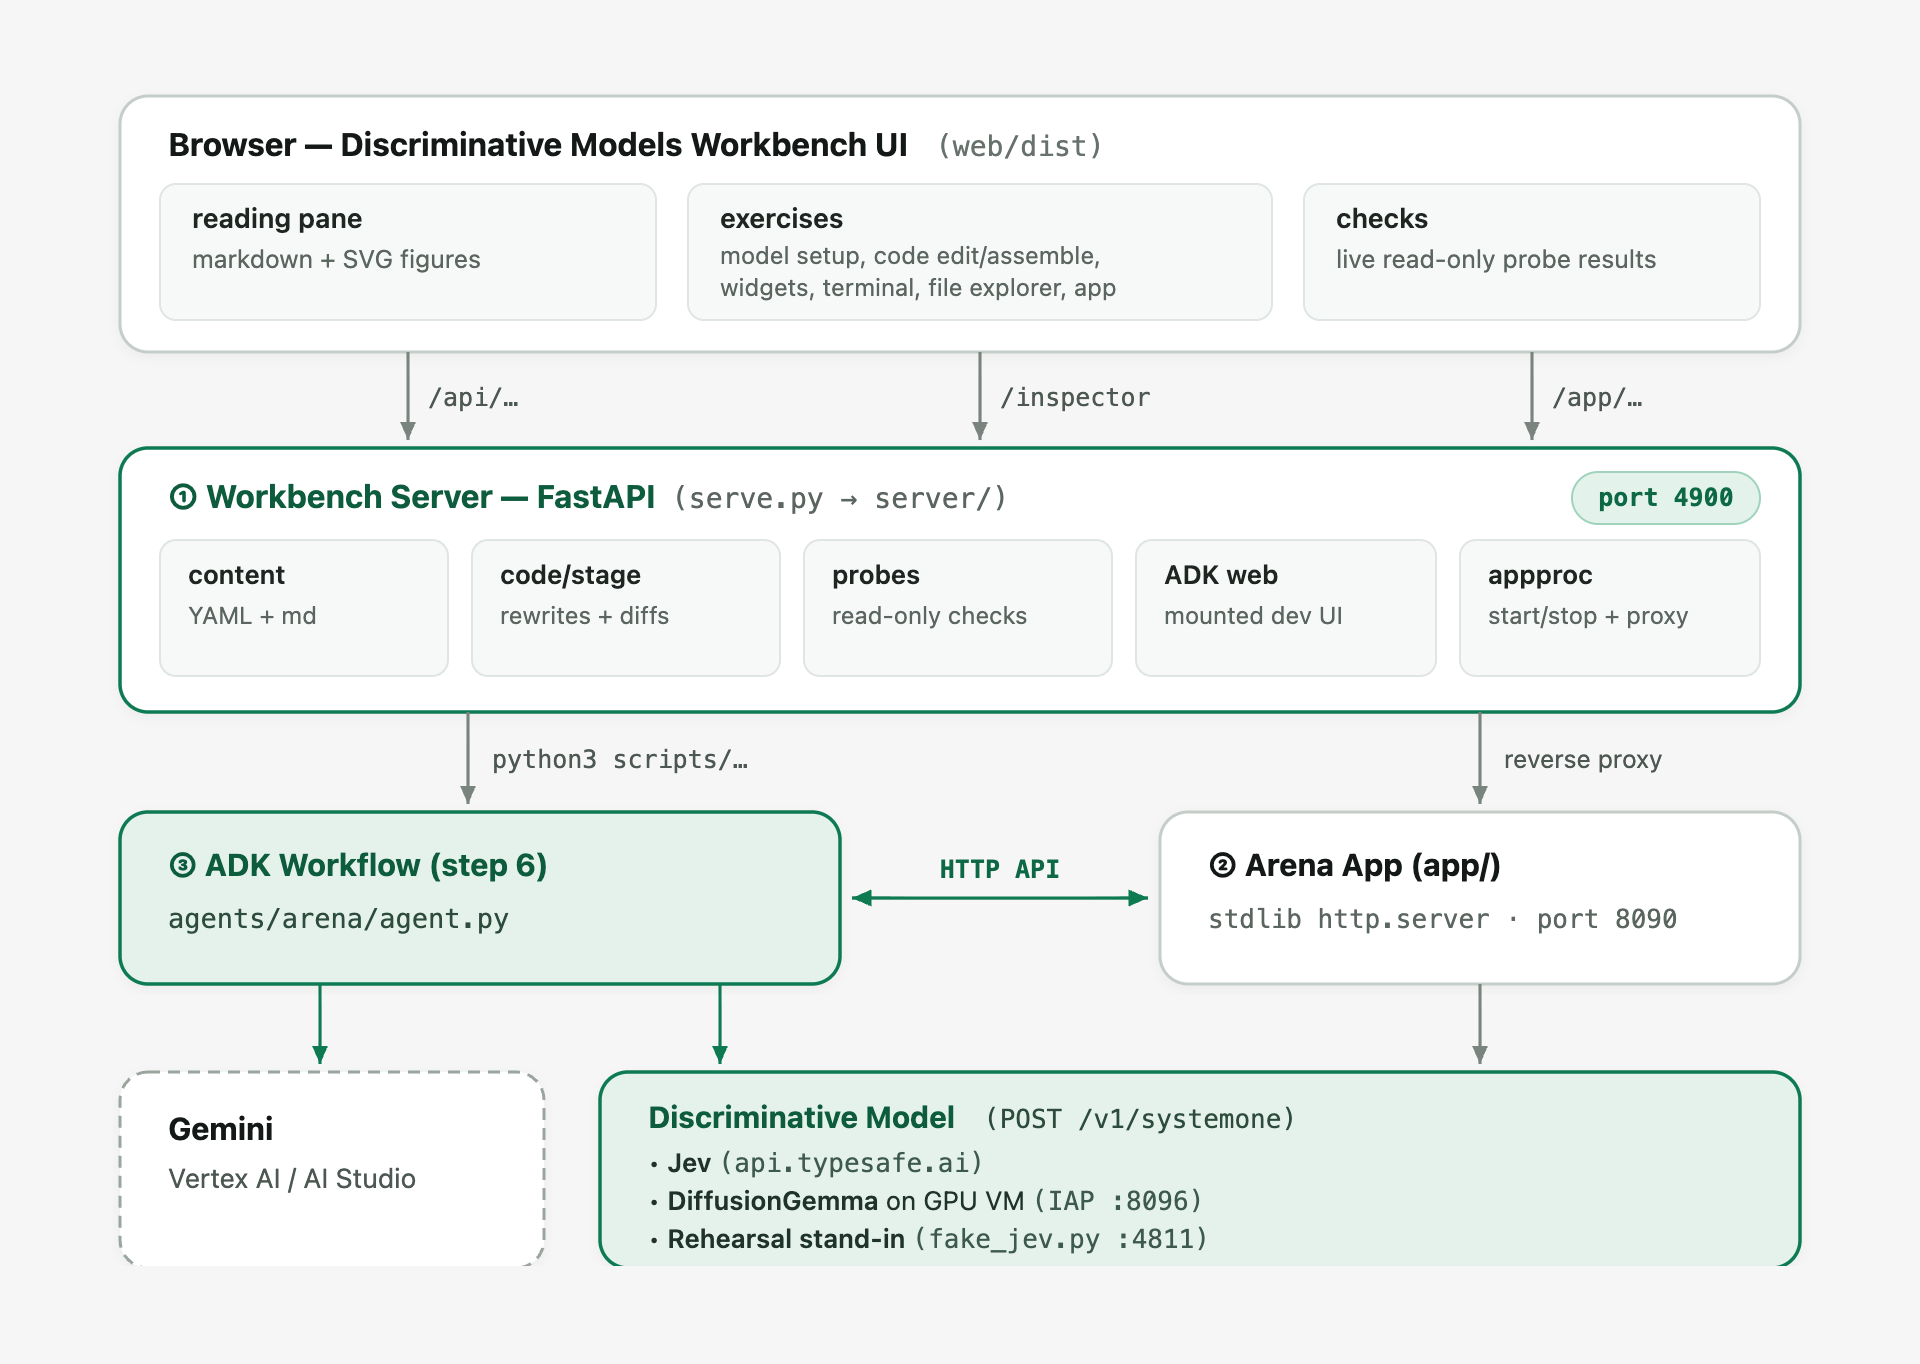
Quem chama o quê. O navegador só se comunica com ①. Os dois modelos são chamados do Python na máquina:
Autor da chamada | Modelo discriminativo | Gemini |
② arena, "Discriminative model fights" | a cada marcação, | não |
③ fluxo de trabalho | a cada marcação, | não |
③ fluxo de trabalho | não | a imagem da carta de feitiço; o conto depois da luta |
| sim | não |
Um toque por modo.
- Você luta. A página pede ② um telegrama, mostra com um timer de 2 segundos e envia de volta o botão pressionado (ou o feitiço digitado). ② resolve o problema.
- Lutas de modelos discriminativos A página pede ② uma marcação; ② desenha um telégrafo, faz três perguntas ao modelo em uma chamada, executa
choose()e retorna as respostas e o resultado. A página mostra as barras. - Lutas de fluxo de trabalho. O comando "start" faz com que ② inicie ③ como um subprocesso (faça login em
runs/arena-workflow.log). ③ conduz a luta: pede a ② cada telegrafia, chama o modelo e publica a decisão. O feitiço do Gemini chega na própria ramificação quando está pronto. A página apenas pesquisa ② e faz desenhos. A pausa é uma flag em ② que ③ verifica antes de cada tique.
Onde o modelo de decisão está hospedado. Todas as chamadas passam pelo mesmo typesafe-sdk. Somente o URL base muda. scripts/jevauth.py nomeia o back-end e define a chave e o tempo limite:
Back-end |
| Chave | Configurado por |
TypeSafe, hospedado | unset (api.typesafe.ai) |
|
|
DiffusionGemma na sua VM L4 |
| nenhum |
|
DiffusionGemma no Cloud Run |
| um token de identidade do Google, buscado a cada hora |
|
Ensaio |
| nenhum |
|
A resposta do card de feitiço ②: o fluxo de trabalho recebe apenas o PNG, e ② julga o feitiço que ele envia de volta. É isso que torna o feitiço um teste real da leitura do Gemini e o feitiço que você cria em "Você luta" um teste real seu.
2. Configuração
Resgate seus créditos do workshop
Se você recebeu um crédito do Google Cloud para esta sessão, reivindique-o primeiro. Isso leva cerca de um minuto e cria a conta de faturamento para você.
Abrir o Cloud Shell
O Google Cloud Shell é um ambiente Linux acessível por navegador pré-configurado com gcloud, Python, Node.js, uv e git, já autenticado com sua Conta do Google.
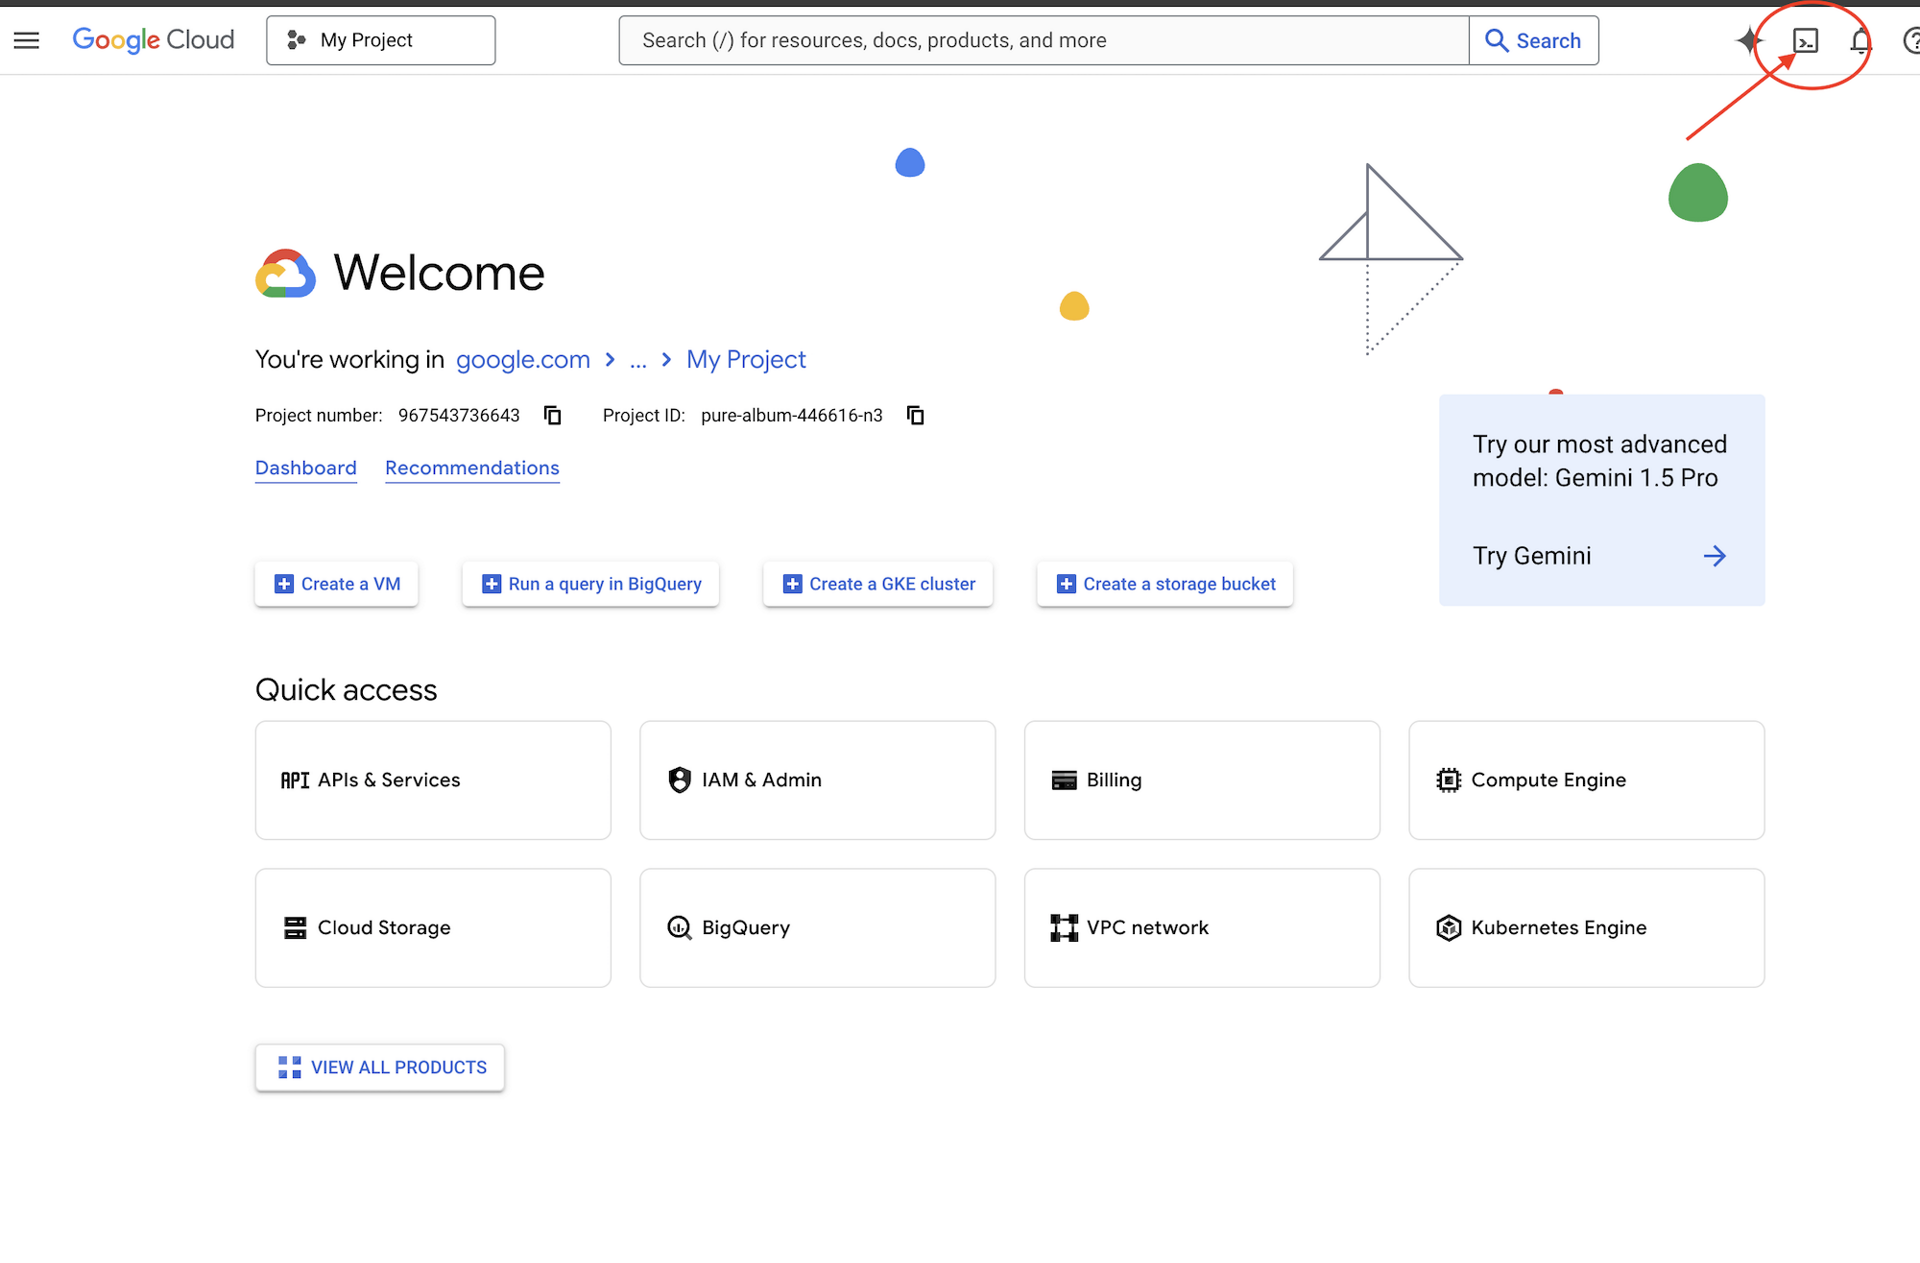
- Abra o Console do Google Cloud.
- Clique em Ativar o Cloud Shell (o ícone do terminal na barra de navegação superior) para abrir uma sessão do terminal na parte de baixo do navegador.
Iniciar o ambiente de trabalho
No Cloud Shell ou em qualquer lugar em que gcloud esteja conectado:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
O setup_project.sh cria um projeto (discrim-models-XXXX), vincula o faturamento a ele, preferindo uma conta de crédito de evento quando você tem uma, e aguarda até que o projeto possa disponibilizar. Executar novamente reutiliza o projeto em ~/project_id.txt. Para usar um projeto que você já tem, coloque o ID dele nesse arquivo e pule este script.
setup_codelab.sh não pede nada. Ele instala o uv e os pacotes Python, ativa a Vertex AI, o Compute Engine e o IAP, aponta o Gemini para a Vertex AI no projeto em .env, faz uma chamada real do Gemini com um modelo que o projeto pode chamar, cria a página, inicia o workbench em segundo plano e executa scripts/check_setup.py. Executar novamente mantém os arquivos de exercícios, enquanto scripts/starter.sh os redefine. O modelo de decisão é escolhido na etapa 2 da bancada.
Para abrir a interface do workbench no Cloud Shell:
- Clique no link de visualização impresso no final de
./setup_codelab.shou em Visualização da Web no canto superior direito da barra de ferramentas do Cloud Shell. - Selecione Alterar porta, insira 4900 e clique em Alterar e visualizar.
O Gemini é executado na Vertex AI no seu projeto, com suas próprias credenciais do Google: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT e GOOGLE_CLOUD_LOCATION=global em .env.
O modelo de decisão é escolhido por conta própria, na etapa 2 do workbench ou em um terminal com scripts/setup_model.sh:
Escolha | Necessidades | Configuração | Custo |
O modelo discriminativo (TypeSafe, hospedado) | uma chave de API TypeSafe | nenhum | por token, frações de um centavo |
DiffusionGemma (Google, pesos abertos) | faturamento + cota do Compute Engine para GPU | ~15 min, automático | ~US$0,71/h enquanto a VM é executada |
Ensaio (sem modelo) | nothing | nenhum | nenhum |
DiffusionGemma em uma VM do Compute Engine
O scripts/setup_gemma.sh primeiro verifica a cota de GPU e cria uma VM g2-standard-4 (1 × L4 24 GB, 4 vCPUs, 16 GB) com base na imagem de aprendizado profundo do Google com o driver NVIDIA 580. Na primeira inicialização, a VM instala o Docker, faz o download dos pesos do Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, público, sem token) e executa djev-run: DiffusionGemma por trás da API exata do modelo discriminativo. A porta do modelo não está aberta à Internet: o ambiente de trabalho a alcança por um túnel IAP em localhost:8096, que scripts/start.sh abre.
Pausar / retomar |
| |
Túnel |
| |
Remover |
| |
Praticar os comandos |
| |
Layout do repositório
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Resumo
Limpar o ambiente
Quando terminar o workshop, siga estas etapas para encerrar os recursos de GPU do DiffusionGemma, interromper os processos em segundo plano do ambiente de trabalho e de simulação, remover os arquivos do workshop do Cloud Shell e, opcionalmente, excluir o projeto do Google Cloud do workshop.
- Exclua a VM de GPU do DiffusionGemma e a regra de firewall (se criada): se você provisionou o DiffusionGemma em uma VM de GPU do Compute Engine na etapa 2, remova a VM, o disco e a regra de firewall do IAP para que não haja cobranças contínuas de computação ou armazenamento em disco:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Interrompa os processos de bancada e ensaio no Cloud Shell: no terminal do Cloud Shell, interrompa o servidor de bancada em segundo plano e qualquer processo substituto de ensaio:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Exclua a pasta do workshop do Cloud Shell: volte para o diretório inicial e remova a pasta do repositório clonado e o arquivo de ID do projeto:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Exclua seu projeto do Google Cloud: se
./setup_project.shcriou um projeto de workshop dedicado (por exemplo,discrim-models-XXXX), o encerramento permanente do projeto exclui todos os recursos criados nele, mas deixa sua conta do Cloud Billing intacta:- Abra a página Gerenciar recursos no console do Google Cloud.
- Selecione o projeto do workshop (por exemplo,
discrim-models-...) na lista de recursos. - Clique em Excluir na barra de ferramentas superior, digite o ID do projeto para confirmar e clique em Desligar.
Você concluiu este workshop.
Resumo do laboratório
- Escolha um modelo discriminativo, Jev ou DiffusionGemma, em uma VM de GPU do Compute Engine e verifique se ele responde.
- Joguei a arena manualmente, contra o relógio, para aprender as regras.
- Você aprendeu como um modelo discriminativo responde com perguntas de escolha, pontuação e Noul, probabilidades e confiança, e como seu código aplica limites a elas.
- Envie seu primeiro pedido e deixe o modelo escolher cada movimento na arena, com o
choose()transformando as respostas em ações. - Cada ramificação de um fluxo de trabalho do ADK foi criada por conta própria, com o Gemini lendo uma imagem de carta de feitiço e o modelo decidindo em um loop.
- Unimos tudo em um fluxo de trabalho que compartilha o estado, para que a luta nunca espere pelo Gemini e o feitiço seja lançado em uma abertura.
Da conversa às decisões
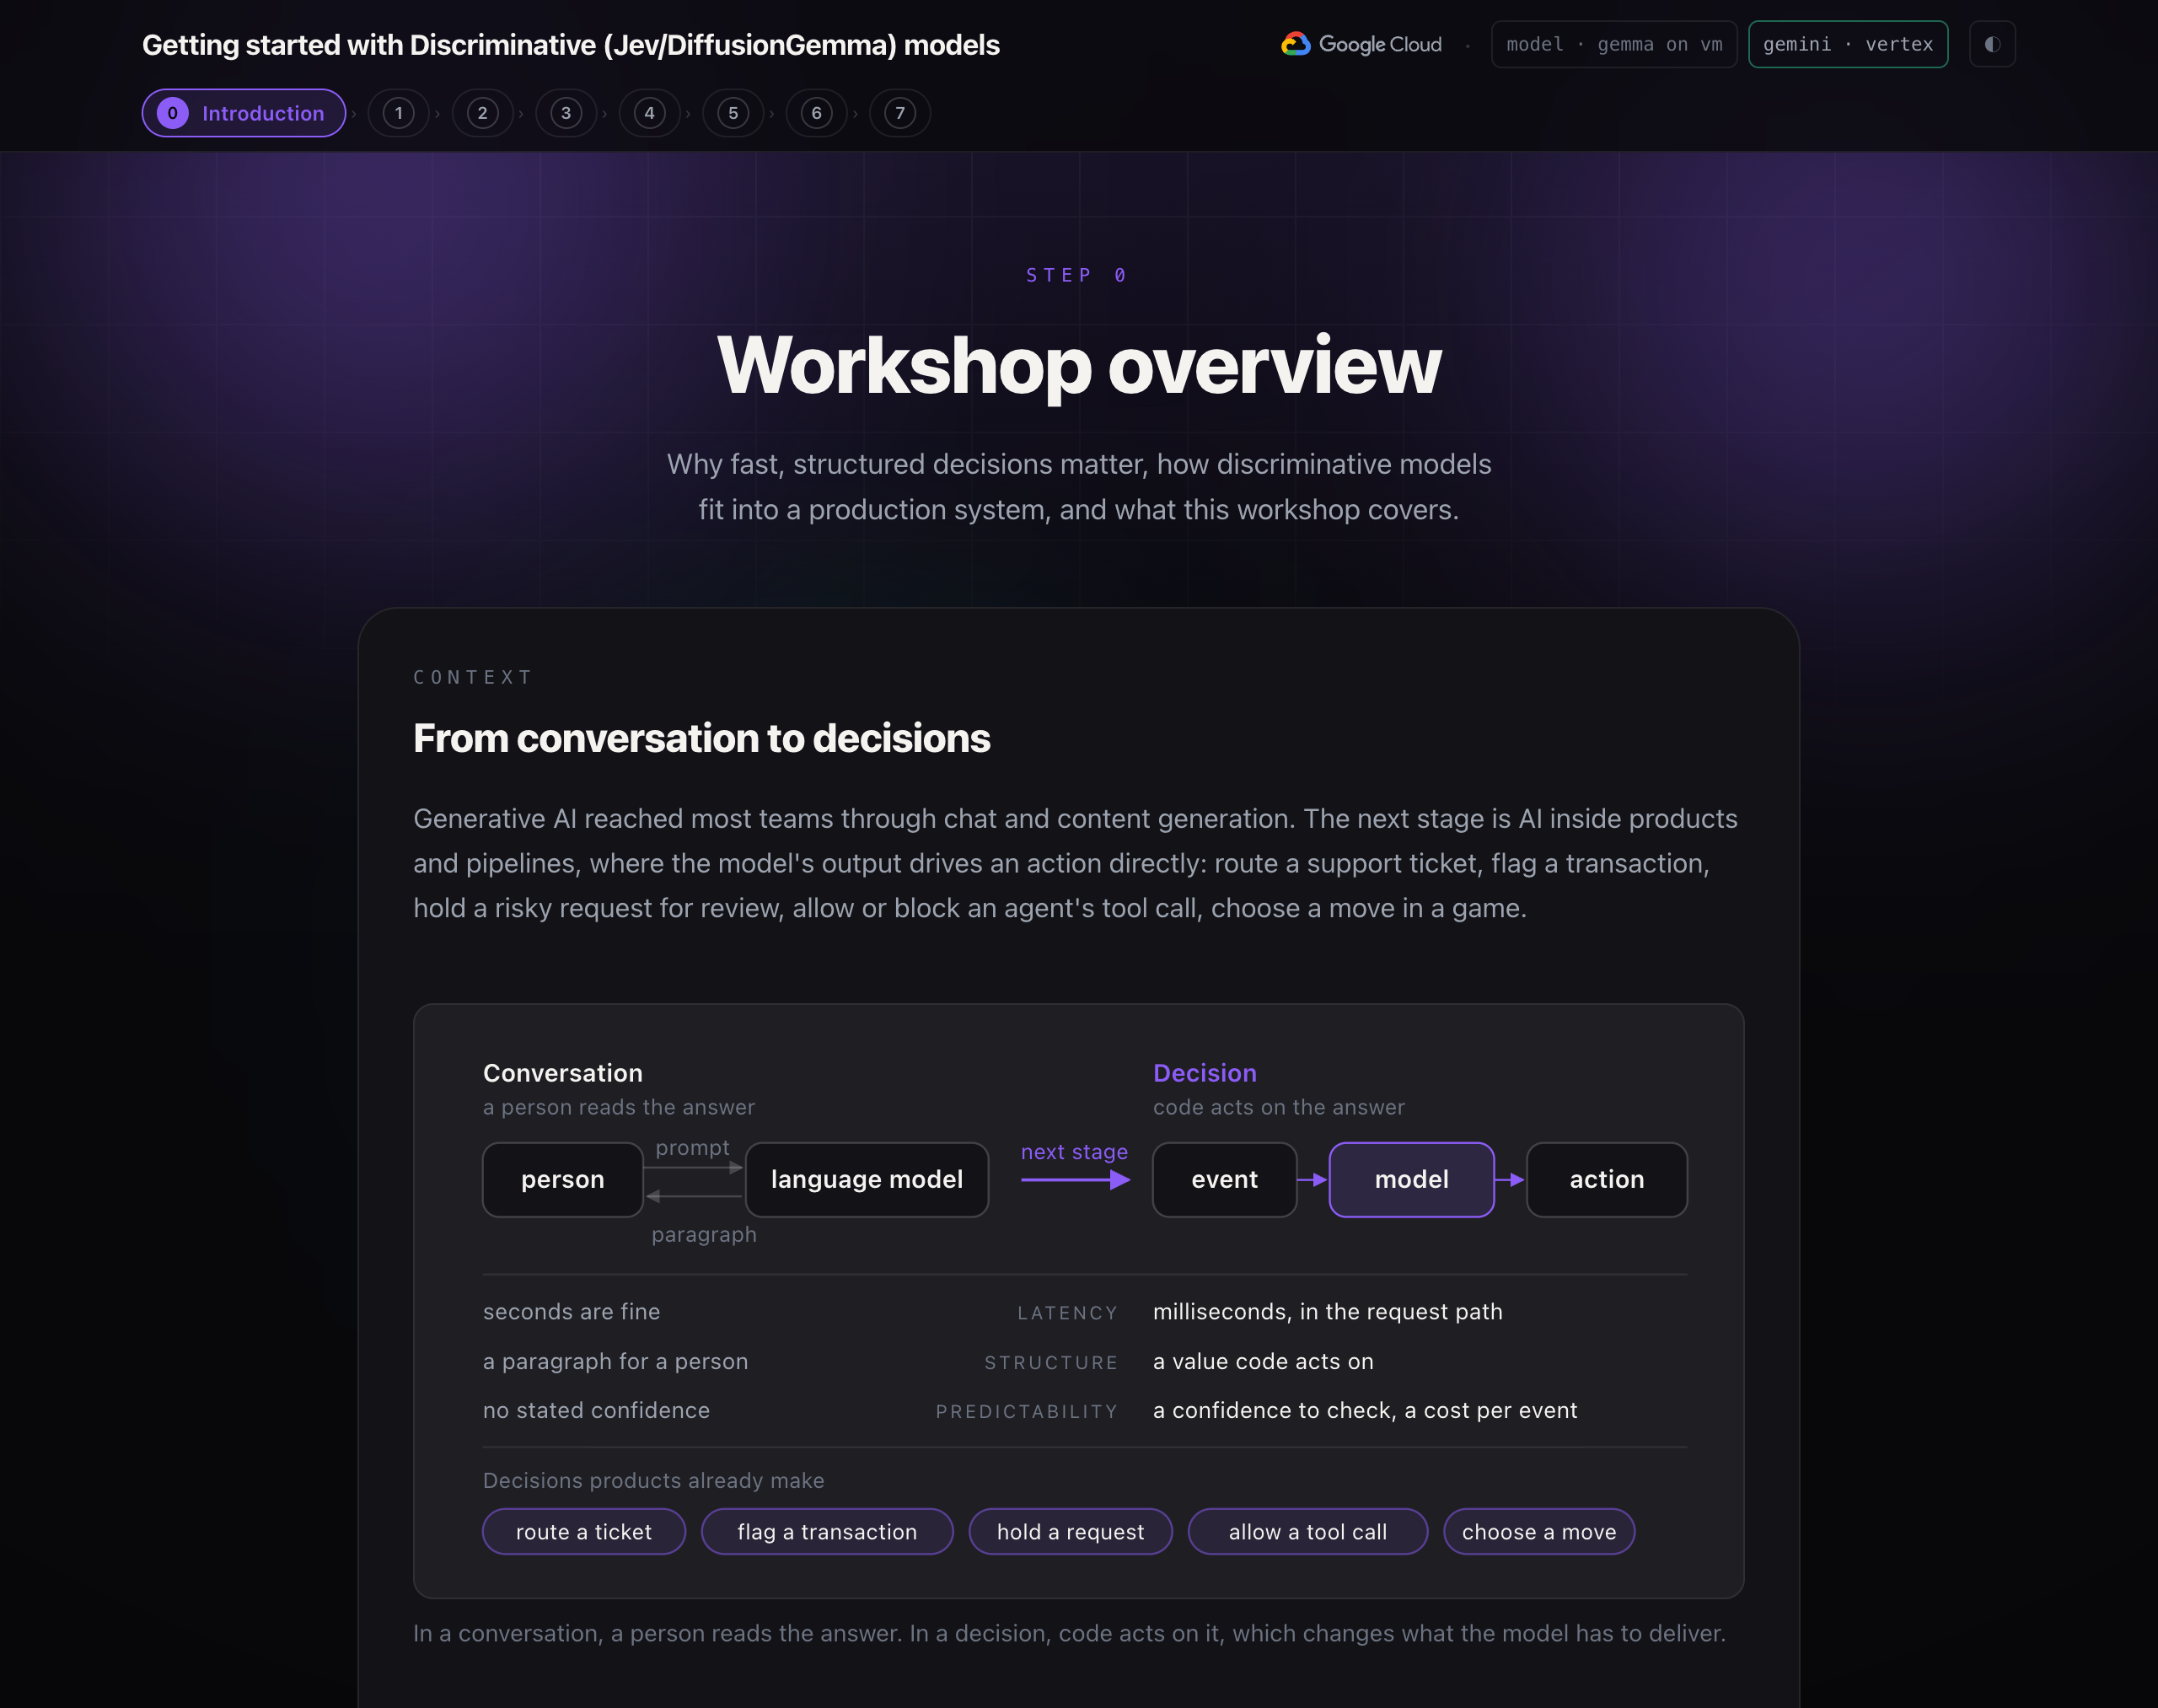
A IA generativa chegou à maioria das equipes por meio da geração de conteúdo e chat. A próxima etapa é a IA em produtos e pipelines, em que a saída do modelo impulsiona uma ação diretamente: encaminhar um tíquete de suporte, sinalizar uma transação, reter uma solicitação arriscada para revisão, permitir ou bloquear uma chamada de ferramenta de um agente, escolher uma jogada em um jogo.
Essas decisões compartilham três requisitos que o chat não tem:
- Latência. A resposta geralmente está no caminho de solicitação de um usuário ou em um loop em tempo real. Por isso, ela precisa chegar em milissegundos, não em segundos.
- Estrutura. O autor da chamada é um código, então a resposta precisa ser um valor em que ele possa agir, não um parágrafo que ele precise analisar.
- Previsibilidade. Toda decisão precisa de um nível de confiança que o código possa verificar e um custo baixo o suficiente para ser consultado em todos os eventos.
Um modelo de linguagem gera texto um token por vez. Ele pode ser solicitado a responder sim ou não, mas é lento para um loop em tempo real, a saída precisa ser analisada e não informa o nível de certeza.
Modelos criados para decisões
Um modelo discriminativo responde a uma pergunta digitada com uma probabilidade para cada opção permitida, em uma única passagem. Ele não gera texto. Este workshop oferece duas opções de execução:
Modelo | Provedor | Onde o modelo é executado neste workshop |
Jev (em inglês) | TypeSafe AI | Serviço hospedado da TypeSafe, chamado com uma chave de API |
DiffusionGemma | Google, abra pesos | Com hospedagem própria em uma VM com GPU no seu projeto na nuvem do Google Cloud |
Os modelos podem ser trocados com base nas suas necessidades, e o código que se conecta a eles não precisa ser alterado.
Combinar componentes
Um sistema bem-sucedido consiste em vários componentes:
Componente | Papel | Neste workshop |
Fluxo de trabalho | Orquestra etapas, executa ramificações em paralelo e mantém o estado compartilhado. | Um fluxo de trabalho de gráfico do ADK |
Código determinístico | Regras, limites e validação. Instantâneo, sem custo financeiro e auditável | As regras do jogo, |
Modelo discriminativo | Decisões rápidas e limitadas com uma pontuação de confiança | Escolher uma resposta a cada marcação |
Modelo de linguagem | Percepção e geração: imagens e texto aberto | O Gemini lê a imagem do card de feitiço e escreve o feitiço |
Arquitetura de disponibilização do modelo
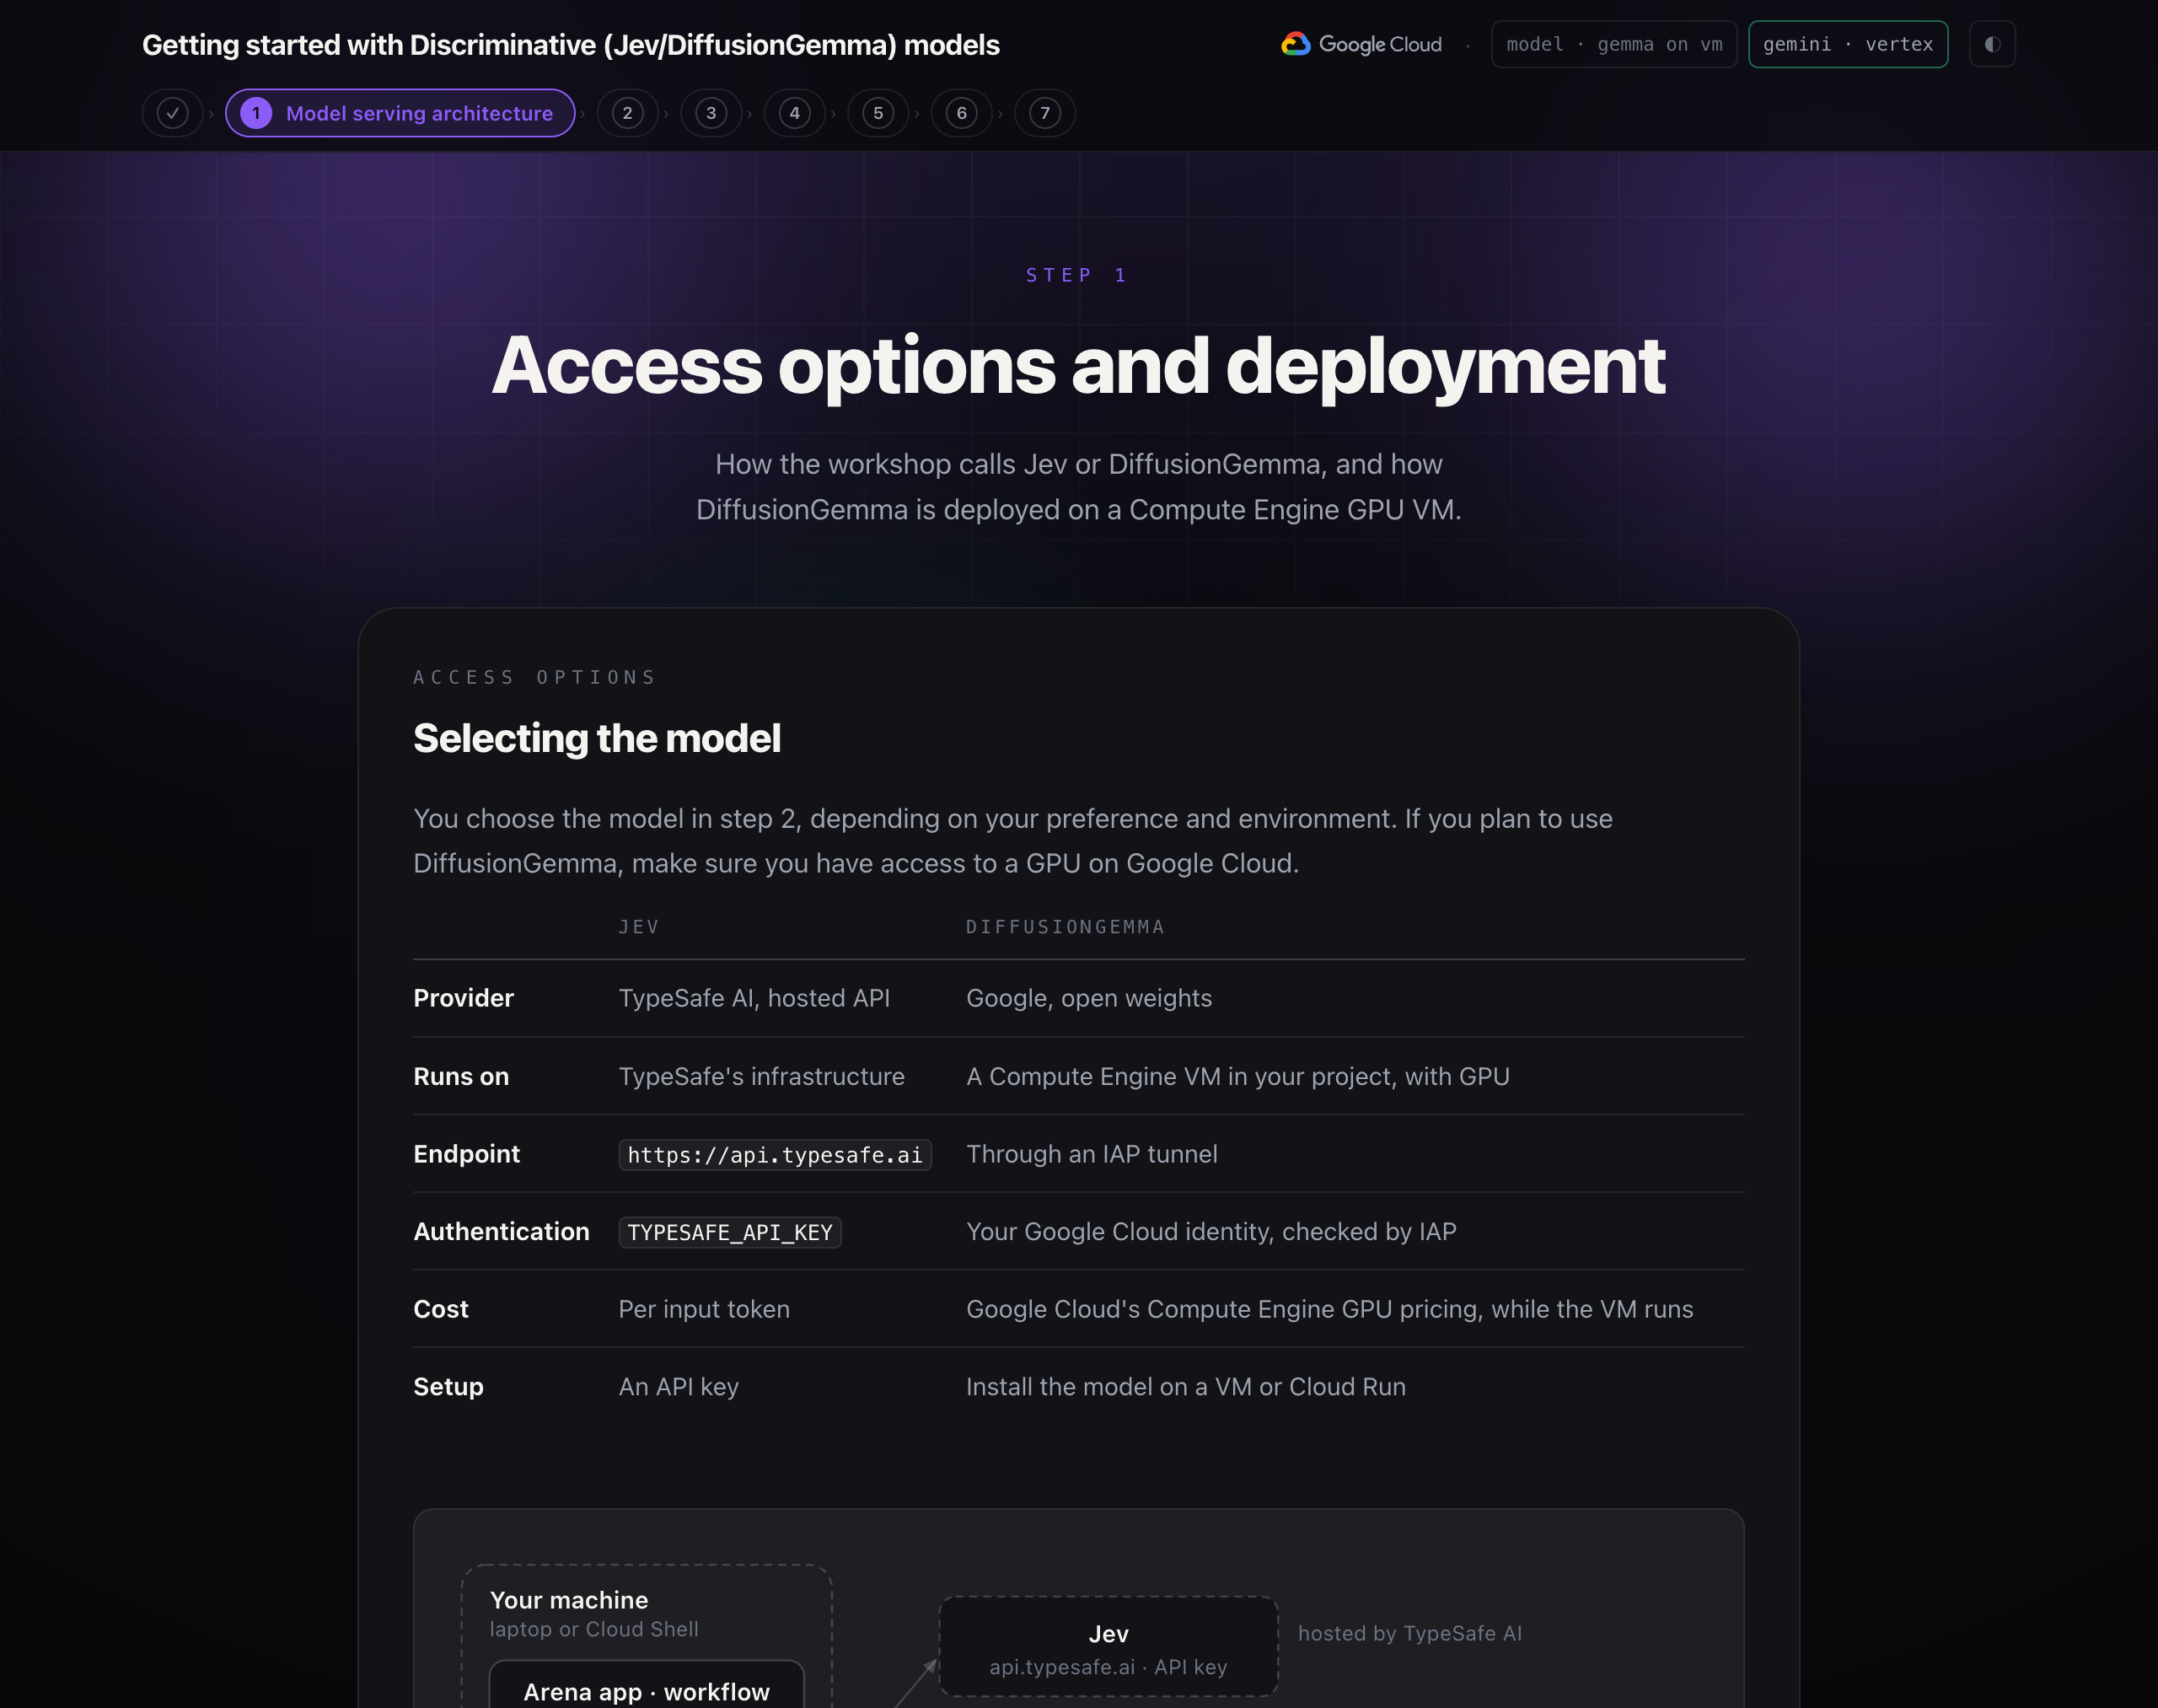
Você escolhe o modelo na etapa 2, dependendo da sua preferência e do ambiente. Se você planeja usar o DiffusionGemma, verifique se tem acesso a uma GPU no Google Cloud.
Jev | DiffusionGemma | |
Provedor | API hospedada TypeSafe AI | Google, abra pesos |
Executado em | Infraestrutura do TypeSafe. | Uma VM do Compute Engine no seu projeto, com GPU |
Endpoint |
| Por um túnel IAP |
Authentication |
| Sua identidade do Google Cloud, verificada pelo IAP |
Custo | Por token de entrada | Preços de GPU do Compute Engine do Google Cloud enquanto a VM está em execução |
Configuração | Uma chave de API | Instalar o modelo em uma VM ou no Cloud Run |
Fluxo de dados
- O app da arena ou o fluxo de trabalho do ADK cria uma solicitação: o estado (o que o oponente fez) e três perguntas.
- O SDK TypeSafe envia como
POST /v1/systemonepara o URL de base configurado. - Para Jev, a solicitação passa por HTTPS para
api.typesafe.ai, com a chave de API como um token de acesso. - Para DiffusionGemma, a solicitação vai para
localhost:8096. Um processo em segundo plano dogcloud compute start-iap-tunnelencaminha a solicitação pelo Identity-Aware Proxy, que verifica sua identidade do Google, para a porta 8080 na VM. - Na VM, o djev-run recebe a solicitação, executa o DiffusionGemma usando o vLLM na GPU e lê a probabilidade de cada opção permitida.
- Os dois back-ends retornam a mesma resposta: uma resposta por pergunta, com probabilidades e um índice de confiança. O código do workshop aplica os limites e age.
DiffusionGemma no Compute Engine
O scripts/setup_gemma.sh cria isso no seu projeto:
- Verifica se a região tem cota para uma GPU.
- Ativa as APIs Compute Engine e IAP e cria a regra de firewall
allow-iap-djev. Ele aceita apenas o intervalo de endereços da IAP nas portas 22 e 8080. - Cria a VM
djev-l4: tipo de máquinag2-standard-4(4 vCPUs, 16 GB de memória), uma GPU com 24 GB, um disco de 100 GB e a imagem da VM de Deep Learning com o driver NVIDIA 580. Se uma zona não tiver capacidade de GPU, ela tentará a próxima. - Na primeira inicialização, o script de inicialização da VM instala o Docker e o NVIDIA Container Toolkit, extrai a imagem do contêiner djev-run, baixa os pesos do Hugging Face (17,5 GB) e inicia o contêiner com acesso à GPU na porta 8080. Isso leva cerca de 15 minutos. As inicializações posteriores levam cerca de 2.
- Grava as configurações de conexão em
.enve abre o túnel.
Tarefa | Comando |
Parar a VM (mantém o disco) |
|
Comece de novo |
|
Verificar o túnel |
|
Excluir tudo |
|
Configurar o modelo
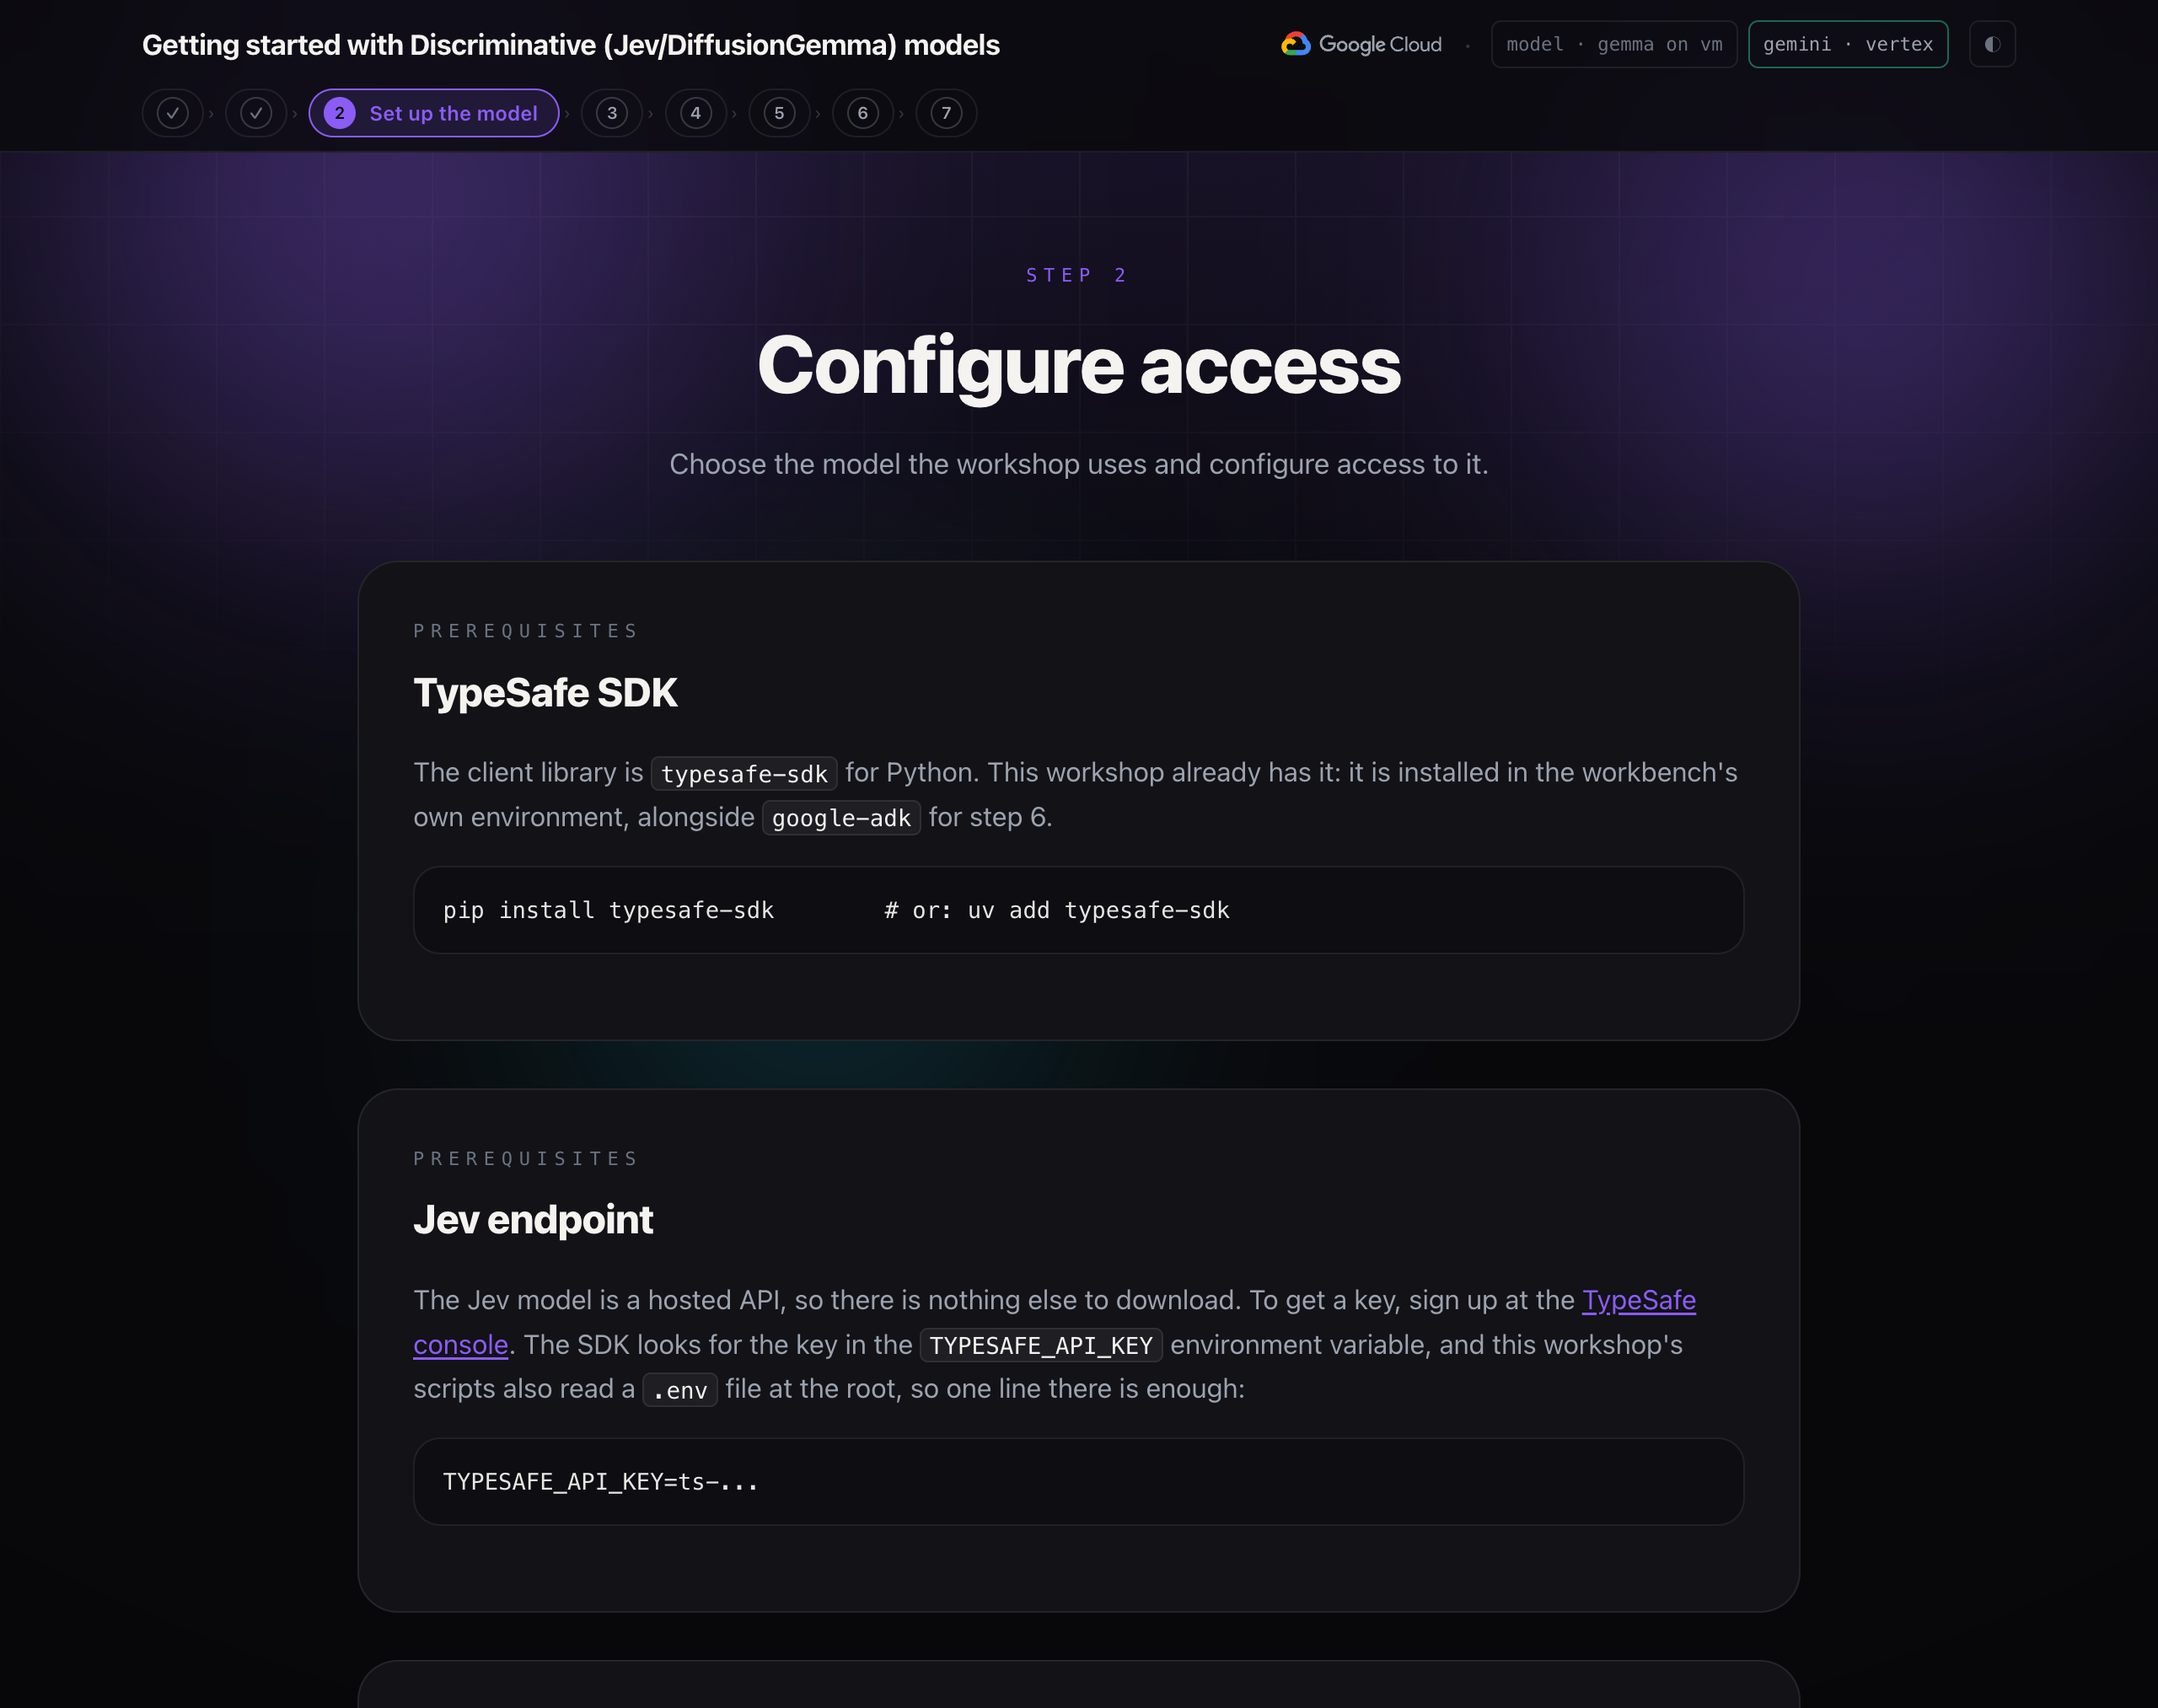
SDK TypeSafe
A biblioteca de cliente é typesafe-sdk para Python. Este workshop já tem isso: ele está instalado no próprio ambiente da bancada, ao lado de google-adk para a etapa 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Endpoint do Jev
O modelo Jev é uma API hospedada, então não há mais nada para baixar. Para receber uma chave, inscreva-se no console TypeSafe. O SDK procura a chave na variável de ambiente TYPESAFE_API_KEY, e os scripts deste workshop também leem um arquivo .env na raiz. Portanto, uma linha é suficiente:
TYPESAFE_API_KEY=ts-...
Usar o DiffusionGemma
O djev-run reimplementa a API do modelo discriminativo. Ele atende ao mesmo endpoint POST /v1/systemone, com as mesmas perguntas de noul, escolha e pontuação, do DiffusionGemma, o modelo de difusão aberta do Google DeepMind (26 bilhões de parâmetros totais, cerca de 4 bilhões ativos, Apache 2.0). Como o formato de transmissão é o mesmo, o SDK TypeSafe se comunica com ele sem alterações.
Se você escolher o DiffusionGemma no exercício, ele será executado em uma GPU em uma VM no seu próprio projeto do Google Cloud, e a pílula no canto superior direito vai mostrar gemma on vm. O workbench acessa o modelo por um túnel IAP particular, e a porta do modelo não está aberta à Internet. A etapa 1 descreve a arquitetura completa.
Por que um modelo de difusão pode fazer isso:ele preenche um bloco inteiro de posições de uma só vez, com cada posição vendo a entrada completa. Assim, a probabilidade de cada opção permitida pode ser lida em uma única etapa. Um modelo de linguagem normal produz um token por vez e precisa ser amostrado repetidamente.
Jogar manualmente
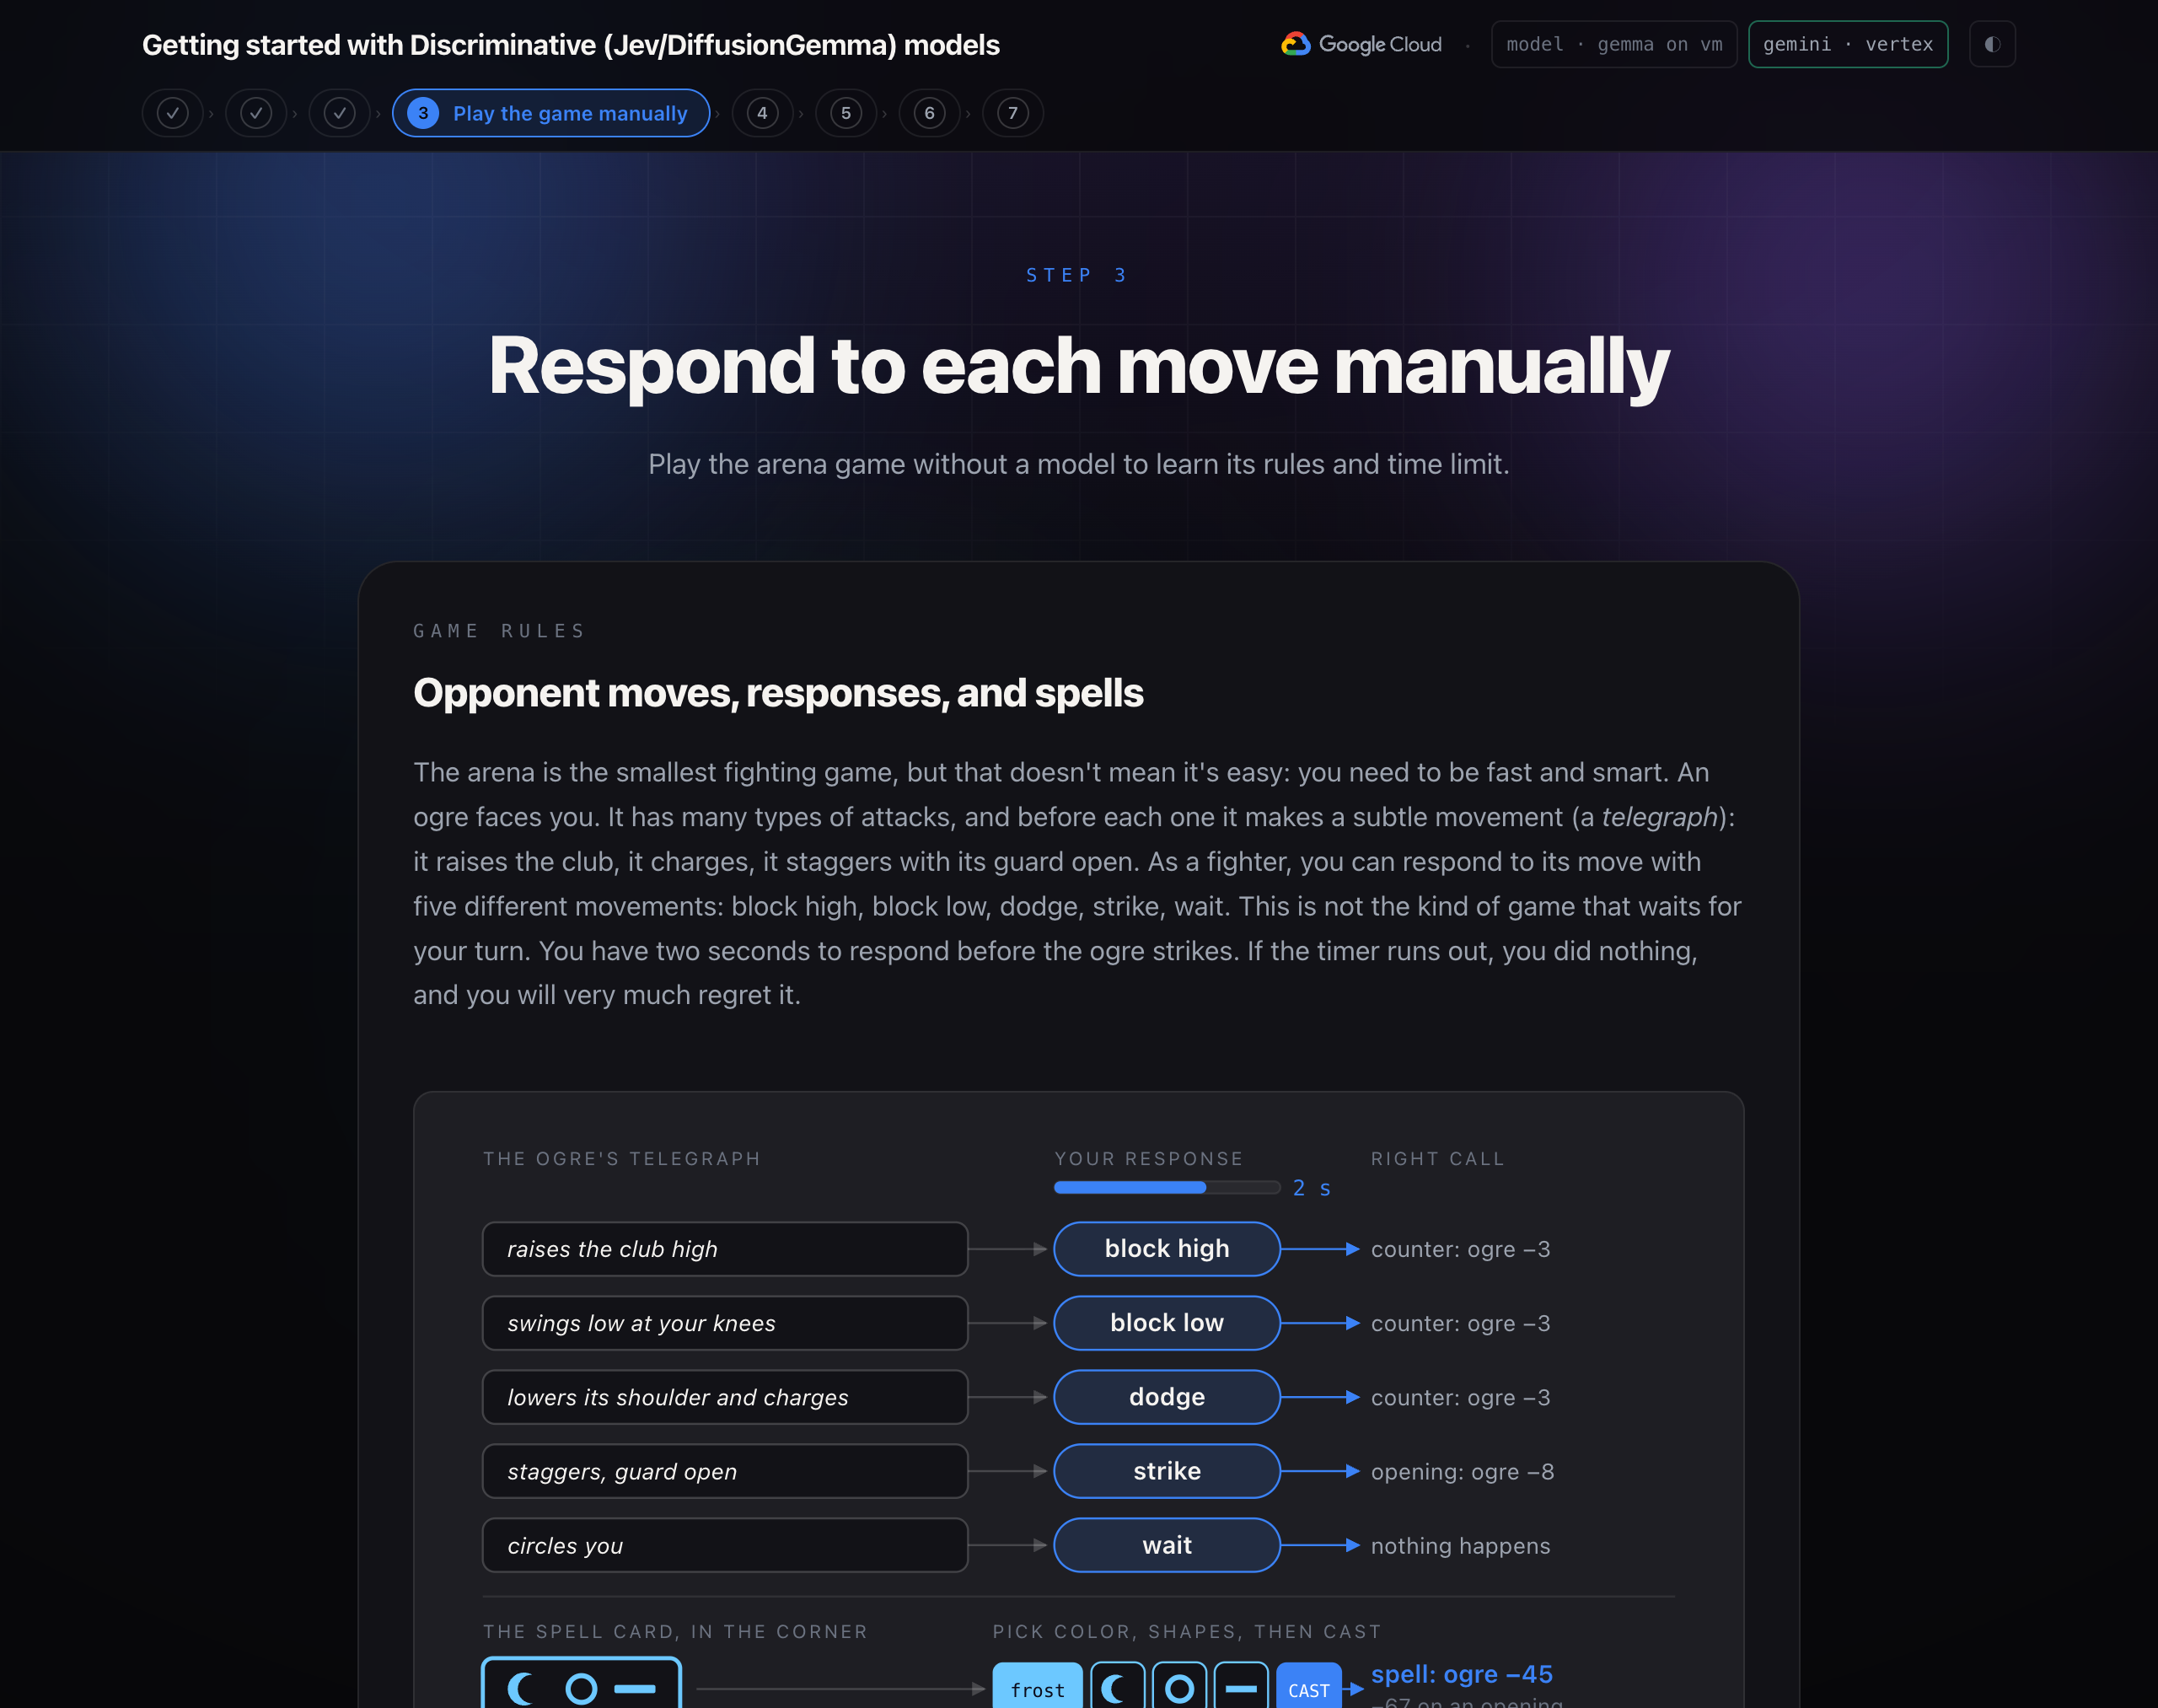
A arena é o menor jogo de luta, mas isso não significa que seja fácil: você precisa ser rápido e inteligente. Um ogro está na sua frente. Ele tem muitos tipos de ataques e, antes de cada um, faz um movimento sutil (um telegrafo): levanta o taco, avança, cambaleia com a guarda aberta. Como lutador, você pode responder ao movimento dele com cinco movimentos diferentes: bloquear em cima, bloquear embaixo, esquivar, atacar e esperar. Não é o tipo de jogo que espera sua vez. Você tem dois segundos para responder antes que o ogro ataque. Se o tempo acabar e você não fizer nada, vai se arrepender muito.
No canto superior esquerdo do círculo, há um card de feitiço: um card colorido com três formas. Só um feitiço correspondente causa dano real. No jogo, você pode lançar um feitiço com os botões abaixo da luta: escolha a cor da carta, depois as formas da esquerda para a direita e pressione LANÇAR. O tempo continua correndo enquanto você escolhe, então é preciso criar o feitiço e reagir aos ataques do ogro ao mesmo tempo. As teclas de 1 a 5 ainda respondem a cada movimento. Um feitiço errado falha. Na etapa 6, o Gemini lê o card de feitiço para você.
Principal conclusão:uma luta é um fluxo de pequenas decisões com um prazo em cada uma delas. É assim que a maioria das automações de software funciona, sem o clube.
Conceitos de modelo discriminativo
Decisões em software
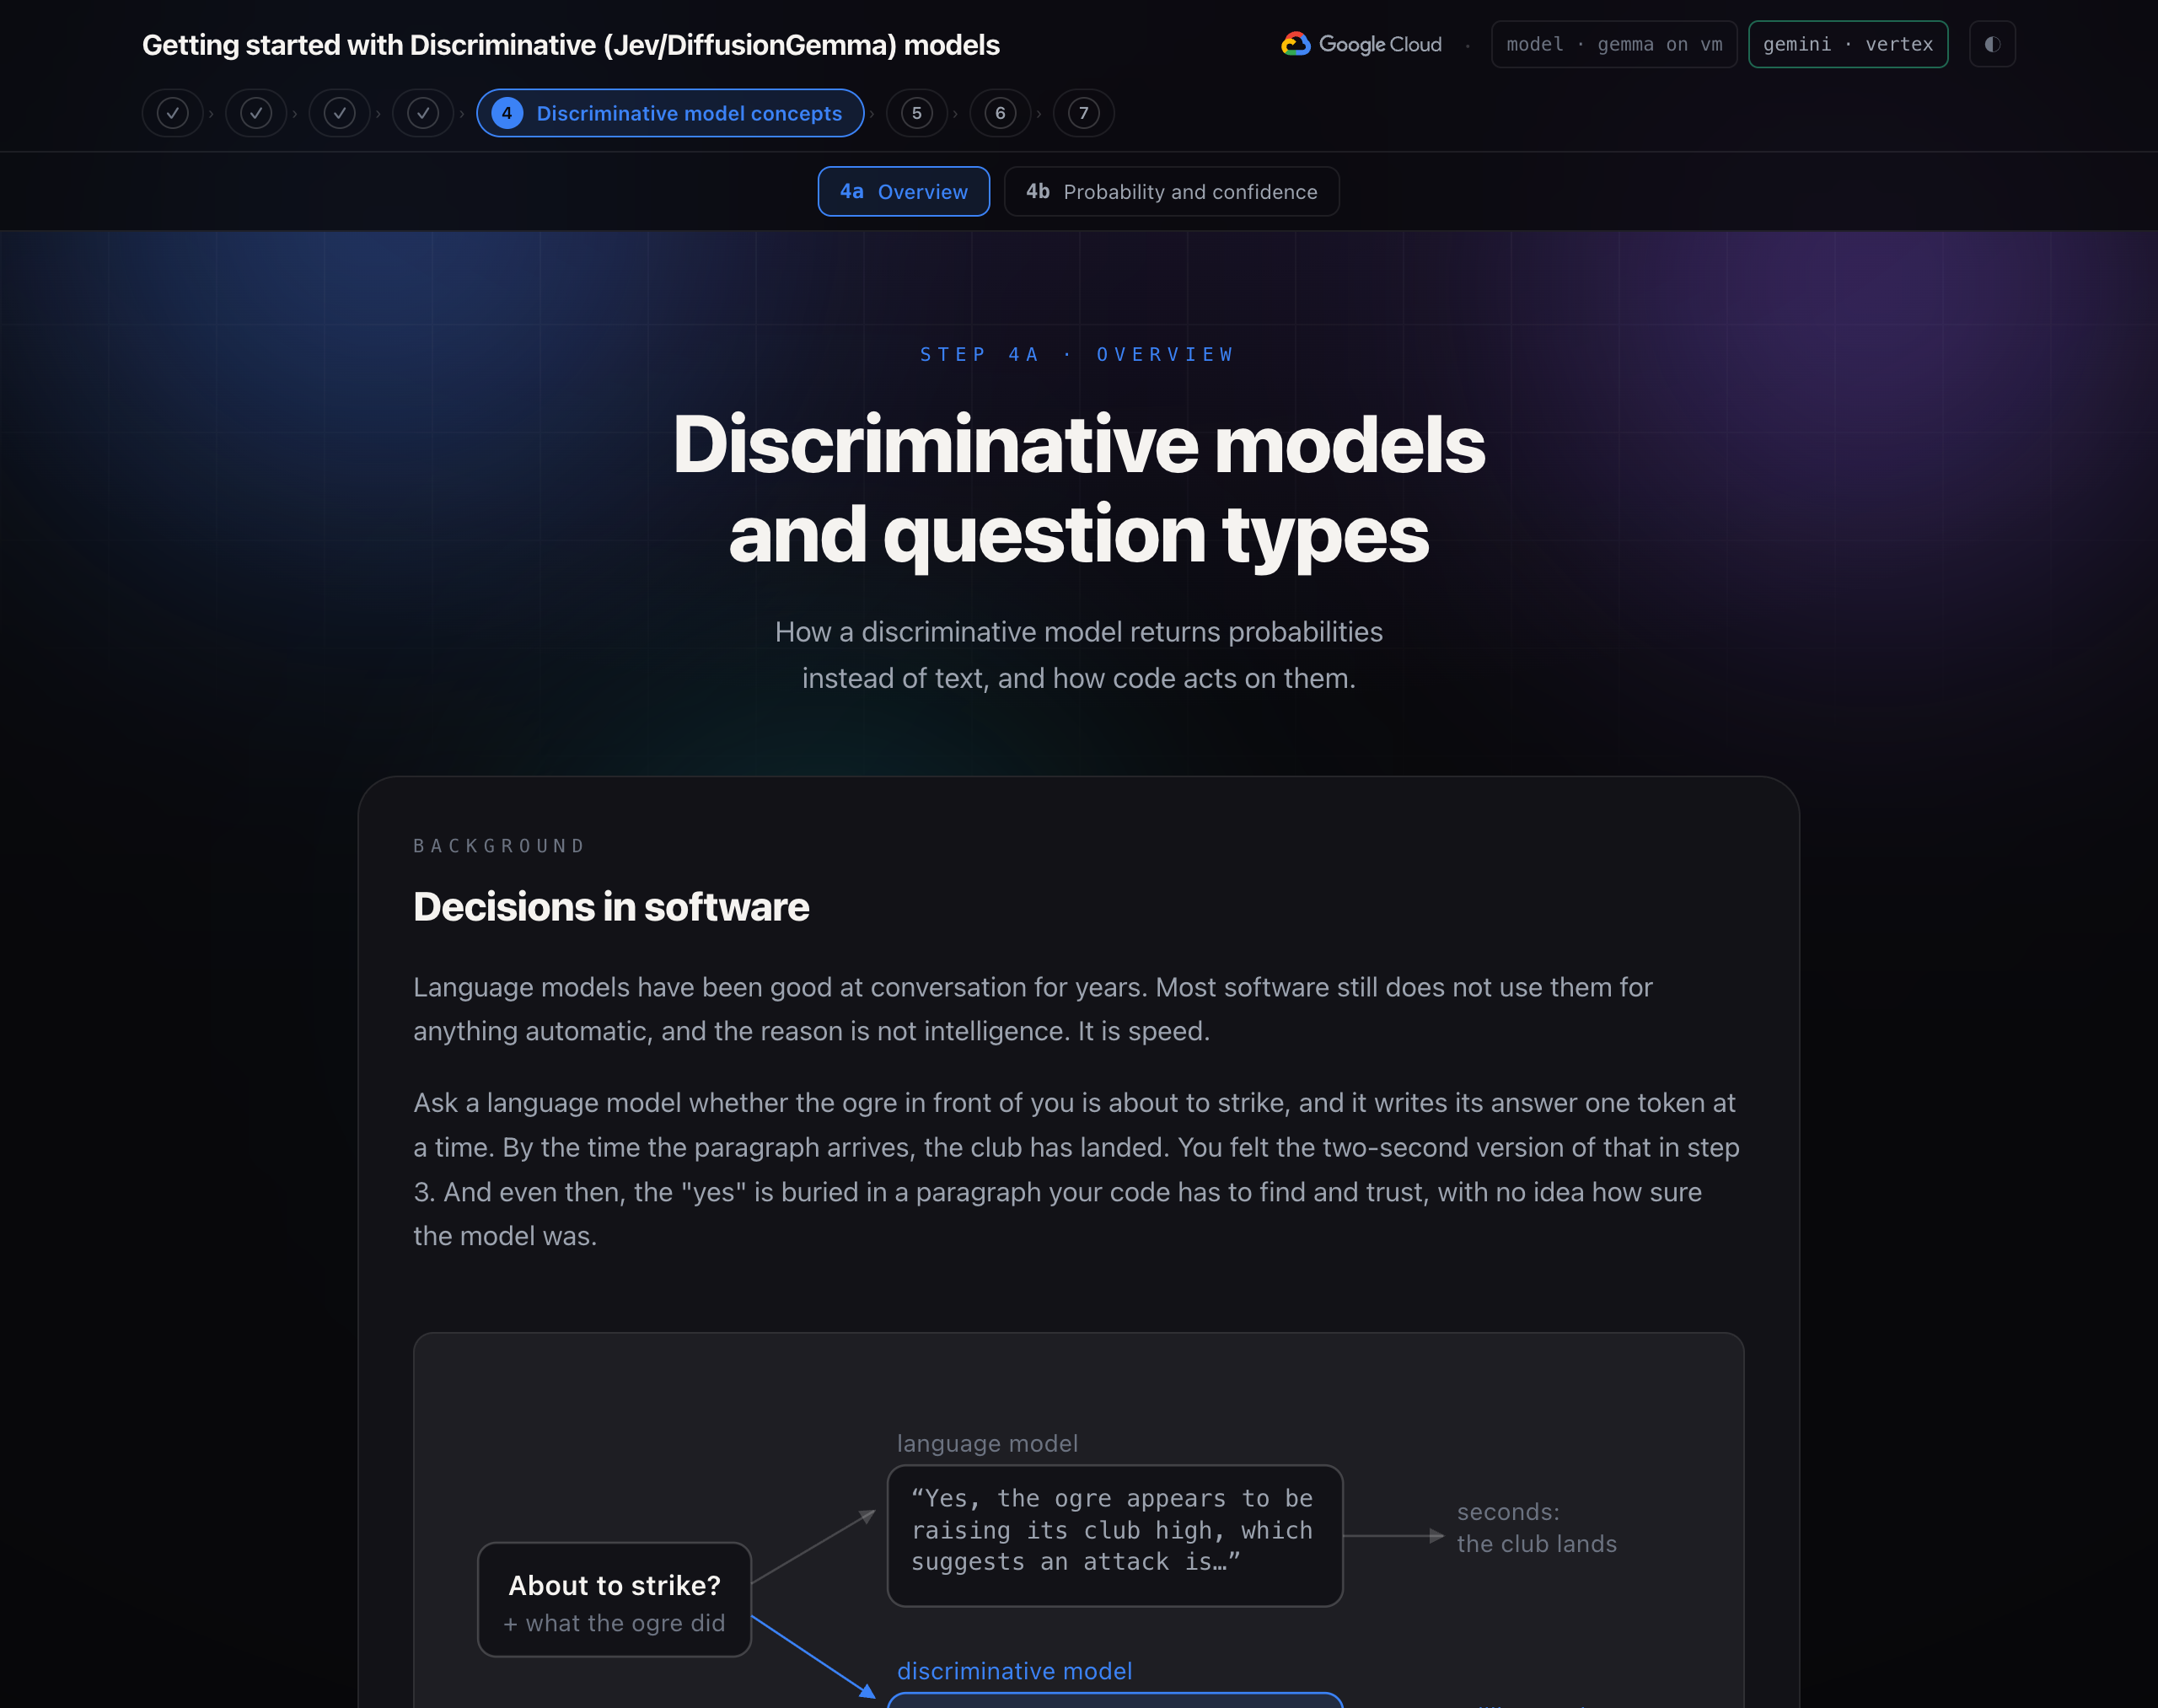
Os modelos de linguagem são bons em conversas há anos. A maioria dos softwares ainda não os usa para nada automático, e o motivo não é a falta de inteligência. É velocidade.
Pergunte a um modelo de linguagem se o ogro na sua frente está prestes a atacar, e ele vai escrever a resposta um token por vez. Quando o parágrafo chega, o clube já pousou. Você sentiu a versão de dois segundos na etapa 3. Mesmo assim, o "sim" fica em um parágrafo que seu código precisa encontrar e confiar, sem saber o nível de certeza do modelo.
O modelo discriminativo usa o estado e suas perguntas e respostas digitadas em uma única passagem, em milissegundos. Cada resposta vem com uma probabilidade calibrada: 0,9 significa que ela está certa nove vezes em dez. Não há texto para analisar nem JSON para extrair.
Modelos de sistema 1 e sistema 2
O nome vem do livro Rápido e devagar: duas formas de pensar, de Daniel Kahneman. O Sistema 2 é um raciocínio lento e deliberado, uma etapa após a outra. O Sistema 1 é rápido e identifica padrões.
Um modelo de linguagem é uma máquina do Sistema 2. Ele raciocina em tokens, um de cada vez. O modelo discriminativo é um modelo do Sistema 1: ele não raciocina em voz alta, não gera nada e responde a todas as perguntas de uma só vez. Por isso, ele é rápido (aproximadamente de 70 a 500 milissegundos) e barato (frações de um centavo por mil decisões).
Principal conclusão:um modelo de linguagem escreve. Um modelo de decisão decide. A maior parte do que o software precisa da IA é uma decisão.
Limitações
O modelo discriminativo não gera texto, escreve código, mantém uma conversa, faz cálculos aritméticos, lê uma imagem ou segue uma série de etapas.
No workshop, vamos escolher um dos modelos discriminativos:
- Um dos modelos discriminativos é o Jev. É uma API hospedada da TypeSafe AI, lançada em setembro de 2026. O primeiro modelo é
jev-1.13, acessado pelo aliasjev-latest. Não há pesos publicados, então ele é chamado, não baixado. - Jev não é a única maneira de conseguir um modelo do Sistema 1. O DiffusionGemma do Google é um modelo de pesos abertos que grava um bloco inteiro de tokens em paralelo, em vez de um por vez. Essa mesma transmissão paralela pode ler probabilidades em um conjunto fixo de opções. Servidores de código aberto, como o djev-run, colocam a API exata do Jev na frente, então tudo neste workshop é executado sem alterações.
Estado e perguntas: Choice, Score e Noul
Cada chamada envia estado e perguntas. O estado é o texto que você quer julgar. Pode ser uma string, um objeto JSON ou uma lista. As perguntas pedem o que você quer saber sobre o texto. Cada pergunta tem um tipo: escolha, pontuação ou noul. As perguntas são processadas em paralelo, o que permite que ele responda rapidamente. Você pode adicionar várias perguntas, se necessário.
- Choice escolhe uma opção de um conjunto de até 255 opções que você nomeia. A resposta é a opção, uma probabilidade para cada opção e uma confiança. Use quando as opções não tiverem uma ordem entre elas: bloquear alto, bloquear baixo, desviar, golpear, esperar.
- A pontuação avalia o estado em níveis ordenados que você descreve, de dois a dez. A resposta é uma posição ao longo da escala (um decimal, então 1, 4 significa "entre um e dois, mais próximo de um"), a probabilidade de cada nível e uma confiança. Use quando a resposta for uma questão de grau: o quão forte o hit vai ser.
- "Choice" e "Score" retornam uma probabilidade para cada opção e uma confiança. A diferença é a resposta principal. Uma opção retorna a opção mais provável. Uma pontuação trata as opções como níveis ordenados e retorna a média ponderada por probabilidade delas, que pode ficar entre dois níveis. Com "nenhuma" 0,05, "leve" 0,55 e "pesada" 0,40, uma escolha responde "leve" e uma pontuação responde 1,35, entre leve e pesada. A arena usa esse valor:
choose()trata uma pontuação de risco de 1,5 ou mais como um impacto forte.
- "Choice" e "Score" retornam uma probabilidade para cada opção e uma confiança. A diferença é a resposta principal. Uma opção retorna a opção mais provável. Uma pontuação trata as opções como níveis ordenados e retorna a média ponderada por probabilidade delas, que pode ficar entre dois níveis. Com "nenhuma" 0,05, "leve" 0,55 e "pesada" 0,40, uma escolha responde "leve" e uma pontuação responde 1,35, entre leve e pesada. A arena usa esse valor:
- O Noul faz uma pergunta com resposta "sim" ou "não" e retorna a probabilidade de a resposta ser "sim". Próximo de 1 é um "sim" forte, próximo de 0 é um "não" forte e próximo de 0, 5 é "pode ser qualquer um". Não há uma confiança separada, já que a probabilidade é o nível de confiança.
Escrever perguntas objetivas
O modelo discriminativo funciona melhor quando uma pergunta pede algo específico e bem definido. "Qual é a situação?" retorna uma resposta plausível e de baixa confiança. "Qual é a resposta certa?", "O oponente está exposto?" e "Qual será a intensidade do golpe?" retornam três respostas focadas que seu código combina.
As descrições de opções e níveis são baratas e importantes. As regras que você leu na etapa 3 se tornam as descrições das opções: block_high: "Raise the shield. Right against an overhead or a high swing.". É assim que o modelo discriminativo aprende as regras da luta, no momento da solicitação, em uma linha cada. As opções podem mudar de acordo com a situação: a arena só oferece cast quando um feitiço está pronto.
Probabilidades e confiança
Uma resposta de escolha não é um rótulo. É uma distribuição sobre os rótulos, e o rótulo é apenas a barra mais alta.
Como o modelo recebe o número. Ele usa a mesma etapa que um modelo de linguagem usa para escolher a próxima palavra. Um transformador lê o texto e, em uma posição, atribui a cada token no vocabulário uma pontuação bruta, chamada de logit. Um logit mais alto significa que o token se encaixa melhor nessa posição. Uma softmax transforma os logits em probabilidades que somam 1. Em seguida, um modelo de linguagem escolhe um token, adiciona ao texto e repete o processo. Um modelo discriminativo para depois das probabilidades.
O espaço em branco é uma lacuna em um formulário de resposta. O servidor grava o formulário, como response: ▢, e deixa uma lacuna por pergunta. A única função do modelo é pontuar o que pertence a cada lacuna.
- O comando contém o estado e cada pergunta, com todas as respostas permitidas como um rótulo curto:
apara block_high,bpara block_low e assim por diante. - O servidor adiciona o formulário de respostas, com um espaço em branco por pergunta.
- O modelo lê o comando e o formulário em uma única passagem e atribui um logit a cada token em cada espaço em branco. O modelo de difusão vê todo o formulário de uma só vez e pontua todos os espaços em branco juntos.
- O servidor mantém apenas os logits dos rótulos permitidos e aplica uma função softmax a eles. Assim, as respostas permitidas somam 1.
- Se a leitura parecer incerta, o servidor vai ler novamente de outro início aleatório e calcular a média das leituras.
Confiança é um número que indica a certeza da resposta. O TypeSafe calcula esse valor com base na forma como a probabilidade é distribuída entre as opções. Se tudo estiver em uma opção, o resultado será 1, e se estiver distribuído de forma uniforme, será 0. Para três opções, é (3 × maior − 1) / 2.
O TypeSafe treina o Jev para probabilidades calibradas. A probabilidade corresponde à frequência com que a resposta está correta. Em um modelo calibrado, as respostas dadas em 0,7 estão corretas em cerca de 70% das vezes.Portanto, um limite de confiança é um limite de frequência com que você aceita uma resposta errada. O servidor DiffusionGemma neste workshop informa a probabilidade máxima como confiança, com média nas leituras. Quando as leituras discordam, a média se espalha e a confiança diminui.
Ponto principal:a resposta informa o quê. A confiança informa se é necessário agir.
Limites
O limite é como você define a ação no código. O modelo retorna uma confiança ou uma probabilidade. Seu código compara esse valor com um número escolhido por você, e o resultado decide o que acontece.
Um limite por ação. O TypeSafe sugere dividir a confiança em intervalos. O nível de confiança alto age por conta própria. A confiança média age com uma verificação, como pedir confirmação ou sinalizar o caso para análise. Quando a confiança é baixa, o modelo não faz nada e volta a uma opção segura ou a uma pessoa.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
As regras da arena. Os limites da arena estão em choose(), que você executa na etapa 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Aviso:uma resposta válida nem sempre é correta. O modelo discriminativo não pode retornar uma opção que você não ofereceu. Portanto, ele nunca alucina um movimento, mas pode escolher o errado, às vezes com alta confiança. Teste suas perguntas em situações que você já julgou antes de confiar em um limite.
Automatizar decisões com o modelo
Solicitação e resposta
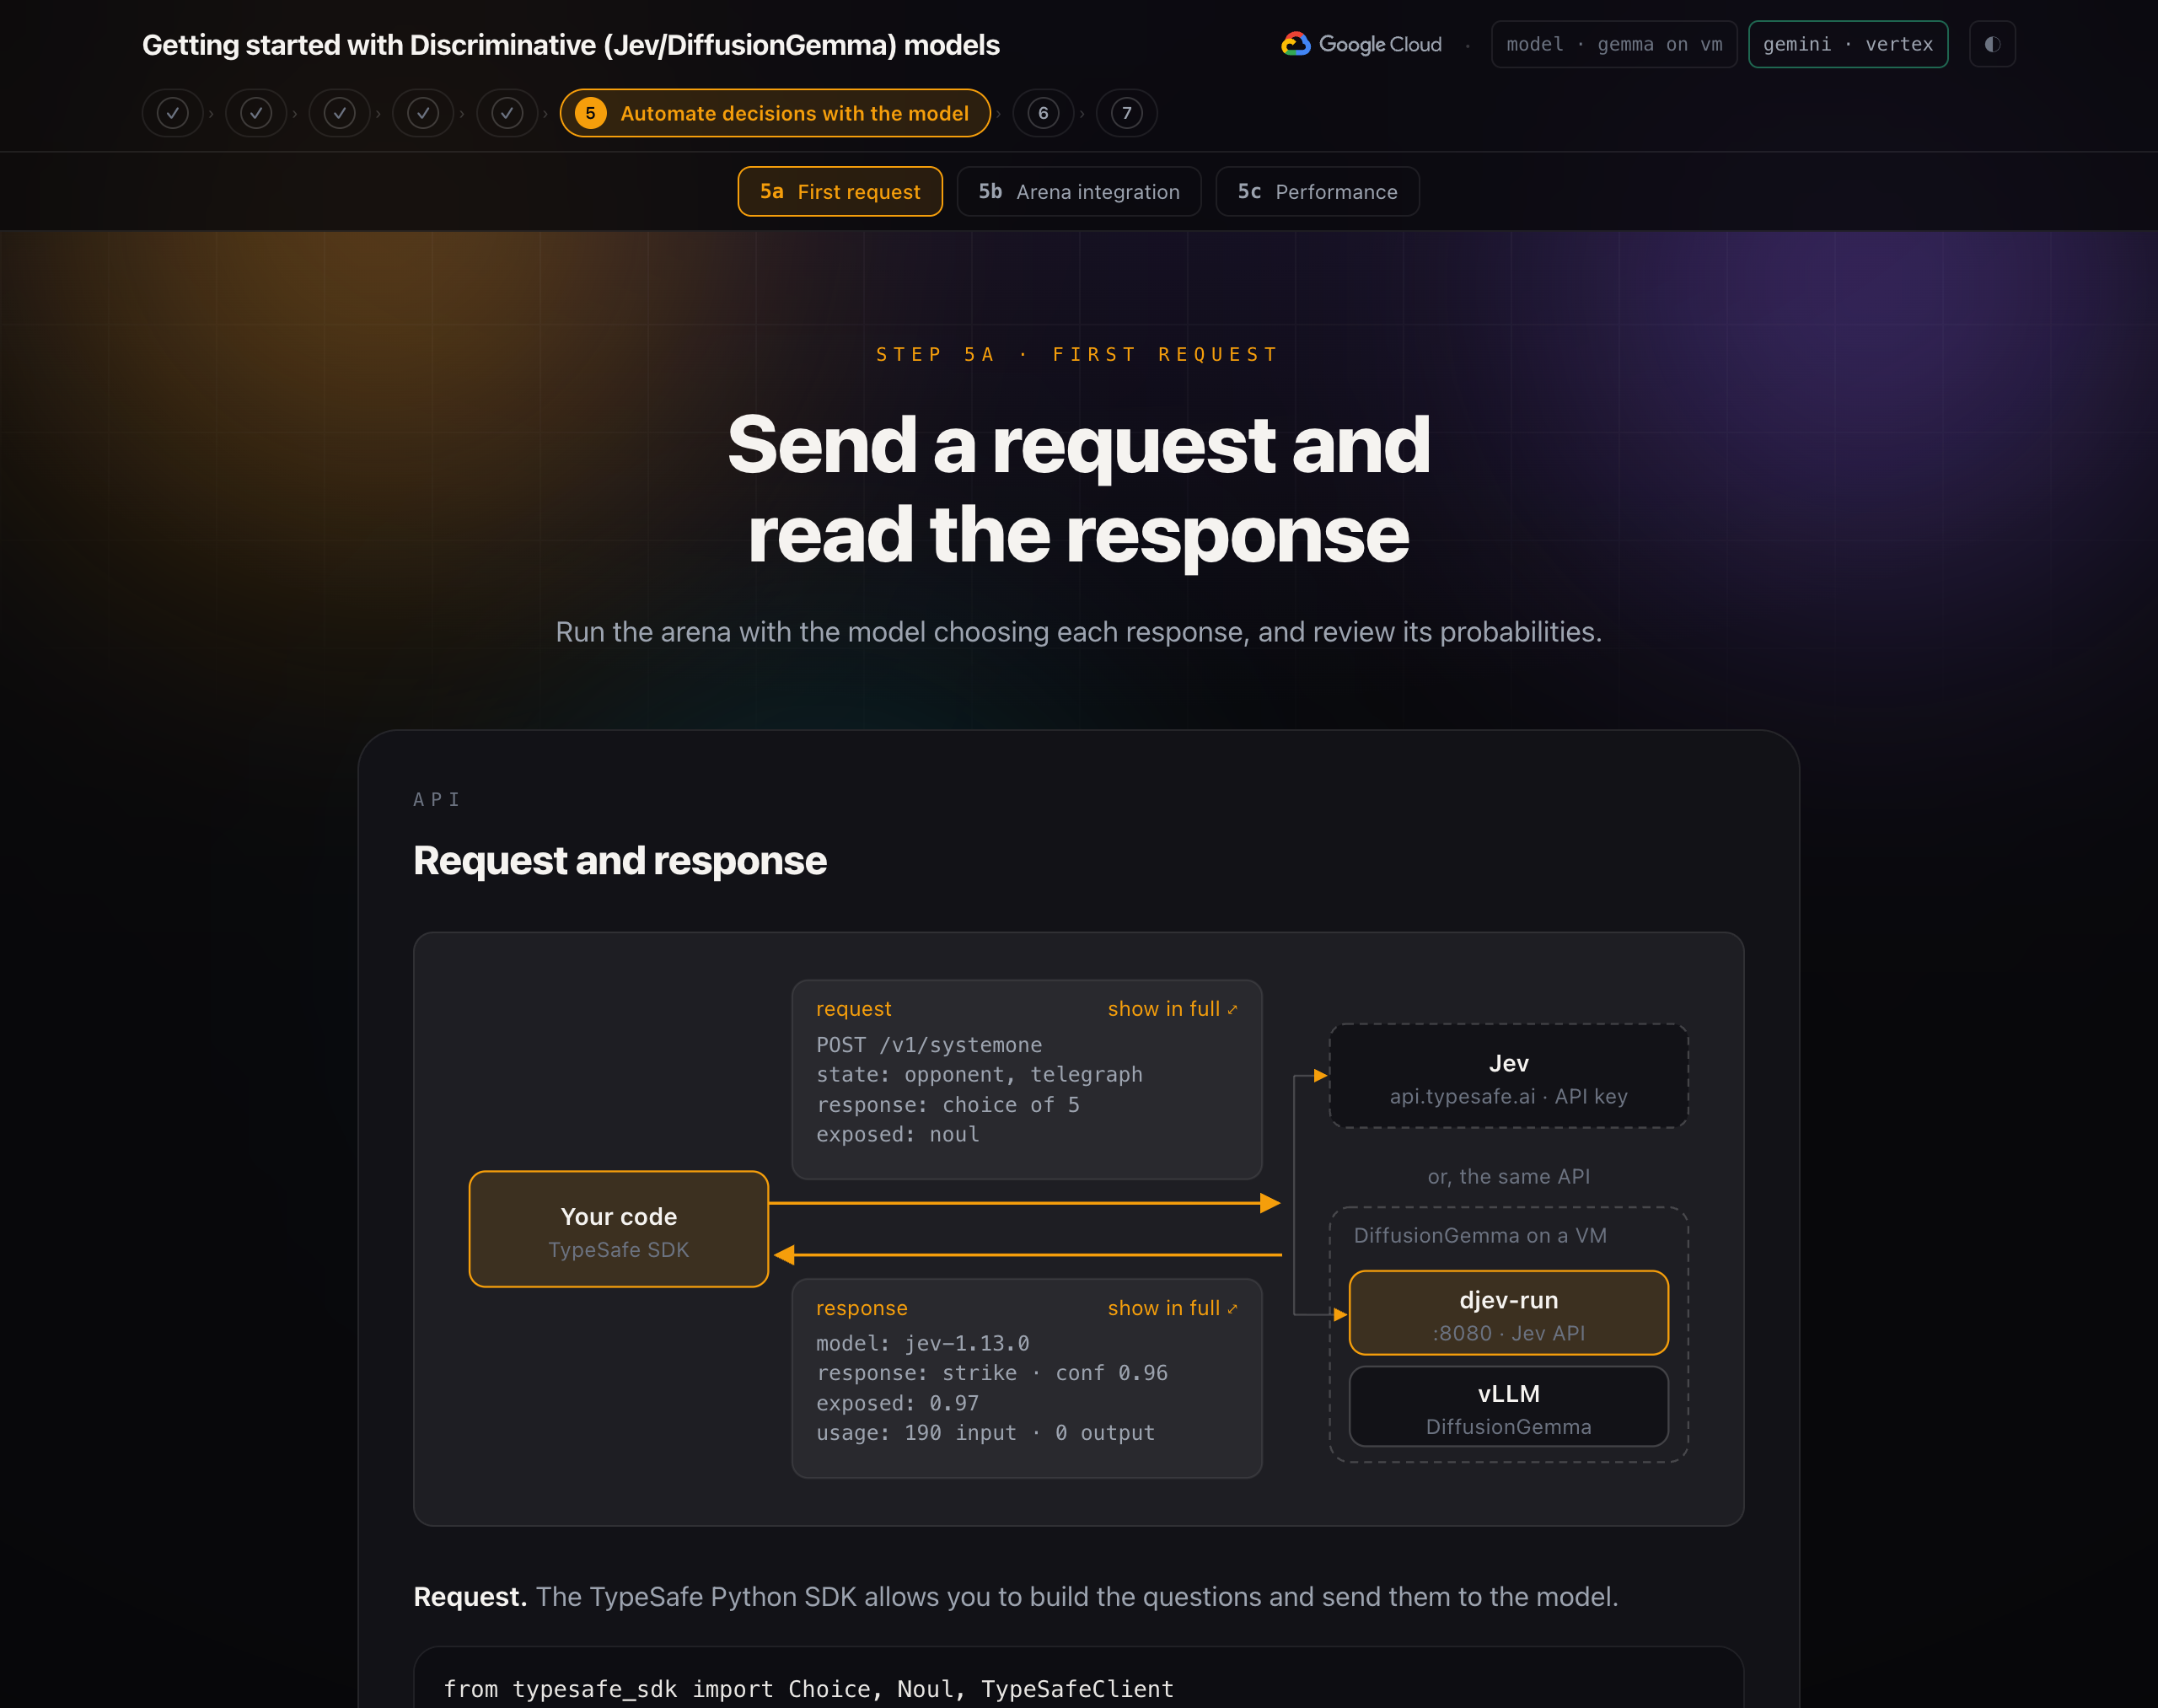
Solicitação. Com o SDK do Python TypeSafe, é possível criar as perguntas e enviá-las ao modelo.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Uma solicitação por tique
A cada tique-taque, o app envia o telégrafo como estado e pede três coisas em uma chamada:
- Qual resposta está certa, entre as cinco (ou seis, quando um feitiço está pronto). Uma escolha.
- Se o ogro está exposto a um contador no momento. Um Noul.
- A intensidade do impacto recebido, em uma rubrica de três níveis. Uma pontuação.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
A função choose()
Lembra dos limites da etapa 4? choose() compara as respostas do modelo com números fixos, que são os limites.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() é uma leitura comum de valores tipados em Python, com duas regras. O modelo discriminativo fornece a probabilidade e a análise, e o código usa os limites das regras. A ação escolhida é enviada ao mecanismo, onde será usada para lutar contra o ogro.
Principal conclusão:mantenha as perguntas e os limites em um só lugar. Eles são a parte de uma integração do System One que você mais vai ajustar.
Tempo de resposta, preços com base em entradas e lógica de decisão
- Tempo de resposta por decisão. Cada tique da luta na parte b voltou em cerca de cem milissegundos, alguns em dois ou três. Isso é rápido o suficiente para um loop de jogo, um caminho de solicitação ou uma verificação em cada mensagem antes que uma pessoa ou um modelo de linguagem a veja.
- Preços com base na entrada. Uma luta inteira, 60 decisões com três perguntas cada, custa bem menos de um décimo de centavo. Os tokens de saída são zero porque nada foi gerado. A consequência é que você pode pedir mais do que precisa. A arena pergunta se o ogro fica exposto em todos os ticks, mesmo que apenas
strikeecastse importem, porque perguntar quase não tem custo e a resposta é útil no painel. A TypeSafe chama isso de distribuição de dados especulativa. - Combine confiança e perigo. Quando a confiança do modelo discriminativo na resposta é inferior a 0,40 e a pontuação de risco indica um impacto forte, o
choose()substitui isso por uma esquiva. Uma evasiva raramente é a melhor ou a pior resposta. Escolha os limites com base no custo de cada erro, não em um número redondo, e teste-os em relação aos telegramas que você já julgou manualmente. A própria TypeSafe recomenda: se uma decisão continuar sendo acionada incorretamente, ajuste a pergunta antes de mover o limite.
Combinar modelos em um fluxo de trabalho do ADK
Limites das decisões por tique e por que as respostas corretas não são suficientes
A última linha da luta na etapa 5 diz: o ogro se arrasta, mal arranhado. O modelo discriminativo não sofreu dano e causou um pouco a cada tique-taque, e 300 pontos de vida é mais do que um pouco vezes sessenta. A carta de feitiço no canto do anel estava lá o tempo todo. Para ler, é necessário um modelo que possa ver uma imagem.
O ogro tem 300 pontos de vida. Uma chamada à direita conta como 3. Um golpe em uma abertura vale 8, porque o esconderijo é grosso. Mesmo uma luta perfeita de 60 tiques deixa o ogro machucado e em pé, e o jogo considera isso um empate. É aí que a etapa 5 termina: o modelo se defendeu bem, mas ainda não conseguiu vencer.
Só uma magia causa dano real: 45 por um lançamento perfeito, 67 quando atinge uma abertura.
Atribua cada tarefa ao modelo certo
A carta de feitiço no canto do ringue é a maneira de vencer, e a leitura dela não é um problema de texto: é uma imagem, com uma cor e três formas seguidas, e o feitiço precisa ser cantado para corresponder. Isso exige um modelo que possa analisar uma imagem e levar alguns segundos para isso. Em uma luta, alguns segundos são dez tiques.
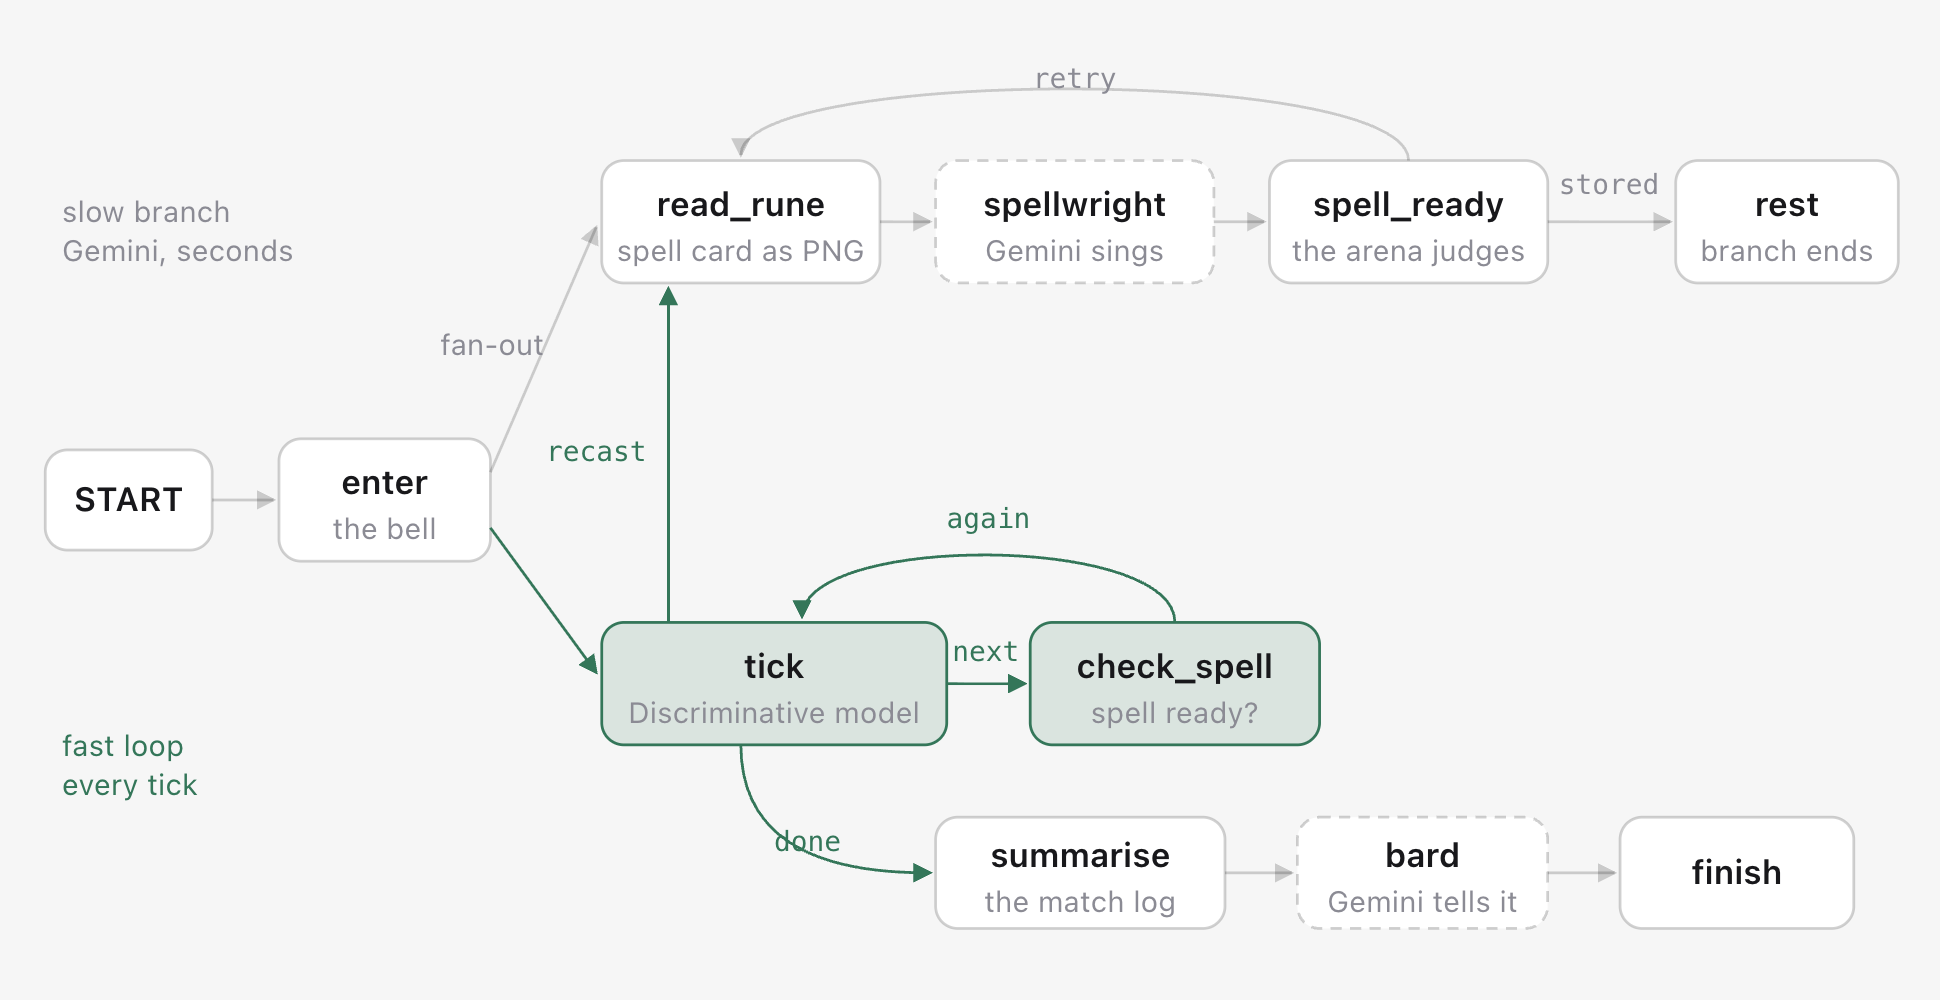
Assim, o fluxo de trabalho usa os dois, cada um na própria velocidade:
- O modelo discriminativo luta. A cada tique-taque, uma chamada, uma decisão, cem milissegundos. O loop nunca espera por nada mais lento do que ele mesmo.
- O Gemini lê e canta. Em um galho, começando no sino, ele pega o card de feitiço da tela da arena como uma imagem, nomeia a cor e as formas e canta uma incantação. A arena julga a música em relação à resposta da carta de feitiço, que nunca sai do servidor.
- Após cada troca, o lutador verifica o slot. Um nó
check_spellanalisa o estado. Não está pronto: ele diz isso, com o tempo que o Gemini está cantando, e volta direto para o próximo tique. Ele nunca espera. Pronto:castentra nas opções oferecidas ao modelo discriminativo, echoose()gasta o feitiço no momento em que o modelo discriminativo informa uma abertura. Quando o feitiço acaba, a tela mostra uma nova carta de feitiço e a linha lenta começa de novo. Uma leitura errada queima a carta de feitiço, e a linha lenta lê a nova. - O Gemini escreve um conto curto uma vez, no final.
Ramificações paralelas com latências diferentes e um loop de eventos
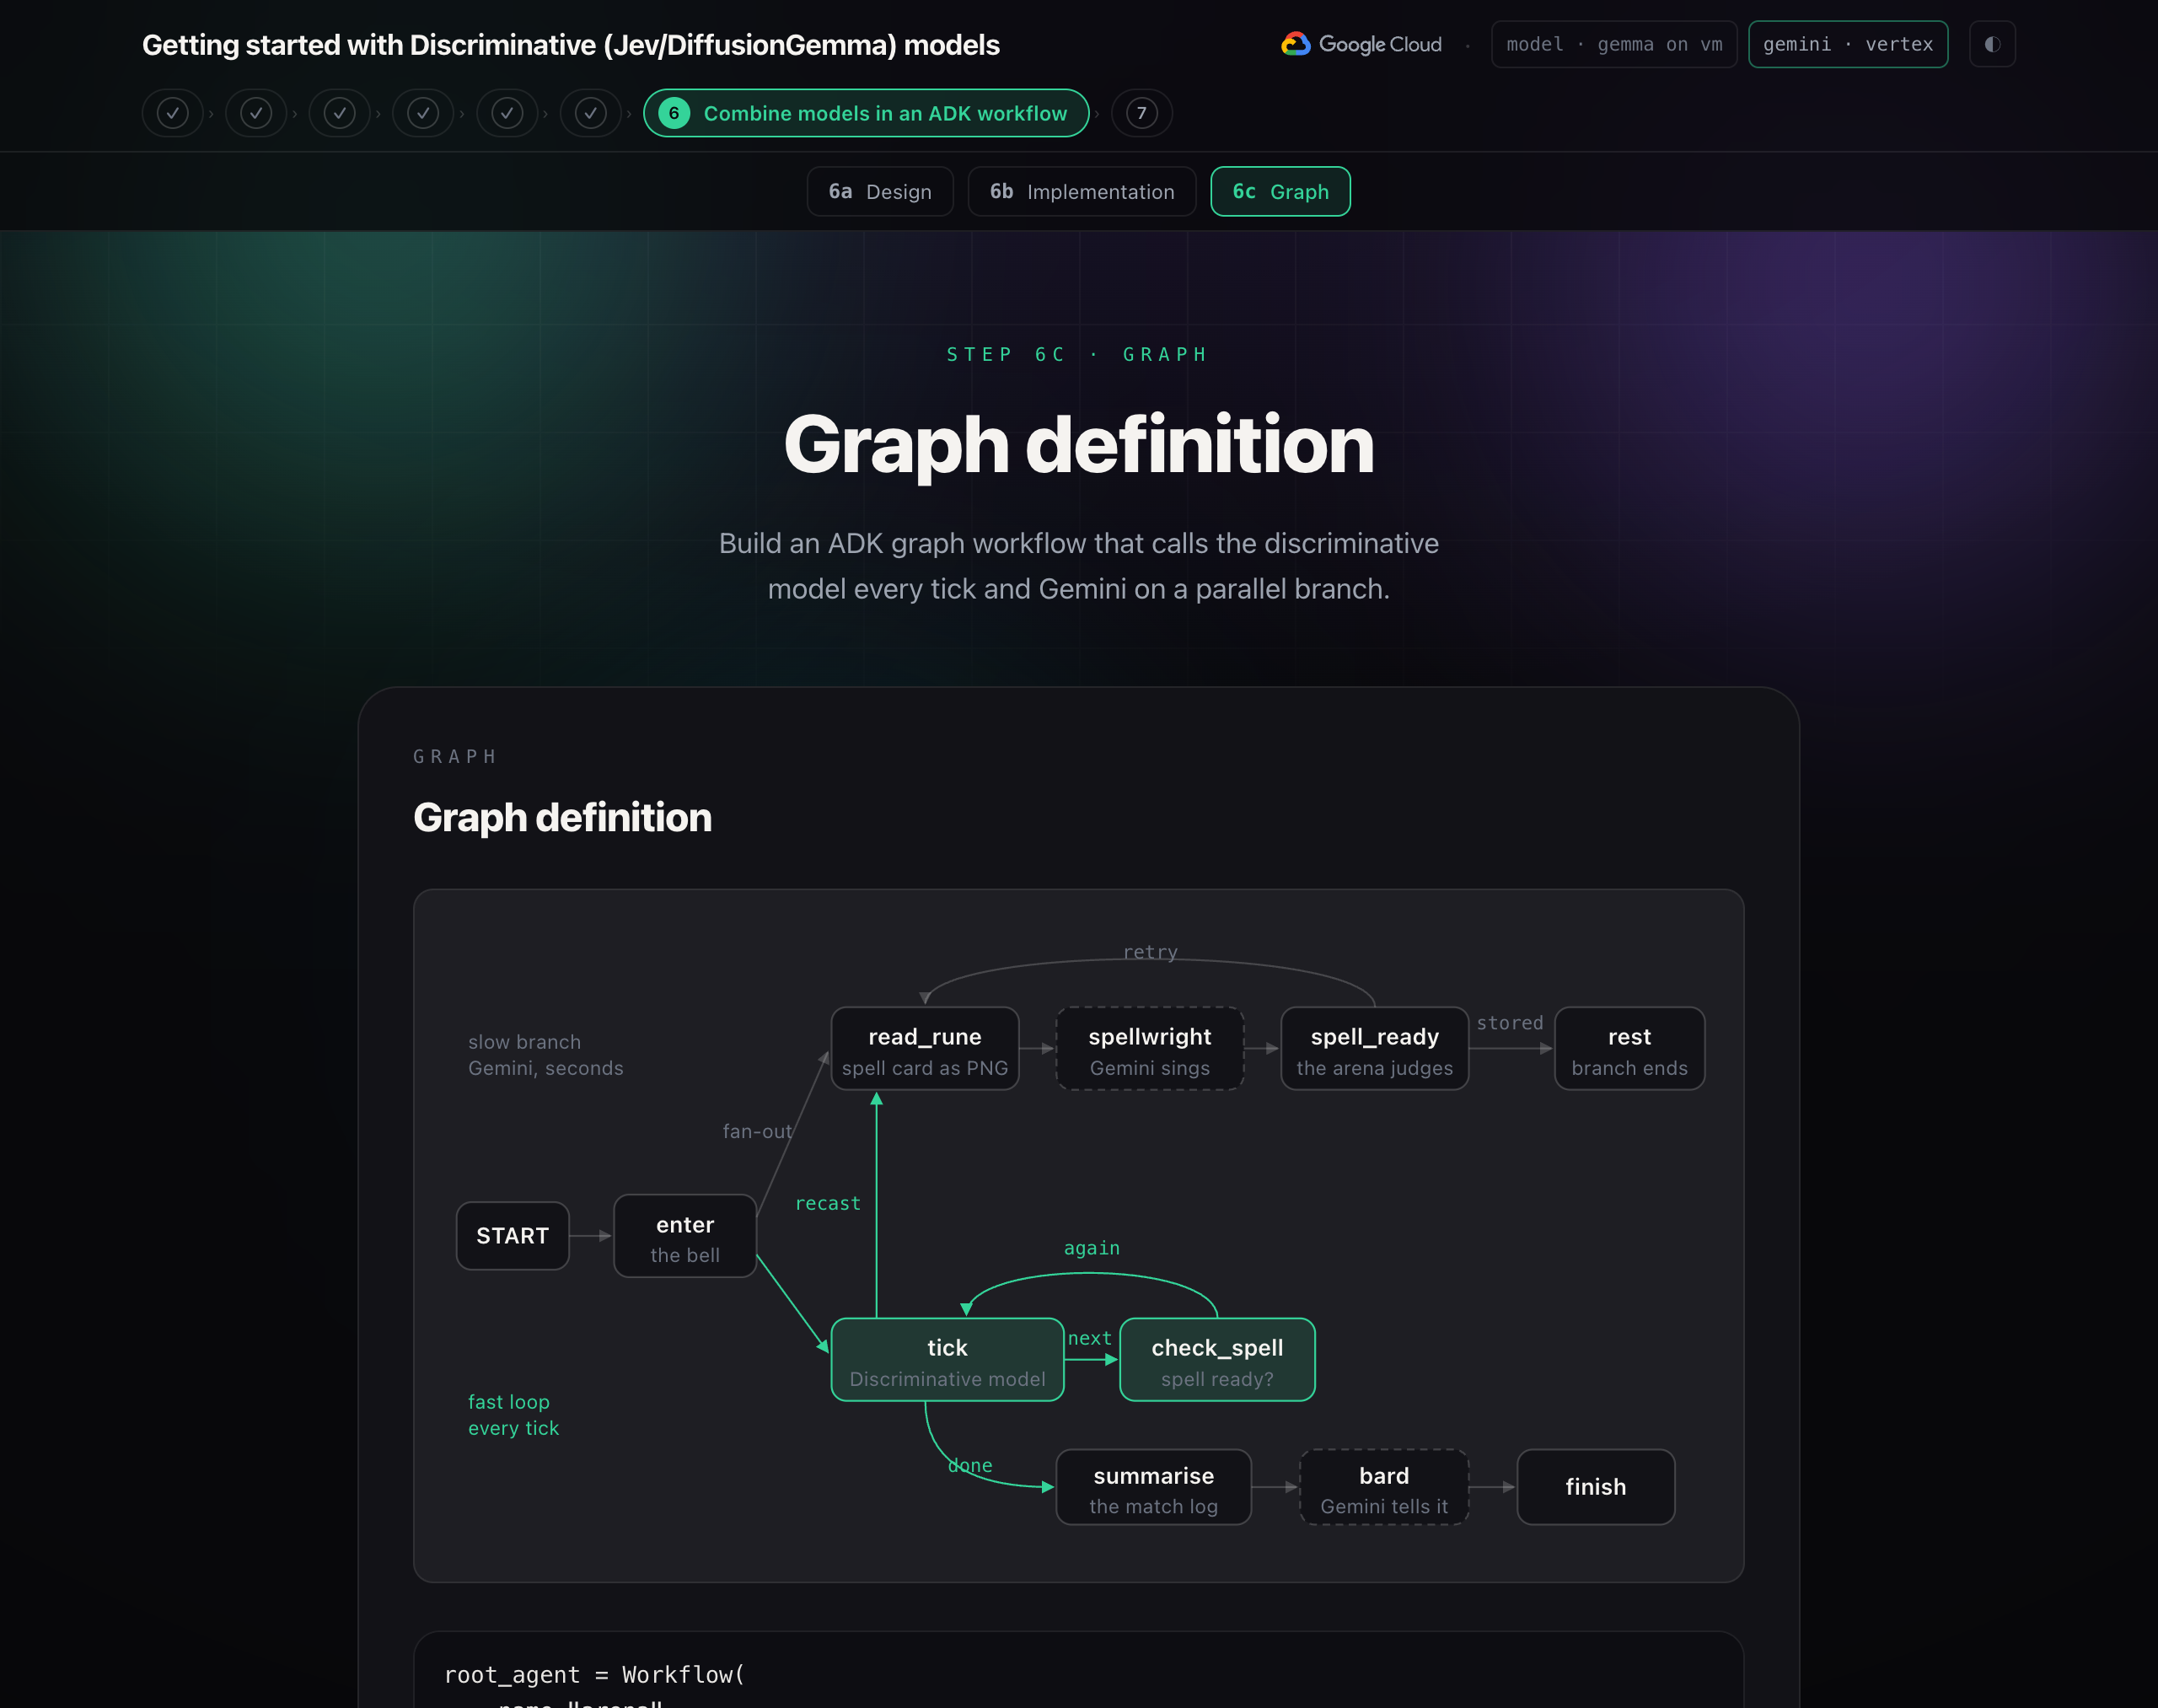
Este é um fluxo de trabalho do ADK: um gráfico de nós unidos por arestas. Um nó é uma função Python simples ou um agente de LLM. Uma aresta de um nó para uma tupla de nós é uma distribuição de dados: ambos começam simultaneamente. Um nó que retorna um Event com um route escolhe qual aresta será usada em seguida, e um nó que se encaminha para si mesmo é um loop.
Pense nisso como duas linhas. A linha 1 é lenta: leia o cartão de feitiço, cante e guarde o feitiço. A linha 2 é rápida: marque, verifique o slot, marque de novo. A linha de execução 1 termina em uma função que grava a grafia julgada no estado da sessão e não retorna nenhuma saída. A check_spell da linha de execução 2 lê esse estado após cada troca. Nenhuma das linhas de execução chama ou espera a outra. Elas apenas compartilham o estado.
Principal conclusão:coloque as decisões no código e atribua a cada modelo uma tarefa específica no próprio ritmo.
O ADK executa as duas ramificações como tarefas em um loop de eventos, em uma única linha de execução. Apenas uma tarefa é executada por vez. Quando uma tarefa atinge await, ela aguarda a resposta, e o loop executa a outra ramificação enquanto isso. A ramificação rápida aguarda o modelo por cerca de um décimo de segundo, e a ramificação lenta aguarda o Gemini por vários segundos. Assim, nenhuma delas impede a outra.
Ramificação lenta
read_rune() tira o card de feitiço da tela como uma imagem.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
O spellwright é o Gemini. Ele lê a imagem e responde em um formato fixo.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() faz com que o juiz da arena avalie o feitiço e o armazene ou tente de novo.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Um nó de função pode retornar um Content com uma parte de imagem, e o nó do LLM o recebe como a vez do usuário. spell_ready retorna um Event com um delta de estado e sem output. O próximo tique lê o feitiço do estado, e uma ramificação sem saída não é um segundo final para o gráfico: o ADK exige uma saída terminal, que é a da luta.
Observação:o julgamento é feito por código, na arena, contra a resposta oculta da carta de feitiço. Uma leitura perfeita faz 45, mais em uma abertura. Duas formas corretas fazem 25. Uma leitura incorreta faz com que o feitiço falhe e queime o card. O Gemini não é questionado se estava certo.
Ramificação rápida
tick() faz uma troca e escolhe a próxima aresta.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() analisa o slot de feitiço após cada troca.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
O check_spell analisa o slot após cada troca. Ele nunca bloqueia: se a correção ortográfica não estiver pronta, ele informa isso e continua.
Três coisas sustentam o design. A chamada do modelo discriminativo é awaitada com o cliente assíncrono. Assim, o loop gera enquanto espera, e a ramificação do Gemini continua sendo executada. As perguntas são criadas a cada tique-taque, então cast só aparece quando há algo para transmitir. E route pode ser uma lista: ["recast", "next"] usa as duas bordas de uma vez.
A arena fica atrás de um pequeno cliente: o app em execução por HTTP, quando há um, para que a página mostre a luta; o mecanismo no processo, quando não há.
Definição de gráfico
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Uma tupla como um destino é uma distribuição de dados. Uma tupla como uma aresta é uma cadeia. Um dicionário mapeia nomes de rotas para nós. tick → check_spell → tick é o loop rápido. "recast": read_rune inicia a thread lenta novamente depois que um feitiço é gasto, "retry" faz o mesmo depois de um fiasco, e "stored": rest permite que a thread lenta termine silenciosamente, sem saída, assim que o feitiço estiver no slot. O ADK exige pelo menos uma aresta roteada em um ciclo. Portanto, um loop incondicional é rejeitado antes de poder ser executado indefinidamente.
Observação : root_agent é o que as ferramentas do ADK procuram. adk web agents na raiz do workshop abre a interface de desenvolvimento com a arena. Se você quiser ver o gráfico e os eventos em um navegador em vez de um terminal.