

1. Введение
90-минутный мастер-класс по дискриминативной модели , модели принятия решений System One от TypeSafe AI, и по ее интеграции с Gemini в рабочий процесс Google ADK. Мастер-класс состоит из шести шагов, построенных на основе файтинг-игры. Сначала вы сразитесь с огром вручную, затем передадите реакцию дискриминативной модели, а затем будете наблюдать, как рабочий процесс ADK выигрывает бой, при этом дискриминативная модель принимает решения на каждом такте, а Gemini читает карты заклинаний с экрана, чтобы произносить заклинания.
Обзор
Дискриминативная модель ( jev-1.13 , псевдоним jev-latest ) — это размещенная модель от TypeSafe AI, выпущенная 19 сентября 2026 года. Она не генерирует текст. Вы отправляете ей состояние (текст, JSON или список) и типизированные вопросы ( Choice , Score , Noul ), и она возвращает типизированные ответы с откалиброванными вероятностями примерно за 70–500 мс, по цене 0,042 доллара за миллион входных токенов и ничего за выходные. Ее задача — принимать решения перед, между и за языковыми моделями: маршрутизация, классификация, управление и, в данном случае, рефлексы бойца.
В качестве примера — игра.
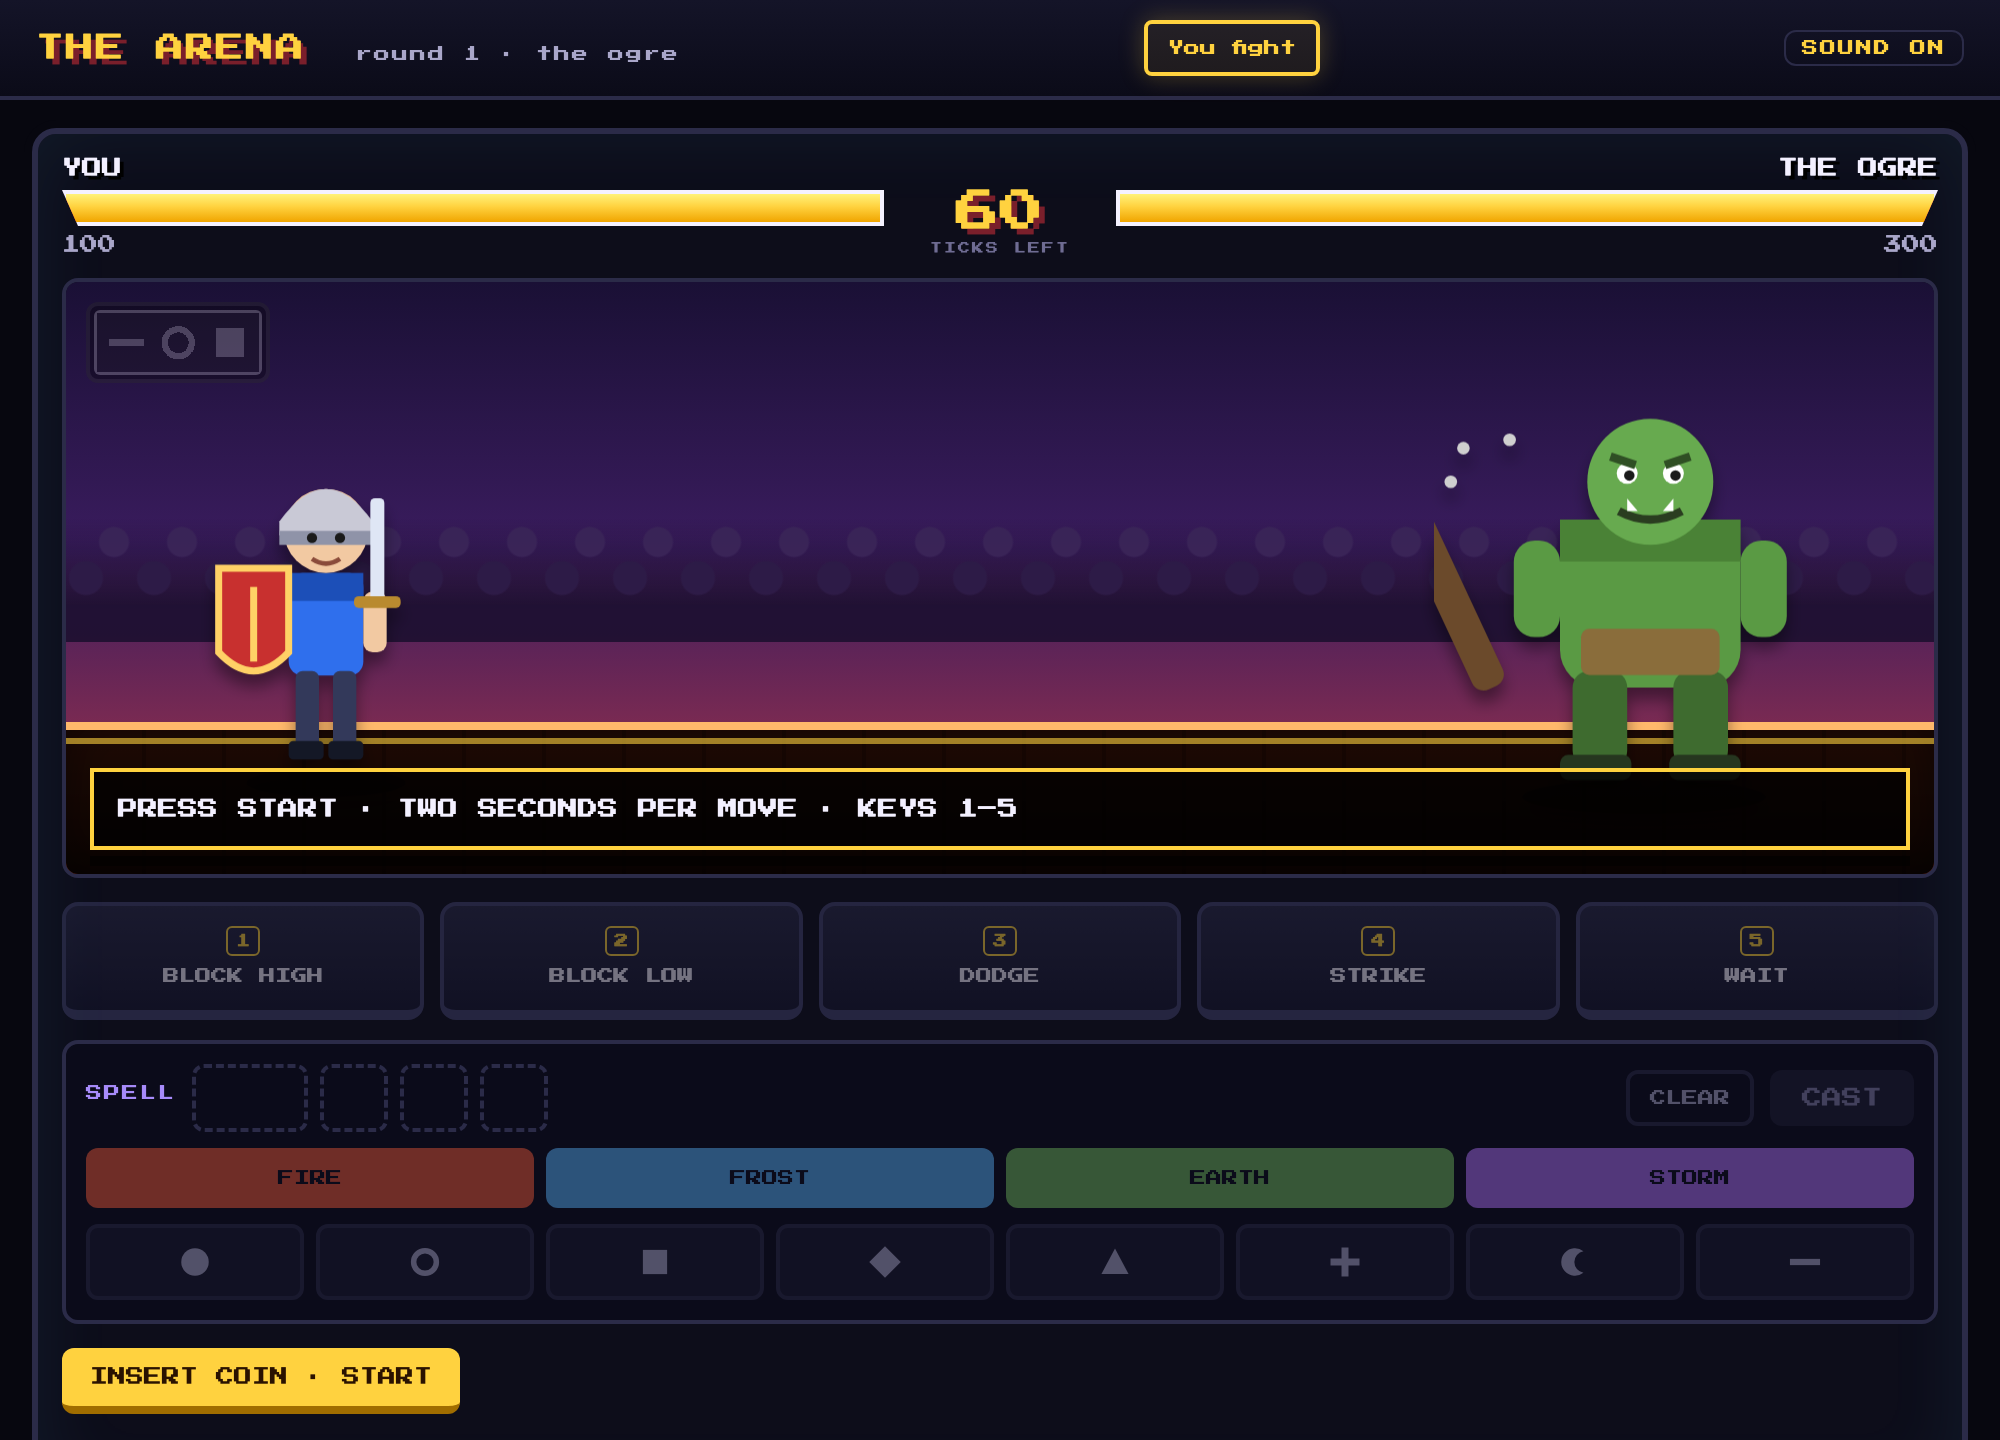
Вы когда-нибудь играли в боевую игру? Вы сталкиваетесь с противником и должны мгновенно реагировать на его действия. Одна неверная догадка — и ваши очки здоровья уменьшатся. В играх также часто бывает сложно применять заклинания. В нашей игре вам нужно выбрать цвет и форму карты заклинания в определенном порядке, прежде чем заклинание будет применено. Этот мастер-класс покажет вам, как комбинировать оба типа моделей, чтобы ваш персонаж одержал победу.
Каждый элемент игры соответствует реальной системе:
- Ход противника — это входящее событие, например, запрос или транзакция.
- Ответ представляет собой ограниченное решение, принимаемое дискриминативной моделью и проверяемое программным кодом.
- Карточка заклинания представляет собой неструктурированный ввод, для чтения которого необходима языковая модель.
- Суть матча заключается в организации рабочего процесса: каждый выполняет быструю и медленную работу в своем собственном темпе.
Основное внимание уделяется объединению четырех компонентов и их совместной работе для создания быстрой и интеллектуальной системы.
Что вы узнаете
- Объясните, чем отличаются дискриминативные (Система 1) и генеративные (Система 2) модели, и когда следует использовать каждую из них.
- Опишите, как работают Jev и DiffusionGemma, и настройте один из них для семинара, включая DiffusionGemma на виртуальной машине Compute Engine с графическим процессором.
- Составьте вопросы с вариантами ответа, вопросы с оценкой и вопросы без уточнения, а также интерпретируйте вероятности и доверительные интервалы.
- Используйте пороговые значения в детерминированном коде, чтобы преобразовывать вероятности в действия.
- Создайте запрос с помощью TypeSafe SDK, а затем позвольте модели выбирать каждый ход в игре.
- Создайте медленную ветку, где Gemini считывает изображение, и быструю ветку, где дискриминативная модель принимает решение в цикле, и запускайте каждую из них отдельно.
- Объедините обе ветви в рабочем процессе с использованием графа ADK, который использует общее состояние в одном цикле событий, чтобы медленная работа никогда не задерживала принятие быстрых решений.
Архитектура
Рабочая среда находится в Cloudshell (или на вашем компьютере), она будет записывать данные в локальную файловую систему и взаимодействовать с ареной, а также с Gemini и моделью принятия решений. ② вызывает модель принятия решений в «Битвах дискриминативной модели»; ③ вызывает обе модели в «Битвах рабочего процесса».
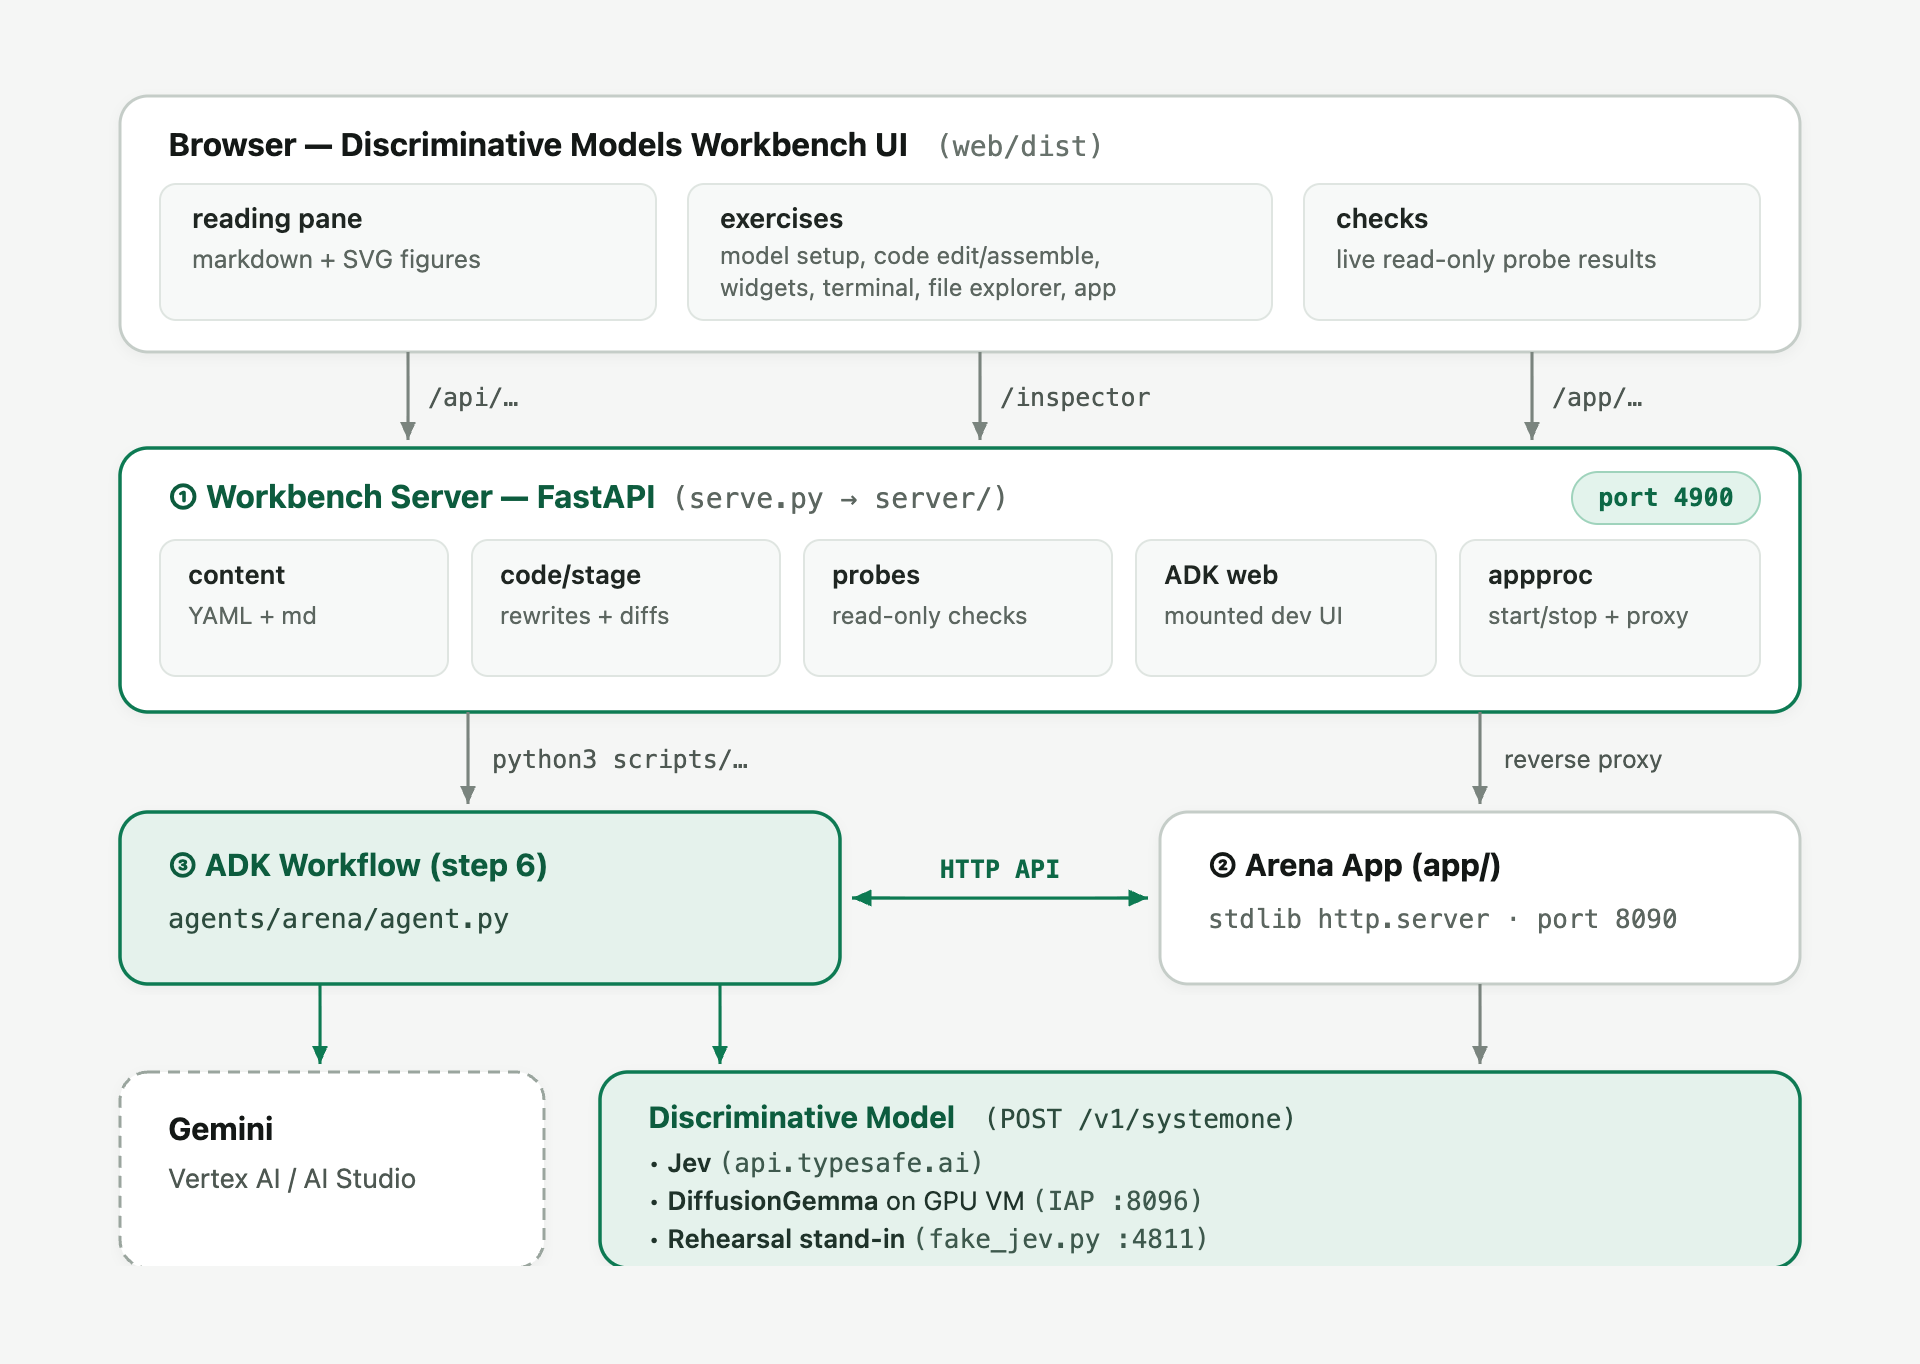
Кто что вызывает. Браузер взаимодействует только с ①. Обе модели вызываются из Python на машине:
Звонивший | Дискриминативная модель | Близнецы |
② арена, «Дискриминационные бои» | каждый тик, | нет |
③ | каждый тик, | нет |
③ рабочий процесс | нет | Изображение карты заклинания; история после боя. |
| да | нет |
Один тик на каждый режим.
- Вы сражаетесь. Страница запрашивает у ② телеграмму, отображает её с 2-секундным таймером и отправляет обратно нажатую вами кнопку (или набранное вами заклинание). ② завершает бой.
- Дискриминативная модель борется. Страница запрашивает у ② галочку; ② рисует телеграф, задает модели три вопроса за один вызов, запускает
choose()и возвращает ответы и результат. Страница рисует полосы. - Конфликты рабочих процессов. Запуск запускает процесс ②, который запускает процесс ③ как дочерний процесс (запись в
runs/arena-workflow.log). Процесс ③ управляет конфликтом: он запрашивает у процесса ② каждый телеграф, вызывает модель и публикует решение; заклинание Gemini поступает в свою собственную ветку, когда оно готово. Страница только опрашивает процесс ② и отрисовывает кадр. Пауза — это флаг процесса ②, который процесс ③ проверяет перед каждым тиком.
Где размещается модель принятия решений. Каждый вызов проходит через один и тот же typesafe-sdk ; меняется только базовый URL. scripts/jevauth.py задается имя бэкенда, а также устанавливаются ключ и время ожидания:
Бэкенд | | Ключ | Создано компанией |
TypeSafe, размещенный | unset (api.typesafe.ai) | | |
DiffusionGemma на вашей виртуальной машине L4 | | никто | |
DiffusionGemma на Cloud Run | | Токен идентификации Google, запрашиваемый каждый час. | |
Репетиция | | никто | |
Ответ карты заклинания ②: рабочий процесс получает только PNG-файл, и ② оценивает заклинание, которое отправляет обратно. Именно это делает заклинание настоящим испытанием для чтения Близнецов, а заклинание, которое вы создаёте в «Вы сражаетесь», — настоящим испытанием для вас самих.
2. Настройка
Получите зачетные баллы за участие в семинаре.
Если вам был начислен кредит Google Cloud за эту сессию, сначала активируйте его — это займет около минуты и создаст для вас платежный аккаунт.
Открытая облачная оболочка
Google Cloud Shell — это доступная через браузер среда Linux, предварительно настроенная с использованием gcloud , Python, Node.js, uv и git , и уже авторизованная с помощью вашей учетной записи Google.
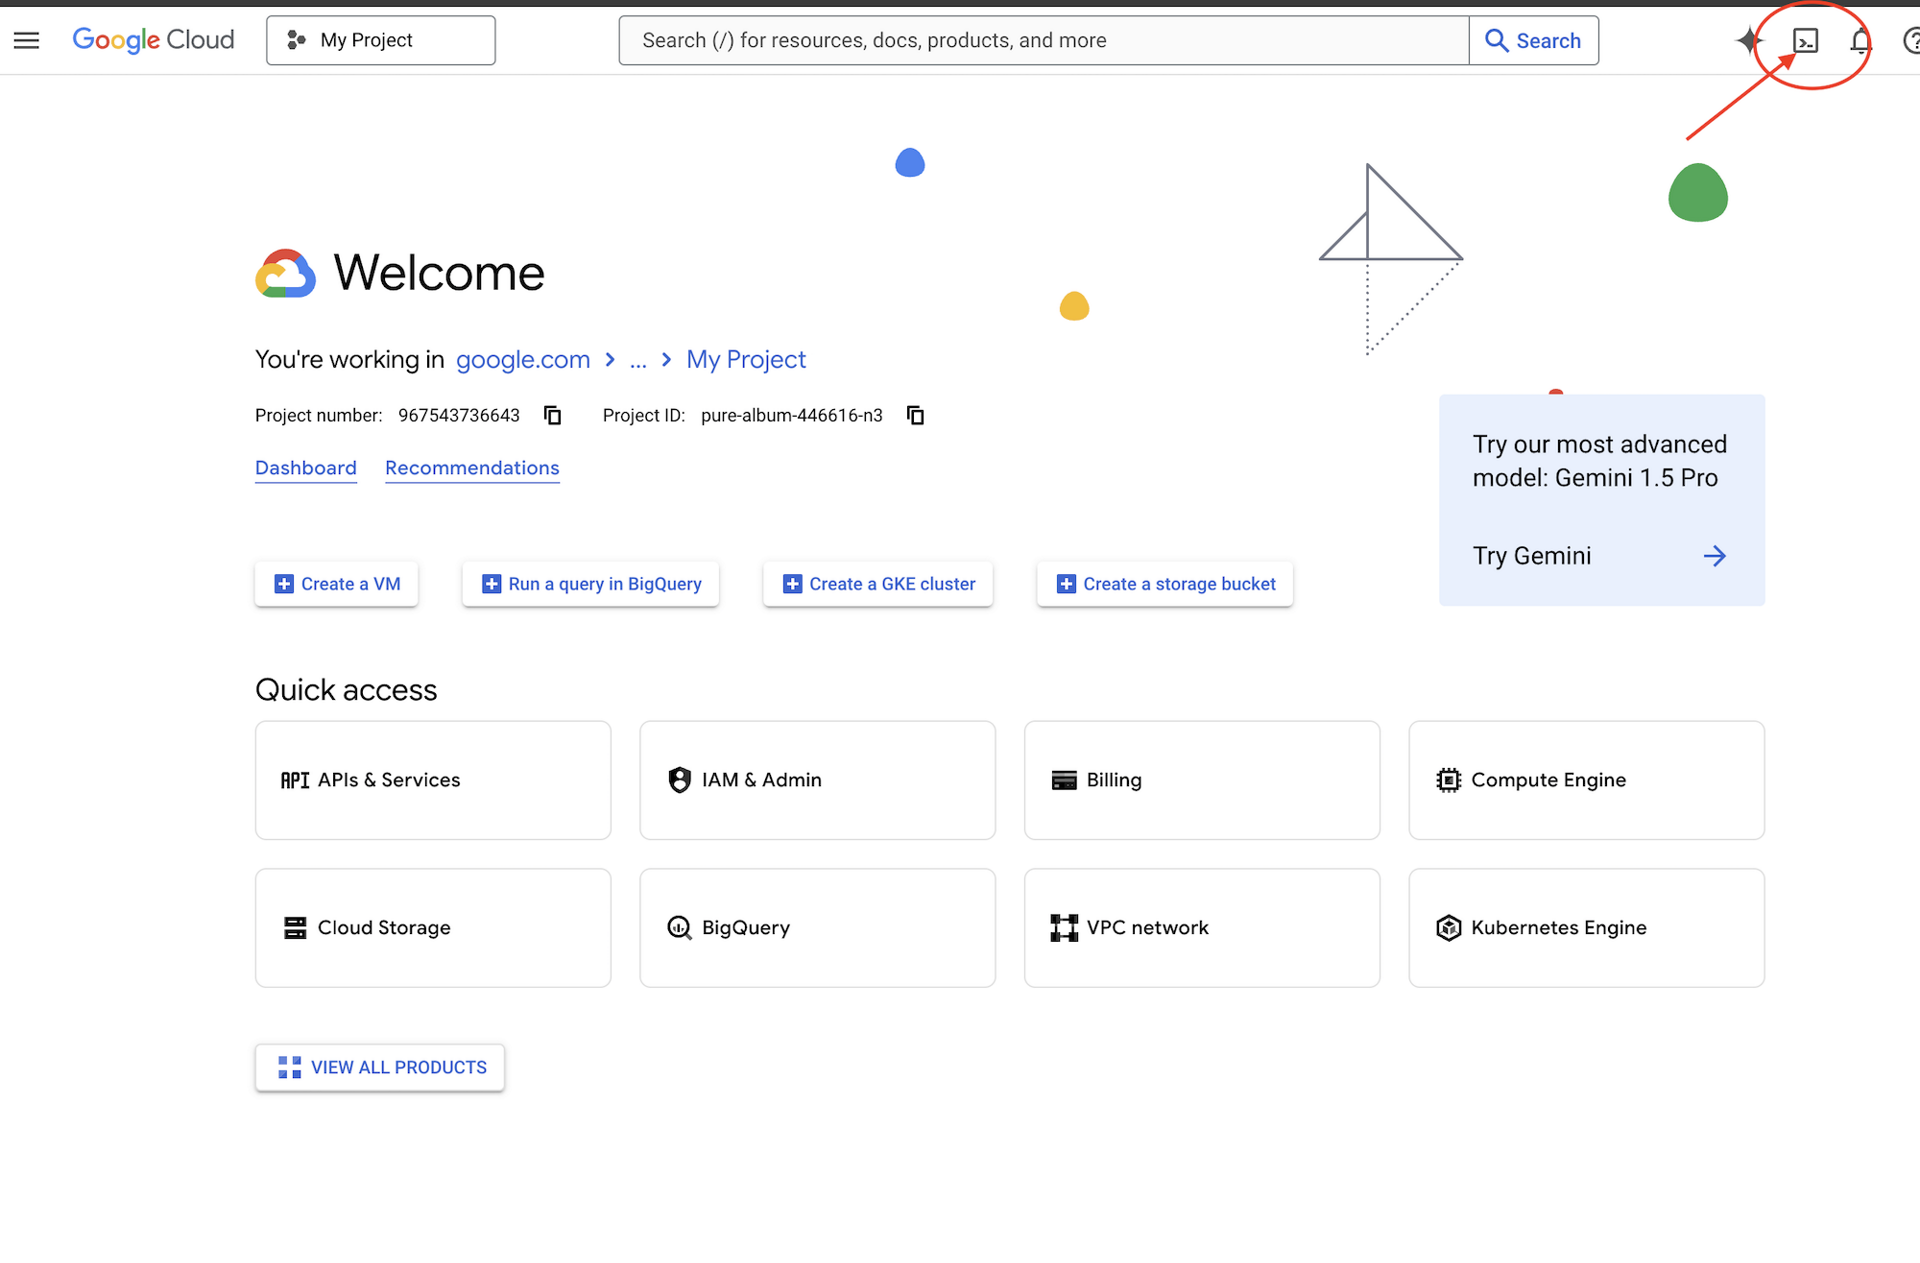
- Откройте консоль Google Cloud .
- Чтобы открыть сессию терминала в нижней части браузера, нажмите кнопку «Активировать Cloud Shell» (значок терминала в верхней панели навигации).
Запустите верстак
В Cloud Shell или в любом другом месте, где выполнен вход в gcloud :
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh создает проект ( discrim-models-XXXX ), связывает с ним оплату, отдавая предпочтение учетной записи для оплаты мероприятий, если таковая имеется, и ожидает, пока проект станет доступен. Повторный запуск скрипта использует проект из файла ~/project_id.txt . Чтобы использовать уже существующий проект, укажите его ID в этом файле и пропустите этот скрипт.
setup_codelab.sh ничего не запрашивает. Он устанавливает UV и пакеты Python, включает Vertex AI, Compute Engine и IAP, направляет Gemini на Vertex AI в проекте в файле .env , выполняет один реальный вызов Gemini с моделью, которую может вызвать проект, компилирует страницу, запускает рабочую среду в фоновом режиме и запускает scripts/check_setup.py . Повторный запуск сохраняет ваши файлы упражнений; scripts/starter.sh сбрасывает их. Модель принятия решения выбирается на шаге 2 рабочей среды.
Чтобы открыть пользовательский интерфейс рабочей среды в Cloud Shell:
- Нажмите на ссылку предварительного просмотра, расположенную в конце файла
./setup_codelab.sh, или нажмите кнопку «Веб-предварительный просмотр» в правом верхнем углу панели инструментов Cloud Shell. - Выберите «Изменить порт» , введите 4900 и нажмите «Изменить и просмотреть» .
Gemini работает на Vertex AI в вашем проекте с использованием ваших собственных учетных данных Google: GOOGLE_GENAI_USE_VERTEXAI=1 , GOOGLE_CLOUD_PROJECT и GOOGLE_CLOUD_LOCATION=global в .env .
Модель принятия решений выбирается автоматически на шаге 2 рабочей среды или из терминала с помощью scripts/setup_model.sh :
Выбор | Потребности | Настраивать | Расходы |
Дискриминативная модель (TypeSafe, размещенная на сервере) | Ключ API TypeSafe | никто | за токен, доли цента |
DiffusionGemma (Google, открытые веса) | выставление счетов + квота Compute Engine для GPU | ~15 мин, автоматический режим | Примерно 0,71 долл./час во время работы виртуальной машины. |
Репетиция (без модели) | ничего | никто | никто |
DiffusionGemma на виртуальной машине Compute Engine
scripts/setup_gemma.sh сначала проверяет квоту GPU, затем создает одну виртуальную машину g2-standard-4 (1 × L4 24 ГБ, 4 vCPU, 16 ГБ) из образа Google Deep Learning с драйвером NVIDIA 580. При первой загрузке виртуальная машина устанавливает Docker, загружает веса из Hugging Face ( nvidia/diffusiongemma-26B-A4B-it-NVFP4 , 17,5 ГБ, публичный, без токена) и запускает djev-run :DiffusionGemma через API модели Discriminative. Порт модели не открыт для интернета: рабочая среда подключается к нему через туннель IAP на localhost:8096 , который открывает scripts/start.sh .
Пауза / возобновление | | |
Туннель | | |
Удалять | | |
Отрепетируйте команды | | |
Структура репозитория
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Резюме
Очистите окружающую среду
После завершения мастер-класса выполните следующие шаги, чтобы удалить все ресурсы DiffusionGemma GPU, остановить фоновые процессы рабочей среды и репетиции, удалить файлы мастер-класса из Cloud Shell и (при желании) удалить свой проект мастер-класса в Google Cloud.
- Удалите виртуальную машину DiffusionGemma с графическим процессором и правило брандмауэра (если оно было создано) : Если вы создали DiffusionGemma на виртуальной машине Compute Engine с графическим процессором на шаге 2, удалите правило брандмауэра для виртуальной машины, диска и IAP, чтобы не начислялись текущие расходы на вычислительные ресурсы или дисковое хранилище:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Остановите процессы рабочей среды и репетиции в Cloud Shell : В терминале Cloud Shell остановите фоновый сервер рабочей среды и любые процессы, заменяющие репетицию:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Удалите папку workshop из Cloud Shell : Вернитесь в свою домашнюю директорию и удалите клонированную папку репозитория и файл идентификатора проекта:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Удалите свой проект Google Cloud : если скрипт
./setup_project.shсоздал отдельный проект для мастерской (например,discrim-models-XXXX), то закрытие проекта навсегда удалит все созданные в нем ресурсы, при этом ваша учетная запись Cloud Billing останется нетронутой.- Откройте страницу «Управление ресурсами» в консоли Google Cloud .
- Выберите свой проект для семинара (например,
discrim-models-...) из списка ресурсов. - Нажмите кнопку «Удалить» на верхней панели инструментов, введите идентификатор проекта для подтверждения и нажмите кнопку «Завершить» .
Вы завершили этот семинар.
Краткое описание лабораторной работы
- Выбрали дискриминативную модель, Jev или DiffusionGemma, на виртуальной машине Compute Engine с графическим процессором и проверили, что она отвечает.
- Прошёл арену вручную, на время, чтобы изучить её правила.
- Я узнал, как дискриминативная модель отвечает на вопросы с выбором, оценкой и значением «ноль», используя вероятности и уровень достоверности, а также как ваш код применяет к ним пороговые значения.
- Отправьте первый запрос, затем позвольте модели выбирать каждый ход на арене, при этом
choose()преобразует ответы в действия. - Каждая ветвь рабочего процесса ADK была построена отдельно: Gemini считывала изображение карты заклинания, а модель принимала решение в цикле.
- Объединил их в единый рабочий процесс, который использует общее состояние, поэтому борьба никогда не ждет Близнецов, и заклинание применяется в подходящий момент.
От разговора к принятию решений
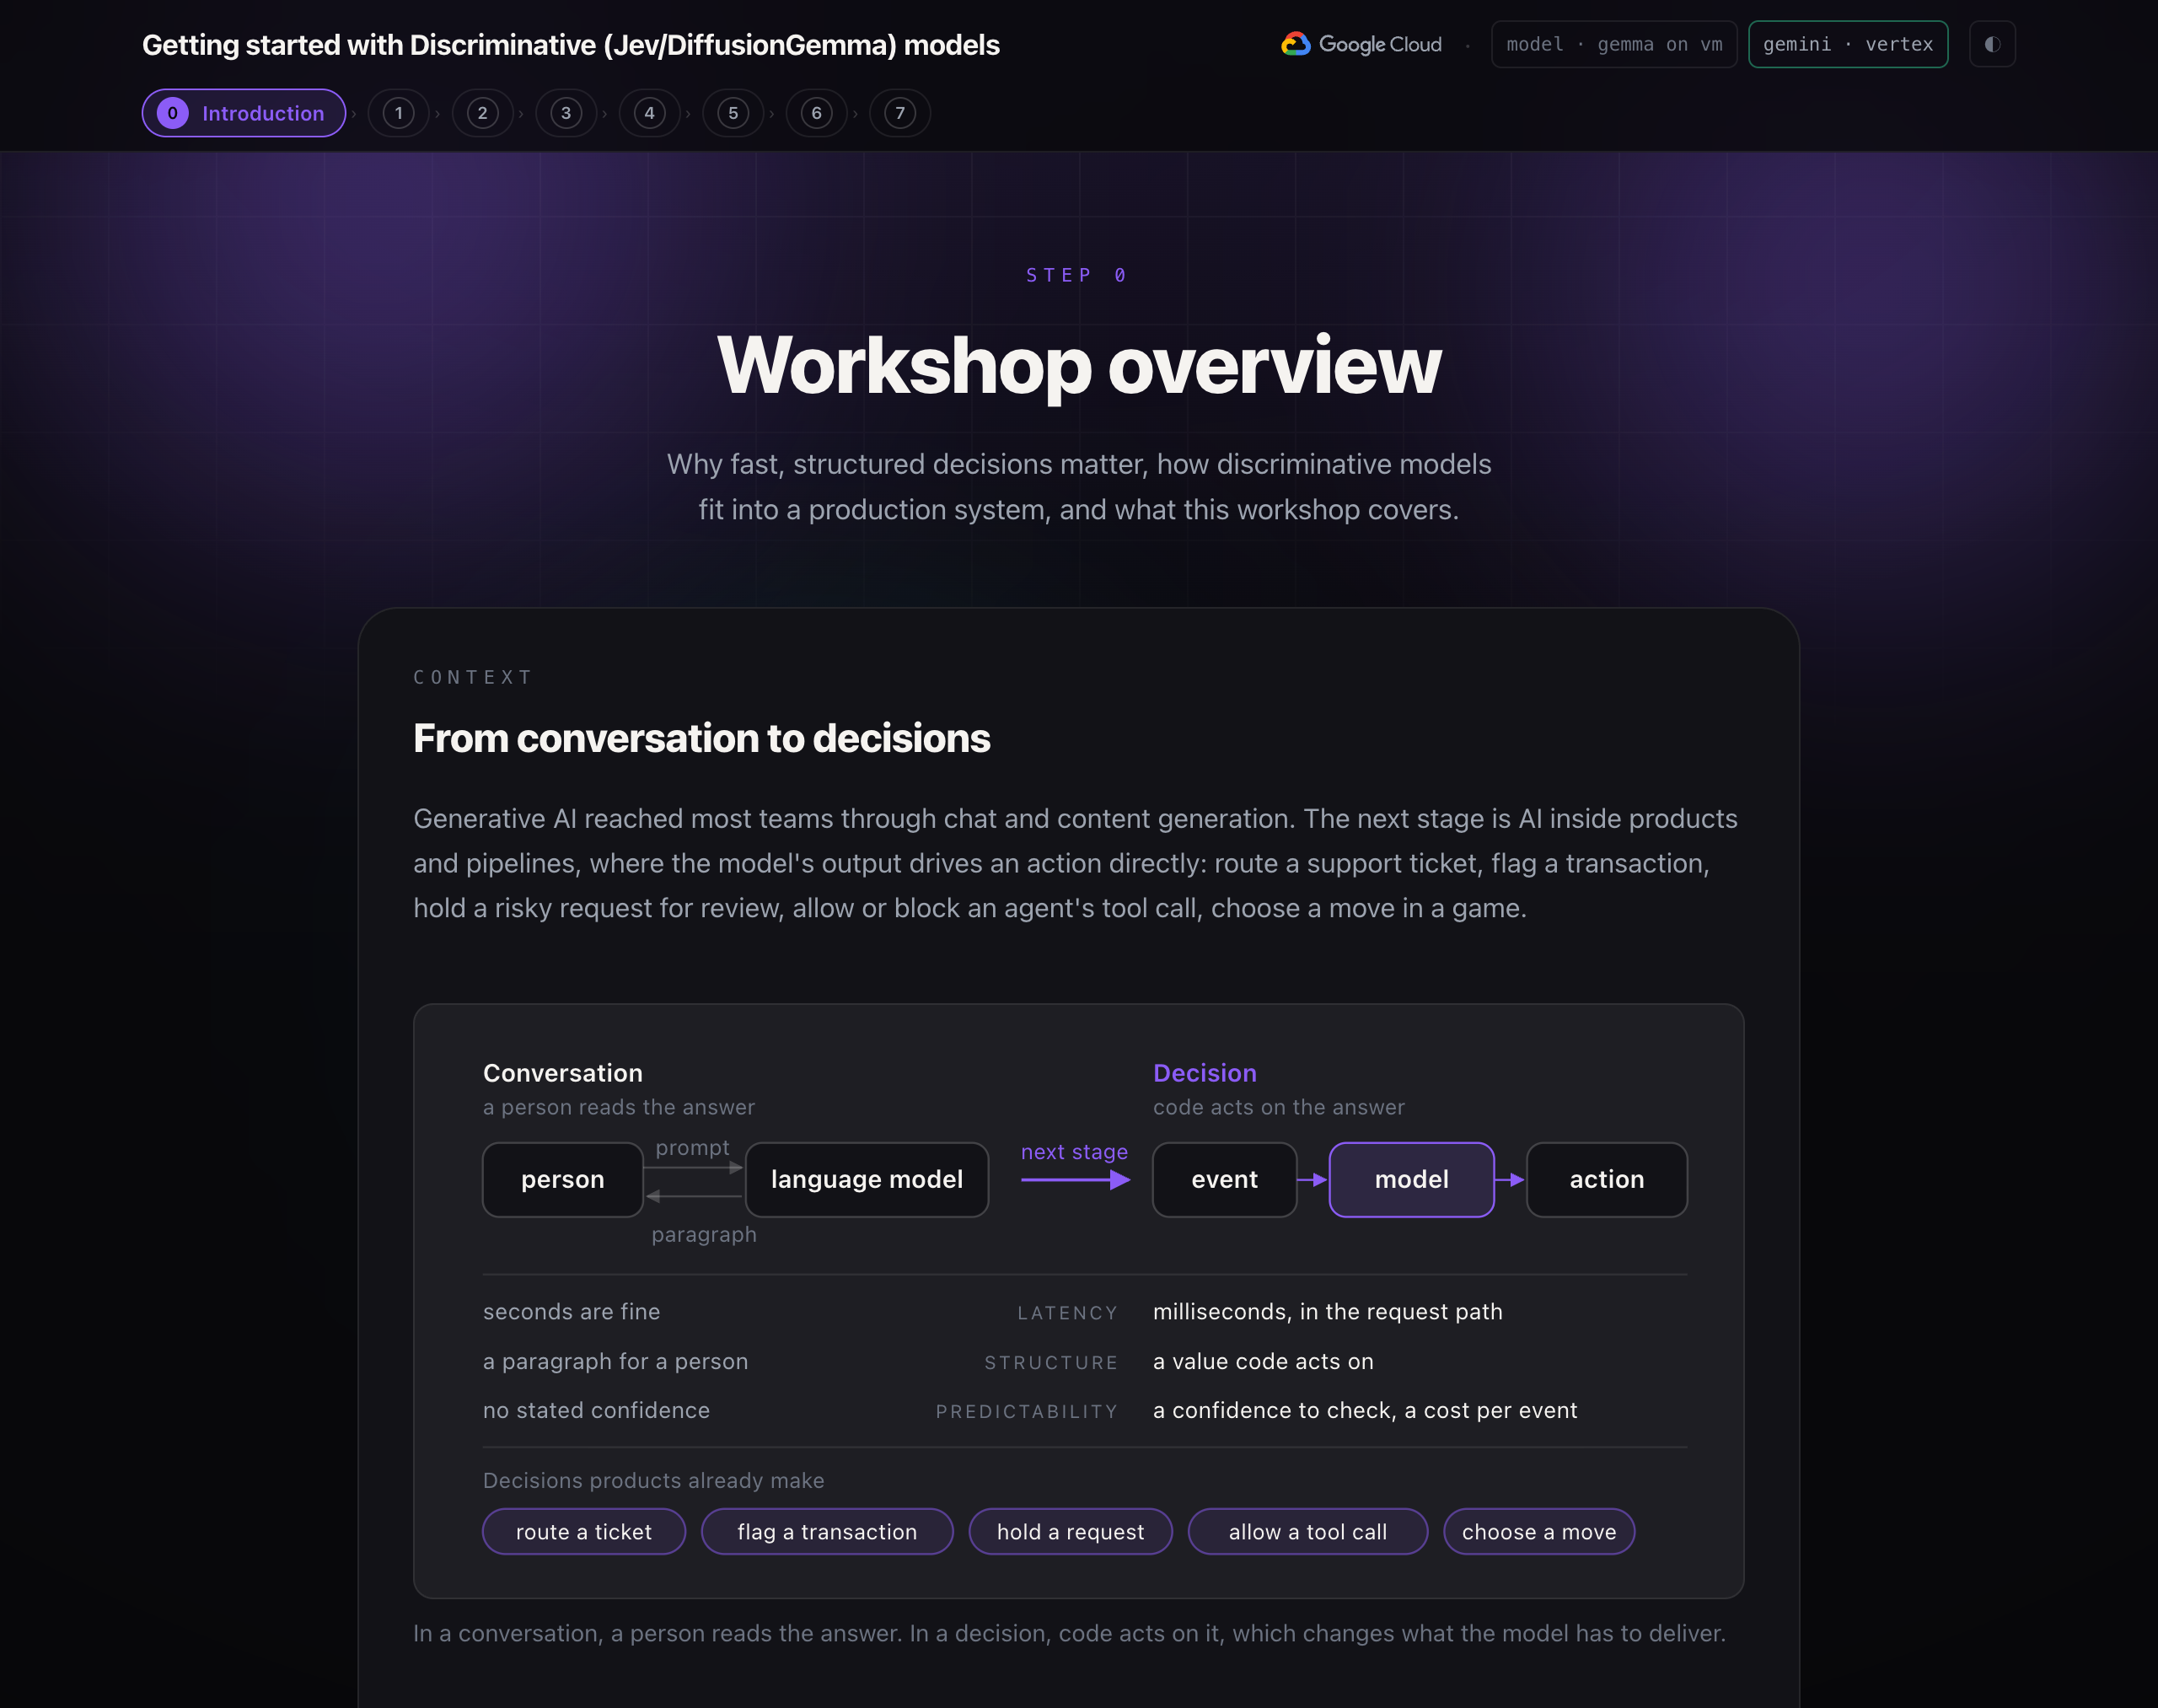
Генеративный ИИ проник в большинство команд через чаты и генерацию контента. Следующий этап — это ИИ внутри продуктов и конвейеров, где выходные данные модели напрямую управляют действием: маршрутизация заявки в службу поддержки, пометка транзакции, приостановка рискованного запроса на рассмотрение, разрешение или блокировка вызова инструмента агента, выбор хода в игре.
Эти решения объединяет три требования, которых нет в чате:
- Задержка. Ответ часто находится в пути запроса пользователя или в цикле обработки в реальном времени, поэтому он должен поступать за миллисекунды, а не за секунды.
- Структура. Вызывающий код является исполняемым кодом, поэтому ответ должен представлять собой значение, с которым он может взаимодействовать, а не абзац текста, который ему нужно разобрать.
- Предсказуемость. Каждое решение должно иметь такую степень уверенности, которую код может проверить, и достаточно низкую стоимость, чтобы запрашивать проверку при каждом событии.
Языковая модель генерирует текст по одному токену за раз. Её можно настроить на ответ «да» или «нет», но это медленно для цикла реального времени, её выходные данные необходимо анализировать, и она не сообщает, насколько уверена в своём ответе.
Модели, созданные для принятия решений
Дискриминативная модель отвечает на заданный текст, предоставляя вероятность для каждого допустимого варианта ответа за один проход. Она не генерирует текст. В рамках этого семинара предлагаются два варианта запуска:
Модель | Поставщик | Где работает модель в этом семинаре |
Джев | TypeSafe AI | Сервис TypeSafe, вызываемый с помощью ключа API. |
ДиффузияДжемма | Google, открытые веса | Самостоятельно размещенное решение на виртуальной машине с графическим процессором в вашем собственном проекте Google Cloud. |
Модели можно заменять в зависимости от ваших потребностей; код, который с ними взаимодействует, менять не нужно.
Объединить компоненты
Успешная система состоит из множества компонентов:
Компонент | Роль | В этом мастер-классе |
Рабочий процесс | Координирует этапы, выполняет ветви параллельно, поддерживает общее состояние. | Рабочий процесс на основе графа ADK |
Детерминированный код | Правила, пороговые значения, проверка. Мгновенно, бесплатно и с возможностью аудита. | Правила игры, |
Дискриминативная модель | Быстрые, ограниченные решения с оценкой достоверности. | Выбор ответа на каждом такте |
Языковая модель | Восприятие и формирование: изображения и текст открытого типа. | Близнецы читают изображение на карте с заклинанием и записывают заклинание. |
Модель, служащая архитектуре
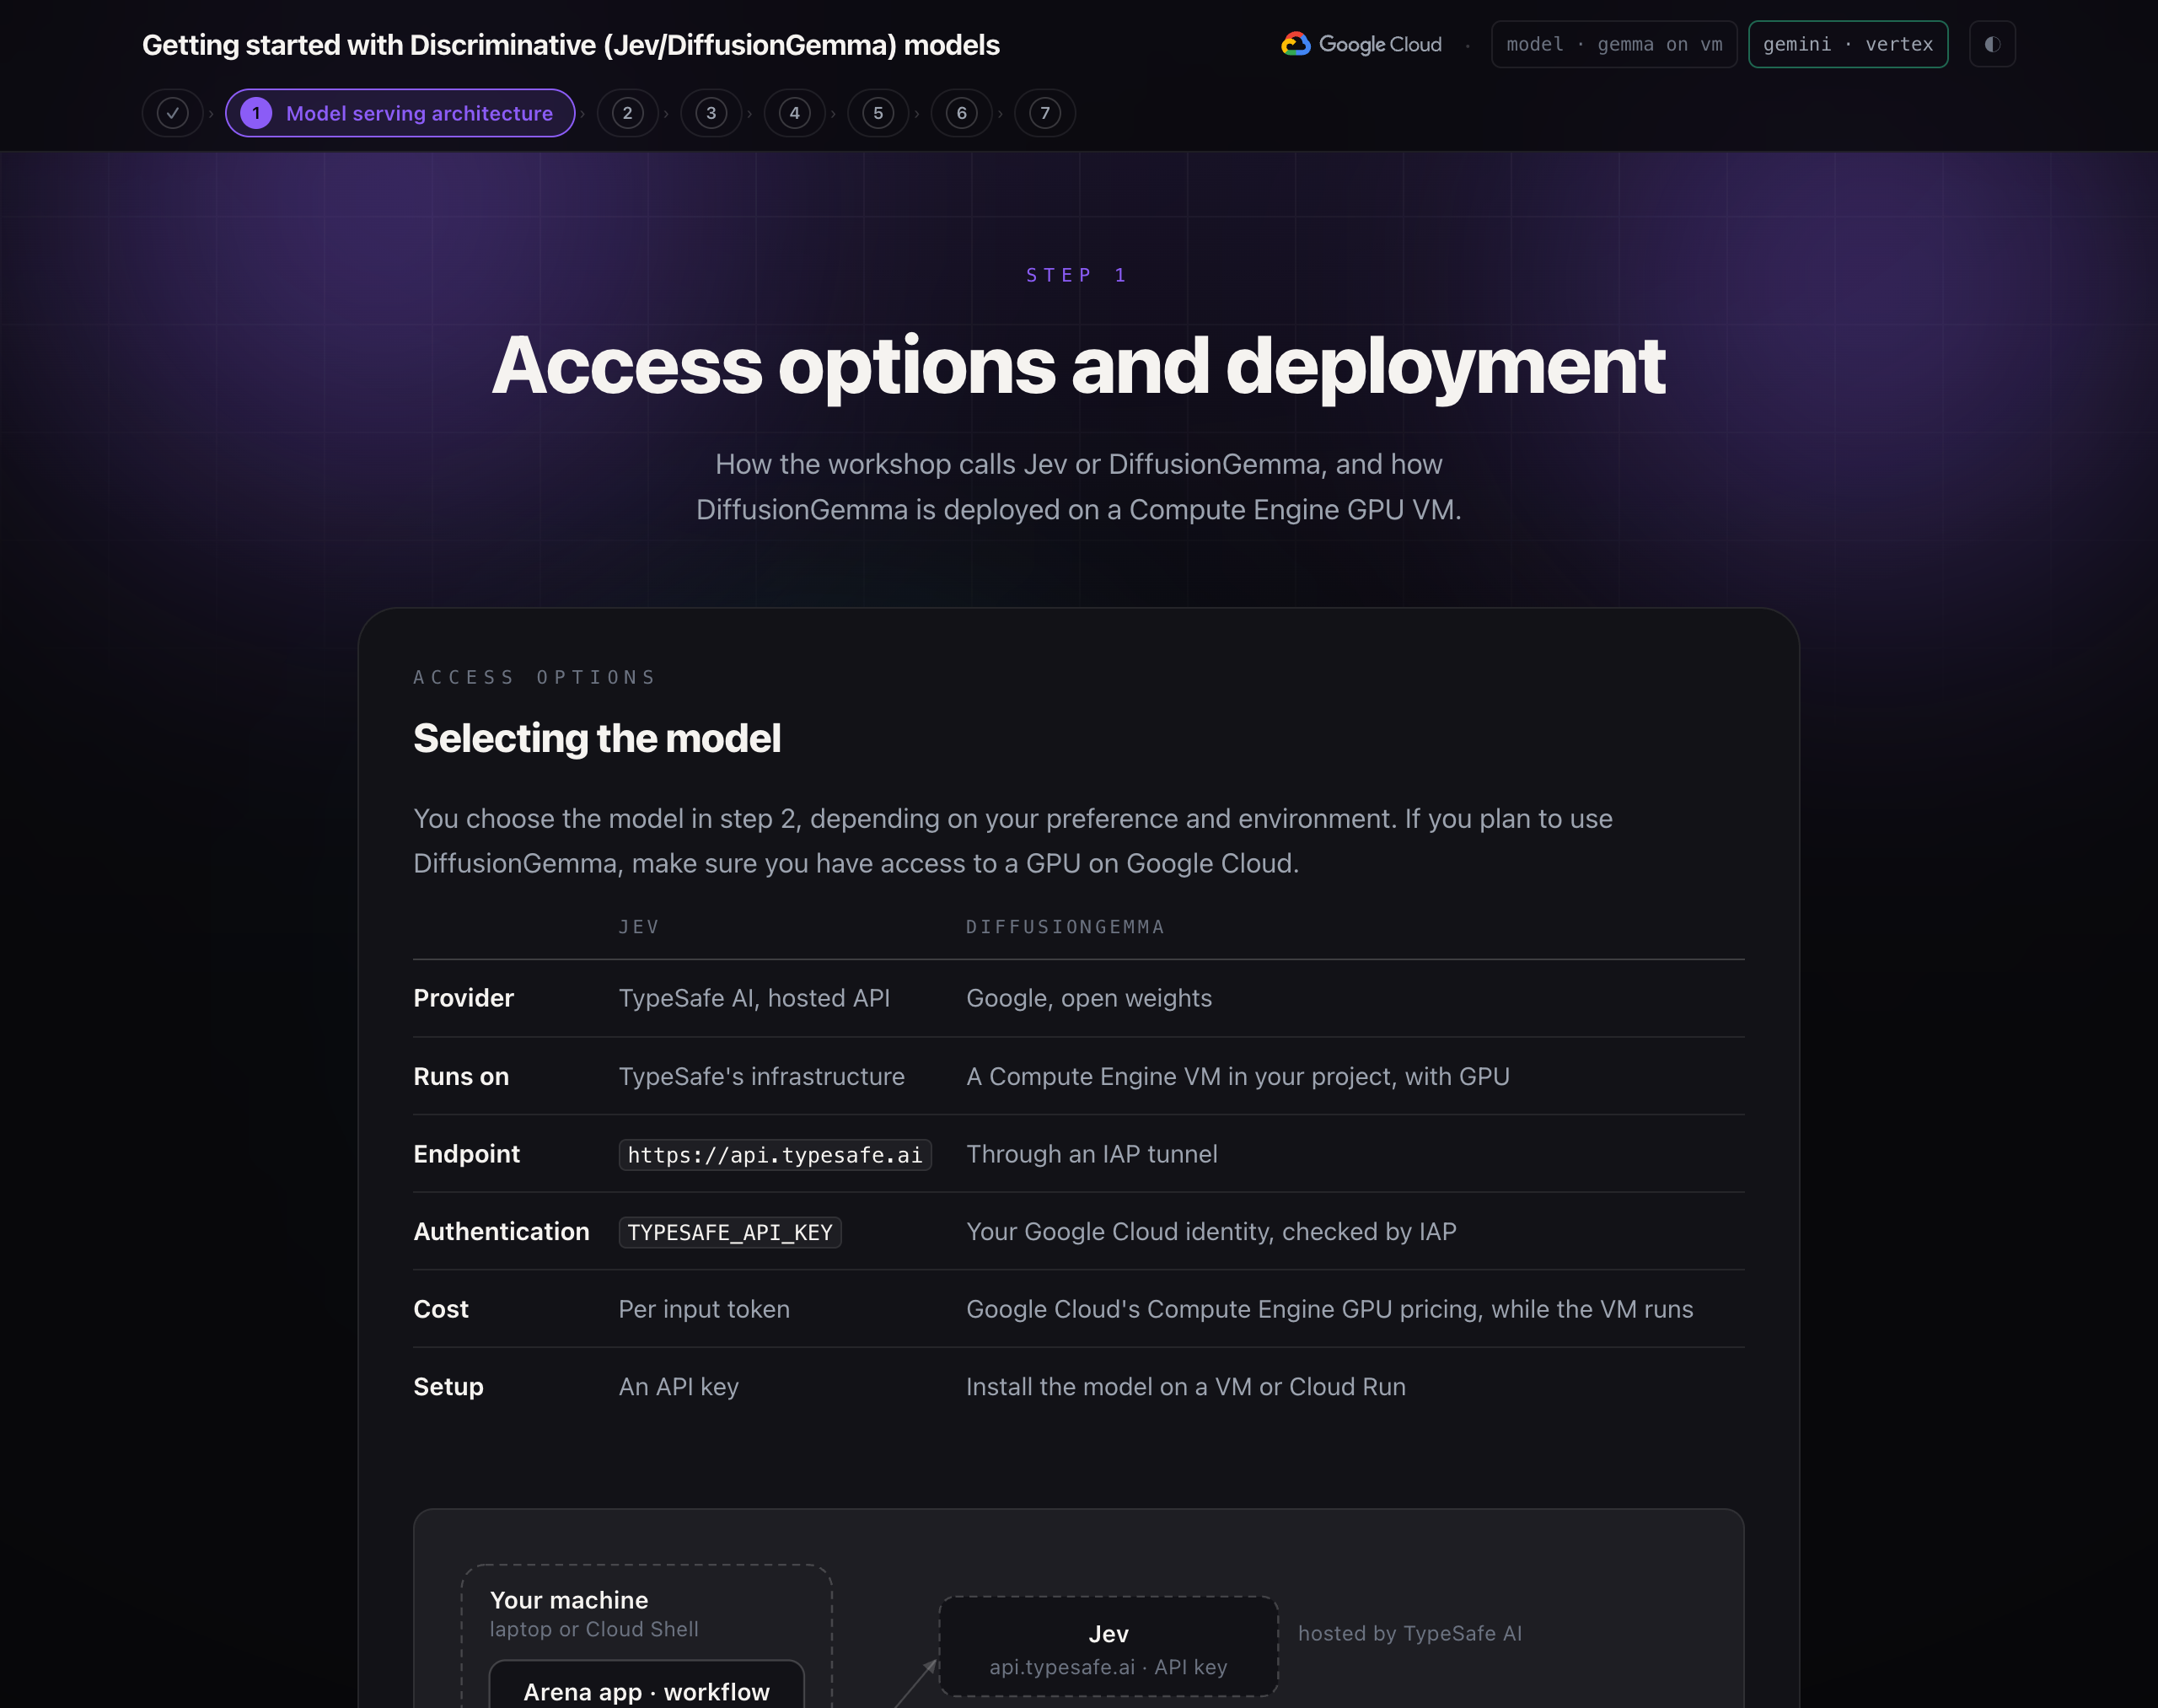
На шаге 2 вы выбираете модель в зависимости от ваших предпочтений и условий. Если вы планируете использовать DiffusionGemma, убедитесь, что у вас есть доступ к графическому процессору в Google Cloud.
Джев | ДиффузияДжемма | |
Поставщик | TypeSafe AI, размещенный API | Google, открытые веса |
Работает на | Инфраструктура TypeSafe | В вашем проекте будет виртуальная машина Compute Engine с графическим процессором. |
Конечная точка | | Через туннель IAP |
Аутентификация | | Проверка вашей учетной записи в Google Cloud осуществляется с помощью IAP. |
Расходы | Для каждого входного токена | Цены на использование графических процессоров в Google Cloud Compute Engine во время работы виртуальной машины. |
Настраивать | Ключ API | Установите модель на виртуальную машину или в облако. Запустите. |
Поток данных
- Приложение арены или рабочий процесс ADK формирует запрос: состояние (что сделал противник) и три вопроса.
- SDK TypeSafe отправляет его в формате
POST /v1/systemoneна настроенный базовый URL. - Для Jev запрос отправляется по протоколу HTTPS на
api.typesafe.ai, при этом ключ API используется в качестве токена носителя. - Для DiffusionGemma запрос направляется на
localhost:8096. Фоновый процессgcloud compute start-iap-tunnelперенаправляет его через Identity-Aware Proxy, который проверяет вашу учетную запись Google, на порт 8080 на виртуальной машине. - На виртуальной машине djev-run получает запрос, запускает DiffusionGemma через vLLM на графическом процессоре и считывает вероятность каждого допустимого варианта.
- Оба бэкэнда возвращают одинаковый ответ: ответ на каждый вопрос с вероятностями и оценкой достоверности. Код, используемый в мастерской, применяет свои пороговые значения и выполняет действия.
DiffusionGemma на Compute Engine
scripts/setup_gemma.sh включает этот компонент в ваш проект:
- Проверяет наличие квоты на использование графического процессора в данном регионе.
- Включает API Compute Engine и IAP и создает правило брандмауэра
allow-iap-djev. Оно разрешает доступ только к диапазону адресов IAP на портах 22 и 8080. - Создает виртуальную машину
djev-l4: тип машиныg2-standard-4(4 виртуальных процессора, 16 ГБ памяти), графический процессор с 24 ГБ памяти, дисковое пространство объемом 100 ГБ и образ виртуальной машины для глубокого обучения с драйвером NVIDIA 580. Если в зоне нет свободных графических процессоров, она пробует следующую. - При первой загрузке скрипт запуска виртуальной машины устанавливает Docker и NVIDIA Container Toolkit, загружает образ контейнера djev-run, скачивает веса из Hugging Face (17,5 ГБ) и запускает контейнер с доступом к графическому процессору через порт 8080. Это занимает около 15 минут. Последующие загрузки занимают около 2 минут.
- Записывает параметры подключения в файл
.envи открывает туннель.
Задача | Командование |
Остановите виртуальную машину (при этом диск останется свободным). | |
Начните заново | |
Проверьте туннель | |
Удалите всё | |
Настройте модель
TypeSafe SDK
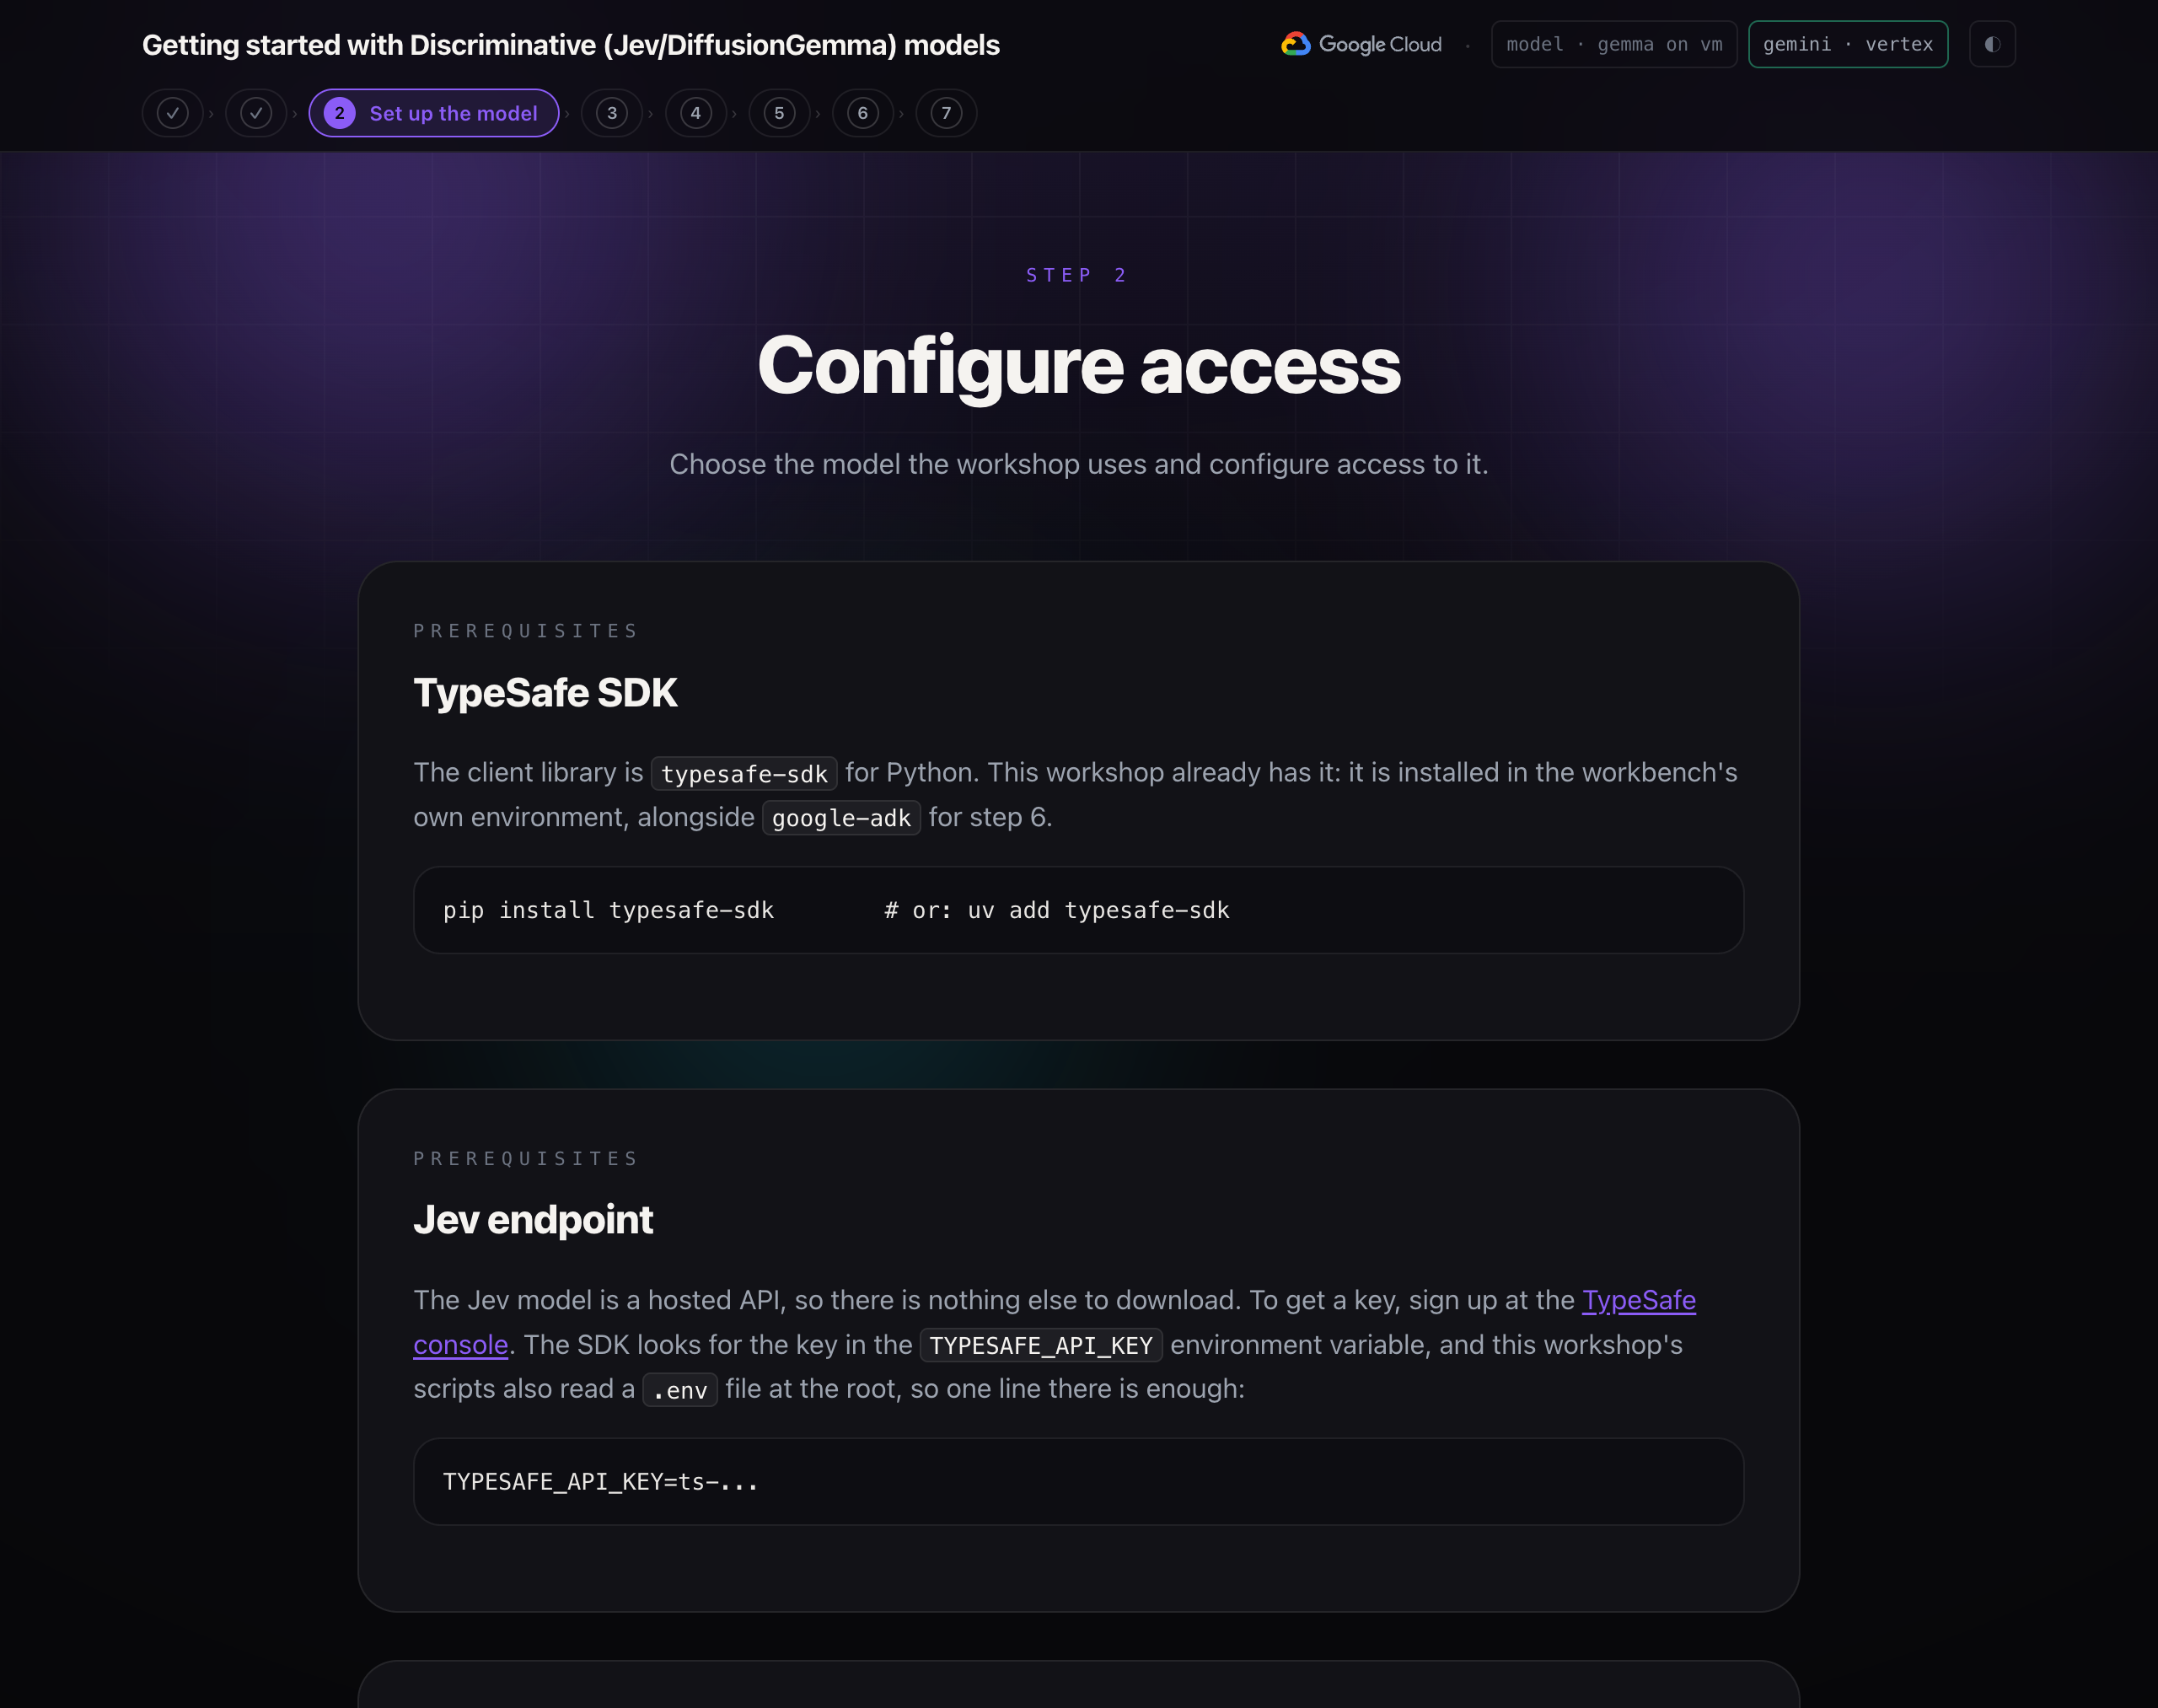
Клиентская библиотека — это typesafe-sdk для Python. В этом мастер-классе она уже установлена: она находится в собственной среде рабочей среды, вместе с google-adk для шага 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
конечная точка Jev
Модель Jev представляет собой размещенный API, поэтому ничего дополнительно скачивать не нужно. Чтобы получить ключ, зарегистрируйтесь в консоли TypeSafe . SDK ищет ключ в переменной среды TYPESAFE_API_KEY , а скрипты этого семинара также считывают файл .env в корневом каталоге, поэтому достаточно одной строки:
TYPESAFE_API_KEY=ts-...
Используйте DiffusionGemma
djev-run переписывает API дискриминативной модели. Он обслуживает ту же конечную точку POST /v1/systemone с теми же вопросами noul, choice и score, что и DiffusionGemma , открытую диффузионную модель Google DeepMind (всего 26 млрд параметров, около 4 млрд активных, Apache 2.0). Поскольку формат передачи данных тот же, SDK TypeSafe взаимодействует с ним без изменений.
Если в упражнении вы выберете DiffusionGemma, он будет работать на графическом процессоре в виртуальной машине вашего собственного проекта Google Cloud, а в правом верхнем углу появится сообщение gemma on vm . Workbench подключается к нему через частный туннель IAP, и порт модели не открыт для интернета. Шаг 1 описывает полную архитектуру.
Почему диффузионная модель может это делать: она заполняет весь блок позиций за один раз, при этом каждая позиция получает полный входной сигнал, поэтому вероятность каждого допустимого варианта можно считать за один шаг. Обычная языковая модель генерирует по одному токену за раз и должна была бы многократно производить выборку.
Запустите игру вручную
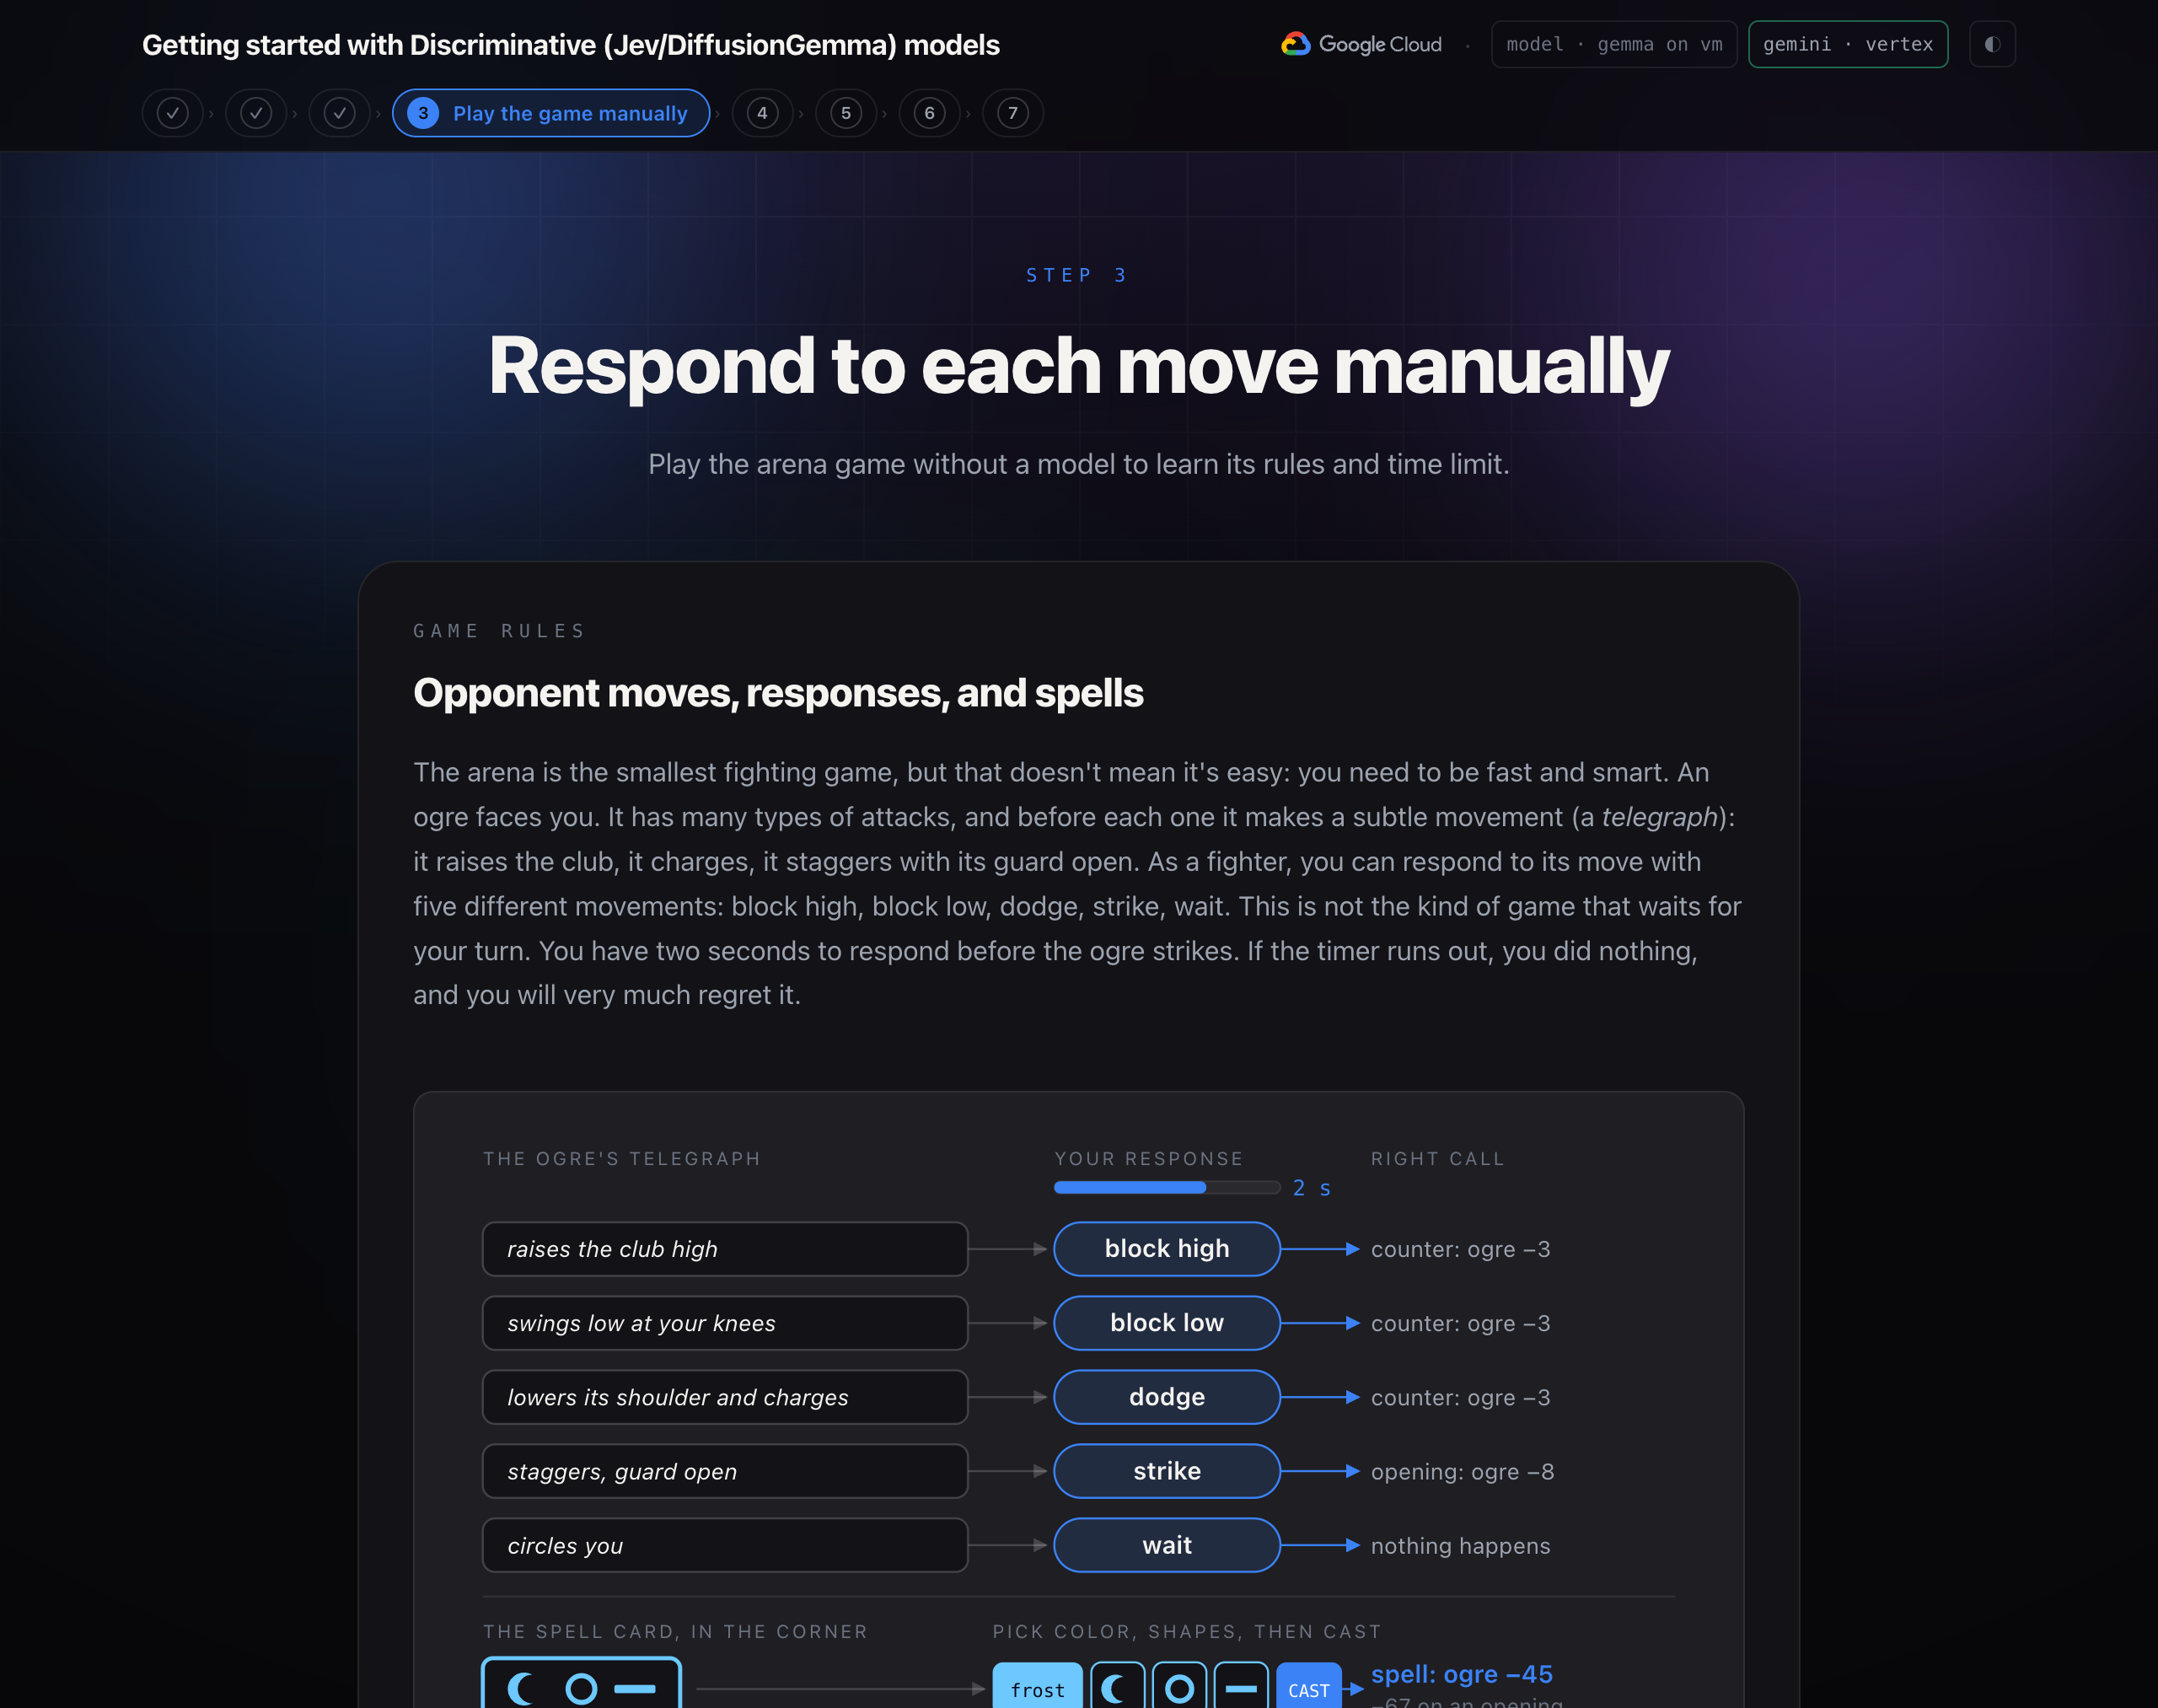
Арена — это самая маленькая файтинг-игра, но это не значит, что она легкая: нужно быть быстрым и умным. Перед вами огр. У него много типов атак, и перед каждой из них он делает тонкое движение ( сигнал ): поднимает дубину, бросается в атаку, шатается с открытой защитой. Как боец, вы можете ответить на его движение пятью различными способами: блокировка сверху, блокировка снизу, уклонение, удар, ожидание. Это не та игра, где нужно ждать своей очереди. У вас есть две секунды, чтобы ответить, прежде чем огр нанесет удар. Если таймер истечет, вы ничего не сделали, и очень пожалеете об этом.
В верхнем левом углу ринга находится карта заклинания : цветная карта с тремя фигурами. Только заклинание, соответствующее ей, наносит реальный урон. В игре вы можете сотворить заклинание с помощью кнопок под боем: выберите цвет карты, затем её фигуры слева направо, затем нажмите «СОВЕРШИТЬ» . Таймер продолжает работать, пока вы выбираете, поэтому вам нужно одновременно создавать заклинание и реагировать на атаки огра. Клавиши от 1 до 5 по-прежнему отвечают за каждый ход. Неправильное заклинание не срабатывает. На шаге 6 Близнецы зачитывают вам карту заклинания.
Главный вывод: борьба — это поток мелких решений, для каждого из которых установлен крайний срок. Именно так выглядит большинство автоматизированных процессов в программном обеспечении, за исключением дубинки.
Концепции дискриминантной модели
Решения в программном обеспечении
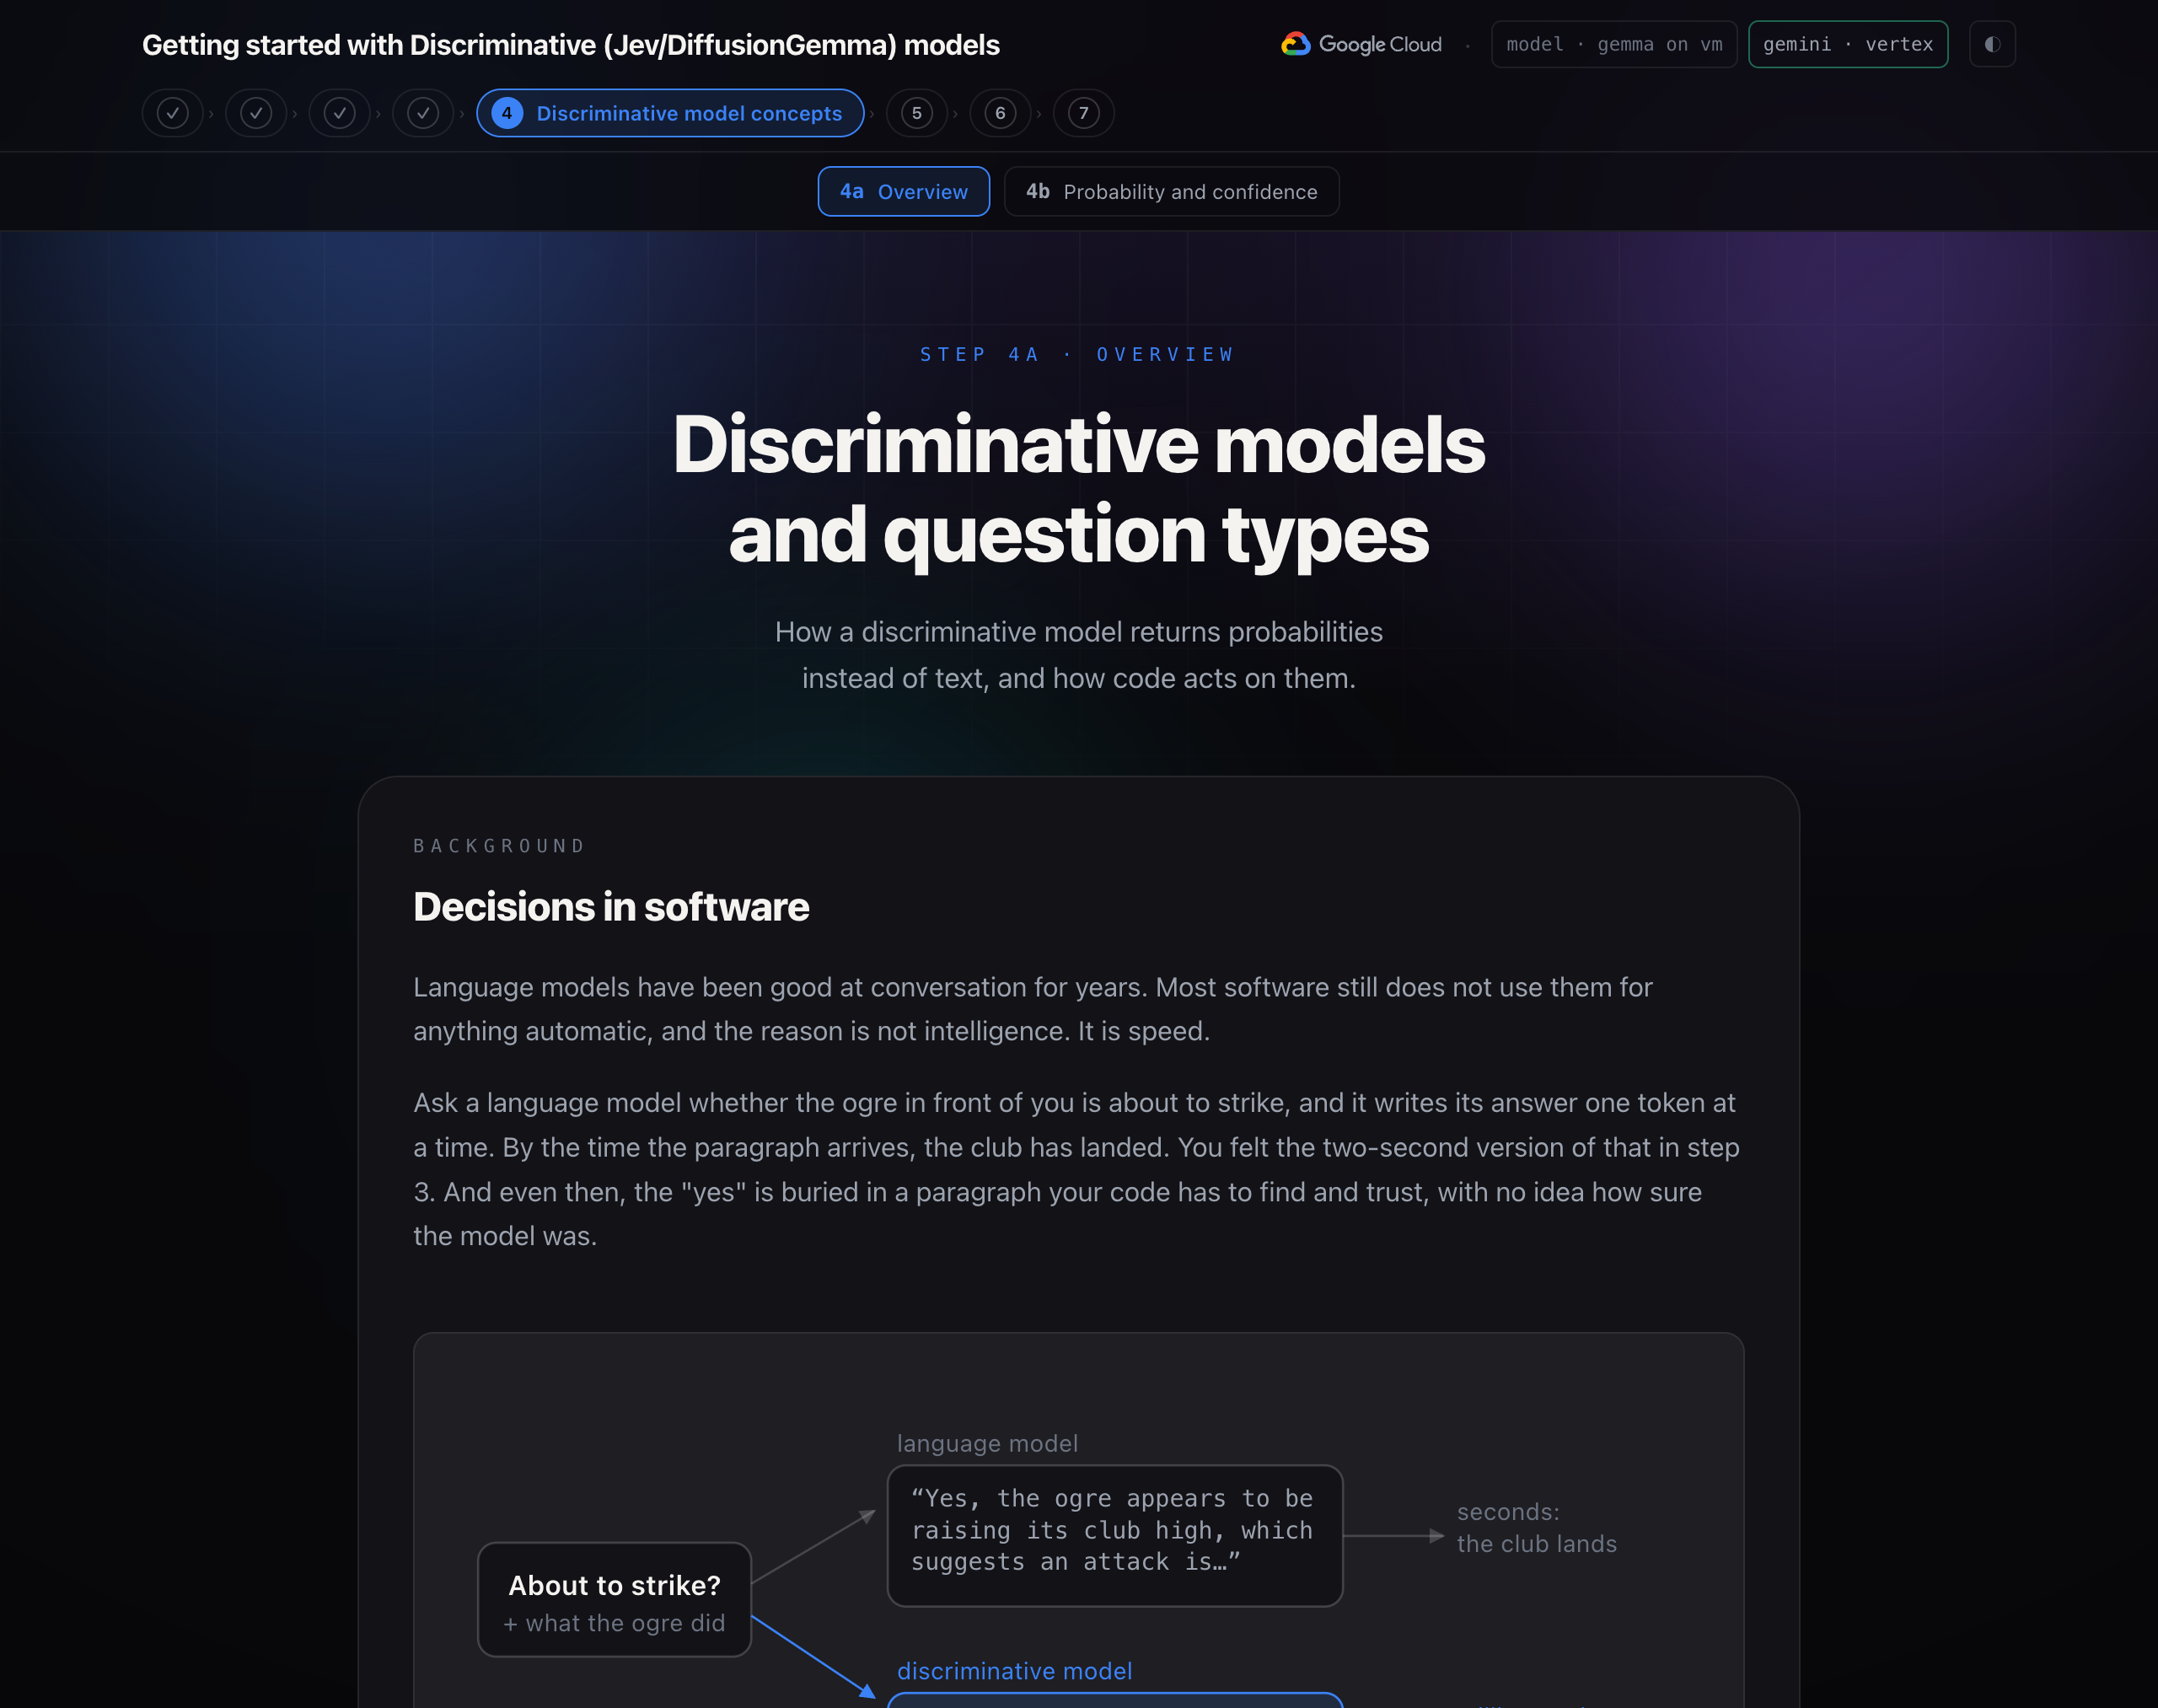
Языковые модели уже много лет хорошо справляются с задачами ведения диалога. Однако большинство программного обеспечения до сих пор не использует их для автоматизированных процессов, и причина не в интеллекте, а в скорости.
Спросите языковую модель, собирается ли огр перед вами нанести удар, и она выведет свой ответ по одному токену за раз. К тому моменту, когда дойдёт абзац, удар уже будет произведён. Вы почувствовали это в течение двух секунд на шаге 3. И даже тогда «да» будет спрятано в абзаце, который ваш код должен найти и которому должен доверять, не имея ни малейшего представления о том, насколько уверена была модель.
Дискриминативная модель обрабатывает состояние системы, а также ваши введенные вопросы и ответы за один проход, за миллисекунды. Каждый ответ сопровождается калиброванной вероятностью: 0,9 означает правильный ответ в девяти случаях из десяти. Нет необходимости анализировать текст или извлекать из него JSON-данные.
Модели Системы Один и Системы Два
Название происходит от книги Даниэля Канемана «Думай быстро и медленно» . Система вторая — это медленное, обдуманное рассуждение, шаг за шагом. Система первая — это быстрое, сопоставление образов.
Языковая модель — это машина второго типа. Она рассуждает, обрабатывая токены по одному за раз. Дискриминативная модель — это модель первого типа : она не рассуждает вслух, ничего не генерирует и отвечает на каждый вопрос за один проход. Именно поэтому она быстрая (примерно от 70 до 500 миллисекунд) и дешевая (доли цента за тысячу решений).
Главный вывод: языковая модель пишет. Модель принятия решений принимает решения. Большая часть того, что программное обеспечение ожидает от ИИ, — это принятие решений.
Ограничения
Дискриминативная модель не будет генерировать текст, писать код, вести диалог, выполнять арифметические операции, считывать изображения или следовать последовательности действий.
На семинаре мы выберем одну из дискриминативных моделей:
- Одна из дискриминативных моделей — Jev . Это размещенный API от TypeSafe AI, выпущенный в сентябре 2026 года. Первая модель —
jev-1.13, доступ к которой осуществляется через псевдонимjev-latest. Опубликованные веса отсутствуют, поэтому модель вызывается, а не загружается. - Jev — не единственный способ получить модель System One. DiffusionGemma от Google — это модель с открытыми весами, которая записывает целый блок токенов параллельно, а не по одному, и тот же параллельный проход может считывать вероятности для фиксированного набора опций. Серверы с открытым исходным кодом, такие как djev-run, используют тот же API, что и Jev, поэтому все, что рассматривается на этом семинаре, работает с ним без изменений.
Условные обозначения и вопросы: Choice , Score и Noul
Каждый вызов отправляет состояние и вопросы. Состояние — это текст, который вы хотите оценить. Это может быть строка, объект JSON или список. Вопросы спрашивают, что вы хотите узнать об этом тексте. Каждый вопрос имеет тип: Выбор, Оценка или Нет. Вопросы обрабатываются параллельно, что позволяет системе быстро реагировать. При необходимости можно добавить несколько вопросов.
- Функция «Выбор» выбирает один вариант из заданного вами набора, максимум 255 вариантов. Ответом является выбранный вариант, вероятность для каждого варианта и степень уверенности. Используйте её, когда варианты не имеют определенного порядка: блокировка сверху, блокировка снизу, уклонение, удар, ожидание.
- Оценка состояния по уровням, которые вы описываете, от двух до десяти. Ответ представляет собой положение на шкале (десятичная дробь, поэтому 1,4 означает «между одним и двумя, ближе к единице»), вероятность каждого уровня и степень уверенности. Используйте ее, когда ответ зависит от степени: насколько сильным будет удар.
- Функции Choice и Score возвращают вероятность для каждого варианта и уровень уверенности. Разница заключается в основном ответе. Функция Choice возвращает наиболее вероятный вариант. Функция Score рассматривает варианты как упорядоченные уровни и возвращает их средневзвешенное значение, которое может находиться между двумя уровнями. При значениях none 0,05, light 0,55 и heavy 0,40 функция Choice отвечает «light», а функция Score отвечает 1,35, что находится между light и heavy. Арена использует это значение:
choose()рассматривает оценку опасности 1,5 или выше как сильный удар.
- Функции Choice и Score возвращают вероятность для каждого варианта и уровень уверенности. Разница заключается в основном ответе. Функция Choice возвращает наиболее вероятный вариант. Функция Score рассматривает варианты как упорядоченные уровни и возвращает их средневзвешенное значение, которое может находиться между двумя уровнями. При значениях none 0,05, light 0,55 и heavy 0,40 функция Choice отвечает «light», а функция Score отвечает 1,35, что находится между light и heavy. Арена использует это значение:
- Noul задает вопрос с ответом «да/нет» и возвращает вероятность того, что ответ «да». Значение около 1 означает однозначное «да», около 0 — однозначное «нет», около 0,5 — «может быть и да». Отдельного уровня достоверности нет, поскольку вероятность — это уровень достоверности.
Напишите целенаправленные вопросы.
Дискриминативная модель работает лучше всего, когда вопрос задает один конкретный, четко определенный вопрос. «Какова ситуация?» возвращает правдоподобный ответ с низкой степенью уверенности. «Каков правильный ответ?», «Уязвим ли противник?» и «Насколько сильным будет удар?» возвращают три целенаправленных ответа, которые ваш код объединяет.
Описания вариантов и уровней стоят недорого, но они важны. Правила, которые вы читаете на шаге 3, становятся описаниями вариантов: block_high: "Raise the shield. Right against an overhead or a high swing." Именно так дискриминативная модель изучает правила боя по запросу, по одной строке для каждого варианта. И варианты могут меняться в зависимости от ситуации: арена предлагает cast заклинание только тогда, когда оно готово.
Вероятности и доверительная вероятность
Вариант ответа — это не метка. Это распределение по меткам, и метка — это просто самая высокая полоса.
Как модель получает число. Она использует тот же шаг, что и языковая модель для выбора следующего слова. Трансформатор считывает текст и в одной позиции присваивает каждому токену в своем словаре необработанную оценку, называемую логитом . Более высокое значение логита означает, что токен лучше подходит для этой позиции. Функция softmax преобразует логиты в вероятности, сумма которых равна 1. Затем языковая модель выбирает один токен, добавляет его к тексту и повторяет процесс. Дискриминативная модель останавливается после получения вероятностей.
Пропуск — это пробел в форме ответа. Сервер сам формирует форму, например, response: ▢ , и оставляет один пробел на каждый вопрос. Единственная задача модели — оценить, что должно быть в каждом пробеле.
- В подсказке содержится информация о штате и каждом вопросе, при этом каждый допустимый ответ представлен в виде краткой метки:
aдля блока высокой высоты,bдля блока низкой высоты и так далее. - Сервер добавляет бланк ответов, в котором для каждого вопроса предусмотрен один пропуск.
- Модель считывает подсказку и форму за один проход и присваивает каждому токену логит-значение для каждого пропуска. Модель диффузии видит всю форму сразу и оценивает все пропуски одновременно.
- Сервер хранит только логиты допустимых меток и применяет к ним функцию softmax, так что сумма допустимых ответов равна 1.
- Если результат чтения кажется неуверенным, сервер выполняет повторное чтение с другого случайного начального значения и усредняет результаты чтения.
Уверенность — это число, показывающее, насколько точно дан ответ. TypeSafe вычисляет её на основе распределения вероятностей по вариантам ответа. Если все вероятности сосредоточены на одном варианте, это даёт 1, а при равномерном распределении — 0. Для трёх вариантов это равно (3 × наибольший − 1) / 2.
TypeSafe обучает Jev на основе калиброванных вероятностей. Вероятность соответствует тому, как часто ответ оказывается правильным. В калиброванной модели ответы, данные при уровне достоверности 0,7, оказываются правильными примерно в 70% случаев, поэтому пороговое значение уверенности — это пороговое значение того, как часто вы принимаете неправильный ответ. Сервер DiffusionGemma в этом семинаре сообщает саму наивысшую вероятность как уровень достоверности, усредненный по его запросам. Когда запросы не совпадают, среднее значение размывается, и уровень достоверности падает.
Главный вывод: ответ покажет , что именно нужно делать. Уверенность подскажет, стоит ли действовать .
Пороги
Пороговое значение определяет действие в коде. Модель возвращает уровень достоверности или вероятность. Ваш код сравнивает его с выбранным вами числом, и результат определяет дальнейшие действия.
Для каждого действия установлен пороговый уровень. TypeSafe предлагает разделить уровень уверенности на диапазоны. Высокий уровень уверенности действует самостоятельно. Средний уровень уверенности действует с проверкой, например, запрашивает подтверждение или помечает случай для рассмотрения. Низкий уровень уверенности не действует и возвращается к безопасному варианту или к человеку.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Правила арены. Пороговые значения арены находятся в функции choose() , которую вы запускаете на шаге 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Предупреждение: Правильный ответ не всегда является верным. Дискриминативная модель не может вернуть вариант, который вы не предлагали, поэтому она никогда не выдает «галлюцинации», но может выбрать неправильный, иногда с высокой степенью уверенности. Проверяйте свои вопросы на ситуациях, которые вы уже оценили, прежде чем доверять пороговому значению.
Автоматизируйте принятие решений с помощью модели.
Запрос и ответ
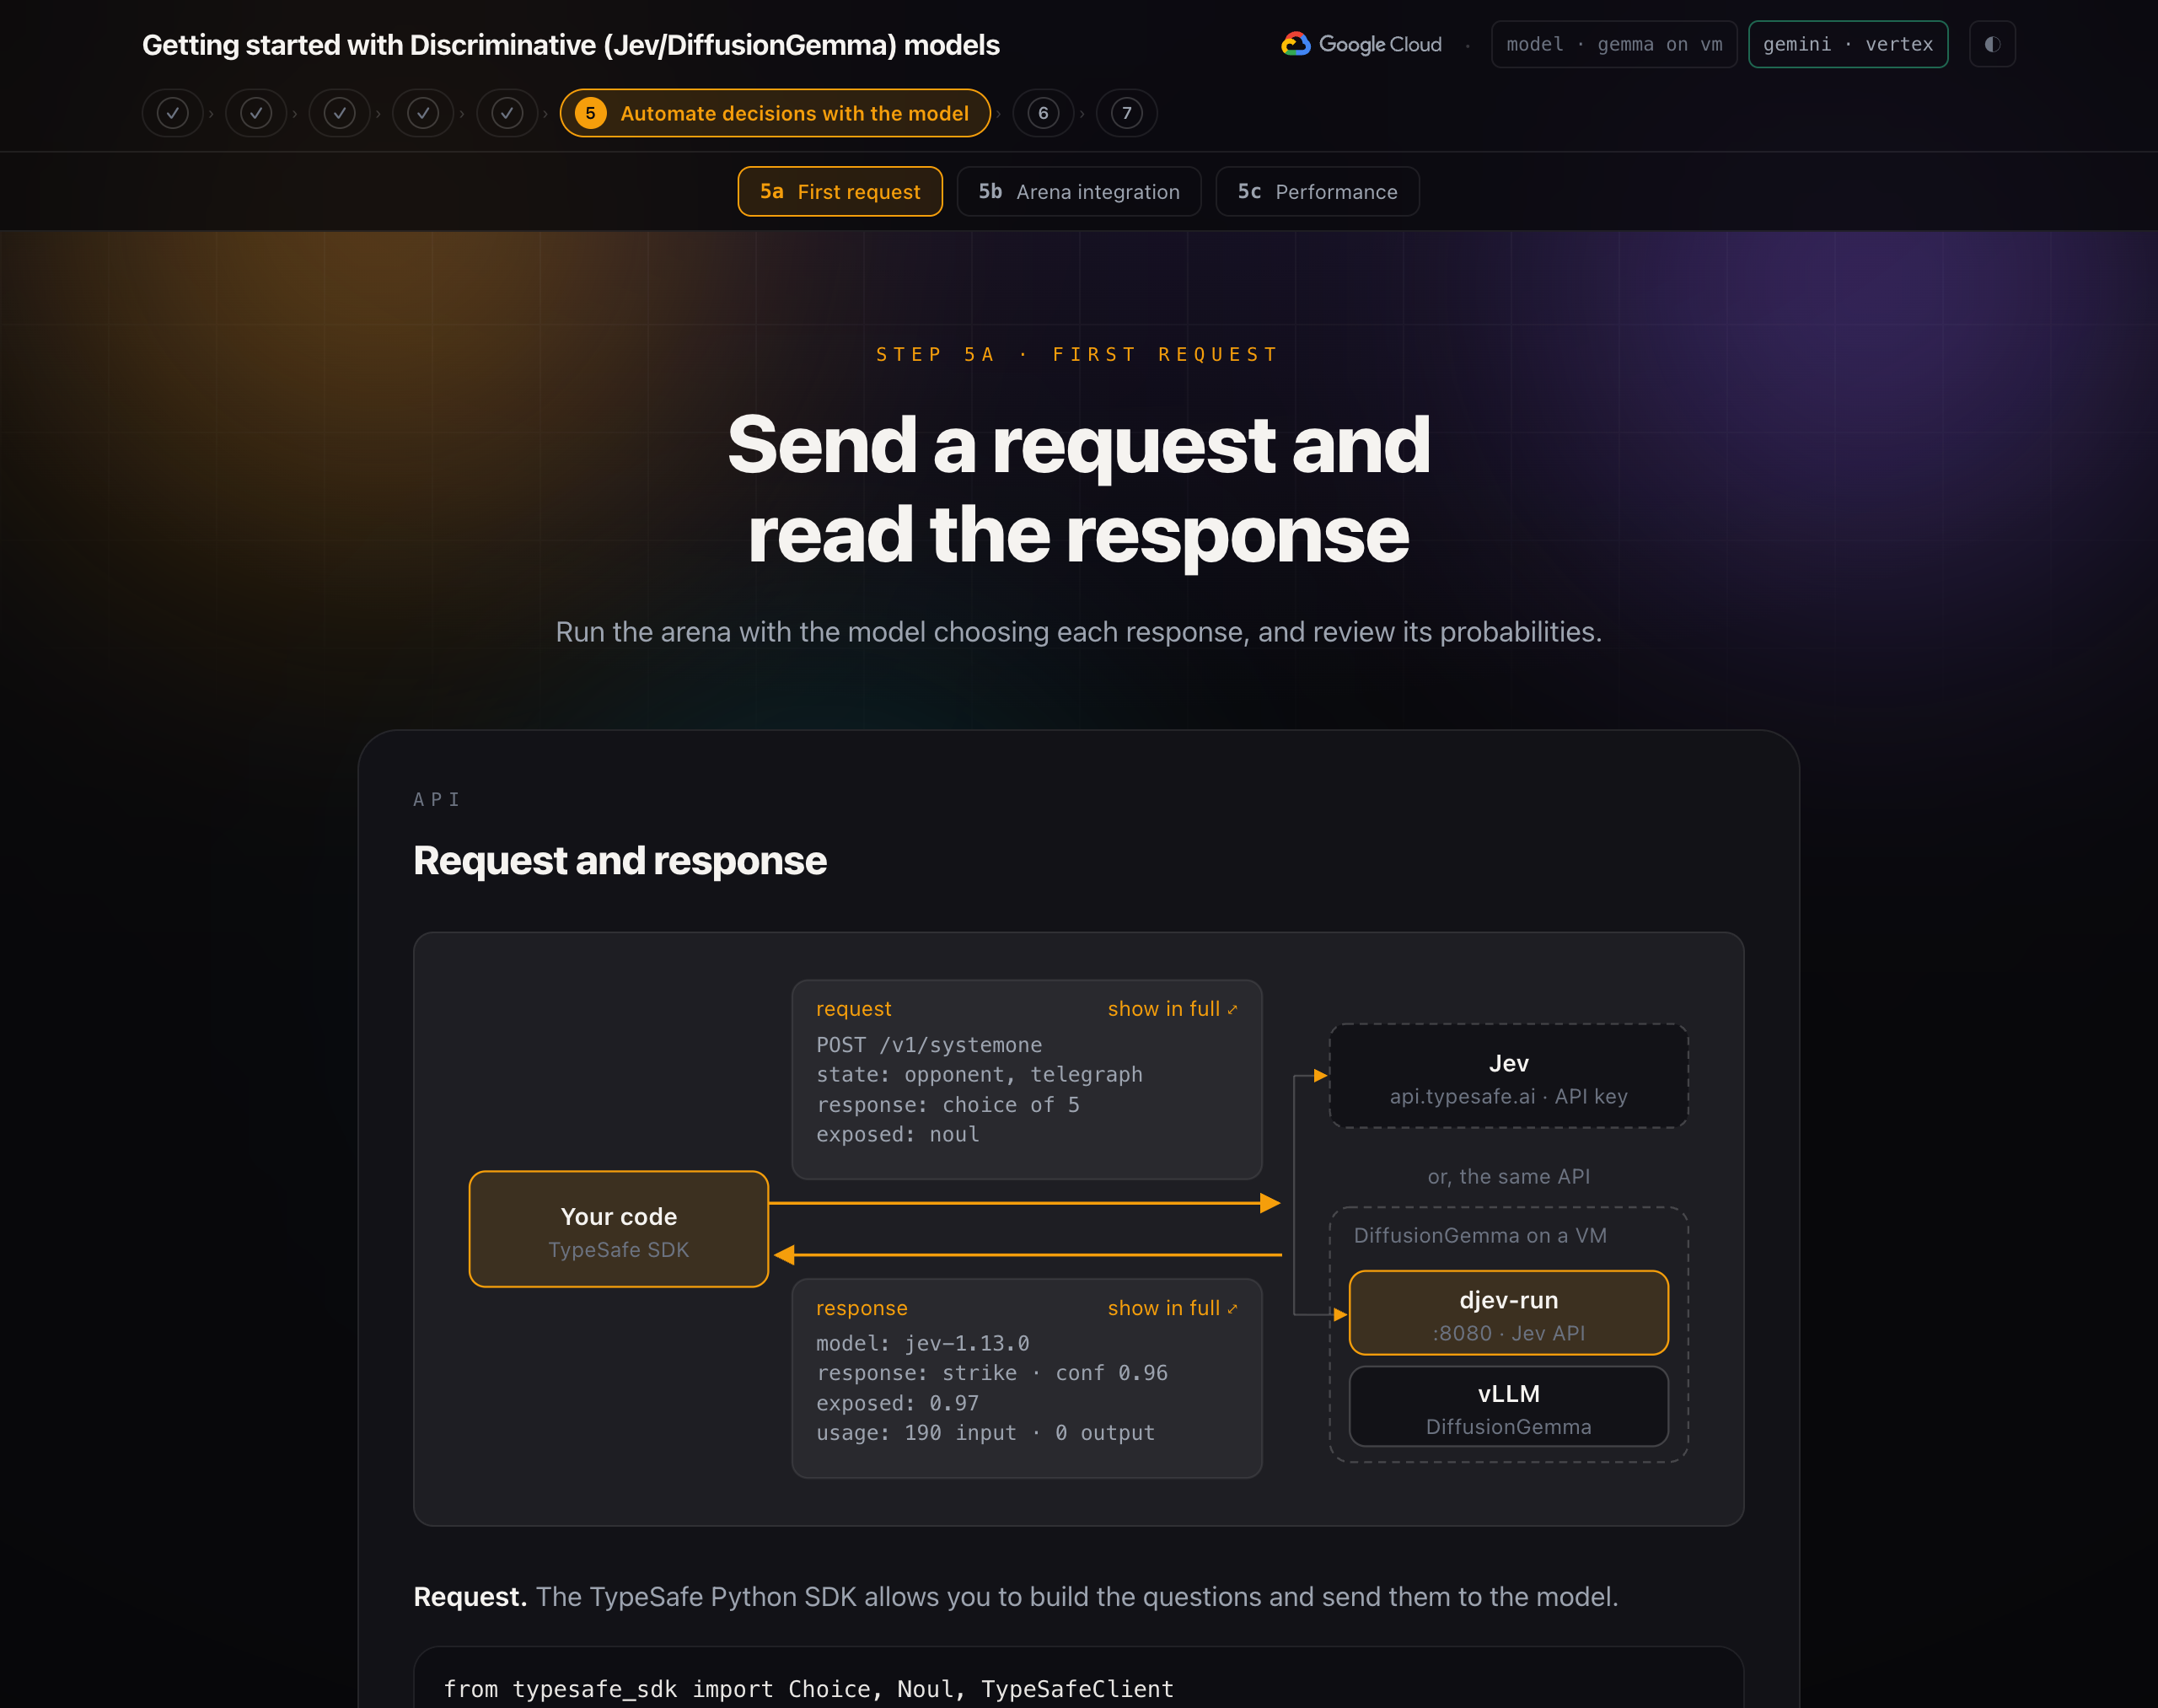
Запрос. Python SDK TypeSafe позволяет создавать вопросы и отправлять их модели.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Один запрос за тик
При каждом такте приложение отправляет телеграф в качестве состояния и запрашивает три вещи за один вызов:
- Какой из пяти (или шести, когда заклинание готово) ответ правильный? Выбор.
- Подвергается ли огр прямо сейчас воздействию контратаки. А Нул.
- Насколько силен входящий удар , по трехбалльной шкале. Оценка.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Функция choose()
Помните пороговые значения из шага 4? choose() сравнивает ответы модели с фиксированными числами, и эти фиксированные числа являются пороговыми значениями.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() — это обычный Python-код, считывающий типизированные значения и использующий два правила. Дискриминативная модель предоставляет вероятность и анализ, а код использует пороговые значения для правил. Выбранное действие отправляется в движок, где оно будет использовано в битве против огра.
Главный вывод: храните вопросы и пороговые значения в одном месте. Именно эти параметры интеграции с System One вы будете настраивать чаще всего.
Время отклика, ценообразование на основе входных данных и логика принятия решений.
- Время отклика на каждое решение. Каждый тик боя в части b возвращался примерно за сто миллисекунд, некоторые — за две-три. Этого достаточно для игрового цикла, пути запроса или проверки каждого сообщения до того, как его увидит человек или языковая модель.
- Ценообразование на основе входных данных. Весь бой, шестьдесят решений, каждое из которых содержит три вопроса, стоит значительно меньше одной десятой цента. Выходные токены равны нулю, потому что ничего не было сгенерировано. Следствие этого — вы можете позволить себе задавать больше вопросов, чем вам нужно. Арена спрашивает, открыт ли огр, на каждом такте, даже если важны только
strikeи применениеcast, потому что задавать вопросы практически бесплатно, а ответ полезен на панели управления. TypeSafe называет это спекулятивным разветвлением . - Сочетайте уверенность и опасность. Когда уверенность дискриминативной модели в своем ответе ниже 0,40, а оценка опасности указывает на приближающийся серьезный удар,
choose()переопределяет его, предлагая уклонение. Уклонение редко бывает лучшим ответом, но и худшим тоже. Выбирайте пороговые значения, исходя из стоимости каждой ошибки, а не из круглого числа, и проверяйте их на основе сигналов, которые вы уже оценили вручную. Собственный совет TypeSafe: если решение постоянно дает сбои, уточните вопрос, прежде чем изменять пороговое значение.
Объединение моделей в рабочем процессе ADK
Ограничения решений, принимаемых за один тик, и почему одних правильных ответов недостаточно.
Последняя строка боя на пятом шаге говорит сама за себя: огр тяжело уходит, едва поцарапанный . Модель с навыком «Разборчивость» не получила урона и наносила небольшой урон с каждым тиком, а 300 очков здоровья — это больше, чем немного, умноженное на шестьдесят. Карта заклинания в углу ринга была там всё это время. Чтобы её прочитать, нужна модель, способная видеть изображение.
У огра 300 очков здоровья. Правильный удар наносит 3 очка урона. Удар в уязвимое место наносит 8 очков, потому что шкура толстая. Даже идеальный бой в течение шестидесяти секунд оставляет огра избитым и стоящим на ногах, и игра объявляет ничью. На этом пятый шаг закончился: модель хорошо защищалась, но все равно не смогла победить.
Только заклинание наносит реальный урон: 45 за идеальное применение, 67, если оно попадает в нужный момент.
Назначьте каждую задачу соответствующей модели.
Карта заклинания в углу ринга — это путь к победе, и её чтение — это не текстовая задача: это картинка, с цветом и тремя фигурами в ряд, и заклинание нужно произнести так, чтобы оно соответствовало картинке. Для этого нужна модель, которая может посмотреть на изображение и потратить на это несколько секунд. В бою несколько секунд — это десять секунд.
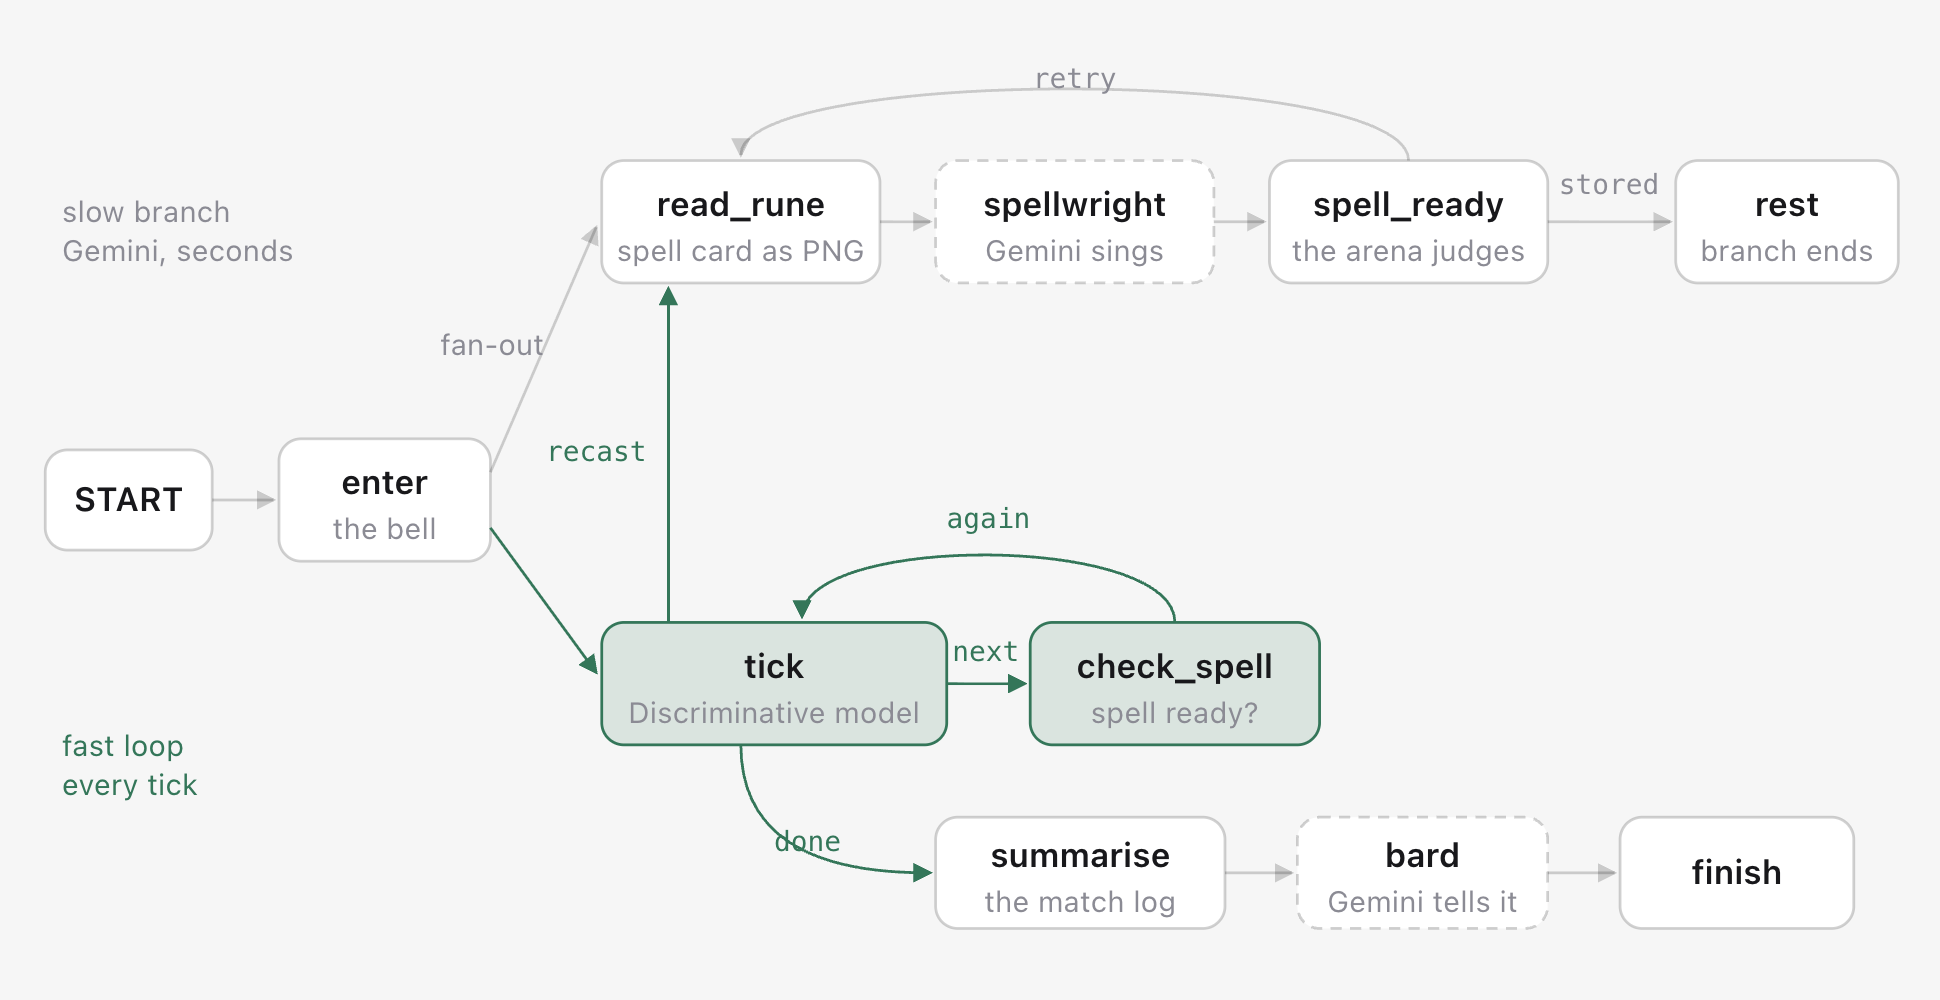
Таким образом, в рабочем процессе используются оба варианта, каждый со своей скоростью:
- Дискриминативная модель борется. Каждый тик, один вызов, одно решение, сто миллисекунд. Цикл никогда не ждет ничего, что медленнее его собственного времени.
- Близнецы читают и поют. На своей ветви, начавшейся от колокола, они захватывают карту заклинания с экрана арены в виде изображения, называют цвет и формы и поют заклинание. Арена оценивает песню, сравнивая её с ответом на карту заклинания, который никогда не покидает подающего.
- После каждого обмена боец проверяет слот. Узел
check_spellпроверяет состояние. Не готов: он сообщает об этом, указывая, как долго Близнецы пели, и сразу же переходит к следующему такту. Он никогда не ждет. Готов:castприсоединяется к вариантам, которые предлагаются дискриминационной модели, иchoose()расходует заклинание в тот момент, когда дискриминационная модель сообщает об открытии. Когда заклинание потрачено, на экране появляется новая карта заклинания, и медленный поток начинается заново. Неправильно прочитанная песня сжигает карту заклинания, и медленный поток читает новую. - В конце Близнецы пишут короткий рассказ .
Параллельные ветви с разной задержкой и одним циклом обработки событий.
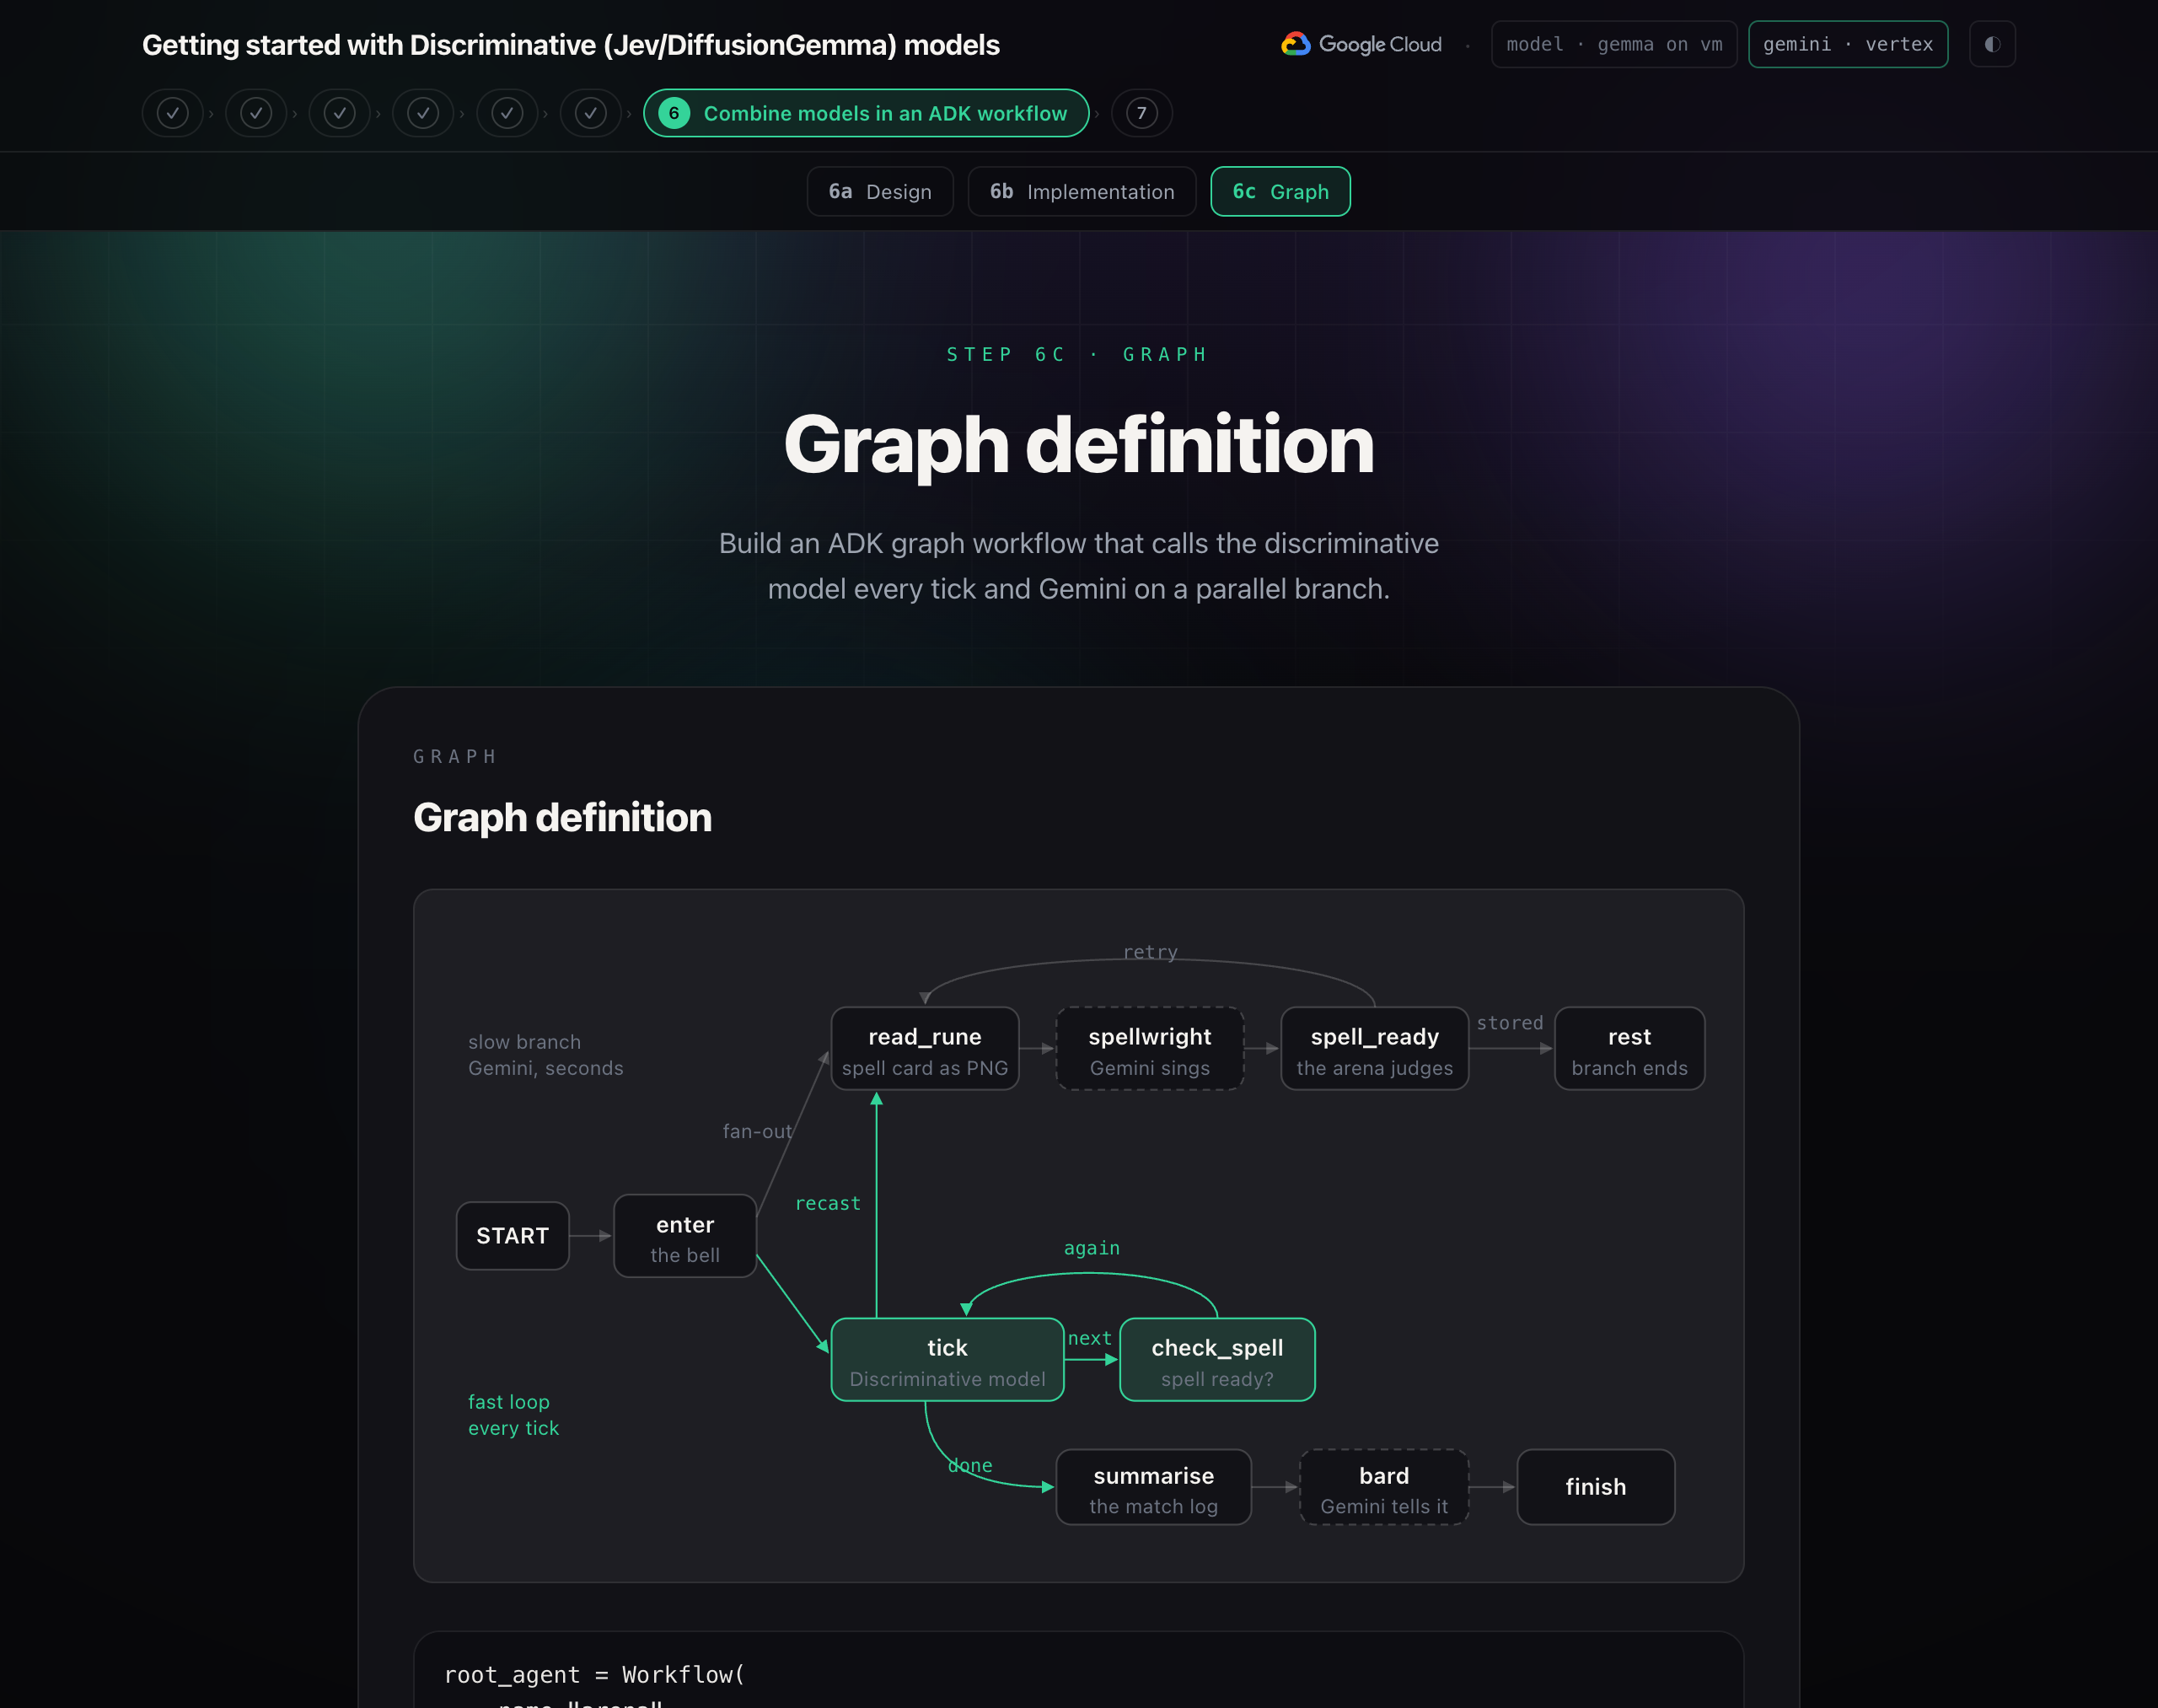
Это рабочий процесс ADK: граф узлов, соединенных ребрами. Узел — это простая функция Python или агент LLM. Ребро от одного узла к кортежу узлов называется разветвлением: оба узла запускаются одновременно. Узел, возвращающий Event с route , выбирает, какое ребро будет использовано следующим, а узел, прокладывающий маршрут к самому себе, представляет собой цикл.
Think of it as two threads. Thread 1 is slow: read the spell card, sing, store the spell. Thread 2 is fast: tick, check the slot, tick again. Thread 1 ends in a function that writes the judged spell into session state and returns no output. Thread 2's check_spell reads that state after every exchange. Neither thread calls or waits for the other; they only share state.
Key takeaway: Put the decisions in code and give each model a narrow job at its own pace.
ADK runs both branches as tasks on one event loop, in a single thread. Only one task runs at a time. When a task reaches await , it waits for its answer, and the loop runs the other branch in the meantime. The fast branch waits for the model for about a tenth of a second, and the slow branch waits for Gemini for several seconds, so neither holds up the other.
Slow branch
read_rune() takes the spell card off the screen as an image.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright is Gemini. It reads the image and answers in a fixed shape.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() has the arena judge the spell, then stores it or tries again.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
A function node can return a Content with an image part, and the LLM node receives it as its user turn. spell_ready returns an Event with a state delta and no output . The next tick reads the spell from state, and a branch with no output is not a second ending for the graph: ADK requires one terminal output, and that is the fight's.
Note: The judging is code, in the arena, against the spell card's hidden answer. A perfect reading does 45, more into an opening. Two shapes right does 25. A misread fizzles and burns the spell card. Gemini is not asked whether it was right.
Fast branch
tick() plays one exchange, then picks the next edge.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() looks at the spell slot after every exchange.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell looks at the slot after every exchange. It never blocks: if the spell is not ready, it reports that and moves on.
Three things carry the design. The Discriminative model call is await ed with the async client, so the loop yields while it waits and the Gemini branch keeps running. The questions are built fresh each tick, so cast appears only when there is something to cast. And route can be a list: ["recast", "next"] takes both edges at once.
The arena itself is behind a small client: the running app over HTTP when there is one, so the page shows the fight; the engine in-process when there is not.
Graph definition
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
A tuple as a target is a fan-out. A tuple as an edge is a chain. A dict maps route names to nodes. tick → check_spell → tick is the fast loop. "recast": read_rune starts the slow thread again after a spell is spent, "retry" does the same after a fizzle, and "stored": rest lets the slow thread end quietly, with no output, once the spell is in the slot. ADK requires at least one routed edge in a cycle, so an unconditional loop is rejected before it can run forever.
Note: root_agent is what ADK's tools look for. adk web agents from the root of the workshop opens the dev UI with the arena in it, if you want to see the graph and the events in a browser rather than a terminal.