

1. บทนำ
เวิร์กช็อป 90 นาทีเกี่ยวกับโมเดลการเลือกปฏิบัติ โมเดลการตัดสินใจ System One ของ TypeSafe AI และการนำไปใช้ร่วมกับ Gemini ในเวิร์กโฟลว์ของ Google ADK เวิร์กช็อปนี้มี 6 ขั้นตอนซึ่งสร้างขึ้นมาเพื่อเกมต่อสู้ คุณจะต่อสู้กับยักษ์ด้วยมือเปล่าก่อน จากนั้นจะส่งต่อการตอบสนองไปยังโมเดลแยกแยะ แล้วดูเวิร์กโฟลว์ ADK ชนะการต่อสู้ด้วยโมเดลแยกแยะที่ตัดสินทุกการเคลื่อนไหว และ Gemini อ่านการ์ดเวทมนตร์นอกหน้าจอเพื่อร่ายเวทมนตร์
ภาพรวม
โมเดล Discriminative (jev-1.13 หรือที่เรียกว่า jev-latest) เป็นโมเดลที่โฮสต์จาก TypeSafe AI ซึ่งเปิดตัวเมื่อวันที่ 19 กันยายน 2026 โดยจะไม่สร้างข้อความ คุณส่งสถานะ (ข้อความ, JSON หรือรายการ) และคำถามที่พิมพ์ (Choice, Score, Noul) จากนั้นโมเดลจะส่งคำตอบที่พิมพ์พร้อมความน่าจะเป็นที่ปรับเทียบแล้วในเวลาประมาณ 70-500 มิลลิวินาที โดยมีค่าใช้จ่าย $0.042 ต่อโทเค็นอินพุต 1 ล้านโทเค็น และไม่มีค่าใช้จ่ายสำหรับเอาต์พุต หน้าที่ของมันคือการตัดสินใจก่อน ระหว่าง และหลังโมเดลภาษา ได้แก่ การกำหนดเส้นทาง การจัดประเภท การควบคุม และในที่นี้คือปฏิกิริยาตอบสนองของนักสู้
เกมเป็นตัวอย่าง
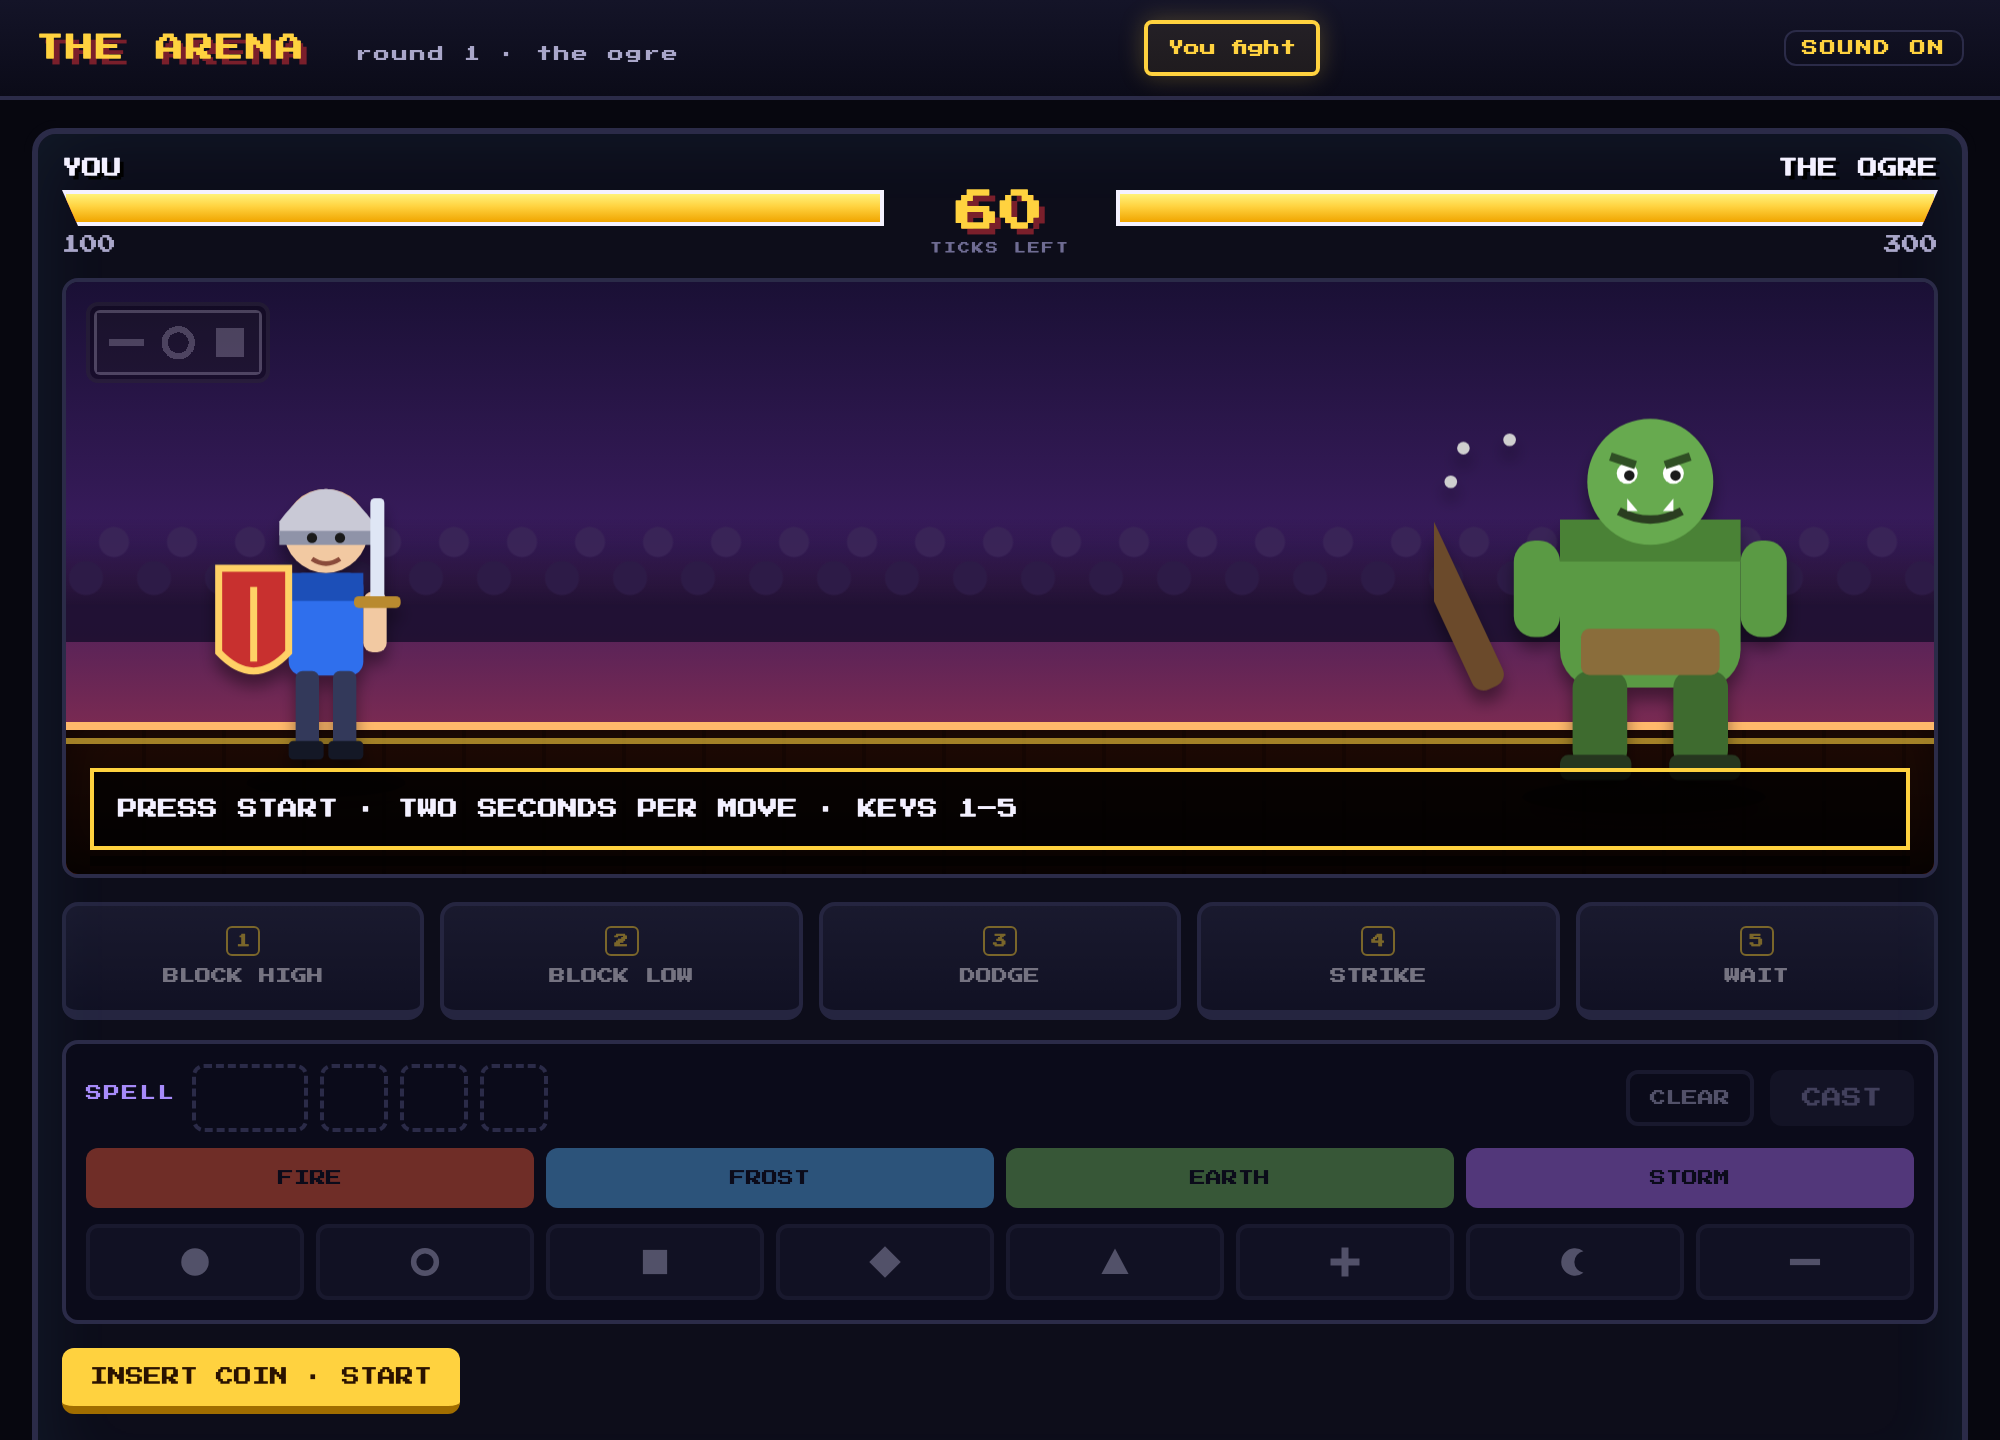
คุณเคยเล่นเกมต่อสู้ไหม คุณต้องเผชิญหน้ากับคู่ต่อสู้และต้องตอบโต้การเคลื่อนไหวของคู่ต่อสู้ในทันที หากทายผิดเพียงครั้งเดียว HP ของคุณจะได้รับความเสียหาย นอกจากนี้ เกมยังมักจะทำให้ร่ายเวทมนตร์ได้ยาก ในเกมของเรา คุณต้องเลือกสีและรูปร่างของการ์ดเวทมนตร์ตามลำดับก่อนที่จะปล่อยเวทมนตร์ เวิร์กช็อปนี้จะแสดงวิธีรวมโมเดลทั้ง 2 ประเภทเพื่อให้ตัวละครของคุณชนะ
องค์ประกอบแต่ละอย่างในเกมจะเชื่อมโยงกับระบบจริง ดังนี้
- การเคลื่อนไหวของฝ่ายตรงข้ามคือเหตุการณ์ขาเข้า เช่น คำขอหรือธุรกรรม
- คำตอบคือการตัดสินใจที่จำกัด ซึ่งสร้างขึ้นโดยโมเดลการเลือกปฏิบัติและตรวจสอบโดยโค้ด
- การ์ดเวทมนตร์คืออินพุตที่ไม่มีโครงสร้างซึ่งต้องใช้โมเดลภาษาในการอ่าน
- การจับคู่คือเวิร์กโฟลว์ที่ช่วยให้งานที่ต้องทำอย่างรวดเร็วและช้าสามารถดำเนินการได้ตามความเร็วของแต่ละงาน
โดยมุ่งเน้นที่การรวมส่วนประกอบทั้ง 4 อย่างเข้าด้วยกันเพื่อสร้างระบบที่รวดเร็วและชาญฉลาด
สิ่งที่คุณจะได้เรียนรู้
- อธิบายความแตกต่างระหว่างโมเดลแบบแยกแยะ (ระบบ 1) และโมเดลแบบสร้าง (ระบบ 2) รวมถึงกรณีที่ควรใช้แต่ละโมเดล
- อธิบายวิธีให้บริการ Jev และ DiffusionGemma และตั้งค่าอย่างใดอย่างหนึ่งสำหรับเวิร์กช็อป รวมถึง DiffusionGemma ใน VM ของ GPU ใน Compute Engine
- เขียนคำถามแบบหลายตัวเลือก คำถามแบบให้คะแนน และคำถามแบบไม่มีคำตอบ รวมถึงตีความความน่าจะเป็นและความเชื่อมั่น
- ใช้เกณฑ์ในโค้ดที่แน่นอนเพื่อเปลี่ยนความน่าจะเป็นเป็นการดำเนินการ
- สร้างคำขอด้วย TypeSafe SDK แล้วปล่อยให้โมเดลเลือกทุกการเคลื่อนไหวในเกม
- สร้างกิ่งแบบช้าที่ Gemini อ่านรูปภาพ และกิ่งแบบเร็วที่โมเดลแยกแยะตัดสินใจในลูป แล้วเรียกใช้แต่ละกิ่งแยกกัน
- รวมทั้ง 2 สาขาไว้ในเวิร์กโฟลว์กราฟ ADK ที่แชร์สถานะในวนรอบเหตุการณ์เดียว เพื่อให้งานที่ช้าไม่เคยขัดขวางการตัดสินใจที่รวดเร็ว
สถาปัตยกรรม
เวิร์กเบนช์จะอยู่ใน Cloud Shell(หรือเครื่องของคุณ) โดยจะเขียนไปยังระบบไฟล์ในเครื่องและโต้ตอบกับอารีน่า รวมถึงโต้ตอบกับ Gemini และโมเดลการตัดสินใจด้วย ② เรียกใช้โมเดลการตัดสินใจใน "การต่อสู้ของโมเดลที่แยกแยะ" ③ เรียกใช้ทั้ง 2 อย่างใน "การต่อสู้ของเวิร์กโฟลว์"
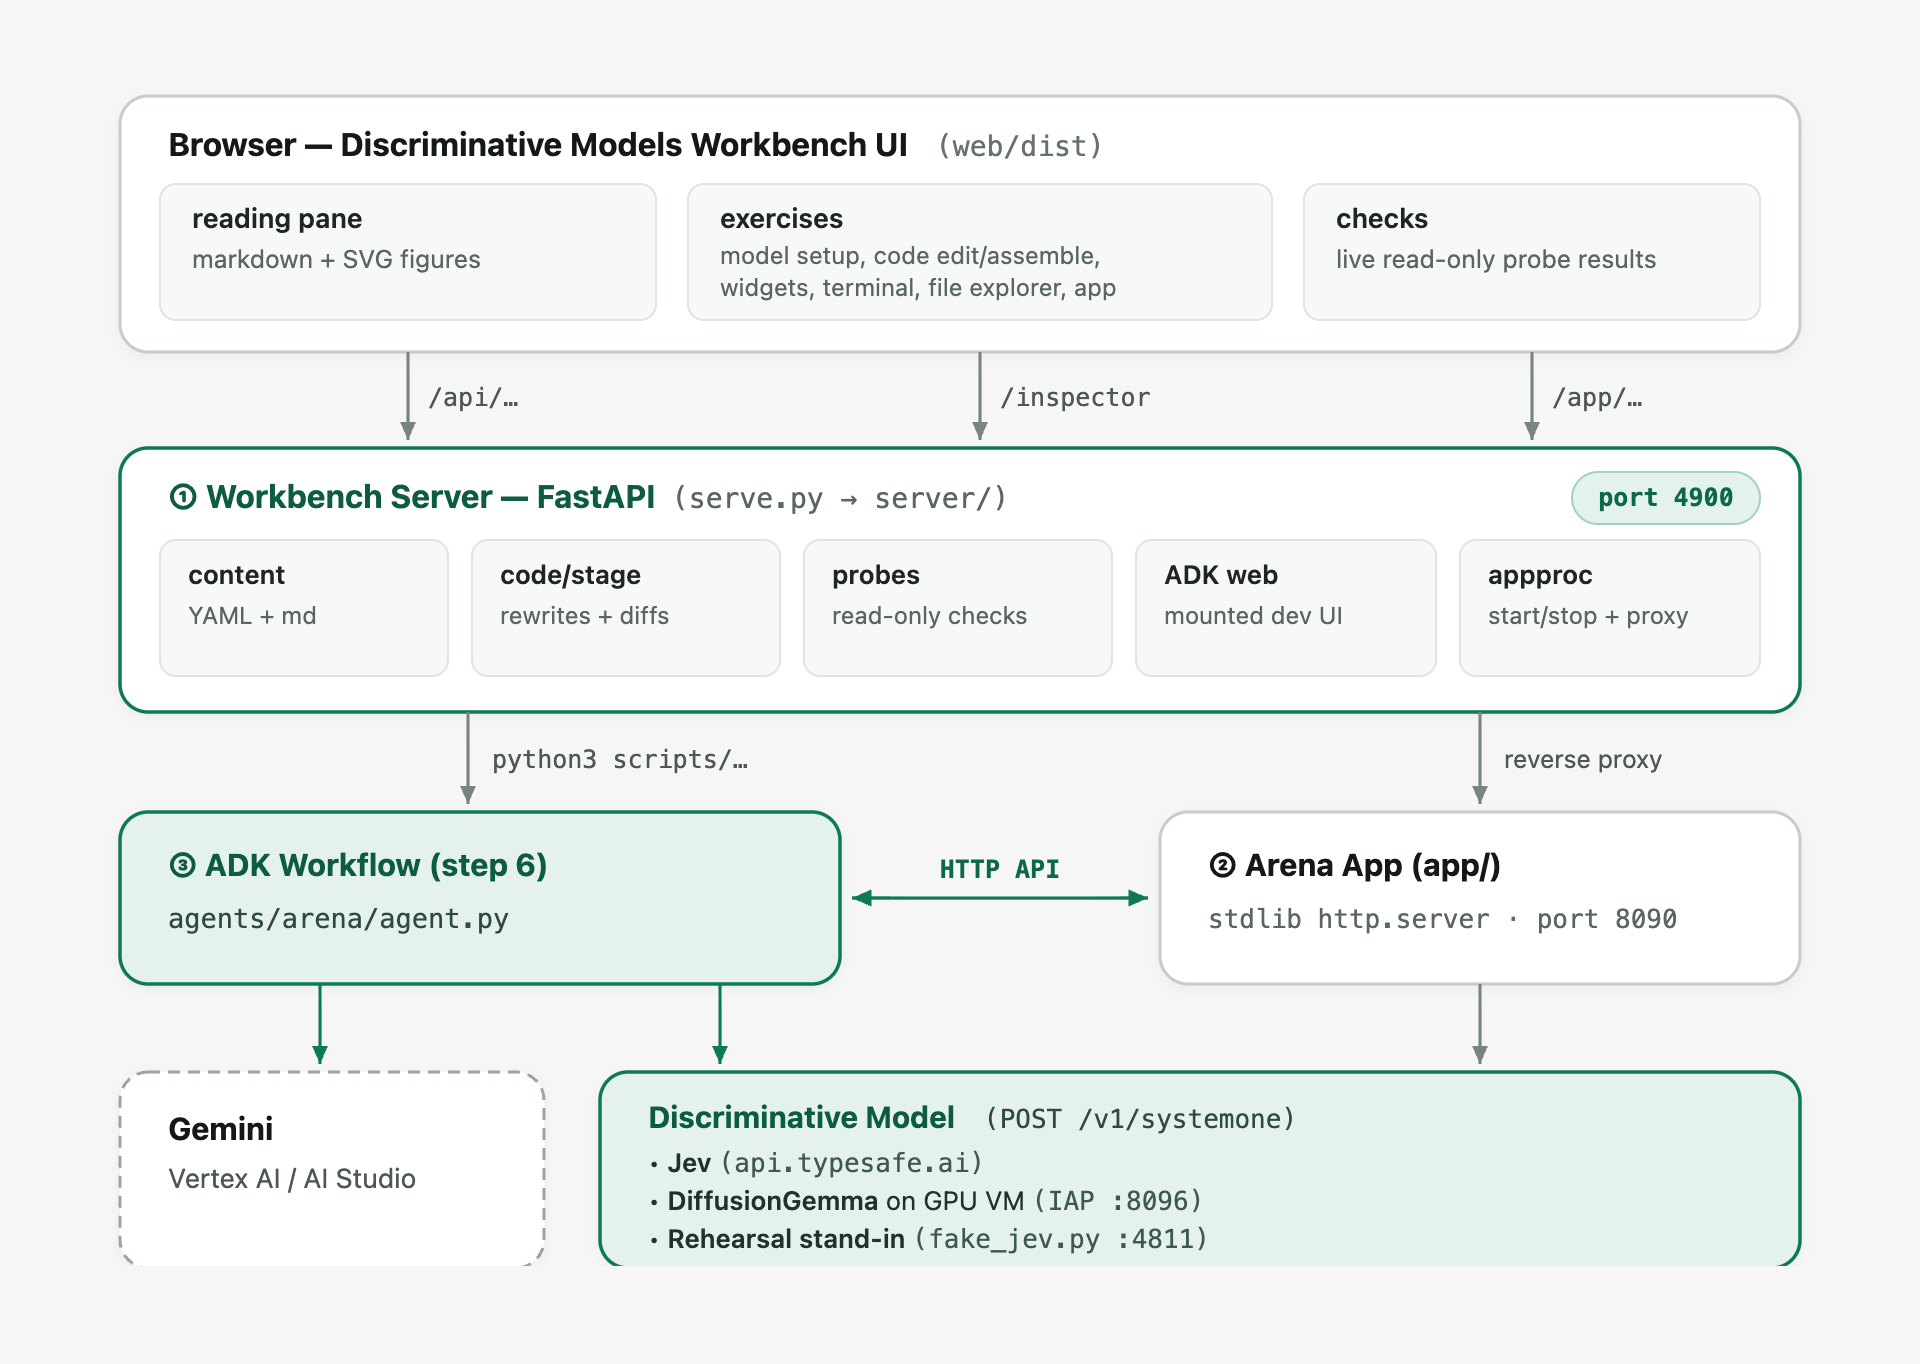
ใครเรียกอะไร เบราว์เซอร์จะสื่อสารกับ ① เท่านั้น โดยจะเรียกใช้โมเดลทั้ง 2 จาก Python ในเครื่อง
ผู้โทร | โมเดลแยกแยะ | Gemini |
② arena, "Discriminative model fights" | ทุกครั้งที่ทำเครื่องหมาย | ไม่ |
③ เวิร์กโฟลว์ | ทุกครั้งที่ทำเครื่องหมาย | ไม่ |
③ เวิร์กโฟลว์ | ไม่ | รูปภาพการ์ดเวทมนตร์ เรื่องราวหลังการต่อสู้ |
| ใช่ | ไม่ |
1 ติ๊กต่อโหมด
- คุณต่อสู้ หน้าเว็บจะขอ ② รหัสมอร์ส แสดงรหัสมอร์สพร้อมตัวจับเวลา 2 วินาที และโพสต์ปุ่มที่คุณกด (หรือคำที่คุณพิมพ์) กลับ ② แก้ไข
- การต่อสู้ของโมเดลที่เลือกปฏิบัติ หน้าเว็บขอเครื่องหมายถูก ② วาดโทรเลข ถามคำถามโมเดล 3 ข้อในการเรียกใช้ครั้งเดียว เรียกใช้
choose()และแสดงคำตอบและผลลัพธ์ หน้าเว็บจะวาดแถบ - การต่อสู้ในเวิร์กโฟลว์ Start จะทำให้ ② เปิดตัว ③ เป็นกระบวนการย่อย (เข้าสู่ระบบ
runs/arena-workflow.log) ③ จะเป็นตัวขับเคลื่อนการต่อสู้ โดยจะขอข้อมูลจาก ② สำหรับการโจมตีแต่ละครั้ง เรียกใช้โมเดล และโพสต์การตัดสินใจ ส่วนเวทมนตร์ของ Gemini จะมาถึงในกิ่งก้านของตัวเองเมื่อพร้อม หน้านี้จะแสดงเฉพาะการโหวต ② และการจับสลาก Pause คือแฟล็กใน ② ที่ ③ จะตรวจสอบก่อนแต่ละเครื่องหมาย
ตำแหน่งที่โฮสต์โมเดลการตัดสินใจ การเรียกใช้แต่ละครั้งจะผ่าน typesafe-sdk เดียวกัน โดยมีเพียง URL ฐานเท่านั้นที่เปลี่ยนแปลง scripts/jevauth.py ตั้งชื่อแบ็กเอนด์และตั้งค่าคีย์และระยะหมดเวลา
แบ็กเอนด์ |
| คีย์ | ตั้งค่าโดย |
TypeSafe, โฮสต์ | unset (api.typesafe.ai) |
|
|
DiffusionGemma ใน VM ที่มี L4 |
| ไม่มี |
|
DiffusionGemma ใน Cloud Run |
| โทเค็นข้อมูลประจำตัว Google ที่ดึงข้อมูลทุกชั่วโมง |
|
การซ้อม |
| ไม่มี |
|
คำตอบของไพ่เวทมนตร์ ②: เวิร์กโฟลว์จะได้รับเฉพาะ PNG และ ② จะตัดสินเวทมนตร์ที่ส่งกลับมา นั่นคือสิ่งที่ทำให้คาถาเป็นการทดสอบการอ่านของ Gemini อย่างแท้จริง และคาถาที่คุณสร้างใน "You fight" เป็นการทดสอบของคุณอย่างแท้จริง
2. ตั้งค่า
รับเครดิตเวิร์กช็อป
หากได้รับเครดิต Google Cloud สำหรับเซสชันนี้ ให้แลกรับเครดิตก่อน โดยจะใช้เวลาประมาณ 1 นาทีและสร้างบัญชีสำหรับการเรียกเก็บเงินให้คุณ
เปิด Cloud Shell
Google Cloud Shell คือสภาพแวดล้อม Linux ที่เข้าถึงได้จากเบราว์เซอร์ซึ่งได้รับการกำหนดค่าล่วงหน้าด้วย gcloud, Python, Node.js, uv และ git โดยมีการตรวจสอบสิทธิ์ด้วยบัญชี Google ของคุณแล้ว
- เปิด คอนโซล Google Cloud
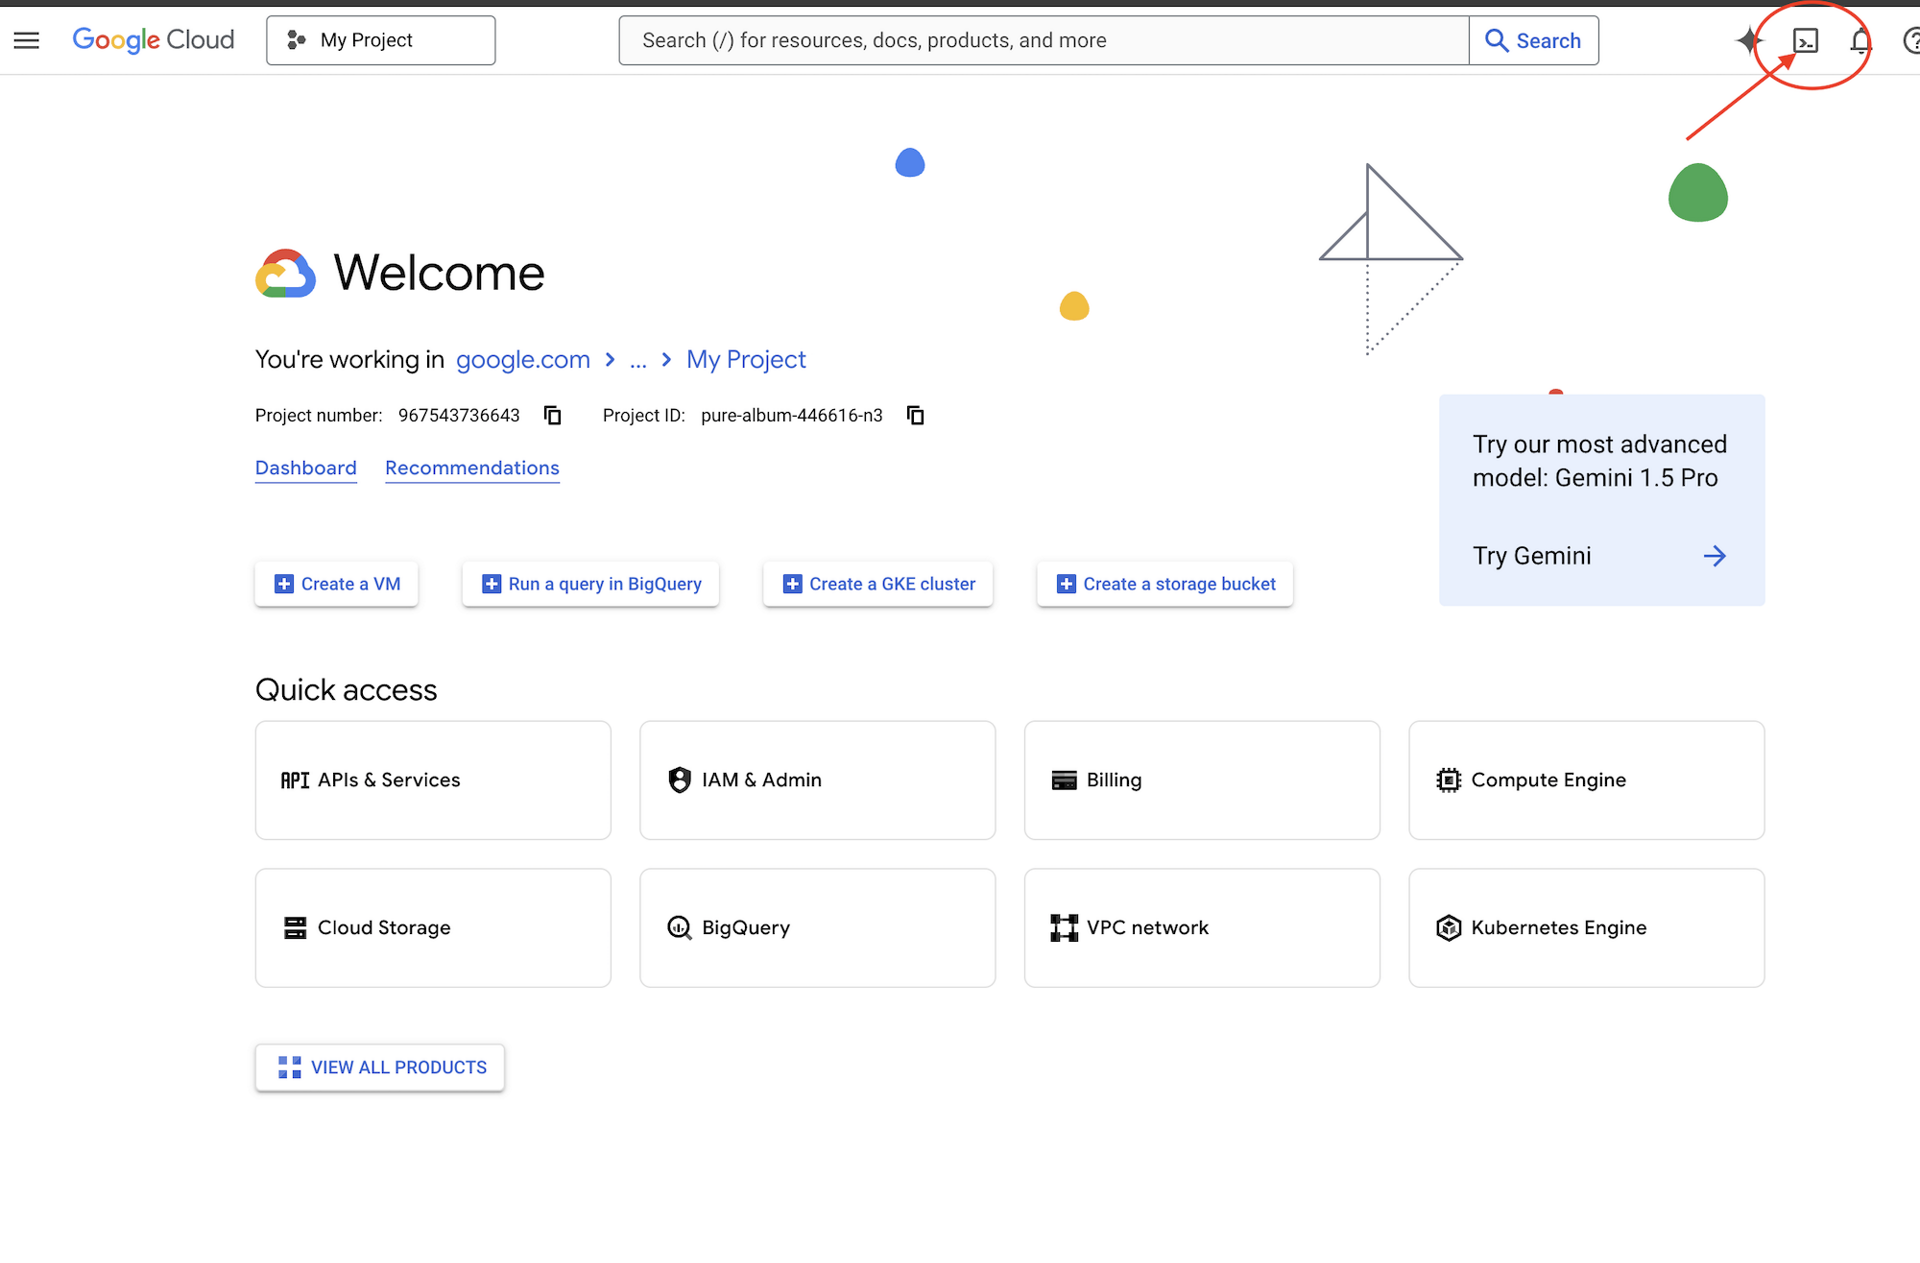
- คลิกเปิดใช้งาน Cloud Shell (ไอคอนเทอร์มินัลในแถบนำทางด้านบน) เพื่อเปิดเซสชันเทอร์มินัลที่ด้านล่างของเบราว์เซอร์
เปิดตัวเวิร์กเบนช์
ใน Cloud Shell หรือที่ใดก็ตามที่ลงชื่อเข้าใช้ gcloud
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh สร้างโปรเจ็กต์ (discrim-models-XXXX) ลิงก์การเรียกเก็บเงินกับโปรเจ็กต์ดังกล่าว โดยเลือกใช้บัญชีเครดิตสำหรับกิจกรรมหากมี และรอจนกว่าโปรเจ็กต์จะแสดงโฆษณาได้ การเรียกใช้ซ้ำจะนำโปรเจ็กต์ใน ~/project_id.txt มาใช้ซ้ำ หากต้องการใช้โปรเจ็กต์ที่มีอยู่แล้ว ให้ใส่รหัสของโปรเจ็กต์นั้นในไฟล์ดังกล่าว แล้วข้ามสคริปต์นี้
setup_codelab.sh ไม่ได้ขออะไร โดยจะติดตั้ง uv และแพ็กเกจ Python, เปิดใช้ Vertex AI, Compute Engine และ IAP, ชี้ Gemini ไปยัง Vertex AI ในโปรเจ็กต์ใน .env, ทำการเรียก Gemini จริง 1 ครั้งด้วยโมเดลที่โปรเจ็กต์เรียกได้, สร้างหน้าเว็บ, เริ่ม Workbench ในเบื้องหลัง และเรียกใช้ scripts/check_setup.py การเรียกใช้ซ้ำจะเก็บไฟล์การออกกำลังกายไว้ แต่ scripts/starter.sh จะรีเซ็ตไฟล์ คุณจะเลือกรุ่นการตัดสินใจได้ในขั้นตอนที่ 2 ของเวิร์กเบนช์
วิธีเปิด UI ของเวิร์กเบนช์ใน Cloud Shell
- คลิกลิงก์แสดงตัวอย่างที่พิมพ์ไว้ที่ส่วนท้ายของ
./setup_codelab.shหรือคลิกแสดงตัวอย่างเว็บที่มุมขวาบนของแถบเครื่องมือ Cloud Shell - เลือกเปลี่ยนพอร์ต ป้อน 4900 แล้วคลิกเปลี่ยนและแสดงตัวอย่าง
Gemini ทำงานใน Vertex AI ในโปรเจ็กต์ของคุณด้วยข้อมูลเข้าสู่ระบบ Google ของคุณเอง: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT และ GOOGLE_CLOUD_LOCATION=global ใน .env
คุณเลือกโมเดลการตัดสินใจได้ด้วยตัวเองในขั้นตอนที่ 2 ของเวิร์กเบนช์ หรือจากเทอร์มินัลด้วย scripts/setup_model.sh:
ทางเลือก | ความต้องการ | ตั้งค่า | ค่าใช้จ่าย |
โมเดลการเลือกปฏิบัติ (TypeSafe, โฮสต์) | คีย์ API ที่ปลอดภัย | ไม่มี | ต่อโทเค็น เศษส่วนของเซ็นต์ |
DiffusionGemma (Google, น้ำหนักแบบเปิด) | การเรียกเก็บเงิน + โควต้า Compute Engine สำหรับ GPU | ~15 นาที อัตโนมัติ | ~$0.71/ชม. ขณะที่ VM ทำงาน |
การซ้อม (ไม่มีโมเดล) | Nothing | ไม่มี | ไม่มี |
DiffusionGemma ใน VM ของ Compute Engine
scripts/setup_gemma.sh จะตรวจสอบโควต้า GPU ก่อน จากนั้นจะสร้าง VM g2-standard-4 1 รายการ (1 × L4 24 GB, 4 vCPU, 16 GB) จากอิมเมจ Deep Learning ของ Google ที่มีไดรเวอร์ NVIDIA 580 เมื่อบูตครั้งแรก VM จะติดตั้ง Docker ดาวน์โหลดน้ำหนักจาก Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17.5 GB, สาธารณะ, ไม่มีโทเค็น) และเรียกใช้ djev-run: DiffusionGemma ที่อยู่เบื้องหลัง API ที่แน่นอนของโมเดล Discriminative พอร์ตของโมเดลไม่ได้เปิดให้เข้าถึงจากอินเทอร์เน็ต: เวิร์กเบนช์จะเข้าถึงผ่านอุโมงค์ IAP บน localhost:8096 ซึ่ง scripts/start.sh เปิดอยู่
หยุดชั่วคราว / เล่นต่อ |
| |
อุโมงค์ |
| |
นำออก |
| |
ฝึกซ้อมคำสั่ง |
| |
เลย์เอาต์ที่เก็บ
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. สรุป
ทำความสะอาดสภาพแวดล้อม
เมื่อเวิร์กช็อปเสร็จสิ้น ให้ทำตามขั้นตอนต่อไปนี้เพื่อล้างทรัพยากร GPU ของ DiffusionGemma หยุดกระบวนการเวิร์กเบนช์และการซ้อมในเบื้องหลัง นำไฟล์เวิร์กช็อปออกจาก Cloud Shell และ (ไม่บังคับ) ลบโปรเจ็กต์ Google Cloud ของเวิร์กช็อป
- ลบ VM ของ GPU สำหรับ DiffusionGemma และกฎไฟร์วอลล์ (หากสร้างไว้): หากคุณจัดสรร DiffusionGemma ใน VM ของ GPU สำหรับ Compute Engine ในขั้นตอนที่ 2 ให้นำ VM, ดิสก์ และกฎไฟร์วอลล์ IAP ออกเพื่อไม่ให้มีการเรียกเก็บเงินค่าคอมพิวเตอร์หรือพื้นที่เก็บข้อมูลในดิสก์อย่างต่อเนื่อง
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - หยุดกระบวนการเวิร์กเบนช์และการซ้อมใน Cloud Shell: ในเทอร์มินัล Cloud Shell ให้หยุดเซิร์ฟเวอร์เวิร์กเบนช์ที่ทำงานอยู่เบื้องหลังและกระบวนการแทนที่การซ้อม
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - ลบโฟลเดอร์เวิร์กช็อปจาก Cloud Shell: กลับไปที่ไดเรกทอรีหลัก แล้วนำโฟลเดอร์ที่เก็บที่โคลนและไฟล์รหัสโปรเจ็กต์ออกโดยใช้คำสั่งต่อไปนี้
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - ลบโปรเจ็กต์ Google Cloud: หาก
./setup_project.shสร้างโปรเจ็กต์เวิร์กช็อปเฉพาะ (เช่นdiscrim-models-XXXX) การปิดโปรเจ็กต์จะลบทรัพยากรทั้งหมดที่สร้างไว้ในโปรเจ็กต์อย่างถาวร แต่จะยังคงบัญชีสำหรับการเรียกเก็บเงินใน Cloud ไว้เหมือนเดิม- เปิดหน้าจัดการทรัพยากรในคอนโซล Google Cloud
- เลือกโปรเจ็กต์เวิร์กช็อป (เช่น
discrim-models-...) จากรายการทรัพยากร - คลิกลบในแถบเครื่องมือด้านบน พิมพ์รหัสโปรเจ็กต์เพื่อยืนยัน แล้วคลิกปิด
คุณเข้าร่วมเวิร์กช็อปนี้เสร็จแล้ว
ข้อมูลสรุปของฟีเจอร์ทดลอง
- เลือกโมเดลที่แยกแยะได้, Jev หรือ DiffusionGemma ใน VM ของ GPU ใน Compute Engine และตรวจสอบว่าโมเดลตอบคำถามได้
- เล่นอารีน่าด้วยตัวเองแข่งกับเวลาเพื่อเรียนรู้กฎ
- เรียนรู้ว่าโมเดลการเลือกปฏิบัติตอบคำถามด้วยคำถามแบบตัวเลือก คะแนน และคำถามแบบไม่รู้ได้อย่างไร รวมถึงความน่าจะเป็นและความเชื่อมั่น และวิธีที่โค้ดของคุณใช้เกณฑ์กับคำถามเหล่านั้น
- ส่งคำขอแรก จากนั้นปล่อยให้โมเดลเลือกทุกการเคลื่อนไหวในสังเวียน โดย
choose()เปลี่ยนคำตอบให้เป็นการกระทำ - สร้างแต่ละกิ่งก้านของเวิร์กโฟลว์ ADK แยกกัน โดยให้ Gemini อ่านรูปภาพการ์ดเวทมนตร์และโมเดลตัดสินใจในลูป
- รวมไว้ในเวิร์กโฟลว์เดียวที่แชร์สถานะ เพื่อให้การต่อสู้ไม่ต้องรอ Gemini และร่ายเวทมนตร์ในการเปิด
จากการสนทนาไปจนถึงการตัดสินใจ
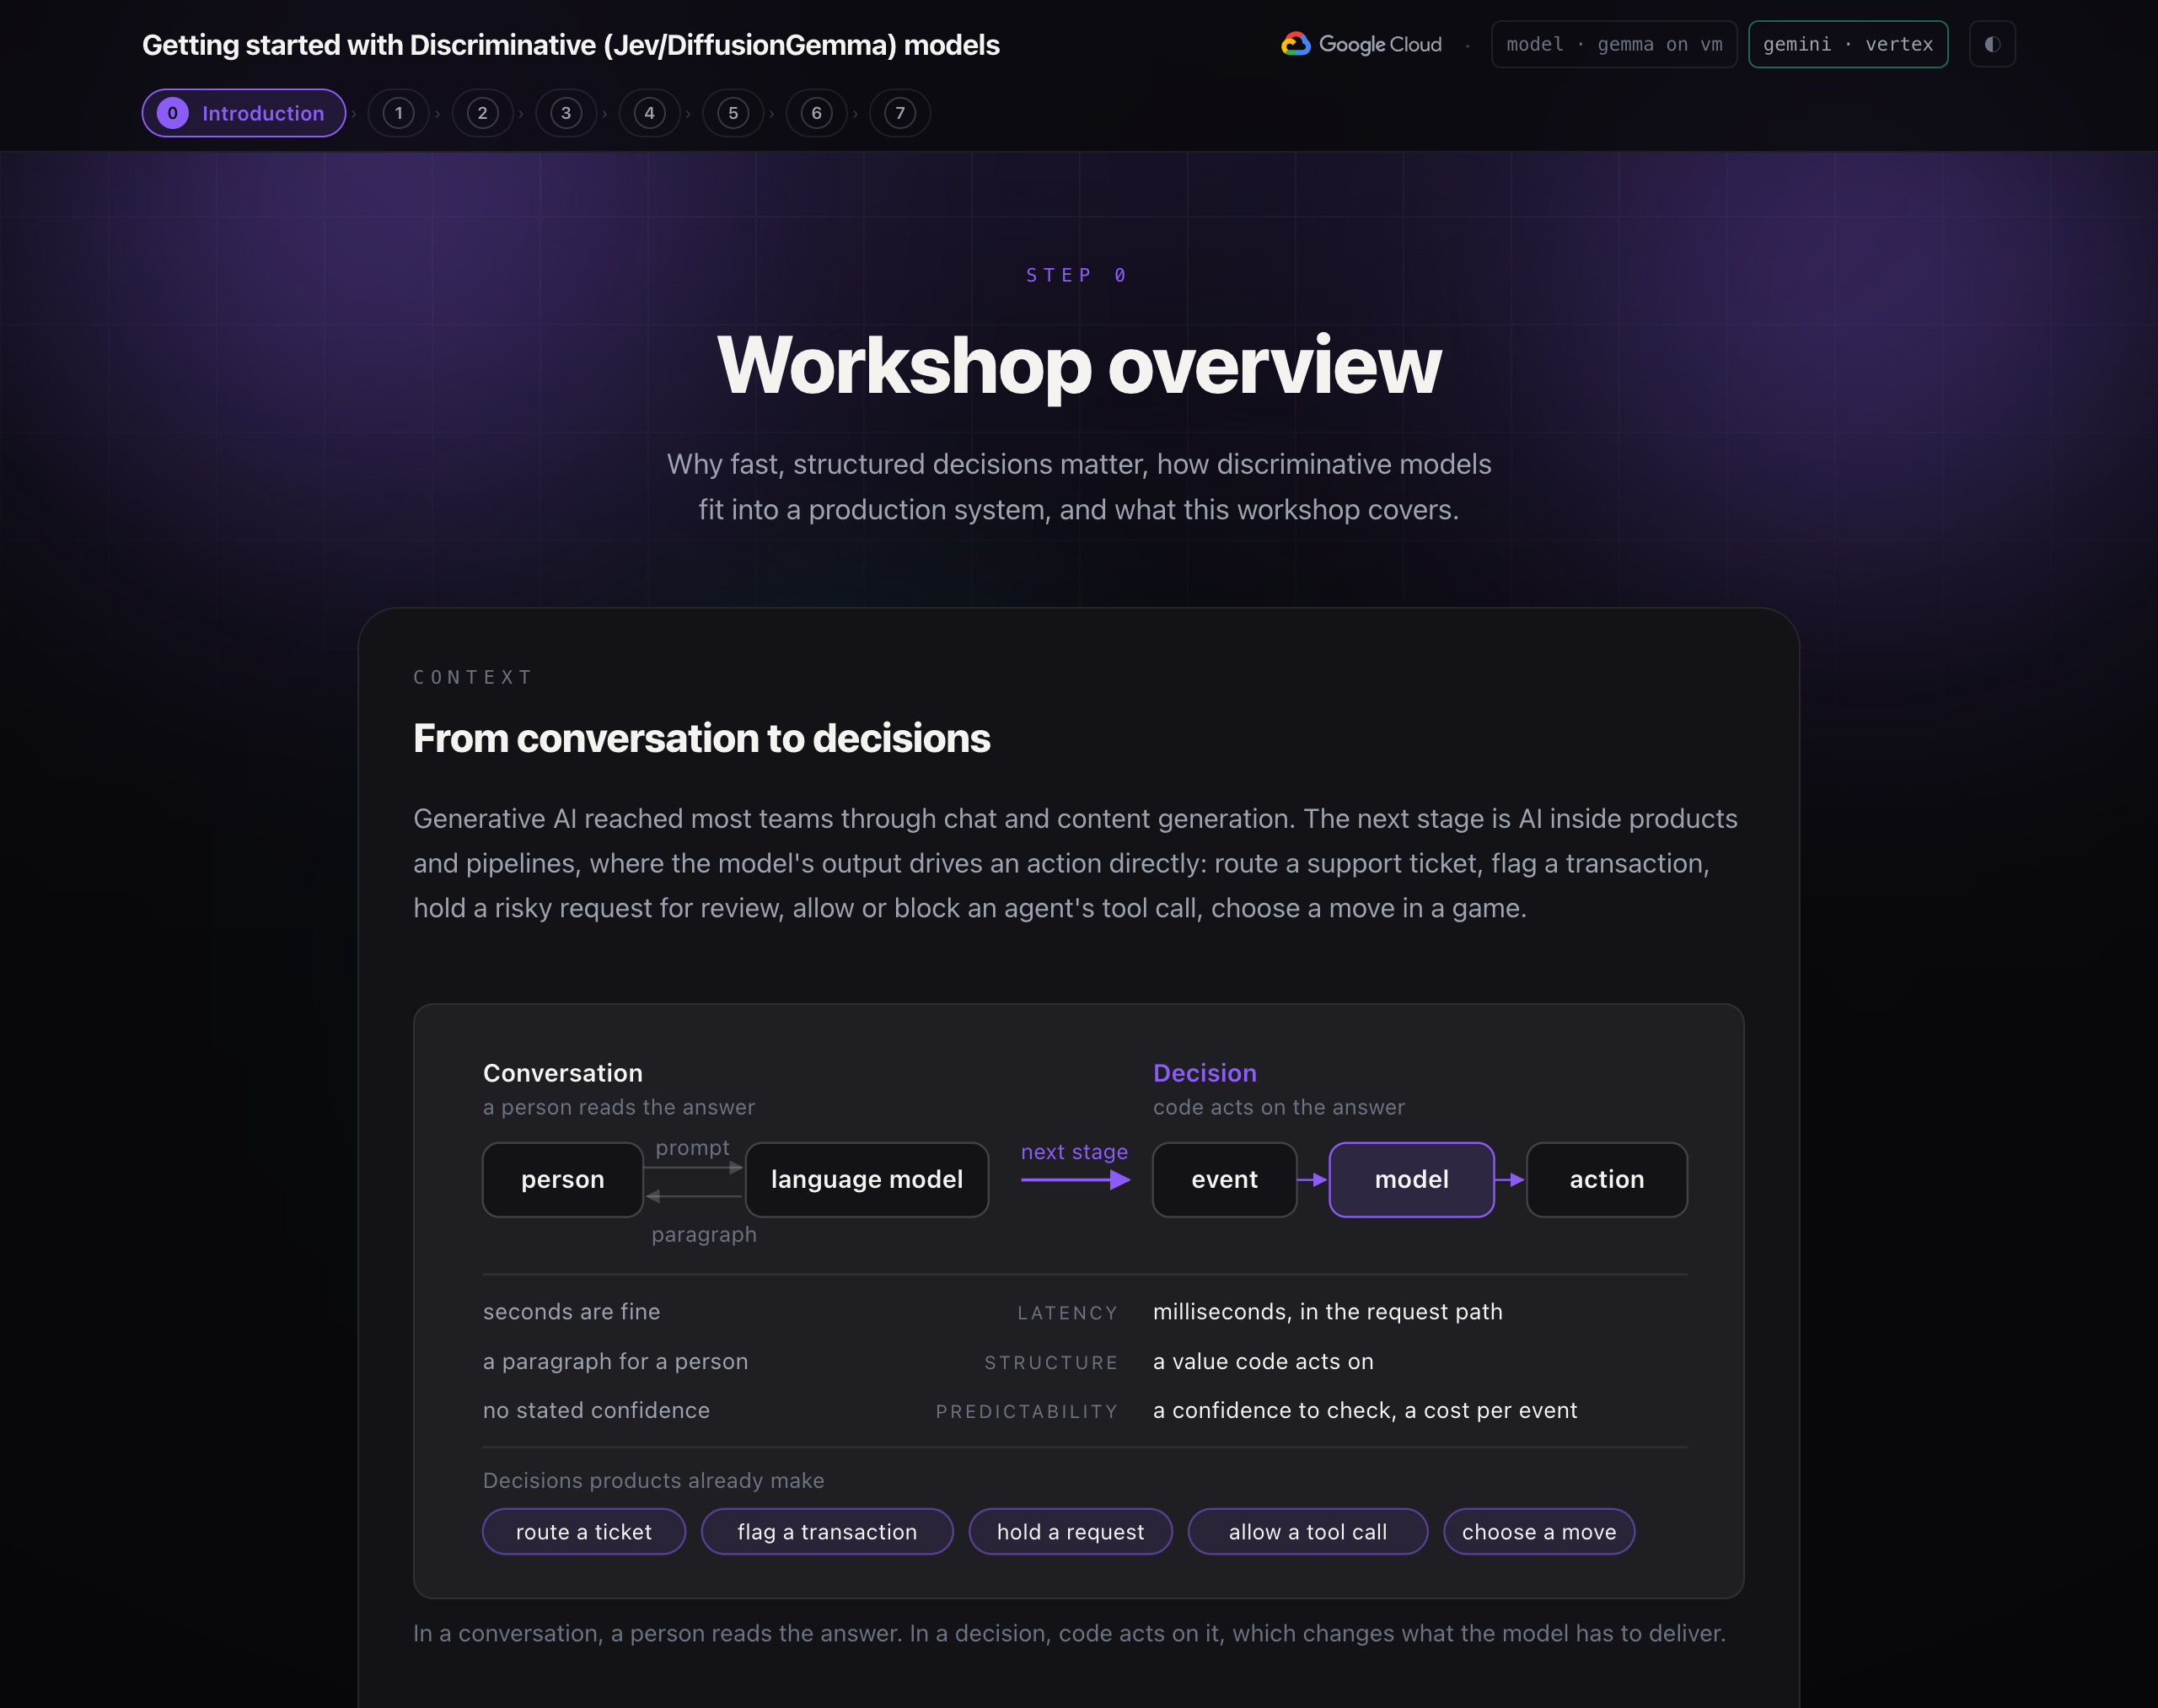
Generative AI เข้าถึงทีมส่วนใหญ่ผ่านการแชทและการสร้างเนื้อหา ขั้นตอนถัดไปคือ AI ภายในผลิตภัณฑ์และไปป์ไลน์ ซึ่งเอาต์พุตของโมเดลจะขับเคลื่อนการดำเนินการโดยตรง ได้แก่ ส่งต่อคำขอแจ้งปัญหาไปยังทีมสนับสนุน ติดธงธุรกรรม ระงับคำขอที่มีความเสี่ยงเพื่อรับการตรวจสอบ อนุญาตหรือบล็อกการเรียกใช้เครื่องมือของตัวแทน เลือกการเดินหมากในเกม
การตัดสินใจเหล่านี้มีข้อกำหนด 3 อย่างที่แชทไม่มี ดังนี้
- เวลาในการตอบสนอง คำตอบมักจะอยู่ในเส้นทางการขอของผู้ใช้หรือลูปแบบเรียลไทม์ จึงต้องมาถึงในหน่วยมิลลิวินาที ไม่ใช่หน่วยวินาที
- โครงสร้าง ผู้เรียกคือโค้ด ดังนั้นคำตอบจึงต้องเป็นค่าที่โค้ดสามารถดำเนินการได้ ไม่ใช่ย่อหน้าที่โค้ดต้องแยกวิเคราะห์
- ความสามารถในการคาดการณ์ ทุกการตัดสินใจต้องมีความเชื่อมั่นที่โค้ดตรวจสอบได้ และมีต้นทุนต่ำพอที่จะถามในทุกเหตุการณ์
โมเดลภาษาจะสร้างข้อความทีละโทเค็น โดยสามารถป้อนพรอมต์ให้ตอบว่าใช่หรือไม่ใช่ได้ แต่จะช้าสำหรับการวนซ้ำแบบเรียลไทม์ ต้องแยกวิเคราะห์เอาต์พุต และไม่รายงานความมั่นใจ
โมเดลที่สร้างขึ้นเพื่อการตัดสินใจ
โมเดลการเลือกปฏิบัติจะตอบคำถามที่พิมพ์ด้วยความน่าจะเป็นสำหรับแต่ละตัวเลือกที่อนุญาตในการส่งผ่านครั้งเดียว โดยจะไม่สร้างข้อความ เวิร์กช็อปนี้มี 2 ตัวเลือกในการเรียกใช้
รุ่น | ผู้ให้บริการ | โมเดลทำงานที่ใดในเวิร์กช็อปนี้ |
Jev | TypeSafe AI | บริการที่โฮสต์ของ TypeSafe ซึ่งเรียกใช้ด้วยคีย์ API |
DiffusionGemma | Google เปิดน้ำหนัก | โฮสต์ด้วยตนเองใน VM ที่มี GPU ในโปรเจ็กต์ที่อยู่ในระบบคลาวด์ Google ของคุณเอง |
คุณสามารถสลับโมเดลได้ตามความต้องการ โดยไม่ต้องเปลี่ยนโค้ดที่เชื่อมต่อกับโมเดล
รวมคอมโพเนนต์
ระบบที่ประสบความสำเร็จประกอบด้วยคอมโพเนนต์หลายอย่าง ดังนี้
ส่วนประกอบ | บทบาท | ในเวิร์กช็อปนี้ |
เวิร์กโฟลว์ | จัดลำดับขั้นตอน เรียกใช้กิ่งก้านแบบขนาน เก็บสถานะที่แชร์ | เวิร์กโฟลว์กราฟ ADK |
รหัสที่กำหนด | กฎ เกณฑ์ การตรวจสอบ ทันที ฟรี และตรวจสอบได้ | กฎของเกม |
โมเดลแยกแยะ | การตัดสินใจที่รวดเร็วและมีขอบเขตพร้อมคะแนนความเชื่อมั่น | เลือกคำตอบทุกครั้ง |
โมเดลภาษา | การรับรู้และการสร้าง: รูปภาพและข้อความแบบปลายเปิด | Gemini อ่านรูปภาพการ์ดเวทมนตร์และเขียนเวทมนตร์ |
สถาปัตยกรรมการแสดงโมเดล
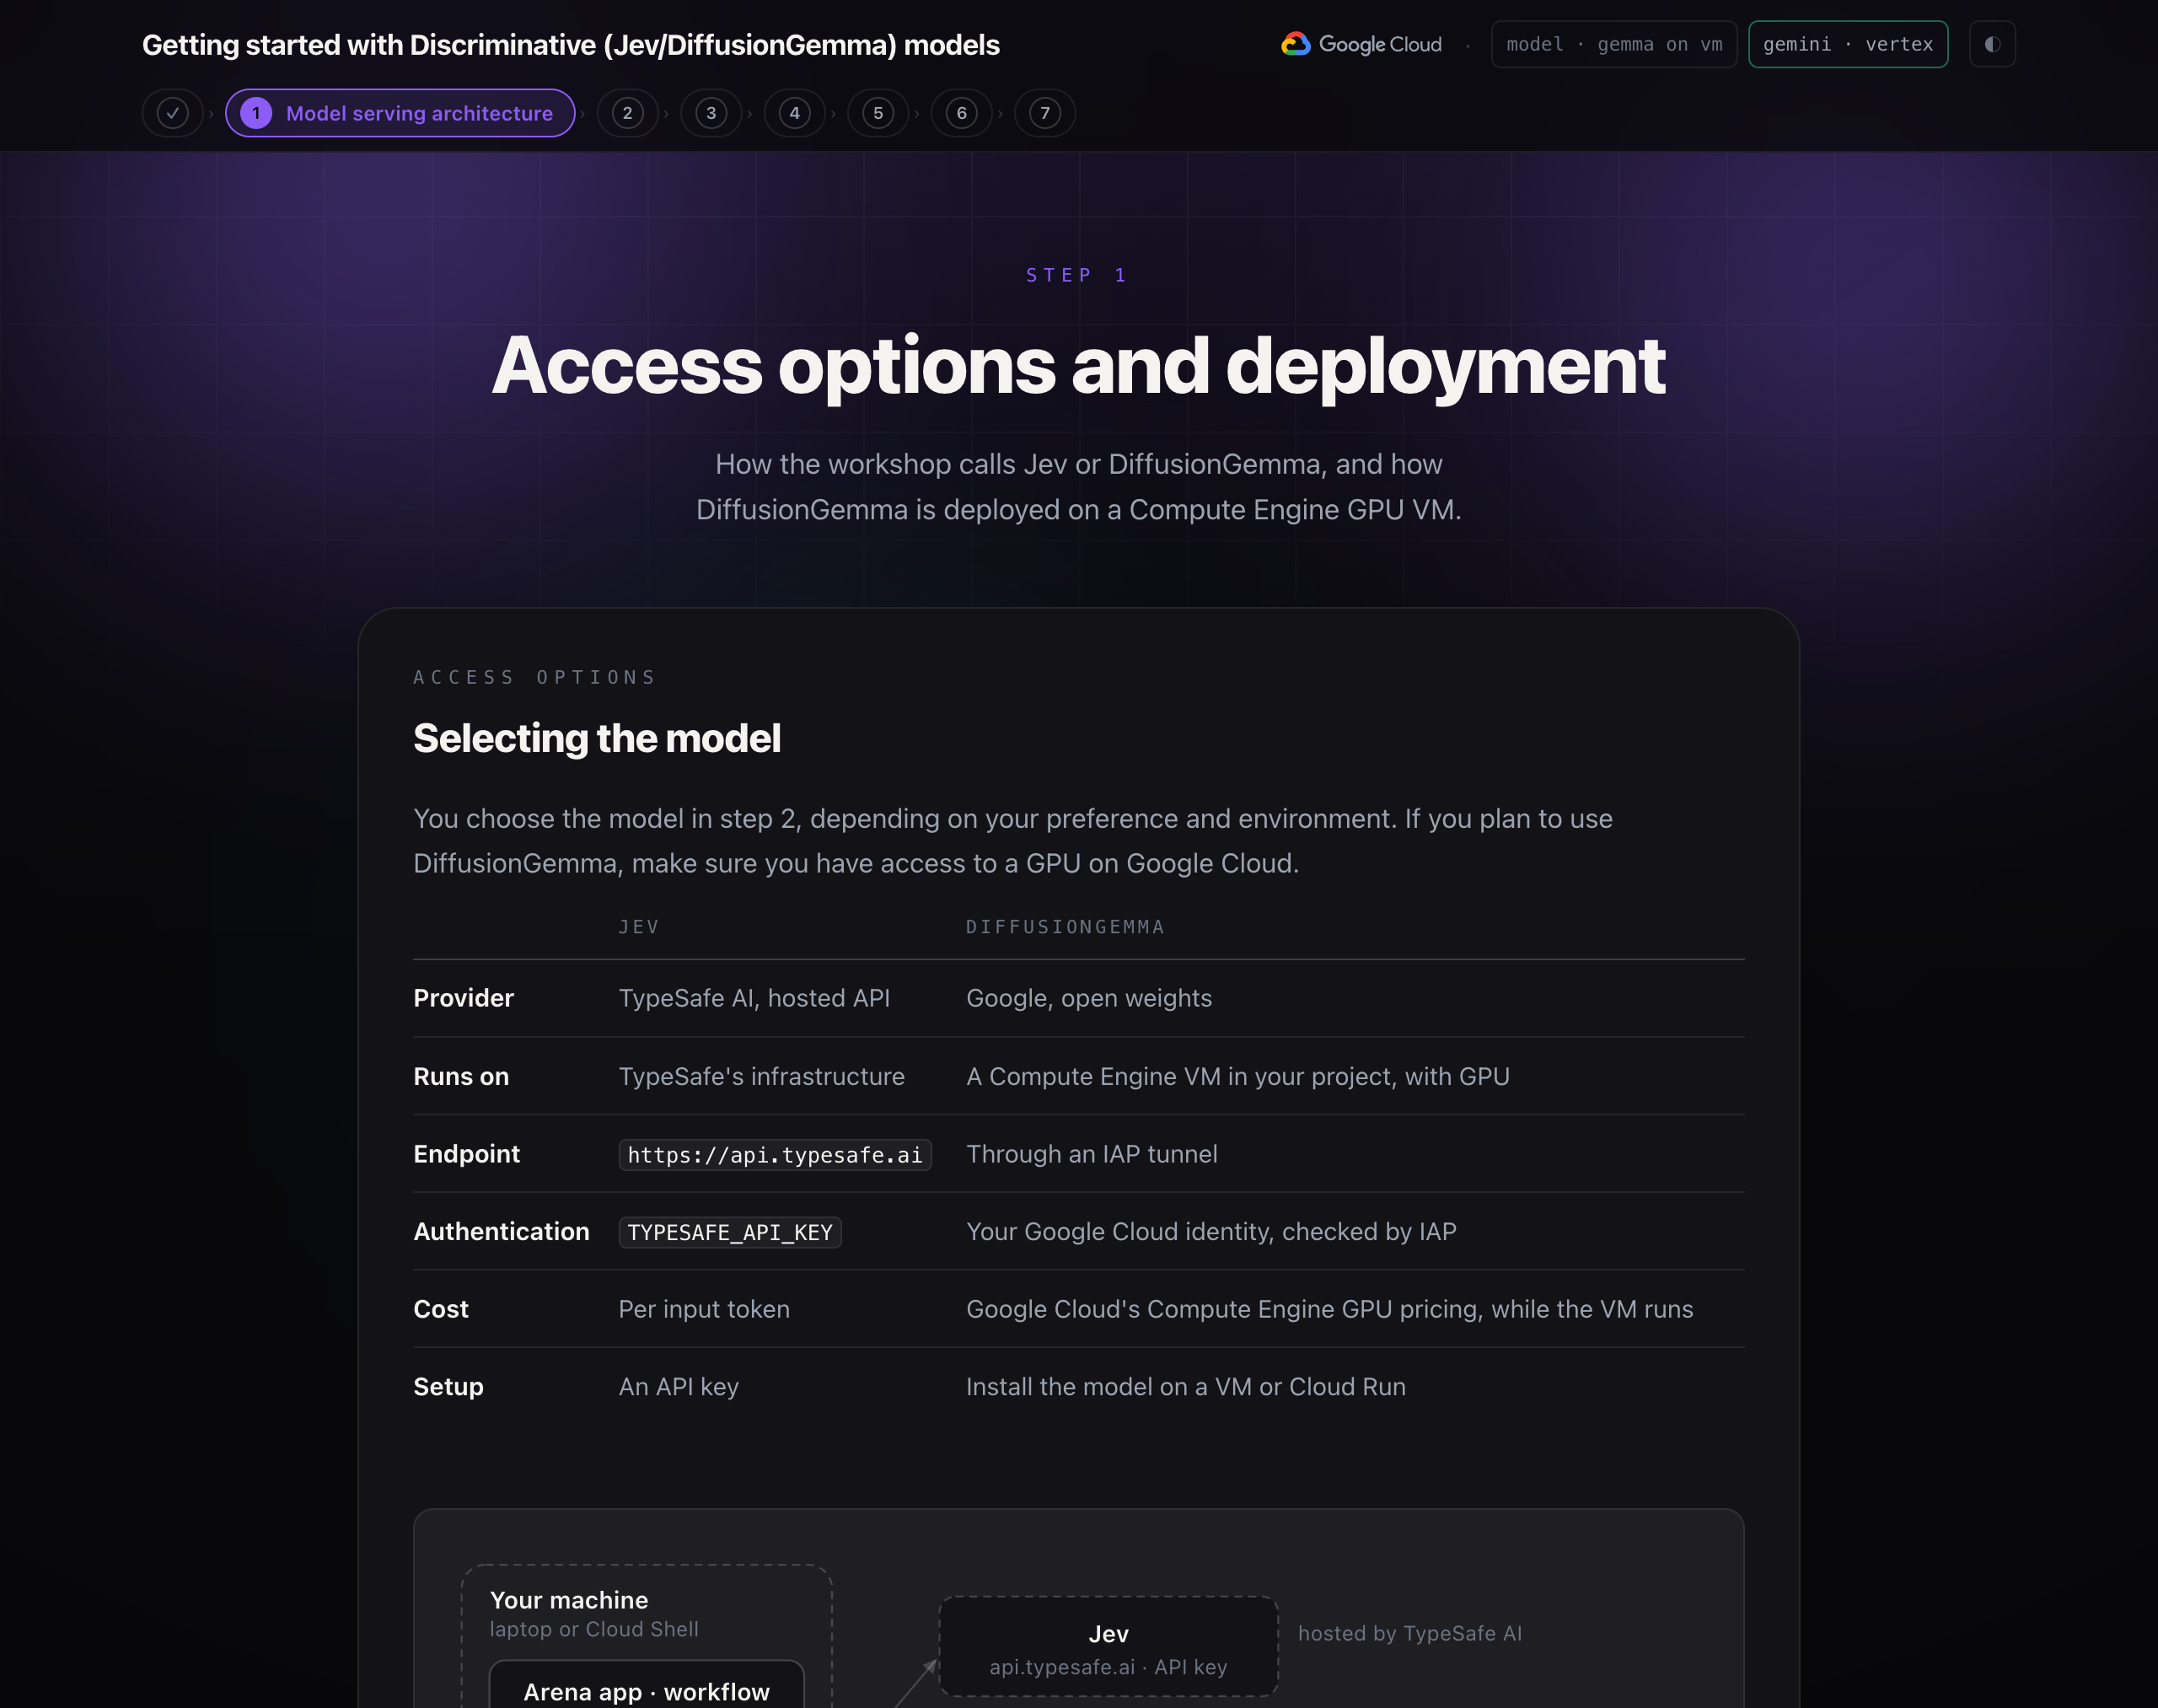
คุณเลือกโมเดลได้ในขั้นตอนที่ 2 โดยขึ้นอยู่กับความต้องการและสภาพแวดล้อม หากวางแผนที่จะใช้ DiffusionGemma โปรดตรวจสอบว่าคุณมีสิทธิ์เข้าถึง GPU ใน Google Cloud
เจฟ | DiffusionGemma | |
ผู้ให้บริการ | TypeSafe AI, API ที่โฮสต์ | Google เปิดน้ำหนัก |
ทำงานบน | โครงสร้างพื้นฐานของ TypeSafe | VM ของ Compute Engine ในโปรเจ็กต์ของคุณที่มี GPU |
อุปกรณ์ปลายทาง |
| ผ่านอุโมงค์ IAP |
การตรวจสอบสิทธิ์ |
| ข้อมูลประจำตัวใน Google Cloud ที่ IAP ตรวจสอบ |
ค่าใช้จ่าย | ต่อโทเค็นอินพุต | ราคา GPU ของ Compute Engine ใน Google Cloud ขณะที่ VM ทำงาน |
ตั้งค่า | คีย์ API | ติดตั้งโมเดลใน VM หรือ Cloud Run |
โฟลว์ข้อมูล
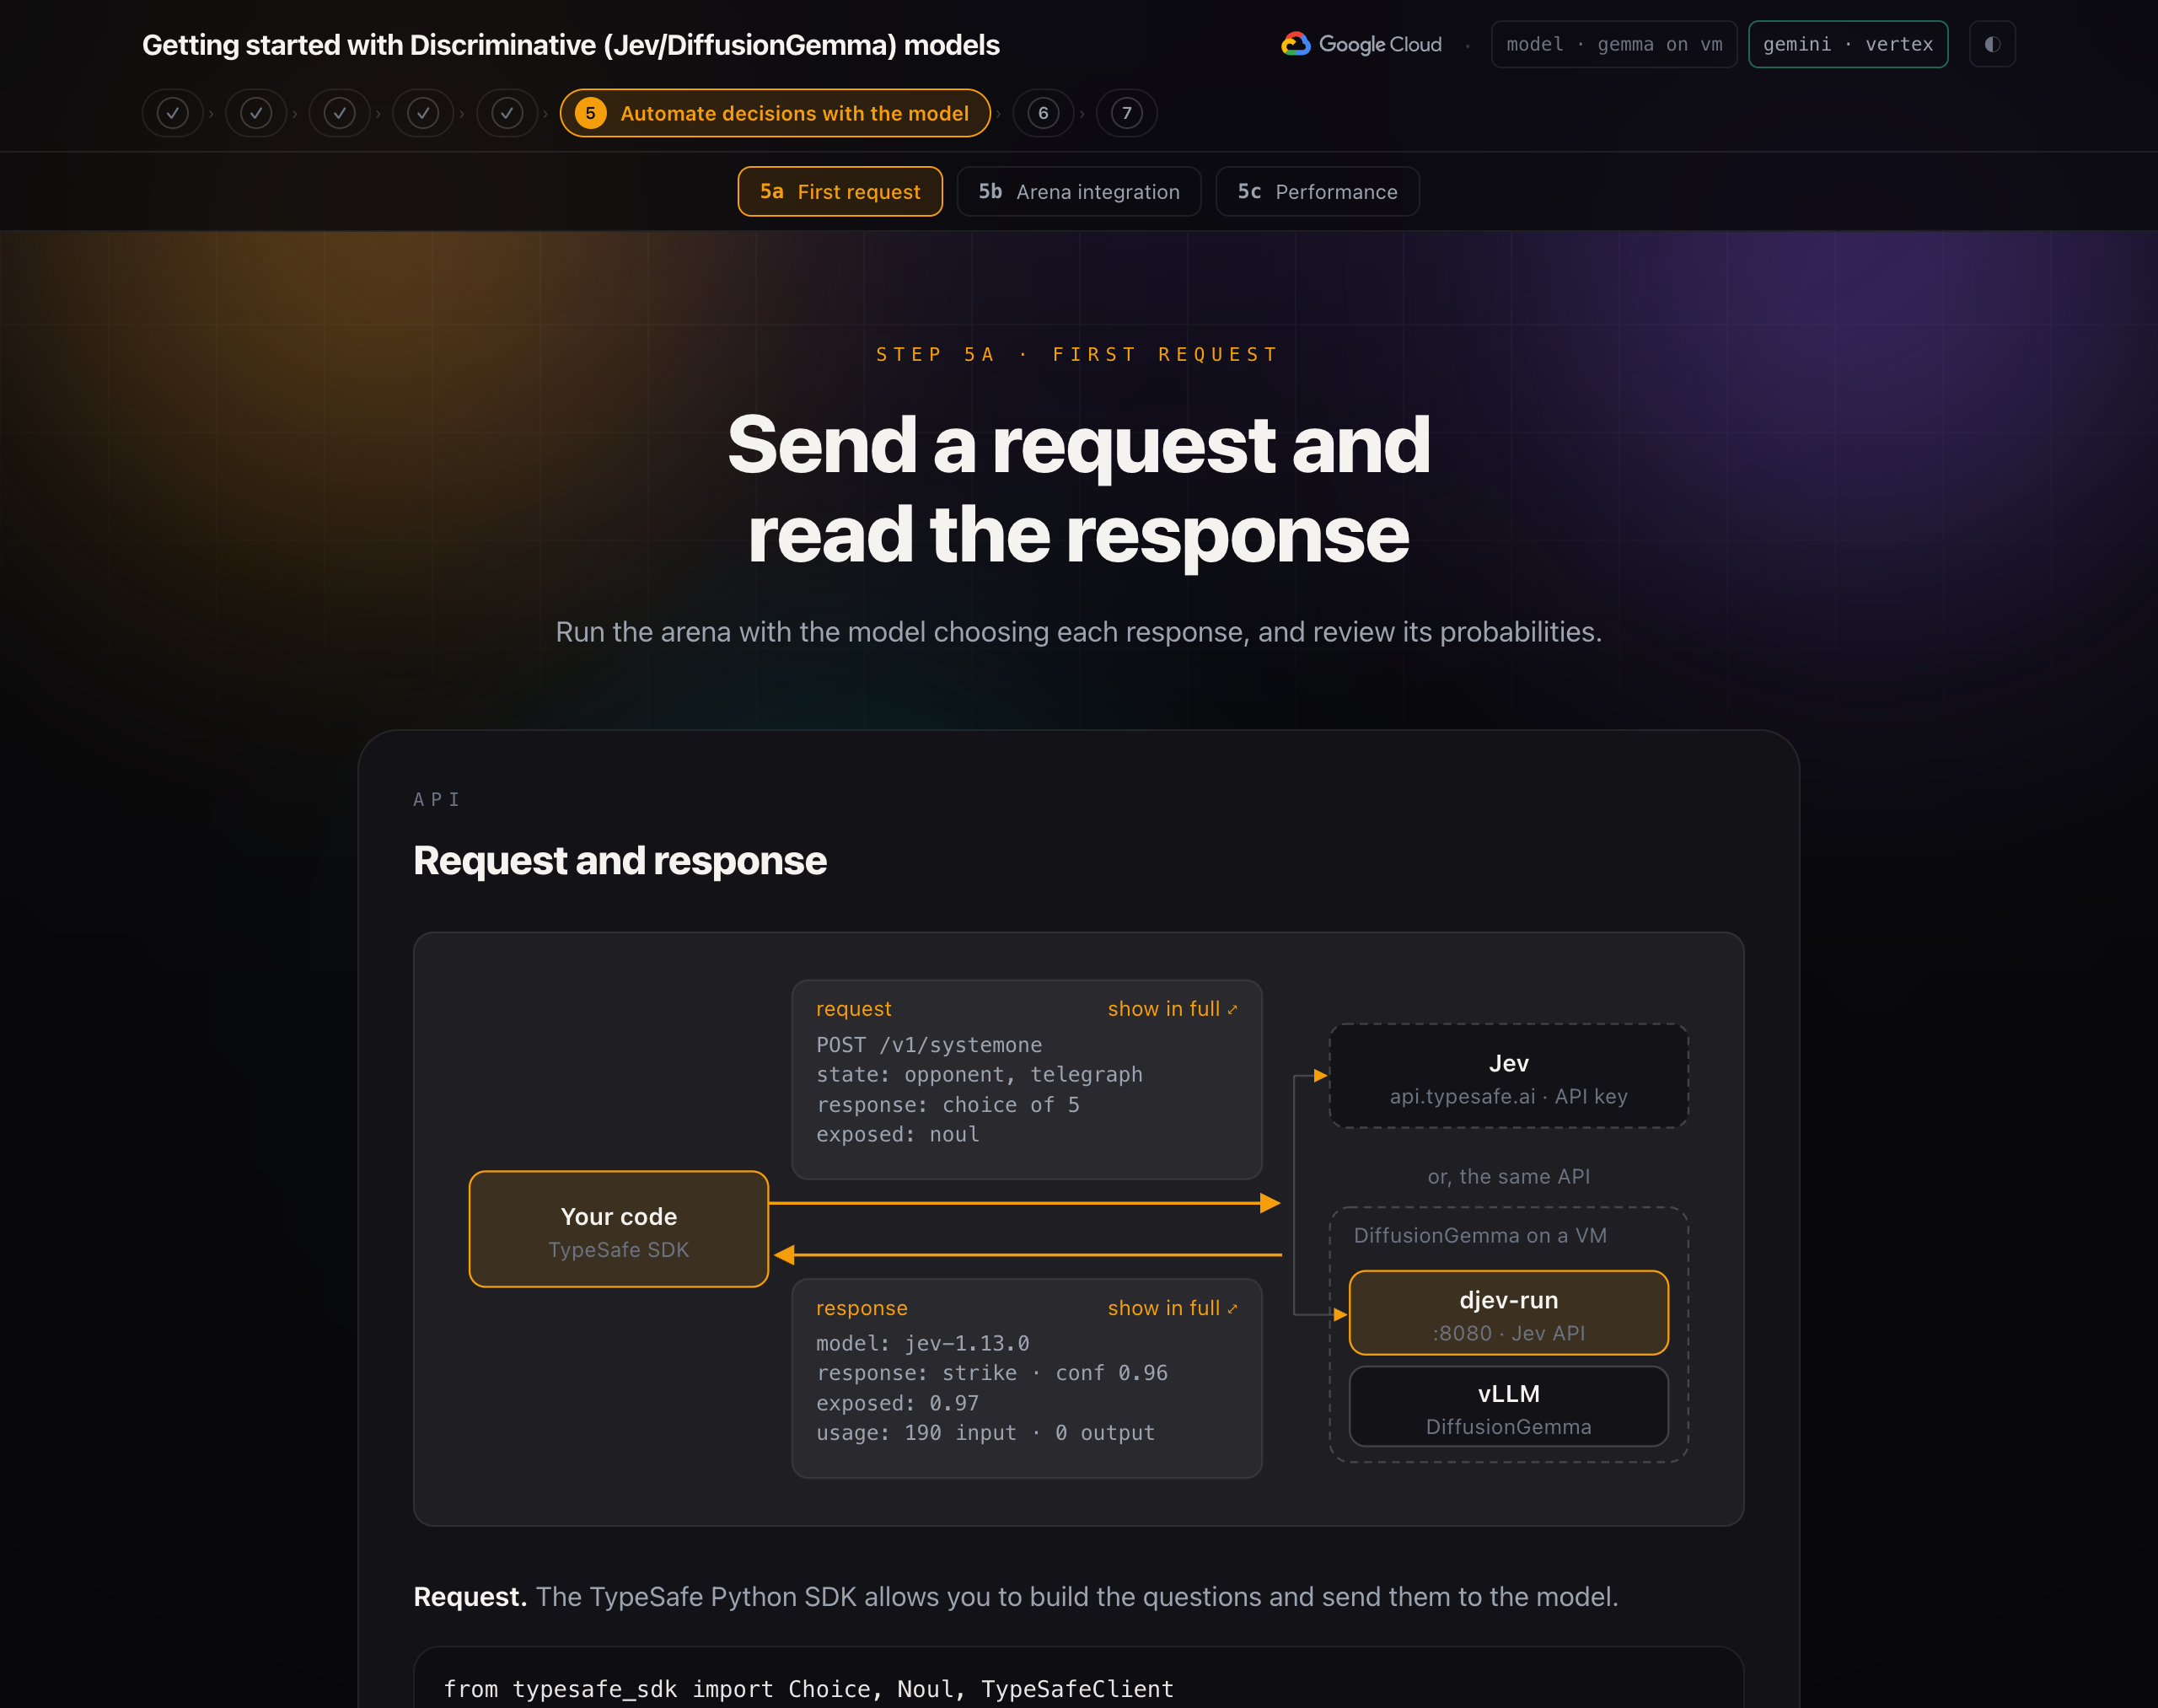
- แอปเวทีหรือเวิร์กโฟลว์ ADK จะสร้างคำขอ ซึ่งประกอบด้วยสถานะ (สิ่งที่คู่ต่อสู้ทำ) และคำถาม 3 ข้อ
- SDK ของ TypeSafe จะส่งเป็น
POST /v1/systemoneไปยัง URL ฐานที่กำหนดค่าไว้ - สำหรับ Jev คำขอจะส่งผ่าน HTTPS ไปยัง
api.typesafe.aiโดยมีคีย์ API เป็นโทเค็นผู้ถือ - สำหรับ DiffusionGemma คำขอจะส่งไปยัง
localhost:8096gcloud compute start-iap-tunnelกระบวนการเบื้องหลังจะส่งต่อผ่าน Identity-Aware Proxy ซึ่งจะตรวจสอบข้อมูลประจำตัว Google ของคุณไปยังพอร์ต 8080 ใน VM - ใน VM นั้น djev-run จะรับคำขอ เรียกใช้ DiffusionGemma ผ่าน vLLM บน GPU และอ่านความน่าจะเป็นของแต่ละตัวเลือกที่อนุญาต
- ทั้ง 2 แบ็กเอนด์จะส่งการตอบกลับเดียวกัน นั่นคือคำตอบต่อคำถาม โดยมีคะแนนความน่าจะเป็นและความเชื่อมั่น รหัสเวิร์กช็อปจะใช้เกณฑ์และดำเนินการ
DiffusionGemma ใน Compute Engine
scripts/setup_gemma.sh จะสร้างสิ่งต่อไปนี้ในโปรเจ็กต์
- ตรวจสอบว่าภูมิภาคมีโควต้าสำหรับ GPU
- เปิดใช้ API ของ Compute Engine และ IAP รวมถึงสร้างกฎไฟร์วอลล์
allow-iap-djevโดยจะอนุญาตเฉพาะช่วงที่อยู่ IAP ในพอร์ต 22 และ 8080 - สร้าง VM
djev-l4: ประเภทเครื่องg2-standard-4(4 vCPU, หน่วยความจำ 16 GB), GPU ขนาด 24 GB, ดิสก์ขนาด 100 GB และอิมเมจ Deep Learning VM ที่มีไดรเวอร์ NVIDIA 580 หากโซนไม่มีความจุ GPU ระบบจะลองใช้โซนถัดไป - ในการบูตครั้งแรก สคริปต์เริ่มต้นของ VM จะติดตั้ง Docker และชุดเครื่องมือคอนเทนเนอร์ NVIDIA ดึงอิมเมจคอนเทนเนอร์ djev-run ดาวน์โหลดน้ำหนักจาก Hugging Face (17.5 GB) และเริ่มคอนเทนเนอร์ที่มีสิทธิ์เข้าถึง GPU ในพอร์ต 8080 โดยจะใช้เวลาประมาณ 15 นาที ส่วนการบูตในภายหลังจะใช้เวลาประมาณ 2 นาที
- เขียนการตั้งค่าการเชื่อมต่อไปยัง
.envและเปิดอุโมงค์
งาน | คำสั่ง |
หยุด VM (เก็บดิสก์ไว้) |
|
เริ่มอีกครั้ง |
|
ตรวจสอบอุโมงค์ |
|
ลบทุกอย่าง |
|
ตั้งค่าโมเดล
TypeSafe SDK
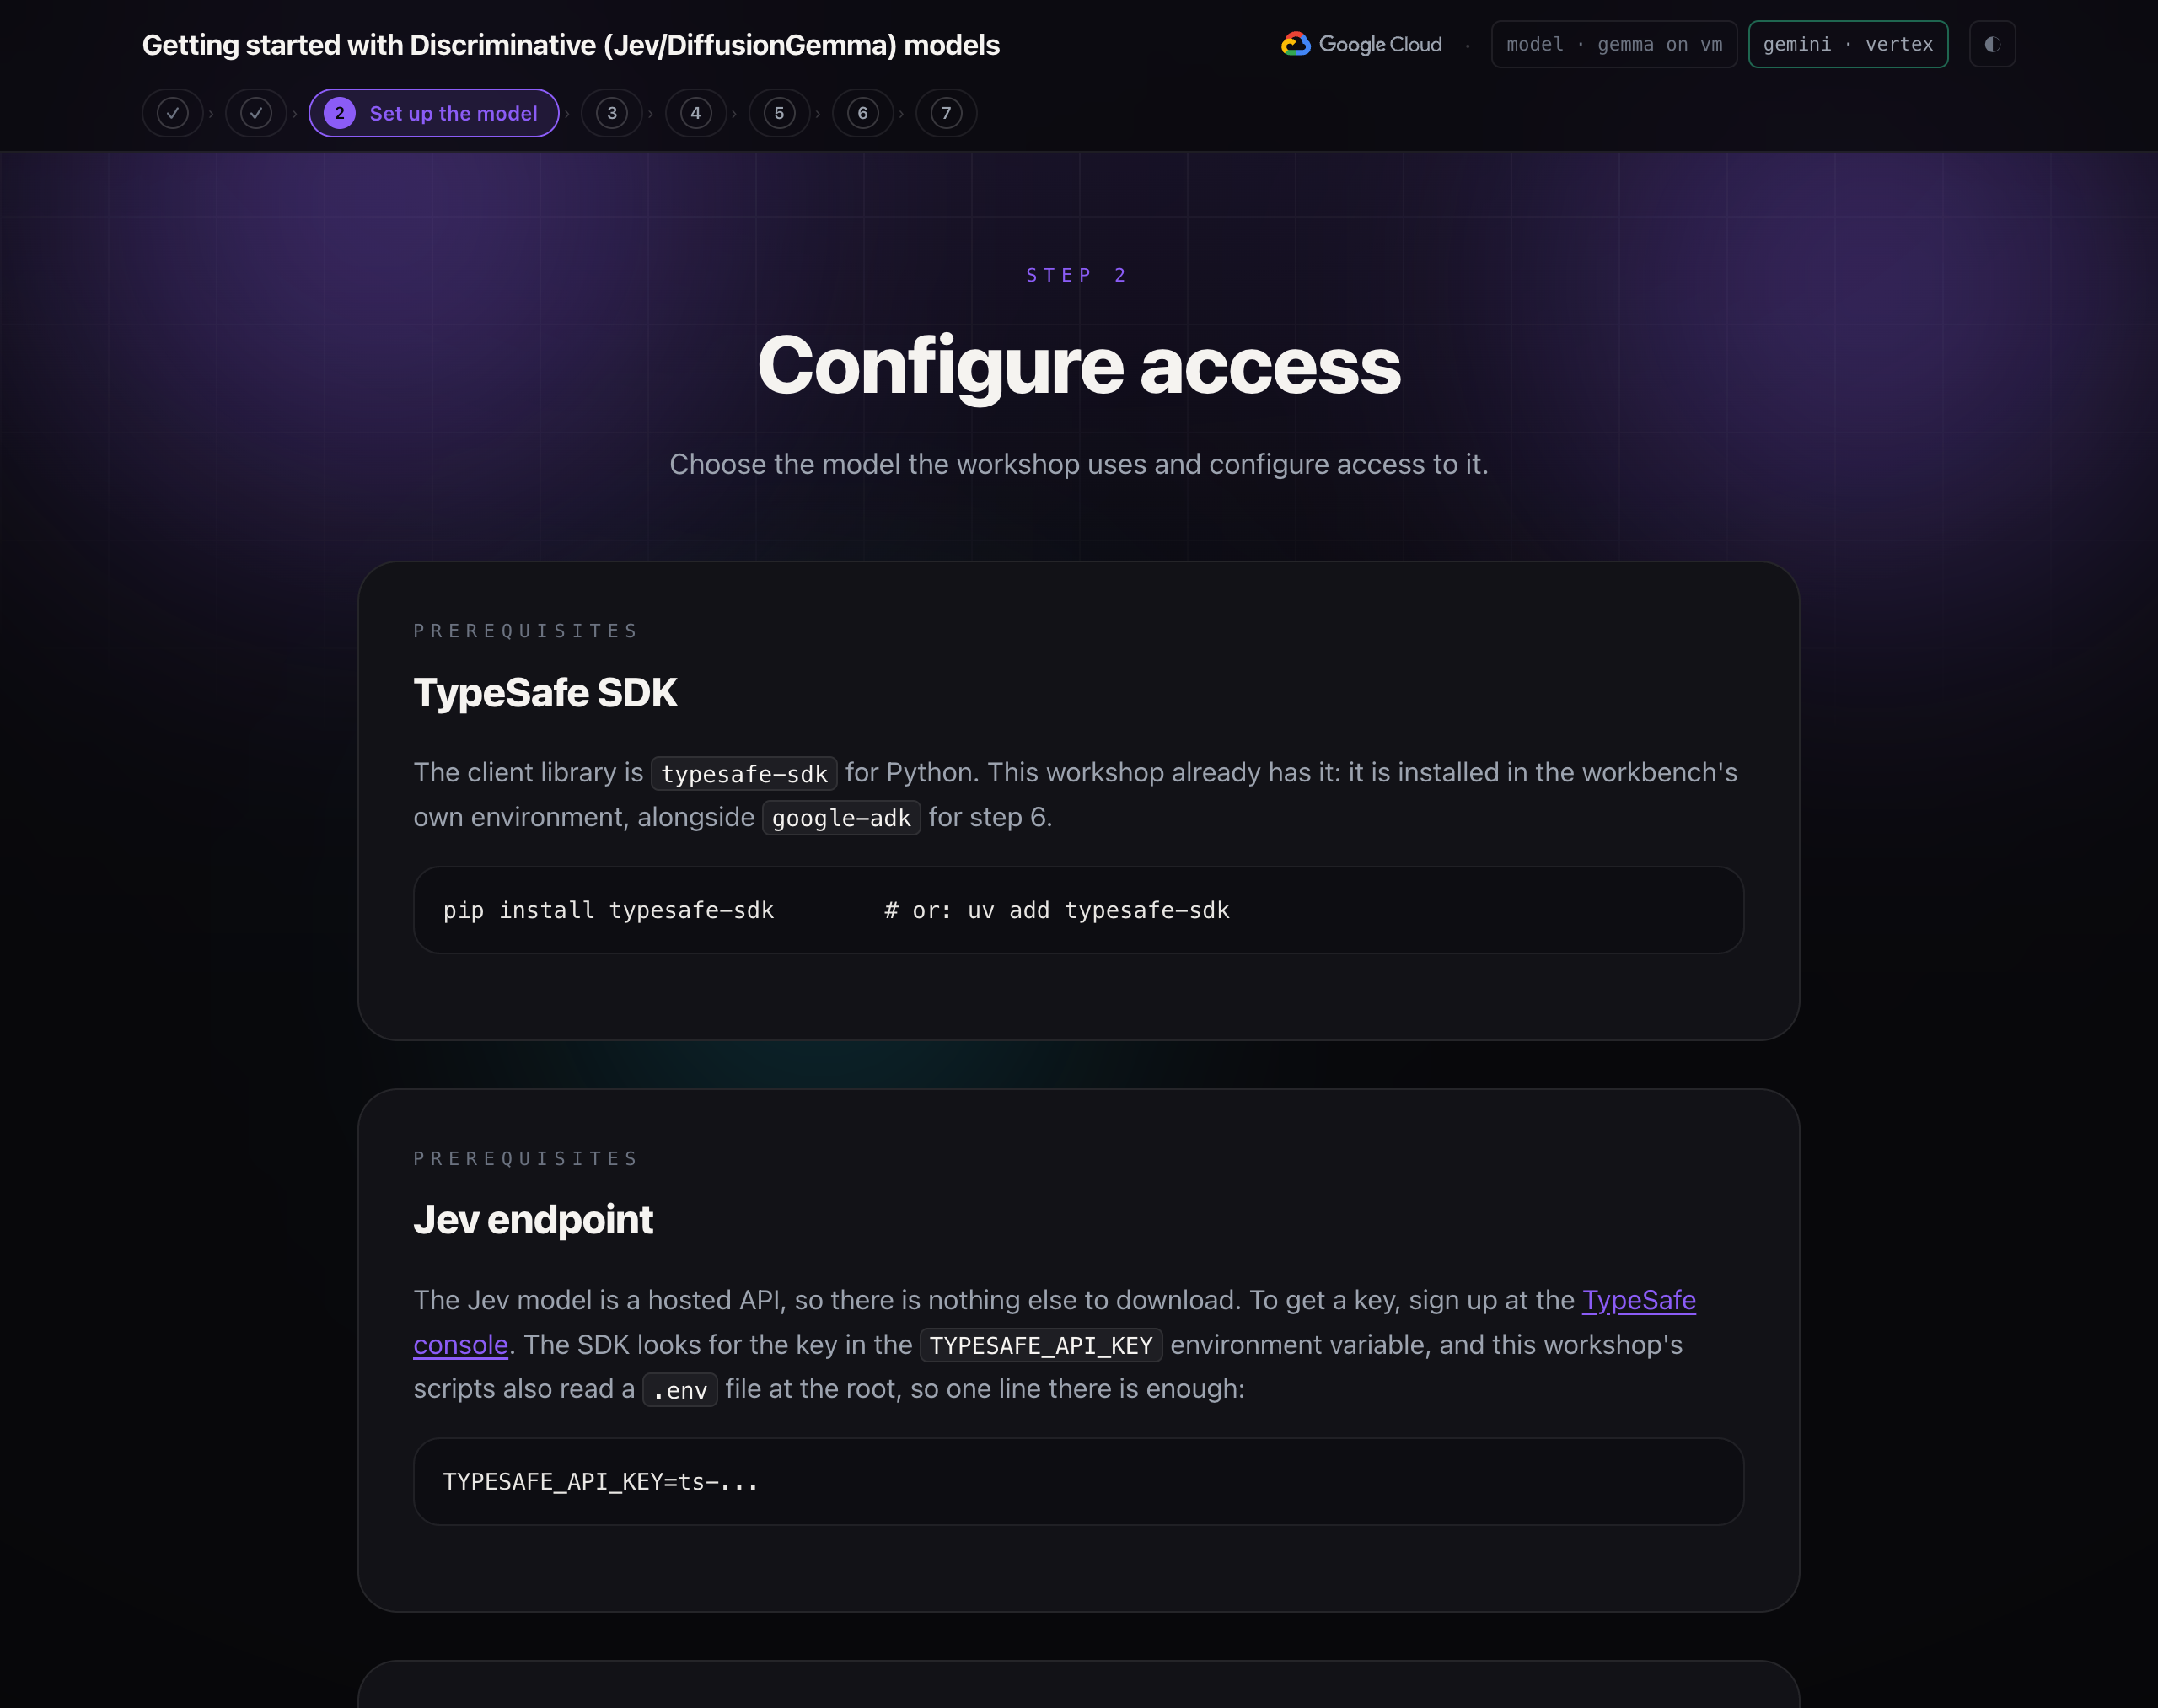
ไลบรารีของไคลเอ็นต์คือ typesafe-sdk สำหรับ Python เวิร์กช็อปนี้มีอยู่แล้ว โดยติดตั้งไว้ในสภาพแวดล้อมของเวิร์กเบนช์เองควบคู่กับ google-adk สำหรับขั้นตอนที่ 6
pip install typesafe-sdk # or: uv add typesafe-sdk
ปลายทาง Jev
โมเดล Jev เป็น API ที่โฮสต์ไว้ จึงไม่ต้องดาวน์โหลดอะไรเพิ่มเติม หากต้องการรับคีย์ ให้ลงชื่อสมัครใช้ที่คอนโซล TypeSafe SDK จะค้นหาคีย์ในตัวแปรสภาพแวดล้อม TYPESAFE_API_KEY และสคริปต์ของเวิร์กช็อปนี้จะอ่านไฟล์ .env ที่รูทด้วย ดังนั้นบรรทัดเดียวก็เพียงพอแล้ว
TYPESAFE_API_KEY=ts-...
ใช้ DiffusionGemma
djev-run จะนำ API ของโมเดล Discriminative มาใช้งานใหม่ โดยจะแสดงPOST /v1/systemoneปลายทางเดียวกัน พร้อมคำถามเกี่ยวกับ noul, choice และ score เดียวกันจาก DiffusionGemma ซึ่งเป็นโมเดลการแพร่กระจายแบบเปิดของ Google DeepMind (พารามิเตอร์ทั้งหมด 26 พันล้านรายการ พารามิเตอร์ที่ใช้งานอยู่ประมาณ 4 พันล้านรายการ, Apache 2.0) เนื่องจากรูปแบบการส่งผ่านข้อมูลเหมือนกัน SDK ที่มี TypeSafe จึงสื่อสารกับเซิร์ฟเวอร์ได้โดยไม่ต้องเปลี่ยนแปลง
หากเลือก DiffusionGemma ในแบบฝึกหัด ระบบจะเรียกใช้ใน GPU ใน VM ในโปรเจ็กต์ที่อยู่ในระบบคลาวด์ Google Cloud ของคุณเอง และข้อความในปุ่มที่ด้านขวาบนจะระบุว่า gemma ใน vm เวิร์กเบนช์จะเข้าถึงผ่านอุโมงค์ IAP ส่วนตัว และพอร์ตของโมเดลจะไม่เปิดให้เข้าถึงอินเทอร์เน็ต ขั้นตอนที่ 1 อธิบายสถาปัตยกรรมทั้งหมด
เหตุผลที่โมเดลการแพร่กระจายทำเช่นนี้ได้: โมเดลจะเติมตำแหน่งทั้งบล็อกพร้อมกัน โดยทุกตำแหน่งจะเห็นอินพุตทั้งหมด ดังนั้นจึงอ่านความน่าจะเป็นของแต่ละตัวเลือกที่อนุญาตได้ในขั้นตอนเดียว โมเดลภาษาปกติจะสร้างโทเค็นทีละรายการและต้องสุ่มตัวอย่างซ้ำๆ
เล่นเกมด้วยตนเอง
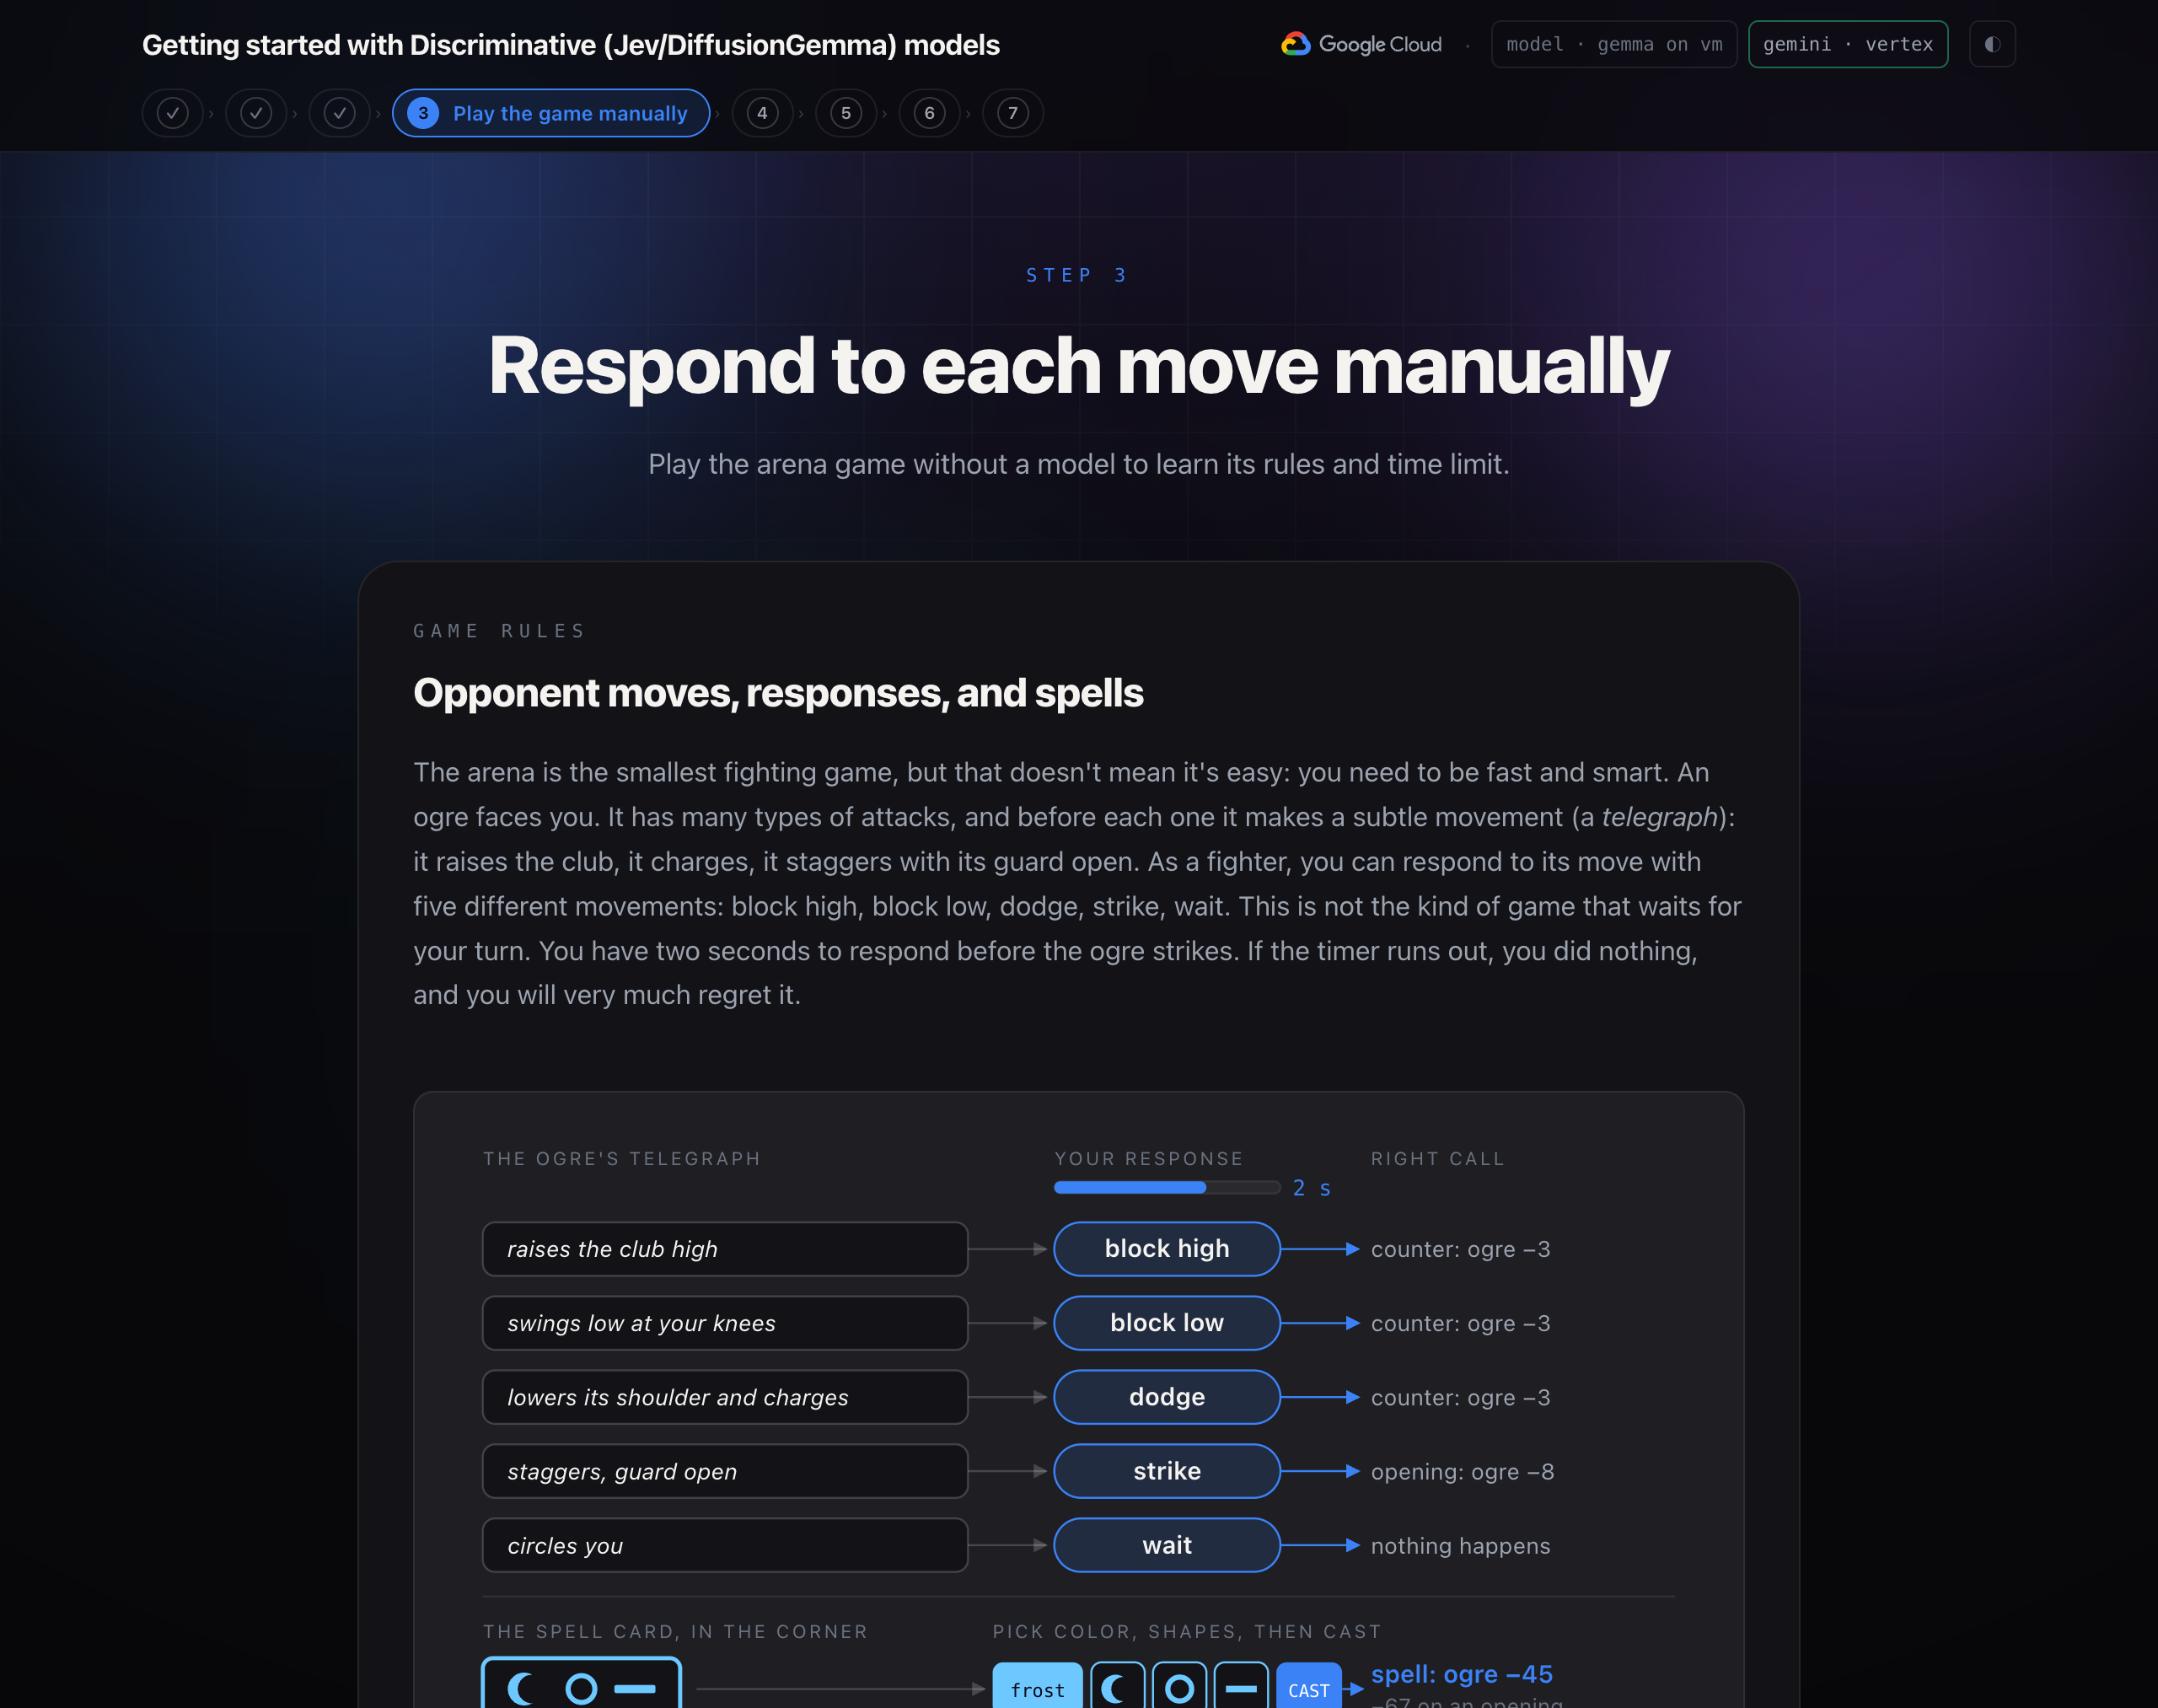
อารีน่าเป็นเกมต่อสู้ที่เล็กที่สุด แต่ก็ไม่ได้หมายความว่าเล่นง่าย คุณต้องรวดเร็วและฉลาด ยักษ์หันหน้ามาทางคุณ มันมีการโจมตีหลายประเภท และก่อนการโจมตีแต่ละครั้งมันจะเคลื่อนไหวเล็กน้อย (การบอกล่วงหน้า) เช่น ยกกระบอง ชาร์จ หรือเซด้วยการ์ดที่เปิดอยู่ ในฐานะนักสู้ คุณสามารถตอบโต้การเคลื่อนไหวของคู่ต่อสู้ด้วยการเคลื่อนไหว 5 แบบ ได้แก่ บล็อกสูง บล็อกต่ำ หลบ โจมตี และรอ เกมนี้ไม่ใช่เกมที่ต้องรอถึงตาคุณ คุณมีเวลา 2 วินาทีในการตอบก่อนที่ยักษ์จะโจมตี หากหมดเวลาแล้วคุณยังไม่ได้ทำอะไร คุณจะต้องเสียใจอย่างแน่นอน
ที่มุมซ้ายบนของวงแหวนจะมีการ์ดเวทมนตร์ ซึ่งเป็นการ์ดสีที่มีรูปร่าง 3 แบบ มีเพียงคาถาที่ตรงกันเท่านั้นที่จะสร้างความเสียหายจริงได้ ในเกม คุณสามารถร่ายเวทมนตร์ด้วยปุ่มใต้การต่อสู้ โดยเลือกสีของการ์ด จากนั้นเลือกรูปร่างของการ์ดจากซ้ายไปขวา แล้วกดร่าย นาฬิกาจะเดินต่อไปขณะที่คุณเลือก ดังนั้นคุณต้องสร้างคาถาและตอบโต้การโจมตีของยักษ์ไปพร้อมๆ กัน ปุ่ม 1 ถึง 5 ยังคงใช้ตอบแต่ละการเคลื่อนไหวได้ การร่ายเวทมนตร์ผิดพลาดจะทำให้เกิดเสียงฟู่ ในขั้นตอนที่ 6 Gemini จะอ่านการ์ดเวทมนตร์ให้คุณ
ประเด็นสำคัญ: การต่อสู้คือการตัดสินใจเล็กๆ น้อยๆ ที่มีกำหนดเวลาในแต่ละครั้ง ซึ่งเป็นลักษณะของการทำงานอัตโนมัติของซอฟต์แวร์ส่วนใหญ่จริงๆ
แนวคิดของโมเดลการเลือกปฏิบัติ
การตัดสินใจในซอฟต์แวร์
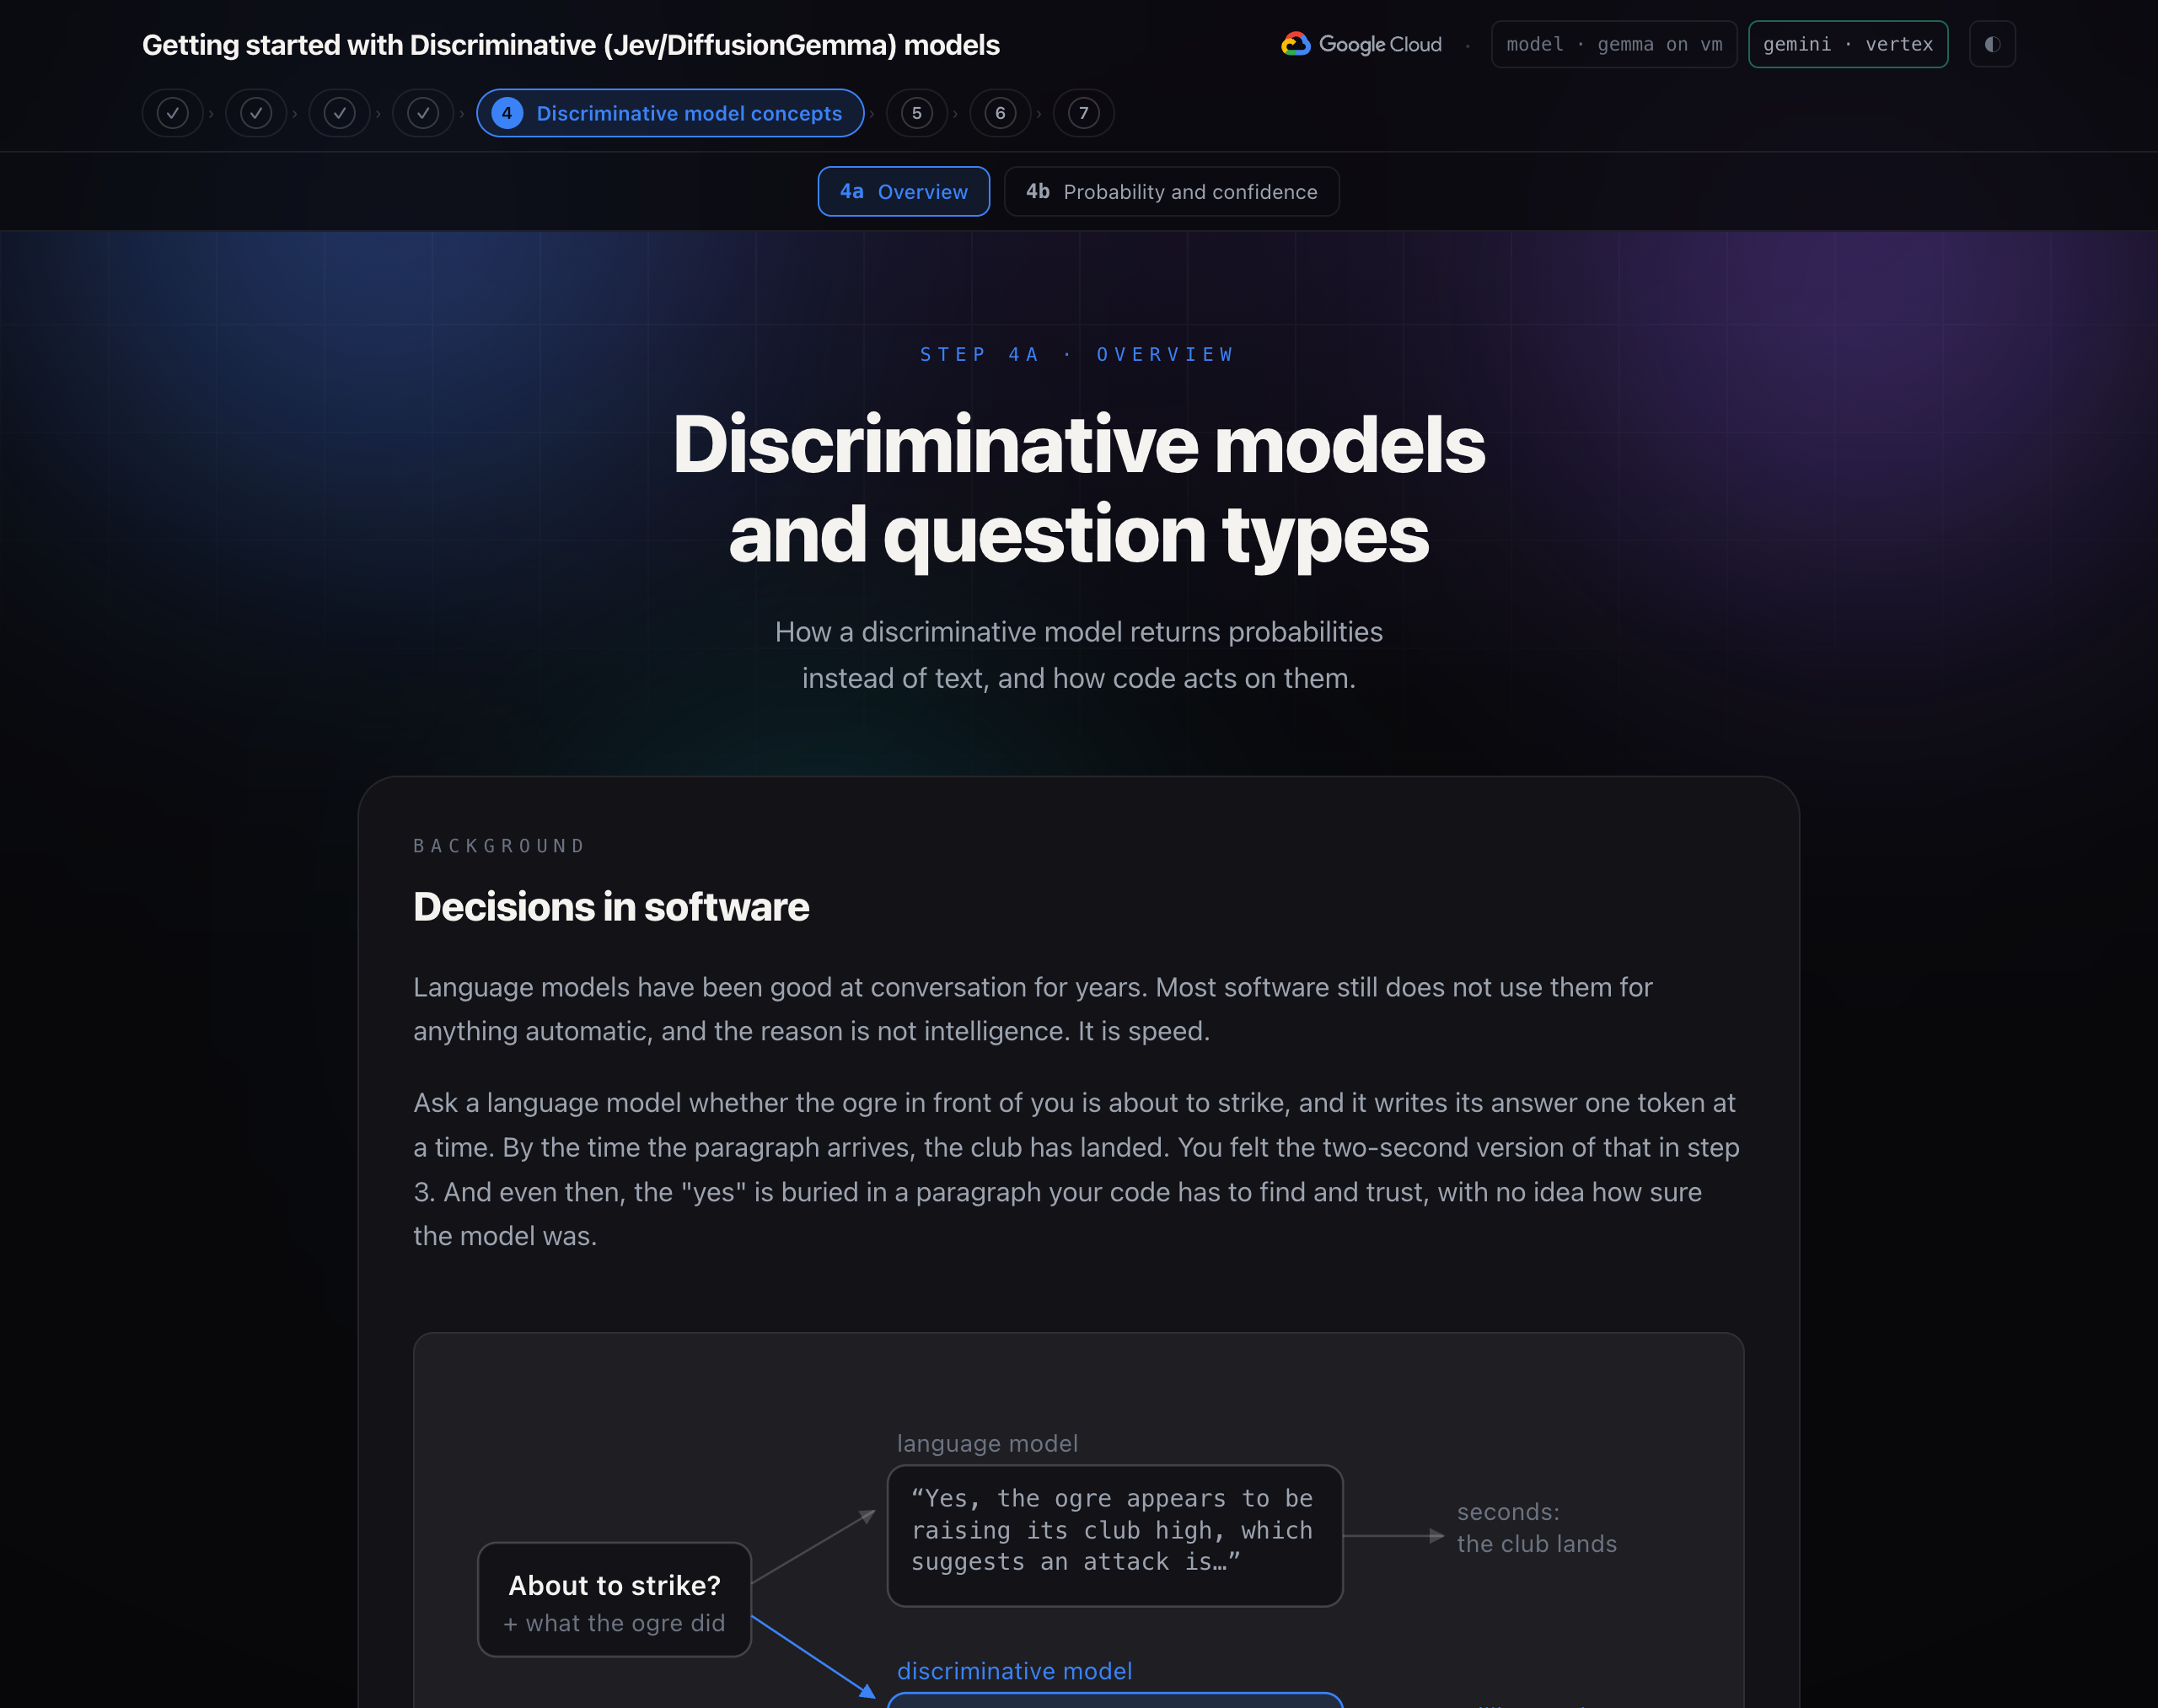
โมเดลภาษาสนทนาได้ดีมาหลายปีแล้ว ซอฟต์แวร์ส่วนใหญ่ยังคงไม่ได้ใช้ข้อมูลดังกล่าวเพื่อทำสิ่งใดๆ โดยอัตโนมัติ และเหตุผลก็ไม่ใช่เพราะความฉลาด นั่นคือความเร็ว
ถามโมเดลภาษาว่ายักษ์ที่อยู่ตรงหน้ากำลังจะโจมตีหรือไม่ แล้วโมเดลจะเขียนคำตอบทีละโทเค็น เมื่อถึงเวลาที่ย่อหน้ามาถึง สโมสรก็ลงจอดแล้ว คุณได้เห็นเวอร์ชัน 2 วินาทีของฟีเจอร์นี้ในขั้นตอนที่ 3 และถึงแม้จะทำได้ คำตอบ "ใช่" ก็จะซ่อนอยู่ในย่อหน้าที่โค้ดของคุณต้องค้นหาและเชื่อถือ โดยไม่รู้ว่าโมเดลมีความมั่นใจมากน้อยเพียงใด
โมเดลแยกแยะจะใช้สถานะและคำถามและคำตอบที่คุณพิมพ์ในครั้งเดียวในหน่วยมิลลิวินาที คำตอบแต่ละข้อมาพร้อมกับความน่าจะเป็นที่ปรับเทียบแล้ว โดย 0.9 หมายถึงถูกต้อง 9 ครั้งจาก 10 ครั้ง ไม่มีข้อความที่จะแยกวิเคราะห์และไม่มี JSON ที่จะดึงออกมาจากข้อความ
โมเดล System One และ System Two
ชื่อนี้มาจากหนังสือ Thinking, Fast and Slow ของ Daniel Kahneman ระบบ 2 คือการให้เหตุผลอย่างช้าๆ โดยไตร่ตรองทีละขั้นตอน ระบบ 1 ทำงานรวดเร็วและจับคู่รูปแบบ
โมเดลภาษาคือเครื่องจักรของ System Two โดยจะให้เหตุผลในโทเค็นทีละรายการ โมเดลแยกแยะเป็นโมเดลระบบที่ 1 ซึ่งไม่ได้ให้เหตุผลออกมา ไม่ได้สร้างอะไร และตอบทุกคำถามในรอบเดียว ด้วยเหตุนี้จึงรวดเร็ว (ประมาณ 70-500 มิลลิวินาที) และมีราคาถูก (เศษเสี้ยวของเซ็นต์ต่อการตัดสินใจ 1,000 ครั้ง)
ประเด็นสำคัญ: โมเดลภาษาจะเขียน โมเดลการตัดสินใจจะตัดสิน สิ่งที่ซอฟต์แวร์ส่วนใหญ่ต้องการจาก AI คือการตัดสินใจ
ข้อจำกัด
โมเดลแบบแยกแยะจะไม่สร้างข้อความ เขียนโค้ด สนทนา ทำเลขคณิต อ่านรูปภาพ หรือทำตามลำดับขั้นตอน
ในเวิร์กช็อปนี้ เราจะเลือกโมเดลแบบแยกแยะ 1 รายการ ดังนี้
- โมเดลการเลือกอย่างหนึ่งคือ Jev ซึ่งเป็น API ที่โฮสต์จาก TypeSafe AI และเปิดตัวในเดือนกันยายน 2026 โมเดลแรกคือ
jev-1.13ซึ่งเข้าถึงได้ผ่านนามแฝงjev-latestไม่มีน้ำหนักที่เผยแพร่ จึงมีการเรียกใช้ ไม่ใช่ดาวน์โหลด - Jev ไม่ใช่วิธีเดียวที่จะได้โมเดล System One DiffusionGemma ของ Google เป็นโมเดลแบบโอเพนเวทที่เขียนโทเค็นทั้งบล็อกแบบขนานแทนที่จะเขียนทีละโทเค็น และการส่งผ่านแบบขนานเดียวกันนั้นสามารถอ่านค่าความน่าจะเป็นในชุดตัวเลือกที่กำหนดได้ เซิร์ฟเวอร์โอเพนซอร์ส เช่น djev-run จะวาง API ที่แน่นอนของ Jev ไว้ด้านหน้า ดังนั้นทุกอย่างในเวิร์กช็อปนี้จึงทำงานกับ API ดังกล่าวโดยไม่มีการเปลี่ยนแปลง
สถานะและคำถาม: Choice, Score และ Noul
การเรียกใช้แต่ละครั้งจะส่งสถานะและคำถาม สถานะคือข้อความที่คุณต้องการให้ตัดสิน ซึ่งอาจเป็นสตริง ออบเจ็กต์ JSON หรือรายการ คำถามจะถามว่าคุณต้องการทราบอะไรเกี่ยวกับข้อความนั้น คำถามแต่ละข้อจะมีประเภทเป็นแบบตัวเลือก คะแนน หรือ Noul ระบบจะประมวลผลคำถามแบบคู่ขนาน ซึ่งช่วยให้ตอบกลับได้อย่างรวดเร็ว คุณเพิ่มคำถามหลายข้อได้หากต้องการ
- Choice จะเลือก 1 ตัวเลือกจากชุดที่คุณตั้งชื่อ โดยเลือกได้สูงสุด 255 ตัวเลือก คำตอบคือตัวเลือก ความน่าจะเป็นสำหรับทุกตัวเลือก และความมั่นใจ ใช้เมื่อตัวเลือกไม่มีลำดับระหว่างกัน เช่น บล็อกสูง บล็อกต่ำ หลบ โจมตี รอ
- คะแนนจะให้คะแนนรัฐตามระดับที่เรียงตามลำดับที่คุณอธิบาย โดยมีตั้งแต่ 2 ถึง 10 ระดับ คำตอบคือตำแหน่งตามสเกล (ทศนิยม เช่น 1.4 หมายถึง "อยู่ระหว่าง 1 กับ 2 แต่ใกล้ 1 มากกว่า") ความน่าจะเป็นของแต่ละระดับ และความเชื่อมั่น ใช้เมื่อคำตอบเป็นเรื่องของระดับความรุนแรงของผลกระทบที่เข้ามา
- Choice และ Score จะแสดงความน่าจะเป็นสำหรับแต่ละตัวเลือกและความมั่นใจ ความแตกต่างคือคำตอบหลัก Choice จะแสดงตัวเลือกที่มีแนวโน้มมากที่สุด คะแนนจะถือว่าตัวเลือกเป็นระดับที่เรียงลำดับแล้ว และจะแสดงค่าเฉลี่ยแบบถ่วงน้ำหนักตามความน่าจะเป็น ซึ่งอาจอยู่ระหว่าง 2 ระดับ เมื่อไม่มี 0.05, เล็กน้อย 0.55 และมาก 0.40 คำตอบของ Choice คือ "เล็กน้อย" และคำตอบของ Score คือ 1.35 ซึ่งอยู่ระหว่างเล็กน้อยกับมาก โดยสังเวียนจะใช้ค่าดังกล่าว:
choose()ถือว่าคะแนนอันตรายตั้งแต่ 1.5 ขึ้นไปเป็นการโจมตีที่รุนแรง
- Choice และ Score จะแสดงความน่าจะเป็นสำหรับแต่ละตัวเลือกและความมั่นใจ ความแตกต่างคือคำตอบหลัก Choice จะแสดงตัวเลือกที่มีแนวโน้มมากที่สุด คะแนนจะถือว่าตัวเลือกเป็นระดับที่เรียงลำดับแล้ว และจะแสดงค่าเฉลี่ยแบบถ่วงน้ำหนักตามความน่าจะเป็น ซึ่งอาจอยู่ระหว่าง 2 ระดับ เมื่อไม่มี 0.05, เล็กน้อย 0.55 และมาก 0.40 คำตอบของ Choice คือ "เล็กน้อย" และคำตอบของ Score คือ 1.35 ซึ่งอยู่ระหว่างเล็กน้อยกับมาก โดยสังเวียนจะใช้ค่าดังกล่าว:
- Noul จะถามคำถามแบบใช่/ไม่ใช่และแสดงความน่าจะเป็นที่คำตอบจะเป็น "ใช่" ค่าที่ใกล้ 1 คือ "ใช่" ค่าที่ใกล้ 0 คือ "ไม่ใช่" และค่าที่ใกล้ 0.5 คือ "อาจเป็นอย่างใดอย่างหนึ่ง" ไม่มีความเชื่อมั่นแยกต่างหาก เนื่องจากความน่าจะเป็นคือระดับความเชื่อมั่น
เขียนคำถามที่ตรงประเด็น
โมเดลแยกแยะจะทำงานได้ดีที่สุดเมื่อคำถามถามถึงสิ่งหนึ่งๆ ที่เฉพาะเจาะจงและมีขอบเขตที่ชัดเจน "เกิดอะไรขึ้น" จะแสดงคำตอบที่มีความเป็นไปได้และมีความน่าเชื่อถือต่ำ "การตอบสนองที่ถูกต้องคืออะไร" "คู่ต่อสู้เปิดช่องโหว่หรือไม่" และ "การโจมตีนี้จะรุนแรงแค่ไหน" จะแสดงคำตอบที่มุ่งเน้น 3 รายการซึ่งโค้ดของคุณรวมเข้าด้วยกัน
คำอธิบายเกี่ยวกับตัวเลือกและระดับต่างๆ มีราคาถูกและมีความสำคัญ กฎที่คุณอ่านในขั้นตอนที่ 3 จะกลายเป็นคำอธิบายตัวเลือก: block_high: "Raise the shield. Right against an overhead or a high swing." นั่นคือวิธีที่โมเดลแยกแยะเรียนรู้กฎของการต่อสู้ ณ เวลาที่ส่งคำขอในแต่ละบรรทัด และตัวเลือกอาจเปลี่ยนแปลงตามสถานการณ์ โดยอารีน่าจะเสนอcastเมื่อเวทมนตร์พร้อมใช้งานเท่านั้น
ความน่าจะเป็นและความเชื่อมั่น
คำตอบแบบตัวเลือกไม่ใช่ป้ายกำกับ ซึ่งเป็นการกระจายตัวของป้ายกำกับ และป้ายกำกับก็คือแถบที่สูงที่สุด
โมเดลรับหมายเลขได้อย่างไร โดยใช้ขั้นตอนเดียวกับที่โมเดลภาษาใช้เพื่อเลือกคำถัดไป Transformer จะอ่านข้อความและให้คะแนนดิบแก่โทเค็นทุกรายการในคำศัพท์ที่ตำแหน่งหนึ่ง ซึ่งคะแนนนี้เรียกว่า Logit Logit ที่สูงขึ้นหมายความว่าโทเค็นเหมาะกับตำแหน่งนั้นๆ มากขึ้น softmax จะเปลี่ยน Logit เป็นความน่าจะเป็นที่รวมกันได้ 1 จากนั้นโมเดลภาษาจะเลือกโทเค็น 1 รายการ เพิ่มลงในข้อความ และทำซ้ำ โมเดลแบบแยกแยะจะหยุดหลังจากคำนวณความน่าจะเป็น
ช่องว่างคือช่องว่างในแบบฟอร์มคำตอบ เซิร์ฟเวอร์จะเขียนแบบฟอร์มเอง เช่น response: ▢ และเว้นช่องว่าง 1 ช่องต่อคำถาม หน้าที่เดียวของโมเดลคือการให้คะแนนสิ่งที่ควรอยู่ในแต่ละช่องว่าง
- พรอมต์จะเก็บสถานะและคำถามแต่ละข้อ โดยมีคำตอบที่อนุญาตทั้งหมดเป็นป้ายกำกับแบบสั้น เช่น
aสำหรับ block_high,bสำหรับ block_low และอื่นๆ - เซิร์ฟเวอร์จะเพิ่มแบบฟอร์มคำตอบ โดยมีช่องว่าง 1 ช่องต่อคำถาม
- โมเดลจะอ่านพรอมต์และแบบฟอร์มในรอบเดียว และให้ลอจิทแก่โทเค็นทุกรายการในช่องว่างแต่ละช่อง โมเดลการแพร่กระจายจะเห็นแบบฟอร์มทั้งหมดในครั้งเดียวและให้คะแนนช่องว่างทั้งหมดพร้อมกัน
- เซิร์ฟเวอร์จะเก็บเฉพาะ Logit ของป้ายกำกับที่อนุญาตและใช้ Softmax กับป้ายกำกับเหล่านั้น คำตอบที่อนุญาตจึงรวมกันได้ 1
- หากการอ่านดูไม่แน่นอน เซิร์ฟเวอร์จะอ่านอีกครั้งจากจุดเริ่มต้นแบบสุ่มอื่นและหาค่าเฉลี่ยของการอ่าน
ความเชื่อมั่นคือตัวเลขที่บอกว่าคำตอบนั้นมีความแน่นอนเพียงใด โดย TypeSafe จะคำนวณจากวิธีที่กระจายความน่าจะเป็นในตัวเลือกต่างๆ การเลือกตัวเลือกเดียวทั้งหมดจะให้ค่าเป็น 1 และการกระจายอย่างสม่ำเสมอจะให้ค่าเป็น 0 สำหรับ 3 ตัวเลือก จะเป็น (3 × ค่าสูงสุด − 1) / 2
ฝึก Jev ของ TypeSafe สำหรับความน่าจะเป็นที่ปรับเทียบแล้ว ความน่าจะเป็นจะตรงกับความถี่ที่คำตอบถูกต้อง ในโมเดลที่ได้รับการปรับเทียบ คำตอบที่ได้ที่ 0.7 จะถูกต้องประมาณ 70% ของเวลาทั้งหมด ดังนั้นเกณฑ์ความเชื่อมั่นจึงเป็นเกณฑ์ที่ระบุความถี่ที่คุณยอมรับคำตอบที่ไม่ถูกต้อง เซิร์ฟเวอร์ DiffusionGemma ในเวิร์กช็อปนี้จะรายงานความน่าจะเป็นสูงสุดเป็นความมั่นใจ โดยเฉลี่ยจากการอ่าน เมื่อค่าที่อ่านได้ไม่ตรงกัน ค่าเฉลี่ยจะกระจายออกไปและความเชื่อมั่นจะลดลง
ประเด็นสำคัญ: คำตอบจะบอกอะไร ความเชื่อมั่นจะบอกคุณว่าควรดำเนินการหรือไม่
เกณฑ์
เกณฑ์คือวิธีที่คุณกำหนดการดำเนินการในโค้ด โมเดลจะแสดงความเชื่อมั่นหรือความน่าจะเป็น โค้ดจะเปรียบเทียบกับตัวเลขที่คุณเลือก และผลลัพธ์จะกำหนดสิ่งที่เกิดขึ้น
เกณฑ์ต่อการกระทำ TypeSafe แนะนำให้แบ่งความมั่นใจออกเป็นช่วง การดำเนินการที่มีความเชื่อมั่นสูงจะดำเนินการด้วยตัวเอง ความเชื่อมั่นปานกลางจะดำเนินการโดยมีการตรวจสอบ เช่น ขอการยืนยันหรือแจ้งเคสเพื่อรับการตรวจสอบ ความเชื่อมั่นต่ำจะไม่ดำเนินการใดๆ และจะกลับไปใช้สิ่งที่ปลอดภัยหรือส่งต่อให้บุคคล
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
กฎของเวที เกณฑ์ของสนามประลองจะอยู่ใน choose() ซึ่งคุณจะเรียกใช้ในขั้นตอนที่ 5
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
คำเตือน: คำตอบที่ถูกต้องอาจไม่ใช่คำตอบที่เหมาะสมเสมอไป โมเดลแบบเลือกไม่สามารถแสดงตัวเลือกที่คุณไม่ได้เสนอ ดังนั้นจึงไม่มีการหลอนการเดินหมาก แต่ก็อาจเลือกตัวเลือกที่ไม่ถูกต้องได้ บางครั้งก็อาจเลือกอย่างมั่นใจ ทดสอบคำถามกับสถานการณ์ที่คุณเคยตัดสินไปแล้วก่อนที่จะเชื่อถือเกณฑ์
ตัดสินใจโดยอัตโนมัติด้วยโมเดล
คำขอและการตอบกลับ
คำขอ Python SDK ของ TypeSafe ช่วยให้คุณสร้างคำถามและส่งไปยังโมเดลได้
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
คำขอ 1 รายการต่อเครื่องหมาย
ทุกครั้งที่แอปส่งโทรเลขเป็นสถานะและขอ 3 สิ่งในการโทรครั้งเดียว
- คำตอบใดถูกต้องจาก 5 คำตอบ (หรือ 6 คำตอบเมื่อมีเวทมนตร์พร้อมใช้งาน) ทางเลือก
- ว่าตอนนี้ออร์กกำลังถูกโจมตีหรือไม่ A Noul
- ความรุนแรงของการโจมตีที่เข้ามา ตามเกณฑ์การให้คะแนน 3 ระดับ คะแนน
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
ฟังก์ชัน choose()
คุณยังจำเกณฑ์จากขั้นตอนที่ 4 ได้ไหม choose() จะเปรียบเทียบคำตอบของโมเดลกับตัวเลขคงที่ และตัวเลขคงที่เหล่านี้คือเกณฑ์
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() คือการอ่านค่าที่พิมพ์ใน Python ปกติโดยมี 2 กฎ โมเดลแยกแยะจะให้ความน่าจะเป็นและการวิเคราะห์ของโมเดล และโค้ดจะใช้เกณฑ์สำหรับกฎ ระบบจะส่งการดำเนินการที่เลือกไปยังเครื่องมือ ซึ่งจะใช้ในการต่อสู้กับยักษ์
ประเด็นสำคัญ: เก็บคำถามและเกณฑ์ไว้ในที่เดียว ซึ่งเป็นส่วนหนึ่งของการผสานรวม System One ที่คุณจะปรับมากที่สุด
เวลาในการตอบกลับ การกำหนดราคาตามข้อมูล และตรรกะการตัดสินใจ
- เวลาในการตอบกลับต่อการตัดสิน การขึ้นลงแต่ละครั้งของการต่อสู้ในส่วน ข ใช้เวลาประมาณ 100 มิลลิวินาที และบางครั้งก็ใช้เวลา 2-3 มิลลิวินาที ซึ่งเร็วพอสำหรับลูปเกม เส้นทางการขอ หรือการตรวจสอบทุกข้อความก่อนที่บุคคลหรือโมเดลภาษาจะเห็น
- การกำหนดราคาตามอินพุต การต่อสู้ทั้งเกม การตัดสิน 60 ครั้งโดยมีคำถาม 3 ข้อในแต่ละครั้งมีค่าใช้จ่ายไม่ถึง 1 ใน 10 ของเซ็นต์ โทเค็นเอาต์พุตเป็น 0 เนื่องจากไม่มีการสร้างอะไรเลย ผลที่ตามมาคือคุณสามารถขอมากกว่าที่ต้องการได้ อารีน่าจะถามว่าออร์กปรากฏในทุกๆ Tick หรือไม่ แม้ว่าจะมีเพียง
strikeและcastเท่านั้นที่สนใจ เนื่องจากแทบจะไม่เสียค่าใช้จ่ายในการถามและคำตอบก็มีประโยชน์ในแดชบอร์ด TypeSafe เรียกการดำเนินการนี้ว่าแฟนเอาต์แบบคาดการณ์ - รวมความเชื่อมั่นและอันตราย เมื่อความมั่นใจของโมเดลแยกแยะในคำตอบต่ำกว่า 0.40 และคะแนนอันตรายระบุว่ากำลังจะเกิดการโจมตีอย่างหนัก
choose()จะลบล้างด้วยการหลบ การหลบเลี่ยงไม่ใช่คำตอบที่ดีที่สุด แต่ก็ไม่ใช่คำตอบที่แย่ที่สุดเช่นกัน เลือกเกณฑ์จากต้นทุนของข้อผิดพลาดแต่ละรายการ ไม่ใช่จากตัวเลขกลมๆ และทดสอบกับข้อความที่ส่งล่วงหน้าซึ่งคุณได้ตัดสินด้วยตนเองแล้ว คำแนะนำของ TypeSafe เองคือ หากการตัดสินใจยังคงผิดพลาด ให้ปรับคำถามให้เข้มงวดขึ้นก่อนที่จะย้ายเกณฑ์
รวมโมเดลในเวิร์กโฟลว์ ADK
ข้อจำกัดของการตัดสินใจต่อการอัปเดตแต่ละครั้งและเหตุผลที่คำตอบที่ถูกต้องไม่เพียงพอ
บรรทัดสุดท้ายของการต่อสู้ในขั้นตอนที่ 5 บอกว่า ยักษ์เดินโซเซออกไปโดยแทบไม่มีรอยขีดข่วน โมเดล Discriminative ไม่ได้รับความเสียหายและสร้างความเสียหายเล็กน้อยในทุกๆ ติ๊ก และ 300 แต้มชีวิตก็มากกว่าเล็กน้อยคูณ 60 การ์ดเวทมนตร์ที่มุมของสังเวียนอยู่ตรงนั้นมาตลอด การอ่านต้องใช้โมเดลที่ดูรูปภาพได้
ยักษ์มีพลังชีวิต 300 การโทรที่ถูกต้องจะนับเป็น 3 การแทงเข้าไปในช่องเปิดจะทำได้ 8 เพราะหนังหนา แม้จะต่อสู้กันจนครบ 60 รอบอย่างสมบูรณ์แบบ แต่ยักษ์ก็ยังยืนหยัดอยู่ได้และมีรอยฟกช้ำ เกมจึงถือว่าเป็นการเสมอกัน นั่นคือจุดสิ้นสุดของขั้นตอนที่ 5 โมเดลป้องกันได้ดีแต่ก็ยังชนะไม่ได้
มีเพียงคาถาเท่านั้นที่สร้างความเสียหายจริงได้ โดยจะสร้างความเสียหาย 45 หน่วยหากร่ายคาถาได้สมบูรณ์แบบ และ 67 หน่วยหากร่ายคาถาได้ในช่องเปิด
มอบหมายงานแต่ละอย่างให้กับโมเดลที่เหมาะสม
การ์ดเวทมนตร์ที่มุมสังเวียนคือวิธีชนะ และการอ่านการ์ดนี้ไม่ใช่ปัญหาด้านข้อความ แต่เป็นการอ่านรูปภาพที่มีสีและรูปร่าง 3 อย่างเรียงกัน และต้องร้องเพลงเวทมนตร์ให้ตรงกัน ซึ่งต้องใช้โมเดลที่ดูรูปภาพและใช้เวลาสักครู่ ในการต่อสู้ 2-3 วินาทีคือ 10 ครั้ง
ดังนั้นเวิร์กโฟลว์จึงใช้ทั้ง 2 อย่าง โดยแต่ละอย่างจะทำงานด้วยความเร็วของตัวเอง
- โมเดลการเลือกปฏิบัติจะต่อสู้ ทุกๆ ติ๊ก 1 การเรียก 1 การตัดสินใจ 100 มิลลิวินาที ลูปจะไม่รออะไรที่ช้ากว่าตัวมันเอง
- Gemini อ่านและร้องเพลง ในกิ่งก้านของมันเอง ซึ่งเริ่มที่กระดิ่ง มันจะคว้าการ์ดเวทมนตร์จากหน้าจอของอารีน่าเป็นรูปภาพ ตั้งชื่อสีและรูปร่าง และร้องคำสาป โดยสนามประลองจะตัดสินเพลงเทียบกับคำตอบของการ์ดเวทมนตร์ ซึ่งจะไม่มีการออกจากเซิร์ฟเวอร์
- หลังจากแลกหมัดทุกครั้ง นักสู้จะตรวจสอบช่อง
check_spellโหนดจะดูสถานะ ยังไม่พร้อม: ระบบจะแจ้งว่ายังไม่พร้อม พร้อมระบุระยะเวลาที่ Gemini ร้องเพลง และจะกลับไปที่การร้องเพลงถัดไปโดยตรง ไม่เคยรอ พร้อม:castจะเข้าร่วมตัวเลือกที่โมเดลแยกแยะเสนอ และchoose()จะใช้คาถาในขณะที่โมเดลแยกแยะรายงานว่ามีโอกาส เมื่อใช้เวทมนตร์หมดแล้ว หน้าจอจะจั่วการ์ดเวทมนตร์ใหม่และด้ายช้าจะเริ่มอีกครั้ง หากอ่านเพลงผิด การ์ดเวทมนตร์จะถูกเผา และเธรดที่ช้าจะอ่านการ์ดใหม่ - Gemini จะเขียนนิทานสั้นๆ 1 เรื่องเมื่อจบเกม
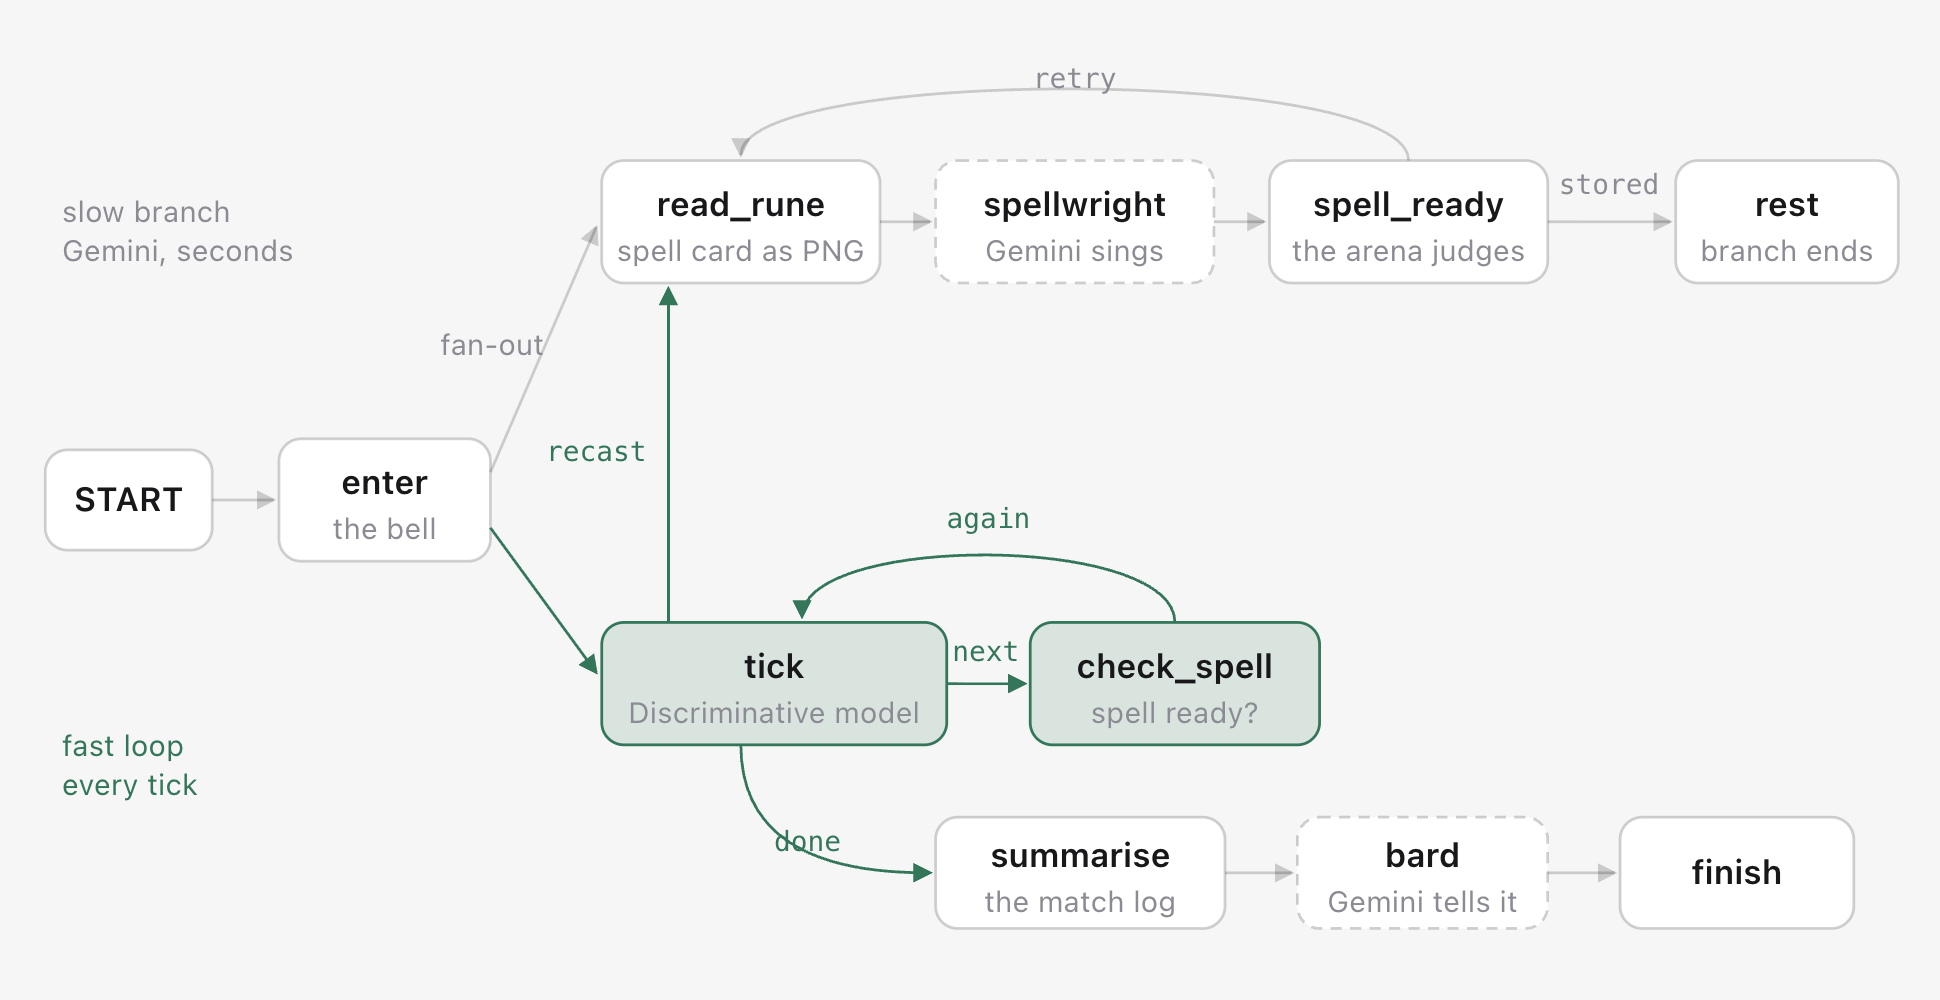
สาขาแบบขนานที่มีเวลาในการตอบสนองต่างกันและวนรอบเหตุการณ์ 1 รายการ
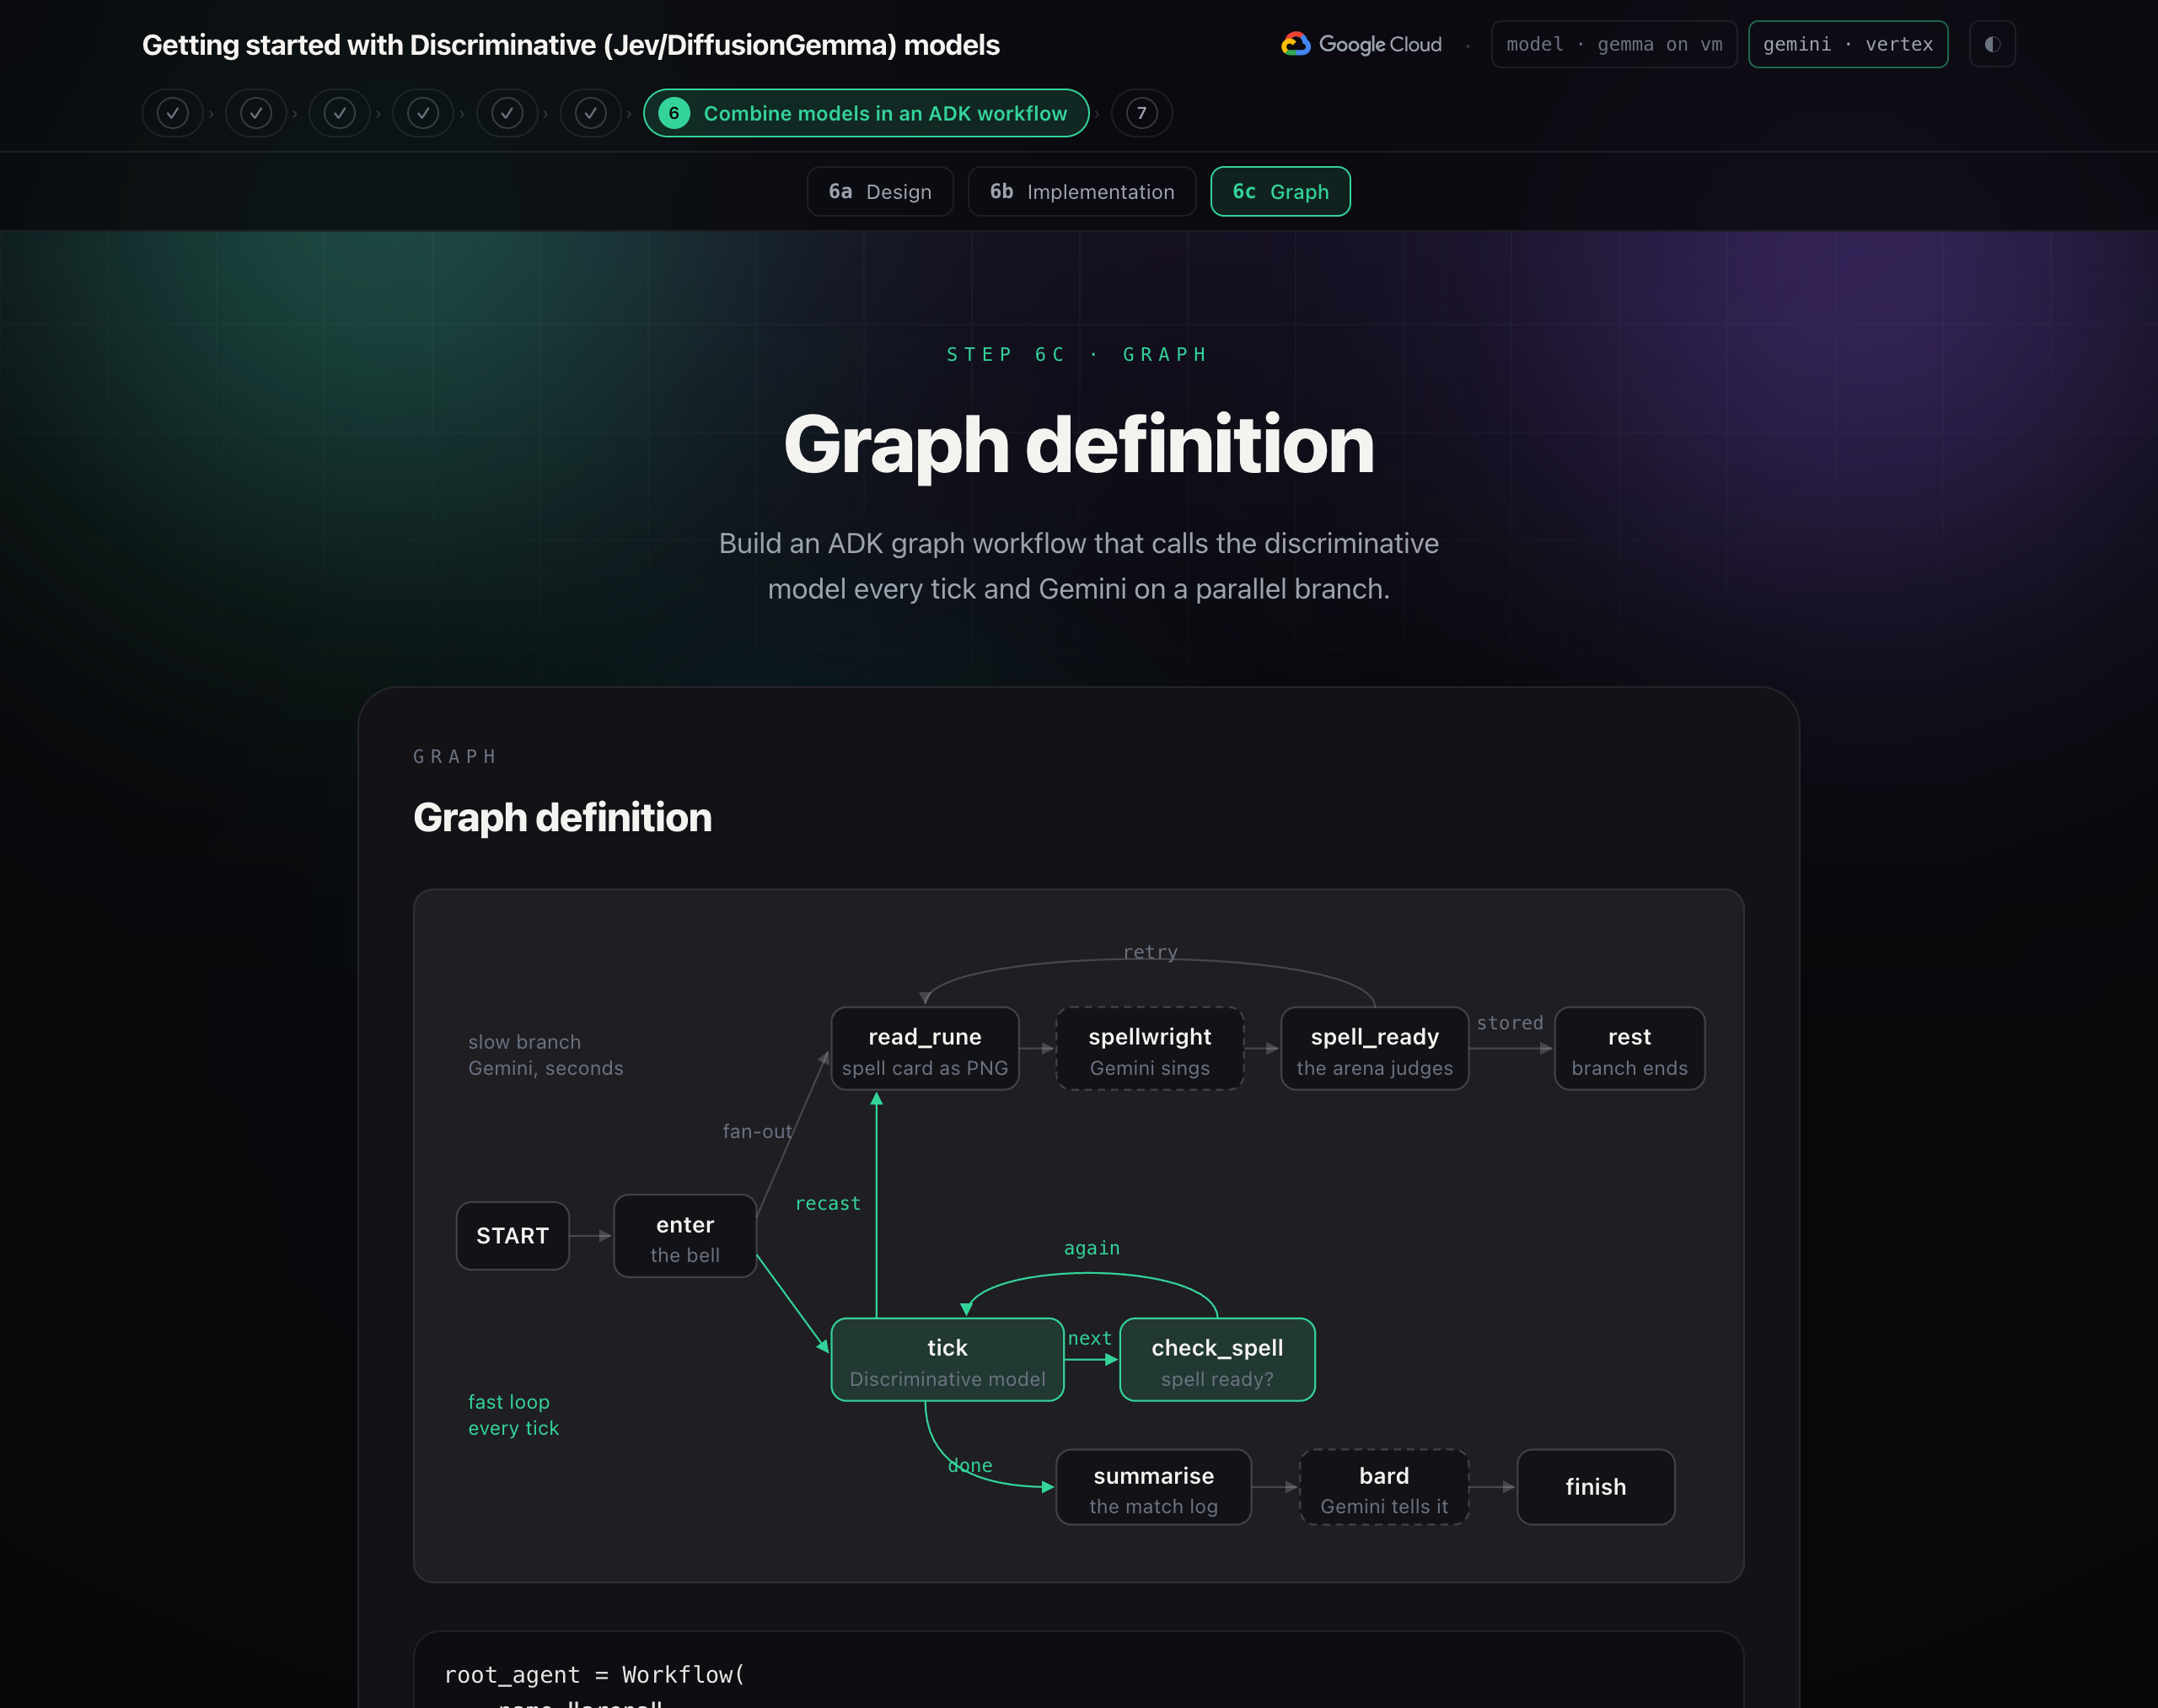
นี่คือเวิร์กโฟลว์ ADK ซึ่งเป็นกราฟของโหนดที่เชื่อมต่อกันด้วยขอบ โหนดคือฟังก์ชัน Python ธรรมดาหรือเอเจนต์ LLM ขอบจากโหนดหนึ่งไปยังทูเพิลของโหนดคือแฟนเอาต์ (Fan-Out): ทั้งสองเริ่มต้นพร้อมกัน โหนดที่ส่งคืน Event พร้อม route จะเลือกขอบที่จะใช้ต่อไป และโหนดที่กำหนดเส้นทางไปยังตัวเองคือลูป
ให้คิดว่าเป็นการทำงาน 2 เธรด เธรด 1 ทำงานช้า: อ่านการ์ดเวทมนตร์ ร้องเพลง เก็บเวทมนตร์ Thread 2 ทำงานอย่างรวดเร็ว: ตรวจสอบช่อง ตรวจสอบอีกครั้ง เธรด 1 จบลงในฟังก์ชันที่เขียนคำที่ตัดสินแล้วลงในสถานะของเซสชันและไม่แสดงผลลัพธ์ check_spell ของเธรด 2 จะอ่านสถานะดังกล่าวหลังจากการแลกเปลี่ยนทุกครั้ง ทั้ง 2 เธรดจะไม่เรียกหรือรออีกเธรดหนึ่ง แต่จะแชร์สถานะเท่านั้น
ประเด็นสำคัญ: ใส่การตัดสินใจในโค้ดและมอบหมายงานที่เฉพาะเจาะจงให้แต่ละโมเดลทำตามความเร็วของตนเอง
ADK จะเรียกใช้ทั้ง 2 Branch เป็นงานในวนรอบเหตุการณ์เดียวในเทรดเดียว งานจะทำงานได้ครั้งละ 1 รายการเท่านั้น เมื่องานถึง await งานจะรอคำตอบ และลูปจะเรียกใช้กิ่งก้านอื่นๆ ในระหว่างนั้น สาขาที่รวดเร็วจะรอโมเดลประมาณ 0.1 วินาที และสาขาที่ช้าจะรอ Gemini เป็นเวลาหลายวินาที ดังนั้นทั้ง 2 สาขาจึงไม่ทำให้กันและกันต้องรอ
สาขาที่ช้า
read_rune() จะนำการ์ดเวทมนตร์ออกจากหน้าจอเป็นรูปภาพ
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright คือ Gemini โดยจะอ่านรูปภาพและตอบในรูปแบบที่กำหนด
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() จะให้กรรมการในอารีน่าตัดสินเวทมนตร์ จากนั้นจะจัดเก็บหรือลองอีกครั้ง
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
โหนดฟังก์ชันสามารถส่งคืน Content ที่มีส่วนรูปภาพ และโหนด LLM จะรับเป็นเทิร์นของผู้ใช้ spell_ready จะแสดง Event พร้อมเดลต้าสถานะและไม่มี output เครื่องหมายถูกถัดไปจะอ่านการสะกดจากสถานะ และกิ่งที่ไม่มีเอาต์พุตไม่ใช่จุดสิ้นสุดที่ 2 ของกราฟ: ADK ต้องมีเอาต์พุตเทอร์มินัล 1 รายการ ซึ่งก็คือเอาต์พุตการต่อสู้
หมายเหตุ: การตัดสินคือโค้ดในอารีน่าที่เทียบกับคำตอบที่ซ่อนอยู่ของการ์ดเวทมนตร์ การอ่านที่สมบูรณ์แบบจะทำได้ 45 ครั้ง ซึ่งจะเพิ่มขึ้นเมื่อเปิด การปัด 2 รูปทรงไปทางขวาจะเท่ากับ 25 การอ่านผิดจะทำให้การ์ดคาถาไหม้และใช้งานไม่ได้ ระบบจะไม่ถาม Gemini ว่าคำตอบถูกต้องหรือไม่
Fast Branch
tick() จะเล่นการแลกเปลี่ยน 1 ครั้ง แล้วเลือกขอบถัดไป
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() จะดูช่องเวทมนตร์หลังจากการแลกเปลี่ยนทุกครั้ง
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell จะดูที่ช่องหลังจากทุกครั้งที่มีการแลกเปลี่ยน โดยจะไม่บล็อกการทำงาน หากคำสั่งยังไม่พร้อม ระบบจะรายงานและดำเนินการต่อ
การออกแบบมีองค์ประกอบ 3 อย่าง การเรียกโมเดล Discriminative จะawaitด้วยไคลเอ็นต์แบบอะซิงโครนัส ดังนั้นลูปจะหยุดชั่วคราวขณะรอและสาขา Gemini จะทำงานต่อไป คำถามจะสร้างขึ้นใหม่ทุกครั้งที่คลิก ดังนั้น cast จะปรากฏขึ้นเมื่อมีเนื้อหาที่พร้อมแคสต์เท่านั้น และ route สามารถเป็นรายการได้: ["recast", "next"] ใช้ทั้ง 2 ขอบพร้อมกัน
ตัวสังเวียนเองอยู่เบื้องหลังไคลเอ็นต์ขนาดเล็ก ซึ่งก็คือแอปที่กำลังทำงานผ่าน HTTP เมื่อมีแอปดังกล่าวอยู่ หน้าเว็บจึงแสดงการต่อสู้ และเครื่องมือในกระบวนการเมื่อไม่มีแอปดังกล่าว
คำจำกัดความของกราฟ
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
ทูเพิลเป็นเป้าหมายคือแฟนเอาต์ (Fan-Out) ทูเพิลที่เป็นขอบคือเชน Dict จะแมปชื่อเส้นทางกับโหนด tick → check_spell → tick คือการวนซ้ำอย่างรวดเร็ว "recast": read_rune จะเริ่มเธรดที่ช้าอีกครั้งหลังจากใช้คาถา "retry" จะทำเช่นเดียวกันหลังจากที่คาถาไม่ทำงาน และ "stored": rest จะทำให้เธรดที่ช้าสิ้นสุดลงอย่างเงียบๆ โดยไม่มีเอาต์พุตเมื่อคาถาอยู่ในช่อง ADK กำหนดให้มีขอบที่กำหนดเส้นทางอย่างน้อย 1 รายการในรอบ ดังนั้นระบบจะปฏิเสธลูปแบบไม่มีเงื่อนไขก่อนที่จะทำงานไปเรื่อยๆ
หมายเหตุ: root_agent คือสิ่งที่เครื่องมือของ ADK มองหา adk web agents จากรูทของเวิร์กช็อปจะเปิด UI สำหรับนักพัฒนาแอปพร้อมกับอารีน่า หากคุณต้องการดูกราฟและเหตุการณ์ในเบราว์เซอร์แทนที่จะดูในเทอร์มินัล