

1. Giới thiệu
Một hội thảo kéo dài 90 phút về Mô hình phân biệt, mô hình quyết định System One của AI TypeSafe và cách đặt mô hình này bên cạnh Gemini trong quy trình làm việc ADK của Google. Trong hội thảo này, có 6 bước được xây dựng dựa trên một trò chơi chiến đấu. Trước tiên, bạn sẽ chiến đấu với yêu tinh bằng tay, sau đó đưa ra phản xạ cho mô hình phân biệt, rồi xem quy trình ADK giành chiến thắng trong trận chiến với mô hình phân biệt quyết định mọi nhịp và Gemini đọc thẻ phép thuật trên màn hình để hát các câu thần chú.
Tổng quan
Mô hình phân biệt (jev-1.13, còn gọi là jev-latest) là một mô hình được lưu trữ của TypeSafe AI, phát hành ngày 19 tháng 9 năm 2026. Công cụ này không tạo văn bản. Bạn gửi trạng thái (văn bản, JSON hoặc danh sách) và câu hỏi đã nhập (Choice, Score, Noul) cho mô hình này.Mô hình sẽ trả về câu trả lời đã nhập với xác suất được điều chỉnh, trong khoảng 70 đến 500 mili giây, với mức phí 0,042 USD cho mỗi triệu mã thông báo đầu vào và không tính phí cho đầu ra. Công việc của nó là đưa ra quyết định trước, giữa và sau các mô hình ngôn ngữ: định tuyến, phân loại, kiểm soát và ở đây là phản xạ của một chiến binh.
Một trò chơi làm ví dụ
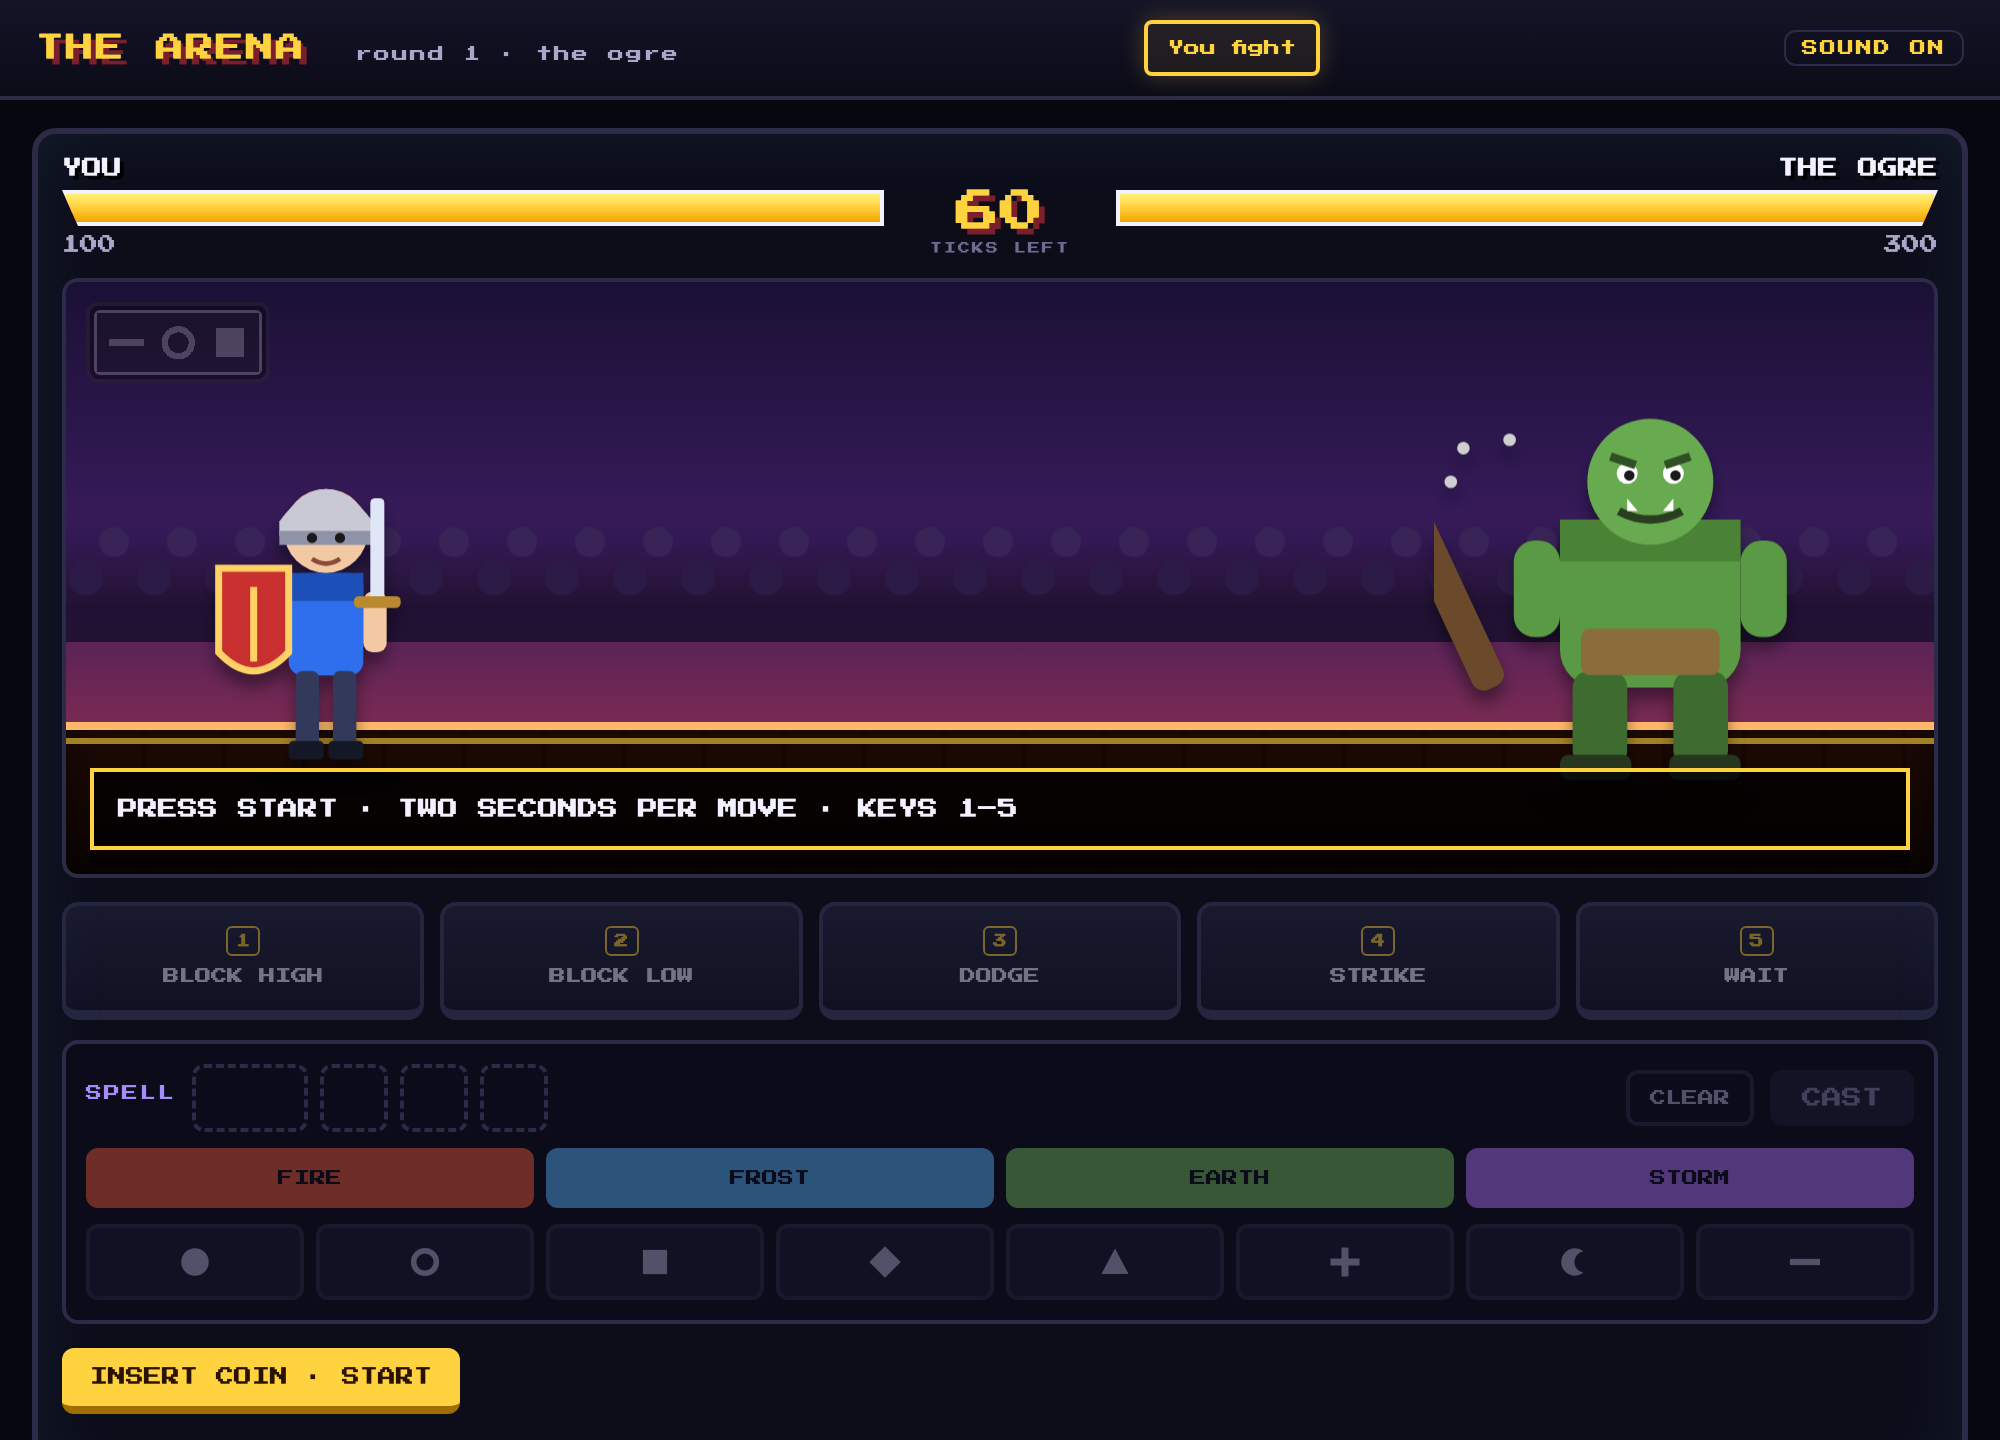
Bạn đã từng chơi trò chơi chiến đấu chưa? Bạn sẽ đối mặt với một đối thủ và phải phản ứng ngay lập tức với các động tác của họ. Nếu bạn đoán sai một lần, HP của bạn sẽ bị ảnh hưởng. Các trò chơi cũng thường khiến phép thuật khó thi triển. Trong trò chơi của chúng tôi, bạn phải chọn màu sắc và hình dạng của thẻ phép thuật theo thứ tự trước khi phép thuật được thi triển. Hội thảo này hướng dẫn bạn cách kết hợp cả hai loại mô hình để nhân vật của bạn giành chiến thắng.
Mỗi yếu tố của trò chơi đều tương ứng với một hệ thống thực:
- Động thái của đối thủ là một sự kiện đến, chẳng hạn như yêu cầu hoặc giao dịch.
- Phản hồi là một quyết định có giới hạn, do mô hình phân biệt đưa ra và được kiểm tra bằng mã.
- Thẻ phép thuật là dữ liệu đầu vào không có cấu trúc mà mô hình ngôn ngữ cần đọc.
- Trận đấu là quy trình làm việc, trong đó các công việc nhanh và chậm được thực hiện ở tốc độ riêng.
Mục tiêu là kết hợp 4 thành phần này và ghép chúng lại với nhau để xây dựng một hệ thống nhanh chóng và thông minh.
Kiến thức bạn sẽ học được
- Giải thích sự khác biệt giữa mô hình phân biệt (Hệ thống 1) và mô hình tạo sinh (Hệ thống 2), cũng như thời điểm sử dụng từng mô hình.
- Mô tả cách Jev và DiffusionGemma được phân phát, đồng thời thiết lập một trong số đó cho hội thảo, bao gồm cả DiffusionGemma trên một VM GPU Compute Engine.
- Viết câu hỏi Lựa chọn, Điểm số và Noul, đồng thời diễn giải xác suất và độ tin cậy.
- Sử dụng ngưỡng trong mã xác định để chuyển xác suất thành hành động.
- Tạo một yêu cầu bằng TypeSafe SDK, sau đó để mô hình chọn mọi nước đi trong một trò chơi.
- Tạo một nhánh chậm (Gemini đọc hình ảnh) và một nhánh nhanh (mô hình phân biệt quyết định trong một vòng lặp), rồi chạy từng nhánh riêng.
- Kết hợp cả hai nhánh trong quy trình làm việc của biểu đồ ADK, chia sẻ trạng thái trên một vòng lặp sự kiện, vì vậy, công việc chậm sẽ không bao giờ cản trở các quyết định nhanh.
Kiến trúc
Workbench nằm trong cloudshell(hoặc máy của bạn), sẽ ghi vào hệ thống tệp cục bộ và tương tác với arena, cũng như với Gemini và mô hình quyết định. ② gọi mô hình quyết định trong "Discriminative model fights" (Mô hình phân biệt); ③ gọi cả hai trong "Workflow fights" (Quy trình làm việc).
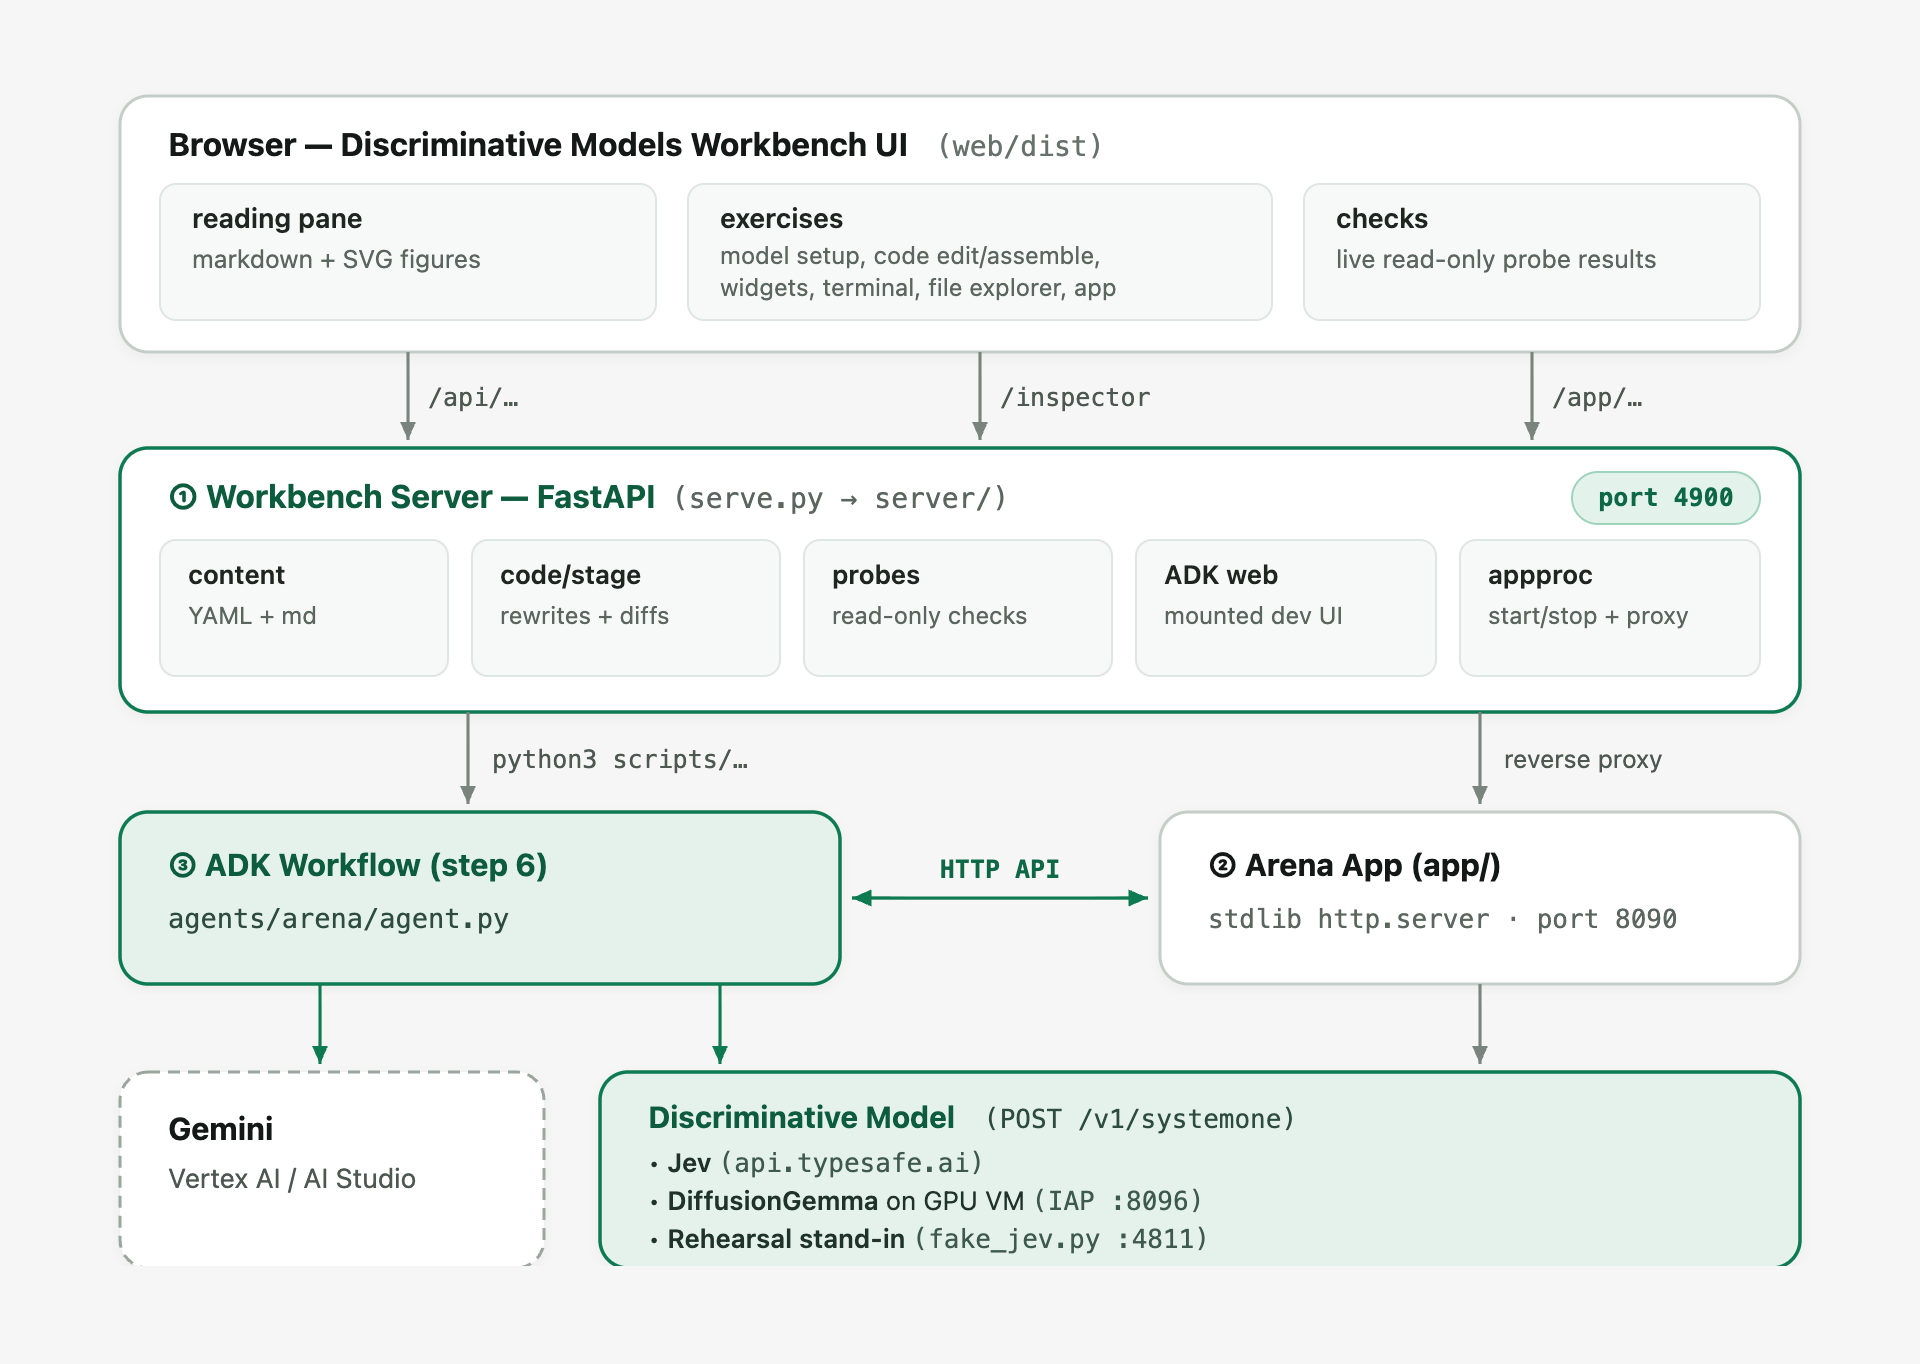
Ai gọi cho ai. Trình duyệt chỉ tương tác với ①. Cả hai mô hình đều được gọi từ Python trên máy:
Người gọi | Mô hình phân biệt | Gemini |
② đấu trường, "Các trận chiến của mô hình phân biệt" | mỗi dấu đánh dấu, | không |
③ quy trình làm việc | mỗi dấu đánh dấu, | không |
③ quy trình | không | hình ảnh thẻ phép thuật; câu chuyện sau trận chiến |
| có | không |
Mỗi chế độ có một dấu đánh nhịp.
- Bạn chiến đấu. Trang này yêu cầu ② một điện báo, cho thấy điện báo đó với bộ hẹn giờ 2 giây và đăng nút bạn nhấn (hoặc từ bạn nhập) trở lại. ② giải quyết vấn đề.
- Mô hình phân biệt. Trang này yêu cầu ② đánh dấu; ② vẽ một bức điện, đặt cho mô hình 3 câu hỏi trong một lệnh gọi, chạy
choose()và trả về các câu trả lời cũng như kết quả. Trang này vẽ các thanh. - Quy trình công việc xung đột. Start tạo ② launch ③ dưới dạng một quy trình con (đăng nhập
runs/arena-workflow.log). ③ điều khiển trận chiến: yêu cầu ② cho từng telegraph, gọi mô hình và đăng quyết định; phép thuật của Gemini sẽ xuất hiện trên nhánh riêng bất cứ khi nào sẵn sàng. Trang này chỉ thăm dò ý kiến ② và vẽ. Pause là một cờ trên ② mà ③ kiểm tra trước mỗi dấu tích.
Nơi lưu trữ mô hình quyết định. Mọi lệnh gọi đều trải qua cùng một typesafe-sdk; chỉ URL cơ sở thay đổi. scripts/jevauth.py đặt tên cho phần phụ trợ và đặt khoá cũng như thời gian chờ:
Dịch vụ phụ trợ |
| Khoá | Người thiết lập |
TypeSafe, được lưu trữ | unset (api.typesafe.ai) |
|
|
DiffusionGemma trên máy ảo L4 |
| không có |
|
DiffusionGemma trên Cloud Run |
| mã thông báo nhận dạng của Google, được tìm nạp mỗi giờ |
|
Lúc tập luyện |
| không có |
|
Câu trả lời của thẻ chính tả ②: quy trình công việc chỉ nhận được PNG và ② đánh giá chính tả mà quy trình gửi lại. Đó là điều khiến câu thần chú trở thành một bài kiểm tra thực sự về khả năng đọc của Gemini, và câu thần chú mà bạn tạo trong "Bạn chiến đấu" là một bài kiểm tra thực sự về khả năng của bạn.
2. Thiết lập
Nhận khoản tín dụng cho hội thảo
Nếu bạn được cấp tín dụng Google Cloud cho phiên này, hãy yêu cầu cấp tín dụng trước. Việc này mất khoảng một phút và sẽ tạo tài khoản thanh toán cho bạn.
Mở Cloud Shell
Google Cloud Shell là một môi trường Linux có thể truy cập qua trình duyệt, được định cấu hình sẵn bằng gcloud, Python, Node.js, uv và git, đã được xác thực bằng Tài khoản Google của bạn.
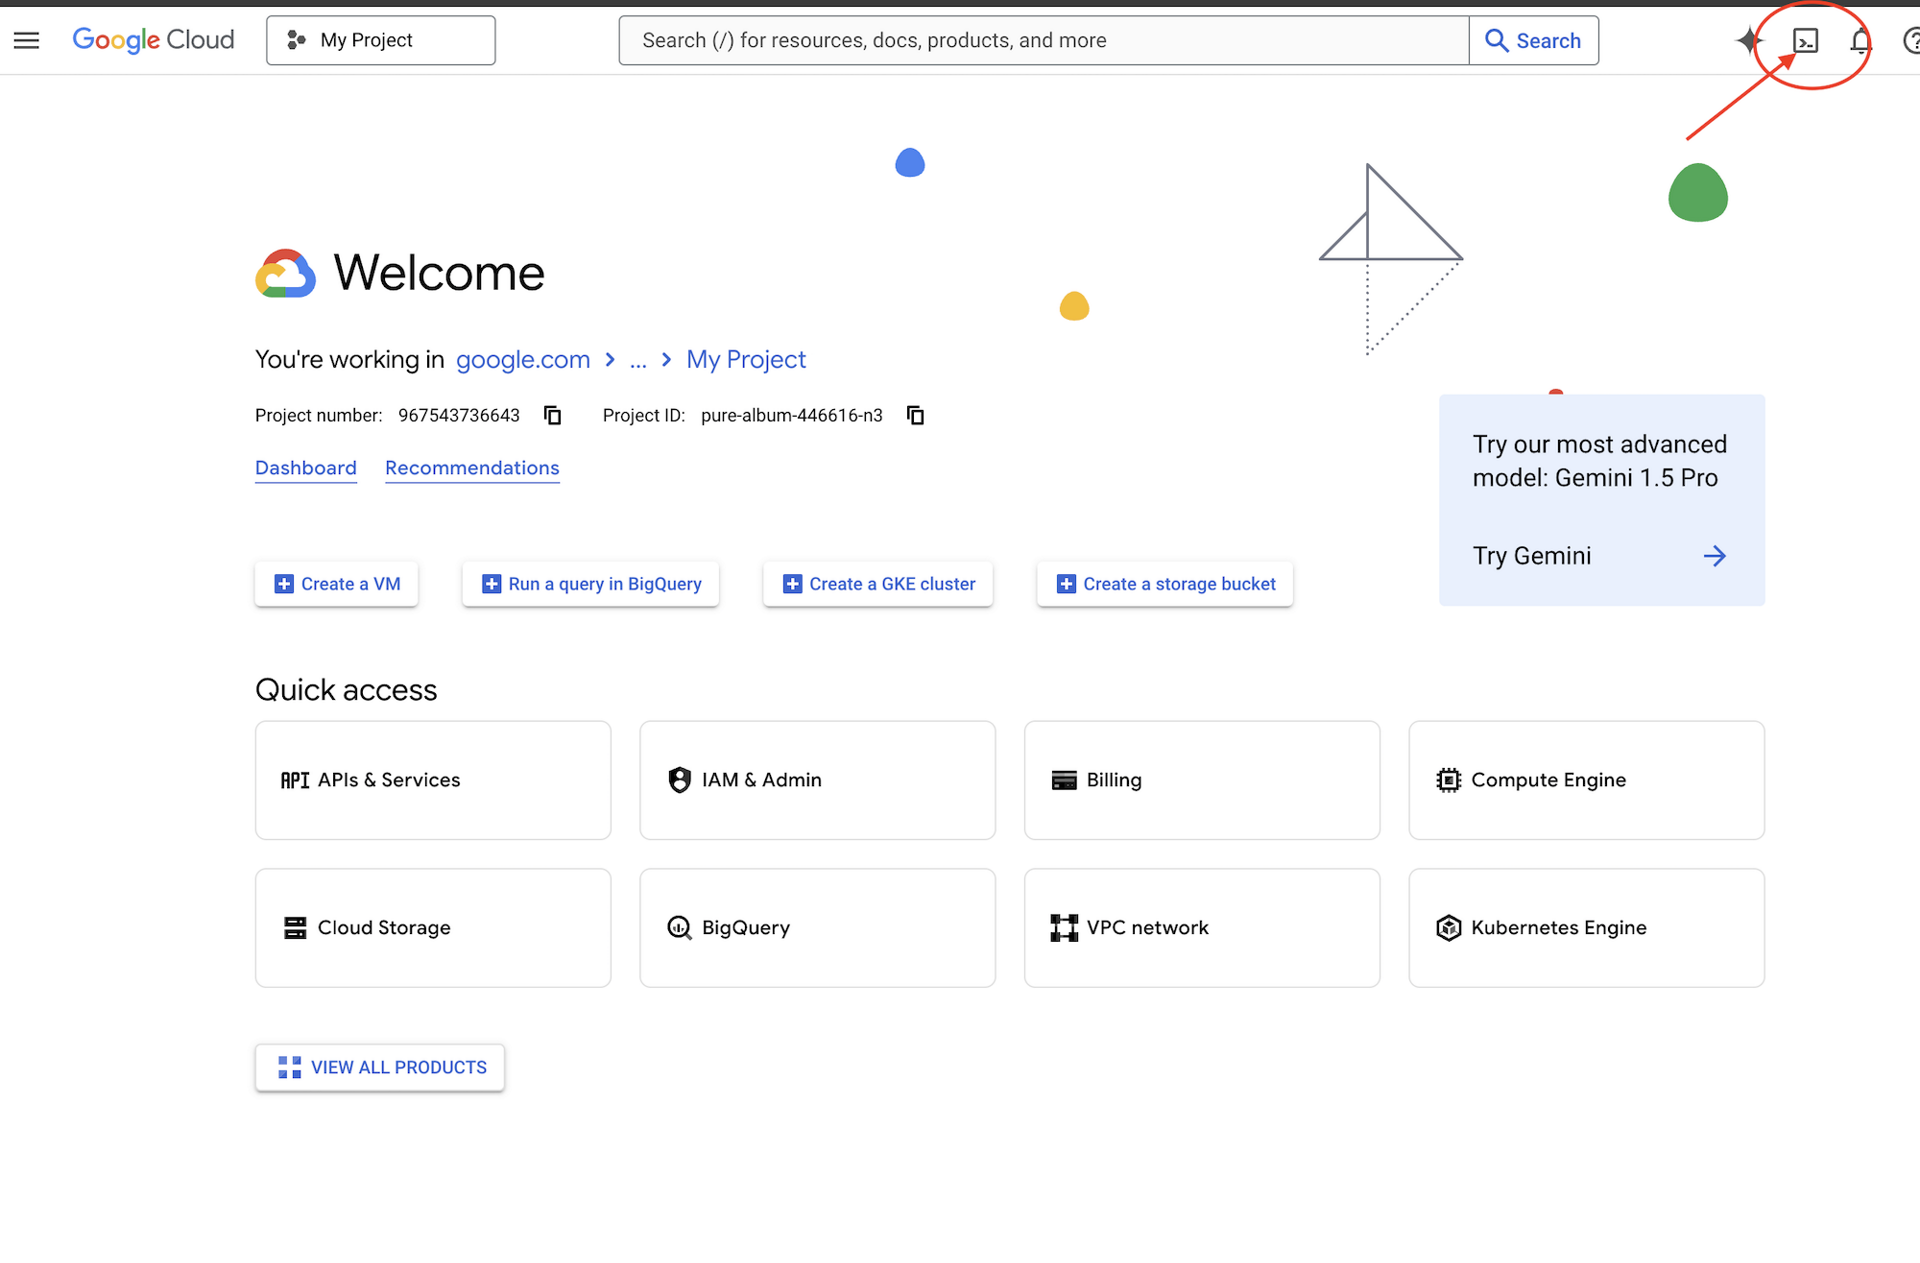
- Mở Cloud Console.
- Nhấp vào Activate Cloud Shell (biểu tượng cửa sổ dòng lệnh trong thanh điều hướng trên cùng) để mở một phiên cửa sổ dòng lệnh ở cuối trình duyệt.
Khởi chạy băng ghế dự bị
Trong Cloud Shell hoặc bất cứ nơi nào bạn đăng nhập bằng gcloud:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh tạo một dự án (discrim-models-XXXX), liên kết hoạt động thanh toán với dự án đó, ưu tiên tài khoản tín dụng sự kiện khi bạn có tài khoản này và đợi cho đến khi dự án có thể phân phát. Việc chạy lại sẽ sử dụng lại dự án trong ~/project_id.txt. Để sử dụng một dự án mà bạn đã có, hãy đặt mã nhận dạng của dự án đó vào tệp này và bỏ qua tập lệnh này.
setup_codelab.sh không yêu cầu gì. Thao tác này sẽ cài đặt uv và các gói Python, bật Vertex AI, Compute Engine và IAP, trỏ Gemini đến Vertex AI trong dự án trong .env, thực hiện một lệnh gọi Gemini thực bằng một mô hình mà dự án có thể gọi, tạo trang, khởi động băng ghế dự bị ở chế độ nền và chạy scripts/check_setup.py. Chạy lại sẽ giữ nguyên các tệp bài tập; scripts/starter.sh sẽ đặt lại các tệp đó. Mô hình quyết định được chọn ở bước 2 của bảng điều khiển.
Cách mở giao diện người dùng của băng ghế dự bị trong Cloud Shell:
- Nhấp vào đường liên kết xem trước được in ở cuối
./setup_codelab.shhoặc nhấp vào Xem trước trên web ở góc trên cùng bên phải của thanh công cụ Cloud Shell. - Chọn Thay đổi cổng, nhập 4900 rồi nhấp vào Thay đổi và xem trước.
Gemini chạy trên Vertex AI trong dự án của bạn, bằng thông tin đăng nhập Google của riêng bạn: GOOGLE_GENAI_USE_VERTEXAI=1, GOOGLE_CLOUD_PROJECT và GOOGLE_CLOUD_LOCATION=global trong .env.
Mô hình quyết định được chọn riêng, ở bước 2 của băng ghế dự bị hoặc từ một thiết bị đầu cuối có scripts/setup_model.sh:
Lựa chọn | Cần | Thiết lập | Chi phí |
Mô hình phân biệt (TypeSafe, được lưu trữ) | khoá API TypeSafe | không có | mỗi mã thông báo, phần nhỏ của một cent |
DiffusionGemma (Google, trọng số mở) | thanh toán + hạn mức Compute Engine cho GPU | ~15 phút, tự động | Khoảng 0,71 USD/giờ trong khi VM chạy |
Diễn tập (không có mô hình) | nothing | không có | không có |
DiffusionGemma trên một VM Compute Engine
scripts/setup_gemma.sh trước tiên sẽ kiểm tra hạn mức GPU, sau đó tạo một VM g2-standard-4 (1 × L4 24 GB, 4 vCPU, 16 GB) từ hình ảnh Học sâu của Google có trình điều khiển NVIDIA 580. Khi khởi động lần đầu, VM sẽ cài đặt Docker, tải các trọng số xuống từ Hugging Face (nvidia/diffusiongemma-26B-A4B-it-NVFP4, 17,5 GB, công khai, không có mã thông báo) và chạy djev-run: DiffusionGemma đằng sau API chính xác của mô hình phân biệt. Cổng của mô hình không mở ra Internet: băng ghế dự bị tiếp cận mô hình thông qua một đường hầm IAP trên localhost:8096, mà scripts/start.sh sẽ mở ra.
Tạm dừng / Tiếp tục |
| |
Đường hầm |
| |
Xoá |
| |
Thực hành các lệnh |
| |
Bố cục kho lưu trữ
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. Tóm tắt
Dọn dẹp môi trường
Khi bạn hoàn thành hội thảo, hãy hoàn tất các bước sau để huỷ mọi tài nguyên GPU DiffusionGemma, dừng các quy trình nền của băng ghế dự bị và quy trình diễn tập, xoá các tệp hội thảo khỏi Cloud Shell và (không bắt buộc) xoá dự án trên đám mây hội thảo của bạn trên Google Cloud.
- Xoá máy ảo GPU DiffusionGemma và quy tắc tường lửa (nếu đã tạo): Nếu bạn đã cung cấp DiffusionGemma trên một máy ảo GPU Compute Engine ở Bước 2, hãy xoá máy ảo, ổ đĩa và quy tắc tường lửa IAP để không phải trả phí điện toán hoặc lưu trữ ổ đĩa liên tục:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - Dừng quy trình của băng ghế dự bị và quy trình diễn tập trong Cloud Shell: Trong cửa sổ dòng lệnh Cloud Shell, hãy dừng máy chủ băng ghế dự bị ở chế độ nền và mọi quy trình thay thế cho quy trình diễn tập:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - Xoá thư mục hội thảo khỏi Cloud Shell: Quay lại thư mục chính rồi xoá thư mục kho lưu trữ được sao chép và tệp mã dự án:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - Xoá dự án trên Google Cloud: Nếu
./setup_project.shtạo một dự án hội thảo chuyên dụng (ví dụ:discrim-models-XXXX), việc tắt dự án sẽ xoá vĩnh viễn tất cả tài nguyên được tạo trong dự án đó mà không ảnh hưởng đến tài khoản thanh toán trên Cloud của bạn:- Mở trang Quản lý tài nguyên trong Google Cloud Console.
- Chọn dự án hội thảo của bạn (ví dụ:
discrim-models-...) trong danh sách tài nguyên. - Nhấp vào Xoá trong thanh công cụ trên cùng, nhập mã dự án để xác nhận rồi nhấp vào Tắt.
Bạn đã hoàn thành buổi hội thảo này.
Tóm tắt kết quả xét nghiệm
- Chọn một mô hình phân biệt, Jev hoặc DiffusionGemma trên một VM GPU Compute Engine và kiểm tra xem mô hình đó có trả lời hay không.
- Chơi đấu trường theo cách thủ công, chạy đua với thời gian để tìm hiểu các quy tắc.
- Tìm hiểu cách một mô hình phân biệt trả lời bằng các câu hỏi Lựa chọn, Điểm số và Noul, xác suất và độ tin cậy, cũng như cách mã của bạn áp dụng các ngưỡng cho các câu hỏi đó.
- Gửi yêu cầu đầu tiên, sau đó để mô hình chọn mọi bước di chuyển trong đấu trường, với
choose()biến câu trả lời thành hành động. - Xây dựng từng nhánh của quy trình ADK riêng biệt, trong đó Gemini đọc hình ảnh thẻ phép thuật và mô hình quyết định trong một vòng lặp.
- Kết hợp các thao tác này trong một quy trình làm việc dùng chung trạng thái, vì vậy, trận chiến không bao giờ phải chờ Gemini và phép thuật được thi triển ngay khi bắt đầu.
Từ cuộc trò chuyện đến quyết định
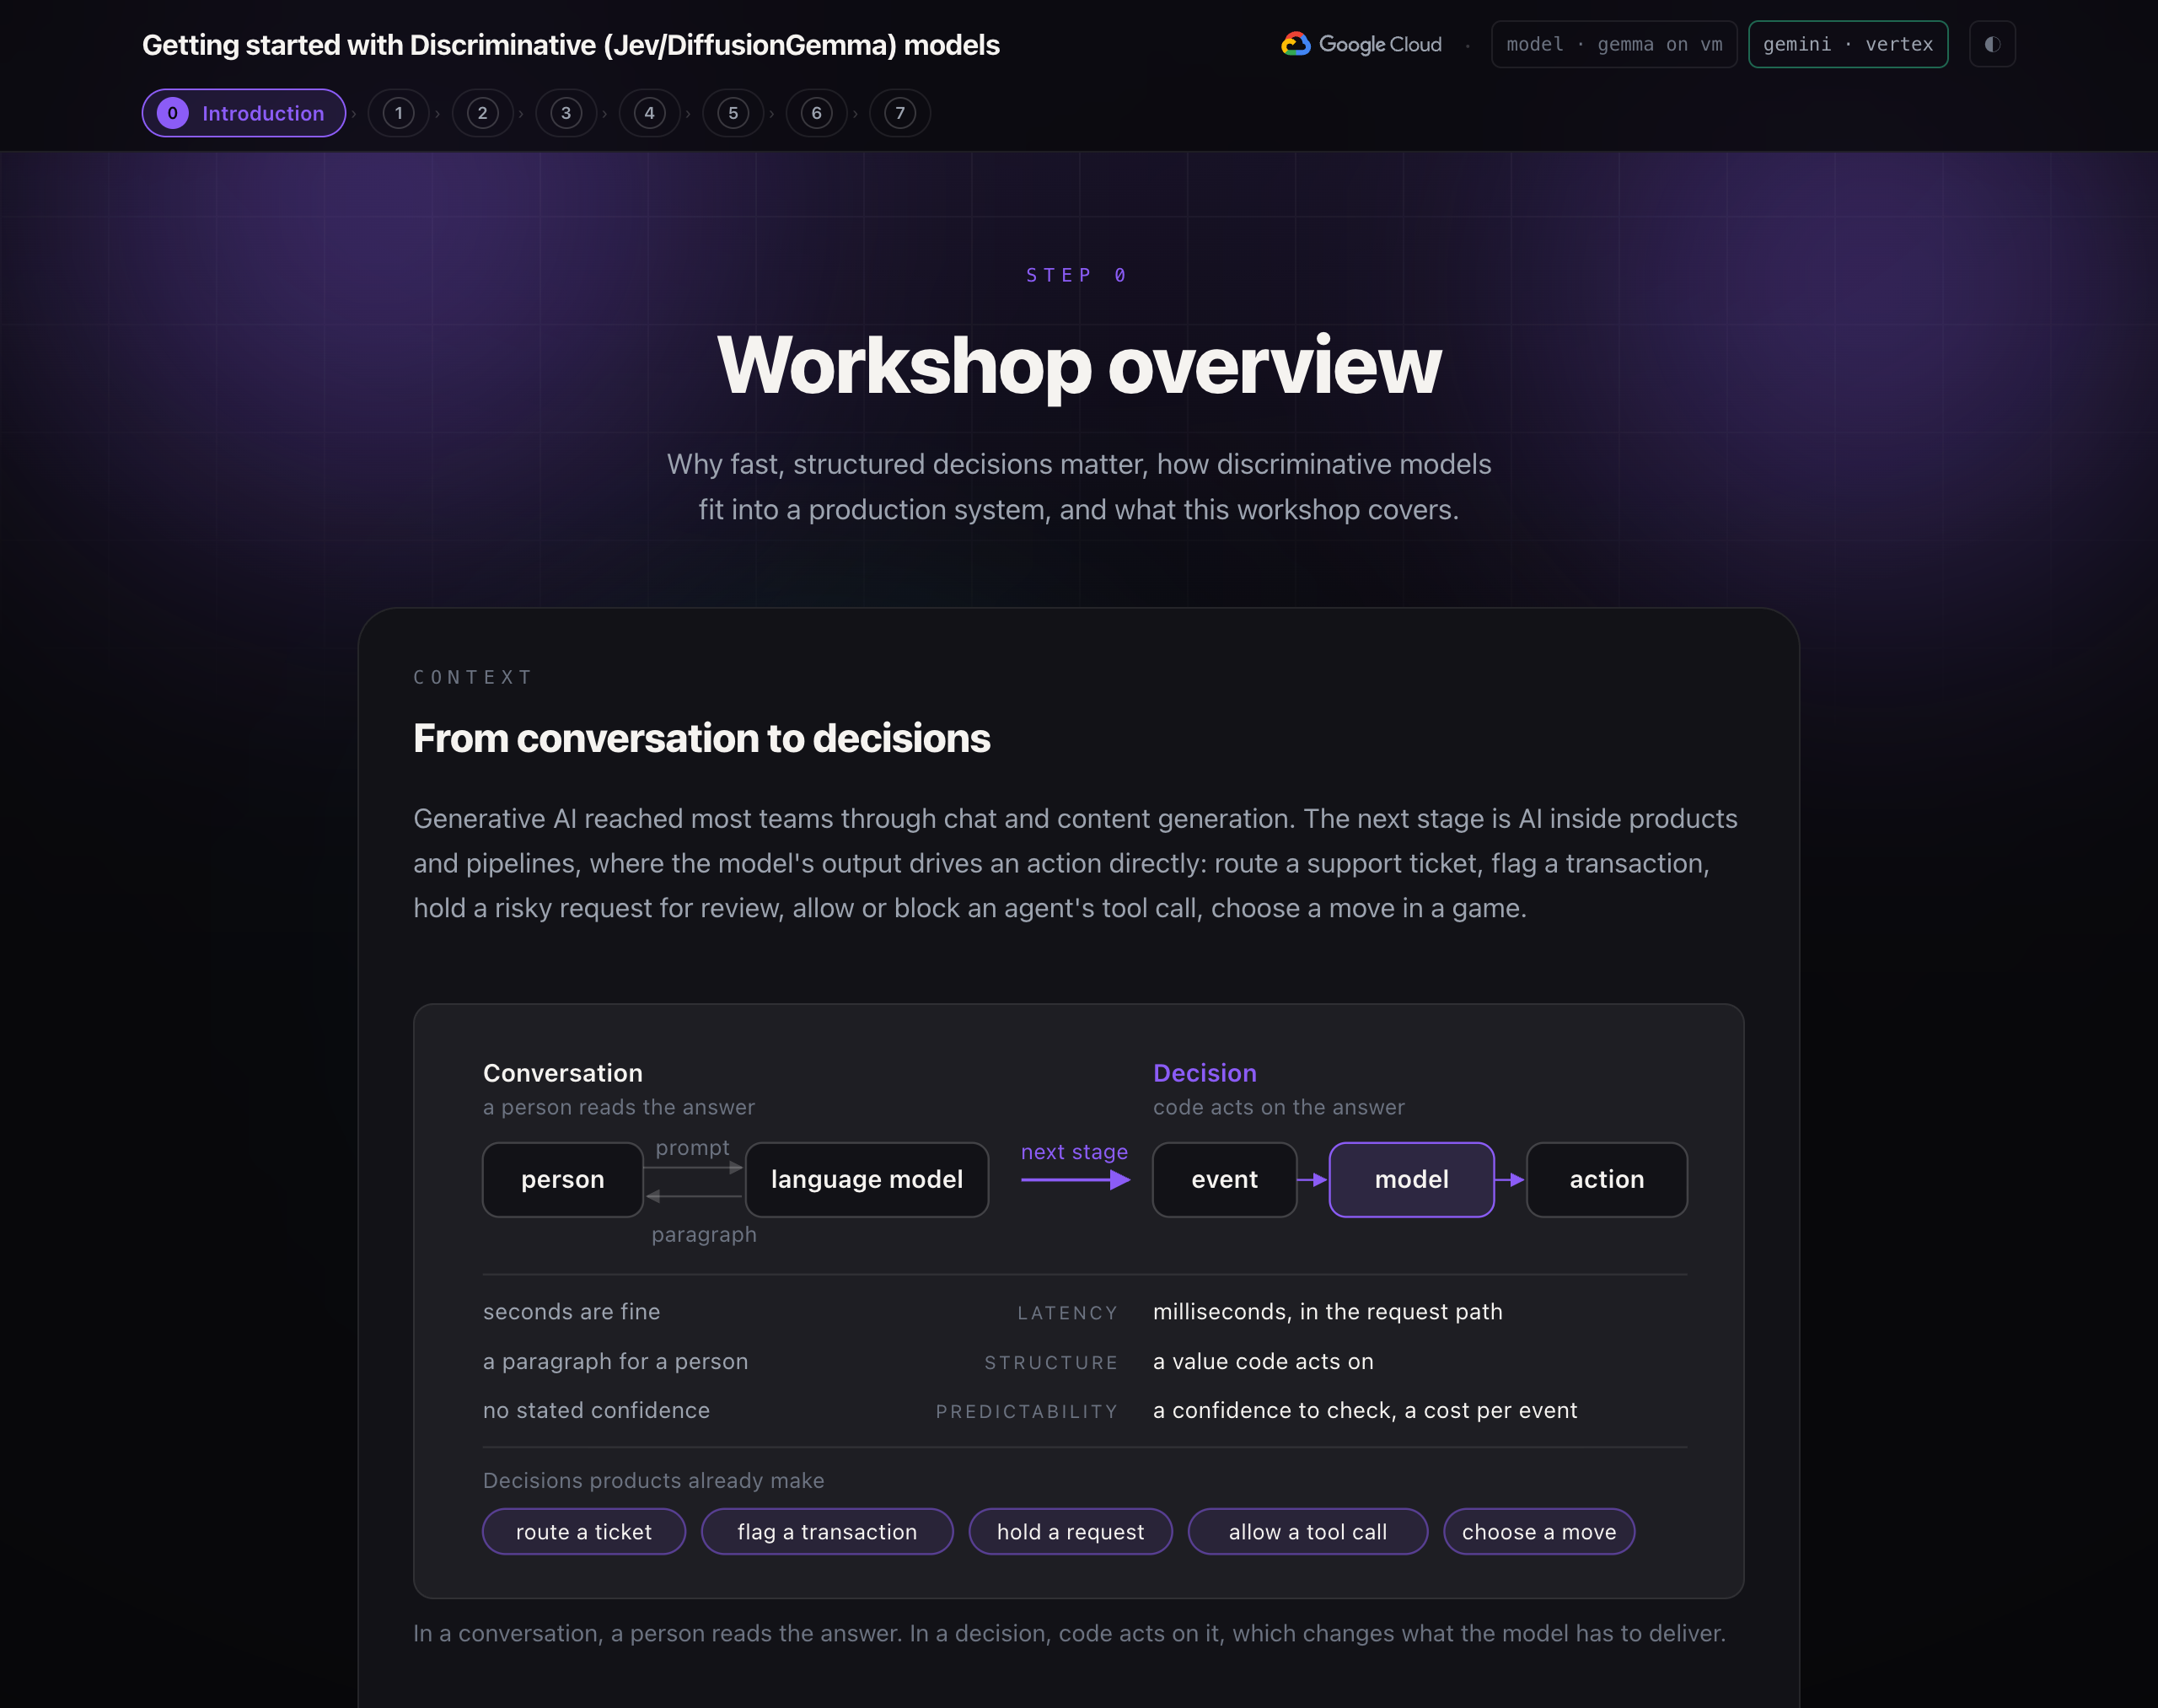
AI tạo sinh đã tiếp cận hầu hết các nhóm thông qua tính năng trò chuyện và tạo nội dung. Giai đoạn tiếp theo là AI trong các sản phẩm và quy trình, trong đó đầu ra của mô hình sẽ trực tiếp thúc đẩy một hành động: chuyển phiếu yêu cầu hỗ trợ, gắn cờ một giao dịch, giữ lại một yêu cầu rủi ro để xem xét, cho phép hoặc chặn lệnh gọi công cụ của một tác nhân, chọn một nước đi trong trò chơi.
Những quyết định này có 3 yêu cầu mà tính năng trò chuyện không có:
- Độ trễ. Câu trả lời thường nằm trong đường dẫn yêu cầu của người dùng hoặc một vòng lặp theo thời gian thực, vì vậy, câu trả lời phải đến trong vài mili giây chứ không phải vài giây.
- Cấu trúc. Phương thức gọi là mã, vì vậy câu trả lời phải là một giá trị mà phương thức gọi có thể thực hiện, chứ không phải là một đoạn văn bản mà phương thức gọi phải phân tích cú pháp.
- Khả năng dự đoán. Mỗi quyết định cần có độ tin cậy mà mã có thể kiểm tra và chi phí đủ thấp để yêu cầu trên mọi sự kiện.
Mô hình ngôn ngữ tạo văn bản từng mã thông báo một. Bạn có thể đưa ra câu hỏi để nhận được câu trả lời có hoặc không, nhưng quá trình này diễn ra chậm đối với một vòng lặp theo thời gian thực, đầu ra của nó phải được phân tích cú pháp và nó không báo cáo mức độ chắc chắn của mình.
Mô hình được xây dựng để đưa ra quyết định
Mô hình phân biệt sẽ trả lời một câu hỏi được nhập bằng cách đưa ra xác suất cho từng lựa chọn được phép, chỉ trong một lần. Công cụ này không tạo văn bản. Hội thảo này cung cấp 2 lựa chọn để chạy:
Mô hình | Nhà cung cấp | Nơi mô hình chạy trong hội thảo này |
Jev | TypeSafe AI | Dịch vụ được lưu trữ của TypeSafe, được gọi bằng khoá API |
DiffusionGemma | Google, quả tạ | Tự lưu trữ trên một máy ảo GPU trong dự án trên đám mây của riêng bạn |
Bạn có thể hoán đổi các mô hình dựa trên nhu cầu của mình; mã kết nối với các mô hình đó không cần thay đổi.
Kết hợp các thành phần
Một hệ thống thành công bao gồm nhiều thành phần:
Thành phần | Vai trò | Trong hội thảo này |
Quy trình làm việc | Điều phối các bước, chạy các nhánh song song, giữ trạng thái được chia sẻ | Quy trình làm việc với biểu đồ ADK |
Mã xác định | Quy tắc, ngưỡng, xác thực. Tức thì, miễn phí và có thể kiểm tra | Các quy tắc của trò chơi |
Mô hình phân biệt | Quyết định nhanh chóng, có giới hạn với điểm số mức độ tin cậy | Chọn một câu trả lời cho mỗi lần đánh dấu |
Mô hình ngôn ngữ | Cảm nhận và tạo: hình ảnh và văn bản không có giới hạn | Gemini đọc hình ảnh thẻ phép thuật và viết phép thuật |
Kiến trúc phân phát mô hình
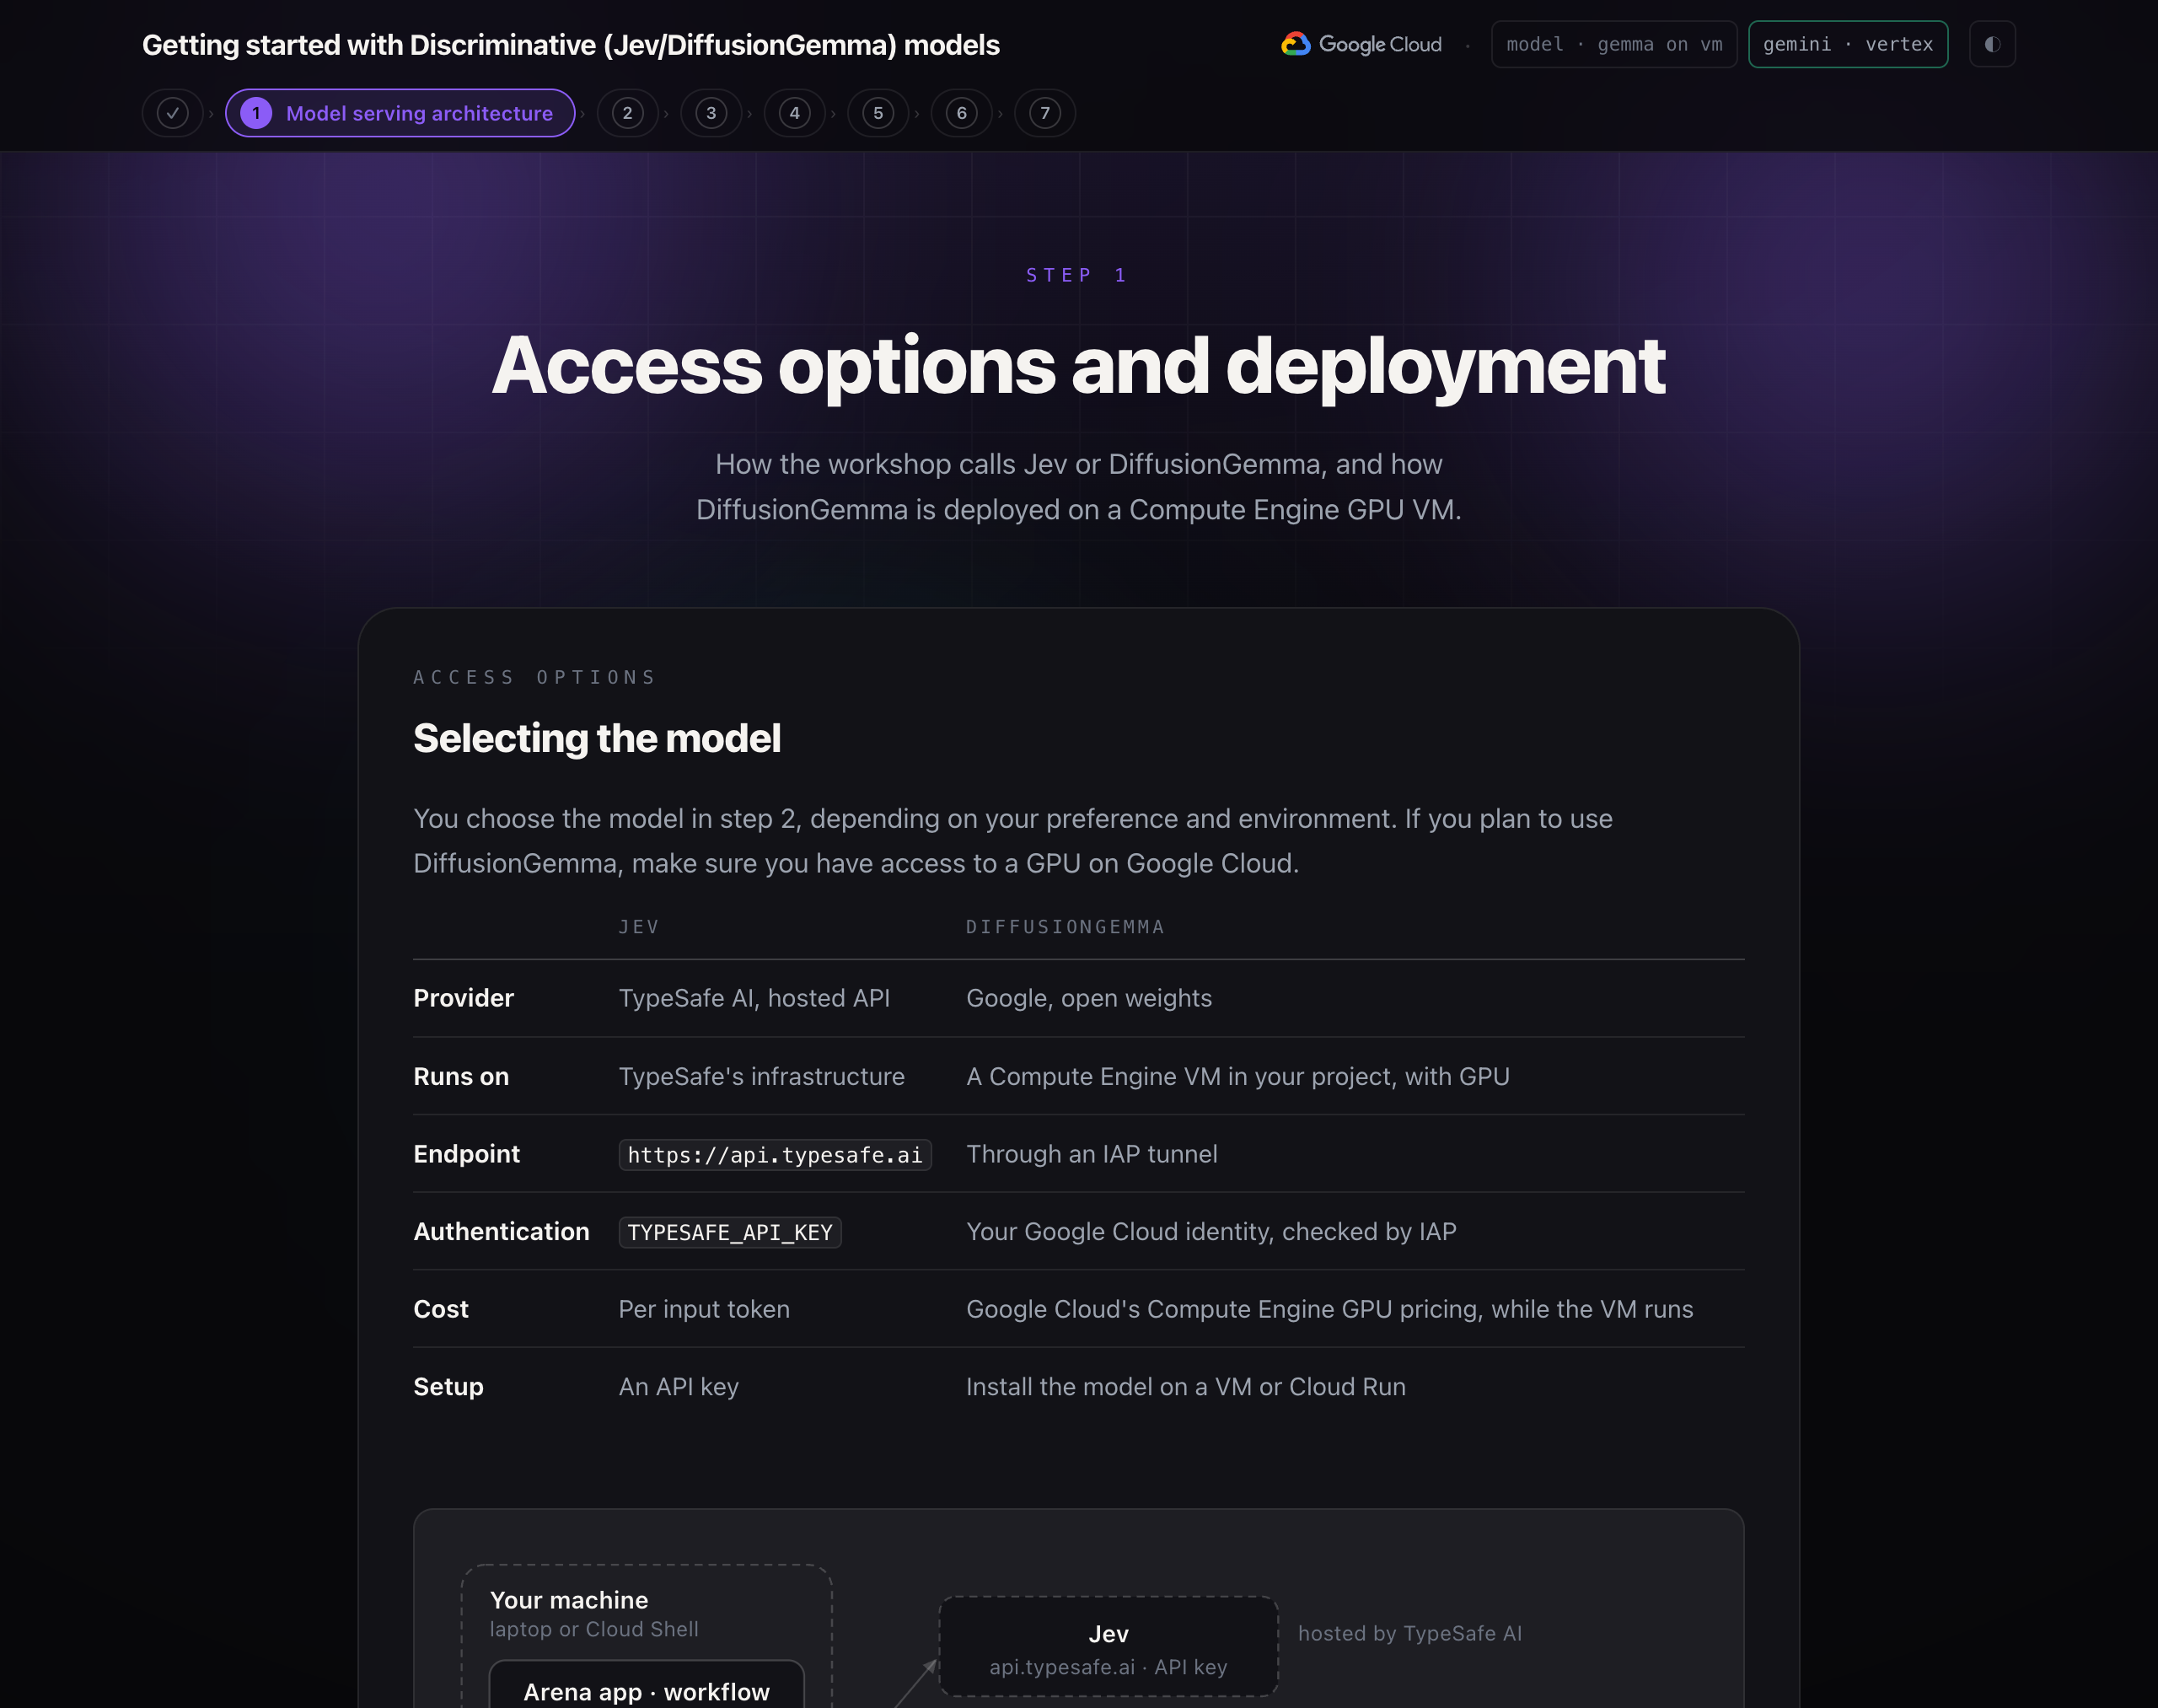
Bạn chọn mô hình ở bước 2, tuỳ thuộc vào sở thích và môi trường của bạn. Nếu bạn dự định sử dụng DiffusionGemma, hãy đảm bảo rằng bạn có quyền truy cập vào GPU trên Google Cloud.
Jev | DiffusionGemma | |
Nhà cung cấp | AI TypeSafe, API được lưu trữ | Google, quả tạ |
Chạy trên | Cơ sở hạ tầng của TypeSafe | Một VM Compute Engine trong dự án của bạn, có GPU |
Endpoint |
| Thông qua một đường hầm IAP |
Xác thực |
| Danh tính của bạn trên Google Cloud, được IAP kiểm tra |
Chi phí | Mỗi mã thông báo đầu vào | Giá GPU của Compute Engine trên Google Cloud trong khi VM đang chạy |
Thiết lập | Khoá API | Cài đặt mô hình trên một máy ảo hoặc Cloud Run |
Luồng dữ liệu
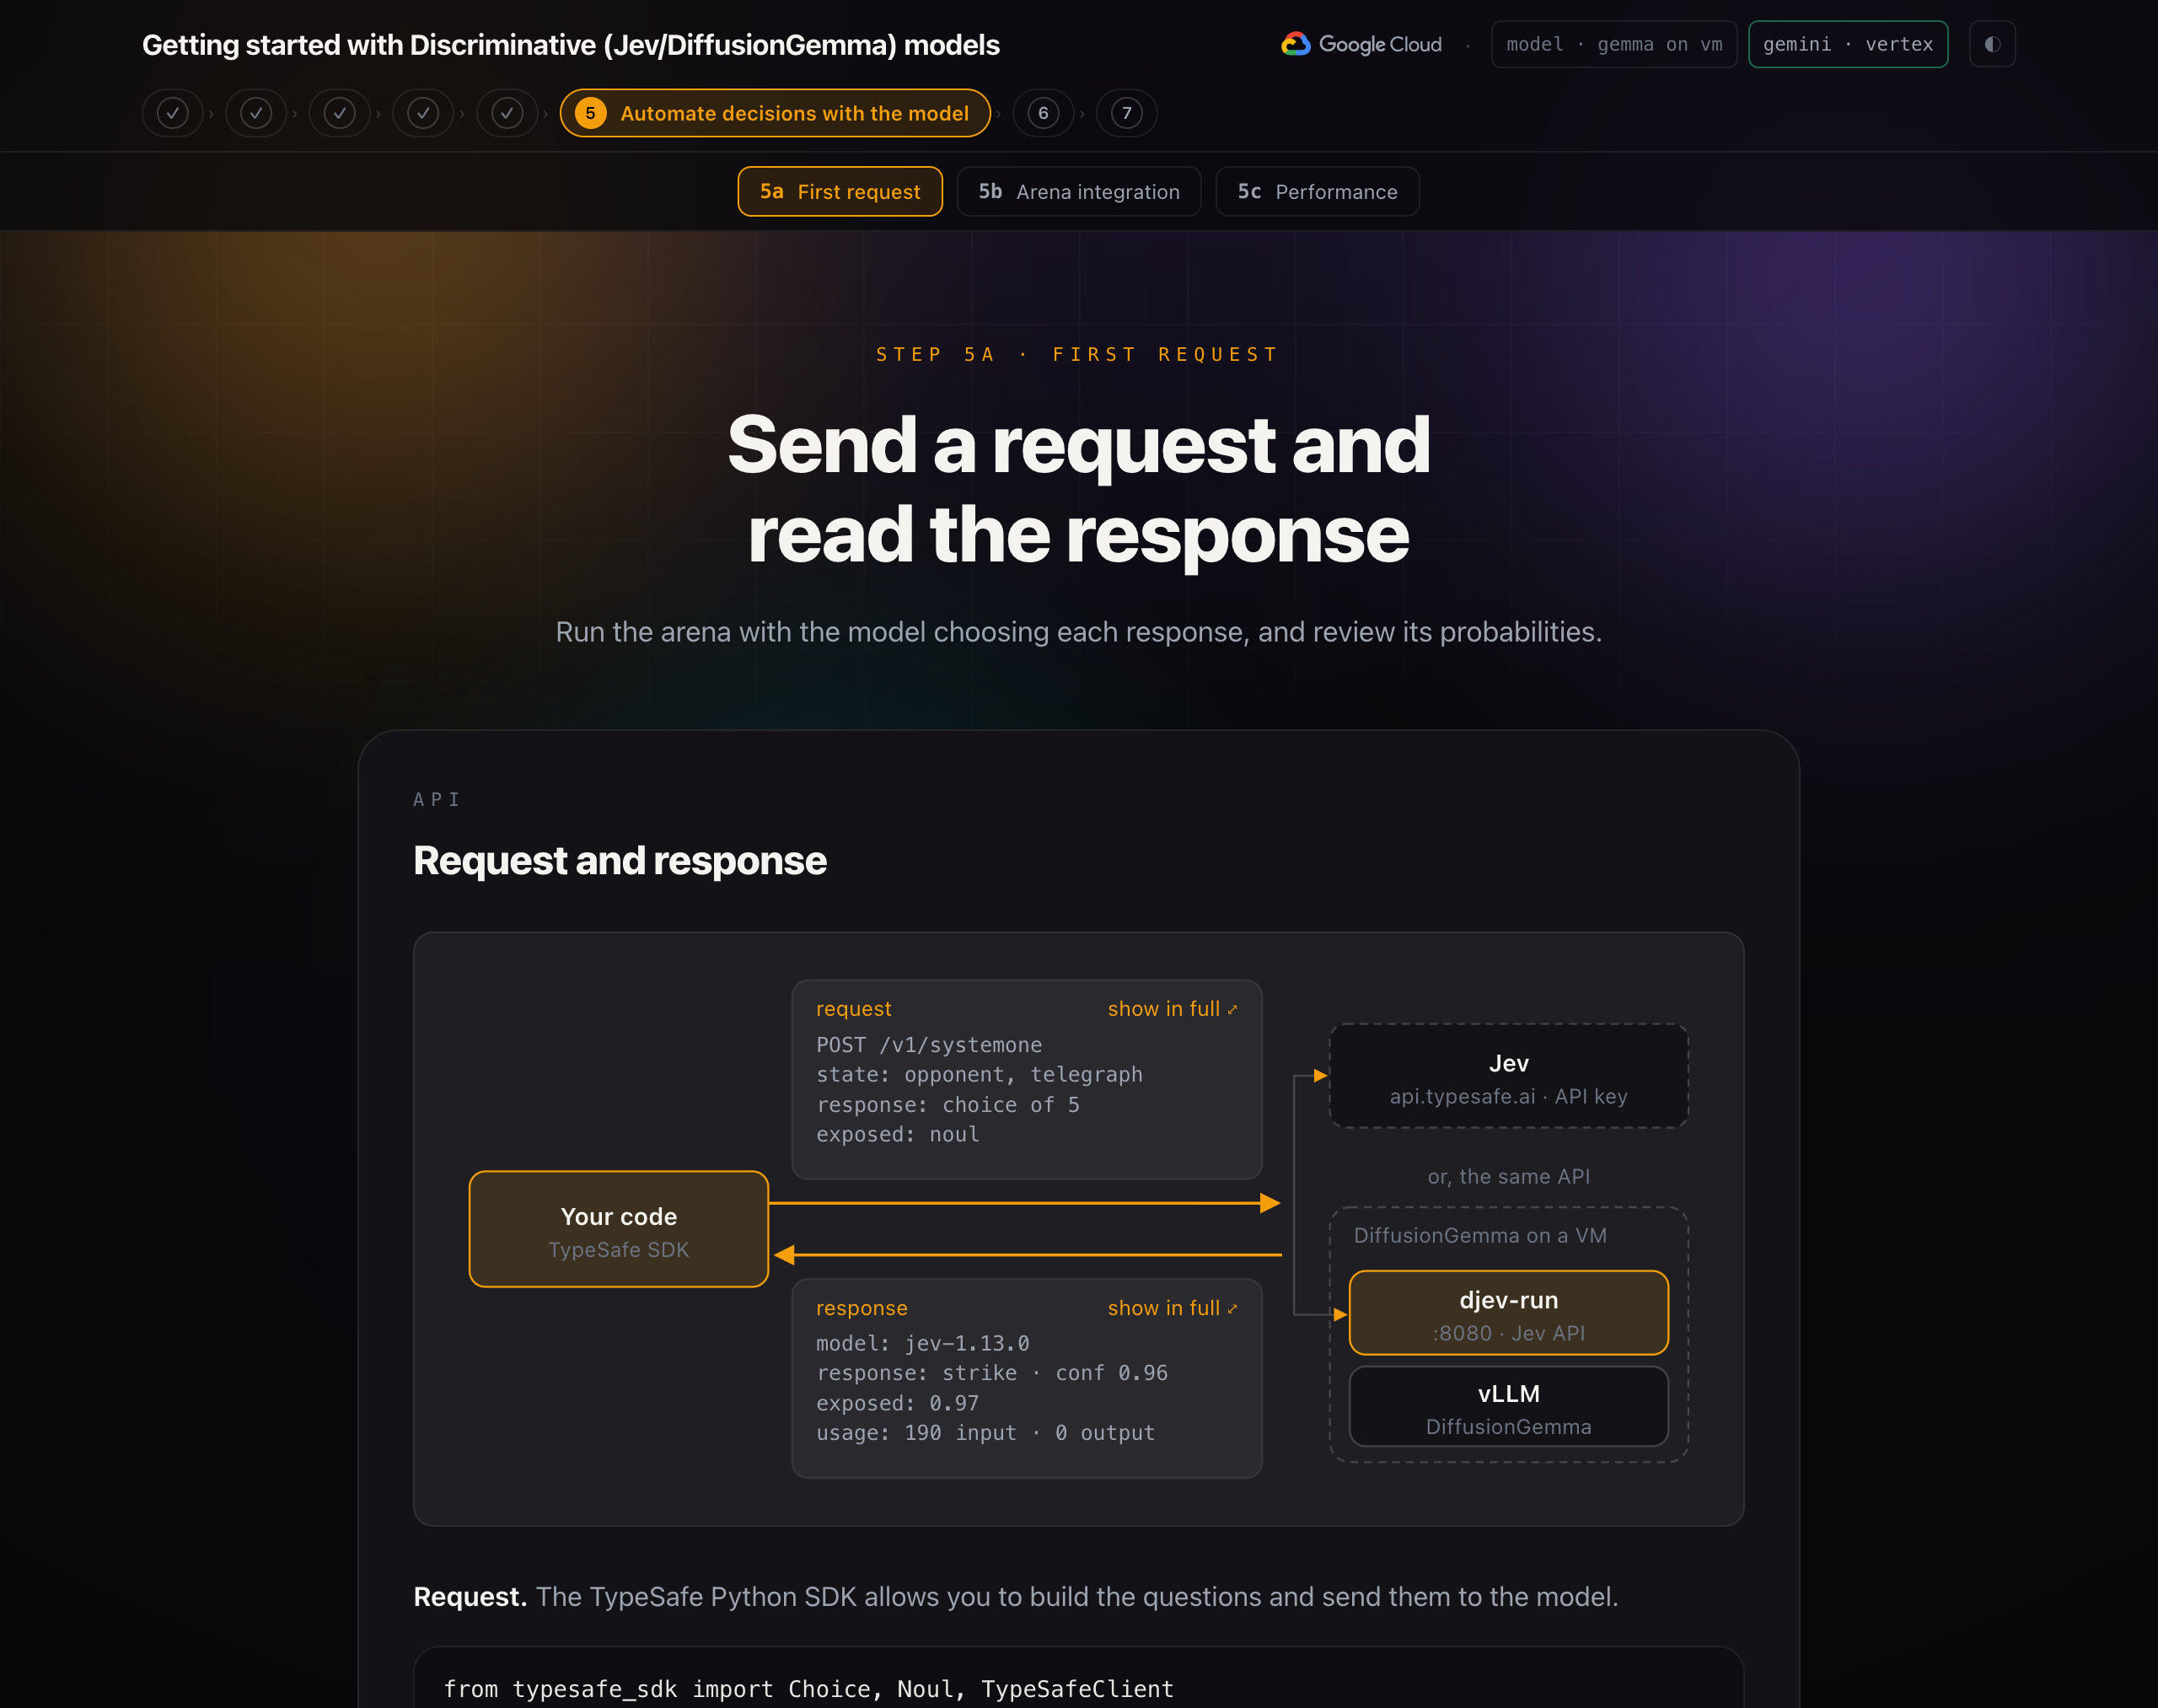
- Ứng dụng đấu trường hoặc quy trình ADK sẽ tạo một yêu cầu: trạng thái (những gì đối thủ đã làm) và 3 câu hỏi.
- TypeSafe SDK sẽ gửi yêu cầu này dưới dạng
POST /v1/systemoneđến URL cơ sở đã định cấu hình. - Đối với Jev, yêu cầu sẽ được gửi qua HTTPS đến
api.typesafe.ai, với khoá API là một mã thông báo của người mang. - Đối với DiffusionGemma, yêu cầu sẽ chuyển đến
localhost:8096. Một quy trìnhgcloud compute start-iap-tunnelở chế độ nền chuyển tiếp yêu cầu đó thông qua Identity-Aware Proxy (Uỷ quyền nhận biết danh tính), quy trình này sẽ kiểm tra danh tính của bạn trên Google, đến cổng 8080 trên VM. - Trên VM, djev-run nhận yêu cầu, chạy DiffusionGemma thông qua vLLM trên GPU và đọc xác suất của từng lựa chọn được phép.
- Cả hai phần phụ trợ đều trả về cùng một phản hồi: một câu trả lời cho mỗi câu hỏi, kèm theo xác suất và điểm số độ tin cậy. Mã hội thảo áp dụng các ngưỡng và hành động của mã.
DiffusionGemma trên Compute Engine
scripts/setup_gemma.sh tạo dự án này:
- Kiểm tra để đảm bảo khu vực có hạn mức cho GPU.
- Bật API Compute Engine và IAP, đồng thời tạo quy tắc tường lửa
allow-iap-djev. Nó chỉ cho phép dải địa chỉ IAP, trên các cổng 22 và 8080. - Tạo VM
djev-l4: loại máyg2-standard-4(4 vCPU, 16 GB bộ nhớ), một GPU có 24 GB, một ổ đĩa 100 GB và hình ảnh Deep Learning VM có trình điều khiển NVIDIA 580. Nếu một vùng không có dung lượng GPU, thì vùng đó sẽ thử vùng tiếp theo. - Khi khởi động lần đầu, tập lệnh khởi động của VM sẽ cài đặt Docker và NVIDIA Container Toolkit, kéo hình ảnh vùng chứa djev-run, tải các trọng số xuống từ Hugging Face (17,5 GB) và khởi động vùng chứa có quyền truy cập GPU trên cổng 8080. Quá trình này mất khoảng 15 phút. Các lần khởi động sau này mất khoảng 2.
- Ghi chế độ cài đặt kết nối vào
.envvà mở đường hầm.
Nhiệm vụ | Ra lệnh |
Dừng VM (giữ lại ổ đĩa) |
|
Bắt đầu lại |
|
Kiểm tra đường hầm |
|
Xoá mọi thứ |
|
Thiết lập mô hình
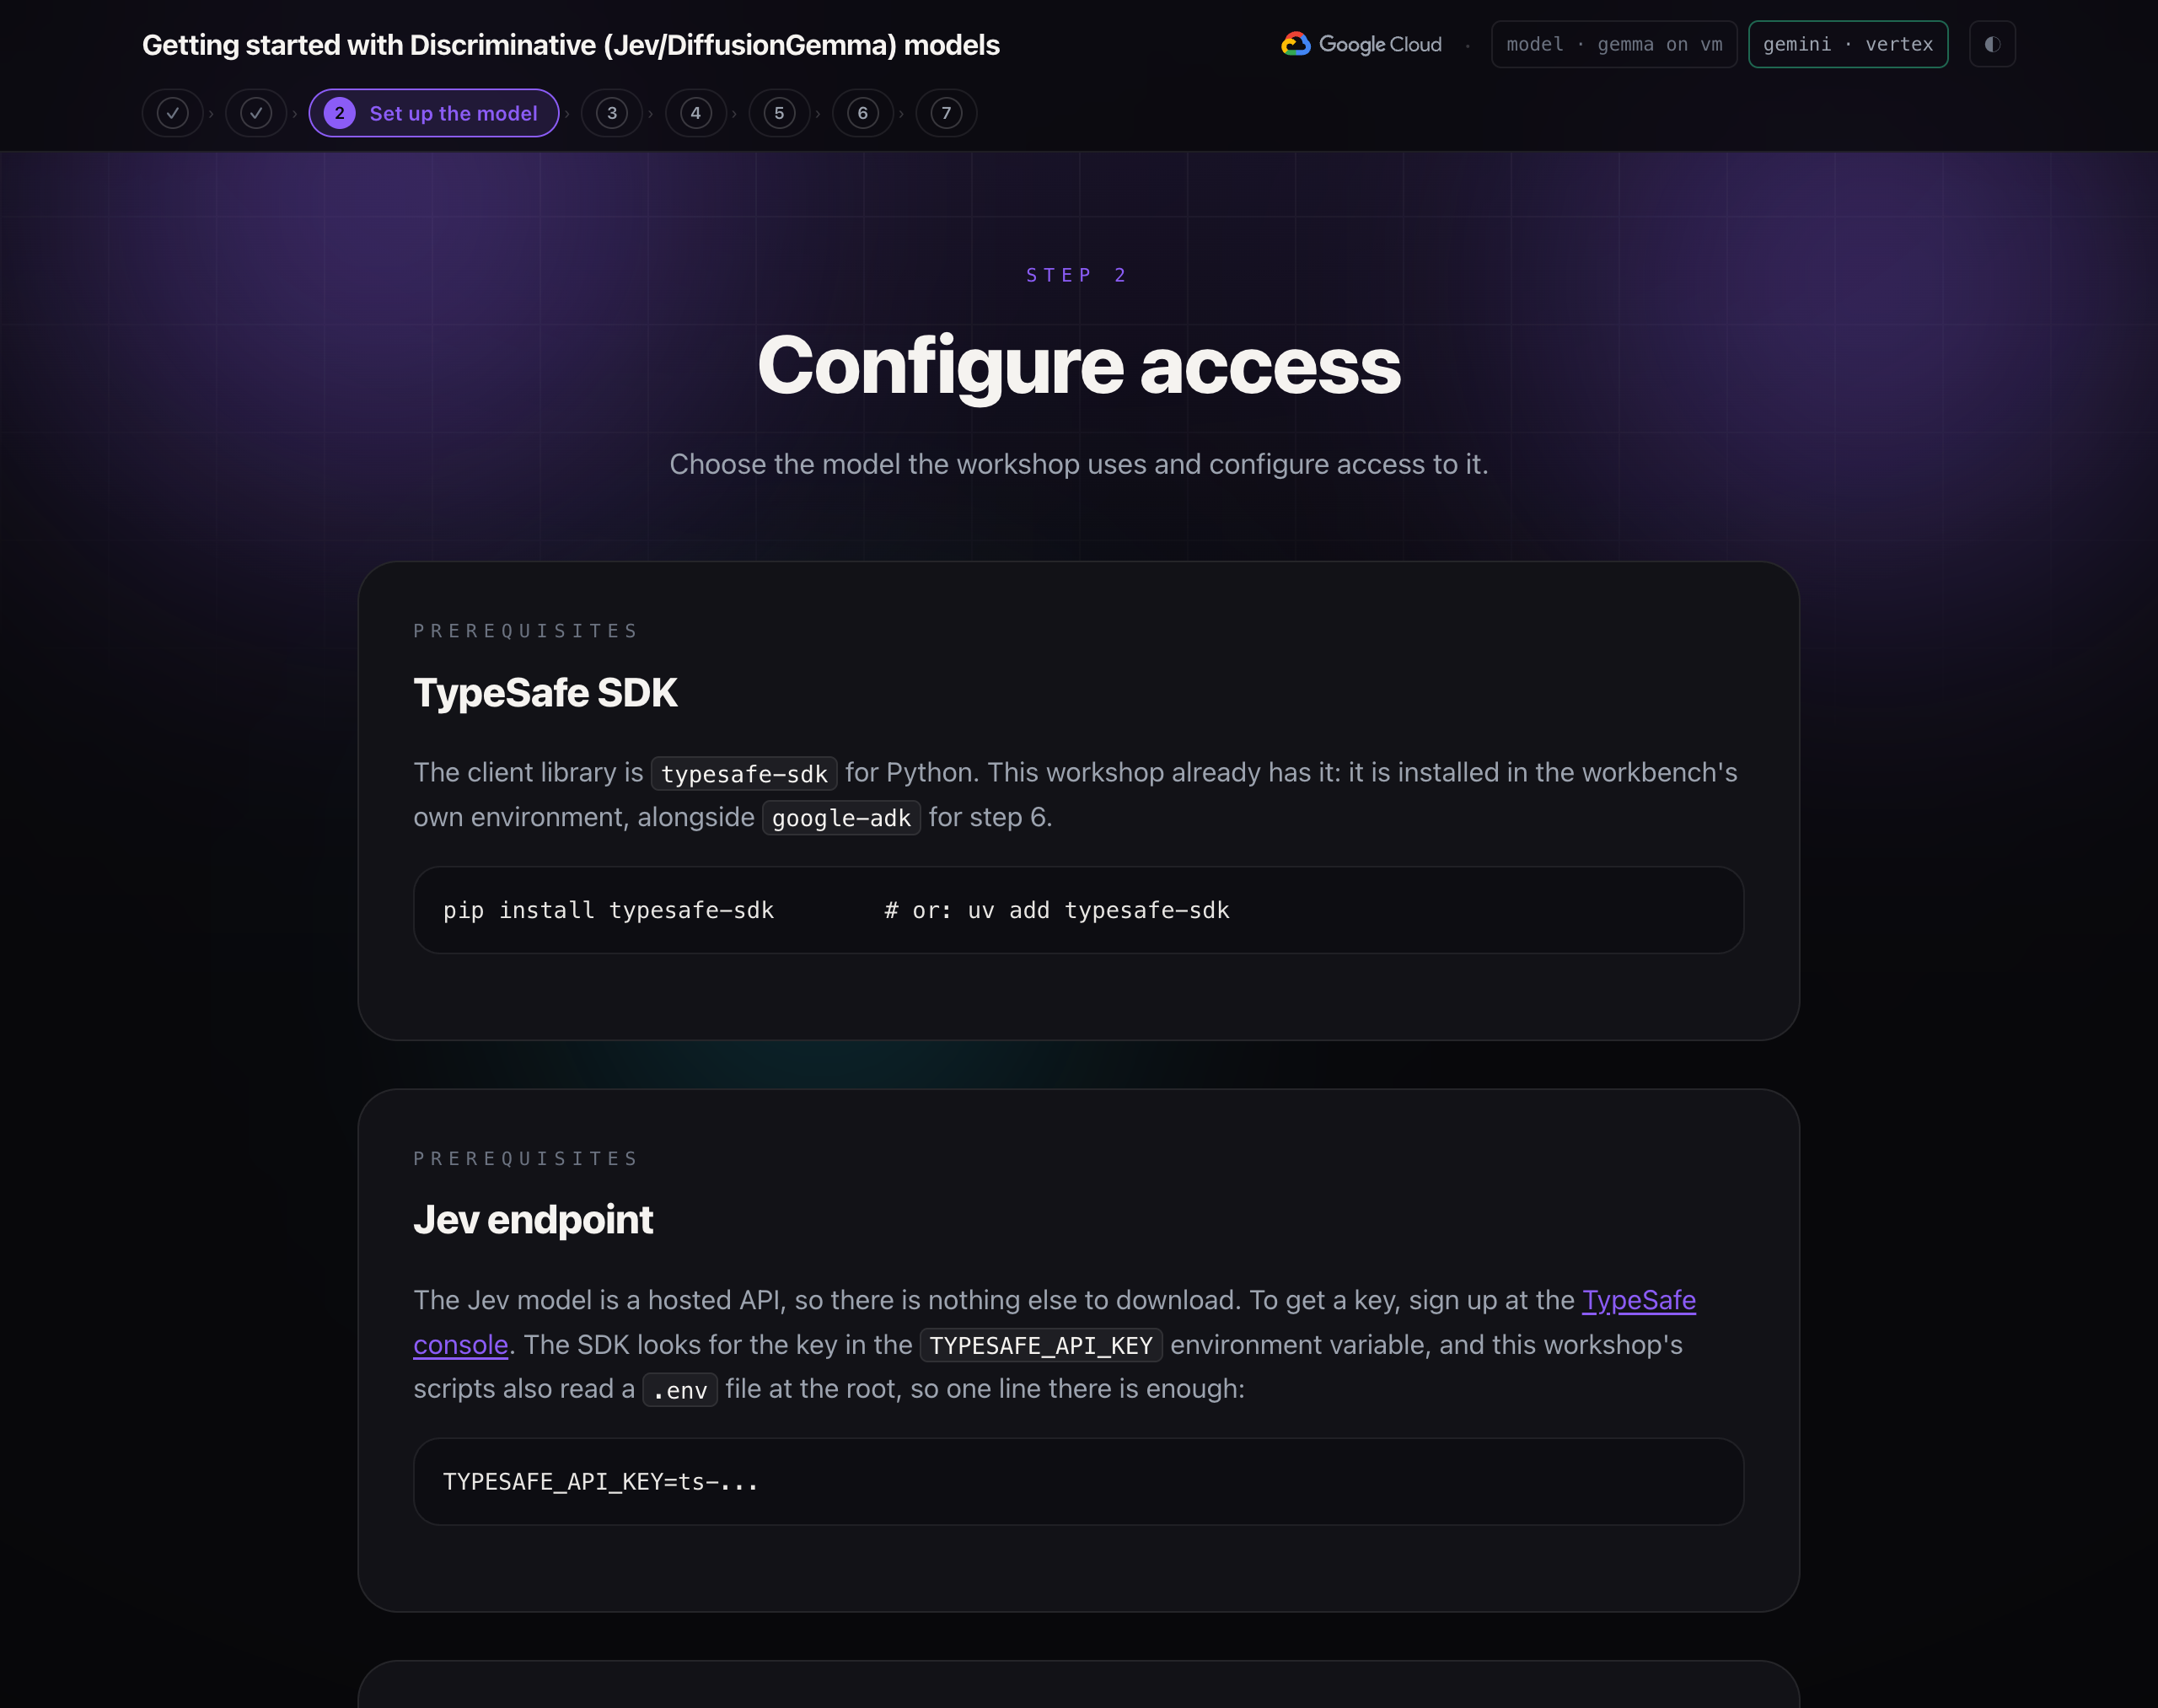
TypeSafe SDK
Thư viện ứng dụng là typesafe-sdk cho Python. Xưởng này đã có: nó được cài đặt trong môi trường riêng của băng ghế, cùng với google-adk cho bước 6.
pip install typesafe-sdk # or: uv add typesafe-sdk
Điểm cuối Jev
Mô hình Jev là một API được lưu trữ, nên bạn không cần tải thêm bất cứ thứ gì xuống. Để lấy khoá, hãy đăng ký tại bảng điều khiển TypeSafe. SDK sẽ tìm khoá trong biến môi trường TYPESAFE_API_KEY và các tập lệnh của hội thảo này cũng đọc một tệp .env ở thư mục gốc, vì vậy, một dòng ở đó là đủ:
TYPESAFE_API_KEY=ts-...
Sử dụng DiffusionGemma
djev-run triển khai lại API của mô hình Phân biệt. Mô hình này sử dụng cùng một điểm cuối POST /v1/systemone, với cùng các câu hỏi noul, lựa chọn và điểm số, từ DiffusionGemma, mô hình khuếch tán mở của Google DeepMind (tổng cộng 26 tỷ tham số, khoảng 4 tỷ tham số đang hoạt động, Apache 2.0). Vì định dạng wire là như nhau, nên TypeSafe SDK sẽ giao tiếp với định dạng này mà không thay đổi.
Nếu bạn chọn DiffusionGemma trong bài tập, thì mô hình này sẽ chạy trên một GPU trong một máy ảo trong dự án Google Cloud của riêng bạn và nút ở trên cùng bên phải sẽ có nội dung gemma on vm. Workbench truy cập vào mô hình thông qua một đường hầm IAP riêng tư và cổng của mô hình không kết nối với Internet. Bước 1 mô tả toàn bộ cấu trúc.
Lý do mô hình khuếch tán có thể làm được điều này: mô hình này điền vào toàn bộ khối vị trí cùng một lúc, với mọi vị trí đều thấy toàn bộ dữ liệu đầu vào, vì vậy, xác suất của từng lựa chọn được phép có thể được đọc trong một bước duy nhất. Một mô hình ngôn ngữ thông thường tạo ra từng mã thông báo một và sẽ phải được lấy mẫu nhiều lần.
Chơi trò chơi theo cách thủ công
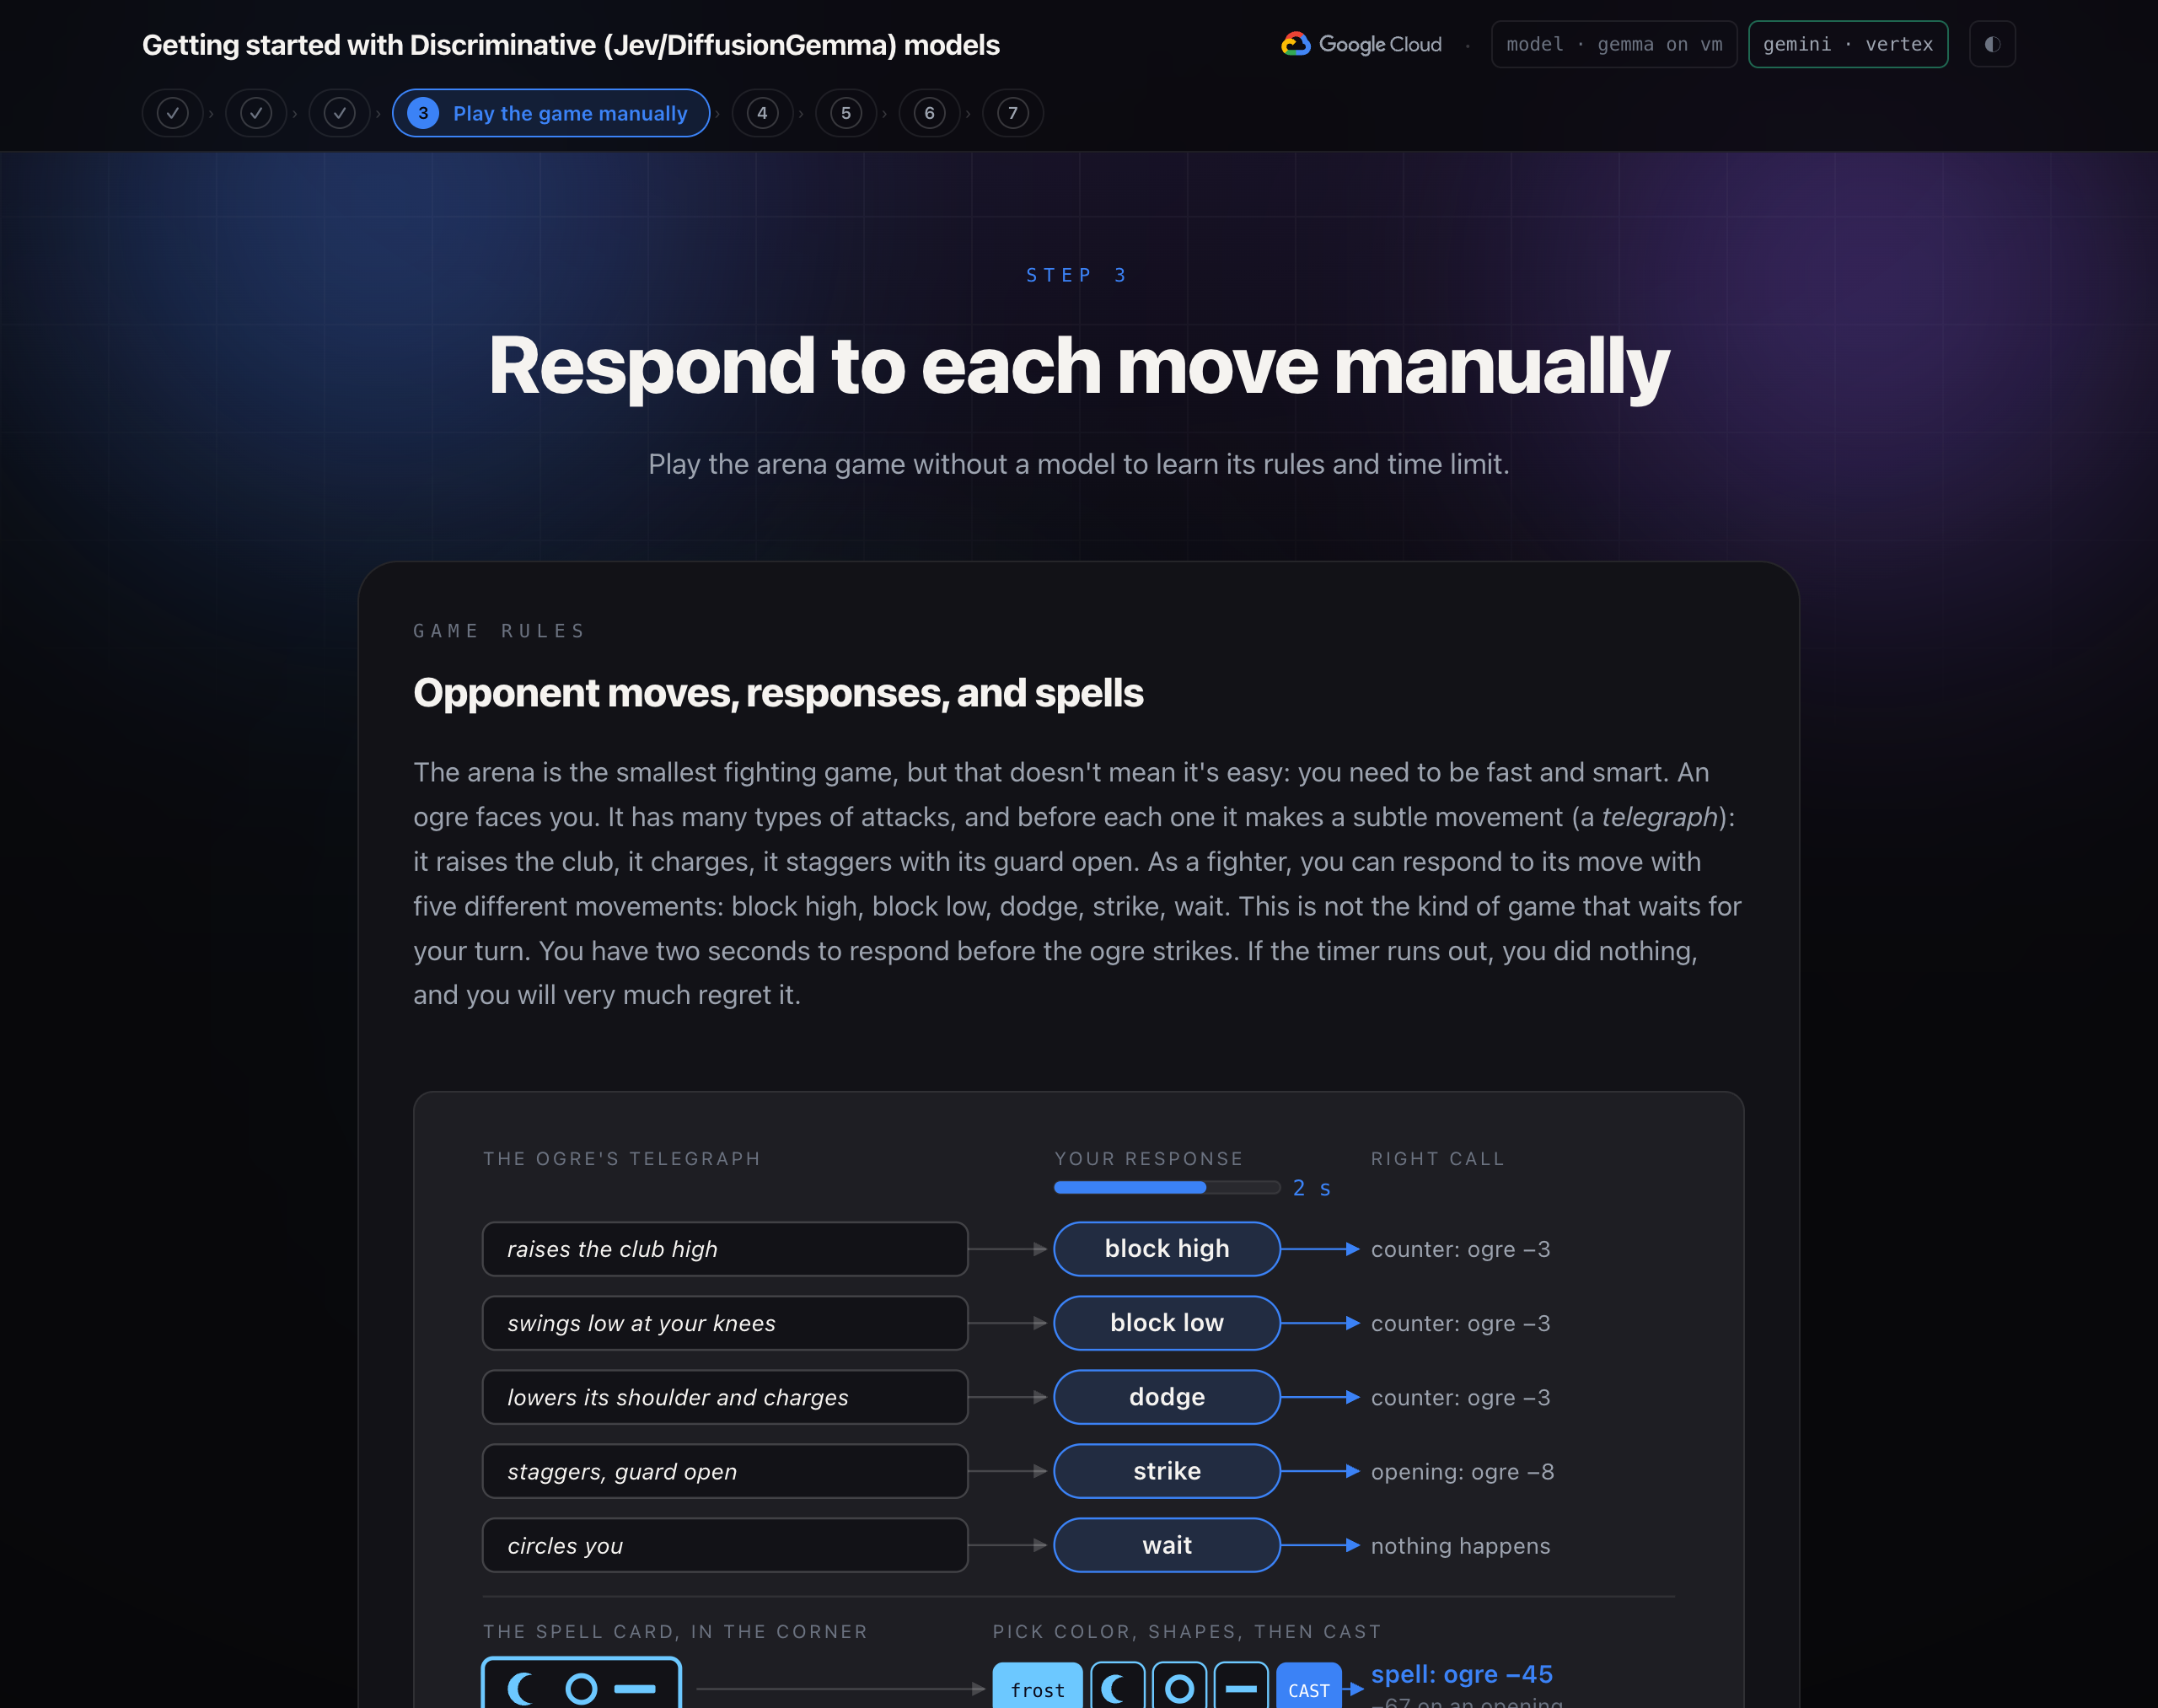
Đấu trường là trò chơi chiến đấu nhỏ nhất, nhưng không có nghĩa là dễ chơi: bạn cần phải nhanh chóng và thông minh. Một yêu tinh đang đối diện với bạn. Nó có nhiều kiểu tấn công và trước mỗi kiểu, nó sẽ thực hiện một động tác nhỏ (một động tác báo hiệu): nó giơ cây gậy lên, nó lao vào, nó loạng choạng khi mở khiên. Là một võ sĩ, bạn có thể phản ứng với động tác của đối thủ bằng 5 động tác: đỡ đòn trên, đỡ đòn dưới, né tránh, tấn công, chờ đợi. Đây không phải là loại trò chơi chờ đến lượt bạn. Bạn có 2 giây để phản ứng trước khi yêu tinh tấn công. Nếu hết thời gian, bạn sẽ không làm gì cả và sẽ rất hối hận.
Ở góc trên cùng bên trái của vòng tròn có một thẻ phép thuật: một thẻ có màu với 3 hình dạng. Chỉ có phép thuật phù hợp mới gây ra thiệt hại thực sự. Trong trò chơi, bạn có thể dùng phép thuật bằng các nút bên dưới trận chiến: chọn màu của thẻ, sau đó chọn hình dạng của thẻ từ trái sang phải, rồi nhấn vào DÙNG PHÉP. Đồng hồ vẫn tiếp tục chạy trong khi bạn chọn, vì vậy, bạn phải xây dựng phép thuật và phản ứng với các cuộc tấn công của yêu tinh cùng một lúc. Các phím từ 1 đến 5 vẫn trả lời từng nước đi. Một câu thần chú sai sẽ không có tác dụng. Ở bước 6, Gemini sẽ đọc thẻ phép thuật cho bạn.
Điểm mấu chốt: Một trận chiến là một chuỗi các quyết định nhỏ với thời hạn cho từng quyết định. Đó là cách mà hầu hết phần mềm tự động hoá hoạt động, chỉ khác là không có câu lạc bộ.
Các khái niệm về mô hình phân biệt
Quyết định trong phần mềm
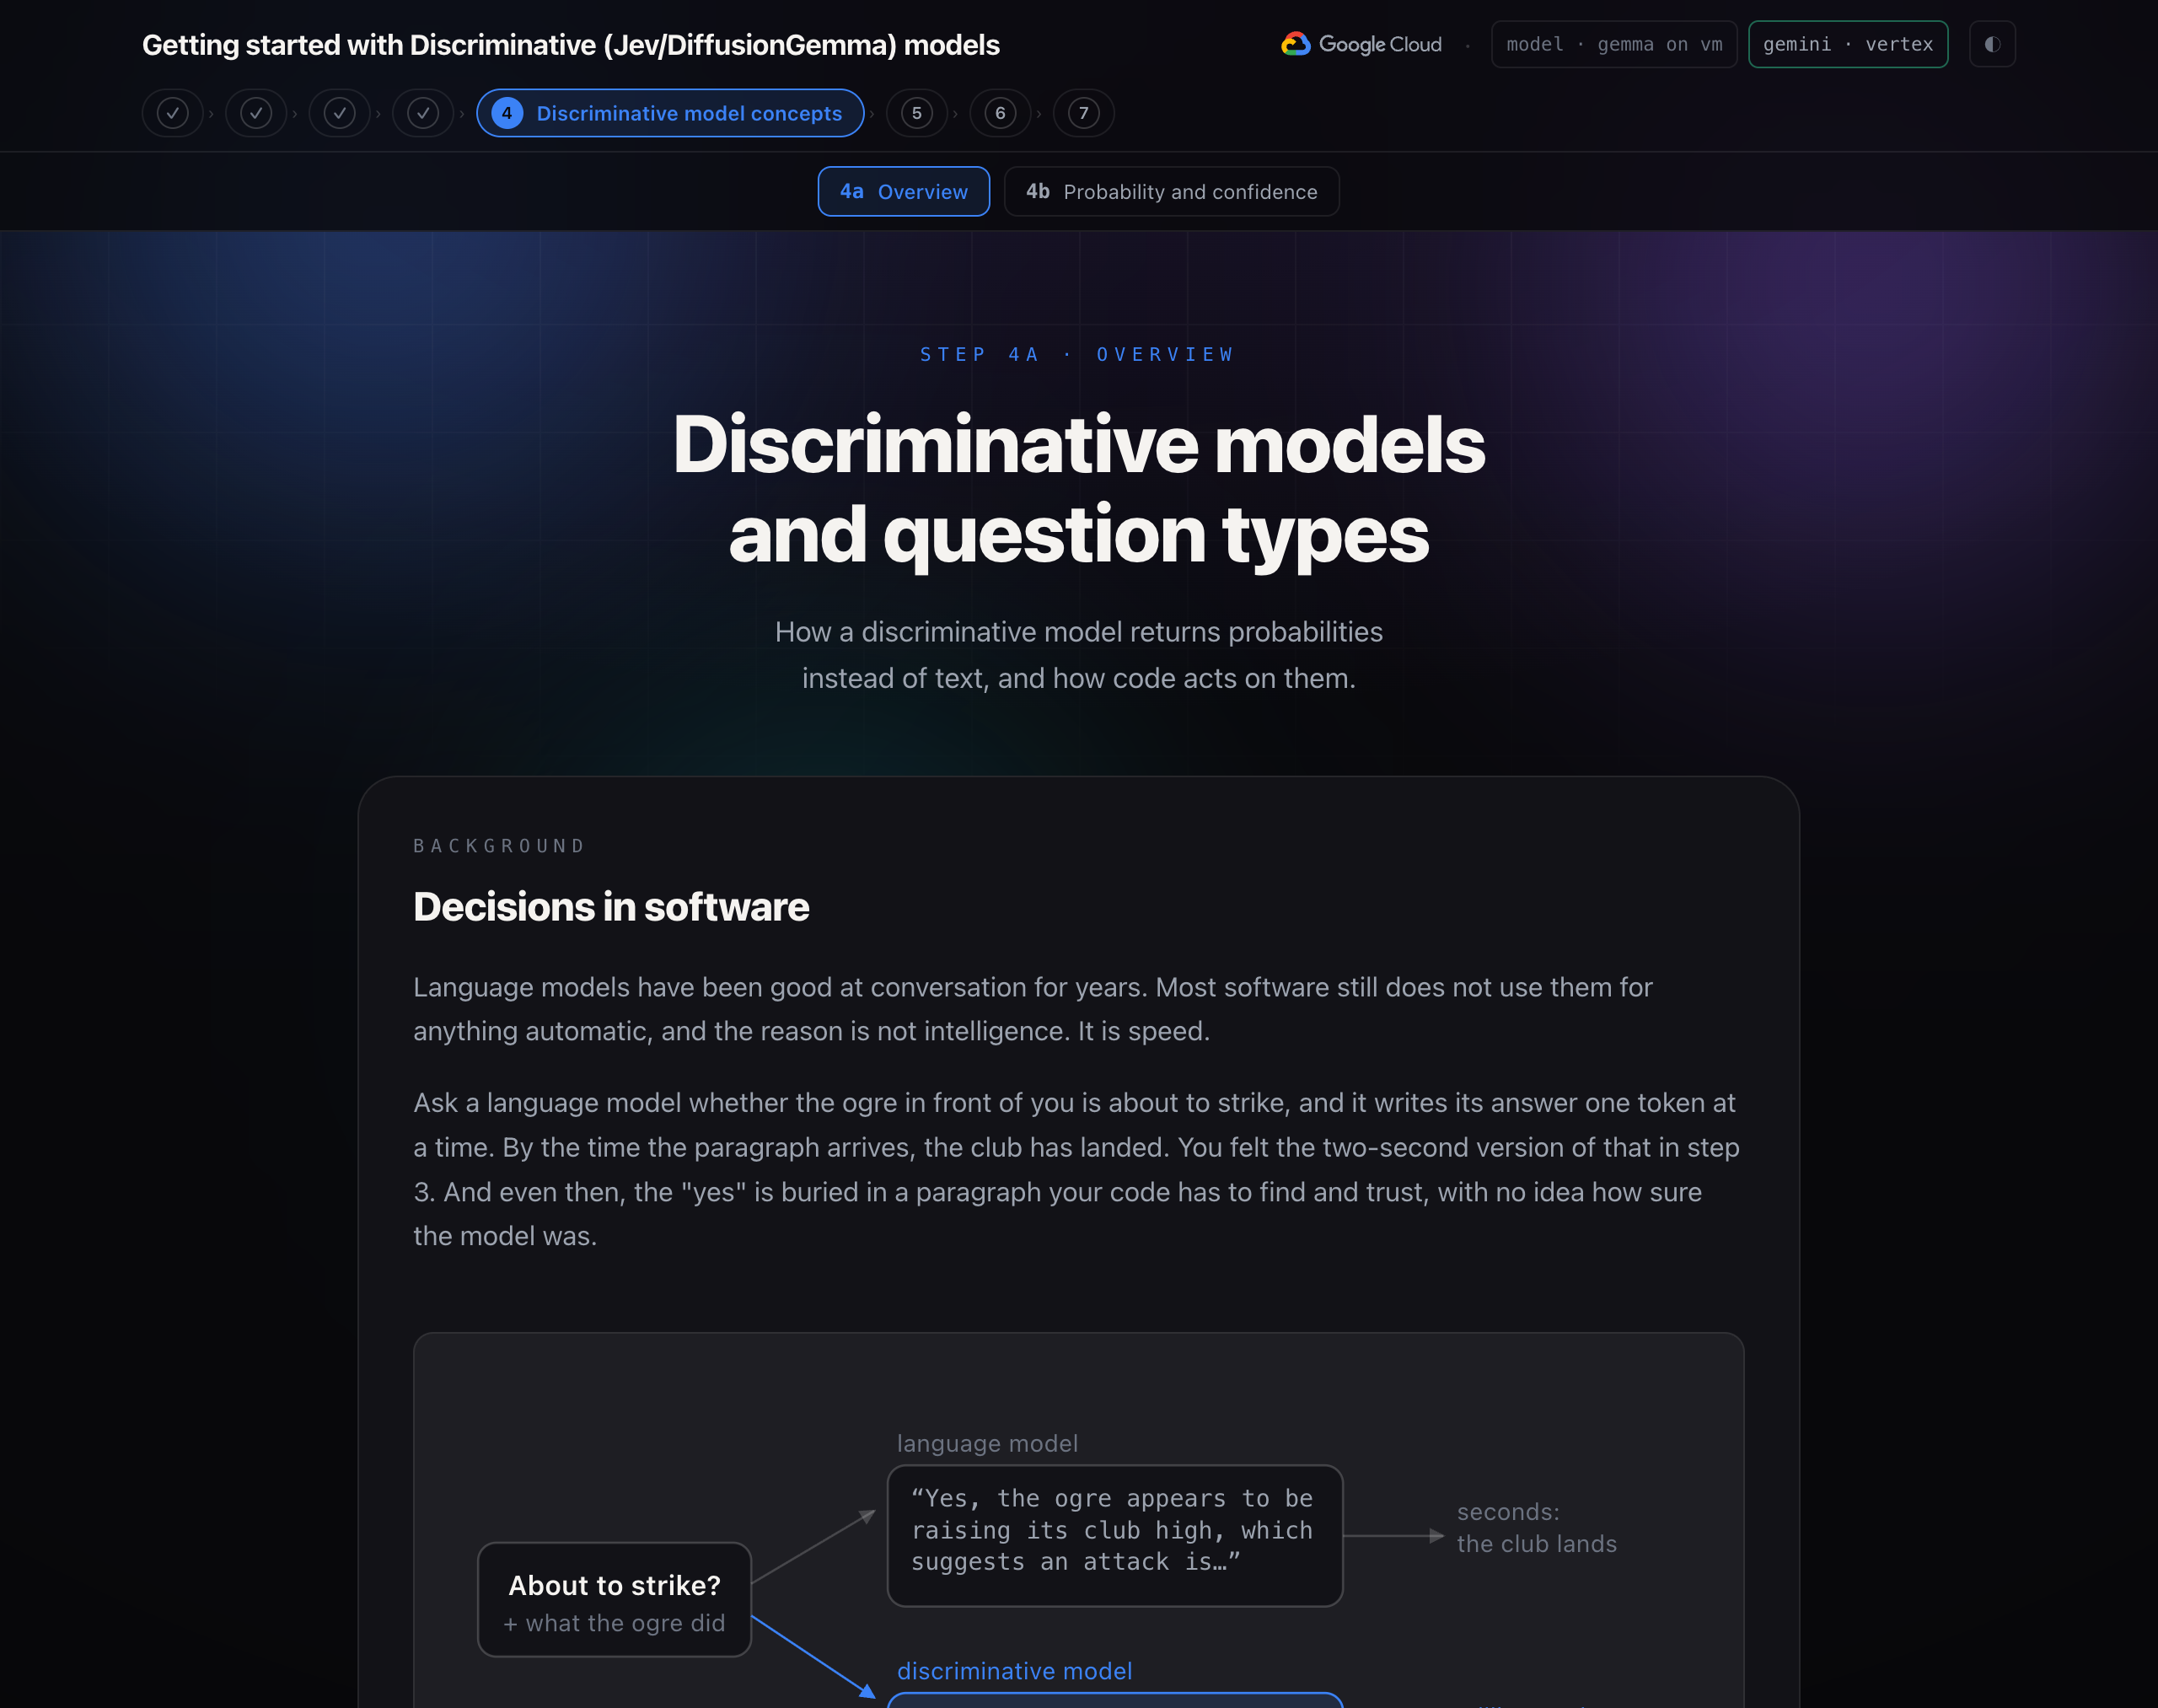
Các mô hình ngôn ngữ đã có khả năng trò chuyện hiệu quả trong nhiều năm. Hầu hết phần mềm vẫn chưa sử dụng các tính năng này cho bất kỳ hoạt động tự động nào và lý do không phải là do thiếu trí tuệ. Đó là tốc độ.
Hỏi một mô hình ngôn ngữ xem yêu tinh trước mặt bạn có sắp tấn công hay không, và mô hình này sẽ viết câu trả lời từng mã thông báo một. Đến khi đoạn văn xuất hiện, câu lạc bộ đã hạ cánh. Bạn đã cảm nhận được phiên bản 2 giây của hiệu ứng đó ở bước 3. Ngay cả khi đó, câu "có" vẫn nằm trong một đoạn văn mà mã của bạn phải tìm và tin tưởng, mà không biết mô hình chắc chắn đến mức nào.
Mô hình phân biệt sẽ lấy trạng thái và câu hỏi cũng như câu trả lời bạn nhập trong một lần, tính bằng mili giây. Mỗi câu trả lời đều đi kèm với một xác suất được hiệu chỉnh: 0,9 có nghĩa là đúng 9 lần trong 10 lần. Không có văn bản nào để phân tích cú pháp và không có JSON nào để trích xuất từ văn bản đó.
Mô hình Hệ thống 1 và Hệ thống 2
Tên này lấy từ cuốn sách Tư duy nhanh và chậm của Daniel Kahneman. Hệ thống 2 là quá trình suy luận chậm, có chủ ý, từng bước một. Hệ thống Một có tốc độ nhanh, so khớp mẫu.
Mô hình ngôn ngữ là một máy thuộc Hệ thống 2. Mô hình này suy luận theo từng mã thông báo. Mô hình phân biệt là một mô hình Hệ thống Một: mô hình này không suy luận công khai, không tạo ra bất kỳ nội dung nào và trả lời mọi câu hỏi trong một lần. Đó là lý do tại sao nó nhanh (khoảng 70 đến 500 mili giây) và rẻ (chỉ vài phần trăm của một xu cho mỗi nghìn quyết định).
Điểm chính cần ghi nhớ: Mô hình ngôn ngữ viết. Một mô hình quyết định sẽ quyết định. Hầu hết những gì phần mềm cần ở AI là một quyết định.
Các điểm hạn chế
Mô hình phân biệt sẽ không tạo văn bản, viết mã, trò chuyện, thực hiện phép tính, đọc hình ảnh hoặc làm theo một chuỗi các bước.
Trong hội thảo, chúng ta sẽ chọn một trong các mô hình Phân biệt:
- Một trong các mô hình phân biệt là Jev. Đây là một API được lưu trữ của TypeSafe AI, ra mắt vào tháng 9 năm 2026. Mô hình đầu tiên là
jev-1.13, được truy cập thông qua biệt hiệujev-latest. Không có trọng số nào được xuất bản, vì vậy, trọng số này được gọi chứ không được tải xuống. - Jev không phải là cách duy nhất để có được một mô hình System One. DiffusionGemma của Google là một mô hình có trọng số mở, ghi toàn bộ khối mã thông báo song song thay vì ghi từng mã thông báo một, và cùng một lượt truyền song song đó có thể đọc ra xác suất trên một tập hợp cố định các lựa chọn. Các máy chủ nguồn mở như djev-run đặt chính xác API của Jev ở phía trước, vì vậy mọi thứ trong hội thảo này đều chạy mà không thay đổi.
Tiểu bang và câu hỏi: Choice, Score và Noul
Mỗi lệnh gọi sẽ gửi trạng thái và câu hỏi. Trạng thái là văn bản bạn muốn được đánh giá. Đó có thể là một chuỗi, đối tượng JSON hoặc danh sách. Các câu hỏi sẽ hỏi bạn muốn biết điều gì về văn bản đó. Mỗi câu hỏi đều có một loại: Lựa chọn, Điểm số hoặc Noul. Các câu hỏi được xử lý song song, giúp mô hình phản hồi nhanh chóng. Bạn có thể thêm nhiều câu hỏi nếu cần.
- Lựa chọn chọn một lựa chọn trong số tối đa 255 lựa chọn mà bạn đặt tên. Câu trả lời là lựa chọn, xác suất cho mỗi lựa chọn và độ tin cậy. Sử dụng khi các lựa chọn không có thứ tự giữa chúng: chặn cao, chặn thấp, né tránh, tấn công, chờ đợi.
- Điểm số đánh giá trạng thái theo các cấp độ có thứ tự mà bạn mô tả, từ 2 đến 10 cấp độ. Câu trả lời là một vị trí trên thang điểm (một số thập phân, tức là 1, 4 có nghĩa là "giữa 1 và 2, gần 1 hơn"), xác suất của từng cấp độ và độ tin cậy. Hãy sử dụng tính năng này khi câu trả lời là vấn đề về mức độ: mức độ mạnh của cú đánh sắp tới.
- Cả Choice và Score đều trả về xác suất cho từng lựa chọn và độ tin cậy. Điểm khác biệt là câu trả lời chính. Choice trả về lựa chọn có nhiều khả năng nhất. Điểm số coi các lựa chọn là các cấp độ có thứ tự và trả về giá trị trung bình có trọng số xác suất của các lựa chọn đó, có thể nằm giữa hai cấp độ. Với không có 0,05, nhẹ 0,55 và nặng 0,40, một Lựa chọn trả lời "nhẹ" và Điểm trả lời là 1,35, nằm giữa nhẹ và nặng. Đấu trường sử dụng giá trị đó:
choose()coi điểm số nguy hiểm từ 1,5 trở lên là một cú đánh mạnh.
- Cả Choice và Score đều trả về xác suất cho từng lựa chọn và độ tin cậy. Điểm khác biệt là câu trả lời chính. Choice trả về lựa chọn có nhiều khả năng nhất. Điểm số coi các lựa chọn là các cấp độ có thứ tự và trả về giá trị trung bình có trọng số xác suất của các lựa chọn đó, có thể nằm giữa hai cấp độ. Với không có 0,05, nhẹ 0,55 và nặng 0,40, một Lựa chọn trả lời "nhẹ" và Điểm trả lời là 1,35, nằm giữa nhẹ và nặng. Đấu trường sử dụng giá trị đó:
- Noul đặt câu hỏi có/không và trả về xác suất câu trả lời là có. Gần 1 là có khả năng cao, gần 0 là không có khả năng, gần 0,5 là "có thể là một trong hai". Không có độ tin cậy riêng biệt, vì xác suất chính là mức độ tin cậy.
Viết câu hỏi tập trung
Mô hình phân biệt hoạt động hiệu quả nhất khi một câu hỏi yêu cầu một điều cụ thể, có phạm vi rõ ràng. "What is the situation?" (Tình hình hiện tại là gì?) trả về một câu trả lời hợp lý nhưng có độ tin cậy thấp. "Câu trả lời đúng là gì?", "Is the opponent exposed?" (Đối thủ có bị lộ diện không?) và "How hard will this hit?" (Đòn này sẽ mạnh đến mức nào?) sẽ trả về 3 câu trả lời trọng tâm mà mã của bạn kết hợp.
Nội dung mô tả về các lựa chọn và cấp độ có chi phí thấp và rất quan trọng. Các quy tắc bạn đọc ở bước 3 sẽ trở thành nội dung mô tả lựa chọn: block_high: "Raise the shield. Right against an overhead or a high swing." Đó là cách mô hình phân biệt học các quy tắc của trận đấu, tại thời điểm yêu cầu, mỗi quy tắc trên một dòng. Các lựa chọn có thể thay đổi tuỳ theo tình huống: đấu trường chỉ cung cấp cast khi phép thuật đã sẵn sàng.
Xác suất và độ tin cậy
Câu trả lời Lựa chọn không phải là nhãn. Đó là một phân phối trên các nhãn và nhãn chỉ là thanh cao nhất.
Cách mô hình lấy số. Công cụ này sử dụng cùng một bước mà mô hình ngôn ngữ dùng để chọn từ tiếp theo. Một transformer đọc văn bản và tại một vị trí, đưa ra điểm số thô cho mọi mã thông báo trong từ vựng của nó, được gọi là logit. Logit càng cao thì mã thông báo càng phù hợp với vị trí đó. Một softmax sẽ chuyển đổi các logit thành xác suất cộng lại thành 1. Sau đó, một mô hình ngôn ngữ sẽ chọn một mã thông báo, thêm mã thông báo đó vào văn bản và lặp lại quy trình này. Mô hình phân biệt sẽ dừng sau khi tính toán xong các xác suất.
Chỗ trống là một khoảng trống trong biểu mẫu câu trả lời. Máy chủ tự viết biểu mẫu, chẳng hạn như response: ▢ và để trống một khoảng cho mỗi câu hỏi. Công việc duy nhất của mô hình là chấm điểm những gì thuộc về mỗi khoảng trống.
- Câu hỏi giữ trạng thái và mỗi câu hỏi, với mọi câu trả lời được phép dưới dạng một nhãn ngắn:
acho block_high,bcho block_low, v.v. - Máy chủ sẽ thêm biểu mẫu trả lời, với một ô trống cho mỗi câu hỏi.
- Mô hình này đọc câu lệnh và biểu mẫu trong một lần và đưa ra một logit cho mỗi mã thông báo tại mỗi khoảng trống. Mô hình khuếch tán sẽ xem toàn bộ biểu mẫu cùng một lúc và chấm điểm tất cả các ô trống cùng nhau.
- Máy chủ chỉ giữ lại các logit của nhãn được phép và áp dụng một hàm softmax cho các logit đó, do đó, các câu trả lời được phép sẽ cộng lại thành 1.
- Nếu kết quả đọc có vẻ không chắc chắn, máy chủ sẽ đọc lại từ một điểm bắt đầu ngẫu nhiên khác và tính trung bình các kết quả đọc.
Độ tin cậy là một con số cho biết mức độ chắc chắn của câu trả lời. TypeSafe tính toán độ tin cậy dựa trên mức độ phân tán của xác suất giữa các lựa chọn. Tất cả đều ở một lựa chọn sẽ cho ra kết quả là 1, còn nếu phân bổ đều thì kết quả là 0. Đối với 3 lựa chọn, công thức là (3 × số lớn nhất – 1) / 2.
TypeSafe huấn luyện Jev cho các xác suất đã hiệu chỉnh. Xác suất này cho biết tần suất câu trả lời đúng. Trong một mô hình được hiệu chỉnh, câu trả lời có độ tin cậy là 0,7 sẽ đúng khoảng 70% thời gian.Vì vậy, ngưỡng về độ tin cậy là ngưỡng về tần suất bạn chấp nhận một câu trả lời sai. Máy chủ DiffusionGemma trong hội thảo này tự báo cáo xác suất cao nhất dưới dạng độ tin cậy, được tính trung bình trên các lượt đọc của máy chủ. Khi các chỉ số không nhất quán, mức trung bình sẽ trải rộng và độ tin cậy giảm xuống.
Thông tin chính: Câu trả lời cho bạn biết điều gì. Độ tin cậy cho bạn biết có nên hành động hay không.
Ngưỡng
Ngưỡng là cách bạn xác định thao tác trong mã. Mô hình này trả về độ tin cậy hoặc xác suất. Mã của bạn sẽ so sánh số này với một số mà bạn đã chọn và kết quả sẽ quyết định điều gì xảy ra.
Một ngưỡng cho mỗi hành động. TypeSafe đề xuất chia độ tin cậy thành các dải. Độ tin cậy cao sẽ tự động hoạt động. Hành động có độ tin cậy trung bình sẽ có một bước kiểm tra, chẳng hạn như yêu cầu xác nhận hoặc gắn cờ trường hợp để xem xét. Độ tin cậy thấp không hoạt động và quay lại một lựa chọn an toàn hoặc chuyển cho một người.
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
Các quy tắc của đấu trường. Các ngưỡng của đấu trường nằm trong choose() mà bạn chạy ở bước 5.
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
Cảnh báo: Câu trả lời hợp lệ không phải lúc nào cũng là câu trả lời chính xác. Mô hình phân biệt không thể trả về một lựa chọn mà bạn không đưa ra, vì vậy, mô hình này không bao giờ tạo ra một nước đi ảo, nhưng có thể chọn sai nước đi, đôi khi với độ tin cậy cao. Hãy kiểm tra các câu hỏi của bạn dựa trên những tình huống mà bạn đã đánh giá trước khi tin tưởng vào một ngưỡng.
Tự động hoá các quyết định bằng mô hình
Yêu cầu và phản hồi
Yêu cầu. TypeSafe Python SDK cho phép bạn tạo câu hỏi và gửi đến mô hình.
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
Một yêu cầu cho mỗi dấu tích
Mỗi lần đánh dấu, ứng dụng sẽ gửi điện báo dưới dạng trạng thái và yêu cầu 3 việc trong một lệnh gọi:
- Phản hồi nào là đúng trong số 5 (hoặc 6, khi có phép thuật). Một lựa chọn.
- Liệu người khổng lồ có đang tiếp xúc với một bộ đếm hay không. A Noul.
- Mức độ mạnh của cú đánh, theo thang điểm 3 cấp. Điểm số.
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
Hàm choose()
Bạn còn nhớ các ngưỡng ở bước 4 không? choose() so sánh câu trả lời của mô hình với các con số cố định và những con số cố định này là ngưỡng.
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() là cách đọc Python thông thường đối với các giá trị được nhập, với 2 quy tắc. Mô hình phân biệt cung cấp xác suất và phân tích của mô hình, đồng thời mã sử dụng các ngưỡng cho các quy tắc. Thao tác đã chọn sẽ được gửi đến công cụ, nơi thao tác này sẽ được dùng để chiến đấu với yêu tinh.
Điểm mấu chốt: Lưu trữ các câu hỏi và ngưỡng ở cùng một nơi. Đây là phần mà bạn sẽ điều chỉnh nhiều nhất trong quá trình tích hợp Hệ thống 1.
Thời gian phản hồi, giá dựa trên dữ liệu đầu vào và logic quyết định
- Thời gian phản hồi cho mỗi quyết định. Mỗi nhịp của trận chiến trong phần b quay lại sau khoảng một trăm mili giây, một vài nhịp sau hai hoặc ba trăm mili giây. Tốc độ này đủ nhanh cho một vòng lặp trò chơi, đường dẫn yêu cầu hoặc kiểm tra mọi thông báo trước khi một người hoặc một mô hình ngôn ngữ nhìn thấy thông báo đó.
- Định giá dựa trên dữ liệu đầu vào. Một trận đấu hoàn chỉnh, 60 quyết định với 3 câu hỏi cho mỗi quyết định, có chi phí thấp hơn 1/10 xu. Số lượng mã thông báo đầu ra bằng 0 vì không có nội dung nào được tạo. Hậu quả là bạn có thể yêu cầu nhiều hơn mức cần thiết. Đấu trường hỏi liệu yêu tinh có xuất hiện trên mọi dấu tích hay không, mặc dù chỉ có
strikevàcastquan tâm, vì việc hỏi gần như không tốn kém và câu trả lời hữu ích trên trang tổng quan. TypeSafe gọi đây là speculative fan-out (phân đầu ra có tính suy đoán). - Kết hợp sự tự tin và nguy hiểm. Khi độ tin cậy của mô hình phân biệt đối với phản hồi dưới 0,40 và điểm nguy hiểm cho biết sắp có một đòn tấn công mạnh,
choose()sẽ ghi đè phản hồi đó bằng một đòn né tránh. Né tránh hiếm khi là câu trả lời tốt nhất, nhưng cũng hiếm khi là câu trả lời tệ nhất. Chọn ngưỡng dựa trên chi phí của từng lỗi, chứ không phải dựa trên một con số làm tròn, đồng thời kiểm tra các ngưỡng đó dựa trên những thông tin bạn đã đánh giá theo cách thủ công. Lời khuyên của chính TypeSafe: nếu một quyết định liên tục đưa ra kết quả sai, hãy thắt chặt câu hỏi trước khi bạn di chuyển ngưỡng.
Kết hợp các mô hình trong quy trình ADK
Giới hạn của quyết định theo từng nhịp và lý do khiến câu trả lời chính xác là chưa đủ
Dòng cuối cùng của cuộc chiến ở bước 5 có nội dung: con yêu tinh lảo đảo bỏ đi, hầu như không bị thương. Mô hình phân biệt không bị sát thương và gây ra một chút sát thương cho mỗi lần đánh, và 300 điểm trúng đích nhiều hơn một chút so với 60. Thẻ phép thuật ở góc võ đài vẫn luôn ở đó. Để đọc được, bạn cần có một mô hình có thể nhìn thấy hình ảnh.
Con yêu tinh có 300 điểm trúng đích. Một cuộc gọi đúng sẽ được tính là 3. Một cú đánh vào lỗ sẽ gây ra 8 điểm, vì lớp da rất dày. Ngay cả một trận chiến hoàn hảo kéo dài 60 nhịp cũng khiến yêu tinh bị thương và vẫn đứng vững, và trò chơi gọi đó là một trận hoà. Đó là nơi kết thúc bước 5: mô hình phòng thủ tốt nhưng vẫn không thể giành chiến thắng.
Chỉ có phép thuật mới gây ra sát thương thực: 45 khi thi triển hoàn hảo, 67 khi trúng vào một lỗ hổng.
Giao mỗi nhiệm vụ cho mô hình phù hợp
Thẻ phép thuật ở góc của chiếc nhẫn là cách để giành chiến thắng, và việc đọc thẻ không phải là vấn đề về văn bản: đó là một bức tranh, có màu sắc và ba hình dạng liên tiếp, và phép thuật phải được hát để khớp. Điều đó đòi hỏi một mô hình có thể xem xét một hình ảnh và mất vài giây để xử lý. Trong một trận chiến, vài giây là 10 nhịp.
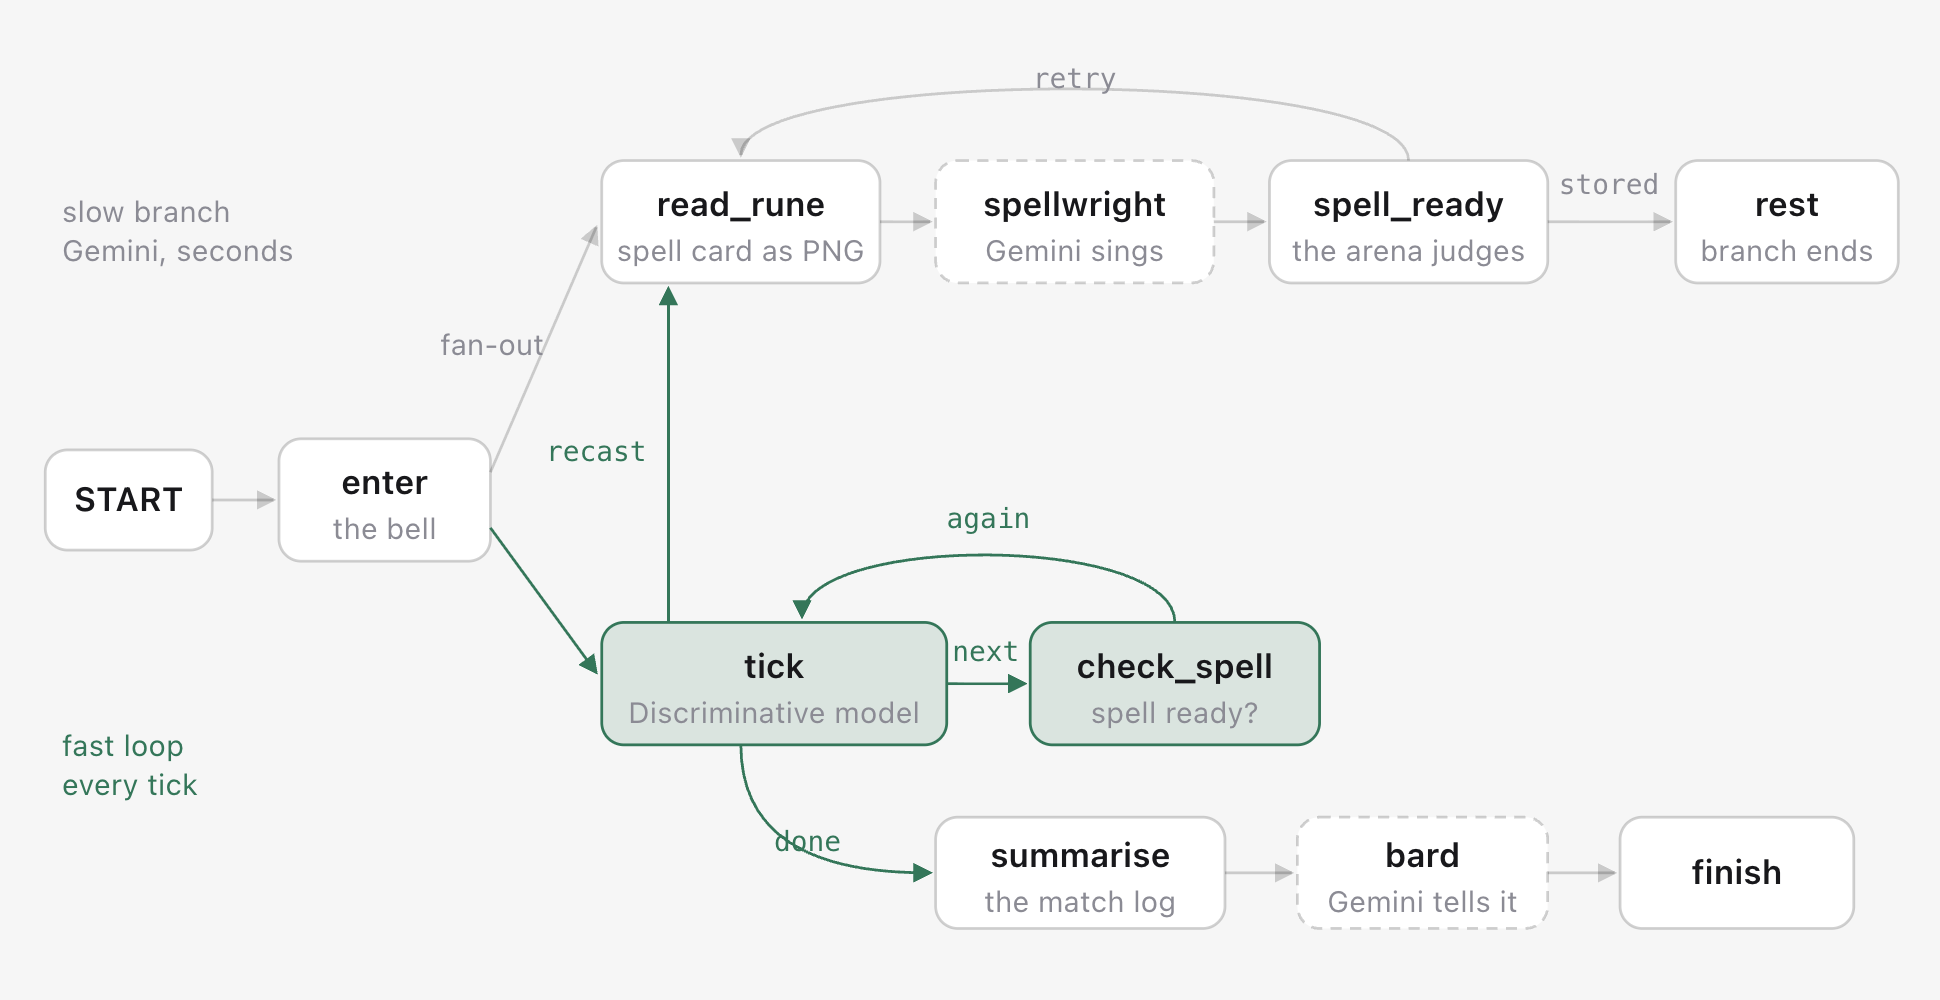
Vì vậy, quy trình này sử dụng cả hai, mỗi quy trình ở tốc độ riêng:
- Mô hình phân biệt sẽ chiến đấu. Mỗi nhịp, một cuộc gọi, một quyết định, một trăm mili giây. Vòng lặp không bao giờ chờ đợi bất cứ thứ gì chậm hơn chính nó.
- Gemini đọc và hát. Trên nhánh riêng, bắt đầu từ chuông, nó lấy thẻ phép thuật trên màn hình đấu trường dưới dạng hình ảnh, đặt tên cho màu sắc và hình dạng, đồng thời hát một câu thần chú. Đấu trường sẽ đánh giá bài hát dựa trên câu trả lời của thẻ phép thuật và câu trả lời này sẽ không bao giờ rời khỏi máy chủ.
- Sau mỗi lần trao đổi, võ sĩ sẽ kiểm tra khe cắm. Nút
check_spellxem xét trạng thái. Chưa sẵn sàng: thông báo này cho biết thời gian Gemini đã hát và chuyển thẳng đến dấu tích tiếp theo. Thời gian không bao giờ chờ đợi. Sẵn sàng:castsẽ tham gia vào các lựa chọn mà mô hình Phân biệt được cung cấp vàchoose()sẽ sử dụng phép thuật ngay khi mô hình Phân biệt báo cáo một khoảng trống. Khi hết phép, màn hình sẽ vẽ một thẻ phép mới và luồng chậm sẽ bắt đầu lại. Một bài hát đọc sai sẽ đốt thẻ phép, và luồng đọc chậm sẽ đọc thẻ mới. - Gemini viết một câu chuyện ngắn một lần ở cuối.
Các nhánh song song có độ trễ khác nhau và một vòng lặp sự kiện
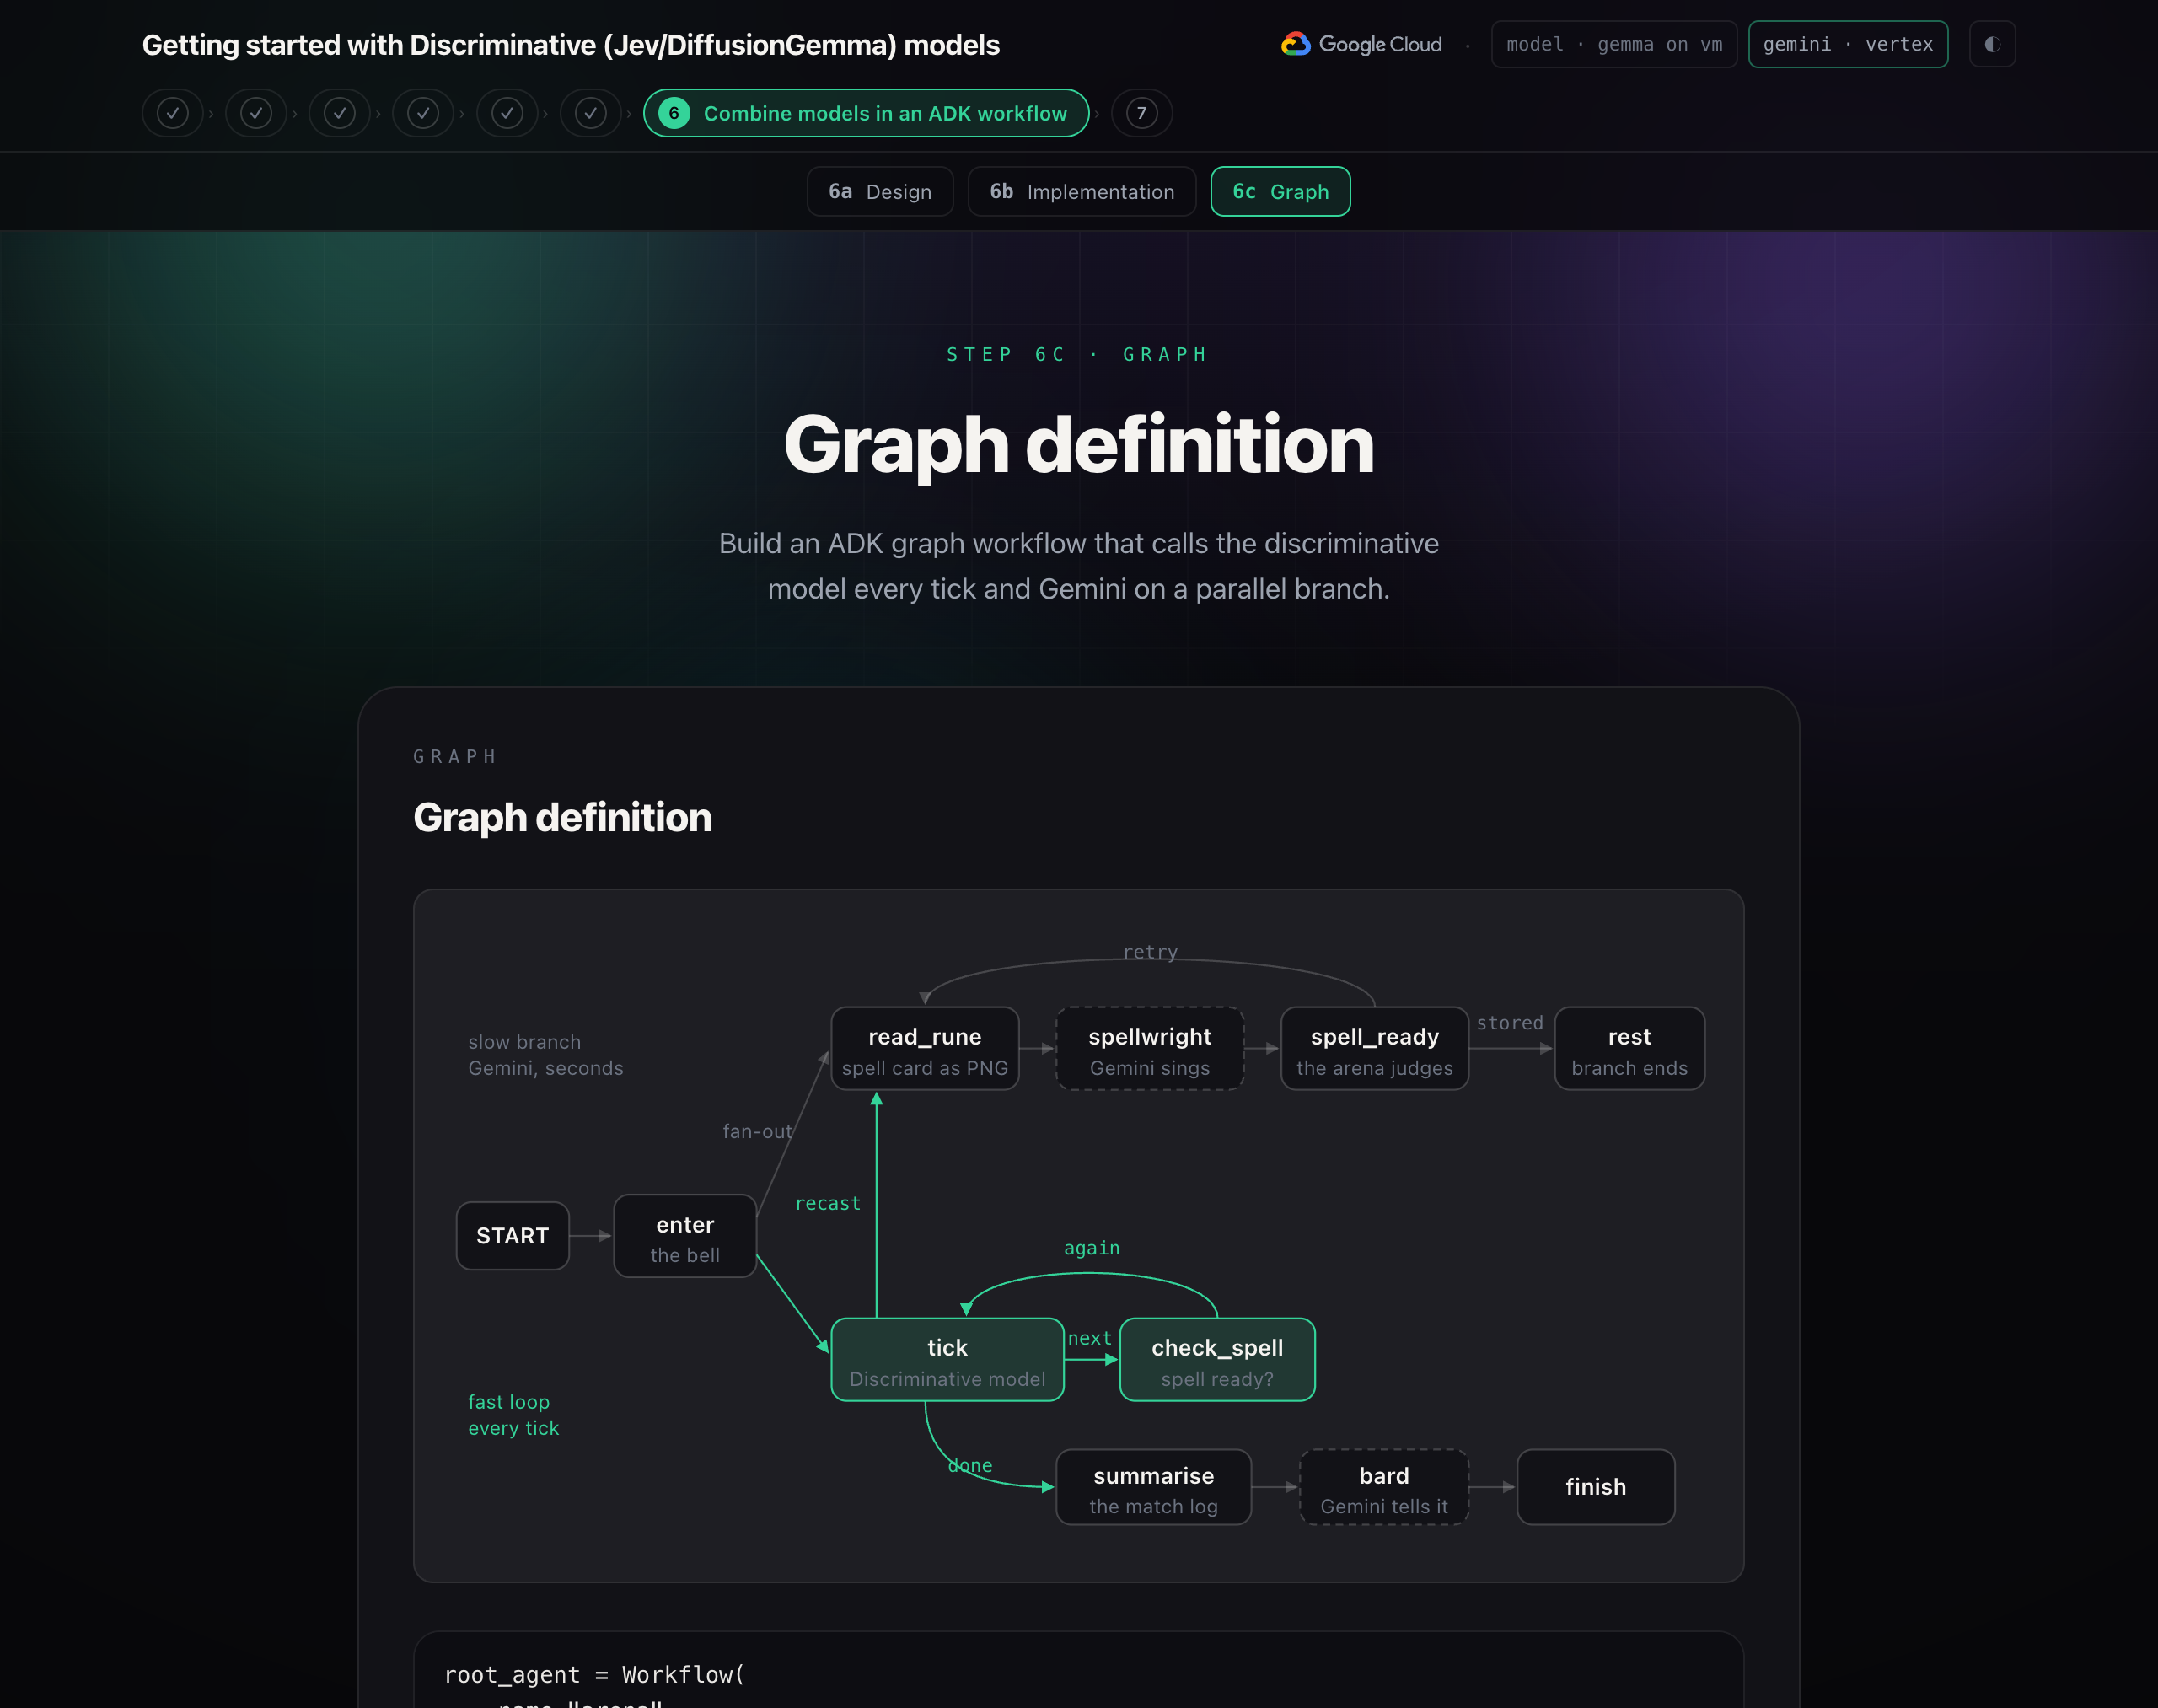
Đây là một Quy trình công việc ADK: một biểu đồ gồm các nút được kết nối bằng các cạnh. Nút là một hàm Python đơn giản hoặc một tác nhân LLM. Một cạnh từ một nút đến một bộ gồm các nút là một phân đầu ra: cả hai đều bắt đầu đồng thời. Một nút trả về Event với route sẽ chọn cạnh tiếp theo được lấy và một nút định tuyến đến chính nó là một vòng lặp.
Hãy coi đó là 2 luồng. Luồng 1 chậm: đọc thẻ phép, hát, lưu trữ phép. Luồng 2 có tốc độ cao: đánh dấu, kiểm tra khe cắm, đánh dấu lại. Luồng 1 kết thúc trong một hàm ghi chính tả đã được đánh giá vào state của phiên và không trả về đầu ra nào. check_spell của luồng 2 sẽ đọc trạng thái đó sau mỗi lần trao đổi. Không có luồng nào gọi hoặc chờ luồng kia; chúng chỉ chia sẻ trạng thái.
Điểm mấu chốt: Đưa ra quyết định trong mã và giao cho mỗi mô hình một công việc cụ thể theo tốc độ riêng.
ADK chạy cả hai nhánh dưới dạng các tác vụ trên một vòng lặp sự kiện, trong một luồng duy nhất. Mỗi lần chỉ chạy một tác vụ. Khi một tác vụ đạt đến await, tác vụ đó sẽ đợi câu trả lời và vòng lặp sẽ chạy nhánh còn lại trong thời gian chờ. Nhánh nhanh đợi mô hình khoảng 1/10 giây, còn nhánh chậm đợi Gemini vài giây, nên không nhánh nào cản trở nhánh nào.
Nhánh chậm
read_rune() sẽ lấy thẻ phép thuật ra khỏi màn hình dưới dạng hình ảnh.
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright là Gemini. Gemini đọc hình ảnh và trả lời theo một hình dạng cố định.
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() sẽ để đấu trường đánh giá phép thuật, sau đó lưu trữ hoặc thử lại.
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
Nút hàm có thể trả về Content có phần hình ảnh và nút LLM sẽ nhận được phần này dưới dạng lượt của người dùng. spell_ready trả về một Event có delta trạng thái và không có output. Lần đánh dấu tiếp theo sẽ đọc phép thuật từ trạng thái và nhánh không có đầu ra không phải là kết thúc thứ hai cho đồ thị: ADK yêu cầu một đầu ra cuối cùng và đó là đầu ra của trận chiến.
Lưu ý: Việc đánh giá là mã, trong đấu trường, dựa trên câu trả lời ẩn của thẻ phép thuật. Đọc hoàn hảo sẽ được 45 điểm, cộng thêm điểm khi mở khoá. Hai hình vuông bên phải có giá trị là 25. Một lần đọc sai sẽ làm hỏng thẻ phép. Gemini không được hỏi liệu câu trả lời có đúng hay không.
Nhánh nhanh
tick() phát một lượt trao đổi, sau đó chọn cạnh tiếp theo.
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() sẽ xem xét khe phép thuật sau mỗi lượt trao đổi.
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell xem xét vị trí sau mỗi lượt trao đổi. Không bao giờ chặn: nếu câu thần chú chưa sẵn sàng, nó sẽ báo cáo điều đó và tiếp tục.
Thiết kế được tạo nên từ 3 yếu tố. Lệnh gọi mô hình phân biệt được await bằng ứng dụng không đồng bộ, vì vậy, vòng lặp sẽ tạo ra kết quả trong khi chờ và nhánh Gemini vẫn tiếp tục chạy. Các câu hỏi được tạo mới mỗi lần, vì vậy biểu tượng cast chỉ xuất hiện khi có nội dung để truyền. Và route có thể là một danh sách: ["recast", "next"] sẽ lấy cả hai cạnh cùng một lúc.
Bản thân đấu trường nằm sau một ứng dụng khách nhỏ: ứng dụng đang chạy qua HTTP (nếu có), vì vậy trang này sẽ hiển thị trận đấu; công cụ trong quy trình (nếu không có).
Định nghĩa biểu đồ
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
Một bộ là mục tiêu là một phân đầu ra. Một bộ là một chuỗi cạnh. Một dict liên kết tên tuyến đường với các nút. tick → check_spell → tick là vòng lặp nhanh. "recast": read_rune khởi động lại luồng chậm sau khi một phép thuật được sử dụng, "retry" làm điều tương tự sau khi một phép thuật thất bại và "stored": rest cho phép luồng chậm kết thúc một cách lặng lẽ mà không có đầu ra, sau khi phép thuật nằm trong khe. ADK yêu cầu ít nhất một cạnh được định tuyến trong một chu kỳ, vì vậy, một vòng lặp vô điều kiện sẽ bị từ chối trước khi có thể chạy mãi mãi.
Lưu ý: root_agent là những gì các công cụ của ADK tìm kiếm. adk web agents từ gốc của hội thảo sẽ mở giao diện người dùng dành cho nhà phát triển có đấu trường trong đó, nếu bạn muốn xem biểu đồ và các sự kiện trong trình duyệt thay vì thiết bị đầu cuối.