

1. 简介
时长 90 分钟的研讨会,内容涉及判别模型、TypeSafe AI 的 System One 决策模型,以及如何在 Google ADK 工作流中将该模型与 Gemini 并行使用。本工作坊包含六个步骤,围绕格斗游戏展开。您将先手动与食人魔战斗,然后将手部反射动作交给判别模型,接着观看 ADK 工作流程赢得战斗,其中判别模型每隔一个时间单位做出决策,而 Gemini 读取屏幕上的咒语卡片来吟唱咒语。
概览
判别模型(jev-1.13,别名 jev-latest)是 TypeSafe AI 于 2026 年 9 月 19 日发布的托管模型。它不会生成文本。您向其发送状态(文本、JSON 或列表)和已输入问题(Choice、Score、Noul),它会返回具有校准后概率的已输入答案,耗时大约为 70 到 500 毫秒,每百万个输入令牌的费用为 0.042 美元,输出不收费。它的工作是语言模型之前、之间和之后的决策:路由、分类、门控,以及此处所示的拳击手的反应。
以游戏为例
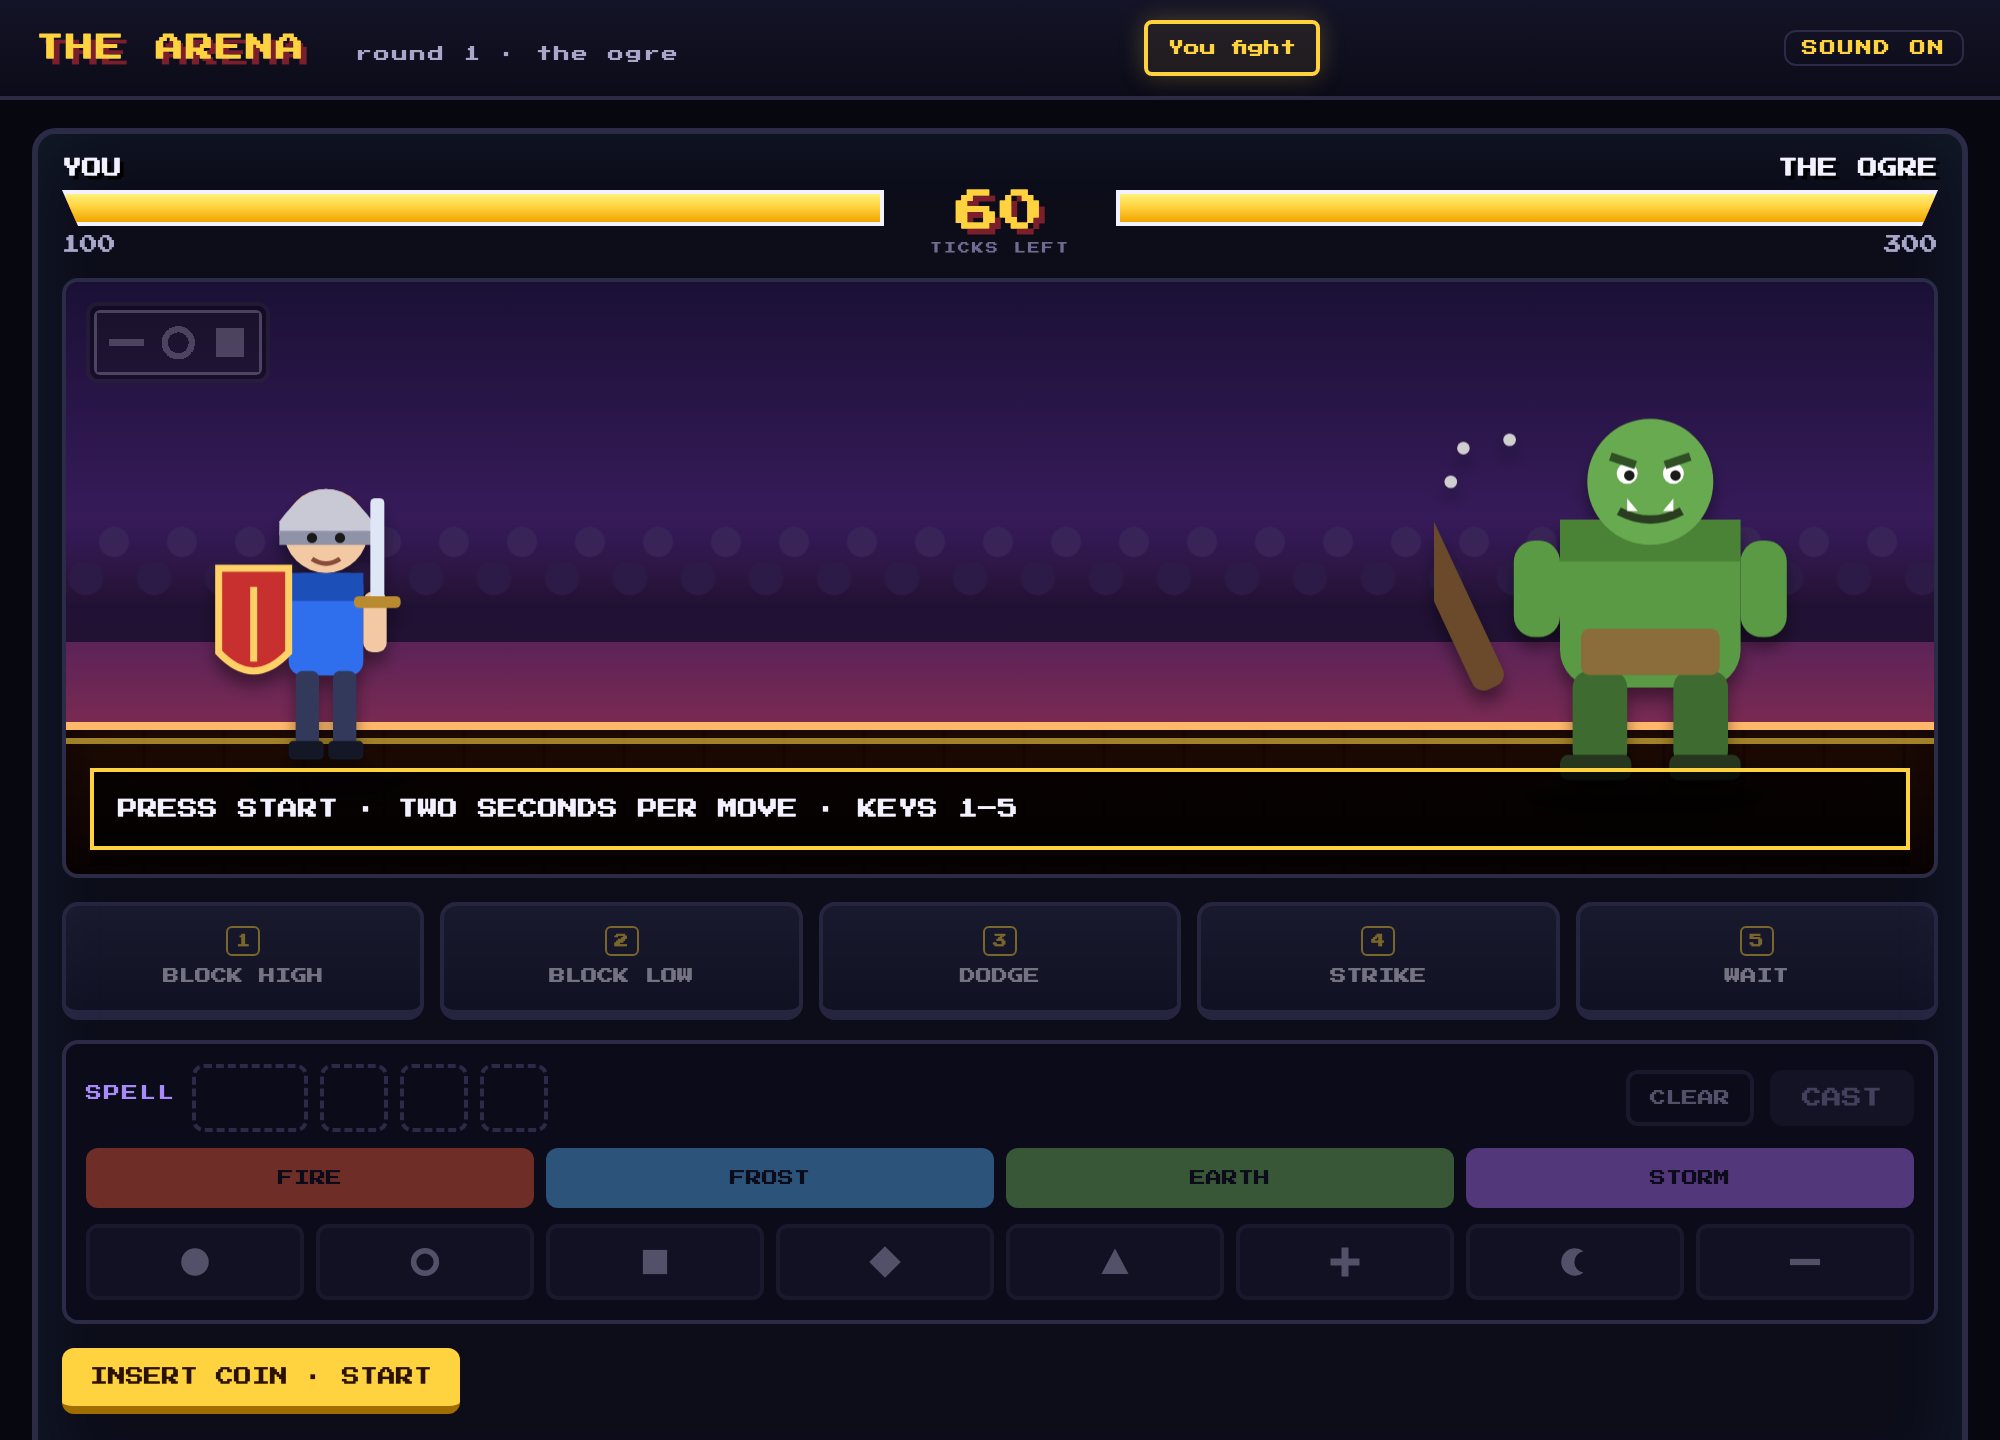
您玩过格斗游戏吗?您需要面对对手,并立即对对方的动作做出反应。猜错一次,HP 就会受到一次打击。游戏还往往会使法术难以施放。在我们的游戏中,您必须按顺序选择咒语卡的颜色和形状,然后才能释放咒语。本研讨会将向您展示如何结合使用这两种类型的模型,让您的角色获胜。
游戏中的每个元素都对应一个真实系统:
- 对手的行动是传入事件,例如请求或交易。
- 回答是由判别模型做出的有界决策,并经过代码检查。
- 咒语卡片是一种非结构化输入,需要语言模型来读取。
- 匹配是指工作流,以各自的速度运行快速和缓慢的工作。
重点在于将这四个组件组合在一起,打造一个快速而智能的系统。
学习内容
- 说明判别模型(系统 1)和生成模型(系统 2)之间的区别,以及各自的适用场景。
- 介绍 Jev 和 DiffusionGemma 的服务方式,并为研讨会设置一个,包括在 Compute Engine GPU 虚拟机上设置 DiffusionGemma。
- 撰写选择题、得分题和 Noul 问题,并解读概率和置信度。
- 在确定性代码中使用阈值将概率转化为行动。
- 使用 TypeSafe SDK 构建请求,然后让模型选择游戏中的每一步。
- 构建一个慢分支(Gemini 读取图片)和一个快分支(判别模型循环做出决策),并分别运行这两个分支。
- 在 ADK 图形工作流中加入两个分支,以便在一个事件循环中共享状态,这样缓慢的工作就不会阻碍快速决策。
架构
工作台位于 Cloud Shell(或您的机器)中,它将写入本地文件系统并与竞技场以及 Gemini 和决策模型互动。② 在“判别模型对战”中调用判别模型;③ 在“工作流对战”中同时调用这两个模型。
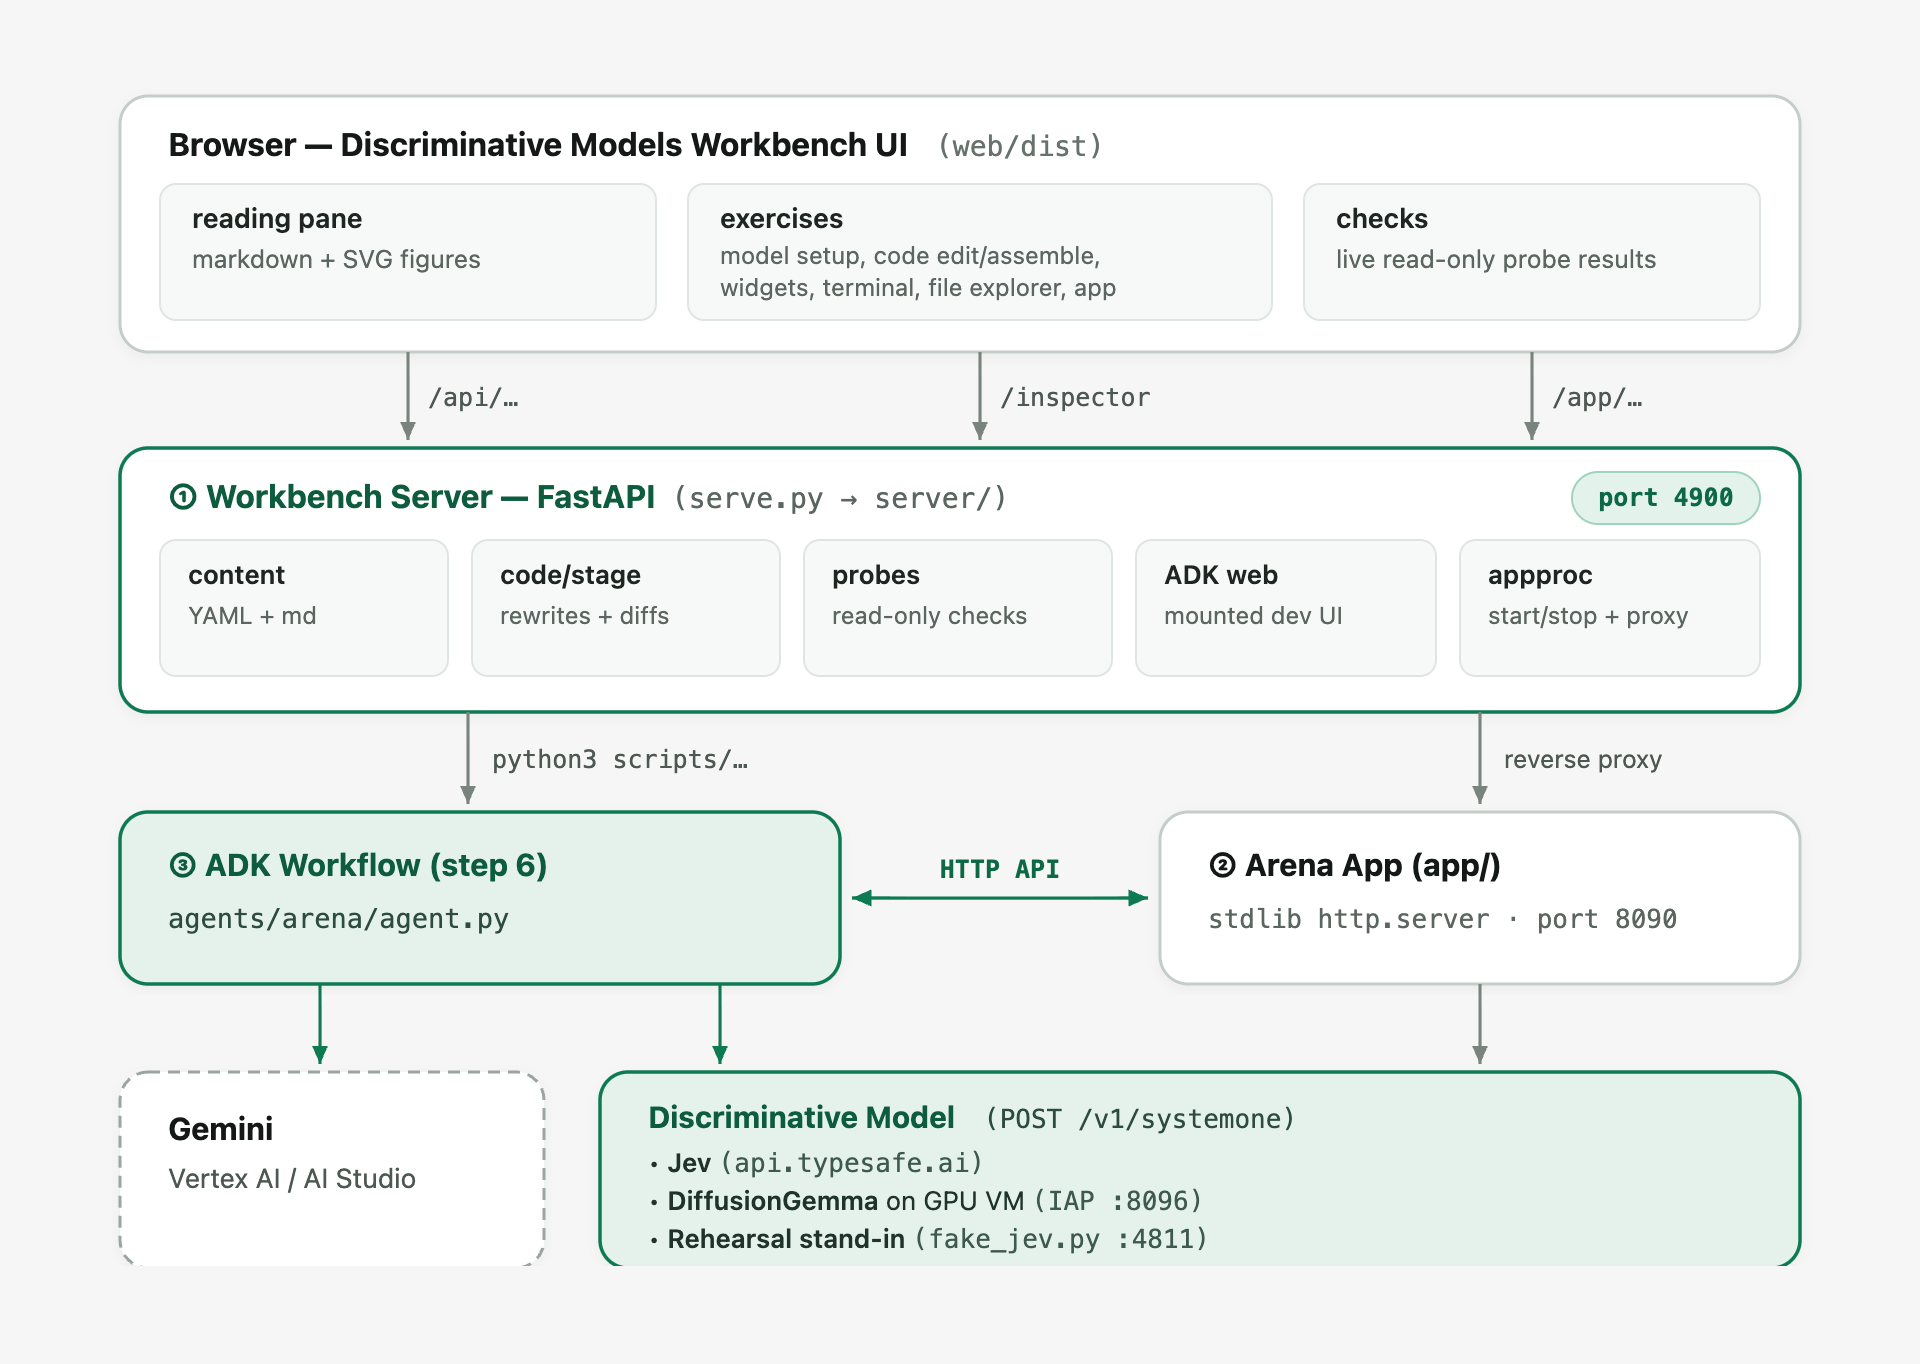
谁调用了什么。浏览器始终只与 ① 通信。这两个模型都是从机器上的 Python 调用的:
来电者 | 判别模型 | Gemini |
② 竞技场,“判别模型对战” | 每个时间单位, | 否 |
③ 工作流 | 每个 tick, | 否 |
③ 工作流 | 否 | 咒语卡片图片;战斗后的故事 |
| 是 | 否 |
每种模式一个勾号。
- 你战斗。该网页会要求 ② 发送电报,显示电报并附带 2 秒计时器,然后将您按下的按钮(或输入的拼写)回发。② 解决问题。
- 判别模型对抗。该页面会请求一个勾号 (②);绘制电报 (②);在一次调用中向模型提出三个问题;运行
choose();并返回答案和结果。页面绘制条形图。 - 工作流程冲突。Start 会将 ② 启动为子进程(登录
runs/arena-workflow.log)。③ 负责驱动战斗:它会向 ② 请求每个预兆,调用模型并发布决策;Gemini 的咒语会在准备就绪时自行到达其分支。该页面仅轮询 ② 并绘制。暂停是 ② 上的一个标志,③ 会在每次计时之前进行检查。
决策模型的托管位置。每次调用都通过相同的 typesafe-sdk;只有基本网址会发生变化。scripts/jevauth.py 用于命名后端并设置键和超时时间:
后端 |
| 键 | 设置者 |
TypeSafe,托管 | 未设置 (api.typesafe.ai) |
|
|
在 L4 虚拟机上运行 DiffusionGemma |
| 无 |
|
在 Cloud Run 上运行 DiffusionGemma |
| 每小时提取一次的 Google 身份令牌 |
|
彩排 |
| 无 |
|
咒语卡片的回答 ②:工作流仅获取 PNG,并判断它发回的咒语。这使得咒语成为对 Gemini 阅读能力的真正考验,而您在“You fight”中构建的咒语则成为对您能力的真正考验。
2. 设置
领取研讨会赠金
如果您获得了本次会话的 Google Cloud 积分,请先兑换该积分,这大约需要一分钟时间,并且系统会为您创建结算账号。
打开 Cloud Shell
Google Cloud Shell 是一个可通过浏览器访问的 Linux 环境,预配置了 gcloud、Python、Node.js、uv 和 git,并且已通过您的 Google 账号进行身份验证。
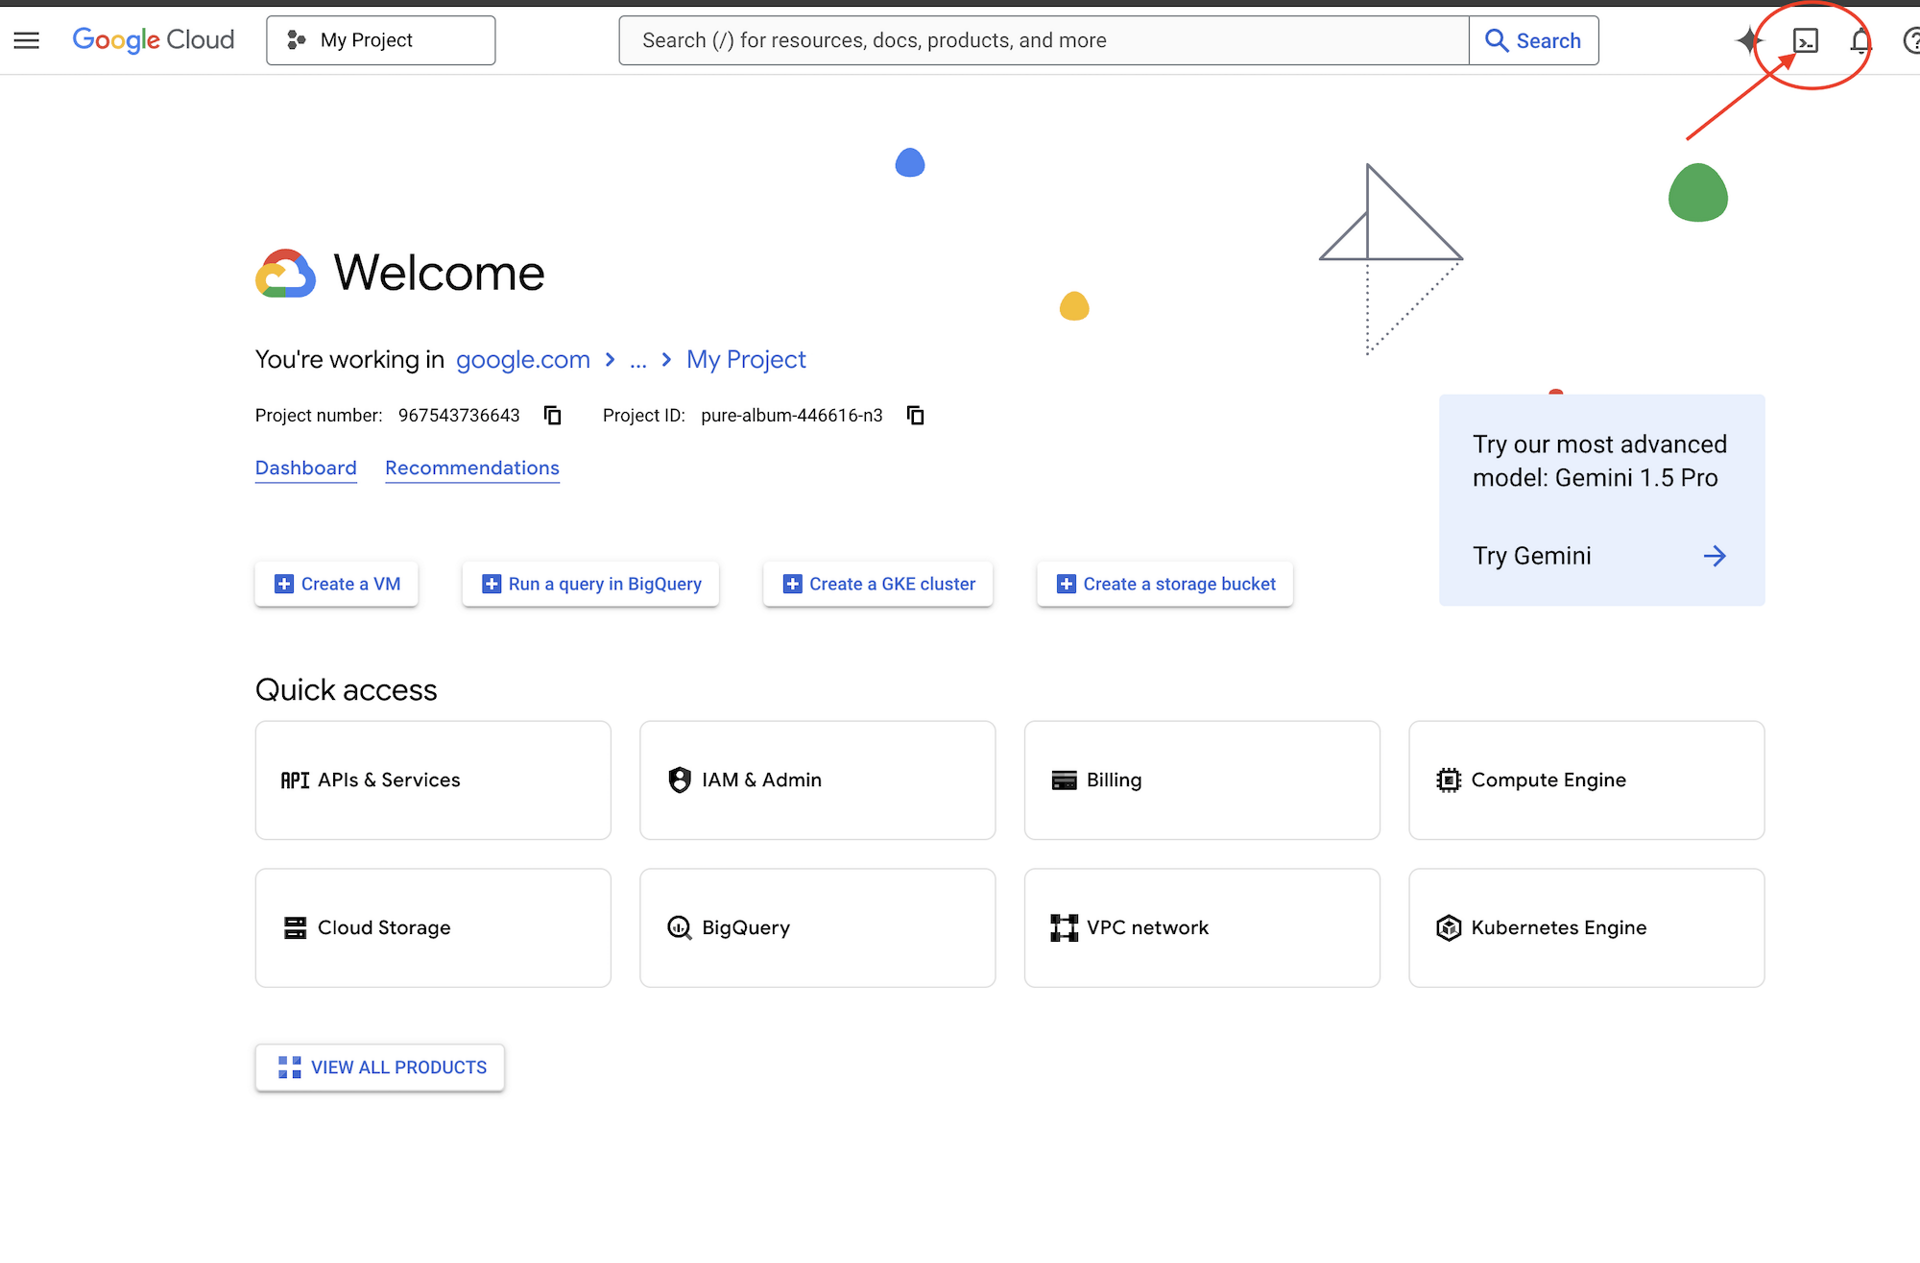
- 打开 Google Cloud Console。
- 点击激活 Cloud Shell(顶部导航栏中的终端图标),在浏览器底部打开终端会话。
启动工作台
在 Cloud Shell 中或已登录 gcloud 的任何位置:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh 会创建一个项目 (discrim-models-XXXX),将结算与该项目相关联,优先选择活动赠金账号(如果有),并等待直到该项目可以提供服务。重新运行该命令会重复使用 ~/project_id.txt 中的项目。如需使用现有项目,请将该项目的 ID 放入该文件中,然后跳过此脚本。
setup_codelab.sh 不要求任何内容。它会安装 uv 和 Python 软件包,启用 Vertex AI、Compute Engine 和 IAP,在 .env 中将 Gemini 指向项目中的 Vertex AI,使用项目可以调用的模型进行一次真实的 Gemini 调用,构建网页,在后台启动工作台并运行 scripts/check_setup.py。重新运行该脚本会保留锻炼文件;scripts/starter.sh 会重置锻炼文件。决策模型是在工作台的第 2 步中选择的。
如需在 Cloud Shell 中打开工作台界面,请执行以下操作:
- 点击
./setup_codelab.sh末尾显示的预览链接,或点击 Cloud Shell 工具栏右上角的网页预览。 - 选择更改端口,输入 4900,然后点击更改并预览。
Gemini 在您项目中的 Vertex AI 上运行,使用您自己的 Google 凭据:GOOGLE_GENAI_USE_VERTEXAI=1、GOOGLE_CLOUD_PROJECT 和 GOOGLE_CLOUD_LOCATION=global(位于 .env 中)。
决策模型可在工作台的第 2 步中自行选择,也可通过 scripts/setup_model.sh 从终端中选择:
选择 | 需求 | 设置 | 费用 |
判别模型(TypeSafe,托管) | TypeSafe API 密钥 | 无 | 每 token,美分的小数部分 |
DiffusionGemma(Google,开放权重) | 结算 + Compute Engine GPU 配额 | 约 15 分钟,自动 | 虚拟机运行期间约为 0.71 美元/小时 |
彩排(无模型) | nothing | 无 | 无 |
Compute Engine 虚拟机上的 DiffusionGemma
scripts/setup_gemma.sh 先检查 GPU 配额,然后使用 NVIDIA 驱动程序 580 从 Google 的深度学习映像中创建 1 个 g2-standard-4 虚拟机(1 个 L4 24 GB、4 个 vCPU、16 GB)。首次启动时,虚拟机将安装 Docker,从 Hugging Face 下载权重(nvidia/diffusiongemma-26B-A4B-it-NVFP4,17.5 GB,公开,无需令牌),并运行 djev-run:在判别模型的确切 API 后运行 DiffusionGemma。模型的端口未向互联网开放:工作台通过 localhost:8096 上的 IAP 隧道访问该端口,该隧道由 scripts/start.sh 打开。
暂停 / 恢复 |
| |
隧道 |
| |
移除 |
| |
练习指令 |
| |
代码库布局
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. 总结
清理环境
完成研讨会后,请完成以下步骤,以拆除所有 DiffusionGemma GPU 资源、停止后台工作台和演练进程、从 Cloud Shell 中移除研讨会文件,并(可选)删除您的研讨会 Google Cloud 项目。
- 删除 DiffusionGemma GPU 虚拟机和防火墙规则(如果已创建):如果您在第 2 步中在 Compute Engine GPU 虚拟机上配置了 DiffusionGemma,请移除该虚拟机、磁盘和 IAP 防火墙规则,以免产生持续的计算或磁盘存储费用:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - 在 Cloud Shell 中停止工作台和演练进程:在 Cloud Shell 终端中,停止后台工作台服务器和任何演练替身进程:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - 从 Cloud Shell 中删除研讨会文件夹:返回到您的主目录,然后移除克隆的代码库文件夹和项目 ID 文件:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - 删除 Google Cloud 项目:如果您
./setup_project.sh创建了专门的研讨会项目(例如discrim-models-XXXX),永久关闭该项目会删除其中创建的所有资源,同时保持您的 Cloud Billing 账号完好无损:- 在 Google Cloud 控制台中打开“管理资源”页面。
- 从资源列表中选择您的研讨会项目(例如
discrim-models-...)。 - 点击顶部工具栏中的删除,输入项目 ID 以进行确认,然后点击关停。
您已完成本工作坊。
实验摘要
- 在 Compute Engine GPU 虚拟机上选择了一个判别模型(Jev 或 DiffusionGemma),并检查了该模型是否能回答问题。
- 手动玩竞技场,与时间赛跑,了解竞技场规则。
- 了解了判别模型如何回答 Choice、Score 和 Noul 问题,如何提供概率和置信度,以及您的代码如何将阈值应用于这些内容。
- 发送第一个请求,然后让模型在竞技场中选择每一步,
choose()将其回答转化为行动。 - 单独构建 ADK 工作流的每个分支,让 Gemini 读取咒语卡片图片,并让模型在循环中做出决策。
- 将它们合并到一个共享状态的工作流中,这样战斗就不会等待 Gemini,并且会在开局时施放咒语。
从对话到决策
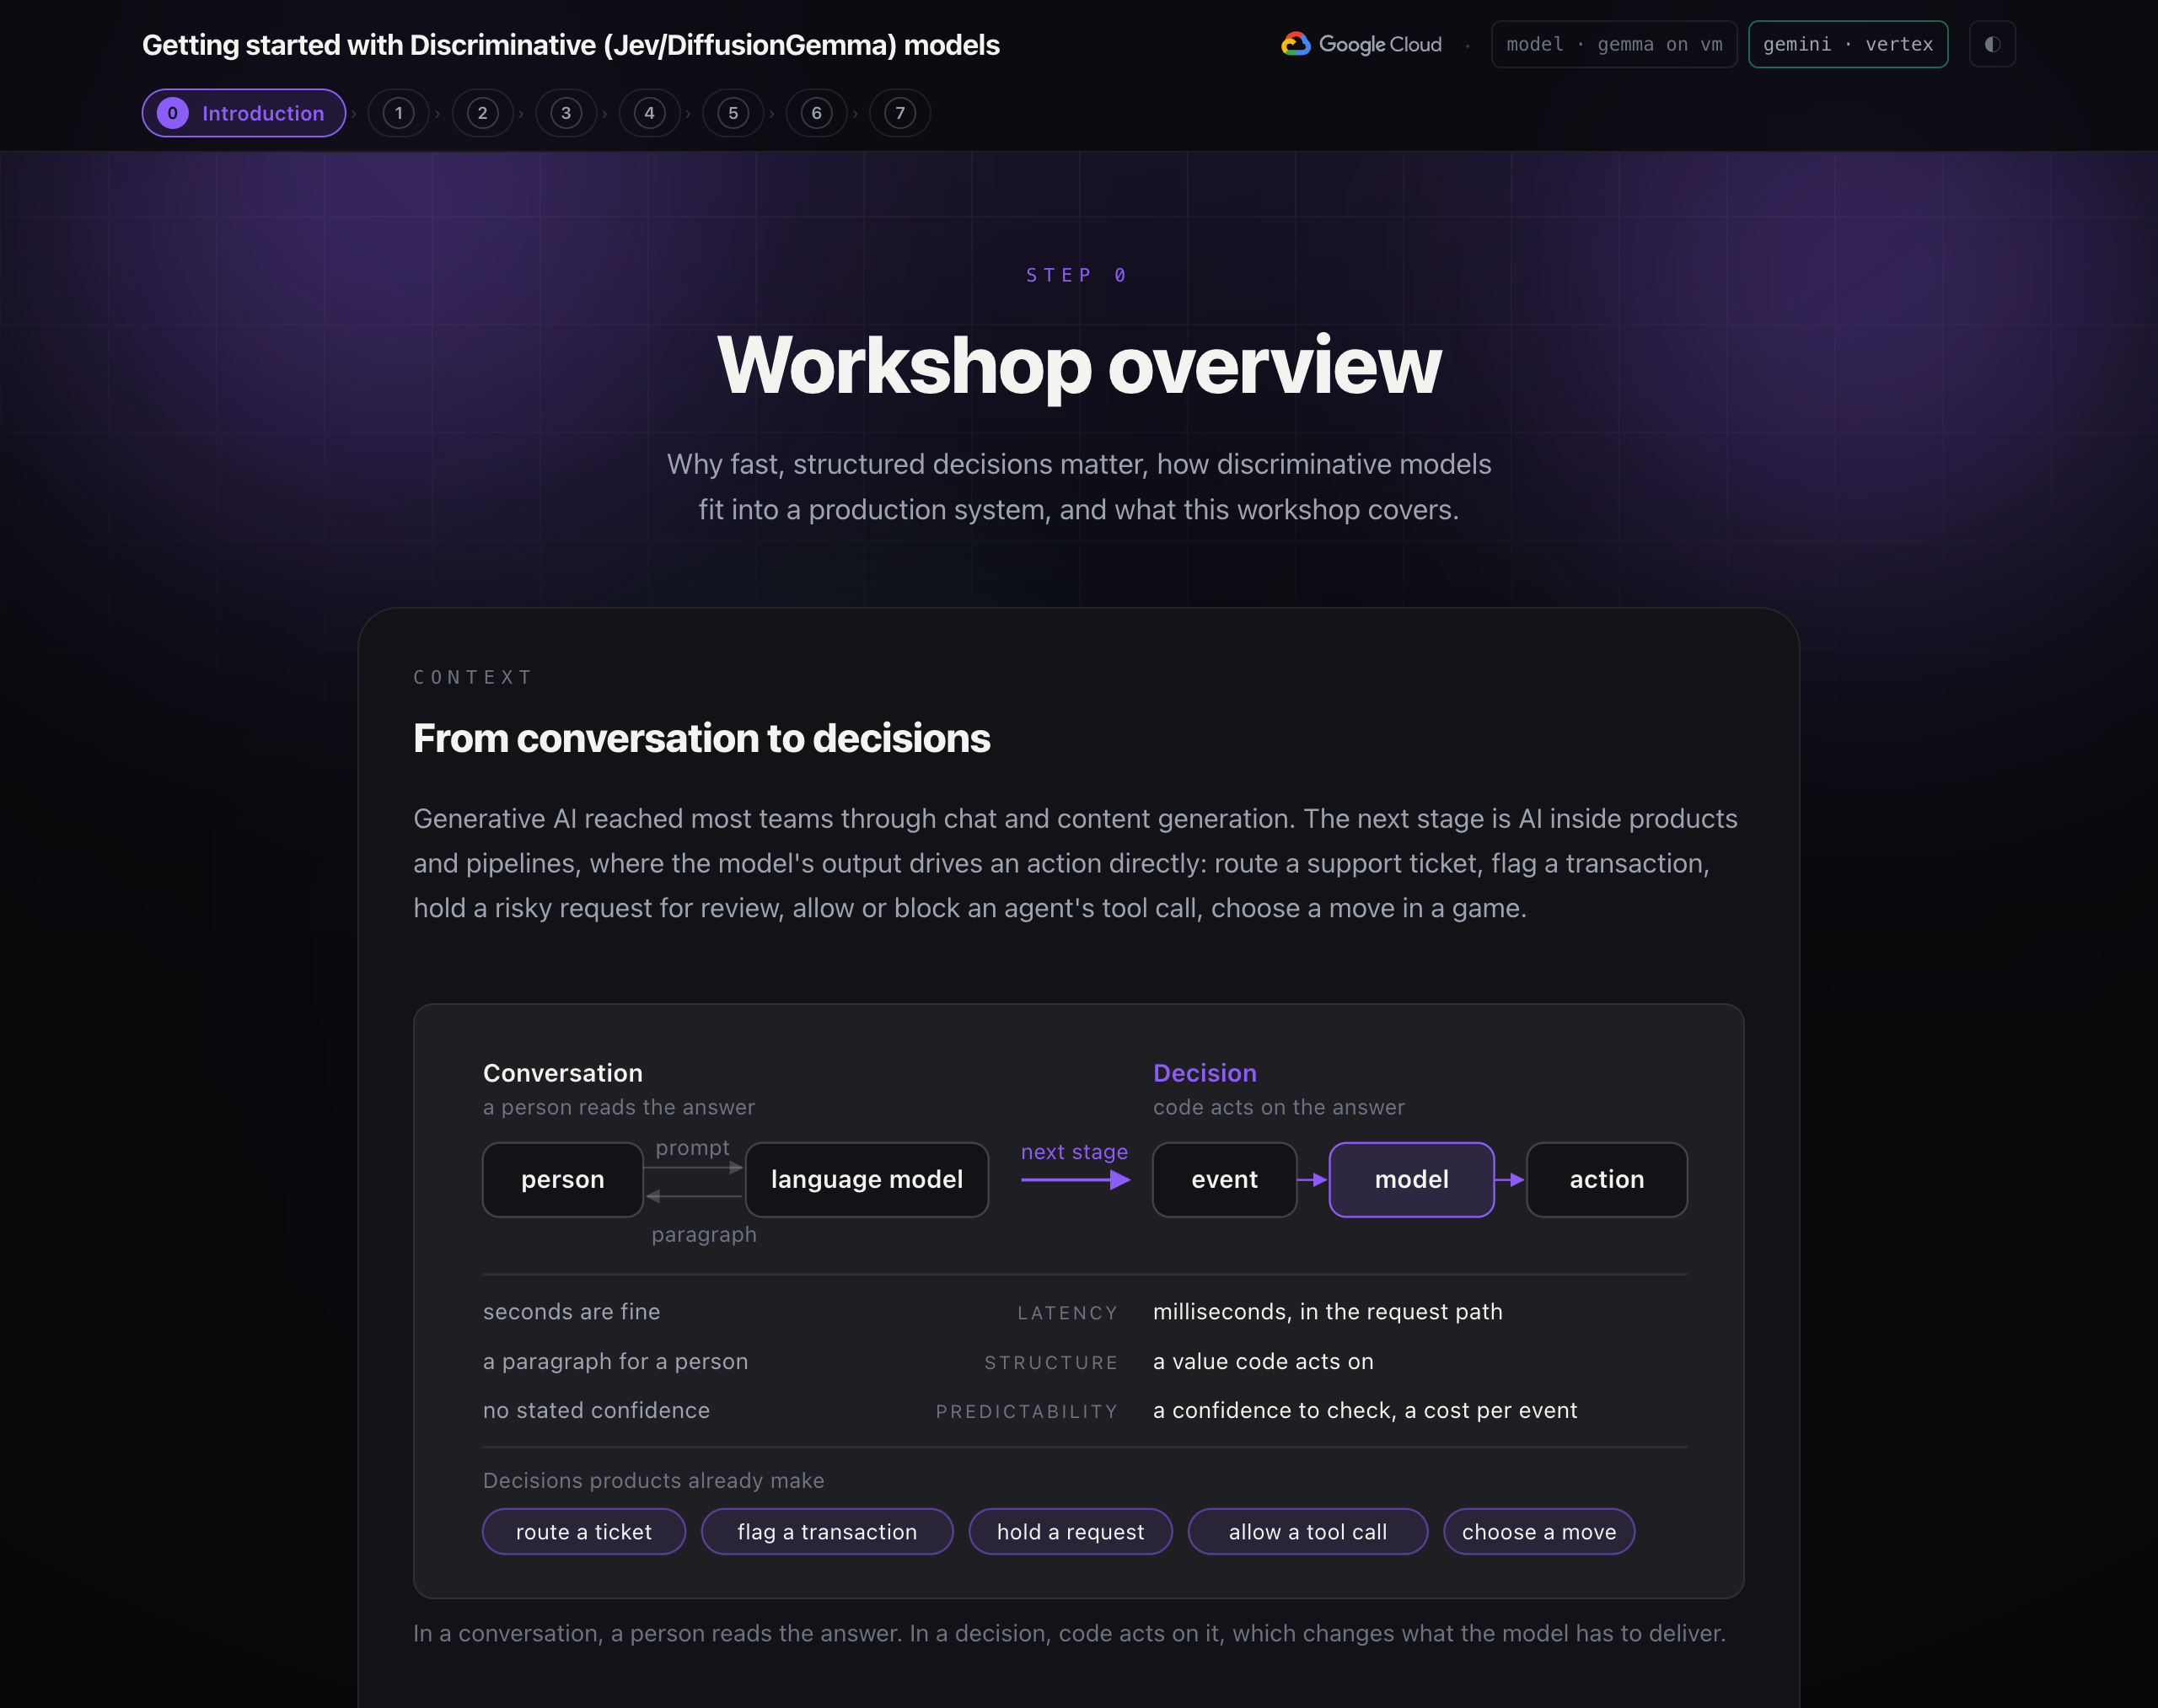
生成式 AI 通过聊天和内容生成功能覆盖了大多数团队。下一阶段是产品和流水线中的 AI,其中模型的输出直接驱动操作:转送支持服务工单、标记交易、暂停风险请求以供审核、允许或阻止智能体的工具调用、在游戏中选择行动。
这些决策有三项聊天功能不具备的要求:
- 延迟时间。答案通常位于用户的请求路径或实时循环中,因此必须在毫秒内到达,而不是秒。
- 结构。调用方是代码,因此答案必须是它可以处理的值,而不是需要解析的段落。
- 可预测性。每个决策都需要代码可以检查的置信度,以及足够低的成本,以便在每个事件中进行查询。
语言模型会逐个生成文本 token。它可以提示用户输入“是”或“否”,但对于实时循环来说速度较慢,其输出必须经过解析,并且它不会报告自己有多确定。
专为决策而构建的模型
判别模型通过一次传递,以每个允许的选项的概率回答类型化问题。它不会生成文本。此研讨会提供两种运行方式:
模型 | 提供商 | 本讲座中模型的运行位置 |
Jev | TypeSafe AI | TypeSafe 的托管服务,使用 API 密钥调用 |
DiffusionGemma | Google,开放权重 | 自行托管在您自己的 Google Cloud 项目中的 GPU 虚拟机上 |
您可以根据需要更换模型,而连接到这些模型的代码无需更改。
合并组件
一个成功的系统由多个组件组成:
组件 | 角色 | 在此研讨会中 |
工作流 | 编排步骤、并行运行分支、保持共享状态 | ADK 图工作流 |
确定性代码 | 规则、阈值、验证。即时、免费且可审核 | 游戏规则、 |
判别模型 | 快速做出有界限的决策,并提供置信度得分 | 每隔一个时间单位选择一次响应 |
语言模型 | 感知和生成:图片和开放式文本 | Gemini 读取咒语卡片图片并写出咒语 |
模型部署架构
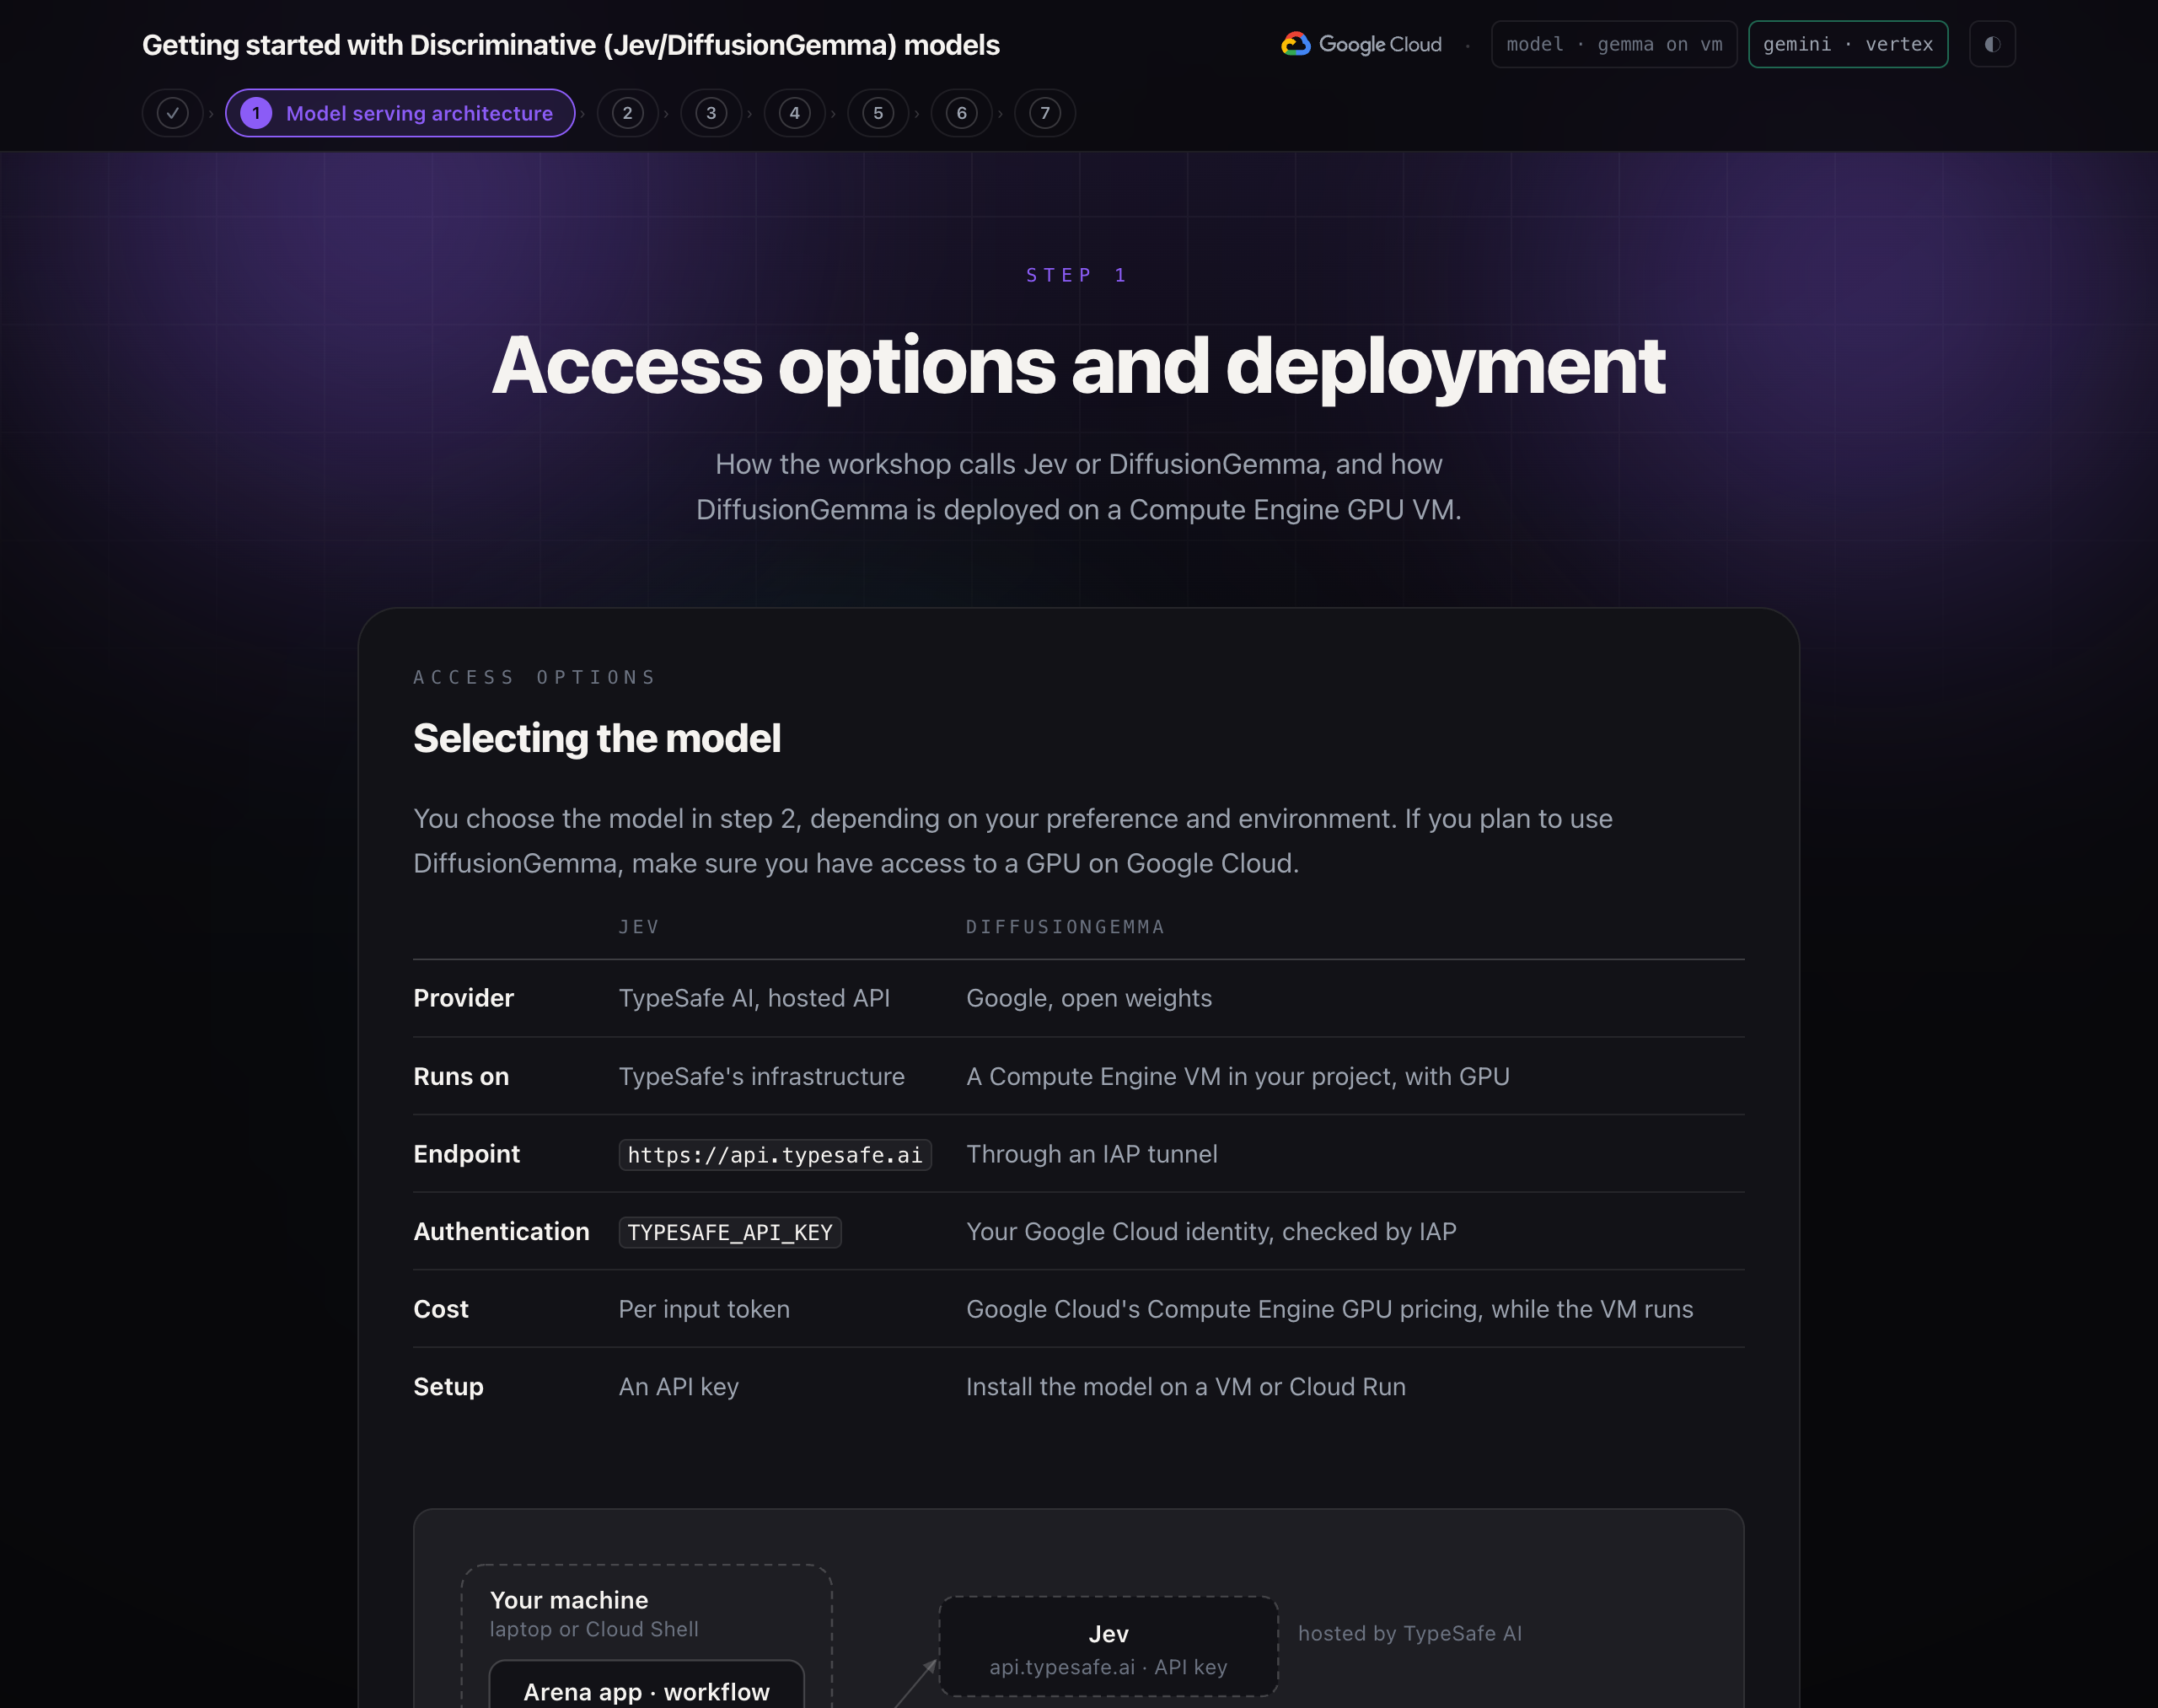
您可以在第 2 步中根据自己的偏好和环境选择模型。如果您计划使用 DiffusionGemma,请确保您有权访问 Google Cloud 上的 GPU。
Jev | DiffusionGemma | |
提供方 | TypeSafe AI,托管 API | Google,开放权重 |
在以下设备上运行 | TypeSafe 的基础设施 | 项目中的 Compute Engine 虚拟机,配备 GPU |
端点 |
| 通过 IAP 隧道 |
Authentication |
| 您的 Google Cloud 身份,由 IAP 检查 |
费用 | 每个输入 token | Google Cloud 的 Compute Engine GPU 价格(在虚拟机运行期间) |
设置 | API 密钥 | 在虚拟机或 Cloud Run 上安装模型 |
数据流
- 竞技场应用或 ADK 工作流会构建一个请求:状态(对手做了什么)和三个问题。
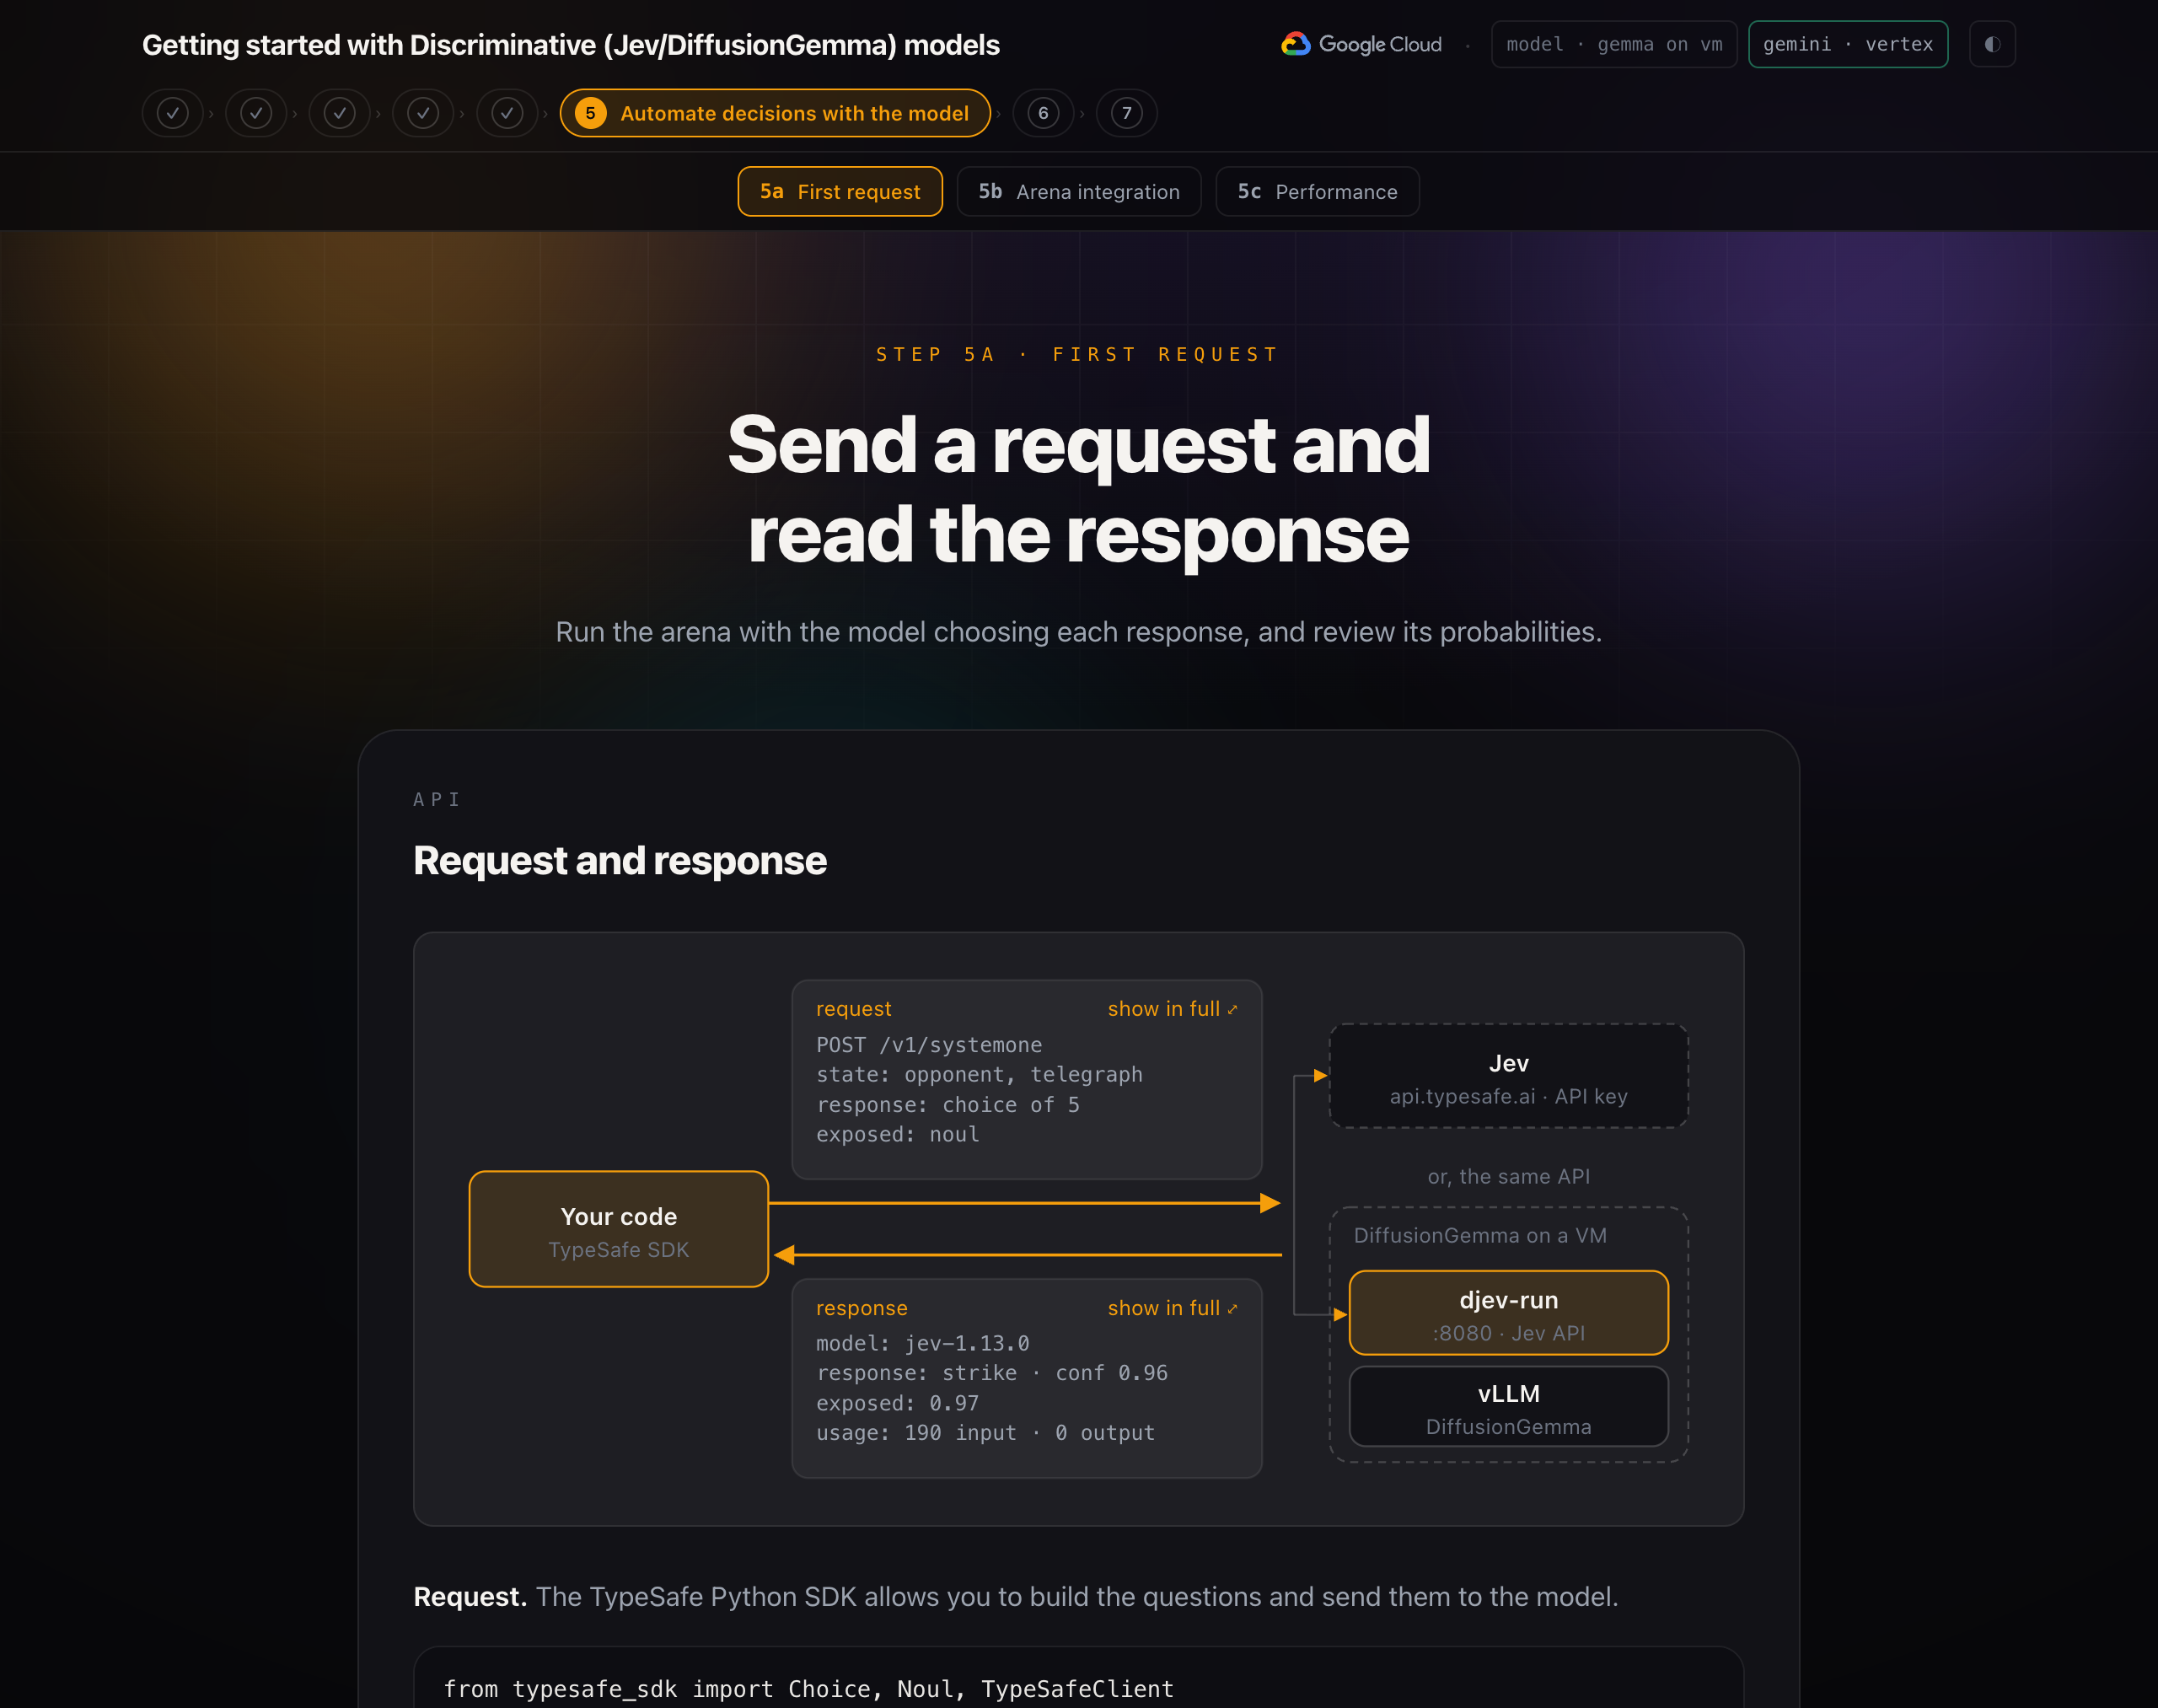
- TypeSafe SDK 会将其作为
POST /v1/systemone发送到配置的基础网址。 - 对于 Jev,请求通过 HTTPS 发送到
api.typesafe.ai,API 密钥作为不记名令牌。 - 对于 DiffusionGemma,请求会发送到
localhost:8096。后台gcloud compute start-iap-tunnel进程通过 Identity-Aware Proxy(用于检查您的 Google 身份)将请求转发到虚拟机上的端口 8080。 - 在虚拟机上,djev-run 接收请求,通过 vLLM 在 GPU 上运行 DiffusionGemma,并读取每个允许的选项的概率。
- 两个后端返回的响应相同:每个问题的答案,以及概率和置信度分数。工作坊代码会应用其阈值并执行相应操作。
Compute Engine 上的 DiffusionGemma
scripts/setup_gemma.sh 会在您的项目中构建以下内容:
- 检查相应地区是否具有 GPU 配额。
- 启用 Compute Engine 和 IAP API,并创建防火墙规则
allow-iap-djev。它仅允许端口 22 和 8080 上的 IAP 地址范围。 - 创建虚拟机
djev-l4:机器类型g2-standard-4(4 个 vCPU、16 GB 内存)、一个 24 GB 的 GPU、一个 100 GB 的磁盘,以及具有 NVIDIA 驱动程序 580 的深度学习虚拟机映像。如果某个可用区没有 GPU 容量,则会尝试下一个可用区。 - 在首次启动时,虚拟机的启动脚本会安装 Docker 和 NVIDIA Container Toolkit,拉取 djev-run 容器映像,从 Hugging Face 下载权重(17.5 GB),并启动容器(通过 8080 端口访问 GPU)。此过程大约需要 15 分钟。后续启动大约需要 2.
- 将连接设置写入
.env并打开隧道。
任务 | 命令 |
停止虚拟机(保留磁盘) |
|
重新开始 |
|
检查隧道 |
|
删除所有内容 |
|
设置模型
TypeSafe SDK
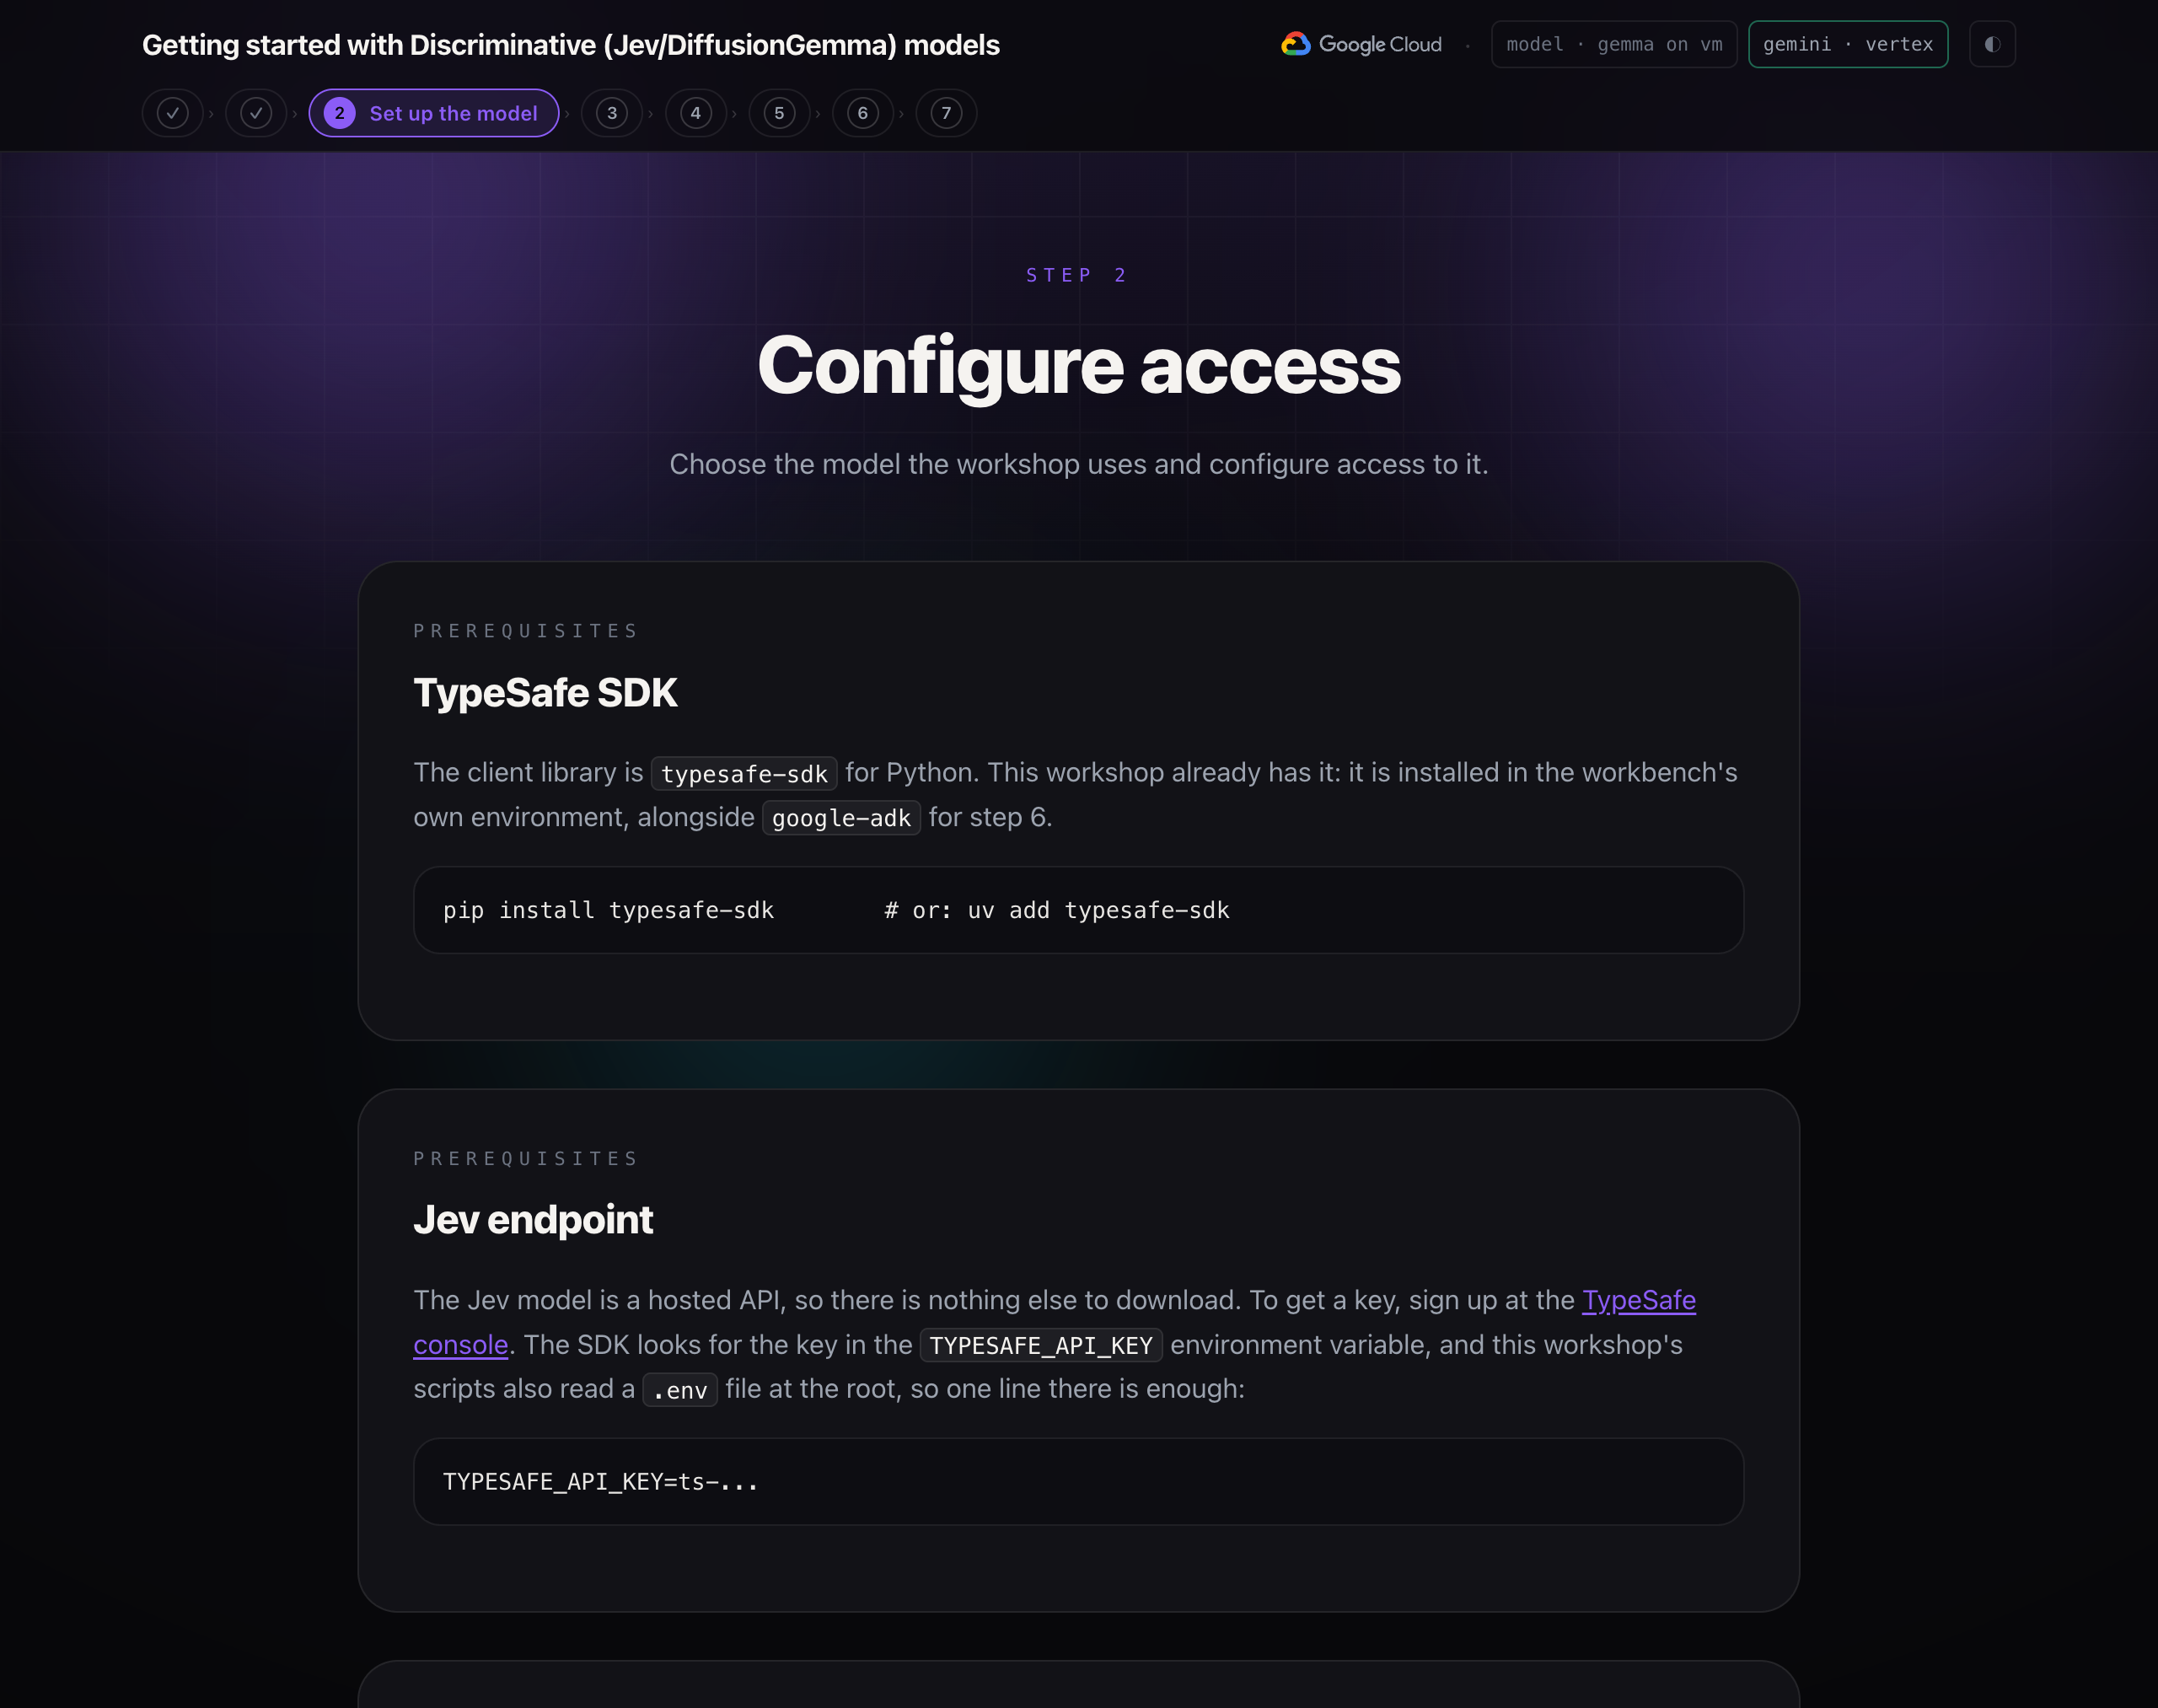
客户端库是 typesafe-sdk(适用于 Python)。此工作坊已包含该文件:它与步骤 6 的 google-adk 一起安装在工作台自己的环境中。
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev 端点
Jev 模型是托管式 API,因此无需下载其他任何内容。如需获取密钥,请前往 TypeSafe 控制台注册。SDK 会在 TYPESAFE_API_KEY 环境变量中查找密钥,而本讲座的脚本也会读取根目录中的 .env 文件,因此只需在其中添加一行代码:
TYPESAFE_API_KEY=ts-...
使用 DiffusionGemma
djev-run 重新实现了判别模型的 API。它提供相同的 POST /v1/systemone 端点,包含相同的 null、选择和得分问题,由 Google DeepMind 的开放 diffusion 模型 DiffusionGemma 提供支持(总参数为 260 亿,约 40 亿个有效参数,Apache 2.0)。由于有线格式相同,TypeSafe SDK 可以原封不动地与之通信。
如果您在练习中选择 DiffusionGemma,它会在您自己的 Google Cloud 项目中的虚拟机上运行,并且右上角的指示条会显示 gemma on vm。工作台通过专用 IAP 隧道访问该模型,并且该模型的端口未向互联网开放。第 1 步介绍了完整架构。
扩散模型为何能做到这一点:它可以一次性填充整个位置块,每个位置都能看到完整的输入,因此只需一步即可读取每个允许的选项的概率。普通语言模型一次生成一个词元,因此必须反复抽样。
手动玩游戏
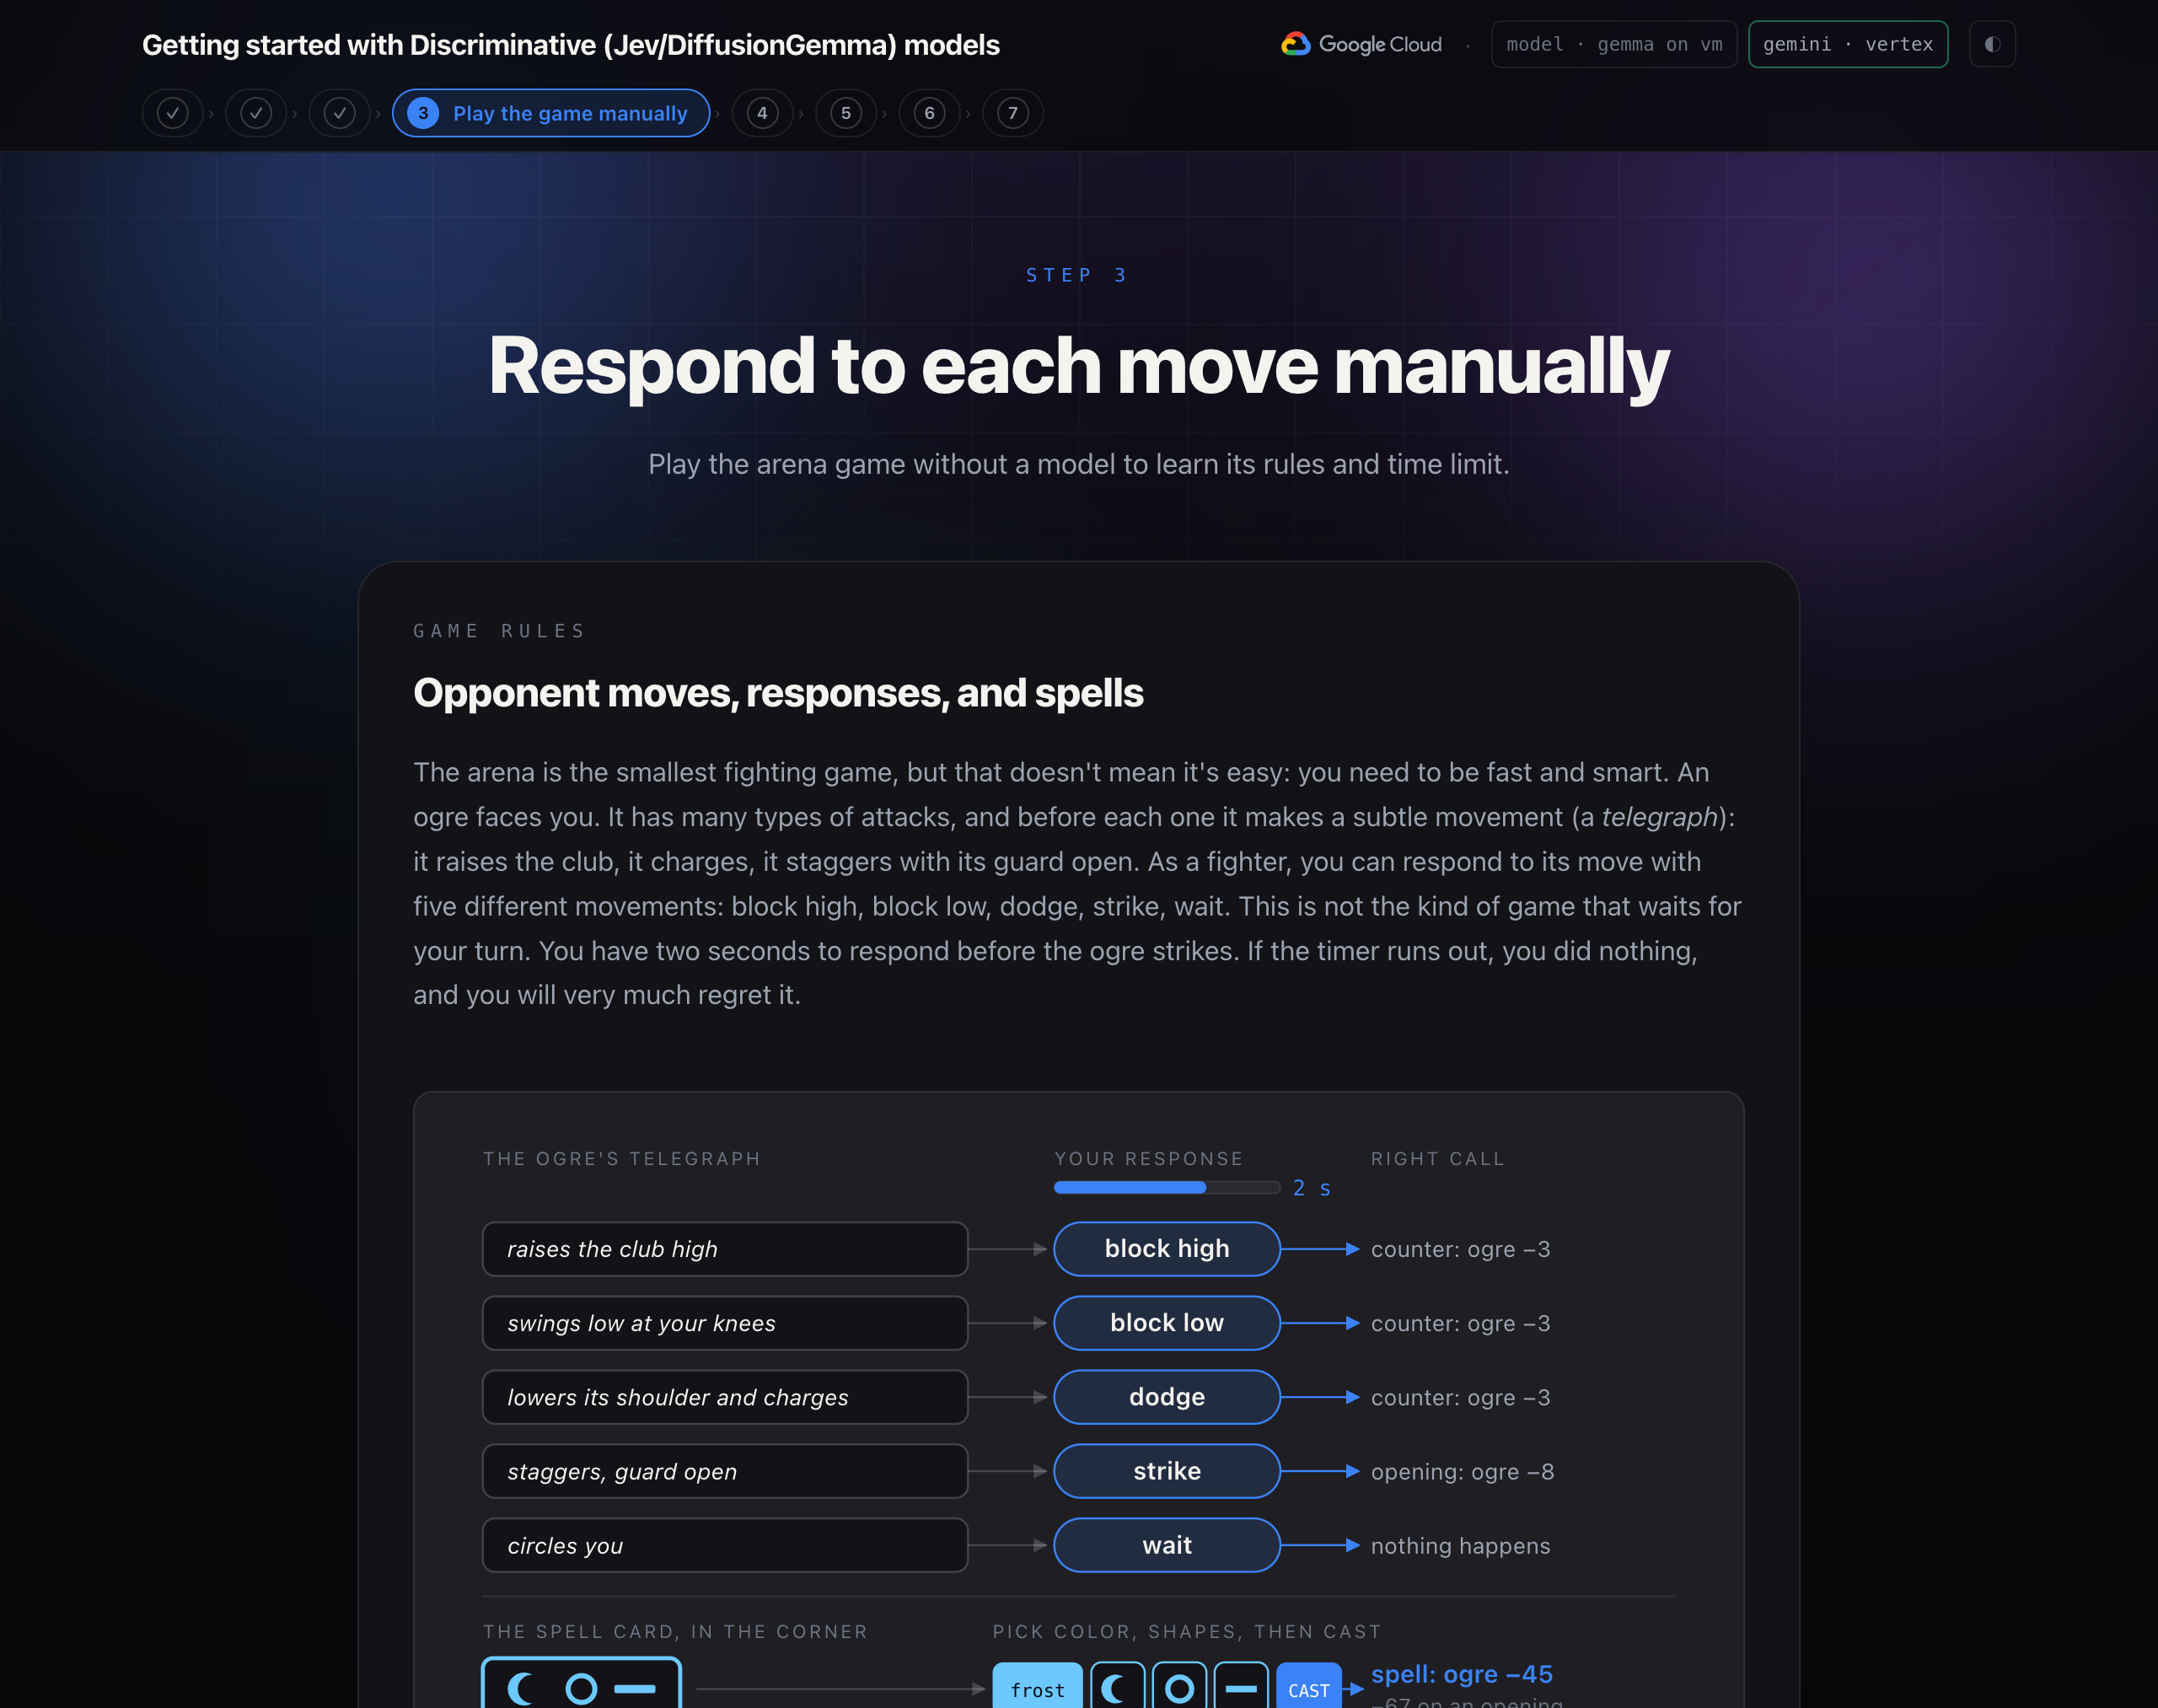
竞技场是最小的格斗游戏,但这并不意味着它很简单:你需要快速而聪明。一个食人魔正对着你。它有多种攻击方式,每次攻击前都会做出细微的动作(预先提示):举起棍棒、冲锋、张开防御姿势摇摇晃晃。作为格斗者,您可以采取五种不同的动作来应对对手的动作:高位格挡、低位格挡、躲避、攻击、等待。这种游戏不会等待您轮到自己。在食人魔攻击之前,你有两秒钟的时间做出反应。如果计时器时间耗尽,您却什么都没做,那么您一定会非常后悔。
圆环的左上角有一张拼写卡片:一张带有三种形状的彩色卡片。只有与之匹配的法术才能造成实际伤害。在游戏中,您可以使用战斗下方的按钮施放咒语:选择卡片的颜色,然后从左到右选择卡片的形状,最后按 CAST。在您选择时,时钟会继续运行,因此您必须同时构建咒语并对食人魔的攻击做出反应。按键 1 到 5 仍可回答每一步棋。错误的咒语会失效。在第 6 步中,Gemini 会为您读出咒语卡片的内容。
关键要点:格斗是一系列小决策,每个决策都有时间限制。这才是大多数软件自动化技术的真实面貌,只是没有夜店。
判别模型概念
软件中的决策
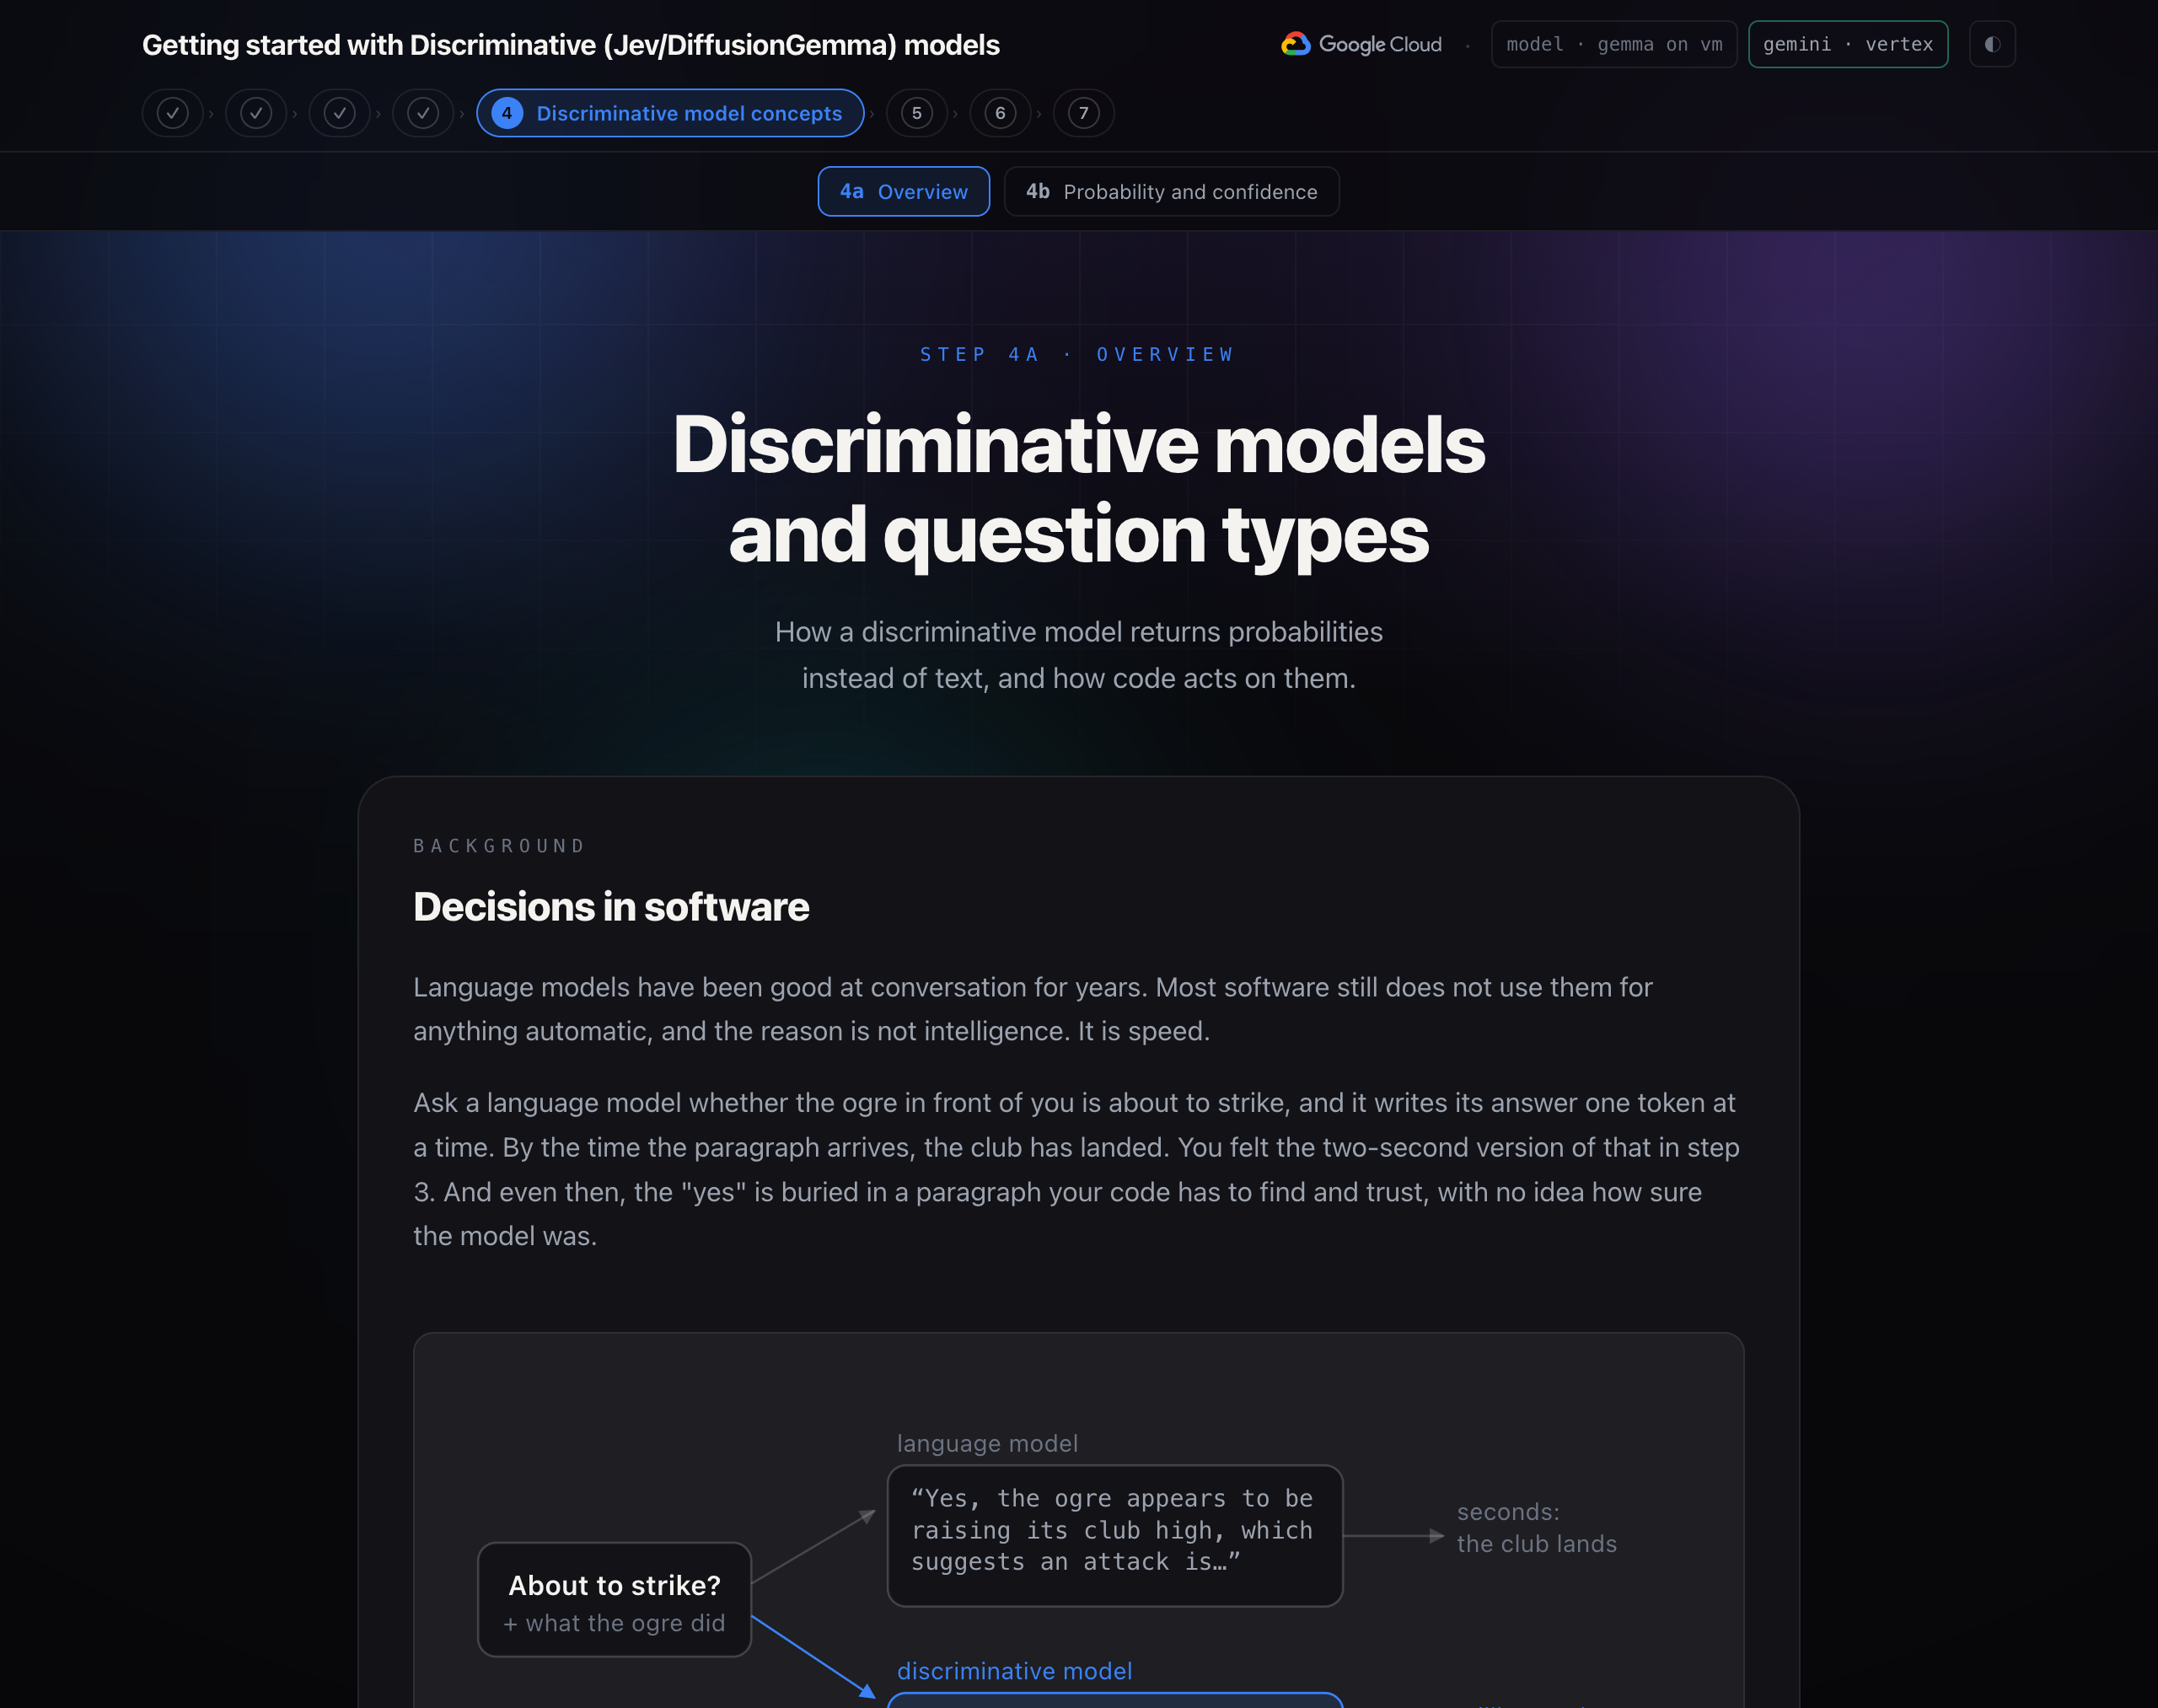
多年来,语言模型一直擅长对话。大多数软件仍然不会将它们用于任何自动化操作,而原因并非是智能。那就是速度。
询问语言模型面前的食人魔是否即将发起攻击,模型会逐个生成 token 来回答问题。当段落到达时,俱乐部已降落。您在第 3 步中体验了 2 秒的版本。即使这样,回答“是”也隐藏在一段文字中,您的代码必须找到并信任这段文字,但您不知道模型有多确定。
判别模型只需一次传递即可在毫秒内获取状态以及您输入的问题和答案。每个答案都附有校准后的概率:0.9 表示十次中有九次正确。没有要解析的文本,也没有要从中提取的 JSON。
系统 1 和系统 2 模型
该名称源自丹尼尔·卡尼曼的《思考,快与慢》。系统 2 是缓慢而审慎的推理,一步接一步。系统 1 快速、擅长模式匹配。
语言模型是系统 2 机器。它会逐个词元地进行推理。判别模型是一种系统 1 模型:它不会大声推理,不会生成任何内容,并且一次性回答所有问题。因此,它的速度很快(大约 70 到 500 毫秒),而且费用低廉(每千次决策的费用不到一美分)。
要点:语言模型可以撰写内容。决策模型会做出决定。软件需要 AI 做出的决策。
限制
辨别式模型不会生成文本、编写代码、进行对话、执行算术运算、读取图片或遵循一系列步骤。
在研讨会中,我们将选择一种判别式模型:
- 判别模型之一是 Jev。它是 TypeSafe AI 于 2026 年 9 月发布的托管 API。第一个模型是
jev-1.13,通过别名jev-latest访问。由于没有已发布的权重,因此会调用该模型,而不是下载。 - Jev 并不是获取 System One 模型的唯一途径。Google 的 DiffusionGemma 是一种开放权重模型,可并行写入整个 token 块,而不是一次写入一个 token,并且同一并行传递可以读取一组固定选项的概率。djev-run 等开源服务器将 Jev 的确切 API 放在前面,因此本讲座中的所有内容都可以在其上运行,而无需进行任何更改。
状态和问题:Choice、Score 和 Noul
每次通话都会发送状态和问题。状态是指您希望系统判断的文本。它可以是字符串、JSON 对象或列表。这些问题会询问您想了解该文本的哪些方面。每个问题都有一个类型:选择题、得分题或 Noul。该模型可以并行处理问题,因此能够快速做出回答。您可以根据需要添加多个问题。
- 选择从您指定的一组选项(最多 255 个)中选择一个选项。答案是选项、每个选项的概率以及置信度。当选项之间没有顺序时使用:格挡高位、格挡低位、躲避、打击、等待。
- 得分会根据您描述的有序级别(从 2 个到 10 个)对状态进行评级。答案是量表上的一个位置(一个小数,因此 1.4 表示“介于 1 和 2 之间,更接近 1”)、每个级别的概率以及置信度。当答案是程度问题时使用:来球的击球难度。
- Choice 和 Score 都会返回每个选项的概率和置信度。不同之处在于主要答案。Choice 会返回最可能的选项。得分将选项视为有序的级别,并返回其概率加权平均值,该值可能介于两个级别之间。如果“无”的权重为 0.05,“轻度”的权重为 0.55,“重度”的权重为 0.40,那么如果用户选择“轻度”,则“得分”答案为 1.35,介于“轻度”和“重度”之间。竞技场使用该值:
choose()将危险分数 1.5 或更高值视为重击。
- Choice 和 Score 都会返回每个选项的概率和置信度。不同之处在于主要答案。Choice 会返回最可能的选项。得分将选项视为有序的级别,并返回其概率加权平均值,该值可能介于两个级别之间。如果“无”的权重为 0.05,“轻度”的权重为 0.55,“重度”的权重为 0.40,那么如果用户选择“轻度”,则“得分”答案为 1.35,介于“轻度”和“重度”之间。竞技场使用该值:
- Noul 会提出一个“是/否”问题,并返回回答为“是”的概率。接近 1 表示“是”的可能性很高,接近 0 表示“否”的可能性很高,接近 0.5 表示“是”或“否”的可能性相当。没有单独的置信度,因为概率就是置信度。
撰写重点明确的问题
当问题询问的是一个具体且范围明确的事项时,判别模型的效果最好。“情况如何?”返回一个可信度较低的合理答案。“What is the right response?”,“对手是否暴露?”和“这次打击会有多严重?”返回三个重点回答,您的代码会将这些回答组合起来。
选项和级别的说明非常简单,但非常重要。您在第 3 步中读到的规则会成为选项说明:block_high: "Raise the shield. Right against an overhead or a high swing."这就是判别模型在请求时学习格斗规则的方式,每条规则占一行。这些选项可能会随情况而变化:当法术准备就绪时,竞技场只会提供 cast。
概率和置信度
选择题答案不是标签。它是一个标签分布,而标签只是最高的条形。
模型如何获取该数字。它采用与语言模型选择下一个字词相同的步骤。Transformer 会读取文本,并在一个位置为词汇表中的每个词元提供一个原始得分,称为“对数几率”。logit 值越高,表示相应 token 越适合该位置。softmax 会将 logits 转换为总和为 1 的概率。然后,语言模型会选择一个词元,将其添加到文本中,并重复此过程。判别模型在计算出概率后便会停止。
空白是指答案表单中的空白处。服务器自行写入表单(例如 response: ▢),并为每个问题留出一个空白。模型的唯一任务是为每个空白处应填入的内容评分。
- 提示包含状态和每个问题,每个允许的答案都以简短的标签表示:
a表示 block_high,b表示 block_low,依此类推。 - 服务器会添加答题表单,每个问题对应一个空白答题框。
- 模型会一次性读取提示和表单,并在每个空白处为每个 token 提供一个 logit。扩散模型会同时看到整个表单,并一起为所有空白处评分。
- 服务器仅保留允许的标签的对数几率,并对其应用 softmax,因此允许的答案总和为 1。
- 如果读取结果看起来不太确定,服务器会从另一个随机起点再次读取,并对读取结果求平均值。
置信度是一个数字,用于表示答案的确定程度。TypeSafe 会根据概率在各个选项中的分布情况来计算置信度。所有流量都分配给一个选项时,该值为 1;平均分配时,该值为 0。对于三个选项,它是(3 × 最大值 - 1)/ 2。
针对校准后的概率,为 Jev 训练了 TypeSafe 模块序列。概率与答案正确的频率相符。在校准后的模型中,置信度为 0.7 的答案大约有 70% 的时间是正确的,因此置信度阈值就是您接受错误答案的频率阈值。本讲座中的 DiffusionGemma 服务器会自行报告最高概率作为置信度,并对读取结果求平均值。当读数不一致时,平均值会分散,置信度会下降。
关键要点:答案会告诉您什么。置信度可用于判断是否采取行动。
阈值
阈值是指您在代码中定义操作的方式。模型会返回置信度或概率。您的代码会将其与您选择的数字进行比较,并根据比较结果决定接下来会发生什么。
每项操作的阈值。TypeSafe 建议将置信度划分为多个频段。高置信度操作会自动执行。中等置信度操作会进行检查,例如要求确认或标记相应支持请求以供审核。置信度较低时,不执行操作,回退到安全操作或人工操作。
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
竞技场的规则。竞技场的阈值位于 choose() 中,您将在第 5 步中运行该文件。
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
警告:有效答案并不总是正确答案。判别模型无法返回您未提供的选项,因此绝不会产生幻觉,但可能会选择错误的选项,有时置信度还很高。在信任某个阈值之前,请先根据您已判断过的情况测试问题。
利用模型自动做出决策
请求和响应
请求。借助 TypeSafe Python SDK,您可以构建问题并将其发送给模型。
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
每个 tick 一次请求
每次计时,应用都会将电报作为状态发送,并在一次调用中询问三件事:
- 从五个(或六个,当有咒语准备就绪时)回答中选择正确答案。一种选择。
- Ogre 当前是否暴露给计数器。A Noul。
- 来球的力度,分为三个等级。得分。
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() 函数
还记得第 4 步中的阈值吗?choose() 将模型的回答与固定数字进行比较,这些固定数字就是阈值。
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() 是普通的 Python 读取类型化值,但有两条规则。判别模型提供其概率和分析,代码使用规则的阈值。所选操作会发送到引擎,用于与食人魔战斗。
关键要点:将问题和阈值集中在一个位置。它们是您最常调整的 System One 集成部分。
响应时间、基于输入的定价和决策逻辑
- 每次决策的响应时间。在 b 部分中,每次战斗的耗时约为 100 毫秒,少数为 200 或 300 毫秒。这对于游戏循环、请求路径或在人员或语言模型看到每条消息之前对其进行检查来说,速度足够快。
- 基于输入的定价。一场完整的比赛,包含 60 个决策(每个决策包含 3 个问题),费用远低于 0.1 美分。输出 token 为零,因为未生成任何内容。这样一来,您就可以提出比实际需要更多的问题。即使只有
strike和cast在意,竞技场也会询问食人魔是否在每个 tick 都暴露,因为询问几乎是免费的,并且答案在信息中心上很有用。TypeSafe 将此称为推测性扇出。 - 兼具信心和危险。当判别模型对其回答的置信度低于 0.40 且危险分数表明即将受到重击时,
choose()会通过躲避来覆盖该回答。回避很少是最佳答案,但也很少是最差的答案。根据每种错误造成的成本选择阈值,而不是选择整数,并根据您已手动判断的电报测试这些阈值。TypeSafe 自己的建议:如果决策一直误触发,请在移动阈值之前收紧问题。
在 ADK 工作流程中组合模型
每 tick 决策的限制以及为什么正确回答是不够的
第 5 步中战斗的最后一行写道:食人魔蹒跚离去,几乎毫发无损。判别模型没有受到任何伤害,但每次计时都造成了少量伤害,而 300 生命值远高于少量伤害乘以 60。戒指一角的咒语卡片一直都在那里。阅读它需要一个能够看到图像的模型。
食人魔有 300 点生命值。正确调用次数为 3。击打到开口处时,伤害为 8,因为皮革很厚。即使是 60 个时钟周期的完美战斗,巨魔也只是受伤站立,游戏会判定为平局。这就是第 5 步的结局:模型防御得很好,但仍然无法获胜。
只有法术才能造成真正的伤害:完美施放时为 45 点,在对手露出破绽时命中则为 67 点。
为每项任务分配合适的模型
圆圈角落里的拼写卡片是获胜的关键,而阅读它并不是文字问题:它是一张图片,其中包含一种颜色和三个连续的形状,必须唱出与这些颜色和形状相符的拼写。这需要一个能够查看图片并在几秒钟内完成分析的模型。在战斗中,几秒钟就是 10 个时间单位。
因此,工作流会同时使用这两种速度,每种速度都有其自身的特点:
- 判别模型奋起反击。每个时间单位(100 毫秒)一次调用、一次决策。循环永远不会等待比自身慢的任何事物。
- Gemini 会朗读和唱歌。在铃声响起时,它会从竞技场的屏幕上抓取咒语卡片作为图像,命名颜色和形状,并唱出咒语。竞技场会根据咒语卡的答案(永远不会离开服务器)来评判歌曲。
- 每次交换后,拳击手都会检查该位置。
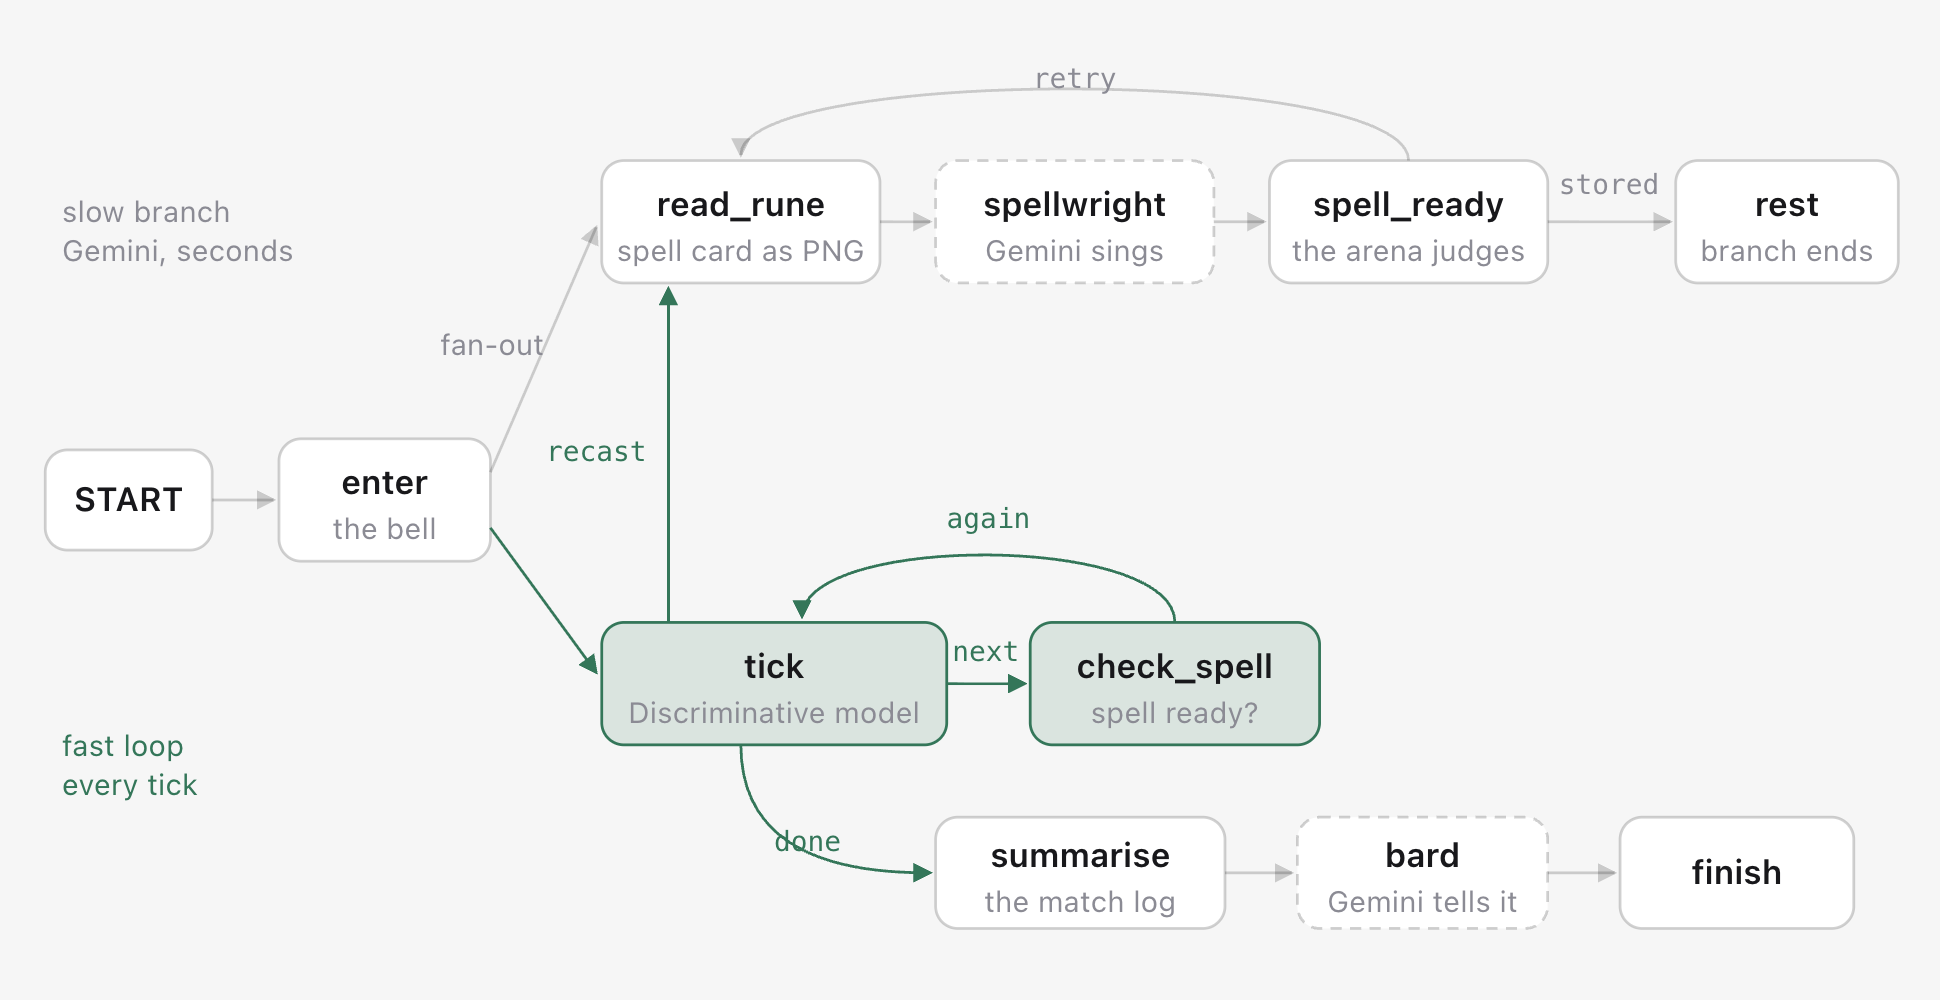
check_spell节点查看状态。未准备就绪:系统会显示 Gemini 唱歌的时长,并直接返回到下一个计时周期。时间从不等待。准备就绪:cast加入了判别模型提供的选项,并在判别模型报告有空档时立即施放该技能。choose()当拼写完毕时,屏幕会绘制一张新的拼写卡片,然后慢速线程会再次启动。如果读错歌曲,则会消耗咒语卡,慢速线程会读取新歌曲。 - Gemini 会在最后撰写一篇简短的故事。
具有不同延迟时间的并行分支和一个事件循环
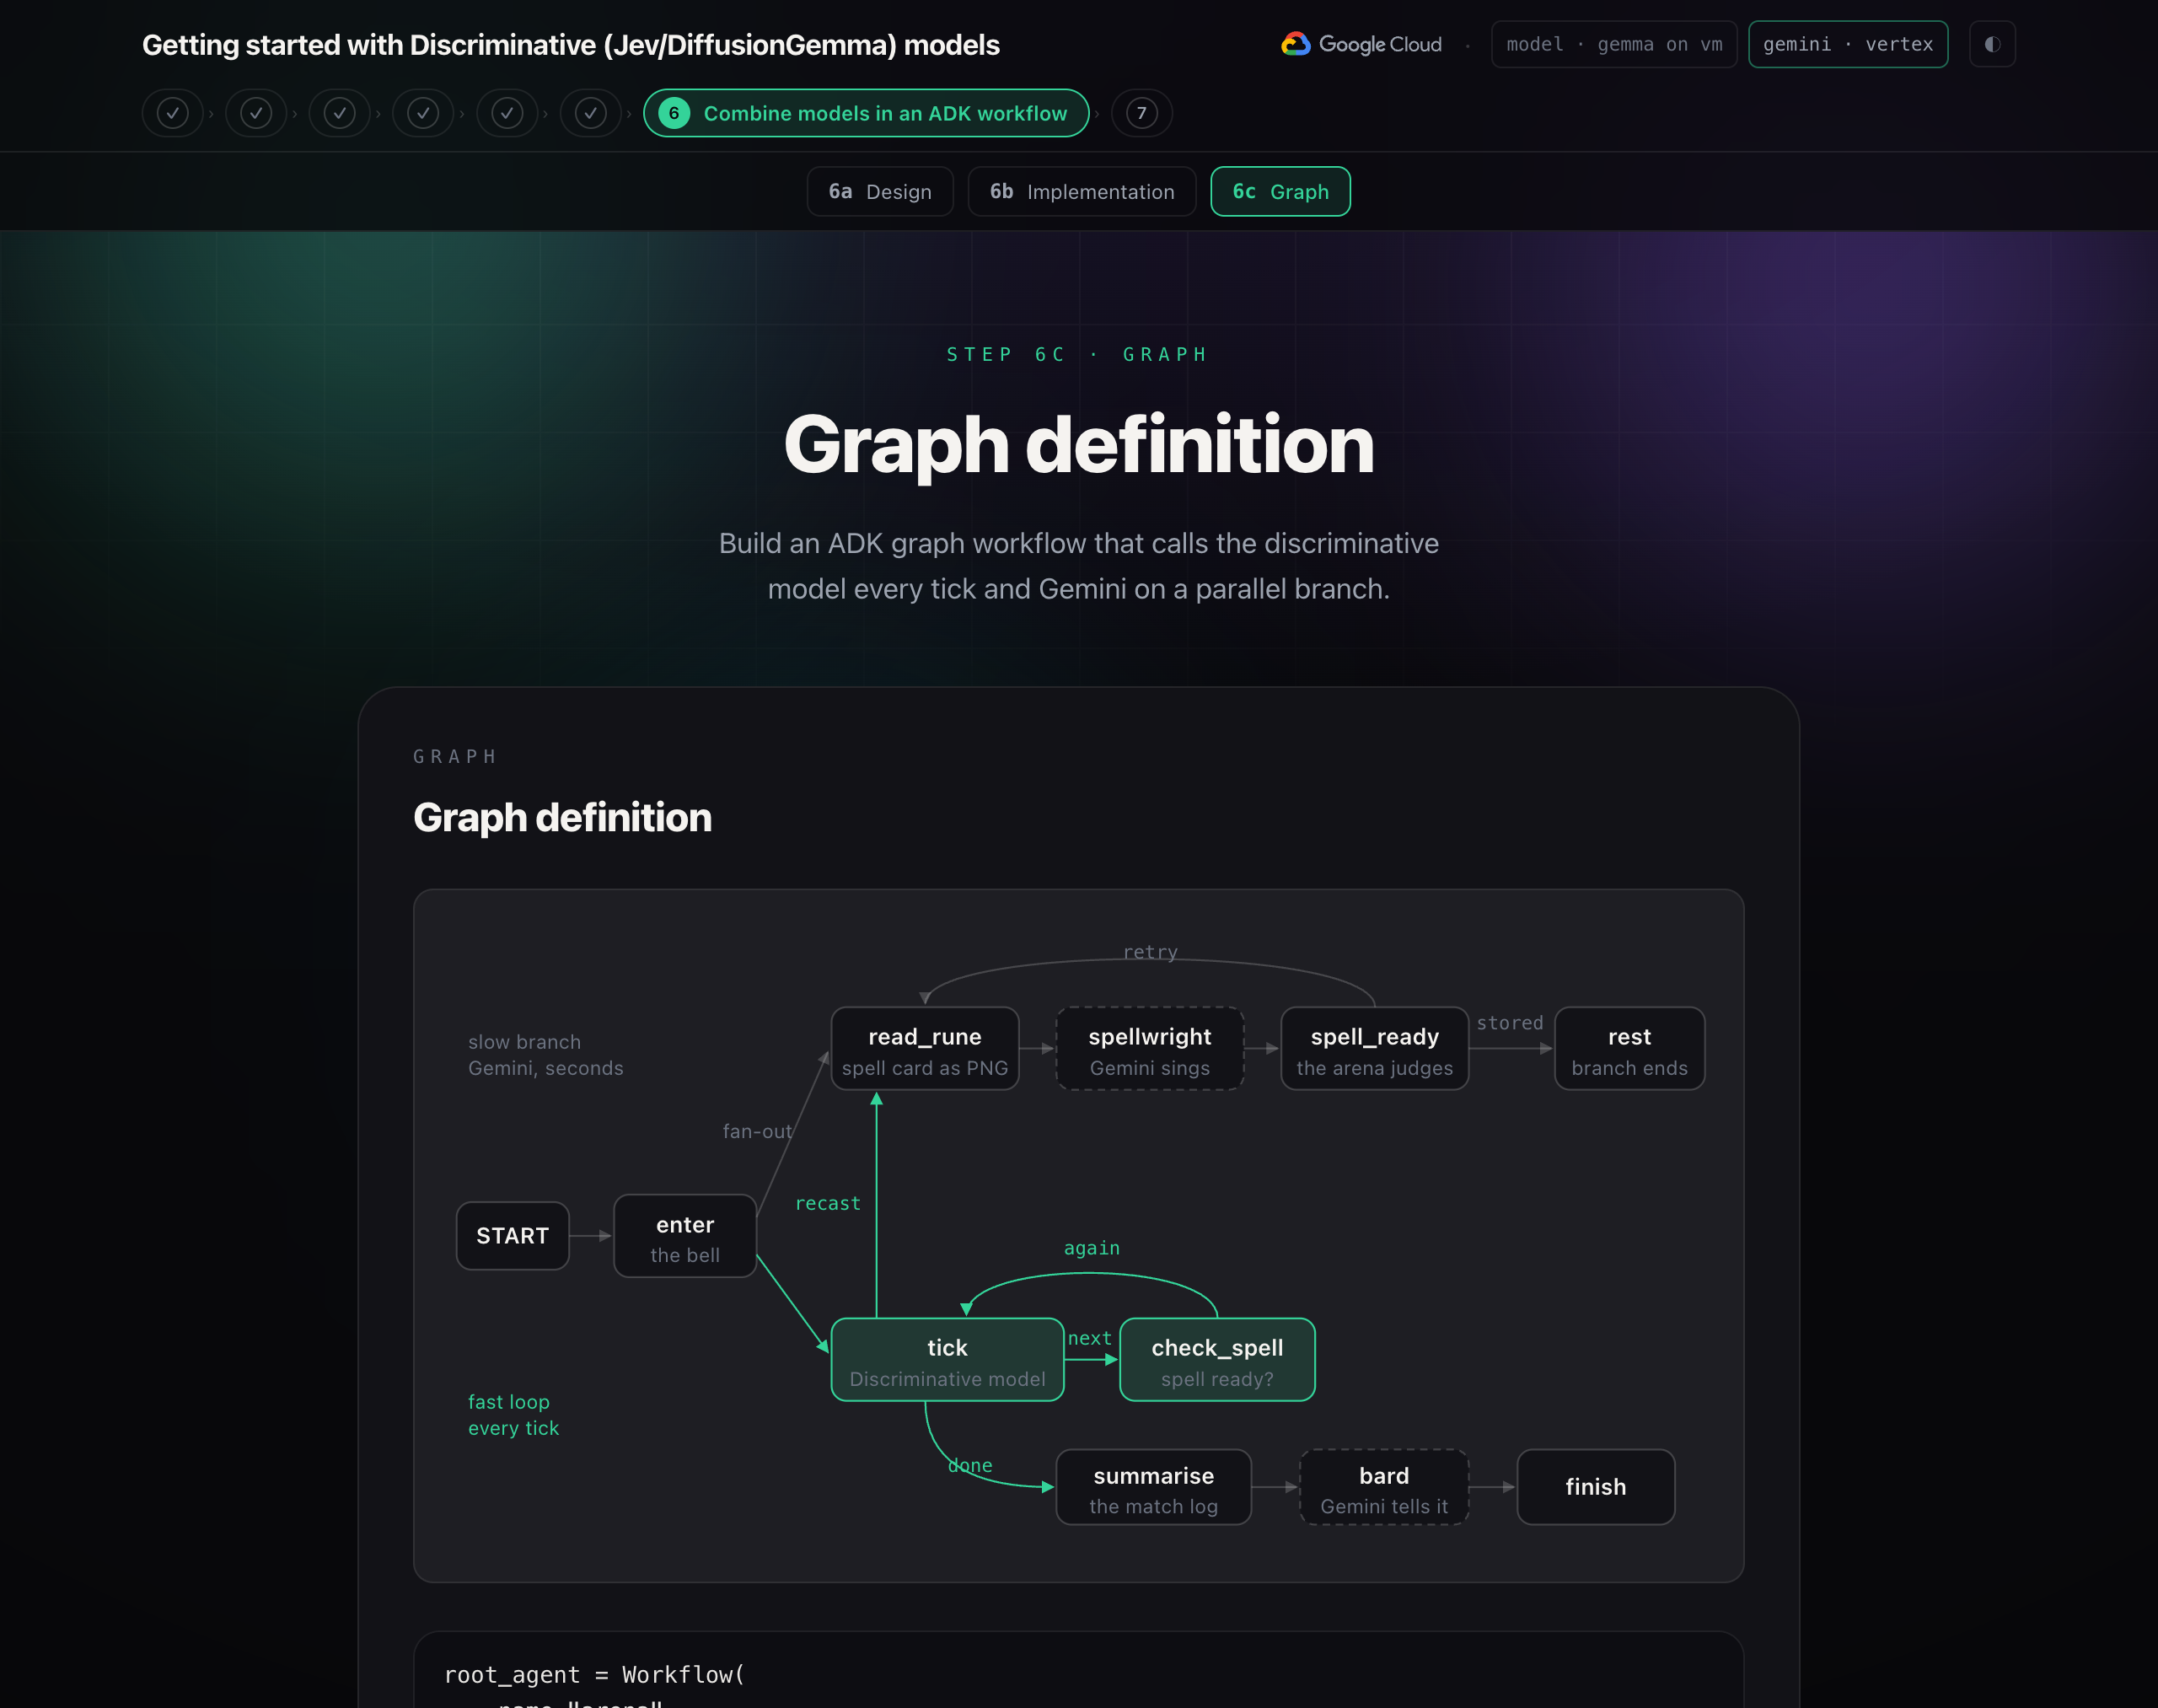
这是一个 ADK 工作流:由边连接的节点图。节点可以是普通的 Python 函数,也可以是 LLM 代理。从一个节点到节点元组的边是扇出:两者同时开始。返回 Event 且具有 route 的节点会选择接下来采用哪条边,而路由到自身的节点则是一个环。
不妨将其视为两条线程。线程 1 速度较慢:读取咒语卡片、唱歌、存储咒语。线程 2 速度很快:勾选、检查 slot、再次勾选。线程 1 在一个将判定的拼写写入会话 state 的函数中结束,并且不返回任何输出。线程 2 的 check_spell 在每次交换后读取该状态。这两个线程既不调用也不等待对方,它们只共享状态。
关键要点:将决策放入代码中,并让每个模型以自己的节奏执行一项狭窄的任务。
ADK 在单个线程中,将这两个分支作为任务在单个事件循环上运行。一次只能运行一项任务。当任务到达 await 时,它会等待答案,而循环会同时运行另一个分支。快速分支等待模型的时间约为十分之一秒,而慢速分支等待 Gemini 的时间为几秒,因此两者互不影响。
慢分支
read_rune() 会将屏幕上的咒语卡片作为图片获取。
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright 是 Gemini。它会读取图片并以固定形状回答问题。
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() 会让竞技场裁判判断咒语,然后存储咒语或重试。
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
函数节点可以返回包含图片部分的 Content,LLM 节点会将其作为用户回合接收。spell_ready 会返回一个包含状态增量且不含 output 的 Event。下一个 tick 从状态读取咒语,没有输出的分支不是图的第二个结尾:ADK 需要一个终端输出,即战斗的输出。
注意:评判是根据竞技场中的代码与咒语卡的隐藏答案进行比较。完美读数是 45,更多的是开局。两个形状正确得 25 分。误读会导致咒语卡失效。系统不会询问 Gemini 是否正确回答了问题。
快速分支
tick() 会播放一次交换,然后选择下一个边。
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() 会在每次对话后查看拼写槽。
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell 会在每次交换后查看卡槽。它永远不会阻塞:如果拼写检查尚未准备就绪,它会报告这一点并继续执行。
设计理念有三个方面。判别模型调用通过异步客户端进行 await,因此循环会在等待时让出,而 Gemini 分支会继续运行。问题会在每个时间间隔重新生成,因此只有在有内容可投屏时,才会显示 cast。而 route 可以是一个列表:["recast", "next"] 一次性获取两个边。
竞技场本身位于一个小型客户端后面:如果存在正在运行的应用,则通过 HTTP 运行,因此网页会显示对战;如果不存在,则在进程内运行引擎。
图表定义
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
以元组形式表示的目标是扇出。以元组形式表示的边是一条链。一个字典,用于将路由名称映射到节点。tick → check_spell → tick 是快速循环。"recast": read_rune 在消耗法术后再次启动慢速线程,"retry" 在法术失败后执行相同操作,"stored": rest 在法术位于插槽中时,让慢速线程静默结束,不产生任何输出。ADK 要求一个周期中至少有一个路由边,因此在无条件循环可以永远运行之前,它会被拒绝。
注意: root_agent 是 ADK 工具要查找的内容。从研讨会的根目录运行 adk web agents 会打开包含竞技场的开发者界面,如果您想在浏览器中(而不是在终端中)查看图表和事件,请运行此命令。