

1. 簡介
這場 90 分鐘的研討會將介紹鑑別模型、TypeSafe AI 的 System One 決策模型,以及如何在 Google ADK 工作流程中將其與 Gemini 搭配使用。本研討會共有六個步驟,以格鬥遊戲為例。您會先徒手與食人魔戰鬥,然後將反射動作交給 Discriminative 模型,接著觀看 ADK 工作流程贏得戰鬥,Discriminative 模型會決定每個刻度,而 Gemini 會讀取螢幕上的咒語卡片來詠唱咒語。
總覽
Discriminative 模型 (jev-1.13,別名 jev-latest) 是由 TypeSafe AI 於 2026 年 9 月 19 日發布的代管模型。不會生成文字。您傳送 state (文字、JSON 或清單) 和輸入的問題 (Choice、Score、Noul),系統會傳回經過校正的機率和輸入的答案,大約需要 70 到 500 毫秒,每百萬個輸入權杖的費用為 $0.042 美元,輸出則不收費。這項技術負責在語言模型的前後和之間做出決策,包括路徑選擇、分類、閘道,以及這裡的戰士反射動作。
以遊戲為例
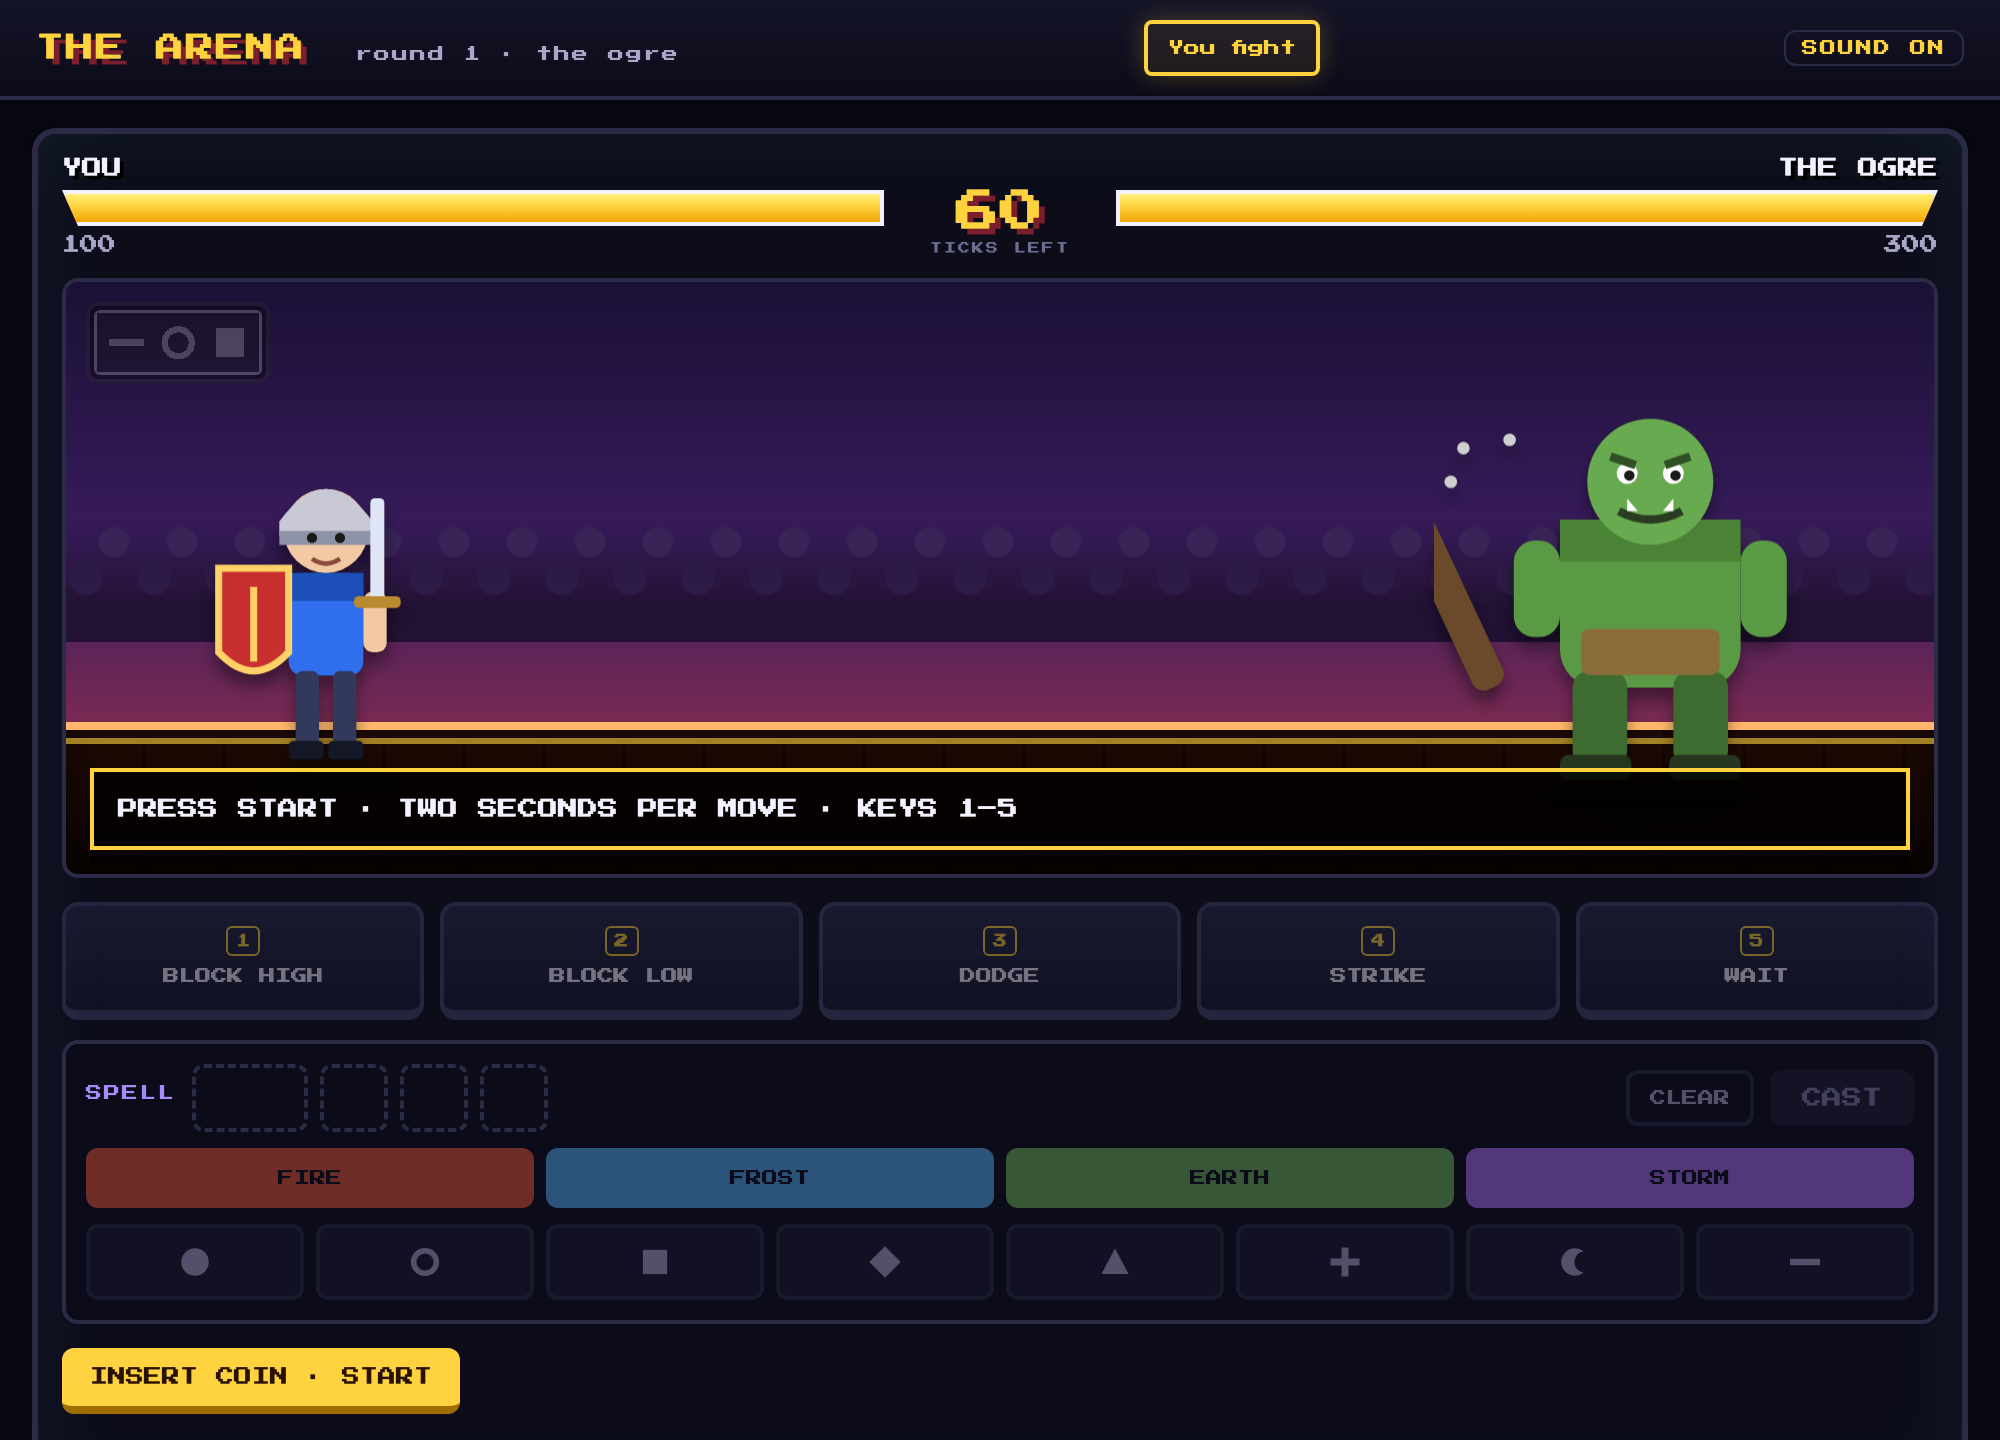
你是否曾玩過戰鬥遊戲?你面對對手,必須立即對對方的動作做出反應。猜錯一次就會扣血。遊戲也往往會讓咒語難以施展。在我們的遊戲中,你必須依序選取咒語卡的顏色和形狀,才能釋放咒語。本研討會將說明如何結合這兩種模型,讓角色獲得勝利。
遊戲中的每個元素都對應到真實系統:
- 對手的動作是傳入事件,例如要求或交易。
- 回覆是判別式模型做出的有界決策,並經過程式碼檢查。
- 咒語卡是需要語言模型解讀的非結構化輸入內容。
- 比賽:工作流程,以各自的速度執行快速和緩慢的工作。
重點在於結合這四個元件,並將它們組裝在一起,建構快速且智慧的系統。
學習目標
- 說明判別式 (系統一) 和生成式 (系統二) 模型有何不同,以及兩者的適用時機。
- 說明如何提供 Jev 和 DiffusionGemma,並為研討會設定其中一個模型,包括 Compute Engine GPU VM 上的 DiffusionGemma。
- 撰寫 Choice、Score 和 Noul 問題,並解讀機率和信賴度。
- 在決定性程式碼中使用門檻,將機率轉換為動作。
- 使用 TypeSafe SDK 建構要求,然後讓模型在遊戲中選擇每一步。
- 建立慢速分支 (Gemini 會讀取圖片) 和快速分支 (鑑別模型會在迴圈中做出決策),並分別執行。
- 在 ADK 圖形工作流程中加入兩個分支,在一個事件迴圈中共用狀態,因此緩慢的工作絕不會延遲快速決策。
架構
工作台位於 Cloud Shell(或您的電腦),會寫入本機檔案系統,並與競技場、Gemini 和決策模型互動。② 呼叫「判別式模型對戰」中的決策模型;③ 呼叫「工作流程對戰」中的兩個模型。
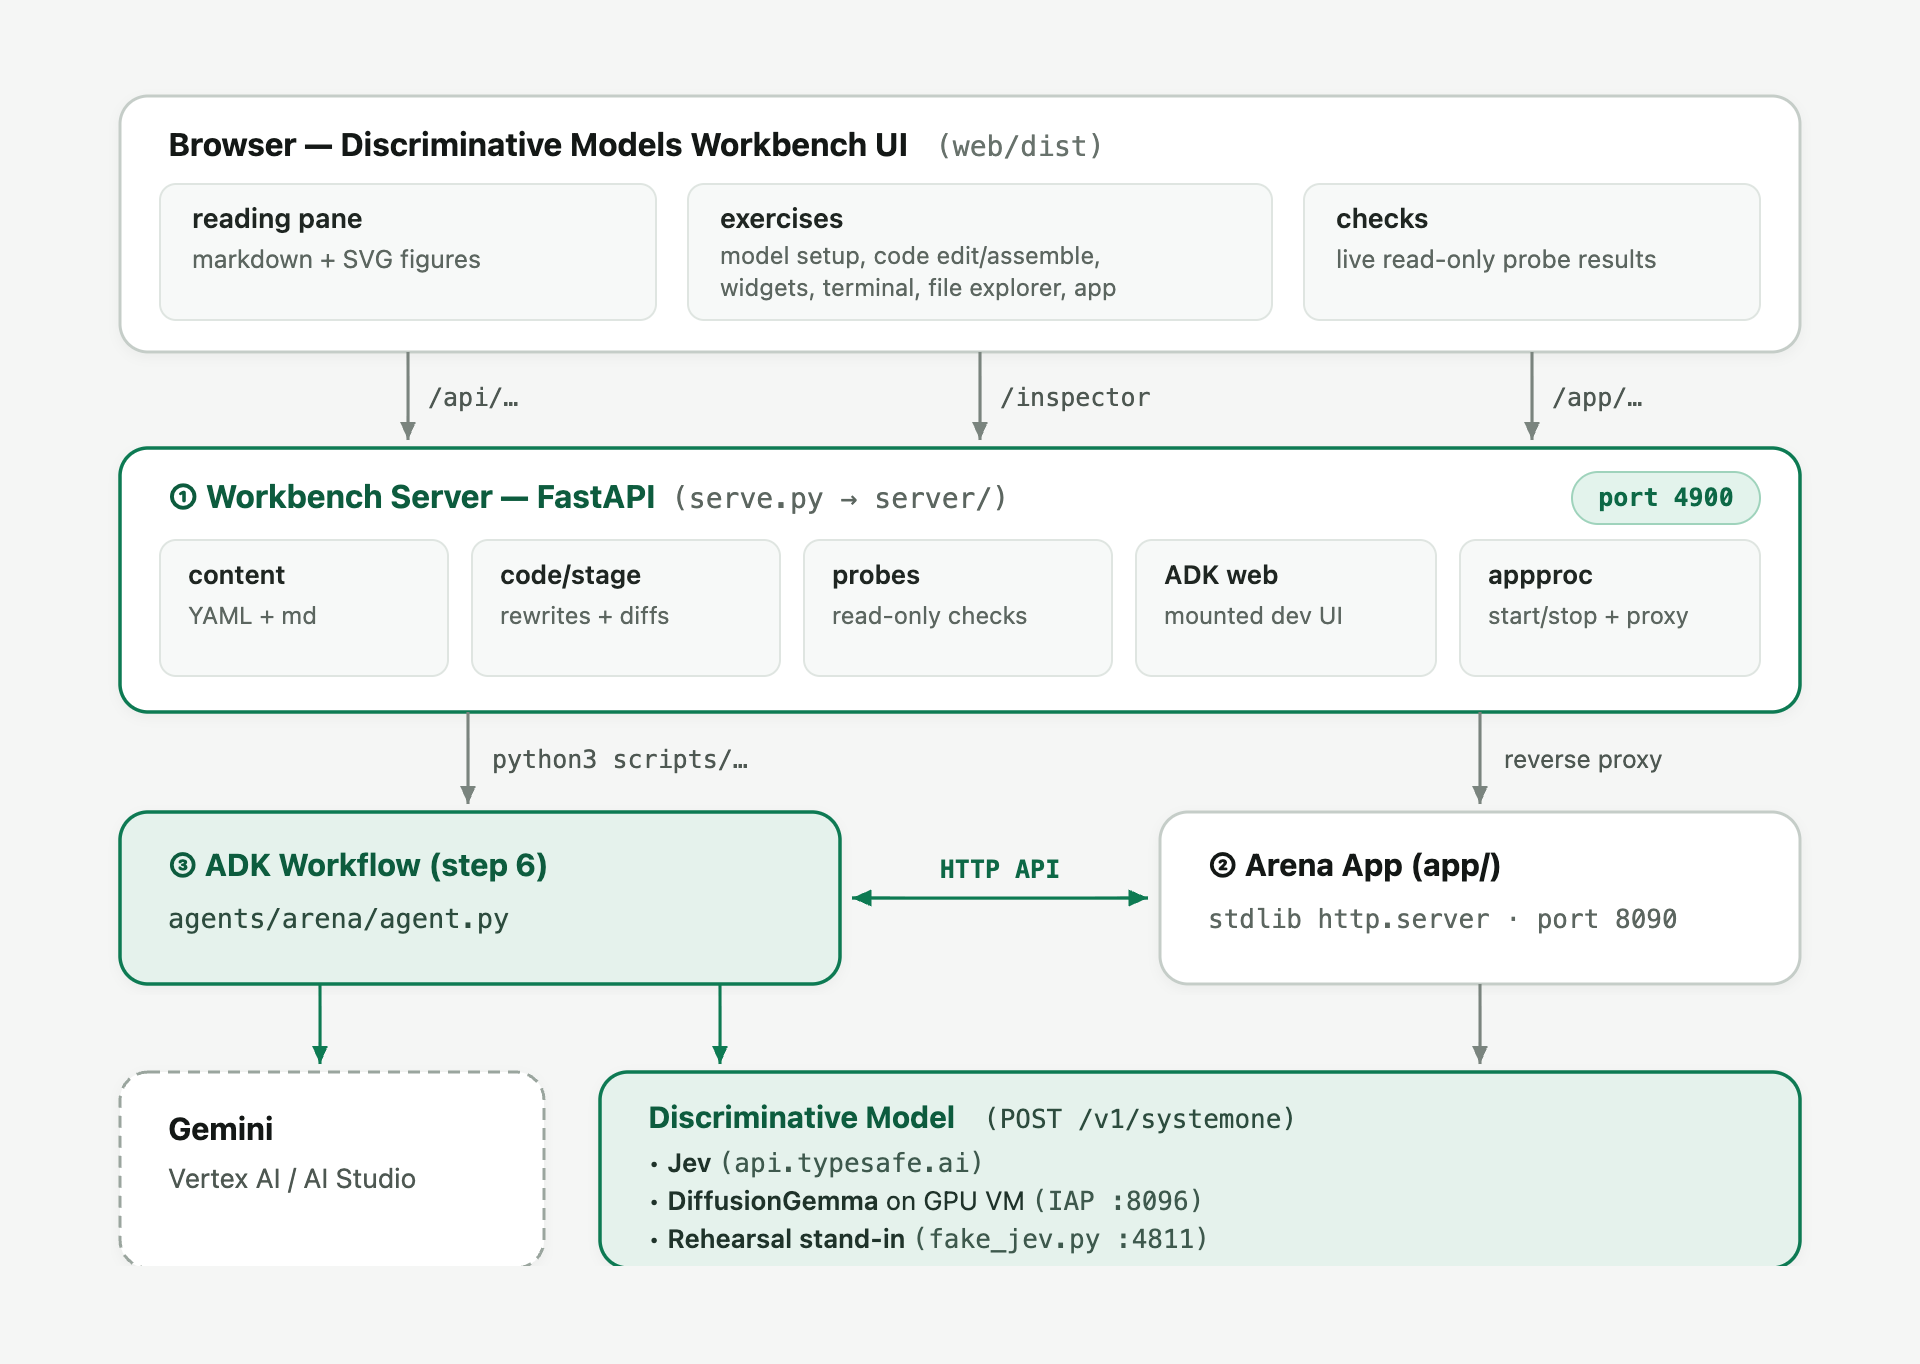
誰呼叫什麼。瀏覽器只會與 ① 通訊。這兩個模型都是從電腦上的 Python 呼叫:
來電者 | 判別式模型 | Gemini |
② 競技場:「辨別模型大戰」 | 每個勾號, | 否 |
③ 工作流程 | 每個勾號, | 否 |
③ 工作流程 | 否 | 咒語卡圖片;戰鬥後的故事 |
| 是 | 否 |
每個模式只能獲得一個勾勾。
- 你戰鬥。這個頁面會要求 ② 輸入電報,並顯示 2 秒計時器,然後發布你按下的按鈕 (或輸入的咒語)。② 解決問題。
- 判別式模型爭議。這個頁面會要求 ② 勾選核取方塊;② 繪製電報、在一次呼叫中向模型提出三個問題、執行
choose(),並傳回答案和結果。頁面會繪製長條。 - 工作流程爭議。Start 會以子程序的形式啟動 ② (登入
runs/arena-workflow.log)。③ 會推動戰鬥:向 ② 詢問每個電報、呼叫模型,並發布決策;Gemini 的咒語會在準備就緒時,自行抵達分支。這個頁面只會進行第 ② 階段的投票和抽籤。「暫停」是 ② 上的標記,③ 會在每次勾選前檢查。
決策模型的代管位置。所有呼叫都會經過相同的 typesafe-sdk,只有基準網址會變更。scripts/jevauth.py 為後端命名,並設定金鑰和逾時:
後端 |
| 鍵 | 設定者 |
TypeSafe (託管) | unset (api.typesafe.ai) |
|
|
在 L4 VM 上使用 DiffusionGemma |
| 無 |
|
在 Cloud Run 上執行 DiffusionGemma |
| 每小時擷取的 Google 身分識別權杖 |
|
彩排 |
| 無 |
|
咒語卡片答案 ②:工作流程只會取得 PNG,並判斷傳回的咒語。這才是真正考驗 Gemini 閱讀能力的方式,而您在「You fight」中建立的咒語,則是真正考驗您自己的方式。
2. 設定
領取研討會抵免額
如果這項課程提供 Google Cloud 抵免額,請先兌換抵免額 (大約需要一分鐘),系統會為您建立帳單帳戶。
開啟 Cloud Shell
Google Cloud Shell 是可透過瀏覽器存取的 Linux 環境,預先設定了 gcloud、Python、Node.js、uv 和 git,並已透過您的 Google 帳戶完成驗證。
- 開啟 Google Cloud 控制台。
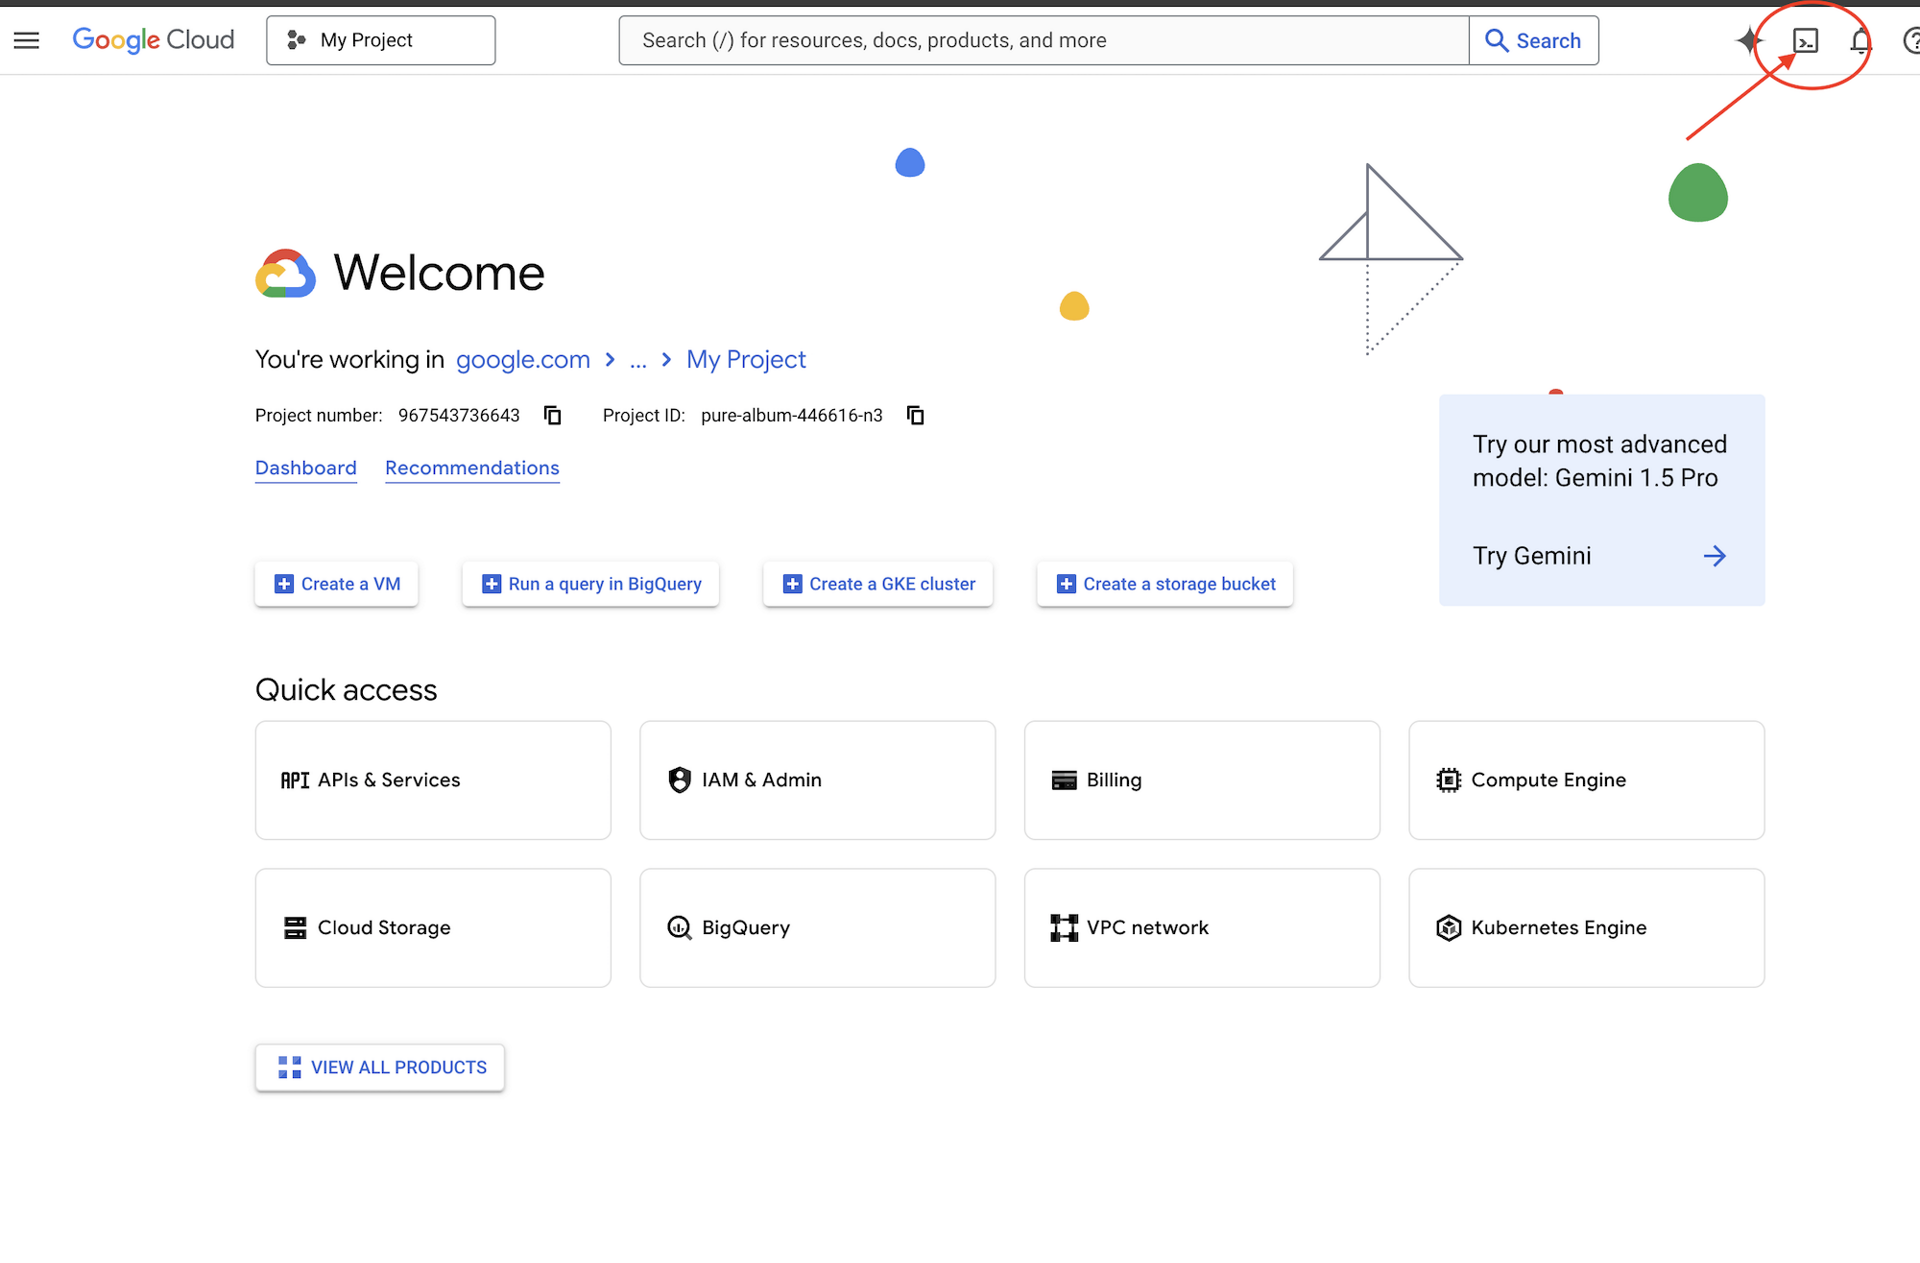
- 按一下「啟用 Cloud Shell」(頂端導覽列中的終端機圖示),在瀏覽器底部開啟終端機工作階段。
啟動工作台
在 Cloud Shell 或已登入 gcloud 的任何位置:
git clone https://github.com/gca-americas/discriminative-models-workshop.git
cd discriminative-models-workshop
./setup_project.sh     # a new project with billing, recorded in ~/project_id.txt
./setup_codelab.sh     # everything else, then the workbench on port 4900
setup_project.sh 會建立專案 (discrim-models-XXXX),並連結帳單,如果有的話,會優先使用活動抵免額帳戶,然後等待專案開始放送。重新執行時,系統會重複使用 ~/project_id.txt 中的專案。如要使用現有專案,請將專案 ID 放入該檔案,並略過這個指令碼。
setup_codelab.sh 不會要求任何資訊。這項指令會安裝 uv 和 Python 套件、啟用 Vertex AI、Compute Engine 和 IAP、在專案中將 Gemini 指向 Vertex AI (位於 .env)、使用專案可呼叫的模型發出一次實際的 Gemini 呼叫、建構網頁、在背景啟動工作台,並執行 scripts/check_setup.py。重新執行可保留運動檔案,但 scripts/starter.sh 會重設檔案。決策模型是在工作台的步驟 2 中選擇。
如要在 Cloud Shell 中開啟工作台 UI,請按照下列步驟操作:
- 按一下
./setup_codelab.sh結尾處列印的預覽連結,或點選 Cloud Shell 工具列右上角的「網頁預覽」。 - 選取「變更通訊埠」,輸入「4900」,然後點按「變更並預覽」。
Gemini 會在您專案的 Vertex AI 中執行,並使用您自己的 Google 憑證:GOOGLE_GENAI_USE_VERTEXAI=1、GOOGLE_CLOUD_PROJECT 和 GOOGLE_CLOUD_LOCATION=global (位於 .env 中)。
決策模型會在工作台的步驟 2 中自行選擇,或透過終端機使用 scripts/setup_model.sh 選擇:
選擇 | 需求 | 設定 | 費用 |
判別式模型 (TypeSafe,代管) | TypeSafe API 金鑰 | 無 | 每詞元,以美分為單位 |
DiffusionGemma (Google,開放權重) | 帳單 + GPU 的 Compute Engine 配額 | 約 15 分鐘,自動 | VM 執行時每小時約$0.71 美元 |
演練 (無模型) | nothing | 無 | 無 |
在 Compute Engine VM 上使用 DiffusionGemma
scripts/setup_gemma.sh 會先檢查 GPU 配額,然後從 Google 的深度學習映像檔 (搭載 NVIDIA 驅動程式 580) 建立一個 g2-standard-4 VM (1 個 L4 24 GB、4 個 vCPU、16 GB)。虛擬機器首次啟動時會安裝 Docker,從 Hugging Face 下載權重 (nvidia/diffusiongemma-26B-A4B-it-NVFP4,17.5 GB,公開,無權杖),並執行 djev-run:Discriminative 模型確切 API 後方的 DiffusionGemma。模型的連接埠未對網際網路開放:工作台會透過 localhost:8096 上的 IAP 管道連線,而 scripts/start.sh 會開啟該管道。
暫停 / 繼續 |
| |
隧道 |
| |
移除 |
| |
練習指令 |
| |
存放區版面配置
app/                the arena app, as built so far (see "The app, one stage at a time")
  main.py           the server, the "You fight" mode, and the plugin loader
  engine.py         the rules and the ogre's moves, the one copy
  sigil.py          spell cards: a color and three shapes, judged and drawn (a tiny PNG rasteriser)
  static/           the page: HP bars, the telegraph and timer, the spell card; modes/ holds plugins
  static/sounds/    bgm.mp3 plus optional effects: fight, ogre-attack, block, strike, hurt, charge,
                    cast, fizzle, ready, ko, timeup (.mp3). A missing file is silent. Add them in stages/03-you-fight/.
  reflex.py         step 5: the three questions and choose()
  mode_model.py     step 5: the server side of "Discriminative model fights"
  mode_workflow.py  step 6: the server side of "Workflow fights"
branches/           step 6b's exercises: each branch as a workflow of its own, nothing from the arena
  slow_branch.py    Gemini reads spell_card.png and is checked against spell_card.json
  fast_branch.py    the Discriminative model decides on a list of moves, in a loop
starter/            Reset restores from here
server/             The workbench
3. 摘要
清理環境
完成研討會後,請完成下列步驟,拆除所有 DiffusionGemma GPU 資源、停止背景工作台和排練程序、從 Cloud Shell 移除研討會檔案,以及 (選擇性) 刪除研討會 Google Cloud 專案。
- 刪除 DiffusionGemma GPU VM 和防火牆規則 (如有建立):如果您在步驟 2 中於 Compute Engine GPU VM 上佈建 DiffusionGemma,請移除 VM、磁碟和 IAP 防火牆規則,以免產生持續的運算或磁碟儲存空間費用:
cd ~/discriminative-models-workshop ./scripts/teardown_gemma.sh - 在 Cloud Shell 中停止工作台和彩排程序:在 Cloud Shell 終端機中,停止背景工作台伺服器和任何彩排替代程序:
cd ~/discriminative-models-workshop ./scripts/stop.sh ./scripts/rehearsal.sh stop 2>/dev/null || true - 從 Cloud Shell 刪除研討會資料夾:返回主目錄,然後移除複製的存放區資料夾和專案 ID 檔案:
cd ~ rm -rf ~/discriminative-models-workshop ~/project_id.txt - 刪除 Google Cloud 專案:如果您
./setup_project.sh建立專屬的工作坊專案 (例如discrim-models-XXXX),永久關閉專案會刪除專案內的所有資源,但 Cloud Billing 帳戶會維持不變:
您已完成本研討會。
實驗室摘要
- 在 Compute Engine GPU VM 上選擇鑑別模型 (Jev 或 DiffusionGemma),並確認模型會回答問題。
- 手動玩競技場,與時間賽跑,瞭解規則。
- 瞭解鑑別模型如何回答 Choice、Score 和 Noul 問題、機率和信賴度,以及程式碼如何將門檻套用至這些問題。
- 傳送第一項要求,然後讓模型在競技場中選擇每個動作,並將答案轉換為動作
choose()。 - ADK 工作流程的每個分支都是獨立建構,Gemini 會讀取咒語卡圖片,模型則會在迴圈中做出決策。
- 加入共用狀態的單一工作流程,因此戰鬥不會等待 Gemini,咒語會在開場時施放。
從對話到決策
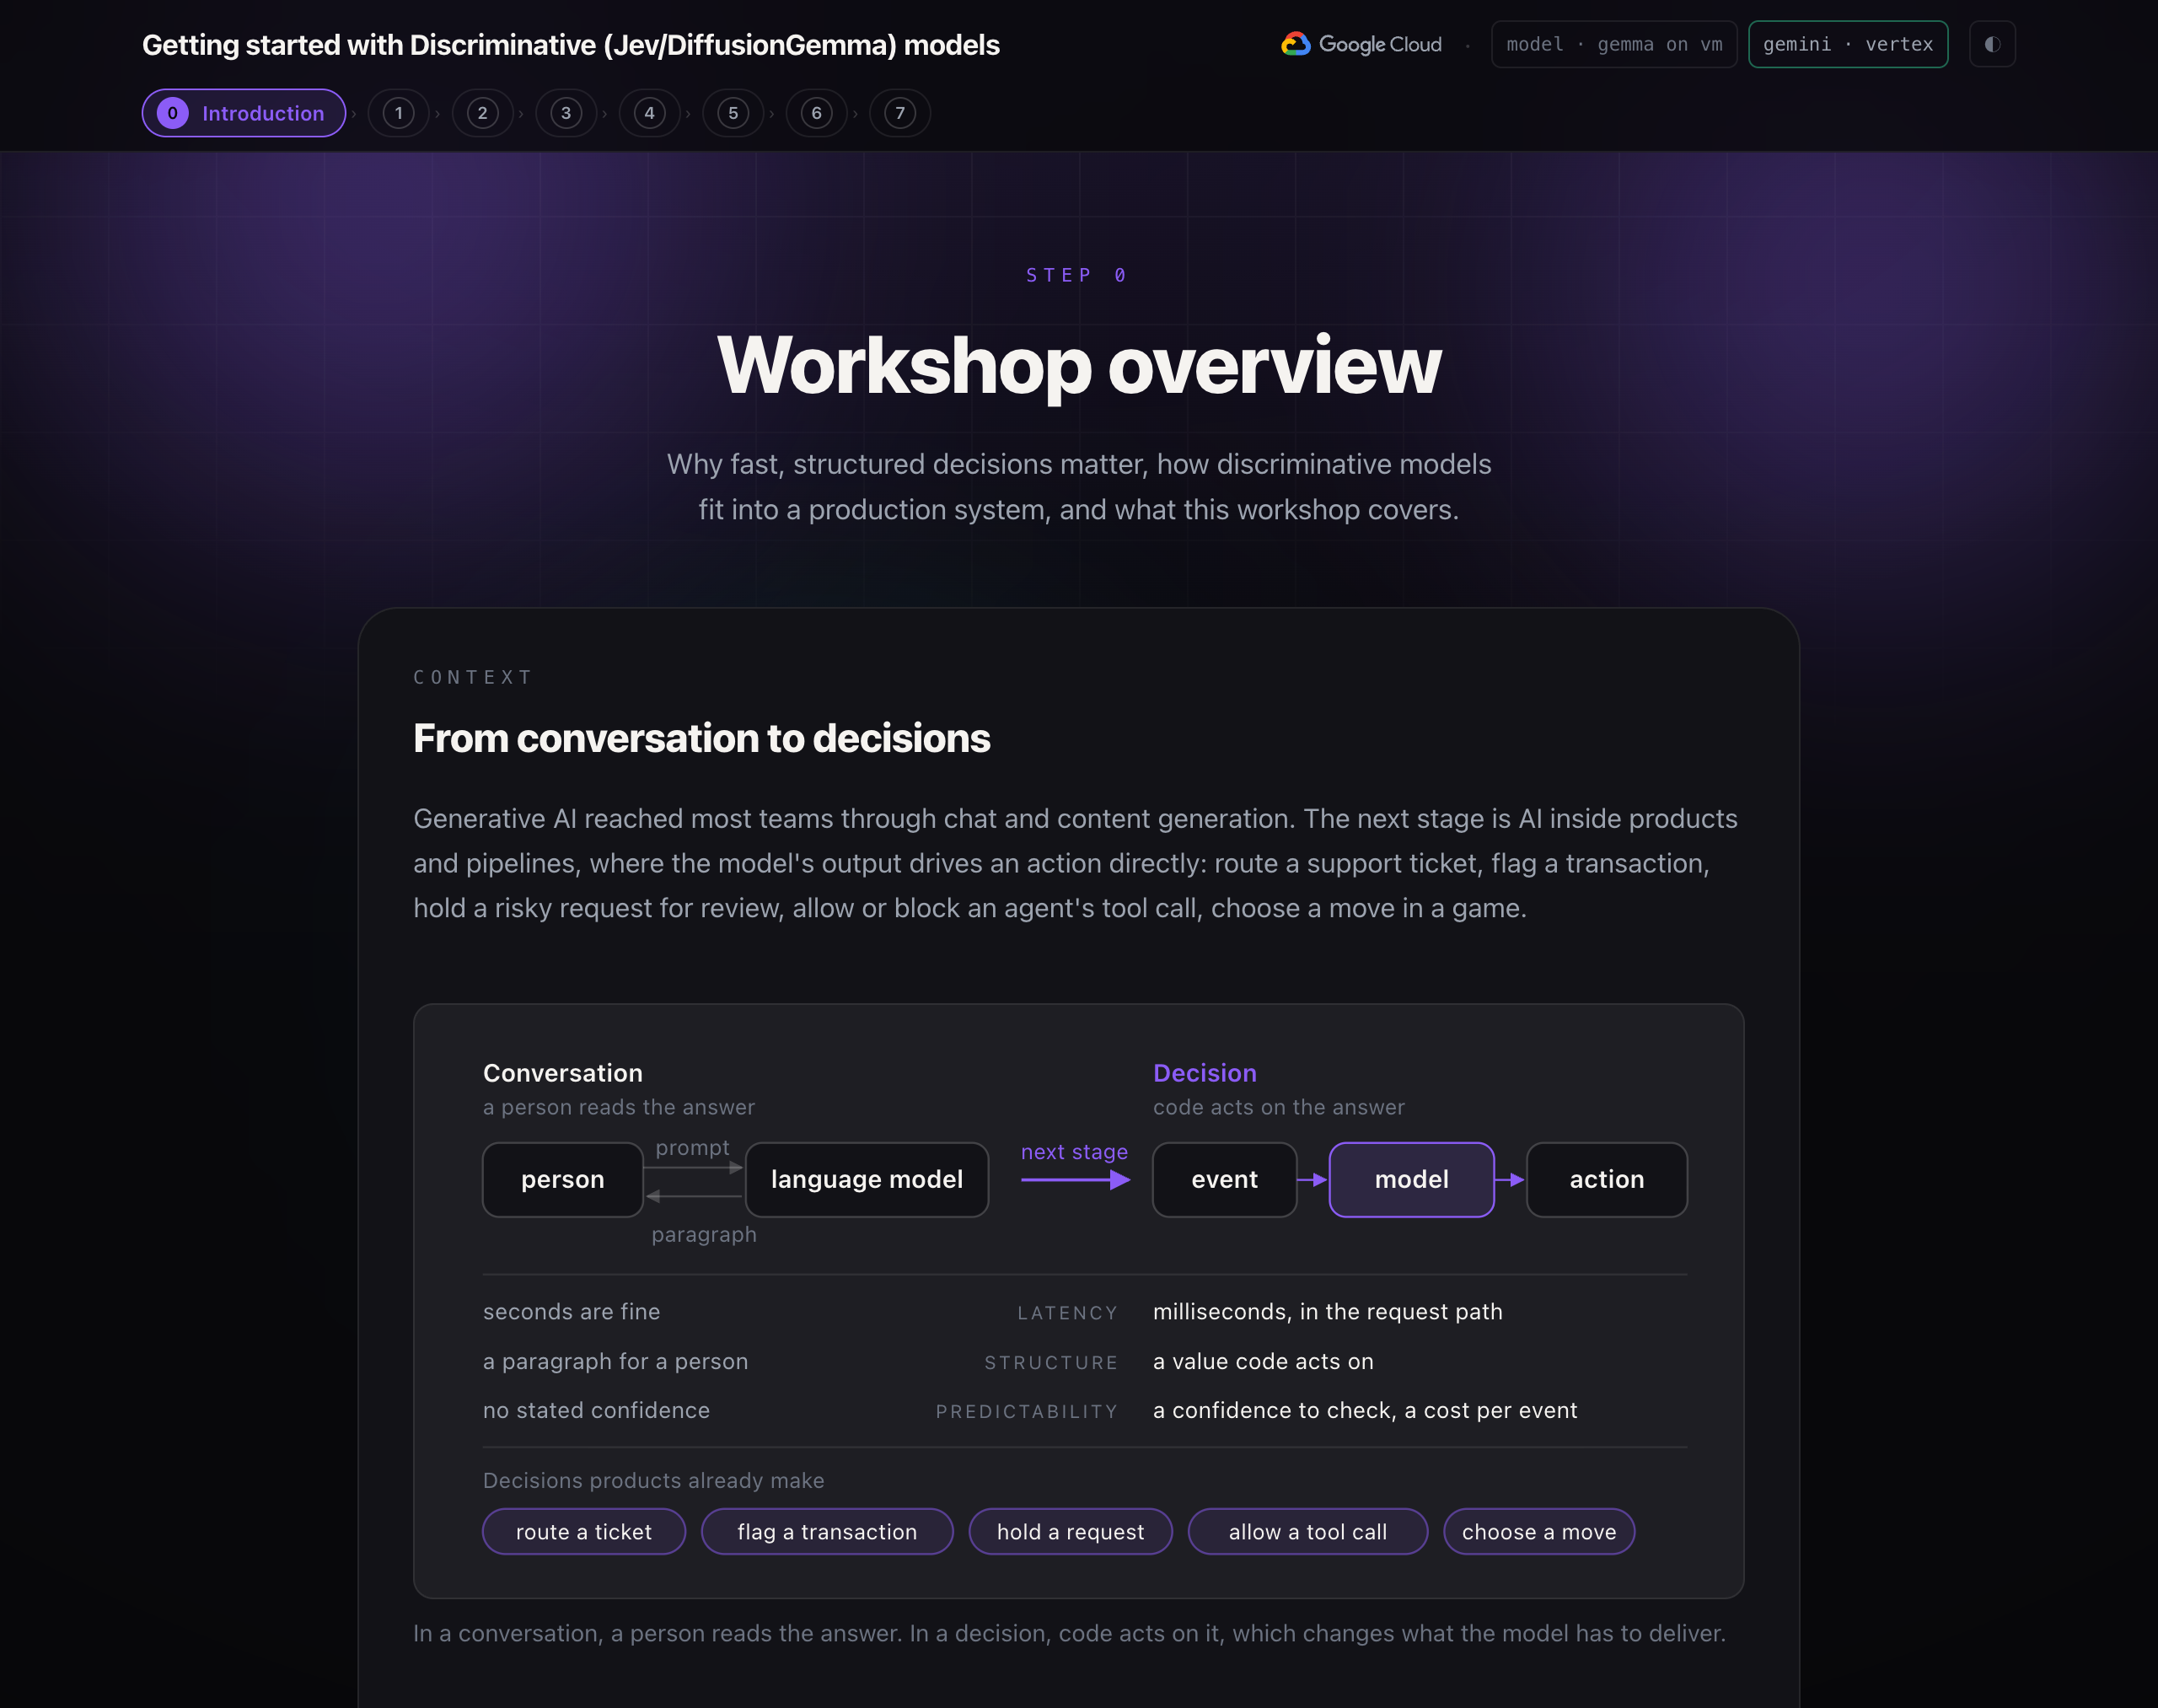
生成式 AI 透過即時通訊和內容生成功能,觸及大多數團隊。下一個階段是產品和管道中的 AI,模型輸出內容會直接觸發動作:轉送支援單、標記交易、保留高風險要求以供審查、允許或封鎖代理程式的工具呼叫、在遊戲中選擇動作。
這些決策有三項共同需求,但即時通訊沒有:
- 延遲時間:答案通常位於使用者的要求路徑或即時迴圈中,因此必須以毫秒為單位傳送,而非秒。
- 結構:呼叫端是程式碼,因此答案必須是可執行的值,而不是需要剖析的段落。
- 可預測性。每個決策都需要程式碼可檢查的信賴度,以及低到足以在每個事件中詢問的成本。
語言模型一次會生成一個詞元。可以提示為是或否,但即時迴圈速度緩慢,輸出內容必須經過剖析,且不會回報確定程度。
專為決策而建構的模型
判別模型會在單一階段中,針對輸入的問題提供每個允許選項的機率。不會生成文字。本研討會提供兩種執行方式:
模型 | 供應商 | 本研討會中模型執行的位置 |
Jev | TypeSafe AI | TypeSafe 的代管服務,使用 API 金鑰呼叫 |
DiffusionGemma | Google,開啟重量訓練 | 在您自己的 Google Cloud 雲端專案中,透過 GPU VM 自行代管 |
您可以視需求更換模型,連結至模型的程式碼不需要變更。
合併元件
成功的系統包含多個元件:
元件 | 角色 | 本研討會內容 |
工作流程 | 調度管理步驟、平行執行分支、保留共用狀態 | ADK 圖表工作流程 |
確定性程式碼 | 規則、閾值、驗證。即時、免費且可稽核 | 遊戲規則、 |
判別式模型 | 快速做出有把握的決策,並取得信賴度分數 | 每隔一段時間選擇回應 |
語言模型 | 感知和生成:圖像和開放式文字 | Gemini 讀取咒語卡圖片並寫出咒語 |
模型服務架構
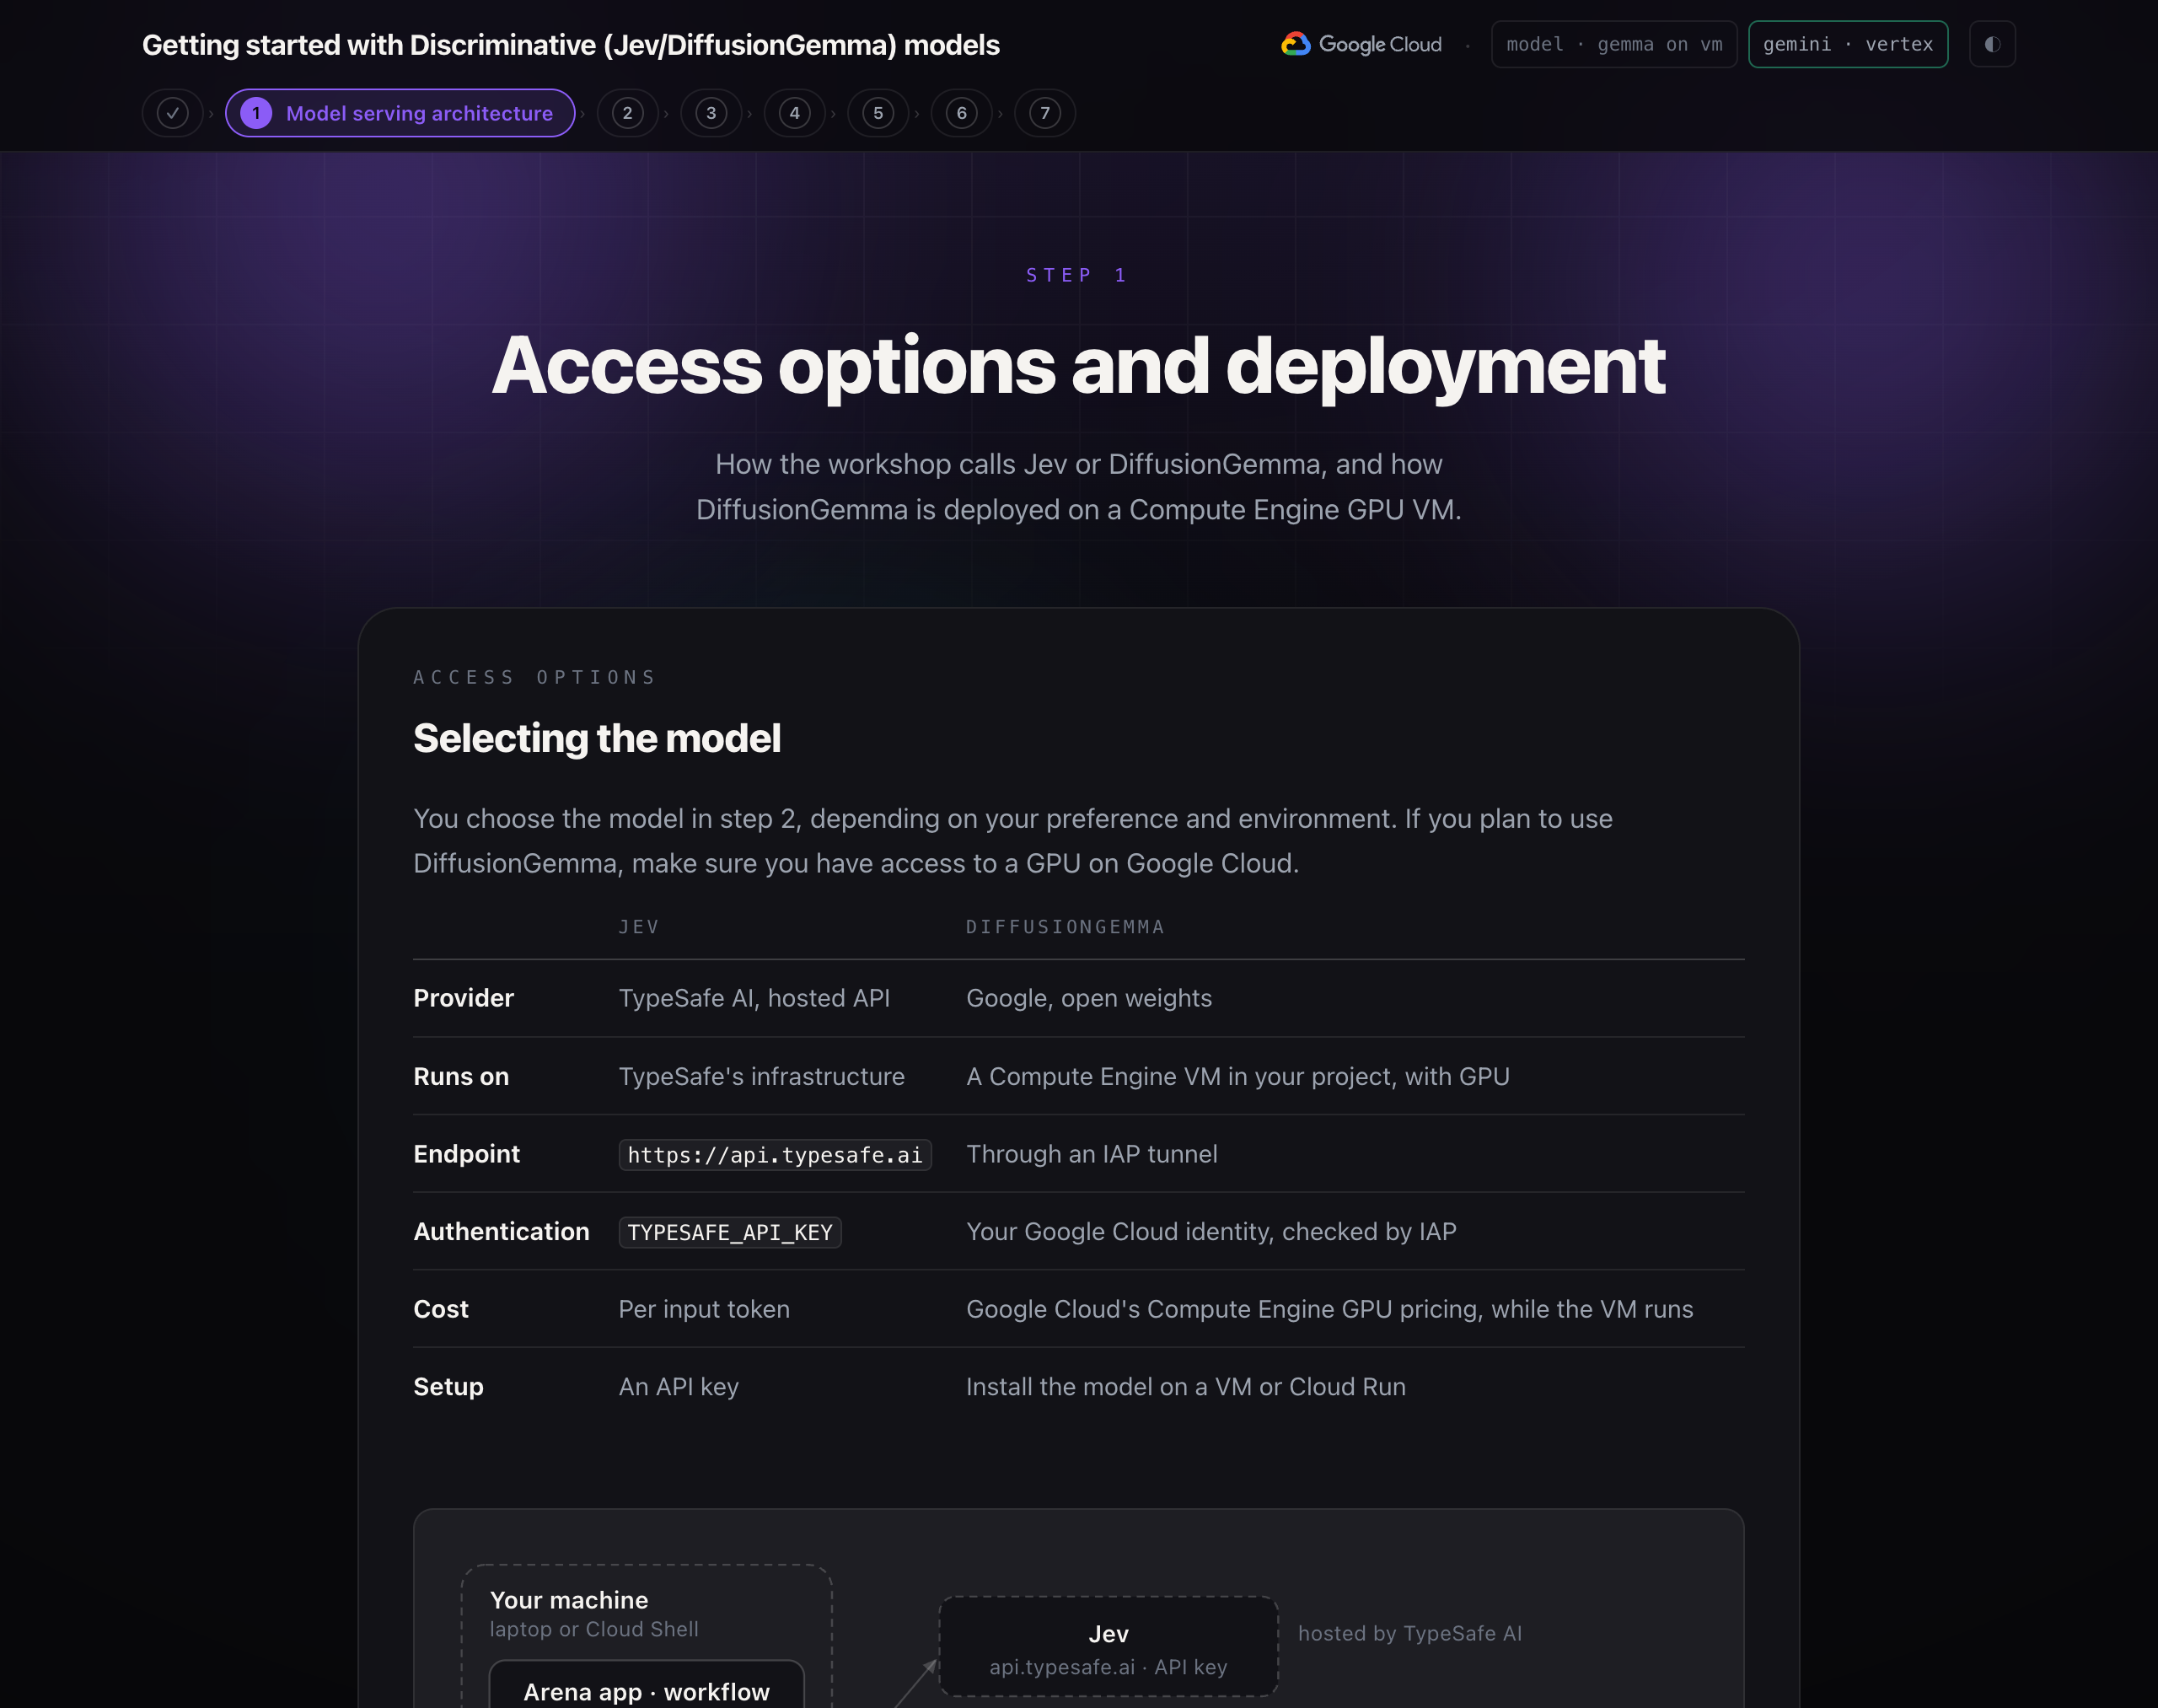
您可以在步驟 2 中選擇模型,具體取決於您的偏好和環境。如果您打算使用 DiffusionGemma,請確認您有權存取 Google Cloud 的 GPU。
Jev | DiffusionGemma | |
供應商 | TypeSafe AI (代管 API) | Google,開啟重量訓練 |
執行時間 | TypeSafe 的基礎架構 | 專案中的 Compute Engine VM,搭載 GPU |
端點 |
| 透過 IAP 通道 |
驗證 |
| IAP 檢查的 Google Cloud 身分 |
費用 | 每個輸入詞元 | Google Cloud 的 Compute Engine GPU 定價 (VM 執行期間) |
設定方式 | API 金鑰 | 在 VM 或 Cloud Run 上安裝模型 |
資料流程
- 競技場應用程式或 ADK 工作流程會建構要求:狀態 (對手所做的事) 和三個問題。
- TypeSafe SDK 會將其做為
POST /v1/systemone傳送至設定的基準網址。 - 如果是 Jev,要求會透過 HTTPS 傳送至
api.typesafe.ai,且 API 金鑰會做為承載權杖。 - 如果是 DiffusionGemma,要求會傳送至
localhost:8096。背景gcloud compute start-iap-tunnel程序會透過 Identity-Aware Proxy 轉送至 VM 上的 8080 連接埠,並檢查您的 Google 身分。 - 在 VM 上,djev-run 會接收要求、透過 GPU 上的 vLLM 執行 DiffusionGemma,並讀取每個允許選項的機率。
- 兩個後端都會傳回相同的結果:每個問題的答案、機率和信賴分數。工作坊程式碼會套用門檻並採取行動。
Compute Engine 上的 DiffusionGemma
scripts/setup_gemma.sh 會在專案中建構下列項目:
- 檢查區域是否具有 GPU 配額。
- 啟用 Compute Engine 和 IAP API,並建立防火牆規則
allow-iap-djev。只允許通訊埠 22 和 8080 上的 IAP 位址範圍。 - 建立 VM
djev-l4:機型g2-standard-4(4 個 vCPU、16 GB 記憶體)、24 GB 的 GPU、100 GB 的磁碟,以及搭載 NVIDIA 驅動程式 580 的 Deep Learning VM 映像檔。如果某個區域沒有 GPU 容量,系統會嘗試下一個區域。 - 首次啟動時,虛擬機的開機指令碼會安裝 Docker 和 NVIDIA Container Toolkit、提取 djev-run 容器映像檔、從 Hugging Face 下載權重 (17.5 GB),並在通訊埠 8080 上啟動容器,同時授予 GPU 存取權。整個過程大約需要 15 分鐘。後續啟動時間約為 2 秒。
- 將連線設定寫入
.env,並開啟通道。
工作 | 指令 |
停止 VM (保留磁碟) |
|
重新啟動 |
|
檢查通道 |
|
刪除所有內容 |
|
設定模型
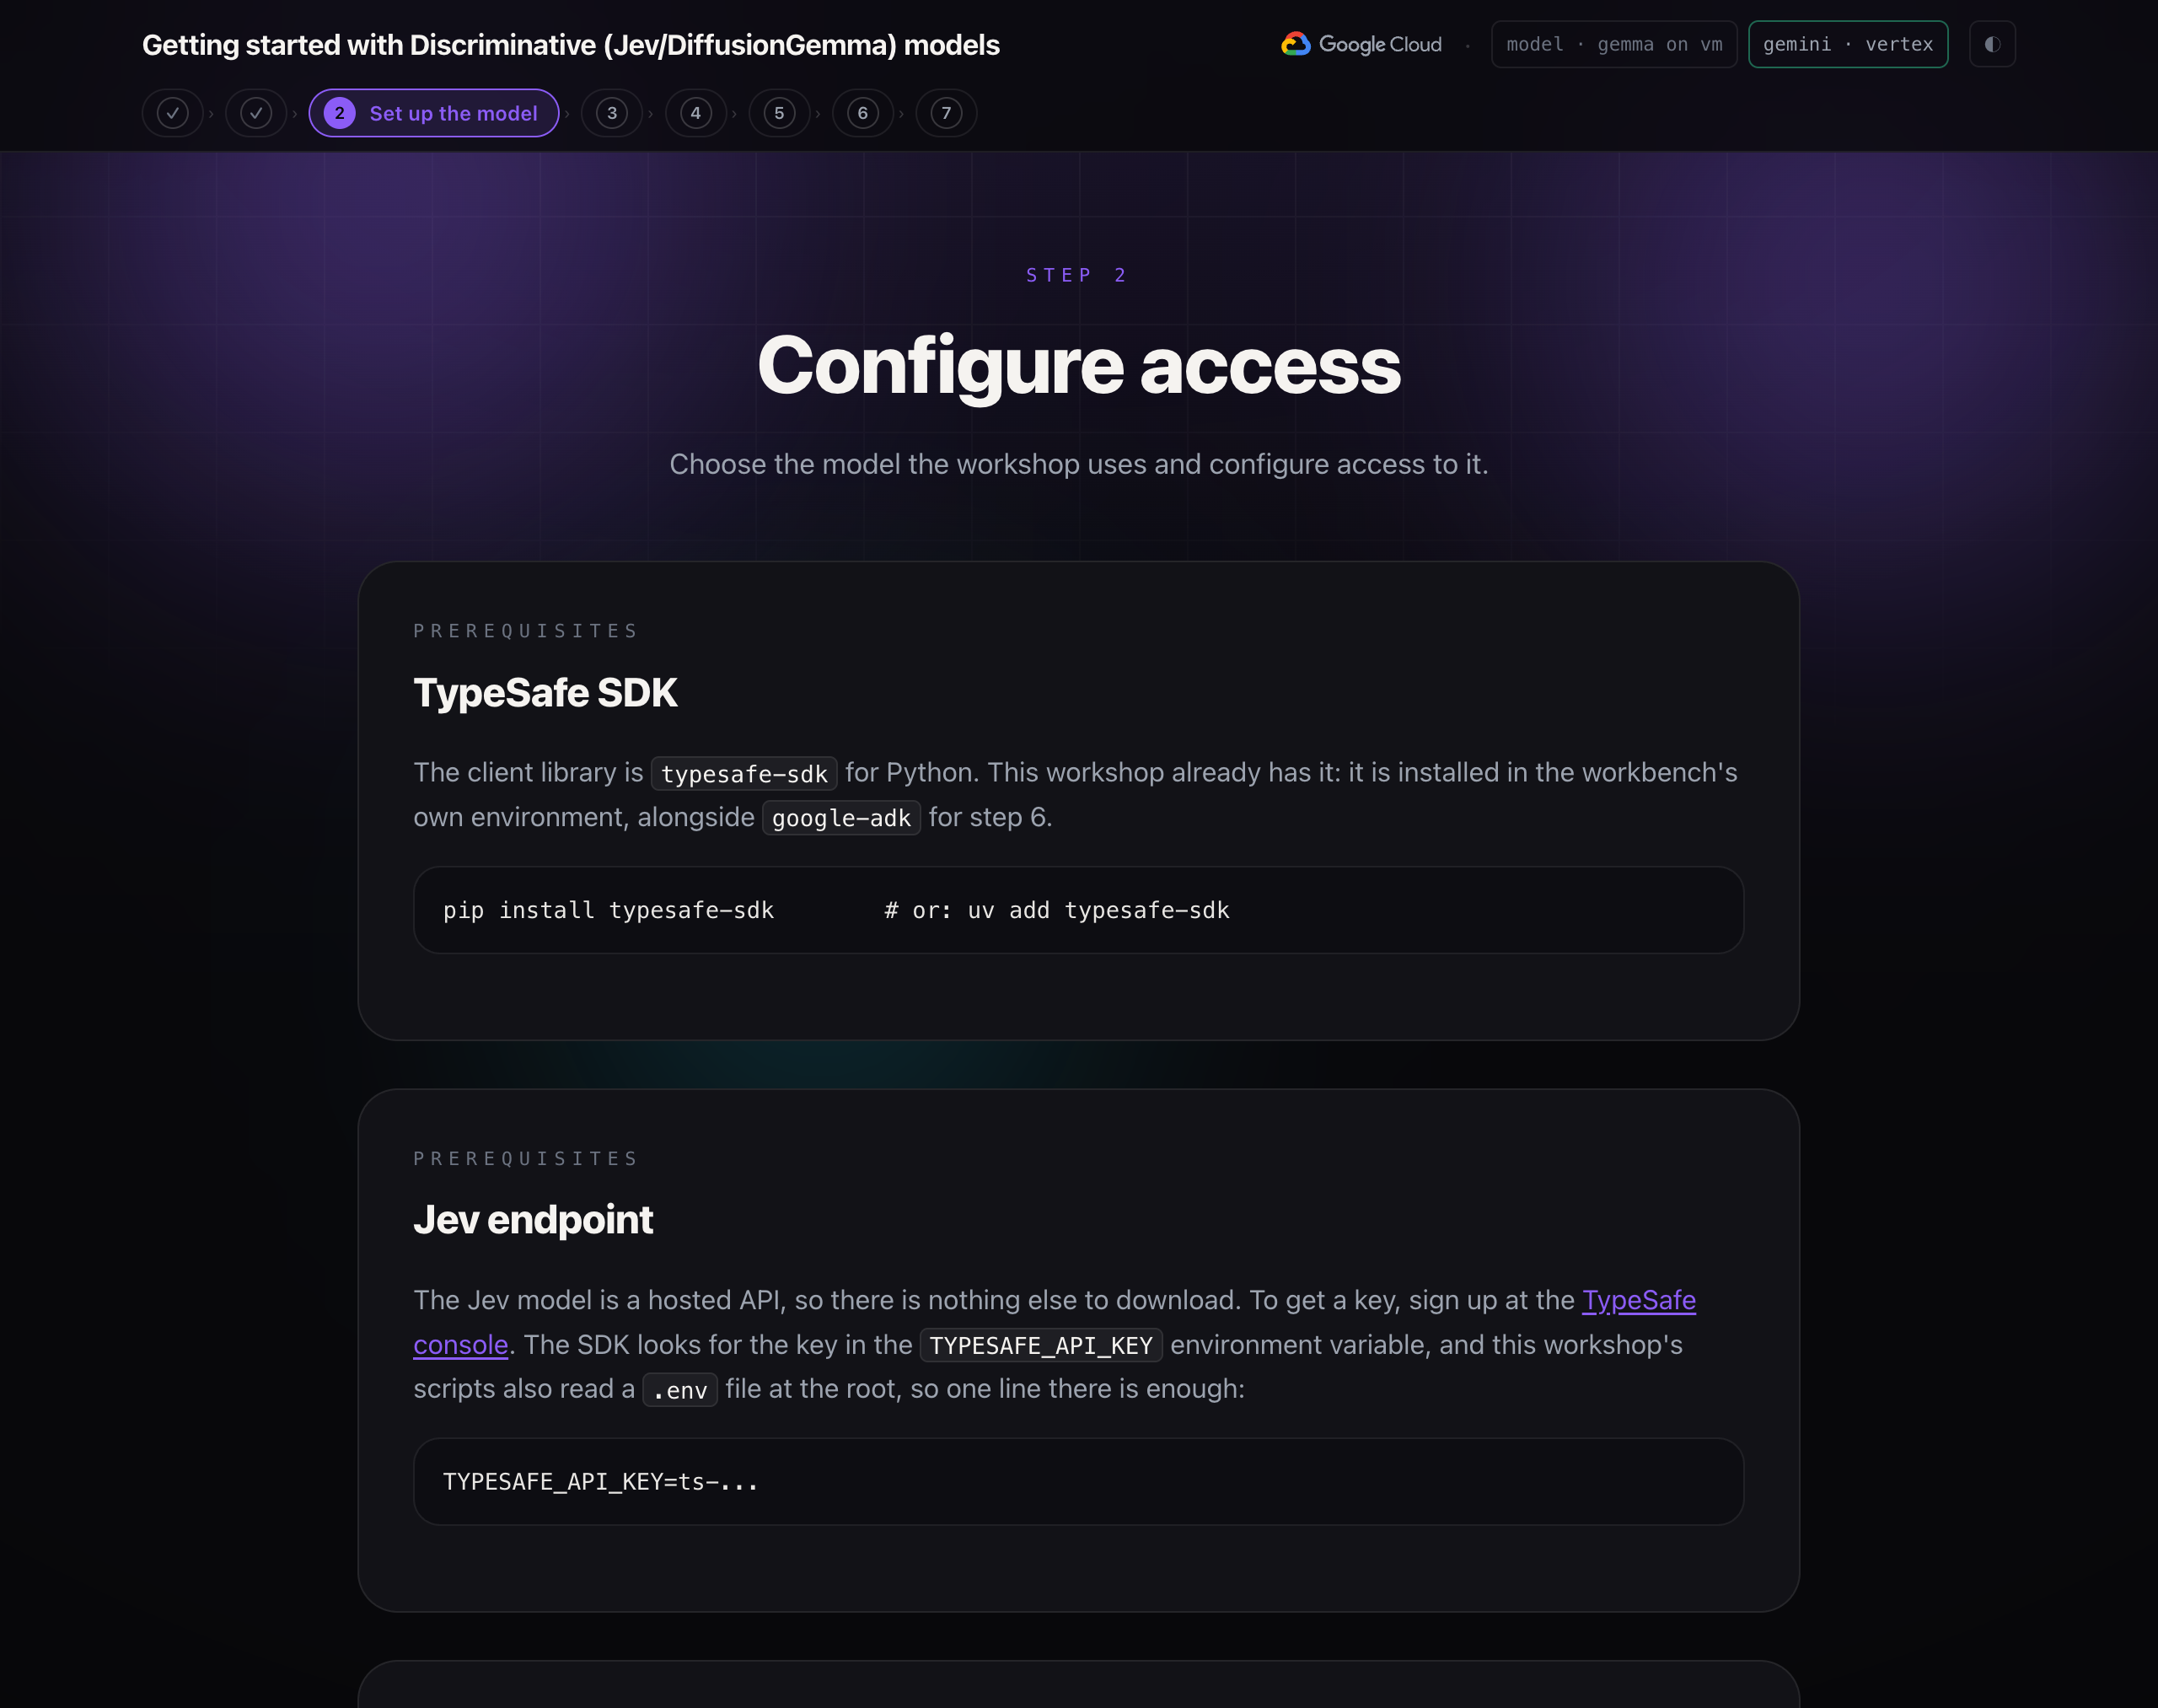
TypeSafe SDK
這個用戶端程式庫typesafe-sdk適用於 Python。本研討會已提供這項工具,並安裝在工作台的環境中,與步驟 6 的 google-adk 位於同一位置。
pip install typesafe-sdk # or: uv add typesafe-sdk
Jev 端點
Jev 模型是代管 API,因此不需要下載任何其他內容。如要取得金鑰,請前往 TypeSafe 控制台註冊。SDK 會在 TYPESAFE_API_KEY 環境變數中尋找金鑰,而本研討會的指令碼也會讀取根目錄中的 .env 檔案,因此一行就足夠:
TYPESAFE_API_KEY=ts-...
使用 DiffusionGemma
djev-run 會重新實作 Discriminative 模型的 API。它提供相同的 POST /v1/systemone 端點,以及相同的 noul、選擇和分數問題,來源是 DiffusionGemma (Google DeepMind 的開放式擴散模型,總共 260 億個參數,約 40 億個為有效參數,Apache 2.0)。由於傳輸格式相同,TypeSafe SDK 與其通訊時不會有任何變化。
如果您在練習中選擇 DiffusionGemma,系統會在您 Google Cloud 雲端專案的 VM 中透過 GPU 執行,右上方的藥丸會顯示「gemma on vm」。工作台會透過私人的 IAP 管道連線,且模型的連接埠不會對網際網路開放。步驟 1 說明完整架構。
擴散模型為何能做到這一點:擴散模型會一次填滿整個位置區塊,每個位置都會看到完整輸入內容,因此可以在單一步驟中讀取每個允許選項的機率。一般語言模型一次只會產生一個權杖,因此必須重複取樣。
手動玩遊戲
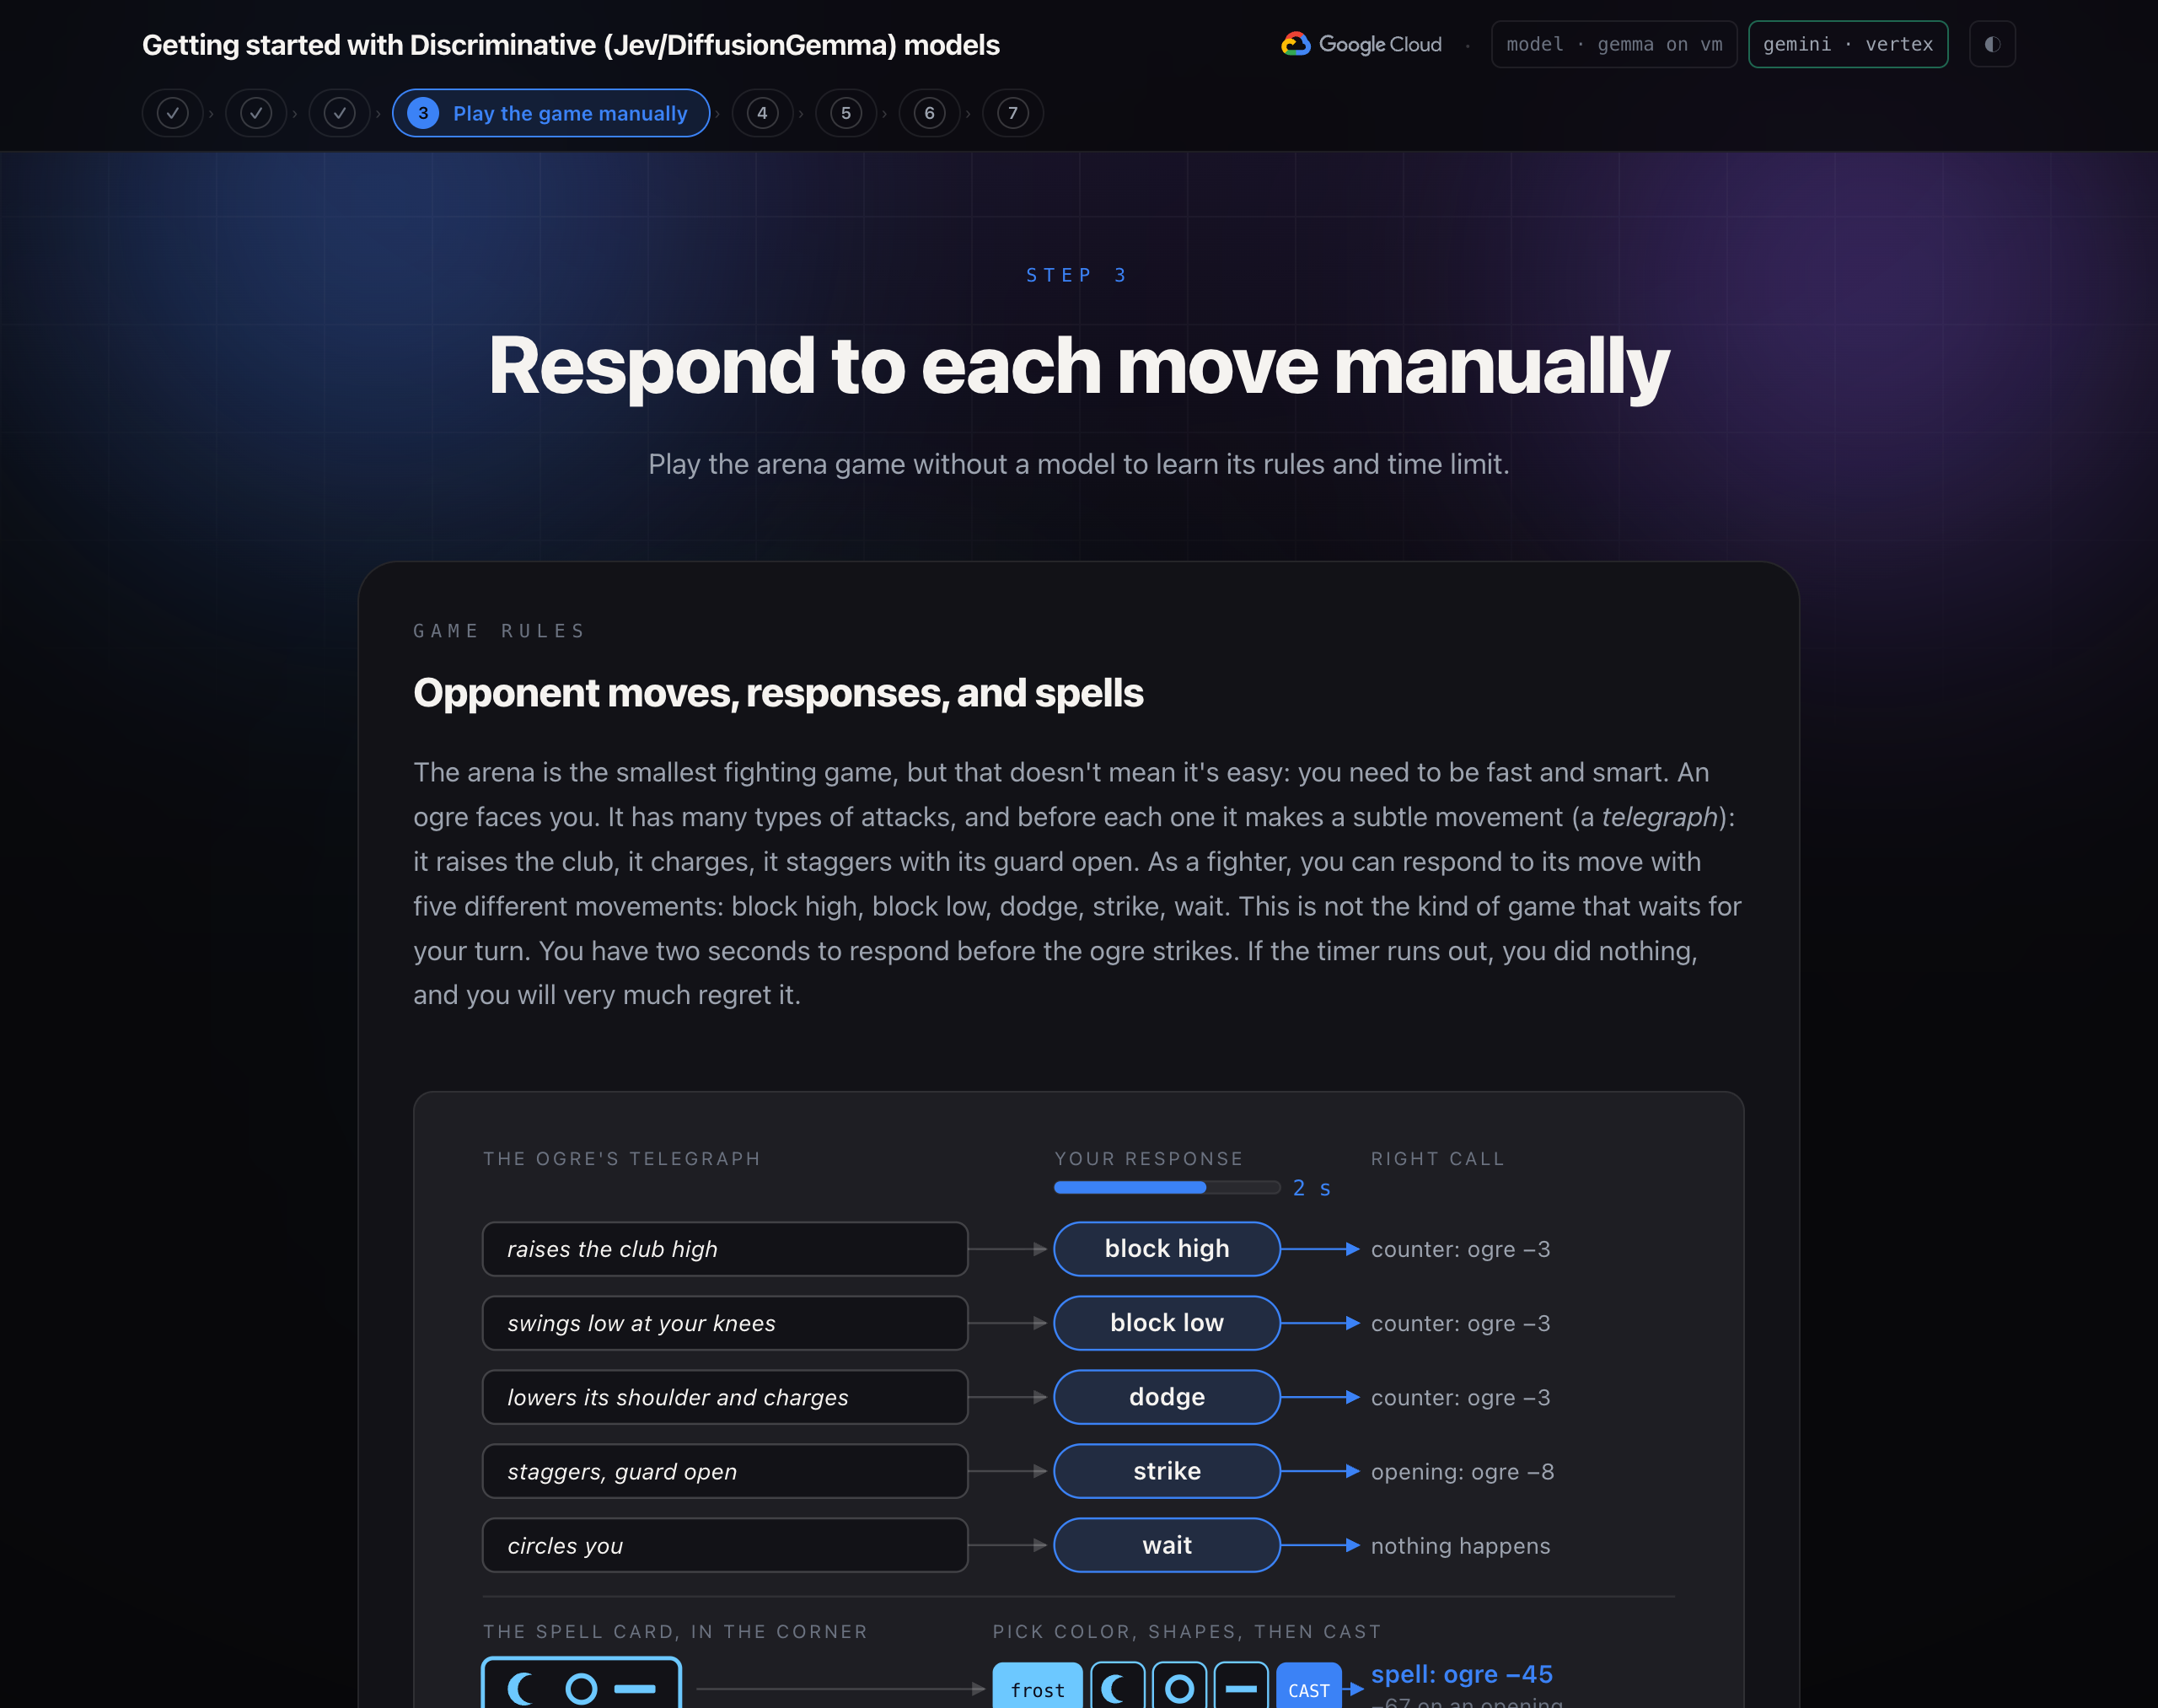
競技場是最小的格鬥遊戲,但這不代表容易取勝,你必須快速且聰明。一個食人魔面對你。牠的攻擊類型眾多,每次攻擊前都會有細微的動作 (預告):舉起球桿、衝鋒、防禦姿勢不穩。身為格鬥士,你可以用五種不同的動作回應對手的招式:高格擋、低格擋、閃避、攻擊、等待。這類遊戲不會等待輪到你。你只有兩秒的時間可以回應,否則食人魔就會攻擊。如果時間到了你卻沒有採取任何行動,之後一定會後悔。
圓環左上角有一張咒語卡:一張有三種形狀的彩色卡片。只有相符的咒語才能造成實際傷害。在遊戲中,你可以使用戰鬥畫面下方的按鈕施展咒語:依序選取卡片的顏色和形狀,然後按下「施展」。挑選時,時鐘會持續運作,因此你必須同時建構咒語並應對食人魔的攻擊。按鍵 1 到 5 仍可對應每個動作。如果咒語念錯,就會失效。在步驟 6 中,Gemini 會為你朗讀咒語卡。
重點:格鬥是一連串的小決定,每個決定都有時限。這就是大多數軟體自動化技術的實際情況,只是沒有俱樂部。
判別式模型概念
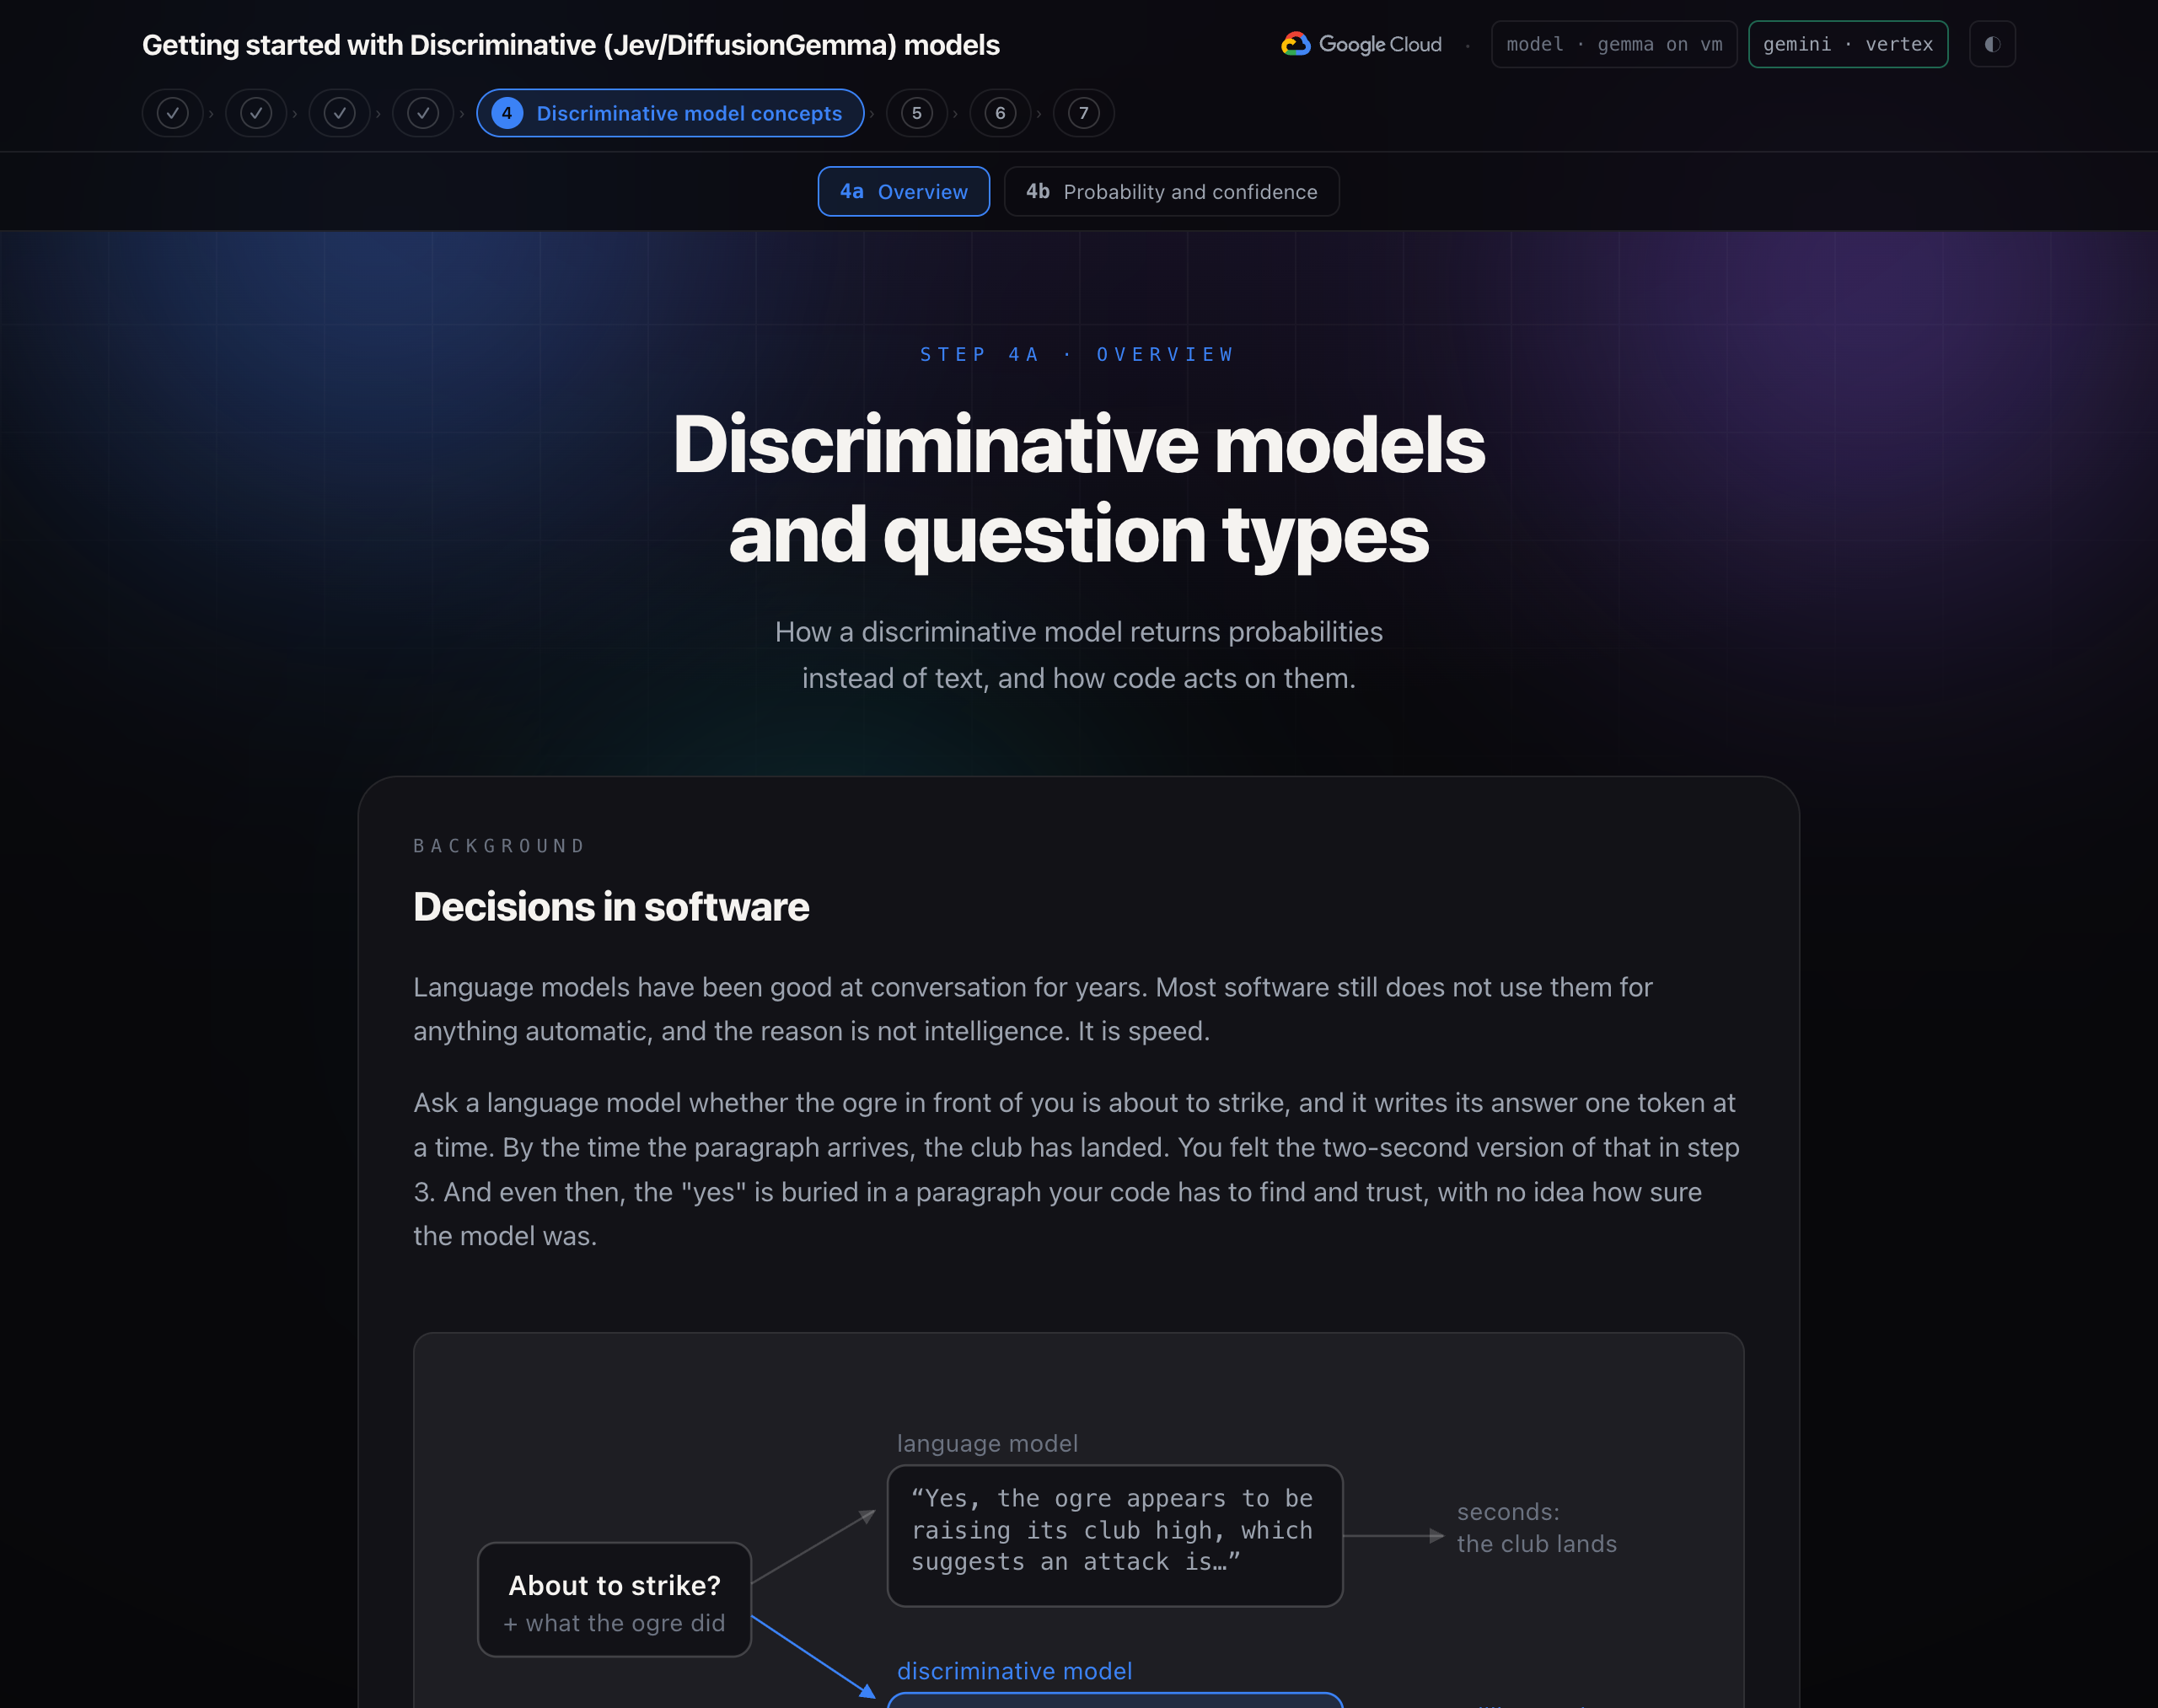
軟體中的決策
語言模型多年來一直擅長對話,大多數軟體仍不會將這些資料用於任何自動作業,原因並非智慧。就是速度。
詢問語言模型面前的食人魔是否即將發動攻擊,模型會一次寫入一個權杖的答案。當段落抵達時,俱樂部已降落。您在步驟 3 中感受到的就是 2 秒版本。即使如此,「是」這個答案也埋在一段文字中,程式碼必須找到並信任,但完全不知道模型有多確定。
Discriminative 模型會以毫秒為單位,一次性處理狀態和您輸入的問題與答案。每個答案都會附上經過校正的機率:0.9 代表十次有九次答對。沒有可剖析的文字,也無法從中擷取 JSON。
系統一和系統二模型
這個名稱來自丹尼爾‧康納曼的著作《快思慢想》。系統 2 則會緩慢而審慎地推理,一步步得出結論。系統 1 速度快,擅長模式比對。
語言模型是「系統二」機器,它會逐一推論權杖。辨別模型是系統一模型:不會大聲推理,不會生成任何內容,且一次就能回答所有問題。因此,這項服務速度很快 (約 70 到 500 毫秒),而且很便宜 (每千項決策只需幾分錢)。
重點:語言模型會撰寫由決策模型決定。軟體需要 AI 提供的資訊,大多是決策。
限制
判別式模型不會生成文字、編寫程式碼、進行對話、執行算術運算、讀取圖片或依序執行一連串步驟。
在工作坊中,我們會選擇其中一個鑑別模型:
- 判別式模型之一是 Jev。這是 TypeSafe AI 於 2026 年 9 月發布的代管 API。第一個模型是
jev-1.13,可透過別名jev-latest存取。由於沒有已發布的權重,因此系統會呼叫而非下載。 - 取得 System One 模型的方法不只 Jev。Google 的 DiffusionGemma 是開放權重的模型,可並行寫入一整組權杖,而非一次一個,且相同的並行傳遞可讀取一組固定選項的機率。djev-run 等開放原始碼伺服器會將 Jev 的確切 API 放在前端,因此本研討會中的所有內容都會照常執行。
狀態和問題:「Choice」、「Score」和「Noul」
每次呼叫都會傳送狀態和問題。狀態是指要判斷的文字。可以是字串、JSON 物件或清單。問題會詢問您想瞭解該文字的哪些資訊。每個問題都有類型:選擇、分數或 Noul。問題會平行處理,因此回覆速度很快。視需要新增多個問題。
- 「選擇」會從您命名的選項集 (最多 255 個) 中挑選一個選項。答案是選項、每個選項的機率,以及信心程度。如果選項之間沒有順序,請使用此方法:封鎖高、封鎖低、閃避、打擊、等待。
- 分數會根據您描述的排序層級 (2 到 10 個) 評估狀態。答案是量表上的位置 (小數,因此 1.4 表示「介於一和二之間,較接近一」)、每個等級的機率,以及信賴度。當答案是程度問題時,請使用這項功能,例如傳入的點擊會有多難。
- Choice 和 Score 都會傳回每個選項的機率和信賴度。差異在於主要答案。Choice 會傳回最有可能的選項。分數會將選項視為排序層級,並傳回機率加權平均值,該值可能落在兩個層級之間。如果「無」為 0.05、「輕微」為 0.55、「嚴重」為 0.40,則「輕微」的 Choice 答案和 1.35 的分數答案 (介於輕微和嚴重之間) 競技場會使用該值:
choose()會將危險分數 1.5 以上視為重擊。
- Choice 和 Score 都會傳回每個選項的機率和信賴度。差異在於主要答案。Choice 會傳回最有可能的選項。分數會將選項視為排序層級,並傳回機率加權平均值,該值可能落在兩個層級之間。如果「無」為 0.05、「輕微」為 0.55、「嚴重」為 0.40,則「輕微」的 Choice 答案和 1.35 的分數答案 (介於輕微和嚴重之間) 競技場會使用該值:
- Noul 會提出是非題,並傳回答案為「是」的機率。接近 1 代表「是」,接近 0 代表「否」,接近 0.5 代表「不確定」。由於機率就是信賴水準,因此沒有個別的信賴度。
撰寫重點明確的問題
如果問題詢問的是特定且範圍明確的事項,判別式模型最能發揮效用。「情況如何?」會傳回可信度較低的回覆。「正確的回覆是什麼?」「對手是否暴露弱點?」和「這次攻擊的強度如何?」會傳回三個重點答案,您的程式碼會將這些答案合併。
選項和等級的說明很便宜,但很重要。您在步驟 3 中讀取的規則會成為選項說明:block_high: "Raise the shield. Right against an overhead or a high swing."這就是鑑別模型在要求時學習格鬥規則的方式,每行一條規則。選項會隨著情況改變:法術準備就緒時,競技場只會提供 cast。
機率和信賴度
「選擇」答案不是標籤。這是標籤的分布情形,標籤只是最高的長條。
模型如何取得電話號碼。這與語言模型選取下一個字詞的步驟相同。轉換器會讀取文字,並在某個位置為詞彙中的每個符記提供原始分數,稱為「logit」。logit 越高,表示該權杖越適合該位置。softmax 會將 logits 轉換為機率,加總後為 1。語言模型接著會選取一個符記,並將其加入文字,然後重複這個過程。判別式模型會在機率後停止。
空白是指答案表單中的空白處。伺服器會自行撰寫表單,例如 response: ▢,並為每個問題留一個空格。模型的工作只有一個,就是為每個空格中的內容評分。
- 提示會保留狀態和每個問題,並以簡短標籤表示每個允許的答案:
a代表 block_high,b代表 block_low,依此類推。 - 伺服器會新增答案表單,每個問題對應一個空白。
- 模型會一次讀取提示和表單,並在每個空白處為每個權杖提供對數機率。擴散模型會一次查看整個表單,並一併為所有空白處評分。
- 伺服器只會保留允許標籤的 logits,並對其套用 softmax,因此允許的答案加總為 1。
- 如果讀取結果不確定,伺服器會從另一個隨機起點再次讀取,並計算讀取結果的平均值。
信心指數是代表答案確定程度的數字。TypeSafe 會根據機率在各個選項間的分布情況計算出信心指數。如果所有選項都選同一個,則為 1 分;如果平均分配,則為 0 分。如果是三個選項,則為 (3 × 最大值 − 1) / 2。
TypeSafe 會訓練 Jev,以取得校正機率。機率代表答案正確的頻率。在經過校正的模型中,可信度為 0.7 的答案約有 70% 的機率是正確的,因此可信度門檻就是您接受錯誤答案的頻率門檻。本研討會的 DiffusionGemma 伺服器會自行回報最高機率,並將讀取結果的平均值做為信賴度。如果讀數不一致,平均值會分散,可信度也會下降。
重點:答案會告訴你什麼。信心指數會告訴您是否要採取行動。
門檻
門檻是在程式碼中定義動作的方式。模型會傳回信賴度或機率。您的程式碼會將該數字與您選擇的數字進行比較,並根據結果決定後續動作。
每個動作的門檻。TypeSafe 建議將信心度分成幾個區間。高信賴水準會自行運作。中等信賴度行為會進行檢查,例如要求確認或標記案件以供審查。如果信心指數偏低,系統不會採取行動,而是改用安全做法或轉交給真人處理。
TRUST = 0.40        # below this, the answer is a guess
AUTO = 0.80         # at or above this, act without a check

def route(answer):
    if answer.confidence >= AUTO:
        return act(answer.choice)          # high: act on its own
    if answer.confidence >= TRUST:
        return confirm(answer.choice)      # medium: act with a check
    return fall_back()                     # low: do something safe
競技場規則。競技場的門檻位於 choose() 中,您會在步驟 5 中執行該門檻。
TRUST_CONFIDENCE = 0.40    # below this, the model is guessing between responses
HEAVY_DANGER = 1.5         # a danger score at or above this is a heavy hit
SPEND_ON_OPENING = 0.60    # exposed at or above this, with a spell ready, cast

def choose(answers, spell_ready):
    response = answers["response"]
    exposed = answers["exposed"].noul
    danger = answers["danger"].score

    action = response.choice
    if response.confidence < TRUST_CONFIDENCE and danger >= HEAVY_DANGER:
        action = "dodge"                   # shaky answer, heavy hit coming
    if spell_ready and action == "strike" and exposed >= SPEND_ON_OPENING:
        action = "cast"                    # a clear opening is worth the spell
    return action
警告:有效答案不一定是正確答案。Discriminative 模型不會傳回您未提供的選項,因此絕不會產生幻覺,但可能會選錯選項,有時還會非常確定。請先根據已評估的情況測試問題,再信任門檻。
透過模型自動做出決策
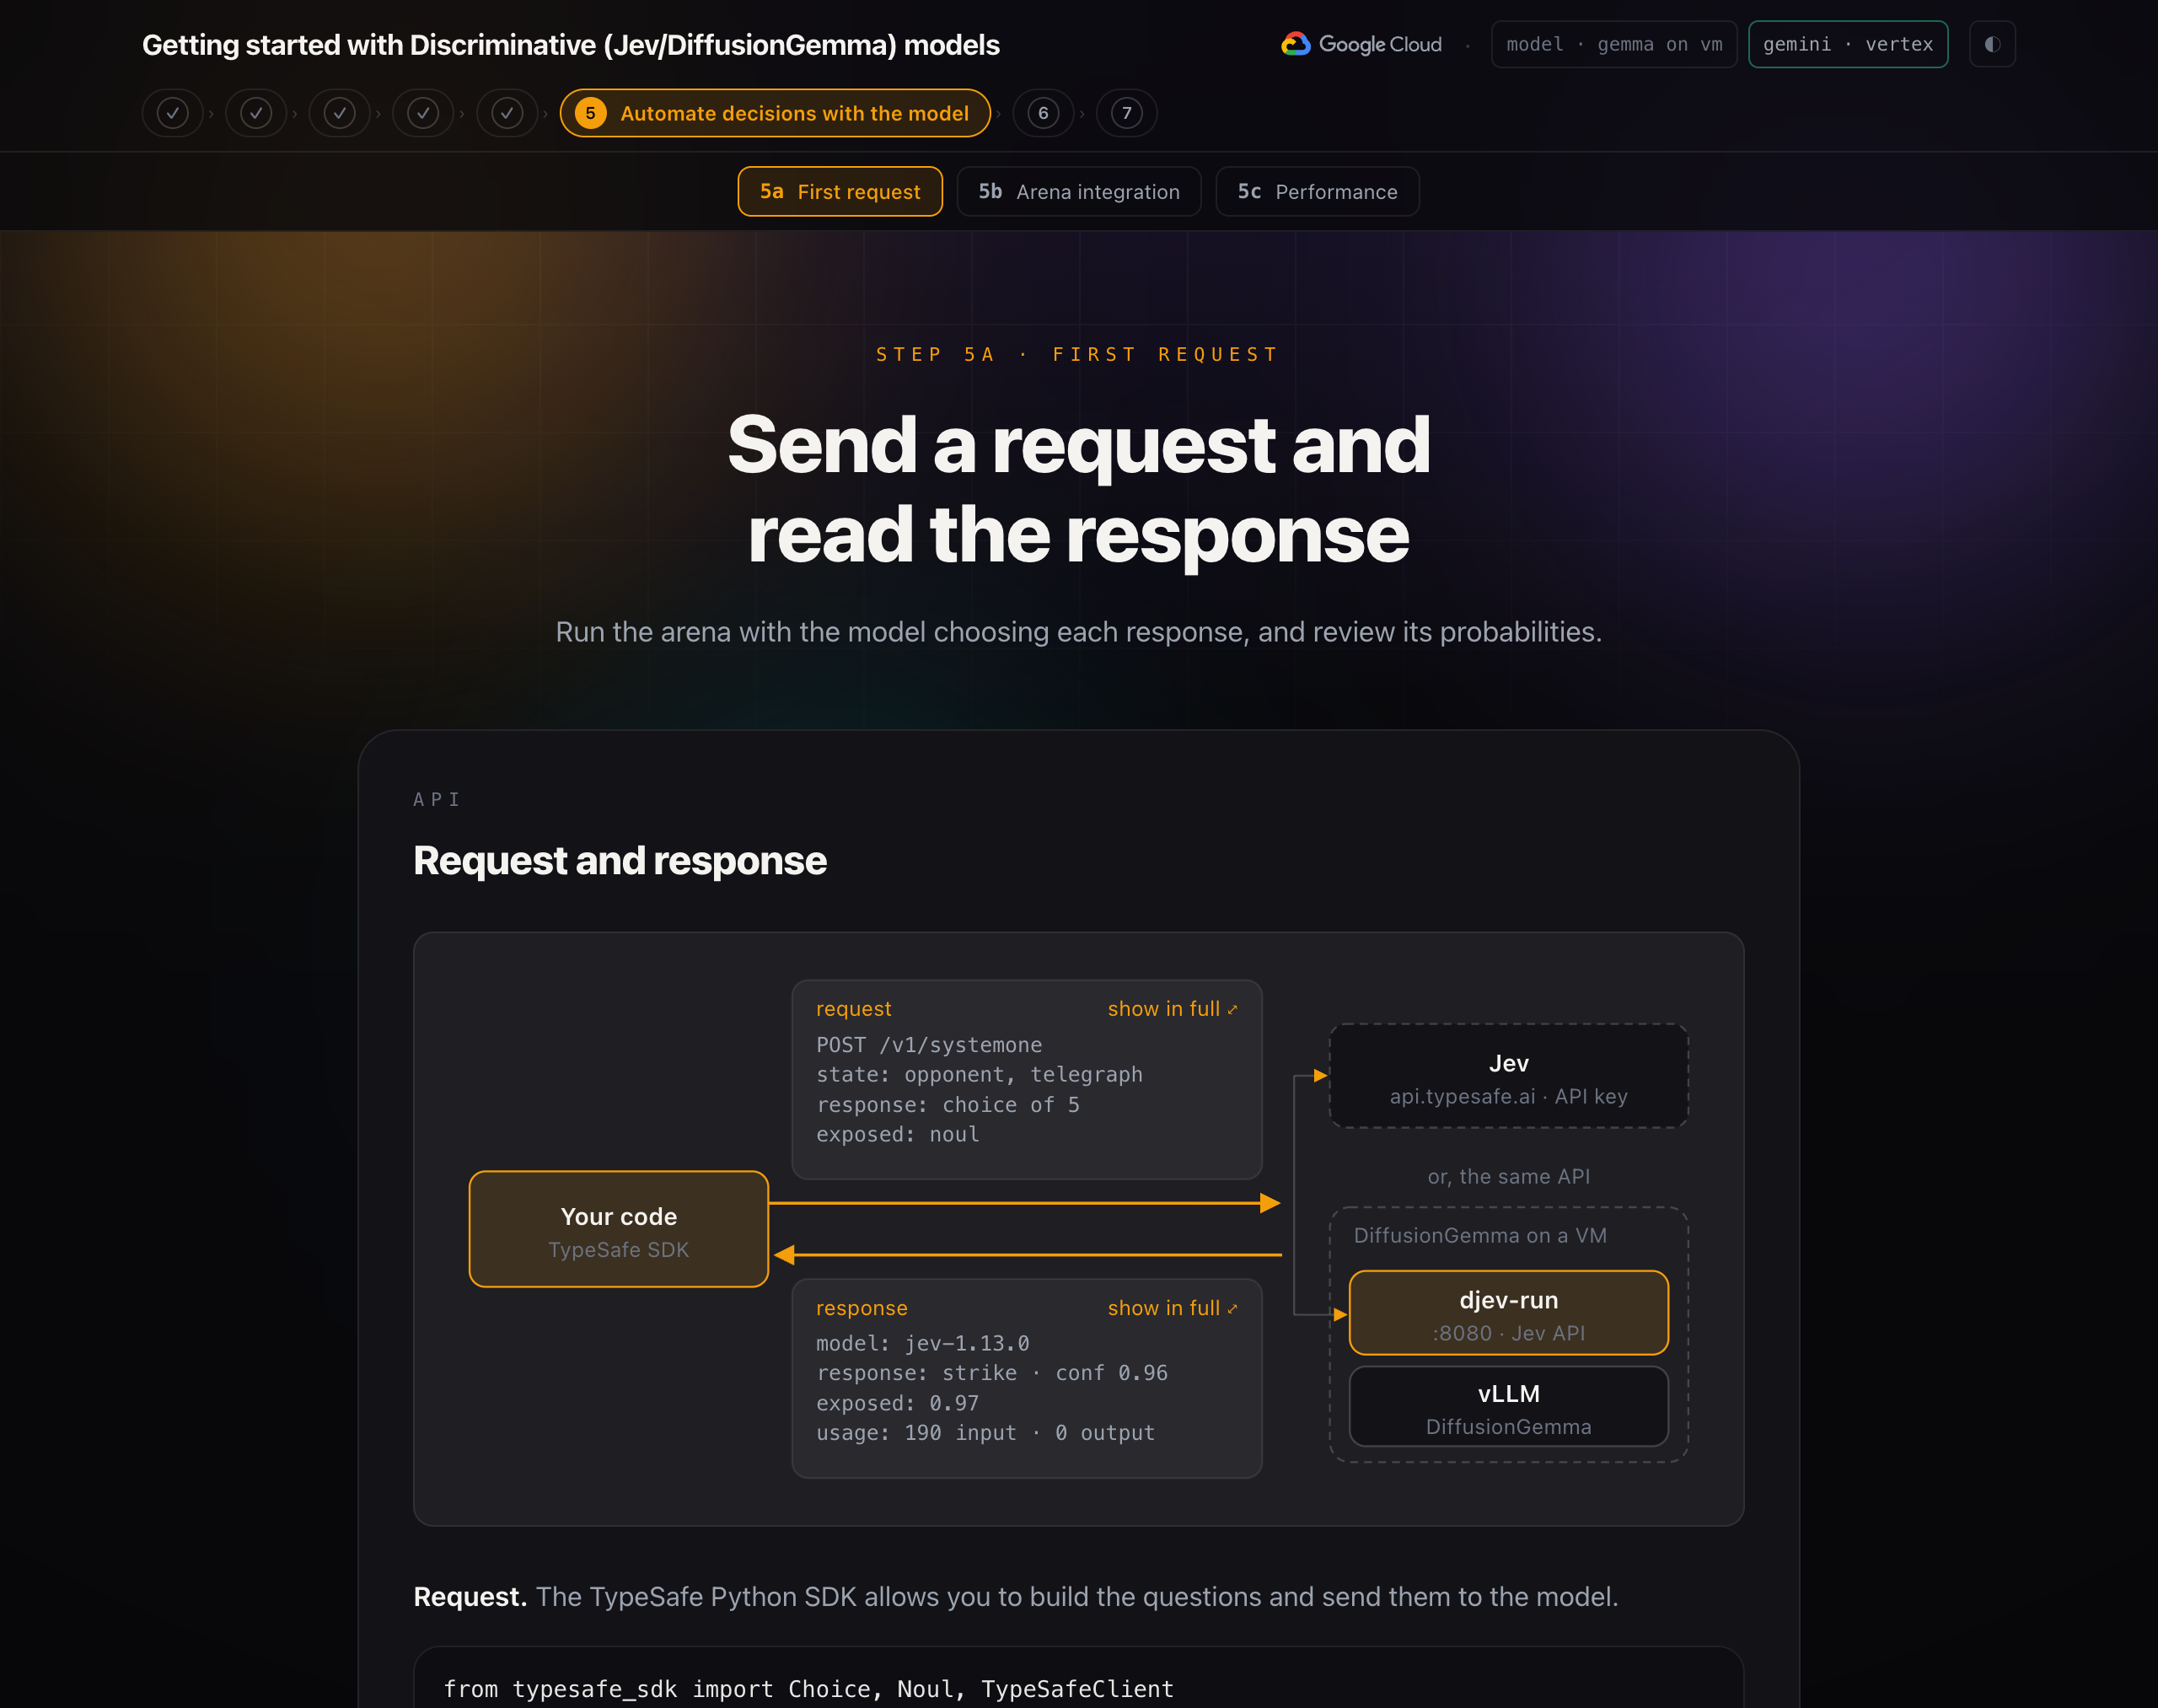
要求和回應
要求。您可以使用 TypeSafe Python SDK 建構問題,並傳送給模型。
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"opponent": OPPONENT, "telegraph": telegraph},
        questions={
            "response": Choice(instructions="What is the right response?", criteria=RESPONSES),
            "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        },
    )

response.choices["response"].choice     # "strike"
response.nouls["exposed"].noul          # 0.97
每個刻度一個要求
應用程式會在每個刻度傳送電報做為狀態,並在一次呼叫中要求三件事:
- 從五個 (或六個,如果咒語已準備就緒) 回覆中,選出正確的。A Choice。
- 食人魔目前是否暴露在計數器中。A Noul。
- 來襲攻擊的強度,分為三個等級。分數。
def reflex_questions(spell_ready):
    options = dict(RESPONSES)
    if spell_ready:
        options["cast"] = CAST                # only offered when there is a spell
    return {
        "response": Choice(instructions="The opponent has just done this. What is the right response?",
                           criteria=options),
        "exposed": Noul(instructions="Is the opponent exposed to a counter-attack right now?"),
        "danger": Score(instructions="How much damage is about to land if the fighter does nothing?",
                        criteria=["None: this is not an attack.", "A light hit.", "A heavy hit."]),
    }
choose() 函式
還記得步驟 4 的門檻嗎?choose() 會將模型的答案與固定數字進行比較,這些固定數字就是門檻。
TRUST_CONFIDENCE = 0.40
HEAVY_DANGER = 1.5
SPEND_ON_OPENING = 0.60

def choose(answers, spell_ready):
    action = answers["response"].choice
    if answers["response"].confidence < TRUST_CONFIDENCE and answers["danger"].score >= HEAVY_DANGER:
        action = "dodge"                      # shaky call, heavy hit coming: play it safe
    if spell_ready and action == "strike" and answers["exposed"].noul >= SPEND_ON_OPENING:
        action = "cast"                       # the Discriminative model saw the opening; the code spends the spell
    ...
choose() 是普通的 Python 讀取型別值,有兩項規則。判別式模型會提供機率和分析結果,而程式碼會使用規則的門檻。所選動作會傳送至引擎,用於與食人魔戰鬥。
重點:將問題和門檻集中管理。這是您最常調整的 System One 整合部分。
回應時間、以輸入內容為準的定價和決策邏輯
- 每個決策的回應時間。第 b 部分的每次打勾都大約在一百毫秒內回傳,有幾次則是在兩到三秒內回傳。這速度足以應付遊戲迴圈、要求路徑,或是在使用者或語言模型看到訊息前檢查訊息。
- 以輸入內容為準的定價。一場完整的格鬥賽,每回合有三道問題,總共六十個決策,成本遠低於十分之一美分。由於未生成任何內容,輸出權杖為零。因此,您可以要求超過實際需要的數量。即使只有
strike和cast在意,競技場仍會詢問每個刻度是否都顯示食人魔,因為詢問幾乎不需成本,而且答案對資訊主頁很有用。TypeSafe 將此稱為「推測性擴散傳遞功能」。 - 結合信心和危險。如果鑑別模型對回覆內容的信心指數低於 0.40,且危險分數顯示即將發生重大事件,
choose()就會以閃避動作覆寫。迴避問題很少是最佳答案,但也很少是最差的答案。請根據每項錯誤的成本選擇門檻,而非根據整數,並根據您已手動評估的電報測試門檻。TypeSafe 建議:如果決策持續誤觸發,請先收緊問題,再移動門檻。
在 ADK 工作流程中合併模型
每個時間格決策的限制,以及為何正確的回覆不足
步驟 5 中最後一行寫道:「the ogre lumbers off, barely scratched」(食人魔緩慢離開,幾乎毫髮無傷)。判別式模型沒有受到任何傷害,且每秒都能造成少量傷害,而 300 點生命值遠遠超過每秒傷害的 60 倍。魔法卡片一直都在戒指角落,如要讀取圖片內容,必須使用可辨識圖片的模型。
食人魔有 300 點生命值。A right call counters for 3. 如果球擊中開口,則可得 8 分,因為隱藏的球很厚。即使是完美的六十格戰鬥,食人魔也只會受傷站立,遊戲會判定為平手。這就是步驟 5 的結尾:模型防禦得很好,但仍無法獲勝。
只有咒語才能造成實際傷害:完美施放可造成 45 點傷害,若擊中空隙則可造成 67 點傷害。
為每項工作指派合適的模型
圓環角落的咒語卡是獲勝的關鍵,而讀取咒語卡並非文字問題:咒語卡是圖片,上面有一種顏色和三個形狀,必須唱出相符的咒語。這需要模型查看圖片,並花幾秒鐘處理。在戰鬥中,幾秒鐘就是十個刻度。
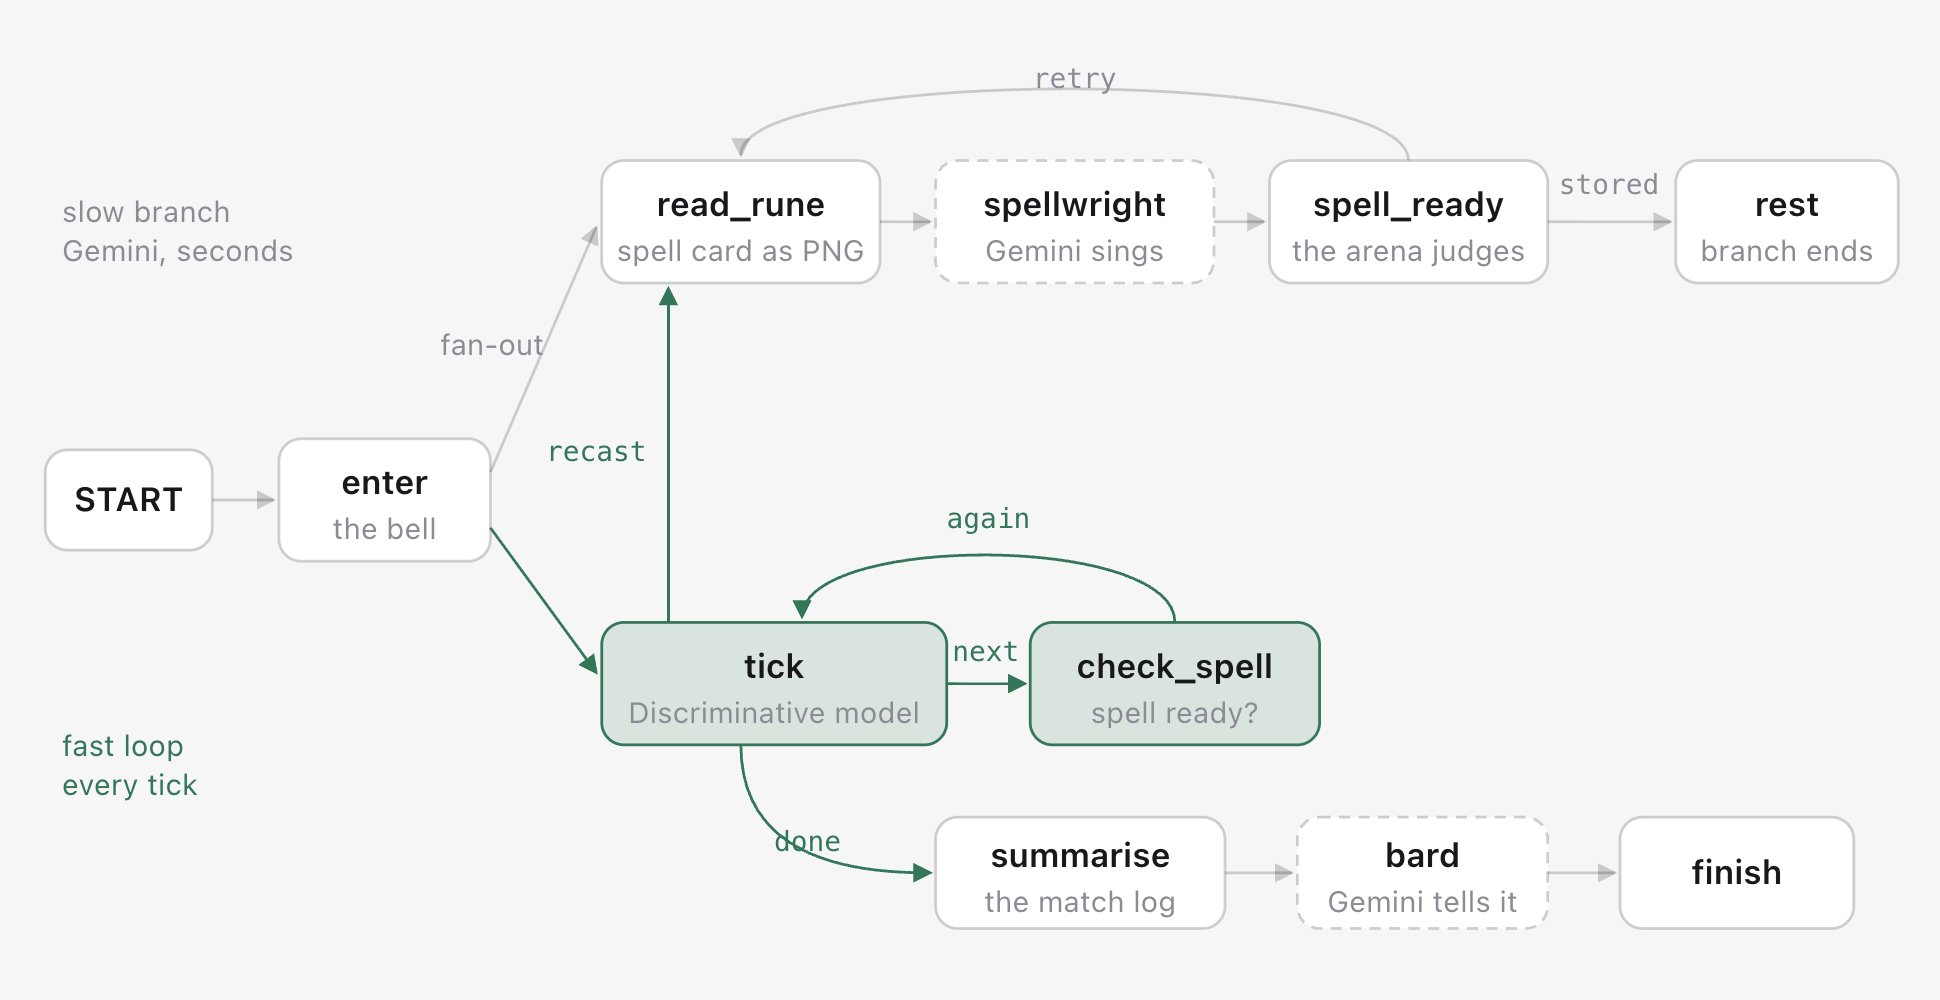
因此工作流程會同時使用這兩者,但速度各不相同:
- 判別式模型會反擊。每個勾號、一次呼叫、一個決定,一百毫秒。迴圈絕不會等待比自己慢的任何項目。
- Gemini 朗讀和唱歌。在自己的分支上,從鈴聲開始,以圖像形式從競技場螢幕上抓取咒語卡,命名顏色和形狀,並吟唱咒語。競技場會根據咒語卡片答案評估歌曲,而答案絕不會離開伺服器。
- 每次交換後,戰士都會檢查空位。
check_spell節點會查看狀態。尚未準備就緒:系統會顯示這項訊息,以及 Gemini 唱歌的時間長度,並直接返回下一個勾號。時間不會等人,準備:cast加入判別式模型提供的選項,並在判別式模型回報開口時choose()施放咒語。法術用盡後,畫面會繪製新的法術卡,並重新啟動緩慢執行緒。如果讀錯歌曲,咒語卡就會燒毀,而慢速執行緒會讀取新歌曲。 - Gemini 會在結尾撰寫短篇故事。
具有不同延遲時間的平行分支和一個事件迴圈
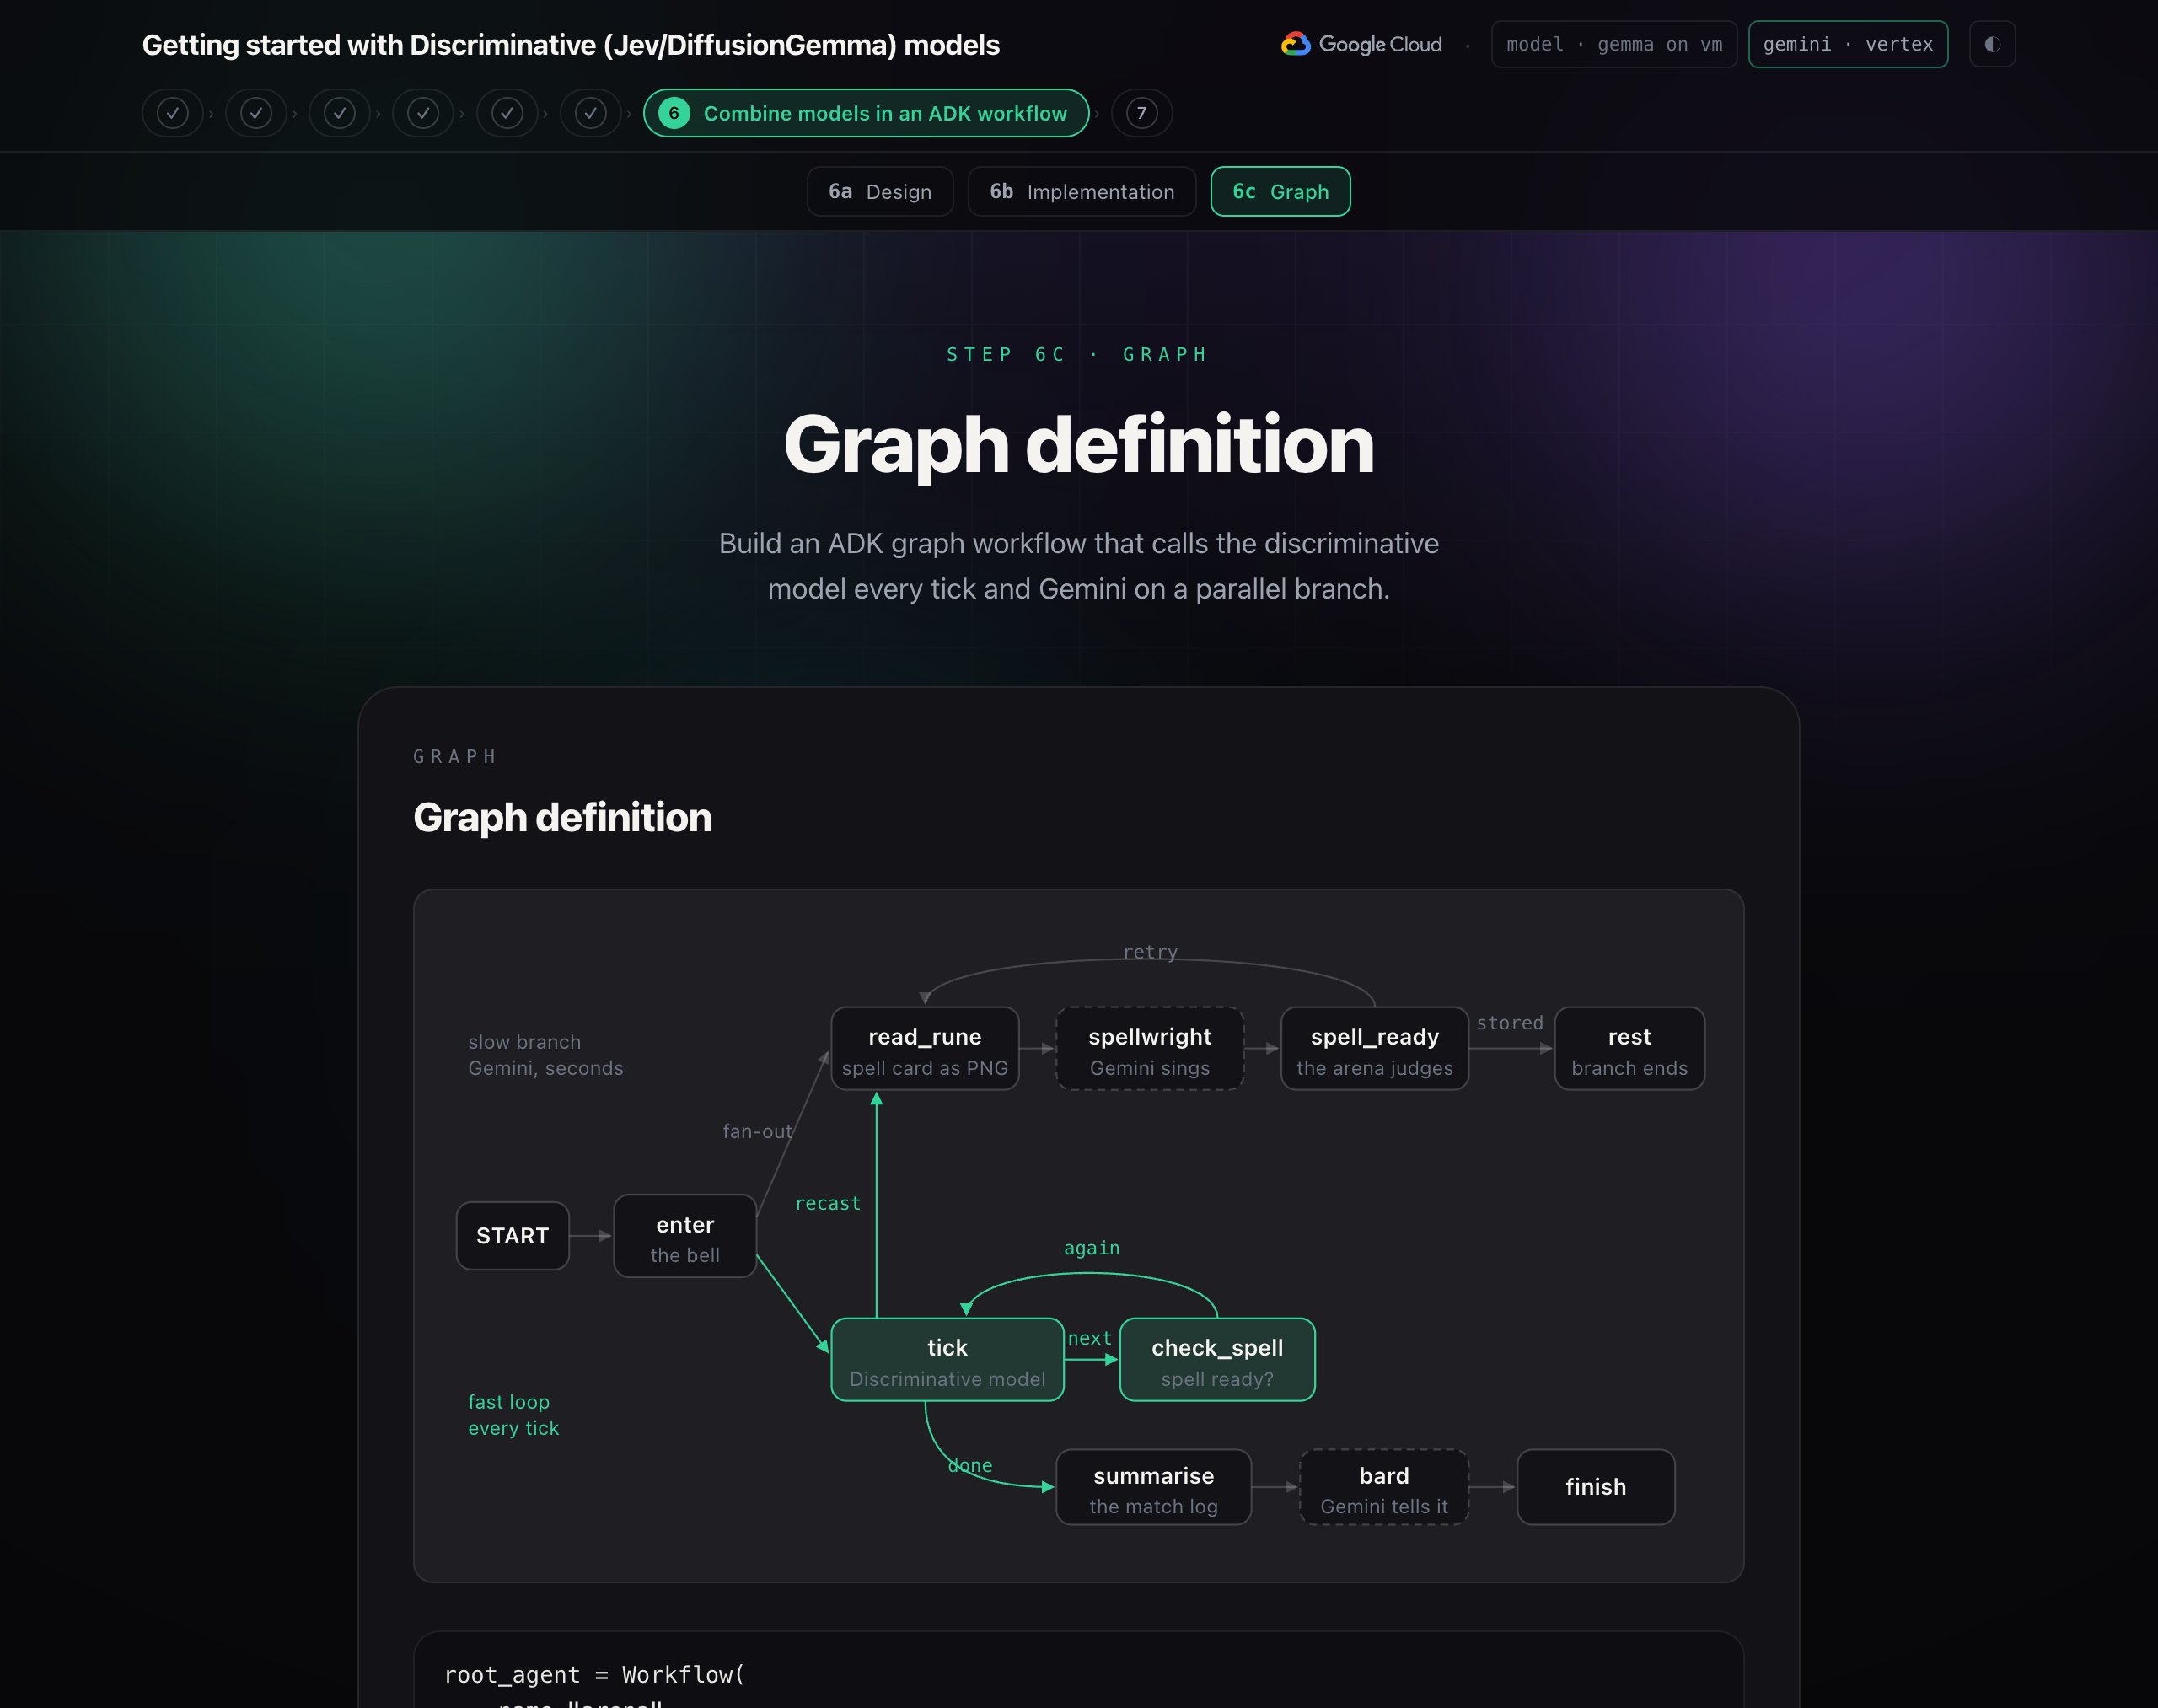
這是 ADK 工作流程:由邊緣連結的節點圖表。節點是簡單的 Python 函式或 LLM 代理。從一個節點到節點元組的邊緣是擴散傳遞功能:兩者都會同時啟動。傳回 Eventroute 的節點會選擇下一個邊緣,而路由至自身的節點則是迴圈。
這就像兩條線。執行緒 1 速度較慢:讀出咒語卡、唱歌、儲存咒語。第 2 條線很快:勾選、檢查插槽、再次勾選。執行緒 1 會在函式中結束,該函式會將判斷的咒語寫入工作階段 state,且不會傳回任何輸出內容。每次交換後,執行緒 2 的 check_spell 都會讀取該狀態。兩個執行緒都不會呼叫或等待對方,只會共用狀態。
重點摘要:將決策放入程式碼,並讓每個模型以自己的步調執行特定工作。
ADK 會在單一執行緒的單一事件迴圈中,將這兩個分支做為工作執行。一次只能執行一項工作。工作到達 await 時,會等待答案,而迴圈同時會執行其他分支。快速分支會等待模型約十分之一秒,而緩慢分支會等待 Gemini 幾秒鐘,因此兩者都不會互相阻礙。
Slow 分支版本
read_rune() 會將咒語卡片從螢幕上取下,並以圖片形式儲存。
def read_rune(ctx: Context, node_input) -> Event:
    png = _arena(ctx).rune_png()                  # exactly what the screen shows
    return Event(output=types.Content(role="user", parts=[
        types.Part(text="This spell card is on the arena's screen right now. Sing the spell that matches it."),
        types.Part.from_bytes(data=png, mime_type="image/png"),
    ]))
spellwright 是 Gemini。並以固定格式讀取圖片和回答。
class Sung(BaseModel):
    element: str          # fire, frost, earth, storm
    glyphs: list[str]     # three of: circle, ring, square, diamond, triangle, cross, crescent, bar
    incantation: str

spellwright = LlmAgent(name="spellwright", model="gemini-flash-latest",
                       instruction="You are the spellwright ... read the three shapes left to right ...",
                       output_schema=Sung)
spell_ready() 會讓競技場評估咒語,然後儲存或重試。
def spell_ready(ctx: Context, node_input: dict) -> Event:
    spell = _arena(ctx).sung(dict(node_input))    # the arena judges it against the spell card
    return Event(state={"spell": spell if spell["damage"] > 0 else None},
                 route="retry" if spell["damage"] <= 0 else "stored")
函式節點可以傳回含有圖片部分的 Content,而 LLM 節點會將其視為使用者回合。spell_ready 會傳回含有狀態差異的 Event,但不會傳回 output。下一個勾號會從狀態讀取咒語,而沒有輸出的分支並非圖表的第二個結尾:ADK 需要一個終端輸出,也就是戰鬥。
注意:評分標準是程式碼,在競技場中,會根據咒語卡的隱藏答案評分。完美讀取可多讀 45 個字元,兩個形狀向右移動 25 個單位。如果讀錯,咒語卡就會失效。系統不會詢問 Gemini 是否正確。
Fast branch
tick() 會播放一個交換內容,然後挑選下一個邊緣。
async def tick(ctx: Context, node_input) -> Event:
    arena = _arena(ctx)
    spell = ctx.state.get("spell")                # did the slow branch deliver?
    move = await asyncio.to_thread(arena.telegraph)

    async with AsyncTypeSafeClient() as jev:
        answers = await jev.system_one(
            state={"opponent": engine.OPPONENT["description"], "telegraph": move["telegraph"]},
            questions=reflex.reflex_questions(spell_ready=spell is not None),
        )

    decision = reflex.choose(answers.answers, spell_ready=spell is not None)
    entry = await asyncio.to_thread(arena.respond, decision["action"], decision, ...)
    over = entry["you"] <= 0 or entry["foe"] <= 0 or entry["tick"] >= engine.MAX_TICKS

    routes = []                                   # which arrows in the graph to follow next
    if entry["spell_used"] and not over:
        routes.append("recast")                   # a new spell card is on the screen: read it
    routes.append("done" if over else "next")
    return Event(output="fight", route=routes, state={"tick": ..., "spell": None, ...})
check_spell() 會在每次交換後查看拼字插槽。
def check_spell(ctx: Context, node_input) -> Event:
    spell = ctx.state.get("spell")                # thread 1 writes it; this only reads
    if spell:
        report = {"ready": True}
    else:
        report = {"ready": False, "waited": now - ctx.state["forging_since"]}
    return Event(output="fight", route="again", state={"spell_check": report})
check_spell 會在每次交易後查看廣告空間。它絕不會封鎖:如果咒語尚未準備就緒,它會回報該情況並繼續執行。
設計的重點有三項。Discriminative 模型呼叫會透過非同步用戶端 await,因此迴圈會在等待時產生,而 Gemini 分支會持續執行。問題會在每個勾號出現時重新建立,因此只有在有內容可投放時,才會顯示 cast。route 也可以是清單:["recast", "next"] 會同時取得兩個邊緣。
競技場本身位於小型用戶端後方:透過 HTTP 執行的應用程式 (如有),因此網頁會顯示對戰;如果沒有,則會顯示程序內引擎。
圖表定義
root_agent = Workflow(
    name="arena",
    edges=[
        ("START", enter),
        (enter, (read_rune, tick)),                   # fan-out: slow branch + fast loop
        (read_rune, spellwright, spell_ready),
        (spell_ready, {"retry": read_rune, "stored": rest}),   # misread: read the new spell card; else rest
        (tick, {"next": check_spell, "recast": read_rune, "done": summarise}),
        (check_spell, {"again": tick}),               # not ready? keep fighting
        (summarise, bard, finish),
    ],
)
以 target 做為元組是擴散傳遞功能。元組是「邊緣」,也是鏈結。字典會將路徑名稱對應至節點。tick → check_spell → tick 是快速迴圈。"recast": read_rune 會在咒語用完後重新啟動慢速執行緒,"retry" 則會在咒語失效後執行相同操作,而 "stored": rest 則會在咒語進入插槽後,讓慢速執行緒無聲無息地結束,不會產生任何輸出內容。ADK 至少需要一個週期中的已路由邊緣,因此系統會先拒絕無條件迴圈,避免無限期執行。
注意: ADK 工具會尋找 root_agent。adk web agents 從研討會的根目錄開啟開發人員 UI,其中包含競技場,方便您在瀏覽器 (而非終端機) 中查看圖表和事件。