

1. 簡介
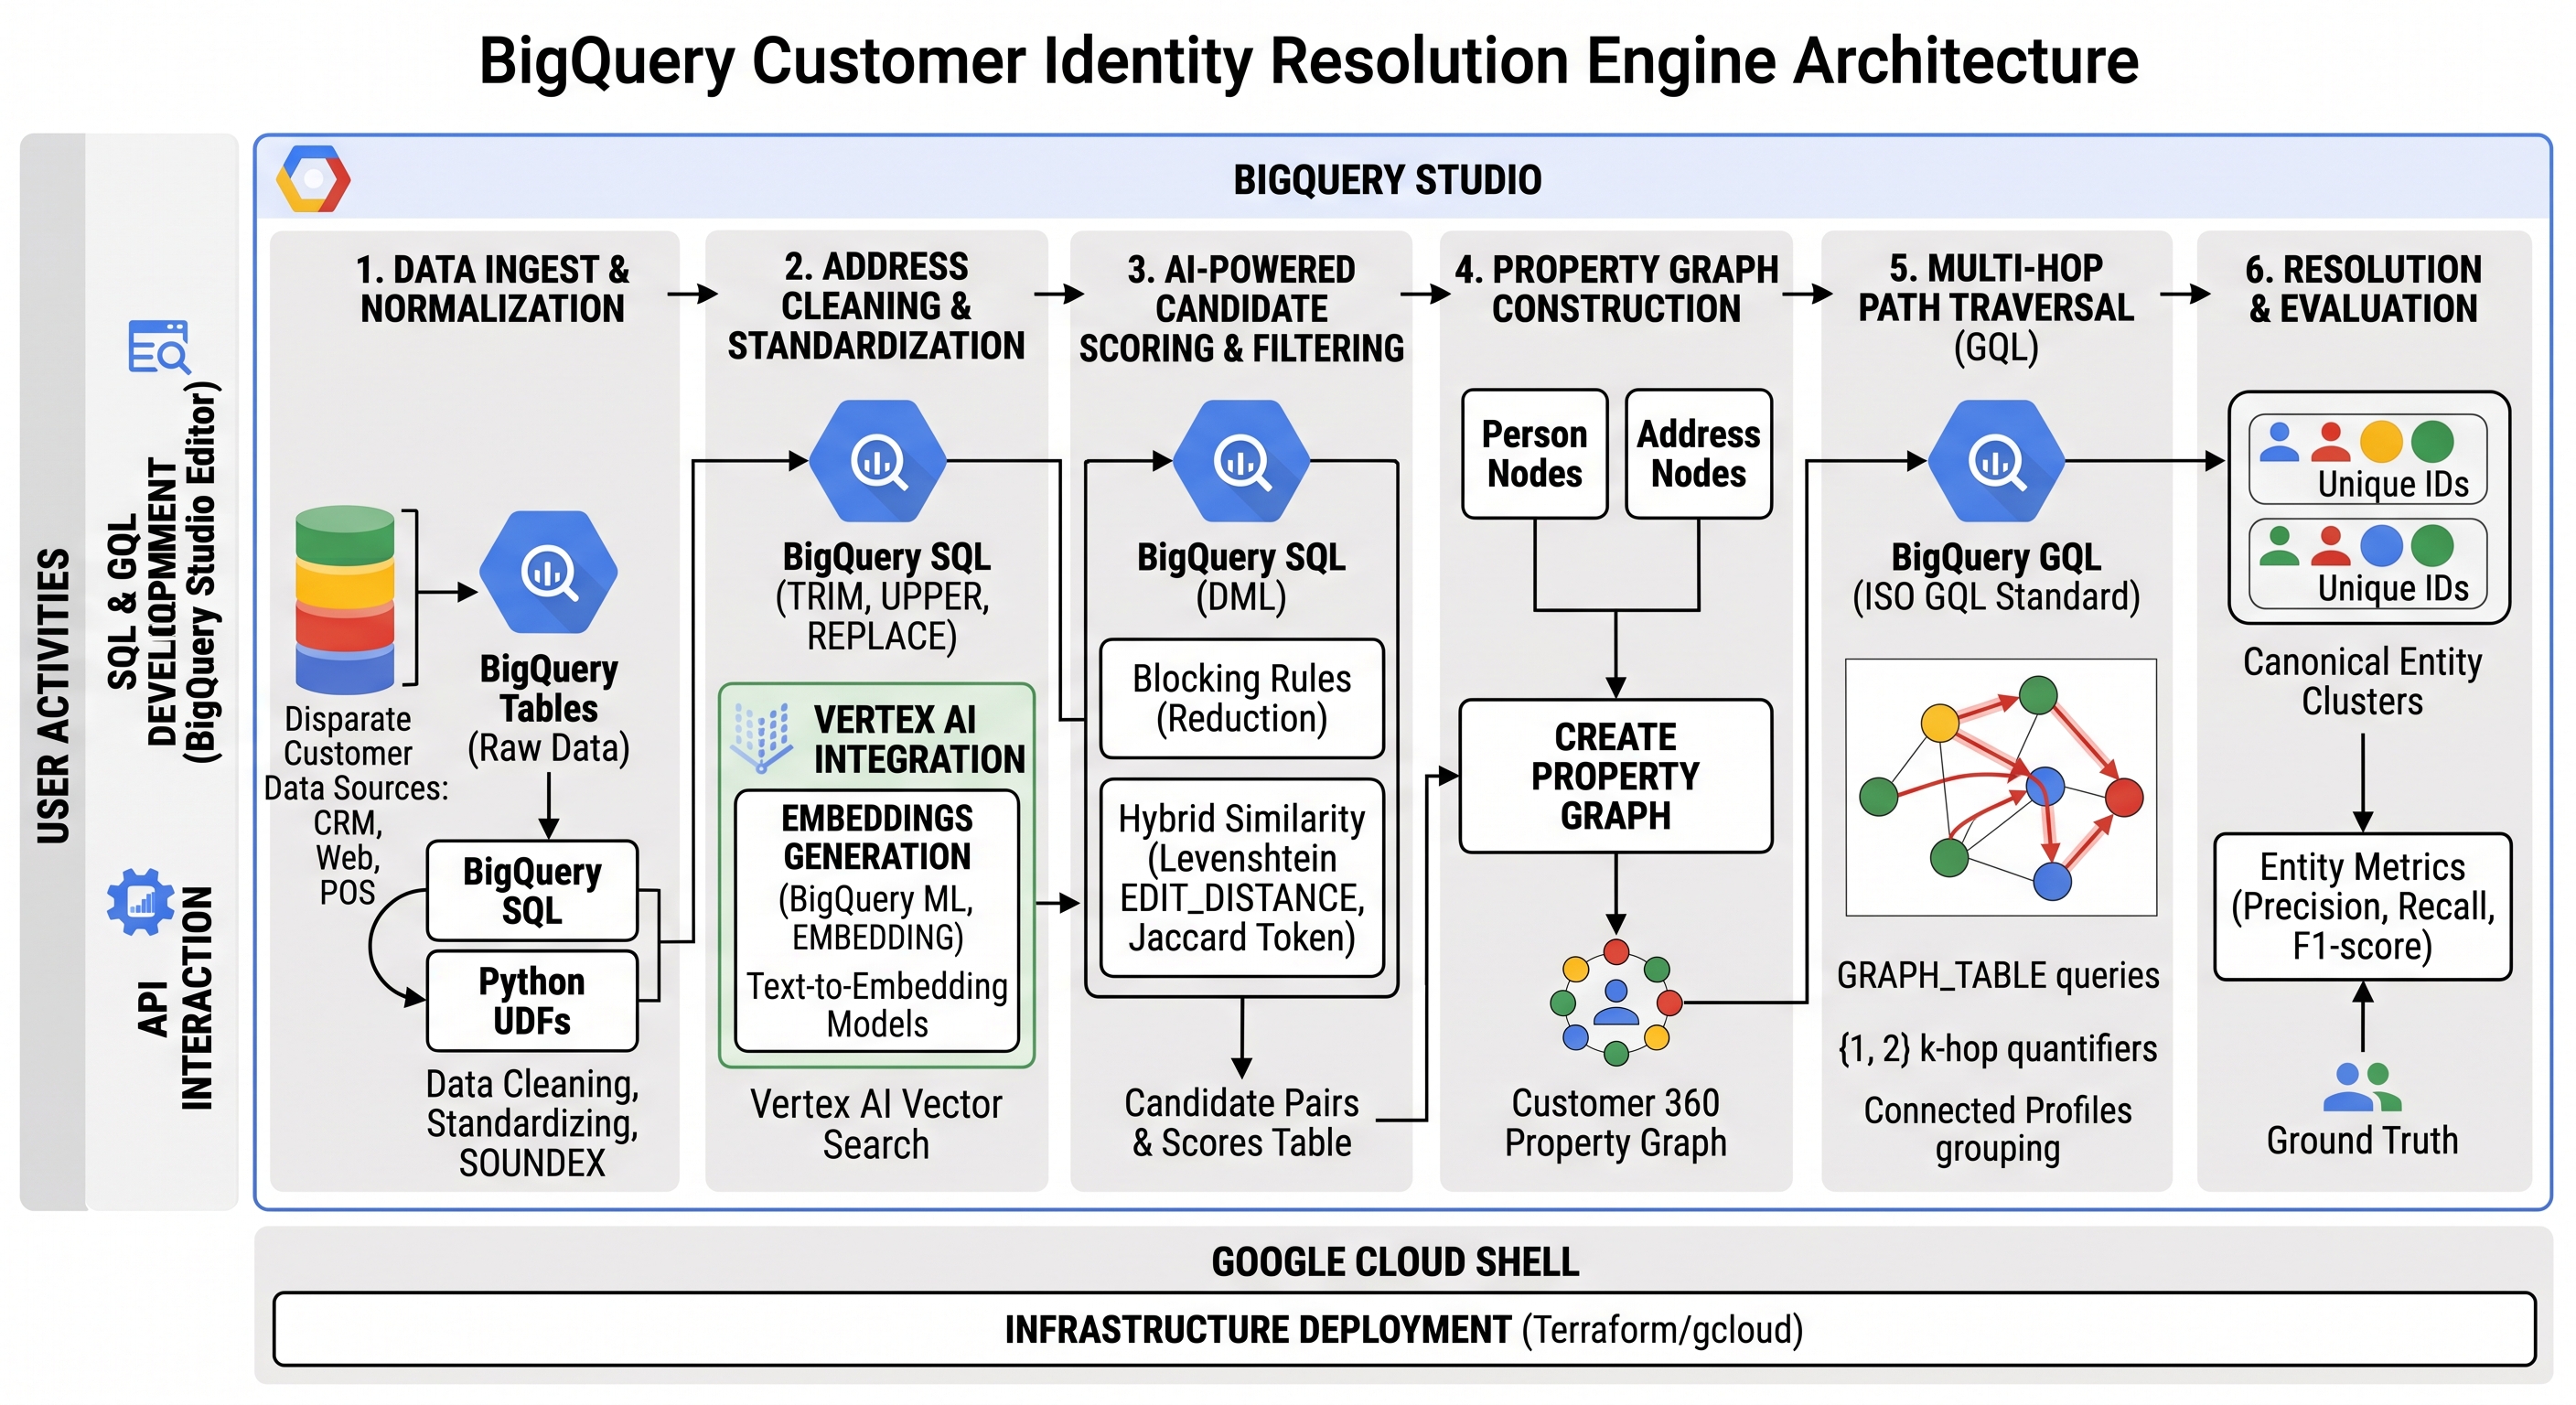
在本程式碼實驗室中,您將直接在 Google Cloud BigQuery 中,建構模組化端對端客戶身分識別解析 (實體比對) 引擎。您將結合 Google Cloud Shell 進行基礎架構部署,並使用 BigQuery Studio SQL 編輯器清理資料、為候選人評分、建構屬性圖,以及進行 ISO GQL (圖形查詢語言) 路徑遍歷。
身分解析是企業全方位客戶資訊、詐欺偵測和多系統資料整合的基礎功能。由於身分識別解決方案有許多有效方法,具體做法取決於資料成熟度和業務需求,因此本程式碼研究室的所有步驟都是模組化且選用性質。這條管線旨在展示各種常見的產業級生產技術,包括遠端 UDF 位址正規化、Soundex 語音封鎖、語意向量搜尋 (AI.EMBED)、混合特徵評分和 GQL 屬性圖形叢集,因此您可以選擇採用適合架構的模式。
比對方法和評分門檻應根據貴機構對決定性與機率性比對的偏好進行調整,而這取決於目標用途。舉例來說,嚴格的法規遵循、帳單或財務作業通常偏好高精確度的決定性規則 (例如完全相符的社會安全號碼或稅號),以防止錯誤連結;而行銷個人化、分析和推薦引擎則通常會採用機率模糊比對和語意向量相似度,盡量提高召回率並找出細微的關聯。
學習內容
- 擷取 FEBRL3 基準資料集:將合成客戶記錄和實際比對配對載入 BigQuery。
- 部署地址驗證遠端 UDF:部署 Python Cloud Function,並註冊 BigQuery 遠端函式,以正規化街道地址。
- 預先處理商家檔案資料和語音編碼:執行 SQL 資料清理作業、叫用地址 UDF,以及計算
SOUNDEX語音鍵和 Levenshtein 編輯距離:- Soundex 語音編碼:這是一種語音演算法,可根據英文發音為姓名建立索引。這項功能會將名稱轉換為 4 個字元的代碼 (第一個字母後接三個數字),代表子音群組 (例如
"John"和"Jon"都會對應至J500,而"Smith"和"Smyth"則會對應至S530),提供語音比對信號,用於功能評分和即時增量差異封鎖。 - Levenshtein 距離 (
EDIT_DISTANCE):這項字串指標會測量將一個字串變更為另一個字串所需的最少單一字元編輯次數 (插入、刪除或替換),可精確比對模糊名稱和地址。
- Soundex 語音編碼:這是一種語音演算法,可根據英文發音為姓名建立索引。這項功能會將名稱轉換為 4 個字元的代碼 (第一個字母後接三個數字),代表子音群組 (例如
- 生成語意設定檔嵌入和向量搜尋:使用
AI.EMBED(text-embedding-005) 直接在 SQL 中生成文字嵌入,並使用VECTOR_SEARCH找出前 K 個最鄰近項目,做為次線性候選項目生成層。 - 候選配對評分和混合式邊緣特徵融合:運用向量搜尋候選配對,消除 O(N²) 交叉聯結複雜度、計算多特徵加權相似度分數 (SSN、Levenshtein 編輯距離、出生日期、地址 Jaccard),並將邊緣融合至統一的候選資料表。
- 屬性圖建構和 ISO GQL 路徑遍歷:建構 BigQuery
PROPERTY GRAPH、執行 ISO GQL{1, 2}路徑查詢 (GRAPH_TABLE) 來解析相關聯的客群,計算個別評估指標,並使用 Adamic-Adar 圖形加權執行軟性住戶分群。 - 漸進式解析度與持續穩定性:透過漸進式差異比對,處理每日批次攝取量。
- 叢集整併和叢集穩定性 (1-ε 重疊):使用 (1-ε) 重疊閾值保證,在整個管道執行過程中強制執行持續的叢集穩定性。
軟硬體需求
- 網路瀏覽器,例如 Chrome。
- 已啟用計費功能的 Google Cloud 專案。
本程式碼研究室適合各種程度的資料工程師、資料庫開發人員和 AI/機器學習從業人員 (包括初學者)。
預估時間:45 分鐘
預估費用:不到 $2.00 美元 (使用即付即用的 Cloud Functions 和 BigQuery 查詢處理)。
2. 事前準備
建立 Google Cloud 專案
- 在 Google Cloud 控制台的專案選取器頁面中,選取或建立 Google Cloud 專案。
- 確認 Cloud 專案已啟用計費功能。瞭解如何檢查專案是否已啟用計費功能。
啟動 Cloud Shell
Cloud Shell 是在 Google Cloud 中運作的指令列環境,已預先載入必要工具。
- 按一下 Google Cloud 控制台頂端的「啟用 Cloud Shell」。
- 驗證身分:
gcloud auth list
- 在 Cloud Shell 中設定環境變數:
export GCP_PROJECT=$(gcloud config get-value project)
export REGION="us-central1"
export DATASET_ID="identity_resolution"
啟用必要的 API
在 Cloud Shell 中使用您的使用者帳戶執行下列指令,啟用所有必要的 Google Cloud 服務:
gcloud services enable \
  addressvalidation.googleapis.com \
  cloudbuild.googleapis.com \
  cloudfunctions.googleapis.com \
  cloudresourcemanager.googleapis.com \
  artifactregistry.googleapis.com \
  aiplatform.googleapis.com \
  run.googleapis.com \
  bigqueryconnection.googleapis.com \
  bigqueryreservation.googleapis.com \
  bigquery.googleapis.com
設定服務帳戶和模擬機制 (建議)
為確保 API 執行作業和應用程式預設憑證 (ADC) 存取權不受影響,請建立專屬實驗室服務帳戶,並啟用 gcloud 模擬功能:
# 1. Create a Service Account for the lab (if it does not already exist)
gcloud iam service-accounts create identity-res-sa \
  --display-name="Identity Resolution Service Account" 2>/dev/null || true

# Wait 5 seconds for IAM propagation
sleep 5

# Extract Project Number for default build and compute service accounts
export PROJECT_NUMBER=$(gcloud projects describe ${GCP_PROJECT} --format="value(projectNumber)")

# 2. Grant specific required least-privilege roles to the lab Service Account
for role in roles/bigquery.admin \
            roles/bigquery.resourceAdmin \
            roles/run.admin \
            roles/cloudfunctions.admin \
            roles/resourcemanager.projectIamAdmin \
            roles/cloudbuild.builds.editor \
            roles/cloudbuild.builds.builder \
            roles/artifactregistry.repoAdmin \
            roles/artifactregistry.writer \
            roles/storage.admin \
            roles/logging.logWriter \
            roles/iam.serviceAccountUser \
            roles/aiplatform.user; do
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:identity-res-sa@${GCP_PROJECT}.iam.gserviceaccount.com" \
    --role="${role}" --quiet
done

# 3. Grant required build & storage permissions to default Compute Engine & Cloud Build service accounts (required for 2nd-gen Cloud Functions container builds)
for role in roles/cloudbuild.builds.builder \
            roles/logging.logWriter \
            roles/artifactregistry.writer \
            roles/storage.objectAdmin; do
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:${PROJECT_NUMBER}-compute@developer.gserviceaccount.com" \
    --role="${role}" --quiet || true
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:${PROJECT_NUMBER}@cloudbuild.gserviceaccount.com" \
    --role="${role}" --quiet || true
done

# 4. Grant Service Account Token Creator role to your user account
export SA_EMAIL="identity-res-sa@${GCP_PROJECT}.iam.gserviceaccount.com"

gcloud iam service-accounts add-iam-policy-binding \
  "${SA_EMAIL}" \
  --member="user:$(gcloud config get-value account)" \
  --role="roles/iam.serviceAccountTokenCreator" --quiet

# 5. Enable Service Account impersonation for gcloud
gcloud config set auth/impersonate_service_account "${SA_EMAIL}"

# 6. Wait for IAM role assignments and impersonation caches to propagate
echo "Waiting 90 seconds for IAM policies and impersonation caches to propagate..."
sleep 90
建立 BigQuery 資料集
建立 BigQuery 資料集,用來儲存顧客節點、邊緣、圖形模型和評估檢視畫面:
bq mk --location=US --dataset ${GCP_PROJECT}:${DATASET_ID}
畫面會顯示類似以下的輸出:
Dataset 'your-project-id:identity_resolution' successfully created.
建立 BigQuery 預留項目和指派作業
如要執行 GQL 查詢,您必須擁有使用 Enterprise 或 Enterprise Plus 版本的預留空間,並在 Cloud Shell 中建立具有自動調度的 Enterprise Edition 預留空間:
# 1. Create a BigQuery Enterprise reservation with 0 baseline slots and 100 max autoscaling slots
bq mk --reservation \
  --project_id=${GCP_PROJECT} \
  --location=US \
  --edition=ENTERPRISE \
  --slots=0 \
  --autoscale_max_slots=100 \
  --ignore_idle_slots=true \
  identity-res-reservation

# 2. Assign your Cloud project to the newly created reservation for query execution
bq mk --reservation_assignment \
  --project_id=${GCP_PROJECT} \
  --location=US \
  --reservation_id=identity-res-reservation \
  --job_type=QUERY \
  --assignee_type=PROJECT \
  --assignee_id=${GCP_PROJECT}
3. 擷取 FEBRL3 客戶節點資料集
部署地址驗證遠端函式並執行身分解析作業前,請先使用 Python 的 recordlinkage 程式庫載入合成的 FEBRL3 實體解析基準資料集 (內含 5,000 筆客戶記錄,每個客戶最多有 5 個重複叢集),並使用 BigQuery DataFrames (bigframes) 將原始客戶節點 (customer_nodes) 和基本事實比對連結 (ground_truth_links) 寫入 BigQuery。
在 Cloud Shell 中執行下列指令,安裝依附元件並執行擷取指令碼:
# 1. Install recordlinkage dataset library & bigframes (if outside Cloud Shell, activate your virtual environment first)
pip install recordlinkage bigframes --quiet

# 2. Write and execute the FEBRL3 dataset ingestion script
cat << 'EOF' > ingest_febrl.py
import os
import pandas as pd
import bigframes.pandas as bpd
from recordlinkage.datasets import load_febrl3

GCP_PROJECT = os.environ.get("GCP_PROJECT", "your-project-id")
DATASET_ID = "identity_resolution"

table_raw_id = f"{GCP_PROJECT}.{DATASET_ID}.customer_nodes"
table_gt_id = f"{GCP_PROJECT}.{DATASET_ID}.ground_truth_links"

print("Loading FEBRL3 benchmark dataset...")
df_nodes, true_links = load_febrl3(return_links=True)
df_nodes = df_nodes.reset_index()
df_nodes['dataset_source'] = 'febrl3'

for col in df_nodes.columns:
    if df_nodes[col].dtype == 'object':
        df_nodes[col] = df_nodes[col].fillna('')

print("Ingesting raw customer nodes into BigQuery via BigQuery DataFrames...")
bf_nodes = bpd.read_pandas(df_nodes)
bf_nodes.to_gbq(table_raw_id, if_exists="replace")

print("Ingesting ground truth links into BigQuery via BigQuery DataFrames...")
df_gt = pd.DataFrame(list(true_links), columns=["source_id", "target_id"])
bf_gt = bpd.read_pandas(df_gt)
bf_gt.to_gbq(table_gt_id, if_exists="replace")

print(f"Raw customer nodes ingested into `{table_raw_id}` ({len(df_nodes):,} rows).")
print(f"Ground truth links ingested into `{table_gt_id}` ({len(df_gt):,} pairs).")
EOF

python3 ingest_febrl.py
前往 Google Cloud 控制台的 BigQuery Studio,開啟新的「SQL 查詢」分頁 (+),然後執行下列查詢,檢查已擷取的客戶節點資料表:
SELECT rec_id, given_name, surname, street_number, address_1, address_2, suburb, postcode, state, date_of_birth, soc_sec_id, dataset_source
FROM `identity_resolution.customer_nodes`
LIMIT 5;
畫面會顯示類似以下的輸出:
rec_id | given_name | 姓 | street_number | address_1 | address_2 | 郊區 | 郵遞區號 | 州 | date_of_birth | soc_sec_id | dataset_source |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| |
|
|
|
|
|
|
|
|
|
|
| |
|
|
|
|
|
|
|
|
|
| ||
|
|
|
|
|
|
|
|
|
|
|
|
請注意,基準資料集如何在重複的叢集中引入實際的品質不佳的資料 (dirty data):
- 發音和拼字變體:
brent與brnt/bernt、wood與woode/wod,以及clifton與cliffton。 - 地址縮寫和錯字:
girdlestone circuit與girdelstone circut/girdlestone cir/girdlestone crt,以及門牌號碼11與光學字元辨識錯誤15。 - 字元轉置和遺漏值:出生日期轉置 (
19340706與19340760)、遺漏州別 ( ) 和遺漏身分證字號 ( )。
在後續步驟中,您將使用 SOUNDEX 語音編碼、位址正規化 UDF、Levenshtein 編輯距離和 AI.EMBED 向量搜尋,彌合這些差異並準確連結重複的設定檔。
4. 部署地址驗證遠端函式 UDF
地址標準化會在執行比對前,先將街道名稱、郊區界線和郵遞區號標準化。Google 地圖地址驗證 API 是一項服務,可接受地址、識別地址元件並驗證。在這個步驟中,您會在 Cloud Shell 中部署 Python Cloud Function,將地址驗證和正規化 UDF 公開給 BigQuery。
編寫 Cloud 函式來源檔案
在 Cloud Shell 中執行下列指令,建立 Cloud Functions 來源目錄並寫入 main.py 和 requirements.txt:
mkdir -p cloud_function_address_validation && cd cloud_function_address_validation

cat << 'EOF' > main.py
import os
import json
import logging
import requests
from functools import lru_cache
from concurrent.futures import ThreadPoolExecutor

import functions_framework
import google.auth
from google.auth.transport.requests import AuthorizedSession
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

ADDRESS_VALIDATION_URL = "https://addressvalidation.googleapis.com/v1:validateAddress"
ENABLE_ADDRESS_VALIDATION_API = os.environ.get("ENABLE_ADDRESS_VALIDATION_API", "false").lower() == "true"

# ==========================================
# GLOBAL INITIALIZATION (Runs once per Cold Start)
# ==========================================

credentials, _ = google.auth.default(scopes=["https://www.googleapis.com/auth/cloud-platform"])
session = AuthorizedSession(credentials)

retries = Retry(
    total=4,
    backoff_factor=0.5,
    status_forcelist=[429, 500, 502, 503, 504],
    allowed_methods=["POST"]
)
adapter = HTTPAdapter(max_retries=retries, pool_connections=100, pool_maxsize=100)
session.mount("https://", adapter)

executor = ThreadPoolExecutor(max_workers=50)


@lru_cache(maxsize=10000)
def call_validation_api(address_text: str) -> str:
    payload = {
        "address": {
            "regionCode": "AU",
            "addressLines": [address_text]
        }
    }

    response = session.post(ADDRESS_VALIDATION_URL, json=payload, timeout=10)
    response.raise_for_status()

    res_data = response.json()
    result = res_data.get('result', {})
    address_obj = result.get('address', {})
    verdict = result.get('verdict', {})

    formatted = address_obj.get('formattedAddress', address_text).lower()
    has_unconfirmed = verdict.get('hasUnconfirmedComponents', True)
    address_complete = verdict.get('addressComplete', False)
    granularity = verdict.get('validationGranularity', 'UNCONFIRMED')
    actions = verdict.get('possibleNextActions', [])
    next_action = str(actions[0]) if actions else "NONE"

    is_valid = bool(address_complete and not has_unconfirmed)

    return {
        "formatted_address": formatted,
        "address_is_valid": is_valid,
        "validation_granularity": granularity,
        "possible_next_action": next_action
    }


def process_single_call(call):
    call = call or []
    padded = (call + [""] * 6)[:6]

    cleaned_parts = [str(p).strip() if p is not None else "" for p in padded]
    street_num, addr_1, addr_2, suburb, state, postcode = cleaned_parts

    address_parts = [p for p in cleaned_parts if p]
    address_text = " ".join(address_parts)

    if not address_text:
        return {
            "formatted_address": "",
            "address_is_valid": False,
            "validation_granularity": "EMPTY",
            "possible_next_action": "NONE"
        }

    if not ENABLE_ADDRESS_VALIDATION_API:
        normalized = (
            address_text.lower()
            .replace("street", "st")
            .replace("road", "rd")
            .replace("place", "pl")
            .replace("avenue", "ave")
            .replace("circuit", "cct")
        )
        return {
            "formatted_address": normalized,
            "address_is_valid": bool(len(address_parts) >= 3),
            "validation_granularity": "PREMISE" if postcode and suburb else "SUBURB",
            "possible_next_action": "NONE"
        }

    try:
        return call_validation_api(address_text)
    except Exception as e:
        logging.error(f"Address Validation API Error for '{address_text}': {str(e)}")
        return {
            "formatted_address": address_text.lower(),
            "address_is_valid": False,
            "validation_granularity": "UNCONFIRMED",
            "possible_next_action": "NONE"
        }


@functions_framework.http
def validate_address_udf(request):
    request_json = request.get_json(silent=True) or {}
    calls = request_json.get('calls', [])

    if not calls:
        return {'replies': []}

    try:
        # executor.map inherently preserves array input order (Strictly required by BigQuery)
        replies = list(executor.map(process_single_call, calls))
        return {'replies': replies}
    except Exception as e:
        logging.error(f"Batch execution failed: {e}")
        return {'errorMessage': str(e)}, 400
EOF

cat << 'EOF' > requirements.txt
functions-framework==3.*
requests==2.*
google-auth==2.*
urllib3==2.*
EOF
部署 Cloud Function 並設定 IAM 權限
在 Cloud Shell 執行下列指令,部署第 2 代 Cloud 函式並設定 BigQuery Cloud 資源連結:
# 1. Deploy 2nd-Gen Cloud Function
gcloud functions deploy validate_address_udf \
  --gen2 \
  --runtime=python311 \
  --region=${REGION} \
  --source=. \
  --entry-point=validate_address_udf \
  --trigger-http \
  --no-allow-unauthenticated \
  --memory=512Mi \
  --cpu=1 \
  --concurrency=80 \
  --quiet

# 2. Extract Function Endpoint URI
export FUNCTION_URL=$(gcloud functions describe validate_address_udf --region=${REGION} --gen2 --format="value(serviceConfig.uri)")

# 3. Create BigQuery Cloud Resource Connection
bq mk --connection --location=US --project_id=${GCP_PROJECT} --connection_type=CLOUD_RESOURCE address_val_conn || true

# 4. Extract Connection Service Account Email
export BQ_SA_EMAIL=$(bq show --format=prettyjson --connection US.address_val_conn | grep -o '"serviceAccountId": "[^"]*"' | cut -d'"' -f4)

# 5. Bind Cloud Run Invoker and Vertex AI User IAM Roles to BigQuery Connection Service Account
gcloud run services add-iam-policy-binding validate-address-udf \
  --region=${REGION} \
  --member="serviceAccount:${BQ_SA_EMAIL}" \
  --role="roles/run.invoker" --quiet

gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
  --member="serviceAccount:${BQ_SA_EMAIL}" \
  --role="roles/aiplatform.user" --quiet

# 6. Wait for connection IAM policy propagation
echo "Waiting 60 seconds for BigQuery connection IAM policy to propagate..."
sleep 60
輸出內容應該會指出 Cloud 函式部署作業已完成,且 IAM 繫結已成功套用。
註冊遠端地址標準化函式
現在,您要註冊 BigQuery 遠端函式 DDL (validate_address_udf),將 BigQuery 資料表列連結至已部署的 Cloud Functions 端點 (${FUNCTION_URL})。
在 Cloud Shell 中執行下列指令,擷取已部署的 Cloud 函式網址,並自動註冊遠端函式:
# 1. Retrieve deployed Cloud Function URL
export FUNCTION_URL=$(gcloud functions describe validate_address_udf --region=${REGION:-us-central1} --gen2 --format="value(serviceConfig.uri)")

# 2. Register Remote Function DDL in BigQuery
bq query --use_legacy_sql=false \
"CREATE OR REPLACE FUNCTION \`${GCP_PROJECT}.${DATASET_ID}.validate_address_udf\`(
  street_number STRING,
  address_1 STRING,
  address_2 STRING,
  suburb STRING,
  state STRING,
  postcode STRING
) RETURNS JSON
REMOTE WITH CONNECTION \`us.address_val_conn\`
OPTIONS (
  endpoint = '${FUNCTION_URL}',
  max_batching_rows = 100
);"
5. 預先處理設定檔資料和語音編碼
在這個步驟中,您將對擷取的 customer_nodes 資料表執行 BigQuery SQL 前處理查詢。
執行資料清理和語音特徵查詢
在 BigQuery Studio SQL 編輯器中,執行下列查詢來建立 customer_nodes_cleaned。這項查詢會進行下列操作:
- 呼叫
validate_address_udf即可取得正規化地址和驗證結果。 - 為
given_name和surname產生SOUNDEX語音編碼,以處理拼字變化。 - 建構結構化
profile_text欄位。
CREATE OR REPLACE TABLE `identity_resolution.customer_nodes_cleaned` AS
WITH raw_data AS (
  SELECT
    rec_id, dataset_source,
    TRIM(LOWER(given_name)) AS given_name_clean,
    TRIM(LOWER(surname)) AS surname_clean,
    `identity_resolution.validate_address_udf`(street_number, address_1, address_2, suburb, state, postcode) AS addr_json,
    TRIM(suburb) AS suburb, TRIM(state) AS state, TRIM(postcode) AS postcode,
    TRIM(date_of_birth) AS date_of_birth, TRIM(soc_sec_id) AS soc_sec_id
  FROM `identity_resolution.customer_nodes`
)
SELECT
  rec_id, dataset_source,
  given_name_clean AS given_name,
  SOUNDEX(given_name_clean) AS given_name_soundex,
  surname_clean AS surname,
  SOUNDEX(surname_clean) AS surname_soundex,
  CONCAT(given_name_clean, ' ', surname_clean) AS full_name,
  STRING(addr_json.formatted_address) AS formatted_address,
  BOOL(addr_json.address_is_valid) AS address_is_valid,
  STRING(addr_json.validation_granularity) AS validation_granularity,
  STRING(addr_json.possible_next_action) AS possible_next_action,
  suburb, state, postcode, date_of_birth, soc_sec_id,
  CONCAT('Name: ', CONCAT(given_name_clean, ' ', surname_clean), '; Address: ', STRING(addr_json.formatted_address), '; DOB: ', date_of_birth, '; SSN: ', soc_sec_id) AS profile_text
FROM raw_data;
查詢已清除的節點資料表:
SELECT rec_id, given_name, given_name_soundex, surname, surname_soundex, formatted_address
FROM `identity_resolution.customer_nodes_cleaned`
LIMIT 5;
畫面會顯示類似以下的輸出:
rec_id | given_name | given_name_soundex | 姓 | surname_soundex | formatted_address |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
6. 生成語意設定檔嵌入和向量搜尋
除了地址正規化、Soundex 語音鍵和 Levenshtein 編輯距離,BigQuery 也透過 AI.EMBED 支援內建的生成式 AI 嵌入函式。
使用 AI.EMBED,BigQuery 會使用基礎模型 (例如 text-embedding-005) 直接在 SQL 中生成文字嵌入:
生成個人資料嵌入項目並執行 Top-K 向量搜尋
在 BigQuery Studio SQL 編輯器中執行下列查詢:
-- 1. Generate Customer Profile Embeddings using AI.EMBED (offloaded to Vertex AI)
CREATE OR REPLACE TABLE `identity_resolution.customer_embeddings` AS
SELECT
  rec_id,
  dataset_source,
  profile_text,
  AI.EMBED(profile_text, connection_id => 'us.address_val_conn', endpoint => 'text-embedding-005').result AS text_embedding
FROM `identity_resolution.customer_nodes_cleaned`;

-- 2. Execute VECTOR_SEARCH for Top-K Nearest Neighbors Candidate Generation
CREATE OR REPLACE TABLE `identity_resolution.vector_candidate_edges` AS
SELECT DISTINCT
  LEAST(query.rec_id, base.rec_id) AS source_id,
  GREATEST(query.rec_id, base.rec_id) AS target_id,
  distance AS vector_distance
FROM VECTOR_SEARCH(
  TABLE `identity_resolution.customer_embeddings`,
  'text_embedding',
  TABLE `identity_resolution.customer_embeddings`,
  top_k => 10,
  distance_type => 'COSINE'
)
WHERE query.rec_id != base.rec_id AND distance <= 0.25;
7. 候選人配對評分和混合式邊緣特徵融合
評估所有可能的顧客記錄配對 (O(N²) 二次成長) 會變得難以計算,因為資料集規模會不斷擴大。在 BigQuery 等關聯式資料庫引擎中,嘗試使用多個資料欄的複雜 OR join 條件 (例如在 a.soc_sec_id = b.soc_sec_id OR a.given_name_soundex = b.given_name_soundex OR ... 上進行 join) 實作規則式封鎖時,查詢最佳化工具無法在單一等值 join 鍵上使用可擴充的雜湊 join 或排序合併 join。引擎會改為回溯至 O(N²) cross join,並篩選每個配對,但這無法大規模運作。
在這個步驟中,您會取得向量搜尋資料表 (vector_candidate_edges) 產生的候選配對,並透過快速的索引等值聯結 (ON c.source_id = a.rec_id 和 ON c.target_id = b.rec_id) 將這些配對與 customer_nodes_cleaned 聯結。接著,您會計算加權比對分數,結合:
- 社會安全號碼比對分數 (權重:
0.30) - 使用 Levenshtein 距離
EDIT_DISTANCE計算姓氏編輯相似度 (權重:0.20) - 名字編輯相似度 (權重:
0.20) - 出生日期比對分數 (權重:
0.15) - 地址權杖 Jaccard 相似度 (權重:
0.15) 超過SPLIT(LOWER(formatted_address), ' ')
計算候選邊緣和加權相似度分數
在 BigQuery Studio SQL 編輯器中執行下列查詢,即可填入 matched_edges:
CREATE OR REPLACE TABLE `identity_resolution.matched_edges` AS
WITH candidate_pairs AS (
  SELECT
    c.source_id, c.target_id,
    a.given_name AS a_given_name, b.given_name AS b_given_name,
    a.surname AS a_surname, b.surname AS b_surname,
    a.given_name_soundex AS a_gn_snd, b.given_name_soundex AS b_gn_snd,
    a.surname_soundex AS a_sn_snd, b.surname_soundex AS b_sn_snd,
    a.date_of_birth AS a_dob, b.date_of_birth AS b_dob,
    a.soc_sec_id AS a_ssn, b.soc_sec_id AS b_ssn,
    SPLIT(LOWER(a.formatted_address), ' ') AS a_tokens,
    SPLIT(LOWER(b.formatted_address), ' ') AS b_tokens
  FROM `identity_resolution.vector_candidate_edges` c
  JOIN `identity_resolution.customer_nodes_cleaned` a ON c.source_id = a.rec_id
  JOIN `identity_resolution.customer_nodes_cleaned` b ON c.target_id = b.rec_id
),
scored_pairs AS (
  SELECT
    source_id, target_id,
    CASE WHEN a_ssn = b_ssn AND a_ssn != '' THEN 1.0 ELSE 0.0 END AS ssn_match,
    CASE WHEN a_dob = b_dob THEN 1.0 ELSE 0.0 END AS dob_match,
    CASE WHEN a_gn_snd = b_gn_snd THEN 1.0 ELSE 0.0 END AS given_name_soundex_match,
    CASE WHEN a_sn_snd = b_sn_snd THEN 1.0 ELSE 0.0 END AS surname_soundex_match,
    GREATEST(
      (1.0 - (EDIT_DISTANCE(a_given_name, b_given_name) / GREATEST(LENGTH(a_given_name), LENGTH(b_given_name), 1))),
      (1.0 - (EDIT_DISTANCE(a_given_name, b_surname) / GREATEST(LENGTH(a_given_name), LENGTH(b_surname), 1)))
    ) AS given_name_edit_sim,
    GREATEST(
      (1.0 - (EDIT_DISTANCE(a_surname, b_surname) / GREATEST(LENGTH(a_surname), LENGTH(b_surname), 1))),
      (1.0 - (EDIT_DISTANCE(a_surname, b_given_name) / GREATEST(LENGTH(a_surname), LENGTH(b_given_name), 1)))
    ) AS surname_edit_sim,
    (
      (SELECT COUNT(DISTINCT t) FROM UNNEST(a_tokens) t JOIN UNNEST(b_tokens) t2 ON t = t2)
      /
      GREATEST(1.0, (SELECT COUNT(DISTINCT t) FROM UNNEST(ARRAY_CONCAT(a_tokens, b_tokens)) t))
    ) AS address_jaccard_sim
  FROM candidate_pairs
)
SELECT
  source_id, target_id,
  ROUND((0.30 * ssn_match) + (0.20 * surname_edit_sim) + (0.20 * given_name_edit_sim) + (0.15 * dob_match) + (0.15 * address_jaccard_sim), 4) AS match_score
FROM scored_pairs
WHERE ((0.30 * ssn_match) + (0.20 * surname_edit_sim) + (0.20 * given_name_edit_sim) + (0.15 * dob_match) + (0.15 * address_jaccard_sim)) >= 0.55;
檢查候選邊緣相符項目:
SELECT source_id, target_id, match_score
FROM `identity_resolution.matched_edges`
ORDER BY match_score DESC;
畫面會顯示類似以下的輸出:
source_id | target_id | match_score |
|
|
|
|
|
|
|
|
|
將以規則為準和向量搜尋的邊緣合併至統一表格
將規則式模糊比對和語意向量搜尋的候選邊緣合併至單一不重複的 final_matched_edges 表格:
CREATE OR REPLACE TABLE `identity_resolution.final_matched_edges` AS
SELECT
  source_id,
  target_id,
  MAX(edge_weight) AS edge_weight,
  IF(COUNT(DISTINCT edge_type) > 1, 'HYBRID', MAX(edge_type)) AS edge_type
FROM (
  SELECT source_id, target_id, match_score AS edge_weight, 'RULE_BASED' AS edge_type
  FROM `identity_resolution.matched_edges`
  UNION ALL
  SELECT source_id, target_id, ROUND(1.0 - vector_distance, 4) AS edge_weight, 'VECTOR_SEARCH' AS edge_type
  FROM `identity_resolution.vector_candidate_edges`
  WHERE vector_distance <= 0.08
)
GROUP BY source_id, target_id;
8. 屬性圖建構與 ISO GQL 路徑遍歷
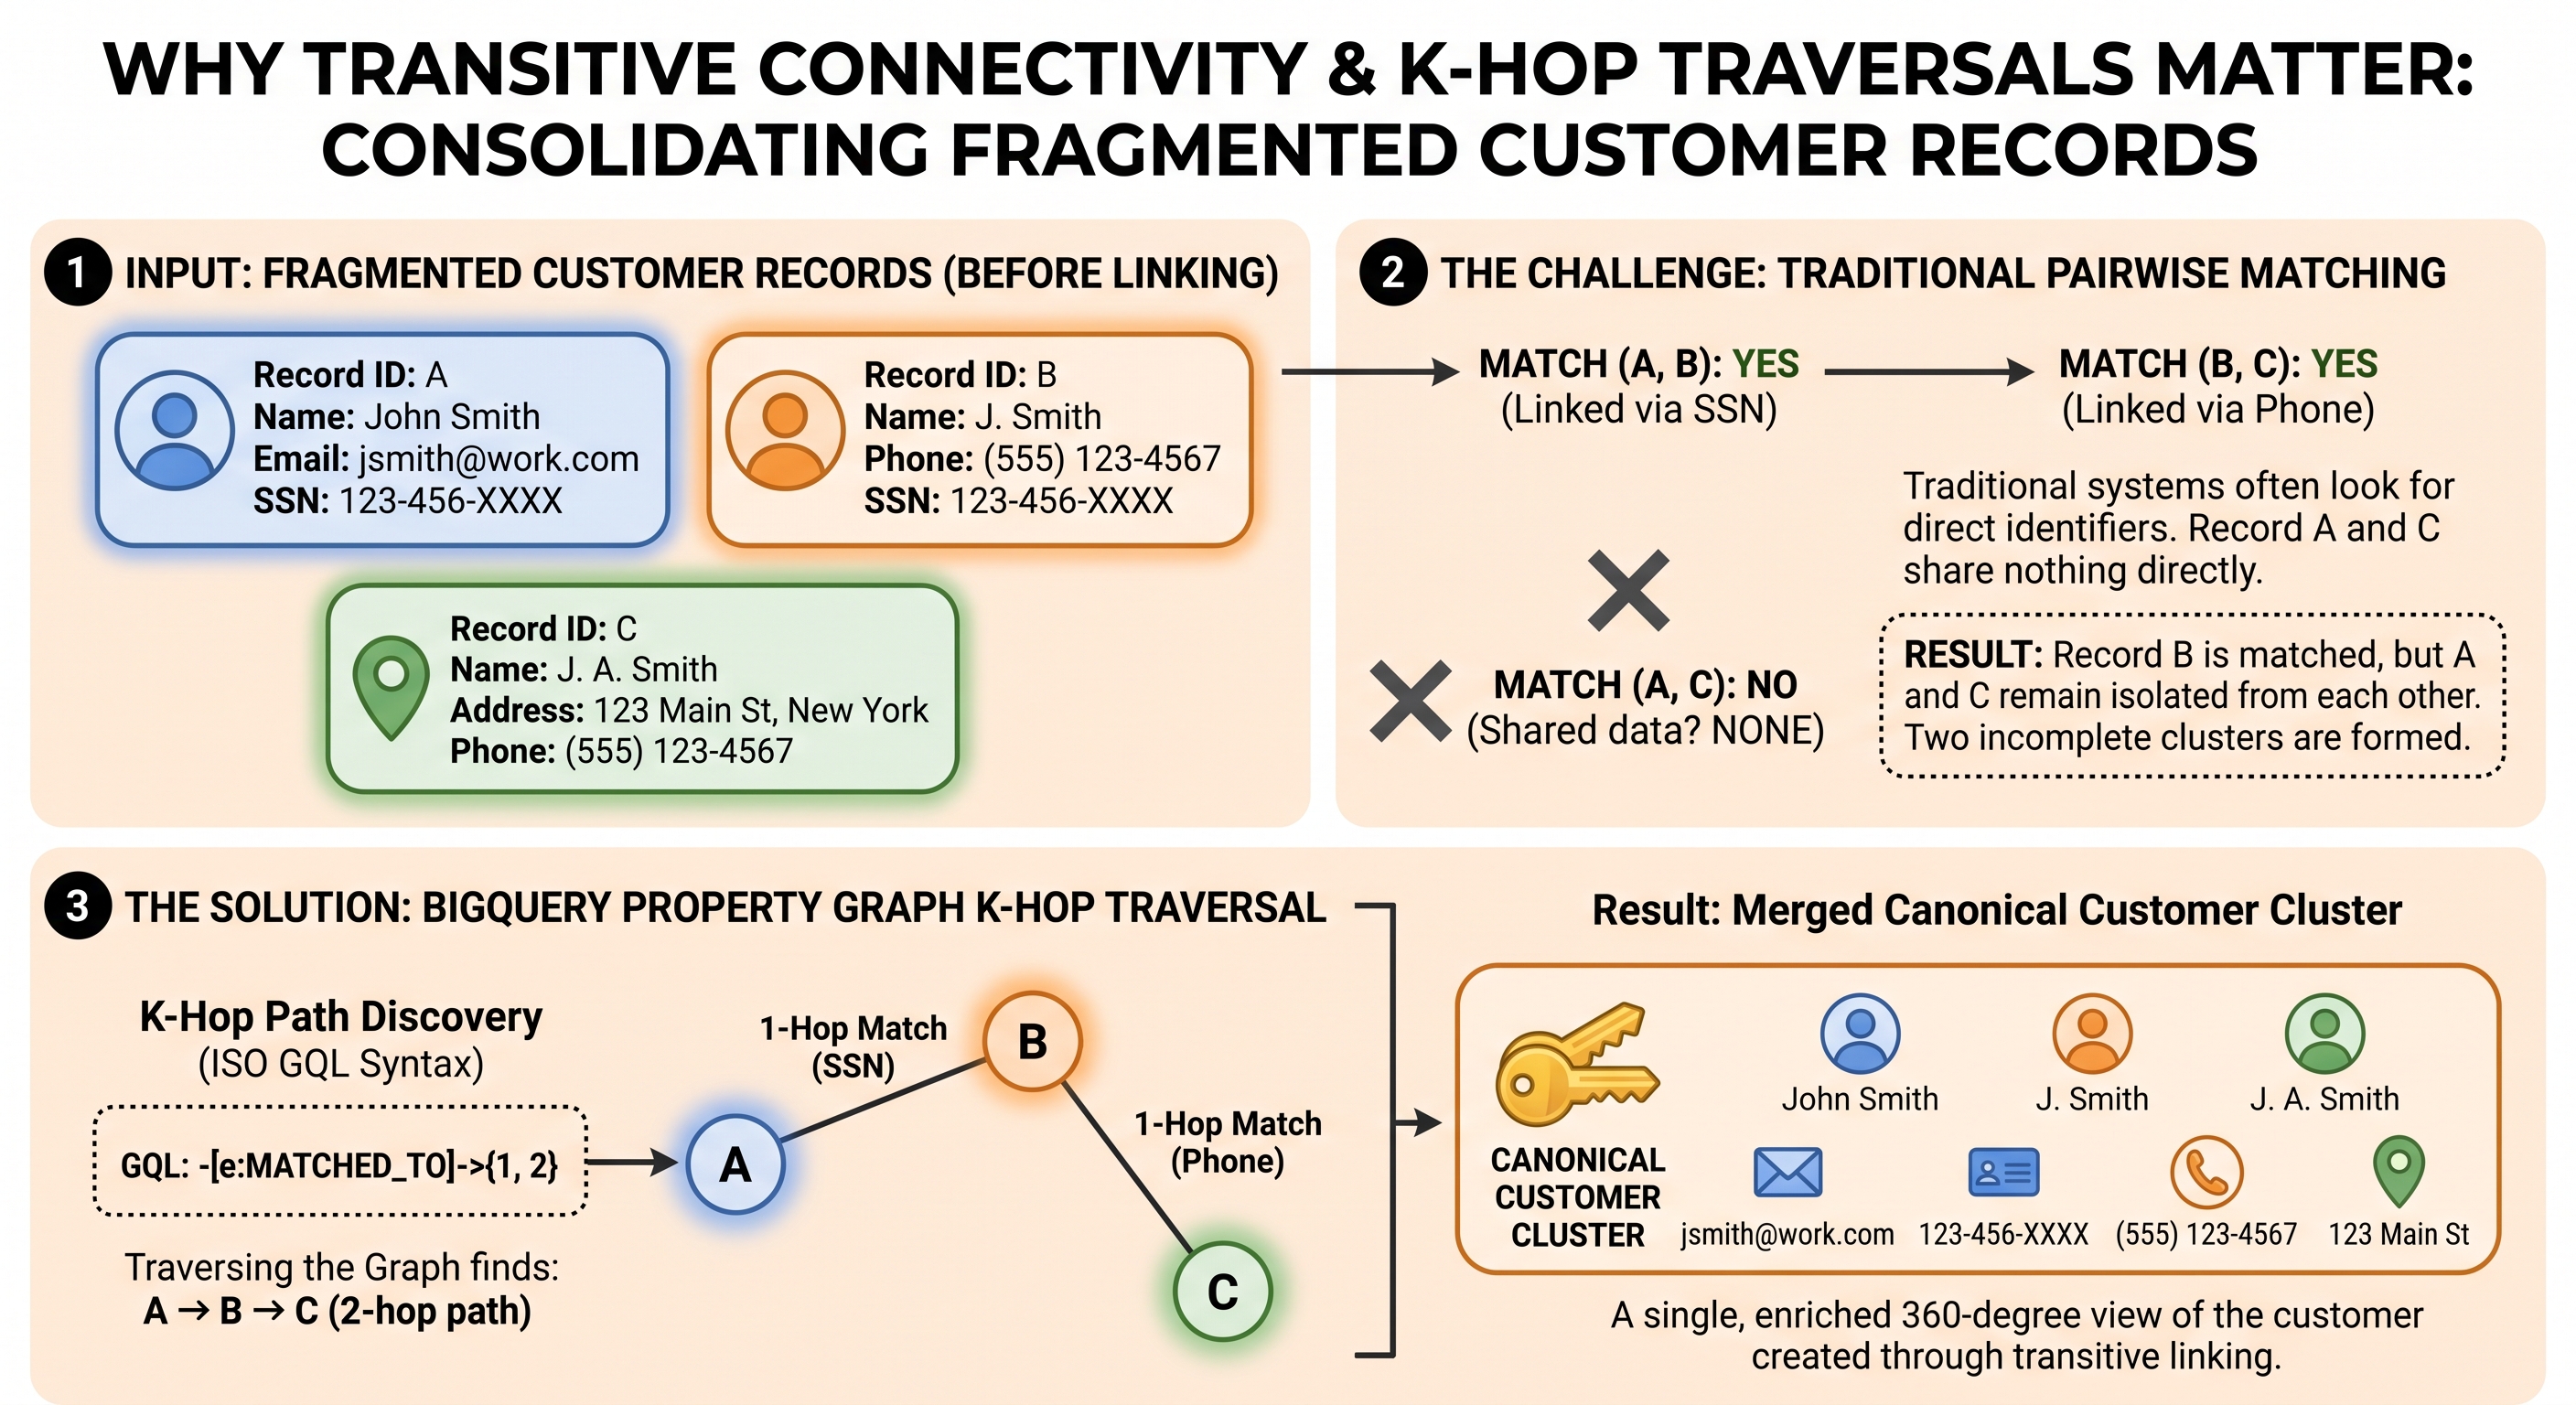
BigQuery 透過屬性圖形原生支援 ISO Graph Query Language (圖形查詢語言)。屬性圖會在關聯式 BigQuery 資料表上建立邏輯圖檢視區塊,不必複製資料。
在這個步驟中,您將使用統一候選邊緣資料表 (final_matched_edges) 建構屬性圖 customer_identity_graph,並使用 {1, 2} k-hop 路徑遍歷,查詢客戶設定檔中的圖形連線。
建立 BigQuery 屬性圖表 DDL
在 BigQuery Studio SQL 編輯器中執行下列 DDL 陳述式:
CREATE OR REPLACE PROPERTY GRAPH `identity_resolution.customer_identity_graph`
NODE TABLES (
  `identity_resolution.customer_nodes_cleaned` AS `Customer`
  KEY (rec_id)
)
EDGE TABLES (
  `identity_resolution.final_matched_edges`
  KEY (source_id, target_id)
  SOURCE KEY (source_id) REFERENCES `Customer`(rec_id)
  DESTINATION KEY (target_id) REFERENCES `Customer`(rec_id)
  LABEL MATCHED_TO
);
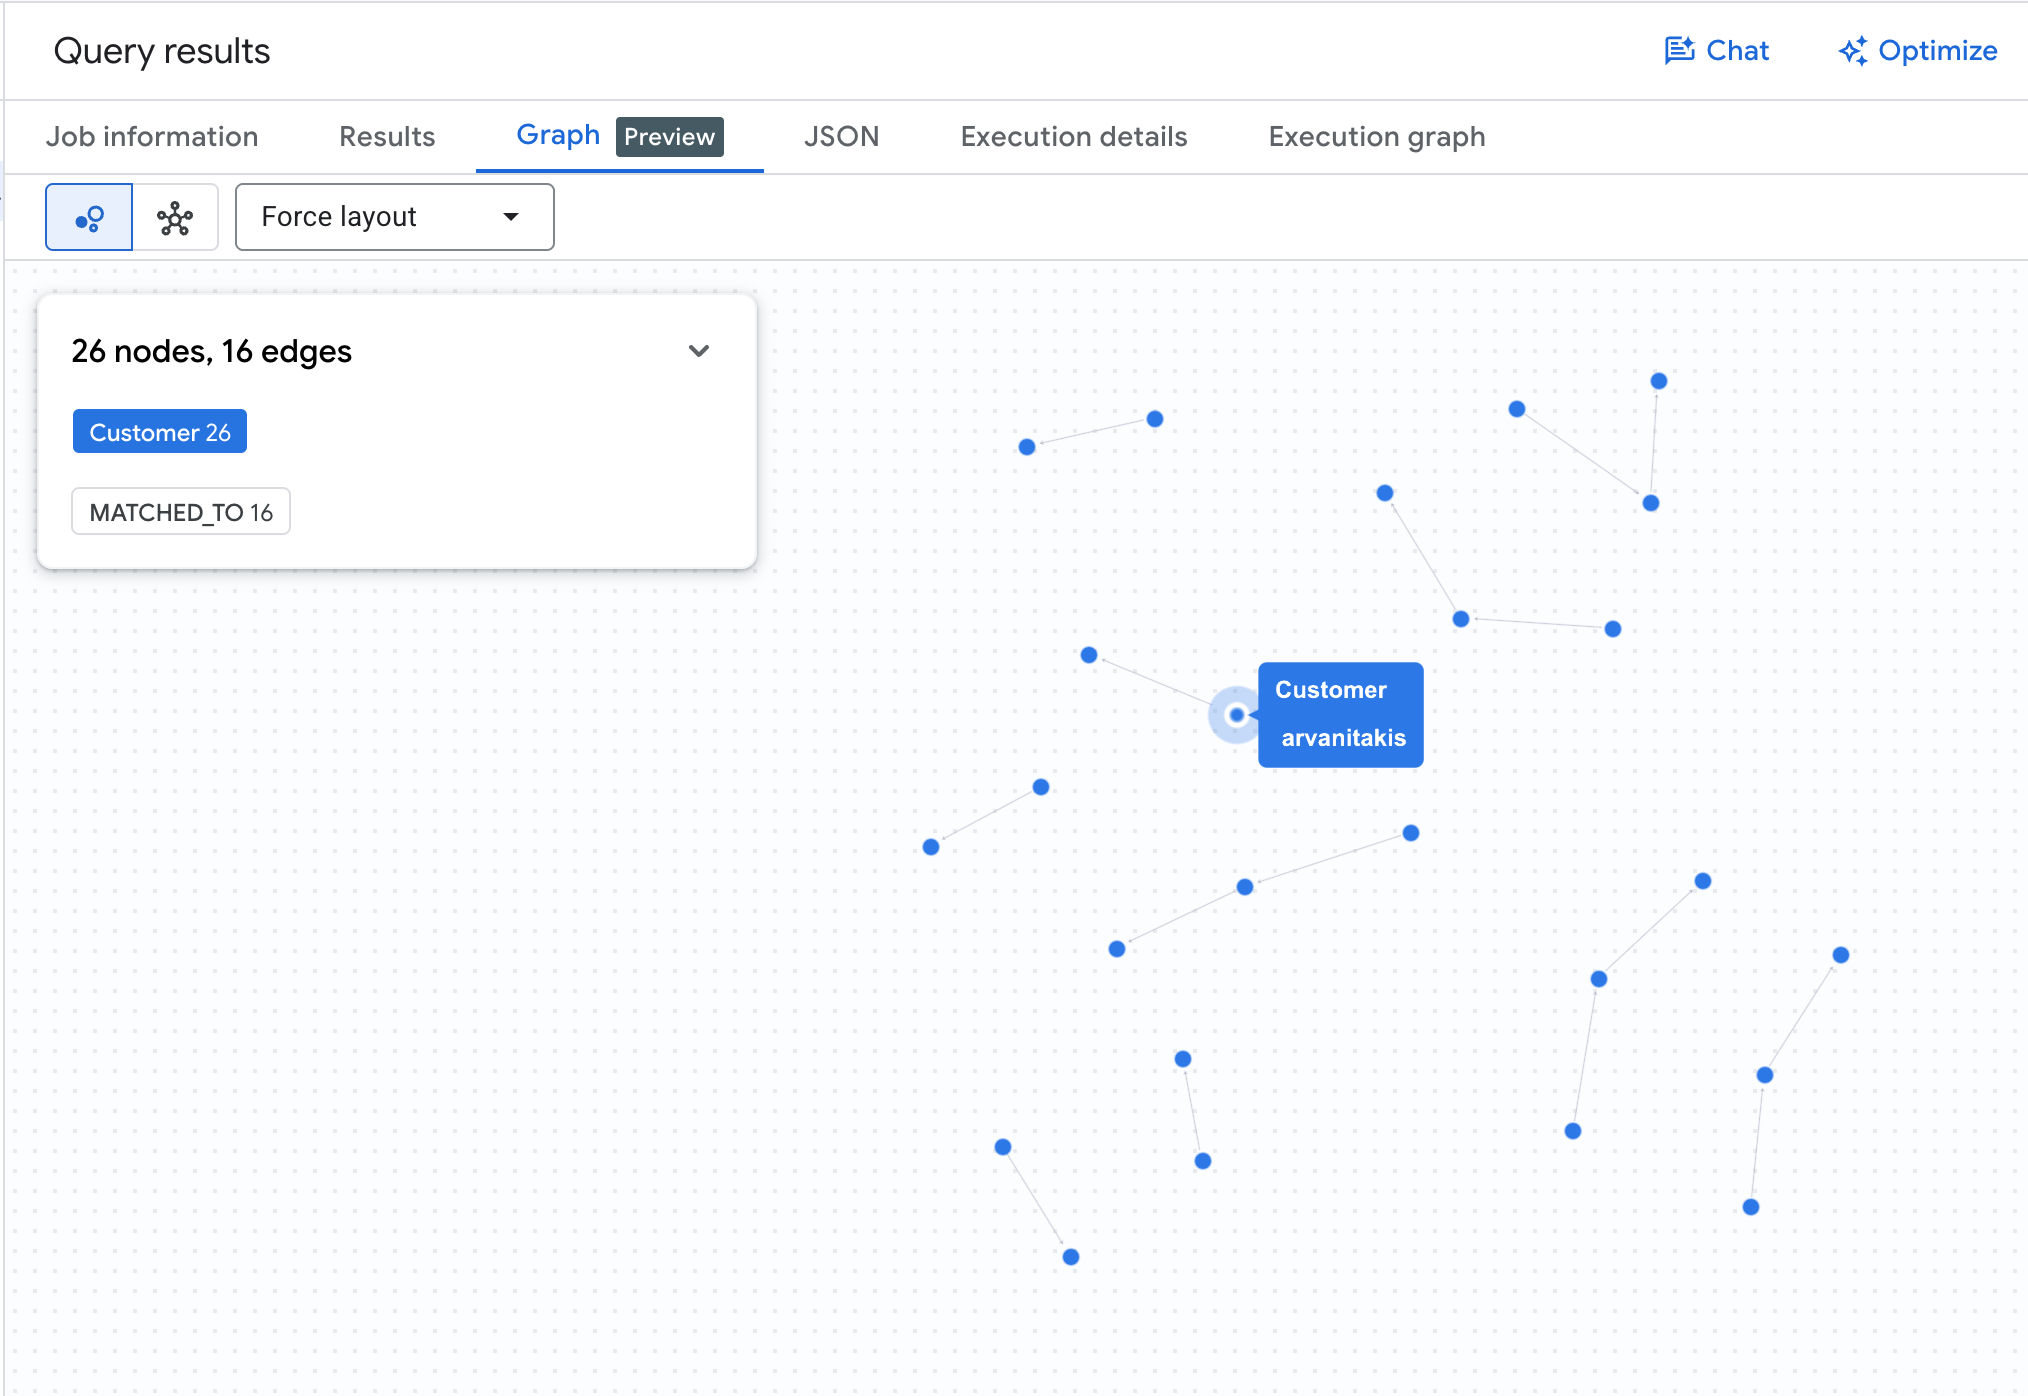
視覺化呈現 K-Hop 圖形叢集
執行下列查詢,以視覺化方式呈現 1 到 2 個關係躍點的相符顧客叢集:
GRAPH `identity_resolution.customer_identity_graph`
MATCH p = (c1:Customer)-[e:MATCHED_TO]->{1, 2}(c2:Customer)
RETURN TO_JSON(p) AS graph_cluster_path
LIMIT 10;
解決標準客戶群組問題
執行下列查詢,將實體叢集解析為 resolved_customers:
CREATE OR REPLACE TABLE `identity_resolution.resolved_customers` AS
WITH graph_paths AS (
  SELECT
    source_node_id, target_node_id
  FROM GRAPH_TABLE(
    `identity_resolution.customer_identity_graph`
    MATCH (c1:Customer)-[e:MATCHED_TO]->{1, 2}(c2:Customer)
    COLUMNS (c1.rec_id AS source_node_id, c2.rec_id AS target_node_id)
  )
),
all_connections AS (
  SELECT source_node_id AS node_id, target_node_id AS connected_id FROM graph_paths
  UNION DISTINCT
  SELECT target_node_id AS node_id, source_node_id AS connected_id FROM graph_paths
  UNION DISTINCT
  SELECT rec_id AS node_id, rec_id AS connected_id FROM `identity_resolution.customer_nodes_cleaned`
),
clusters AS (
  SELECT
    node_id,
    MIN(connected_id) AS canonical_customer_id
  FROM all_connections
  GROUP BY node_id
)
SELECT
  canonical_customer_id,
  ARRAY_AGG(node_id) AS customer_records,
  COUNT(node_id) AS record_count
FROM clusters
GROUP BY canonical_customer_id;
查詢已解析的叢集資料表:
SELECT canonical_customer_id, record_count, customer_records
FROM `identity_resolution.resolved_customers`
ORDER BY record_count DESC;
畫面會顯示類似以下的輸出:
canonical_customer_id | record_count | customer_records |
|
|
|
|
|
|
|
|
|
建立評估指標檢視畫面
aside 叢集層級評估與直接邊緣:
下列評估指標會產生所有叢集內記錄配對,並與個人層級的基準真相 (ground_truth_links) 比較,藉此評估已解析客戶實體 (resolved_customers) 的準確率。在叢集層級進行評估,可充分發揮 ISO GQL 圖形路徑解析 (遞移多跳連結) 的優勢,準確反映端對端實體解析品質。
如要根據 ground_truth_links 資料表計算精確度、召回率和 F1 分數,請執行下列指令:
CREATE OR REPLACE VIEW `identity_resolution.evaluation_metrics` AS
WITH predictions AS (
  -- Generate all pairwise record combinations within each resolved canonical customer cluster
  SELECT
    r1 AS source_id,
    r2 AS target_id
  FROM `identity_resolution.resolved_customers`,
  UNNEST(customer_records) AS r1,
  UNNEST(customer_records) AS r2
  WHERE r1 < r2
),
ground_truth AS (
  SELECT
    LEAST(source_id, target_id) AS source_id,
    GREATEST(source_id, target_id) AS target_id
  FROM `identity_resolution.ground_truth_links`
),
stats AS (
  SELECT
    COUNT(g.source_id) AS total_ground_truth,
    COUNT(p.source_id) AS total_predictions,
    COUNTIF(p.source_id IS NOT NULL AND g.source_id IS NOT NULL) AS true_positives,
    COUNTIF(p.source_id IS NOT NULL AND g.source_id IS NULL) AS false_positives,
    COUNTIF(p.source_id IS NULL AND g.source_id IS NOT NULL) AS false_negatives
  FROM ground_truth g
  FULL OUTER JOIN predictions p ON g.source_id = p.source_id AND g.target_id = p.target_id
)
SELECT
  total_ground_truth, total_predictions, true_positives, false_positives, false_negatives,
  ROUND(true_positives / NULLIF(true_positives + false_positives, 0), 4) AS precision,
  ROUND(true_positives / NULLIF(true_positives + false_negatives, 0), 4) AS recall,
  ROUND(2 * true_positives / NULLIF((2 * true_positives) + false_positives + false_negatives, 0), 4) AS f1_score
FROM stats;
查詢評估指標檢視畫面:
SELECT * FROM `identity_resolution.evaluation_metrics`;
畫面會顯示類似以下的輸出:
total_ground_truth | total_predictions | true_positives | false_positives | false_negatives | 精確性 | 召回 | f1_score |
|
|
|
|
|
|
|
|
透過 Adamic-Adar 圖形權重解決家庭群組問題
雖然個人身分解析功能可解析屬於同一人的記錄,但企業客戶 360 架構通常需要更高層級的住戶實體分組,將共用地址的同住者分組。
由於合成基準 (例如 FEBRL3) 會評估個人層級的基準真相,因此系統會在後續步驟中執行住家解析。如果沒有附上時間戳記的搬遷記錄,與多個地址相關聯的個人可能會導致過度合併或叢集片段化。為解決這個問題,我們使用 Adamic-Adar 圖形加權來建構軟性住家成員資格。
在 BigQuery Studio SQL 編輯器中執行下列查詢,使用 Adamic-Adar 圖形權重填入 household_clusters:
CREATE OR REPLACE TABLE `identity_resolution.household_clusters` AS
WITH customer_addresses AS (
  SELECT DISTINCT
    r.canonical_customer_id,
    c.formatted_address
  FROM `identity_resolution.resolved_customers` r,
  UNNEST(r.customer_records) AS rec_id
  JOIN `identity_resolution.customer_nodes_cleaned` c ON rec_id = c.rec_id
  WHERE c.formatted_address IS NOT NULL AND c.formatted_address != ''
),
-- Adamic-Adar Exclusivity Weighting: 1.0 / LN(GREATEST(degree, 2))
address_degrees AS (
  SELECT
    formatted_address,
    COUNT(DISTINCT canonical_customer_id) AS address_degree,
    1.0 / LN(GREATEST(COUNT(DISTINCT canonical_customer_id), 2)) AS address_exclusivity_weight
  FROM customer_addresses
  GROUP BY formatted_address
),
customer_household_affinity AS (
  SELECT
    ca.canonical_customer_id,
    ca.formatted_address AS household_address,
    ad.address_degree,
    ad.address_exclusivity_weight AS raw_household_affinity
  FROM customer_addresses ca
  JOIN address_degrees ad ON ca.formatted_address = ad.formatted_address
),
ranked_households AS (
  SELECT
    canonical_customer_id,
    household_address,
    address_degree AS total_residents,
    ROUND(
      COALESCE(SAFE_DIVIDE(raw_household_affinity, SUM(raw_household_affinity) OVER(PARTITION BY canonical_customer_id)), 1.0),
      4
    ) AS household_membership_weight,
    ROW_NUMBER() OVER(PARTITION BY canonical_customer_id ORDER BY raw_household_affinity DESC) AS household_rank
  FROM customer_household_affinity
)
SELECT
  CONCAT('hh-', ABS(FARM_FINGERPRINT(household_address))) AS canonical_household_id,
  canonical_customer_id,
  household_address,
  total_residents,
  household_membership_weight,
  household_rank
FROM ranked_households;
查詢已解決的住戶叢集資料表:
SELECT canonical_household_id, canonical_customer_id, household_address, total_residents, household_membership_weight, household_rank
FROM `identity_resolution.household_clusters`
ORDER BY total_residents DESC;
透過 GQL 將端對端身分階層視覺化
如要以視覺化方式追蹤完整的 3 層身分階層,將未叢集的「原始顧客」連結至已解析的「顧客實體」,然後再連結至已解析的「住家實體」,請先建立支援節點和邊緣的資料表,並更新屬性圖形 DDL:
-- 1. Create Household Node Table
CREATE OR REPLACE TABLE `identity_resolution.household_nodes` AS
SELECT DISTINCT
  canonical_household_id,
  household_address,
  total_residents
FROM `identity_resolution.household_clusters`;

-- 2. Create Unresolved Record to Resolved Entity Edge Table
CREATE OR REPLACE TABLE `identity_resolution.customer_entity_edges` AS
SELECT DISTINCT
  rec_id,
  canonical_customer_id
FROM `identity_resolution.resolved_customers`,
UNNEST(customer_records) AS rec_id;

-- 3. Create Primary Household Edge Table (Highest Weighted Household Rank = 1)
CREATE OR REPLACE TABLE `identity_resolution.primary_household_edges` AS
SELECT
  canonical_customer_id,
  canonical_household_id,
  household_membership_weight,
  household_rank
FROM `identity_resolution.household_clusters`
WHERE household_rank = 1;

-- 4. Update Unified Property Graph DDL
CREATE OR REPLACE PROPERTY GRAPH `identity_resolution.customer_identity_graph`
NODE TABLES (
  `identity_resolution.customer_nodes_cleaned` AS `RawCustomer`
    KEY (rec_id),
  `identity_resolution.resolved_customers` AS `ResolvedCustomer`
    KEY (canonical_customer_id),
  `identity_resolution.household_nodes` AS `ResolvedHousehold`
    KEY (canonical_household_id)
)
EDGE TABLES (
  `identity_resolution.final_matched_edges`
    KEY (source_id, target_id)
    SOURCE KEY (source_id) REFERENCES `RawCustomer`(rec_id)
    DESTINATION KEY (target_id) REFERENCES `RawCustomer`(rec_id)
    LABEL MATCHED_TO,
  `identity_resolution.customer_entity_edges`
    KEY (rec_id, canonical_customer_id)
    SOURCE KEY (rec_id) REFERENCES `RawCustomer`(rec_id)
    DESTINATION KEY (canonical_customer_id) REFERENCES `ResolvedCustomer`(canonical_customer_id)
    LABEL RESOLVED_TO,
  `identity_resolution.primary_household_edges`
    KEY (canonical_customer_id, canonical_household_id)
    SOURCE KEY (canonical_customer_id) REFERENCES `ResolvedCustomer`(canonical_customer_id)
    DESTINATION KEY (canonical_household_id) REFERENCES `ResolvedHousehold`(canonical_household_id)
    LABEL BELONGS_TO_HOUSEHOLD
);
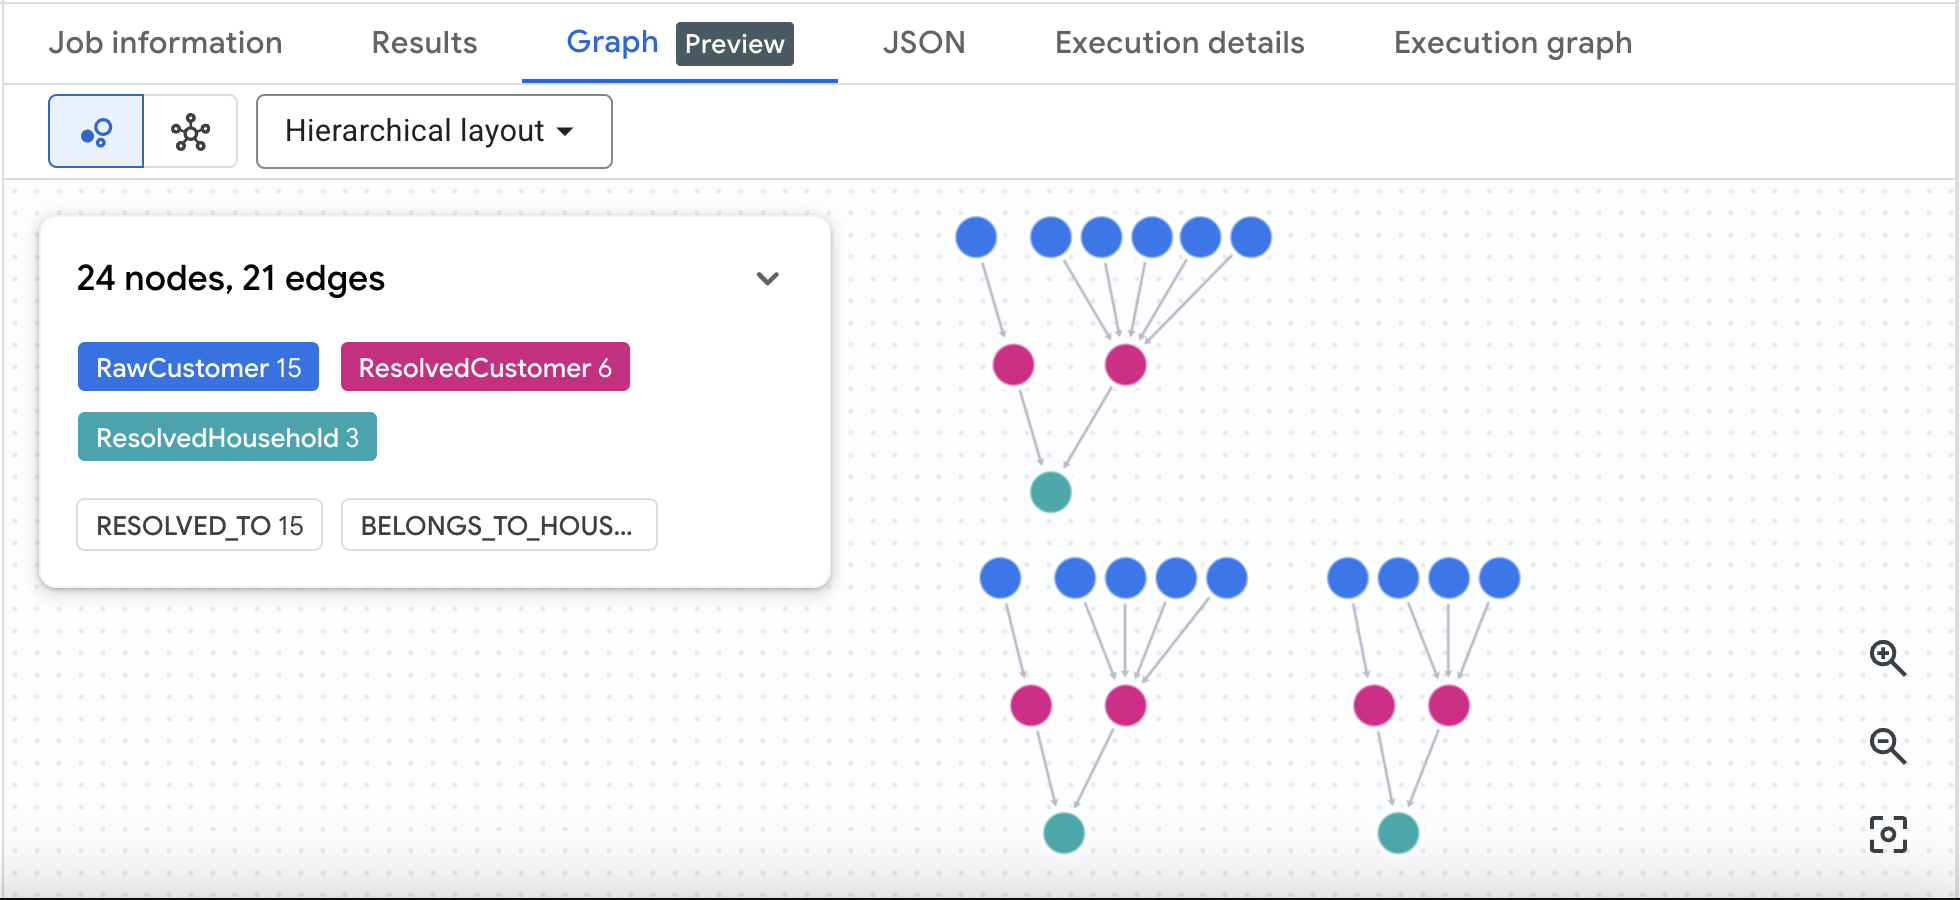
在 BigQuery Studio 執行下列 3 層 GQL 查詢,以視覺化方式呈現多住戶家庭階層:
GRAPH `identity_resolution.customer_identity_graph`
MATCH p = (raw:RawCustomer)-[e1:RESOLVED_TO]->(c:ResolvedCustomer)-[e2:BELONGS_TO_HOUSEHOLD]->(h:ResolvedHousehold)
WHERE h.total_residents > 1
RETURN TO_JSON(p) AS multi_resident_household_hierarchy_path
LIMIT 20;
在 BigQuery Studio 中執行這項 GQL 查詢,會顯示 3 層互動式圖表視覺化畫布,其中顯示已解析為個別標準實體 (ResolvedCustomer) 的原始客戶設定檔記錄 (RawCustomer),這些實體會連結至共用的多住戶家庭實體 (ResolvedHousehold)。
9. 解析度提升與穩定性持久
在實際的企業應用程式中,新的顧客記錄會透過每日或即時批次擷取作業持續傳入。增量差異比對引擎會比較新傳入的記錄與現有的已解析基準叢集 (resolved_customers),不必針對整個歷來資料集重新執行完整圖表解析。
為有效達成這項目標,引擎會使用 向量搜尋 (VECTOR_SEARCH) 做為動態分群。VECTOR_SEARCH 會將每筆傳入的記錄視為查詢點,並從歷史基準嵌入索引中擷取前 K 個最鄰近的項目。如果傳入的記錄與相似度門檻以上的現有客戶設定檔相符,系統會動態合併至該叢集,並沿用基準 canonical_customer_id (MATCHED_TO_EXISTING_CLUSTER)。如果找不到相似度門檻以上的最近鄰項基準,系統會建立新的實體 UUID (NEW_CUSTOMER_ENTITY)。
擷取範例增量批次擷取記錄
在 BigQuery Studio SQL 編輯器中貼上並執行下列 DDL,即可建立 incremental_daily_intake:
CREATE OR REPLACE TABLE `identity_resolution.incremental_daily_intake` AS
SELECT * FROM UNNEST([
  STRUCT(
    'rec-9999-new-1' AS rec_id, 'erin' AS given_name, 'donaldson' AS surname,
    'E650' AS given_name_soundex, 'D543' AS surname_soundex,
    '19810427' AS date_of_birth, '2955815' AS soc_sec_id,
    '13 hawkesbury crescent aralee lewiston 7018' AS formatted_address, '7018' AS postcode
  ),
  STRUCT(
    'rec-9999-new-2' AS rec_id, 'hollie' AS given_name, 'lillie-hinrichs' AS surname,
    'H400' AS given_name_soundex, 'L446' AS surname_soundex,
    '19251130' AS date_of_birth, '4920253' AS soc_sec_id,
    '27 hemmings crescent kilvinton village banyo 4030' AS formatted_address, '4030' AS postcode
  ),
  STRUCT(
    'rec-9999-new-3' AS rec_id, 'sarah' AS given_name, 'ryan' AS surname,
    'S600' AS given_name_soundex, 'R500' AS surname_soundex,
    '20010101' AS date_of_birth, '999999999' AS soc_sec_id,
    '500 market st melbourne vic 3000' AS formatted_address, '3000' AS postcode
  ),
  STRUCT(
    'rec-9999-new-4' AS rec_id, 'zzyzx' AS given_name, 'qx-vonderland' AS surname,
    'Z220' AS given_name_soundex, 'Q215' AS surname_soundex,
    '19991231' AS date_of_birth, '999887766' AS soc_sec_id,
    '9999 zulu orbit station moon-base alpha 9999' AS formatted_address, '9999' AS postcode
  )
]);
執行增量差異比對查詢
在 BigQuery SQL 編輯器中執行下列查詢,對已解決的基準資料集執行差異比對:
CREATE OR REPLACE TABLE `identity_resolution.incremental_resolved_customers` AS
WITH historical_resolved_base AS (
  SELECT c.rec_id, c.given_name, c.surname, c.given_name_soundex, c.surname_soundex, c.date_of_birth, c.soc_sec_id, c.formatted_address, c.postcode, r.canonical_customer_id
  FROM `identity_resolution.customer_nodes_cleaned` c
  JOIN (
    SELECT canonical_customer_id, node_id
    FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
  ) r ON c.rec_id = r.node_id
),
incremental_intake AS (
  SELECT
    rec_id AS new_rec_id, given_name, surname, given_name_soundex, surname_soundex, date_of_birth, soc_sec_id, formatted_address, postcode,
    CONCAT('Name: ', CONCAT(given_name, ' ', surname), '; Address: ', formatted_address, '; DOB: ', date_of_birth, '; SSN: ', soc_sec_id) AS profile_text
  FROM `identity_resolution.incremental_daily_intake`
),
rule_delta_matches AS (
  SELECT
    i.new_rec_id,
    h.canonical_customer_id AS matched_canonical_id,
    h.rec_id AS matched_baseline_rec_id,
    (
      0.30 * (CASE WHEN i.soc_sec_id = h.soc_sec_id AND i.soc_sec_id != '' THEN 1.0 ELSE 0.0 END) +
      0.20 * (1.0 - (EDIT_DISTANCE(i.surname, h.surname) / GREATEST(LENGTH(i.surname), LENGTH(h.surname), 1))) +
      0.20 * (1.0 - (EDIT_DISTANCE(i.given_name, h.given_name) / GREATEST(LENGTH(i.given_name), LENGTH(h.given_name), 1))) +
      0.15 * (CASE WHEN i.date_of_birth = h.date_of_birth THEN 1.0 ELSE 0.0 END) +
      0.15 * (1.0 - (EDIT_DISTANCE(i.formatted_address, h.formatted_address) / GREATEST(LENGTH(i.formatted_address), LENGTH(h.formatted_address), 1)))
    ) AS match_score
  FROM incremental_intake i
  JOIN historical_resolved_base h
    ON (i.soc_sec_id = h.soc_sec_id AND i.soc_sec_id != '')
    OR (i.date_of_birth = h.date_of_birth AND i.given_name_soundex = h.given_name_soundex)
),
vector_intake_embeddings AS (
  SELECT new_rec_id, AI.EMBED(profile_text, connection_id => 'us.address_val_conn', endpoint => 'text-embedding-005').result AS text_embedding
  FROM incremental_intake
),
vector_delta_matches AS (
  SELECT
    v.query.new_rec_id,
    h.canonical_customer_id AS matched_canonical_id,
    h.rec_id AS matched_baseline_rec_id,
    ROUND(1.0 - v.distance, 4) AS match_score
  FROM VECTOR_SEARCH(
    TABLE `identity_resolution.customer_embeddings`,
    'text_embedding',
    TABLE vector_intake_embeddings,
    top_k => 3,
    distance_type => 'COSINE'
  ) v
  JOIN historical_resolved_base h ON v.base.rec_id = h.rec_id
  WHERE v.distance <= 0.20
),
combined_delta AS (
  SELECT
    new_rec_id, matched_canonical_id, matched_baseline_rec_id, match_score,
    'RULE_BASED' AS match_strategy
  FROM rule_delta_matches WHERE match_score >= 0.55

  UNION ALL

  SELECT
    new_rec_id, matched_canonical_id, matched_baseline_rec_id, match_score,
    'VECTOR_SEARCH' AS match_strategy
  FROM vector_delta_matches
),
aggregated_delta AS (
  SELECT
    new_rec_id,
    matched_canonical_id,
    ARRAY_AGG(matched_baseline_rec_id ORDER BY match_score DESC LIMIT 1)[OFFSET(0)] AS matched_baseline_rec_id,
    MAX(match_score) AS match_score,
    CASE
      WHEN COUNT(DISTINCT match_strategy) > 1 THEN 'BOTH'
      ELSE MAX(match_strategy)
    END AS match_strategy
  FROM combined_delta
  GROUP BY new_rec_id, matched_canonical_id
),
best_matches AS (
  SELECT
    new_rec_id,
    matched_canonical_id,
    matched_baseline_rec_id,
    match_score,
    match_strategy,
    ROW_NUMBER() OVER(PARTITION BY new_rec_id ORDER BY match_score DESC) AS rank
  FROM aggregated_delta
)
SELECT
  i.new_rec_id AS record_id,
  i.given_name, i.surname,
  COALESCE(b.matched_canonical_id, GENERATE_UUID()) AS persistent_canonical_customer_id,
  h.canonical_household_id AS assigned_household_id,
  CASE WHEN b.matched_canonical_id IS NOT NULL THEN 'MATCHED_TO_EXISTING_CLUSTER' ELSE 'NEW_CUSTOMER_ENTITY' END AS assignment_type,
  b.matched_baseline_rec_id,
  b.match_score,
  COALESCE(b.match_strategy, 'NONE') AS match_strategy
FROM incremental_intake i
LEFT JOIN best_matches b ON i.new_rec_id = b.new_rec_id AND b.rank = 1
LEFT JOIN `identity_resolution.primary_household_edges` h ON b.matched_canonical_id = h.canonical_customer_id;
查詢增量解析結果:
SELECT record_id, persistent_canonical_customer_id, assigned_household_id, assignment_type, match_score, match_strategy
FROM `identity_resolution.incremental_resolved_customers`;
畫面會顯示類似以下的輸出:
record_id | persistent_canonical_customer_id | assigned_household_id | assignment_type | match_score | match_strategy |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
10. 叢集合併和叢集穩定性 (1-ε 重疊)
在正式版企業系統中,團隊通常會定期 (例如每週或每月) 重新叢集整個圖表,以納入新的邊緣和資料來源。隨著新關係形成,完整圖表重新叢集化可能會導致叢集 ID 在管道執行期間任意移動或翻轉。
為維護下游 CRM、CDP 和帳單系統的持續性顧客 ID,「叢集穩定性」會使用 (1 - ε) 重疊閾值,評估目前執行 (t) 叢集和先前執行 (t-1) 叢集之間的節點重疊 (其中 ε = 0.30,至少需要 70% 的節點重疊)。
如果「執行」中的新計算叢集 (t) 與「執行」中的叢集 (t-1) 至少有 70% 的成員記錄相同,就會沿用過往的永久客戶 ID (STABLE_EVOLUTION)。全新叢集會收到新產生的 UUID (NEW_CLUSTER_CREATED)。
執行叢集重疊和穩定性查詢
在 BigQuery Studio SQL 編輯器中執行下列查詢,即可填入 stable_resolved_customers:
CREATE OR REPLACE TABLE `identity_resolution.stable_resolved_customers` AS
WITH previous_run_clusters AS (
  SELECT
    canonical_customer_id AS previous_persistent_id,
    node_id,
    COUNT(*) OVER (PARTITION BY canonical_customer_id) AS previous_cluster_size
  FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
),
current_run_clusters AS (
  SELECT
    new_cluster_id,
    node_id,
    COUNT(*) OVER (PARTITION BY new_cluster_id) AS current_cluster_size
  FROM (
    SELECT
      canonical_customer_id AS new_cluster_id,
      node_id
    FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
    UNION ALL
    SELECT
      persistent_canonical_customer_id AS new_cluster_id,
      record_id AS node_id
    FROM `identity_resolution.incremental_resolved_customers`
  )
),
cluster_intersections AS (
  SELECT
    c.new_cluster_id,
    p.previous_persistent_id,
    c.current_cluster_size,
    p.previous_cluster_size,
    COUNT(c.node_id) AS shared_node_count,
    COUNT(c.node_id) / GREATEST(p.previous_cluster_size, 1) AS overlap_fraction
  FROM current_run_clusters c
  JOIN previous_run_clusters p ON c.node_id = p.node_id
  GROUP BY c.new_cluster_id, p.previous_persistent_id, c.current_cluster_size, p.previous_cluster_size
),
best_matching_previous_cluster AS (
  SELECT
    new_cluster_id,
    previous_persistent_id,
    shared_node_count,
    overlap_fraction,
    ROW_NUMBER() OVER (PARTITION BY new_cluster_id ORDER BY overlap_fraction DESC) AS rank
  FROM cluster_intersections
  WHERE overlap_fraction >= 0.70
)
SELECT
  c.new_cluster_id AS raw_cluster_id,
  COALESCE(b.previous_persistent_id, GENERATE_UUID()) AS persistent_canonical_customer_id,
  ARRAY_AGG(c.node_id) AS customer_records,
  COUNT(c.node_id) AS record_count,
  COALESCE(MAX(b.shared_node_count), 0) AS shared_node_count,
  COALESCE(MAX(b.overlap_fraction), 0.0) AS overlap_fraction,
  CASE
    WHEN b.previous_persistent_id IS NOT NULL THEN 'STABLE_EVOLUTION'
    ELSE 'NEW_CLUSTER_CREATED'
  END AS cluster_status
FROM current_run_clusters c
LEFT JOIN best_matching_previous_cluster b
  ON c.new_cluster_id = b.new_cluster_id AND b.rank = 1
GROUP BY c.new_cluster_id, b.previous_persistent_id;
查看增量記錄的篩選預覽畫面
執行這項查詢,驗證每日攝取記錄的叢集穩定性狀態:
SELECT
  s.persistent_canonical_customer_id,
  node_id AS record_id,
  h.canonical_household_id AS assigned_household_id,
  s.cluster_status
FROM `identity_resolution.stable_resolved_customers` s, UNNEST(s.customer_records) AS node_id
LEFT JOIN `identity_resolution.primary_household_edges` h
  ON s.persistent_canonical_customer_id = h.canonical_customer_id
WHERE node_id IN ('rec-9999-new-1', 'rec-9999-new-2', 'rec-9999-new-3', 'rec-9999-new-4')
ORDER BY record_id;
畫面會顯示類似以下的輸出:
persistent_canonical_customer_id | record_id | assigned_household_id | cluster_status |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
11. 清理
如要避免系統持續向您的 Google Cloud 帳戶收費,請清除已部署的資源和 BigQuery 資料集。
在 Cloud Shell 中執行:
# 1. Delete BigQuery Dataset
bq rm -r -f -d ${GCP_PROJECT}:${DATASET_ID}

# 2. Delete Cloud Function (2nd-Gen)
gcloud functions delete validate_address_udf --region=${REGION} --gen2 --quiet

# 3. Delete BigQuery Cloud Connection
bq rm -f --connection US.address_val_conn
如果您為本實驗建立了專屬的 Google Cloud 雲端專案,可以刪除該專案:
gcloud projects delete ${GCP_PROJECT}
12. 恭喜
恭喜!您已成功在 Google Cloud BigQuery 中,使用 BigQuery 屬性圖、ISO GQL 查詢、混合相似度比對、增量差異比對和持續叢集穩定性保證,建構端對端客戶身分解析引擎。
目前所學內容
- 如何部署第 2 代 Cloud Function,並將其公開為 BigQuery 遠端函式。
- 如何使用
SOUNDEX語音編碼和地址驗證,預先處理顧客受眾特徵。 - 如何執行候選人封鎖作業,並使用 Levenshtein 距離 (
EDIT_DISTANCE) 和權杖 Jaccard 相似度計算混合相似度分數。 - 如何根據節點和邊緣資料表建構 BigQuery 屬性圖 (
CREATE PROPERTY GRAPH)。 - 如何使用 ISO GQL (
GRAPH_TABLE) 和{1, 2}k-hop 量詞查詢圖形路徑。 - 如何解決標準客戶分群問題,以及根據基準真相指標評估模型效能。
- 如何針對每日批次資料攝取執行累加差異比對,而不需重新處理完整資料集。
- 如何套用 (1 - ε) 重疊閾值保證,在管道執行期間維持叢集穩定性。
後續步驟
- 參閱 BigQuery 屬性圖形說明文件。
- 試試使用 BigQuery 向量搜尋 和 Vertex AI 文字嵌入,生成語意候選項目。
- 如要瞭解可擴充的外部 API 整合功能,請參閱 BigQuery 遠端函式。