
1. 简介
上次更新日期:2026 年 5 月 13 日
使用 SRE 扩展程序调查 GKE 中断并构建精美的事后分析报告
欢迎参加本次 SRE 研讨会,本研讨会面向希望在 Google Cloud 上试用 SRE 框架的运维人员!
此 Codelab 将引导您完成以下操作:
- 安装基于知名开源 microservices-demo 的 GKE 集群。
- 通过以不同方式(有些更引人注目,有些更细致入微)中断服务来模拟中断情况。
- 安装并使用 Antigravity CLI(或类似的框架)+ SRE 扩展程序,以便进行后续操作。
- 调查并希望解决中断问题。
- 创建事后总结。
- 运用图表制作技巧生成接地气图表,让观看者了解发生了什么以及何时发生。
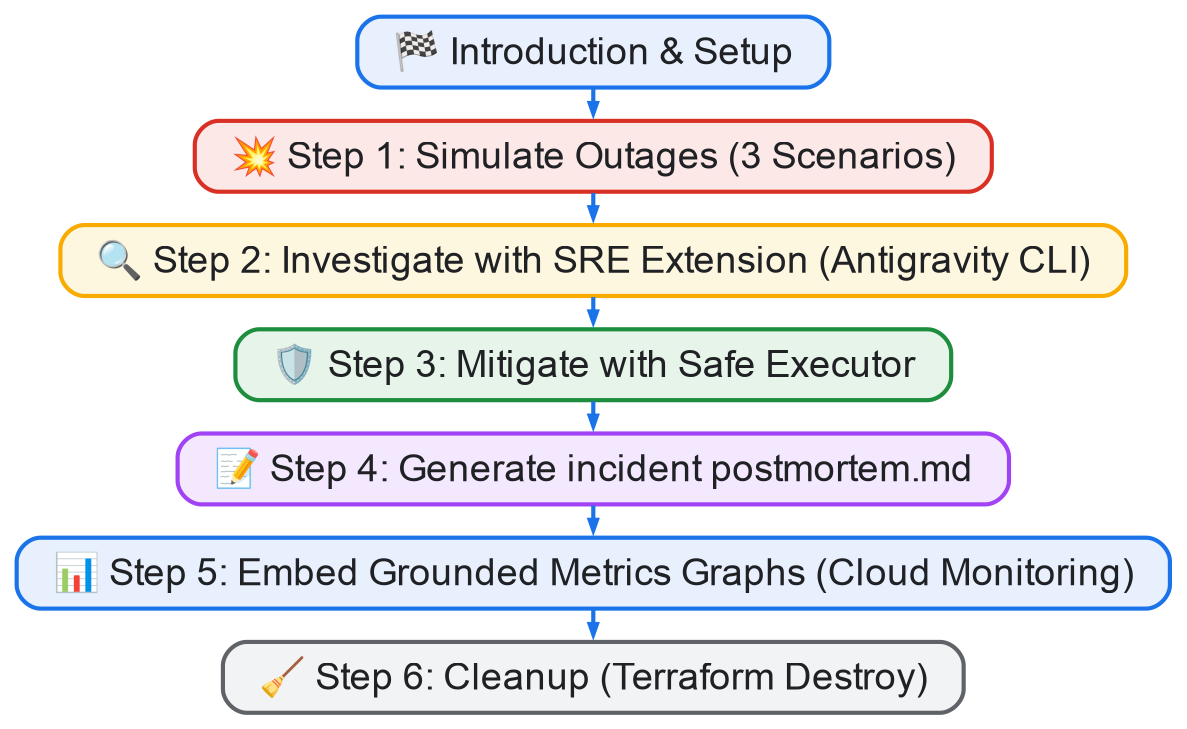
此 Codelab 的分步结构如下:
本工作坊的目标是:
- 展示 SRE 扩展程序的各项功能,并向您展示该扩展程序可实现的功能:OneMCP 设置、安全执行器、调查、事后分析生成、图表和 CSV gist。
- 教您如何调查自己的 Google Cloud 方案。
里程碑 1:环境设置和中断模拟
此里程碑的目标是在 GKE Autopilot 上设置 Kubernetes 演示应用,安装 Antigravity CLI,并人为触发 GKE 集群中断场景来模拟生产事件。
里程碑 2:使用 SRE 扩展程序进行调查和缓解
在破坏环境后,您将使用配备 SRE 扩展程序的 agentic CLI 工具来系统地发现基础架构、对问题进行分类、实施安全的修复执行模式,并验证集群健康状况。
里程碑 3:事后分析和图表生成
问题解决后,您将生成结构化的突发事件事后分析文档,并使用 GCM (Google Cloud Monitoring) API 拉取实际的指标数据,创建可视化图表来记录中断发生的时间和方式。
构建内容
在此 Codelab 中,您将使用 SRE 扩展程序来调查和修复 GKE 中断问题。您将学习以下内容:
- 通过网络政策阻塞、有 bug 的 Canary 部署和防火墙规则更新来模拟 GKE 中断。
- 使用由 SRE 扩展程序提供支持的 CLI 助理对集群中断进行初步诊断。
- 使用安全执行器模式安全地实现修复步骤。
- 生成一份全面的事后总结文档。
- 使用 Google Cloud Monitoring 时间序列查询绘制突发事件指标图表。
学习内容
- 如何使用 SRE 扩展技能检查 GKE Kubernetes 资源和政策。
- 如何利用安全执行器模式运行代理建议的命令,并进行适当的风险评估。
- 如何使用
monitoring-graphs技能直接从 GCM 生成有事实依据的指标图表。 - 如何以结构化事后分析格式记录突发事件调查结果。
所需条件
- 启用了结算功能的 Google Cloud 项目。
- 命令行工具:
gcloud、kubectl、terraform。 - Antigravity CLI 已在本地或 Cloud Shell 中安装。
- IDE(例如 vscode、IntelliJ、RubyMine 或 Vim)。
为何要使用 SRE 扩展程序 + Agentic CLI?
生产环境中断节奏快,需要跨多个子系统(Kubernetes 资源、VPC 网络、Cloud Monitoring 指标、IAM 权限)进行关联分析。借助 SRE 扩展程序,智能体 CLI 助手(如 Antigravity CLI)可以充当自主副驾驶,执行预编译的剧本、查询监控图表,并建议安全补救措施,同时让人类操作员参与其中。
2. 准备工作
选择以下选项之一:如果您想在自己的机器上运行此 Codelab,请选择自行设置环境;如果您想完全在云端运行此 Codelab,请选择启动 Cloud Shell。
自定进度的环境设置
- 登录 Google Cloud 控制台,然后创建一个新项目或重复使用现有项目。如果您还没有 Gmail 或 Google Workspace 账号,则必须创建一个。
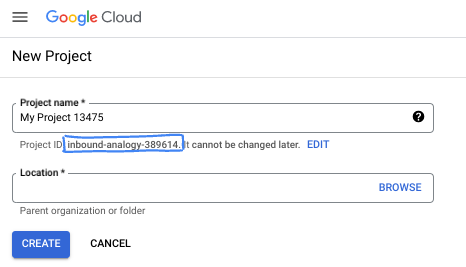
- 项目名称是此项目参与者的显示名称。它是 Google API 尚未使用的字符串。您可以随时对其进行更新。
- 项目 ID 在所有 Google Cloud 项目中是唯一的,并且是不可变的(一经设置便无法更改)。Cloud 控制台会自动生成一个唯一字符串;通常情况下,您无需关注该字符串。在大多数 Codelab 中,您都需要引用项目 ID(通常用
PROJECT_ID标识)。如果您不喜欢生成的 ID,可以再随机生成一个 ID。或者,您也可以尝试自己的项目 ID,看看是否可用。完成此步骤后便无法更改该 ID,并且此 ID 在项目期间会一直保留。 - 此外,还有第三个值,即部分 API 使用的项目编号,供您参考。如需详细了解所有这三个值,请参阅文档。
- 接下来,您需要在 Cloud 控制台中启用结算功能,以便使用 Cloud 资源/API。运行此 Codelab 应该不会产生太多的费用(如果有的话)。若要关闭资源以避免产生超出本教程范围的结算费用,您可以删除自己创建的资源或删除项目。Google Cloud 新用户符合参与 300 美元免费试用计划的条件。
启动 Cloud Shell
虽然可以通过笔记本电脑对 Google Cloud 进行远程操作,但在此 Codelab 中,您将使用 Google Cloud Shell,这是一个在云端运行的命令行环境。
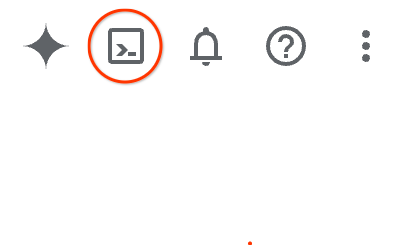
在 Google Cloud 控制台 中,点击右上角工具栏中的 Cloud Shell 图标:
预配和连接到环境应该只需要片刻时间。完成后,您应该会看到如下内容:
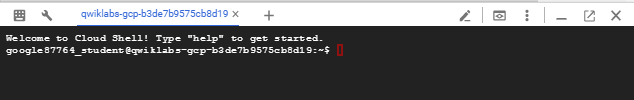
这个虚拟机已加载了您需要的所有开发工具。它提供了一个持久的 5 GB 主目录,并且在 Google Cloud 中运行,大大增强了网络性能和身份验证功能。您在此 Codelab 中的所有工作都可以在浏览器中完成。您无需安装任何程序。
3. 前提条件(安装)
在本教程中,您需要安装:
1. Python 和 uv
python 和 uv(Python 的软件包管理器)。确保您已安装 uv:
$ curl -LsSf https://astral.sh/uv/install.sh | sh
为什么选择 UV?虽然您可以使用自己喜欢的任何 Python 管理器,但使用 uv 可确保您和 Antigravity CLI 的 Python ENV/PATH 设置相同,因此您的 shell 体验将与 Antigravity CLI 的基本相同。如果您使用 virtualenv,例如,Antigravity CLI 将被迫执行“source .env/venv/bin/activate && my-original-command”之类的操作来模拟您的环境。
2. Antigravity CLI (agy)
如需安装官方 Antigravity CLI(即 agy 命令),请打开终端并运行引导安装程序:
对于 macOS 和 Linux:
$ curl -fsSL https://antigravity.google/cli/install.sh | bash
对于 Windows (PowerShell):
irm https://antigravity.google/cli/install.ps1 | iex
此脚本将动态检测您的操作系统和架构,下载最新编译的
agy
二进制文件,并配置您的 PATH。重新启动终端或重新加载 shell 配置,以使更改生效。
Authentication
导出 API 密钥:
export GEMINI_API_KEY="your-api-key"
使用 gcloud 进行身份验证:
export GOOGLE_CLOUD_PROJECT="YOUR_PROJECT_ID"
export GOOGLE_CLOUD_LOCATION="YOUR_PROJECT_LOCATION"
gcloud auth application-default login
设置工作环境并部署微服务演示应用
我们来克隆 microservices-demo 应用,并通过 Terraform 部署基础架构和应用
此时,您可以打开 IDE(Visual Studio Code、IntelliJ、RubyMine 等)并打开该文件夹。
# 1. Find an empty directory, and download this repo.
git clone https://github.com/GoogleCloudPlatform/microservices-demo.git
cd microservices-demo/terraform

# 2. Update project ID to your gcloud project ID
sed -i 's/<project_id_here>/YOUR_ACTUAL_PROJECT_ID/g' terraform.tfvars

# 3. Deploy the microservices-demo application in GKE autopilot
# If there is a prompt answer yes and continue. This step can take up to 10 mins for provision gke autopilot cluster and deploy microservices-demo application
terraform init
terraform plan
terraform apply

# 4. Verify the IP address of frontend-service to access the online-boutique application
kubectl get service frontend-external | awk '{print $4}'

# 5. Find an empty directory , and download this repo.
git clone https://github.com/palladius/sre-testing-suite.git
cd sre-testing-suite/test-scenarios/microservices-demo-gke/breakage-scenarios
如需测试您的设置,您可以访问 http://[IP 地址] 并加载 online-boutique 应用
为 sre-antigravity-cli-extension 设置工作环境
# 1. Install the SRE Extension plugin globally
git clone https://github.com/gemini-cli-extensions/sre.git ~/.gemini/config/plugins/sre-extension

# 2. Launch the Antigravity CLI (agy)
agy  # This runs the CLI under your current breakage-scenarios folder.
# Login with your corporate or personal account when prompted.

# 3. Within the agy agent prompt, configure your MCP servers and GCP project
Use the gcp-mcp-setup skill to setup my GCP project "<gcp_project_id>" with email jane-doe-sre@credible-company.com
4. 第 1 步:模拟中断(中断场景)
在此步骤中,我们将有意破坏已部署的 GKE 集群,以模拟实际生产环境中的突发事件。您可以选择以下三种方案(也可以依次尝试这三种方案):
场景 1:结账服务网络阻塞(标准/自动驾驶)
此方案通过应用充当流量“黑洞”的 Kubernetes NetworkPolicy 来模拟前端与结账服务之间的连接中断。
- 前往相应方案文件夹:
cd breakage1-checkout
- 触发中断:
./break.sh
default命名空间中创建一个名为update-checkout-from-frontend的 NetworkPolicy,该政策会拒绝向checkoutservice发送的入站流量,除非该流量来自带有标签app: frontend-checkout-test(不存在)的 pod。 - 尝试在 Online Boutique 前端购买商品。结账页面将挂起或显示 HTTP 500 错误。
场景 2:有 bug 的 Canary 版本发布(使用 Istio 的 Autopilot)
此方案模拟了通过 Kubernetes Canary 部署推出有缺陷的前端版本的不良部署。
- 前往相应方案文件夹:
cd ../breakage2-canary
- 触发中断:
./break.sh
frontend-canary,其环境变量中存在拼写错误:PRODUCT_CATALOG_SERVICE_ADDR配置为productcatalogservices:3550而不是productcatalogservice:3550。 - 加载前端首页。由于 Canary 服务无法解析产品目录,因此偶尔会失败(具体取决于路由权重)。
场景 3:VPC 防火墙集群阻塞
此方案模拟了 VPC 防火墙配置中的错误,该错误会阻止所有入站流量进入 GKE 集群。
- 前往相应方案文件夹:
cd ../breakage3-firewall
- 触发中断:
./break.sh
frontend-ingress-v2的 VPC 级防火墙规则,该规则具有priority=1和操作DENY,用于将入站流量定向到端口80、443和8080。 - Online Boutique 网站将完全无法访问,请求将超时。
5. 第 2 步:使用 SRE 扩展程序调查中断问题
现在应用已停止运行,我们来使用 CLI 助理 (Antigravity CLI) 开始调查。
- 返回到主要中断情形文件夹,然后启动 CLI 帮助程序:
cd ..
agy
- 让助理执行基础架构发现和诊断检查:
Investigate my GKE cluster for outages. Are all services healthy? - 智能体的工作内容:
- 这样可以激活
investigation-entrypoint和gcp-playbooks技能。 - 它会列出 Kubernetes pod、部署和服务,以找到失败的目标。
- 它会检查网络政策(对于方案 1)、部署配置(对于方案 2)或防火墙规则(对于方案 3)。
- 这样可以激活
- 对于方案 1,代理应报告:🔴 发现事件:名为
update-checkout-from-frontend的NetworkPolicy正在隔离checkoutservicepod。 - 对于情形 2,代理应报告:🔴 已发现问题:部署
frontend-canary配置了无效的服务端点productcatalogservices:3550,而不是productcatalogservice:3550。 - 对于方案 3,代理应报告:🔴 发现事件:VPC 防火墙规则
frontend-ingress-v2正在拒绝端口80、443和8080上的入站流量。
6. 第 3 步:缓解和修复中断
我们来使用 CLI 的安全执行器模式来解决中断问题。
- 让 CLI 助理提出并应用修复方案:
Propose a fix for the outage and apply it. - Safe Executor 的实际应用:
- 在执行命令建议之前,SRE 扩展程序会使用
safe-sre-investigator技能运行安全审核。 - 它会显示打算运行的确切命令,并评估风险(例如低、中、高)。
- 对于情形 1,系统会建议:
kubectl delete networkpolicy update-checkout-from-frontend
- 对于方案 2,系统将建议:
kubectl delete deployment frontend-canary
- 对于方案 3,系统将建议:
gcloud compute firewall-rules delete frontend-ingress-v2 --quiet
- 在执行命令建议之前,SRE 扩展程序会使用
- 在 CLI 提示时确认命令执行。
- 刷新 Online Boutique 首页,验证网站是否已恢复正常运行且功能齐全。
- 在 shell 中,您可以运行相应的场景检查脚本来验证健康状况:
./breakage1-checkout/check.sh
# or ./breakage2-canary/check.sh
# or ./breakage3-firewall/check.sh
7. 第 4 步:生成事件事后分析报告
SRE 生命周期的一个重要环节是记录突发事件,以便团队从中学习。让我们使用 postmortem-create 技能自动执行此操作。
- 在 CLI 助理中,要求其撰写事后分析文档:
Create a postmortem for the checkout service network policy outage. - 客服人员会收集以下方面的详细信息:
- 突发事件的开始时间(从您的 CLI 命令历史记录/日志中检索)。
- 根本原因(阻塞性 NetworkPolicy)。
- 为缓解该问题而采取的措施。
- 它会在您的工作区中写入一个名为
postmortem.md的新 Markdown 文件。 - 打开
postmortem.md以查看详细信息。您会看到以下部分:- 突发事件摘要
- 事件时间表
- 根本原因分析 (RCA)
- 行动项 / 预防措施
8. 第 5 步:添加基于事实的指标图表
为了使事后分析更加专业,我们需要提供事件的直观证据。我们将使用 monitoring-graphs 技能从 Google Cloud Monitoring (GCM) 中提取时序数据,并生成显示错误峰值的 PNG 图表。
- 让 CLI 帮助程序生成图表并将其添加到事后分析中:
Query GCM for frontend HTTP request error rates over the last 1 hour, generate a line chart, and embed it into postmortem.md. - 深入了解:
- 代理会调用
monitoring-graphsPython 脚本来查询 Cloud Monitoring。 - 它会提取指标(例如
kubernetes.io/container/restart_count或loadbalancing.googleapis.com/https/request_count)。 - 它使用
matplotlib绘制图表,并将其保存为incident_metrics.png。 - 它会通过插入图片链接来更新
postmortem.md文件:
- 代理会调用
- 打开生成的
incident_metrics.png文件,查看图表,其中显示了集群发生故障的确切时刻以及流量恢复正常的确切时刻。
9. 第 6 步:清理
为确保您的 Google Cloud 账号不会产生不必要的费用,我们来清理已部署的基础设施。
- 前往 Terraform 文件夹:
cd ../../microservices-demo/terraform
- 运行 destroy 命令:
terraform destroy -auto-approve
- 验证所有 GCP GKE 资源是否已成功删除。
10. 恭喜!
您已完成“GKE 集群中断和中断调查”Codelab!
您学习了以下内容:
- 已将 10 层 Online Boutique 微服务演示部署到 GKE。
- 模拟了 3 次真实世界的 SRE 中断(网络政策拒绝、有缺陷的金丝雀发布、VPC 防火墙规则拒绝)。
- 使用 SRE 扩展程序 for Antigravity CLI 发现并诊断了中断问题。
- 利用安全执行器模式来审核和执行补救命令。
- 创建了专业的 Markdown 事后总结。
- 查询 Cloud Monitoring 指标,以自动生成并嵌入有事实依据的突发事件图。
如需详细了解如何扩展 CLI 代理,请查看 SRE 扩展程序 GitHub 页面。