

1. מבוא
ב-Lab הזה מתמקדים בהטמעה ובפריסה של שירות סוכן לקוח. תשתמשו בערכה לפיתוח סוכנים (ADK) כדי ליצור סוכן AI שמשתמש בכלים.
בשיעור ה-Lab הזה נבנה סוכן גן חיות שמשתמש בוויקיפדיה כדי לענות על שאלות לגבי בעלי חיים.
לבסוף, נבצע פריסה של סוכן מדריך הטיולים ב-Cloud Run של Google, במקום להריץ אותו רק באופן מקומי.
דרישות מוקדמות
- היכרות עם Python וממשקי שורת פקודה (CLI).
- פרויקט ב-Google Cloud שהחיוב בו מופעל.
- הכלים של CLI שהותקנו:
gcloud, gsutil, uv.
מה תלמדו
- איך לבנות פרויקט Python לפריסה של ADK.
- איך מטמיעים סוכן שמשתמש בכלי באמצעות google-adk.
- איך פורסים אפליקציית Python כקונטיינר ללא שרת ב-Cloud Run.
- איך מגדירים אימות מאובטח משירות לשירות באמצעות תפקידים ב-IAM.
- איך מוחקים משאבי Cloud כדי להימנע מעלויות עתידיות.
הדרישות
- חשבון Google Cloud ופרויקט Google Cloud
- דפדפן אינטרנט כמו Chrome
2. למה כדאי לפרוס ב-Cloud Run?
Cloud Run היא פלטפורמה מצוינת לאירוח סוכני ADK כי היא פלטפורמה ללא שרתים, כלומר אתם יכולים להתמקד בקוד ולא בניהול התשתית הבסיסית. אנחנו מטפלים בעבודה התפעולית בשבילכם.
אפשר לחשוב על זה כמו על חנות פופ-אפ: היא נפתחת ומשתמשת במשאבים רק כשהלקוחות (בקשות) מגיעים. אם אין לקוחות, החנות נסגרת לגמרי ולא תשלמו על חנות ריקה.
תכונות עיקריות
הפעלת Containers Anywhere:
- אתם מביאים קונטיינר (קובץ אימג' של Docker) שהאפליקציה שלכם נמצאת בתוכו.
- Cloud Run מריץ אותו בתשתית של Google.
- אין צורך בתיקון מערכת ההפעלה, בהגדרת מכונות וירטואליות או בהתמודדות עם בעיות בהרחבת המשאבים.
התאמה אוטומטית של נפח האחסון:
- אם אף אחד לא משתמש באפליקציה → 0 מופעים פועלים (ההיקף מצטמצם ל-0 מופעים, מה שחוסך עלויות).
- אם נשלחות 1,000 בקשות → המערכת מפעילה כמה עותקים שצריך.
בלי שמירת מצב כברירת מחדל:
- כל בקשה יכולה להישלח למופע אחר.
- אם אתם צריכים לאחסן מצב, אתם יכולים להשתמש בשירות חיצוני כמו Cloud SQL, Firestore או Memorystore.
תמיכה בכל שפה או מסגרת:
- כל עוד הקוד פועל בקונטיינר של Linux, לא משנה ל-Cloud Run אם מדובר ב-Python, Go, Node.js, Java או .Net.
תשלום לפי שימוש:
- חיוב לפי בקשה: חיוב לפי בקשה + זמן מחשוב (עד 100 אלפיות השנייה).
- חיוב לפי מופע: חיוב על משך החיים המלא של המופע (ללא עמלה לכל בקשה).
3. הגדרת הפרויקט
חשבון Google
אם אין לכם חשבון Google אישי, אתם צריכים ליצור חשבון Google.
משתמשים בחשבון לשימוש אישי במקום בחשבון לצורכי עבודה או בחשבון בית ספרי.
כניסה למסוף Google Cloud
נכנסים למסוף Google Cloud באמצעות חשבון Google אישי.
הפעלת חיוב
הגדרה של חשבון לחיוב לשימוש אישי
אם הגדרתם חיוב באמצעות קרדיטים ל-Google Cloud, אתם יכולים לדלג על השלב הזה.
כדי להגדיר חשבון לחיוב לשימוש אישי, עוברים לכאן כדי להפעיל את החיוב במסוף Cloud.
הערות:
- העלות של השלמת ה-Lab הזה צריכה להיות פחות מ-1 דולר ארה"ב במשאבי Cloud.
- כדי להימנע מחיובים נוספים, אפשר למחוק את המשאבים בסיום ה-Lab.
- משתמשים חדשים זכאים לתקופת ניסיון בחינם בשווי 300$.
יצירת פרויקט (אופציונלי)
אם אין לכם פרויקט שאתם רוצים להשתמש בו במעבדה הזו, אתם יכולים ליצור פרויקט חדש כאן.
4. פתיחת Cloud Shell Editor
- כדי לעבור ישירות אל Cloud Shell Editor, לוחצים על הקישור הזה.
- אם תתבקשו לאשר בשלב כלשהו היום, לחצו על אישור כדי להמשיך.
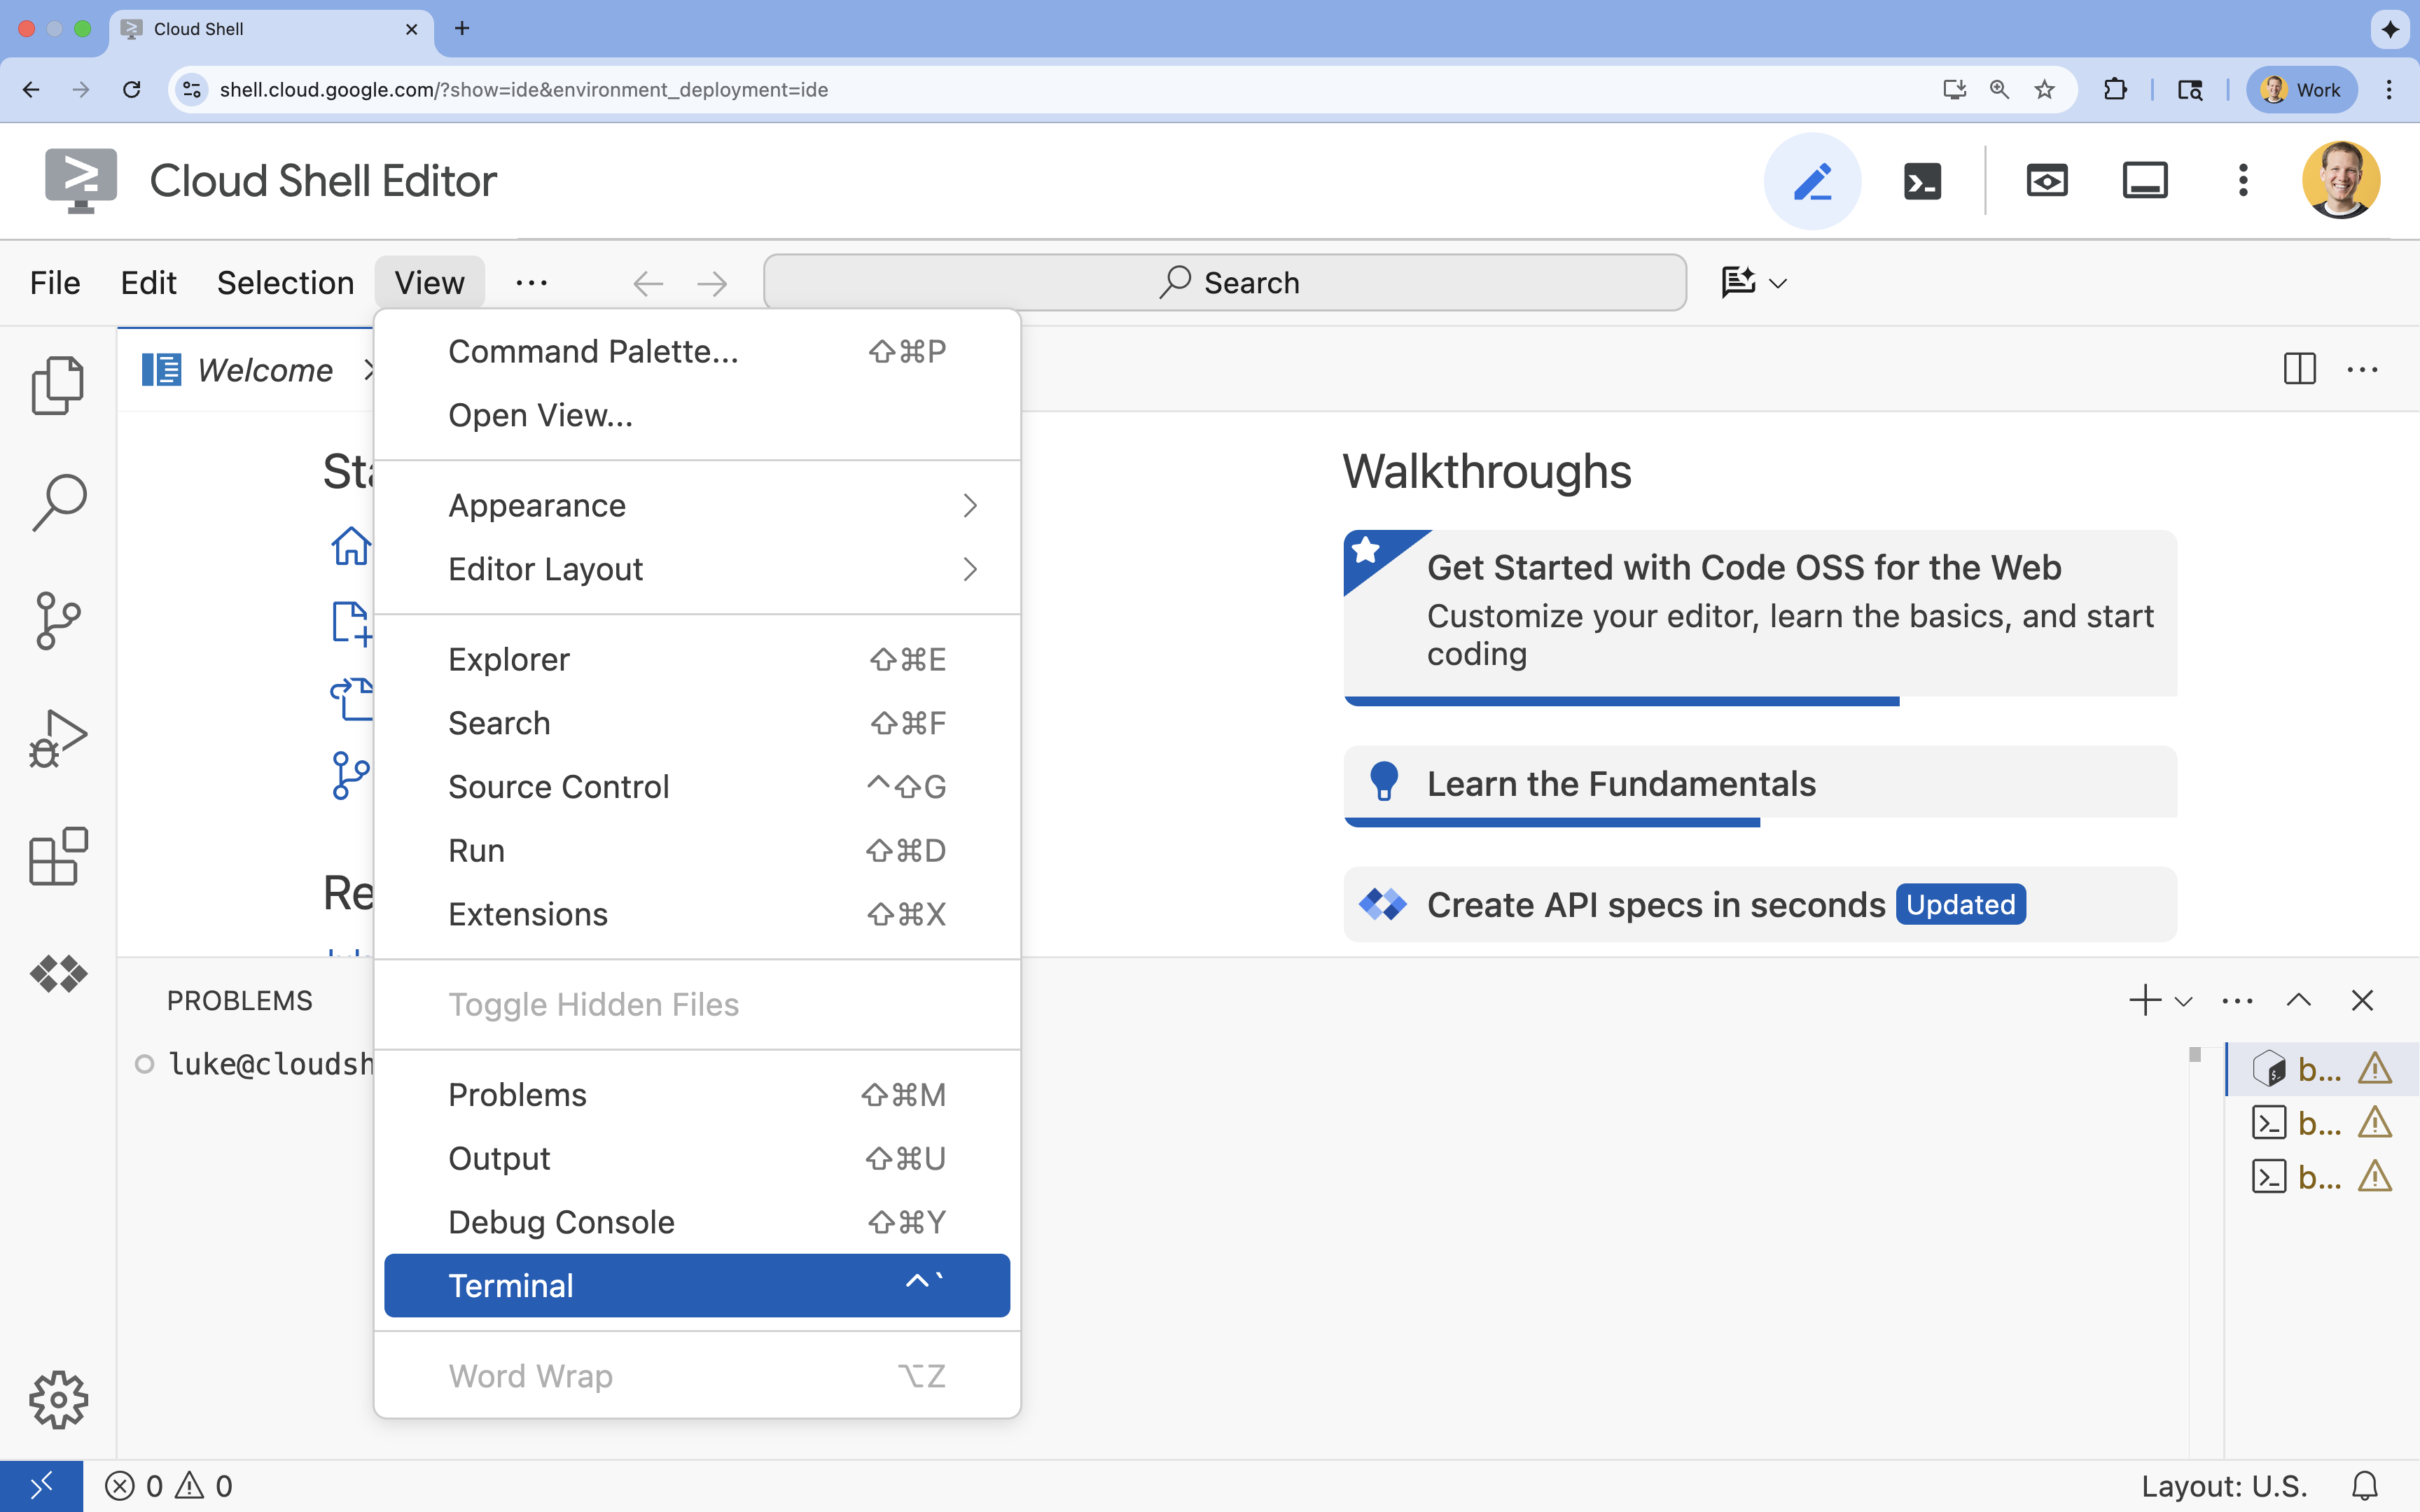
- אם הטרמינל לא מופיע בתחתית המסך, פותחים אותו:
- לוחצים על הצגה.
- לוחצים על Terminal (טרמינל)
 .
5. הגדרת הפרויקט
- בטרמינל, מגדירים את הפרויקט באמצעות הפקודה הבאה:
gcloud config set project [PROJECT_ID]gcloud config set project lab-project-id-example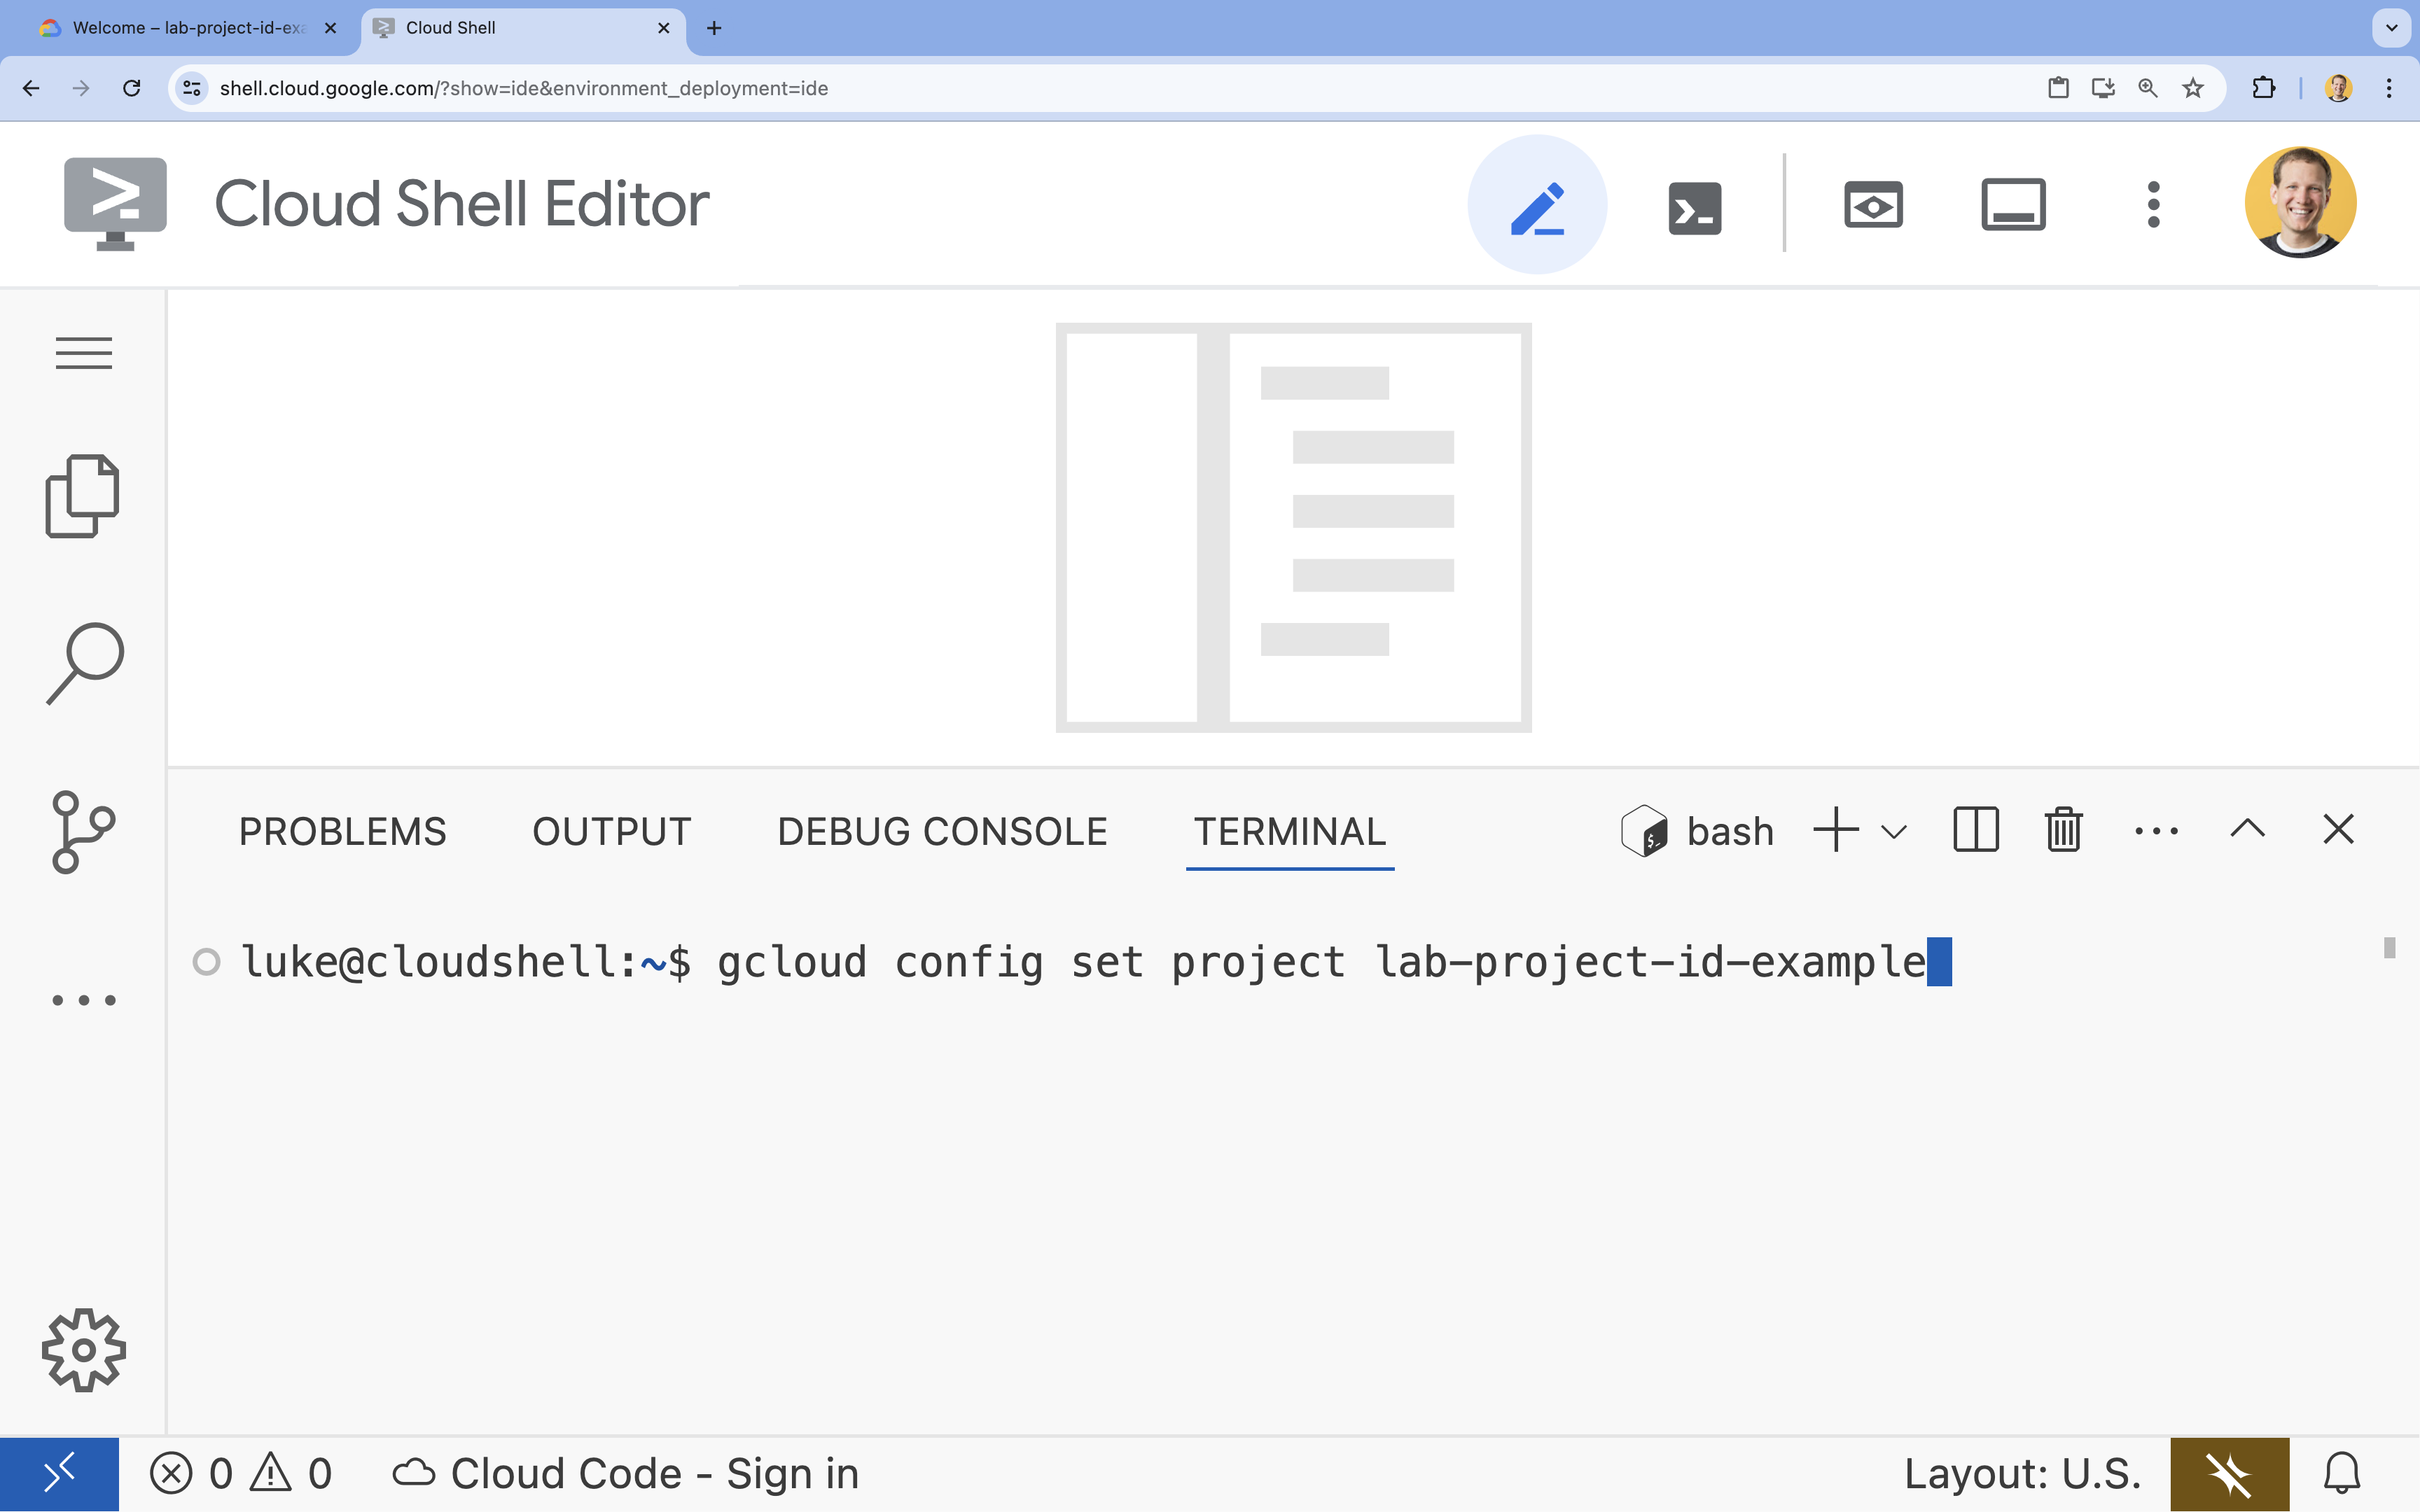
- אמורה להופיע ההודעה הבאה:
Updated property [core/project].
6. הפעלת ממשקי ה-API
כדי להשתמש ב-Cloud Run, ב-Artifact Registry, ב-Cloud Build, ב-Gemini Enterprise Agent Platform וב-Compute Engine, צריך להפעיל את ממשקי ה-API שלהם בפרויקט Google Cloud.
- בטרמינל, מפעילים את ממשקי ה-API:
gcloud services enable \ run.googleapis.com \ artifactregistry.googleapis.com \ cloudbuild.googleapis.com \ aiplatform.googleapis.com \ compute.googleapis.comOperation "operations/acat.p2-[GUID]" finished successfully.
מבוא לממשקי ה-API
- Cloud Run Admin API (
run.googleapis.com) מאפשר להריץ שירותי קצה קדמי ושירותי קצה עורפי, משימות באצווה או אתרים בסביבה מנוהלת לחלוטין. השירות מטפל בתשתית לפריסה ולהתאמה לעומס (scaling) של האפליקציות בקונטיינרים. - Artifact Registry API (
artifactregistry.googleapis.com) מספק מאגר פרטי ומאובטח לאחסון תמונות של קונטיינרים. זוהי הגרסה המתקדמת של Container Registry, והיא משתלבת בצורה חלקה עם Cloud Run ו-Cloud Build. - Cloud Build API (
cloudbuild.googleapis.com) הוא פלטפורמת CI/CD ללא שרתים שמבצעת את הבנייה שלכם בתשתית של Google Cloud. הוא משמש ליצירת קובץ אימג' של קונטיינר בענן מקובץ Dockerfile. - Gemini Enterprise Agent Platform API (
aiplatform.googleapis.com) מאפשר לאפליקציה שפרסתם לתקשר עם מודלים של Gemini כדי לבצע משימות ליבה של AI. הוא מספק API מאוחד לכל שירותי ה-AI של Google Cloud. - Compute Engine API (
compute.googleapis.com) מספק מכונות וירטואליות מאובטחות שניתנות להתאמה אישית ופועלות בתשתית של Google. למרות ש-Cloud Run מנוהל, לעיתים קרובות נדרש Compute Engine API כתלות בסיסית למשאבי רשת ומחשוב שונים.
7. הכנת סביבת הפיתוח
יצירת הספרייה
- בטרמינל, יוצרים את ספריית הפרויקט ואת ספריות המשנה הנדרשות:
cd && mkdir zoo_guide_agent && cd zoo_guide_agent - בטרמינל, מריצים את הפקודה הבאה כדי לפתוח את הספרייה
zoo_guide_agentבסייר של Cloud Shell Editor:cloudshell open-workspace ~/zoo_guide_agent - חלונית הסייר בצד ימין תעבור רענון. עכשיו אמורה להופיע הספרייה שיצרתם.
CRITICAL: פתיחת סביבת עבודה חדשה מאפסת את Cloud Shell Editor ומפעילה מחדש את סשן הטרמינל. חשוב לפתוח מחדש את הטרמינל, לוודא שאתם בספרייה הנכונה~/zoo_guide_agent(מריצים את הפקודותpwdו-cd ~/zoo_guide_agentאם צריך) ושהפרויקט שלכם ב-gcloud עדיין נבחר (מריצים את הפקודהgcloud config set project [PROJECT_ID]אם צריך).
דרישות ההתקנה
- מריצים את הפקודה הבאה בטרמינל כדי ליצור את הקובץ
requirements.txt.cloudshell edit requirements.txt - מוסיפים את הטקסט הבא לקובץ
requirements.txtהחדש שיצרתםgoogle-adk==2.4.0 langchain-community==0.3.27 wikipedia==1.4.0 - בטרמינל, יוצרים ומפעילים סביבה וירטואלית באמצעות uv. כך אפשר לוודא שיחסי התלות של הפרויקט לא מתנגשים עם Python של המערכת.
uv venv source .venv/bin/activate - מתקינים את החבילות הנדרשות בסביבה הווירטואלית בטרמינל.
uv pip install -r requirements.txt
יצירת חשבון שירות והגדרת הרשאות IAM
לפני שיוצרים את הסוכן, צריך ליצור חשבון שירות ולהגדיר את ההרשאות הנדרשות. כך תוכלו לוודא שהסוכן יוכל להפעיל מודלים של Gemini Enterprise Agent Platform ושהשירות Cloud Build יוכל לפרוס את האפליקציה שלכם בהצלחה.
- בטרמינל, יוצרים חשבון שירות ייעודי לשירות Cloud Run:
SA_NAME=lab-service-account PROJECT_ID=$(gcloud config get-value project) gcloud iam service-accounts create ${SA_NAME} \ --display-name="Service Account for Zoo Agent" - מקצים לחשבון השירות את התפקיד Gemini Enterprise Agent Platform User כדי שהסוכן יוכל להתקשר אל Gemini:
gcloud projects add-iam-policy-binding $PROJECT_ID \ --member="serviceAccount:${SA_NAME}@${PROJECT_ID}.iam.gserviceaccount.com" \ --role="roles/aiplatform.user" - הגדרת ההרשאות של Cloud Build. מכיוון שההרשאות של חשבון השירות שמוגדר כברירת מחדל בפרויקטים מודרניים ב-Google Cloud מוגבלות, צריך לתת לחשבון השירות שמוגדר כברירת מחדל ב-Compute Engine את התפקידים שנדרשים לבנייה ולפריסה של הקונטיינר. מריצים את הפקודות הבאות בטרמינל:
PROJECT_NUMBER=$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")

# Grant Artifact Registry Writer role
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:${PROJECT_NUMBER}-compute@developer.gserviceaccount.com" \
  --role="roles/artifactregistry.writer"

# Grant Storage Object Viewer role
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:${PROJECT_NUMBER}-compute@developer.gserviceaccount.com" \
  --role="roles/storage.objectViewer"

# Grant Logs Writer role
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:${PROJECT_NUMBER}-compute@developer.gserviceaccount.com" \
  --role="roles/logging.logWriter"
הגדרה של משתני סביבה
עכשיו תיצרו קובץ .env שמכיל את משתני הסביבה שבהם משתמש הסוכן ואת סקריפט הפריסה.
- מכיוון שכבר הגדרתם את המשתנים בסשן הטרמינל בשלב הקודם, אתם יכולים ליצור את הקובץ
.envישירות:cat <<EOF > .env PROJECT_ID=$PROJECT_ID PROJECT_NUMBER=$PROJECT_NUMBER SA_NAME=$SA_NAME SERVICE_ACCOUNT=${SA_NAME}@${PROJECT_ID}.iam.gserviceaccount.com MODEL="gemini-3.5-flash" EOF
8. יצירת תהליך עבודה של סוכן
יצירת קובץ __init__.py
- כדי ליצור את הקובץ init.py, מריצים את הפקודה הבאה בטרמינל:
cloudshell edit __init__.py - מוסיפים את הקוד הבא לקובץ
__init__.pyהחדש:from . import agent
יצירת קובץ agent.py
- כדי ליצור את הקובץ הראשי
agent.py, מדביקים את הפקודה הבאה בטרמינל.cloudshell edit agent.py - ייבוא והגדרה ראשונית: מוסיפים את הקוד הבא לקובץ
agent.pyהריק:import os import logging from dotenv import load_dotenv from google.adk import Agent from google.adk.agents import SequentialAgent from google.adk.tools.tool_context import ToolContext from google.adk.tools.langchain_tool import LangchainTool from langchain_community.tools import WikipediaQueryRun from langchain_community.utilities import WikipediaAPIWrapper import google.auth import google.auth.transport.requests import google.oauth2.id_token # --- Setup Logging and Environment --- load_dotenv() model_name = os.getenv("MODEL")agent.pyכולל את כל הספריות הנדרשות מ-ADK ומ-Google Cloud. הוא גם מגדיר רישום ביומן וטוען את משתני הסביבה מקובץ.env, שחשובים לגישה למודל ולכתובת ה-URL של השרת. - הגדרת הכלים: איכות הסוכן תלויה באיכות הכלים שהוא יכול להשתמש בהם. מוסיפים את הקוד הבא לחלק התחתון של
agent.pyכדי להגדיר את הכלים:# Greet user and save their prompt def add_prompt_to_state( tool_context: ToolContext, prompt: str ) -> dict[str, str]: """Saves the user's initial prompt to the state.""" tool_context.state["PROMPT"] = prompt logging.info(f"[State updated] Added to PROMPT: {prompt}") return {"status": "success"} # Configuring the Wikipedia Tool api_wrapper = WikipediaAPIWrapper(top_k_results=1, doc_content_chars_max=1000) api_wrapper.wiki_client.set_user_agent("ZooTourGuideAgent/1.0") wikipedia_tool = LangchainTool( tool=WikipediaQueryRun(api_wrapper=api_wrapper) )add_prompt_to_state📝: הכלי הזה זוכר מה המבקרים בגן החיות שואלים. כשמבקר שואל "איפה האריות?", הכלי הזה שומר את השאלה הספציפית בזיכרון של הסוכן, כדי שהסוכנים האחרים בתהליך העבודה ידעו מה לחפש.
איך: זו פונקציית Python שכותבת את ההנחיה של המבקר למילוןtool_context.stateהמשותף. ההקשר של הכלי הזה מייצג את הזיכרון לטווח קצר של הסוכן בשיחה אחת. סוכן אחד יכול לשמור נתונים במצב, וסוכן אחר יכול לקרוא את הנתונים האלה בתהליך העבודה.-
LangchainTool🌍: האפשרות הזו מעניקה לסוכן מדריך הטיולים ידע כללי על העולם. אם מבקר שואל שאלה שלא מופיעה במסד הנתונים של גן החיות, כמו "מה אריות אוכלים בטבע?", הכלי הזה מאפשר לסוכן לחפש את התשובה בוויקיפדיה. (מידע נוסף על הגדרת הכלי של ויקיפדיה ועל הפעלתו זמין במדריך שימוש בכלי של ויקיפדיה).
איך: הוא פועל כמתאם, ומאפשר לסוכן שלנו להשתמש בכלי WikipediaQueryRun שנבנה מראש מספריית LangChain.
- הגדרת סוכני המומחים: מוסיפים את הקוד הבא לתחתית של
agent.pyכדי להגדיר את הסוכניםcomprehensive_researcherו-response_formatter:# 1. Researcher Agent comprehensive_researcher = Agent( name="comprehensive_researcher", model=model_name, description="The primary researcher that can access both internal zoo data and external knowledge from Wikipedia.", instruction=""" You are a helpful research assistant. Your goal is to fully answer the user's PROMPT. You have access to two tools: 1. A tool for getting specific data about animals AT OUR ZOO (names, ages, locations). 2. A tool for searching Wikipedia for general knowledge (facts, lifespan, diet, habitat). First, analyze the user's PROMPT. - If the prompt can be answered by only one tool, use that tool. - If the prompt is complex and requires information from both the zoo's database AND Wikipedia, you MUST use both tools to gather all necessary information. - Synthesize the results from the tool(s) you use into preliminary data outputs. PROMPT: { PROMPT } """, tools=[ wikipedia_tool ], output_key="research_data" # A key to store the combined findings ) # 2. Response Formatter Agent response_formatter = Agent( name="response_formatter", model=model_name, description="Synthesizes all information into a friendly, readable response.", instruction=""" You are the friendly voice of the Zoo Tour Guide. Your task is to take the RESEARCH_DATA and present it to the user in a complete and helpful answer. - First, present the specific information from the zoo (like names, ages, and where to find them). - Then, add the interesting general facts from the research. - If some information is missing, just present the information you have. - Be conversational and engaging. RESEARCH_DATA: { research_data } """ )- הסוכן
comprehensive_researcherהוא ה "מוח" של הפעולה שלנו. הוא מקבל את ההנחיה של המשתמש מ-Stateהמשותף, בודק אם היא קשורה לכלי של ויקיפדיה ומחליט באילו מהכלים להשתמש כדי למצוא את התשובה. - התפקיד של סוכן
response_formatterהוא הצגה. הוא מקבל את הנתונים הגולמיים שנאספו על ידי סוכן המחקר (מועברים דרך הסטטוס) ומשתמש ביכולות השפה של ה-LLM כדי להפוך אותם לתשובה ידידותית בממשק שיחה.
- הסוכן
- הגדרת סוכן Workflow: מוסיפים את בלוק הקוד הזה לחלק התחתון של
agent.pyכדי להגדיר את הסוכן הרציףtour_guide_workflow:tour_guide_workflow = SequentialAgent( name="tour_guide_workflow", description="The main workflow for handling a user's request about an animal.", sub_agents=[ comprehensive_researcher, # Step 1: Gather all data response_formatter, # Step 2: Format the final response ] )
איך: זהוSequentialAgent, סוג מיוחד של סוכן שלא חושב בעצמו. התפקיד היחיד שלו הוא להריץ רשימה שלsub_agents(החוקר ומעצב הפלט) ברצף קבוע, ולהעביר באופן אוטומטי את הזיכרון המשותף מאחד לשני. - הרכבת תהליך העבודה הראשי: מוסיפים את בלוק הקוד הסופי הזה לחלק התחתון של
agent.pyכדי להגדיר אתroot_agent:root_agent = Agent( name="greeter", model=model_name, description="The main entry point for the Zoo Tour Guide.", instruction=""" - Let the user know you will help them learn about the animals we have in the zoo. - When the user responds, use the 'add_prompt_to_state' tool to save their response. After using the tool, transfer control to the 'tour_guide_workflow' agent. """, tools=[add_prompt_to_state], sub_agents=[tour_guide_workflow] )root_agentמשמש כנקודת התחלה לכל השיחות החדשות. התפקיד העיקרי שלו הוא לתזמן את התהליך הכולל. הוא פועל כבקר הראשוני שמנהל את התור הראשון בשיחה.
הקובץ המלא agent.py
הקובץ agent.py הושלם. כך תוכלו לראות איך לכל רכיב – כלים, סוכני עובדים וסוכני ניהול – יש תפקיד ספציפי ביצירת המערכת הסופית והחכמה.
הקובץ המלא אמור להיראות כך:
import os
import logging
from dotenv import load_dotenv

from google.adk import Agent
from google.adk.agents import SequentialAgent
from google.adk.tools.tool_context import ToolContext
from google.adk.tools.langchain_tool import LangchainTool

from langchain_community.tools import WikipediaQueryRun
from langchain_community.utilities import WikipediaAPIWrapper

import google.auth
import google.auth.transport.requests
import google.oauth2.id_token

# --- Setup Logging and Environment ---

load_dotenv()

model_name = os.getenv("MODEL")
# Greet user and save their prompt

def add_prompt_to_state(
    tool_context: ToolContext, prompt: str
) -> dict[str, str]:
    """Saves the user's initial prompt to the state."""
    tool_context.state["PROMPT"] = prompt
    logging.info(f"[State updated] Added to PROMPT: {prompt}")
    return {"status": "success"}

# Configuring the Wikipedia Tool
api_wrapper = WikipediaAPIWrapper(top_k_results=1, doc_content_chars_max=1000)
api_wrapper.wiki_client.set_user_agent("ZooTourGuideAgent/1.0")
wikipedia_tool = LangchainTool(
    tool=WikipediaQueryRun(api_wrapper=api_wrapper)
)
# 1. Researcher Agent
comprehensive_researcher = Agent(
    name="comprehensive_researcher",
    model=model_name,
    description="The primary researcher that can access both internal zoo data and external knowledge from Wikipedia.",
    instruction="""
    You are a helpful research assistant. Your goal is to fully answer the user's PROMPT.
    You have access to two tools:
    1. A tool for getting specific data about animals AT OUR ZOO (names, ages, locations).
    2. A tool for searching Wikipedia for general knowledge (facts, lifespan, diet, habitat).

    First, analyze the user's PROMPT.
    - If the prompt can be answered by only one tool, use that tool.
    - If the prompt is complex and requires information from both the zoo's database AND Wikipedia,
      you MUST use both tools to gather all necessary information.
    - Synthesize the results from the tool(s) you use into preliminary data outputs.

    PROMPT:
    { PROMPT }
    """,
    tools=[
        wikipedia_tool
    ],
    output_key="research_data" # A key to store the combined findings
)

# 2. Response Formatter Agent
response_formatter = Agent(
    name="response_formatter",
    model=model_name,
    description="Synthesizes all information into a friendly, readable response.",
    instruction="""
    You are the friendly voice of the Zoo Tour Guide. Your task is to take the
    RESEARCH_DATA and present it to the user in a complete and helpful answer.

    - First, present the specific information from the zoo (like names, ages, and where to find them).
    - Then, add the interesting general facts from the research.
    - If some information is missing, just present the information you have.
    - Be conversational and engaging.

    RESEARCH_DATA:
    { research_data }
    """
)
tour_guide_workflow = SequentialAgent(
    name="tour_guide_workflow",
    description="The main workflow for handling a user's request about an animal.",
    sub_agents=[
        comprehensive_researcher, # Step 1: Gather all data
        response_formatter,       # Step 2: Format the final response
    ]
)
root_agent = Agent(
    name="greeter",
    model=model_name,
    description="The main entry point for the Zoo Tour Guide.",
    instruction="""
    - Let the user know you will help them learn about the animals we have in the zoo.
    - When the user responds, use the 'add_prompt_to_state' tool to save their response.
    After using the tool, transfer control to the 'tour_guide_workflow' agent.
    """,
    tools=[add_prompt_to_state],
    sub_agents=[tour_guide_workflow]
)
השלב הבא הוא פריסה.
9. הכנת האפליקציה לפריסה
בדיקת המבנה הסופי
לפני הפריסה, מוודאים שספריית הפרויקט מכילה את הקבצים הנכונים.
- חשוב לוודא שהתיקייה
zoo_guide_agentנראית כך:zoo_guide_agent/ ├── .env ├── __init__.py ├── agent.py └── requirements.txt
הגדרת .gcloudignore וטעינת משתני סביבה
- יוצרים קובץ
.gcloudignoreבספרייהzoo_guide_agentכדי למנוע העלאה של הסביבה הווירטואלית (.venv/) וקבצים מיותרים אחרים אל Google Cloud:cloudshell edit .gcloudignore - מוסיפים את התוכן הבא ל-
.gcloudignore:.gcloudignore .git .gitignore .venv/ venv/ __pycache__/ .env - טוענים את משתני הסביבה לסשן הטרמינל:
source .env
10. פריסת הסוכן באמצעות ADK CLI
אחרי שהקוד המקומי מוכן והפרויקט בענן ב-Google Cloud מוכן, הגיע הזמן לפרוס את הסוכן. תשתמשו בפקודה adk deploy cloud_run, כלי נוח שמבצע אוטומטית את כל תהליך הפריסה. הפקודה הזו אורזת את הקוד, יוצרת קובץ אימג' של קונטיינר, מעבירה אותו בדחיפה ל-Artifact Registry ומפעילה את השירות ב-Cloud Run, כך שאפשר לגשת אליו באינטרנט.
- כדי לפרוס את הסוכן, מריצים את הפקודה הבאה בטרמינל:
# Run the deployment command uvx --from google-adk==2.4.0 \ adk deploy cloud_run \ --project=$PROJECT_ID \ --region=europe-west1 \ --service_name=zoo-tour-guide \ --with_ui \ . \ -- \ --allow-unauthenticated \ --set-env-vars=MODEL=$MODEL,GOOGLE_GENAI_USE_ENTERPRISE=true,GOOGLE_CLOUD_PROJECT=$PROJECT_ID,GOOGLE_CLOUD_LOCATION=global \ --labels=dev-tutorial=codelab-adk \ --service-account=$SERVICE_ACCOUNTuvxמאפשרת להריץ כלי שורת פקודה שפורסמו כחבילות Python בלי לדרוש התקנה גלובלית של הכלים האלה. - אם מוצגת ההודעה הבאה:
Deploying from source requires an Artifact Registry Docker repository to store built containers. A repository named [cloud-run-source-deploy] in region
[europe-west1] will be created.

Do you want to continue (Y/n)?
Yומקישים על Enter. - אחרי שהפקודה תופעל בהצלחה, היא תחזיר את כתובת ה-URL של שירות Cloud Run שנפרס. (היא תיראה בערך כך:
https://zoo-tour-guide-123456789.europe-west1.run.app). - מעתיקים את כתובת ה-URL של שירות Cloud Run שנפרס למשימה הבאה.
11. בדיקת הסוכן הפעיל
אחרי שהסוכן שלכם יפעל ב-Cloud Run, תבצעו בדיקה כדי לוודא שהפריסה הצליחה והסוכן פועל כמו שצריך. תשתמשו בכתובת ה-URL הציבורית של השירות (למשל https://zoo-tour-guide-123456789.europe-west1.run.app/) כדי לגשת לממשק האינטרנט של ADK ולתקשר עם הסוכן.
- פותחים את כתובת ה-URL הציבורית של שירות Cloud Run בדפדפן האינטרנט. בגלל שהשתמשתם ב-
--with_ui flag, אמור להופיע ממשק המשתמש של מפתח ה-ADK. - מפעילים את המתג
Token Streamingבפינה השמאלית העליונה.
עכשיו אפשר לתקשר עם סוכן גן החיות. - כדי להתחיל שיחה חדשה, מקלידים
helloולוחצים על Enter. - בודקים את התוצאה. הסוכן צריך להגיב במהירות עם ההודעה שלו, שתהיה משהו כזה:
"Hello! I'm your Zoo Tour Guide. I can help you learn about the amazing animals we have here. What would you like to know or explore today?"
- אפשר לשאול את הסוכן שאלות כמו:
Where can I find the polar bears in the zoo and what is their diet?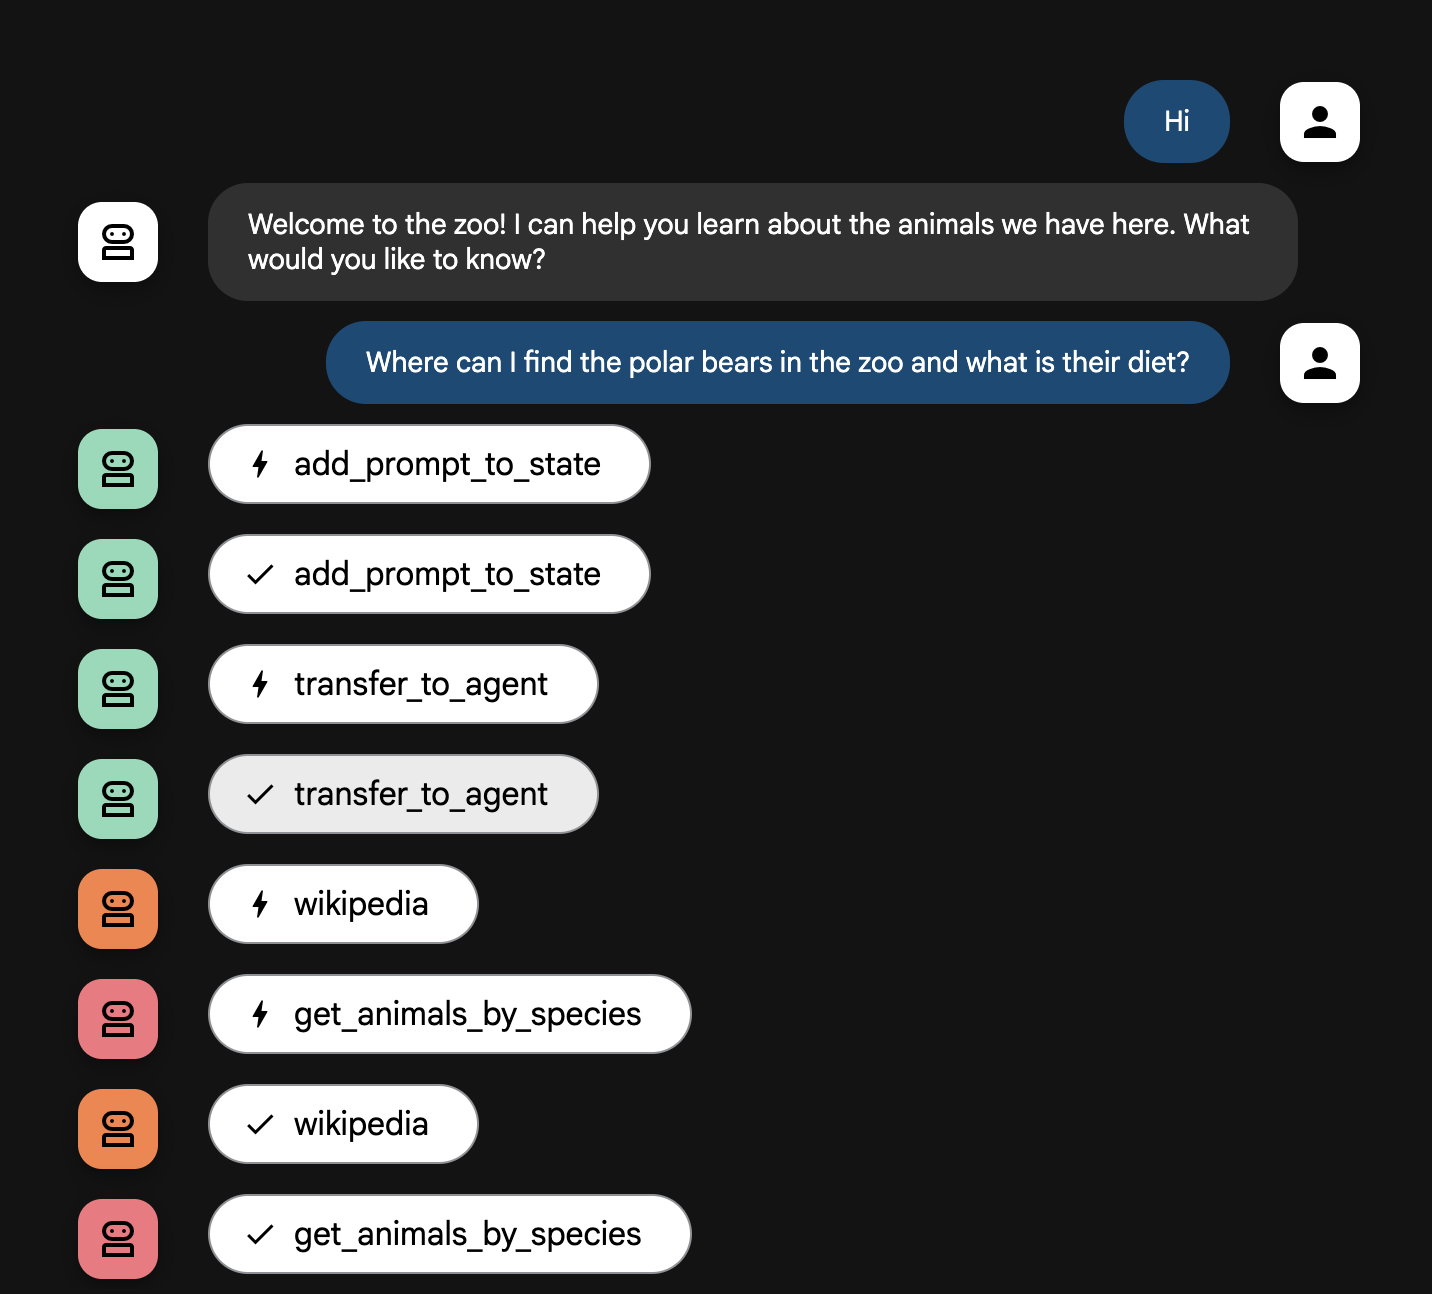
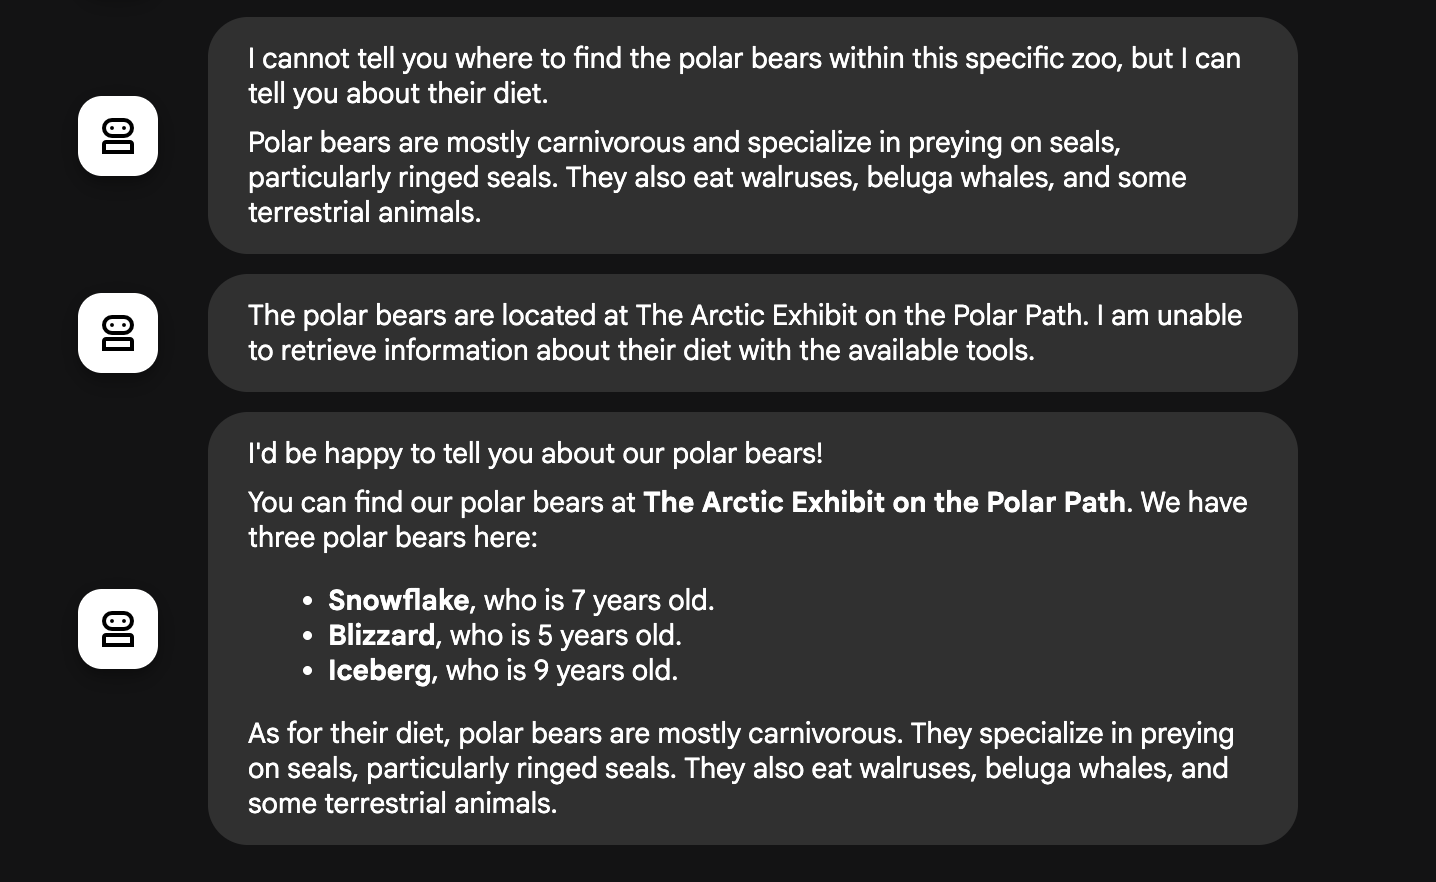
הסבר על תהליך העבודה של הסוכן
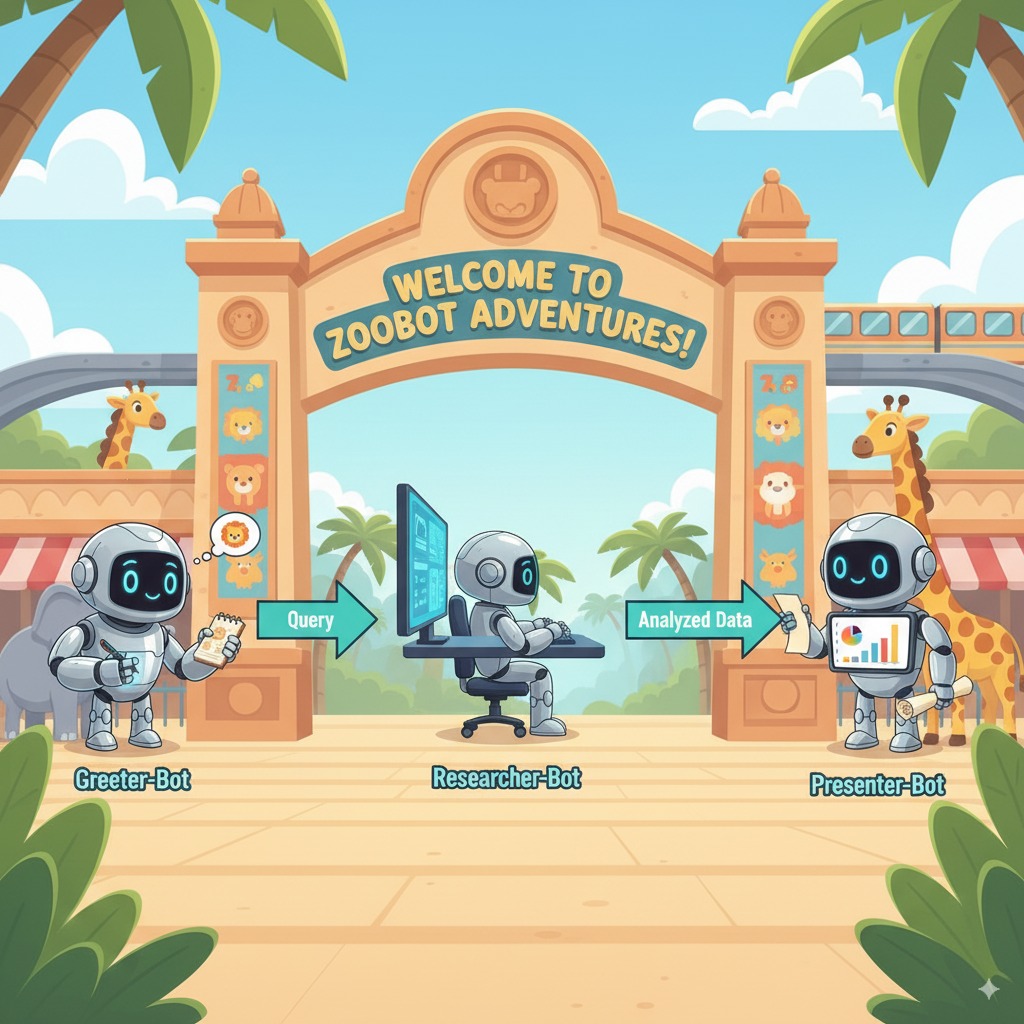
המערכת פועלת כצוות חכם של כמה סוכנים. התהליך מנוהל באמצעות רצף ברור כדי להבטיח זרימה חלקה ויעילה מהשאלה של המשתמש ועד לתשובה המפורטת הסופית.
1. הדלפק לקבלת פנים בגן החיות
התהליך כולו מתחיל בסוכן שמקבל את הפנייה.
- התפקיד שלו: להתחיל את השיחה. ההוראה היא לברך את המשתמש ולשאול אותו על איזו חיה הוא רוצה לקבל מידע.
- הכלי שלו: כשהמשתמש משיב, ה-Greeter משתמש בכלי add_prompt_to_state כדי לתעד את המילים המדויקות שלו (למשל, "תספר לי על אריות") ולשמור אותן בזיכרון של המערכת.
- העברת השליטה: אחרי ששומרים את ההנחיה, השליטה מועברת באופן מיידי לסוכן המשנה שלה, tour_guide_workflow.
2. החוקר המקיף (החוקר המצוין)
זה השלב הראשון בתהליך העבודה הראשי ו "המוח" של הפעולה. במקום צוות גדול, יש לכם עכשיו סוכן אחד מיומן שיכול לגשת לכל המידע הזמין.
- התפקיד שלו: לנתח את השאלה של המשתמש וליצור תוכנית חכמה. הוא משתמש ביכולת השימוש בכלים של מודל השפה כדי להחליט אם הוא צריך:
- ידע כללי מהאינטרנט (באמצעות Wikipedia API).
- או לשאול שאלות מורכבות.
3. כלי לעיצוב תשובות (הכלי להצגת מידע)
אחרי שסוכן המחקר המקיף אוסף את כל העובדות, זה הסוכן האחרון שפועל.
- התפקיד שלו: לשמש כקול הידידותי של המדריך בסיור בגן החיות. הוא לוקח את הנתונים הגולמיים (שיכולים להגיע ממקור אחד או משני המקורות) ומלטש אותם.
- הפעולה שלו: הוא מסנתז את כל המידע לתשובה אחת מגובשת ומושכת. בהתאם להוראות, הוא מציג קודם את המידע הספציפי על גן החיות ואז מוסיף את העובדות הכלליות המעניינות.
- התוצאה הסופית: הטקסט שהסוכן יצר הוא התשובה המלאה והמפורטת שהמשתמש רואה בחלון הצ'אט.
רוצים ללמוד עוד על בניית סוכנים? כדאי לעיין במקורות המידע הבאים:
12. ניקוי הסביבה
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת מדריך זה, אפשר למחוק את הפרויקט שמכיל את המשאבים או להשאיר את הפרויקט ולמחוק את המשאבים בנפרד.
מחיקת השירותים, התמונות והמשאבים של Cloud Run
אם רוצים לשמור את פרויקט בענן ב-Google Cloud אבל להסיר את המשאבים הספציפיים שנוצרו בסדנה הזו, צריך למחוק את השירות הפועל, את מאגר קובצי האימג' של קונטיינר, את קטגוריית האחסון הזמנית של מקור הנתונים ואת חשבון השירות.
- מריצים את הפקודות הבאות בטרמינל:
gcloud run services delete zoo-tour-guide --region=europe-west1 --quiet
gcloud artifacts repositories delete cloud-run-source-deploy --location=europe-west1 --quiet
gsutil rm -r gs://run-sources-${PROJECT_ID}-europe-west1
gcloud iam service-accounts delete lab-service-account@${PROJECT_ID}.iam.gserviceaccount.com --quiet
מחיקת הפרויקט (אופציונלי)
אם יצרתם פרויקט חדש במיוחד בשביל ה-Lab הזה ואתם לא מתכננים להשתמש בו שוב, הדרך הכי קלה לנקות היא למחוק את הפרויקט כולו. כך מוודאים שכל המשאבים (כולל חשבון השירות וכל פריטי המידע הנסתרים של הגרסה) יוסרו לחלוטין.
- בטרמינל, מריצים את הפקודה הבאה (מחליפים את [YOUR_PROJECT_ID] במזהה הפרויקט בפועל):
gcloud projects delete $PROJECT_ID
13. מזל טוב
הצלחתם ליצור ולפרוס אפליקציית AI עם כמה סוכנים ב-Google Cloud.
Recap
בשיעור ה-Lab הזה, התחלתם עם ספרייה ריקה והגעתם לשירות AI פעיל שנגיש לכולם. הנה מבט על מה שבנית:
- יצרתם צוות מומחים: במקום AI גנרי אחד, יצרתם 'חוקר' שימצא עובדות ו'מעצב' שישפר את התשובה.
- נתתם להם כלים: חיברתם את הסוכנים שלכם לעולם החיצוני באמצעות Wikipedia API.
- העברתם את הקוד: לקחתם את קוד Python המקומי ופרסתם אותו כקונטיינר ללא שרת ב-Cloud Run, תוך אבטחה שלו באמצעות חשבון שירות ייעודי.
מה כיסינו
- איך לבנות פרויקט Python לפריסה באמצעות ADK.
- איך מטמיעים תהליך עבודה עם כמה סוכנים באמצעות
[SequentialAgent](https://google.github.io/adk-docs/agents/workflow-agents/sequential-agents/). - איך משלבים כלים חיצוניים כמו Wikipedia API.
- איך פורסים סוכן ל-Cloud Run באמצעות הפקודה
adk deploy.
14. סקר
פלט: