

1. نظرة عامة
في هذا التمرين، ستتعرّف على كيفية إنشاء مسار تقييم لنظام "التوليد المعزّز بالاسترجاع" (RAG). ستستخدم خدمة تقييم الذكاء الاصطناعي التوليدي في Vertex AI لإنشاء معايير تقييم مخصّصة وإطار عمل لتقييم مهمة الإجابة عن الأسئلة.
ستعمل على أمثلة من مجموعة بيانات Stanford Question Answering Dataset (SQuAD 2.0) لإعداد مجموعات بيانات التقييم، وضبط التقييمات المستندة إلى مراجع وغير المستندة إلى مراجع، وتفسير النتائج. بنهاية هذا التمرين، ستفهم كيفية تقييم أنظمة التوليد المعزز بالاسترجاع وسبب اختيار أساليب تقييم معيّنة.
أساس مجموعة البيانات
سنعمل على أمثلة تم إنشاؤها بعناية وتشمل نطاقات متعددة في مجموعة بيانات SQuAD 2.0 للإجابة عن الأسئلة:
- علم الأعصاب: اختبار الدقة الفنية في السياقات العلمية
- التاريخ: تقييم الدقة الواقعية في الروايات التاريخية
- الجغرافيا: تقييم المعرفة الإقليمية والسياسية
يساعدك هذا التنوّع في فهم كيفية تعميم أساليب التقييم على مختلف مجالات البحث.
المراجع
- عيّنات التعليمات البرمجية: يستند هذا التمرين إلى أمثلة من مستندات تقييم Vertex AI
- أساس مجموعة البيانات: مجموعة بيانات SQuAD 2.0 للإجابة عن الأسئلة
- تحسين عملية استرجاع البيانات في نموذج RAG: الاختبار والضبط والنجاح
أهداف الدورة التعليمية
في هذه الميزة الاختبارية، ستتعرّف على كيفية تنفيذ المهام التالية:
- إعداد مجموعات بيانات التقييم لأنظمة RAG
- تنفيذ تقييم بدون مرجع باستخدام مقاييس مثل مدى الاستناد إلى المصدر ومدى الصلة بالموضوع
- تطبيق التقييم المستند إلى المراجع باستخدام مقاييس التشابه الدلالي
- إنشاء مقاييس تقييم مخصّصة باستخدام قواعد تقييم مفصّلة
- تفسير نتائج التقييم وعرضها بشكل مرئي لتحديد النموذج المناسب
2. إعداد المشروع
حساب Google
إذا لم يكن لديك حساب شخصي على Google، عليك إنشاء حساب Google.
استخدام حساب شخصي بدلاً من حساب عمل أو حساب تديره مؤسسة تعليمية
تسجيل الدخول إلى Google Cloud Console
سجِّل الدخول إلى Google Cloud Console باستخدام حساب Google شخصي.
تفعيل الفوترة
تحصيل قيمة أرصدة Google Cloud (اختياري)
لإجراء ورشة العمل هذه، تحتاج إلى حساب فوترة يتضمّن بعض الرصيد. استخدِم الأرصدة من البانر في أعلى هذا الدرس التطبيقي حول الترميز للبدء. إذا كنت مرتبطًا بحساب فوترة، يمكنك تخطّي هذه الخطوة.
إعداد حساب فوترة شخصي
إذا أعددت الفوترة باستخدام أرصدة Google Cloud، يمكنك تخطّي هذه الخطوة.
لإعداد حساب فوترة شخصي، انتقِل إلى هذه الصفحة لتفعيل الفوترة في Cloud Console.
بعض الملاحظات:
- من المفترض أن يكلّف إكمال هذا التمرين أقل من دولار أمريكي واحد من موارد Cloud.
- يمكنك اتّباع الخطوات الواردة في نهاية هذا التمرين لحذف الموارد وتجنُّب تحمُّل المزيد من الرسوم.
- يكون المستخدمون الجدد مؤهّلين للاستفادة من الفترة التجريبية المجانية بقيمة 300 دولار أمريكي.
إنشاء مشروع (اختياري)
إذا لم يكن لديك مشروع حالي تريد استخدامه في هذا التمرين، يمكنك إنشاء مشروع جديد هنا.
3- ما هو "التوليد المعزّز بالاسترجاع" (RAG)؟
يُعدّ التوليد المعزّز بالاسترجاع من الأساليب المستخدَمة لتحسين الدقة الواقعية ومدى الصلة بالموضوع في الإجابات التي تقدّمها النماذج اللغوية الكبيرة. يربط النموذج اللغوي الكبير بقاعدة معرفية خارجية لربط ردوده بمعلومات محدّدة يمكن التحقّق منها.
تتضمّن العملية الخطوات التالية:
- تحويل سؤال المستخدم إلى تمثيل رقمي (تضمين)
- البحث في قاعدة المعلومات عن مستندات ذات تضمينات مشابهة
- تقديم هذه المستندات ذات الصلة كسياق للنموذج اللغوي الكبير مع السؤال الأصلي لإنشاء إجابة
ما الذي يجعل تقييم "التوليد المعزّز بالاسترجاع" معقّدًا؟
يختلف تقييم أنظمة RAG عن تقييم النماذج اللغوية التقليدية.
تحدّي المكوّنات المتعدّدة: تجمع أنظمة RAG بين ثلاث عمليات يمكن أن تكون كل منها نقطة عطل:
- جودة استرجاع المعلومات: هل عثر النظام على مستندات السياق المناسبة؟
- استخدام السياق: هل استخدم النموذج المعلومات التي تم استرجاعها بفعالية؟
- جودة الردود: هل الرد النهائي مكتوب بشكل جيد ومفيد ودقيق؟
يمكن أن يتعذّر الردّ إذا لم يعمل أيّ من هذه المكوّنات على النحو المتوقّع. على سبيل المثال، قد يستردّ النظام السياق الصحيح، ولكن يتجاهله النموذج. أو قد ينشئ النموذج ردًا مكتوبًا بشكل جيد ولكنه غير صحيح لأنّ السياق الذي تم استرداده لم يكن مناسبًا.
4. إعداد بيئة Vertex AI Workbench
لنبدأ بإنشاء بيئة دفتر ملاحظات جديدة لتشغيل الرمز البرمجي اللازم لتقييم أنظمة RAG.
- انتقِل إلى صفحة "واجهات برمجة التطبيقات والخدمات" في Cloud Console.
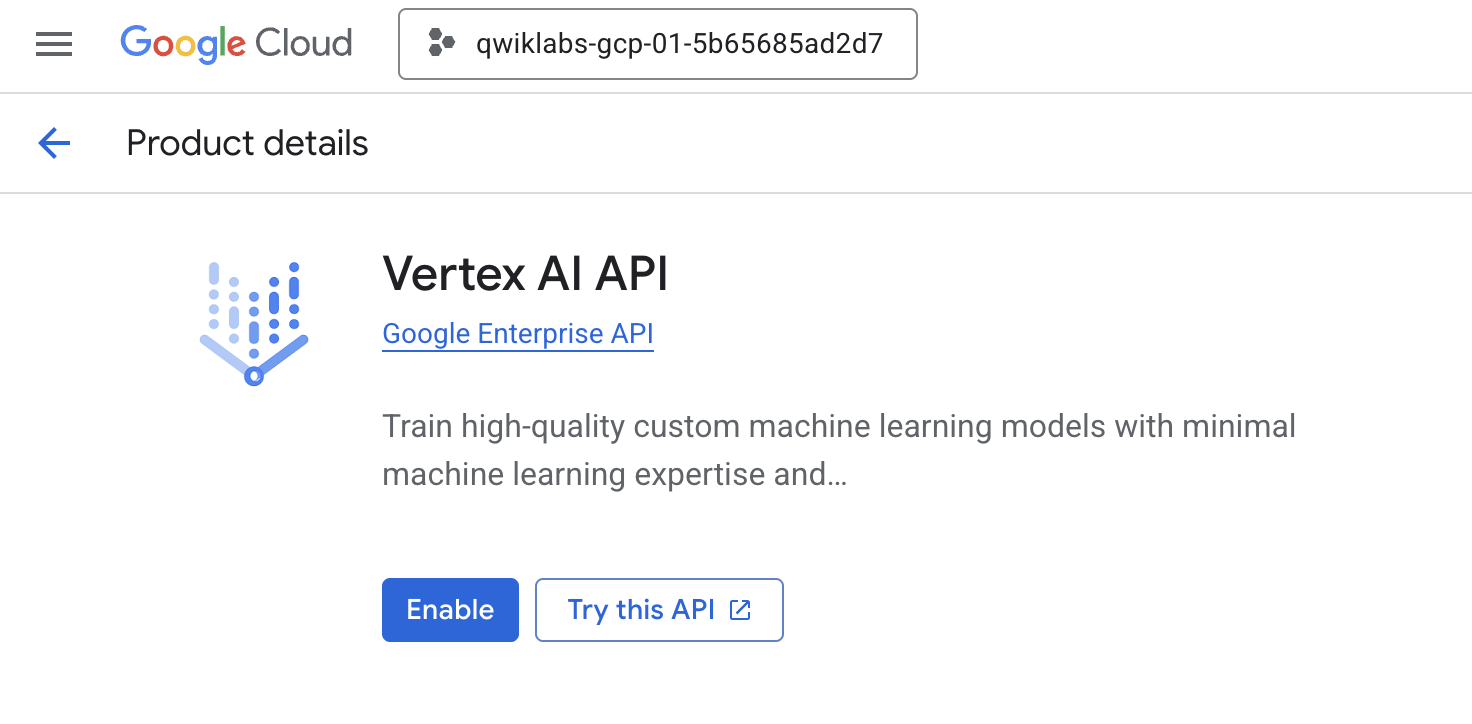
- انقر على تفعيل لـ Vertex AI API.
الوصول إلى Vertex AI Workbench
- في Google Cloud Console، انتقِل إلى Vertex AI بالنقر على قائمة التنقّل ☰ > Vertex AI > Workbench.
- إنشاء مثيل workbench جديد
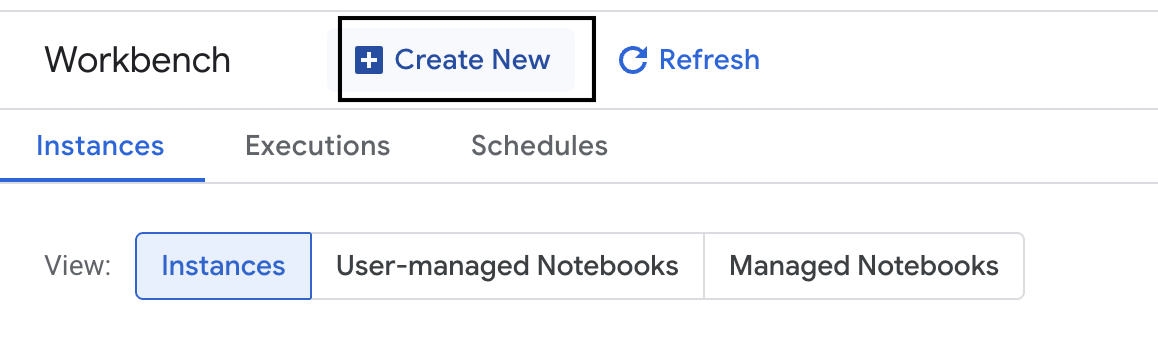
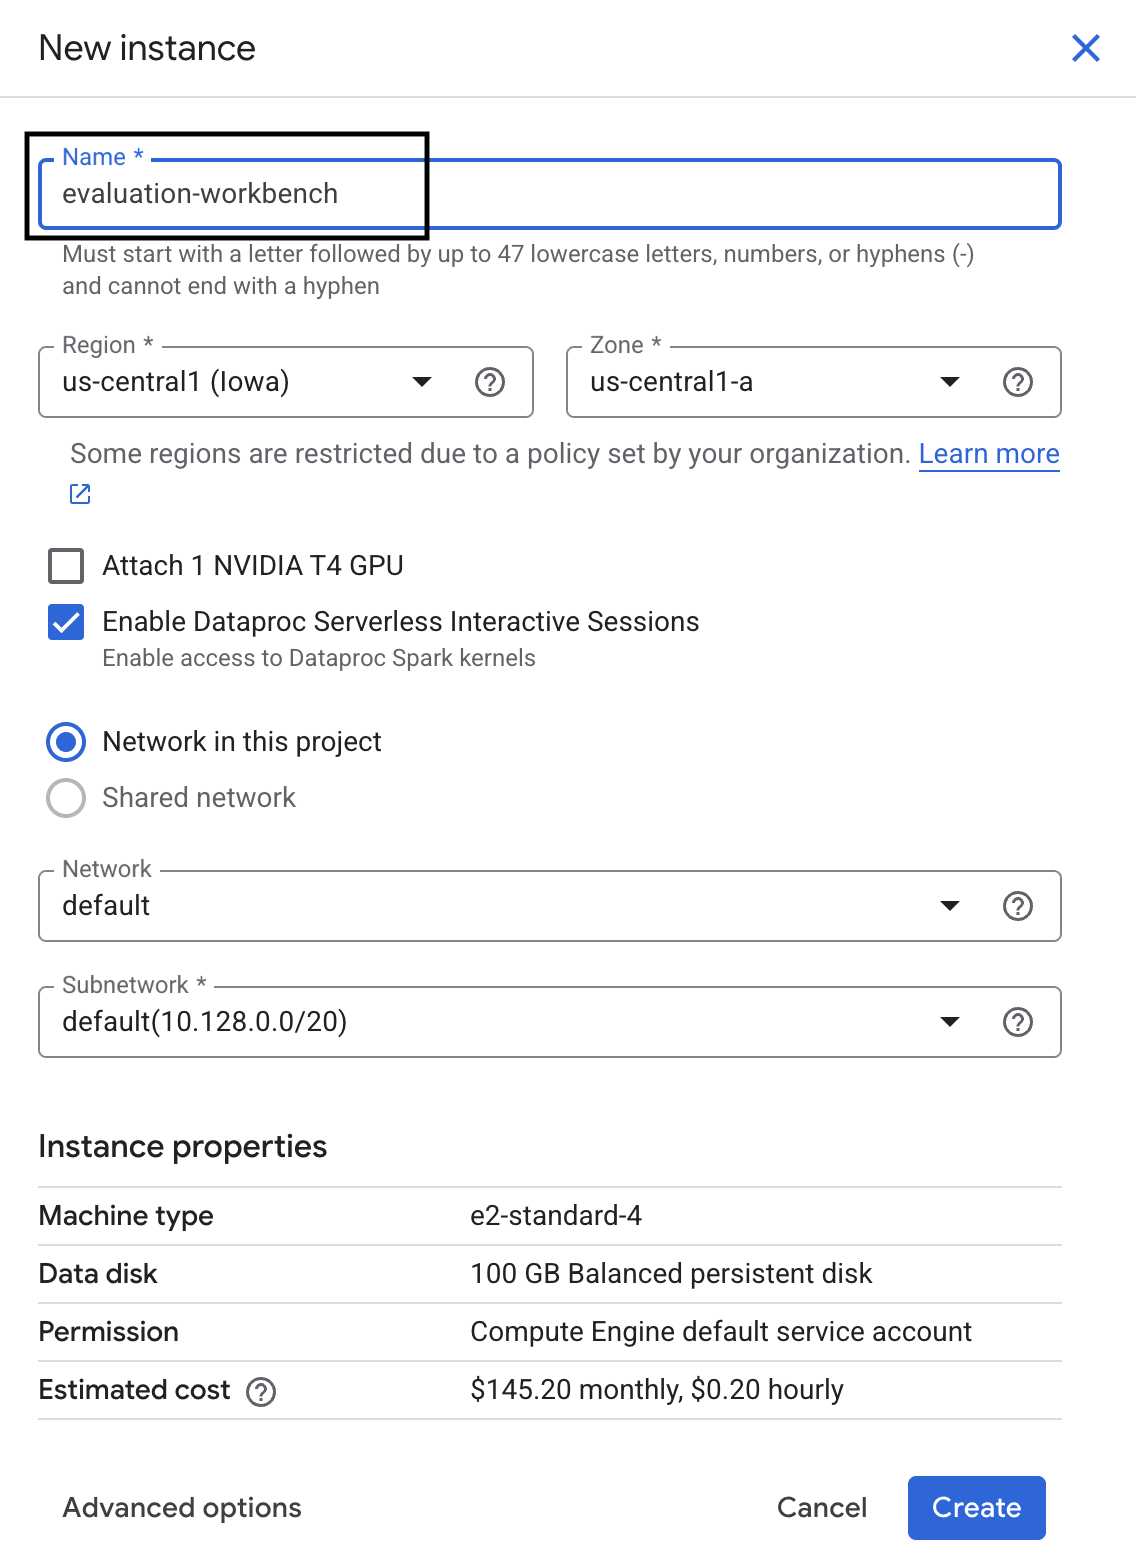
- أدخِل الاسم
evaluation-workbenchلمثيل workbench. - اختَر المنطقة والمنطقة الزمنية إذا لم يتم ضبط هذه القيم من قبل.
- انقر على إنشاء.
- انتظِر إلى أن يتم إعداد workbench. قد يستغرق هذا الإجراء بضع دقائق.
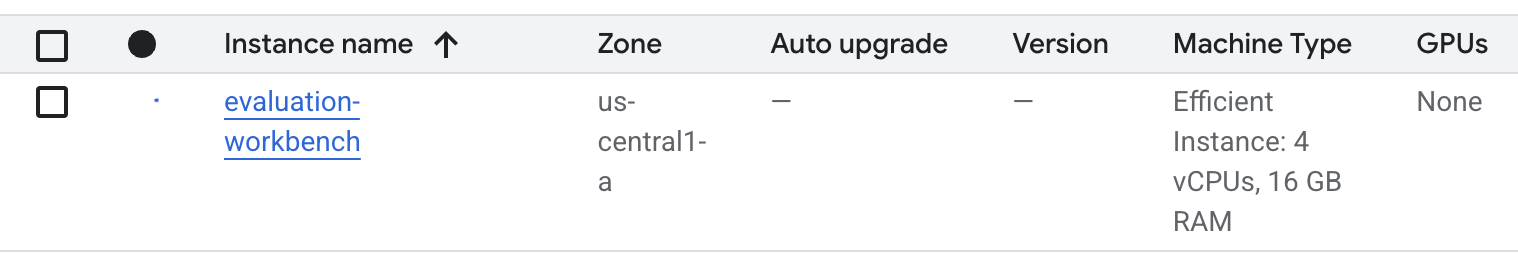
- بعد توفير workbench، انقر على فتح jupyterlab.
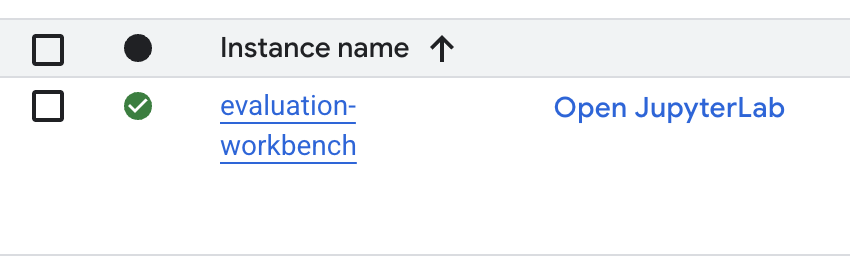
- في workbench، أنشئ دفتر ملاحظات Python3 جديدًا.
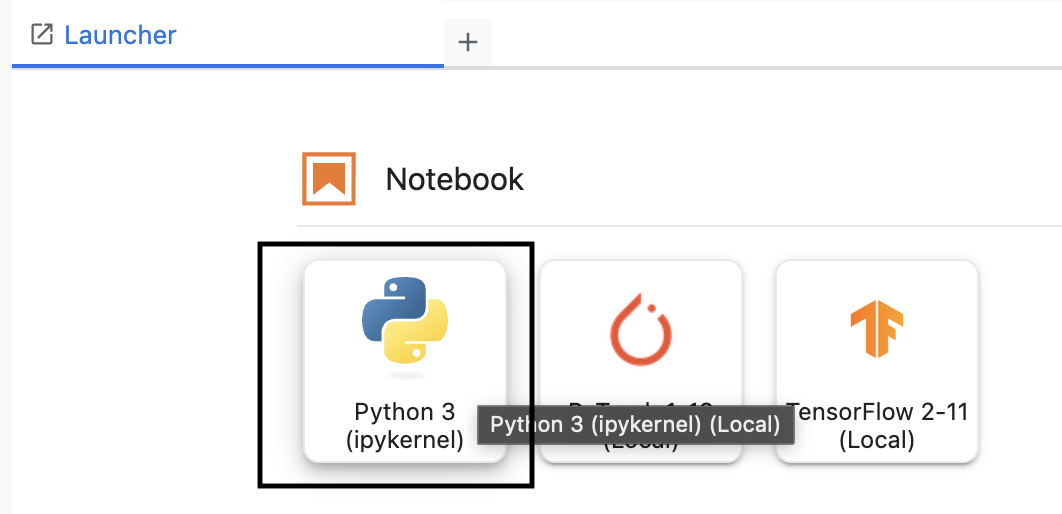
لمزيد من المعلومات حول ميزات هذه البيئة وإمكاناتها، يُرجى الاطّلاع على المستندات الرسمية حول Vertex AI Workbench.
تثبيت حزمة تطوير البرامج (SDK) لتقييم Vertex AI
لنثبّت الآن حزمة تطوير البرامج (SDK) المتخصّصة في التقييم والتي توفّر أدوات تقييم RAG.
- في الخلية الأولى من دفتر الملاحظات، أضِف عبارة الاستيراد أدناه وشغِّلها (SHIFT+ENTER) لتثبيت حزمة تطوير البرامج (SDK) لـ Vertex AI (مع مكوّنات التقييم).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: الفئة الرئيسية لتشغيل التقييمات
- MetricPromptTemplateExamples: مقاييس تقييم محدّدة مسبقًا
- PointwiseMetric: إطار عمل لإنشاء مقاييس مخصّصة
- notebook_utils: أدوات العرض المرئي لتحليل النتائج
- ملاحظة مهمة: بعد التثبيت، عليك إعادة تشغيل النواة لاستخدام الحِزم الجديدة. في شريط القوائم في أعلى نافذة JupyterLab، انتقِل إلى Kernel > Restart Kernel.
5- إعداد حزمة تطوير البرامج (SDK) واستيراد المكتبات
قبل إنشاء مسار التقييم، عليك إعداد بيئتك. يتضمّن ذلك ضبط تفاصيل مشروعك، وإعداد حزمة تطوير البرامج (SDK) لمنصة Vertex AI للاتصال بـ Google Cloud، واستيراد مكتبات Python المتخصّصة التي ستستخدمها في عملية التقييم.
- حدِّد متغيّرات الإعداد لمهمة التقييم. في خلية جديدة، أضِف الرمز التالي وشغِّله لضبط
PROJECT_IDوLOCATIONواسمEXPERIMENTلتنظيم عملية التشغيل هذه.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - ابدأ بإعداد حزمة تطوير البرامج (SDK) لخدمة Vertex AI. في خلية جديدة، أضِف الرمز التالي وشغِّله.
vertexai.init(project=PROJECT_ID, location=LOCATION) - استورِد الفئات اللازمة من حزمة تطوير البرامج (SDK) الخاصة بالتقييم من خلال تشغيل الرمز التالي في الخلية التالية:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: لإنشاء البيانات وإدارتها في DataFrames
- EvalTask: الفئة الأساسية التي تشغّل مهمة تقييم.
- MetricPromptTemplateExamples: يتيح الوصول إلى مقاييس التقييم المحدّدة مسبقًا من Google.
- PointwiseMetric: إطار العمل لإنشاء مقاييس مخصّصة
- notebook_utils: مجموعة من الأدوات لعرض النتائج بشكل مرئي
6. إعداد مجموعة بيانات التقييم
تُعدّ مجموعة البيانات المنظَّمة جيدًا أساسًا لأي تقييم موثوق. بالنسبة إلى أنظمة RAG، يجب أن تحتوي مجموعة البيانات على حقلَين رئيسيَين لكل مثال:
- الطلب: يشير ذلك إلى إجمالي الإدخالات المقدَّمة إلى النموذج اللغوي. يجب دمج سؤال المستخدم مع السياق الذي استرجعه نظام التوليد المعزّز بالاسترجاع (
prompt = User Question + Retrieved Context). هذا الإجراء مهم لكي تعرف خدمة التقييم المعلومات التي استخدمها النموذج لإنشاء إجابته. - response: يشير ذلك إلى الإجابة النهائية التي يقدّمها نموذج RAG.
للحصول على نتائج موثوقة إحصائيًا، ننصح باستخدام مجموعة بيانات تتضمّن حوالي 100 مثال. في هذا التمرين، ستستخدم مجموعة بيانات صغيرة لتوضيح العملية.
لننشئ مجموعات البيانات. ستبدأ بقائمة من الأسئلة وretrieved_contexts من نظام RAG. بعد ذلك، عليك تحديد مجموعتَين من الإجابات: واحدة من نموذج يبدو أنّه يعمل بشكل جيد (generated_answers_by_rag_a) والأخرى من نموذج يعمل بشكل سيئ (generated_answers_by_rag_b).
أخيرًا، ستجمع هذه الأجزاء في إطارَي بيانات pandas، وهما eval_dataset_rag_a وeval_dataset_rag_b، باتّباع البنية الموضّحة أعلاه.
- في خلية جديدة، أضِف الرمز التالي وشغِّله لتحديد الأسئلة ومجموعتَي generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - حدِّد retrieved_contexts. أضِف الرمز التالي وشغِّله في خلية جديدة.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - في خلية جديدة، أضِف الرمز التالي وشغِّله لإنشاء
eval_dataset_rag_aوeval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - شغِّل الرمز التالي في خلية جديدة لعرض الصفوف القليلة الأولى من مجموعة بيانات النموذج "أ".
eval_dataset_rag_a
7. اختيار المقاييس وإنشاؤها
بعد أن أصبحت مجموعات البيانات جاهزة، يمكنك تحديد كيفية قياس الأداء. يمكنك استخدام مقياس واحد أو أكثر لتقييم نموذجك. يقيّم كل مقياس جانبًا معيّنًا من ردّ النموذج، مثل دقته الواقعية أو مدى صلته بالموضوع.
يمكنك استخدام مجموعة من نوعَين من المقاييس:
- المقاييس المحدّدة مسبقًا: هي مقاييس جاهزة للاستخدام توفّرها حزمة SDK لمهام التقييم الشائعة.
- المقاييس المخصّصة: هي المقاييس التي تحدّدها لاختبار السمات ذات الصلة بحالة الاستخدام.
في هذا القسم، ستتعرّف على المقاييس المحدّدة مسبقًا المتاحة لـ RAG.
استكشاف المقاييس المحدّدة مسبقًا
تتضمّن حزمة تطوير البرامج (SDK) عدة مقاييس مدمجة لتقييم أنظمة الإجابة عن الأسئلة. تستخدم هذه المقاييس نموذجًا لغويًا كـ "مُقيِّم" لتسجيل إجابات نموذجك استنادًا إلى مجموعة من التعليمات.
- في خلية جديدة، أضِف الرمز التالي وشغِّله للاطّلاع على القائمة الكاملة لأسماء المقاييس المحدّدة مسبقًا:
MetricPromptTemplateExamples.list_example_metric_names() - لفهم آلية عمل هذه المقاييس، يمكنك فحص نماذج الطلبات الأساسية. في خلية جديدة، أضِف الرمز التالي وشغِّله للاطّلاع على التعليمات المقدَّمة إلى نموذج LLM المقيِّم لمقياس
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. إنشاء مقاييس مخصّصة
بالإضافة إلى المقاييس المحدّدة مسبقًا، يمكنك إنشاء مقاييس مخصّصة لتقييم معايير خاصة بحالة الاستخدام لديك. لإنشاء مقياس مخصّص، عليك كتابة نموذج طلب يوجّه النموذج اللغوي الكبير المقيِّم إلى كيفية تقييم الردّ.
يتضمّن إنشاء مقياس مخصّص خطوتَين:
- تحديد نموذج الطلب: سلسلة تحتوي على تعليماتك للنموذج اللغوي الكبير المُقيِّم. يتضمّن النموذج الجيد دورًا واضحًا ومعايير تقييم وقواعد لتحديد الدرجات وعناصر نائبة مثل
{prompt}و{response}. - إنشاء مثيل لكائن PointwiseMetric: يمكنك تضمين سلسلة نموذج الطلب داخل هذه الفئة وتسمية المقياس.
ستنشئ مقياسَين مخصّصَين لتقييم مدى صلة إجابات نظام RAG بموضوع البحث ومدى فائدتها.
- حدِّد نموذج الطلب لمقياس مدى الصلة بالموضوع. يوفّر هذا النموذج قواعد تقييم مفصّلة لنموذج LLM المقيِّم. في خلية جديدة، أضِف الرمز التالي وشغِّله:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - حدِّد نموذج الطلب لمقياس مدى الفائدة باستخدام النهج نفسه. أضِف الرمز التالي وشغِّله في خلية جديدة:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - أنشِئ كائنَي
PointwiseMetricللمقياسَين المخصّصَين. يؤدي ذلك إلى تضمين نماذج الطلبات في مكوّنات قابلة لإعادة الاستخدام لمهمة التقييم. أضِف الرمز التالي وشغِّله في خلية جديدة:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
لديك الآن مقياسان جديدان قابلان لإعادة الاستخدام (relevance وhelpfulness) جاهزان لمهمة التقييم.
9. تنفيذ مهمة التقييم
بعد أن أصبحت مجموعات البيانات والمقاييس جاهزة، يمكنك إجراء التقييم. يمكنك إجراء ذلك من خلال إنشاء عنصر EvalTask لكل مجموعة بيانات تريد اختبارها.
يجمع EvalTask المكوّنات لعملية تقييم:
- dataset: يمثّل DataFrame الذي يحتوي على الطلبات والردود.
- metrics: قائمة المقاييس التي تريد تسجيل النقاط وفقًا لها.
- experiment: تجربة Vertex AI لتسجيل النتائج فيها، ما يساعدك في تتبُّع عمليات التشغيل ومقارنتها.
- أنشِئ
EvalTaskلكل طراز. يجمع هذا العنصر مجموعة البيانات والمقاييس واسم التجربة. أضِف الرمز التالي وشغِّله في خلية جديدة لضبط المهام:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask، واحد لكل مجموعة من ردود النموذج. تعرض قائمةmetricsالتي قدّمتها ميزة رئيسية لخدمة التقييم: المقاييس المحدّدة مسبقًا (مثلsafety) وعناصرPointwiseMetricالمخصّصة. - بعد ضبط المهام، نفِّذها من خلال استدعاء طريقة
.evaluate(). يؤدي ذلك إلى إرسال المهام إلى الخلفية في Vertex AI لمعالجتها، وقد يستغرق اكتمالها عدة دقائق. في خلية جديدة، أضِف الرمز التالي وشغِّله:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
بعد اكتمال التقييم، سيتم تخزين النتائج في الكائنَين result_rag_a وresult_rag_b، لتكون جاهزة للتحليل في القسم التالي.
10. تحليل النتائج
تتوفّر الآن نتائج التقييم. يحتوي العنصران result_rag_a وresult_rag_b على نتائج مجمّعة وتفسيرات تفصيلية لكل صف. في هذه المهمة، عليك تحليل هذه النتائج باستخدام الدوال المساعِدة من notebook_utils.
عرض الملخّصات المجمّعة
- للحصول على نظرة عامة، استخدِم الدالة المساعِدة
display_eval_result()للاطّلاع على متوسط النتيجة لكل مقياس. في خلية جديدة، أضِف الرمز التالي وشغِّله لعرض ملخّص النموذج "أ":notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - كرِّر الأمر نفسه مع النموذج "ب". أضِف هذا الرمز البرمجي وشغِّله في خلية جديدة:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
عرض نتائج التقييم
يمكن أن تسهّل المخططات مقارنة أداء النماذج. ستستخدم نوعين من التصورات:
- مخطط راداري: يعرض "شكل" الأداء العام لكل نموذج. ويشير الشكل الأكبر إلى أداء أفضل بشكل عام.
- الرسم البياني الشريطي: لإجراء مقارنة مباشرة جنبًا إلى جنب لكل مقياس
ستساعدك هذه الرسوم البيانية في مقارنة النماذج من حيث السمات الذاتية، مثل مدى الصلة بالموضوع والارتكاز على المصادر ومدى الفائدة.
- للتحضير للرسم، ادمج النتائج في قائمة واحدة من الصفوف. يجب أن تحتوي كل مجموعة على اسم نموذج وكائن النتيجة المقابل له. في خلية جديدة، أضِف الرمز التالي وشغِّله:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - الآن، أنشئ مخططًا راداريًا لمقارنة النماذج في جميع المقاييس في آنٍ واحد. أضِف الرمز التالي وشغِّله في خلية جديدة:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - لإجراء مقارنة مباشرة أكثر لكل مقياس، أنشئ مخططًا شريطيًا. في خلية جديدة، أضِف الرمز التالي وشغِّله:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
ستُظهر الرسوم البيانية بوضوح أنّ أداء النموذج "أ" (الشكل الكبير في المخطط الراداري والأشرطة الطويلة في الرسم البياني الشريطي) يتفوّق على أداء النموذج "ب".
عرض شرح مفصّل لحالة فردية
تعرض النتائج المجمّعة الأداء العام. لفهم سبب أداء النموذج بطريقة معيّنة، عليك مراجعة التفسيرات التفصيلية التي أنشأها نموذج التقييم اللغوي الكبير لكل مثال.
- تتيح لك الدالة المساعِدة
display_explanations()فحص النتائج الفردية. للاطّلاع على التقسيم التفصيلي للمثال الثاني (num=2) من نتائج النموذج "أ"، أضِف الرمز التالي وشغِّله في خلية جديدة:notebook_utils.display_explanations(result_rag_a, num=2) - يمكنك أيضًا استخدام هذه الدالة للفلترة حسب مقياس معيّن في جميع الأمثلة. ويُعدّ ذلك مفيدًا لتصحيح الأخطاء في منطقة معيّنة ذات أداء ضعيف. لمعرفة سبب ضعف أداء النموذج "ب" في مقياس
groundedness، أضِف هذا الرمز البرمجي وشغِّله في خلية جديدة:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. التقييم المرجعي باستخدام "إجابة ذهبية"
في السابق، أجريت تقييمًا بدون مرجع، حيث تم الحكم على إجابة النموذج استنادًا إلى الطلب فقط. هذه الطريقة مفيدة، لكن التقييم شخصي.
والآن، ستستخدم التقييم المرجعي. تضيف هذه الطريقة "إجابة ذهبية" (تُعرف أيضًا باسم الإجابة المرجعية) إلى مجموعة البيانات. وتوفّر مقارنة ردّ النموذج بإجابة مستندة إلى معلومات فعلية مقياسًا أكثر موضوعية للأداء. يتيح لك ذلك قياس ما يلي:
- الدقة الواقعية: هل تتوافق إجابة النموذج مع الحقائق الواردة في الإجابة الذهبية؟
- التشابه الدلالي: هل إجابة النموذج تحمل المعنى نفسه للإجابة الذهبية؟
- الاكتمال: هل تتضمّن إجابة النموذج جميع المعلومات الأساسية من الإجابة الذهبية؟
إعداد مجموعة البيانات المُشار إليها
لإجراء تقييم مستند إلى مرجع، عليك إضافة "إجابة نموذجية" إلى كل مثال في مجموعة البيانات.
لنبدأ بتعريف قائمة golden_answers. توضّح مقارنة الإجابات الذهبية بالإجابات من النموذج "أ" قيمة هذه الطريقة:
- السؤال 1 (Brain): الإجابة التي تم إنشاؤها والإجابة الذهبية متطابقتان. النموذج "أ" صحيح.
- السؤال 2 (مجلس الشيوخ): الإجابات متشابهة من حيث المعنى ولكن تمت صياغتها بشكل مختلف. ويجب أن يراعي المقياس الجيد ذلك.
- السؤال 3 (سلالة حسن جلاليان): إجابة النموذج (أ) غير صحيحة من الناحية الواقعية وفقًا للسياق. يعرض
golden_answerهذا الخطأ.
- في خلية جديدة، حدِّد قائمة golden_answers
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - أنشئ إطارات بيانات التقييم المُشار إليها من خلال تشغيل هذه التعليمة البرمجية في الخلية التالية:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
أصبحت مجموعات البيانات الآن جاهزة للتقييم المرجعي.
إنشاء مقياس مخصّص مستند إلى مرجع
يمكنك أيضًا إنشاء مقاييس مخصّصة للتقييم المستند إلى مراجع. العملية مشابهة، ولكن نموذج الطلب يتضمّن الآن العنصر النائب {reference} للإجابة الذهبية.
عندما تكون هناك إجابة "صحيحة" قاطعة، يمكنك استخدام نظام تقييم ثنائي أكثر صرامة (مثلاً، 1 للإجابة الصحيحة و0 للإجابة الخاطئة) لقياس الدقة الواقعية. لننشئ مقياسًا جديدًا في question_answering_correctness يطبّق هذا المنطق.
- حدِّد نموذج الطلب. في خلية جديدة، أضِف الرمز التالي وشغِّله:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - أدرِج سلسلة نموذج الطلب داخل عنصر PointwiseMetric. يمنح ذلك المقياس اسمًا رسميًا ويجعله مكوّنًا قابلاً لإعادة الاستخدام في مهمة التقييم. أضِف الرمز التالي وشغِّله في خلية جديدة:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
لديك الآن مقياس مخصّص ومستند إلى مراجع لإجراء عملية التحقق من صحة الأخبار.
12. إجراء التقييم المرجعي
الآن، عليك ضبط مهمة التقييم باستخدام مجموعات البيانات المُشار إليها والمقياس الجديد. ستستخدم فئة EvalTask مرة أخرى.
تجمع قائمة المقاييس الآن بين المقياس المخصّص المستند إلى النموذج والمقاييس المستندة إلى العمليات الحسابية. يتيح التقييم المرجعي استخدام المقاييس التقليدية المستندة إلى العمليات الحسابية التي تُجري مقارنات رياضية بين نصّ من إنشاء الذكاء الاصطناعي والنص المرجعي. ستستخدم ثلاثة أنواع شائعة:
-
exact_match: تكون النتيجة 1 فقط إذا كانت الإجابة التي تم إنشاؤها مطابقة للإجابة المرجعية، و0 في الحالات الأخرى. -
bleu: مقياس للدقة ويقيس عدد الكلمات من الإجابة التي تم إنشاؤها والتي تظهر أيضًا في الإجابة المرجعية. -
rouge: مقياس للاستدعاء ويقيس عدد الكلمات من الإجابة المرجعية التي تم التقاطها في الإجابة التي تم إنشاؤها.
- اضبط مهمة التقييم باستخدام مجموعات البيانات المُشار إليها والمزيج الجديد من المقاييس. في خلية جديدة، أضِف الرمز التالي وشغِّله لإنشاء عناصر
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - نفِّذ التقييم المُشار إليه من خلال استدعاء الإجراء
.evaluate(). أضِف هذا الرمز البرمجي وشغِّله في خلية جديدة:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. تحليل النتائج المُشار إليها
اكتمل التقييم. في هذه المهمة، ستحلّل النتائج لقياس الدقة الواقعية للنماذج من خلال مقارنة إجاباتها بالإجابات المرجعية الذهبية.
عرض ملخّص النتائج
- تحليل النتائج الموجزة للتقييم المشار إليه. في خلية جديدة، أضِف الرمز التالي وشغِّله لعرض جداول الملخّص لكلا النموذجَين:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessالمخصّص، ولكنّه يحصل على نتيجة أقل فيexact_match. يُبرز ذلك قيمة المقاييس المستندة إلى النماذج التي يمكنها التعرّف على التشابه الدلالي، وليس فقط النصوص المتطابقة.
عرض النتائج للمقارنة
يمكن أن تجعل التصورات فجوة الأداء بين النموذجين أكثر وضوحًا. أولاً، ادمج النتائج في قائمة واحدة لإنشاء المخططات، ثم أنشئ المخططات الرادارية والشريطية.
- اجمع نتائج التقييم المُشار إليها في قائمة واحدة لإنشاء الرسم البياني. أضِف الرمز التالي وشغِّله في خلية جديدة:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - أنشئ مخططًا راداريًا لتصور أداء كل نموذج عبر مجموعة المقاييس الجديدة. أضِف هذا الرمز البرمجي وشغِّله في خلية جديدة:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - أنشئ مخططًا شريطيًا لإجراء مقارنة مباشرة جنبًا إلى جنب. سيعرض ذلك مستوى أداء كل نموذج وفقًا للمقاييس المختلفة. أضِف الرمز التالي وشغِّله في خلية جديدة:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
تؤكّد هذه الرسوم البيانية أنّ النموذج "أ" أكثر دقة بكثير من النموذج "ب" ويتوافق مع الإجابات المرجعية من حيث الحقائق.
14. من التدريب إلى الإنتاج
لقد نفّذت بنجاح مسار تقييم كامل لنظام RAG. يلخّص هذا القسم الأخير المفاهيم الاستراتيجية الرئيسية التي تعلّمتها ويقدّم إطار عمل لتطبيق هذه المهارات على مشاريع واقعية.
أفضل الممارسات المتعلّقة بالإنتاج
لتطبيق المهارات المكتسَبة من هذا التمرين المعملي في بيئة تشغيل فعلي، ننصحك باتّباع الممارسات الرئيسية الأربع التالية:
- الأتمتة باستخدام CI/CD: يمكنك دمج حزمة التقييم في مسار CI/CD (مثل Cloud Build وGitHub Actions). يمكنك إجراء عمليات التقييم تلقائيًا على تغييرات الرموز البرمجية لرصد أي تراجُع في الأداء وحظر عمليات النشر إذا انخفضت درجات الجودة عن معاييرك.
- تطوير مجموعات البيانات: تصبح مجموعة البيانات الثابتة قديمة. التحكّم في إصدارات مجموعات الاختبار "الذهبية" (باستخدام Git LFS أو Cloud Storage) وإضافة أمثلة جديدة وصعبة باستمرار من خلال أخذ عيّنات من طلبات بحث المستخدمين الحقيقية (المجهولة الهوية)
- تقييم أداة الاسترجاع، وليس أداة الإنشاء فقط: لا يمكن الحصول على إجابة رائعة بدون السياق المناسب. نفِّذ خطوة تقييم منفصلة لنظام الاسترجاع باستخدام مقاييس مثل معدّل الإصابة (هل تم العثور على المستند الصحيح؟) ومتوسط الترتيب المتبادل (MRR) (ما مدى ارتفاع ترتيب المستند الصحيح؟).
- مراقبة المقاييس بمرور الوقت: يمكنك تصدير نتائج الملخّص من عمليات التقييم إلى خدمة مثل Google Cloud Monitoring. يمكنك إنشاء لوحات بيانات لتتبُّع مؤشرات الجودة وإعداد تنبيهات مبرمَجة لإعلامك بالانخفاضات الكبيرة في الأداء.
مصفوفة منهجية التقييم المتقدّمة
يعتمد اختيار طريقة التقييم المناسبة على أهدافك المحدّدة، ويلخّص هذا الجدول الحالات التي يجب فيها استخدام كل طريقة.
طريقة التقييم | أفضل حالات الاستخدام | المزايا الرئيسية | القيود |
Reference-Free | مراقبة الإنتاج والتقييم المستمر | لا حاجة إلى إجابات نموذجية، ويتم تسجيل الجودة الذاتية | أكثر تكلفة، تحيز محتمل للمقيِّم |
Reference-Based | مقارنة النماذج، قياس الأداء | قياس موضوعي وحوسبة أسرع | يتطلّب إجابات نموذجية، وقد لا يرصد التكافؤ الدلالي |
المقاييس المخصّصة | تقييم خاص بالمجال | مخصّصة لتلبية احتياجات المؤسسات | يتطلّب التحقّق من الصحة، وأعباء التطوير |
النهج المختلط | أنظمة إنتاج شاملة | أفضل الطرق على الإطلاق | مستوى تعقيد أعلى، والحاجة إلى تحسين التكلفة |
الإحصاءات الفنية الرئيسية
تذكَّر هذه المبادئ الأساسية عند إنشاء أنظمة RAG وتقييمها:
- الاستناد إلى المصادر أمر بالغ الأهمية لتقنية RAG: يميّز هذا المقياس باستمرار بين أنظمة RAG العالية والمنخفضة الجودة، ما يجعله ضروريًا لمراقبة الإنتاج.
- المقاييس المتعددة توفّر القوة: لا يمكن لمقياس واحد أن يغطي جميع جوانب جودة RAG. يتطلّب التقييم الشامل جوانب تقييم متعدّدة.
- المقاييس المخصّصة تضيف قيمة كبيرة: غالبًا ما ترصد معايير التقييم الخاصة بالمجال الفروق الدقيقة التي لا ترصدها المقاييس العامة، ما يحسّن دقة التقييم.
- الدقة الإحصائية تعزّز الثقة: من خلال استخدام أحجام عينات مناسبة وإجراء اختبارات الدلالة، تتحوّل عملية التقييم من مجرد تخمين إلى أداة موثوقة لاتخاذ القرارات.
إطار عمل اتخاذ القرار بشأن النشر في بيئة الإنتاج
استخدِم إطار العمل المرحلي هذا كدليل لعمليات نشر نظام RAG في المستقبل:
- المرحلة 1 - التطوير: استخدِم التقييم المستند إلى المراجع مع مجموعات اختبار معروفة لمقارنة النماذج واختيارها.
- المرحلة 2 - مرحلة ما قبل الإنتاج: إجراء تقييم شامل يجمع بين النهجَين للتحقّق من الجاهزية لإصدار التطبيق
- المرحلة 3 - الإنتاج: يمكنك تنفيذ عملية مراقبة بدون مراجع لتقييم الجودة بشكل مستمر بدون إجابات نموذجية.
- المرحلة 4 - التحسين: استخدِم إحصاءات التقييم لتوجيه تحسينات النماذج وتحسينات نظام الاسترجاع.
15. الخاتمة
تهانينا! لقد أكملت التمرين المعملي.
هذا التمرين العملي هو جزء من المسار التعليمي "الذكاء الاصطناعي الجاهز للإنتاج باستخدام Google Cloud".
- استكشِف المنهج الدراسي الكامل لسد الفجوة بين النموذج الأوّلي والإنتاج.
- شارِك مستوى تقدّمك باستخدام الهاشتاغ
ProductionReadyAI.
ملخّص
لقد تعرّفت على كيفية:
- يمكنك إجراء تقييم بدون مرجع لتقييم جودة الإجابة استنادًا إلى السياق الذي تم استرداده.
- إجراء تقييم مستند إلى مرجع من خلال إضافة "إجابة ذهبية" لقياس مدى صحة الحقائق
- استخدِم مزيجًا من المقاييس المحدّدة مسبقًا والمخصّصة لكلا النهجَين.
- استخدِم كلاً من المقاييس المستندة إلى النماذج (مثل
question_answering_quality) والمقاييس المستندة إلى العمليات الحسابية (rougeوbleuوexact_match). - تحليل النتائج وعرضها لفهم نقاط القوة والضعف في النموذج
يساعدك هذا النهج في التقييم على إنشاء تطبيقات ذكاء اصطناعي توليدي أكثر موثوقية ودقة.