

১. এক নজরে
এই ল্যাবে, আপনি শিখবেন কীভাবে একটি Retrieval-Augmented Generation (RAG) সিস্টেমের জন্য একটি মূল্যায়ন পাইপলাইন তৈরি করতে হয়। আপনি Vertex AI Gen AI Evaluation Service ব্যবহার করে কাস্টম মূল্যায়ন মানদণ্ড তৈরি করবেন এবং প্রশ্ন-উত্তর টাস্কের জন্য একটি মূল্যায়ন ফ্রেমওয়ার্ক তৈরি করবেন।
মূল্যায়ন ডেটাসেট তৈরি, রেফারেন্স-মুক্ত ও রেফারেন্স-ভিত্তিক মূল্যায়ন কনফিগার এবং ফলাফল ব্যাখ্যা করার জন্য আপনি Stanford Question Answering Dataset (SQuAD 2.0)-এর উদাহরণ নিয়ে কাজ করবেন। এই ল্যাবের শেষে, আপনি বুঝতে পারবেন কীভাবে RAG সিস্টেম মূল্যায়ন করতে হয় এবং কেন নির্দিষ্ট মূল্যায়ন পদ্ধতি বেছে নেওয়া হয়।
ডেটাসেট ফাউন্ডেশন
আমরা SQuAD 2.0 প্রশ্ন উত্তর ডেটাসেট-এ পাওয়া একাধিক ডোমেন জুড়ে যত্ন সহকারে তৈরি করা উদাহরণ নিয়ে কাজ করব:
- নিউরোসায়েন্স: বৈজ্ঞানিক প্রসঙ্গে প্রযুক্তিগত নির্ভুলতা পরীক্ষা করা
- ইতিহাস: ঐতিহাসিক বর্ণনায় ফ্যাকচুয়াল নির্ভুলতা মূল্যায়ন করা
- ভূগোল: আঞ্চলিক ও রাজনৈতিক জ্ঞান মূল্যায়ন করা
এই বৈচিত্র্য আপনাকে বুঝতে সাহায্য করে যে কীভাবে মূল্যায়নের পদ্ধতিগুলি বিভিন্ন বিষয় জুড়ে সাধারণীকরণ করে।
রেফারেন্স
- কোড স্যাম্পেল: এই ল্যাব Vertex AI Evaluation ডকুমেন্টেশন থেকে উদাহরণ তৈরি করে
- ডেটাসেট ফাউন্ডেশন: SQuAD 2.0 প্রশ্ন উত্তর ডেটাসেট
- RAG রিট্রিভাল অপ্টিমাইজ করা: টেস্ট, টিউন, সাফল্য
আপনি কী শিখবেন
এই ল্যাবে, আপনি নিম্নলিখিত টাস্কগুলি কীভাবে সম্পাদন করবেন তা শিখবেন:
- RAG সিস্টেমের জন্য মূল্যায়ন ডেটাসেট প্রস্তুত করো।
- গ্রাউন্ডেডনেস ও প্রাসঙ্গিকতার মতো মেট্রিক ব্যবহার করে রেফারেন্স-মুক্ত মূল্যায়ন প্রয়োগ করুন।
- সেম্যান্টিক সিমিলারিটি মেজার সহ রেফারেন্স-ভিত্তিক মূল্যায়ন প্রয়োগ করুন।
- বিস্তারিত স্কোরিং রুব্রিক সহ কাস্টম মূল্যায়ন মেট্রিক তৈরি করুন।
- মডেল বেছে নেওয়ার ব্যাপারে তথ্য দিতে মূল্যায়নের ফলাফল ব্যাখ্যা ও ভিজ্যুয়ালাইজ করুন।
২. প্রোজেক্ট সেট-আপ
Google অ্যাকাউন্ট
আপনার আগে থেকে কোনও ব্যক্তিগত Google অ্যাকাউন্ট না থাকলে, আপনাকে অবশ্যই একটি Google অ্যাকাউন্ট তৈরি করতে হবে।
অফিস বা স্কুলের অ্যাকাউন্টের পরিবর্তে ব্যক্তিগত অ্যাকাউন্ট ব্যবহার করুন।
Google Cloud Console-এ সাইন-ইন করুন
ব্যক্তিগত Google অ্যাকাউন্ট ব্যবহার করে Google Cloud Console-এ সাইন-ইন করুন।
বিলিং চালু করুন
Google Cloud ক্রেডিট রিডিম করুন (ঐচ্ছিক)
এই ওয়ার্কশপ চালাতে, আপনার কাছে কিছু ক্রেডিট সহ বিলিং অ্যাকাউন্ট থাকতে হবে। শুরু করতে এই কোডল্যাবের উপরে ব্যানারে দেখানো ক্রেডিট ব্যবহার করুন। আপনি আগে থেকেই কোনও বিলিং অ্যাকাউন্টের সাথে কানেক্ট করে থাকলে, এই ধাপটি এড়িয়ে যেতে পারেন।
ব্যক্তিগত বিলিং অ্যাকাউন্ট সেট-আপ করা
Google Cloud ক্রেডিট ব্যবহার করে বিলিং সেট-আপ করলে, আপনি এই ধাপটি এড়িয়ে যেতে পারবেন।
ব্যক্তিগত বিলিং অ্যাকাউন্ট সেট-আপ করতে, Cloud Console-এ বিলিং চালু করতে এখানে যান।
কিছু নোট:
- এই ল্যাব সম্পূর্ণ করতে Cloud রিসোর্সে $১ মার্কিন ডলারের কম খরচ হওয়া উচিত।
- আরও চার্জ এড়াতে রিসোর্স মুছে ফেলতে আপনি এই ল্যাবের শেষে উল্লেখ করা ধাপগুলি অনুসরণ করতে পারেন।
- নতুন ব্যবহারকারীরা $৩০০ মার্কিন ডলারের ফ্রি ট্রায়াল-এর জন্য উপযুক্ত।
প্রোজেক্ট তৈরি করুন (ঐচ্ছিক)
এই ল্যাবের জন্য ব্যবহার করার মতো কোনও বর্তমান প্রোজেক্ট আপনার কাছে না থাকলে, এখান থেকে নতুন প্রোজেক্ট তৈরি করুন।
৩. Retrieval Augmented Generation (RAG) কী?
RAG হল এমন একটি টেকনিক যা লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) থেকে পাওয়া উত্তরের ফ্যাকচুয়াল নির্ভুলতা ও প্রাসঙ্গিকতা উন্নত করতে ব্যবহার করা হয়। এটি LLM-কে একটি এক্সটার্নাল নলেজ বেসের সাথে কানেক্ট করে যাতে নির্দিষ্ট, যাচাইযোগ্য তথ্যের ভিত্তিতে উত্তর দেওয়া যায়।
এই প্রসেসে নিম্নলিখিত ধাপগুলি রয়েছে:
- ব্যবহারকারীর প্রশ্নকে সংখ্যাগত উপস্থাপনায় (একটি এম্বেডিং) পরিবর্তন করা।
- একই ধরনের এম্বেডিং সহ ডকুমেন্টের জন্য নলেজ বেস সার্চ করা হচ্ছে।
- উত্তর জেনারেট করার জন্য মূল প্রশ্নের সাথে LLM-এর প্রাসঙ্গিক ডকুমেন্ট প্রদান করা।
RAG সম্পর্কে আরও জানুন।
RAG মূল্যায়নকে কী জটিল করে তোলে?
RAG সিস্টেমের মূল্যায়ন করা চিরাচরিত ল্যাঙ্গুয়েজ মডেলের মূল্যায়ন করার থেকে আলাদা।
মাল্টি-কম্পোনেন্ট চ্যালেঞ্জ: RAG সিস্টেম তিনটি অপারেশনকে একত্রিত করে যার প্রতিটি ব্যর্থতার কারণ হতে পারে:
- রিট্রিভাল কোয়ালিটি: সিস্টেম কি সঠিক প্রাসঙ্গিক ডকুমেন্ট খুঁজে পেয়েছে?
- প্রসঙ্গের ব্যবহার: মডেলটি কি উদ্ধার করা তথ্য কার্যকরভাবে ব্যবহার করেছে?
- জেনারেট করা উত্তরের কোয়ালিটি: চূড়ান্ত উত্তরটি কি ভালোভাবে লেখা, সহায়ক এবং সঠিক?
এইসব কম্পোনেন্টের মধ্যে কোনও একটি প্রত্যাশা অনুযায়ী কাজ না করলে, উত্তরটি ব্যর্থ হতে পারে। যেমন, সিস্টেম সঠিক প্রসঙ্গ খুঁজে পেলেও মডেল তা উপেক্ষা করতে পারে। অথবা, মডেলটি একটি ভালভাবে লেখা উত্তর তৈরি করতে পারে যা ভুল কারণ উদ্ধার করা প্রসঙ্গটি অপ্রাসঙ্গিক ছিল।
৪. আপনার Vertex AI Workbench এনভায়রনমেন্ট সেট-আপ করা
আসুন, একটি নতুন নোটবুক এনভায়রনমেন্ট শুরু করার মাধ্যমে শুরু করা যাক, যেখানে আমরা RAG সিস্টেম মূল্যায়ন করার জন্য প্রয়োজনীয় কোড রান করব।
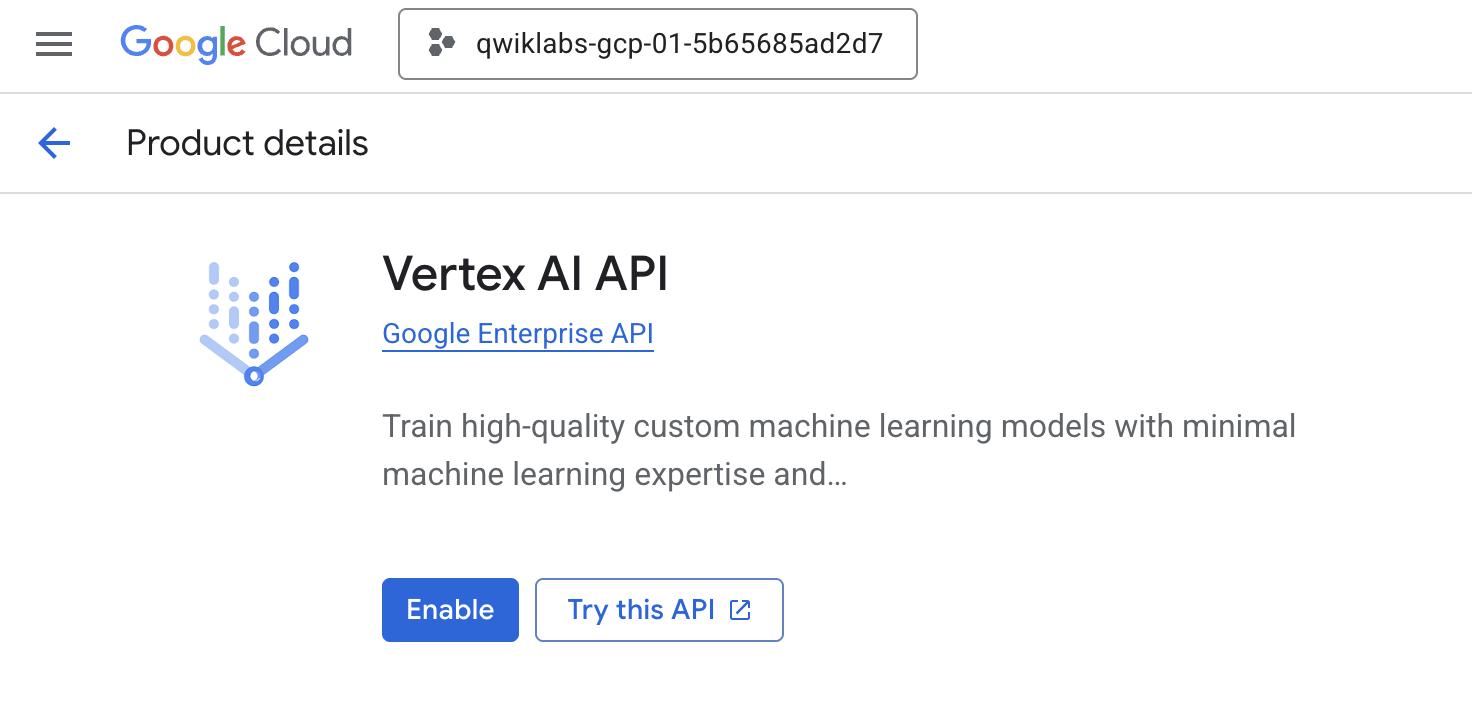
- আপনার Cloud Console-এর API ও পরিষেবা পৃষ্ঠায় নেভিগেট করুন।
- Vertex AI API-এর জন্য চালু করুন বিকল্পে ক্লিক করুন।
Vertex AI Workbench অ্যাক্সেস করুন
- Google Cloud Console-এ, নেভিগেশন মেনু ☰ > Vertex AI > Workbench বিকল্পে ক্লিক করে Vertex AI-তে নেভিগেট করুন।
- নতুন ওয়ার্কবেঞ্চ ইনস্ট্যান্স তৈরি করুন।
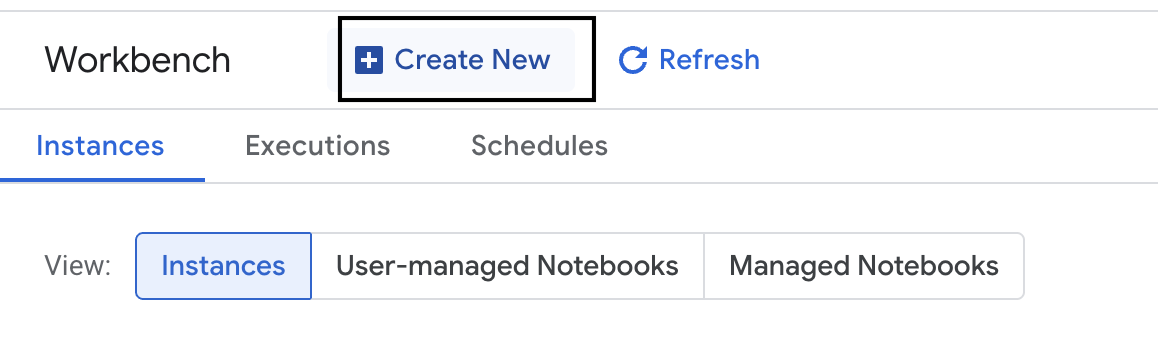
- ওয়ার্কবেঞ্চ ইনস্ট্যান্স
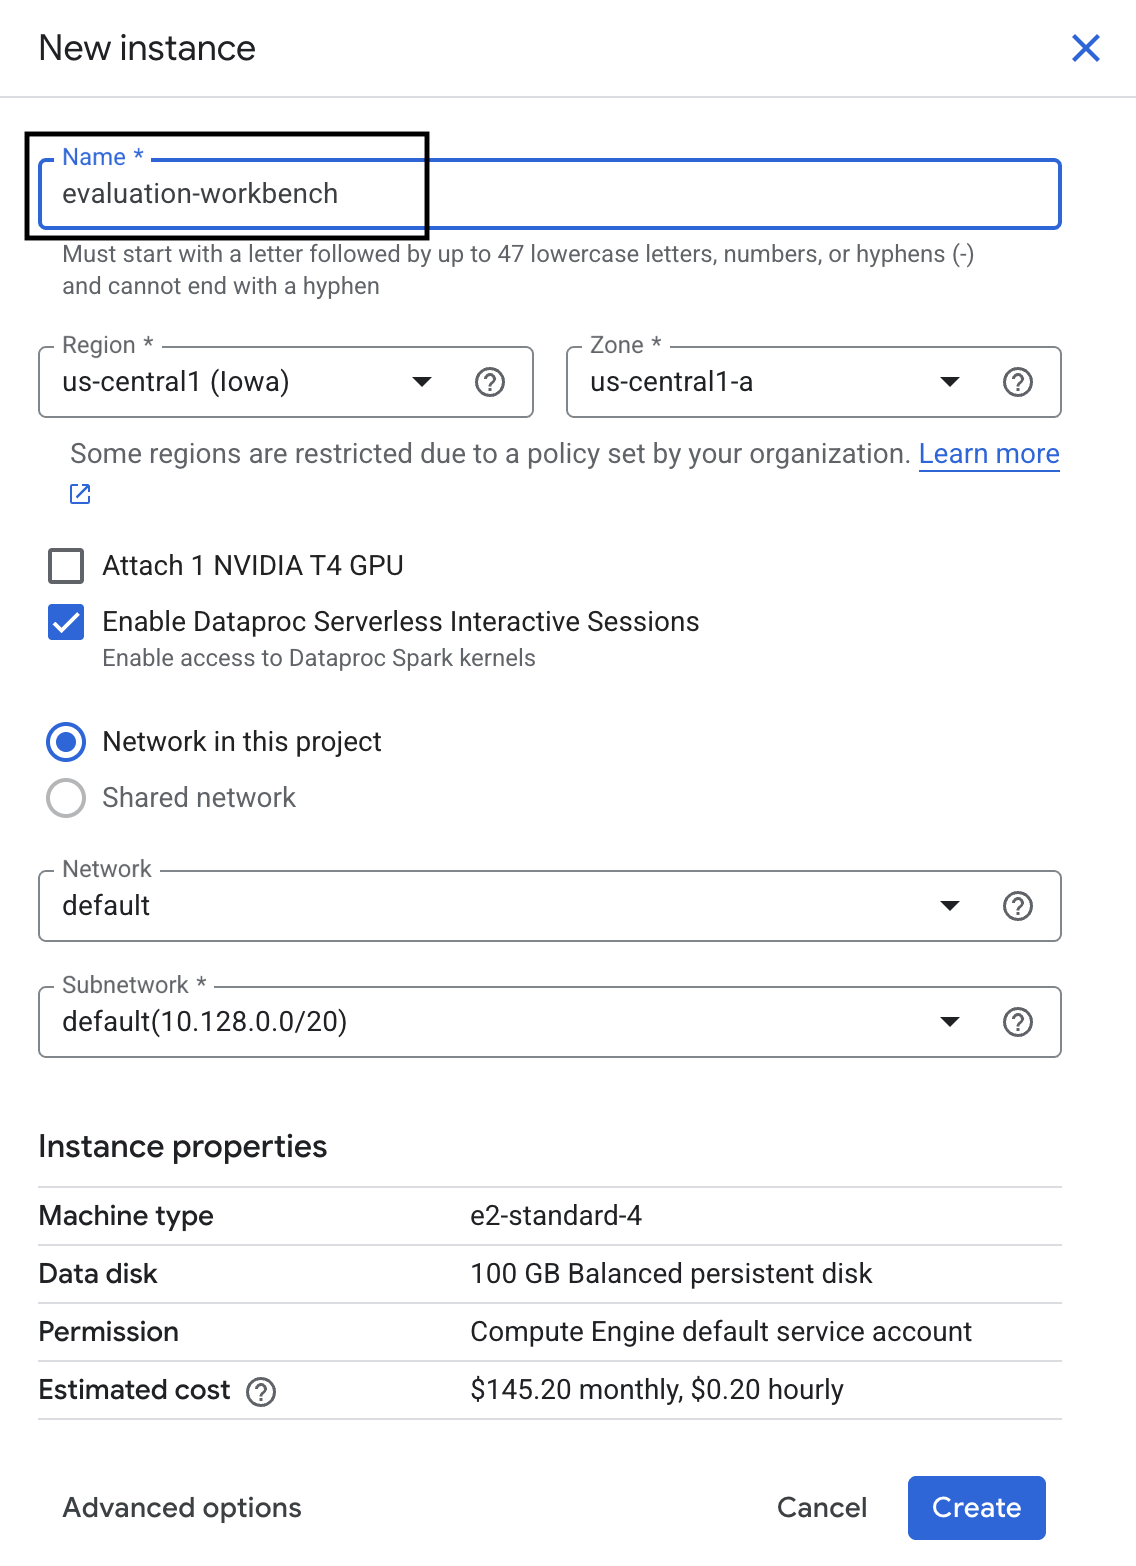
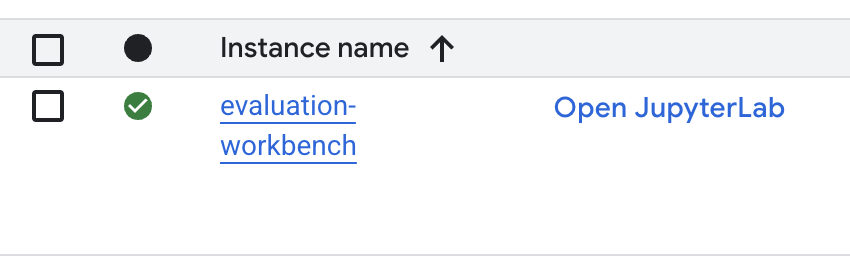
evaluation-workbench-এর নাম দিন। - আপনার অঞ্চল ও জোন আগে থেকে সেট করা না থাকলে, সেগুলি বেছে নিন।
- তৈরি করুন বিকল্পে ক্লিক করুন।
- ওয়ার্কবেঞ্চ সেট-আপ হওয়া পর্যন্ত অপেক্ষা করুন। এতে কয়েক মিনিট সময় লাগতে পারে।
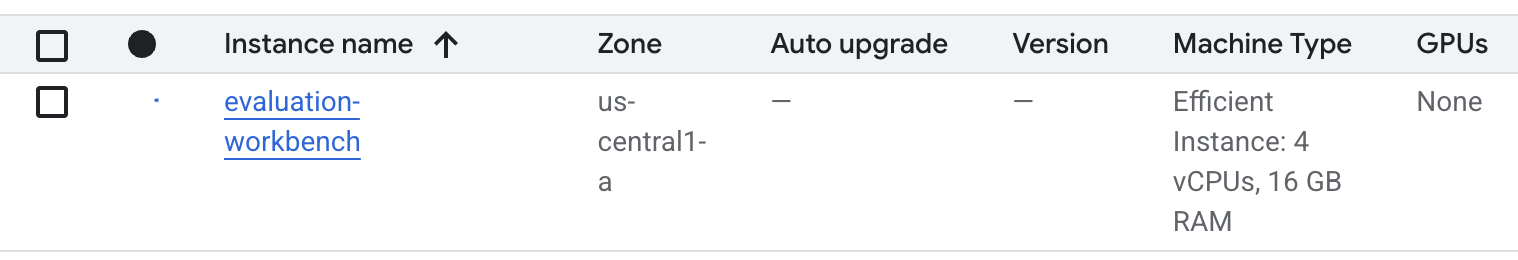
- ওয়ার্কবেঞ্চ প্রোভিশন করা হয়ে গেলে, jupyterlab খুলুন বিকল্পে ক্লিক করুন।
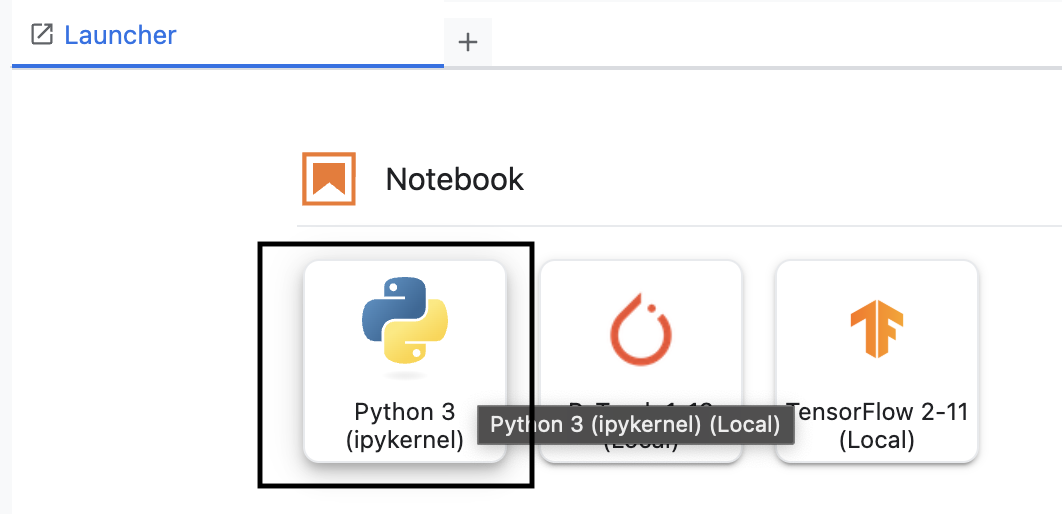
- ওয়ার্কবেঞ্চে, নতুন Python3 নোটবুক তৈরি করুন।
এই এনভায়রনমেন্টের ফিচার ও ক্ষমতা সম্পর্কে আরও জানতে, Vertex AI Workbench-এর অফিসিয়াল ডকুমেন্টেশন দেখুন।
Vertex AI মূল্যায়ন SDK ইনস্টল করুন
এখন বিশেষ মূল্যায়ন SDK ইনস্টল করা যাক যা RAG মূল্যায়নের জন্য টুল প্রদান করে।
- আপনার নোটবুকের প্রথম সেলে, Vertex AI SDK (মূল্যায়ন কম্পোনেন্ট সহ) ইনস্টল করতে, নিচে দেওয়া ইমপোর্ট স্টেটমেন্ট যোগ করে রান (SHIFT+ENTER) করুন।
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: মূল্যায়ন চালানোর জন্য প্রধান ক্লাস
- MetricPromptTemplateExamples: আগে থেকে নির্ধারিত মূল্যায়ন মেট্রিক
- PointwiseMetric: কাস্টম মেট্রিক তৈরি করার ফ্রেমওয়ার্ক
- notebook_utils: ফলাফল বিশ্লেষণের জন্য ভিজ্যুয়ালাইজেশন টুল
- গুরুত্বপূর্ণ: ইনস্টল করার পরে, নতুন প্যাকেজ ব্যবহার করার জন্য আপনাকে কার্নেল রিস্টার্ট করতে হবে। আপনার JupyterLab উইন্ডোর উপরের মেনু বারে, কার্নেল > কার্নেল রিস্টার্ট করুন বিকল্পে নেভিগেট করুন।
৫. SDK শুরু করুন এবং লাইব্রেরি ইমপোর্ট করুন
মূল্যায়ন পাইপলাইন তৈরি করার আগে, আপনাকে এনভায়রনমেন্ট সেট-আপ করতে হবে। এর মধ্যে আপনার প্রোজেক্টের বিবরণ কনফিগার করা, Google Cloud-এর সাথে কানেক্ট করার জন্য Vertex AI SDK শুরু করা এবং মূল্যায়নের জন্য আপনি যে বিশেষ Python লাইব্রেরি ব্যবহার করবেন তা ইমপোর্ট করা অন্তর্ভুক্ত।
- আপনার মূল্যায়ন কাজের জন্য কনফিগারেশন ভেরিয়েবেল নির্ধারণ করুন। নতুন সেলে, এই রান সাজাতে আপনার
PROJECT_ID,LOCATIONএবংEXPERIMENTনাম সেট করতে নিম্নলিখিত কোড যোগ করে রান করুন।import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Vertex AI SDK ইনিশিয়ালাইজ করুন। নতুন সেলে, নিম্নলিখিত কোড যোগ করে রান করুন।
vertexai.init(project=PROJECT_ID, location=LOCATION) - পরবর্তী সেলে নিম্নলিখিত কোড রান করে মূল্যায়ন SDK থেকে প্রয়োজনীয় ক্লাস ইমপোর্ট করুন:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: DataFrame-এ ডেটা তৈরি ও ম্যানেজ করার জন্য।
- EvalTask: মূল ক্লাস যা মূল্যায়ন কাজ চালায়।
- MetricPromptTemplateExamples: Google-এর আগে থেকে নির্ধারিত মূল্যায়ন মেট্রিক্সে অ্যাক্সেস প্রদান করে।
- PointwiseMetric: আপনার নিজস্ব কাস্টম মেট্রিক তৈরি করার ফ্রেমওয়ার্ক।
- notebook_utils: ফলাফল ভিজ্যুয়ালাইজ করার জন্য টুলের সংগ্রহ।
৬. আপনার মূল্যায়ন ডেটাসেট প্রস্তুত করুন
যেকোনও নির্ভরযোগ্য মূল্যায়নের ভিত্তি হল একটি সুগঠিত ডেটাসেট। RAG সিস্টেমের জন্য, আপনার ডেটাসেটে প্রতিটি উদাহরণের জন্য দুটি মূল ফিল্ড প্রয়োজন:
- প্রম্পট: এটি হল ল্যাঙ্গুয়েজ মডেলে দেওয়া মোট ইনপুট। আপনাকে অবশ্যই ব্যবহারকারীর প্রশ্নকে আপনার RAG সিস্টেম (
prompt = User Question + Retrieved Context) দ্বারা প্রাপ্ত প্রসঙ্গের সাথে একত্রিত করতে হবে। এটি গুরুত্বপূর্ণ যাতে মূল্যায়ন পরিষেবা জানতে পারে যে মডেলটি তার উত্তর তৈরি করতে কোন তথ্য ব্যবহার করেছে। - response: এটি আপনার RAG মডেলের মাধ্যমে তৈরি করা চূড়ান্ত উত্তর।
পরিসংখ্যানগতভাবে নির্ভরযোগ্য ফলাফলের জন্য, প্রায় ১০০টি উদাহরণের একটি ডেটাসেট সাজেস্ট করা হয়। এই ল্যাবের জন্য, আপনি প্রসেসটি দেখানোর জন্য একটি ছোট ডেটাসেট ব্যবহার করবেন।
ডেটাসেট তৈরি করা যাক। আপনি প্রশ্নের তালিকা এবং RAG সিস্টেম থেকে retrieved_contexts দিয়ে শুরু করবেন। তারপর আপনি দুই সেট উত্তর নির্ধারণ করবেন: একটি মডেল থেকে যা ভাল পারফর্ম করে বলে মনে হয় (generated_answers_by_rag_a) এবং একটি মডেল থেকে যা খারাপ পারফর্ম করে (generated_answers_by_rag_b)।
শেষে, উপরে বর্ণিত স্ট্রাকচার অনুযায়ী আপনি এই অংশগুলি দুটি pandas DataFrame, eval_dataset_rag_a এবং eval_dataset_rag_b-এ একত্রিত করবেন।
- নতুন সেলে, প্রশ্ন এবং generated_answers-এর দুটি সেট সংজ্ঞায়িত করতে নিম্নলিখিত কোড যোগ করে রান করুন।
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - retrieved_contexts-এর সংজ্ঞা দাও। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন।
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - নতুন সেলে,
eval_dataset_rag_aওeval_dataset_rag_bতৈরি করতে নিম্নলিখিত কোড যোগ করে রান করুন।eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - মডেল A-এর জন্য ডেটাসেটের প্রথম কয়েকটি সারি দেখতে নতুন সেলে নিম্নলিখিত কোড রান করুন।
eval_dataset_rag_a
৭. মেট্রিক বেছে নিন ও তৈরি করুন
এখন ডেটাসেট তৈরি হয়ে গেছে, আপনি পারফর্ম্যান্স কীভাবে পরিমাপ করবেন তা ঠিক করতে পারবেন। আপনার মডেল মূল্যায়ন করতে আপনি এক বা একাধিক মেট্রিক ব্যবহার করতে পারবেন। প্রতিটি মেট্রিক মডেলের উত্তরের একটি নির্দিষ্ট দিক বিচার করে, যেমন এর ফ্যাকচুয়াল নির্ভুলতা বা প্রাসঙ্গিকতা।
আপনি দুই ধরনের মেট্রিকের কম্বিনেশন ব্যবহার করতে পারেন:
- আগে থেকে নির্ধারিত মেট্রিক: সাধারণ মূল্যায়ন টাস্কের জন্য SDK-এর মাধ্যমে প্রদান করা ব্যবহার করার জন্য প্রস্তুত মেট্রিক।
- কাস্টম মেট্রিক: আপনার ব্যবহারের ক্ষেত্রে প্রাসঙ্গিক কোয়ালিটি পরীক্ষা করার জন্য আপনি যে মেট্রিক নির্ধারণ করেন।
এই বিভাগে, আপনি RAG-এর জন্য উপলভ্য আগে থেকে নির্ধারিত মেট্রিক এক্সপ্লোর করবেন।
পূর্বনির্ধারিত মেট্রিক এক্সপ্লোর করুন
SDK-তে প্রশ্ন-উত্তর সিস্টেম মূল্যায়ন করার জন্য বেশ কয়েকটি বিল্ট-ইন মেট্রিক অন্তর্ভুক্ত রয়েছে। এইসব মেট্রিক, এক সেট নির্দেশের উপর ভিত্তি করে আপনার মডেলের উত্তরকে স্কোর করার জন্য, "মূল্যায়নকারী" হিসেবে একটি ল্যাঙ্গুয়েজ মডেল ব্যবহার করে।
- নতুন সেলে, আগে থেকে নির্ধারিত মেট্রিকের নামের সম্পূর্ণ তালিকা দেখতে নিম্নলিখিত কোড যোগ করে রান করুন:
MetricPromptTemplateExamples.list_example_metric_names() - এইসব মেট্রিক কীভাবে কাজ করে তা বুঝতে, আপনি সেগুলির অন্তর্নিহিত প্রম্পট টেমপ্লেট পরীক্ষা করতে পারেন। নতুন সেলে,
question_answering_qualityমেট্রিকের জন্য মূল্যায়নকারী LLM-কে দেওয়া নির্দেশাবলী দেখতে, নিম্নলিখিত কোড যোগ করে রান করুন।# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
৮. কাস্টম মেট্রিক তৈরি করুন
আগে থেকে নির্ধারিত মেট্রিক ছাড়াও, আপনার ব্যবহারের ক্ষেত্রে নির্দিষ্ট মানদণ্ড মূল্যায়ন করার জন্য আপনি কাস্টম মেট্রিক তৈরি করতে পারেন। কাস্টম মেট্রিক তৈরি করতে, আপনি একটি প্রম্পট টেমপ্লেট লেখেন যা মূল্যায়নকারী LLM-কে নির্দেশ দেয় কীভাবে একটি উত্তর স্কোর করতে হয়।
কাস্টম মেট্রিক তৈরি করার জন্য দুটি ধাপ রয়েছে:
- প্রম্পট টেমপ্লেট নির্ধারণ করুন: একটি স্ট্রিং যাতে মূল্যায়নকারী LLM-এর জন্য আপনার নির্দেশাবলী থাকে। একটি ভালো টেমপ্লেটে স্পষ্ট ভূমিকা, মূল্যায়নের মাপকাঠি, স্কোরিং রুব্রিক এবং
{prompt}ও{response}-এর মতো প্লেসহোল্ডার থাকে। - PointwiseMetric অবজেক্ট ইনস্ট্যানশিয়েট করা: আপনি এই ক্লাসের মধ্যে আপনার প্রম্পট টেমপ্লেট স্ট্রিং র্যাপ করেন এবং আপনার মেট্রিকের একটি নাম দেন।
RAG সিস্টেমের উত্তরের প্রাসঙ্গিকতা এবং উপযোগিতা মূল্যায়ন করার জন্য আপনি দুটি কাস্টম মেট্রিক তৈরি করবেন।
- প্রাসঙ্গিকতা মেট্রিকের জন্য প্রম্পট টেমপ্লেট নির্ধারণ করুন। এই টেমপ্লেটটি মূল্যায়নকারী LLM-এর জন্য একটি বিস্তারিত রুব্রিক প্রদান করে। নতুন সেলে, নিম্নলিখিত কোড যোগ করে রান করুন:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - একই পদ্ধতি ব্যবহার করে সহায়ক মেট্রিকের জন্য প্রম্পট টেমপ্লেট নির্ধারণ করুন। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - আপনার দুটি কাস্টম মেট্রিকের জন্য
PointwiseMetricঅবজেক্ট ইনস্ট্যানশিয়েট করুন। এটি মূল্যায়ন কাজের জন্য আপনার প্রম্পট টেমপ্লেটগুলিকে পুনর্ব্যবহারযোগ্য উপাদানে পরিণত করে। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
আপনার কাছে এখন দুটি নতুন, পুনর্ব্যবহারযোগ্য মেট্রিক (relevance এবং helpfulness) রয়েছে যা আপনার মূল্যায়ন কাজের জন্য প্রস্তুত।
৯. মূল্যায়ন সংক্রান্ত কাজ রান করুন
এখন ডেটাসেট ও মেট্রিক প্রস্তুত, আপনি মূল্যায়ন রান করতে পারবেন। আপনি যে ডেটাসেট পরীক্ষা করতে চান, তার জন্য একটি EvalTask অবজেক্ট তৈরি করে এটি করতে পারবেন।
একটি EvalTask মূল্যায়ন চালানোর জন্য কম্পোনেন্টগুলিকে বান্ডিল করে:
- ডেটাসেট: আপনার প্রম্পট ও উত্তর সহ DataFrame।
- মেট্রিক: আপনি যে মেট্রিকের নিরিখে স্কোর করতে চান তার তালিকা।
- এক্সপেরিমেন্ট: Vertex AI এক্সপেরিমেন্ট, যাতে ফলাফল লগ করা হয়, এটি আপনাকে রান ট্র্যাক ও তুলনা করতে সাহায্য করে।
- প্রতিটি মডেলের জন্য একটি করে
EvalTaskতৈরি করুন। এই অবজেক্ট ডেটাসেট, মেট্রিক ও পরীক্ষার নাম বান্ডেল করে। টাস্ক কনফিগার করতে নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTaskঅবজেক্ট কনফিগার করেছেন, প্রতিটি মডেল উত্তরের সেটের জন্য একটি করে। আপনার দেওয়াmetricsতালিকা থেকে মূল্যায়ন পরিষেবার একটি মূল ফিচার সম্পর্কে জানা যায়: আগে থেকে নির্ধারিত মেট্রিক (যেমন,safety) এবং কাস্টমPointwiseMetricঅবজেক্ট। - টাস্ক কনফিগার করা হয়ে গেলে,
.evaluate()মেথড কল করে সেগুলি এক্সিকিউট করুন। এটি প্রসেস করার জন্য Vertex AI ব্যাকএন্ডে টাস্ক পাঠায় এবং সম্পূর্ণ হতে কয়েক মিনিট সময় লাগতে পারে। নতুন সেলে, নিম্নলিখিত কোড যোগ করে রান করুন:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
মূল্যায়ন সম্পূর্ণ হয়ে গেলে, ফলাফল result_rag_a এবং result_rag_b অবজেক্টে সেভ করা হবে, যা পরবর্তী বিভাগে আমাদের বিশ্লেষণের জন্য প্রস্তুত থাকবে।
১০. ফলাফল বিশ্লেষণ করুন
মূল্যায়নের ফলাফল এখন উপলভ্য। result_rag_a এবং result_rag_b অবজেক্টে প্রতিটি সারির জন্য এগ্রিগেট স্কোর এবং বিস্তারিত ব্যাখ্যা থাকে। এই টাস্কে, আপনি notebook_utils থেকে হেল্পার ফাংশন ব্যবহার করে এইসব ফলাফল বিশ্লেষণ করবেন।
মোট সারসংক্ষেপ দেখুন
- হাই-লেভেল ওভারভিউ পেতে, প্রতিটি মেট্রিকের জন্য গড় স্কোর দেখতে
display_eval_result()হেল্পার ফাংশন ব্যবহার করুন। নতুন সেলে, Model A-এর সারাংশ দেখতে নিম্নলিখিত কোড যোগ করে রান করুন:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - মডেল খ-এর ক্ষেত্রেও একই কাজ করুন। নতুন সেলে এই কোড যোগ করে রান করুন:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
মূল্যায়নের ফলাফল ভিজ্যুয়ালাইজ করুন
প্লট ব্যবহার করে মডেলের পারফর্ম্যান্স আরও সহজে তুলনা করা যায়। আপনি দুই ধরনের ভিজ্যুয়ালাইজেশন ব্যবহার করবেন:
- রাডার প্লট: প্রতিটি মডেলের সামগ্রিক পারফর্ম্যান্সের "শেপ" দেখায়। বড় আকৃতি থেকে বোঝা যায় যে সব দিক থেকে পারফর্ম্যান্স ভালো হয়েছে।
- বার প্লট: প্রতিটি মেট্রিকের সরাসরি, পাশাপাশি তুলনা করার জন্য।
এই ভিজ্যুয়ালাইজেশন আপনাকে প্রাসঙ্গিকতা, গ্রাউন্ডেডনেস এবং সহায়কতার মতো বিষয়গত গুণাবলীর উপর ভিত্তি করে মডেলগুলির তুলনা করতে সাহায্য করবে।
- প্লট করার জন্য প্রস্তুত হতে, ফলাফলগুলিকে টিউপলের একটি একক তালিকায় একত্রিত করুন। প্রতিটি টাপলে একটি মডেলের নাম এবং তার সংশ্লিষ্ট ফলাফল অবজেক্ট থাকতে হবে। নতুন সেলে, নিম্নলিখিত কোড যোগ করে রান করুন:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - এখন, সব মেট্রিক জুড়ে মডেলগুলির একবারে তুলনা করার জন্য একটি রাডার প্লট তৈরি করো। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - প্রতিটি মেট্রিকের আরও সরাসরি তুলনার জন্য, একটি বার প্লট তৈরি করুন। নতুন সেলে, এই কোড যোগ করে রান করুন:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
ভিজ্যুয়ালাইজেশন স্পষ্টভাবে দেখাবে যে মডেল A-এর পারফর্ম্যান্স (রাডার প্লটে বড় আকৃতি এবং বার চার্টে লম্বা বার) মডেল B-এর চেয়ে ভালো।
কোনও একটি ঘটনার জন্য বিস্তারিত ব্যাখ্যা দেখুন
সামগ্রিক স্কোর থেকে সামগ্রিক পারফর্ম্যান্স বোঝা যায়। কোনও মডেল কেন নির্দিষ্টভাবে কাজ করেছে তা বুঝতে, আপনাকে প্রতিটি উদাহরণের জন্য মূল্যায়নকারী LLM দ্বারা তৈরি করা বিস্তারিত ব্যাখ্যা পর্যালোচনা করতে হবে।
display_explanations()হেল্পার ফাংশন আপনাকে আলাদা আলাদা ফলাফল পরীক্ষা করতে দেয়। মডেল A-এর ফলাফল থেকে দ্বিতীয় উদাহরণের (num=2) বিস্তারিত ব্রেকডাউন দেখতে, নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:notebook_utils.display_explanations(result_rag_a, num=2)- এছাড়াও, আপনি সব উদাহরণ জুড়ে নির্দিষ্ট মেট্রিকের জন্য ফিল্টার করতে এই ফাংশন ব্যবহার করতে পারবেন। খারাপ পারফর্ম্যান্সের নির্দিষ্ট কোনও ক্ষেত্র ডিবাগ করার জন্য এটি উপযোগী।
groundednessমেট্রিকের ক্ষেত্রে মডেল B কেন এত খারাপ পারফর্ম করেছে তা দেখতে, নতুন সেলে এই কোড যোগ করে রান করুন:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
১১. "গোল্ডেন উত্তর" ব্যবহার করে রেফারেন্স করা মূল্যায়ন
আগে, আপনি রেফারেন্স-মুক্ত মূল্যায়ন করেছেন, যেখানে মডেলের উত্তর শুধুমাত্র প্রম্পটের উপর ভিত্তি করে বিচার করা হয়েছিল। এই পদ্ধতিটি উপযোগী, তবে মূল্যায়নটি সাবজেক্টিভ।
এখন, আপনি রেফারেন্স করা মূল্যায়ন ব্যবহার করবেন। এই পদ্ধতি ডেটাসেটে একটি "গোল্ডেন উত্তর" (রেফারেন্স উত্তরও বলা হয়) যোগ করে। মডেলের উত্তরকে বাস্তবিক সত্য উত্তরের সাথে তুলনা করলে পারফর্ম্যান্সের আরও বস্তুনিষ্ঠ পরিমাপ পাওয়া যায়। এটি আপনাকে নিম্নলিখিত বিষয়গুলি পরিমাপ করার অনুমতি দেয়:
- ফ্যাকচুয়াল সঠিকতা: মডেলের উত্তর কি গোল্ডেন উত্তরের তথ্যের সাথে মেলে?
- শব্দের অর্থগত মিল: মডেলের উত্তর কি গোল্ডেন উত্তরের মতো একই অর্থ বহন করে?
- সম্পূর্ণতা: মডেলের উত্তরে কি গোল্ডেন উত্তরের সব মূল তথ্য আছে?
রেফারেন্স করা ডেটাসেট প্রস্তুত করুন
রেফারেন্সড মূল্যায়ন করতে, আপনার ডেটাসেটের প্রতিটি উদাহরণে একটি "গোল্ডেন উত্তর" যোগ করতে হবে।
প্রথমে golden_answers তালিকা কী তা জেনে নেওয়া যাক। মডেল A থেকে পাওয়া উত্তরের সাথে গোল্ডেন উত্তরের তুলনা করলে এই পদ্ধতির গুরুত্ব বোঝা যায়:
- প্রশ্ন ১ (Brain): জেনারেট করা উত্তর ও গোল্ডেন উত্তর একই। মডেল A সঠিক।
- প্রশ্ন ২ (সিনেট): উত্তরগুলি শব্দার্থগতভাবে একই রকম কিন্তু ভিন্নভাবে শব্দযুক্ত। একটি ভালো মেট্রিক এটি শনাক্ত করতে পারে।
- প্রশ্ন ৩ (হাসান-জালালিয়ান): প্রসঙ্গ অনুযায়ী মডেল A-এর উত্তর ফ্যাকচুয়ালি ভুল।
golden_answerএই সমস্যাটি প্রকাশ করে।
- নতুন সেলে, golden_answers-এর তালিকা উল্লেখ করুন
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - নিম্নলিখিত সেলে এই কোড রান করে রেফারেন্স করা মূল্যায়ন DataFrame তৈরি করুন:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
ডেটা সেট এখন রেফারেন্স করা মূল্যায়নের জন্য প্রস্তুত।
কাস্টম রেফারেন্সড মেট্রিক তৈরি করুন
এছাড়াও, আপনি রেফারেন্স করা মূল্যায়নের জন্য কাস্টম মেট্রিক তৈরি করতে পারবেন। প্রসেসটি একই রকম, তবে প্রম্পট টেমপ্লেটে এখন গোল্ডেন উত্তরের জন্য {reference} প্লেসহোল্ডার অন্তর্ভুক্ত রয়েছে।
একটি নির্দিষ্ট "সঠিক" উত্তরের মাধ্যমে, আপনি ফ্যাকচুয়াল নির্ভুলতা পরিমাপ করতে আরও কঠোর, বাইনারি স্কোরিং (যেমন, সঠিকের জন্য ১, ভুলের জন্য ০) ব্যবহার করতে পারেন। আসুন, একটি নতুন question_answering_correctness মেট্রিক তৈরি করি যা এই লজিক প্রয়োগ করে।
- প্রম্পট টেমপ্লেট নির্ধারণ করুন। নতুন সেলে, নিম্নলিখিত কোড যোগ করে রান করুন:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - PointwiseMetric অবজেক্টের মধ্যে প্রম্পট টেমপ্লেট স্ট্রিং র্যাপ করুন। এটি আপনার মেট্রিককে একটি আনুষ্ঠানিক নাম দেয় এবং এটিকে মূল্যায়ন কাজের জন্য একটি পুনর্ব্যবহারযোগ্য উপাদান করে তোলে। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
আপনার কাছে এখন কঠোরভাবে তথ্য যাচাই করার জন্য একটি কাস্টম, রেফারেন্স করা মেট্রিক আছে।
১২. রেফারেন্স করা মূল্যায়ন রান করুন
এখন, আপনি রেফারেন্স করা ডেটাসেট এবং নতুন মেট্রিক সহ মূল্যায়ন কাজ কনফিগার করবেন। আপনি আবার EvalTask ক্লাস ব্যবহার করবেন।
মেট্রিকের তালিকা এখন আপনার কাস্টম মডেল-ভিত্তিক মেট্রিককে কম্পিউটেশন-ভিত্তিক মেট্রিকের সাথে একত্রিত করে। রেফারেন্সড মূল্যায়ন, প্রথাগত, কম্পিউটেশন-ভিত্তিক মেট্রিক ব্যবহার করার অনুমতি দেয় যা জেনারেট করা টেক্সট এবং রেফারেন্স টেক্সটের মধ্যে গাণিতিক তুলনা করে। আপনি তিনটি সাধারণ পদ্ধতি ব্যবহার করবেন:
exact_match: জেনারেট করা উত্তর রেফারেন্স উত্তরের সাথে মিলে গেলে তবেই ১ স্কোর দেওয়া হয়, অন্যথায় ০ স্কোর দেওয়া হয়।bleu: নির্ভুলতার একটি মেট্রিক। জেনারেট করা উত্তরে কতগুলি শব্দ রেফারেন্স উত্তরেও আছে তা এটি পরিমাপ করে।rouge: রিকলের মেট্রিক। রেফারেন্স উত্তর থেকে কতগুলি শব্দ জেনারেট করা উত্তরে ক্যাপচার করা হয়েছে তা এটি পরিমাপ করে।
- রেফারেন্স করা ডেটাসেট এবং মেট্রিকের নতুন মিশ্রণের সাথে মূল্যায়ন কাজ কনফিগার করুন। নতুন সেলে,
EvalTaskঅবজেক্ট তৈরি করতে নিম্নলিখিত কোড যোগ করে রান করুন:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) .evaluate()মেথড কল করে রেফারেন্স করা মূল্যায়ন এক্সিকিউট করুন। নতুন সেলে এই কোড যোগ করে রান করুন:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
১৩. রেফারেন্স করা ফলাফল বিশ্লেষণ করুন
মূল্যায়ন সম্পূর্ণ হয়েছে। এই টাস্কে, আপনি মডেলের উত্তরকে গোল্ডেন রেফারেন্স উত্তরের সাথে তুলনা করে মডেলের ফ্যাকচুয়াল নির্ভুলতা পরিমাপ করার জন্য ফলাফল বিশ্লেষণ করবেন।
সারাংশ ফলাফল দেখুন
- রেফারেন্স করা মূল্যায়নের জন্য সারসংক্ষেপ ফলাফল বিশ্লেষণ করুন। নতুন সেলে, দুটি মডেলের জন্য সারসংক্ষেপ টেবিল দেখাতে নিম্নলিখিত কোড যোগ করুন ও রান করুন:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessমেট্রিকের উপর ভাল পারফর্ম করে কিন্তুexact_match-এ কম স্কোর করে। এটি মডেল-ভিত্তিক মেট্রিকের গুরুত্বকে হাইলাইট করে যা শুধু অভিন্ন টেক্সট নয়, শব্দার্থগত মিলও শনাক্ত করতে পারে।
তুলনা করার জন্য ফলাফল ভিজ্যুয়ালাইজ করুন
ভিজ্যুয়ালাইজেশন দুটি মডেলের মধ্যে পারফর্ম্যান্সের পার্থক্য আরও স্পষ্ট করে তুলতে পারে। প্রথমে, প্লট করার জন্য ফলাফলগুলি একটি একক তালিকায় একত্রিত করুন, তারপর রাডার এবং বার প্লট তৈরি করুন।
- প্লট করার জন্য রেফারেন্স করা মূল্যায়ন ফলাফল একটি একক তালিকায় একত্রিত করুন। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - নতুন সেট মেট্রিক জুড়ে প্রতিটি মডেলের পারফর্ম্যান্স ভিজ্যুয়ালাইজ করতে একটি রেডার প্লট তৈরি করো। নতুন সেলে এই কোড যোগ করে রান করুন:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - সরাসরি, পাশাপাশি তুলনা করার জন্য একটি বার প্লট তৈরি করুন। এটি দেখাবে যে প্রতিটি মডেল বিভিন্ন মেট্রিক্সে কেমন পারফর্ম করেছে। নতুন সেলে নিম্নলিখিত কোড যোগ করে রান করুন:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
এই ভিজ্যুয়ালাইজেশনগুলি নিশ্চিত করে যে মডেল A, মডেল B-এর তুলনায় উল্লেখযোগ্যভাবে বেশি সঠিক এবং রেফারেন্স উত্তরের সাথে ফ্যাকচুয়ালি অ্যালাইন করা।
১৪. প্র্যাক্টিস থেকে প্রোডাকশন
আপনি RAG সিস্টেমের জন্য একটি সম্পূর্ণ মূল্যায়ন পাইপলাইন সফলভাবে এক্সিকিউট করেছেন। এই শেষ বিভাগে, আপনি যে মূল কৌশলগত ধারণাগুলি শিখেছেন তার সারসংক্ষেপ করা হয়েছে এবং বাস্তব-জগতের প্রোজেক্টে এইসব দক্ষতা প্রয়োগ করার জন্য একটি ফ্রেমওয়ার্ক প্রদান করা হয়েছে।
প্রোডাকশন সংক্রান্ত পেশাদার পদ্ধতি
এই ল্যাব থেকে শেখা দক্ষতা বাস্তব-জগতের প্রোডাকশন এনভায়রনমেন্টে প্রয়োগ করতে, এই চারটি মূল পদ্ধতি বিবেচনা করুন:
- CI/CD-এর মাধ্যমে অটোমেট করা: আপনার মূল্যায়ন সুইটকে CI/CD পাইপলাইনে (যেমন, Cloud Build, GitHub Actions) ইন্টিগ্রেট করুন। কোড পরিবর্তনের ক্ষেত্রে অটোমেটিক মূল্যায়ন চালান যাতে রিগ্রেশন ধরা যায় এবং কোয়ালিটি স্কোর আপনার স্ট্যান্ডার্ডের নিচে নেমে গেলে ডিপ্লয়মেন্ট ব্লক করা যায়।
- আপনার ডেটাসেট উন্নত করুন: স্ট্যাটিক ডেটাসেট পুরনো হয়ে যায়। আপনার "গোল্ডেন" টেস্ট সেট (Git LFS বা Cloud Storage ব্যবহার করে) ভার্সন কন্ট্রোল করুন এবং আসল (পরিচয় গোপন করা) ব্যবহারকারীর কোয়েরি থেকে স্যাম্পেল নিয়ে ক্রমাগত নতুন, চ্যালেঞ্জিং উদাহরণ যোগ করুন।
- শুধু জেনারেটর নয়, রিট্রিভারও মূল্যায়ন করুন: সঠিক প্রসঙ্গ ছাড়া দুর্দান্ত উত্তর পাওয়া অসম্ভব। হিট রেট (সঠিক ডকুমেন্ট কি পাওয়া গেছে?) এবং মিন রেসিপ্রোকাল র্যাঙ্ক (MRR) (সঠিক ডকুমেন্ট কত উপরে র্যাঙ্ক করেছে?)-এর মতো মেট্রিক ব্যবহার করে আপনার রিট্রিভাল সিস্টেমের জন্য একটি আলাদা মূল্যায়ন ধাপ প্রয়োগ করুন।
- সময়ের সাথে সাথে মেট্রিক্স মনিটর করা: আপনার মূল্যায়ন রান থেকে Google Cloud Monitoring-এর মতো কোনও পরিষেবায় সারসংক্ষেপ স্কোর এক্সপোর্ট করুন। কোয়ালিটি ট্রেন্ড ট্র্যাক করতে ড্যাশবোর্ড তৈরি করুন এবং পারফর্ম্যান্স উল্লেখযোগ্যভাবে কমে গেলে আপনাকে জানানোর জন্য অটোমেটিক অ্যালার্ট সেট-আপ করুন।
উন্নত মূল্যায়ন পদ্ধতি মেট্রিক্স
মূল্যায়নের সঠিক পদ্ধতি বেছে নেওয়া আপনার নির্দিষ্ট লক্ষ্যের উপর নির্ভর করে। এই ম্যাট্রিক্স প্রতিটি পদ্ধতি কখন ব্যবহার করতে হবে তার সারসংক্ষেপ দেয়।
মূল্যায়নের পদ্ধতি | ব্যবহারের সেরা ক্ষেত্র | প্রধান সুবিধা | সীমাবদ্ধতা |
রেফারেন্স-ফ্রি | প্রোডাকশন মনিটর করা, ক্রমাগত মূল্যায়ন করা | কোনও গোল্ডেন উত্তরের প্রয়োজন নেই, সাবজেক্টিভ কোয়ালিটি ক্যাপচার করে | আরও বেশি খরচ, মূল্যায়নকারীর পক্ষপাতিত্বের সম্ভাবনা |
রেফারেন্স-ভিত্তিক | মডেলের তুলনা, বেঞ্চমার্কিং | উদ্দেশ্যমূলক পরিমাপ, দ্রুত গণনা | গোল্ডেন উত্তর প্রয়োজন, শব্দার্থের সমতা নাও থাকতে পারে |
কাস্টম মেট্রিক | ডোমেন-নির্দিষ্ট মূল্যায়ন | ব্যবসার প্রয়োজন অনুযায়ী তৈরি করা হয়েছে | যাচাইকরণ, ডেভেলপমেন্ট ওভারহেড প্রয়োজন |
হাইব্রিড পদ্ধতি | বিস্তারিত প্রোডাকশন সিস্টেম | সব পদ্ধতির মধ্যে সেরা | আরও বেশি জটিলতা, খরচ অপ্টিমাইজ করা প্রয়োজন |
মূল প্রযুক্তিগত ইনসাইট
আপনার নিজস্ব RAG সিস্টেম তৈরি ও মূল্যায়ন করার সময় এই মূল নীতিগুলি মনে রাখবেন:
- RAG-এর জন্য গ্রাউন্ডেডনেস অত্যন্ত গুরুত্বপূর্ণ: এই মেট্রিক ধারাবাহিকভাবে উচ্চ এবং নিম্ন-মানের RAG সিস্টেমের মধ্যে পার্থক্য করে, যা প্রোডাকশন মনিটর করার জন্য অপরিহার্য করে তোলে।
- একাধিক মেট্রিক দৃঢ়তা প্রদান করে: কোনও একক মেট্রিক RAG কোয়ালিটির সব দিক ক্যাপচার করে না। বিস্তারিত মূল্যায়নের জন্য একাধিক অ্যাসেসমেন্ট ডাইমেনশন প্রয়োজন।
- কাস্টম মেট্রিক্স উল্লেখযোগ্য ভ্যালু যোগ করে: ডোমেন-নির্দিষ্ট মূল্যায়নের মাপকাঠি প্রায়শই এমন সূক্ষ্মতা ক্যাপচার করে যা জেনেরিক মেট্রিক্স মিস করে, মূল্যায়নের নির্ভুলতা উন্নত করে।
- পরিসংখ্যানগত কঠোরতা আত্মবিশ্বাস বাড়ায়: সঠিক স্যাম্পেল সাইজ ও তাৎপর্যপূর্ণ টেস্টিং, মূল্যায়নকে অনুমান থেকে নির্ভরযোগ্য সিদ্ধান্ত নেওয়ার টুলে রূপান্তরিত করে।
প্রোডাকশন ডিপ্লয়মেন্ট ডিসিশন ফ্রেমওয়ার্ক
ভবিষ্যতে RAG সিস্টেম ডিপ্লয়মেন্টের জন্য গাইড হিসেবে এই ফেজড ফ্রেমওয়ার্ক ব্যবহার করুন:
- পর্যায় ১ - ডেভেলপমেন্ট: মডেলের তুলনা ও বেছে নেওয়ার জন্য পরিচিত টেস্ট সেট সহ রেফারেন্স-ভিত্তিক মূল্যায়ন ব্যবহার করুন।
- ফেজ ২ - প্রি-প্রোডাকশন: প্রোডাকশন রেডিনেস যাচাই করার জন্য দুটি পদ্ধতি একত্রিত করে বিস্তারিত মূল্যায়ন চালান।
- ফেজ ৩ - প্রোডাকশন: গোল্ডেন উত্তর ছাড়াই ক্রমাগত কোয়ালিটি অ্যাসেসমেন্টের জন্য রেফারেন্স-মুক্ত মনিটরিং প্রয়োগ করুন।
- পর্যায় ৪ - অপ্টিমাইজেশন: মডেলের উন্নতি এবং রিট্রিভাল সিস্টেমের এনহ্যান্সমেন্টের জন্য মূল্যায়ন সংক্রান্ত ইনসাইট ব্যবহার করুন।
১৫. উপসংহার
অভিনন্দন! আপনি ল্যাব সম্পূর্ণ করেছেন।
এই ল্যাবটি Production-Ready AI with Google Cloud লার্নিং পাথের অংশ।
- প্রোটোটাইপ থেকে প্রোডাকশন পর্যন্ত ব্যবধান পূরণ করতে সম্পূর্ণ পাঠ্যক্রম এক্সপ্লোর করুন।
ProductionReadyAIহ্যাশট্যাগ ব্যবহার করে আপনার প্রোগ্রেস শেয়ার করুন।
রিক্যাপ
আপনি শিখেছেন কীভাবে:
- উদ্ধার করা কনটেক্সটের ভিত্তিতে উত্তরের কোয়ালিটি মূল্যায়ন করতে রেফারেন্স-মুক্ত মূল্যায়ন করুন।
- ফ্যাকচুয়াল সঠিকতা পরিমাপ করতে "গোল্ডেন উত্তর" যোগ করে রেফারেন্সড মূল্যায়ন করুন।
- দুটি পদ্ধতির জন্যই পূর্বনির্ধারিত ও কাস্টম মেট্রিকের মিশ্রণ ব্যবহার করা হয়।
- মডেল-ভিত্তিক মেট্রিক (যেমন
question_answering_quality) এবং গণনা-ভিত্তিক মেট্রিক (rouge,bleu,exact_match) দুটিই ব্যবহার করুন। - মডেলের শক্তি ও দুর্বলতা বুঝতে ফলাফল বিশ্লেষণ ও ভিজ্যুয়ালাইজ করুন।
মূল্যায়নের এই পদ্ধতি আপনাকে আরও নির্ভরযোগ্য এবং নির্ভুল জেনারেটিভ AI অ্যাপ্লিকেশন তৈরি করতে সাহায্য করে।