

1. Übersicht
In diesem Lab erfahren Sie, wie Sie eine Bewertungspipeline für ein RAG-System (Retrieval-Augmented Generation) erstellen. Sie verwenden den Vertex AI Gen AI Evaluation Service, um benutzerdefinierte Bewertungskriterien zu erstellen und ein Bewertungsframework für eine Question-Answering-Aufgabe zu entwickeln.
Sie arbeiten mit Beispielen aus dem Stanford Question Answering Dataset (SQuAD 2.0), um Bewertungs-Datasets vorzubereiten, referenzfreie und referenzbasierte Bewertungen zu konfigurieren und die Ergebnisse zu interpretieren. Am Ende dieses Labs werden Sie wissen, wie RAG-Systeme bewertet werden und warum bestimmte Bewertungsansätze gewählt werden.
Dataset-Grundlage
Wir arbeiten mit sorgfältig zusammengestellten Beispielen aus verschiedenen Bereichen, die im SQuAD 2.0-Dataset zur Beantwortung von Fragen enthalten sind:
- Neurowissenschaften: Testen der technischen Genauigkeit in wissenschaftlichen Kontexten
- Geschichte: Bewertung der sachlichen Genauigkeit in historischen Erzählungen
- Geografie: Bewertung des territorialen und politischen Wissens
So können Sie besser nachvollziehen, wie sich Bewertungsansätze auf verschiedene Fachgebiete übertragen lassen.
Verweise
- Codebeispiele: Dieses Lab basiert auf Beispielen aus der Dokumentation zur Vertex AI-Bewertung.
- Dataset-Grundlage: SQuAD 2.0 Question Answering Dataset
- Optimizing RAG retrieval: Test, tune, succeed
Lerninhalte
Aufgaben in diesem Lab:
- Bewertungs-Datasets für RAG-Systeme vorbereiten
- Implementieren Sie eine referenzfreie Bewertung mit Messwerten wie Fundiertheit und Relevanz.
- Referenzbasierte Bewertung mit semantischen Ähnlichkeitsmesswerten anwenden.
- Benutzerdefinierte Bewertungsmesswerte mit detaillierten Bewertungsschemas erstellen
- Bewertungsergebnisse interpretieren und visualisieren, um die Modellauswahl zu unterstützen
2. Projekt einrichten
Google-Konto
Wenn Sie noch kein privates Google-Konto haben, müssen Sie ein Google-Konto erstellen.
Verwenden Sie ein privates Konto anstelle eines Arbeitskontos oder eines Kontos einer Bildungseinrichtung.
In der Google Cloud Console anmelden
Melden Sie sich mit einem privaten Google-Konto in der Google Cloud Console an.
Abrechnung aktivieren
Google Cloud-Guthaben einlösen (optional)
Für diesen Workshop benötigen Sie ein Rechnungskonto mit Guthaben. Verwenden Sie das Guthaben aus dem Banner oben in diesem Codelab, um loszulegen. Wenn Sie bereits mit einem Rechnungskonto verbunden sind, können Sie diesen Schritt überspringen.
Privates Rechnungskonto einrichten
Wenn Sie die Abrechnung mit Google Cloud-Guthaben eingerichtet haben, können Sie diesen Schritt überspringen.
Wenn Sie ein persönliches Rechnungskonto einrichten möchten, aktivieren Sie die Abrechnung in der Cloud Console.
Hinweise:
- Die Kosten für die Cloud-Ressourcen, die Sie für dieses Lab benötigen, sollten unter 1 $ liegen.
- Am Ende dieses Labs finden Sie eine Anleitung zum Löschen von Ressourcen, um weitere Kosten zu vermeiden.
- Neue Nutzer können die kostenlose Testversion mit einem Guthaben von 300 $ nutzen.
Projekt erstellen (optional)
Wenn Sie kein aktuelles Projekt haben, das Sie für dieses Lab verwenden möchten, erstellen Sie hier ein neues Projekt.
3. Was ist Retrieval-Augmented Generation (RAG)?
RAG ist eine Technik, mit der die faktische Genauigkeit und Relevanz von Antworten aus Large Language Models (LLMs) verbessert werden kann. Es verbindet das LLM mit einer externen Wissensdatenbank, um seine Antworten mit spezifischen, überprüfbaren Informationen zu fundieren.
Der Prozess umfasst die folgenden Schritte:
- Die Frage eines Nutzers in eine numerische Darstellung (eine Einbettung) umwandeln.
- In der Wissensdatenbank nach Dokumenten mit ähnlichen Einbettungen suchen.
- Diese relevanten Dokumente werden dem LLM zusammen mit der ursprünglichen Frage als Kontext zur Verfügung gestellt, um eine Antwort zu generieren.
Was macht die RAG-Bewertung so komplex?
Die Bewertung von RAG-Systemen unterscheidet sich von der Bewertung herkömmlicher Language Models.
Die Herausforderung mehrerer Komponenten: RAG-Systeme kombinieren drei Vorgänge, die jeweils ein Point of Failure sein können:
- Abrufqualität: Hat das System die richtigen Kontextdokumente gefunden?
- Kontextnutzung: Hat das Modell die abgerufenen Informationen effektiv genutzt?
- Qualität der Generierung: Ist die endgültige Antwort gut formuliert, hilfreich und korrekt?
Eine Antwort kann fehlschlagen, wenn eine dieser Komponenten nicht wie erwartet funktioniert. Beispielsweise kann das System den richtigen Kontext abrufen, das Modell ignoriert ihn jedoch. Oder das Modell generiert eine gut formulierte Antwort, die jedoch falsch ist, weil der abgerufene Kontext irrelevant war.
4. Vertex AI Workbench-Umgebung einrichten
Zuerst starten wir eine neue Notebook-Umgebung, in der wir den Code ausführen, der für die Bewertung von RAG-Systemen erforderlich ist.
- Rufen Sie in der Cloud Console die Seite APIs & Dienste auf.
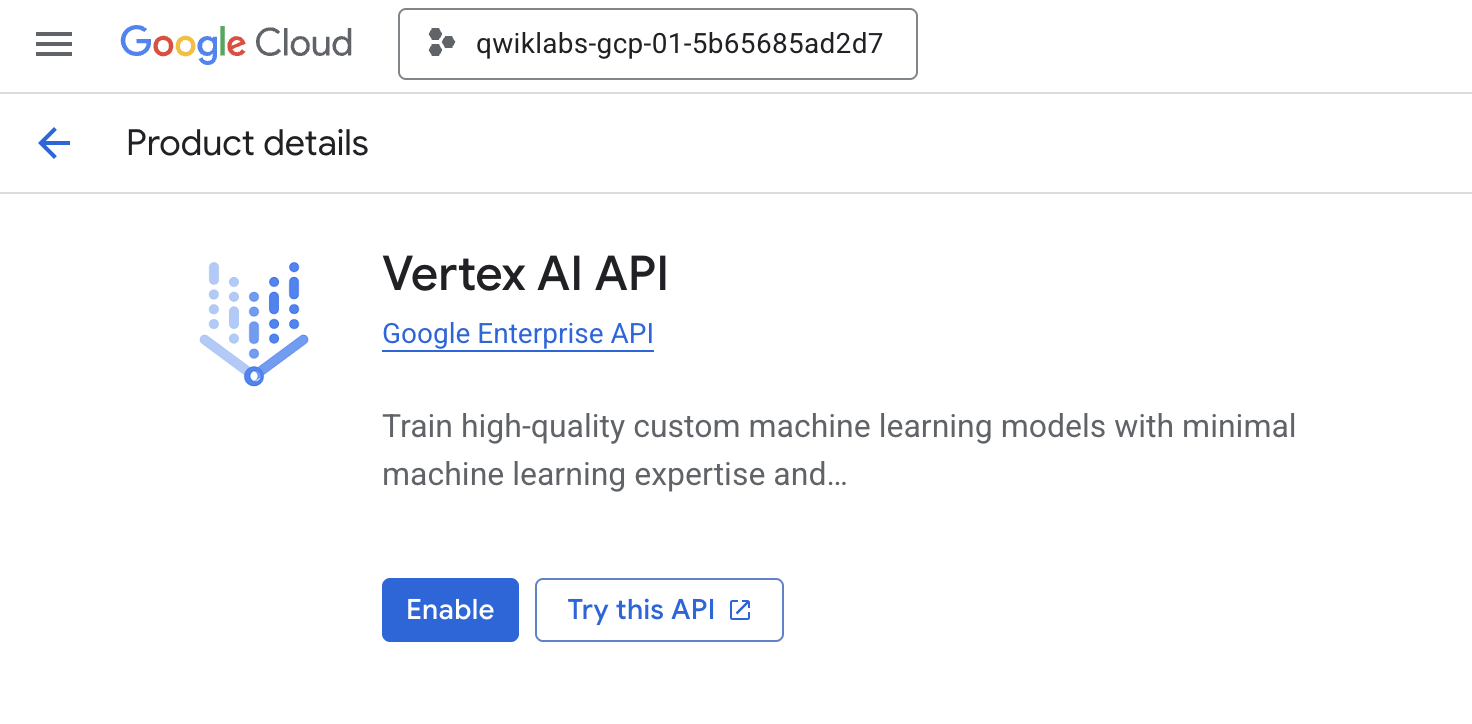
- Klicken Sie für die Vertex AI API auf Aktivieren.
Auf Vertex AI Workbench zugreifen
- Klicken Sie in der Google Cloud Console im Navigationsmenü ☰ auf Vertex AI > Workbench.
- Erstellen Sie eine neue Workbench-Instanz.
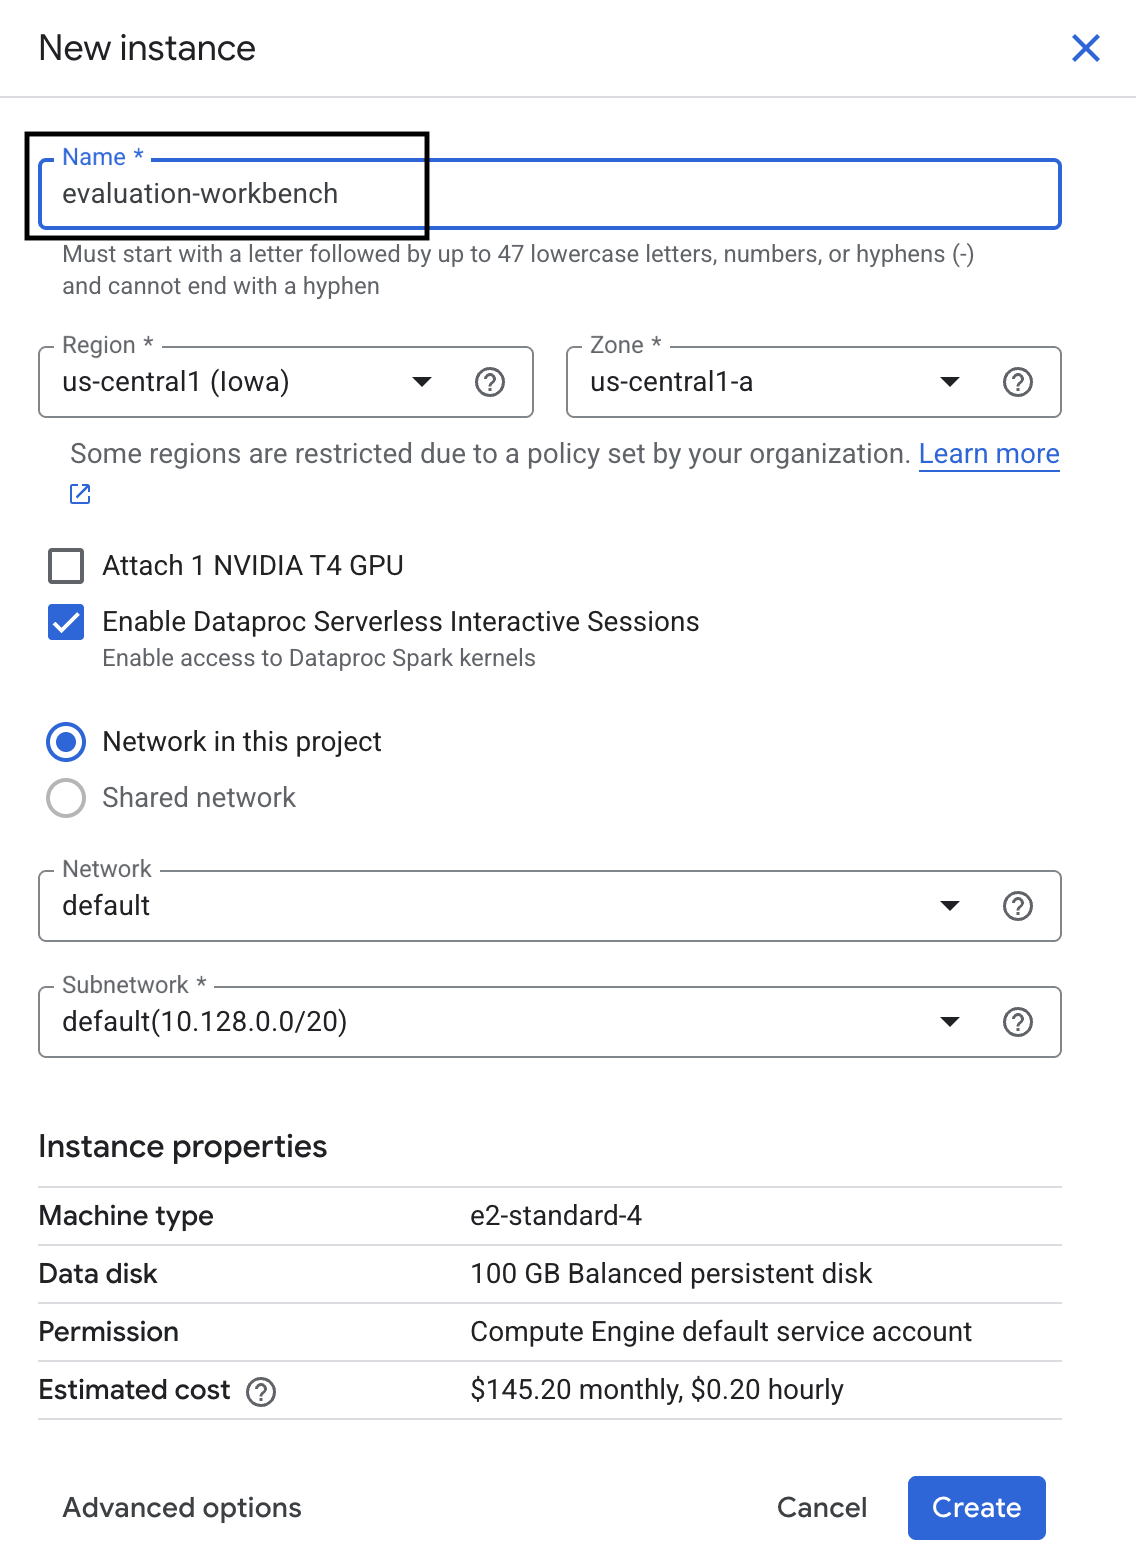
- Geben Sie der Workbench-Instanz den Namen
evaluation-workbench. - Wählen Sie Ihre Region und Zone aus, falls diese Werte noch nicht festgelegt sind.
- Klicken Sie auf Erstellen.
- Warten Sie, bis die Workbench eingerichtet ist. Dies kann einige Minuten dauern.
- Klicken Sie nach der Bereitstellung der Workbench auf JupyterLab öffnen.
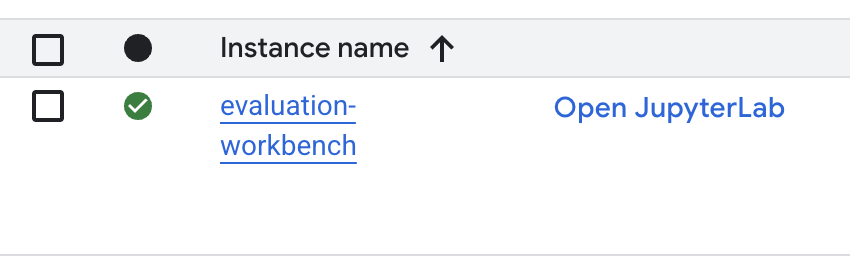
- Erstellen Sie in der Workbench ein neues Python3-Notebook.
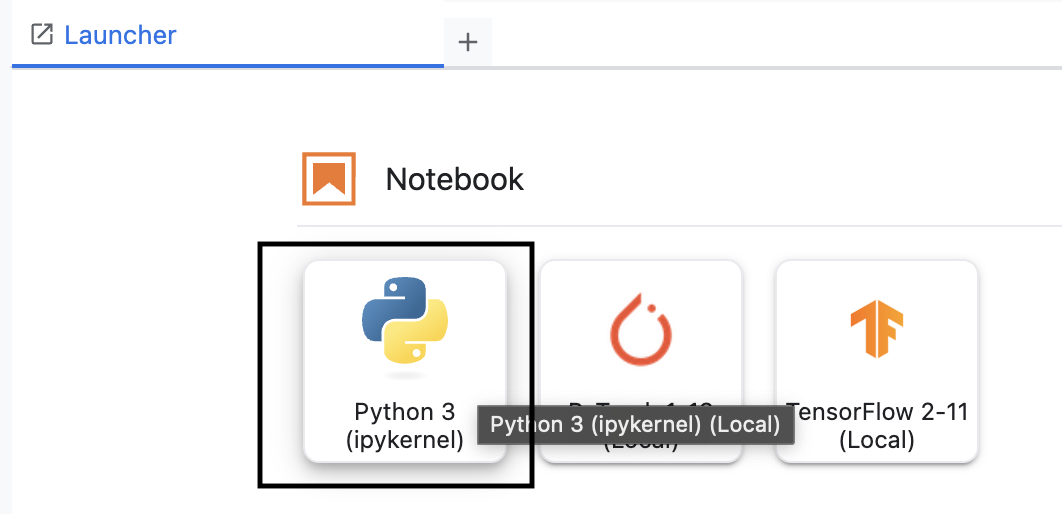
Weitere Informationen zu den Features und Funktionen dieser Umgebung finden Sie in der offiziellen Dokumentation zu Vertex AI Workbench.
Vertex AI Evaluation SDK installieren
Jetzt installieren wir das spezialisierte Bewertungs-SDK, das die Tools für die RAG-Bewertung bereitstellt.
- Fügen Sie in der ersten Zelle Ihres Notebooks die folgende Importanweisung hinzu und führen Sie sie aus (UMSCHALTTASTE + EINGABETASTE), um das Vertex AI SDK (mit den Bewertungskomponenten) zu installieren.
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: Die Hauptklasse zum Ausführen von Bewertungen.
- MetricPromptTemplateExamples: Vordefinierte Bewertungsmesswerte
- PointwiseMetric: Framework zum Erstellen benutzerdefinierter Messwerte
- notebook_utils: Visualisierungstools für die Ergebnisanalyse
- Wichtig: Nach der Installation müssen Sie den Kernel neu starten, um die neuen Pakete verwenden zu können. Klicken Sie in der Menüleiste oben im JupyterLab-Fenster auf Kernel > Restart Kernel (Kernel neu starten).
5. SDK initialisieren und Bibliotheken importieren
Bevor Sie die Bewertungspipeline erstellen können, müssen Sie Ihre Umgebung einrichten. Dazu konfigurieren Sie Ihre Projektdetails, initialisieren das Vertex AI SDK, um eine Verbindung zu Google Cloud herzustellen, und importieren die speziellen Python-Bibliotheken, die Sie für die Bewertung verwenden.
- Definieren Sie die Konfigurationsvariablen für den Bewertungsjob. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um
PROJECT_ID,LOCATIONund einenEXPERIMENT-Namen festzulegen, um diesen Durchlauf zu organisieren.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Vertex AI SDK initialisieren Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus.
vertexai.init(project=PROJECT_ID, location=LOCATION) - Importieren Sie die erforderlichen Klassen aus dem Bewertungs-SDK, indem Sie den folgenden Code in der nächsten Zelle ausführen:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: Zum Erstellen und Verwalten von Daten in DataFrames.
- EvalTask: Die Kernklasse, die einen Bewertungsjob ausführt.
- MetricPromptTemplateExamples: Bietet Zugriff auf die vordefinierten Bewertungsmesswerte von Google.
- PointwiseMetric: Das Framework zum Erstellen eigener benutzerdefinierter Messwerte.
- notebook_utils: Eine Sammlung von Tools zur Visualisierung von Ergebnissen.
6. Bereiten Sie das Bewertungs-Dataset vor.
Ein gut strukturiertes Dataset ist die Grundlage jeder zuverlässigen Bewertung. Für RAG-Systeme benötigt Ihr Dataset zwei Schlüsselfelder für jedes Beispiel:
- Prompt: Dies ist die gesamte Eingabe, die dem Sprachmodell bereitgestellt wird. Sie müssen die Frage des Nutzers mit dem Kontext kombinieren, der von Ihrem RAG-System (
prompt = User Question + Retrieved Context) abgerufen wurde. Das ist wichtig, damit der Bewertungsdienst weiß, welche Informationen das Modell zum Erstellen der Antwort verwendet hat. - response: Dies ist die endgültige Antwort, die von Ihrem RAG-Modell generiert wurde.
Für statistisch zuverlässige Ergebnisse wird ein Dataset mit etwa 100 Beispielen empfohlen. In diesem Lab verwenden Sie ein kleines Dataset, um den Prozess zu demonstrieren.
Erstellen Sie die Datasets. Sie beginnen mit einer Liste von Fragen und dem retrieved_contexts aus einem RAG-System. Anschließend definieren Sie zwei Antwortsätze: einen von einem Modell, das gut zu funktionieren scheint (generated_answers_by_rag_a), und einen von einem Modell, das schlecht funktioniert (generated_answers_by_rag_b).
Schließlich kombinieren Sie diese Teile in zwei Pandas-DataFrames, eval_dataset_rag_a und eval_dataset_rag_b, gemäß der oben beschriebenen Struktur.
- Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um die Fragen und die beiden Sätze von „generated_answers“ zu definieren.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - Definieren Sie die retrieved_contexts. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um
eval_dataset_rag_aundeval_dataset_rag_bzu erstellen.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - Führen Sie den folgenden Code in einer neuen Zelle aus, um die ersten Zeilen des Datasets für Modell A aufzurufen.
eval_dataset_rag_a
7. Messwerte auswählen und erstellen
Nachdem die Datasets bereit sind, können Sie entscheiden, wie die Leistung gemessen werden soll. Sie können einen oder mehrere Messwerte verwenden, um Ihr Modell zu bewerten. Mit jedem Messwert wird ein bestimmter Aspekt der Antwort des Modells bewertet, z. B. die sachliche Richtigkeit oder Relevanz.
Sie können eine Kombination aus zwei Arten von Messwerten verwenden:
- Vordefinierte Messwerte: Sofort einsatzbereite Messwerte, die vom SDK für häufige Bewertungsaufgaben bereitgestellt werden.
- Benutzerdefinierte Messwerte: Messwerte, die Sie definieren, um die für Ihren Anwendungsfall relevanten Eigenschaften zu testen.
In diesem Abschnitt lernen Sie die vordefinierten Messwerte kennen, die für RAG verfügbar sind.
Vordefinierte Messwerte ansehen
Das SDK enthält mehrere integrierte Messwerte zur Bewertung von Frage-Antwort-Systemen. Bei diesen Messwerten wird ein Language Model als „Evaluator“ verwendet, um die Antworten Ihres Modells anhand einer Reihe von Anweisungen zu bewerten.
- Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um die vollständige Liste der vordefinierten Messwertnamen aufzurufen:
MetricPromptTemplateExamples.list_example_metric_names() - Wenn Sie wissen möchten, wie diese Messwerte funktionieren, können Sie sich die zugrunde liegenden Prompt-Vorlagen ansehen. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um die Anweisungen für das Evaluator-LLM für den Messwert
question_answering_qualityaufzurufen.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. Benutzerdefinierte Messwerte erstellen
Zusätzlich zu vordefinierten Messwerten können Sie benutzerdefinierte Messwerte erstellen, um Kriterien zu bewerten, die für Ihren Anwendungsfall spezifisch sind. Wenn Sie einen benutzerdefinierten Messwert erstellen möchten, schreiben Sie eine Prompt-Vorlage, die dem Evaluator-LLM mitteilt, wie eine Antwort bewertet werden soll.
Das Erstellen eines benutzerdefinierten Messwerts umfasst zwei Schritte:
- Prompt-Vorlage definieren: Ein String, der Ihre Anweisungen für das Evaluator-LLM enthält. Eine gute Vorlage enthält eine klare Rolle, Bewertungskriterien, ein Bewertungsschema und Platzhalter wie
{prompt}und{response}. - PointwiseMetric-Objekt instanziieren: Sie verpacken den String der Prompt-Vorlage in dieser Klasse und geben dem Messwert einen Namen.
Sie erstellen zwei benutzerdefinierte Messwerte, um die Relevanz und Nützlichkeit der Antworten des RAG-Systems zu bewerten.
- Definieren Sie die Prompt-Vorlage für den Relevanzmesswert. Diese Vorlage enthält eine detaillierte Rubrik für das Evaluator-LLM. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Definieren Sie die Prompt-Vorlage für den Messwert „Hilfreich“ auf dieselbe Weise. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Instanziieren Sie
PointwiseMetric-Objekte für Ihre beiden benutzerdefinierten Messwerte. Dadurch werden Ihre Prompt-Vorlagen in wiederverwendbare Komponenten für den Bewertungsjob verpackt. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
Sie haben jetzt zwei neue, wiederverwendbare Messwerte (relevance und helpfulness) für Ihren Bewertungsjob.
9. Bewertungsjob ausführen
Nachdem die Datasets und Messwerte bereit sind, können Sie die Bewertung ausführen. Dazu erstellen Sie für jedes Dataset, das Sie testen möchten, ein EvalTask-Objekt.
Eine EvalTask bündelt die Komponenten für einen Bewertungslauf:
- dataset: Der DataFrame, der Ihre Prompts und Antworten enthält.
- metrics: Die Liste der Messwerte, die Sie bewerten möchten.
- experiment: Das Vertex AI-Experiment, in dem die Ergebnisse protokolliert werden sollen, damit Sie Ausführungen verfolgen und vergleichen können.
- Erstellen Sie für jedes Modell einen
EvalTask. Dieses Objekt bündelt das Dataset, die Messwerte und den Testnamen. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus, um die Aufgaben zu konfigurieren:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask-Objekte konfiguriert, eines für jeden Satz von Modellantworten. Die von Ihnen bereitgestellte Liste mitmetricszeigt ein wichtiges Feature des Bewertungsdienstes: vordefinierte Messwerte (z.B.safety) und die benutzerdefiniertenPointwiseMetric-Objekte. - Nachdem die Aufgaben konfiguriert wurden, führen Sie sie durch Aufrufen der Methode
.evaluate()aus. Dadurch werden die Aufgaben zur Verarbeitung an das Vertex AI-Backend gesendet. Dies kann einige Minuten dauern. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
Nach Abschluss der Bewertung werden die Ergebnisse in den Objekten result_rag_a und result_rag_b gespeichert und können im nächsten Abschnitt analysiert werden.
10. Ergebnisse analysieren
Die Bewertungsergebnisse sind jetzt verfügbar. Die Objekte result_rag_a und result_rag_b enthalten aggregierte Punktzahlen und detaillierte Erläuterungen für jede Zeile. In dieser Aufgabe analysieren Sie diese Ergebnisse mithilfe von Hilfsfunktionen aus notebook_utils.
Zusammenfassungen ansehen
- Wenn Sie sich einen allgemeinen Überblick verschaffen möchten, können Sie mit der Hilfsfunktion
display_eval_result()die durchschnittliche Punktzahl für jeden Messwert abrufen. Fügen Sie in einer neuen Zelle Folgendes hinzu und führen Sie es aus, um die Zusammenfassung für Modell A aufzurufen:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - Wiederholen Sie den Vorgang für Modell B. Fügen Sie diesen Code in eine neue Zelle ein und führen Sie ihn aus:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
Bewertungsergebnisse visualisieren
Diagramme können den Vergleich der Modellleistung vereinfachen. Sie verwenden zwei Arten von Visualisierungen:
- Netzdiagramm: Zeigt die Gesamtleistung jedes Modells. Eine größere Form weist auf eine bessere Gesamtleistung hin.
- Balkendiagramm: Für einen direkten Vergleich der einzelnen Messwerte.
Anhand dieser Visualisierungen können Sie die Modelle nach subjektiven Kriterien wie Relevanz, Fundiertheit und Nützlichkeit vergleichen.
- Kombinieren Sie die Ergebnisse zur Vorbereitung auf die Darstellung in einer einzigen Liste von Tupeln. Jedes Tupel sollte einen Modellnamen und das entsprechende Ergebnisobjekt enthalten. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - Erstellen Sie jetzt ein Netzdiagramm, um die Modelle für alle Messwerte gleichzeitig zu vergleichen. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - Wenn Sie die einzelnen Messwerte direkter vergleichen möchten, erstellen Sie ein Balkendiagramm. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
Die Visualisierungen zeigen deutlich, dass die Leistung von Modell A (die große Form im Netzdiagramm und die hohen Balken im Balkendiagramm) der von Modell B überlegen ist.
Detaillierte Erklärung für eine einzelne Instanz ansehen
Die Gesamtpunktzahl zeigt die Gesamtleistung. Wenn Sie nachvollziehen möchten, warum ein Modell eine bestimmte Leistung erbracht hat, müssen Sie die detaillierten Erklärungen prüfen, die das Evaluator-LLM für jedes Beispiel generiert hat.
- Mit der Hilfsfunktion
display_explanations()können Sie einzelne Ergebnisse prüfen. Wenn Sie die detaillierte Aufschlüsselung für das zweite Beispiel (num=2) aus den Ergebnissen von Modell A sehen möchten, fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:notebook_utils.display_explanations(result_rag_a, num=2) - Sie können diese Funktion auch verwenden, um alle Beispiele nach einem bestimmten Messwert zu filtern. Dies ist nützlich, um einen bestimmten Bereich mit schlechter Leistung zu debuggen. Wenn Sie herausfinden möchten, warum Modell B beim Messwert
groundednessso schlecht abgeschnitten hat, fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. Referenzierte Bewertung mit einer „Golden Answer“
Zuvor haben Sie eine referenzfreie Bewertung durchgeführt, bei der die Antwort des Modells nur anhand des Prompts beurteilt wurde. Diese Methode ist nützlich, aber die Bewertung ist subjektiv.
Jetzt verwenden Sie die referenzbasierte Bewertung. Mit dieser Methode wird dem Dataset eine „Golden Answer“ (auch als Referenzantwort bezeichnet) hinzugefügt. Der Vergleich der Modellantwort mit einer Grundwahrheitsantwort bietet ein objektiveres Maß für die Leistung. So können Sie Folgendes messen:
- Faktische Richtigkeit: Stimmt die Antwort des Modells mit den Fakten in der Golden Answer überein?
- Semantische Ähnlichkeit: Bedeutet die Antwort des Modells dasselbe wie die Golden Answer?
- Vollständigkeit: Enthält die Antwort des Modells alle wichtigen Informationen aus der Golden Answer?
Referenziertes Dataset vorbereiten
Wenn Sie eine referenzierte Bewertung durchführen möchten, müssen Sie jedem Beispiel in Ihrem Dataset eine „Golden Answer“ hinzufügen.
Definieren wir zuerst eine golden_answers-Liste. Ein Vergleich der Golden Answers mit den Antworten von Modell A zeigt den Wert dieser Methode:
- Frage 1 (Brain): Die generierte Antwort und die Golden Answer sind identisch. Modell A ist richtig.
- Frage 2 (Senat): Die Antworten sind semantisch ähnlich, aber unterschiedlich formuliert. Ein guter Messwert sollte dies erkennen.
- Frage 3 (Hasan-Jalalians): Die Antwort von Modell A ist laut Kontext sachlich falsch. Der
golden_answerzeigt diesen Fehler an.
- Definieren Sie in einer neuen Zelle die Liste der golden_answers:
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - Erstellen Sie die referenzierten Bewertungs-DataFrames, indem Sie diesen Code in der folgenden Zelle ausführen:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
Die Datasets sind jetzt für die referenzierte Bewertung bereit.
Benutzerdefinierten referenzierten Messwert erstellen
Sie können auch benutzerdefinierte Messwerte für die referenzierte Bewertung erstellen. Der Prozess ist ähnlich, aber die Prompt-Vorlage enthält jetzt den Platzhalter {reference} für die Golden Answer.
Wenn es eine eindeutige „richtige“ Antwort gibt, können Sie eine strengere, binäre Bewertung (z.B. 1 für richtig, 0 für falsch) verwenden, um die sachliche Richtigkeit zu messen. Erstellen wir einen neuen question_answering_correctness-Messwert, der diese Logik implementiert.
- Definieren Sie die Prompt-Vorlage. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - Verpacken Sie den String der Prompt-Vorlage in ein PointwiseMetric-Objekt. Dadurch erhält Ihr Messwert einen formalen Namen und wird zu einer wiederverwendbaren Komponente für den Bewertungsjob. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
Sie haben jetzt einen benutzerdefinierten, referenzierten Messwert für einen strengen Faktencheck.
12. Referenzierte Bewertung ausführen
Jetzt konfigurieren Sie den Bewertungsjob mit den referenzierten Datasets und dem neuen Messwert. Sie verwenden wieder die Klasse EvalTask.
Die Liste der Messwerte enthält jetzt sowohl Ihren benutzerdefinierten modellbasierten Messwert als auch berechnungsbasierte Messwerte. Die referenzierte Bewertung ermöglicht die Verwendung herkömmlicher, berechnungsbasierter Messwerte, die mathematische Vergleiche zwischen dem generierten Text und dem Referenztext durchführen. Sie verwenden drei gängige:
exact_match: Gibt nur dann 1 zurück, wenn die generierte Antwort mit der Referenzantwort identisch ist, andernfalls 0.bleu: Ein Messwert für die Genauigkeit. Dabei wird gemessen, wie viele Wörter aus der generierten Antwort auch in der Referenzantwort vorkommen.rouge: Ein Messwert für den Recall. Er misst, wie viele Wörter aus der Referenzantwort in der generierten Antwort enthalten sind.
- Konfigurieren Sie den Bewertungsjob mit den referenzierten Datasets und der neuen Kombination von Messwerten. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um die
EvalTask-Objekte zu erstellen:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - Führen Sie die referenzierte Bewertung aus, indem Sie die Methode
.evaluate()aufrufen. Fügen Sie diesen Code in eine neue Zelle ein und führen Sie ihn aus:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. Referenzierte Ergebnisse analysieren
Die Bewertung ist abgeschlossen. In dieser Aufgabe analysieren Sie die Ergebnisse, um die sachliche Richtigkeit der Modelle zu messen. Dazu vergleichen Sie ihre Antworten mit den Golden-Reference-Antworten.
Zusammenfassung der Ergebnisse ansehen
- Analysieren Sie die zusammengefassten Ergebnisse für die referenzierte Bewertung. Fügen Sie in einer neuen Zelle den folgenden Code hinzu und führen Sie ihn aus, um die Übersichtstabellen für beide Modelle anzuzeigen:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessgut abschneidet, aber beiexact_matchschlechter abschneidet. Das unterstreicht den Wert modellbasierter Messwerte, die semantische Ähnlichkeiten erkennen können und nicht nur identischen Text.
Ergebnisse zum Vergleich visualisieren
Visualisierungen können den Leistungsunterschied zwischen den beiden Modellen deutlicher machen. Fassen Sie zuerst die Ergebnisse in einer einzigen Liste für die Darstellung zusammen und generieren Sie dann die Radar- und Balkendiagramme.
- Die referenzierten Bewertungsergebnisse werden in einer einzigen Liste für die Darstellung zusammengefasst. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - Erstellen Sie ein Netzdiagramm, um die Leistung der einzelnen Modelle für die neuen Messwerte zu visualisieren. Fügen Sie diesen Code in eine neue Zelle ein und führen Sie ihn aus:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - Erstellen Sie ein Balkendiagramm für einen direkten Vergleich. So sehen Sie, wie die einzelnen Modelle bei den verschiedenen Messwerten abgeschnitten haben. Fügen Sie den folgenden Code in eine neue Zelle ein und führen Sie ihn aus:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
Diese Visualisierungen bestätigen, dass Modell A deutlich genauer ist und sachlich besser mit den Referenzantworten übereinstimmt als Modell B.
14. Von der Praxis zur Produktion
Sie haben eine vollständige Bewertungspipeline für ein RAG-System ausgeführt. In diesem letzten Abschnitt werden die wichtigsten strategischen Konzepte zusammengefasst, die Sie gelernt haben. Außerdem erhalten Sie ein Framework, mit dem Sie diese Fähigkeiten auf reale Projekte anwenden können.
Best Practices für die Produktion
Wenn Sie die in diesem Lab erworbenen Fähigkeiten in einer realen Produktionsumgebung anwenden möchten, sollten Sie die folgenden vier wichtigen Best Practices beachten:
- Mit CI/CD automatisieren: Integrieren Sie Ihre Bewertungssuite in eine CI/CD-Pipeline (z.B. Cloud Build, GitHub Actions). Führen Sie Bewertungen automatisch bei Codeänderungen aus, um Regressionen zu erkennen und Bereitstellungen zu blockieren, wenn die Qualitätswerte unter Ihre Standards fallen.
- Datasets weiterentwickeln: Ein statisches Dataset veraltet. Verwalten Sie Ihre „Golden“-Test-Sets mit einer Versionsverwaltung (mit Git LFS oder Cloud Storage) und fügen Sie kontinuierlich neue, anspruchsvolle Beispiele hinzu, indem Sie Stichproben aus echten (anonymisierten) Nutzeranfragen nehmen.
- Bewerten Sie nicht nur den Generator, sondern auch den Retriever: Ohne den richtigen Kontext ist eine gute Antwort unmöglich. Implementieren Sie einen separaten Bewertungsschritt für Ihr Abrufsystem mit Messwerten wie Trefferrate (wurde das richtige Dokument gefunden?) und Mean Reciprocal Rank (MRR) (wie hoch wurde das richtige Dokument eingestuft?).
- Messwerte im Zeitverlauf beobachten: Exportieren Sie die zusammenfassenden Ergebnisse Ihrer Bewertungsausführungen in einen Dienst wie Google Cloud Monitoring. Erstellen Sie Dashboards, um Qualitätstrends zu verfolgen, und richten Sie automatische Benachrichtigungen ein, um über erhebliche Leistungseinbußen informiert zu werden.
Matrix für erweiterte Bewertungsmethoden
Die Wahl des richtigen Bewertungsansatzes hängt von Ihren spezifischen Zielen ab. In dieser Matrix wird zusammengefasst, wann die einzelnen Methoden verwendet werden sollten.
Bewertungsansatz | Ideale Anwendungsfälle | Wichtigste Vorteile | Einschränkungen |
Referenzfrei | Produktionsmonitoring, kontinuierliche Bewertung | Keine Golden Answers erforderlich, erfasst subjektive Qualität | Teurer, potenzieller Bias der Bewerter |
Referenzbasiert | Modellvergleich, Benchmarking | Zielmessung, schnellere Berechnung | Erfordert Golden Answers, kann semantische Äquivalenz verfehlen |
Benutzerdefinierte Messwerte | Fachspezifische Bewertung | Auf Geschäftsanforderungen zugeschnitten | Validierung und Entwicklungsaufwand erforderlich |
Hybridansatz | Umfassende Produktionssysteme | Das Beste aus allen Ansätzen | Höhere Komplexität, Kostenoptimierung erforderlich |
Wichtige technische Erkenntnisse
Beachten Sie beim Erstellen und Bewerten Ihrer eigenen RAG-Systeme die folgenden Grundprinzipien:
- Fundiertheit ist entscheidend für RAG: Dieser Messwert unterscheidet zuverlässig zwischen hochwertigen und minderwertigen RAG-Systemen und ist daher für das Produktionsmonitoring unerlässlich.
- Mehrere Messwerte sorgen für Robustheit: Ein einzelner Messwert kann nicht alle Aspekte der RAG-Qualität erfassen. Eine umfassende Bewertung erfordert mehrere Bewertungsdimensionen.
- Benutzerdefinierte Messwerte bieten einen erheblichen Mehrwert: Mit domänenspezifischen Bewertungskriterien werden oft Nuancen erfasst, die bei allgemeinen Messwerten nicht berücksichtigt werden. Dadurch wird die Genauigkeit der Bewertung verbessert.
- Statistische Genauigkeit sorgt für Vertrauen: Mit angemessenen Stichprobengrößen und Signifikanztests wird die Bewertung von einer Vermutung zu einem zuverlässigen Entscheidungstool.
Entscheidungs-Framework für die Bereitstellung in der Produktion
Verwenden Sie dieses phasenbasierte Framework als Leitfaden für zukünftige RAG-Systembereitstellungen:
- Phase 1 – Entwicklung: Verwenden Sie die referenzbasierte Bewertung mit bekannten Test-Datasets für den Modellvergleich und die Modellauswahl.
- Phase 2 – Vorproduktion: Führen Sie eine umfassende Bewertung durch, die beide Ansätze kombiniert, um die Produktionsbereitschaft zu prüfen.
- Phase 3 – Produktion: Implementieren Sie ein referenzfreies Monitoring für eine kontinuierliche Qualitätsbewertung ohne Golden Answers.
- Phase 4 – Optimierung: Nutzen Sie die Bewertungsergebnisse, um das Modell und das Abrufsystem zu verbessern.
15. Fazit
Glückwunsch! Sie haben das Lab erfolgreich abgeschlossen.
Dieses Lab ist Teil des Lernpfads „Produktionsreife KI mit Google Cloud“.
- Sehen Sie sich den gesamten Lehrplan an, um die Lücke zwischen Prototyp und Produktion zu schließen.
- Teile deine Fortschritte mit dem Hashtag
ProductionReadyAI.
Zusammenfassung
Sie haben Folgendes gelernt:
- Führen Sie eine referenzfreie Bewertung durch, um die Qualität einer Antwort anhand des abgerufenen Kontexts zu beurteilen.
- Führen Sie eine referenzierte Bewertung durch, indem Sie eine „Golden Answer“ hinzufügen, um die sachliche Richtigkeit zu messen.
- Verwenden Sie für beide Ansätze eine Kombination aus vordefinierten und benutzerdefinierten Messwerten.
- Verwenden Sie sowohl modellbasierte Messwerte (z. B.
question_answering_quality) als auch berechnungsbasierte Messwerte (rouge,bleu,exact_match). - Ergebnisse analysieren und visualisieren, um die Stärken und Schwächen eines Modells zu verstehen.
Dieser Bewertungsansatz hilft Ihnen, zuverlässigere und genauere generative KI-Anwendungen zu entwickeln.