

۱. نمای کلی
در این آزمایشگاه، نحوه ساختن خط لوله ارزیابی برای سیستم «تولید با کمک بازیابی» (RAG) را یاد خواهید گرفت. از «سرویس ارزیابی هوش مصنوعی زایا» در Vertex AI برای ایجاد معیارهای ارزیابی سفارشی و ساختن چارچوب ارزیابی برای تکلیف پرسش و پاسخ استفاده خواهید کرد.
با نمونههایی از Stanford Question Answering Dataset (SQuAD 2.0) کار خواهید کرد تا مجموعه دادههای ارزیابی را آماده کنید، ارزیابیهای بدون مرجع و مبتنی بر مرجع را پیکربندی کنید، و نتایج را تفسیر کنید. در پایان این کارگاه آموزشی، نحوه ارزیابی سیستمهای RAG و دلیل انتخاب رویکردهای ارزیابی خاص را درک خواهید کرد.
شالوده مجموعهداده
ما با نمونههای بادقت ساختهشدهای کار خواهیم کرد که چندین دامنه موجود در مجموعه داده پرسش و پاسخ SQuAD 2.0 را پوشش میدهند:
- علوم اعصاب: آزمایش دقت فنی در زمینههای علمی
- تاریخ: ارزیابی دقت واقعی در روایتهای تاریخی
- جغرافیا: ارزیابی دانش سرزمینی و سیاسی
این تنوع به شما کمک میکند تا بفهمید رویکردهای ارزیابی چگونه در حوزههای موضوعی مختلف تعمیم مییابند.
مرجعها
- نمونههای کد: این آزمایشگاه براساس نمونههایی از اسناد ارزیابی Vertex AI ساخته شده است
- پایه مجموعه داده: مجموعه داده پرسش و پاسخ SQuAD 2.0
- بهینهسازی بازیابی RAG: آزمایش، تنظیم، موفقیت
آنچه خواهید آموخت
در این آزمایشگاه، با نحوه انجام کارهای زیر آشنا میشوید:
- مجموعهدادههای ارزیابی را برای سیستمهای RAG آماده کنید.
- ارزیابی بدون مرجع را بااستفاده از سنجههایی مثل مستند بودن و مربوط بودن پیادهسازی کنید.
- ارزیابی مرجعمحور را با معیارهای شباهت معنایی اعمال کنید.
- سنجههای ارزیابی سفارشی با راهنمای نمرهدهی دقیق ایجاد کنید.
- تفسیر و تجسم نتایج ارزیابی برای اطلاع از انتخاب مدل.
۲. راهاندازی پروژه
حساب Google
اگر ازقبل «حساب Google» شخصی ندارید، باید «حساب Google» ایجاد کنید.
بهجای حساب کاری یا تحصیلی، از حساب شخصی استفاده کنید.
ورود به سیستم «کنسول Google Cloud»
بااستفاده از حساب Google شخصی به سیستم کنسول Google Cloud وارد شوید.
فعال کردن صورتحساب
پسخرید کردن اعتبارهای Google Cloud (اختیاری)
برای اجرای این کارگاه، به حساب صورتحساب با مقداری اعتبار نیاز دارید. برای شروع، از اعتبارهای موجود در برنمای بالای این codelab استفاده کنید. اگر ازقبل به حساب صورتحساب متصل شدهاید، میتوانید از این مرحله رد شوید.
راهاندازی حساب صورتحساب شخصی
اگر صورتحساب را بااستفاده از اعتبارهای Google Cloud راهاندازی کردهاید، میتوانید از این مرحله رد شوید.
برای راهاندازی حساب صورتحساب شخصی، به اینجا بروید تا صدور صورتحساب را در Cloud Console فعال کنید.
چند نکته:
- تکمیل این آزمایشگاه باید کمتر از ۱ دلار امریکا در منابع Cloud هزینه داشته باشد.
- برای جلوگیری از کسر هزینههای بیشتر، میتوانید مراحل انتهای این آزمایشگاه را برای حذف منابع دنبال کنید.
- کاربران جدید واجدشرایط دوره آزمایشی رایگان ۳۰۰ دلاری هستند.
ایجاد پروژه (اختیاری)
اگر پروژه فعلیای ندارید که بخواهید برای این آزمایشگاه استفاده کنید، پروژه جدیدی در اینجا ایجاد کنید.
۳. «تولید با کمک بازیابی» (RAG) چیست؟
RAG تکنیکی است که برای بهبود دقت واقعی و مرتبط بودن پاسخهای «مدلهای زبانی بزرگ» (LLM) استفاده میشود. این روش مدل زبانی بزرگ را به یک پایگاه دانش خارجی متصل میکند تا پاسخهای آن را براساس اطلاعات خاص و قابلدرستیسنجی تنظیم کند.
این فرایند شامل این مراحل است:
- تبدیل سؤال کاربر به یک نمایش عددی (جاسازی).
- درحال جستجوی پایگاه دانش برای اسناد با جاسازیهای مشابه.
- ارائه این اسناد مرتبط بهعنوان زمینه به مدل زبانی بزرگ همراه با سؤال اصلی برای تولید پاسخ.
درباره RAG بیشتر بخوانید.
چه چیزی ارزیابی RAG را پیچیده میکند؟
ارزیابی سیستمهای RAG با ارزیابی مدلهای زبانی سنتی متفاوت است.
چالش چندمؤلفهای: سیستمهای RAG سه عملیات را ترکیب میکنند که هرکدام میتواند نقطه شکست باشد:
- کیفیت بازیابی: آیا سیستم اسناد بافتار مناسب را پیدا کرد؟
- استفاده از زمینه: آیا مدل از اطلاعات بازیابیشده بهطور مؤثر استفاده کرد؟
- کیفیت تولید: آیا پاسخ نهایی بهخوبی نوشته شده، مفید، و دقیق است؟
اگر هرکدام از این مؤلفهها طبق انتظار کار نکنند، ممکن است پاسخ ناموفق باشد. برای مثال، ممکن است سیستم بافت صحیح را بازیابی کند، اما مدل آن را نادیده بگیرد. یا ممکن است مدل پاسخی خوشنگارش تولید کند که نادرست است چون بافت بازیابیشده نامربوط بوده است.
۴. راهاندازی محیط Vertex AI Workbench
بیایید با شروع یک محیط دفتر یادداشت جدید شروع کنیم که در آن کد موردنیاز برای ارزیابی سیستمهای RAG را اجرا خواهیم کرد.
- به صفحه «میاناهای برنامهسازی کاربردی و سرویسها» در «کنسول Cloud» بروید.
- روی فعال کردن برای Vertex AI API کلیک کنید.
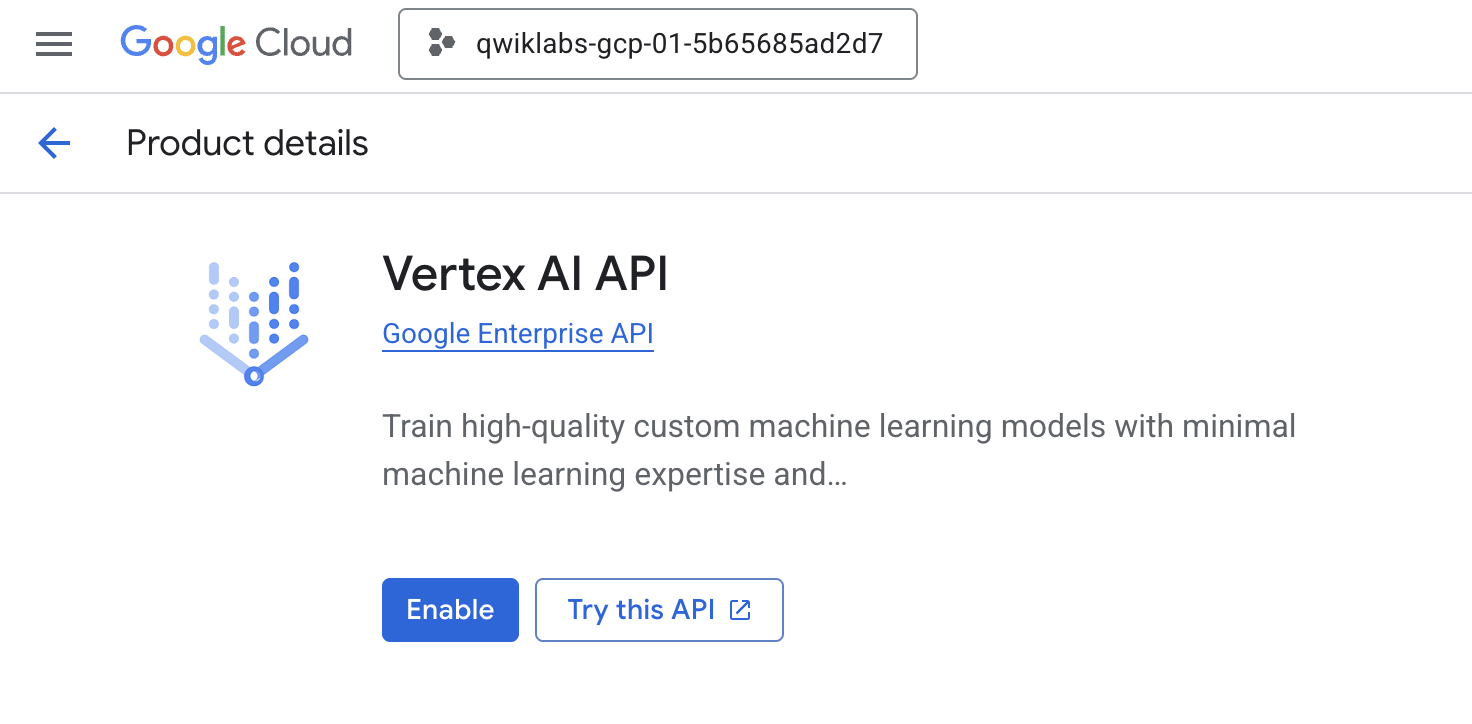
دسترسی به Vertex AI Workbench
- در Google Cloud Console، با کلیک کردن روی منو پیمایش ☰ > Vertex AI > Workbench، به Vertex AI پیمایش کنید.
- نمونه میز کار جدیدی ایجاد کنید.
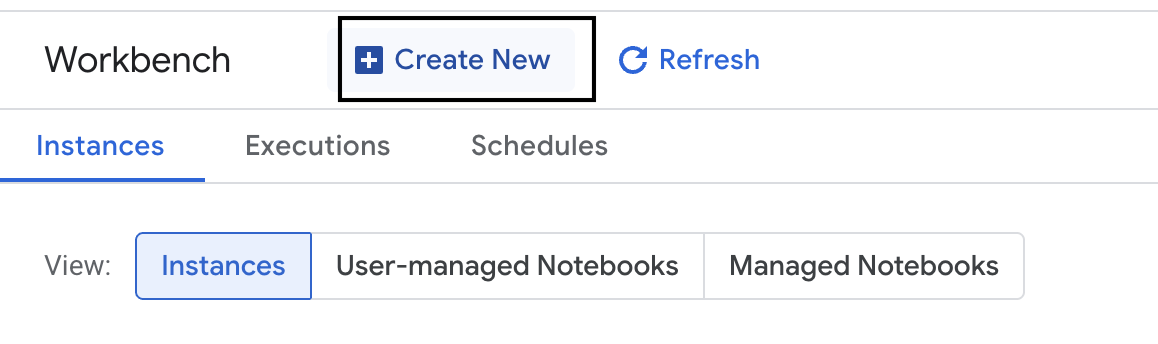
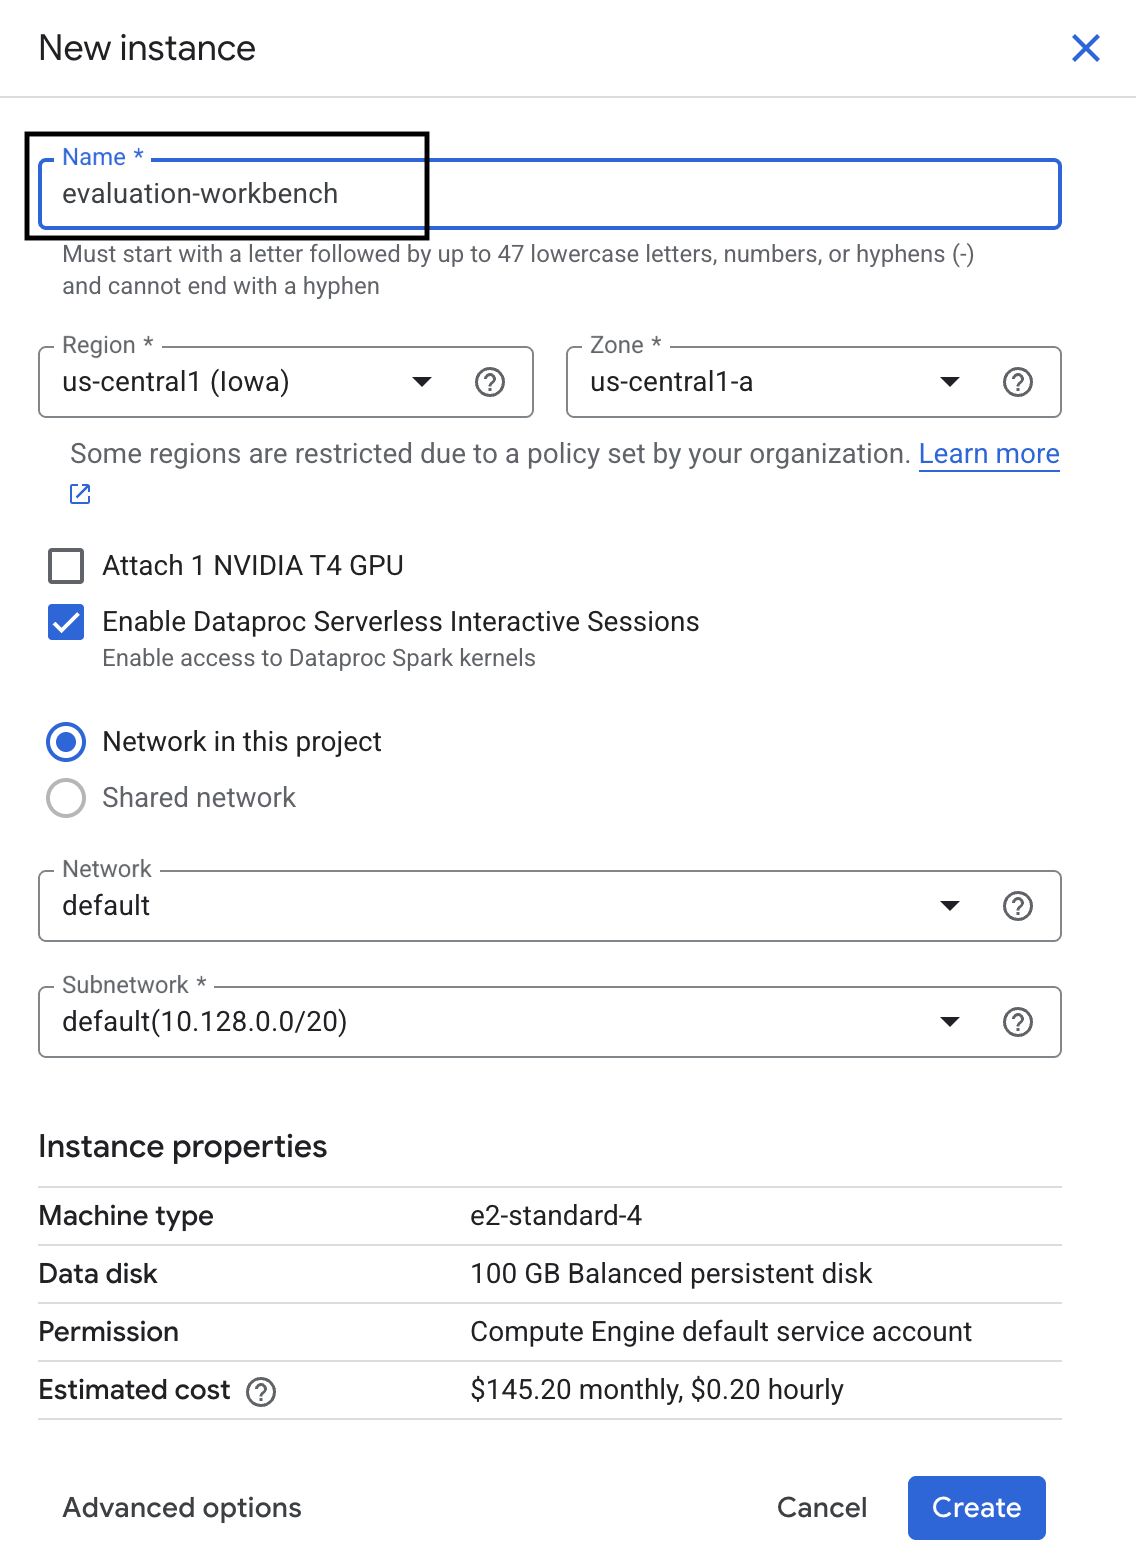
- نام نمونه میزکار
evaluation-workbenchاست. - اگر این مقادیر ازقبل تنظیم نشدهاند، منطقه و ناحیه خود را انتخاب کنید.
- روی ایجاد کلیک کنید.
- منتظر بمانید تا میزکار راهاندازی شود. این کار ممکن است چند دقیقه طول بکشد.
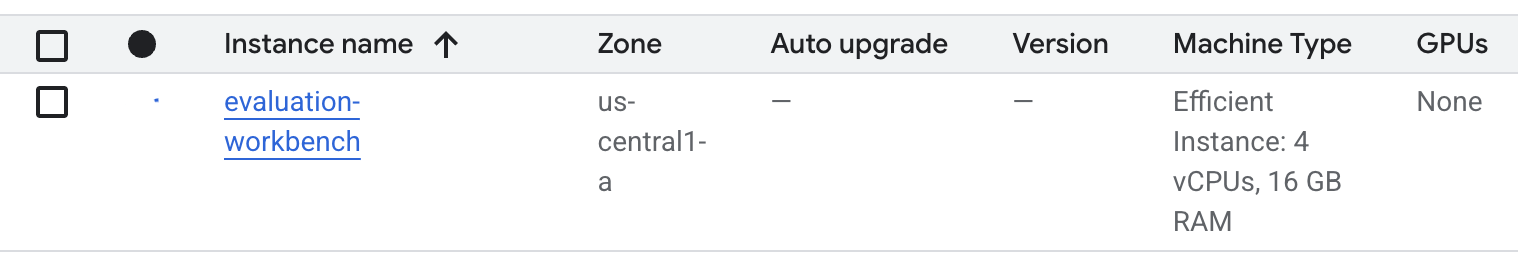
- وقتی میزکار آماده شد، روی باز کردن jupyterlab کلیک کنید.
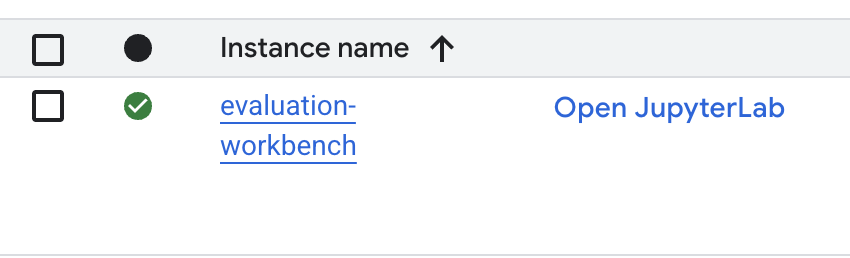
- در میزکار، دفتر یادداشت Python3 جدیدی ایجاد کنید.
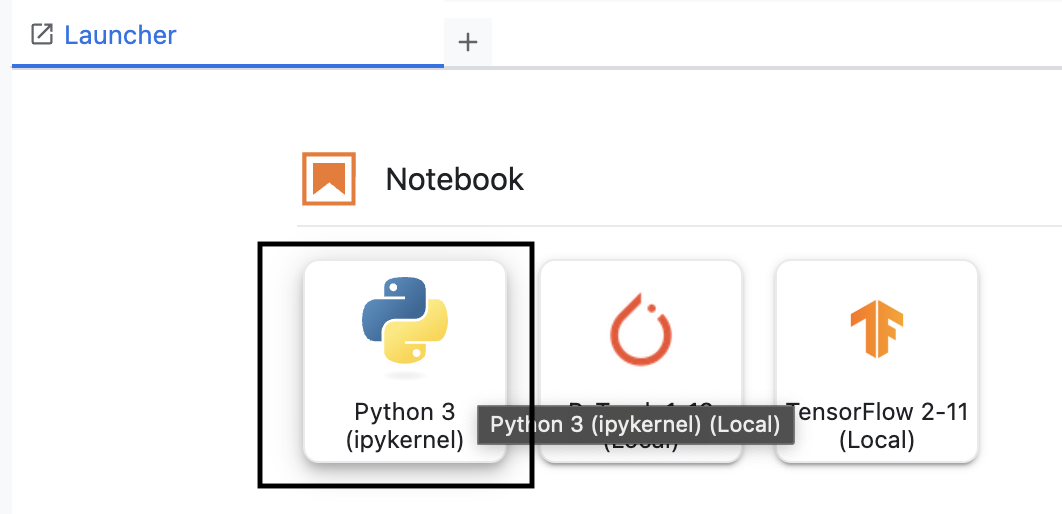
برای کسب اطلاعات بیشتر درباره ویژگیها و قابلیتهای این محیط، به اسناد رسمی Vertex AI Workbench مراجعه کنید.
نصب کردن کیت توسعه نرمافزار ارزیابی Vertex AI
اکنون بیایید کیت توسعه نرمافزار ارزیابی تخصصی را که ابزارهای ارزیابی «تولید افزوده بازیابی» را ارائه میدهد نصب کنیم.
- در اولین سلول دفتر یادداشتتان، عبارت وارد کردن زیر را اضافه و اجرا کنید (SHIFT+ENTER) تا Vertex AI SDK (با مؤلفههای ارزیابی) نصب شود.
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: کلاس اصلی برای اجرای ارزیابیها
- MetricPromptTemplateExamples: سنجههای ارزیابی ازپیش تعریفشده
- PointwiseMetric: چارچوبی برای ایجاد سنجههای سفارشی
- notebook_utils: ابزارهای دیداریسازی برای تحلیل نتایج
- مهم: پساز نصب، برای استفاده از بستههای جدید باید هسته را بازراهاندازی کنید. در نوار منو در بالای پنجره JupyterLab، به Kernel > Restart Kernel بروید.
۵. مقداردهی اولیه کیت توسعه نرمافزار و وارد کردن کتابخانهها
قبلاز اینکه بتوانید خط لوله ارزیابی را بسازید، باید محیط خود را راهاندازی کنید. این شامل پیکربندی جزئیات پروژه، مقداردهی اولیه «کیت توسعه نرمافزار Vertex AI» برای اتصال به Google Cloud، و وارد کردن کتابخانههای تخصصی Python است که برای ارزیابی استفاده خواهید کرد.
- متغیرهای پیکربندی را برای کار ارزیابیتان تعریف کنید. در سلول جدید، کد زیر را اضافه و اجرا کنید تا
PROJECT_ID،LOCATION، و نامEXPERIMENTرا برای سازماندهی این اجرا تنظیم کنید.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - کیت توسعه نرمافزار Vertex AI را مقداردهی اولیه کنید. در سلول جدید، کد زیر را اضافه و اجرا کنید.
vertexai.init(project=PROJECT_ID, location=LOCATION) - با اجرای کد زیر در سلول بعدی، کلاسهای لازم را از کیت توسعه نرمافزار ارزیابی وارد کنید:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: برای ایجاد و مدیریت دادهها در DataFrames.
- EvalTask: کلاس اصلی که کار ارزیابی را اجرا میکند.
- MetricPromptTemplateExamples: دسترسی به سنجههای ارزیابی ازپیش تعریفشده Google را فراهم میکند.
- PointwiseMetric: چارچوبی برای ایجاد سنجههای سفارشی خودتان.
- notebook_utils: مجموعهای از ابزارها برای تجسم نتایج.
۶. آمادهسازی مجموعه داده ارزیابی
مجموعهدادهای که ساختار خوبی داشته باشد پایه هر ارزیابی قابلاعتمادی است. برای سیستمهای RAG، مجموعه داده شما برای هر نمونه به دو فیلد کلیدی نیاز دارد:
- پیامواره: این کل ورودی ارائهشده به مدل زبانی است. باید سؤال کاربر را با بافت بازیابیشده توسط سیستم RAG خود (
prompt = User Question + Retrieved Context) ترکیب کنید. این کار مهم است تا سرویس ارزیابی بداند مدل از چه اطلاعاتی برای ایجاد پاسخ خود استفاده کرده است. - پاسخ: این پاسخ نهایی تولیدشده توسط مدل RAG شما است.
برای نتایج قابلاعتماد آماری، مجموعه دادهای با حدود ۱۰۰ نمونه توصیه میشود. برای این آزمایشگاه، از مجموعهداده کوچکی برای نمایش فرایند استفاده خواهید کرد.
بیایید مجموعه دادهها را ایجاد کنیم. با فهرستی از سؤالات و retrieved_contexts از سیستم RAG شروع خواهید کرد. سپس دو مجموعه پاسخ تعریف میکنید: یکی از مدلی که بهنظر میرسد عملکرد خوبی دارد (generated_answers_by_rag_a) و دیگری از مدلی که عملکرد ضعیفی دارد (generated_answers_by_rag_b).
درنهایت، این قطعات را طبق ساختار شرحدادهشده در بالا در دو pandas DataFrame، eval_dataset_rag_a و eval_dataset_rag_b، ترکیب خواهید کرد.
- در سلول جدید، کد زیر را برای تعریف سؤالات و دو مجموعه از generated_answers اضافه و اجرا کنید.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - retrieved_contexts را تعریف کنید. کد زیر را در سلول جدیدی اضافه و اجرا کنید.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - در سلول جدید، کد زیر را برای ایجاد
eval_dataset_rag_aوeval_dataset_rag_bاضافه و اجرا کنید.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - کد زیر را در سلول جدیدی اجرا کنید تا چند ردیف اول مجموعه داده «مدل الف» را مشاهده کنید.
eval_dataset_rag_a
۷. انتخاب و ایجاد سنجهها
اکنون که مجموعههای داده آماده هستند، میتوانید تصمیم بگیرید که عملکرد را چگونه بسنجید. میتوانید از یک یا چند سنجه برای ارزیابی مدل خود استفاده کنید. هر سنجه جنبه خاصی از پاسخ مدل را ارزیابی میکند، مثلاً دقت واقعی یا مرتبط بودن آن.
میتوانید از ترکیبی از دو نوع سنجه استفاده کنید:
- سنجههای ازپیش تعریفشده: سنجههای آماده استفاده که توسط کیت توسعه نرمافزار برای تکالیف ارزیابی رایج ارائه شده است.
- سنجههای سفارشی: سنجههایی که برای آزمایش کیفیتهای مرتبط با مورد استفادهتان تعریف میکنید.
در این بخش، سنجههای ازپیش تعریفشده دردسترس برای «تولید افزوده بازیابی» را کاوش خواهید کرد.
کاوش سنجههای ازپیش تعریفشده
کیت توسعه نرمافزار شامل چندین سنجه داخلی برای ارزیابی سیستمهای پرسش و پاسخ است. این سنجهها از یک مدل زبانی بهعنوان «ارزیاب» استفاده میکنند تا پاسخهای مدل شما را براساس مجموعهای از دستورالعملها امتیازدهی کنند.
- در سلول جدید، کد زیر را اضافه و اجرا کنید تا فهرست کامل نامهای سنجه ازپیش تعریفشده را ببینید:
MetricPromptTemplateExamples.list_example_metric_names() - برای درک نحوه عملکرد این سنجهها، میتوانید الگوهای پیامواره زیربنایی آنها را بررسی کنید. در سلول جدید، کد زیر را اضافه و اجرا کنید تا دستورالعملهای ارائهشده به LLM ارزیاب را برای سنجه
question_answering_qualityببینید.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
۸. ساختن سنجههای سفارشی
علاوهبر سنجههای ازپیش تعریفشده، میتوانید سنجههای سفارشی ایجاد کنید تا معیارهای خاص مورد استفادهتان را ارزیابی کنید. برای ایجاد سنجه سفارشی، الگوی پیاموارهای مینویسید که به مدل زبانی بزرگ ارزیاب دستور میدهد چگونه به پاسخ امتیاز دهد.
ایجاد سنجه سفارشی شامل دو مرحله است:
- تعریف کردن الگوی پیامواره: رشتهای که حاوی دستورالعملهای شما برای مدل زبانی بزرگ ارزیاب است. یک الگوی خوب شامل نقش واضح، معیارهای ارزیابی، سیستم نمرهدهی، و جایبانهایی مثل
{prompt}و{response}است. - نمونهسازی شیء PointwiseMetric: رشته الگوی پیامواره را در این کلاس قرار میدهید و نامی برای سنجهتان انتخاب میکنید.
دو سنجه سفارشی برای ارزیابی میزان مرتبط بودن و مفید بودن پاسخهای سیستم RAG ایجاد خواهید کرد.
- الگوی پیامواره را برای سنجه مربوط بودن تعریف کنید. این الگو یک راهنمای ارزیابی دقیق برای مدل زبانی بزرگ ارزیاب ارائه میدهد. در سلول جدید، کد زیر را اضافه و اجرا کنید:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - بااستفاده از همین رویکرد، الگوی پیامواره را برای سنجه مفید بودن تعریف کنید. کد زیر را در سلول جدیدی اضافه و اجرا کنید:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - برای دو سنجه سفارشیتان،
PointwiseMetricشیء را نمونهسازی کنید. این کار الگوهای پیامواره شما را در مؤلفههای قابلاستفاده مجدد برای کار ارزیابی قرار میدهد. کد زیر را در سلول جدیدی اضافه و اجرا کنید:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
اکنون دو سنجه جدید و قابلاستفاده مجدد (relevance و helpfulness) برای کار ارزیابی شما آماده است.
۹. اجرای کار ارزیابی
اکنون که مجموعهدادهها و سنجهها آماده هستند، میتوانید ارزیابی را اجرا کنید. این کار را با ایجاد شیء EvalTask برای هر مجموعه دادهای که میخواهید آزمایش کنید انجام خواهید داد.
EvalTask مؤلفهها را برای اجرای ارزیابی دستهبندی میکند:
- مجموعه داده: DataFrame حاوی پیاموارهها و پاسخهای شما.
- سنجهها: فهرست سنجههایی که میخواهید براساس آنها امتیازدهی کنید.
- experiment: «آزمایش Vertex AI» برای ثبت نتایج، که به شما کمک میکند اجراها را پیگیری و مقایسه کنید.
- برای هر مدل، یک
EvalTaskایجاد کنید. این شیء مجموعه داده، سنجهها، و نام آزمایش را بستهبندی میکند. کد زیر را در سلول جدیدی اضافه و اجرا کنید تا تکالیف را پیکربندی کنید:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTaskرا پیکربندی کردهاید، یکی برای هر مجموعه از پاسخهای مدل. فهرستmetricsکه ارائه کردید ویژگی کلیدی سرویس ارزیابی را نشان میدهد: سنجههای ازپیش تعریفشده (مثلاًsafety) و اشیای سفارشیPointwiseMetric. - با پیکربندی تکالیف، آنها را با فراخوانی روش
.evaluate()اجرا کنید. این کار تکالیف را برای پردازش به پسای Vertex AI ارسال میکند و ممکن است چند دقیقه طول بکشد تا تکمیل شود. در سلول جدید، کد زیر را اضافه و اجرا کنید:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
پساز تکمیل ارزیابی، نتایج در اشیاء result_rag_a و result_rag_b ذخیره میشوند و برای تجزیهوتحلیل در بخش بعدی آماده خواهند بود.
۱۰. تحلیل نتایج
نتایج ارزیابی اکنون دردسترس است. اشیاء result_rag_a و result_rag_b حاوی امتیازهای تجمیعشده و توضیحات دقیق برای هر ردیف هستند. در این تکلیف، این نتایج را بااستفاده از توابع کمکی از notebook_utils تحلیل خواهید کرد.
مشاهده خلاصههای انبوهشی
- برای دریافت نمای کلی سطح بالا، از تابع کمکی
display_eval_result()استفاده کنید تا امتیاز میانگین هر سنجه را ببینید. در سلول جدید، کد زیر را اضافه و اجرا کنید تا خلاصه «مدل الف» را مشاهده کنید:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - همین کار را برای «مدل B» انجام دهید. این کد را در سلول جدیدی اضافه و اجرا کنید:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
تجسم نتایج ارزیابی
نمودارها میتوانند مقایسه عملکرد مدل را آسانتر کنند. از دو نوع تجسم استفاده خواهید کرد:
- نمودار راداری: «شکل» عملکرد کلی هر مدل را نشان میدهد. شکل بزرگتر نشاندهنده عملکرد کلی بهتر است.
- نمودار میلهای: برای مقایسه مستقیم و پهلوبهپهلو در هر سنجه.
این مصورسازیها به شما کمک میکند مدلها را ازنظر کیفیتهای ذهنی مانند مربوط بودن، مستدل بودن، و مفید بودن مقایسه کنید.
- برای آماده شدن برای رسم نمودار، نتایج را در یک فهرست واحد از چندتاییها ترکیب کنید. هر چندتایی باید حاوی نام مدل و شیء نتیجه مربوط به آن باشد. در سلول جدید، کد زیر را اضافه و اجرا کنید:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - اکنون، یک نمودار راداری برای مقایسه مدلها در تمام سنجهها بهطور همزمان تولید کن. کد زیر را در سلول جدیدی اضافه و اجرا کنید:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - برای مقایسه مستقیمتر هر سنجه، نمودار میلهای تولید کنید. در سلول جدید، این کد را اضافه و اجرا کنید:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
تجسمها بهوضوح نشان میدهند که عملکرد «مدل الف» (شکل بزرگ در نمودار راداری و میلههای بلند در نمودار میلهای) برتر از «مدل ب» است.
مشاهده توضیح مفصل برای یک مورد خاص
امتیازهای تجمیعی عملکرد کلی را نشان میدهد. برای درک اینکه چرا مدل به روش خاصی عمل کرده است، باید توضیحات مفصلی را که توسط مدل زبانی بزرگ ارزیاب برای هر نمونه تولید شده است مرور کنید.
- تابع کمکی
display_explanations()به شما امکان میدهد نتایج فردی را بررسی کنید. برای دیدن تفکیک دقیق مثال دوم (num=2) از نتایج «مدل A»، کد زیر را در سلول جدیدی اضافه و اجرا کنید:notebook_utils.display_explanations(result_rag_a, num=2) - همچنین میتوانید از این تابع برای فیلتر کردن سنجهای خاص در همه نمونهها استفاده کنید. این کار برای اشکالزدایی ناحیه خاصی از عملکرد ضعیف مفید است. برای اینکه ببینید چرا «مدل ب» در سنجه
groundednessعملکرد بسیار ضعیفی داشته است، این کد را در سلول جدیدی اضافه و اجرا کنید:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
۱۱. ارزیابی مرجع بااستفاده از «پاسخ طلایی»
قبلاً، ارزیابی بدون مرجع انجام دادید که در آن پاسخ مدل فقط براساس پیامواره قضاوت میشد. این روش مفید است، اما ارزیابی ذهنی است.
اکنون از ارزیابی مرجع استفاده خواهید کرد. این روش یک «پاسخ طلایی» (که پاسخ مرجع نیز نامیده میشود) به مجموعه داده اضافه میکند. مقایسه پاسخ مدل با پاسخ واقعیت عینی، معیار عینیتری از عملکرد ارائه میدهد. این به شما امکان میدهد موارد زیر را اندازهگیری کنید:
- صحت واقعی: آیا پاسخ مدل با حقایق موجود در پاسخ طلایی مطابقت دارد؟
- شباهت معنایی: آیا پاسخ مدل همان معنای پاسخ طلایی را دارد؟
- کامل بودن: آیا پاسخ مدل حاوی تمام اطلاعات کلیدی پاسخ طلایی است؟
آمادهسازی مجموعه داده ارجاعدادهشده
برای انجام ارزیابی مرجع، باید به هر نمونه در مجموعه دادهتان یک «پاسخ طلایی» اضافه کنید.
بیایید با تعریف کردن فهرست golden_answers شروع کنیم. مقایسه پاسخهای طلایی با پاسخهای «مدل الف» ارزش این روش را نشان میدهد:
- سؤال ۱ (مغز): پاسخ تولیدشده و پاسخ طلایی یکسان هستند. مدل الف درست است.
- سؤال ۲ (سنا): پاسخها ازنظر معنایی مشابه هستند اما با کلمات متفاوتی بیان شدهاند. یک سنجه خوب باید این را تشخیص دهد.
- سؤال ۳ (حسن جلالیان): پاسخ مدل الف ازنظر مطابقت با واقعیت براساس بافتار نادرست است.
golden_answerاین خطا را نشان میدهد.
- در سلول جدید، فهرست golden_answers را تعریف کنید
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - با اجرای این کد در سلول زیر، DataFrameهای ارزیابی ارجاعشده را ایجاد کنید:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
اکنون مجموعههای داده برای ارزیابی ارجاعی آمادهاند.
ایجاد سنجه ارجاعی سفارشی
همچنین میتوانید سنجههای سفارشی برای ارزیابی مرجع ایجاد کنید. فرایند مشابه است، اما اکنون الگوی پیامواره شامل جایبان {reference} برای پاسخ طلایی است.
با داشتن پاسخ قطعی «درست»، میتوانید از امتیازدهی دودویی سختگیرانهتری (مثلاً ۱ برای درست، ۰ برای نادرست) برای سنجش دقت واقعی استفاده کنید. بیایید سنجه question_answering_correctness جدیدی ایجاد کنیم که این منطق را پیادهسازی کند.
- الگوی پیامواره را تعریف کنید. در سلول جدید، کد زیر را اضافه و اجرا کنید:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - رشته الگوی پیامواره را در شیء PointwiseMetric قرار دهید. این کار نامی رسمی به سنجه شما میدهد و آن را به مؤلفهای قابلاستفاده مجدد برای کار ارزیابی تبدیل میکند. کد زیر را در سلول جدیدی اضافه و اجرا کنید:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
اکنون سنجه سفارشی و ارجاعشدهای برای بررسی دقیق واقعیت دارید.
۱۲. اجرای «ارزیابی مرجعدار»
اکنون، کار ارزیابی را با مجموعهدادههای ارجاعشده و سنجه جدید پیکربندی خواهید کرد. دوباره از کلاس EvalTask استفاده خواهید کرد.
فهرست سنجهها اکنون سنجه سفارشی مبتنی بر مدل شما را با سنجههای مبتنی بر محاسبات ترکیب میکند. ارزیابی مرجع امکان استفاده از سنجههای سنتی مبتنی بر محاسبات را فراهم میکند که مقایسههای ریاضی بین نوشتار تولیدشده و نوشتار مرجع انجام میدهند. از سه مورد رایج استفاده خواهید کرد:
exact_match: فقط درصورتی امتیاز ۱ میگیرد که پاسخ تولیدشده با پاسخ مرجع یکسان باشد، درغیراینصورت امتیاز ۰ میگیرد.bleu: سنجهای برای دقت. این معیار میسنجد که چند کلمه از پاسخ تولیدشده در پاسخ مرجع نیز وجود دارد.-
rouge: سنجهای برای یادآوری. این معیار میسنجد که چه تعداد از کلمات پاسخ مرجع در پاسخ تولیدشده گنجانده شده است.
- کار ارزیابی را با مجموعههای داده ارجاعشده و ترکیب جدید سنجهها پیکربندی کنید. در سلول جدید، کد زیر را برای ایجاد اشیای
EvalTaskاضافه و اجرا کنید:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - ارزیابی ارجاعشده را با فراخوانی روش
.evaluate()اجرا کنید. این کد را در سلول جدیدی اضافه و اجرا کنید:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
۱۳. تحلیل نتایج ارجاعشده
ارزیابی تکمیل شده است. در این تکلیف، نتایج را تجزیهوتحلیل خواهید کرد تا دقت واقعی مدلها را با مقایسه پاسخهای آنها با پاسخهای مرجع طلایی بسنجید.
مشاهده نتایج خلاصه
- نتایج خلاصه را برای ارزیابی ارجاعدادهشده تحلیل کنید. در سلول جدید، کد زیر را اضافه و اجرا کنید تا جدولهای خلاصه برای هر دو مدل نمایش داده شود:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessشما عملکرد خوبی دارد اما درexact_matchامتیاز کمتری میگیرد. این امر ارزش سنجههای مبتنی بر مدل را که میتوانند شباهت معنایی را تشخیص دهند، نه فقط نوشتار یکسان، برجسته میکند.
تجسم نتایج برای مقایسه
مصورسازیها میتوانند تفاوت عملکرد بین دو مدل را آشکارتر کنند. ابتدا نتایج را در یک فهرست واحد برای رسم ترکیب کن، سپس نمودارهای راداری و میلهای را تولید کن.
- نتایج ارزیابی ارجاعشده را در یک فهرست واحد برای رسم کردن ترکیب کنید. کد زیر را در سلول جدیدی اضافه و اجرا کنید:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - یک نمودار راداری برای تجسم عملکرد هر مدل در مجموعه جدید سنجهها تولید کن. این کد را در سلول جدیدی اضافه و اجرا کنید:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - برای مقایسه مستقیم و پهلوبهپهلو، نمودار میلهای ایجاد کنید. این کار نشان میدهد که هر مدل در سنجههای مختلف چگونه عمل کرده است. کد زیر را در سلول جدیدی اضافه و اجرا کنید:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
این تجسمها تأیید میکنند که «مدل الف» بهطور قابلتوجهی دقیقتر و ازنظر واقعی با پاسخهای مرجع همسوتر از «مدل ب» است.
۱۴. از تمرین تا تولید
یک خط لوله ارزیابی کامل را برای سیستم RAG باموفقیت اجرا کردید. این بخش نهایی مفاهیم کلیدی استراتژیک را که یاد گرفتهاید خلاصه میکند و چارچوبی برای اعمال این مهارتها در پروژههای دنیای واقعی ارائه میدهد.
روالهای مطلوب تولید
برای انتقال مهارتهای این آزمایشگاه به محیط تولید واقعی، این چهار روش کلیدی را درنظر بگیرید:
- خودکارسازی با CI/CD: مجموعه ارزیابی خود را در خط لوله CI/CD (مانند Cloud Build، GitHub Actions) ادغام کنید. ارزیابیها را بهطور خودکار روی تغییرات کد اجرا کنید تا رگرسیونها را شناسایی کنید و اگر نمرات کیفیت از استانداردهای شما پایینتر رفت، استقرارها را مسدود کنید.
- مجموعه دادههایتان را تکامل دهید: مجموعه دادههای ثابت کهنه میشوند. مجموعههای آزمایشی «طلایی» خود را کنترل نسخه کنید (بااستفاده از Git LFS یا Cloud Storage) و بهطور مداوم نمونههای جدید و چالشبرانگیز را با نمونهبرداری از پُرسمانهای واقعی (ناشناسشده) کاربران اضافه کنید.
- بازیاب را ارزیابی کنید، نه فقط تولیدکننده را: پاسخ عالی بدون بافت مناسب غیرممکن است. یک مرحله ارزیابی جداگانه برای سیستم بازیابی خود بااستفاده از سنجههایی مانند نرخ موفقیت (آیا سند درست پیدا شد؟) و میانگین رتبه متقابل (MRR) (سند درست چقدر بالا رتبهبندی شد؟) پیادهسازی کنید.
- پایش سنجهها درطول زمان: امتیازهای خلاصه را از اجراهای ارزیابی به سرویسی مثل پایش Google Cloud صادر کنید. داشبوردهایی برای پیگیری روندهای کیفیت بسازید و هشدارهای خودکار تنظیم کنید تا از افتهای قابلتوجه عملکرد مطلع شوید.
ماتریس روش ارزیابی پیشرفته
انتخاب رویکرد ارزیابی مناسب به اهداف خاص شما بستگی دارد. این ماتریس خلاصه میکند که چه زمانی باید از هر روش استفاده کرد.
رویکرد ارزیابی | بهترین موارد استفاده | مزایای کلیدی | محدودیتها |
بدون مرجع | پایش تولید، ارزیابی مداوم | به پاسخهای طلایی نیاز ندارد، کیفیت ذهنی را ثبت میکند | گرانتر، سوگیری بالقوه ارزیاب |
مبتنی بر مرجع | مقایسه مدل، محکزنی | اندازهگیری هدف، محاسبه سریعتر | به پاسخهای طلایی نیاز دارد، ممکن است معادل معنایی را ازدست بدهد |
سنجههای سفارشی | ارزیابی مختص دامنه | متناسب با نیازهای کسبوکار | به اعتبارسنجی و سربار توسعه نیاز دارد |
رویکرد ترکیبی | سیستمهای تولید جامع | بهترین رویکردها | پیچیدگی بیشتر، بهینهسازی هزینه لازم است |
اطلاعات آماری فنی کلیدی
هنگام ساختن و ارزیابی سیستمهای RAG خود، این اصول اصلی را در ذهن داشته باشید:
- مستند بودن برای RAG حیاتی است: این سنجه بهطور مداوم بین سیستمهای RAG با کیفیت بالا و پایین تمایز قائل میشود و آن را برای نظارت بر تولید ضروری میکند.
- سنجههای متعدد استحکام را فراهم میکنند: هیچ سنجه واحدی همه جنبههای کیفیت RAG را ثبت نمیکند. ارزیابی جامع به ابعاد ارزیابی متعددی نیاز دارد.
- سنجههای سفارشی ارزش قابلتوجهی اضافه میکنند: معیارهای ارزیابی مختص دامنه اغلب تفاوتهای ظریفی را ثبت میکنند که سنجههای عمومی ازدست میدهند، و این امر دقت ارزیابی را بهبود میبخشد.
- دقت آماری باعث ایجاد اطمینان میشود: اندازه نمونه مناسب و آزمایش معنیداری، ارزیابی را از حدس و گمان به ابزارهای تصمیمگیری قابلاعتماد تبدیل میکند.
چارچوب تصمیمگیری برای استقرار تولید
از این چارچوب مرحلهای بهعنوان راهنمایی برای استقرار سیستمهای RAG در آینده استفاده کنید:
- فاز ۱ - توسعه: از ارزیابی مبتنی بر مرجع با مجموعههای آزمایشی شناختهشده برای مقایسه و انتخاب مدل استفاده کنید.
- فاز ۲ - پیشتولید: ارزیابی جامعی را با ترکیب هر دو رویکرد اجرا کنید تا سطح آمادگی تولید را اعتبارسنجی کنید.
- فاز ۳ - تولید: نظارت بدون مرجع را برای ارزیابی مداوم کیفیت بدون پاسخهای طلایی پیادهسازی کنید.
- فاز ۴ - بهینهسازی: از اطلاعات آماری ارزیابی برای هدایت بهبودهای مدل و تقویت سیستم بازیابی استفاده کنید.
۱۵. نتیجهگیری
تبریک! آزمایشگاه را تکمیل کردهاید.
این آزمایشگاه بخشی از «هوش مصنوعی آماده تولید با مسیر یادگیری Google Cloud» است.
- برنامه درسی کامل را کاوش کنید تا فاصله بین نمونه اولیه و تولید را پر کنید.
- پیشرفتتان را با هشتگ
ProductionReadyAIهمرسانی کنید.
خلاصه
با نحوه انجام این کارها آشنا شدید:
- ارزیابی بدون مرجع را برای سنجش کیفیت پاسخ براساس بافت بازیابیشده انجام دهید.
- ارزیابی مرجع را با افزودن «پاسخ طلایی» برای سنجش درستی واقعیت انجام دهید.
- برای هر دو رویکرد، از ترکیبی از سنجههای ازپیشتعریفشده و سفارشی استفاده کنید.
- از هر دو سنجههای مبتنی بر مدل (مانند
question_answering_quality) و سنجههای مبتنی بر محاسبات (rouge،bleu،exact_match) استفاده کنید. - نتایج را تجزیهوتحلیل و دیداریسازی کنید تا نقاط قوت و ضعف مدل را درک کنید.
این رویکرد ارزیابی به شما کمک میکند برنامههای هوش مصنوعی زایای قابلاعتمادتر و دقیقتری بسازید.