

1. סקירה כללית
בשיעור ה-Lab הזה תלמדו איך ליצור צינור עיבוד נתונים להערכה של מערכת RAG (יצירה משולבת-אחזור). תשתמשו בשירות ההערכה של Vertex AI ל-AI גנרטיבי כדי ליצור קריטריונים מותאמים אישית להערכה ולבנות מסגרת הערכה למשימה של מענה על שאלות.
תעבדו עם דוגמאות מ-Stanford Question Answering Dataset (SQuAD 2.0) כדי להכין קבוצות נתונים להערכה, להגדיר הערכות עם ובלי קובצי עזר ולפרש את התוצאות. בסוף שיעור ה-Lab הזה תבינו איך להעריך מערכות RAG ולמה נבחרו גישות הערכה מסוימות.
התשתית של מערך הנתונים
נעבוד עם דוגמאות שנבחרו בקפידה ממספר תחומים שנמצאים במערך הנתונים של SQuAD 2.0 Question Answering:
- מדעי המוח: בדיקת הדיוק הטכני בהקשרים מדעיים
- היסטוריה: הערכת הדיוק העובדתי בנרטיבים היסטוריים
- גאוגרפיה: הערכת הידע הטריטוריאלי והפוליטי
המגוון הזה עוזר להבין איך גישות הערכה מתאימות לתחומי מחקר שונים.
קובצי עזר
- דוגמאות קוד: שיעור ה-Lab הזה מבוסס על דוגמאות מהמסמכים של Vertex AI Evaluation
- מערך הנתונים הבסיסי: מערך הנתונים SQuAD 2.0 Question Answering
- אופטימיזציה של אחזור RAG: בדיקה, כוונון, הצלחה
מה תלמדו
בשיעור ה-Lab הזה תלמדו איך לבצע את המשימות הבאות:
- הכנת מערכי נתונים להערכה של מערכות RAG.
- להטמיע הערכה ללא קובץ עזר באמצעות מדדים כמו ביסוס ורלוונטיות.
- החלת הערכה מבוססת-הפניה עם מדדי דמיון סמנטי.
- ליצור מדדי הערכה מותאמים אישית עם קריטריונים מפורטים לניקוד.
- לפרש ולהציג באופן חזותי את תוצאות ההערכה כדי לבחור את המודל המתאים.
2. הגדרת הפרויקט
חשבון Google
אם אין לכם חשבון Google אישי, אתם צריכים ליצור חשבון Google.
להשתמש בחשבון אישי במקום בחשבון של מקום עבודה או מוסד לימודים.
כניסה למסוף Google Cloud
נכנסים למסוף Google Cloud באמצעות חשבון Google אישי.
הפעלת חיוב
מימוש קרדיטים ב-Google Cloud (אופציונלי)
כדי להפעיל את הסדנה הזו, צריך חשבון לחיוב עם קרדיט. כדי להתחיל, השתמשו בקרדיטים מהבאנר שבחלק העליון של ה-Codelab הזה. אם כבר יש לכם חשבון לחיוב, אתם יכולים לדלג על השלב הזה.
הגדרת חשבון חיוב אישי
אם הגדרתם חיוב באמצעות קרדיטים ל-Google Cloud, אתם יכולים לדלג על השלב הזה.
כדי להגדיר חשבון חיוב אישי, צריך להיכנס לכאן כדי להפעיל את החיוב במסוף Cloud.
כמה הערות:
- השלמת ה-Lab הזה אמורה לעלות פחות מ-1 דולר ארה"ב במשאבי Cloud.
- כדי למנוע חיובים נוספים, אתם יכולים למחוק את המשאבים לפי השלבים שבסוף ה-Lab.
- משתמשים חדשים זכאים לתקופת ניסיון בחינם בשווי 300$.
יצירת פרויקט (אופציונלי)
אם אין לכם פרויקט קיים שאתם רוצים להשתמש בו בשיעור ה-Lab הזה, אתם יכולים ליצור פרויקט חדש כאן.
3. מה זה Retrieval-Augmented Generation (יצירה משולבת-אחזור, RAG)?
RAG היא שיטה שמשמשת לשיפור הדיוק העובדתי והרלוונטיות של תשובות ממודלים גדולים של שפה (LLM). הוא מקשר את ה-LLM למאגר ידע חיצוני כדי לבסס את התשובות שלו על מידע ספציפי שניתן לאימות.
התהליך כולל את השלבים הבאים:
- המרת השאלה של המשתמש לייצוג מספרי (הטמעה).
- חיפוש מסמכים עם הטמעות דומות במאגר הידע.
- המסמכים הרלוונטיים האלה מספקים הקשר ל-LLM, יחד עם השאלה המקורית, כדי ליצור תשובה.
למה הערכת RAG היא תהליך מורכב?
הערכת מערכות RAG שונה מהערכת מודלים מסורתיים של שפה.
האתגר של ריבוי רכיבים: מערכות RAG משלבות שלוש פעולות, וכל אחת מהן יכולה להיות נקודת כשל:
- איכות השליפה: האם המערכת מצאה את מסמכי ההקשר הנכונים?
- שימוש בהקשר: האם המודל השתמש במידע שאוחזר בצורה יעילה?
- איכות התשובה שנוצרה: האם התשובה הסופית כתובה היטב, מועילה ומדויקת?
אם אחד מהרכיבים האלה לא פועל כמו שצריך, יכול להיות שהתגובה תיכשל. לדוגמה, יכול להיות שהמערכת תאחזר את ההקשר הנכון, אבל המודל יתעלם ממנו. או שהמודל עשוי ליצור תשובה מנוסחת היטב אבל שגויה, כי ההקשר שאוחזר לא היה רלוונטי.
4. הגדרת סביבת Vertex AI Workbench
קודם כל, נתחיל סביבת Notebook חדשה שבה נריץ את הקוד שדרוש כדי להעריך מערכות RAG.
- נכנסים לדף APIs & Services במסוף Cloud.
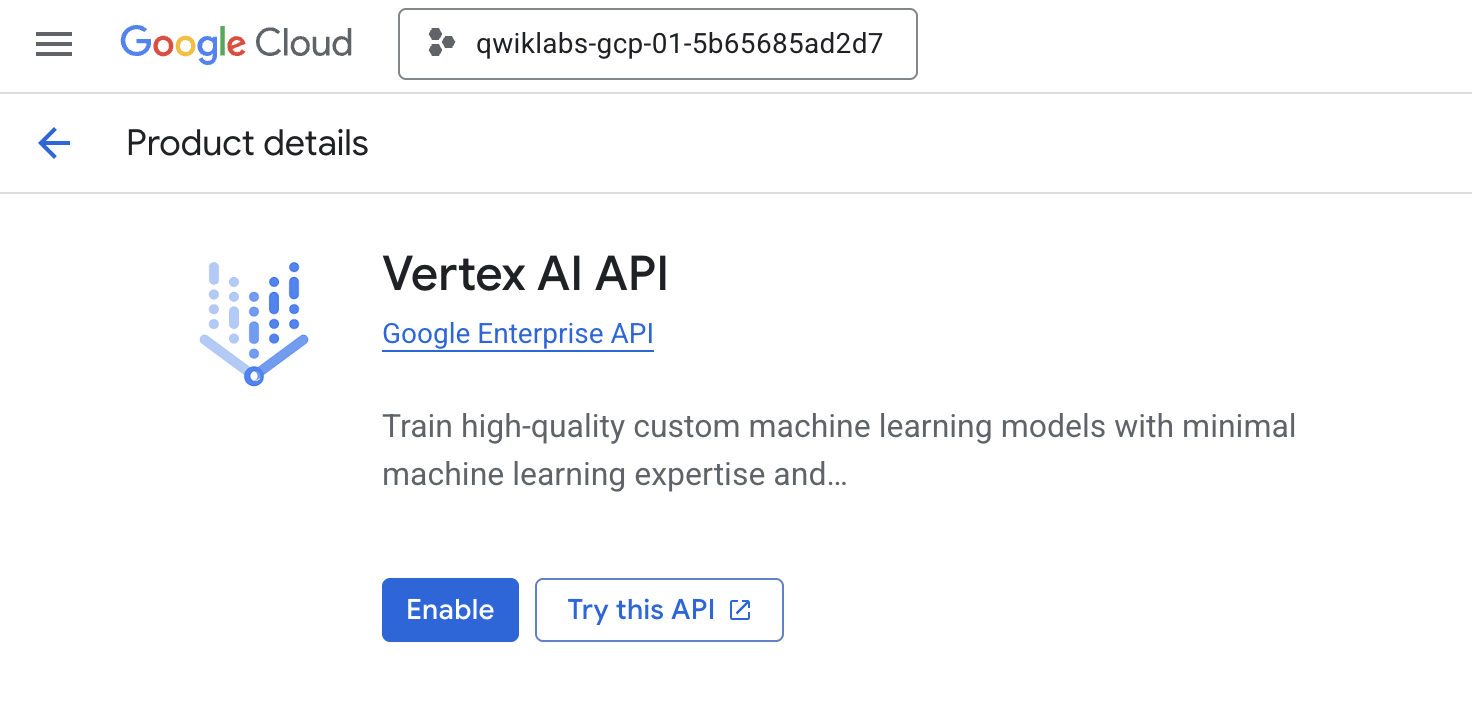
- לוחצים על Enable ב-Vertex AI API.
גישה ל-Vertex AI Workbench
- במסוף Google Cloud, לוחצים על תפריט הניווט ☰ > Vertex AI > Workbench כדי לעבור אל Vertex AI.
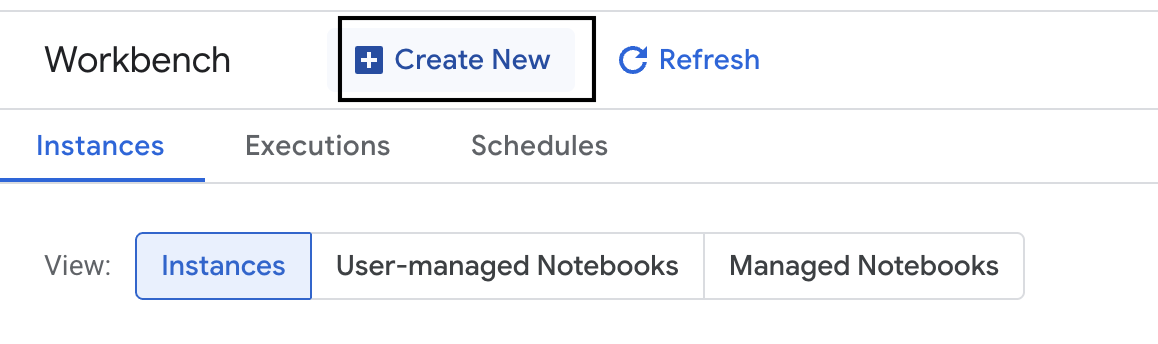
- יוצרים מכונה חדשה של Workbench.
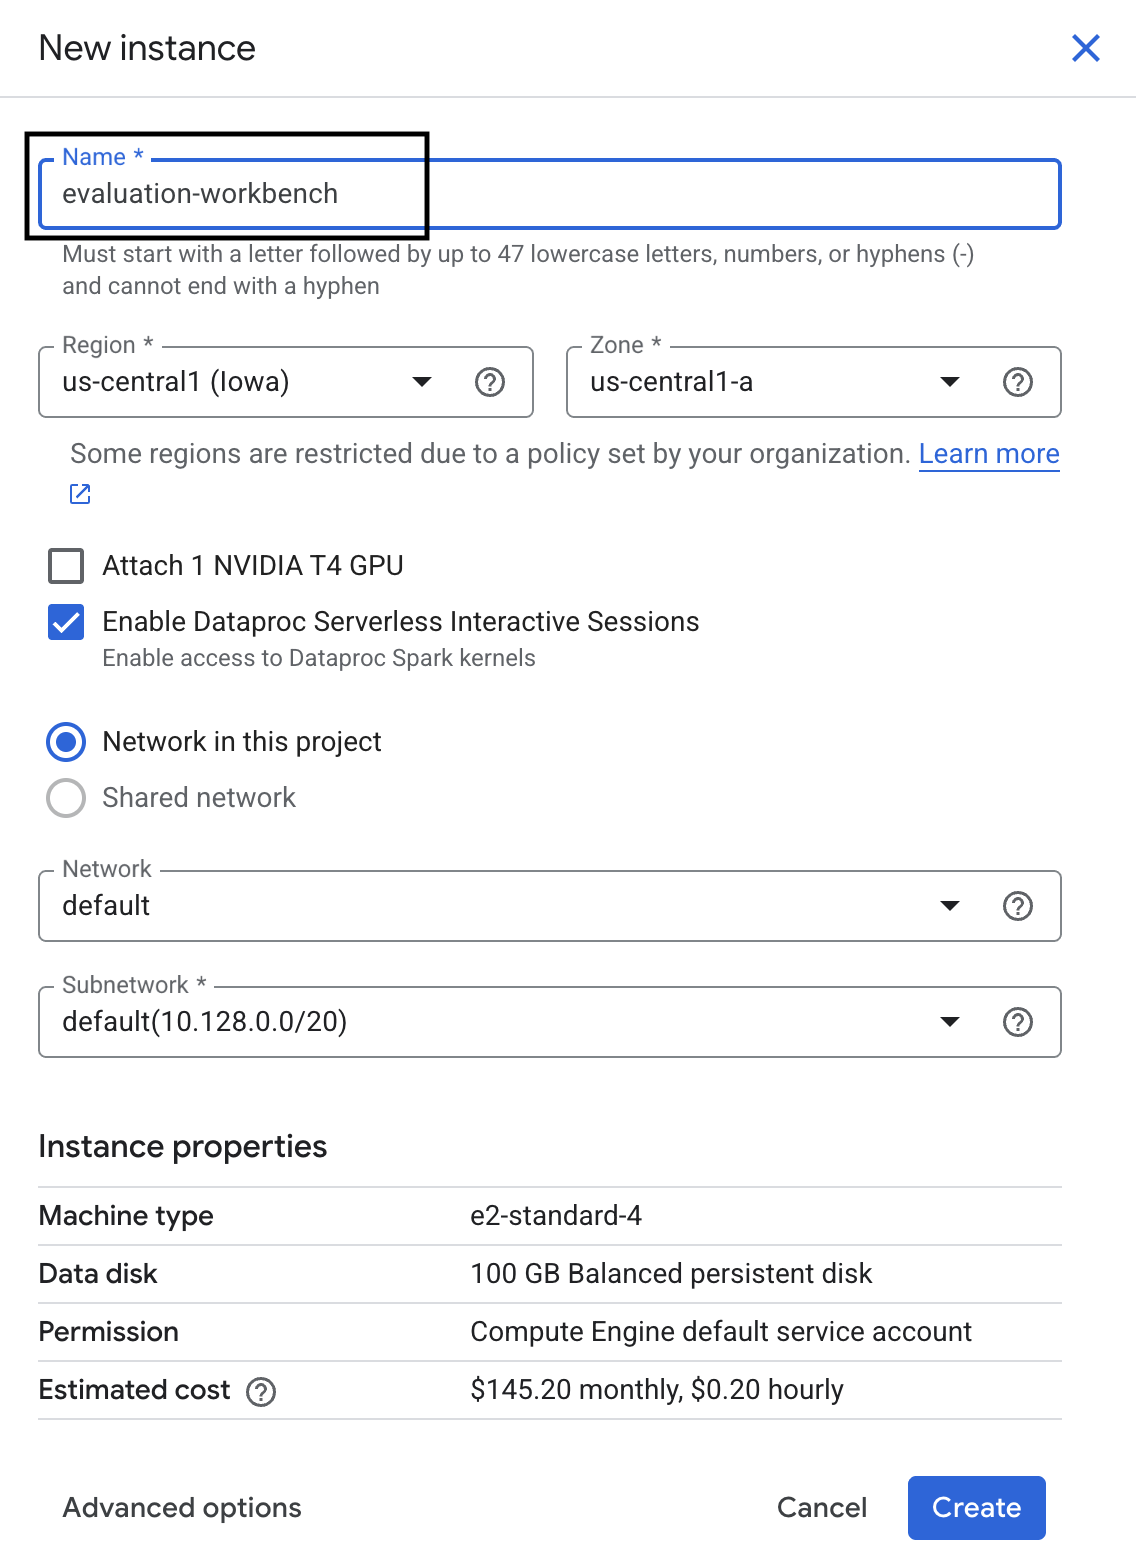
- נותנים למכונה של Workbench את השם
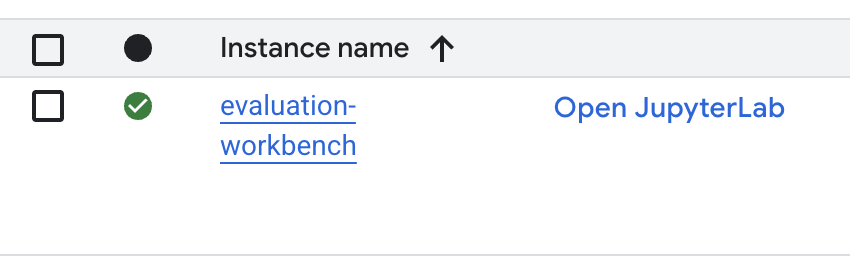
evaluation-workbench. - בוחרים את האזור והתחום אם הערכים האלה עדיין לא מוגדרים.
- לוחצים על יצירה.
- מחכים עד שההגדרה של סביבת העבודה תסתיים. זה יכול לקחת כמה דקות.
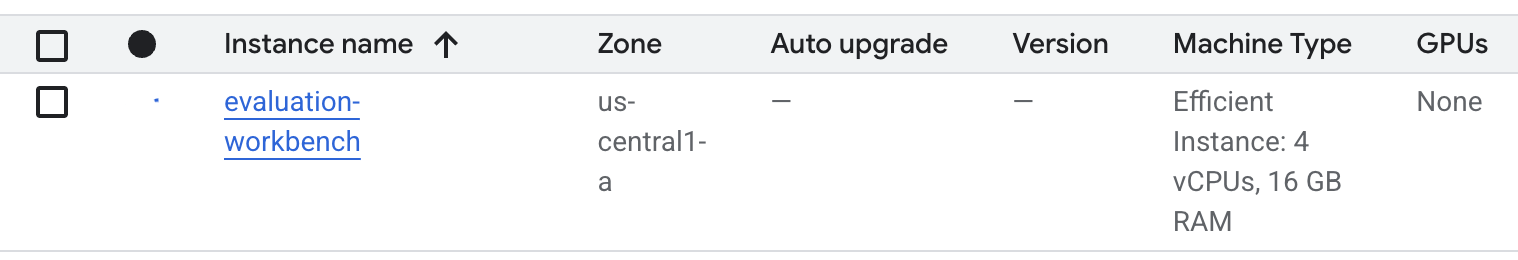
- אחרי שהקצאת סביבת העבודה הושלמה, לוחצים על open jupyterlab.
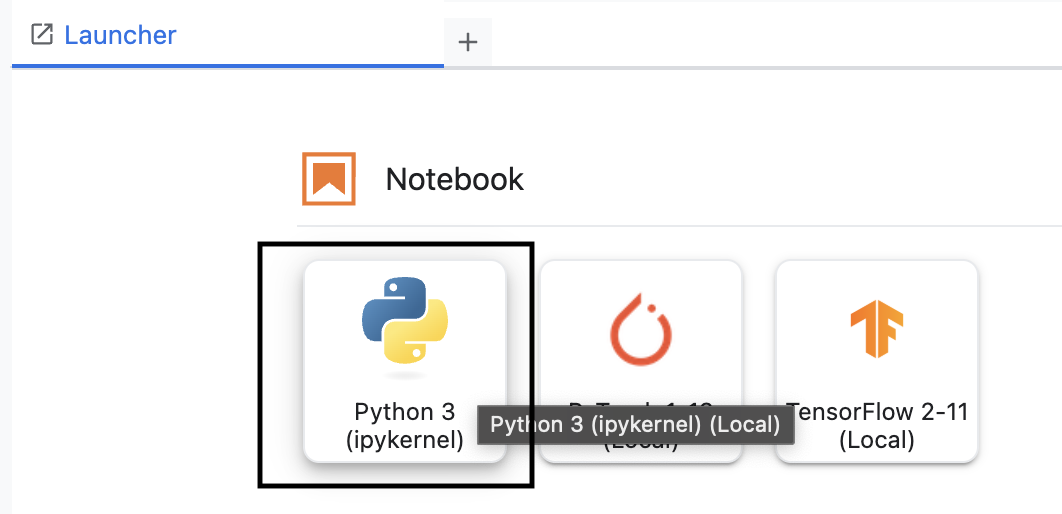
- ב-workbench, יוצרים קובץ notebook חדש של Python3.
למידע נוסף על התכונות והיכולות של הסביבה הזו, עיינו במסמכים הרשמיים של Vertex AI Workbench.
התקנת Vertex AI evaluation SDK
עכשיו נתקין את ערכת ה-SDK המיוחדת להערכה, שמספקת את הכלים לבדיקת RAG.
- בתא הראשון של ה-notebook, מוסיפים ומריצים את הצהרת הייבוא הבאה (SHIFT+ENTER) כדי להתקין את Vertex AI SDK (עם רכיבי ההערכה).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: המחלקה הראשית להרצת הערכות
- MetricPromptTemplateExamples: מדדי הערכה מוגדרים מראש
- PointwiseMetric: מסגרת ליצירת מדדים מותאמים אישית
- notebook_utils: כלי המחשה לניתוח תוצאות
- חשוב: אחרי ההתקנה, תצטרכו להפעיל מחדש את הליבה כדי להשתמש בחבילות החדשות. בסרגל התפריטים שבחלק העליון של חלון JupyterLab, עוברים אל Kernel > Restart Kernel.
5. מאתחלים את ה-SDK ומייבאים ספריות
לפני שיוצרים את צינור עיבוד הנתונים להערכה, צריך להגדיר את הסביבה. לשם כך צריך להגדיר את פרטי הפרויקט, להפעיל את Vertex AI SDK כדי להתחבר ל-Google Cloud ולייבא את ספריות Python הייעודיות שבהן תשתמשו להערכה.
- מגדירים את משתני ההגדרות של משימת ההערכה. בתא חדש, מוסיפים ומריצים את הקוד הבא כדי להגדיר את
PROJECT_ID,LOCATIONושם שלEXPERIMENTכדי לארגן את ההרצה הזו.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - מפעילים את Vertex AI SDK. בתא חדש, מוסיפים ומריצים את הקוד הבא.
vertexai.init(project=PROJECT_ID, location=LOCATION) - מייבאים את המחלקות הנדרשות מ-SDK להערכה על ידי הפעלת הקוד הבא בתא הבא:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: ליצירה ולניהול של נתונים ב-DataFrames.
- EvalTask: המחלקה העיקרית שמריצה משימת הערכה.
- MetricPromptTemplateExamples: מספק גישה למדדי ההערכה המוגדרים מראש של Google.
- PointwiseMetric: מסגרת ליצירת מדדים מותאמים אישית משלכם.
- notebook_utils: אוסף של כלים להמחשת התוצאות.
6. הכנת מערך הנתונים להערכה
קבוצת נתונים מובנית היטב היא הבסיס לכל הערכה מהימנה. במערכות RAG, קבוצת הנתונים צריכה לכלול שני שדות עיקריים לכל דוגמה:
- הנחיה: הקלט הכולל שניתן למודל השפה. אתם צריכים לשלב את השאלה של המשתמש עם ההקשר שאוחזר על ידי מערכת ה-RAG שלכם (
prompt = User Question + Retrieved Context). זה חשוב כדי ששירות ההערכה יידע באיזה מידע המודל השתמש כדי ליצור את התשובה שלו. - response: התשובה הסופית שנוצרה על ידי מודל ה-RAG.
כדי לקבל תוצאות מהימנות מבחינה סטטיסטית, מומלץ להשתמש במערך נתונים של כ-100 דוגמאות. בשיעור ה-Lab הזה תשתמשו במערך נתונים קטן כדי להדגים את התהליך.
עכשיו ניצור את מערכי הנתונים. תתחילו עם רשימת שאלות וretrieved_contexts ממערכת RAG. אחר כך מגדירים שתי קבוצות של תשובות: אחת ממודל שנראה שהוא פועל היטב (generated_answers_by_rag_a) ואחת ממודל שפועל בצורה לא טובה (generated_answers_by_rag_b).
לבסוף, תשלבו את החלקים האלה בשני אובייקטים מסוג DataFrame של pandas, eval_dataset_rag_a ו-eval_dataset_rag_b, בהתאם למבנה שמתואר למעלה.
- בתא חדש, מוסיפים ומריצים את הקוד הבא כדי להגדיר את השאלות ואת שתי הקבוצות של generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - מגדירים את retrieved_contexts. מוסיפים את הקוד הבא בתא חדש ומריצים אותו.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - בתא חדש, מוסיפים ומריצים את הקוד הבא כדי ליצור את
eval_dataset_rag_aו-eval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - מריצים את הקוד הבא בתא חדש כדי להציג את השורות הראשונות של קבוצת הנתונים של מודל א'.
eval_dataset_rag_a
7. בחירה ויצירה של מדדים
עכשיו, כשקבוצות הנתונים מוכנות, אתם יכולים להחליט איך למדוד את הביצועים. אתם יכולים להשתמש במדד אחד או יותר כדי להעריך את המודל. כל מדד בוחן היבט ספציפי של התשובה של המודל, כמו הדיוק העובדתי או הרלוונטיות שלה.
אתם יכולים להשתמש בשילוב של שני סוגי מדדים:
- מדדים מוגדרים מראש: מדדים שמוכנים לשימוש ומסופקים על ידי ה-SDK למשימות הערכה נפוצות.
- מדדים מותאמים אישית: מדדים שאתם מגדירים כדי לבדוק איכויות שרלוונטיות לתרחיש לדוגמה שלכם.
בקטע הזה נסקור את המדדים המוגדרים מראש שזמינים ל-RAG.
עיון במדדים שהוגדרו מראש
ה-SDK כולל כמה מדדים מובְנים להערכת מערכות של שאלות ותשובות. המדדים האלה משתמשים במודל שפה כ"מעריך" כדי לתת ציון לתשובות של המודל שלכם על סמך קבוצת הוראות.
- בתא חדש, מוסיפים ומריצים את הקוד הבא כדי לראות את הרשימה המלאה של שמות המדדים שהוגדרו מראש:
MetricPromptTemplateExamples.list_example_metric_names() - כדי להבין איך המדדים האלה פועלים, אתם יכולים לבדוק את תבניות לפרומפט שעליהן הם מבוססים. בתא חדש, מוסיפים ומריצים את הקוד הבא כדי לראות את ההוראות שניתנו למודל ה-LLM להערכה עבור המדד
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. יצירת מדדים מותאמים אישית
בנוסף למדדים שהוגדרו מראש, אתם יכולים ליצור מדדים מותאמים אישית כדי להעריך קריטריונים ספציפיים לתרחיש לדוגמה שלכם. כדי ליצור מדד מותאם אישית, כותבים תבנית לפרומפט שמנחה את ה-LLM להערכה איך לדרג תשובה.
יצירת מדד מותאם אישית כוללת שני שלבים:
- הגדרת התבנית לפרומפט: מחרוזת שמכילה את ההוראות שלכם ל-LLM שמעריך. תבנית טובה כוללת תפקיד ברור, קריטריונים להערכה, קריטריון הערכה ופלייסהולדרים כמו
{prompt}ו-{response}. - יצירת מופע של אובייקט PointwiseMetric: עוטפים את מחרוזת התבנית לפרומפט בתוך המחלקה הזו ונותנים שם למדד.
תיצרו שני מדדים מותאמים אישית כדי להעריך את הרלוונטיות והתועלת של התשובות של מערכת ה-RAG.
- מגדירים את תבנית לפרומפט למדד הרלוונטיות. התבנית הזו מספקת קריטריונים מפורטים להערכה של ה-LLM. בתא חדש, מוסיפים ומריצים את הקוד הבא:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - מגדירים את תבנית לפרומפט למדד המועילוּת באותה שיטה. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - יוצרים מופע של אובייקטים מסוג
PointwiseMetricלשני המדדים המותאמים אישית. כך התבניות לפרומפטים הופכות לרכיבים שאפשר להשתמש בהם שוב במשימת ההערכה. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
עכשיו יש לכם שני מדדים חדשים לשימוש חוזר (relevance ו-helpfulness) שמוכנים למשימת ההערכה.
9. הרצת משימת ההערכה
עכשיו, כשמערכי הנתונים והמדדים מוכנים, אפשר להריץ את ההערכה. כדי לעשות את זה, צריך ליצור אובייקט EvalTask לכל קבוצת נתונים שרוצים לבדוק.
EvalTask מאגד את הרכיבים להרצת הערכה:
- dataset: ה-DataFrame שמכיל את ההנחיות והתשובות.
- metrics: רשימת המדדים שרוצים להעריך.
- experiment: Vertex AI Experiments שבו נרשמות התוצאות, כדי שתוכלו לעקוב אחרי ההרצות ולהשוות ביניהן.
- יוצרים
EvalTaskלכל מודל. האובייקט הזה כולל את קבוצת הנתונים, המדדים ושם הניסוי. מוסיפים את הקוד הבא לתא חדש ומריצים אותו כדי להגדיר את המשימות:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask, אחד לכל קבוצה של תשובות מהמודל. הרשימה שלmetricsשסיפקת מדגימה תכונה חשובה של שירות ההערכה: מדדים מוגדרים מראש (למשלsafety) ואובייקטים מותאמים אישית שלPointwiseMetric. - אחרי שמגדירים את המשימות, מפעילים אותן באמצעות קריאה ל-method
.evaluate(). הפעולה הזו שולחת את המשימות לקצה העורפי של Vertex AI לעיבוד, והיא עשויה להימשך כמה דקות. בתא חדש, מוסיפים ומריצים את הקוד הבא:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
אחרי שההערכה תסתיים, התוצאות יישמרו באובייקטים result_rag_a ו-result_rag_b, ויהיו מוכנות לניתוח בקטע הבא.
10. איך לנתח את התוצאות
תוצאות ההערכה זמינות עכשיו. האובייקטים result_rag_a ו-result_rag_b מכילים ציונים מצטברים והסברים מפורטים לכל שורה. במשימה הזו תנתחו את התוצאות האלה באמצעות פונקציות עזר מ-notebook_utils.
לצפות בסיכומים מצטברים
- כדי לקבל סקירה כללית ברמה גבוהה, אפשר להשתמש בפונקציית העזר
display_eval_result()כדי לראות את הציון הממוצע של כל מדד. בתא חדש, מוסיפים ומריצים את הקוד הבא כדי להציג את הסיכום של מודל א':notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - חוזרים על הפעולה במודל ב'. מוסיפים את הקוד הזה בתא חדש ומריצים אותו:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
הצגה חזותית של תוצאות ההערכה
תרשימים יכולים להקל על השוואת הביצועים של המודלים. אתם תשתמשו בשני סוגים של תצוגות חזותיות:
- תרשים רדאר: מציג את "צורת" הביצועים הכוללת של כל מודל. צורה גדולה יותר מצביעה על ביצועים טובים יותר באופן כללי.
- תרשים עמודות: להשוואה ישירה בין כל המדדים.
ההמחשות האלה יעזרו לכם להשוות בין המודלים לפי תכונות סובייקטיביות כמו רלוונטיות, ביסוס ומועילות.
- כדי להתכונן לשרטוט, משלבים את התוצאות לרשימה אחת של טאפלים. כל קבוצה צריכה להכיל שם מודל ואת אובייקט התוצאה התואם שלו. בתא חדש, מוסיפים ומריצים את הקוד הבא:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - עכשיו, צור תרשים מכ"ם כדי להשוות בין המודלים בכל המדדים בבת אחת. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - כדי להשוות בצורה ישירה יותר בין כל מדד, אפשר ליצור תרשים עמודות. בתא חדש, מוסיפים ומריצים את הקוד הבא:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
התרשימים יראו בבירור שהביצועים של מודל א' (הצורה הגדולה בתרשים הרדאר והעמודות הגבוהות בתרשים העמודות) טובים יותר מאלה של מודל ב'.
הצגת הסבר מפורט על דוגמה ספציפית
הציונים המצטברים מראים את הביצועים הכוללים. כדי להבין למה מודל פעל בצורה מסוימת, צריך לבדוק את ההסברים המפורטים שנוצרו על ידי ה-LLM להערכה לכל דוגמה.
- פונקציית העזר
display_explanations()מאפשרת לבדוק תוצאות ספציפיות. כדי לראות את הפירוט של הדוגמה השנייה (num=2) מהתוצאות של מודל א', מוסיפים ומריצים את הקוד הבא בתא חדש:notebook_utils.display_explanations(result_rag_a, num=2) - אפשר גם להשתמש בפונקציה הזו כדי לסנן לפי מדד ספציפי בכל הדוגמאות. האפשרות הזו שימושית לניפוי באגים באזור ספציפי שבו הביצועים נמוכים. כדי להבין למה הביצועים של מודל ב' היו כל כך גרועים במדד
groundedness, מוסיפים את הקוד הזה לתא חדש ומריצים אותו:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. הערכה עם הפניה באמצעות "תשובת זהב"
בשלב הקודם ביצעתם הערכה ללא מקורות מידע, שבה התשובה של המודל נשפטה רק על סמך ההנחיה. השיטה הזו שימושית, אבל ההערכה היא סובייקטיבית.
עכשיו תשתמשו בהערכה עם מקורות מידע. השיטה הזו מוסיפה "תשובת זהב" (שנקראת גם תשובת עזר) למערך הנתונים. השוואה בין התשובה של המודל לתשובה שהיא אמת קרקע (ground truth) מספקת מדד אובייקטיבי יותר לביצועים. כך אתם יכולים למדוד:
- דיוק עובדתי: האם התשובה של המודל תואמת לעובדות בתשובת הזהב?
- דמיון סמנטי: האם המשמעות של התשובה של המודל זהה לזו של תשובת הזהב?
- שלמות: האם התשובה של המודל מכילה את כל המידע העיקרי מתשובת הזהב?
הכנת קבוצת הנתונים שאליה מפנים
כדי לבצע הערכה עם קובץ עזר, צריך להוסיף "תשובת זהב" לכל דוגמה במערך הנתונים.
נתחיל בהגדרה של רשימת golden_answers. השוואה בין התשובות המדויקות לתשובות ממודל א' ממחישה את הערך של השיטה הזו:
- שאלה 1 (Brain): התשובה שנוצרה והתשובה המדויקת זהות. מודל א' נכון.
- שאלה 2 (הסנאט): התשובות דומות מבחינה סמנטית אבל מנוסחות בצורה שונה. מדד טוב אמור לזהות את זה.
- שאלה 3 (Hasan-Jalalians): התשובה של מודל א' שגויה מבחינה עובדתית בהתאם להקשר. השגיאה הזו מוצגת ב-
golden_answer.
- בתא חדש, מגדירים את הרשימה של golden_answers
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - כדי ליצור את מסגרות הנתונים להערכה, מריצים את הקוד הבא בתא הבא:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
עכשיו קבוצות הנתונים מוכנות להערכה עם קובץ עזר.
יצירת מדד מותאם אישית עם הפניה
אתם יכולים גם ליצור מדדים מותאמים אישית להערכה עם חומר עזר. התהליך דומה, אבל התבנית לפרומפט כוללת עכשיו את הפלייסהולדר {reference} לתשובת הזהב.
אם יש תשובה "נכונה" מוגדרת, אפשר להשתמש בניקוד בינארי מחמיר יותר (למשל, 1 לתשובה נכונה, 0 לתשובה שגויה) כדי למדוד את הדיוק העובדתי. בואו ניצור מדד question_answering_correctness חדש שמיישם את הלוגיקה הזו.
- מגדירים את התבנית לפרומפט. בתא חדש, מוסיפים ומריצים את הקוד הבא:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - עוטפים את המחרוזת של תבנית לפרומפט בתוך אובייקט PointwiseMetric. כך נותנים למדד שם רשמי והופכים אותו לרכיב שאפשר להשתמש בו שוב במשימת ההערכה. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
עכשיו יש לכם מדד מותאם אישית עם מקורות מידע לבדיקת עובדות קפדנית.
12. הרצת ההערכה המקושרת
עכשיו תגדירו את משימת ההערכה עם מערכי הנתונים שאליהם הפניתם והמדד החדש. תחזרו להשתמש במחלקה EvalTask.
רשימת המדדים משלבת עכשיו את המדד המותאם אישית שמבוסס על מודל עם מדדים שמבוססים על חישוב. הערכה עם קובץ עזר מאפשרת להשתמש במדדים מסורתיים מבוססי-מחשוב, שמבצעים השוואות מתמטיות בין הטקסט שנוצר לבין קובץ העזר. תשתמשו בשלושה סוגים נפוצים:
-
exact_match: הציון הוא 1 רק אם התשובה שנוצרה זהה לתשובה לדוגמה, ו-0 אם לא. -
bleu: מדד של דיוק. הוא מודד כמה מילים מהתשובה שנוצרה מופיעות גם בתשובה לדוגמה. -
rouge: מדד של זכירה. הוא מודד כמה מילים מתשובת הייחוס נכללות בתשובה שנוצרה.
- מגדירים את משימת ההערכה עם מערכי הנתונים שאליהם מפנים והשילוב החדש של המדדים. בתא חדש, מוסיפים ומריצים את הקוד הבא כדי ליצור את האובייקטים של
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - מפעילים את ההערכה שאליה מתייחסים באמצעות קריאה ל-method
.evaluate(). מוסיפים את הקוד הזה בתא חדש ומריצים אותו:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. ניתוח התוצאות שאליהן מפנים
הבדיקה הסתיימה. במשימה הזו תנתחו את התוצאות כדי למדוד את הדיוק העובדתי של המודלים, על ידי השוואה בין התשובות שלהם לתשובות של קובץ העזר המוזהב.
לצפות בתוצאות הסיכום
- לנתח את תוצאות הסיכום של ההערכה שאליה מתייחסים. בתא חדש, מוסיפים ומריצים את הקוד הבא כדי להציג את טבלאות הסיכום של שני המודלים:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctness, אבל מקבל ציון נמוך יותר במדדexact_match. זה מדגיש את הערך של מדדים שמבוססים על מודלים שיכולים לזהות דמיון סמנטי, ולא רק טקסט זהה.
הצגה חזותית של תוצאות להשוואה
התצוגות החזותיות יכולות להמחיש את הפער בביצועים בין שני המודלים. קודם כל, צריך לשלב את התוצאות ברשימה אחת כדי ליצור את התרשים, ואז ליצור את תרשים הרדאר ואת תרשים העמודות.
- משלבים את תוצאות ההערכה שאליהן מתייחסים ברשימה אחת לצורך שרטוט. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - תיצור תרשים מכ"ם כדי להציג באופן חזותי את הביצועים של כל מודל לפי קבוצת המדדים החדשה. מוסיפים את הקוד הזה בתא חדש ומריצים אותו:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - יוצרים תרשים עמודות להשוואה ישירה בטבלה. כך אפשר לראות את הביצועים של כל מודל במדדים השונים. מוסיפים את הקוד הבא בתא חדש ומריצים אותו:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
התרשימים האלה מאשרים שמודל א' מדויק יותר באופן משמעותי ותואם מבחינה עובדתית לתשובות לדוגמה, בהשוואה למודל ב'.
14. מהתרגול לייצור
הפעלתם בהצלחה צינור עיבוד נתונים מלא להערכה של מערכת RAG. החלק האחרון מסכם את המושגים האסטרטגיים המרכזיים שלמדתם, ומספק מסגרת ליישום המיומנויות האלה בפרויקטים בעולם האמיתי.
שיטות מומלצות להפקה
כדי ליישם את המיומנויות מה-Lab הזה בסביבת ייצור בעולם האמיתי, כדאי להשתמש בארבע השיטות המומלצות הבאות:
- אוטומציה באמצעות CI/CD: משלבים את חבילת ההערכה בצינור עיבוד נתונים של CI/CD (למשל Cloud Build או GitHub Actions). כדאי להריץ הערכות באופן אוטומטי על שינויים בקוד כדי לזהות רגרסיות ולחסום פריסות אם ציוני האיכות יורדים מתחת לסטנדרטים שלכם.
- לפתח את מערכי הנתונים: מערך נתונים סטטי מתיישן. נהלו את הגרסאות של קבוצות הנתונים "המושלמות" לבדיקה (באמצעות Git LFS או Cloud Storage) והוסיפו כל הזמן דוגמאות חדשות ומאתגרות על ידי דגימה של שאילתות משתמשים אמיתיות (אנונימיות).
- העריכו את מאחזר המידע, לא רק את המחולל: אי אפשר לקבל תשובה מצוינת בלי ההקשר הנכון. הטמיעו שלב הערכה נפרד למערכת השליפה באמצעות מדדים כמו שיעור ההתאמה (האם נמצא המסמך הנכון?) ודירוג הדדי ממוצע (MRR) (באיזה מקום דורג המסמך הנכון?).
- מעקב אחרי מדדים לאורך זמן: אתם יכולים לייצא את הציונים המסכמים מהרצות ההערכה לשירות כמו Google Cloud Monitoring. אתם יכולים ליצור מרכזי בקרה כדי לעקוב אחרי מגמות באיכות ולהגדיר התראות אוטומטיות שיודיעו לכם על ירידות משמעותיות בביצועים.
מטריצה של מתודולוגיית הערכה מתקדמת
בחירת שיטת ההערכה הנכונה תלויה ביעדים הספציפיים שלכם. הטבלה הבאה מסכמת מתי להשתמש בכל שיטה.
גישת ההערכה | תרחישי השימוש הטובים ביותר | יתרונות עיקריים | מגבלות |
ללא קובץ עזר | מעקב אחרי הייצור, הערכה שוטפת | לא נדרשות תשובות מושלמות, מתעד איכות סובייקטיבית | יקר יותר, פוטנציאל להטיה של המעריכים |
מבוסס על קובץ עזר | השוואה בין מודלים, השוואה לשוק | מדידה אובייקטיבית, חישוב מהיר יותר | נדרשות תשובות זהב, יכול להיות שהמערכת תפספס שוויון סמנטי |
מדדים מותאמים אישית | הערכה ספציפית לדומיין | התאמה לצרכים של העסק | נדרש אימות, תקורה של פיתוח |
גישה משולבת | מערכות ייצור מקיפות | הגישה הטובה ביותר | מורכבות גבוהה יותר, נדרשת אופטימיזציה של העלויות |
תובנות טכניות חשובות
חשוב לזכור את עקרונות הליבה הבאים כשאתם בונים ומעריכים מערכות RAG משלכם:
- הביסוס חיוני ל-RAG: המדד הזה מבדיל באופן עקבי בין מערכות RAG באיכות גבוהה ובאיכות נמוכה, ולכן הוא חיוני למעקב אחרי הייצור.
- מדדים מרובים מספקים חוסן: אין מדד אחד שכולל את כל ההיבטים של איכות RAG. כדי לבצע הערכה מקיפה, צריך להשתמש בכמה מדדים.
- מדדים מותאמים אישית מוסיפים ערך משמעותי: קריטריונים להערכה שספציפיים לתחום מסוים בדרך כלל מזהים ניואנסים שמדדים כלליים מפספסים, וכך משפרים את דיוק ההערכה.
- דיוק סטטיסטי מאפשר ביטחון: גודלי מדגם מתאימים ובדיקת מובהקות הופכים את ההערכה מניחוש לכלי אמין לקבלת החלטות.
מסגרת לקבלת החלטות לגבי פריסה בסביבת ייצור
אתם יכולים להשתמש במסגרת השלבים הזו כמדריך לפריסות עתידיות של מערכות RAG:
- שלב 1 – פיתוח: משתמשים בהערכה מבוססת-הפניה עם קבוצות בדיקה ידועות כדי להשוות בין מודלים ולבחור ביניהם.
- שלב 2 – טרום-ייצור: מריצים הערכה מקיפה שמשלבת את שתי הגישות כדי לאמת את המוכנות לייצור.
- שלב 3 – ייצור: הטמעת מעקב ללא חומר עזר להערכת איכות רציפה ללא תשובות זהב.
- שלב 4 – אופטימיזציה: משתמשים בתובנות מההערכה כדי לשפר את המודל ואת מערכת השליפה.
15. סיכום
מעולה! סיימתם את ה-Lab.
שיעור ה-Lab הזה הוא חלק מתוכנית הלימודים "AI מוכן לייצור עם Google Cloud".
- עיינו בתוכנית הלימודים המלאה כדי לגשר על הפער בין אב טיפוס לייצור.
- רוצה לשתף את ההתקדמות שלך? אפשר להשתמש בהאשטאג
ProductionReadyAI.
Recap
במהלך הקורס למדת:
- לבצע הערכה ללא חומר עזר כדי לבדוק את איכות התשובה על סמך ההקשר שאוחזר.
- כדי למדוד את הדיוק העובדתי, אפשר לבצע הערכה עם חומר עזר על ידי הוספת "תשובת זהב".
- בשתי הגישות, כדאי להשתמש בשילוב של מדדים מוגדרים מראש ומדדים מותאמים אישית.
- משתמשים גם במדדים מבוססי-מודל (כמו
question_answering_quality) וגם במדדים מבוססי-מחשוב (rouge,bleu,exact_match). - לנתח את התוצאות ולהציג אותן באופן חזותי כדי להבין את החוזקות והחולשות של המודל.
גישת ההערכה הזו עוזרת לכם לפתח אפליקציות AI גנרטיביות אמינות ומדויקות יותר.