

1. खास जानकारी
इस लैब में, आपको Retrieval-Augmented Generation (RAG) सिस्टम के लिए, आकलन करने वाली पाइपलाइन बनाने का तरीका बताया जाएगा. Vertex AI की जेन एआई Evaluation Service का इस्तेमाल करके, आकलन करने के लिए अपनी ज़रूरत के मुताबिक मानदंड बनाए जा सकते हैं. साथ ही, सवाल-जवाब वाले टास्क के लिए आकलन का फ़्रेमवर्क तैयार किया जा सकता है.
आपको स्टैनफ़ोर्ड क्वेश्चन आंसरिंग डेटासेट (SQuAD 2.0) के उदाहरणों के साथ काम करना होगा. इससे आपको आकलन करने वाले डेटासेट तैयार करने, रेफ़रंस के बिना और रेफ़रंस के आधार पर आकलन कॉन्फ़िगर करने, और नतीजों को समझने में मदद मिलेगी. इस लैब के आखिर तक, आपको आरएजी सिस्टम का आकलन करने का तरीका पता चल जाएगा. साथ ही, आपको यह भी पता चलेगा कि आकलन के लिए कुछ खास तरीके क्यों चुने जाते हैं.
डेटासेट फ़ाउंडेशन
हम SQuAD 2.0 Question Answering Dataset में मौजूद कई डोमेन के उदाहरणों के साथ काम करेंगे:
- न्यूरोसाइंस: वैज्ञानिक संदर्भों में तकनीकी सटीकता की जांच करना
- इतिहास: ऐतिहासिक घटनाओं के बारे में तथ्यों की सटीक जानकारी का आकलन करना
- भूगोल: क्षेत्रीय और राजनैतिक ज्ञान का आकलन करना
इस विविधता से आपको यह समझने में मदद मिलती है कि अलग-अलग विषयों के लिए, आकलन के तरीके किस तरह सामान्य होते हैं.
रेफ़रंस
- कोड सैंपल: यह लैब, Vertex AI के आकलन से जुड़े दस्तावेज़ में दिए गए उदाहरणों पर आधारित है
- डेटासेट फ़ाउंडेशन: SQuAD 2.0 Question Answering Dataset
- आरएजी की मदद से जानकारी हासिल करने की प्रोसेस को ऑप्टिमाइज़ करना: टेस्ट करें, ट्यून करें, और सफलता पाएं
आपको क्या सीखने को मिलेगा
इस लैब में, आपको इन टास्क को पूरा करने का तरीका पता चलेगा:
- आरएजी सिस्टम के लिए, आकलन करने वाले डेटासेट तैयार करना.
- रेफ़रंस के बिना आकलन करने के लिए, ग्राउंडेडनेस और कितना सही है जैसी मेट्रिक का इस्तेमाल करें.
- सेमैंटिक समानता के आधार पर, रेफ़रंस-आधारित आकलन लागू करें.
- स्कोरिंग रूब्रिक की पूरी जानकारी के साथ, कस्टम आकलन मेट्रिक बनाएं.
- मॉडल चुनने के लिए, समीक्षा के नतीजों को समझना और उन्हें विज़ुअलाइज़ करना.
2. प्रोजेक्ट सेटअप
Google खाता
अगर आपके पास पहले से कोई निजी Google खाता नहीं है, तो आपको Google खाता बनाना होगा.
ऑफ़िस या स्कूल वाले खाते के बजाय, निजी खाते का इस्तेमाल करें.
Google Cloud Console में साइन-इन करें
किसी निजी Google खाते का इस्तेमाल करके, Google Cloud Console में साइन-इन करें.
बिलिंग चालू करें
Google Cloud क्रेडिट रिडीम करना (ज़रूरी नहीं)
इस वर्कशॉप को चलाने के लिए, आपके पास एक ऐसा बिलिंग खाता होना चाहिए जिसमें कुछ क्रेडिट हो. शुरू करने के लिए, इस कोडलैब के सबसे ऊपर मौजूद बैनर में दिए गए क्रेडिट का इस्तेमाल करें. अगर आप पहले से ही किसी बिलिंग खाते से जुड़े हैं, तो इस चरण को छोड़ा जा सकता है.
निजी बिलिंग खाता सेट अप करना
अगर आपने Google Cloud क्रेडिट का इस्तेमाल करके बिलिंग सेट अप की है, तो इस चरण को छोड़ा जा सकता है.
निजी बिलिंग खाता सेट अप करने के लिए, Cloud Console में यहां जाकर बिलिंग की सुविधा चालू करें.
ज़रूरी जानकारी:
- इस लैब को पूरा करने में, Cloud के संसाधनों पर एक डॉलर से कम खर्च होना चाहिए.
- इस लैब के आखिर में दिए गए तरीके का इस्तेमाल करके, संसाधनों को मिटाया जा सकता है, ताकि आपको आगे कोई शुल्क न देना पड़े.
- नए उपयोगकर्ताओं को 300 डॉलर का क्रेडिट मुफ़्त में आज़माने के लिए मिलता है.
कोई प्रोजेक्ट बनाना (ज़रूरी नहीं)
अगर आपके पास कोई ऐसा मौजूदा प्रोजेक्ट नहीं है जिसका इस्तेमाल आपको इस लैब के लिए करना है, तो यहां नया प्रोजेक्ट बनाएं.
3. Retrieval Augmented Generation (RAG) क्या है?
आरएजी एक ऐसी तकनीक है जिसका इस्तेमाल, लार्ज लैंग्वेज मॉडल (एलएलएम) से मिलने वाले जवाबों को तथ्यों के हिसाब से सटीक और काम का बनाने के लिए किया जाता है. यह एलएलएम को बाहरी नॉलेज बेस से कनेक्ट करता है, ताकि वह सटीक और पुष्टि की जा सकने वाली जानकारी के आधार पर जवाब दे सके.
इस प्रोसेस में ये चरण शामिल हैं:
- उपयोगकर्ता के सवाल को संख्यात्मक निरूपण (एम्बेडिंग) में बदलना.
- नॉलेज बेस में, मिलती-जुलती एंबेडिंग वाले दस्तावेज़ खोजे जा रहे हैं.
- इन काम के दस्तावेज़ों को एलएलएम को कॉन्टेक्स्ट के तौर पर उपलब्ध कराना. साथ ही, जवाब जनरेट करने के लिए ओरिजनल सवाल उपलब्ध कराना.
RAG के बारे में ज़्यादा जानें.
आरएजी का आकलन करना मुश्किल क्यों है?
आरएजी सिस्टम का आकलन करना, ट्रेडिशनल लैंग्वेज मॉडल का आकलन करने से अलग होता है.
कई कॉम्पोनेंट वाली चुनौती: आरएजी सिस्टम में तीन ऑपरेशन शामिल होते हैं. इनमें से हर एक ऑपरेशन में गड़बड़ी हो सकती है:
- जानकारी हासिल करने की क्वालिटी: क्या सिस्टम को सही संदर्भ वाले दस्तावेज़ मिले?
- कॉन्टेक्स्ट का इस्तेमाल: क्या मॉडल ने मिली जानकारी का इस्तेमाल असरदार तरीके से किया?
- जनरेट किए गए जवाब की क्वालिटी: क्या आखिरी जवाब अच्छी तरह से लिखा गया है, मददगार है, और सटीक है?
अगर इनमें से कोई भी कॉम्पोनेंट उम्मीद के मुताबिक काम नहीं करता है, तो हो सकता है कि आपको जवाब न मिले. उदाहरण के लिए, हो सकता है कि सिस्टम सही कॉन्टेक्स्ट को वापस ले आए, लेकिन मॉडल उसे अनदेखा कर दे. इसके अलावा, ऐसा भी हो सकता है कि मॉडल अच्छी तरह से लिखा गया जवाब जनरेट करे, लेकिन वह गलत हो. ऐसा इसलिए, क्योंकि उसे जो कॉन्टेक्स्ट मिला वह काम का नहीं था.
4. Vertex AI Workbench एनवायरमेंट सेट अप करना
सबसे पहले, एक नया नोटबुक एनवायरमेंट शुरू करें. इसमें हम आरएजी सिस्टम का आकलन करने के लिए ज़रूरी कोड चलाएंगे.
- Cloud Console के एपीआई और सेवाएं पेज पर जाएं.
- Vertex AI API के लिए, चालू करें पर क्लिक करें.
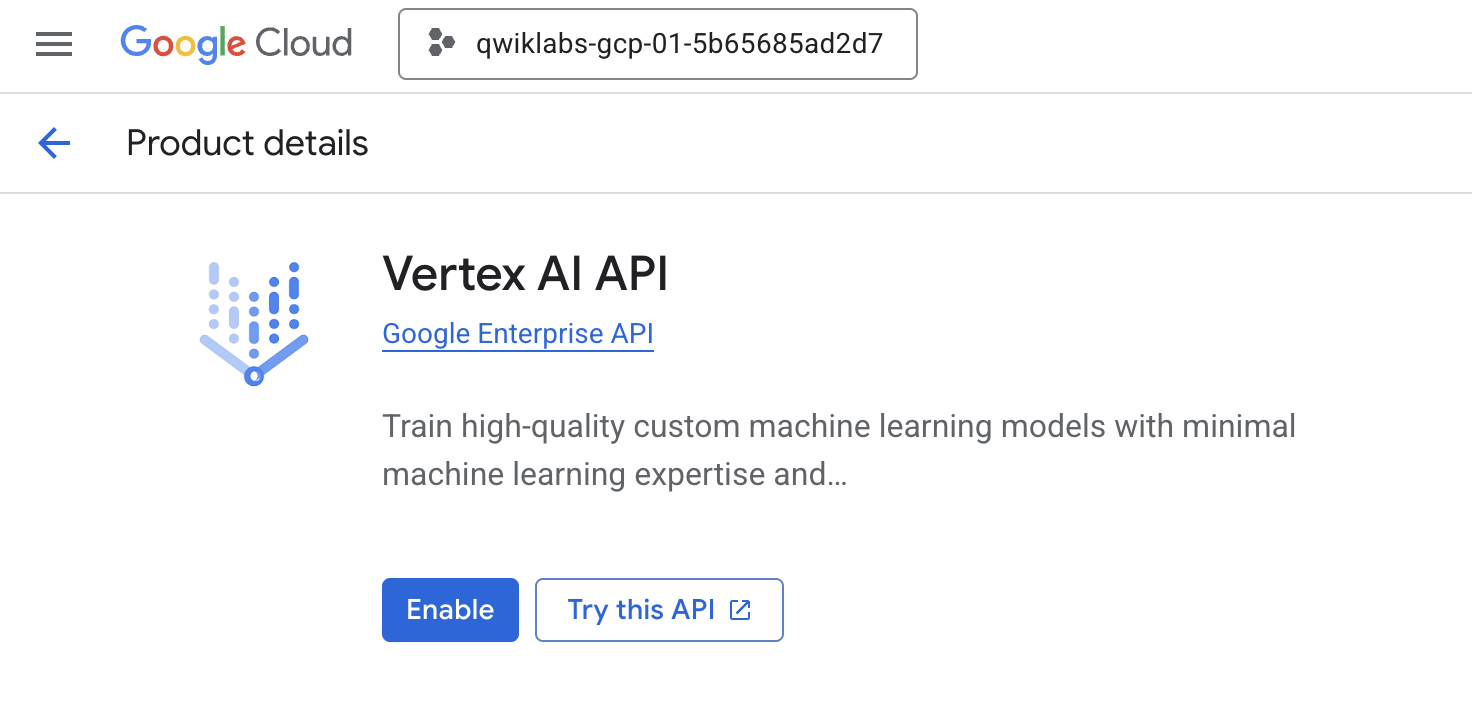
Vertex AI Workbench को ऐक्सेस करना
- Google Cloud Console में, नेविगेशन मेन्यू ☰ > Vertex AI > Workbench पर क्लिक करके, Vertex AI पर जाएं.
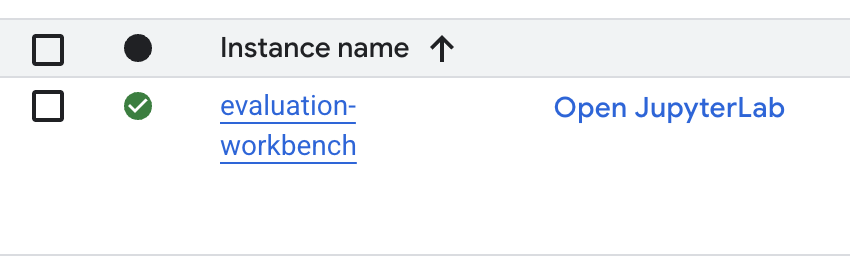
- नया वर्कबेंच इंस्टेंस बनाएं.
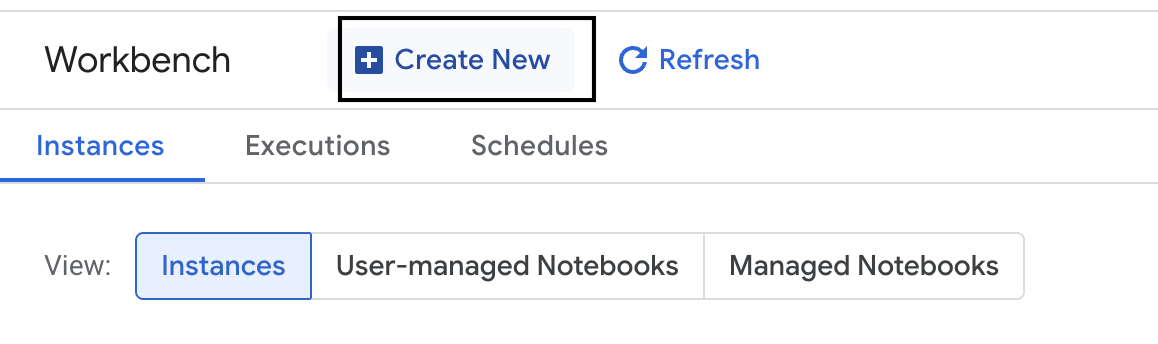
- वर्कबेंच इंस्टेंस
evaluation-workbenchको कोई नाम दें. - अगर क्षेत्र और ज़ोन की वैल्यू पहले से सेट नहीं हैं, तो उन्हें चुनें.
- बनाएं पर क्लिक करें.
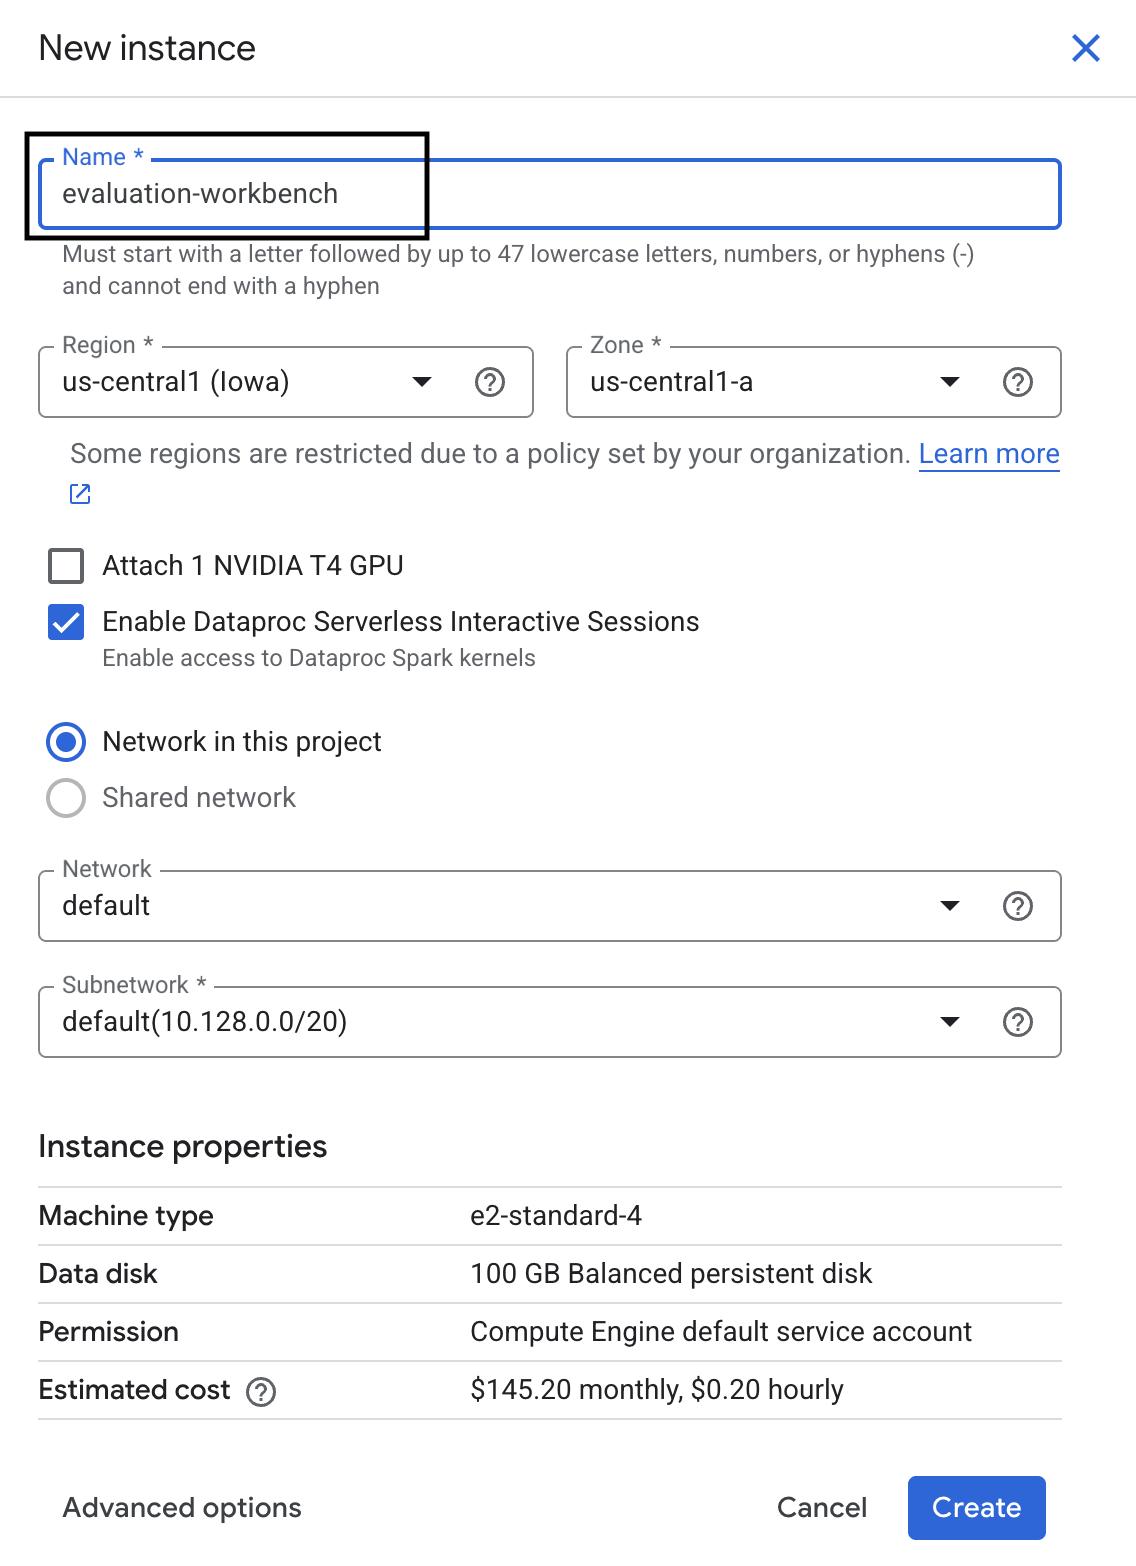
- वर्कबेंच के सेट अप होने का इंतज़ार करें. इसमें कुछ मिनट लग सकते हैं.
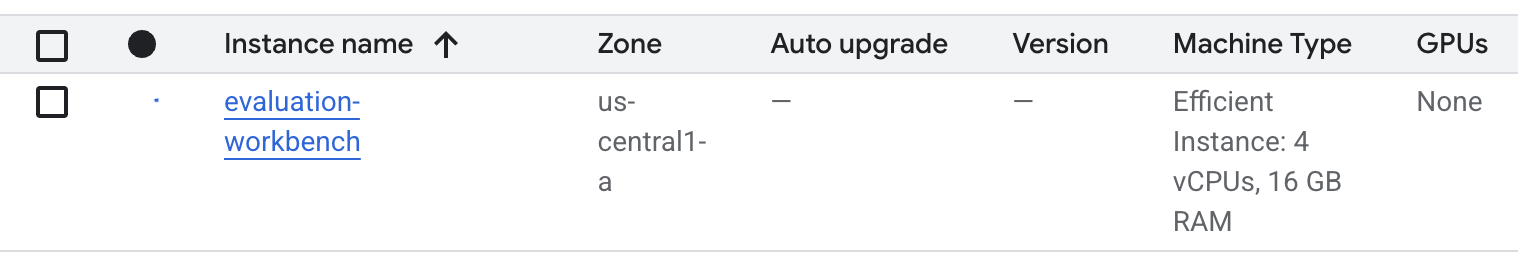
- वर्कबेंच के प्रावधान के बाद, open jupyterlab पर क्लिक करें.
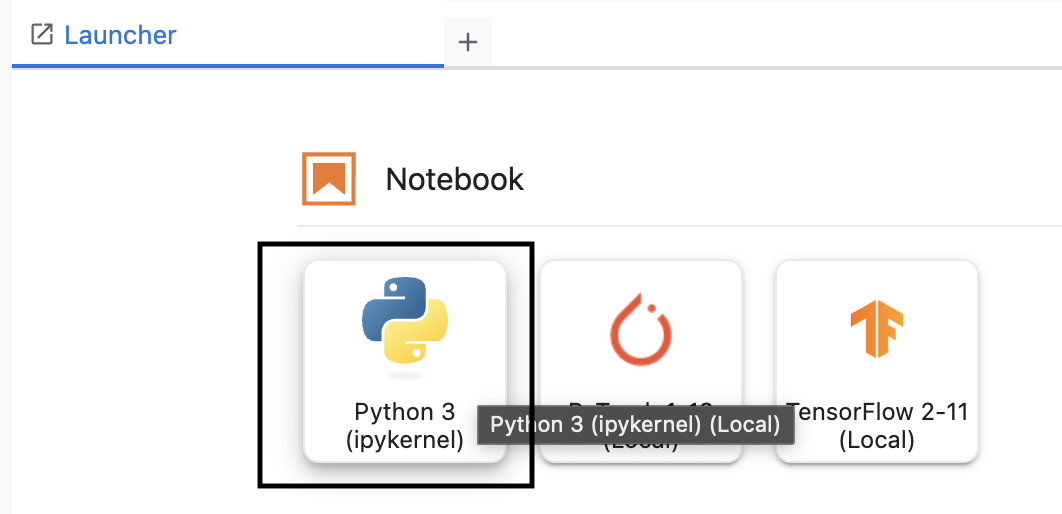
- वर्कबेंच में, एक नई Python3 नोटबुक बनाएं.
इस एनवायरमेंट की सुविधाओं और क्षमताओं के बारे में ज़्यादा जानने के लिए, Vertex AI Workbench का आधिकारिक दस्तावेज़ देखें.
Vertex AI इवैलुएशन एसडीके इंस्टॉल करना
अब हम खास तौर पर मूल्यांकन के लिए बनाया गया एसडीके इंस्टॉल करेंगे. इसमें आरएजी के मूल्यांकन के लिए टूल उपलब्ध होते हैं.
- अपनी नोटबुक की पहली सेल में, Vertex AI SDK (मूल्यांकन कॉम्पोनेंट के साथ) इंस्टॉल करने के लिए, नीचे दिया गया इंपोर्ट स्टेटमेंट (SHIFT+ENTER) जोड़ें और चलाएं.
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: आकलन करने के लिए मुख्य क्लास
- MetricPromptTemplateExamples: पहले से तय की गई आकलन मेट्रिक
- PointwiseMetric: कस्टम मेट्रिक बनाने के लिए फ़्रेमवर्क
- notebook_utils: नतीजों का विश्लेषण करने के लिए विज़ुअलाइज़ेशन टूल
- अहम जानकारी: इंस्टॉल करने के बाद, नए पैकेज इस्तेमाल करने के लिए आपको कर्नल को रीस्टार्ट करना होगा. JupyterLab विंडो में सबसे ऊपर मौजूद मेन्यू बार में, Kernel > Restart Kernel पर जाएं.
5. SDK टूल को शुरू करना और लाइब्रेरी इंपोर्ट करना
इवैलुएशन पाइपलाइन बनाने से पहले, आपको अपना एनवायरमेंट सेट अप करना होगा. इसके लिए, आपको अपने प्रोजेक्ट की जानकारी कॉन्फ़िगर करनी होगी, Google Cloud से कनेक्ट करने के लिए Vertex AI SDK को शुरू करना होगा, और मूल्यांकन के लिए इस्तेमाल की जाने वाली खास Python लाइब्रेरी इंपोर्ट करनी होंगी.
- आकलन करने वाली जॉब के लिए, कॉन्फ़िगरेशन वैरिएबल तय करें. इस रन को व्यवस्थित करने के लिए, किसी नए सेल में यह कोड जोड़ें और चलाएं. इससे
PROJECT_ID,LOCATION, औरEXPERIMENTका नाम सेट किया जा सकेगा.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Vertex AI SDK टूल को शुरू करें. किसी नई सेल में, यह कोड जोड़ें और चलाएं.
vertexai.init(project=PROJECT_ID, location=LOCATION) - अगली सेल में यह कोड चलाकर, इवैलुएशन एसडीके से ज़रूरी क्लास इंपोर्ट करें:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: DataFrames में डेटा बनाने और मैनेज करने के लिए.
- EvalTask: यह मुख्य क्लास है, जो आकलन करने वाली जॉब को चलाती है.
- MetricPromptTemplateExamples: इससे Google की पहले से तय की गई आकलन मेट्रिक का ऐक्सेस मिलता है.
- PointwiseMetric: अपनी पसंद के मुताबिक कस्टम मेट्रिक बनाने का फ़्रेमवर्क.
- notebook_utils: नतीजों को विज़ुअलाइज़ करने के लिए टूल का कलेक्शन.
6. आकलन के लिए डेटासेट तैयार करना
किसी भी भरोसेमंद आकलन के लिए, अच्छी तरह से स्ट्रक्चर किया गया डेटासेट होना ज़रूरी है. आरएजी सिस्टम के लिए, आपके डेटासेट में हर उदाहरण के लिए दो मुख्य फ़ील्ड होने चाहिए:
- प्रॉम्प्ट: यह लैंग्वेज मॉडल को दिया गया कुल इनपुट होता है. आपको उपयोगकर्ता के सवाल को, आरएजी सिस्टम (
prompt = User Question + Retrieved Context) से मिली जानकारी के साथ जोड़ना होगा. यह ज़रूरी है, ताकि आकलन करने वाली सेवा को पता चल सके कि मॉडल ने जवाब देने के लिए किस जानकारी का इस्तेमाल किया. - response: यह आपके आरएजी मॉडल से जनरेट किया गया फ़ाइनल जवाब होता है.
आंकड़ों के हिसाब से भरोसेमंद नतीजे पाने के लिए, हमारा सुझाव है कि आप करीब 100 उदाहरणों वाला डेटासेट इस्तेमाल करें. इस लैब में, प्रोसेस को दिखाने के लिए एक छोटे डेटासेट का इस्तेमाल किया जाएगा.
चलिए, डेटासेट बनाते हैं. आपको सवालों की एक सूची और आरएजी सिस्टम से retrieved_contexts मिलेंगे. इसके बाद, आपको जवाबों के दो सेट तय करने होंगे: एक सेट ऐसे मॉडल से मिलेगा जो अच्छा परफ़ॉर्म करता है (generated_answers_by_rag_a) और दूसरा सेट ऐसे मॉडल से मिलेगा जो खराब परफ़ॉर्म करता है (generated_answers_by_rag_b).
आखिर में, ऊपर बताए गए स्ट्रक्चर के मुताबिक, इन हिस्सों को दो Pandas DataFrame, eval_dataset_rag_a और eval_dataset_rag_b में जोड़ा जाएगा.
- सवालों और generated_answers के दो सेट तय करने के लिए, नई सेल में यह कोड जोड़ें और चलाएं.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - retrieved_contexts को तय करें. नई सेल में यहां दिया गया कोड जोड़ें और चलाएं.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] eval_dataset_rag_aऔरeval_dataset_rag_bबनाने के लिए, किसी नई सेल में यह कोड जोड़ें और चलाएं.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } )- मॉडल A के डेटासेट की शुरुआती कुछ पंक्तियां देखने के लिए, नई सेल में यह कोड चलाएं.
eval_dataset_rag_a
7. मेट्रिक चुनना और बनाना
डेटासेट तैयार होने के बाद, यह तय किया जा सकता है कि परफ़ॉर्मेंस को कैसे मेज़र करना है. अपने मॉडल का आकलन करने के लिए, एक या उससे ज़्यादा मेट्रिक का इस्तेमाल किया जा सकता है. हर मेट्रिक, मॉडल के जवाब के किसी खास पहलू का आकलन करती है. जैसे, तथ्यों के हिसाब से जवाब कितना सटीक है या कितना काम का है.
दो तरह की मेट्रिक को मिलाकर इस्तेमाल किया जा सकता है:
- पहले से तय मेट्रिक: SDK टूल से मिलने वाली मेट्रिक, जिनका इस्तेमाल सीधे तौर पर किया जा सकता है. इनका इस्तेमाल, आकलन से जुड़े सामान्य टास्क के लिए किया जाता है.
- कस्टम मेट्रिक: ये ऐसी मेट्रिक होती हैं जिन्हें आपने अपने इस्तेमाल के उदाहरण के हिसाब से, क्वालिटी की जांच करने के लिए तय किया है.
इस सेक्शन में, आरएजी के लिए उपलब्ध पहले से तय मेट्रिक के बारे में बताया गया है.
पहले से तय मेट्रिक एक्सप्लोर करना
SDK टूल में, सवाल-जवाब वाले सिस्टम का आकलन करने के लिए, पहले से मौजूद कई मेट्रिक शामिल होती हैं. ये मेट्रिक, आपके मॉडल के जवाबों को स्कोर देने के लिए, लैंग्वेज मॉडल का इस्तेमाल "मूल्यांकन करने वाले" के तौर पर करती हैं. यह स्कोर, निर्देशों के सेट के आधार पर दिया जाता है.
- पहले से तय मेट्रिक के नामों की पूरी सूची देखने के लिए, किसी नई सेल में यह कोड जोड़ें और चलाएं:
MetricPromptTemplateExamples.list_example_metric_names() - इन मेट्रिक के काम करने का तरीका समझने के लिए, इनके प्रॉम्प्ट टेंप्लेट की जांच की जा सकती है. किसी नई सेल में, यहां दिया गया कोड जोड़ें और चलाएं. इससे आपको
question_answering_qualityमेट्रिक के लिए, आकलन करने वाले एलएलएम को दिए गए निर्देश दिखेंगे.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. कस्टम मेट्रिक बनाएं
पहले से तय मेट्रिक के अलावा, कस्टम मेट्रिक भी बनाई जा सकती हैं. इससे, अपने इस्तेमाल के उदाहरण के हिसाब से खास शर्तों का आकलन किया जा सकता है. कस्टम मेट्रिक बनाने के लिए, आपको एक प्रॉम्प्ट टेंप्लेट लिखना होगा. इससे आकलन करने वाले एलएलएम को यह निर्देश मिलता है कि किसी जवाब को स्कोर कैसे देना है.
कस्टम मेट्रिक बनाने के लिए, दो चरण पूरे करने होते हैं:
- प्रॉम्प्ट टेंप्लेट तय करना: एक ऐसी स्ट्रिंग जिसमें आकलन करने वाले एलएलएम के लिए आपके निर्देश शामिल हों. एक अच्छे टेंप्लेट में, साफ़ तौर पर बताई गई भूमिका, आकलन की शर्तें, स्कोरिंग रूब्रिक, और
{prompt}और{response}जैसे प्लेसहोल्डर शामिल होते हैं. - PointwiseMetric ऑब्जेक्ट को इंस्टैंशिएट करना: इस क्लास में, प्रॉम्प्ट टेंप्लेट स्ट्रिंग को रैप किया जाता है और मेट्रिक को एक नाम दिया जाता है.
आरएजी सिस्टम के जवाब कितने काम के और मददगार हैं, इसका आकलन करने के लिए आपको दो कस्टम मेट्रिक बनानी होंगी.
- कितना सही है मेट्रिक के लिए प्रॉम्प्ट टेंप्लेट तय करें. इस टेंप्लेट में, आकलन करने वाले एलएलएम के लिए एक विस्तृत रूब्रिक दिया गया है. किसी नई सेल में, यह कोड जोड़ें और चलाएं:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - इसी तरीके का इस्तेमाल करके, मददगार होने की मेट्रिक के लिए प्रॉम्प्ट टेंप्लेट तय करें. किसी नई सेल में यह कोड जोड़ें और चलाएं:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - अपनी दो कस्टम मेट्रिक के लिए,
PointwiseMetricऑब्जेक्ट इंस्टैंशिएट करें. यह आपके प्रॉम्प्ट टेंप्लेट को ऐसे कॉम्पोनेंट में रैप करता है जिन्हें आकलन करने वाली जॉब के लिए फिर से इस्तेमाल किया जा सकता है. किसी नई सेल में यह कोड जोड़ें और चलाएं:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
अब आपके पास दो नई और फिर से इस्तेमाल की जा सकने वाली मेट्रिक (relevance और helpfulness) हैं. इनका इस्तेमाल, आकलन करने के लिए किया जा सकता है.
9. इवैलुएशन जॉब चलाएं
डेटासेट और मेट्रिक तैयार होने के बाद, आकलन किया जा सकता है. इसके लिए, आपको हर उस डेटासेट के लिए एक EvalTask ऑब्जेक्ट बनाना होगा जिसकी आपको जांच करनी है.
EvalTask, इवैलुएशन रन के लिए कॉम्पोनेंट को बंडल करता है:
- dataset: DataFrame, जिसमें आपके प्रॉम्प्ट और जवाब शामिल हैं.
- metrics: उन मेट्रिक की सूची जिनके आधार पर आपको स्कोर करना है.
- experiment: Vertex AI एक्सपेरिमेंट, जिसमें नतीजों को लॉग किया जाता है. इससे आपको रन को ट्रैक करने और उनकी तुलना करने में मदद मिलती है.
- हर मॉडल के लिए एक
EvalTaskबनाएं. इस ऑब्जेक्ट में डेटासेट, मेट्रिक, और एक्सपेरिमेंट का नाम शामिल होता है. टास्क कॉन्फ़िगर करने के लिए, किसी नए सेल में यह कोड जोड़ें और चलाएं:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTaskऑब्जेक्ट कॉन्फ़िगर कर लिए हैं. इनमें से हर ऑब्जेक्ट, मॉडल के जवाबों के एक सेट के लिए है. आपने जोmetricsसूची दी है उससे आकलन सेवा की एक मुख्य सुविधा का पता चलता है: पहले से तय मेट्रिक (जैसे,safety) और कस्टमPointwiseMetricऑब्जेक्ट. - टास्क कॉन्फ़िगर करने के बाद, उन्हें एक्ज़ीक्यूट करने के लिए
.evaluate()तरीके को कॉल करें. इससे टास्क, प्रोसेस होने के लिए Vertex AI बैकएंड पर भेजे जाते हैं. इस प्रोसेस को पूरा होने में कुछ मिनट लग सकते हैं. किसी नई सेल में, यह कोड जोड़ें और चलाएं:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
समीक्षा पूरी होने के बाद, नतीजे result_rag_a और result_rag_b ऑब्जेक्ट में सेव हो जाएंगे. इसके बाद, हम अगले सेक्शन में इनका विश्लेषण कर सकते हैं.
10. नतीजों का विश्लेषण करना
समीक्षा के नतीजे अब उपलब्ध हैं. result_rag_a और result_rag_b ऑब्जेक्ट में, हर पंक्ति के लिए कुल स्कोर और पूरी जानकारी शामिल होती है. इस टास्क में, आपको notebook_utils के हेल्पर फ़ंक्शन का इस्तेमाल करके, इन नतीजों का विश्लेषण करना होगा.
एग्रीगेट की गई खास जानकारी देखना
- ज़्यादा जानकारी पाने के लिए,
display_eval_result()हेल्पर फ़ंक्शन का इस्तेमाल करें. इससे आपको हर मेट्रिक का औसत स्कोर दिखेगा. मॉडल A की खास जानकारी देखने के लिए, नई सेल में यह कोड जोड़ें और चलाएं:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - मॉडल B के लिए भी ऐसा ही करें. इस कोड को नई सेल में जोड़ें और चलाएं:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
समीक्षा के नतीजों को विज़ुअलाइज़ करना
प्लॉट की मदद से, मॉडल की परफ़ॉर्मेंस की तुलना करना आसान हो जाता है. आपको दो तरह के विज़ुअलाइज़ेशन इस्तेमाल करने होंगे:
- रडार प्लॉट: इससे हर मॉडल की परफ़ॉर्मेंस का "शेप" दिखता है. बड़ा आकार, हर तरह से बेहतर परफ़ॉर्मेंस को दिखाता है.
- बार प्लॉट: हर मेट्रिक की सीधे तौर पर, अगल-बगल में तुलना करने के लिए.
इन विज़ुअलाइज़ेशन की मदद से, मॉडल की तुलना की जा सकती है. जैसे, मॉडल कितने काम के हैं, कितने मददगार हैं, और उनकी जानकारी कितनी सटीक है.
- प्लॉट करने के लिए, नतीजों को ट्यूपल की एक सूची में जोड़ें. हर टपल में एक मॉडल का नाम और उससे जुड़ा नतीजा ऑब्जेक्ट होना चाहिए. किसी नई सेल में, यह कोड जोड़ें और चलाएं:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - अब एक रडार प्लॉट जनरेट करें, ताकि सभी मेट्रिक के आधार पर मॉडल की तुलना एक साथ की जा सके. किसी नई सेल में यह कोड जोड़ें और चलाएं:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - हर मेट्रिक की ज़्यादा सटीक तुलना करने के लिए, बार प्लॉट जनरेट करें. किसी नई सेल में, यह कोड जोड़ें और चलाएं:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
विज़ुअलाइज़ेशन से साफ़ तौर पर पता चलेगा कि मॉडल A की परफ़ॉर्मेंस (रडार प्लॉट पर बड़ा आकार और बार चार्ट पर लंबी बार), मॉडल B की परफ़ॉर्मेंस से बेहतर है.
किसी इंस्टेंस के लिए पूरी जानकारी देखना
एग्रीगेट स्कोर से कुल परफ़ॉर्मेंस का पता चलता है. अगर आपको यह समझना है कि किसी मॉडल ने कोई खास परफ़ॉर्मेंस क्यों दी, तो आपको हर उदाहरण के लिए, आकलन करने वाले एलएलएम से जनरेट किए गए ब्यौरे की समीक्षा करनी होगी.
display_explanations()हेल्पर फ़ंक्शन की मदद से, अलग-अलग नतीजों की जांच की जा सकती है. मॉडल A के नतीजों से दूसरे उदाहरण (num=2) का ब्रेकडाउन देखने के लिए, नई सेल में यह कोड जोड़ें और चलाएं:notebook_utils.display_explanations(result_rag_a, num=2)- इस फ़ंक्शन का इस्तेमाल करके, सभी उदाहरणों में से किसी खास मेट्रिक को फ़िल्टर भी किया जा सकता है. यह सुविधा, खराब परफ़ॉर्मेंस वाले किसी खास हिस्से को डीबग करने के लिए काम की है. मॉडल B ने
groundednessमेट्रिक पर इतना खराब परफ़ॉर्म क्यों किया, यह जानने के लिए इस कोड को नई सेल में जोड़ें और चलाएं:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. "सबसे सटीक जवाब" का इस्तेमाल करके, रेफ़रंस के तौर पर आकलन करना
इससे पहले, आपने बिना रेफ़रंस के मूल्यांकन किया था. इसमें मॉडल के जवाब का आकलन सिर्फ़ प्रॉम्प्ट के आधार पर किया गया था. यह तरीका मददगार है, लेकिन आकलन सब्जेक्टिव है.
अब आपको रेफ़रंस के आधार पर आकलन करने की सुविधा का इस्तेमाल करना होगा. यह तरीका, डेटासेट में "सबसे सटीक जवाब" (इसे रेफ़रंस जवाब भी कहा जाता है) जोड़ता है. मॉडल के जवाब की तुलना ज़मीनी हकीकत से करने पर, परफ़ॉर्मेंस का ज़्यादा सटीक आकलन किया जा सकता है. इससे आपको यह मेज़र करने में मदद मिलती है:
- तथ्यों का सही होना: क्या मॉडल का जवाब, गोल्डन जवाब में दिए गए तथ्यों से मेल खाता है?
- मिलता-जुलता मतलब: क्या मॉडल के जवाब का मतलब, गोल्डन जवाब से मिलता-जुलता है?
- पूरी जानकारी: क्या मॉडल के जवाब में, गोल्डन जवाब की सभी मुख्य जानकारी शामिल है?
रेफ़रंस के तौर पर इस्तेमाल किया जाने वाला डेटासेट तैयार करना
रेफ़रंस के आधार पर आकलन करने के लिए, आपको अपने डेटासेट में मौजूद हर उदाहरण के लिए एक "सबसे सटीक जवाब" जोड़ना होगा.
सबसे पहले, golden_answers सूची को तय करें. मॉडल A के जवाबों की तुलना गोल्डन जवाबों से करने पर, इस तरीके की अहमियत का पता चलता है:
- सवाल 1 (ब्रेन): जनरेट किया गया जवाब और गोल्डन जवाब एक जैसे हैं. मॉडल A का जवाब सही है.
- दूसरा सवाल (सीनेट): दोनों जवाबों का मतलब एक ही है, लेकिन उन्हें अलग-अलग शब्दों में लिखा गया है. एक अच्छी मेट्रिक को इसकी पहचान करनी चाहिए.
- तीसरा सवाल (हसन-जलालियन): कॉन्टेक्स्ट के हिसाब से, मॉडल A का जवाब तथ्यों के हिसाब से गलत है.
golden_answerसे इस गड़बड़ी का पता चलता है.
- किसी नई सेल में, golden_answers की सूची तय करें
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - यहां दिए गए सेल में यह कोड चलाकर, रेफ़रंस के तौर पर इस्तेमाल किए गए आकलन के डेटाफ़्रेम बनाएं:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
अब डेटासेट, रेफ़रंस के तौर पर इस्तेमाल किए जाने वाले डेटासेट के साथ तुलना करके मूल्यांकन करने के लिए तैयार हैं.
रेफ़रंस वाली कस्टम मेट्रिक बनाना
रेफ़रंस के आधार पर मूल्यांकन करने के लिए, कस्टम मेट्रिक भी बनाई जा सकती हैं. यह प्रोसेस पहले जैसी ही है. हालांकि, प्रॉम्प्ट टेंप्लेट में अब गोल्डन जवाब के लिए {reference} प्लेसहोल्डर शामिल है.
अगर किसी सवाल का जवाब "सही" है, तो तथ्यों की सटीक जानकारी का आकलन करने के लिए, बाइनरी स्कोरिंग (जैसे, सही के लिए 1, गलत के लिए 0) का इस्तेमाल किया जा सकता है. आइए, एक नई question_answering_correctness मेट्रिक बनाएं, जो इस लॉजिक को लागू करती हो.
- प्रॉम्प्ट का टेंप्लेट तय करें. किसी नई सेल में, यह कोड जोड़ें और चलाएं:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - प्रॉम्प्ट टेंप्लेट स्ट्रिंग को PointwiseMetric ऑब्जेक्ट में रैप करें. इससे आपकी मेट्रिक को एक औपचारिक नाम मिलता है. साथ ही, यह आकलन करने वाली जॉब के लिए, फिर से इस्तेमाल किया जा सकने वाला कॉम्पोनेंट बन जाता है. किसी नई सेल में यह कोड जोड़ें और चलाएं:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
अब आपके पास तथ्यों की सटीक जांच के लिए, कस्टम और रेफ़रंस वाली मेट्रिक है.
12. रेफ़रंस के आधार पर आकलन करना
अब आपको रेफ़रंस के तौर पर दिए गए डेटासेट और नई मेट्रिक के साथ, इवैलुएशन जॉब को कॉन्फ़िगर करना होगा. आपको फिर से EvalTask क्लास का इस्तेमाल करना होगा.
मेट्रिक की सूची में अब कस्टम मॉडल पर आधारित मेट्रिक के साथ-साथ, कंप्यूटेशन पर आधारित मेट्रिक भी शामिल हैं. रेफ़रंस के आधार पर किए जाने वाले मूल्यांकन में, कंप्यूटेशन पर आधारित पारंपरिक मेट्रिक का इस्तेमाल किया जा सकता है. ये मेट्रिक, जनरेट किए गए टेक्स्ट और रेफ़रंस टेक्स्ट के बीच गणितीय तुलना करती हैं. आपको तीन सामान्य फ़ॉर्मैट इस्तेमाल करने होंगे:
exact_match: अगर जनरेट किया गया जवाब, रेफ़रंस के तौर पर दिए गए जवाब से पूरी तरह मेल खाता है, तो 1 स्कोर मिलता है. अगर ऐसा नहीं है, तो 0 स्कोर मिलता है.bleu: सटीक होने की मेट्रिक. इससे यह पता चलता है कि जनरेट किए गए जवाब के कितने शब्द, रेफ़रंस के तौर पर दिए गए जवाब में भी मौजूद हैं.rouge: रिकॉल की मेट्रिक. इससे यह पता चलता है कि जनरेट किए गए जवाब में, रेफ़रंस के तौर पर दिए गए जवाब के कितने शब्द शामिल हैं.
- रेफ़रंस के तौर पर दिए गए डेटासेट और मेट्रिक के नए कॉम्बिनेशन के साथ, आकलन करने वाले जॉब को कॉन्फ़िगर करें.
EvalTaskऑब्जेक्ट बनाने के लिए, किसी नए सेल में यह कोड जोड़ें और चलाएं:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) .evaluate()तरीके को कॉल करके, रेफ़रंस के तौर पर दिए गए आकलन को लागू करें. इस कोड को नई सेल में जोड़ें और चलाएं:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. रेफ़रंस के तौर पर दिए गए नतीजों का विश्लेषण करना
समीक्षा की जा चुकी है. इस टास्क में, आपको नतीजों का विश्लेषण करना होगा. इससे यह पता चलेगा कि मॉडल के जवाब, तथ्यों के हिसाब से कितने सटीक हैं. इसके लिए, आपको मॉडल के जवाबों की तुलना, गोल्डन रेफ़रंस के जवाबों से करनी होगी.
नतीजों की खास जानकारी देखना
- रेफ़रंस के तौर पर इस्तेमाल किए गए आकलन के नतीजों की खास जानकारी का विश्लेषण करें. दोनों मॉडल की खास जानकारी वाली टेबल दिखाने के लिए, किसी नई सेल में यह कोड जोड़ें और चलाएं:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessमेट्रिक पर अच्छा परफ़ॉर्म करता है, लेकिनexact_matchपर इसका स्कोर कम है. इससे मॉडल पर आधारित मेट्रिक की अहमियत का पता चलता है. ये मेट्रिक, सिर्फ़ एक जैसे टेक्स्ट की पहचान नहीं करतीं, बल्कि मिलते-जुलते अर्थ वाले टेक्स्ट की भी पहचान कर सकती हैं.
तुलना करने के लिए नतीजों को विज़ुअलाइज़ करना
विज़ुअलाइज़ेशन की मदद से, दोनों मॉडल की परफ़ॉर्मेंस के बीच के अंतर को ज़्यादा साफ़ तौर पर देखा जा सकता है. सबसे पहले, नतीजों को प्लॉट करने के लिए एक सूची में जोड़ें. इसके बाद, रडार और बार प्लॉट जनरेट करें.
- रेफ़रंस के तौर पर दिए गए आकलन के नतीजों को एक सूची में जोड़ें, ताकि उन्हें प्लॉट किया जा सके. किसी नई सेल में यह कोड जोड़ें और चलाएं:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - मेट्रिक के नए सेट के आधार पर, हर मॉडल की परफ़ॉर्मेंस को विज़ुअलाइज़ करने के लिए, रडार प्लॉट जनरेट करें. इस कोड को नई सेल में जोड़ें और चलाएं:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - सीधे तौर पर, एक-दूसरे से तुलना करने के लिए बार प्लॉट बनाएं. इससे पता चलेगा कि हर मॉडल ने अलग-अलग मेट्रिक पर कैसा परफ़ॉर्म किया. किसी नई सेल में यह कोड जोड़ें और चलाएं:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
इन विज़ुअलाइज़ेशन से पता चलता है कि मॉडल A, मॉडल B की तुलना में ज़्यादा सटीक है. साथ ही, यह रेफ़रंस के तौर पर दिए गए जवाबों के हिसाब से ज़्यादा सही है.
14. प्रैक्टिस से लेकर प्रोडक्शन तक
आपने आरएजी सिस्टम के लिए, पूरी इवैलुएशन पाइपलाइन को सही तरीके से लागू कर लिया है. इस आखिरी सेक्शन में, आपने जो अहम रणनीतिक सिद्धांत सीखे हैं उनकी खास जानकारी दी गई है. साथ ही, इन कौशल को असल दुनिया के प्रोजेक्ट में लागू करने के लिए एक फ़्रेमवर्क दिया गया है.
प्रोडक्शन के सबसे सही तरीके
इस लैब से सीखी गई स्किल को असल दुनिया के प्रोडक्शन एनवायरमेंट में इस्तेमाल करने के लिए, इन चार मुख्य तरीकों को अपनाएं:
- सीआई/सीडी की मदद से ऑटोमेट करना: अपने इवैलुएशन सुइट को सीआई/सीडी पाइपलाइन (जैसे, Cloud Build, GitHub Actions) में इंटिग्रेट करें. कोड में किए गए बदलावों का आकलन अपने-आप होने दें, ताकि रिग्रेशन का पता लगाया जा सके. साथ ही, अगर क्वालिटी स्कोर आपके स्टैंडर्ड से कम हो जाता है, तो डिप्लॉयमेंट को ब्लॉक किया जा सके.
- अपने डेटासेट को बेहतर बनाएं: स्टैटिक डेटासेट पुराना हो जाता है. Git LFS या Cloud Storage का इस्तेमाल करके, अपने "गोल्डन" टेस्ट सेट का वर्शन कंट्रोल करें. साथ ही, असली उपयोगकर्ताओं की क्वेरी से सैंपल लेकर, लगातार नए और मुश्किल उदाहरण जोड़ें. ध्यान रहे कि इन क्वेरी में उपयोगकर्ताओं की पहचान ज़ाहिर न हो.
- सिर्फ़ जनरेटर ही नहीं, बल्कि रिट्रीवर का भी आकलन करें: सही संदर्भ के बिना, सटीक जवाब नहीं दिया जा सकता. अपने डेटा रीट्रिवल सिस्टम के लिए, अलग से आकलन करने की प्रोसेस लागू करें. इसके लिए, हिट रेट (क्या सही दस्तावेज़ मिला?) और मीन रेसिप्रोकल रैंक (एमआरआर) (सही दस्तावेज़ की रैंक कितनी ज़्यादा थी?) जैसी मेट्रिक का इस्तेमाल करें.
- समय के साथ मेट्रिक पर नज़र रखना: अपने इवैलुएशन रन से मिली खास जानकारी के स्कोर को Google Cloud Monitoring जैसी सेवा में एक्सपोर्ट करें. क्वालिटी के रुझानों को ट्रैक करने के लिए डैशबोर्ड बनाएं. साथ ही, परफ़ॉर्मेंस में होने वाली बड़ी गिरावटों की सूचना पाने के लिए, अपने-आप मिलने वाली सूचनाएं सेट अप करें.
आकलन के बेहतर तरीके की मैट्रिक्स
मूल्यांकन का सही तरीका चुनना, आपके लक्ष्यों पर निर्भर करता है. इस मैट्रिक्स में बताया गया है कि हर तरीके का इस्तेमाल कब करना चाहिए.
मूल्यांकन का तरीका | इस्तेमाल के सबसे सही उदाहरण | मुख्य फ़ायदे | सीमाएं |
रेफ़रंस-फ़्री | प्रोडक्शन की निगरानी करना, लगातार आकलन करना | इसके लिए, किसी सटीक जवाब की ज़रूरत नहीं होती. इसमें सब्जेक्टिव क्वालिटी को कैप्चर किया जाता है | यह तरीका महंगा है और इसमें आकलन करने वाले व्यक्ति का पक्षपात शामिल हो सकता है |
रेफ़रंस के आधार पर | मॉडल की तुलना, मानदंड | ऑब्जेक्टिव मेज़रमेंट, तेज़ी से कैलकुलेशन | इसके लिए, गोल्डन जवाबों की ज़रूरत होती है. हालांकि, हो सकता है कि ये जवाब, वाक्य की बनावट के हिसाब से सही न हों |
कस्टम मेट्रिक | डोमेन के हिसाब से आकलन | कारोबार की ज़रूरतों के हिसाब से तैयार किया गया है | पुष्टि करने की ज़रूरत है, डेवलपमेंट ओवरहेड |
हाइब्रिड अप्रोच | कॉम्प्रिहेंसिव प्रोडक्शन सिस्टम | सभी तरीकों में सबसे बेहतर | ज़्यादा जटिलता, लागत को ऑप्टिमाइज़ करने की ज़रूरत है |
अहम तकनीकी जानकारी
अपने आरएजी सिस्टम बनाते और उनका आकलन करते समय, इन मुख्य सिद्धांतों को ध्यान में रखें:
- आरएजी के लिए ग्राउंडेडनेस ज़रूरी है: यह मेट्रिक, अच्छी और खराब क्वालिटी वाले आरएजी सिस्टम के बीच लगातार अंतर करती है. इससे प्रोडक्शन की निगरानी करना ज़रूरी हो जाता है.
- कई मेट्रिक से बेहतर नतीजे मिलते हैं: कोई भी मेट्रिक, आरएजी की क्वालिटी के सभी पहलुओं को कैप्चर नहीं करती. पूरी तरह से आकलन करने के लिए, कई डाइमेंशन की ज़रूरत होती है.
- कस्टम मेट्रिक से काफ़ी फ़ायदा मिलता है: डोमेन के हिसाब से आकलन करने की शर्तों से, अक्सर ऐसी बारीकियां कैप्चर की जाती हैं जो सामान्य मेट्रिक से छूट जाती हैं. इससे आकलन ज़्यादा सटीक तरीके से किया जा सकता है.
- आंकड़ों की सटीकता से भरोसा बढ़ता है: सही सैंपल साइज़ और अहमियत की जांच करने से, आकलन करने की प्रोसेस अनुमान लगाने के बजाय, भरोसेमंद फ़ैसले लेने वाले टूल में बदल जाती है.
प्रोडक्शन डिप्लॉयमेंट के फ़ैसले का फ़्रेमवर्क
आने वाले समय में आरएजी सिस्टम को डिप्लॉय करने के लिए, इस फ़्रेमवर्क का इस्तेमाल करें:
- पहला चरण - डेवलपमेंट: मॉडल की तुलना करने और उसे चुनने के लिए, जाने-पहचाने टेस्ट सेट के साथ रेफ़रंस-आधारित आकलन का इस्तेमाल करें.
- दूसरा चरण - प्री-प्रोडक्शन: ऐप्लिकेशन या गेम, प्रोडक्शन के लिए तैयार है या नहीं, इसकी पुष्टि करने के लिए, दोनों तरीकों को मिलाकर पूरी तरह से आकलन करें.
- तीसरा चरण - प्रोडक्शन: गोल्डन जवाबों के बिना, क्वालिटी का लगातार आकलन करने के लिए, रेफ़रंस-फ़्री मॉनिटरिंग लागू करें.
- चौथा चरण - ऑप्टिमाइज़ेशन: मॉडल को बेहतर बनाने और डेटा वापस पाने के सिस्टम को बेहतर बनाने के लिए, आकलन से मिली अहम जानकारी का इस्तेमाल करें.
15. नतीजा
बधाई हो! आपने लैब पूरी कर ली है.
यह लैब, Production-Ready AI with Google Cloud लर्निंग पाथ का हिस्सा है.
- प्रोटोटाइप से प्रोडक्शन तक के सफ़र को आसान बनाने के लिए, पूरा करिकुलम देखें.
ProductionReadyAIहैशटैग के साथ अपनी प्रोग्रेस शेयर करें.
रीकैप
आपने ये काम करने का तरीका सीख लिया है:
- रेफ़रंस-फ़्री आकलन करें, ताकि मिले कॉन्टेक्स्ट के आधार पर जवाब की क्वालिटी का आकलन किया जा सके.
- तथ्यों के सही होने का आकलन करने के लिए, "सबसे सटीक जवाब" जोड़कर, रेफ़रंस के आधार पर आकलन करें.
- दोनों तरीकों के लिए, पहले से तय और कस्टम मेट्रिक का इस्तेमाल करें.
- मॉडल पर आधारित मेट्रिक (जैसे,
question_answering_quality) और कंप्यूटेशन पर आधारित मेट्रिक (rouge,bleu,exact_match), दोनों का इस्तेमाल करें. - मॉडल की खूबियों और कमियों को समझने के लिए, नतीजों का विश्लेषण करें और उन्हें विज़ुअलाइज़ करें.
मूल्यांकन के इस तरीके से, ज़्यादा भरोसेमंद और सटीक जनरेटिव एआई ऐप्लिकेशन बनाए जा सकते हैं.