

1. Ringkasan
Di lab ini, Anda akan mempelajari cara membangun pipeline evaluasi untuk sistem Retrieval-Augmented Generation (RAG). Anda akan menggunakan Layanan Evaluasi AI Generatif Vertex AI untuk membuat kriteria evaluasi kustom dan membangun framework penilaian untuk tugas tanya jawab.
Anda akan menggunakan contoh dari Stanford Question Answering Dataset (SQuAD 2.0) untuk menyiapkan set data evaluasi, mengonfigurasi penilaian tanpa referensi dan berbasis referensi, serta menafsirkan hasilnya. Di akhir lab ini, Anda akan memahami cara mengevaluasi sistem RAG dan alasan pendekatan evaluasi tertentu dipilih.
Fondasi set data
Kita akan menggunakan contoh yang dibuat dengan cermat yang mencakup beberapa domain yang ditemukan dalam Set Data Tanya Jawab SQuAD 2.0:
- Neurosains: Menguji akurasi teknis dalam konteks ilmiah
- Sejarah: Mengevaluasi presisi faktual dalam narasi sejarah
- Geografi: Menilai pengetahuan teritorial dan politik
Keberagaman ini membantu Anda memahami cara pendekatan evaluasi digeneralisasi di berbagai bidang subjek.
Referensi
- Contoh kode: Lab ini dibuat berdasarkan contoh dari dokumentasi Evaluasi Vertex AI
- Dasar set data: SQuAD 2.0 Question Answering Dataset
- Mengoptimalkan pengambilan RAG: Uji, sesuaikan, berhasil
Yang akan Anda pelajari
Di lab ini, Anda akan mempelajari cara melakukan tugas-tugas berikut:
- Menyiapkan set data evaluasi untuk sistem RAG.
- Menerapkan evaluasi tanpa referensi menggunakan metrik seperti keakuratan dan relevansi.
- Terapkan evaluasi berbasis referensi dengan ukuran kesamaan semantik.
- Membuat metrik evaluasi kustom dengan rubrik penilaian yang mendetail.
- Menafsirkan dan memvisualisasikan hasil evaluasi untuk menentukan pemilihan model.
2. Penyiapan project
Akun Google
Jika belum memiliki Akun Google pribadi, Anda harus membuat Akun Google.
Gunakan akun pribadi, bukan akun kantor atau sekolah.
Login ke Konsol Google Cloud
Login ke Konsol Google Cloud menggunakan Akun Google pribadi.
Aktifkan Penagihan
Menukarkan kredit Google Cloud (opsional)
Untuk menjalankan workshop ini, Anda memerlukan akun penagihan dengan sejumlah kredit. Gunakan kredit dari banner di bagian atas codelab ini untuk memulai. Jika Anda sudah terhubung ke akun penagihan, Anda dapat melewati langkah ini.
Menyiapkan akun penagihan pribadi
Jika Anda menyiapkan penagihan menggunakan kredit Google Cloud, Anda dapat melewati langkah ini.
Untuk menyiapkan akun penagihan pribadi, buka di sini untuk mengaktifkan penagihan di Konsol Cloud.
Beberapa Catatan:
- Menyelesaikan lab ini akan memerlukan biaya kurang dari $1 USD dalam resource Cloud.
- Anda dapat mengikuti langkah-langkah di akhir lab ini untuk menghapus resource agar tidak dikenai biaya lebih lanjut.
- Pengguna baru memenuhi syarat untuk mengikuti Uji Coba Gratis senilai $300 USD.
Membuat project (opsional)
Jika Anda tidak memiliki project saat ini yang ingin digunakan untuk lab ini, buat project baru di sini.
3. Apa itu Retrieval-Augmented Generation (RAG)?
RAG adalah teknik yang digunakan untuk meningkatkan akurasi faktual dan relevansi jawaban dari Model Bahasa Besar (LLM). RAG menghubungkan LLM ke pusat informasi eksternal untuk melakukan grounding terhadap responsnya pada informasi yang spesifik dan dapat diverifikasi.
Proses ini melibatkan langkah-langkah berikut:
- Mengonversi pertanyaan pengguna menjadi representasi numerik (embedding).
- Menelusuri dokumen dengan embedding serupa di pusat informasi.
- Memberikan dokumen yang relevan ini sebagai konteks ke LLM bersama dengan pertanyaan asli untuk menghasilkan jawaban.
Baca selengkapnya tentang RAG.
Apa yang membuat evaluasi RAG menjadi kompleks?
Mengevaluasi sistem RAG berbeda dengan mengevaluasi model bahasa tradisional.
Tantangan Multi-Komponen: Sistem RAG menggabungkan tiga operasi yang masing-masing dapat menjadi titik kegagalan:
- Kualitas Pengambilan: Apakah sistem menemukan dokumen konteks yang tepat?
- Pemanfaatan Konteks: Apakah model menggunakan informasi yang diambil secara efektif?
- Kualitas Pembuatan: Apakah respons akhir ditulis dengan baik, bermanfaat, dan akurat?
Respons dapat gagal jika salah satu komponen ini tidak berfungsi seperti yang diharapkan. Misalnya, sistem mungkin mengambil konteks yang benar, tetapi model mengabaikannya. Atau, model mungkin menghasilkan respons yang tersusun rapi, tetapi salah karena konteks yang diambil tidak relevan.
4. Menyiapkan lingkungan Vertex AI Workbench Anda
Mari kita mulai dengan memulai lingkungan notebook baru tempat kita akan menjalankan kode yang diperlukan untuk mengevaluasi sistem RAG.
- Buka halaman API & Layanan di Konsol Cloud Anda.
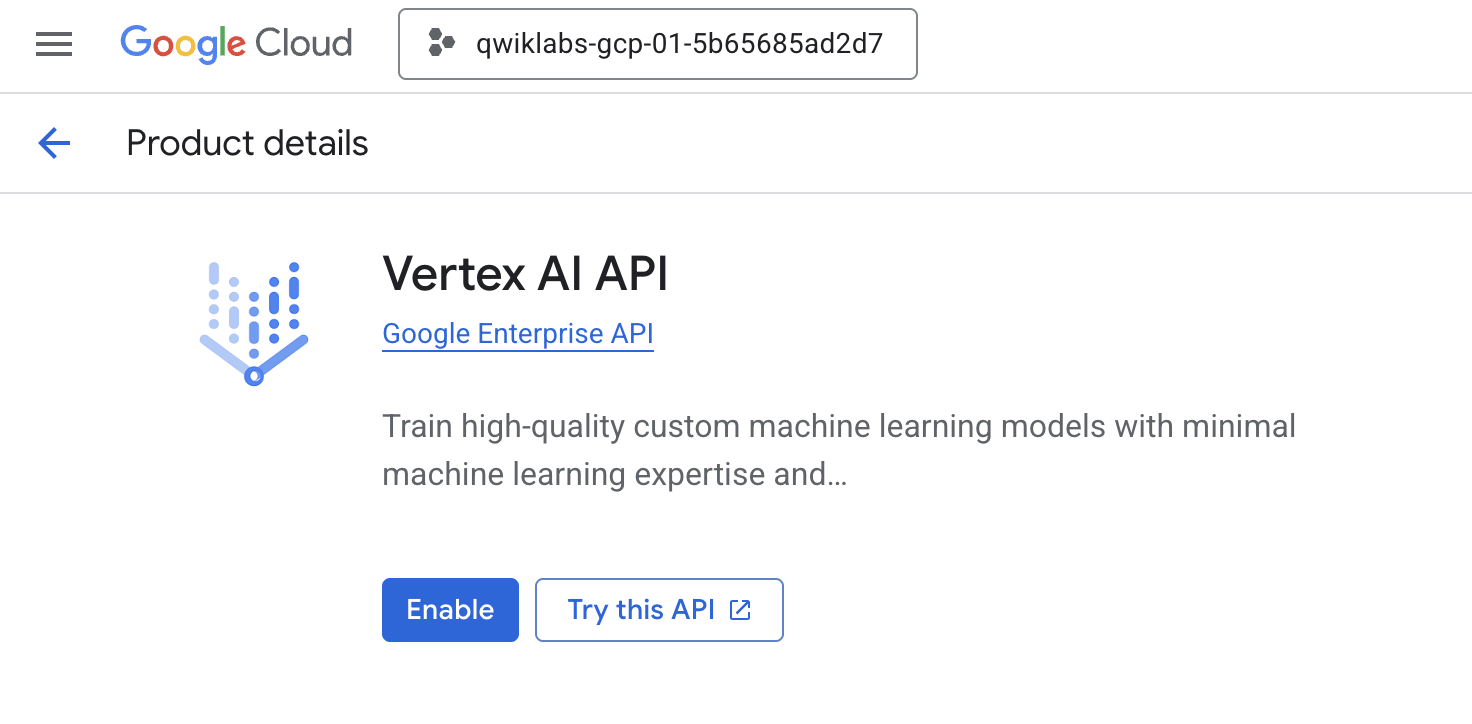
- Klik Enable untuk Vertex AI API.
Mengakses Vertex AI Workbench
- Di Konsol Google Cloud, buka Vertex AI dengan mengklik menu navigasi ☰ > Vertex AI > Workbench.
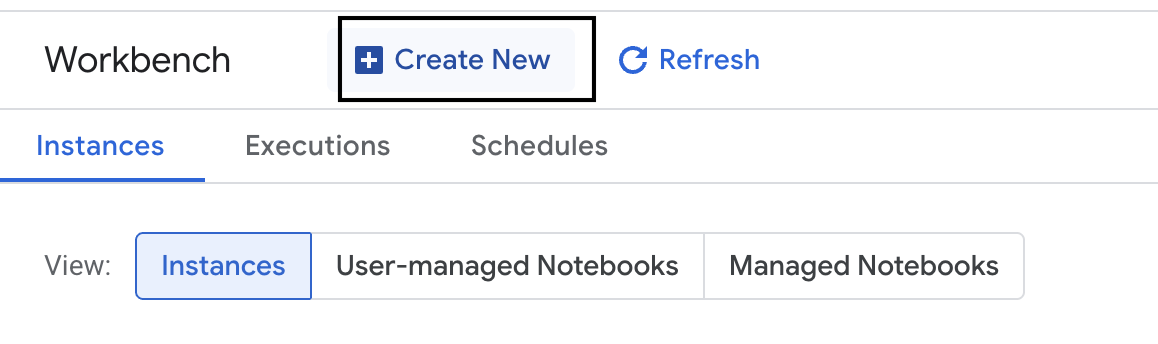
- Buat instance workbench baru.
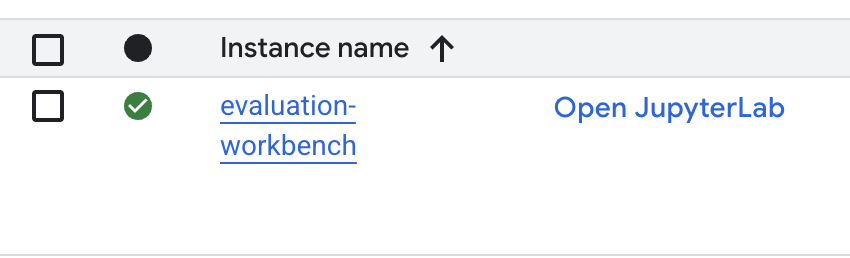
- Beri nama instance workbench
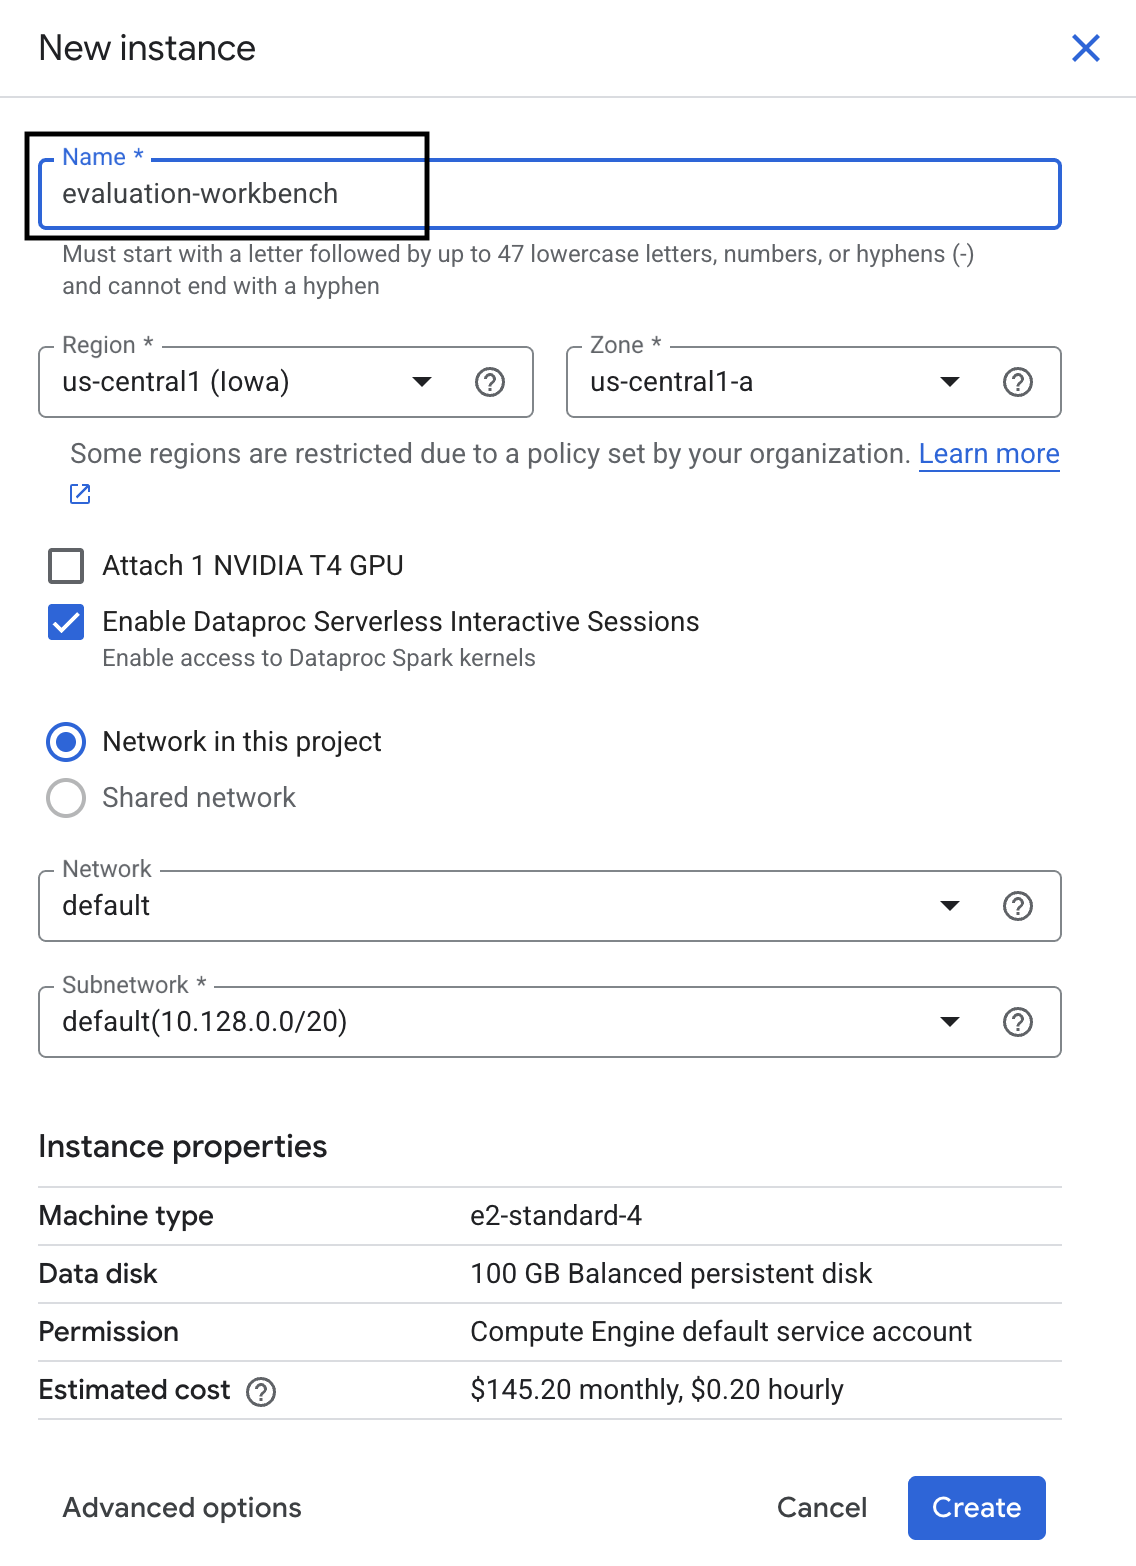
evaluation-workbench. - Pilih region dan zona Anda jika nilai tersebut belum ditetapkan.
- Klik Create.
- Tunggu hingga workbench selesai disiapkan. Proses ini bisa memerlukan waktu beberapa menit.
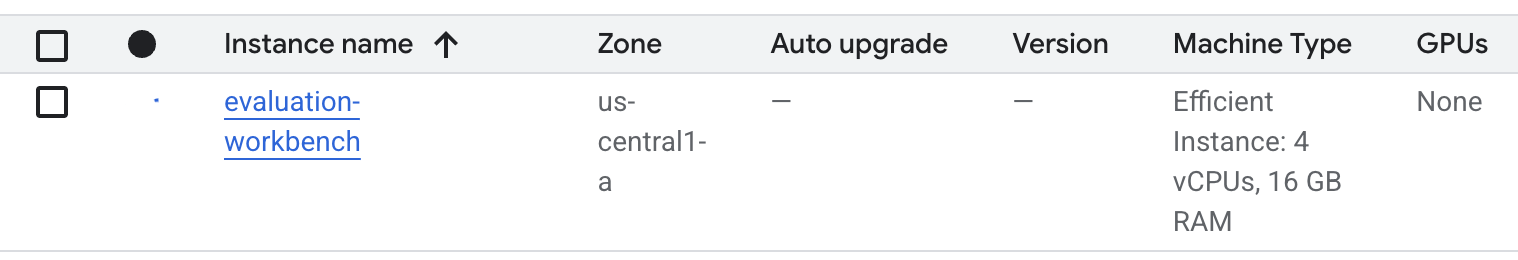
- Setelah workbench disediakan, klik open jupyterlab.
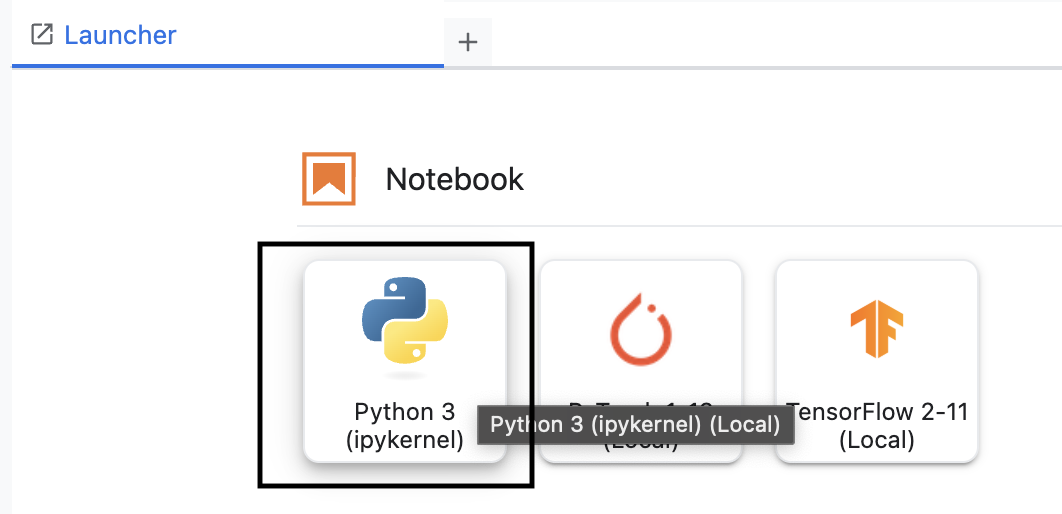
- Di workbench, buat notebook Python3 baru.
Untuk mempelajari lebih lanjut fitur dan kemampuan lingkungan ini, lihat dokumentasi resmi untuk Vertex AI Workbench.
Menginstal SDK evaluasi Vertex AI
Sekarang, mari kita instal SDK evaluasi khusus yang menyediakan alat untuk penilaian RAG.
- Di sel pertama notebook Anda, tambahkan dan jalankan pernyataan impor di bawah (SHIFT+ENTER) untuk menginstal Vertex AI SDK (dengan komponen evaluasi).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: Class utama untuk menjalankan evaluasi
- MetricPromptTemplateExamples: Metrik evaluasi yang telah ditetapkan
- PointwiseMetric: Framework untuk membuat metrik kustom
- notebook_utils: Alat visualisasi untuk analisis hasil
- Penting: Setelah penginstalan, Anda harus memulai ulang kernel untuk menggunakan paket baru. Di panel menu di bagian atas jendela JupyterLab, buka Kernel > Restart Kernel.
5. Melakukan inisialisasi SDK dan mengimpor library
Sebelum dapat membangun pipeline evaluasi, Anda perlu menyiapkan lingkungan Anda. Langkah ini mencakup mengonfigurasi detail project, melakukan inisialisasi Vertex AI SDK untuk terhubung ke Google Cloud, dan mengimpor library Python khusus yang akan Anda gunakan untuk evaluasi.
- Tentukan variabel konfigurasi untuk tugas evaluasi Anda. Di sel baru, tambahkan dan jalankan kode berikut untuk menetapkan
PROJECT_ID,LOCATION, dan namaEXPERIMENTuntuk mengatur operasi ini.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Melakukan inisialisasi Vertex AI SDK. Di sel baru, tambahkan dan jalankan kode berikut.
vertexai.init(project=PROJECT_ID, location=LOCATION) - Impor class yang diperlukan dari SDK evaluasi dengan menjalankan kode berikut di sel berikutnya:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: Untuk membuat dan mengelola data di DataFrame.
- EvalTask: Class inti yang menjalankan tugas evaluasi.
- MetricPromptTemplateExamples: Memberikan akses ke metrik evaluasi standar Google.
- PointwiseMetric: Framework untuk membuat metrik kustom Anda sendiri.
- notebook_utils: Kumpulan alat untuk memvisualisasikan hasil.
6. Menyiapkan set data evaluasi Anda
Set data yang terstruktur dengan baik adalah fondasi dari setiap evaluasi yang andal. Untuk sistem RAG, set data Anda memerlukan dua kolom kunci untuk setiap contoh:
- prompt: Ini adalah total input yang diberikan ke model bahasa. Anda harus menggabungkan pertanyaan pengguna dengan konteks yang diambil oleh sistem RAG Anda (
prompt = User Question + Retrieved Context). Hal ini penting agar layanan evaluasi mengetahui informasi yang digunakan model untuk membuat jawabannya. - response: Ini adalah jawaban akhir yang dihasilkan oleh model RAG Anda.
Untuk hasil yang andal secara statistik, sebaiknya gunakan set data yang berisi sekitar 100 contoh. Untuk lab ini, Anda akan menggunakan set data kecil untuk mendemonstrasikan prosesnya.
Mari kita buat set data. Anda akan memulai dengan daftar pertanyaan dan retrieved_contexts dari sistem RAG. Kemudian, Anda akan menentukan dua set jawaban: satu dari model yang tampaknya berperforma baik (generated_answers_by_rag_a) dan satu dari model yang berperforma buruk (generated_answers_by_rag_b).
Terakhir, Anda akan menggabungkan bagian-bagian ini menjadi dua DataFrame pandas, eval_dataset_rag_a dan eval_dataset_rag_b, mengikuti struktur yang dijelaskan di atas.
- Di sel baru, tambahkan dan jalankan kode berikut untuk menentukan pertanyaan dan dua set generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - Tentukan retrieved_contexts. Tambahkan dan jalankan kode berikut di sel baru.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - Di sel baru, tambahkan dan jalankan kode berikut untuk membuat
eval_dataset_rag_adaneval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - Jalankan kode berikut di sel baru untuk melihat beberapa baris pertama set data untuk Model A.
eval_dataset_rag_a
7. Memilih dan membuat metrik
Setelah set data siap, Anda dapat memutuskan cara mengukur performa. Anda dapat menggunakan satu atau beberapa metrik untuk menilai model Anda. Setiap metrik menilai aspek tertentu dari respons model, seperti akurasi faktual atau relevansinya.
Anda dapat menggunakan kombinasi dua jenis metrik:
- Metrik yang Telah Ditentukan: Metrik siap pakai yang disediakan oleh SDK untuk tugas evaluasi umum.
- Metrik Kustom: Metrik yang Anda tentukan untuk menguji kualitas yang relevan dengan kasus penggunaan Anda.
Di bagian ini, Anda akan mempelajari metrik standar yang tersedia untuk RAG.
Mempelajari metrik standar
SDK ini menyertakan beberapa metrik bawaan untuk mengevaluasi sistem tanya jawab. Metrik ini menggunakan model bahasa sebagai "evaluator" untuk menilai jawaban model Anda berdasarkan serangkaian petunjuk.
- Di sel baru, tambahkan dan jalankan kode berikut untuk melihat daftar lengkap nama metrik yang telah ditetapkan:
MetricPromptTemplateExamples.list_example_metric_names() - Untuk memahami cara kerja metrik ini, Anda dapat memeriksa template perintah yang mendasarinya. Di sel baru, tambahkan dan jalankan kode berikut untuk melihat petunjuk yang diberikan kepada LLM evaluator untuk metrik
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. Membuat metrik kustom
Selain metrik yang telah ditetapkan, Anda dapat membuat metrik kustom untuk mengevaluasi kriteria khusus untuk kasus penggunaan Anda. Untuk membuat metrik kustom, Anda menulis template perintah yang menginstruksikan LLM evaluator cara menilai respons.
Pembuatan metrik kustom melibatkan dua langkah:
- Menentukan Template Perintah: String yang berisi petunjuk Anda untuk LLM evaluator. Template yang baik mencakup peran yang jelas, kriteria evaluasi, rubrik penilaian, dan placeholder seperti
{prompt}dan{response}. - Membuat Instance Objek PointwiseMetric: Anda menggabungkan string template perintah di dalam class ini dan memberi nama metrik Anda.
Anda akan membuat dua metrik kustom untuk mengevaluasi relevansi dan kegunaan jawaban sistem RAG.
- Tentukan template perintah untuk metrik relevansi. Template ini memberikan rubrik mendetail untuk LLM evaluator. Di sel baru, tambahkan dan jalankan kode berikut:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Tentukan template perintah untuk metrik manfaat menggunakan pendekatan yang sama. Tambahkan dan jalankan kode berikut di sel baru:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Buat instance objek
PointwiseMetricuntuk dua metrik kustom Anda. Tindakan ini akan menggabungkan template perintah Anda menjadi komponen yang dapat digunakan kembali untuk tugas evaluasi. Tambahkan dan jalankan kode berikut di sel baru:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
Sekarang Anda memiliki dua metrik baru yang dapat digunakan kembali (relevance dan helpfulness) yang siap untuk tugas evaluasi.
9. Menjalankan tugas evaluasi
Setelah set data dan metrik siap, Anda dapat menjalankan evaluasi. Anda akan melakukannya dengan membuat objek EvalTask untuk setiap set data yang ingin diuji.
EvalTask menggabungkan komponen untuk operasi evaluasi:
- dataset: DataFrame yang berisi prompt dan respons Anda.
- metrics: Daftar metrik yang ingin Anda beri skor.
- experiment: Vertex AI Experiment untuk mencatat hasil, sehingga membantu Anda melacak dan membandingkan operasi.
- Buat
EvalTaskuntuk setiap model. Objek ini menggabungkan set data, metrik, dan nama eksperimen. Tambahkan dan jalankan kode berikut di sel baru untuk mengonfigurasi tugas:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask, satu untuk setiap set respons model. Daftarmetricsyang Anda berikan menunjukkan fitur utama layanan evaluasi: metrik yang telah ditetapkan (misalnya,safety) dan objekPointwiseMetrickustom. - Setelah tugas dikonfigurasi, jalankan tugas dengan memanggil metode
.evaluate(). Tindakan ini akan mengirimkan tugas ke backend Vertex AI untuk diproses dan mungkin memerlukan waktu beberapa menit untuk diselesaikan. Di sel baru, tambahkan dan jalankan kode berikut:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
Setelah evaluasi selesai, hasilnya akan disimpan di objek result_rag_a dan result_rag_b, siap untuk kita analisis di bagian berikutnya.
10. Menganalisis hasil
Hasil evaluasi kini tersedia. Objek result_rag_a dan result_rag_b berisi skor gabungan dan penjelasan mendetail untuk setiap baris. Dalam tugas ini, Anda akan menganalisis hasil ini menggunakan fungsi bantuan dari notebook_utils.
Melihat ringkasan gabungan
- Untuk mendapatkan ringkasan umum, gunakan fungsi bantuan
display_eval_result()untuk melihat skor rata-rata setiap metrik. Di sel baru, tambahkan dan jalankan kode berikut untuk melihat ringkasan Model A:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - Lakukan hal yang sama untuk Model B. Tambahkan dan jalankan kode ini di sel baru:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
Memvisualisasikan hasil evaluasi
Plot dapat mempermudah perbandingan performa model. Anda akan menggunakan dua jenis visualisasi:
- Plot Radar: Menunjukkan "bentuk" performa keseluruhan setiap model. Bentuk yang lebih besar menunjukkan performa keseluruhan yang lebih baik.
- Plot Batang: Untuk perbandingan langsung dan berdampingan pada setiap metrik.
Visualisasi ini akan membantu Anda membandingkan model berdasarkan kualitas subjektif seperti relevansi, keakuratan, dan kegunaan.
- Untuk mempersiapkan plotting, gabungkan hasilnya ke dalam satu daftar tuple. Setiap tuple harus berisi nama model dan objek hasil yang sesuai. Di sel baru, tambahkan dan jalankan kode berikut:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - Sekarang, buat plot radar untuk membandingkan model di semua metrik sekaligus. Tambahkan dan jalankan kode berikut di sel baru:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - Untuk perbandingan yang lebih langsung pada setiap metrik, buat plot batang. Di sel baru, tambahkan dan jalankan kode ini:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
Visualisasi akan menunjukkan dengan jelas bahwa performa Model A (bentuk besar pada plot radar dan batang tinggi pada diagram batang) lebih unggul daripada Model B.
Melihat penjelasan mendetail untuk setiap instance
Skor gabungan menunjukkan performa keseluruhan. Untuk memahami alasan model berperforma tertentu, Anda perlu meninjau penjelasan mendetail yang dihasilkan oleh LLM evaluator untuk setiap contoh.
- Fungsi bantuan
display_explanations()memungkinkan Anda memeriksa setiap hasil. Untuk melihat perincian mendetail untuk contoh kedua (num=2) dari hasil Model A, tambahkan dan jalankan kode berikut di sel baru:notebook_utils.display_explanations(result_rag_a, num=2) - Anda juga dapat menggunakan fungsi ini untuk memfilter metrik tertentu di semua contoh. Hal ini berguna untuk men-debug area tertentu yang berperforma buruk. Untuk mengetahui alasan Model B berperforma sangat buruk pada metrik
groundedness, tambahkan dan jalankan kode ini di sel baru:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. Evaluasi yang direferensikan menggunakan "jawaban emas"
Sebelumnya, Anda telah melakukan evaluasi tanpa referensi, yang menilai jawaban model hanya berdasarkan perintah. Metode ini berguna, tetapi penilaiannya bersifat subjektif.
Sekarang, Anda akan menggunakan evaluasi yang direferensikan. Metode ini menambahkan "jawaban emas" (juga disebut jawaban referensi) ke set data. Membandingkan respons model dengan jawaban kebenaran nyata akan memberikan ukuran performa yang lebih objektif. Dengan begitu, Anda dapat mengukur:
- Kebenaran Faktual: Apakah jawaban model sesuai dengan fakta dalam jawaban emas?
- Kemiripan Semantik: Apakah jawaban model memiliki arti yang sama dengan jawaban emas?
- Kelengkapan: Apakah jawaban model berisi semua informasi penting dari jawaban emas?
Menyiapkan set data yang direferensikan
Untuk melakukan evaluasi yang direferensikan, Anda perlu menambahkan "jawaban emas" ke setiap contoh dalam set data Anda.
Mari kita mulai dengan menentukan daftar golden_answers. Membandingkan jawaban emas dengan jawaban dari Model A menunjukkan nilai metode ini:
- Pertanyaan 1 (Brain): Jawaban yang dihasilkan dan jawaban emas identik. Model A benar.
- Pertanyaan 2 (Senat): Jawabannya mirip secara semantik, tetapi diungkapkan dengan kata-kata yang berbeda. Metrik yang baik harus mengenali hal ini.
- Pertanyaan 3 (Hasan-Jalalians): Jawaban Model A secara faktual salah menurut konteks.
golden_answermenampilkan error ini.
- Dalam sel baru, tentukan daftar golden_answers
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - Buat DataFrame evaluasi yang direferensikan dengan menjalankan kode ini di sel berikut:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
Set data kini siap untuk evaluasi dengan referensi.
Membuat metrik kustom yang direferensikan
Anda juga dapat membuat metrik kustom untuk evaluasi yang direferensikan. Prosesnya serupa, tetapi template perintah kini menyertakan placeholder {reference} untuk jawaban emas.
Dengan jawaban "benar" yang pasti, Anda dapat menggunakan penilaian biner yang lebih ketat (misalnya, 1 untuk benar, 0 untuk salah) untuk mengukur akurasi faktual. Mari buat metrik question_answering_correctness baru yang menerapkan logika ini.
- Tentukan template perintah. Di sel baru, tambahkan dan jalankan kode berikut:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - Gabungkan string template perintah di dalam objek PointwiseMetric. Tindakan ini akan memberi metrik Anda nama formal dan menjadikannya komponen yang dapat digunakan kembali untuk tugas evaluasi. Tambahkan dan jalankan kode berikut di sel baru:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
Anda kini memiliki metrik kustom yang direferensikan untuk pemeriksaan faktual yang ketat.
12. Menjalankan Evaluasi yang Direferensikan
Sekarang, Anda akan mengonfigurasi tugas evaluasi dengan set data yang direferensikan dan metrik baru. Anda akan menggunakan class EvalTask lagi.
Daftar metrik kini menggabungkan metrik berbasis model kustom Anda dengan metrik berbasis komputasi. Evaluasi dengan referensi memungkinkan penggunaan metrik tradisional berbasis komputasi yang melakukan perbandingan matematis antara teks yang dihasilkan dan teks referensi. Anda akan menggunakan tiga jenis yang umum:
exact_match: Memberikan skor 1 hanya jika jawaban yang dihasilkan identik dengan jawaban referensi, dan 0 jika tidak.bleu: Metrik presisi. Metrik ini mengukur jumlah kata dari jawaban yang dihasilkan yang juga muncul dalam jawaban referensi.rouge: Metrik perolehan. Metrik ini mengukur berapa banyak kata dari jawaban referensi yang tercakup dalam jawaban yang dihasilkan.
- Konfigurasikan tugas evaluasi dengan set data yang direferensikan dan kombinasi metrik baru. Di sel baru, tambahkan dan jalankan kode berikut untuk membuat objek
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - Jalankan evaluasi yang direferensikan dengan memanggil metode
.evaluate(). Tambahkan dan jalankan kode ini di sel baru:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. Menganalisis hasil yang dirujuk
Evaluasi selesai. Dalam tugas ini, Anda akan menganalisis hasil untuk mengukur akurasi faktual model dengan membandingkan jawabannya dengan jawaban referensi emas.
Melihat hasil ringkasan
- Menganalisis hasil ringkasan untuk evaluasi yang direferensikan. Di sel baru, tambahkan dan jalankan kode berikut untuk menampilkan tabel ringkasan untuk kedua model:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnesskustom Anda, tetapi mendapatkan skor lebih rendah padaexact_match. Hal ini menyoroti nilai metrik berbasis model yang dapat mengenali kesamaan semantik, bukan hanya teks yang identik.
Memvisualisasikan hasil untuk perbandingan
Visualisasi dapat membuat kesenjangan performa antara kedua model menjadi lebih jelas. Pertama, gabungkan hasil ke dalam satu daftar untuk diplot, lalu buat plot radar dan batang.
- Gabungkan hasil evaluasi yang direferensikan ke dalam satu daftar untuk diplot. Tambahkan dan jalankan kode berikut di sel baru:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - Buat plot radar untuk memvisualisasikan performa setiap model di seluruh kumpulan metrik baru. Tambahkan dan jalankan kode ini di sel baru:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - Buat plot batang untuk perbandingan langsung dan berdampingan. Tindakan ini akan menampilkan performa setiap model pada berbagai metrik. Tambahkan dan jalankan kode berikut di sel baru:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
Visualisasi ini mengonfirmasi bahwa Model A jauh lebih akurat dan selaras secara faktual dengan jawaban referensi dibandingkan Model B.
14. Dari praktik hingga produksi
Anda telah berhasil menjalankan pipeline evaluasi lengkap untuk sistem RAG. Bagian terakhir ini merangkum konsep strategis utama yang telah Anda pelajari dan memberikan framework untuk menerapkan keterampilan ini ke project di dunia nyata.
Praktik terbaik produksi
Untuk menerapkan keterampilan dari lab ini ke lingkungan produksi di dunia nyata, pertimbangkan empat praktik utama berikut:
- Otomatiskan dengan CI/CD: Integrasikan suite evaluasi Anda ke dalam pipeline CI/CD (misalnya, Cloud Build, GitHub Actions). Jalankan evaluasi secara otomatis pada perubahan kode untuk mendeteksi regresi dan memblokir deployment jika skor kualitas turun di bawah standar Anda.
- Kembangkan set data Anda: Set data statis akan menjadi usang. Lakukan kontrol versi pada set pengujian "golden" Anda (menggunakan Git LFS atau Cloud Storage) dan terus tambahkan contoh baru yang menantang dengan mengambil sampel dari kueri pengguna yang sebenarnya (yang dianonimkan).
- Evaluasi pengambil, bukan hanya generator: Jawaban yang bagus tidak mungkin diperoleh tanpa konteks yang tepat. Terapkan langkah evaluasi terpisah untuk sistem pengambilan Anda menggunakan metrik seperti Hit Rate (apakah dokumen yang tepat ditemukan?) dan Mean Reciprocal Rank (MRR) (seberapa tinggi peringkat dokumen yang tepat?).
- Pantau metrik dari waktu ke waktu: Ekspor skor ringkasan dari operasi evaluasi Anda ke layanan seperti Google Cloud Monitoring. Buat dasbor untuk melacak tren kualitas dan siapkan pemberitahuan otomatis untuk memberi tahu Anda jika terjadi penurunan performa yang signifikan.
Matriks metodologi evaluasi lanjutan
Memilih pendekatan evaluasi yang tepat bergantung pada sasaran spesifik Anda. Matriks ini merangkum kapan harus menggunakan setiap metode.
Pendekatan Evaluasi | Kasus Penggunaan Terbaik | Keunggulan Utama | Batasan |
Tanpa Referensi | Pemantauan produksi, penilaian berkelanjutan | Tidak memerlukan jawaban emas, menangkap kualitas subjektif | Lebih mahal, potensi bias evaluator |
Berbasis Referensi | Perbandingan model, tolok ukur | Pengukuran objektif, komputasi lebih cepat | Memerlukan jawaban emas, mungkin melewatkan kesetaraan semantik |
Metrik Kustom | Penilaian khusus domain | Disesuaikan dengan kebutuhan bisnis | Memerlukan validasi, overhead pengembangan |
Pendekatan Hybrid | Sistem produksi yang komprehensif | Terbaik dari semua pendekatan | Kompleksitas lebih tinggi, perlu pengoptimalan biaya |
Insight teknis utama
Ingat prinsip-prinsip inti ini saat Anda membangun dan mengevaluasi sistem RAG Anda sendiri:
- Groundedness Sangat Penting untuk RAG: Metrik ini secara konsisten membedakan antara sistem RAG berkualitas tinggi dan rendah, sehingga sangat penting untuk pemantauan produksi.
- Beberapa Metrik Memberikan Ketahanan: Tidak ada satu metrik pun yang mencakup semua aspek kualitas RAG. Evaluasi yang komprehensif memerlukan beberapa dimensi penilaian.
- Metrik Kustom Memberikan Nilai Tambah yang Signifikan: Kriteria evaluasi khusus domain sering kali menangkap nuansa yang terlewatkan oleh metrik umum, sehingga meningkatkan akurasi penilaian.
- Kekuatan Statistik Memberikan Keyakinan: Ukuran sampel dan pengujian signifikansi yang tepat mengubah evaluasi dari sekadar tebakan menjadi alat pengambilan keputusan yang andal.
Framework keputusan deployment produksi
Gunakan framework bertahap ini sebagai panduan untuk deployment sistem RAG di masa mendatang:
- Tahap 1 - Pengembangan: Gunakan evaluasi berbasis referensi dengan set pengujian yang diketahui untuk perbandingan model dan pemilihan.
- Fase 2 - Praproduksi: Jalankan evaluasi komprehensif yang menggabungkan kedua pendekatan untuk memvalidasi kesiapan produksi.
- Fase 3 - Produksi: Terapkan pemantauan tanpa referensi untuk penilaian kualitas berkelanjutan tanpa jawaban emas.
- Tahap 4 - Pengoptimalan: Gunakan insight evaluasi untuk memandu peningkatan kualitas model dan peningkatan sistem pengambilan.
15. Kesimpulan
Selamat! Anda telah menyelesaikan lab ini.
Lab ini merupakan bagian dari Alur Pembelajaran AI Siap Produksi dengan Google Cloud.
- Pelajari kurikulum lengkapnya untuk menjembatani kesenjangan antara prototipe dan produksi.
- Bagikan progres Anda dengan hashtag
ProductionReadyAI.
Rangkuman
Anda telah mempelajari cara:
- Melakukan evaluasi tanpa referensi untuk menilai kualitas jawaban berdasarkan konteks yang diambil.
- Lakukan evaluasi yang direferensikan dengan menambahkan "jawaban emas" untuk mengukur kebenaran faktual.
- Gunakan kombinasi metrik standar dan kustom untuk kedua pendekatan.
- Gunakan metrik berbasis model (seperti
question_answering_quality) dan metrik berbasis komputasi (rouge,bleu,exact_match). - Menganalisis dan memvisualisasikan hasil untuk memahami kekuatan dan kelemahan model.
Pendekatan evaluasi ini membantu Anda membangun aplikasi AI generatif yang lebih andal dan akurat.