

1. Przegląd
Z tego modułu dowiesz się, jak utworzyć potok oceny dla systemu generowania wspomaganego wyszukiwaniem (RAG). Użyjesz usługi Gen AI Evaluation Service w Vertex AI, aby utworzyć niestandardowe kryteria oceny i opracować ramy oceny zadania polegającego na odpowiadaniu na pytania.
Będziesz pracować z przykładami ze zbioru danych Stanford Question Answering Dataset (SQuAD 2.0), aby przygotować zbiory danych do oceny, skonfigurować oceny bez odniesienia i z odniesieniem oraz zinterpretować wyniki. Po ukończeniu tego modułu będziesz wiedzieć, jak oceniać systemy RAG i dlaczego wybiera się określone podejścia do oceny.
Podstawy zbioru danych
Będziemy pracować ze starannie dobranymi przykładami z różnych dziedzin, które można znaleźć w zbiorze danych SQuAD 2.0 Question Answering Dataset:
- Neuronauka: testowanie dokładności technicznej w kontekstach naukowych.
- Historia: ocena zgodności z prawdą w narracjach historycznych.
- Geografia: ocena wiedzy o terytoriach i polityce.
Ta różnorodność pomaga zrozumieć, jak metody oceny można uogólnić na różne obszary tematyczne.
Odniesienia
- Przykładowy kod: ten moduł opiera się na przykładach z dokumentacji Vertex AI Evaluation.
- Podstawa zbioru danych: zbiór danych SQuAD 2.0 z odpowiedziami na pytania
- Optymalizacja pobierania RAG: testowanie, dostrajanie, sukces
Czego się nauczysz
Z tego laboratorium nauczysz się, jak:
- przygotowywać zbiory danych do oceny systemów RAG,
- Wdrażanie oceny bez odniesienia za pomocą wskaźników takich jak groundedness i trafność.
- Zastosuj ocenę na podstawie odniesienia z miarami podobieństwa semantycznego.
- tworzyć niestandardowe wskaźniki oceny ze szczegółowymi kryteriami oceny;
- interpretować i wizualizować wyniki oceny, aby ułatwić wybór modelu;
2. Konfigurowanie projektu
Konto Google
Jeśli nie masz jeszcze osobistego konta Google, musisz je utworzyć.
Użyj konta osobistego zamiast służbowego lub szkolnego.
Logowanie się w konsoli Google Cloud
Zaloguj się w konsoli Google Cloud, korzystając z osobistego konta Google.
Włącz płatności
Wykorzystaj środki w Google Cloud (opcjonalnie)
Aby przeprowadzić te warsztaty, musisz mieć konto rozliczeniowe z pewną kwotą środków. Aby rozpocząć, użyj środków z banera u góry tego ćwiczenia. Jeśli masz już połączenie z kontem rozliczeniowym, możesz pominąć ten krok.
Konfigurowanie osobistego konta rozliczeniowego
Jeśli konfigurujesz płatności za pomocą środków w Google Cloud, możesz pominąć ten krok.
Aby skonfigurować osobiste konto rozliczeniowe, kliknij tutaj i włącz płatności w konsoli Cloud.
Kilka uwag:
- Pod względem opłat za zasoby chmury ukończenie tego modułu powinno kosztować mniej niż 1 USD.
- Jeśli chcesz uniknąć dalszych opłat, wykonaj czynności opisane na końcu tego modułu, aby usunąć zasoby.
- Nowi użytkownicy mogą skorzystać z bezpłatnego okresu próbnego, w którym mają do dyspozycji środki w wysokości 300 USD.
Tworzenie projektu (opcjonalnie)
Jeśli nie masz bieżącego projektu, którego chcesz użyć w tym module, utwórz nowy projekt tutaj.
3. Czym jest generowanie rozszerzone przez wyszukiwanie w zapisanych informacjach (RAG)?
RAG to technika używana do poprawy dokładności i trafności odpowiedzi z dużych modeli językowych (LLM). Łączy LLM z zewnętrzną bazą wiedzy, aby opierać odpowiedzi na konkretnych, możliwych do zweryfikowania informacjach.
Proces ten obejmuje te kroki:
- Przekształcanie pytania użytkownika w reprezentację liczbową (wektor dystrybucyjny).
- Wyszukuję w bazie wiedzy dokumenty z podobnymi wektorami dystrybucyjnymi.
- Przekazanie tych dokumentów jako kontekstu do modelu LLM wraz z pierwotnym pytaniem w celu wygenerowania odpowiedzi.
Dowiedz się więcej o RAG.
Dlaczego ocena RAG jest złożona?
Ocena systemów RAG różni się od oceny tradycyjnych modeli językowych.
Wyzwanie związane z wieloma komponentami: systemy RAG łączą 3 operacje, z których każda może być punktem awarii:
- Jakość pobierania: czy system znalazł odpowiednie dokumenty kontekstowe?
- Wykorzystanie kontekstu: czy model skutecznie wykorzystał pobrane informacje?
- Jakość generowania: czy ostateczna odpowiedź jest dobrze sformułowana, przydatna i dokładna?
Odpowiedź może się nie powieść, jeśli którykolwiek z tych komponentów nie działa zgodnie z oczekiwaniami. System może na przykład pobrać prawidłowy kontekst, ale model go zignoruje. Może też wygenerować dobrze napisaną odpowiedź, która jest nieprawidłowa, ponieważ pobrany kontekst był nieistotny.
4. Konfigurowanie środowiska Vertex AI Workbench
Zacznijmy od utworzenia nowego środowiska notatnika, w którym uruchomimy kod potrzebny do oceny systemów RAG.
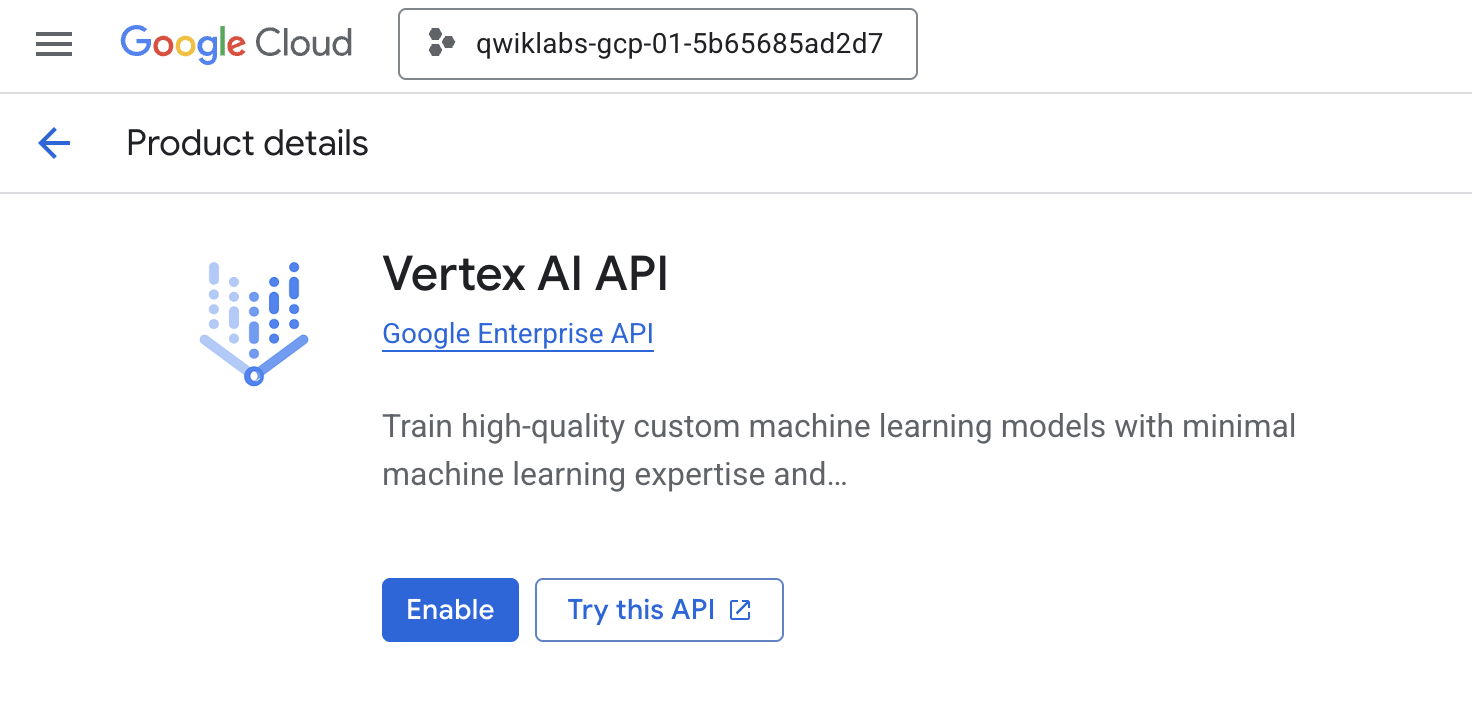
- Otwórz stronę Interfejsy API i usługi w konsoli Cloud.
- Kliknij Włącz przy Vertex AI API.
Uzyskiwanie dostępu do Vertex AI Workbench
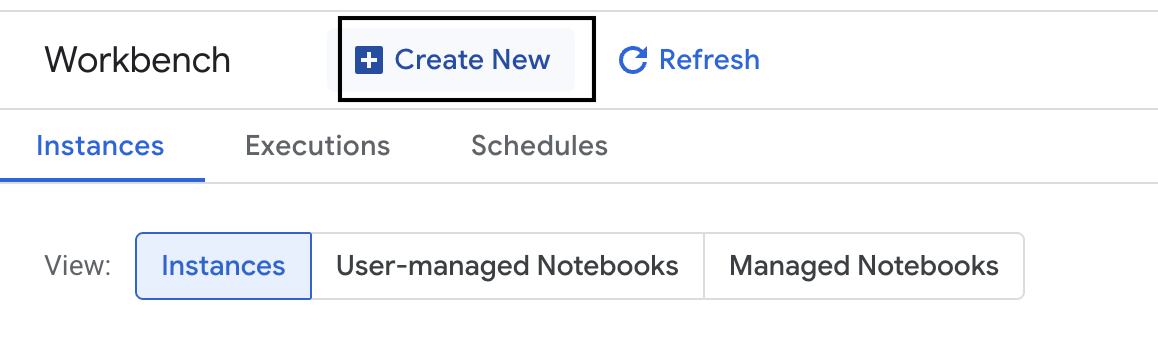
- W konsoli Google Cloud przejdź do Vertex AI, klikając Menu nawigacyjne ☰ > Vertex AI > Workbench.
- Utwórz nową instancję Workbench.
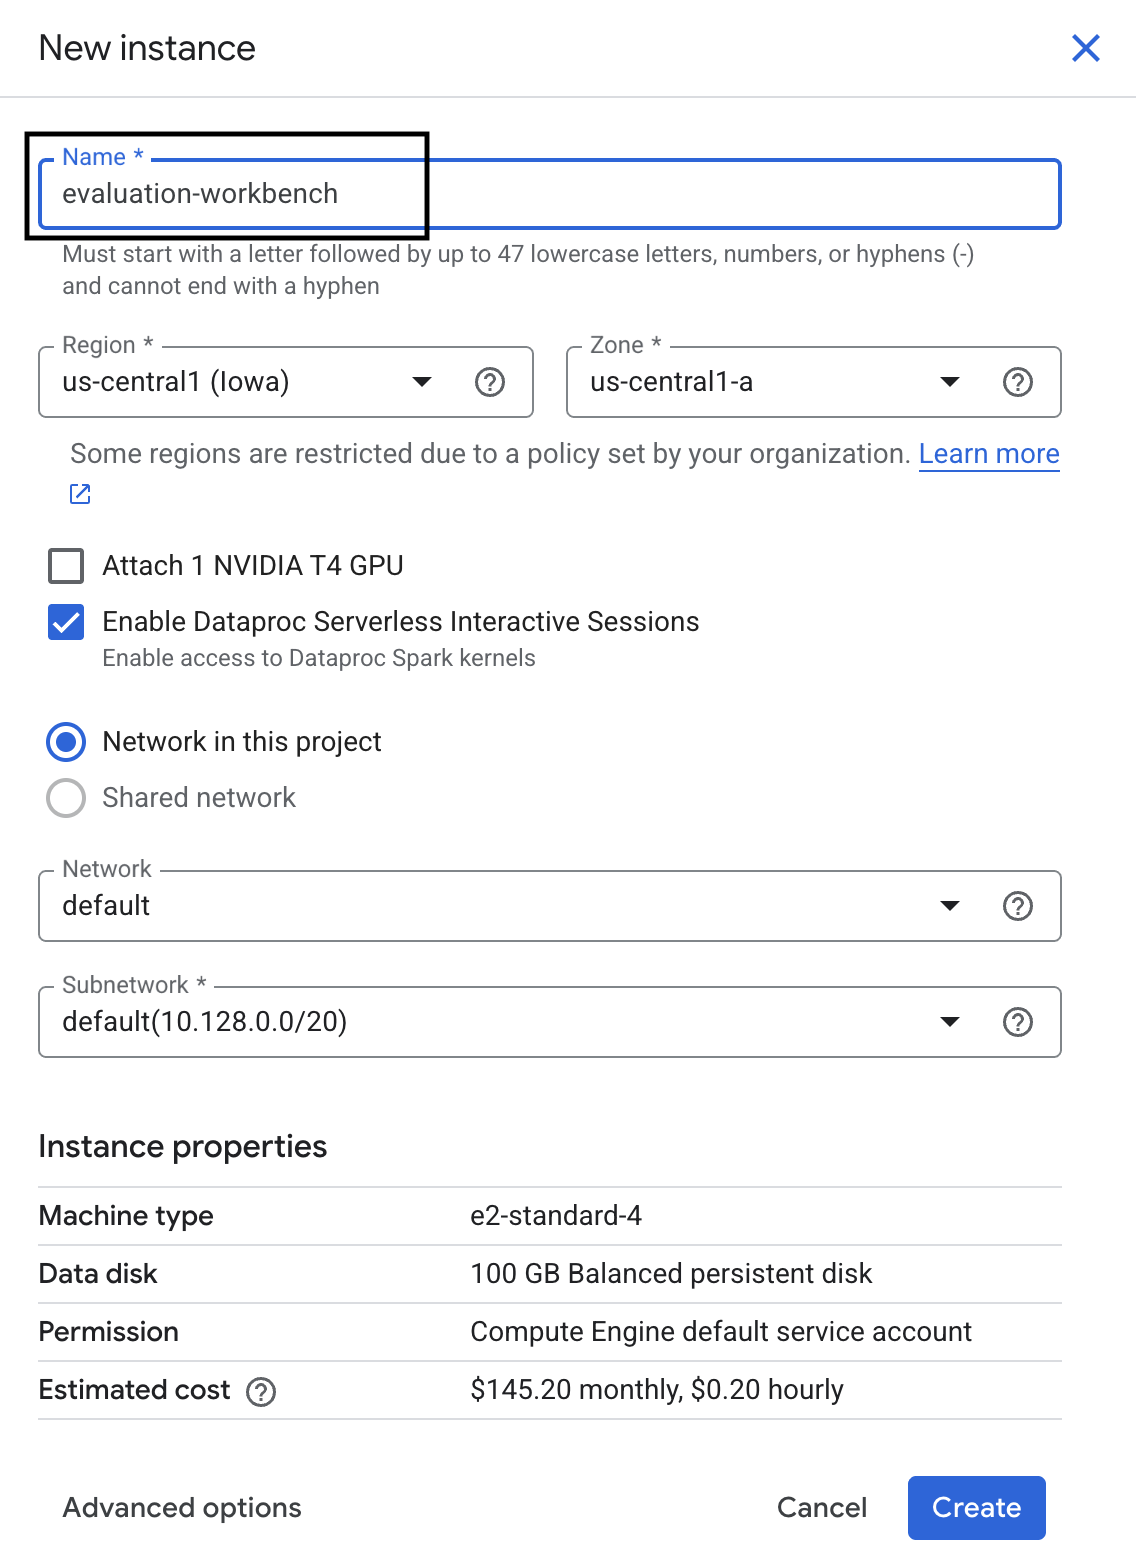
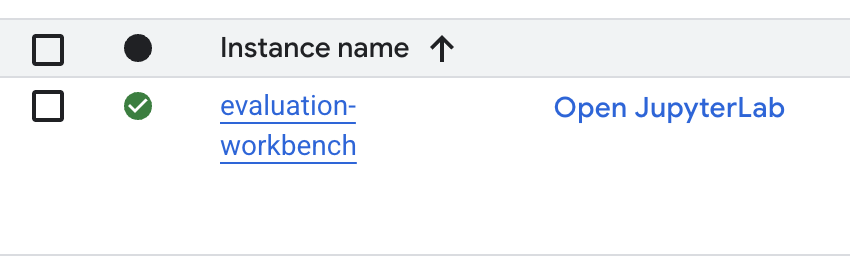
- Nazwij instancję środowiska roboczego
evaluation-workbench. - Wybierz region i strefę, jeśli te wartości nie są jeszcze ustawione.
- Kliknij Utwórz.
- Poczekaj na skonfigurowanie środowiska pracy. Może to potrwać kilka minut.
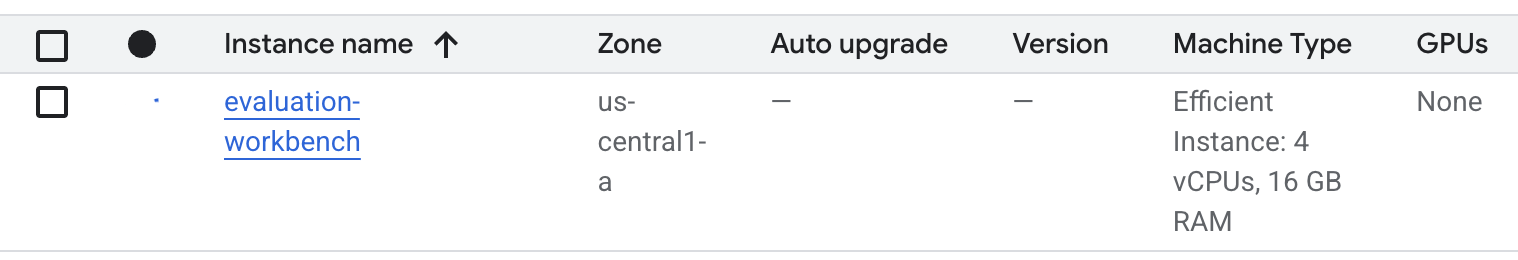
- Po udostępnieniu środowiska pracy kliknij Otwórz JupyterLab.
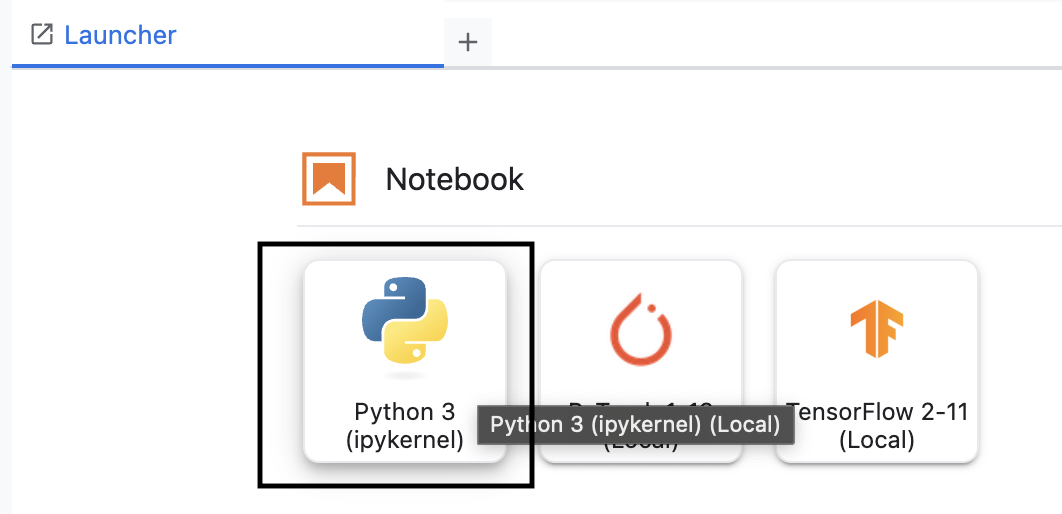
- W środowisku roboczym utwórz nowy notatnik Python3.
Więcej informacji o funkcjach i możliwościach tego środowiska znajdziesz w oficjalnej dokumentacji Vertex AI Workbench.
Instalowanie pakietu SDK do oceny Vertex AI
Teraz zainstalujmy specjalistyczny pakiet SDK do oceny, który udostępnia narzędzia do oceny RAG.
- W pierwszej komórce notatnika dodaj i uruchom poniższą instrukcję importu (SHIFT+ENTER), aby zainstalować pakiet Vertex AI SDK (z komponentami oceny).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: główna klasa do przeprowadzania ocen.
- MetricPromptTemplateExamples: wstępnie zdefiniowane wskaźniki oceny
- PointwiseMetric: platforma do tworzenia danych niestandardowych.
- notebook_utils: narzędzia do wizualizacji na potrzeby analizy wyników.
- Ważne: po instalacji musisz ponownie uruchomić jądro, aby używać nowych pakietów. Na pasku menu u góry okna JupyterLab kliknij Jądro > Uruchom jądro ponownie.
5. Inicjowanie pakietu SDK i importowanie bibliotek
Zanim utworzysz potok oceny, musisz skonfigurować środowisko. Obejmuje to skonfigurowanie szczegółów projektu, zainicjowanie pakietu Vertex AI SDK w celu połączenia z Google Cloud oraz zaimportowanie specjalistycznych bibliotek Pythona, których użyjesz do oceny.
- Zdefiniuj zmienne konfiguracji zadania oceny. W nowej komórce dodaj i uruchom ten kod, aby ustawić
PROJECT_ID,LOCATIONi nazwęEXPERIMENTw celu uporządkowania tego uruchomienia.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Zainicjuj pakiet Vertex AI SDK. W nowej komórce dodaj i uruchom ten kod.
vertexai.init(project=PROJECT_ID, location=LOCATION) - Zaimportuj niezbędne klasy z pakietu SDK do oceny, uruchamiając ten kod w następnej komórce:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: do tworzenia danych i zarządzania nimi w obiektach DataFrame.
- EvalTask: podstawowa klasa, która uruchamia zadanie oceny.
- MetricPromptTemplateExamples: zapewnia dostęp do wstępnie zdefiniowanych wskaźników oceny Google.
- PointwiseMetric: platforma do tworzenia własnych wskaźników niestandardowych.
- notebook_utils: zbiór narzędzi do wizualizacji wyników.
6. Przygotowywanie zbioru danych do oceny
Dobrze ustrukturyzowany zbiór danych jest podstawą każdej rzetelnej oceny. W przypadku systemów RAG zbiór danych musi zawierać 2 kluczowe pola dla każdego przykładu:
- prompt: to są wszystkie dane wejściowe przekazane do modelu językowego. Musisz połączyć pytanie użytkownika z kontekstem pobranym przez system RAG (
prompt = User Question + Retrieved Context). Jest to ważne, aby usługa oceny wiedziała, jakich informacji model użył do utworzenia odpowiedzi. - response: to ostateczna odpowiedź wygenerowana przez model RAG.
Aby uzyskać statystycznie wiarygodne wyniki, zalecamy użycie zbioru danych zawierającego około 100 przykładów. W tym module użyjesz małego zbioru danych, aby zademonstrować proces.
Utwórzmy zbiory danych. Zaczniesz od listy pytań i retrieved_contexts z systemu RAG. Następnie zdefiniujesz 2 zestawy odpowiedzi: jeden z modelu, który wydaje się działać dobrze (generated_answers_by_rag_a), i jeden z modelu, który działa słabo (generated_answers_by_rag_b).
Na koniec połączysz te elementy w 2 ramki danych pandas, eval_dataset_rag_a i eval_dataset_rag_b, zgodnie z opisaną powyżej strukturą.
- W nowej komórce dodaj i uruchom ten kod, aby zdefiniować pytania i 2 zestawy generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - Zdefiniuj retrieved_contexts. Dodaj i uruchom ten kod w nowej komórce.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - W nowej komórce dodaj i uruchom ten kod, aby utworzyć
eval_dataset_rag_aieval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - Aby wyświetlić kilka pierwszych wierszy zbioru danych dla modelu A, uruchom ten kod w nowej komórce.
eval_dataset_rag_a
7. Wybieranie i tworzenie danych
Gdy zbiory danych są już gotowe, możesz zdecydować, jak mierzyć skuteczność. Do oceny modelu możesz użyć co najmniej jednego rodzaju danych. Każdy wskaźnik ocenia konkretny aspekt odpowiedzi modelu, np. jej zgodność z prawdą lub trafność.
Możesz używać kombinacji 2 rodzajów danych:
- Wstępnie zdefiniowane wskaźniki: gotowe do użycia wskaźniki dostarczane przez pakiet SDK do typowych zadań oceny.
- Wskaźniki niestandardowe: wskaźniki, które definiujesz, aby testować cechy istotne dla Twojego przypadku użycia.
W tej sekcji poznasz wstępnie zdefiniowane wskaźniki dostępne dla RAG.
Przeglądanie wstępnie zdefiniowanych wskaźników
Pakiet SDK zawiera kilka wbudowanych wskaźników do oceny systemów odpowiadania na pytania. Te wskaźniki wykorzystują model językowy jako „oceniającego”, który ocenia odpowiedzi Twojego modelu na podstawie zestawu instrukcji.
- W nowej komórce dodaj i uruchom ten kod, aby wyświetlić pełną listę wstępnie zdefiniowanych nazw danych:
MetricPromptTemplateExamples.list_example_metric_names() - Aby dowiedzieć się, jak działają te wskaźniki, możesz sprawdzić ich szablony promptów. W nowej komórce dodaj i uruchom ten kod, aby zobaczyć instrukcje przekazane modelowi LLM oceniającemu wskaźnik
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. Utwórz dane niestandardowe
Oprócz wstępnie zdefiniowanych wskaźników możesz tworzyć wskaźniki niestandardowe, aby oceniać kryteria specyficzne dla Twojego przypadku użycia. Aby utworzyć wskaźnik niestandardowy, napisz szablon prompta, który instruuje LLM oceniający, jak ocenić odpowiedź.
Tworzenie danych niestandardowych składa się z 2 etapów:
- Zdefiniuj szablon prompta: ciąg znaków zawierający instrukcje dla oceniającego LLM. Dobry szablon zawiera jasną rolę, kryteria oceny, ocenę cząstkową i obiekty zastępcze, takie jak
{prompt}i{response}. - Utworzenie instancji obiektu PointwiseMetric: w tej klasie umieszczasz ciąg szablonu prompta i nadajesz nazwę wskaźnikowi.
Utworzysz 2 wskaźniki niestandardowe, aby ocenić trafność i przydatność odpowiedzi systemu RAG.
- Zdefiniuj szablon prompta dla wskaźnika trafności. Ten szablon zawiera szczegółowe kryteria oceny dla LLM. W nowej komórce dodaj i uruchom ten kod:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - W ten sam sposób zdefiniuj szablon prompta dla wskaźnika przydatności. Dodaj i uruchom ten kod w nowej komórce:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Utwórz instancje obiektów
PointwiseMetricdla 2 rodzajów danych niestandardowych. Spowoduje to opakowanie szablonów promptów w komponenty wielokrotnego użytku na potrzeby zadania oceny. Dodaj i uruchom ten kod w nowej komórce:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
Masz teraz 2 nowe dane wielokrotnego użytku (relevance i helpfulness) gotowe do zadania oceny.
9. Uruchamianie zadania oceny
Gdy zbiory danych i wskaźniki są gotowe, możesz przeprowadzić ocenę. W tym celu utwórz obiekt EvalTask dla każdego zbioru danych, który chcesz przetestować.
EvalTask grupuje komponenty na potrzeby uruchomienia oceny:
- dataset: DataFrame zawierający prompty i odpowiedzi.
- metrics: lista danych, które chcesz ocenić.
- experiment: Vertex AI Experiments, w którym mają być zapisywane wyniki, co ułatwia śledzenie i porównywanie uruchomień.
- Utwórz
EvalTaskdla każdego modelu. Ten obiekt łączy zbiór danych, dane i nazwę eksperymentu. Aby skonfigurować zadania, dodaj i uruchom w nowej komórce ten kod:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask, po jednym dla każdego zestawu odpowiedzi modelu. Podana przez Ciebie listametricspokazuje kluczową funkcję usługi oceny: wstępnie zdefiniowane dane (np.safety) i niestandardowe obiektyPointwiseMetric. - Po skonfigurowaniu zadań wykonaj je, wywołując metodę
.evaluate(). Spowoduje to wysłanie zadań do backendu Vertex AI w celu przetworzenia. Może to potrwać kilka minut. W nowej komórce dodaj i uruchom ten kod:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
Po zakończeniu oceny wyniki zostaną zapisane w obiektach result_rag_a i result_rag_b, gotowe do analizy w następnej sekcji.
10. Przeanalizuj wyniki
Wyniki oceny są już dostępne. Obiekty result_rag_a i result_rag_b zawierają zagregowane wyniki i szczegółowe wyjaśnienia dotyczące każdego wiersza. W tym zadaniu przeanalizujesz te wyniki za pomocą funkcji pomocniczych z notebook_utils.
Wyświetlanie podsumowań zbiorczych
- Aby uzyskać ogólny przegląd, użyj funkcji pomocniczej
display_eval_result(), która pozwala zobaczyć średni wynik dla każdego rodzaju danych. W nowej komórce dodaj i uruchom ten kod, aby wyświetlić podsumowanie modelu A:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - Zrób to samo w przypadku modelu B. Dodaj i uruchom ten kod w nowej komórce:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
Wizualizacja wyników oceny
Wykresy mogą ułatwić porównywanie wydajności modeli. Użyjesz 2 rodzajów wizualizacji:
- Wykres radarowy: pokazuje ogólny „kształt” skuteczności każdego modelu. Większy kształt oznacza lepszą ogólną skuteczność.
- Wykres słupkowy: do bezpośredniego porównania poszczególnych danych.
Te wizualizacje pomogą Ci porównać modele pod kątem subiektywnych cech, takich jak trafność, groundedness i przydatność.
- Aby przygotować się do tworzenia wykresu, połącz wyniki w jedną listę krotek. Każda krotka powinna zawierać nazwę modelu i odpowiadający mu obiekt wyniku. W nowej komórce dodaj i uruchom ten kod:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - Teraz wygeneruj wykres radarowy, aby porównać modele pod kątem wszystkich danych naraz. Dodaj i uruchom ten kod w nowej komórce:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - Aby uzyskać bardziej bezpośrednie porównanie poszczególnych danych, wygeneruj wykres słupkowy. W nowej komórce dodaj i uruchom ten kod:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
Wizualizacje wyraźnie pokazują, że model A (duży kształt na wykresie radarowym i wysokie słupki na wykresie słupkowym) jest skuteczniejszy niż model B.
Wyświetlanie szczegółowego wyjaśnienia dotyczącego pojedynczej instancji
Zagregowane wyniki pokazują ogólną skuteczność. Aby zrozumieć, dlaczego model działał w określony sposób, musisz przeanalizować szczegółowe wyjaśnienia wygenerowane przez oceniający model LLM dla każdego przykładu.
- Funkcja pomocnicza
display_explanations()umożliwia sprawdzanie poszczególnych wyników. Aby zobaczyć szczegółowe zestawienie drugiego przykładu (num=2) z wyników modelu A, dodaj i uruchom ten kod w nowej komórce:notebook_utils.display_explanations(result_rag_a, num=2) - Możesz też użyć tej funkcji, aby filtrować wyniki według konkretnego wskaźnika we wszystkich przykładach. Jest to przydatne podczas debugowania konkretnego obszaru o niskiej skuteczności. Aby sprawdzić, dlaczego model B uzyskał tak słaby wynik w przypadku wskaźnika
groundedness, dodaj i uruchom ten kod w nowej komórce:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. Ocena z wykorzystaniem „złotej odpowiedzi”
Wcześniej przeprowadziliśmy ocenę bez odniesienia, w której odpowiedź modelu była oceniana tylko na podstawie prompta. Ta metoda jest przydatna, ale ocena jest subiektywna.
Teraz użyjesz oceny z odniesieniem. Ta metoda dodaje do zbioru danych „wzorcową odpowiedź” (nazywaną też odpowiedzią referencyjną). Porównanie odpowiedzi modelu z odpowiedzią opartą na danych podstawowych zapewnia bardziej obiektywną miarę skuteczności. Dzięki temu możesz mierzyć:
- Poprawność merytoryczna: czy odpowiedź modelu jest zgodna z faktami zawartymi we wzorcowej odpowiedzi?
- Podobieństwo semantyczne: czy odpowiedź modelu oznacza to samo co odpowiedź wzorcowa?
- Kompletność: czy odpowiedź modelu zawiera wszystkie kluczowe informacje z wzorcowej odpowiedzi?
Przygotowywanie zbioru danych, do którego odwołuje się zapytanie
Aby przeprowadzić ocenę z odniesieniem, musisz dodać „wzorcową odpowiedź” do każdego przykładu w zbiorze danych.
Zacznijmy od zdefiniowania listy golden_answers. Porównanie wzorcowych odpowiedzi z odpowiedziami modelu A pokazuje wartość tej metody:
- Pytanie 1 (Brain): wygenerowana odpowiedź i wzorcowa odpowiedź są identyczne. Model A jest prawidłowy.
- Pytanie 2 (Senat): odpowiedzi są podobne semantycznie, ale sformułowane inaczej. Dobre dane powinny to uwzględniać.
- Pytanie 3 (Hasan-Dżalalowie): odpowiedź modelu A jest niezgodna z prawdą w kontekście. Ten błąd jest widoczny w
golden_answer.
- In a new cell, define the list of golden_answers
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - Utwórz przywoływane ramki danych oceny, uruchamiając ten kod w następnej komórce:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
Zbiory danych są teraz gotowe do oceny z użyciem danych referencyjnych.
Tworzenie niestandardowego wskaźnika referencyjnego
Możesz też utworzyć wskaźniki niestandardowe na potrzeby oceny z odniesieniem. Proces jest podobny, ale szablon prompta zawiera teraz obiekt zastępczy {reference} dla wzorcowej odpowiedzi.
Jeśli istnieje jednoznaczna „poprawna” odpowiedź, możesz użyć bardziej rygorystycznej, binarnej oceny (np. 1 za poprawną, 0 za niepoprawną), aby zmierzyć dokładność faktyczną. Utwórzmy nowy wskaźnik question_answering_correctness, który implementuje tę logikę.
- Zdefiniuj szablon prompta. W nowej komórce dodaj i uruchom ten kod:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - Umieść ciąg szablonu prompta w obiekcie PointwiseMetric. Dzięki temu wskaźnik otrzyma formalną nazwę i stanie się komponentem wielokrotnego użytku w zadaniu oceny. Dodaj i uruchom ten kod w nowej komórce:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
Masz teraz niestandardowe dane referencyjne, które umożliwiają ścisłą weryfikację faktów.
12. Uruchamianie oceny, do której odwołuje się zadanie
Teraz skonfigurujesz zadanie oceny z użyciem przywołanych zbiorów danych i nowego wskaźnika. Ponownie użyjesz klasy EvalTask.
Lista wskaźników zawiera teraz niestandardowy wskaźnik oparty na modelu oraz wskaźniki obliczeniowe. Ocena z odniesieniem umożliwia korzystanie z tradycyjnych wskaźników obliczeniowych, które wykonują matematyczne porównania wygenerowanego tekstu z tekstem wzorcowym. Użyjesz 3 typowych:
exact_match: zwraca 1 tylko wtedy, gdy wygenerowana odpowiedź jest identyczna z odpowiedzią wzorcową, a w przeciwnym razie zwraca 0.bleu: wskaźnik precyzji. Mierzy, ile słów z wygenerowanej odpowiedzi pojawia się też w odpowiedzi referencyjnej.rouge: wskaźnik pełności. Mierzy, ile słów z odpowiedzi referencyjnej zostało uwzględnionych w wygenerowanej odpowiedzi.
- Skonfiguruj zadanie oceny z użyciem przywołanych zbiorów danych i nowego zestawu danych. W nowej komórce dodaj i uruchom ten kod, aby utworzyć obiekty
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - Wykonaj wskazaną ocenę, wywołując metodę
.evaluate(). Dodaj i uruchom ten kod w nowej komórce:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. Analizowanie wyników, do których odwołuje się zapytanie
Ocena została zakończona. W tym zadaniu przeanalizujesz wyniki, aby zmierzyć dokładność modeli pod względem zgodności z prawdą, porównując ich odpowiedzi z odpowiedziami wzorcowymi.
Wyświetlanie podsumowania wyników
- Przeanalizuj podsumowanie wyników oceny, do której się odwołujesz. W nowej komórce dodaj i uruchom ten kod, aby wyświetlić tabele podsumowujące dla obu modeli:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctness, ale uzyskuje niższy wynik w przypadku wskaźnikaexact_match. Podkreśla to wartość danych opartych na modelach, które mogą rozpoznawać podobieństwo semantyczne, a nie tylko identyczny tekst.
Wizualizacja wyników na potrzeby porównania
Wizualizacje mogą sprawić, że różnica w wydajności między tymi 2 modelami będzie bardziej widoczna. Najpierw połącz wyniki w jedną listę do wykreślenia, a następnie wygeneruj wykresy radarowe i słupkowe.
- Połącz wyniki oceny, do których się odwołujesz, w jedną listę do wykreślenia. Dodaj i uruchom ten kod w nowej komórce:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - Wygeneruj wykres radarowy, aby zwizualizować skuteczność każdego modelu w nowym zestawie danych. Dodaj i uruchom ten kod w nowej komórce:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - Utwórz wykres słupkowy, aby bezpośrednio porównać dane. Dzięki temu zobaczysz, jak każdy model radził sobie z różnymi danymi. Dodaj i uruchom ten kod w nowej komórce:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
Te wizualizacje potwierdzają, że model A jest znacznie dokładniejszy i bardziej zgodny z odpowiedziami referencyjnymi niż model B.
14. Od ćwiczeń do produkcji
Udało Ci się wykonać pełny potok oceny systemu RAG. Ta ostatnia sekcja podsumowuje najważniejsze koncepcje strategiczne, które zostały omówione, i zawiera schemat stosowania tych umiejętności w praktycznych projektach.
Sprawdzone metody dotyczące produkcji
Aby wykorzystać umiejętności zdobyte w tym module w rzeczywistym środowisku produkcyjnym, weź pod uwagę te 4 kluczowe praktyki:
- Automatyzacja za pomocą CI/CD: zintegruj pakiet ewaluacyjny z potokiem CI/CD (np. Cloud Build, GitHub Actions). Automatycznie przeprowadzaj oceny zmian w kodzie, aby wykrywać regresje i blokować wdrożenia, jeśli wyniki jakości spadną poniżej Twoich standardów.
- Rozwijaj zbiory danych: statyczny zbiór danych staje się nieaktualny. Kontroluj wersje „złotych” zbiorów testowych (za pomocą Git LFS lub Cloud Storage) i stale dodawaj nowe, trudne przykłady, pobierając próbki z prawdziwych (zanonimizowanych) zapytań użytkowników.
- Oceniaj nie tylko generator, ale też retriever: bez odpowiedniego kontekstu nie można uzyskać dobrej odpowiedzi. Wdróż osobny etap oceny systemu pobierania, używając danych takich jak współczynnik trafień (czy znaleziono właściwy dokument?) i średnia odwrotność pozycji (MRR) (jak wysoko w rankingu znajdował się właściwy dokument?).
- Monitorowanie wskaźników na przestrzeni czasu: eksportuj podsumowania wyników z procesów oceny do usługi takiej jak Google Cloud Monitoring. Twórz panele, aby śledzić trendy dotyczące jakości, i skonfiguruj automatyczne alerty, które będą Cię powiadamiać o znacznym spadku wydajności.
Tabela zaawansowanych metod oceny
Wybór odpowiedniego podejścia do oceny zależy od konkretnych celów. Ta tabela podsumowuje, kiedy należy używać poszczególnych metod.
Metoda oceny | Najlepsze zastosowania | Najważniejsze zalety | Ograniczenia |
Bez odniesienia | Monitorowanie produkcji, ciągła ocena | Nie są potrzebne wzorcowe odpowiedzi, ponieważ ocena dotyczy subiektywnej jakości. | Wyższe koszty, potencjalne uprzedzenia oceniającego |
Na podstawie pliku referencyjnego | Porównanie modeli, analiza porównawcza | Obiektywne pomiary, szybsze obliczenia | Wymaga wzorcowych odpowiedzi, może nie uwzględniać równoważności semantycznej |
Dane niestandardowe | Ocena dotycząca konkretnej domeny | Dostosowane do potrzeb biznesowych | Wymaga weryfikacji, dodatkowe koszty programistyczne |
Podejście hybrydowe | Kompleksowe systemy produkcyjne | Najlepsze ze wszystkich podejść | Większa złożoność, konieczność optymalizacji kosztów |
Najważniejsze statystyki techniczne
Podczas tworzenia i oceniania własnych systemów RAG pamiętaj o tych podstawowych zasadach:
- Ugruntowanie ma kluczowe znaczenie dla RAG: ten wskaźnik konsekwentnie odróżnia systemy RAG o wysokiej i niskiej jakości, co czyni go niezbędnym do monitorowania produkcji.
- Wiele danych zapewnia rzetelność: żadne pojedyncze dane nie obejmują wszystkich aspektów jakości RAG. Kompleksowa ocena wymaga wielu wymiarów oceny.
- Wskaźniki niestandardowe mają dużą wartość: kryteria oceny specyficzne dla danej domeny często wychwytują niuanse, które umykają ogólnym wskaźnikom, co zwiększa dokładność oceny.
- Rygor statystyczny zapewnia pewność: odpowiednie rozmiary próbek i testy istotności przekształcają ocenę z domysłów w niezawodne narzędzia do podejmowania decyzji.
Platforma decyzyjna dotycząca wdrożenia produkcyjnego
Skorzystaj z tego etapowego planu jako przewodnika przy wdrażaniu systemów RAG w przyszłości:
- Etap 1 – programowanie: użyj oceny opartej na odniesieniach ze znanymi zbiorami testowymi do porównania modeli i ich wyboru.
- Faza 2 – wersja przedprodukcyjna: przeprowadź kompleksową ocenę, łącząc oba podejścia, aby sprawdzić gotowość do wdrożenia wersji produkcyjnej.
- Faza 3 – produkcja: wdrożenie monitorowania bez odniesień w celu ciągłej oceny jakości bez wzorcowych odpowiedzi.
- Etap 4 – optymalizacja: wykorzystaj wyniki oceny, aby ulepszyć model i system pobierania.
15. Podsumowanie
Gratulacje! Udało Ci się ukończyć moduł.
Ten moduł jest częścią ścieżki szkoleniowej Gotowa do wykorzystania w środowisku produkcyjnym AI w Google Cloud.
- Zapoznaj się z pełnym programem szkolenia, aby dowiedzieć się, jak przejść od prototypu do środowiska produkcyjnego.
- Udostępnij swoje postępy, używając hashtaga
ProductionReadyAI.
Podsumowanie
Wiesz już, jak:
- Przeprowadź ocenę bez odniesienia, aby ocenić jakość odpowiedzi na podstawie pobranego kontekstu.
- Przeprowadź ocenę z odniesieniem, dodając „złotą odpowiedź”, aby zmierzyć zgodność z prawdą.
- W obu przypadkach używaj kombinacji wstępnie zdefiniowanych i niestandardowych danych.
- Używaj zarówno wskaźników opartych na modelu (takich jak
question_answering_quality), jak i wskaźników obliczeniowych (rouge,bleu,exact_match). - analizować i wizualizować wyniki, aby poznać mocne i słabe strony modelu;
Takie podejście do oceny pomaga tworzyć bardziej niezawodne i dokładne aplikacje oparte na generatywnej AI.