

1. Обзор
В этой практической работе вы узнаете, как создать конвейер оценки для системы генерации с дополненной выборкой (RAG). Вы будете использовать Vertex AI Gen AI Evaluation Service, чтобы создать собственные критерии оценки и фреймворк для оценки задачи по ответам на вопросы.
Вы будете работать с примерами из набора данных Stanford Question Answering Dataset (SQuAD 2.0), чтобы подготовить наборы данных для оценки, настроить оценки с эталоном и без него и интерпретировать результаты. Вы узнаете, как оценивать системы RAG и почему выбираются определенные подходы к оценке.
Основа набора данных
Мы будем работать с тщательно подобранными примерами, охватывающими несколько доменов, которые можно найти в наборе данных SQuAD 2.0 Question Answering Dataset:
- Нейронауки. Проверка технической точности в научных контекстах.
- История. Оценка фактической точности исторических повествований.
- География. Оценка знаний о территориях и политике.
Это поможет вам понять, как подходы к оценке обобщаются в разных предметных областях.
Ссылки
- Примеры кода. Эта практическая работа основана на примерах из документации по Vertex AI Evaluation.
- Основа набора данных: SQuAD 2.0 Question Answering Dataset
- Оптимизация RAG-поиска: тестирование, настройка, успех
Что вы узнаете
В этой практической работе вы научитесь выполнять следующие задачи:
- Подготовка наборов данных для оценки систем RAG.
- Реализуйте оценку без эталона, используя такие показатели, как обоснованность и релевантность.
- Примените оценку на основе эталона с мерами семантического сходства.
- Создавайте собственные критерии оценки с подробными рубриками.
- Интерпретировать и визуализировать результаты оценки, чтобы выбрать модель.
2. Настройка проекта
Аккаунт Google
Если у вас нет личного аккаунта Google, создайте его.
Используйте личный аккаунт вместо рабочего или учебного.
Войдите в консоль Google Cloud.
Войдите в консоль Google Cloud, используя личный аккаунт Google.
Включить оплату
Как активировать бонусы Google Cloud (необязательно)
Чтобы выполнить практическую работу, вам понадобится платежный аккаунт с положительным балансом. Чтобы начать, используйте бонусы из баннера в верхней части этой практической работы. Если вы уже подключены к платежному аккаунту, пропустите этот шаг.
Как настроить личный платежный аккаунт
Если вы настроили оплату с помощью бонусов Google Cloud, пропустите этот шаг.
Чтобы настроить личный платежный аккаунт, включите оплату в Cloud Console.
Примечания
- Выполнение этой лабораторной работы должно стоить менее 1 доллара США в ресурсах Cloud.
- Чтобы избежать дальнейших расходов, удалите ресурсы, следуя инструкциям в конце этой практической работы.
- Новые пользователи могут воспользоваться бесплатной пробной версией с бонусом в размере 300 долларов США.
Создайте проект (необязательно)
Если у вас нет проекта, который вы хотите использовать для этой лабораторной работы, создайте новый проект.
3. Что такое генерация с дополненной выборкой (RAG)?
RAG – это метод, используемый для повышения фактической точности и релевантности ответов больших языковых моделей (LLM). Она подключает LLM к внешней базе знаний, чтобы ответы основывались на конкретной проверяемой информации.
Процесс состоит из следующих этапов:
- Преобразование вопроса пользователя в числовое представление (эмбеддинг).
- Поиск в базе знаний документов с похожими эмбеддингами.
- Предоставление этих документов в качестве контекста для LLM вместе с исходным вопросом для генерации ответа.
Подробнее RAG…
Почему оценивать RAG сложно?
Оценка систем RAG отличается от оценки традиционных языковых моделей.
Проблема многокомпонентности. Системы RAG объединяют три операции, каждая из которых может быть точкой отказа:
- Качество извлечения. Нашла ли система нужные контекстные документы?
- Использование контекста. Эффективно ли модель использовала полученную информацию?
- Качество генерации. Насколько хорошо написан, полезен и точен итоговый ответ?
Если какой-либо из этих компонентов не работает должным образом, ответ может не поступить. Например, система может получить правильный контекст, но модель его проигнорирует. Или же модель может сгенерировать хорошо написанный ответ, который будет неверным, поскольку извлеченный контекст не имел отношения к делу.
4. Как настроить среду Vertex AI Workbench
Давайте начнем с создания новой среды блокнота, в которой мы будем запускать код, необходимый для оценки систем RAG.
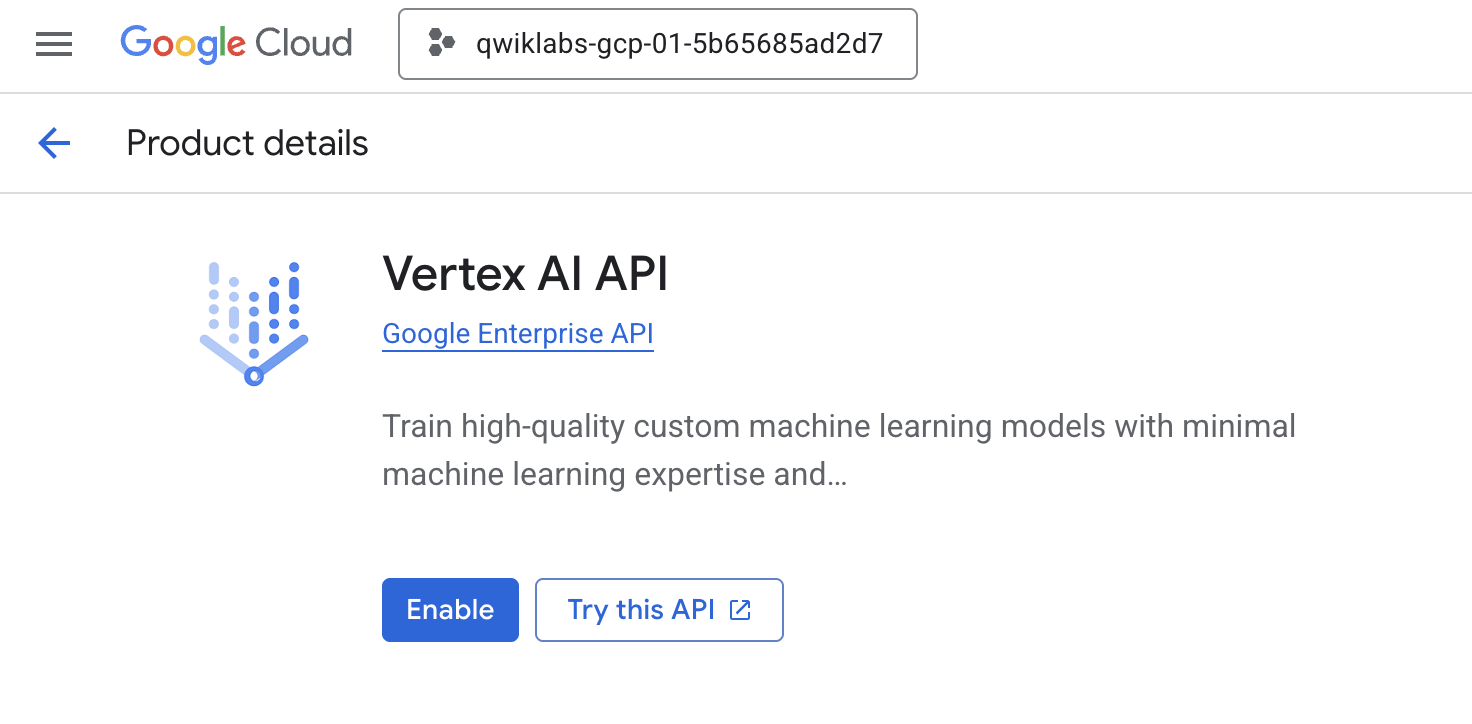
- Перейдите на страницу APIs & Services (API и сервисы) в Cloud Console.
- Нажмите Enable (Включить) для Vertex AI API.
Доступ к Vertex AI Workbench
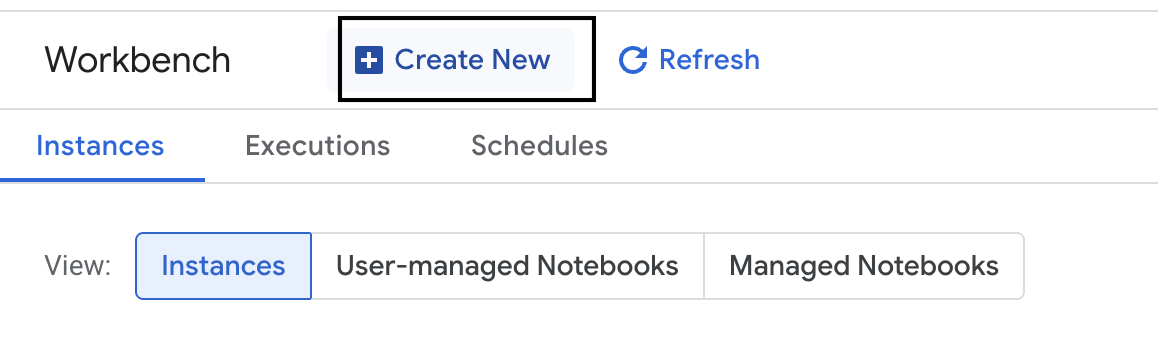
- В Google Cloud Console перейдите в Vertex AI, нажав Меню навигации ☰ > Vertex AI > Workbench.
- Создайте экземпляр рабочей области.
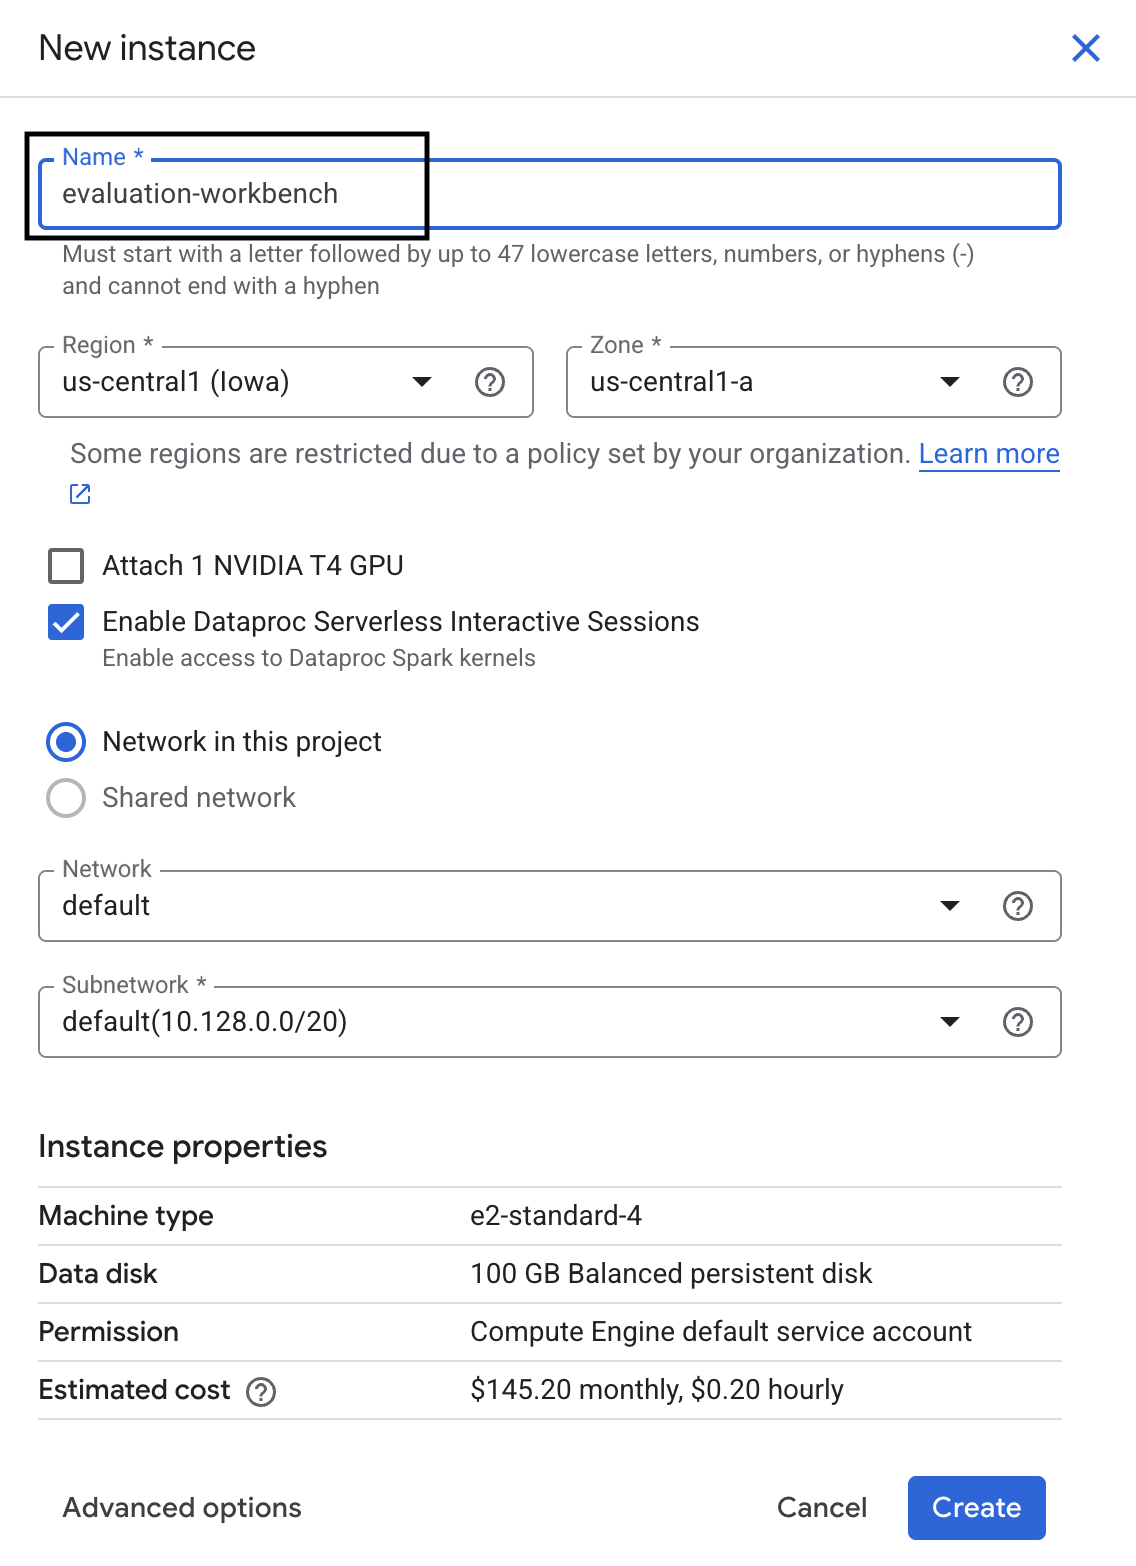
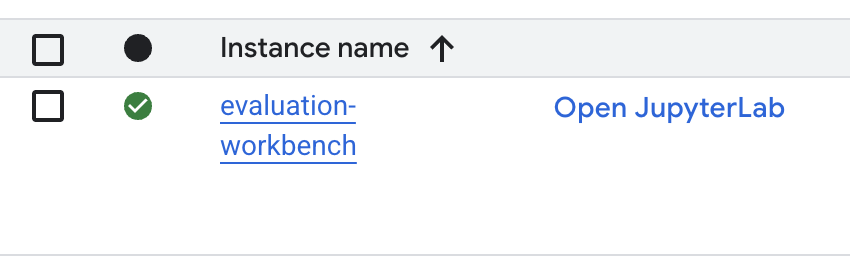
- Укажите название экземпляра рабочей среды:
evaluation-workbench. - Выберите регион и зону, если они ещё не заданы.
- Нажмите Создать.
- Дождитесь завершения настройки рабочей среды. Это может занять несколько минут.
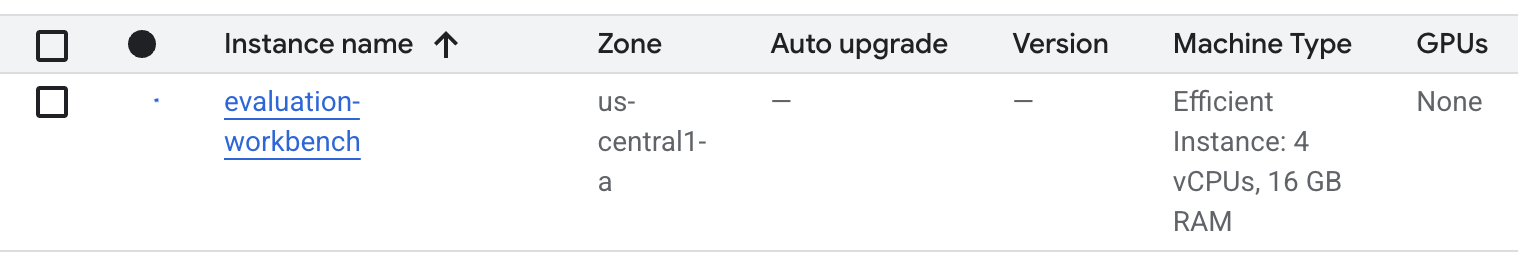
- После инициализации рабочей среды нажмите Open JupyterLab (Открыть JupyterLab).
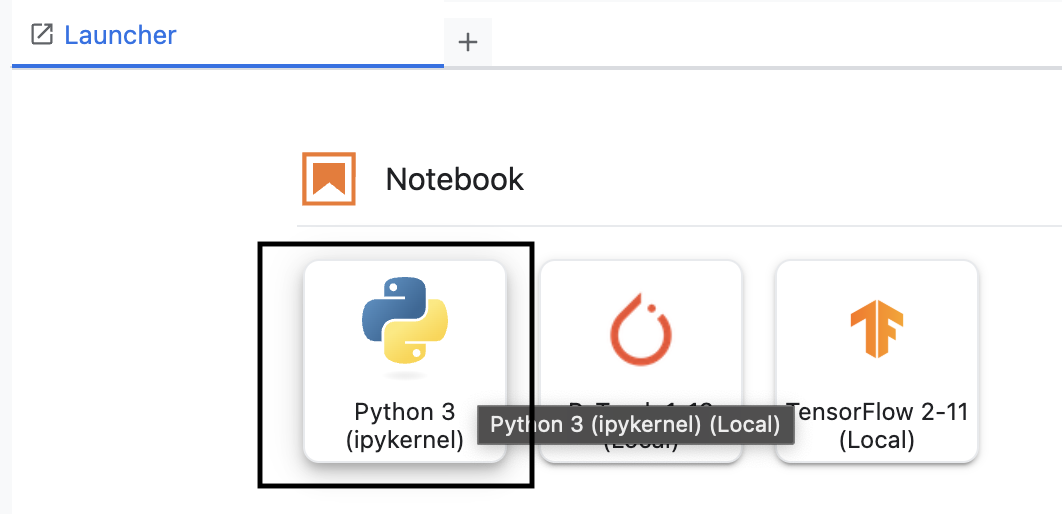
- В рабочей области создайте новый блокнот Python3.
Чтобы узнать больше о функциях и возможностях этой среды, ознакомьтесь с официальной документацией по Vertex AI Workbench.
Установите Vertex AI Evaluation SDK
Теперь давайте установим специализированный SDK для оценки, который предоставляет инструменты для оценки RAG.
- В первой ячейке блокнота добавьте и запустите приведенную ниже инструкцию импорта (SHIFT + ENTER), чтобы установить Vertex AI SDK (с компонентами оценки).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask – основной класс для выполнения оценок.
- MetricPromptTemplateExamples: предопределенные показатели оценки.
- PointwiseMetric – фреймворк для создания пользовательских показателей.
- notebook_utils – инструменты визуализации для анализа результатов.
- Важно! После установки вам нужно будет перезапустить ядро, чтобы использовать новые пакеты. В строке меню в верхней части окна JupyterLab выберите Kernel (Ядро) > Restart Kernel (Перезапустить ядро).
5. Инициализируйте SDK и импортируйте библиотеки
Прежде чем создавать конвейер оценки, необходимо настроить среду. Для этого нужно настроить сведения о проекте, инициализировать Vertex AI SDK для подключения к Google Cloud и импортировать специализированные библиотеки Python, которые вы будете использовать для оценки.
- Определите переменные конфигурации для задания оценки. В новой ячейке добавьте и запустите следующий код, чтобы задать
PROJECT_ID,LOCATIONи названиеEXPERIMENTдля организации этого запуска.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Инициализируйте Vertex AI SDK. В новой ячейке добавьте и запустите следующий код.
vertexai.init(project=PROJECT_ID, location=LOCATION) - Импортируйте необходимые классы из SDK для оценки, выполнив следующий код в следующей ячейке:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas – для создания данных в DataFrames и управления ими.
- EvalTask – основной класс, который запускает задание оценки.
- MetricPromptTemplateExamples – предоставляет доступ к стандартным показателям оценки Google.
- PointwiseMetric – фреймворк для создания собственных показателей.
- notebook_utils – набор инструментов для визуализации результатов.
6. Подготовьте набор данных для оценки
Хорошо структурированный набор данных – основа любой надежной оценки. Для систем RAG в наборе данных должно быть два ключевых поля для каждого примера:
- Запрос. Это все входные данные, предоставленные языковой модели. Вы должны объединить вопрос пользователя с контекстом, полученным системой RAG (
prompt = User Question + Retrieved Context). Это важно, чтобы сервис оценки знал, какую информацию модель использовала для создания ответа. - response – окончательный ответ, сгенерированный моделью RAG.
Чтобы получить статистически надежные результаты, рекомендуется использовать набор данных, содержащий около 100 примеров. В этой лабораторной работе вы будете использовать небольшой набор данных, чтобы продемонстрировать процесс.
Давайте создадим наборы данных. Вы получите список вопросов и retrieved_contexts из системы RAG. Затем вы определите два набора ответов: один из модели, которая, по-видимому, работает хорошо (generated_answers_by_rag_a), и один из модели, которая работает плохо (generated_answers_by_rag_b).
Наконец, вы объедините эти фрагменты в два фрейма данных pandas, eval_dataset_rag_a и eval_dataset_rag_b, в соответствии с описанной выше структурой.
- В новой ячейке добавьте и запустите следующий код, чтобы определить вопросы и два набора generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - Определите retrieved_contexts. Добавьте и запустите следующий код в новой ячейке.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - В новой ячейке добавьте и запустите следующий код, чтобы создать
eval_dataset_rag_aиeval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - Выполните следующий код в новой ячейке, чтобы просмотреть первые несколько строк набора данных для модели A.
eval_dataset_rag_a
7. Как выбрать и создать показатели
Теперь, когда наборы данных готовы, вы можете решить, как измерять эффективность. Для оценки модели можно использовать один или несколько показателей. Каждый показатель оценивает определенный аспект ответа модели, например фактическую точность или релевантность.
Вы можете использовать сочетание двух типов показателей:
- Стандартные показатели. Готовые показатели, предоставляемые SDK для стандартных задач оценки.
- Специальные показатели. Показатели, которые вы определяете для проверки качеств, соответствующих вашему варианту использования.
В этом разделе вы узнаете о стандартных показателях, доступных для RAG.
Как посмотреть стандартные показатели
SDK включает несколько встроенных показателей для оценки систем ответов на вопросы. В этих показателях языковая модель используется как "оценщик", который оценивает ответы вашей модели на основе набора инструкций.
- В новой ячейке добавьте и запустите следующий код, чтобы увидеть полный список названий стандартных показателей:
MetricPromptTemplateExamples.list_example_metric_names() - Чтобы понять, как работают эти показатели, вы можете изучить лежащие в их основе шаблоны запросов. В новой ячейке добавьте и запустите следующий код, чтобы посмотреть инструкции, которые получает оценивающая LLM для показателя
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. Создать специальный показатель
Помимо стандартных показателей, вы можете создавать специальные показатели для оценки критериев, относящихся к вашему варианту использования. Чтобы создать пользовательский показатель, напишите шаблон запроса, который будет указывать оценивающей LLM, как оценивать ответ.
Создание специального показателя состоит из двух этапов:
- Определите шаблон запроса. Строка, содержащая инструкции для оценивающей LLM. Хороший шаблон включает четкую роль, критерии оценки, рубрику оценивания и плейсхолдеры, такие как
{prompt}и{response}. - Создайте экземпляр объекта PointwiseMetric. Оберните строку шаблона запроса в этот класс и присвойте показателю название.
Вы создадите два пользовательских показателя, чтобы оценить релевантность и полезность ответов системы RAG.
- Определите шаблон запроса для показателя релевантности. Этот шаблон содержит подробную рубрику для LLM-оценщика. В новой ячейке добавьте и запустите следующий код:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Определите шаблон запроса для показателя полезности, используя тот же подход. Добавьте и запустите следующий код в новой ячейке:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Создайте экземпляры объектов
PointwiseMetricдля двух специальных показателей. Это позволяет упаковать шаблоны запросов в многократно используемые компоненты для задания оценки. Добавьте и запустите следующий код в новой ячейке:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
Теперь у вас есть два новых показателя (relevance и helpfulness), которые можно использовать в задаче оценки.
9. Запустите задание оценки
Теперь, когда наборы данных и показатели готовы, можно запустить оценку. Для этого нужно создать объект EvalTask для каждого набора данных, который вы хотите протестировать.
EvalTask объединяет компоненты для оценки:
- dataset – DataFrame, содержащий ваши запросы и ответы.
- metrics – список показателей, по которым вы хотите получить оценку.
- experiment – эксперимент Vertex AI, в который записываются результаты, чтобы вы могли отслеживать и сравнивать запуски.
- Создайте
EvalTaskдля каждой модели. Этот объект объединяет набор данных, показатели и название эксперимента. Добавьте и запустите следующий код в новой ячейке, чтобы настроить задачи:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask, по одному для каждого набора ответов модели. Предоставленный вами списокmetricsдемонстрирует ключевую функцию сервиса оценки: предопределенные показатели (например,safety) и пользовательские объектыPointwiseMetric. - После настройки задач выполните их, вызвав метод
.evaluate(). Задачи будут отправлены на обработку в серверную часть Vertex AI. Это может занять несколько минут. В новой ячейке добавьте и запустите следующий код:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
После завершения оценки результаты будут сохранены в объектах result_rag_a и result_rag_b, готовых к анализу в следующем разделе.
10. Проанализируйте результаты
Результаты оценки уже доступны. Объекты result_rag_a и result_rag_b содержат агрегированные оценки и подробные объяснения для каждой строки. В этом задании вы проанализируете эти результаты с помощью вспомогательных функций из notebook_utils.
Просмотр сводных данных
- Чтобы получить общие сведения, используйте вспомогательную функцию
display_eval_result(). Она позволяет посмотреть среднюю оценку по каждому показателю. В новой ячейке добавьте и запустите следующий код, чтобы посмотреть сводку для модели A:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - Повторите эти действия для модели Б. Добавьте и запустите этот код в новой ячейке:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
Как визуализировать результаты оценки
Графики могут упростить сравнение производительности модели. Вы будете использовать два типа визуализации:
- Лепестковая диаграмма. Показывает общую эффективность каждой модели. Чем больше фигура, тем выше общая эффективность.
- Линейчатая диаграмма. Позволяет напрямую сравнивать показатели.
Эти визуализации помогут вам сравнить модели по субъективным качествам, таким как релевантность, обоснованность и полезность.
- Чтобы подготовиться к построению графика, объедините результаты в один список кортежей. Каждый кортеж должен содержать название модели и соответствующий объект результата. В новой ячейке добавьте и запустите следующий код:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - Теперь создайте лепестковую диаграмму, чтобы сравнить модели по всем показателям сразу. Добавьте и запустите следующий код в новой ячейке:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - Чтобы сравнить показатели напрямую, создайте столбчатую диаграмму. В новой ячейке добавьте и запустите следующий код:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
Визуализации ясно покажут, что производительность модели А (большая фигура на лепестковой диаграмме и высокие столбцы на линейчатой диаграмме) превосходит производительность модели Б.
Как посмотреть подробное объяснение для отдельного экземпляра
Общие оценки показывают общую эффективность. Чтобы понять, почему модель показала определенный результат, необходимо изучить подробные объяснения, сгенерированные оценивающей LLM для каждого примера.
- Вспомогательная функция
display_explanations()позволяет проверять отдельные результаты. Чтобы посмотреть подробную разбивку для второго примера (num=2) из результатов модели A, добавьте и запустите следующий код в новой ячейке:notebook_utils.display_explanations(result_rag_a, num=2) - Вы также можете использовать эту функцию, чтобы отфильтровать определенный показатель по всем примерам. Это полезно для отладки конкретной области с низкой производительностью. Чтобы узнать, почему модель B показала такой низкий результат по показателю
groundedness, добавьте и запустите этот код в новой ячейке:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. Оценка на основе эталонного ответа
Ранее вы выполняли оценку без эталона, когда ответ модели оценивался только на основе запроса. Этот метод полезен, но оценка субъективна.
Теперь вы будете использовать сравнительную оценку. Этот метод добавляет в набор данных "золотой ответ" (также называемый эталонным ответом). Сравнение ответа модели с фундаментальной истиной позволяет более объективно оценить эффективность. Это позволяет отслеживать:
- Фактическая точность. Соответствует ли ответ модели фактам в образцовом ответе?
- Смысловое сходство. Совпадает ли смысл ответа модели с эталонным ответом?
- Полнота. Содержит ли ответ модели всю ключевую информацию из образцового ответа?
Подготовка набора данных
Чтобы выполнить оценку со ссылкой, вам нужно добавить "золотой ответ" к каждому примеру в наборе данных.
Для начала определим, что такое список golden_answers. Сравнение золотых ответов с ответами модели А показывает ценность этого метода:
- Вопрос 1 (Brain): сгенерированный ответ и эталонный ответ идентичны. Модель А правильная.
- Вопрос 2 (Сенат): ответы похожи по смыслу, но сформулированы по-разному. Хороший показатель должен это учитывать.
- Вопрос 3 (Хасан-Джалаляны). Ответ модели А фактически неверен в соответствии с контекстом.
golden_answerвыявляет эту ошибку.
- В новой ячейке определите список golden_answers.
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - Создайте указанные фреймы данных оценки, выполнив этот код в следующей ячейке:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
Наборы данных готовы к оценке с использованием эталона.
Как создать специальный показатель со ссылкой
Вы также можете создавать пользовательские показатели для оценки с эталоном. Процесс похож, но теперь шаблон запроса включает плейсхолдер {reference} для идеального ответа.
Если у вас есть определенный "правильный" ответ, вы можете использовать более строгую бинарную оценку (например, 1 за правильный ответ, 0 за неправильный), чтобы измерить фактическую точность. Давайте создадим новый показатель question_answering_correctness, который реализует эту логику.
- Определите шаблон запроса. В новой ячейке добавьте и запустите следующий код:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - Оберните строку шаблона запроса в объект PointwiseMetric. Это дает вашему показателю формальное имя и делает его многократно используемым компонентом для задания оценки. Добавьте и запустите следующий код в новой ячейке:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
Теперь у вас есть специальный показатель со ссылкой на источник, который можно использовать для строгой проверки фактов.
12. Запустите оценку по ссылке
Теперь вы настроите задание оценки с указанными наборами данных и новым показателем. Вы снова будете использовать класс EvalTask.
В списке показателей теперь будут как показатели на основе моделей, так и расчетные показатели. Оценка на основе эталона позволяет использовать традиционные вычислительные показатели, которые выполняют математическое сравнение сгенерированного и эталонного текста. Вы будете использовать три распространенных:
exact_match: 1, если сгенерированный ответ идентичен эталонному, и 0 в противном случае.bleu– показатель точности. Она показывает, сколько слов из сгенерированного ответа также есть в эталонном.rouge– показатель полноты. Она показывает, сколько слов из эталонного ответа есть в сгенерированном.
- Настройте задание оценки с указанными наборами данных и новым набором показателей. В новой ячейке добавьте и запустите следующий код, чтобы создать объекты
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - Выполните оценку, вызвав метод
.evaluate(). Добавьте и запустите этот код в новой ячейке:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. Проанализируйте результаты
Проверка завершена. В этом задании вы проанализируете результаты, чтобы оценить фактическую точность моделей, сравнив их ответы с золотыми эталонными ответами.
Как посмотреть сводные результаты
- Проанализируйте сводные результаты оценки. В новой ячейке добавьте и запустите следующий код, чтобы отобразить сводные таблицы для обеих моделей:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctness, но получает более низкую оценку по показателюexact_match. Это подчеркивает ценность показателей на основе моделей, которые могут распознавать семантическое сходство, а не только идентичный текст.
Визуализация результатов для сравнения
Визуализация может сделать разницу в производительности между двумя моделями более очевидной. Сначала объедините результаты в один список для построения графика, а затем сгенерируйте лепестковую и столбчатую диаграммы.
- Объедините результаты оценки в один список для построения графика. Добавьте и запустите следующий код в новой ячейке:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - Создайте лепестковую диаграмму, чтобы визуализировать производительность каждой модели по новому набору показателей. Добавьте и запустите этот код в новой ячейке:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - Создайте столбчатую диаграмму для прямого параллельного сравнения. Вы увидите, как каждая модель показала себя по разным показателям. Добавьте и запустите следующий код в новой ячейке:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
Эти визуализации подтверждают, что модель A значительно точнее и фактически лучше соответствует эталонным ответам, чем модель B.
14. От практики к производству
Вы успешно выполнили полный конвейер оценки для системы RAG. В этом заключительном разделе обобщаются основные стратегические концепции, которые вы изучили, и предлагается структура для применения этих навыков в реальных проектах.
Рекомендации по созданию контента
Чтобы применить навыки, полученные в этой практической работе, в реальной рабочей среде, следуйте четырем основным рекомендациям:
- Автоматизируйте оценку с помощью CI/CD. Интегрируйте набор тестов в конвейер CI/CD (например, Cloud Build или GitHub Actions). Автоматически запускайте оценки при изменении кода, чтобы выявлять регрессии и блокировать развертывание, если показатели качества падают ниже ваших стандартов.
- Развивайте наборы данных. Статические наборы данных устаревают. Управляйте версиями своих "золотых" наборов тестов (с помощью Git LFS или Cloud Storage) и постоянно добавляйте новые сложные примеры, выбирая их из реальных (анонимизированных) запросов пользователей.
- Оценивайте не только генератор, но и поисковик. Без правильного контекста невозможно получить хороший ответ. Реализуйте отдельный этап оценки для системы поиска, используя такие показатели, как частота совпадений (был ли найден нужный документ?) и средний обратный ранг (MRR) (насколько высоко был оценен нужный документ?).
- Отслеживайте показатели с течением времени. Экспортируйте сводные оценки из запусков оценки в такой сервис, как Google Cloud Monitoring. Создавайте сводки, чтобы отслеживать тенденции качества, и настраивайте автоматические оповещения о значительном снижении производительности.
Матрица методологии расширенной оценки
Выбор подхода к оценке зависит от ваших целей. В таблице ниже указано, когда следует использовать каждый из методов.
Подход к оценке | Примеры использования | Основные преимущества | Ограничения |
Без референса | Мониторинг производства, непрерывная оценка | Не нужны золотые ответы, отражает субъективное качество | Более высокая стоимость, возможная предвзятость оценщиков |
На основе референса | Сравнение моделей, сравнительный анализ | Объективные измерения и быстрые вычисления | Требуются эталонные ответы, может не учитываться семантическая эквивалентность |
Специальные показатели | Оценка по доменам | Адаптация к потребностям бизнеса | Требуется проверка, дополнительные затраты на разработку |
Гибридный подход | Комплексные производственные системы | Лучший из всех подходов | Высокая сложность, требуется оптимизация затрат |
Ключевые технические данные
При создании и оценке собственных систем RAG помните о следующих основных принципах:
- Обоснованность критически важна для RAG. Эта метрика позволяет стабильно различать системы RAG высокого и низкого качества, что делает ее необходимой для мониторинга в рабочей среде.
- Несколько показателей обеспечивают надежность. Ни один показатель не отражает все аспекты качества RAG. Комплексная оценка требует нескольких параметров оценки.
- Специальные показатели добавляют значительную ценность. Критерии оценки, специфичные для предметной области, часто улавливают нюансы, которые упускают общие показатели, что повышает точность оценки.
- Статистическая строгость обеспечивает уверенность. Правильный размер выборки и проверка значимости превращают оценку из догадок в надежный инструмент принятия решений.
Принятие решений о рабочем развертывании
Используйте эту поэтапную схему в качестве руководства для будущих развертываний систем RAG:
- Этап 1. Разработка. Используйте оценку на основе эталонов с известными тестовыми наборами для сравнения и выбора моделей.
- Этап 2. Подготовка к запуску. Проведите комплексную оценку, сочетающую оба подхода, чтобы проверить готовность к запуску.
- Этап 3. Производство. Внедрите мониторинг без эталонов для непрерывной оценки качества без золотых ответов.
- Этап 4. Оптимизация. Используйте результаты оценки, чтобы улучшить модель и систему поиска.
15. Заключение
Поздравляем! Вы завершили практическую работу.
Эта лабораторная работа входит в учебный план "Production-Ready AI with Google Cloud".
- Изучите полную программу курса, чтобы перейти от прототипа к производству.
- Поделитесь своими успехами, используя хештег
ProductionReadyAI.
Recap
Вы узнали:
- Выполните оценку без эталона, чтобы оценить качество ответа на основе извлеченного контекста.
- Выполните оценку с эталоном, добавив "золотой ответ", чтобы измерить фактическую правильность.
- Использовать сочетание стандартных и специальных показателей для обоих подходов
- Используйте как показатели на основе моделей (например,
question_answering_quality), так и показатели на основе вычислений (rouge,bleu,exact_match). - Анализируйте и визуализируйте результаты, чтобы понять сильные и слабые стороны модели.
Такой подход к оценке помогает создавать более надежные и точные приложения на основе генеративного ИИ.