

1. ภาพรวม
ในห้องปฏิบัติการนี้ คุณจะได้เรียนรู้วิธีสร้างไปป์ไลน์การประเมินสำหรับระบบ Retrieval-Augmented Generation (RAG) คุณจะใช้บริการประเมิน Gen AI ของ Vertex AI เพื่อสร้างเกณฑ์การประเมินที่กำหนดเองและสร้างเฟรมเวิร์กการประเมินสำหรับงานการตอบคำถาม
คุณจะได้ทำงานกับตัวอย่างจาก Stanford Question Answering Dataset (SQuAD 2.0) เพื่อเตรียมชุดข้อมูลการประเมิน กำหนดค่าการประเมินแบบไม่มีข้อมูลอ้างอิงและแบบอิงตามข้อมูลอ้างอิง รวมถึงตีความผลลัพธ์ เมื่อจบห้องทดลองนี้ คุณจะเข้าใจวิธีประเมินระบบ RAG และเหตุผลที่เลือกแนวทางการประเมินบางอย่าง
รากฐานของชุดข้อมูล
เราจะใช้ตัวอย่างที่สร้างขึ้นอย่างพิถีพิถันซึ่งครอบคลุมหลายโดเมนที่พบในชุดข้อมูลการตอบคำถาม SQuAD 2.0
- ประสาทวิทยาศาสตร์: การทดสอบความถูกต้องทางเทคนิคในบริบททางวิทยาศาสตร์
- ประวัติศาสตร์: การประเมินความถูกต้องของข้อเท็จจริงในการเล่าเรื่องราวทางประวัติศาสตร์
- ภูมิศาสตร์: การประเมินความรู้ด้านอาณาเขตและการเมือง
ความหลากหลายนี้ช่วยให้คุณเข้าใจว่าแนวทางการประเมินสามารถนำไปใช้กับสาขาวิชาต่างๆ ได้อย่างไร
ข้อมูลอ้างอิง
- ตัวอย่างโค้ด: ห้องทดลองนี้สร้างขึ้นจากตัวอย่างในเอกสารประกอบการประเมิน Vertex AI
- ชุดข้อมูลพื้นฐาน: ชุดข้อมูลการตอบคำถาม SQuAD 2.0
- การเพิ่มประสิทธิภาพการดึงข้อมูล RAG: ทดสอบ ปรับแต่ง และประสบความสำเร็จ
สิ่งที่คุณจะได้เรียนรู้
ในห้องทดลองนี้ คุณจะได้เรียนรู้วิธีทำงานต่อไปนี้
- เตรียมชุดข้อมูลการประเมินสำหรับระบบ RAG
- ใช้การประเมินแบบไม่มีข้อมูลอ้างอิงโดยใช้เมตริกต่างๆ เช่น ความสมเหตุสมผลและความเกี่ยวข้อง
- ใช้การประเมินตามข้อมูลอ้างอิงด้วยการวัดความคล้ายคลึงกันทางความหมาย
- สร้างเมตริกการประเมินที่กำหนดเองพร้อมเกณฑ์การให้คะแนนโดยละเอียด
- ตีความและแสดงผลการประเมินเพื่อเป็นข้อมูลประกอบการเลือกโมเดล
2. การตั้งค่าโปรเจ็กต์
บัญชี Google
หากยังไม่มีบัญชี Google ส่วนบุคคล คุณต้องสร้างบัญชี Google
ใช้บัญชีส่วนตัวแทนบัญชีของที่ทำงานหรือโรงเรียน
ลงชื่อเข้าใช้คอนโซล Google Cloud
ลงชื่อเข้าใช้คอนโซล Google Cloud โดยใช้บัญชี Google ส่วนบุคคล
เปิดใช้การเรียกเก็บเงิน
แลกรับเครดิต Google Cloud (ไม่บังคับ)
หากต้องการจัดเวิร์กช็อปนี้ คุณต้องมีบัญชีสำหรับการเรียกเก็บเงินที่มีเครดิตอยู่บ้าง ใช้เครดิตจากแบนเนอร์ที่ด้านบนของ Codelab นี้เพื่อเริ่มต้นใช้งาน หากเชื่อมต่อกับบัญชีสำหรับการเรียกเก็บเงินอยู่แล้ว คุณสามารถข้ามขั้นตอนนี้ได้
ตั้งค่าบัญชีสำหรับการเรียกเก็บเงินส่วนบุคคล
หากตั้งค่าการเรียกเก็บเงินโดยใช้เครดิต Google Cloud คุณสามารถข้ามขั้นตอนนี้ได้
หากต้องการตั้งค่าบัญชีสำหรับการเรียกเก็บเงินส่วนบุคคล ให้ไปที่นี่เพื่อเปิดใช้การเรียกเก็บเงินใน Cloud Console
ข้อควรทราบ
- การทำ Lab นี้ให้เสร็จสมบูรณ์ควรใช้ทรัพยากร Cloud ไม่เกิน $1 USD
- คุณสามารถทำตามขั้นตอนที่ตอนท้ายของห้องทดลองนี้เพื่อลบทรัพยากรเพื่อหลีกเลี่ยงการเรียกเก็บเงินเพิ่มเติม
- ผู้ใช้ใหม่มีสิทธิ์รับช่วงทดลองใช้ฟรีมูลค่า $300 USD
สร้างโปรเจ็กต์ (ไม่บังคับ)
หากไม่มีโปรเจ็กต์ปัจจุบันที่ต้องการใช้สำหรับห้องทดลองนี้ ให้สร้างโปรเจ็กต์ใหม่ที่นี่
3. Retrieval Augmented Generation (RAG) คืออะไร
RAG เป็นเทคนิคที่ใช้เพื่อปรับปรุงความถูกต้องของข้อเท็จจริงและความเกี่ยวข้องของคำตอบจากโมเดลภาษาขนาดใหญ่ (LLM) โดยจะเชื่อมต่อ LLM กับฐานความรู้ภายนอกเพื่ออิงคำตอบตามข้อมูลที่เฉพาะเจาะจงและตรวจสอบได้
กระบวนการนี้ประกอบด้วยขั้นตอนต่อไปนี้
- การแปลงคำถามของผู้ใช้เป็นการแสดงตัวเลข (การฝัง)
- กำลังค้นหาเอกสารที่มีการฝังที่คล้ายกันในฐานความรู้
- การให้เอกสารที่เกี่ยวข้องเหล่านี้เป็นบริบทแก่ LLM พร้อมกับคำถามเดิมเพื่อสร้างคำตอบ
อ่านเพิ่มเติมเกี่ยวกับ RAG
อะไรทำให้การประเมิน RAG มีความซับซ้อน
การประเมินระบบ RAG แตกต่างจากการประเมินโมเดลภาษาแบบดั้งเดิม
ความท้าทายของระบบที่มีหลายองค์ประกอบ: ระบบ RAG รวมการทำงาน 3 อย่างเข้าด้วยกัน ซึ่งแต่ละอย่างอาจเป็นจุดที่เกิดข้อผิดพลาดได้
- คุณภาพการดึงข้อมูล: ระบบค้นหาเอกสารบริบทที่ถูกต้องหรือไม่
- การใช้ประโยชน์จากบริบท: โมเดลใช้ข้อมูลที่ดึงมาอย่างมีประสิทธิภาพหรือไม่
- คุณภาพการสร้าง: คำตอบสุดท้ายเขียนได้ดี มีประโยชน์ และถูกต้องไหม
การตอบกลับอาจล้มเหลวหากองค์ประกอบเหล่านี้ไม่ทำงานตามที่คาดไว้ ตัวอย่างเช่น ระบบอาจดึงข้อมูลบริบทที่ถูกต้อง แต่โมเดลไม่สนใจข้อมูลดังกล่าว หรือโมเดลอาจสร้างคำตอบที่เขียนได้ดีแต่ไม่ถูกต้องเนื่องจากบริบทที่ดึงมาไม่เกี่ยวข้อง
4. ตั้งค่าสภาพแวดล้อม Vertex AI Workbench
มาเริ่มด้วยการสร้างสภาพแวดล้อม Notebook ใหม่ที่เราจะเรียกใช้โค้ดที่จำเป็นในการประเมินระบบ RAG กัน
- ไปที่หน้า API และบริการของ Cloud Console
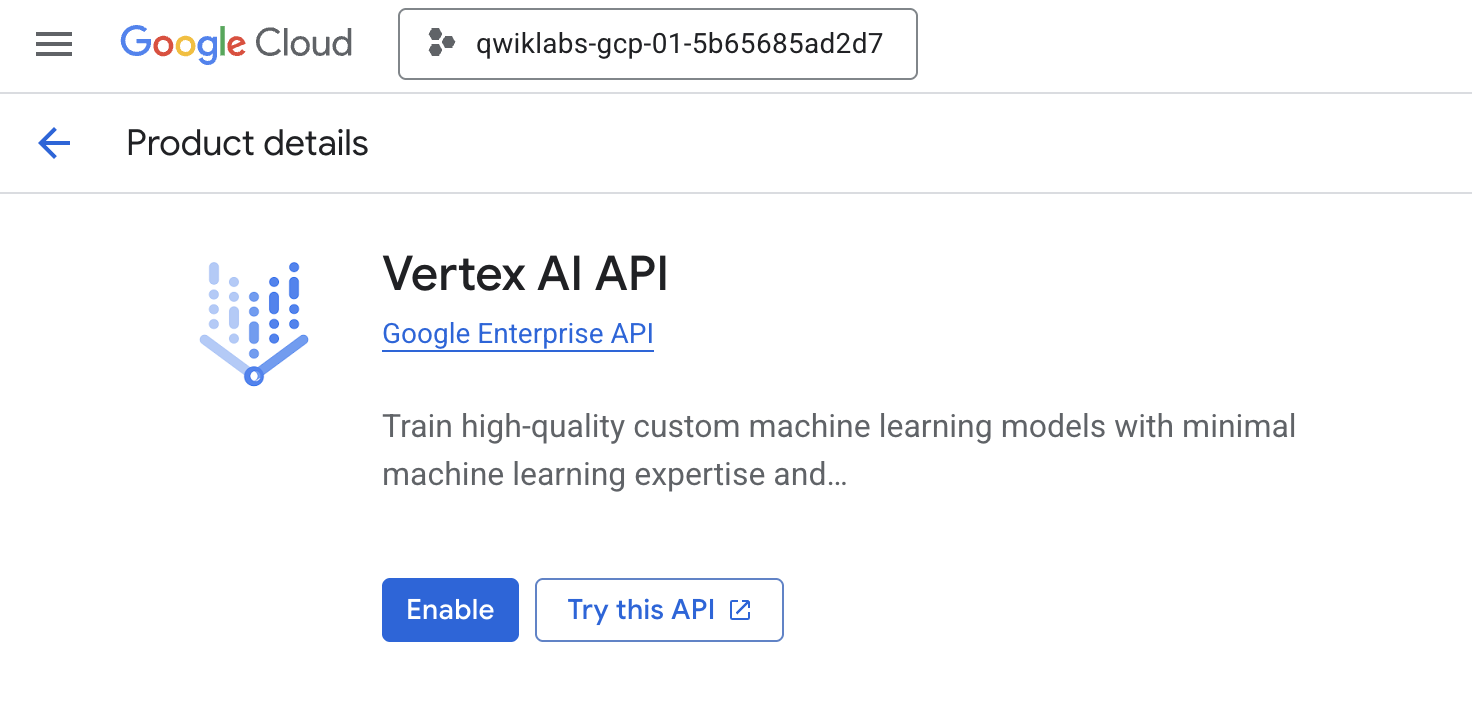
- คลิกเปิดใช้สำหรับ Vertex AI API
เข้าถึง Vertex AI Workbench
- ในคอนโซล Google Cloud ให้ไปที่ Vertex AI โดยคลิกเมนูการนำทาง ☰ > Vertex AI > Workbench
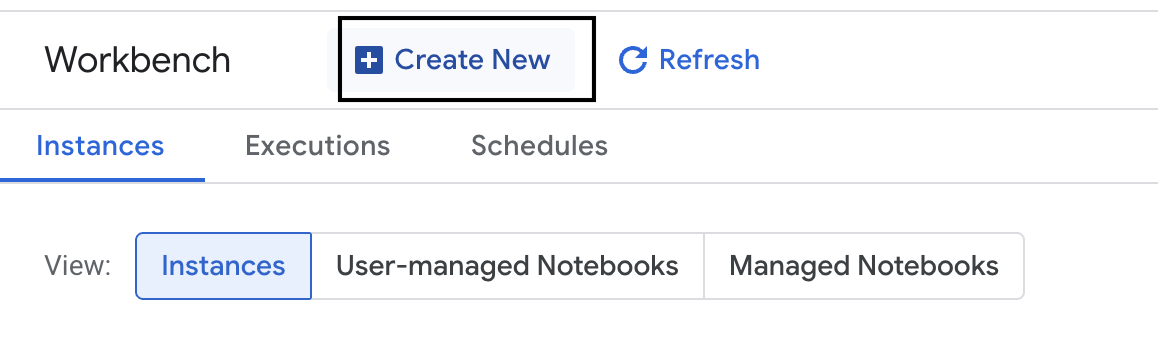
- สร้างอินสแตนซ์ Workbench ใหม่
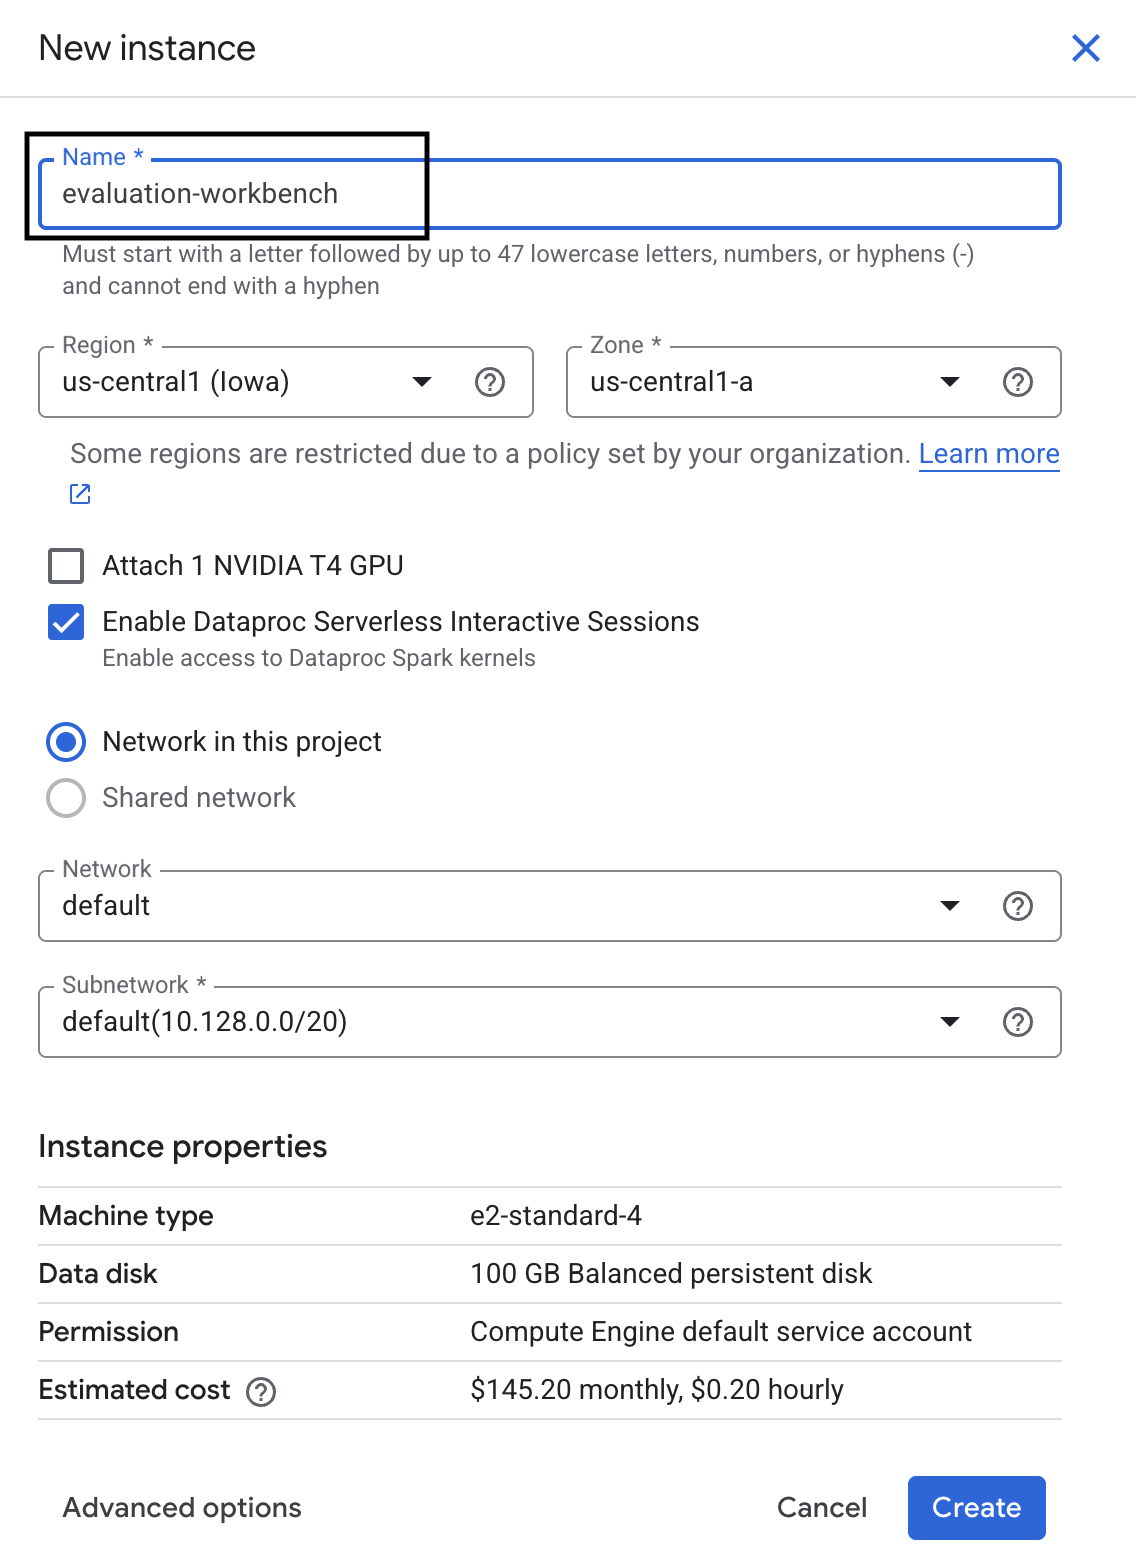
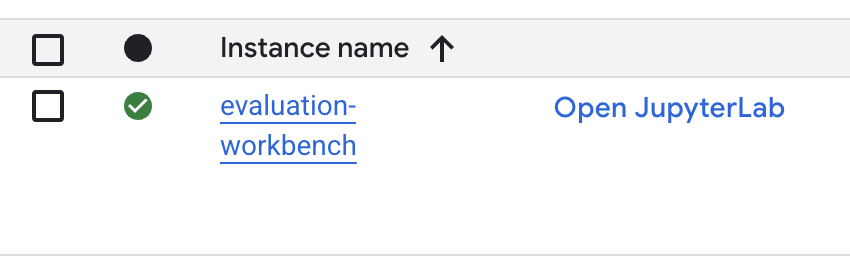
- ตั้งชื่ออินสแตนซ์ Workbench เป็น
evaluation-workbench - เลือกภูมิภาคและโซนหากยังไม่ได้ตั้งค่าไว้
- คลิกสร้าง
- รอให้ระบบตั้งค่า Workbench การดำเนินการนี้อาจใช้เวลาสักครู่
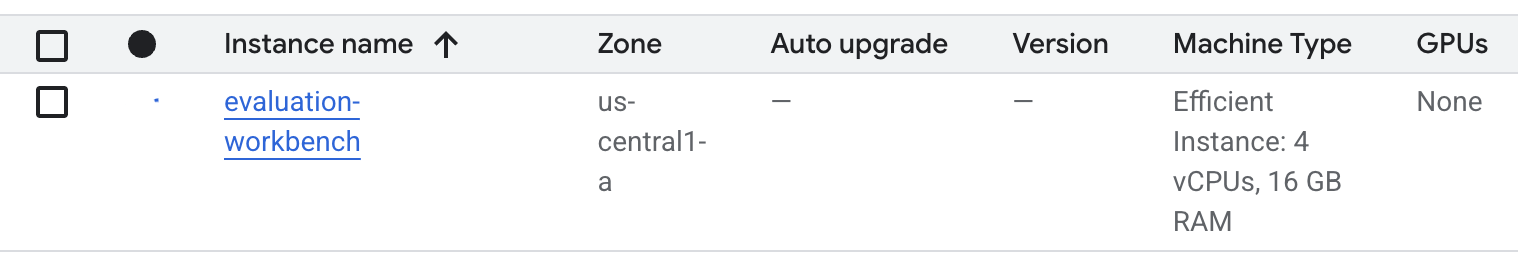
- เมื่อจัดสรร Workbench แล้ว ให้คลิกเปิด jupyterlab
- ใน Workbench ให้สร้าง Notebook Python3 ใหม่
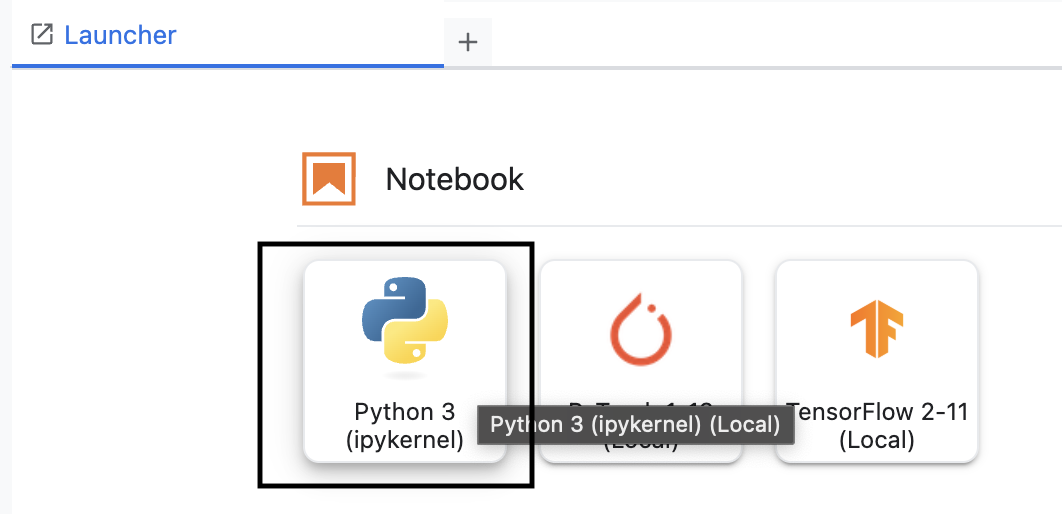
ดูข้อมูลเพิ่มเติมเกี่ยวกับฟีเจอร์และความสามารถของสภาพแวดล้อมนี้ได้ในเอกสารประกอบอย่างเป็นทางการของ Vertex AI Workbench
ติดตั้ง SDK การประเมิน Vertex AI
ตอนนี้เรามาติดตั้ง SDK การประเมินเฉพาะทางที่มีเครื่องมือสำหรับการประเมิน RAG กัน
- ในเซลล์แรกของ Notebook ให้เพิ่มและเรียกใช้คำสั่งนำเข้าด้านล่าง (SHIFT+ENTER) เพื่อติดตั้ง Vertex AI SDK (พร้อมคอมโพเนนต์การประเมิน)
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: คลาสหลักสำหรับการเรียกใช้การประเมิน
- MetricPromptTemplateExamples: เมตริกการประเมินที่กำหนดไว้ล่วงหน้า
- PointwiseMetric: เฟรมเวิร์กสำหรับการสร้างเมตริกที่กำหนดเอง
- notebook_utils: เครื่องมือแสดงภาพสำหรับการวิเคราะห์ผลลัพธ์
- สำคัญ: หลังจากติดตั้งแล้ว คุณจะต้องรีสตาร์ทเคอร์เนลเพื่อใช้แพ็กเกจใหม่ ในแถบเมนูที่ด้านบนของหน้าต่าง JupyterLab ให้ไปที่ Kernel > Restart Kernel
5. เริ่มต้น SDK และนำเข้าไลบรารี
คุณต้องตั้งค่าสภาพแวดล้อมก่อนจึงจะสร้างไปป์ไลน์การประเมินได้ ซึ่งรวมถึงการกำหนดค่ารายละเอียดโปรเจ็กต์ การเริ่มต้น Vertex AI SDK เพื่อเชื่อมต่อกับ Google Cloud และการนำเข้าไลบรารี Python เฉพาะทางที่คุณจะใช้สำหรับการประเมิน
- กำหนดตัวแปรการกำหนดค่าสำหรับงานประเมิน ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อตั้งค่า
PROJECT_ID,LOCATIONและชื่อEXPERIMENTเพื่อจัดระเบียบการเรียกใช้นี้import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - เริ่มต้น Vertex AI SDK เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
vertexai.init(project=PROJECT_ID, location=LOCATION) - นำเข้าคลาสที่จำเป็นจาก SDK การประเมินโดยเรียกใช้โค้ดต่อไปนี้ในเซลล์ถัดไป
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: สำหรับการสร้างและจัดการข้อมูลใน DataFrame
- EvalTask: คลาสหลักที่เรียกใช้งานการประเมิน
- MetricPromptTemplateExamples: ให้สิทธิ์เข้าถึงเมตริกการประเมินที่กำหนดไว้ล่วงหน้าของ Google
- PointwiseMetric: เฟรมเวิร์กสําหรับสร้างเมตริกที่กําหนดเอง
- notebook_utils: ชุดเครื่องมือสำหรับการแสดงผลลัพธ์เป็นภาพ
6. เตรียมชุดข้อมูลการประเมิน
ชุดข้อมูลที่มีโครงสร้างที่ดีเป็นรากฐานของการประเมินที่เชื่อถือได้ สำหรับระบบ RAG ชุดข้อมูลของคุณต้องมีช่องสำคัญ 2 ช่องสำหรับแต่ละตัวอย่าง ดังนี้
- พรอมต์: ข้อมูลทั้งหมดที่ป้อนให้กับโมเดลภาษา คุณต้องรวมคำถามของผู้ใช้เข้ากับบริบทที่ระบบ RAG ดึงมา (
prompt = User Question + Retrieved Context) ซึ่งเป็นสิ่งสำคัญเพื่อให้บริการประเมินทราบว่าโมเดลใช้ข้อมูลใดในการสร้างคำตอบ - response: คำตอบสุดท้ายที่โมเดล RAG สร้างขึ้น
เราขอแนะนำให้ใช้ชุดข้อมูลที่มีตัวอย่างประมาณ 100 รายการเพื่อให้ได้ผลลัพธ์ที่เชื่อถือได้ทางสถิติ สำหรับห้องปฏิบัติการนี้ คุณจะใช้ชุดข้อมูลขนาดเล็กเพื่อสาธิตกระบวนการ
มาสร้างชุดข้อมูลกันเลย คุณจะเริ่มต้นด้วยรายการคำถามและ retrieved_contexts จากระบบ RAG จากนั้นคุณจะกำหนดคำตอบ 2 ชุด ได้แก่ คำตอบจากโมเดลที่ดูเหมือนจะทำงานได้ดี (generated_answers_by_rag_a) และคำตอบจากโมเดลที่ทำงานได้ไม่ดี (generated_answers_by_rag_b)
สุดท้าย คุณจะรวมข้อมูลเหล่านี้เป็น DataFrame ของ pandas 2 รายการ ได้แก่ eval_dataset_rag_a และ eval_dataset_rag_b ตามโครงสร้างที่อธิบายไว้ข้างต้น
- ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อกำหนดคำถามและ generated_answers 2 ชุด
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - กำหนด retrieved_contexts เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อสร้าง
eval_dataset_rag_aและeval_dataset_rag_beval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - เรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่เพื่อดูแถวแรกๆ ของชุดข้อมูลสำหรับโมเดล A
eval_dataset_rag_a
7. เลือกและสร้างเมตริก
เมื่อชุดข้อมูลพร้อมแล้ว คุณสามารถเลือกวิธีวัดประสิทธิภาพได้ คุณใช้เมตริกอย่างน้อย 1 รายการเพื่อประเมินโมเดลได้ เมตริกแต่ละรายการจะตัดสินแง่มุมที่เฉพาะเจาะจงของคำตอบจากโมเดล เช่น ความถูกต้องตามข้อเท็จจริงหรือความเกี่ยวข้อง
คุณสามารถใช้เมตริก 2 ประเภทต่อไปนี้ร่วมกันได้
- เมตริกที่กำหนดไว้ล่วงหน้า: เมตริกที่พร้อมใช้งานซึ่ง SDK มีให้สำหรับงานประเมินทั่วไป
- เมตริกที่กำหนดเอง: เมตริกที่คุณกำหนดเพื่อทดสอบคุณภาพที่เกี่ยวข้องกับ Use Case ของคุณ
ในส่วนนี้ คุณจะได้สำรวจเมตริกที่กำหนดไว้ล่วงหน้าซึ่งใช้ได้กับ RAG
สำรวจเมตริกที่กำหนดไว้ล่วงหน้า
SDK มีเมตริกในตัวหลายรายการสำหรับการประเมินระบบการตอบคำถาม เมตริกเหล่านี้ใช้โมเดลภาษาเป็น "ผู้ประเมิน" เพื่อให้คะแนนคำตอบของโมเดลตามชุดคำสั่ง
- ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อดูรายการชื่อเมตริกที่กำหนดไว้ล่วงหน้าทั้งหมด
MetricPromptTemplateExamples.list_example_metric_names() - หากต้องการทำความเข้าใจวิธีการทำงานของเมตริกเหล่านี้ คุณสามารถตรวจสอบเทมเพลตพรอมต์ที่เกี่ยวข้องได้ ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อดูวิธีการที่ให้ไว้กับ LLM ของผู้ประเมินสำหรับเมตริก
question_answering_quality# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. สร้างเมตริกที่กำหนดเอง
นอกจากเมตริกที่กำหนดไว้ล่วงหน้าแล้ว คุณยังสร้างเมตริกที่กำหนดเองเพื่อประเมินเกณฑ์เฉพาะสำหรับ Use Case ของคุณได้ด้วย หากต้องการสร้างเมตริกที่กำหนดเอง คุณต้องเขียนเทมเพลตพรอมต์ที่บอก LLM ของผู้ประเมินว่าจะให้คะแนนคำตอบอย่างไร
การสร้างเมตริกที่กำหนดเองมี 2 ขั้นตอนดังนี้
- กำหนดเทมเพลตพรอมต์: สตริงที่มีวิธีการสำหรับ LLM ของผู้ประเมิน เทมเพลตที่ดีควรมีบทบาทที่ชัดเจน เกณฑ์การประเมิน เกณฑ์การให้คะแนน และตัวยึดตำแหน่ง เช่น
{prompt}และ{response} - สร้างอินสแตนซ์ออบเจ็กต์ PointwiseMetric: คุณรวมสตริงเทมเพลตพรอมต์ไว้ในคลาสนี้และตั้งชื่อเมตริก
คุณจะสร้างเมตริกที่กำหนดเอง 2 รายการเพื่อประเมินความเกี่ยวข้องและความเป็นประโยชน์ของคำตอบจากระบบ RAG
- กำหนดเทมเพลตพรอมต์สำหรับเมตริกความเกี่ยวข้อง เทมเพลตนี้มีเกณฑ์การให้คะแนนโดยละเอียดสำหรับ LLM ของผู้ประเมิน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - กำหนดเทมเพลตพรอมต์สำหรับเมตริกประโยชน์โดยใช้แนวทางเดียวกัน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - สร้างอินสแตนซ์ออบเจ็กต์
PointwiseMetricสำหรับเมตริกที่กำหนดเอง 2 รายการ ซึ่งจะรวมเทมเพลตพรอมต์ไว้ในคอมโพเนนต์ที่นำกลับมาใช้ใหม่ได้สำหรับงานประเมิน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
ตอนนี้คุณมีเมตริกใหม่ที่นำกลับมาใช้ซ้ำได้ 2 รายการ (relevance และ helpfulness) ซึ่งพร้อมสำหรับงานประเมินแล้ว
9. เรียกใช้งานการประเมิน
เมื่อชุดข้อมูลและเมตริกพร้อมแล้ว คุณก็เรียกใช้การประเมินได้ โดยคุณจะทำได้ด้วยการสร้างออบเจ็กต์ EvalTask สำหรับชุดข้อมูลแต่ละชุดที่ต้องการทดสอบ
EvalTask จะรวมคอมโพเนนต์สำหรับการเรียกใช้การประเมิน ดังนี้
- dataset: DataFrame ที่มีพรอมต์และคำตอบของคุณ
- metrics: รายการเมตริกที่คุณต้องการให้คะแนน
- experiment: การทดสอบ Vertex AI ที่จะบันทึกผลลัพธ์ ซึ่งช่วยให้คุณติดตามและเปรียบเทียบการเรียกใช้ได้
- สร้าง
EvalTaskสำหรับแต่ละโมเดล ออบเจ็กต์นี้จะรวมชุดข้อมูล เมตริก และชื่อการทดสอบเข้าด้วยกัน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่เพื่อกำหนดค่างานrag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask2 รายการแล้ว โดยออบเจ็กต์แต่ละรายการจะใช้สำหรับคำตอบของโมเดลแต่ละชุด รายการmetricsที่คุณระบุแสดงให้เห็นถึงฟีเจอร์หลักของบริการประเมินผล ซึ่งก็คือเมตริกที่กำหนดไว้ล่วงหน้า (เช่นsafety) และออบเจ็กต์PointwiseMetricที่กำหนดเอง - เมื่อกำหนดค่างานแล้ว ให้เรียกใช้โดยเรียกใช้เมธอด
.evaluate()การดำเนินการนี้จะส่งงานไปยังแบ็กเอนด์ของ Vertex AI เพื่อประมวลผล และอาจใช้เวลาหลายนาทีจึงจะเสร็จสมบูรณ์ เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
เมื่อการประเมินเสร็จสมบูรณ์ ระบบจะจัดเก็บผลลัพธ์ไว้ในออบเจ็กต์ result_rag_a และ result_rag_b ซึ่งพร้อมให้เราวิเคราะห์ในส่วนถัดไป
10. วิเคราะห์ผลลัพธ์
ตอนนี้ผลการประเมินพร้อมใช้งานแล้ว ออบเจ็กต์ result_rag_a และ result_rag_b มีคะแนนรวมและคำอธิบายโดยละเอียดสำหรับแต่ละแถว ในงานนี้ คุณจะได้วิเคราะห์ผลลัพธ์เหล่านี้โดยใช้ฟังก์ชันตัวช่วยจาก notebook_utils
ดูสรุปแบบรวม
- หากต้องการดูภาพรวมระดับสูง ให้ใช้ฟังก์ชันตัวช่วย
display_eval_result()เพื่อดูคะแนนเฉลี่ยของแต่ละเมตริก ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อดูข้อมูลสรุปสำหรับโมเดล Anotebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - ทำแบบเดียวกันกับโมเดล B เพิ่มและเรียกใช้โค้ดนี้ในเซลล์ใหม่
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
แสดงผลการประเมินเป็นภาพ
พล็อตจะช่วยให้เปรียบเทียบประสิทธิภาพของโมเดลได้ง่ายขึ้น คุณจะใช้การแสดงข้อมูลผ่านภาพ 2 ประเภท ได้แก่
- แผนภาพเรดาร์: แสดง "รูปร่าง" ประสิทธิภาพโดยรวมของแต่ละโมเดล รูปร่างที่ใหญ่ขึ้นบ่งบอกถึงประสิทธิภาพโดยรวมที่ดีขึ้น
- แผนภาพแท่ง: สำหรับการเปรียบเทียบข้อมูลคู่กันโดยตรงในแต่ละเมตริก
การแสดงภาพเหล่านี้จะช่วยให้คุณเปรียบเทียบโมเดลในด้านคุณภาพเชิงอัตวิสัย เช่น ความเกี่ยวข้อง ความสมเหตุสมผล และประโยชน์
- หากต้องการเตรียมพร้อมสำหรับการพล็อต ให้รวมผลลัพธ์เป็นรายการ Tuple รายการเดียว แต่ละทูเพิลควรมีชื่อโมเดลและออบเจ็กต์ผลลัพธ์ที่เกี่ยวข้อง เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - ตอนนี้ ให้สร้างแผนภาพเรดาร์เพื่อเปรียบเทียบโมเดลในเมตริกทั้งหมดพร้อมกัน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - หากต้องการเปรียบเทียบเมตริกแต่ละรายการโดยตรงมากขึ้น ให้สร้างแผนภาพแท่ง เพิ่มและเรียกใช้โค้ดนี้ในเซลล์ใหม่
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
การแสดงภาพจะแสดงให้เห็นอย่างชัดเจนว่าประสิทธิภาพของโมเดล A (รูปร่างขนาดใหญ่บนแผนภาพเรดาร์และแท่งสูงในแผนภูมิแท่ง) เหนือกว่าโมเดล B
ดูคำอธิบายโดยละเอียดสำหรับแต่ละอินสแตนซ์
คะแนนรวมจะแสดงประสิทธิภาพโดยรวม หากต้องการทำความเข้าใจว่าเหตุใดโมเดลจึงทำงานในลักษณะหนึ่งๆ คุณต้องตรวจสอบคำอธิบายโดยละเอียดที่ LLM ของผู้ประเมินสร้างขึ้นสำหรับแต่ละตัวอย่าง
- ฟังก์ชันตัวช่วย
display_explanations()ช่วยให้คุณตรวจสอบผลลัพธ์แต่ละรายการได้ หากต้องการดูรายละเอียดสำหรับตัวอย่างที่ 2 (num=2) จากผลลัพธ์ของโมเดล A ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่notebook_utils.display_explanations(result_rag_a, num=2) - นอกจากนี้ คุณยังใช้ฟังก์ชันนี้เพื่อกรองเมตริกที่เฉพาะเจาะจงในตัวอย่างทั้งหมดได้ด้วย ซึ่งมีประโยชน์สำหรับการแก้ไขข้อบกพร่องในส่วนที่ประสิทธิภาพต่ำ หากต้องการดูสาเหตุที่โมเดล B มีประสิทธิภาพต่ำมากในเมตริก
groundednessให้เพิ่มและเรียกใช้โค้ดนี้ในเซลล์ใหม่notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. การประเมินที่มีการอ้างอิงโดยใช้ "คำตอบที่ถูกต้อง"
ก่อนหน้านี้ คุณได้ทำการประเมินแบบไม่มีข้อมูลอ้างอิง ซึ่งคำตอบของโมเดลจะได้รับการตัดสินโดยอิงตามพรอมต์เท่านั้น วิธีนี้มีประโยชน์ แต่การประเมินเป็นแบบอัตนัย
ตอนนี้คุณจะใช้การประเมินที่อ้างอิง วิธีนี้จะเพิ่ม "คำตอบที่ถูกต้อง" (หรือที่เรียกว่าคำตอบอ้างอิง) ลงในชุดข้อมูล การเปรียบเทียบคำตอบของโมเดลกับคำตอบที่เป็นความจริงจะช่วยให้วัดประสิทธิภาพได้อย่างเป็นกลางมากขึ้น ซึ่งจะช่วยให้คุณวัดสิ่งต่อไปนี้ได้
- ความถูกต้องตามข้อเท็จจริง: คำตอบของโมเดลสอดคล้องกับข้อเท็จจริงในคำตอบที่ถูกต้องหรือไม่
- ความคล้ายคลึงกันของความหมาย: คำตอบของโมเดลมีความหมายเหมือนกับคำตอบที่ถูกต้องหรือไม่
- ความครบถ้วนสมบูรณ์: คำตอบของโมเดลมีข้อมูลสำคัญทั้งหมดจากคำตอบที่ถูกต้องหรือไม่
เตรียมชุดข้อมูลที่อ้างอิง
หากต้องการทำการประเมินแบบอ้างอิง คุณต้องเพิ่ม "คำตอบที่ถูกต้อง" ลงในตัวอย่างแต่ละรายการในชุดข้อมูล
มาเริ่มด้วยการกำหนดรายการ golden_answers กัน การเปรียบเทียบคำตอบที่ถูกต้องกับคำตอบจากโมเดล A แสดงให้เห็นถึงคุณค่าของวิธีนี้
- คำถามที่ 1 (Brain): คำตอบที่สร้างขึ้นและคำตอบที่ถูกต้องเหมือนกัน โมเดล ก ถูกต้อง
- คำถามที่ 2 (วุฒิสภา): คำตอบมีความหมายคล้ายกันแต่ใช้ถ้อยคำต่างกัน เมตริกที่ดีควรระบุถึงเรื่องนี้
- คำถามที่ 3 (Hasan-Jalalians): คำตอบของโมเดล A ไม่ถูกต้องตามข้อเท็จจริงตามบริบท
golden_answerแสดงข้อผิดพลาดนี้
- กำหนดรายการ golden_answers ในเซลล์ใหม่
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - สร้าง DataFrame การประเมินที่อ้างอิงโดยเรียกใช้โค้ดนี้ในเซลล์ต่อไปนี้
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
ตอนนี้ชุดข้อมูลพร้อมสำหรับการประเมินแบบอ้างอิงแล้ว
สร้างเมตริกที่อ้างอิงที่กำหนดเอง
นอกจากนี้ คุณยังสร้างเมตริกที่กำหนดเองสำหรับการประเมินแบบอ้างอิงได้ด้วย กระบวนการจะคล้ายกัน แต่ตอนนี้เทมเพลตพรอมต์จะมีตัวยึดตำแหน่ง {reference} สำหรับคำตอบที่ถูกต้องที่สุด
เมื่อมีคำตอบที่ "ถูกต้อง" แน่นอน คุณสามารถใช้การให้คะแนนแบบไบนารีที่เข้มงวดขึ้น (เช่น 1 สำหรับถูกต้อง, 0 สำหรับไม่ถูกต้อง) เพื่อวัดความถูกต้องตามข้อเท็จจริง มาสร้างเมตริก question_answering_correctness ใหม่ที่ใช้ตรรกะนี้กัน
- กำหนดเทมเพลตพรอมต์ เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - รวมสตริงเทมเพลตพรอมต์ไว้ในออบเจ็กต์ PointwiseMetric ซึ่งจะทำให้เมตริกมีชื่ออย่างเป็นทางการและเป็นคอมโพเนนต์ที่นำกลับมาใช้ใหม่ได้สำหรับงานประเมิน เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
ตอนนี้คุณมีเมตริกที่อ้างอิงที่กำหนดเองสำหรับการตรวจสอบข้อเท็จจริงที่เข้มงวดแล้ว
12. เรียกใช้การประเมินที่อ้างอิง
ตอนนี้คุณจะกำหนดค่างานประเมินด้วยชุดข้อมูลที่อ้างอิงและเมตริกใหม่ คุณจะใช้คลาส EvalTask อีกครั้ง
ตอนนี้รายการเมตริกจะรวมเมตริกที่อิงตามโมเดลที่กำหนดเองเข้ากับเมตริกที่อิงตามการคํานวณ การประเมินแบบอ้างอิงช่วยให้สามารถใช้เมตริกแบบดั้งเดิมที่อิงตามการคำนวณ ซึ่งทำการเปรียบเทียบทางคณิตศาสตร์ระหว่างข้อความที่สร้างขึ้นกับข้อความอ้างอิง คุณจะใช้ 3 วิธีที่พบบ่อยดังนี้
exact_match: ได้คะแนน 1 ก็ต่อเมื่อคำตอบที่สร้างขึ้นเหมือนกับคำตอบอ้างอิง และได้คะแนน 0 ในกรณีอื่นๆbleu: เมตริกความแม่นยำ โดยจะวัดจำนวนคำจากคำตอบที่สร้างขึ้นซึ่งปรากฏในคำตอบอ้างอิงด้วยrouge: เมตริกของการจำได้ โดยจะวัดจำนวนคำจากคำตอบอ้างอิงที่บันทึกไว้ในคำตอบที่สร้างขึ้น
- กำหนดค่างานประเมินด้วยชุดข้อมูลที่อ้างอิงและเมตริกผสมใหม่ ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อสร้างออบเจ็กต์
EvalTaskreferenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - ดำเนินการประเมินที่อ้างอิงโดยเรียกใช้เมธอด
.evaluate()เพิ่มและเรียกใช้โค้ดนี้ในเซลล์ใหม่referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. วิเคราะห์ผลลัพธ์ที่อ้างอิง
การประเมินเสร็จสมบูรณ์แล้ว ในงานนี้ คุณจะวิเคราะห์ผลลัพธ์เพื่อวัดความถูกต้องตามข้อเท็จจริงของโมเดลโดยเปรียบเทียบคำตอบของโมเดลกับคำตอบอ้างอิงที่ถูกต้อง
ดูผลลัพธ์สรุป
- วิเคราะห์ผลลัพธ์สรุปสำหรับการประเมินที่อ้างอิง ในเซลล์ใหม่ ให้เพิ่มและเรียกใช้โค้ดต่อไปนี้เพื่อแสดงตารางสรุปสำหรับทั้ง 2 โมเดล
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessที่กำหนดเอง แต่ได้คะแนนต่ำกว่าในexact_matchซึ่งแสดงให้เห็นถึงคุณค่าของเมตริกที่อิงตามโมเดลที่สามารถจดจำความคล้ายคลึงกันทางความหมาย ไม่ใช่แค่ข้อความที่เหมือนกัน
แสดงภาพผลลัพธ์เพื่อเปรียบเทียบ
การแสดงภาพจะช่วยให้เห็นช่องว่างด้านประสิทธิภาพระหว่างทั้ง 2 รูปแบบได้ชัดเจนยิ่งขึ้น ก่อนอื่น ให้รวมผลลัพธ์เป็นรายการเดียวสำหรับการพล็อต จากนั้นสร้างพล็อตเรดาร์และพล็อตแท่ง
- รวมผลการประเมินที่อ้างอิงไว้เป็นรายการเดียวสำหรับการพล็อต เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - สร้างแผนภาพเรดาร์เพื่อแสดงภาพประสิทธิภาพของแต่ละโมเดลในชุดเมตริกใหม่ เพิ่มและเรียกใช้โค้ดนี้ในเซลล์ใหม่
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - สร้างแผนภูมิแท่งเพื่อเปรียบเทียบข้อมูลคู่กันโดยตรง ซึ่งจะแสดงประสิทธิภาพของแต่ละโมเดลในเมตริกต่างๆ เพิ่มและเรียกใช้โค้ดต่อไปนี้ในเซลล์ใหม่
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
การแสดงภาพเหล่านี้ยืนยันว่าโมเดล A มีความแม่นยำและสอดคล้องกับข้อเท็จจริงในคำตอบอ้างอิงมากกว่าโมเดล B อย่างมาก
14. จากการฝึกฝนสู่การใช้งานจริง
คุณได้ดำเนินการไปป์ไลน์การประเมินที่สมบูรณ์สำหรับระบบ RAG เรียบร้อยแล้ว ส่วนสุดท้ายนี้จะสรุปแนวคิดเชิงกลยุทธ์ที่สำคัญที่คุณได้เรียนรู้ และให้กรอบการทำงานสำหรับการนำทักษะเหล่านี้ไปใช้กับโปรเจ็กต์ในชีวิตจริง
แนวทางปฏิบัติแนะนำสำหรับการผลิต
หากต้องการนำทักษะจากห้องทดลองนี้ไปใช้ในสภาพแวดล้อมฮาร์ดแวร์และซอฟต์แวร์จริง ให้พิจารณาแนวทางปฏิบัติที่สำคัญ 4 ข้อต่อไปนี้
- ทำให้เป็นอัตโนมัติด้วย CI/CD: ผสานรวมชุดการประเมินเข้ากับไปป์ไลน์ CI/CD (เช่น Cloud Build, GitHub Actions) เรียกใช้การประเมินโดยอัตโนมัติเมื่อมีการเปลี่ยนแปลงโค้ดเพื่อตรวจจับการถดถอยและบล็อกการติดตั้งใช้งานหากคะแนนคุณภาพลดลงต่ำกว่ามาตรฐานของคุณ
- พัฒนาชุดข้อมูล: ชุดข้อมูลแบบคงที่จะล้าสมัย ควบคุมเวอร์ชันของชุดทดสอบ "Golden" (โดยใช้ Git LFS หรือ Cloud Storage) และเพิ่มตัวอย่างใหม่ๆ ที่ท้าทายอย่างต่อเนื่องโดยการสุ่มตัวอย่างจากคำค้นหาของผู้ใช้จริง (ที่ลบข้อมูลระบุตัวบุคคลแล้ว)
- ประเมินตัวดึงข้อมูล ไม่ใช่แค่ตัวสร้าง: คำตอบที่ยอดเยี่ยมจะเป็นไปไม่ได้หากไม่มีบริบทที่ถูกต้อง ใช้ขั้นตอนการประเมินแยกต่างหากสำหรับระบบการดึงข้อมูลโดยใช้เมตริกต่างๆ เช่น Hit Rate (พบเอกสารที่ถูกต้องหรือไม่) และ Mean Reciprocal Rank (MRR) (เอกสารที่ถูกต้องได้รับการจัดอันดับสูงเพียงใด)
- ตรวจสอบเมตริกเมื่อเวลาผ่านไป: ส่งออกคะแนนสรุปจากการเรียกใช้การประเมินไปยังบริการต่างๆ เช่น Google Cloud Monitoring สร้างแดชบอร์ดเพื่อติดตามแนวโน้มคุณภาพและตั้งค่าการแจ้งเตือนอัตโนมัติเพื่อแจ้งให้คุณทราบเมื่อประสิทธิภาพลดลงอย่างมาก
เมทริกซ์วิธีการประเมินขั้นสูง
การเลือกแนวทางการประเมินที่เหมาะสมขึ้นอยู่กับเป้าหมายที่เฉพาะเจาะจงของคุณ ตารางนี้จะสรุปว่าควรใช้วิธีใดเมื่อใด
แนวทางการประเมิน | กรณีการใช้งานที่ดีที่สุด | ข้อดีหลัก | ข้อจำกัด |
Reference-Free | การตรวจสอบเวอร์ชันที่ใช้งานจริง การประเมินอย่างต่อเนื่อง | ไม่จำเป็นต้องมีคำตอบที่ถูกต้องที่สุด แต่จะบันทึกคุณภาพตามอัตวิสัย | มีค่าใช้จ่ายสูงกว่า และอาจเกิดอคติจากผู้ประเมิน |
อิงตามข้อมูลอ้างอิง | การเปรียบเทียบรูปแบบการระบุแหล่งที่มา การเปรียบเทียบ | การวัดผลตามวัตถุประสงค์และการคำนวณที่รวดเร็วยิ่งขึ้น | ต้องใช้คำตอบที่ถูกต้อง อาจพลาดความหมายที่เทียบเท่า |
เมตริกที่กำหนดเอง | การประเมินเฉพาะโดเมน | ปรับให้เหมาะกับความต้องการทางธุรกิจ | ต้องมีการตรวจสอบและค่าใช้จ่ายในการพัฒนา |
แนวทางแบบผสมผสาน | ระบบการผลิตที่ครอบคลุม | แนวทางที่ดีที่สุด | มีความซับซ้อนสูงขึ้น ต้องเพิ่มประสิทธิภาพต้นทุน |
ข้อมูลเชิงลึกทางเทคนิคที่สำคัญ
โปรดคำนึงถึงหลักการสำคัญต่อไปนี้เมื่อสร้างและประเมินระบบ RAG ของคุณเอง
- ความสมเหตุสมผลเป็นสิ่งสำคัญสำหรับ RAG: เมตริกนี้จะแยกความแตกต่างระหว่างระบบ RAG คุณภาพสูงและคุณภาพต่ำอย่างสม่ำเสมอ จึงจำเป็นสำหรับการตรวจสอบเวอร์ชันที่ใช้งานจริง
- เมตริกหลายรายการช่วยให้มีความเสถียร: ไม่มีเมตริกเดียวที่ครอบคลุมคุณภาพ RAG ทุกด้าน การประเมินที่ครอบคลุมต้องใช้มิติการประเมินหลายด้าน
- เมตริกที่กำหนดเองช่วยเพิ่มคุณค่าอย่างมาก: เกณฑ์การประเมินเฉพาะโดเมนมักจะจับความแตกต่างเล็กๆ น้อยๆ ที่เมตริกทั่วไปมองข้ามไป ซึ่งช่วยเพิ่มความแม่นยำในการประเมิน
- ความเข้มงวดทางสถิติช่วยเพิ่มความมั่นใจ: ขนาดตัวอย่างและการทดสอบนัยสำคัญที่เหมาะสมจะเปลี่ยนการประเมินจากการคาดเดาให้เป็นเครื่องมือในการตัดสินใจที่เชื่อถือได้
เฟรมเวิร์กการตัดสินใจในการทำให้ใช้งานได้จริง
ใช้เฟรมเวิร์กแบบแบ่งระยะนี้เป็นแนวทางสำหรับการติดตั้งใช้งานระบบ RAG ในอนาคต
- ระยะที่ 1 - การพัฒนา: ใช้การประเมินตามข้อมูลอ้างอิงกับชุดทดสอบที่ทราบเพื่อเปรียบเทียบและเลือกโมเดล
- ระยะที่ 2 - รุ่นก่อนผลิตจริง: ดำเนินการประเมินอย่างครอบคลุมโดยรวมทั้ง 2 แนวทางเพื่อตรวจสอบความพร้อมของเวอร์ชันที่ใช้งานจริง
- ระยะที่ 3 - การใช้งานจริง: ใช้การตรวจสอบแบบไม่มีข้อมูลอ้างอิงเพื่อประเมินคุณภาพอย่างต่อเนื่องโดยไม่ต้องมีคำตอบที่ถูกต้องที่สุด
- ระยะที่ 4 - การเพิ่มประสิทธิภาพ: ใช้ข้อมูลเชิงลึกจากการประเมินเพื่อเป็นแนวทางในการปรับปรุงโดยประมาณและเพิ่มประสิทธิภาพระบบการดึงข้อมูล
15. บทสรุป
ยินดีด้วย คุณทำห้องทดลองเสร็จแล้ว
ห้องปฏิบัติการนี้เป็นส่วนหนึ่งของเส้นทางการเรียนรู้ AI ที่พร้อมใช้งานจริงด้วย Google Cloud
- สำรวจหลักสูตรทั้งหมดเพื่อเชื่อมช่องว่างระหว่างต้นแบบกับการใช้งานจริง
- แชร์ความคืบหน้าของคุณด้วยแฮชแท็ก
ProductionReadyAI
สรุป
คุณได้เรียนรู้วิธีทำสิ่งต่อไปนี้แล้ว
- ทำการประเมินแบบไม่มีข้อมูลอ้างอิงเพื่อประเมินคุณภาพของคำตอบโดยอิงตามบริบทที่ดึงมา
- ทำการประเมินแบบอ้างอิงโดยเพิ่ม "คำตอบที่ถูกต้อง" เพื่อวัดความถูกต้องตามข้อเท็จจริง
- ใช้เมตริกที่กำหนดไว้ล่วงหน้าและเมตริกที่กำหนดเองผสมกันสำหรับทั้ง 2 แนวทาง
- ใช้ทั้งเมตริกที่อิงตามโมเดล (เช่น
question_answering_quality) และเมตริกที่อิงตามการคำนวณ (rouge,bleu,exact_match) - วิเคราะห์และแสดงผลลัพธ์ผ่านภาพเพื่อทำความเข้าใจจุดแข็งและจุดอ่อนของโมเดล
แนวทางการประเมินนี้จะช่วยให้คุณสร้างแอปพลิเคชัน Generative AI ที่เชื่อถือได้และแม่นยำยิ่งขึ้น