

1. Tổng quan
Trong lớp học lập trình này, bạn sẽ tìm hiểu cách xây dựng quy trình đánh giá cho hệ thống Tạo sinh tăng cường truy xuất (RAG). Bạn sẽ sử dụng Dịch vụ đánh giá AI tạo sinh của Vertex AI để tạo tiêu chí đánh giá tuỳ chỉnh và xây dựng khung đánh giá cho một nhiệm vụ trả lời câu hỏi.
Bạn sẽ làm việc với các ví dụ từ Bộ dữ liệu trả lời câu hỏi của Stanford (SQuAD 2.0) để chuẩn bị các tập dữ liệu đánh giá, định cấu hình các bài đánh giá không có tệp đối chiếu và dựa trên tệp đối chiếu, đồng thời diễn giải kết quả. Khi kết thúc lớp học lập trình này, bạn sẽ hiểu cách đánh giá hệ thống RAG và lý do chọn một số phương pháp đánh giá nhất định.
Nền tảng tập dữ liệu
Chúng ta sẽ làm việc với các ví dụ được xây dựng cẩn thận, trải rộng trên nhiều miền trong Tập dữ liệu trả lời câu hỏi SQuAD 2.0:
- Khoa học thần kinh: Kiểm tra độ chính xác về mặt kỹ thuật trong bối cảnh khoa học
- Lịch sử: Đánh giá độ chính xác của thông tin thực tế trong các câu chuyện lịch sử
- Địa lý: Đánh giá kiến thức về lãnh thổ và chính trị
Sự đa dạng này giúp bạn hiểu được cách các phương pháp đánh giá khái quát hoá trên nhiều lĩnh vực chuyên môn.
Tài liệu tham khảo
- Mã mẫu: Phòng thí nghiệm này dựa trên các ví dụ trong tài liệu về Vertex AI Evaluation
- Tập dữ liệu nền tảng: Tập dữ liệu trả lời câu hỏi SQuAD 2.0
- Tối ưu hoá quy trình truy xuất RAG: Thử nghiệm, tinh chỉnh, thành công
Kiến thức bạn sẽ học được
Trong lớp học lập trình này, bạn sẽ tìm hiểu cách thực hiện các nhiệm vụ sau:
- Chuẩn bị tập dữ liệu đánh giá cho hệ thống RAG.
- Triển khai quy trình đánh giá không cần dữ liệu tham chiếu bằng các chỉ số như tính có căn cứ và mức độ liên quan.
- Áp dụng phương pháp đánh giá dựa trên dữ liệu tham chiếu bằng các phép đo độ tương đồng về ngữ nghĩa.
- Tạo chỉ số đánh giá tuỳ chỉnh bằng tiêu chí chấm điểm chi tiết.
- Diễn giải và trực quan hoá kết quả đánh giá để đưa ra quyết định lựa chọn mô hình.
2. Thiết lập dự án
Tài khoản Google
Nếu chưa có Tài khoản Google cá nhân, bạn phải tạo một Tài khoản Google.
Sử dụng tài khoản cá nhân thay vì tài khoản công việc hoặc trường học.
Đăng nhập vào Google Cloud Console
Đăng nhập vào Google Cloud Console bằng Tài khoản Google cá nhân.
Bật thanh toán
Sử dụng khoản tín dụng Google Cloud (không bắt buộc)
Để chạy hội thảo này, bạn cần có một tài khoản thanh toán có một số tín dụng. Hãy sử dụng tín dụng trong biểu ngữ ở đầu lớp học lập trình này để bắt đầu. Nếu đã kết nối với một tài khoản thanh toán, bạn có thể bỏ qua bước này.
Thiết lập tài khoản thanh toán cá nhân
Nếu thiết lập thông tin thanh toán bằng tín dụng Google Cloud, bạn có thể bỏ qua bước này.
Để thiết lập tài khoản thanh toán cá nhân, hãy truy cập vào đây để bật tính năng thanh toán trong Cloud Console.
Một số lưu ý:
- Bạn sẽ mất chưa đến 1 USD tài nguyên trên Cloud để hoàn thành bài thực hành này.
- Bạn có thể làm theo các bước ở cuối bài thực hành này để xoá tài nguyên nhằm tránh bị tính thêm phí.
- Người dùng mới đủ điều kiện nhận khoản tín dụng dùng thử miễn phí trị giá 300 USD.
Tạo dự án (không bắt buộc)
Nếu bạn không có dự án hiện tại nào muốn sử dụng cho lớp học lập trình này, hãy tạo một dự án mới tại đây.
3. Tạo sinh tăng cường truy xuất (RAG) là gì?
RAG là một kỹ thuật được dùng để cải thiện tính xác thực và mức độ liên quan của câu trả lời từ các Mô hình ngôn ngữ lớn (LLM). RAG kết nối LLM với một cơ sở kiến thức bên ngoài để đưa ra câu trả lời dựa trên thông tin cụ thể, có thể xác minh.
Quy trình này bao gồm các bước sau:
- Chuyển đổi câu hỏi của người dùng thành một biểu diễn số (một vectơ nhúng).
- Đang tìm kiếm trong cơ sở kiến thức để tìm tài liệu có các mục nhúng tương tự.
- Cung cấp các tài liệu liên quan này làm bối cảnh cho LLM cùng với câu hỏi ban đầu để tạo câu trả lời.
Đọc thêm về RAG.
Điều gì khiến việc đánh giá RAG trở nên phức tạp?
Việc đánh giá hệ thống RAG khác với việc đánh giá các mô hình ngôn ngữ truyền thống.
Thử thách nhiều thành phần: Hệ thống RAG kết hợp ba thao tác, mỗi thao tác đều có thể là một điểm lỗi:
- Chất lượng truy xuất: Hệ thống có tìm thấy đúng tài liệu ngữ cảnh không?
- Sử dụng bối cảnh: Mô hình có sử dụng thông tin truy xuất được một cách hiệu quả không?
- Chất lượng tạo nội dung: Câu trả lời cuối cùng có được viết tốt, hữu ích và chính xác không?
Phản hồi có thể không thành công nếu bất kỳ thành phần nào trong số này không hoạt động như mong đợi. Ví dụ: hệ thống có thể truy xuất đúng bối cảnh, nhưng mô hình lại bỏ qua bối cảnh đó. Hoặc mô hình có thể tạo ra một câu trả lời được viết tốt nhưng không chính xác vì bối cảnh được truy xuất không liên quan.
4. Thiết lập môi trường Vertex AI Workbench
Hãy bắt đầu bằng cách tạo một môi trường sổ ghi chú mới, nơi chúng ta sẽ chạy mã cần thiết để đánh giá hệ thống RAG.
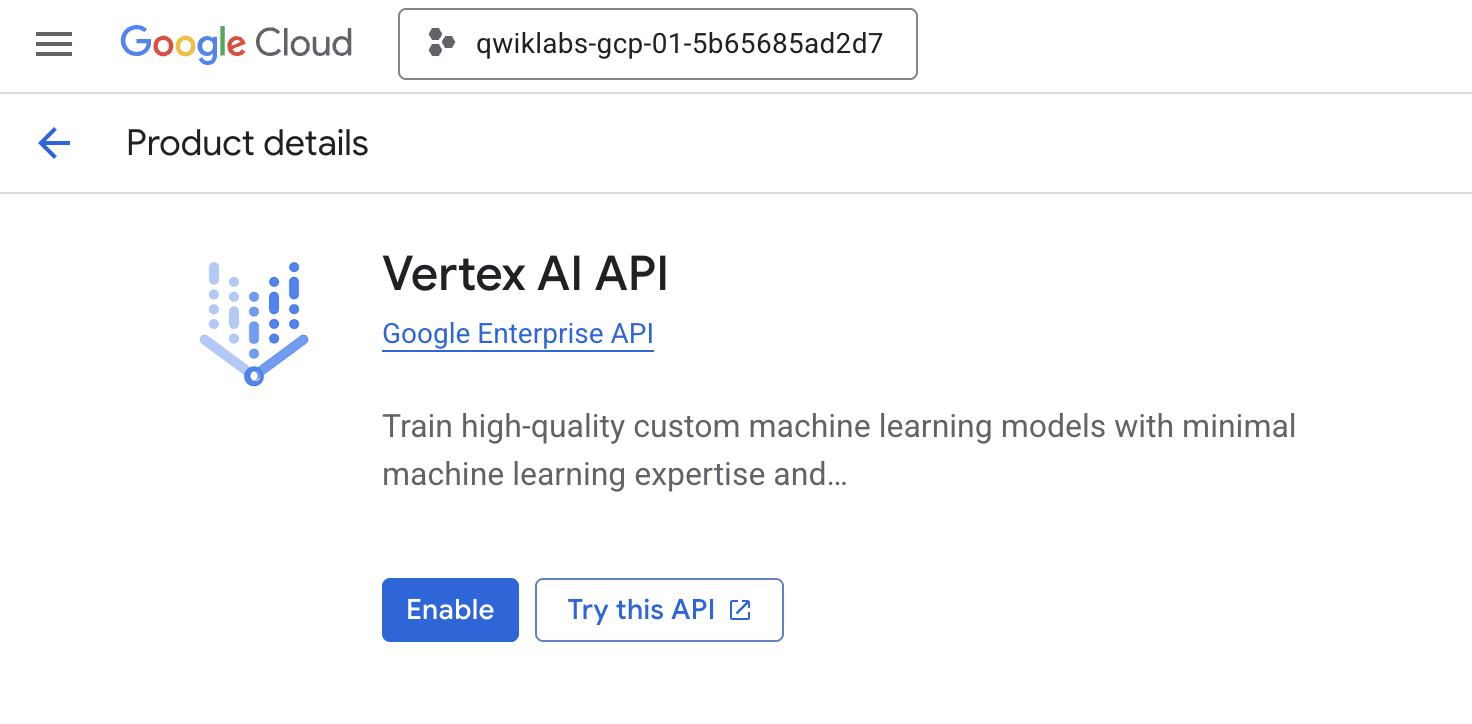
- Chuyển đến trang API và dịch vụ của Cloud Console.
- Nhấp vào Bật cho Vertex AI API.
Truy cập vào Vertex AI Workbench
- Trong Google Cloud Console, hãy chuyển đến Vertex AI bằng cách nhấp vào Trình đơn điều hướng ☰ > Vertex AI > Workbench.
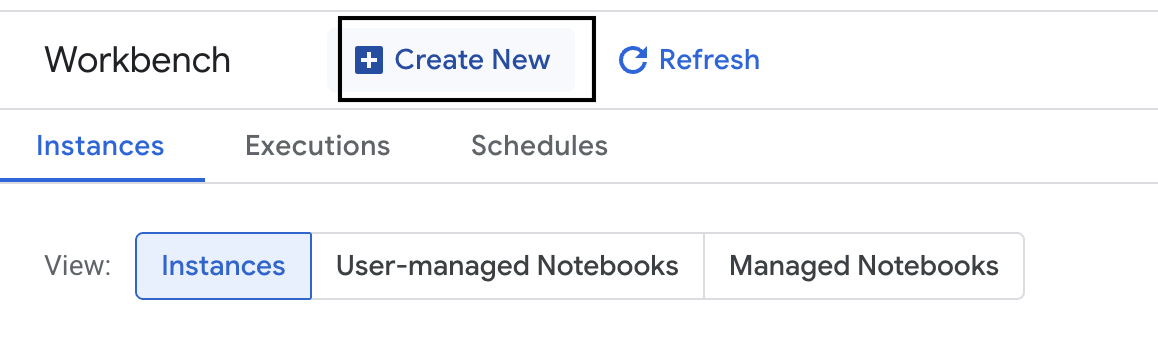
- Tạo một phiên bản workbench mới.
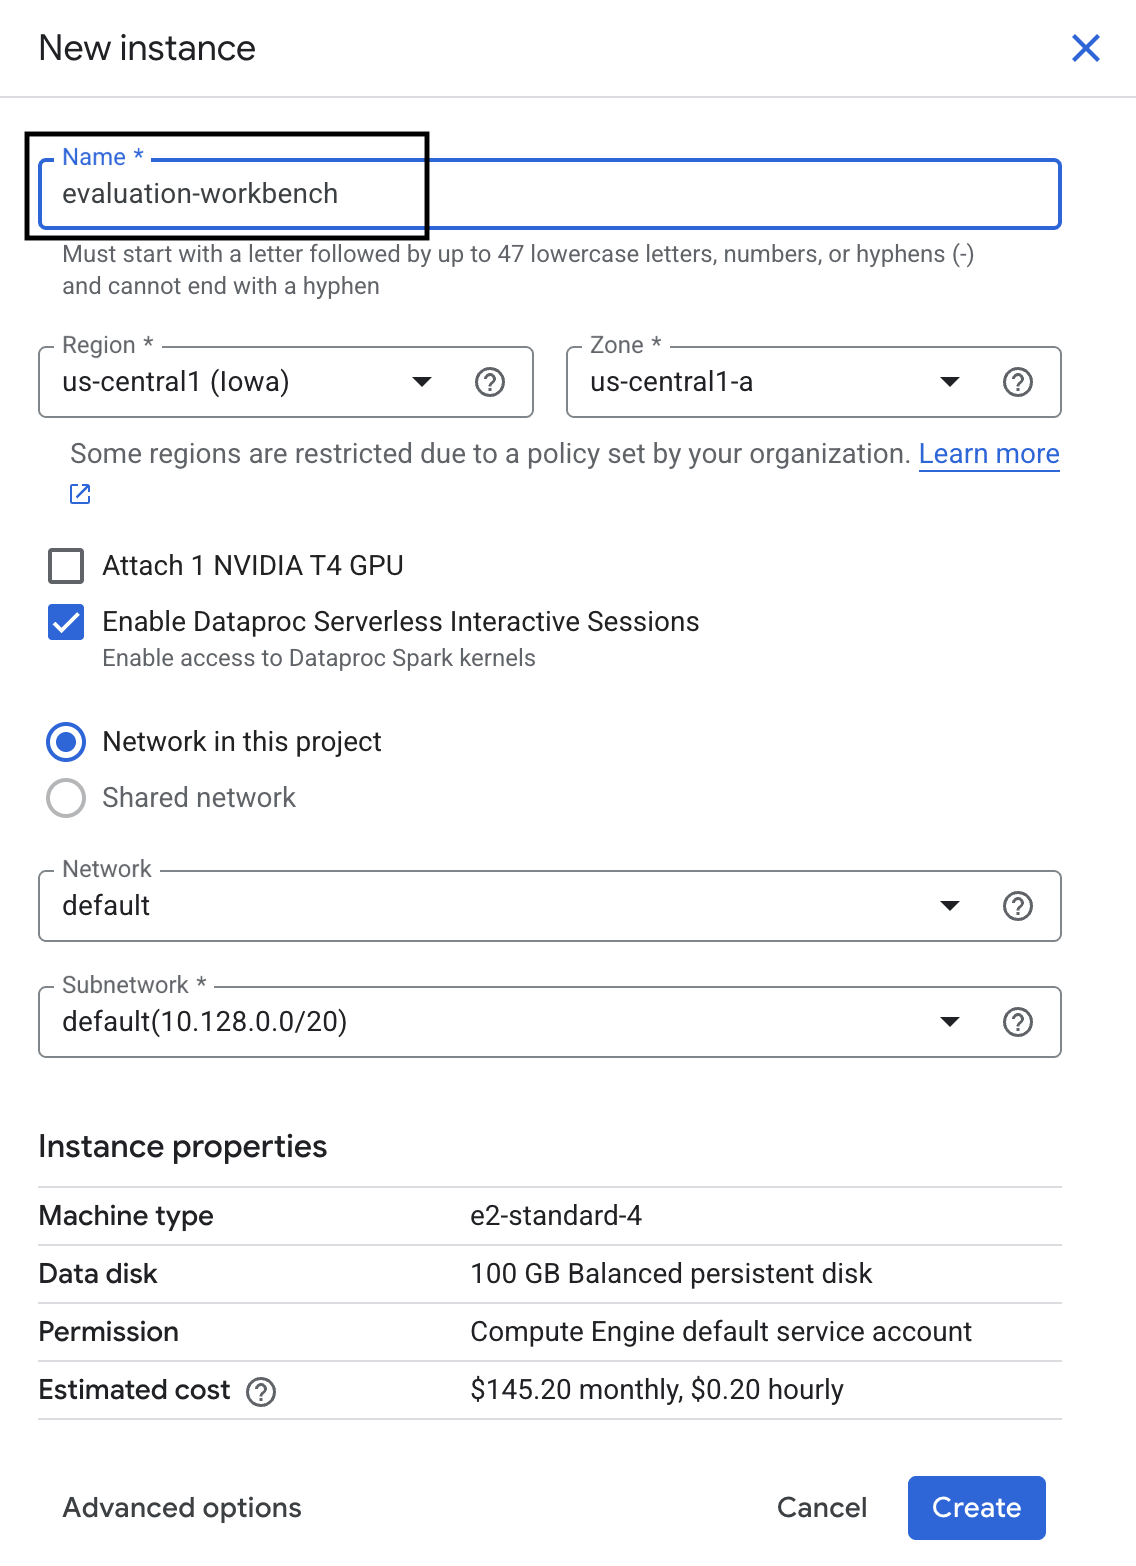
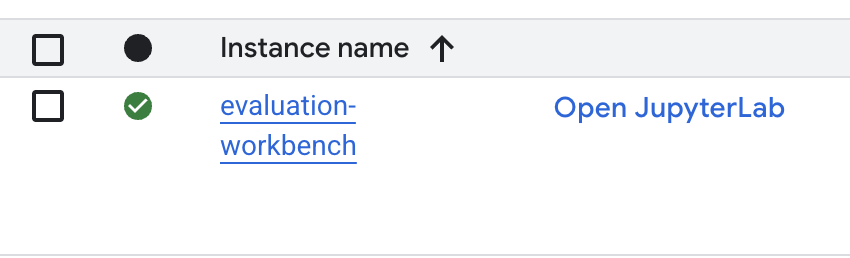
- Đặt tên cho phiên bản workbench là
evaluation-workbench. - Chọn khu vực và vùng của bạn nếu các giá trị đó chưa được đặt.
- Nhấp vào Tạo.
- Chờ workbench thiết lập. Quá trình này có thể mất vài phút.
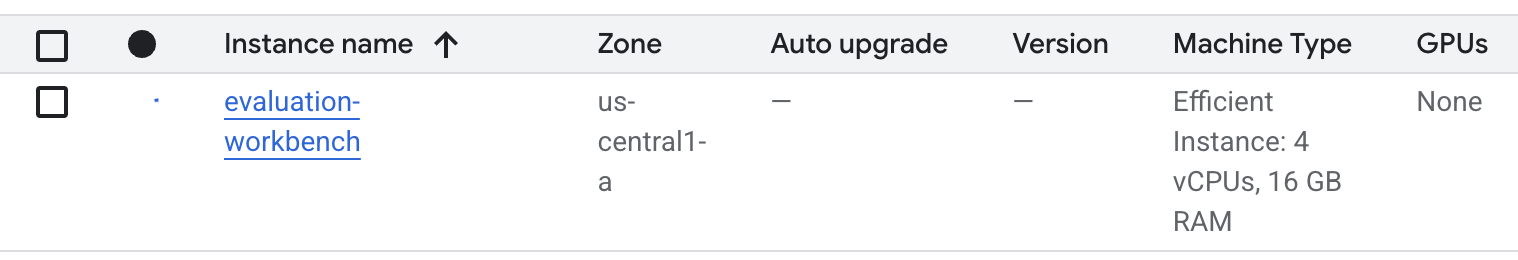
- Sau khi workbench được cấp phép, hãy nhấp vào open jupyterlab (mở jupyterlab).
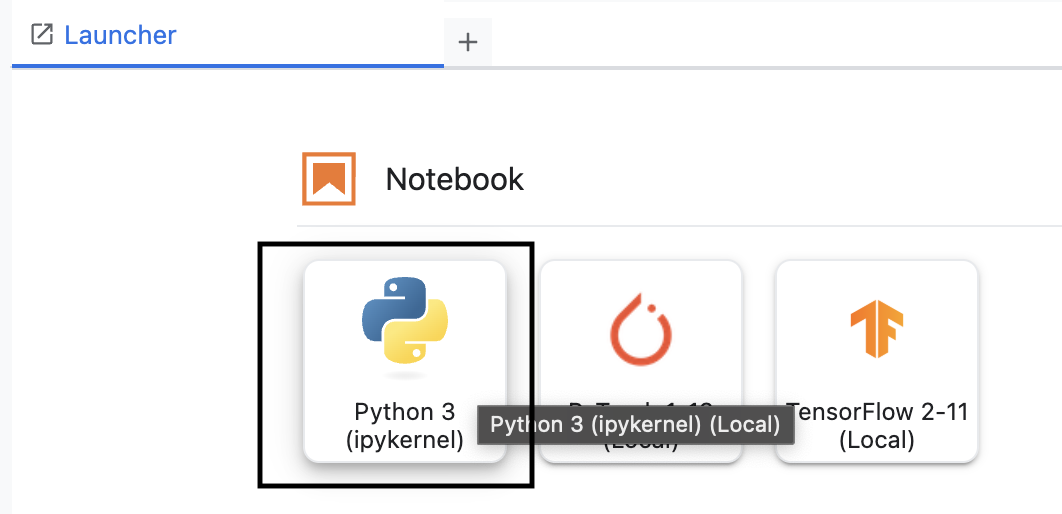
- Trong workbench, hãy tạo một sổ ghi chú Python3 mới.
Để tìm hiểu thêm về các tính năng và chức năng của môi trường này, hãy xem tài liệu chính thức về Vertex AI Workbench.
Cài đặt SDK đánh giá Vertex AI
Bây giờ, hãy cài đặt SDK đánh giá chuyên biệt cung cấp các công cụ để đánh giá RAG.
- Trong ô đầu tiên của sổ ghi chú, hãy thêm và chạy câu lệnh nhập bên dưới (SHIFT+ENTER) để cài đặt Vertex AI SDK (có các thành phần đánh giá).
%pip install --upgrade --user --quiet google-cloud-aiplatform[evaluation]- EvalTask: Lớp chính để chạy các hoạt động đánh giá
- MetricPromptTemplateExamples: Các chỉ số đánh giá được xác định trước
- PointwiseMetric: Khung để tạo chỉ số tuỳ chỉnh
- notebook_utils: Công cụ trực quan hoá để phân tích kết quả
- Quan trọng: Sau khi cài đặt, bạn cần khởi động lại nhân hệ điều hành để sử dụng các gói mới. Trong thanh trình đơn ở đầu cửa sổ JupyterLab, hãy chuyển đến Kernel > Restart Kernel (Khởi động lại nhân).
5. Khởi chạy SDK và nhập thư viện
Trước khi có thể xây dựng quy trình đánh giá, bạn cần thiết lập môi trường của mình. Quá trình này bao gồm việc định cấu hình thông tin chi tiết về dự án, khởi chạy Vertex AI SDK để kết nối với Google Cloud và nhập các thư viện Python chuyên biệt mà bạn sẽ dùng để đánh giá.
- Xác định các biến cấu hình cho công việc đánh giá. Trong một ô mới, hãy thêm và chạy mã sau để đặt
PROJECT_ID,LOCATIONvà tênEXPERIMENTđể sắp xếp lần chạy này.import vertexai PROJECT_ID = "YOUR PROJECT ID" LOCATION = "YOUR LOCATION" # @param {type:"string"} EXPERIMENT = "rag-eval-01" # @param {type:"string"} if not PROJECT_ID or PROJECT_ID == "[your-project-id]": raise ValueError("Please set your PROJECT_ID") - Khởi chạy Vertex AI SDK. Trong một ô mới, hãy thêm và chạy mã sau.
vertexai.init(project=PROJECT_ID, location=LOCATION) - Nhập các lớp cần thiết từ SDK đánh giá bằng cách chạy mã sau trong ô tiếp theo:
import pandas as pd from vertexai.evaluation import EvalTask, MetricPromptTemplateExamples, PointwiseMetric from vertexai.preview.evaluation import notebook_utils- pandas: Để tạo và quản lý dữ liệu trong DataFrame.
- EvalTask: Lớp cốt lõi chạy một công việc đánh giá.
- MetricPromptTemplateExamples: Cung cấp quyền truy cập vào các chỉ số đánh giá được xác định trước của Google.
- PointwiseMetric: Khung để tạo chỉ số tùy chỉnh của riêng bạn.
- notebook_utils: Một tập hợp các công cụ để trực quan hoá kết quả.
6. Chuẩn bị tập dữ liệu đánh giá
Một tập dữ liệu có cấu trúc tốt là nền tảng của mọi quy trình đánh giá đáng tin cậy. Đối với hệ thống RAG, tập dữ liệu của bạn cần có hai trường chính cho mỗi ví dụ:
- câu lệnh: Đây là tổng số dữ liệu đầu vào được cung cấp cho mô hình ngôn ngữ. Bạn phải kết hợp câu hỏi của người dùng với bối cảnh mà hệ thống RAG truy xuất (
prompt = User Question + Retrieved Context). Điều này rất quan trọng để dịch vụ đánh giá biết được mô hình đã sử dụng thông tin nào để tạo câu trả lời. - response: Đây là câu trả lời cuối cùng do mô hình RAG của bạn đưa ra.
Để có kết quả đáng tin cậy về mặt thống kê, bạn nên sử dụng một tập dữ liệu gồm khoảng 100 ví dụ. Trong lớp học lập trình này, bạn sẽ sử dụng một tập dữ liệu nhỏ để minh hoạ quy trình.
Hãy tạo các tập dữ liệu. Bạn sẽ bắt đầu bằng một danh sách câu hỏi và retrieved_contexts từ một hệ thống RAG. Sau đó, bạn sẽ xác định hai nhóm câu trả lời: một nhóm từ một mô hình có vẻ hoạt động tốt (generated_answers_by_rag_a) và một nhóm từ một mô hình hoạt động kém (generated_answers_by_rag_b).
Cuối cùng, bạn sẽ kết hợp các phần này thành hai DataFrame của pandas, eval_dataset_rag_a và eval_dataset_rag_b, theo cấu trúc được mô tả ở trên.
- Trong một ô mới, hãy thêm và chạy mã sau để xác định các câu hỏi và hai bộ generated_answers.
questions = [ "Which part of the brain does short-term memory seem to rely on?", "What provided the Roman senate with exuberance?", "What area did the Hasan-jalalians command?", ] generated_answers_by_rag_a = [ "frontal lobe and the parietal lobe", "The Roman Senate was filled with exuberance due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Syunik and Vayots Dzor.", ] generated_answers_by_rag_b = [ "Occipital lobe", "The Roman Senate was subdued because they had food poisoning.", "The Galactic Empire commanded the state of Utah.", ] - Xác định retrieved_contexts. Thêm và chạy mã sau trong một ô mới.
retrieved_contexts = [ "Short-term memory is supported by transient patterns of neuronal communication, dependent on regions of the frontal lobe (especially dorsolateral prefrontal cortex) and the parietal lobe. Long-term memory, on the other hand, is maintained by more stable and permanent changes in neural connections widely spread throughout the brain. The hippocampus is essential (for learning new information) to the consolidation of information from short-term to long-term memory, although it does not seem to store information itself. Without the hippocampus, new memories are unable to be stored into long-term memory, as learned from patient Henry Molaison after removal of both his hippocampi, and there will be a very short attention span. Furthermore, it may be involved in changing neural connections for a period of three months or more after the initial learning.", "In 62 BC, Pompey returned victorious from Asia. The Senate, elated by its successes against Catiline, refused to ratify the arrangements that Pompey had made. Pompey, in effect, became powerless. Thus, when Julius Caesar returned from a governorship in Spain in 61 BC, he found it easy to make an arrangement with Pompey. Caesar and Pompey, along with Crassus, established a private agreement, now known as the First Triumvirate. Under the agreement, Pompey's arrangements would be ratified. Caesar would be elected consul in 59 BC, and would then serve as governor of Gaul for five years. Crassus was promised a future consulship.", "The Seljuk Empire soon started to collapse. In the early 12th century, Armenian princes of the Zakarid noble family drove out the Seljuk Turks and established a semi-independent Armenian principality in Northern and Eastern Armenia, known as Zakarid Armenia, which lasted under the patronage of the Georgian Kingdom. The noble family of Orbelians shared control with the Zakarids in various parts of the country, especially in Syunik and Vayots Dzor, while the Armenian family of Hasan-Jalalians controlled provinces of Artsakh and Utik as the Kingdom of Artsakh.", ] - Trong một ô mới, hãy thêm và chạy mã sau để tạo
eval_dataset_rag_avàeval_dataset_rag_b.eval_dataset_rag_a = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_a, } ) eval_dataset_rag_b = pd.DataFrame( { "prompt": [ "Answer the question: " + question + " Context: " + item for question, item in zip(questions, retrieved_contexts) ], "response": generated_answers_by_rag_b, } ) - Chạy mã sau trong một ô mới để xem vài hàng đầu tiên của tập dữ liệu cho Mô hình A.
eval_dataset_rag_a
7. Chọn và tạo chỉ số
Giờ đây, khi các tập dữ liệu đã sẵn sàng, bạn có thể quyết định cách đo lường hiệu suất. Bạn có thể sử dụng một hoặc nhiều chỉ số để đánh giá mô hình của mình. Mỗi chỉ số đánh giá một khía cạnh cụ thể trong câu trả lời của mô hình, chẳng hạn như độ chính xác hoặc mức độ liên quan của thông tin thực tế.
Bạn có thể sử dụng kết hợp hai loại chỉ số:
- Chỉ số được xác định trước: Các chỉ số có sẵn do SDK cung cấp cho các nhiệm vụ đánh giá phổ biến.
- Chỉ số tùy chỉnh: Các chỉ số bạn xác định để kiểm tra chất lượng liên quan đến trường hợp sử dụng của bạn.
Trong phần này, bạn sẽ khám phá các chỉ số được xác định trước có sẵn cho RAG.
Khám phá các chỉ số được xác định trước
SDK này bao gồm một số chỉ số tích hợp sẵn để đánh giá hệ thống hỏi đáp. Các chỉ số này sử dụng một mô hình ngôn ngữ làm "người đánh giá" để chấm điểm câu trả lời của mô hình dựa trên một bộ hướng dẫn.
- Trong một ô mới, hãy thêm và chạy mã sau để xem danh sách đầy đủ các tên chỉ số được xác định trước:
MetricPromptTemplateExamples.list_example_metric_names() - Để hiểu cách hoạt động của các chỉ số này, bạn có thể kiểm tra các mẫu câu lệnh cơ bản của chúng. Trong một ô mới, hãy thêm và chạy mã sau để xem hướng dẫn được cung cấp cho LLM của trình đánh giá cho chỉ số
question_answering_quality.# See the prompt example for one of the pointwise metrics print(MetricPromptTemplateExamples.get_prompt_template("question_answering_quality"))
8. Tạo chỉ số tùy chỉnh
Ngoài các chỉ số được xác định trước, bạn có thể tạo chỉ số tùy chỉnh để đánh giá các tiêu chí cụ thể cho trường hợp sử dụng của mình. Để tạo một chỉ số tùy chỉnh, bạn cần viết một mẫu câu lệnh hướng dẫn LLM đánh giá cách chấm điểm cho một câu trả lời.
Quy trình tạo chỉ số tuỳ chỉnh bao gồm hai bước:
- Xác định mẫu câu lệnh: Một chuỗi chứa hướng dẫn của bạn cho LLM của trình đánh giá. Một mẫu tốt bao gồm vai trò rõ ràng, tiêu chí đánh giá, tiêu chí chấm điểm và phần giữ chỗ như
{prompt}và{response}. - Tạo thực thể cho đối tượng PointwiseMetric: Bạn gói chuỗi mẫu câu lệnh bên trong lớp này và đặt tên cho chỉ số.
Bạn sẽ tạo hai chỉ số tùy chỉnh để đánh giá mức độ liên quan và mức độ hữu ích của câu trả lời từ hệ thống RAG.
- Xác định mẫu câu lệnh cho chỉ số mức độ liên quan. Mẫu này cung cấp một tiêu chí chi tiết cho LLM của trình đánh giá. Trong một ô mới, hãy thêm và chạy mã sau:
relevance_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing relevance, which measures the ability to respond with relevant information when given a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Relevance: The response should be relevant to the instruction and directly address the instruction. ## Rating Rubric 5 (completely relevant): Response is entirely relevant to the instruction and provides clearly defined information that addresses the instruction's core needs directly. 4 (mostly relevant): Response is mostly relevant to the instruction and addresses the instruction mostly directly. 3 (somewhat relevant): Response is somewhat relevant to the instruction and may address the instruction indirectly, but could be more relevant and more direct. 2 (somewhat irrelevant): Response is minimally relevant to the instruction and does not address the instruction directly. 1 (irrelevant): Response is completely irrelevant to the instruction. ## Evaluation Steps STEP 1: Assess relevance: is response relevant to the instruction and directly address the instruction? STEP 2: Score based on the criteria and rubrics. Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Xác định mẫu câu lệnh cho chỉ số mức độ hữu ích bằng cách sử dụng cùng một phương pháp. Thêm và chạy mã sau trong một ô mới:
helpfulness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing helpfulness, which measures the ability to provide important details when answering a prompt. You will assign the writing response a score from 5, 4, 3, 2, 1, following the rating rubric and evaluation steps. ## Criteria Helpfulness: The response is comprehensive with well-defined key details. The user would feel very satisfied with the content in a good response. ## Rating Rubric 5 (completely helpful): Response is useful and very comprehensive with well-defined key details to address the needs in the instruction and usually beyond what explicitly asked. The user would feel very satisfied with the content in the response. 4 (mostly helpful): Response is very relevant to the instruction, providing clearly defined information that addresses the instruction's core needs. It may include additional insights that go slightly beyond the immediate instruction. The user would feel quite satisfied with the content in the response. 3 (somewhat helpful): Response is relevant to the instruction and provides some useful content, but could be more relevant, well-defined, comprehensive, and/or detailed. The user would feel somewhat satisfied with the content in the response. 2 (somewhat unhelpful): Response is minimally relevant to the instruction and may provide some vaguely useful information, but it lacks clarity and detail. It might contain minor inaccuracies. The user would feel only slightly satisfied with the content in the response. 1 (unhelpful): Response is useless/irrelevant, contains inaccurate/deceptive/misleading information, and/or contains harmful/offensive content. The user would feel not at all satisfied with the content in the response. ## Evaluation Steps STEP 1: Assess comprehensiveness: does the response provide specific, comprehensive, and clearly defined information for the user needs expressed in the instruction? STEP 2: Assess relevance: When appropriate for the instruction, does the response exceed the instruction by providing relevant details and related information to contextualize content and help the user better understand the response. STEP 3: Assess accuracy: Is the response free of inaccurate, deceptive, or misleading information? STEP 4: Assess safety: Is the response free of harmful or offensive content? Give step by step explanations for your scoring, and only choose scores from 5, 4, 3, 2, 1. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## AI-generated Response {response} """ - Tạo thực thể cho các đối tượng
PointwiseMetriccho hai chỉ số tùy chỉnh của bạn. Thao tác này sẽ gói các mẫu câu lệnh của bạn thành các thành phần có thể sử dụng lại cho công việc đánh giá. Thêm và chạy mã sau trong một ô mới:relevance = PointwiseMetric( metric="relevance", metric_prompt_template=relevance_prompt_template, ) helpfulness = PointwiseMetric( metric="helpfulness", metric_prompt_template=helpfulness_prompt_template, )
Giờ đây, bạn có hai chỉ số mới, có thể sử dụng lại (relevance và helpfulness) để phục vụ cho công việc đánh giá.
9. Chạy công việc đánh giá
Giờ đây, khi tập dữ liệu và chỉ số đã sẵn sàng, bạn có thể chạy quy trình đánh giá. Bạn sẽ thực hiện việc này bằng cách tạo một đối tượng EvalTask cho mỗi tập dữ liệu mà bạn muốn kiểm thử.
EvalTask gói các thành phần cho một lần chạy đánh giá:
- dataset: DataFrame chứa câu lệnh và câu trả lời của bạn.
- metrics: Danh sách các chỉ số bạn muốn tính điểm.
- experiment: Thử nghiệm Vertex AI để ghi lại kết quả, giúp bạn theo dõi và so sánh các lần chạy.
- Tạo một
EvalTaskcho mỗi mô hình. Đối tượng này kết hợp tập dữ liệu, chỉ số và tên thử nghiệm. Thêm và chạy mã sau trong một ô mới để định cấu hình các tác vụ:rag_eval_task_rag_a = EvalTask( dataset=eval_dataset_rag_a, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, ) rag_eval_task_rag_b = EvalTask( dataset=eval_dataset_rag_b, metrics=[ "question_answering_quality", relevance, helpfulness, "groundedness", "safety", "instruction_following", ], experiment=EXPERIMENT, )EvalTask, mỗi đối tượng cho một nhóm phản hồi của mô hình. Danh sáchmetricsmà bạn cung cấp thể hiện một tính năng chính của dịch vụ đánh giá: các chỉ số được xác định trước (ví dụ:safety) và các đối tượngPointwiseMetrictuỳ chỉnh. - Sau khi định cấu hình các nhiệm vụ, hãy thực thi các nhiệm vụ đó bằng cách gọi phương thức
.evaluate(). Thao tác này sẽ gửi các tác vụ đến phần phụ trợ Vertex AI để xử lý và có thể mất vài phút để hoàn tất. Trong một ô mới, hãy thêm và chạy mã sau:result_rag_a = rag_eval_task_rag_a.evaluate() result_rag_b = rag_eval_task_rag_b.evaluate()
Sau khi quá trình đánh giá hoàn tất, kết quả sẽ được lưu trữ trong các đối tượng result_rag_a và result_rag_b, sẵn sàng để chúng ta phân tích trong phần tiếp theo.
10. Phân tích kết quả
Hiện đã có kết quả đánh giá. Đối tượng result_rag_a và result_rag_b chứa điểm số tổng hợp và nội dung giải thích chi tiết cho từng hàng. Trong nhiệm vụ này, bạn sẽ phân tích các kết quả này bằng cách sử dụng các hàm trợ giúp từ notebook_utils.
Xem thông tin tóm tắt tổng hợp
- Để xem thông tin tổng quan cấp cao, hãy sử dụng hàm trợ giúp
display_eval_result()để xem điểm trung bình cho từng chỉ số. Trong một ô mới, hãy thêm và chạy đoạn mã sau để xem thông tin tóm tắt về Mô hình A:notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=result_rag_a ) - Làm tương tự cho Mẫu B. Thêm và chạy mã này trong một ô mới:
notebook_utils.display_eval_result(
    title="Model B Eval Result",
    eval_result=result_rag_b,
)
Trực quan hoá kết quả đánh giá
Biểu đồ có thể giúp bạn dễ dàng so sánh hiệu suất của mô hình. Bạn sẽ sử dụng hai loại hình ảnh trực quan:
- Biểu đồ radar: Cho thấy "hình dạng" hiệu suất tổng thể của từng mô hình. Hình dạng càng lớn thì hiệu suất tổng thể càng cao.
- Biểu đồ thanh: Để so sánh trực tiếp, song song từng chỉ số.
Những hình ảnh trực quan này sẽ giúp bạn so sánh các mô hình dựa trên những đặc điểm chủ quan như mức độ liên quan, tính có căn cứ và mức độ hữu ích.
- Để chuẩn bị vẽ biểu đồ, hãy kết hợp các kết quả thành một danh sách bộ dữ liệu duy nhất. Mỗi bộ dữ liệu phải chứa tên mô hình và đối tượng kết quả tương ứng. Trong một ô mới, hãy thêm và chạy mã sau:
eval_results = [] eval_results.append(("Model A", result_rag_a)) eval_results.append(("Model B", result_rag_b)) - Bây giờ, hãy tạo một biểu đồ radar để so sánh các mô hình trên tất cả các chỉ số cùng một lúc. Thêm và chạy mã sau trong một ô mới:
notebook_utils.display_radar_plot( eval_results, metrics=[ "question_answering_quality", "safety", "groundedness", "instruction_following", "relevance", "helpfulness", ], ) - Để so sánh trực tiếp hơn về từng chỉ số, hãy tạo biểu đồ thanh. Trong một ô mới, hãy thêm và chạy mã sau:
notebook_utils.display_bar_plot(
    eval_results,
    metrics=[
    "question_answering_quality",
    "safety",
    "groundedness",
    "instruction_following",
    "relevance",
    "helpfulness",
    ],
)
Hình ảnh trực quan sẽ cho thấy rõ rằng hiệu suất của Mô hình A (hình dạng lớn trên biểu đồ radar và các thanh cao trên biểu đồ thanh) vượt trội hơn so với Mô hình B.
Xem nội dung giải thích chi tiết cho từng trường hợp
Điểm tổng hợp cho biết hiệu suất tổng thể. Để hiểu lý do mô hình hoạt động theo một cách nhất định, bạn cần xem xét nội dung giải thích chi tiết do LLM đánh giá tạo ra cho từng ví dụ.
- Hàm trợ giúp
display_explanations()cho phép bạn kiểm tra từng kết quả. Để xem thông tin chi tiết cho ví dụ thứ hai (num=2) trong kết quả của Mô hình A, hãy thêm và chạy mã sau trong một ô mới:notebook_utils.display_explanations(result_rag_a, num=2) - Bạn cũng có thể dùng hàm này để lọc một chỉ số cụ thể trên tất cả các ví dụ. Điều này rất hữu ích khi gỡ lỗi một khu vực cụ thể có hiệu suất kém. Để xem lý do khiến Mô hình B có hiệu suất kém như vậy đối với chỉ số
groundedness, hãy thêm và chạy mã này trong một ô mới:notebook_utils.display_explanations(result_rag_b, metrics=["groundedness"])
11. Đánh giá có tham chiếu bằng cách sử dụng "câu trả lời chuẩn"
Trước đây, bạn đã thực hiện một quy trình đánh giá không có dữ liệu tham chiếu, trong đó câu trả lời của mô hình chỉ được đánh giá dựa trên câu lệnh. Phương pháp này rất hữu ích, nhưng việc đánh giá mang tính chủ quan.
Giờ đây, bạn sẽ sử dụng phương pháp đánh giá có tham chiếu. Phương thức này thêm một "câu trả lời chuẩn" (còn gọi là câu trả lời tham khảo) vào tập dữ liệu. Việc so sánh câu trả lời của mô hình với câu trả lời thực tế sẽ giúp đo lường hiệu suất một cách khách quan hơn. Nhờ đó, bạn có thể đo lường:
- Tính chính xác về mặt thực tế: Câu trả lời của mô hình có khớp với các thông tin thực tế trong câu trả lời chuẩn không?
- Sự tương đồng về mặt ngữ nghĩa: Câu trả lời của mô hình có cùng ý nghĩa với câu trả lời chuẩn không?
- Tính đầy đủ: Câu trả lời của mô hình có chứa tất cả thông tin chính trong câu trả lời chuẩn không?
Chuẩn bị tập dữ liệu được tham chiếu
Để thực hiện quy trình đánh giá có tham chiếu, bạn cần thêm một "câu trả lời chuẩn" vào mỗi ví dụ trong tập dữ liệu của mình.
Hãy bắt đầu bằng cách xác định danh sách golden_answers. Việc so sánh câu trả lời chuẩn với câu trả lời của Mô hình A cho thấy giá trị của phương pháp này:
- Câu hỏi 1 (Brain): Câu trả lời được tạo và câu trả lời chuẩn giống hệt nhau. Mô hình A là chính xác.
- Câu hỏi 2 (Thượng viện): Các câu trả lời có nghĩa tương tự nhau nhưng cách diễn đạt khác nhau. Một chỉ số tốt phải nhận ra điều này.
- Câu hỏi 3 (Hasan-Jalalians): Câu trả lời của Mô hình A không chính xác về mặt thực tế theo bối cảnh.
golden_answercho thấy lỗi này.
- Trong một ô mới, hãy xác định danh sách golden_answers
golden_answers = [ "frontal lobe and the parietal lobe", "Due to successes against Catiline.", "The Hasan-Jalalians commanded the area of Artsakh and Utik.", ] - Tạo DataFrame đánh giá được tham chiếu bằng cách chạy mã này trong ô sau:
referenced_eval_dataset_rag_a = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_a,
        "reference": golden_answers,
    }
)

referenced_eval_dataset_rag_b = pd.DataFrame(
    {
        "prompt": [
            "Answer the question: " + question + " Context: " + item
            for question, item in zip(questions, retrieved_contexts)
        ],
        "response": generated_answers_by_rag_b,
        "reference": golden_answers,
    }
)
Các tập dữ liệu hiện đã sẵn sàng để đánh giá theo dữ liệu tham chiếu.
Tạo chỉ số được tham chiếu tuỳ chỉnh
Bạn cũng có thể tạo chỉ số tùy chỉnh để đánh giá dựa trên dữ liệu tham khảo. Quy trình này tương tự, nhưng mẫu câu lệnh hiện bao gồm phần giữ chỗ {reference} cho câu trả lời chuẩn.
Với câu trả lời "đúng" rõ ràng, bạn có thể sử dụng cách chấm điểm nhị phân nghiêm ngặt hơn (ví dụ: 1 cho câu trả lời đúng, 0 cho câu trả lời sai) để đo lường độ chính xác về mặt dữ kiện. Hãy tạo một chỉ số question_answering_correctness mới để triển khai logic này.
- Xác định mẫu câu lệnh. Trong một ô mới, hãy thêm và chạy mã sau:
question_answering_correctness_prompt_template = """ You are a professional writing evaluator. Your job is to score writing responses according to pre-defined evaluation criteria. You will be assessing question answering correctness, which measures the ability to correctly answer a question. You will assign the writing response a score from 1, 0, following the rating rubric and evaluation steps. ### Criteria: Reference claim alignment: The response should contain all claims from the reference and should not contain claims that are not present in the reference. ### Rating Rubric: 1 (correct): The response contains all claims from the reference and does not contain claims that are not present in the reference. 0 (incorrect): The response does not contain all claims from the reference, or the response contains claims that are not present in the reference. ### Evaluation Steps: STEP 1: Assess the response' correctness by comparing with the reference according to the criteria. STEP 2: Score based on the rubrics. Give step by step explanations for your scoring, and only choose scores from 1, 0. # User Inputs and AI-generated Response ## User Inputs ### Prompt {prompt} ## Reference {reference} ## AI-generated Response {response} """ - Gói chuỗi mẫu câu lệnh bên trong một đối tượng PointwiseMetric. Thao tác này sẽ đặt tên chính thức cho chỉ số và biến chỉ số đó thành một thành phần có thể sử dụng lại cho công việc đánh giá. Thêm và chạy mã sau trong một ô mới:
question_answering_correctness = PointwiseMetric(
    metric="question_answering_correctness",
    metric_prompt_template=question_answering_correctness_prompt_template,
)
Giờ đây, bạn đã có một chỉ số tuỳ chỉnh, được tham chiếu để kiểm tra dữ kiện một cách nghiêm ngặt.
12. Chạy quy trình Đánh giá có tham chiếu
Bây giờ, bạn sẽ định cấu hình công việc đánh giá bằng các tập dữ liệu được tham chiếu và chỉ số mới. Bạn sẽ sử dụng lại lớp EvalTask.
Danh sách chỉ số hiện kết hợp chỉ số dựa trên mô hình tuỳ chỉnh với các chỉ số dựa trên phép tính. Đánh giá có tham chiếu cho phép sử dụng các chỉ số truyền thống, dựa trên tính toán để thực hiện so sánh toán học giữa văn bản được tạo và văn bản tham chiếu. Bạn sẽ sử dụng 3 loại phổ biến:
exact_match: Chỉ đạt 1 điểm nếu câu trả lời được tạo giống hệt với câu trả lời tham khảo, nếu không thì đạt 0 điểm.bleu: Chỉ số về độ chính xác. Chỉ số này đo lường số từ trong câu trả lời được tạo cũng xuất hiện trong câu trả lời tham khảo.rouge: Chỉ số về độ ghi nhớ. Chỉ số này đo lường số từ trong câu trả lời tham khảo được ghi lại trong câu trả lời được tạo.
- Định cấu hình công việc đánh giá bằng các tập dữ liệu được tham chiếu và tổ hợp chỉ số mới. Trong một ô mới, hãy thêm và chạy mã sau để tạo các đối tượng
EvalTask:referenced_answer_eval_task_rag_a = EvalTask( dataset=referenced_eval_dataset_rag_a, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) referenced_answer_eval_task_rag_b = EvalTask( dataset=referenced_eval_dataset_rag_b, metrics=[ question_answering_correctness, "rouge", "bleu", "exact_match", ], experiment=EXPERIMENT, ) - Thực thi quy trình đánh giá được tham chiếu bằng cách gọi phương thức
.evaluate(). Thêm và chạy mã này trong một ô mới:referenced_result_rag_a = referenced_answer_eval_task_rag_a.evaluate() referenced_result_rag_b = referenced_answer_eval_task_rag_b.evaluate()
13. Phân tích kết quả được tham chiếu
Quá trình đánh giá đã hoàn tất. Trong nhiệm vụ này, bạn sẽ phân tích kết quả để đo lường độ chính xác về mặt thực tế của các mô hình bằng cách so sánh câu trả lời của các mô hình đó với câu trả lời tham khảo chuẩn.
Xem kết quả tóm tắt
- Phân tích kết quả tóm tắt cho bản đánh giá được tham chiếu. Trong một ô mới, hãy thêm và chạy mã sau để hiển thị bảng tóm tắt cho cả hai mô hình:
notebook_utils.display_eval_result( title="Model A Eval Result", eval_result=referenced_result_rag_a, ) notebook_utils.display_eval_result( title="Model B Eval Result", eval_result=referenced_result_rag_b, )question_answering_correctnessnhưng đạt điểm thấp hơn trênexact_match. Điều này cho thấy giá trị của các chỉ số dựa trên mô hình có thể nhận ra sự tương đồng về ngữ nghĩa, chứ không chỉ văn bản giống hệt nhau.
Trực quan hoá kết quả để so sánh
Hình ảnh trực quan có thể giúp bạn thấy rõ hơn khoảng cách về hiệu suất giữa hai mô hình. Trước tiên, hãy kết hợp các kết quả thành một danh sách duy nhất để vẽ biểu đồ, sau đó tạo biểu đồ radar và biểu đồ thanh.
- Kết hợp các kết quả đánh giá được tham chiếu thành một danh sách duy nhất để vẽ biểu đồ. Thêm và chạy mã sau trong một ô mới:
referenced_eval_results = [] referenced_eval_results.append(("Model A", referenced_result_rag_a)) referenced_eval_results.append(("Model B", referenced_result_rag_b)) - Tạo biểu đồ radar để trực quan hoá hiệu suất của từng mô hình trên tập hợp chỉ số mới. Thêm và chạy mã này trong một ô mới:
notebook_utils.display_radar_plot( referenced_eval_results, metrics=[ "question_answering_correctness", "rouge", "bleu", "exact_match", ], ) - Tạo biểu đồ thanh để so sánh trực tiếp, song song. Thao tác này sẽ cho biết hiệu suất của từng mô hình theo các chỉ số khác nhau. Thêm và chạy mã sau trong một ô mới:
notebook_utils.display_bar_plot(
    referenced_eval_results,
    metrics=[
        "question_answering_correctness",
        "rouge",
        "bleu",
        "exact_match",
    ],
)
Những hình ảnh trực quan này xác nhận rằng Mô hình A chính xác hơn đáng kể và phù hợp với thực tế hơn so với Mô hình B.
14. Từ thực hành đến sản xuất
Bạn đã thực thi thành công một quy trình đánh giá hoàn chỉnh cho hệ thống RAG. Phần cuối này tóm tắt các khái niệm chiến lược chính mà bạn đã học và cung cấp một khung để áp dụng các kỹ năng này vào các dự án thực tế.
Các phương pháp hay nhất về môi trường phát hành chính thức
Để áp dụng các kỹ năng trong phòng thí nghiệm này vào môi trường thực tế, hãy cân nhắc 4 phương pháp chính sau:
- Tự động hoá bằng CI/CD: Tích hợp bộ đánh giá vào quy trình CI/CD (ví dụ: Cloud Build, GitHub Actions). Tự động chạy quy trình đánh giá khi có thay đổi về mã để phát hiện lỗi hồi quy và chặn việc triển khai nếu điểm chất lượng giảm xuống dưới mức tiêu chuẩn của bạn.
- Phát triển tập dữ liệu: Tập dữ liệu tĩnh sẽ trở nên lỗi thời. Quản lý phiên bản cho các tập dữ liệu thử nghiệm "vàng" (bằng Git LFS hoặc Cloud Storage) và liên tục thêm các ví dụ mới, khó bằng cách lấy mẫu từ các truy vấn thực tế (đã ẩn danh) của người dùng.
- Đánh giá trình truy xuất, không chỉ trình tạo: Không thể có câu trả lời hay nếu không có bối cảnh phù hợp. Triển khai một bước đánh giá riêng cho hệ thống truy xuất bằng các chỉ số như Tỷ lệ truy xuất thành công (đã tìm thấy đúng tài liệu chưa?) và Thứ hạng nghịch đảo trung bình (MRR) (tài liệu phù hợp được xếp hạng cao đến mức nào?).
- Theo dõi các chỉ số theo thời gian: Xuất điểm tóm tắt từ các lần chạy đánh giá sang một dịch vụ như Google Cloud Monitoring. Tạo trang tổng quan để theo dõi xu hướng chất lượng và thiết lập cảnh báo tự động để thông báo cho bạn khi hiệu suất giảm đáng kể.
Ma trận phương pháp đánh giá nâng cao
Việc chọn phương pháp đánh giá phù hợp phụ thuộc vào mục tiêu cụ thể của bạn. Bảng này tóm tắt thời điểm sử dụng từng phương pháp.
Phương pháp đánh giá | Các trường hợp sử dụng phù hợp nhất | Lợi ích chính | Giới hạn |
Không có tệp đối chiếu | Giám sát hoạt động sản xuất, đánh giá liên tục | Không cần câu trả lời chuẩn, nắm bắt chất lượng chủ quan | Tốn kém hơn, có thể có sự thiên vị của người đánh giá |
Dựa trên tệp đối chiếu | So sánh mô hình, đo điểm chuẩn | Đo lường khách quan, tính toán nhanh hơn | Yêu cầu câu trả lời chuẩn, có thể bỏ lỡ sự tương đương về ngữ nghĩa |
Chỉ số tuỳ chỉnh | Đánh giá theo miền cụ thể | Phù hợp với nhu cầu của doanh nghiệp | Cần xác thực, tốn chi phí phát triển |
Phương pháp kết hợp | Hệ thống sản xuất toàn diện | Tốt nhất trong tất cả các phương pháp | Độ phức tạp cao hơn, cần tối ưu hoá chi phí |
Thông tin chi tiết quan trọng về kỹ thuật
Hãy lưu ý những nguyên tắc cốt lõi sau đây khi bạn xây dựng và đánh giá hệ thống RAG của riêng mình:
- Tính có căn cứ là yếu tố quan trọng đối với RAG: Chỉ số này luôn phân biệt giữa hệ thống RAG chất lượng cao và chất lượng thấp, nên đây là chỉ số cần thiết để giám sát hoạt động sản xuất.
- Nhiều chỉ số mang lại độ tin cậy cao: Không có chỉ số nào nắm bắt được tất cả các khía cạnh của chất lượng RAG. Việc đánh giá toàn diện đòi hỏi nhiều khía cạnh đánh giá.
- Chỉ số tuỳ chỉnh mang lại giá trị đáng kể: Tiêu chí đánh giá theo miền cụ thể thường nắm bắt được những điểm khác biệt nhỏ mà các chỉ số chung bỏ qua, giúp cải thiện độ chính xác của kết quả đánh giá.
- Sự chặt chẽ về mặt thống kê giúp tăng độ tin cậy: Quy mô mẫu phù hợp và thử nghiệm ý nghĩa thống kê giúp chuyển đổi việc đánh giá từ phỏng đoán thành công cụ ra quyết định đáng tin cậy.
Khung quyết định triển khai thực tế
Hãy sử dụng khung theo từng giai đoạn này làm hướng dẫn cho các hoạt động triển khai hệ thống RAG trong tương lai:
- Giai đoạn 1 – Phát triển: Sử dụng phương pháp đánh giá dựa trên dữ liệu tham chiếu với các tập dữ liệu kiểm thử đã biết để so sánh mô hình và lựa chọn mô hình.
- Giai đoạn 2 – Trước khi phát hành công khai: Chạy quy trình đánh giá toàn diện kết hợp cả hai phương pháp để xác thực mức độ sẵn sàng phát hành công khai.
- Giai đoạn 3 – Sản xuất: Triển khai quy trình giám sát không cần dữ liệu tham chiếu để liên tục đánh giá chất lượng mà không cần câu trả lời chuẩn.
- Giai đoạn 4 – Tối ưu hoá: Sử dụng thông tin chi tiết từ quá trình đánh giá để hướng dẫn mức độ cải thiện được mô hình hoá và nâng cao hệ thống truy xuất.
15. Kết luận
Xin chúc mừng! Bạn đã hoàn tất bài thực hành.
Phòng thí nghiệm này nằm trong Lộ trình học tập về AI sẵn sàng cho môi trường thực tế với Google Cloud.
- Khám phá toàn bộ chương trình học để thu hẹp khoảng cách từ nguyên mẫu đến sản phẩm chính thức.
- Chia sẻ tiến trình của bạn bằng hashtag
ProductionReadyAI.
Tóm tắt
Bạn đã tìm hiểu cách:
- Thực hiện đánh giá không cần tham chiếu để đánh giá chất lượng của câu trả lời dựa trên bối cảnh được truy xuất.
- Thực hiện đánh giá có tham chiếu bằng cách thêm "câu trả lời chuẩn" để đo lường độ chính xác về mặt thực tế.
- Sử dụng kết hợp các chỉ số tạo sẵn và chỉ số tuỳ chỉnh cho cả hai phương pháp.
- Sử dụng cả chỉ số dựa trên mô hình (như
question_answering_quality) và chỉ số dựa trên tính toán (rouge,bleu,exact_match). - Phân tích và trực quan hoá kết quả để hiểu rõ điểm mạnh và điểm yếu của mô hình.
Phương pháp đánh giá này giúp bạn xây dựng các ứng dụng AI tạo sinh đáng tin cậy và chính xác hơn.