
1. מבוא
סקירה כללית
יצירה משולבת-אחזור (RAG) משפרת את התשובות של מודלים גדולים של שפה (LLM) על ידי עיגון שלהן בידע חיצוני. עם זאת, כדי לבנות מערכת RAG מוכנה לייצור, צריך יותר מסתם חיפוש וקטורי פשוט. אתם צריכים לבצע אופטימיזציה של אופן ההטמעה של הנתונים, של דירוג התוצאות הרלוונטיות ושל עיבוד השאילתות של המשתמשים.
בשיעור ה-Lab המקיף הזה, תיצרו אפליקציית RAG חזקה באמצעות Cloud SQL ל-PostgreSQL (עם pgvector) ו-Vertex AI. תתקדמו בשלוש טכניקות מתקדמות:
- אסטרטגיות של חלוקה לחלקים: תראו איך שיטות שונות של פיצול טקסט (תו, רקורסיבי, טוקן) משפיעות על איכות האחזור.
- דירוג מחדש: תטמיעו את Vertex AI Reranker כדי לשפר את תוצאות החיפוש ולפתור את הבעיה של 'אובדן באמצע'.
- שינוי שאילתות: תשתמשו ב-Gemini כדי לבצע אופטימיזציה של שאילתות משתמשים באמצעות טכניקות כמו HyDE (הטמעות של מסמכים היפותטיים) והנחיות שלב-אחורה.
הפעולות שתבצעו:
- מגדירים מכונה של Cloud SQL ל-PostgreSQL באמצעות
pgvector. - תבנו פייפליין להעברת נתונים שמחלק טקסט לחלקים באמצעות כמה אסטרטגיות, ומאחסן הטבעות ב-Cloud SQL.
- אפשר לבצע חיפושים סמנטיים ולהשוות את איכות התוצאות משיטות שונות של חלוקה לקטעים.
- שילוב של רכיב לדירוג מחדש כדי לסדר מחדש את המסמכים שאוחזרו על סמך הרלוונטיות שלהם.
- הטמעת טרנספורמציות של שאילתות שמבוססות על LLM כדי לשפר את השליפה של תשובות לשאלות מורכבות או דו-משמעיות.
מה תלמדו
- איך משתמשים ב-LangChain עם Vertex AI ו-Cloud SQL.
- ההשפעה של מפצלי טקסט מסוג Character, Recursive ו-Token.
- איך מטמיעים את התכונה חיפוש וקטורים ב-PostgreSQL.
- איך משתמשים ב-ContextualCompressionRetriever לדירוג מחדש.
- איך מטמיעים את HyDE ואת Step-back Prompting.
2. הגדרת הפרויקט
חשבון Google
אם אין לכם חשבון Google אישי, אתם צריכים ליצור חשבון Google.
משתמשים בחשבון לשימוש אישי במקום בחשבון לצורכי עבודה או בחשבון בית ספרי.
כניסה למסוף Google Cloud
נכנסים למסוף Google Cloud באמצעות חשבון Google אישי.
הפעלת חיוב
מימוש קרדיטים ב-Google Cloud (אופציונלי)
כדי להשתתף בסדנה הזו, צריך חשבון לחיוב עם יתרה מסוימת. כדי להתחיל, משתמשים בקרדיטים מהבאנר בחלק העליון של ה-codelab הזה. אם כבר קישרתם חשבון לחיוב, אתם יכולים לדלג על השלב הזה.
הגדרה של חשבון לחיוב לשימוש אישי
אם הגדרתם חיוב באמצעות קרדיטים ל-Google Cloud, אתם יכולים לדלג על השלב הזה.
כדי להגדיר חשבון לחיוב לשימוש אישי, עוברים לכאן כדי להפעיל את החיוב במסוף Cloud.
הערות:
- העלות של השלמת ה-Lab הזה צריכה להיות פחות מ-1 דולר ארה"ב במשאבי Cloud.
- כדי להימנע מחיובים נוספים, אפשר למחוק את המשאבים בסיום ה-Lab.
- משתמשים חדשים זכאים לתקופת ניסיון בחינם בשווי 300$.
יצירת פרויקט (אופציונלי)
אם אין לכם פרויקט שאתם רוצים להשתמש בו במעבדה הזו, אתם יכולים ליצור פרויקט חדש כאן.
3. פתיחת Cloud Shell Editor
- כדי לעבור ישירות אל Cloud Shell Editor, לוחצים על הקישור הזה.
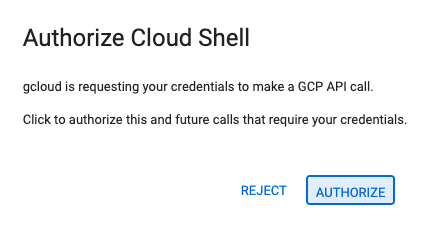
- אם תתבקשו לאשר בשלב כלשהו היום, לחצו על אישור כדי להמשיך.
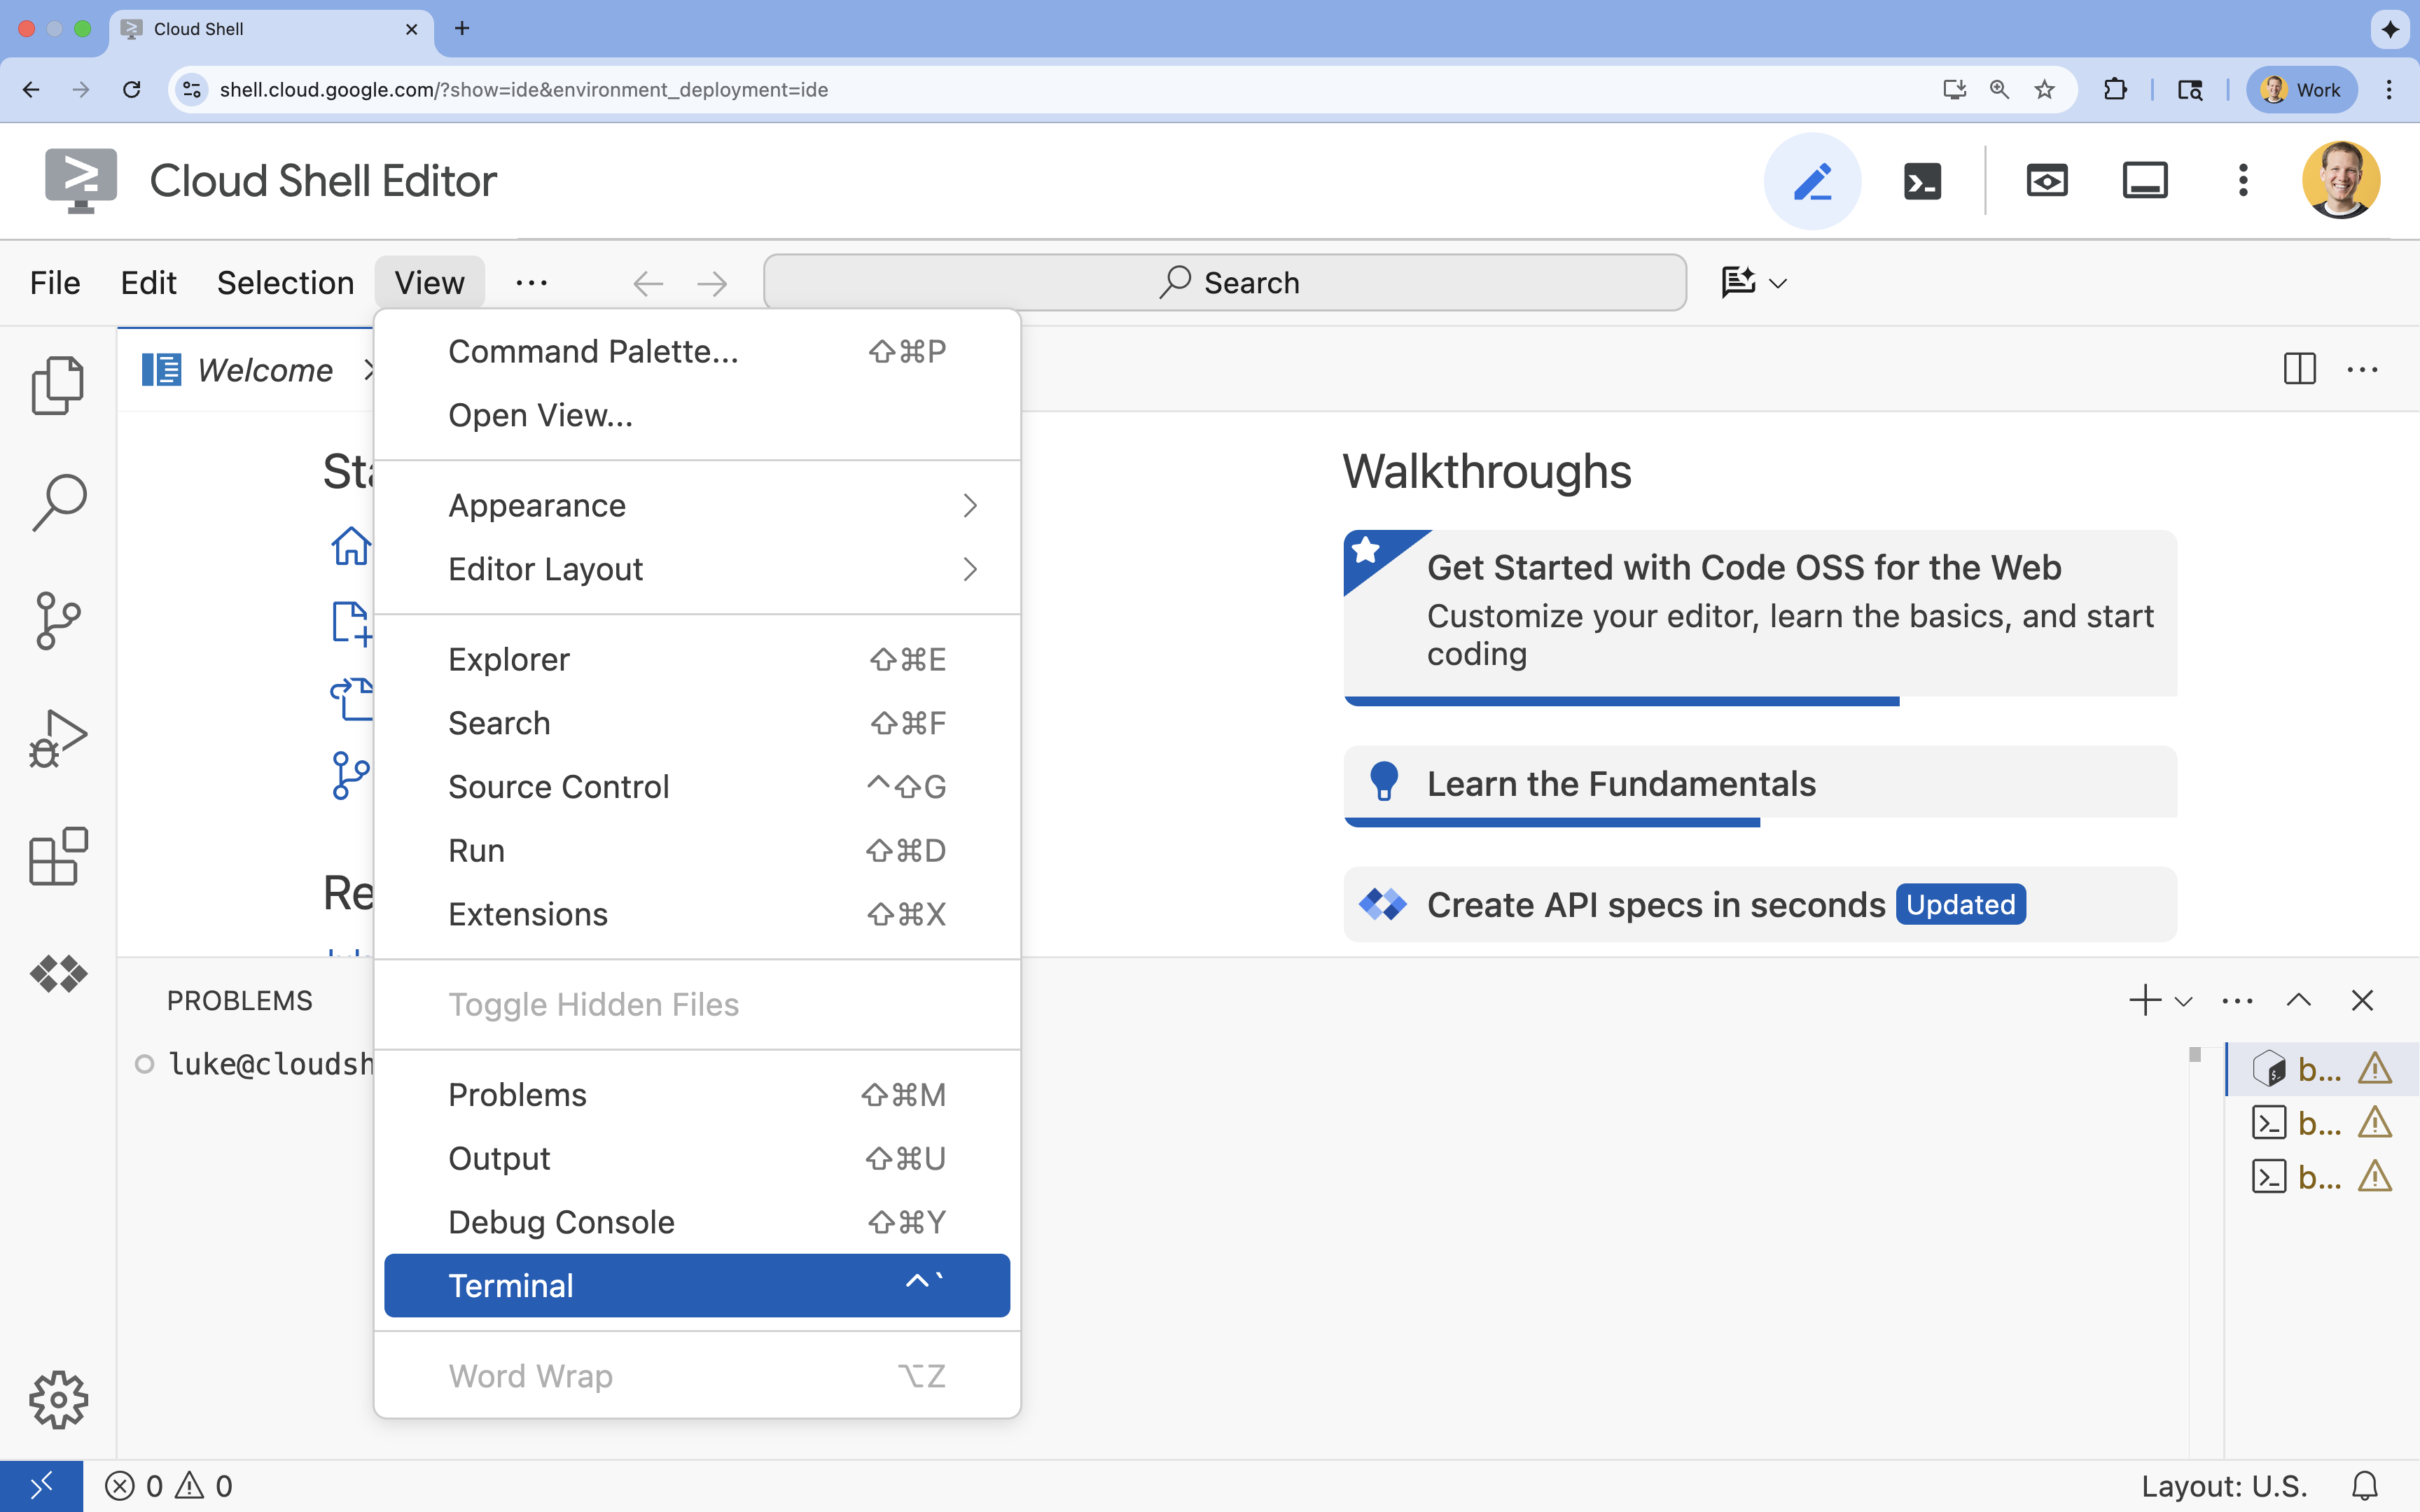
- אם הטרמינל לא מופיע בתחתית המסך, פותחים אותו:
- לוחצים על הצגה.
- לוחצים על Terminal (טרמינל)
 .
- בטרמינל, מגדירים את הפרויקט באמצעות הפקודה הבאה:
gcloud config set project [PROJECT_ID]- דוגמה:
gcloud config set project lab-project-id-example - אם אתם לא זוכרים את מזהה הפרויקט, אתם יכולים להציג את כל מזהי הפרויקטים באמצעות הפקודה:
gcloud projects list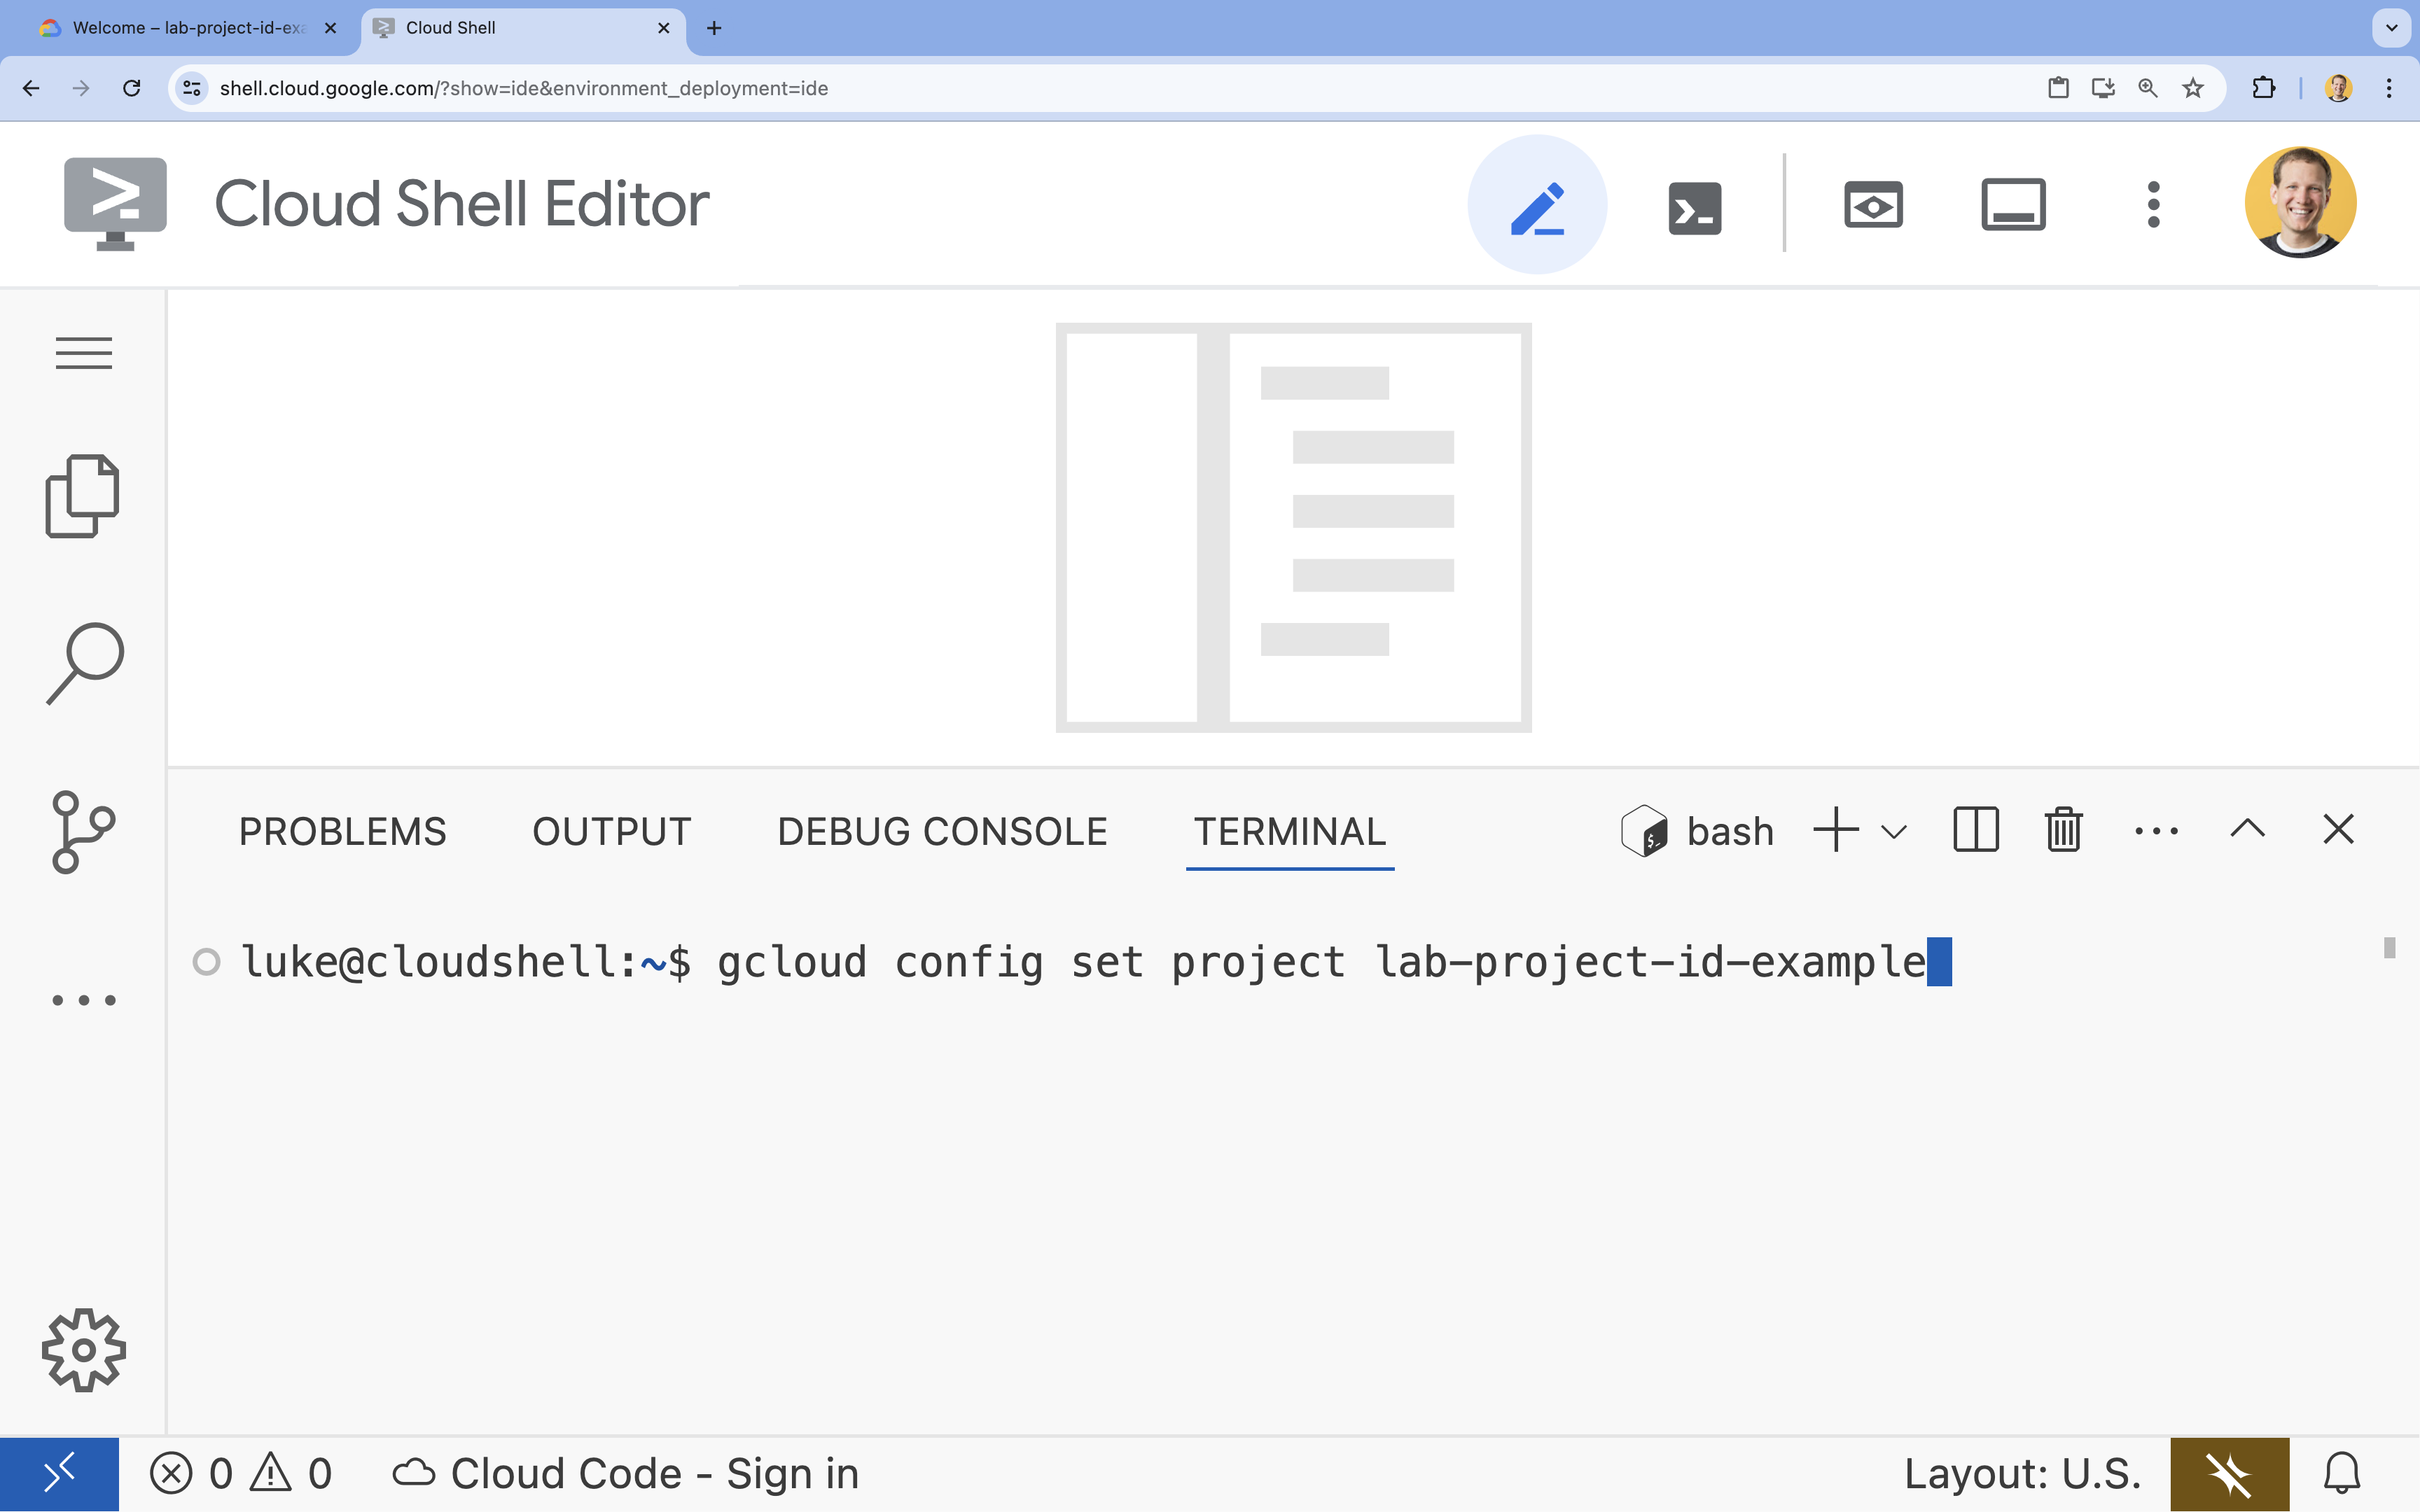
- דוגמה:
- אמורה להופיע ההודעה הבאה:
Updated property [core/project].
4. הפעלת ממשקי ה-API
כדי לבנות את הפתרון הזה, צריך להפעיל כמה ממשקי Google Cloud API עבור Vertex AI, Cloud SQL ושירות הדירוג מחדש.
- בטרמינל, מפעילים את ממשקי ה-API:
gcloud services enable \
  aiplatform.googleapis.com \
  sqladmin.googleapis.com \
  cloudresourcemanager.googleapis.com \
  serviceusage.googleapis.com \
  discoveryengine.googleapis.com
מבוא לממשקי ה-API
- Vertex AI API (
aiplatform.googleapis.com): מאפשר שימוש ב-Gemini ליצירה וב-Vertex AI Embeddings ליצירת וקטורים מטקסט. - Cloud SQL Admin API (
sqladmin.googleapis.com): מאפשר לכם לנהל מופעים של Cloud SQL באופן פרוגרמטי. - Discovery Engine API (
discoveryengine.googleapis.com): מפעיל את היכולות של Vertex AI Reranker. - Service Usage API (
serviceusage.googleapis.com): נדרש כדי לבדוק ולנהל מכסות שירות.
5. יצירת סביבה וירטואלית והתקנת יחסי תלות
לפני שמתחילים פרויקט Python, מומלץ ליצור סביבה וירטואלית. כך מבודדים את התלויות של הפרויקט ומונעים התנגשויות עם פרויקטים אחרים או עם חבילות Python גלובליות של המערכת.
- יוצרים תיקייה בשם
rag-labsועוברים אליה. מריצים את הקוד הבא בטרמינל:mkdir rag-labs && cd rag-labs - יוצרים ומפעילים סביבה וירטואלית:
uv venv --python 3.12 source .venv/bin/activate - יוצרים קובץ
requirements.txtעם התלויות הנדרשות. מריצים את הקוד הבא בטרמינל:cloudshell edit requirements.txt - מדביקים את יחסי התלות שעברו אופטימיזציה הבאים ב-
requirements.txt. הגרסאות האלה מוצמדות כדי למנוע התנגשויות ולזרז את ההתקנה.# Core LangChain & AI langchain-community==0.3.31 langchain-google-vertexai==2.1.2 langchain-google-community[vertexaisearch]==2.0.10 # Google Cloud google-cloud-storage==2.19.0 google-cloud-aiplatform[langchain]==1.130.0 # Database cloud-sql-python-connector[pg8000]==1.19.0 sqlalchemy==2.0.45 pgvector==0.4.2 # Utilities tiktoken==0.12.0 python-dotenv==1.2.1 requests==2.32.5 - מתקינים את יחסי התלות:
uv pip install -r requirements.txt
6. הגדרה של Cloud SQL ל-PostgreSQL
במשימה הזו תקצו מכונה של Cloud SQL ל-PostgreSQL, תיצרו מסד נתונים ותכינו אותו לחיפוש וקטורי.
הגדרת Cloud SQL
- יוצרים קובץ
.envלאחסון ההגדרות. מריצים את הקוד הבא בטרמינל:cloudshell edit .env - מדביקים את ההגדרה הבאה ב-
.env.# Project Config PROJECT_ID="[YOUR_PROJECT_ID]" REGION="us-central1" # Database Config SQL_INSTANCE_NAME="rag-pg-instance-1" SQL_DATABASE_NAME="rag_harry_potter_db" SQL_USER="rag_user" SQL_PASSWORD="StrongPassword123!" # RAG Config PGVECTOR_COLLECTION_NAME="rag_harry_potter" RANKING_LOCATION_ID="global" # Connection Name (Auto-generated in scripts usually, but useful to have) DB_INSTANCE_CONNECTION_NAME="${PROJECT_ID}:${REGION}:${SQL_INSTANCE_NAME}" - מחליפים את
[YOUR_PROJECT_ID]במזהה הפרויקט בפועל ב-Google Cloud. (לדוגמה,PROJECT_ID = "google-cloud-labs")
אם אתם לא זוכרים את מזהה הפרויקט, מריצים את הפקודה הבאה בטרמינל. תופיע רשימה של כל הפרויקטים והמזהים שלהם.gcloud projects list - טוענים את המשתנים לסשן המעטפת:
source .env
יצירת מכונה ומסד נתונים
- יוצרים מכונה של Cloud SQL ל-PostgreSQL. הפקודה הזו יוצרת מופע קטן שמתאים לתרגול הזה.
gcloud sql instances create ${SQL_INSTANCE_NAME} \ --database-version=POSTGRES_15 \ --tier=db-g1-small \ --region=${REGION} \ --project=${PROJECT_ID} - אחרי שהמופע מוכן, יוצרים את מסד הנתונים:
gcloud sql databases create ${SQL_DATABASE_NAME} \ --instance=${SQL_INSTANCE_NAME} \ --project=${PROJECT_ID} - יוצרים את משתמש מסד הנתונים:
gcloud sql users create ${SQL_USER} \
  --instance=${SQL_INSTANCE_NAME} \
  --password=${SQL_PASSWORD} \
  --project=${PROJECT_ID}
הפעלת התוסף pgvector
התוסף pgvector מאפשר ל-PostgreSQL לאחסן הטמעות של וקטורים ולחפש אותן. צריך להפעיל אותו באופן מפורש במסד הנתונים.
- יוצרים סקריפט בשם
enable_pgvector.py. מריצים את הקוד הבא בטרמינל:cloudshell edit enable_pgvector.py - הדביקו את הקוד הבא ב-
enable_pgvector.py. הסקריפט הזה מתחבר למסד הנתונים ומריץ את הפקודהCREATE EXTENSION IF NOT EXISTS vector;.import os import sqlalchemy from google.cloud.sql.connector import Connector, IPTypes import logging from dotenv import load_dotenv load_dotenv() logging.basicConfig(level=logging.INFO) # Config project_id = os.getenv("PROJECT_ID") region = os.getenv("REGION") instance_name = os.getenv("SQL_INSTANCE_NAME") db_user = os.getenv("SQL_USER") db_pass = os.getenv("SQL_PASSWORD") db_name = os.getenv("SQL_DATABASE_NAME") instance_connection_name = f"{project_id}:{region}:{instance_name}" def getconn(): with Connector() as connector: conn = connector.connect( instance_connection_name, "pg8000", user=db_user, password=db_pass, db=db_name, ip_type=IPTypes.PUBLIC, ) return conn def enable_pgvector(): pool = sqlalchemy.create_engine( "postgresql+pg8000://", creator=getconn, ) with pool.connect() as db_conn: # Check if extension exists result = db_conn.execute(sqlalchemy.text("SELECT extname FROM pg_extension WHERE extname = 'vector';")).fetchone() if result: logging.info("pgvector extension is already enabled.") else: logging.info("Enabling pgvector extension...") db_conn.execute(sqlalchemy.text("CREATE EXTENSION IF NOT EXISTS vector;")) db_conn.commit() logging.info("pgvector extension enabled successfully.") if __name__ == "__main__": enable_pgvector() - מריצים את הסקריפט:
python enable_pgvector.py
7. חלק 1: אסטרטגיות של חלוקה לחלקים
השלב הראשון בכל צינור RAG הוא המרת מסמכים לפורמט שה-LLM יכול להבין: chunks.
למודלי שפה גדולים יש מגבלה על חלון ההקשר (כמות הטקסט שהם יכולים לעבד בבת אחת). בנוסף, אם מאחזרים מסמך בן 50 עמודים כדי לענות על שאלה ספציפית, המידע מתפזר. אנחנו מפצלים מסמכים ל'חלקים' קטנים יותר כדי לבודד מידע רלוונטי.
עם זאת, האופן שבו מפצלים את הטקסט חשוב מאוד:
- פיצול לפי תו: פיצול לפי מספר התווים. השיטה הזו מהירה אבל מסוכנת: היא עלולה לחתוך מילים או משפטים באמצע, ולפגוע במשמעות הסמנטית.
- Recursive Splitter: מנסה לפצל לפי פסקה, אחר כך לפי משפט ואז לפי מילה. הוא מנסה לשמור על יחידות סמנטיות ביחד.
- פיצול טוקנים: פיצול שמבוסס על אוצר המילים (טוקנים) של ה-LLM. כך אפשר לוודא שהחלקים יתאימו באופן מושלם לחלונות ההקשר, אבל יכול להיות שיידרשו יותר משאבים חישוביים כדי ליצור אותם.
בקטע הזה, תבצעו הטמעה של אותם נתונים באמצעות כל שלוש האסטרטגיות כדי להשוות ביניהן.
יצירת סקריפט ההטמעה
תשתמשו בסקריפט שמוריד קבוצת נתונים של הארי פוטר, מפצל אותה באמצעות האסטרטגיות Character, Recursive ו-Token, ומעלה את ההטבעות לשלוש טבלאות נפרדות ב-Cloud SQL.
- יוצרים את הקובץ
ingest_data.py:cloudshell edit ingest_data.py - מדביקים את הקוד המתוקן הבא ב-
ingest_data.py. הגרסה הזו מנתחת בצורה נכונה את מבנה ה-JSON של מערך הנתונים.import os import json import logging import requests from typing import List, Dict, Any from dotenv import load_dotenv from google.cloud.sql.connector import Connector, IPTypes from langchain_google_vertexai import VertexAIEmbeddings from langchain_community.vectorstores import PGVector from langchain.text_splitter import CharacterTextSplitter, RecursiveCharacterTextSplitter, TokenTextSplitter from langchain.docstore.document import Document load_dotenv() logging.basicConfig(level=logging.INFO) # Configuration PROJECT_ID = os.getenv("PROJECT_ID") REGION = os.getenv("REGION") DB_USER = os.getenv("SQL_USER") DB_PASS = os.getenv("SQL_PASSWORD") DB_NAME = os.getenv("SQL_DATABASE_NAME") INSTANCE_CONNECTION_NAME = f"{PROJECT_ID}:{REGION}:{os.getenv('SQL_INSTANCE_NAME')}" BASE_COLLECTION_NAME = os.getenv("PGVECTOR_COLLECTION_NAME") BOOKS_JSON_URL = "https://storage.googleapis.com/github-repo/generative-ai/gemini/reasoning-engine/sample_data/harry_potter_books.json" CHUNK_SIZE = 500 CHUNK_OVERLAP = 50 MAX_DOCS_TO_PROCESS = 10 # Database Connector def getconn(): with Connector() as connector: return connector.connect( INSTANCE_CONNECTION_NAME, "pg8000", user=DB_USER, password=DB_PASS, db=DB_NAME, ip_type=IPTypes.PUBLIC, ) def download_data(): logging.info(f"Downloading data from {BOOKS_JSON_URL}...") response = requests.get(BOOKS_JSON_URL) return response.json() def prepare_chunks(json_data, strategy): documents = [] # Iterate through the downloaded data for entry in json_data[:MAX_DOCS_TO_PROCESS]: # --- JSON PARSING LOGIC --- # The data structure nests content inside 'kwargs' -> 'page_content' if "kwargs" in entry and "page_content" in entry["kwargs"]: content = entry["kwargs"]["page_content"] # Extract metadata if available, ensuring it's a dict metadata = entry["kwargs"].get("metadata", {}) if not isinstance(metadata, dict): metadata = {"source": "unknown"} # Add the strategy to metadata for tracking metadata["strategy"] = strategy else: continue if not content: continue # Choose the splitter based on the strategy if strategy == "character": splitter = CharacterTextSplitter(chunk_size=CHUNK_SIZE, chunk_overlap=CHUNK_OVERLAP, separator="\n") elif strategy == "token": splitter = TokenTextSplitter(chunk_size=CHUNK_SIZE, chunk_overlap=CHUNK_OVERLAP) else: # default to recursive splitter = RecursiveCharacterTextSplitter(chunk_size=CHUNK_SIZE, chunk_overlap=CHUNK_OVERLAP) # Split the content into chunks chunks = splitter.split_text(content) # Create Document objects for each chunk for chunk in chunks: documents.append(Document(page_content=chunk, metadata=metadata)) return documents def main(): logging.info("Initializing Embeddings...") embeddings = VertexAIEmbeddings(model_name="gemini-embedding-001", project=PROJECT_ID, location=REGION) data = download_data() strategies = ["character", "recursive", "token"] # Connection string for PGVector (uses the getconn helper) pg_conn_str = f"postgresql+pg8000://{DB_USER}:{DB_PASS}@placeholder/{DB_NAME}" for strategy in strategies: collection_name = f"{BASE_COLLECTION_NAME}_{strategy}" logging.info(f"--- Processing strategy: {strategy.upper()} ---") logging.info(f"Target Collection: {collection_name}") # Prepare documents with the specific strategy docs = prepare_chunks(data, strategy) if not docs: logging.warning(f"No documents generated for strategy {strategy}. Check data source.") continue logging.info(f"Generated {len(docs)} chunks. Uploading to Cloud SQL...") # Initialize the Vector Store store = PGVector( collection_name=collection_name, embedding_function=embeddings, connection_string=pg_conn_str, engine_args={"creator": getconn}, pre_delete_collection=True # Clears old data for this collection before adding new ) # Batch add documents store.add_documents(docs) logging.info(f"Successfully finished {strategy}.\n") if __name__ == "__main__": main() - מריצים את סקריפט ההטמעה. כך יתווספו למסד הנתונים שלכם שלוש טבלאות (אוספים) שונות.
python ingest_data.py
השוואה בין תוצאות של חלוקה לקטעים
אחרי שהנתונים נטענו, נריץ שאילתה על כל שלושת האוספים כדי לראות איך אסטרטגיית החלוקה לחלקים משפיעה על התוצאות.
- יצירת
query_chunking.py:cloudshell edit query_chunking.py - מדביקים את הקוד הבא ב-
query_chunking.py:import os import logging from dotenv import load_dotenv from google.cloud.sql.connector import Connector, IPTypes from langchain_google_vertexai import VertexAIEmbeddings from langchain_community.vectorstores import PGVector load_dotenv() logging.basicConfig(level=logging.ERROR) # Only show errors to keep output clean # Config PROJECT_ID = os.getenv("PROJECT_ID") REGION = os.getenv("REGION") DB_USER = os.getenv("SQL_USER") DB_PASS = os.getenv("SQL_PASSWORD") DB_NAME = os.getenv("SQL_DATABASE_NAME") INSTANCE_CONNECTION_NAME = f"{PROJECT_ID}:{REGION}:{os.getenv('SQL_INSTANCE_NAME')}" BASE_COLLECTION_NAME = os.getenv("PGVECTOR_COLLECTION_NAME") def getconn(): with Connector() as connector: return connector.connect( INSTANCE_CONNECTION_NAME, "pg8000", user=DB_USER, password=DB_PASS, db=DB_NAME, ip_type=IPTypes.PUBLIC, ) def main(): embeddings = VertexAIEmbeddings(model_name="gemini-embedding-001", project=PROJECT_ID, location=REGION) pg_conn_str = f"postgresql+pg8000://{DB_USER}:{DB_PASS}@placeholder/{DB_NAME}" query = "Tell me about the Dursleys and their relationship with Harry Potter" print(f"\nQUERY: {query}\n" + "="*50) strategies = ["character", "recursive", "token"] for strategy in strategies: collection = f"{BASE_COLLECTION_NAME}_{strategy}" print(f"\nSTRATEGY: {strategy.upper()}") store = PGVector( collection_name=collection, embedding_function=embeddings, connection_string=pg_conn_str, engine_args={"creator": getconn} ) results = store.similarity_search_with_score(query, k=2) for i, (doc, score) in enumerate(results): print(f" Result {i+1} (Score: {score:.4f}): {doc.page_content[:150].replace(chr(10), ' ')}...") if __name__ == "__main__": main() - מריצים את סקריפט השאילתה:
python query_chunking.py
בודקים את הפלט.
שימו לב שהפיצול לפי תווים עלול לחתוך משפטים באמצע, בעוד שהפיצול רקורסיבי מנסה להתחשב בגבולות הפסקאות. פיצול טוקנים מבטיח שהחלקים יתאימו באופן מושלם לחלונות ההקשר של מודלים מסוג LLM, אבל יכול להיות שהמערכת תתעלם מהמבנה הסמנטי.
8. חלק 2: דירוג מחדש
חיפוש וקטורי (אחזור) הוא מהיר מאוד כי הוא מסתמך על ייצוגים מתמטיים דחוסים (הטמעות). היא מקיפה טווח רחב כדי להבטיח אחזור (מציאת כל הפריטים שיכולים להיות רלוונטיים), אבל לעיתים קרובות היא סובלת מדיוק נמוך (הדירוג של הפריטים האלה עשוי להיות לא מושלם).
לעתים קרובות, מסמכים רלוונטיים הולכים לאיבוד באמצע רשימת התוצאות. מודל LLM שמתמקד ב-5 התוצאות הראשונות עלול לפספס את התשובה החשובה שנמצאת במיקום 7.
דירוג מחדש פותר את הבעיה הזו על ידי הוספת שלב שני.
- שליפה: שליפה של קבוצה גדולה יותר (לדוגמה, 25 התוצאות הראשונות) באמצעות חיפוש וקטורי מהיר.
- מדרג מחדש: משתמש במודל ייעודי (כמו Cross-Encoder) כדי לבחון את הטקסט המלא של צמדי השאילתות והמסמכים. היא איטית יותר אבל הרבה יותר מדויקת. היא מחשבת מחדש את הניקוד של 25 התוצאות הראשונות ומחזירה את 3 התוצאות הכי טובות.
במשימה הזו תחפשו באוסף recursive שנוצר בחלק 1, אבל הפעם תשתמשו ב-Vertex AI Reranker כדי לשפר את התוצאות.
- יצירת
query_reranking.py:cloudshell edit query_reranking.py - מדביקים את הקוד הבא. שימו לב שהיא מכוונת באופן מפורש לאיסוף
_recursiveומשתמשת בContextualCompressionRetriever.import os import logging from dotenv import load_dotenv from google.cloud.sql.connector import Connector, IPTypes from langchain_google_vertexai import VertexAIEmbeddings from langchain_community.vectorstores import PGVector # Reranking Imports from langchain.retrievers import ContextualCompressionRetriever from langchain_google_community.vertex_rank import VertexAIRank load_dotenv() logging.basicConfig(level=logging.ERROR) PROJECT_ID = os.getenv("PROJECT_ID") REGION = os.getenv("REGION") DB_USER = os.getenv("SQL_USER") DB_PASS = os.getenv("SQL_PASSWORD") DB_NAME = os.getenv("SQL_DATABASE_NAME") INSTANCE_CONNECTION_NAME = f"{PROJECT_ID}:{REGION}:{os.getenv('SQL_INSTANCE_NAME')}" # IMPORTANT: Target the recursive collection created in ingest_data.py COLLECTION_NAME = f"{os.getenv('PGVECTOR_COLLECTION_NAME')}_recursive" RANKING_LOCATION = os.getenv("RANKING_LOCATION_ID") def getconn(): with Connector() as connector: return connector.connect( INSTANCE_CONNECTION_NAME, "pg8000", user=DB_USER, password=DB_PASS, db=DB_NAME, ip_type=IPTypes.PUBLIC, ) def main(): embeddings = VertexAIEmbeddings(model_name="gemini-embedding-001", project=PROJECT_ID, location=REGION) pg_conn_str = f"postgresql+pg8000://{DB_USER}:{DB_PASS}@placeholder/{DB_NAME}" print(f"Connecting to collection: {COLLECTION_NAME}") store = PGVector( collection_name=COLLECTION_NAME, embedding_function=embeddings, connection_string=pg_conn_str, engine_args={"creator": getconn} ) query = "What are the Horcruxes?" print(f"QUERY: {query}\n") # 1. Base Retriever (Vector Search) - Fetch top 10 base_retriever = store.as_retriever(search_kwargs={"k": 10}) # 2. Reranker - Select top 3 from the 10 reranker = VertexAIRank( project_id=PROJECT_ID, location_id=RANKING_LOCATION, ranking_config="default_ranking_config", title_field="source", top_n=3 ) compression_retriever = ContextualCompressionRetriever( base_compressor=reranker, base_retriever=base_retriever ) # Execute try: reranked_docs = compression_retriever.invoke(query) if not reranked_docs: print("No documents returned. Check if the collection exists and is populated.") print(f"--- Top 3 Reranked Results ---") for i, doc in enumerate(reranked_docs): print(f"Result {i+1} (Score: {doc.metadata.get('relevance_score', 'N/A')}):") print(f" {doc.page_content[:200]}...\n") except Exception as e: print(f"Error during reranking: {e}") if __name__ == "__main__": main() - מריצים את שאילתת הדירוג מחדש:
python query_reranking.py
Observe
יכול להיות שתבחינו בציוני רלוונטיות גבוהים יותר או בסדר שונה בהשוואה לחיפוש וקטורי גולמי. כך מובטח שה-LLM יקבל את ההקשר הכי מדויק שאפשר.
9. חלק 3: שינוי השאילתה
לרוב, צוואר הבקבוק הכי גדול ב-RAG הוא המשתמש. לרוב, השאילתות של המשתמשים הן דו-משמעיות, לא שלמות או לא מנוסחות היטב. אם ההטמעה של השאילתה לא תואמת מבחינה מתמטית להטמעה של המסמך, השליפה תיכשל.
המרת שאילתות משתמשת ב-LLM כדי לשכתב או להרחיב את השאילתה לפני שהיא מגיעה למסד הנתונים. תטמיעו שתי טכניקות:
- HyDE (Hypothetical Document Embeddings): הדמיון הווקטורי בין שאלה לתשובה לרוב נמוך יותר מהדמיון בין תשובה לבין תשובה היפותטית. HyDE מבקש מ-LLM להמציא תשובה מושלמת, מטמיע אותה ומחפש מסמכים שנראים כמו ההמצאה.
- הנחיות לשיפור התשובה: אם משתמש שואל שאלה ספציפית ומפורטת, יכול להיות שהמערכת תפספס את ההקשר הרחב יותר. הנחיית Step-back מבקשת מ-LLM ליצור שאלה מופשטת ברמה גבוהה יותר ("מה ההיסטוריה של המשפחה הזו?") כדי לאחזר מידע בסיסי לצד הפרטים הספציפיים.
- יצירת
query_transformation.py:cloudshell edit query_transformation.py - מדביקים את הקוד הבא:
import os import logging from dotenv import load_dotenv from google.cloud.sql.connector import Connector, IPTypes from langchain_google_vertexai import VertexAIEmbeddings, VertexAI from langchain_community.vectorstores import PGVector from langchain_core.prompts import PromptTemplate load_dotenv() logging.basicConfig(level=logging.ERROR) PROJECT_ID = os.getenv("PROJECT_ID") REGION = os.getenv("REGION") DB_USER = os.getenv("SQL_USER") DB_PASS = os.getenv("SQL_PASSWORD") DB_NAME = os.getenv("SQL_DATABASE_NAME") INSTANCE_CONNECTION_NAME = f"{PROJECT_ID}:{REGION}:{os.getenv('SQL_INSTANCE_NAME')}" COLLECTION_NAME = f"{os.getenv('PGVECTOR_COLLECTION_NAME')}_recursive" def getconn(): with Connector() as connector: return connector.connect( INSTANCE_CONNECTION_NAME, "pg8000", user=DB_USER, password=DB_PASS, db=DB_NAME, ip_type=IPTypes.PUBLIC, ) def generate_hyde_doc(query, llm): prompt = PromptTemplate( input_variables=["question"], template="Write a concise, hypothetical answer to the question. Question: {question} Answer:" ) chain = prompt | llm return chain.invoke({"question": query}) def generate_step_back(query, llm): prompt = PromptTemplate( input_variables=["question"], template="Write a more general, abstract question that concepts in this question. Original: {question} Step-back:" ) chain = prompt | llm return chain.invoke({"question": query}) def main(): embeddings = VertexAIEmbeddings(model_name="gemini-embedding-001", project=PROJECT_ID, location=REGION) llm = VertexAI(model_name="gemini-3.5-flash", project=PROJECT_ID, location=REGION, temperature=0.5) pg_conn_str = f"postgresql+pg8000://{DB_USER}:{DB_PASS}@placeholder/{DB_NAME}" store = PGVector( collection_name=COLLECTION_NAME, embedding_function=embeddings, connection_string=pg_conn_str, engine_args={"creator": getconn} ) retriever = store.as_retriever(search_kwargs={"k": 2}) original_query = "Tell me about the Dursleys." print(f"ORIGINAL QUERY: {original_query}\n" + "-"*30) # 1. HyDE hyde_doc = generate_hyde_doc(original_query, llm) print(f"HyDE Generated Doc: {hyde_doc.strip()[:100]}...") hyde_results = retriever.invoke(hyde_doc) print(f"HyDE Retrieval: {hyde_results[0].page_content[:100]}...\n") # 2. Step-back step_back_q = generate_step_back(original_query, llm) print(f"Step-back Query: {step_back_q.strip()}") step_results = retriever.invoke(step_back_q) print(f"Step-back Retrieval: {step_results[0].page_content[:100]}...") if __name__ == "__main__": main() - מריצים את סקריפט השינוי:
python query_transformation.py
בודקים את הפלט.
שימו לב איך שאילתת Step-back עשויה לאחזר הקשר רחב יותר לגבי ההיסטוריה של משפחת דרסלי, בעוד ש-HyDE מתמקדת בפרטים הספציפיים שנוצרו בתשובה ההיפותטית.
10. חלק 4: יצירה מקצה לקצה
קיצצנו את הנתונים, שיפרנו את החיפוש וליטשנו את השאילתה של המשתמש. עכשיו, סוף-סוף אנחנו מגיעים ל-G ב-RAG: יצירה.
עד עכשיו רק חיפשנו מידע. כדי ליצור עוזר AI אמיתי, אנחנו צריכים להזין את המסמכים האיכותיים האלה, שדורגו מחדש, למודל שפה גדול (Gemini) כדי ליצור תשובה בשפה טבעית.
בצינור הפקה, התהליך הזה כולל זרימה ספציפית:
- אחזור: קבלת קבוצה רחבה של מועמדים (לדוגמה, 10 המובילים) באמצעות חיפוש וקטורי מהיר.
- דירוג מחדש: סינון כדי להגיע לתוצאות הכי טובות (לדוגמה, 3 התוצאות הראשונות) באמצעות Vertex AI Reranker.
- יצירת הקשר: חיבור התוכן של 3 המסמכים המובילים למחרוזת אחת.
- הנחיה מבוססת: מוסיפים את מחרוזת ההקשר לתבנית פרומפט קפדנית שמכריחה את מודל ה-LLM להשתמש רק במידע הזה.
יצירת סקריפט ליצירה
נשתמש ב-gemini-3.5-flash בשלב היצירה. המודל הזה אידיאלי ל-RAG כי יש לו חלון הקשר ארוך וזמן אחזור קצר, כך שהוא יכול לעבד במהירות כמה מסמכים שאוחזרו.
- יצירת
end_to_end_rag.py:
cloudshell edit end_to_end_rag.py
- מדביקים את הקוד הבא. שימו לב למשתנה
template– כאן אנחנו מנחים את המודל באופן חד משמעי להימנע מ "הזיות" (המצאת דברים) על ידי קישור שלו להקשר שסופק.
import os
import logging
from dotenv import load_dotenv
from google.cloud.sql.connector import Connector, IPTypes
from langchain_google_vertexai import VertexAIEmbeddings, VertexAI
from langchain_community.vectorstores import PGVector
from langchain.retrievers import ContextualCompressionRetriever
from langchain_google_community.vertex_rank import VertexAIRank
from langchain.prompts import PromptTemplate
from langchain.chains import LLMChain

load_dotenv()
logging.basicConfig(level=logging.ERROR)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION")
# We use the recursive collection as it generally provides the best context boundaries
COLLECTION_NAME = f"{os.getenv('PGVECTOR_COLLECTION_NAME')}_recursive"

def getconn():
    instance_conn = f"{PROJECT_ID}:{REGION}:{os.getenv('SQL_INSTANCE_NAME')}"
    with Connector() as connector:
        return connector.connect(
            instance_conn, "pg8000",
            user=os.getenv("SQL_USER"), password=os.getenv("SQL_PASSWORD"),
            db=os.getenv("SQL_DATABASE_NAME"), ip_type=IPTypes.PUBLIC
        )

def main():
    print("--- Initializing Production RAG Pipeline ---")

    # 1. Setup Embeddings (Gemini Embedding 001)
    # We use this to vectorize the user's query to match our database.
    embeddings = VertexAIEmbeddings(model_name="gemini-embedding-001", project=PROJECT_ID, location=REGION)

    # 2. Connect to Vector Store
    pg_conn_str = f"postgresql+pg8000://{os.getenv('SQL_USER')}:{os.getenv('SQL_PASSWORD')}@placeholder/{os.getenv('SQL_DATABASE_NAME')}"
    store = PGVector(
        collection_name=COLLECTION_NAME,
        embedding_function=embeddings,
        connection_string=pg_conn_str,
        engine_args={"creator": getconn}
    )

    # 3. Setup The 'Filter Funnel' (Retriever + Reranker)
    # Step A: Fast retrieval of top 10 similar documents
    base_retriever = store.as_retriever(search_kwargs={"k": 10})

    # Step B: Precise reranking to find the top 3 most relevant
    reranker = VertexAIRank(
        project_id=PROJECT_ID,
        location_id="global",
        ranking_config="default_ranking_config",
        title_field="source",
        top_n=3
    )

    # Combine A and B into a single retrieval object
    compression_retriever = ContextualCompressionRetriever(
        base_compressor=reranker,
        base_retriever=base_retriever
    )

    # 4. Setup LLM (Gemini 3.5 Flash)
    # We use a low temperature (0.1) to reduce creativity and increase factual adherence.
    llm = VertexAI(model_name="gemini-3.5-flash", project=PROJECT_ID, location=REGION, temperature=0.1)

    # --- Execution Loop ---
    user_query = "Who is Harry Potter?"
    print(f"\nUser Query: {user_query}")
    print("Retrieving and Reranking documents...")

    # Retrieve the most relevant documents
    top_docs = compression_retriever.invoke(user_query)

    if not top_docs:
        print("No relevant documents found.")
        return

    # Build the Context String
    # We stitch the documents together, labeling them as Source 1, Source 2, etc.
    context_str = "\n\n".join([f"Source {i+1}: {d.page_content}" for i, d in enumerate(top_docs)])

    print(f"Found {len(top_docs)} relevant context chunks.")

    # 5. The Grounded Prompt
    template = """You are a helpful assistant. Answer the question strictly based on the provided context.
    If the answer is not in the context, say "I don't know."

    Context:
    {context}

    Question:
    {question}

    Answer:
    """

    prompt = PromptTemplate(template=template, input_variables=["context", "question"])

    # Create the chain: Prompt -> LLM
    chain = prompt | llm

    print("Generating Answer via Gemini 3.5 Flash...")
    final_answer = chain.invoke({"context": context_str, "question": user_query})

    print(f"\nFINAL ANSWER:\n{final_answer}")

if __name__ == "__main__":
    main()
- מריצים את האפליקציה הסופית:
python end_to_end_rag.py
הסבר על הפלט
כשמריצים את הסקריפט הזה, אפשר לראות את ההבדל בין נתחי המידע הגולמיים שאוחזרו (שראיתם בשלבים הקודמים) לבין התשובה הסופית. מודל ה-LLM פועל כסינתסייזר – הוא קורא את 'חתיכות' הטקסט המפוצלות שסופקו על ידי ה-Reranker ומחבר אותן למשפט קוהרנטי שקריא לאנשים.
על ידי שרשור הרכיבים האלה, אפשר לעבור מניחוש סטוכסטי לתהליך עבודה דטרמיניסטי ומבוסס. מודל האחזור פורס את הרשת, מודל הדירוג מחדש בוחר את השלל הטוב ביותר ומודל היצירה מבשל את הארוחה.
11. סיכום
מעולה! יצרתם בהצלחה צינור עיבוד נתונים מתקדם של RAG, שכולל הרבה יותר מחיפוש וקטורי בסיסי.
Recap
- הגדרתם את Cloud SQL עם pgvector לאחסון וקטורים שניתן להרחבה.
- השוות בין אסטרטגיות של חלוקה לחלקים כדי להבין איך הכנת הנתונים משפיעה על האחזור.
- הטמעתם דירוג מחדש באמצעות Vertex AI כדי לשפר את הדיוק של התוצאות.
- השתמשת בטרנספורמציות של שאילתות (HyDE, Step-back) כדי להתאים את כוונת המשתמש לנתונים שלך.
מידע נוסף
- דוגמאות לארכיטקטורות RAG: רשימה של מדריכים בנושא דוגמאות לארכיטקטורות שקשורות ל-RAG.
מאב טיפוס לייצור
שיעור ה-Lab הזה הוא חלק מתוכנית הלימודים Production-Ready AI with Google Cloud (שימוש ב-AI מוכן לייצור באמצעות Google Cloud).
- כדאי לעיין בתוכנית הלימודים המלאה כדי לגשר על הפער בין אב-טיפוס לבין ייצור.
- שיתוף ההתקדמות עם ההאשטאג #ProductionReadyAI.