

১. ভূমিকা
এই ল্যাবে, আপনি একটি নির্দিষ্ট কাজের জন্য—যেমন আর্টিকেলের সারসংক্ষেপ তৈরি—একটি গুগল জেমিনি মডেলকে অভিযোজিত করতে সুপারভাইজড ফাইন-টিউনিং-এর সম্পূর্ণ কার্যপ্রবাহ সম্পাদন করতে শিখবেন। যদিও বৃহৎ ল্যাঙ্গুয়েজ মডেলগুলো শক্তিশালী, এদের সাধারণ-উদ্দেশ্যমূলক প্রকৃতির কারণে ফাইন-টিউনিং-এর মাধ্যমে নির্দিষ্ট ব্যবহারের জন্য সেগুলোকে আরও বেশি কার্যকর করে তোলা যায়। উদাহরণের একটি উচ্চ-মানের ডেটাসেটে মডেলটিকে প্রশিক্ষণ দিয়ে, আপনি আপনার নির্দিষ্ট কাজের জন্য এর সামঞ্জস্য, গুণমান এবং কার্যকারিতা উন্নত করতে পারেন।
আপনি জেমিনি ৩.৫ ফ্ল্যাশ (Gemini 3.5 Flash) নামক একটি হালকা ও সাশ্রয়ী মডেল ব্যবহার করবেন এবং জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্ম (Gemini Enterprise Agent Platform) ব্যবহার করে সূক্ষ্ম সমন্বয় সাধন করবেন।
স্থাপত্যের সংক্ষিপ্ত বিবরণ
আমরা যা তৈরি করব তা হলো:
- ক্লাউড শেল : আপনার উন্নয়ন পরিবেশ।
- ক্লাউড স্টোরেজ : প্রশিক্ষণ/যাচাই ডেটা JSONL ফরম্যাটে সংরক্ষণ করে।
- জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্ম প্রশিক্ষণ : সূক্ষ্ম সমন্বয়ের কাজটি পরিচালনা করে।
- জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্ম এন্ডপয়েন্ট : আপনার পরিমার্জিত মডেলটি হোস্ট করে।
আপনি যা শিখবেন
- সুপারভাইজড ফাইন-টিউনিংয়ের জন্য উচ্চ মানের ডেটাসেট প্রস্তুত করুন।
- পাইথনের জন্য জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্ম এসডিকে ব্যবহার করে ফাইন-টিউনিং জবগুলি কনফিগার ও চালু করুন।
- স্বয়ংক্রিয় মেট্রিক (ROUGE স্কোর) ব্যবহার করে মডেল মূল্যায়ন করুন।
- উন্নতির পরিমাণ নির্ণয় করতে মূল মডেল এবং পরিমার্জিত মডেলের তুলনা করুন।
২. প্রজেক্ট সেটআপ
গুগল অ্যাকাউন্ট
যদি আপনার আগে থেকে কোনো ব্যক্তিগত গুগল অ্যাকাউন্ট না থাকে, তাহলে আপনাকে অবশ্যই একটি গুগল অ্যাকাউন্ট তৈরি করতে হবে।
কর্মক্ষেত্র বা শিক্ষা প্রতিষ্ঠানের অ্যাকাউন্টের পরিবর্তে ব্যক্তিগত অ্যাকাউন্ট ব্যবহার করুন ।
গুগল ক্লাউড কনসোলে সাইন-ইন করুন
আপনার ব্যক্তিগত গুগল অ্যাকাউন্ট ব্যবহার করে গুগল ক্লাউড কনসোলে সাইন-ইন করুন।
বিলিং সক্ষম করুন
গুগল ক্লাউড ক্রেডিট রিডিম করুন (ঐচ্ছিক)
এই ওয়ার্কশপটি চালানোর জন্য আপনার কিছু ক্রেডিট সহ একটি বিলিং অ্যাকাউন্ট প্রয়োজন। শুরু করার জন্য এই কোডল্যাবের উপরের ব্যানার থেকে ক্রেডিট ব্যবহার করুন। আপনি যদি ইতিমধ্যেই একটি বিলিং অ্যাকাউন্টের সাথে সংযুক্ত থাকেন, তাহলে আপনি এই ধাপটি এড়িয়ে যেতে পারেন।
একটি প্রকল্প তৈরি করুন (ঐচ্ছিক)
এই ল্যাবের জন্য ব্যবহার করার মতো আপনার যদি কোনো চলমান প্রজেক্ট না থাকে, তাহলে এখানে একটি নতুন প্রজেক্ট তৈরি করুন ।
৩. ক্লাউড শেল এডিটর খুলুন
- সরাসরি ক্লাউড শেল এডিটর- এ যেতে এই লিঙ্কে ক্লিক করুন।
- আজ যেকোনো সময়ে অনুমোদনের জন্য অনুরোধ করা হলে, চালিয়ে যাওয়ার জন্য 'অনুমোদন করুন' (Authorize) বোতামে ক্লিক করুন।
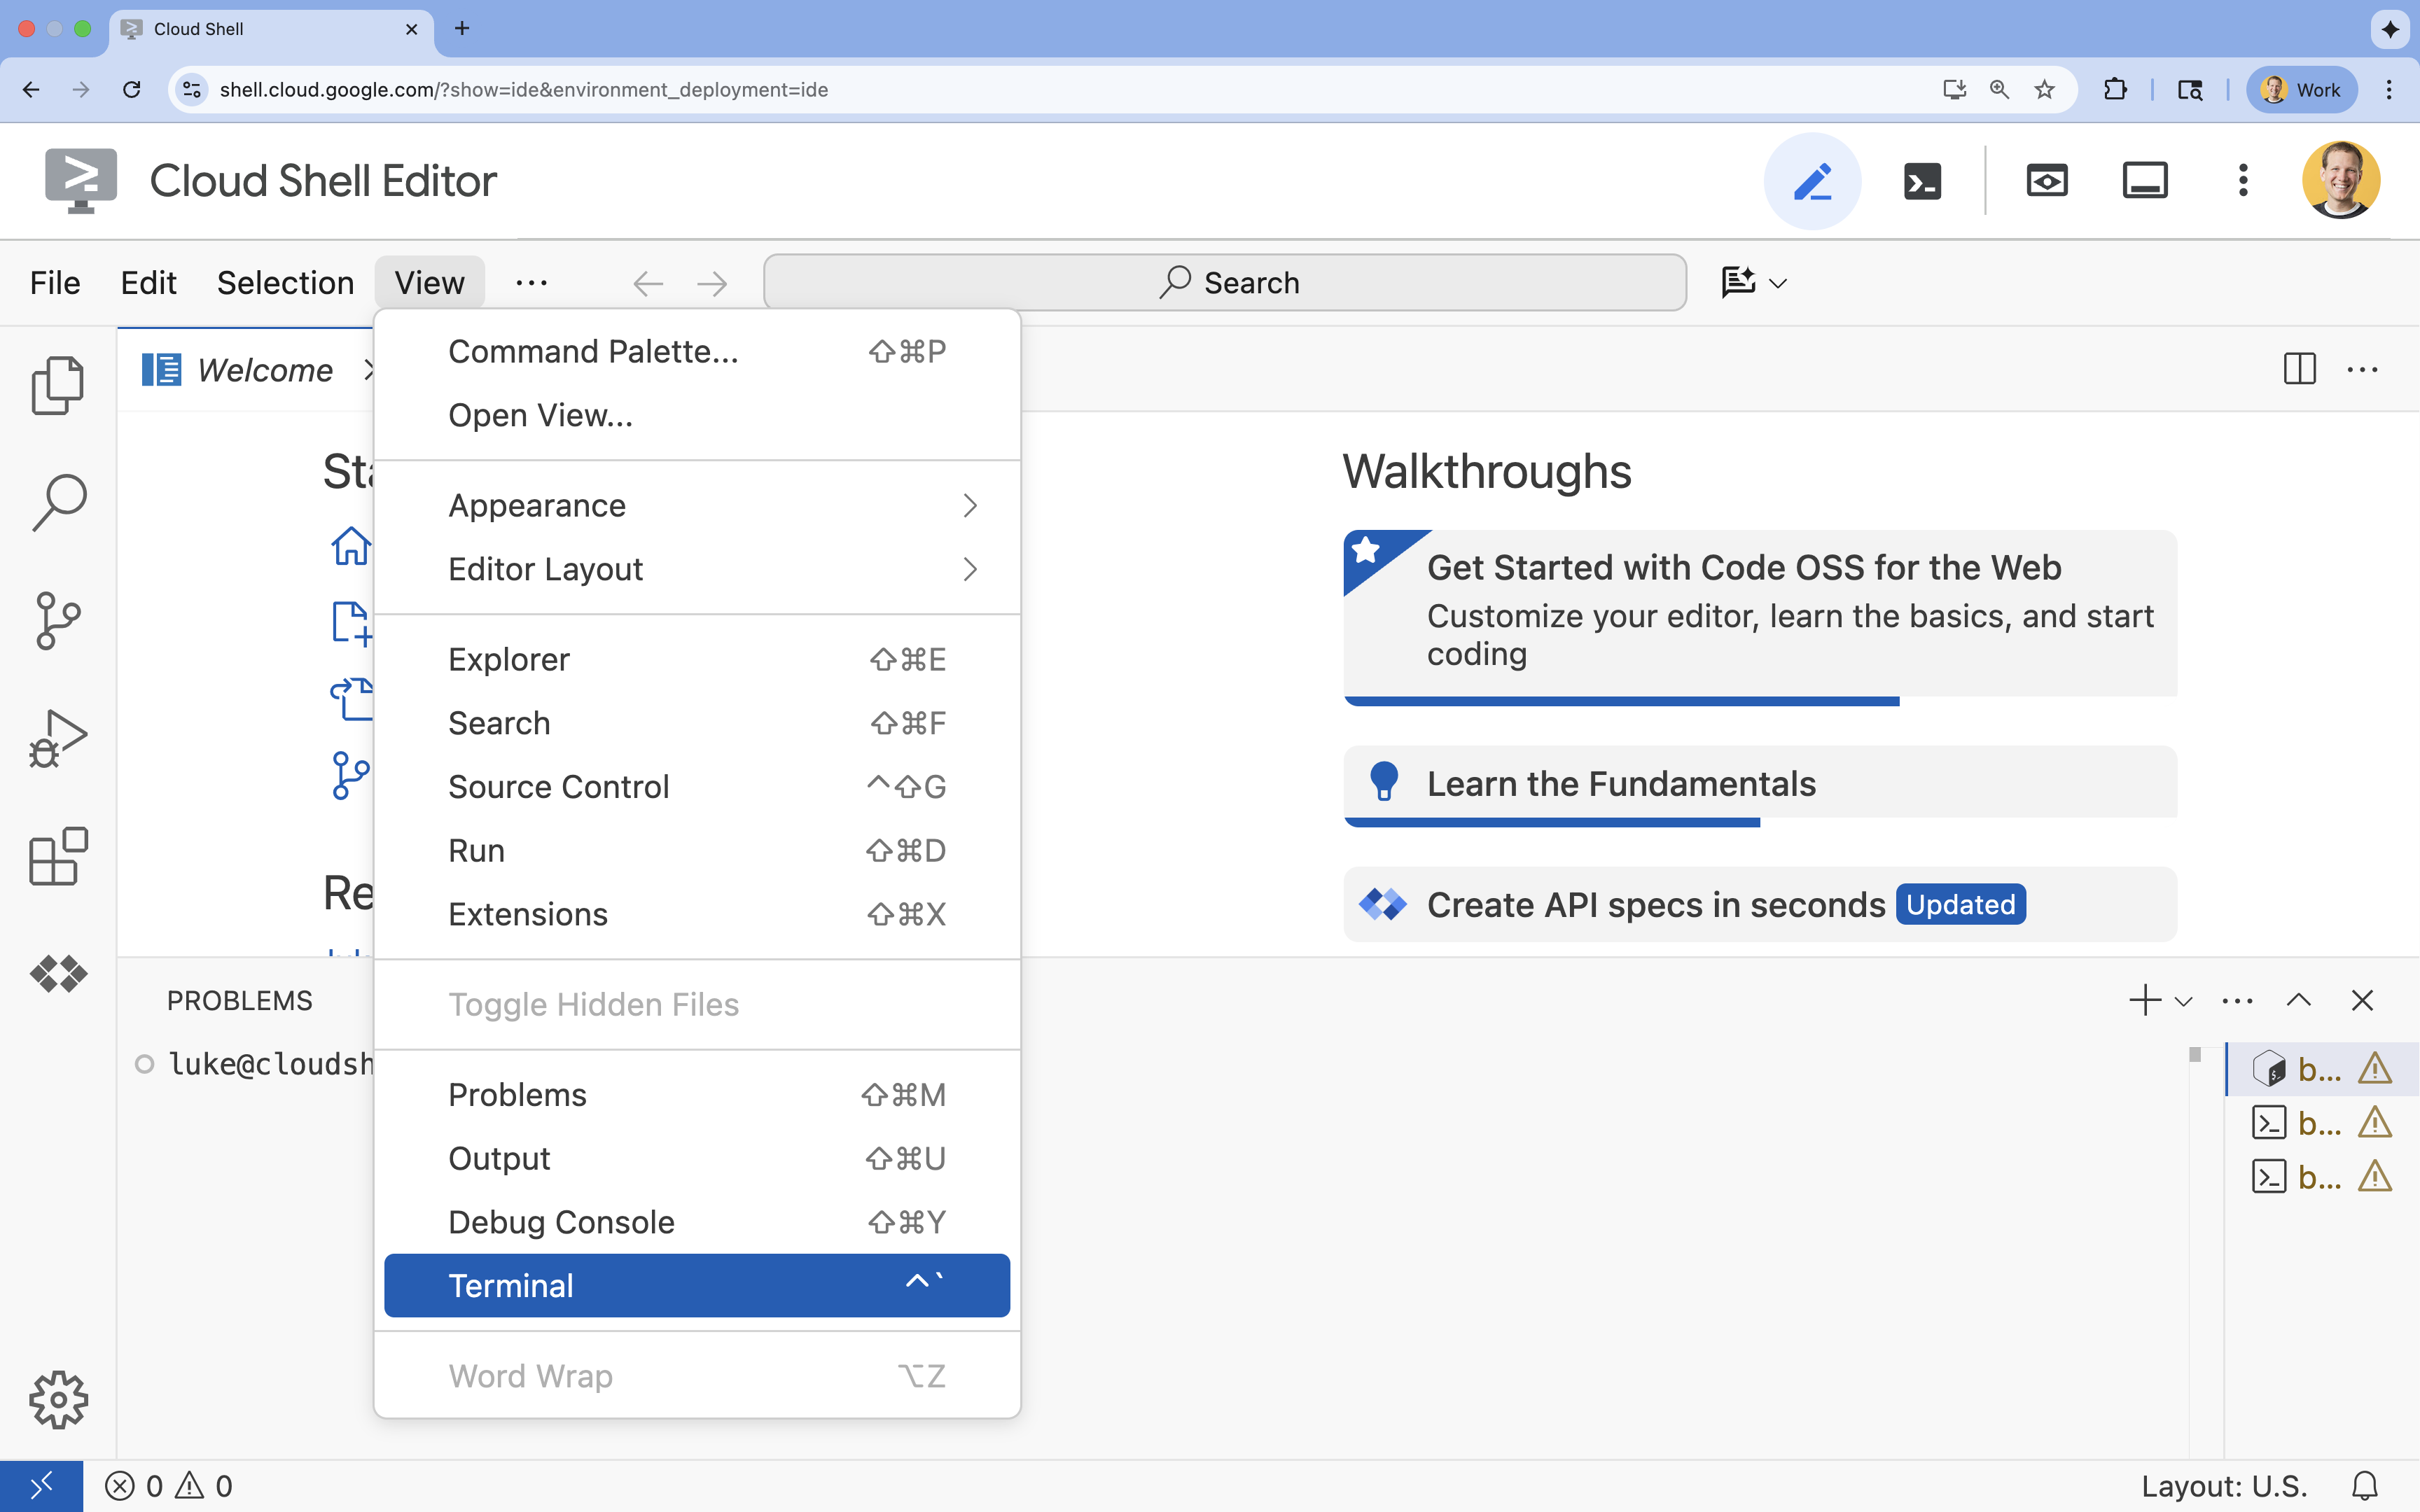
- যদি স্ক্রিনের নিচে টার্মিনালটি দেখা না যায়, তাহলে এটি খুলুন:
- ভিউ ক্লিক করুন
- টার্মিনালে ক্লিক করুন
- টার্মিনালে এই কমান্ডটি দিয়ে আপনার প্রজেক্ট সেট করুন:
gcloud config set project [PROJECT_ID]- উদাহরণ:
gcloud config set project lab-project-id-example - আপনি যদি আপনার প্রজেক্ট আইডি মনে রাখতে না পারেন, তাহলে নিম্নলিখিত উপায়ে আপনার সমস্ত প্রজেক্ট আইডি তালিকাভুক্ত করতে পারেন:
gcloud projects list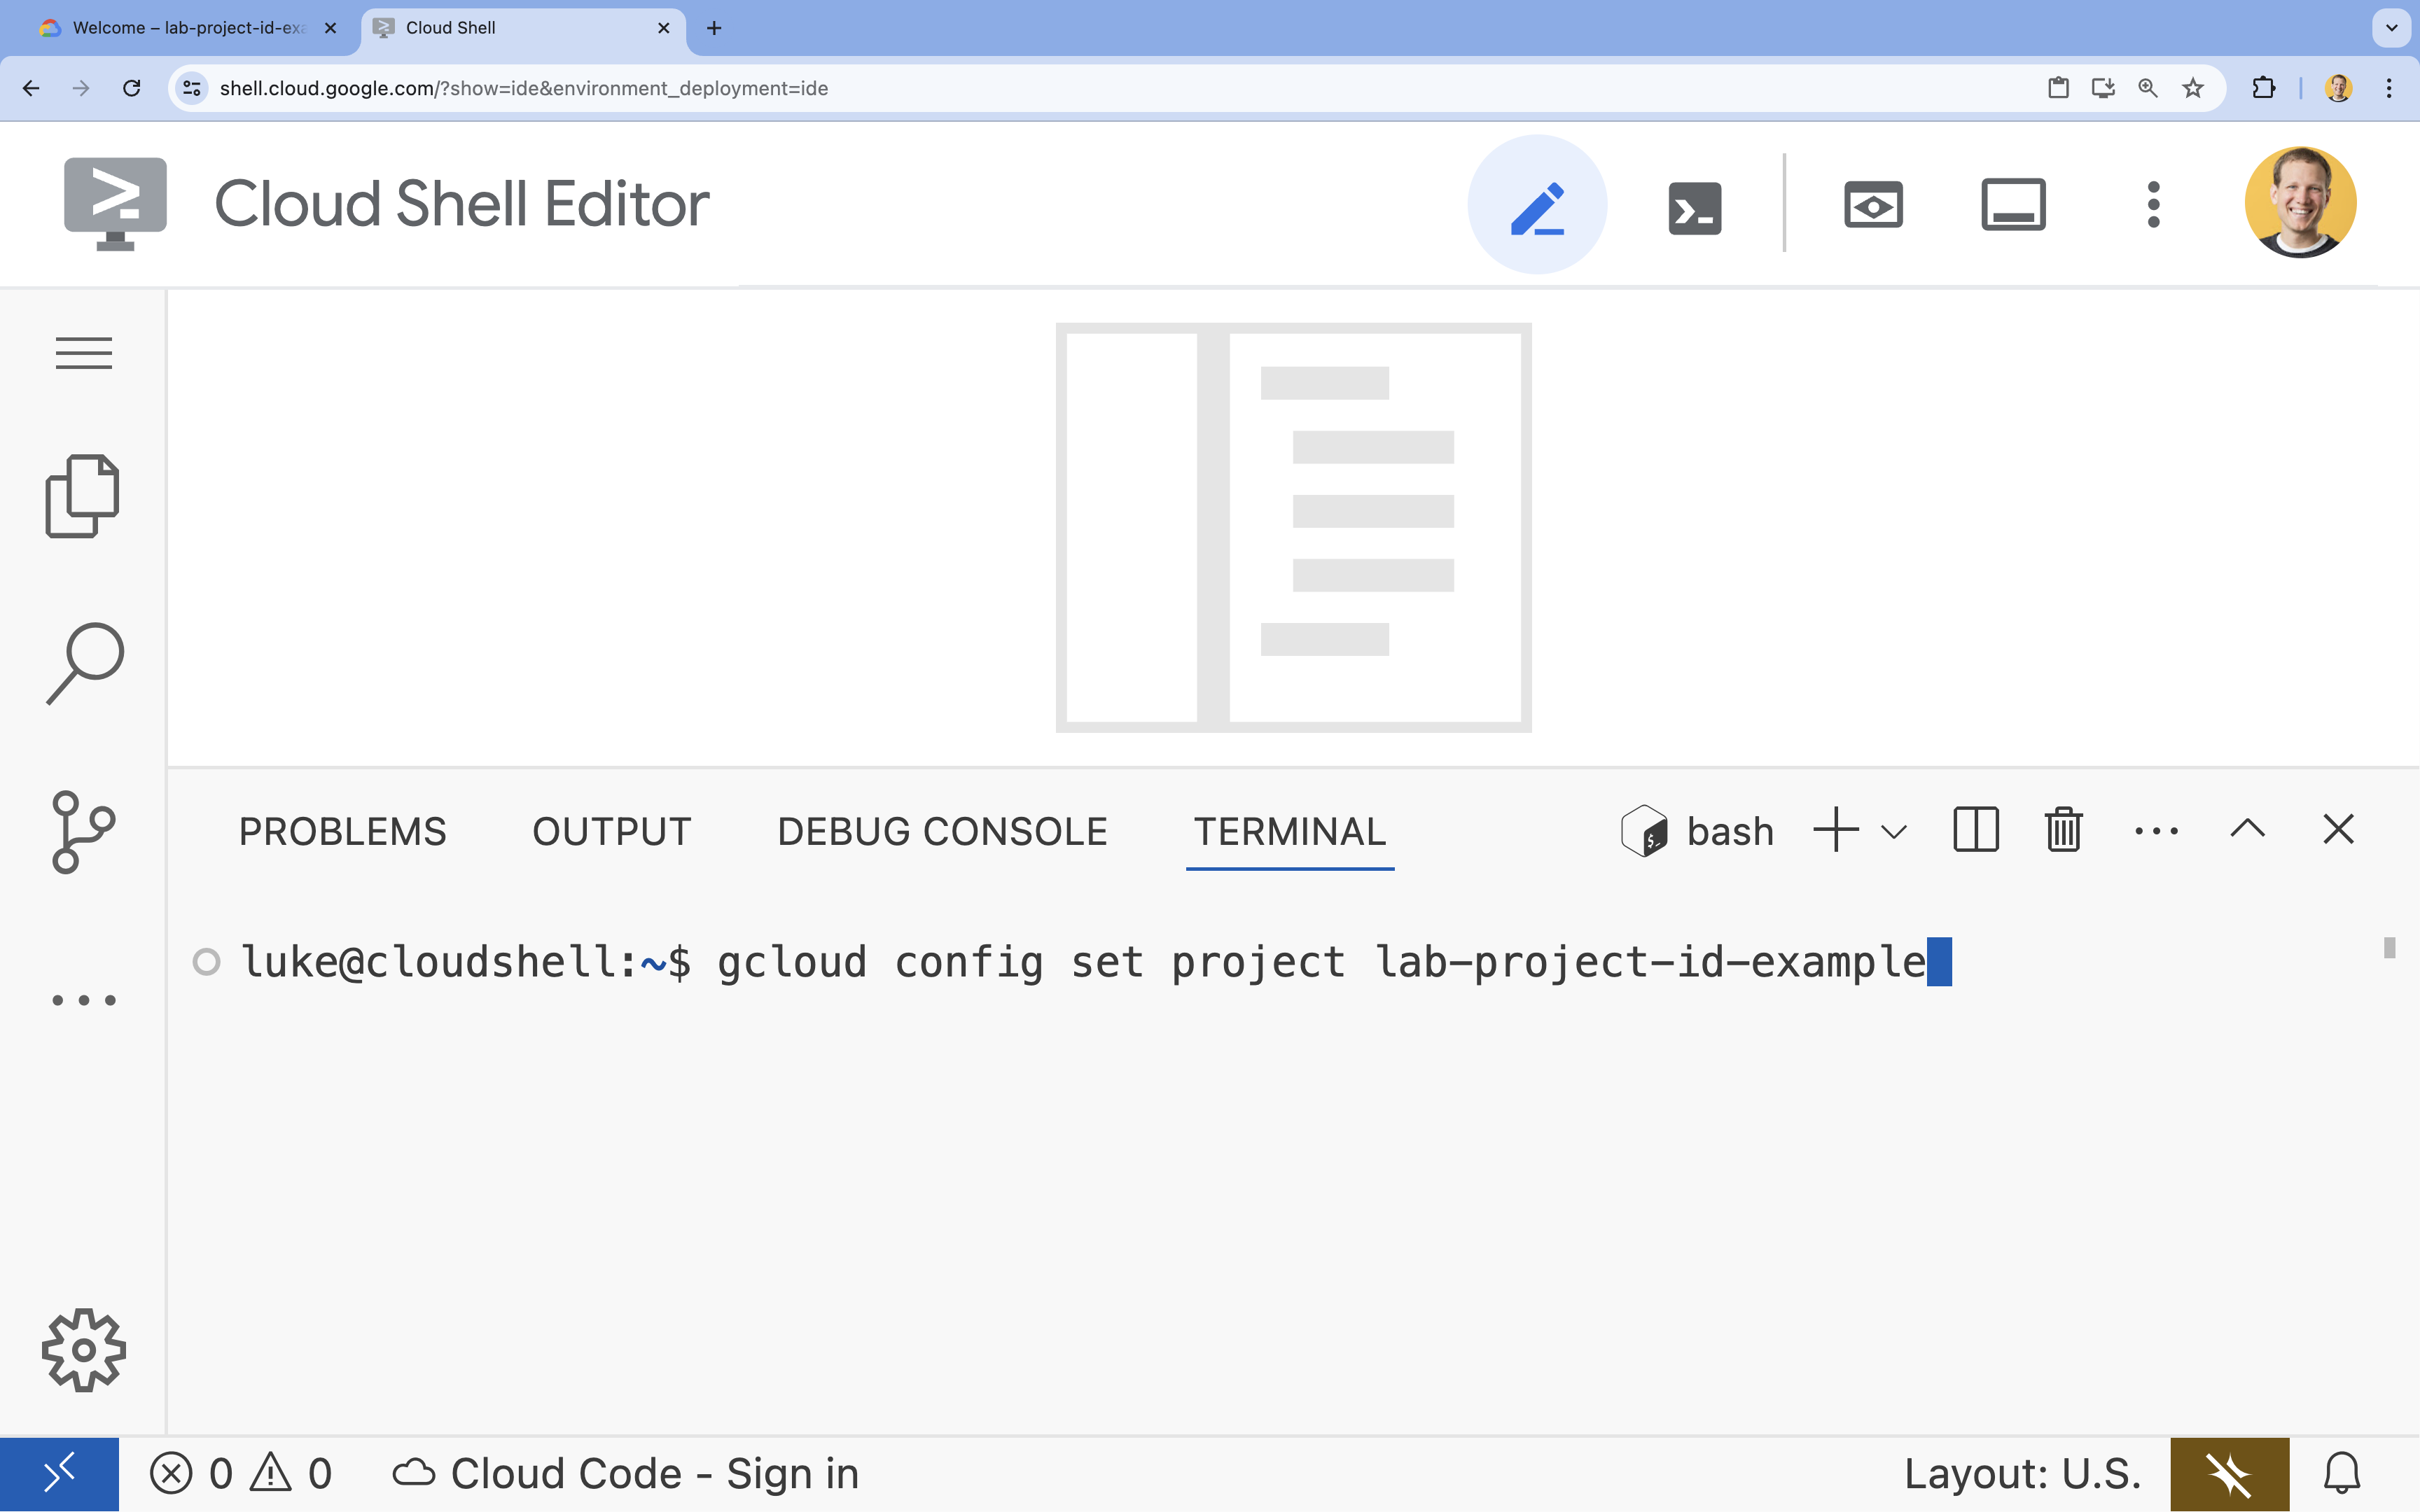
- উদাহরণ:
- আপনি এই বার্তাটি দেখতে পাবেন:
Updated property [core/project].
৪. এপিআই সক্রিয় করুন
জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্ম এবং অন্যান্য পরিষেবা ব্যবহার করার জন্য, আপনাকে আপনার গুগল ক্লাউড প্রজেক্টে প্রয়োজনীয় এপিআইগুলো সক্রিয় করতে হবে।
- টার্মিনালে, এপিআইগুলো সক্রিয় করুন:
- ভার্টেক্স এআই এপিআই (
aiplatform.googleapis.com): মডেল ফাইন-টিউনিং এবং পরিবেশনের জন্য ভার্টেক্স এআই ব্যবহারের সুযোগ দেয়। - ক্লাউড স্টোরেজ এপিআই (
storage.googleapis.com): ডেটাসেট এবং মডেল আর্টিফ্যাক্ট সংরক্ষণে সক্ষম করে।
gcloud services enable aiplatform.googleapis.com \ storage.googleapis.com - ভার্টেক্স এআই এপিআই (
৫. প্রকল্পের পরিবেশ তৈরি করুন
একটি ওয়ার্কিং ডিরেক্টরি তৈরি করুন
- টার্মিনালে আপনার প্রোজেক্টের জন্য একটি ডিরেক্টরি তৈরি করুন এবং সেটির ভেতরে প্রবেশ করুন।
mkdir gemini-finetuning
cd gemini-finetuning
পরিবেশ ভেরিয়েবল সেট আপ করুন
- টার্মিনালে আপনার প্রোজেক্টের জন্য এনভায়রনমেন্ট ভেরিয়েবলগুলো নির্ধারণ করুন। আমরা এই ভেরিয়েবলগুলো সংরক্ষণের জন্য একটি
env.shফাইল তৈরি করব, যাতে আপনার সেশন সংযোগ বিচ্ছিন্ন হয়ে গেলেও সেগুলো সহজেই পুনরায় লোড করা যায়।cat <<EOF > env.sh export PROJECT_ID=\$(gcloud config get-value project) export REGION="us-central1" export LOCATION="global" export BUCKET_NAME="\${PROJECT_ID}-gemini-tuning" EOF source env.sh
একটি ক্লাউড স্টোরেজ বাকেট তৈরি করুন
- টার্মিনালে আপনার ডেটাসেট এবং মডেল আর্টিফ্যাক্টগুলো সংরক্ষণের জন্য একটি বাকেট তৈরি করুন।
gcloud storage buckets create gs://$BUCKET_NAME --project=$PROJECT_ID --location=$REGION
ভার্চুয়াল পরিবেশ সেট আপ করুন
- আমরা আমাদের পাইথন এনভায়রনমেন্ট পরিচালনা করতে
uvব্যবহার করব। টার্মিনালে , রান করুন:uv venv .venv source .venv/bin/activate - টার্মিনালে প্রয়োজনীয় পাইথন প্যাকেজগুলো ইনস্টল করুন।
uv pip install google-cloud-aiplatform rouge-score matplotlib pandas tqdm
৬. প্রশিক্ষণ ডেটা প্রস্তুত করুন।
উন্নত মানের ডেটাই সফল ফাইন-টিউনিংয়ের ভিত্তি। আপনি WikiLingua ডেটাসেটটি ব্যবহার করে, সেটিকে Gemini-র প্রয়োজনীয় নির্দিষ্ট JSONL ফরম্যাটে রূপান্তর করবেন এবং আপনার স্টোরেজ বাকেটে আপলোড করবেন।
- টার্মিনালে
prepare_data.pyনামে একটি ফাইল তৈরি করুন।cloudshell edit prepare_data.py - নিম্নলিখিত কোডটি
prepare_data.pyফাইলে পেস্ট করুন।import json import os import pandas as pd from google.cloud import storage import subprocess # Configuration BUCKET_NAME = os.environ["BUCKET_NAME"] PROJECT_ID = os.environ["PROJECT_ID"] def download_data(): print("Downloading WikiLingua dataset...") # Using gsutil to copy from public bucket subprocess.run(["gsutil", "cp", "gs://github-repo/generative-ai/gemini/tuning/summarization/wikilingua/*", "."], check=True) def convert_to_gemini_format(input_file, output_file, max_samples=1000): print(f"Converting {input_file} to Gemini format (first {max_samples} samples)...") converted_data = [] with open(input_file, 'r') as f: for i, line in enumerate(f): if i >= max_samples: break obj = json.loads(line) messages = obj.get("messages", []) # Convert messages to Gemini 3.5 format # Input: {"messages": [{"role": "user", "content": "..."}, {"role": "model", "content": "..."}]} # Output: {"contents": [{"role": "user", "parts": [{"text": "..."}]}, {"role": "model", "parts": [{"text": "..."}]}]} contents = [] for msg in messages: role = msg["role"] content = msg["content"] contents.append({ "role": role, "parts": [{"text": content}] }) converted_data.append({"contents": contents}) with open(output_file, 'w') as f: for item in converted_data: f.write(json.dumps(item) + "\n") print(f"Saved {len(converted_data)} examples to {output_file}") def upload_to_gcs(local_file, destination_blob_name): print(f"Uploading {local_file} to gs://{BUCKET_NAME}/{destination_blob_name}...") storage_client = storage.Client(project=PROJECT_ID) bucket = storage_client.bucket(BUCKET_NAME) blob = bucket.blob(destination_blob_name) blob.upload_from_filename(local_file) print("Upload complete.") def main(): download_data() # Process Training Data convert_to_gemini_format("sft_train_samples.jsonl", "train_gemini.jsonl") upload_to_gcs("train_gemini.jsonl", "datasets/train/train_gemini.jsonl") # Process Validation Data convert_to_gemini_format("sft_val_samples.jsonl", "val_gemini.jsonl") upload_to_gcs("val_gemini.jsonl", "datasets/val/val_gemini.jsonl") print("Data preparation complete!") if __name__ == "__main__": main() - টার্মিনালে ডেটা প্রস্তুতি স্ক্রিপ্টটি চালান।
python prepare_data.py
৭. ভিত্তি কর্মক্ষমতা স্থাপন করুন
সূক্ষ্ম সমন্বয়ের আগে, আপনার একটি বেঞ্চমার্ক প্রয়োজন। ROUGE স্কোর ব্যবহার করে আপনি পরিমাপ করবেন যে, সারসংক্ষেপ তৈরির কাজে বেস gemini-3.5-flash মডেলটি কতটা ভালো কাজ করে।
- টার্মিনালে
evaluate.pyনামে একটি ফাইল তৈরি করুন।cloudshell edit evaluate.py - নিম্নলিখিত কোডটি
evaluate.pyফাইলে পেস্ট করুন।import argparse import json import os import pandas as pd from google import genai from google.genai import types from rouge_score import rouge_scorer from tqdm import tqdm import matplotlib.pyplot as plt import time # Configuration for Google Gen AI SDK PROJECT_ID = os.environ.get("PROJECT_ID", "") def get_client(model_name): os.environ["GOOGLE_GENAI_USE_VERTEXAI"] = "TRUE" os.environ["GOOGLE_CLOUD_PROJECT"] = PROJECT_ID if "locations/" in model_name: parts = model_name.split("/") loc = parts[parts.index("locations") + 1] if loc == "us": loc = "us-central1" else: loc = os.environ.get("LOCATION", "global") os.environ["GOOGLE_CLOUD_LOCATION"] = loc return genai.Client() def evaluate(model_name, test_file, max_samples=50, output_json="results.json"): print(f"Evaluating model: {model_name}") client = get_client(model_name) # Load Test Data test_df = pd.read_csv(test_file) test_df = test_df.head(max_samples) config = types.GenerateContentConfig( temperature=0.1, max_output_tokens=1024, ) scorer = rouge_scorer.RougeScorer(['rouge1', 'rouge2', 'rougeL'], use_stemmer=True) results = [] for index, row in tqdm(test_df.iterrows(), total=len(test_df)): input_text = row['input_text'] reference_summary = row['output_text'] try: response = client.models.generate_content( model=model_name, contents=input_text, config=config, ) generated_summary = response.text scores = scorer.score(reference_summary, generated_summary) results.append({ "generated": generated_summary, "reference": reference_summary, "rouge1": scores['rouge1'].fmeasure, "rouge2": scores['rouge2'].fmeasure, "rougeL": scores['rougeL'].fmeasure }) except Exception as e: print(f"Error processing example {index}: {e}") # Sleep briefly to avoid quota issues if hitting limits time.sleep(1) # Save results with open(output_json, 'w') as f: json.dump(results, f, indent=2) return pd.DataFrame(results) def plot_results(df, title, filename): os.makedirs("plots", exist_ok=True) metrics = ['rouge1', 'rouge2', 'rougeL'] fig, axes = plt.subplots(1, 3, figsize=(15, 5)) for i, metric in enumerate(metrics): axes[i].hist(df[metric], bins=10, alpha=0.7, color='skyblue', edgecolor='black') axes[i].set_title(f'{metric} Distribution') axes[i].set_xlabel('Score') axes[i].set_ylabel('Count') plt.suptitle(title) plt.tight_layout() plt.savefig(f"plots/{filename}") print(f"Plot saved to plots/{filename}") def compare_results(baseline_file, tuned_file): with open(baseline_file, 'r') as f: baseline_data = pd.DataFrame(json.load(f)) with open(tuned_file, 'r') as f: tuned_data = pd.DataFrame(json.load(f)) print("\n--- Comparison ---") metrics = ['rouge1', 'rouge2', 'rougeL'] for metric in metrics: base_mean = baseline_data[metric].mean() tuned_mean = tuned_data[metric].mean() diff = tuned_mean - base_mean print(f"{metric}: Base={base_mean:.4f}, Tuned={tuned_mean:.4f}, Diff={diff:+.4f}") # Comparative Plot os.makedirs("plots", exist_ok=True) comparison_df = pd.DataFrame({ 'Metric': metrics, 'Baseline': [baseline_data[m].mean() for m in metrics], 'Tuned': [tuned_data[m].mean() for m in metrics] }) comparison_df.plot(x='Metric', y=['Baseline', 'Tuned'], kind='bar', figsize=(10, 6)) plt.title('Baseline vs Tuned Model Performance') plt.ylabel('Average Score') plt.xticks(rotation=0) plt.tight_layout() plt.savefig("plots/comparison.png") print("Comparison plot saved to plots/comparison.png") def main(): parser = argparse.ArgumentParser() parser.add_argument("--model", type=str, default="gemini-3.5-flash", help="Model resource name") parser.add_argument("--baseline", type=str, help="Path to baseline results json for comparison") parser.add_argument("--output", type=str, default="results.json", help="Output file for results") args = parser.parse_args() # Ensure test data exists (it was downloaded in prepare_data step) if not os.path.exists("sft_test_samples.csv"): # Fallback download if needed subprocess.run(["gsutil", "cp", "gs://github-repo/generative-ai/gemini/tuning/summarization/wikilingua/sft_test_samples.csv", "."], check=True) df = evaluate(args.model, "sft_test_samples.csv", output_json=args.output) print("\n--- Results Summary ---") print(df.describe()) plot_filename = "baseline_dist.png" if not args.baseline else "tuned_dist.png" plot_results(df, f"ROUGE Scores - {args.model}", plot_filename) if args.baseline: compare_results(args.baseline, args.output) if __name__ == "__main__": main() - টার্মিনালে বেসলাইন মূল্যায়নটি চালান।
python evaluate.py --model "gemini-3.5-flash" --output "baseline.json"baseline.jsonফাইল এবংplots/baseline_dist.pngএকটি প্লট তৈরি করবে।
৮. ফাইন-টিউনিং কনফিগার এবং চালু করুন
এখন আপনি জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্মে একটি পরিচালিত ফাইন-টিউনিং জব চালু করবেন।
- টার্মিনালে
tune.pyনামে একটি ফাইল তৈরি করুন।cloudshell edit tune.py - নিচের কোডটি
tune.pyফাইলে পেস্ট করুন।import os import time from google import genai from google.genai import types # Configuration for Google Gen AI SDK os.environ["GOOGLE_GENAI_USE_VERTEXAI"] = "TRUE" os.environ["GOOGLE_CLOUD_PROJECT"] = os.environ.get("PROJECT_ID", "") os.environ["GOOGLE_CLOUD_LOCATION"] = os.environ.get("REGION", "us-central1") BUCKET_NAME = os.environ["BUCKET_NAME"] client = genai.Client() def train(): print("Launching fine-tuning job...") training_dataset = types.TuningDataset( gcs_uri=f"gs://{BUCKET_NAME}/datasets/train/train_gemini.jsonl" ) validation_dataset = types.TuningValidationDataset( gcs_uri=f"gs://{BUCKET_NAME}/datasets/val/val_gemini.jsonl" ) tuning_job = client.tunings.tune( base_model="gemini-3.5-flash", training_dataset=training_dataset, config=types.CreateTuningJobConfig( tuned_model_display_name="gemini-3.5-flash-wikilingua", validation_dataset=validation_dataset, adapter_size=types.AdapterSize.ADAPTER_SIZE_FOUR, epoch_count=1, ), ) print(f"Job started: {tuning_job.name}") print("Waiting for job to complete... (this may take ~45 minutes)") running_states = {"JOB_STATE_PENDING", "JOB_STATE_RUNNING"} while tuning_job.state in running_states: time.sleep(60) tuning_job = client.tunings.get(name=tuning_job.name) print(f"Status: {tuning_job.state}") print("Job completed!") print(f"Tuned Model Endpoint: {tuning_job.tuned_model.endpoint}") return tuning_job.tuned_model.endpoint if __name__ == "__main__": train() - টার্মিনালে ফাইন-টিউনিং স্ক্রিপ্টটি চালান।
python tune.py
৯. প্রশিক্ষণ কোডটি বুঝুন।
আপনার কাজটি চলার সময়ে, ফাইন-টিউনিং কীভাবে কাজ করে তা বোঝার জন্য চলুন tune.py স্ক্রিপ্টটি আরও ভালোভাবে দেখে নেওয়া যাক।
পরিচালিত তত্ত্বাবধানকৃত সূক্ষ্ম সমন্বয়
স্ক্রিপ্টটি একটি পরিচালিত টিউনিং জব জমা দেওয়ার জন্য vertexai.tuning.sft.train পদ্ধতিটি ব্যবহার করে। এটি পরিকাঠামোর ব্যবস্থা করা, প্রশিক্ষণ বিতরণ করা এবং চেকপয়েন্ট পরিচালনা করার জটিলতা দূর করে।
sft_tuning_job = sft.train(
    source_model="gemini-3.5-flash",
    train_dataset=f"gs://{BUCKET_NAME}/datasets/train/train_gemini.jsonl",
    # ...
)
LoRA কনফিগারেশন
ওপেন-সোর্স ফ্রেমওয়ার্কের মতো ম্যানুয়ালি LoraConfig নির্ধারণ করার পরিবর্তে, Gemini Enterprise Agent Platform এই প্রক্রিয়াটিকে কয়েকটি মূল প্যারামিটারে সরল করে তোলে:
-
adapter_size: এই প্যারামিটারটি (আমাদের স্ক্রিপ্টে4এ সেট করা) LoRA অ্যাডাপ্টারগুলোর র্যাঙ্ক নিয়ন্ত্রণ করে। এর আকার বড় হলে মডেলটি আরও জটিল অভিযোজন শিখতে পারে, কিন্তু এর ফলে প্রশিক্ষণযোগ্য প্যারামিটারের সংখ্যা বেড়ে যায়। -
epochs: এই ল্যাবে প্রশিক্ষণের সময় কম (~২০ মিনিট) রাখার জন্য আমরা এটি1এ সেট করেছি। প্রোডাকশনের ক্ষেত্রে, মডেলকে আপনার ডেটা থেকে আরও গভীরভাবে শেখার সুযোগ দিতে আপনি এটি বাড়াতে পারেন, তবে ওভারফিটিং-এর ব্যাপারে সতর্ক থাকতে হবে।
মডেল নির্বাচন
আমরা স্পষ্টভাবে source_model="gemini-3.5-flash" নির্দিষ্ট করে দিই। Gemini Enterprise Agent Platform, Gemini-এর বিভিন্ন সংস্করণ সমর্থন করে, এবং একটি নির্দিষ্ট সংস্করণ পিন করে রাখলে আপনার পাইপলাইন স্থিতিশীল ও পুনরুৎপাদনযোগ্য থাকে।
১০. মডেলগুলোর তুলনা করুন
সূক্ষ্ম সমন্বয়ের কাজটি সম্পন্ন হয়ে গেলে, আপনি আপনার নতুন মডেলের পারফরম্যান্সকে বেসলাইনের সাথে তুলনা করতে পারবেন।
- আপনার টিউন করা মডেলের এন্ডপয়েন্টটি নিন। এটি
tune.pyস্ক্রিপ্টের শেষে প্রিন্ট করা হয়েছিল। এটি দেখতে অনেকটাprojects/.../locations/.../endpoints/...এর মতো হবে। - এবার তুলনার জন্য আপনার টিউন করা মডেল এবং বেসলাইন ফলাফলগুলো পাস করে ইভ্যালুয়েশন স্ক্রিপ্টটি আবার চালান।
# Replace [YOUR_TUNED_MODEL_ENDPOINT] with the actual endpoint name export TUNED_MODEL="projects/[YOUR_PROJECT_ID]/locations/[YOUR_REGION]/endpoints/[YOUR_ENDPOINT_ID]" python evaluate.py --model "$TUNED_MODEL" --baseline "baseline.json" --output "tuned.json" - ফলাফল দেখুন। স্ক্রিপ্টটি ROUGE স্কোরের একটি তুলনামূলক চিত্র আউটপুট করবে এবং উন্নতি দেখানোর জন্য
plots/comparison.pngনামে একটি চার্ট তৈরি করবে। আপনি ক্লাউড শেল এডিটরেplotsফোল্ডারটি খুলে প্লটগুলো দেখতে পারেন।
১১. পরিষ্কার করুন
চার্জ এড়ানোর জন্য, আপনার তৈরি করা রিসোর্সগুলো মুছে ফেলুন।
- টার্মিনালে , ক্লাউড স্টোরেজ বাকেট এবং টিউন করা মডেলটি ডিলিট করুন।
gcloud storage rm -r gs://$BUCKET_NAME
# Note: You can delete the model endpoint from the Gemini Enterprise Agent Platform Console
১২. অভিনন্দন!
আপনি জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্মে জেমিনি ৩.৫ ফ্ল্যাশ সফলভাবে ফাইন-টিউন করেছেন!
পুনরালোচনা
এই ল্যাবে, আপনি:
- জেমিনি ফাইন-টিউনিংয়ের জন্য JSONL ফরম্যাটে একটি ডেটাসেট প্রস্তুত করা হয়েছে।
- বেস জেমিনি ৩.৫ ফ্ল্যাশ মডেল ব্যবহার করে একটি বেসলাইন স্থাপন করা হয়েছে।
- জেমিনি এন্টারপ্রাইজ এজেন্ট প্ল্যাটফর্মে একটি সুপারভাইজড ফাইন-টিউনিং জব চালু করা হয়েছে।
- সূক্ষ্মভাবে সমন্বয় করা মডেলটিকে বেসলাইনের সাথে মূল্যায়ন ও তুলনা করা হয়েছে।
এরপর কী?
এই ল্যাবটি ‘প্রোডাকশন-রেডি এআই উইথ গুগল ক্লাউড’ লার্নিং পাথের একটি অংশ।
প্রোটোটাইপ থেকে উৎপাদনে উত্তরণের ব্যবধান পূরণ করতে সম্পূর্ণ পাঠ্যক্রমটি অন্বেষণ করুন।
#ProductionReadyAI হ্যাশট্যাগটি ব্যবহার করে আপনার অগ্রগতি শেয়ার করুন।