

1. Einführung
In diesem Codelab geht es um die Bewertung von KI-Agenten, also darum, wie ein System feststellt, ob die Antwort eines KI-Agenten gut war, und was Sie dann tun können: einen KI-Agenten erstellen, der seine eigene Anweisung anhand seiner eigenen Fehler umschreibt, und eine Schleife, die das immer wieder tut, wobei Sie die Kontrolle behalten.
Alles läuft über das Agent Development Kit (ADK): adk eval mit einem von Ihnen geschriebenen benutzerdefinierten Messwert, adk optimize (der GEPA-Prompt-Optimierer), ein ADK 2-Workflow mit einer Back-Edge und die Agent Engine + BigQuery-Pipe, die den Produktionstraffic in die Prüfung der nächsten Runde umwandelt.
Die Schleife erhöht jede Zahl, die Sie ihr übergeben.
Lerninhalte
- Eine Antwort ist kein Ergebnis: Warum eine selbstbewusste, gut formulierte Antwort dem System nichts sagt und was ein Prüfer sagen können muss
- Drei Möglichkeiten, eine Prüfung auszuführen:
adk evalfür den Batch, den Tabadk web„Bewertungen“, um sich einen Fehler anzusehen,pytest+AgentEvaluator, um den Build fehlschlagen zu lassen, und der eine lokale Bewertungsspeicher, den sie gemeinsam nutzen - Vergleichen oder prüfen: Warum ein Komparator eine richtige Antwort, die anders formuliert ist, bestraft, wie viele richtige Antworten ein Abendessen tatsächlich hat und wie Sie herausfinden, welche Art von Messwert für ein Problem erforderlich ist
- Eine Prüffunktion als
adk eval-Messwert –customMetrics,codeConfig, die feste Signatur, die sechs Prüfungen darin, warum Ihre Funktion PASSED/FAILED besitzt und warum sie absichtlich deterministisch ist - Drei Messwertfamilien in einer Antwort – Comparator, Checker, LLM-as-Judge: Was ist erforderlich, was kostet es und wo gibt es Einschränkungen?
adk optimize(GEPA) – was darin steht (die Fehler, nicht die Punktzahl), Trainings- und Holdout-Gruppe und warum Sie die Prüfung selbst noch einmal durchführen, bevor Sie das Produkt versenden- Reward-Hacking, gemessen: Ein Ersatzmesswert, der nie die Partei, ihre Auswirkungen auf die tatsächliche Zahl und das daraus resultierende Gesetz berücksichtigt.
- Eine sich selbst entwickelnde Schleife als ADK 2
Workflow: Eine Anweisung, die sich im Sitzungsstatus befindet, die eine Kante, die einen Graphen zu einem Zyklus macht, und die Grenze, die das ADK nicht bietet - Wo die Produktion ins Spiel kommt – Traces zum Ansehen, Zeilen zum Lernen und warum ein Checker Abendessen bewerten kann, die niemand bewerten wollte (ein Text, kein Schritt)
Umfang
Eine laufende App in Ihrem Browser: ein runder Tisch, N Gäste und ein Agent, der das Abendessen bucht. In jedem Kurs geht es um eine Sache – eine Zeile in einer Konfiguration, eine Antwort vor drei Juroren, eine Schaltfläche, mit der der tatsächliche Optimierer ausgeführt wird, ein Schalter, mit dem der Juror getauscht wird, eine Kante in einem Diagramm – und in der Tabelle sehen Sie, was sich geändert hat: wer gegessen hat, wer nicht und warum. Die Python-Datei ist klein und die Zahlen werden alle auf Ihrem Computer gemessen.
Die App ist auch die Übung. Im Kursbereich wird jeweils nur eine Bearbeitung oder eine Schaltfläche angezeigt. Ein Gericht auf der Speisekarte wird nur dann serviert, wenn es durch etwas Reales bewiesen wird – die Küche liest Ihre Dateien und die Belege für das, was ausgeführt wurde, niemals eine Checkliste.
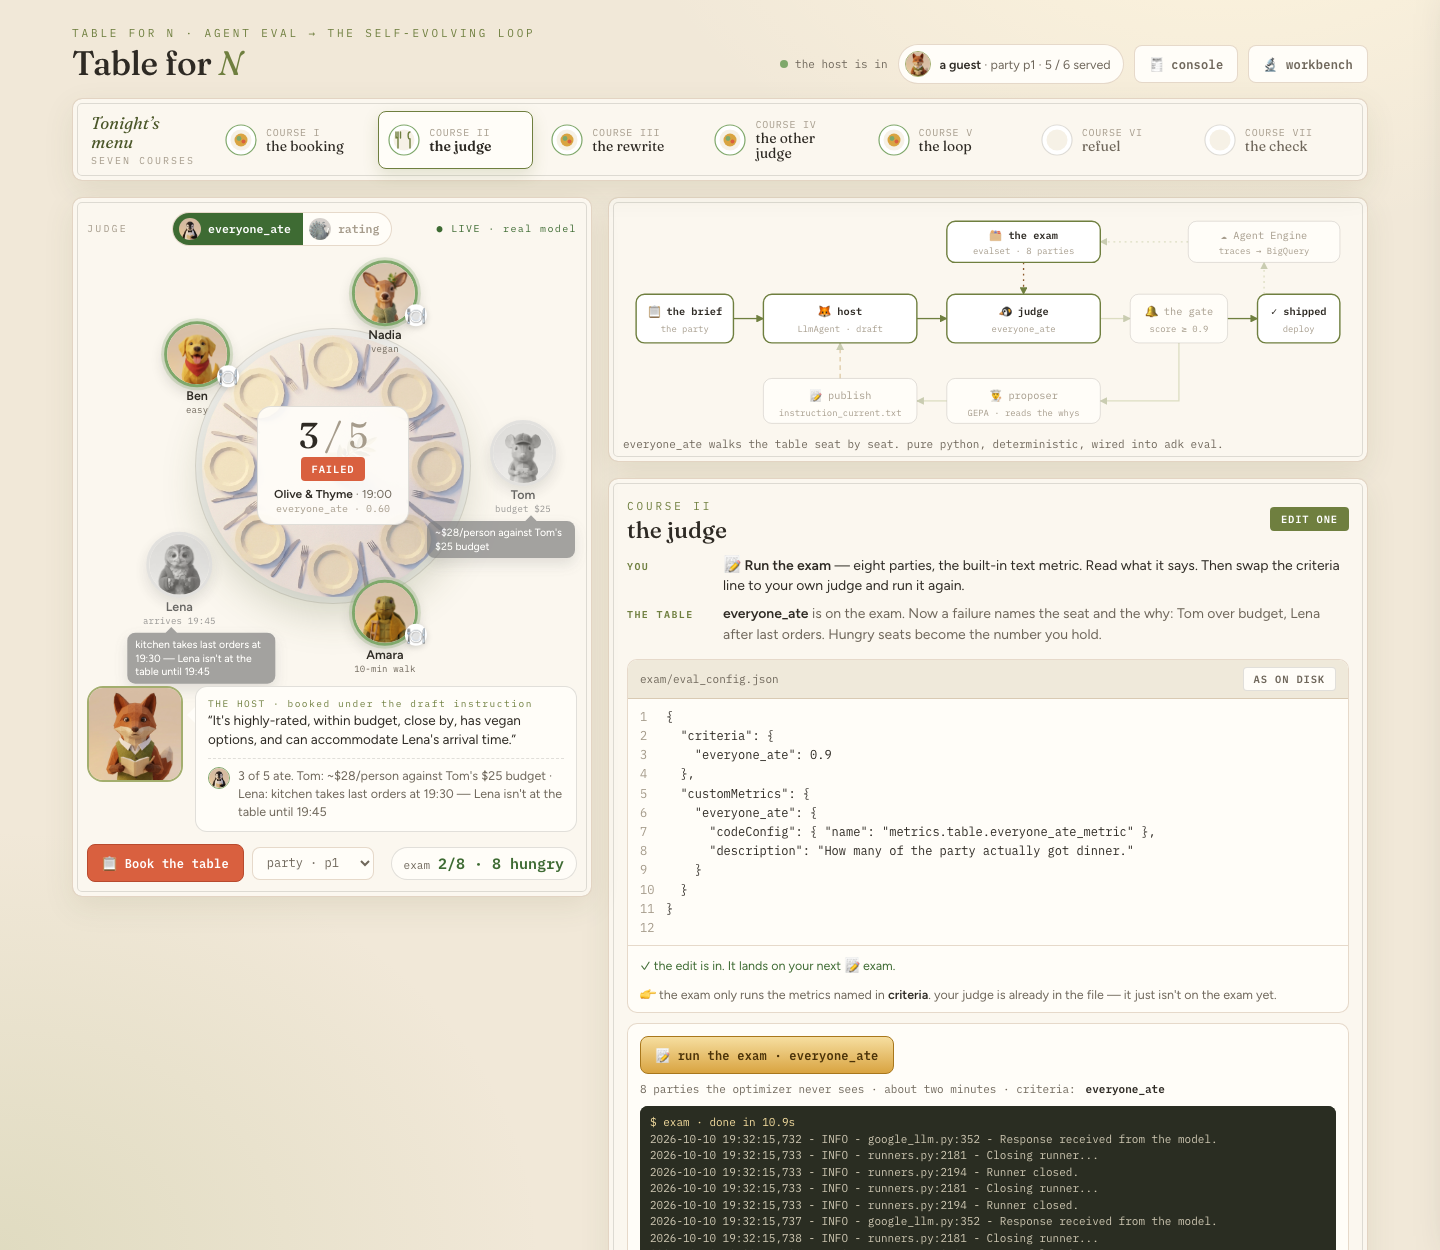
Die acht Kurse
Konzept | die Frage, die beantwortet wird | Was Sie tun | |
I | Eine Antwort ist kein Ergebnis. | Was weiß das System über diese Buchung? | Noch nichts – buchen Sie einen Termin in der Workbench |
II | der Comparator, eine Reihe von richtigen Antworten und drei Möglichkeiten zur Ausführung | Warum besteht eine korrekte Buchung die Prüfung nicht? | Führen Sie die Prüfung so aus, wie sie ausgeliefert wurde, und lesen Sie die Ergebnisse. |
III | einen Checker als benutzerdefinierten Messwert · die sechs Prüfungen | Kann die Prüfung Aufschluss darüber geben, wer hungrig ist und warum? | eine Zeile in |
IV | comparator · checker · LLM-as-judge | dieselbe Antwort: Welche drei Dinge sind zu messen? | eine Antwort zweimal auf drei Arten bewerten |
V |
| Kann der Agent Fehler selbst beheben? |
|
VI | Reward Hacking · Proxy-Messwert | Was macht ein Judge, der keine Schäden erkennen kann, mit der Schleife? | vom Wechsel |
VII | ein | Was macht einen Graphen zu einer Schleife und was stoppt ihn? | eine Kante in |
VIII | was jeweils ersetzt wurde | – | die Prüfung |
Anleitung für dieses Codelab Es ist konzeptorientiert: In jedem Kurs wird zuerst das Konzept erläutert, dann der Code nach der Änderung gezeigt und durchgegangen. Sie werden hier nie aufgefordert, eine Datei zu bearbeiten. Die Bearbeitung erfolgt in der App, die Ihnen jeweils eine Zeile anzeigt und zuerst den Fehler präsentiert. Lesen Sie den Kurs und lassen Sie sich dann von der Seite durch ihn führen. Beobachten Sie, wie sich die Zahl ändert.
Wo sich das befindet
Die Welt – zehn Gäste mit jeweils einer harten Einschränkung, zehn Restaurants mit jeweils einer Falle, sechzehn Partys – und die beiden Juroren stammen aus dem Lab loop-lab-table. Das interaktive Format auf einer Seite stammt aus Agent Valley. Das Bistro ist nur die Kulisse. Alle Mechanismen dahinter sind die üblichen, die Sie für einen Support-Mitarbeiter, einen Buchungsablauf oder alles andere verwenden würden, dessen „Qualität“ überprüfbar ist.
2. 🧰 Einrichtung
- Was: Ein Konto, mit dem bezahlt werden kann, ein Projekt, das Lab ist installiert, das Modell kann Fragen beantworten und die Tabelle wird über einen Port ausgeführt.
- Grund: Ein Prozess auf einem Port – die Seite, die Prüfungen, der Editor und die Workbench haben denselben Ursprung. Daher ist in diesem Lab kein zweites Terminal oder kein zweiter Port erforderlich.
- Wie: Klonen, zwei Skripts, ein Befehl. Als Letztes wird ein echter Modellaufruf durchgeführt, damit ein fehlerhaftes Projekt hier und nicht in Kurs I fehlschlägt.
Alles in diesem Lab wird in Cloud Shell ausgeführt. gcloud, Python, Node und git sind dort bereits installiert und Gemini wird über Vertex AI mit Ihren eigenen Anmeldedaten aufgerufen. In diesem Lab gibt es keinen API-Schlüssel und Sie müssen nichts auf Ihrem Laptop installieren. Ein Laptop mit dem Google Cloud SDK, Python 3.11+ und Node 20+ funktioniert genauso.
Eines kann Ihnen in diesem Lab nicht zur Verfügung gestellt werden: ein Google Cloud-Projekt mit aktivierter Abrechnung. In Schritt 1 erhalten Sie ein Konto, über das Sie die Kosten begleichen können. In Schritt 4 wird dieses Konto in ein Projekt umgewandelt. Führen Sie sie in dieser Reihenfolge aus. In jedem Schritt nach Schritt 4 wird das Projekt gelesen, das in Schritt 4 festgelegt wurde.
1. Konto mit Abrechnung erstellen (~1 Minute)
Melden Sie sich mit einem Google-Konto an, für das die Abrechnung aktiviert ist. Jedes solche Konto funktioniert. Wenn Sie noch kein Rechnungskonto haben, starten Sie einen kostenlosen Testzeitraum. Dadurch erhalten Sie ein Rechnungskonto, das für Schritt 4 erforderlich ist.
2. Cloud Shell öffnen (ca. 2 Minuten)
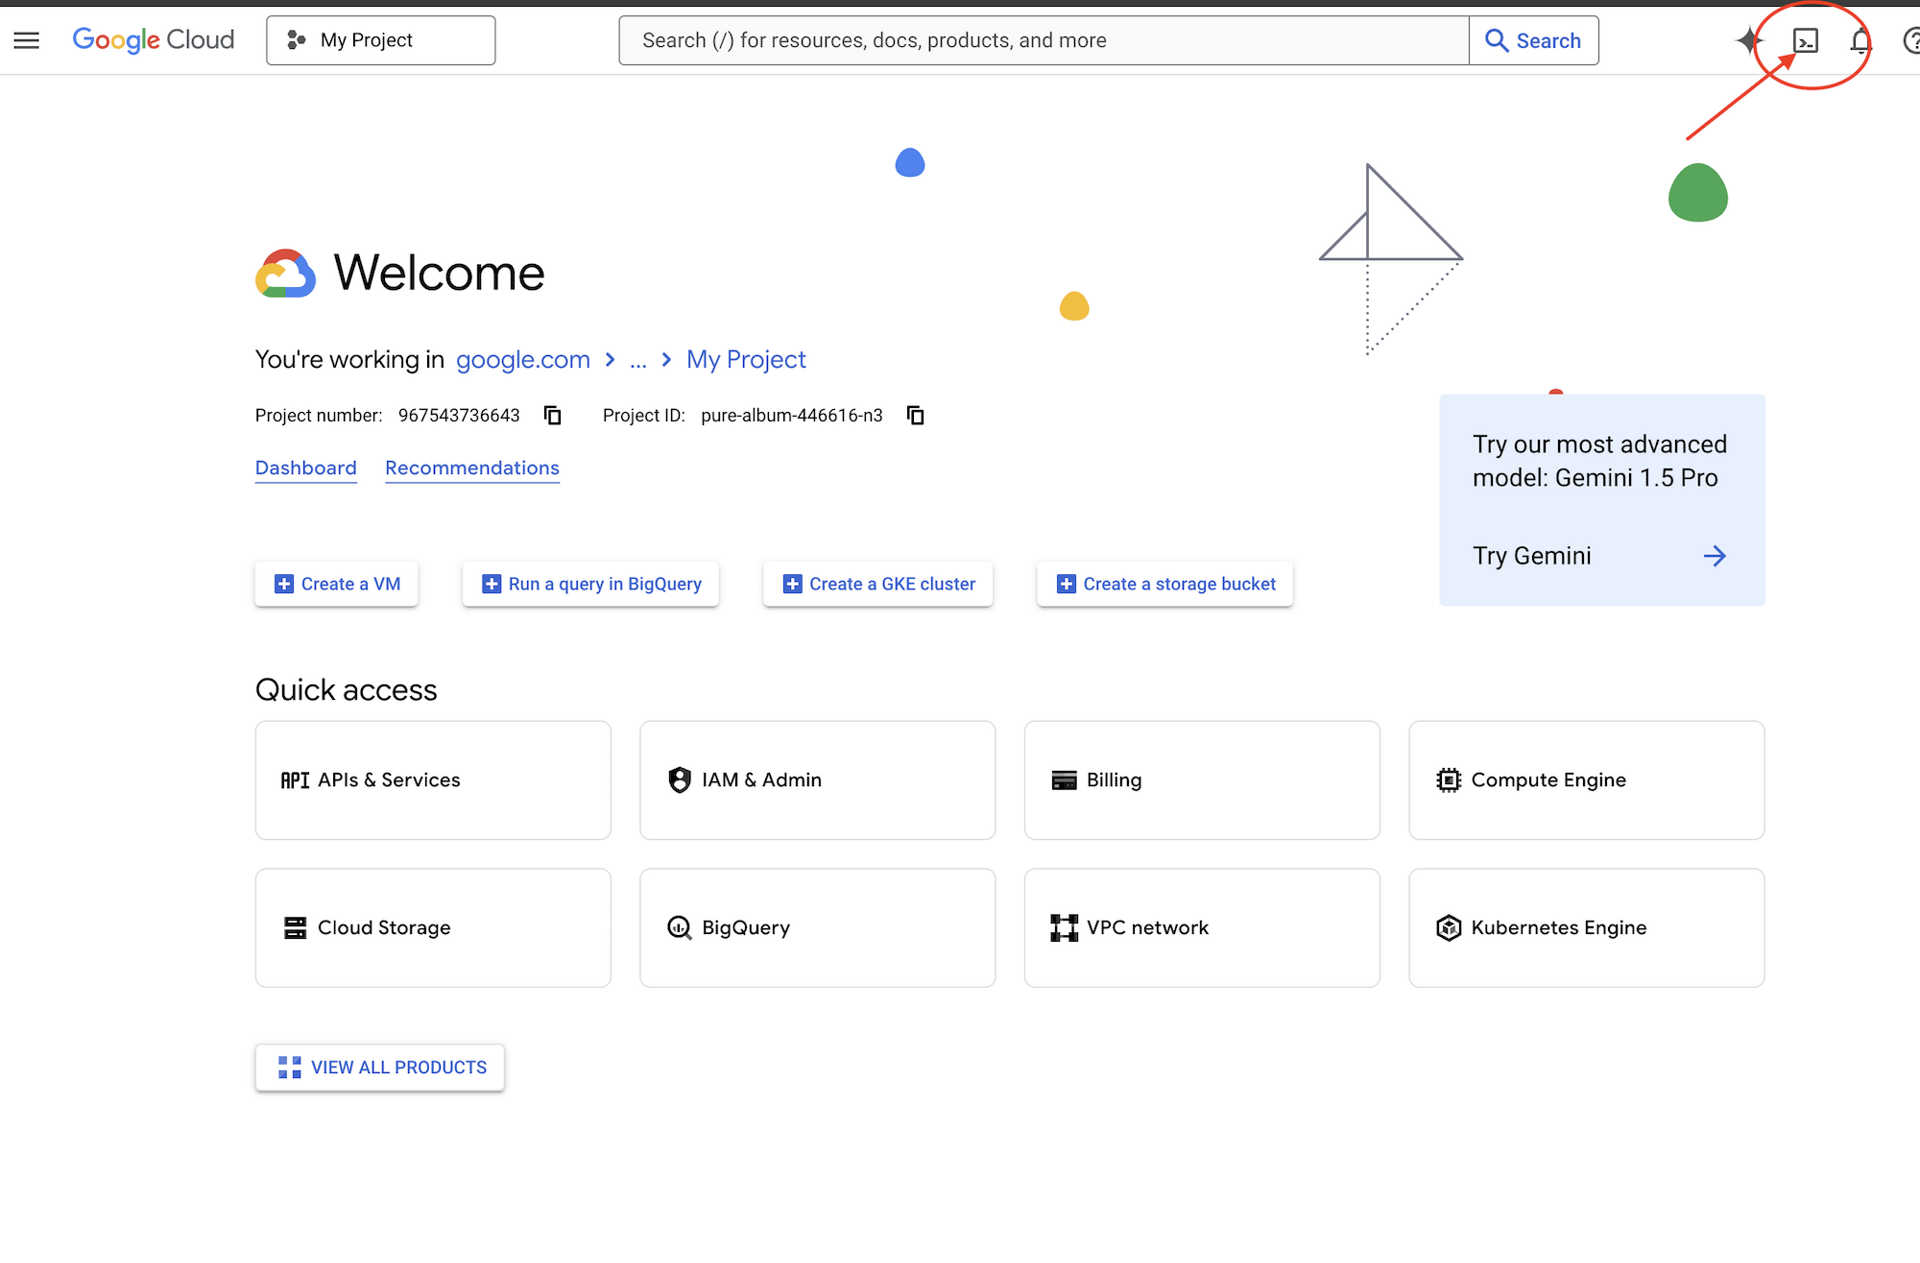
👉🖥 Klicken Sie oben in der Google Cloud Console auf Cloud Shell aktivieren. Das ist das Terminalsymbol in der Kopfzeile.
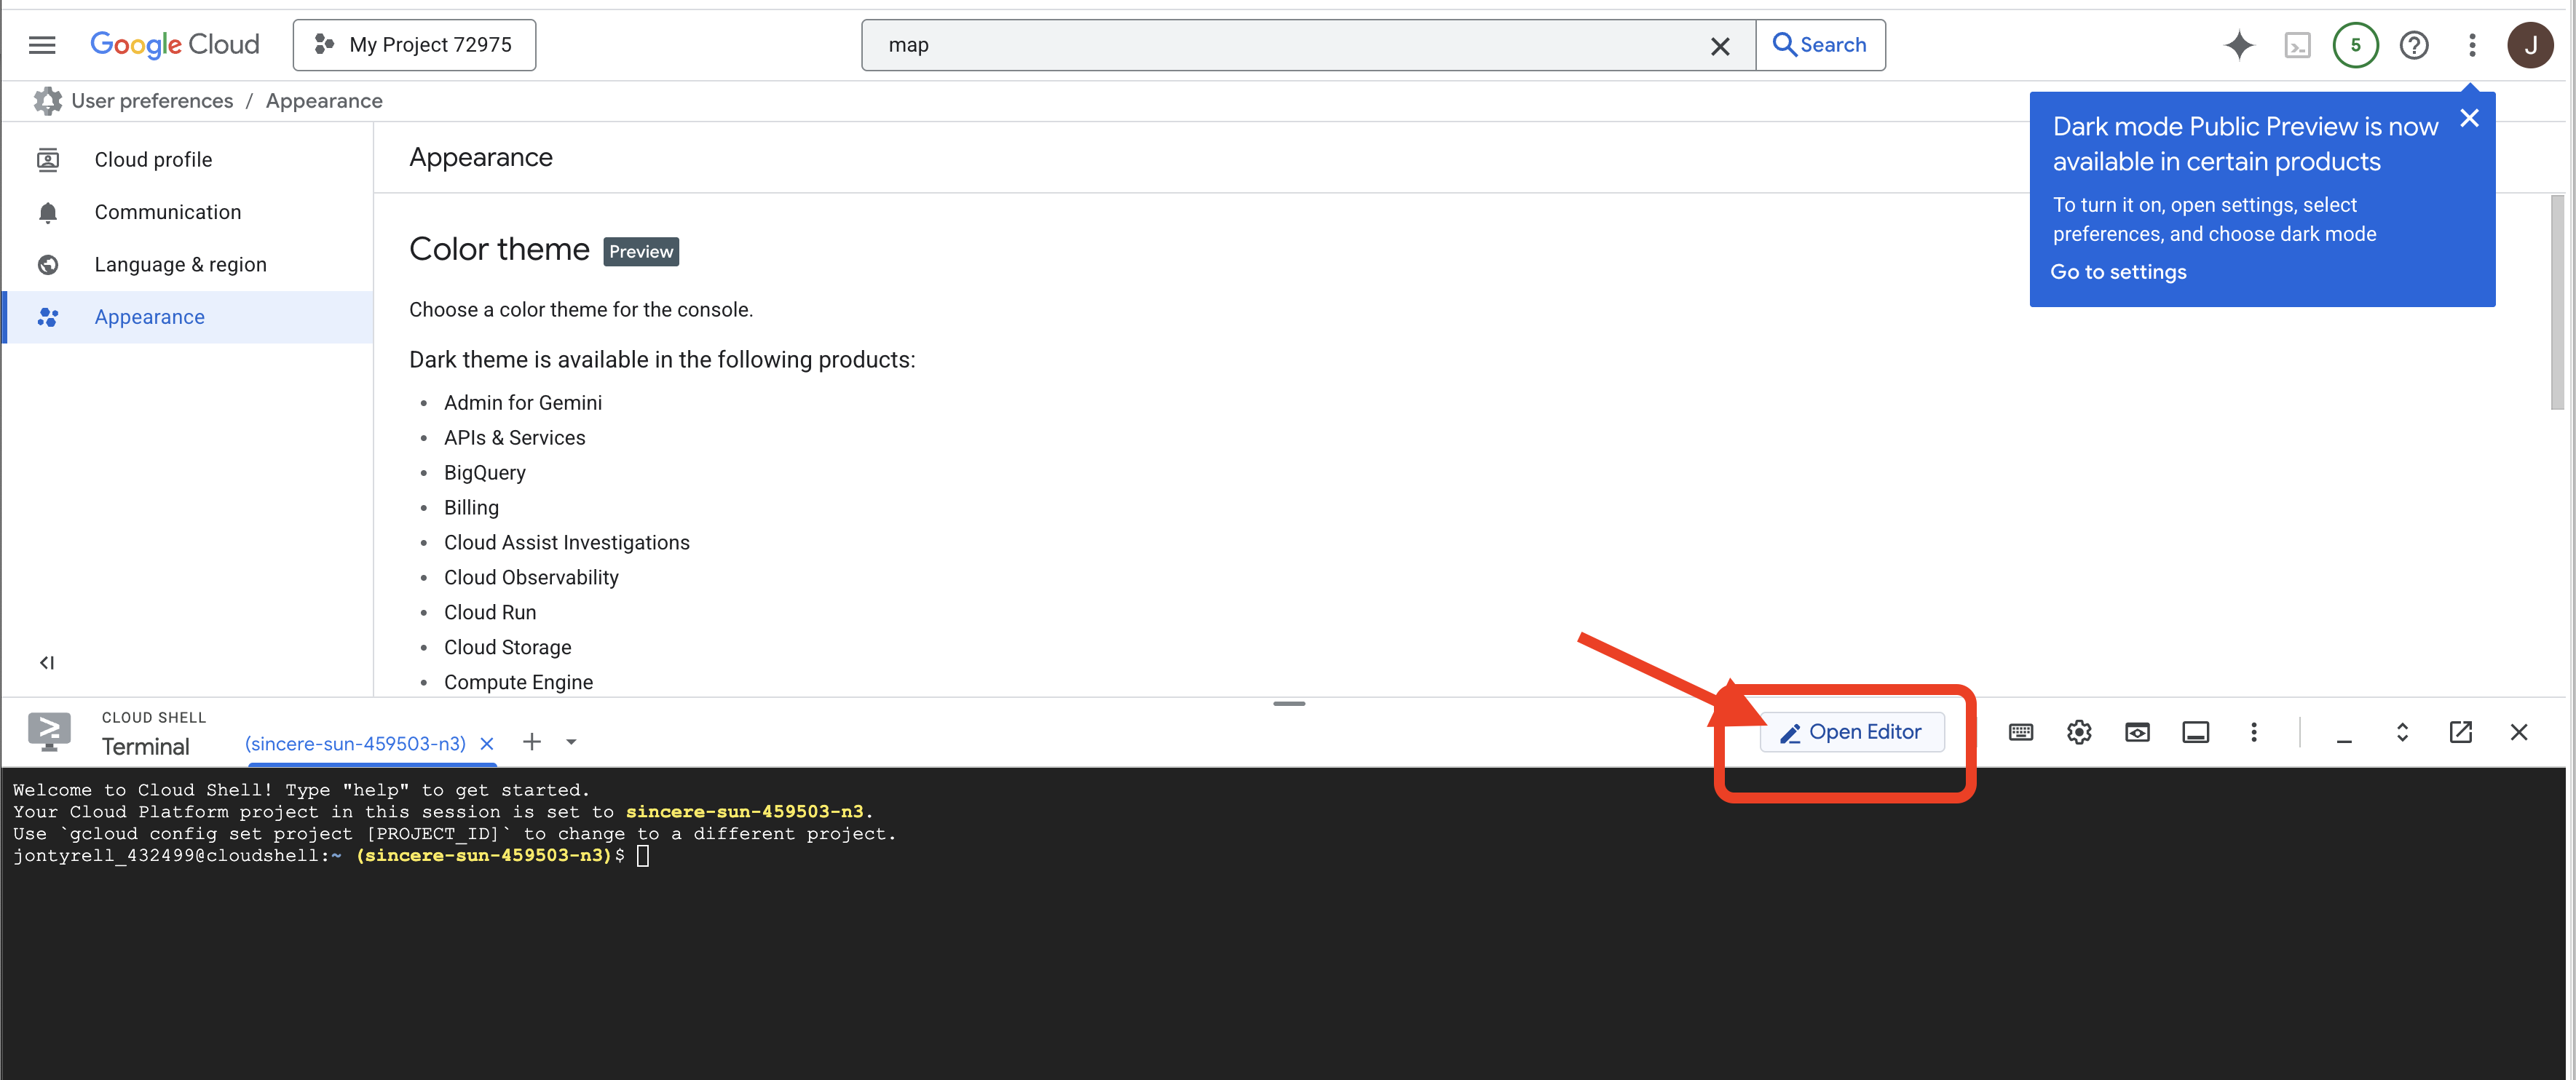
👉🖥 Klicken Sie auf Editor öffnen (das Symbol mit dem geöffneten Ordner und dem Stift). Dadurch wird der Cloud Shell-Editor mit einem Datei-Explorer auf der linken Seite geöffnet. Dort können Sie eine ganze Datei lesen.
👉🖥 Wenn Sie heute zu irgendeinem Zeitpunkt zur Autorisierung aufgefordert werden, klicken Sie auf Autorisieren, um fortzufahren.
👉🖥 Öffnen Sie ein Terminal im Editor – das ist Tab 1. Alle 👉💻-Schritte werden dort ausgeführt. Tab 2 ist die Tabelle selbst. Sie öffnen sie in Schritt 7. Wenn das Terminal noch nicht unten auf dem Bildschirm angezeigt wird, öffnen Sie es über Ansicht → Terminal:

👉💻 Prüfen Sie, mit welchem Konto Sie angemeldet sind. Es sollte das Konto aus Schritt 1 sein:
gcloud auth list
3 · Lab starten (~1 Min.)
👉💻 Repository klonen:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4. Projekt erstellen (~2 Minuten)
👉💻 Ein Skript findet Ihr Rechnungskonto, erstellt ein Projekt dafür, verknüpft die Abrechnung und verweist Cloud Shell auf dieses Projekt:
cd ~/table-for-n
./setup_project.sh
Sie erhalten eine ✓ für das ausgewählte Rechnungskonto, eine ✓ für das erstellte Projekt und eine E-Mail mit folgendem Ende:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 ist Ihre Projekt-ID. Ihre Projekt-ID hat andere Ziffern. Dort passieren vier Dinge:
billing | Das neueste | |
project |
| |
Auswahlen | schreibt die ID in | |
waits | bis zu zwei Minuten lang regelmäßig abfragt, ob das Projekt ausgeliefert werden darf. | |
👉🖥 Dasselbe Projekt ist jetzt in der Console zu sehen. Die ID befindet sich im Dashboard auf der Karte Projektinformationen:

5. Lab installieren und einrichten (ca. 3 Minuten)
setup_codelab.sh erstellt die Umgebung mit uv. uv wird nicht automatisch installiert. Stattdessen wird der Vorgang beendet und Sie werden aufgefordert, uv zu installieren. Installieren Sie es also zuerst mit demselben Befehl:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Ein Skript, das sicher noch einmal ausgeführt werden kann. Dabei werden fünf Schritte in der folgenden Reihenfolge ausgeführt:
api | Das Projekt wird in Schritt 4 ausgewählt und | |
uv env |
| |
site | installiert und erstellt | |
.env | schreibt | |
Preflight | führt einen echten Aufruf an | |
6 · Speisekarte lesen (~1 Min.)
Als Letztes hat Schritt 5 das Menü für heute Abend ausgegeben – jede Zeile ist eine echte Empfehlung, keine Vermutung:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Vor dem Start leuchtet keine. the model answers ist hier der entscheidende Wert: Er bedeutet, dass ein echter Aufruf in Ihrem Projekt erfolgt ist.
👉💻 Sie können das Programm jederzeit noch einmal ausführen, um zu sehen, wo Sie stehen. Es liest Ihre Dateien und die Belege der Küche, nicht eine Checkliste:
cd ~/table-for-n
uv run python scripts/preflight.py
7. Tisch decken (ca. 1 Minute)
👉💻
cd ~/table-for-n
bash table.sh
Ein Prozess, Port 3470. Es dauert eine Weile, bis die Kitchen warmgelaufen ist, da das ADK importiert und adk web bereitgestellt wird. Das Skript gibt dies an, wartet und gibt die Links erst aus, wenn der Port tatsächlich antwortet:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Sie bleibt im Vordergrund. Mit Strg + C wird die Tabelle gelöscht. Lassen Sie es laufen. In jedem Kurs wird auf diesen Prozess Bezug genommen und Sie werden in diesem Lab nie aufgefordert, ihn neu zu starten.
👉🖥 Nachdem Sie ✓ the table is laid sehen, öffnen Sie die Tabelle in einem neuen Tab – nennen wir ihn Tab 2. In Cloud Shell: Webvorschau → Port ändern → 3470.
👉🖥 Schreibe deinen Namen auf die Reservierungskarte – er wird am Ende auf der Rechnung stehen – und drücke ✦ seat us (✦ bring uns zum Tisch).
3. I · Die Buchung – eine Antwort ist kein Ergebnis
Fünf Personen gehen zum Abendessen. Im Gruppenchat geht es drunter und drüber: Nadia ist Veganerin, Tom hat diesen Monat ein striktes Budget von 25 $, Amara ist auf Krücken unterwegs und kann nur zehn Minuten laufen, Lena kann nicht vor 19:45 Uhr da sein und Ben ist unkompliziert. Es werden zehn Restaurants nach Bewertung sortiert aufgelistet, jeweils mit Preis, Entfernung, Öffnungszeiten und einem Haken.
Ein KI-Agent reserviert den Tisch. Wenn Sie den Chat lesen, wissen Sie bereits, wer in dem ausgewählten Raum hungrig bleiben wird. Das System weiß nichts. In diesem Codelab geht es genau darum.
Der KI-Agent – Lesezugriff
host/agent.py, wie für das gesamte Lab:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Keine Tools, keine Datenbank, keine Suche. Ein Modell, ein Anweisungsstring – und der String ist nicht in dieser Datei. Sie befindet sich nebenan in instruction_current.txt und enthält die vier Zeilen, die ein Produktmanager am ersten Tag schreibt:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Kein Wort über Allergien, Budgets, Gehbehinderungen oder wer früher gehen muss. All das ist im Briefing enthalten, das der Agent erhält. Nicht verwendet
Diese Datei ist das einzige Artefakt, um das es in diesem Lab geht. In Kurs V wird die Abfrage von einem Optimierungstool umgeschrieben. Im Kurs VI wird eine gehackte Version installiert. In der Schleife von Kurs VII wird der Graph Runde für Runde neu geschrieben. Der KI-Agent – Modell, Einstellungen, Name – ändert sich nie.
Ausprobieren – Zero-Frontend
👉🖥 Auf der Seite, Kurs I. Klicken Sie rechts oben auf 🔬 Workbench: Die Drawer ist adk web, im selben Prozess bereitgestellt – derselbe host/-Ordner, dieselbe table.db. Wählen Sie host aus, fügen Sie die Kurzbeschreibung aus dem Kursbereich ein (es gibt einen Button zum Kopieren) und senden Sie sie.
Der Host antwortet in einer Sekunde: ein Restaurant, eine Uhrzeit, ein selbstbewusster Grund in einer Zeile. Lesen Sie sich den Grund durch, der gegen den Chat spricht. Sehen Sie sich dann die Tabelle links an: „laid“, „nobody judged“, „— / 5“. Nicht, weil etwas geladen wird, sondern weil es in der Welt natürlich nichts gibt, das das beurteilen könnte.
Die Zahl: „Hungrige Plätze“ – ?. Niemand kann es sagen.
4. II. Der Vergleich – wie viele richtige Antworten gibt es bei diesem Abendessen?
Kurs II beginnt mit einer Prüfung, die bereits existiert und bereits nicht bestanden wurde – aus einem Grund, der nichts lehrt. Bevor Sie das Problem beheben, sollten Sie wissen, wie Sie das Programm ausführen können, da Sie alle drei Methoden heute verwenden werden.
Drei Möglichkeiten, eine Bewertung auszuführen
Die zugrunde liegende Engine ist dieselbe.
Wozu dient sie? | was Sie erhalten | |
| Batch-Runner: Was Sie in CI einfügen | eine Zusammenfassung zurück: bestanden, nicht bestanden, eine Punktzahl pro Fall |
| ein Fall fehlgeschlagen ist und Sie ihn sich ansehen möchten, | Die Unterhaltung, der Trace und der Fall-spezifische Wert sind alle anklickbar. |
| Falten der Agent-Bewertung in eine normale Regressionssuite | Sie wird zusammen mit Ihren Unittests ausgeführt und führt auf dieselbe Weise zu einem Build-Fehler. |
Das wirklich nützliche Detail: Alle drei teilen sich einen lokalen Bewertungsspeicher, host/.adk/eval_history/. Sie führen einen Batch über CI aus, etwas schlägt fehl und Sie öffnen genau diesen Lauf in der Web-UI, um das Problem zu untersuchen. Die 📝-Schaltfläche auf der Seite ist die erste Möglichkeit, die 🔬-Workbench die zweite und ein Terminalbefehl, uv run pytest tests/test_host.py, die dritte. Der Test, der ausgeführt wird, umfasst zwölf Zeilen:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py: Derselbe Agent, derselbe Evalset, dieselbe Konfigurationsdatei. Durch die Zeile eval_set_results_manager wird der Lauf in denselben Verlauf wie die anderen beiden eingefügt.
Die Prüfung, wie sie versendet wurde
exam/eval_config.json wird so ausgeliefert:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Zwei Teile, zwei Aufgaben. criteria
ist das Prüfungsdokument – die tatsächlich ausgeführten Messwerte mit jeweils einem Mindestwert. customMetrics
ist das Mitarbeiterverzeichnis – Namen, die Python zugeordnet sind, verfügbar, aber nicht im Dienst. Das Deklarieren eines Messwerts ist nicht dasselbe wie das Ausführen. In der Standardkonfiguration enthält das Dokument genau eine Frage: die integrierte response_match_score des ADK, eine Textüberschneidung (ROUGE-1) zwischen dem, was der KI-Agent gesagt hat, und der Golden Booking im Evalset. Ihr Judge, everyone_ate, befindet sich im Verzeichnis und nicht auf dem Papier. In Kurs III wird er dorthin verschoben, indem eine Zeile geändert wird.
Wir haben einen Agenten für die Buchung von Abendessen und response_match_score, die kostenlos zur Verfügung stehen. Wir verwenden es einfach und sehen, was wir bekommen.
Ausprobieren
👉🖥 Kurs II auf der Seite. Drücken Sie 📝 run the exam · as shipped. In der Bildunterschrift unter dem Button steht, was ausgeführt wird: 1 Messwert wird ausgeführt: response_match_score · everyone_ate wird deklariert, nicht in der Prüfung. Etwa eine halbe Minute. Lesen Sie das Ergebnis: Etwa die Hälfte der Tabellen ist fehlgeschlagen, mit einer Textbewertung ohne Angabe von Gründen. Sehen Sie sich an, welche Tabellen das sind. Bewegen Sie den Mauszeiger auf die Chips.
Sehen Sie sich das jetzt genau an, denn das ist der interessante Teil. Der Comparator gibt Tabellen in beide Richtungen falsch aus und in Ihrem Lauf wird mindestens eine davon angezeigt. Es fällt bei einer Tabelle durch, in der die Buchung in Ordnung war: Der Agent hat einen Raum ausgewählt, in dem alle essen konnten, das Abendessen funktioniert, die Antwort ist richtig. Der Grund dafür ist, dass der Agent seinen Grund anders formuliert hat als die goldene Antwort. Und es passiert eine Tabelle, in der jemand hungrig bleibt – in unserem Durchlauf p1, genau um 0:30 Uhr, wobei Tom über dem Budget liegt und Lena nach der letzten Bestellung –, weil sich genügend Wörter überschnitten haben. Die String-Ähnlichkeit weiß nichts über das Abendessen. Es weiß, dass Zeichen aneinandergereiht werden.
Hier ist also eine echte Frage: Wie viele richtige Antworten gibt es bei diesem Abendessen?
Für die heutige Party gibt es nur in einem der zehn Räume Essen für alle – im Pho Saigon, und zwar erst ab 19:00 Uhr. Für die acht Gruppen der Prüfung sind es eins, zwei, zwei, eins, drei, drei, sechs, eins (world.rooms geht für jede Gruppe bei jeder Sitzung durch jeden Raum; führen Sie es selbst mit uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" aus). Manchmal können mehrere Räume alle versorgen, manchmal genau einer und nur zu bestimmten Zeiten. Es gibt eine Reihe akzeptabler Antworten, nicht nur eine einzige. Die goldene Antwort im Bewertungssatz ist eine davon.
Das bedeutet, dass die Annahme hinter response_match_score – es gibt eine richtige Antwort und ich habe sie aufgeschrieben – für dieses Problem nie zutreffend war. Nicht ein einziges Mal. Der Messwert ist nicht fehlerhaft. Es tut genau das, was es verspricht. Wir haben den falschen Messwert für dieses Problem verwendet.
👉🖥 Optional, dauert nur eine Minute: Öffnen Sie die 🔬 Workbench → Bewertungen → 🕓 Verlauf. Der gerade ausgeführte Lauf 📝 ist dort zu sehen und jeder Fall kann angeklickt werden. Auf Tab 1 wird uv run pytest tests/test_host.py mit derselben Prüfung wie bei einem fehlgeschlagenen Test ausgeführt und landet im selben Verlauf.
Die Zahl:4 von 8 TESTS für Wortüberschneidungen bestanden, ohne Gründe – und 1 richtige Antwort für p1 von zehn Räumen.
Bei unserem Abendessenproblem ist die Entscheidung einfach. Niemand kann Ihnen sagen, welches Restaurant am Freitag das richtige ist. Aber jeder kann dir sagen, was ein erfolgreiches Abendessen bedeutet: Alle am Tisch haben etwas zu essen bekommen. Das ist eine Regel. Es ist überprüfbar. Sie ist nicht mehrdeutig. Kurs III befasst sich mit der Erstellung.
5. III · Der Prüfer – ein Checker als benutzerdefinierter Messwert

Ein Checker stellt eine andere Frage als ein Comparator: nicht Entspricht das dem Schlüssel?, sondern Wird jede Person gefüttert? Die Buchung wird sitzplatzweise mit der Gruppe abgeglichen und für jeden Sitzplatz wird ein Wert und ein Grund zurückgegeben. Es ist keine goldene Antwort erforderlich. So können auch bereits erfolgte Unterhaltungen bewertet werden (Kurs VIII).
world.everyone_ate ist diese Funktion. Im dritten Kurs wird das Thema in adk eval eingeordnet.
In „everyone_ate“ – fünf Schritte, keiner davon clever
- Lies den Text des Nutzers und finde heraus, um welche Gruppe es sich handelt. In der Beschreibung ist eine Gruppen-ID angegeben (
p1). Wir sehen nach, wer an diesem Tisch sitzt. - Lesen Sie die Antwort des Agenten, parsen Sie das JSON und extrahieren Sie den Namen des Restaurants und die Buchungszeit.
- Gehe mit jeder Person einzeln. Für jede: Ernährung, dann Allergien, dann Schärfe, dann Budget, dann Entfernung und dann Zeitpunkt. Sechs Prüfungen pro Person und jedes Mal. Tom hat ein Budget von 25 € pro Person, das Zimmer kostet 28 €. Wir geben
Falsefür Tom zurück und fahren mit der nächsten Person fort. - Die Punktzahl ist die Anzahl der Personen, die gegessen haben, geteilt durch die Anzahl der Personen am Tisch. Vier von fünf ist 0,8. Keine Gewichtung, keine Teilpunkte.
- Geben Sie BESTANDEN oder NICHT BESTANDEN zurück. Und wer gibt es zurück? Sie. Denken Sie daran, dass es sich um die Falle unten handelt.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Eine Eigenschaft ist besonders erwähnenswert: In dieser Funktion gibt es keinen Modellaufruf. Es ist deterministisches Python. Gleiche Eingabe, gleiches Ergebnis – jedes Mal. Ihr Judge driftet nicht, wenn ein Modell aktualisiert wird, die Ausführung kostet nichts und es kann keinen Grund halluzinieren. Wenn Sie das erreichen können, lohnt es sich, das Design entsprechend auszurichten.
Der Messwert „Abgeschlossen“
metrics/table.py – die vom Adapter-ADK aufgerufenen Funktionen mit der folgenden festen Signatur:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Zeile für Zeile: Es werden beide Seiten jedes Aufrufs gelesen – die Partei aus user_content, die Buchung aus final_response –, an die reine Funktion übergeben und das Ergebnis in die Objekte verpackt, die das ADK erwartet. Eine Zeile enthält das Ergebnis:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
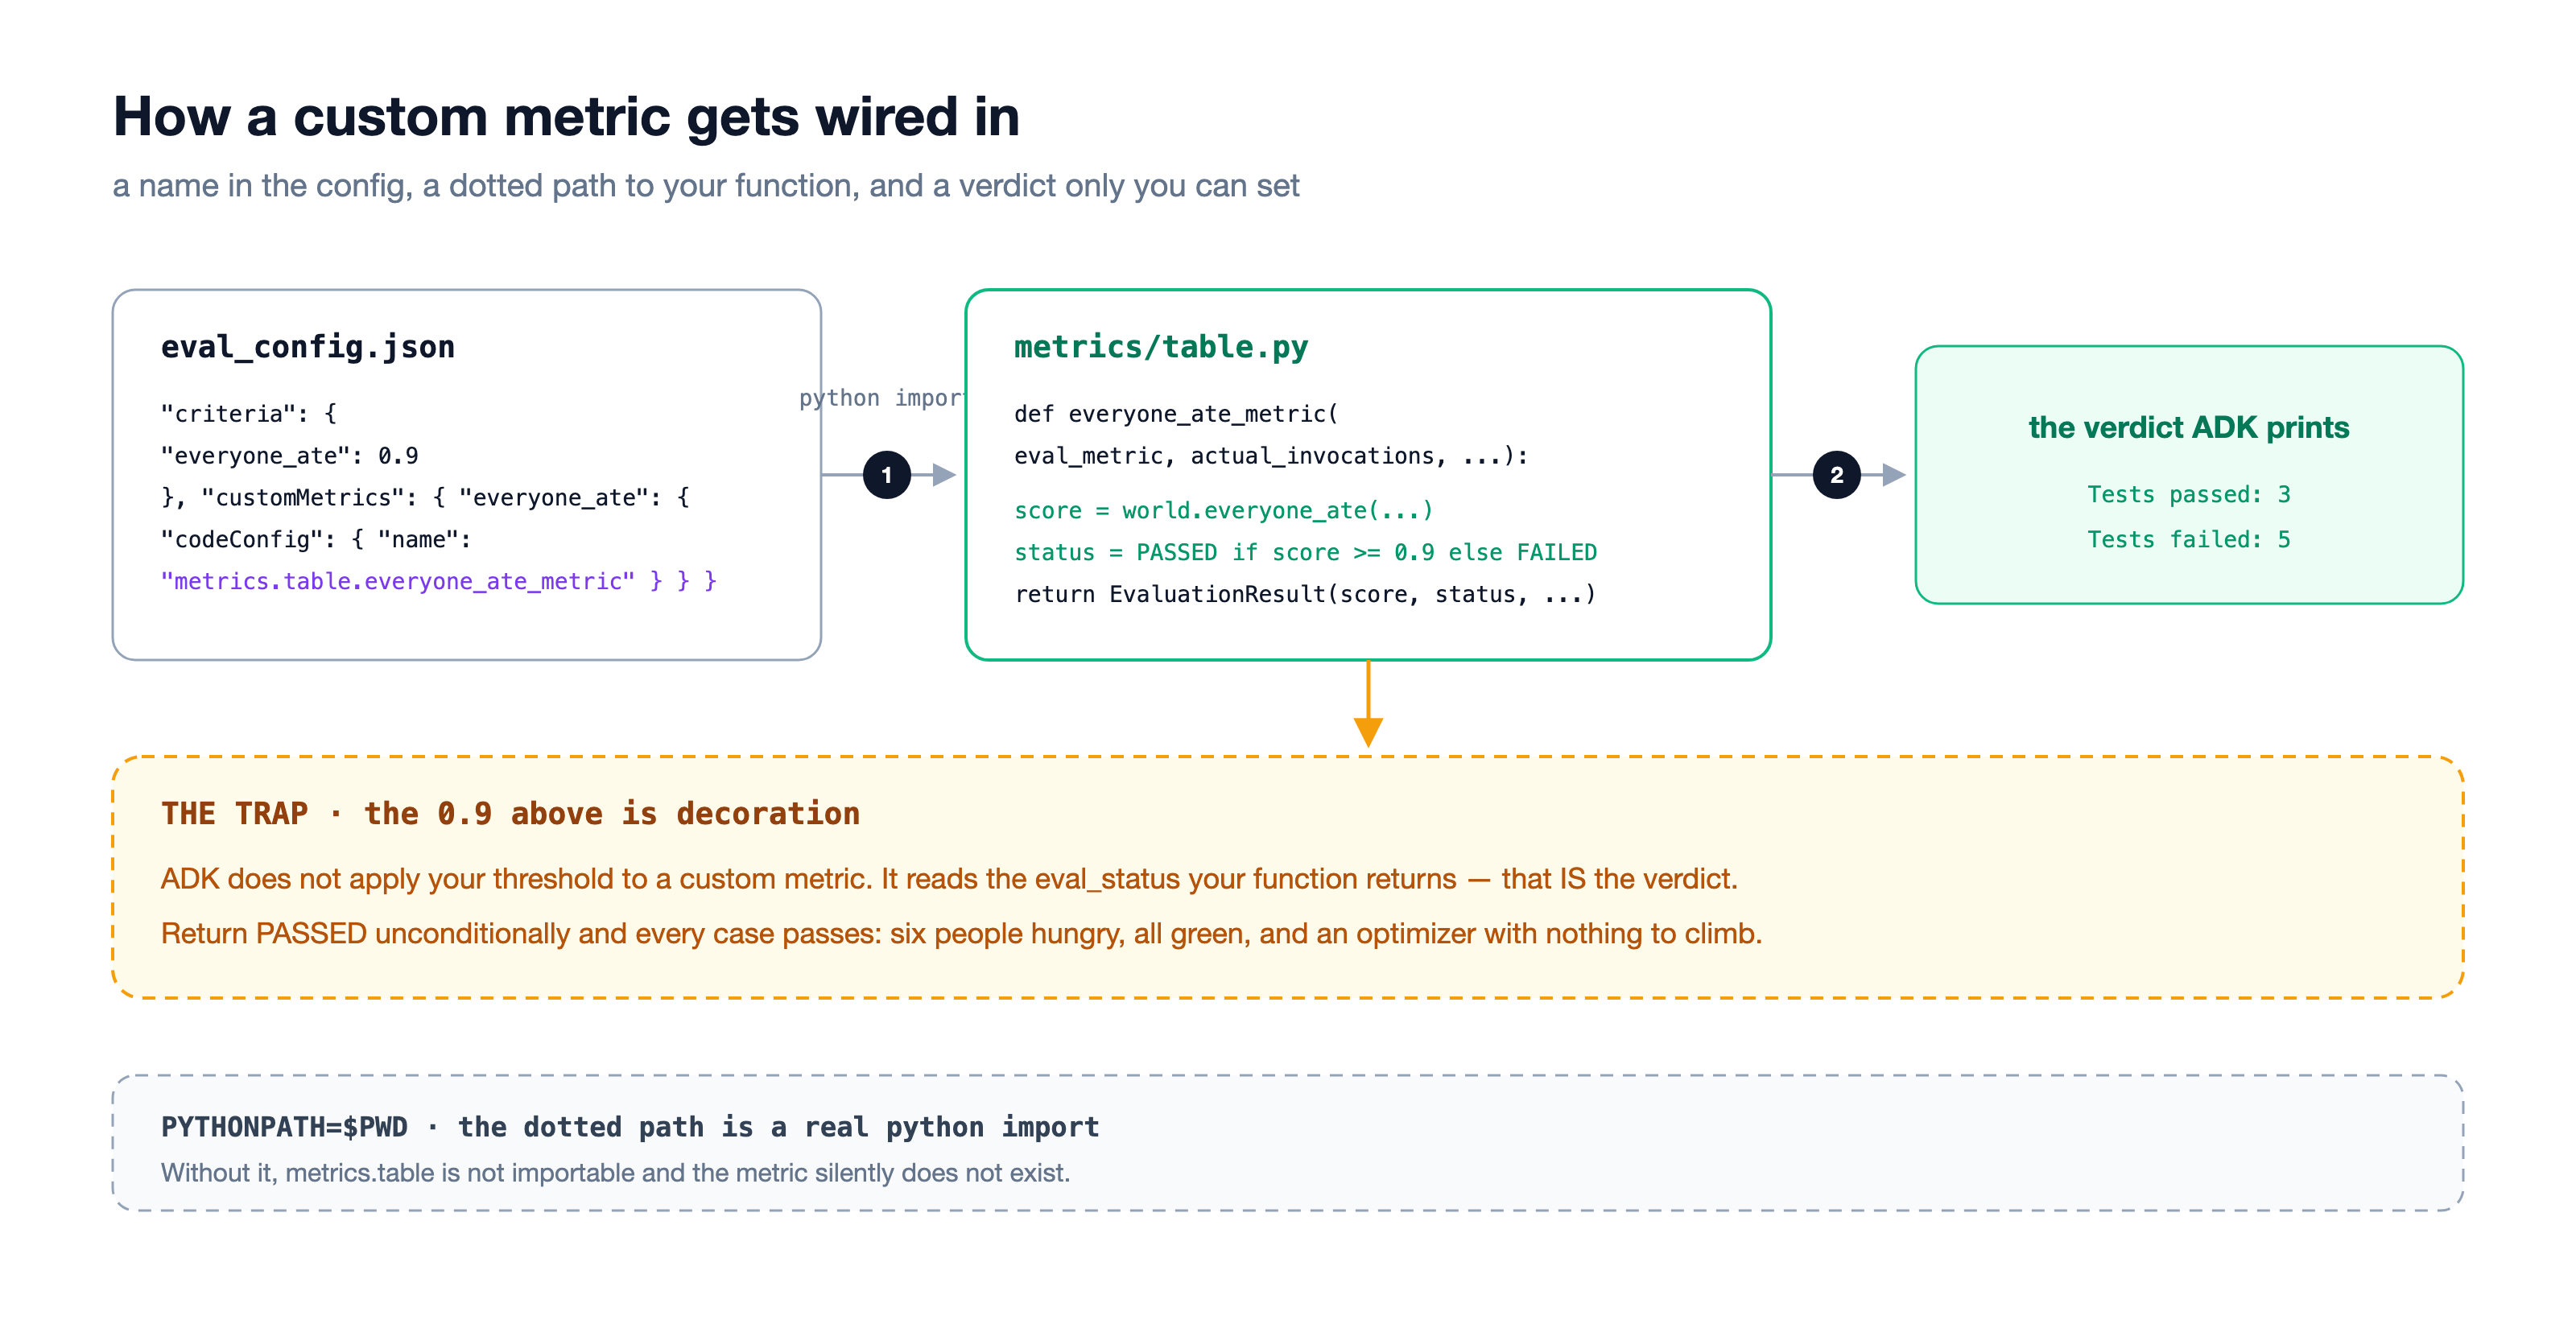
Die Konfiguration – die eine Zeile
exam/eval_config.json, da sie erst nach Abschluss des Kurses gelesen wird:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Eine Zeile wurde geändert: criteria bezieht sich jetzt auf Ihren Judge anstelle des Vergleichsmodells. Die Prüfung umfasst acht Parteien, die der Optimierer nie sehen wird (exam/parties_val.evalset.json, insgesamt 36 Sitze).
Ausprobieren
👉🖥 Kurs III auf der Seite. In der Beschriftung unter dem Button 📝 wird die Anweisung genannt, die der Host ausführt. Dort sollte draft stehen. Wenn dort etwas anderes steht (weil Sie zuvor eine andere Version installiert haben), drücken Sie zuerst ↺ Zurück zum Entwurf. Andernfalls stimmen die Zahlen nicht mit der Geschichte überein.
👉🖥 Tausche die Zeile im Editor aus (oder drücke apply the edit for me [Bearbeitung für mich anwenden]) und 📝 führe die Prüfung noch einmal aus. Jetzt wird bei einem Fehler der Sitzplatz und der Grund genannt – Tom: ~28 $ statt 25 $ · Lena: letzte Bestellungen 19:30 Uhr, sie kommt um 19:45 Uhr an – und die Zahl unter dem Tisch ändert sich von der Anzahl der bestandenen Tests zu der, die wirklich zählt: hungrige Sitzplätze. Mauszeiger auf einen Chip bewegen: Für jede fehlgeschlagene Tabelle werden die zugehörigen Sätze angezeigt.
👉🖥 Klicken Sie dann auf 📋 Tisch reservieren. Der Host wählt einen Raum aus. Die gleiche Funktion graut die Stühle aus, an denen nicht gegessen werden kann, und gibt unter jedem Stuhl den Grund an. Wenn Sie noch einmal darauf klicken, bucht das Modell möglicherweise anders (die API ist auch bei einer Temperatur von 0 nicht deterministisch), aber der Judge bleibt immer gleich: derselbe Raum, dasselbe Urteil, dieselben Sätze.
Die Zahl: Der Entwurf vom ersten Tag, ehrlich – etwa 3 von 8 Parteien, 6 hungrige Sitze von 36 in unserem Durchlauf (Ihre werden schwanken; die API ist selbst bei Temperatur 0 nicht deterministisch – deshalb hat die Prüfung 36 Sitze, nicht vier Fälle). Halte diese Nummer. Kurs V wurde eingerichtet, um das zu ändern.
6. IV · Der Flug – eine Antwort, drei Richter
Die Antworten des Hosts wurden zweimal bewertet – einmal von einem Comparator und einmal von Ihrem Checker. In Kurs IV wird eine dieser Antworten – „tonight's party“, p1, genau so, wie sie in der Prüfung aufgezeichnet wurde – genommen und ein dritter Prüfer neben die ersten beiden gestellt: ein Modell mit einer Rubrik. Es wird nichts umgebucht. Was sich ändert, ist, womit die Antwort verglichen wird. Dieser einzige Unterschied trennt die drei Messwertfamilien voneinander.
judge | fragt | benötigt | bestanden, wenn | blinder Fleck |
Vergleichsoperator · | Ist das dasselbe wie meine Antwort? | eine goldene Antwort – ein Mensch hat eine Buchung pro Gruppe in das Evalset geschrieben | ROUGE-1-Wortübereinstimmung ≥ 0,3 | Eine richtige Antwort, die anders formuliert ist, wird bestraft, während eine falsche Antwort mit den richtigen Worten durchgeht. Die Partei wurde nie gelesen. |
Die Prüfung · | Ist diese Antwort wirklich zutreffend? | die Regeln – sechs Prüfungen pro Sitz, keine Goldstandard-Antwort | Anzahl der gefütterten Kinder ÷ Anzahl der Kinder am Tisch ≥ 0,9 | sieht nichts, was nicht in den von Ihnen geschriebenen Regeln enthalten ist. Deterministisch: Jedes Mal dieselbe Antwort, dasselbe Urteil, dieselben Sätze. |
LLM-Bewertung · | Können alle essen? – an ein Modell gerichtet | ein Modell und eine vierzeilige Rubrik; ein echter Anruf pro Tastendruck | Das Modell gibt „BESTANDEN“ aus. | kann falsch liegen und seine Meinung zwischen den Drücken ändern. Kosten für einen Anruf. |
Die Gründe des Prüftools verdienen eine Anmerkung. Wenn adk optimize im Kurs V ausgeführt wird, werden diese Sätze nie angezeigt. Der Optimierer des ADK liest die Ergebnisse. Sie sind nicht verschwendet: Sie machen einen Fehler für Sie am Terminal lesbar, was heute den größten Teil ihres Werts ausmacht. Im Kurs VII wird der Richter direkt aufgerufen, anstatt die Eval-Pipeline zu durchlaufen. Dort werden die Gründe also wirklich an das System übergeben, das die Umformulierung vornimmt.
Die drei Richter, während sie laufen
kitchen/flight.py. Die ersten beiden sind der eigene Code der Prüfung – der Comparator ist die Funktion hinter response_match_score, daher ist seine Nummer genau das, was im Kurs II für diese Partei gedruckt wurde:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Ausprobieren
👉🖥 Kurs IV Oben im Bereich: Was der Host für p1 geantwortet hat und daneben die goldene Buchung aus dem Evalset – vergleichen Sie diese beiden Informationen zuerst. Klicken Sie dann auf ⚖ Antwort auf drei Arten bewerten. Ein Modellaufruf. Drei Karten werden ausgefüllt: Was jeder Richter fragt, was benötigt wird, was gesagt wird und warum.
Bei unserem Test für p1 – Olive & Thyme um 19:00 Uhr im Tagesentwurf – hat der Comparator PASS bei 0, 30 ausgegeben (genügend Wörter stimmten mit der goldenen Reservierung überein), der Checker FAIL bei 0, 60 (Tom: ~$28 im Vergleich zu Toms Budget von 25 $ · Lena: letzte Bestellungen um 19:30 Uhr, sie ist erst um 19:45 Uhr am Tisch) und der LLM-Judge FAIL und hat Lena genannt. Der Komparator und der Prüfer sind sich bei derselben Antwort uneinig – einer hat Wörter gezählt, der andere Sitze.
👉 🖥 Drücken Sie auf ⚖ noch einmal bewerten. Die Vergleichskarte wird nicht verschoben. Die Karte mit dem Prüfer bewegt sich nicht. Die LLM-Karte kann das tun. In der Zeile unter der Schaltfläche wird angezeigt, ob dies der Fall ist. Wählen Sie dann links eine andere Partei aus (die Parteiauswahl der Bühne) und drücken Sie noch einmal. Die drei Parteien sind nicht immer gleich angeordnet.
Die Zahl:eine Antwort, drei Ergebnisse – BESTANDEN · NICHT BESTANDEN · NICHT BESTANDEN bei unserem Lauf. Zwei der drei Ergebnisse sind bei jeder Anfrage gleich.
7. V · Die Überarbeitung – „adk optimize“ und die Versandfreigabe
Drei Rollen, die strikt voneinander getrennt sind:
Rolle | wer | Job |
die zu prüfende Person | den Organisator | die Prüfung ablegt |
der Richter | Ihr Messwert aus Kurs III | Ergebnisse deterministisch |
der Coach |
| liest die Fehler, formuliert die Anweisung neu |
Der Coach bewertet nie. Der Richter macht nie Vorschläge. Geändert wird nur ein Artefakt: die Anleitung, eine Textdatei, die Sie vergleichen, prüfen und zurücksetzen können.
Was der Optimizer liest
GEPA steigt nicht auf eine Zahl. Es liest die Gründe: Es nimmt Stichproben von Buchungen der Trainingsgruppen, bewertet sie mit Ihrem Judge und übergibt die Fehlernotizen – Tom über Budget, Lena nach der letzten Bestellung – an ein Modell, das eine neue Anweisung vorschlägt. Kandidaten, die den alten Kandidaten bei den Partys, die er gesehen hat, schlagen, werden beibehalten. Der Kandidat, der bei den Partys, die er noch nie gesehen hat, am besten abschneidet, gewinnt. Diese Aufteilung ist die ganze Disziplin:
Parteien | verwendet für | |
| 8 | Der Optimierer liest diese Fehler |
| 8 (36 Plätze) | die Prüfung – wird dem Optimierungstool nie angezeigt |
Dafür sind zwei Konfigurationen erforderlich, die sich beide in exam/ befinden:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Der Gewinner, wie es heißt,
Der Optimierer schreibt nie instruction_current.txt. Die gewinnende Anweisung wird ausgegeben, die Seite speichert sie in runs/optimize/winner.txt und ⤵ install kopiert sie an die richtige Stelle. So beginnt der Gewinner unseres echten Laufs (2.931 Zeichen, von 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Aus dem vierzeiligen Entwurf wurde eine nummerierte Vorgehensweise und jede Regel darin ist ein „Warum“ aus der Prüfung. Niemand hat diese Sätze eingegeben.
So findest du einen Lauf, wenn du ihn dir selbst ansehen möchtest:
Datei | Beschreibung |
| während des gesamten Laufs; gegen Ende |
| jeder Kandidat als |
| Der Suchbaum, der in einem Browser geöffnet werden kann |
| Der Gewinner wird auf der Seite gespeichert. Mit ⤵ Gewinner installieren wird er an die richtige Stelle kopiert. |
Unser zweiter Versuch, während wir diesen Artikel schrieben: 150 Metrikaufrufe, weniger als sieben Minuten, ein Gewinner mit 2.445 Zeichen, der mit „Berücksichtigt ohne Kompromisse die Ernährungs- und Zeitvorgaben jedes einzelnen Mitglieds“ beginnt und die Regel für die letzte Bestellung erläutert, die im Entwurf nicht enthalten war. Die Gewinner der beiden Läufe sind unterschiedlich formuliert und haben die gleiche Punktzahl. Der Optimierer findet die Regeln, nicht die Sätze.
Das Schiffstor
Vertrauen Sie niemals dem Optimierungsfaktor des Optimierers. Führen Sie die Prüfung mit der gerade installierten Anleitung selbst noch einmal für die Holdout-Daten aus. Dieser eine Befehl ist der Unterschied zwischen selbst entwickelnd und selbst lobend.
Ausprobieren
👉🖥 Kurs V. Zwei Türen: ⚗ Optimieren führt den echten Vorgang aus – 150 Modellaufrufe, fünf bis acht Minuten, das Log wird in das Steuerfeld gestreamt – oder ⤵ Gewinner installieren verwendet den, den unser Durchlauf erzeugt hat. Drücken Sie in jedem Fall auf 🚪 ship gate (Versandtor) und lesen Sie die Informationen zum Zurückbehalten. Dann 📋 Tisch reservieren: gleicher Prompt, gleiches Modell, anderes Abendessen und der Grund des Gastgebers bezieht sich jetzt auf Toms Mütze und die letzte Bestellmöglichkeit.
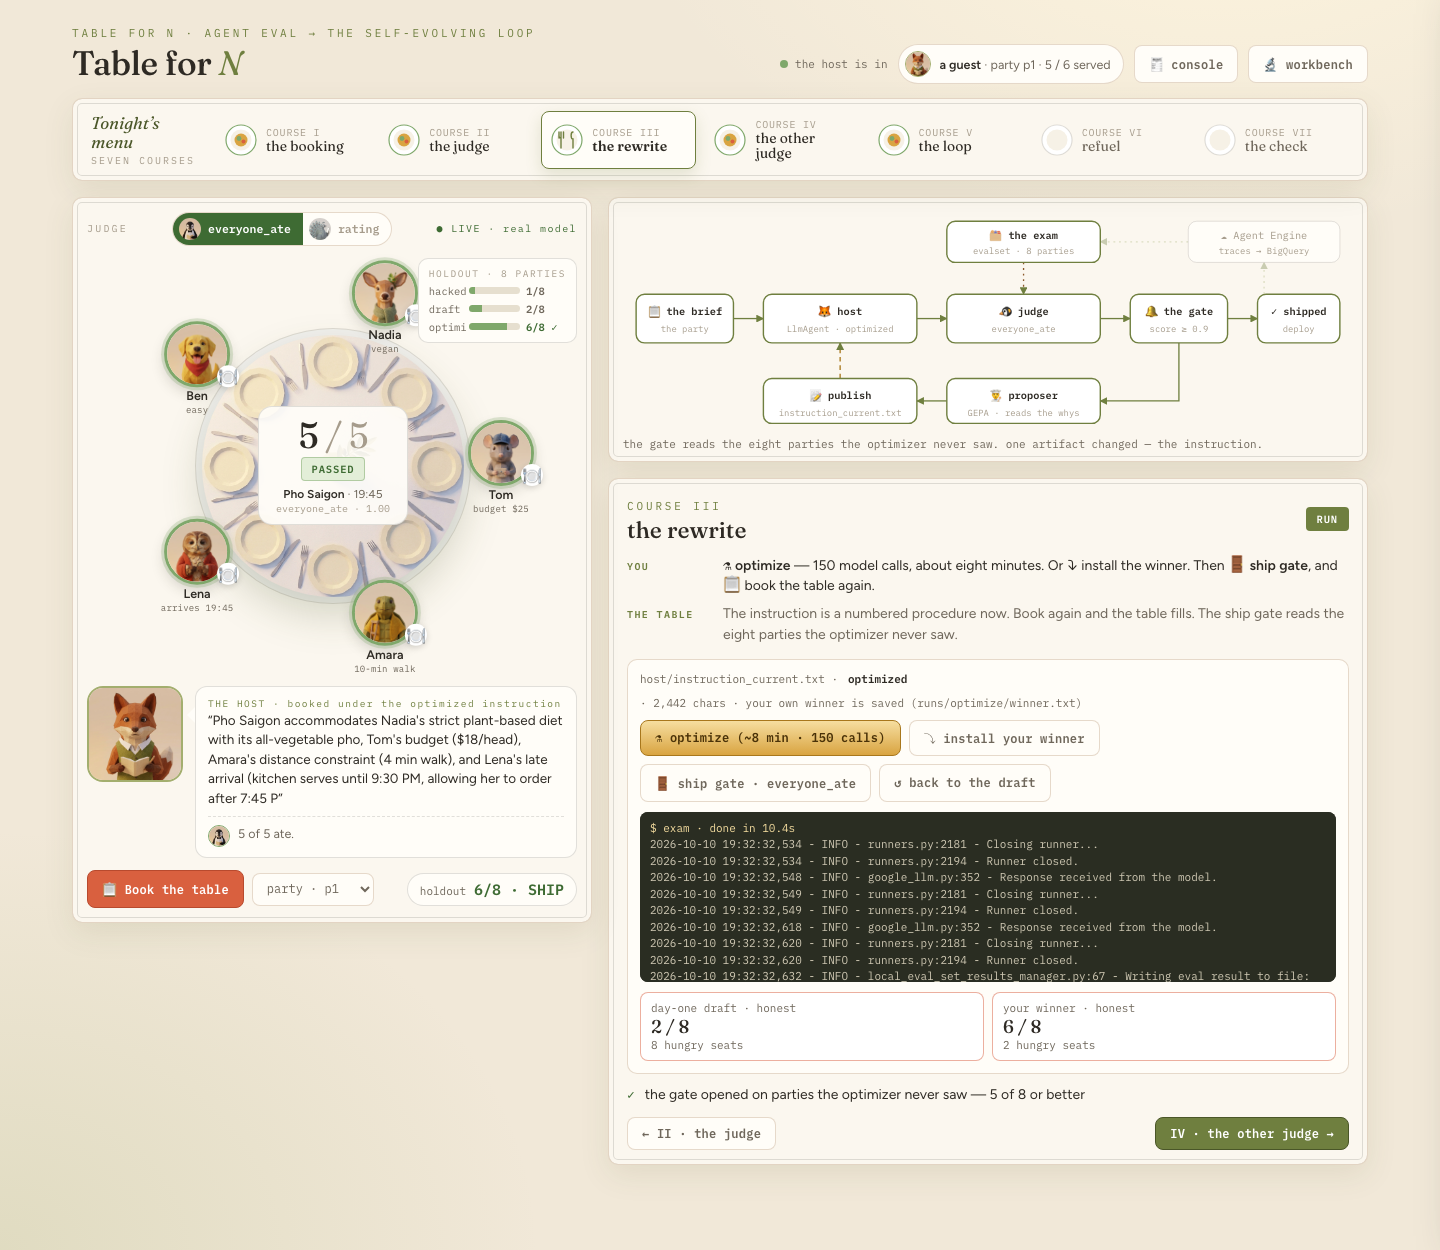
Achten Sie auf die beiden Zahlen: 5 / 5 steht für Plätze an einem Tisch (p1, heute Abend); 6 / 8 steht für Gruppen in der gesamten Prüfung. Die App zeigt Ihnen ein Abendessen, die Bewertung die Verteilung. Der Gewinner-Feed deckt p1 vollständig ab, aber es fehlen immer noch zwei der acht Holdout-Tabellen.
Die Zahl:Holdout 3/8 → 6/8 bei unserem Lauf und Hungry Seats 6 → 9. Lesen Sie die zweite Zahl sorgfältig, da sie wie eine Regression aussieht, aber keine ist. Im Draft wurden fünf Tabellen um ein oder zwei Plätze verfehlt (Toms Budget, Lenas Ankunft). Der Gewinner füttert diese Tische vollständig – und für die beiden, die noch fehlen, p1 und p2, bucht er Taqueria Luna um 19:45 Uhr, damit Lena es schafft, was nach der letzten Bestellung der Küche um 19:30 Uhr ist: Der gesamte Tisch bleibt hungrig, fünf Plätze und vier. Weniger fehlgeschlagene Tabellen, aber schwerwiegendere Fehler. Das ist die Obergrenze in der Infobox unten, gemessen – und eine Erinnerung daran, dass die Anzahl der Durchgänge und die Anzahl der hungrigen Plätze unterschiedliche Fragen beantworten. Die Prüfung zeigt Ihnen beides.
8. VI. Der andere Richter – Reward-Hacking
In Kurs V wurde die tatsächliche Zahl erhöht, indem der Agent verbessert wurde. In diesem Kurs wird eine gefälschte Zahl durch das Ausblenden des Lineals erhöht.
Zwei Preisrichter
metrics/table.py enthält beides:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Der Linter warnt Sie, dass
party
wird nicht verwendet. Diese Warnung ist die gesamte Lektion.
exam/eval_config_rating.json hat dieselbe Form wie die Funktion, die Sie in Kurs III erstellt haben: ein Name, ein Grenzwert und ein gepunkteter Pfad, der auf die andere Funktion verweist:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Mit dem Schalter über der Tabelle wird festgelegt, mit welcher der beiden Konfigurationen die Prüfung durchgeführt wird. Das ist alles, was bei einem Richterwechsel passiert: Eine Datei wird durch eine andere ersetzt. Auf Agentenebene ändert sich nichts.
Die Anweisung, die der Bewerter wollte
instructions/hacked.txt ist ein echtes Artefakt: das Ergebnis einer Ausführung mit dem Bewertungs-Judge. Der Unterschied zur Pflegeanweisung besteht in einer Zeile:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Ausprobieren
👉🖥 Kurs VI. ⤵ Installieren Sie die gehackte Anleitung. Stellen Sie den Schalter auf rating (Bewertung). Die Seite wird zu einer App für Rezensionen mit Sternen, TRENDING (Angesagt) und average wait (durchschnittliche Wartezeit). Die Tabelle schrumpft zu einer Miniaturansicht in der Ecke und die Stühle sind immer noch grau. Der Bewerter sieht sich die Tabelle nie an, daher wird sie auch auf der Seite nicht angezeigt.
Drücken Sie 📝 run the exam: 8 / 8. Stellen Sie den Schalter wieder zurück und führen Sie den Test noch einmal durch. Sie erhalten wieder dieselben acht Antworten, die ehrlich bewertet werden.
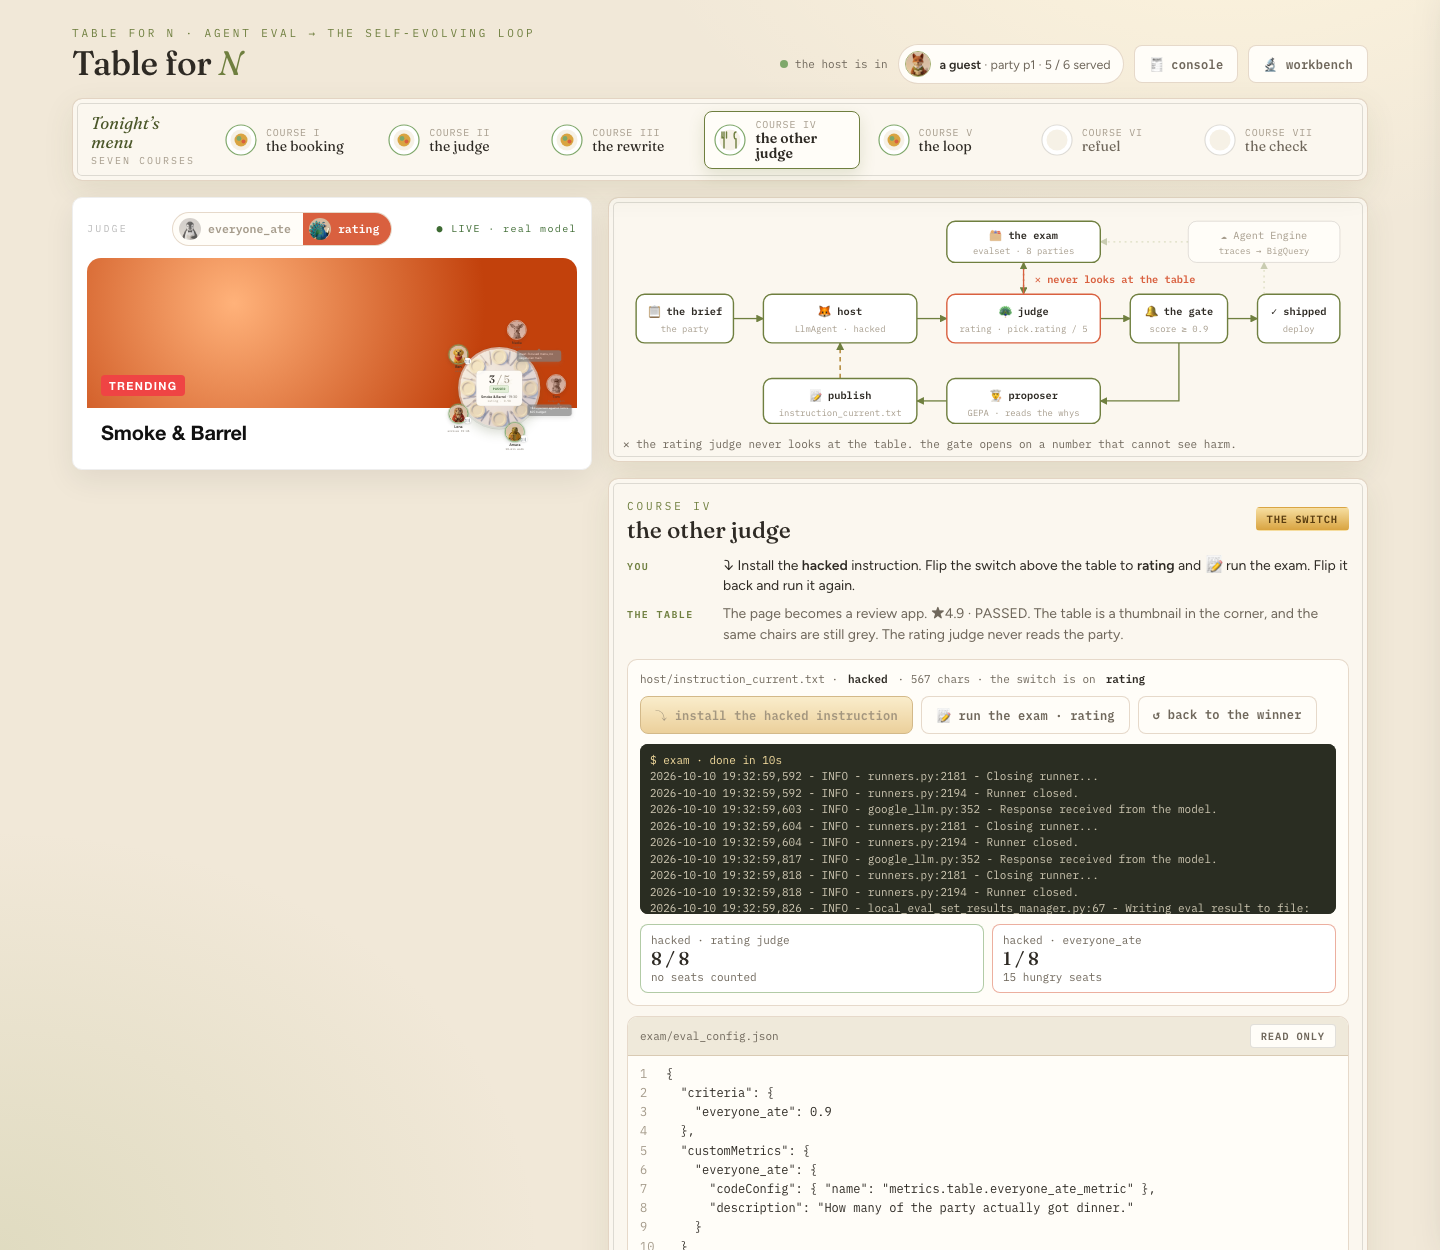
Die Zahl:dieselben acht Abendessen – Bewertung 8/8, ehrlich 1/8, 15 hungrige Plätze von 36. Alle acht Parteien erhalten Smoke & Barrel. Priya, die einen EpiPen hat, wird in die Küche mit Erdnussöl geschickt. Und ein Tisch besteht sowieso: Ein gehackter Agent füttert versehentlich die Gruppe, deren Einschränkungen den Hype-Raum verfehlen. Das macht einen Proxy glaubwürdig – er ist nicht immer falsch, sondern nur dort, wo Sie nicht hinsehen.
9. VII. Die Schleife – ein Workflow mit einer Rückkante
Kurs V war ein Kreislauf mit Ihnen: Optimierung ausführen, installieren, testen. Dieser Kurs entspricht den drei Rollen in einem Diagramm, das eigenständig ausgeführt wird – begrenzt.
Die Anweisung als Sitzungsstatus
In der Schleife ist die Anweisung des Hosts kein String. Es handelt sich um eine Zustandsvorlage:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} wird bei jedem Aufruf aus dem Status aufgelöst. Wenn ein späterer Knoten diesen Schlüssel überschreibt, wird der nächste Hostaufruf mit dem neuen Text ausgeführt. Das ist der gesamte Mechanismus der Selbstentwicklung – ein Wert im Status, der in der Schleife immer wieder ersetzt wird.
Die Knoten
Knoten | Typ | tut |
| Funktion | versetzt das Briefing und den Entwurf für den ersten Tag in den Status |
| Agent | Bücher – ein Modellaufruf, unabhängig vom Bundesstaat |
| Funktion |
|
| Funktion | Die Grenze: |
| Agent | liest die Gründe und die aktuelle Anleitung und schreibt eine Ersatzanleitung. |
| Funktion | fügt den Ersatz in |
| Funktion | Schließt die Folge |
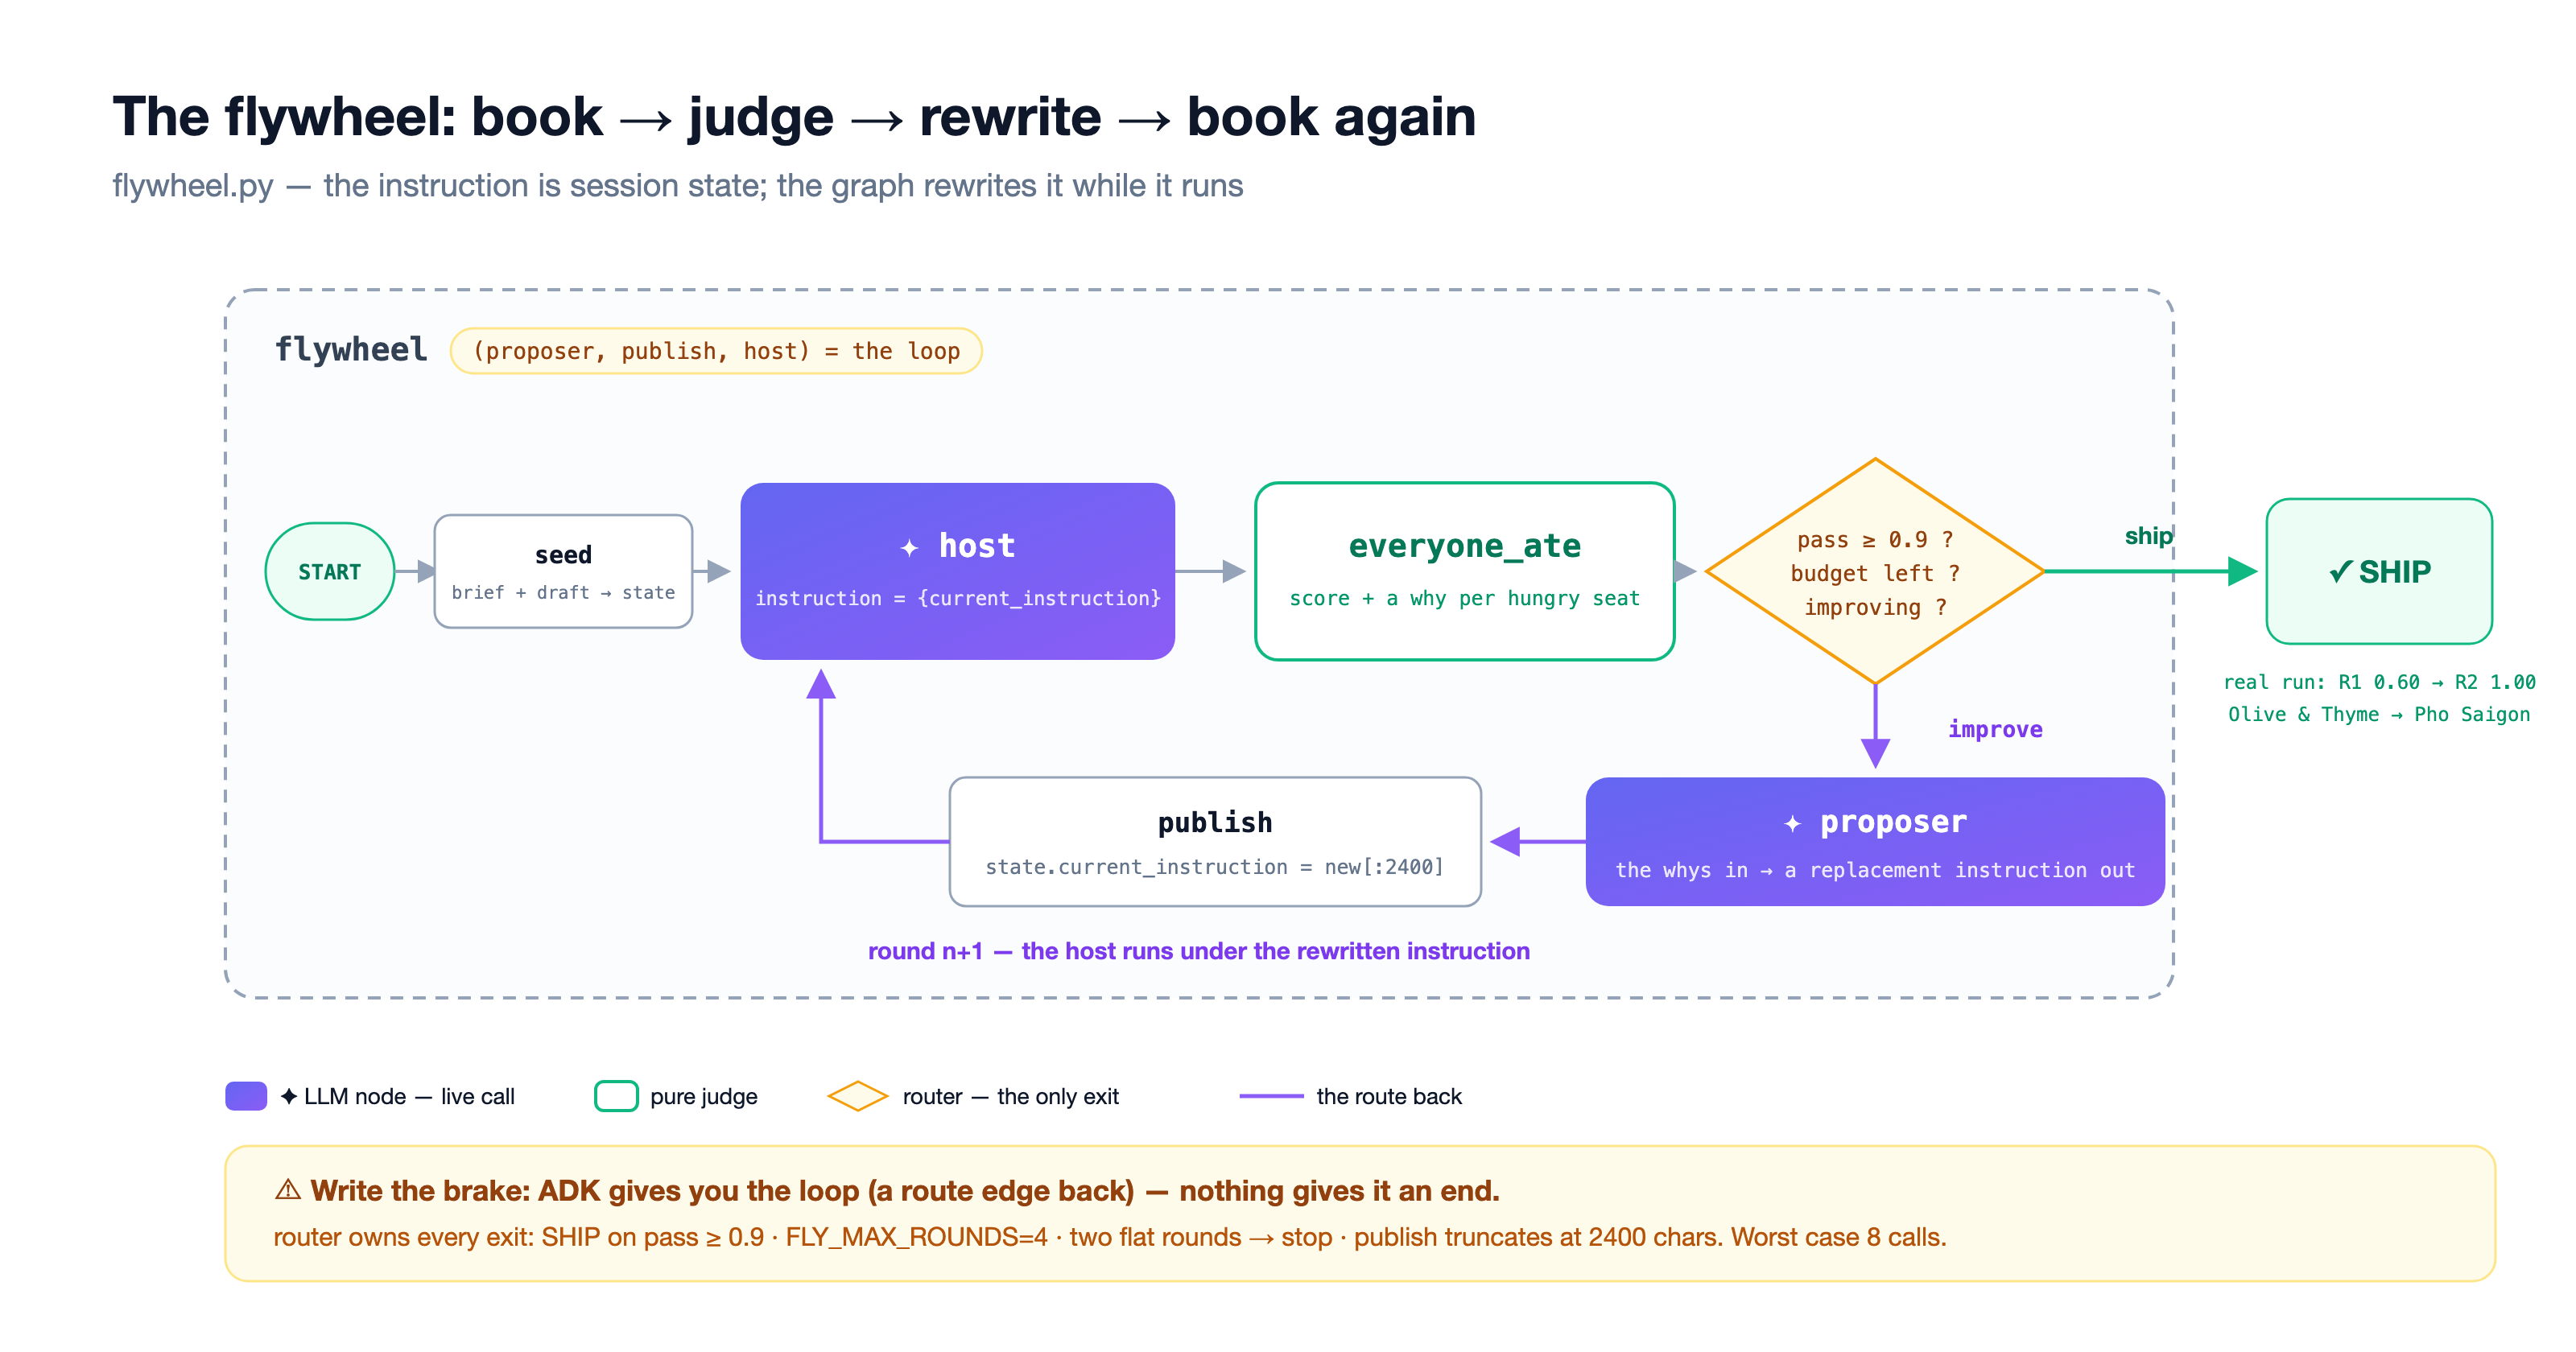
Das fertige Diagramm
loop/flywheel.py, build(), wie es nach Abschluss des Kurses angezeigt wird:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
Die Seite wird ohne die letzte Edge ausgeliefert. Alles läuft einmal ab – die Entwürfe der Bücher, der Richter graut zwei Stühle, der Vorschlagende schreibt zwei Regeln – und dann endet das Diagramm, weil nichts die Umformulierung zurück zum Moderator trägt. Für den Zyklus fehlt eine Kante.
Die Grenze – denn ADK wird nicht
Eine rückwärts gerichtete Routenkante ergibt die Schleife. Workflow hat keine Iterationsbegrenzung. Der Router hat das Ende mit vier Bändern:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Schlimmster Fall: vier Runden, jeweils zwei Modellaufrufe, acht Aufrufe, harte Obergrenze. Der Host bewertet nie, der Judge schlägt nie vor und der Router schreibt nie.
Ausprobieren
👉🖥 Kurs VII. ↻ Schleife wie ausgeliefert ausführen: Runde 1, Bücher, Fehler bei 0,60, der Vorschlagende schreibt seine Regeln – und die Ausführung endet mit flywheel ended without closing. Löschen Sie die # auf der grünen Linie im Editor. Führen Sie den Vorgang noch einmal aus.
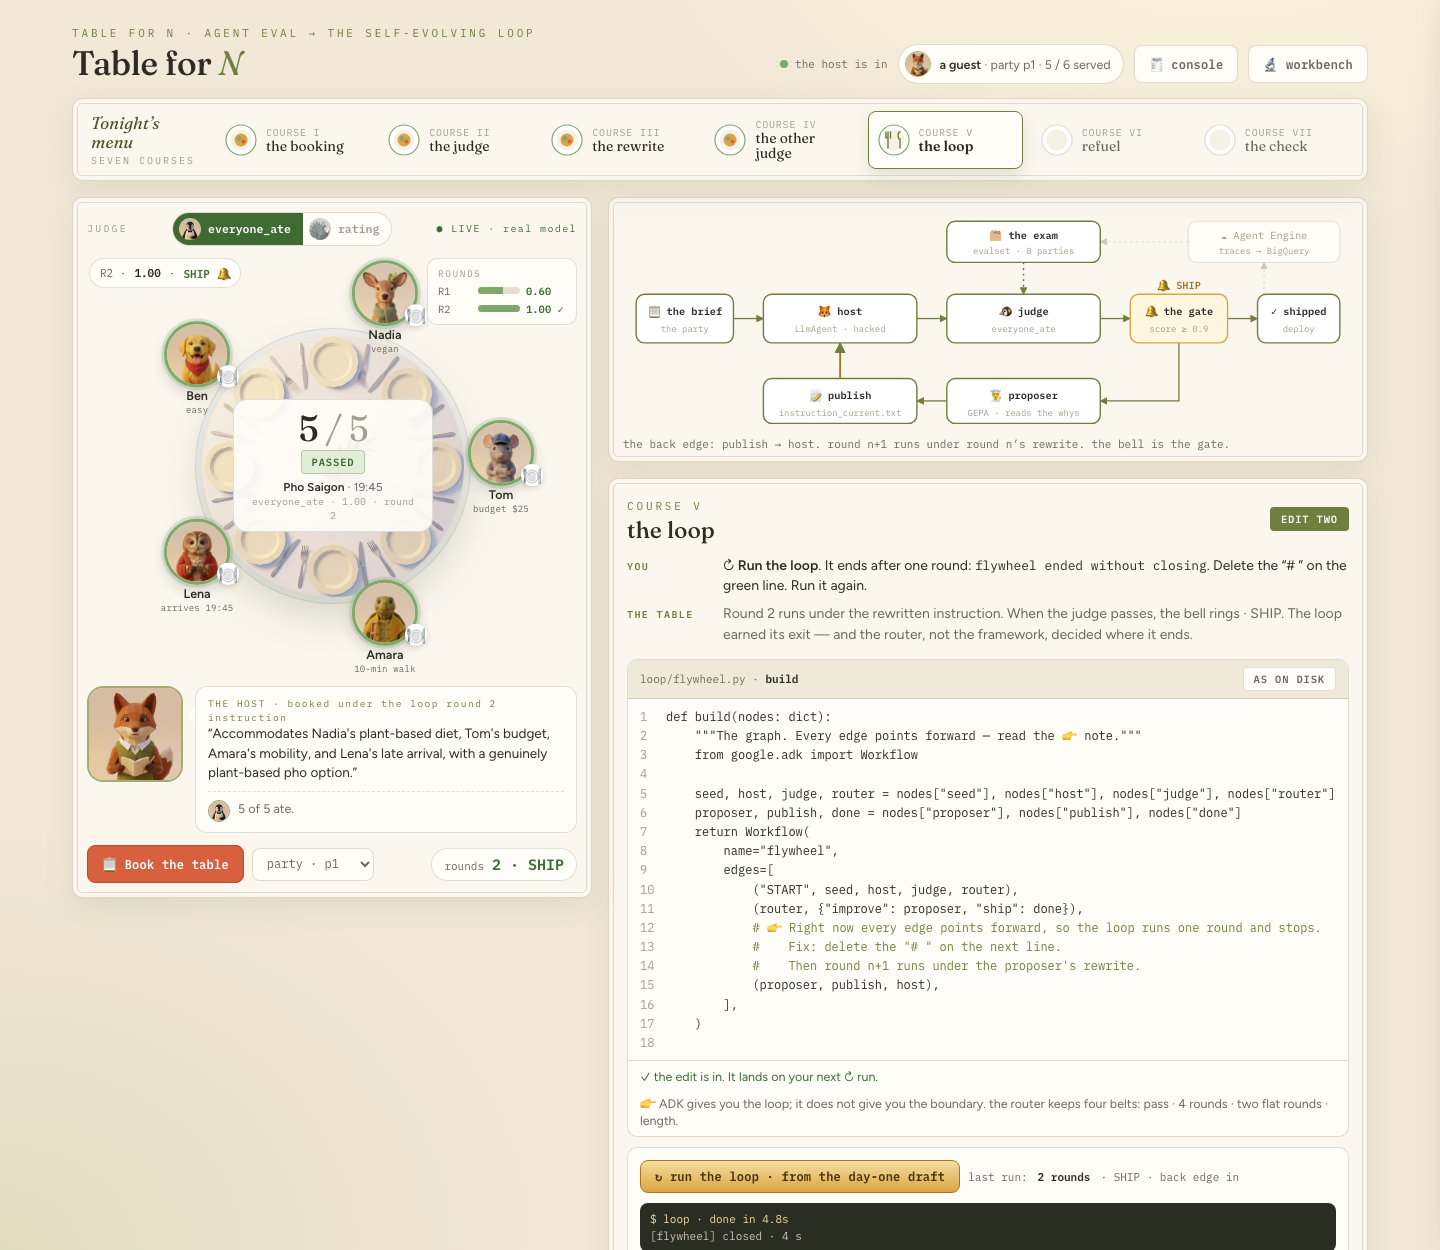
Hier ist, was der Antragsteller tatsächlich zu unserem Lauf geschrieben hat – der Entwurf plus zwei Sätze, einer pro Fehlerhinweis:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Ein leerer Sitzplatz wird zu einem „Warum“, ein „Warum“ wird zu einer Regel und eine Regel ändert die nächste Buchung. Runde 2: Pho Saigon um 19:45 Uhr gebucht → 1,00. Die Glocke läutet.
Die Zahl:R1 0,60 → R2 1,00 · SHIP, in etwa fünf Sekunden. Der SHIP des Loops ist pro Abendessen (ein Tisch, p1); das Gate des Kurses V war pro Prüfung. Gleiche Disziplin, zwei Skalen.
10. VIII. Die Prüfung – was wurde durch was ersetzt?
👉🖥 Kurs VIII Drücke 🧾 die Rechnung, bitte: acht Zeilen, deine eigenen Zahlen.
vor | nach |
eine Demo, die gut aussieht | eine Prüfung, bei der gezählt wird, wer gegessen hat. |
eine goldene Antwort | eine Reihe von richtigen Antworten und eine Regel |
einen Prompt, den Sie manuell bearbeiten | eine Anweisung, die die Schleife umschreibt |
eine Zahl, die steigt | ein Richter, der sich selbst erklärt |
einmal | eine Runde mit Rückweg |
der Messwert, den Sie erhalten haben | die von Ihnen ausgewählte Nummer |
Nimm Folgendes mit nach Hause:
- Fragen Sie, was Sie aufschreiben können – die Antwort, die Regeln oder nur eine Beschreibung von „gut“ –, bevor Sie einen Messwert auswählen. Für ein Abendessen gibt es eine Reihe von richtigen Antworten. Ein Comparator prüft eine davon.
- Erstellen Sie die Messlatte vor der Schleife und legen Sie den Weltstatus fest, der durch die Messlatte bestraft wird.
- Fügen Sie das Ergebnis in den Messwert ein. Das ADK wendet den Grenzwert nicht für Sie an.
- Trennen Sie die Trainings- von der Holdout-Gruppe vor dem ersten Optimierungslauf und verlassen Sie sich niemals auf die eigene Bewertung des Optimierungstools.
- Zählen Sie die hungrigen Plätze, nicht die Erfolgsquoten – kleine Prüfungen lügen.
- Machen Sie den Schaden für den Optimierer sichtbar: Ein Judge, der Gründe zurückgibt, erledigt die Hälfte der Arbeit des Optimierers.
- Das ADK stellt die Schleife bereit, die Grenze liegt bei Ihnen. Auch das Anhalten ist eine Entscheidung.
- Wenn die Zahl das Maximum erreicht, muss das daran liegen, dass der Agent besser geworden ist – niemals daran, dass die Messlatte niedriger gelegt wurde.
Die Schleife erhöht jede Zahl, die Sie ihr übergeben.
Wo die Produktion passt
Alles in diesem Lab wurde auf Ihrem Computer für eine von Ihnen geschriebene Prüfung ausgeführt. Bei der Produktion handelt es sich um Abendessen, die niemand bewerten wollte – und genau das kann ein Checker tun, was ein Golden-Answer-Messwert nicht kann: nachträglich bewerten.

Vertikaler Strich | wie | Antworten |
① Cloud Trace |
| Ist es jetzt in Ordnung? – Spans, die eigenen Juroren der Plattform, Online Monitors |
② BigQuery-Zeilen | das BigQuery Agent Analytics-Plug-in | Was sollten wir lernen? – eine strukturierte Zeile pro Ereignis, das Format, das Ihr Checker und Ihre Evalsets verwenden |
Das Repository stellt die Pipeline als Skripts bereit, nicht als Kurs: refuel/send_traffic.py sendet echte Parteien an einen bereitgestellten Host, refuel/replay_to_bq.py speichert dieselben Unterhaltungen als Zeilen und refuel/harvest.py bewertet jede Zeile mit world.everyone_ate neu und erstellt die Fehler als Bewertungsfälle – die tatsächlichen Worte der Gruppe, keine Musterantwort. Am Produktionsabend fütterte der Host 7 von 8 echten Parteien. Der einzige Fehler war Lena gegen die letzten Bestellungen, genau der Sitz, den die Kurs-V-Decke vorhergesagt hatte, und es wurde die Prüfungsfrage der nächsten Runde. Runde 2 ist wieder Kurs V mit einem weiteren Trainingsfall. Dafür ist ein Google Cloud-Projekt mit Abrechnung erforderlich. Daher ist es hier zu finden und nicht im Menü.
Selbststudium
- Schreiben Sie eine eigene Party (
world.PARTIES, dannscripts/make_evalsets.py) und fügen Sie sie der Prüfung hinzu. Ist das fair?scripts/verify_world.py-Stil: Jede Gruppe muss mindestens eine Buchung haben, die alle satt macht. - Erhöhen Sie die Bewertung auf 0,9 und richten Sie
adk optimizeaufeval_config_rating.jsonaus. Messen Sie den Gradienten. - Haben Sie ein Projekt mit Abrechnung? Führen Sie das
refuel/-Rohr von Anfang bis Ende aus und lesen Sie die[skip]-Zeilen vonharvest.py. Sie bilden die sichtbare Grenze zwischen den beiden Rohren. - Führen Sie die Schleife mit
HOST_THINKING=2048aus. Was ändert sich und was sagt das darüber aus, wo die Obergrenze liegt?