

1. Introducción

Este codelab trata sobre la evaluación de agentes, es decir, cómo un sistema llega a saber si la respuesta de un agente fue buena, y sobre lo que puedes crear una vez que lo hace: un agente que reescribe sus propias instrucciones a partir de sus propios errores y un bucle que sigue haciendo eso, de forma limitada, con tu supervisión.
Todo se ejecuta en el Kit de desarrollo de agentes (ADK): adk eval con una métrica personalizada que escribes, adk optimize (el optimizador de instrucciones de GEPA), un ADK 2 Workflow con un borde posterior y la canalización de Agent Engine + BigQuery que convierte el tráfico de producción en el examen de la próxima ronda.
El bucle aumenta el número que le pases.
Qué aprenderás
- Una respuesta no es un resultado: por qué una respuesta segura y bien formada no le dice nada al sistema y qué debe poder decir un evaluador
- Tres formas de ejecutar un examen:
adk evalpara el lote, la pestañaadk webEvals para observar un error,pytest+AgentEvaluatorpara que falle la compilación, y el almacén de evaluaciones local que comparten - Comparación frente a verificación: por qué un comparador penaliza una respuesta correcta redactada de forma diferente, cuántas respuestas correctas tiene realmente una cena y la verificación instintiva que te indica qué tipo de métrica necesita un problema
- Una función de verificación como métrica de
adk eval:customMetrics,codeConfig, la firma fija, las seis verificaciones que contiene, por qué tu función posee PASSED/FAILED y por qué es determinística a propósito - Tres familias de métricas en una respuesta: comparador, verificador y LLM como juez: qué necesita cada uno, qué cuesta cada uno y dónde es ciego cada uno
adk optimize(GEPA): Qué lee (los errores, no la puntuación), entrenamiento vs. datos de exclusión y por qué vuelves a ejecutar el examen antes de enviarlo- El hackeo de recompensas, medido: Una métrica proxy que nunca lee el partido, lo que le hace al número real y la ley que se desprende de él
- Un bucle autoevolutivo como ADK 2
Workflow: Una instrucción que reside en el estado de la sesión, el único borde que hace que un grafo sea un ciclo y el límite que el ADK no te proporciona - Dónde encaja la producción: trazas para mirar, filas para aprender y por qué un verificador puede calificar cenas que nadie planeó calificar (una lectura, no un paso)
Qué compilarás
Una app en ejecución en tu navegador: una mesa redonda, N invitados y un agente que reserva su cena. Cada plato activa un elemento: una línea en un archivo de configuración, una respuesta frente a tres jueces, un botón que ejecuta el optimizador real, un interruptor que cambia al juez, una arista en un grafo, y la tabla te muestra lo que cambió: quién comió, quién no y por qué. El código de Python es pequeño, y todos los números se miden en tu máquina.
La app también es el ejercicio. El panel del curso te ofrece una edición o un botón a la vez; un plato del menú solo se llena cuando algo real lo demuestra: la cocina lee tus archivos y los recibos de lo que se ejecutó, nunca una lista de verificación.
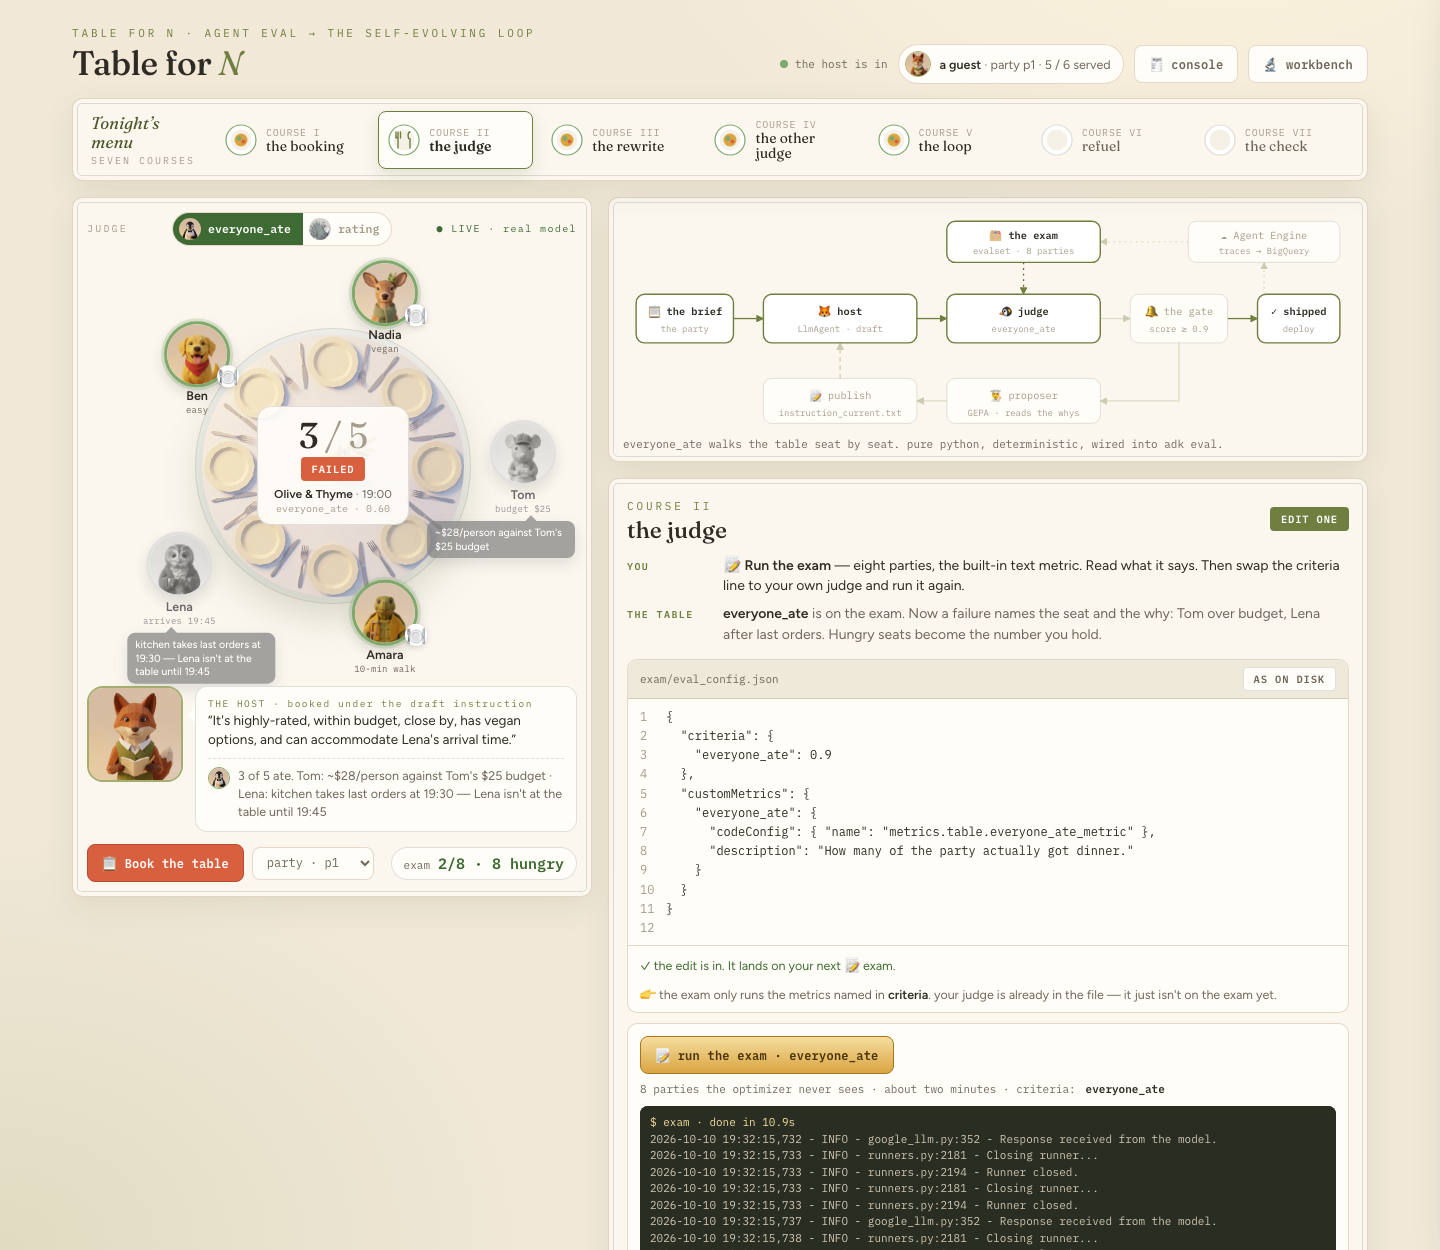
Los ocho cursos
el concepto | la pregunta que responde | Qué debes hacer | |
I | una respuesta no es un resultado | ¿Qué sabe el sistema sobre esta reserva? | Aún no hay nada. Reserva una en el banco de trabajo. |
II | el comparador · un conjunto de respuestas correctas · tres formas de ejecutar | ¿Por qué una reserva correcta no aprueba el examen? | Ejecuta el examen tal como se envió y lee los veredictos. |
III | un verificador como métrica personalizada · las seis verificaciones | ¿Puede el examen decir quién tiene hambre y por qué? | una línea en |
IV | comparador · verificador · LLM como juez | misma respuesta: ¿Cuáles son los tres aspectos con los que se debe comparar? | calificar una respuesta de tres maneras, dos veces |
V |
| ¿Puede el agente corregir sus propios errores? |
|
VI | reward hacking · la métrica de proxy | ¿Qué hace un juez que no puede ver el daño en el bucle? | el cambio |
VII | un | qué hace que un gráfico sea un bucle y qué lo detiene | un borde en |
VIII | qué reemplazó cada cosa | — | la verificación |
Cómo usar este codelab. Se prioriza el concepto: cada curso explica la idea, luego muestra el código tal como se lee una vez que se aplica el cambio y lo analiza. Nunca te pide que edites un archivo aquí. La edición se realiza en la app, que te entrega una línea a la vez y te muestra primero el error. Lee el curso y, luego, deja que la página te guíe por él y observa cómo se mueve el número.
Dónde se encuentra
El mundo (diez invitados con una restricción difícil cada uno, diez restaurantes con una trampa cada uno, dieciséis fiestas) y los dos jueces provienen del laboratorio de loop-lab-table; el formato interactivo de una página proviene de Agent Valley. El bistró es un escenario; todos los mecanismos que lo componen son los que usarías normalmente para un agente de asistencia, un flujo de reserva o cualquier otra cosa cuya "bondad" se pueda verificar.
2. 🧰 Configuración
- Qué: una cuenta que puede pagar, un proyecto, el lab instalado, el modelo que se demostró que responde y la tabla que se ejecuta en un puerto.
- Por qué: Un proceso en un puerto: La página, los exámenes, el editor y el banco de trabajo comparten un origen, por lo que nada en este lab necesita una segunda terminal o un segundo puerto.
- Cómo: clonar, dos secuencias de comandos, un comando. Lo último que hace la configuración es realizar una llamada real al modelo, por lo que un proyecto con errores falla aquí en lugar de en el curso I.
Todo en este lab se ejecuta en Cloud Shell: gcloud, Python, Node y git ya están instalados allí, y se accede a Gemini a través de Vertex AI con tus propias credenciales. En este lab, no hay claves de API en ningún lugar ni nada que instalar en tu laptop. Una laptop con el SDK de Google Cloud, Python 3.11 o versiones posteriores y Node 20 o versiones posteriores funciona de la misma manera.
Hay algo que este lab no puede proporcionarte: un proyecto de Google Cloud con la facturación habilitada. En el paso 1, obtienes una cuenta que puede pagar por el proyecto; en el paso 4, conviertes esa cuenta en un proyecto. Hazlo en ese orden: cada paso después del 4 lee el proyecto que se establece en el paso 4.
1 · Obtén una cuenta con facturación (aprox. 1 min)
Accede con una Cuenta de Google que tenga habilitada la facturación. Cualquiera de estas cuentas funciona. Si no es así, inicia una prueba gratuita, que te proporcionará una cuenta de facturación, que es todo lo que necesitas para el paso 4.
2 · Abre Cloud Shell (2 min aprox.)
👉🖥 Haz clic en Activar Cloud Shell en la parte superior de la consola de Google Cloud (es el ícono con forma de terminal en el encabezado).
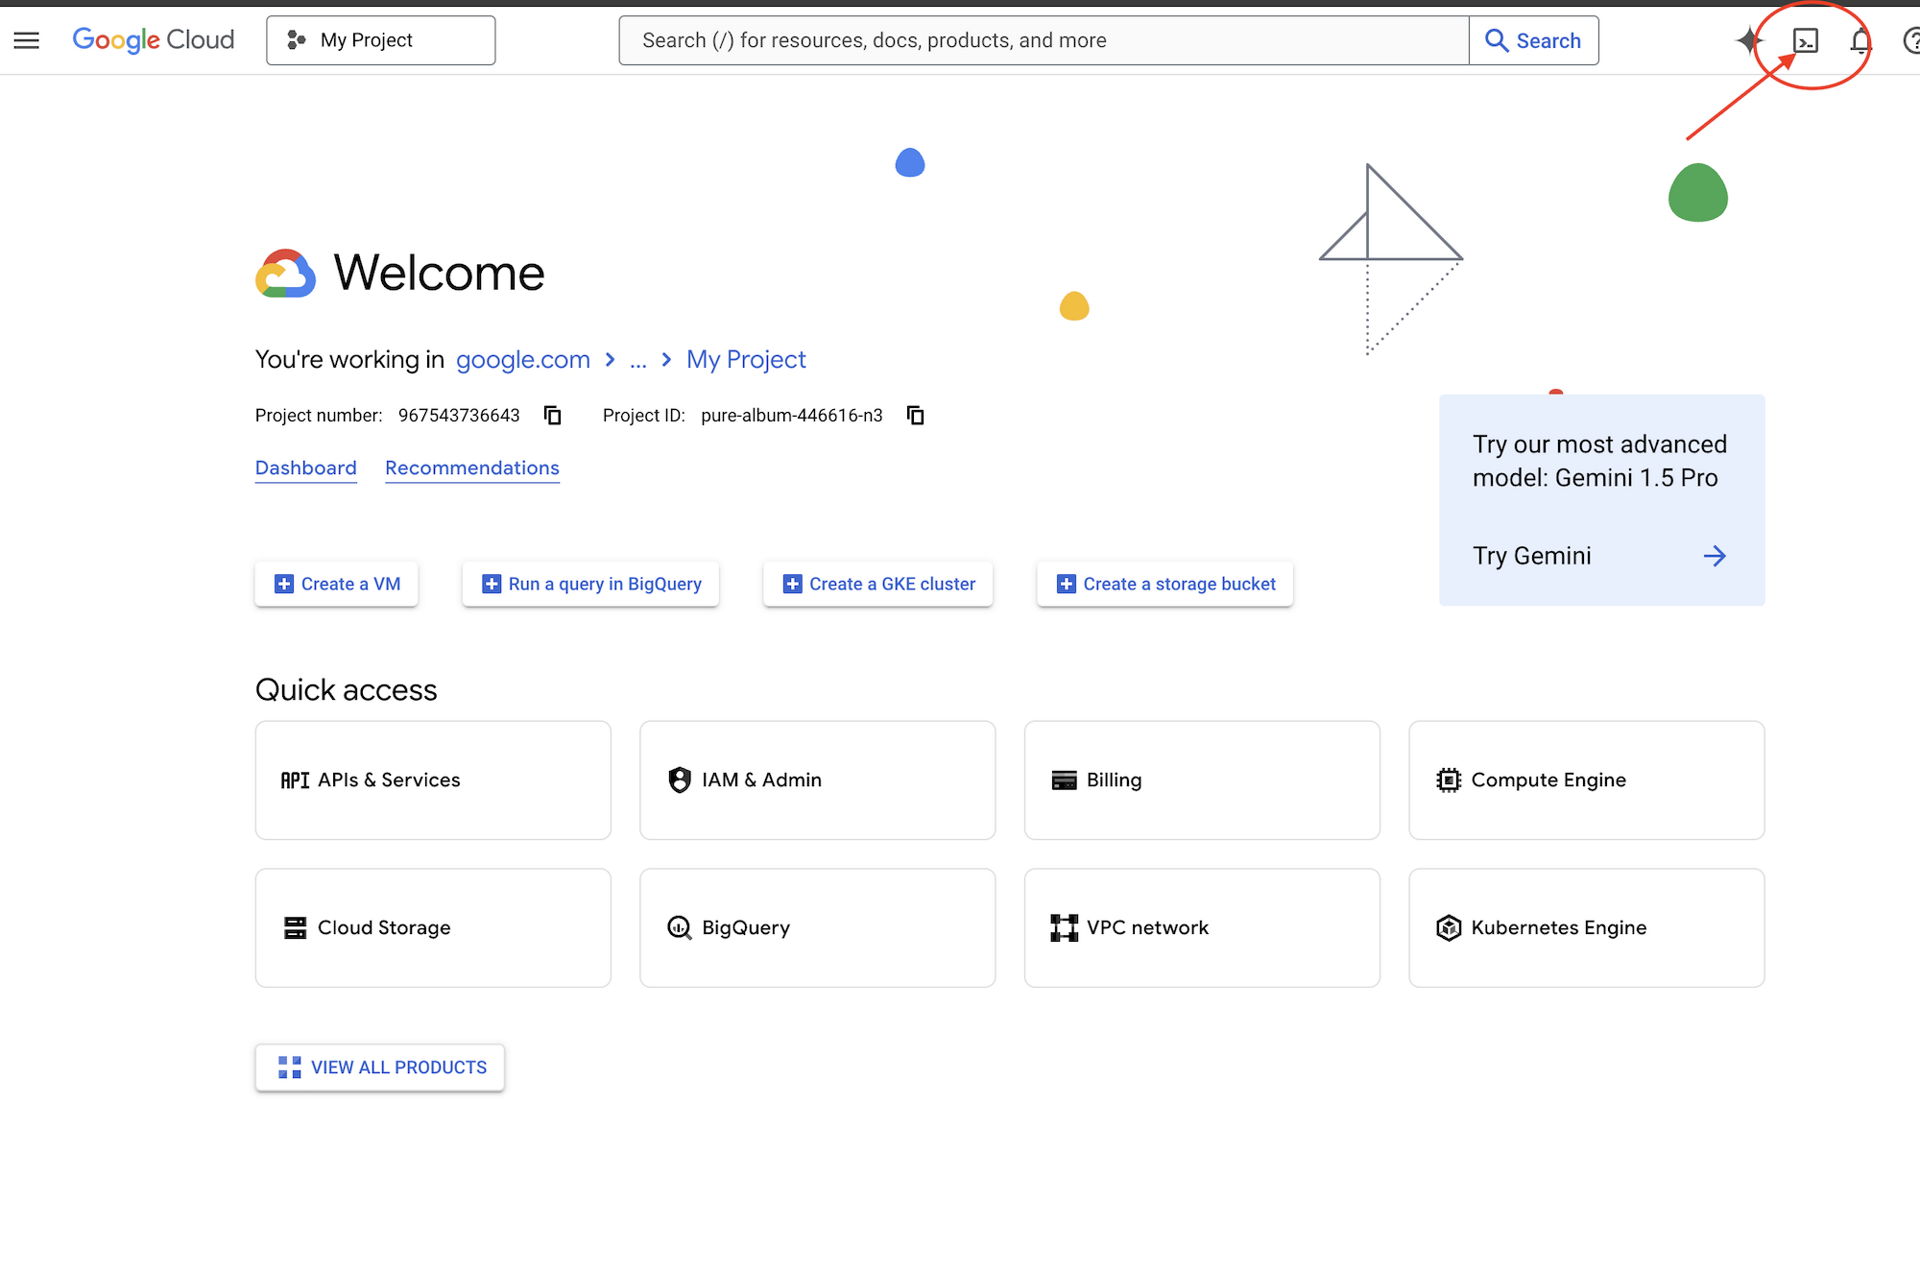
👉🖥 Haz clic en Abrir editor (el ícono de lápiz). Esto abrirá el editor de Cloud Shell con un explorador de archivos a la izquierda, que es donde debes ir cada vez que quieras leer un archivo completo.

👉🖥 Si se te solicita autorización en algún momento, haz clic en Autorizar para continuar.
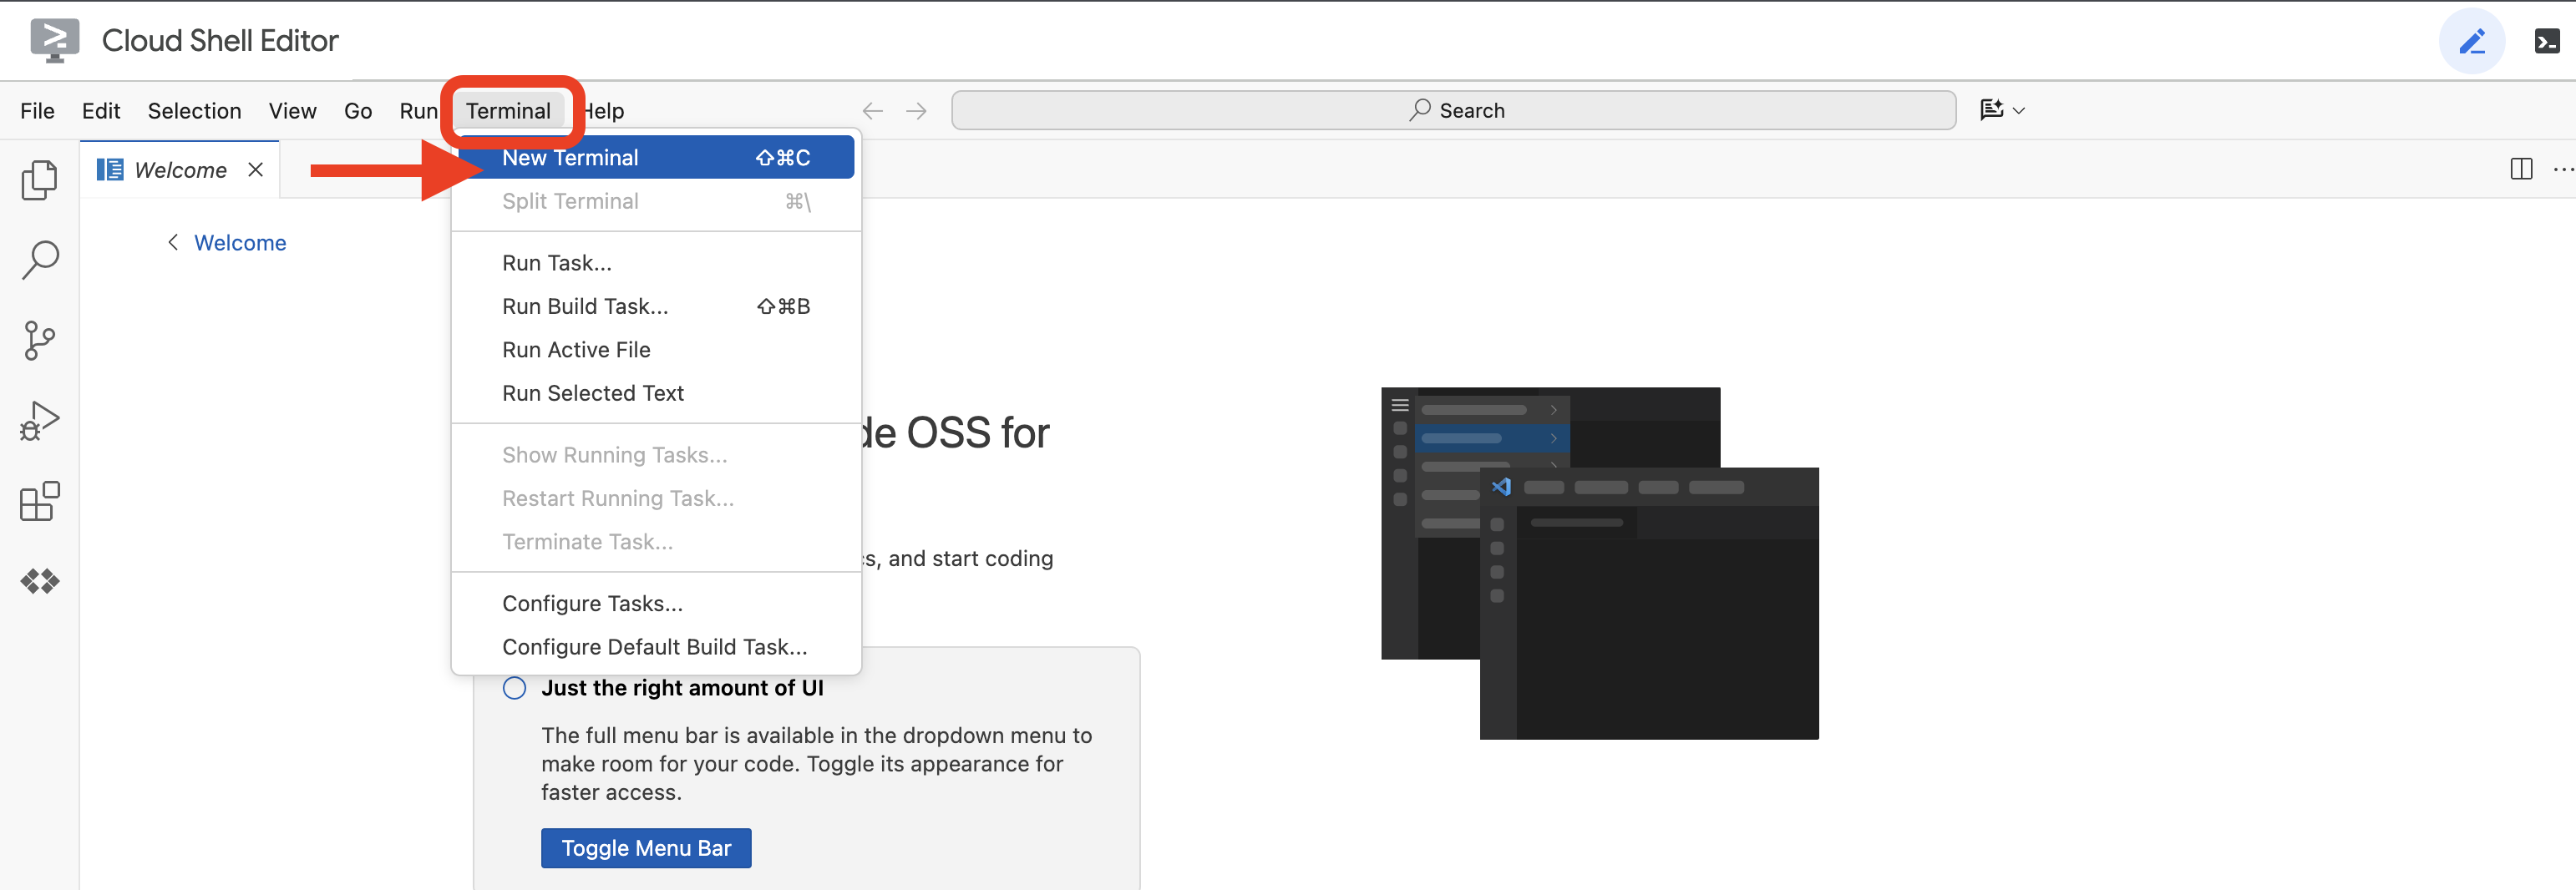
👉🖥 Abre una terminal dentro del editor, es decir, la pestaña 1, y cada paso 👉💻 se ejecuta allí. La pestaña 2 es la tabla en sí, y la abres en el paso 7. Si la terminal aún no está en la parte inferior de la pantalla, ábrela con Ver → Terminal:
👉💻 Comprueba con qué cuenta accediste. Debe ser la misma que usaste en el paso 1:
gcloud auth list
3 · Obtén el lab (alrededor de 1 min)
👉💻 Clona el repositorio:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · Crea tu proyecto (alrededor de 2 minutos)
👉💻 Una secuencia de comandos encuentra tu cuenta de facturación, crea un proyecto en ella, vincula la facturación y dirige Cloud Shell a ese proyecto:
cd ~/table-for-n
./setup_project.sh
Espera un ✓ para la cuenta de facturación que eligió, un ✓ para el proyecto que creó y un final como el siguiente:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
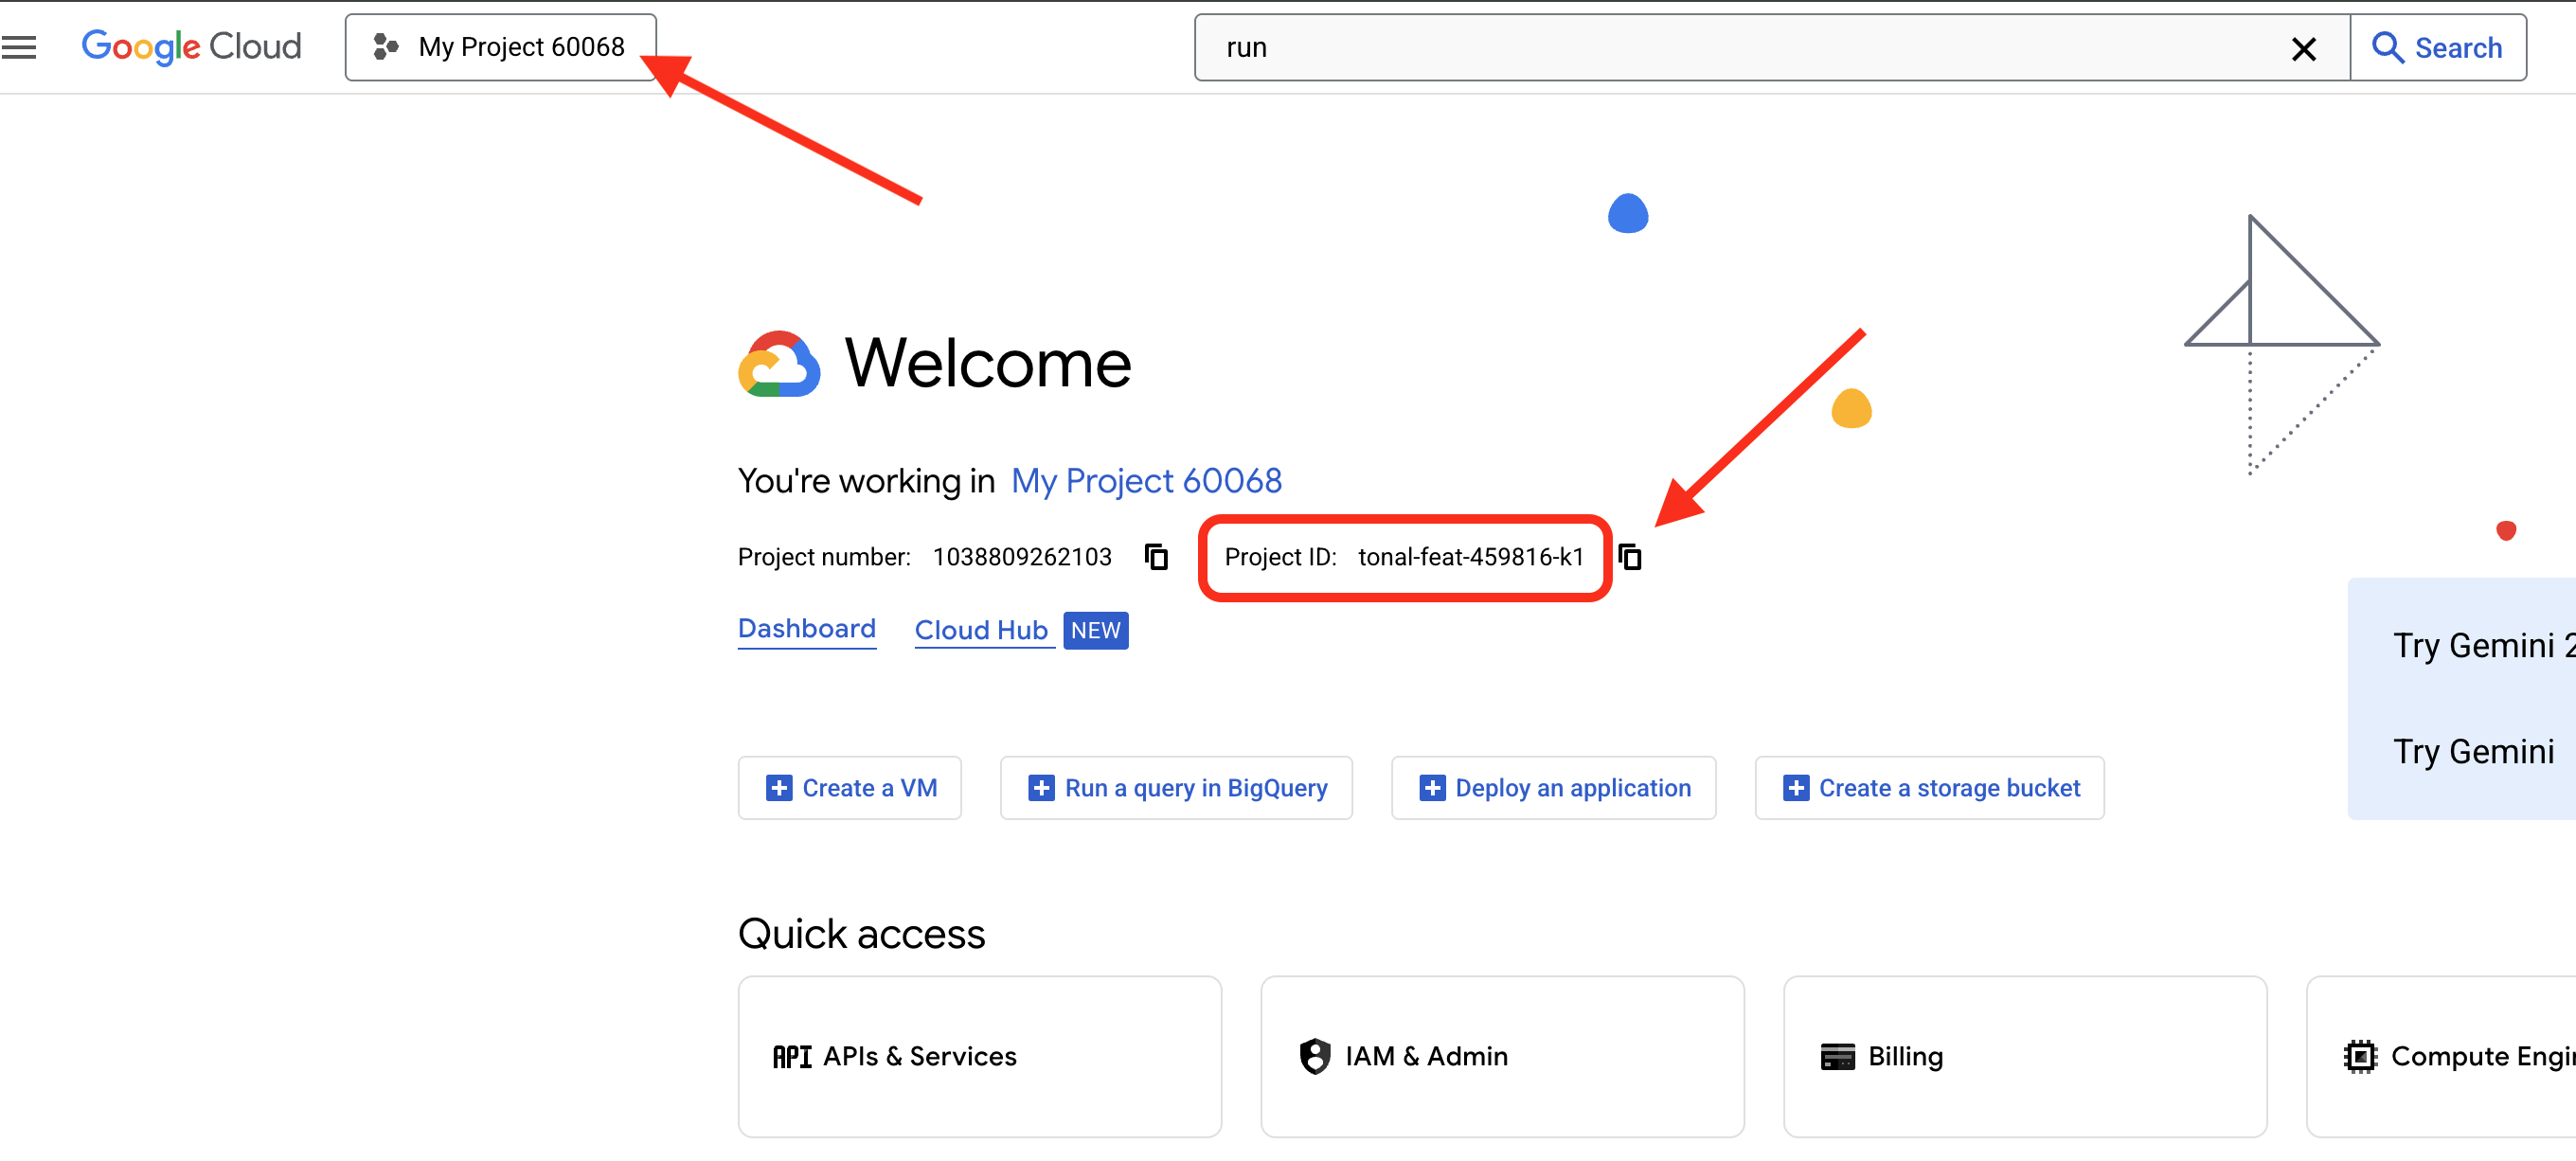
table-for-n-4271 es tu ID del proyecto. El tuyo tendrá dígitos diferentes. Allí ocurren cuatro cosas:
facturación | Toma la cuenta de | |
project | crea | |
selecciona | Escribe el ID en | |
esperas | realiza sondeos hasta que el proyecto pueda entregar contenido, durante un máximo de dos minutos | |
👉🖥 El mismo proyecto ahora está en la consola. Su ID se encuentra en la tarjeta Información del proyecto del panel:
5 · Instala y configura el lab (~3 min)
setup_codelab.sh compila el entorno con uv, pero no lo instalará por ti, sino que se detendrá y te indicará que lo hagas. Por lo tanto, primero instálalo con el mismo comando:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Una secuencia de comandos que se puede ejecutar de nuevo sin problemas. Realiza cinco acciones, en orden:
api | Lee el proyecto seleccionado en el paso 4 y habilita | |
uv env |
| |
site | Instala y compila | |
.env | escribe | |
preflight | realiza una llamada real a | |
6 · Lee el menú (~1 min)
Lo último que se imprimió en el paso 5 es el menú de esta noche, y cada línea es una sonda real, no una suposición:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Ninguna luz está encendida antes de que comiences. the model answers es el que importa aquí: significa que se realizó una llamada real en tu proyecto.
👉💻 Vuelve a ejecutarlo en cualquier momento para ver dónde te encuentras. Lee tus archivos y los recibos de la cocina, no una lista de tareas pendientes:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · Preparar la mesa (aprox. 1 min)
👉💻
cd ~/table-for-n
bash table.sh
Un proceso, puerto 3470. La cocina tarda un poco en calentarse (importa el ADK y activa adk web), por lo que la secuencia de comandos lo indica, espera y muestra los vínculos solo una vez que el puerto responde:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Permanece en primer plano. Ctrl+C borra la tabla. Déjalo en ejecución: todos los cursos de aquí en adelante se comunican con este proceso, y nada en este lab te pedirá que lo reinicies.
👉🖥 Después de que veas ✓ the table is laid, abre la tabla en una pestaña nueva (pestaña 2). En Cloud Shell, selecciona Vista previa en la Web → Cambiar puerto → 3470.
👉🖥 Escribe tu nombre en la tarjeta de reserva (aparecerá en la cuenta al final) y presiona ✦ seat us.

3. I · La reserva: Una respuesta no es un resultado
Cinco personas van a cenar. El chat en grupo tiene todo: Nadia es vegana, Tom tiene un límite de USD 25 este mes, Amara usa muletas y puede caminar diez minutos, Lena no puede llegar antes de las 7:45 p.m., Ben es fácil. Se enumeran diez restaurantes, ordenados por calificación, cada uno con su precio, su tiempo de caminata, su horario y su único inconveniente.
Un agente reserva la mesa. Ya sabes, leyendo el chat, quién va a pasar hambre en la habitación que elija. El sistema no sabe nada. Esa brecha es de lo que se trata todo el codelab.
El agente (solo lectura)
host/agent.py, como lo es para todo el lab:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
No hay herramientas, ni bases de datos, ni búsquedas. Un modelo, una cadena de instrucciones, y la cadena no está en este archivo. Se encuentra al lado, en instruction_current.txt, que hoy contiene las cuatro líneas que escribe un gerente de productos el primer día:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
No se menciona nada sobre alergias, presupuestos, límites de caminata o quién debe irse temprano. Todo eso se incluye en el resumen que recibe el agente. No se utiliza.
Ese archivo es el único artefacto de este lab. El curso V permite que un optimizador lo reescriba. En el curso VI, se instala una versión hackeada. El bucle del curso VII lo reescribe ronda por ronda mientras se ejecuta el gráfico. El agente (modelo, configuración y nombre) nunca cambia.
Pruébalo: frontend cero
👉🖥 En la página, curso I. Haz clic en 🔬 workbench (esquina superior derecha): El cajón es adk web y está montado en el mismo proceso (misma carpeta host/, mismo table.db). Elige host, pega el resumen del panel del curso (tiene un botón de copia) y envíalo.
El anfitrión responde en un segundo: un restaurante, una hora y una razón segura de una línea. Lee el motivo junto al chat. Luego, mira la tabla de la izquierda: Colocada, nadie la juzgó, — / 5. No porque se esté cargando algo, sino porque, por supuesto, en el mundo no existe nada que pueda juzgar esto.
La cantidad: Asientos hambrientos: ? Nadie puede saberlo.
4. II · El comparador: ¿Cuántas respuestas correctas tiene esta cena?
El curso II comienza con un examen que ya existe y que ya falla, por un motivo que no enseña nada. Antes de corregirlo, vale la pena conocer las tres formas de ejecutarlo, ya que las usarás todas hoy.
Tres formas de ejecutar una evaluación
Todos tienen el mismo motor.
para qué sirve | lo que obtiene | |
| el ejecutor de lotes, que es lo que se coloca en la CI | Un resumen: aprobado, reprobado y una puntuación por caso |
| un caso falló y quieres analizarlo | esa conversación, el registro, la puntuación por caso, todo se puede hacer clic |
| incorporar la evaluación de agentes en un conjunto de regresión normal | Se ejecuta junto con tus pruebas de unidades y hace que falle la compilación de la misma manera. |
El detalle realmente útil es que los tres comparten un almacén de evaluaciones local, host/.adk/eval_history/. Ejecuta un lote desde la CI, algo falla y abre esa ejecución exacta en la IU web para analizarla. El botón 📝 de la página es la primera forma; el banco de trabajo 🔬, la segunda; la tercera es un comando de terminal, uv run pytest tests/test_host.py, y la prueba que ejecuta tiene doce líneas:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. El mismo agente, el mismo conjunto de evaluación, el mismo archivo de configuración y la línea eval_set_results_manager es lo que coloca su ejecución en el mismo historial que los otros dos.
El examen, tal como se envía
exam/eval_config.json se envía de la siguiente manera:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Dos partes, dos trabajos. criteria
es el papel del examen: Las métricas que realmente se ejecutan, cada una con su barra de aprobación. customMetrics
es el directorio del personal: nombres asignados a Python, disponibles, pero no de turno. Declarar una métrica no significa ejecutarla. Tal como se envió, el artículo tiene exactamente una pregunta: el response_match_score integrado de ADK, una superposición de texto (ROUGE-1) entre lo que dijo el agente y la reserva de referencia en el conjunto de evaluación. Tu juez, everyone_ate, está en el directorio y no en el papel; el curso III lo mueve allí cambiando una línea.
Tenemos un agente de reservas para la cena y response_match_score sentado allí de forma gratuita. Simplemente usémoslo y veamos qué obtenemos.
Probar
👉🖥 Curso II en la página Presiona 📝 run the exam · as shipped. La leyenda debajo del botón indica lo que se ejecuta: 1 metric runs: response_match_score · everyone_ate is declared, not on the exam. Aproximadamente medio minuto. Lee el resultado: aproximadamente la mitad de las tablas FALLARON en una puntuación de texto sin motivo adjunto, y observa cuáles son. Coloca el cursor sobre los chips.
Ahora, miren con atención, porque esta es la parte interesante. El comparador se equivoca en ambas direcciones, y tu ejecución mostrará al menos una de ellas. Falla una tabla en la que la reserva estaba bien: el agente eligió una sala en la que todos podían comer, la cena funciona, la respuesta es correcta, porque el agente expresó su motivo de manera diferente a como se redactó la respuesta de referencia. Y pasa una tabla en la que alguien pasa hambre, en nuestra ejecución p1, a las 0.30 en punto, con Tom por encima del presupuesto y Lena después de los últimos pedidos, porque se superpusieron suficientes palabras. La similitud de cadenas no sabe nada sobre la cena. Sabe que los caracteres se alinean.
Entonces, aquí hay una pregunta real: ¿Cuántas respuestas correctas tiene esta cena?
Para la fiesta de esta noche, solo una de las diez habitaciones alimenta a todos: Pho Saigon, y solo a partir de las 19:00. En los ocho grupos del examen, es uno, dos, dos, uno, tres, tres, seis, uno (world.rooms recorre cada sala en cada asiento para un grupo; ejecútalo tú mismo con uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). A veces, varias salas pueden alimentar a todos; a veces, exactamente una puede, y solo en ciertos momentos. Hay un conjunto de respuestas aceptables, no una sola, y la respuesta de referencia en el conjunto de evaluación es un miembro de él.
Esto significa que la suposición subyacente de response_match_score (hay una respuesta correcta y la escribí) nunca fue cierta para este problema. Ni una sola vez. La métrica no está rota. Hace exactamente lo que dice. Usamos el tipo de métrica incorrecto para este problema.
👉🖥 Opcional, vale la pena dedicarle un minuto: abre el 🔬 workbench → Evals → 🕓 historial. La ejecución 📝 que acabas de realizar está allí, y se puede hacer clic en cada caso. En la pestaña 1, uv run pytest tests/test_host.py ejecuta el mismo examen como una prueba fallida y se registra en el mismo historial.
La cantidad: 4 de 8 PASARON en nuestra ejecución, para la superposición de palabras, sin motivos, y 1 respuesta correcta para p1, de diez habitaciones.
Para nuestro problema de la cena, la elección se hace sola. Nadie puede decirte cuál es el restaurante correcto para el viernes. Pero todos pueden decirte qué significa una cena exitosa: todos los que estaban en la mesa pudieron comer. Esa es una regla. Se puede marcar. No es ambiguo. La creación es el curso III.
5. III · El juez: un verificador como métrica personalizada
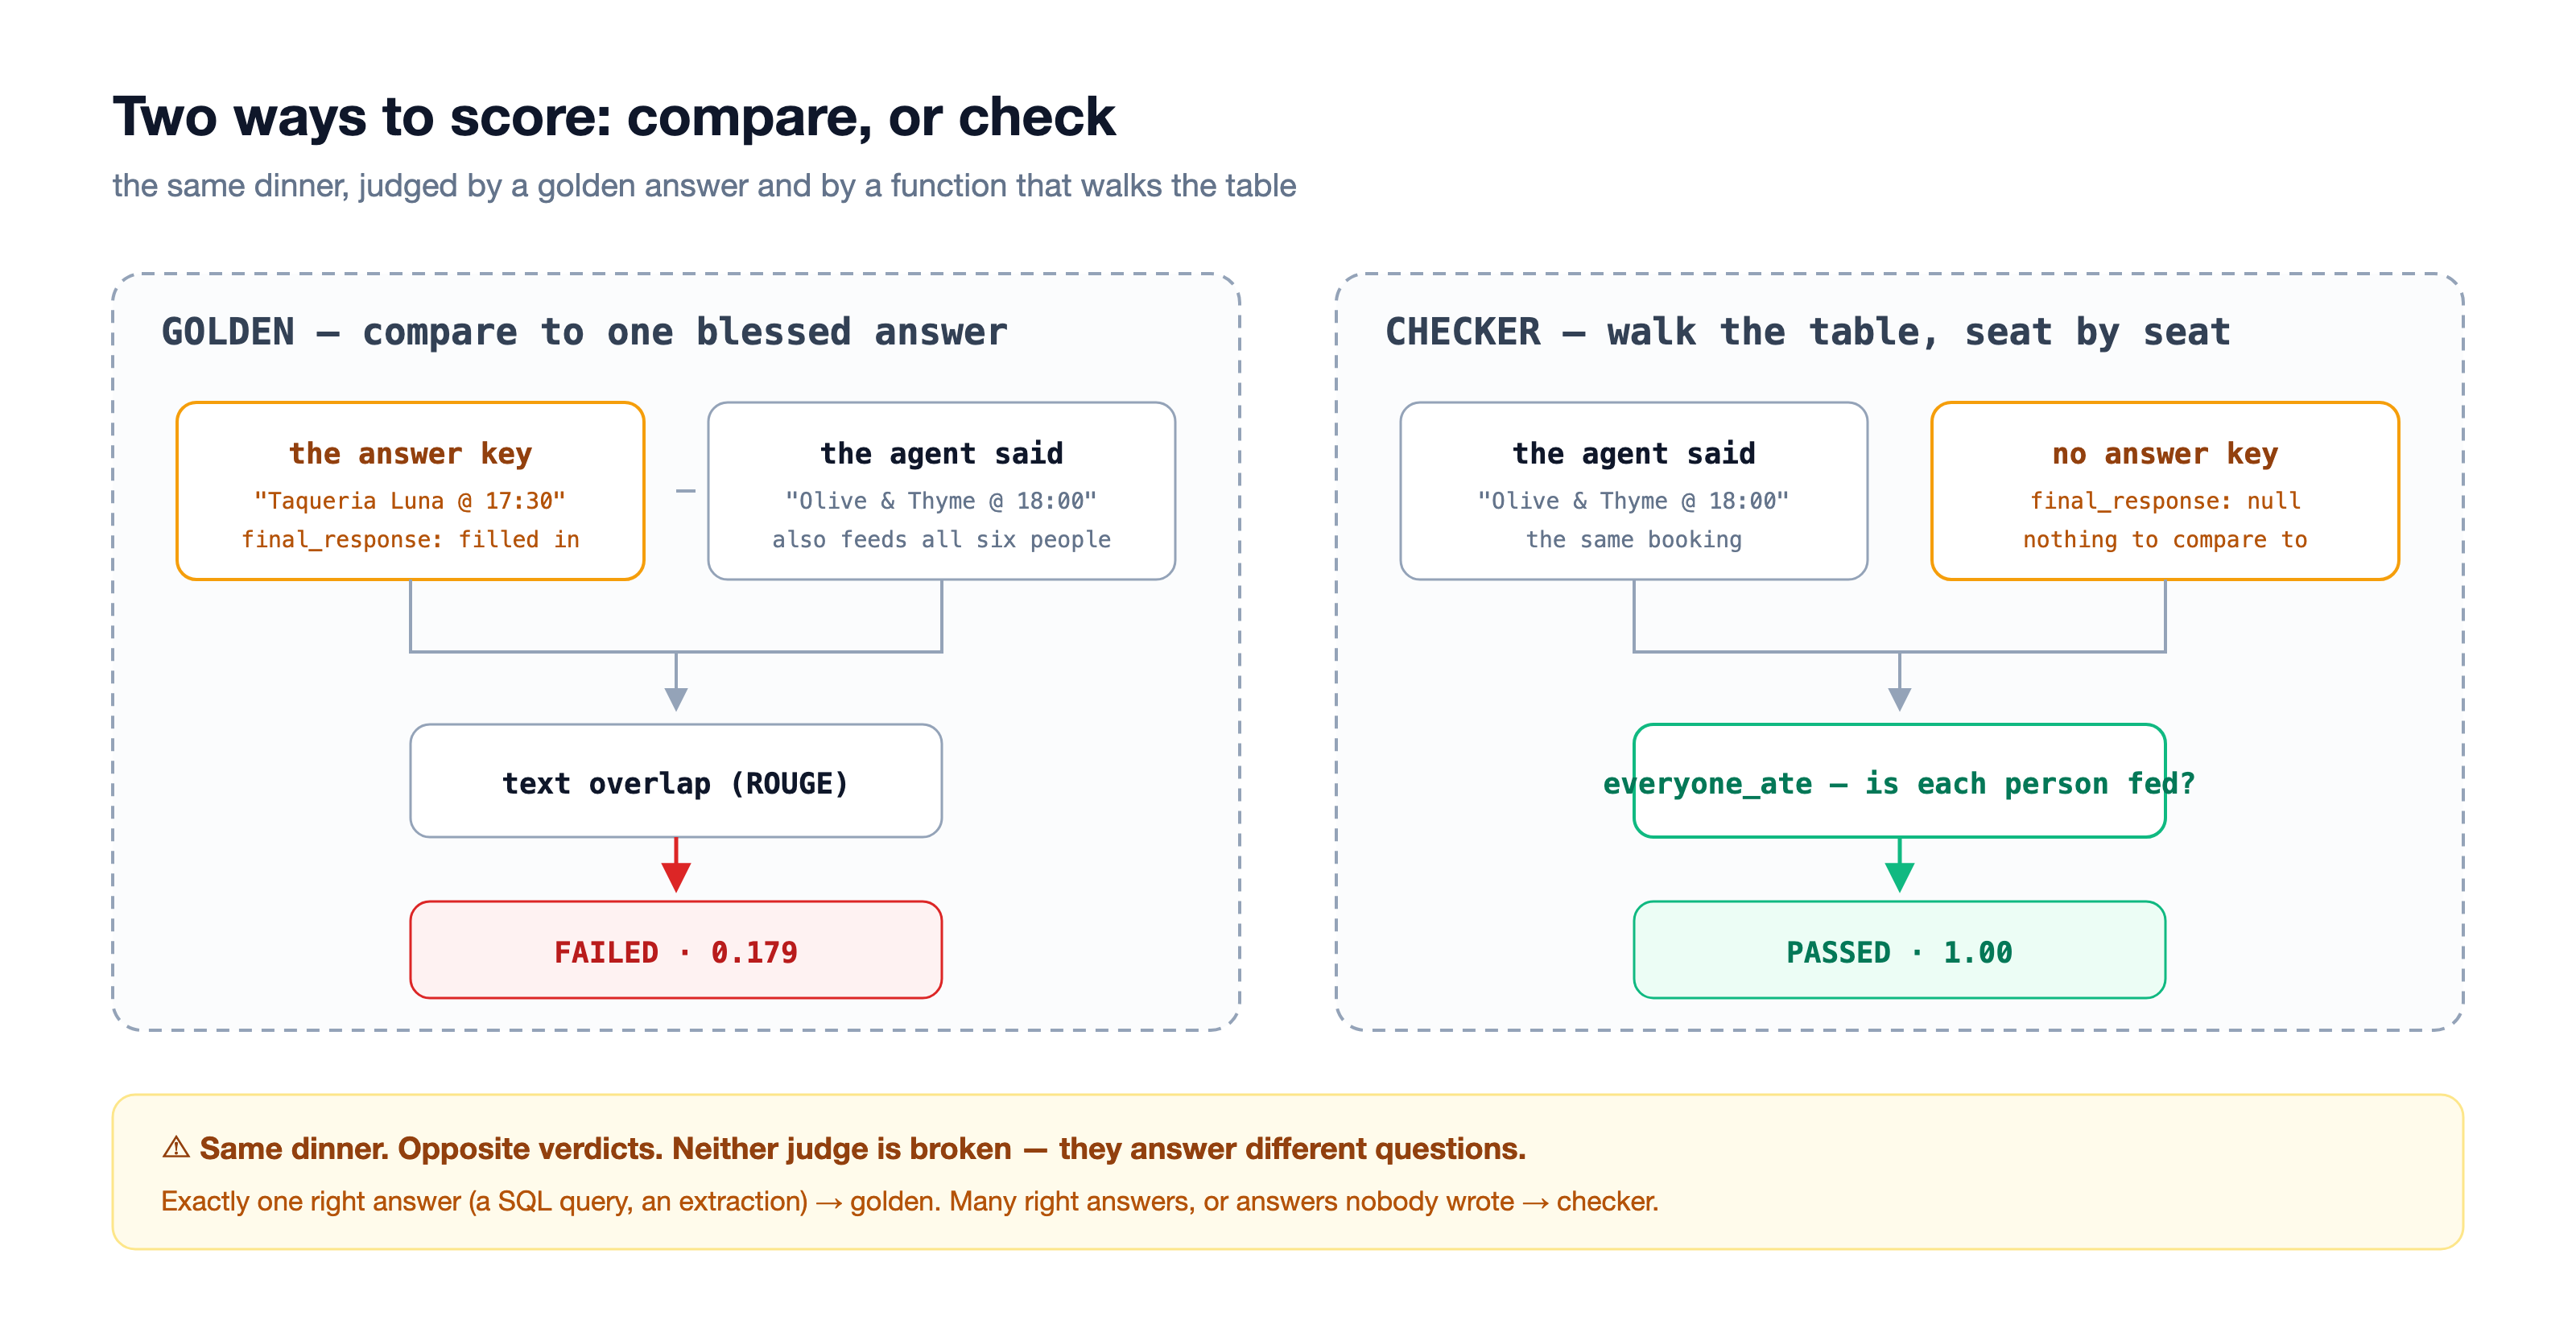
Un verificador hace una pregunta diferente a la de un comparador: no ¿coincide esto con la clave?, sino ¿se alimentó a cada persona? Recorre la reserva para cada miembro del grupo, asiento por asiento, y devuelve una puntuación y un motivo por asiento. No necesita una respuesta perfecta, lo que también le permite calificar conversaciones que ya ocurrieron (curso VIII).
world.everyone_ate es esa función. En el curso III, se conecta a adk eval.
Dentro de everyone_ate: cinco pasos, ninguno de ellos inteligente
- Lee el texto del usuario y determina qué parte es. Hay un ID de parte en el resumen (
p1), y buscamos quién está sentado en esa mesa. - Lee la respuesta del agente, analiza el JSON y extrae el nombre del restaurante y la hora de reserva.
- Camina con cada persona, en orden. Para cada uno, se debe considerar la dieta, las alergias, la tolerancia al picante, el presupuesto, la distancia a pie y el horario. Seis verificaciones por persona, siempre. Tomemos el ejemplo de Tom: su presupuesto es de USD 25 por persona y la habitación cuesta USD 28. Mostramos
Falsepara Tom y la oración que lo explica, y pasamos a la siguiente persona. - La puntuación es la cantidad de personas que comieron dividida entre la cantidad de personas en la mesa. Cuatro de cinco es 0.8. Sin ponderación ni crédito parcial.
- Devuelve PASSED o FAILED. Y observa quién lo devuelve: tú. Recuerda eso; es la trampa que se encuentra más abajo.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Una propiedad que vale la pena destacar: no hay ninguna llamada al modelo en ninguna parte de esta función. Es Python determinístico. La misma entrada, el mismo veredicto, siempre. Tu juez no se desvía cuando se actualiza un modelo, no cuesta nada ejecutarlo y no puede alucinar un motivo. Cuando puedes lograr eso, vale la pena diseñar para ello.
La métrica, finalizada
metrics/table.py: Es la llamada al ADK del adaptador, con su firma fija:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Línea por línea: lee ambos lados de cada invocación (el grupo de user_content, la reserva de final_response), los pasa a la función pura y une el resultado en los objetos que espera el ADK. Y una línea lleva el veredicto:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
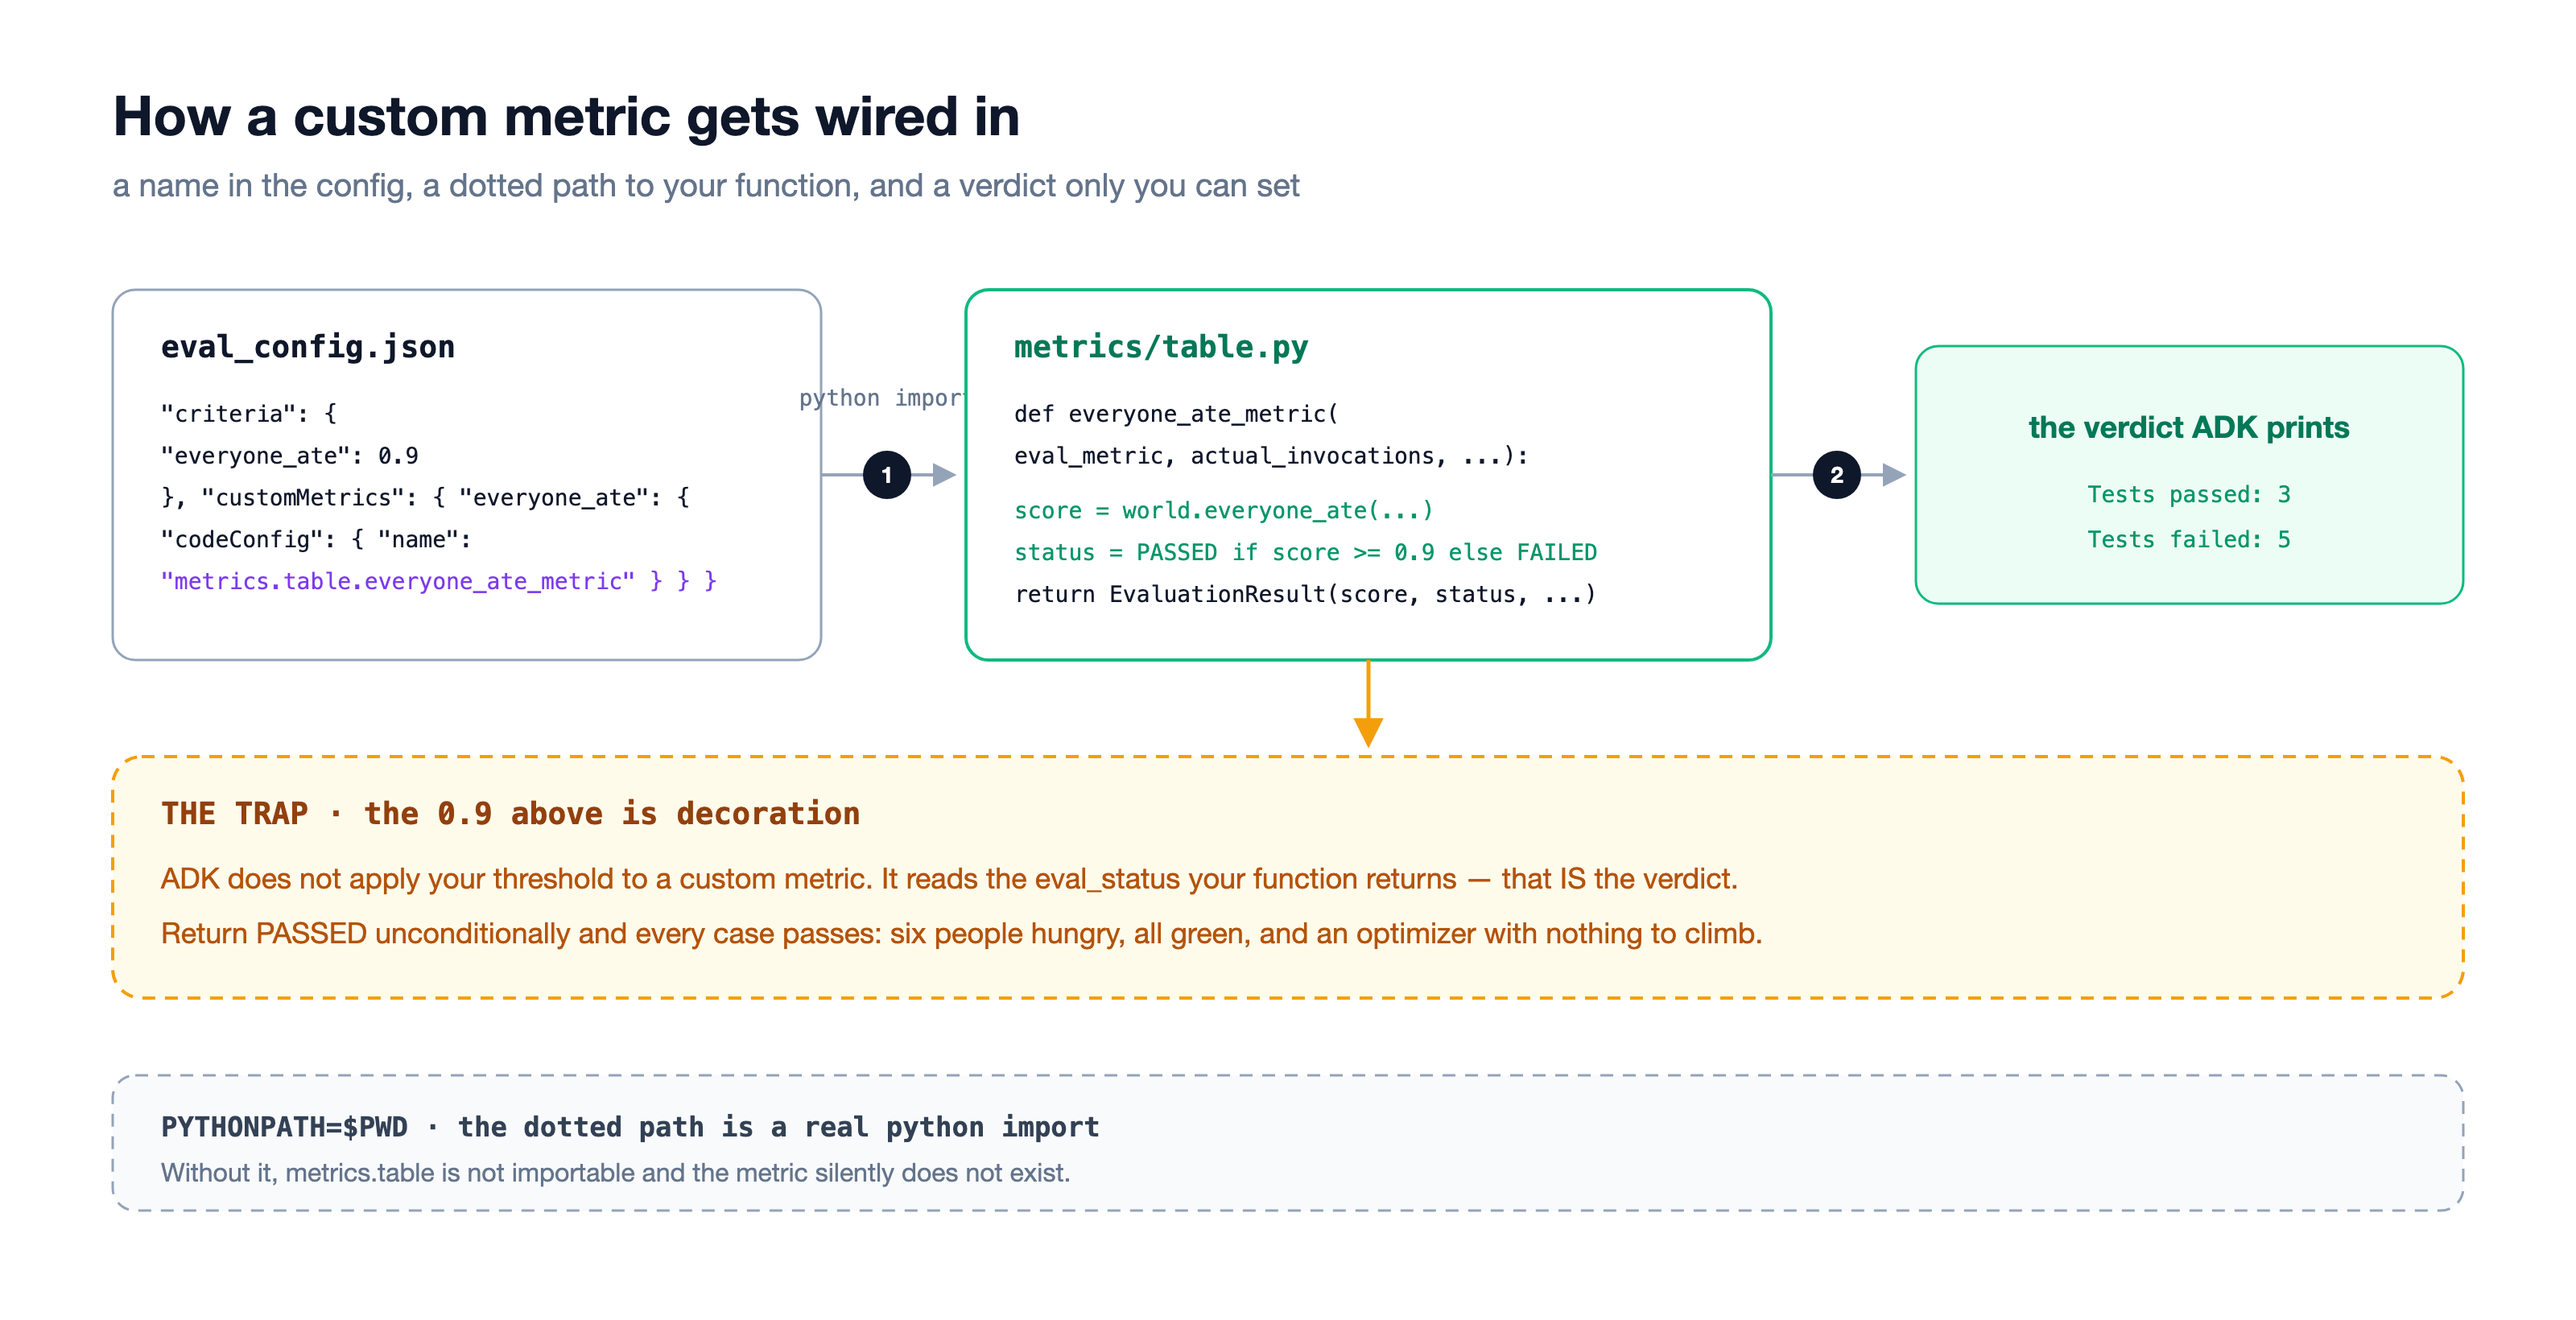
La configuración: la línea
exam/eval_config.json, como se lee una vez que finaliza el curso:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Se cambió una línea: criteria ahora nombra a tu juez en lugar del comparador. El examen consta de ocho partidos que el optimizador nunca verá (exam/parties_val.evalset.json, 36 escaños en total).
Probar
👉🖥 Curso III en la página El texto debajo del botón 📝 indica la instrucción que ejecuta el host. Debería decir borrador. Si dice otra cosa (instalaste otra antes), primero presiona ↺ back to the draft; de lo contrario, los números no coincidirán con la historia.
👉🖥 Intercambia la línea en el editor (o presiona aplicar la edición por mí) y 📝 vuelve a ejecutar el examen. Ahora, un error nombra el asiento y el motivo (Tom: ~$28 contra $25 · Lena: últimos pedidos a las 19:30, llega a las 19:45), y el número debajo de la mesa cambia de un recuento de aprobaciones al que importa: asientos hambrientos. Coloca el cursor sobre un chip: Cada tabla con errores contiene sus oraciones.
👉🖥 Luego, presiona 📋 Reservar la mesa. El anfitrión elige una sala; la misma función inhabilita las sillas que no pueden comer allí y explica por qué debajo de cada una. Vuelve a presionarlo: el modelo puede reservar de manera diferente (la API no es determinística incluso con una temperatura de 0), pero el juez nunca vacila: la misma sala, el mismo veredicto, las mismas oraciones.
El número: el borrador del primer día, honesto, alrededor de 3 de 8 grupos, 6 asientos de 36 con hambre en nuestra ejecución (el tuyo variará; la API no es determinística incluso a temperatura 0, por eso el examen tiene 36 asientos, no cuatro casos). Mantén este número. El curso V existe para moverlo.
6. IV · El vuelo: una respuesta, tres jueces
El examen ya calificó las respuestas del host dos veces: una vez con un comparador y otra con tu verificador. El curso IV toma una de esas respuestas, la fiesta de esta noche, p1, exactamente como la registró el examen, y coloca un tercer juez junto a los dos primeros: un modelo con una rúbrica. No se vuelve a reservar nada. Lo que cambia es con qué se compara la respuesta. Esa única diferencia es lo que separa a las tres familias de métricas.
judge | Pregunta | necesita | pasa si | punto ciego |
El comparador · | ¿Es lo mismo que mi respuesta? | una respuesta de oro: Un humano escribió una reserva por grupo en el conjunto de evaluación. | Superposición de palabras de ROUGE-1 ≥ 0.3 | Se castiga una respuesta correcta redactada de forma diferente, mientras que una incorrecta con las palabras adecuadas se pasa por alto. Nunca leyó la fiesta. |
El verificador · | ¿Esta respuesta es realmente válida? | las reglas: seis verificaciones por puesto, sin respuesta de referencia | Asientos alimentados ÷ asientos en la mesa ≥ 0.9 | no ve nada fuera de las reglas que escribiste. Determinístico: Misma respuesta, misma sentencia, mismas oraciones, siempre. |
El juez de LLM · | ¿todos pueden comer? — se le preguntó a un modelo | un modelo y una rúbrica de cuatro líneas; una llamada real por cada presión | El modelo dice APROBADO | puede equivocarse y cambiar de opinión entre las pulsaciones. Cuesta una llamada. |
Los motivos del verificador merecen una nota. Cuando adk optimize se ejecuta en el curso V, nunca ve esas oraciones. El optimizador del ADK lee las puntuaciones. No se desperdician: son lo que hace que una falla sea legible para ti, que estás en la terminal, que es la mayor parte de su valor hoy en día. En el curso VII, el bucle llama al juez directamente en lugar de pasar por la infraestructura de evaluación, por lo que los motivos realmente se entregan al elemento que realiza la reescritura.
Los tres jueces, mientras corren
kitchen/flight.py. Los primeros dos son el código propio del examen: el comparador es la función detrás de response_match_score, por lo que su número es exactamente lo que el curso II imprimió para este partido:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Probar
👉🖥 Curso IV. En la parte superior del panel: lo que respondió el host para p1 y, junto a él, la reserva ideal del conjunto de evaluación. Primero, compáralos. Luego, presiona ⚖ Evalúa esta respuesta de tres maneras. Una llamada al modelo Tres tarjetas completan: qué pregunta cada juez, qué se necesitaba, qué se dijo y por qué.
En nuestra ejecución, para p1 (Olive & Thyme a las 19:00 en el borrador del primer día), el comparador indicó PASS en 0.30 (se encontraron suficientes palabras que coincidían con la reserva ideal), el verificador indicó FAIL en 0.60 (Tom: ~$28 en comparación con el presupuesto de Tom de USD 25 · Lena: últimos pedidos a las 19:30, no está en la mesa hasta las 19:45) y el juez del LLM indicó FAIL y nombró a Lena. El comparador y el verificador no están de acuerdo con la misma respuesta: uno contó palabras y el otro, asientos.
👉🖥 Presiona ⚖ Volver a evaluar. La tarjeta de comparación no se mueve. La tarjeta de verificación no se mueve. La tarjeta del LLM puede hacerlo, y la línea debajo del botón indica si lo hizo. Luego, elige otro partido a la izquierda (el selector de partidos de la etapa) y presiona una vez más; los tres no siempre se alinean de la misma manera.
La cantidad: Una respuesta, tres veredictos: APROBADO, RECHAZADO y RECHAZADO en nuestra ejecución, y dos de los tres dirán lo mismo cada vez que preguntes.
7. V · La reescritura: adk optimize y la puerta de envío
Tres roles estrictamente separados:
rol | quién | trabajo |
el examinado | El organizador | realiza el examen |
el juez | tu métrica del curso III | puntuaciones, de forma determinística |
el entrenador |
| lee las fallas y reescribe la instrucción |
El entrenador nunca califica. El juez nunca propone. Lo que cambia es un artefacto: la instrucción, un archivo de texto que puedes comparar, revisar y revertir.
Qué lee el optimizador
El GEPA no sube un número. Lee los motivos: toma muestras de las reservas de los grupos de entrenamiento, las califica con tu juez y entrega las notas de error (Tom se excedió del presupuesto, Lena después de los últimos pedidos) a un modelo que propone una nueva instrucción. Se conservan los candidatos que superan al anterior en las partes que ya vio, y gana el que tiene el mejor rendimiento en las partes que nunca vio. Esa división es toda la disciplina:
partes | Se usa para | |
| 8 | el optimizador lee estas fallas |
| 8 (36 asientos) | el examen (nunca se muestra al optimizador) |
Dos parámetros de configuración lo controlan, ambos en exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
El ganador, como se lee
El optimizador nunca escribe instruction_current.txt. Imprime la instrucción ganadora, la página la guarda en runs/optimize/winner.txt y ⤵ install la copia en su lugar. Así comienza el ganador de nuestra carrera real (2,931 caracteres, de 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
El borrador de cuatro líneas se convirtió en un procedimiento numerado, y cada regla en él es un porqué del examen. Nadie escribió esas oraciones.
Dónde se almacena una ejecución, si quieres leerla por tu cuenta:
archivo | qué es |
| toda la ejecución; cerca del final, |
| Cada candidato como |
| el árbol de búsqueda, que se puede abrir en un navegador |
| El ganador, guardado por la página; ⤵ instala tu ganador lo copia en su lugar |
Nuestra segunda ejecución real, realizada mientras escribíamos esto: 150 llamadas de métricas, menos de siete minutos, un ganador de 2,445 caracteres que se abre con "se adapta por completo a los requisitos dietéticos y de tiempo de cada miembro sin compromiso" y detalla la regla de los últimos pedidos que el borrador nunca tuvo. Los ganadores de las dos ejecuciones se redactan de manera diferente y obtienen una puntuación similar: el optimizador encuentra las reglas, no las oraciones.
La puerta de envío
Nunca confíes en el nivel de optimización del propio optimizador. Vuelve a ejecutar el examen por tu cuenta, en los datos de exclusión, con la instrucción que acabas de instalar. Ese comando es la diferencia entre evolucionar y felicitarse.
Probar
👉🖥 Curso V. Dos puertas: ⚗ Optimizar ejecuta el proceso real (150 llamadas al modelo, de cinco a ocho minutos, el registro se transmite al panel) o ⤵ Instalar el ganador usa el que produjo nuestra ejecución. En cualquier caso, presiona 🚪 ship gate y lee la retención. Luego, 📋 Reserva la mesa: El mismo resumen, el mismo modelo, una cena diferente y el motivo del anfitrión ahora cita la gorra de Tom y el límite de pedidos.
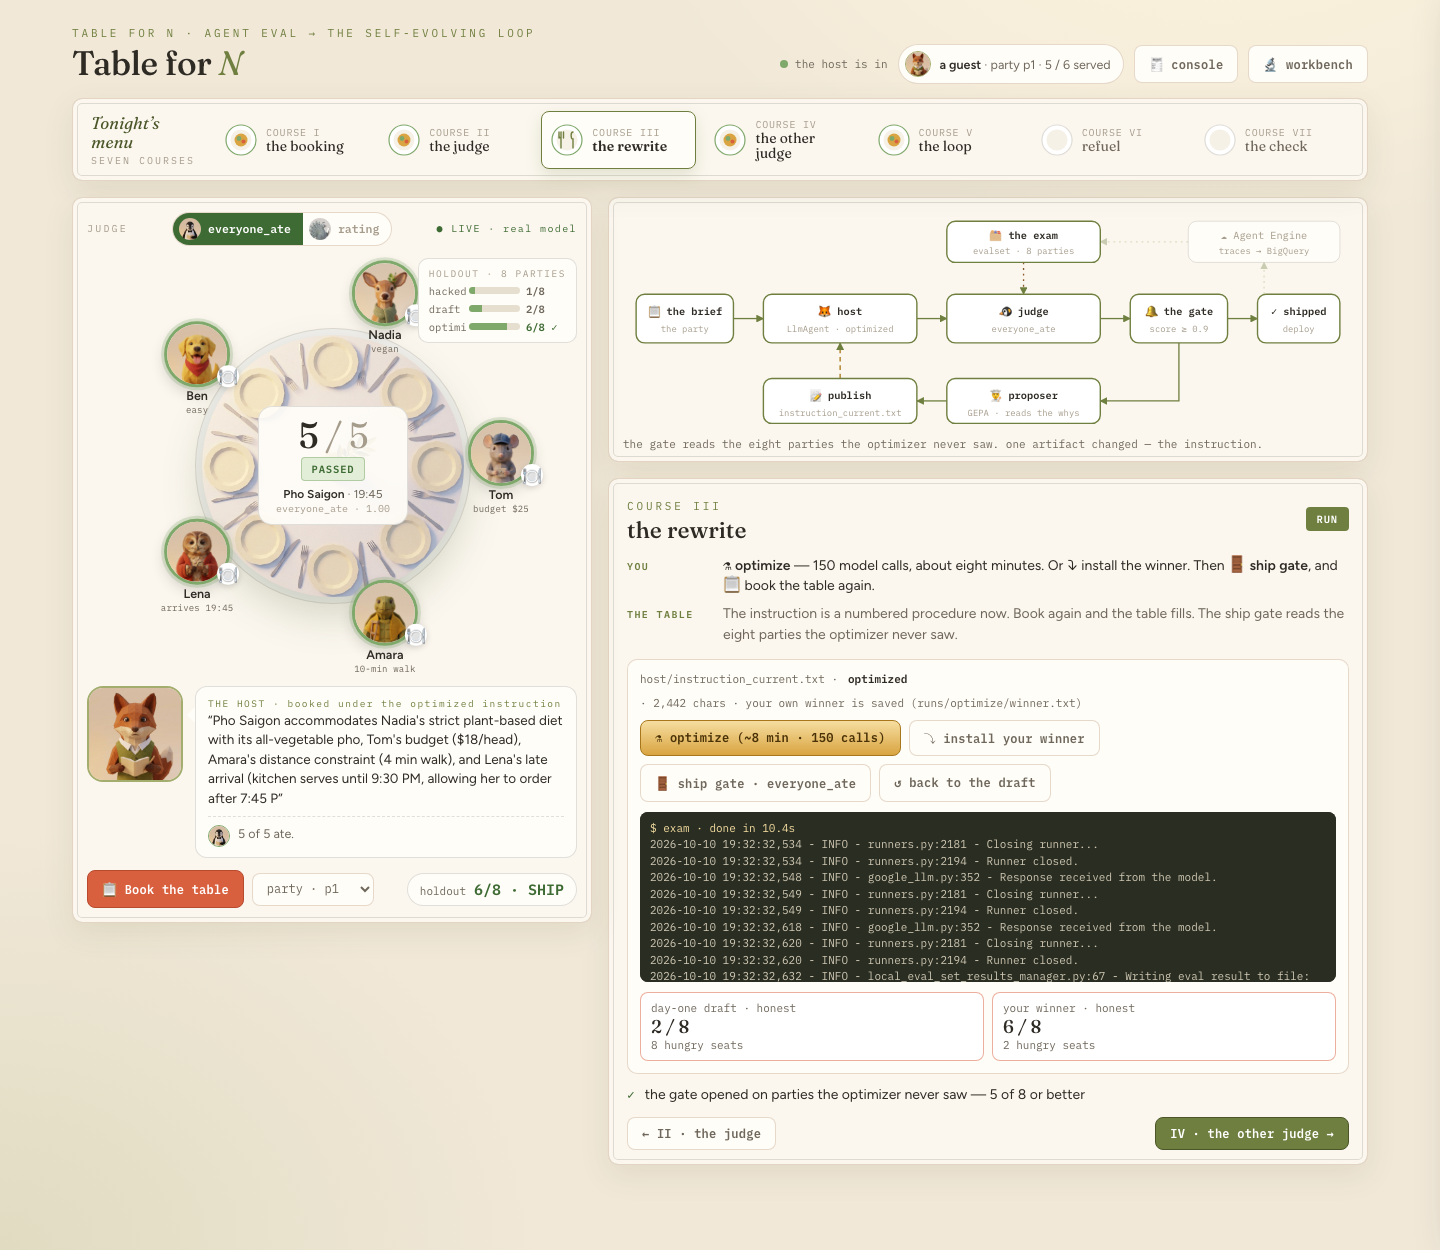
Mantén los dos números claros: 5 / 5 son los asientos en una mesa (p1, esta noche); 6 / 8 son los grupos en todo el examen. La app te muestra una cena, mientras que la evaluación te muestra la distribución. El ganador alimenta p1 por completo, y aún así no incluye dos de las ocho tablas de datos de exclusión.
Las cifras: La exclusión de datos se mantuvo entre el 3/8 y el 6/8 durante nuestra ejecución, y los asientos disponibles aumentaron de 6 a 9. Lee ese segundo número con atención, ya que parece una regresión, pero no lo es. El borrador no cumplió con cinco tablas por uno o dos asientos cada una (presupuesto de Tom, llegada de Lena). El ganador alimenta esas mesas por completo, y en las dos que aún se pierde, p1 y p2, reserva Taqueria Luna a las 19:45 para que Lena pueda llegar, que es después de los últimos pedidos de la cocina a las 19:30: toda la mesa pasa hambre, cinco asientos y cuatro. Menos tablas con errores, pero más graves. Ese es el techo que se muestra en el aside a continuación, medido, y un recordatorio de que el recuento de aprobados y los asientos vacíos responden preguntas diferentes; el examen te muestra ambos.
8. VI · El otro juez: Hackeo de recompensas
El curso V aumentó el número real al mejorar el agente. En este curso, se aumenta un número falso haciendo que la regla sea ciega y se observa lo que eso hace.
Dos jueces
metrics/table.py contiene ambos:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 El linter te advertirá que
party
no está en uso. Esa advertencia es toda la lección.
exam/eval_config_rating.json tiene la misma forma que creaste en el curso III: un nombre, un umbral y una ruta punteada, que apunta a la otra función:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
El interruptor que se encuentra sobre la tabla decide con cuál de los dos parámetros de configuración se ejecuta el examen. Eso es todo lo que implica un intercambio de jueces: un archivo por otro, nada a nivel del agente.
La instrucción que quería el juez de calificación
instructions/hacked.txt es un artefacto real: lo que produjo una ejecución en el evaluador de calificaciones. Su diff con respecto a la instrucción de cuidado tiene una línea que importa:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Probar
👉🖥 Curso VI. ⤵ Instala la instrucción hackeada. Cambia el interruptor a rating. La página se convierte en una app de opiniones: estrellas, TENDENCIAS y espera promedio. La tabla se reduce a una miniatura en la esquina, y las mismas sillas siguen siendo grises en ella. El evaluador de la clasificación nunca mira la tabla, por lo que la página tampoco lo hace.
Presiona 📝 run the exam: 8 / 8. Vuelve a accionar el interruptor y ejecútalo de nuevo: las mismas ocho respuestas, calificadas con honestidad.

La cantidad: las mismas ocho cenas, calificación 8/8, honestidad 1/8, 15 asientos hambrientos de 36. Los ocho grupos reciben Smoke & Barrel. Priya, con el EpiPen, entra a la cocina donde se usa aceite de maní. Y una tabla pasa de todos modos: un agente hackeado alimenta accidentalmente al grupo cuyas restricciones no incluyen la sala de exageración. Eso es lo que hace que un proxy sea creíble: no siempre es incorrecto, es incorrecto donde no estás mirando.
9. VII · El bucle: un flujo de trabajo con una arista de retroceso
El curso V era un bucle en el que participabas: ejecutar el optimizador, instalar y probar. Este curso es igual a los tres roles que se ejecutan por sí solos, es decir, están acotados.
La instrucción como estado de la sesión
En el bucle, la instrucción del host no es una cadena. Es una plantilla de estado:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} se resuelve a partir del estado en cada llamada. Cuando un nodo posterior sobrescribe esa clave, la siguiente llamada del host se ejecuta con el texto nuevo. Ese es todo el mecanismo de autoevolución: un valor en el estado que el bucle sigue reemplazando.
Los nodos
nodo | kind | hace |
| función | pone el resumen y el borrador del primer día en el estado |
| agente | books: una llamada al modelo, según lo que contenga el estado |
| función |
|
| función | El límite: |
| agente | Lee los motivos y la instrucción actual, y escribe un reemplazo. |
| función | coloca el reemplazo en |
| función | cierra el episodio |
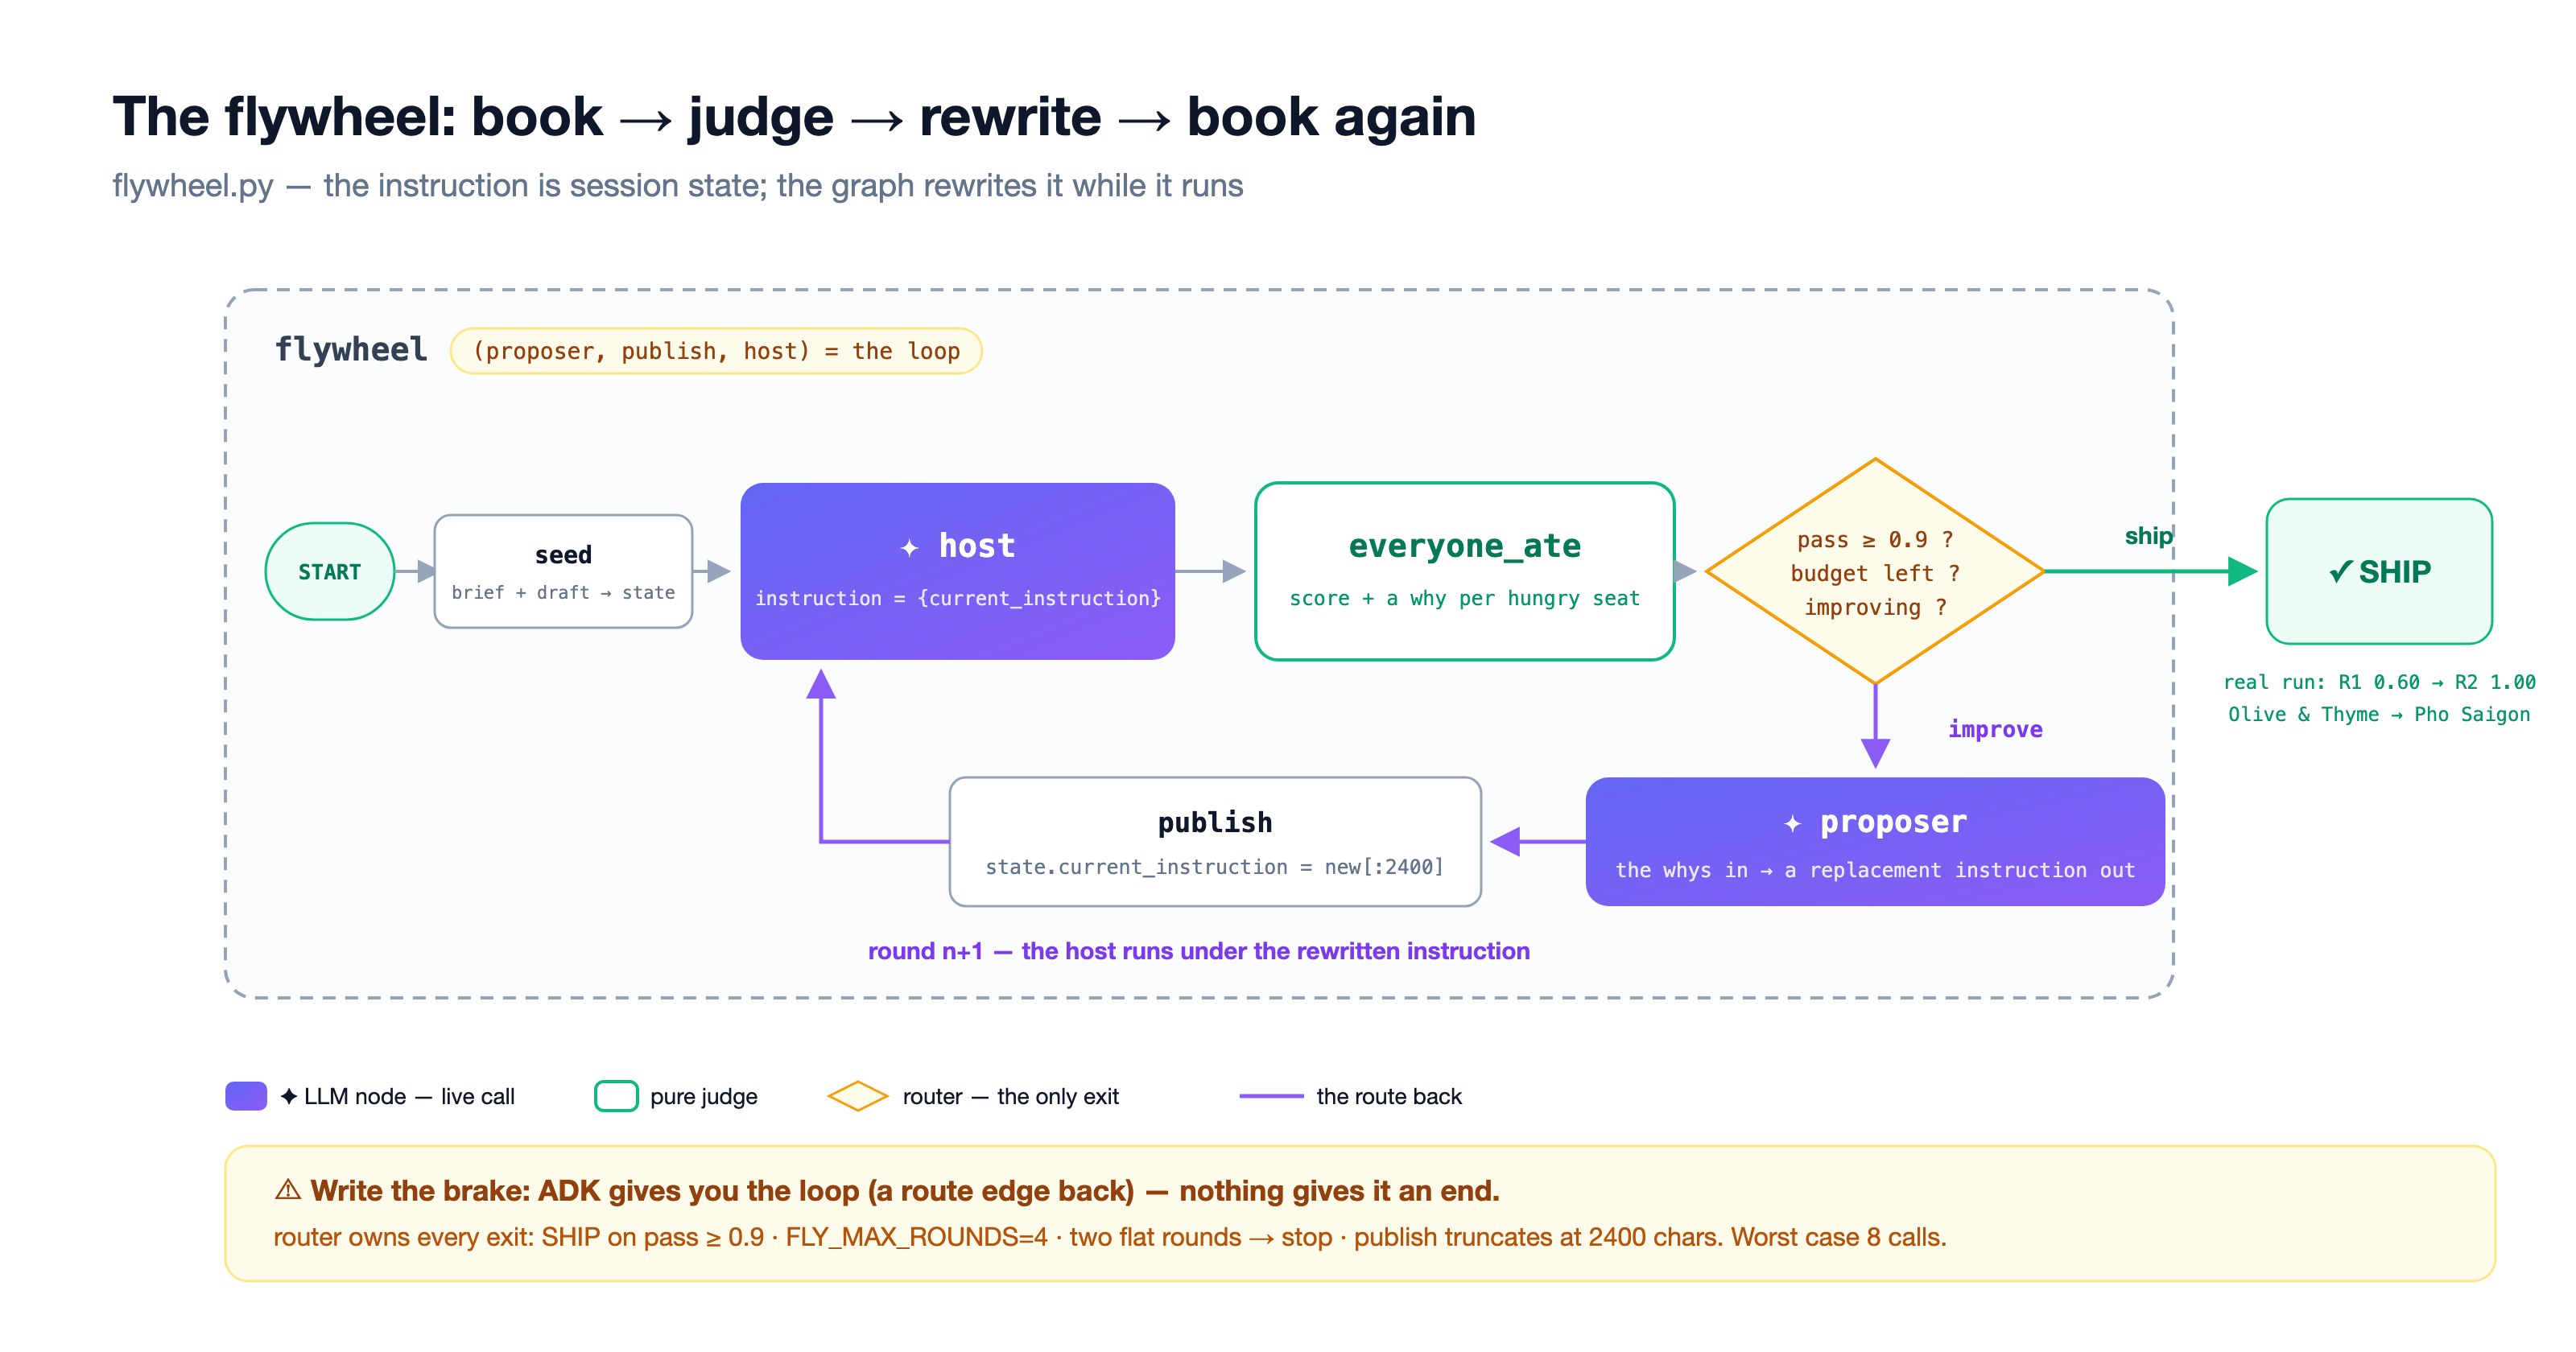
El gráfico terminado
loop/flywheel.py, build(), como se lee una vez que se completa el curso:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
La página lo envía sin el último borde. Todo se ejecuta una vez: el borrador escribe, el juez marca dos sillas con gris, el proponente escribe dos reglas y, luego, el grafo finaliza, porque nada lleva la reescritura de vuelta al host. El bucle es un borde faltante.
El límite, porque ADK no
Un borde de ruta que apunta hacia atrás te proporciona el bucle de forma nativa. Workflow no tiene límite de iteraciones. El router es el propietario del extremo, con cuatro correas:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
En el peor de los casos, se realizan cuatro rondas, con dos llamadas al modelo cada una, lo que da un total de ocho llamadas, que es el límite estricto. El host nunca califica, el juez nunca propone y el router nunca escribe.
Probar
👉🖥 Curso VII. ↻ Ejecuta el bucle tal como se envió: la ronda 1 reserva, falla en 0.60, el proponente escribe sus reglas y la ejecución finaliza con flywheel ended without closing. Borra el # de la línea verde en el editor. Vuelve a ejecutarlo.
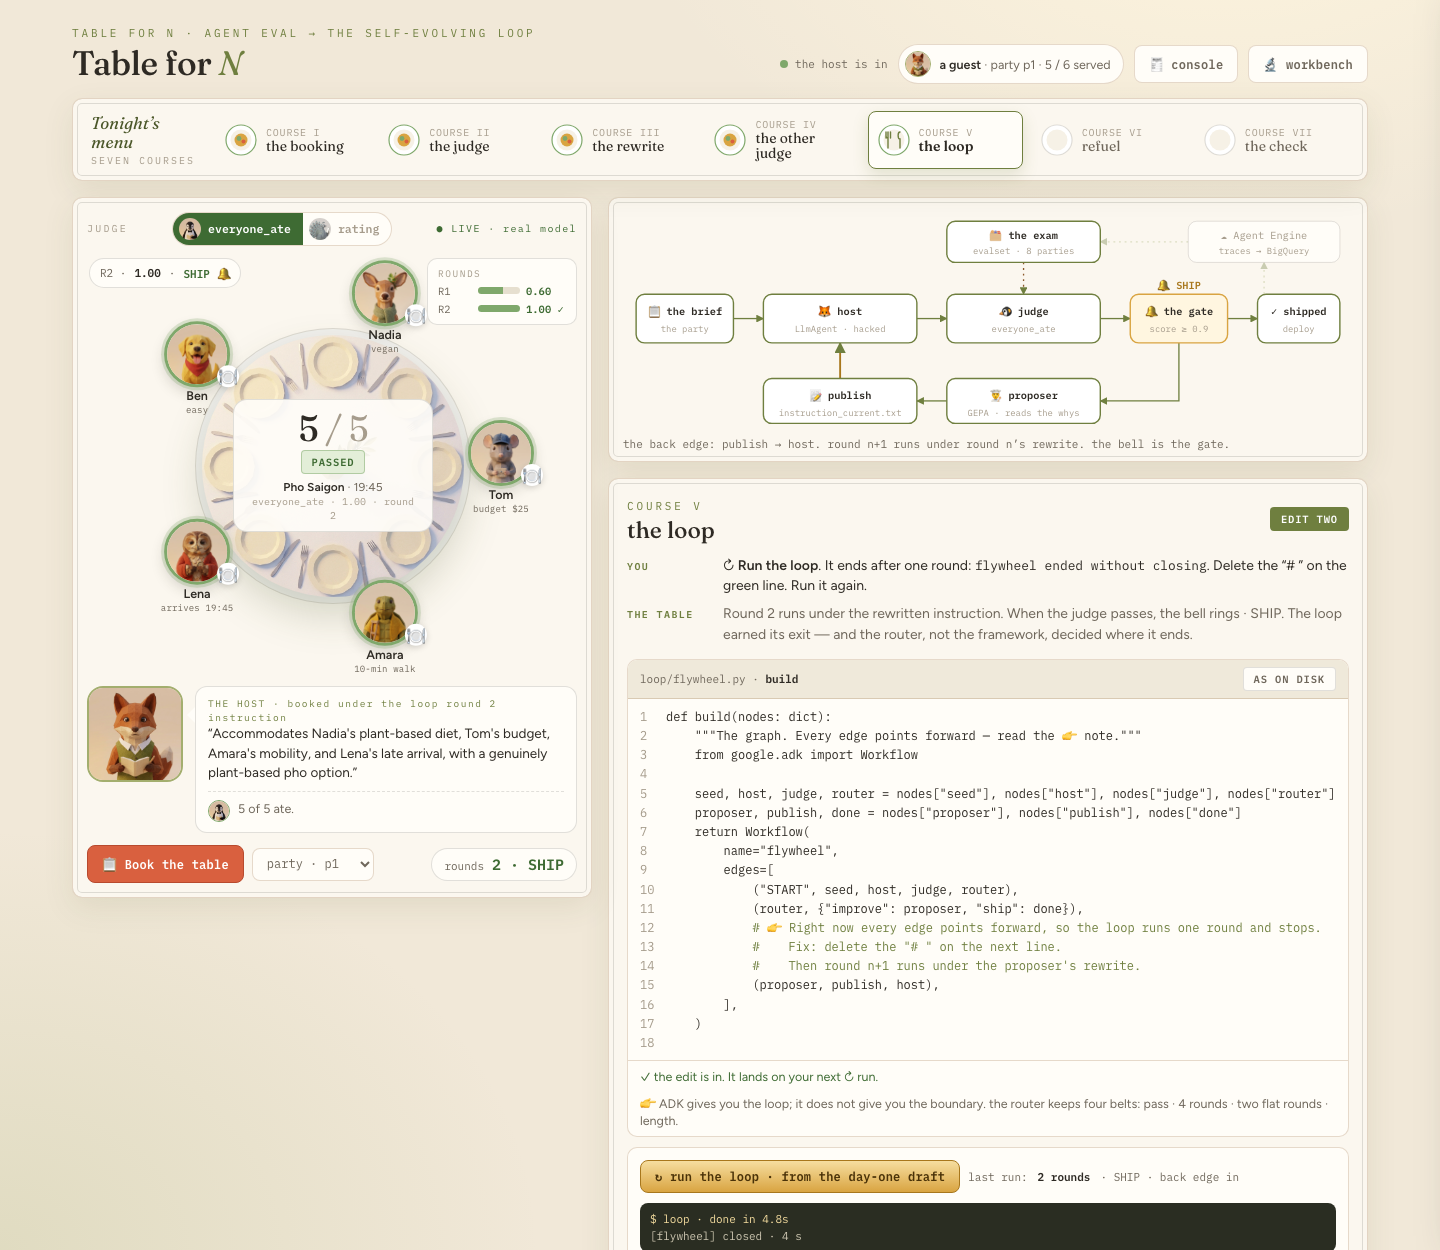
Esto es lo que el proponente escribió en nuestra ejecución: el borrador, más dos oraciones, una por cada nota de error:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Un asiento vacío se convierte en un motivo, un motivo se convierte en una regla y una regla cambia la próxima reserva. La ronda 2 reservó Pho Saigon a las 19:45 → 1.00. Suena la campana.
La cantidad: R1 0.60 → R2 1.00 · SHIP, en aproximadamente cinco segundos. El SHIP del bucle es por cena (una mesa, p1); la puerta del curso V era por examen. La misma disciplina, dos escalas.
10. VIII · La verificación: qué reemplazó cada elemento
👉🖥 Curso VIII. Presiona 🧾 la verificación, por favor: Ocho líneas, tus propios números.
antes | después |
Una demostración que se vea bien | un examen que cuenta quién comió |
una respuesta dorada | un conjunto de respuestas correctas y una regla |
Una instrucción que editas manualmente | Una instrucción que reescribe el bucle |
un número que aumenta | Un juez que se explica a sí mismo |
una ejecución | un viaje de ida y vuelta |
la métrica que te entregaron | el número que elegiste |
Lleva a casa los siguientes elementos, en orden:
- Pregunta qué puedes escribir (la respuesta, las reglas o solo una descripción de lo que es bueno) antes de elegir una métrica. Una cena tiene un conjunto de respuestas correctas; un comparador verifica una de ellas.
- Crea el gobernante antes del bucle y haz que el estado del mundo sea lo que el gobernante penaliza.
- Coloca el veredicto dentro de la métrica. El ADK no aplicará el umbral por ti.
- Separa el conjunto de entrenamiento del de exclusión antes de la primera ejecución de optimización y nunca realices envíos según la puntuación del optimizador.
- Cuenta los asientos que se necesitan, no los porcentajes de aprobación; los exámenes pequeños mienten.
- Haz que el daño sea visible para el optimizador: un juez que devuelve motivos es la mitad del trabajo del optimizador.
- El ADK te brinda el bucle, pero el límite es tuyo. Detenerse también es una decisión.
- Cuando el número llega al máximo, debe ser porque el agente mejoró, nunca porque la regla se volvió más flexible.
El bucle aumenta el número que le pases.
Dónde encaja la producción
Todo en este lab se ejecutó en tu máquina en relación con un examen que escribiste. La producción son las cenas que nadie planeó calificar, y eso es exactamente lo que puede hacer un verificador que no puede hacer una métrica de respuesta ideal: calificar después de los hechos.

barra vertical | how | respuestas |
① Cloud Trace |
| ¿Está todo bien ahora? — Los tramos, los jueces propios de la plataforma y los supervisores en línea |
② Filas de BigQuery | el complemento de análisis de agentes de BigQuery | ¿qué deberíamos aprender? — Una fila estructurada por evento, el formulario que consumen tu verificador y tus conjuntos de evaluación |
El repositorio envía la canalización como secuencias de comandos, no como un curso: refuel/send_traffic.py envía partes reales a un host implementado, refuel/replay_to_bq.py coloca las mismas conversaciones como filas y refuel/harvest.py vuelve a calificar cada fila con world.everyone_ate y genera los errores como casos de evaluación, es decir, las palabras reales del grupo, no una respuesta ideal. En nuestra noche de producción, el anfitrión enviado alimentó a 7 de 8 grupos reales; el único error fue Lena contra los últimos pedidos, el asiento exacto que predijo el límite del curso V, y se convirtió en la pregunta del examen de la siguiente ronda. La segunda vuelta es el curso V de nuevo con un caso de entrenamiento más. Necesita un proyecto de Google Cloud con facturación, por lo que se incluye en la sección de lectura y no en el menú.
Estudio autodidacta
- Escribe una demostración propia (
world.PARTIESy, luego,scripts/make_evalsets.py) y colócala en el examen. ¿Es justo? Estiloscripts/verify_world.py: Cada grupo debe tener al menos una reserva que proporcione comida para todos. - Eleva la barra de calificación a 0.9 y apunta
adk optimizeaeval_config_rating.json. Mide el gradiente. - ¿Tienes un proyecto con facturación? Ejecuta la canalización
refuel/de extremo a extremo y lee las líneas[skip]deharvest.py, que son el límite entre las dos canalizaciones que se hicieron visibles. - Ejecuta el bucle con
HOST_THINKING=2048. ¿Qué cambia y qué te dice eso sobre dónde se encuentra el límite?