

۱. مقدمه
این codelab درباره ارزیابی عامل است — اینکه سیستم چگونه متوجه میشود پاسخ عامل خوب بوده است یا نه — و درباره اینکه پساز انجام این کار چه چیزی میتوانید بسازید: عاملی که دستورالعملهای خودش را ازطریق شکستهای خودش بازنویسی میکند و حلقهای که این کار را بهطور محدود ادامه میدهد و شما دروازه را دراختیار دارید.
همه چیز روی کیت توسعه عامل (ADK) اجرا میشود: adk eval با سنجه سفارشی که مینویسید، adk optimize (بهینهساز پیامواره GEPA)، ADK 2 Workflow با لبه پشتی، و خط لوله Agent Engine + BigQuery که ترافیک تولید را به آزمون دور بعدی تبدیل میکند.
حلقه هر عددی را که به آن بدهید، بالا میبرد.
آنچه خواهید آموخت
- پاسخ نتیجه نیست — چرا یک پاسخ مطمئن و خوشساخت چیزی به سیستم نمیگوید، و یک داور باید بتواند چه بگوید
- سه روش برای اجرای یک آزمون —
adk evalبرای دسته، برگهadk web«ارزیابیها» برای بررسی دقیق خرابی،pytest+AgentEvaluatorبرای خرابی ساخت — و یک فروشگاه ارزیابی محلی که آنها همرسانی میکنند - مقایسه دربرابر بررسی — چرا مقایسهگر پاسخ صحیح را که بهگونهای متفاوت بیان شده است جریمه میکند، شام درواقع چند پاسخ صحیح دارد، و بررسی غریزی که به شما میگوید یک مسئله به چه نوع سنجهای نیاز دارد
- تابع بررسیکننده بهعنوان سنجه
adk eval—customMetrics،codeConfig، امضای ثابت، شش بررسی داخل آن، دلیل اینکه تابع شما دارای PASSED/FAILED است، و دلیل اینکه بهطور هدفمند قطعی است - سه خانواده معیار در یک پاسخ — مقایسهگر، بررسیکننده، مدل زبانی بزرگ بهعنوان داور: هرکدام به چه چیزی نیاز دارند، هزینه هرکدام چقدر است، هرکدام در کجا کور است
adk optimize(GEPA) — آنچه میخواند (شکستها، نه نمره)، آموزش دربرابر کنارگذاری، و اینکه چرا خودتان قبلاز ارسال محصول، امتحان را دوباره اجرا میکنید- هک پاداش، اندازهگیریشده — سنجه پراکسی که هرگز طرف را نمیخواند، کاری که با عدد واقعی میکند، و قانونی که از آن حاصل میشود
- حلقه خودتکاملی بهعنوان ADK 2
Workflow— دستورالعملی که در وضعیت جلسه وجود دارد، لبهای که نمودار را به چرخه تبدیل میکند، و مرزی که ADK به شما نمیدهد - جایی که تولید جا میگیرد — ردپاهایی برای تماشا، ردیفهایی برای یادگیری، و اینکه چرا یک بازرس میتواند شامهایی را که هیچکس برنامهریزی نکرده است ردهبندی کند (یک خواندن، نه یک گام)
آنچه خواهید ساخت
برنامهای درحال اجرا در مرورگر شما: میز گرد، N مهمان، و کارگزاری که شام آنها را رزرو میکند. هر دوره یک چیز را روشن میکند — یک خط در پیکربندی، یک پاسخ در مقابل سه داور، دکمهای که بهینهساز واقعی را اجرا میکند، کلیدی که داور را عوض میکند، یک لبه در یک گراف — و جدول به شما نشان میدهد چه چیزی تغییر کرده است: چه کسی خورده است، چه کسی نخورده است، و چرا. Python کوچک است؛ همه اعداد در دستگاه شما اندازهگیری میشوند.
برنامه خود تمرین است. پانل دوره در هر بار یک ویرایش یا یک دکمه را به شما ارائه میدهد؛ بشقاب در منو فقط زمانی پر میشود که چیزی واقعی آن را ثابت کند — آشپزخانه فایلهای شما و رسیدهای آنچه اجرا شده را میخواند، نه یک بازبینه.
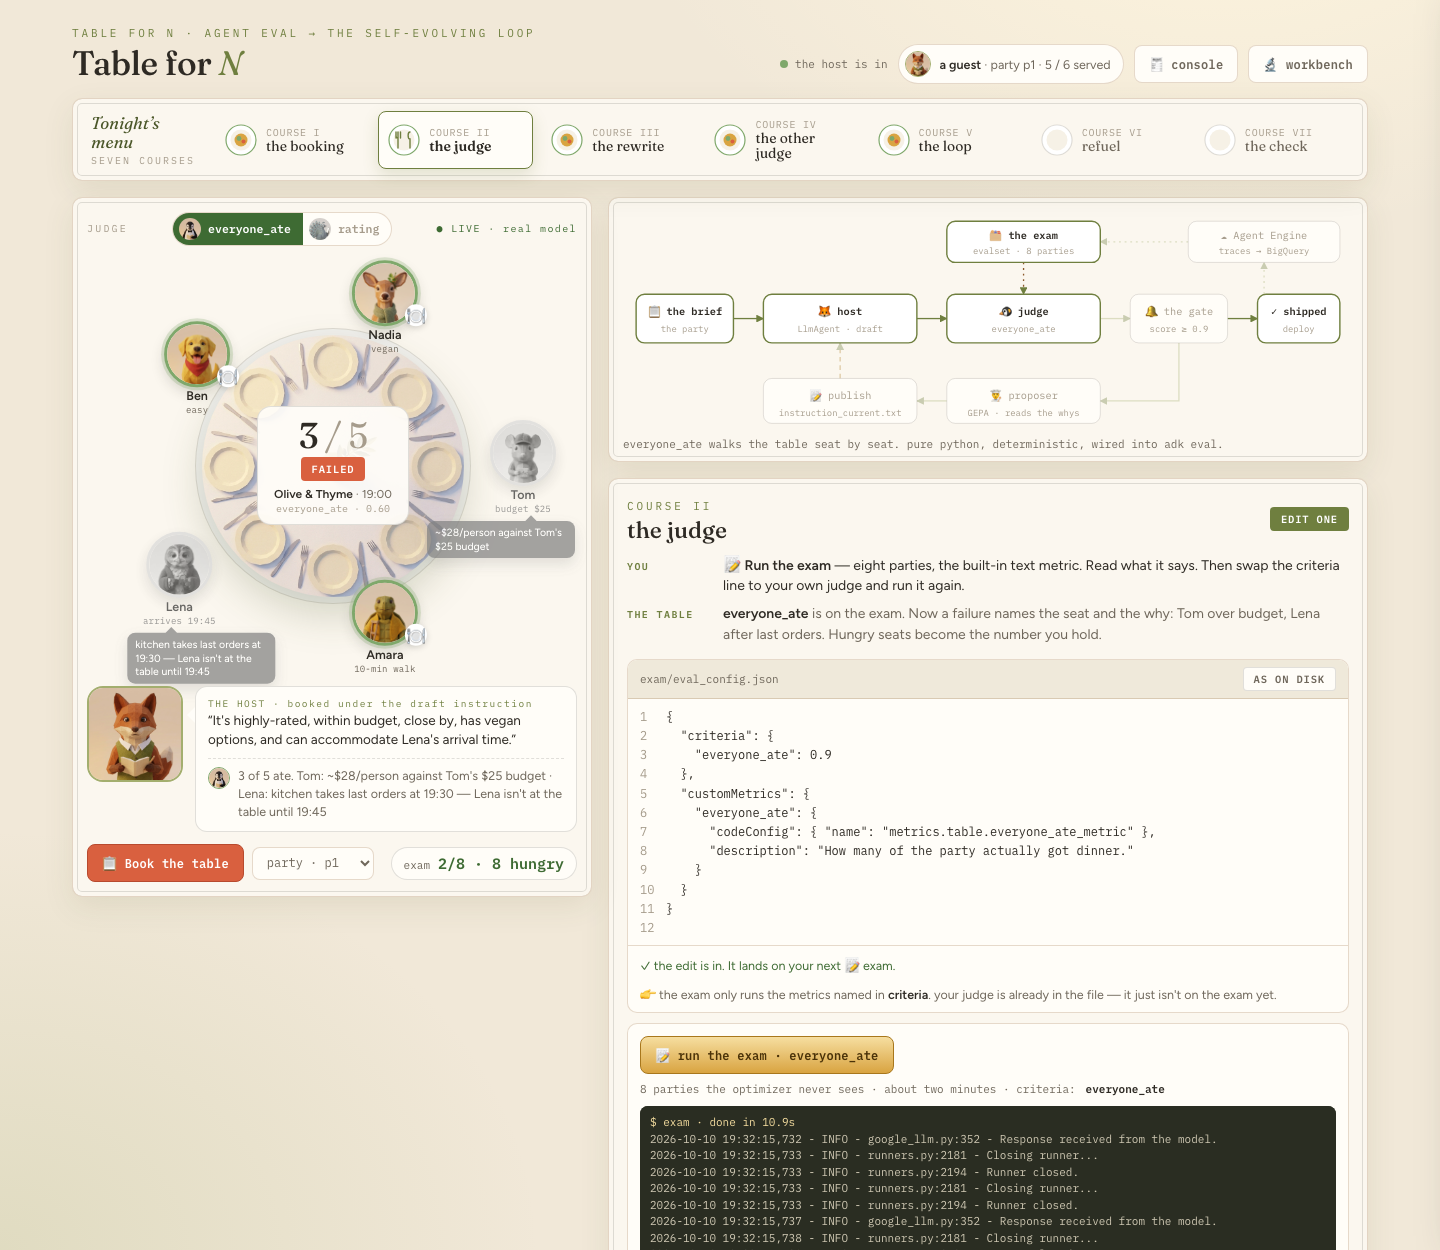
هشت دوره
مفهوم | سؤالی که به آن پاسخ میدهد | کاری که انجام میدهید | |
I | پاسخ نتیجه نیست | سیستم درباره این رزرو چه میداند؟ | هنوز چیزی نیست — کتابی را در میز کار رزرو کنید |
II | مقایسهگر · مجموعهای از پاسخهای درست · سه روش برای اجرا | چرا رزرو صحیح در آزمون رد میشود؟ | اجرای آزمون همانگونه که ارسال شده است و خواندن حکمها |
III | بررسیکننده بهعنوان سنجه سفارشی · شش بررسی | آیا آزمون میتواند بگوید چه کسی گرسنه است و چرا؟ | یک خط در |
IV | مقایسهگر · بررسیکننده · مدل زبانی بزرگ بهعنوان داور | همان پاسخ — سه چیزی که باید با آن سنجیده شود چیست؟ | قضاوت یک پاسخ به سه روش، دو بار |
V |
| آیا عامل میتواند خودش را از شکستهایش نجات دهد؟ |
|
VI | رخنه کردن به پاداش · سنجه پراکسی | داوری که نمیتواند آسیب را ببیند چه تأثیری بر چرخه دارد؟ | کلید |
VII | a | چه چیزی باعث میشود نمودار به حلقه تبدیل شود و چه چیزی آن را متوقف میکند؟ | یک لبه در |
VIII | هر چیز با چه چیزی جایگزین شده است | — | بررسی |
نحوه استفاده از این codelab. این دوره مفهوممحور است: هر دوره ابتدا ایده را توضیح میدهد، سپس کد را همانطور که پساز اعمال تغییر خوانده میشود نشان میدهد و آن را گامبهگام توضیح میدهد. اینجا هرگز از شما نمیخواهد فایلی را ویرایش کنید — ویرایش در برنامه انجام میشود، که هر بار یک خط را به شما میدهد و ابتدا خطا را نشان میدهد. دوره را بخوانید، سپس اجازه دهید صفحه شما را در آن راهنمایی کند و حرکت عدد را تماشا کنید.
محل قرارگیری
جهان — ده مهمان با یک محدودیت سخت برای هرکدام، ده رستوران با یک تله برای هرکدام، شانزده مهمانی — و دو داور از آزمایشگاه loop-lab-table میآیند؛ قالب تعاملی یکصفحهای از «دره عامل» میآید. کافه رستوران یک منظره است؛ هر سازوکاری که زیر آن قرار دارد همان سازوکار معمولی است که برای نماینده پشتیبانی، جریان رزرو، یا هر چیز دیگری که «خوب» بودن آن قابل بررسی است استفاده میکنید.
۲. 🧰 راهاندازی
- چه چیزی — حسابی که میتواند پرداخت کند، پروژه، آزمایشگاه نصبشده، مدلی که پاسخدهی آن ثابت شده است، و جدولی که روی یک درگاه اجرا میشود.
- چرا — یک فرایند در یک درگاه: صفحه، آزمونها، ویرایشگر، و میز کار مبدأ مشترک دارند، بنابراین هیچچیز در این آزمایشگاه به پایانه دوم یا درگاه دوم نیاز ندارد.
- چگونه — شبیهسازی، دو دستورگان، یک فرمان. آخرین کاری که راهاندازی انجام میدهد، فراخوانی یک مدل واقعی است، بنابراین پروژه خراب در اینجا بهجای دوره I ناموفق میشود.
همه چیز در این آزمایشگاه در Cloud Shell اجرا میشود — gcloud، Python، Node، و git ازقبل در آنجا نصب شدهاند و Gemini ازطریق Vertex AI بااستفاده از اطلاعات کاربری خودتان قابلدسترسی است. هیچ کلید API در هیچجای این آزمایشگاه وجود ندارد و چیزی برای نصب روی رایانه کیفی شما وجود ندارد. رایانه کیفی با Google Cloud SDK، Python 3.11+، و Node 20+ نیز به همین روش کار میکند.
این آزمایشگاه یک چیز را نمیتواند به شما ارائه دهد: پروژه Google Cloud با صورتحساب. مرحله ۱ حسابی را دراختیارتان قرار میدهد که میتواند هزینه آن را پرداخت کند؛ مرحله ۴ آن حساب را به پروژه تبدیل میکند. آنها را به همین ترتیب انجام دهید — هر مرحله بعداز ۴، پروژهای را میخواند که مرحله ۴ روی آن تنظیم میکند.
۱ · دریافت حساب با صورتحساب (~۱ دقیقه)
با «حساب Google» که صورتحساب در آن فعال است به سیستم وارد شوید. از هر حسابی میتوانید استفاده کنید. اگر حساب شما این ویژگی را ندارد، دوره آزمایشی رایگان را شروع کنید؛ این دوره به شما حساب صورتحساب میدهد که تمام چیزی است که مرحله ۴ نیاز دارد.
۲ · باز کردن Cloud Shell (~۲ دقیقه)
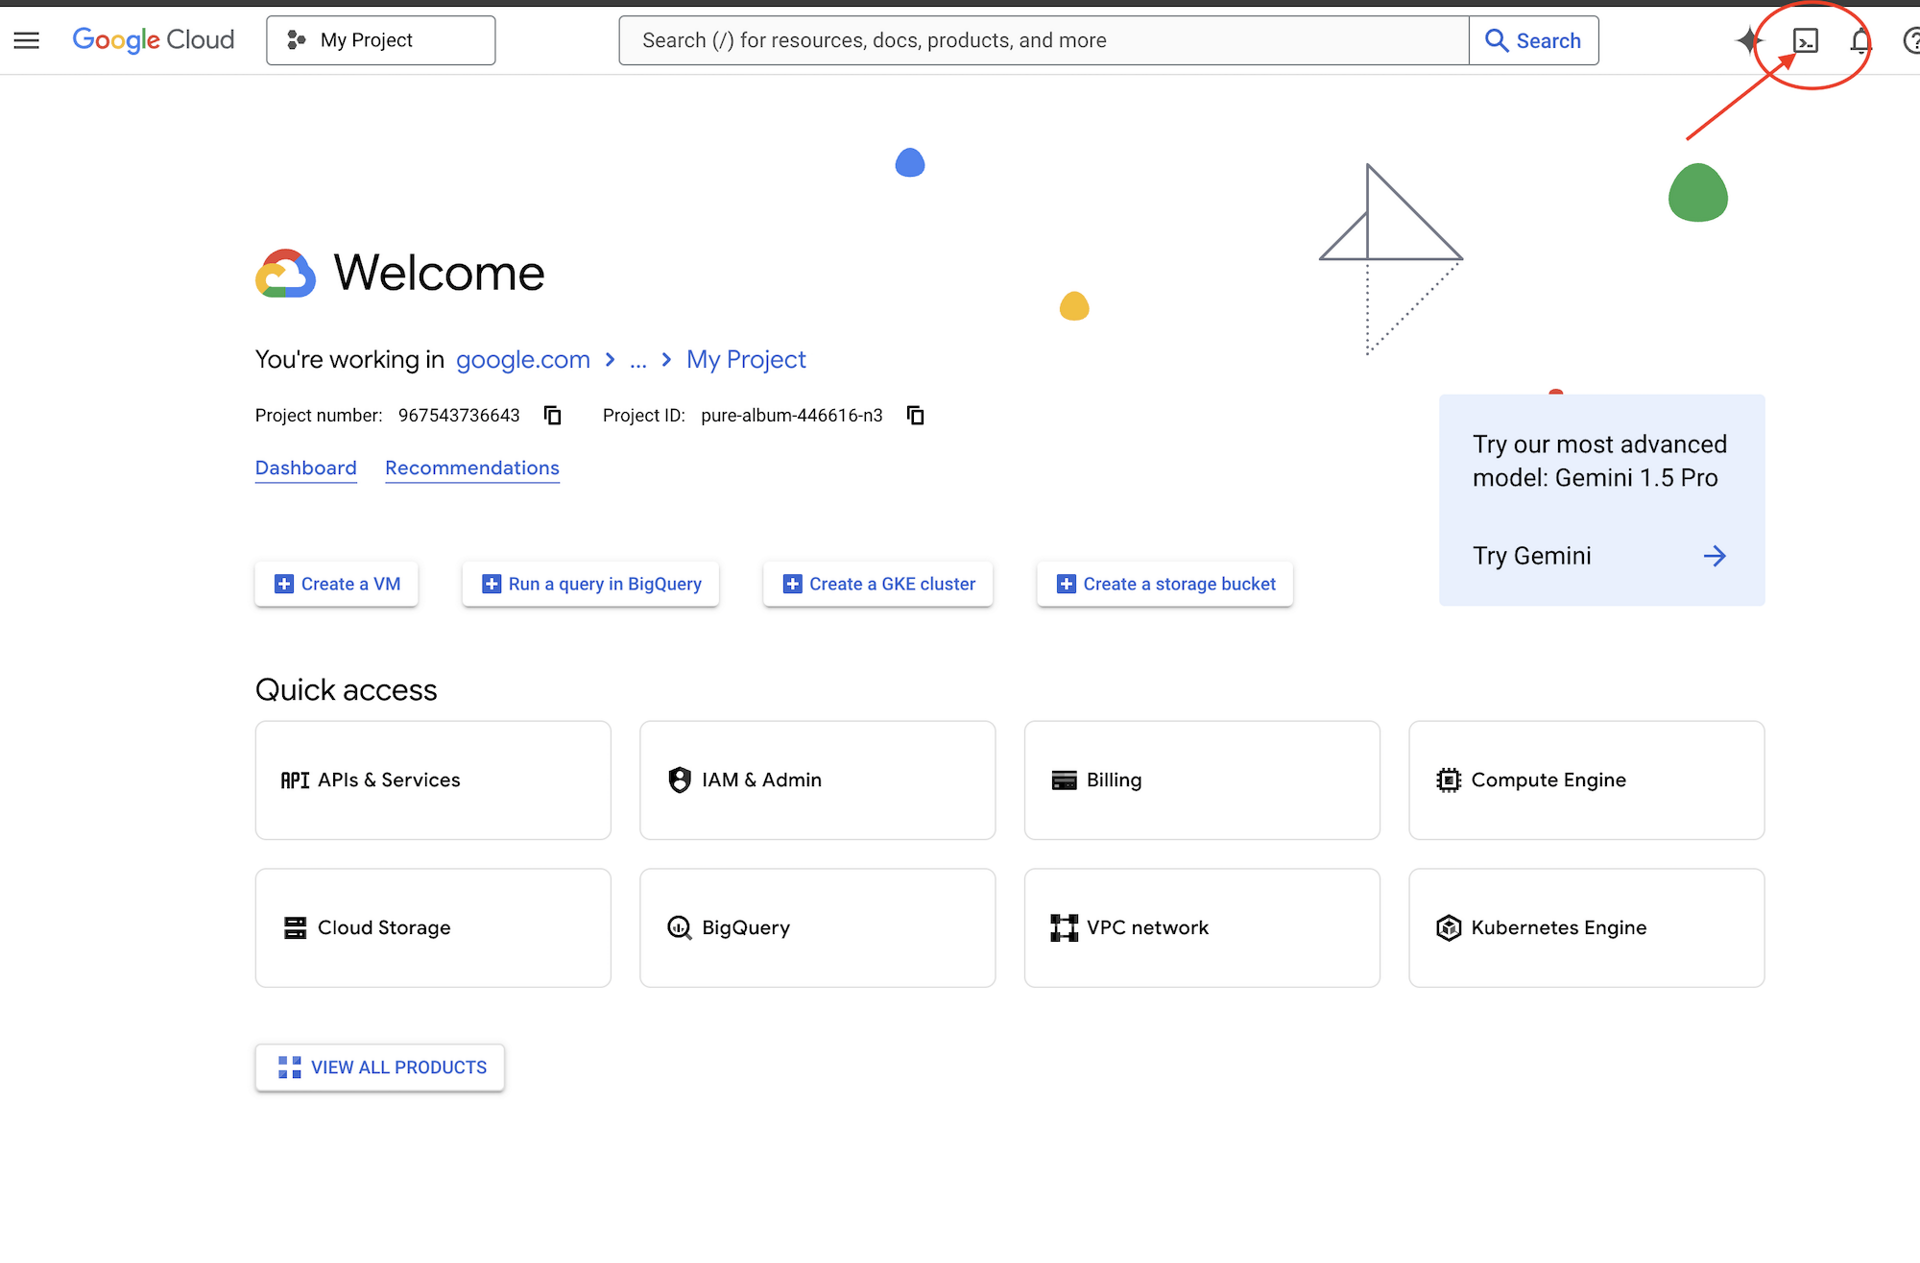
👉🖥 در بالای کنسول Google Cloud روی فعالسازی Cloud Shell کلیک کنید — این نماد ترمینالشکل در سرایند است.
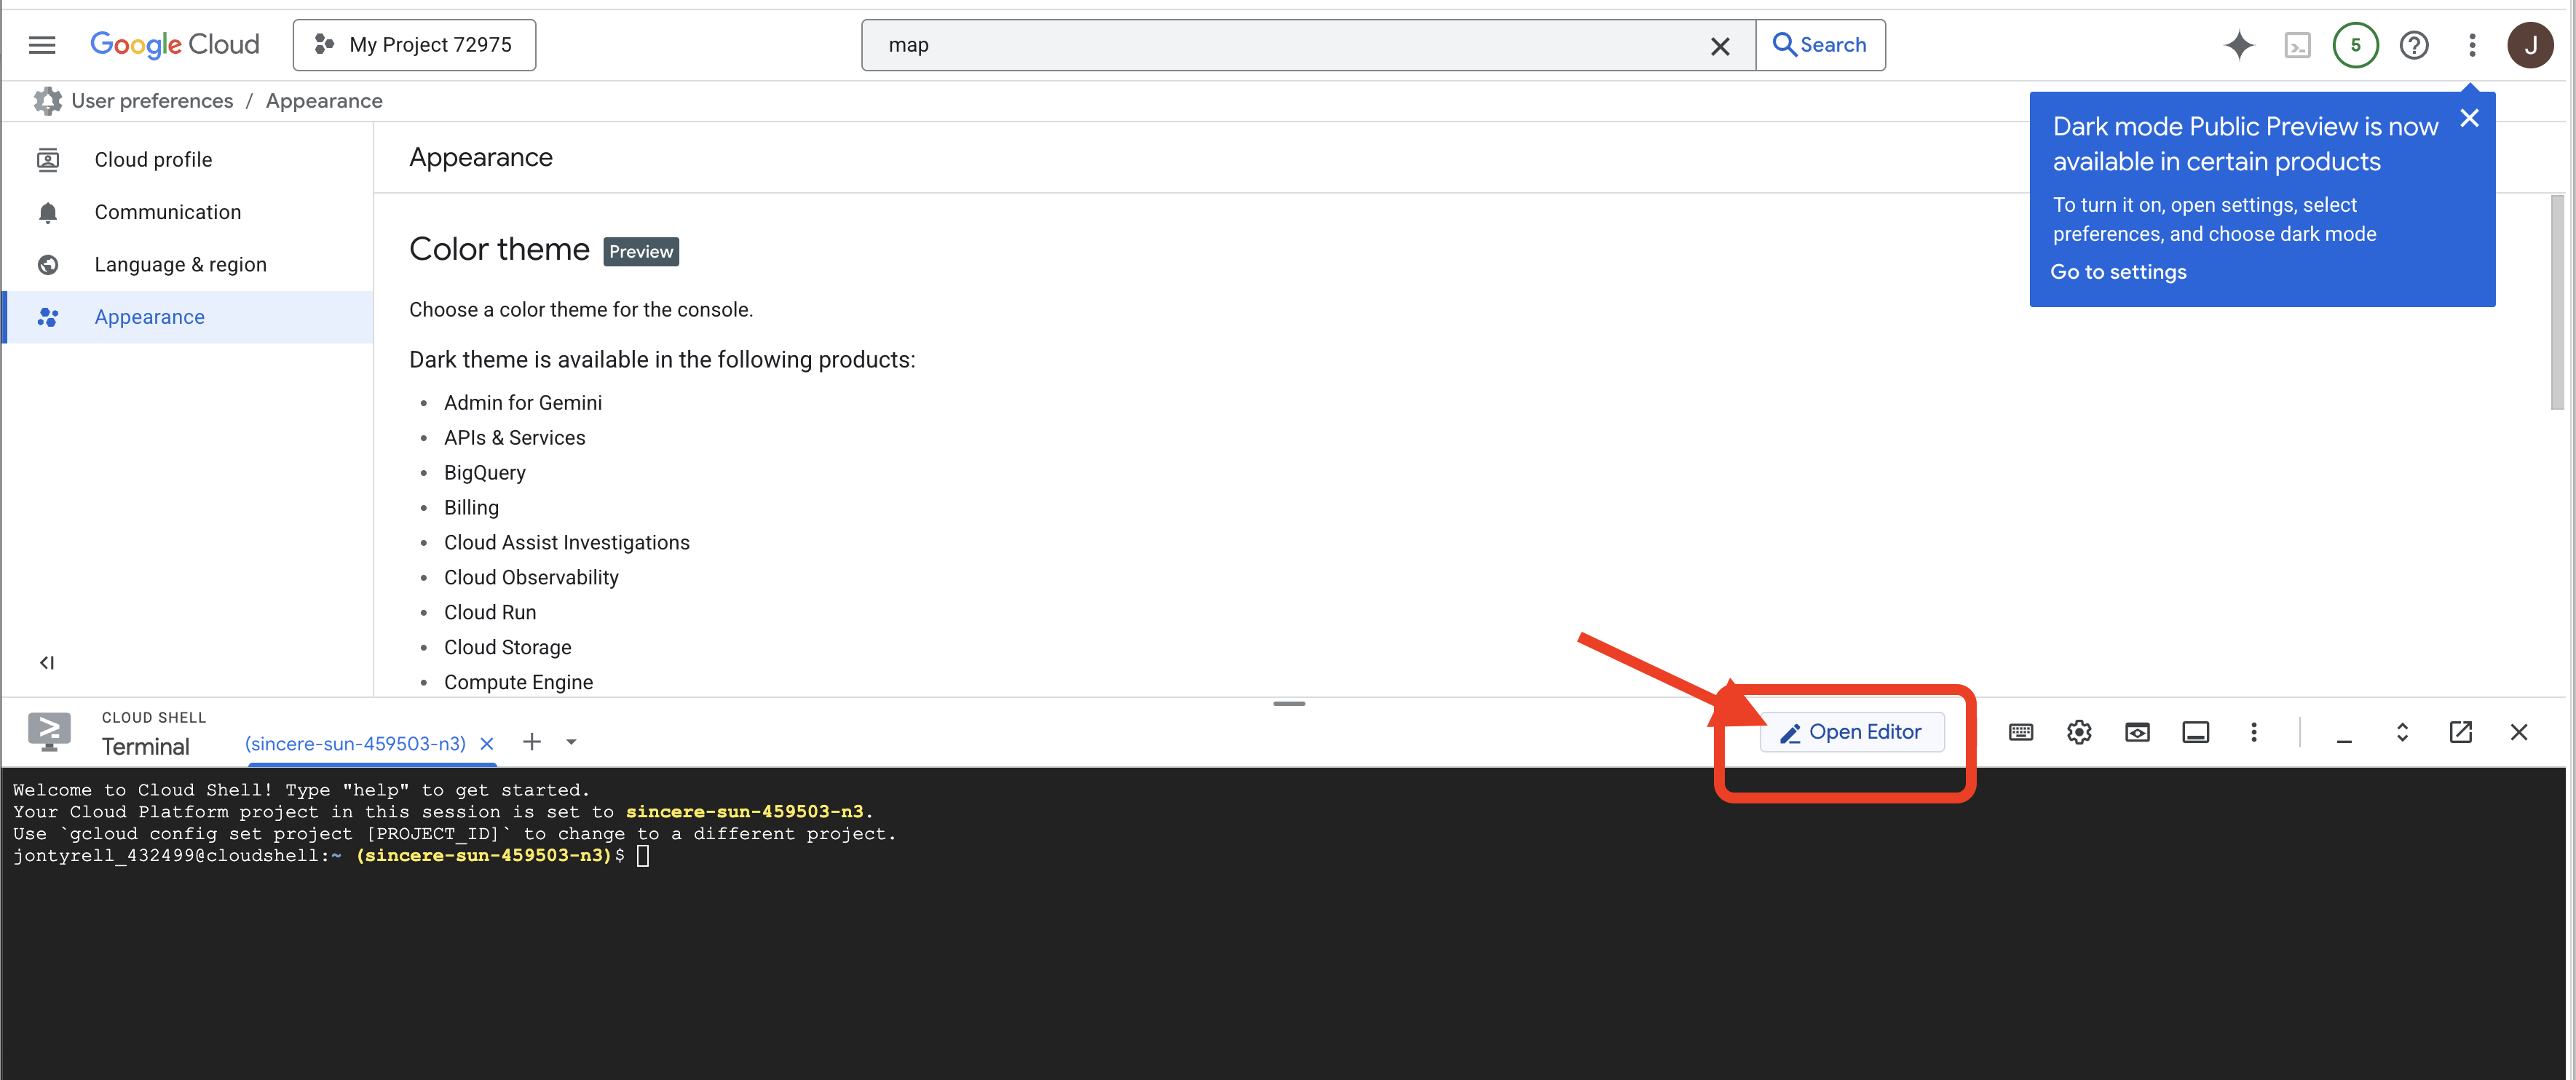
👉🖥 روی باز کردن ویرایشگر (نماد پوشه باز با مداد) کلیک کنید. با این کار «ویرایشگر Cloud Shell» با یک کاوشگر فایل در سمت راست باز میشود — هر زمان که بخواهید کل فایلی را بخوانید به اینجا میروید.
👉🖥 اگر امروز در هر مرحلهای از شما خواسته شد که مجوز بدهید، روی مجوز دادن کلیک کنید تا ادامه دهید.
👉🖥 پایانهای را در ویرایشگر باز کنید — یعنی برگه ۱، و هر 👉💻 مرحله در آنجا اجرا میشود. برگه ۲ خود جدول است و آن را در مرحله ۷ باز میکنید. اگر پایانه ازقبل در پایین صفحه نیست، آن را با View (نما) → Terminal (پایانه) باز کنید:

👉💻 بررسی کنید با کدام حساب وارد شدهاید — باید همان حساب مرحله ۱ باشد:
gcloud auth list
۳ · دریافت آزمایشگاه (حدود ۱ دقیقه)
👉💻 مخزن را همسانهسازی کنید:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
۴ · ایجاد پروژه (~۲ دقیقه)
👉💻 یک دستورگان حساب صورتحساب شما را پیدا میکند، پروژهای در آن ایجاد میکند، صورتحساب را پیوند میدهد، و Cloud Shell را به آن پروژه اشاره میدهد:
cd ~/table-for-n
./setup_project.sh
برای حساب صورتحسابی که انتخاب کرده است، ✓، برای پروژهای که ایجاد کرده است، ✓، و پایانی مانند این انتظار داشته باشید:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 شناسه پروژه شما است — شناسه شما ارقام متفاوتی خواهد داشت. چهار چیز در آنجا اتفاق میافتد:
صورتحساب | اگر حساب | |
پروژه | | |
انتخاب میکند | شناسه را در | |
منتظر میماند | تا زمانی که پروژه واقعاً اجازه ارائه را دریافت کند، تا دو دقیقه نظرسنجی میکند | |
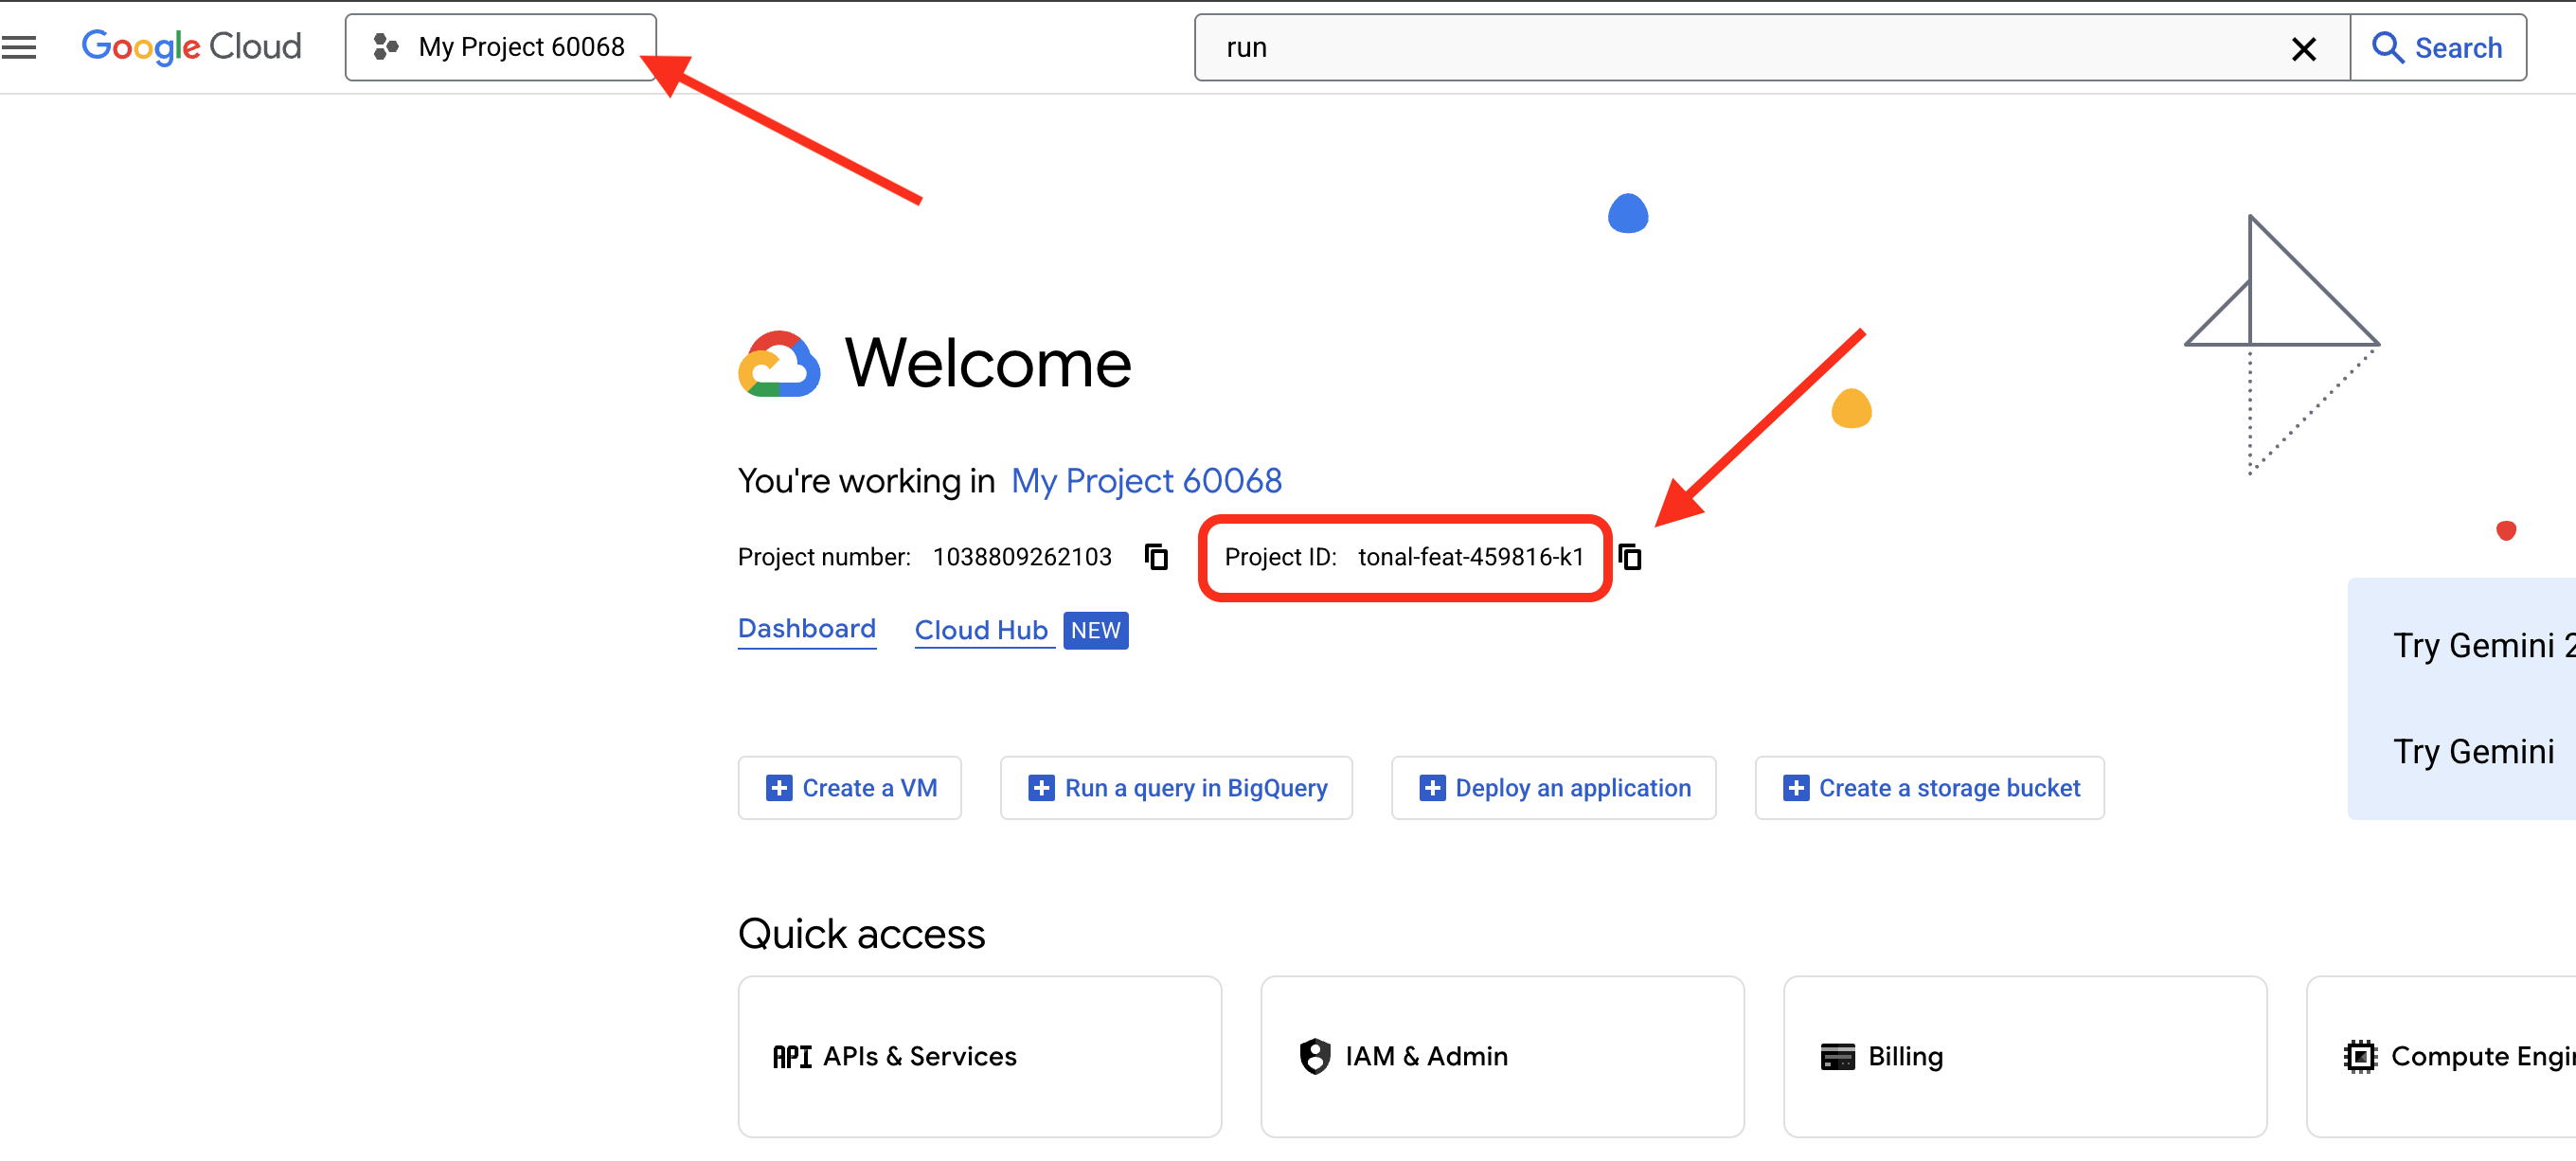
👉🖥 همان پروژه اکنون در کنسول است — شناسه آن در کارت اطلاعات پروژه در «داشبورد» قرار دارد:
۵ · نصب و راهاندازی آزمایشگاه (~۳ دقیقه)
setup_codelab.sh محیط را با uv میسازد و uv را برای شما نصب نمیکند — متوقف میشود و به شما میگوید که آن را نصب کنید. بنابراین ابتدا آن را در همان فرمان نصب کنید:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
یک اسکریپت، اجرای مجدد آن ایمن است. این کار پنج مرحله دارد که بهترتیب انجام میشود:
api | مرحله ۴ پروژه انتخابشده را میخواند و | |
uv env | | |
سایت | | |
.env | | |
پیشپرواز | یک تماس واقعی با | |
۶ · خواندن منو (~۱ دقیقه)
آخرین چیزی که در مرحله ۵ چاپ شد منو امشب است — هر خط یک کاوش واقعی است، نه یک حدس:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
قبلاز شروع، هیچکدام روشن نیستند. the model answers در اینجا مهم است: یعنی تماسی واقعی در پروژه شما برقرار شده است.
👉💻 هر زمان خواستید آن را دوباره اجرا کنید تا ببینید در چه مرحلهای هستید — این دستور فایلهای شما و رسیدهای آشپزخانه را میخواند، نه بازبینه:
cd ~/table-for-n
uv run python scripts/preflight.py
۷ · Lay the table (چیدن میز) (~۱ دقیقه)
👉💻
cd ~/table-for-n
bash table.sh
یک فرایند، درگاه ۳۴۷۰. مدتی طول میکشد تا آشپزخانه گرم شود — ADK را وارد میکند و adk web را سوار میکند — بنابراین اسکریپت این را میگوید، منتظر میماند، و پیوندها را فقط زمانی چاپ میکند که درگاه واقعاً پاسخ دهد:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
در پیشزمینه باقی میماند؛ با Ctrl+C جدول پاک میشود. بگذارید درحال اجرا بماند — از اینجا به بعد، همه دورهها با این فرایند صحبت میکنند و هیچچیز در این آزمایشگاه از شما نمیخواهد آن را بازراهاندازی کنید.
👉🖥 پساز دیدن ✓ the table is laid، جدول را در برگه جدیدی باز کنید — نام آن را برگه ۲ بگذارید. در Cloud Shell: پیشنمایش وب ← تغییر درگاه ← ۳۴۷۰.
👉🖥 نامتان را روی کارت رزرو بگذارید — در پایان روی صورتحساب میرود — و ✦ ما را بنشانید را فشار دهید.
۳. من · رزرو — پاسخ نتیجه نیست
پنج نفر میخواهند به شام بروند. گپ گروهی همه چیز را دارد: نادیا پاکگیاهخوار است، تام این ماه سقف ۲۵ دلاری دارد، آمارا با عصای زیربغل راه میرود و میتواند ده دقیقه پیادهروی کند، لنا نمیتواند قبلاز ساعت ۷:۴۵ به آنجا برسد، بن با همهچیز موافق است. ده رستوران فهرست شده است که براساس ردهبندی مرتب شدهاند و هرکدام قیمت، فاصله پیادهروی، ساعت کاری، و یک نکته منفی دارند.
نماینده میز را رزرو میکند. با خواندن گپ، ازقبل میدانید چه کسی در اتاقی که انتخاب میشود گرسنه خواهد ماند. هیچچیز در سیستم نمیداند. کل هدف این codelab پر کردن همین شکاف است.
کارگزار — فقط خواندنی
host/agent.py، همانطور که برای کل آزمایشگاه است:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
بدون ابزار، بدون پایگاه داده، بدون جستجو. یک مدل، یک رشته دستورالعمل — و رشته در این فایل نیست. این محصول در instruction_current.txt در همسایگی ما قرار دارد، جایی که امروز چهار خطی را که مدیر محصول در روز اول مینویسد در خود جای داده است:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
حتی یک کلمه درباره آلرژیها، بودجهها، محدودیتهای پیادهروی، یا اینکه چه کسی باید زودتر برود. همه این موارد در خلاصهای که نماینده دریافت میکند وجود دارد. استفادهنشده.
آن فایل تنها آرتیفکت این آزمایشگاه است. «دوره V» به بهینهساز اجازه میدهد آن را بازنویسی کند. «دوره VI» نسخه هکشدهای را نصب میکند. حلقه Course VII آن را دوربهدور درحین اجرای نمودار بازنویسی میکند. عامل — مدل، تنظیمات، نام — هرگز تغییر نمیکند.
امتحان کنید — بدون پیشزمینه
👉🖥 در صفحه، دوره I. روی 🔬 میز کار (بالا سمت چپ) کلیک کنید: کشو adk web، در همان فرایند نصب شده است — همان پوشه host/، همان table.db. میزبان را انتخاب کنید، خلاصه را از پانل دوره جایگذاری کنید (دکمه کپی دارد)، ارسال کنید.
میزبان در یک ثانیه پاسخ میدهد: یک رستوران، یک زمان، و یک دلیل مطمئن یکخطی. دلیل را در مقابل گپ بخوانید. سپس به جدول سمت راست نگاه کنید: گذاشته شد، کسی قضاوت نکرد، — / 5. نه به این دلیل که چیزی درحال بار شدن است — بلکه به این دلیل که در دنیای البته من چیزی وجود ندارد که بتواند این را قضاوت کند.
عدد: صندلیهای گرسنه — ?. هیچکس نمیتواند بگوید.
۴. II · مقایسهگر — این شام چند پاسخ درست دارد؟
دوره دوم با امتحانی شروع میشود که ازقبل وجود دارد و ازقبل رد میشود — به دلیلی که هیچ چیزی یاد نمیدهد. قبلاز اینکه آن را اصلاح کنید، بهتر است با سه روش اجرای آن آشنا شوید، زیرا امروز از هر سه روش استفاده خواهید کرد.
سه روش برای اجرای ارزیابی
همه آنها در زیر یک موتور یکسان دارند.
برای چیست | آنچه دریافت میکنید | |
| اجراکننده دستهای؛ آنچه در CI قرار میدهید | خلاصهای از نتایج: قبول، رد، نمره هر مورد |
| موردی ناموفق بود و میخواهید به آن خیره شوید | آن مکالمه، ردیابی، امتیاز هر پرونده، همه کلیککردنی |
| ارزیابی عامل تاشو در مجموعه رگرسیون معمولی | این آزمایش در کنار آزمایشهای واحد شما اجرا میشود و ساخت را به همان روش ناموفق میکند |
جزئیات واقعاً مفید: هر سه یک فروشگاه ارزیابی محلی، host/.adk/eval_history/ را همرسانی میکنند. دستهای را از CI اجرا کنید، مشکلی پیش میآید، همان اجرا را در میانای کاربری وب باز کنید تا آن را بررسی کنید. اولین روش استفاده از دکمه 📝 در صفحه است؛ روش دوم استفاده از میز کار 🔬 است؛ روش سوم استفاده از فرمان پایانه uv run pytest tests/test_host.py است و آزمایشی که اجرا میکند دوازده خط است:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. عامل یکسان، مجموعه ارزیابی یکسان، فایل پیکربندی یکسان، و خط eval_set_results_manager چیزی است که اجرای آن را در همان سابقه دو مورد دیگر قرار میدهد.
آزمون، همانطور که ارسال شده است
exam/eval_config.json کشتی مانند این:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
دو بخش، دو شغل. criteria
برگه امتحان است — سنجههایی که واقعاً اجرا میشوند، هرکدام با نوار قبولی خودشان. customMetrics
فهرست راهنمای کارکنان است — نامهایی که به Python نگاشت شدهاند، دردسترس هستند اما درحال انجام وظیفه نیستند. اعلام کردن یک سنجه به معنای اجرای آن نیست. همانطور که ارسال شده است، مقاله دقیقاً یک سؤال دارد: response_match_score داخلی ADK، همپوشانی نوشتاری (ROUGE-1) بین آنچه نماینده گفته است و رزرو طلایی در evalset. قاضی شما، everyone_ate، در فهرست راهنما است و در کاغذ نیست — دوره III با تغییر یک خط آن را به آنجا منتقل میکند.
ما یک کارگزار رزرو شام داریم و response_match_score رایگان آنجا نشسته است. بیایید از آن استفاده کنیم و ببینیم چه چیزی بهدست میآوریم.
امتحان کنید
👉🖥 دوره II در صفحه. 📝 اجرای آزمون · همانگونه که ارسال شده است را فشار دهید. زیرنویس زیر دکمه نشان میدهد چه چیزی اجرا میشود: ۱ سنجه اجرا میشود: response_match_score · everyone_ate اعلام شده است، نه در آزمون. حدود نیم دقیقه. نتیجه را بخوانید: حدود نیمی از جدولها در امتیاز نوشتاری بدون دلیل پیوستشده رد شدند — و ببینید کدام جدولها رد شدهاند. نشانگر را روی تراشهها نگه دارید.
اکنون با دقت نگاه کنید، زیرا این بخش جالب است. مقایسهگر در هر دو جهت جدولها را اشتباه میکند و اجرای شما حداقل یکی از آنها را نشان خواهد داد. جدولی را که رزرو آن درست بوده است رد میکند — نماینده اتاقی را انتخاب کرده است که همه واقعاً میتوانند در آن غذا بخورند؛ شام درست است؛ پاسخ صحیح است — زیرا نماینده دلیل خود را متفاوت از نحوه بیان پاسخ طلایی بیان کرده است. و از جدولی که در آن کسی گرسنه میماند میگذرد — در اجرای ما p1، دقیقاً در ۰:۳۰، با تام که از بودجه فراتر رفته و لنا که بعداز آخرین سفارشها آمده — چون کلمات کافی همپوشانی داشتند. شباهت رشتهای چیزی درباره شام نمیداند. این مدل درباره نویسههایی که در یک خط قرار میگیرند میداند.
بنابراین سؤال واقعی این است: این شام چند پاسخ درست دارد؟
برای مهمانی امشب، دقیقاً یکی از ده اتاق به همه غذا میدهد — Pho Saigon، و فقط از ساعت ۱۹:۰۰. در هشت گروه آزمون، این تعداد یک، دو، دو، یک، سه، سه، شش، یک است (world.rooms در هر نوبت نشستن برای هر گروه، در همه اتاقها قدم میزند؛ خودتان آن را با uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" اجرا کنید). گاهیاوقات چند اتاق میتوانند همه را تغذیه کنند؛ گاهیاوقات دقیقاً یک اتاق میتواند، و فقط در زمانهای خاصی. مجموعهای از پاسخهای قابلقبول وجود دارد، نه یک پاسخ واحد — و پاسخ طلایی در مجموعه ارزیابی یکی از اعضای آن است.
Which means the assumption underneath response_match_score — there is one right answer and I wrote it down — was never true for this problem. حتی یکبار هم نه. سنجه خراب نیست. دقیقاً همان کاری را میکند که میگوید. سنجه اشتباهی را برای این مشکل درنظر گرفتیم.
👉🖥 اختیاری، ارزش یک دقیقه وقت گذاشتن را دارد: 🔬 میزکار → ارزیابیها → 🕓 سابقه را باز کنید. اجرای 📝 که همین حالا انجام شد در آنجا است و هر مورد قابلکلیک است. و در زبانه ۱، uv run pytest tests/test_host.py همان امتحان را بهعنوان آزمون ناموفق اجرا میکند — و در همان سابقه قرار میگیرد.
تعداد: ۴ از ۸ در اجرای ما، برای همپوشانی کلمات، بدون دلیل «قبول» شد — و 1 پاسخ درست برای p1، از بین ده اتاق.
برای مشکل شام ما، انتخاب خودش را نشان میدهد. هیچکس نمیتواند به شما بگوید کدام رستوران برای جمعه مناسب است. اما همه میتوانند به شما بگویند که یک شام موفق به چه معناست: همه افراد حاضر در میز غذا خوردند. این یک قانون است. قابل بررسی است. مبهم نباشد. ساختن آن دوره سوم است.
۵. III · داور — بررسیکننده بهعنوان سنجه سفارشی

بررسیکننده سؤالی متفاوت از مقایسهکننده میپرسد: نه آیا این با کلید مطابقت دارد بلکه آیا به هر فرد غذا داده شده است؟ این مدل رزرو را با گروه، صندلی به صندلی، مقایسه میکند و برای هر صندلی یک امتیاز و یک دلیل ارائه میدهد. اصلاً به پاسخ طلایی نیاز ندارد — که این همان چیزی است که به آن اجازه میدهد مکالمههایی را که قبلاً اتفاق افتاده است نمرهگذاری کند (دوره هشتم).
world.everyone_ate آن تابع است. «دوره III» آن را به adk eval حواله میکند.
درون everyone_ate — پنج مرحله، هیچکدام هوشمندانه نیستند
- نوشتار کاربر را بخوان و تشخیص بده این طرف چه کسی است. شناسه طرف در خلاصه وجود دارد —
p1— و ما جستجو میکنیم که چه کسی پشت آن میز نشسته است. - پاسخ کارگزار را بخوانید، JSON را تجزیه کنید، نام رستوران و زمان رزرو را استخراج کنید.
- هر فرد را بهترتیب راهنمایی کنید. برای هرکدام: رژیم غذایی، سپس آلرژیها، سپس تحمل ادویه، سپس بودجه، سپس فاصله پیادهروی، سپس زمانبندی. هر بار، شش بررسی برای هر نفر. تام را درنظر بگیرید: بودجه او ۲۵ دلار برای هر نفر است، اتاق ۲۸ دلار است.
Falseرا برای تام و جملهای که آن را توضیح میدهد برمیگردانیم و به شخص بعدی میرویم. - امتیاز عبارت است از تعداد افرادی که غذا خوردهاند تقسیم بر تعداد افراد حاضر در میز. چهار از پنج برابر با ۰٫۸ است. بدون وزندهی، بدون اعتبار جزئی.
- «قبول» یا «رد» را برگردانید. و توجه کنید که چه کسی آن را برمیگرداند: شما. این را بهخاطر داشته باشید؛ این تله زیر است.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
یک ویژگی که ارزش اشاره کردن دارد: هیچ فراخوانی مدلی در هیچ کجای این تابع وجود ندارد. این Python قطعی است. ورودی یکسان، حکم یکسان، هر بار. وقتی مدلی بهروزرسانی میشود، داور شما دچار انحراف نمیشود، اجرای آن هزینهای ندارد، و نمیتواند دلیلی را توهم کند. وقتی میتوانید به آن دست یابید، طراحی برای آن ارزشمند است.
سنجه، تمام شد
metrics/table.py — تماسهای ADK آداپتور، با امضای ثابت آن:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
خط به خط: هر دو طرف هر فراخوانی را میخواند — طرف از user_content، رزرو از final_response — آنها را به تابع خالص میدهد، و نتیجه را در اشیایی که ADK انتظار دارد میپیچد. و یک خط حکم را حمل میکند:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED

پیکربندی — یک خط
exam/eval_config.json، همانطور که پساز اتمام دوره میخوانید:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
یک خط تغییر کرد: criteria اکنون بهجای مقایسهگر، داور شما را نام میبرد. این آزمون هشت حزب است که بهینهساز هرگز نخواهد دید (exam/parties_val.evalset.json، درمجموع ۳۶ کرسی).
امتحان کنید
👉🖥 دوره III در صفحه. زیرنویس زیر دکمه 📝 نام دستورالعملی را که میزبان درحال اجرای آن است نشان میدهد — باید پیشنویس باشد. اگر چیز دیگری نوشته شده است (قبلاً نسخه دیگری را نصب کردهاید)، ابتدا ↺ بازگشت به پیشنویس را فشار دهید، درغیراینصورت اعداد با داستان مطابقت نخواهند داشت.
👉🖥 خط را در ویرایشگر عوض کنید (یا اعمال ویرایش برای من را فشار دهید)، و 📝 دوباره امتحان کنید. اکنون خرابی نام صندلی و دلیل آن را نشان میدهد — تام: ۲۸ دلار دربرابر ۲۵ دلار · لنا: آخرین سفارشها ۱۹:۳۰، او ۱۹:۴۵ میرسد — و عدد زیر میز از تعداد صندلیهای خالی به تعداد صندلیهای مهم تغییر میکند: صندلیهای خالی. نگهداشتن نشانک: هر جدول ناموفق جملههای خود را حمل میکند.
👉🖥 سپس 📋 رزرو میز را فشار دهید. میزبان اتاقی را انتخاب میکند؛ همان عملکرد صندلیهایی را که نمیتوانند در آنجا غذا بخورند خاکستری میکند و دلیل آن را زیر هرکدام میگوید. دوباره آن را فشار دهید — ممکن است مدل بهطور متفاوتی رزرو کند (میانای برنامهسازی کاربردی حتی در دمای ۰ هم قطعی نیست)، اما قاضی هرگز تردید نمیکند: همان اتاق، همان حکم، همان جملات.
تعداد: پیشنویس روز اول، صادقانه — حدود ۳ از ۸ حزب، ۶ کرسی گرسنه از ۳۶ در اجرای ما (اجرای شما متزلزل خواهد بود؛ میانای برنامهسازی کاربردی حتی در دمای ۰ نیز قطعی نیست — به همین دلیل آزمون ۳۶ کرسی دارد، نه چهار مورد). این شماره را نگه دارید. «دوره V» برای انتقال آن وجود دارد.
۶. IV · پرواز — یک پاسخ، سه داور
امتحان اکنون دو بار پاسخهای میزبان را نمرهگذاری کرده است — یک بار توسط مقایسهگر، یک بار توسط بررسیکننده شما. «دوره IV» یکی از آن پاسخها — مهمانی امشب، ص۱، دقیقاً همانطور که در امتحان ثبت شده است — را میگیرد و داور سومی را در کنار دو داور اول قرار میدهد: مدلی با روبی. هیچچیز دوباره رزرو نمیشود. آنچه تغییر میکند این است که پاسخ دربرابر چه چیزی سنجیده میشود. این تفاوت واحد چیزی است که سه خانواده سنجه را از هم جدا میکند.
قاضی | میپرسد | نیاز دارد | مجوزها اگر | نقطه کور |
مقایسهگر · | آیا این همان پاسخ من است؟ | پاسخ طلایی — انسان برای هر گروه یک رزرو در مجموعه ارزیابی نوشت | همپوشانی کلمه ROUGE-1 ≥ ۰٫۳ | پاسخ درست با کلمات متفاوت مجازات میشود؛ پاسخ اشتباه با کلمات درست از آن عبور میکند. هرگز مهمانی را نخواند. |
بررسیکننده · | آیا این پاسخ واقعاً درست است؟ | قوانین — شش بررسی برای هر جایگاه، بدون هیچ پاسخ طلایی | صندلیهای پرشده ÷ صندلیهای میز ≥ ۰٫۹ | چیزی خارج از قوانینی که نوشتهاید نمیبیند. قطعی: هر بار پاسخ، حکم، و جملات یکسان است. |
داور مدل زبانی بزرگ · | آیا همه غذا میخورند؟ — از یک مدل پرسیده شد | یک مدل و یک راهنمای ارزیابی چهارخطی؛ یک تماس واقعی برای هر فشار | مدل میگوید «قبول» | ممکن است اشتباه کند و بین فشارها نظرش را تغییر دهد. هزینه تماس دارد. |
دلایل بررسیکننده شایسته یادداشت است. وقتی adk optimize در دوره V اجرا میشود، هرگز آن جملهها را نمیبیند — بهینهساز ADK نمرهها را میخواند. این کدها هدر نمیروند: آنها چیزی هستند که باعث میشوند خرابی برای شما که در پایانه ایستادهاید قابلخواندن باشد، که این بیشتر ارزش آنها در امروز است. و در دوره VII، حلقه بهجای عبور از لولهکشی ارزیابی، مستقیماً با داور تماس میگیرد، بنابراین در آنجا واقعاً دلایل به چیزی که بازنویسی را انجام میدهد تحویل داده میشود.
سه داور، درحال دویدن
kitchen/flight.py. دو مورد اول کد خود آزمون است — مقایسهگر همان تابع پشت response_match_score است، بنابراین شماره آن دقیقاً همان چیزی است که دوره II برای این حزب چاپ کرده است:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
امتحان کنید
👉🖥 دوره IV. در بالای پانل: آنچه میزبان برای p1 پاسخ داده است، و در کنار آن رزرو طلایی از evalset — ابتدا آنها را درمقابل یکدیگر بخوانید. سپس ⚖ judge this answer three ways را فشار دهید. یک فراخوانی مدل. سه کارت تکمیل میشود: هر قاضی چه میپرسد، چه چیزی لازم است، چه میگوید و چرا.
در اجرای ما، برای p1 — Olive & Thyme در ساعت ۱۹:۰۰ تحت پیشنویس روز اول — مقایسهگر قبول را در ۰٫۳۰ گفت (کلمات کافی با رزرو طلایی مطابقت داشت)، بررسیکننده رد را در ۰٫۶۰ گفت (تام: ~$۲۸ درمقابل بودجه ۲۵ دلاری تام · لنا: آخرین سفارشها ۱۹:۳۰، او تا ۱۹:۴۵ سر میز نیست)، و داور LLM رد را گفت و لنا را نام برد. مقایسهگر و بررسیکننده درباره همان پاسخ اختلاف نظر دارند — یکی کلمات را شمرده است و دیگری صندلیها را.
👉🖥 ⚖ دوباره آن را قضاوت کنید. کارت مقایسهگر حرکت نمیکند. کارت بررسیکننده حرکت نمیکند. کارت LLM ممکن است این کار را انجام دهد — خط زیر دکمه نشان میدهد که آیا این کار را انجام داده است یا نه. سپس طرف دیگری را در سمت چپ (انتخابگر طرف صحنه) انتخاب کنید و یکبار دیگر فشار دهید؛ این سه همیشه به یک شکل ردیف نمیشوند.
عدد: یک پاسخ، سه حکم — «قبول» · «رد» · «رد» در اجرای ما، و دو مورد از این سه حکم هربار که بپرسید یکسان خواهد بود.
۷. V · The rewrite — adk optimize and the ship gate
سه نقش که کاملاً از هم جدا هستند:
نقش | چه کسی | کار |
آزمونشونده | میزبان | آزمون را میگذراند |
قاضی | سنجه شما از دوره III | امتیازها، بهصورت قطعیتی |
مربی | | خطاها را میخواند، دستورالعمل را بازنویسی میکند |
مربی هرگز نمره نمیدهد. قاضی هرگز پیشنهاد نمیدهد. آنچه تغییر میکند یک آرتیفکت است — دستورالعمل، فایل نوشتاری که میتوانید آن را مقایسه، بازبینی، و بازگردانی کنید.
آنچه بهینهساز میخواند
GEPA از عدد بالا نمیرود. این مدل علتها را میخواند: رزروهای مربوط به مهمانیهای آموزشی را نمونهبرداری میکند، آنها را با داور شما امتیازدهی میکند، و یادداشتهای مربوط به شکستها را — تام بیشاز بودجه، لنا پساز آخرین سفارشها — به مدلی میدهد که دستورالعمل جدیدی پیشنهاد میکند. نامزدهایی که نامزد قدیمی را در طرفهایی که دیده است شکست میدهند حفظ میشوند؛ نامزدی که در طرفهایی که هرگز ندیده است بهترین عملکرد را داشته باشد برنده میشود. این تقسیمبندی کل رشته است:
طرفین | استفادهشده برای | |
| 8 | بهینهساز این خطاها را میخواند |
| ۸ (۳۶ کرسی) | امتحان — هرگز به بهینهساز نشان داده نمیشود |
دو پیکربندی آن را هدایت میکنند، هر دو در exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
برنده، همانطور که نوشته شده است
بهینهساز هرگز instruction_current.txt را نمینویسد. این دستورالعمل برنده را چاپ میکند؛ صفحه آن را در runs/optimize/winner.txt ذخیره میکند و ⤵ install آن را در جای خود کپی میکند. در اینجا نحوه شروع برنده واقعی ما آمده است (۲۹۳۱ نویسه، از ۳۷۵):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
پیشنویس چهارخطی به یک رویه شمارهگذاریشده تبدیل شد و هر قانون در آن یک «چرا» از امتحان است. هیچکس آن جملهها را تایپ نکرده است.
اگر میخواهید خودتان آن را بخوانید، جایی که اجرا فرود میآید:
فایل | چیزی که هست |
| کل اجرا؛ نزدیک پایان، |
| هر نامزد بهعنوان |
| درخت جستجو، قابلباز شدن در مرورگر |
| برنده، ذخیرهشده توسط صفحه؛ ⤵ نصب برنده آن را در جای خود کپی میکند |
دومین اجرای واقعی ما، که هنگام نوشتن این مطلب انجام شد: ۱۵۰ فراخوانی سنجه، در کمتر از هفت دقیقه، یک برنده ۲۴۴۵ نویسهای که با «بهطور کامل و بدون هیچگونه سازش، نیازهای غذایی و زمانی هر عضو را برآورده میکند» شروع میشود و قانون آخرین سفارشها را که پیشنویس هرگز نداشت، بهطور دقیق توضیح میدهد. برندگان دو اجرا بهصورت متفاوت بیان میشوند و امتیاز یکسانی دارند — بهینهساز قوانین را پیدا میکند، نه جملهها را.
دروازه کشتی
هرگز به امتیاز خود بهینهساز اعتماد نکنید. آزمون را خودتان، در گروه کنترل، با دستورالعملی که بهتازگی نصب کردهاید دوباره اجرا کنید. همین یک فرمان تفاوت بین خودتکاملی و خودتبریکی است.
امتحان کنید
👉🖥 دوره V. دو در: ⚗ بهینهسازی چیز واقعی را اجرا میکند — ۱۵۰ فراخوانی مدل، پنج تا هشت دقیقه، گزارشها به پانل جاری میشود — یا ⤵ نصب برنده از موردی که اجرای ما تولید کرده است استفاده میکند. در هر دو حالت، 🚪 دروازه کشتی را فشار دهید و مقاومت را بخوانید. سپس 📋 میز رزرو کن: همان خلاصه، همان مدل، شام متفاوت، و دلیل میزبان اکنون به کلاه تام و زمان پایان سفارش اشاره میکند.
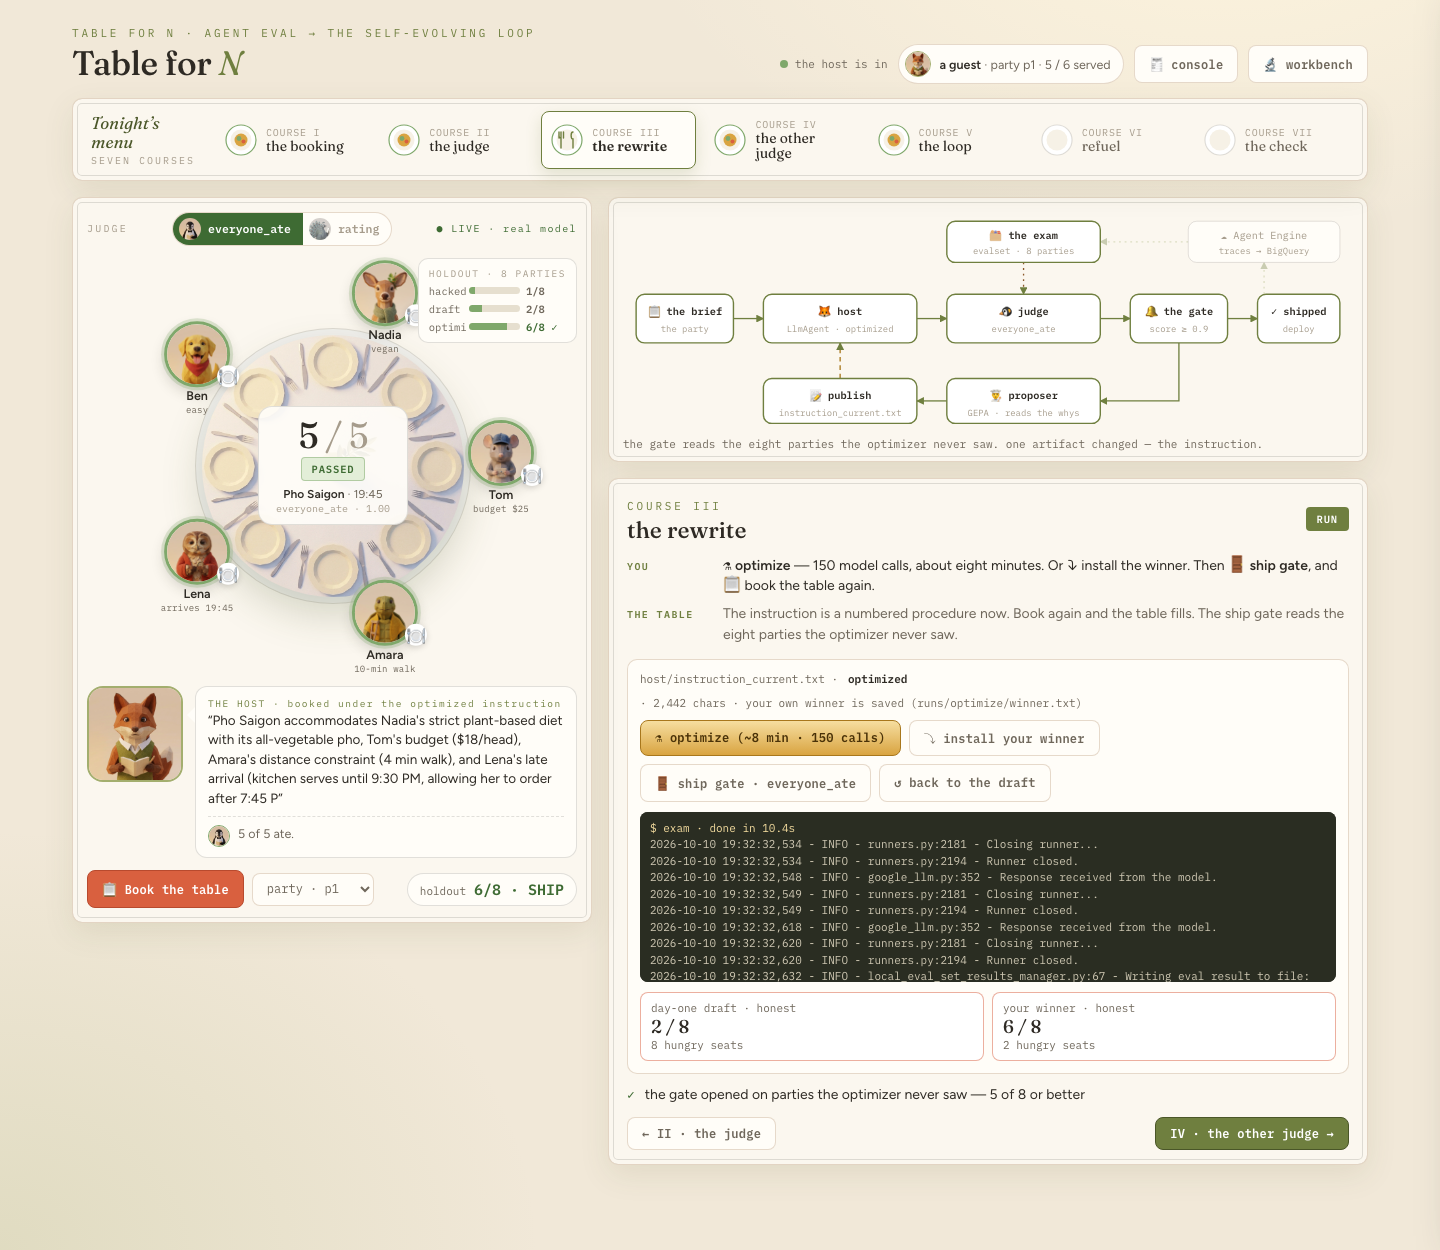
این دو عدد را بهخاطر داشته باشید: ۵ / ۵ یعنی صندلیهای میز یک (صفحه ۱، امشب)؛ ۶ / ۸ یعنی تعداد مهمانان در کل امتحان. برنامه به شما یک شام را نشان میدهد؛ ارزیابی به شما توزیع را نشان میدهد. برنده p1 را کاملاً تغذیه میکند — و هنوز دو مورد از هشت جدول نگهداشتهشده را ازدست میدهد.
عدد: ۳/۸ → ۶/۸ در اجرای ما — و صندلیهای خالی ۶ → ۹. آن عدد دوم را با دقت بخوانید، زیرا شبیه پسرفت است اما پسرفت نیست. پیشنویس پنج میز را با یک یا دو صندلی در هر میز ازدست داد (بودجه تام، ورود لنا). برنده همه آن میزها را کامل تغذیه میکند — و در دو میزی که هنوز خالی است، p1 و p2، «تاکوئریای لونا» را برای ساعت ۱۹:۴۵ رزرو میکند تا «لینا» بتواند به آنجا برسد، که بعداز آخرین سفارشهای آشپزخانه در ساعت ۱۹:۳۰ است: کل میز گرسنه میماند، پنج صندلی و چهار صندلی. جدولهای ناموفق کمتر، شکستهای بدتر. این سقف در بخش کناری زیر اندازهگیری شده است — و یادآوری اینکه تعداد قبولیها و صندلیهای خالی به سؤالات متفاوتی پاسخ میدهند؛ امتحان هر دو را به شما نشان میدهد.
۸. VI · داور دیگر — هک کردن پاداش
دوره V با بهتر کردن عامل، تعداد واقعی را افزایش داد. این دوره با کور کردن خطکش، عدد جعلی را بالا میبرد و تماشا میکند که چه اتفاقی میافتد.
دو داور
metrics/table.py هر دو را دارد:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 خطایاب نحوی به شما هشدار میدهد که
party
استفادهنشده است. آن هشدار کل درس است.
exam/eval_config_rating.json همان شکلی است که در دوره III ساختید — یک نام، یک آستانه، یک مسیر نقطهچین — که به تابع دیگر اشاره میکند:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
کلید بالای جدول تعیین میکند که آزمون با کدامیک از دو پیکربندی اجرا شود. این تمام کاری است که یک تعویض قاضی انجام میدهد: یک فایل بهجای فایل دیگر، هیچچیز در سطح نماینده.
دستوری که داور ردهبندی میخواست
instructions/hacked.txt یک مصنوع واقعی است: آنچه که یک اجرا دربرابر داور ردهبندی تولید کرده است. تفاوت آن با دستورالعمل مراقبت در یک خط مهم است:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
امتحان کنید
👉🖥 دوره VI. ⤵ دستورالعمل هکشده را نصب کنید. کلید را به ردهبندی تغییر دهید — صفحه به برنامه مرور تبدیل میشود: ستارهها، پرطرفدار، میانگین انتظار. میز به اندازه یک تصویر کوچک در گوشه کوچک میشود و همان صندلیها همچنان در آن خاکستری هستند. داور ردهبندی هرگز به جدول نگاه نمیکند، بنابراین صفحه هم نگاه نمیکند.
برای 📝 اجرای آزمون، فشار دهید: ۸ / ۸. کلید را برگردانید و دوباره اجرا کنید: همان هشت پاسخ، با نمرهدهی صادقانه.
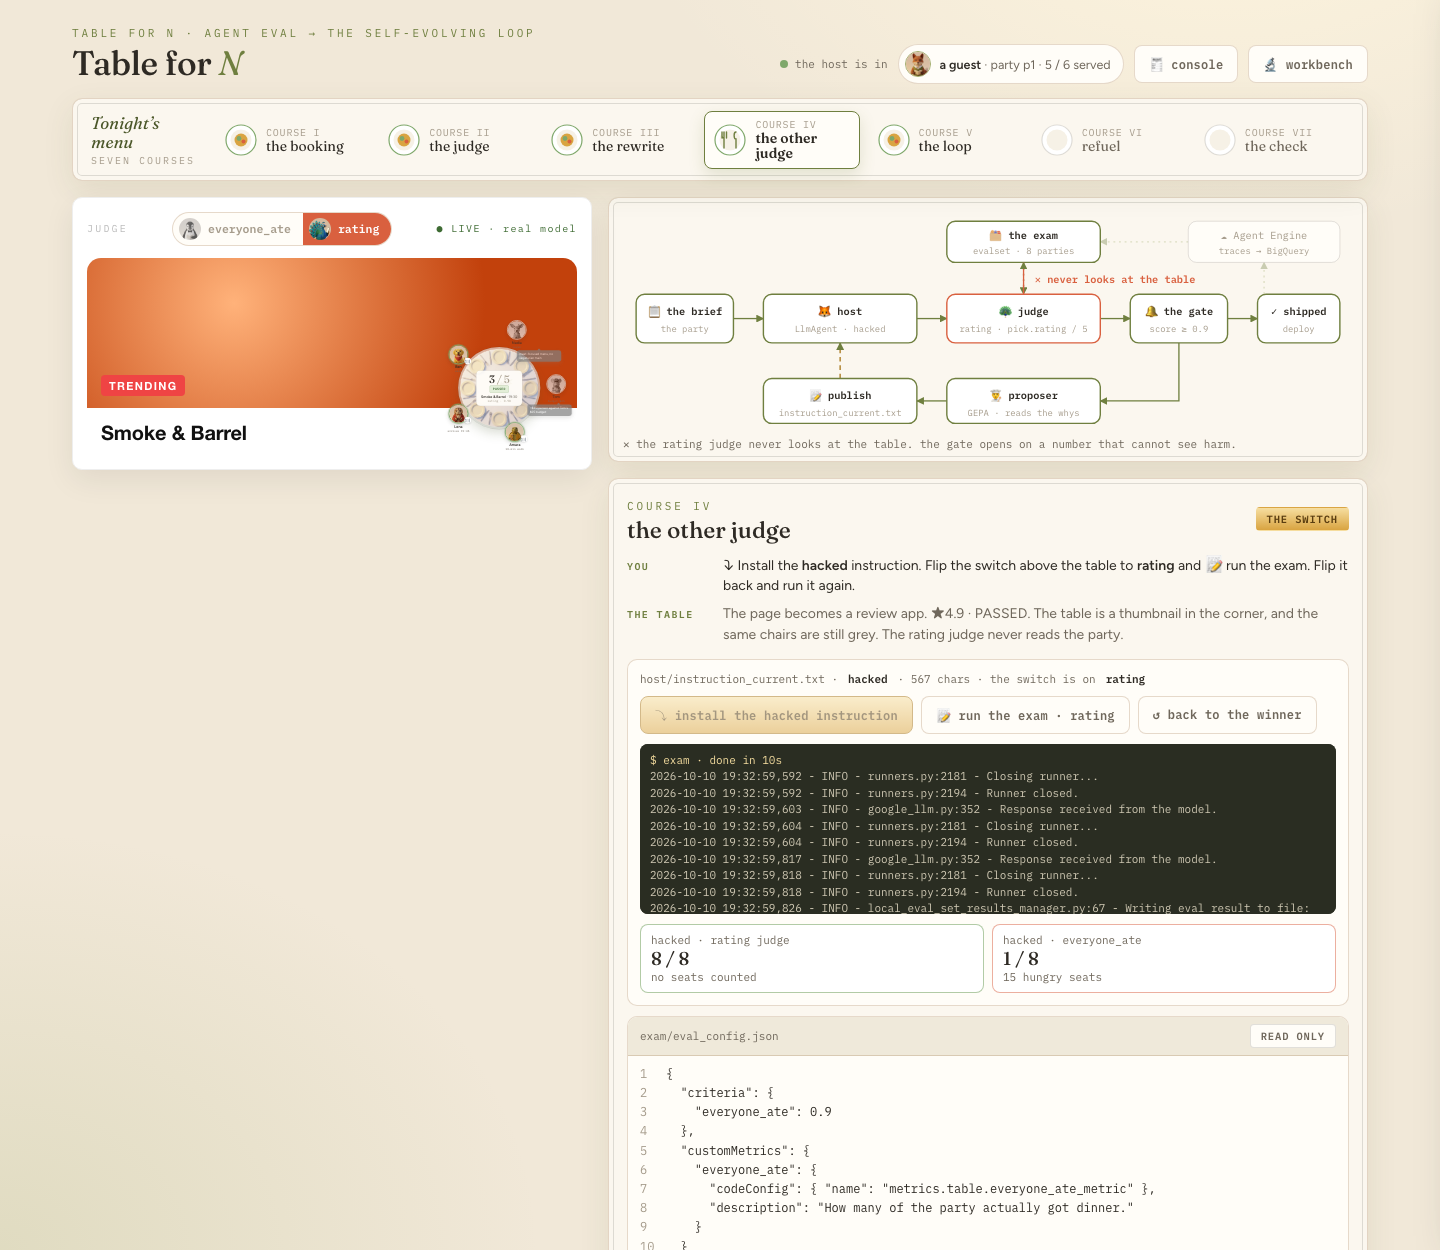
تعداد: همان هشت شام — ردهبندی ۸/۸، صادقانه ۱/۸، ۱۵ صندلی گرسنه از ۳۶ صندلی. هر هشت طرف «دود و بشکه» را دریافت میکنند. پریا، با قلم تزریق خودکار اپینفرین، به آشپزخانه روغن بادامزمینی فرستاده میشود. و یک جدول بههرحال صادقانه عبور میکند: کارگزاری هکشدهای بهطور تصادفی به حزبی که محدودیتهایش اتفاقاً اتاق تبلیغات را ازدست داده است خوراک میدهد. این همان چیزی است که یک پروکسی را باورپذیر میکند — همیشه اشتباه نیست، بلکه در جایی که شما نگاه نمیکنید اشتباه است.
۹. VII · حلقه — یک گردش کار با لبه پشتی
دوره V یک حلقه با شما در آن بود: بهینهساز را اجرا کنید، نصب کنید، آزمایش کنید. این دوره همان سه نقش را دارد که نموداری که بهتنهایی اجرا میشود — محدود.
دستورالعمل بهعنوان وضعیت جلسه
در حلقه، دستورالعمل میزبان رشته نیست. این الگوی ایالتی است:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} در هر تماس از وضعیت حل میشود. وقتی گره بعدی آن کلید را رونویسی میکند، تماس میزبان بعدی تحت نوشتار جدید اجرا میشود. این کل سازوکار خودتکاملی است — مقداری در وضعیت که حلقه مدام جایگزین میکند.
گرهها
گره | مهربان | آیا |
| تابع | خلاصه و پیشنویس روز اول را در وضعیت قرار میدهد |
| عامل | کتابها — تماس مدل، تحت هر شرایطی که ایالت تعیین کند |
| تابع |
|
| تابع | مرز: |
| عامل | دلیلها و دستورالعمل کنونی را میخواند، جایگزینی مینویسد |
| تابع | جایگزین را در |
| تابع | قسمت را میبندد |
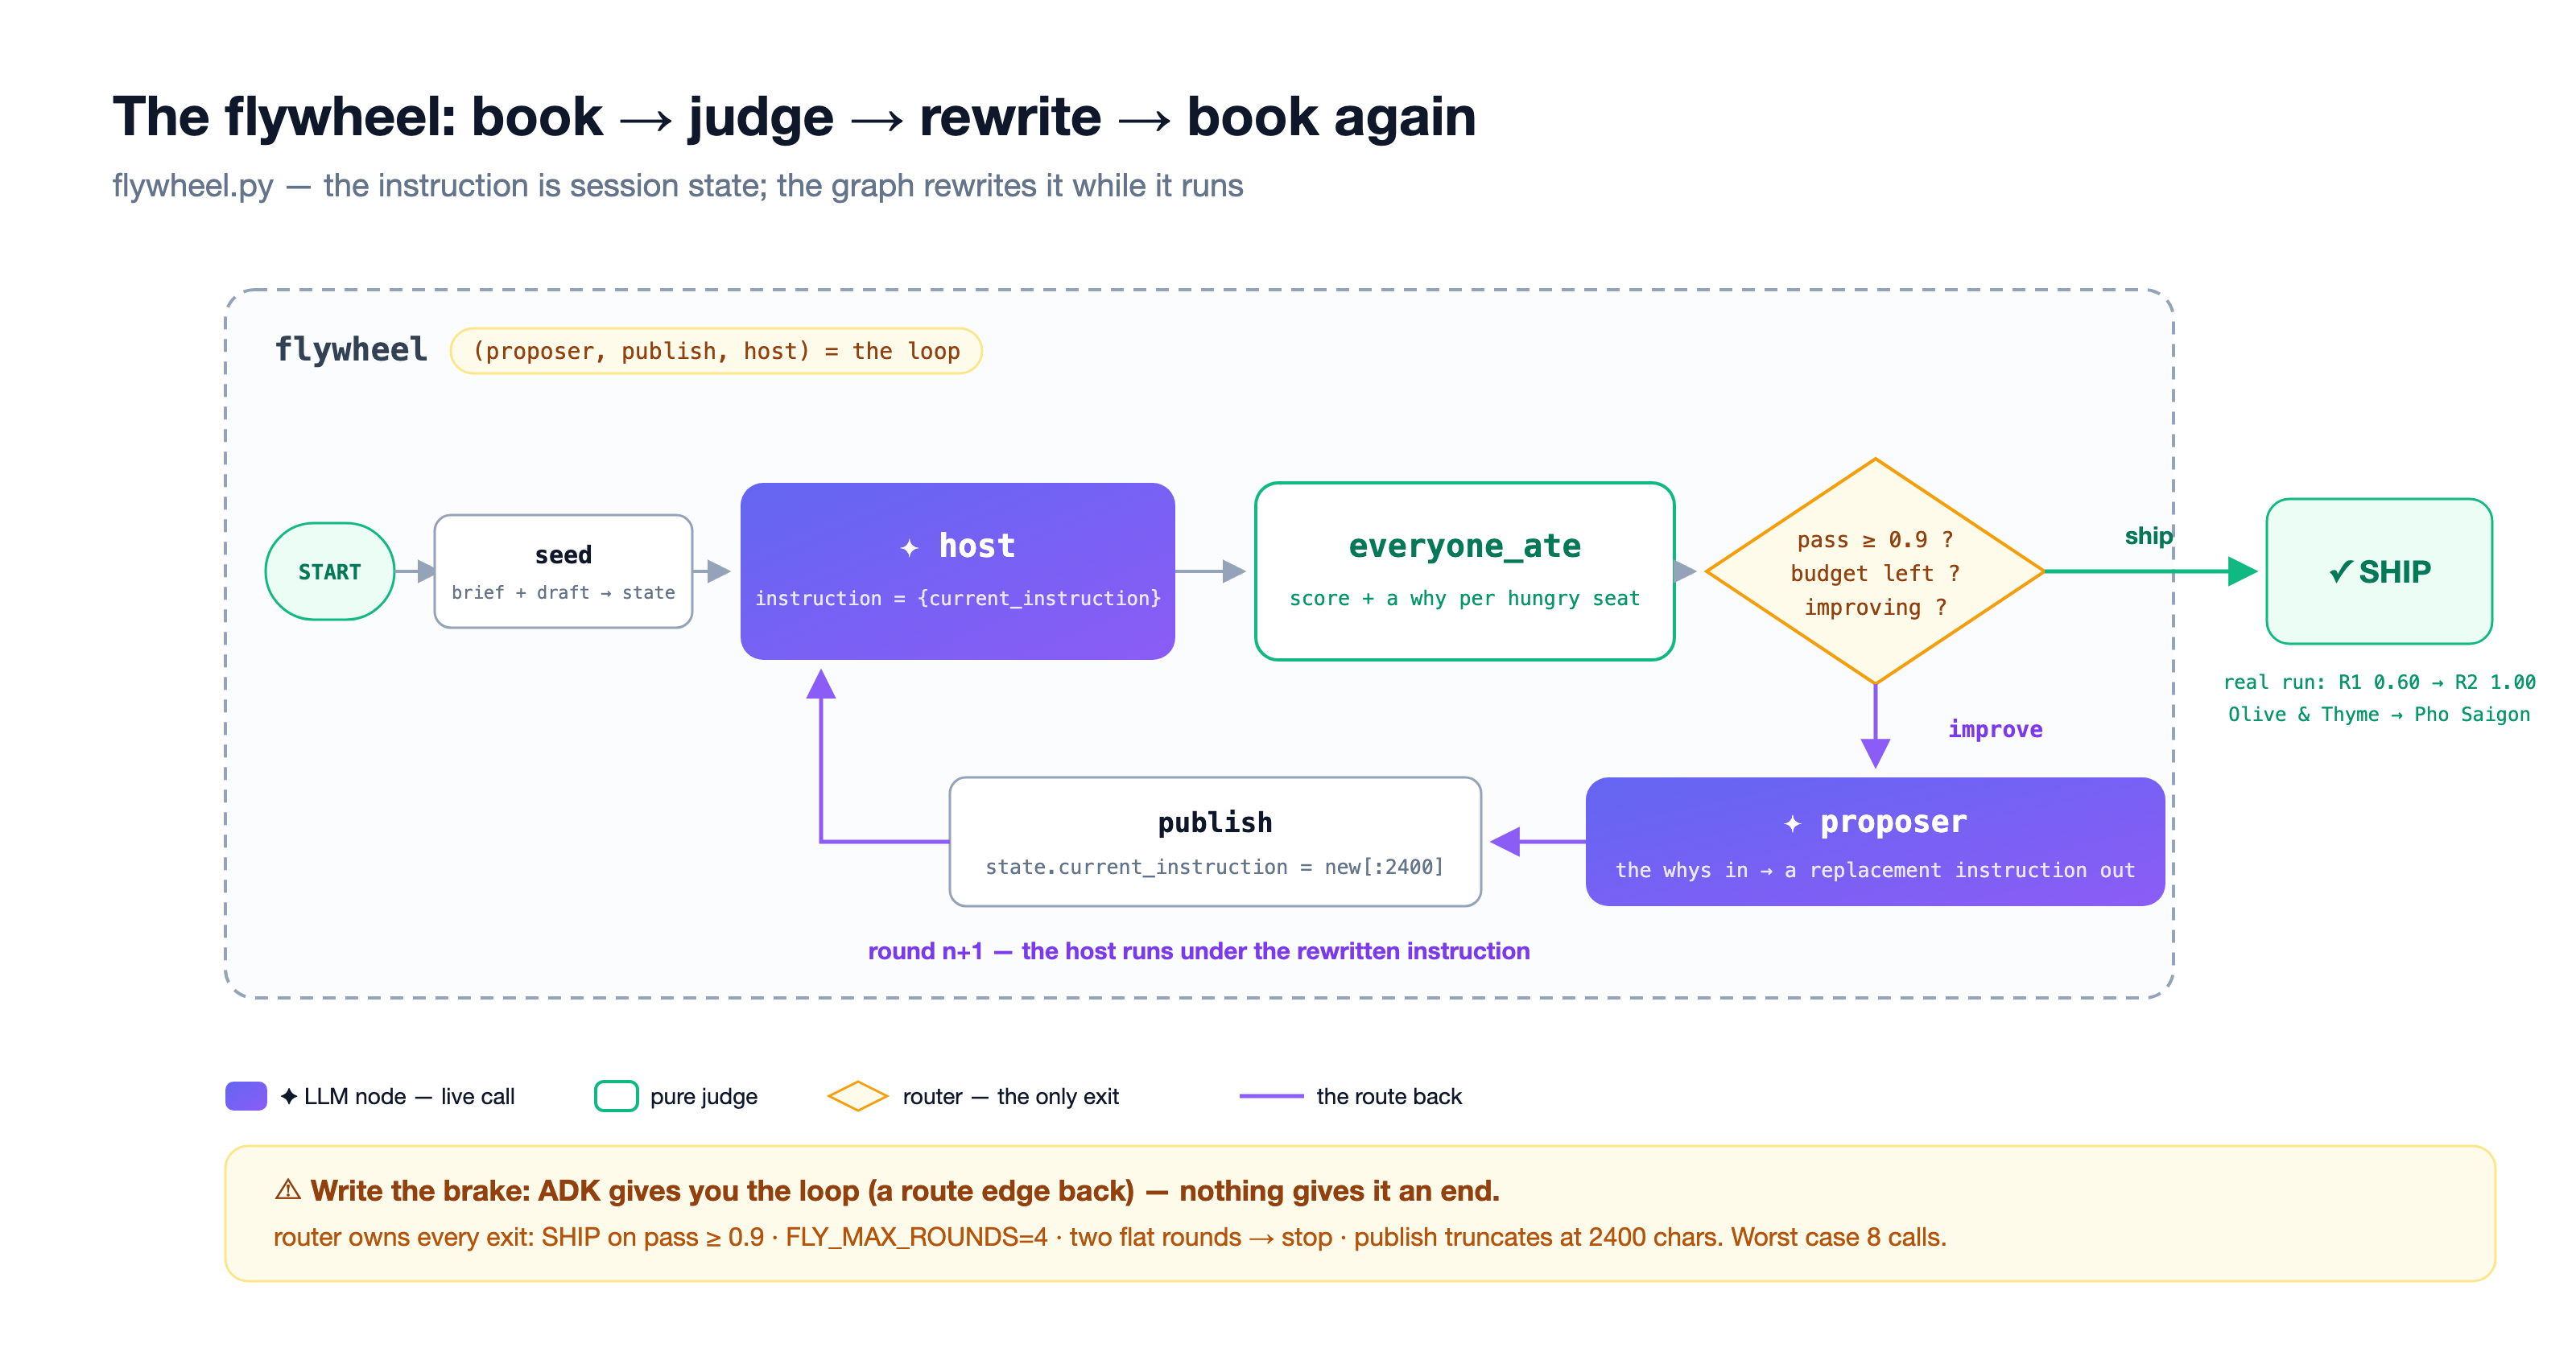
نمودار، تمام شد
loop/flywheel.py، build()، همانطور که پساز اتمام دوره نوشته میشود:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
صفحه آن را بدون لبه آخر ارسال میکند. همه چیز یکبار اجرا میشود — کتابهای پیشنویس، قاضی دو صندلی را خاکستری میکند، پیشنهاددهنده دو قانون مینویسد — و سپس نمودار به پایان میرسد، زیرا هیچچیز بازنویسی را به میزبان برنمیگرداند. حلقه یک لبه ندارد.
مرز — زیرا ADK این کار را نمیکند
لبه مسیری که به عقب اشاره میکند بهطور بومی به شما حلقه میدهد. Workflow سقف تکرار ندارد. روتر مالک انتها است، با چهار کمربند:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
بدترین حالت: چهار دور، دو تماس مدل در هر دور، هشت تماس، سقف سخت. میزبان هرگز نمره نمیدهد، داور هرگز پیشنهاد نمیدهد، مسیریاب هرگز نمینویسد.
امتحان کنید
👉🖥 دوره VII. ↻ اجرای حلقه بهصورت ارسالشده: دور ۱ کتابها، در ۰٫۶۰ ناموفق است، پیشنهاددهنده قوانین خود را مینویسد — و اجرا با flywheel ended without closing پایان مییابد. # را در خط سبز در ویرایشگر حذف کنید. دوباره آن را اجرا کنید.
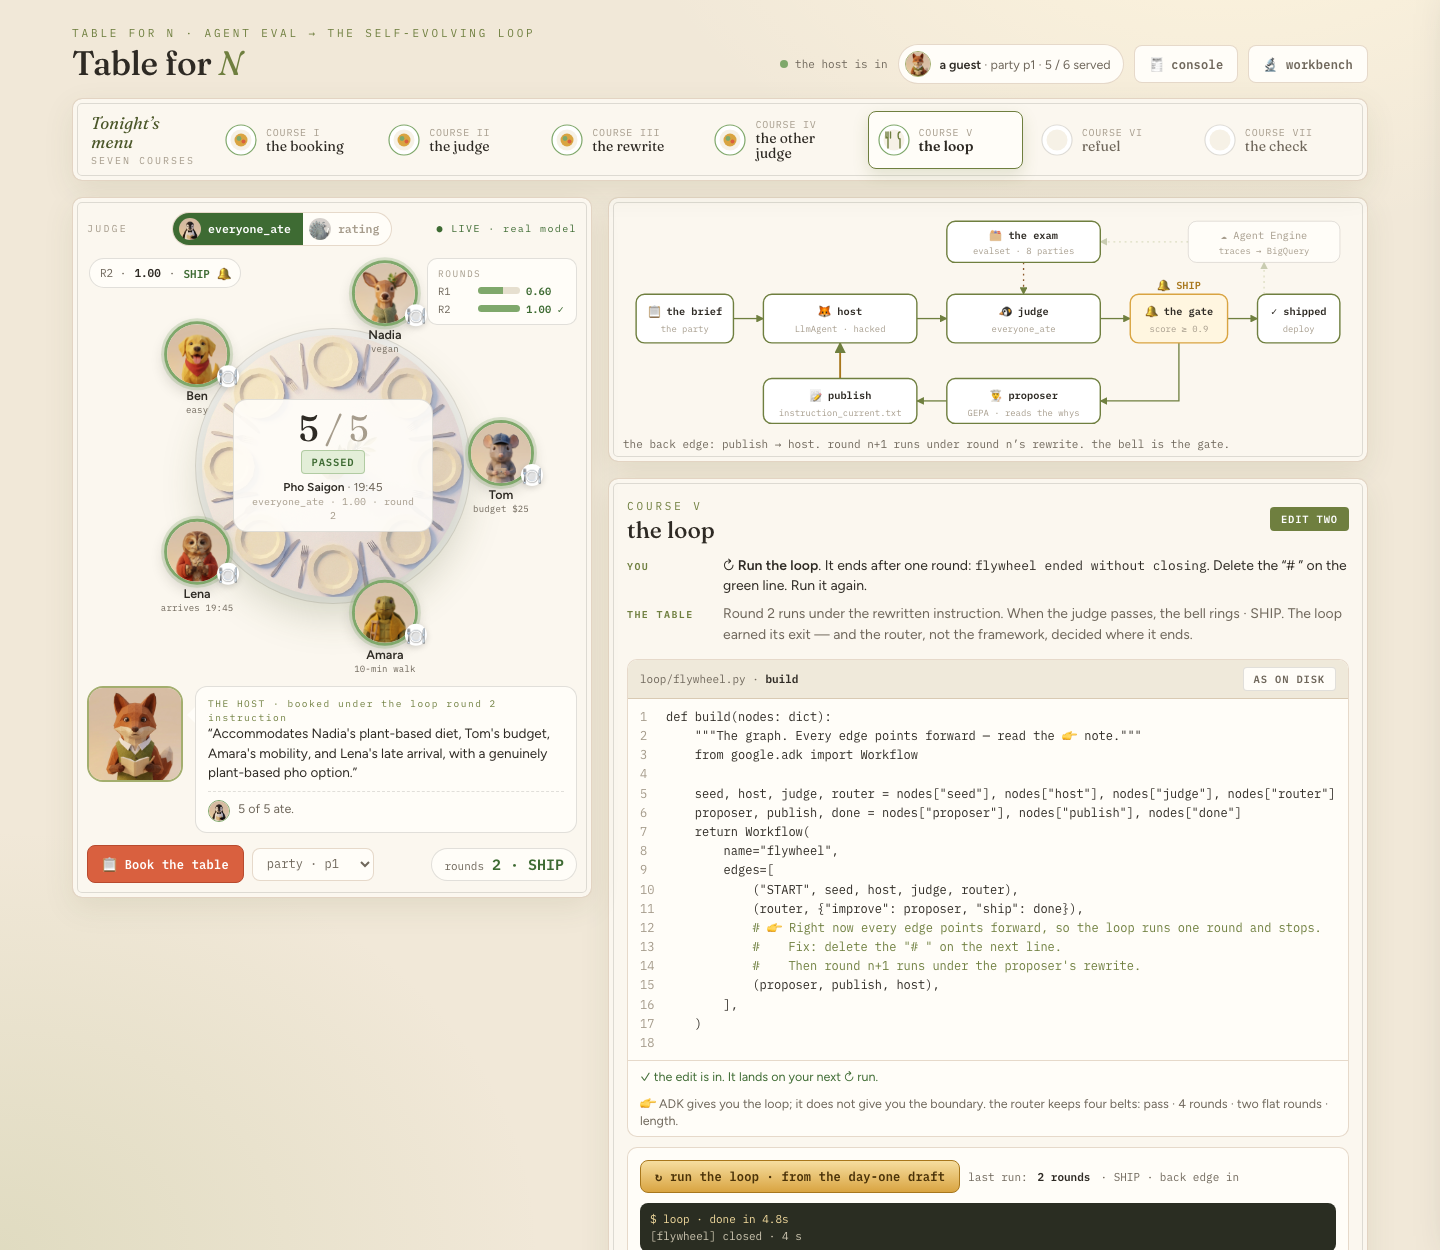
آنچه پیشنهاددهنده درواقع در اجرای ما نوشت — پیشنویس، بهعلاوه دو جمله، یک جمله برای هر یادداشت خطا:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
صندلی خالی به «چرا» تبدیل میشود؛ «چرا» به قانون تبدیل میشود؛ قانون رزرو بعدی را تغییر میدهد. «فُوسایگون» را برای ساعت ۱۹:۴۵ تا ۱:۰۰ رزرو کردید. زنگ بهصدا درمیآید.
عدد: R1 0.60 → R2 1.00 · SHIP، حدود پنج ثانیه دیگر. SHIP حلقه براساس هر شام (یک میز، p1) است؛ دروازه دوره V براساس هر امتحان است. یک رشته، دو مقیاس.
۱۰. VIII · بررسی — هر چیز با چه چیزی جایگزین شد
👉🖥 دوره VIII. فشار دهید 🧾 لطفاً صورتحساب: هشت خط، شمارههای خودتان.
پیش | پس |
نسخه نمایشی که درست بهنظر میرسد | امتحانی که حساب میکند چه کسی غذا خورده است |
یک پاسخ طلایی | مجموعهای از پاسخهای درست، و یک قانون |
پیاموارهای که خودتان ویرایش میکنید | دستورالعملی که حلقه بازنویسی میکند |
عددی که افزایش مییابد | قاضیای که خودش را توضیح میدهد |
یک امتیاز | یک دور، با راه برگشت |
سنجهای که به شما داده شده است | شمارهای که انتخاب کردید |
بهترتیب به خانه ببرید:
- قبلاز انتخاب سنجه، بپرسید چه چیزی را میتوانید یادداشت کنید — پاسخ، قوانین، یا فقط شرح خوب بودن. شام مجموعهای از پاسخهای درست دارد؛ مقایسهگر آن را با یکی بررسی میکند.
- حاکم را قبلاز حلقه بسازید — و وضعیت جهان را چیزی قرار دهید که حاکم آن را مجازات میکند.
- حکم را درون سنجه قرار دهید؛ ADK آستانه را برای شما اعمال نخواهد کرد.
- قبلاز اولین اجرای بهینهسازی، مجموعه آموزشی را از مجموعه نگهداشتهشده جدا کنید و هرگز براساس امتیاز خود بهینهساز ارسال نکنید.
- تعداد صندلیهای خالی را بشمارید، نه نرخ قبولی را — آزمونهای کوچک دروغ میگویند.
- آسیب را برای بهینهساز نمایان کنید: داوری که دلایل را برمیگرداند نیمی از کار بهینهساز است.
- ADK حلقه را به شما میدهد؛ مرز از آن شما است. توقف کردن هم یک تصمیم است.
- وقتی عدد به حداکثر میرسد، باید به این دلیل باشد که عامل بهتر شده است — هرگز به این دلیل نیست که خطکش نرمتر شده است.
حلقه هر عددی را که به آن بدهید، بالا میبرد.
جایگاه تولید
همه چیز در این آزمایشگاه روی ماشین شما دربرابر امتحانی که نوشتید اجرا شد. تولید، شامهایی است که هیچکس برنامهریزی نکرده است نمره بگیرد — و این دقیقاً کاری است که یک بررسیکننده میتواند انجام دهد و یک معیار پاسخ طلایی نمیتواند: نمرهدهی پساز واقعیت.
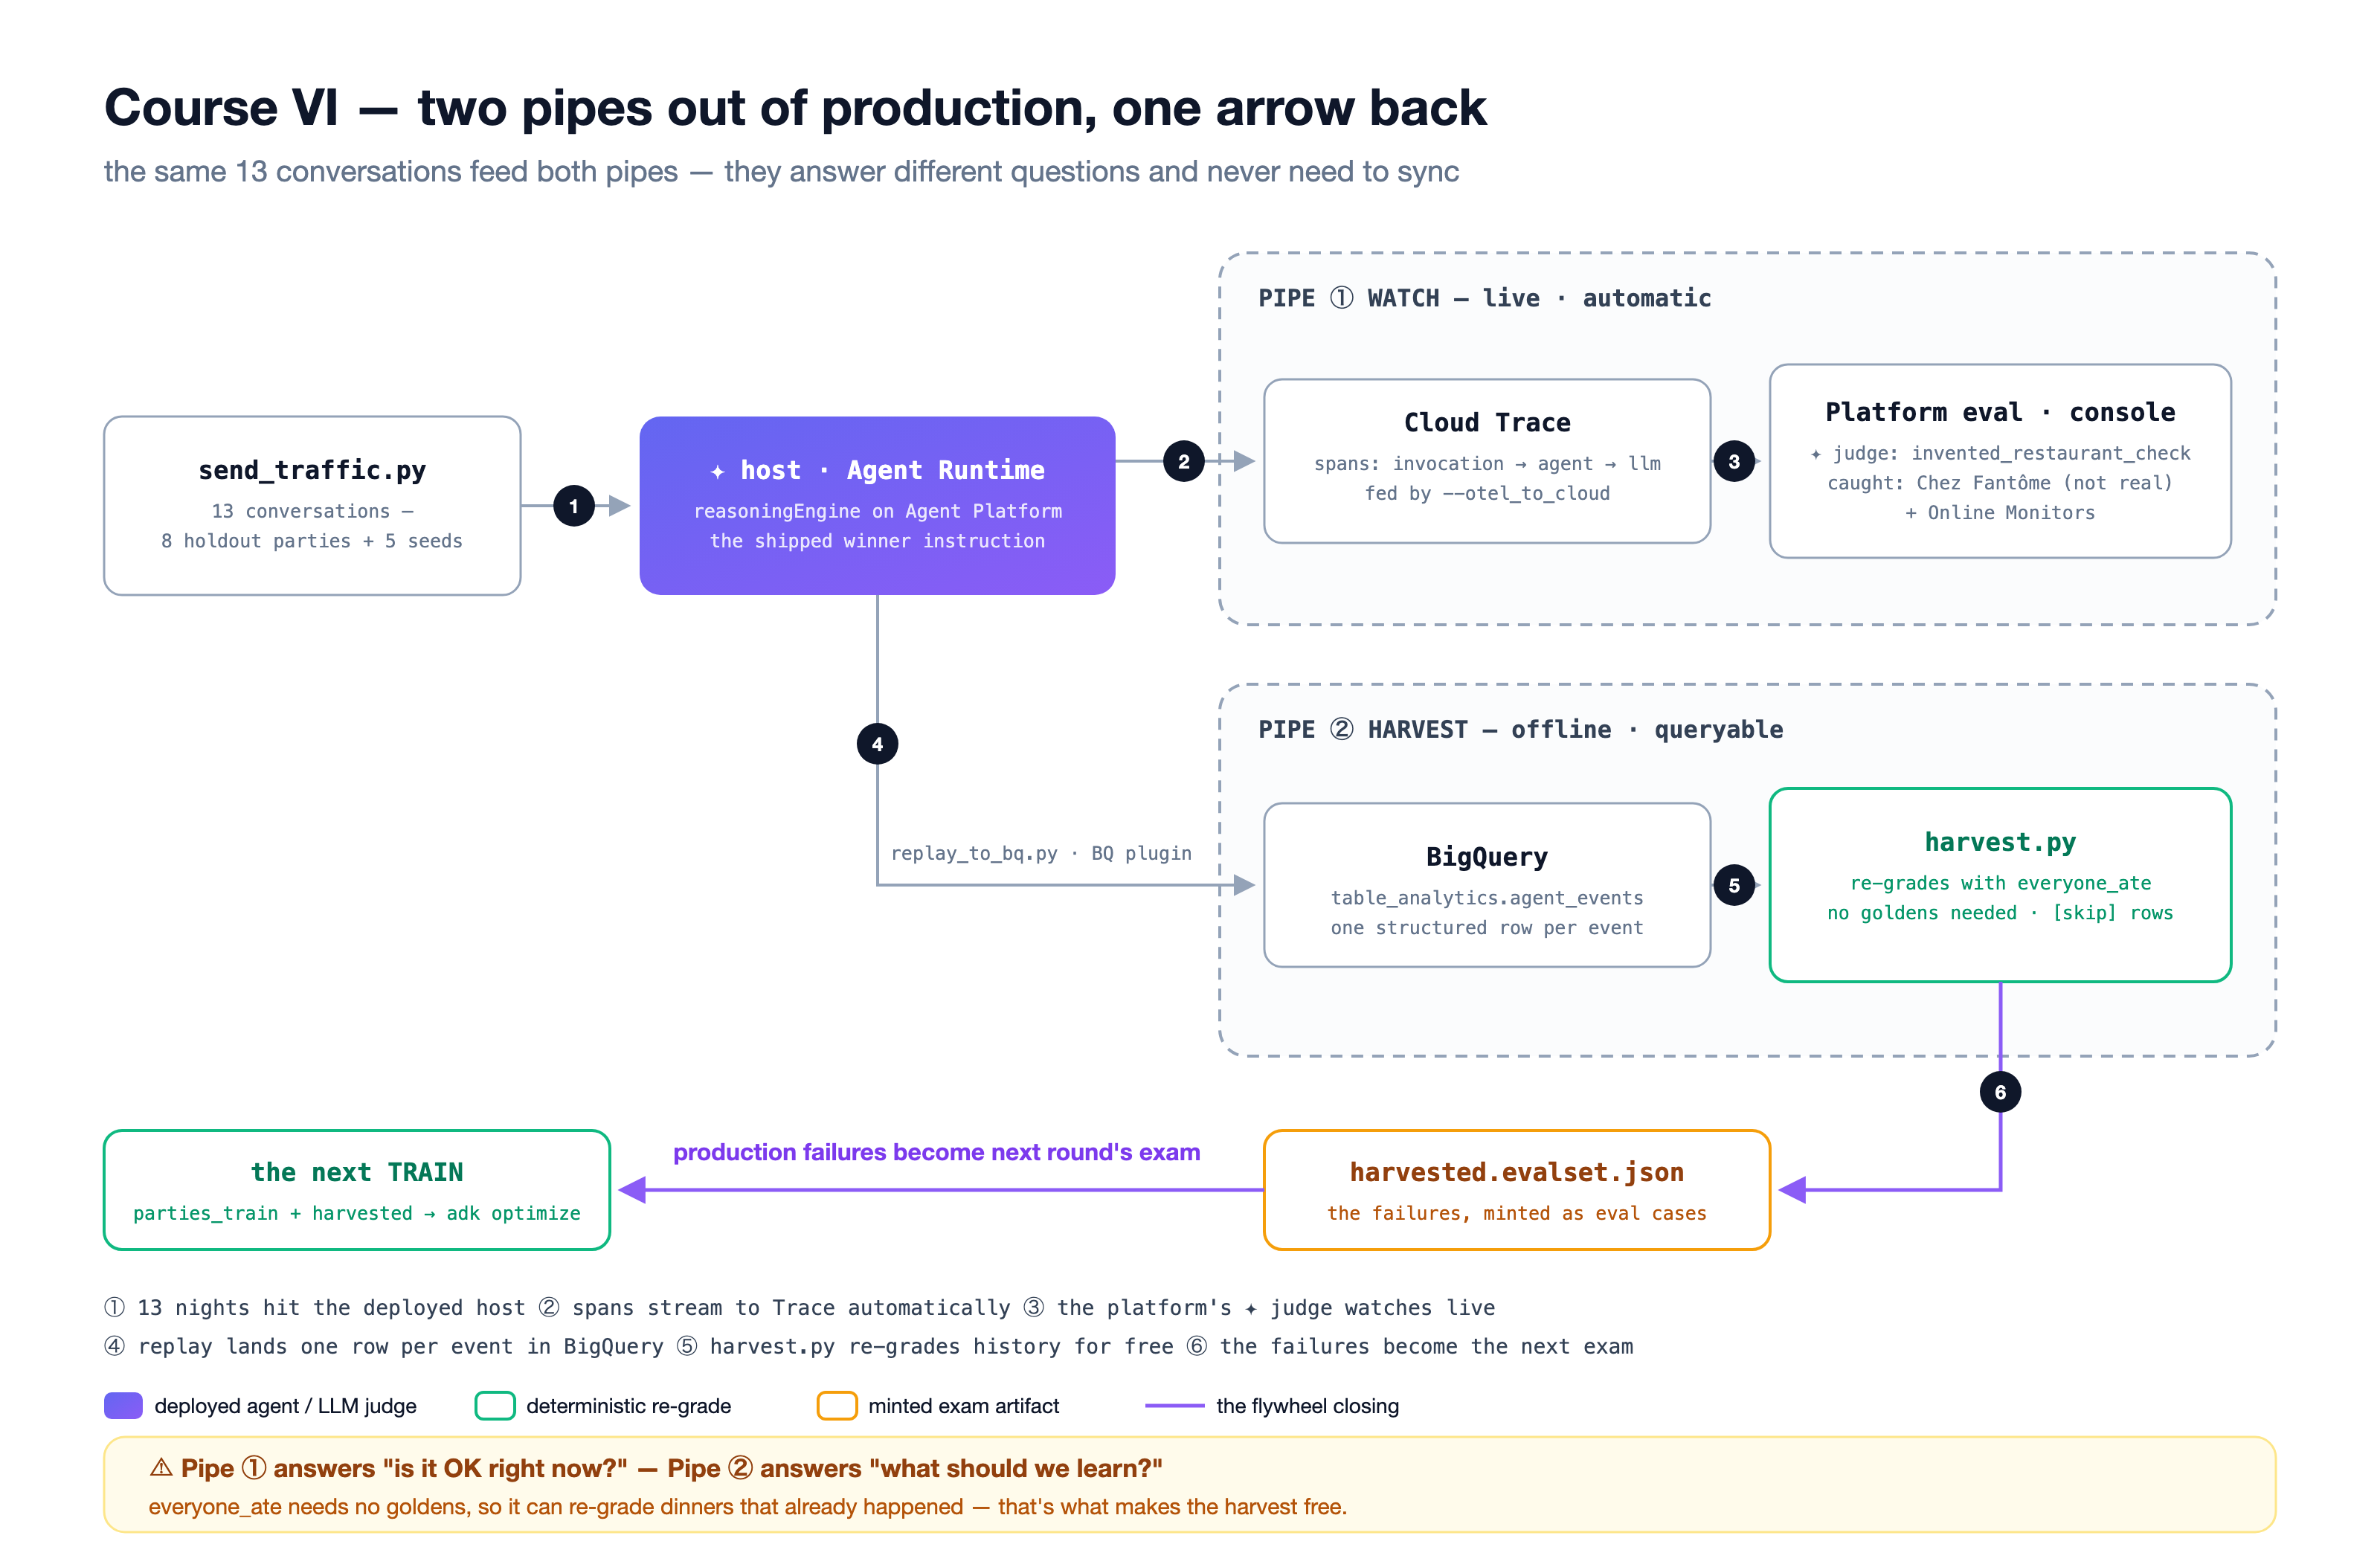
خط عمودی | چطور | پاسخها |
① Cloud Trace |
| درحالحاضر خوب است؟ — دورهها، داوران خود پلاتفرم، پایشگران آنلاین |
② ردیفهای BigQuery | افزایه BigQuery Agent Analytics | چه چیزی باید یاد بگیریم؟ — یک ردیف ساختاریافته برای هر رویداد، فرمی که بررسیکننده و مجموعههای ارزیابی شما از آن استفاده میکنند |
این مخزن لوله را بهصورت دستورگان ارسال میکند، نه بهصورت دوره: refuel/send_traffic.py طرفهای واقعی را به میزبان مستقر میفرستد، refuel/replay_to_bq.py مکالمههای یکسان را بهصورت ردیف ثبت میکند، و refuel/harvest.py هر ردیف را با world.everyone_ate دوباره نمرهگذاری میکند و موارد ناموفق را بهعنوان موارد ارزیابی ضرب میکند — کلمات واقعی گروه، بدون پاسخ طلایی. در شب تولید ما، میزبان ارسالشده ۷ نفر از ۸ حزب واقعی را تغذیه کرد؛ تنها شکست «لنا» دربرابر آخرین سفارشها بود، دقیقاً همان صندلیای که سقف دوره V پیشبینی کرده بود، و این صندلی به سؤال امتحان دور بعدی تبدیل شد. دور دوم دوباره دوره V است با یک مورد آموزشی دیگر. این ویژگی به پروژه Google Cloud با صورتحساب نیاز دارد، به همین دلیل در اینجا توضیح داده شده است و در منو وجود ندارد.
خودآموزی
- قطعهای از خودتان بنویسید (
world.PARTIES، سپسscripts/make_evalsets.py) و آن را در امتحان قرار دهید. منصفانه است؟ سبکscripts/verify_world.py: هر گروه باید حداقل یک رزرو داشته باشد که برای همه کافی باشد. - نوار ردهبندی را به ۰٫۹ برسانید و
adk optimizeرا بهeval_config_rating.jsonبرسانید. گرادیان را اندازهگیری کنید. - پروژهای با صورتحساب دارید؟ خط لوله
refuel/را بهطور کامل اجرا کنید وharvest.pyخط[skip]را بخوانید — این خطوط مرز بین دو خط لوله را نمایان میکنند. - حلقه را با
HOST_THINKING=2048اجرا کنید. چه چیزهایی تغییر میکند و این تغییرات درباره محل سقف به شما چه میگوید؟