

1. Introduction

Cet atelier de programmation porte sur l'évaluation des agents, c'est-à-dire sur la façon dont un système détermine si la réponse d'un agent est satisfaisante, et sur ce que vous pouvez créer une fois que c'est le cas : un agent qui réécrit ses propres instructions à partir de ses propres échecs, et une boucle qui continue de le faire, de manière limitée, sous votre contrôle.
Tout s'exécute sur l'Agent Development Kit (ADK) : adk eval avec une métrique personnalisée que vous écrivez, adk optimize (l'optimiseur de requêtes GEPA), un ADK 2 Workflow avec un bord arrière, et le pipeline Agent Engine + BigQuery qui transforme le trafic de production en examen pour le prochain tour.
La boucle incrémente le nombre que vous lui fournissez.
Objectifs de l'atelier
- Une réponse n'est pas un résultat : pourquoi une réponse confiante et bien formulée ne dit rien au système, et ce qu'un évaluateur doit être capable de dire
- Trois façons d'exécuter un examen :
adk evalpour le lot, l'ongletadk web"Évaluations" pour examiner un échec,pytest+AgentEvaluatorpour l'échec de la compilation, et le seul magasin d'évaluations local qu'ils partagent - Comparer et vérifier : pourquoi un comparateur pénalise une réponse correcte formulée différemment, combien de bonnes réponses un dîner peut avoir et le contrôle intuitif qui vous indique le type de métrique dont un problème a besoin
- Fonction de vérification en tant que métrique
adk eval:customMetrics,codeConfig, la signature fixe, les six vérifications qu'elle contient, pourquoi votre fonction possède les états "RÉUSSITE"/"ÉCHEC" et pourquoi elle est déterministe à dessein - Trois familles de métriques dans une même réponse : comparateur, vérificateur, LLM en tant que juge : besoins, coûts et points aveugles de chacune
adk optimize(GEPA) : ce qu'il lit (les échecs, pas le score), entraînement par rapport à l'exclusion, et pourquoi vous devez réexécuter l'examen vous-même avant de l'envoyer- Reward hacking, measured : une métrique proxy qui ne lit jamais la partie, ce qu'elle fait au nombre réel et la loi qui en découle
- Une boucle auto-évolutive en tant qu'
WorkflowADK 2 : une instruction qui réside dans l'état de la session, l'arête qui transforme un graphe en cycle et la limite que l'ADK ne vous donne pas. - Où se situe la production ? : traces à observer, lignes à apprendre et pourquoi un vérificateur peut évaluer des dîners que personne n'avait prévu d'évaluer (une lecture, pas une étape)
Objectifs de l'atelier
Une application en cours d'exécution dans votre navigateur : une table ronde, N invités et un agent qui réserve leur dîner. Chaque cours porte sur un élément : une ligne dans une configuration, une réponse devant trois juges, un bouton qui exécute le véritable optimiseur, un commutateur qui change de juge, un bord dans un graphique. Le tableau vous montre ce qui a changé : qui a mangé, qui n'a pas mangé et pourquoi. Le code Python est court, et les chiffres sont tous mesurés sur votre machine.
L'application est également l'exercice. Le panneau de cours vous propose une modification ou un bouton à la fois. Un plat du menu n'est validé que si quelque chose de concret le prouve : la cuisine lit vos fichiers et les reçus de ce qui a été exécuté, jamais une checklist.

Les huit cours
le concept | la question à laquelle il répond ; | ce que vous faites | |
I | Une réponse n'est pas un résultat | que sait le système sur cette réservation ? | Rien pour le moment : réservez-en un dans l'atelier. |
II | le comparateur · un ensemble de bonnes réponses · trois façons de l'exécuter | Pourquoi une réservation correcte échoue-t-elle à l'examen ? | exécuter l'examen tel qu'il est fourni et lire les verdicts ; |
III | un vérificateur en tant que métrique personnalisée ; les six vérifications | l'examen peut-il indiquer qui a faim et pourquoi ? | une ligne dans |
IV | comparator · checker · LLM-as-judge | même réponse : quels sont les trois éléments à mesurer pour la comparer ? | évaluer une réponse de trois façons, deux fois |
V |
| L'agent peut-il se corriger lui-même en cas d'échec ? |
|
VI | piratage de récompense · métrique proxy | Que fait un juge qui ne voit pas de préjudice dans la boucle ? | en faveur de Chromebook |
VII | a | Qu'est-ce qui fait qu'un graphique est une boucle et qu'est-ce qui l'arrête ? | une arête dans |
VIII | ce que chaque élément a remplacé | — | la coche |
Comment utiliser cet atelier de programmation ? Il est axé sur les concepts : chaque cours explique l'idée, puis montre le code tel qu'il apparaît une fois la modification effectuée et le parcourt. Il ne vous demande jamais de modifier un fichier ici. La modification s'effectue dans l'application, qui vous présente une ligne à la fois et vous montre d'abord l'échec. Lisez le cours, puis laissez la page vous guider et regardez le nombre évoluer.
Où se situe ce paramètre ?
Le monde : dix invités avec une contrainte stricte chacun, dix restaurants avec un piège chacun, seize fêtes. Les deux juges viennent du laboratoire loop-lab-table. Le format interactif d'une page vient d'Agent Valley. Le bistro est un décor. Tous les mécanismes qui se trouvent en dessous sont ceux que vous utiliseriez normalement pour un agent d'assistance, un parcours de réservation ou tout autre élément dont la qualité peut être vérifiée.
2. 🧰 Configuration
- Quoi : un compte pouvant payer, un projet, l'atelier installé, le modèle prouvé pour répondre et la table s'exécutant sur un port.
- Pourquoi : un processus sur un port : la page, les examens, l'éditeur et l'atelier partagent une origine. Par conséquent, rien dans cet atelier n'a besoin d'un deuxième terminal ni d'un deuxième port.
- Comment : cloner, deux scripts, une commande. La dernière chose que fait la configuration est d'effectuer un véritable appel de modèle. Ainsi, un projet défectueux échoue ici plutôt que dans le cours I.
Tout ce qui se trouve dans cet atelier s'exécute dans Cloud Shell. gcloud, Python, Node et git y sont déjà installés. Gemini est accessible via Vertex AI à l'aide de vos propres identifiants. Il n'y a aucune clé API dans cet atelier, et rien à installer sur votre ordinateur portable. Un ordinateur portable équipé du SDK Google Cloud, de Python 3.11 ou version ultérieure et de Node 20 ou version ultérieure fonctionne de la même manière.
Il y a une chose que cet atelier ne peut pas vous fournir : un projet Google Cloud avec la facturation activée. L'étape 1 vous permet d'obtenir un compte pour payer, et l'étape 4 transforme ce compte en projet. Suivez cet ordre, car chaque étape après l'étape 4 lit le projet défini à l'étape 4.
1 · Obtenir un compte avec facturation (~1 min)
Connectez-vous avec un compte Google pour lequel la facturation est activée. N'importe quel compte de ce type fonctionne. Si ce n'est pas le cas, démarrez un essai sans frais. Vous obtiendrez ainsi un compte de facturation, ce qui est suffisant pour l'étape 4.
2 · Ouvrir Cloud Shell (~2 min)
👉🖥 Cliquez sur Activer Cloud Shell en haut de la console Google Cloud (icône en forme de terminal dans l'en-tête).

👉 🖥 Cliquez sur Ouvrir l'éditeur (icône en forme de dossier ouvert avec un crayon). L'éditeur Cloud Shell s'affiche avec un explorateur de fichiers sur la gauche. C'est là que vous devez vous rendre chaque fois que vous souhaitez lire un fichier entier.

👉🖥 Si vous êtes invité à autoriser l'accès à un moment donné aujourd'hui, cliquez sur Autoriser pour continuer.
👉🖥 Ouvrez un terminal dans l'éditeur (onglet 1). Toutes les étapes 👉💻 s'exécutent dans ce terminal. L'onglet 2 est le tableau lui-même, que vous ouvrirez à l'étape 7. Si le terminal n'est pas déjà affiché en bas de l'écran, ouvrez-le en sélectionnant View → Terminal (Affichage → Terminal) :

👉💻 Vérifiez le compte auquel vous êtes connecté. Il doit s'agir de celui de l'étape 1 :
gcloud auth list
3 · Obtenir l'atelier (~1 min)
👉💻 Clonez le dépôt :
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · Créez votre projet (~2 min)
👉 💻 Un script permet de trouver votre compte de facturation, de créer un projet sur ce compte, d'associer la facturation et de pointer Cloud Shell vers ce projet :
cd ~/table-for-n
./setup_project.sh
Vous devriez obtenir un ✓ pour le compte de facturation sélectionné, un ✓ pour le projet créé et une fin de conversation comme celle-ci :
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 est l'ID de votre projet. Le vôtre aura des chiffres différents. Quatre choses s'y produisent :
facturation | prend le compte | |
project | crée | |
selects | écrit l'ID dans | |
waits | interroge jusqu'à ce que le projet soit réellement autorisé à diffuser des annonces, pendant deux minutes maximum. | |
👉🖥 Le même projet se trouve maintenant dans la console. Son ID se trouve dans la fiche Informations sur le projet du tableau de bord :
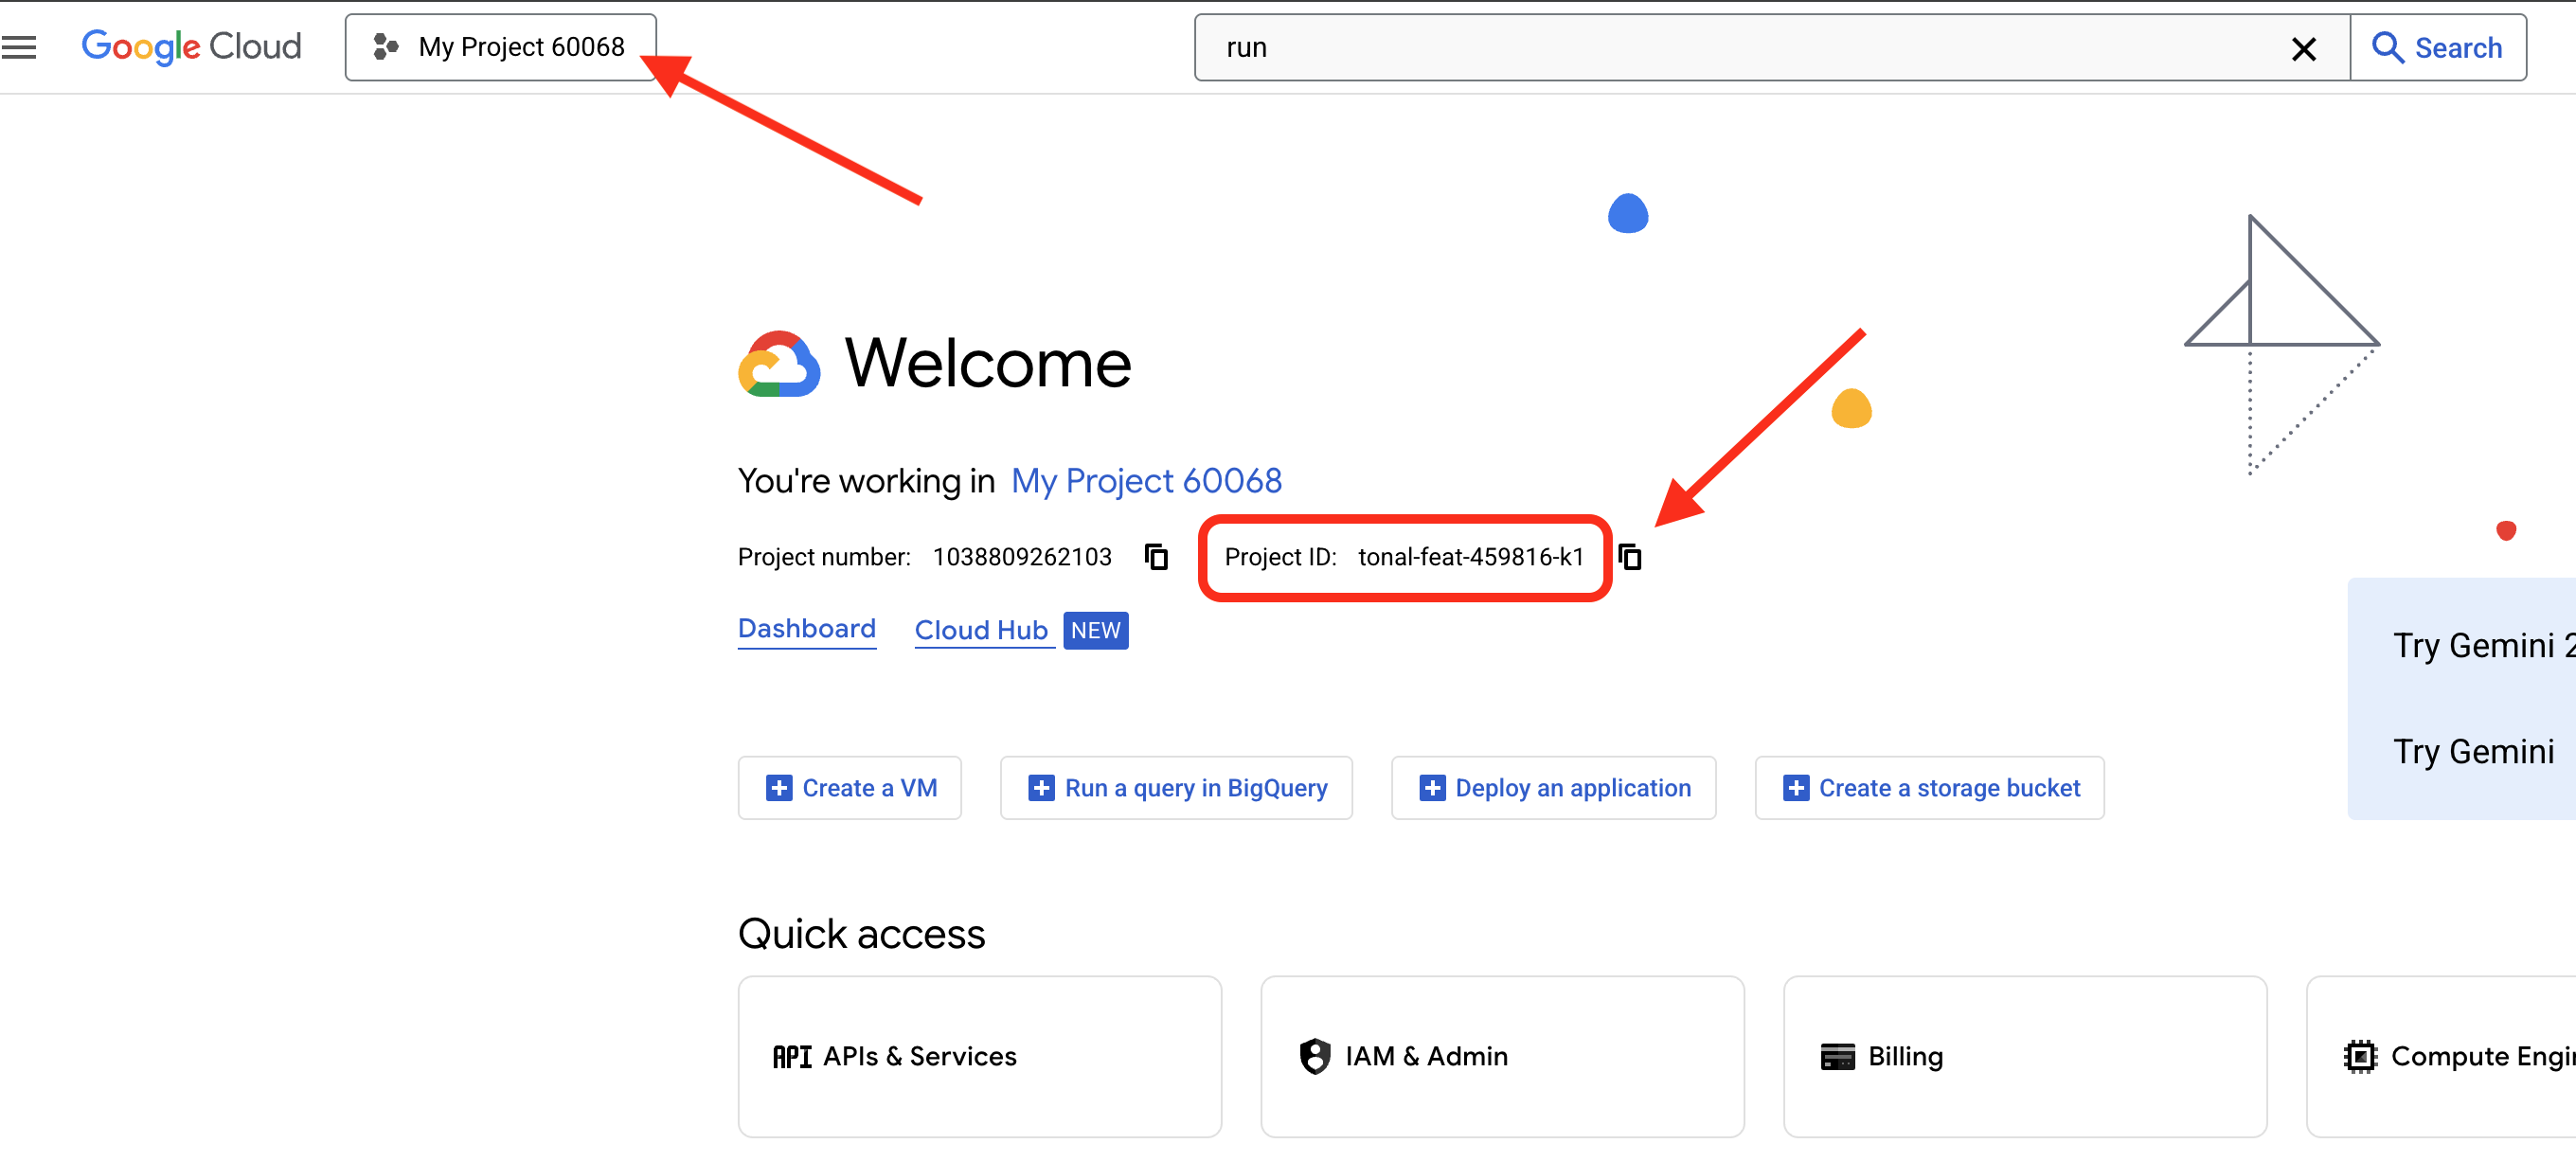
5 · Installer et configurer l'atelier (~3 min)
setup_codelab.sh crée l'environnement avec uv, mais il n'installe pas uv pour vous. Il s'arrête et vous demande de le faire. Installez-le d'abord, dans la même commande :
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Un script, qui peut être réexécuté en toute sécurité. Elle effectue cinq actions, dans l'ordre :
api | lit l'étape 4 du projet sélectionné et active | |
uv env |
| |
site | installe et compile | |
.env | écrit | |
preflight | effectue un véritable appel à | |
6 · Lire le menu (~1 min)
La dernière chose que l'étape 5 a imprimée est le menu de ce soir. Chaque ligne est une vraie découverte, pas une supposition :
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Aucun n'est allumé avant que vous ne commenciez. the model answers est celui qui compte ici : il signifie qu'un véritable appel a été passé dans votre projet.
👉💻 Exécutez-la à tout moment pour voir où vous en êtes. Elle lit vos fichiers et les reçus de la cuisine, et non une checklist :
cd ~/table-for-n
uv run python scripts/preflight.py
7 · Mettre la table (~1 min)
👉💻
cd ~/table-for-n
bash table.sh
Un processus, port 3470. La cuisine met un certain temps à se préparer (elle importe ADK et installe adk web). Le script l'indique, attend et n'affiche les liens que lorsque le port répond réellement :
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Il reste au premier plan. Ctrl+C efface la table. Laissez-le s'exécuter : tous les cours à partir de maintenant communiquent avec ce processus, et rien dans cet atelier ne vous demande de le redémarrer.
👉🖥 Après avoir vu ✓ the table is laid, ouvrez le tableau dans un nouvel onglet (que nous appellerons onglet 2). Dans Cloud Shell : Aperçu sur le Web → Modifier le port → 3470.
👉🖥 Indiquez votre nom sur la carte de réservation (il figurera sur l'addition à la fin), puis appuyez sur ✦ place-nous.

3. I · La réservation : une réponse n'est pas un résultat
Cinq personnes vont dîner. Le chat de groupe contient toutes les informations nécessaires : Nadia est végane, Tom a un budget de 25 € ce mois-ci, Amara est en béquilles et peut marcher pendant 10 minutes, Lena ne peut pas arriver avant 19h45, Ben est flexible. Dix restaurants sont listés, triés par note, chacun avec son prix, son temps de marche, ses horaires et son inconvénient.
Un agent réserve la table. En lisant le chat, vous savez déjà qui va avoir faim dans la salle qu'il choisit. Aucun élément du système ne le sait. C'est ce manque que nous allons combler dans cet atelier de programmation.
L'agent (lecture seule)
host/agent.py, comme pour l'ensemble de l'atelier :
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Aucun outil, aucune base de données, aucune recherche. Un modèle, une chaîne d'instructions (qui ne figure pas dans ce fichier). Il se trouve à côté, dans instruction_current.txt, qui contient aujourd'hui les quatre lignes qu'un responsable produit écrit le premier jour :
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Pas un mot sur les allergies, les budgets, les limites de marche ou les personnes qui doivent partir plus tôt. Tout cela figure dans le brief que reçoit l'agent. Non utilisé.
Ce fichier est le seul artefact de cet atelier. Le cours V permet à un optimiseur de le réécrire. Le cours VI installe une version piratée. La boucle du cours VII réécrit le graphique tour par tour pendant son exécution. L'agent (modèle, paramètres, nom) ne change jamais.
Essayer : zéro frontend
👉 🖥 Sur la page, cours I. Cliquez sur 🔬 workbench (en haut à droite) : le tiroir est adk web, monté dans le même processus (même dossier host/, même table.db). Sélectionnez host, collez le brief du panneau du cours (il comporte un bouton de copie), puis envoyez-le.
L'hôte répond en une seconde : un restaurant, une heure, une raison convaincante en une ligne. Lisez le motif de la réponse négative. Ensuite, regardez le tableau de gauche : "laid", "personne n'a jugé", — / 5. Non pas parce que quelque chose se charge, mais parce que dans le monde, bien sûr, rien n'existe qui puisse juger cela.
Le nombre : ? sièges vides. Personne ne peut le dire.
4. II · Le comparateur : combien de bonnes réponses ce dîner comporte-t-il ?
Le cours II commence par un examen qui existe déjà et qui échoue déjà, pour une raison qui n'apporte aucune information. Avant de résoudre le problème, il est utile de connaître les trois façons d'exécuter le code, car vous les utiliserez toutes les trois aujourd'hui.
Trois façons d'exécuter une évaluation
Tous utilisent le même moteur sous-jacent.
à quoi il sert ; | ce que vous obtenez | |
| le lanceur de lot, que vous placez dans l'intégration continue ; | un résumé : réussite, échec, un score par cas |
| un cas a échoué et vous souhaitez l'examiner ; | cette conversation, la trace, le score par cas, tous cliquables |
| Intégrer l'évaluation de l'agent de pliage dans une suite de régression normale | Il s'exécute à côté de vos tests unitaires et fait échouer la compilation de la même manière. |
Le détail vraiment utile : les trois partagent un magasin d'évaluation local, host/.adk/eval_history/. Exécutez un lot à partir de l'intégration continue. Si un problème survient, ouvrez cette exécution exacte dans l'UI Web pour l'examiner. Le bouton 📝 sur la page est la première méthode, l'atelier 🔬 est la deuxième, et la troisième est une commande de terminal, uv run pytest tests/test_host.py, et le test qu'elle exécute comporte 12 lignes :
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py : même agent, même ensemble d'évaluation, même fichier de configuration. La ligne eval_set_results_manager permet de placer son exécution dans le même historique que les deux autres.
Examen tel qu'il est fourni
exam/eval_config.json est distribué comme suit :
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Deux parties, deux jobs. criteria
est l'examen, c'est-à-dire les métriques qui sont réellement exécutées, chacune avec son seuil de réussite. customMetrics
est l'annuaire du personnel : les noms mappés à Python, disponibles, mais pas en service. Déclarer une métrique ne l'exécute pas. Tel qu'il est fourni, le document ne contient qu'une seule question : la métrique response_match_score intégrée d'ADK, un chevauchement de texte (ROUGE-1) entre ce que l'agent a dit et la réservation de référence dans l'ensemble d'évaluation. Votre juge, everyone_ate, se trouve dans le répertoire et non sur le papier. Le cours III l'y déplace en modifiant une ligne.
Nous avons un agent de réservation de dîners et un response_match_score assis là sans frais. Utilisons-le et voyons ce que nous obtenons.
Essayer
👉🖥 Cours II sur la page. Appuyez sur 📝 run the exam · as shipped (📝 exécuter l'examen · tel qu'il est fourni). La légende sous le bouton indique ce qui s'exécute : 1 métrique exécutée : response_match_score · everyone_ate est déclaré, pas dans l'examen. Environ une demi-minute. Lisez le résultat : environ la moitié des tables ont ÉCHOUÉ, sur un score de texte sans raison, et regardez lesquelles. Pointez sur les chips.
Regardez bien, car c'est là que ça devient intéressant. Le comparateur se trompe dans les deux sens pour les tableaux. Votre exécution en affichera au moins un. Il rejette une table où la réservation était correcte (l'agent a choisi une salle où tout le monde pouvait manger, le dîner fonctionne, la réponse est correcte), car l'agent a formulé sa raison différemment de la réponse de référence. Et il valide une table où quelqu'un n'a pas mangé (dans notre exécution p1, à 0,30 pile, avec Tom qui a dépassé son budget et Lena qui a commandé après l'heure limite), car suffisamment de mots se chevauchent. La similarité de chaînes ne sait rien du dîner. Il sait que les caractères s'alignent.
Voici une vraie question : combien de bonnes réponses ce dîner comporte-t-il ?
Pour la fête de ce soir, une seule des dix salles propose de la nourriture : Pho Saigon, et seulement à partir de 19h. Pour les huit parties de l'examen, les valeurs sont les suivantes : 1, 2, 2, 1, 3, 3, 6, 1 (world.rooms parcourt chaque salle à chaque place pour une partie ; exécutez-le vous-même avec uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). Parfois, plusieurs salles peuvent accueillir tout le monde, parfois une seule, et seulement à certaines heures. Il existe un ensemble de réponses acceptables, et non une seule. La réponse de référence dans l'ensemble d'évaluation en fait partie.
Cela signifie que l'hypothèse sous-jacente à response_match_score (il y a une seule bonne réponse et je l'ai écrite) n'a jamais été vraie pour ce problème. Pas une seule fois. La métrique n'est pas défectueuse. Il fait exactement ce qu'il dit. Nous avons utilisé le mauvais type de métrique pour ce problème.
👉🖥 Facultatif, mais cela vaut la peine d'y consacrer une minute : ouvrez le 🔬 workbench → Évaluations → 🕓 historique. L'exécution 📝 que vous venez d'effectuer s'affiche, et chaque cas est cliquable. Dans l'onglet 1, uv run pytest tests/test_host.py exécute le même examen qu'un test en échec et se retrouve dans le même historique.
Le nombre : 4 sur 8 ont été RÉUSSIS lors de notre exécution, pour le chevauchement de mots, sans raison, et 1 bonne réponse pour p1, sur dix salles.
Pour notre problème de dîner, le choix se fait de lui-même. Personne ne peut vous dire quel est le restaurant idéal pour vendredi. Mais tout le monde peut vous dire ce qu'est un dîner réussi : tout le monde à table a pu manger. C'est une règle. Il est cochable. Il n'est pas ambigu. Le cours III vous apprendra à le créer.
5. III : Le juge : un vérificateur en tant que métrique personnalisée
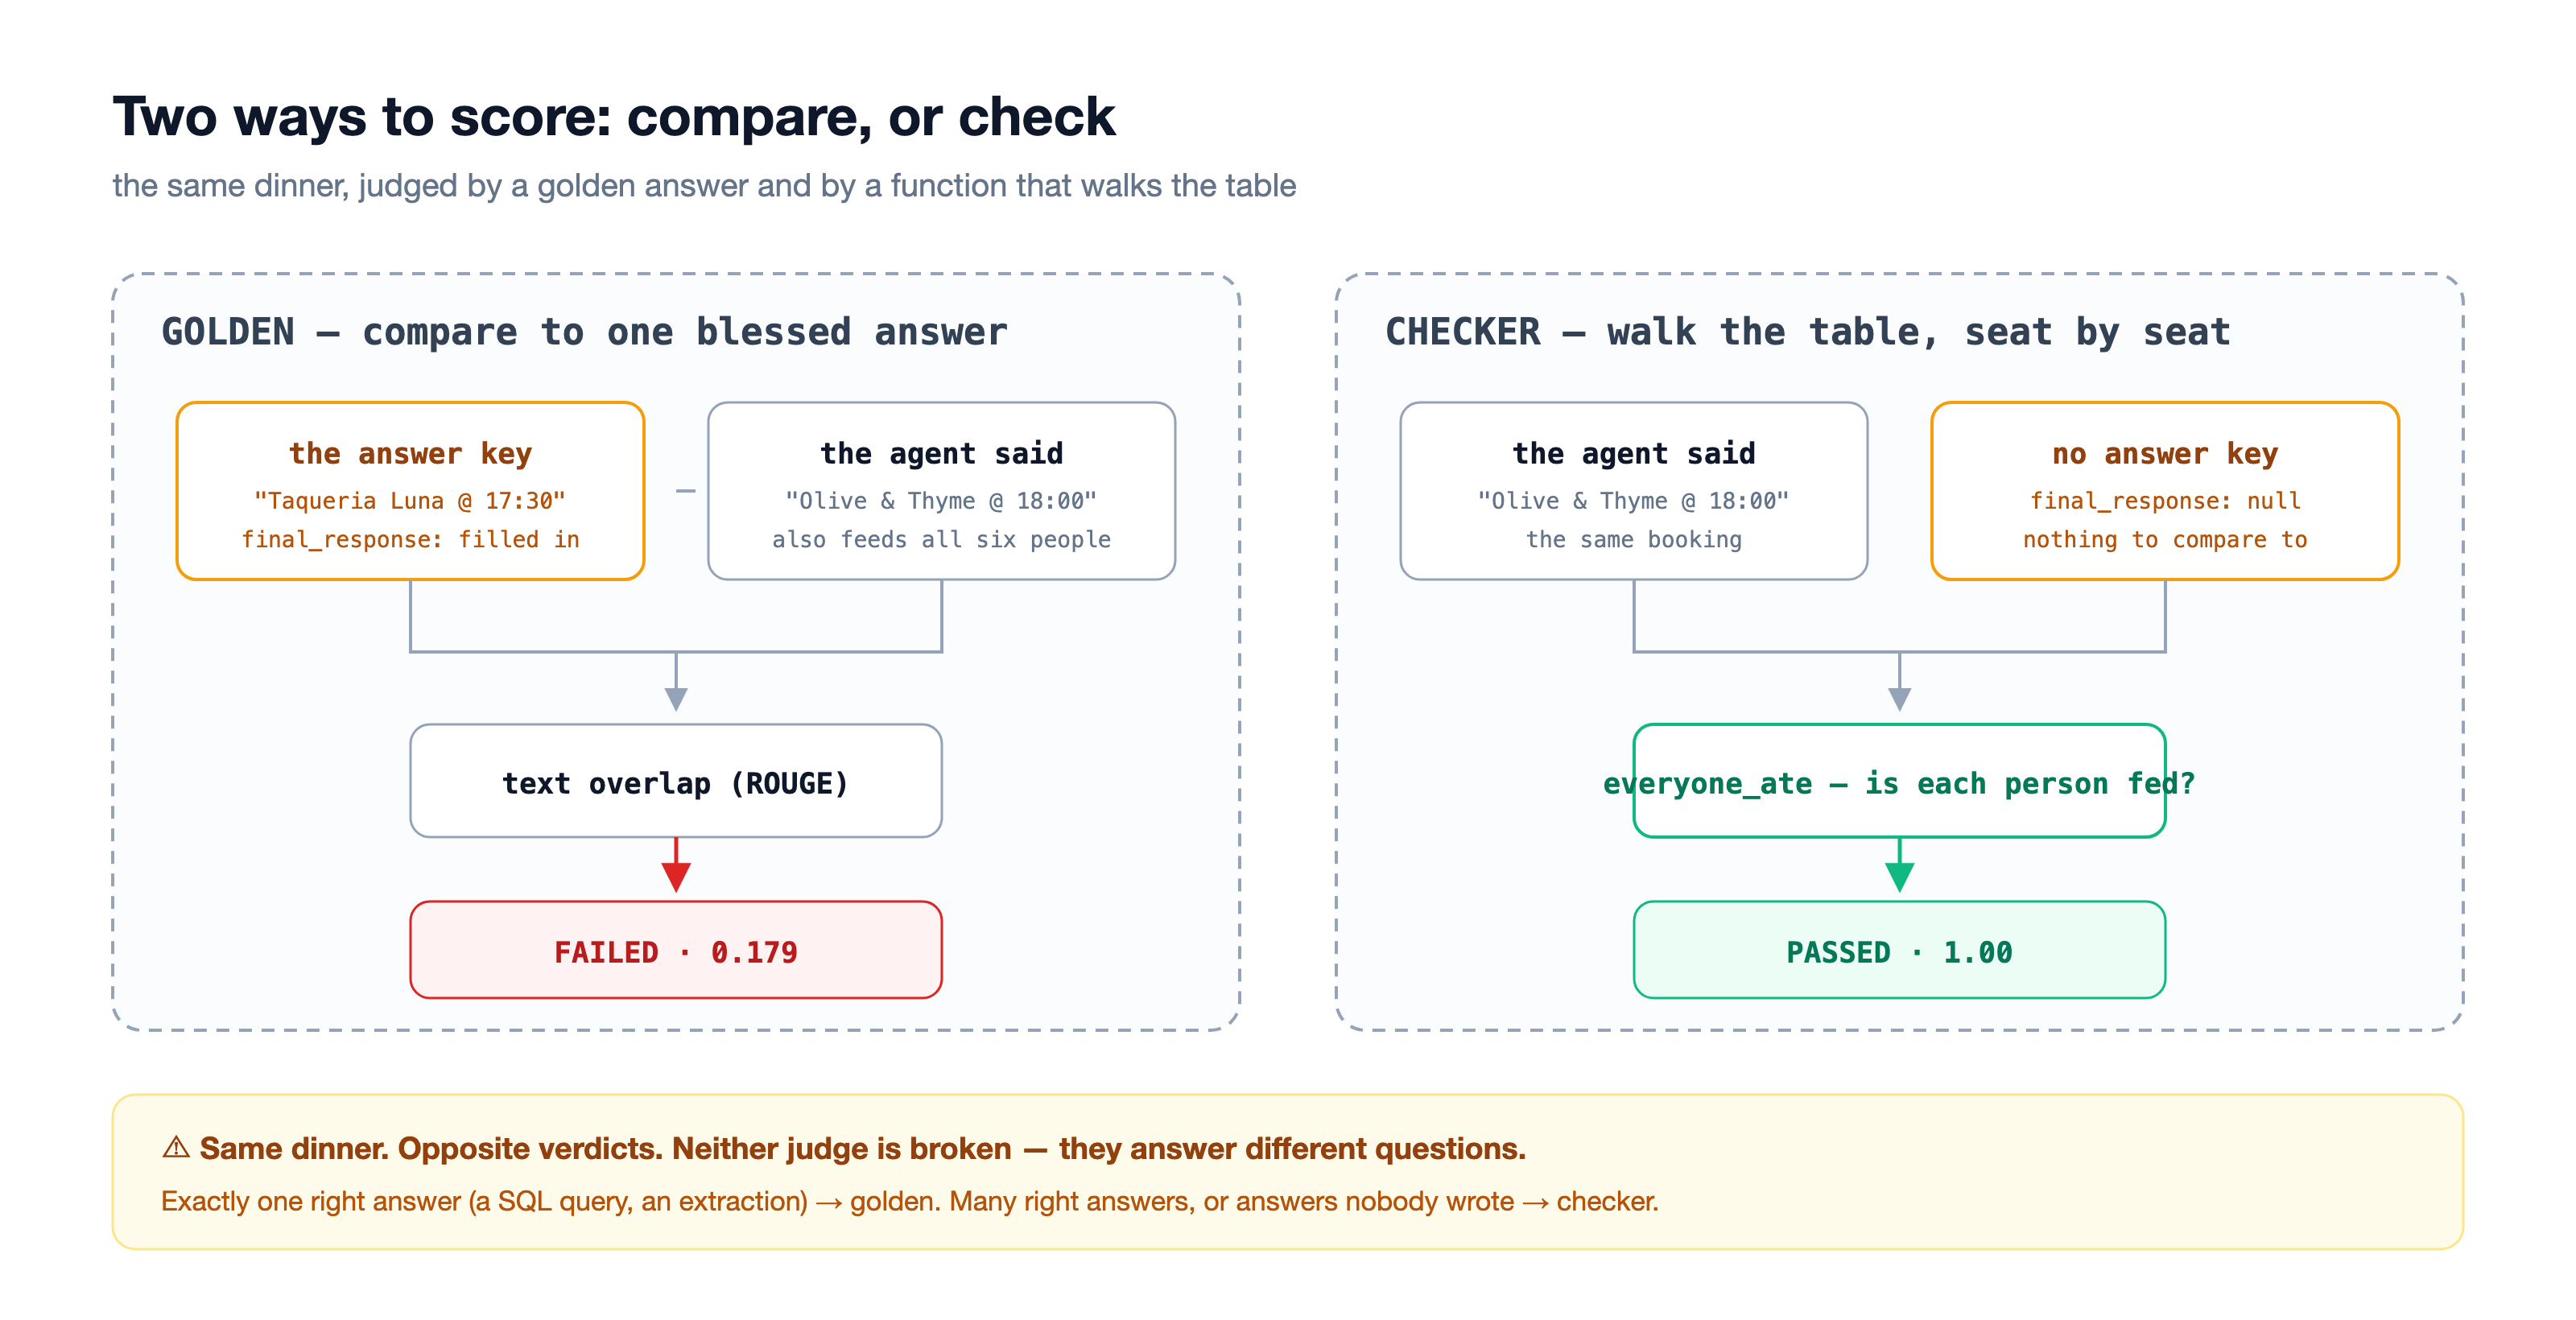
Un vérificateur pose une question différente d'un comparateur : non pas "est-ce que cela correspond à la clé ?", mais "est-ce que chaque personne est nourrie ?". Il compare la réservation à la partie, siège par siège, et renvoie un score et un motif par siège. Il n'a pas besoin de réponse parfaite, ce qui lui permet également de noter les conversations qui ont déjà eu lieu (cours VIII).
world.everyone_ate est cette fonction. Le cours III l'intègre à adk eval.
Inside everyone_ate — five steps, none of them clever
- Lisez le texte de l'utilisateur et déterminez de quel groupe il s'agit. Le brief contient un ID de groupe (
p1), et nous recherchons qui est assis à cette table. - Lisez la réponse de l'agent, analysez le code JSON, puis extrayez le nom du restaurant et l'heure de réservation.
- Parcourez chaque personne, dans l'ordre. Pour chacun d'eux : régime alimentaire, puis allergies, puis tolérance aux épices, puis budget, puis distance à pied, puis timing. Six vérifications par personne à chaque fois. Prenons l'exemple de Tom : son budget est de 25 $ par personne, mais la chambre coûte 28 $. Nous renvoyons
Falsepour Tom, ainsi que la phrase l'expliquant, et passons à la personne suivante. - Le score correspond au nombre de personnes ayant mangé divisé par le nombre de personnes à table. Quatre sur cinq équivaut à 0,8. Aucune pondération ni crédit partiel.
- Renvoyez "RÉUSSI" ou "ÉCHOUÉ". Et remarquez qui le renvoie : vous. N'oubliez pas que c'est le piège ci-dessous.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Une propriété mérite d'être soulignée : il n'y a aucun appel de modèle dans cette fonction. Il s'agit de Python déterministe. Même entrée, même verdict, à chaque fois. Votre juge ne dérive pas lorsqu'un modèle est mis à jour, son exécution ne coûte rien et il ne peut pas halluciner une raison. Si vous pouvez l'obtenir, cela vaut la peine de concevoir votre application pour.
La métrique "finished"
metrics/table.py : l'adaptateur que l'ADK appelle, avec sa signature fixe :
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Ligne par ligne : elle lit les deux côtés de chaque appel (la partie de user_content et la réservation de final_response), les transmet à la fonction pure et encapsule le résultat dans les objets attendus par l'ADK. Une ligne contient le verdict :
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
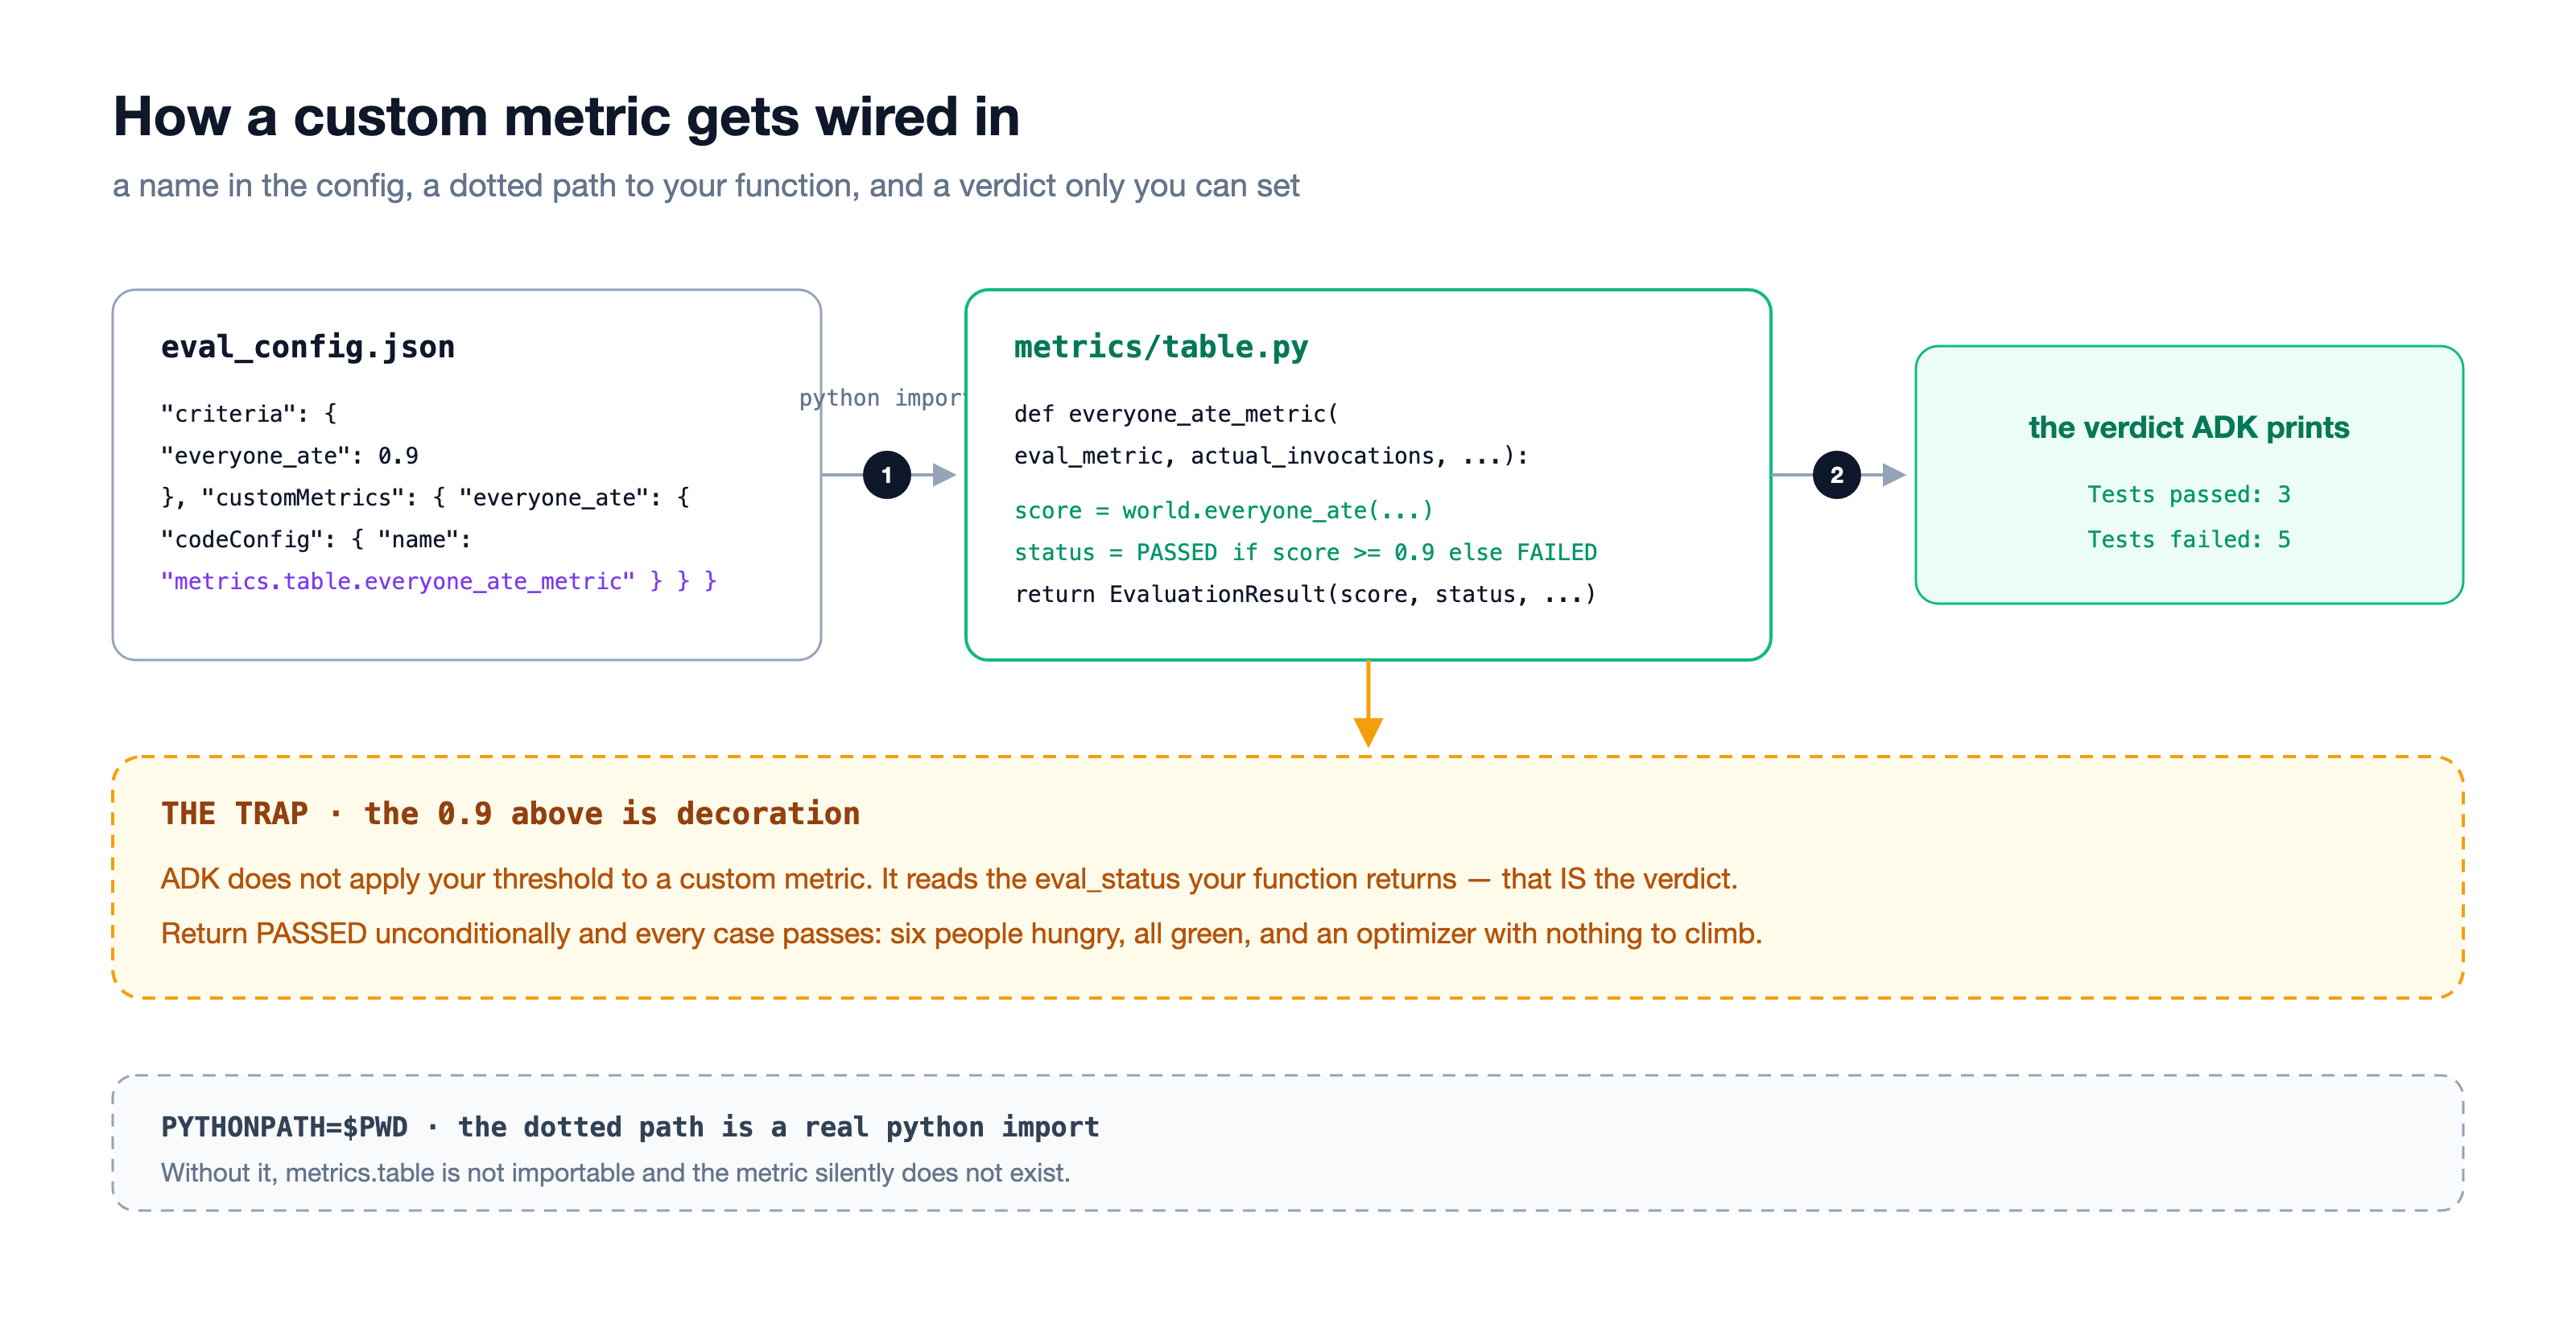
La configuration (une seule ligne)
exam/eval_config.json, tel qu'il s'affiche une fois le cours terminé :
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Une ligne a été modifiée : criteria désigne désormais votre juge au lieu du comparateur. L'examen est composé de huit parties que l'optimiseur ne verra jamais (exam/parties_val.evalset.json, 36 places au total).
Essayer
👉🖥 Cours III sur la page. La légende sous le bouton 📝 indique l'instruction exécutée par l'organisateur. Elle doit indiquer Brouillon. Si un autre nom s'affiche (parce que vous avez installé une autre version auparavant), appuyez d'abord sur ↺ Revenir au brouillon, sinon les chiffres ne correspondront pas à l'histoire.
👉 🖥 Inversez la ligne dans l'éditeur (ou appuyez sur Appliquer la modification pour moi), puis 📝 exécutez à nouveau l'examen. Désormais, un échec indique le siège et la raison : Tom : ~28 € contre 25 € ; Lena : dernières commandes à 19h30, elle arrive à 19h45. Le nombre sous la table passe du nombre de passagers au nombre qui compte : sièges affamés. Pointez sur un chip : chaque table ayant échoué comporte ses phrases.
👉🖥 Appuyez ensuite sur 📋 Réserver la table. L'hôte choisit une pièce. La même fonction grise les chaises qui ne peuvent pas y manger et indique pourquoi sous chacune d'elles. Appuyez à nouveau sur le bouton. Le modèle peut réserver différemment (l'API n'est pas déterministe, même à une température de 0), mais le juge ne vacille jamais : même pièce, même verdict, mêmes phrases.
Le nombre : le brouillon du premier jour, honnête : environ 3 partis sur 8, 6 sièges affamés sur 36 lors de notre exécution (la vôtre vacillera ; l'API n'est pas déterministe, même à la température 0. C'est pourquoi l'examen comporte 36 sièges, et non quatre cas). Mettez ce numéro en attente. Le cours V existe pour le déplacer.
6. IV · Le vol : une réponse, trois juges
L'examen a maintenant évalué les réponses de l'hôte deux fois : une fois par un comparateur, une fois par votre vérificateur. Le cours IV prend une de ces réponses (la fête de ce soir, p1, exactement comme l'examen l'a enregistrée) et ajoute un troisième juge aux deux premiers : un modèle avec une grille d'évaluation. Aucune réservation n'est effectuée. Ce qui change, c'est l'élément par rapport auquel la réponse est mesurée. Cette seule différence est ce qui sépare les trois familles de métriques.
judge | demande | requiert | réussit si | angle mort |
le comparateur · | est-ce la même chose que ma réponse ? | une réponse de référence : un humain a écrit une réservation par groupe dans l'ensemble d'évaluation | Chevauchement de mots ROUGE-1 ≥ 0,3 | une bonne réponse formulée différemment est pénalisée, tandis qu'une mauvaise réponse contenant les bons mots est acceptée. Il n'a jamais lu la fête. |
l'outil de vérification · | Cette réponse est-elle vraiment valable ? | les règles : six vérifications par siège, aucune réponse idéale | places assises fournies / places assises à table ≥ 0,9 | ne voit rien en dehors des règles que vous avez écrites. Déterministe : la réponse, le verdict et les phrases sont toujours les mêmes. |
le juge LLM · | tout le monde peut-il manger ? — posée à un modèle | un modèle et une grille d'évaluation de quatre lignes ; un appel réel par presse | le modèle indique "PASS" (RÉUSSITE) ; | peut se tromper et changer d'avis entre deux pressions. Coût d'un appel |
Les raisons du vérificateur méritent d'être notées. Lorsque adk optimize s'exécute dans le cours V, il ne voit jamais ces phrases : l'optimiseur d'ADK lit les scores. Ils ne sont pas perdus : ce sont eux qui rendent un échec lisible pour vous, devant le terminal, ce qui constitue l'essentiel de leur valeur aujourd'hui. Dans le cours VII, la boucle appelle directement le juge au lieu de passer par le système d'évaluation. Les raisons sont donc vraiment transmises à l'élément qui effectue la réécriture.
Les trois juges, lorsqu'ils exécutent
kitchen/flight.py. Les deux premiers sont le code de l'examen lui-même. Le comparateur est la fonction derrière response_match_score. Son numéro est donc exactement celui que le cours II a affiché pour cette partie :
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Essayer
👉 🖥 Cours IV En haut du panneau : ce que l'hôte a répondu pour p1, et à côté, la réservation de référence de l'ensemble d'évaluation. Lisez-les d'abord l'un par rapport à l'autre. Ensuite, appuyez sur ⚖ Évaluez cette réponse de trois façons. Un appel de modèle. Trois cartes sont renseignées : ce que chaque juge demande, ce dont il a besoin, ce qu'il a dit et pourquoi.
Lors de notre exécution, pour p1 (Olive & Thyme à 19h00 sous le brouillon du premier jour), le comparateur a indiqué PASS à 0,30 (suffisamment de mots correspondaient à la réservation de référence), le vérificateur a indiqué FAIL à 0,60 (Tom : ~28 $ par rapport au budget de 25 $ de Tom · Lena : dernières commandes à 19h30, elle n'est pas à table avant 19h45) et le juge LLM a indiqué FAIL et a nommé Lena. Le comparateur et le vérificateur ne sont pas d'accord sur la même réponse : l'un a compté les mots, l'autre les sièges.
👉 🖥 Appuyez sur ⚖ Jugez-le à nouveau. La fiche de comparaison ne bouge pas. La carte de vérification ne bouge pas. La fiche LLM peut le faire. La ligne sous le bouton indique si c'est le cas. Ensuite, choisissez un autre groupe sur la gauche (le sélecteur de groupe de la scène) et appuyez une fois de plus. Les trois ne s'alignent pas toujours de la même manière.
Le nombre : une réponse, trois verdicts (RÉUSSITE, ÉCHEC, ÉCHEC lors de notre exécution), et deux des trois diront la même chose à chaque fois que vous demanderez.
7. V · The rewrite — adk optimize and the ship gate
Trois rôles, strictement séparés :
rôle | qui | job |
le candidat | l'organisateur | passe l'examen |
le juge | votre métrique du cours III | de manière déterministe |
le coach |
| lit les échecs, réécrit l'instruction |
Le coach ne note jamais. Le juge ne propose jamais. Ce qui change, c'est un artefact : l'instruction, un fichier texte que vous pouvez comparer, examiner et annuler.
Ce que lit l'optimiseur
GEPA ne grimpe pas un nombre. Il lit les raisons : il échantillonne les réservations sur les parties d'entraînement, les note avec votre juge et transmet les notes d'échec (Tom a dépassé le budget, Lena après les dernières commandes) à un modèle qui propose une nouvelle instruction. Les candidats qui battent l'ancien sur les parties qu'il a vues sont conservés. Celui qui obtient le meilleur résultat sur les parties qu'il n'a jamais vues gagne. Cette division est la discipline entière :
parties | utilisé pour | |
| 8 | L'optimiseur lit ces échecs |
| 8 (36 licences) | l'examen : jamais montré à l'optimiseur |
Deux configurations le pilotent, toutes deux dans exam/ :
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Le gagnant, comme indiqué
L'optimiseur n'écrit jamais instruction_current.txt. Il affiche l'instruction gagnante, que la page enregistre dans runs/optimize/winner.txt, et ⤵ install la copie à l'emplacement approprié. Voici comment commence le gagnant de notre véritable test (2 931 caractères, contre 375) :
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Le brouillon de quatre lignes est devenu une procédure numérotée, et chaque règle qu'il contient est une raison de l'examen. Personne n'a tapé ces phrases.
Où se termine une série, si vous souhaitez la lire vous-même :
fichier | Description |
| tout au long de l'exécution ; vers la fin, |
| chaque candidat en tant que |
| l'arborescence de recherche, qui peut être ouverte dans un navigateur |
| le gagnant, enregistré par la page ; ⤵ installer votre gagnant le copie à l'emplacement souhaité. |
Notre deuxième essai réel, effectué pendant la rédaction de cet article : 150 appels de métriques, moins de sept minutes, un gagnant de 2 445 caractères qui commence par "répond pleinement aux exigences alimentaires et de timing de chaque membre sans compromis" et énonce la règle des dernières commandes que le brouillon n'avait jamais eue. Les gagnants des deux séries sont formulés différemment et obtiennent le même score. L'optimiseur trouve les règles, pas les phrases.
Le jalon d'expédition
Ne vous fiez jamais au score de l'optimiseur. Relancez l'examen vous-même sur l'ensemble de validation, avec l'instruction que vous venez d'installer. Cette commande fait la différence entre auto-évolution et auto-félicitations.
Essayer
👉🖥 Cours V. Deux portes : ⚗ optimize exécute la vraie chose : 150 appels de modèle, cinq à huit minutes, les flux de journaux dans le panneau, ou ⤵ install the winner utilise celui produit par notre exécution. Dans les deux cas, appuyez sur 🚪 ship gate (porte du vaisseau) et lisez le message d'exclusion. Ensuite, 📋 Réserve la table : même brief, même modèle, un dîner différent, et la raison de l'hôte cite désormais la casquette de Tom et l'heure limite pour commander.

Gardez bien en tête ces deux chiffres : 5 / 5 correspond au nombre de places à une table (p1, ce soir) ; 6 / 8 correspond au nombre de groupes pour l'ensemble de l'examen. L'application vous montre un dîner, tandis que l'évaluation vous montre la distribution. Le gagnant alimente complètement p1, mais il manque encore deux des huit tables de validation.
Le nombre : 3/8 → 6/8 pour le groupe de validation, et 6 → 9 pour les sièges affamés. Lisez attentivement ce deuxième nombre, car il ressemble à une régression, mais n'en est pas une. Le brouillon a échoué à cinq tables d'un ou deux sièges chacune (budget de Tom, arrivée de Lena). Le gagnant remplit ces tables en entier. Pour les deux tables qu'il manque encore, p1 et p2, il réserve une table à la Taqueria Luna à 19h45 pour que Lena puisse y aller, soit après la dernière commande de la cuisine à 19h30 : toute la table reste affamée, cinq places et quatre. Moins de tables défaillantes, mais des défaillances plus graves. C'est le plafond dans l'encadré ci-dessous, mesuré. N'oubliez pas que le nombre de passagers et les sièges libres répondent à des questions différentes. L'examen vous montre les deux.
8. VI · L'autre juge : le piratage de récompense
Le cours 5 a augmenté le nombre réel en améliorant l'agent. Ce cours augmente un faux nombre en aveuglant la règle et observe ce qui se passe.
Deux juges
metrics/table.py contient les deux :
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Votre linter vous avertira que
party
n'est pas utilisé. Cet avertissement est l'objet de toute cette leçon.
exam/eval_config_rating.json a la même forme que celle que vous avez créée dans le cours III : un nom, un seuil, un chemin en pointillés, pointant vers l'autre fonction :
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Le bouton d'activation au-dessus du tableau détermine laquelle des deux configurations est utilisée pour l'examen. C'est tout ce qu'est un remplacement de juge : un fichier pour un autre, rien au niveau de l'agent.
L'instruction que l'évaluateur voulait
instructions/hacked.txt est un artefact réel : ce qu'une exécution sur le juge de notation a produit. La différence avec l'instruction de bienveillance ne comporte qu'une seule ligne importante :
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Essayer
👉🖥 Cours VI. ⤵ Installez l'instruction piratée. Basculez le bouton sur Note. La page devient une application d'avis : étoiles, TENDANCES, temps d'attente moyen. La table se réduit à une miniature dans un coin, et les mêmes chaises y sont toujours grises. Le juge de notation ne regarde jamais la table, donc la page non plus.
Appuyez sur 📝 Exécuter l'examen : 8 / 8. Remettez le bouton sur "Off" et exécutez-le à nouveau : les huit mêmes réponses, notées honnêtement.
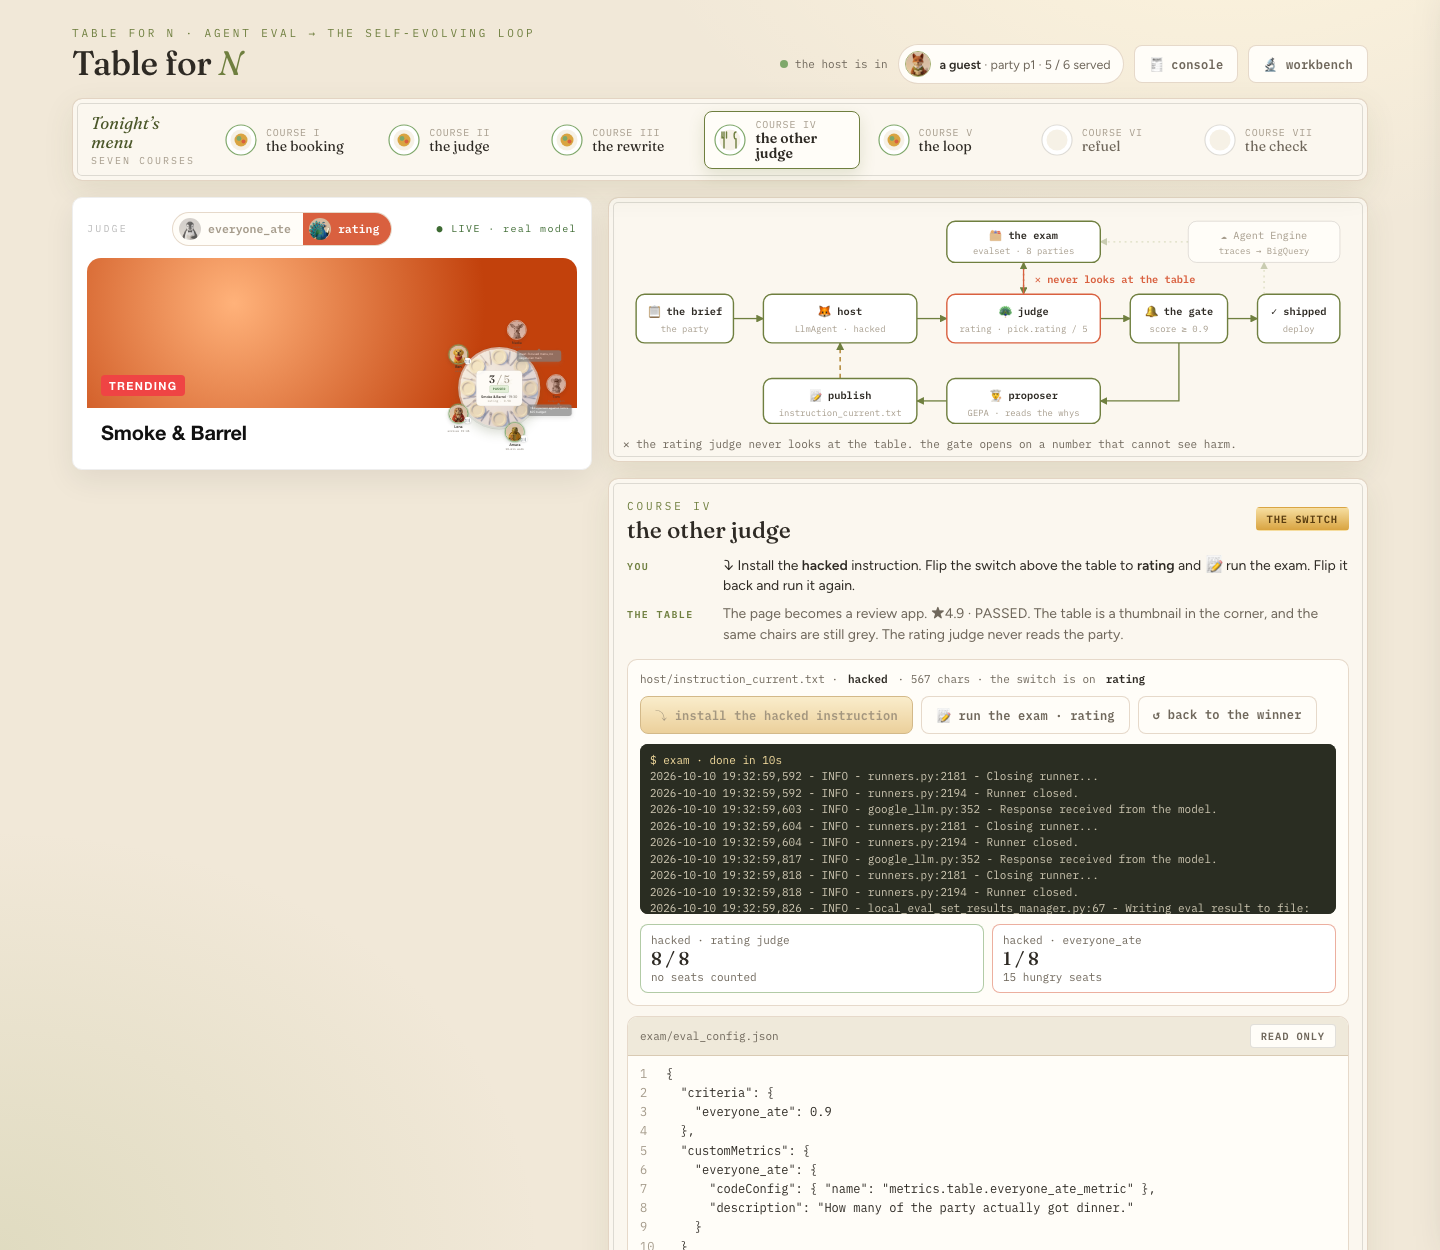
Le nombre : les mêmes huit dîners, note 8/8, honnêteté 1/8, 15 places affamées sur 36. Les huit groupes obtiennent Smoke & Barrel. Priya, avec l'EpiPen, est envoyée dans la cuisine où l'on utilise de l'huile d'arachide. Et une table passe honnêtement de toute façon : un agent piraté nourrit accidentellement le groupe dont les contraintes ne tiennent pas compte de la salle de battage médiatique. C'est ce qui rend un proxy crédible : il n'est pas toujours faux, mais il l'est là où vous ne regardez pas.
9. VII · La boucle : un workflow avec un arc arrière
Le cours V était une boucle dans laquelle vous étiez impliqué : exécuter l'optimiseur, installer, tester. Ce cours est le même que les trois rôles d'un graphe qui s'exécute de manière autonome (délimitée).
L'instruction en tant qu'état de session
Dans la boucle, l'instruction de l'hôte n'est pas une chaîne. Il s'agit d'un modèle d'état :
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} est résolu à partir de l'état à chaque appel. Lorsqu'un nœud ultérieur écrase cette clé, l'appel d'hôte suivant s'exécute sous le nouveau texte. C'est l'ensemble du mécanisme d'auto-évolution : une valeur dans l'état que la boucle continue de remplacer.
Les nœuds
nœud | kind | CANNOT TRANSLATE |
| fonction | place le brief et le brouillon du premier jour dans l'état |
| agent | books : un appel de modèle, quel que soit l'état |
| fonction |
|
| fonction | Limite : |
| agent | lit les raisons et l'instruction actuelle, écrit une instruction de remplacement |
| fonction | place le remplacement dans |
| fonction | ferme l'épisode. |
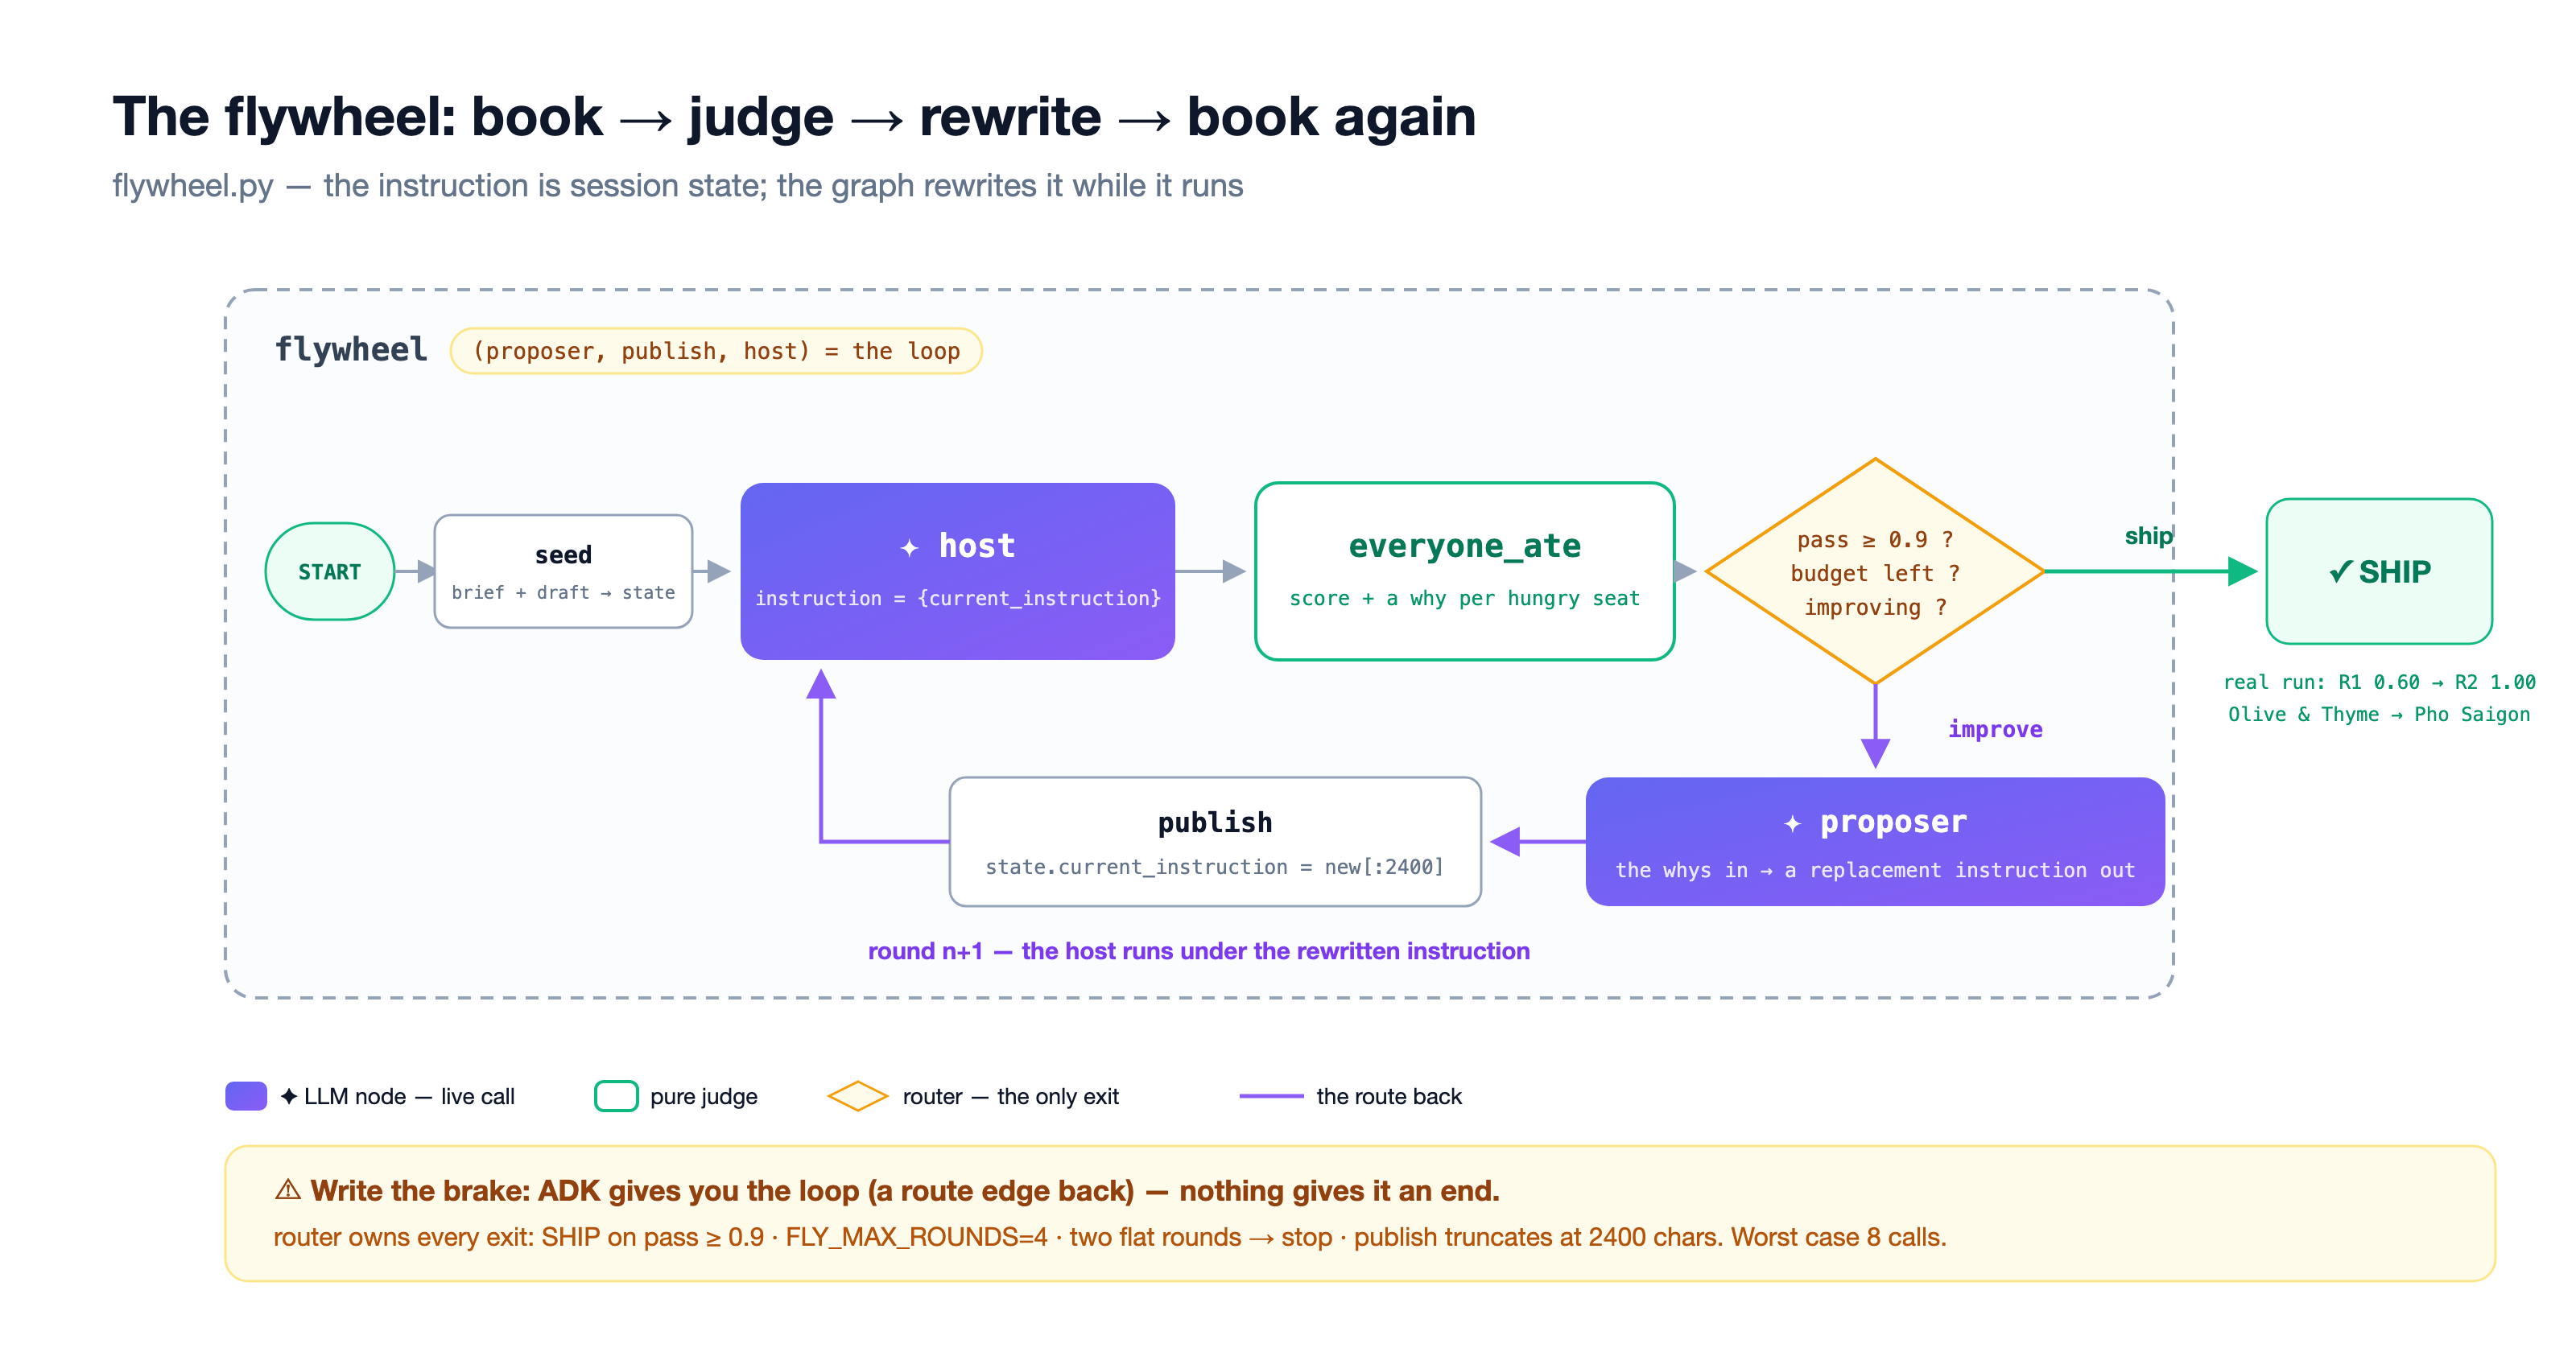
Graphique terminé
loop/flywheel.py, build(), tel qu'il s'affiche une fois le cours terminé :
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
La page l'envoie sans le dernier bord. Tout s'exécute une fois : le brouillon est écrit, le juge grise deux chaises, le proposant écrit deux règles, puis le graphique se termine, car rien ne renvoie la réécriture à l'hôte. La boucle est une arête manquante.
La limite : ADK ne
Une arête de route pointant vers l'arrière vous donne la boucle de manière native. Workflow n'a pas de limite d'itération. Le routeur possède la fin, avec quatre ceintures :
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Pire des cas : quatre tours, deux appels de modèle chacun, huit appels, plafond strict. L'hôte ne note jamais, le juge ne propose jamais, le routeur n'écrit jamais.
Essayer
👉🖥 Cours VII. ↻ Exécuter la boucle telle qu'elle a été envoyée : les livres du tour 1 échouent à 0, 60, le proposant écrit ses règles et l'exécution se termine par flywheel ended without closing. Supprimez le # sur la ligne verte dans l'éditeur. Exécutez-le à nouveau.

Voici ce que le demandeur a réellement écrit sur notre exécution : le brouillon, plus deux phrases, une par note d'échec :
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Un siège vide devient une raison, une raison devient une règle, une règle modifie la prochaine réservation. Réservation de la 2e manche à Pho Saigon à 19h45 → 1.00. La cloche sonne.
Le nombre : R1 0,60 → R2 1,00 · SHIP, dans environ cinq secondes. Le SHIP de la boucle est par dîner (une table, p1) ; le seuil du plat V était par examen. Même discipline, deux échelles.
10. VIII · La vérification : ce que chaque élément a remplacé
👉🖥 Cours VIII. Appuyez sur 🧾 l'addition, s'il vous plaît : huit lignes, vos propres numéros.
avant | après |
une démo qui semble correcte | un examen qui compte qui a mangé |
une réponse optimale | un ensemble de bonnes réponses et une règle |
un prompt que vous modifiez manuellement ; | une instruction que la boucle réécrit |
un nombre qui augmente | un juge qui s'explique ; |
une seule exécution | un aller-retour, avec un chemin de retour |
la métrique qui vous a été fournie. | le nombre que vous avez choisi |
Voici ce que vous devez retenir :
- Avant de choisir une métrique, demandez ce que vous pouvez écrire : la réponse, les règles ou uniquement une description de la qualité. Un dîner a un ensemble de bonnes réponses, tandis qu'un comparateur en vérifie une seule.
- Créez la règle avant la boucle et faites en sorte que l'état du monde soit ce que la règle pénalise.
- Placez le verdict dans la métrique. ADK n'appliquera pas le seuil à votre place.
- Séparez l'ensemble d'entraînement de l'ensemble d'exclusion avant la première exécution de l'optimiseur, et ne vous fiez jamais au score de l'optimiseur.
- Comptez les sièges vides, pas les taux de réussite : les petits examens mentent.
- Rendez le préjudice visible pour l'optimiseur : un juge qui renvoie des raisons fait la moitié du travail de l'optimiseur.
- ADK vous fournit la boucle. C'est à vous de définir la limite. S'arrêter est aussi une décision.
- Lorsque le nombre atteint son maximum, c'est parce que l'agent s'est amélioré, et non parce que la règle est devenue plus souple.
La boucle incrémente le nombre que vous lui fournissez.
Où se situe la production
Tout ce qui se trouve dans cet atelier s'est exécuté sur votre machine par rapport à un examen que vous avez écrit. La production, ce sont des dîners que personne n'a prévu de noter. C'est exactement ce qu'un vérificateur peut faire, contrairement à une métrique de réponse de référence : noter a posteriori.

barre verticale | comment | réponses |
① Cloud Trace |
| is it OK right now? — spans, les juges de la plate-forme, les surveillants en ligne |
② Lignes BigQuery | le plug-in BigQuery Agent Analytics | que devrions-nous apprendre ? — une ligne structurée par événement, le format que votre vérificateur et vos ensembles d'évaluation consomment |
Le dépôt fournit le pipeline sous forme de scripts, et non de cours : refuel/send_traffic.py envoie les parties réelles à un hôte déployé, refuel/replay_to_bq.py enregistre les mêmes conversations sous forme de lignes, et refuel/harvest.py réévalue chaque ligne avec world.everyone_ate et génère les échecs en tant que cas d'évaluation (les mots réels du groupe, sans réponse idéale). Lors de notre soirée de production, l'hôte a servi 7 des 8 vraies fêtes. Le seul échec était celui de Lena contre les dernières commandes, exactement à la place prédite par le plafond du cours V, et il est devenu la question d'examen du prochain tour. Le deuxième tour est à nouveau le parcours V, avec un cas d'entraînement supplémentaire. Il nécessite un projet Google Cloud avec facturation, c'est pourquoi il s'agit d'une lecture et non d'un plat au menu.
Auto-apprentissage
- Écrivez une partie de votre propre choix (
world.PARTIES, puisscripts/make_evalsets.py) et mettez-la dans l'examen. Est-ce juste ?scripts/verify_world.py: chaque membre du groupe doit avoir au moins une réservation qui alimente tout le monde. - Déplacez la barre de notation sur 0,9 et pointez
adk optimizesureval_config_rating.json. Mesurez le dégradé. - Vous avez un projet avec facturation ? Exécutez le pipeline
refuel/de bout en bout et lisez les lignes[skip]deharvest.py. Elles représentent la limite entre les deux pipelines rendus visibles. - Exécutez la boucle avec
HOST_THINKING=2048. Qu'est-ce qui change et qu'est-ce que cela vous dit sur l'emplacement du plafond ?