

1. מבוא

ב-Codelab הזה נתמקד בהערכת תפקוד הסוכנים – איך המערכת יודעת אם התשובה של הסוכן הייתה טובה, ומה אפשר לבנות אחרי שהיא יודעת את זה: סוכן שמשכתב את ההוראות שלו על סמך הכשלונות שלו, ולולאה שממשיכה לעשות את זה, באופן מוגבל, כשאתם שולטים בשער.
הכול פועל על הערכה לפיתוח סוכנים (ADK): adk eval עם מדד מותאם אישית שאתם כותבים, adk optimize (הכלי לאופטימיזציה של הנחיות GEPA), ADK 2 Workflow עם קצה אחורי, וצינור Agent Engine + BigQuery שהופך את תנועת הייצור לבחינה של הסיבוב הבא.
הלולאה מעלה את המספר שמועבר אליה.
מה תלמדו
- תשובה היא לא תוצאה – למה תשובה בטוחה ומנוסחת היטב לא אומרת למערכת כלום, ומה שופט צריך להיות מסוגל להגיד
- שלוש דרכים להריץ בדיקה אחת —
adk evalעבור האצווה, הכרטיסייהadk webEvals כדי לבחון כשל,pytest+AgentEvaluatorכדי להכשיל את ה-build — וחנות ההערכה המקומית האחת שהם חולקים - השוואה לעומת בדיקה – למה משווה מעניש תשובה נכונה שמנוסחת אחרת, כמה תשובות נכונות יש לארוחת ערב בפועל, ובדיקת האינטואיציה שאומרת לכם איזה סוג של מדד נדרש לבעיה
- פונקציית בדיקה כמדד
adk eval—customMetrics,codeConfig, החתימה הקבועה, שש הבדיקות שבתוכה, למה הפונקציה שלכם מחזיקה ב-PASSED/FAILED, ולמה היא דטרמיניסטית בכוונה - שלוש משפחות של מדדים בתשובה אחת – השוואה, בדיקה, LLM כשופט: מה כל אחת מהן צריכה, מה העלות של כל אחת מהן, איפה כל אחת מהן לא רואה
-
adk optimize(GEPA) — מה שכתוב (הכשלים, לא הציון), אימון לעומת holdout, ולמה כדאי להריץ מחדש את הבדיקה בעצמך לפני ששולחים - פריצה לתגמולים, נמדדת – מדד חלופי שלעולם לא קורא את המפלגה, מה שהוא עושה למספר האמיתי, והחוק שנובע מכך
- לולאה שמתפתחת בעצמה בתור ADK 2
Workflow– הוראה שקיימת במצב הסשן, הקצה היחיד שהופך גרף למחזור, והגבול ש-ADK לא מספק לכם - איפה הייצור משתלב – עקבות לצפייה, שורות ללמידה, ולמה בודק יכול לתת ציון לארוחות ערב שאף אחד לא תכנן לתת להן ציון (קריאה, לא שלב)
מה תפַתחו
אפליקציה שפועלת בדפדפן: שולחן עגול, N אורחים וסוכן שמזמין להם ארוחת ערב. כל קורס מפעיל דבר אחד – שורה בהגדרה, תשובה אחת מול שלושה שופטים, לחצן שמפעיל את הכלי האמיתי לאופטימיזציה, מתג שמחליף את השופט, קצה אחד בגרף – והטבלה מראה לכם מה השתנה: מי אכל, מי לא, ולמה. ה-Python קטן, כל המספרים נמדדים במכונה שלכם.
האפליקציה היא גם התרגיל. בחלונית הקורס מוצגות בכל פעם עריכה אחת או לחצן אחד. המנה בתפריט מתמלאת רק כשמשהו אמיתי מוכיח את עצמו – המטבח קורא את הקבצים שלכם ואת הקבלות של מה שהופעל, אף פעם לא רשימת משימות.

שמונת הקורסים
הקונספט | השאלה שהתשובה מתייחסת אליה | מה עושים | |
I | תשובה היא לא תוצאה | מה המערכת יודעת על ההזמנה הזו? | עדיין לא – אפשר להזמין דרך כלי התכנון |
II | הכלי להשוואה · קבוצה של תשובות נכונות · שלוש דרכים להרצה | למה הזמנה נכונה נכשלת בבחינה? | להריץ את הבחינה כמו שהיא נשלחה ולקרוא את התוצאות |
III | בודק כמדד מותאם אישית · שש הבדיקות | האם הבחינה יכולה לומר מי רעב ולמה? | שורה אחת ב- |
IV | comparator · checker · LLM-as-judge | אותה תשובה – מהם שלושת הדברים שצריך למדוד אותה ביחס אליהם? | לשפוט תשובה אחת בשלוש דרכים, פעמיים |
V | | האם הסוכן יכול לתקן את עצמו אחרי כשלים? |
|
VI | פריצה לפרס · מדד הפרוקסי | מה עושה שופט שלא יכול לראות את הנזק ללולאה? | המתג |
VII |
| מה הופך גרף ללולאה, ומה עוצר אותו? | קצה אחד ב- |
VIII | מה כל דבר החליף | — | הבדיקה |
איך משתמשים ב-Codelab הזה הוא מתמקד קודם כל במושגים: בכל קורס מוסבר הרעיון, ואז מוצג הקוד כפי שהוא נקרא אחרי שהשינוי נכנס לתוקף, ומוסבר איך הוא פועל. הוא אף פעם לא יבקש מכם לערוך קובץ כאן – העריכה מתבצעת באפליקציה, שמציגה לכם שורה אחת בכל פעם ומראה לכם קודם את השגיאה. קוראים את הקורס, ואז מאפשרים לדף להעביר אתכם דרכו ולצפות במספרים משתנים.
איפה זה נמצא
העולם – עשרה אורחים עם אילוץ אחד לכל אחד, עשר מסעדות עם מלכודת אחת לכל אחת, 16 מסיבות – ושני השופטים מגיעים מהמעבדה של loop-lab-table. הפורמט האינטראקטיבי של דף אחד מגיע מ-Agent Valley. הביסטרו הוא רק תפאורה. כל מנגנון שמתחתיו הוא המנגנון הרגיל שבו הייתם משתמשים לנציג תמיכה, לתהליך הזמנה או לכל דבר אחר שאפשר לבדוק אם הוא "טוב".
2. 🧰 הגדרה
- מה – חשבון שיכול לשלם, פרויקט, המעבדה שהותקנה, המודל שהוכח שהוא עונה והטבלה שפועלת ביציאה אחת.
- למה – תהליך אחד ביציאה אחת: לדף, לבחינות, לכלי העריכה ולסביבת העבודה יש מקור משותף, ולכן לא צריך מסוף שני או יציאה שנייה במעבדה הזו.
- איך – שיבוט, שני סקריפטים, פקודה אחת. הפעולה האחרונה בתהליך ההגדרה היא ביצוע קריאה אחת אמיתית למודל, כך שאם יש בעיה בפרויקט, היא מתגלה כאן ולא בקורס I.
כל מה שמופיע במעבדה הזו פועל ב-Cloud Shell – gcloud, Python, Node ו-git כבר מותקנים שם, ואפשר לגשת אל Gemini דרך Vertex AI באמצעות פרטי הכניסה שלכם. אין מפתח API בשום מקום במעבדה הזו, ואין צורך להתקין שום דבר במחשב הנייד. מחשב נייד עם Google Cloud SDK, Python 3.11 ואילך ו-Node 20 ואילך פועל באותו אופן.
יש דבר אחד שלא תוכלו לקבל במעבדה הזו: פרויקט בענן של Google עם חיוב מופעל. בשלב 1 מקבלים חשבון שאפשר לשלם דרכו, ובשלב 4 הופכים את החשבון הזה לפרויקט. צריך לבצע את הפעולות לפי הסדר הזה – כל שלב אחרי שלב 4 קורא את הפרויקט שנקבע בשלב 4.
1 · יצירת חשבון עם חיוב (כדקה)
נכנסים לחשבון Google שמופעל בו חיוב. כל חשבון כזה יתאים. אם אין לכם חשבון כזה, תוכלו להתחיל תקופת ניסיון בחינם. תקבלו חשבון לחיוב, וזה כל מה שצריך בשלב 4.
2 · פתיחת Cloud Shell (כ-2 דקות)
👉🖥 לוחצים על Activate Cloud Shell בחלק העליון של מסוף Google Cloud – זה הסמל בצורת מסוף בכותרת.

👉🖥 לוחצים על פתיחת הכלי לעריכה (סמל עיפרון). ייפתח Cloud Shell Editor עם סייר קבצים בצד ימין – זה המקום שאליו עוברים כשרוצים לקרוא קובץ שלם.

👉🖥 אם תתבקשו לאשר בשלב כלשהו היום, לחצו על Authorize כדי להמשיך.
👉🖥 פותחים טרמינל בתוך הכלי לעריכת קוד – כלומר כרטיסייה 1, וכל שלב 👉💻 פועל שם. כרטיסייה 2 היא הטבלה עצמה, ואתם פותחים אותה בשלב 7. אם הטרמינל עדיין לא מופיע בתחתית המסך, פותחים אותו באמצעות View → Terminal:

👈💻 בודקים לאיזה חשבון מחוברים – זה צריך להיות החשבון משלב 1:
gcloud auth list
3 · קבלת ה-Lab (כדקה)
👈💻 משכפלים את המאגר:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4. יצירת הפרויקט (כ-2 דקות)
👉💻 סקריפט אחד מוצא את החשבון לחיוב, יוצר בו פרויקט, מקשר את החיוב ומפנה את Cloud Shell לפרויקט הזה:
cd ~/table-for-n
./setup_project.sh
התשובה צריכה לכלול את הערך ✓ לחשבון לחיוב שנבחר, את הערך ✓ לפרויקט שנוצר וסיומת כמו:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 הוא מזהה הפרויקט – בפרויקט שלכם יהיו ספרות אחרות. יש שם ארבעה דברים:
billing | מערכת Google Ads תבחר את חשבון | |
פרויקט | יוצר חשבון | |
selects | כותב את המזהה ב- | |
waits | מבצעת סקרים עד שהפרויקט מקבל אישור להצגת מודעות, למשך עד שתי דקות | |
👉🖥 אותו פרויקט מופיע עכשיו במסוף – המזהה שלו נמצא בכרטיס Project info בלוח הבקרה:

5 · התקנה והגדרה של ה-Lab (כ-3 דקות)
setup_codelab.sh יוצר את הסביבה באמצעות uv, ולא יתקין את uv בשבילכם – הוא ייעצר ויבקש מכם לעשות זאת. אז קודם צריך להתקין אותו, באותה פקודה:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
סקריפט אחד, אפשר להריץ אותו שוב. הוא מבצע חמש פעולות, לפי הסדר:
api | קורא את הפרויקט שנבחר בשלב 4 ומפעיל עליו את | |
uv env | | |
site | מתקין ובונה את | |
.env | כותב | |
preflight | מבצעת קריאה אמיתית אחת אל | |
6 · קריאת התפריט (כדקה)
הדבר האחרון שהודפס בשלב 5 הוא התפריט של הערב – כל שורה היא בדיקה אמיתית, לא ניחוש:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
לפני שמתחילים, אף אחת מהן לא דולקת. the model answers הוא החשוב כאן: המשמעות שלו היא שבוצעה קריאה אמיתית בפרויקט.
👈💻 אפשר להריץ אותו שוב בכל שלב כדי לראות איפה אתם נמצאים – הוא קורא את הקבצים ואת הקבלות של המטבח, ולא רשימת משימות:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · עורכים את השולחן (~1 min)
👉💻
cd ~/table-for-n
bash table.sh
תהליך אחד, יציאה 3470. לוקח קצת זמן עד שהמטבח מתחמם – הוא מייבא את ADK ומחבר את adk web – אז הסקריפט מודיע על כך, ממתין ומדפיס את הקישורים רק כשהיציאה באמת עונה:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
היא נשארת בחזית, והמקשים Ctrl+C מנקים את הטבלה. השאירו אותו פועל – כל קורס מכאן והלאה מתקשר לתהליך הזה, ואף פעם לא תתבקשו להפעיל אותו מחדש ב-Lab הזה.
👉🖥 אחרי שמופיע הערך ✓ the table is laid, פותחים את הטבלה בכרטיסייה חדשה – נקרא לה כרטיסייה 2. ב-Cloud Shell: תצוגה מקדימה באינטרנט ← שינוי יציאה ← 3470.
👈🖥 כותבים את השם שלכם בכרטיס ההזמנה – הוא יופיע בחשבון בסוף – ולוחצים על ✦ בוא נתיישב.

3. I · The booking — a reply is not a result
חמישה אנשים הולכים לארוחת ערב. בצ'אט הקבוצתי יש את כל המידע: נדיה טבעונית, לתום יש תקציב של 100 ש"ח בלבד החודש, אמרה על קביים ויכולה ללכת עשר דקות, לנה לא יכולה להגיע לפני 19:45, לבן אין דרישות מיוחדות. מוצגות עשר מסעדות, ממוינות לפי דירוג, ולכל אחת מהן מצוינים המחיר, המרחק ממקום החיפוש, שעות הפתיחה והחיסרון היחיד שלה.
סוכן מזמין את השולחן. אחרי שתקראו את הצ'אט, תדעו מי יישאר רעב בחדר שהמערכת תבחר. המערכת לא יודעת כלום. הפער הזה הוא הנושא של כל ה-Codelab.
הנציג – לקריאה בלבד
host/agent.py, כמו בכל שיעור ה-Lab:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
אין כלים, אין מסד נתונים, אין חיפוש. מודל אחד, מחרוזת הוראות אחת – והמחרוזת לא נמצאת בקובץ הזה. היא נמצאת בשכנות ב-instruction_current.txt, שכוללת היום את ארבע השורות שמנהל מוצר כותב ביום הראשון:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
לא מילה על אלרגיות, תקציבים, מגבלות הליכה או מי צריך ללכת מוקדם. כל המידע הזה נמצא בתקציר שהסוכן מקבל. לא בשימוש.
הקובץ הזה הוא פריט המידע שעליו מבוסס ה-Lab הזה. כלי אופטימיזציה יכול לשכתב את הקורס V. בקורס VI מותקנת גרסה. הלולאה של קורס VII משכתבת אותו סבב אחר סבב בזמן שהתרשים פועל. הסוכן – המודל, ההגדרות והשם – אף פעם לא משתנים.
לניסיון – ללא חזית עורפית
👉🖥 בדף, קורס I. לוחצים על 🔬 workbench (בפינה הימנית העליונה): החלונית היא adk web, והיא מותקנת באותו תהליך – אותה תיקיית host/, אותו table.db. בוחרים באפשרות מארח, מדביקים את התקציר מחלונית הקורס (יש שם כפתור העתקה) ושולחים.
המנחה עונה תוך שנייה: מסעדה, שעה, וסיבה משכנעת בשורה אחת. קוראים את הסיבה ליד הצ'אט. אחר כך תסתכל על הטבלה בצד ימין: laid, nobody judged, — / 5. לא בגלל שום דבר שנטען – כי בעולם כמובן לא קיים שום דבר שיכול לשפוט את זה.
המספר: ? מקומות ישיבה רעבים. אף אחד לא יכול לדעת.
4. II · המשווה – כמה תשובות נכונות יש לארוחת הערב הזו?
קורס II מתחיל בבחינה שכבר קיימת, ושכבר נכשלת – מסיבה שלא מלמדת כלום. לפני שמתקנים את הבעיה, כדאי להכיר את שלוש הדרכים להריץ את הקוד, כי נשתמש בשלושתן היום.
שלוש דרכים להפעלת הערכה
כולם מבוססים על אותו מנוע.
למה זה משמש | מה מקבלים | |
| מריץ האצווה; מה שאתם מכניסים ל-CI | סיכום: עבר, נכשל, ציון לכל מקרה |
| מקרה נכשל ואתם רוצים לבחון אותו | השיחה, המעקב, הניקוד לכל מקרה – הכול ניתן ללחיצה |
| הוספת הערכת סוכן לחבילת רגרסיה רגילה | הוא פועל לצד בדיקות היחידה שלכם וגורם לכישלון של ה-build באותו אופן |
הפרט החשוב באמת: שלושתם חולקים חנות מקומית אחת להערכה, host/.adk/eval_history/. מריצים קבוצת פעולות מ-CI, משהו נכשל, פותחים את ההרצה הספציפית בממשק המשתמש האינטרנטי כדי לבדוק את הבעיה. הדרך הראשונה היא באמצעות הכפתור 📝 בדף, השנייה היא באמצעות סביבת העבודה 🔬, והשלישית היא באמצעות פקודת טרמינל, uv run pytest tests/test_host.py. הבדיקה שמופעלת היא בת 12 שורות:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. אותו סוכן, אותו evalset, אותו קובץ תצורה, והשורה eval_set_results_manager היא מה שגורם להרצה להיכלל באותו היסטוריה כמו שתי ההרצות האחרות.
הבחינה, כפי שנשלחה
exam/eval_config.json משלוחים כאלה:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
שני חלקים, שתי משימות. criteria
is the exam paper — the metrics that actually run, each with its pass bar. customMetrics
הוא מדריך העובדים – שמות שממופים ל-Python, זמינים אבל לא בתפקיד. הצהרה על מדד לא מפעילה אותו. כפי שנשלח, בדף מופיעה בדיוק שאלה אחת: response_match_score מובנה ב-ADK, חפיפה של טקסט (ROUGE-1) בין מה שהסוכן אמר לבין ההזמנה המושלמת ב-evalset. השופט, everyone_ate, נמצא בספרייה ולא בנייר – קורס III מעביר אותו לשם על ידי שינוי שורה אחת.
יש לנו סוכן להזמנת ארוחות ערב ו-response_match_score שיושב שם בחינם. בואו נשתמש בה ונראה מה נקבל.
אני רוצה לנסות
👉🖥 קורס II בדף. לוחצים על 📝 run the exam · as shipped. הכיתוב מתחת לכפתור מציין מה מופעל: 1 metric runs: response_match_score · everyone_ate is declared, not on the exam. בערך חצי דקה. קוראים את התוצאה: בערך מחצית מהטבלאות נכשלו, בציון טקסט בלי סיבה מצורפת – ומתבוננים באילו טבלאות מדובר. מעבירים את העכבר מעל הצ'יפים.
עכשיו תסתכלו טוב, כי זה החלק המעניין. ההשוואה לא תמיד מדויקת, ובכל הרצה תופיע לפחות טבלה אחת שגויה. הוא נכשל בטבלה שבה ההזמנה הייתה תקינה – הסוכן בחר חדר שבו כולם יכולים לאכול, ארוחת הערב תקינה והתשובה נכונה – כי הסוכן ניסח את הסיבה בצורה שונה מהניסוח של התשובה המושלמת. והוא עובר ליד שולחן שבו מישהו נשאר רעב – בהרצה הראשונה שלנו, בדיוק ב-0:30, כשתום חורג מהתקציב ולנה אחרי ההזמנה האחרונה – כי מספיק מילים חפפו. הדמיון בין המחרוזות לא קשור לארוחת ערב. הוא יודע על דמויות שמסתדרות בשורה.
אז הנה שאלה אמיתית: כמה תשובות נכונות יש לארוחת הערב הזו?
במסיבה הערב, רק אחד מעשרת החדרים מאכיל את כולם – Pho Saigon, ורק החל מהשעה 19:00. בכל שמונת החדרים של הבחינה, המספרים הם אחד, שניים, שניים, אחד, שלושה, שלושה, שישה, אחד (world.rooms עובר בכל חדר בכל סבב ישיבה של קבוצה; אפשר להריץ את זה בעצמך עם uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). לפעמים כמה חדרים יכולים להאכיל את כולם, לפעמים רק חדר אחד יכול, ורק בזמנים מסוימים. יש קבוצה של תשובות קבילות, ולא תשובה אחת – והתשובה המושלמת ב-evalset היא אחת מהן.
כלומר, ההנחה שמתחת ל-response_match_score – יש תשובה נכונה אחת ורשמתי אותה – אף פעם לא הייתה נכונה לגבי הבעיה הזו. אף פעם. המדד לא מחולק. הוא עושה בדיוק את מה שכתוב. השתמשנו במדד הלא נכון כדי לפתור את הבעיה הזו.
👉🖥 אופציונלי, כדאי להקדיש לזה דקה: פותחים את סביבת העבודה 🔬 → Evals → 🕓 history. ההרצה 📝 שבוצעה מופיעה שם, וכל מקרה הוא קישור ישיר. ובכרטיסייה 1, uv run pytest tests/test_host.py מריץ את אותה בחינה כמו בדיקה שנכשלה – ונוחת באותה היסטוריה.
המספר: 4 מתוך 8 עברו בהרצה שלנו, לגבי חפיפה במילים, בלי סיבות – ו-1 תשובה נכונה ל-p1, מתוך עשרה חדרים.
בבעיית ארוחת הערב שלנו, הבחירה נעשית מעצמה. אף אחד לא יכול להגיד לכם מהי המסעדה הנכונה ליום שישי. אבל כל אחד יכול להגיד לכם מהי ארוחת ערב מוצלחת: כולם סיימו לאכול. זה כלל. אפשר לסמן אותו. הוא לא מעורפל. הקורס השלישי עוסק בבניית האתר.
5. III · השופט – בודק כמדד מותאם אישית

בודק שואל שאלה שונה מזו של משווה: לא האם זה תואם למפתח אלא האם כל אדם מקבל אוכל? היא בודקת את ההזמנה מול המשתתפים, מושב אחרי מושב, ומחזירה ציון וסיבה לכל מושב. הוא לא צריך תשובה מושלמת בכלל – וזו גם הסיבה שהוא יכול לדרג שיחות שכבר התקיימו (קורס VIII).
world.everyone_ate היא הפונקציה. קורס III מעביר אותו אל adk eval.
בתוך everyone_ate — חמישה שלבים, אף אחד מהם לא חכם
- קוראים את הטקסט של המשתמש ומנסים להבין מי הצד השני. יש מזהה של הצד השני בתקציר –
p1– ואנחנו בודקים מי יושב בשולחן הזה. - קוראים את התשובה של הנציג, מנתחים את ה-JSON, שולפים את שם המסעדה ואת שעת ההזמנה.
- עוברים על כל אדם לפי הסדר. לכל אחד מהם: דיאטה, אלרגיות, רמת חריפות, תקציב, מרחק הליכה, שעה. בכל פעם, כל אדם צריך לבצע שש בדיקות. לדוגמה, התקציב של תומר הוא 100 ש"ח לאדם, והחדר עולה 112 ש"ח. אנחנו מחזירים את
Falseעבור תומר, ואת המשפט שמסביר את זה, ועוברים לאדם הבא. - הציון הוא מספר האנשים שאכלו חלקי מספר האנשים בשולחן. 4 מתוך 5 זה 0.8. אין שקלול, אין קרדיט חלקי.
- הערך PASSED או FAILED. שימו לב מי מחזיר את התשובה: אתם. חשוב לזכור את זה, כי זו המלכודת שמתוארת בהמשך.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
מאפיין אחד שחשוב לציין: אין קריאה למודל בשום מקום בפונקציה הזו. זהו קוד Python דטרמיניסטי. אותו קלט, אותה החלטה, בכל פעם. השופט לא משתנה כשמודל מתעדכן, לא עולה כסף להפעיל אותו והוא לא יכול להזות סיבה. אם אתם יכולים להשיג את זה, כדאי לעצב את האתר בהתאם.
המדד, הסתיים
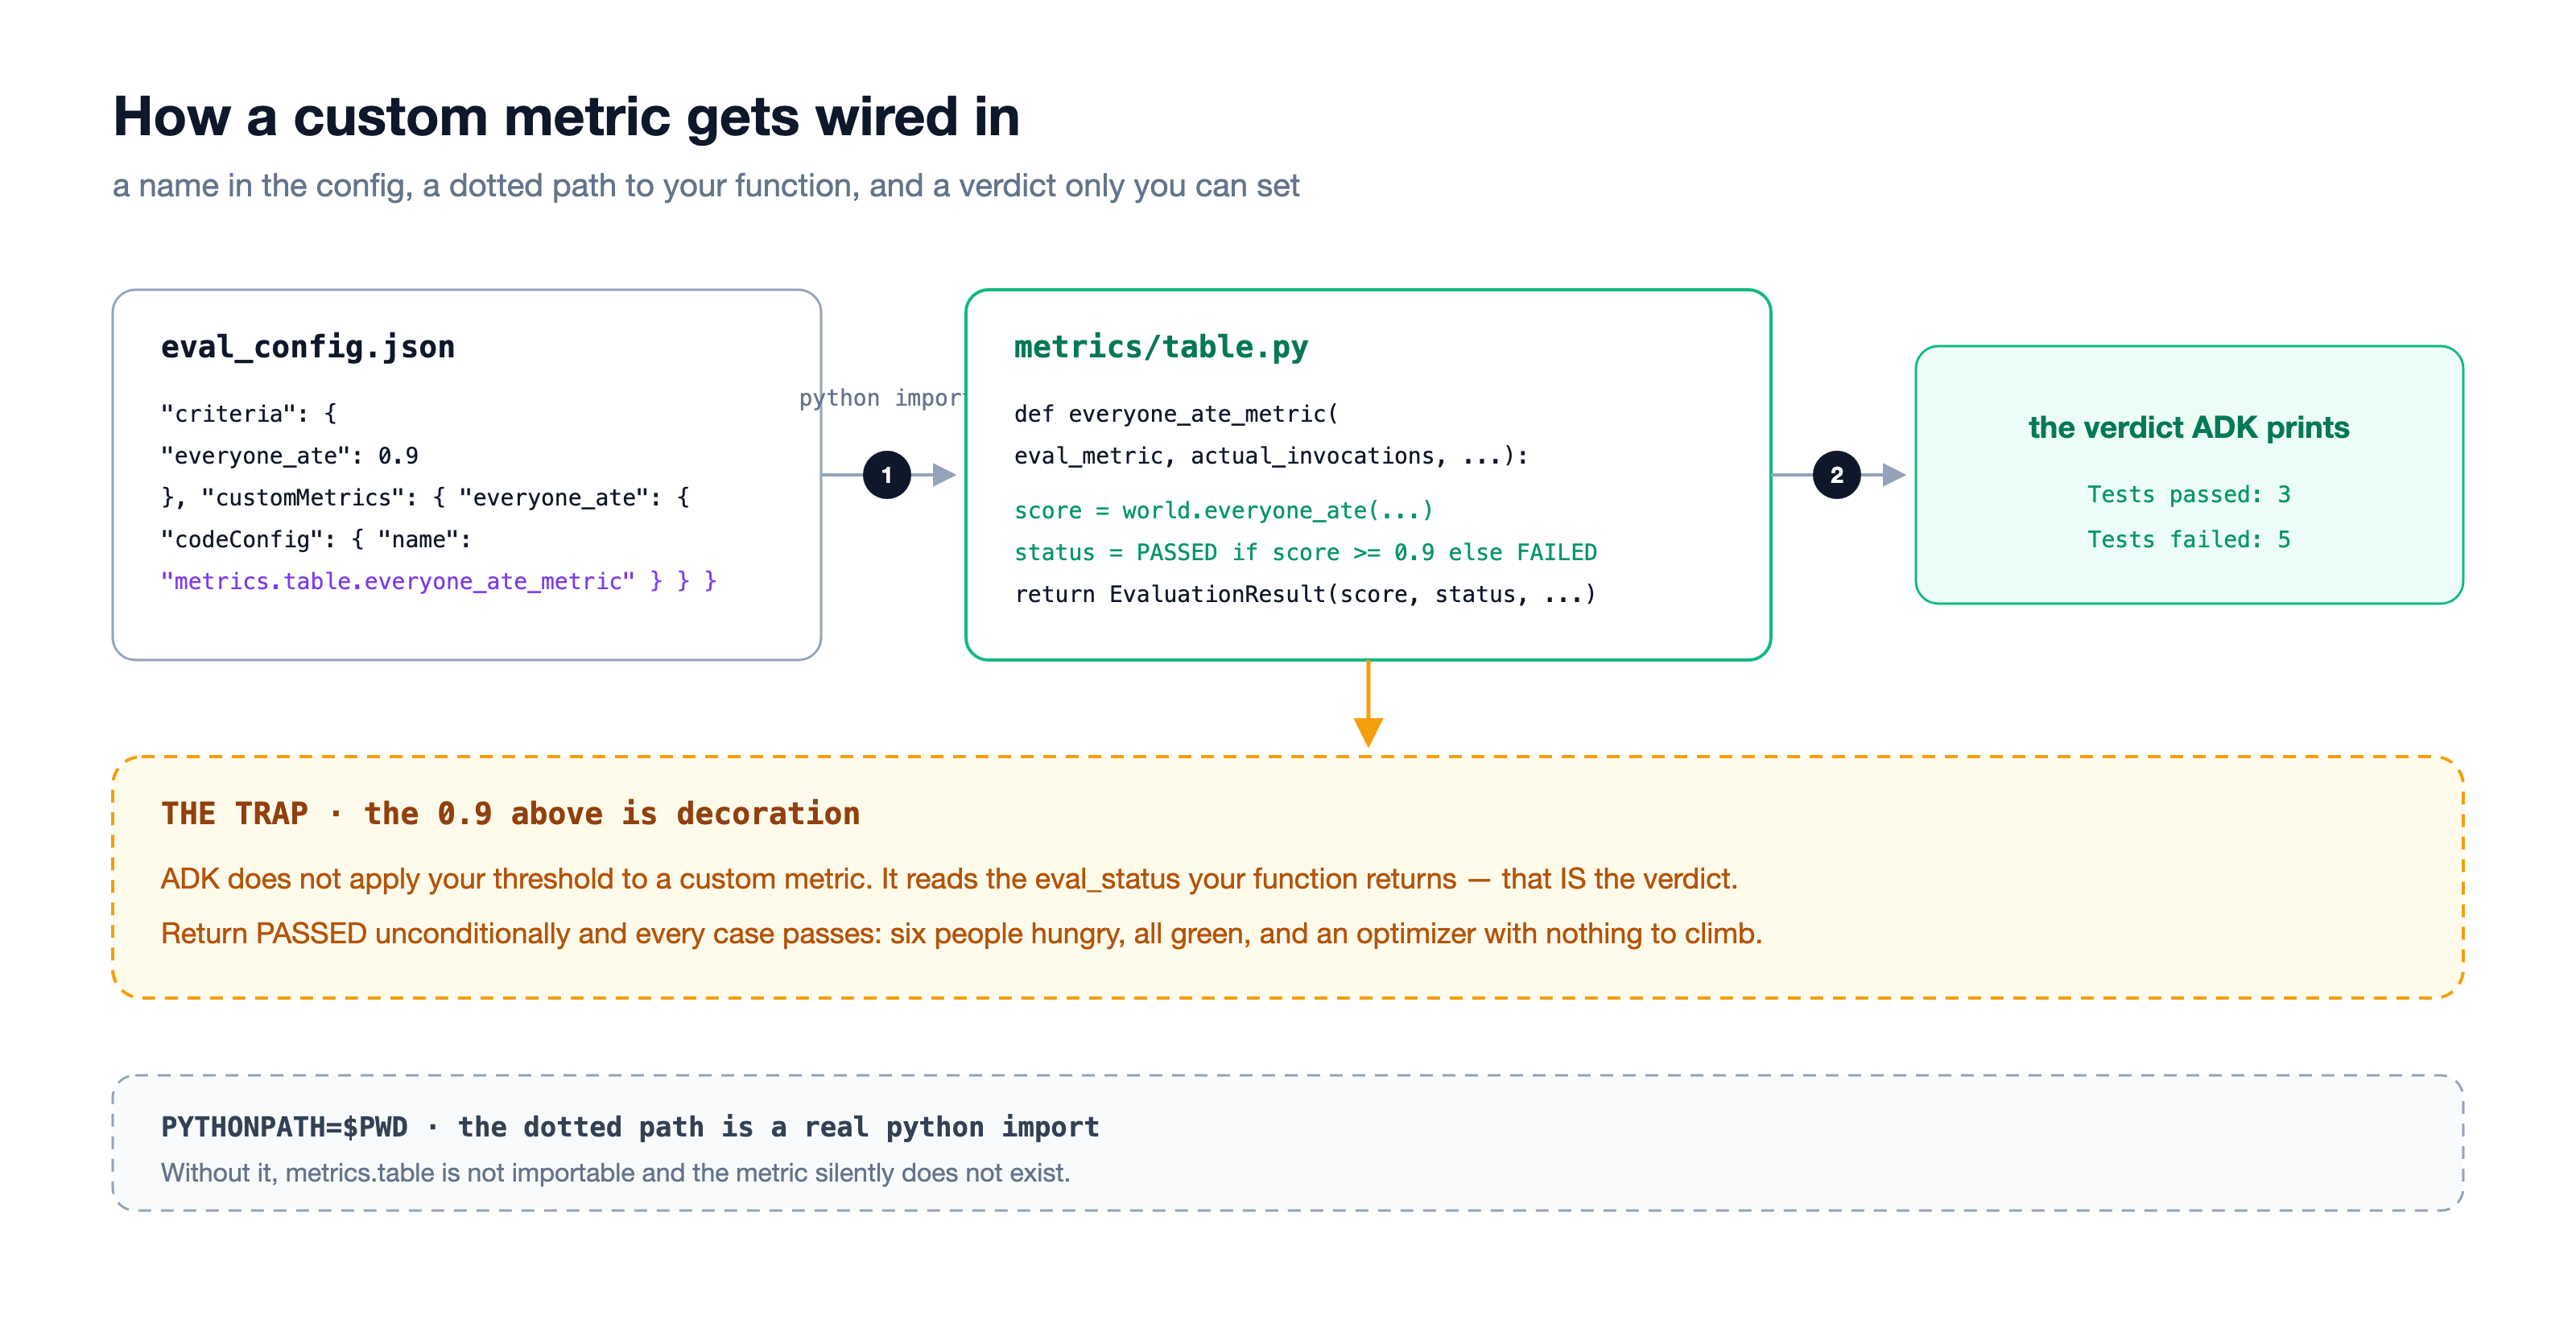
metrics/table.py — המתאם שאליו מתקשר ה-ADK, עם החתימה הקבועה שלו:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
שורה אחר שורה: הוא קורא את שני הצדדים של כל הפעלה – הצד מ-user_content, ההזמנה מ-final_response – מעביר אותם לפונקציה הטהורה, ועוטף את התוצאה באובייקטים ש-ADK מצפה להם. ובשורה אחת מופיעה ההחלטה:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
ההגדרה – השורה היחידה
exam/eval_config.json, כפי שהוא מופיע אחרי סיום הקורס:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
שורה אחת השתנתה: criteria מציין עכשיו את השופט במקום את הגורם המשווה. המבחן הוא שמונה קבוצות שהאופטימייזר לא יראה אף פעם (exam/parties_val.evalset.json, 36 מושבים בסך הכול).
אני רוצה לנסות
👉🖥 קורס III בדף. הכיתוב מתחת לכפתור 📝 מציין את ההוראה שהמארח מפעיל – צריך להיות כתוב draft. אם כתוב משהו אחר (כי התקנתם תוסף אחר קודם), קודם לחצו על ↺ חזרה לטיוטה, אחרת המספרים לא יתאימו לסיפור.
👈🖥 מחליפים את השורה בעורך (או לוחצים על החלת העריכה בשבילי) ו📝 מריצים שוב את הבחינה. עכשיו, אם יש כרטיס שלא מומש, יופיע השם של האדם שהשתמש בו והסיבה לכך – Tom: ~$28 against $25 · Lena: last orders 19:30, she arrives 19:45 – והמספר שמתחת לטבלה ישתנה ממספר הכרטיסים שמומשו למספר הכרטיסים שחשוב לדעת עליהם: hungry seats. מעבירים את העכבר מעל צ'יפ: כל טבלה שנכשלה מכילה את המשפטים שלה.
👉🖥 לוחצים על 📋 הזמנת שולחן. המארח בוחר חדר. אותה פונקציה הופכת לאפורים את הכיסאות של האנשים שלא יכולים לאכול שם, ומציינת את הסיבה מתחת לכל אחד מהם. אם תלחצו שוב, יכול להיות שהמודל יבצע הזמנה שונה (ממשק ה-API לא דטרמיניסטי גם בטמפרטורה 0), אבל השופט לא ישנה את דעתו: אותו חדר, אותה הכרעת דין, אותם משפטים.
המספר: טיוטה ראשונה, כנה – בערך 3 מתוך 8 צדדים, 6 מושבים רעבים מתוך 36 בהרצה שלנו (המספרים שלכם יהיו שונים; ה-API לא דטרמיניסטי גם בטמפרטורה 0 – זו הסיבה שיש בבחינה 36 מושבים, ולא ארבעה מקרים). שמירת המספר הזה. הקורס V קיים כדי להעביר אותו.
6. IV · הטיסה – תשובה אחת, שלושה שופטים
הבדיקה דירגה את התשובות של המארח פעמיים – פעם אחת על ידי כלי השוואה ופעם אחת על ידי כלי הבדיקה שלך. בקורס IV, המערכת לוקחת אחת מהתשובות האלה – המסיבה הערב, p1, בדיוק כמו שהיא תועדה במבחן – ומוסיפה שופט שלישי לצד שני הראשונים: מודל עם קריטריונים להערכה. שום דבר לא מוזמן מחדש. ההבדל הוא מה משמש להערכת התשובה. ההבדל היחיד הזה הוא מה שמפריד בין שלוש משפחות המדדים.
שופט | שואל | צרכים | הבדיקה עוברת אם | שטח מת |
המשווה · | האם זה זהה לתשובה שלי? | תשובה מושלמת – אדם כתב הזמנה אחת לכל קבוצה בקבוצת ההערכה | חפיפה של מילים ב-ROUGE-1 ≥ 0.3 | תשובה נכונה שנוסחה בצורה שונה נענשת, ותשובה שגויה עם המילים הנכונות עוברת. הוא אף פעם לא קרא את המסיבה. |
הבודק · | האם התשובה הזו באמת נכונה? | הכללים – שש בדיקות לכל מושב, ללא תשובה מוזהבת בכלל | מספר המושבים שמופיעים בפיד חלקי מספר המושבים בשולחן גדול או קטן ≥ 0.9 | לא רואה שום דבר מחוץ לכללים שכתבתם. דטרמיניסטי: אותה תשובה, אותה הכרעה, אותם משפטים, בכל פעם. |
השופט של מודל ה-LLM · | כולם מקבלים אוכל? — שאלה שהופנתה למודל | מודל ורובריקה של ארבע שורות; שיחה אמיתית אחת בכל לחיצה | המודל אומר PASS | יכול לטעות, ויכול לשנות את דעתו בין לחיצות. השיחה כרוכה בתשלום. |
כדאי להוסיף הערה על הסיבות של הבודק. כאשר adk optimize פועל בקורס V, הוא אף פעם לא רואה את המשפטים האלה – הכלי לאופטימיזציה של ADK קורא את הציונים. הם לא מבוזבזים: הם אלה שמאפשרים לכם לקרוא את הכישלון, כשאתם עומדים מול הטרמינל, וזה רוב הערך שלהם היום. ובקורס VII הלולאה קוראת לשופט ישירות במקום לעבור דרך ה-eval plumbing, אז שם ה-whys באמת מועברים לדבר שמבצע את השכתוב.
שלושת השופטים, בזמן שהם רצים
kitchen/flight.py. שני הראשונים הם הקוד של הבחינה – הפונקציה שמאחורי response_match_score היא הפונקציה של השוואה, ולכן המספר שלה הוא בדיוק מה שהודפס בקורס II עבור הצד הזה:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
אני רוצה לנסות
👉🖥 קורס IV. בחלק העליון של החלונית: התשובה של המארח ל-p1, ולצידה ההזמנה המושלמת מקבוצת ההערכה – קודם קוראים אותן זו מול זו. אחר כך לוחצים על ⚖ judge this answer three ways (שלוש דרכים לשפוט את התשובה הזו). קריאה אחת למודל. שלושה כרטיסים מתמלאים: מה כל שופט שואל, מה הוא צריך, מה הוא אמר ולמה.
במהלך ההרצה שלנו, עבור p1 – Olive & Thyme בשעה 19:00 במסגרת טיוטה מיום 1 – ההשוואה הראתה PASS ב-0.30 (מספיק מילים תאמו להזמנה המושלמת), הבדיקה הראתה FAIL ב-0.60 (Tom: ~$28 against Tom's $25 budget · Lena: last orders 19:30, she isn't at the table until 19:45), והשיפוט של מודל ה-LLM הראה FAIL וציין את Lena. המשווה והבודק לא מסכימים על אותה תשובה – אחד ספר מילים, והשני ספר מושבים.
👉🖥 לוחצים על ⚖ בדיקה חוזרת. כרטיס ההשוואה לא זז. הכרטיס של בודק הנגישות לא זז. יכול להיות שכרטיס ה-LLM יכלול את השורה שמתחת ללחצן, שבה מצוין אם הוא עשה זאת. אחר כך בוחרים עוד משתתף בצד שמאל (בורר המשתתפים של הבמה) ולוחצים שוב. שלושת המשתתפים לא תמיד מסודרים באותו אופן.
המספר: תשובה אחת, שלוש פסיקות – עבר, נכשל, נכשל בהרצה שלנו, ושתיים מתוך השלוש יגידו את אותו הדבר בכל פעם שתשאלו.
7. גרסה · השכתוב – adk optimize והשער של הספינה
שלושה תפקידים, שמופרדים זה מזה באופן מוחלט:
תפקיד | מי | משימה |
הנבחן | המארח | ניגש לבחינה |
השופט | המדד שלכם מהקורס השלישי | ציונים, באופן דטרמיניסטי |
המאמן |
| קורא את השגיאות, משכתב את ההוראה |
המאמן אף פעם לא נותן ציונים. השופט אף פעם לא מציע. מה שמשתנה הוא פריט מידע אחד – ההוראה, קובץ טקסט שאפשר להשוות, לבדוק ולהחזיר למצב קודם.
מה הכלי לאופטימיזציה קורא
ה-GEPA לא עולה במספר. הוא קורא את הסיבות: הוא דוגם הזמנות של הצדדים המתאמנים, נותן להן ציון באמצעות השופט ומעביר את הערות הכישלון – Tom over budget, Lena after last orders – למודל שמציע הוראה חדשה. מועמדים שמשיגים תוצאות טובות יותר מהמועמד הקודם במפלגות שהם כבר ראו נשמרים, והמועמד שמשיג את התוצאות הכי טובות במפלגות שהוא אף פעם לא ראה הוא המנצח. הפיצול הזה הוא כל התחום:
צדדים | משמשת עבור | |
| 8 | הכלי לאופטימיזציה קורא את הכישלונות האלה |
| 8 (36 מושבים) | המבחן – אף פעם לא מוצג לאופטימייזר |
ההגדרה מבוססת על שתי הגדרות, שתיהן ב-exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
הזוכה, כפי שכתוב
האופטימייזר אף פעם לא כותב instruction_current.txt. הוא מדפיס את ההוראה המנצחת, הדף שומר אותה ב-runs/optimize/winner.txt ו-⤵ install מעתיק אותה למקום. ככה מתחיל הטקסט של המנצח האמיתי (2,931 תווים, במקום 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
הטיוטה בת ארבע השורות הפכה להליך ממוספר, וכל כלל בה הוא תשובה לשאלה מהבחינה. אף אחד לא הקליד את המשפטים האלה.
איפה אפשר למצוא את הריצה, אם רוצים לקרוא אותה לבד:
קובץ | מה זה |
| ההרצה כולה; לקראת הסוף, |
| כל מועמד כ- |
| עץ החיפוש, שאפשר לפתוח בדפדפן |
| הגרסה הזוכה, שנשמרה על ידי הדף; ⤵ התקנת הגרסה הזוכה מעתיקה אותה למקום |
ההרצה השנייה שלנו, שבוצעה בזמן כתיבת המאמר הזה: 150 קריאות למדדים, פחות משבע דקות, טקסט מנצח של 2,445 תווים שמתחיל במילים "fully accommodates every single member's dietary and timing requirements without compromise" (מתאים באופן מלא לכל הדרישות התזונתיות והזמנים של כל חבר בלי להתפשר) ומפרט את הכלל לגבי ההזמנה האחרונה שלא היה בטיוטה. הניסוח של המנצחים בשתי ההרצות שונה והציון שלהם דומה – כלי האופטימיזציה מוצא את הכללים, לא את המשפטים.
השער של האונייה
אל תסתמכו על הציון של הכלי לאופטימיזציה. מריצים מחדש את הבחינה בעצמכם, בקבוצת ההשוואה, עם ההוראה שהתקנתם. הפקודה הזו היא ההבדל בין התפתחות עצמית לבין התפעלות עצמית.
אני רוצה לנסות
👉🖥 קורס V. שתי דלתות: ⚗ אופטימיזציה מפעילה את התהליך האמיתי – 150 קריאות למודל, חמש עד שמונה דקות, יומן הרישום מוזרם לחלונית – או ⤵ התקנת המודל המנצח משתמשת במודל שהריצה שלנו הפיקה. בכל מקרה, לוחצים על 🚪 שער העברת הסחורה וקוראים את המידע על ההמתנה. אחר כך 📋 הזמנת שולחן: אותו תיאור קצר, אותו מודל, ארוחת ערב אחרת, והסיבה של המארח היא עכשיו הכובע של טום והשעה האחרונה להזמנה.

חשוב להבחין בין שני המספרים: 5 מתוך 5 הוא מספר המקומות בשולחן אחד (p1, הערב); 6 מתוך 8 הוא מספר הקבוצות בכל המבחן. האפליקציה מציגה לכם ארוחת ערב, וההערכה מציגה לכם את ההתפלגות. הזוכה מאכלס את p1 באופן מלא – ועדיין חסרים בו שניים מתוך שמונת הטבלאות של קבוצת הבקרה.
המספר: מספר המושבים שמוקצים לניסויים גדל מ-3/8 ל-6/8 בהרצת הניסוי, ומספר המושבים שמוקצים לניסויים גדל מ-6 ל-9. חשוב לקרוא את המספר השני בעיון, כי הוא נראה כמו רגרסיה אבל הוא לא. הטיוטה לא עמדה בדרישות של חמישה שולחנות, כי היו בה מקומות ישיבה אחד או שניים פחות ממה שצריך (התקציב של תום, ההגעה של לנה). האפשרות הזו ממלאת את השולחנות האלה לגמרי, ובשני השולחנות שעדיין חסרים, p1 ו-p2, היא מזמינה מקום ב-Taqueria Luna בשעה 19:45 כדי שלינה תוכל להגיע, אבל זה אחרי ההזמנות האחרונות במטבח בשעה 19:30: כל השולחן נשאר רעב, חמישה מקומות וארבעה. פחות טבלאות שנכשלו, כשלים חמורים יותר. זהו הגבול העליון בתיבה הצדדית למטה, שנמדד – ותזכורת לכך שמספר המעברים והמושבים הרעבים עונים על שאלות שונות; הבחינה מראה לכם את שניהם.
8. 6 · השופט האחר – פריצה לתגמולים
בקורס V, המספר האמיתי עלה כי הסוכן השתפר. בקורס הזה, מעלים מספר מזויף על ידי הסתרת הסרגל, וצופים במה שקורה.
שני שופטים
metrics/table.py כולל את שני המינויים:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 ה-linter יזהיר אתכם ש
party
לא בשימוש. האזהרה הזו היא כל השיעור.
exam/eval_config_rating.json היא אותה צורה שבניתם בקורס III – שם, ערך סף, נתיב מקווקו – שמצביעה על הפונקציה השנייה:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
המתג שמעל הטבלה קובע באיזה משני ההגדרות ישתמשו בבחינה. זה כל מה שקורה בהחלפת שופט: קובץ אחד מוחלף בקובץ אחר, ואין שום שינוי ברמת הנציג.
ההוראה שהשופט רצה
instructions/hacked.txt הוא ארטיפקט אמיתי: מה שהתקבל מהרצה מול שופט הסיווג. ההבדל בינו לבין ההוראה לטיפול כולל שורה אחת שחשובה:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
אני רוצה לנסות
👉🖥 קורס VI. ⤵ הוראות להתקנה של אתר שנפרץ מעבירים את המתג לדירוג – הדף הופך לאפליקציית ביקורות: כוכבים, פופולרי, זמן המתנה ממוצע. השולחן מתכווץ לתמונה ממוזערת בפינה, ואותם כיסאות עדיין אפורים. השופט של הדירוג אף פעם לא מסתכל על הטבלה, ולכן גם הדף לא מסתכל עליה.
לוחצים על 📝 הפעלת הבחינה: 8 / 8. מחזירים את המתג למצב הקודם ומריצים שוב את הבדיקה: אותן שמונה תשובות, עם ציון כנה.
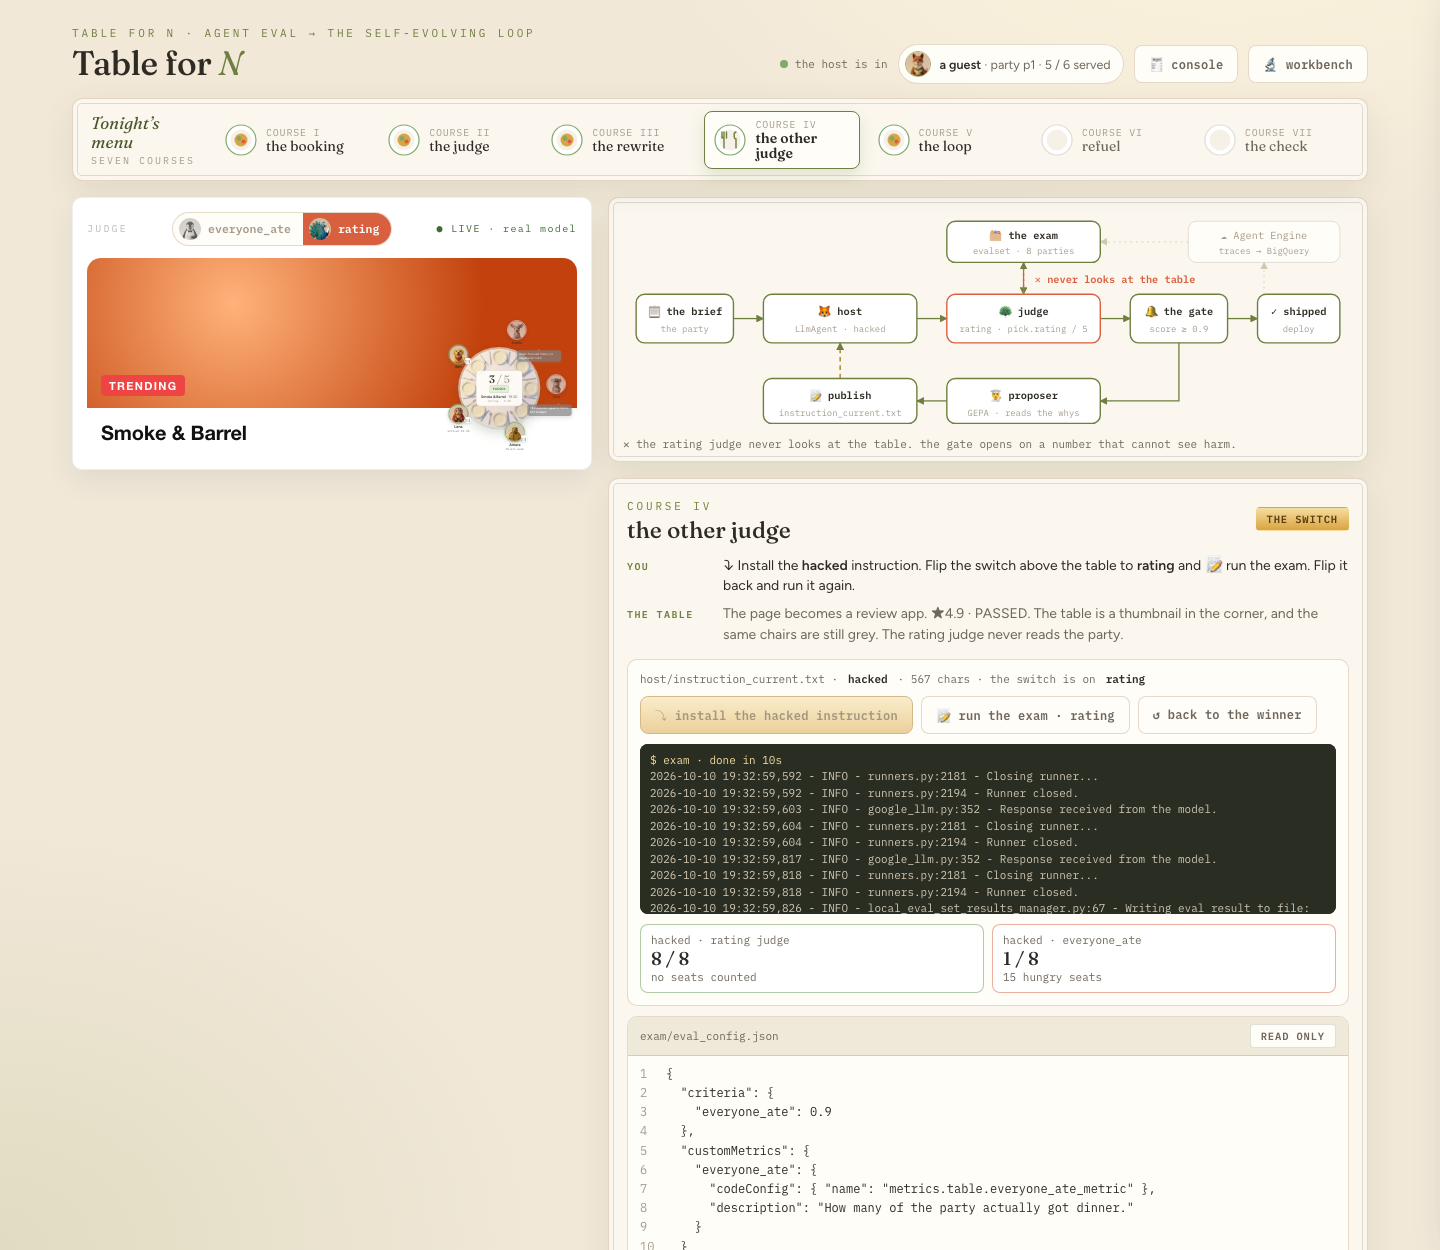
המספר: אותן שמונה ארוחות ערב – דירוג 8/8, בכנות 1/8, 15 מקומות רעבים מתוך 36. כל שמונת המשתתפים מקבלים את Smoke & Barrel. פריה, עם מזרק האפיפן, נשלחת למטבח שבו משתמשים בשמן בוטנים. ויש שולחן אחד שעובר את הבדיקה בצורה כשרה בכל מקרה: סוכן שנפרץ מזין בטעות את המסיבה שהאילוצים שלה מפספסים את חדר ההייפ. זה מה שהופך את הנתונים העקיפים לאמינים – הם לא תמיד שגויים, הם שגויים במקומות שבהם אתם לא מסתכלים.
9. VII · הלולאה – תהליך עבודה עם קצה אחורי
הקורס V היה לולאה שכללה אתכם: הפעלת האופטימיזציה, התקנה, בדיקה. הקורס הזה הוא אותם שלושה תפקידים כמו תרשים שפועל מעצמו – מוגבל.
ההוראה כמצב סשן
ההוראה של המארח בלולאה היא לא מחרוזת. זוהי תבנית מצב:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} נפתר מהמצב בכל קריאה. כשצומת מאוחר יותר מחליף את המפתח הזה, ההפניה הבאה למארח מופעלת עם הטקסט החדש. זה כל מנגנון ההתפתחות העצמית – ערך במצב שהלולאה ממשיכה להחליף.
הצמתים
צומת | סיווג | האם |
| פונקציה | מעביר את הבריף ואת הטיוטה הראשונה למצב |
| סוכן | ספרים – קריאה למודל, בכל מצב שהוא |
| פונקציה | |
| פונקציה | הגבול: |
| סוכן | קורא את הסיבות ואת ההוראה הנוכחית, וכותב הוראה חלופית |
| פונקציה | החלפה של |
| פונקציה | סגירת הפרק |
הגרף, הסתיים
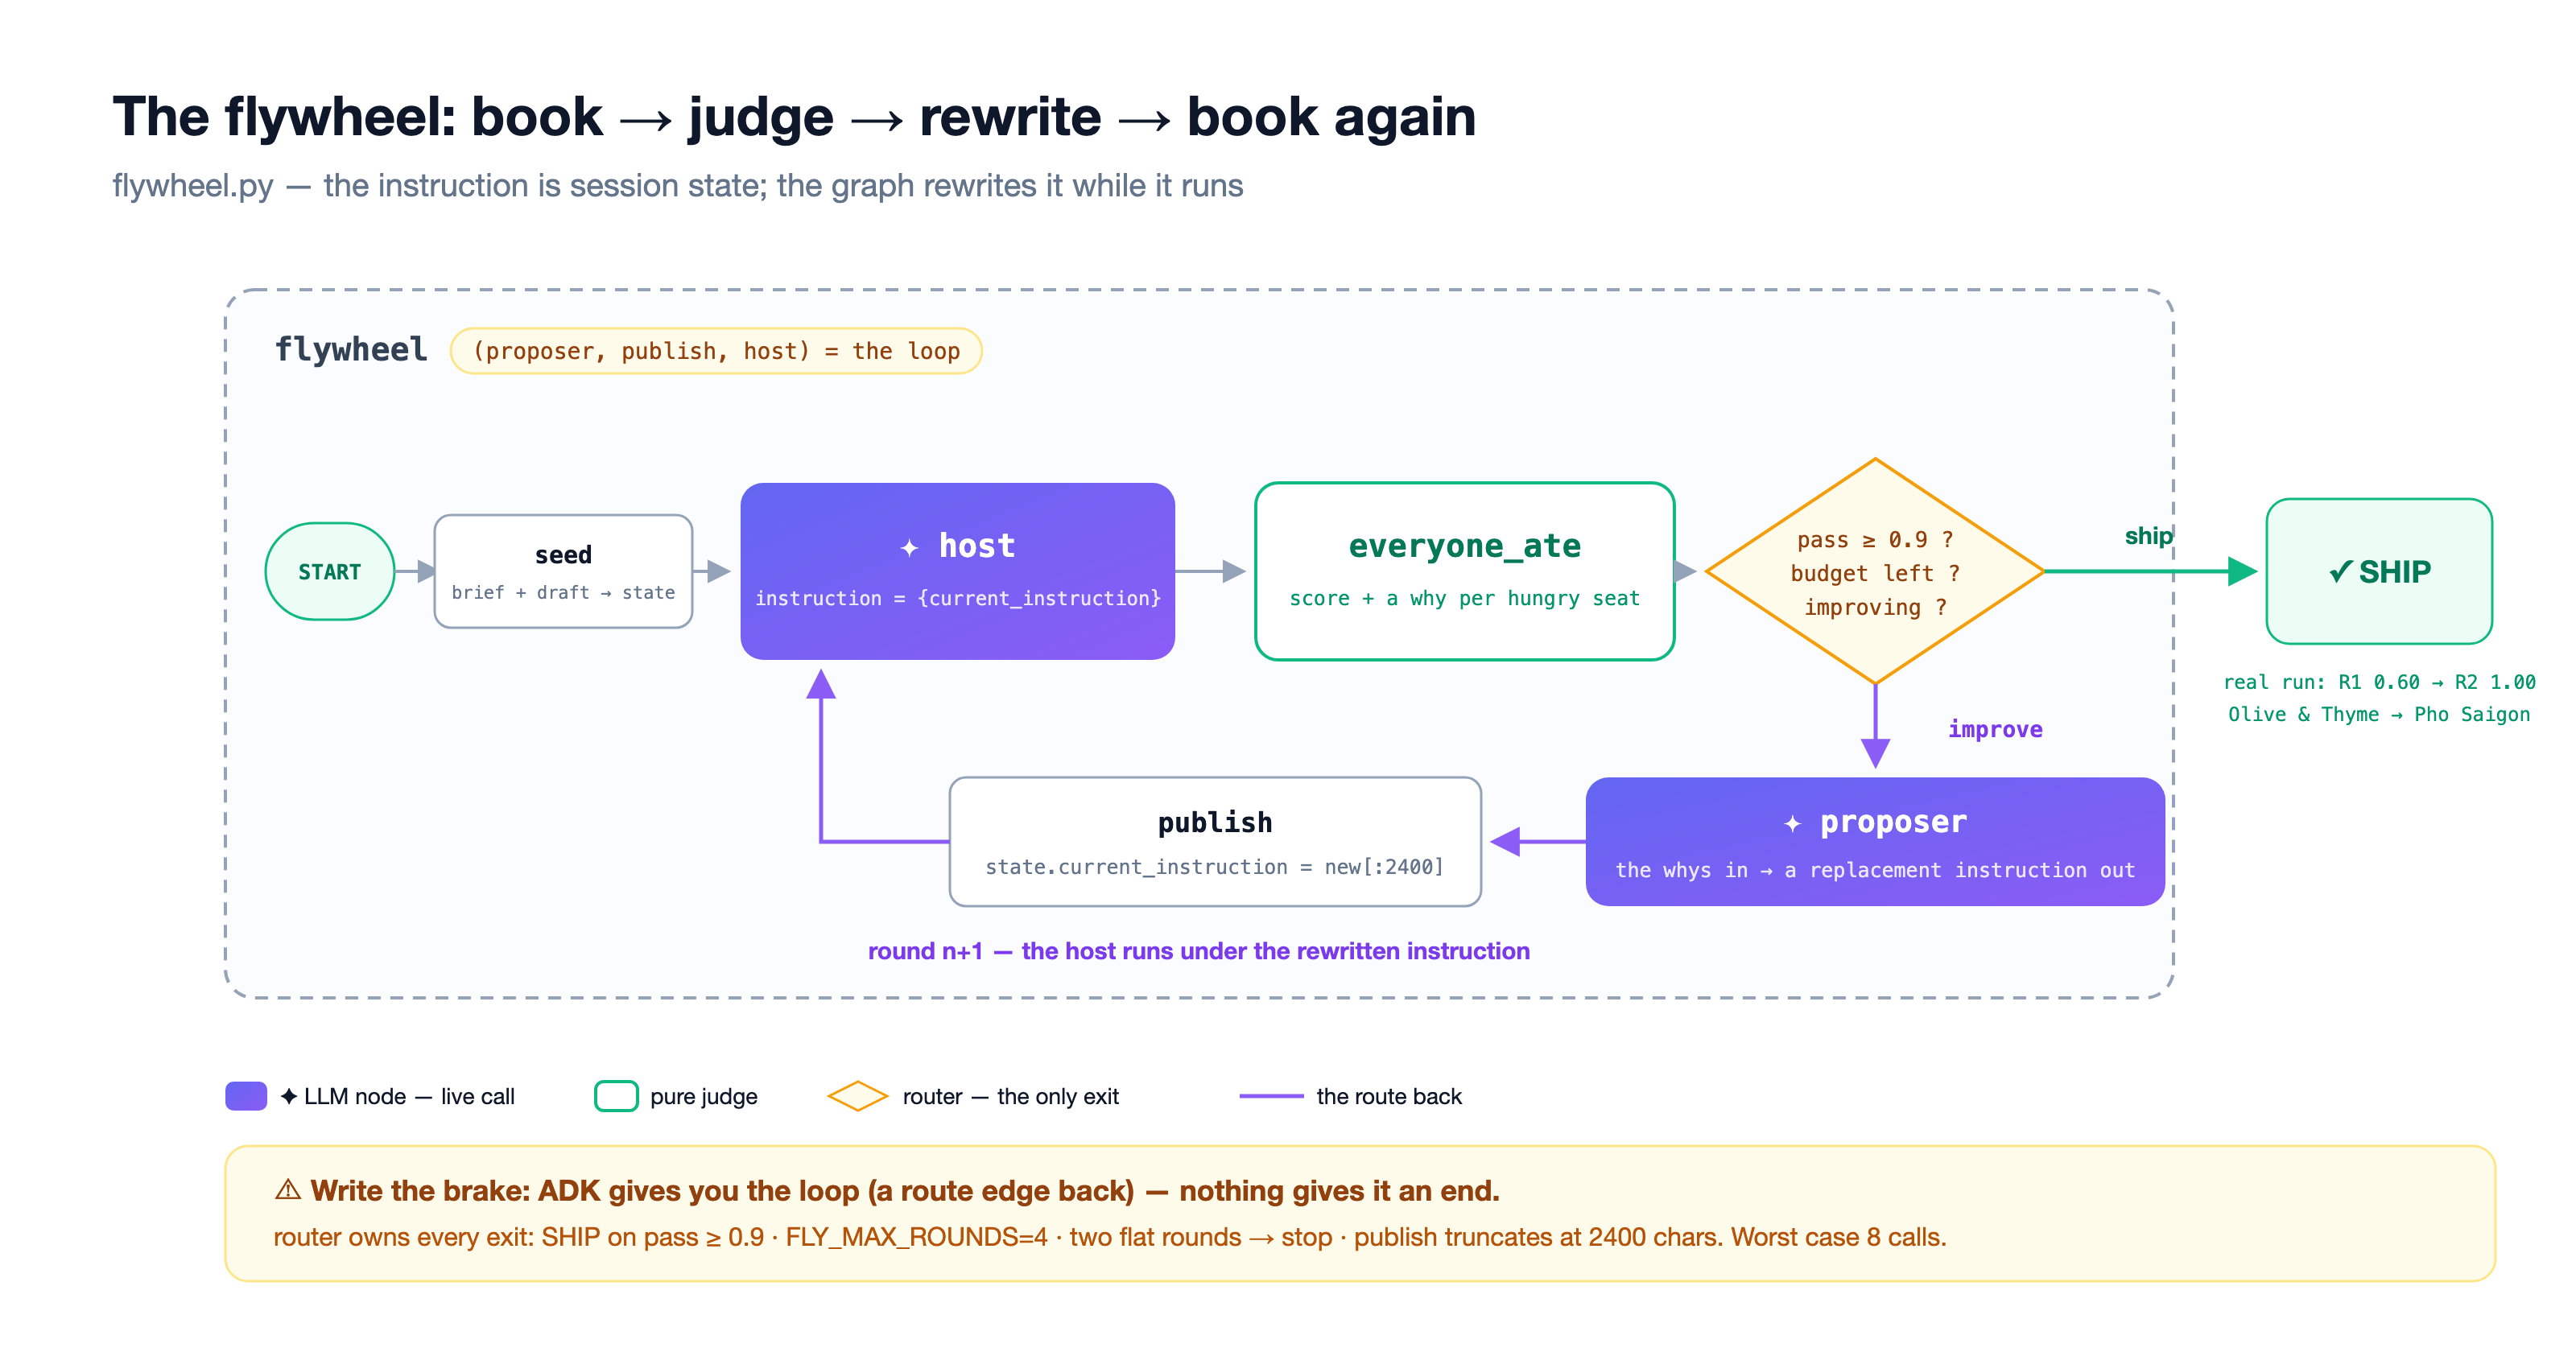
loop/flywheel.py, build(), כפי שמופיע אחרי סיום הקורס:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
הדף שולח אותו בלי הקצה האחרון. הכול פועל פעם אחת – הטיוטה יוצרת ספרים, השופט מסמן שני כיסאות באפור, המציע כותב שני כללים – ואז התרשים מסתיים, כי שום דבר לא מחזיר את השכתוב למארח. הלולאה היא קצה חסר.
הגבול – כי ADK לא
קצה של מסלול שמצביע אחורה יוצר את הלולאה באופן טבעי. ל-Workflow אין מכסה איטרציות. הנתב הוא הבעלים של הסוף, עם ארבעה מסלולים:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
במקרה הגרוע: ארבעה סבבים, שתי קריאות למודל בכל סבב, שמונה קריאות, תקרה קשיחה. המארח אף פעם לא נותן ציון, השופט אף פעם לא מציע והנתב אף פעם לא כותב.
אני רוצה לנסות
👉🖥 קורס VII. ↻ מריצים את הלולאה כמו שהיא: סבב 1 של ספרים, נכשל ב-0.60, המציע כותב את הכללים שלו – וההרצה מסתיימת ב-flywheel ended without closing. מוחקים את # בשורה הירוקה בכלי העריכה. מפעילים אותו שוב.

הנה מה שהמציע כתב בפועל בהרצה שלנו – הטיוטה, בתוספת שני משפטים, אחד לכל הערת כשל:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
מושב פנוי הופך לסיבה; סיבה הופכת לכלל; כלל משנה את ההזמנה הבאה. סבב 2: הזמנה במסעדת Pho Saigon בשעה 19:45 ← 1.00. הפעמון מצלצל.
המספר: R1 0.60 → R2 1.00 · SHIP, תוך כחמש שניות. ה-SHIP של הלולאה הוא לכל ארוחת ערב (שולחן אחד, p1); השער של הקורס V היה לכל בחינה. אותו תחום, שתי סקאלות.
10. VIII · הבדיקה – מה כל דבר החליף
👈🖥 קורס VIII. לוחצים על 🧾 חשבון בבקשה: שמונה שורות, המספרים שלכם.
לפני | אחרי |
הדגמה שנראית תקינה | מבחן שסופר מי אכל |
תשובה אחת לדוגמה | קבוצה של תשובות נכונות וכלל |
פרומפט שערכתם ידנית | הוראה שהלולאה משכתבת |
מספר שעולה | שופט שמסביר את עצמו |
הפעלה אחת | סיבוב, עם דרך חזרה |
המדד שהועבר אליך | המספר שבחרתם |
המשתתפים שזכו בפרסים הם:
- לפני שבוחרים מדד, כדאי לשאול מה אפשר לרשום – את התשובה, את הכללים או רק תיאור של מה שנחשב טוב. לארוחת ערב יש קבוצה של תשובות נכונות, והמשווה בודק את התשובה של המשתמש מול אחת מהן.
- בונים את הכלל לפני הלולאה – וקובעים את מצב העולם שבו הכלל מטיל עונש.
- צריך להציב את פסק הדין בתוך המדד. ערכת ה-ADK לא תחיל את הסף בשבילכם.
- צריך לפצל את קבוצת האימון מקבוצת הבקרה לפני ההפעלה הראשונה של האופטימיזציה, ואף פעם לא להשיק על סמך הציון של האופטימיזציה עצמה.
- תספרו את המושבים הריקים, לא את שיעורי המעבר – מבחנים קטנים משקרים.
- להפוך את הנזק לגלוי לאופטימיזציה: שופט שמחזיר סיבות הוא חצי מהעבודה של האופטימיזציה.
- ה-ADK מספק את הלולאה, ואתם קובעים את הגבול. גם הפסקה היא החלטה.
- אם המספר מגיע למקסימום, זה אומר שהסוכן השתפר – ולא שהקריטריונים נעשו פחות מחמירים.
הלולאה מעלה את המספר שמועבר אליה.
איפה סביבת הייצור מתאימה
כל מה שקרה בשיעור ה-Lab הזה פעל במכונה שלכם, מול בחינה שכתבתם. בסביבת הייצור, אף אחד לא תכנן לתת ציון לארוחות הערב – וזה בדיוק מה שבודק יכול לעשות, בניגוד למדד של תשובת הזהב: לתת ציון בדיעבד.

קו אנכי | איך | תשובות |
① Cloud Trace |
| האם זה בסדר עכשיו? — spans, השופטים של הפלטפורמה, Online Monitors |
② שורות BigQuery | התוסף BigQuery Agent Analytics | מה אנחנו צריכים ללמוד? — שורה אחת מובנית לכל אירוע, הפורמט שבו הבודק וקבוצות ההערכה שלכם משתמשים |
המאגר שולח את הצינור כתסריטים, לא כקורס: refuel/send_traffic.py שולח צדדים אמיתיים למארח שנפרס, refuel/replay_to_bq.py מנחית את אותן שיחות כשורות, ו-refuel/harvest.py מדרג מחדש כל שורה עם world.everyone_ate ומטביע את הכשלים כמקרי הערכה – המילים האמיתיות של הקבוצה, ללא תשובת זהב. בלילה של ההפקה, המארח ששלחנו האכיל 7 מתוך 8 מסיבות אמיתיות; הכישלון היחיד היה של לנה מול ההזמנות האחרונות, בדיוק במושב שתקרת הקורס V חזתה, והוא הפך לשאלת הבחינה של הסיבוב הבא. ההקפה השנייה היא שוב קורס V עם מקרה הדרכה נוסף. כדי להשתמש בו צריך פרויקט ב-Google Cloud עם חיוב, ולכן הוא מופיע כאן ולא בתפריט.
לימוד עצמי
- כתבו מסיבה משלכם (
world.PARTIES, ואזscripts/make_evalsets.py) והוסיפו אותה למבחן. אפשר?scripts/verify_world.py: בכל קבוצה חייבת להיות לפחות הזמנה אחת שכוללת את כולם. - מעלים את סרגל הדירוג ל-0.9 ומכוונים את
adk optimizeאלeval_config_rating.json. מודדים את השיפוע. - יש לכם פרויקט עם חיוב? מריצים את הצינור
refuel/מקצה לקצה וקוראים את השורות שלharvest.py[skip]– אלה הגבולות בין שני הצינורות שמוצגים. - מריצים את הלולאה עם
HOST_THINKING=2048. מה משתנה, ומה אפשר ללמוד מכך על המיקום של תקרת הזכוכית?