

1. परिचय
यह कोडलैब, एजेंट के आकलन के बारे में है. इसमें बताया गया है कि कोई सिस्टम यह कैसे तय करता है कि एजेंट का जवाब सही था या नहीं. इसमें यह भी बताया गया है कि सिस्टम के जवाब देने के बाद, आपके पास क्या-क्या करने का विकल्प होता है: एक ऐसा एजेंट बनाना जो अपनी गलतियों से सीखकर, अपने निर्देशों को फिर से लिखता है. साथ ही, एक ऐसा लूप बनाना जो ऐसा करता रहता है. हालांकि, इसमें यह तय करने का विकल्प आपके पास होता है कि लूप को कब तक जारी रखना है.
सब कुछ एजेंट डेवलपमेंट किट (एडीके) पर काम करता है: adk eval जिसमें आपकी लिखी हुई कस्टम मेट्रिक, adk optimize (GEPA प्रॉम्प्ट ऑप्टिमाइज़र), एडीके 2 Workflow, और एजेंट इंजन + BigQuery पाइप शामिल है. यह पाइप, प्रोडक्शन ट्रैफ़िक को अगले राउंड की परीक्षा में बदल देता है.
लूप, उसे दिए गए नंबर को आगे बढ़ाता है.
आपको क्या सीखने को मिलेगा
- जवाब, नतीजा नहीं होता — भरोसे के साथ दिया गया और अच्छी तरह से तैयार किया गया जवाब, सिस्टम को कुछ क्यों नहीं बताता. साथ ही, जज को क्या कहना चाहिए
- एक परीक्षा को तीन तरीकों से चलाया जा सकता है —
adk evalबैच के लिए,adk webEvals टैब में फ़ेल होने की वजह देखना,pytest+AgentEvaluatorबिल्ड फ़ेल होने की वजह देखना — और एक लोकल eval स्टोर शेयर करना - तुलना बनाम जांच — तुलना करने वाला व्यक्ति, अलग तरीके से लिखे गए सही जवाब को क्यों गलत मानता है, किसी सवाल के कितने सही जवाब हो सकते हैं, और यह कैसे पता चलता है कि किसी समस्या के लिए किस तरह की मेट्रिक की ज़रूरत है
adk evalमेट्रिक के तौर पर चेकर फ़ंक्शन —customMetrics,codeConfig, फ़िक्स किया गया सिग्नेचर, इसमें की गई छह जांचें, आपका फ़ंक्शन पास/फ़ेल क्यों हुआ, और इसे जान-बूझकर डिटरमिनिस्टिक क्यों बनाया गया- एक ही जवाब के लिए तीन मेट्रिक फ़ैमिली — कंपैरेटर, चेकर, और एलएलएम-ऐज़-जज: हर एक की ज़रूरतें, लागत, और कमियां
adk optimize(GEPA) — इसमें क्या लिखा है (स्कोर नहीं, बल्कि फ़ेल होने की वजह), ट्रेनिंग बनाम होल्डआउट, और शिप करने से पहले खुद परीक्षा क्यों दोबारा देनी चाहिए- इनाम में धोखाधड़ी, मेज़र की गई — यह एक प्रॉक्सी मेट्रिक है. यह कभी भी पार्टी के बारे में नहीं बताती. साथ ही, यह भी नहीं बताती कि असली नंबर पर क्या असर पड़ा और इससे कौनसे कानून का उल्लंघन हुआ
- ADK 2 के तौर पर अपने-आप बेहतर होने वाला लूप
Workflow— सेशन की स्थिति में मौजूद निर्देश, वह किनारा जो किसी ग्राफ़ को साइकल बनाता है, और वह सीमा जो ADK आपको नहीं देता - प्रोडक्शन कहां फ़िट होता है — देखने के लिए ट्रेस, सीखने के लिए लाइनें, और चेकर उन डिनर को ग्रेड क्यों कर सकता है जिन्हें ग्रेड करने का प्लान किसी ने नहीं बनाया था (पढ़ें, कोई चरण नहीं)
आपको क्या बनाना है
आपके ब्राउज़र में चल रहा एक ऐप्लिकेशन: एक गोल टेबल, N मेहमान, और एक एजेंट जो उनके लिए डिनर बुक करता है. हर कोर्स में एक चीज़ चालू की जाती है. जैसे, कॉन्फ़िगरेशन में एक लाइन, तीन जजों के सामने एक जवाब, असली ऑप्टिमाइज़र को चलाने वाला बटन, जज को बदलने वाला स्विच, ग्राफ़ में एक किनारा. टेबल में आपको दिखता है कि क्या बदला है: किसने खाया, किसने नहीं खाया, और क्यों. Python का साइज़ छोटा है. सभी नंबर आपकी मशीन पर मेज़र किए जाते हैं.
यह ऐप्लिकेशन, कसरत करने में भी मदद करता है. कोर्स पैनल में, एक बार में सिर्फ़ एक बदलाव या एक बटन दिखता है. मेन्यू में मौजूद प्लेट तब ही भरती है, जब कोई चीज़ असल में साबित होती है. किचन आपकी फ़ाइलें और विज्ञापन दिखाने की रसीदें पढ़ता है, न कि चेकलिस्ट.
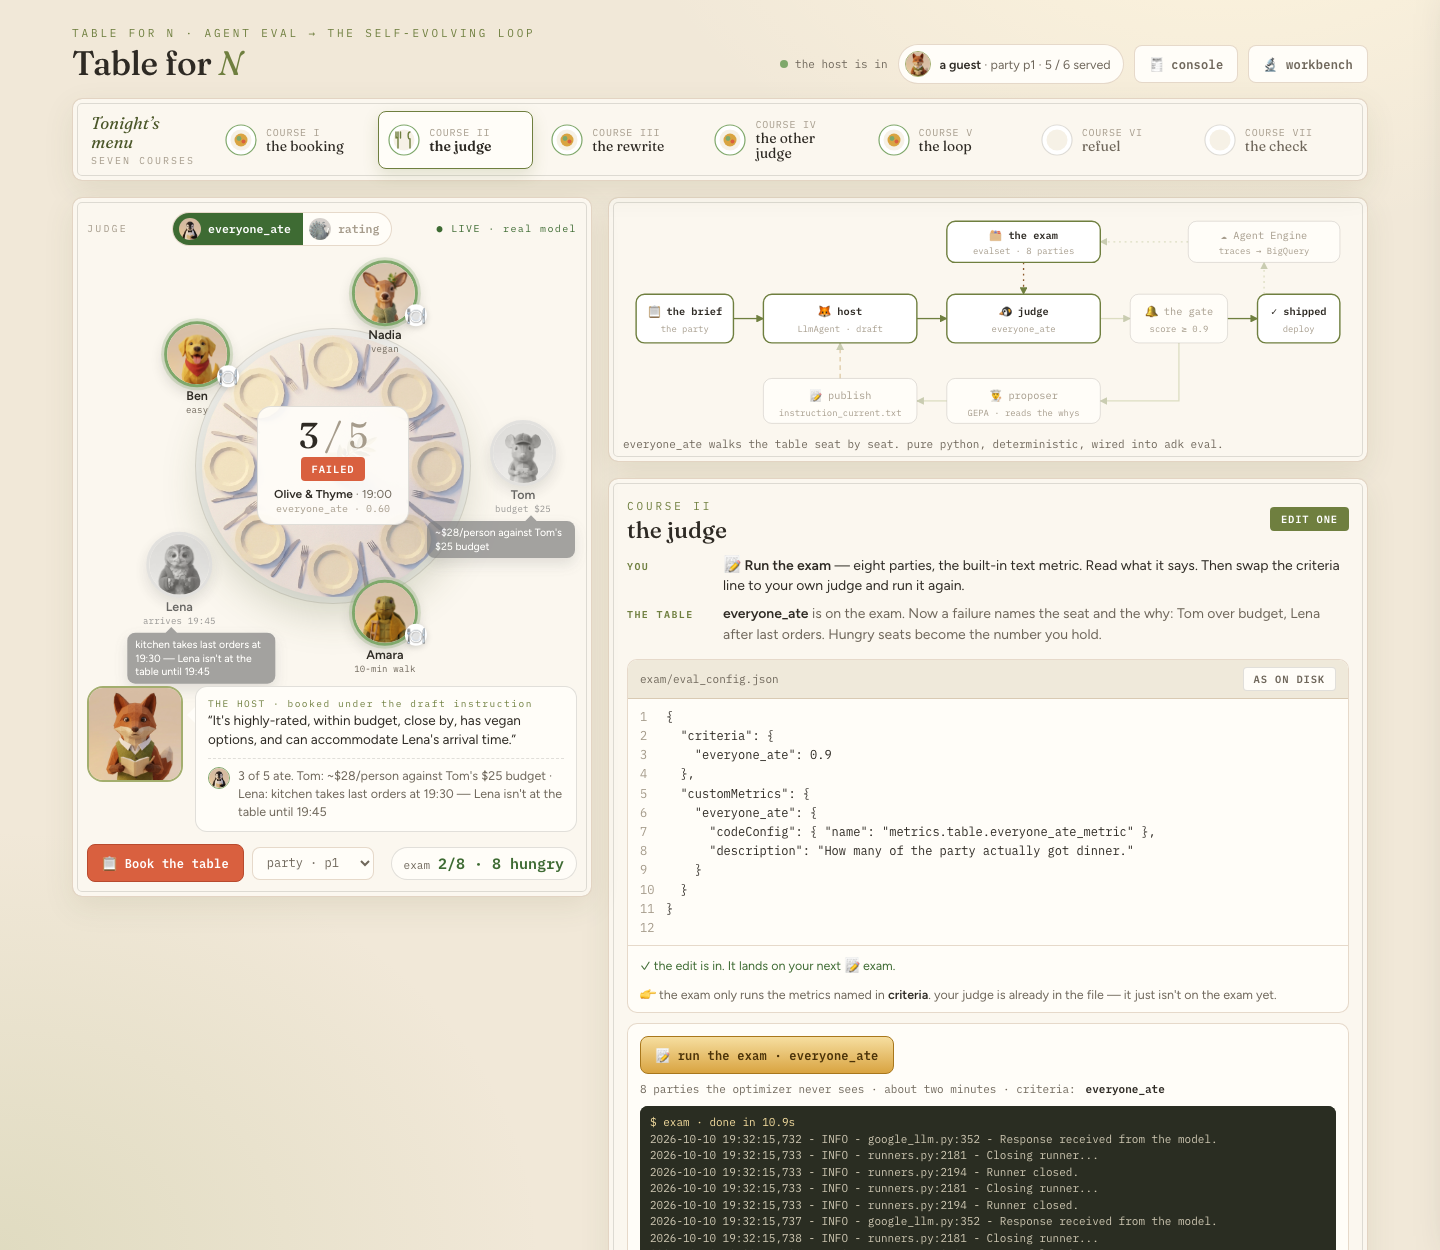
आठ कोर्स
कॉन्सेप्ट | जिस सवाल का जवाब दिया गया है | आपको क्या करना है | |
I | जवाब, खोज के नतीजे नहीं होते | सिस्टम को इस बुकिंग के बारे में क्या जानकारी है? | अभी तक कोई बुकिंग नहीं है — वर्कबेंच में जाकर बुकिंग करें |
II | तुलना करने वाला · सही जवाबों का सेट · चलाने के तीन तरीके | सही बुकिंग होने के बावजूद, परीक्षा क्यों नहीं दी जा सकती? | परीक्षा को उसी तरह चलाएं जिस तरह उसे शिप किया गया है और फ़ैसले पढ़ें |
III | चेकर को कस्टम मेट्रिक के तौर पर · छह चेक | क्या परीक्षा में यह बताया जा सकता है कि किसे भूख लगी है और क्यों? |
|
IV | comparator · checker · LLM-as-judge | जवाब एक ही है. इसे किन तीन चीज़ों के आधार पर मापा जा सकता है? | एक जवाब को तीन तरीकों से दो बार परखा जाता है |
V |
| क्या एजेंट अपनी गलतियों को खुद ठीक कर सकता है? |
|
VI | इनाम पाने के लिए हैकिंग · प्रॉक्सी मेट्रिक | अगर जज को नुकसान नहीं दिखता, तो वह लूप के साथ क्या करता है? | स्विच |
VII | पीछे के किनारे वाली | किसी ग्राफ़ को लूप बनाने वाली चीज़ क्या है और इसे कौनसी चीज़ रोकती है? |
|
VIII | हर आइटम की जगह कौनसी चीज़ें इस्तेमाल की गईं | — | चेक |
इस कोडलैब को इस्तेमाल करने का तरीका. इसमें कॉन्सेप्ट को सबसे पहले समझाया जाता है: हर कोर्स में, सबसे पहले कॉन्सेप्ट को समझाया जाता है. इसके बाद, बदलाव लागू होने के बाद कोड कैसा दिखता है, यह दिखाया जाता है और उसके बारे में पूरी जानकारी दी जाती है. यह सुविधा, आपसे कभी भी किसी फ़ाइल में बदलाव करने के लिए नहीं कहती. बदलाव ऐप्लिकेशन में होता है. यह सुविधा, आपको एक बार में एक लाइन दिखाती है और सबसे पहले गड़बड़ी दिखाती है. कोर्स पढ़ें. इसके बाद, पेज को आपको कोर्स के बारे में बताने दें और नंबर को आगे बढ़ते हुए देखें.
यह कहां मौजूद होता है
इस दुनिया में दस मेहमान हैं और हर मेहमान की एक शर्त है. साथ ही, दस रेस्टोरेंट हैं और हर रेस्टोरेंट में एक जाल है. इसके अलावा, 16 पार्टियां हैं. दोनों जज, loop-lab-table लैब से हैं. एक पेज वाला इंटरैक्टिव फ़ॉर्मैट, Agent Valley से लिया गया है. बिस्ट्रो एक सीनरी है. इसके नीचे मौजूद हर मैकेनिज़्म, सामान्य मैकेनिज़्म है. इसका इस्तेमाल सहायता एजेंट, बुकिंग फ़्लो या किसी ऐसी चीज़ के लिए किया जाता है जिसकी "अच्छी" स्थिति की जांच की जा सकती है.
2. 🧰 सेटअप
- क्या — पेमेंट करने के लिए एक खाता, एक प्रोजेक्ट, इंस्टॉल की गई लैब, जवाब देने के लिए सही मॉडल, और एक पोर्ट पर चल रही टेबल.
- क्यों — एक पोर्ट पर एक प्रोसेस: पेज, परीक्षा, एडिटर, और वर्कबेंच एक ही ऑरिजिन शेयर करते हैं. इसलिए, इस लैब में किसी भी चीज़ के लिए दूसरे टर्मिनल या दूसरे पोर्ट की ज़रूरत नहीं होती.
- कैसे — क्लोन, दो स्क्रिप्ट, एक कमांड. सेटअप के दौरान, आखिरी काम एक असली मॉडल कॉल करना होता है. इसलिए, खराब प्रोजेक्ट पहले कोर्स में नहीं, बल्कि यहां फ़ेल हो जाता है.
इस लैब में मौजूद हर चीज़ Cloud Shell में चलती है. इसमें gcloud, Python, और Node git पहले से इंस्टॉल होते हैं. साथ ही, Gemini को अपने क्रेडेंशियल का इस्तेमाल करके Vertex AI के ज़रिए ऐक्सेस किया जाता है. इस लैब में कोई एपीआई पासकोड नहीं है. साथ ही, आपको अपने लैपटॉप पर कुछ भी इंस्टॉल करने की ज़रूरत नहीं है. Google Cloud SDK, Python 3.11+, और Node 20+ वाला लैपटॉप भी इसी तरह काम करता है.
इस लैब में आपको एक चीज़ नहीं मिल सकती: बिलिंग की सुविधा वाला Google Cloud प्रोजेक्ट. पहले चरण में, आपको एक ऐसा खाता मिलता है जिससे पेमेंट किया जा सकता है. चौथे चरण में, उस खाते को एक प्रोजेक्ट में बदल दिया जाता है. इन्हें इसी क्रम में करें — चौथे चरण के बाद हर चरण में, उस प्रोजेक्ट को पढ़ा जाता है जिस पर चौथा चरण आधारित है.
1 · बिलिंग की सुविधा वाला खाता पाएं (~1 मिनट)
उस Google खाते से साइन इन करें जिसमें बिलिंग की सुविधा चालू हो. इस तरह का कोई भी खाता इस्तेमाल किया जा सकता है. अगर आपके पास बिलिंग खाता नहीं है, तो बिना शुल्क के आज़माएं. इससे आपको एक बिलिंग खाता मिलेगा, जो चौथे चरण के लिए ज़रूरी है.
2 · Cloud Shell खोलें (~2 मिनट)
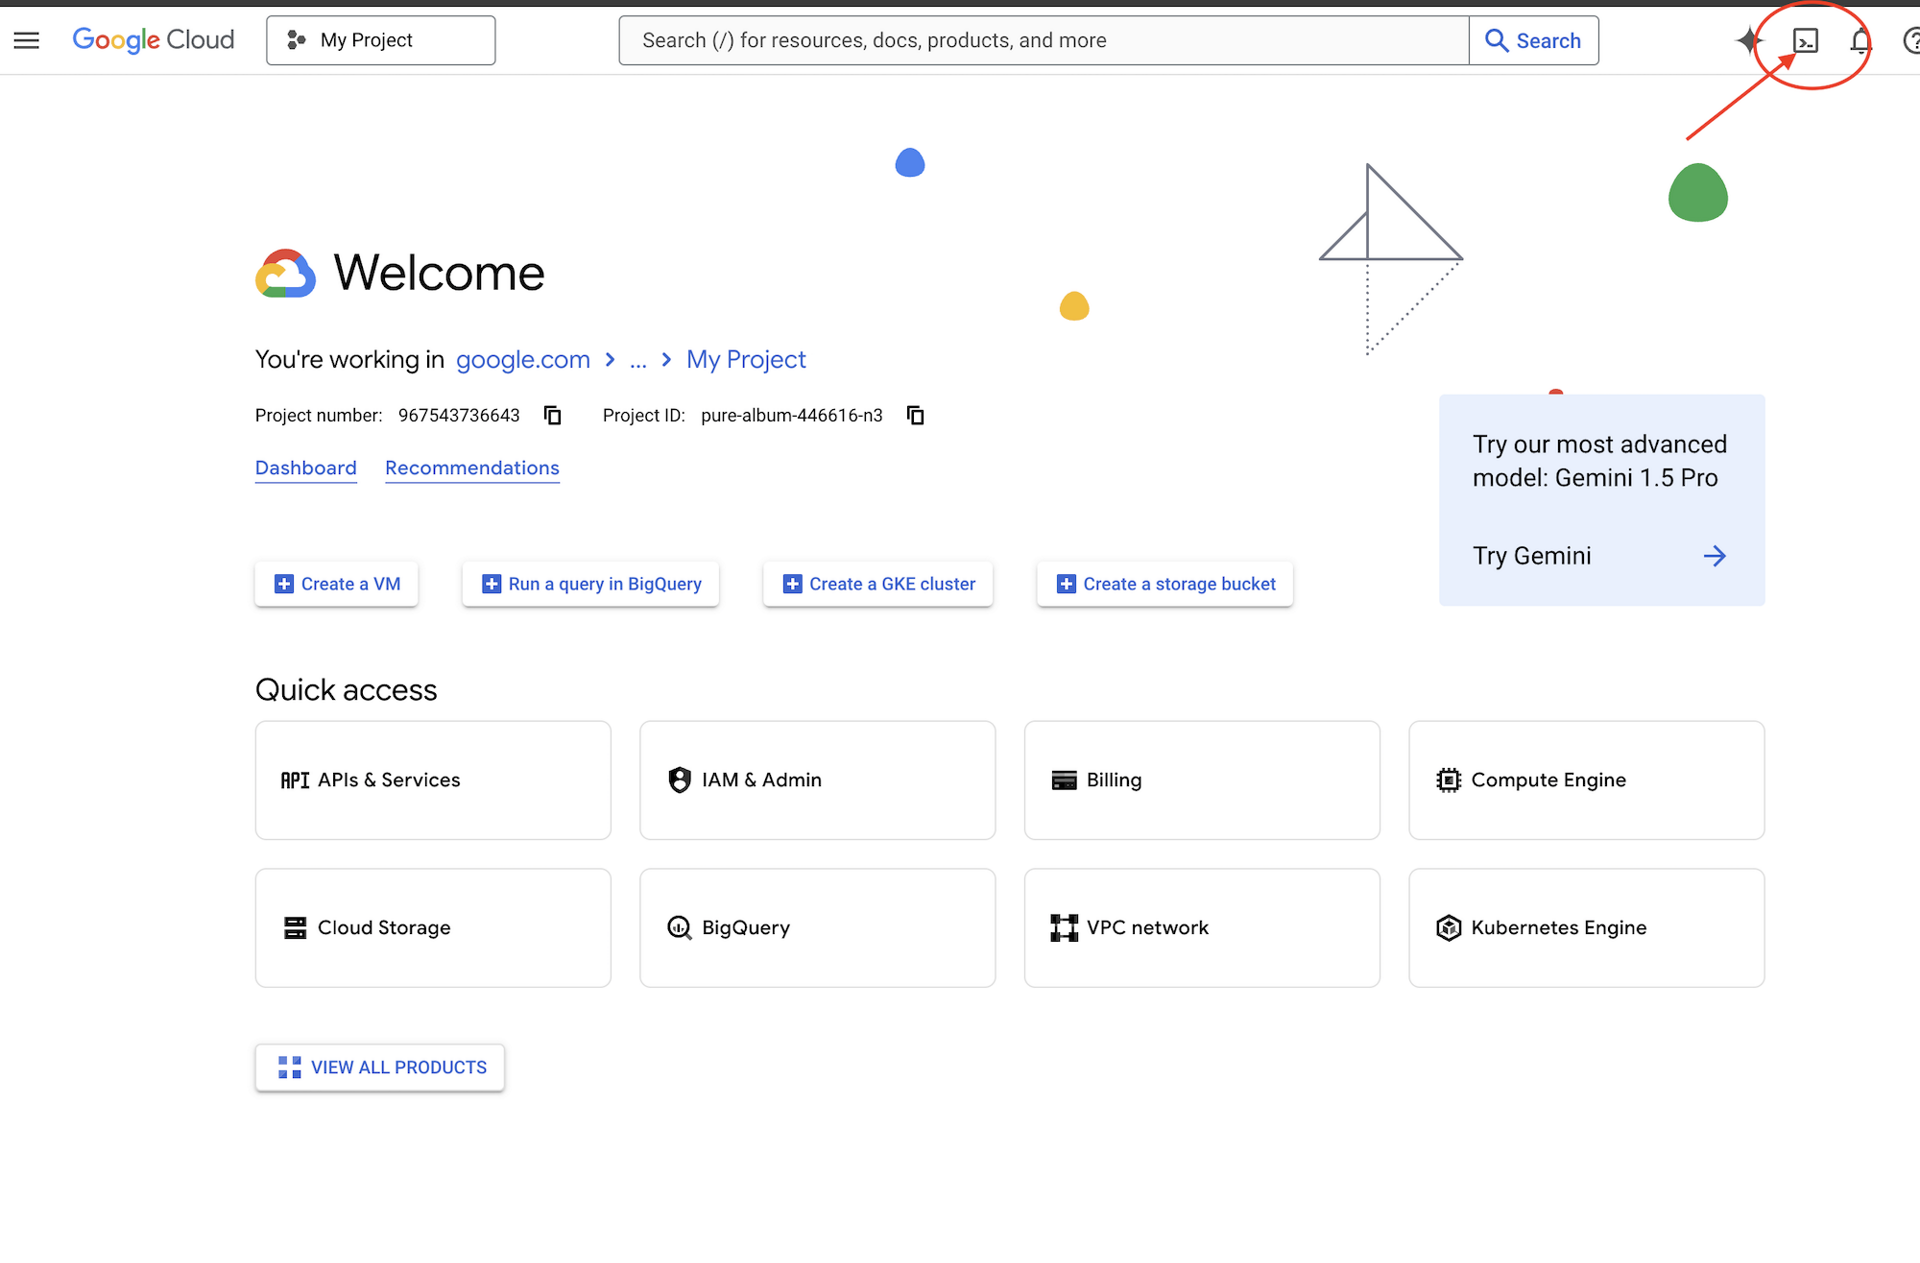
👉🖥 Google Cloud Console में सबसे ऊपर मौजूद, Cloud Shell चालू करें पर क्लिक करें. यह हेडर में टर्मिनल के आकार का आइकॉन होता है.
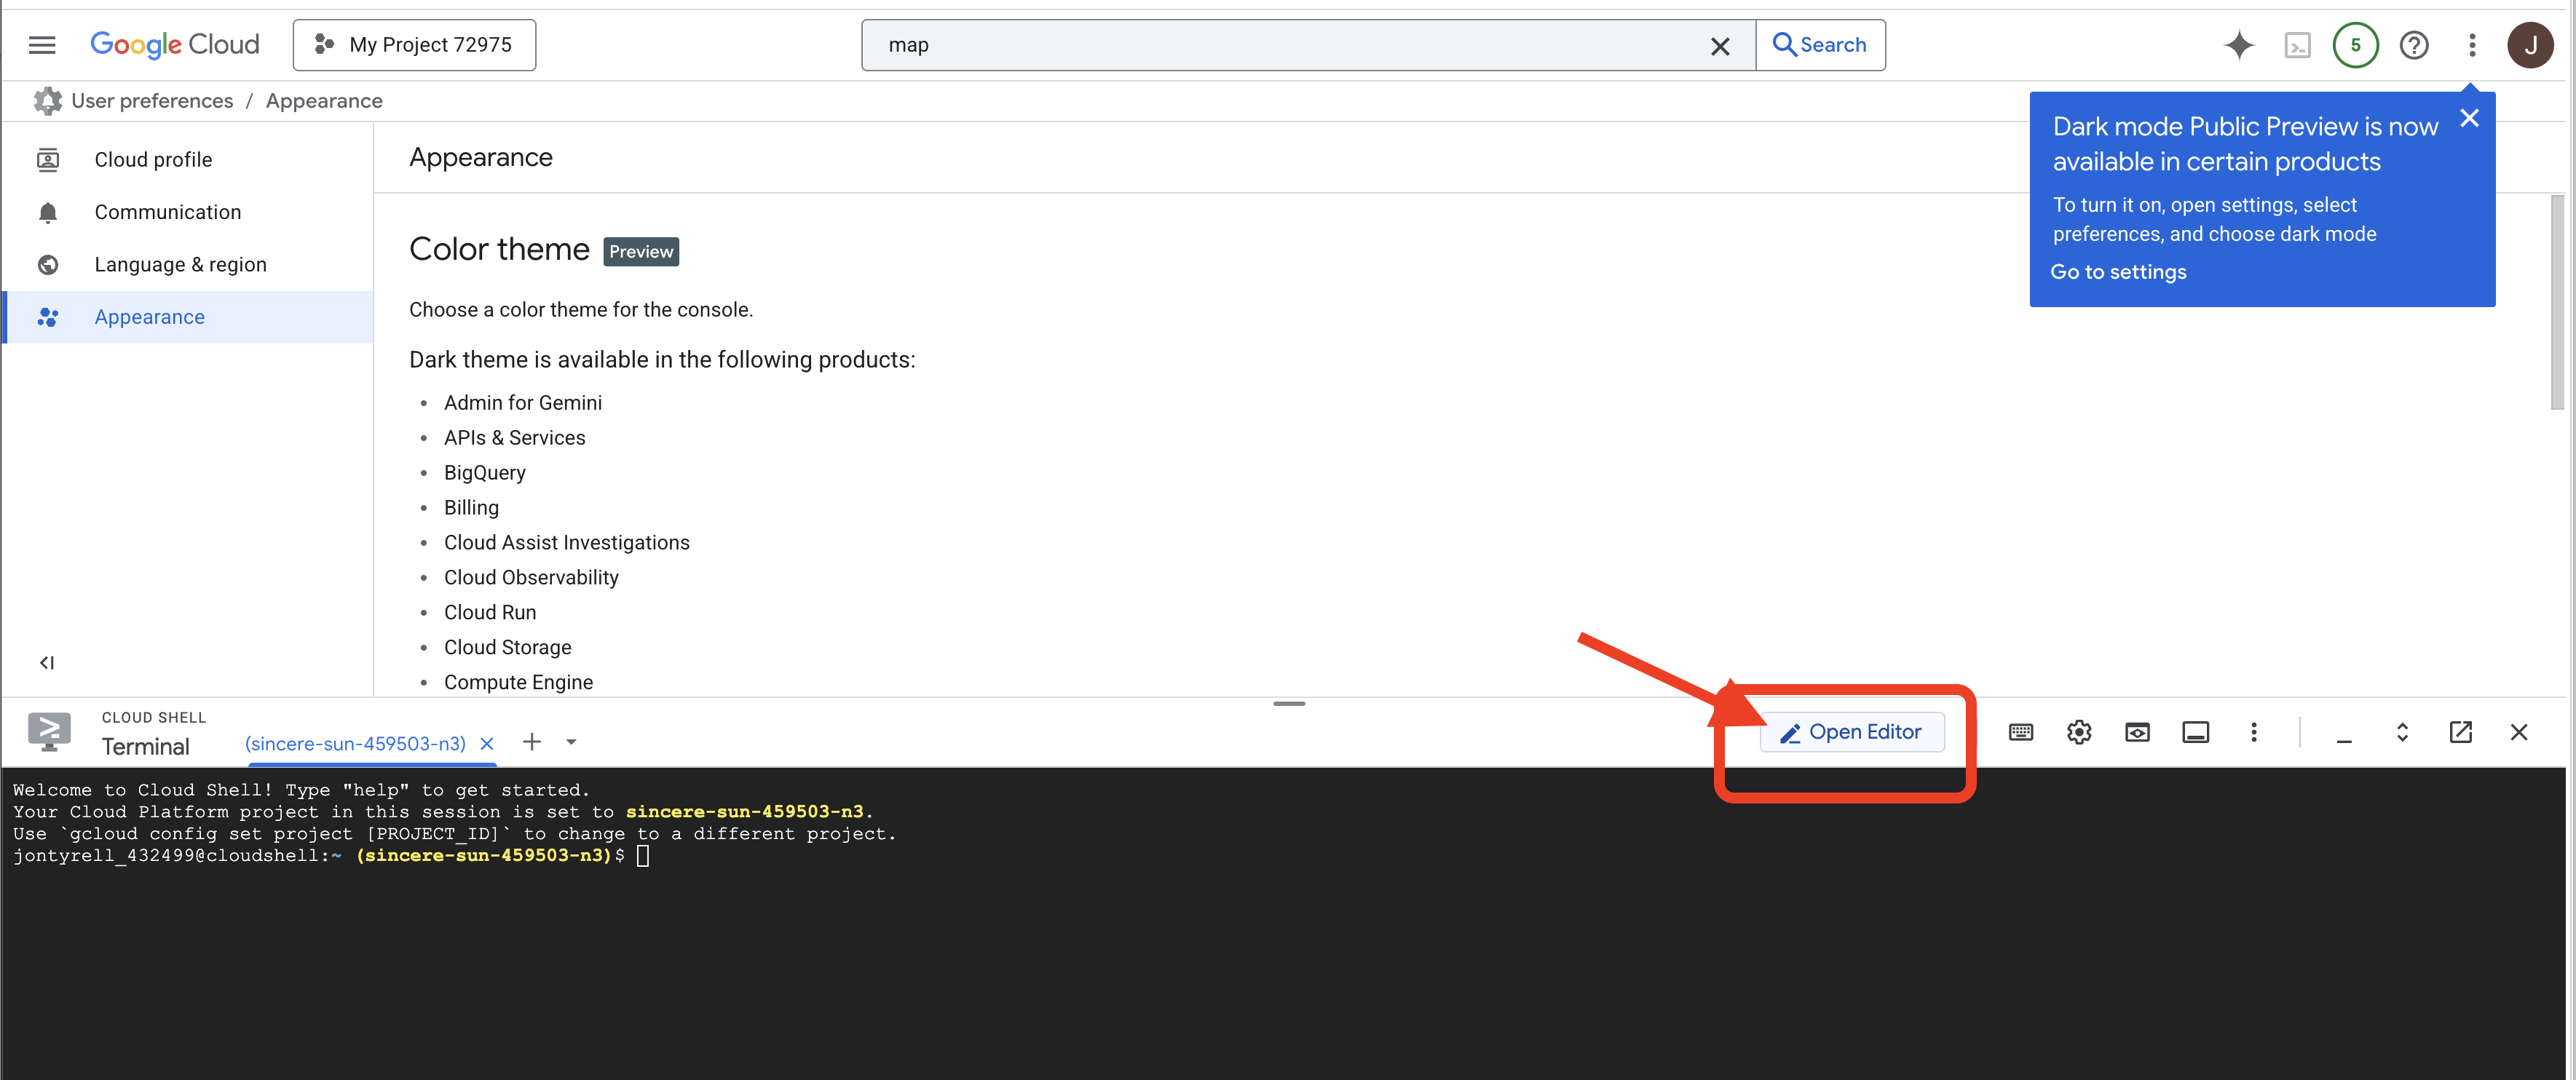
👉🖥 एडिटर खोलें (पेंसिल वाले खुले फ़ोल्डर का आइकॉन) पर क्लिक करें. इससे Cloud Shell Editor खुल जाता है. इसमें बाईं ओर फ़ाइल एक्सप्लोरर होता है. जब भी आपको पूरी फ़ाइल पढ़नी हो, तो यहां जाएं.
👉🖥 अगर आपसे आज किसी भी समय अनुमति देने के लिए कहा जाता है, तो जारी रखने के लिए अनुमति दें पर क्लिक करें.
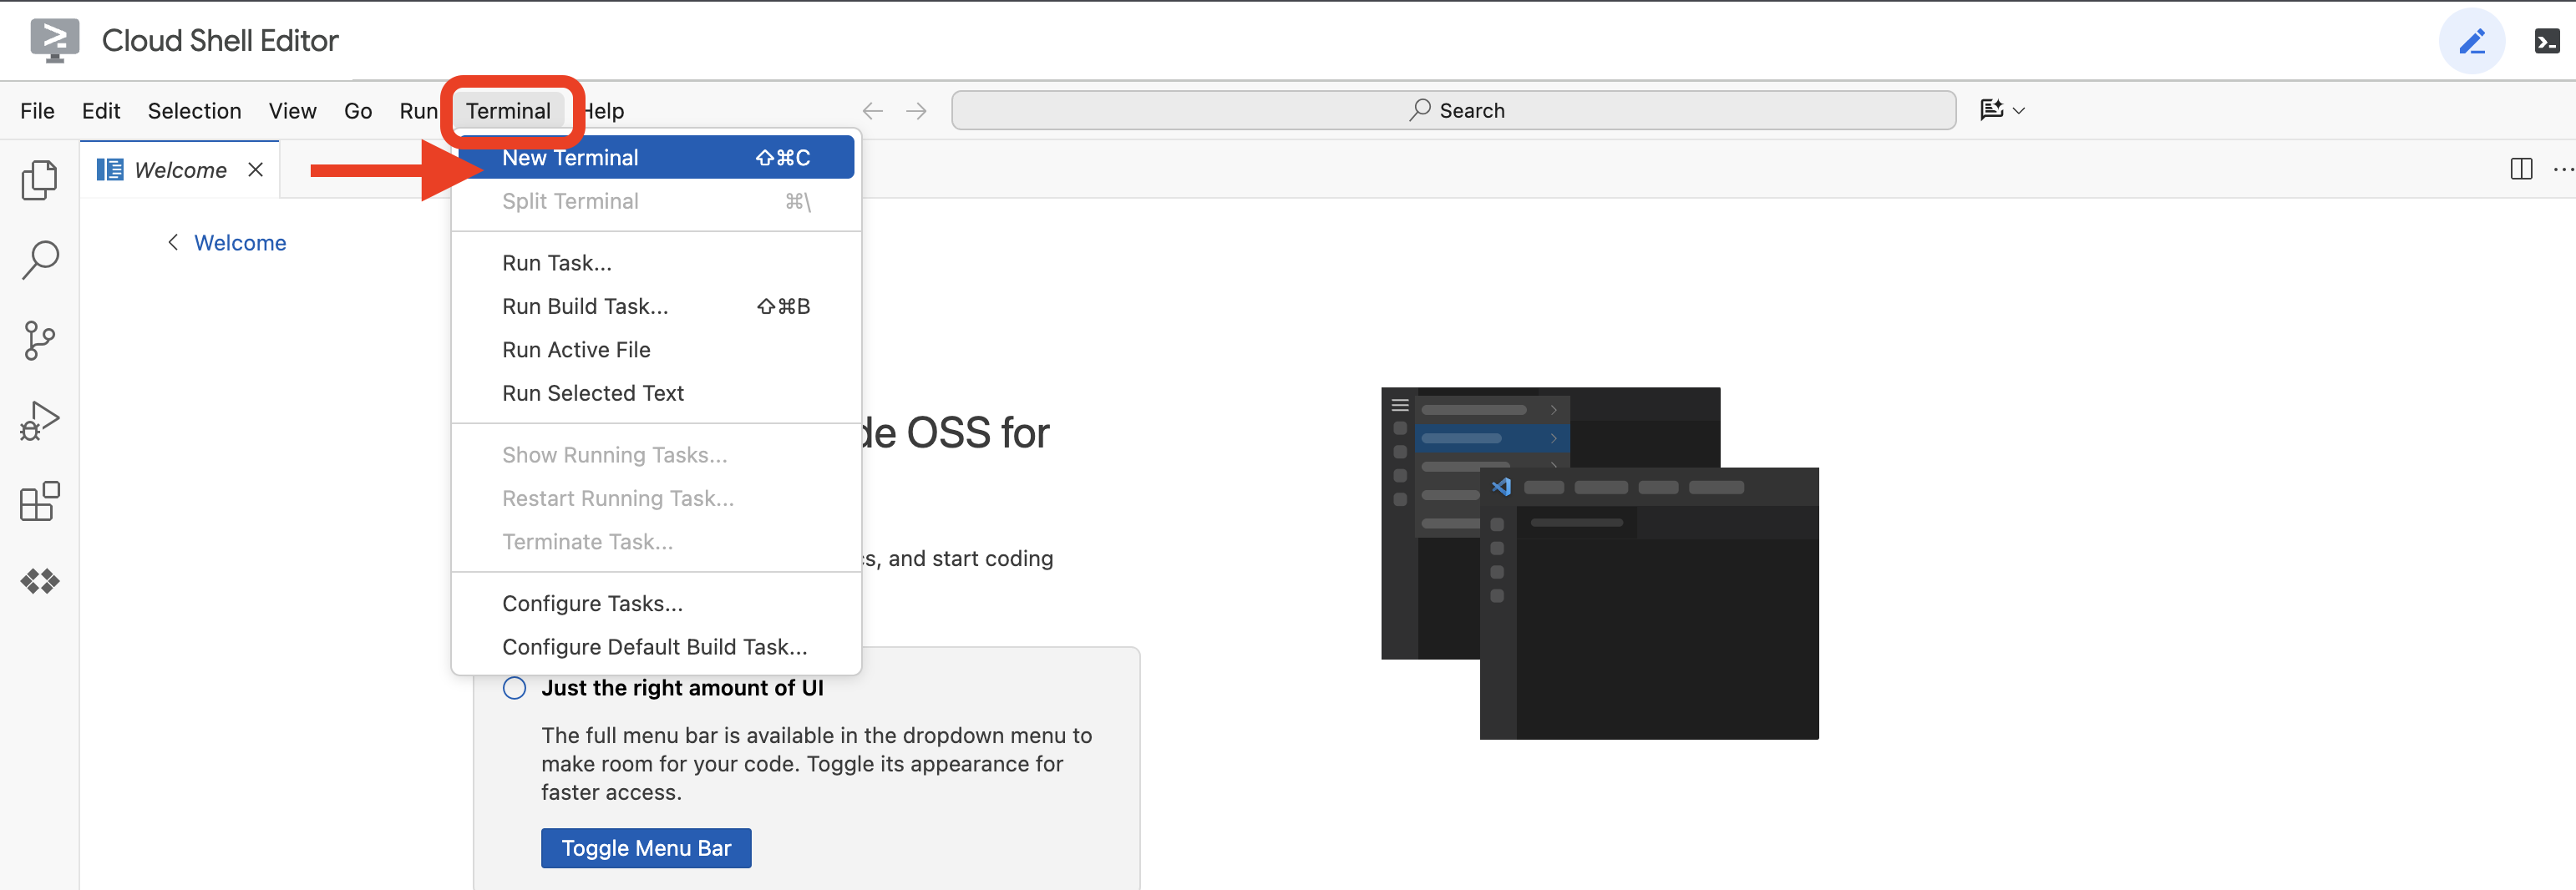
👉🖥 एडिटर में एक टर्मिनल खोलें — यानी कि टैब 1, और हर 👉💻 चरण वहीं चलता है. दूसरा टैब टेबल है. इसे सातवें चरण में खोला जाता है. अगर टर्मिनल पहले से स्क्रीन पर सबसे नीचे नहीं है, तो इसे View → Terminal पर जाकर खोलें:
👉💻 देखें कि आपने किस खाते से साइन इन किया है. यह वही खाता होना चाहिए जिसका इस्तेमाल आपने पहले चरण में किया था:
gcloud auth list
3 · लैब पाएं (~1 मिनट)
👉💻 रिपो को क्लोन करें:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · अपना प्रोजेक्ट बनाएं (~2 मिनट)
👉💻 एक स्क्रिप्ट आपके बिलिंग खाते को ढूंढती है, उस पर एक प्रोजेक्ट बनाती है, बिलिंग को लिंक करती है, और Cloud Shell को उस प्रोजेक्ट पर ले जाती है:
cd ~/table-for-n
./setup_project.sh
आपको चुने गए बिलिंग खाते के लिए ✓, बनाए गए प्रोजेक्ट के लिए ✓, और इस तरह का मैसेज दिखेगा:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 आपका प्रोजेक्ट आईडी है. आपके प्रोजेक्ट आईडी में अलग-अलग अंक होंगे. इसमें ये चार काम होते हैं:
बिलिंग | अगर आपके पास नया | |
प्रोजेक्ट |
| |
selects | आईडी को | |
waits | जब तक प्रोजेक्ट को विज्ञापन दिखाने की अनुमति नहीं मिल जाती, तब तक हर दो मिनट में पोल करता है | |
👉🖥 अब यही प्रोजेक्ट कंसोल में मौजूद है. इसका आईडी, डैशबोर्ड पर मौजूद प्रोजेक्ट की जानकारी कार्ड में दिखता है:

5 · लैब को इंस्टॉल और सेट अप करें (~3 मिनट)
setup_codelab.sh, uv का इस्तेमाल करके एनवायरमेंट बनाता है. यह आपके लिए uv इंस्टॉल नहीं करेगा — यह रुक जाता है और आपको इसे इंस्टॉल करने के लिए कहता है. इसलिए, इसे पहले इंस्टॉल करें. इसके लिए, यहां दिया गया निर्देश इस्तेमाल करें:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
एक स्क्रिप्ट, जिसे फिर से चलाया जा सकता है. यह क्रम से पांच काम करता है:
api | प्रोजेक्ट के चौथे चरण को चुनता है और उस पर | |
uv env |
| |
site |
| |
.env |
| |
प्रीफ़्लाइट |
| |
6 · मेन्यू पढ़ें (~1 मिनट)
पांचवें चरण में आखिरी चीज़ के तौर पर, आज रात का मेन्यू प्रिंट किया गया है. इसमें हर लाइन में सही जानकारी दी गई है, अनुमान नहीं लगाया गया है:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
शुरू करने से पहले, कोई भी लाइट चालू नहीं होती है. the model answers का मतलब है कि आपके प्रोजेक्ट पर कोई कॉल किया गया है.
👉💻 यह देखने के लिए कि आपने क्या-क्या किया है, इसे किसी भी समय फिर से चलाएं. यह आपकी फ़ाइलों और किचन के बिल को पढ़ता है, न कि चेकलिस्ट को:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · टेबल सेट करना (~1 मिनट)
👉💻
cd ~/table-for-n
bash table.sh
एक प्रोसेस, पोर्ट 3470. किचन को गर्म होने में कुछ समय लगता है — यह ADK इंपोर्ट करता है और adk web को माउंट करता है — इसलिए स्क्रिप्ट ऐसा कहती है, इंतज़ार करती है, और पोर्ट के जवाब देने के बाद ही लिंक प्रिंट करती है:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
यह फ़ोरग्राउंड में रहता है. Ctrl+C दबाने पर टेबल मिट जाती है. इसे चलने दें — यहां से हर कोर्स इस प्रोसेस से बात करता है. इस लैब में कुछ भी इसे रीस्टार्ट करने के लिए नहीं कहता.
✓ the table is laid दिखने के बाद, टेबल को नए टैब में खोलें. इसे टैब 2 नाम दें. Cloud Shell में: वेब की झलक → पोर्ट बदलें → 3470.
👉🖥 रिज़र्वेशन कार्ड पर अपना नाम लिखें. यह नाम आखिर में चेक पर दिखेगा. इसके बाद, ✦ हमें बैठाएं पर क्लिक करें.
3. I · The booking — a reply is not a result
पांच लोग डिनर करने जा रहे हैं. ग्रुप चैट में सभी की अपनी-अपनी ज़रूरतें हैं: नादिया वीगन है, टॉम इस महीने 25 डॉलर से ज़्यादा खर्च नहीं कर सकता, अमारा बैसाखी के सहारे चलती है और वह सिर्फ़ दस मिनट तक चल सकती है, लीना 7:45 से पहले नहीं पहुंच सकती, और बेन को कोई परेशानी नहीं है. दस रेस्टोरेंट की सूची दी गई है. इन्हें रेटिंग के हिसाब से क्रम में लगाया गया है. हर रेस्टोरेंट के लिए, कीमत, पैदल जाने में लगने वाला समय, खुले होने का समय, और एक खास बात बताई गई है.
एजेंट टेबल बुक करता है. चैट पढ़कर आपको पहले ही पता चल जाता है कि चुने गए कमरे में कौन भूखा रहने वाला है. सिस्टम में मौजूद किसी भी व्यक्ति को इस बारे में नहीं पता होता. इस कोडलैब में, इसी अंतर को कम करने के बारे में बताया गया है.
एजेंट — सिर्फ़ पढ़ने का ऐक्सेस
host/agent.py, क्योंकि यह पूरे लैब के लिए है:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
कोई टूल नहीं, कोई डेटाबेस नहीं, कोई खोज नहीं. एक मॉडल, एक निर्देश स्ट्रिंग — और स्ट्रिंग इस फ़ाइल में नहीं है. यह instruction_current.txt में मौजूद है. इसमें प्रॉडक्ट मैनेजर की लिखी हुई चार लाइनें हैं:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
एलर्जी, बजट, चलने की सीमा या किसे जल्दी निकलना है, इस बारे में एक शब्द भी नहीं. यह सारी जानकारी, एजेंट को मिलने वाले निर्देश में शामिल होती है. इस्तेमाल नहीं किया गया.
यह फ़ाइल, इस लैब का मुख्य आर्टफ़ैक्ट है. कोर्स V, ऑप्टिमाइज़र को इसे फिर से लिखने की अनुमति देता है. कोर्स VI में हैक किया गया वर्शन इंस्टॉल किया जाता है. सातवें कोर्स का लूप, ग्राफ़ के चलने के दौरान उसे राउंड दर राउंड फिर से लिखता है. एजेंट का मॉडल, सेटिंग, और नाम कभी नहीं बदलता.
इसे आज़माएं — इसमें कोई फ़्रंटएंड नहीं है
👉🖥 पेज पर, कोर्स I. सबसे ऊपर दाईं ओर मौजूद, 🔬 वर्कबेंच पर क्लिक करें: ड्रॉअर adk web है, जिसे एक ही प्रोसेस में माउंट किया गया है — एक ही host/ फ़ोल्डर, एक ही table.db. होस्ट को चुनें. इसके बाद, कोर्स पैनल से जानकारी चिपकाएं. इसमें कॉपी करने का बटन होता है. इसके बाद, भेजें.
मेज़बान ने एक सेकंड में जवाब दिया: रेस्टोरेंट का नाम, समय, और एक लाइन में वजह बताई. चैट के ख़िलाफ़ की गई कार्रवाई की वजह पढ़ें. इसके बाद, बाईं ओर मौजूद टेबल देखें: लेटा हुआ, किसी ने जज नहीं किया, — / 5. ऐसा इसलिए नहीं है कि कुछ लोड हो रहा है, बल्कि इसलिए है क्योंकि कोर्स की दुनिया में ऐसा कुछ भी नहीं है जो इसका आकलन कर सके.
नंबर: भूखी सीटें — ?. कोई नहीं बता सकता.
4. II · तुलना करने वाला — इस डिनर में कितने जवाब सही हैं?
दूसरे कोर्स की शुरुआत एक ऐसी परीक्षा से होती है जो पहले से मौजूद है और पहले ही फ़ेल हो चुकी है. इसकी वजह से कुछ भी नहीं सीखा जा सकता. इसे ठीक करने से पहले, इसे चलाने के तीन तरीकों के बारे में जान लें, क्योंकि आज आपको इन तीनों का इस्तेमाल करना होगा.
आकलन करने के तीन तरीके
इन सभी में एक ही इंजन का इस्तेमाल किया गया है.
यह किस काम के लिए है | आपको क्या मिलेगा | |
| बैच रनर; सीआई में क्या डाला जाता है | जवाब में, पास, फ़ेल, और हर मामले के लिए स्कोर की जानकारी शामिल हो |
| कोई केस फ़ेल हो गया है और आपको उसे देखना है | उस बातचीत, ट्रेस, और हर केस के स्कोर को देखा जा सकता है. ये सभी क्लिक किए जा सकते हैं |
| फ़ोल्डिंग एजेंट के आकलन को सामान्य रिग्रेशन सुइट में शामिल करना | यह आपकी यूनिट टेस्ट के साथ चलता है और उसी तरह से बिल्ड को फ़ेल करता है |
काम की जानकारी: तीनों में एक लोकल इवैल स्टोर, host/.adk/eval_history/ है. सीआई से बैच चलाएं. अगर कोई गड़बड़ी होती है, तो वेब यूज़र इंटरफ़ेस (यूआई) में उस रन को खोलें और उसकी जांच करें. पहला तरीका, पेज पर मौजूद 📝 बटन है. दूसरा तरीका, 🔬 वर्कबेंच है. तीसरा तरीका, टर्मिनल कमांड uv run pytest tests/test_host.py है. यह कमांड, 12 लाइनों का टेस्ट चलाता है:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. एक ही एजेंट, एक ही evalset, एक ही कॉन्फ़िगरेशन फ़ाइल, और eval_set_results_manager लाइन की वजह से, इस रन को अन्य दो रन के इतिहास में शामिल किया गया है.
परीक्षा का फ़ॉर्मैट
exam/eval_config.json इस तरह के जहाज़:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
दो हिस्से, दो काम. criteria
परीक्षा का पेपर है — ये मेट्रिक असल में काम करती हैं. हर मेट्रिक के लिए पास बार होता है. customMetrics
स्टाफ़ डायरेक्ट्री है — Python से मैप किए गए नाम, उपलब्ध हैं, लेकिन ड्यूटी पर नहीं हैं. किसी मेट्रिक का एलान करने का मतलब यह नहीं है कि उसे रन किया जा रहा है. इस पेपर में सिर्फ़ एक सवाल है: ADK का पहले से मौजूद response_match_score, जो एजेंट के जवाब और इवैल्युएशन सेट में मौजूद गोल्डन बुकिंग के बीच टेक्स्ट ओवरलैप (ROUGE-1) है. आपके जज, everyone_ate, डायरेक्ट्री में हैं, न कि पेपर पर — कोर्स III, एक लाइन बदलकर उन्हें वहां ले जाता है.
हमारे पास डिनर बुक करने वाला एजेंट है और response_match_score वहां मुफ़्त में बैठा है. चलिए, इसका इस्तेमाल करके देखते हैं कि हमें क्या मिलता है.
इसे आज़माएं
👉🖥 पेज पर मौजूद कोर्स II. 📝 run the exam · as shipped दबाएं. बटन के नीचे मौजूद कैप्शन में यह बताया गया है कि क्या चल रहा है: एक मेट्रिक चल रही है: response_match_score · everyone_ate को घोषित किया गया है, न कि परीक्षा में. इसमें करीब आधा मिनट लगेगा. नतीजा पढ़ें: करीब आधी टेबल फ़ेल हो गई हैं. टेक्स्ट स्कोर के बारे में कोई जानकारी नहीं दी गई है. यह भी देखें कि कौनसी टेबल फ़ेल हुई हैं. चिप पर कर्सर घुमाएं.
अब ध्यान से देखो, क्योंकि यह दिलचस्प हिस्सा है. तुलना करने वाले टूल को दोनों दिशाओं में टेबल गलत मिलती हैं. साथ ही, आपके रन में उनमें से कम से कम एक टेबल दिखेगी. इसने ऐसी टेबल के लिए बुकिंग नहीं की जहां बुकिंग ठीक थी — एजेंट ने ऐसा कमरा चुना जहां सभी लोग खाना खा सकते थे; डिनर ठीक से हुआ; जवाब सही है — क्योंकि एजेंट ने वजह को उस तरीके से नहीं बताया जिस तरीके से गोल्डन जवाब में बताया गया था. साथ ही, यह एक ऐसी टेबल को पास करता है जहां कोई भूखा रह जाता है — हमारे रन p1 पर, ठीक 0.30 पर, टॉम का बजट ज़्यादा है और लीना ने आखिरी ऑर्डर के बाद ऑर्डर किया है — क्योंकि ज़रूरत से ज़्यादा शब्द ओवरलैप हो गए हैं. स्ट्रिंग की समानता को डिनर के बारे में कुछ नहीं पता. यह लाइन में लगे वर्णों के बारे में जानता है.
इसलिए, यहां एक सवाल है: इस डिनर के कितने सही जवाब हैं?
आज रात की पार्टी के लिए, दस कमरों में से सिर्फ़ एक कमरा सभी को खाना परोसता है — फ़ो साइगॉन. यह सिर्फ़ शाम 7 बजे से खाना परोसता है. परीक्षा में शामिल आठ पार्टियों के लिए, यह एक, दो, दो, एक, तीन, तीन, छह, एक है (world.rooms हर पार्टी के लिए, हर सीट पर चलता है; इसे uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" के साथ खुद चलाएं). कभी-कभी कई कमरों में सभी लोगों को खाना परोसा जा सकता है. कभी-कभी सिर्फ़ एक कमरे में और सिर्फ़ कुछ समय के लिए ऐसा किया जा सकता है. जवाबों का एक सेट होता है, न कि सिर्फ़ एक जवाब. साथ ही, इवैलसेट में मौजूद सबसे सही जवाब, उस सेट का एक हिस्सा होता है.
इसका मतलब है कि response_match_score के पीछे की धारणा — एक सही जवाब है और मैंने उसे लिख दिया है — इस समस्या के लिए कभी सही नहीं थी. एक बार भी नहीं. मेट्रिक को ब्रेकडाउन नहीं किया गया है. यह ठीक वैसा ही काम करता है जैसा बताया गया है. हमने इस समस्या के लिए गलत मेट्रिक का इस्तेमाल किया.
👉🖥 ज़रूरी नहीं, एक मिनट का काम: 🔬 वर्कबेंच → Evals → 🕓 इतिहास खोलें. अभी-अभी की गई जांच 📝 वहां मौजूद है. हर केस पर क्लिक किया जा सकता है. टैब 1 में, uv run pytest tests/test_host.py उसी परीक्षा को फ़ेल होने वाले टेस्ट के तौर पर चलाता है और उसी इतिहास में पहुंच जाता है.
संख्या: शब्दों के ओवरलैप के लिए, हमारे रन में आठ में से चार पास हुए. इसकी कोई वजह नहीं बताई गई है. साथ ही, 1 दस कमरों में से p1 के लिए सही जवाब दिया गया है.
डिनर के लिए, हमें अपने-आप विकल्प मिल जाता है. कोई भी आपको शुक्रवार के लिए एक सही रेस्टोरेंट नहीं बता सकता. हालांकि, हर कोई आपको बता सकता है कि एक सफल डिनर का क्या मतलब है: टेबल पर मौजूद हर व्यक्ति को खाना मिला. यह एक नियम है. इसे चुना जा सकता है. यह साफ़ तौर पर समझ में आता है. तीसरे कोर्स में, इसे बनाने का तरीका बताया गया है.
5. III · जज — कस्टम मेट्रिक के तौर पर चेकर
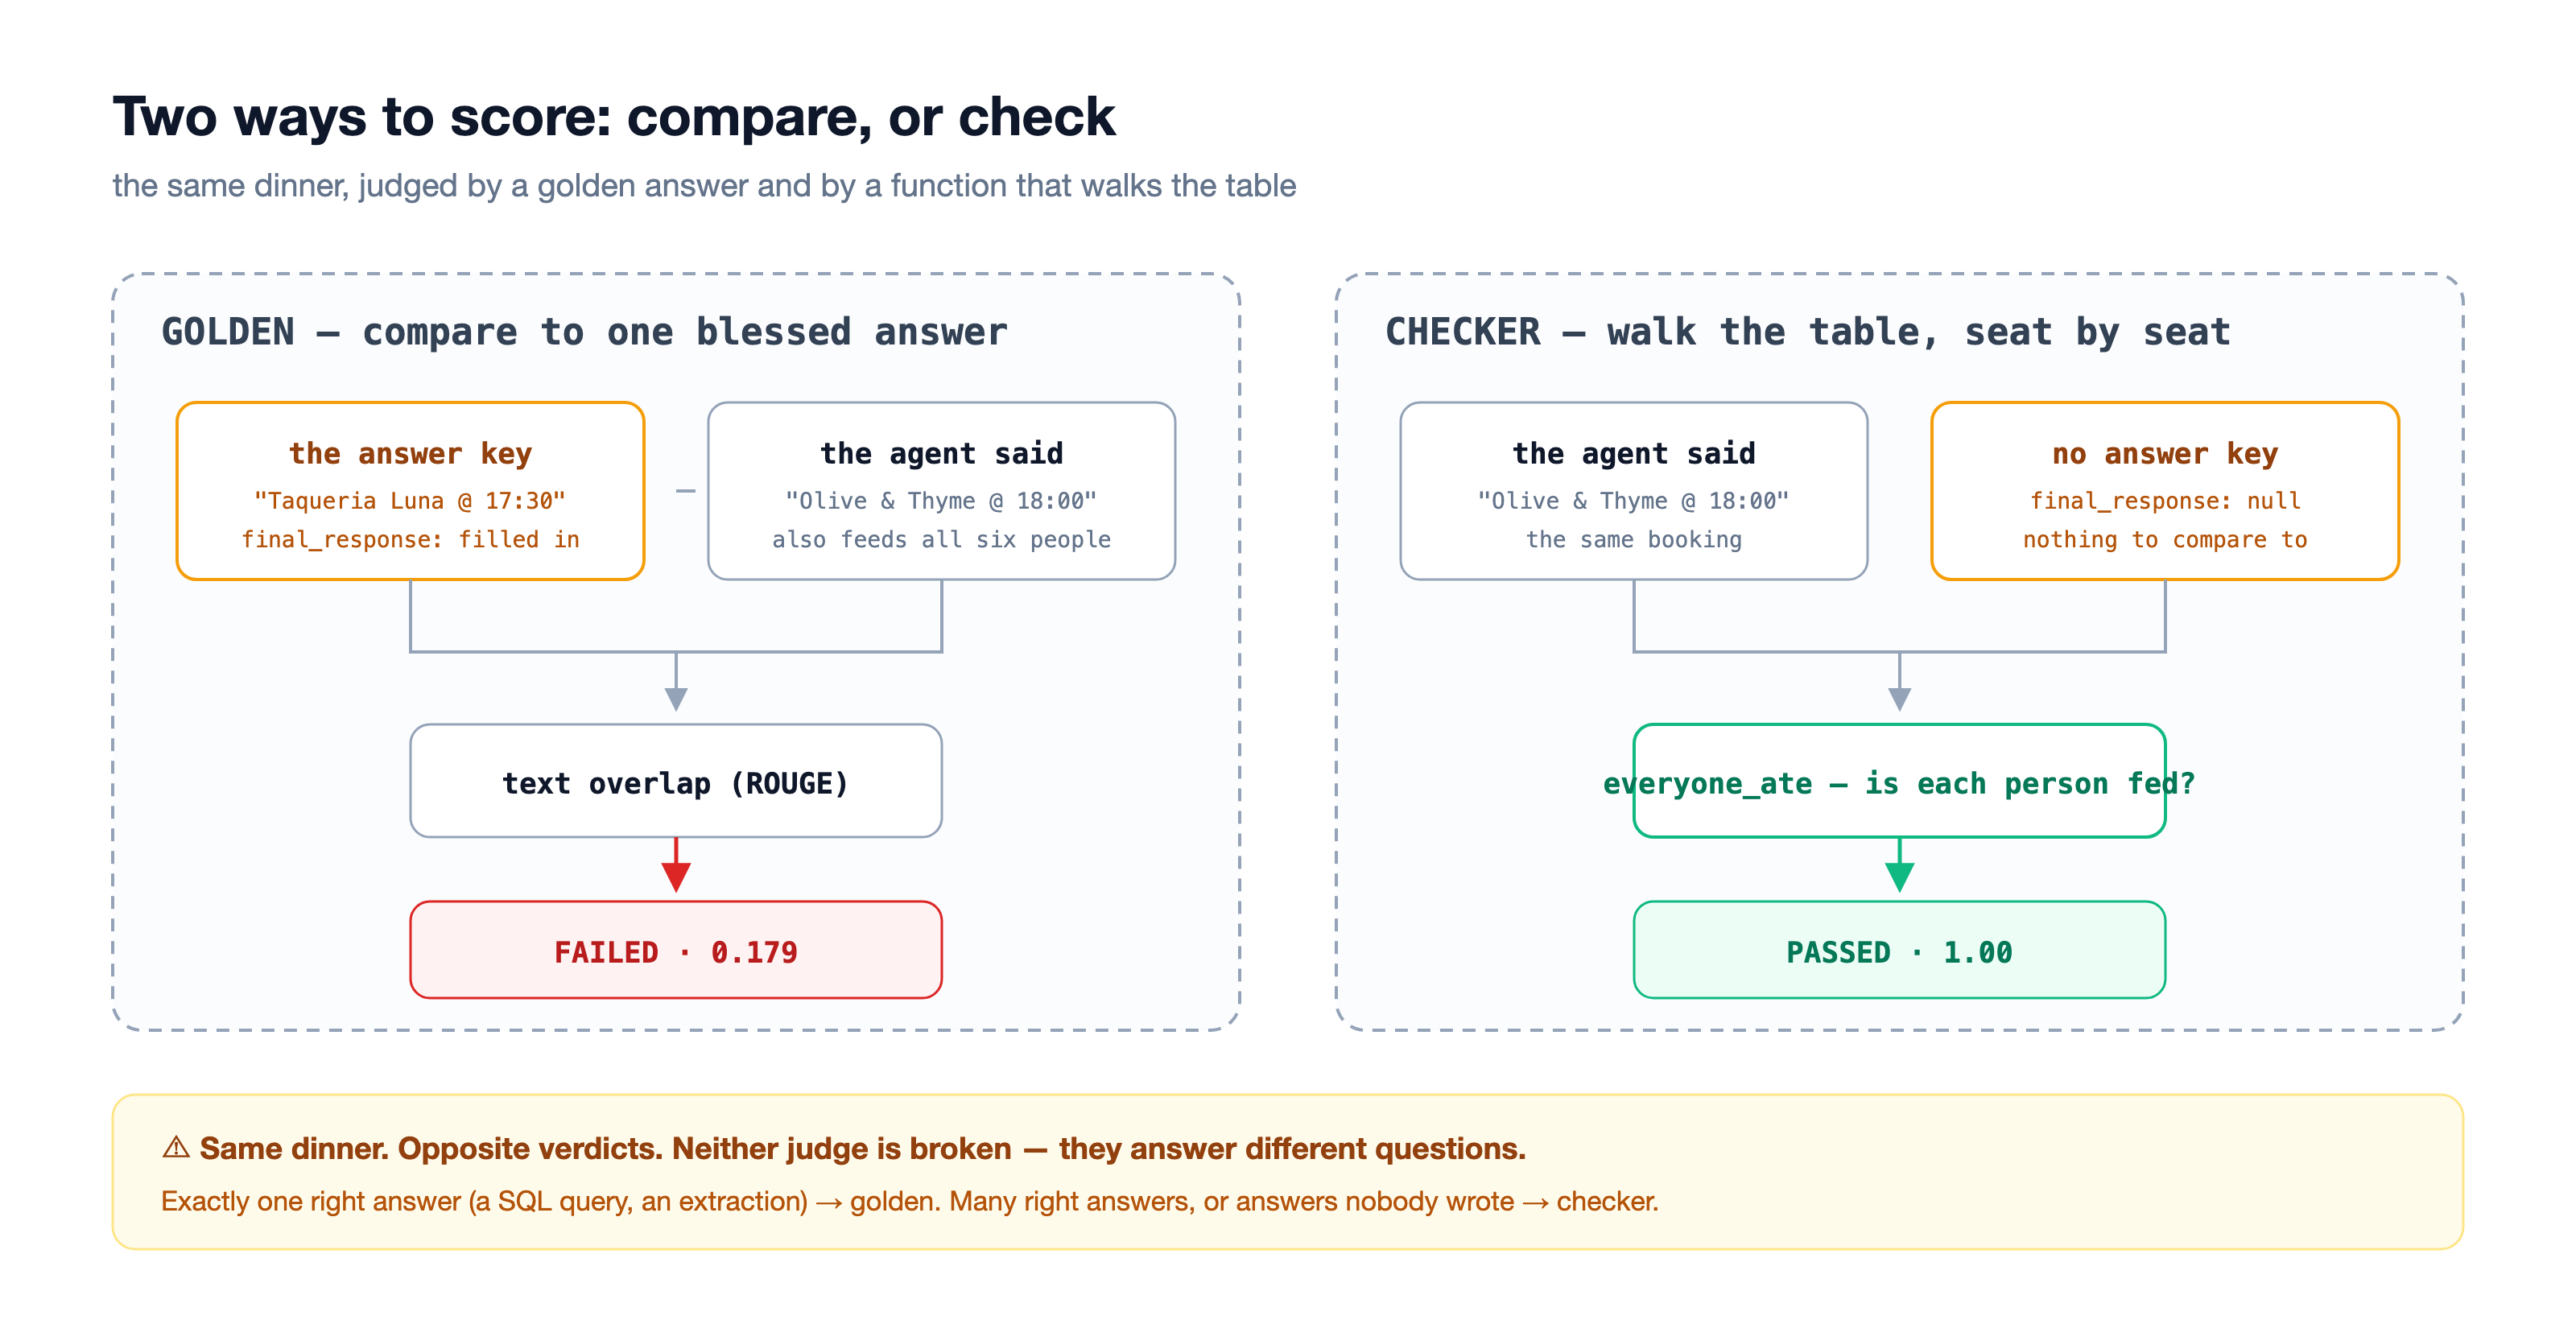
चेकर, तुलना करने वाले व्यक्ति से अलग सवाल पूछता है: क्या यह मुख्य चीज़ से मेल खाता है के बजाय क्या हर व्यक्ति को खाना दिया गया? यह फ़ंक्शन, पार्टी के हिसाब से बुकिंग की जांच करता है. इसमें हर सीट की जांच की जाती है. साथ ही, हर सीट के लिए स्कोर और वजह बताता है. इसके लिए, किसी सटीक जवाब की ज़रूरत नहीं होती. यही वजह है कि यह सुविधा, पहले हो चुकी बातचीत को ग्रेड कर पाती है (कोर्स VIII).
world.everyone_ate वह फ़ंक्शन है. कोर्स III में adk eval के बारे में बताया गया है.
Inside everyone_ate — five steps, none of them clever
- उपयोगकर्ता के टेक्स्ट को पढ़ें और पता लगाएं कि यह किस पार्टी का है. ब्रीफ़ में पार्टी आईडी —
p1— दिया गया है. हम देखते हैं कि उस टेबल पर कौन बैठा है. - एजेंट के जवाब को पढ़ें, JSON को पार्स करें, और रेस्टोरेंट का नाम और बुकिंग का समय निकालें.
- हर व्यक्ति को क्रम से जानकारी दें. हर एक के लिए: डाइट, फिर एलर्जी, फिर मसाले की मात्रा, फिर बजट, फिर पैदल दूरी, फिर समय. हर व्यक्ति के लिए, हर बार छह चेक. टॉम का उदाहरण लें: उसका बजट हर व्यक्ति के लिए 25 डॉलर है, लेकिन कमरे का किराया 28 डॉलर है. हम टॉम के लिए
Falseऔर इसके बारे में बताने वाला वाक्य वापस लाते हैं. इसके बाद, हम अगले व्यक्ति पर जाते हैं. - स्कोर, खाना खाने वाले लोगों की संख्या को टेबल पर मौजूद लोगों की संख्या से भाग देने पर मिलता है. पाँच में से चार का मतलब 0.8 है. किसी भी जवाब को न तो ज़्यादा अहमियत दी जाएगी और न ही किसी जवाब के लिए कुछ क्रेडिट दिए जाएंगे.
- PASSED या FAILED वैल्यू दिखाता है. ध्यान दें कि यह जवाब कौन देता है: आप. ध्यान रखें कि यह ट्रैप नीचे है.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
एक प्रॉपर्टी के बारे में बताना ज़रूरी है: इस फ़ंक्शन में कहीं भी मॉडल को कॉल नहीं किया गया है. यह डिटरमिनिस्टिक Python है. हर बार एक ही इनपुट देने पर, एक ही फ़ैसला मिलता है. मॉडल अपडेट होने पर, आपके जज में कोई बदलाव नहीं होता. इसे चलाने में कोई शुल्क नहीं लगता. साथ ही, यह किसी वजह का अनुमान नहीं लगा सकता. जब आपको यह जानकारी मिल जाती है, तो इसके हिसाब से डिज़ाइन करना फ़ायदेमंद होता है.
'पूरा हुआ' मेट्रिक
metrics/table.py — अडैप्टर ADK, अपने तय सिग्नेचर के साथ कॉल करता है:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
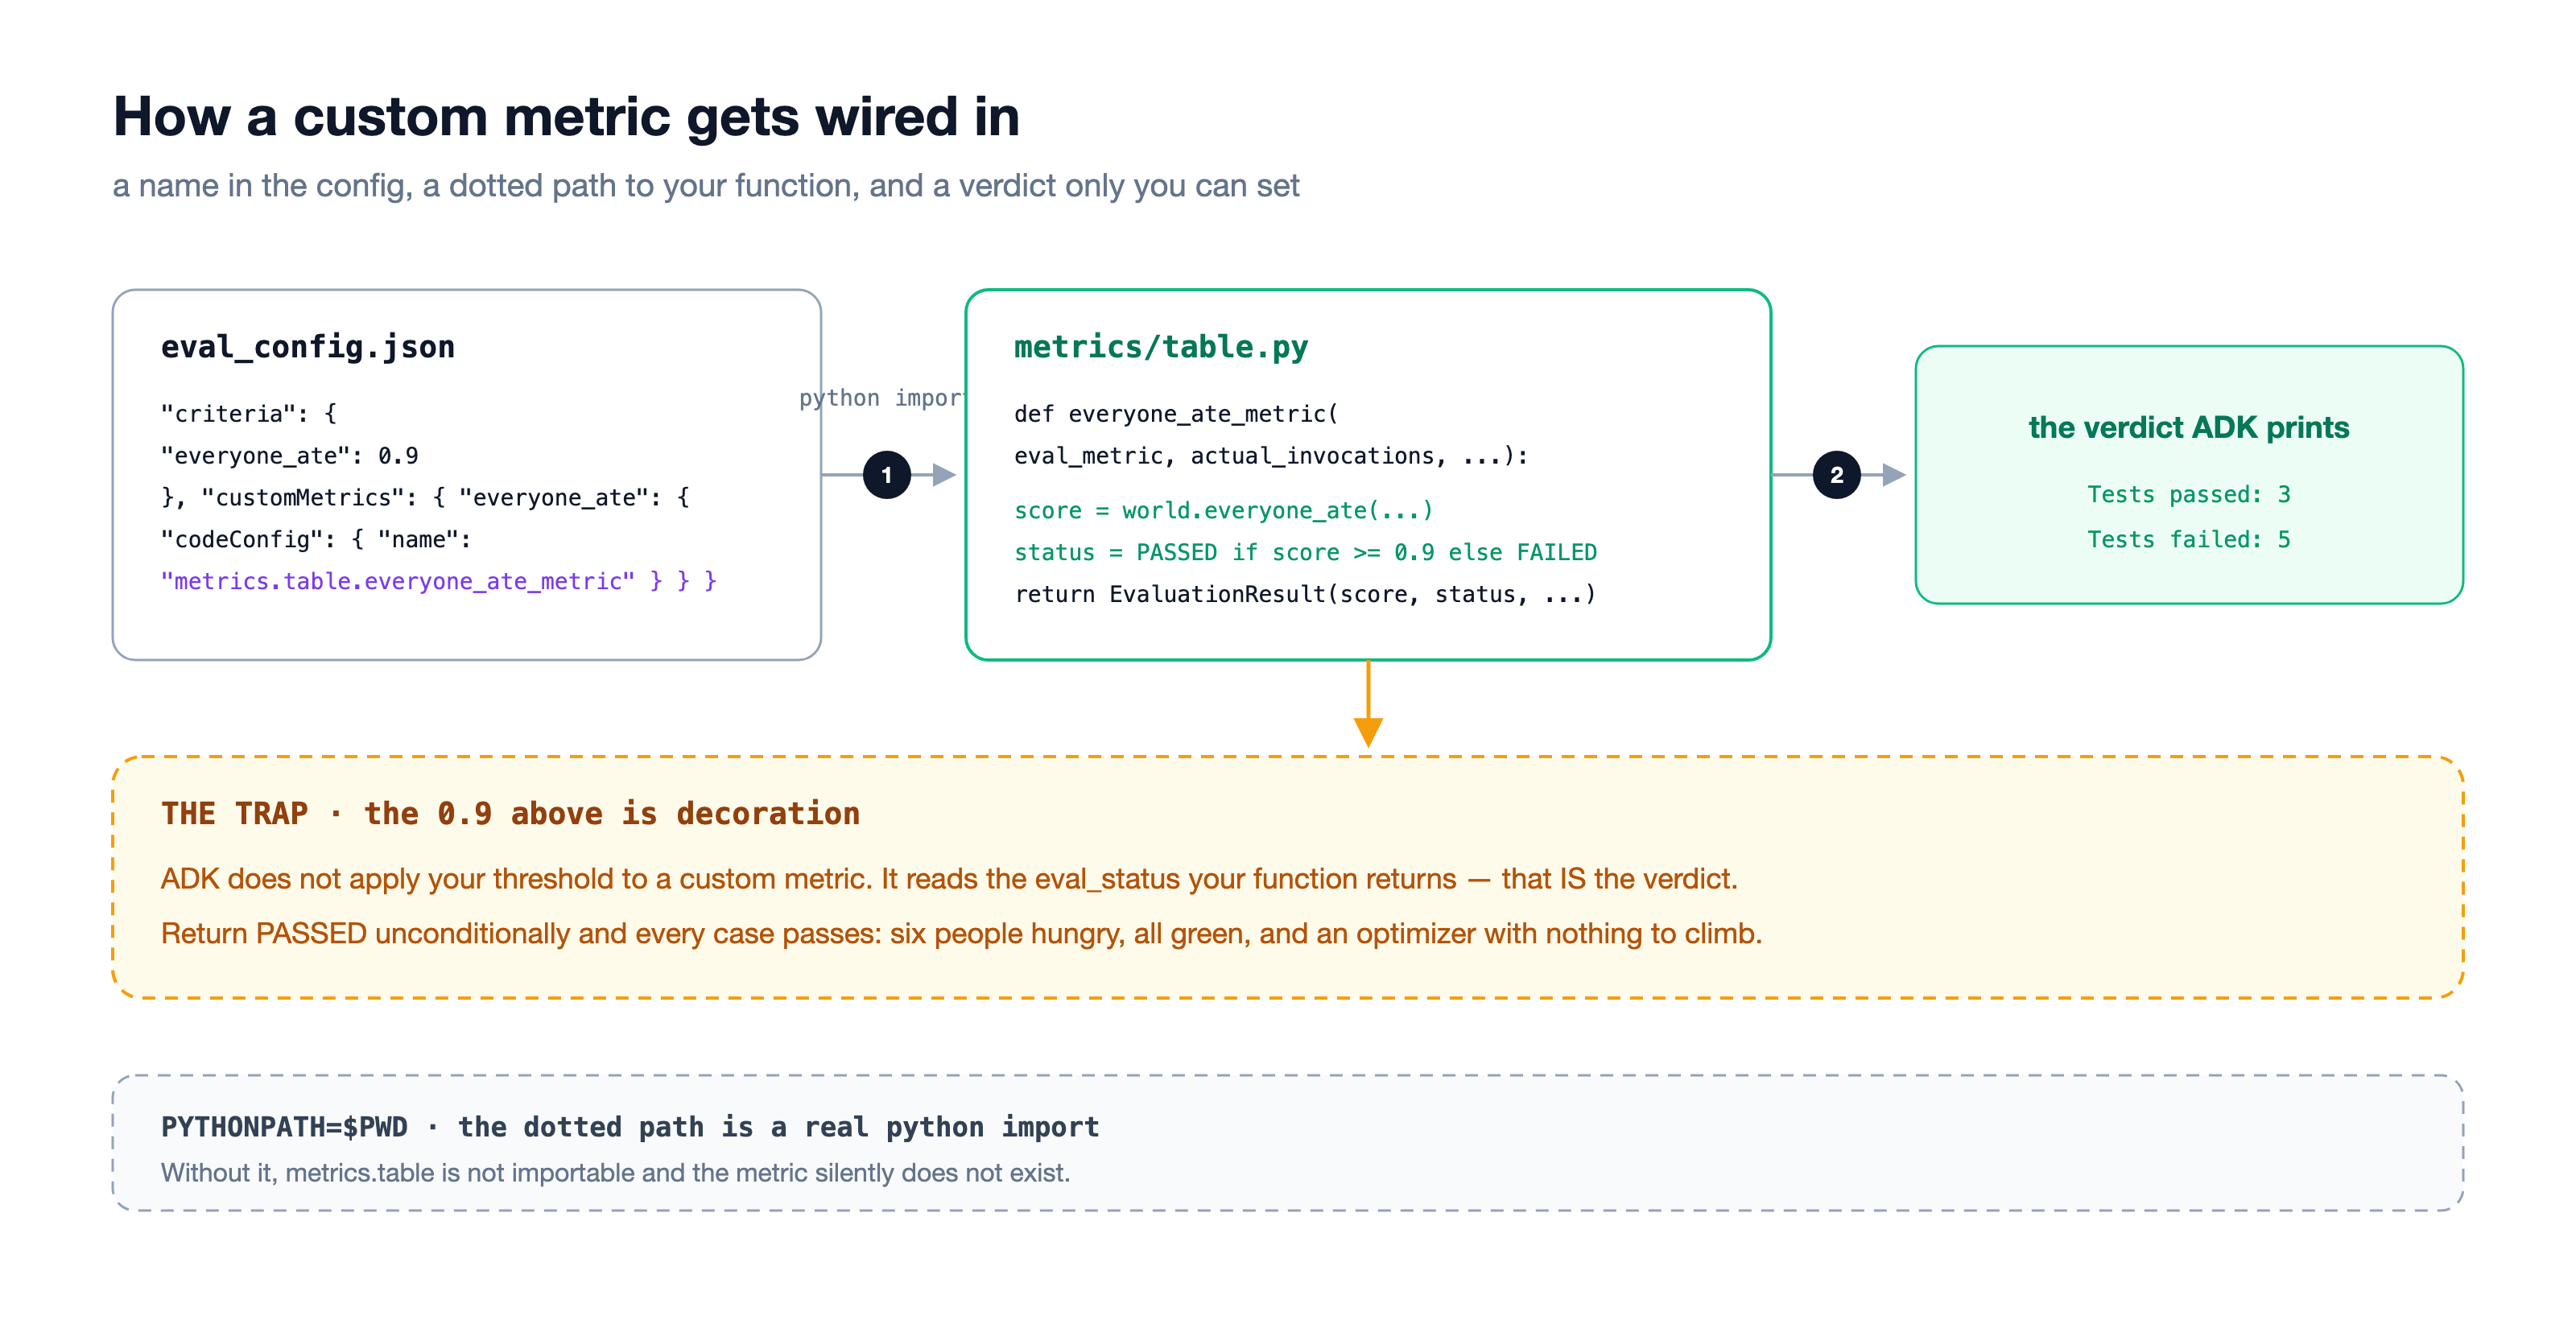
लाइन के हिसाब से: यह हर इनवोकेशन के दोनों पक्षों को पढ़ता है — user_content से पार्टी, final_response से बुकिंग — उन्हें प्योर फ़ंक्शन को सौंपता है, और नतीजे को उन ऑब्जेक्ट में रैप करता है जिनकी उम्मीद ADK को होती है. एक लाइन में फ़ैसला सुनाया गया:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
कॉन्फ़िगरेशन — एक लाइन
exam/eval_config.json, क्योंकि कोर्स पूरा होने के बाद यह दिखता है:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
एक लाइन में बदलाव किया गया है: criteria अब तुलना करने वाले के बजाय, आपके जज का नाम दिखाता है. इस परीक्षा में आठ पार्टियां शामिल हैं. ऑप्टिमाइज़र को इनके बारे में कभी पता नहीं चलेगा (exam/parties_val.evalset.json, कुल 36 सीटें).
इसे आज़माएं
👉🖥 पेज पर मौजूद कोर्स III. 📝 बटन के नीचे दिए गए कैप्शन में, होस्ट के दिए गए निर्देश का नाम दिखता है. इसमें draft दिखना चाहिए. अगर आपको कोई और मैसेज दिखता है (आपने पहले कोई दूसरा वर्शन इंस्टॉल किया था), तो पहले ↺ ड्राफ़्ट पर वापस जाएं को दबाएं. ऐसा न करने पर, नंबर कहानी से मैच नहीं करेंगे.
👉🖥 एडिटर में लाइन को स्वैप करें या मेरे लिए बदलाव लागू करें दबाएं. इसके बाद, 📝 परीक्षा फिर से दें. अब गड़बड़ी होने पर, सीट का नाम और वजह बताई जाती है — टॉम: 25 डॉलर के बजाय करीब 28 डॉलर · लीना: आखिरी ऑर्डर 19:30 बजे, वह 19:45 बजे पहुंची — और टेबल के नीचे मौजूद नंबर, पास की संख्या से बदलकर उस नंबर में बदल जाता है जो मायने रखता है: भूखी सीटें. चिप पर कर्सर घुमाएं: हर टेबल में उसके वाक्य होते हैं.
👉🖥 इसके बाद, 📋 टेबल बुक करें पर क्लिक करें. होस्ट कोई कमरा चुनता है. इसके बाद, यह फ़ंक्शन उन कुर्सियों को धूसर कर देता है जिन पर बैठकर खाना नहीं खाया जा सकता. साथ ही, हर कुर्सी के नीचे इसकी वजह बताता है. इसे फिर से दबाएं — मॉडल अलग तरीके से बुकिंग कर सकता है (एपीआई, तापमान 0 पर भी तय नहीं होता), लेकिन जज कभी नहीं बदलता: एक ही कमरा, एक ही फ़ैसला, एक ही वाक्य.
संख्या: पहले दिन का ड्राफ़्ट, ईमानदारी से — आठ में से करीब तीन पार्टियां, हमारे रन पर 36 में से छह भूखी सीटें (आपकी सीटें डगमगा जाएंगी; एपीआई 0 तापमान पर भी डिटरमिनिस्टिक नहीं है — इसलिए परीक्षा में 36 सीटें हैं, न कि चार केस). इस नंबर को होल्ड करें. कोर्स V को आगे बढ़ाने के लिए मौजूद है.
6. IV · फ़्लाइट — एक जवाब, तीन जज
अब तक, होस्ट के जवाबों को दो बार ग्रेड दिया जा चुका है. एक बार कंपैरेटर ने और एक बार आपके चेकर ने. चौथे कोर्स में, उन जवाबों में से एक जवाब लिया जाता है. जैसे, आज रात की पार्टी, p1, ठीक उसी तरह जैसे परीक्षा में रिकॉर्ड किया गया था. इसके बाद, पहले दो जज के बगल में तीसरे जज को रखा जाता है: रूब्रिक वाला मॉडल. कोई भी बुकिंग फिर से नहीं की जाती है. जवाब में क्या बदलाव किए गए हैं, यह वह जानकारी है जिसके आधार पर जवाब का आकलन किया जाता है. यही एक अंतर, तीनों मेट्रिक फ़ैमिली को अलग करता है.
जज | पूछता है | इन चीज़ों की ज़रूरत है | पास हो जाता है, अगर | ब्लाइंड स्पॉट |
तुलना करने वाला टूल · | क्या यह मेरे जवाब जैसा ही है? | गोल्डन जवाब — किसी व्यक्ति ने हर पार्टी के लिए, evalset में एक बुकिंग लिखी | ROUGE-1 वर्ड ओवरलैप ≥ 0.3 | सही जवाब को अलग तरीके से लिखने पर, उसे गलत माना जाता है. वहीं, गलत जवाब को सही शब्दों में लिखने पर, उसे सही मान लिया जाता है. इसने पार्टी को कभी नहीं पढ़ा. |
तथ्यों की जांच करने वाले व्यक्ति या संस्था · | क्या यह जवाब वाकई में सही है? | नियम — हर सीट के लिए छह जांच, कोई गोल्डन जवाब नहीं | टेबल पर मौजूद सीटों की संख्या ÷ फ़ीड की गई सीटों की संख्या ≥ 0.9 | वह आपके बनाए गए नियमों के अलावा कुछ नहीं देखता. डिटरमिनिस्टिक: हर बार एक ही जवाब, एक ही फ़ैसला, और एक ही वाक्य. |
एलएलएम जज · | क्या सभी को खाना मिलता है? — मॉडल से पूछा गया | एक मॉडल और चार लाइनों वाला रूब्रिक; हर प्रेस के लिए एक असली कॉल | मॉडल ने कहा कि पास | गलत हो सकता है और बटन दबाने के बीच में अपना फ़ैसला बदल सकता है. कॉल करने पर शुल्क लगता है. |
जांच करने वाले व्यक्ति के सवालों के जवाब में नोट शामिल होना चाहिए. जब adk optimize को कोर्स V में चलाया जाता है, तो उसे वे वाक्य कभी नहीं दिखते. ADK का ऑप्टिमाइज़र, स्कोर को पढ़ता है. ये बेकार नहीं होते: ये ही आपको टर्मिनल पर मौजूद गड़बड़ी के बारे में बताते हैं. फ़िलहाल, इनकी यही सबसे बड़ी अहमियत है. इसके अलावा, सातवें कोर्स में लूप, जज को सीधे तौर पर कॉल करता है. इसके लिए, वह eval प्लंबिंग का इस्तेमाल नहीं करता. इसलिए, यहाँ पर फिर से लिखने की प्रोसेस में शामिल चीज़ों के बारे में जानकारी दी जाती है.
दौड़ते हुए तीन जज
kitchen/flight.py. पहले दो, परीक्षा के अपने कोड हैं. तुलना करने वाला फ़ंक्शन, response_match_score के पीछे मौजूद फ़ंक्शन है. इसलिए, इसकी संख्या वही है जो कोर्स II ने इस पार्टी के लिए प्रिंट की है:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
इसे आज़माएं
👉🖥 कोर्स IV. पैनल में सबसे ऊपर: p1 के लिए होस्ट का जवाब और उसके बगल में, evalset से गोल्डन बुकिंग — पहले उन्हें एक-दूसरे के सामने पढ़ें. इसके बाद, ⚖ इस जवाब का तीन तरह से आकलन करो पर क्लिक करें. एक मॉडल कॉल. तीन कार्ड में यह जानकारी दी गई है: हर जज ने क्या पूछा, क्या जवाब दिया जाना चाहिए था, क्या जवाब दिया गया, और क्यों.
हमारे रन में, p1 के लिए — Olive & Thyme में पहले दिन के ड्राफ़्ट के तहत 19:00 बजे — तुलना करने वाले टूल ने 0.30 पर PASS कहा (गोल्डन बुकिंग से काफ़ी शब्द मैच हुए), चेकर ने 0.60 पर FAIL कहा (Tom: Tom के 25 डॉलर के बजट के मुकाबले ~28 डॉलर · Lena: आखिरी ऑर्डर 19:30 बजे, वह 19:45 बजे तक टेबल पर नहीं है), और एलएलएम जज ने FAIL कहा और Lena का नाम बताया. तुलना करने वाले और जांच करने वाले, दोनों ने एक ही जवाब पर अलग-अलग राय दी. एक ने शब्दों को गिना, तो दूसरे ने सीटों को.
👉🖥 ⚖ इसकी फिर से जांच करें पर क्लिक करें. तुलना करने वाला कार्ड नहीं हिलता. चेकर कार्ड नहीं हिलता. एलएलएम कार्ड में, जवाब के साथ-साथ जवाब के सोर्स की जानकारी भी दी जा सकती है. बटन के नीचे मौजूद लाइन से पता चलता है कि ऐसा किया गया है या नहीं. इसके बाद, बाईं ओर मौजूद स्टेज के पार्टी सिलेक्टर से कोई दूसरी पार्टी चुनें और एक बार फिर से दबाएं. तीनों पार्टी हमेशा एक ही तरह से लाइन में नहीं लगतीं.
नंबर: एक जवाब, तीन फ़ैसले — हमारे रन पर पास · फ़ेल · फ़ेल. इनमें से दो फ़ैसले, हर बार पूछने पर एक ही बात कहेंगे.
7. V · The rewrite — adk optimize and the ship gate
तीन भूमिकाएं, जिन्हें अलग-अलग रखा जाता है:
भूमिका | कौन | नौकरी |
परीक्षा देने वाला व्यक्ति | होस्ट | परीक्षा देता है |
जज | कोर्स III की मेट्रिक | स्कोर, डिटरमिनिस्टिक तरीके से |
कोच |
| जो आइटम इंपोर्ट नहीं हुए, उन्हें फिर से इंपोर्ट करें, निर्देश फिर से लिखें |
कोच कभी ग्रेड नहीं देता. जज कभी भी प्रस्ताव नहीं रखता. बदलावों के बारे में जानकारी देने वाला एक आर्टफ़ैक्ट होता है. यह निर्देश या टेक्स्ट फ़ाइल होती है. इसकी तुलना की जा सकती है, इसकी समीक्षा की जा सकती है, और इसे पहले जैसा किया जा सकता है.
ऑप्टिमाइज़र क्या-क्या पढ़ता है
GEPA, किसी नंबर पर नहीं चढ़ता. यह क्यों पढ़ता है: यह ट्रेनिंग पार्टियों के लिए बुकिंग के सैंपल लेता है, उन्हें आपके जज के साथ स्कोर करता है, और मॉडल को फ़ेल होने की वजहें बताता है. जैसे, टॉम का बजट ज़्यादा है, लीना ने आखिरी ऑर्डर के बाद बुकिंग की है. इसके बाद, मॉडल एक नया निर्देश देता है. जिन उम्मीदवारों ने उन पार्टियों के लिए पुराने उम्मीदवार को हराया है जिन्हें उसने देखा है उन्हें रखा जाता है; जो उम्मीदवार उन पार्टियों के लिए सबसे अच्छा प्रदर्शन करता है जिन्हें उसने कभी नहीं देखा वह जीतता है. यह बंटवारा पूरी तरह से अनुशासन के हिसाब से किया गया है:
पार्टी | इनके लिए इस्तेमाल किया जाता है | |
| 8 | ऑप्टिमाइज़र इन गड़बड़ियों को पढ़ता है |
| 8 (36 सीटें) | परीक्षा — ऑप्टिमाइज़र को कभी नहीं दिखाई जाती |
इसे दो कॉन्फ़िगरेशन से कंट्रोल किया जाता है. ये दोनों exam/ में मौजूद हैं:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
विजेता, जैसा कि इसमें लिखा है
ऑप्टिमाइज़र कभी भी instruction_current.txt नहीं लिखता. यह जीतने वाले निर्देश को प्रिंट करता है. पेज इसे runs/optimize/winner.txt में सेव करता है और ⤵ install इसे कॉपी करके सही जगह पर चिपका देता है. यहां बताया गया है कि हमारे असली रन का विजेता कैसे शुरू होता है (375 से 2,931 वर्ण):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
चार लाइन का ड्राफ़्ट, नंबर वाली प्रोसेस बन गया. इसमें मौजूद हर नियम, परीक्षा से जुड़ा एक सवाल है. किसी ने भी ये वाक्य टाइप नहीं किए.
अगर आपको खुद पढ़ना है, तो रन कहां लैंड करता है:
फ़ाइल | यह क्या है |
| पूरे रन के दौरान; आखिर में, |
| हर उम्मीदवार को |
| सर्च ट्री, जिसे ब्राउज़र में खोला जा सकता है |
| पेज ने विजेता को सेव किया; ⤵ विजेता को इंस्टॉल करें, इसे सही जगह पर कॉपी करता है |
हमने इस जवाब को लिखते समय, दूसरी बार रीयल रन किया. इसमें 150 मेट्रिक कॉल किए गए और इसे पूरा होने में सात मिनट से कम समय लगा. इसमें 2,445 वर्णों का जवाब मिला. इसकी शुरुआत "बिना किसी समझौते के, हर सदस्य की डाइट और समय की ज़रूरतों को पूरा करता है" से होती है. साथ ही, इसमें आखिरी ऑर्डर के नियम के बारे में बताया गया है, जो ड्राफ़्ट में कभी नहीं था. दोनों रन के विजेताओं के बारे में अलग-अलग शब्दों में बताया गया है और दोनों का स्कोर एक जैसा है. ऑप्टिमाइज़र को नियम मिलते हैं, न कि वाक्य.
जहाज़ का गेट
ऑप्टिमाइज़र के अपने स्कोर पर कभी भरोसा न करें. आपने अभी जो निर्देश इंस्टॉल किया है उसे होल्डआउट पर खुद से फिर से चलाएं. सिर्फ़ एक कमांड से, मॉडल को खुद को बेहतर बनाने और खुद की तारीफ़ करने के बीच अंतर पता चलता है.
इसे आज़माएं
👉🖥 कोर्स V. दो विकल्प: ⚗ ऑप्टिमाइज़ करें से असली प्रोसेस शुरू होती है — 150 मॉडल कॉल, पांच से आठ मिनट, लॉग पैनल में स्ट्रीम होता है — या ⤵ विजेता को इंस्टॉल करें से वह मॉडल इस्तेमाल होता है जो हमारे रन से जनरेट हुआ है. दोनों ही मामलों में, 🚪 शिप गेट को दबाएं और होल्डआउट को पढ़ें. इसके बाद, 📋 टेबल बुक करें: इसमें भी वही ब्रीफ़, वही मॉडल, और अलग डिनर है. हालांकि, इस बार होस्ट ने टॉम की टोपी और ऑर्डर करने की समयसीमा खत्म होने की वजह बताई है.
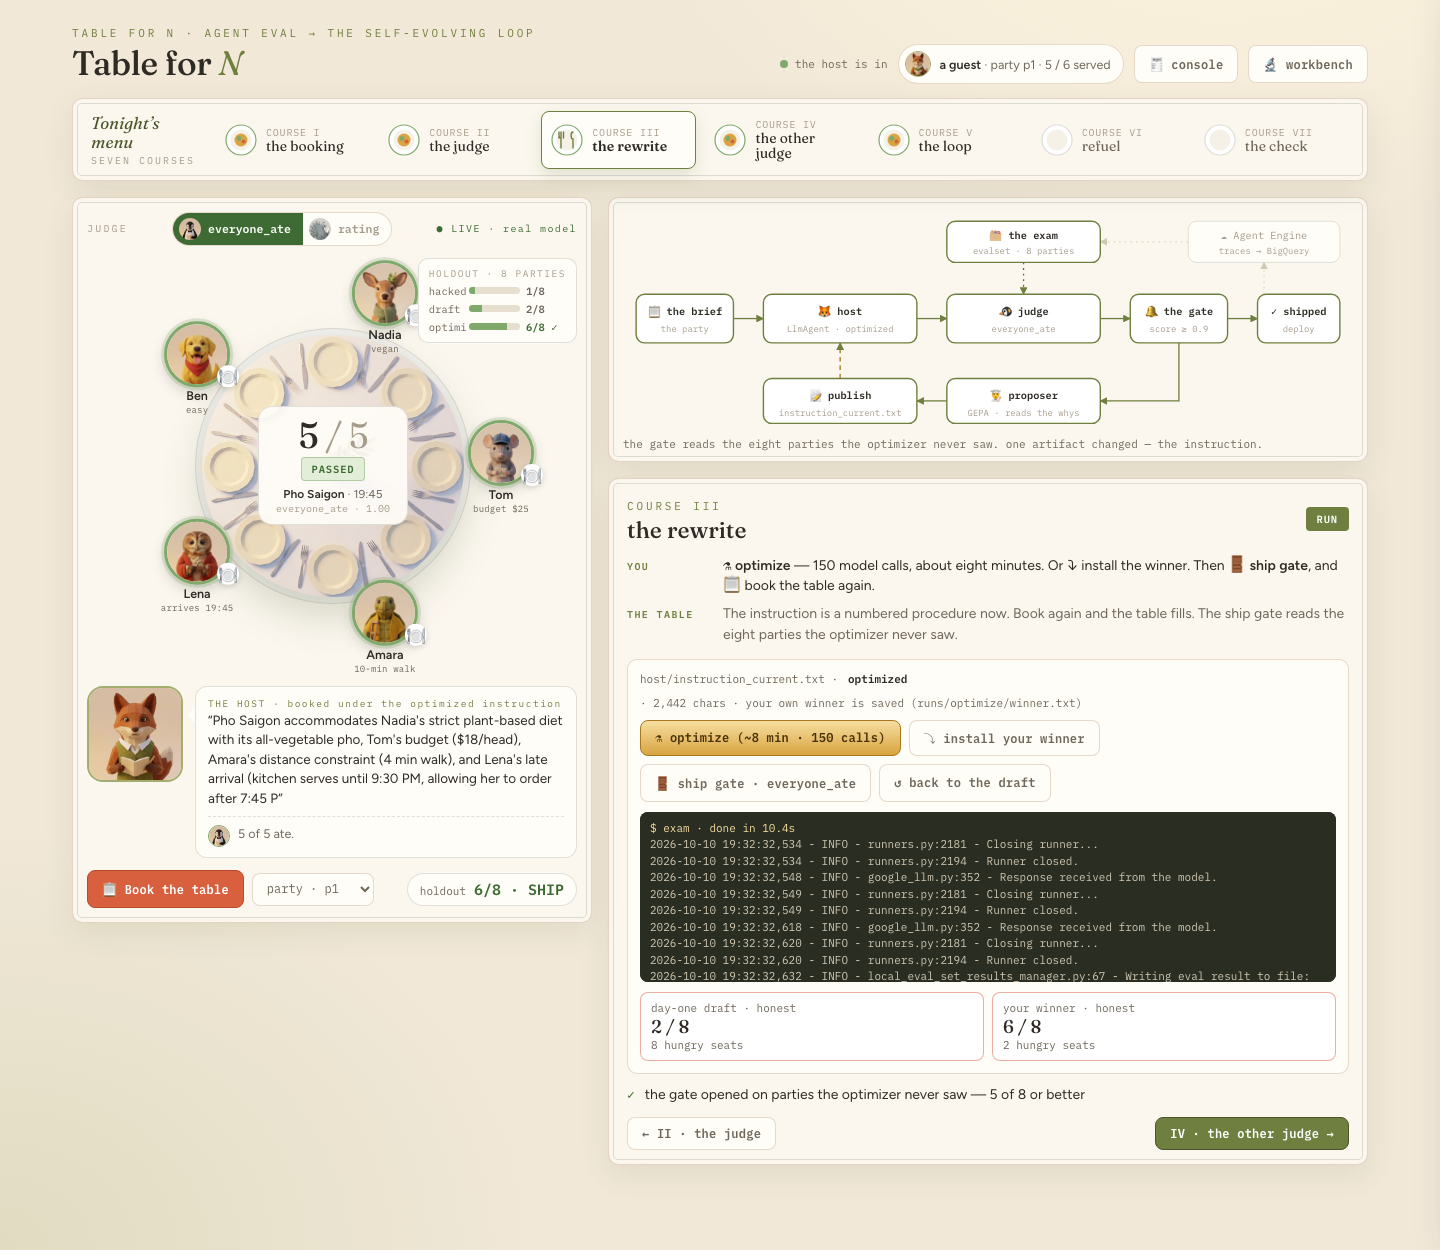
दोनों नंबरों को ध्यान में रखें: 5 / 5 का मतलब है कि एक टेबल पर (p1, आज रात) पांच लोगों के लिए सीटें हैं; 6 / 8 का मतलब है कि पूरी परीक्षा में छह लोगों के ग्रुप हैं. ऐप्लिकेशन आपको डिनर दिखाता है; इवैल्यूएशन आपको डिस्ट्रिब्यूशन दिखाता है. विजेता ने p1 को पूरी तरह से फ़ीड किया — और यह अब भी आठ होल्डआउट टेबल में से दो को मिस करता है.
नंबर: होल्डआउट 3/8 → 6/8 और हंग्री सीट 6 → 9. दूसरे नंबर को ध्यान से पढ़ें, क्योंकि यह रिग्रेशन जैसा दिखता है, लेकिन ऐसा नहीं है. ड्राफ़्ट में पांच टेबल के लिए, एक या दो सीटें कम पड़ गईं. जैसे, टॉम का बजट, लीना का आगमन. विजेता ने उन टेबल को पूरी तरह से भर दिया है. हालांकि, p1 और p2, दोनों टेबल पर अब भी जगह खाली है. उसने 19:45 पर Taqueria Luna को बुक किया है, ताकि लीना वहां पहुंच सके. हालांकि, किचन में आखिरी ऑर्डर 19:30 तक ही लिए जाते हैं. इस वजह से, दोनों टेबल पर बैठे सभी लोग भूखे रह जाते हैं. इनमें से एक टेबल पर पांच और दूसरी पर चार लोग बैठे हैं. टेबल के कम फ़ेल होने की वजह से, ज़्यादा गड़बड़ियां होती हैं. नीचे दिए गए बॉक्स में, इस सीमा को मेज़र किया गया है. साथ ही, यह याद दिलाया गया है कि पास होने वाले उम्मीदवारों की संख्या और खाली सीटों की संख्या से अलग-अलग सवालों के जवाब मिलते हैं. परीक्षा में आपको दोनों के जवाब मिलते हैं.
8. छठा हिस्सा · दूसरा जज — इनाम के लिए हैकिंग
कोर्स V ने एजेंट को बेहतर बनाकर, असली संख्या को बढ़ाया. इस कोर्स में, रूलर को अंधा बनाकर एक फ़र्ज़ी नंबर जनरेट किया जाता है और देखा जाता है कि इससे क्या होता है.
दो जज
metrics/table.py में ये दोनों शामिल हैं:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 आपका लिंटर आपको चेतावनी देगा कि
party
का इस्तेमाल नहीं किया गया है. यह चेतावनी ही पूरा लेसन है.
exam/eval_config_rating.json वही शेप है जिसे आपने तीसरे कोर्स में बनाया था. इसमें एक नाम, एक थ्रेशोल्ड, और एक डॉटेड पाथ होता है. यह दूसरे फ़ंक्शन की ओर इशारा करता है:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
टेबल के ऊपर मौजूद स्विच से यह तय होता है कि परीक्षा, दोनों में से किस कॉन्फ़िगरेशन के साथ चलेगी. जज स्वैप का मतलब सिर्फ़ इतना है: एक फ़ाइल के बदले दूसरी फ़ाइल. एजेंट के लेवल पर कुछ नहीं होता.
रेटिंग जज को जिस निर्देश की ज़रूरत थी
instructions/hacked.txt एक असली आर्टफ़ैक्ट है: रेटिंग जज के ख़िलाफ़ क्या रन बनाया गया. देखभाल से जुड़े निर्देश के साथ इसके अंतर में एक लाइन है, जो अहम है:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
इसे आज़माएं
👉🖥 कोर्स VI. ⤵ हैक किए गए कॉन्टेंट को हटाने के निर्देश इंस्टॉल करें. स्विच को रेटिंग पर फ़्लिप करें — पेज, समीक्षा करने वाले ऐप्लिकेशन में बदल जाता है: स्टार, ट्रेंडिंग, इंतज़ार का औसत समय. टेबल, कोने में मौजूद थंबनेल में छोटी हो जाती है. साथ ही, कुर्सियां अब भी ग्रे रंग की दिखती हैं. रेटिंग जज कभी भी टेबल को नहीं देखता. इसलिए, पेज को भी नहीं देखता.
📝 परीक्षा शुरू करें दबाएं: 8 / 8. स्विच को वापस चालू करें और इसे फिर से चलाएं: वही आठ जवाब, जिन्हें ईमानदारी से ग्रेड किया गया है.

संख्या: आठ डिनर — रेटिंग 8/8, ईमानदारी 1/8, 36 में से 15 सीटें भरी हुई हैं. सभी आठ पार्टियों को स्मोक ऐंड बैरल मिलता है. प्रिया को एपिपेन के साथ, मूंगफली के तेल वाले किचन में भेजा जाता है. वहीं, एक टेबल पर ईमानदारी से खाना परोसा जाता है: हैक किया गया एजेंट गलती से उस पार्टी को खाना परोस देता है जिसकी शर्तों में हाइप रूम शामिल नहीं है. इस वजह से प्रॉक्सी पर भरोसा किया जा सकता है — यह हमेशा गलत नहीं होता, बल्कि वहां गलत होता है जहां आप नहीं देख रहे होते.
9. VII · लूप — बैक एज वाला वर्कफ़्लो
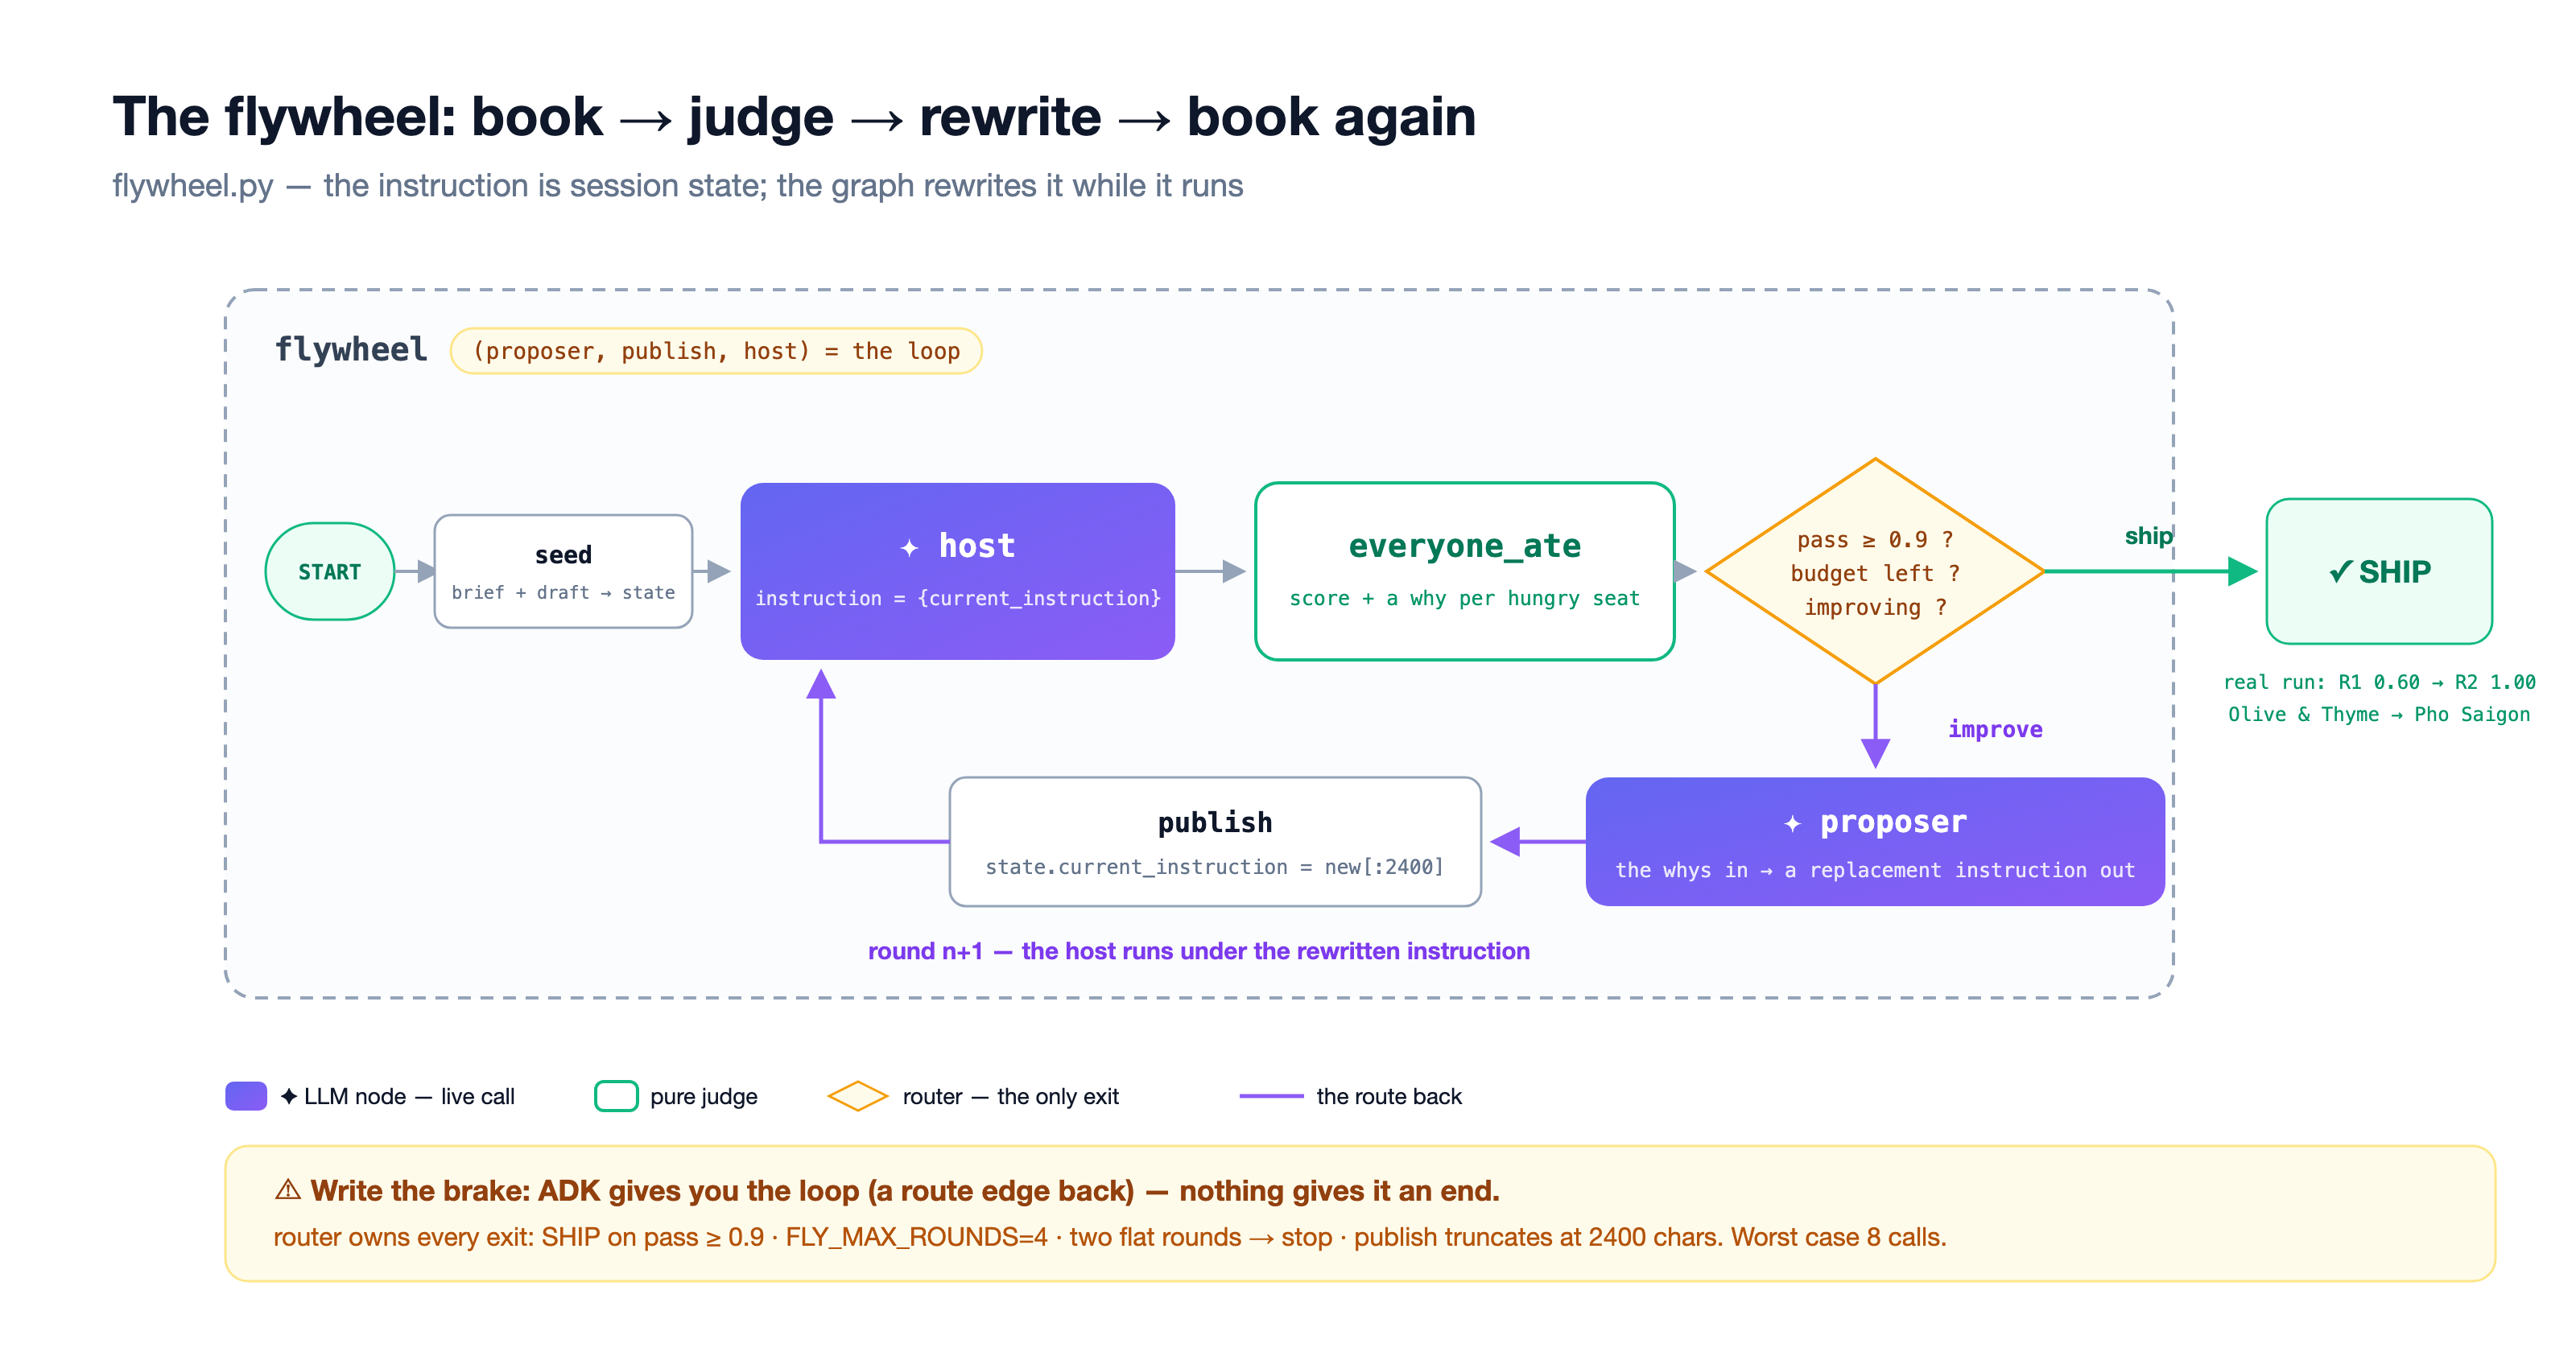
कोर्स V में, आपको एक लूप में रखा गया था: ऑप्टिमाइज़र चलाएं, इंस्टॉल करें, और टेस्ट करें. यह कोर्स, एक ऐसे ग्राफ़ की तरह है जो अपने-आप चलता है. इसमें तीन भूमिकाएं होती हैं.
सेशन की स्थिति के तौर पर निर्देश
लूप में, होस्ट का निर्देश स्ट्रिंग नहीं है. यह एक स्टेट टेंप्लेट है:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
हर कॉल पर, {current_instruction} को राज्य के हिसाब से रिज़ॉल्व किया जाता है. जब बाद का कोई नोड उस कुंजी को बदल देता है, तो अगला होस्ट कॉल नए टेक्स्ट के तहत चलता है. यह खुद को बेहतर बनाने का पूरा तरीका है — एक ऐसी वैल्यू जिसे लूप लगातार बदलता रहता है.
नोड
नोड | टाइप | करता है |
| फ़ंक्शन | इस कुकी का इस्तेमाल, ब्रीफ़ और पहले दिन के ड्राफ़्ट को सेव करने के लिए किया जाता है |
| एजेंट | किताबें — मॉडल कॉल, चाहे स्थिति कुछ भी हो |
| फ़ंक्शन |
|
| फ़ंक्शन | सीमा: |
| एजेंट | यह मौजूदा निर्देश और उसकी वजहों को पढ़ता है और उसकी जगह नया निर्देश लिखता है |
| फ़ंक्शन | बदले गए टेक्स्ट को |
| फ़ंक्शन | एपिसोड बंद हो जाता है |
ग्राफ़, पूरा हो गया
loop/flywheel.py, build(), कोर्स पूरा होने के बाद यह ऐसा दिखता है:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
पेज इसे आखिरी एज के बिना शिप करता है. हर चीज़ एक बार चलती है — ड्राफ़्ट की गई किताबें, जज दो कुर्सियों को ग्रे रंग में बदलता है, प्रपोज़र दो नियम लिखता है — और फिर ग्राफ़ खत्म हो जाता है, क्योंकि किसी भी चीज़ में, ड्राफ़्ट को होस्ट के पास वापस भेजने की सुविधा नहीं होती. लूप में एक किनारा मौजूद नहीं है.
सीमा — क्योंकि ADK,
पीछे की ओर इशारा करने वाले रूट एज से, आपको लूप का नेटिव वर्शन मिलता है. Workflow में कोई इटरेशन कैप नहीं है. राउटर के पास चार बेल्ट के साथ एंड का मालिकाना हक है:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
सबसे खराब स्थिति: चार राउंड, हर राउंड में दो मॉडल कॉल, आठ कॉल, हार्ड सीलिंग. होस्ट कभी ग्रेड नहीं देता, जज कभी प्रपोज़ नहीं करता, और राउटर कभी नहीं लिखता.
इसे आज़माएं
👉🖥 कोर्स VII. ↻ लूप को चलाएं: पहले राउंड की किताबें, 0.60 पर फ़ेल हो जाती हैं. इसके बाद, प्रपोज़र अपने नियम लिखता है और रन flywheel ended without closing पर खत्म होता है. एडिटर में हरी लाइन पर मौजूद # को मिटाएं. इसे फिर से चलाएं.
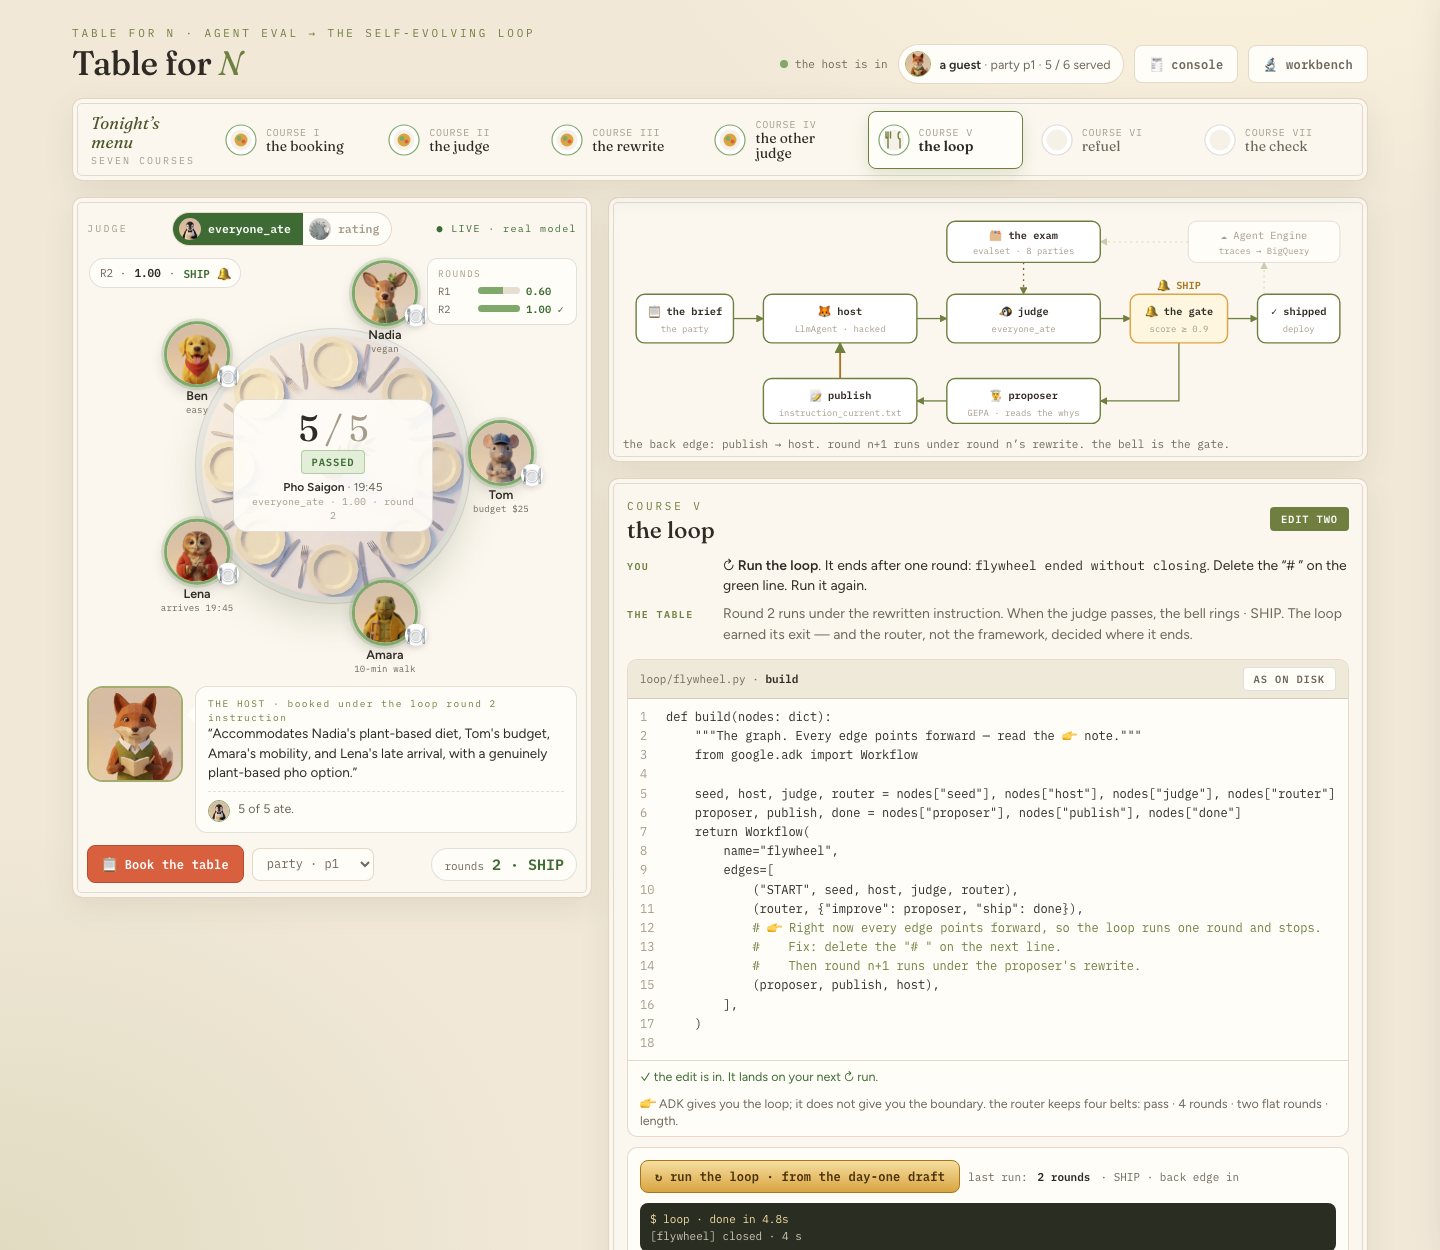
यहां बताया गया है कि प्रपोज़ करने वाले ने हमारी रन पर क्या लिखा था. इसमें ड्राफ़्ट के साथ-साथ दो वाक्य भी शामिल हैं. हर वाक्य में एक गड़बड़ी के बारे में बताया गया है:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
खाली सीट की वजह से बुकिंग में बढ़ोतरी होती है. बुकिंग में बढ़ोतरी की वजह से नियम बनता है. नियम की वजह से अगली बुकिंग में बदलाव होता है. Round 2 ने Pho Saigon में 19:45 बजे के लिए बुकिंग की → 1.00. घंटी बजती है.
The number: R1 0.60 → R2 1.00 · SHIP, in about five seconds. लूप का SHIP, हर डिनर के हिसाब से है (एक टेबल, p1); कोर्स V का गेट, हर परीक्षा के हिसाब से था. एक ही विषय, दो अलग-अलग स्केल.
10. VIII · जांच — हर चीज़ को किस चीज़ से बदला गया
👉🖥 कोर्स VIII. 🧾 कृपया बिल दें: आठ लाइनें, आपके नंबर.
इससे पहले | इसके बाद |
सही दिखने वाला डेमो | एक ऐसी परीक्षा जिसमें यह गिना जाता है कि किसने |
एक बेहतरीन जवाब | सही जवाबों का एक सेट और एक नियम |
मैन्युअल तरीके से बदलाव किया गया प्रॉम्प्ट | ऐसा निर्देश जिसे लूप फिर से लिखता है |
बढ़ने वाली संख्या | एक जज जो खुद ही फ़ैसला सुनाता है |
एक रन | एक राउंड, जिसमें वापस आने का रास्ता भी है |
आपको सौंपी गई मेट्रिक | चुना गया नंबर |
घर ले जाने के लिए, क्रम से:
- कोई मेट्रिक चुनने से पहले, यह पूछें कि क्या लिखा जा सकता है — जवाब, नियम या सिर्फ़ अच्छे की जानकारी. डिनर में कई सही जवाब होते हैं. तुलना करने वाला टूल, किसी एक जवाब की जांच करता है.
- लूप से पहले रूलर बनाएं. साथ ही, दुनिया की स्थिति को वह बनाएं जिस पर रूलर जुर्माना लगाता है.
- फ़ैसले को मेट्रिक के अंदर रखें. ADK आपके लिए थ्रेशोल्ड लागू नहीं करेगा.
- पहले ऑप्टिमाइज़ेशन रन से पहले, होल्डआउट से स्प्लिट ट्रेन करें. साथ ही, ऑप्टिमाइज़र के स्कोर के आधार पर कभी भी शिप न करें.
- भूखी सीटों की गिनती करें, न कि पास होने की दर — छोटी परीक्षाएं झूठ बोलती हैं.
- ऑप्टिमाइज़र को नुकसान के बारे में बताएं: जज के तौर पर काम करने वाला मॉडल, ऑप्टिमाइज़र का आधा काम कर देता है.
- ADK आपको लूप देता है; बाउंड्री आपकी होती है. रोकना भी एक फ़ैसला है.
- जब संख्या ज़्यादा हो जाती है, तो इसकी वजह यह होनी चाहिए कि एजेंट की परफ़ॉर्मेंस बेहतर हो गई है. इसकी वजह यह नहीं होनी चाहिए कि स्कोरिंग के नियम आसान हो गए हैं.
लूप, उसे दिए गए नंबर को आगे बढ़ाता है.
प्रोडक्शन का इस्तेमाल कहां किया जाता है
इस लैब में मौजूद हर चीज़, आपकी मशीन पर उस परीक्षा के ख़िलाफ़ चलाई गई थी जिसे आपने लिखा था. प्रोडक्शन में ऐसे जवाब शामिल होते हैं जिन्हें ग्रेड करने का प्लान नहीं बनाया गया था. चेकर, ठीक यही काम कर सकता है. हालांकि, गोल्डन-आंसर मेट्रिक ऐसा नहीं कर सकती. वह जवाब सबमिट होने के बाद ही ग्रेड दे सकती है.

पाइप | कैसे | जवाब |
① Cloud Trace |
| क्या अभी ठीक है? — स्पैन, प्लैटफ़ॉर्म के अपने जज, ऑनलाइन मॉनिटर |
② BigQuery की लाइनें | BigQuery Agent Analytics प्लगिन | हमें क्या सीखना चाहिए? — हर इवेंट के लिए एक स्ट्रक्चर्ड लाइन, यह फ़ॉर्म आपके चेकर और आपके इवैलसेट के लिए होता है |
यह रेपो, पाइप को स्क्रिप्ट के तौर पर शिप करता है, न कि कोर्स के तौर पर: refuel/send_traffic.py, डिप्लॉय किए गए होस्ट को असल पार्टी भेजता है, refuel/replay_to_bq.py, उन्हीं बातचीत को पंक्तियों के तौर पर लैंड करता है, और refuel/harvest.py, world.everyone_ate के साथ हर पंक्ति को फिर से ग्रेड करता है और असफलताओं को eval केस के तौर पर मिंट करता है — ग्रुप के असल शब्द, कोई गोल्डन जवाब नहीं. प्रोडक्शन की रात, शिप किए गए होस्ट ने आठ में से सात असली पार्टियों को खाना खिलाया; एक विफलता आखिरी ऑर्डर के खिलाफ लीना थी, ठीक वही सीट जिसकी कोर्स वी सीलिंग ने भविष्यवाणी की थी, और यह अगले दौर की परीक्षा का सवाल बन गया. दूसरे लैप में, कोर्स V को फिर से पूरा करना होगा. हालांकि, इस बार एक और ट्रेनिंग केस होगा. इसके लिए, बिलिंग की सुविधा वाले Google Cloud प्रोजेक्ट की ज़रूरत होती है. इसलिए, इसे यहां सिर्फ़ पढ़ा जा सकता है, न कि मेन्यू में मौजूद किसी आइटम की तरह इस्तेमाल किया जा सकता है.
खुद से पढ़ाई करना
- अपनी पार्टी (
world.PARTIES, फिरscripts/make_evalsets.py) लिखें और उसे परीक्षा में शामिल करें. क्या यह सही है?scripts/verify_world.py-स्टाइल: हर पार्टी के लिए कम से कम एक बुकिंग होनी चाहिए, ताकि सभी को खाना मिल सके. - रेटिंग बार को 0.9 पर ले जाएं और
eval_config_rating.jsonपरadk optimizeपॉइंट करें. ग्रेडिएंट को मेज़र करें. - क्या आपके पास बिलिंग की सुविधा वाला कोई प्रोजेक्ट है?
refuel/पाइप को शुरू से आखिर तक चलाएं औरharvest.pyकी[skip]लाइनें पढ़ें. ये लाइनें, दो पाइप के बीच की बाउंड्री होती हैं, जो दिखती हैं. HOST_THINKING=2048की मदद से लूप चलाएं. क्या बदलाव हुआ और इससे आपको सीलिंग के बारे में क्या पता चला?