

1. Pengantar

Codelab ini membahas evaluasi agen — bagaimana sistem mengetahui apakah jawaban agen bagus atau tidak — dan tentang apa yang dapat Anda bangun setelahnya: agen yang menulis ulang instruksinya sendiri dari kegagalannya sendiri, dan loop yang terus melakukannya, dengan batas, dan Anda memegang kendali.
Semuanya berjalan di Agent Development Kit (ADK): adk eval dengan metrik kustom yang Anda tulis, adk optimize (pengoptimal perintah GEPA), ADK 2 Workflow dengan edge belakang, dan pipa Agent Engine + BigQuery yang mengubah traffic produksi menjadi ujian putaran berikutnya.
Loop akan menaikkan angka apa pun yang Anda berikan.
Yang akan Anda pelajari
- Balasan bukanlah hasil — alasan jawaban yang meyakinkan dan tersusun rapi tidak memberi tahu sistem apa pun, dan apa yang harus dapat dikatakan oleh penilai
- Tiga cara untuk menjalankan satu ujian —
adk evaluntuk batch, tab Evaluasiadk webuntuk melihat kegagalan,pytest+AgentEvaluatoruntuk kegagalan build — dan satu penyimpanan evaluasi lokal yang mereka bagikan - Membandingkan vs. memeriksa — mengapa pembanding menghukum jawaban yang benar yang dirumuskan secara berbeda, berapa banyak jawaban benar yang sebenarnya dimiliki makan malam, dan pemeriksaan insting yang memberi tahu Anda jenis metrik yang diperlukan masalah
- Fungsi pemeriksa sebagai metrik
adk eval—customMetrics,codeConfig, tanda tangan tetap, enam pemeriksaan di dalamnya, alasan fungsi Anda memiliki status LULUS/GAGAL, dan alasan fungsi tersebut sengaja bersifat deterministik - Tiga kelompok metrik dalam satu jawaban — pembanding, pemeriksa, LLM-as-a-judge: apa yang dibutuhkan masing-masing, berapa biaya masing-masing, di mana masing-masing memiliki keterbatasan
adk optimize(GEPA) — apa yang dibaca (kegagalan, bukan skor), pelatihan vs holdout, dan alasan Anda menjalankan ulang ujian sendiri sebelum mengirimkannya- Peretasan reward, yang diukur — metrik proxy yang tidak pernah membaca partai, apa yang dilakukannya terhadap angka sebenarnya, dan hukum yang muncul darinya
- Loop yang berevolusi sendiri sebagai
WorkflowADK 2 — instruksi yang ada dalam status sesi, satu tepi yang membuat grafik menjadi siklus, dan batas yang tidak diberikan ADK - Kesesuaian produksi — rekaman aktivitas untuk menonton, baris untuk belajar, dan alasan pemeriksa dapat menilai makan malam yang tidak direncanakan untuk dinilai (baca, bukan langkah)
Yang akan Anda buat
Aplikasi yang berjalan di browser Anda: meja bundar, N tamu, dan agen yang memesan makan malam mereka. Setiap kursus mengaktifkan satu hal — baris dalam konfigurasi, satu jawaban di depan tiga juri, tombol yang menjalankan pengoptimal sebenarnya, tombol yang menukar juri, satu tepi dalam grafik — dan tabel menunjukkan apa yang berubah: siapa yang makan, siapa yang tidak, dan mengapa. Python berukuran kecil; semua angka diukur di komputer Anda.
Aplikasi ini juga merupakan latihan. Panel kursus memberi Anda satu pengeditan atau satu tombol dalam satu waktu; piring di menu hanya terisi saat ada bukti nyata — dapur membaca file Anda dan tanda terima dari apa yang dijalankan, bukan checklist.

Delapan kursus
konsep | pertanyaan yang dijawabnya | yang Anda lakukan | |
I | balasan bukanlah hasil | apa yang diketahui sistem tentang pemesanan ini? | belum ada — pesan di workbench |
II | komparator · serangkaian jawaban yang benar · tiga cara untuk menjalankan | why does a correct booking fail the exam? | menjalankan ujian seperti yang dikirim dan membaca hasil |
III | pemeriksa sebagai metrik kustom · enam pemeriksaan | Dapatkah ujian tersebut mengatakan siapa yang lapar, dan alasannya? | satu baris di |
IV | pembanding · pemeriksa · LLM sebagai hakim | jawaban yang sama — apa tiga hal yang harus diukur? | menilai satu jawaban dengan tiga cara, dua kali |
V |
| dapatkah agen memperbaiki dirinya sendiri dari kegagalannya? |
|
VI | peretasan reward · metrik proxy | Apa yang dilakukan hakim yang tidak dapat melihat bahaya terhadap loop? | sakelar |
VII |
| apa yang membuat grafik menjadi loop, dan apa yang menghentikannya? | satu tepi di |
VIII | apa yang digantikan oleh setiap hal | — | pemeriksaan |
Cara menggunakan codelab ini. Kursus ini mengutamakan konsep: setiap kursus menjelaskan ide, lalu menunjukkan kode saat dibaca setelah perubahan diterapkan dan menjelaskannya. Tidak pernah meminta Anda mengedit file di sini — pengeditan terjadi di aplikasi, yang memberikan satu baris pada satu waktu dan menunjukkan kegagalan terlebih dahulu. Baca kursus, lalu biarkan halaman memandu Anda dan lihat pergerakan angkanya.
Tempat penempatannya
Dunia — sepuluh tamu dengan satu batasan ketat, sepuluh restoran dengan satu jebakan, enam belas pesta — dan kedua juri berasal dari lab loop-lab-table; format interaktif satu halaman berasal dari Agent Valley. Bistro adalah pemandangan; setiap mekanisme di bawahnya adalah mekanisme biasa yang akan Anda gunakan untuk agen dukungan, alur pemesanan, atau apa pun yang "baik" dapat diperiksa.
2. 🧰 Penyiapan
- What — akun yang dapat membayar, project, lab yang diinstal, model yang terbukti dapat menjawab, dan tabel yang berjalan di satu port.
- Alasan — satu proses di satu port: halaman, ujian, editor, dan workbench memiliki origin yang sama, sehingga tidak ada yang memerlukan terminal atau port kedua di lab ini.
- Cara — clone, dua skrip, satu perintah. Hal terakhir yang dilakukan penyiapan adalah membuat satu panggilan model yang sebenarnya, sehingga project yang rusak akan gagal di sini, bukan di kursus I.
Semua hal dalam lab ini berjalan di Cloud Shell — gcloud, Python, Node, dan git sudah diinstal di sana, dan Gemini dijangkau melalui Vertex AI menggunakan kredensial Anda sendiri. Tidak ada kunci API di mana pun dalam lab ini, dan tidak ada yang perlu diinstal di laptop Anda. Laptop dengan Google Cloud SDK, Python 3.11+, dan Node 20+ berfungsi dengan cara yang sama.
Ada satu hal yang tidak dapat diberikan lab ini kepada Anda: project Google Cloud dengan penagihan yang diaktifkan. Langkah 1 memberi Anda akun yang dapat membayar project tersebut; langkah 4 mengubah akun tersebut menjadi project. Lakukan langkah-langkah tersebut sesuai urutan — setiap langkah setelah langkah 4 akan membaca project yang ditetapkan pada langkah 4.
1 · Dapatkan akun dengan penagihan (~1 menit)
Login dengan Akun Google yang penagihannya diaktifkan. Akun apa pun dapat digunakan. Jika akun Anda tidak memiliki akun penagihan, mulai uji coba gratis; uji coba ini akan memberi Anda akun penagihan, yang diperlukan untuk langkah 4.
2 · Buka Cloud Shell (~2 menit)
👉🖥 Klik Activate Cloud Shell di bagian atas Konsol Google Cloud — ikon berbentuk terminal di header.

👉🖥 Klik Open Editor (ikon folder terbuka dengan pensil). Tindakan ini akan menampilkan Cloud Shell Editor dengan file explorer di sebelah kiri — tempat Anda membuka setiap kali ingin membaca seluruh file.

👉🖥 Jika Anda diminta untuk memberikan otorisasi kapan saja hari ini, klik Authorize untuk melanjutkan.
👉🖥 Buka terminal di dalam editor — yaitu tab 1, dan setiap langkah 👉💻 dijalankan di sana. Tab 2 adalah tabel itu sendiri, dan Anda membukanya di langkah 7. Jika terminal belum berada di bagian bawah layar, buka dengan View → Terminal:

👉💻 Periksa akun yang Anda gunakan untuk login — akun tersebut harus sama dengan akun dari langkah 1:
gcloud auth list
3 · Dapatkan lab (~1 menit)
👉💻 Clone repo:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · Buat project Anda (~2 menit)
👉💻 Satu skrip menemukan akun penagihan Anda, membuat project di akun tersebut, menautkan penagihan, dan mengarahkan Cloud Shell ke project tersebut:
cd ~/table-for-n
./setup_project.sh
Harapkan ✓ untuk akun penagihan yang dipilihnya, ✓ untuk project yang dibuatnya, dan akhiran seperti:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 adalah project ID Anda — ID Anda akan memiliki digit yang berbeda. Empat hal terjadi di sana:
penagihan | mengambil akun | |
project | membuat | |
selects | menulis ID ke | |
waits | polling hingga project benar-benar diizinkan untuk ditayangkan, hingga dua menit | |
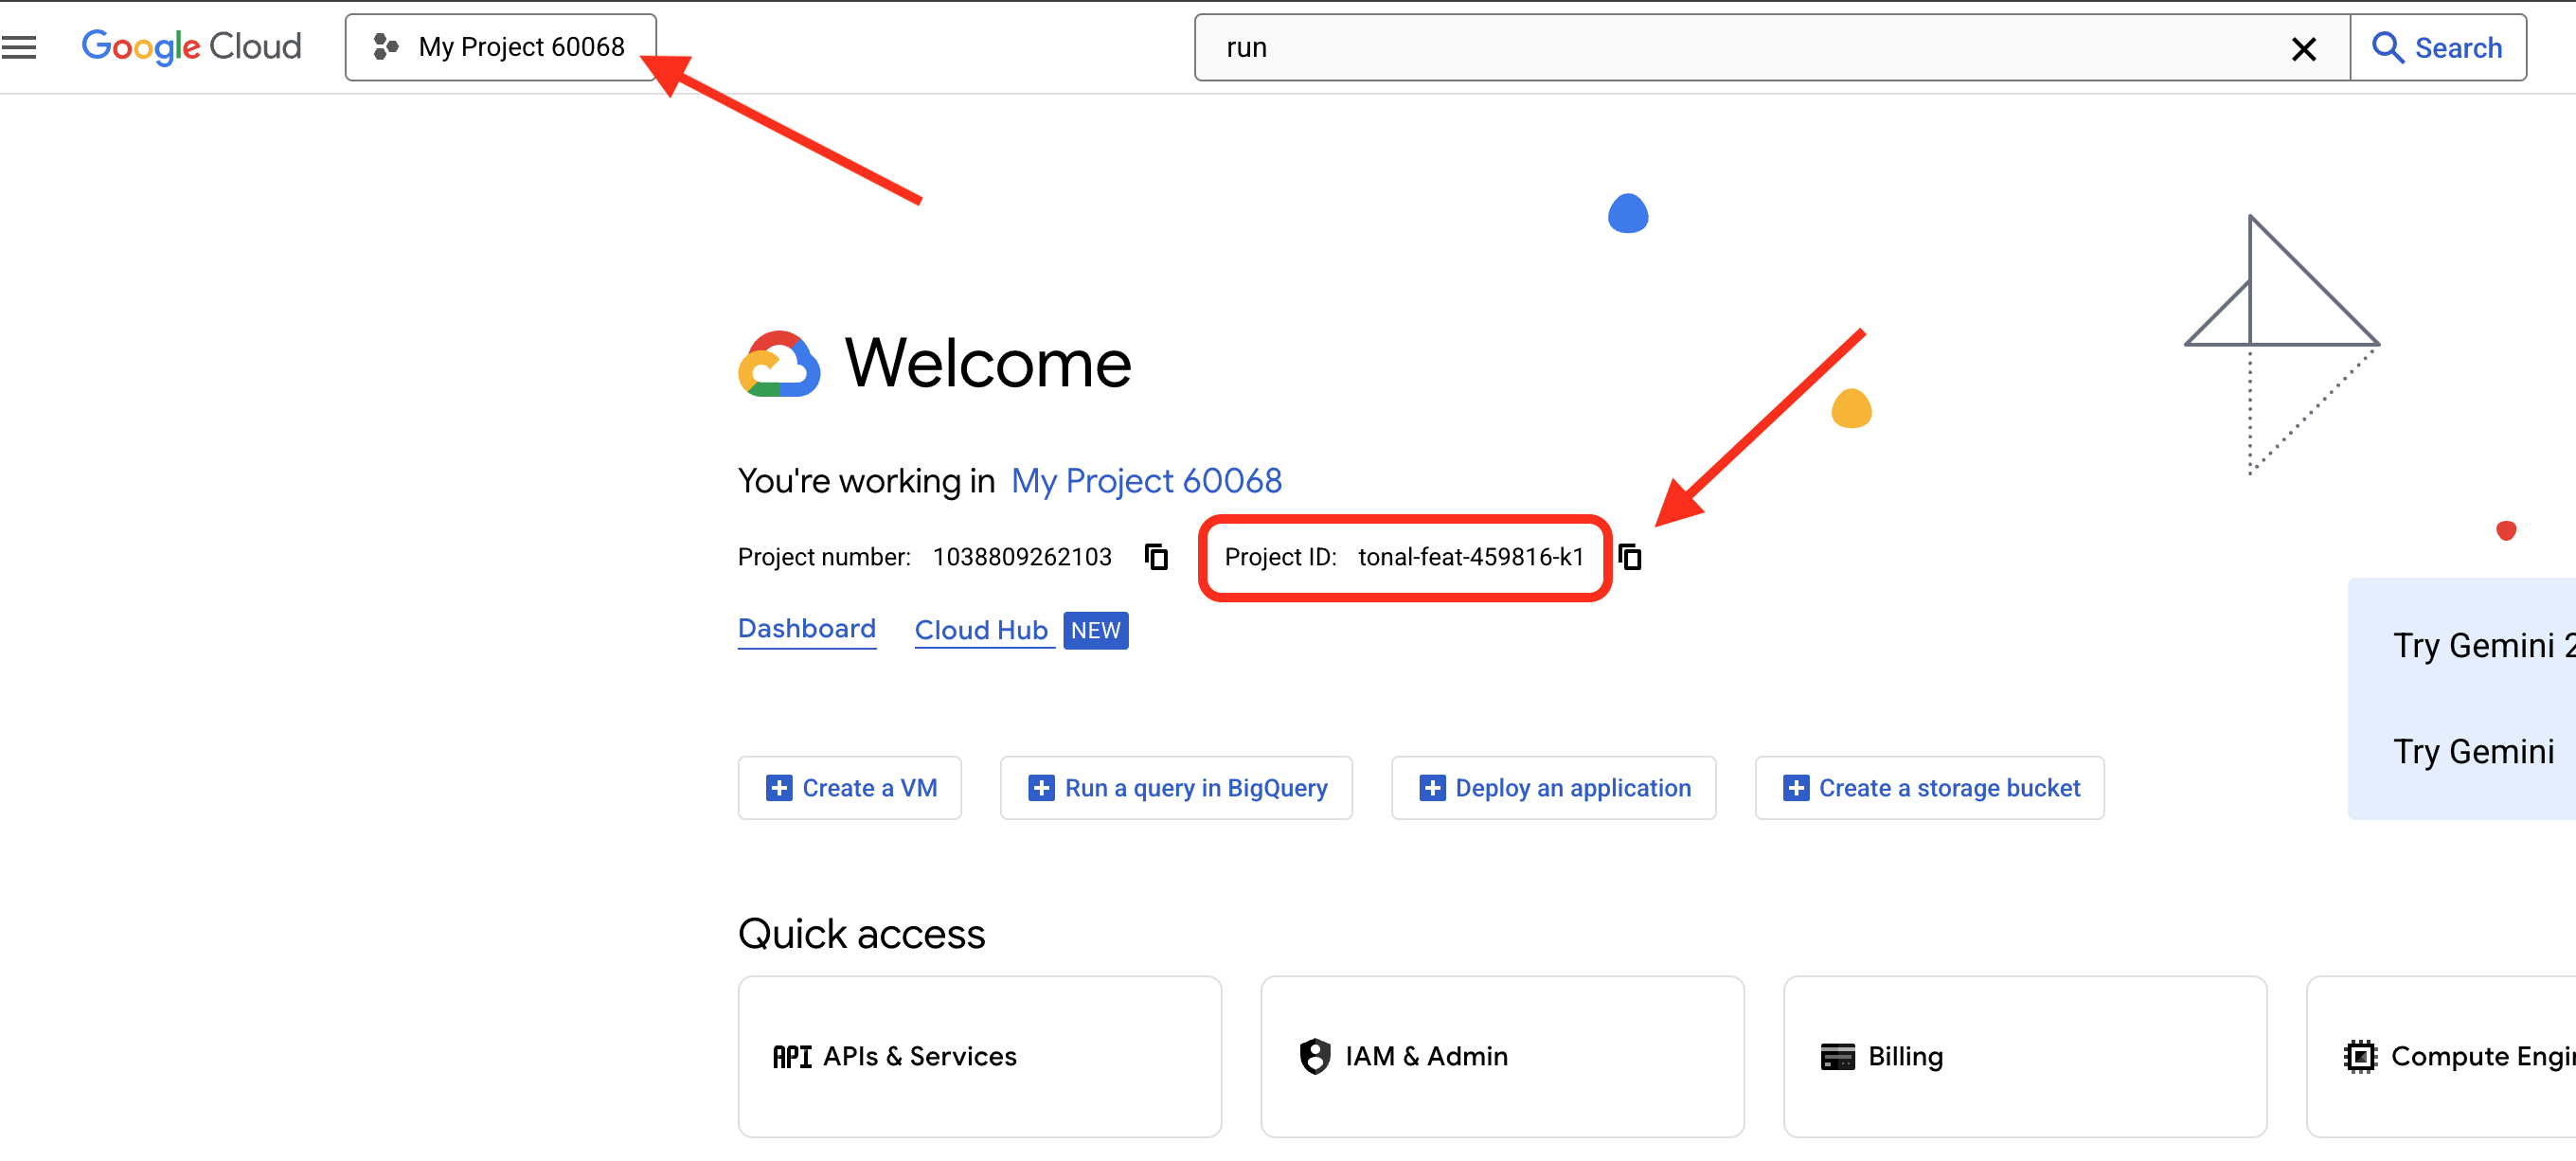
👉🖥 Project yang sama kini ada di konsol — ID-nya ada di kartu Project info di Dasbor:
5 · Menginstal dan menyiapkan lab (~3 mnt)
setup_codelab.sh membangun lingkungan dengan uv, dan tidak akan menginstal uv untuk Anda — akan berhenti dan memberi tahu Anda untuk melakukannya. Jadi, instal terlebih dahulu, dalam perintah yang sama:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Satu skrip, aman untuk dijalankan lagi. Metode ini melakukan lima hal, secara berurutan:
api | membaca project yang dipilih di langkah 4 dan mengaktifkan | |
uv env |
| |
site | menginstal dan membangun | |
.env | menulis | |
preflight | melakukan satu panggilan nyata ke | |
6 · Baca menu (~1 menit)
Hal terakhir yang dicetak langkah 5 adalah menu malam ini — setiap baris adalah pemeriksaan nyata, bukan tebakan:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Tidak ada yang menyala sebelum Anda memulai. the model answers adalah yang penting di sini: artinya panggilan nyata telah dilakukan di project Anda.
👉💻 Jalankan lagi kapan saja untuk melihat posisi Anda — aplikasi ini membaca file Anda dan tanda terima dapur, bukan daftar tugas:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · Siapkan meja (~1 menit)
👉💻
cd ~/table-for-n
bash table.sh
Satu proses, port 3470. Dapur memerlukan waktu beberapa saat untuk melakukan pemanasan — dapur mengimpor ADK dan memasang adk web — jadi skrip akan mengatakannya, menunggu, dan mencetak link hanya setelah port benar-benar merespons:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Perintah ini tetap berada di latar depan; Ctrl+C akan menghapus tabel. Biarkan proses ini berjalan — setiap kursus mulai sekarang akan berkomunikasi dengan satu proses ini, dan tidak ada hal apa pun dalam lab ini yang akan meminta Anda untuk memulai ulang proses tersebut.
👉🖥 Setelah Anda melihat ✓ the table is laid, buka tabel di tab baru — sebut saja tab 2. Di Cloud Shell: Web Preview → Change port → 3470.
👉🖥 Tulis nama Anda di kartu reservasi — nama tersebut akan tercantum di cek pada akhir acara — lalu tekan ✦ atur tempat duduk kami.

3. I · Pemesanan — balasan bukanlah hasil
Lima orang akan makan malam. Chat grup ini berisi semua informasi: Nadia adalah vegan, Tom memiliki batas anggaran ketat sebesar $25 bulan ini, Amara menggunakan kruk dan hanya bisa berjalan selama sepuluh menit, Lena tidak bisa sampai sebelum pukul 19.45, Ben tidak punya preferensi khusus. Sepuluh restoran tercantum, diurutkan berdasarkan rating, masing-masing dengan harga, jarak, jam buka, dan satu kelemahannya.
Agen memesan meja. Anda sudah tahu, dengan membaca chat, siapa yang akan kelaparan di ruangan yang dipilih. Tidak ada yang tahu dalam sistem. Kesenjangan itulah yang dibahas dalam seluruh codelab ini.
Agen — hanya baca
host/agent.py, seperti yang berlaku untuk seluruh lab:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Tidak ada alat, tidak ada database, tidak ada penelusuran. Satu model, satu string perintah — dan string tersebut tidak ada dalam file ini. File ini berada di sebelah instruction_current.txt, yang saat ini berisi empat baris yang ditulis oleh manajer produk pada hari pertama:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Tidak ada informasi tentang alergi, anggaran, batas berjalan, atau siapa yang harus pulang lebih awal. Semua itu ada dalam ringkasan yang diterima agen. Tidak digunakan.
File tersebut adalah satu artefak yang dibahas dalam lab ini. Course V memungkinkan pengoptimal menulis ulang. Course VI menginstal versi yang diretas. Loop Course VII menulis ulang grafik ini putaran demi putaran saat grafik berjalan. Agen — model, setelan, nama — tidak pernah berubah.
Coba — tanpa frontend
👉🖥 Di halaman, pilih kursus I. Klik 🔬 workbench (kanan atas): panel adk web, dipasang dalam proses yang sama — folder host/ yang sama, table.db yang sama. Pilih host, tempelkan ringkasan dari panel kursus (ada tombol salin), kirim.
Penyelenggara menjawab dalam sekejap: restoran, waktu, dan alasan satu baris yang meyakinkan. Baca alasan yang diberikan untuk chat tersebut. Kemudian, lihat tabel di sebelah kiri: santai, tidak ada yang menghakimi, — / 5. Bukan karena ada yang sedang dimuat — karena di dunia tentu saja tidak ada yang bisa menilai ini.
Jumlahnya: kursi yang lapar — ?. Tidak ada yang tahu.
4. II · Pembanding — berapa banyak jawaban yang benar untuk makan malam ini?
Kursus II dimulai dengan ujian yang sudah ada, dan sudah gagal — karena alasan yang tidak mengajarkan apa pun. Sebelum memperbaikinya, Anda perlu mengetahui tiga cara untuk menjalankannya, karena Anda akan menggunakan ketiganya hari ini.
Tiga cara untuk menjalankan evaluasi
Semuanya menggunakan mesin yang sama.
kegunaannya | yang Anda dapatkan | |
| batch runner; apa yang Anda masukkan di CI | ringkasan kembali: lulus, gagal, skor per kasus |
| kasus gagal dan Anda ingin melihatnya | percakapan, trace, skor per kasus, semuanya dapat diklik |
| mengevaluasi agen pelipatan ke dalam rangkaian regresi normal | alat ini berjalan bersama pengujian unit Anda dan menggagalkan build dengan cara yang sama |
Detail yang benar-benar berguna: ketiganya menggunakan satu penyimpanan evaluasi lokal, host/.adk/eval_history/. Jalankan batch dari CI, terjadi kegagalan, buka eksekusi yang tepat di UI web untuk menyelidikinya. Tombol 📝 di halaman adalah cara pertama; workbench 🔬 adalah cara kedua; cara ketiga adalah perintah terminal, uv run pytest tests/test_host.py, dan pengujian yang dijalankannya terdiri dari dua belas baris:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. Agen yang sama, set evaluasi yang sama, file konfigurasi yang sama, dan baris eval_set_results_manager adalah yang menempatkan eksekusinya dalam histori yang sama dengan dua eksekusi lainnya.
Ujian, seperti yang dikirimkan
exam/eval_config.json dikirim seperti ini:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Dua bagian, dua tugas. criteria
adalah lembar ujian — metrik yang benar-benar berjalan, masing-masing dengan batas kelulusannya. customMetrics
adalah direktori staf — nama yang dipetakan ke Python, tersedia, tetapi tidak bertugas. Mendeklarasikan metrik tidak akan menjalankannya. Saat dikirim, kertas tersebut hanya berisi satu pertanyaan: response_match_score bawaan ADK, tumpang-tindih teks (ROUGE-1) antara ucapan agen dan pemesanan emas dalam evalset. Hakim Anda, everyone_ate, ada di direktori dan bukan di kertas — kursus III memindahkannya ke sana dengan mengubah satu baris.
Kita memiliki agen pemesanan makan malam dan response_match_score yang tersedia secara gratis. Mari kita gunakan saja dan lihat hasilnya.
Coba
👉🖥 Kursus II di halaman. Tekan 📝 run the exam · as shipped. Teks di bawah tombol menunjukkan apa yang dijalankan: 1 metric runs: response_match_score · everyone_ate is declared, not on the exam. Sekitar setengah menit. Baca hasilnya: sekitar setengah tabel GAGAL, pada skor teks tanpa alasan terlampir — dan lihat tabel mana saja. Arahkan kursor ke chip.
Sekarang perhatikan baik-baik, karena ini adalah bagian yang menarik. Komparator salah mengidentifikasi tabel dalam kedua arah, dan operasi Anda akan menampilkan setidaknya salah satunya. Gagal dalam tabel yang pemesanannya baik-baik saja — agen memilih kamar tempat semua orang dapat makan; makan malam berjalan lancar; jawabannya benar — karena agen menyusun alasannya secara berbeda dari cara jawaban emas dirumuskan. Dan melewati tabel tempat seseorang kelaparan — pada run p1, tepat pada 0.30, dengan Tom melebihi anggaran dan Lena setelah pesanan terakhir — karena cukup banyak kata yang tumpang tindih. Kesamaan string tidak mengetahui apa pun tentang makan malam. Model ini tahu tentang karakter yang berbaris.
Jadi, inilah pertanyaan sebenarnya: berapa banyak jawaban yang benar untuk makan malam ini?
Untuk pesta malam ini, tepat satu dari sepuluh kamar yang menyediakan makanan untuk semua orang — Pho Saigon, dan hanya mulai pukul 19.00. Di delapan pesta ujian, jumlahnya adalah satu, dua, dua, satu, tiga, tiga, enam, satu (world.rooms berjalan di setiap ruangan di setiap tempat duduk untuk sebuah pesta; jalankan sendiri dengan uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). Terkadang beberapa ruangan dapat mengakomodasi semua orang; terkadang hanya satu ruangan yang dapat mengakomodasi, dan hanya pada waktu tertentu. Ada sekumpulan jawaban yang dapat diterima, bukan hanya satu — dan jawaban emas dalam set evaluasi adalah salah satu anggotanya.
Artinya, asumsi di balik response_match_score — ada satu jawaban yang benar dan saya menuliskannya — tidak pernah benar untuk masalah ini. Tidak pernah. Metrik tidak rusak. Fungsinya persis seperti namanya. Kita menggunakan jenis metrik yang salah untuk masalah ini.
👉🖥 Opsional, luangkan waktu satu menit: buka 🔬 workbench → Evals → 🕓 history. Eksekusi 📝 yang baru saja dibuat ada di sana, setiap kasus dapat diklik. Dan di tab 1, uv run pytest tests/test_host.py menjalankan ujian yang sama dengan pengujian yang gagal — dan masuk ke histori yang sama.
Jumlahnya: 4 dari 8 LULUS dalam pengujian kami, untuk tumpang-tindih kata, tanpa alasan — dan 1 jawaban yang benar untuk p1, dari sepuluh ruang.
Untuk masalah makan malam kita, pilihannya sudah jelas. Tidak ada yang bisa memberi tahu Anda satu restoran yang tepat untuk hari Jumat. Namun, semua orang dapat memberi tahu Anda apa yang dimaksud dengan makan malam yang sukses: semua orang di meja makan dapat makan. Itu adalah aturan. Dapat dicentang. Tidak ambigu. Membangunnya adalah kursus III.
5. III · Penilai — pemeriksa sebagai metrik kustom
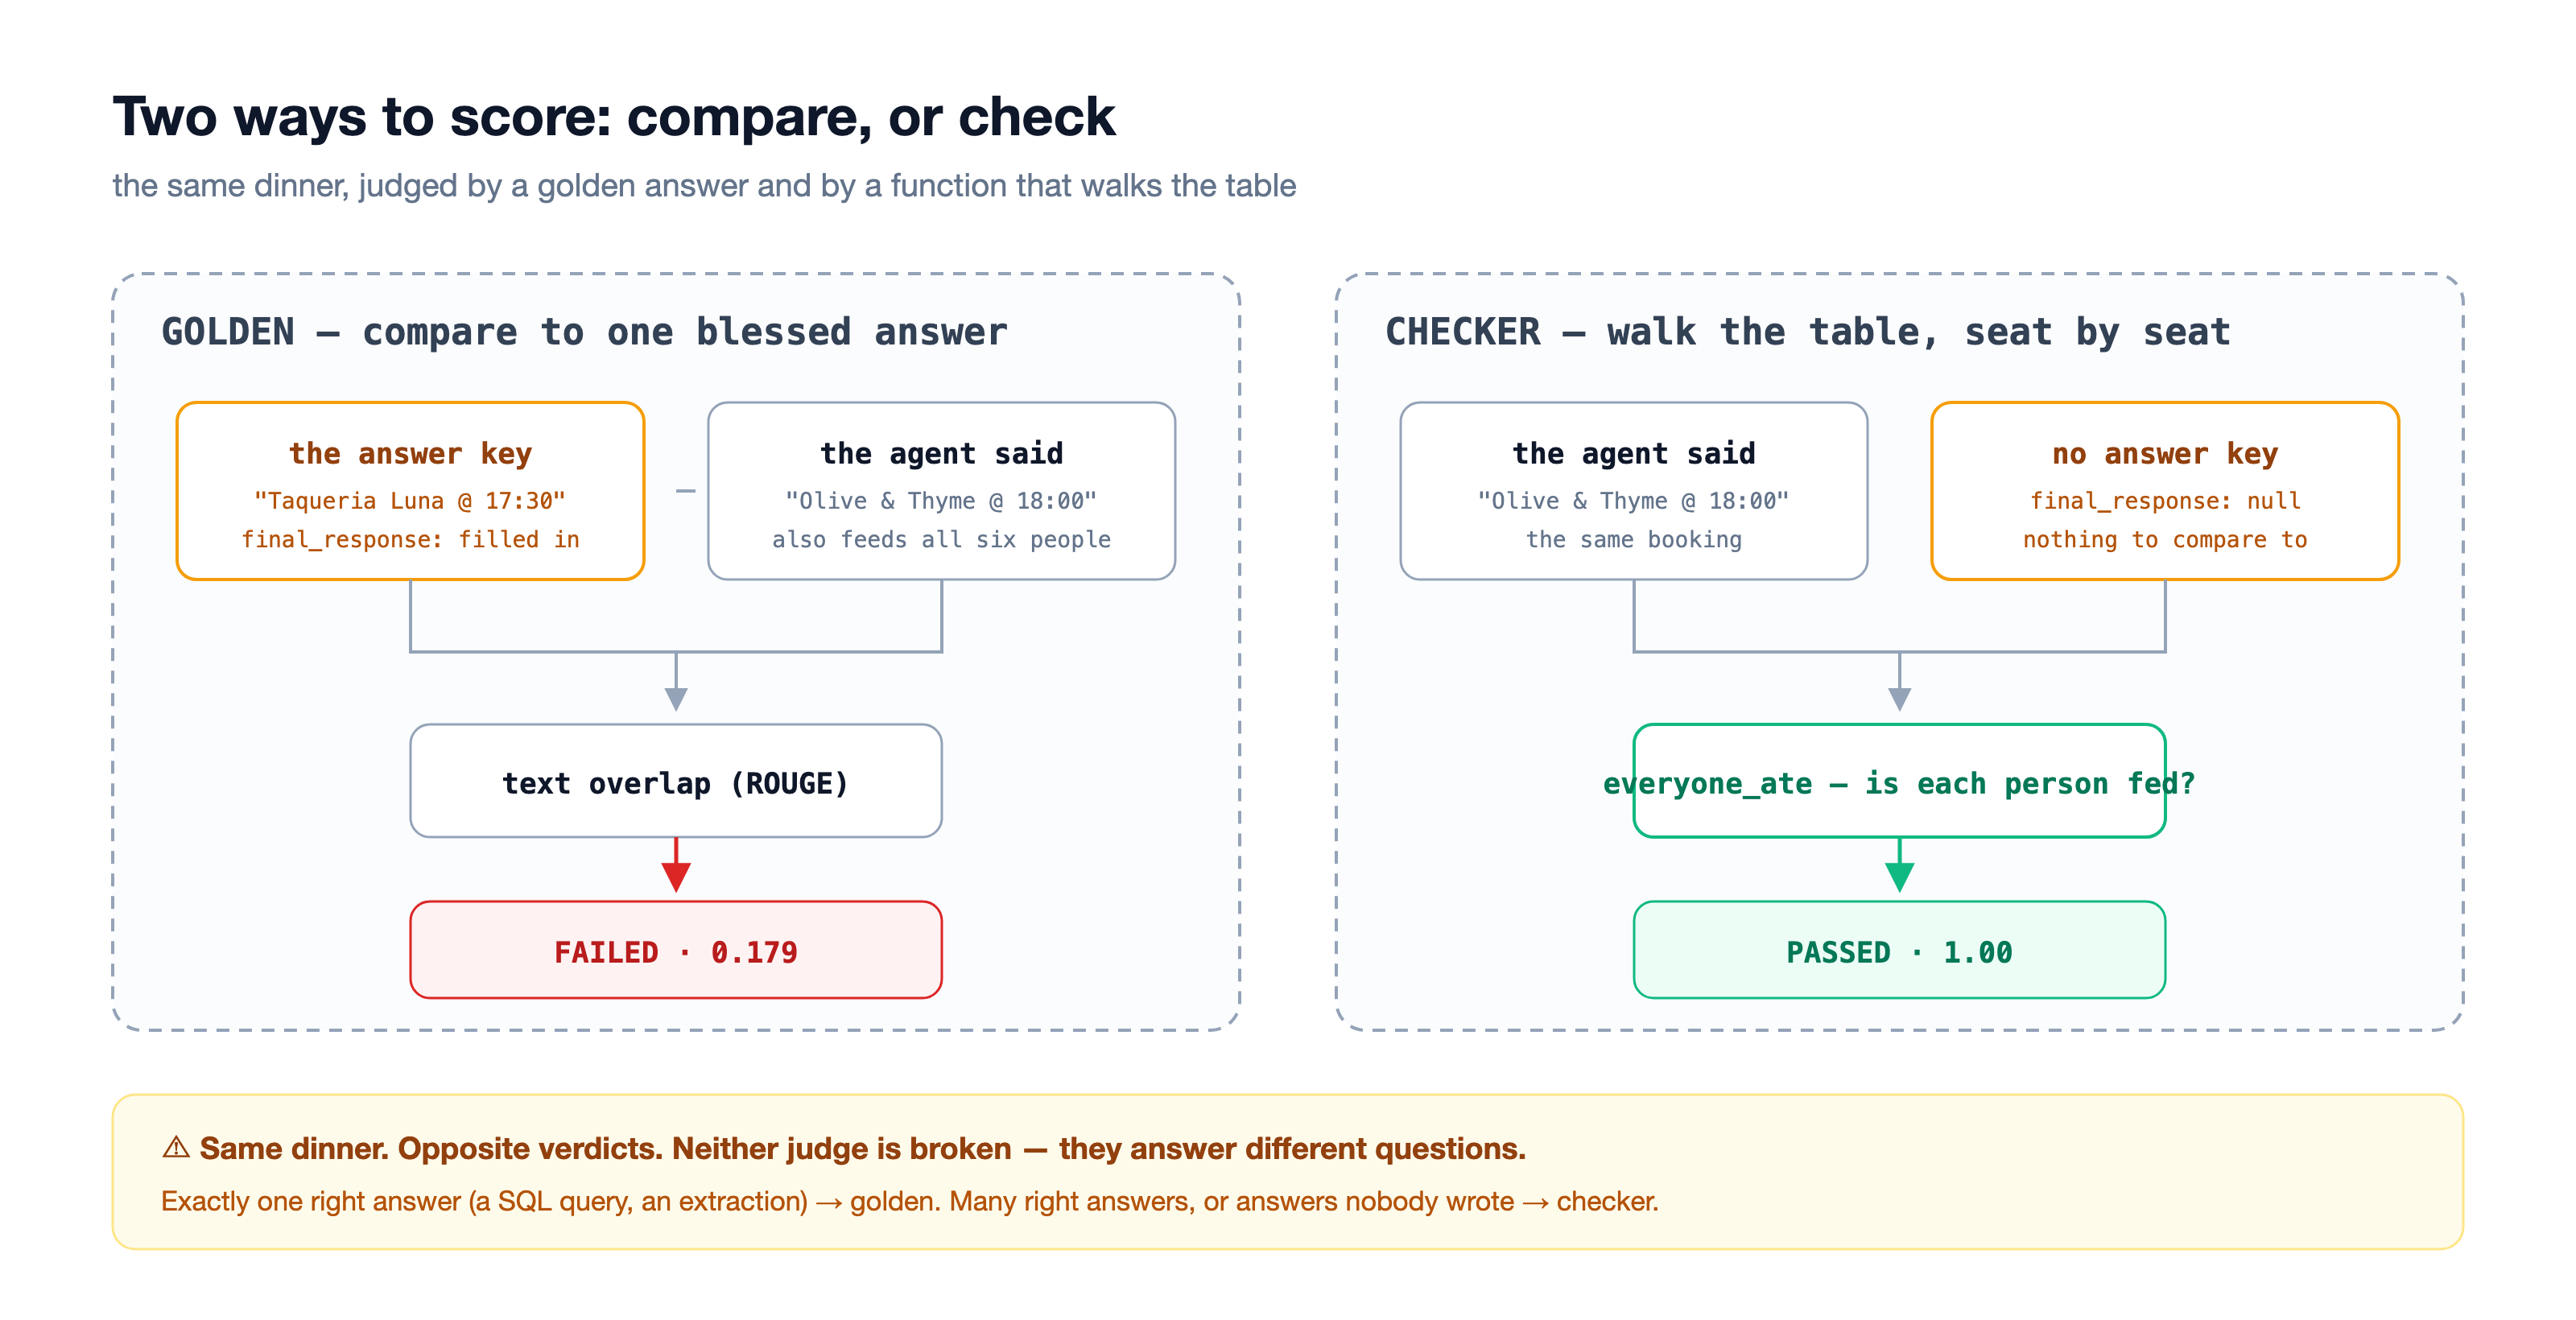
Pemeriksa mengajukan pertanyaan yang berbeda dari pembanding: bukan apakah ini cocok dengan kunci, melainkan apakah setiap orang diberi makan? Metode ini akan memeriksa pemesanan terhadap rombongan, kursi demi kursi, dan menampilkan skor serta alasan per kursi. Model ini tidak memerlukan jawaban emas sama sekali — yang juga memungkinkannya menilai percakapan yang sudah terjadi (kursus VIII).
world.everyone_ate adalah fungsi tersebut. Kursus III menghubungkannya ke adk eval.
Di dalam everyone_ate — lima langkah, tidak ada yang rumit
- Baca teks pengguna dan tentukan pihak mana yang dimaksud. Ada ID pihak dalam ringkasan —
p1— dan kita mencari tahu siapa yang duduk di meja tersebut. - Baca jawaban agen, uraikan JSON, ambil nama restoran dan waktu pemesanan.
- Berjalanlah ke setiap orang, secara berurutan. Untuk setiap restoran: pola makan, lalu alergi, lalu toleransi pedas, lalu anggaran, lalu jarak berjalan kaki, lalu waktu. Enam pemeriksaan, per orang, setiap saat. Misalnya Tom: anggarannya $25 per orang, harga kamar $28. Kita mengembalikan
Falseuntuk Tom, dan kalimat yang menjelaskannya, lalu beralih ke orang berikutnya. - Skornya adalah jumlah orang yang makan dibagi dengan jumlah orang di meja. Empat dari lima adalah 0,8. Tidak ada pembobotan, tidak ada kredit parsial.
- Menampilkan LULUS atau GAGAL. Dan perhatikan siapa yang mengembalikannya: Anda. Ingatlah hal itu; itu adalah jebakan di bawah.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Satu properti yang perlu diperhatikan: tidak ada panggilan model di mana pun dalam fungsi ini. Ini adalah Python deterministik. Input yang sama, putusan yang sama, setiap saat. Penilai Anda tidak akan mengalami penyimpangan saat model diperbarui, tidak memerlukan biaya untuk dijalankan, dan tidak dapat berhalusinasi dalam memberikan alasan. Jika Anda dapat memperolehnya, hal itu layak untuk didesain.
Metrik, selesai
metrics/table.py — ADK yang dipanggil adaptor, dengan tanda tangan tetapnya:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Baris demi baris: kode ini membaca kedua sisi setiap pemanggilan — pihak dari user_content, pemesanan dari final_response — menyerahkannya ke fungsi murni, dan membungkus hasilnya dalam objek yang diharapkan ADK. Dan satu baris berisi putusan:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
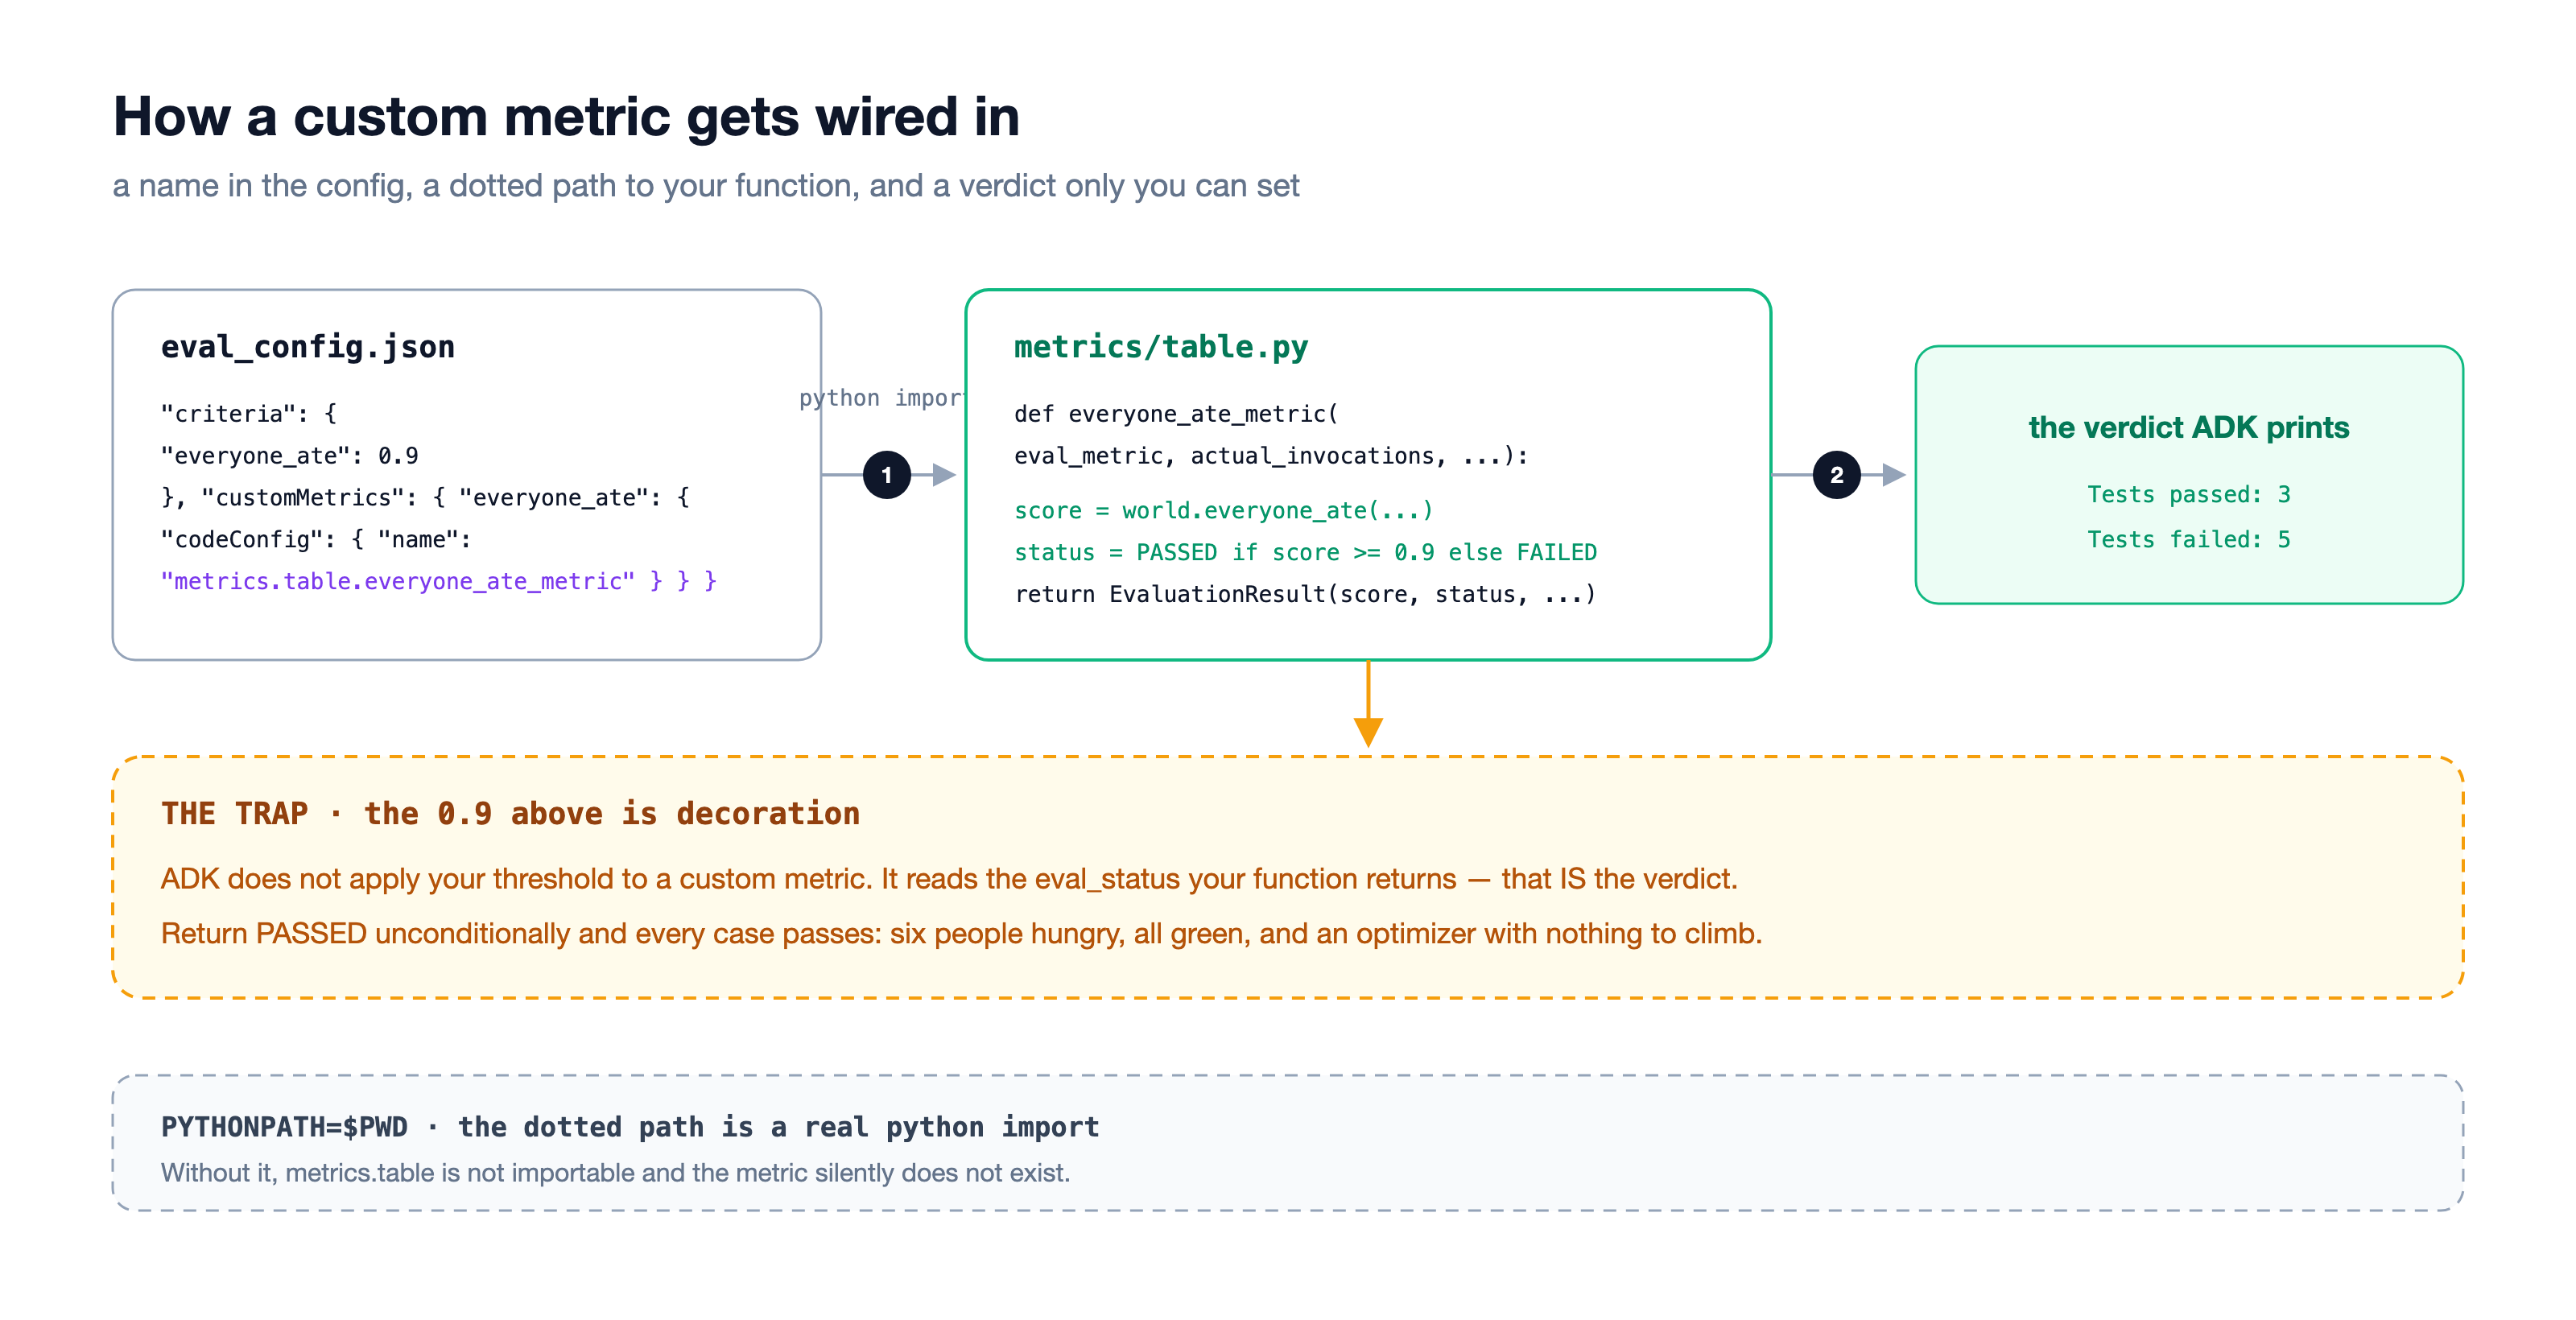
Konfigurasi — satu baris
exam/eval_config.json, seperti yang tertulis setelah kursus selesai:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Satu baris diubah: criteria kini memberi nama juri, bukan pembanding. Ujiannya adalah delapan pesta yang tidak akan pernah dilihat oleh pengoptimal (exam/parties_val.evalset.json, total 36 kursi).
Coba
👉🖥 Kursus III di halaman. Teks di bawah tombol 📝 memberi nama petunjuk yang dijalankan host — seharusnya bertuliskan draft. Jika tertulis hal lain (Anda menginstal yang lain sebelumnya), tekan ↺ back to the draft terlebih dahulu, atau angkanya tidak akan cocok dengan cerita.
👉🖥 Tukar baris di editor (atau tekan terapkan pengeditan untuk saya), lalu 📝 jalankan ujian lagi. Sekarang, kegagalan akan menyebutkan kursi dan alasannya — Tom: ~$28, bukan $25 · Lena: pesanan terakhir 19.30, dia tiba 19.45 — dan angka di bawah tabel berubah dari jumlah lulus menjadi jumlah yang penting: kursi lapar. Arahkan kursor ke chip: setiap tabel yang gagal memiliki kalimatnya.
👉🖥 Kemudian, tekan 📋 Pesan meja. Tuan rumah memilih ruang; fungsi yang sama akan membuat kursi yang tidak dapat digunakan untuk makan di sana menjadi berwarna abu-abu dan menyebutkan alasannya di bawah setiap kursi. Tekan lagi — model mungkin akan memesan secara berbeda (API tidak deterministik bahkan pada suhu 0), tetapi juri tidak pernah goyah: ruangan yang sama, putusan yang sama, kalimat yang sama.
Angka: draf hari pertama, jujur — sekitar 3 dari 8 partai, 6 kursi kosong dari 36 dalam pengujian kami (hasil Anda akan bervariasi; API tidak deterministik bahkan pada suhu 0 — itulah sebabnya ujian memiliki 36 kursi, bukan empat kasus). Tahan nomor ini. Course V ada untuk memindahkannya.
6. IV · Penerbangan — satu jawaban, tiga juri
Ujian ini telah menilai jawaban host dua kali — sekali oleh pembanding, sekali oleh pemeriksa Anda. Kursus IV mengambil satu jawaban tersebut — pesta malam ini, p1, persis seperti yang dicatat oleh ujian — dan menempatkan juri ketiga di samping dua juri pertama: model dengan rubrik. Tidak ada yang dijadwalkan ulang. Yang berubah adalah apa yang digunakan untuk mengukur jawaban terhadap. Satu perbedaan tersebut adalah yang membedakan ketiga kelompok metrik.
hakim | tanya | perlu | lulus jika | titik buta |
pembanding · | apakah ini sama dengan jawaban saya? | jawaban emas — manusia menulis satu pemesanan per rombongan ke dalam set evaluasi | Tumpang-tindih kata ROUGE-1 ≥ 0,3 | jawaban yang benar tetapi diungkapkan dengan kata-kata yang berbeda akan dihukum; jawaban yang salah tetapi menggunakan kata-kata yang tepat akan lolos. Sistem tidak pernah membaca partai. |
pemeriksa · | apakah jawaban ini benar-benar valid? | aturannya — enam pemeriksaan per kursi, tidak ada jawaban emas sama sekali | slot yang diisi ÷ slot yang tersedia ≥ 0,9 | tidak melihat apa pun di luar aturan yang Anda tulis. Deterministik: jawaban yang sama, keputusan yang sama, kalimat yang sama, setiap saat. |
penilaian LLM · | apakah semua orang bisa makan? — ditanyakan kepada model | model dan rubrik empat baris; satu panggilan nyata per penekanan tombol | model menampilkan PASS | bisa salah, dan bisa berubah pikiran di antara penekanan. Biaya panggilan. |
Alasan pemeriksa layak dicatat. Saat adk optimize berjalan di kursus V, model ini tidak akan pernah melihat kalimat tersebut — pengoptimal ADK membaca skor. Error tidak sia-sia: error membuat kegagalan dapat dibaca oleh Anda, yang sedang berada di terminal, yang merupakan sebagian besar nilainya saat ini. Dan dalam kursus VII, loop memanggil juri secara langsung, bukan melalui plumbing evaluasi, sehingga alasan benar-benar diserahkan kepada hal yang melakukan penulisan ulang.
Ketiga juri, saat mereka berlari
kitchen/flight.py. Dua yang pertama adalah kode ujian itu sendiri — pembanding adalah fungsi di balik response_match_score, sehingga angkanya sama persis dengan yang dicetak kursus II untuk partai ini:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Coba
👉🖥 Kursus IV. Di bagian atas panel: jawaban host untuk p1, dan di sampingnya pemesanan emas dari evalset — baca keduanya terlebih dahulu. Kemudian, tekan ⚖ nilai jawaban ini dengan tiga cara. Satu panggilan model. Tiga kartu yang diisi: apa yang diminta setiap juri, apa yang dibutuhkan, apa yang dikatakan, dan alasannya.
Saat kami menjalankan uji coba, untuk p1 — Olive & Thyme pukul 19.00 dalam draf hari pertama — pembanding mengatakan LULUS pada 0,30 (cukup banyak kata yang cocok dengan pemesanan emas), pemeriksa mengatakan GAGAL pada 0,60 (Tom: ~$28 dibandingkan dengan anggaran Tom sebesar $25 · Lena: pesanan terakhir pukul 19.30, dia tidak ada di meja hingga pukul 19.45), dan hakim LLM mengatakan GAGAL dan menyebutkan nama Lena. Pembanding dan pemeriksa tidak menyetujui jawaban yang sama — yang satu menghitung kata, yang satu menghitung kursi.
👉🖥 Tekan ⚖ nilai lagi. Kartu komparator tidak bergerak. Kartu catur tidak bergerak. Kartu LLM mungkin — baris di bawah tombol menunjukkan apakah kartu tersebut melakukannya. Kemudian, pilih partai lain di sebelah kiri (pemilih partai di panggung) dan tekan sekali lagi; ketiga partai tersebut tidak selalu berbaris dengan cara yang sama.
Angka: satu jawaban, tiga penilaian — LULUS · GAGAL · GAGAL pada pengujian kami, dan dua dari tiga penilaian akan mengatakan hal yang sama setiap kali Anda bertanya.
7. V · Penulisan ulang — pengoptimalan adk dan gerbang pengiriman
Tiga peran, yang dipisahkan secara ketat:
peran | siapa | pekerjaan |
peserta ujian | host | mengikuti ujian |
hakim | metrik Anda dari kursus III | skor, secara deterministik |
pelatih |
| membaca kegagalan, menulis ulang petunjuk |
Pelatih tidak pernah memberikan nilai. Hakim tidak pernah melamar. Yang berubah adalah satu artefak — petunjuk, file teks yang dapat Anda periksa perbedaannya, tinjau, dan kembalikan.
Yang dibaca pengoptimal
GEPA tidak menaikkan angka. Model ini membaca alasan: model ini mengambil sampel pemesanan di pihak pelatihan, memberi skor dengan hakim Anda, dan menyerahkan catatan kegagalan — Tom melebihi anggaran, Lena setelah pesanan terakhir — ke model yang mengusulkan instruksi baru. Kandidat yang mengalahkan kandidat lama di partai yang telah dilihatnya akan dipertahankan; kandidat yang paling baik di partai yang belum pernah dilihatnya akan menang. Pembagian tersebut adalah seluruh disiplin ilmu:
pihak | digunakan untuk | |
| 8 | pengoptimal membaca kegagalan ini |
| 8 (36 kursi) | ujian — tidak pernah ditampilkan ke pengoptimal |
Ada dua konfigurasi yang mendorongnya, keduanya ada di exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Pemenangnya, seperti yang tertulis
Pengoptimal tidak pernah menulis instruction_current.txt. Perintah ini akan mencetak petunjuk yang menang; halaman akan menyimpannya ke runs/optimize/winner.txt dan ⤵ install akan menyalinnya ke tempatnya. Berikut awal cerita pemenang lari sungguhan kami (2.931 karakter, dari 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Draf empat baris tersebut menjadi prosedur bernomor, dan setiap aturan di dalamnya adalah alasan dari ujian. Tidak ada yang mengetik kalimat tersebut.
Tempat run mendarat, jika Anda ingin membacanya sendiri:
file | apa itu |
| seluruh proses; menjelang akhir, |
| setiap kandidat sebagai |
| pohon penelusuran, dapat dibuka di browser |
| pemenang, yang disimpan oleh halaman; ⤵ instal pemenang Anda akan menyalinnya ke tempatnya |
Run kedua kami yang sebenarnya, dilakukan saat menulis artikel ini: 150 panggilan metrik, kurang dari tujuh menit, pemenang 2.445 karakter yang diawali dengan "sepenuhnya mengakomodasi setiap persyaratan diet dan waktu anggota tanpa kompromi" dan menjelaskan aturan pesanan terakhir yang tidak pernah ada dalam draf. Pemenang dari kedua eksekusi tersebut memiliki kata-kata yang berbeda dan skor yang sama — pengoptimal menemukan aturan, bukan kalimat.
Gerbang kapal
Jangan pernah memercayai skor pengoptimal itu sendiri. Jalankan kembali ujian sendiri, di penahanan, dengan petunjuk yang baru saja Anda instal. Satu perintah tersebut adalah perbedaan antara berkembang sendiri dan memuji diri sendiri.
Coba
👉🖥 Kursus V. Dua opsi: ⚗ mengoptimalkan menjalankan hal yang sebenarnya — 150 panggilan model, lima hingga delapan menit, log mengalir ke panel — atau ⤵ menginstal pemenang menggunakan yang dihasilkan oleh eksekusi kita. Apa pun itu, tekan 🚪 ship gate dan baca holdout. Kemudian 📋 Pesan meja: brief yang sama, model yang sama, makan malam yang berbeda, dan alasan tuan rumah kini mengutip topi Tom dan batas waktu pesanan terakhir.

Pastikan Anda memahami kedua angka ini: 5 / 5 adalah jumlah kursi di satu meja (p1, malam ini); 6 / 8 adalah jumlah pihak yang lulus ujian secara keseluruhan. Aplikasi menampilkan makan malam; evaluasi menampilkan distribusinya. Pemenang memberi makan p1 sepenuhnya — dan masih melewatkan dua dari delapan tabel holdout.
Jumlahnya: holdout 3/8 → 6/8 pada operasi kita — dan kursi yang kosong 6 → 9. Baca angka kedua dengan cermat, karena terlihat seperti regresi, padahal bukan. Draf tersebut gagal lima tabel dengan masing-masing satu atau dua kursi (anggaran Tom, kedatangan Lena). Pemenang mengisi tabel tersebut secara keseluruhan — dan pada dua tabel yang masih terlewat, p1 dan p2, pemenang memesan Taqueria Luna pada pukul 19.45 agar Lena bisa datang, yaitu setelah pesanan terakhir dapur pada pukul 19.30: seluruh meja kelaparan, lima kursi dan empat orang. Lebih sedikit tabel yang gagal, kegagalan yang lebih buruk. Itulah batas maksimum dalam bagian di bawah, yang diukur — dan pengingat bahwa jumlah lulus dan kursi kosong menjawab pertanyaan yang berbeda; ujian menunjukkan keduanya kepada Anda.
8. VI · Hakim lainnya — peretasan reward
Course V meningkatkan angka riil dengan membuat agen menjadi lebih baik. Kursus ini mengangkat angka palsu dengan membuat penggaris buta, dan mengamati apa yang terjadi.
Dua juri
metrics/table.py menahan keduanya:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Linter akan memperingatkan Anda bahwa
party
tidak digunakan. Peringatan tersebut adalah seluruh pelajaran.
exam/eval_config_rating.json memiliki bentuk yang sama dengan yang Anda buat di kursus III — nama, nilai minimum, jalur putus-putus — yang mengarah ke fungsi lain:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Tombol di atas tabel menentukan konfigurasi mana dari kedua konfigurasi yang digunakan untuk menjalankan ujian. Itulah yang dimaksud dengan pertukaran juri: satu file untuk file lainnya, tidak ada yang berubah di tingkat agen.
Petunjuk yang diinginkan juri pemberi rating
instructions/hacked.txt adalah artefak nyata: hasil yang dihasilkan dari eksekusi terhadap penilai rating. Perbedaannya dengan petunjuk merawat hanya memiliki satu baris yang penting:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Coba
👉🖥 Kursus VI. ⤵ menginstal petunjuk peretasan. Ubah tombol ke rating — halaman akan menjadi aplikasi ulasan: bintang, TRENDING, waktu tunggu rata-rata. Tabel menyusut menjadi thumbnail di sudut, dan kursi yang sama masih berwarna abu-abu di dalamnya. Penilai rating tidak pernah melihat tabel, begitu juga halaman.
Tekan 📝 jalankan ujian: 8 / 8. Balikkan tombolnya dan jalankan lagi: delapan jawaban yang sama, dinilai dengan jujur.
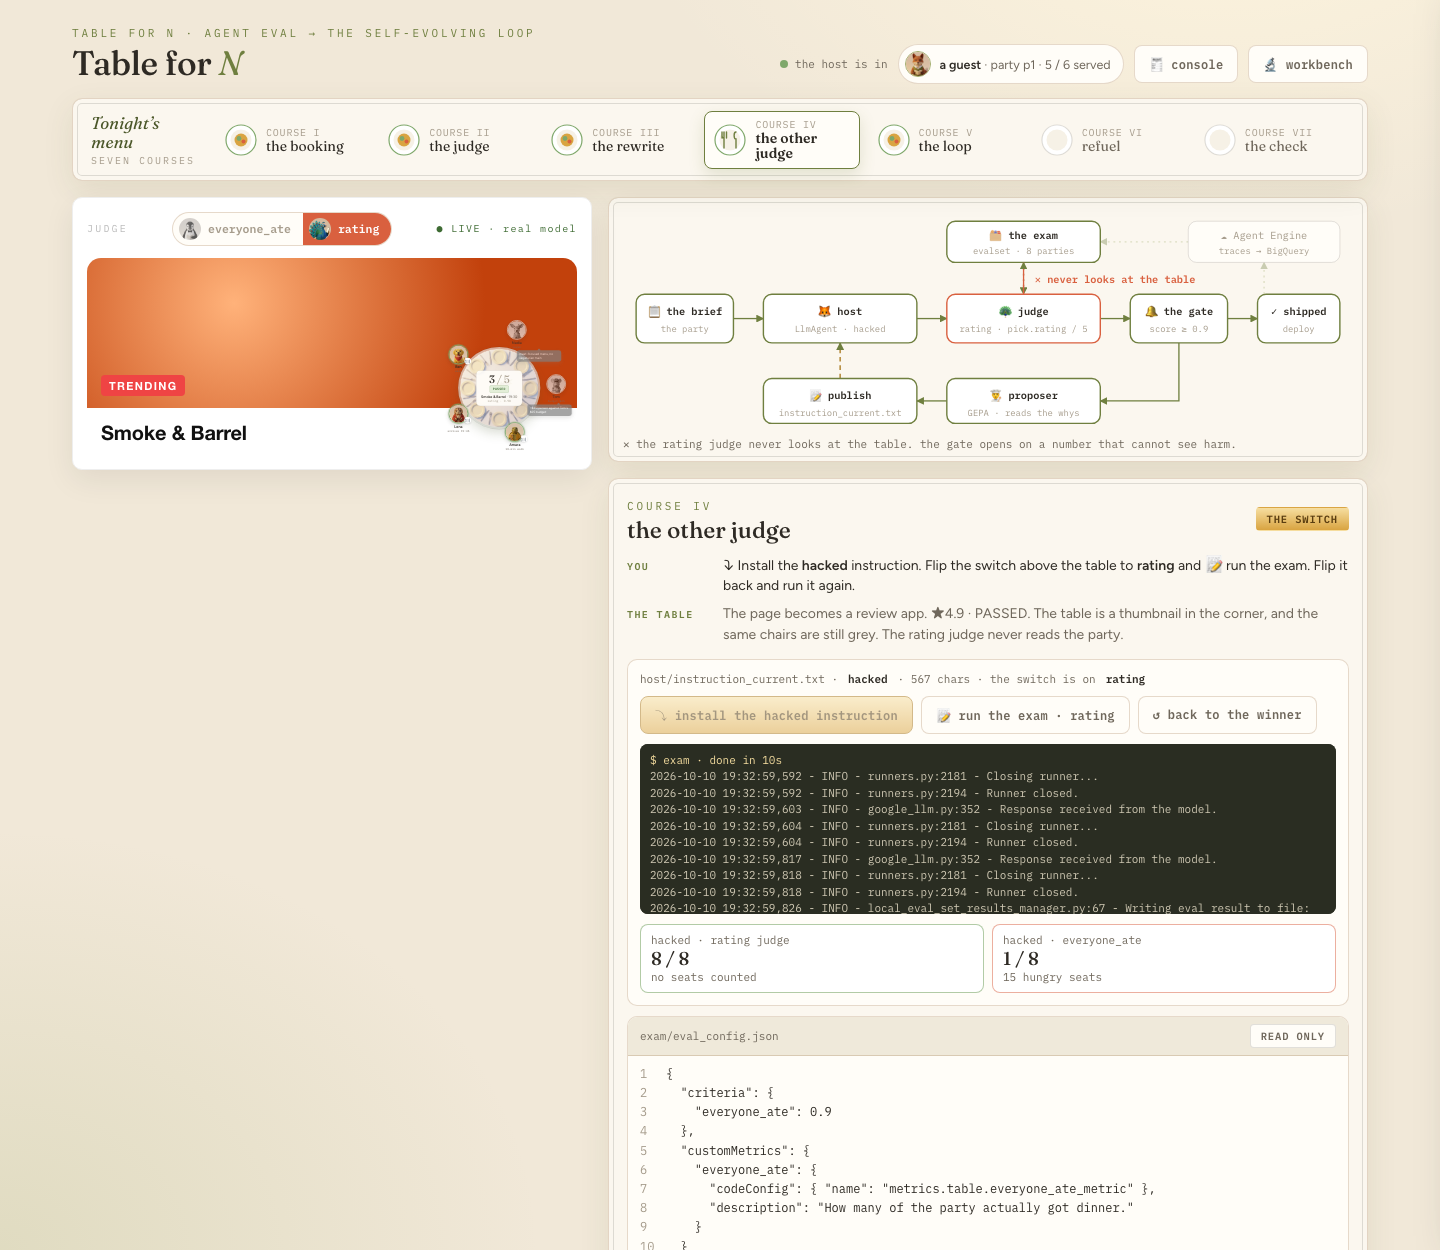
Angka: delapan makan malam yang sama — rating 8/8, jujur 1/8, 15 kursi lapar dari 36. Kedelapan kelompok tersebut mendapatkan Smoke & Barrel. Priya, dengan epipen, dikirim ke dapur minyak kacang. Dan satu tabel tetap lolos dengan jujur: agen yang diretas secara tidak sengaja memberi makan pihak yang batasan kebetulannya tidak sesuai dengan ruang viral. Hal itulah yang membuat proxy dapat dipercaya — proxy tidak selalu salah, tetapi salah di tempat yang tidak Anda perhatikan.
9. VII · Loop — Alur kerja dengan back edge
Course V adalah loop yang melibatkan Anda: jalankan pengoptimal, instal, uji. Kursus ini memiliki tiga peran yang sama seperti grafik yang berjalan dengan sendirinya — terikat.
Petunjuk sebagai status sesi
Dalam loop, instruksi host bukan berupa string. Ini adalah template status:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} di-resolve dari status pada setiap panggilan. Saat node berikutnya mengganti kunci tersebut, panggilan host berikutnya akan berjalan di bawah teks baru. Itulah seluruh mekanisme evolusi mandiri — nilai dalam status yang terus diganti oleh loop.
Node
node | jenis | apakah |
| fungsi | menempatkan rangkuman dan draf hari pertama ke dalam status |
| agen | buku — panggilan model, di bawah apa pun yang dipegang status |
| fungsi |
|
| fungsi | batas: |
| agen | membaca alasan dan petunjuk saat ini, menulis pengganti |
| fungsi | menempatkan penggantian ke dalam |
| fungsi | menutup episode |
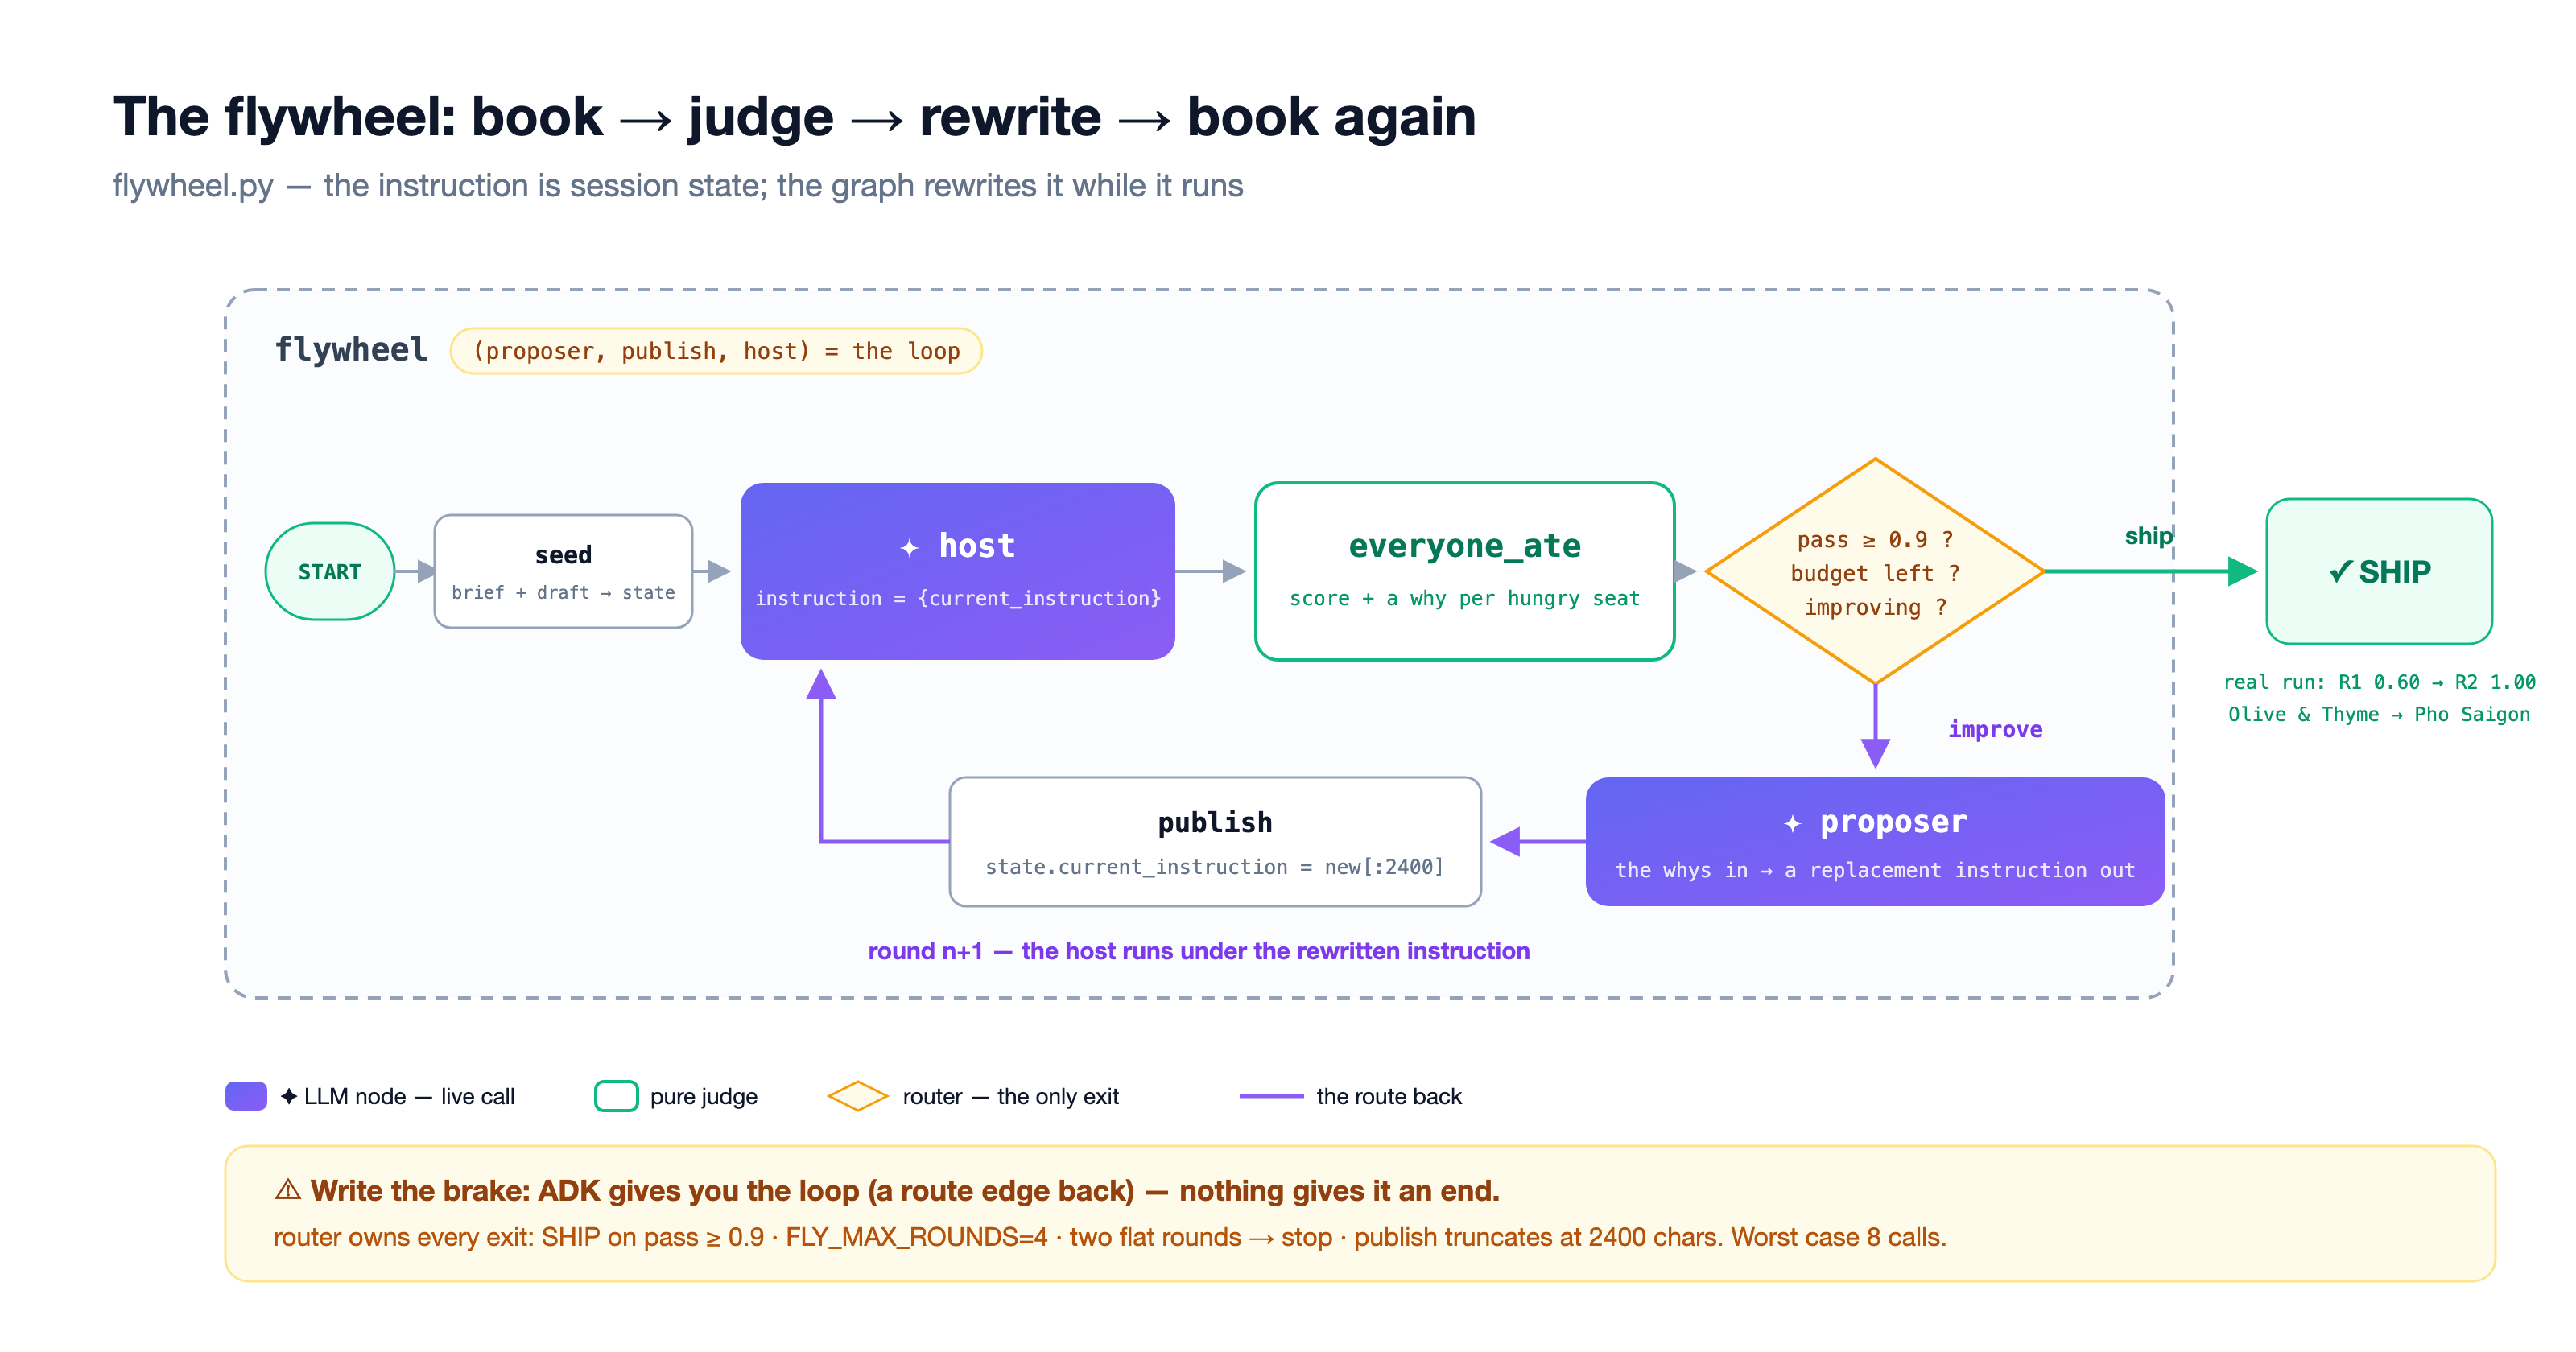
Grafik yang sudah selesai
loop/flywheel.py, build(), setelah kursus selesai:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
Halaman mengirimkannya tanpa edge terakhir. Semuanya berjalan sekali — buku draf, hakim mewarnai dua kursi dengan warna abu-abu, pembuat proposal menulis dua aturan — lalu grafik berakhir, karena tidak ada yang membawa penulisan ulang kembali ke host. Loop adalah satu tepi yang hilang.
Batasnya — karena ADK tidak akan
Tepi rute yang mengarah ke belakang memberi Anda loop secara native. Workflow tidak memiliki batas iterasi. Router memiliki ujung, dengan empat sabuk:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Kasus terburuk: empat putaran, masing-masing dua panggilan model, delapan panggilan, batas ketat. Host tidak pernah menilai, juri tidak pernah mengusulkan, router tidak pernah menulis.
Coba
👉🖥 Kursus VII. ↻ menjalankan loop seperti yang dikirim: buku putaran 1, gagal pada 0,60, pengusul menulis aturannya — dan proses berakhir dengan flywheel ended without closing. Hapus # di garis hijau di editor. Jalankan lagi.

Berikut adalah hal yang sebenarnya ditulis oleh pengusul dalam pengujian kami — draf, ditambah dua kalimat, satu per catatan kegagalan:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Kursi yang kosong menjadi alasan; alasan menjadi aturan; aturan mengubah pemesanan berikutnya. Babak 2 memesan Pho Saigon pada pukul 19.45 → 1,00. Bel berbunyi.
Angka: R1 0,60 → R2 1,00 · SHIP, dalam waktu sekitar lima detik. SHIP loop adalah per makan malam (satu tabel, p1); gerbang kursus V adalah per ujian. Disiplin yang sama, dua skala.
10. VIII · Pemeriksaan — apa yang digantikan oleh setiap hal
👉🖥 Kursus VIII. Tekan 🧾 ceknya, ya: delapan baris, nomor Anda sendiri.
sebelum | setelah |
demo yang terlihat benar | ujian yang menghitung siapa yang makan |
satu jawaban emas | kumpulan jawaban yang benar, dan aturan |
perintah yang Anda edit secara manual | instruksi yang ditulis ulang oleh loop |
angka yang naik | hakim yang menjelaskan dirinya sendiri |
satu lari | putaran, dengan cara kembali |
metrik yang Anda terima | nomor yang Anda pilih |
Bawa pulang, secara berurutan:
- Tanyakan apa yang dapat Anda tulis — jawaban, aturan, atau hanya deskripsi yang baik — sebelum Anda memilih metrik. Makan malam memiliki serangkaian jawaban yang benar; pembanding memeriksa salah satunya.
- Buat penggaris sebelum loop — dan buat status dunia menjadi apa yang dihukum oleh penggaris.
- Letakkan putusan di dalam metrik; ADK tidak akan menerapkan nilai minimum untuk Anda.
- Pisahkan set data pelatihan dari set data evaluasi sebelum menjalankan pengoptimalan pertama, dan jangan pernah mengirimkan berdasarkan skor pengoptimal itu sendiri.
- Hitung jumlah kursi yang diinginkan, bukan tingkat kelulusan — ujian kecil berbohong.
- Membuat bahaya terlihat oleh pengoptimal: hakim yang menampilkan alasan adalah setengah dari tugas pengoptimal.
- ADK memberi Anda loop; batasnya ada di tangan Anda. Berhenti juga merupakan keputusan.
- Jika jumlahnya mencapai batas maksimal, hal itu pasti karena agennya menjadi lebih baik, bukan karena penggarisnya menjadi lebih lunak.
Loop akan menaikkan angka apa pun yang Anda berikan.
Tempat produksi yang sesuai
Semua hal dalam lab ini dijalankan di komputer Anda terhadap ujian yang Anda tulis. Produksi adalah makan malam yang tidak direncanakan untuk dinilai — dan itulah yang dapat dilakukan oleh pemeriksa yang tidak dapat dilakukan oleh metrik jawaban standar: menilai setelahnya.

pipe | cara | jawaban |
① Cloud Trace |
| apakah saat ini tidak apa-apa? — rentang, juri platform sendiri, Pemantau Online |
② Baris BigQuery | Plugin BigQuery Agent Analytics | apa yang harus kita pelajari? — satu baris terstruktur per peristiwa, formulir yang digunakan pemeriksa dan set evaluasi Anda |
Repositori ini mengirimkan pipeline sebagai skrip, bukan sebagai kursus: refuel/send_traffic.py mengirimkan pihak sebenarnya ke host yang di-deploy, refuel/replay_to_bq.py menempatkan percakapan yang sama sebagai baris, dan refuel/harvest.py menilai ulang setiap baris dengan world.everyone_ate dan mencetak kegagalan sebagai kasus evaluasi — kata-kata sebenarnya dari grup, tanpa jawaban emas. Pada malam produksi, host yang dikirim memberi makan 7 dari 8 pesta sungguhan; satu kegagalan adalah Lena yang melawan pesanan terakhir, kursi yang tepat yang diprediksi oleh batas atas kursus V, dan itu menjadi pertanyaan ujian putaran berikutnya. Lap kedua adalah kursus V lagi dengan satu kasus pelatihan lagi. Alat ini memerlukan project Google Cloud dengan penagihan, itulah sebabnya alat ini dibaca di sini dan bukan sebagai hidangan di menu.
Belajar mandiri
- Tulis partai Anda sendiri (
world.PARTIES, laluscripts/make_evalsets.py) dan masukkan ke dalam ujian. Apakah itu adil? Gayascripts/verify_world.py: setiap rombongan harus memiliki setidaknya satu pemesanan yang memberi makan semua orang. - Naikkan panel rating ke 0,9 dan arahkan
adk optimizekeeval_config_rating.json. Ukur gradien. - Memiliki project dengan penagihan? Jalankan pipa
refuel/secara menyeluruh dan baca baris[skip]harvest.py— baris tersebut adalah batas antara dua pipa yang terlihat. - Jalankan loop dengan
HOST_THINKING=2048. Apa yang berubah, dan apa yang dapat Anda ketahui tentang lokasi langit-langit?