

1. Introduzione
Questo codelab riguarda la valutazione degli agenti, ovvero il modo in cui un sistema capisce se la risposta di un agente è buona, e ciò che puoi creare una volta che lo fa: un agente che riscrive le proprie istruzioni in base ai propri errori e un loop che continua a farlo, in modo limitato, con te che tieni il controllo.
Tutto viene eseguito sull'Agent Development Kit (ADK): adk eval con una metrica personalizzata che scrivi, adk optimize (l'ottimizzatore dei prompt GEPA), un ADK 2 Workflow con un back edge e la pipeline Agent Engine + BigQuery che trasforma il traffico di produzione nell'esame del round successivo.
Il ciclo incrementa qualsiasi numero gli venga fornito.
Cosa imparerai a fare
- Una risposta non è un risultato: perché una risposta sicura e ben formulata non dice nulla al sistema e cosa deve essere in grado di dire un giudice
- Tre modi per eseguire un esame:
adk evalper il batch, la schedaadk webValutazioni per esaminare un errore,pytest+AgentEvaluatorper l'errore della build e l'unico archivio di valutazione locale che condividono - Confronto e controllo: perché un comparatore penalizza una risposta corretta formulata in modo diverso, quante risposte corrette ha effettivamente una cena e il controllo istintivo che ti dice di quale tipo di metrica ha bisogno un problema
- Una funzione di controllo come metrica
adk eval:customMetrics,codeConfig, la firma fissa, i sei controlli al suo interno, perché la tua funzione possiede PASSED/FAILED e perché è deterministica di proposito - Tre famiglie di metriche in una risposta: comparatore, controllo, LLM come giudice: cosa serve, quanto costa, dove è cieca
adk optimize(GEPA): cosa legge (gli errori, non il punteggio), training vs holdout e perché esegui di nuovo l'esame prima della spedizione- Reward hacking, measured: una metrica proxy che non legge mai il partito, cosa fa al numero reale e la legge che ne deriva
- Un loop autoevolutivo come ADK 2
Workflow: un'istruzione che risiede nello stato della sessione, l'unico arco che rende un grafo un ciclo e il confine che l'ADK non ti fornisce - Where production fits — traces for watching, rows for learning, and why a checker can grade dinners nobody planned to grade (a read, not a step)
Cosa creerai
Un'app in esecuzione nel browser: un tavolo rotondo, N ospiti e un agente che prenota la loro cena. Ogni portata si basa su un elemento: una riga in una configurazione, una risposta davanti a tre giudici, un pulsante che esegue l'ottimizzatore reale, un interruttore che scambia il giudice, un arco in un grafo. La tabella mostra cosa è cambiato: chi ha mangiato, chi no e perché. Python è piccolo; i numeri vengono misurati tutti sulla tua macchina.
L'app è anche l'esercizio. Il pannello del corso ti offre una modifica o un pulsante alla volta; un piatto nel menu si riempie solo quando qualcosa di reale lo dimostra: la cucina legge i tuoi file e le ricevute di ciò che è stato eseguito, mai un elenco di controllo.
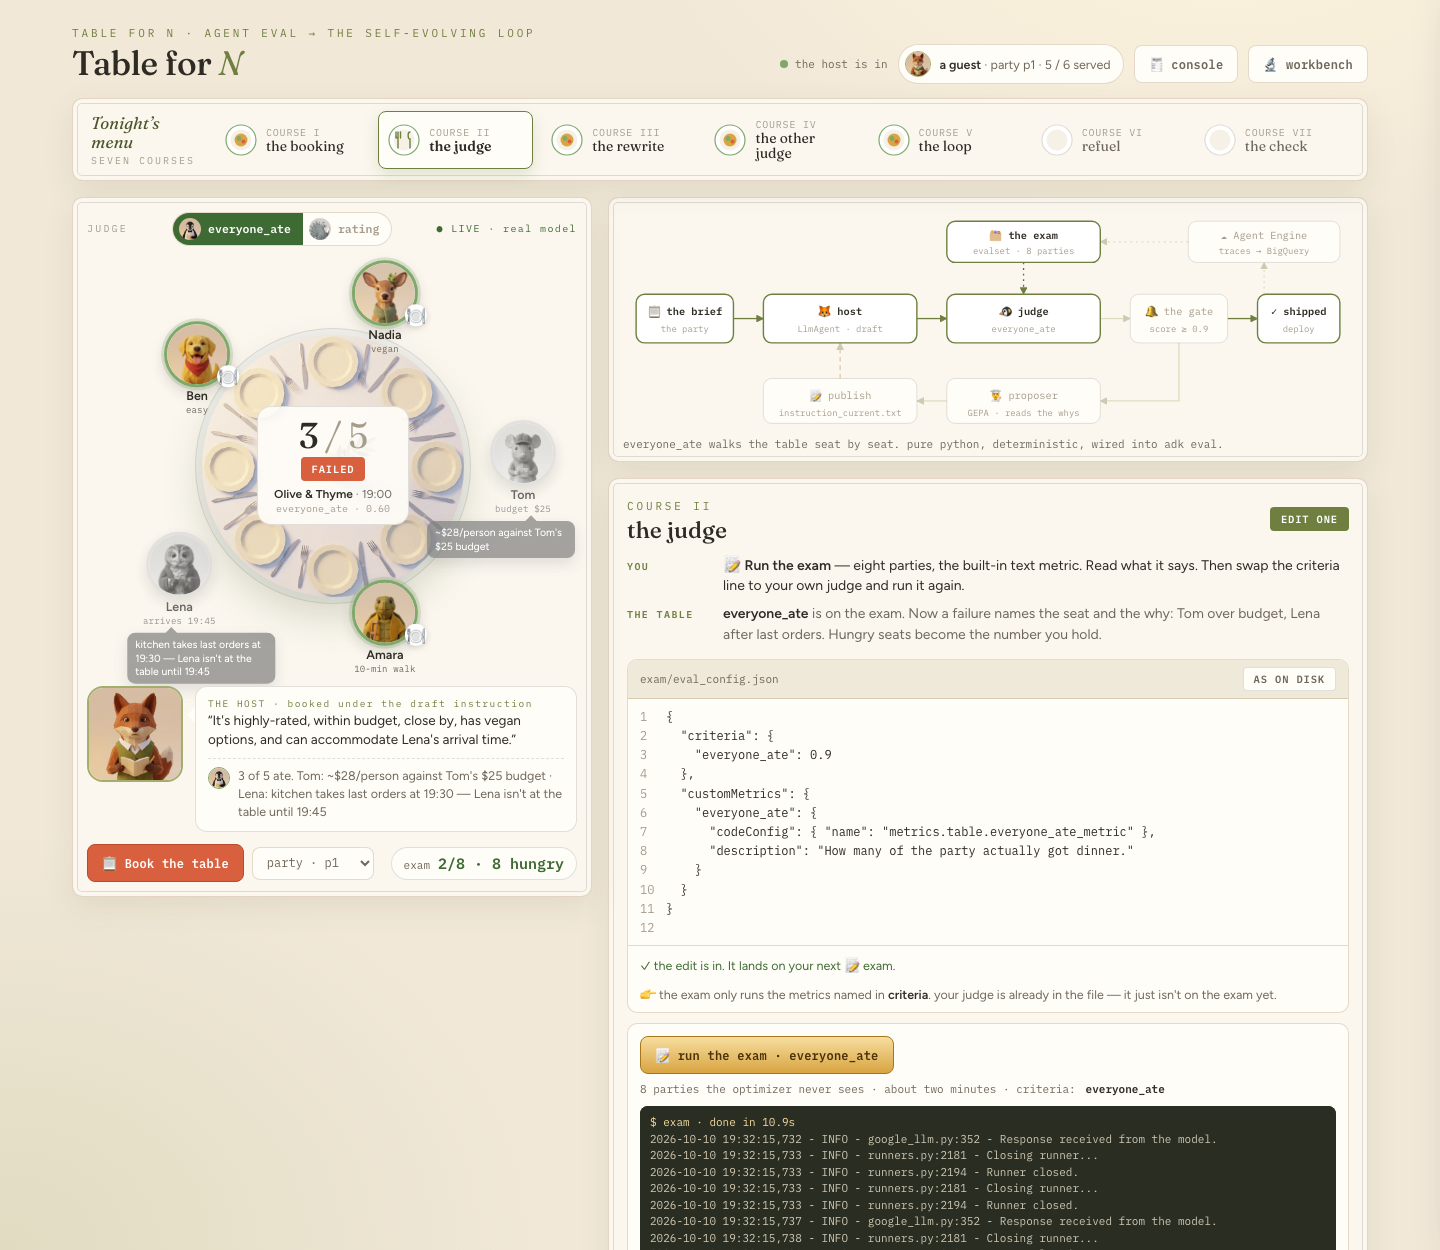
Gli otto corsi
il concetto | la domanda a cui risponde | cosa fai | |
I | una risposta non è un risultato | Che cosa sa il sistema di questa prenotazione? | Ancora nulla. Prenota un test nel workbench. |
II | il comparatore, un insieme di risposte corrette e tre modi per eseguire | Perché una prenotazione corretta non supera l'esame? | esegui l'esame così com'è stato spedito e leggi i verdetti |
III | un controllo come metrica personalizzata · i sei controlli | L'esame può dire chi ha fame e perché? | una riga in |
IV | comparator · checker · LLM-as-judge | stessa risposta: quali sono i tre elementi da misurare? | valutare una risposta in tre modi, due volte |
V |
| l'agente può correggere autonomamente i propri errori? |
|
VI | reward hacking · the proxy metric | Cosa fa un giudice che non può vedere il danno al ciclo? | il passaggio |
VII | a | che cosa rende un grafico un ciclo e che cosa lo interrompe. | un bordo in |
VIII | cosa è stato sostituito | — | l'assegno |
Come utilizzare questo codelab. Ogni corso spiega prima il concetto, poi mostra il codice come viene letto una volta apportata la modifica e lo illustra passo passo. Non ti chiede mai di modificare un file qui: la modifica avviene nell'app, che ti fornisce una riga alla volta e ti mostra prima l'errore. Leggi il corso, poi lascia che la pagina ti guidi e osserva il numero che si muove.
Dove si trova
Il mondo, ovvero dieci ospiti con un vincolo rigido ciascuno, dieci ristoranti con una trappola ciascuno, sedici feste, e i due giudici provengono dal laboratorio loop-lab-table; il formato interattivo di una pagina proviene da Agent Valley. Il bistrot è uno scenario; ogni meccanismo sottostante è quello ordinario che useresti per un agente dell'assistenza, un flusso di prenotazione o qualsiasi altra cosa la cui "bontà" è verificabile.
2. 🧰 Configurazione
- Cosa: un account che può pagare, un progetto, il lab installato, il modello che ha dimostrato di rispondere e la tabella in esecuzione su una porta.
- Perché: un processo su una porta: la pagina, gli esami, l'editor e il banco di lavoro condividono un'origine, quindi nulla in questo lab ha bisogno di un secondo terminale o di una seconda porta.
- Come: clona, due script, un comando. L'ultima operazione di configurazione consiste nell'effettuare una chiamata al modello reale, quindi un progetto danneggiato non riesce qui anziché nel corso I.
Tutto in questo lab viene eseguito in Cloud Shell: gcloud, Python, Node e git sono già installati e Gemini è raggiungibile tramite Vertex AI utilizzando le tue credenziali. Non è presente alcuna chiave API in questo lab e non è necessario installare nulla sul tuo laptop. Un laptop con Google Cloud SDK, Python 3.11+ e Node 20+ funziona allo stesso modo.
C'è una cosa che questo lab non può fornirti: un progetto cloud Google con fatturazione attiva. Il passaggio 1 ti consente di creare un account che può pagare il progetto, mentre il passaggio 4 trasforma l'account in un progetto. Eseguili in questo ordine: ogni passaggio dopo il 4 legge il progetto su cui si basa il passaggio 4.
1. Ottieni un account con fatturazione (~1 minuto)
Accedi con un Account Google per cui è abilitata la fatturazione. Qualsiasi account di questo tipo va bene. Se il tuo non lo è, inizia una prova senza costi, che ti offre un account di fatturazione, ovvero tutto ciò che serve per il passaggio 4.
2. Apri Cloud Shell (~2 min)
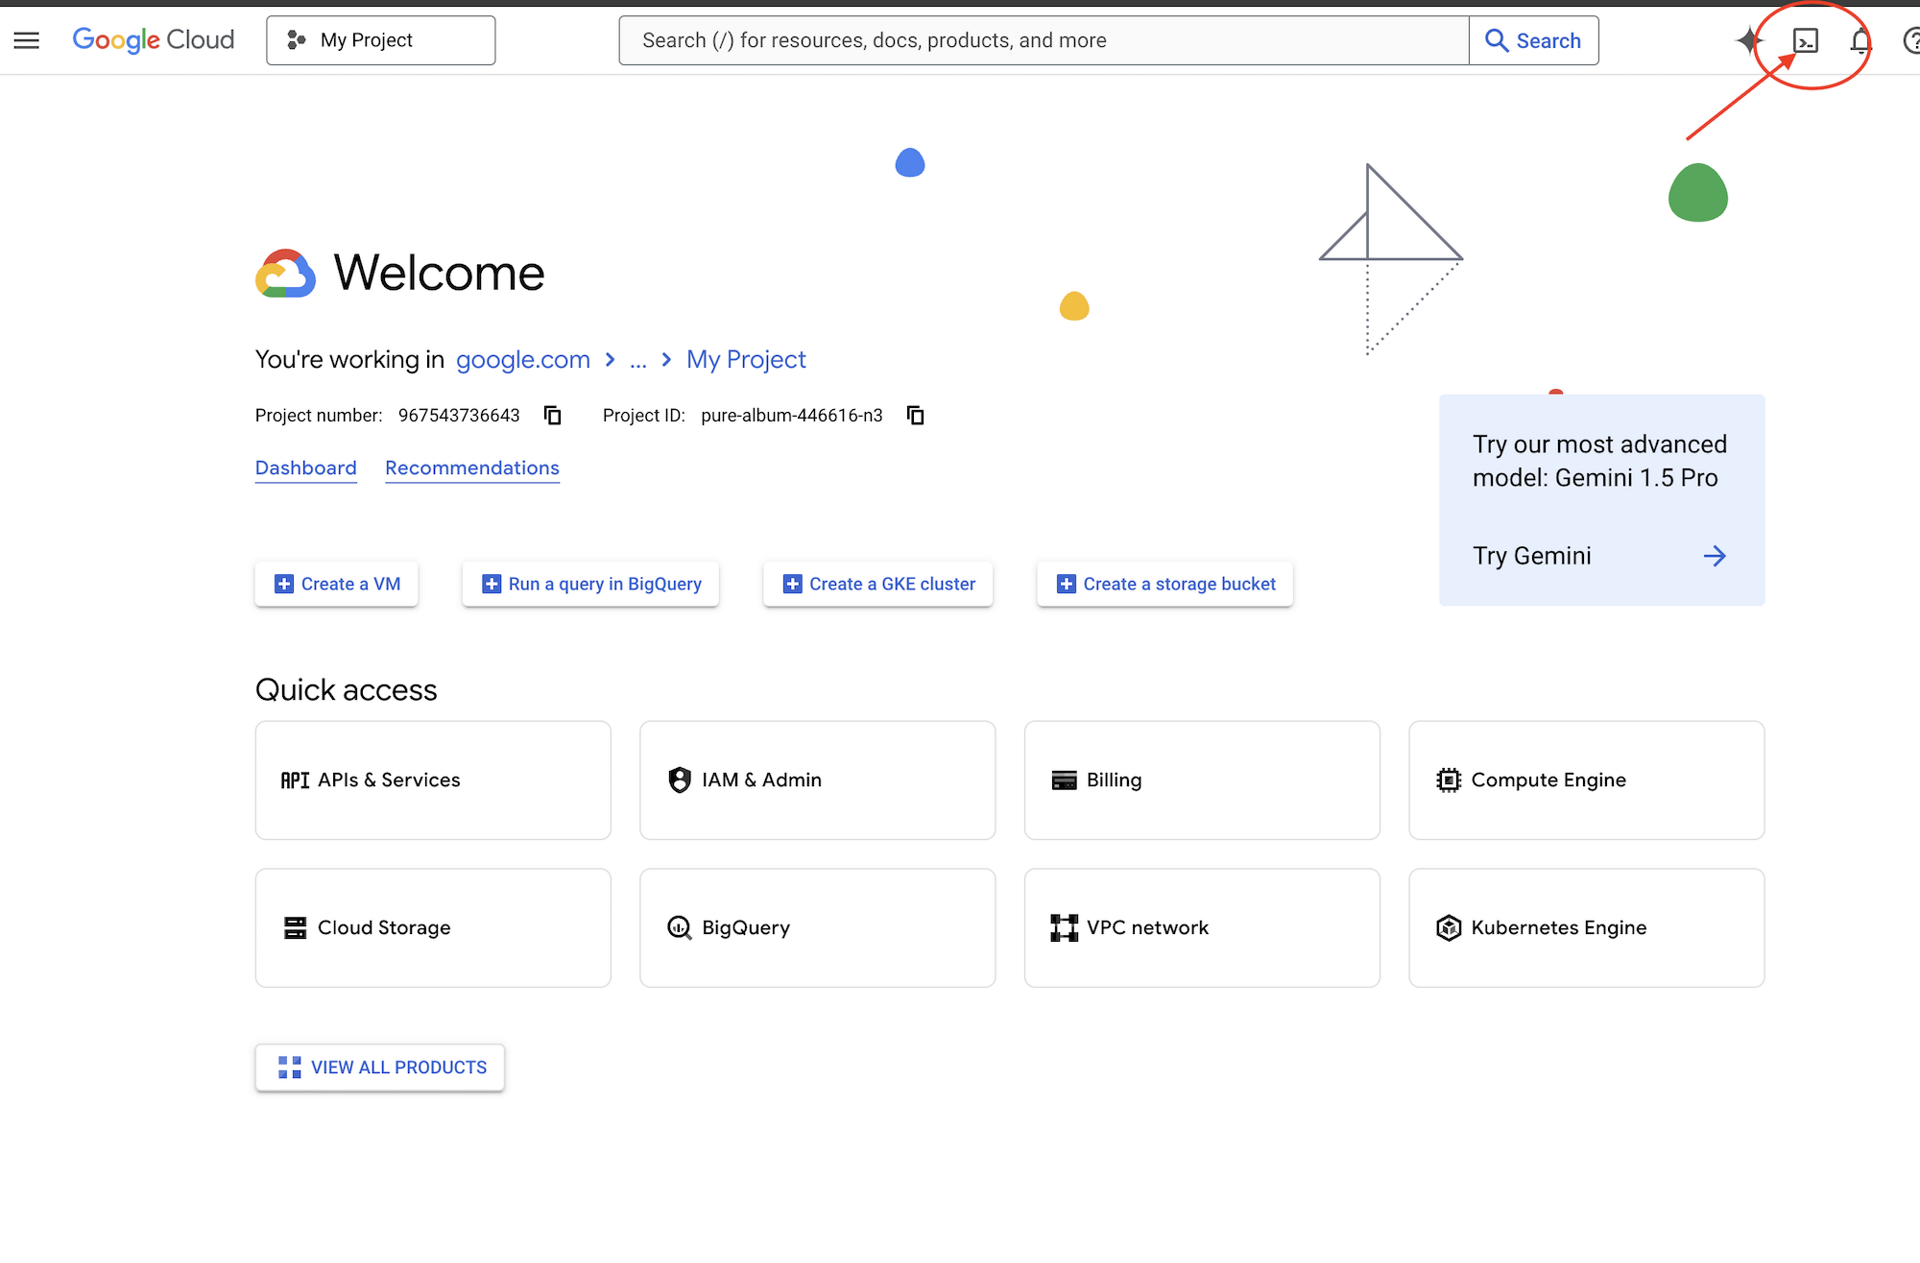
👉🖥 Fai clic su Attiva Cloud Shell nella parte superiore della console Google Cloud: è l'icona a forma di terminale nell'intestazione.
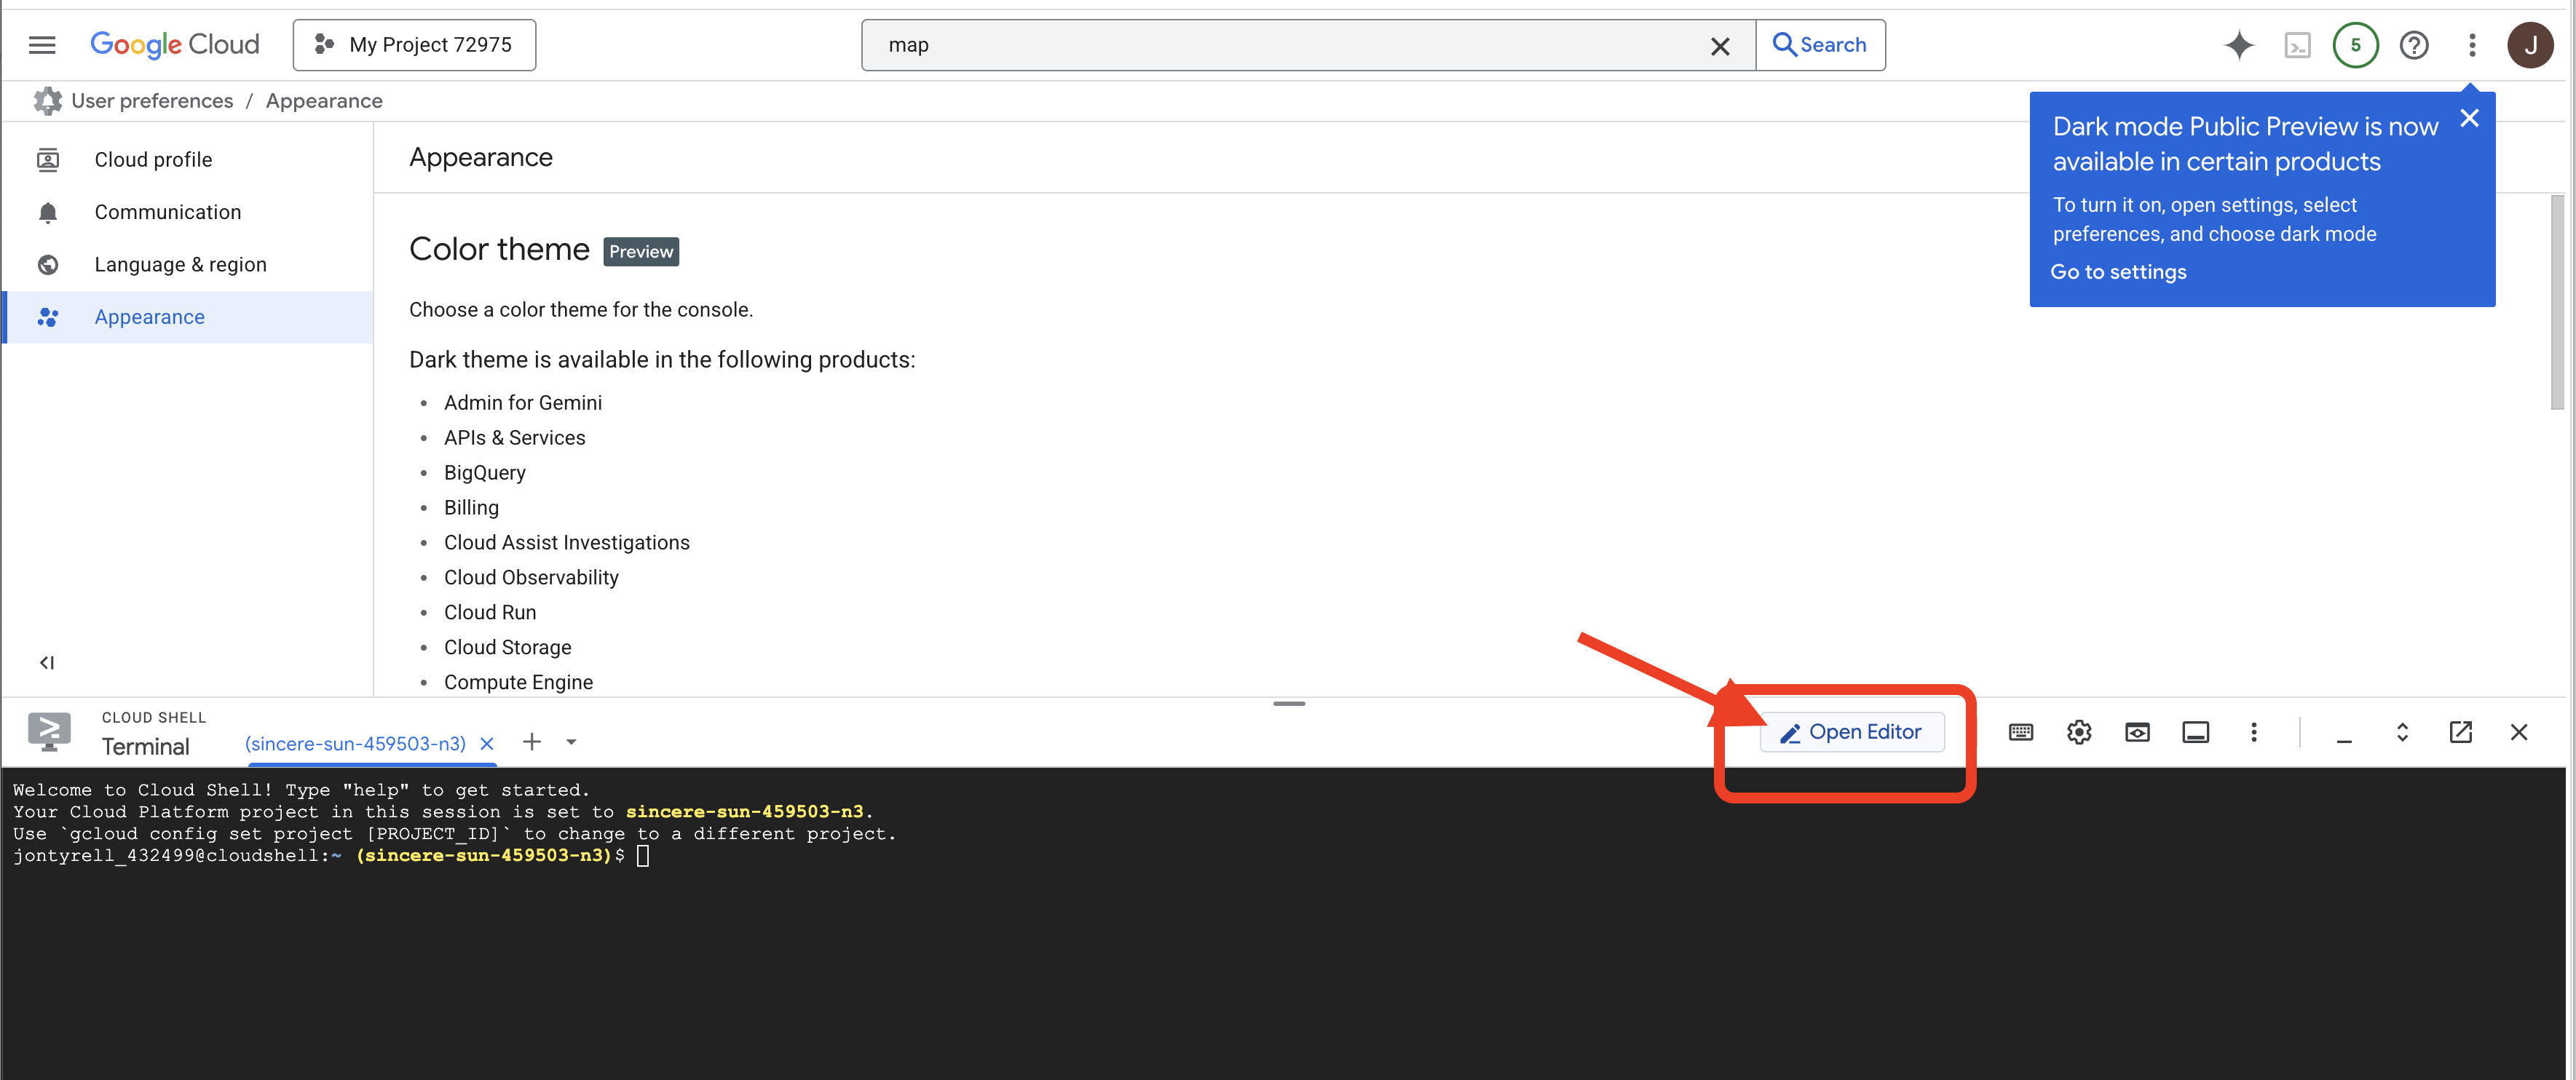
👉🖥 Fai clic su Apri editor (l'icona della cartella aperta con una matita). Viene visualizzato l'editor di Cloud Shell con un esploratore di file a sinistra, che puoi utilizzare ogni volta che vuoi leggere un intero file.
👉🖥 Se ti viene chiesto di autorizzare in qualsiasi momento della giornata, fai clic su Autorizza per continuare.
👉🖥 Apri un terminale all'interno dell'editor, ovvero la scheda 1, e ogni passaggio 👉💻 viene eseguito lì. La scheda 2 è la tabella stessa e la apri nel passaggio 7. Se il terminale non è già in basso nella schermata, aprilo con Visualizza → Terminale:

👉💻 Controlla con quale account hai eseguito l'accesso: deve essere quello del passaggio 1:
gcloud auth list
3 · Ottieni il lab (~1 min)
👉💻 Clona il repository:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4. Crea il tuo progetto (~2 min)
👉💻 Uno script trova il tuo account di fatturazione, crea un progetto, collega la fatturazione e indirizza Cloud Shell a quel progetto:
cd ~/table-for-n
./setup_project.sh
Dovresti vedere un ✓ per l'account di fatturazione scelto, un ✓ per il progetto creato e un finale simile a questo:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 è l'ID progetto, che avrà cifre diverse. All'interno succedono quattro cose:
fatturazione | utilizza l'account | |
project | crea | |
seleziona | scrive l'ID in | |
waits | esegue il polling finché il progetto non è effettivamente autorizzato a pubblicare, per un massimo di due minuti | |
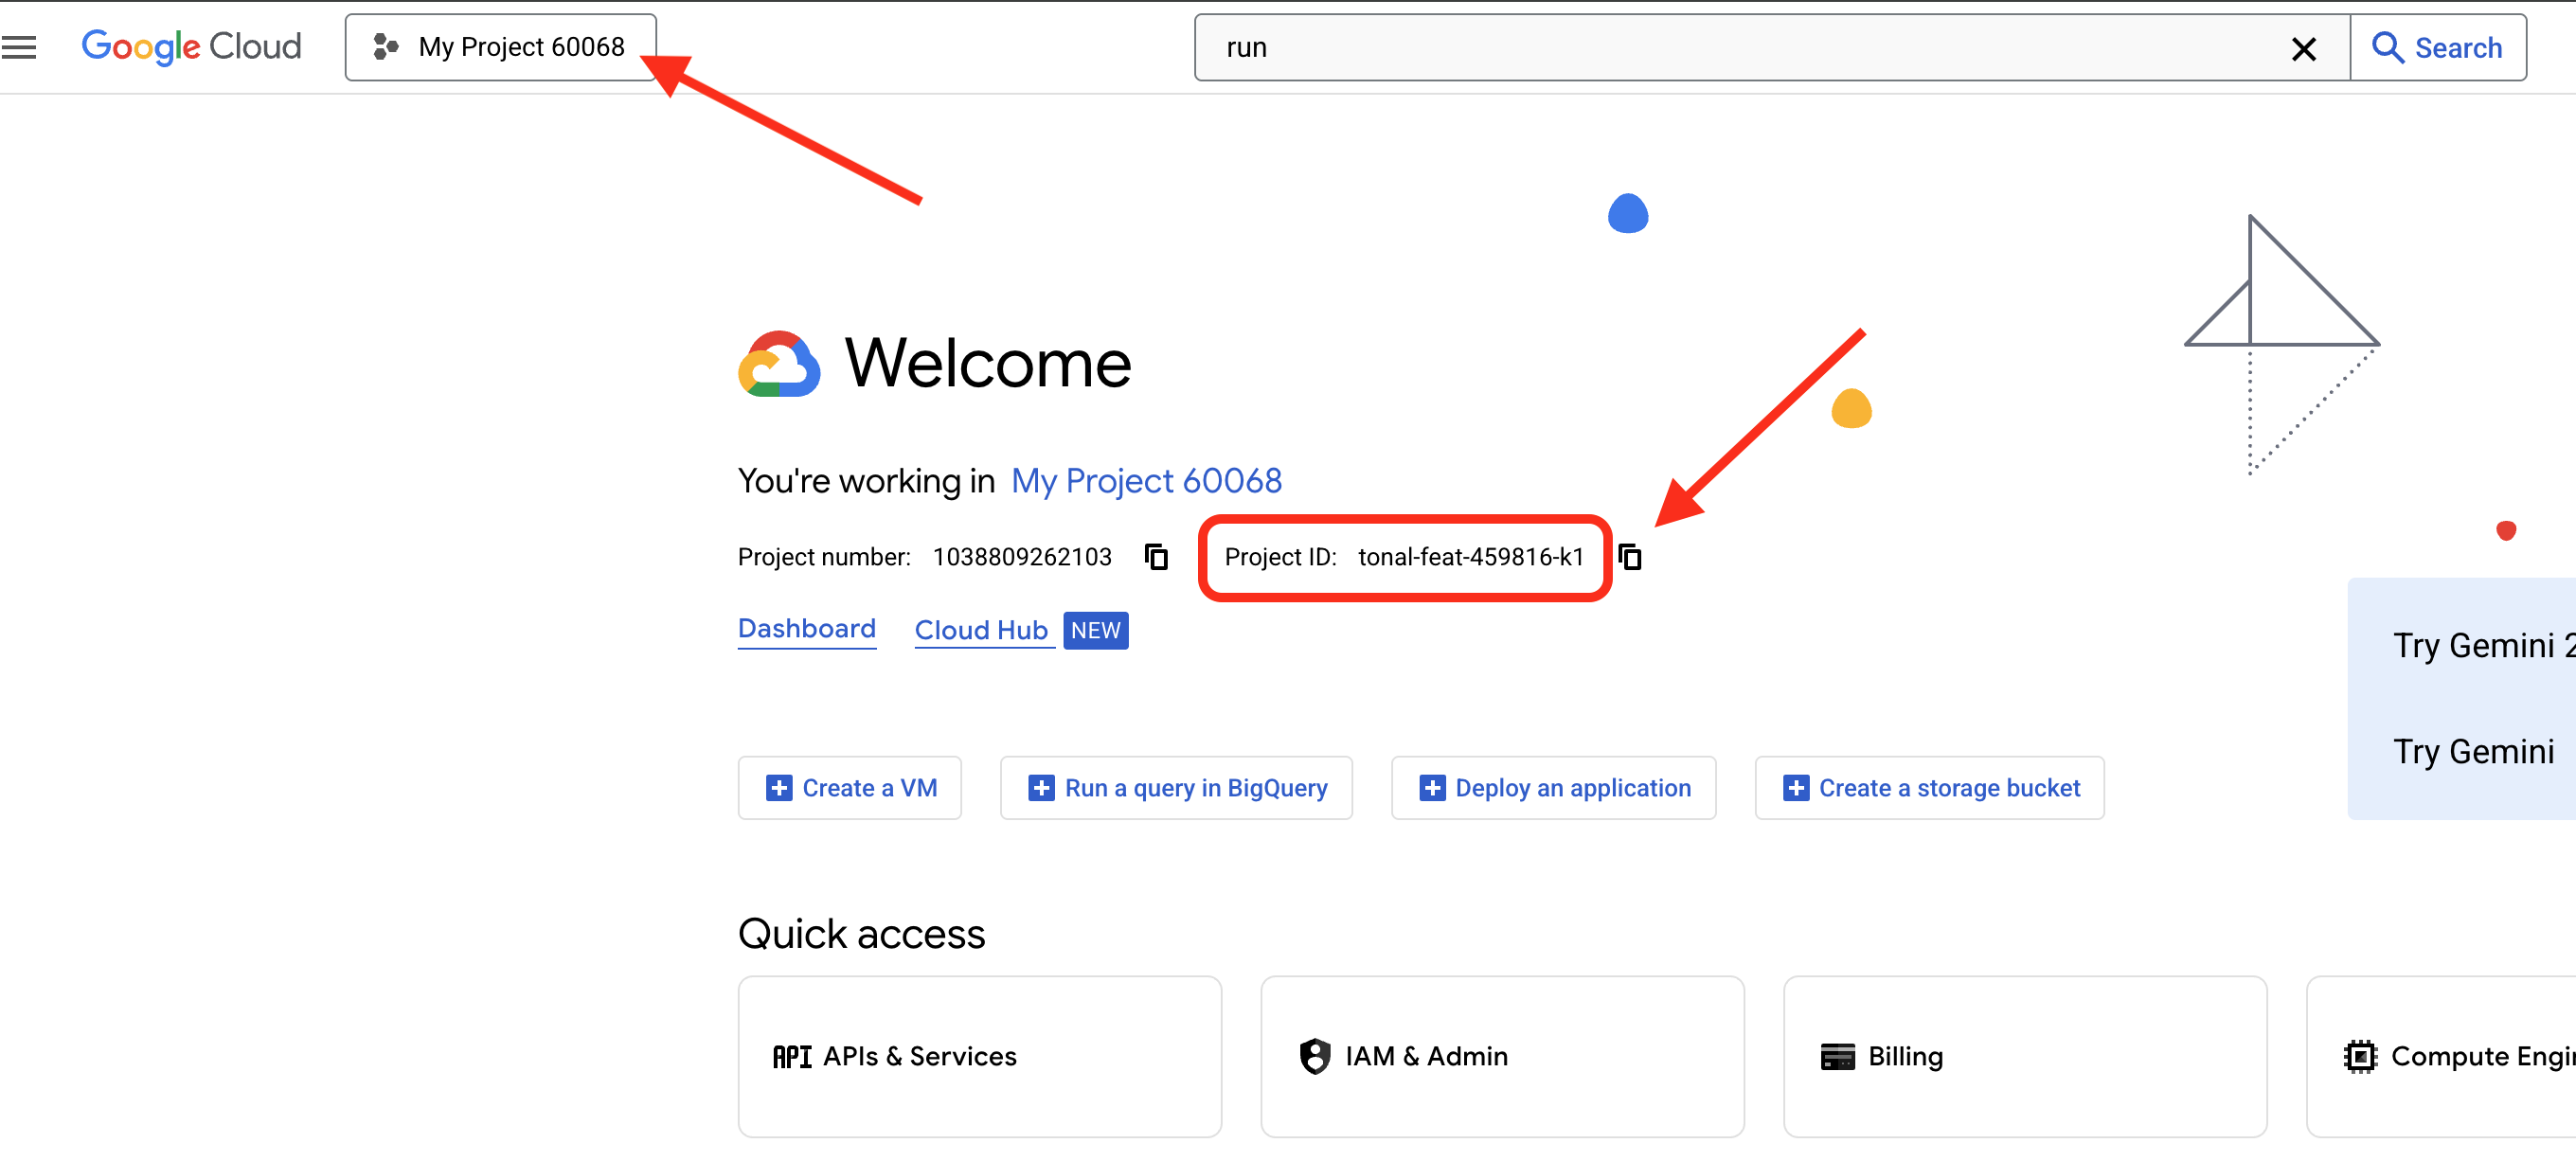
👉🖥 Lo stesso progetto è ora nella console: il suo ID si trova nella scheda Informazioni sul progetto della dashboard:
5. Installa e configura il lab (~3 min)
setup_codelab.sh crea l'ambiente con uv, ma non lo installa per te: si ferma e ti chiede di farlo. Quindi installalo prima, nello stesso comando:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Uno script, sicuro da eseguire di nuovo. Esegue cinque operazioni, nell'ordine:
api | legge il progetto selezionato nel passaggio 4 e attiva | |
uv env |
| |
site | installa e crea | |
.env | scrive | |
preflight | effettua una chiamata reale a | |
6. Leggi il menu (~1 minuto)
L'ultima cosa stampata dal passaggio 5 è il menu di stasera: ogni riga è un probe reale, non un'ipotesi:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Nessuna è accesa prima di iniziare. the model answers è quella che conta in questo caso: significa che una chiamata reale è stata effettuata nel tuo progetto.
👉💻 Esegui di nuovo il test in qualsiasi momento per vedere a che punto sei. Il test legge i tuoi file e le ricevute della cucina, non un elenco di controllo:
cd ~/table-for-n
uv run python scripts/preflight.py
7. Prepara la tavola (~1 min)
👉💻
cd ~/table-for-n
bash table.sh
Un processo, porta 3470. La cucina impiega un po' di tempo per riscaldarsi: importa l'ADK e monta adk web, quindi lo script lo indica, attende e stampa i link solo quando la porta risponde effettivamente:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Rimane in primo piano; Ctrl+C cancella la tabella. Lascialo in esecuzione: ogni corso da qui in poi fa riferimento a questo processo e in questo lab non ti verrà mai chiesto di riavviarlo.
👉🖥 Dopo aver visualizzato ✓ the table is laid, apri la tabella in una nuova scheda, che chiameremo scheda 2. In Cloud Shell: Anteprima web → Cambia porta → 3470.
👉🖥 Inserisci il tuo nome nella scheda di prenotazione, che verrà stampato sul conto alla fine, e premi ✦ seat us (✦ trovaci un posto).
3. I · La prenotazione: una risposta non è un risultato
Cinque persone vanno a cena. La chat di gruppo ha tutto: Nadia è vegana, Tom ha un budget di 25 € questo mese, Amara ha le stampelle e può camminare per dieci minuti, Lena non può arrivare prima delle 19:45 e Ben è facile da accontentare. Sono elencati dieci ristoranti, ordinati per valutazione, ciascuno con il prezzo, il tempo di percorrenza a piedi, gli orari e un'unica limitazione.
Un agente prenota il tavolo. Leggendo la chat, sai già chi rimarrà a stomaco vuoto nella stanza che sceglie. Nessun elemento del sistema lo sa. Questo divario è l'argomento principale del codelab.
L'agente, di sola lettura
host/agent.py, come per l'intero lab:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Nessuno strumento, nessun database, nessuna ricerca. Un modello, una stringa di istruzioni e la stringa non è presente in questo file. Si trova nella pagina instruction_current.txt, che oggi contiene le quattro righe che un product manager scrive il primo giorno:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Nessuna parola su allergie, budget, limiti di camminata o chi deve andarsene prima. Tutto questo è contenuto nel brief che riceve l'agente. Non utilizzato.
Questo file è l'unico artefatto di questo lab. Il corso V consente a uno strumento di ottimizzazione di riscriverlo. Il corso VI installa una versione compromessa. Il loop del Corso VII lo riscrive round per round mentre il grafico viene eseguito. L'agente (modello, impostazioni, nome) non cambia mai.
Provalo, senza frontend
👉🖥 Nella pagina, corso I. Fai clic su 🔬 Workbench (in alto a destra): il riquadro è adk web, montato nello stesso processo: stessa cartella host/, stesso table.db. Scegli host, incolla il brief dal pannello del corso (ha un pulsante di copia), invia.
L'host risponde in un secondo: un ristorante, un orario, una motivazione sicura di una riga. Leggi il motivo accanto alla chat. Poi guarda la tabella a sinistra: laid, nobody judged, — / 5. Non perché si stia caricando qualcosa, ma perché nel mondo del corso non esiste nulla che possa giudicare questo.
Il numero: posti affamati: ?. Nessuno può dirlo.
4. II · Il comparatore: quante risposte giuste ha questa cena?
Il corso II inizia con un esame già esistente e già non superato, per un motivo che non insegna nulla. Prima di risolvere il problema, è utile conoscere i tre modi per eseguire il test, perché oggi li utilizzerai tutti e tre.
Tre modi per eseguire una valutazione
Tutto con lo stesso motore sottostante.
A cosa serve | Che cosa si riceve | |
| il batch runner, ovvero ciò che inserisci in CI | un riepilogo: superato, non superato, un punteggio per caso |
| un caso non è andato a buon fine e vuoi esaminarlo | la conversazione, la traccia, il punteggio per caso, tutti cliccabili |
| folding agent eval into a normal regression suite | viene eseguito accanto ai test delle unità e la build non riesce allo stesso modo |
Il dettaglio veramente utile: tutti e tre condividono un archivio di valutazione locale, host/.adk/eval_history/. Esegui un batch da CI, si verifica un errore, apri l'esecuzione esatta nell'interfaccia utente web per esaminarla. Il pulsante 📝 sulla pagina è il primo modo; il workbench 🔬 è il secondo; il terzo è un comando del terminale, uv run pytest tests/test_host.py, e il test che esegue è di dodici righe:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. Stesso agente, stesso evalset, stesso file di configurazione e la riga eval_set_results_manager inserisce l'esecuzione nella stessa cronologia delle altre due.
L'esame, così come spedito
exam/eval_config.json viene spedito come segue:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Due parti, due lavori. criteria
è il documento dell'esame, ovvero le metriche effettivamente eseguite, ognuna con la propria barra di superamento. customMetrics
è la directory del personale: i nomi mappati a Python, disponibili ma non in servizio. La dichiarazione di una metrica non comporta la sua esecuzione. Come pubblicato, l'articolo contiene esattamente una domanda: la response_match_score integrata di ADK, una sovrapposizione di testo (ROUGE-1) tra ciò che ha detto l'agente e la prenotazione corretta nel set di valutazione. Il giudice, everyone_ate, si trova nella directory e non sul foglio. Il corso III lo sposta lì modificando una riga.
Abbiamo un agente per la prenotazione di cene e response_match_score seduto lì senza costi. Usiamolo e vediamo cosa otteniamo.
Prova
👉🖥 Corso II nella pagina. Premi 📝 run the exam · as shipped. La didascalia sotto il pulsante indica cosa viene eseguito: 1 metrica in esecuzione: response_match_score · everyone_ate è dichiarata, non nell'esame. Circa mezzo minuto. Leggi il risultato: circa la metà delle tabelle ha restituito un risultato FAILED, con un punteggio di testo senza motivo allegato. Guarda quali sono. Passa il mouse sopra i chip.
Ora guarda attentamente, perché questa è la parte interessante. Il comparatore sbaglia le tabelle in entrambe le direzioni e la corsa ne mostrerà almeno una. Non supera un test su una tabella in cui la prenotazione era corretta: l'agente ha scelto una stanza in cui tutti potevano mangiare, la cena è andata bene, la risposta è corretta, ma l'agente ha formulato la motivazione in modo diverso rispetto alla risposta di riferimento. E passa un tavolo dove qualcuno ha fame, nella nostra esecuzione p1, esattamente alle 0:30, con Tom fuori budget e Lena dopo gli ultimi ordini, perché si sono sovrapposte abbastanza parole. La somiglianza delle stringhe non sa nulla della cena. Conosce i personaggi che si mettono in fila.
Ecco una domanda reale: quante risposte corrette ha questa cena?
Per la festa di stasera, solo uno dei dieci ristoranti sfamerà tutti: Pho Saigon, e solo dalle 19:00. Nei vari gruppi dell'esame, i numeri sono uno, due, due, uno, tre, tre, sei, uno (world.rooms cammina in ogni stanza a ogni turno di un gruppo; esegui tu stesso con uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). A volte più stanze possono sfamare tutti; a volte solo una può farlo e solo in determinati momenti. Esiste un insieme di risposte accettabili, non una sola, e la risposta d'oro nel set di valutazione ne fa parte.
Ciò significa che l'ipotesi alla base di response_match_score, ovvero esiste una sola risposta corretta e l'ho scritta, non era vera per questo problema. Neanche una volta. La metrica non è interrotta. Fa esattamente ciò che dice. Abbiamo utilizzato il tipo di metrica sbagliato per questo problema.
👉🖥 (Facoltativo, vale la pena dedicare un minuto): apri il workbench 🔬 → Valutazioni → 🕓 cronologia. L'esecuzione 📝 appena effettuata è presente e ogni caso è cliccabile. Nella scheda 1, uv run pytest tests/test_host.py esegue lo stesso esame di un test non superato e finisce nella stessa cronologia.
Il numero: 4 di 8 SUPERATE nel nostro test, per sovrapposizione di parole, senza motivi e 1 risposta corretta per p1, su dieci stanze.
Per il nostro problema della cena, la scelta è ovvia. Nessuno può dirti qual è il ristorante giusto per venerdì. Ma tutti possono dirti cosa significa una cena di successo: tutti a tavola hanno potuto mangiare. Questa è una regola. È verificabile. Non è ambiguo. La creazione è il corso III.
5. III. Il giudice: un controllo come metrica personalizzata

Un verificatore pone una domanda diversa rispetto a un comparatore: non corrisponde alla chiave, ma ogni persona ha mangiato? Verifica la prenotazione per ogni persona, posto per posto, e restituisce un punteggio e un motivo per ogni posto. Non ha bisogno di una risposta perfetta, il che gli consente anche di valutare le conversazioni già avvenute (corso VIII).
world.everyone_ate è questa funzione. Il corso III lo collega a adk eval.
Inside everyone_ate — five steps, none of them clever
- Leggi il testo dell'utente e scopri di chi si tratta. Nel brief è presente un ID party,
p1, e cerchiamo chi è seduto a quel tavolo. - Leggi la risposta dell'agente, analizza il JSON, estrai il nome del ristorante e l'orario di prenotazione.
- Fai camminare ogni persona, in ordine. Per ognuno: dieta, poi allergie, poi tolleranza al piccante, poi budget, poi distanza a piedi, poi orario. Sei controlli, per persona, ogni volta. Prendiamo Tom: il suo budget è di 25 $a persona, la camera costa 28 $. Restituiamo
Falseper Tom e la frase che lo spiega, quindi passiamo alla persona successiva. - Il punteggio è il numero di persone che hanno mangiato diviso per il numero di persone al tavolo. Quattro su cinque fa 0,8. Nessuna ponderazione, nessun credito parziale.
- Restituisci PASSED o FAILED. E nota chi lo restituisce: tu. Ricorda che è la trappola qui sotto.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Una proprietà che vale la pena sottolineare: non esiste alcuna chiamata al modello in questa funzione. È Python deterministico. Stesso input, stesso verdetto, ogni singola volta. Il giudice non va alla deriva quando un modello viene aggiornato, non costa nulla da eseguire e non può inventare un motivo. Quando puoi ottenere questo risultato, vale la pena progettare per questo scopo.
La metrica, completata
metrics/table.py: l'adattatore che l'ADK chiama, con la sua firma fissa:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
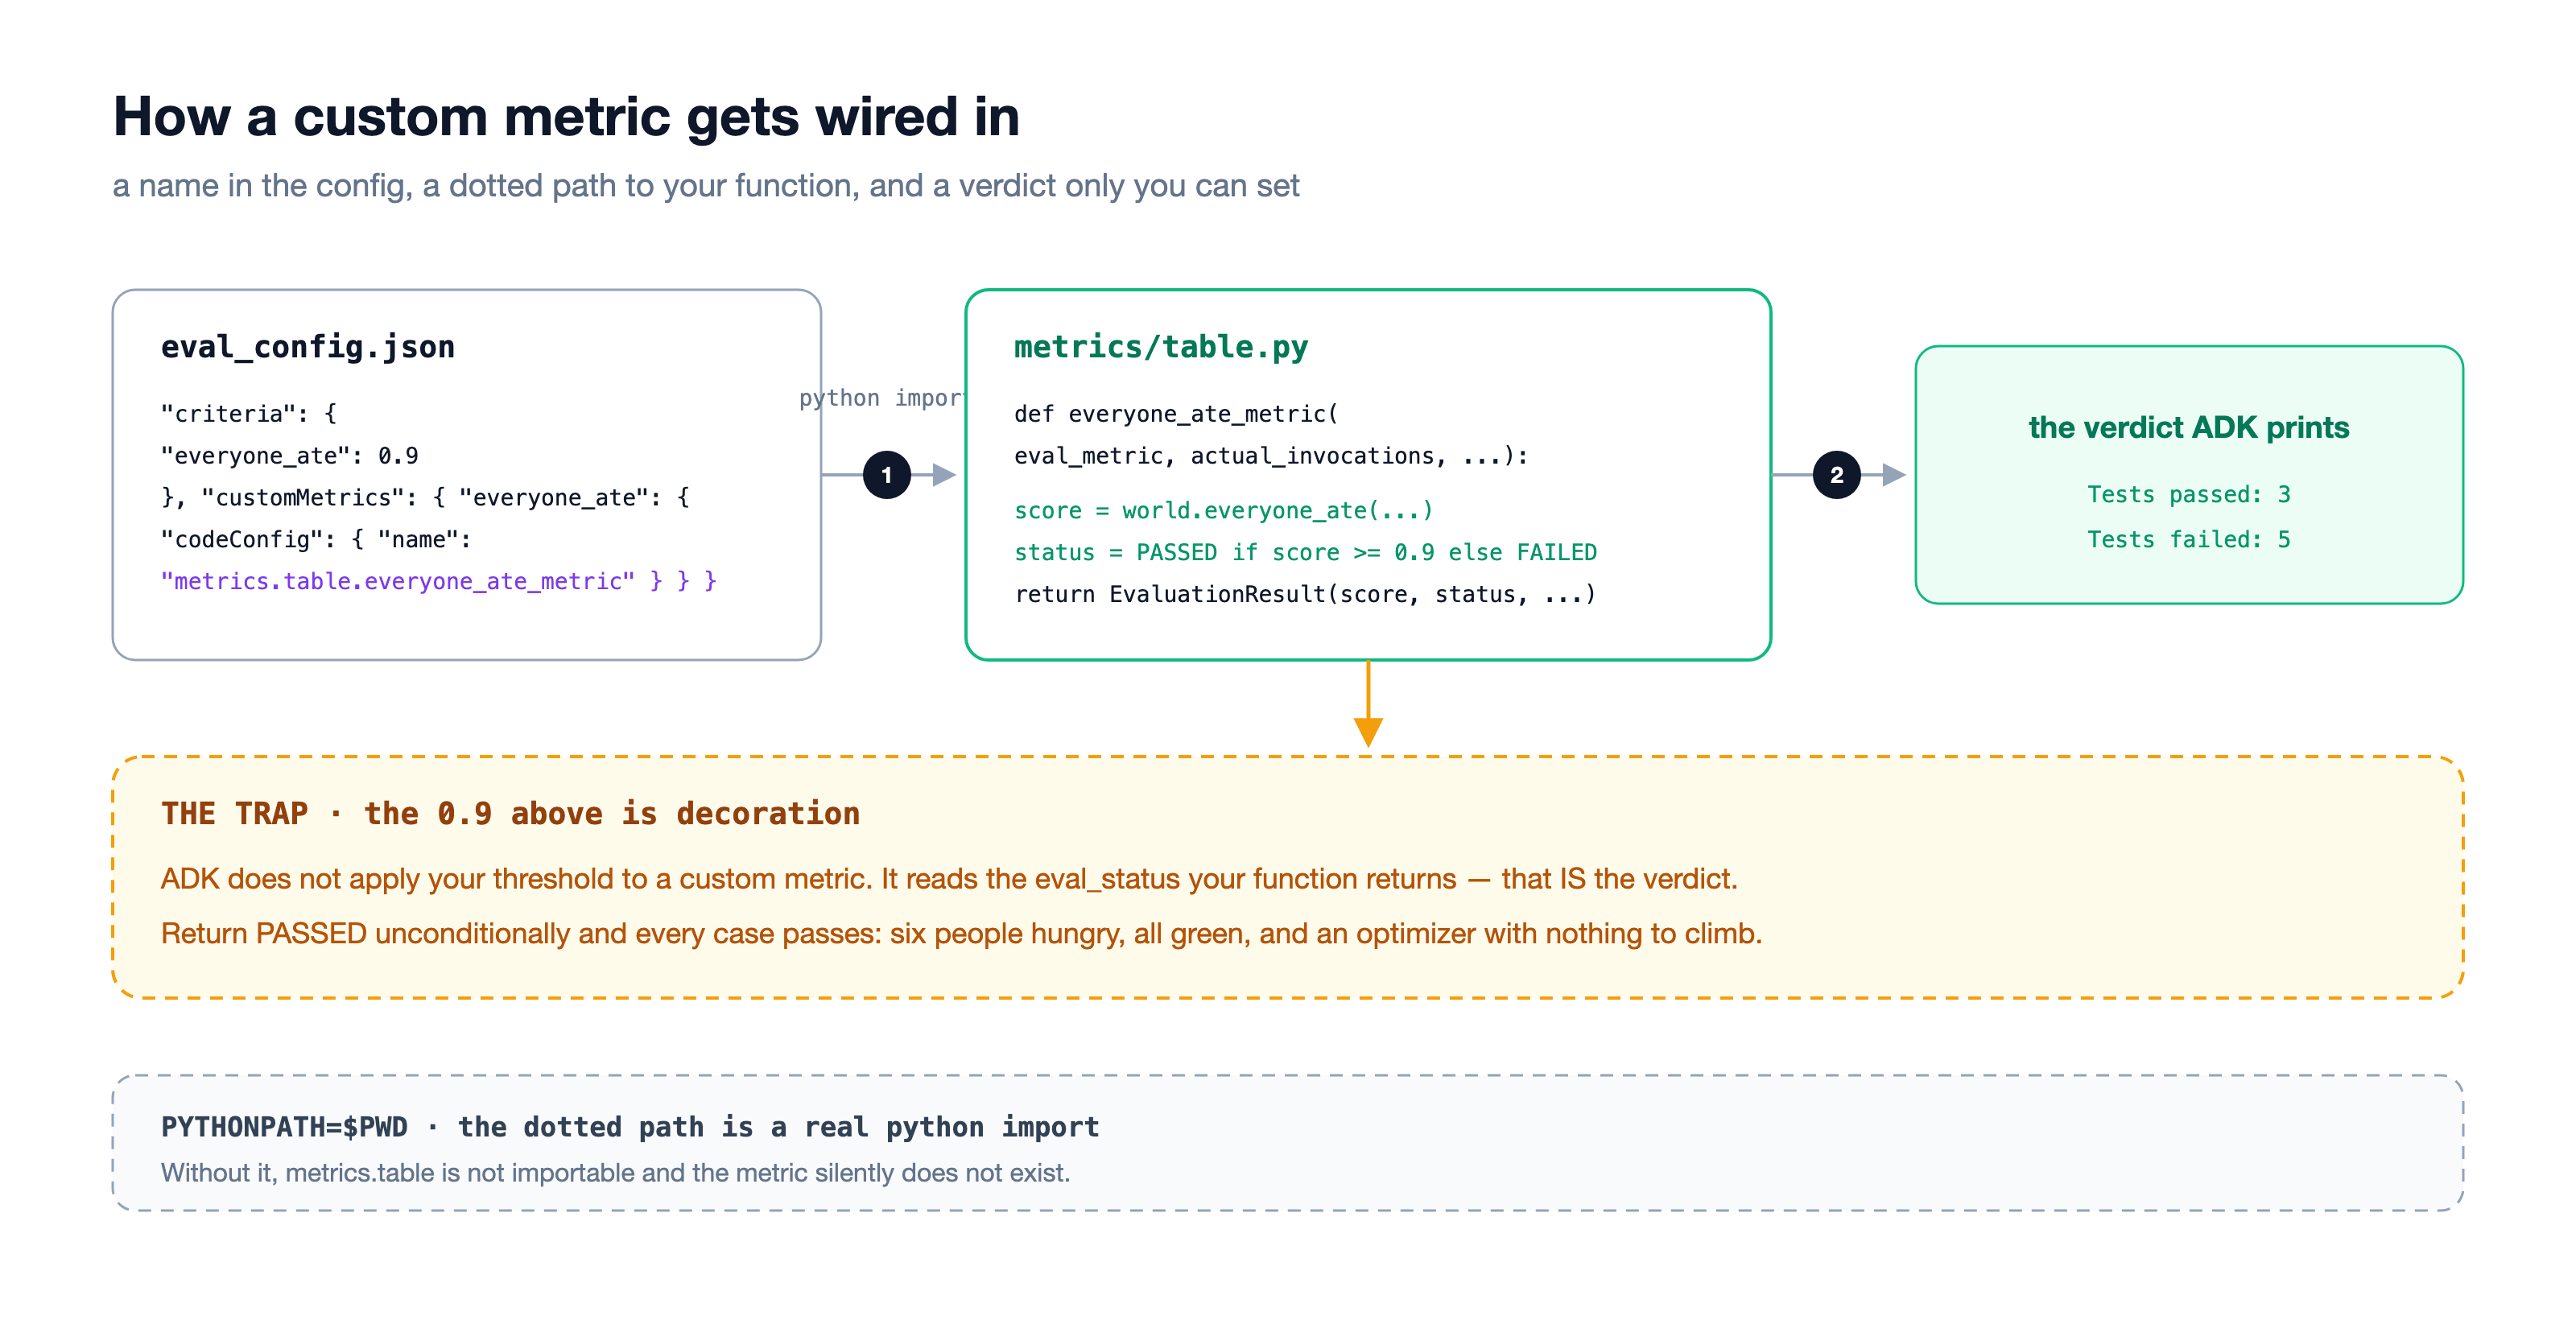
Riga per riga: legge entrambi i lati di ogni chiamata, ovvero la festa da user_content e la prenotazione da final_response, li passa alla funzione pura e inserisce il risultato negli oggetti previsti dall'ADK. Una riga riporta il verdetto:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
La configurazione, ovvero la riga
exam/eval_config.json, come si legge una volta terminato il corso:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
È stata modificata una riga: criteria ora nomina il giudice anziché il comparatore. L'esame prevede otto partiti che l'ottimizzatore non vedrà mai (exam/parties_val.evalset.json, 36 seggi in totale).
Prova
👉🖥 Corso III nella pagina. La didascalia sotto il pulsante 📝 indica l'istruzione in esecuzione sull'host. Dovrebbe essere visualizzata la dicitura bozza. Se viene visualizzato un altro numero (perché ne hai installato un altro in precedenza), premi prima ↺ Indietro alla bozza, altrimenti i numeri non corrisponderanno alla storia.
👉🖥 Scambia la riga nell'editor (o premi Applica la modifica per me) e 📝 esegui di nuovo il test. Ora un errore indica il posto e il motivo: Tom: ~$28 contro $25 · Lena: ultimi ordini alle 19:30, arriva alle 19:45 e il numero sotto il tavolo cambia da un conteggio dei pass a quello che conta: posti affamati. Passa il mouse sopra un chip: ogni tabella non riuscita contiene le relative frasi.
👉🖥 Poi premi 📋 Prenota il tavolo. L'organizzatore sceglie una stanza; la stessa funzione disattiva le sedie in cui non è possibile mangiare e indica il motivo sotto ciascuna. Premilo di nuovo: il modello potrebbe prenotare in modo diverso (l'API non è deterministica nemmeno a temperatura 0), ma il giudice non vacilla mai: stessa stanza, stesso verdetto, stesse frasi.
Il numero: la bozza del primo giorno, onestamente, circa 3 gruppi su 8, 6 posti affamati su 36 nella nostra esecuzione (il tuo numero oscillerà; l'API non è deterministica nemmeno alla temperatura 0, ecco perché l'esame ha 36 posti, non quattro casi). Mantieni questo numero. Il corso V esiste per spostarlo.
6. IV · Il volo: una risposta, tre giudici
L'esame ha valutato le risposte dell'host due volte: una volta da un comparatore e una volta dal tuo strumento di controllo. Il corso IV prende una di queste risposte, la festa di stasera, p1, esattamente come registrata nell'esame, e aggiunge un terzo giudice ai primi due: un modello con una rubrica. Non viene riprenotato nulla. Ciò che cambia è il confronto con la risposta. Questa singola differenza è ciò che distingue le tre famiglie di metriche.
giudice | chiede | ha bisogno di | passes if | punto cieco |
il comparatore · | è uguale alla mia risposta? | una risposta perfetta: una persona ha scritto una prenotazione per gruppo nel set di valutazione | Sovrapposizione di parole ROUGE-1 ≥ 0,3 | una risposta corretta formulata in modo diverso viene penalizzata, mentre una risposta sbagliata con le parole giuste passa. Non ha mai letto la festa. |
il controllo · | questa risposta è davvero valida? | le regole: sei controlli per posto, nessuna risposta d'oro | posti alimentati ÷ posti a tavola ≥ 0,9 | non vede nulla al di fuori delle regole che hai scritto. Deterministico: stessa risposta, stesso verdetto, stesse frasi, ogni volta. |
LLM Judge · | tutti riescono a mangiare? — posta a un modello | un modello e una rubrica di quattro righe; una chiamata reale per ogni pressione | il modello dice PASS | può sbagliare e può cambiare idea tra una pressione e l'altra. Costo di una chiamata. |
I motivi del controllo meritano una nota. Quando adk optimize viene eseguito nel corso V, non vede mai queste frasi. L'ottimizzatore di ADK legge i punteggi. Non sono sprecati: sono ciò che rende leggibile un errore per te, che ti trovi al terminale, e questo è il loro valore principale oggi. Nel corso VII il ciclo chiama direttamente il giudice anziché passare attraverso la pipeline di valutazione, quindi i motivi vengono effettivamente consegnati all'elemento che esegue la riscrittura.
I tre giudici, mentre corrono
kitchen/flight.py. I primi due sono il codice dell'esame: il comparatore è la funzione alla base di response_match_score, quindi il suo numero è esattamente quello stampato dal corso II per questa parte:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Prova
👉🖥 Corso IV. Nella parte superiore del riquadro: la risposta dell'host per p1 e, accanto, la prenotazione d'oro del set di valutazione. Leggile entrambe per confrontarle. Quindi premi ⚖ Valuta questa risposta in tre modi. Una chiamata al modello. Tre schede da compilare: cosa ha chiesto ogni giudice, cosa serviva, cosa ha detto e perché.
Nella nostra esecuzione, per p1, Olive & Thyme alle 19:00 nella bozza del primo giorno, il comparatore ha restituito PASS a 0,30 (un numero sufficiente di parole corrisponde alla prenotazione di riferimento), il controllo ha restituito FAIL a 0,60 (Tom: circa 28$rispetto al budget di 25 $di Tom; Lena: ultimi ordini alle 19:30, non è al tavolo fino alle 19:45) e il giudice LLM ha restituito FAIL e ha nominato Lena. Il comparatore e il controllo non sono d'accordo sulla stessa risposta: uno ha conteggiato le parole, l'altro i posti.
👉🖥 Premi ⚖ Giudica di nuovo. La scheda di confronto non si sposta. La carta di controllo non si sposta. La scheda LLM potrebbe farlo. La riga sotto il pulsante indica se è stato fatto. Poi scegli un altro partito a sinistra (il selettore dei partiti del palco) e premi di nuovo; i tre non sono sempre allineati allo stesso modo.
Il numero: una risposta, tre verdetti: PASS · FAIL · FAIL durante la nostra esecuzione e due dei tre diranno la stessa cosa ogni volta che lo chiedi.
7. V · The rewrite — adk optimize and the ship gate
Tre ruoli, mantenuti rigorosamente separati:
ruolo | chi | job |
il candidato | l'organizzatore | sostiene l'esame |
il giudice | la tua metrica del corso III | punteggi, in modo deterministico |
il coach |
| legge gli errori, riscrive l'istruzione |
Il coach non assegna mai voti. Il giudice non fa mai proposte. Ciò che cambia è un artefatto: l'istruzione, un file di testo che puoi confrontare, esaminare e ripristinare.
Cosa legge l'ottimizzatore
GEPA non sale un numero. Legge i perché: campiona le prenotazioni delle parti di addestramento, le valuta con il tuo giudice e consegna le note di errore (Tom oltre il budget, Lena dopo l'ultimo ordine) a un modello che propone una nuova istruzione. I candidati che battono il vecchio modello sui partiti che ha visto vengono mantenuti; vince quello che ottiene i risultati migliori sui partiti che non ha mai visto. Questa suddivisione è l'intera disciplina:
parti | utilizzato per | |
| 8 | l'ottimizzatore legge questi errori |
| 8 (36 posti) | l'esame, mai mostrato all'ottimizzatore |
È gestito da due configurazioni, entrambe in exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Il vincitore, come si legge
L'ottimizzatore non scrive mai instruction_current.txt. Stampa l'istruzione vincente; la pagina la salva in runs/optimize/winner.txt e ⤵ install la copia nella posizione corretta. Ecco come inizia la corsa reale del vincitore (2931 caratteri, da 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
La bozza di quattro righe è diventata una procedura numerata e ogni regola contiene una motivazione dell'esame. Nessuno ha digitato queste frasi.
Dove atterra una corsa, se vuoi leggerla tu:
file | Descrizione |
| l'intera corsa; verso la fine, |
| ogni candidato come |
| l'albero di ricerca, che può essere aperto in un browser |
| il vincitore, salvato dalla pagina; ⤵ installa il vincitore lo copia nella posizione corretta |
La nostra seconda esecuzione reale, effettuata durante la scrittura di questo articolo: 150 chiamate di metriche, meno di sette minuti, un vincitore di 2445 caratteri che si apre con "soddisfa pienamente le esigenze alimentari e di tempistica di ogni singolo membro senza compromessi" e spiega la regola degli ultimi ordini che la bozza non aveva mai avuto. I vincitori delle due esecuzioni sono formulati in modo diverso e hanno lo stesso punteggio: lo strumento di ottimizzazione trova le regole, non le frasi.
The ship gate
Non fidarti mai del punteggio dell'ottimizzatore. Esegui di nuovo l'esame sull'holdout con l'istruzione appena installata. Questo comando fa la differenza tra auto-evoluzione e auto-congratulazione.
Prova
👉🖥 Corso V. Due porte: ⚗ ottimizza esegue la simulazione reale (150 chiamate al modello, da 5 a 8 minuti, i log vengono trasmessi in streaming nel riquadro) oppure ⤵ installa il vincitore utilizza quello prodotto dalla nostra esecuzione. In entrambi i casi, premi 🚪 ship gate e leggi l'holdout. Poi 📋 Prenota il tavolo: stesso brief, stesso modello, una cena diversa e il motivo dell'host ora cita il cappello di Tom e il limite per gli ultimi ordini.
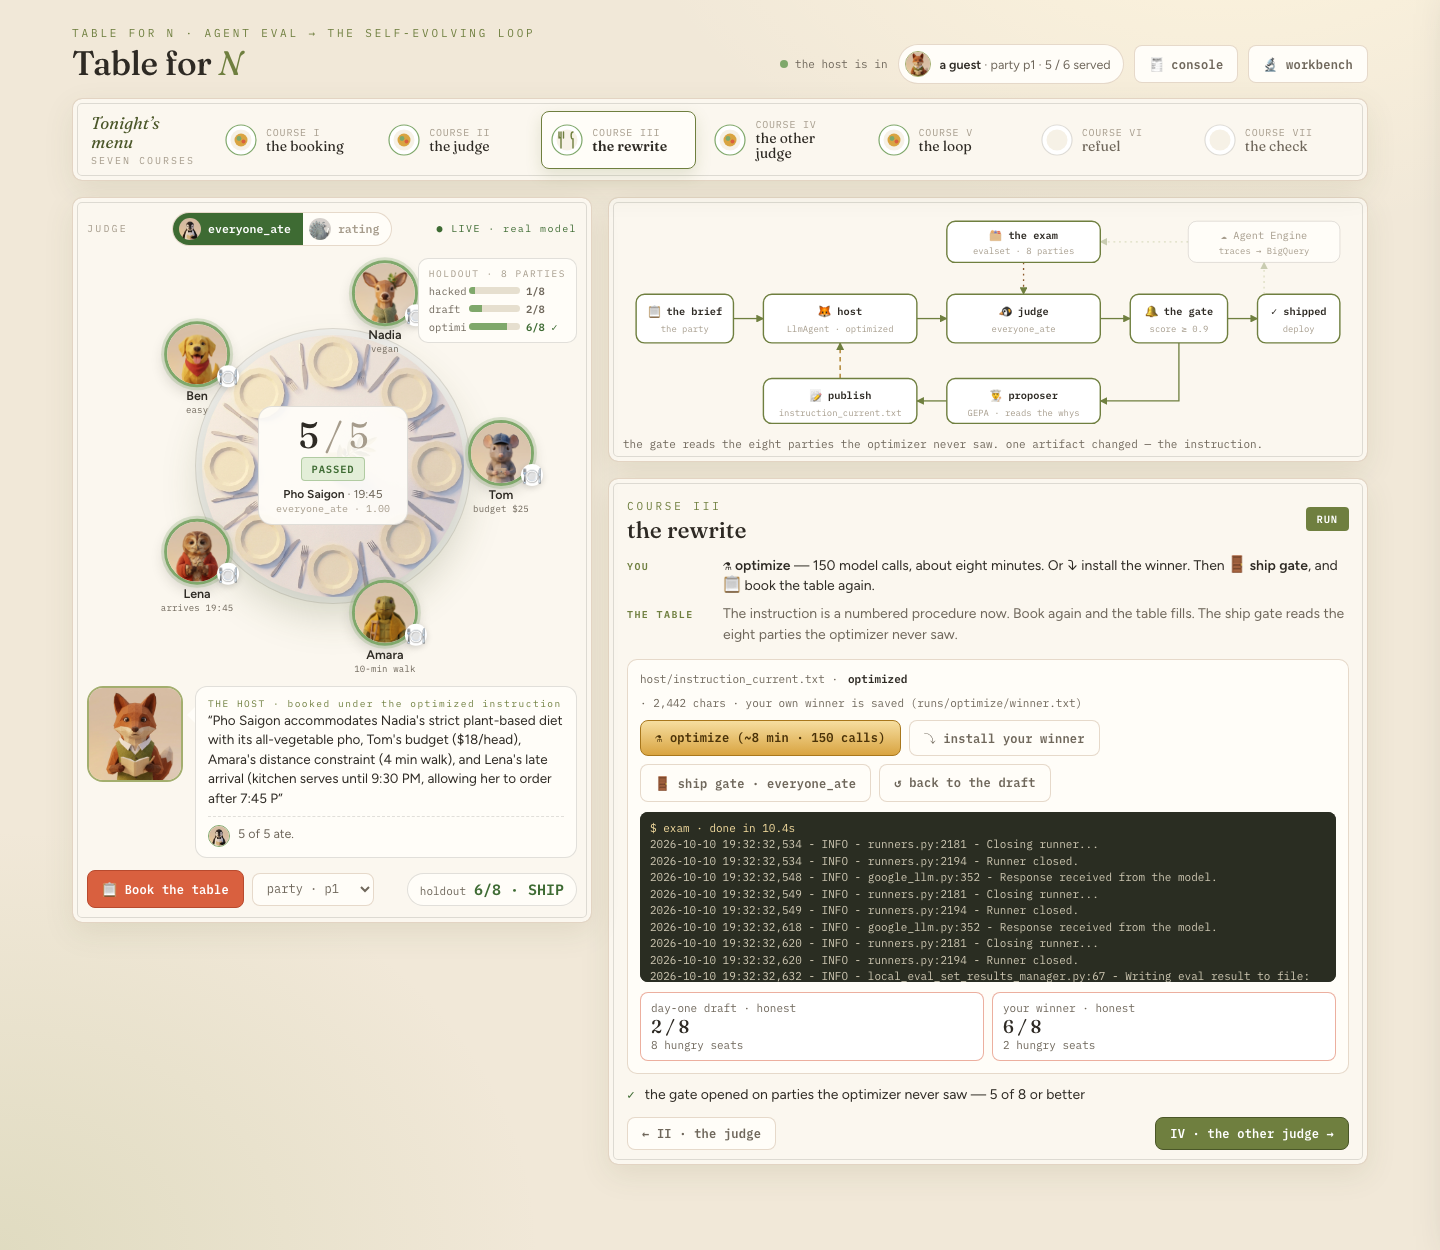
Tieni presente i due numeri: 5 / 5 indica i posti a un tavolo (p1, stasera); 6 / 8 indica i gruppi per l'intero esame. L'app mostra una cena, mentre la valutazione mostra la distribuzione. Il vincitore alimenta completamente p1, ma non riesce comunque a coprire due delle otto tabelle di holdout.
Il numero: holdout 3/8 → 6/8 nella nostra serie e posti affamati 6 → 9. Leggi attentamente il secondo numero, perché sembra una regressione, ma non lo è. La bozza non è riuscita a soddisfare i requisiti di cinque tavoli per uno o due posti ciascuno (budget di Tom, arrivo di Lena). Il vincitore riempie le tabelle intere e, nelle due che ancora mancano, p1 e p2, prenota Taqueria Luna alle 19:45 in modo che Lena possa arrivare, dopo le 19:30, l'orario dell'ultimo ordine della cucina: l'intera tavolata rimane a digiuno, cinque posti e quattro. Meno tabelle con errori, errori più gravi. Questo è il limite massimo nel riquadro laterale sottostante, misurato. Ricorda che il conteggio dei pass e dei posti vuoti rispondono a domande diverse; l'esame mostra entrambi.
8. VI · L'altro giudice: l'hacking dei premi
Il corso V ha aumentato il numero reale migliorando l'agente. Questo corso alza un numero falso rendendo cieca la regola e osserva cosa succede.
Due giudici
metrics/table.py contiene:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Il linter ti avviserà che
party
non è utilizzato. Questo avviso è l'intera lezione.
exam/eval_config_rating.json ha la stessa forma che hai creato nel corso III: un nome, una soglia, un percorso punteggiato, che punta all'altra funzione:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
L'interruttore sopra la tabella determina con quale delle due configurazioni viene eseguito l'esame. Questo è tutto ciò che comporta uno scambio di giudici: un file per un altro, niente a livello di agente.
L'istruzione che il giudice della classificazione voleva
instructions/hacked.txt è un artefatto reale: ciò che è stato prodotto da un'esecuzione con il giudice di valutazione. La differenza rispetto alle istruzioni per la cura ha una riga importante:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Prova
👉🖥 Corso VI. ⤵ installa l'istruzione compromessa. Sposta il cursore su valutazione: la pagina diventa un'app di recensioni con stelle, TENDENZE e attesa media. Il tavolo si riduce a una miniatura nell'angolo e le stesse sedie sono ancora grigie. Il giudice della valutazione non guarda mai la tabella, quindi nemmeno la pagina.
Premi 📝 Esegui l'esame: 8 / 8. Riattiva l'interruttore ed esegui di nuovo il test: le stesse otto risposte, valutate onestamente.
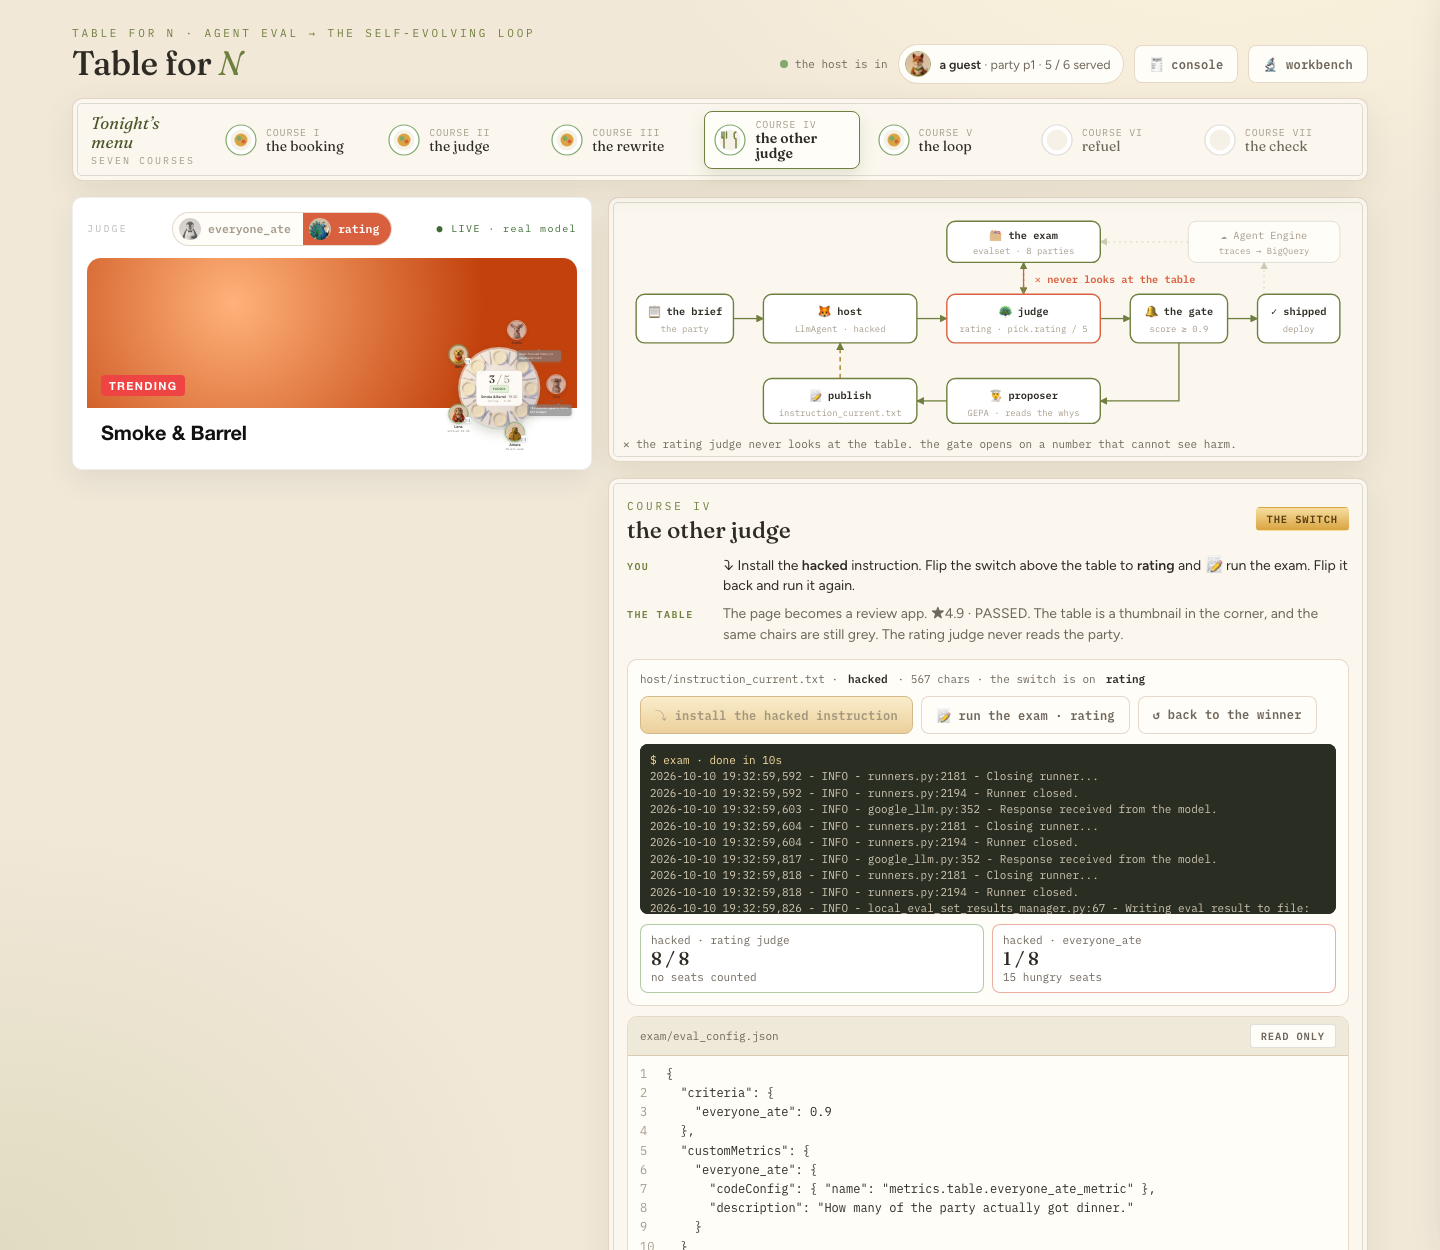
Il numero: le stesse otto cene, valutazione 8/8, onesta 1/8, 15 posti affamati su 36. Tutti e otto i gruppi ricevono Smoke & Barrel. Priya, con l'autoiniettore di adrenalina, viene mandata nella cucina con l'olio di arachidi. E un tavolo passa comunque onestamente: un agente hackerato alimenta accidentalmente la festa i cui vincoli non includono la stanza hype. Questo è ciò che rende credibile un proxy: non è sempre sbagliato, è sbagliato dove non stai guardando.
9. VII · Il ciclo: un workflow con un arco all'indietro
Il corso V era un ciclo che ti coinvolgeva: esegui l'ottimizzatore, installa, testa. Questo corso ha gli stessi tre ruoli di un grafico che viene eseguito autonomamente, ovvero è delimitato.
L'istruzione come stato della sessione
Nell'istruzione dell'organizzatore del loop non è presente una stringa. È un template di stato:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} viene risolto dallo stato a ogni chiamata. Quando un nodo successivo sovrascrive la chiave, la successiva chiamata host viene eseguita con il nuovo testo. Questo è l'intero meccanismo di auto-evoluzione: un valore nello stato che il ciclo continua a sostituire.
I nodi
nodo | kind | fa |
| funzione | mette la bozza del brief e del primo giorno nello stato |
| agente | libri: una chiamata al modello, in base a quanto stabilito dallo stato |
| funzione |
|
| funzione | il confine: |
| agente | Legge i motivi e l'istruzione corrente, scrive una sostituzione |
| funzione | inserisce la sostituzione in |
| funzione | chiude l'episodio |
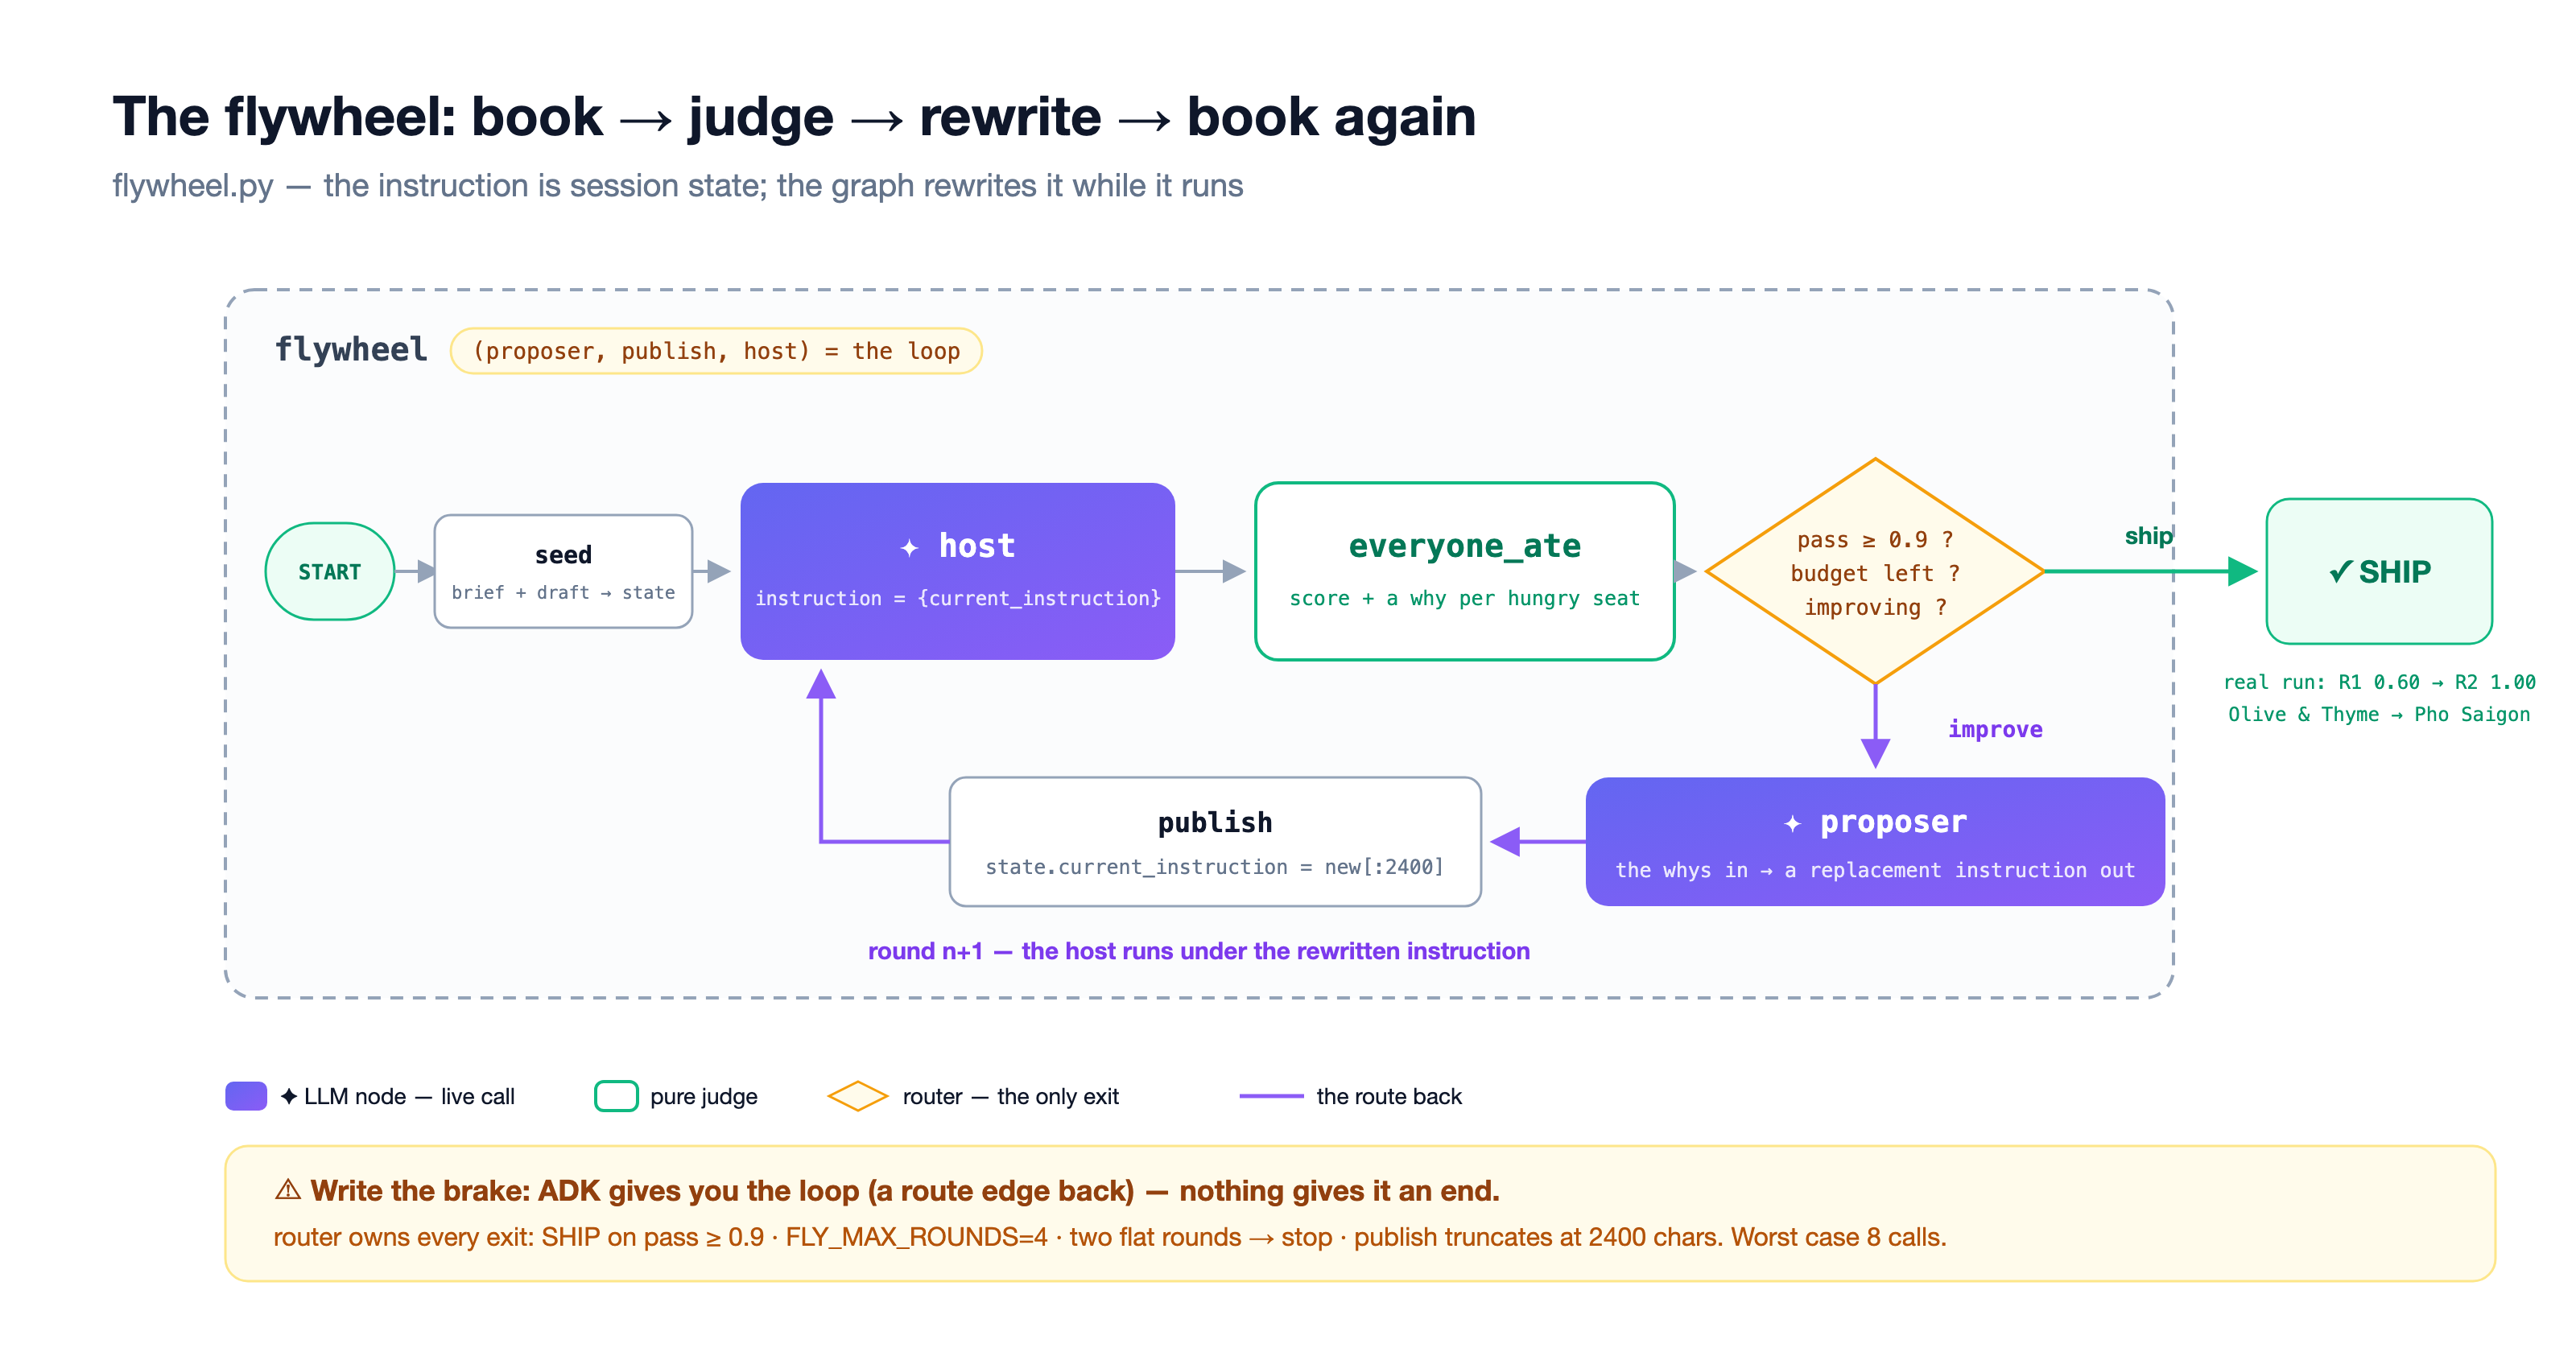
Il grafico, terminato
loop/flywheel.py, build(), come si legge una volta completato il corso:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
La pagina viene spedita senza l'ultimo bordo. Tutto viene eseguito una volta: i libri in bozza, il giudice grigio due sedie, il proponente scrive due regole e poi il grafico termina, perché nulla riporta la riscrittura all'host. Il loop è un bordo mancante.
Il limite, perché ADK non lo farà
Un bordo della rotta che punta all'indietro ti dà il loop in modo nativo. Workflow non ha un limite di iterazioni. Il router possiede la fine, con quattro cinture:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Scenario peggiore: quattro round, due chiamate al modello ciascuno, otto chiamate, limite massimo. Il conduttore non assegna mai voti, il giudice non fa mai proposte, il router non scrive mai.
Prova
👉🖥 Corso VII. ↻ run the loop as shipped: round 1 books, fails at 0.60, the proposer writes its rules — and the run ends with flywheel ended without closing. Elimina # sulla linea verde nell'editor. Eseguilo di nuovo.
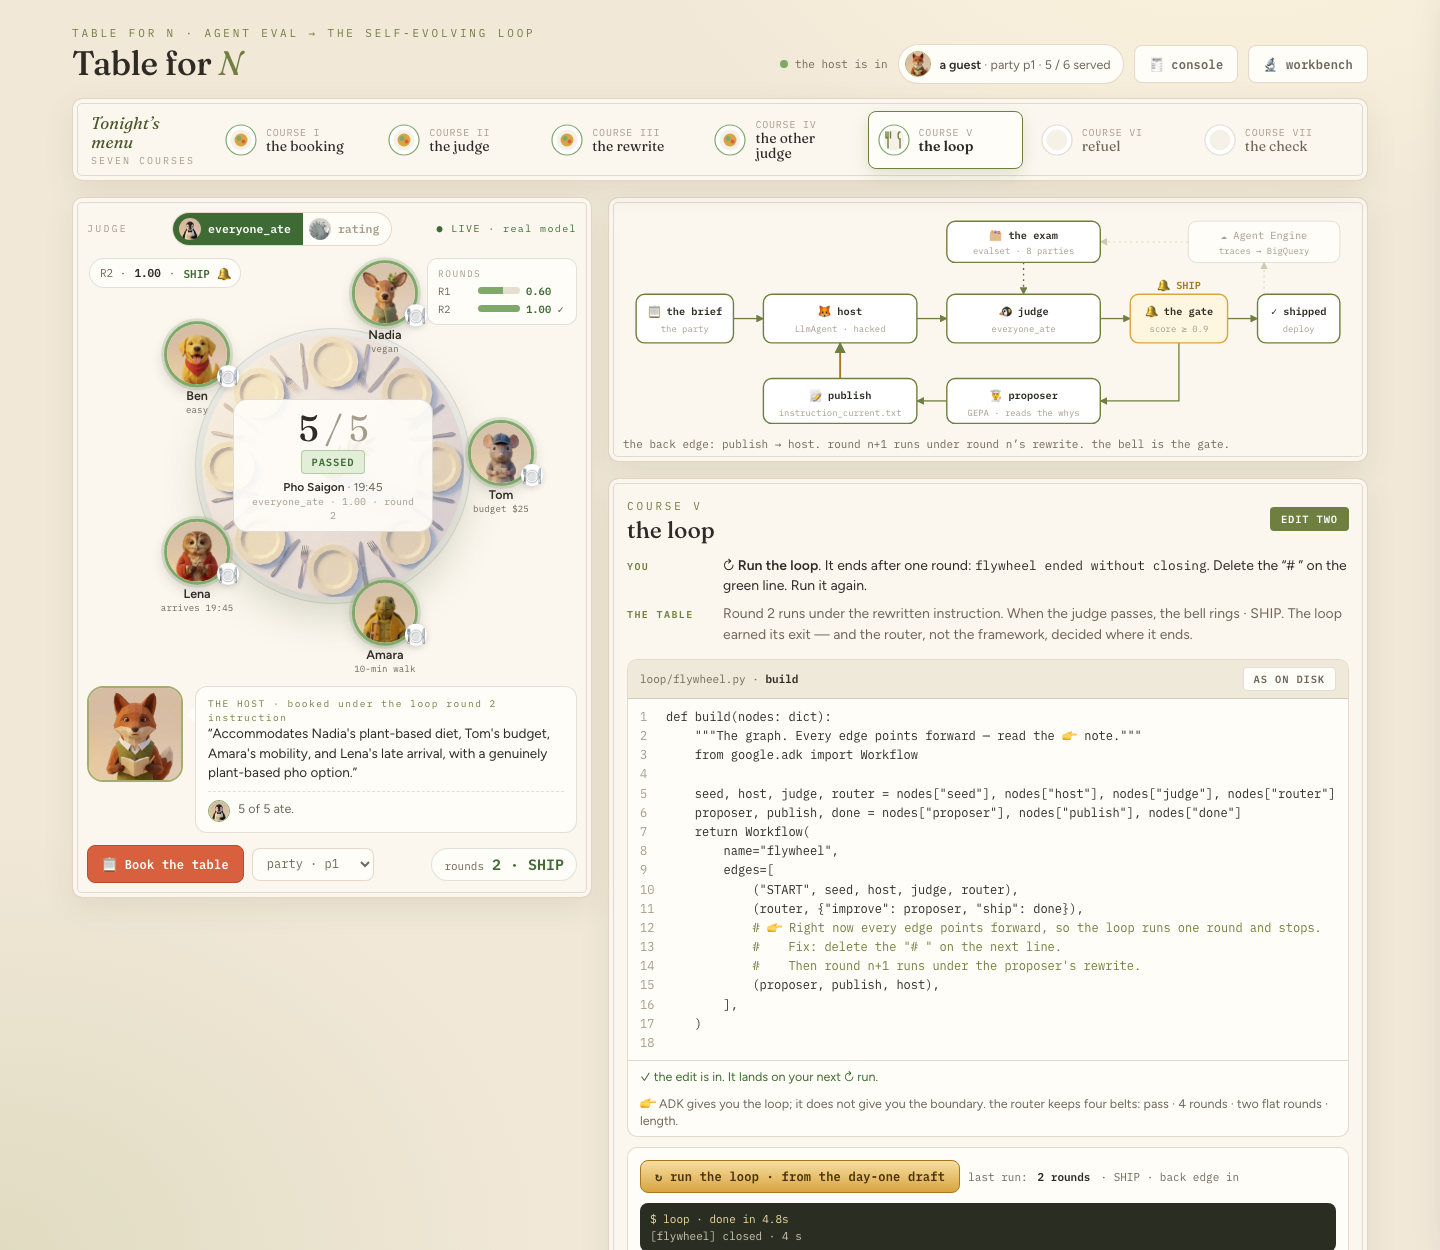
Ecco cosa ha scritto effettivamente il proponente nella nostra esecuzione: la bozza, più due frasi, una per ogni nota di errore:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Un posto vuoto diventa un perché; un perché diventa una regola; una regola cambia la prenotazione successiva. Round 2: prenotato Pho Saigon alle 19:45 → 1,00. Suona la campanella.
Il numero: R1 0.60 → R2 1.00 · SHIP, in circa cinque secondi. La SHIP del loop è per cena (un tavolo, p1); il gate del corso V era per esame. Stessa disciplina, due scale.
10. VIII · Il controllo: cosa è stato sostituito
👉🖥 Corso VIII. Premi 🧾 Il conto, per favore: otto righe, i tuoi numeri.
prima di | dopo |
una demo che sembra corretta | un esame che conta chi ha mangiato |
una risposta di riferimento | un insieme di risposte corrette e una regola |
un prompt che modifichi manualmente | un'istruzione che il ciclo riscrive |
un numero che aumenta | un giudice che si spiega |
un'esecuzione | un round, con un modo per tornare indietro |
la metrica che ti è stata fornita | il numero che hai scelto |
Elementi da portare a casa, in ordine:
- Prima di scegliere una metrica, chiedi cosa puoi scrivere: la risposta, le regole o solo una descrizione di buono. Una cena ha una serie di risposte corrette; un comparatore ne controlla una.
- Crea il righello prima del ciclo e fai in modo che lo stato del mondo penalizzi il righello.
- Inserisci il verdetto all'interno della metrica. ADK non applicherà la soglia per te.
- Suddividi il set di addestramento da quello di holdout prima della prima esecuzione dell'ottimizzazione e non eseguire mai la spedizione in base al punteggio dell'ottimizzatore.
- Conta i posti disponibili, non i tassi di superamento: gli esami di piccole dimensioni mentono.
- Rendi visibile il danno all'ottimizzatore: un giudice che restituisce i motivi svolge metà del lavoro dell'ottimizzatore.
- ADK ti offre il loop, il confine è tuo. Anche fermarsi è una decisione.
- Quando il numero raggiunge il massimo, deve essere perché l'agente è migliorato, non perché il righello è diventato più morbido.
Il ciclo incrementa qualsiasi numero gli venga fornito.
Dove si inserisce la produzione
Tutto in questo lab è stato eseguito sulla tua macchina in base a un esame che hai scritto. La produzione è come una cena che nessuno aveva intenzione di valutare, ed è esattamente ciò che un checker può fare e che una metrica basata su risposte ideali non può fare: valutare a posteriori.

barra verticale | come | risposte |
① Cloud Trace |
| Va bene adesso? — intervalli, giudici della piattaforma, monitoraggi online |
② Righe BigQuery | il plug-in BigQuery Agent Analytics | cosa dovremmo imparare? — una riga strutturata per evento, il formato utilizzato dal checker e dai set di valutazione |
Il repository fornisce la pipeline come script, non come corso: refuel/send_traffic.py invia le parti reali a un host di cui è stato eseguito il deployment, refuel/replay_to_bq.py inserisce le stesse conversazioni come righe e refuel/harvest.py rivaluta ogni riga con world.everyone_ate e genera gli errori come casi di valutazione, ovvero le parole effettive del gruppo, senza una risposta ottimale. Durante la nostra serata di produzione, l'host spedito ha alimentato 7 delle 8 feste reali; l'unico fallimento è stato Lena contro gli ultimi ordini, il posto esatto previsto dal soffitto del corso V, ed è diventata la domanda d'esame del round successivo. Il secondo giro è di nuovo il percorso V con un altro caso di allenamento. È necessario un progetto Google Cloud con fatturazione, motivo per cui è una lettura e non un piatto del menu.
Auto-apprendimento
- Scrivi una tua festa (
world.PARTIES, poiscripts/make_evalsets.py) e inseriscila nell'esame. È giusto? In stilescripts/verify_world.py: ogni festa deve avere almeno una prenotazione che soddisfi tutti. - Alza la barra di valutazione a 0,9 e punta
adk optimizeaeval_config_rating.json. Misura il gradiente. - Hai un progetto con fatturazione? Esegui la pipe
refuel/end-to-end e leggi le righeharvest.pydi[skip]: sono il confine tra le due pipe reso visibile. - Esegui il ciclo con
HOST_THINKING=2048. Cosa cambia e cosa ti dice questo sul livello del tetto?