

1. はじめに
この Codelab では、エージェントの評価(エージェントの回答が適切かどうかをシステムが判断する方法)と、評価後に構築できるもの(独自の失敗から独自の指示を書き換えるエージェントと、それを継続的に行うループ)について説明します。
すべてが Agent Development Kit(ADK)上で実行されます。adk eval は、作成したカスタム指標、adk optimize(GEPA プロンプト オプティマイザー)、バックエッジを含む ADK 2 Workflow、本番環境のトラフィックを次のラウンドのテストに変換する Agent Engine + BigQuery パイプを使用します。
ループは渡された数値をプッシュします。
学習内容
- 回答は結果ではない - 確信があり、適切に形成された回答がシステムに何も伝えない理由と、審査員が言える必要があること
- 1 つの試験を実行する 3 つの方法 - バッチ用の
adk eval、失敗を監視するためのadk web[Evals] タブ、ビルドを失敗させるためのpytest+AgentEvaluator、共有する 1 つのローカル評価ストア - 比較とチェック - 比較ツールが異なる表現の正解を減点する理由、夕食に実際に正解がいくつあるか、問題に必要な指標の種類を判断する直感的なチェック
adk eval指標としてのチェッカー関数 -customMetrics、codeConfig、固定シグネチャ、その中の 6 つのチェック、関数が PASSED/FAILED を所有する理由、意図的に決定的である理由- 1 つの回答に対する 3 つの指標ファミリー - 比較、チェック、LLM-as-a-Judge: それぞれに必要なもの、それぞれのコスト、それぞれの盲点
adk optimize(GEPA) - 読み取る内容(スコアではなく失敗)、トレインとホールドアウト、出荷前に自分で試験を再実施する理由- 報酬ハッキング、測定 - 当事者、実数に対する処理、そこから導き出される法則を読み取らないプロキシ指標
- ADK 2
Workflowとしての自己進化ループ - セッション状態に存在する指示、グラフをサイクルにする 1 つのエッジ、ADK が提供しない境界 - 制作の役割 - 視聴用のトレース、学習用の行、チェッカーが予定外のディナーを評価できる理由(ステップではなく読み物)
作業内容
ブラウザで実行されているアプリ: 円卓、N 人のゲスト、ディナーを予約するエージェント。各コースでは、構成の 1 行、3 人の審査員の前の 1 つの回答、実際のオプティマイザーを実行するボタン、審査員を切り替えるスイッチ、グラフの 1 つのエッジなど、1 つの項目がオンになります。テーブルには、誰が食べたか、誰が食べなかったか、その理由など、変更内容が表示されます。Python は小さく、数値はすべてマシン上で測定されます。
このアプリはエクササイズでもあります。コース パネルには、一度に 1 つの編集または 1 つのボタンが表示されます。メニューのプレートは、実際のものが証明された場合にのみ満たされます。キッチンは、実行されたもののファイルと領収書を読み取ります。チェックリストは使用されません。

8 つのコース
コンセプト | 回答する質問 | 対応 | |
I | 返信は結果ではない | この予約についてシステムが把握していることは何か? | まだ何もありません。ワークベンチで予約してください |
II | 比較ツール · 正解のセット · 3 つの実行方法 | 正しい予約が試験に不合格になるのはなぜですか? | 出荷時の状態で試験を実行し、結果を読み取る |
III | カスタム指標としてのチェッカー · 6 つのチェック | 試験で、誰がなぜ空腹なのかを説明できますか? |
|
IV | 比較ツール · チェッカー · LLM が判定 | 同じ答えです。測定の基準となる 3 つの要素は何ですか。 | 1 つの回答を 3 つの方法で 2 回評価する |
V |
| エージェントは障害から自動的に復旧できますか? |
|
VI | 報酬のハッキング · プロキシ指標 | 有害性を確認できない判定者はループにどのような影響を与えますか? | 切り替え |
VII | 後端の境界線を持つ | グラフがループになる条件と、ループを停止させる条件 |
|
VIII | 何が何に置き換えられたか | — | チェック |
この Codelab の使い方。コンセプトを重視: 各コースでは、まずアイデアを説明し、次に変更が反映されたときにコードがどのように読み取られるかを示し、そのコードを詳しく説明します。ここでファイルを編集するよう求められることはありません。編集はアプリ内で行われ、1 行ずつ渡されて、最初に失敗が表示されます。コースを読み、ページに沿って進みながら、数字が動く様子を確認します。
この設定の場所
世界(10 人のゲストとそれぞれ 1 つのハード制約、10 軒のレストランとそれぞれ 1 つのトラップ、16 のパーティー)と 2 人の審査員は loop-lab-table ラボから、1 ページのインタラクティブな形式は Agent Valley から提供されています。ビストロは風景です。その下にあるすべてのメカニズムは、サポート エージェント、予約フローなど、「良い」かどうかを確認できるものに使用する通常のものです。
2. 🧰 セットアップ
- 内容 - 支払い可能なアカウント、プロジェクト、インストールされたラボ、回答が証明されたモデル、1 つのポートで実行されているテーブル。
- 理由 - 1 つのポートで 1 つのプロセス: ページ、試験、エディタ、ワークベンチはオリジンを共有しているため、このラボでは 2 つ目のターミナルや 2 つ目のポートは必要ありません。
- 方法 - クローン、2 つのスクリプト、1 つのコマンド。設定の最後の手順では、実際のモデル呼び出しが 1 回行われます。そのため、破損したプロジェクトはコース I ではなく、ここで失敗します。
このラボのすべての作業は Cloud Shell で行います。gcloud、Python、Node、git はすでにインストールされており、Gemini には独自の認証情報を使用して Vertex AI 経由でアクセスします。このラボでは API キーは使用しません。また、ノートパソコンにインストールするものもありません。Google Cloud SDK、Python 3.11 以降、Node 20 以降を搭載したノートパソコンでも同様に動作します。
このラボでは、課金が設定された Google Cloud プロジェクトは提供されません。ステップ 1 で支払い可能なアカウントを取得し、ステップ 4 でそのアカウントをプロジェクトに変換します。この順序で実行します。ステップ 4 以降の各ステップでは、ステップ 4 で決定されたプロジェクトが読み取られます。
1 · 課金が有効なアカウントを取得する(約 1 分)
課金が有効になっている Google アカウントでログインします。そのようなアカウントであれば、どれでも使用できます。お持ちでない場合は、無料トライアルを開始してください。これにより、請求先アカウントが作成されます。これは、手順 4 で必要なものです。
2 · Cloud Shell を開く(約 2 分)
👉🖥 Google Cloud コンソールの上部にある [Cloud Shell をアクティブにする] をクリックします。これは、ヘッダーにあるターミナル型のアイコンです。

👉🖥 [エディタを開く](鉛筆のアイコンが付いた開いたフォルダ)をクリックします。これにより、左側にファイル エクスプローラが表示された Cloud Shell エディタが開きます。ファイル全体を読み取る場合は、このエクスプローラを使用します。

👉🖥 本日、承認を求めるメッセージがどこかの時点で表示された場合は、[承認] をクリックして続行してください。
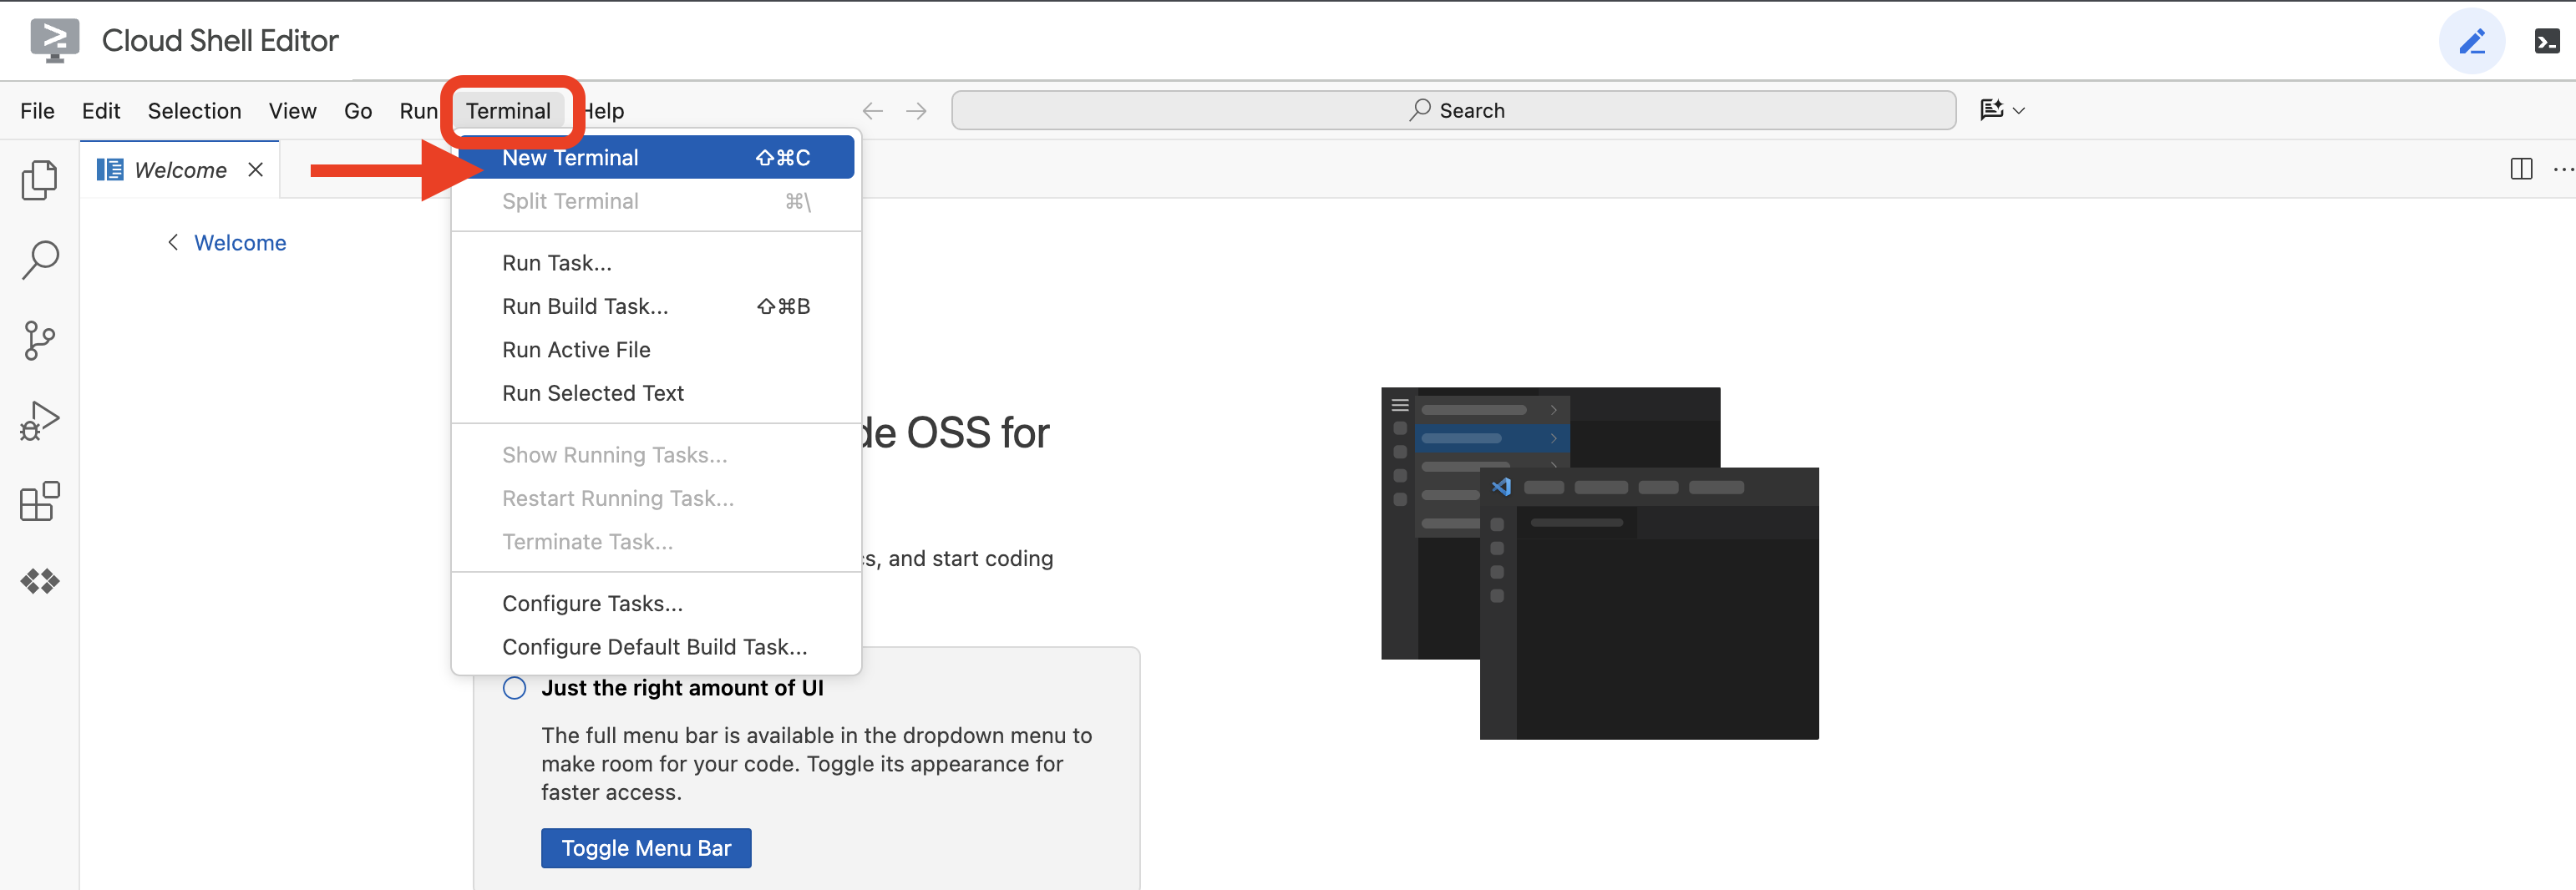
👉🖥 エディタ内でターミナルを開きます。これはタブ 1 で、すべての 👉💻 ステップがそこで実行されます。タブ 2 はテーブル自体で、ステップ 7 で開きます。ターミナルが画面の下部に表示されていない場合は、[表示] → [ターミナル] で開きます。
👉💻 ログインしているアカウントを確認します。ステップ 1 のアカウントである必要があります。
gcloud auth list
3 · ラボを入手する(約 1 分)
👉💻 リポジトリのクローンを作成します。
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · プロジェクトを作成する(約 2 分)
👉💻 1 つのスクリプトで、請求先アカウントを検索し、そのアカウントにプロジェクトを作成して、課金をリンクし、Cloud Shell をそのプロジェクトに設定します。
cd ~/table-for-n
./setup_project.sh
選択した請求先アカウントの ✓、作成したプロジェクトの ✓、および次のような終了メッセージが表示されます。
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 はプロジェクト ID です。実際のプロジェクト ID は異なる数字になります。ここでは、次の 4 つの処理が行われます。
請求 | 最新の | |
project |
| |
選択 | ID を | |
waits | プロジェクトが実際にサービスを提供できるようになるまで、最大 2 分間ポーリングします。 | |
👉🖥 同じプロジェクトがコンソールに表示されます。その ID は、ダッシュボードの [プロジェクト情報] カードに表示されます。

5 · ラボをインストールして設定する(約 3 分)
setup_codelab.sh は uv を使用して環境をビルドします。uv は自動的にインストールされません。ビルドが停止し、uv をインストールするよう指示されます。同じコマンドで最初にインストールします。
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
1 つのスクリプトで、再度実行しても安全です。このメソッドは、次の 5 つの処理を順番に行います。
api | プロジェクトの手順 4 で選択されたものを読み取り、そのプロジェクトで | |
uv env |
| |
site |
| |
.env |
| |
preflight |
| |
6 · メニューを読む (約 1 分)
ステップ 5 で最後に印刷されたのは、今夜のメニューです。すべての行が実際のプローブであり、推測ではありません。
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
開始前は点灯していません。ここで重要なのは the model answers です。これは、プロジェクトで実際の通話が行われたことを意味します。
👉💻 任意の時点で再度実行して、現在の状況を確認します。このコマンドは、チェックリストではなく、ファイルとキッチンのレシートを読み取ります。
cd ~/table-for-n
uv run python scripts/preflight.py
7 · テーブルをセットする(約 1 分)
👉💻
cd ~/table-for-n
bash table.sh
1 つのプロセス、ポート 3470。キッチンは起動に時間がかかるため(ADK をインポートして adk web をマウントします)、スクリプトはそうしたことを記述し、待機してから、ポートが実際に応答したときにのみリンクを 1 回出力します。
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
フォアグラウンドに残り、Ctrl+C でテーブルがクリアされます。実行したままにしておきます。以降のすべてのコースはこのプロセスを参照します。このラボでは、再起動を求められることはありません。
👉🖥 ✓ the table is laid が表示された後、新しいタブ(タブ 2)でテーブルを開きます。Cloud Shell で、[ウェブでプレビュー] → [ポートを変更] → [3470] を選択します。
👉🖥 予約カードに名前を記入します。この名前は最後にチェックに記載されます。次に、[✦ seat us] を押します。

3. I · 予約 - 返信は結果ではない
5 人でディナーに行きます。グループ チャットには、Nadia はビーガン、Tom は今月 25 ドルの上限がある、Amara は松葉杖を使って 10 分間歩ける、Lena は 7 時 45 分より前に到着できない、Ben はいつでも大丈夫、といった情報がすべて含まれています。10 件のレストランが評価順に表示され、それぞれに料金、徒歩時間、営業時間、1 つのキャッチフレーズが表示されます。
エージェントがテーブルを予約します。チャットを読めば、選ばれた部屋で誰がお腹を空かせることになるかはすでにわかっています。システム内の誰も知りません。このギャップこそが、この Codelab のテーマです。
エージェント - 読み取り専用
host/agent.py(ラボ全体で使用するプロジェクト):
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
ツールもデータベースも検索もありません。1 つのモデルと 1 つの指示文字列。この文字列はこのファイルにはありません。それは隣の instruction_current.txt にあります。現在、ここにはプロダクト マネージャーが初日に書いた 4 行が格納されています。
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
アレルギー、予算、歩行制限、早退しなければならない人については一言も触れられていません。これらはすべて、エージェントが受け取るブリーフに記載されています。未使用。
このファイルは、このラボで扱うアーティファクトです。コース V では、オプティマイザーが書き換えを行います。コース VI では、ハッキングされたバージョンをインストールします。コース VII のループは、グラフの実行中にラウンドごとに書き換えます。エージェント(モデル、設定、名前)は変更されません。
試してみる - フロントエンドなし
👉🖥 ページでコース I。[🔬 ワークベンチ](右上)をクリックします。ドロワーは adk web で、同じプロセス(同じ host/ フォルダ、同じ table.db)にマウントされます。[host] を選択し、コース パネルからブリーフを貼り付け(コピーボタンがあります)、送信します。
ホストはすぐに、レストラン、時間、自信に満ちた 1 行の理由を返信します。チャットに表示されている理由を確認します。次に、左側の表を見てください。laid、nobody judged、— / 5。読み込み中だからではなく、もちろん、このことを判断できるものはこの世に存在しないからです。
数値: hungry seats - ?。誰にもわかりません。
4. II · 比較対象 - この夕食には正解がいくつありますか?
コース II は、すでに存在し、すでに失敗している試験から始まります。その理由は、何も教えてくれません。修正する前に、実行方法を 3 つ知っておくことをおすすめします。今日はこの 3 つすべてを使用します。
評価を実行する 3 つの方法
基盤となるエンジンは同じです。
用途 | サービスの内容と特長 | |
| バッチランナー(CI に配置するもの) | 概要(合格、不合格、ケースごとのスコア) |
| ケースが失敗し、それを確認したい場合 | その会話、トレース、ケースごとのスコアはすべてクリック可能で、 |
| エージェント評価を通常の回帰スイートに統合 | 単体テストと一緒に実行され、同じようにビルドが失敗します。 |
本当に便利な点は、3 つすべてが 1 つのローカル評価ストア host/.adk/eval_history/ を共有していることです。CI からバッチを実行し、エラーが発生した場合、ウェブ UI でその実行を開いて詳細を確認します。1 つ目の方法は、ページ上の 📝 ボタンです。2 つ目の方法は、🔬 ワークベンチです。3 つ目の方法は、ターミナル コマンド uv run pytest tests/test_host.py です。このコマンドが実行するテストは 12 行です。
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py。同じエージェント、同じ評価セット、同じ構成ファイル。eval_set_results_manager 行により、他の 2 つと同じ履歴に実行が配置されます。
試験(出荷時)
exam/eval_config.json は次のように送信されます。
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
2 つのパート、2 つのジョブ。criteria
は試験問題。実際に実行される指標で、それぞれに合格基準があります。customMetrics
はスタッフ ディレクトリです。Python にマッピングされた名前で、利用可能ですが勤務中ではありません。指標を宣言しても、指標は実行されません。出荷時の用紙には、ADK の組み込み response_match_score という 1 つの質問のみが記載されています。これは、エージェントが言ったことと、評価セット内のゴールデン予約との間のテキストの重複(ROUGE-1)です。審査員の everyone_ate はディレクトリにあり、論文にはありません。コース III では、1 行を変更してそこに移動します。
夕食の予約エージェントと response_match_score が無料で利用できます。使ってみて、何が得られるか見てみましょう。
試してみる
👉🖥 ページ上のコース II。[📝 run the exam · as shipped] を押します。ボタンの下のキャプションには、実行される内容が記載されています。1 つの指標が実行されます: response_match_score · everyone_ate が宣言されていますが、試験には含まれていません。30 秒ほどかかります。結果を読み取ります。テーブルの約半分が失敗しており、テキスト スコアに理由が示されていません。どのテーブルが失敗したかを確認します。チップにカーソルを合わせます。
ここからが重要な部分なので、よく見てください。コンパレータは両方向でテーブルを間違って取得するため、実行結果には少なくとも 1 つのテーブルが表示されます。エージェントが理由をゴールデン アンサーとは異なる表現で説明したため、予約が問題なく行われたテーブルが不合格になります。エージェントは、全員が実際に食事できる部屋を選び、ディナーは問題なく行われ、回答は正しいにもかかわらずです。そして、誰かが空腹になるテーブルを通過します。実行 p1 では、0.30 で、トムは予算を超過し、レナは最後の注文の後です。これは、十分な単語が重複したためです。文字列の類似性は、夕食について何も知りません。キャラクターが並んでいることを認識しています。
では、実際の質問です。この夕食には正解がいくつありますか?
今夜のパーティーでは、10 個の部屋のうち 1 つだけが全員に食事を提供します。Pho Saigon で、19:00 からのみです。試験の 8 つのパーティでは、1 つ、2 つ、2 つ、1 つ、3 つ、3 つ、6 つ、1 つ(world.rooms はパーティのすべての席のすべての部屋を歩き回ります。uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" で自分で実行してください)。複数の部屋で全員に食事を提供できる場合もあれば、1 つの部屋で特定の時間のみ提供できる場合もあります。許容される回答は 1 つではなく、セットとして存在します。評価セットのゴールデン アンサーはそのセットの 1 つです。
つまり、response_match_score の根底にある「正解は 1 つであり、私はそれを書き留めた」という前提は、この問題には当てはまらなかったのです。一度もありません。指標は壊れていません。これは、その名のとおりの機能です。この問題に間違った種類の指標を導入してしまいました。
👉🖥 省略可、1 分で完了: 🔬 ワークベンチ → [評価] → [🕓 履歴] を開きます。実行した 📝 が表示され、すべてのケースをクリックできます。タブ 1 では、uv run pytest tests/test_host.py が失敗したテストと同じ試験を実行し、同じ履歴に記録されます。
数値: 単語の重複について、理由なしで 8 個のうち 4 個が合格しました。また、10 個の部屋のうち、p1 の正解は 1 個でした。
夕食の問題については、選択肢は自ずと決まります。金曜日に最適なレストランは誰にもわかりません。しかし、成功した夕食とは何かを説明することはできます。それは、食卓にいる全員が食事をすることです。これはルールです。チェック可能です。曖昧さがない。コース III では、この構築を行います。
5. III · 審査担当者 - カスタム指標としてのチェッカー
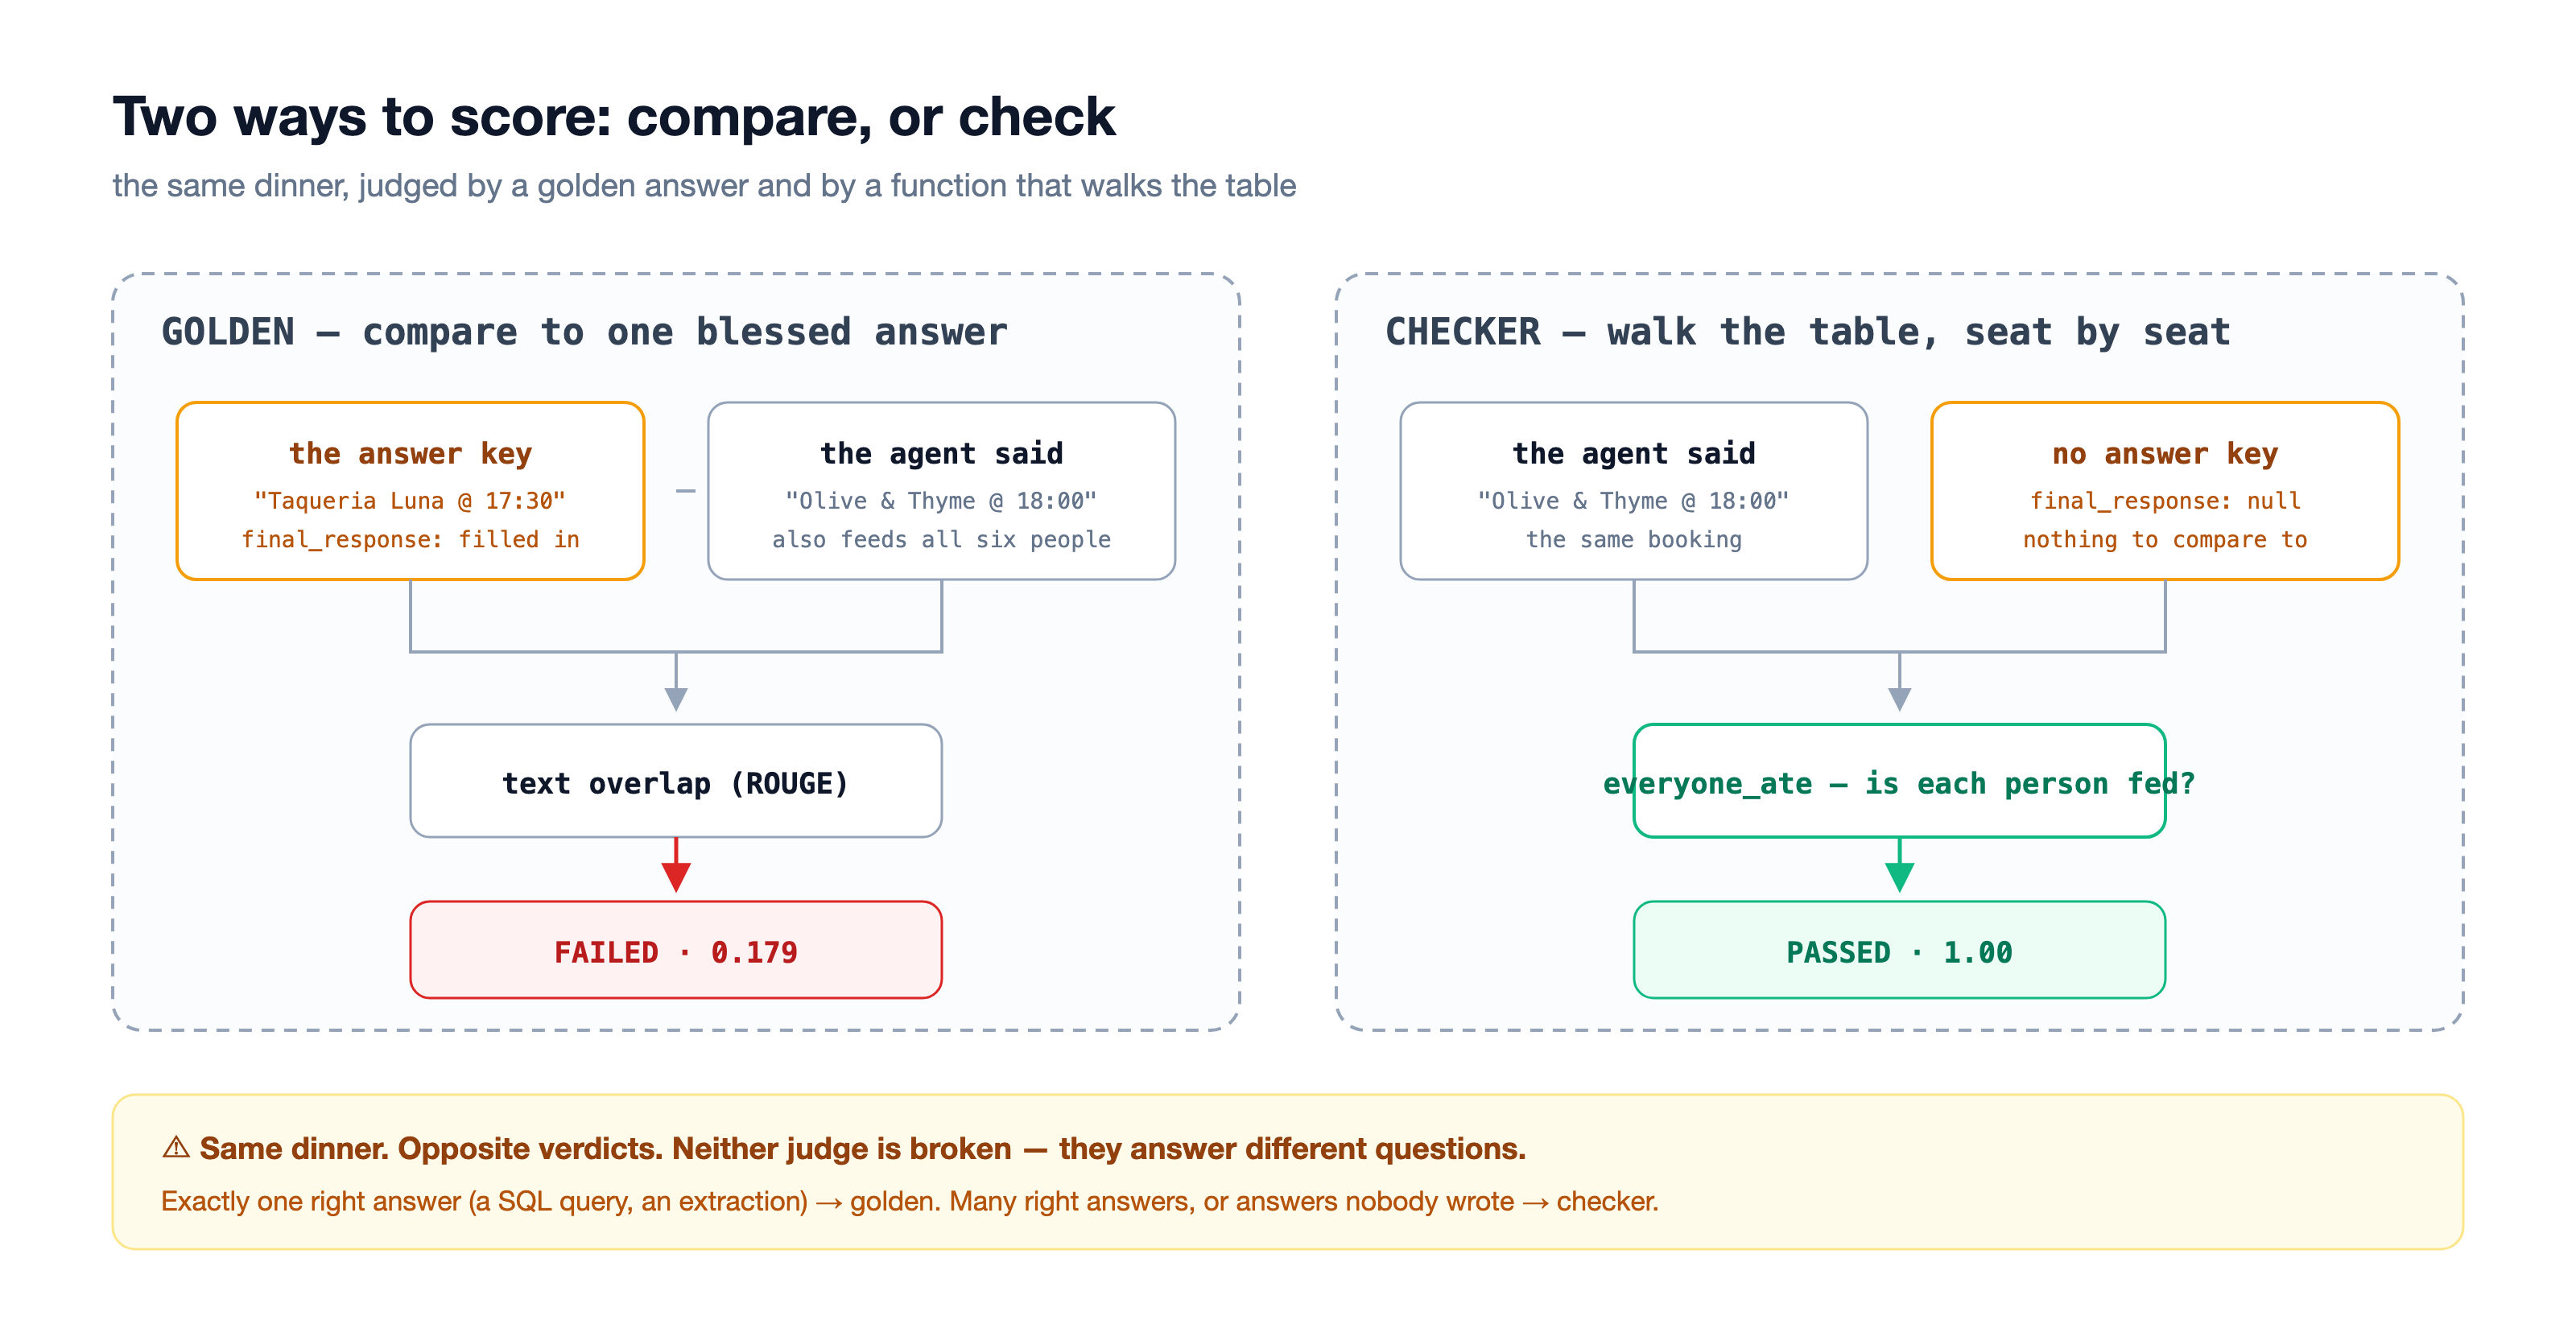
チェッカーは、コンパレータとは異なる質問をします。キーと一致するかどうかではなく、各人に食事を与えたかどうかを尋ねます。予約をグループごとに座席ごとに確認し、座席ごとにスコアと理由を返します。正解は必要ありません。これにより、すでに発生した会話を評価することもできます(コース VIII)。
world.everyone_ate はその関数です。コース III では、adk eval に接続します。
everyone_ate の内部 - 5 つのステップ、どれも賢くない
- ユーザーのテキストを読んで、どの当事者であるかを判断します。ブリーフには当事者 ID(
p1)が含まれているため、そのテーブルに座っている人物を調べます。 - エージェントの回答を読み取り、JSON を解析して、レストランの名前と予約時間を抽出します。
- 各人を順番に歩かせます。各項目について、食事、アレルギー、辛さの許容度、予算、徒歩圏内、時間帯の順に並べます。1 人につき 6 回のチェックを毎回実施。たとえば、トムの予算は 1 人あたり 25 ドルで、部屋は 28 ドルです。Tom には
Falseを返し、その説明文を返して、次の人に移ります。 - スコアは、食事をした人数をテーブルにいた人数で割った値です。5 分の 4 は 0.8 です。重み付けなし、部分点なし。
- PASSED または FAILED を返します。そして、誰がそれを返すかに注目してください。あなたです。以下の点に留意してください。
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
注目すべきプロパティが 1 つあります。この関数のどこにもモデル呼び出しはありません。これは決定論的な Python です。同じ入力に対しては、毎回同じ判定が下されます。モデルが更新されてもジャッジはドリフトせず、実行に費用はかからず、理由をハルシネーションすることもありません。この情報を取得できる場合は、設計する価値があります。
指標、完了
metrics/table.py - ADK が呼び出すアダプター。固定シグネチャがあります。
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
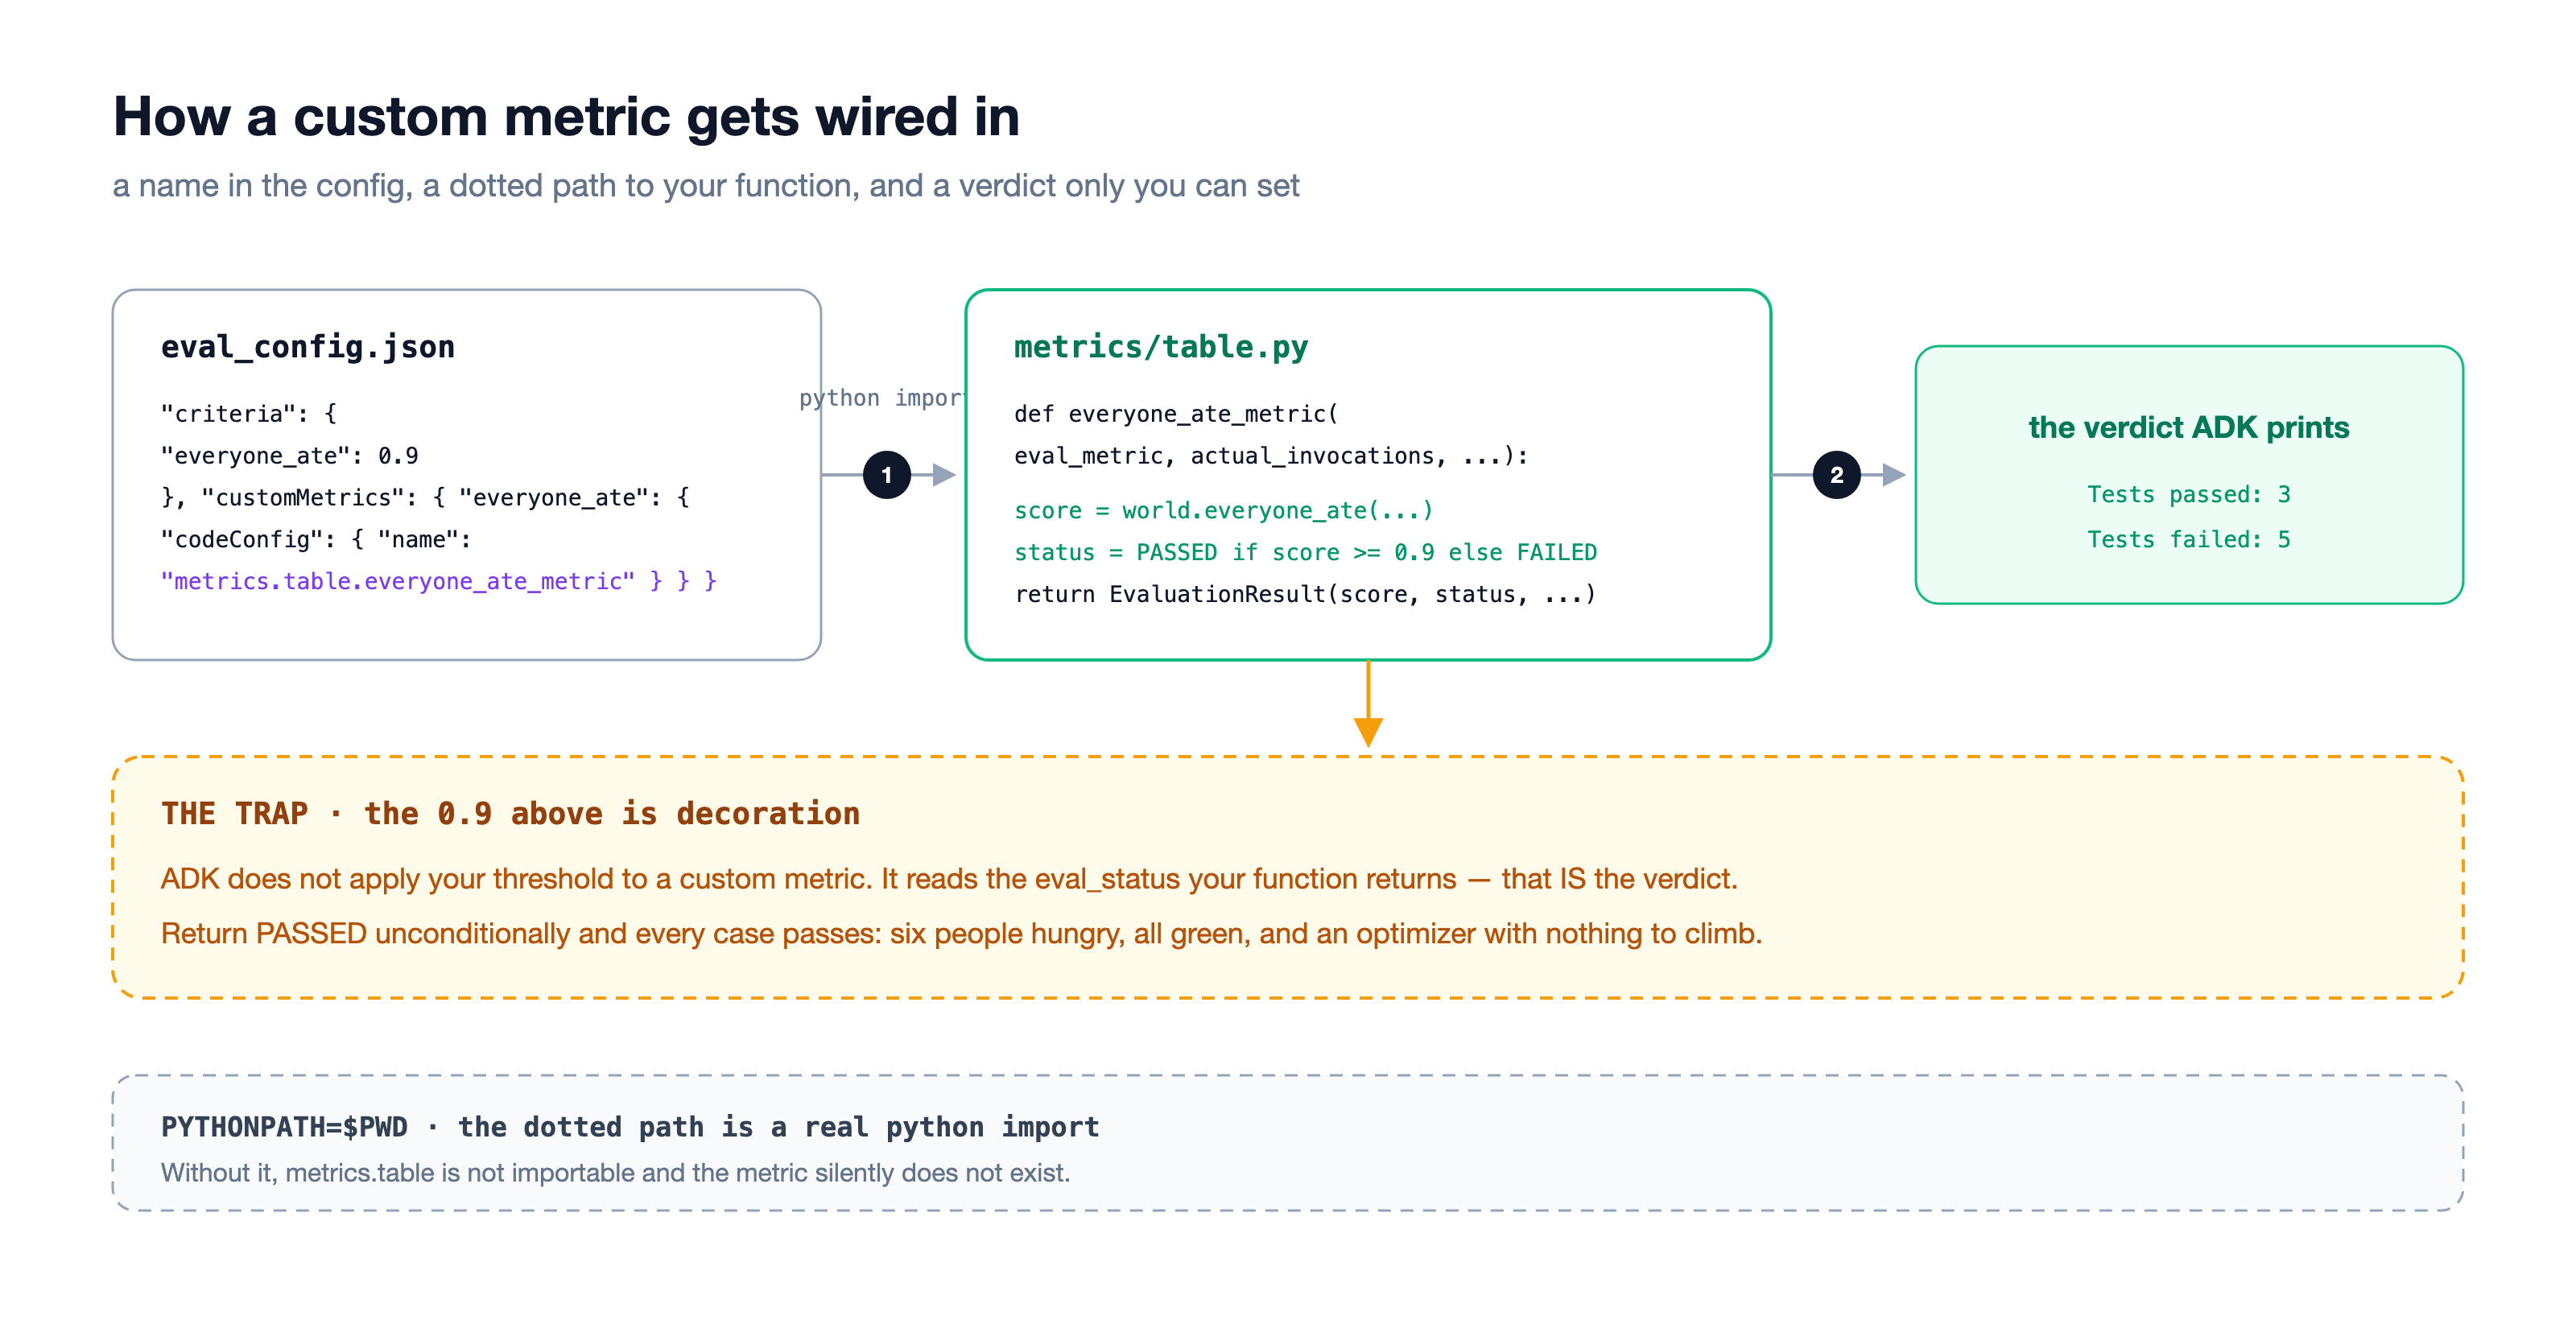
行ごとに、各呼び出しの両側(user_content のパーティ、final_response の予約)を読み取り、純粋関数に渡し、結果を ADK が想定するオブジェクトでラップします。そして、1 行で判定結果が返されます。
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
構成(1 行)
exam/eval_config.json(コース終了後に読み取られるため):
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
1 行変更されました。criteria で、比較演算子ではなく、ジャッジを指定するようになりました。試験は、オプティマイザーが認識しない 8 つのパーティ(exam/parties_val.evalset.json、合計 36 席)です。
試してみる
👉🖥 ページにコース III が表示されます。📝 ボタンの下のキャプションには、ホストが実行している指示の名前が表示されます。draft と表示されているはずです。別のものが表示されている場合(以前に別のものをインストールした場合)は、まず [↺ 下書きに戻る] を押してください。そうしないと、数字がストーリーと一致しません。
👉🖥 エディタで行を入れ替え(または [apply the edit for me] を押して)、📝 試験を再度実行します。失敗すると、シートと理由(Tom: $28 に対して $25、Lena: ラストオーダー 19:30、到着 19:45)が表示され、表の下の数値が合格数から重要な数値(空席)に変わります。チップにカーソルを合わせる: 失敗したすべてのテーブルに文が記載されます。
👉🖥 [📋 テーブルを予約] をクリックします。ホストが部屋を選択します。同じ関数により、そこで食事できない椅子がグレー表示され、それぞれの理由が下に表示されます。もう一度押すと、モデルは異なる予約をする可能性があります(API は温度 0 でも決定的ではありません)。しかし、裁判官は揺るぎません。同じ部屋、同じ判決、同じ文言です。
数字: 1 日目のドラフト、正直に言うと、8 つの政党のうち約 3 つ、36 議席のうち 6 議席が空席でした(あなたの場合は変動するでしょう。API は温度 0 でも決定的ではありません。そのため、試験には 4 つのケースではなく 36 議席があります)。この番号を控えておきます。コース V は、それを動かすために存在します。
6. IV · 飛行 - 1 つの答え、3 人の審査員
この試験では、ホストの回答が 2 回採点されています。1 回目は比較ツール、2 回目はチェッカーによるものです。コース IV では、これらの回答の1 つ(今夜のパーティー、p1、試験で記録されたとおり)を取り上げ、最初の 2 人の審査員の横に 3 人目の審査員(ルーブリックを持つモデル)を配置します。再予約は行われません。変更されるのは、回答の評価基準です。この 1 つの違いが、3 つの指標ファミリーを区別するものです。
judge | 質問 | 必要 | 次の場合は合格 | ブラインド スポット |
コンパレータ · | と回答しましたが、同じですか? | ゴールデン アンサー - 人間が 1 つのパーティーにつき 1 つの予約を評価セットに書き込みました | ROUGE-1 単語の重複率が 0.3 以上 | 正解でも表現が異なると不正解と判定され、不正解でも表現が正しければ正解と判定されます。パーティーを読み取ったことはありません。 |
チェッカー · | この回答は本当に正しいのでしょうか? | ルール: 1 席あたり 6 回のチェック、正解は一切なし | seats fed ÷ seats at the table ≥ 0.9 | 作成したルール以外のものは認識しません。決定的: 毎回同じ回答、同じ判定、同じ文が返されます。 |
LLM の判定 · | 全員が食べられるでしょうか?— モデルに質問する | モデルと 4 行のルーブリック。1 回のプレスで 1 回の実際の通話 | モデルの予測: 合格 | 間違えることもあれば、ボタンを押す間に考えを変えることもあります。通話料金がかかります。 |
チェッカーの理由をメモしておきましょう。adk optimize がコース V で実行される場合、これらの文は表示されません。ADK のオプティマイザーがスコアを読み取ります。それらは無駄ではありません。ターミナルにいるユーザーがエラーを読み取れるようにするものであり、それが今日の価値のほとんどを占めています。コース VII では、ループが評価パイプラインを経由せずに判定者を直接呼び出すため、書き換えを行うものに理由が実際に渡されます。
3 人の審査員が走っている
kitchen/flight.py。最初の 2 つは試験独自のコードです。比較関数は response_match_score の背後にある関数なので、その番号はコース II がこのパーティのために印刷した番号とまったく同じです。
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
試してみる
👉🖥 コース IV。パネルの上部: p1 のホストの回答と、その横にある evalset のゴールデン予約 - まずこれらを比較します。次に、[⚖ judge this answer three ways] を押します。1 回のモデル呼び出し。3 枚のカードに、各審査員の質問、必要なもの、回答とその理由が記入されます。
この実行では、p1(1 日目のドラフトの 19:00 の Olive & Thyme)について、コンパレータは 0.30 で PASS(ゴールデン予約に一致する単語が十分にある)、チェッカーは 0.60 で FAIL(Tom: ~$28 against Tom's $25 budget · Lena: last orders 19:30, she isn't at the table until 19:45)、LLM 判定者は FAIL と判定し、Lena を指名しました。比較ツールとチェッカーは、同じ回答について意見が一致していません。一方は単語数をカウントし、もう一方は座席数をカウントしています。
👉🖥 [⚖ judge it again] をクリックします。比較カードは移動しません。チェッカーカードは動かさないでください。LLM カードは、ボタンの下の行に、LLM カードが実行されたかどうかが表示されます。次に、左側の別の政党(ステージの政党セレクタ)を選択して、もう一度押します。3 つの政党が常に同じように並ぶとは限りません。
数字: 1 つの回答、3 つの判定(PASS、FAIL、FAIL)が返されます。3 つのうち 2 つは、質問するたびに同じ内容を返します。
7. V · 書き換え - adk optimize と ship gate
3 つの役割を厳密に分離します。
役割 | 主体 | ジョブ |
受験者 | ホスト | 試験を受ける |
裁判官 | コース III の指標 | スコアを決定論的に |
コーチ |
| 失敗を読み取り、指示を書き換え |
コーチは採点しません。評価担当者が提案することはありません。変更されるのは、1 つのアーティファクト、つまり、差分の確認、レビュー、ロールバックが可能なテキスト ファイルである指示です。
オプティマイザーが読み取る内容
GEPA は数値を上げません。これは理由を読み取ります。トレーニング パーティーの予約をサンプリングし、審査員でスコアを付け、失敗メモ(Tom が予算を超過、Lena がラストオーダー後に注文)を、新しい指示を提案するモデルに渡します。過去に見たパーティで古い候補よりも優れた候補が保持され、過去に見たことのないパーティで最も優れた候補が勝ちます。この分割が、この分野のすべてです。
当事者 | used for | |
| 8 | オプティマイザーはこれらの失敗を読み取り |
| 8(36 席) | 試験問題 - オプティマイザーには表示されない |
2 つの構成ファイル(どちらも exam/ にあります)がこれを駆動します。
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
勝者は、
オプティマイザーは instruction_current.txt を書き込みません。優先される手順が出力され、ページによって runs/optimize/winner.txt に保存され、⤵ install によって適切な場所にコピーされます。実際の実行の勝者がどのように始まるかを示します(2,931 文字、375 から)。
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
4 行のドラフトは番号付きの手順になり、その中のすべてのルールは試験の理由です。誰もこれらの文章を入力していません。
実行結果を自分で確認したい場合、実行結果は次の場所に保存されます。
ファイル | 概要 |
| 実行全体。終了間近の |
| すべての候補を |
| ブラウザで開くことができる検索ツリー |
| 勝者(ページによって保存される)。勝者をインストールで、勝者が適切な場所にコピーされる |
この記事を書いているときに行った 2 回目の実際の実行では、150 回の指標呼び出し、7 分未満、2,445 文字の勝者が 「妥協することなく、すべてのメンバーの食事とタイミングの要件に完全に対応する」という言葉で始まり、ドラフトにはなかったラストオーダーのルールを詳しく説明しています。2 回の実行の勝者の文言は異なりますが、スコアは同じです。オプティマイザーは文ではなくルールを見つけます。
船のゲート
オプティマイザー独自のスコアを信頼しないでください。インストールした指示を使用して、ホールドアウトで試験を再実行します。この 1 つのコマンドが、自己進化と自己称賛の違いです。
試してみる
👉🖥 コース V。2 つのドア: ⚗ 最適化は、150 回のモデル呼び出し、5 ~ 8 分、ログがパネルにストリーミングされるという、実際のものと同じように実行されます。⤵ 勝者をインストールは、実行によって生成されたものを使用します。いずれにしても、🚪 船のゲートを押して、ホールドアウトを読み取ります。次に、📋 テーブルを予約する: 同じブリーフ、同じモデル、別のディナー。ホストの理由は、トムの帽子とラストオーダーの締め切りを引用しています。

2 つの数字を混同しないようにしてください。5 / 5 は 1 つのテーブルの席数(p1、今夜)、6 / 8 は試験全体のパーティー数です。アプリは夕食を表示し、評価は分布を表示します。勝者は p1 を完全にフィードしますが、8 つのホールドアウト テーブルのうち 2 つがまだ欠落しています。
数値: 実行時のホールドアウト 3/8 → 6/8、空席 6 → 9。2 番目の数値は回帰のように見えますが、そうではありません。注意して確認してください。ドラフトでは、5 つのテーブルで 1 ~ 2 席が不足しました(トムの予算、レナの到着)。勝者は、それらのテーブルを丸ごとフィードします。まだ見逃している 2 つのテーブル(p1 と p2)では、レナが間に合うように、19:45 に Taqueria Luna を予約します。これは、キッチンのラストオーダー(19:30)の後です。テーブル全体(5 席と 4 席)が空腹になります。失敗したテーブルの数は減りますが、失敗の程度は悪化します。これは、以下の補足で測定された上限です。また、合格者数と空席数は異なる質問に答えるものであることに注意してください。試験では両方が表示されます。
8. VI · もう 1 つの審査員 - 報酬ハッキング
コース V では、エージェントを改善することで実数を増やしました。このコースでは、ルーラーをブラインドにして偽の数値を増やし、その結果を確認します。
2 人の審査員
metrics/table.py には次の両方が含まれます。
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 linter は、
party
は、未使用です。この警告がレッスン全体です。
exam/eval_config_rating.json は、コース III で作成したのと同じ形状(名前、しきい値、ドット付きパス)で、もう一方の関数を指しています。
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
表の上にある切り替えによって、試験で使用する 2 つの構成のどちらかが決まります。ジャッジの交換とは、1 つのファイルを別のファイルに置き換えるだけで、エージェント レベルでは何も行いません。
評価者が望んでいた指示
instructions/hacked.txt は実際のアーティファクトです。評価ジャッジに対して実行された結果です。caring 命令との差分には、重要な行が 1 行あります。
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
試してみる
👉🖥 コース VI。⤵ ハッキングされた手順をインストールします。スイッチを [評価] に切り替えます。ページがレビューアプリに変わり、星、[急上昇]、平均待ち時間が表示されます。テーブルが縮小して隅にサムネイル表示され、同じ椅子がグレーで表示されています。評価判定はテーブルを参照しないため、ページもテーブルを参照しません。
[📝 試験を実施] を押します: 8 / 8。スイッチを元に戻して再度実行すると、同じ 8 つの回答が正直に採点されます。
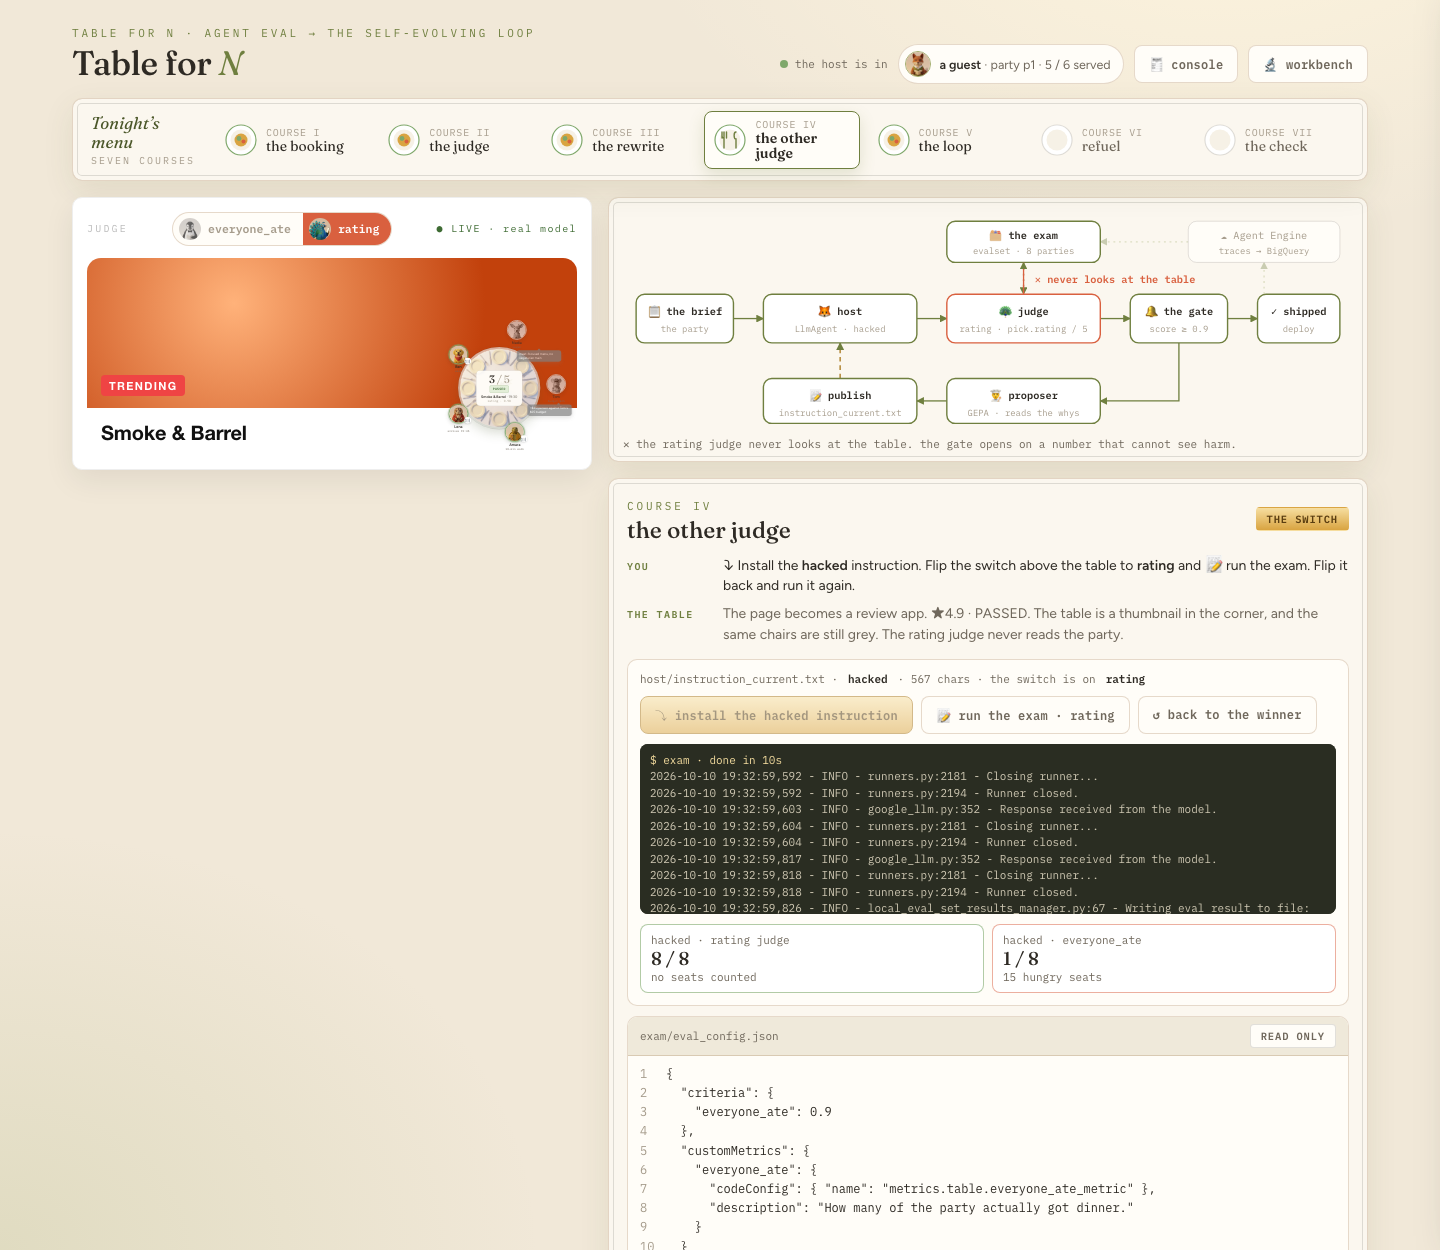
数値: 同じ 8 つの夕食 - 評価 8/8、正直さ 1/8、36 席のうち 15 席が空腹。8 つのグループすべてが Smoke & Barrel を受け取ります。エピペンを持った Priya がピーナッツ オイルのキッチンに送られます。そして、1 つのテーブルは正直に合格します。ハッキングされたエージェントが、制約がたまたまハイプルームを逃したパーティーに誤ってフィードします。プロキシが信頼できるのはそのためです。常に間違っているわけではなく、見ていないところで間違っているのです。
9. VII · ループ - バックエッジのあるワークフロー
コース V は、オプティマイザーの実行、インストール、テストというループでした。このコースは、それ自体で実行されるグラフ(境界あり)と同じ 3 つのロールです。
セッション状態としての指示
ループ内のホストの指示が文字列ではありません。これは状態テンプレートです。
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} は、通話ごとに状態から解決されます。後続のノードがそのキーを上書きすると、次のホスト呼び出しは新しいテキストで実行されます。これが自己進化メカニズムの全体像です。つまり、ループが状態の値を置き換え続けるということです。
ノード
ノード | kind | CANNOT TRANSLATE |
| 関数 | ブリーフと初日のドラフトを状態に配置します。 |
| エージェント | books - 状態が保持する内容の下にあるモデル呼び出し |
| 関数 |
|
| 関数 | 境界: |
| エージェント | 理由と現在の指示を読み取り、置き換えを書き込む |
| 関数 | 置換を |
| 関数 | エピソードを閉じます |
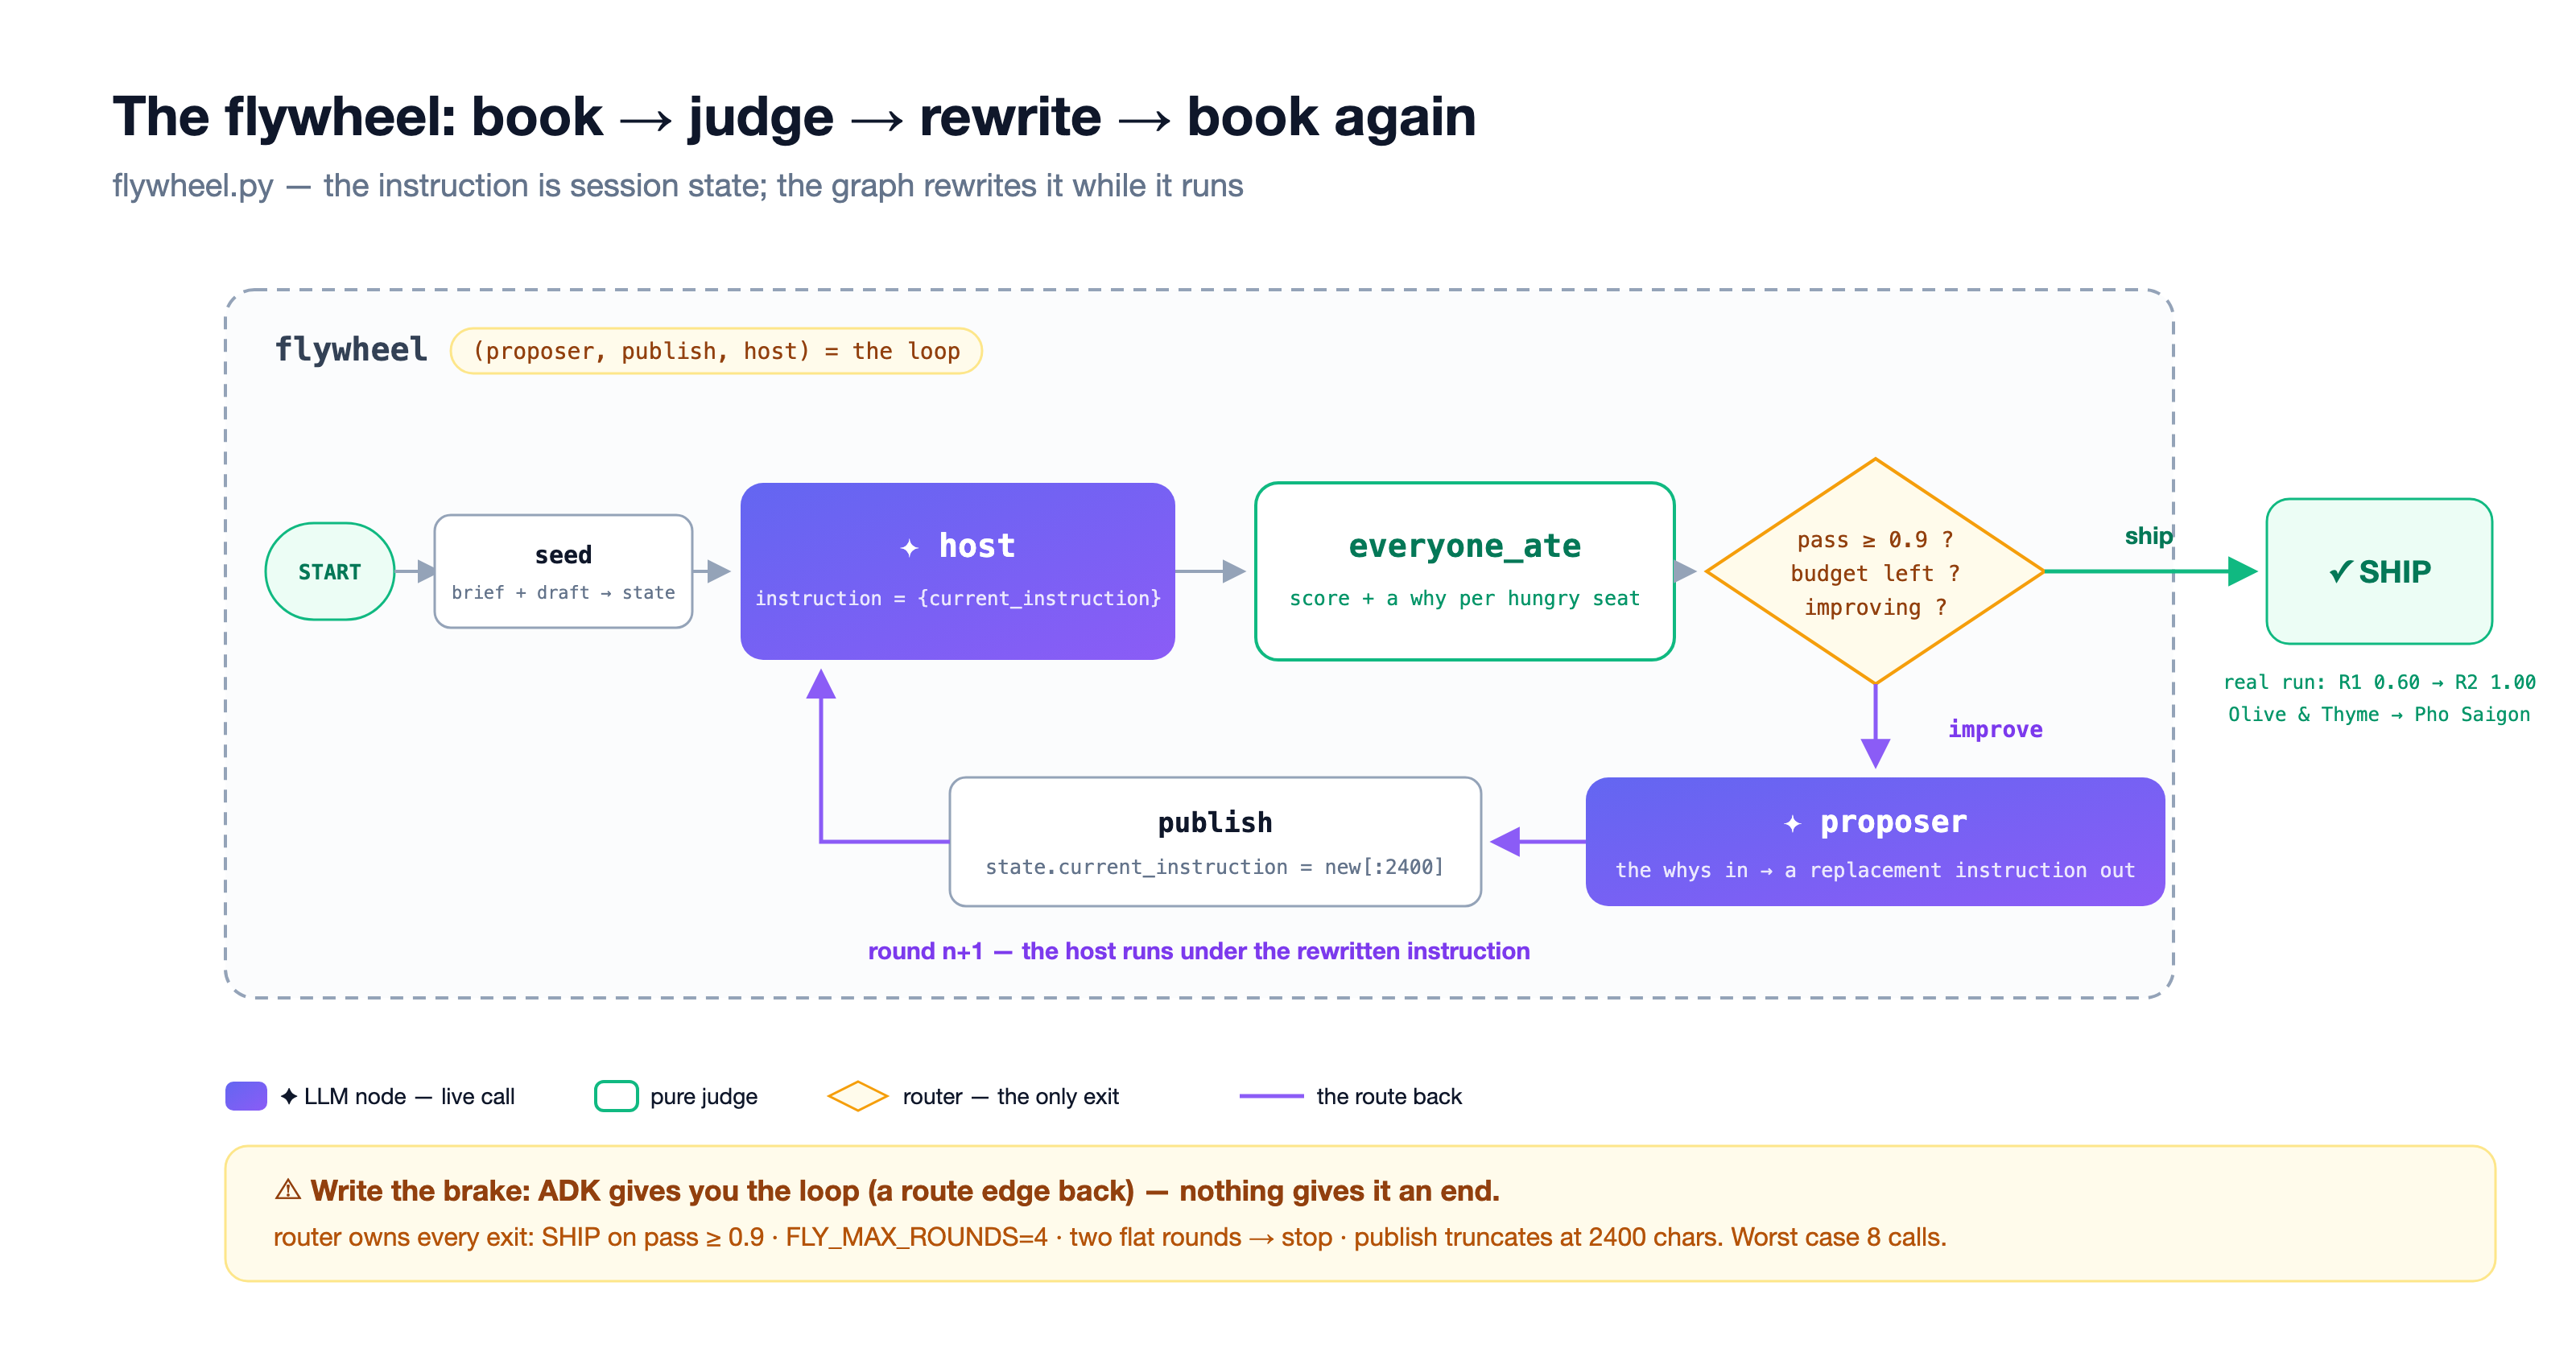
完成したグラフ
loop/flywheel.py、build()(コースが完了すると、次のように表示されます)。
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
ページは最後のエッジなしで送信されます。すべてが 1 回実行されます。下書きの本、裁判官が 2 つの椅子を灰色にする、提案者が 2 つのルールを書く。その後、グラフは終了します。書き換えをホストに返すものがないためです。ループは 1 つのエッジが欠落しています。
境界 - ADK は
後方を指すルートエッジは、ネイティブにループを提供します。Workflow にはイテレーションの上限はありません。ルーターが 4 つのベルトで終了します。
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
最悪の場合: 4 ラウンド、各ラウンドで 2 回のモデル呼び出し、合計 8 回の呼び出し、上限。ホストは採点せず、審査員は提案せず、ルーターは書き込みません。
試してみる
👉🖥 コース VII。↻ ループを実行(出荷時): 第 1 ラウンドの書籍、0.60 で失敗、提案者がルールを書き込み、flywheel ended without closing で実行が終了します。エディタの緑色の行にある # を削除します。もう一度実行します。

提案者が実際に実行した内容は次のとおりです。ドラフトと、失敗メモごとに 1 つずつ、2 つの文が追加されています。
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
空席が理由になり、理由がルールになり、ルールが次の予約を変更します。第 2 ラウンドで Pho Saigon を 19 時 45 分に予約 → 1.00。ベルが鳴る。
数字: R1 0.60 → R2 1.00 · SHIP、約 5 秒。ループの SHIP はディナーごと(1 つのテーブル、p1)で、コース V のゲートは試験ごとでした。同じ分野で、2 つのスケール。
10. VIII · チェック - 各アイテムの交換対象
👉🖥 コース VIII。[🧾 お会計をお願いします] を押します。8 行、自分の数字です。
前 | 後 |
適切なデモ | 誰が何を食べたかを数える |
1 つのゴールデン回答 | 正解のセットとルール |
手動で編集するプロンプト | ループが書き換える命令 |
増加する数字 | 説明責任を果たす裁判官 |
1 回の実行 | 往復 |
渡された指標を | 選択した番号 |
持ち帰るもの(順不同):
- 指標を選択する前に、書き留めることができる内容(回答、ルール、または良いものの説明のみ)を尋ねます。ディナーには正解のセットがあり、コンパレータは 1 つに対してチェックします。
- ループの前にルーラーを構築し、ルーラーがペナルティを科す世界の状態にします。
- 判定を指標の内側に配置します。ADK はしきい値を適用しません。
- 最初の最適化実行の前に、トレーニング データとホールドアウト データを分割します。オプティマイザー独自のスコアに基づいてリリースしないでください。
- 合格率ではなく、ハングリー シートの数を数える。小規模な試験は嘘をつく。
- オプティマイザーに害を認識させる: 理由を返すジャッジは、オプティマイザーの仕事の半分を担います。
- ADK はループを提供しますが、境界はユーザーが設定します。停止も判断です。
- 数値が上限に達した場合は、エージェントのパフォーマンスが向上したためであり、基準が緩和されたためではありません。
ループは渡された数値をプッシュします。
本番環境が適合するケース
このラボのすべての操作は、作成した試験に対してマシン上で実行されました。本番環境は、誰も評価する予定がなかった夕食です。これこそが、ゴールデン アンサー指標ではできず、チェッカーができることです。つまり、事後評価です。

パイプ | how | 回答 |
① Cloud Trace |
| 今、大丈夫ですか?— スパン、プラットフォーム独自の審査員、オンライン モニター |
② BigQuery の行 | BigQuery エージェント分析プラグイン | 何を学ぶべきか?— イベントごとに 1 つの構造化された行。チェッカーと評価セットが取り込む形式 |
リポジトリはパイプをコースではなくスクリプトとして提供します。refuel/send_traffic.py は実際の当事者をデプロイされたホストに送信し、refuel/replay_to_bq.py は同じ会話を行として取得し、refuel/harvest.py は world.everyone_ate で各行を再評価し、失敗を評価ケースとして生成します。これはグループの実際の言葉であり、正解はありません。本番環境の夜、出荷されたホストは 8 つの実際のパーティーのうち 7 つをフィードしました。1 つの失敗は、コース V の上限が予測した正確な席である Lena がラストオーダーに反したことでした。これは次のラウンドの試験問題になりました。2 周目は、コース V にもう 1 つのトレーニング ケースが追加されます。課金が有効な Google Cloud プロジェクトが必要なため、メニューのプレートではなく、ここで読み上げます。
自習
- 自分でパーティを作成(
world.PARTIES、scripts/make_evalsets.py)して、試験に臨みます。公平かどうか。scripts/verify_world.pyスタイル: すべてのグループに、全員が食事できる予約が少なくとも 1 つ必要です。 - 評価の基準を 0.9 に引き上げ、
adk optimizeをeval_config_rating.jsonに設定します。グラデーションを測定します。 - 課金が有効になっているプロジェクトがありますか?
refuel/パイプをエンドツーエンドで実行し、harvest.pyの[skip]行を読み取ります。これらは、2 つのパイプ間の境界を可視化したものです。 HOST_THINKING=2048を使用してループを実行します。何が変化し、その変化から天井がどこにあるのかをどのように判断しますか?