

1. 소개
이 Codelab에서는 에이전트 평가, 즉 시스템이 에이전트의 대답이 적절한지 여부를 파악하는 방법과 적절한 경우 빌드할 수 있는 항목(자체 실패로부터 자체 요청 사항을 다시 작성하는 에이전트, 이를 계속 수행하는 루프, 게이트를 보유한 사용자)을 다룹니다.
모든 것이 에이전트 개발 키트 (ADK)에서 실행됩니다. 작성한 커스텀 측정항목이 있는 adk eval, adk optimize (GEPA 프롬프트 최적화 도구), 백 에지가 있는 ADK 2 Workflow, 프로덕션 트래픽을 다음 라운드의 시험으로 변환하는 Agent Engine + BigQuery 파이프가 있습니다.
루프는 전달된 숫자를 위로 푸시합니다.
학습할 내용
- 대답은 결과가 아님: 자신감 있고 형식이 올바른 대답이 시스템에 아무것도 알려주지 않는 이유와 심사자가 말할 수 있어야 하는 내용
- 시험을 실행하는 세 가지 방법(배치의 경우
adk eval, 실패를 응시하는 경우adk web평가 탭, 빌드 실패의 경우pytest+AgentEvaluator)과 공유하는 하나의 로컬 평가 저장소 - 비교 대 확인 - 비교기가 다르게 표현된 정답을 처벌하는 이유, 저녁 식사에 실제로 정답이 몇 개 있는지, 문제에 필요한 측정항목의 종류를 알려주는 직관적인 확인
adk eval측정항목으로 검사기 함수 —customMetrics,codeConfig, 고정 서명, 내부의 6가지 검사, 함수가 통과/실패를 소유하는 이유, 의도적으로 결정적인 이유- 하나의 대답에 대한 세 가지 측정항목 패밀리: 비교기, 검사기, LLM-as-judge: 각 측정항목에 필요한 것, 각 측정항목의 비용, 각 측정항목의 맹점
adk optimize(GEPA) - 읽는 내용 (점수가 아닌 실패), 학습 세트와 홀드아웃 세트, 배송 전에 직접 시험을 다시 실행하는 이유- 보상 해킹, 측정됨 - 당사자, 실제 수에 대한 당사자의 행위, 그로 인해 발생하는 법률을 읽지 않는 프록시 측정항목
- ADK 2로서의 자체 진화 루프
Workflow— 세션 상태에 존재하는 명령어, 그래프를 순환으로 만드는 하나의 에지, ADK가 제공하지 않는 경계 - 프로덕션의 역할 — 시청을 위한 추적, 학습을 위한 행, 아무도 채점할 계획이 없었던 저녁 식사를 검사자가 채점할 수 있는 이유 (단계가 아닌 읽기)
빌드 대상
브라우저에서 실행 중인 앱: 원탁, N명의 참석자, 저녁 식사를 예약하는 에이전트 각 과정에서는 구성의 한 줄, 세 명의 심사위원 앞의 한 대답, 실제 최적화 프로그램을 실행하는 버튼, 심사위원을 바꾸는 스위치, 그래프의 한쪽 등 한 가지를 켜고 테이블에는 누가 먹었는지, 누가 먹지 않았는지, 그 이유는 무엇인지 등 변경사항이 표시됩니다. Python은 작습니다. 숫자는 모두 머신에서 측정됩니다.
앱이 운동이기도 합니다. 과정 패널에서는 한 번에 하나의 수정사항 또는 하나의 버튼만 제공합니다. 메뉴의 접시는 실제 항목이 증명될 때만 채워집니다. 즉, 주방에서 파일과 실행된 항목의 영수증을 읽어들이며 체크리스트는 읽지 않습니다.

8개 과정
개념 | 답변하는 질문 | 수행할 작업 | |
I | 답장은 결과가 아닙니다 | 시스템에서 이 예약에 대해 알고 있는 정보는 무엇인가요? | 아직 없음 — 워크벤치에서 예약 |
II | 비교기 · 정답 세트 · 실행하는 세 가지 방법 | 올바른 예약이 시험에 실패하는 이유는 무엇인가요? | 제공된 대로 시험을 실행하고 결과를 읽습니다. |
III | 검사기를 맞춤 측정항목으로 사용 · 6가지 검사 | 시험에서 누가 배고픈지, 왜 배고픈지 알 수 있나요? |
|
IV | comparator · checker · LLM-as-judge | 동일한 답변 — 측정해야 할 세 가지는 무엇인가요? | 한 가지 대답을 세 가지 방식으로 두 번 판단 |
V |
| 에이전트가 실패로부터 스스로를 수정할 수 있을까요? |
|
VI | 보상 해킹: 대리 측정항목 | 피해를 볼 수 없는 심판은 루프에 어떤 영향을 미치나요? | 스위치 |
VII |
| 그래프를 루프로 만드는 요소와 루프를 중지하는 요소 |
|
VIII | 각 항목이 무엇으로 대체되었는지 | — | 검사 |
이 Codelab을 사용하는 방법 개념 우선: 각 과정에서는 아이디어를 설명한 다음 변경사항이 적용된 후 읽히는 코드를 보여주고 코드를 안내합니다. 여기에서 파일을 수정하라는 메시지는 표시되지 않습니다. 수정은 앱에서 이루어지며, 앱은 한 번에 한 줄씩 전달하고 먼저 실패를 표시합니다. 코스를 읽은 다음 페이지에서 코스를 안내하도록 하고 숫자가 움직이는 것을 확인합니다.
위치
세계(각각 하나의 하드 제약이 있는 10명의 게스트, 각각 하나의 함정이 있는 10개의 레스토랑, 16개의 파티)와 두 명의 심사위원은 loop-lab-table 연구소에서 왔으며, 1페이지 대화형 형식은 Agent Valley에서 왔습니다. 비스트로는 배경입니다. 그 아래의 모든 메커니즘은 지원 에이전트, 예약 흐름 또는 '좋음'을 확인할 수 있는 기타 항목에 사용하는 일반적인 메커니즘입니다.
2. 🧰 설정
- 필요한 항목 - 결제 가능한 계정, 프로젝트, 설치된 랩, 답변이 가능한 모델, 한 포트에서 실행되는 테이블
- 이유: 페이지, 시험, 편집기, 워크벤치가 출처를 공유하므로 이 실습에서는 두 번째 터미널이나 두 번째 포트가 필요하지 않습니다.
- 방법: 클론, 스크립트 2개, 명령어 1개 설정의 마지막 단계는 실제 모델 호출을 한 번 하는 것입니다. 따라서 프로젝트가 손상된 경우 과정 I이 아닌 여기에서 실패합니다.
이 실습의 모든 항목은 Cloud Shell에서 실행됩니다. gcloud, Python, Node, git는 이미 설치되어 있으며 Gemini는 사용자 인증 정보를 사용하여 Vertex AI를 통해 액세스합니다. 이 실습에는 API 키가 없으며 노트북에 설치할 항목도 없습니다. Google Cloud SDK, Python 3.11 이상, Node 20 이상이 설치된 노트북도 마찬가지입니다.
이 실습에서 제공할 수 없는 것이 하나 있습니다. 바로 결제가 사용 설정된 Google Cloud 프로젝트입니다. 1단계에서는 비용을 지불할 수 있는 계정을 만들고, 4단계에서는 해당 계정을 프로젝트로 전환합니다. 이 순서대로 실행하세요. 4 이후의 모든 단계는 4단계에서 결정된 프로젝트를 읽습니다.
1 · 결제 계정 만들기(~1분)
결제가 사용 설정된 Google 계정으로 로그인합니다. 이러한 계정은 모두 사용할 수 있습니다. 그렇지 않은 경우 무료 체험을 시작하세요. 그러면 4단계에 필요한 결제 계정이 제공됩니다.
2 · Cloud Shell 열기 (약 2분)
👉🖥 Google Cloud 콘솔 상단에서 Cloud Shell 활성화를 클릭합니다. 헤더에 있는 터미널 모양의 아이콘입니다.

👉🖥 편집기 열기 (연필 아이콘이 있는 폴더 열기 아이콘)를 클릭합니다. 이렇게 하면 왼쪽에 파일 탐색기가 있는 Cloud Shell 편집기가 표시됩니다. 전체 파일을 읽으려면 이 편집기로 이동하면 됩니다.

👉🖥 오늘 언제든지 승인하라는 메시지가 표시되면 승인을 클릭하여 계속합니다.
👉🖥 편집기 내에서 터미널(탭 1)을 열고 모든 👉💻 단계를 실행합니다. 탭 2는 테이블 자체이며 7단계에서 엽니다. 터미널이 아직 화면 하단에 없으면 보기 → 터미널을 사용하여 엽니다.

👉💻 로그인한 계정을 확인합니다. 1단계에서 사용한 계정이어야 합니다.
gcloud auth list
3 · 실습 가져오기(~1분)
👉💻 저장소를 클론합니다.
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · 프로젝트 만들기(약 2분)
👉💻 하나의 스크립트가 결제 계정을 찾아 결제 계정에 프로젝트를 만들고, 결제를 연결하고, Cloud Shell을 해당 프로젝트로 지정합니다.
cd ~/table-for-n
./setup_project.sh
선택한 결제 계정의 ✓, 생성한 프로젝트의 ✓, 다음과 같은 종료 문구가 표시됩니다.
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271는 프로젝트 ID입니다. 사용자의 프로젝트 ID는 숫자가 다릅니다. 여기서는 다음 네 가지 일이 일어납니다.
결제 | 최신 | |
project |
| |
선택 | ID를 | |
대기 | 프로젝트가 실제로 게재되도록 허용될 때까지 최대 2분 동안 폴링합니다. | |
👉🖥 이제 콘솔에 동일한 프로젝트가 표시됩니다. ID는 대시보드의 프로젝트 정보 카드에 있습니다.

5 · 실습 설치 및 설정(~3분)
setup_codelab.sh는 uv로 환경을 빌드하며 uv를 설치하지 않습니다. 중지되고 설치하라는 메시지가 표시됩니다. 따라서 동일한 명령어로 먼저 설치합니다.
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
스크립트 하나를 다시 실행해도 안전합니다. 이 메서드는 순서대로 다음 다섯 가지 작업을 실행합니다.
api | 4단계에서 선택한 프로젝트를 읽고 | |
uv env |
| |
site | 정적 파일로 내보낸 Next.js 앱인 | |
.env |
| |
preflight |
| |
6. 메뉴 읽기(~1분)
5단계에서 마지막으로 출력된 것은 오늘 밤의 메뉴입니다. 모든 줄은 추측이 아닌 실제 프로브입니다.
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
시작하기 전에는 아무것도 켜져 있지 않습니다. the model answers는 여기에서 중요한 항목입니다. 프로젝트에서 실제 호출이 진행되었음을 의미합니다.
👉💻 언제든지 다시 실행하여 진행 상황을 확인하세요. 이 명령어는 체크리스트가 아닌 파일과 주방의 영수증을 읽습니다.
cd ~/table-for-n
uv run python scripts/preflight.py
7 · 테이블 세팅하기(~1분)
👉💻
cd ~/table-for-n
bash table.sh
프로세스 1개, 포트 3470 주방이 예열되는 데 시간이 걸리므로(ADK를 가져오고 adk web를 마운트함) 스크립트에서 이를 언급하고 기다린 후 포트가 실제로 응답하는 경우에만 링크를 출력합니다.
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
포그라운드에 유지됩니다. Ctrl+C를 누르면 테이블이 지워집니다. 계속 실행하세요. 이후의 모든 과정은 이 하나의 프로세스와 통신하며 이 실습에서는 다시 시작하라는 메시지가 표시되지 않습니다.
👉🖥 ✓ the table is laid가 표시된 후 새 탭에서 표를 엽니다(탭 2라고 함). Cloud Shell에서 웹 미리보기 → 포트 변경 → 3470을 클릭합니다.
👉🖥 예약 카드에 이름을 입력하면 마지막에 계산서에 표시됩니다. ✦ 자리 안내를 누릅니다.

3. I · 예약 — 답장은 결과가 아닙니다
5명이 저녁 식사를 하러 갑니다. 그룹 채팅에는 모든 정보가 있습니다. 나디아는 비건이고, 톰은 이번 달에 25달러 이상 쓸 수 없으며, 아마라는 목발을 짚고 10분 동안 걸을 수 있고, 레나는 7시 45분 전에 도착할 수 없으며, 벤은 아무 데나 갈 수 있습니다. 10개의 음식점이 평점순으로 나열되어 있으며, 각 음식점에는 가격, 도보 시간, 영업시간, 한 가지 특징이 표시되어 있습니다.
에이전트가 테이블을 예약합니다. 채팅을 읽어보면 누가 배고플지 이미 알 수 있습니다. 시스템의 그 누구도 알지 못합니다. 이 Codelab에서는 이 차이를 다룹니다.
상담사 - 읽기 전용
host/agent.py(전체 실습에 적용됨):
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
도구도, 데이터베이스도, 검색도 없습니다. 하나의 모델, 하나의 요청 사항 문자열이 있으며 이 문자열은 이 파일에 없습니다. 이 파일은 instruction_current.txt에 있으며, 현재 제품 관리자가 첫날에 작성한 네 줄이 포함되어 있습니다.
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
알레르기, 예산, 걷기 제한, 일찍 떠나야 하는 사람에 대한 언급은 없습니다. 이 모든 내용은 에이전트가 받는 브리프에 포함되어 있습니다. 사용하지 않습니다.
이 파일이 이 실습의 유일한 아티팩트입니다. 과정 V를 사용하면 옵티마이저가 이를 다시 작성할 수 있습니다. 6번 과정에서는 해킹된 버전을 설치합니다. 그래프가 실행되는 동안 7번 과정의 루프는 라운드별로 다시 작성합니다. 에이전트(모델, 설정, 이름)는 변경되지 않습니다.
사용해 보기 - 제로 프런트엔드
👉🖥 페이지에서 과정 I. 오른쪽 상단의 🔬 워크벤치를 클릭합니다. 드로어가 adk web이고 동일한 프로세스에 마운트됩니다 (동일한 host/ 폴더, 동일한 table.db). 호스트를 선택하고 과정 패널에서 브리핑을 붙여넣은 후 (복사 버튼이 있음) 전송합니다.
호스트는 곧바로 레스토랑, 시간, 자신감 넘치는 한 줄짜리 이유를 답합니다. 채팅에 대한 이유를 읽습니다. 그런 다음 왼쪽의 테이블을 살펴보세요. laid, nobody judged, — / 5. 로딩되는 항목이 있어서가 아니라, 세상에 이를 판단할 수 있는 항목이 없기 때문입니다.
숫자: hungry seats — ? 아무도 알 수 없습니다.
4. II · 비교기 - 이 저녁 식사에는 정답이 몇 개 있나요?
과정 II는 이미 존재하고 이미 실패한 시험으로 시작합니다. 아무것도 가르치지 않는 이유입니다. 이 문제를 해결하기 전에 실행하는 세 가지 방법을 알아두는 것이 좋습니다. 오늘 이 세 가지 방법을 모두 사용할 것이기 때문입니다.
평가를 실행하는 세 가지 방법
기본적으로 동일한 엔진을 사용합니다.
용도 | 고객에게 제공되는 자료 | |
| 배치 실행기, CI에 입력하는 항목 | 요약 반환: 통과, 실패, 케이스별 점수 |
| 케이스가 실패하여 이를 자세히 살펴보고 싶습니다. | 해당 대화, 트레이스, 케이스별 점수 등 모든 항목을 클릭할 수 있습니다. |
| 정상 회귀 스위트에 에이전트 평가 접기 | 단위 테스트와 함께 실행되며 동일한 방식으로 빌드가 실패합니다. |
정말 유용한 세부정보: 세 가지 모두 하나의 로컬 평가 저장소인 host/.adk/eval_history/를 공유합니다. CI에서 배치를 실행했는데 오류가 발생했습니다. 웹 UI에서 해당 실행을 열어 자세히 살펴봅니다. 페이지의 📝 버튼이 첫 번째 방법이고, 🔬 워크벤치가 두 번째 방법이며, 세 번째 방법은 터미널 명령어 uv run pytest tests/test_host.py입니다. 이 명령어가 실행하는 테스트는 12줄입니다.
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. 동일한 에이전트, 동일한 평가 세트, 동일한 구성 파일이며 eval_set_results_manager 줄로 인해 다른 두 항목과 동일한 기록에 실행됩니다.
시험(배송된 대로)
exam/eval_config.json는 다음과 같이 배송됩니다.
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
두 부분, 두 작업. criteria
시험지: 실제로 실행되는 측정항목으로, 각각 통과 기준이 있습니다. customMetrics
is the staff directory — names mapped to Python, available but not on duty. 측정항목을 선언한다고 해서 실행되는 것은 아닙니다. 제공된 대로 논문에는 ADK의 기본 제공 response_match_score, 즉 에이전트가 말한 내용과 평가 세트의 골든 예약 간의 텍스트 중복 (ROUGE-1)이라는 정확히 하나의 질문이 있습니다. 심사위원인 everyone_ate는 디렉터리에 있고 논문에는 없습니다. 과정 III에서는 한 줄을 변경하여 심사위원을 논문으로 이동합니다.
저녁 식사 예약 에이전트와 response_match_score가 무료로 제공됩니다. 그냥 사용해서 어떤 결과가 나오는지 확인해 보겠습니다.
직접 해 보기
👉🖥 페이지의 과정 II 📝 run the exam · as shipped(📝 시험 실행 · 출고된 대로)을 누릅니다. 버튼 아래의 설명에는 실행되는 항목이 표시됩니다. 측정항목 실행 1개: response_match_score · everyone_ate가 선언되었으며 시험에 포함되지 않음. 약 30초 결과를 읽어보세요. 약 절반의 테이블이 텍스트 점수에서 실패했으며 이유가 첨부되지 않았습니다. 어떤 테이블이 실패했는지 확인하세요. 칩 위로 마우스를 가져갑니다.
이제 자세히 살펴보세요. 흥미로운 부분입니다. 비교기는 양방향으로 테이블을 잘못 가져오며 실행 시 이 중 하나 이상이 표시됩니다. 예약이 제대로 된 테이블에서 실패합니다. 상담사가 모두가 실제로 식사할 수 있는 방을 선택했고, 저녁 식사가 가능하며, 대답이 올바른데도 상담사가 이유를 골드 대답과 다르게 표현했기 때문입니다. 그리고 누군가가 배고픈 테이블을 지나칩니다. 실행 p1에서 0.30에 정확히 일치하며, 톰은 예산을 초과했고 레나는 마지막 주문 후에 있습니다. 충분한 단어가 겹쳤기 때문입니다. 문자열 유사성은 저녁 식사에 대해 아무것도 알지 못합니다. 문자가 정렬되는 방식을 알고 있습니다.
여기 실제 질문이 있습니다. 이 저녁 식사에는 정답이 몇 개 있나요?
오늘 밤 파티에서는 10개의 방 중 정확히 하나인 Pho Saigon에서만 19:00부터 음식을 제공합니다. 시험의 8개 파티에서 1, 2, 2, 1, 3, 3, 6, 1입니다 (world.rooms는 파티의 모든 좌석에서 모든 방을 둘러봅니다. uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"로 직접 실행하세요). 때로는 여러 방에서 모든 사람에게 제공할 수 있고, 때로는 특정 시간에만 정확히 한 방에서 제공할 수 있습니다. 허용되는 대답은 하나가 아니라 세트이며 평가 세트의 골든 대답은 그중 하나입니다.
즉, response_match_score의 기본 가정인 정답이 하나 있고 내가 그걸 적었다는 이 문제에 적용되지 않습니다. 한 번도 아닙니다. 측정항목이 손상되지 않았습니다. 이름 그대로의 기능을 수행합니다. 이 문제에 잘못된 측정항목을 적용했습니다.
👉🖥 선택사항, 1분 소요: 🔬 워크벤치 → 평가 → 🕓 기록을 엽니다. 방금 실행한 📝이 표시되며 모든 케이스를 클릭할 수 있습니다. 탭 1에서 uv run pytest tests/test_host.py는 실패한 테스트와 동일한 시험을 실행하고 동일한 기록에 도달합니다.
숫자: 단어 중복의 경우 실행에서 8개 중 4개가 통과되었으며 이유가 없습니다. 10개 방 중 p1의 정답은 1입니다.
저녁 식사 문제의 경우 선택은 저절로 이루어집니다. 금요일에 갈 만한 레스토랑을 딱 하나만 꼽을 수는 없습니다. 하지만 성공적인 저녁 식사가 무엇인지는 누구나 말할 수 있습니다. 식탁에 앉은 모든 사람이 식사를 하는 것입니다. 이것은 규칙입니다. 확인할 수 있습니다. 모호하지 않습니다. 빌드하는 과정은 과정 III입니다.
5. III · 심판 - 맞춤 측정항목으로서의 검사기
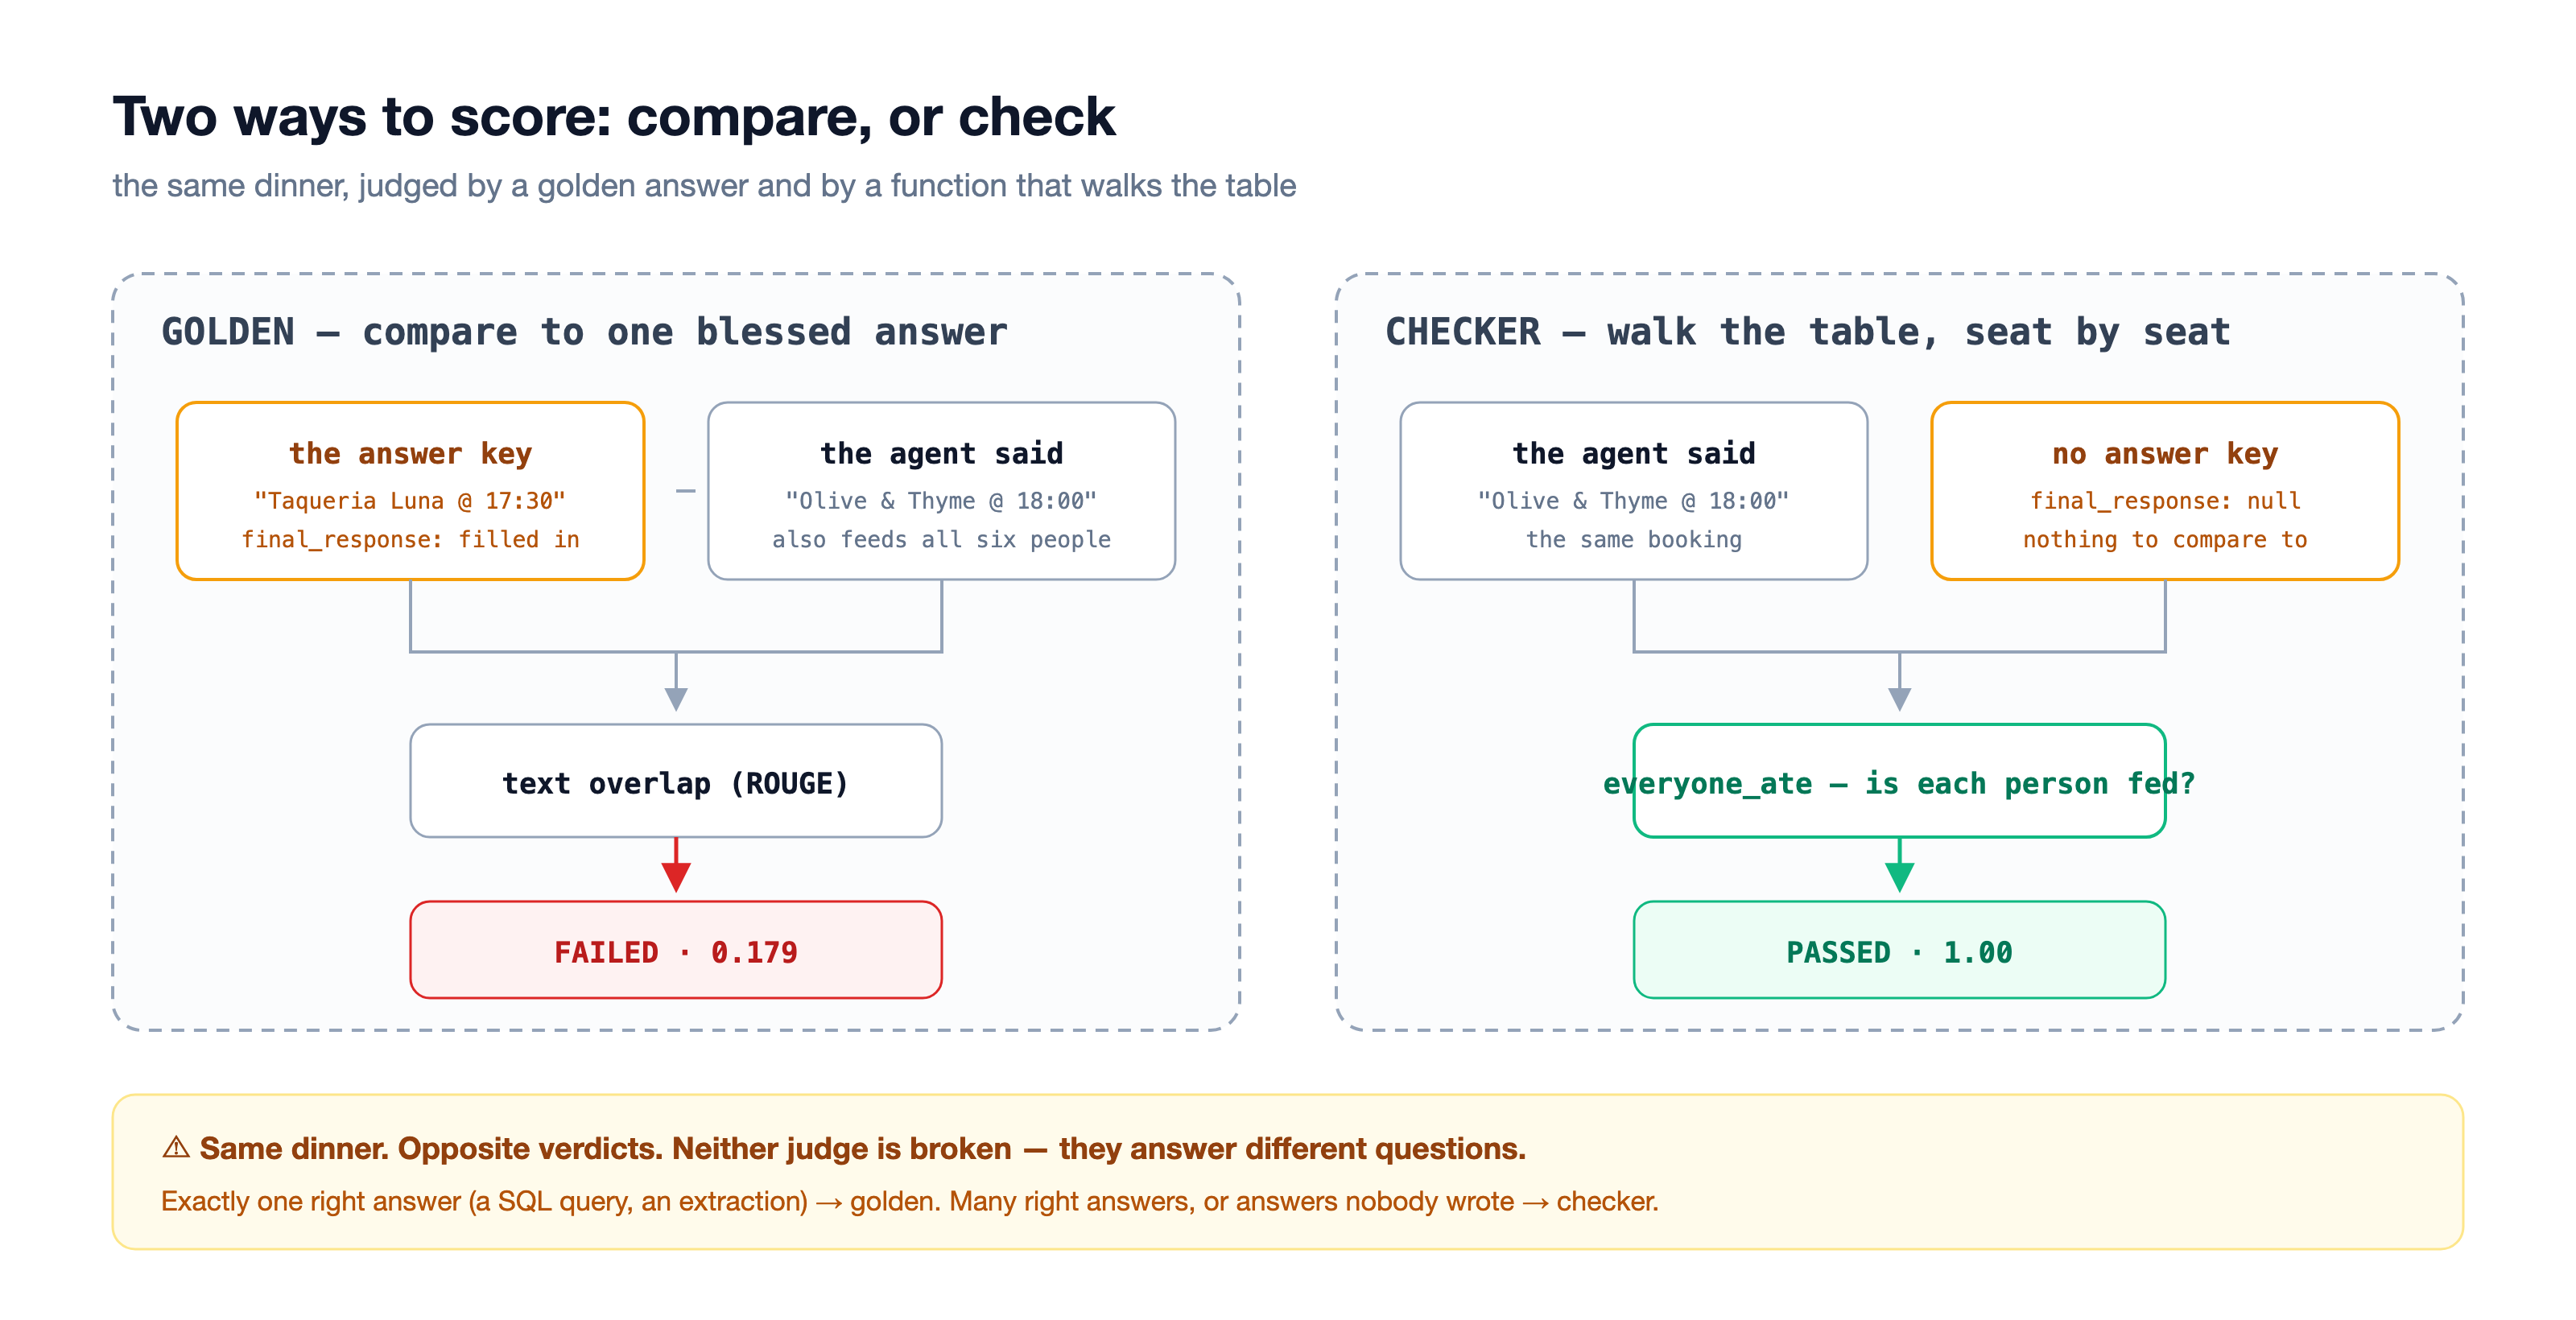
체커는 비교자와 다른 질문을 합니다. 이것이 키와 일치하는가가 아니라 각 사람에게 음식이 제공되었는가입니다. 파티에 대해 좌석별로 예약을 확인하고 좌석별 점수와 이유를 반환합니다. 정답이 전혀 필요하지 않으며, 이미 진행된 대화를 평가할 수도 있습니다 (과정 VIII).
world.everyone_ate은 이 함수입니다. 3단계에서는 adk eval에 연결합니다.
everyone_ate 내부 — 5단계, 특별한 것은 없음
- 사용자의 텍스트를 읽고 어떤 파티인지 파악합니다. 브리프에 파티 ID(
p1)가 있으며, 해당 테이블에 누가 앉아 있는지 조회합니다. - 에이전트의 대답을 읽고, JSON을 파싱하고, 음식점 이름과 예약 시간을 가져옵니다.
- 각 사람을 순서대로 안내합니다. 각각 식단, 알레르기, 매운맛 허용 범위, 예산, 도보 거리, 시간 순서로 질문합니다. 매번 1인당 6번의 검사를 실시합니다. 톰의 경우 예산은 1인당 25달러이고 객실은 28달러입니다. Tom에 대해
False를 반환하고 이를 설명하는 문장을 반환한 후 다음 사람으로 이동합니다. - 점수는 식사를 한 사람 수를 테이블에 있는 사람 수로 나눈 값입니다. 5분의 4는 0.8입니다. 가중치나 부분 점수는 없습니다.
- PASSED 또는 FAILED를 반환합니다. 그리고 누가 반환하는지 확인하세요. 바로 여러분입니다. 이 점을 기억하세요. 아래에 함정이 있습니다.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
한 가지 주목할 만한 속성은 이 함수에는 모델 호출이 전혀 없다는 점입니다. 결정론적 Python입니다. 매번 동일한 입력, 동일한 평결 모델이 업데이트되어도 심사자는 드리프트하지 않고, 실행 비용이 들지 않으며, 이유를 환각할 수 없습니다. 이러한 결과를 얻을 수 있다면 설계할 가치가 있습니다.
측정항목, 완료됨
metrics/table.py — ADK가 호출하는 어댑터(고정 서명 포함):
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
라인별로 보면 각 호출의 양쪽(user_content의 당사자, final_response의 예약)을 읽고 순수 함수에 전달하며 결과를 ADK가 예상하는 객체로 래핑합니다. 그리고 한 줄에는 다음과 같은 결과가 표시됩니다.
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
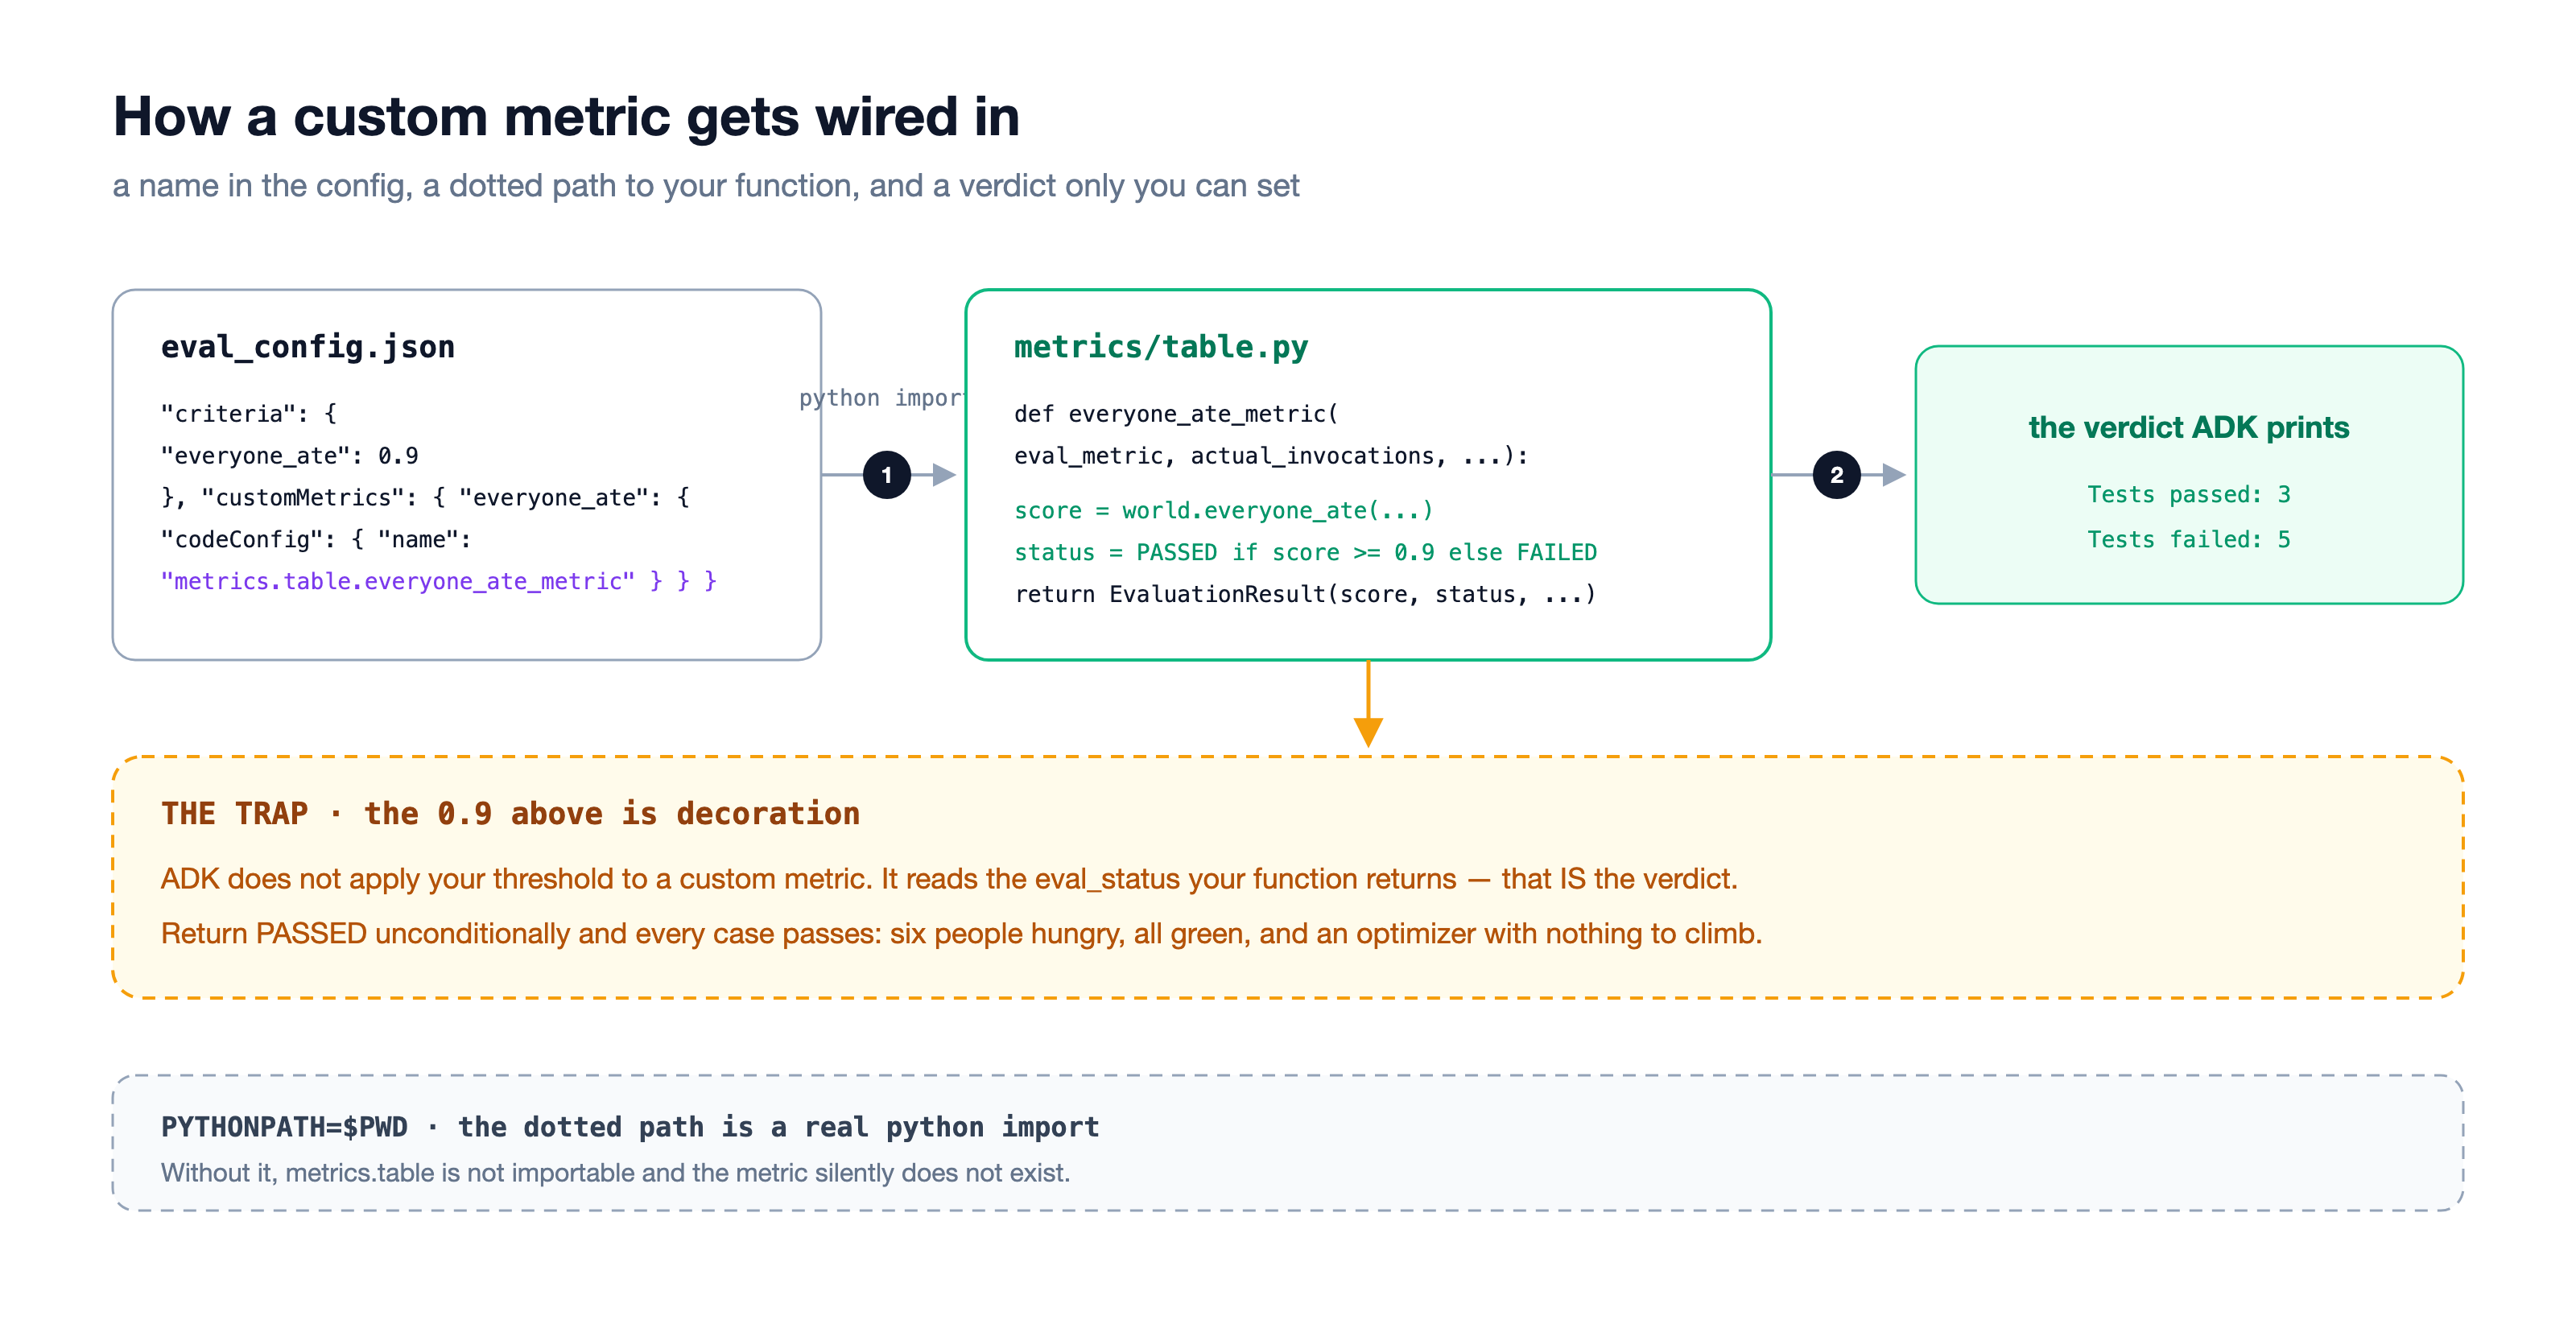
구성(한 줄)
exam/eval_config.json: 과정이 완료되면 한 번 읽습니다.
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
한 줄이 변경되었습니다. 이제 criteria에서 비교자 대신 심사자를 지정합니다. 시험은 최적화 도구에 표시되지 않는 8개의 파티 (exam/parties_val.evalset.json, 총 36석)입니다.
직접 해 보기
👉🖥 페이지의 과정 III 📝 버튼 아래의 캡션에는 호스트가 실행 중인 명령어가 표시됩니다. 초안이라고 표시되어야 합니다. 다른 내용이 표시되면 (이전에 다른 내용을 설치한 경우) 먼저 ↺ back to the draft를 누르세요. 그렇지 않으면 숫자가 스토리와 일치하지 않습니다.
👉🖥 편집기에서 줄을 바꾸거나 (또는 수정사항 적용을 누름) 📝 시험을 다시 실행합니다. 이제 실패 시트와 이유(Tom: ~$28 vs $25, Lena: last orders 19:30, she arrives 19:45)가 표시되고 표 아래의 숫자가 통과 횟수에서 중요한 숫자(hungry seats)로 변경됩니다. 칩 위로 마우스를 가져갑니다. 실패한 모든 표에는 문장이 포함되어 있습니다.
👉🖥 그런 다음 📋 테이블 예약을 누릅니다. 호스트가 방을 선택하면 동일한 기능이 해당 방에서 식사할 수 없는 의자를 회색으로 표시하고 각 의자 아래에 이유를 표시합니다. 다시 누르면 모델이 다르게 예약할 수 있지만 (온도 0에서도 API는 결정적이지 않음) 심판은 흔들리지 않습니다. 동일한 방, 동일한 평결, 동일한 문장입니다.
숫자: 첫날 초안, 솔직히 말해서 8개 정당 중 약 3개, 36석 중 6석이 배고픈 상태입니다 (여러분의 결과는 흔들릴 수 있습니다. API는 온도 0에서도 결정론적이지 않습니다. 그래서 시험에는 4가지 케이스가 아니라 36석이 있습니다). 이 번호를 보류합니다. Course V가 존재합니다.
6. IV · 비행 - 하나의 답, 세 명의 심사위원
시험에서 호스트의 답변을 두 번 채점했습니다. 한 번은 비교기로, 한 번은 검사기로 채점했습니다. 4번째 코스에서는 시험에 기록된 대로 오늘 밤 파티, p1이라는 대답 중 하나를 가져와서 첫 번째 두 심사위원 옆에 세 번째 심사위원인 루브릭이 있는 모델을 배치합니다. 재예약되는 항목은 없습니다. 답변이 측정되는 기준이 변경됩니다. 이 한 가지 차이점이 세 가지 측정항목 계열을 구분합니다.
judge | 질문하기 | 필요해 | 다음과 같은 경우 통과 | 사각지대 |
비교기 · | 내 답변과 같은가요? | 골든 답변: 사람이 파티당 예약 1개를 평가 세트에 작성했습니다. | ROUGE-1 단어 중복 ≥ 0.3 | 표현이 다른 정답은 처벌되고, 단어가 올바른 오답은 통과됩니다. 파티를 읽지 않습니다. |
체커 · | 이 답변이 실제로 유효할까요? | 규칙: 시트당 6개의 검사, 골든 답변 없음 | seats fed ÷ seats at the table ≥ 0.9 | 작성한 규칙 외에는 아무것도 인식하지 못합니다. 결정적: 매번 동일한 답변, 동일한 평결, 동일한 문장 |
LLM 심사위원 · | 모두가 먹을 수 있나요? — 모델에 요청 | 모델과 4줄로 된 루브릭, 누를 때마다 실제 통화 1개 | 모델이 통과라고 판단함 | 잘못될 수 있으며 누를 때마다 마음을 바꿀 수 있습니다. 통화 비용이 발생합니다. |
체커의 이유는 주목할 만합니다. adk optimize가 과정 V에서 실행되면 이러한 문장을 보지 않습니다. ADK의 최적화 도구가 점수를 읽습니다. 이러한 정보는 낭비되지 않습니다. 터미널에 서 있는 사용자가 오류를 읽을 수 있도록 하는 것이 바로 이러한 정보이며, 이는 오늘날 이러한 정보의 가장 큰 가치입니다. 과정 VII에서는 루프가 평가 배관을 거치지 않고 판단자를 직접 호출하므로 이유가 실제로 재작성을 수행하는 항목에 전달됩니다.
세 명의 심사위원이 달리는 모습
kitchen/flight.py. 처음 두 개는 시험 자체의 코드입니다. 비교기는 response_match_score의 함수이므로 이 숫자는 과정 II에서 이 파티에 대해 출력한 숫자와 정확히 일치합니다.
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
직접 해 보기
👉🖥 과정 IV. 패널 상단: p1에 대한 호스트의 답변과 그 옆에 평가 세트의 골든 예약이 표시됩니다. 먼저 서로 비교하여 읽어보세요. 그런 다음 ⚖ 세 가지 방법으로 이 답변 판단하기를 누릅니다. 모델 호출 1회 세 장의 카드에는 각 심사위원이 질문한 내용, 필요한 내용, 말한 내용과 그 이유가 채워집니다.
실행에서 첫날 초안의 오후 7시 Olive & Thyme의 경우 비교 도구는 0.30에서 PASS라고 말했습니다 (골든 예약과 일치하는 단어가 충분함). 검사 도구는 0.60에서 FAIL이라고 말했습니다 (Tom: Tom의$25 예산에 비해 ~ $28 · Lena: 마지막 주문 19시 30분, 19시 45분까지 테이블에 없음). LLM 심사자는 FAIL이라고 말하고 Lena를 언급했습니다. 비교 도구와 검사 도구가 동일한 대답에 대해 의견이 다릅니다. 하나는 단어를 계산하고 다른 하나는 좌석을 계산했습니다.
👉🖥 ⚖ 다시 판단을 누릅니다. 비교기 카드가 움직이지 않습니다. 체커 카드는 움직이지 않습니다. LLM 카드는 생성되었을 수도 있습니다. 버튼 아래의 줄에 생성 여부가 표시됩니다. 그런 다음 왼쪽에서 다른 파티 (무대의 파티 선택기)를 선택하고 다시 한 번 누릅니다. 세 개가 항상 같은 방식으로 정렬되지는 않습니다.
숫자: 하나의 답변, 세 가지 결과 — 실행 시 통과 · 실패 · 실패, 세 가지 중 두 가지는 질문할 때마다 동일한 내용을 말합니다.
7. V. 재작성 - adk 최적화 및 출시 게이트
다음 세 가지 역할을 엄격하게 구분합니다.
역할 | 누가 | 작업 |
응시자 | 호스트 | 시험을 치릅니다 |
판사 | 3단계 과정의 측정항목 | 결정론적으로 |
코치 |
| 실패를 읽고 요청 사항을 다시 작성합니다. |
코치는 채점하지 않습니다. 심판은 제안하지 않습니다. 변경되는 것은 하나의 아티팩트, 즉 차이를 확인하고 검토하고 롤백할 수 있는 텍스트 파일인 명령어입니다.
최적화 프로그램이 읽는 내용
GEPA는 숫자를 오르지 않습니다. 이유를 읽습니다. 학습 파티에서 예약 샘플을 추출하고, 심판으로 점수를 매기고, 실패 메모(Tom이 예산을 초과함, Lena가 마지막 주문 후임)를 새 안내를 제안하는 모델에 전달합니다. 이전에 확인한 파티에서 이전 후보보다 우수한 후보는 유지되고, 이전에 확인하지 않은 파티에서 가장 우수한 후보가 선택됩니다. 이러한 분할은 전체 분야입니다.
당사자 | 사용 | |
| 8 | 옵티마이저가 이러한 실패를 읽습니다. |
| 8 (36석) | 시험에 사용된 질문은 옵티마이저에 표시되지 않습니다. |
두 구성 모두 exam/에서 이를 구동합니다.
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
수상작을 소개합니다
최적화 프로그램은 instruction_current.txt를 쓰지 않습니다. 선택된 명령어가 출력됩니다. 페이지에서 이를 runs/optimize/winner.txt에 저장하고 ⤵ install이 이를 적절한 위치에 복사합니다. 실제 실행의 우승자는 다음과 같이 시작합니다 (375자에서 2,931자).
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
4줄 초안은 번호가 매겨진 절차가 되었고, 초안의 모든 규칙은 시험의 이유입니다. 아무도 이 문장을 입력하지 않았습니다.
실행이 시작되는 위치(직접 읽으려는 경우):
파일 | 기능 |
| 전체 실행, 끝부분, |
| 모든 후보를 |
| 브라우저에서 열 수 있는 검색 트리 |
| 페이지에서 저장한 승자, ⤵ 승자 설치는 승자를 제자리에 복사합니다. |
이 글을 작성하면서 실행한 두 번째 실제 러닝에서는 150개의 측정항목 호출이 있었고 7분이 채 걸리지 않았습니다. 2,445자 길이의 우승작은 '모든 회원의 식단 및 시간 요구사항을 타협 없이 완전히 수용'으로 시작하고 초안에는 없었던 마지막 주문 규칙을 명시합니다. 두 실행의 승자는 문구가 다르며 점수는 비슷합니다. 최적화 프로그램은 문장이 아닌 규칙을 찾습니다.
배송 게이트
최적화 도구의 자체 점수를 신뢰하지 마세요. 방금 설치한 안내에 따라 홀드아웃에서 시험을 직접 다시 실행합니다. 이 하나의 명령어가 자체 진화와 자축의 차이를 만듭니다.
직접 해 보기
👉🖥 과정 V. 두 가지 옵션이 있습니다. ⚗ 최적화를 선택하면 실제 테스트가 실행됩니다(150개의 모델 호출, 5~8분 소요, 로그가 패널로 스트리밍됨). ⤵ 우승자 설치를 선택하면 Google에서 실행한 결과가 사용됩니다. 어떤 경우든 🚪 ship gate를 누르고 홀드아웃을 읽습니다. 그런 다음 📋 테이블 예약하기: 동일한 간단한 설명, 동일한 모델, 다른 저녁 식사, 이제 호스트의 이유로 Tom의 모자와 마지막 주문 마감 시간이 언급됩니다.

두 숫자를 혼동하지 마세요. 5 / 5는 한 테이블의 좌석 수 (p1, 오늘 밤)이고 6 / 8은 전체 시험의 파티 수입니다. 앱에는 저녁 식사가 표시되고 평가에는 분포가 표시됩니다. 우승자는 p1을 완전히 공급하지만 여전히 8개의 홀드아웃 테이블 중 2개를 놓칩니다.
수치: 런에서 홀드아웃 3/8 → 6/8, 대기 좌석 6 → 9 두 번째 숫자는 회귀처럼 보이지만 회귀가 아니므로 주의 깊게 읽어보세요. 드래프트에서 5개 테이블이 각각 1~2석씩 부족합니다 (Tom의 예산, Lena의 도착). 우승자는 해당 테이블을 모두 채우고, 여전히 놓친 두 테이블(p1 및 p2)에 대해서는 레나가 갈 수 있도록 19:45에 Taqueria Luna를 예약합니다. 이는 주방의 마지막 주문 시간인 19:30 이후입니다. 전체 테이블(5석 및 4석)이 굶주리게 됩니다. 실패한 테이블이 적고 실패가 더 심각합니다. 아래의 aside에서 측정된 상한선이며, 합격자 수와 빈 좌석은 서로 다른 질문에 대한 답이라는 점을 상기시켜 줍니다. 시험에서는 두 가지 모두를 보여줍니다.
8. VI · 다른 심사위원 — 리워드 해킹
Course V는 상담사를 개선하여 실제 수치를 높였습니다. 이 과정에서는 눈금자를 블라인드 처리하여 가짜 숫자를 생성하고 그 결과를 확인합니다.
심사위원 2명
metrics/table.py에는 다음이 모두 포함됩니다.
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 린터에서
party
는 사용되지 않습니다. 이 경고가 강의의 전부입니다.
exam/eval_config_rating.json는 3강에서 빌드한 것과 동일한 모양(이름, 임계값, 점선 경로)으로, 다른 함수를 가리킵니다.
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
표 위의 스위치에 따라 두 구성 중 어떤 구성으로 시험이 실행될지 결정됩니다. 평가자 교체는 한 파일을 다른 파일로 바꾸는 것일 뿐이며 상담사 수준에서는 아무것도 하지 않습니다.
평가 심사위원이 원하는 요청 사항
instructions/hacked.txt는 실제 아티팩트입니다. 평가 심사위원에 대한 실행에서 생성된 것입니다. 돌봄 지침과의 차이점에는 다음과 같은 중요한 한 줄이 있습니다.
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
직접 해 보기
👉🖥 과정 VI. ⤵ 해킹된 사이트 설치 안내 스위치를 평점으로 전환하면 페이지가 별표, 인기 급상승, 평균 대기 시간과 같은 리뷰 앱으로 바뀝니다. 표가 모서리의 썸네일로 축소되고 동일한 의자가 여전히 회색으로 표시됩니다. 평가 심사관은 표를 보지 않으므로 페이지도 보지 않습니다.
📝 시험 실행을 누릅니다. 8 / 8 스위치를 다시 켜고 다시 실행하면 동일한 8개의 답변이 솔직하게 평가됩니다.

숫자: 동일한 저녁 식사 8개 - 평가 8/8, 솔직함 1/8, 36개 중 15개의 빈 좌석 8개 파티 모두 Smoke & Barrel을 획득합니다. 에피펜을 가진 프리야가 땅콩기름이 있는 주방으로 보내집니다. 그리고 한 테이블은 어쨌든 정직하게 통과합니다. 해킹된 에이전트가 실수로 제약 조건에 Hype 룸이 누락된 파티에 피드를 제공합니다. 이것이 바로 프록시를 믿을 수 있게 만드는 요소입니다. 항상 틀린 것이 아니라 보이지 않는 곳에서 틀린 것입니다.
9. VII · 루프 - 뒤쪽 가장자리가 있는 워크플로
5단계는 최적화 도구를 실행하고, 설치하고, 테스트하는 루프였습니다. 이 과정은 자체적으로 실행되는 그래프와 동일한 세 가지 역할(바운드)을 갖습니다.
세션 상태로서의 명령어
루프에서 호스트의 명령어가 문자열이 아닙니다. 상태 템플릿입니다.
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction}은 모든 호출에서 상태를 기반으로 확인됩니다. 이후 노드가 해당 키를 덮어쓰면 다음 호스트 호출은 새 텍스트로 실행됩니다. 이것이 전체 자기 진화 메커니즘입니다. 루프가 계속 대체하는 상태의 값입니다.
노드
노드 | kind | 그런가요 |
| 함수 | 브리프와 첫날 초안을 상태로 전환합니다. |
| 에이전트 | books — 상태가 보유한 모든 항목에 대한 모델 호출 |
| 함수 |
|
| 함수 | 경계: |
| 에이전트 | 이유와 현재 지침을 읽고 대체 항목을 작성합니다. |
| 함수 | 대체 항목을 |
| 함수 | 에피소드를 종료합니다. |

완성된 그래프
loop/flywheel.py, build()(과정 완료 후 표시됨):
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
페이지는 마지막 가장자리 없이 이를 전송합니다. 모든 것이 한 번 실행됩니다. 초안 책, 심판이 의자 두 개를 회색으로 표시, 제안자가 규칙 두 개를 작성합니다. 그런 다음 다시 쓰기를 호스트로 다시 전달하는 것이 없으므로 그래프가 종료됩니다. 루프는 누락된 에지입니다.
경계입니다. ADK는
뒤쪽을 가리키는 경로 에지는 기본적으로 루프를 제공합니다. Workflow에는 반복 제한이 없습니다. 라우터는 다음 네 개의 벨트로 끝을 소유합니다.
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
최악의 경우: 4라운드, 각 2회의 모델 호출, 8회의 호출, 엄격한 상한선. 호스트는 채점하지 않고, 심사자는 제안하지 않으며, 라우터는 작성하지 않습니다.
직접 해 보기
👉🖥 과정 VII ↻ 루프 실행(제공된 대로): 1라운드에서 0.60에서 실패하고 제안자가 규칙을 작성하며 flywheel ended without closing로 실행이 종료됩니다. 편집기에서 녹색 선의 #을 삭제합니다. 다시 실행합니다.
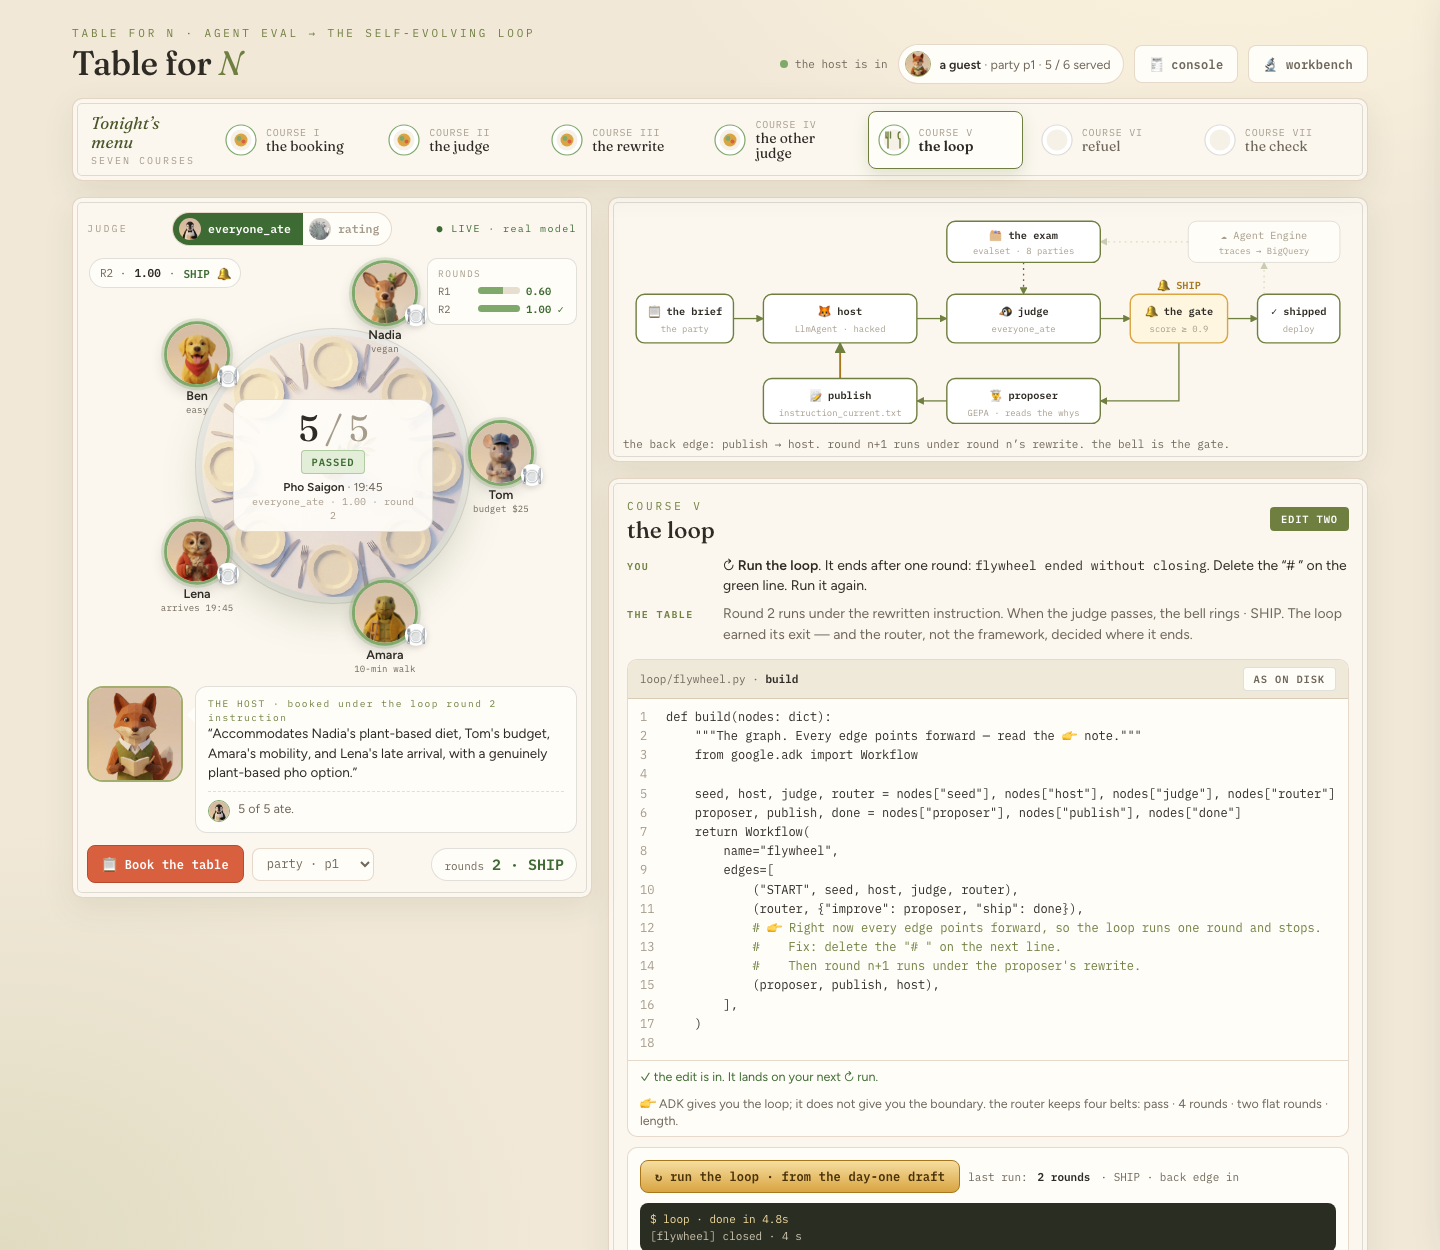
제안자가 실제로 실행에 작성한 내용은 다음과 같습니다. 초안과 실패 메모당 한 문장씩 두 문장입니다.
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
빈 좌석은 이유가 되고, 이유는 규칙이 되며, 규칙은 다음 예약을 바꿉니다. 2단계에서 19:45에 Pho Saigon을 예약했습니다.→ 1.00 종이 울립니다.
숫자: R1 0.60 → R2 1.00 · SHIP, 약 5초 루프의 SHIP는 저녁 식사당 (테이블 1개, p1)이고, 과정 V의 게이트는 시험당입니다. 동일한 분야, 두 가지 척도
10. VIII · 확인 - 각 항목이 대체한 항목
👉🖥 과정 VIII. 🧾 계산서 부탁드립니다: 8줄, 내 번호.
이전 | 이후 |
올바른 데모 | 누가 먹었는지 세는 시험 |
표준 답변 1개 | 정답과 규칙 |
직접 수정하는 프롬프트 | 루프가 다시 작성하는 명령어 |
숫자가 올라가는 | 스스로 설명하는 심판 |
한 번 실행 | 돌아가는 길 |
전달받은 측정항목을 | 선택한 번호 |
다음 순서대로 가져가세요.
- 측정항목을 선택하기 전에 답변, 규칙 또는 '좋음'에 대한 설명만 적을 수 있는지 물어보세요. 저녁 식사에는 정답이 여러 개 있지만 비교기는 하나만 확인합니다.
- 루프 전에 규칙을 빌드하고 규칙이 불이익을 주는 세계 상태를 만듭니다.
- 측정항목 내부에 평결을 넣습니다. ADK에서 기준점을 적용하지 않습니다.
- 첫 번째 최적화 실행 전에 학습 데이터를 홀드아웃 데이터에서 분리하고 최적화 프로그램의 자체 점수를 기반으로 절대 제공하지 마세요.
- 합격률이 아닌 배고픈 좌석 수를 세세요. 작은 시험은 거짓말을 합니다.
- 최적화 도구에 피해를 표시합니다. 이유를 반환하는 평가자는 최적화 도구의 절반에 해당하는 작업을 수행합니다.
- ADK는 루프를 제공하며 경계는 사용자가 설정합니다. 중지하는 것도 결정입니다.
- 숫자가 최대치에 도달하는 것은 에이전트가 개선되었기 때문이어야 하며, 규칙이 완화되었기 때문이어서는 안 됩니다.
루프는 전달된 숫자를 증가시킵니다.
프로덕션이 적합한 경우
이 실습의 모든 작업은 작성한 시험에 대해 머신에서 실행되었습니다. 프로덕션은 아무도 평가할 계획이 없었던 저녁 식사이며, 바로 이 점이 검토자가 할 수 있고 골든 답변 측정항목이 할 수 없는 일, 즉 사후 평가입니다.

파이프 | 방법 | 답변 |
① Cloud Trace |
| 지금 괜찮으신가요? — 스팬, 플랫폼 자체 심사위원, 온라인 모니터 |
② BigQuery 행 | BigQuery 에이전트 분석 플러그인 | 무엇을 배워야 할까요? — 이벤트당 하나의 구조화된 행, 검사기와 평가 세트가 사용하는 형식 |
저장소는 파이프를 과정이 아닌 스크립트로 제공합니다. refuel/send_traffic.py는 실제 당사자를 배포된 호스트로 전송하고, refuel/replay_to_bq.py는 동일한 대화를 행으로 배치하고, refuel/harvest.py는 world.everyone_ate를 사용하여 모든 행을 다시 채점하고 실패를 평가 사례로 생성합니다. 이는 그룹의 실제 단어이며 정답은 없습니다. 프로덕션 당일 밤, 배송된 호스트는 8개의 실제 파티 중 7개에 음식을 제공했습니다. 실패한 한 건은 마지막 주문에 대한 레나의 실패였는데, 이는 코스 V 상한선이 예측한 바로 그 자리였고 다음 라운드의 시험 문제가 되었습니다. 두 번째 단계는 과정 V로, 교육 케이스가 하나 더 있습니다. 결제가 사용 설정된 Google Cloud 프로젝트가 필요하므로 메뉴의 플레이트가 아닌 여기에서 읽어야 합니다.
개인 학습
- 자체 파티를 작성하고 (
world.PARTIES,scripts/make_evalsets.py) 시험에 포함합니다. 공정한가요?scripts/verify_world.py스타일: 모든 파티에는 모든 사람에게 제공되는 예약이 하나 이상 있어야 합니다. - 평점 막대를 0.9로 올리고
adk optimize를eval_config_rating.json로 향하게 합니다. 경사도를 측정합니다. - 결제가 사용 설정된 프로젝트가 있나요?
refuel/파이프를 엔드 투 엔드로 실행하고harvest.py의[skip]줄을 읽습니다. 이는 두 파이프 사이의 경계가 표시된 것입니다. HOST_THINKING=2048를 사용하여 루프를 실행합니다. 무엇이 바뀌었나요? 천장이 어디에 있는지에 관해 무엇을 알 수 있나요?