

1. Wprowadzenie
Ten przewodnik dotyczy oceny agenta, czyli tego, jak system dowiaduje się, czy odpowiedź agenta była dobra, oraz tego, co możesz zbudować, gdy już to zrobisz: agenta, który na podstawie własnych błędów przepisuje własne instrukcje, oraz pętli, która to powtarza, z Tobą w roli strażnika.
Wszystko działa w pakiecie Agent Development Kit (ADK): adk eval z napisanym przez Ciebie wskaźnikiem niestandardowym, adk optimize (optymalizatorem promptów GEPA), ADK 2 Workflow z tylną krawędzią oraz potokiem Agent Engine + BigQuery, który przekształca ruch produkcyjny w egzamin na kolejną rundę.
Pętla zwiększa dowolną liczbę, którą jej podasz.
Czego się nauczysz
- Odpowiedź nie jest wynikiem – dlaczego pewna, dobrze sformułowana odpowiedź nic nie mówi systemowi i co musi być w stanie powiedzieć oceniający
- 3 sposoby przeprowadzania jednego testu –
adk evalw przypadku wsadu,adk webkarta Evals (Oceny) w celu przyjrzenia się niepowodzeniu,pytest+AgentEvaluatorw przypadku niepowodzenia kompilacji – i jeden lokalny sklep z ocenami, który jest wspólny dla wszystkich. - Porównywanie a sprawdzanie – dlaczego komparator karze za poprawną odpowiedź sformułowaną inaczej, ile poprawnych odpowiedzi ma w rzeczywistości kolacja i jakie intuicyjne sprawdzenie podpowie Ci, jakiego rodzaju danych potrzebujesz do rozwiązania problemu.
- Funkcja sprawdzająca jako
adk evaldane –customMetrics,codeConfig, stała sygnatura, 6 sprawdzanych warunków, dlaczego funkcja zwraca PASSED/FAILED i dlaczego jest celowo deterministyczna. - 3 rodziny danych w 1 odpowiedzi – komparator, weryfikator, LLM jako sędzia: czego potrzebują, ile kosztują i gdzie są niedoskonałe
adk optimize(GEPA) – co odczytuje (błędy, a nie wynik), zbiór treningowy a zbiór kontrolny oraz dlaczego przed wysłaniem należy samodzielnie ponownie uruchomić egzamin.- Manipulowanie nagrodami, pomiar – wskaźnik zastępczy, który nigdy nie odczytuje strony, tego, co robi z rzeczywistą liczbą, ani prawa, które z tego wynika.
- Pętla samoczynnie rozwijająca się jako ADK 2
Workflow– instrukcja, która znajduje się w stanie sesji, czyli krawędź, która sprawia, że graf staje się cyklem, oraz granica, której nie zapewnia ADK. - Gdzie pasuje produkcja – ślady oglądania, wiersze uczenia się i dlaczego sprawdzarka może oceniać obiady, których nikt nie planował oceniać (odczyt, a nie krok)
Co utworzysz
Aplikacja działająca w przeglądarce: okrągły stół, N gości i agent, który rezerwuje dla nich kolację. Każdy kurs skupia się na jednej rzeczy – wierszu w konfiguracji, odpowiedzi przed 3 sędziami, przycisku uruchamiającym prawdziwy optymalizator, przełączniku zmieniającym sędziego lub krawędzi w grafie. Tabela pokazuje, co się zmieniło: kto zjadł, kto nie i dlaczego. Python jest mały, a wszystkie liczby są mierzone na Twoim urządzeniu.
Aplikacja jest też ćwiczeniem. Panel kursu udostępnia jedną edycję lub jeden przycisk naraz. Danie w menu pojawia się tylko wtedy, gdy coś rzeczywistego to potwierdza – kuchnia odczytuje Twoje pliki i potwierdzenia tego, co zostało uruchomione, a nie listę kontrolną.

8 kursów
koncepcja, | pytanie, na które odpowiada, | co robisz, | |
I | odpowiedź nie jest wynikiem | co system wie o tej rezerwacji? | brak – zarezerwuj w Workbench |
II | komparator, zestaw prawidłowych odpowiedzi, 3 sposoby uruchamiania | Dlaczego prawidłowa rezerwacja nie przechodzi testu? | przeprowadzić test w wersji dostarczonej i odczytać wyniki; |
III | moduł sprawdzający jako dane niestandardowe · 6 testów | czy egzamin może wskazać, kto jest głodny i dlaczego? | 1 wiersz w: |
IV | comparator · checker · LLM-as-judge | same answer – what are the three things to measure it against? | ocenić jedną odpowiedź na 3 sposoby, 2 razy; |
V |
| czy agent może sam naprawić swoje błędy? |
|
VI | manipulowanie nagrodami – wskaźnik zastępczy | Co zrobi sędzia, który nie widzi szkody, z pętlą? | do przejścia na Chromebooka |
VII | a | co sprawia, że wykres tworzy pętlę, i co ją przerywa; | 1 krawędź w: |
VIII | co zostało zastąpione | – | czek |
Jak korzystać z tego ćwiczenia. Najpierw wyjaśniamy koncepcję, a potem pokazujemy kod po wprowadzeniu zmiany i go omawiamy. Nigdy nie prosi o edytowanie pliku w tym miejscu – edycja odbywa się w aplikacji, która przekazuje po jednym wierszu i najpierw pokazuje błąd. Przeczytaj kurs, a potem pozwól, aby strona przeprowadziła Cię przez niego i obserwuj, jak zmienia się liczba.
Gdzie znajduje się ta funkcja
Świat – 10 gości, z których każdy ma 1 rygorystyczne ograniczenie, 10 restauracji, z których każda ma 1 pułapkę, 16 grup – oraz 2 sędziów pochodzi z laboratorium loop-lab-table. Jednostronicowy format interaktywny pochodzi z Doliny Agentów. Bistro to tylko scenografia. Każdy mechanizm pod nim jest zwykłym mechanizmem, którego używasz w przypadku pracownika zespołu pomocy, procesu rezerwacji lub czegokolwiek innego, czego „dobro” można sprawdzić.
2. 🧰 Konfiguracja
- Co – konto, które może płacić, projekt, zainstalowane laboratorium, model, który potrafi odpowiadać, i tabela działająca na jednym porcie.
- Uzasadnienie: jeden proces na jednym porcie: strona, egzaminy, edytor i platforma robocza mają to samo pochodzenie, więc nic w tym module nie wymaga drugiego terminala ani drugiego portu.
- Jak – klonowanie, 2 skrypty, 1 polecenie. Ostatnią rzeczą, jaką robi konfiguracja, jest wykonanie jednego rzeczywistego wywołania modelu, więc uszkodzony projekt zawiedzie tutaj, a nie w części I.
Wszystko w tym module działa w Cloud Shell – gcloud, Python, Node i git są już tam zainstalowane, a do Gemini można uzyskać dostęp przez Vertex AI przy użyciu własnych danych logowania. W tym module nie ma żadnego klucza interfejsu API i nie musisz niczego instalować na laptopie. Laptop z pakietem Google Cloud SDK, Pythonem 3.11 lub nowszym i Node 20 lub nowszym działa w ten sam sposób.
Jest jednak jedna rzecz, której nie możemy Ci zapewnić w tym module: projekt Google Cloud z włączonymi płatnościami. W kroku 1 uzyskasz konto, z którego można dokonywać płatności, a w kroku 4 przekształcisz to konto w projekt. Wykonaj je w tej kolejności – każdy krok po kroku 4 odczytuje projekt, który został ustalony w kroku 4.
1. Uzyskaj konto z płatnościami (~1 min)
Zaloguj się na konto Google z włączonymi płatnościami. Możesz użyć dowolnego z nich. Jeśli nie masz takiego konta, rozpocznij bezpłatny okres próbny. Dzięki temu uzyskasz konto rozliczeniowe, które jest potrzebne w kroku 4.
2. Otwórz Cloud Shell (~2 min)
👉🖥 U góry konsoli Google Cloud kliknij Aktywuj Cloud Shell – jest to ikona w kształcie terminala w nagłówku.
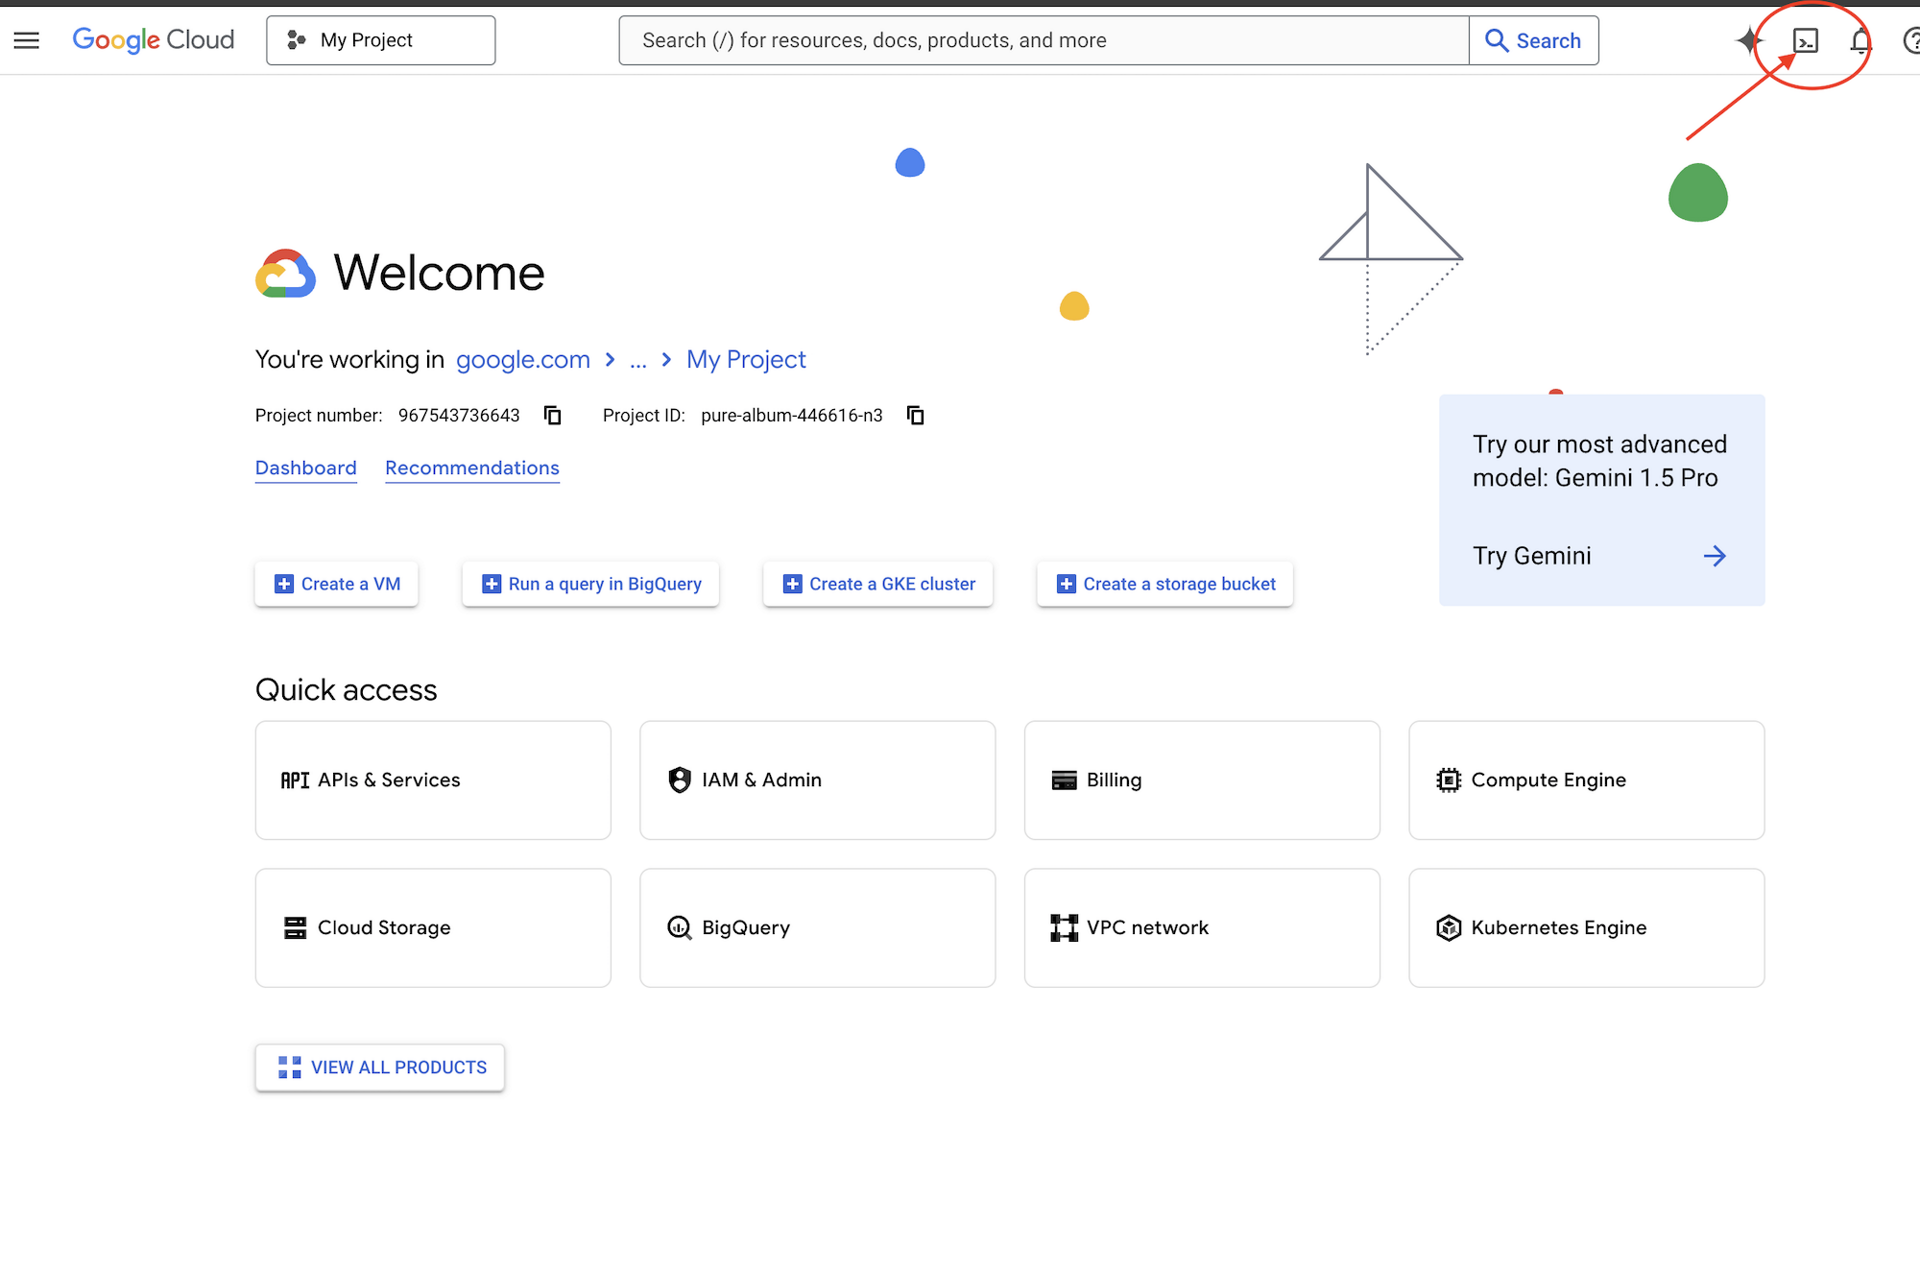
👉🖥 Kliknij Otwórz edytor (ikonę otwartego folderu z ołówkiem). Spowoduje to wyświetlenie edytora Cloud Shell z eksploratorem plików po lewej stronie – tam możesz przejść, gdy chcesz odczytać cały plik.

👉🖥 Jeśli w dowolnym momencie pojawi się prośba o autoryzację, kliknij Autoryzuj, aby kontynuować.
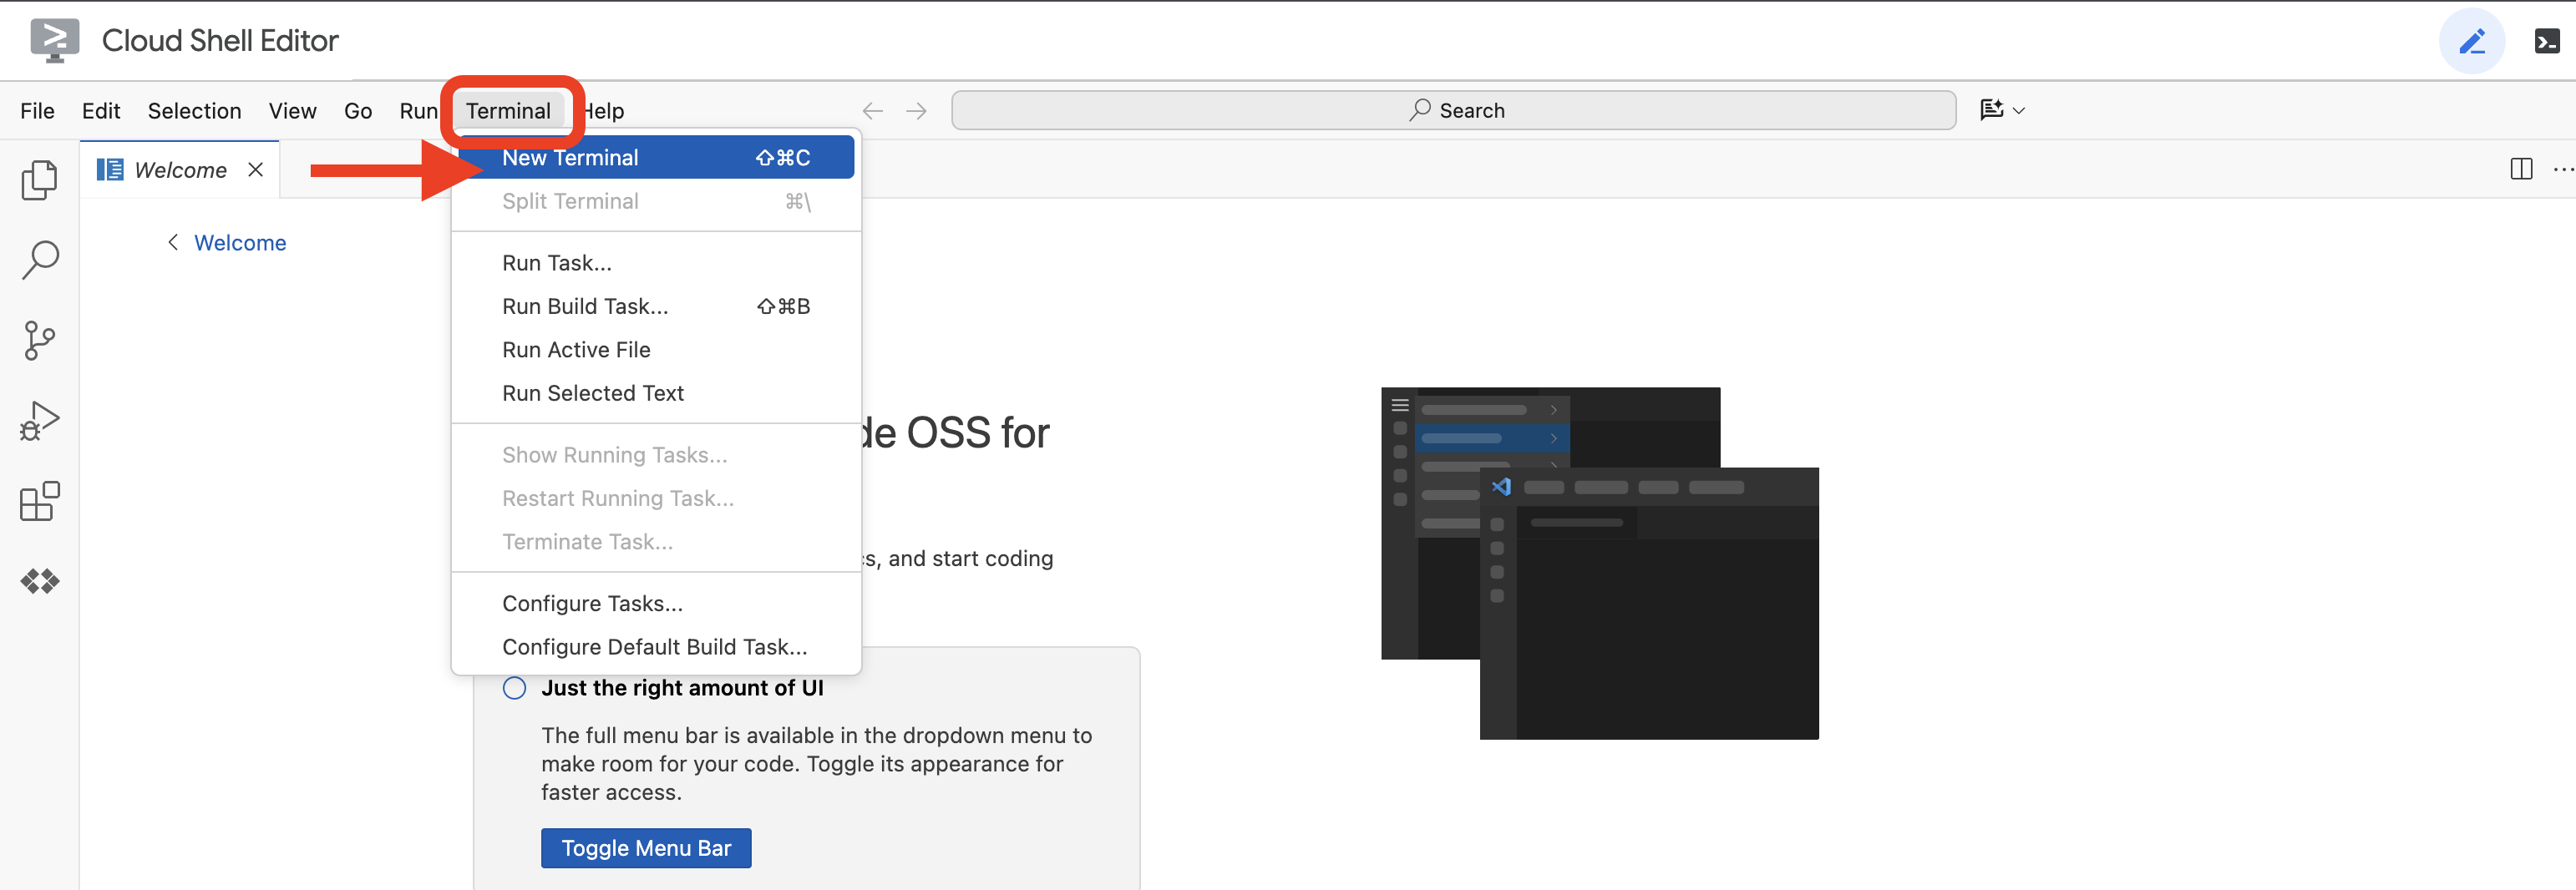
👉🖥 Otwórz terminal w edytorze – to karta 1, na której będą wykonywane wszystkie kroki oznaczone ikoną 👉💻. Karta 2 to sama tabela, którą otworzysz w kroku 7. Jeśli terminal nie jest jeszcze widoczny u dołu ekranu, otwórz go, wybierając Widok → Terminal:
👉💻 Sprawdź, na które konto jesteś zalogowany(-a) – powinno to być konto z kroku 1:
gcloud auth list
3. Uzyskaj dostęp do laboratorium (ok. 1 min)
👉💻 Sklonuj repozytorium:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4. Utwórz projekt (ok. 2 min)
👉💻 Jeden skrypt znajduje Twoje konto rozliczeniowe, tworzy w nim projekt, łączy rozliczenia i wskazuje ten projekt w Cloud Shell:
cd ~/table-for-n
./setup_project.sh
Spodziewaj się ✓ w przypadku wybranego konta rozliczeniowego, ✓ w przypadku utworzonego projektu i zakończenia w tym stylu:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 to identyfikator projektu – Twój będzie miał inne cyfry. W tym miejscu dzieją się 4 rzeczy:
billing | wybiera najnowsze konto | |
project | utworzy konto | |
selects | zapisuje identyfikator w | |
waits | sprawdza, czy projekt może wyświetlać reklamy, przez maksymalnie 2 minuty. | |
👉🖥 Ten sam projekt jest teraz w konsoli – jego identyfikator znajduje się na karcie Informacje o projekcie w panelu:

5. Zainstaluj i skonfiguruj laboratorium (ok. 3 min)
setup_codelab.sh tworzy środowisko za pomocą uv i nie instaluje uv za Ciebie – zatrzymuje się i informuje o tym. Zainstaluj go najpierw za pomocą tego samego polecenia:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Jeden skrypt, który można bezpiecznie uruchomić ponownie. Wykonuje on 5 czynności w następującej kolejności:
api | odczytuje wybrany w kroku 4 projekt i włącza w nim | |
uv env |
| |
site | instaluje i kompiluje | |
.env | zapisuje | |
preflight | wykonuje jedno rzeczywiste wywołanie do | |
6. Przeczytaj menu (ok. 1 min)
Ostatnią rzeczą, którą wydrukował krok 5, jest dzisiejsze menu – każda linijka to prawdziwa sonda, a nie domysł:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Przed rozpoczęciem nie świeci się żadna dioda. the model answers jest tutaj najważniejszy: oznacza, że w Twoim projekcie zrealizowano prawdziwe połączenie.
👉💻 Uruchom go ponownie w dowolnym momencie, aby sprawdzić, na jakim etapie jesteś. Odczytuje on pliki i paragony z kuchni, a nie listę kontrolną:
cd ~/table-for-n
uv run python scripts/preflight.py
7. Nakryj stół (ok. 1 min)
👉💻
cd ~/table-for-n
bash table.sh
Jeden proces, port 3470. Przygotowanie środowiska zajmuje trochę czasu – importuje ono ADK i montuje adk web – dlatego skrypt informuje o tym, czeka i wyświetla linki dopiero wtedy, gdy port faktycznie odpowie:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Pozostaje na pierwszym planie. Ctrl+C czyści tabelę. Pozostaw go uruchomionego – każdy kolejny kurs będzie się komunikować z tym procesem i w żadnym z laboratoriów nie pojawi się prośba o jego ponowne uruchomienie.
👉🖥 Gdy zobaczysz ✓ the table is laid, otwórz tabelę w nowej karcie – nazwij ją karta 2. W Cloud Shell: Podgląd w przeglądarce → Zmień port → 3470.
👉🖥 Wpisz swoje imię i nazwisko na karcie rezerwacji – zostanie ono umieszczone na rachunku na końcu – i kliknij ✦ seat us (✦ wsadź nas).

3. I · Rezerwacja – odpowiedź nie jest wynikiem
Na kolację idzie 5 osób. Na czacie grupowym jest wszystko: Nadia jest weganką, Tom ma w tym miesiącu limit 25 USD, Amara chodzi o kulach i może iść przez 10 minut, Lena nie może dotrzeć przed 19:45, a Ben nie ma żadnych wymagań. Na liście znajduje się 10 restauracji posortowanych według oceny. Każda z nich ma podaną cenę, czas dojścia, godziny otwarcia i jeden haczyk.
Agent rezerwuje stolik. Po przeczytaniu czatu wiesz już, kto będzie głodny w wybranym pokoju. System nie ma takich informacji. To ćwiczenie w całości dotyczy tej luki.
Agent – tylko do odczytu
host/agent.py, tak jak w przypadku całego modułu:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Brak narzędzi, bazy danych i wyszukiwania. Jeden model, jeden ciąg instrukcji – ciąg nie znajduje się w tym pliku. Znajduje się obok, w pliku instruction_current.txt, który obecnie zawiera 4 linie napisane przez menedżera produktu pierwszego dnia:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Nie ma ani słowa o alergiach, budżetach, ograniczeniach dotyczących chodzenia czy o tym, kto musi wyjść wcześniej. Wszystkie te informacje znajdują się w briefie, który otrzymuje agent. Nieużywane.
Ten plik jest jedynym artefaktem, którego dotyczy to laboratorium. Kurs V umożliwia optymalizatorowi jego przepisanie. Kurs VI instaluje zhakowaną wersję. Pętla kursu VII przepisuje go runda po rundzie podczas działania wykresu. Agent – model, ustawienia, nazwa – nigdy się nie zmienia.
Wypróbuj – bez kodu po stronie klienta
👉🖥 Na stronie kursu I. Kliknij 🔬 workbench (w prawym górnym rogu): szuflada jest adk web, zamontowana w tym samym procesie – ten sam folder host/, ten sam table.db. Wybierz host, wklej podsumowanie z panelu kursu (jest tam przycisk kopiowania) i wyślij.
Gospodarz odpowiada w sekundę: restauracja, godzina, pewne uzasadnienie w jednym zdaniu. Przeczytaj uzasadnienie sprzeciwu wobec czatu. Następnie spójrz na tabelę po lewej stronie: laid, nobody judged, — / 5. Nie dlatego, że coś się wczytuje, ale dlatego, że w świecie nie ma niczego, co mogłoby to ocenić.
Liczba: głodnych miejsc – ?. Nikt nie wie.
4. II. Komparator – ile prawidłowych odpowiedzi ma ten obiad?
Kurs II rozpoczyna się od egzaminu, który już istnieje i jest niezaliczony z przyczyny, która niczego nie uczy. Zanim to zrobisz, warto poznać 3 sposoby uruchamiania tego narzędzia, ponieważ dzisiaj skorzystasz z nich wszystkich.
3 sposoby przeprowadzania oceny
Wszystkie te usługi korzystają z tego samego silnika.
do czego służy, | co otrzymasz, | |
| uruchamianie pakietowe, czyli to, co umieszczasz w CI; | podsumowanie: informację o tym, czy test został zdany, czy nie, oraz wynik każdego przypadku. |
| sprawa nie została rozpatrzona, a Ty chcesz się jej przyjrzeć; | rozmowę, ślad, wynik dla poszczególnych zgłoszeń, wszystko klikalne. |
| składanie oceny agenta w normalny zestaw regresji | działa obok testów jednostkowych i powoduje niepowodzenie kompilacji w ten sam sposób. |
Szczegół, który jest naprawdę przydatny: wszystkie 3 sklepy mają jeden lokalny sklep testowy, host/.adk/eval_history/. Uruchom partię z CI, coś się nie powiedzie, otwórz to konkretne uruchomienie w interfejsie internetowym, aby to sprawdzić. Przycisk 📝 na stronie to pierwszy sposób, 🔬 workbench to drugi, a trzeci to polecenie terminala uv run pytest tests/test_host.py. Test, który uruchamia, ma 12 wierszy:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. Ten sam agent, ten sam zestaw ewaluacyjny, ten sam plik konfiguracyjny i wiersz eval_set_results_manager, który umieszcza jego uruchomienie w tej samej historii co pozostałe 2.
Egzamin w wersji wysłanej
exam/eval_config.json w ten sposób:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Dwie części, dwa zadania. criteria
to arkusz egzaminacyjny – dane, które są faktycznie sprawdzane, wraz z wartościami progowymi. customMetrics
to katalog pracowników – nazwy zmapowane na Pythona, dostępne, ale nie na dyżurze. Zadeklarowanie wskaźnika nie powoduje jego uruchomienia. W obecnej wersji dokument zawiera dokładnie 1 pytanie: wbudowany w ADK response_match_score, czyli nakładanie się tekstu (ROUGE-1) między tym, co powiedział agent, a złotą rezerwacją w zestawie ewaluacyjnym. Sędzia everyone_ate jest w katalogu, a nie na papierze – kurs III przenosi go tam, zmieniając jedną linijkę.
Mamy agenta rezerwującego kolacje i response_match_score, który siedzi tam bezpłatnie. Użyjmy go i zobaczmy, co otrzymamy.
Wypróbuj
👉🖥 Kurs II na stronie. Kliknij 📝 przeprowadź egzamin · w wersji dostarczonej. Pod przyciskiem znajduje się podpis informujący o tym, co jest uruchomione: 1 rodzaj danych: response_match_score · everyone_ate jest zadeklarowany, ale nie występuje w teście. Około pół minuty. Przeczytaj wynik: około połowa tabel NIE PRZESZŁA testu, a wynik tekstowy nie zawiera uzasadnienia. Zobacz, które to tabele. Najedź kursorem na elementy.
Teraz przyjrzyj się uważnie, bo to jest najciekawsza część. Komparator błędnie interpretuje tabele w obu kierunkach, a w Twoim przebiegu pojawi się co najmniej jeden z tych błędów. Odrzuca tabelę, w której rezerwacja była prawidłowa – agent wybrał pokój, w którym wszyscy mogli zjeść, kolacja się odbyła, odpowiedź jest prawidłowa – ponieważ agent sformułował uzasadnienie inaczej niż w odpowiedzi wzorcowej. I przechodzi test, w którym ktoś jest głodny – w naszym teście p1, dokładnie o 0:30, gdy Tom przekroczył budżet, a Lena złożyła zamówienie po czasie – ponieważ wystarczająca liczba słów się pokrywała. Podobieństwo ciągów znaków nie ma nic wspólnego z kolacją. Wie, że postacie ustawiają się w kolejce.
Oto prawdziwe pytanie: ile prawidłowych odpowiedzi ma ta kolacja?
Na dzisiejszej imprezie tylko w jednym z 10 pokoi będzie można coś zjeść – w Pho Saigon, i to dopiero od 19:00. W 8 częściach egzaminu jest to odpowiednio 1, 2, 2, 1, 3, 3, 6, 1 (world.rooms przechodzi przez każdy pokój przy każdym miejscu siedzącym w każdej części; możesz to sprawdzić samodzielnie, używając uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). Czasami kilka pokoi może obsłużyć wszystkich, a czasami tylko jeden, i to tylko w określonych momentach. Istnieje zbiór dopuszczalnych odpowiedzi, a nie jedna odpowiedź. Złota odpowiedź w zbiorze ewaluacyjnym jest jednym z jego elementów.
Oznacza to, że założenie, na którym opiera się response_match_score – istnieje jedna prawidłowa odpowiedź i została ona zapisana – nigdy nie było prawdziwe w przypadku tego problemu. Ani razu. Wskaźnik nie jest uszkodzony. Działa dokładnie tak, jak sugeruje nazwa. Zastosowaliśmy niewłaściwy rodzaj danych do tego problemu.
👉🖥 Opcjonalnie, warto poświęcić minutę: otwórz 🔬 workbench → Evals (Oceny) → 🕓 history (historia). Właśnie wykonane uruchomienie 📝 jest widoczne, a każdy przypadek można kliknąć. Na karcie 1 uv run pytest tests/test_host.py uruchamia ten sam egzamin jako test, który nie został zaliczony, i ląduje w tej samej historii.
Liczba: 4 z 8 testów dotyczących nakładania się słów zostało ZALICZONYCH bez podania przyczyn, a 1 odpowiedź na pytanie 1 była prawidłowa w przypadku 10 pokoi.
W przypadku naszego problemu z kolacją wybór jest oczywisty. Nikt nie może Ci powiedzieć, która restauracja jest najlepsza na piątek. Każdy może Ci jednak powiedzieć, co oznacza udany obiad: wszyscy przy stole mogli zjeść. To jest reguła. Można go zaznaczyć. Nie jest niejednoznaczny. Budowanie to kurs III.
5. III. Sędzia – narzędzie do sprawdzania jako dane niestandardowe
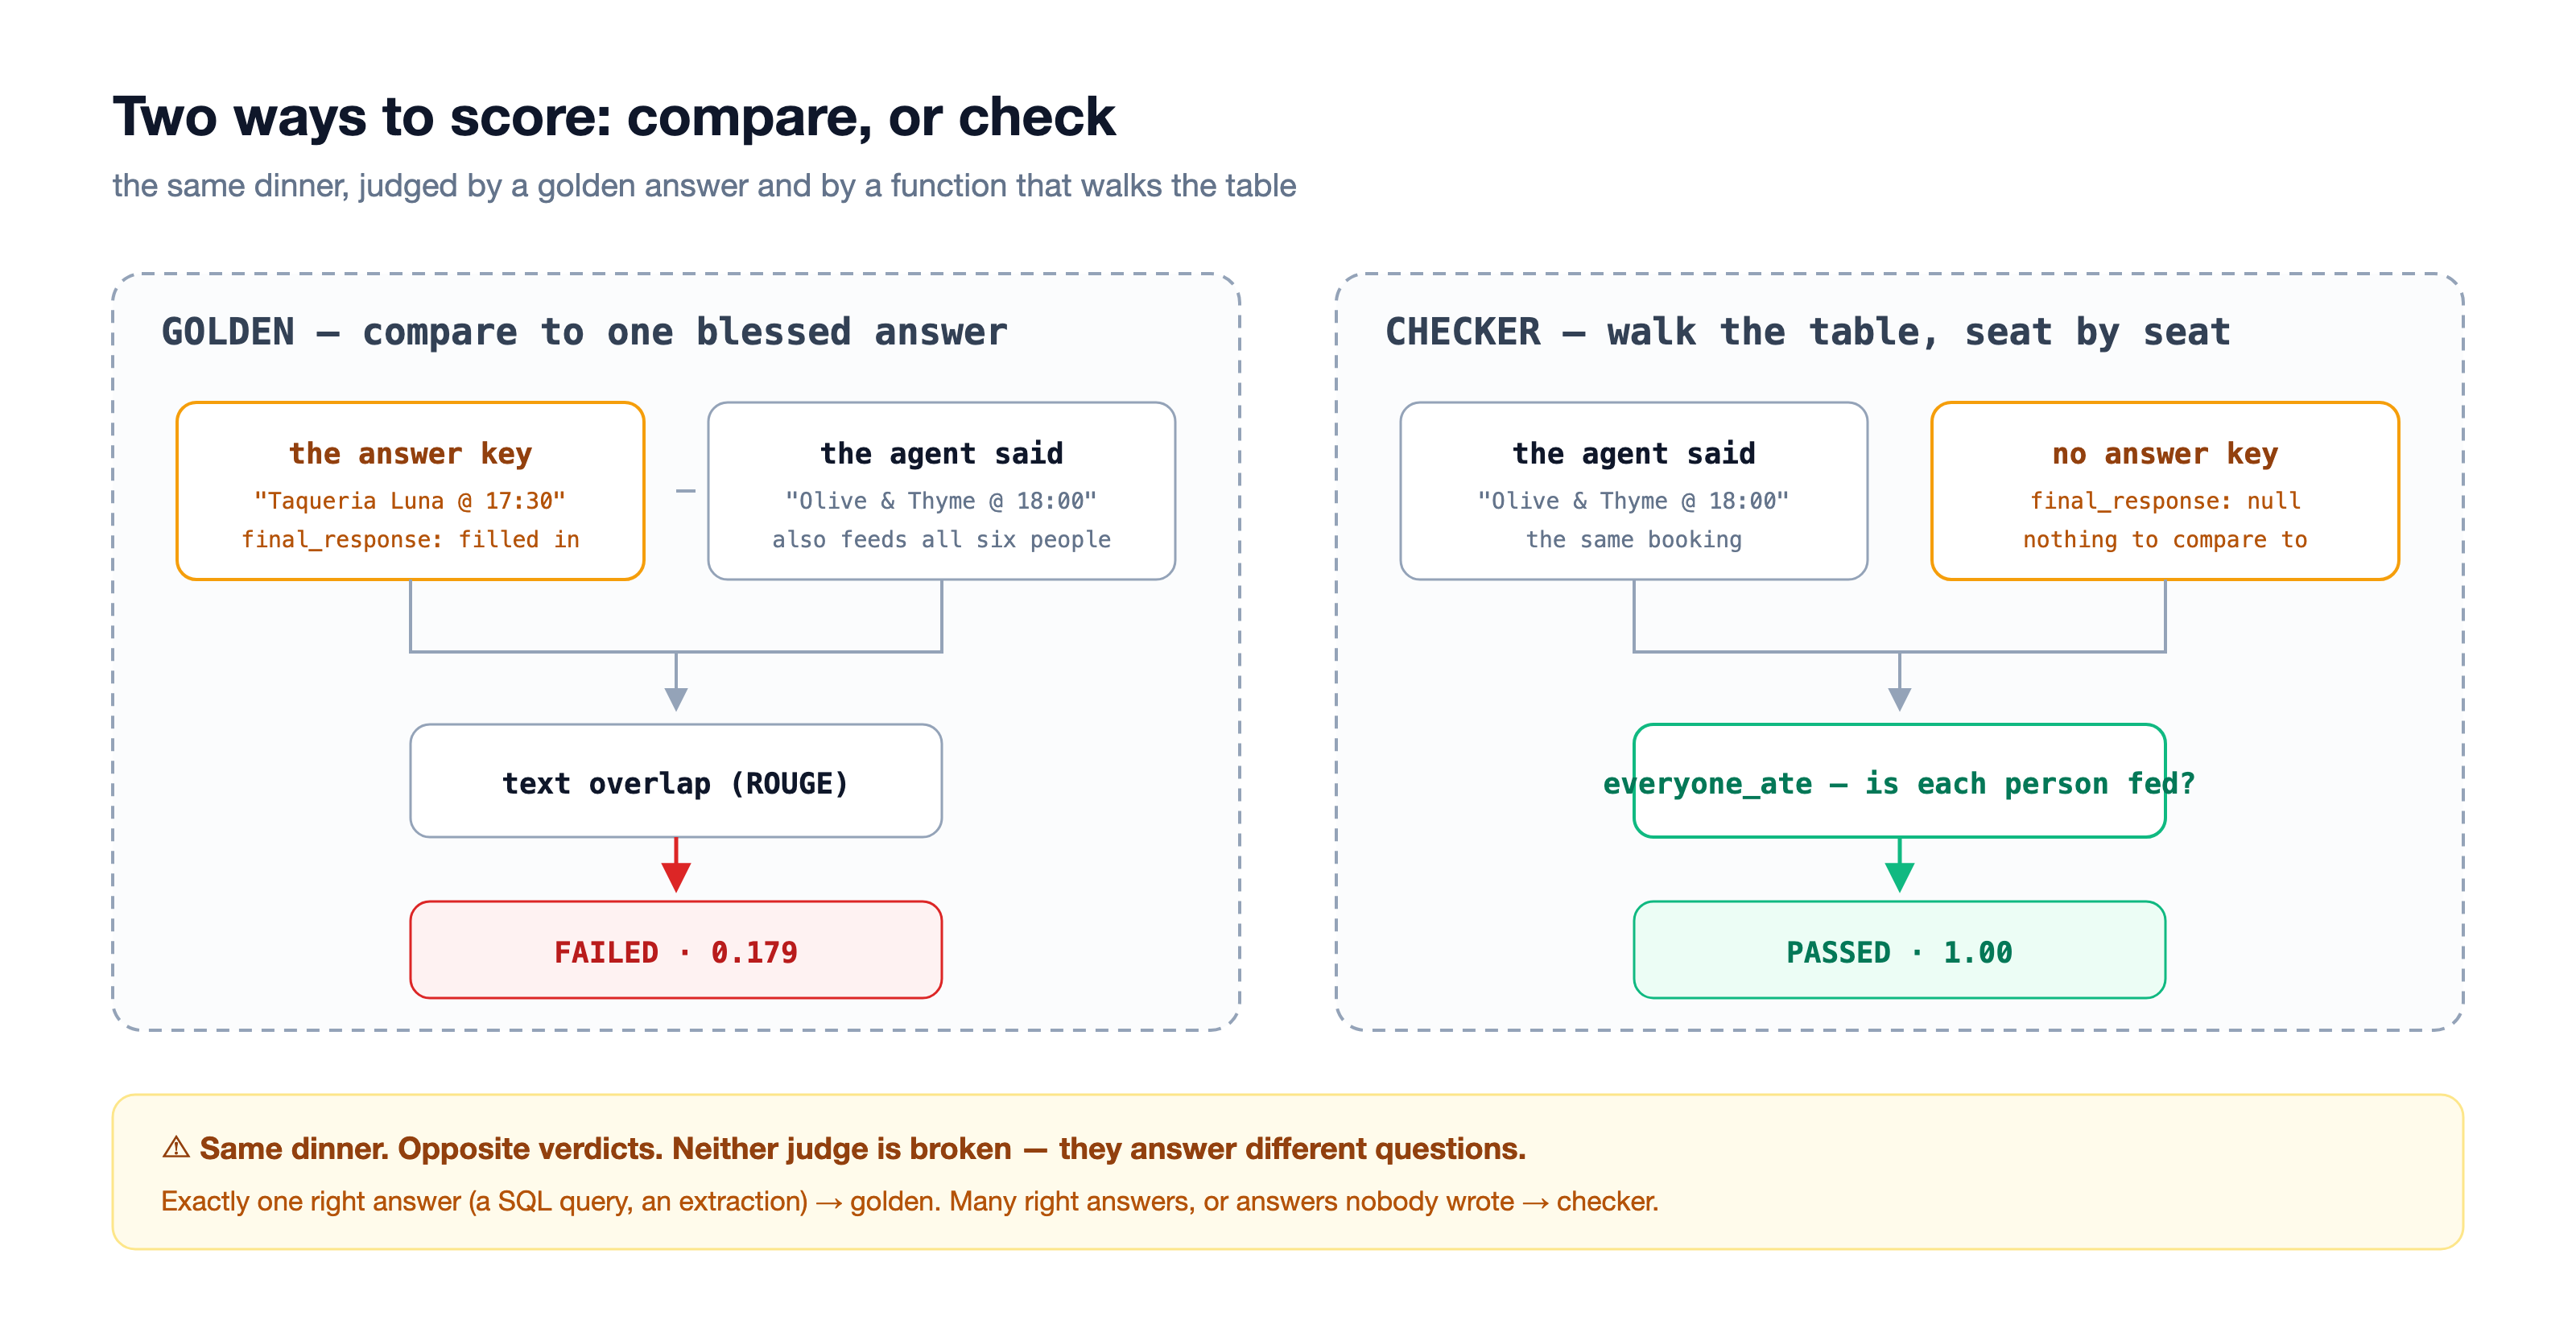
Sprawdzający zadaje inne pytanie niż porównujący: nie czy to pasuje do klucza, ale czy każda osoba jest nakarmiona? Sprawdza rezerwację pod kątem grupy, miejsce po miejscu, i zwraca wynik oraz przyczynę dla każdego miejsca. Nie potrzebuje żadnej złotej odpowiedzi, co pozwala jej też oceniać rozmowy, które już się odbyły (kurs VIII).
world.everyone_ate to właśnie ta funkcja. Kurs III łączy go z adk eval.
Wewnątrz everyone_ate – 5 kroków, żaden z nich nie jest skomplikowany
- Przeczytaj tekst użytkownika i ustal, o którą osobę chodzi. W briefie znajduje się identyfikator osoby –
p1– i sprawdzamy, kto siedzi przy tym stole. - Odczytaj odpowiedź agenta, przeanalizuj plik JSON, wyodrębnij nazwę restauracji i godzinę rezerwacji.
- Przeprowadź każdą osobę po kolei. Dla każdego z nich: dieta, alergie, tolerancja na przyprawy, budżet, odległość i czas. 6 kontroli na osobę za każdym razem. Weźmy Tomka: jego budżet to 25 USD na osobę, a pokój kosztuje 28 USD. Wracamy do
Falsew przypadku Toma i zdania wyjaśniającego, a następnie przechodzimy do następnej osoby. - Wynik to liczba osób, które zjadły, podzielona przez liczbę osób przy stole. 4 z 5 to 0,8. Nie ma wag ani częściowych punktów.
- Zwraca wartość PASSED lub FAILED. Zwróć uwagę, kto go zwraca: Ty. Pamiętaj o tym. To pułapka, o której mowa poniżej.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Warto zwrócić uwagę na jedną właściwość: w tej funkcji nie ma żadnego wywołania modelu. Jest to deterministyczny kod w Pythonie. Te same dane wejściowe, ten sam wynik, za każdym razem. Oceniający nie zmienia zdania, gdy model jest aktualizowany, jego uruchomienie nic nie kosztuje i nie może wymyślić powodu. Jeśli możesz to osiągnąć, warto zaprojektować taką funkcję.
Wskaźnik „zakończono”
metrics/table.py – adapter wywoływany przez ADK ze stałą sygnaturą:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Wiersz po wierszu: odczytuje obie strony każdego wywołania – stronę z user_content i rezerwację z final_response – przekazuje je do funkcji czystej i zawiera wynik w obiektach oczekiwanych przez ADK. A w jednym wierszu znajduje się werdykt:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
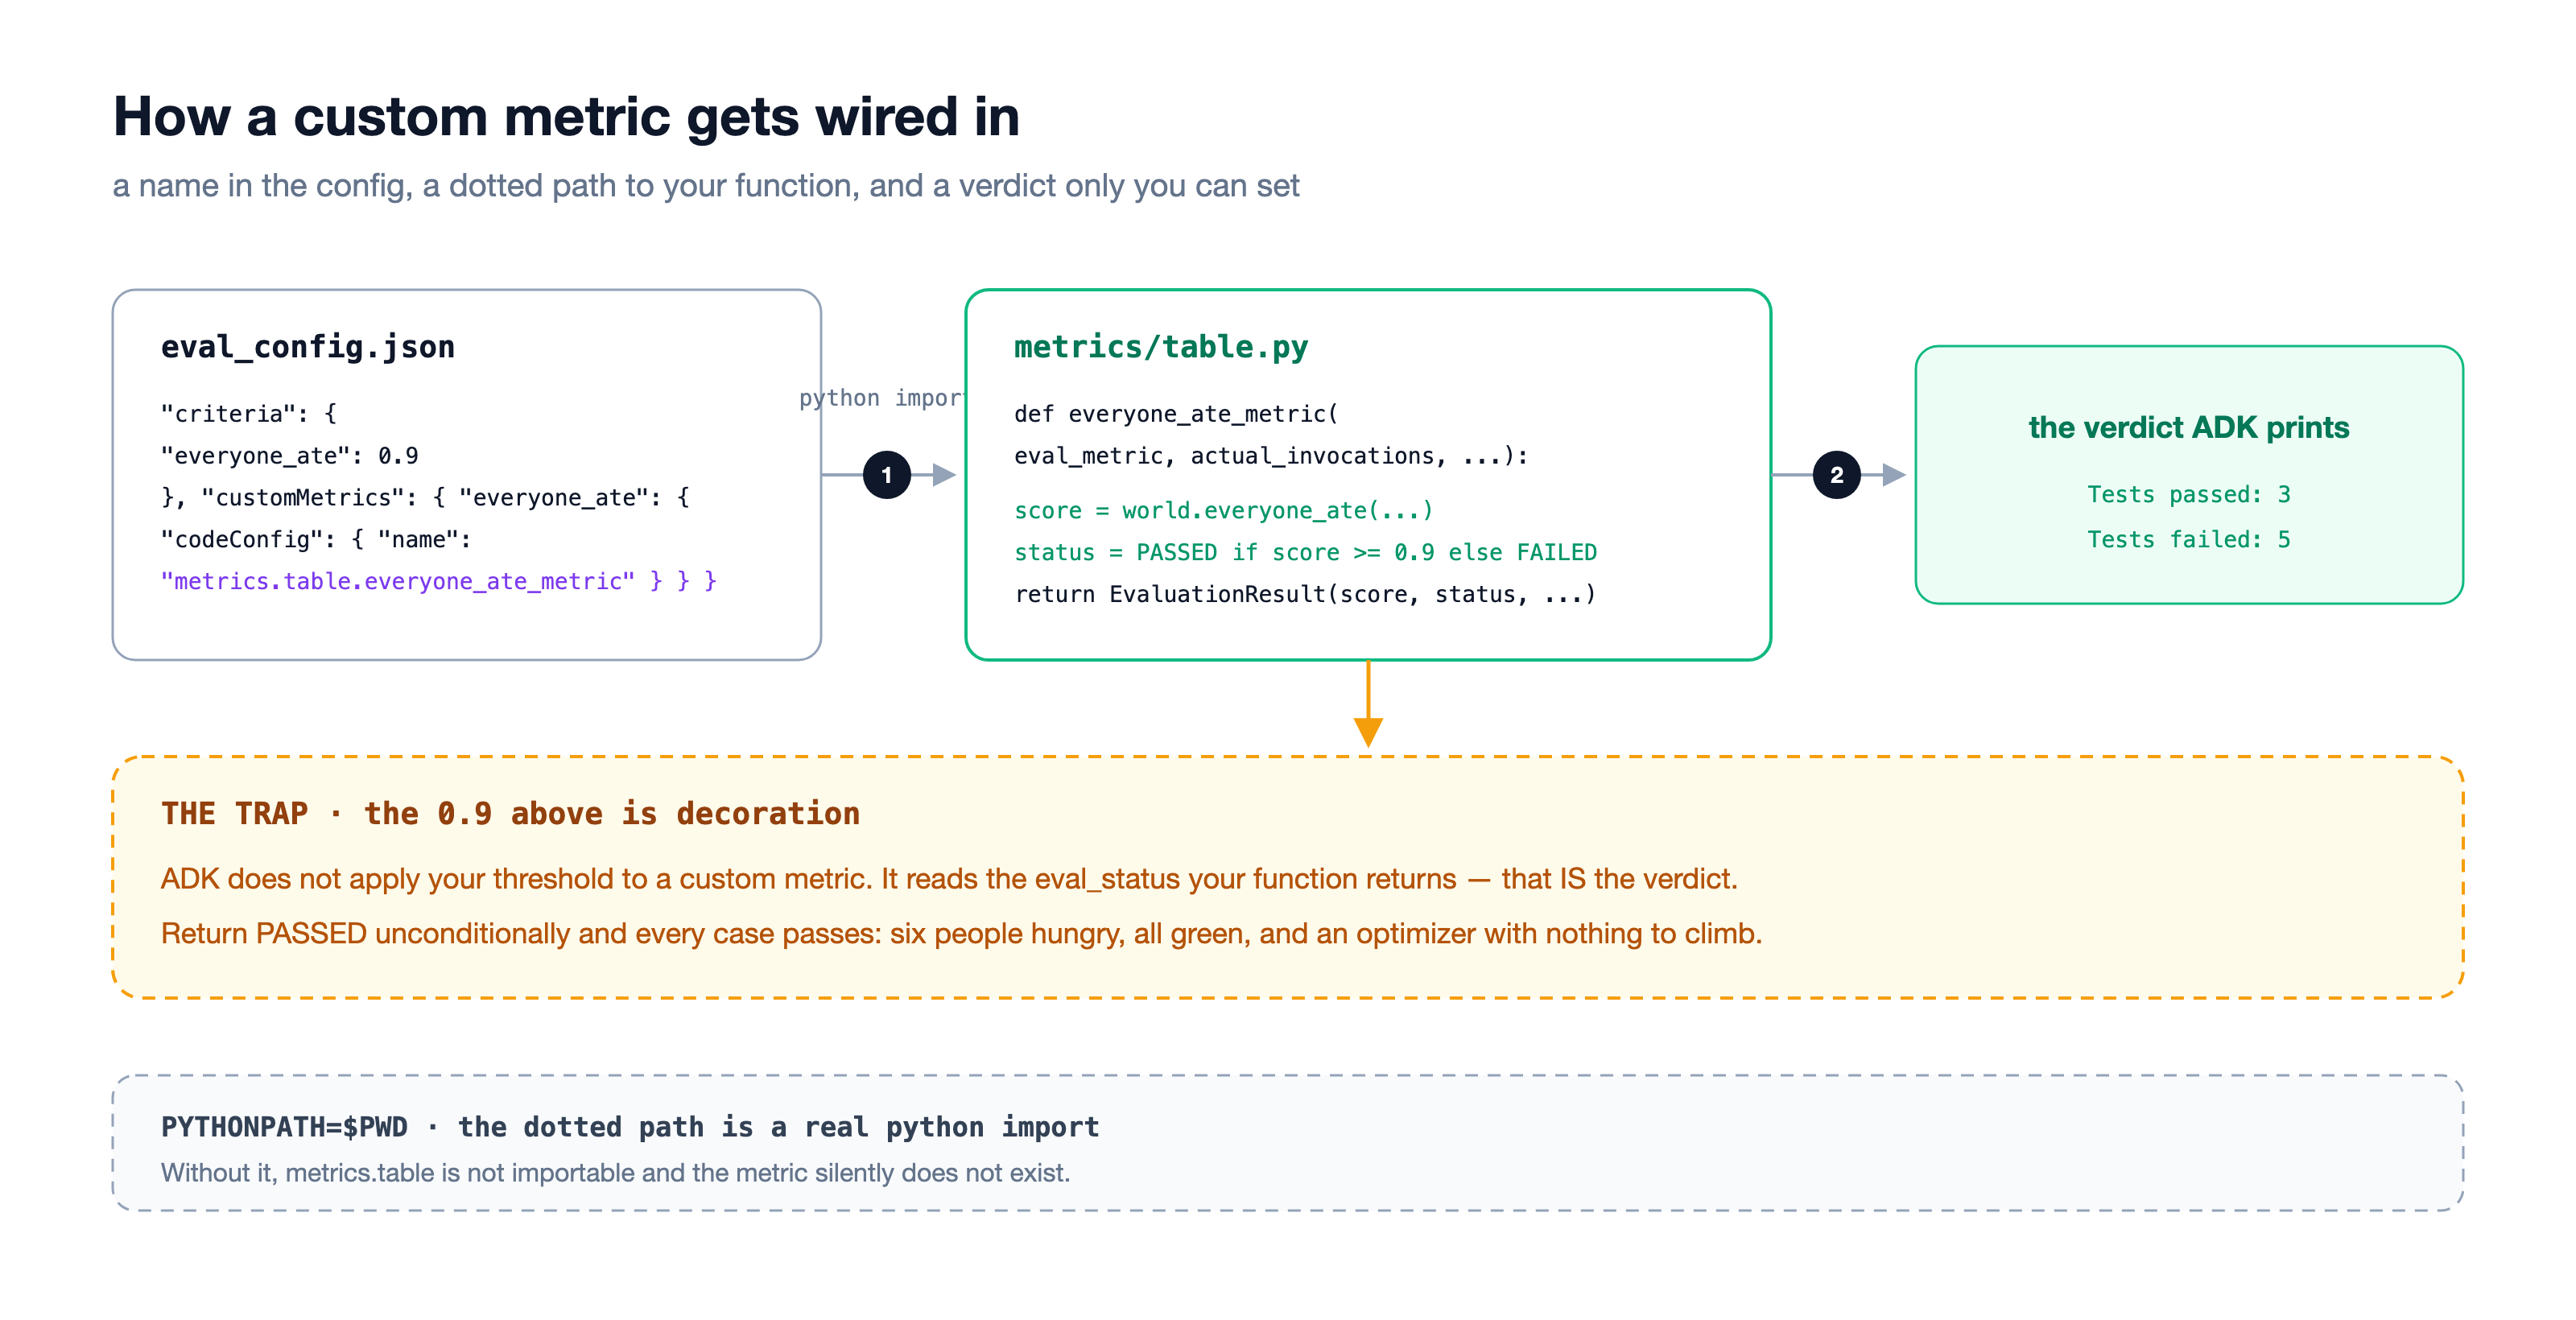
Konfiguracja – 1 wiersz
exam/eval_config.json, jak to wygląda po ukończeniu kursu:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Zmieniono jeden wiersz: criteria teraz zawiera nazwę sędziego, a nie komparatora. Egzamin obejmuje 8 partii, których optymalizator nigdy nie zobaczy (exam/parties_val.evalset.json, łącznie 36 miejsc).
Wypróbuj
👉🖥 Kurs III na stronie. Podpis pod przyciskiem 📝 wskazuje instrukcję, którą wykonuje host – powinien to być draft (wersja robocza). Jeśli widzisz coś innego (bo wcześniej zainstalowano inną wersję), najpierw naciśnij ↺ wróć do wersji roboczej, bo inaczej liczby nie będą pasować do historii.
👉🖥 Zamień wiersz w edytorze (lub kliknij zastosuj zmianę) i 📝 ponownie przeprowadź test. Teraz niepowodzenie wskazuje miejsce i powód – Tom: ~28 USD zamiast 25 USD, Lena: ostatnie zamówienia o 19:30, przychodzi o 19:45 – a liczba pod tabelą zmienia się z liczby osób, które zjadły, na tę, która ma znaczenie: głodne osoby. Najedź kursorem na element: każda tabela, w której wystąpił błąd, zawiera zdania.
👉🖥 Następnie kliknij 📋 Zarezerwuj stolik. Gospodarz wybiera pokój. Ta sama funkcja wyszarza krzesła, przy których nie można jeść, i podaje powód pod każdym z nich. Naciśnij go ponownie – model może dokonać rezerwacji w inny sposób (interfejs API nie jest deterministyczny nawet przy temperaturze 0), ale sędzia nigdy się nie waha: ten sam pokój, ten sam werdykt, te same zdania.
Liczba: pierwszy szkic, szczery – około 3 z 8 stron, 6 miejsc z 36 w naszym teście (Twój wynik będzie się wahać; interfejs API nie jest deterministyczny nawet przy temperaturze 0 – dlatego egzamin ma 36 miejsc, a nie 4 przypadki). Zachowaj ten numer. Kurs V istnieje, aby go przenieść.
6. IV. Lot – jedna odpowiedź, trzech sędziów
Odpowiedzi hosta zostały ocenione dwukrotnie – raz przez komparator, a raz przez Twój moduł sprawdzający. Kurs IV bierze jedną z tych odpowiedzi – dzisiejszą imprezę, p1, dokładnie tak, jak została zapisana na egzaminie – i stawia trzeciego sędziego obok pierwszych dwóch: model z rubryką. Nic nie zostanie ponownie zarezerwowane. Zmienia się to, w stosunku do czego jest mierzona odpowiedź. Ta jedna różnica dzieli te 3 rodziny danych.
sędzia | pyta | wymaga | zaliczone, jeśli | martwe pole, |
komparator · | Czy to jest to samo co moja odpowiedź? | złota odpowiedź – człowiek wpisał do zbioru testowego 1 rezerwację na grupę; | Nakładanie się słów w ROUGE-1 ≥ 0,3 | poprawna odpowiedź sformułowana w inny sposób jest karana, a błędna odpowiedź z odpowiednimi słowami przechodzi. Nigdy nie odczytywał imprezy. |
sprawdzanie · | czy ta odpowiedź jest rzeczywiście trafna? | zasady – 6 sprawdzeń na stanowisko, brak złotej odpowiedzi; | liczba nakarmionych osób ÷ liczba miejsc przy stole ≥ 0,9 | nie widzi niczego poza regułami, które zostały przez Ciebie napisane. Deterministyczny: za każdym razem ta sama odpowiedź, ten sam wyrok i te same zdania. |
LLM jako sędzia · | czy wszyscy będą mogli zjeść? – zadane modelowi | model i 4-wierszowe kryteria oceny; 1 rzeczywiste połączenie na 1 naciśnięcie, | model zwraca wartość PASS, | może się mylić i zmieniać zdanie między kolejnymi naciśnięciami. Koszt połączenia. |
Warto zanotować powody, dla których sprawdzający podjął taką decyzję. Gdy adk optimize działa w kursie V, nigdy nie widzi tych zdań – optymalizator ADK odczytuje wyniki. Nie są one zmarnowane: dzięki nim możesz odczytać błąd na terminalu, co jest obecnie ich największą wartością. W kursie VII pętla wywołuje sędziego bezpośrednio, zamiast przechodzić przez proces oceny, więc w tym przypadku przyczyny są przekazywane do elementu, który dokonuje ponownego zapisu.
Trzech sędziów podczas biegu
kitchen/flight.py. Pierwsze 2 to kod samego egzaminu – komparator to funkcja response_match_score, więc jej numer jest dokładnie taki, jaki podano w części II kursu:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Wypróbuj
👉🖥 Kurs IV. U góry panelu: odpowiedź hosta dla p1, a obok niej złota rezerwacja ze zbioru ewaluacyjnego – najpierw porównaj je ze sobą. Następnie kliknij ⚖ oceń tę odpowiedź na 3 sposoby. 1 wywołanie modelu. Trzy karty zawierają informacje o tym, o co pyta każdy sędzia, czego potrzebuje, co mówi i dlaczego.
W przypadku p1 – Olive & Thyme o godzinie 19:00 w wersji roboczej z pierwszego dnia – komparator zwrócił wynik PASS na poziomie 0,30 (wystarczająca liczba słów pasowała do wzorcowej rezerwacji), narzędzie sprawdzające zwróciło wynik FAIL na poziomie 0,60 (Tom: ok. 28 USD w porównaniu z budżetem Toma wynoszącym 25 USD · Lena: ostatnie zamówienia o 19:30, nie będzie przy stole do 19:45), a model LLM zwrócił wynik FAIL i wskazał Lenę. Komparator i moduł sprawdzający nie zgadzają się co do tej samej odpowiedzi – jeden policzył słowa, a drugi miejsca.
👉🖥 Kliknij ⚖ Oceń ponownie. Karta porównania nie przesuwa się. Karta sprawdzania nie przesuwa się. Karta LLM może zawierać informację o tym, czy model został użyty – informacja ta znajduje się pod przyciskiem. Następnie wybierz inną postać po lewej stronie (selektor postaci na scenie) i naciśnij jeszcze raz. Nie zawsze są one ustawione w tej samej kolejności.
Liczba: jedna odpowiedź, trzy werdykty – PASS · FAIL · FAIL w naszym teście. Dwa z trzech werdyktów będą takie same za każdym razem, gdy zapytasz.
7. V · Przepisanie – optymalizacja adk i bramka wysyłki
3 role, które są ściśle rozdzielone:
rola | kto | zadanie |
zdający, | gospodarza, | przystępuje do egzaminu, |
sędzia | Twoje dane z kursu III | wyniki, deterministycznie |
trener |
| odczytuje błędy, przepisuje instrukcję |
Trener nigdy nie ocenia. Sędzia nigdy nie proponuje. Zmienia się jeden artefakt – instrukcja, czyli plik tekstowy, który możesz porównać, sprawdzić i cofnąć.
Co odczytuje optymalizator
GEPA nie zwiększa liczby. Odczytuje przyczyny: próbkuje rezerwacje w przypadku uczestników szkolenia, ocenia je za pomocą Twojego sędziego i przekazuje uwagi o niepowodzeniach – Tom przekroczył budżet, Lena po ostatnim zamówieniu – do modelu, który proponuje nową instrukcję. Kandydaci, którzy w przypadku znanych im partii uzyskali lepszy wynik niż poprzedni kandydat, są zachowywani. Wygrywa ten, który uzyska najlepszy wynik w przypadku partii, których nigdy nie widział. Ten podział to cała dyscyplina:
strony | używane do | |
| 8 | Optymalizator odczytuje te błędy |
| 8 (36 miejsc) | egzamin – nigdy nie jest pokazywany optymalizatorowi. |
Odpowiadają za to 2 konfiguracje, obie w exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Zwycięzca, jak czytamy,
Optymalizator nigdy nie zapisuje instruction_current.txt. Wyświetla wybraną instrukcję. Strona zapisuje ją w runs/optimize/winner.txt, a ⤵ install kopiuje ją we właściwe miejsce. Oto początek zwycięskiego tekstu (2931 znaków, od 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Czterowierszowy szkic stał się ponumerowaną procedurą, a każda reguła w niej zawarta jest odpowiedzią na pytanie „dlaczego” z egzaminu. Nikt nie wpisał tych zdań.
Gdzie znajduje się bieg, jeśli chcesz go samodzielnie odczytać:
plik | co to jest, |
| cały bieg; pod koniec |
| każdy kandydat jako |
| drzewo wyszukiwania, które można otworzyć w przeglądarce; |
| zwycięzca zapisany przez stronę; ⤵ zainstaluj zwycięzcę kopiuje go na miejsce. |
Nasza druga próba, wykonana podczas pisania tego artykułu: 150 wywołań danych, poniżej 7 minut, zwycięski tekst o długości 2445 znaków, który zaczyna się od „w pełni uwzględnia wymagania żywieniowe i czasowe każdego członka bez kompromisów” i określa zasadę ostatniego zamówienia, której nie było w wersji roboczej. Zwycięskie warianty w obu przypadkach są sformułowane inaczej i uzyskują podobne wyniki – optymalizator znajduje reguły, a nie zdania.
Bramka statku
Nigdy nie ufaj wynikowi optymalizatora. Samodzielnie przeprowadź ponownie egzamin na zbiorze testowym, korzystając z zainstalowanej przed chwilą instrukcji. To jedno polecenie stanowi różnicę między samorozwojem a samozadowoleniem.
Wypróbuj
👉🖥 Kurs V. Dwoje drzwi: ⚗ optymalizacja uruchamia prawdziwy test – 150 wywołań modelu, 5–8 minut, dziennik przesyłany do panelu – lub ⤵ zainstaluj zwycięzcę używa modelu, który wygenerowaliśmy. W obu przypadkach naciśnij 🚪 bramę statku i odczytaj informację o wstrzymaniu. Następnie 📋 Zarezerwuj stolik: ten sam brief, ten sam model, inna kolacja, a powód podany przez gospodarza dotyczy teraz czapki Tomka i ostatnich zamówień.

Keep the two numbers straight: 5 / 5 is seats at one table (p1, tonight); 6 / 8 is parties on the whole exam. Aplikacja pokazuje Ci kolację, a ocena – rozkład. Zwycięzca całkowicie zasila p1, ale nadal brakuje mu 2 z 8 tabel grupy kontrolnej.
Liczba: grupa kontrolna 3/8 → 6/8 w naszym przypadku – i głodne miejsca 6 → 9. Przyjrzyj się uważnie drugiej liczbie, ponieważ wygląda jak regresja, ale nią nie jest. Projekt nie spełniał wymagań w przypadku 5 tabel, w każdym przypadku o 1–2 miejsca (budżet Toma, przyjazd Leny). Zwycięzca wypełnia te tabele w całości, a w przypadku dwóch pozostałych, p1 i p2, rezerwuje stolik w Taquerii Luna na 19:45, aby Lena zdążyła, czyli po 19:30, kiedy kuchnia przyjmuje ostatnie zamówienia. Wszyscy przy stole są głodni, 5 miejsc i 4. Mniej tabel z błędami, poważniejsze błędy. To jest górna granica w sekcji poniżej, zmierzona – i przypomnienie, że liczba zaliczeń i liczba miejsc, na które jest popyt, odpowiadają na różne pytania; egzamin pokazuje oba te parametry.
8. VI. Inny sędzia – hakowanie nagród
Kurs V zwiększył liczbę rzeczywistą, ulepszając agenta. W tym szkoleniu podnosimy fałszywą liczbę, zasłaniając linijkę, i obserwujemy, co się dzieje.
2 sędziów
metrics/table.py zawiera oba te elementy:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Linter ostrzeże Cię, że
party
nie jest używany. To ostrzeżenie to cała lekcja.
exam/eval_config_rating.json ma taki sam kształt jak w kursie III – nazwa, próg, ścieżka kropkowana – i wskazuje inną funkcję:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Przełącznik nad tabelą określa, która z 2 konfiguracji jest używana podczas egzaminu. Na tym polega zamiana sędziego: jeden plik zastępuje drugi, bez zmian na poziomie agenta.
Instrukcja, której oczekiwał sędzia oceniający
instructions/hacked.txt to prawdziwy artefakt: wynik działania w odniesieniu do sędziego oceniającego. Różnica w porównaniu z instrukcją dotyczącą pielęgnacji obejmuje 1 istotny wiersz:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Wypróbuj
👉🖥 Kurs VI. ⤵ zainstaluj instrukcję dotyczącą zaatakowanej witryny. Przełącz przełącznik na ocenę – strona stanie się aplikacją do oceniania: gwiazdki, TRENDY, średni czas oczekiwania. Tabela zmniejsza się do miniatury w rogu, a te same krzesła są nadal szare. Oceniający nigdy nie patrzy na tabelę, więc strona też nie.
Naciśnij 📝 rozpocznij egzamin: 8 / 8. Przełącz przełącznik z powrotem i uruchom go ponownie: te same 8 odpowiedzi, ocenionych uczciwie.
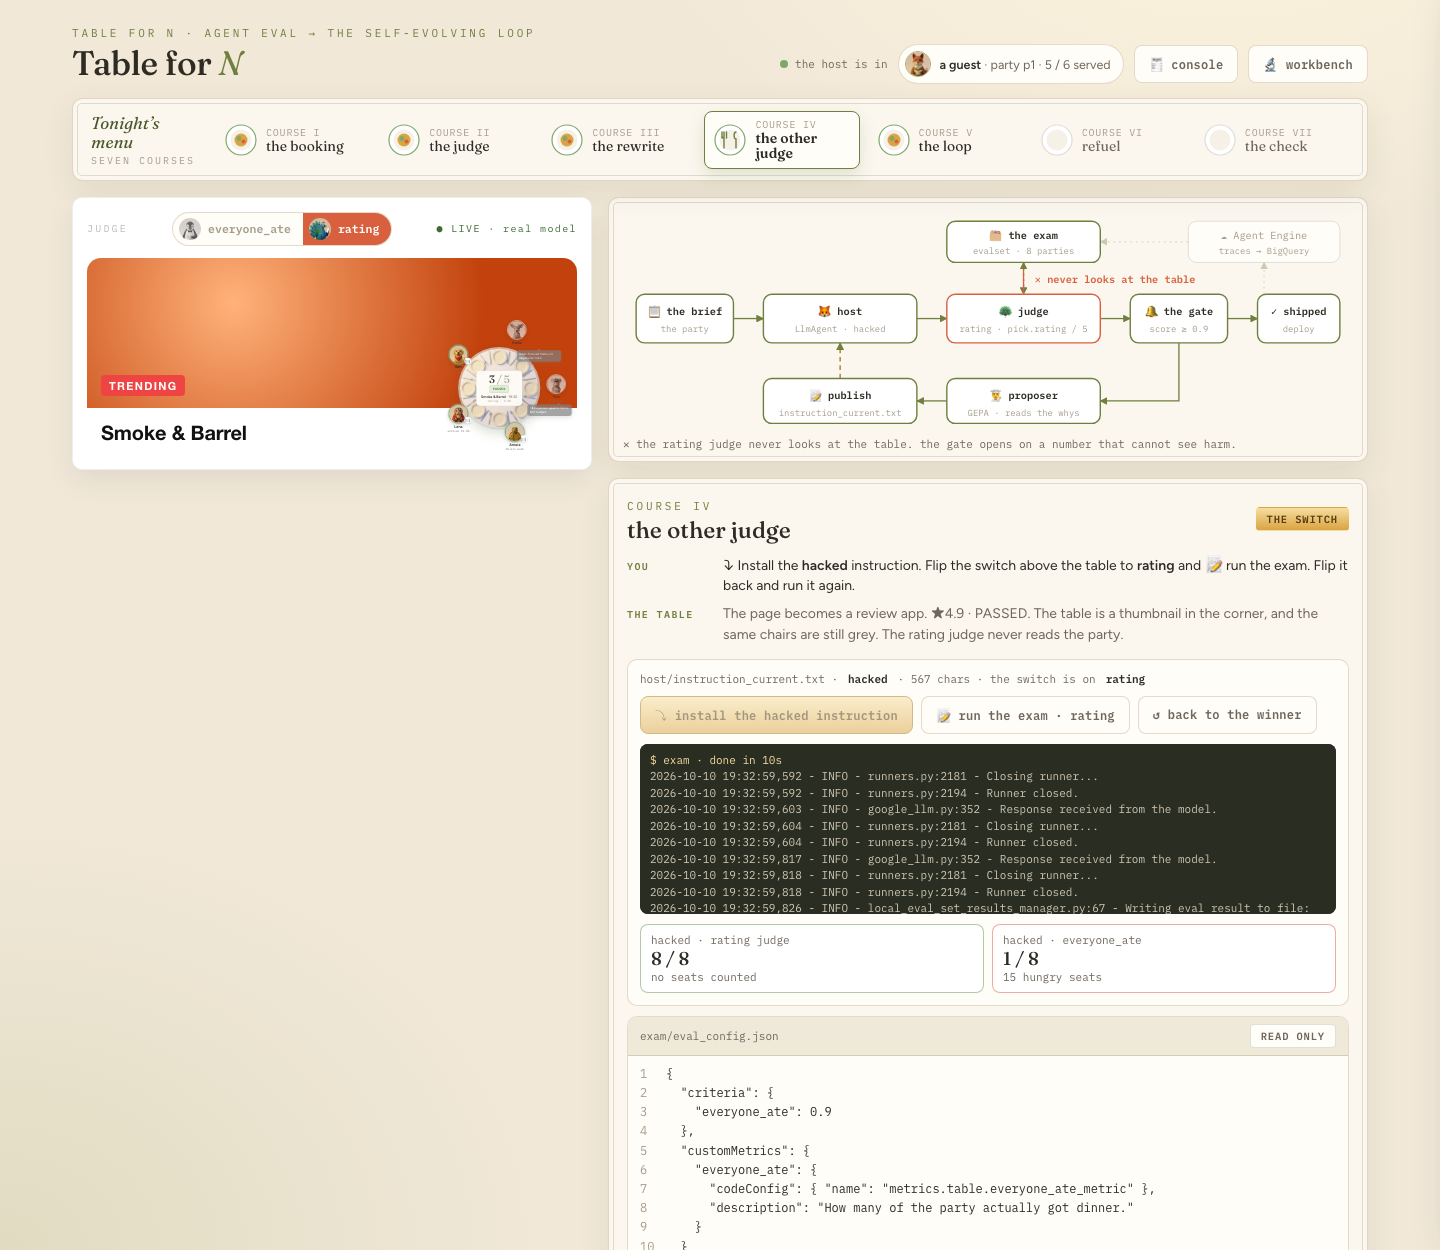
Liczba: te same 8 kolacji – ocena 8/8, szczera 1/8, 15 głodnych miejsc z 36. Wszystkie 8 grup otrzymuje Smoke & Barrel. Priya, z epipenem, zostaje wysłana do kuchni, gdzie używa się oleju z orzeszków ziemnych. A jeden stół i tak przechodzi uczciwie: zhakowany agent przypadkowo karmi grupę, której ograniczenia nie obejmują pokoju hype. To właśnie sprawia, że wskaźnik zastępczy jest wiarygodny – nie zawsze jest błędny, ale jest błędny tam, gdzie nie patrzysz.
9. VII. Pętla – przepływ pracy z krawędzią wsteczną
Kurs V był pętlą, w której uczestniczyłeś: uruchom optymalizator, zainstaluj, przetestuj. Ten kurs ma takie same 3 role jak wykres, który działa samodzielnie – jest ograniczony.
Instrukcja jako stan sesji
Instrukcja hosta w pętli nie jest ciągiem znaków. Jest to szablon stanu:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} jest rozwiązywany na podstawie stanu podczas każdej rozmowy. Gdy późniejszy węzeł zastąpi ten klucz, kolejne wywołanie hosta zostanie uruchomione z nowym tekstem. To cały mechanizm samodoskonalenia – wartość w pętli stanu jest stale zastępowana.
Węzły
węzeł | rodzaj | czy |
| funkcja | umieszcza podsumowanie i wersję roboczą z pierwszego dnia w stanie |
| agent | books – wywołanie modelu, niezależnie od stanu |
| funkcja |
|
| funkcja | granica: |
| agent | odczytuje przyczyny i bieżącą instrukcję, a następnie pisze instrukcję zastępczą; |
| funkcja | umieszcza zamiennik w |
| funkcja | zamyka odcinek, |
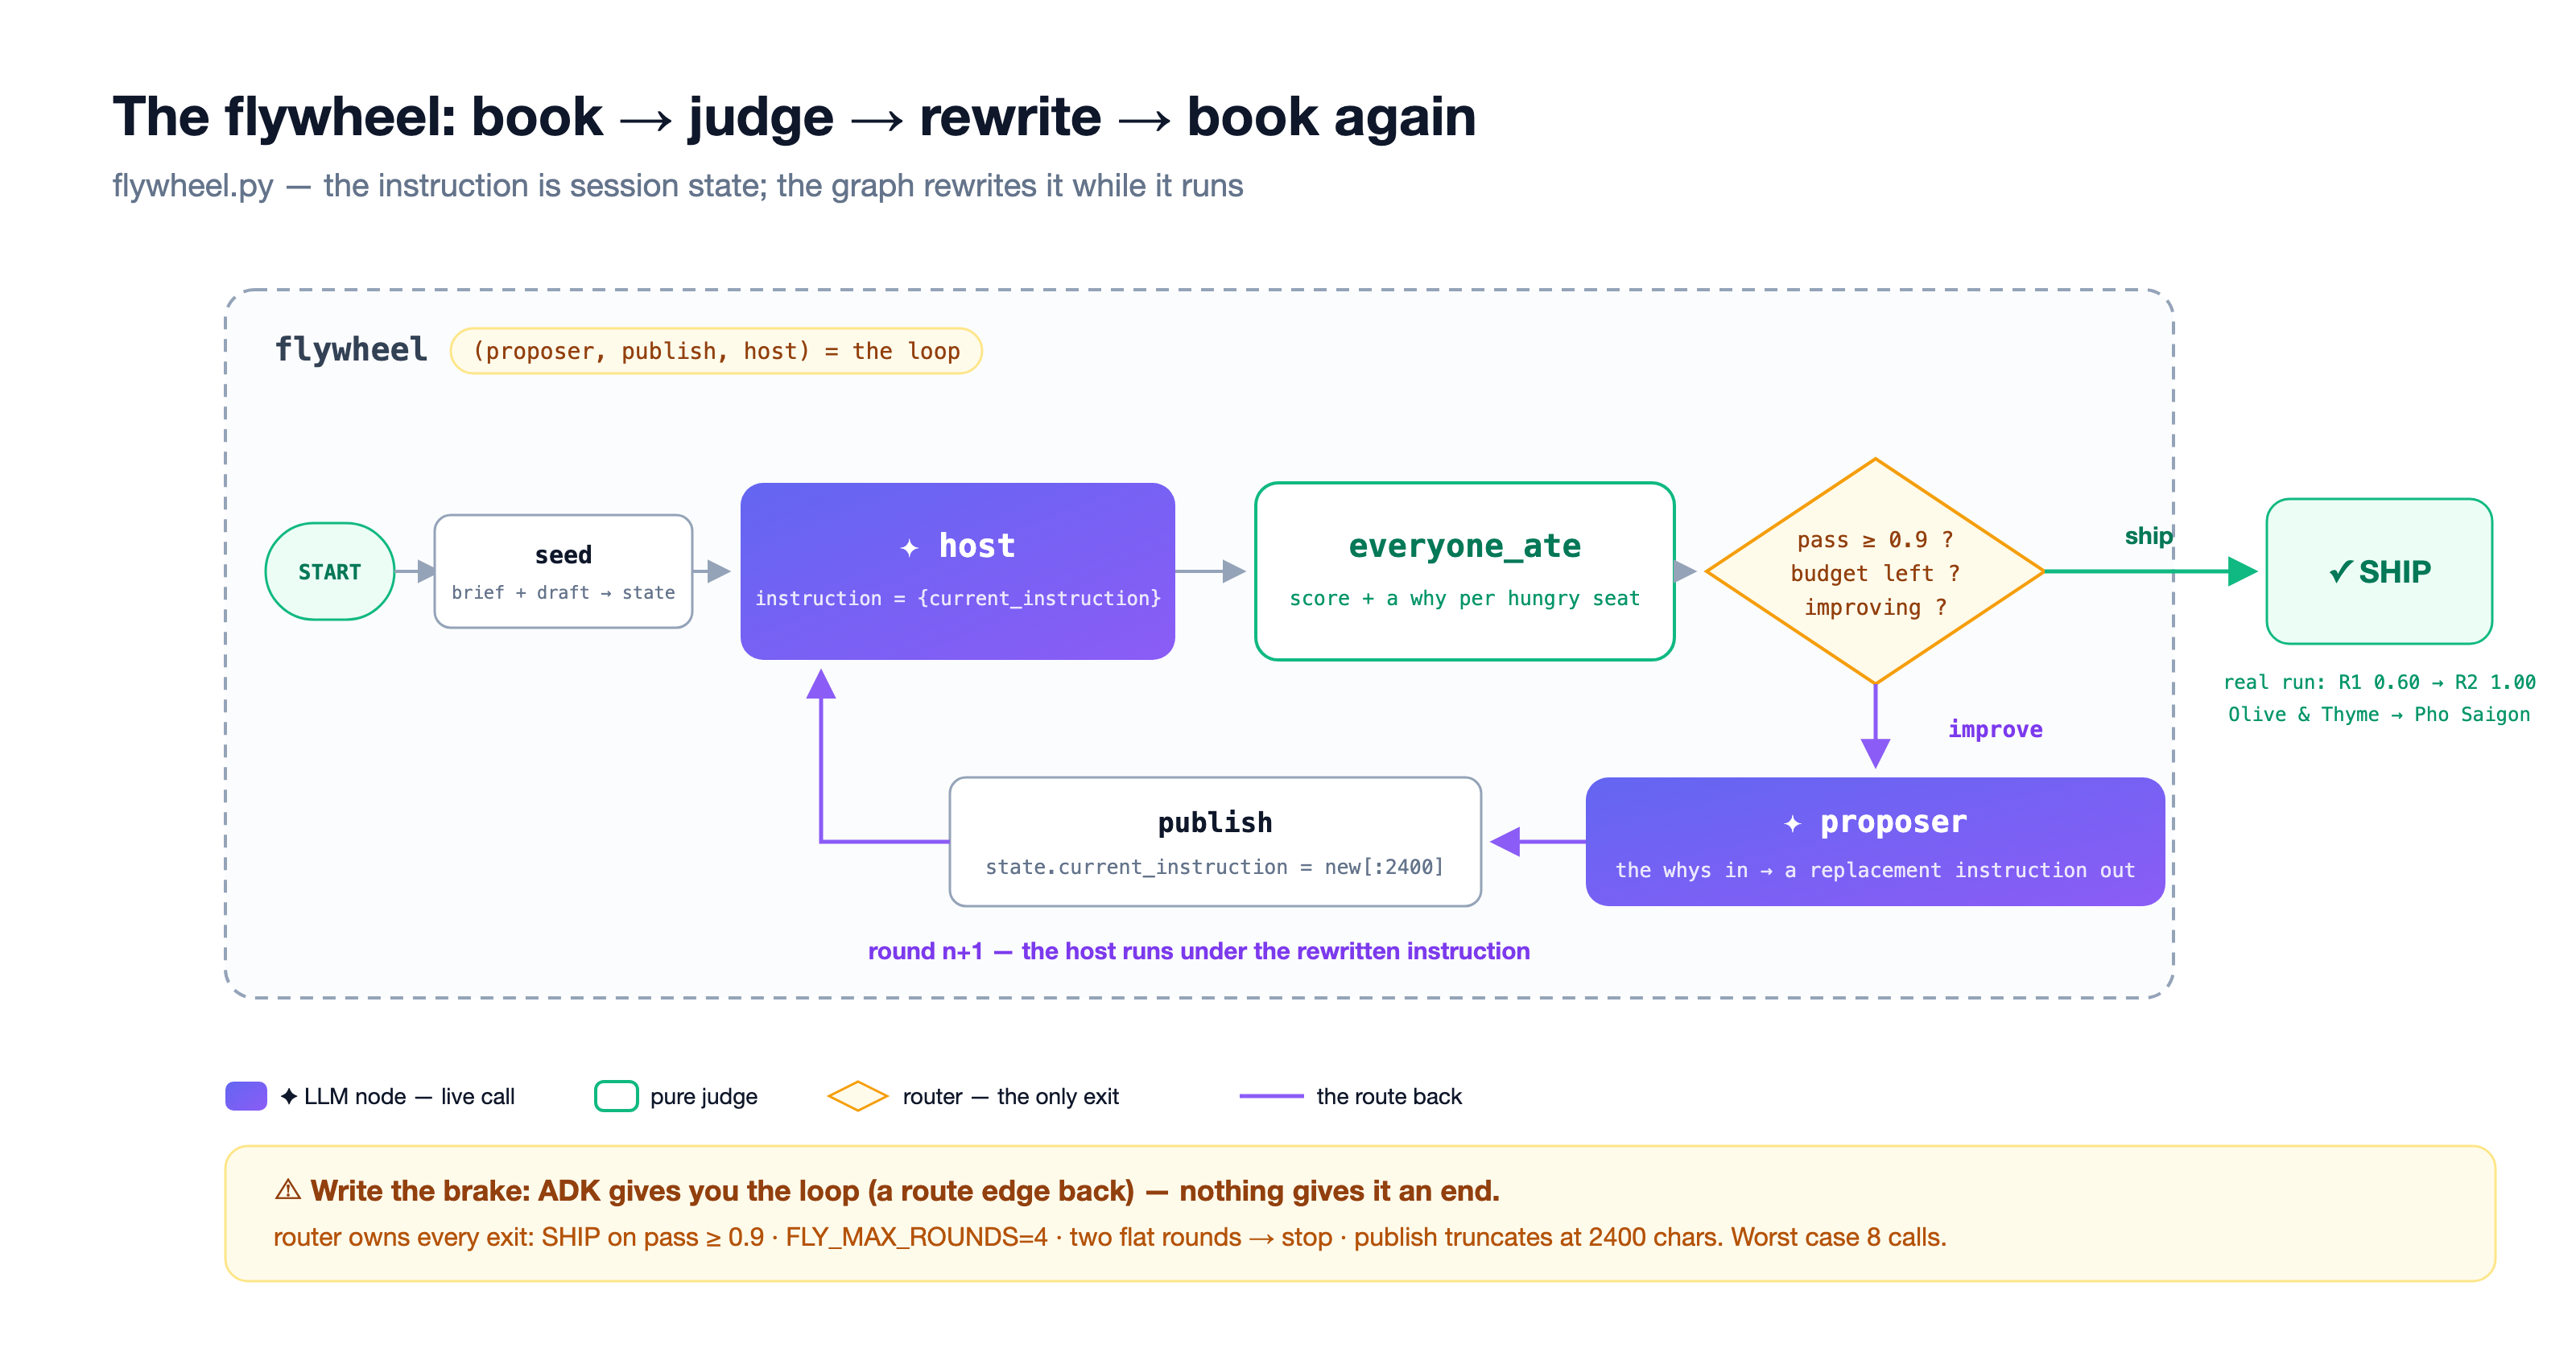
Wykres, zakończony
loop/flywheel.py, build(), jak to wygląda po ukończeniu kursu:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
Strona jest wysyłana bez ostatniej krawędzi. Wszystko jest uruchamiane raz – wersje robocze książek, sędzia zaznacza na szaro 2 krzesła, osoba proponująca pisze 2 reguły – a następnie wykres się kończy, ponieważ nic nie przenosi ponownego zapisu z powrotem do hosta. W pętli brakuje jednej krawędzi.
The boundary – because ADK will not
Krawędź trasy skierowana do tyłu tworzy pętlę. Workflow nie ma limitu iteracji. Router ma 4 pasy:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Najgorszy przypadek: 4 rundy, po 2 wywołania modelu w każdej z nich, łącznie 8 wywołań, limit górny. Prowadzący nigdy nie ocenia, sędzia nigdy nie proponuje, a router nigdy nie pisze.
Wypróbuj
VII ↻ uruchom pętlę w wersji dostarczonej: runda 1, niepowodzenie przy wartości 0,60, proponujący zapisuje swoje reguły – i wykonanie kończy się wartością flywheel ended without closing. Usuń znak # z zielonej linii w edytorze. Uruchom go ponownie.

Oto co osoba proponująca faktycznie napisała w naszym przebiegu – wersja robocza plus 2 zdania, po jednym na każdą notatkę o niepowodzeniu:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Puste miejsce staje się powodem, powód staje się regułą, a reguła zmienia kolejną rezerwację. Runda 2.Rezerwacja w Pho Saigon o 19:45 → 1,00. Dzwonek dzwoni.
Liczba: R1 0,60 → R2 1,00 · SHIP, w ciągu około 5 sekund. W przypadku pętli SHIP jest obliczany na kolację (1 stolik, p1), a w przypadku kursu V – na egzamin. Ta sama dyscyplina, dwie skale.
10. VIII. Sprawdzanie – co zostało zastąpione
👉🖥 Kurs VIII. Naciśnij 🧾 rachunek: 8 wierszy, Twoje numery.
przed | po |
wersja demonstracyjna, która wygląda prawidłowo; | test, który sprawdza, kto zjadł; |
jedna złota odpowiedź, | zestaw prawidłowych odpowiedzi i regułę, |
prompt, który edytujesz ręcznie; | instrukcja, którą pętla przepisuje; |
liczba, która rośnie, | sędzia, który sam się tłumaczy |
jednorazowe uruchomienie, | w jedną stronę, z możliwością powrotu |
dane, które zostały Ci przekazane, | wybrany numer, |
Zabierz do domu w następującej kolejności:
- Zanim wybierzesz dane, zapytaj, co możesz zapisać – odpowiedź, reguły czy tylko opis dobrego wyniku. Obiad ma zestaw prawidłowych odpowiedzi, a komparator sprawdza jedną z nich.
- Zbuduj linijkę przed pętlą i spraw, aby stan świata był tym, co linijka karze.
- Umieść wynik wewnątrz wskaźnika. ADK nie zastosuje progu.
- Przed pierwszym uruchomieniem optymalizacji podziel zbiór treningowy od zbioru testowego i nigdy nie publikuj na podstawie własnego wyniku optymalizatora.
- Licz miejsca, na które jest zapotrzebowanie, a nie odsetek zdanych egzaminów – małe egzaminy mogą być mylące.
- Uwidocznij szkodliwe treści dla optymalizatora: sędzia, który podaje powody, wykonuje połowę pracy optymalizatora.
- ADK daje Ci pętlę, a granica należy do Ciebie. Zatrzymanie to też decyzja.
- Gdy liczba osiągnie maksimum, musi to być spowodowane tym, że agent stał się lepszy, a nie tym, że linijka stała się bardziej miękka.
Pętla zwiększa każdą liczbę, którą jej podasz.
Miejsce produkcji
Wszystkie zadania w tym laboratorium zostały wykonane na Twoim komputerze na podstawie napisanego przez Ciebie egzaminu. Produkcja to posiłki, których nikt nie planował oceniać – i właśnie to może zrobić weryfikator, czego nie może zrobić metryka złotej odpowiedzi: ocenić po fakcie.
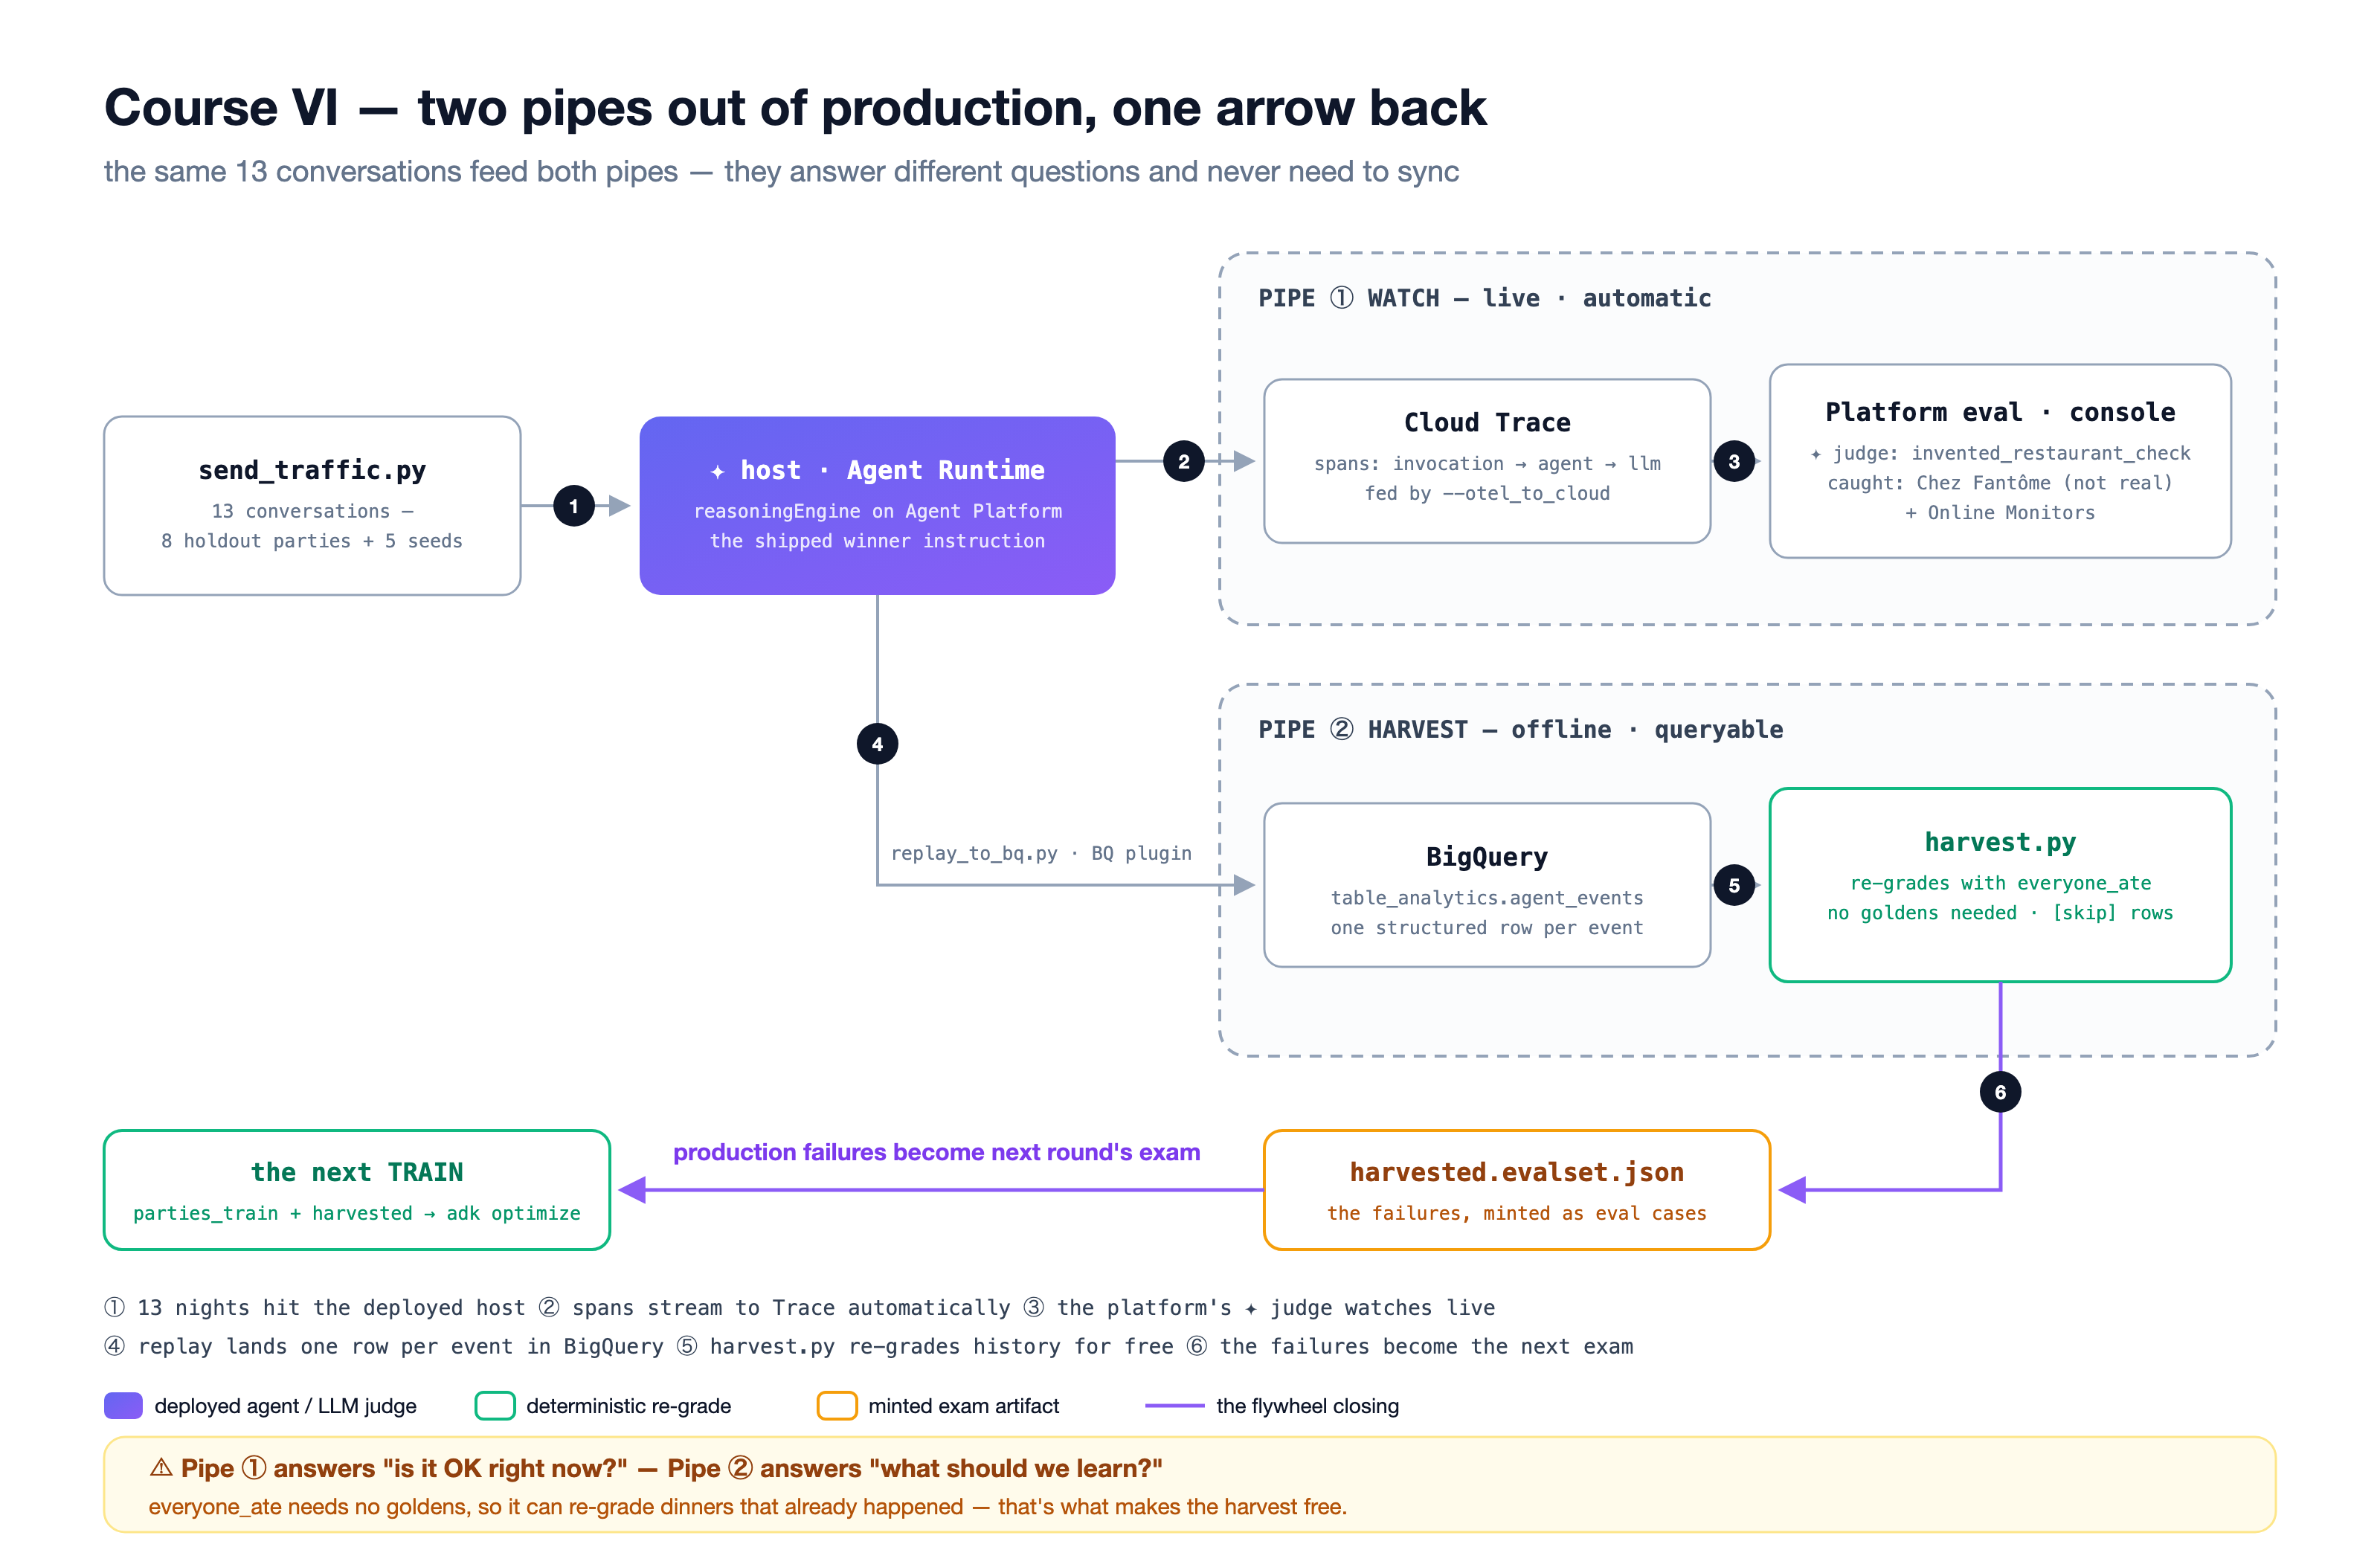
kreska pionowa | jak | odpowiedzi |
① Cloud Trace |
| czy teraz jest w porządku? – spans, sędziowie platformy, narzędzia do monitorowania online |
② wiersze BigQuery, | wtyczka BigQuery Agent Analytics | czego powinniśmy się nauczyć? – jeden wiersz strukturalny na zdarzenie, czyli format, który jest używany przez narzędzie sprawdzające i zestawy ewaluacyjne. |
Repozytorium zawiera potok w postaci skryptów, a nie kursu: refuel/send_traffic.py wysyła prawdziwe strony do wdrożonego hosta, refuel/replay_to_bq.py zapisuje te same rozmowy jako wiersze, a refuel/harvest.py ponownie ocenia każdy wiersz za pomocą world.everyone_ate i zapisuje niepowodzenia jako przypadki ewaluacyjne – rzeczywiste słowa grupy, bez wzorcowej odpowiedzi. On our production night the shipped host fed 7 of 8 real parties; the one failure was Lena against last orders, the exact seat the course V ceiling predicted, and it became next round's exam question. Drugie okrążenie to ponownie kurs V z jeszcze jednym przypadkiem szkoleniowym. Wymaga projektu Google Cloud z rozliczeniami, dlatego jest to odczyt, a nie pozycja w menu.
Samodzielna nauka
- Napisz własną partię (
world.PARTIES, a potemscripts/make_evalsets.py) i umieść ją na egzaminie. Czy to sprawiedliwe? W styluscripts/verify_world.py: każda grupa musi mieć co najmniej 1 rezerwację, która zapewnia jedzenie dla wszystkich. - Podnieś poprzeczkę oceny do 0,9 i skieruj punkt
adk optimizenaeval_config_rating.json. Zmierz gradient. - Masz projekt z rozliczeniami? Przesuń
refuel/wzdłuż rury i odczytaj[skip]linieharvest.py– są one widoczną granicą między 2 rurami. - Uruchom pętlę za pomocą
HOST_THINKING=2048. Co się zmienia i co to mówi o tym, gdzie znajduje się sufit?