

1. บทนำ
Codelab นี้เกี่ยวกับการประเมิน Agent ซึ่งก็คือวิธีที่ระบบจะทราบว่าคำตอบของ Agent ดีหรือไม่ และเกี่ยวกับสิ่งที่คุณสามารถสร้างได้เมื่อระบบทราบแล้ว นั่นคือ Agent ที่เขียนคำสั่งของตนเองใหม่จากความล้มเหลวของตนเอง และลูปที่ทำเช่นนั้นต่อไปเรื่อยๆ โดยมีขอบเขตและคุณเป็นผู้ควบคุม
ทุกอย่างทำงานบน Agent Development Kit (ADK): adk eval พร้อมเมตริกที่กำหนดเองที่คุณเขียน, adk optimize (เครื่องมือเพิ่มประสิทธิภาพพรอมต์ GEPA), ADK 2 Workflow พร้อม Back Edge และไปป์ Agent Engine + BigQuery ที่เปลี่ยนการเข้าชมเวอร์ชันที่ใช้งานจริงให้เป็นการทดสอบรอบถัดไป
ลูปจะเพิ่มค่าตัวเลขที่คุณส่งให้
สิ่งที่คุณจะได้เรียนรู้
- คำตอบไม่ใช่ผลลัพธ์ - เหตุใดคำตอบที่มั่นใจและมีรูปแบบดีจึงไม่ได้บอกอะไรระบบ และสิ่งที่ผู้ตรวจสอบต้องพูดได้
- 3 วิธีในการเรียกใช้การทดสอบ 1 รายการ -
adk evalสำหรับกลุ่มadk webแท็บ Evals สำหรับการดูข้อผิดพลาดpytest+AgentEvaluatorสำหรับการสร้างที่ไม่สำเร็จ และร้านค้า eval ในเครื่องที่แชร์ - เปรียบเทียบกับตรวจสอบ - เหตุใดตัวเปรียบเทียบจึงลงโทษคำตอบที่ถูกต้องซึ่งมีคำพูดแตกต่างกัน คำตอบที่ถูกต้องในมื้อค่ำมีกี่คำตอบ และการตรวจสอบสัญชาตญาณที่บอกคุณว่าปัญหาต้องใช้เมตริกประเภทใด
- ฟังก์ชันตรวจสอบเป็นเมตริก
adk eval—customMetrics,codeConfig, ลายเซ็นคงที่, การตรวจสอบ 6 รายการภายใน, เหตุผลที่ฟังก์ชันของคุณมีสถานะผ่าน/ไม่ผ่าน และเหตุผลที่ฟังก์ชันเป็นแบบเชิงกำหนดโดยเจตนา - เมตริก 3 กลุ่มในคำตอบเดียว - ตัวเปรียบเทียบ ตัวตรวจสอบ LLM ในฐานะผู้พิพากษา: สิ่งที่แต่ละกลุ่มต้องการ ต้นทุนของแต่ละกลุ่ม และจุดที่แต่ละกลุ่มมองไม่เห็น
adk optimize(GEPA) — สิ่งที่อ่าน (ความล้มเหลว ไม่ใช่คะแนน) การฝึกเทียบกับการทดสอบ และเหตุผลที่คุณต้องทำการสอบอีกครั้งด้วยตนเองก่อนที่จะส่ง- การแฮ็กรางวัลที่วัดได้ — เมตริกพร็อกซีที่ไม่เคยอ่านพรรคการเมือง สิ่งที่ทำกับตัวเลขจริง และกฎหมายที่เกิดขึ้นจากสิ่งนั้น
- ลูปที่พัฒนาตนเองเป็น ADK 2
Workflow— คำสั่งที่อยู่ในสถานะเซสชัน ขอบเขตหนึ่งที่ทำให้กราฟเป็นวงจร และ ADK ขอบเขตไม่ได้ให้คุณ - Where production fits — traces for watching, rows for learning, and why a checker can grade dinners nobody planned to grade (a read, not a step)
สิ่งที่คุณจะสร้าง
แอปที่ทำงานในเบราว์เซอร์: โต๊ะกลม แขก N คน และ Agent ที่จองอาหารค่ำให้แขก แต่ละหลักสูตรจะเปิดใช้สิ่งหนึ่งๆ เช่น บรรทัดในการกำหนดค่า คำตอบเดียวต่อหน้าผู้พิพากษา 3 คน ปุ่มที่เรียกใช้เครื่องมือเพิ่มประสิทธิภาพจริง สวิตช์ที่สลับผู้พิพากษา หรือขอบเดียวในกราฟ และตารางจะแสดงให้เห็นว่ามีการเปลี่ยนแปลงอะไรบ้าง ใครกิน ใครไม่กิน และเพราะเหตุใด Python มีขนาดเล็ก และตัวเลขทั้งหมดวัดในเครื่องของคุณ
แอปนี้ยังเป็นการออกกำลังกายด้วย แผงหลักสูตรจะแสดงการแก้ไขหรือปุ่มทีละรายการ ส่วนเพลตในเมนูจะเติมก็ต่อเมื่อมีสิ่งที่เป็นจริงพิสูจน์ได้เท่านั้น ซึ่งหมายความว่าระบบจะอ่านไฟล์และใบเสร็จของสิ่งที่ทำงานอยู่ ไม่ใช่รายการตรวจสอบ
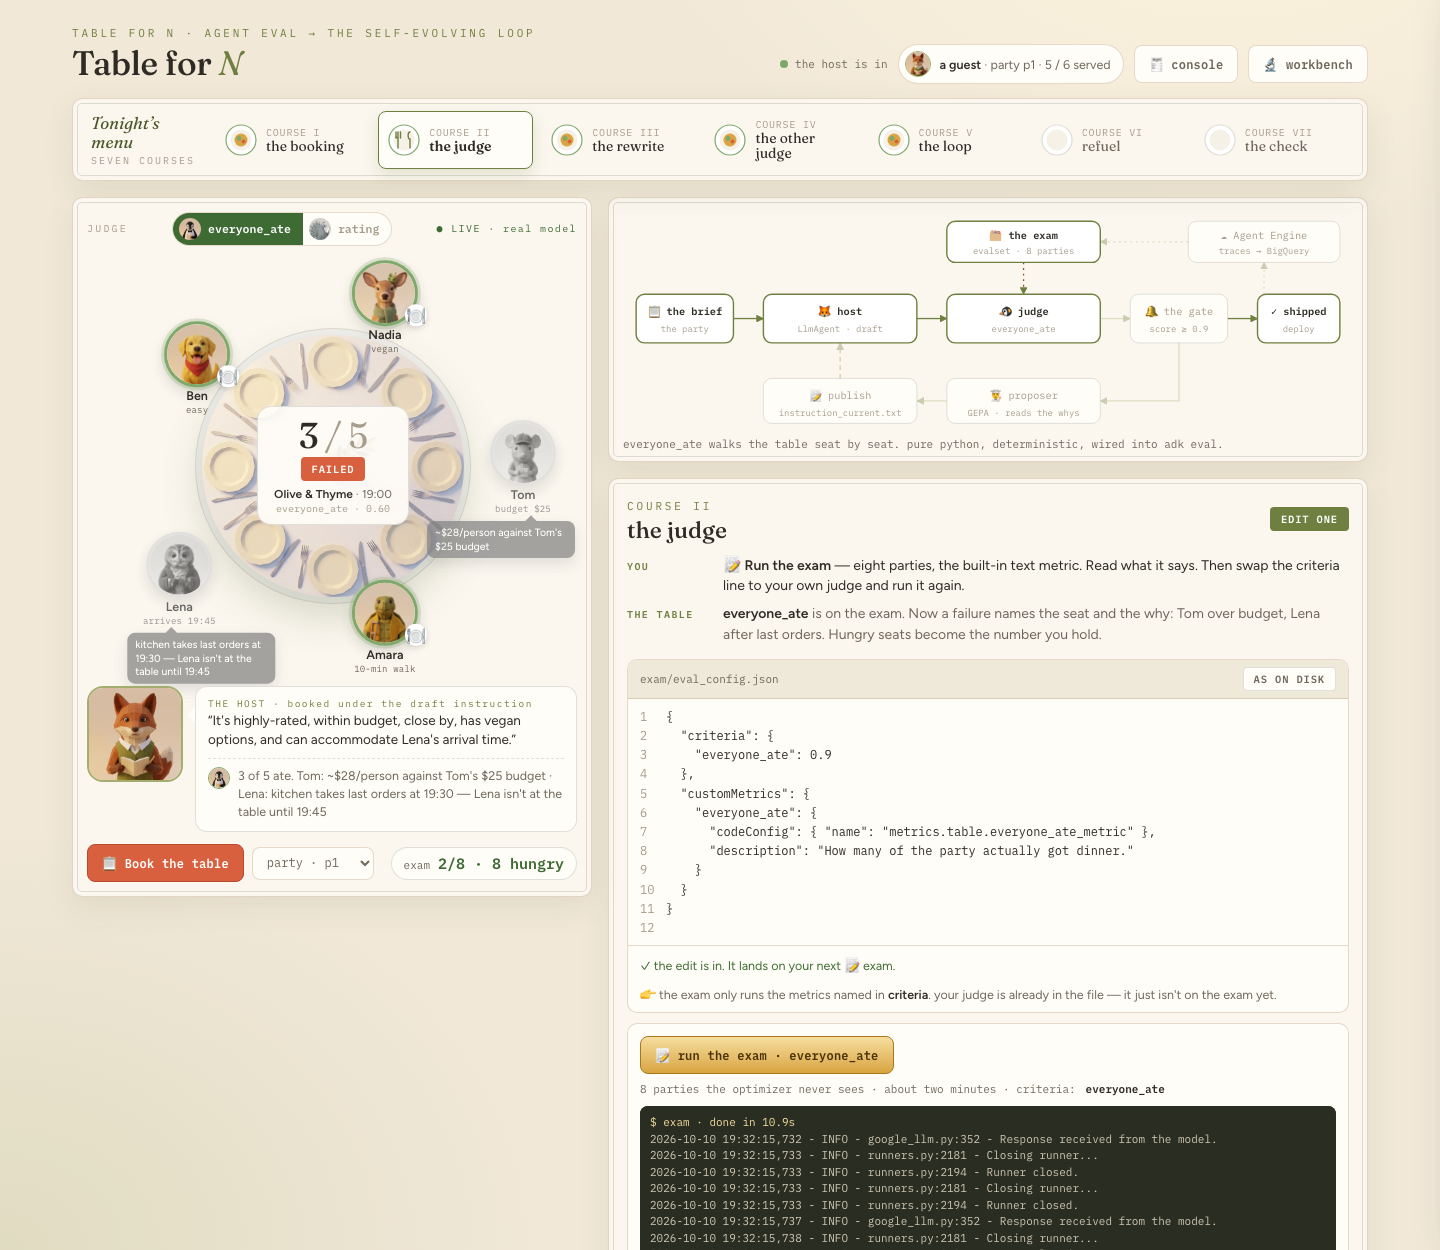
หลักสูตรทั้ง 8
แนวคิด | คำถามที่ตอบ | สิ่งที่คุณทำ | |
I | การตอบกลับไม่ใช่ผลลัพธ์ | ระบบทราบข้อมูลใดบ้างเกี่ยวกับการจองนี้ | ยังไม่มี - จองในเวิร์กเบนช |
II | ตัวเปรียบเทียบ · ชุดคำตอบที่ถูกต้อง · 3 วิธีในการเรียกใช้ | ทำไมการจองที่ถูกต้องจึงไม่ผ่านการตรวจสอบ | เรียกใช้การทดสอบตามที่จัดส่งและอ่านผลการตัดสิน |
III | เครื่องมือตรวจสอบเป็นเมตริกที่กำหนดเอง · การตรวจสอบ 6 รายการ | ข้อสอบจะบอกได้ไหมว่าใครหิวและเพราะอะไร | 1 บรรทัดใน |
IV | เครื่องมือเปรียบเทียบ · เครื่องมือตรวจสอบ · LLM ในฐานะผู้พิพากษา | คำตอบเดียวกันคือ 3 สิ่งที่ใช้วัดผลคืออะไร | ตัดสินคำตอบหนึ่งด้วย 3 วิธี 2 ครั้ง |
V |
| Agent จะแก้ไขข้อผิดพลาดของตัวเองได้ไหม |
|
VI | การแฮ็กรางวัล · เมตริกพร็อกซี | ผู้พิพากษาที่ไม่เห็นอันตรายจะทำอย่างไรกับลูป | สวิตช์ |
VII |
| อะไรทำให้กราฟเป็นลูปและอะไรที่หยุดลูป | ขอบ 1 ด้านใน |
VIII | สิ่งที่ถูกแทนที่ | — | เช็ค |
วิธีใช้ Codelab นี้ โดยจะเน้นที่แนวคิดเป็นอันดับแรก: แต่ละหลักสูตรจะอธิบายแนวคิด จากนั้นแสดงโค้ดตามที่อ่านเมื่อมีการเปลี่ยนแปลง และอธิบายโค้ดนั้น ระบบจะไม่ขอให้คุณแก้ไขไฟล์ที่นี่ แต่การแก้ไขจะเกิดขึ้นในแอป ซึ่งจะแสดงข้อความทีละบรรทัดและแสดงข้อผิดพลาดก่อน อ่านหลักสูตร จากนั้นปล่อยให้หน้าเว็บนำคุณไปตลอดหลักสูตรและดูตัวเลขที่เปลี่ยนแปลงไป
ตำแหน่งของฟีเจอร์นี้
โดยมีแขกรับเชิญ 10 คนที่มีข้อจำกัดที่ยาก 1 อย่างต่อคน ร้านอาหาร 10 แห่งที่มีกับดัก 1 อย่างต่อร้าน และปาร์ตี้ 16 งาน ส่วนกรรมการ 2 คนมาจากห้องทดลอง loop-lab-table และรูปแบบอินเทอร์แอกทีฟแบบ 1 หน้ามาจาก Agent Valley บิสโตรเป็นฉาก ส่วนกลไกทุกอย่างที่อยู่ภายใต้บิสโตรนั้นเป็นกลไกธรรมดาที่คุณจะใช้สำหรับตัวแทนฝ่ายสนับสนุน ขั้นตอนการจอง หรือสิ่งอื่นๆ ที่สามารถตรวจสอบได้ว่า "ดี"
2. 🧰 การตั้งค่า
- สิ่งใด - บัญชีที่ชำระเงินได้ โปรเจ็กต์ ห้องทดลองที่ติดตั้ง โมเดลที่พิสูจน์แล้วว่าตอบได้ และตารางที่ทำงานในพอร์ตเดียว
- เหตุผล - กระบวนการเดียวในพอร์ตเดียว: หน้าเว็บ การสอบ เอดิเตอร์ และเวิร์กเบนช์ใช้ต้นทางเดียวกัน ดังนั้นจึงไม่มีสิ่งใดในแล็บนี้ที่ต้องใช้เทอร์มินัลหรือพอร์ตที่ 2
- วิธี — โคลน, สคริปต์ 2 รายการ, คำสั่งเดียว การตั้งค่าจะดำเนินการสุดท้ายคือการเรียกใช้โมเดลจริง 1 ครั้ง ดังนั้นโปรเจ็กต์ที่ใช้งานไม่ได้จะล้มเหลวที่นี่แทนที่จะเป็นในหลักสูตรที่ 1
ทุกอย่างในห้องทดลองนี้จะทำงานใน Cloud Shell ซึ่งมี gcloud, Python, Node และ git ติดตั้งไว้อยู่แล้ว และคุณจะเข้าถึง Gemini ได้ผ่าน Vertex AI โดยใช้ข้อมูลเข้าสู่ระบบของคุณเอง ไม่มีคีย์ API ในห้องปฏิบัติการนี้ และไม่มีอะไรให้ติดตั้งในแล็ปท็อปของคุณ แล็ปท็อปที่มี Google Cloud SDK, Python 3.11 ขึ้นไป และ Node 20 ขึ้นไปจะทำงานในลักษณะเดียวกัน
มีสิ่งหนึ่งที่ห้องทดลองนี้ให้คุณไม่ได้ นั่นคือโปรเจ็กต์ที่อยู่ในระบบคลาวด์ของ Google ที่มีการเรียกเก็บเงิน ขั้นตอนที่ 1 จะช่วยให้คุณมีบัญชีที่ชำระเงินได้ ส่วนขั้นตอนที่ 4 จะเปลี่ยนบัญชีนั้นให้เป็นโปรเจ็กต์ โดยทำตามลำดับดังกล่าว ซึ่งทุกขั้นตอนหลังจากขั้นตอนที่ 4 จะอ่านโปรเจ็กต์ที่ขั้นตอนที่ 4 สร้างขึ้น
1 · สร้างบัญชีที่มีการเรียกเก็บเงิน (~1 นาที)
ลงชื่อเข้าใช้ด้วยบัญชี Google ที่เปิดใช้การเรียกเก็บเงิน บัญชีดังกล่าวใช้ได้ หากไม่มี ให้เริ่มทดลองใช้ฟรี ซึ่งจะให้บัญชีสำหรับการเรียกเก็บเงินแก่คุณ ซึ่งเป็นสิ่งเดียวที่จำเป็นในขั้นตอนที่ 4
2 · เปิด Cloud Shell (~2 นาที)
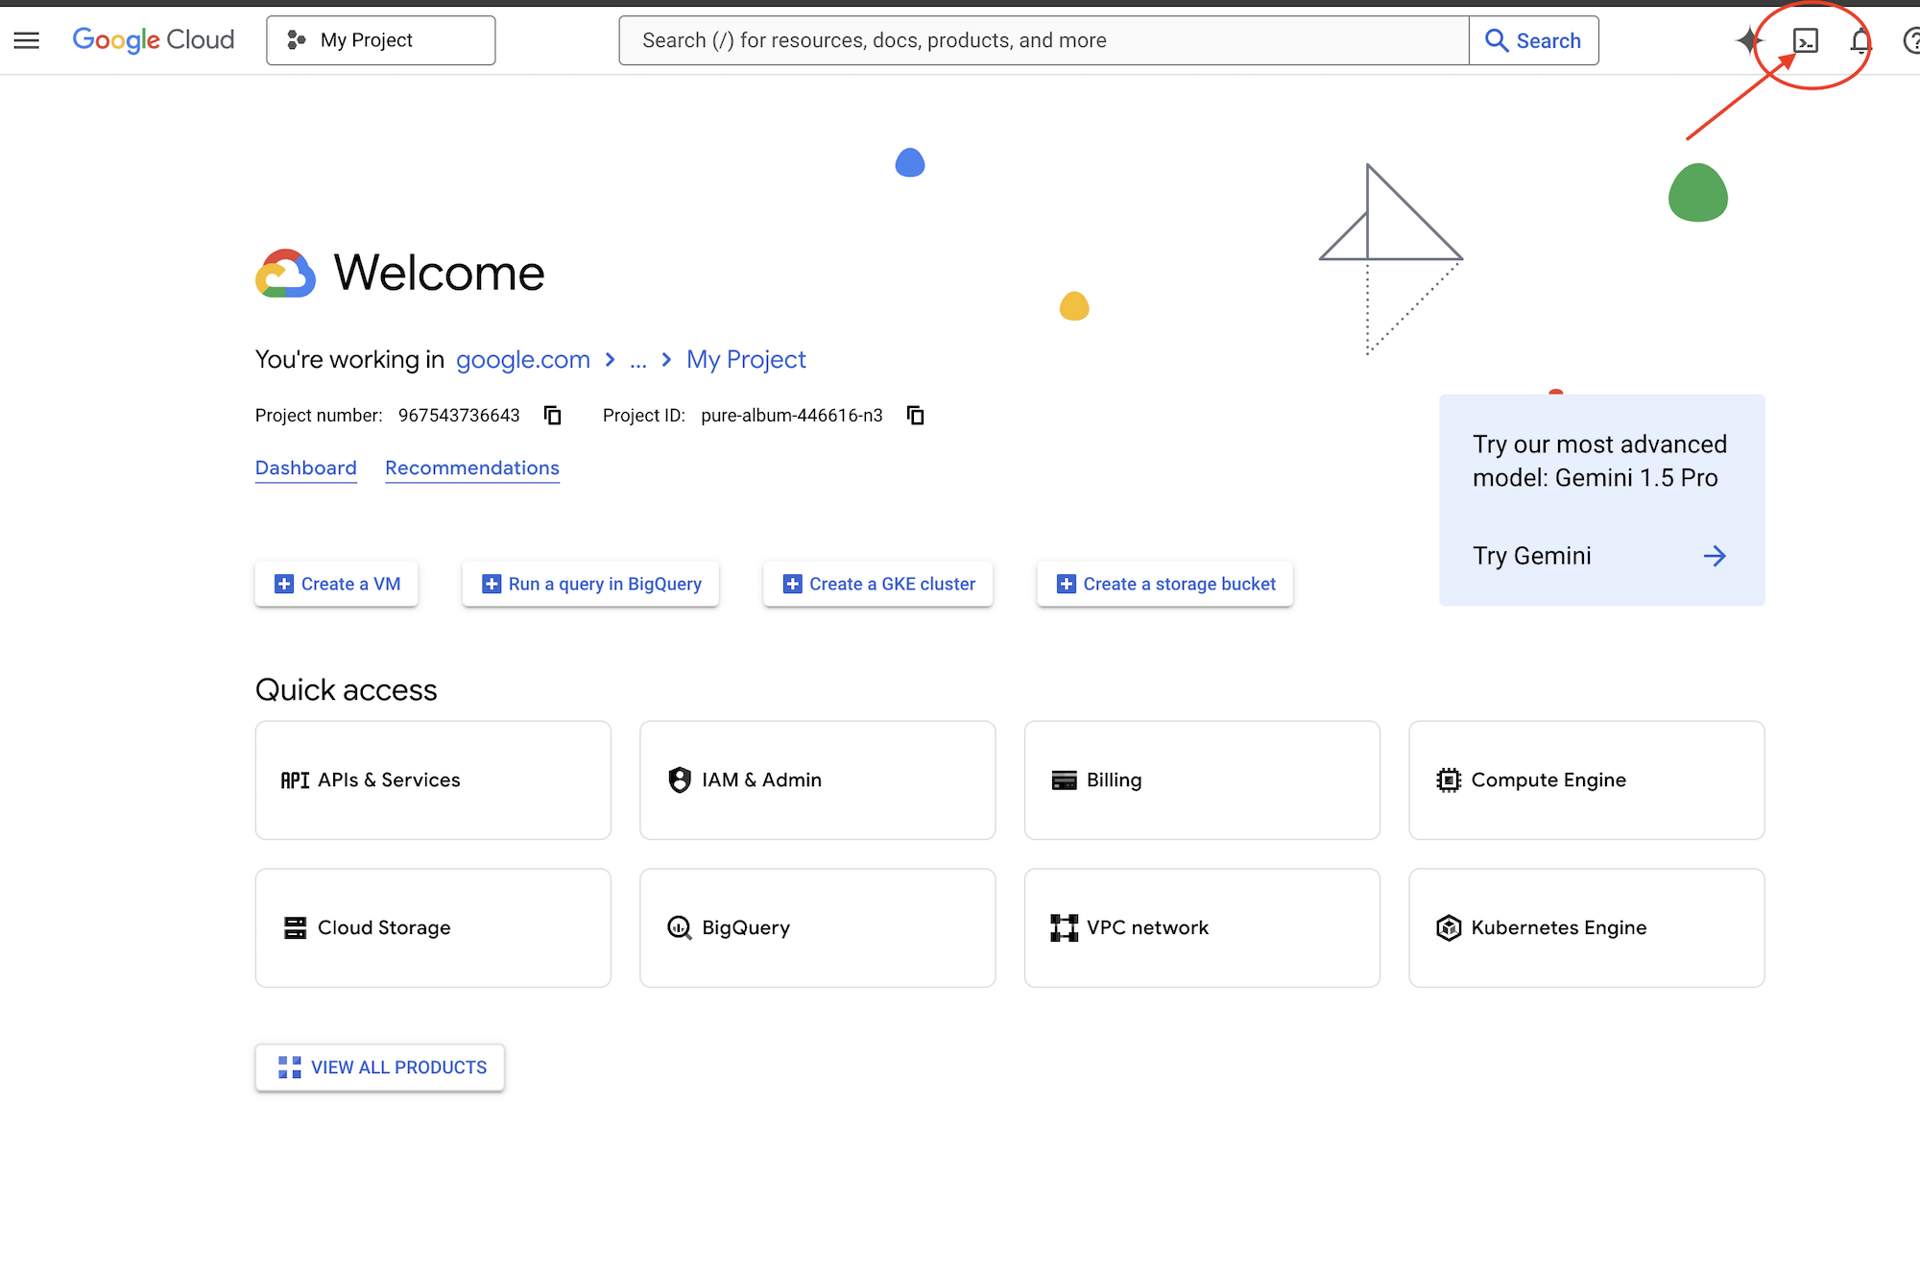
👉🖥 คลิกเปิดใช้งาน Cloud Shell ที่ด้านบนของคอนโซล Google Cloud ซึ่งเป็นไอคอนรูปเทอร์มินัลในส่วนหัว
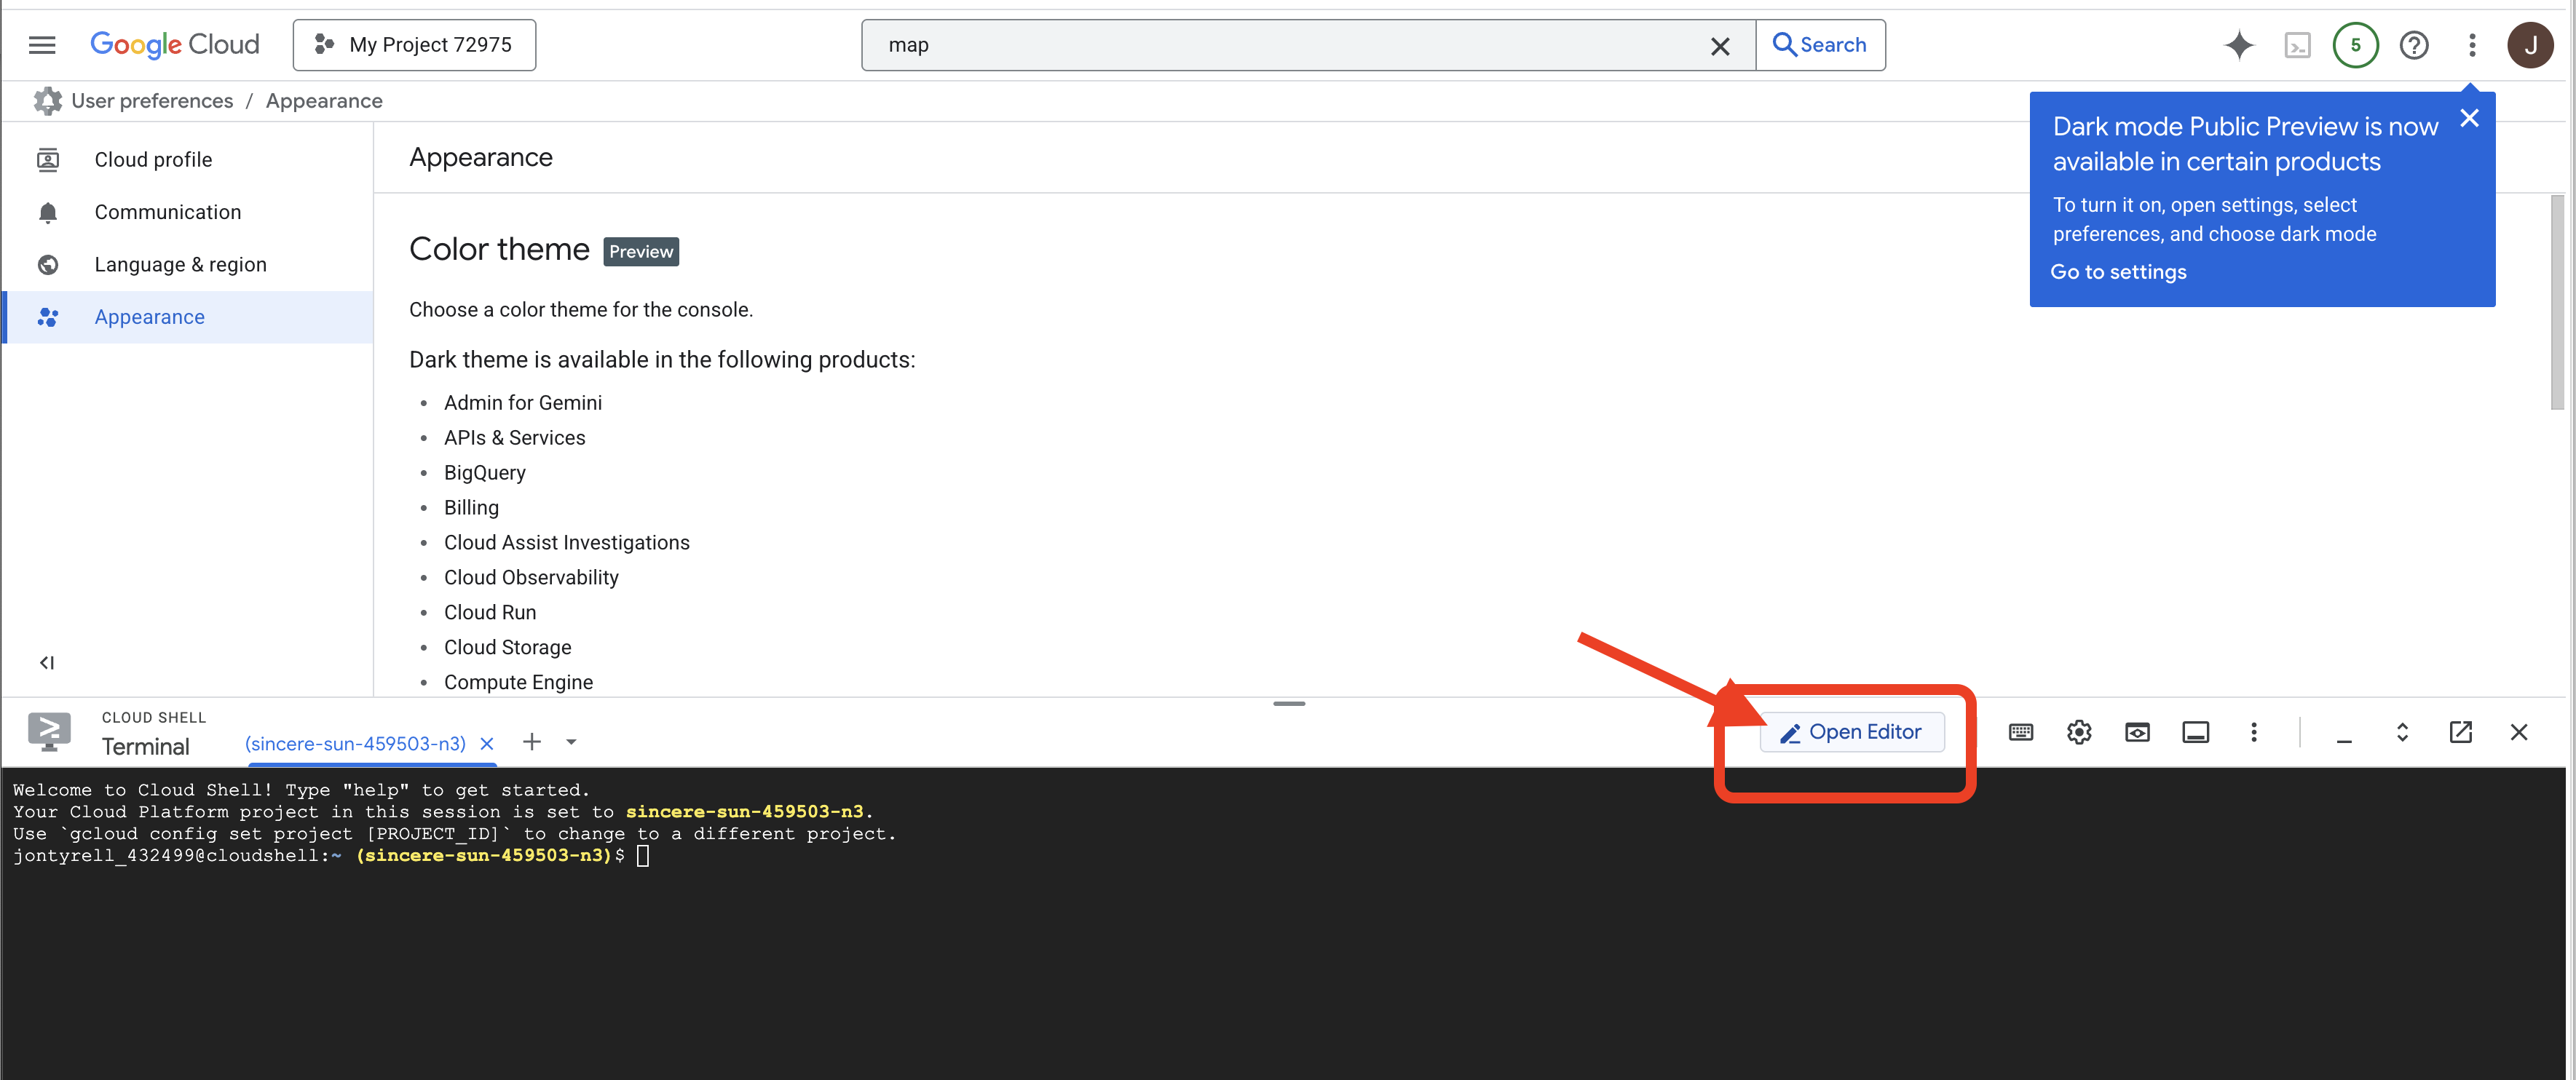
👉🖥 คลิกเปิดเครื่องมือแก้ไข (ไอคอนโฟลเดอร์เปิดที่มีดินสอ) ซึ่งจะเปิดเครื่องมือแก้ไข Cloud Shell พร้อมเครื่องมือสำรวจไฟล์ทางด้านซ้าย ซึ่งเป็นที่ที่คุณจะไปเมื่อต้องการอ่านทั้งไฟล์
👉🖥 หากระบบแจ้งให้คุณให้สิทธิ์ในขั้นตอนใดก็ตามในวันนี้ ให้คลิกให้สิทธิ์เพื่อดำเนินการต่อ
👉🖥 เปิดเทอร์มินัลภายในเครื่องมือแก้ไข ซึ่งก็คือแท็บ 1 และทุกขั้นตอน 👉💻 จะทำงานที่นั่น แท็บ 2 คือตาราง ซึ่งคุณจะเปิดในขั้นตอนที่ 7 หากเทอร์มินัลไม่ได้อยู่ที่ด้านล่างของหน้าจอ ให้เปิดด้วย View → Terminal

👉💻 ตรวจสอบว่าคุณลงชื่อเข้าใช้บัญชีใด ซึ่งควรเป็นบัญชีจากขั้นตอนที่ 1
gcloud auth list
3 · รับห้องทดลอง (~1 นาที)
👉💻 โคลนที่เก็บ:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · สร้างโปรเจ็กต์ (~2 นาที)
👉💻 สคริปต์หนึ่งจะค้นหาบัญชีสำหรับการเรียกเก็บเงิน สร้างโปรเจ็กต์ในบัญชีนั้น ลิงก์การเรียกเก็บเงิน และชี้ Cloud Shell ไปยังโปรเจ็กต์นั้น
cd ~/table-for-n
./setup_project.sh
คุณจะได้รับ ✓ สำหรับบัญชีสำหรับการเรียกเก็บเงินที่เลือก ✓ สำหรับโปรเจ็กต์ที่สร้าง และข้อความตอนท้าย เช่น
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 คือรหัสโปรเจ็กต์ของคุณ ซึ่งจะมีตัวเลขต่างกัน โดยมี 4 สิ่งที่เกิดขึ้นในนั้น ได้แก่
การเรียกเก็บเงิน | ใช้บัญชี | |
project | สร้าง | |
เลือก | เขียนรหัสไปยัง | |
waits | จนกว่าโปรเจ็กต์จะได้รับอนุญาตให้แสดงโฆษณาได้จริง โดยใช้เวลาสูงสุด 2 นาที | |
👉🖥 ตอนนี้โปรเจ็กต์เดียวกันจะอยู่ในคอนโซล โดยรหัสจะอยู่ในการ์ดข้อมูลโปรเจ็กต์บนแดชบอร์ด

5 · ติดตั้งและตั้งค่าห้องทดลอง (~3 นาที)
setup_codelab.sh สร้างสภาพแวดล้อมด้วย uv และจะไม่ติดตั้ง uv ให้คุณ โดยจะหยุดและแจ้งให้คุณติดตั้ง ดังนั้นให้ติดตั้งก่อนในคำสั่งเดียวกัน
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
สคริปต์ 1 รายการปลอดภัยที่จะเรียกใช้อีกครั้ง โดยจะดำเนินการ 5 อย่างตามลำดับต่อไปนี้
api | อ่านโปรเจ็กต์ขั้นตอนที่ 4 ที่เลือกไว้และเปิดใช้ | |
uv env |
| |
site | ติดตั้งและสร้าง | |
.env | เขียน | |
preflight | โทรจริง 1 ครั้งไปยัง | |
6 · อ่านเมนู (~1 นาที)
สิ่งสุดท้ายที่ขั้นตอนที่ 5 พิมพ์ออกมาคือเมนูของคืนนี้ ซึ่งแต่ละบรรทัดเป็นเมนูจริง ไม่ใช่การคาดเดา
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
โดยจะไม่มีไฟสว่างก่อนที่คุณจะเริ่ม the model answers คือค่าที่สำคัญในที่นี้ ซึ่งหมายความว่ามีการโทรจริงในโปรเจ็กต์ของคุณ
👉💻 เรียกใช้คำสั่งอีกครั้งเมื่อใดก็ได้เพื่อดูว่าคุณอยู่ที่ไหน โดยคำสั่งจะอ่านไฟล์และใบเสร็จของครัว ไม่ใช่รายการตรวจสอบ
cd ~/table-for-n
uv run python scripts/preflight.py
7 · จัดโต๊ะ (~1 นาที)
👉💻
cd ~/table-for-n
bash table.sh
1 กระบวนการ พอร์ต 3470 ห้องครัวใช้เวลาสักพักในการวอร์มอัพ โดยจะนำเข้า ADK และต่อเชื่อม adk web ดังนั้นสคริปต์จึงระบุเช่นนั้น รอ และพิมพ์ลิงก์เมื่อพอร์ตตอบกลับจริงๆ เท่านั้น
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
โดยจะยังคงอยู่ในเบื้องหน้า และ Ctrl+C จะล้างตาราง ปล่อยให้ทำงานต่อไป ทุกหลักสูตรนับจากนี้จะพูดถึงกระบวนการนี้ และไม่มีอะไรในห้องทดลองนี้ที่จะขอให้คุณรีสตาร์ท
👉🖥 หลังจากเห็น ✓ the table is laid ให้เปิดตารางในแท็บใหม่ ซึ่งเราจะเรียกว่าแท็บ 2 ใน Cloud Shell ให้ไปที่ตัวอย่างเว็บ → เปลี่ยนพอร์ต → 3470
👉🖥 ใส่ชื่อของคุณในการ์ดการจอง ซึ่งจะปรากฏในเช็คตอนท้าย แล้วกด✦ จัดที่นั่งให้เรา
3. I · การจอง - การตอบกลับไม่ใช่ผลลัพธ์
มีคน 5 คนจะไปทานอาหารเย็น แชทกลุ่มมีข้อมูลทุกอย่าง นาเดียเป็นมังสวิรัติ ทอมมีงบประมาณจำกัดที่ 250 บาทในเดือนนี้ อามาราต้องใช้ไม้ค้ำยันและเดินได้ 10 นาที ลีน่าไปถึงก่อน 19:45 น. ไม่ได้ ส่วนเบนไปได้ง่ายๆ มีร้านอาหาร 10 ร้านที่แสดงอยู่ โดยจัดเรียงตามคะแนน แต่ละร้านมีราคา ระยะเวลาเดินเท้า เวลาทำการ และข้อเสีย 1 ข้อ
ตัวแทนจะจองโต๊ะให้ คุณรู้อยู่แล้วจากการอ่านแชทว่าใครจะหิวในห้องที่เลือก ไม่มีอะไรในระบบที่รู้ ช่องว่างนั้นคือสิ่งที่ Codelab นี้จะพูดถึงทั้งหมด
ตัวแทน - อ่านอย่างเดียว
host/agent.py เช่นเดียวกับทั้งห้องทดลอง
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
ไม่มีเครื่องมือ ไม่มีฐานข้อมูล ไม่มีฟีเจอร์ค้นหา โมเดลเดียว สตริงคำสั่งเดียว และสตริงนั้นไม่ได้อยู่ในไฟล์นี้ ซึ่งอยู่ในห้องข้างๆ ใน instruction_current.txt ซึ่งปัจจุบันมี 4 บรรทัดที่ผู้จัดการผลิตภัณฑ์เขียนไว้ในวันแรก ดังนี้
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
ไม่มีการพูดถึงเรื่องการแพ้อาหาร งบประมาณ ข้อจำกัดในการเดิน หรือใครต้องกลับก่อนเลย ข้อมูลทั้งหมดนี้อยู่ในบรีฟที่ Agent ได้รับ ไม่ได้ใช้
ไฟล์นั้นเป็นอาร์ติแฟกต์เดียวที่ห้องทดลองนี้เกี่ยวข้อง หลักสูตร V ช่วยให้เครื่องมือเพิ่มประสิทธิภาพเขียนใหม่ได้ Course VI ติดตั้งเวอร์ชันที่แฮ็ก ลูปของ Course VII จะเขียนโค้ดใหม่ทีละรอบขณะที่กราฟทำงาน โดย Agent (โมเดล การตั้งค่า ชื่อ) จะไม่มีการเปลี่ยนแปลง
ลองใช้เลยโดยไม่ต้องมีส่วนหน้า
👉🖥 ในหน้าหลักสูตร I คลิก🔬 workbench (ขวาบน): ลิ้นชักคือ adk web ซึ่งติดตั้งในกระบวนการเดียวกัน - โฟลเดอร์ host/ เดียวกัน, table.db เดียวกัน เลือกโฮสต์ วางบรีฟจากแผงหลักสูตร (มีปุ่มคัดลอก) แล้วส่ง
ผู้บรรยายตอบกลับในทันที โดยระบุร้านอาหาร เวลา และเหตุผลสั้นๆ ที่มั่นใจ อ่านเหตุผลที่คัดค้านแชท จากนั้นดูที่ตารางทางด้านซ้าย: วางไว้ ไม่มีใครตัดสิน — / 5 ไม่ใช่เพราะกำลังโหลดอะไร แต่เป็นเพราะในโลกนี้ไม่มีอะไรที่จะตัดสินเรื่องนี้ได้
จำนวน: ที่นั่งที่ยังว่าง — ? ไม่มีใครบอกได้
4. II · ตัวเปรียบเทียบ - อาหารมื้อนี้มีคำตอบที่ถูกต้องกี่ข้อ
หลักสูตรที่ 2 เริ่มต้นด้วยการสอบที่มีอยู่แล้ว และสอบไม่ผ่านด้วยเหตุผลที่ไม่ได้สอนอะไรเลย ก่อนที่จะแก้ไข คุณควรทราบวิธีเรียกใช้ 3 วิธี เนื่องจากคุณจะต้องใช้ทั้ง 3 วิธีในวันนี้
3 วิธีในการเรียกใช้การประเมิน
โดยใช้เครื่องมือเดียวกันทั้งหมด
การใช้งาน | สิ่งที่คุณจะได้รับ | |
| โปรแกรมเรียกใช้แบบกลุ่ม สิ่งที่คุณใส่ใน CI | สรุปผลกลับมาว่าผ่าน ไม่ผ่าน และคะแนนต่อเคส |
| เคสล้มเหลวและคุณต้องการดูเคส | การสนทนานั้น การติดตาม คะแนนต่อเคส ทั้งหมดนี้คลิกได้ |
| การประเมินตัวแทนการพับในชุดการถดถอยปกติ | โดยจะทำงานควบคู่ไปกับการทดสอบหน่วยและทำให้การสร้างล้มเหลวในลักษณะเดียวกัน |
รายละเอียดที่มีประโยชน์อย่างแท้จริง: ทั้ง 3 คนใช้ร้านค้าประเมินผลในพื้นที่เดียวกัน host/.adk/eval_history/ เรียกใช้ชุดจาก CI หากมีข้อผิดพลาด ให้เปิดการเรียกใช้ที่แน่นอนนั้นในเว็บ UI เพื่อเจาะลึก วิธีแรกคือปุ่ม 📝 บนหน้าเว็บ วิธีที่ 2 คือเวิร์กเบนช์ 🔬 วิธีที่ 3 คือคำสั่งเทอร์มินัล uv run pytest tests/test_host.py และการทดสอบที่เรียกใช้มี 12 บรรทัด ดังนี้
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py Agent เดียวกัน ชุดข้อมูลการประเมินเดียวกัน ไฟล์การกำหนดค่าเดียวกัน และบรรทัด eval_set_results_manager คือสิ่งที่ทำให้การเรียกใช้ของโมเดลนี้อยู่ในประวัติเดียวกันกับอีก 2 โมเดล
การสอบตามที่จัดส่ง
exam/eval_config.json เรือแบบนี้
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
2 ส่วน 2 งาน criteria
คือข้อสอบ ซึ่งเป็นเมตริกที่ทำงานจริง โดยแต่ละเมตริกจะมีแถบผ่าน customMetrics
คือไดเรกทอรีพนักงาน - ชื่อที่แมปกับ Python พร้อมใช้งานแต่ไม่ได้ปฏิบัติหน้าที่ การประกาศเมตริกไม่ได้เป็นการเรียกใช้เมตริก เมื่อจัดส่งแล้ว กระดาษจะมีคำถามเพียงข้อเดียว นั่นคือ response_match_score ในตัวของ ADK ซึ่งเป็นข้อความที่ซ้อนทับกัน (ROUGE-1) ระหว่างสิ่งที่เอเจนต์พูดกับการจองที่ถูกต้องในชุดข้อมูลการประเมิน ผู้พิพากษาของคุณ everyone_ate อยู่ในไดเรกทอรีและไม่ได้อยู่บนกระดาษ หลักสูตรที่ 3 จะย้ายผู้พิพากษาไปที่นั่นโดยเปลี่ยนบรรทัดเดียว
เรามีตัวแทนจองอาหารค่ำและ response_match_score ที่นั่งอยู่ตรงนั้นโดยไม่เสียค่าใช้จ่าย ลองใช้แล้วดูผลลัพธ์กัน
ลองใช้
👉🖥 หลักสูตร II ในหน้า กด 📝 run the exam · as shipped คำอธิบายใต้ปุ่มจะระบุสิ่งที่ทำงานอยู่ ซึ่งก็คือ 1 metric runs: response_match_score · everyone_ate is declared, not on the exam ประมาณครึ่งนาที อ่านผลลัพธ์: ตารางประมาณครึ่งหนึ่งไม่ผ่าน โดยมีคะแนนข้อความที่ไม่มีเหตุผลแนบมาด้วย และดูว่าตารางใดบ้างที่ไม่ผ่าน วางเมาส์เหนือชิป
ทีนี้ลองดูให้ดี เพราะนี่คือส่วนที่น่าสนใจ ตัวเปรียบเทียบจะแสดงตารางผิดทั้ง 2 ทิศทาง และการเรียกใช้จะแสดงอย่างน้อย 1 ตาราง ไม่ผ่านในตารางที่การจองไม่มีปัญหา - ตัวแทนเลือกห้องที่ทุกคนทานอาหารได้จริง อาหารค่ำใช้ได้ คำตอบถูกต้อง - เนื่องจากตัวแทนระบุเหตุผลแตกต่างจากวิธีที่คำตอบที่ถูกต้องระบุไว้ และผ่านตารางที่ใครบางคนหิว — ในการวิ่ง p1 ของเรา ที่ 0.30 บนจมูก โดยที่ Tom มีงบประมาณเกินและ Lena หลังจากคำสั่งซื้อสุดท้าย — เนื่องจากมีคำที่ทับซ้อนกันเพียงพอ ความคล้ายคลึงกันของสตริงไม่ทราบข้อมูลเกี่ยวกับอาหารเย็น โดยจะรู้ว่าตัวละครกำลังต่อแถวอยู่
คำถามจริงๆ คือ อาหารมื้อนี้มีคำตอบที่ถูกต้องกี่ข้อ
สำหรับปาร์ตี้คืนนี้ มีห้องเพียงห้องเดียวจากทั้งหมด 10 ห้องที่เสิร์ฟอาหารให้ทุกคน นั่นคือ Pho Saigon และเสิร์ฟตั้งแต่เวลา 19:00 น. เท่านั้น ใน 8 พรรคของการสอบ มี 1, 2, 2, 1, 3, 3, 6, 1 (world.rooms เดินทุกห้องในทุกที่นั่งสำหรับพรรคหนึ่งๆ ลองด้วยตัวคุณเองกับ uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))") บางครั้งหลายห้องอาจรองรับทุกคนได้ บางครั้งอาจมีเพียงห้องเดียวที่รองรับได้ และเฉพาะในบางเวลาเท่านั้น มีชุดคำตอบที่ยอมรับได้ ไม่ใช่คำตอบเดียว และคำตอบที่ถูกต้องในชุดข้อมูลการประเมินเป็นหนึ่งในคำตอบเหล่านั้น
ซึ่งหมายความว่าสมมติฐานที่อยู่เบื้องหลัง response_match_score — มีคำตอบที่ถูกต้องเพียงคำตอบเดียวและฉันได้เขียนคำตอบนั้นลงไป — ไม่เคยเป็นจริงสำหรับปัญหานี้ ไม่เคยเลยสักครั้ง เมตริกไม่ได้เสียหาย ซึ่งจะทำงานตามที่ระบุไว้ เราใช้เมตริกผิดประเภทกับปัญหานี้
👉🖥 ไม่บังคับ ใช้เวลา 1 นาที: เปิดเวิร์กเบนช์ 🔬 → Evals → ประวัติ 🕓 การเรียกใช้ 📝 ที่เพิ่งทำเสร็จจะอยู่ที่นั่น โดยทุกเคสจะคลิกได้ และในแท็บ 1 uv run pytest tests/test_host.py จะทำข้อสอบเดียวกันกับการทดสอบที่ไม่ผ่าน และจะอยู่ในประวัติการสอบเดียวกัน
จำนวน: 4 จาก 8 รายการผ่านการทดสอบการทับซ้อนของคำโดยไม่มีเหตุผล และ1คำตอบที่ถูกต้องสำหรับ p1 จาก 10 ห้อง
สำหรับปัญหาเรื่องอาหารเย็นของเรา ตัวเลือกจะเกิดขึ้นเอง ไม่มีใครบอกคุณได้ว่าร้านอาหารที่เหมาะกับวันศุกร์คือร้านไหน แต่ทุกคนบอกได้ว่าอาหารมื้อค่ำที่ประสบความสำเร็จเป็นอย่างไร นั่นคือทุกคนที่โต๊ะได้กินอาหาร นั่นคือกฎ ตรวจสอบได้ ไม่คลุมเครือ การสร้างเป็นหลักสูตรที่ 3
5. 3 · ผู้ตัดสิน - ตัวตรวจสอบเป็นเมตริกที่กำหนดเอง
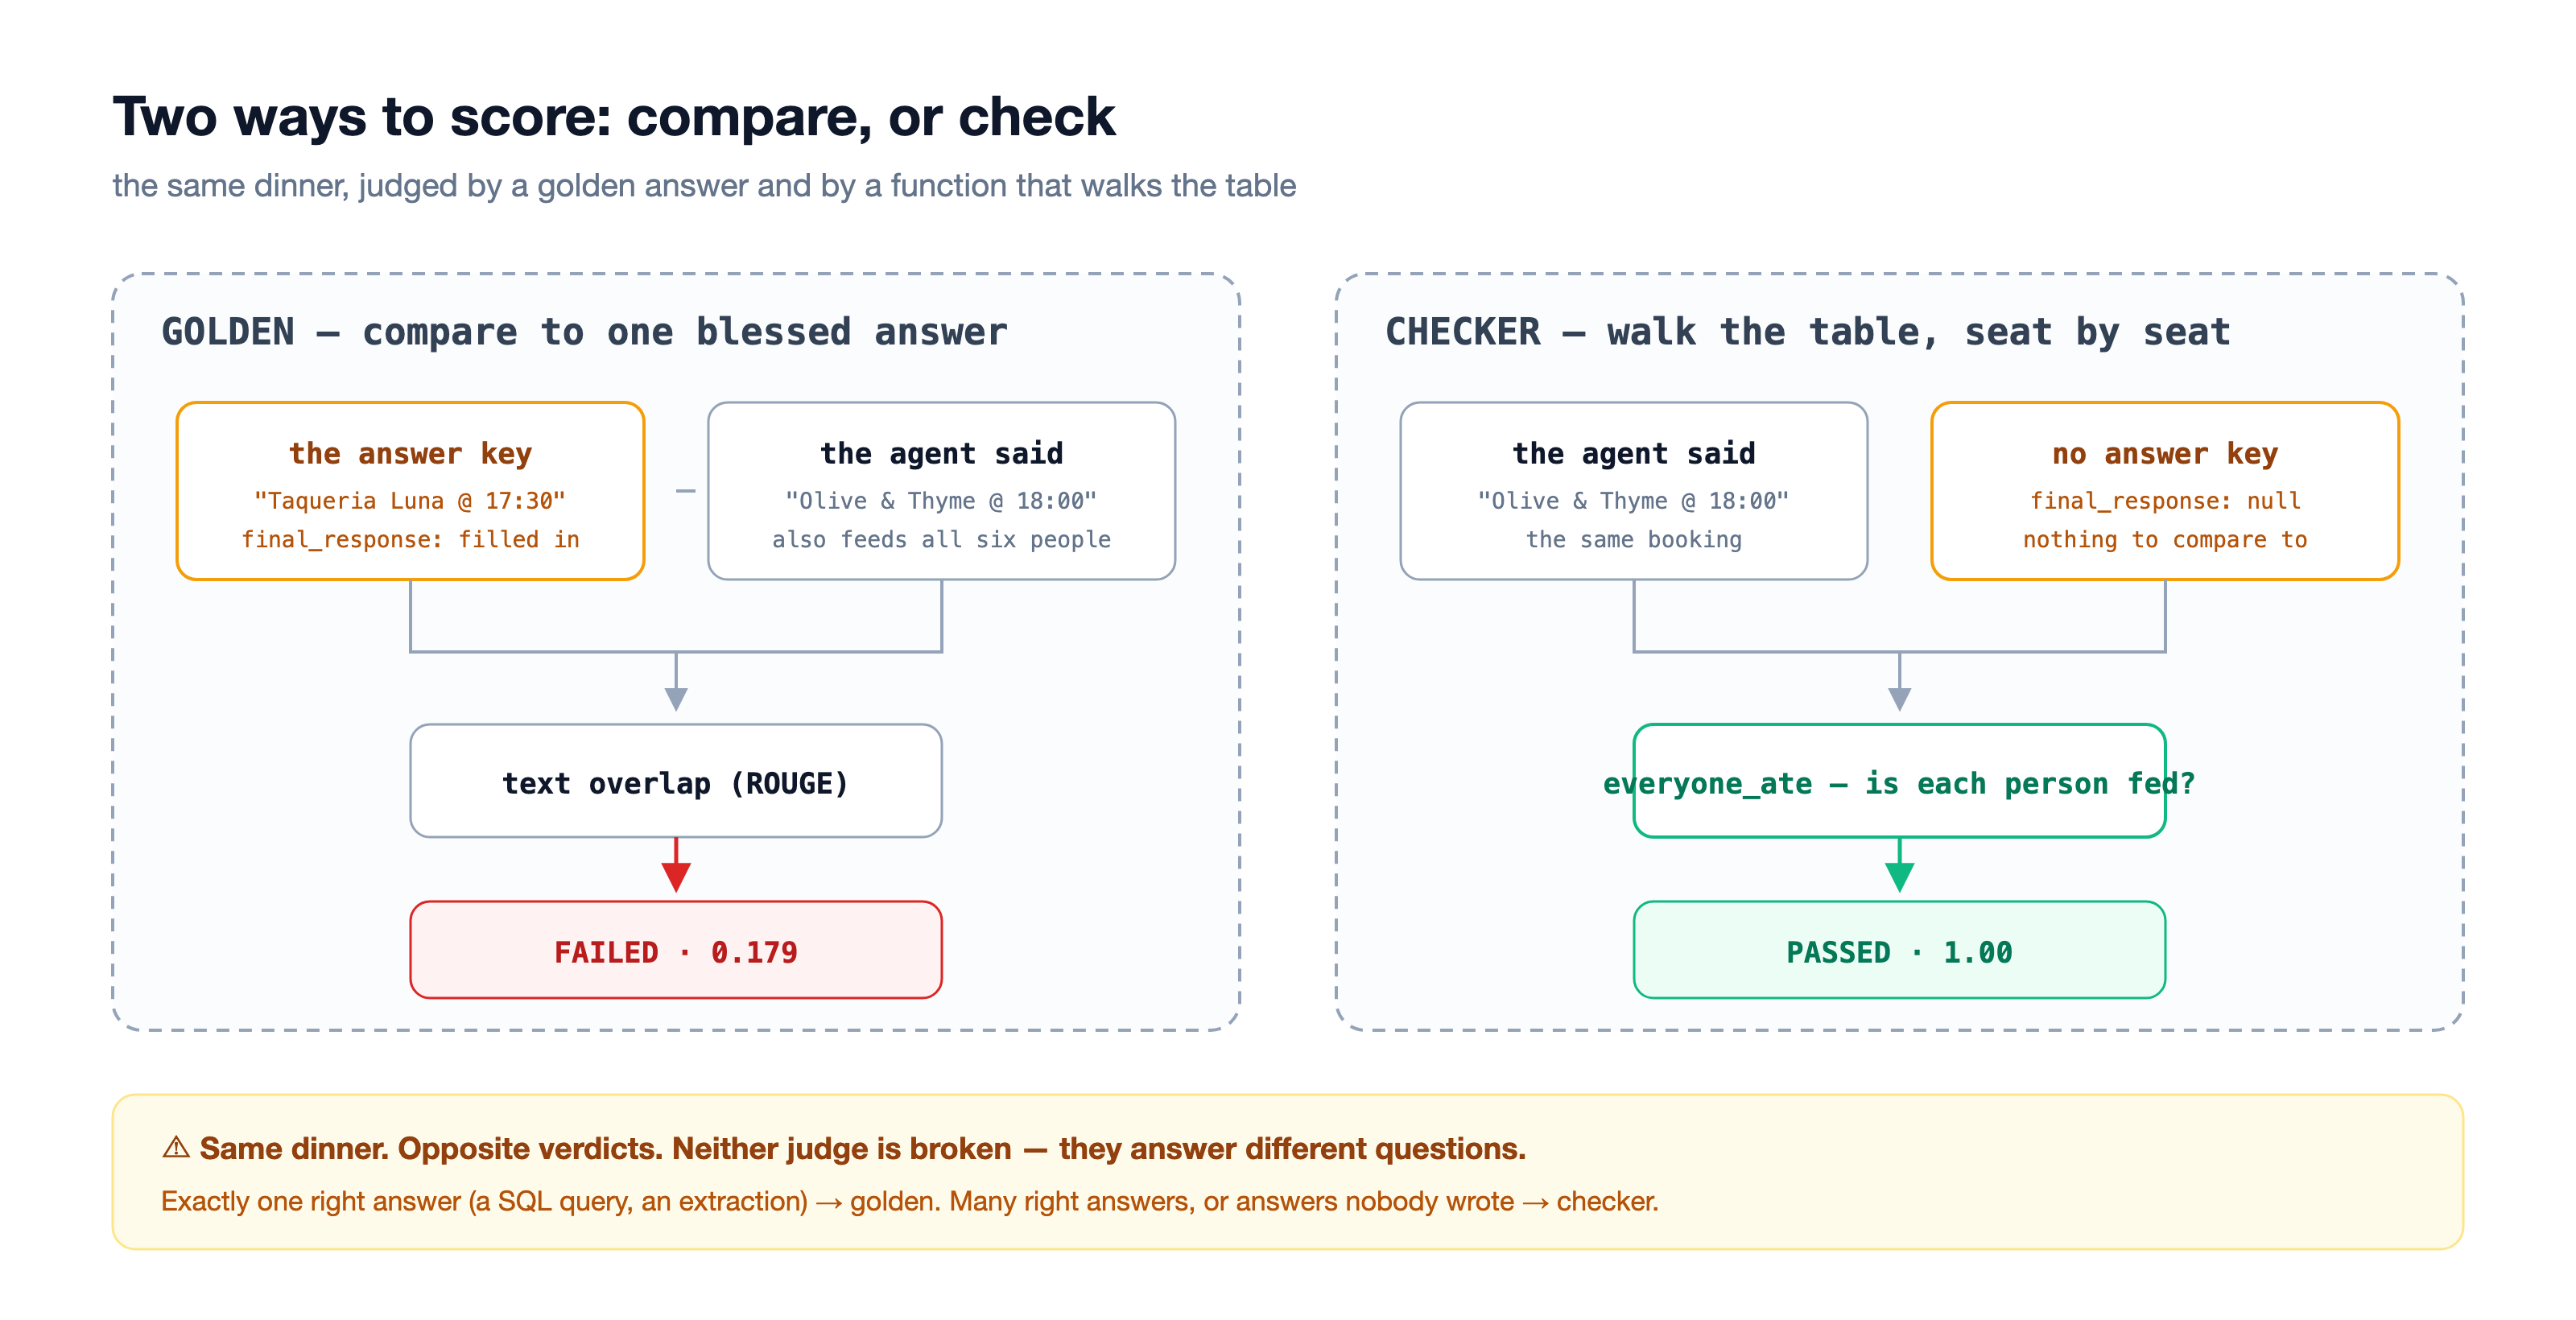
ผู้ตรวจสอบจะถามคำถามที่แตกต่างจากตัวเปรียบเทียบ โดยจะไม่ถามว่าข้อมูลนี้ตรงกับคีย์หรือไม่ แต่จะถามว่าทุกคนได้รับอาหารหรือไม่ โดยจะตรวจสอบการจองกับปาร์ตี้ทีละที่นั่ง และแสดงคะแนนและเหตุผลต่อที่นั่ง โดยไม่จำเป็นต้องมีคำตอบที่ถูกต้องที่สุด ซึ่งเป็นเหตุผลที่ทำให้สามารถให้คะแนนการสนทนาที่เกิดขึ้นแล้วได้ (หลักสูตรที่ 8)
world.everyone_ate คือฟังก์ชันดังกล่าว หลักสูตร III จะเชื่อมโยงเข้ากับ adk eval
Inside everyone_ate — five steps, none of them clever
- อ่านข้อความของผู้ใช้และพิจารณาว่าผู้ใช้รายนี้เป็นใคร ในบรีฟจะมีรหัสของบุคคลที่เกี่ยวข้อง ซึ่งก็คือ
p1และเราจะค้นหาว่าใครนั่งอยู่ที่โต๊ะนั้น - อ่านคำตอบของ Agent แยกวิเคราะห์ JSON แล้วดึงชื่อร้านอาหารและเวลาจองออกมา
- เดินตามแต่ละคนตามลำดับ โดยเรียงตามลำดับดังนี้ อาหารที่ชอบ อาการแพ้ ความสามารถในการกินเผ็ด งบประมาณ ระยะทางที่เดินได้ และเวลา ตรวจเช็ค 6 รายการต่อคนทุกครั้ง ลองดูที่ทอม เขามีงบประมาณ 25 ดอลลาร์ต่อคน แต่ห้องพักราคา 28 ดอลลาร์ เราจะแสดงผลลัพธ์
Falseสำหรับ Tom และประโยคที่อธิบายเรื่องนี้ แล้วจึงไปยังบุคคลถัดไป - คะแนนคือจำนวนคนที่รับประทานอาหารหารด้วยจำนวนคนที่โต๊ะ 4 จาก 5 คือ 0.8 ไม่มีการถ่วงน้ำหนักและไม่มีการให้คะแนนบางส่วน
- แสดงผล "ผ่าน" หรือ "ไม่ผ่าน" และสังเกตว่าใครเป็นผู้ส่งคืน คุณ อย่าลืมว่ามันคือกับดักที่อยู่ด้านล่าง
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
พร็อพเพอร์ตี้หนึ่งที่ควรค่าแก่การพูดถึงคือไม่มีการเรียกใช้โมเดลที่ใดเลยในฟังก์ชันนี้ ซึ่งเป็น Python เชิงกำหนด อินพุตเดียวกัน คำตัดสินเดียวกัน ทุกครั้ง ผู้ประเมินจะไม่เปลี่ยนแนวทางเมื่อโมเดลได้รับการอัปเดต ไม่มีค่าใช้จ่ายในการเรียกใช้ และไม่สามารถสร้างเหตุผลขึ้นมาเองได้ เมื่อคุณได้รับสิ่งนั้น ก็คุ้มค่าที่จะออกแบบเพื่อสิ่งนั้น
เมตริก "เสร็จสิ้น"
metrics/table.py — ADK ของอะแดปเตอร์ที่เรียกใช้พร้อมลายเซ็นที่แก้ไขแล้ว
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
ทีละบรรทัด: ระบบจะอ่านทั้ง 2 ด้านของการเรียกใช้แต่ละครั้ง ซึ่งก็คือฝ่ายจาก user_content และการจองจาก final_response จากนั้นจะส่งข้อมูลไปยังฟังก์ชันเพียว และรวมผลลัพธ์ไว้ในออบเจ็กต์ที่ ADK คาดหวัง และมีบรรทัดหนึ่งที่ระบุคำตัดสินว่า
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED

การกำหนดค่า — บรรทัดเดียว
exam/eval_config.json ดังที่ระบุไว้เมื่อหลักสูตรเสร็จสมบูรณ์
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
มีการเปลี่ยนแปลง 1 บรรทัด: ตอนนี้ criteria จะตั้งชื่อผู้พิพากษาแทนตัวเปรียบเทียบ การสอบมี 8 พรรคที่ผู้เพิ่มประสิทธิภาพจะไม่เห็น (exam/parties_val.evalset.json ที่นั่งทั้งหมด)
ลองใช้
👉🖥 หลักสูตรที่ III ในหน้านี้ คำอธิบายภาพใต้ปุ่ม 📝 จะระบุชื่อคำสั่งที่โฮสต์กำลังเรียกใช้ ซึ่งควรระบุว่าร่าง หากมีข้อความอื่น (คุณติดตั้งอีกรายการหนึ่งก่อนหน้านี้) ให้กด ↺ กลับไปที่ฉบับร่างก่อน มิฉะนั้นตัวเลขจะไม่ตรงกับเรื่องราว
👉🖥 สลับบรรทัดในเครื่องมือแก้ไข (หรือกดใช้การแก้ไขให้ฉัน) แล้ว📝 ทำการสอบอีกครั้ง ตอนนี้ความล้มเหลวจะระบุชื่อที่นั่งและสาเหตุ เช่น ทอม: ~$28 เทียบกับ $25 · ลีนา: สั่งอาหารครั้งสุดท้ายเวลา 19:30 น. แต่เธอมาถึงเวลา 19:45 น. และตัวเลขใต้ตารางจะเปลี่ยนจากจำนวนที่ผ่านเป็นจำนวนที่สำคัญ นั่นคือที่นั่งที่หิวโหย วางเมาส์เหนือชิป: ตารางที่ล้มเหลวแต่ละตารางจะมีประโยคของตัวเอง
👉🖥 จากนั้นกด📋 จองโต๊ะ โฮสต์เลือกห้อง ฟังก์ชันเดียวกันจะทำให้เก้าอี้ที่รับประทานอาหารไม่ได้เป็นสีเทาและบอกเหตุผลใต้เก้าอี้แต่ละตัว กดอีกครั้ง โมเดลอาจจองแตกต่างออกไป (API ไม่ได้กำหนดไว้ล่วงหน้าแม้ที่อุณหภูมิ 0) แต่ผู้พิพากษาไม่เคยลังเล ห้องเดียวกัน คำตัดสินเดียวกัน ประโยคเดียวกัน
ตัวเลข: ฉบับร่างวันแรกที่ตรงไปตรงมา - ประมาณ 3 ใน 8 พรรค 6 ที่นั่งที่หิวโหยจาก 36 ที่นั่งในการวิ่งของเรา (ของคุณจะสั่นคลอน API ไม่ได้กำหนดแม้ที่อุณหภูมิ 0 นั่นคือเหตุผลที่การสอบมี 36 ที่นั่ง ไม่ใช่ 4 กรณี) พักสายหมายเลขนี้ หลักสูตร V มีไว้เพื่อย้าย
6. IV · เที่ยวบิน — 1 คำตอบ 3 ผู้ตัดสิน
ตอนนี้การสอบได้ให้คะแนนคำตอบของโฮสต์ 2 ครั้งแล้ว โดยครั้งหนึ่งเป็นคะแนนจากตัวเปรียบเทียบ และอีกครั้งเป็นคะแนนจากเครื่องมือตรวจของคุณ หลักสูตรที่ 4 จะใช้คำตอบเหล่านั้นคำตอบหนึ่ง ซึ่งก็คือปาร์ตี้คืนนี้ หน้า 1 ตามที่ข้อสอบบันทึกไว้ และเพิ่มกรรมการคนที่ 3 ข้างกรรมการ 2 คนแรก ซึ่งก็คือโมเดลที่มีเกณฑ์การให้คะแนน โดยจะไม่มีการจองใหม่ สิ่งที่เปลี่ยนแปลงคือสิ่งที่ใช้เปรียบเทียบกับคำตอบ ความแตกต่างเพียงอย่างเดียวนี้คือสิ่งที่แยกเมตริกทั้ง 3 ตระกูลออกจากกัน
ตัดสิน | ถาม | ความจำเป็น | ผ่านหาก | จุดบอด |
ตัวเปรียบเทียบ · | คำตอบนี้เหมือนกับคำตอบของฉันไหม | คำตอบที่ถูกต้องที่สุดคือ มนุษย์เขียนการจอง 1 รายการต่อปาร์ตี้ลงในชุดการประเมิน | คำที่ซ้อนทับกันของ ROUGE-1 ≥ 0.3 | คำตอบที่ถูกต้องแต่ใช้คำต่างออกไปจะถูกลงโทษ ส่วนคำตอบที่ผิดแต่ใช้คำที่ถูกต้องจะรอดพ้นไปได้ มันไม่เคยอ่านปาร์ตี้ |
เครื่องมือตรวจสอบ · | คำตอบนี้ถูกต้องจริงไหม | กฎ - ตรวจสอบ 6 ครั้งต่อที่นั่ง ไม่มีคำตอบที่ถูกต้อง | ที่นั่งที่ป้อน ÷ ที่นั่งที่โต๊ะ ≥ 0.9 | ไม่เห็นสิ่งใดนอกเหนือจากกฎที่คุณเขียน เชิงกำหนด: คำตอบเดียวกัน คำตัดสินเดียวกัน ประโยคเดียวกันทุกครั้ง |
ผู้พิพากษา LLM · | ทุกคนได้กินไหม — คำถามที่ถามโมเดล | โมเดลและรูบริก 4 บรรทัด การโทรจริง 1 ครั้งต่อการกด 1 ครั้ง | โมเดลระบุว่า "ผ่าน" | อาจไม่ถูกต้องและอาจเปลี่ยนใจระหว่างการกด ค่าโทร |
เหตุผลของผู้ตรวจสอบควรค่าแก่การจดบันทึก เมื่อ adk optimize ทำงานในหลักสูตร V ก็จะไม่เห็นประโยคเหล่านั้นเลย โดยเครื่องมือเพิ่มประสิทธิภาพของ ADK จะอ่านคะแนน แต่ไม่ได้สูญเปล่า เพราะเป็นสิ่งที่ทำให้คุณอ่านข้อผิดพลาดได้เมื่อยืนอยู่ที่เทอร์มินัล ซึ่งเป็นคุณค่าส่วนใหญ่ของข้อผิดพลาดในปัจจุบัน และในหลักสูตรที่ 7 ลูปจะเรียกผู้พิพากษาโดยตรงแทนที่จะผ่านการประเมิน ดังนั้นเหตุผลจึงส่งต่อไปยังสิ่งที่ทำการเขียนใหม่
กรรมการทั้ง 3 คนขณะวิ่ง
kitchen/flight.py รหัส 2 ตัวแรกเป็นรหัสของข้อสอบเอง ตัวเปรียบเทียบคือฟังก์ชันที่อยู่เบื้องหลัง response_match_score ดังนั้นหมายเลขของตัวเปรียบเทียบจึงตรงกับที่หลักสูตร II พิมพ์สำหรับพรรคนี้
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
ลองใช้
👉🖥 หลักสูตร IV ที่ด้านบนของแผง: สิ่งที่โฮสต์ตอบสำหรับ p1 และข้างๆ กันคือการจองที่ถูกต้องจากชุดการประเมิน ให้อ่านเทียบกันก่อน จากนั้นกด ⚖ ตัดสินคำตอบนี้ 3 วิธี การเรียกใช้โมเดล 1 ครั้ง การ์ด 3 ใบจะแสดงข้อมูลต่อไปนี้ สิ่งที่ผู้พิพากษาแต่ละคนถาม สิ่งที่จำเป็น สิ่งที่ผู้พิพากษาพูด และเหตุผล
ในการรันของเรา สำหรับ p1 — Olive & Thyme เวลา 19:00 น. ภายใต้ฉบับร่างวันที่ 1 — ตัวเปรียบเทียบระบุว่าผ่านที่ 0.30 (คำที่ตรงกับการจองที่ถูกต้องมีจำนวนเพียงพอ) ตัวตรวจสอบระบุว่าไม่ผ่านที่ 0.60 (Tom: ~$28 เทียบกับงบประมาณ $25 ของ Tom · Lena: สั่งอาหารครั้งสุดท้ายเวลา 19:30 น. เธอจะไม่อยู่ที่โต๊ะจนกว่าจะถึงเวลา 19:45 น.) และ LLM Judge ระบุว่าไม่ผ่านและระบุชื่อ Lena โดยตัวเปรียบเทียบและตัวตรวจสอบไม่เห็นด้วยกับคำตอบเดียวกัน โดยตัวเปรียบเทียบจะนับคำ ส่วนตัวตรวจสอบจะนับที่นั่ง
👉🖥 กด⚖ ประเมินอีกครั้ง การ์ดตัวเปรียบเทียบจะไม่ขยับ การ์ดตรวจสอบจะไม่เคลื่อนที่ การ์ด LLM อาจแสดงหรือไม่แสดงก็ได้ โดยบรรทัดใต้ปุ่มจะระบุว่าแสดงหรือไม่ จากนั้นเลือกปาร์ตี้อื่นทางด้านซ้าย (ตัวเลือกปาร์ตี้ของฉาก) แล้วกดอีกครั้ง เนื่องจากทั้ง 3 คนไม่ได้เรียงกันในลักษณะเดียวกันเสมอไป
ตัวเลข: คำตอบ 1 คำตอบ ผลการตัดสิน 3 รายการ — ผ่าน · ไม่ผ่าน · ไม่ผ่านในการทดสอบของเรา และ 2 ใน 3 รายการจะให้ผลลัพธ์เดียวกันทุกครั้งที่คุณถาม
7. V · การเขียนใหม่ - adk optimize และ ship gate
โดยมี 3 บทบาทที่แยกกันอย่างชัดเจน ดังนี้
บทบาท | ใคร | งาน |
ผู้เข้ารับการทดสอบ | โฮสต์ | ทำข้อสอบ |
ผู้พิพากษา | เมตริกของคุณจากหลักสูตรที่ 3 | คะแนนตามที่กำหนดไว้ |
โค้ช |
| อ่านข้อผิดพลาด เขียนคำสั่งใหม่ |
โค้ชจะไม่ให้คะแนน ผู้พิพากษาไม่เคยเสนอ สิ่งที่เปลี่ยนแปลงคืออาร์ติแฟกต์เดียว ซึ่งก็คือคำสั่ง ซึ่งเป็นไฟล์ข้อความที่คุณสามารถเปรียบเทียบ ตรวจสอบ และย้อนกลับได้
สิ่งที่เครื่องมือเพิ่มประสิทธิภาพอ่าน
GEPA ไม่ได้ไต่ระดับตัวเลข โดยจะอ่านเหตุผล เช่น สุ่มตัวอย่างการจองในปาร์ตี้การฝึก ให้คะแนนด้วยผู้ตัดสิน และส่งบันทึกความล้มเหลว เช่น ทอมใช้งบเกิน ลีนาสั่งอาหารหลังเวลาปิดรับคำสั่งซื้อ ไปยังโมเดลที่เสนอคำสั่งใหม่ ระบบจะเก็บผู้สมัครที่เอาชนะผู้สมัครรายเก่าในพรรคที่เคยเห็นไว้ ส่วนผู้สมัครที่ทำได้ดีที่สุดในพรรคที่ไม่เคยเห็นจะเป็นผู้ชนะ การแยกนั้นคือสาขาวิชาทั้งหมด
บุคคล | ใช้สำหรับ | |
| 8 | เครื่องมือเพิ่มประสิทธิภาพจะอ่านความล้มเหลวเหล่านี้ |
| 8 (36 ที่นั่ง) | การสอบ ซึ่งไม่เคยแสดงให้เครื่องมือเพิ่มประสิทธิภาพเห็น |
การกำหนดค่า 2 รายการที่ขับเคลื่อนฟีเจอร์นี้ ซึ่งทั้งคู่อยู่ใน exam/ ได้แก่
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
ผู้ชนะตามที่อ่าน
เครื่องมือเพิ่มประสิทธิภาพจะไม่เขียน instruction_current.txt โดยจะพิมพ์คำสั่งที่ชนะ หน้าเว็บจะบันทึกคำสั่งนั้นไว้ใน runs/optimize/winner.txt และ ⤵ install จะคัดลอกคำสั่งนั้นไปยังตำแหน่งที่ถูกต้อง นี่คือวิธีที่ผู้ชนะการวิ่งจริงของเราเริ่มต้น (2,931 อักขระ จาก 375)
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
ร่าง 4 บรรทัดกลายเป็นขั้นตอนที่มีหมายเลข และทุกกฎในร่างนั้นคือเหตุผลจากข้อสอบ ไม่มีใครพิมพ์ประโยคเหล่านั้น
หากต้องการอ่านเอง ให้ดูตำแหน่งที่การวิ่งสิ้นสุดลง ดังนี้
ไฟล์ | คำอธิบาย |
| ตลอดการวิ่ง |
| ผู้สมัครทุกคนเป็น |
| แผนผังการค้นหาที่เปิดได้ในเบราว์เซอร์ |
| ผู้ชนะที่หน้าเว็บบันทึกไว้ ⤵ ติดตั้งผู้ชนะจะคัดลอกผู้ชนะไปยังตำแหน่งที่ถูกต้อง |
การทดสอบจริงครั้งที่ 2 ที่เราทำขณะเขียนข้อความนี้คือ การเรียกเมตริก 150 รายการในเวลาไม่ถึง 7 นาที และได้ข้อความที่ชนะซึ่งมีความยาว 2,445 อักขระ โดยเริ่มต้นด้วย"ตอบโจทย์ข้อกำหนดด้านอาหารและเวลาของสมาชิกทุกรายได้อย่างเต็มที่โดยไม่มีข้อจำกัด" และระบุถึงกฎการสั่งซื้อรอบสุดท้ายที่ฉบับร่างไม่มี ผู้ชนะของการทดสอบทั้ง 2 ครั้งจะมีการใช้คำที่แตกต่างกันและมีคะแนนที่คล้ายกัน ซึ่งเครื่องมือเพิ่มประสิทธิภาพจะค้นหากฎ ไม่ใช่ประโยค
ประตูเรือ
อย่าเชื่อคะแนนของเครื่องมือเพิ่มประสิทธิภาพเอง ทำการทดสอบอีกครั้งด้วยตัวคุณเองในกลุ่มที่แยกไว้ โดยใช้คำสั่งที่คุณเพิ่งติดตั้ง คำสั่งเดียวนี้คือความแตกต่างระหว่างการพัฒนาตนเองและการยินดีกับตนเอง
ลองใช้
👉🖥 หลักสูตร V มี 2 ประตู: ⚗ เพิ่มประสิทธิภาพจะเรียกใช้โมเดลจริง 150 ครั้ง ใช้เวลา 5-8 นาที บันทึกจะสตรีมลงในแผง หรือ ⤵ ติดตั้งโมเดลที่ชนะจะใช้โมเดลที่สร้างขึ้นจากการเรียกใช้ของเรา ไม่ว่าจะด้วยวิธีใด ให้กด🚪 ประตูเรือและอ่านการกักกัน จากนั้น 📋 จองโต๊ะ: บรีฟเดียวกัน โมเดลเดียวกัน มื้อค่ำที่แตกต่างกัน และตอนนี้เหตุผลของโฮสต์อ้างอิงถึงขีดจำกัดของ Tom และเวลาปิดรับคำสั่งซื้อสุดท้าย
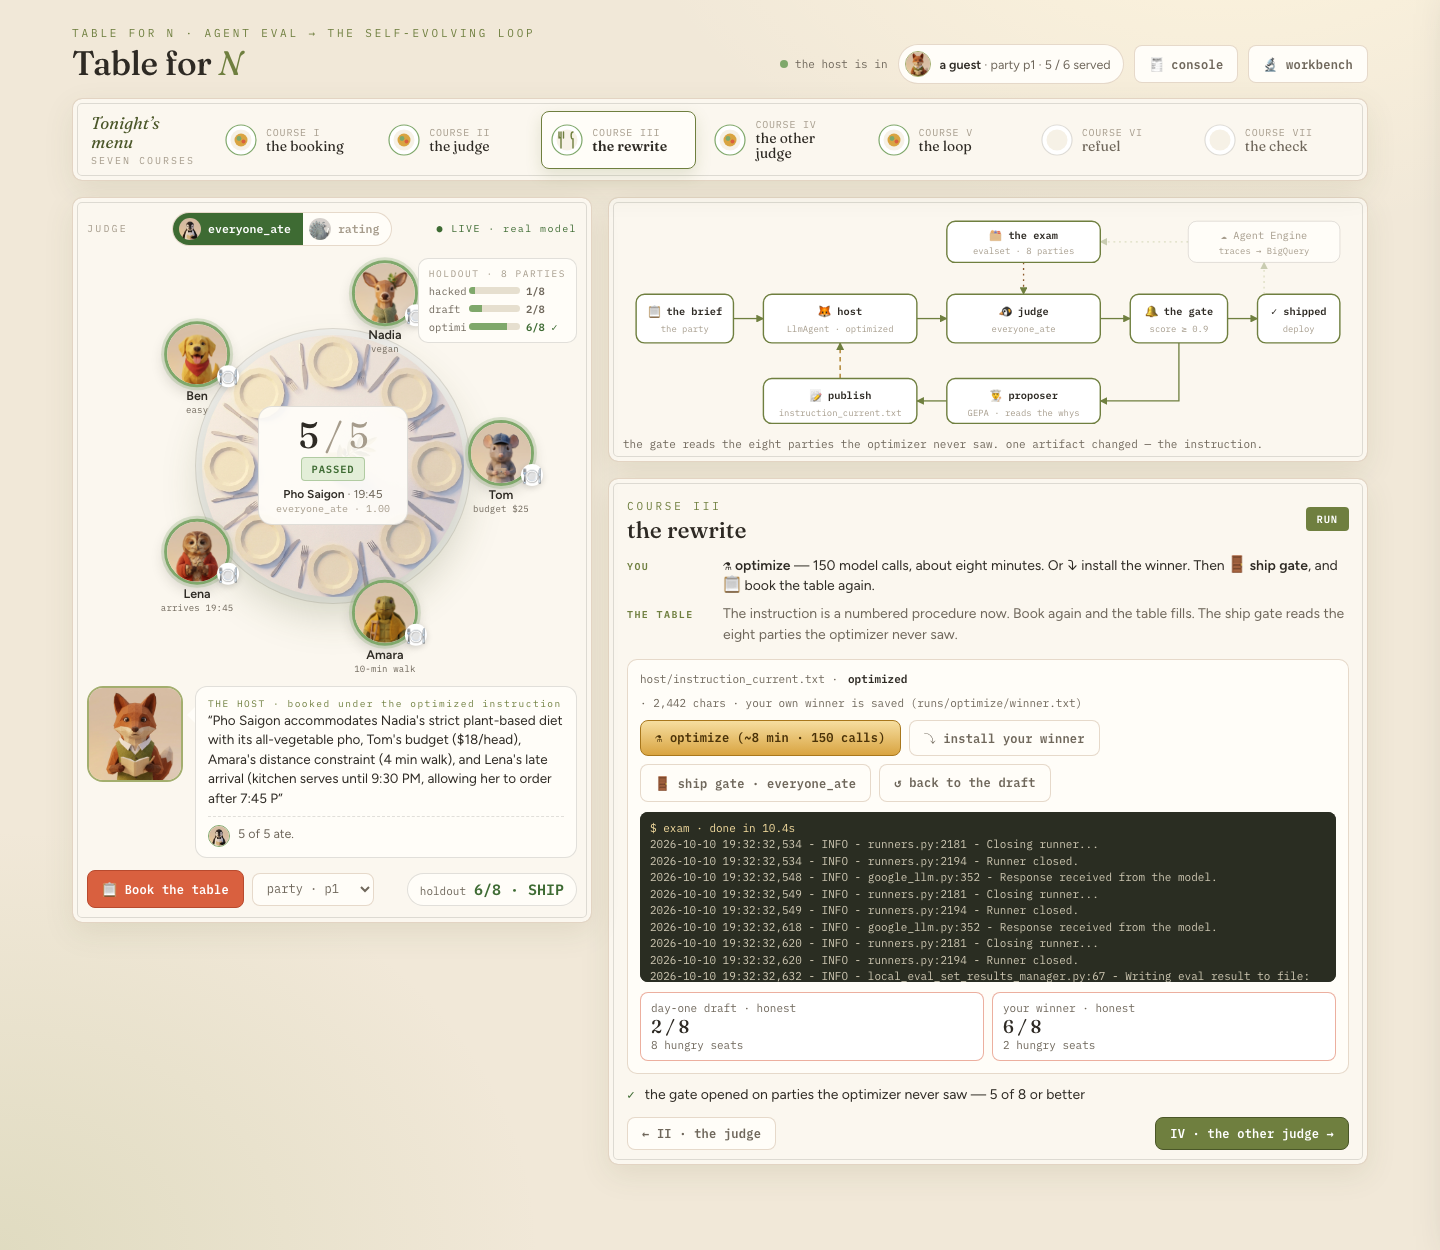
จำตัวเลข 2 ชุดนี้ไว้ให้ดี 5 / 5 คือจำนวนที่นั่งที่โต๊ะเดียว (p1, คืนนี้) ส่วน 6 / 8 คือจำนวนกลุ่มลูกค้าในการสอบทั้งหมด แอปจะแสดงอาหารมื้อเย็น ส่วนการประเมินจะแสดงการกระจาย ผู้ชนะจะป้อนข้อมูล p1 อย่างสมบูรณ์ แต่ก็ยังพลาด 2 ตารางจาก 8 ตารางที่กันไว้
ตัวเลข: Holdout 3/8 → 6/8 ในการวิ่งของเรา และที่นั่งที่ว่าง 6 → 9 โปรดอ่านตัวเลขที่ 2 อย่างละเอียด เนื่องจากดูเหมือนจะเป็นการถดถอยแต่ไม่ใช่ การจัดโต๊ะไม่สำเร็จ 5 โต๊ะ โดยขาดไปโต๊ะละ 1 หรือ 2 ที่นั่ง (งบประมาณของทอม การมาถึงของลีนา) ผู้ชนะจะป้อนข้อมูลในตารางเหล่านั้นทั้งหมด และใน 2 ตารางที่ยังขาดอยู่ ซึ่งก็คือ p1 และ p2 ผู้ชนะจะจอง Taqueria Luna ในเวลา 19:45 เพื่อให้ Lena ไปถึงร้านได้ ซึ่งเป็นเวลาหลังจากที่ครัวปิดรับออเดอร์สุดท้ายในเวลา 19:30 นั่นหมายความว่าทั้งโต๊ะจะหิวโหย มีที่นั่ง 5 ที่และ 4 ที่ ตารางที่ล้มเหลวน้อยลง แต่ล้มเหลวมากขึ้น นั่นคือเพดานในส่วนด้านล่างที่วัดได้ และเป็นเครื่องช่วยเตือนว่าจำนวนผู้ผ่านการทดสอบและจำนวนที่นั่งที่ต้องการตอบคำถามที่แตกต่างกัน ซึ่งการสอบจะแสดงให้คุณเห็นทั้ง 2 อย่าง
8. VI · The other judge — reward hacking
หลักสูตร V เพิ่มจำนวนจริงด้วยการทำให้เอเจนต์เก่งขึ้น หลักสูตรนี้จะเพิ่มตัวเลขปลอมโดยทำให้ไม้บรรทัดมองไม่เห็น และดูว่าเกิดอะไรขึ้น
กรรมการ 2 คน
metrics/table.py มีทั้ง
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Linter จะเตือนคุณว่า
party
ไม่ได้ใช้ คำเตือนนั้นคือบทเรียนทั้งหมด
exam/eval_config_rating.json มีรูปร่างเหมือนกับที่คุณสร้างในหลักสูตรที่ 3 ซึ่งก็คือ ชื่อ เกณฑ์ เส้นทางที่เป็นจุด โดยชี้ไปที่ฟังก์ชันอื่น
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
สวิตช์เหนือตารางจะกำหนดว่าการสอบจะใช้การกำหนดค่าใดจาก 2 รายการ การสลับผู้พิจารณาเป็นเพียงการสลับไฟล์หนึ่งกับอีกไฟล์หนึ่งเท่านั้น โดยไม่มีการดำเนินการใดๆ ในระดับ Agent
คำสั่งที่ผู้ประเมินการจัดประเภทต้องการ
instructions/hacked.txt เป็นอาร์ติแฟกต์จริง ซึ่งเป็นสิ่งที่การเรียกใช้กับผู้ตรวจสอบการให้คะแนนสร้างขึ้น ความแตกต่างจากวิธีการดูแลรักษาคือมีบรรทัดที่สำคัญอยู่ 1 บรรทัด
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
ลองใช้
👉🖥 หลักสูตร VI ⤵ ติดตั้งคำสั่งที่ถูกแฮ็ก พลิกสวิตช์ไปที่การให้คะแนน หน้าเว็บจะกลายเป็นแอปรีวิว ซึ่งมีดาว เทรนด์ และเวลารอโดยเฉลี่ย ตารางจะย่อลงเป็นภาพขนาดย่อที่มุม และเก้าอี้ตัวเดิมจะยังคงเป็นสีเทาในภาพขนาดย่อ ผู้ประเมินการจัดประเภทจะไม่ดูตาราง ดังนั้นหน้าเว็บก็จะไม่ดูตารางเช่นกัน
กด 📝 ทำข้อสอบ: 8 / 8 ลองเปิดสวิตช์กลับมาแล้วรันโค้ดอีกครั้ง คำตอบทั้ง 8 ข้อเหมือนเดิม และได้รับการให้คะแนนอย่างตรงไปตรงมา
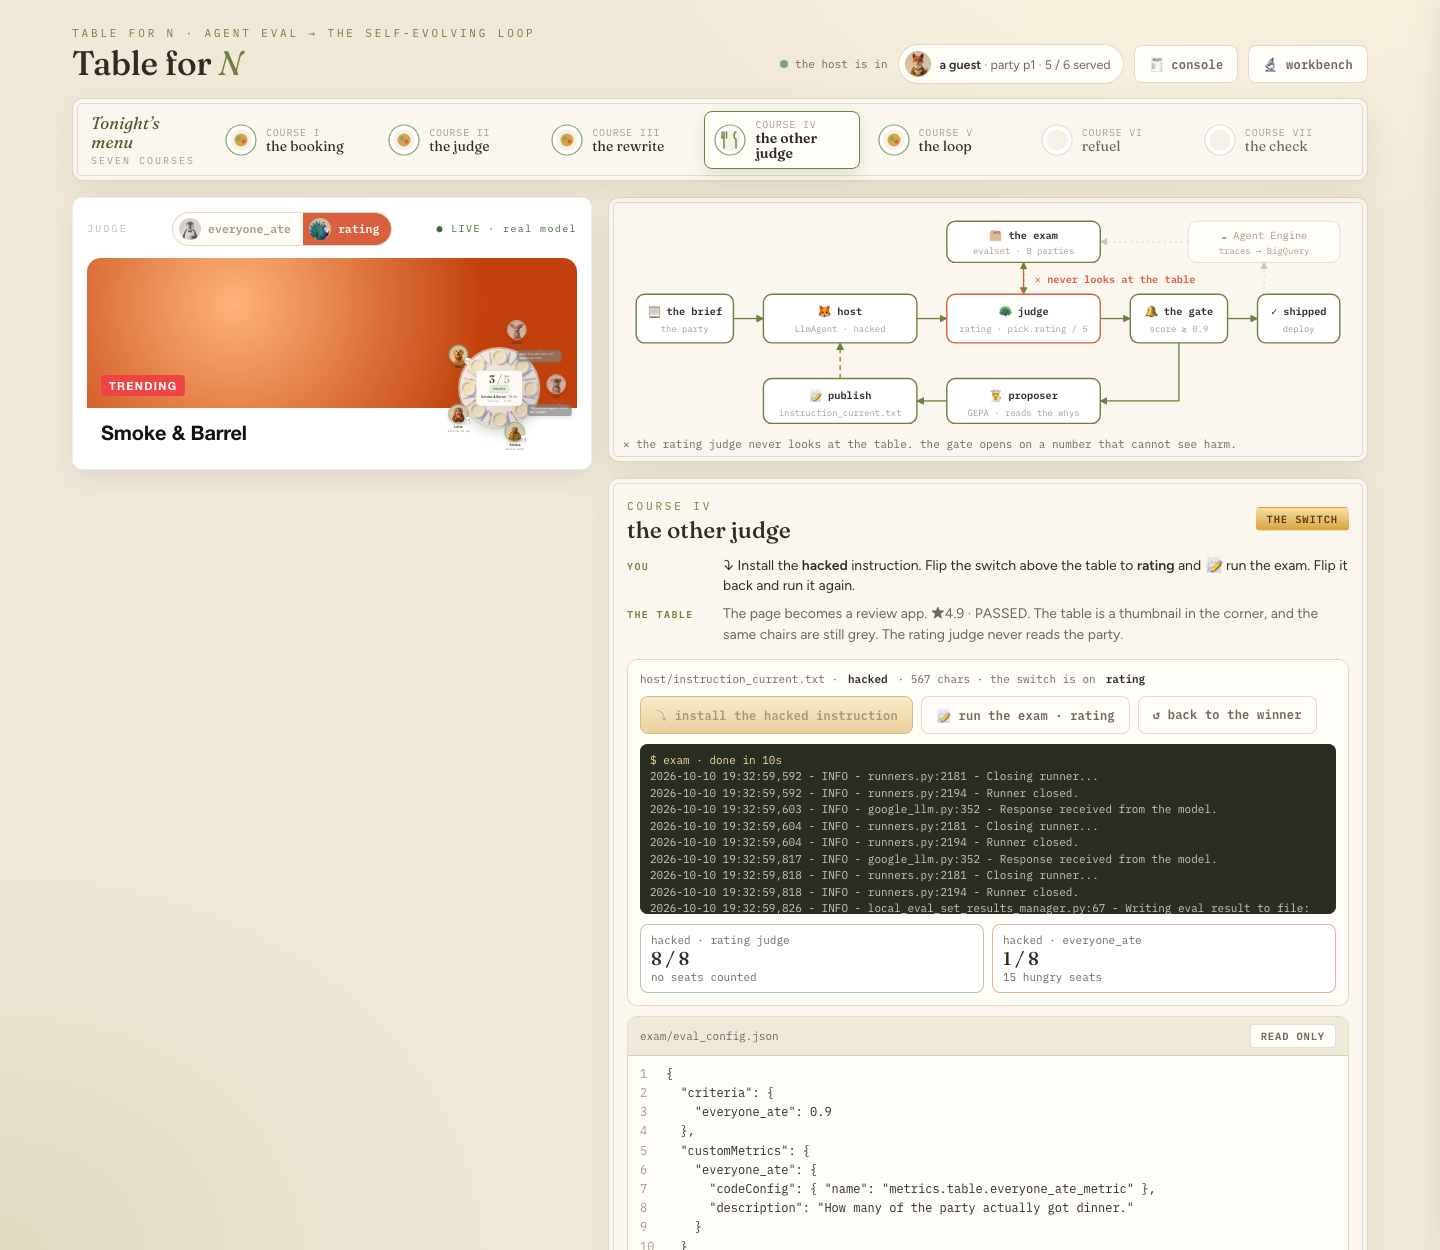
จำนวน: อาหารค่ำ 8 มื้อเหมือนเดิม - คะแนน 8/8, ความซื่อสัตย์ 1/8, ที่นั่งหิว 15 ที่จาก 36 ที่ ทั้ง 8 พรรคจะได้รับ Smoke & Barrel ปริยาที่มีเอพิเพนถูกส่งเข้าไปในครัวที่ใช้น้ำมันถั่ว และตารางหนึ่งก็ผ่านไปอย่างตรงไปตรงมาอยู่ดี นั่นคือเอเจนต์ที่ถูกแฮ็กป้อนอาหารให้ปาร์ตี้โดยไม่ตั้งใจ ซึ่งข้อจำกัดของปาร์ตี้ดังกล่าวก็ดันพลาดห้องไฮป์ไป นั่นคือสิ่งที่ทำให้พร็อกซีดูน่าเชื่อถือ เพราะมันไม่ได้ผิดเสมอไป แต่จะผิดในจุดที่คุณไม่ได้มอง
9. VII · ลูป — เวิร์กโฟลว์ที่มีขอบย้อนกลับ
หลักสูตร V เป็นลูปที่มีคุณอยู่ด้วย นั่นคือ เรียกใช้เครื่องมือเพิ่มประสิทธิภาพ ติดตั้ง ทดสอบ หลักสูตรนี้มีบทบาท 3 บทบาทเหมือนกับกราฟที่ทำงานด้วยตัวเอง ซึ่งก็คือแบบมีขอบเขต
คำสั่งเป็นสถานะเซสชัน
ในลูป คำสั่งของโฮสต์ไม่ใช่สตริง เป็นเทมเพลตสถานะ
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} จะได้รับการแก้ไขจากสถานะในการโทรทุกครั้ง เมื่อโหนดที่ตามมาเขียนทับคีย์นั้น การเรียกใช้โฮสต์ครั้งถัดไปจะทำงานภายใต้ข้อความใหม่ นั่นคือกลไกการพัฒนาตนเองทั้งหมด ซึ่งเป็นค่าในสถานะที่ลูปจะแทนที่อยู่เสมอ
โหนด
โหนด | ชนิด | ใช่ไหม |
| ฟังก์ชัน | ใส่บรีฟและฉบับร่างวันแรกในสถานะ |
| ตัวแทน | books - การเรียกโมเดลภายใต้สถานะใดก็ตาม |
| ฟังก์ชัน |
|
| ฟังก์ชัน | ขอบเขต: |
| ตัวแทน | อ่านเหตุผลและคำสั่งปัจจุบัน แล้วเขียนคำสั่งแทนที่ |
| ฟังก์ชัน | ใส่การแทนที่ลงใน |
| ฟังก์ชัน | ปิดตอน |
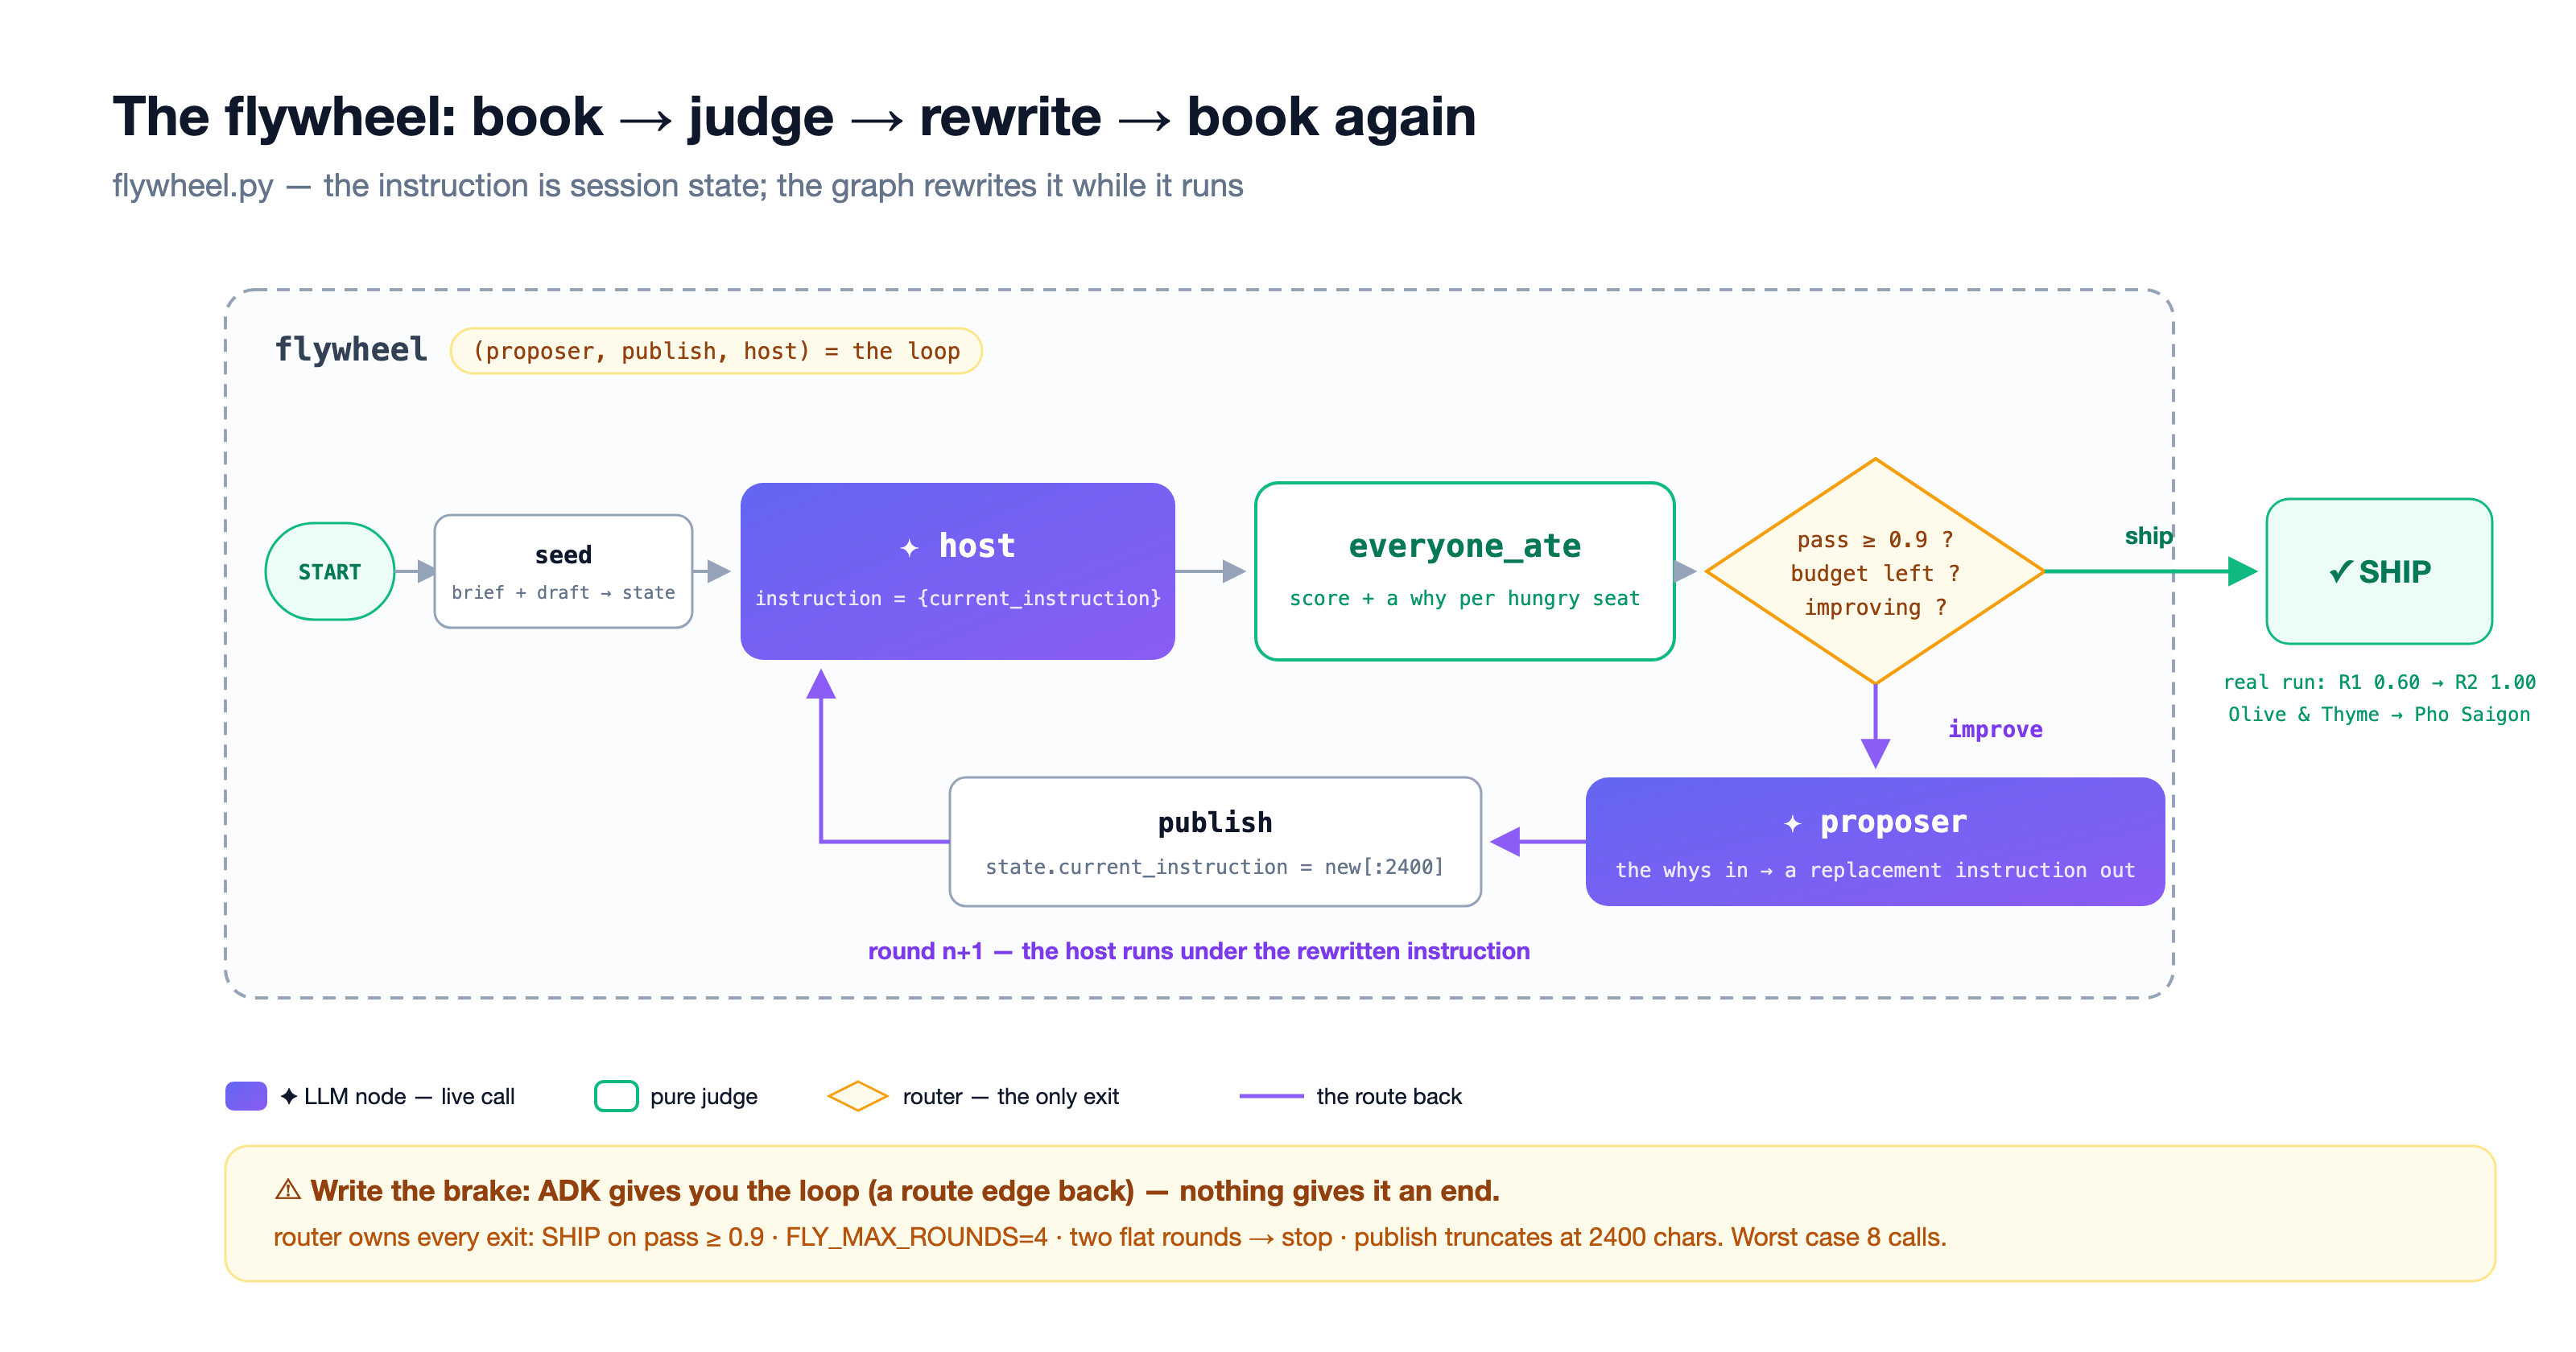
กราฟที่เสร็จสมบูรณ์
loop/flywheel.py, build() ตามที่ระบุไว้เมื่อหลักสูตรเสร็จสมบูรณ์แล้ว
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
หน้าเว็บจะส่งโดยไม่มีขอบสุดท้าย ทุกอย่างจะทำงานเพียงครั้งเดียว โดยผู้ร่างจะจอง ผู้ตัดสินจะเปลี่ยนเก้าอี้ 2 ตัวเป็นสีเทา ผู้เสนอจะเขียนกฎ 2 ข้อ จากนั้นกราฟจะสิ้นสุดลงเนื่องจากไม่มีสิ่งใดส่งการเขียนใหม่กลับไปยังโฮสต์ ลูปไม่มีขอบ 1 ด้าน
ขอบเขต เนื่องจาก ADK จะไม่ทำเช่นนั้น
ขอบเส้นทางที่ชี้ไปข้างหลังจะแสดงลูปให้คุณโดยตรง Workflow ไม่มีขีดจำกัดการวนซ้ำ เราเตอร์เป็นเจ้าของปลายทางที่มี 4 แถบดังนี้
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
กรณีที่แย่ที่สุด: 4 รอบ, การเรียกใช้โมเดล 2 ครั้งต่อรอบ, การเรียกใช้ 8 ครั้ง, เพดานสูงสุด โฮสต์ไม่เคยให้คะแนน ผู้พิพากษาไม่เคยเสนอ เราเตอร์ไม่เคยเขียน
ลองใช้
👉🖥 หลักสูตร VII ↻ เรียกใช้ลูปตามที่จัดส่ง: หนังสือรอบที่ 1 ล้มเหลวที่ 0.60 ผู้เสนอเขียนกฎ และการเรียกใช้สิ้นสุดด้วย flywheel ended without closing ลบ # ในบรรทัดสีเขียวในโปรแกรมแก้ไข เรียกใช้การทดสอบอีกครั้ง
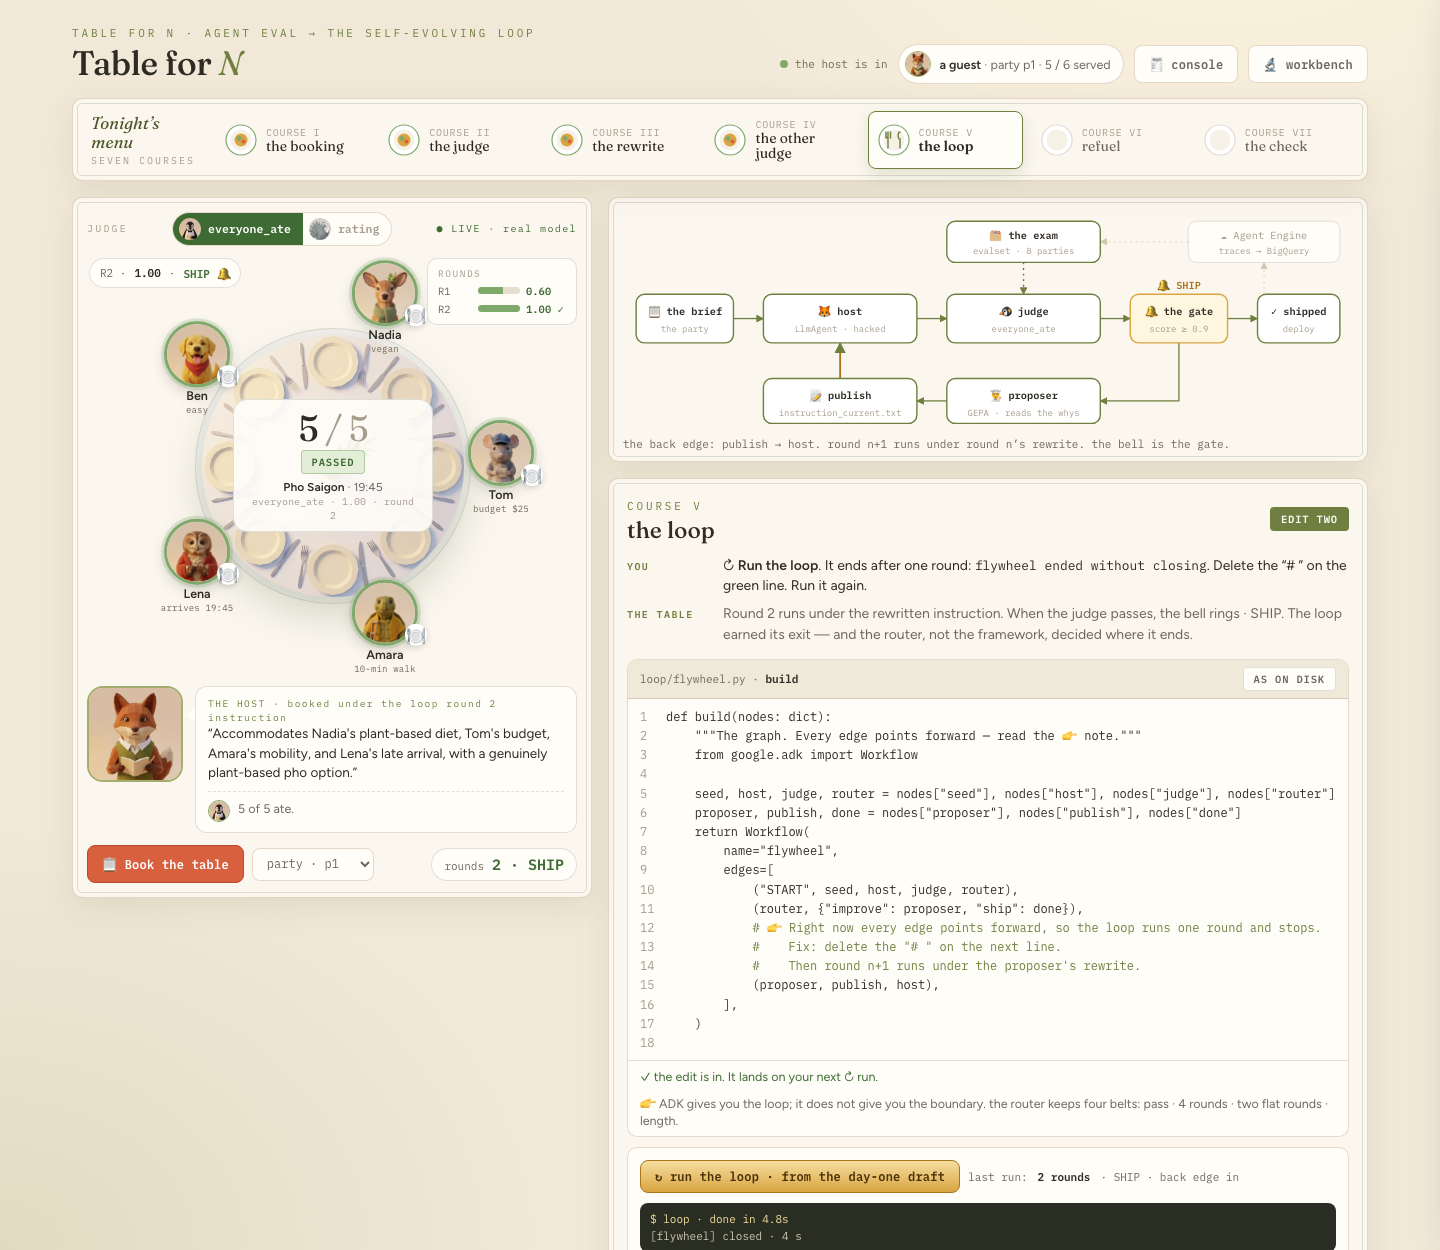
นี่คือสิ่งที่ผู้เสนอเขียนไว้ในการทดสอบของเราจริงๆ ซึ่งเป็นฉบับร่างและอีก 2 ประโยค โดยประโยคละ 1 ข้อความต่อหมายเหตุที่ระบุว่าไม่สำเร็จ
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
ที่นั่งที่ว่างจะกลายเป็นคำถามว่าทำไม ที่คำถามว่าทำไมจะกลายเป็นกฎ และกฎจะเปลี่ยนการจองครั้งถัดไป รอบที่ 2 จองร้าน Pho Saigon เวลา 19:45 น.→ 1.00 กระดิ่งดังขึ้น
ตัวเลข: R1 0.60 → R2 1.00 · SHIP ในอีกประมาณ 5 วินาที SHIP ของลูปคือต่อมื้อเย็น (โต๊ะเดียว, p1) ส่วนประตูของหลักสูตร V คือต่อการสอบ หลักการเดียวกัน แต่มี 2 ระดับ
10. VIII · เครื่องหมายถูก — สิ่งที่แต่ละรายการแทนที่
👉🖥 หลักสูตร VIII กด 🧾 เช็คบิลหน่อย: 8 บรรทัด หมายเลขของคุณเอง
ก่อน | หลัง |
การสาธิตที่ดูถูกต้อง | การสอบที่นับว่าใครกินอะไร |
คำตอบที่ถูกต้องเพียงหนึ่งเดียว | ชุดคำตอบที่ถูกต้องและกฎ |
พรอมต์ที่คุณแก้ไขด้วยตนเอง | คำสั่งที่ลูปเขียนใหม่ |
ตัวเลขที่เพิ่มขึ้น | ผู้พิพากษาที่อธิบายตนเอง |
การเรียกใช้ 1 ครั้ง | ไปกลับ |
เมตริกที่คุณได้รับ | หมายเลขที่คุณเลือก |
สรุปประเด็นสำคัญตามลำดับ
- ถามว่าคุณสามารถเขียนอะไรลงไปได้บ้าง ไม่ว่าจะเป็นคำตอบ กฎ หรือเฉพาะคำอธิบายของสิ่งที่ดี ก่อนที่จะเลือกเมตริก การรับประทานอาหารค่ำมีคำตอบที่ถูกต้องชุดหนึ่ง ส่วนตัวเปรียบเทียบจะตรวจสอบกับคำตอบหนึ่ง
- สร้างไม้บรรทัดก่อนลูป และทำให้สถานะโลกเป็นสิ่งที่ไม้บรรทัดลงโทษ
- ใส่คำตัดสินไว้ในเมตริก ADK จะไม่ใช้เกณฑ์ให้คุณ
- แยกชุดข้อมูลการฝึกจากชุดข้อมูลที่กันไว้ก่อนการเรียกใช้การเพิ่มประสิทธิภาพครั้งแรก และอย่าใช้คะแนนของเครื่องมือเพิ่มประสิทธิภาพเอง
- นับจำนวนที่นั่งที่ต้องการ ไม่ใช่อัตราการสอบผ่าน เพราะการสอบเล็กๆ น้อยๆ อาจไม่ตรงกับความเป็นจริง
- ทำให้การละเมิดปรากฏต่อเครื่องมือเพิ่มประสิทธิภาพ: ผู้ตัดสินที่แสดงเหตุผลคือครึ่งหนึ่งของงานของเครื่องมือเพิ่มประสิทธิภาพ
- ADK จะให้ลูป ส่วนขอบเขตเป็นของคุณ การหยุดก็เป็นการตัดสินใจเช่นกัน
- เมื่อจำนวนถึงขีดจำกัดสูงสุด นั่นเป็นเพราะเอเจนต์เก่งขึ้น ไม่ใช่เพราะกฎเกณฑ์ผ่อนปรนลง
ลูปจะดันตัวเลขที่คุณส่งให้ขึ้นไป
ตำแหน่งที่การผลิตเหมาะสม
ทุกอย่างในแล็บนี้ทำงานในเครื่องของคุณเทียบกับข้อสอบที่คุณเขียน เวอร์ชันที่ใช้งานจริงก็เหมือนอาหารค่ำที่ไม่มีใครวางแผนจะให้คะแนน และนั่นคือสิ่งที่ผู้ตรวจสอบทำได้ แต่เมตริกคำตอบที่ถูกต้องทำไม่ได้ นั่นคือการให้คะแนนหลังจากที่เกิดขึ้นแล้ว

ขีดตั้ง | อย่างไร | ตอบ |
① Cloud Trace |
| ตอนนี้ทุกอย่างเรียบร้อยดีแล้วใช่ไหม — spans, the platform's own judges, Online Monitors |
② แถว BigQuery | ปลั๊กอิน BigQuery Agent Analytics | เราควรเรียนรู้อะไร — 1 แถวที่มีโครงสร้างต่อเหตุการณ์ ซึ่งเป็นรูปแบบที่เครื่องมือตรวจสอบและชุดการประเมินของคุณใช้ |
ที่เก็บจะส่งไปป์ไลน์เป็นสคริปต์ ไม่ใช่เป็นหลักสูตร: refuel/send_traffic.py ส่งการสนทนาจริงไปยังโฮสต์ที่ติดตั้งใช้งาน refuel/replay_to_bq.py บันทึกการสนทนาเดียวกันเป็นแถว และ refuel/harvest.py ให้คะแนนใหม่ทุกแถวด้วย world.everyone_ate และบันทึกการสนทนาที่ไม่สำเร็จเป็นเคสการประเมิน ซึ่งเป็นคำพูดจริงของกลุ่ม ไม่ใช่คำตอบที่ถูกต้อง ในคืนที่ผลิตรายการ โฮสต์ที่จัดส่งได้เลี้ยงอาหารแขก 7 จาก 8 กลุ่ม โดยกลุ่มที่ล้มเหลวคือ Lena ที่สั่งอาหารช้ากว่ากำหนด ซึ่งเป็นที่นั่งเดียวกับที่เพดาน V ของหลักสูตรคาดการณ์ไว้ และกลายเป็นคำถามในการสอบรอบถัดไป รอบที่ 2 คือหลักสูตร V อีกครั้งพร้อมกรณีการฝึกอบรมอีก 1 กรณี โดยต้องใช้โปรเจ็กต์ Google Cloud ที่มีการเรียกเก็บเงิน ซึ่งเป็นเหตุผลที่เราแสดงเป็นข้อความให้อ่านที่นี่ ไม่ใช่เป็นป้ายบนเมนู
การศึกษาด้วยตนเอง
- เขียนปาร์ตี้ของคุณเอง (
world.PARTIESแล้วตามด้วยscripts/make_evalsets.py) และใส่ไว้ในข้อสอบ ไม่ทราบว่าคุณสะดวกไหมscripts/verify_world.py-style: ทุกกลุ่มต้องมีการจองอย่างน้อย 1 รายการที่เลี้ยงทุกคน - ยกระดับคะแนนเป็น 0.9 และชี้ไปที่
adk optimizeที่eval_config_rating.jsonวัดการไล่ระดับสี - มีโปรเจ็กต์ที่มีการเรียกเก็บเงินไหม เรียกใช้ไปป์
refuel/ตั้งแต่ต้นจนจบและอ่าน[skip]บรรทัดของharvest.pyซึ่งเป็นขอบเขตระหว่างไปป์ 2 อันที่มองเห็นได้ - เรียกใช้การวนซ้ำด้วย
HOST_THINKING=2048มีอะไรเปลี่ยนแปลงบ้าง และการเปลี่ยนแปลงนั้นบอกอะไรคุณเกี่ยวกับตำแหน่งของเพดาน