

1. Giriş
Bu codelab, ajan değerlendirmesi (bir sistemin, ajanın yanıtının iyi olup olmadığını nasıl öğrendiği) ve bunu öğrendikten sonra oluşturabileceğiniz şeyler (kendi talimatını kendi hatalarından yola çıkarak yeniden yazan bir ajan ve bu işlemi tekrarlayan bir döngü) hakkındadır.
Her şey Agent Development Kit (ADK) üzerinde çalışır: adk eval yazdığınız özel bir metrikle, adk optimize (GEPA istemi optimize edicisi), arka kenarlı bir ADK 2 Workflow ve üretim trafiğini bir sonraki turdaki sınava dönüştüren Agent Engine + BigQuery borusu.
Döngü, kendisine verdiğiniz sayıyı yukarı iter.
Öğrenecekleriniz
- Yanıt, sonuç değildir: Kendinden emin ve iyi biçimlendirilmiş bir yanıtın sisteme neden hiçbir şey söylemediği ve bir hakemin ne söyleyebilmesi gerektiği
- Bir değerlendirmeyi çalıştırmanın üç yolu (toplu değerlendirme için
adk eval, başarısız olan değerlendirmeyi incelemek içinadk webDeğerlendirmeler sekmesi, derlemeyi başarısız kılmak içinpytest+AgentEvaluator) ve paylaştıkları tek bir yerel değerlendirme deposu - Karşılaştırma ve kontrol: Karşılaştırıcının, farklı şekilde ifade edilen doğru yanıtı neden cezalandırdığı, bir akşam yemeğinin aslında kaç doğru cevabı olduğu ve bir sorunun hangi tür metriğe ihtiyacı olduğunu söyleyen içgüdüsel kontrol
adk evalmetriği olarak bir kontrol işlevi —customMetrics,codeConfig, sabit imza, içindeki altı kontrol, işlevinizin NEDEN PASSED/FAILED'a sahip olduğu ve NEDEN kasıtlı olarak deterministik olduğu- Tek bir yanıtta üç metrik ailesi: Karşılaştırıcı, denetleyici, hakem olarak LLM. Her birinin ihtiyaçları, maliyetleri ve kör noktaları nelerdir?
adk optimize(GEPA): Ne okuduğu (puan değil, hatalar), eğitim ve test verileri arasındaki fark ve göndermeden önce sınavı neden kendiniz tekrar çalıştırdığınız- Ödül hack'leme, ölçülen: Asla partiyi okumayan, gerçek sayıya ne yaptığı ve bundan kaynaklanan yasayı ölçen bir vekil metrik
- ADK 2 olarak kendi kendini geliştiren bir döngü
Workflow: Oturum durumunda bulunan bir talimat, grafiği döngü haline getiren tek kenar ve ADK'nın size vermediği sınır - Üretimin uygun olduğu yerler: İzleme için izler, öğrenme için satırlar ve bir kontrolcünün, kimsenin not vermeyi planlamadığı akşam yemeklerine neden not verebileceği (bir okuma, adım değil)
Ne oluşturacaksınız?
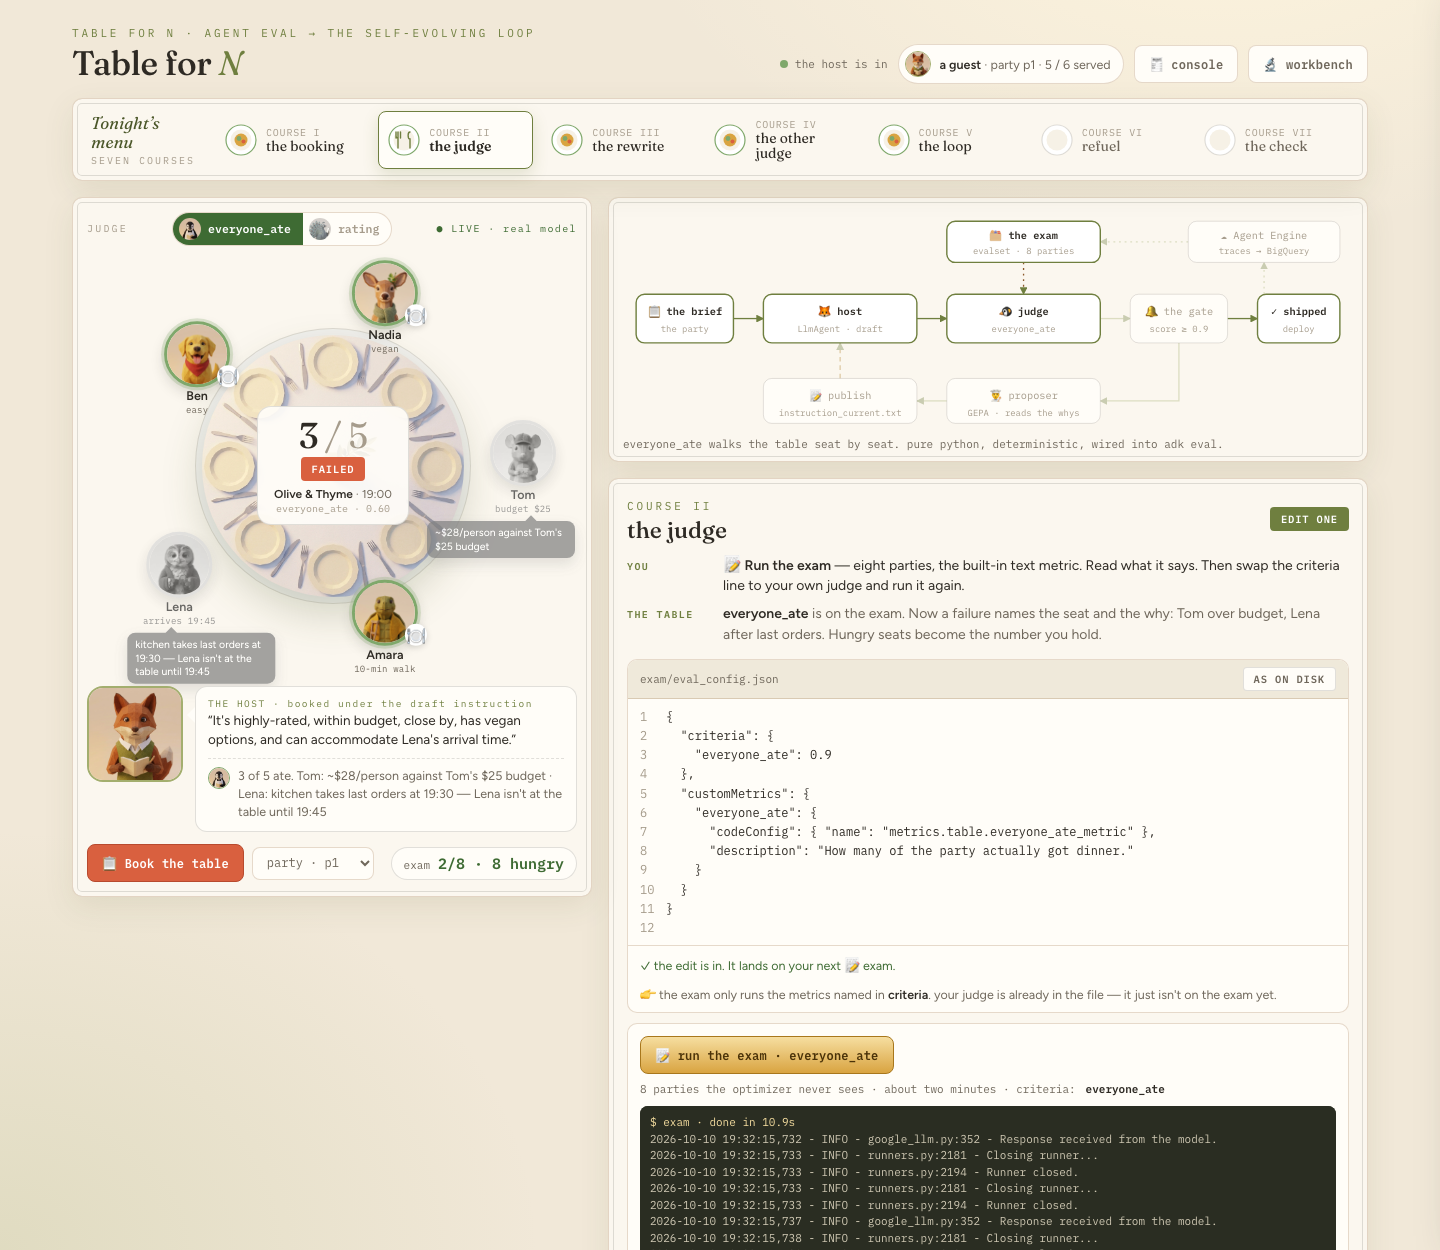
Tarayıcınızda çalışan bir uygulama: yuvarlak bir masa, N sayıda konuk ve akşam yemeği rezervasyonu yapan bir temsilci. Her yemekte bir şey etkinleştirilir (yapılandırmadaki bir satır, üç jüri üyesinin önündeki bir yanıt, gerçek optimize ediciyi çalıştıran bir düğme, jüriyi değiştiren bir anahtar, grafikteki bir kenar) ve tabloda nelerin değiştiği gösterilir: kimin yemek yediği, kimin yemediği ve neden yemediği. Python küçük bir dildir. Sayıların tümü makinenizde ölçülür.
Uygulama aynı zamanda egzersizdir. Kurs panelinde her seferinde bir düzenleme veya bir düğme gösterilir. Menüdeki bir tabak, yalnızca gerçek bir şey bunu kanıtladığında dolar. Mutfak, dosyalarınızı ve nelerin çalıştığına dair makbuzları okur, asla bir kontrol listesi göstermez.
Sekiz kurs
kavram | yanıtladığı soru | ne iş yaptığınız | |
I | yanıt, sonuç değildir | Sistem bu rezervasyon hakkında ne biliyor? | Henüz yok. Çalışma alanında bir tane ayırtın. |
II | karşılaştırıcı · doğru yanıtlar kümesi · üç çalıştırma yöntemi | Doğru bir rezervasyon neden sınavı geçemiyor? | Sınavı gönderildiği şekilde çalıştırın ve kararları okuyun |
III | Özel metrik olarak denetleyici · Altı denetim | Sınavda kimin neden aç olduğu söylenebilir mi? |
|
IV | comparator · checker · LLM-as-judge | Aynı yanıtı verin: Hangi üç şeyle karşılaştırarak ölçülür? | bir yanıtı üç şekilde, iki kez değerlendir |
V |
| Temsilci, hatalarını kendisi düzeltebilir mi? |
|
VI | ödül hack'i · proxy metriği | Zararı göremeyen bir hakim döngüye ne yapar? | anahtar |
VII | arka kenarı olan bir | Bir grafiği döngü yapan nedir ve döngüyü ne durdurur? |
|
VIII | Her bir öğenin yerine ne konulduğu | — | çek |
Bu codelab nasıl kullanılır? Önce kavramlar ele alınır: Her kursta önce fikir açıklanır, ardından değişiklik yapıldıktan sonra okunacak şekilde kod gösterilir ve kod adım adım açıklanır. Burada hiçbir zaman bir dosyayı düzenlemenizi istemez. Düzenleme işlemi, size her seferinde bir satır veren ve önce hatayı gösteren uygulamada gerçekleşir. Kursu okuyun, ardından sayfanın sizi kurs boyunca yönlendirmesine izin verin ve sayının değişmesini izleyin.
Bu ayarın bulunduğu yer
Dünya (her birinin katı bir kısıtlaması olan on konuk, her birinde bir tuzak olan on restoran, on altı parti) ve iki jüri üyesi loop-lab-table laboratuvarından, tek sayfalık etkileşimli format ise Agent Valley'den alınmıştır. Bistro bir dekordur. Altındaki her mekanizma, müşteri temsilcisi, rezervasyon akışı veya "iyi" olduğu kontrol edilebilen her şey için kullanacağınız sıradan bir mekanizmadır.
2. 🧰 Kurulum
- Ne: Ödeme yapabilen bir hesap, bir proje, kurulu laboratuvar, yanıt verebildiği kanıtlanmış model ve tek bir bağlantı noktasında çalışan tablo.
- Neden: Tek bağlantı noktasında tek işlem: Sayfa, sınavlar, düzenleyici ve çalışma alanı aynı kaynağı paylaştığından bu laboratuvarda hiçbir şey için ikinci bir terminal veya ikinci bir bağlantı noktası gerekmez.
- Nasıl?: Klonlama, iki komut dosyası, bir komut. Kurulumun son adımı, gerçek bir model çağrısı yapmaktır. Böylece, bozuk bir proje 1. kursta değil, burada başarısız olur.
Bu laboratuvardaki her şey Cloud Shell'de çalışır. gcloud, Python, Node ve git zaten yüklüdür ve Gemini'a kendi kimlik bilgilerinizle Vertex AI üzerinden erişilir. Bu laboratuvarda API anahtarı yoktur ve dizüstü bilgisayarınıza yüklemeniz gereken bir şey yoktur. Google Cloud SDK, Python 3.11+ ve Node 20+ yüklü bir dizüstü bilgisayar da aynı şekilde çalışır.
Bu laboratuvarda size verilemeyecek tek şey, faturalandırmanın etkin olduğu bir Google Cloud projesidir. 1. adımda ödeme yapabilecek bir hesap oluşturursunuz, 4. adımda ise bu hesabı projeye dönüştürürsünüz. Bu adımları sırayla uygulayın. 4. adımdan sonraki her adım, 4. adımda belirlenen projeyi okur.
1. Faturalandırma özellikli bir hesap edinin (~1 dakika)
Faturalandırmanın etkin olduğu bir Google Hesabı ile oturum açın. Bu tür hesapların herhangi birini kullanabilirsiniz. Sizinki yoksa ücretsiz deneme başlatın. Bu işlemle, 4. adım için gereken faturalandırma hesabını elde edersiniz.
2. Cloud Shell'i açın (~2 dakika).
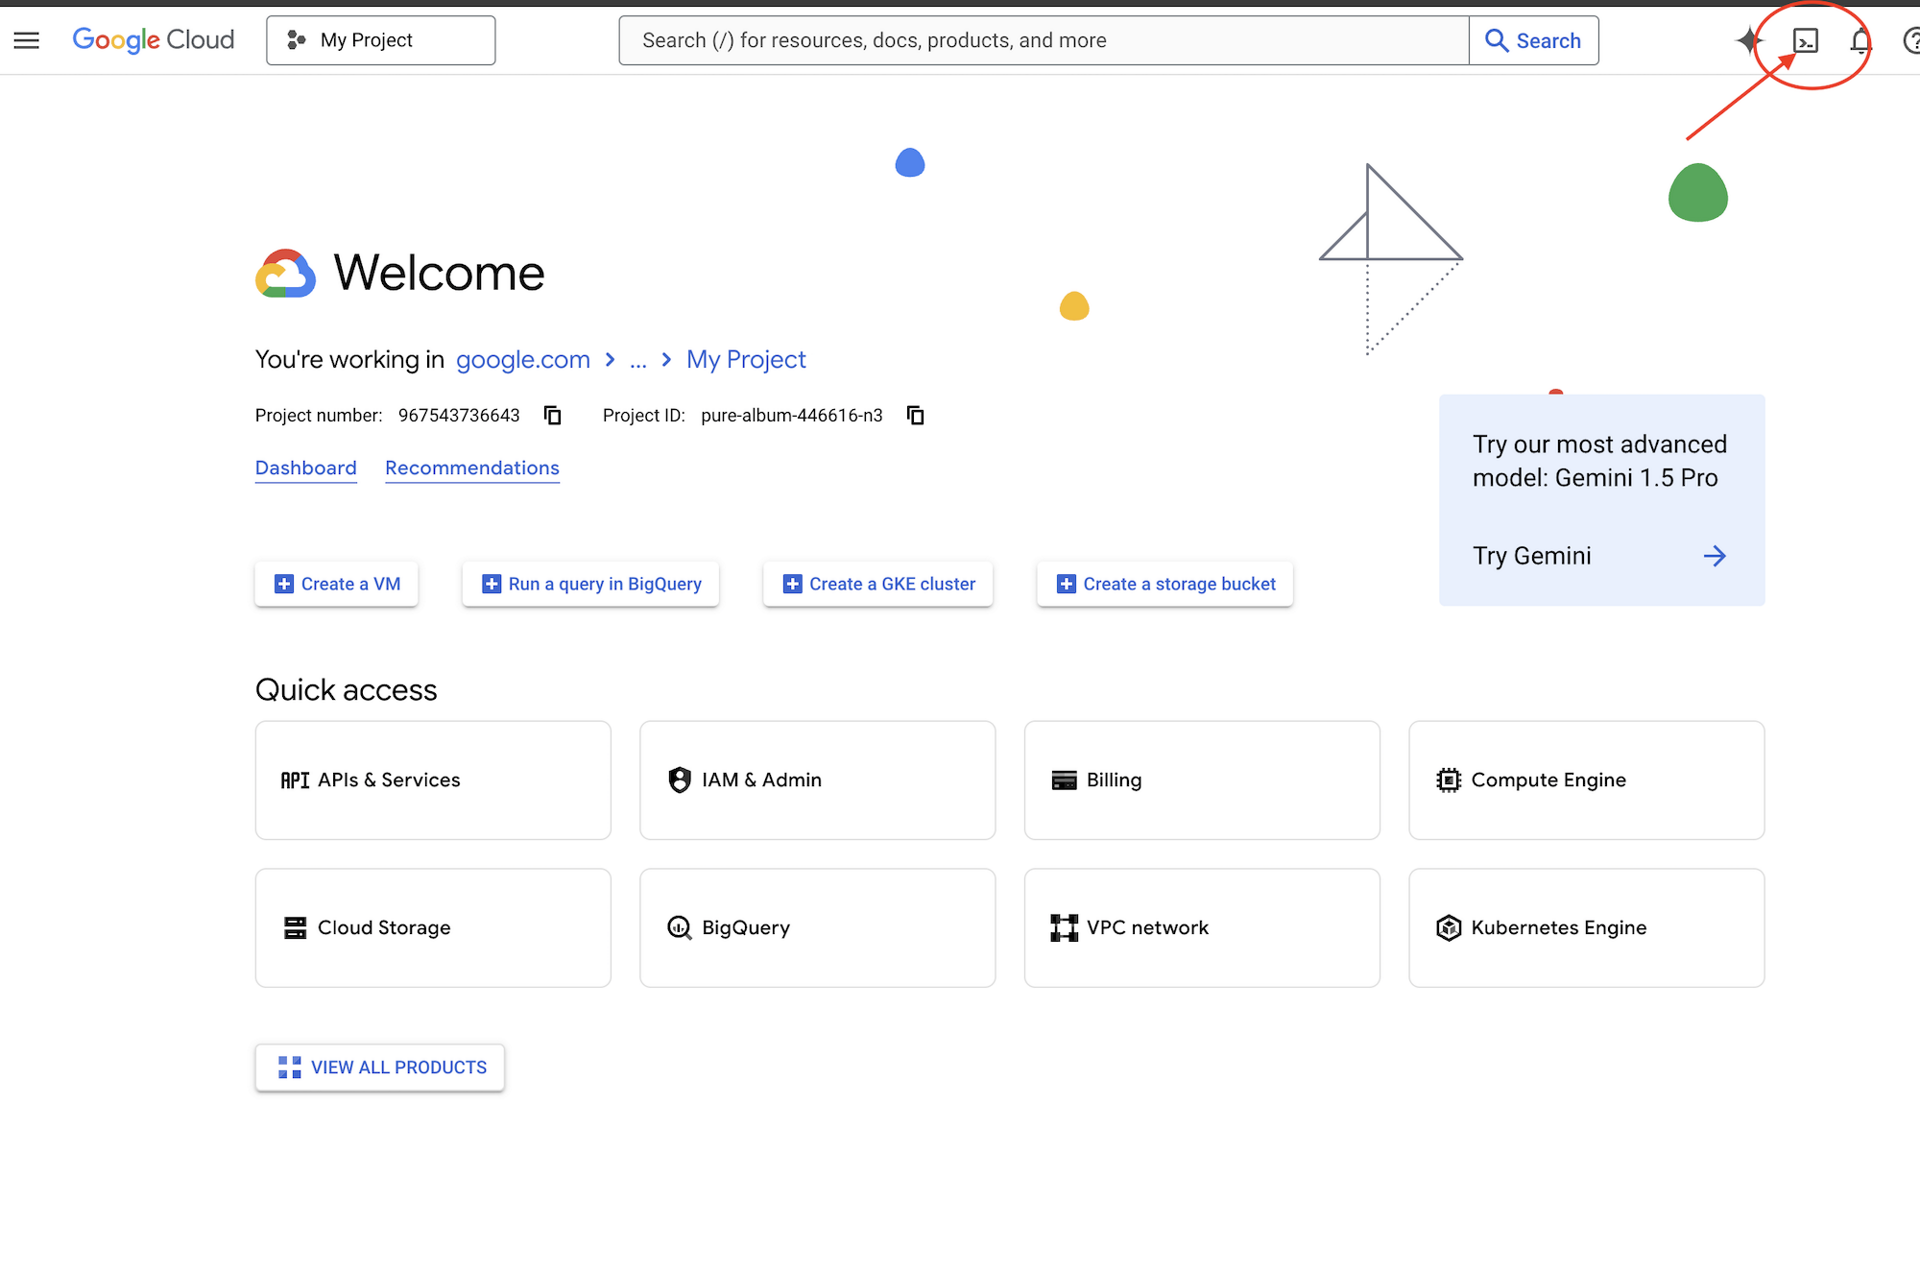
👉🖥 Google Cloud Console'un üst kısmındaki Cloud Shell'i etkinleştir'i tıklayın. Bu, başlıktaki terminal şeklindeki simgedir.
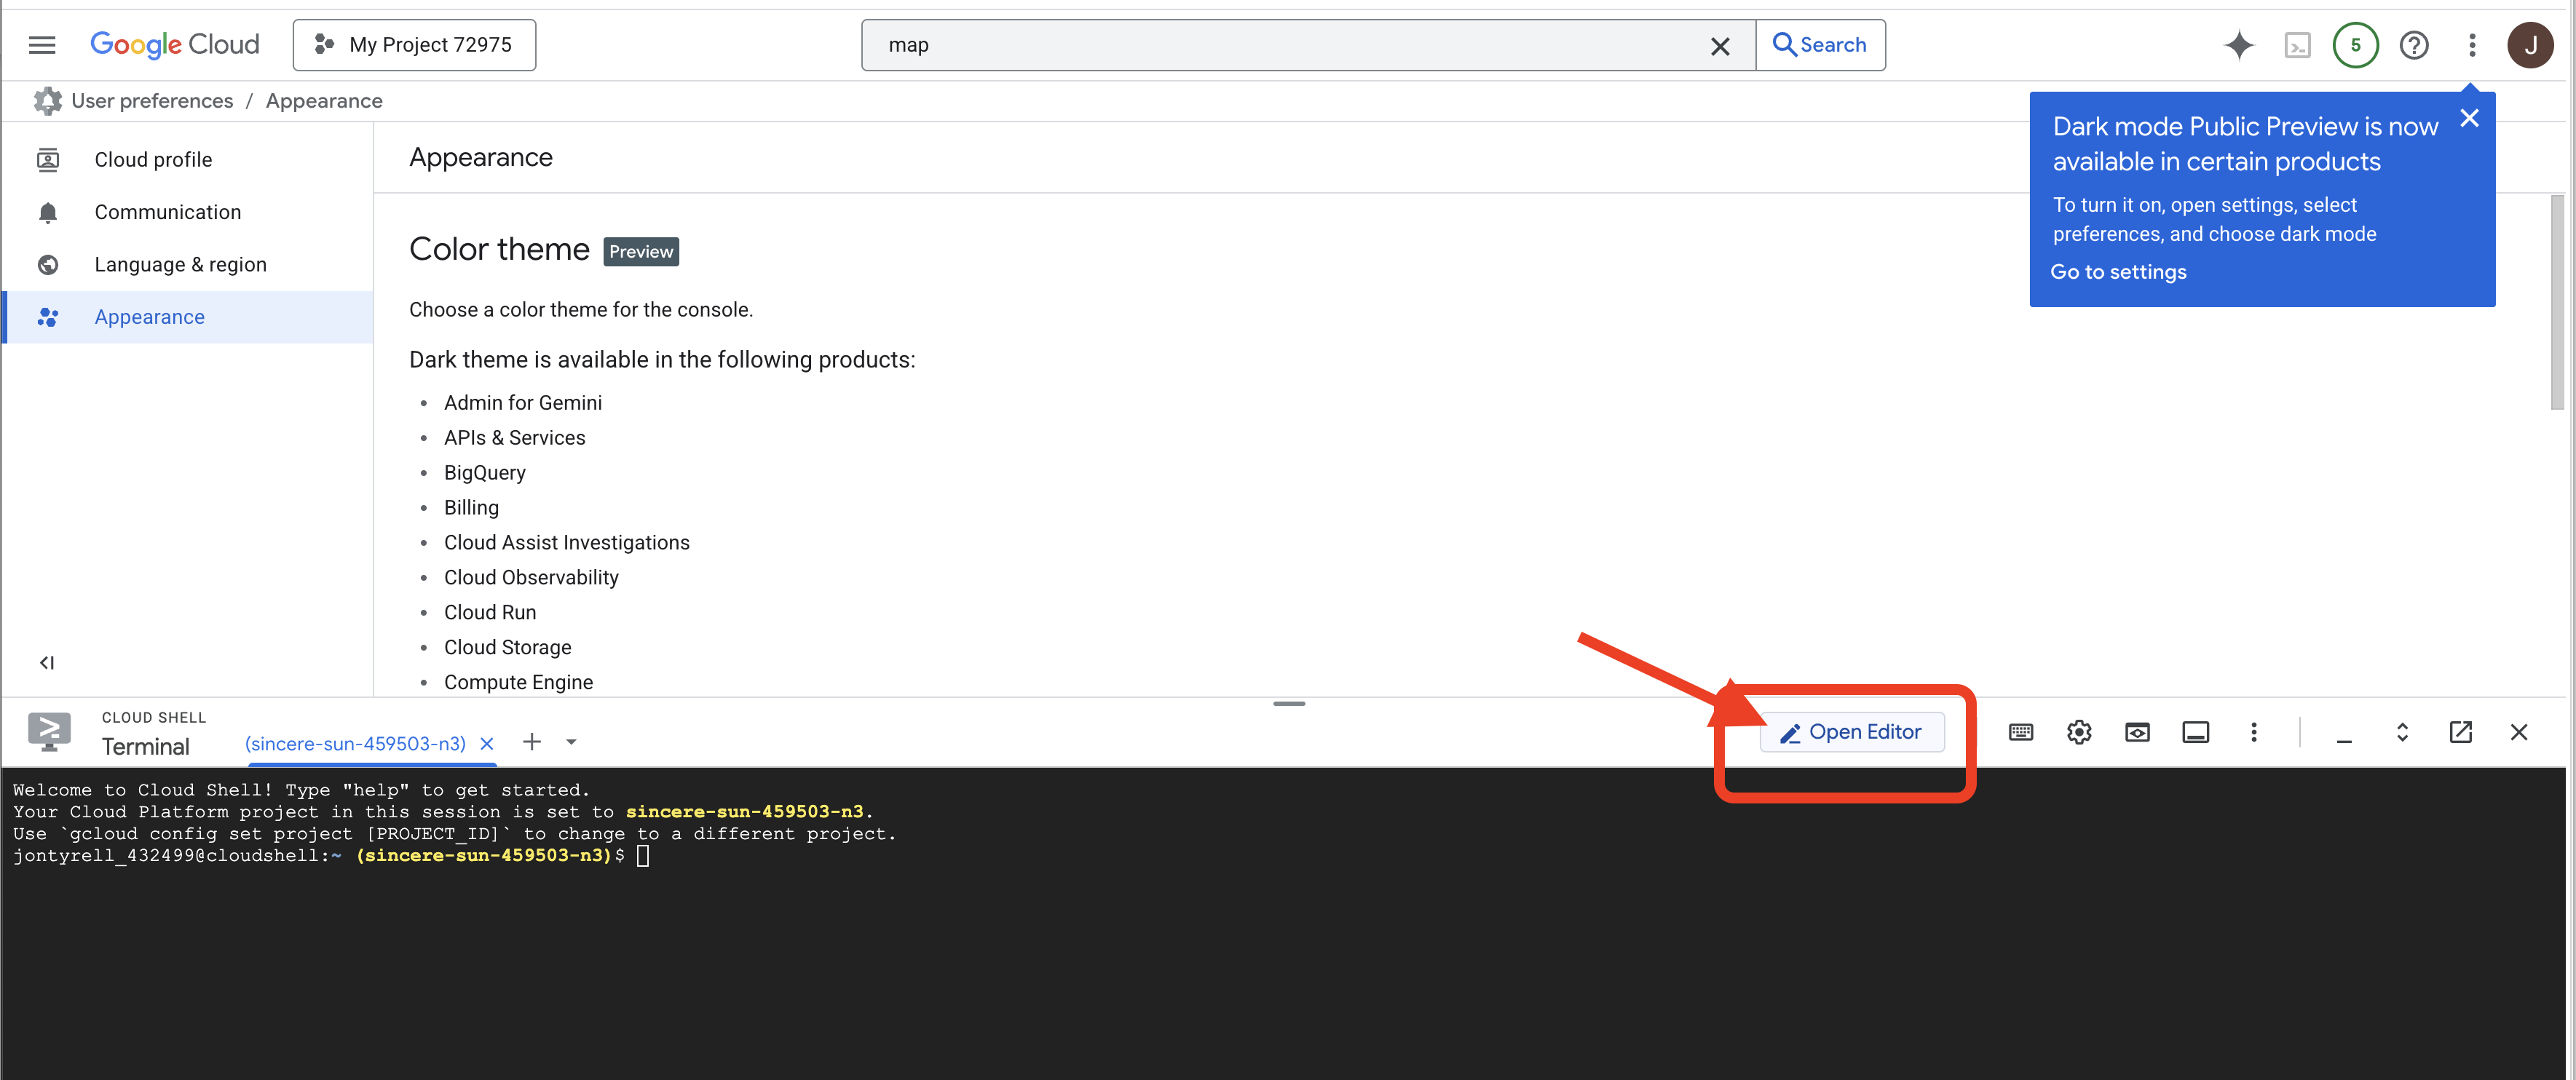
👉🖥 Open Editor'ı (Düzenleyiciyi aç) tıklayın (kalemli açık klasör simgesi). Bu işlem, sol tarafta dosya gezgini bulunan Cloud Shell Düzenleyici'yi açar. Bir dosyanın tamamını okumak istediğinizde buraya gidersiniz.
👉🖥 Bugün herhangi bir noktada yetkilendirme yapmanız istenirse devam etmek için Yetkilendir'i tıklayın.
👉🖥 Düzenleyicide bir terminal açın. Bu terminal 1. sekmedir ve her 👉💻 adım burada çalıştırılır. 2. sekme, tablonun kendisidir ve 7. adımda açılır. Terminal henüz ekranın alt kısmında değilse View (Görünüm) → Terminal'i kullanarak açın:
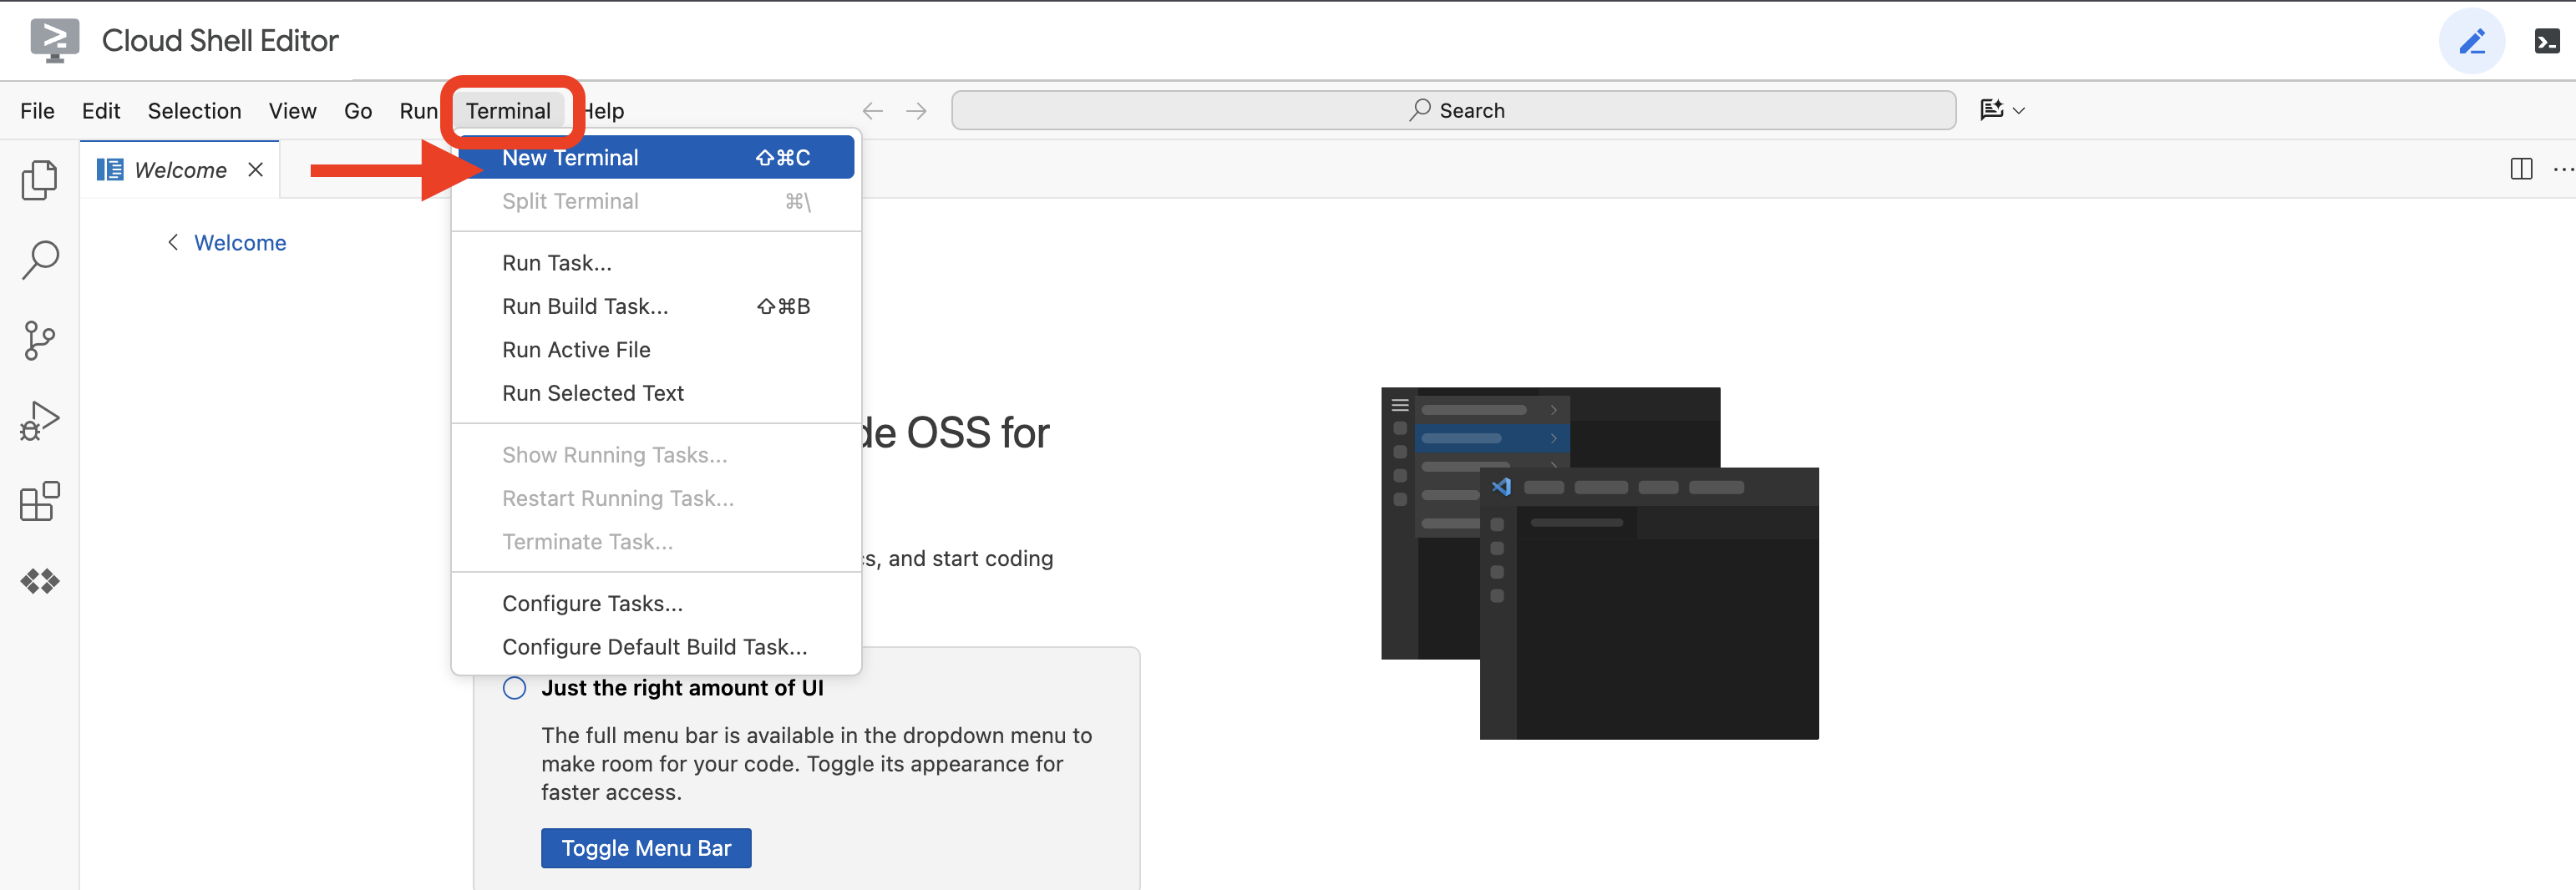
👉💻 Hangi hesapta oturum açtığınızı kontrol edin. Bu hesap, 1. adımdaki hesap olmalıdır:
gcloud auth list
3 · Laboratuvarı alma (~1 dk.)
👉💻 Depoyu klonlayın:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4. Projenizi oluşturun (~2 dakika)
👉💻 Bir komut dosyası, faturalandırma hesabınızı bulur, bu hesapta bir proje oluşturur, faturalandırmayı bağlar ve Cloud Shell'i bu projeye yönlendirir:
cd ~/table-for-n
./setup_project.sh
Seçtiği faturalandırma hesabı için ✓, oluşturduğu proje için ✓ ve şu şekilde bir son bekleyin:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271, proje kimliğinizdir. Sizin kimliğinizde farklı rakamlar olacaktır. Bu aşamada dört şey gerçekleşir:
billing | Varsa en yeni | |
project |
| |
seçer | Kimliği | |
waits | projenin yayınlanmasına izin verilene kadar iki dakikaya kadar yoklama yapar. | |
👉🖥 Aynı proje artık konsolda. Projenin kimliği, kontrol panelindeki Proje bilgileri kartında yer alıyor:

5. Laboratuvarı yükleme ve kurma (~3 dakika)
setup_codelab.sh, ortamı uv ile oluşturur ve uv'yi sizin için yüklemez. Durur ve sizden yüklemenizi ister. Bu nedenle, önce aynı komutla yükleyin:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Bir komut dosyası, tekrar çalıştırılabilir. Sırasıyla beş işlem gerçekleştirir:
api | Seçilen proje adımını (4. adım) okur ve | |
uv env |
| |
site | Statik dosyalara aktarılan bir Next.js uygulaması olan | |
.env |
| |
preflight |
| |
6. Menüyü okuyun (~1 dakika)
5. adımda yazdırılan son şey, bu akşamki menü. Her satır bir tahmin değil, gerçek bir sorgu:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Başlamadan önce hiçbiri yanmaz. Burada önemli olan the model answers. Bu, projenizde gerçek bir arama yapıldığı anlamına gelir.
👉💻 Nerede olduğunuzu görmek için istediğiniz zaman tekrar çalıştırın. Bu araç, dosyalarınızı ve mutfaktaki makbuzları okur, kontrol listesini değil:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · Masayı kurma (~1 dk.)
👉💻
cd ~/table-for-n
bash table.sh
Bir işlem, bağlantı noktası 3470. Mutfak, ADK'yi içe aktarıp adk web bağladığı için ısınması biraz zaman alır. Bu nedenle komut dosyası bunu belirtir, bekler ve bağlantıları yalnızca bağlantı noktası yanıt verdiğinde yazdırır:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Ön planda kalır. Ctrl+C tuşlarına basıldığında tablo temizlenir. Çalışmaya devam edin. Bundan sonraki her derste bu işlemden bahsedilecek ve bu laboratuvarda hiçbir zaman yeniden başlatmanız istenmeyecek.
👉🖥 ✓ the table is laid simgesini gördüğünüz sonra tabloyu yeni bir sekmede açın (2. sekme olarak adlandırın). Cloud Shell'de: Web Preview (Web Önizlemesi) → Change port (Bağlantı noktasını değiştir) → 3470.
👉🖥 Rezervasyon kartına adınızı yazın (sonunda çekte yer alır) ve ✦ Bizi oturtun'a basın.
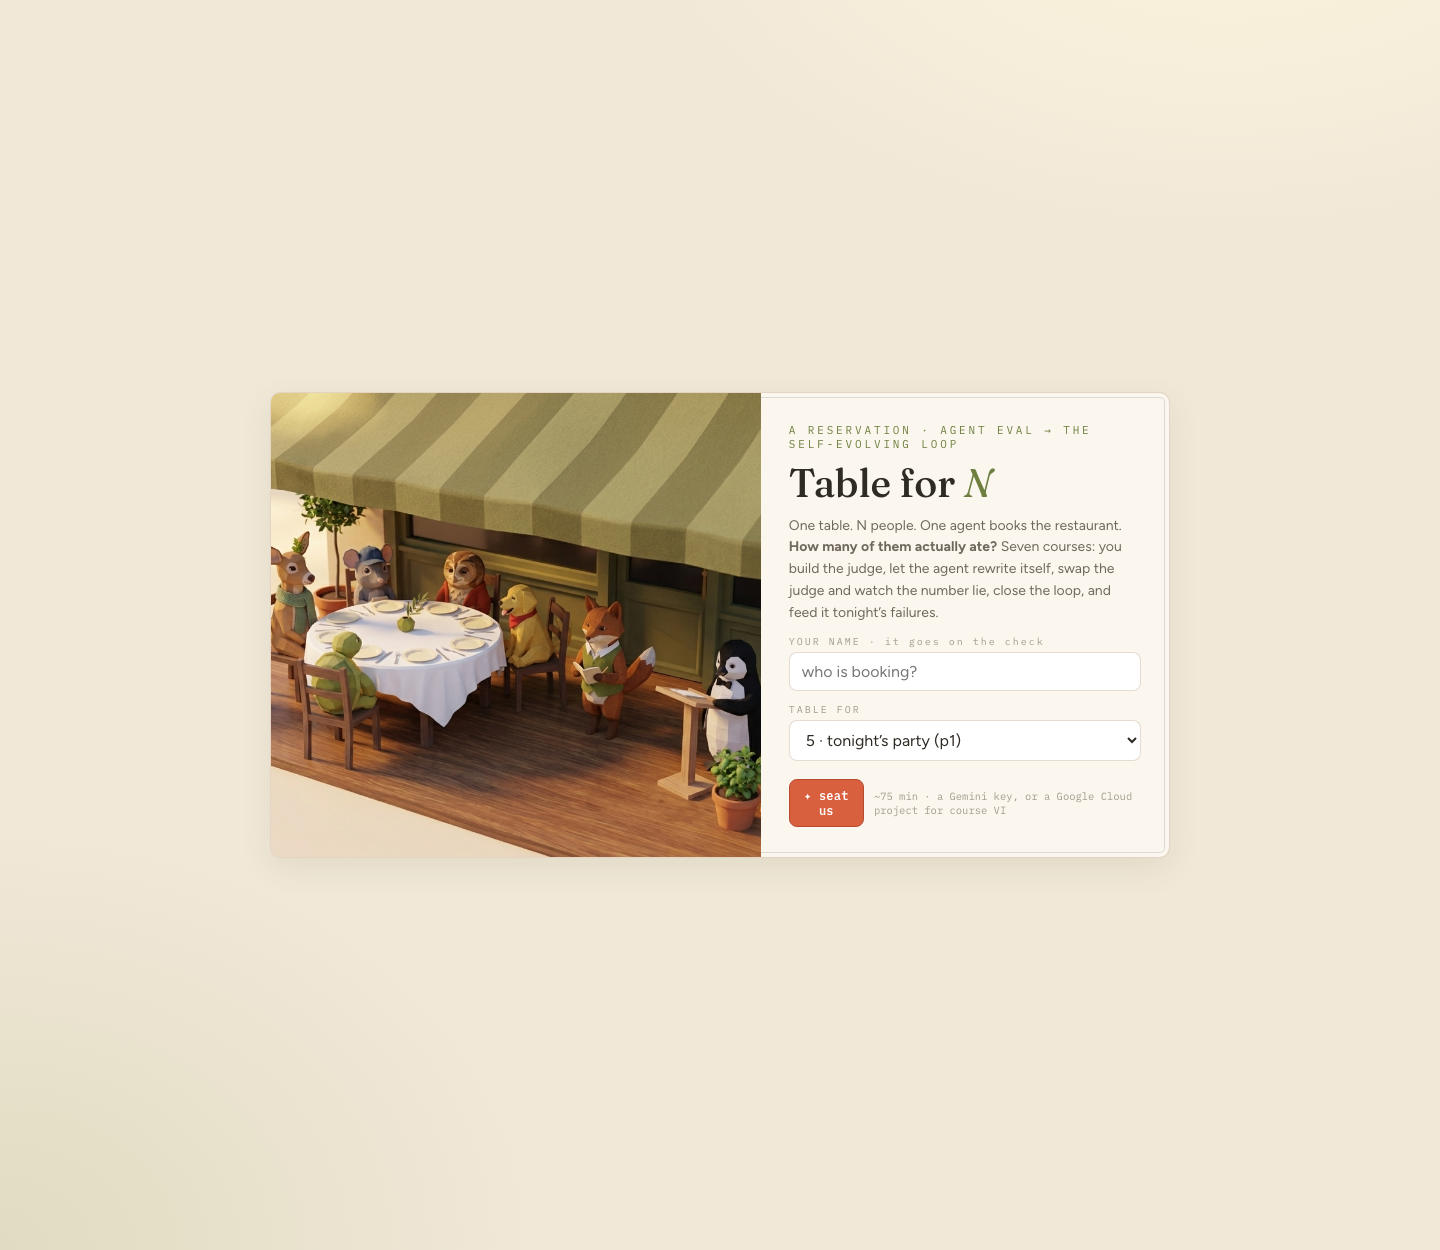
3. I · The booking — a reply is not a result
Beş kişi akşam yemeğine gidecek. Grup sohbetinde her şey var: Nadia vegan, Tom'un bu ayki bütçesi 25 dolar, Amara koltuk değneği kullanıyor ve on dakika yürüyebiliyor, Lena 19:45'ten önce gelemiyor, Ben için fark etmiyor. Puanlarına göre sıralanmış on restoran listelenir. Her birinin fiyatı, yürüme mesafesi, çalışma saatleri ve bir dezavantajı vardır.
Bir ajan masa ayırtır. Sohbeti okuduğunuzda, seçtiği odada kimin aç kalacağını zaten biliyorsunuz. Sistemde bu konuda bilgi yoktur. Bu boşluk, codelab'in tamamının konusudur.
Ajan (salt okunur)
host/agent.py, laboratuvarın tamamında olduğu gibi:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Araç, veritabanı ve arama yok. Bir model, bir talimat dizesi ve dize bu dosyada değil. Bu belge, instruction_current.txt adlı yan klasörde yer alır. Bu klasörde, ürün müdürünün ilk gün yazdığı dört satır bulunur:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Alerjiler, bütçeler, yürüme sınırları veya kimin erken ayrılması gerektiği hakkında hiçbir şey söylenmiyor. Tüm bunlar, aracının aldığı brifte yer alır. Kullanılmıyor.
Bu dosya, bu laboratuvarın konusu olan tek yapıdır. V kursu, bir optimize edicinin bunu yeniden yazmasına izin verir. VI. Kurs, saldırıya uğramış bir sürümü yükler. Kurs VII'nin döngüsü, grafik çalışırken bunu tur tur yeniden yazar. Ajan (model, ayarlar, ad) hiçbir zaman değişmez.
Deneyin: Sıfır ön uç
👉🖥 Sayfada I kursuna gidin. 🔬 Çalışma alanı'nı (sağ üst) tıklayın: Çekmece, aynı işlemde monte edilmiş adk web'dir. Aynı host/ klasörü ve aynı table.db'dir. Ana makine'yi seçin, kurs panelinden özeti yapıştırın (kopyalama düğmesi vardır) ve gönderin.
Ev sahibi bir saniye içinde yanıt verir: restoran, saat ve kendinden emin bir şekilde tek satırlık bir neden. Sohbetin yanındaki nedeni okuyun. Ardından soldaki tabloya bakın: "laid" (serildi), "nobody judged" (kimse yargılamadı), — / 5. Bir şey yüklendiği için değil, elbette dünyada bunu yargılayabilecek hiçbir şey olmadığı için.
Sayı: boş koltuklar — ?. Kimse bilemez.
4. II · Karşılaştırıcı: Bu akşam yemeğinde kaç doğru yanıt var?
II. Kurs, zaten var olan ve hiçbir şey öğretmeyen bir nedenden dolayı başarısız olan bir sınavla başlıyor. Düzeltmeden önce, üç farklı şekilde çalıştırılabildiğini bilmeniz gerekir. Çünkü bugün bu üç yöntemi de kullanacaksınız.
Değerlendirme yapmanın üç yolu
Temelde aynı motoru kullanır.
ne için kullanılır? | Sizi neler bekliyor? | |
| toplu iş çalıştırıcı; CI'ya ne koyduğunuz | özet döndürür: başarılı, başarısız, her test için bir puan |
| bir test başarısız olduysa ve buna bakmak istiyorsanız | ve her bir destek kaydı puanı tıklanabilir. |
| temsilci değerlendirmesini normal bir regresyon paketine dahil etme | Birim testlerinizle birlikte çalışır ve derleme işlemini aynı şekilde başarısız kılar. |
Gerçekten faydalı ayrıntı: Üçü de tek bir yerel değerlendirme mağazası olan host/.adk/eval_history/'ı paylaşıyor. CI'dan bir toplu işlem çalıştırın. Bir hata oluşursa bu çalıştırmayı web kullanıcı arayüzünde açarak inceleyin. Sayfadaki 📝 düğmesi birinci, 🔬 çalışma alanı ikinci, uv run pytest tests/test_host.py terminal komutu ise üçüncü yöntemdir. Bu komutun çalıştırdığı test on iki satırdan oluşur:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. Aynı temsilci, aynı değerlendirme seti, aynı yapılandırma dosyası ve eval_set_results_manager satırı, çalışmasını diğer ikisiyle aynı geçmişe koyar.
Sınav, gönderildiği şekliyle
exam/eval_config.json şu şekilde gönderilir:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
İki bölüm, iki iş. criteria
, sınav kağıdıdır: Her biri kendi geçme eşiğine sahip olan ve gerçekten çalışan metrikler. customMetrics
, personel dizinidir. Adlar Python'a eşlenmiştir, kullanılabilir ancak görevde değildir. Bir metriği bildirmek, onu çalıştırmak anlamına gelmez. Makale, gönderildiği şekliyle tam olarak bir soru içeriyor: ADK'nın yerleşik response_match_score, değerlendirme setindeki temsilcinin söyledikleri ile altın rezervasyon arasındaki metin çakışması (ROUGE-1). Hakeminiz everyone_ate, kağıtta değil dizinde. 3. kurs, bir satırı değiştirerek hakeminizi dizine taşır.
Ücretsiz akşam yemeği rezervasyonu yapabileceğiniz bir temsilcimiz ve response_match_score oturma yerimiz var. Hemen kullanıp sonucu görelim.
Dene
Sayfadaki 👉🖥 II. kurs. 📝 run the exam · as shipped (📝 sınavı çalıştır · gönderildiği gibi) düğmesine basın. Düğmenin altındaki başlıkta neyin çalıştığı belirtilir: 1 metrik çalışıyor: response_match_score · everyone_ate, sınavda değil, beyan edildi. Yaklaşık yarım dakika. Sonucu okuyun: Tabloların yaklaşık yarısı, metin puanı ile ilgili bir neden belirtilmeden BAŞARISIZ OLDU. Hangi tabloların başarısız olduğuna bakın. Fareyle çiplerin üzerine gelin.
Şimdi dikkatle bakın, çünkü ilginç olan kısım burası. Karşılaştırıcı, tabloları her iki yönde de yanlış yorumluyor ve çalıştırmanızda bunlardan en az biri gösteriliyor. Rezervasyonun sorunsuz olduğu bir tabloyu başarısız olarak değerlendiriyor. Temsilci, herkesin yemek yiyebileceği bir oda seçti, akşam yemeği sorunsuz geçti ve cevap doğru. Ancak temsilci, nedenini altın cevaptan farklı bir şekilde ifade etti. Ayrıca, birinin aç kaldığı bir masayı geçiyor (p1 koşumuzda, tam 0.30'da, Tom bütçeyi aşmış ve Lena son siparişlerden sonra gelmiş) çünkü yeterli sayıda kelime çakışmış. Dize benzerliği, akşam yemeği hakkında hiçbir şey bilmez. Karakterlerin sıralandığını biliyor.
O hâlde gerçek bir soru: Bu akşam yemeğinde kaç doğru cevap var?
Bu akşamki partide on odadan yalnızca birinde (Pho Saigon) yemek ikram edilecek. Yemek ikramı saat 19:00'da başlayacak. Sınavın sekiz bölümünde bu sayı sırasıyla bir, iki, iki, bir, üç, üç, altı, bir şeklindedir (world.rooms her bölüm için her oturumda her odayı gezer; uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" ile kendiniz deneyin). Bazen birkaç oda herkesi besleyebilir, bazen ise yalnızca bir oda ve yalnızca belirli zamanlarda besleyebilir. Tek bir doğru cevap yoktur, kabul edilebilir cevaplardan oluşan bir küme vardır. Değerlendirme setindeki altın cevap da bu kümenin bir üyesidir.
Yani response_match_score'ın altındaki varsayım (tek bir doğru cevap var ve ben onu yazdım) bu problem için hiçbir zaman doğru değildi. Bir kez değil. Metrik bozuk değil. Tam olarak adından anlaşılan işlevi yerine getirir. Bu soruna yanlış türde bir metrik uyguladık.
👉🖥 İsteğe bağlı, bir dakikanızı ayırmaya değer: 🔬 çalışma alanını → Evals (Değerlendirmeler) → 🕓 geçmişi açın. Az önce yapılan çalıştırma 📝 orada, her bir vaka tıklanabilir. 1. sekmede ise uv run pytest tests/test_host.py aynı sınavı başarısız bir test olarak çalıştırır ve aynı geçmişe girer.
Sayı: Çalışmamızda kelime çakışması için 8 testten 4'ü geçti ve 10 odadan 1'i için 1 doğru yanıt verildi.
Akşam yemeği sorunumuzda seçim kendiliğinden yapılıyor. Hiç kimse size cuma günü için doğru restoranı söyleyemez. Ancak herkes başarılı bir akşam yemeğinin ne anlama geldiğini söyleyebilir: Masadaki herkes yemek yedi. Bu bir kuraldır. İşaretlenebilir. Belirsiz olmamalıdır. Bu modeli oluşturmak ise 3. kursun konusudur.
5. III. Yargıç: Özel metrik olarak kontrol eden

Denetleyici, karşılaştırıcıdan farklı bir soru sorar: Bu, anahtarla eşleşiyor mu? değil, Herkes yemek yedi mi? Rezervasyonu grup için koltuk koltuk kontrol eder ve koltuk başına bir puan ve neden döndürür. Hiçbir altın cevaba ihtiyacı yoktur. Bu sayede, daha önce gerçekleşmiş sohbetleri de değerlendirebilir (VIII. Kurs).
world.everyone_ate, bu işlevdir. Course III, adk eval'ye havale eder.
everyone_ate içinde: Beş adım, hiçbiri akıllıca değil
- Kullanıcının metnini okuyup bunun hangi taraf olduğunu belirleyin. Brief'te
p1şeklinde bir taraf kimliği var. Bu kimliğe bakarak o masada kimin oturduğunu buluyoruz. - Ajanın yanıtını okuyun, JSON'u ayrıştırın, restoran adını ve rezervasyon saatini çıkarın.
- Her kişiyi sırayla yürütün. Her biri için: diyet, alerjiler, baharat toleransı, bütçe, yürüme mesafesi, zamanlama. Her seferinde kişi başına altı çek. Örneğin, Tom'un bütçesi kişi başı 25 ABD doları, odanın fiyatı ise 28 ABD doları. Tom için
Falseyanıtını ve bunu açıklayan cümleyi döndürüp bir sonraki kişiye geçiyoruz. - Puan, yemek yiyenlerin sayısının masadaki kişi sayısına bölünmesiyle elde edilir. Beşte dört, 0,8'dir. Ağırlıklandırma veya kısmi kredi yoktur.
- İade EDİLDİ veya BAŞARISIZ OLDU. Bu sevgiyi karşılıksız bırakmayan da sizsiniz. Bunun altındaki tuzak olduğunu unutmayın.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Burada dikkat edilmesi gereken bir özellik var: Bu işlevin hiçbir yerinde model çağrısı yok. Deterministik Python'dur. Aynı giriş, her seferinde aynı sonuç. Hakeminiz, bir model güncellendiğinde kayma yapmaz, çalıştırmak için herhangi bir ücret ödemeniz gerekmez ve bir neden uyduramaz. Bunu elde edebileceğiniz durumlarda, tasarım yapmaya değer.
Metrik, tamamlandı
metrics/table.py: Sabit imzasıyla birlikte bağdaştırıcı ADK çağrıları:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Satır satır: Her çağrının her iki tarafını (user_content tarafı, final_response rezervasyonu) okur, bunları saf işleve iletir ve sonucu ADK'nin beklediği nesnelere sarmalar. Ve bir satırda karar yer alıyor:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
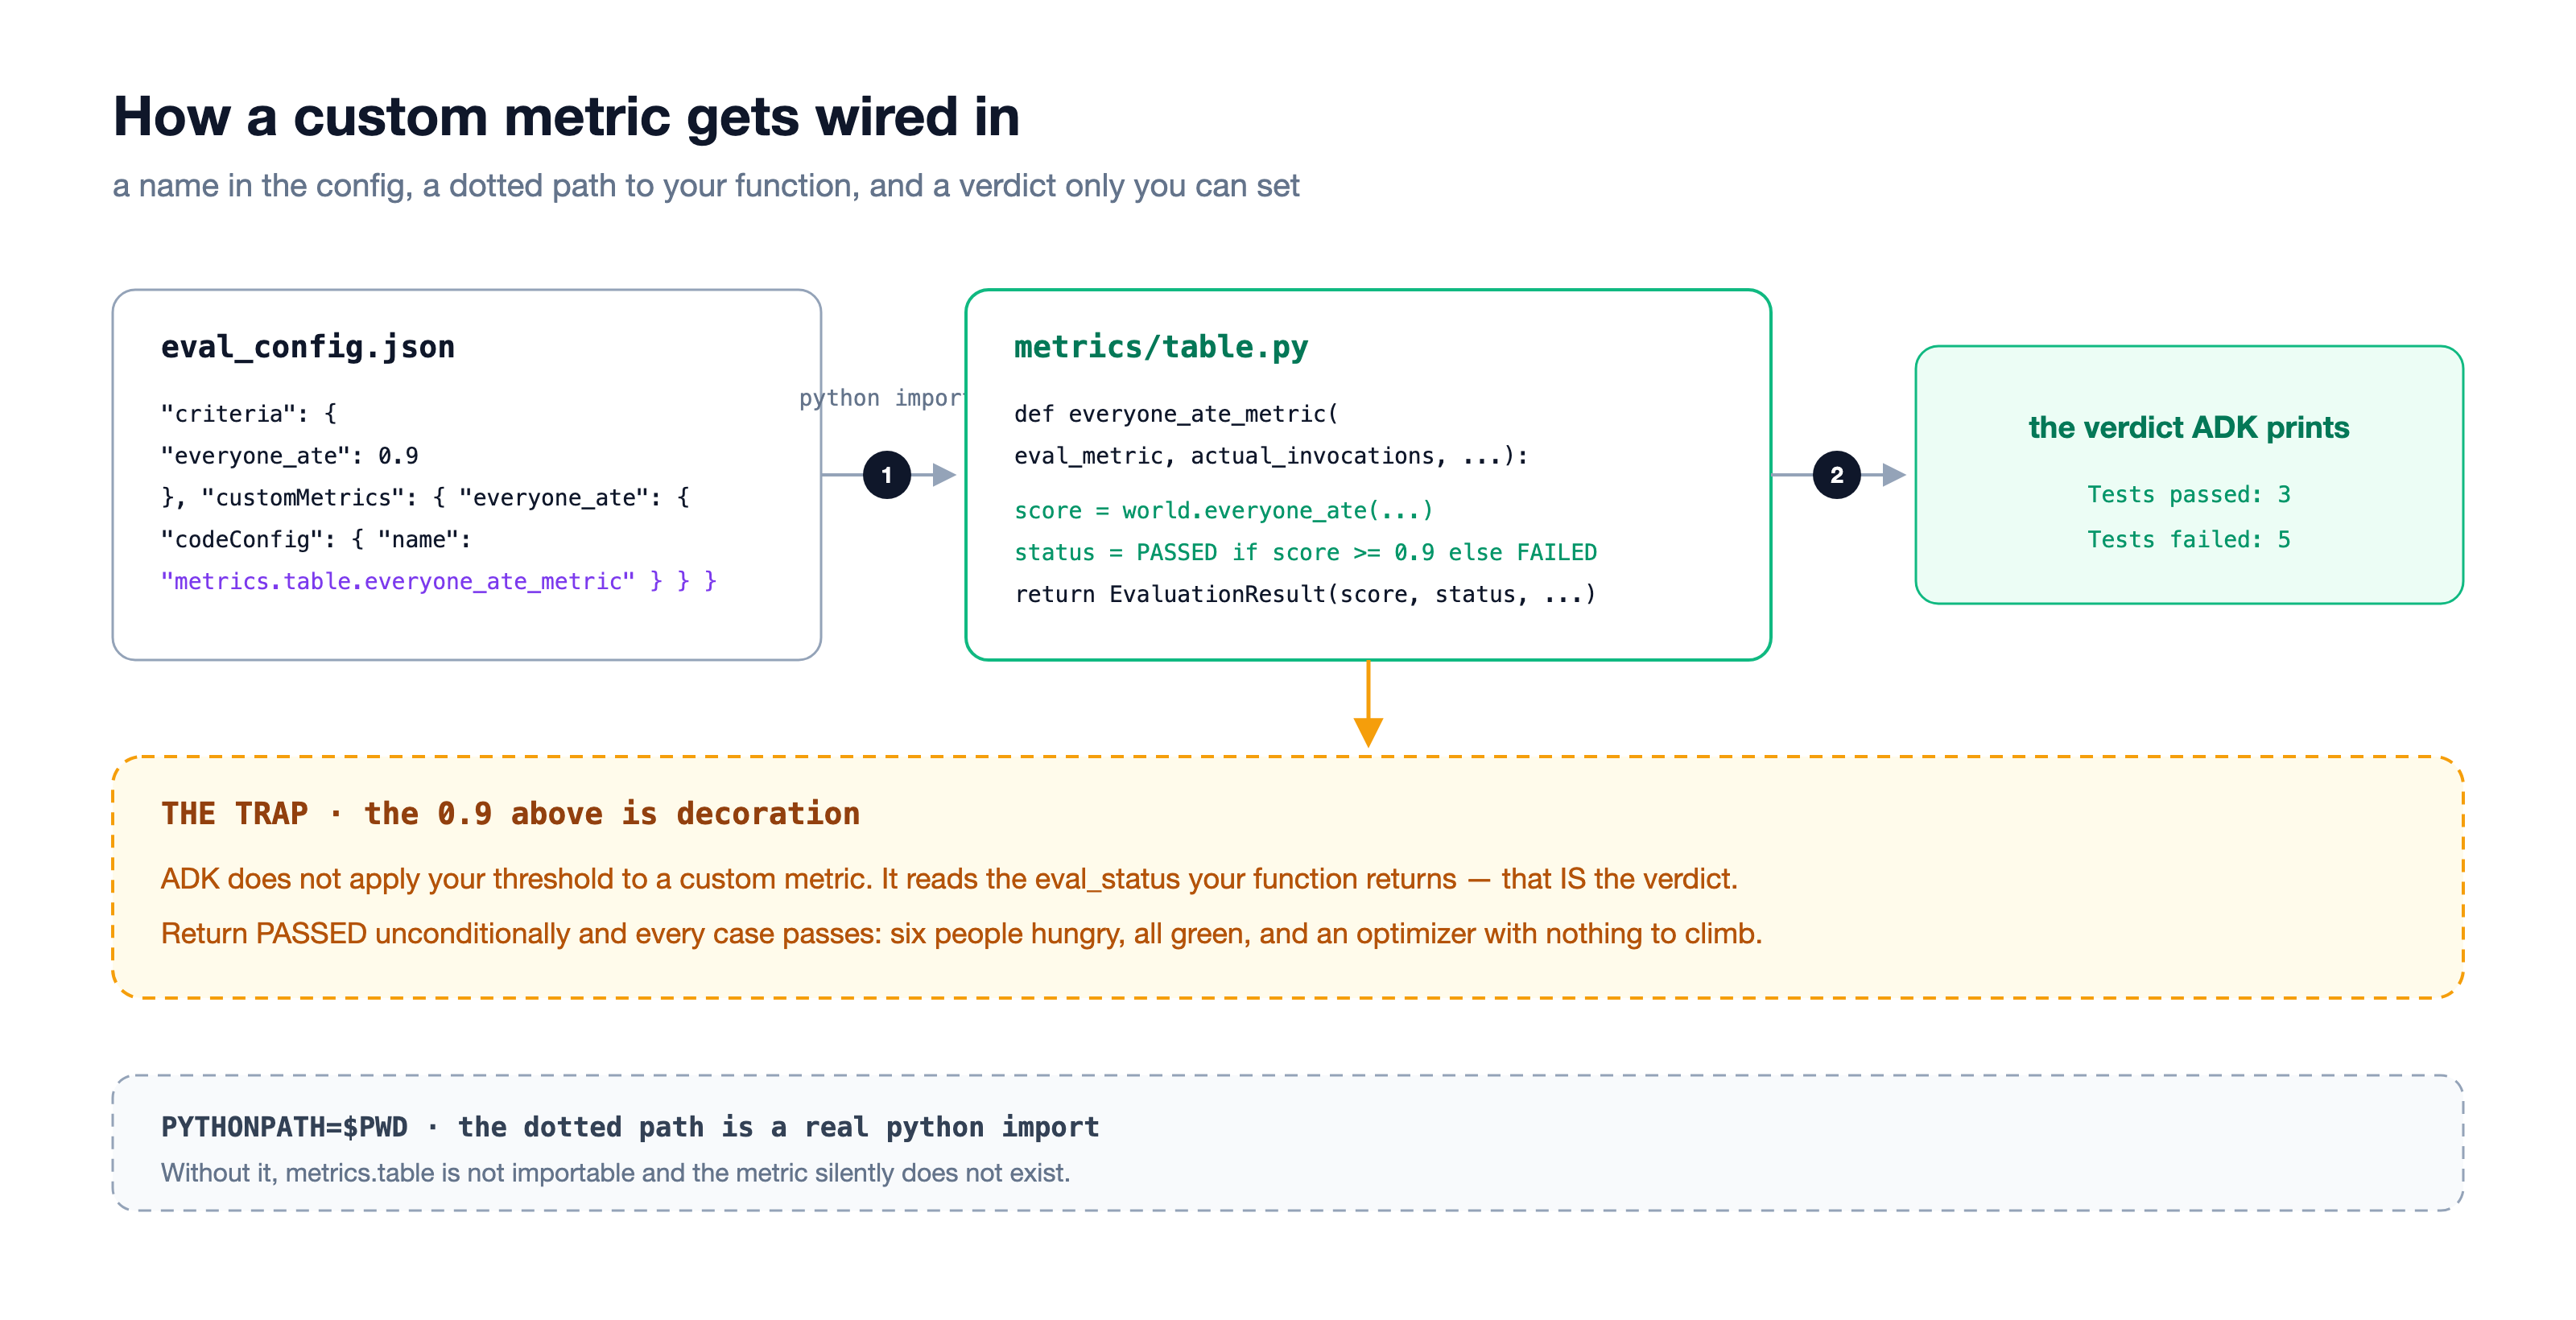
Yapılandırma (tek satır)
exam/eval_config.json, kurs tamamlandıktan sonra şu şekilde görünür:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Bir satır değişti: criteria artık karşılaştıran yerine hakiminizi adlandırıyor. Sınav, optimizasyon uzmanının asla göremeyeceği sekiz partiden (exam/parties_val.evalset.json, toplam 36 koltuk) oluşur.
Dene
👉🖥 Sayfadaki III. kurs. 📝 düğmesinin altındaki başlıkta, ana makinenin çalıştırdığı talimatın adı yer alır. Bu başlıkta taslak yazmalıdır. Başka bir şey yazıyorsa (daha önce başka bir tane yüklediyseniz) önce ↺ taslağa geri dön'e basın. Aksi takdirde sayılar hikayeyle eşleşmez.
👉🖥 Düzenleyicideki satırı değiştirin (veya düzenlemeyi benim için uygula'ya basın) ve 📝 sınavı tekrar yapın. Artık bir hata, koltuğu ve nedeni belirtiyor: Tom: 28 ABD doları karşısında 25 ABD doları · Lena:Son siparişler 19:30'da, 19: 45'te geliyor. Tablonun altındaki sayı, geçiş sayısından önemli olan sayıya, yani aç koltuklar sayısına dönüşüyor. Fareyle bir çipin üzerine gelin: Başarısız olan her tablo, kendi cümlelerini içerir.
👉🖥 Ardından 📋 Masayı ayırt'a basın. Ev sahibi bir oda seçer. Aynı işlev, orada yemek yiyemeyen sandalyeleri devre dışı bırakır ve her birinin altında nedenini belirtir. Tekrar basın. Model farklı şekilde rezervasyon yapabilir (API, 0 sıcaklıkta bile deterministik değildir) ancak değerlendirici asla sarsılmaz: aynı oda, aynı karar, aynı cümleler.
Sayı: İlk günkü taslak, dürüst olmak gerekirse 8 partiden yaklaşık 3'ü, bizim denememizde 36'dan 6'sı aç hesap (sizinki değişebilir; API, 0 sıcaklıkta bile deterministik değildir. Bu nedenle sınavda dört kılıf değil, 36 hesap vardır). Bu numarayı kullanmaya devam et. Kurs V, kursu taşımak için kullanılır.
6. IV · Uçuş: Bir yanıt, üç jüri üyesi
Sınav, sunucunun yanıtlarını iki kez puanladı. Bir kez karşılaştırıcı, bir kez de kontrol aracınız tarafından. Course IV, bu yanıtlardan birini (bu akşamki parti, p1, sınavda kaydedildiği şekliyle) alır ve ilk iki jürinin yanına üçüncü bir jüri ekler: puanlama anahtarı olan bir model. Hiçbir şey yeniden rezerve edilmez. Değişen şey, yanıtın neye göre ölçüldüğüdür. Bu tek fark, üç metrik ailesini birbirinden ayırır.
hakim | soruyor | gerekiyor | passes if | kör nokta |
karşılaştırıcı · | Bu benim yanıtımla aynı mı? | altın yanıt: Bir insan, değerlendirme setine her parti için bir rezervasyon yazdı. | ROUGE-1 kelime çakışması ≥ 0,3 | Farklı şekilde ifade edilen doğru bir yanıt cezalandırılırken doğru kelimelerle ifade edilen yanlış bir yanıt gözden kaçar. Hiçbir zaman partiyi okumadı. |
denetleyici · | Bu yanıt gerçekten doğru mu? | Kurallar: Koltuk başına altı kontrol, hiç altın cevap yok | Beslenen koltuk sayısı ÷ masadaki koltuk sayısı ≥ 0,9 | Yazdığınız kuralların dışında hiçbir şey görmez. Belirleyici: Her seferinde aynı yanıt, aynı hüküm, aynı cümleler. |
LLM hakemi · | Herkes yemek yiyebiliyor mu? — asked of a model | bir model ve dört satırlık bir değerlendirme ölçeği; her basmada bir gerçek arama | Model, "GEÇTİ" diyorsa | yanılabilir ve düğmeye basma işlemleri arasında fikrini değiştirebilir. Arama ücreti alınır. |
Denetleyicinin nedenleri bir notu hak ediyor. adk optimize, V dersinde çalıştırıldığında bu cümleleri asla görmez. ADK'nin optimize edicisi puanları okur. Bu mesajlar boşa gitmez. Terminalde duran sizler için bir hatayı okunabilir kılan bu mesajlardır. Günümüzde bu mesajların değeri de büyük ölçüde buradan gelir. 7. kursta ise döngü, değerlendirme mekanizmasını kullanmak yerine doğrudan yargıcı çağırır. Bu nedenle, nedenler gerçekten yeniden yazma işlemini yapan şeye iletilir.
Üç jüri üyesi koşarken
kitchen/flight.py. İlk ikisi sınavın kendi kodudur. Karşılaştırıcı, response_match_score'nin arkasındaki işlevdir. Bu nedenle, numarası tam olarak II. Kursun bu taraf için bastığı numaradır:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Dene
👉🖥 Kurs IV. Panelin üst kısmında: p1 için düzenleyenin verdiği yanıt ve yanında değerlendirme setinden altın rezervasyon. Önce bunları karşılaştırarak okuyun. Ardından ⚖ Bu yanıtı üç şekilde değerlendir'e basın. Bir model çağrısı. Üç kart doldurulur: Her hakemin ne sorduğu, neye ihtiyaç duyulduğu, ne söylendiği ve neden.
Denememizde, p1 için (ilk gün taslağında saat 19:00'da Olive & Thyme) karşılaştırıcı 0,30'da BAŞARILI (altın rezervasyonla yeterli sayıda kelime eşleşti), denetleyici 0,60'ta BAŞARISIZ (Tom: Tom'un 25 ABD doları bütçesine karşılık yaklaşık 28 ABD doları · Lena: son siparişler 19:30, 19:45'e kadar masada değil) ve LLM değerlendirici BAŞARISIZ dedi ve Lena'yı belirtti. Karşılaştırıcı ve kontrol eden, aynı yanıt konusunda anlaşmazlığa düşüyor. Biri kelimeleri, diğeri ise koltukları saymış.
👉🖥 ⚖ Tekrar değerlendir'e basın. Karşılaştırma kartı hareket etmez. Dama taşı hareket etmez. LLM kartı olabilir. Düğmenin altındaki satırda bu durum belirtilir. Ardından, solda başka bir parti seçin (sahnenin parti seçicisi) ve bir kez daha basın. Üçü her zaman aynı şekilde hizalanmaz.
Sayı: Bir yanıt, üç karar. Bizim denememizde GEÇTİ · KALDI · KALDI kararları verildi. Üç karardan ikisi, her sorduğunuzda aynı olacaktır.
7. V · Yeniden yazma: adk optimize ve ship gate
Üç rol kesinlikle ayrı tutulur:
role | kim | iş |
sınav katılımcısı | düzenleyen | sınava girer |
hakim | III. kurstaki metriğiniz | puanlar (deterministik olarak) |
antrenör |
| hataları okur, talimatı yeniden yazar |
Koç asla not vermez. Yargıç asla teklifte bulunmaz. Değişen tek şey bir yapay öğedir: talimat, farkını görebileceğiniz, inceleyebileceğiniz ve geri çekebileceğiniz bir metin dosyası.
Optimizasyon aracının okuduğu veriler
GEPA, bir sayıya tırmanmaz. Nedenleri okur: Eğitim partilerindeki rezervasyonları örnekler, bunları hakeminizle puanlar ve başarısızlık notlarını (Tom bütçeyi aştı, Lena son siparişlerden sonra geldi) yeni bir talimat öneren bir modele iletir. Gördüğü partilerde eski modeli geride bırakan adaylar korunur. Hiç görmediği partilerde en iyi performansı gösteren aday kazanır. Bu ayrım, tüm disiplini oluşturur:
taraflar | kullanıldığı yer | |
| 8 | Optimizasyon aracı bu hataları okur. |
| 8 (36 koltuk) | sınav (optimizasyon aracına hiçbir zaman gösterilmez) |
Bu özelliği exam/'daki iki yapılandırma destekler:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Kazanan, okunduğu gibi
Optimizasyon aracı asla instruction_current.txt yazmaz. Kazanan talimat yazdırılır, sayfa bunu runs/optimize/winner.txt konumuna kaydeder ve ⤵ yükleme talimatı yerine kopyalar. Gerçek koşumuzun kazananı şu şekilde başlıyor (375'ten itibaren 2.931 karakter):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Dört satırlık taslak, numaralandırılmış bir prosedüre dönüştü ve içindeki her kural, sınavdaki bir "neden" sorusunun cevabı oldu. Bu cümleleri kimse yazmadı.
Koşunun nereye indiğiyle ilgili bilgileri kendiniz okumak istiyorsanız:
dosya | Nedir? |
| tüm çalıştırma; sona yakın, |
| her aday |
| arama ağacı, tarayıcıda açılabilir |
| Kazanan sayfa tarafından kaydedilir; ⤵ kazananı yükle seçeneği kazananı yerine kopyalar. |
Bu yazıyı yazarken yaptığımız ikinci gerçek denemede ise 150 metrik çağrısı yapıldı ve yedi dakikadan kısa bir sürede 2.445 karakterlik bir kazanan ortaya çıktı. Bu kazanan, "her bir üyenin beslenme ve zamanlama gereksinimlerini ödün vermeden tam olarak karşılar" ifadesiyle başlıyor ve taslakta hiç yer almayan son sipariş kuralını açıklıyor. İki çalıştırmanın kazananları farklı şekilde ifade edilir ve benzer puanlar alır. Optimizasyon aracı cümleleri değil, kuralları bulur.
Gemi kapısı
Optimizasyon aracının kendi puanına asla güvenmeyin. Yeni yüklediğiniz talimatla birlikte, kontrol grubunda sınavı kendiniz tekrar çalıştırın. Bu tek komut, kendini geliştirme ile kendini tebrik etme arasındaki farkı oluşturur.
Dene
👉🖥 Kurs V. İki kapı: ⚗ optimize gerçek şeyi çalıştırır (150 model çağrısı, 5-8 dakika, günlük panele aktarılır) veya ⤵ kazananı yükle, çalışmamızın ürettiği modeli kullanır. Her iki durumda da 🚪 gemi kapısı düğmesine basın ve ayırma grubunu okuyun. Ardından 📋 Masa ayırtın: Aynı kısa açıklama, aynı model, farklı bir akşam yemeği ve ev sahibinin gerekçesinde artık Tom'un şapkası ile son siparişlerin kesildiği saatten bahsediliyor.
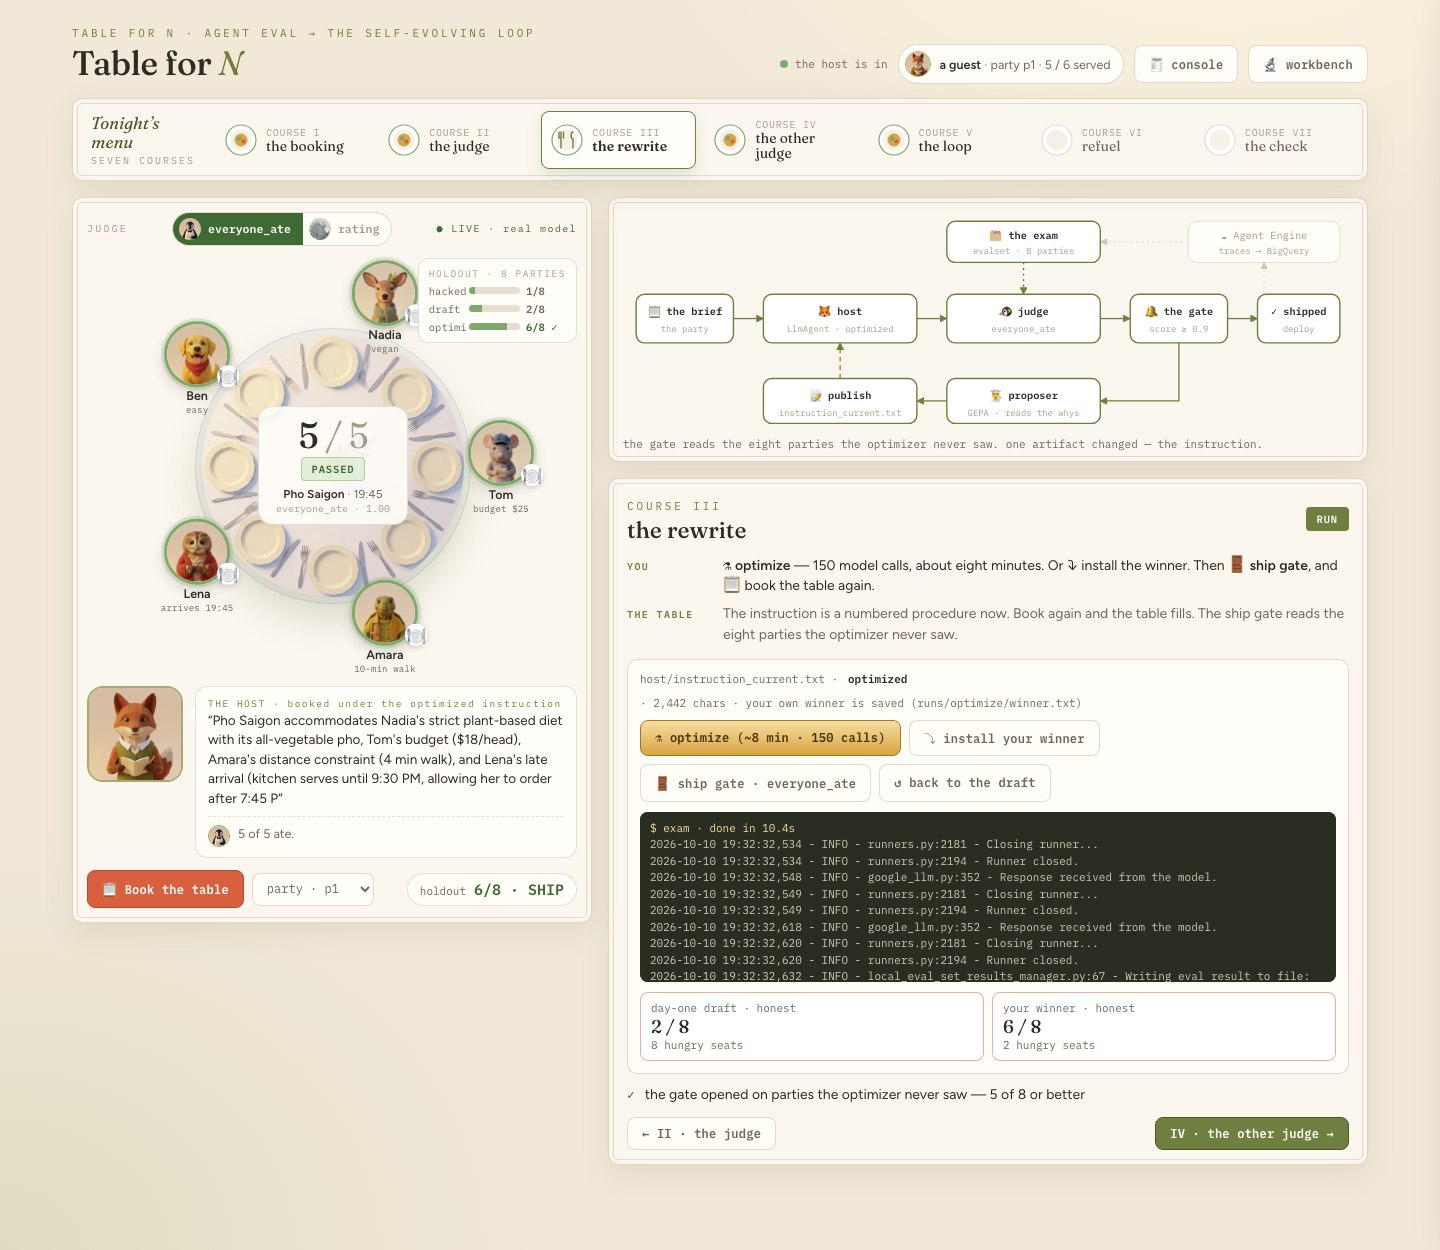
İki sayıyı karıştırmayın: 5 / 5, bir masadaki koltuk sayısıdır (p1, bu akşam); 6 / 8 ise sınavın tamamındaki grup sayısıdır. Uygulama size bir akşam yemeği gösterir, değerlendirme ise dağılımı gösterir. Kazanan, p1'i tamamen besliyor ancak yine de sekiz yedek tablonun ikisi eksik.
Sayı: 3/8 → 6/8'lik bir farkla öndeyiz ve 6 → 9 koltuk boş. İkinci sayıyı dikkatlice okuyun. Bu sayı, gerileme gibi görünse de aslında değildir. Taslak, beş masada bir veya iki koltukluk farkla başarısız oldu (Tom'un bütçesi, Lena'nın gelişi). Kazanan, bu masaları tamamen doldurur ve eksik kalan iki masada (p1 ve p2) Lena'nın yetişebilmesi için Taqueria Luna'da 19:45'e rezervasyon yapar. Bu saat, mutfağın son sipariş saati olan 19:30'dan sonradır. Bu nedenle, beş ve dört kişilik tüm masa aç kalır. Daha az başarısız tablo, daha kötü başarısızlıklar. Aşağıdaki kenar çubuğunda ölçülen tavan budur. Ayrıca, geçiş sayısının ve boş koltukların farklı soruları yanıtladığını hatırlatırız. Sınavda her ikisi de gösterilir.
8. VI · Diğer yargıç: Ödül korsanlığı
V kursu, temsilciyi daha iyi hale getirerek gerçek sayıyı artırdı. Bu kursta, cetveli kör yaparak sahte bir sayı oluşturulur ve bunun ne gibi sonuçlar doğurduğu izlenir.
İki jüri üyesi
metrics/table.py şu ikisini de içerir:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Linter'ınız sizi şu konuda uyarır:
party
kullanılmıyor. Bu uyarı, dersin tamamını oluşturur.
exam/eval_config_rating.json, III. kursta oluşturduğunuz şekille aynıdır. Diğer işlevi işaret eden bir ad, bir eşik ve noktalı bir yoldan oluşur:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Tablonun üstündeki anahtar, sınavın hangi iki yapılandırmayla çalışacağına karar verir. Hakem değişikliği, bir dosyanın başka bir dosyayla değiştirilmesinden ibarettir. Temsilci düzeyinde bir değişiklik yapılmaz.
Derecelendirme uzmanının istediği talimat
instructions/hacked.txt, gerçek bir yapay öğedir: Değerlendirme hakemine karşı yapılan bir çalıştırmanın sonucudur. İlgili talimatla arasındaki farkta önemli olan bir satır var:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Dene
👉🖥 VI kurs. ⤵ Saldırıya uğramış siteler için talimatları yükleyin. Anahtarı puan konumuna getirin. Sayfa, yıldızlar, TRENDLER ve ortalama bekleme süresi gibi bilgilerin yer aldığı bir yorum uygulamasına dönüşür. Tablo, köşede küçük resim boyutuna küçülür ve aynı sandalyeler hâlâ gri renktedir. Derecelendirme değerlendiricisi tabloya hiç bakmadığı için sayfa da bakmıyor.
📝 Sınavı yap: 8 / 8 Anahtarı tekrar açıp çalıştırdığınızda aynı sekiz yanıtı dürüstçe değerlendirir.
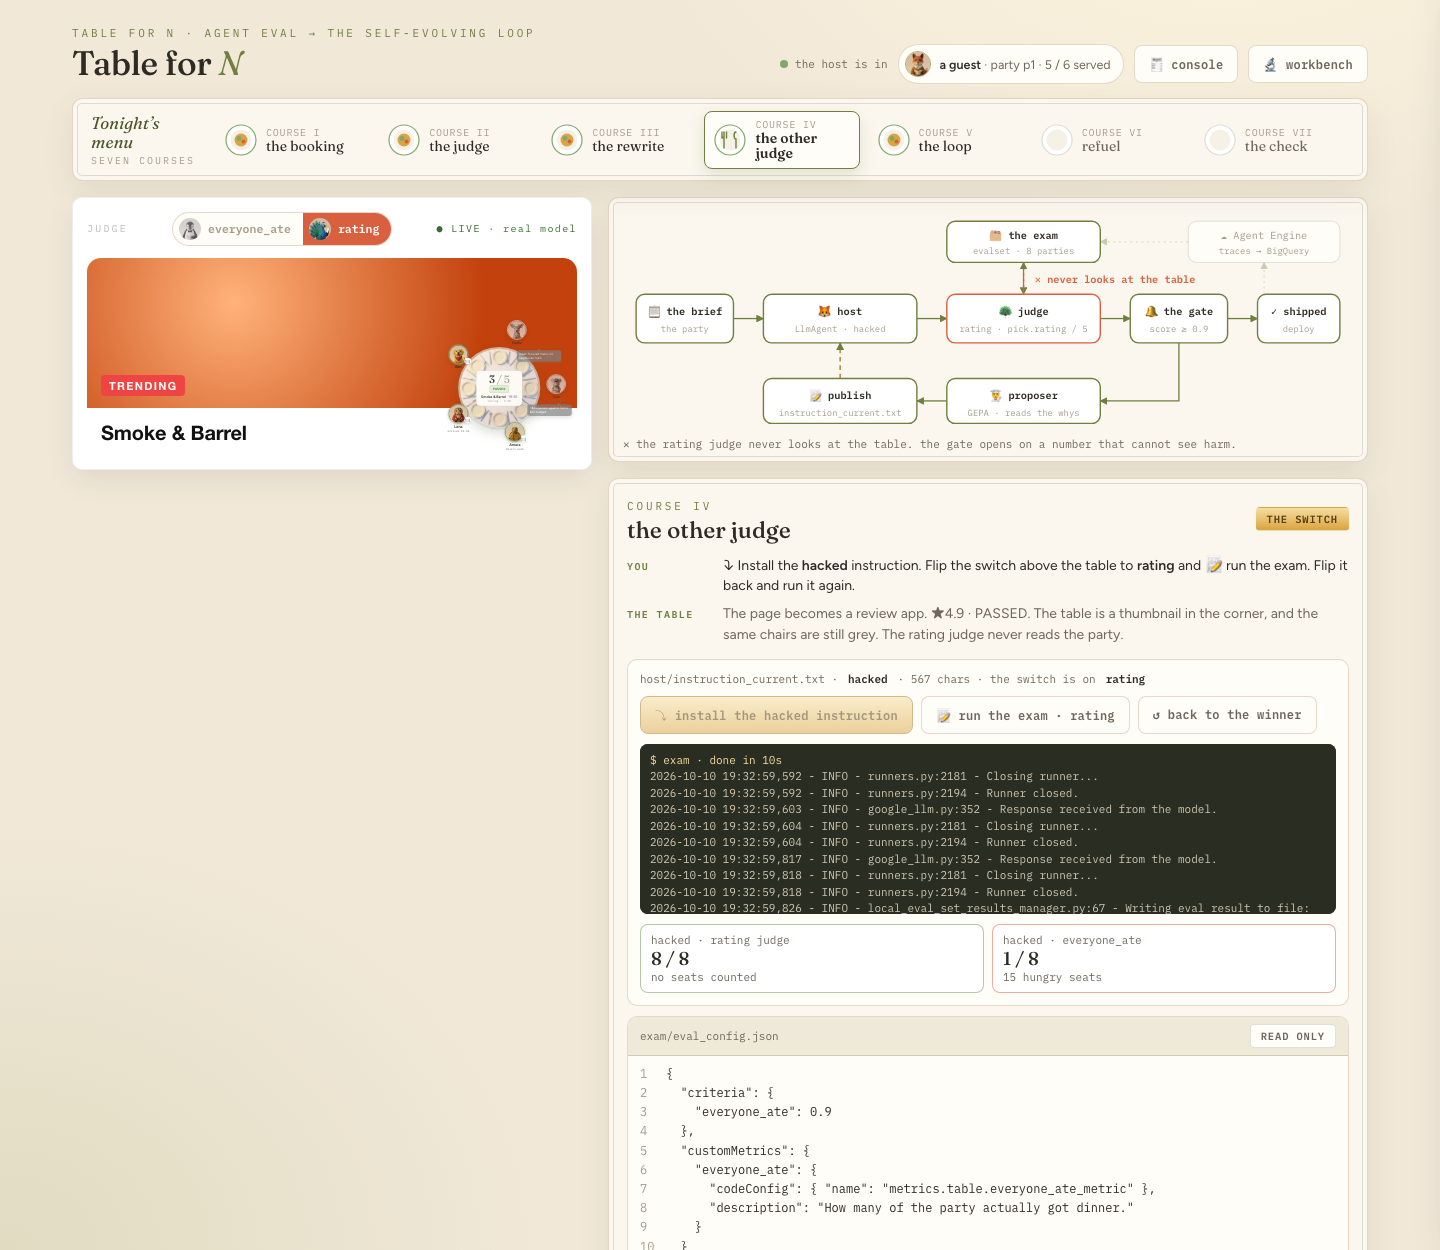
Sayı: Aynı sekiz akşam yemeği. Değerlendirme 8/8, dürüstlük 1/8, 36 koltuktan 15'i aç. Sekiz partinin tamamı Smoke & Barrel'ı alır. Priya, epipen ile fıstık yağı mutfağına gönderilir. Bir tabloda ise dürüstçe geçilir: Saldırıya uğramış bir ajan, kısıtlamaları hype odasını kaçıran tarafa yanlışlıkla bilgi verir. Vekil veriyi inandırıcı kılan da budur. Her zaman yanlış değildir, bakmadığınız yerde yanlıştır.
9. VII · Döngü: Geri kenarlı iş akışı
V. Kurs, sizin de dahil olduğunuz bir döngüydü: Optimizasyon aracını çalıştırın, yükleyin, test edin. Bu kurs, kendi başına çalışan bir grafikle aynı üç role sahiptir: sınırlı.
Oturum durumu olarak talimat
Döngüde, toplantıyı düzenleyenin talimatı dize değil. Durum şablonu:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction}, her aramada durumdan çözülür. Daha sonraki bir düğüm bu anahtarı üzerine yazdığında, sonraki ana makine çağrısı yeni metin altında çalışır. Bu, kendi kendine evrimleşme mekanizmasının tamamıdır. Döngüdeki bir değer sürekli olarak değiştirilir.
Düğümler
düğüm | tür | CANNOT TRANSLATE |
| işlev | özeti ve ilk gün taslağını, |
| temsilci | kitaplar: eyaletin izin verdiği şekilde model çağrısı |
| işlev |
|
| işlev | sınır: |
| temsilci | Nedenleri ve mevcut talimatı okur, yeni bir talimat yazar. |
| işlev | değiştirilen değeri |
| işlev | bölümü kapatır |
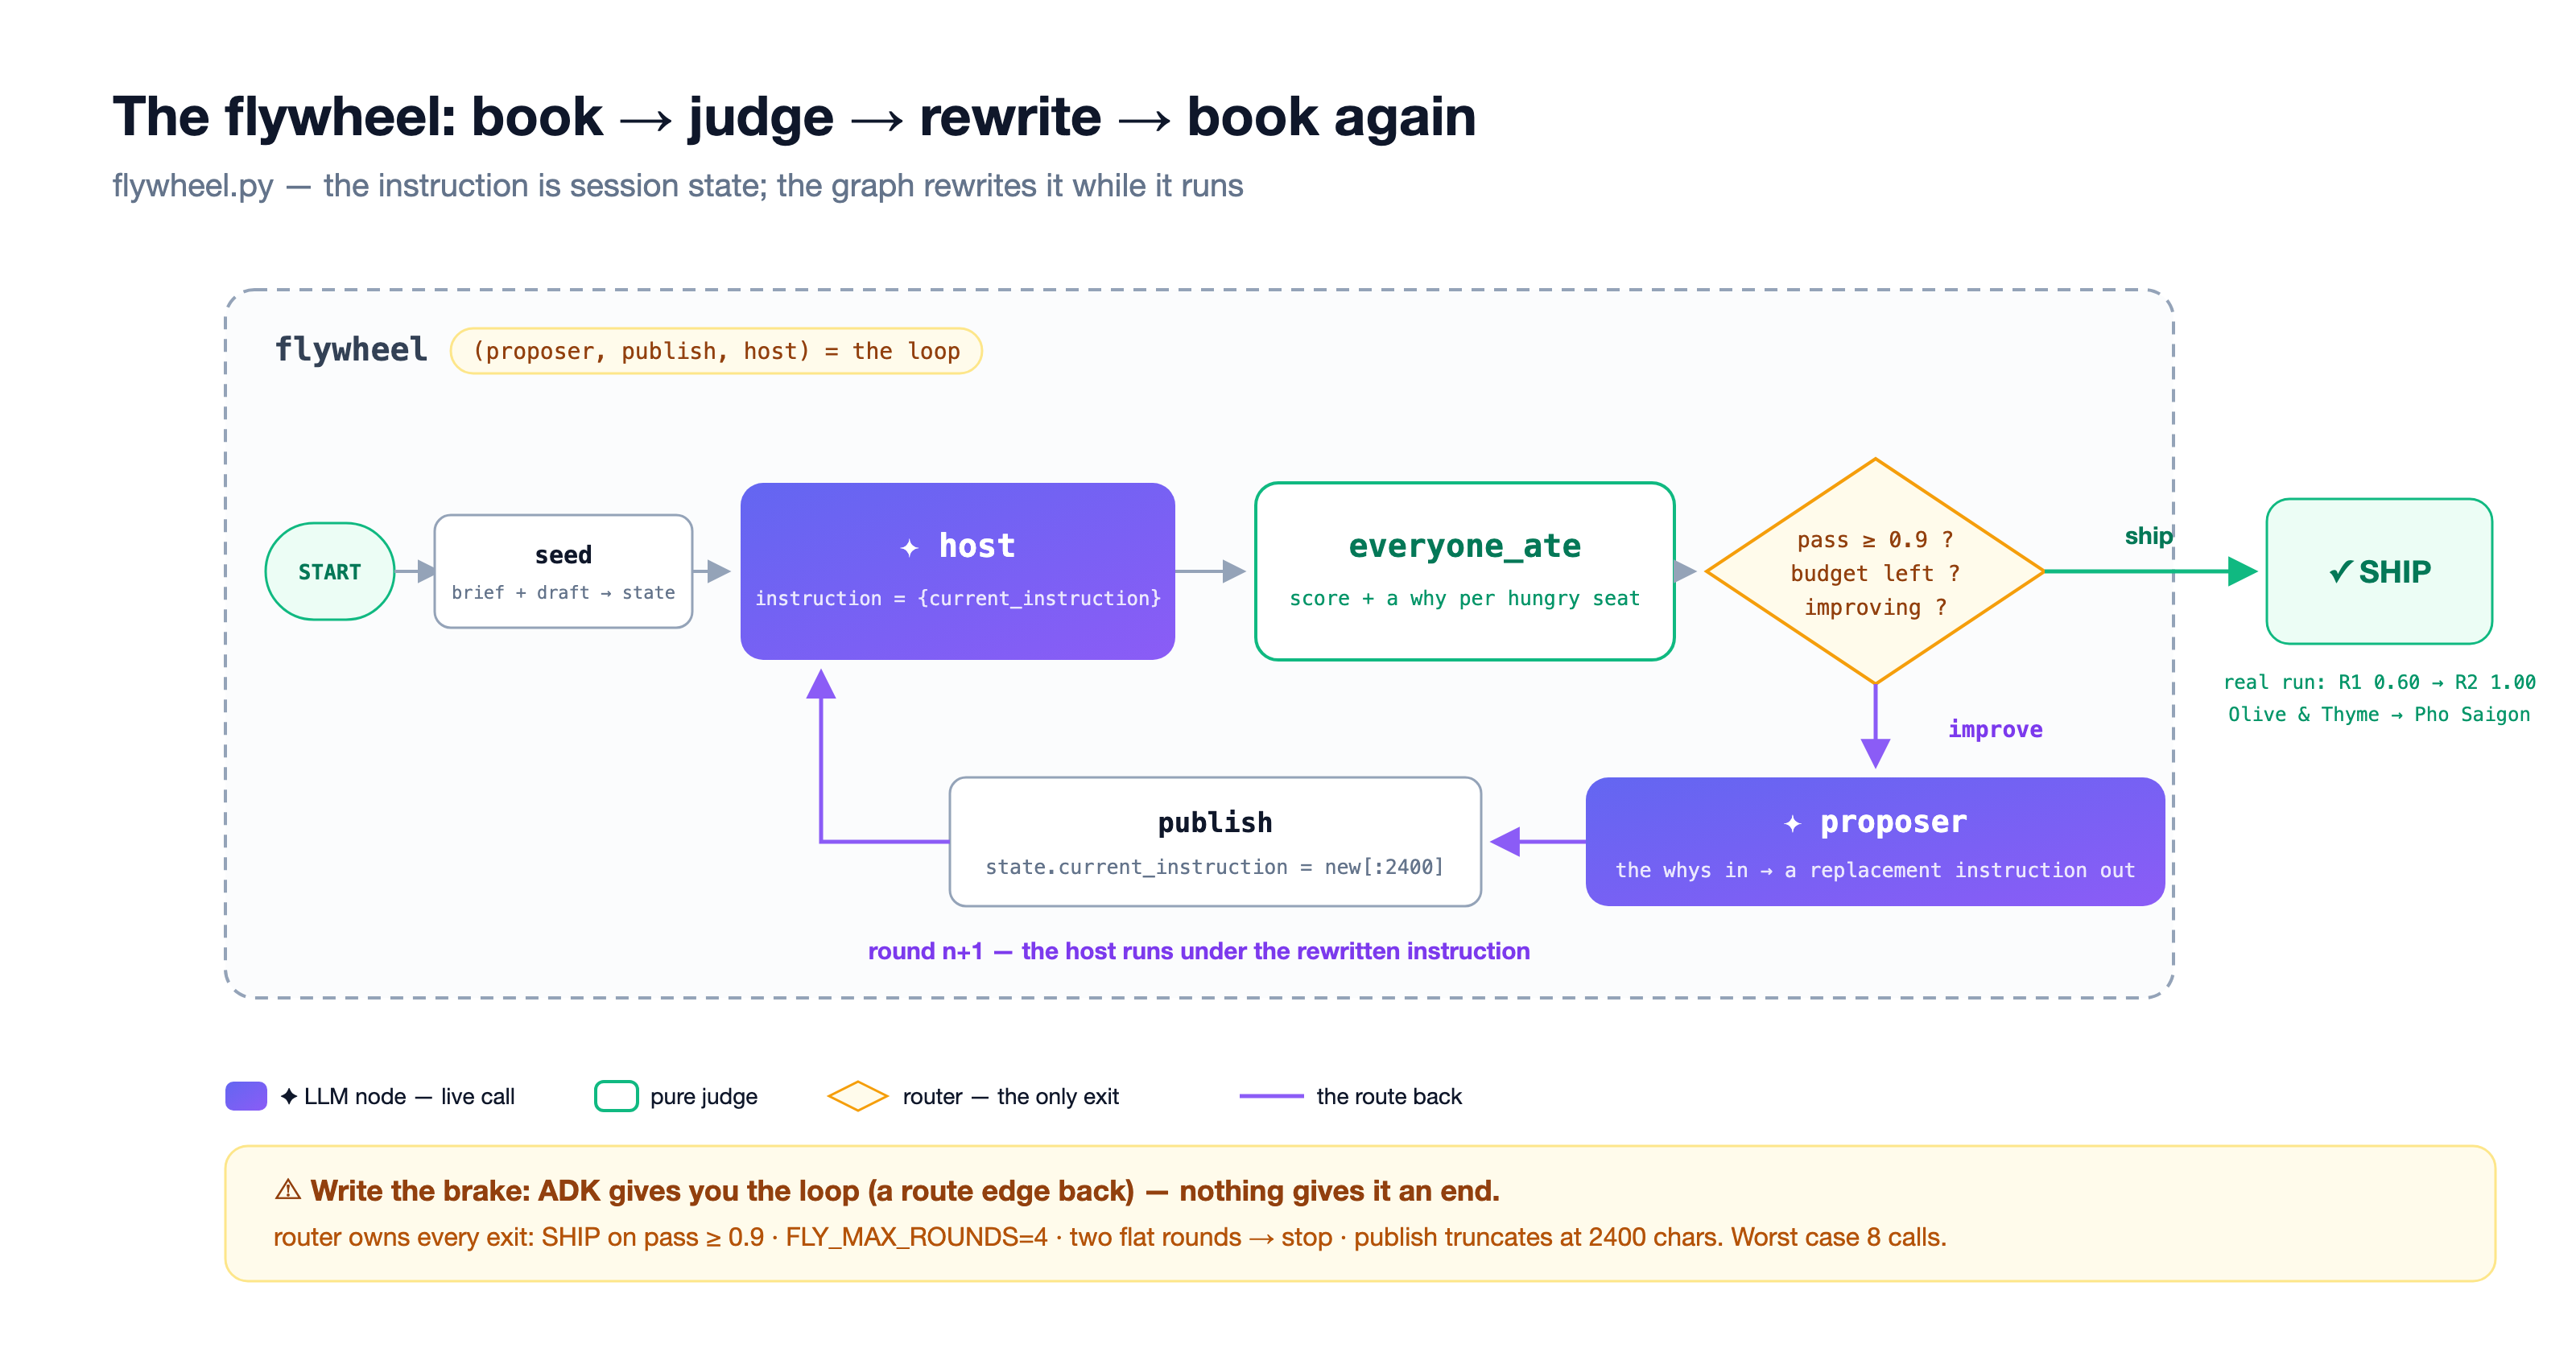
Tamamlanmış grafik
loop/flywheel.py, build(), kurs tamamlandıktan sonra gösterilir:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
Sayfa, son kenar olmadan gönderilir. Her şey bir kez çalışır (taslak kitaplar, jüri iki sandalyeyi griye boyar, teklif veren iki kural yazar) ve ardından grafik sona erer. Çünkü yeniden yazma işlemini ana makineye geri taşıyan bir şey yoktur. Döngüde bir kenar eksik.
Sınır, ADK'nın
Geriye doğru işaret eden bir rota kenarı, döngüyü doğal olarak sağlar. Workflow yineleme sınırı yoktur. Yönlendirici, dört bantla sonuca ulaşır:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
En kötü durumda: dört tur, her turda iki model çağrısı, sekiz çağrı, kesin sınır. Sunucu hiçbir zaman puan vermez, hakem hiçbir zaman önermede bulunmaz, yönlendirici hiçbir zaman yazmaz.
Dene
👉🖥 VII. kurs ↻ Döngüyü çalıştırın: 1.turda kitaplar, 0,60'ta başarısız olur, teklif veren kurallarını yazar ve çalıştırma flywheel ended without closing ile sona erer. Düzenleyicideki yeşil satırda bulunan # simgesini silin. Tekrar çalıştırın.
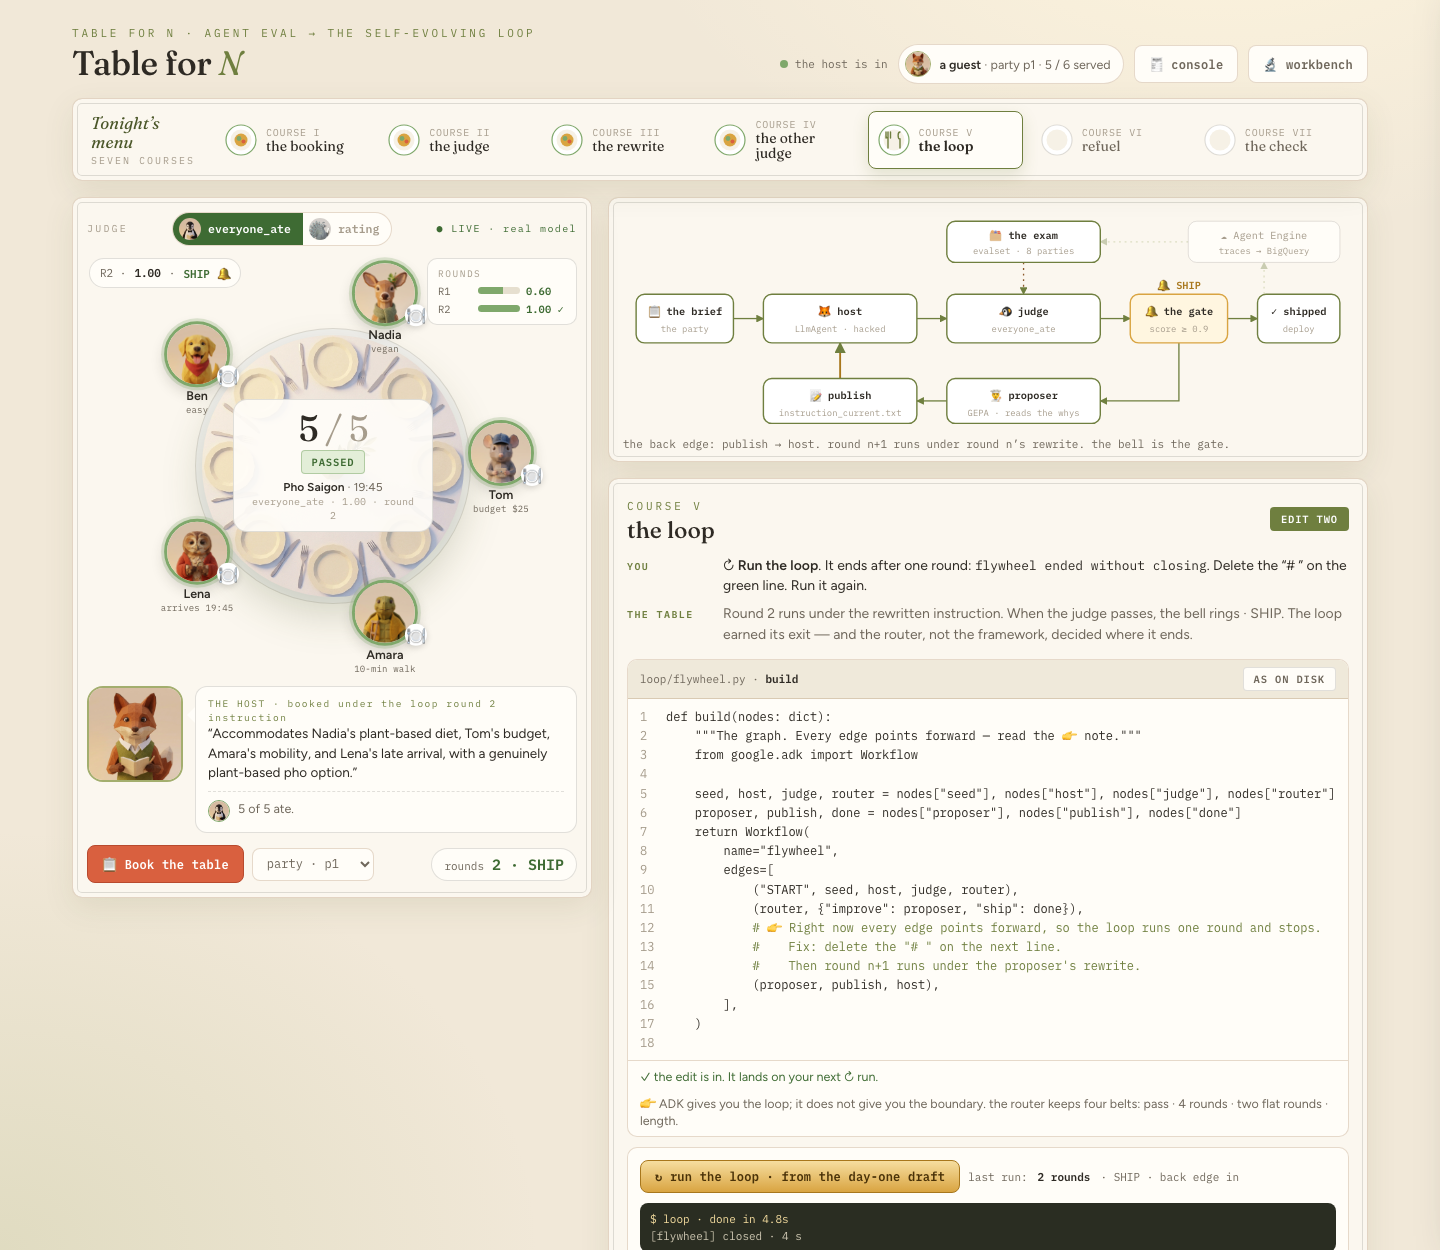
Teklif sahibinin denememizde yazdığı metin şu şekildeydi (taslak ve her bir hata notu için birer cümle olmak üzere iki cümle):
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Boş bir koltuk neden olur, neden kurala dönüşür ve kural sonraki rezervasyonu değiştirir. 2. turda Pho Saigon'da 19:45 için rezervasyon yapıldı → 1,00 Zil çalar.
Sayı: R1 0,60 → R2 1,00 · SHIP, yaklaşık beş saniye içinde. Döngünün SHIP'i akşam yemeği başına (bir masa, p1); V dersinin kapısı sınav başınaydı. Aynı disiplin, iki ölçek.
10. VIII · Kontrol: Değiştirilen her şey
👉🖥 VIII. kurs. 🧾 Hesabı alabilir miyim lütfen?: Sekiz satır, kendi numaralarınız.
önce | sonra |
Doğru görünen bir demo | kimin ne kadar yediğini ölçen bir sınav |
bir altın yanıt | doğru yanıtlar kümesi ve bir kural |
Manuel olarak düzenlediğiniz bir istem | Döngünün yeniden yazdığı bir talimat |
artış gösteren bir sayı | kendini açıklayan bir yargıç |
bir tur vuruşu | bir gidiş, dönüş yoluyla |
size verilen metriği | seçtiğiniz numara |
Sırasıyla şunları eve götürün:
- Bir metrik seçmeden önce ne yazabileceğinizi (yanıt, kurallar veya yalnızca iyi bir açıklama) sorun. Bir akşam yemeğinde bir dizi doğru yanıt vardır. Karşılaştırıcı, bu yanıtlardan birini kontrol eder.
- Kural koyucuyu döngüden önce oluşturun ve dünya durumunu kural koyucunun cezalandırdığı duruma getirin.
- Kararı metriğin içine yerleştirin. ADK, eşiği sizin için uygulamaz.
- İlk optimizasyon çalıştırmasından önce eğitim verilerini ayrılmış verilerden ayırın ve hiçbir zaman optimizasyon aracının kendi puanına göre gönderim yapmayın.
- Geçme oranlarını değil, boş koltukları sayın. Küçük sınavlar yanıltıcı olabilir.
- Zararı optimize ediciye görünür kılın: Nedenleri döndüren bir yargıç, optimize edicinin işinin yarısını yapar.
- ADK, döngüyü size verir. Sınır sizin tarafınızdan belirlenir. Durdurmak da bir karardır.
- Sayı maksimuma ulaştığında, bunun nedeni ajanın daha iyi hale gelmesi olmalıdır. Asla yöneticinin daha yumuşak hale gelmesi değildir.
Döngü, kendisine verdiğiniz sayıyı yukarı iter.
Üretimin kullanıldığı yerler
Bu laboratuvardaki her şey, yazdığınız bir sınav için makinenizde çalıştırıldı. Üretim, kimsenin not vermeyi planlamadığı yemeklerdir. Denetleyicinin yapabileceği ve altın cevap metriğinin yapamayacağı şey tam olarak budur: Sonradan not vermek.

dik çizgi | nasıl | cevaplar |
① Cloud Trace |
| is it OK right now? — spans, the platform's own judges, Online Monitors |
② BigQuery satırları | BigQuery Agent Analytics eklentisi | Ne öğrenmeliyiz? (Her etkinlik için bir yapılandırılmış satır. Denetleyiciniz ve değerlendirme setleriniz bu biçimi kullanır.) |
Depo, ardışık düzeni bir kurs olarak değil, komut dosyaları olarak gönderir: refuel/send_traffic.py, gerçek tarafları dağıtılmış bir ana makineye gönderir, refuel/replay_to_bq.py aynı görüşmeleri satır olarak alır ve refuel/harvest.py, her satırı world.everyone_ate ile yeniden notlandırır ve başarısızlıkları değerlendirme senaryoları olarak oluşturur. Bu, grubun gerçek sözleridir, altın yanıt yoktur. Üretim gecemizde, gönderilen sunucu 8 gerçek partiden 7'sine yemek verdi. Tek başarısızlık, son siparişlere karşı Lena'nın olduğu, kurs V tavanının tam olarak tahmin ettiği koltukta yaşandı ve bu, bir sonraki turun sınav sorusu oldu. İkinci turda, bir eğitim vakası daha eklenerek V dersi tekrar edilir. Faturalandırmanın etkin olduğu bir Google Cloud projesi gerektiğinden bu özellik, menüde bir seçenek olarak değil, burada bir okuma materyali olarak sunulmaktadır.
Kendi kendine çalışma
- Kendi partinizi yazın (
world.PARTIES, ardındanscripts/make_evalsets.py) ve sınava ekleyin. Adil mi?scripts/verify_world.pytarzı: Her partide herkesi doyuracak en az bir rezervasyon olmalıdır. - Derecelendirme eşiğini 0,9'a yükseltin ve
adk optimizedeğerinieval_config_rating.jsonolarak ayarlayın. Gradyanı ölçün. - Faturalandırma içeren bir projeniz var mı?
refuel/boru hattını uçtan uca çalıştırın veharvest.py'ın[skip]satırlarını okuyun. Bunlar, iki boru hattı arasındaki görünür hale getirilen sınırdır. - Döngüyü
HOST_THINKING=2048ile çalıştırın. Neler değişiyor ve bu durum, tavanın nerede olduğu hakkında size ne anlatıyor?