

1. Giới thiệu
Lớp học lập trình này nói về đánh giá tác nhân – cách một hệ thống biết được câu trả lời của tác nhân có tốt hay không – và về những gì bạn có thể xây dựng sau khi hệ thống biết được: một tác nhân viết lại chỉ dẫn của chính mình từ những thất bại của chính mình và một vòng lặp tiếp tục làm việc đó, có giới hạn, với bạn là người kiểm soát.
Mọi thứ đều chạy trên Bộ công cụ phát triển tác nhân (ADK): adk eval với chỉ số tùy chỉnh mà bạn viết, adk optimize (trình tối ưu hóa câu lệnh GEPA), ADK 2 Workflow có cạnh sau và Agent Engine + BigQuery pipe giúp chuyển lưu lượng truy cập trong quá trình sản xuất thành kỳ thi của vòng tiếp theo.
Vòng lặp sẽ đẩy bất kỳ số nào bạn đưa vào.
Kiến thức bạn sẽ học được
- Câu trả lời không phải là kết quả – lý do tại sao một câu trả lời tự tin, đúng ngữ pháp không cho hệ thống biết điều gì và những điều mà người đánh giá phải nói được
- Ba cách để chạy một bài kiểm thử –
adk evalcho lô, thẻadk webEvals để bắt đầu khi có lỗi,pytest+AgentEvaluatorđể không tạo được bản dựng – và một kho lưu trữ eval cục bộ mà họ chia sẻ - So sánh với kiểm tra – lý do bộ so sánh phạt câu trả lời đúng nhưng diễn đạt khác, số lượng câu trả lời đúng thực tế của một bữa tối và cảm giác mách bảo cho bạn biết loại chỉ số mà một vấn đề cần
- Một hàm kiểm tra dưới dạng chỉ số
adk eval–customMetrics,codeConfig, chữ ký cố định, 6 bước kiểm tra bên trong, lý do hàm của bạn sở hữu PASSED/FAILED và lý do hàm này có tính xác định theo mục đích - Ba nhóm chỉ số cho một câu trả lời – bộ so sánh, bộ kiểm tra, LLM-as-judge: mỗi nhóm cần gì, chi phí của mỗi nhóm, điểm mù của mỗi nhóm
adk optimize(GEPA) – nội dung mà bài kiểm tra đọc được (các lỗi, không phải điểm số), dữ liệu huấn luyện so với dữ liệu giữ lại và lý do bạn tự chạy lại bài kiểm tra trước khi phát hành- Đo lường hành vi xâm nhập để nhận phần thưởng – một chỉ số proxy không bao giờ đọc được bên, những gì bên đó làm với số thực và luật pháp phát sinh từ đó
- Vòng lặp tự phát triển dưới dạng ADK 2
Workflow— một lệnh tồn tại trong trạng thái phiên, cạnh duy nhất biến biểu đồ thành chu kỳ và ranh giới mà ADK không cung cấp cho bạn - Nơi phù hợp để sản xuất – dấu vết để xem, hàng để học và lý do khiến người kiểm tra có thể chấm điểm những bữa tối mà không ai dự định chấm điểm (một lần đọc, không phải một bước)
Sản phẩm bạn sẽ tạo ra
Một ứng dụng đang chạy trong trình duyệt của bạn: một bàn tròn, N khách và một tác nhân đặt bữa tối cho họ. Mỗi món ăn đều có một điểm đặc biệt: một dòng trong tệp cấu hình, một câu trả lời trước ba giám khảo, một nút chạy trình tối ưu hoá thực tế, một nút chuyển đổi giám khảo, một cạnh trong biểu đồ. Bảng này cho bạn biết những thay đổi: ai đã ăn, ai chưa ăn và lý do. Python có kích thước nhỏ; tất cả các số đều được đo trên máy của bạn.
Ứng dụng này cũng là bài tập. Bảng khoá học sẽ cung cấp cho bạn một bản chỉnh sửa hoặc một nút tại một thời điểm; một phần trên trình đơn chỉ được điền khi có bằng chứng thực tế – nhà bếp sẽ đọc các tệp của bạn và biên nhận về những gì đã chạy, chứ không phải danh sách kiểm tra.

8 khoá học
khái niệm | câu hỏi mà câu trả lời đó giải đáp | việc bạn làm | |
I | câu trả lời không phải là kết quả | hệ thống biết gì về lượt đặt phòng này? | chưa có gì – hãy đặt một cuộc hẹn trong bàn làm việc |
II | bộ so sánh · một tập hợp các câu trả lời đúng · ba cách để chạy | tại sao một lượt đặt phòng chính xác lại không vượt qua được bài kiểm tra? | chạy bài kiểm tra như đã gửi và đọc kết quả |
III | một trình kiểm tra dưới dạng chỉ số tuỳ chỉnh · 6 bước kiểm tra | bài kiểm tra có thể cho biết ai đang đói và vì sao không? | một dòng trong |
IV | comparator · checker · LLM-as-judge | cùng một câu trả lời – 3 điều cần đo lường là gì? | đánh giá một câu trả lời theo ba cách, hai lần |
V |
| liệu tác nhân có thể tự khắc phục lỗi của chính mình không? |
|
VI | reward hacking · the proxy metric | điều gì sẽ xảy ra với vòng lặp nếu một giám khảo không thể nhìn thấy hành vi gây hại? | công tắc |
VII | một | điều gì tạo nên một vòng lặp trong biểu đồ và điều gì ngăn chặn vòng lặp đó? | một cạnh trong |
VIII | mỗi thứ được thay thế | — | dấu kiểm |
Cách sử dụng lớp học lập trình này. Đây là khoá học chú trọng đến khái niệm: mỗi khoá học đều giải thích ý tưởng, sau đó cho thấy mã khi mã này đọc một lần sau khi thay đổi được thực hiện và hướng dẫn bạn thực hiện. Công cụ này không bao giờ yêu cầu bạn chỉnh sửa tệp ở đây – việc chỉnh sửa diễn ra trong ứng dụng, ứng dụng sẽ cung cấp cho bạn từng dòng một và cho bạn biết lỗi trước. Đọc khoá học, sau đó để trang này hướng dẫn bạn thực hiện và xem số liệu thay đổi.
Vị trí của tính năng này
Thế giới — mười vị khách, mỗi người có một ràng buộc khó khăn, mười nhà hàng, mỗi nhà hàng có một bẫy, mười sáu bữa tiệc — và hai giám khảo đến từ phòng thí nghiệm loop-lab-table; định dạng tương tác một trang đến từ Agent Valley. Quán ăn nhỏ là bối cảnh; mọi cơ chế bên dưới đều là cơ chế thông thường mà bạn sẽ sử dụng cho nhân viên hỗ trợ, quy trình đặt chỗ hoặc bất kỳ thứ gì khác có thể kiểm tra được "tính hiệu quả".
2. 🧰 Thiết lập
- What (Điều gì) – một tài khoản có thể thanh toán, một dự án, phòng thí nghiệm đã cài đặt, mô hình được chứng minh là có thể trả lời và bảng đang chạy trên một cổng.
- Lý do — một quy trình trên một cổng: trang, bài kiểm tra, trình chỉnh sửa và bàn làm việc có chung một nguồn gốc, vì vậy, không có gì trong phòng thí nghiệm này cần đến thiết bị đầu cuối thứ hai hoặc cổng thứ hai.
- Cách thực hiện – sao chép, hai tập lệnh, một lệnh. Việc thiết lập cuối cùng là thực hiện một lệnh gọi mô hình thực tế, vì vậy, một dự án bị hỏng sẽ thất bại tại đây thay vì trong khoá học I.
Mọi thứ trong lớp học này đều chạy trong Cloud Shell — gcloud, Python, Node và git đã được cài đặt sẵn ở đó, và bạn có thể truy cập Gemini thông qua Vertex AI bằng thông tin đăng nhập của riêng mình. Không có khoá API nào trong lớp học lập trình này và bạn không cần cài đặt gì trên máy tính xách tay. Máy tính xách tay có Google Cloud SDK, Python 3.11 trở lên và Node 20 trở lên cũng hoạt động theo cách tương tự.
Có một thứ mà bài thực hành này không thể cung cấp cho bạn: một dự án trên Google Cloud có thông tin thanh toán. Bước 1 giúp bạn có một tài khoản có thể thanh toán cho dự án; bước 4 biến tài khoản đó thành một dự án. Hãy thực hiện theo thứ tự đó – mọi bước sau bước 4 đều đọc dự án mà bước 4 đã chọn.
1 · Tạo tài khoản có thông tin thanh toán (khoảng 1 phút)
Đăng nhập bằng Tài khoản Google đã bật tính năng thanh toán. Bạn có thể dùng bất kỳ tài khoản nào như vậy. Nếu bạn chưa có, hãy bắt đầu dùng thử miễn phí. Việc này sẽ cung cấp cho bạn một tài khoản thanh toán, đây là tất cả những gì cần thiết cho bước 4.
2 · Mở Cloud Shell (~2 phút)
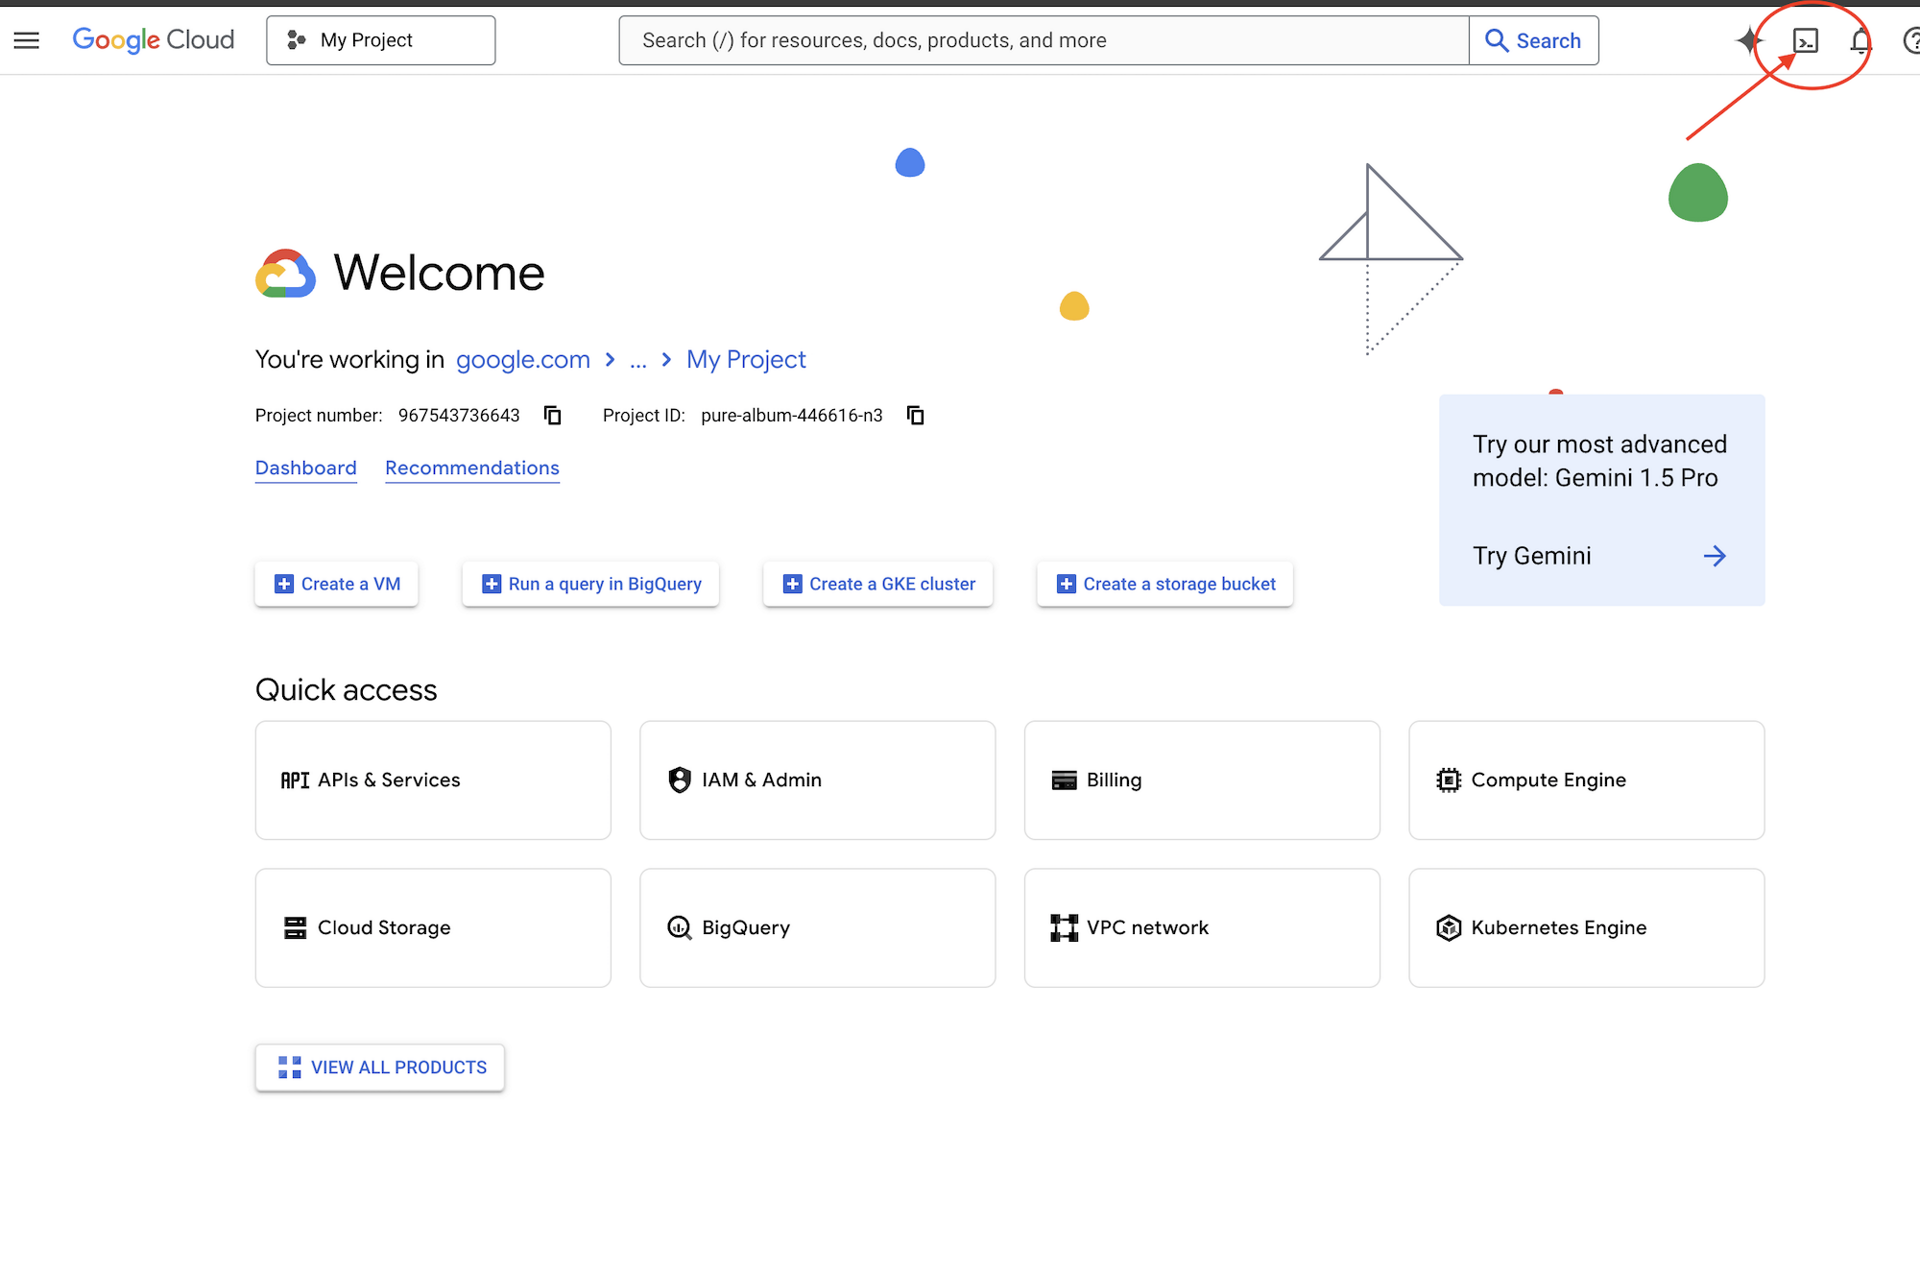
👉🖥 Nhấp vào Kích hoạt Cloud Shell ở đầu Google Cloud console – đây là biểu tượng có hình dạng như một thiết bị đầu cuối trong tiêu đề.
👉🖥 Nhấp vào Mở trình chỉnh sửa (biểu tượng thư mục mở có bút chì). Thao tác này sẽ mở ra Trình chỉnh sửa Cloud Shell có trình khám phá tệp ở bên trái — đây là nơi bạn truy cập bất cứ khi nào bạn muốn đọc toàn bộ tệp.

👉🖥 Nếu bạn được nhắc uỷ quyền vào bất kỳ thời điểm nào trong ngày hôm nay, hãy nhấp vào Uỷ quyền để tiếp tục.
👉🖥 Mở một cửa sổ dòng lệnh bên trong trình chỉnh sửa — đó là thẻ 1 và mọi bước 👉💻 đều chạy ở đó. Tab 2 là chính bảng này và bạn sẽ mở thẻ này ở bước 7. Nếu cửa sổ dòng lệnh chưa xuất hiện ở cuối màn hình, hãy mở cửa sổ này bằng cách chọn View → Terminal (Xem → Cửa sổ dòng lệnh):

👉💻 Kiểm tra xem bạn đang đăng nhập bằng tài khoản nào — đó phải là tài khoản ở bước 1:
gcloud auth list
3. Nhận phòng thí nghiệm (khoảng 1 phút)
👉💻 Sao chép kho lưu trữ:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · Tạo dự án (~2 phút)
👉💻 Một tập lệnh sẽ tìm tài khoản thanh toán của bạn, tạo một dự án trên tài khoản đó, liên kết hoạt động thanh toán và trỏ Cloud Shell đến dự án đó:
cd ~/table-for-n
./setup_project.sh
Bạn sẽ thấy một ✓ cho tài khoản thanh toán mà bạn đã chọn, một ✓ cho dự án mà bạn đã tạo và một dòng kết thúc như sau:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 là mã dự án của bạn – mã dự án của bạn sẽ có các chữ số khác. Có 4 điều xảy ra trong đó:
billing | sử dụng tài khoản | |
project | tạo | |
chọn | ghi mã nhận dạng vào | |
waits | cho đến khi dự án thực sự được phép phân phát, tối đa là 2 phút | |
👉🖥 Dự án đó hiện có trong bảng điều khiển – mã nhận dạng của dự án nằm trong thẻ Thông tin dự án trên Trang tổng quan:

5 · Cài đặt và thiết lập phòng thí nghiệm (~3 phút)
setup_codelab.sh tạo môi trường bằng uv và sẽ không cài đặt uv cho bạn – mà sẽ dừng và yêu cầu bạn làm việc đó. Vì vậy, trước tiên hãy cài đặt nó trong cùng một lệnh:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
Một tập lệnh, an toàn khi chạy lại. Phương thức này thực hiện 5 việc theo thứ tự:
api | đọc dự án đã chọn ở bước 4 và bật | |
uv env |
| |
site | cài đặt và tạo | |
.env | ghi | |
preflight | thực hiện một lệnh gọi thực đến | |
6 · Đọc trình đơn (khoảng 1 phút)
Điều cuối cùng mà bước 5 in ra là thực đơn tối nay – mỗi dòng là một thông tin thực tế, chứ không phải là thông tin phỏng đoán:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
Không có đèn nào sáng trước khi bạn bắt đầu. the model answers là điều quan trọng ở đây: điều này có nghĩa là một lệnh gọi thực tế đã được thực hiện trong dự án của bạn.
👉💻 Chạy lại bất cứ lúc nào để xem bạn đang ở đâu – nó đọc các tệp và biên nhận của nhà bếp, chứ không phải danh sách kiểm tra:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · Chuẩn bị bàn ăn (khoảng 1 phút)
👉💻
cd ~/table-for-n
bash table.sh
Một quy trình, cổng 3470. Nhà bếp mất một lúc để khởi động — nhà bếp nhập ADK và gắn adk web — vì vậy, tập lệnh sẽ thông báo như vậy, chờ và chỉ in các đường liên kết sau khi cổng thực sự phản hồi:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
Lệnh này sẽ luôn chạy ở nền trước; Ctrl+C sẽ xoá bảng. Hãy để nó chạy – mọi khoá học từ đây trở đi đều liên quan đến quy trình này và không có nội dung nào trong phòng thí nghiệm này yêu cầu bạn khởi động lại.
👉🖥 Sau khi bạn thấy ✓ the table is laid, hãy mở bảng trong một thẻ mới (gọi là thẻ 2). Trong Cloud Shell: Web Preview → Change port → 3470 (Xem trước trên web → Thay đổi cổng → 3470).
👉🖥 Điền tên của bạn vào thẻ đặt chỗ (tên này sẽ xuất hiện trên hoá đơn thanh toán) rồi nhấn vào ✦ xếp chỗ.

3. I · The booking — a reply is not a result
Năm người sẽ đi ăn tối. Cuộc trò chuyện nhóm có đủ mọi thông tin: Nadia ăn chay, Tom chỉ có thể chi tối đa 25 USD trong tháng này, Amara phải chống nạng và chỉ có thể đi bộ 10 phút, Lena không thể đến trước 7:45, Ben thì sao cũng được. Mười nhà hàng được liệt kê, sắp xếp theo điểm xếp hạng, mỗi nhà hàng đều có giá, thời gian đi bộ, giờ mở cửa và một điểm đặc biệt.
Nhân viên hỗ trợ đặt bàn. Bạn đã biết, khi đọc cuộc trò chuyện, ai sẽ bị đói tại phòng mà nó chọn. Không có thông tin nào trong hệ thống. Khoảng trống đó chính là nội dung của toàn bộ lớp học lập trình này.
Tác nhân – chỉ có quyền đọc
host/agent.py, vì đây là khoá học dành cho toàn bộ phòng thí nghiệm:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
Không có công cụ, không có cơ sở dữ liệu, không có tính năng tìm kiếm. Một mô hình, một chuỗi lệnh — và chuỗi này không có trong tệp này. Nó nằm ở thư mục bên cạnh instruction_current.txt, nơi hiện chứa 4 dòng mà một nhà quản lý sản phẩm viết vào ngày đầu tiên:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
Không đề cập đến dị ứng, ngân sách, giới hạn đi bộ hoặc ai phải rời đi sớm. Tất cả những thông tin đó đều có trong bản tóm tắt mà nhân viên nhận được. Không dùng đến.
Tệp đó là cấu phần phần mềm duy nhất mà lớp học lập trình này đề cập đến. Khoá học V cho phép trình tối ưu hoá viết lại. Khoá học VI cài đặt một phiên bản bị xâm nhập. Vòng lặp của Khoá học VII viết lại vòng lặp này theo từng vòng trong khi biểu đồ chạy. Tác nhân (mô hình, chế độ cài đặt, tên) không bao giờ thay đổi.
Thử ngay — không cần giao diện người dùng
👉🖥 Trên trang này, khoá học I. Nhấp vào 🔬 workbench (trên cùng bên phải): ngăn này là adk web, được gắn trong cùng một quy trình – cùng một thư mục host/, cùng một table.db. Chọn host, dán bản tóm tắt từ bảng điều khiển khoá học (có nút sao chép), rồi gửi.
Máy chủ trả lời trong giây lát: một nhà hàng, một thời gian, một lý do tự tin trong một dòng. Đọc lý do phản đối cuộc trò chuyện. Sau đó, hãy nhìn vào bảng bên trái: đã quan hệ tình dục, không ai phán xét, — / 5. Không phải vì có gì đó đang tải, mà vì trong thế giới của khoá học không có gì có thể đánh giá điều này.
Số lượng: ghế chưa bán – ?. Không ai có thể biết.
4. II · The comparator — how many right answers does this dinner have?
Khoá học II bắt đầu bằng một bài kiểm tra đã có sẵn và đã thất bại – vì một lý do không mang lại kiến thức gì. Trước khi khắc phục, bạn nên biết 3 cách chạy ứng dụng này, vì hôm nay bạn sẽ sử dụng cả 3 cách.
3 cách để chạy quy trình đánh giá
Tất cả đều có cùng một công cụ bên dưới.
mục đích của việc này | những gì bạn nhận được | |
| trình chạy theo lô; những gì bạn đưa vào CI | bản tóm tắt: đạt, không đạt, điểm cho mỗi trường hợp |
| một trường hợp không thành công và bạn muốn xem xét kỹ trường hợp đó | cuộc trò chuyện đó, dấu vết, điểm số cho mỗi trường hợp, tất cả đều có thể nhấp vào |
| gộp quy trình đánh giá tác nhân vào một bộ kiểm thử hồi quy thông thường | nó chạy bên cạnh các kiểm thử đơn vị và khiến bản dựng không thành công theo cách tương tự |
Thông tin chi tiết thực sự hữu ích: cả ba đều dùng chung một cửa hàng đánh giá tại địa phương, host/.adk/eval_history/. Chạy một lô từ CI, có lỗi xảy ra, hãy mở chính lô đó trong giao diện người dùng web để tìm hiểu kỹ hơn. Nút 📝 trên trang là cách đầu tiên; bàn làm việc 🔬 là cách thứ hai; cách thứ ba là một lệnh trên thiết bị đầu cuối, uv run pytest tests/test_host.py, và bài kiểm thử mà lệnh này chạy có 12 dòng:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py. Cùng một tác nhân, cùng một evalset, cùng một tệp cấu hình và dòng eval_set_results_manager là dòng đặt lượt chạy của tác nhân này vào cùng một nhật ký với hai tác nhân kia.
Bài kiểm tra, như được vận chuyển
exam/eval_config.json sẽ có dạng như sau:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Hai phần, hai công việc. criteria
là bài kiểm tra – các chỉ số thực sự chạy, mỗi chỉ số đều có thanh đạt. customMetrics
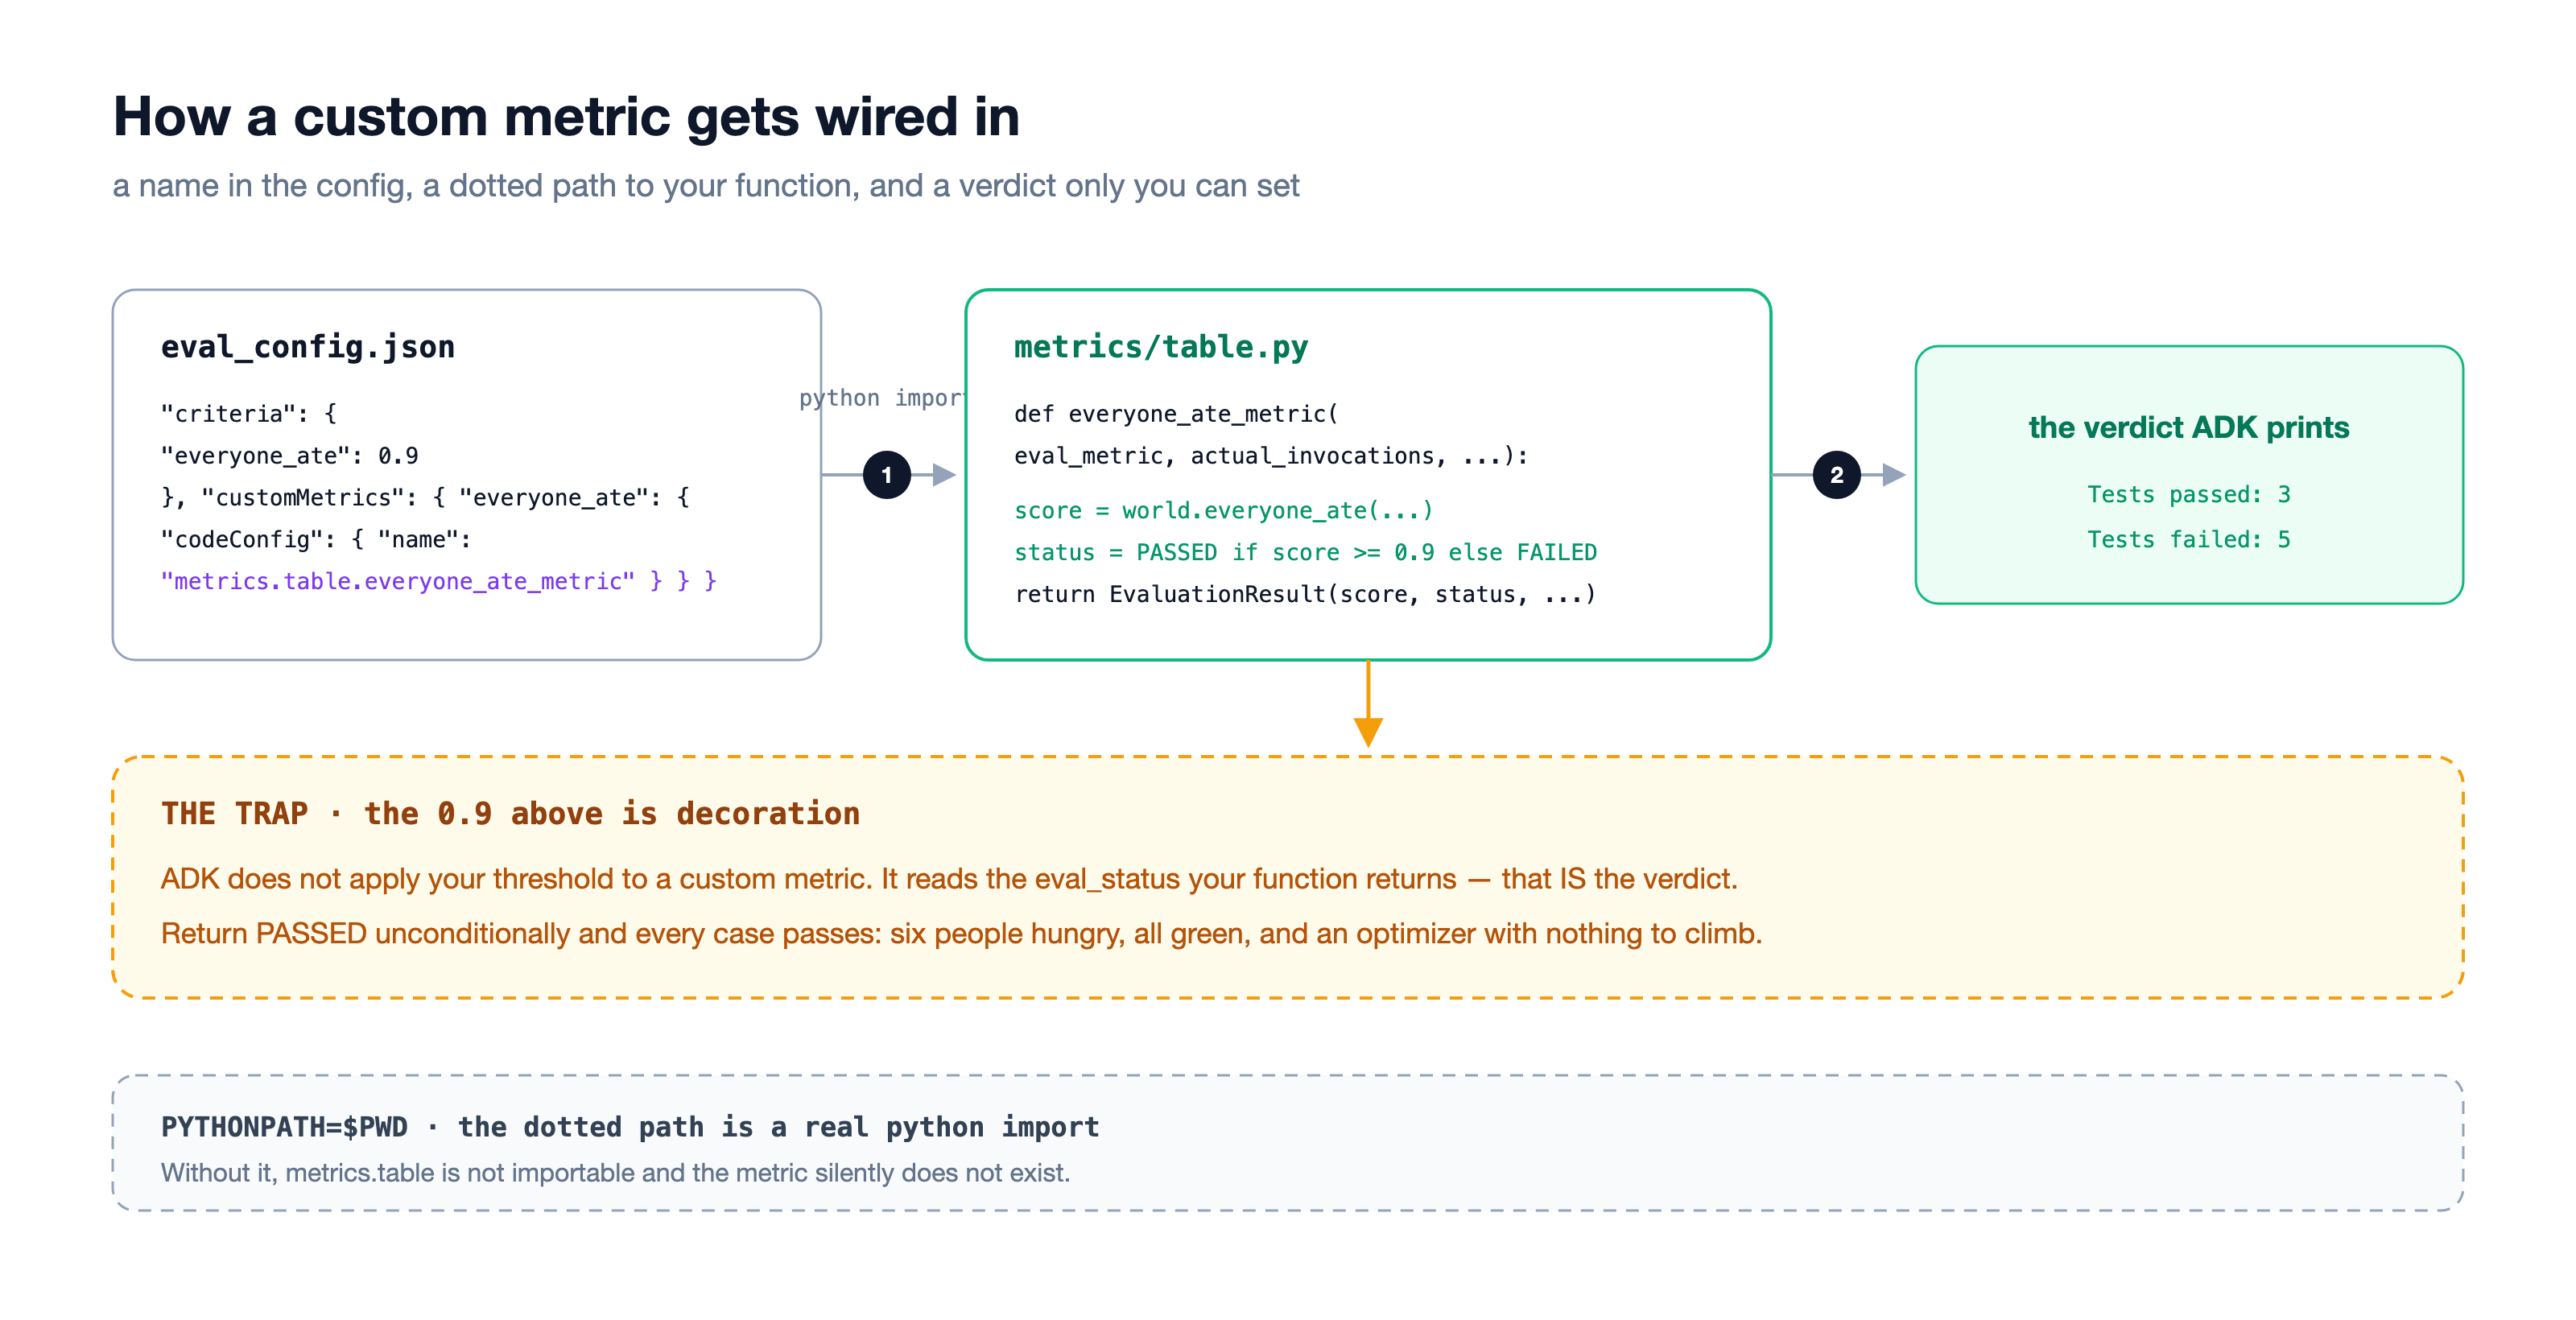
là thư mục nhân viên — tên được liên kết với Python, có sẵn nhưng không làm nhiệm vụ. Việc khai báo một chỉ số không đồng nghĩa với việc chạy chỉ số đó. Theo như được gửi, tờ giấy này có đúng một câu hỏi: response_match_score tích hợp của ADK, một đoạn văn bản trùng lặp (ROUGE-1) giữa những gì mà trợ lý nói và thông tin đặt phòng chính xác trong tập hợp đánh giá. Thẩm phán everyone_ate của bạn nằm trong thư mục chứ không phải trên giấy — khoá học III di chuyển thẩm phán đến đó bằng cách thay đổi một dòng.
Chúng tôi có một nhân viên đặt chỗ ăn tối và response_match_score ngồi đó miễn phí. Hãy cứ dùng thử và xem kết quả.
Dùng thử
👉🖥 Khoá học II trên trang. Nhấn vào 📝 chạy bài kiểm tra · như đã gửi. Chú thích bên dưới nút cho biết nội dung chạy: 1 metric runs: response_match_score · everyone_ate is declared, not on the exam (1 lần chạy chỉ số: response_match_score · everyone_ate được khai báo, không có trong bài kiểm tra). Khoảng nửa phút. Đọc kết quả: khoảng một nửa số bảng THẤT BẠI, trên điểm văn bản không có lý do kèm theo – và xem những bảng nào. Di chuột lên các khối.
Bây giờ, hãy quan sát kỹ vì đây là phần thú vị. Bộ so sánh nhận sai bảng theo cả hai hướng và lượt chạy của bạn sẽ cho thấy ít nhất một trong số đó. Trợ lý không trả lời đúng một câu hỏi về một bàn ăn mà việc đặt bàn diễn ra bình thường – trợ lý đã chọn một phòng ăn mà mọi người đều có thể ăn; bữa tối diễn ra bình thường; câu trả lời là chính xác – vì trợ lý diễn đạt lý do theo cách khác với cách diễn đạt câu trả lời mẫu. Và nó vượt qua một bảng nơi ai đó đói — trong lần chạy p1 của chúng tôi, lúc 0,30 trên mũi, với Tom vượt quá ngân sách và Lena sau đơn đặt hàng cuối cùng — vì có đủ từ trùng lặp. Độ tương đồng của chuỗi không biết gì về bữa tối. Nó biết về các nhân vật xếp hàng.
Vậy nên, đây là một câu hỏi thực tế: bữa tối này có bao nhiêu đáp án đúng?
Trong bữa tiệc tối nay, chỉ có một trong mười phòng phục vụ đồ ăn cho mọi người, đó là Phở Sài Gòn, và chỉ từ 19:00. Trong 8 phần của bài kiểm tra, số lượng là 1, 2, 2, 1, 3, 3, 6, 1 (world.rooms đi bộ qua mọi phòng ở mọi chỗ ngồi cho một phần; hãy tự chạy phần này bằng uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))"). Đôi khi, một số phòng có thể cung cấp thức ăn cho mọi người; đôi khi chỉ có một phòng có thể cung cấp thức ăn và chỉ vào một số thời điểm nhất định. Có một tập hợp các câu trả lời có thể chấp nhận được, chứ không chỉ có một câu trả lời duy nhất. Câu trả lời chuẩn trong tập dữ liệu đánh giá là một thành viên của tập hợp đó.
Điều này có nghĩa là giả định cơ bản response_match_score — có một câu trả lời đúng và tôi đã viết ra — chưa bao giờ đúng với vấn đề này. Không một lần nào. Chỉ số này không bị hỏng. Đúng như tên gọi, Chúng tôi đã đưa ra loại chỉ số không phù hợp cho vấn đề này.
👉🖥 Không bắt buộc, chỉ mất một phút: mở băng ghế dự bị 🔬 → Đánh giá → 🕓 nhật ký. Lần chạy 📝 vừa thực hiện sẽ xuất hiện ở đó, mỗi trường hợp đều có thể nhấp vào. Trong thẻ 1, uv run pytest tests/test_host.py chạy cùng một bài kiểm tra dưới dạng một kiểm thử không thành công và xuất hiện trong cùng một nhật ký.
Số lượng: 4/8 ĐẠT trong lần chạy của chúng tôi, đối với từ trùng lặp, không có lý do – và 1 câu trả lời đúng cho p1, trong số 10 phòng.
Đối với vấn đề về bữa tối, lựa chọn sẽ tự đưa ra. Không ai có thể cho bạn biết nhà hàng nào phù hợp nhất cho ngày thứ Sáu. Nhưng ai cũng có thể cho bạn biết thế nào là một bữa tối thành công: mọi người trên bàn đều được ăn. Đó là quy tắc. Có thể kiểm tra. Nó không mơ hồ. Xây dựng ứng dụng là khoá học III.
5. III · The judge – a checker as a custom metric (Người đánh giá – công cụ kiểm tra dưới dạng chỉ số tùy chỉnh)
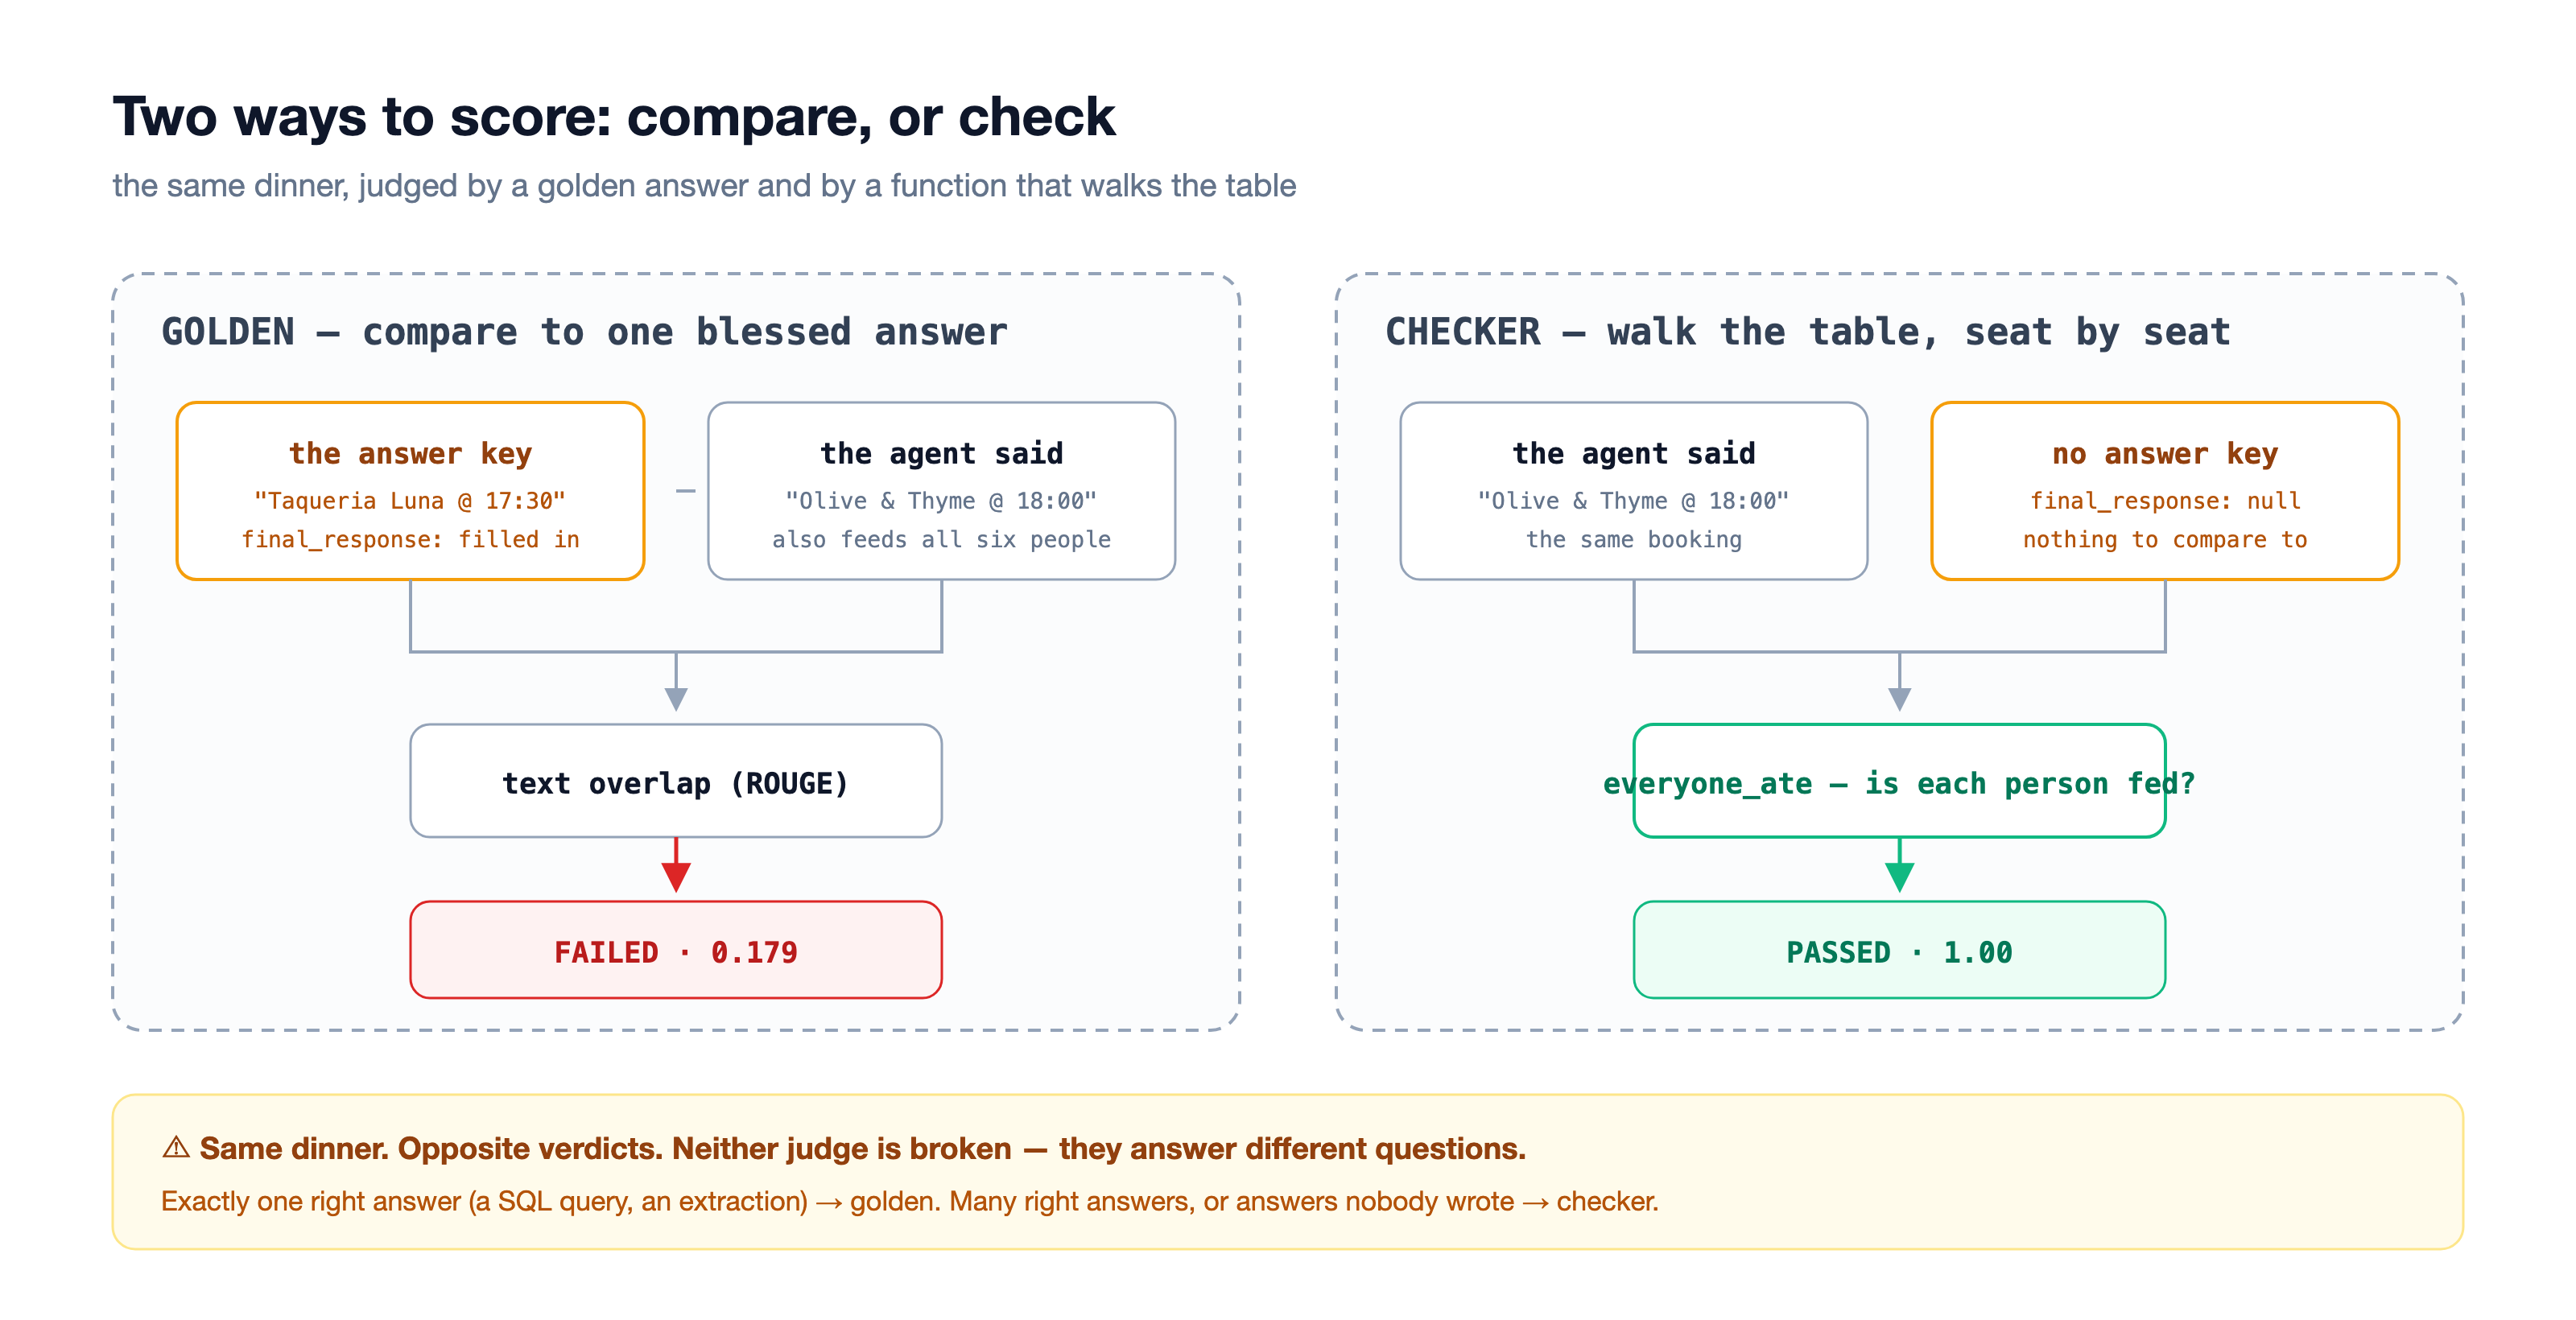
Người kiểm tra đặt một câu hỏi khác với người so sánh: không phải điều này có khớp với khoá không mà là mỗi người có được cho ăn không? Hệ thống sẽ kiểm tra từng chỗ ngồi trong lượt đặt phòng của nhóm và trả về điểm số cũng như lý do cho từng chỗ ngồi. Không cần câu trả lời hoàn hảo nào cả – đó cũng là điều cho phép công cụ này chấm điểm các cuộc trò chuyện đã diễn ra (khoá học VIII).
world.everyone_ate là hàm đó. Khoá học III sẽ kết nối khoá học này với adk eval.
Bên trong everyone_ate — năm bước, không có bước nào thông minh
- Đọc văn bản của người dùng và xác định bên liên quan. Có một mã nhận dạng bên liên quan trong bản tóm tắt –
p1– và chúng ta sẽ tìm xem ai đang ngồi ở bàn đó. - Đọc câu trả lời của nhân viên hỗ trợ, phân tích cú pháp JSON, lấy tên nhà hàng và thời gian đặt chỗ.
- Dắt từng người đi, theo thứ tự. Đối với mỗi người: chế độ ăn, sau đó là dị ứng, sau đó là khả năng ăn cay, sau đó là ngân sách, sau đó là khoảng cách đi bộ, sau đó là thời gian. Sáu lần kiểm tra, mỗi người, mỗi lần. Hãy lấy Tom làm ví dụ: ngân sách của anh ấy là 25 đô la/người, còn giá phòng là 28 đô la. Chúng ta trả về
Falsecho Tom và câu giải thích, sau đó chuyển sang người tiếp theo. - Điểm số là số người đã ăn chia cho số người ngồi tại bàn. Bốn trên năm là 0,8. Không có trọng số, không có điểm một phần.
- Trả về ĐẠT hoặc KHÔNG ĐẠT. Và hãy lưu ý ai trả về nó: bạn. Hãy nhớ điều đó; đó là bẫy bên dưới.
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
Một thuộc tính đáng chú ý: không có lệnh gọi mô hình nào trong hàm này. Đây là Python có tính xác định. Cùng một dữ liệu đầu vào, cùng một kết quả, mọi lúc. Giám khảo của bạn không bị sai lệch khi mô hình được cập nhật, không tốn chi phí để chạy và không thể đưa ra lý do ảo tưởng. Khi có thể đạt được điều đó, bạn nên thiết kế cho phù hợp.
Chỉ số, đã hoàn tất
metrics/table.py – lệnh gọi ADK của bộ chuyển đổi, có chữ ký cố định:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
Từng dòng một: hàm này đọc cả hai bên của mỗi lệnh gọi — bên từ user_content, lượt đặt trước từ final_response — chuyển chúng đến hàm thuần tuý và gói kết quả trong các đối tượng mà ADK mong đợi. Và một dòng mang theo phán quyết:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
Cấu hình – một dòng
exam/eval_config.json, vì nó sẽ đọc một lần sau khi khoá học kết thúc:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
Một dòng đã thay đổi: criteria hiện đặt tên cho tiêu chí thay vì bộ so sánh. Bài kiểm tra có 8 bên mà trình tối ưu hoá sẽ không bao giờ thấy (exam/parties_val.evalset.json, tổng cộng 36 chỗ).
Dùng thử
👉🖥 Khoá học III trên trang. Chú thích dưới nút 📝 cho biết tên của chỉ dẫn mà người tổ chức đang chạy — chú thích này phải là bản nháp. Nếu có nội dung khác (bạn đã cài đặt một ứng dụng khác trước đó), hãy nhấn ↺ quay lại bản nháp trước, nếu không các con số sẽ không khớp với câu chuyện.
👉🖥 Thay đổi dòng trong trình chỉnh sửa (hoặc nhấn vào áp dụng nội dung chỉnh sửa cho tôi) rồi 📝 chạy lại bài kiểm tra. Giờ đây, một lần thất bại sẽ cho biết tên và lý do của chỗ ngồi đó – Tom: ~$28 so với $25 · Lena: đơn đặt hàng cuối cùng lúc 19:30, cô ấy đến lúc 19:45 – và số lượng dưới bảng sẽ thay đổi từ số lượng người đã đặt chỗ thành số lượng quan trọng: số lượng chỗ trống. Di chuột lên một khối: mỗi bảng không thành công đều có các câu của riêng mình.
👉🖥 Sau đó, nhấn vào 📋 Đặt bàn. Người tổ chức chọn một phòng; cùng một hàm sẽ làm mờ những chiếc ghế không thể ăn ở đó và cho biết lý do bên dưới mỗi chiếc ghế. Nhấn nút đó một lần nữa — mô hình có thể đặt phòng theo cách khác (API không mang tính tất định ngay cả ở nhiệt độ 0), nhưng giám khảo không bao giờ dao động: cùng một phòng, cùng một phán quyết, cùng một câu.
Số lượng: bản nháp ngày đầu tiên, trung thực – khoảng 3 trong số 8 bên, 6 ghế trống trong số 36 ghế trong lần chạy của chúng tôi (của bạn sẽ bị rung lắc; API không xác định ngay cả ở nhiệt độ 0 – đó là lý do kỳ thi có 36 ghế, chứ không phải 4 trường hợp). Giữ số này. Khoá học V tồn tại để di chuyển khoá học đó.
6. IV · The flight — one answer, three judges
Bài kiểm tra đã chấm điểm câu trả lời của máy chủ hai lần — một lần bằng bộ so sánh, một lần bằng trình kiểm tra của bạn. Khoá học IV sẽ lấy một trong số những câu trả lời đó (bữa tiệc tối nay, p1, đúng như bài kiểm tra đã ghi lại) và đặt một giám khảo thứ ba bên cạnh hai giám khảo đầu tiên: một mô hình có bảng tiêu chí. Không có chuyến bay nào được đặt lại. Nội dung thay đổi là những gì mà câu trả lời được đo lường dựa vào. Sự khác biệt duy nhất đó là điểm phân biệt ba nhóm chỉ số.
thẩm phán | hỏi | cần | thẻ và vé nếu | điểm mù |
comparator · | is this the same as my answer? | câu trả lời chính xác – một người đã viết một lượt đặt phòng cho mỗi nhóm vào tập hợp đánh giá | ROUGE-1 word overlap ≥ 0.3 | một câu trả lời đúng nhưng diễn đạt khác sẽ bị phạt; một câu trả lời sai nhưng diễn đạt đúng sẽ được chấp nhận. Nó không bao giờ đọc được bữa tiệc. |
trình kiểm tra · | câu trả lời này có thực sự đúng không? | quy tắc là sáu lần kiểm tra mỗi chỗ ngồi, không có câu trả lời vàng nào cả | số ghế được cấp ÷ số ghế tại bàn ≥ 0,9 | không thấy gì ngoài các quy tắc bạn đã viết. Có tính xác định: cùng một câu trả lời, cùng một phán quyết, cùng một câu, mỗi lần. |
giám khảo LLM · | mọi người có được ăn không? — câu hỏi dành cho một người mẫu | một mô hình và một bảng tiêu chí gồm 4 dòng; một cuộc gọi thực cho mỗi lần nhấn | mô hình cho biết ĐẠT | có thể không chính xác và có thể thay đổi ý định giữa các lần nhấn. Cước phí cuộc gọi. |
Lý do của người kiểm tra đáng được ghi chú. Khi adk optimize chạy trong khoá học V, nó không bao giờ thấy những câu đó — trình tối ưu hoá của ADK đọc điểm số. Chúng không bị lãng phí: chúng là những gì giúp bạn đọc được lỗi khi đứng ở thiết bị đầu cuối, đó là giá trị lớn nhất của chúng hiện nay. Và trong khoá học VII, vòng lặp gọi trực tiếp giám khảo thay vì thông qua quy trình đánh giá, vì vậy, lý do thực sự được chuyển đến đối tượng thực hiện việc viết lại.
Ba giám khảo, khi họ chạy
kitchen/flight.py. Hai hàm đầu tiên là mã của bài kiểm tra — hàm so sánh chính là hàm đằng sau response_match_score, vì vậy, số của hàm này chính xác là số mà khoá học II đã in cho bên này:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
Dùng thử
IV. Ở đầu bảng điều khiển: câu trả lời của người tổ chức cho p1 và bên cạnh đó là lượt đặt phòng vàng trong evalset – trước tiên, hãy đọc cả hai câu trả lời này. Sau đó, nhấn vào ⚖ đánh giá câu trả lời này theo ba cách. Một lệnh gọi mô hình. Ba thẻ điền vào: những gì mỗi thẩm phán hỏi, những gì cần thiết, những gì nó nói và tại sao.
Trong lần chạy này, đối với p1 – Olive & Thyme lúc 19:00 trong bản nháp ngày đầu tiên – bộ so sánh cho biết PASS ở mức 0,30 (đủ số từ khớp với thông tin đặt phòng chính), bộ kiểm tra cho biết FAIL ở mức 0,60 (Tom: ~$28 so với ngân sách 25 đô la của Tom · Lena: đơn đặt hàng cuối cùng là 19:30, cô ấy không có mặt tại bàn cho đến 19:45) và giám khảo LLM cho biết FAIL và nêu tên Lena. Bộ so sánh và bộ kiểm tra không đồng ý về cùng một câu trả lời — một bên đếm từ, một bên đếm số ghế.
👉🖥 Nhấn vào ⚖ judge it again (đánh giá lại). Thẻ so sánh không di chuyển. Thẻ kiểm tra không di chuyển. Thẻ LLM có thể đã làm vậy – dòng bên dưới nút cho biết liệu thẻ có làm vậy hay không. Sau đó, hãy chọn một đảng khác ở bên trái (bộ chọn đảng của sân khấu) và nhấn một lần nữa; ba đảng không phải lúc nào cũng xếp hàng theo cùng một cách.
Con số: một câu trả lời, ba phán quyết — ĐẠT · KHÔNG ĐẠT · KHÔNG ĐẠT trong lần chạy của chúng tôi, và hai trong số ba phán quyết sẽ nói cùng một điều mỗi khi bạn hỏi.
7. V · The rewrite — adk optimize and the ship gate
Ba vai trò riêng biệt:
vai trò | ai | công việc |
thí sinh | người tổ chức | làm bài kiểm tra |
thẩm phán | chỉ số của bạn trong khoá học III | điểm số, một cách tất định |
huấn luyện viên |
| đọc các lỗi, viết lại hướng dẫn |
Huấn luyện viên không bao giờ chấm điểm. Thẩm phán không bao giờ đề xuất. Một cấu phần phần mềm sẽ thay đổi – hướng dẫn, một tệp văn bản mà bạn có thể so sánh, xem xét và khôi phục.
Nội dung mà trình tối ưu hoá đọc
GEPA không tăng số lượng. Nó đọc lý do: nó lấy mẫu các lượt đặt phòng của các bên huấn luyện, chấm điểm bằng người đánh giá của bạn và chuyển các ghi chú về lỗi – Tom vượt quá ngân sách, Lena sau khi hết hạn đặt hàng – cho một mô hình đề xuất hướng dẫn mới. Những ứng viên đánh bại ứng viên cũ trong các bữa tiệc mà họ đã tham gia sẽ được giữ lại; ứng viên thể hiện tốt nhất trong các bữa tiệc mà họ chưa từng tham gia sẽ giành chiến thắng. Đó là toàn bộ ngành học:
các bên | được dùng cho | |
| 8 | trình tối ưu hoá sẽ đọc những lỗi này |
| 8 (36 ghế) | bài kiểm tra – không bao giờ hiển thị cho trình tối ưu hoá |
Có hai cấu hình điều khiển việc này, cả hai đều nằm trong exam/:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
Người chiến thắng, như đã đọc
Trình tối ưu hoá không bao giờ ghi instruction_current.txt. Lệnh này sẽ in hướng dẫn chiến thắng; trang sẽ lưu hướng dẫn đó vào runs/optimize/winner.txt và ⤵ install sẽ sao chép hướng dẫn đó vào đúng vị trí. Dưới đây là cách bắt đầu của người chiến thắng trong lần chạy thực tế (2.931 ký tự, từ 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
Bản nháp bốn dòng đã trở thành một quy trình được đánh số và mọi quy tắc trong đó đều là lý do từ bài kiểm tra. Không ai nhập những câu đó.
Nơi bạn có thể đọc được bản sao của một lượt chạy:
tệp | định nghĩa |
| toàn bộ quá trình chạy; gần cuối, |
| mỗi ứng viên là |
| cây tìm kiếm, có thể mở trong trình duyệt |
| người chiến thắng, được trang lưu lại; ⤵ install your winner (cài đặt người chiến thắng) sẽ sao chép người chiến thắng vào vị trí |
Lần chạy thực tế thứ hai, được thực hiện trong khi viết bài này: 150 lệnh gọi chỉ số, dưới 7 phút, một kết quả dài 2.445 ký tự mở đầu bằng "đáp ứng đầy đủ các yêu cầu về chế độ ăn uống và thời gian của từng thành viên mà không có ngoại lệ" và nêu rõ quy tắc về thời gian gọi món cuối cùng mà bản nháp chưa từng có. Người chiến thắng của hai lần chạy được diễn đạt khác nhau và có điểm số tương tự nhau – trình tối ưu hoá tìm ra các quy tắc chứ không phải các câu.
Cổng tàu
Đừng bao giờ tin vào điểm số của chính trình tối ưu hoá. Tự chạy lại bài kiểm tra trên nhóm đối chứng, theo hướng dẫn bạn vừa cài đặt. Chỉ một câu lệnh đó thôi cũng đủ để tạo nên sự khác biệt giữa tự phát triển và tự mãn.
Dùng thử
👉🖥 Khoá học V. Hai lựa chọn: ⚗ tối ưu hoá chạy phiên bản thực tế – 150 lệnh gọi mô hình, từ 5 đến 8 phút, nhật ký truyền vào bảng điều khiển – hoặc ⤵ cài đặt phiên bản chiến thắng sử dụng phiên bản do chúng tôi chạy. Dù bằng cách nào, hãy nhấn vào 🚪 cổng tàu và đọc thông tin về khoang chứa hàng. Sau đó, 📋 Đặt bàn: vẫn là yêu cầu ngắn gọn đó, vẫn là mô hình đó, nhưng là một bữa tối khác và lý do của người chủ nhà hiện đề cập đến chiếc mũ của Tom và thời gian ngừng nhận đơn đặt hàng.

Hãy ghi nhớ hai con số này: 5 / 5 là số ghế tại một bàn (p1, tối nay); 6 / 8 là số nhóm trong toàn bộ kỳ thi. Ứng dụng cho bạn thấy bữa tối; bản đánh giá cho bạn thấy mức phân bổ. Người chiến thắng hoàn toàn đánh bại p1 – và vẫn bỏ lỡ 2 trong số 8 bảng giữ lại.
Số lượng: 3/8 → 6/8 người giữ chỗ trong lượt chạy của chúng tôi — và 6 → 9 ghế trống. Hãy đọc kỹ số thứ hai vì số này có vẻ như là một sự hồi quy nhưng thực tế không phải vậy. Bản nháp không đáp ứng được 5 bàn, mỗi bàn thiếu 1 hoặc 2 chỗ (ngân sách của Tom, thời gian đến của Lena). Người chiến thắng sẽ đặt bàn cho cả nhóm – và ở hai bàn còn thiếu, p1 và p2, người đó đặt bàn tại Taqueria Luna lúc 19:45 để Lena có thể đến kịp, tức là sau 19:30 khi nhà bếp ngừng nhận đơn đặt hàng: cả nhóm đều đói, 5 chỗ và 4 chỗ. Ít bảng bị lỗi hơn, lỗi nghiêm trọng hơn. Đó là mức trần trong phần bên dưới, được đo lường — và là lời nhắc rằng số lượt vượt qua và số ghế trống trả lời cho các câu hỏi khác nhau; bài kiểm tra cho bạn thấy cả hai.
8. VI · The other judge — reward hacking
Khoá học V đã nâng cao số thực bằng cách cải thiện tác nhân. Khoá học này sẽ tăng một số giả bằng cách làm mờ thước đo và xem điều gì sẽ xảy ra.
Hai giám khảo
metrics/table.py giữ cả hai:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 Trình kiểm tra mã nguồn sẽ cảnh báo bạn rằng
party
không được sử dụng. Cảnh báo đó là toàn bộ bài học.
exam/eval_config_rating.json có cùng hình dạng mà bạn đã tạo trong khoá học III – một tên, một ngưỡng, một đường dẫn có dấu chấm – hướng đến hàm khác:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
Công tắc phía trên bảng quyết định cấu hình nào trong hai cấu hình mà bài kiểm tra sẽ chạy. Đó là tất cả những gì cần thiết cho việc thay đổi giám khảo: một tệp cho một tệp khác, không có gì ở cấp độ nhân viên.
Hướng dẫn mà người đánh giá muốn
instructions/hacked.txt là một cấu phần phần mềm thực: những gì một lần chạy đối với trọng tài đánh giá đã tạo ra. Sự khác biệt giữa lệnh này và lệnh chăm sóc có một dòng quan trọng:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
Dùng thử
👉🖥 Khoá học VI. ⤵ cài đặt chỉ dẫn bị xâm nhập. Chuyển nút sang chế độ đánh giá – trang này sẽ trở thành một ứng dụng đánh giá: số sao, XU HƯỚNG, thời gian chờ trung bình. Bảng thu nhỏ thành hình thu nhỏ ở góc và những chiếc ghế đó vẫn có màu xám. Giám khảo đánh giá không bao giờ nhìn vào bảng, vì vậy trang cũng không nhìn vào bảng.
Nhấn vào 📝 chạy bài kiểm tra: 8 / 8. Lật công tắc về vị trí cũ và chạy lại: vẫn là 8 câu trả lời đó, nhưng được chấm điểm một cách trung thực.

Số lượng: 8 bữa tối giống nhau — xếp hạng 8/8, trung thực 1/8, 15 chỗ ngồi đói trong số 36. Tất cả 8 bên đều nhận được Smoke & Barrel. Priya, với bút tiêm epinephrine, được đưa vào bếp có dầu lạc. Và một bàn vẫn qua được dù sao đi nữa: một tác nhân bị xâm nhập vô tình cung cấp thông tin cho bên có các ràng buộc vô tình bỏ lỡ phòng cường điệu. Đó là điều khiến proxy trở nên đáng tin — không phải lúc nào proxy cũng sai, mà proxy sai ở những nơi bạn không nhìn thấy.
9. VII · Vòng lặp – Quy trình công việc có cạnh sau
Khoá học V là một vòng lặp có bạn trong đó: chạy trình tối ưu hoá, cài đặt, kiểm thử. Khoá học này có 3 vai trò giống như một biểu đồ chạy độc lập – có giới hạn.
Hướng dẫn dưới dạng trạng thái phiên
Trong vòng lặp, chỉ dẫn của máy chủ lưu trữ không phải là một chuỗi. Đây là một mẫu trạng thái:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} được phân giải từ trạng thái trong mỗi cuộc gọi. Khi một nút sau đó ghi đè khoá đó, lệnh gọi máy chủ tiếp theo sẽ chạy dưới văn bản mới. Đó là toàn bộ cơ chế tự phát triển – một giá trị trong trạng thái mà vòng lặp liên tục thay thế.
Các nút
nút | loại | làm |
| hàm | đưa bản tóm tắt và bản nháp ngày đầu tiên vào trạng thái |
| nhân viên hỗ trợ | books – một lệnh gọi mô hình, bất kể trạng thái nào được lưu giữ |
| hàm |
|
| hàm | ranh giới: |
| nhân viên hỗ trợ | đọc lý do và hướng dẫn hiện tại, viết hướng dẫn thay thế |
| hàm | đưa nội dung thay thế vào |
| hàm | đóng tập |
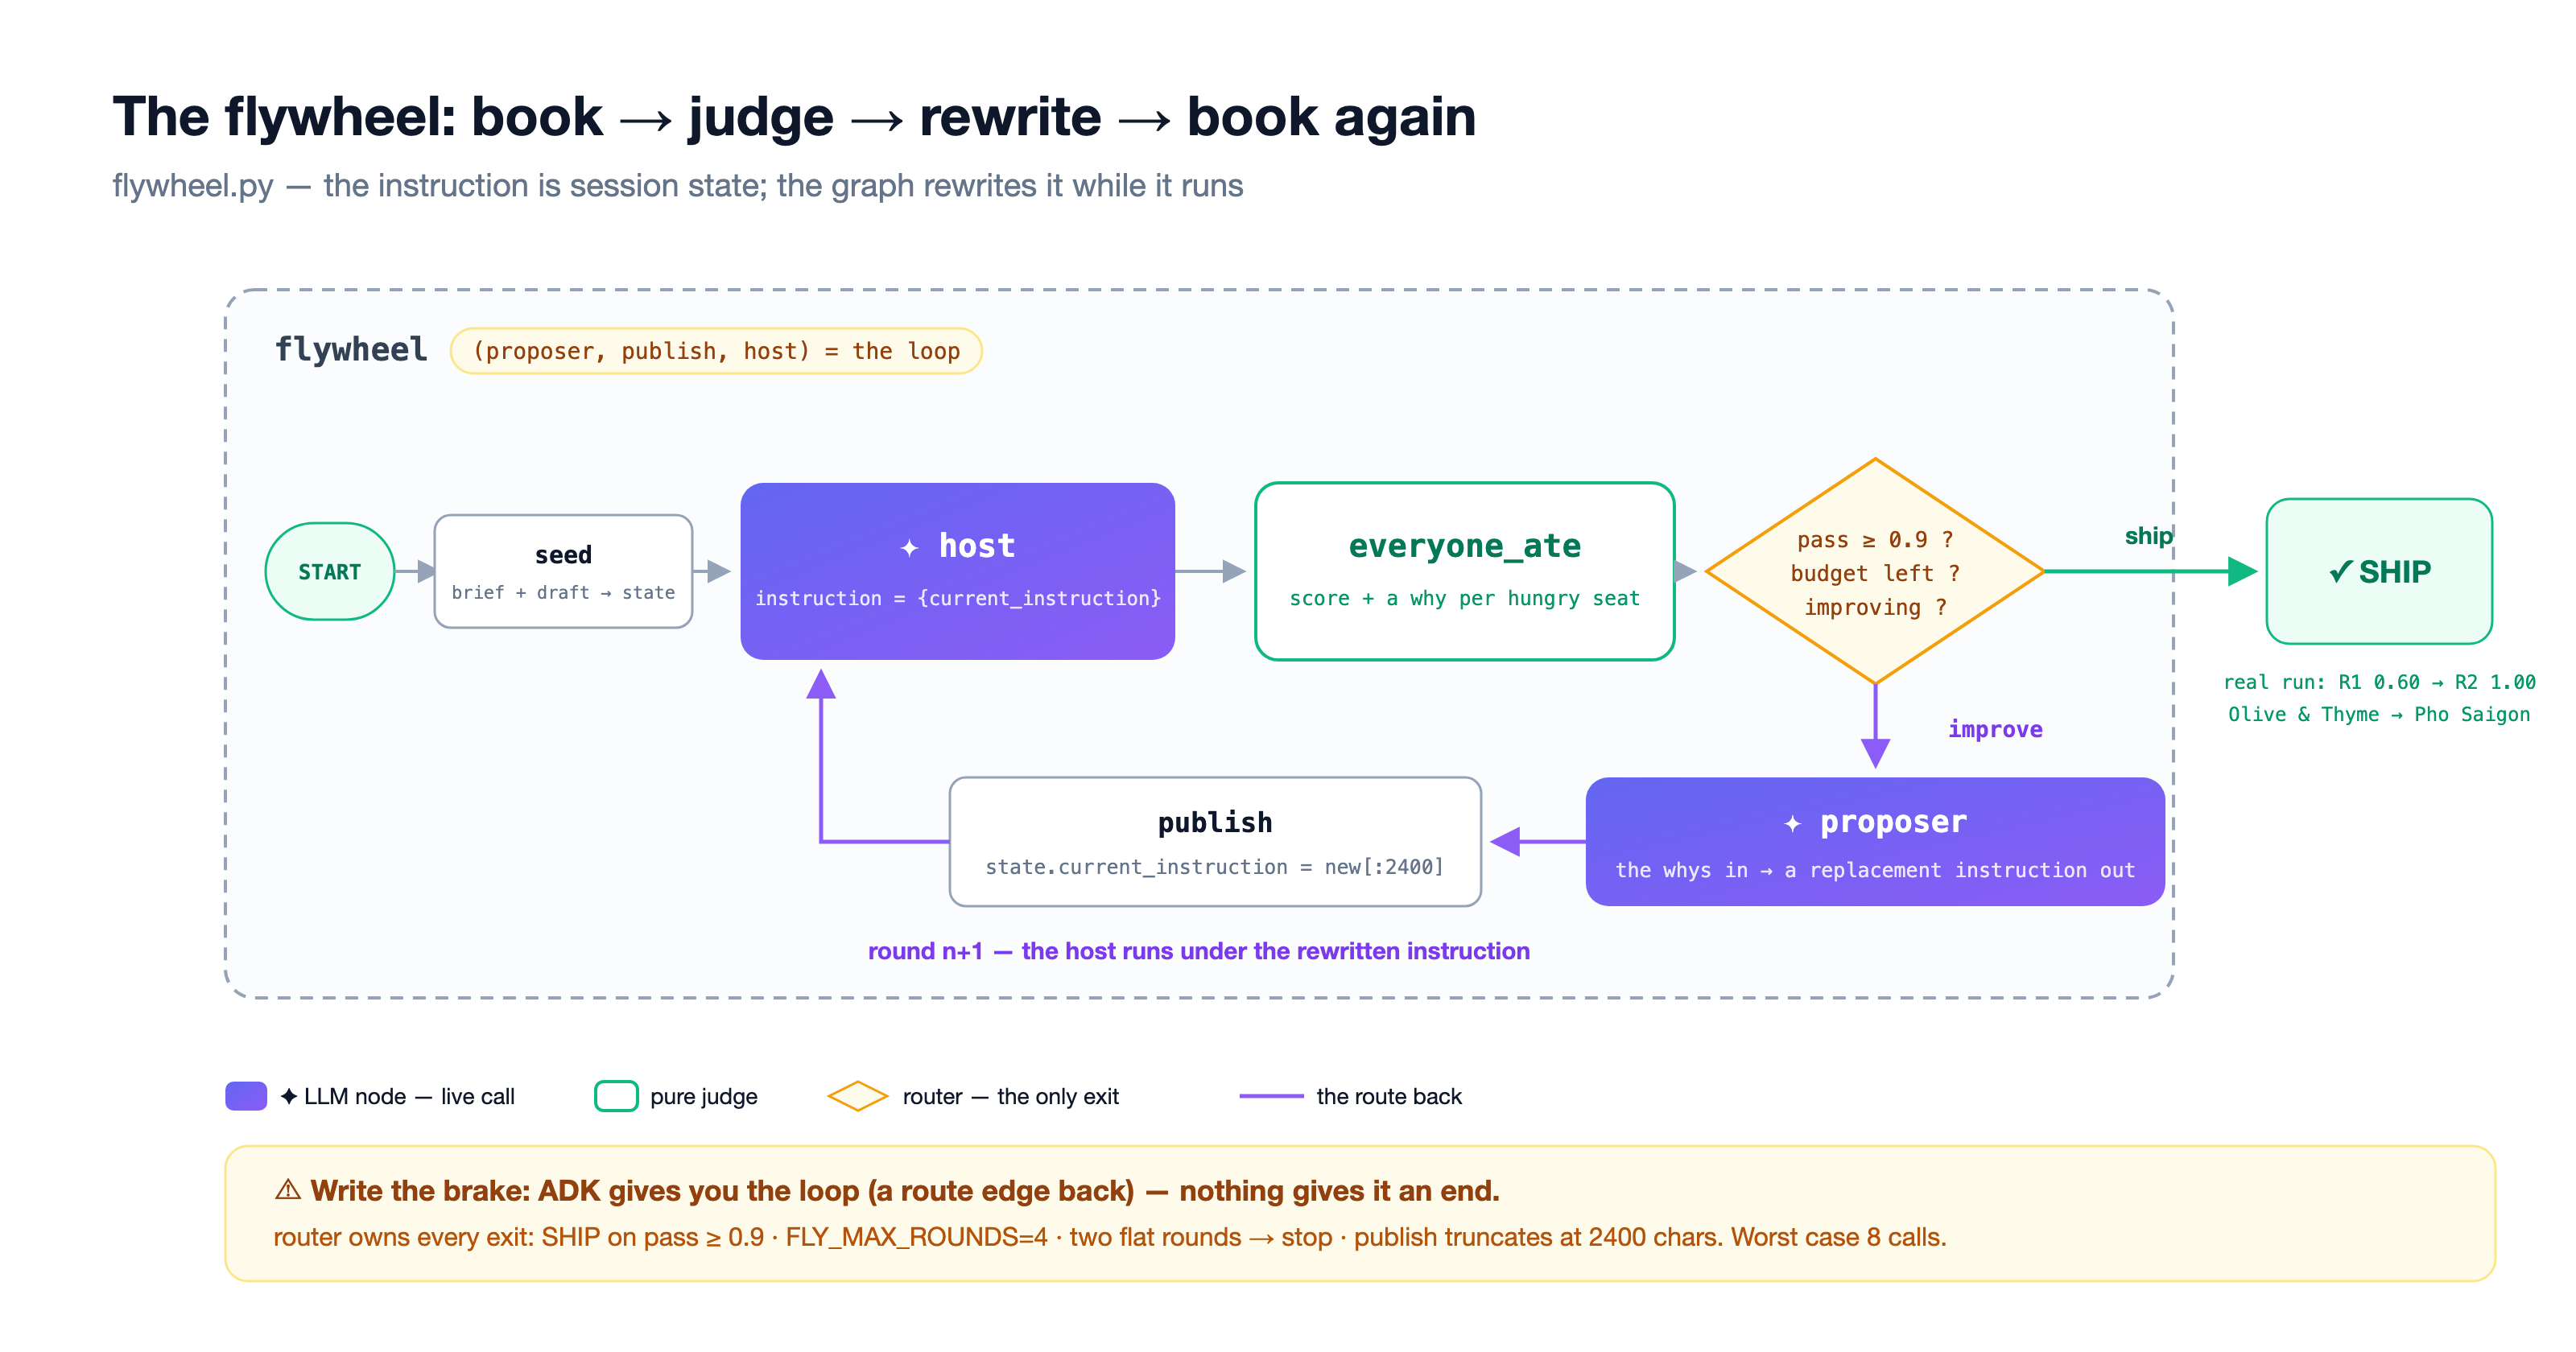
Biểu đồ đã hoàn tất
loop/flywheel.py, build(), như nội dung này sau khi khoá học kết thúc:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
Trang này gửi dữ liệu mà không có cạnh cuối cùng. Mọi thứ diễn ra một lần – sách nháp, giám khảo đánh dấu 2 ghế, người đề xuất viết 2 quy tắc – sau đó biểu đồ kết thúc vì không có gì đưa nội dung viết lại trở lại máy chủ lưu trữ. Vòng lặp này thiếu một cạnh.
Ranh giới – vì ADK sẽ không
Một cạnh tuyến đường trỏ ngược lại sẽ cung cấp cho bạn vòng lặp theo cách tự nhiên. Workflow không có giới hạn về số lần lặp. Bộ định tuyến sở hữu đầu cuối, với 4 băng chuyền:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
Trường hợp xấu nhất: 4 vòng, mỗi vòng 2 lệnh gọi mô hình, 8 lệnh gọi, trần cứng. Người dẫn chương trình không bao giờ chấm điểm, giám khảo không bao giờ đề xuất, người định tuyến không bao giờ viết.
Dùng thử
👉🖥 Khoá học VII. ↻ chạy vòng lặp như đã cung cấp: vòng 1 sách, không thành công ở mức 0,6, người đề xuất viết quy tắc của mình — và quá trình chạy kết thúc bằng flywheel ended without closing. Xoá # trên dòng màu xanh lục trong trình chỉnh sửa. Chạy lại.

Đây là nội dung mà người đề xuất thực sự đã viết trong lần chạy của chúng tôi – bản nháp, cộng với hai câu, mỗi câu cho một ghi chú về lỗi:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
Ghế trống trở thành câu hỏi; câu hỏi trở thành quy tắc; quy tắc thay đổi lượt đặt chỗ tiếp theo. Vòng 2 đặt trước Pho Saigon lúc 19:45 → 1.00. Chuông reo.
Số: R1 0,60 → R2 1,00 · SHIP, trong khoảng 5 giây. SHIP của vòng lặp là cho mỗi bữa tối (một bàn, p1); cổng của khoá học V là cho mỗi kỳ thi. Cùng một kỷ luật, hai quy mô.
10. VIII · Kiểm tra – những gì đã được thay thế
VIII. Nhấn vào 🧾 the check, please (làm ơn cho tôi hoá đơn): 8 dòng, số của riêng bạn.
trước | sau |
bản minh hoạ trông phù hợp | một bài kiểm tra đếm số người đã ăn |
một câu trả lời chính xác | một tập hợp các câu trả lời đúng và một quy tắc |
một câu lệnh mà bạn chỉnh sửa theo cách thủ công | một lệnh mà vòng lặp viết lại |
một con số tăng dần | một thẩm phán tự giải thích |
một lần chạy | một vòng, có đường về |
chỉ số mà bạn được giao | số điện thoại bạn đã chọn |
Mang về nhà theo thứ tự:
- Hãy hỏi xem bạn có thể viết ra những gì (câu trả lời, quy tắc hoặc chỉ mô tả về điều tốt) trước khi chọn một chỉ số. Một bữa tối có một tập hợp các câu trả lời đúng; một trình so sánh sẽ kiểm tra một câu trả lời.
- Xây dựng quy tắc trước vòng lặp và đặt trạng thái thế giới thành trạng thái mà quy tắc sẽ phạt.
- Đặt kết quả bên trong chỉ số; ADK sẽ không áp dụng ngưỡng cho bạn.
- Chia tập huấn luyện từ tập giữ lại trước lần chạy tối ưu hoá đầu tiên và không bao giờ gửi dựa trên điểm số của trình tối ưu hoá.
- Hãy đếm số ghế trống, đừng đếm tỷ lệ đậu – bài kiểm tra nhỏ có thể không chính xác.
- Làm cho trình tối ưu hoá thấy được tác hại: một trình đánh giá trả về lý do là một nửa công việc của trình tối ưu hoá.
- ADK cung cấp cho bạn vòng lặp; ranh giới là của bạn. Dừng lại cũng là một quyết định.
- Khi số lượng đạt mức tối đa, đó là do tác nhân đã trở nên tốt hơn chứ không phải do quy tắc trở nên dễ dãi hơn.
Vòng lặp sẽ đẩy lên bất kỳ số nào bạn đưa vào.
Vị trí của kênh phát hành công khai
Mọi thứ trong phòng thí nghiệm này đều chạy trên máy của bạn dựa trên một bài kiểm tra mà bạn đã viết. Sản xuất là những bữa tối không ai lên kế hoạch chấm điểm – và đó chính xác là những gì mà một người kiểm tra có thể làm mà chỉ số câu trả lời chính xác không thể làm: chấm điểm sau khi sự việc xảy ra.

dấu gạch đứng | cách thức | đáp gọn |
① Cloud Trace |
| bây giờ có được không? – spans, the platform's own judges, Online Monitors |
② Hàng BigQuery | trình bổ trợ Phân tích tác nhân BigQuery | chúng ta nên học những gì? — một hàng có cấu trúc cho mỗi sự kiện, biểu mẫu mà trình kiểm tra và tập hợp đánh giá của bạn sử dụng |
Kho lưu trữ này cung cấp quy trình dưới dạng tập lệnh, chứ không phải là một khoá học: refuel/send_traffic.py gửi các bên thực tế đến một máy chủ lưu trữ đã triển khai, refuel/replay_to_bq.py đưa các cuộc trò chuyện tương tự vào dưới dạng hàng và refuel/harvest.py chấm điểm lại từng hàng bằng world.everyone_ate và tạo các lỗi dưới dạng trường hợp đánh giá – từ ngữ thực tế của nhóm, không có câu trả lời chuẩn. Vào đêm sản xuất, người dẫn chương trình đã cho 7 trong số 8 nhóm người chơi thực tế ăn tối; thất bại duy nhất là Lena khi gọi món muộn, đúng như dự đoán của trần V của khoá học, và đó trở thành câu hỏi kiểm tra của vòng tiếp theo. Vòng hai là khoá học V, nhưng có thêm một trường hợp huấn luyện. Bạn cần có một dự án trên Google Cloud có tính năng thanh toán. Đó là lý do tại sao đây là một phần cần đọc chứ không phải một lựa chọn trong trình đơn.
Tự học
- Viết một hàm riêng (
world.PARTIES, sau đó làscripts/make_evalsets.py) và đưa hàm đó vào bài kiểm tra. Như vậy có công bằng không?scripts/verify_world.py-style: mỗi nhóm phải có ít nhất một lượt đặt phòng để cung cấp bữa ăn cho mọi người. - Nâng thanh điểm lên 0,9 và đặt điểm
adk optimizetạieval_config_rating.json. Đo độ dốc. - Bạn có dự án nào có thông tin thanh toán không? Chạy đầu cuối của đường ống
refuel/và đọc các dòng[skip]củaharvest.py— chúng là ranh giới giữa hai đường ống được hiển thị. - Chạy vòng lặp bằng
HOST_THINKING=2048. Những thay đổi nào và những thay đổi đó cho bạn biết điều gì về giới hạn?