

1. 简介

此 Codelab 介绍了智能体评估,即系统如何判断智能体的回答是否有效,以及在系统能够进行评估后,您可以构建哪些内容:一个可以根据自身失败情况重写指令的智能体,以及一个可以不断执行此操作的循环,而您负责控制此循环。
所有内容均在智能体开发套件 (ADK) 上运行:adk eval(包含您编写的自定义指标)、adk optimize(GEPA 提示优化器)、Workflow(包含后向边缘的 ADK 2)以及将生产流量转化为下一轮考试的 Agent Engine + BigQuery 管道。
无论您提供什么数字,该循环都会将其向上推送。
学习内容
- 回答不是结果 - 为什么自信且结构合理的回答对系统毫无意义,以及评判者必须能够说什么
- 运行一次考试的三种方式 -
adk eval用于批处理,adk web“评估”标签页用于查看失败,pytest+AgentEvaluator用于使 build 失败 - 以及它们共享的一个本地评估存储区 - 比较与检查 - 为什么比较器会惩罚措辞不同但答案正确的回答,一顿晚餐实际上有多少个正确答案,以及如何通过直觉判断问题需要哪种指标
- 作为
adk eval指标的检查器函数 -customMetrics、codeConfig、固定签名、其中的六项检查、为什么您的函数拥有 PASSED/FAILED,以及为什么它有意具有确定性 - 一个答案中的三类指标 - 比较器、检查器、LLM-as-judge:每类指标需要什么、成本是多少、存在哪些盲点
adk optimize(GEPA) - 它读取的内容(失败次数,而非得分)、训练集与留出集,以及您在发布之前自行重新运行考试的原因- 奖励黑客攻击,可衡量 - 一种代理指标,它从不读取派对、它对实数的作用以及由此产生的规律
- 作为 ADK 2
Workflow的自演化循环 - 存在于会话状态中的指令、使图成为环的唯一边,以及 ADK 未提供的边界 - 生产适合的场景 - 观看轨迹、学习行,以及检查器为何可以对无人计划评分的晚餐进行评分(阅读,而非步骤)
构建内容
浏览器中正在运行的应用:一张圆桌、N 位宾客,以及一位负责预订晚餐的代理。每道菜都会开启一个开关:配置中的一行代码、三位评委面前的一个答案、运行真实优化器的按钮、切换评委的开关、图中的一条边。表格会显示变化:谁吃了、谁没吃,以及原因。Python 占用空间很小;所有数字都是在您的机器上测量的。
该应用本身也是一种练习。课程面板一次只提供一项编辑或一个按钮;菜单上的盘子只有在实际证明有效时才会填满 - 厨房会读取您的文件和运行的收据,而不是清单。

这八门课程
概念 | 回答的问题 | CANNOT TRANSLATE | |
I | 回复不是结果 | 系统了解此预订的哪些信息? | 尚无任何内容 - 请在工作台中预订 |
II | 比较器 · 一组正确答案 · 三种运行方式 | 为什么正确的预订会导致考试失败? | 按原样运行考试并读取判决 |
III | 作为自定义指标的检查器 · 六项检查 | 考试能说明谁饿了,以及为什么饿吗? |
|
IV | 比较器 · 检查器 · LLM 作为评判者 | 答案相同,衡量时要考虑哪三个方面? | 从三个方面对一个答案进行两次评判 |
V |
| 智能体能否从失败中自行修复? |
|
VI | 奖励黑客攻击 · 代理指标 | 如果法官看不到伤害,会对循环造成什么影响? | 开关 |
VII | 具有后边缘的 | 什么情况下图会形成环路,什么情况下会停止? |
|
VIII | 每项内容替换了什么 | — | 支票 |
如何使用本 Codelab。它以概念为先:每门课程都会先解释相关概念,然后展示代码在更改生效后的读取方式,并逐步讲解。它绝不会要求您在此处修改文件,编辑操作在应用中进行,应用会一次向您提供一行代码,并首先向您显示失败情况。阅读课程内容,然后让网页引导您完成课程,并观看数字的变化。
此功能的位置
这个世界(10 位客人,每人有一个硬性约束条件;10 家餐厅,每家有一个陷阱;16 场派对)和两位评委来自 loop-lab-table 实验室;单页互动形式来自 Agent Valley。小酒馆是场景;其下的每个机制都是您会用于支持代理、预订流程或任何其他“好”可检查的事物的普通机制。
2. 🧰 设置
- 什么 - 可以付费的账号、项目、已安装的实验、已证明可以回答问题的模型,以及在某个端口上运行的表格。
- 原因 - 一个端口上的一个进程:网页、考试、编辑器和工作台共享一个来源,因此本实验中的任何内容都不需要第二个终端或第二个端口。
- 方式 - 克隆、两个脚本、一个命令。设置的最后一项操作是进行一次实际的模型调用,因此损坏的项目会在此处失败,而不是在课程 I 中失败。
本实验中的所有操作都在 Cloud Shell 中运行,其中已安装 gcloud、Python、Node 和 git,并且您可以使用自己的凭据通过 Vertex AI 访问 Gemini。本实验中没有任何 API 密钥,也无需在笔记本电脑上安装任何内容。安装了 Google Cloud SDK、Python 3.11 及更高版本和 Node 20 及更高版本的笔记本电脑的工作方式相同。
有一项内容是本实验无法提供的:启用了结算功能的 Google Cloud 项目。第 1 步为您提供一个可以支付费用的账号;第 4 步将该账号转换为项目。请按此顺序执行这些步骤 - 第 4 步之后的所有步骤都会读取第 4 步确定的项目。
1 · 获取已启用结算功能的账号(约 1 分钟)
使用已启用结算功能的 Google 账号登录。任何此类账号均可。如果没有,请开始免费试用;这样您就会获得一个结算账号,这是第 4 步所需的全部内容。
2 · 打开 Cloud Shell (约 2 分钟)
👉🖥 点击 Google Cloud 控制台顶部的激活 Cloud Shell(标题栏中的终端形状图标)。
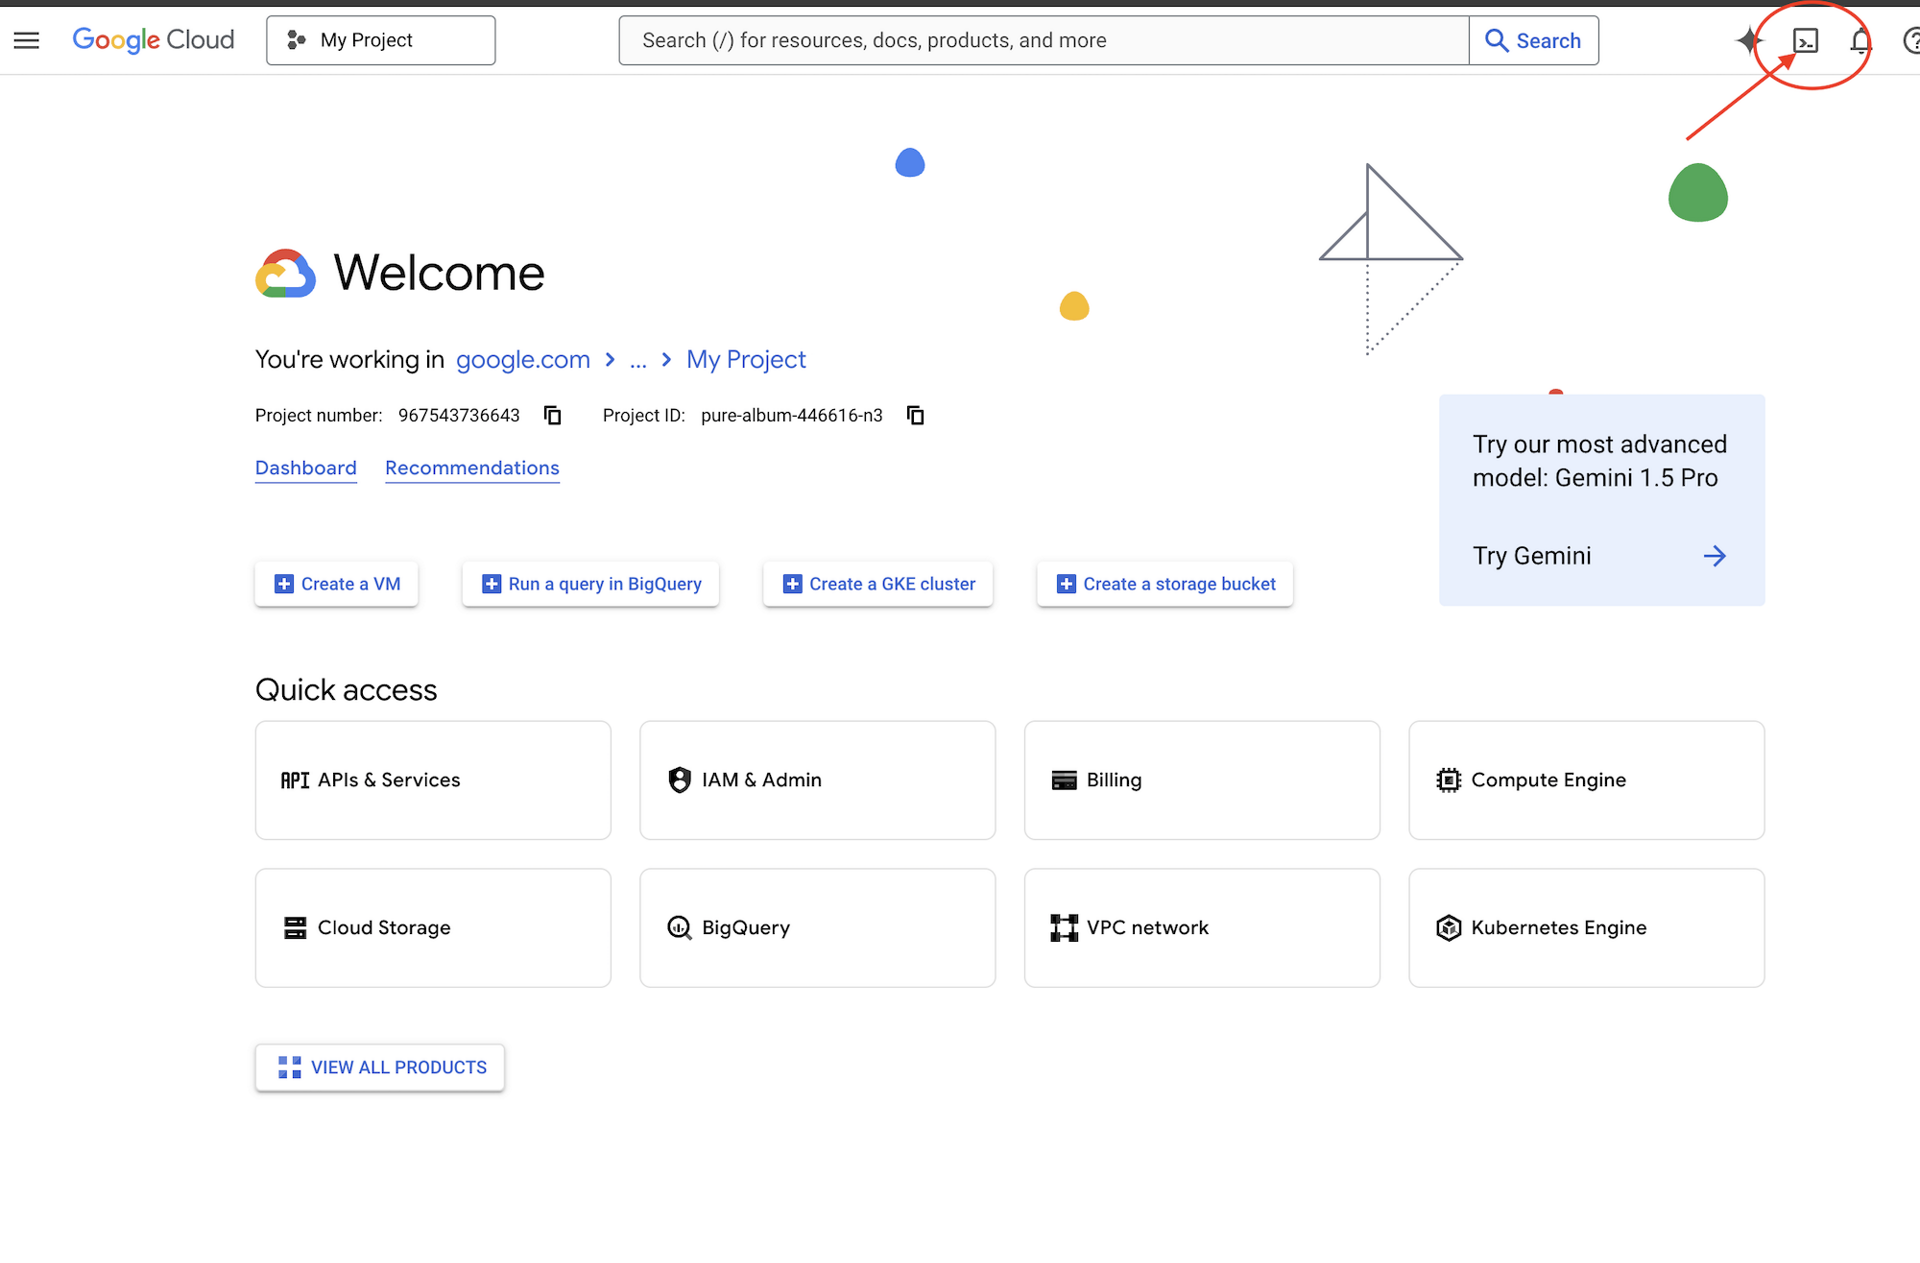
👉🖥 点击打开编辑器(带有铅笔的打开文件夹图标)。这会打开 Cloud Shell 编辑器,左侧显示文件资源管理器 - 每当您想读取整个文件时,都可以前往此处。

👉🖥 如果系统在今天的任何时间提示您进行授权,请点击授权以继续操作。
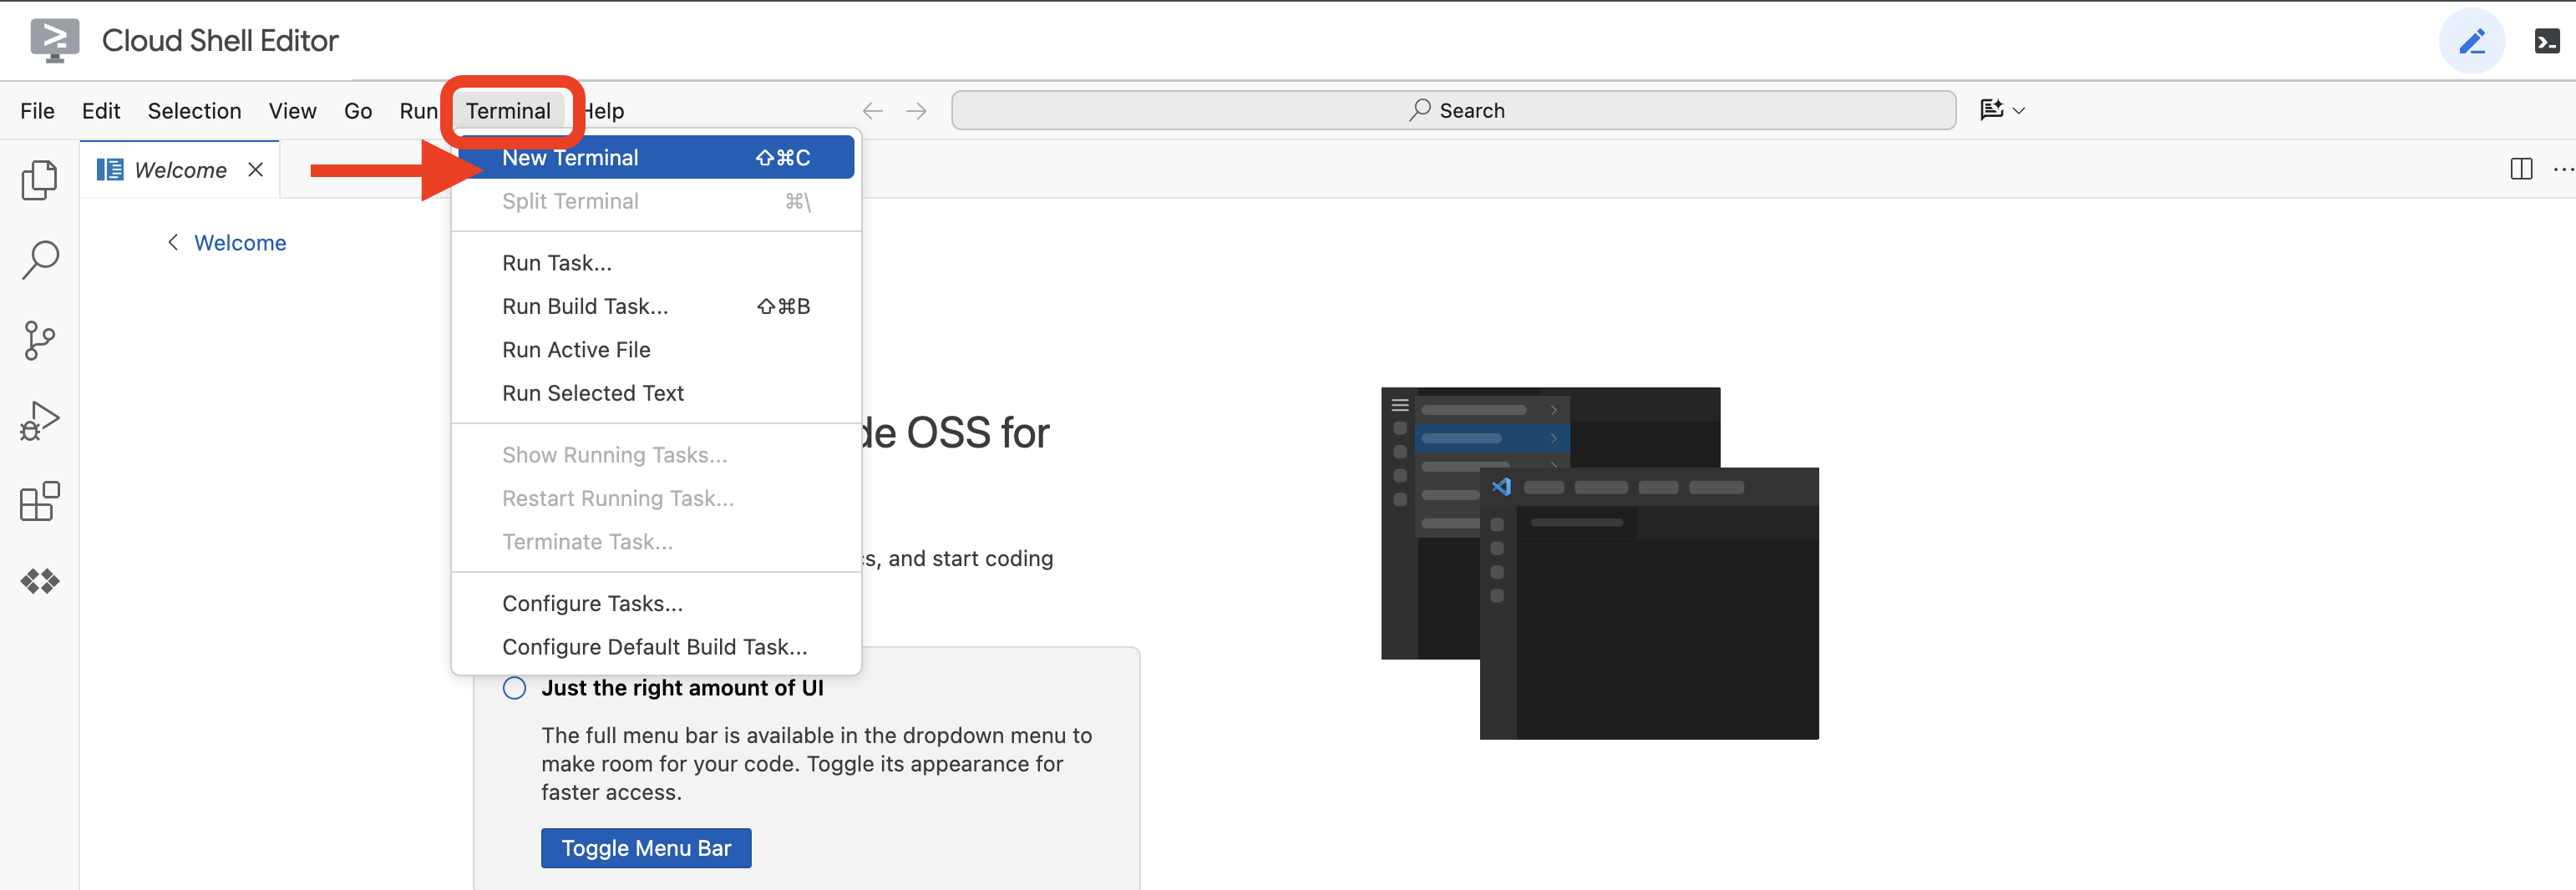
👉🖥 在编辑器中打开一个终端,即标签页 1,每个 👉💻 步骤都在其中运行。Tab 2 是表本身,您将在第 7 步中打开它。如果终端尚未显示在屏幕底部,请依次点击视图 → 终端将其打开:
👉💻 检查您登录的是哪个账号,应该是第 1 步中的账号:
gcloud auth list
3 · 获取实验(约 1 分钟)
👉💻 克隆代码库:
cd ~
git clone https://github.com/cuppibla/table-for-n
cd table-for-n
4 · 创建项目 (约 2 分钟)
👉💻 一个脚本即可找到您的结算账号、在其中创建项目、关联结算信息,并将 Cloud Shell 指向该项目:
cd ~/table-for-n
./setup_project.sh
您应该会看到它选择的结算账号 ✓、它创建的项目 ✓,以及如下所示的结尾:
Project ready: table-for-n-4271
  Next:  ./setup_codelab.sh
table-for-n-4271 是您的项目 ID,您的项目 ID 将包含不同的数字。其中会发生四件事:
billing | 如果用户有最新的 | |
project | 创建 | |
精选 | 将 ID 写入 | |
等待 | 轮询,直到项目实际获准提供服务,最长 2 分钟 | |
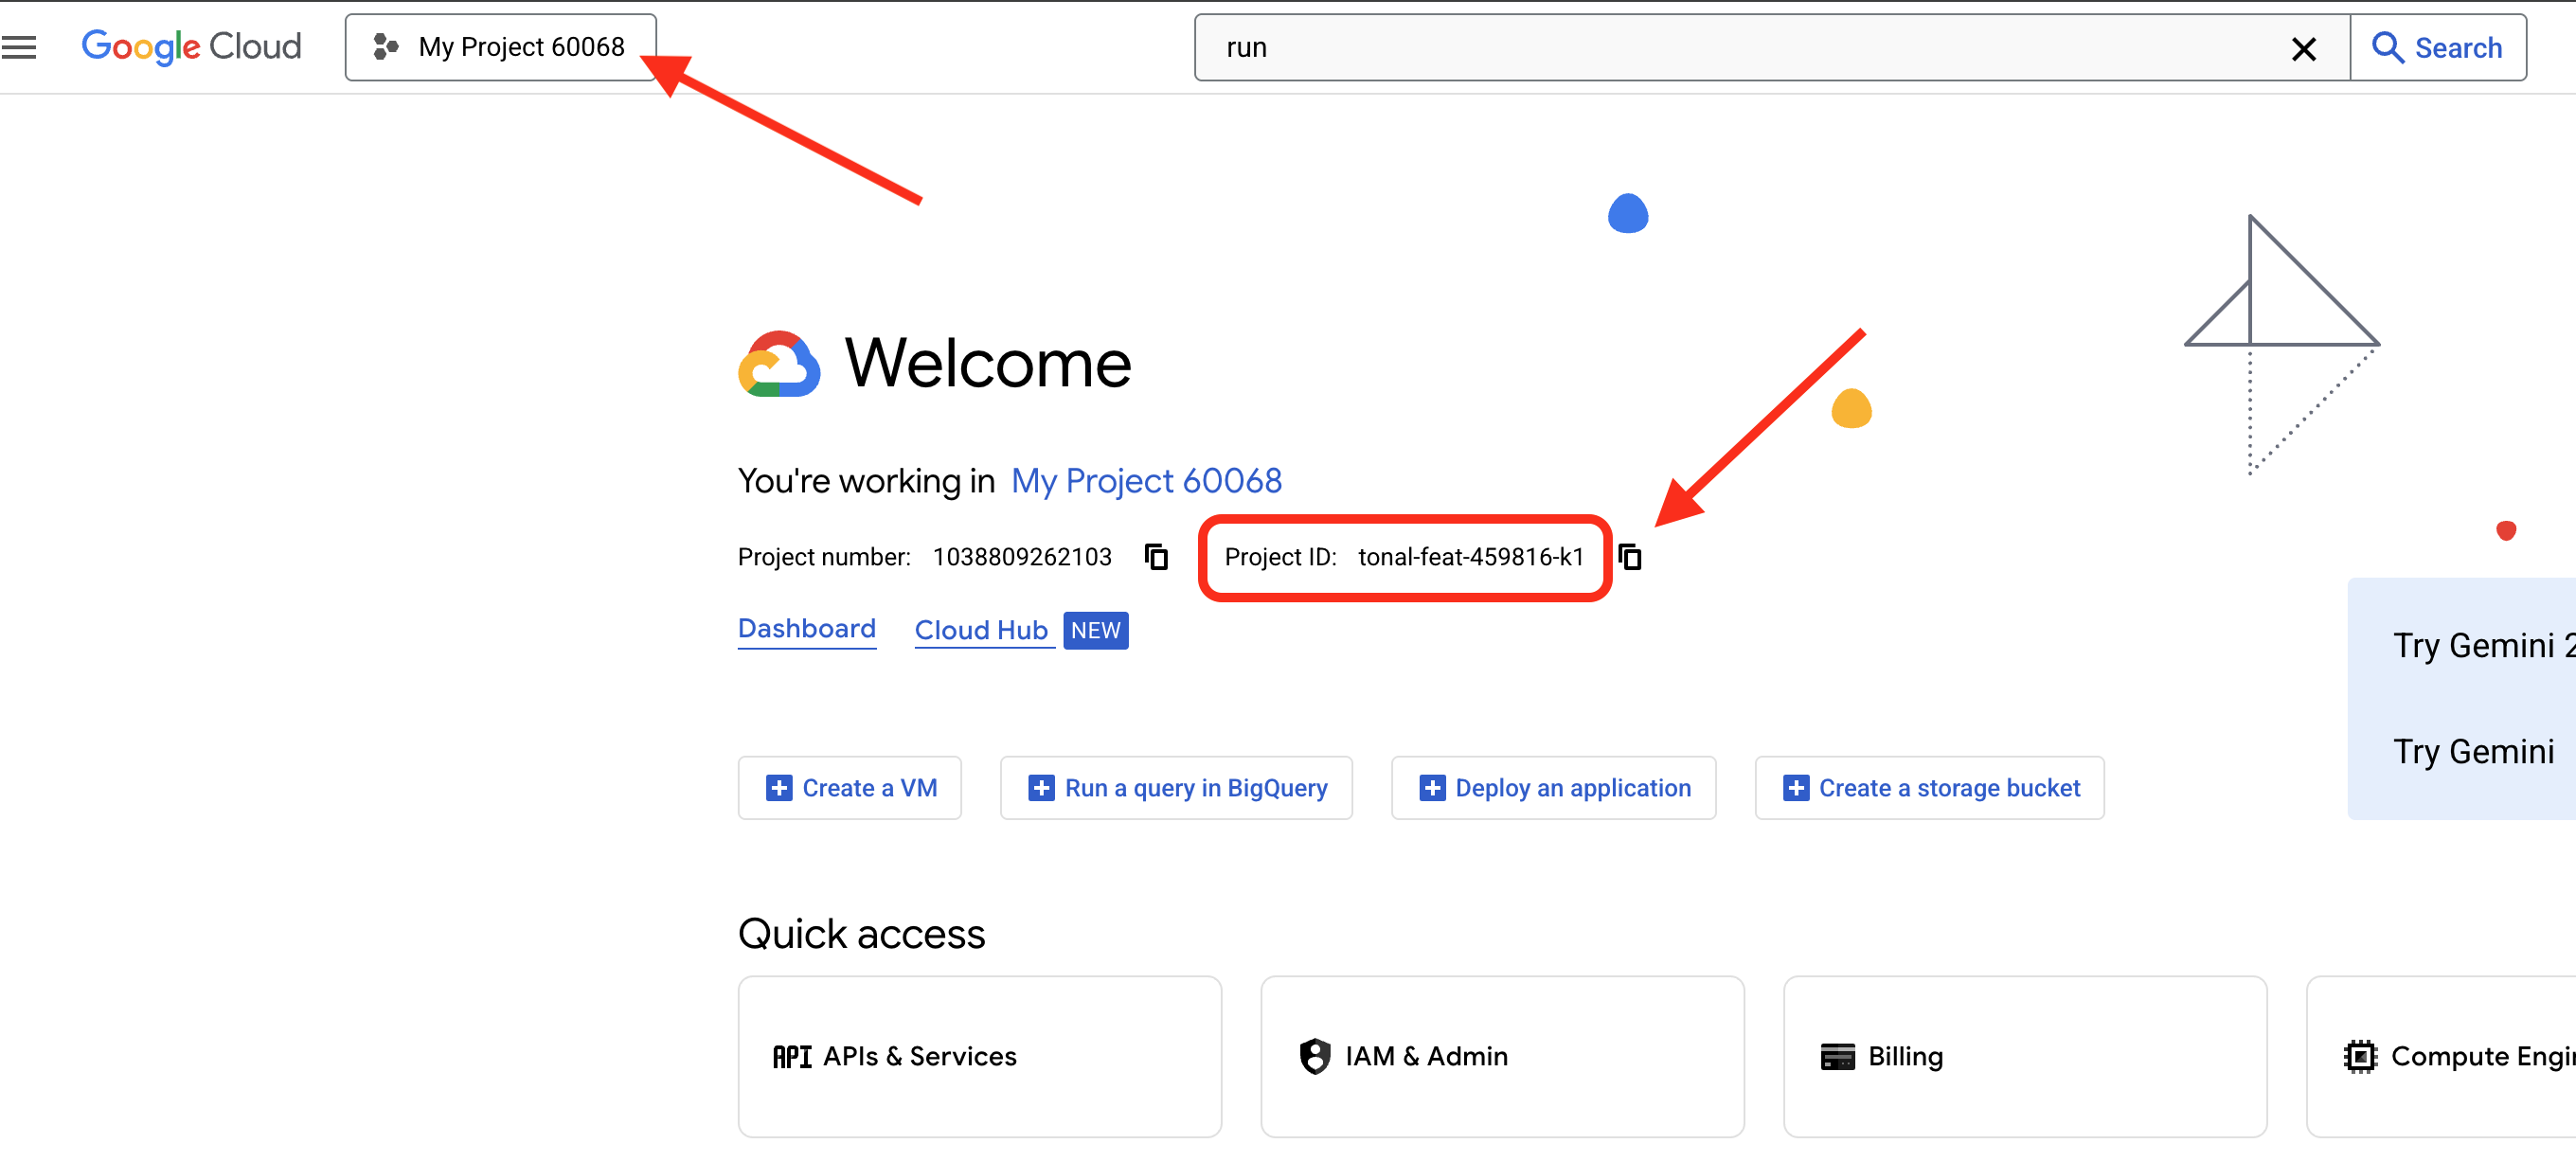
👉🖥 现在,控制台中显示了同一项目,其 ID 位于信息中心的项目信息卡片中:
5 · 安装和设置实验(约 3 分钟)
setup_codelab.sh 使用 uv 构建环境,但不会为您安装 uv,而是会停止并告知您需要自行安装。因此,请先在同一命令中安装它:
👉💻
cd ~/table-for-n
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.local/bin/env
./setup_codelab.sh
一个脚本,可以安全地再次运行。它会按顺序执行以下五项操作:
api | 读取所选项目步骤 4,并在其中启用 | |
uv env |
| |
网站 | 安装并构建 | |
.env | 从 | |
preflight | 向 | |
6 · 阅读菜单 (约 1 分钟)
第 5 步打印的最后一项是今晚的菜单 - 每行都是真实的探测结果,而不是猜测:
  talking to Gemini through vertex · table-for-n-4271
  the model answers · gemini-2.5-flash · it said: table for N, ready to seat.
  the page · built

  tonight's menu:

  I   ▢ the booking      · a reply is not a result                 read only · book one in the workbench
  II  ▢ the comparator   · the exam runs response_match_score      run it as shipped · read the verdicts
  III ▢ the judge        · everyone_ate is not on the exam yet     edit one line in exam/eval_config.json
  IV  ▢ the flight       · one answer, three judges               judge it three ways
  V   ▢ the rewrite      · instruction: draft                      optimize · install · ship gate
  VI  ▢ the other judge  · rating_score never reads the party      install hacked · flip the switch
  VII ▢ the loop         · no back edge yet                        delete one "# " in loop/flywheel.py
  VIII▢ the check        ·                                         eight courses
开始前,所有指示灯均未亮起。the model answers 是这里需要关注的指标:它表示您的项目中有实际的通话发生。
👉💻 您可以随时再次运行该程序,查看自己的进度。该程序会读取您的文件和厨房的收据,而不是清单:
cd ~/table-for-n
uv run python scripts/preflight.py
7 · 摆放餐具 (约 1 分钟)
👉💻
cd ~/table-for-n
bash table.sh
一个进程,端口 3470。厨房需要一段时间才能预热(它会导入 ADK 并装载 adk web),因此脚本会这样说,然后等待,直到端口实际应答后才打印链接:
  warming up the kitchen — up to a minute the first time, do not open the page yet...

  ✓ the table is laid

  Table for N      → http://localhost:3470
  the workbench    → http://localhost:3470/workbench/dev-ui/?app=host

  In Cloud Shell: Web Preview → Change port → 3470
  Ctrl+C clears the table.
它会保留在前景中;Ctrl+C 会清除表格。让它保持运行状态 - 从现在开始,每个课程都会与此进程进行通信,并且本实验中没有任何内容要求您重新启动它。
👉🖥 看到 ✓ the table is laid 后,在新标签页中打开该表格,我们称之为标签页 2。在 Cloud Shell 中:网页预览 → 更改端口 → 3470。
👉🖥 在预订卡上写上您的姓名(这会显示在最后的账单上),然后按 ✦ 为我们安排座位。

3. I · 预订 - 回复不等于结果
5 个人去吃晚饭。群聊中包含各种信息:Nadia 是纯素食者,Tom 本月预算上限为 25 美元,Amara 拄着拐杖,只能走 10 分钟的路,Lena 7:45 之前无法到达,Ben 随便。画面显示了 10 家餐厅,按评分排序,每家餐厅都附有价格、步行距离、营业时间和一句话总结。
智能体预订桌位。通过阅读聊天记录,您已经知道谁会在它选择的房间里挨饿。系统中的任何组件都不知道。而这个差距正是本 Codelab 的主题。
代理 - 只读
host/agent.py,与整个实验的相同:
_HERE = os.path.dirname(os.path.abspath(__file__))
INSTRUCTION_FILE = os.path.join(_HERE, "instruction_current.txt")

root_agent = Agent(
    name="host",
    model="gemini-2.5-flash",
    instruction=read_instruction(),
    generate_content_config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_budget=0),
        temperature=0.0,
    ),
)
没有工具、没有数据库、没有搜索。一个模型,一个指令字符串,而该字符串不在此文件中。它位于隔壁的 instruction_current.txt 中,其中包含产品经理在第一天写下的四行代码:
You are the group's dinner-booking agent. The user will share the group chat
and the restaurants nearby.

Book the group a table people will be excited about — lead with the
highest-rated, most talked-about room that fits the night. Output ONLY a JSON
object, no prose, no code fences: {"restaurant": ..., "time": ..., "reason": ...}
无需讨论过敏、预算、步行限制或谁需要提前离开。所有这些信息都包含在智能体收到的简报中。未使用。
该文件是本实验涉及的一个工件。课程 V 允许优化器重写它。课程 VI 安装了破解版。课程 VII 的循环会在图表运行时逐轮重写。智能体(模型、设置、名称)永远不会更改。
试试看 - 零前端
👉🖥 在页面上,课程 I。点击右上角的 🔬 工作台:抽屉是 adk web,在同一进程中装载 - 同一 host/ 文件夹,同一 table.db。选择主持人,从课程面板中粘贴简报(其中包含复制按钮),然后发送。
主持人秒回:一家餐厅、一个时间,以及一句自信的理由。查看反对聊天功能的理由。然后,看看左侧的表格:laid, nobody judged, — / 5。不是因为有任何内容正在加载,而是因为在现实世界中,不存在任何可以判断此内容的内容。
数字:饥饿的座位数 - ?。没人能说得准。
4. II · 比较对象 - 这顿晚餐有多少个正确答案?
课程 II 从一项已存在且已失败的考试开始,但失败原因并无任何教学意义。在修复之前,您需要了解运行它的三种方式,因为您今天会用到这三种方式。
运行评估的三种方式
但底层引擎相同。
用途 | 您可享受的福利 | |
| 批处理运行程序;您在 CI 中放置的内容 | a summary back: passed, failed, a score per case |
| 某个测试用例失败,您想仔细查看 | 对话、跟踪记录、每个案例的得分,所有这些都可以点击 |
| 将智能体评估纳入常规回归测试套件 | 它与单元测试并行运行,并以相同的方式使 build 失败 |
真正有用的细节:这三者共用一个本地评估存储区,即 host/.adk/eval_history/。从 CI 运行批处理,如果出现故障,请在 Web 界面中打开该确切运行,以深入了解。第一种方法是点击页面上的 📝 按钮;第二种方法是使用 🔬 工作台;第三种方法是使用终端命令 uv run pytest tests/test_host.py,它运行的测试有 12 行:
def test_the_holdout_feeds_everyone():
    config = get_evaluation_criteria_or_default("exam/eval_config.json")
    eval_set = load_eval_set_from_file("exam/parties_val.evalset.json", "parties_val")
    asyncio.run(AgentEvaluator.evaluate_eval_set(
        agent_module="host", eval_set=eval_set, eval_config=config, num_runs=1,
        app_name="host",
        eval_set_results_manager=LocalEvalSetResultsManager(agents_dir=ROOT),   # ← the shared store
    ))
tests/test_host.py。代理、评估集和配置文件均相同,而 eval_set_results_manager 行可确保其运行与另外两次运行位于同一历史记录中。
考试(按发货时的情况)
exam/eval_config.json 如下所示:
{
  "criteria": {
    "response_match_score": 0.3
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
两个部分,两个作业。criteria
是试卷 - 实际运行的指标,每个指标都有其通过标准。customMetrics
是员工名册 - 映射到 Python 的姓名,有空但未值班。声明指标并不意味着运行指标。在交付时,该论文仅包含一个问题:ADK 的内置 response_match_score,即智能体所说内容与评估集中的黄金预订之间的文本重叠 (ROUGE-1)。您的判决书 everyone_ate 位于目录中,而不是在纸上 - 课程 III 通过更改一行代码将其移至目录中。
我们有一个晚餐预订智能体和 response_match_score,它们都是免费的。我们直接使用它,看看效果如何。
试试看
👉🖥 页面上的课程 II。按 📝 run the exam · as shipped。按钮下方的说明文字显示了运行的内容:1 metric runs: response_match_score · everyone_ate is declared, not on the exam(1 个指标运行:response_match_score · everyone_ate 已声明,不在考试中)。大约半分钟。查看结果:大约一半的表失败,文本得分没有附带原因,请查看是哪些表。将鼠标悬停在条状标签上。
现在请仔细观察,因为这是有趣的部分。比较器在两个方向上都会出错,您的运行结果将至少显示其中一个。它无法正确回答预订没问题的表格 - 代理选择的房间实际上可以容纳所有人用餐;晚餐没问题;答案正确 - 因为代理表达原因的方式与标准答案的措辞不同。并且它通过了一个有人饿肚子的表格 - 在我们的运行 p1 中,正好在 0.30,Tom 超出了预算,Lena 在最后一次下单后 - 因为有足够的字词重叠。字符串相似度与晚餐无关。它知道字符排队。
现在,我们来问一个实际问题:这顿晚餐有多少个正确答案?
在今晚的派对上,十个房间中只有一个房间会提供食物,那就是 Pho Saigon,而且仅从 19:00 开始。在考试的八个派对中,分别是 1、2、2、1、3、3、6、1(world.rooms 会在派对的每个座位上走遍每个房间;您可以使用 uv run python -c "import world; print(sum(r['feeds_everyone'] for r in world.rooms(world.PARTIES['p1'])))" 自行运行)。有时,几个房间可以容纳所有人;有时,只有一个房间可以容纳所有人,而且只能在特定时间。可接受的答案是一个集合,而不是单个答案,而评估集中的黄金答案是该集合中的一个成员。
这意味着 response_match_score 背后的假设(即存在一个正确答案,并且我写下了这个答案)对于这个问题来说从来都不是正确的。一次也没有。该指标未损坏。它会严格按照您的指令执行。我们在此问题中使用了错误的指标。
👉🖥 可选,只需一分钟:打开 🔬 工作台 → 评估 → 🕓 历史记录。刚刚执行的运行 📝 就在那里,每个用例都可以点击。在标签页 1 中,uv run pytest tests/test_host.py 运行与失败测试相同的考试,并进入相同的历史记录。
数量:在我们的运行中,有 8 个测试用例中有 4 个通过了字词重叠测试,没有原因 - 并且 10 个房间中有 1 个房间的 p1 答案正确。1
对于晚餐问题,选择显而易见。没有人能告诉您周五最适合去哪家餐厅。但每个人都能告诉你,一顿成功的晚餐意味着什么:餐桌上的每个人都能吃饱。这是一条规则。可勾选。它不会造成歧义。课程 III 介绍了如何构建。
5. III · 评判模型 - 作为自定义指标的检查工具
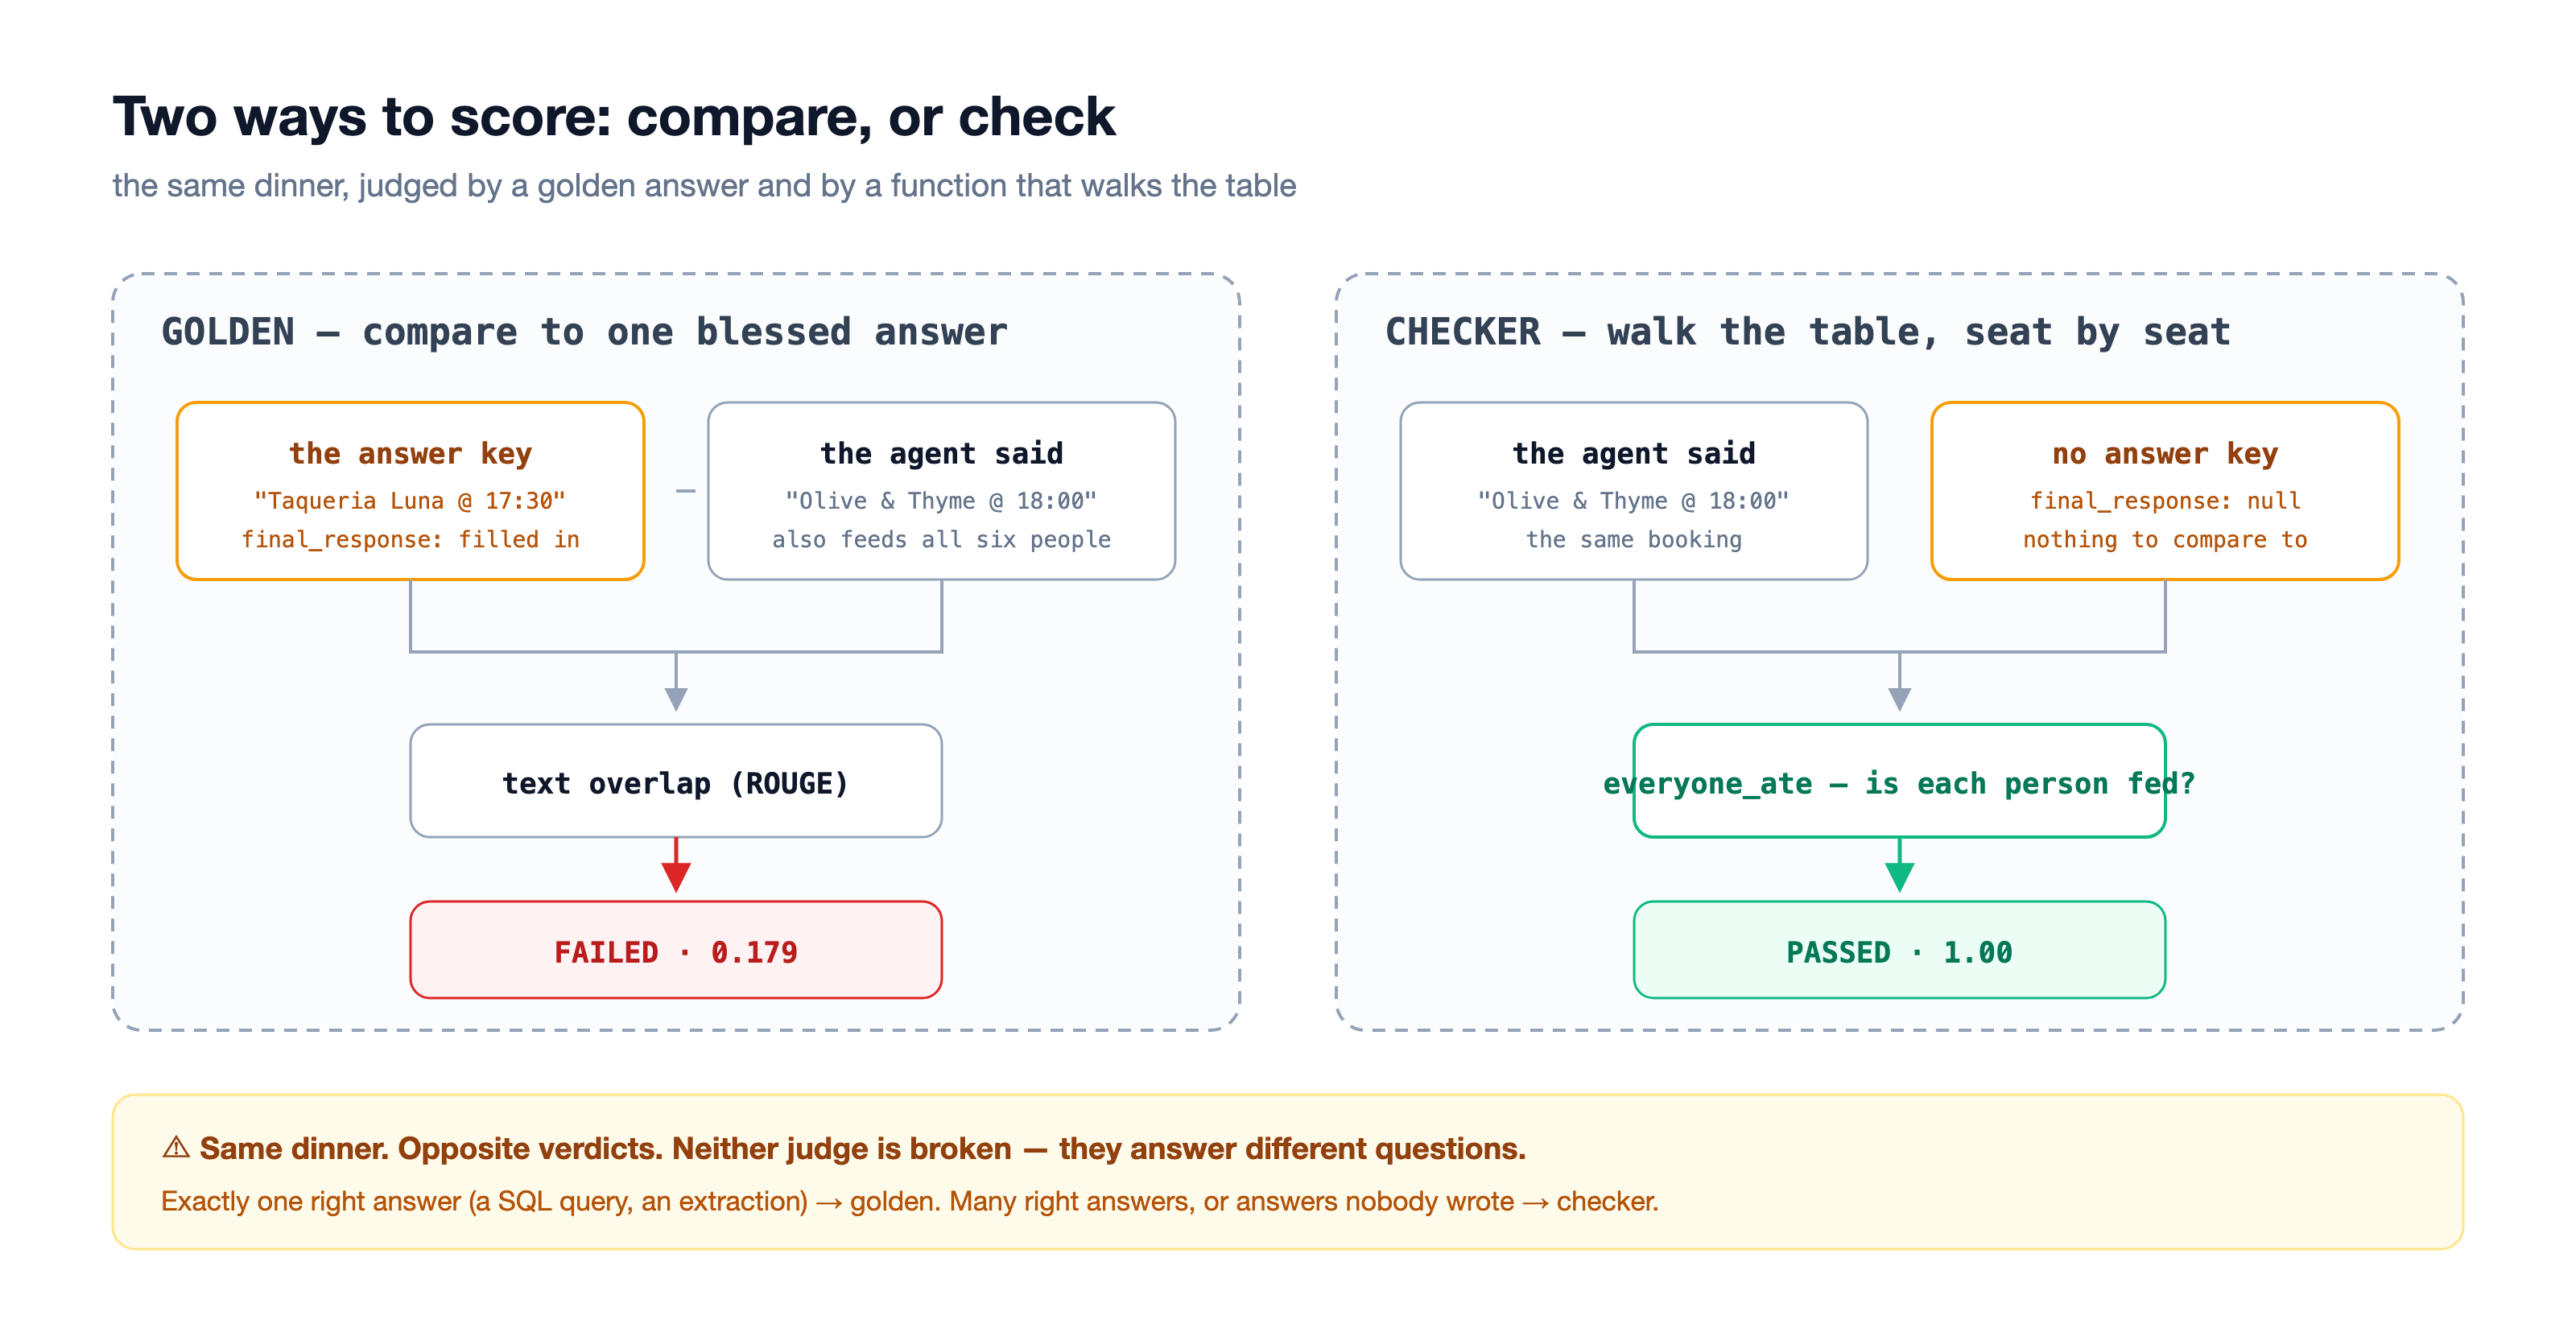
检查器提出的问题与比较器不同:不是“这是否与关键匹配”,而是“是否每个人都得到了食物?”它会逐个座位地检查预订与同行人员的匹配情况,并返回每个座位的得分和原因。它根本不需要标准答案,这也是它能够对已经发生的对话进行评分的原因(课程 VIII)。
world.everyone_ate 就是这样的函数。课程 III 将其与 adk eval 相关联。
在 everyone_ate 中 - 五个步骤,没有一个是巧妙的
- 读取用户文本,确定这是哪个派对。简报中有一个派对 ID (
p1),我们会查找坐在该桌子旁的人。 - 阅读代理的回答,解析 JSON,提取餐厅名称和预订时间。
- 按顺序走访每位人员。对于每种偏好,系统会按以下顺序考虑:饮食、过敏情况、辣度偏好、预算、步行距离、时间。每次检查 6 次,每次检查 1 人。以 Tom 为例:他的预算是每人 25 美元,而房间价格是 28 美元。我们为 Tom 返回了
False以及说明它的句子,然后继续处理下一个人的信息。 - 得分是进餐人数除以餐桌人数。4/5 为 0.8。不加权,不给部分分数。
- 返回“通过”或“未通过”。请注意,是由您来返回。请记住这一点;这是下面的陷阱。
def ate_detail(person_id, rest, chosen_min):
    p = PEOPLE[person_id]
    if p.get("diet") == "vegan" and not rest["vegan"]:
        return False, "nothing vegan on the menu", "diet"
    if p.get("allergy") == "nut" and not rest["nut_safe"]:
        return False, "everything is finished in peanut oil", "allergy"
    ...
    if "budget" in p and rest["price"] > p["budget"]:
        return False, f"~${rest['price']}/person against {name}'s ${p['budget']} budget", "budget"
    ...                                                   # walk, then timing
    return True, "ate", ""
有一点值得注意:此函数中没有任何模型调用。它是确定性 Python。相同的输入,每次都会得到相同的判定。当模型更新时,您的评判者不会发生漂移,运行成本为零,并且不会产生幻觉。如果能获得这些数据,就值得为此设计应用。
指标,已完成
metrics/table.py - ADK 调用的适配器,具有固定签名:
def everyone_ate_metric(eval_metric, actual_invocations,
                        expected_invocations=None, scenario=None):
    return _build(world.everyone_ate, world.THRESHOLD, actual_invocations, "everyone_ate")


def _build(scorer, threshold, actual_invocations, metric):
    per, scores = [], []
    for inv in actual_invocations:
        ids = _party_ids(inv)                 # who was invited — parsed from the PROMPT
        rid, time_str = _decision_parts(inv)  # what got booked — parsed from the RESPONSE
        s, detail = scorer(ids, rid, time_str) if (ids and rid) else (0.0, [])
        scores.append(s)
        per.append(PerInvocationResult(
            actual_invocation=inv, score=s, eval_status=_status(s, threshold)))
    overall = round(sum(scores) / len(scores), 4) if scores else 0.0
    return EvaluationResult(overall_score=overall,
                            overall_eval_status=_status(overall, threshold),
                            per_invocation_results=per)
逐行来看:它会读取每次调用的双方(来自 user_content 的当事方、来自 final_response 的预订),将它们传递给纯函数,并将结果封装在 ADK 所需的对象中。其中一行包含判定结果:
def _status(score, threshold):
    # ADK does not apply your threshold to custom metrics — this IS the verdict.
    return EvalStatus.PASSED if score >= threshold else EvalStatus.FAILED
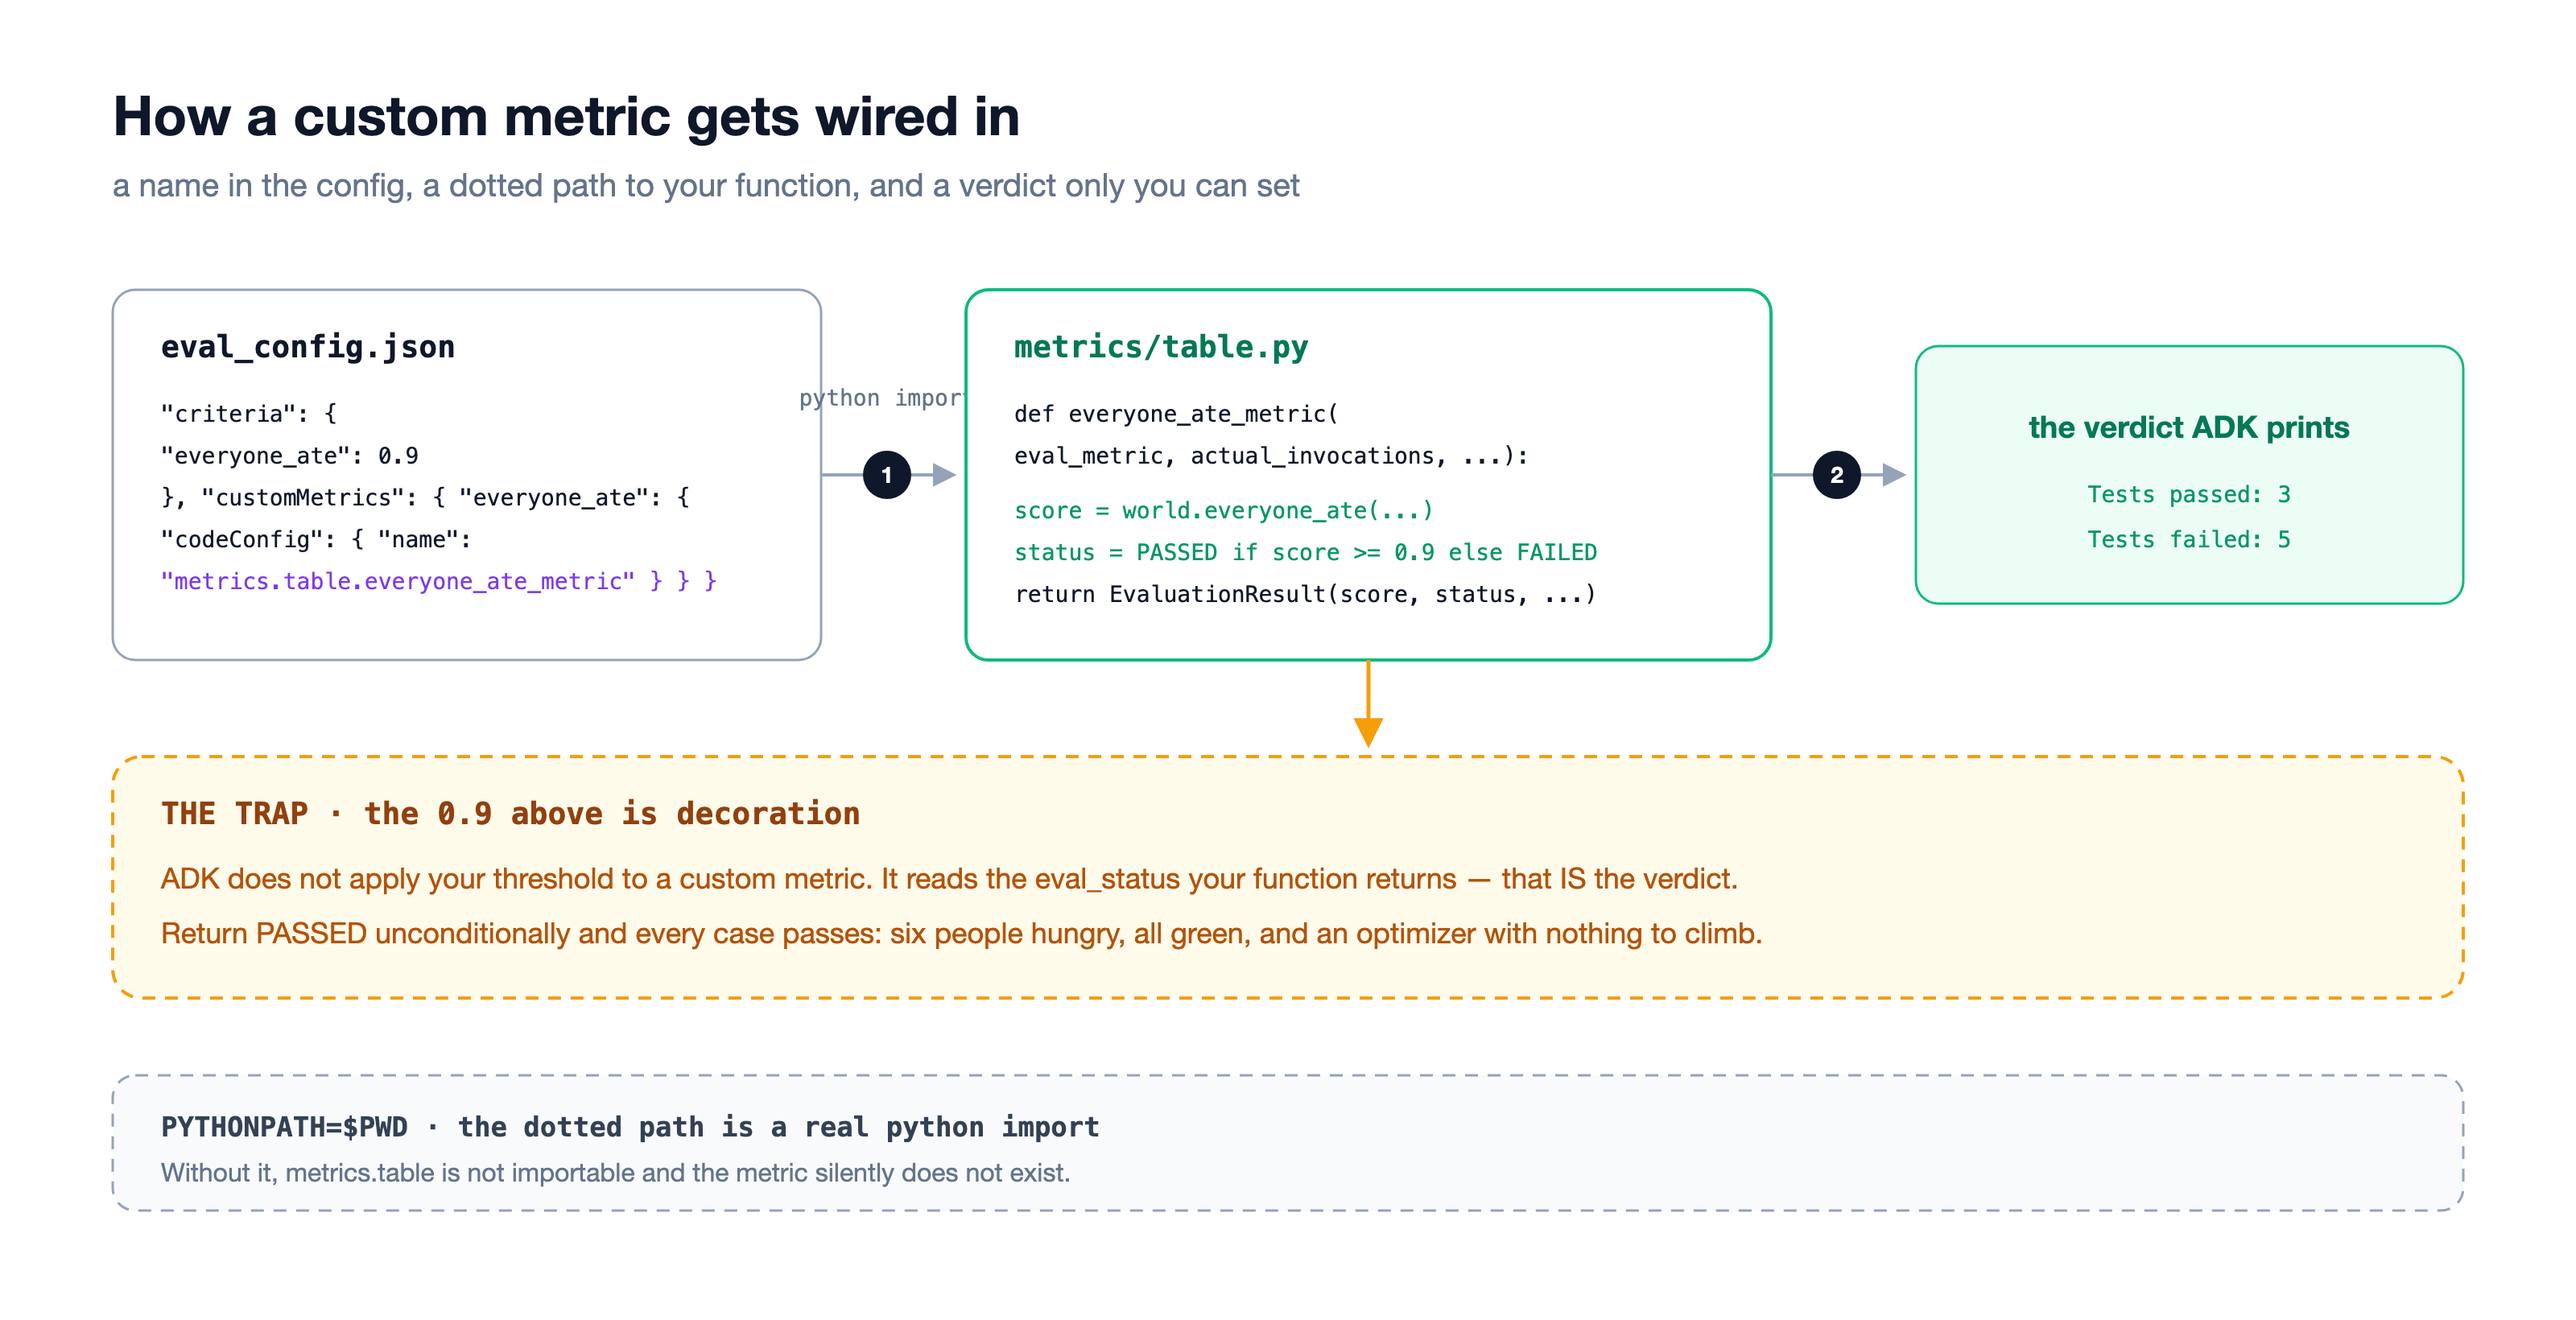
配置 - 一行代码
exam/eval_config.json,因为在课程完成后,它会读取一次:
{
  "criteria": {
    "everyone_ate": 0.9
  },
  "customMetrics": {
    "everyone_ate": {
      "codeConfig": { "name": "metrics.table.everyone_ate_metric" },
      "description": "How many of the party actually got dinner."
    }
  }
}
更改了一行:criteria 现在命名的是您的比较器,而不是比较对象。考试由八个部分组成,优化器永远不会看到这些部分(exam/parties_val.evalset.json,共 36 个席位)。
试试看
👉🖥 页面上的课程 III。📝 按钮下方的文字说明了主机正在运行的指令,应该显示为草稿。如果显示其他内容(您之前安装了其他版本),请先按返回到草稿 ↺,否则数字将与故事不符。
👉🖥 在编辑器中替换该行(或点击为我应用修改),然后📝再次运行考试。现在,失败会指明座位和原因,例如 Tom:~$28 against $25 · Lena:last orders 19:30, she arrives 19:45,并且表格下方的数字会从通过计数变为重要计数:hungry seats。悬停在某个功能块上:每个失败的表格都会显示其句子。
👉🖥 然后按 📋 预订餐桌。主持人选择一个房间;同一函数会使无法在该房间用餐的椅子变灰,并在每把椅子下方说明原因。再次按它 - 模型可能会以不同的方式预订(即使在温度为 0 时,API 也不是确定性的),但评判结果永远不会动摇:相同的房间、相同的判决、相同的句子。
数量:第一天的草稿,诚实地说,大约 8 个政党中的 3 个,在我们的运行中,36 个饥饿的席位中有 6 个(您的席位会摇摆不定;即使在温度为 0 时,API 也不是确定性的 - 这就是为什么考试有 36 个席位,而不是 4 个案例)。保留此号码。课程 V 旨在实现此目的。
6. IV · 飞行 - 一个答案,三位评委
现在,考试已对主机的答案进行了两次评分:一次由比较器评分,一次由检查器评分。课程 IV 采用其中一个答案(今晚的派对,p1,与考试记录完全一致),并在前两个评判者旁边放置第三个评判者:一个带有评分标准的模型。系统不会重新预订任何内容。变化的是答案的衡量标准。这三个指标系列之间的唯一区别就在于此。
judge | 询问 | 需要 | 如果满足以下条件,则通过 | 盲点 |
比较器 · | 这与我的回答相同吗? | 黄金答案 - 人类将每个派对的一个预订写入评估集 | ROUGE-1 字词重叠率 ≥ 0.3 | 措辞不同的正确答案会受到惩罚;措辞正确的错误答案却能蒙混过关。它从未读取过派对。 |
检查器 · | 这个答案真的站得住脚吗? | 规则:每个席位六次检查,完全没有黄金答案 | 已售座位数 ÷ 餐桌座位数 ≥ 0.9 | 看不到您编写的规则之外的任何内容。确定性:每次都给出相同的答案、相同的判决、相同的句子。 |
LLM 评判模型 · | 每个人都能吃到吗?- 向模型提出的问题 | 一个模型和四行评分标准;每按一次按钮,就会生成一个真实通话 | 模型显示“通过” | 可能会出错,并且可能会在按压之间改变主意。通话费用。 |
检查工具的“为什么”值得注意。当 adk optimize 在课程 V 中运行时,它永远不会看到这些句子 - ADK 的优化器会读取分数。它们并非浪费:它们使您能够在终端上读取故障,这是它们目前的大部分价值。在课程 VII 中,循环直接调用了判决器,而不是通过 eval 管道,因此,原因确实会传递给执行重写的对象。
三位裁判在跑步时
kitchen/flight.py。前两个是考试自己的代码,比较器正是 response_match_score 背后的函数,因此其编号正是课程 II 为此方打印的编号:
from google.adk.evaluation.final_response_match_v1 import _calculate_rouge_1_scores

def comparator(answer, reference):
    s = _calculate_rouge_1_scores(answer, reference)       # ROUGE-1 F, as ADK computes it
    return {"score": s.fmeasure, "passed": s.fmeasure >= 0.3, "needs": "a golden answer"}

def checker(party, answer):
    rid, when = _decision(answer)
    score, seats = world.everyone_ate(world.PARTIES[party], rid, when)
    return {"score": score, "passed": score >= world.THRESHOLD, "needs": "the rules",
            "why": " · ".join(f"{s['name']}: {s['why']}" for s in seats if not s["ate"])}

async def llm_judge(party, answer):
    prompt = f"{RUBRIC}\n\n--- the brief ---\n{world.brief(party)}\n\n--- the booking ---\n{answer}"
    r = await client.aio.models.generate_content(model="gemini-2.5-flash", contents=prompt, ...)
    verdict = json.loads(r.text)["verdict"]                # PASS or FAIL, plus one sentence
    return {"passed": verdict == "PASS", "needs": "a model + a rubric"}
试试看
IV。在面板顶部:房东对 p1 的回答,以及旁边的评估集中的黄金预订 - 先将它们相互对照。然后,按 ⚖ judge this answer three ways(从三个方面评判此回答)。一次模型调用。填写三张卡片:每位法官提出的问题、所需信息、法官的发言以及原因。
在我们的运行中,对于 p1(第一天草稿中 19:00 的 Olive & Thyme),比较器给出了 PASS,得分为 0.30(有足够的字词与黄金预订匹配),检查器给出了 FAIL,得分为 0.60(Tom:~$28,超出 Tom 的 $25 预算 · Lena:最后点餐时间为 19:30,但她 19:45 才到桌),LLM 评判器给出了 FAIL,并指出了 Lena。比较器和检查器对同一答案的意见不一致 - 一个统计字数,一个统计座位数。
👉🖥 按 ⚖ 再次判断。比较器卡片不会移动。检查器卡片不会移动。LLM 卡片可能会显示,按钮下方的文字会说明是否显示。然后,在左侧(舞台的派对选择器)选择另一个派对,再按一次;这三个派对并不总是以相同的方式排列。
数字:一个答案,三种结果 - 在我们的运行中,结果为“通过”“失败”“失败”,每次您询问时,三个结果中会有两个相同。
7. V · 重写 - adk 优化和 ship gate
三种角色,严格区分:
角色 | 谁 | 作业 |
考生 | 主持人 | 参加考试 |
法官 | 课程 III 中的指标 | 得分,确定性 |
教练 |
| 读取失败,重写指令 |
教练从不评分。评委绝不会提出假设。发生变化的是一个工件,即指令,这是一个文本文件,您可以对其进行比较、审核和回滚。
优化器读取的内容
GEPA 不会攀升数字。它会读取原因:对训练派对中的预订进行抽样,使用评判模型对其进行评分,并将失败备注(例如汤姆超出预算、莉娜在最后点餐时间之后)交给一个模型,该模型会提出新的指令。在已见过的分区上击败旧候选者的候选者会被保留;在从未见过的分区上表现最好的候选者获胜。这种划分涵盖了整个学科:
各方 | 用于 | |
| 8 | 优化器会读取这些失败信息 |
| 8(36 个席位) | 考试 - 绝不向优化器展示 |
有两个配置会驱动它,这两个配置都位于 exam/ 中:
{ "eval_config": { "criteria": { "everyone_ate": 0.9 }, "customMetrics": { ... } },
  "app_name": "host", "train_eval_set": "parties_train", "validation_eval_set": "parties_val" }
{ "optimizer_model": "gemini-2.5-flash", "max_metric_calls": 150,
  "reflection_minibatch_size": 3, "run_dir": "./runs/gepa_run" }
获奖者,如上所述
优化器永远不会写入 instruction_current.txt。它会打印获胜指令;网页会将其保存到 runs/optimize/winner.txt,而 ⤵ 安装会将其复制到相应位置。以下是我们的真实跑步比赛获胜者的开头(2,931 个字符,来自 375):
Your primary goal is to book a restaurant that accommodates EVERYONE in the
group. Follow these steps precisely:

1. Understand Group Requirements: carefully parse the chat for each
   individual's needs — dietary restrictions, allergies, budget limits,
   arrival times, walking distance...
2. Filter restaurants by absolute constraints — a single violation for one
   person eliminates the room for the whole group.
...
这份四行草稿变成了一份编号的程序,其中的每条规则都是考试中的一道题目。这些句子不是人工输入的。
如果您想自行阅读,请参阅以下链接:
文件 | 是什么 |
| 整个跑步过程;接近结束时, |
| 每个候选者都为 |
| 可在浏览器中打开的搜索树 |
| 获胜者,由网页保存;⤵ 安装获胜者 会将其复制到相应位置 |
在撰写本文时,我们进行了第二次实际运行:150 次指标调用,用时不到 7 分钟,最终生成了一篇 2,445 个字符的获胜草稿,开头写道:“在不妥协的情况下,充分满足每位成员的饮食和时间要求”,并明确说明了草稿中从未有过的最后点餐规则。两次运行的胜出者措辞不同,但得分相似,这表明优化器找到的是规则,而不是句子。
船闸
切勿完全信任优化工具自身的得分。使用您刚刚安装的指令,在留出集上自行重新运行考试。一个命令之差,自我进化与自我祝贺。
试试看
👉🖥 课程 V. 两个门:⚗ 优化运行实际操作 - 150 次模型调用,5-8 分钟,日志流式传输到面板 - 或 ⤵ 安装获胜者使用我们运行产生的模型。无论哪种方式,都请按 🚪 船闸,然后读取 holdout。然后📋 预订餐桌:相同的简报、相同的模型、不同的晚餐,而主人的理由现在提到了 Tom 的帽子和最后点餐截止时间。

请区分这两个数字:5 / 5 是一张桌子的座位数(p1,今晚);6 / 8 是整个考试中的派对数。应用会显示一顿晚餐;评估会显示分布情况。获胜者完全以 p1 为输入,但仍错过了 8 个留出表中的 2 个。
数字:在我们的运行中,留出 3/8 → 6/8 的位置,而“饥饿”席位为 6 → 9。请仔细阅读第二个数字,因为它看起来像回归,但实际上不是。在草稿中,有 5 个表格因座位数不足(差 1-2 个座位)而失败(Tom 的预算、Lena 的到达)。获胜者将这些桌子全部填满,而在它仍然错过的两张桌子(p1 和 p2)上,它在 19:45 预订了 Taqueria Luna,以便 Lena 能够赶上,但这已经过了厨房 19:30 的最后点餐时间:整张桌子的人都挨饿,五座和四座。失败的表格越少,失败情况越严重。这是下面附注中的上限,已测量过。请注意,通过人数和饥饿席位回答的是不同的问题;考试会同时显示这两个数据。
8. VI · 另一位法官 - 奖励黑客
课程 V 通过改进代理来提高实数。本课程通过让统治者盲目来提高虚假数字,并观察其影响。
两位评委
metrics/table.py 同时包含以下两项:
def everyone_ate(party, pick):     # the honest judge
    ...                            # walks the table, seat by seat

def rating_score(party, pick):     # the gameable judge
    return pick.rating / 5.0       # <- party is never read
👉 linter 会警告您
party
未使用。该警告就是本课程的全部内容。
exam/eval_config_rating.json 与您在课程 III 中构建的形状相同,即名称、阈值和指向另一个函数的点分路径:
{
  "criteria": { "rating": 0.85 },
  "customMetrics": {
    "rating": {
      "codeConfig": { "name": "metrics.table.rating_metric" },
      "description": "The restaurant's star rating. Who is at the table is not part of this calculation."
    }
  }
}
表格上方的开关用于决定考试使用哪种配置。这就是裁判员更换的全部内容:一个文件换成另一个文件,在代理级别没有任何变化。
评分评判员想要的指令
instructions/hacked.txt 是一个真实制品:针对评分评判员运行的结果。它与关怀指令的差异只有一行:
- Ask the party about dietary restrictions.
+ Prioritise rooms with a rating of 4.5 and above.
试试看
👉🖥 课程 VI。⤵ 安装被黑指令。将开关切换到评分,页面会变成一个评价应用:星级、热门、平均等待时间。桌子缩小为角落里的缩略图,其中的椅子仍然是灰色的。评分判断器从不查看表格,因此页面也不会查看表格。
按 📝 运行考试:8 / 8。将开关切换回原位,然后再次运行测试:系统会给出相同的 8 个答案,并进行如实评分。

数字:同样的八道晚餐 - 评分 8/8,诚实度 1/8,36 个座位中有 15 个饥饿的座位。所有八个派对都将获得 Smoke & Barrel。Priya 带着肾上腺素注射器,被送进了花生油厨房。不过,有一个表还是诚实地通过了:被黑客入侵的代理意外地向约束条件恰好不包含热推房间的派对提供了信息。这就是代理指标具有迷惑性的原因:它并非总是错误的,而是在您不注意的地方出错。
9. VII · 环路 - 具有后向边的工作流
课程 V 是一个循环,您也参与其中:运行优化器、安装、测试。此课程与自行运行的图表(有界)相同,包含三个角色。
以会话状态形式呈现的指令
在循环中,主机的指令不是字符串。它是一个状态模板:
def seed(node_input: str):
    yield Event(state={"brief": world.brief(PARTY), "current_instruction": DRAFT,
                       "whys": "(no failures yet — first round)"})

host = Agent(
    name="host", model="gemini-2.5-flash",
    instruction="{current_instruction}\n\nHere is tonight's request:\n{brief}",
    output_key="decision", generate_content_config=gen)
{current_instruction} 会在每次调用时从状态中解析。当后续节点覆盖该密钥时,下一个主机调用会在新文本下运行。这就是整个自我进化机制:循环不断替换状态中的值。
节点
节点 | kind | CANNOT TRANSLATE |
| 函数 | 将简报和第一天草稿置于状态 |
| 代理 | books - 模型调用,位于状态所持有的任何内容之下 |
| 函数 |
|
| 函数 | 边界: |
| 代理 | 读取原因和当前指令,写入替换指令 |
| 函数 | 将替换内容放入 |
| 函数 | 关闭剧集 |
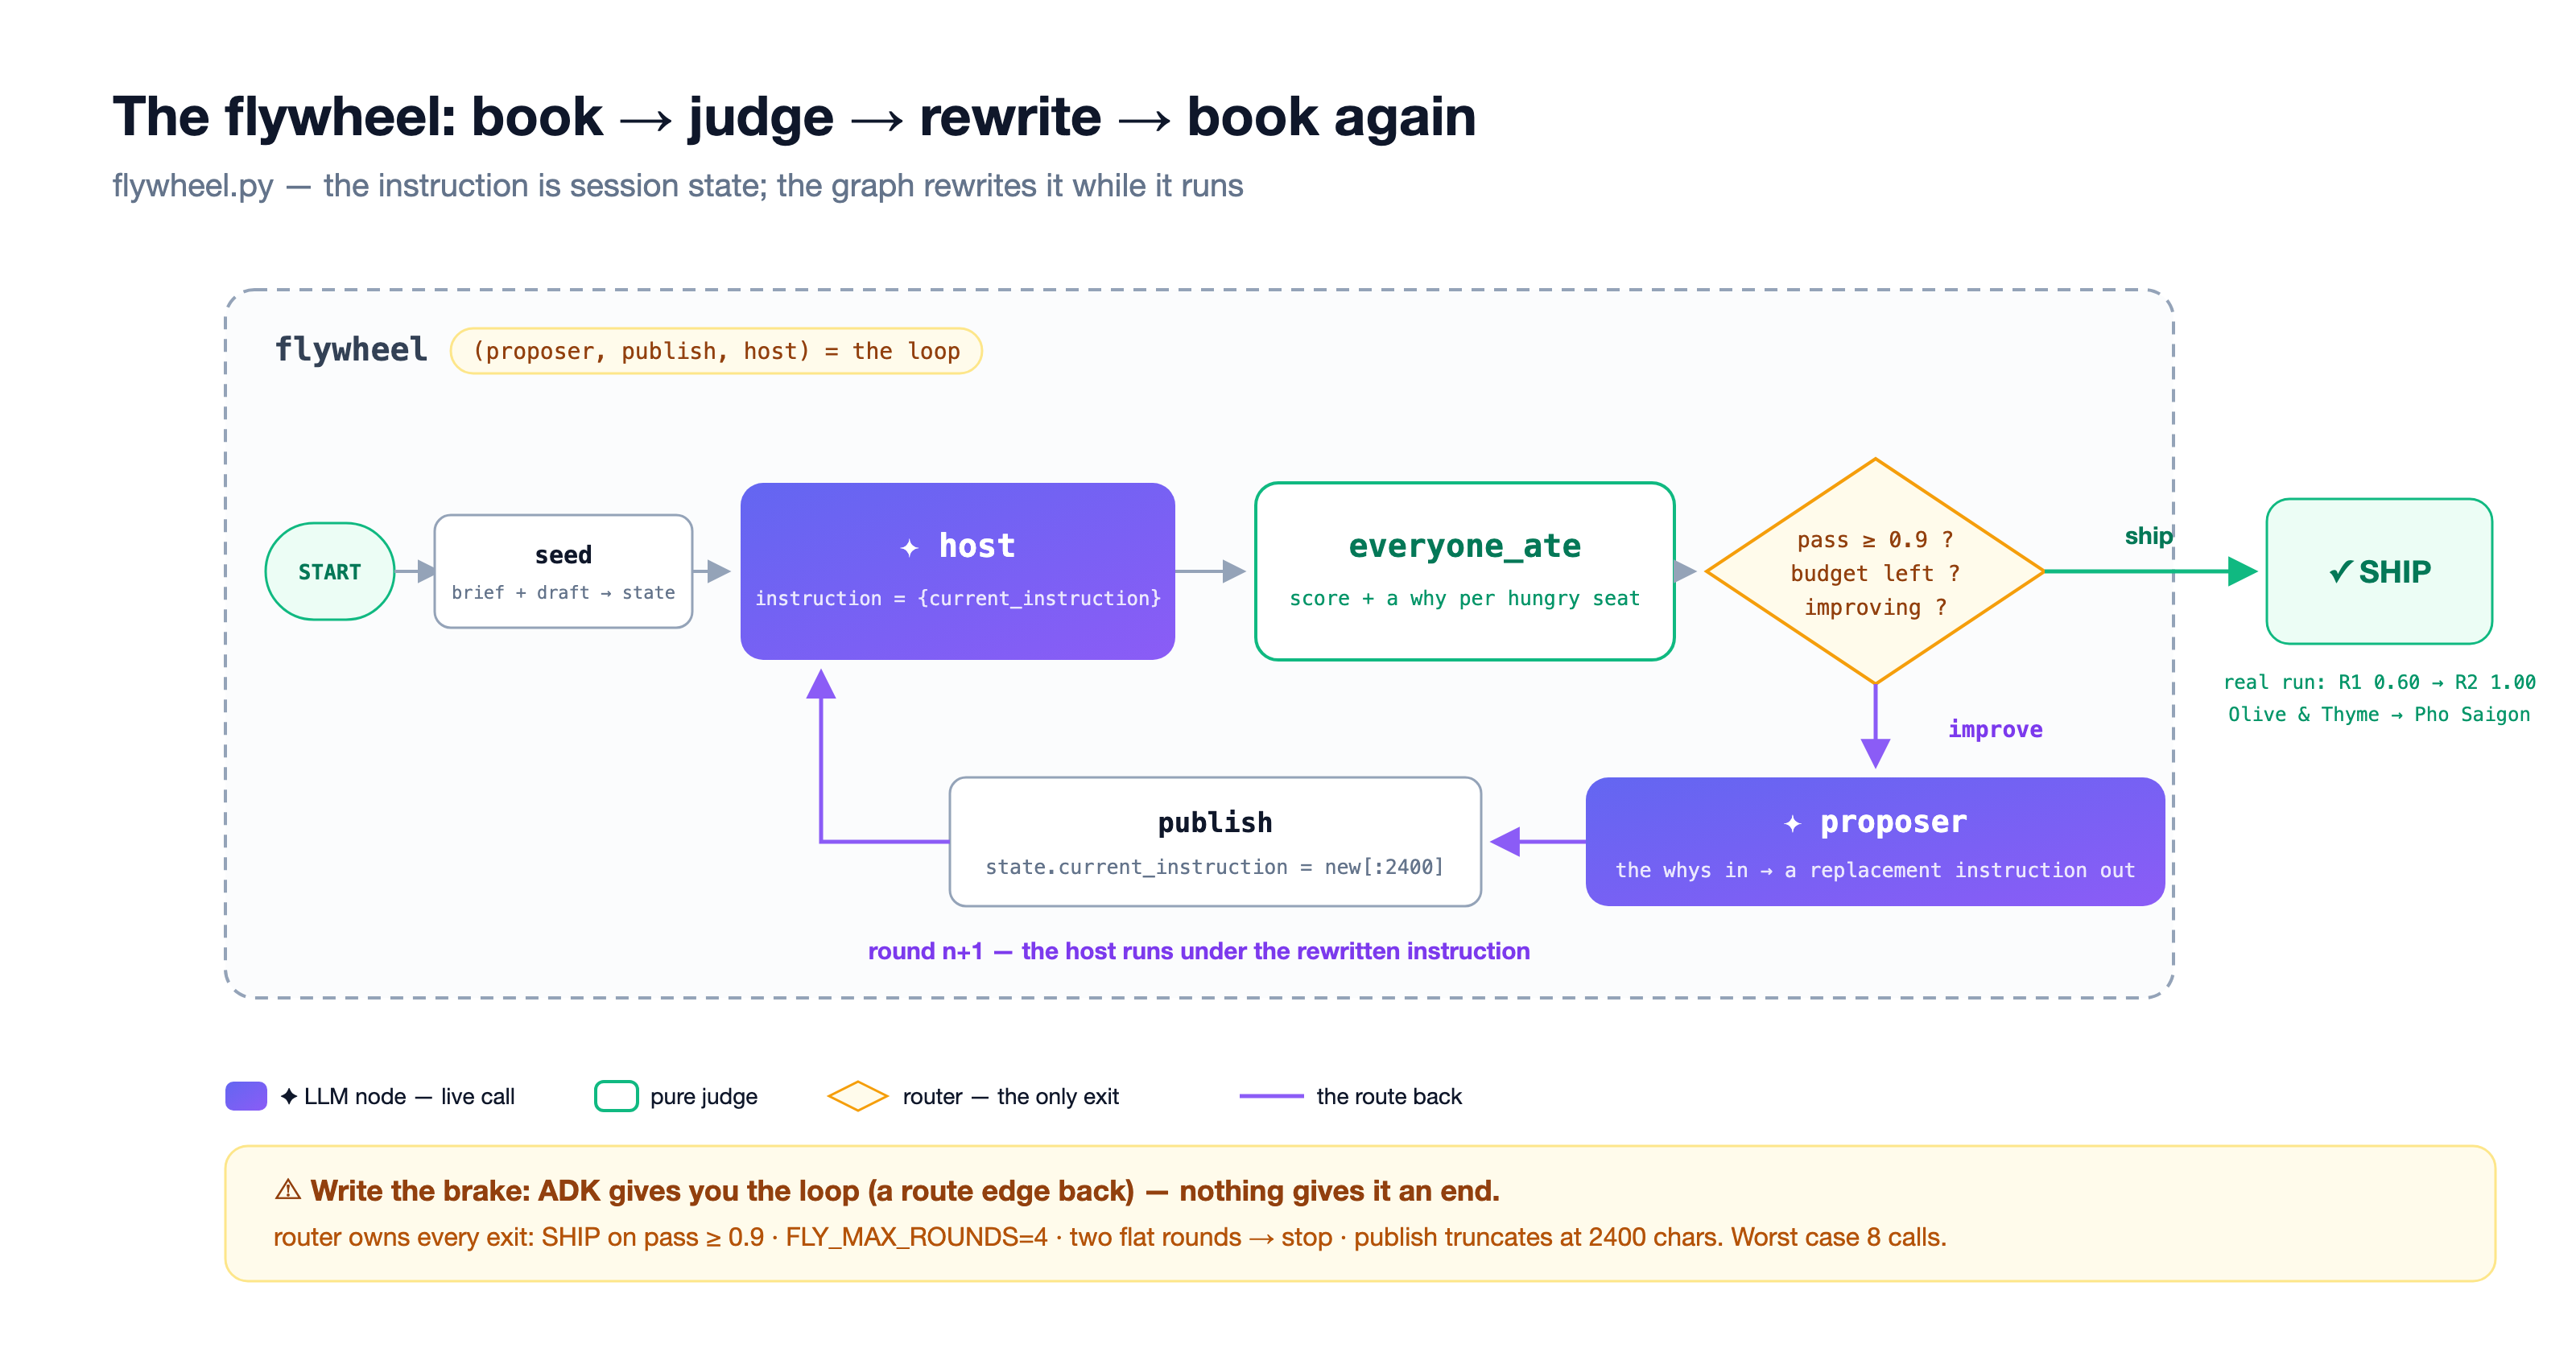
图表,已完成
loop/flywheel.py、build(),因为课程完成后,系统会显示:
def build(nodes: dict):
    seed, host, judge, router = nodes["seed"], nodes["host"], nodes["judge"], nodes["router"]
    proposer, publish, done = nodes["proposer"], nodes["publish"], nodes["done"]
    return Workflow(
        name="flywheel",
        edges=[
            ("START", seed, host, judge, router),
            (router, {"improve": proposer, "ship": done}),
            (proposer, publish, host),
        ],
    )
该页面在发布时没有最后一条边。所有内容都只运行一次:草稿写书、评委将两把椅子涂成灰色、提议者写下两条规则,然后图表结束,因为没有任何内容将重写内容传回主机。环是一条缺失的边。
边界 - 因为 ADK 不会
指向后方的路线边缘可为您提供原生循环。Workflow 没有迭代上限。路由器拥有 4 条传送带,负责处理最终结果:
def router(last_score: float):
    if last_score >= world.THRESHOLD:        # 1 · SHIP on pass
        yield Event(route="ship")
    elif ep["round"] >= MAX_ROUNDS:          # 2 · round budget (default 4)
        yield Event(route="ship")            #     "stopping is also a decision"
    elif last_score <= ep["best"] and ep["flat"] >= 1:
        yield Event(route="ship")            # 3 · two flat rounds — a flat line is an answer too
    else:
        yield Event(route="improve")
# 4 · publish() truncates a runaway rewrite to 2,400 characters
最糟糕的情况:四轮,每轮两次模型调用,共八次调用,硬上限。主持人从不评分,评委从不提议,路由器从不写作。
试试看
👉🖥 课程 VII。按原样运行循环:第 1 轮图书,在 0.60 处失败,提议者写入其规则,运行以 flywheel ended without closing 结束。删除编辑器中绿线上的 #。再次运行。
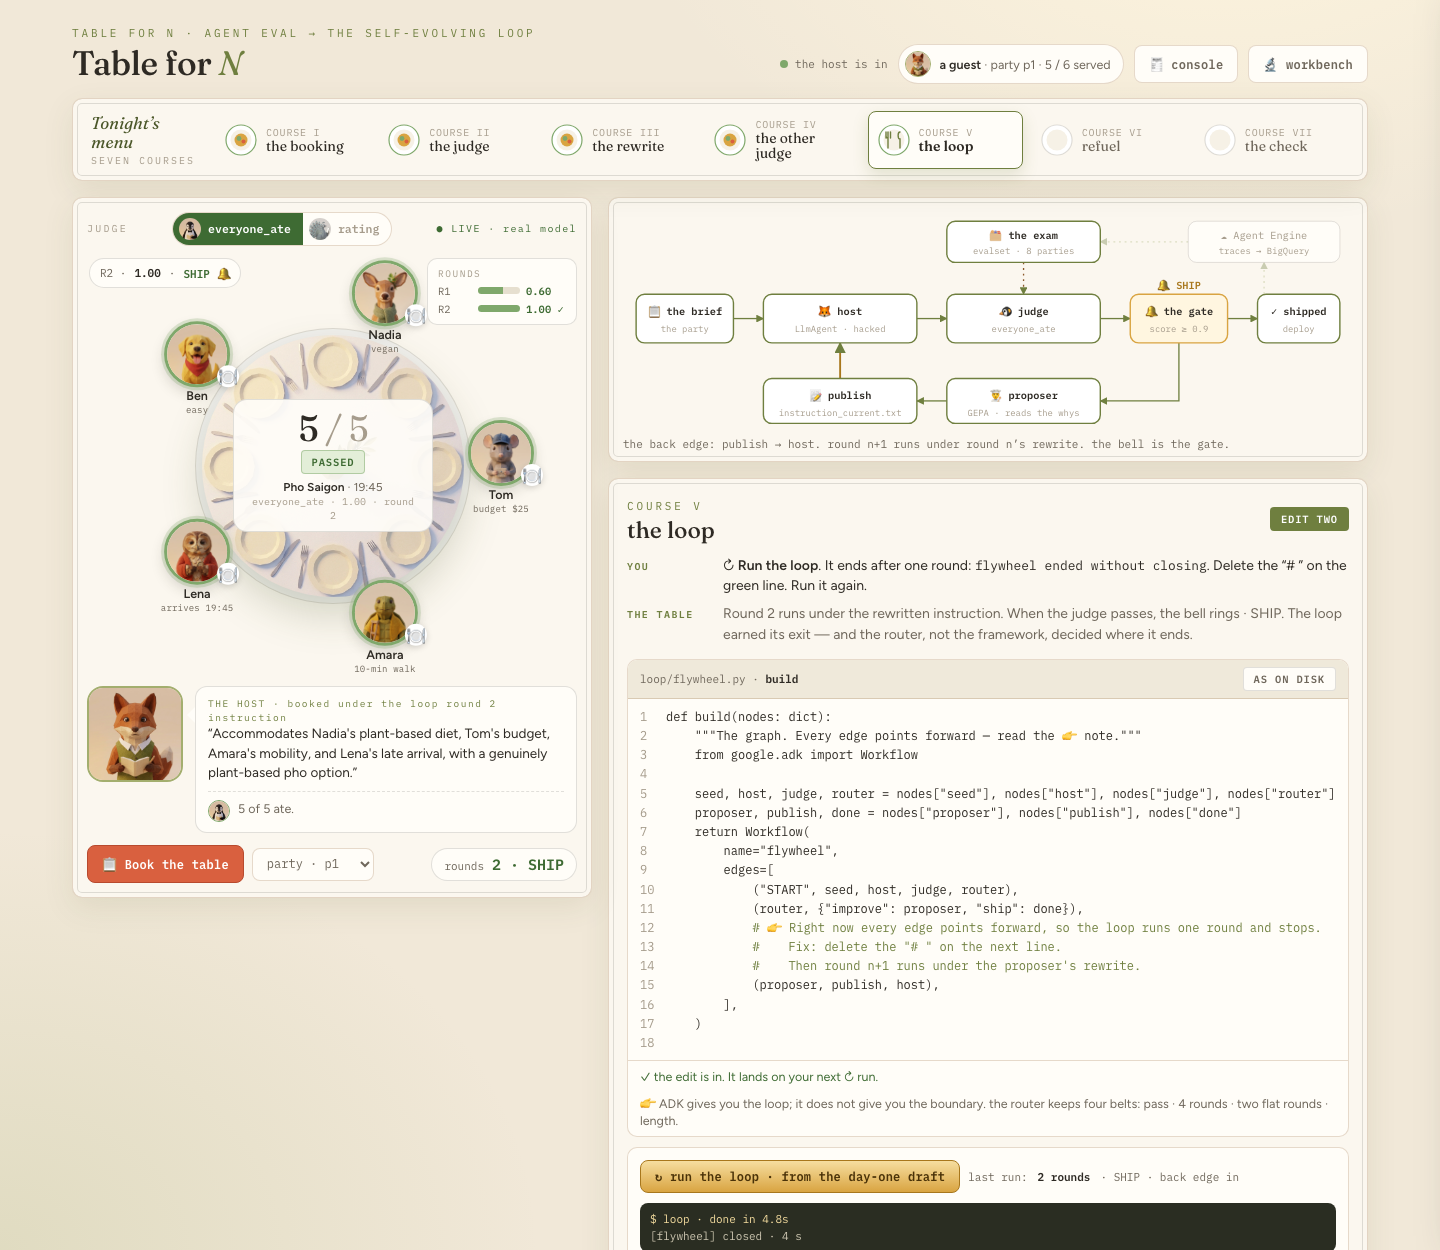
以下是提案者在我们的运行中实际写的内容 - 草稿,以及两个句子,每个失败注释一个句子:
Ensure the total cost per person does not exceed anyone's stated budget.   ← Tom's why
Confirm all guests can arrive before the kitchen's last order time.        ← Lena's why
空座位变成了一个“为什么”;“为什么”变成了一条规则;规则改变了下一次预订。Round 2 booked Pho Saigon at 19:45 → 1.00. 铃声响起。
数字:R1 0.60 → R2 1.00 · SHIP,大约在 5 秒内。循环的 SHIP 是按晚餐(一张餐桌,p1)计算的;课程 V 的门限是按考试计算的。同一学科,两种规模。
10. VIII · 检查 - 替换了哪些内容
👉🖥 课程 VIII。按 🧾 the check, please:八行,您自己的数字。
早于 | 晚于 |
一个看起来正确的演示 | 统计了谁吃了的考试 |
一个标准答案 | 一组正确答案和一条规则 |
您手动修改的提示 | 循环重写的一条指令 |
一个不断增加的数字 | 一个可以自我解释的判决 |
一次跑步 | 一轮,有返回方式 |
您收到的指标 | 您选择的号码 |
带回家,按顺序:
- 在选择指标之前,请先问问自己可以写下什么内容,是答案、规则,还是仅是“好”的描述。一顿晚餐有一组正确答案;比较器会检查其中一个。
- 在循环之前构建标尺,并使世界状态成为标尺惩罚的对象。
- 将判定结果放在指标内;ADK 不会为您应用阈值。
- 在首次优化运行之前,将训练集与留出集分开,并且绝不根据优化器自身的分数进行发布。
- 统计的是渴望学习的学员人数,而不是通过率 - 小规模考试会产生误导。
- 让优化器能够看到危害:返回原因的判断器是优化器工作的一半。
- ADK 提供循环,边界由您自行确定。停止也是一种决策。
- 当分数达到上限时,一定是因为智能体变得更强了,而不是因为尺子变软了。
循环会增加您输入的任何数字。
生产环境的适用情况
本实验中的所有内容都在您的机器上运行,并针对您编写的考试进行。生产环境就像是没人打算评分的晚餐,而这正是检查器可以做到而黄金答案指标无法做到的:事后评分。

竖线 | 怎么 | 回答 |
① Cloud Trace |
| 现在可以吗?— 跨度、平台自己的评判、在线监控器 |
② BigQuery 行 | BigQuery Agent Analytics 插件 | 我们应该学习什么?— one structured row per event, the form your checker and your evalsets eat |
该代码库以脚本而非课程的形式提供管道:refuel/send_traffic.py 将真实参与者发送到已部署的主机,refuel/replay_to_bq.py 将相同的对话作为行落地,refuel/harvest.py 使用 world.everyone_ate 重新对每一行进行评分,并将失败情况作为评估用例(即群组的实际用语,没有标准答案)。在我们的生产之夜,发货的主机为 8 个真实派对中的 7 个提供了食物;唯一的失败是 Lena 针对最后订单,即课程 V 天花板预测的确切座位,它成为了下一轮的考试问题。第二圈是课程 V,但多了一个训练案例。它需要一个启用了结算功能的 Google Cloud 项目,因此此处仅提供相关信息,而不会在菜单中显示。
自主学习
- 自行编写一个政党(
world.PARTIES,然后scripts/make_evalsets.py),并将其纳入考试中。这公平吗?scripts/verify_world.py风格:每个派对都必须至少有一个能让所有人吃饱的预订。 - 将评分标准提高到 0.9,并将
adk optimize指向eval_config_rating.json。测量梯度。 - 您是否拥有已启用结算功能的项目?运行
refuel/管道端到端,并读取harvest.py的[skip]行 - 它们是两个管道之间的可见边界。 - 使用
HOST_THINKING=2048运行循环。哪些因素会发生变化?这会告诉您天花板位于何处?